BRPI0618369B1 - Método para a preparação de um vírus alvo não adenoviral ou uma ou mais proteína(s) alvo que não é(são) relacionada(s) a adenovírus, método para a preparação de uma célula de expressão de vertebrado imortalizada e seu uso - Google Patents
Método para a preparação de um vírus alvo não adenoviral ou uma ou mais proteína(s) alvo que não é(são) relacionada(s) a adenovírus, método para a preparação de uma célula de expressão de vertebrado imortalizada e seu uso Download PDFInfo
- Publication number
- BRPI0618369B1 BRPI0618369B1 BRPI0618369-7A BRPI0618369A BRPI0618369B1 BR PI0618369 B1 BRPI0618369 B1 BR PI0618369B1 BR PI0618369 A BRPI0618369 A BR PI0618369A BR PI0618369 B1 BRPI0618369 B1 BR PI0618369B1
- Authority
- BR
- Brazil
- Prior art keywords
- cell
- pix
- cells
- protein
- virus
- Prior art date
Links
- 108090000623 proteins and genes Proteins 0.000 title claims abstract description 82
- 230000014509 gene expression Effects 0.000 title claims abstract description 54
- 241000700605 Viruses Species 0.000 title claims abstract description 50
- 102000004169 proteins and genes Human genes 0.000 title claims abstract description 47
- 238000000034 method Methods 0.000 title claims description 34
- 241000701161 unidentified adenovirus Species 0.000 title claims description 24
- 241000251539 Vertebrata <Metazoa> Species 0.000 title claims description 16
- 102000034356 gene-regulatory proteins Human genes 0.000 claims abstract description 36
- 108091006104 gene-regulatory proteins Proteins 0.000 claims abstract description 36
- 239000013598 vector Substances 0.000 claims description 36
- 101150075174 E1B gene Proteins 0.000 claims description 28
- 150000007523 nucleic acids Chemical group 0.000 claims description 20
- 108010050904 Interferons Proteins 0.000 claims description 16
- 102000014150 Interferons Human genes 0.000 claims description 16
- 241000272525 Anas platyrhynchos Species 0.000 claims description 15
- 241000271566 Aves Species 0.000 claims description 13
- 230000003612 virological effect Effects 0.000 claims description 11
- 230000002238 attenuated effect Effects 0.000 claims description 9
- 108700026758 Adenovirus hexon capsid Proteins 0.000 claims description 8
- 229940024142 alpha 1-antitrypsin Drugs 0.000 claims description 8
- 210000004556 brain Anatomy 0.000 claims description 8
- 230000001413 cellular effect Effects 0.000 claims description 8
- 239000003550 marker Substances 0.000 claims description 8
- 108091028043 Nucleic acid sequence Proteins 0.000 claims description 7
- 241000700647 Variola virus Species 0.000 claims description 7
- 102000015395 alpha 1-Antitrypsin Human genes 0.000 claims description 7
- 108010050122 alpha 1-Antitrypsin Proteins 0.000 claims description 7
- 238000002360 preparation method Methods 0.000 claims description 6
- 210000002023 somite Anatomy 0.000 claims description 6
- 210000001525 retina Anatomy 0.000 claims description 5
- 229960005486 vaccine Drugs 0.000 claims description 5
- FWMNVWWHGCHHJJ-SKKKGAJSSA-N 4-amino-1-[(2r)-6-amino-2-[[(2r)-2-[[(2r)-2-[[(2r)-2-amino-3-phenylpropanoyl]amino]-3-phenylpropanoyl]amino]-4-methylpentanoyl]amino]hexanoyl]piperidine-4-carboxylic acid Chemical compound C([C@H](C(=O)N[C@H](CC(C)C)C(=O)N[C@H](CCCCN)C(=O)N1CCC(N)(CC1)C(O)=O)NC(=O)[C@H](N)CC=1C=CC=CC=1)C1=CC=CC=C1 FWMNVWWHGCHHJJ-SKKKGAJSSA-N 0.000 claims description 4
- 102100031334 Elongation factor 2 Human genes 0.000 claims description 4
- 108091006027 G proteins Proteins 0.000 claims description 4
- 102000030782 GTP binding Human genes 0.000 claims description 4
- 108091000058 GTP-Binding Proteins 0.000 claims description 4
- 230000001605 fetal effect Effects 0.000 claims description 4
- 108010077519 Peptide Elongation Factor 2 Proteins 0.000 claims description 3
- 230000010354 integration Effects 0.000 claims description 3
- 238000002955 isolation Methods 0.000 claims description 3
- 102000039446 nucleic acids Human genes 0.000 claims description 3
- 108020004707 nucleic acids Proteins 0.000 claims description 3
- 230000005945 translocation Effects 0.000 claims description 3
- 239000013603 viral vector Substances 0.000 claims description 3
- 108010057360 Adenovirus E1 Proteins Proteins 0.000 claims description 2
- 108010024878 Adenovirus E1A Proteins Proteins 0.000 claims description 2
- 241000702421 Dependoparvovirus Species 0.000 claims description 2
- 102000003951 Erythropoietin Human genes 0.000 claims description 2
- 108090000394 Erythropoietin Proteins 0.000 claims description 2
- XQFRJNBWHJMXHO-RRKCRQDMSA-N IDUR Chemical compound C1[C@H](O)[C@@H](CO)O[C@H]1N1C(=O)NC(=O)C(I)=C1 XQFRJNBWHJMXHO-RRKCRQDMSA-N 0.000 claims description 2
- 241000713666 Lentivirus Species 0.000 claims description 2
- 241000701244 Mastadenovirus Species 0.000 claims description 2
- 206010037742 Rabies Diseases 0.000 claims description 2
- 108010008281 Recombinant Fusion Proteins Proteins 0.000 claims description 2
- 102000007056 Recombinant Fusion Proteins Human genes 0.000 claims description 2
- 102000018120 Recombinases Human genes 0.000 claims description 2
- 108010091086 Recombinases Proteins 0.000 claims description 2
- 239000002253 acid Substances 0.000 claims description 2
- 239000000427 antigen Substances 0.000 claims description 2
- 108091007433 antigens Proteins 0.000 claims description 2
- 102000036639 antigens Human genes 0.000 claims description 2
- 239000003114 blood coagulation factor Substances 0.000 claims description 2
- 238000012258 culturing Methods 0.000 claims description 2
- 229940105423 erythropoietin Drugs 0.000 claims description 2
- 206010022000 influenza Diseases 0.000 claims description 2
- 229940047124 interferons Drugs 0.000 claims description 2
- 239000000813 peptide hormone Substances 0.000 claims description 2
- OXCMYAYHXIHQOA-UHFFFAOYSA-N potassium;[2-butyl-5-chloro-3-[[4-[2-(1,2,4-triaza-3-azanidacyclopenta-1,4-dien-5-yl)phenyl]phenyl]methyl]imidazol-4-yl]methanol Chemical compound [K+].CCCCC1=NC(Cl)=C(CO)N1CC1=CC=C(C=2C(=CC=CC=2)C2=N[N-]N=N2)C=C1 OXCMYAYHXIHQOA-UHFFFAOYSA-N 0.000 claims description 2
- 125000003275 alpha amino acid group Chemical group 0.000 claims 3
- 241000700626 Cowpox virus Species 0.000 claims 2
- 241000178270 Canarypox virus Species 0.000 claims 1
- 208000000666 Fowlpox Diseases 0.000 claims 1
- 241000700662 Fowlpox virus Species 0.000 claims 1
- 201000003740 cowpox Diseases 0.000 claims 1
- 238000004519 manufacturing process Methods 0.000 abstract description 11
- 230000003389 potentiating effect Effects 0.000 abstract 1
- 210000004027 cell Anatomy 0.000 description 294
- 238000001890 transfection Methods 0.000 description 30
- 108020004414 DNA Proteins 0.000 description 26
- 208000015181 infectious disease Diseases 0.000 description 22
- 239000002609 medium Substances 0.000 description 20
- 108020001507 fusion proteins Proteins 0.000 description 19
- 102000037865 fusion proteins Human genes 0.000 description 19
- 239000013612 plasmid Substances 0.000 description 16
- 239000006144 Dulbecco’s modified Eagle's medium Substances 0.000 description 15
- 230000000694 effects Effects 0.000 description 15
- 229940079322 interferon Drugs 0.000 description 14
- 108700019146 Transgenes Proteins 0.000 description 13
- 230000012010 growth Effects 0.000 description 12
- 230000004927 fusion Effects 0.000 description 10
- RXWNCPJZOCPEPQ-NVWDDTSBSA-N puromycin Chemical compound C1=CC(OC)=CC=C1C[C@H](N)C(=O)N[C@H]1[C@@H](O)[C@H](N2C3=NC=NC(=C3N=C2)N(C)C)O[C@@H]1CO RXWNCPJZOCPEPQ-NVWDDTSBSA-N 0.000 description 10
- 229960001727 tretinoin Drugs 0.000 description 10
- YQYJSBFKSSDGFO-UHFFFAOYSA-N Epihygromycin Natural products OC1C(O)C(C(=O)C)OC1OC(C(=C1)O)=CC=C1C=C(C)C(=O)NC1C(O)C(O)C2OCOC2C1O YQYJSBFKSSDGFO-UHFFFAOYSA-N 0.000 description 9
- OKKJLVBELUTLKV-UHFFFAOYSA-N Methanol Chemical compound OC OKKJLVBELUTLKV-UHFFFAOYSA-N 0.000 description 9
- SHGAZHPCJJPHSC-YCNIQYBTSA-N all-trans-retinoic acid Chemical compound OC(=O)\C=C(/C)\C=C\C=C(/C)\C=C\C1=C(C)CCCC1(C)C SHGAZHPCJJPHSC-YCNIQYBTSA-N 0.000 description 9
- 238000010899 nucleation Methods 0.000 description 9
- 230000010076 replication Effects 0.000 description 9
- 229930002330 retinoic acid Natural products 0.000 description 9
- 102000006802 Retinoic Acid Receptor alpha Human genes 0.000 description 8
- 239000012634 fragment Substances 0.000 description 8
- 230000006698 induction Effects 0.000 description 8
- 108091008726 retinoic acid receptors α Proteins 0.000 description 8
- 108091032973 (ribonucleotides)n+m Proteins 0.000 description 7
- 239000000047 product Substances 0.000 description 7
- 239000000725 suspension Substances 0.000 description 7
- 241001135569 Human adenovirus 5 Species 0.000 description 6
- 238000009826 distribution Methods 0.000 description 6
- 238000002474 experimental method Methods 0.000 description 6
- 238000012423 maintenance Methods 0.000 description 6
- 239000002773 nucleotide Substances 0.000 description 6
- 125000003729 nucleotide group Chemical group 0.000 description 6
- 238000004114 suspension culture Methods 0.000 description 6
- 230000035899 viability Effects 0.000 description 6
- 230000029812 viral genome replication Effects 0.000 description 6
- 102000040650 (ribonucleotides)n+m Human genes 0.000 description 5
- 108700026244 Open Reading Frames Proteins 0.000 description 5
- 239000004743 Polypropylene Substances 0.000 description 5
- 229960000074 biopharmaceutical Drugs 0.000 description 5
- 238000006243 chemical reaction Methods 0.000 description 5
- 210000004978 chinese hamster ovary cell Anatomy 0.000 description 5
- 238000012303 cytoplasmic staining Methods 0.000 description 5
- 238000012217 deletion Methods 0.000 description 5
- 230000037430 deletion Effects 0.000 description 5
- 230000006870 function Effects 0.000 description 5
- 210000004962 mammalian cell Anatomy 0.000 description 5
- 210000004940 nucleus Anatomy 0.000 description 5
- -1 polypropylene Polymers 0.000 description 5
- 229920001155 polypropylene Polymers 0.000 description 5
- 108090000765 processed proteins & peptides Proteins 0.000 description 5
- 229950010131 puromycin Drugs 0.000 description 5
- AYEKOFBPNLCAJY-UHFFFAOYSA-O thiamine pyrophosphate Chemical compound CC1=C(CCOP(O)(=O)OP(O)(O)=O)SC=[N+]1CC1=CN=C(C)N=C1N AYEKOFBPNLCAJY-UHFFFAOYSA-O 0.000 description 5
- 241000710188 Encephalomyocarditis virus Species 0.000 description 4
- 241000287828 Gallus gallus Species 0.000 description 4
- GRRNUXAQVGOGFE-UHFFFAOYSA-N Hygromycin-B Natural products OC1C(NC)CC(N)C(O)C1OC1C2OC3(C(C(O)C(O)C(C(N)CO)O3)O)OC2C(O)C(CO)O1 GRRNUXAQVGOGFE-UHFFFAOYSA-N 0.000 description 4
- 108091034117 Oligonucleotide Proteins 0.000 description 4
- 102000008230 Toll-like receptor 3 Human genes 0.000 description 4
- 108010060885 Toll-like receptor 3 Proteins 0.000 description 4
- 238000009825 accumulation Methods 0.000 description 4
- 238000003556 assay Methods 0.000 description 4
- 230000010261 cell growth Effects 0.000 description 4
- 230000008859 change Effects 0.000 description 4
- 210000000805 cytoplasm Anatomy 0.000 description 4
- 230000003111 delayed effect Effects 0.000 description 4
- 238000001514 detection method Methods 0.000 description 4
- 238000000605 extraction Methods 0.000 description 4
- 210000005260 human cell Anatomy 0.000 description 4
- GRRNUXAQVGOGFE-NZSRVPFOSA-N hygromycin B Chemical compound O[C@@H]1[C@@H](NC)C[C@@H](N)[C@H](O)[C@H]1O[C@H]1[C@H]2O[C@@]3([C@@H]([C@@H](O)[C@@H](O)[C@@H](C(N)CO)O3)O)O[C@H]2[C@@H](O)[C@@H](CO)O1 GRRNUXAQVGOGFE-NZSRVPFOSA-N 0.000 description 4
- 229940097277 hygromycin b Drugs 0.000 description 4
- 239000000411 inducer Substances 0.000 description 4
- 108020004999 messenger RNA Proteins 0.000 description 4
- 239000000203 mixture Substances 0.000 description 4
- 230000008569 process Effects 0.000 description 4
- 102000005962 receptors Human genes 0.000 description 4
- 108020003175 receptors Proteins 0.000 description 4
- 108091008146 restriction endonucleases Proteins 0.000 description 4
- 230000002207 retinal effect Effects 0.000 description 4
- 210000001519 tissue Anatomy 0.000 description 4
- 239000003981 vehicle Substances 0.000 description 4
- 208000036762 Acute promyelocytic leukaemia Diseases 0.000 description 3
- IAZDPXIOMUYVGZ-UHFFFAOYSA-N Dimethylsulphoxide Chemical compound CS(C)=O IAZDPXIOMUYVGZ-UHFFFAOYSA-N 0.000 description 3
- 241000598171 Human adenovirus sp. Species 0.000 description 3
- 102100040019 Interferon alpha-1/13 Human genes 0.000 description 3
- 241001465754 Metazoa Species 0.000 description 3
- 102000004142 Trypsin Human genes 0.000 description 3
- 108090000631 Trypsin Proteins 0.000 description 3
- 208000036142 Viral infection Diseases 0.000 description 3
- 238000004115 adherent culture Methods 0.000 description 3
- 230000001464 adherent effect Effects 0.000 description 3
- 230000027455 binding Effects 0.000 description 3
- 238000005119 centrifugation Methods 0.000 description 3
- 238000010367 cloning Methods 0.000 description 3
- 238000011161 development Methods 0.000 description 3
- 230000018109 developmental process Effects 0.000 description 3
- 239000013613 expression plasmid Substances 0.000 description 3
- 239000000499 gel Substances 0.000 description 3
- 238000001415 gene therapy Methods 0.000 description 3
- BRZYSWJRSDMWLG-CAXSIQPQSA-N geneticin Natural products O1C[C@@](O)(C)[C@H](NC)[C@@H](O)[C@H]1O[C@@H]1[C@@H](O)[C@H](O[C@@H]2[C@@H]([C@@H](O)[C@H](O)[C@@H](C(C)O)O2)N)[C@@H](N)C[C@H]1N BRZYSWJRSDMWLG-CAXSIQPQSA-N 0.000 description 3
- 238000010166 immunofluorescence Methods 0.000 description 3
- 238000003780 insertion Methods 0.000 description 3
- 230000037431 insertion Effects 0.000 description 3
- 230000004048 modification Effects 0.000 description 3
- 238000012986 modification Methods 0.000 description 3
- 238000012758 nuclear staining Methods 0.000 description 3
- 238000004806 packaging method and process Methods 0.000 description 3
- 101150088856 pix gene Proteins 0.000 description 3
- 230000008488 polyadenylation Effects 0.000 description 3
- 230000006798 recombination Effects 0.000 description 3
- 238000005215 recombination Methods 0.000 description 3
- 230000002829 reductive effect Effects 0.000 description 3
- 210000002966 serum Anatomy 0.000 description 3
- MPLHNVLQVRSVEE-UHFFFAOYSA-N texas red Chemical compound [O-]S(=O)(=O)C1=CC(S(Cl)(=O)=O)=CC=C1C(C1=CC=2CCCN3CCCC(C=23)=C1O1)=C2C1=C(CCC1)C3=[N+]1CCCC3=C2 MPLHNVLQVRSVEE-UHFFFAOYSA-N 0.000 description 3
- 238000013518 transcription Methods 0.000 description 3
- 230000035897 transcription Effects 0.000 description 3
- 230000002103 transcriptional effect Effects 0.000 description 3
- 239000012588 trypsin Substances 0.000 description 3
- 230000009385 viral infection Effects 0.000 description 3
- 238000001262 western blot Methods 0.000 description 3
- YBJHBAHKTGYVGT-ZKWXMUAHSA-N (+)-Biotin Chemical compound N1C(=O)N[C@@H]2[C@H](CCCCC(=O)O)SC[C@@H]21 YBJHBAHKTGYVGT-ZKWXMUAHSA-N 0.000 description 2
- 229920000936 Agarose Polymers 0.000 description 2
- 108020004705 Codon Proteins 0.000 description 2
- 102000004190 Enzymes Human genes 0.000 description 2
- 108090000790 Enzymes Proteins 0.000 description 2
- LFQSCWFLJHTTHZ-UHFFFAOYSA-N Ethanol Chemical compound CCO LFQSCWFLJHTTHZ-UHFFFAOYSA-N 0.000 description 2
- 206010053759 Growth retardation Diseases 0.000 description 2
- 101000866749 Homo sapiens Elongation factor 2 Proteins 0.000 description 2
- 102000003996 Interferon-beta Human genes 0.000 description 2
- 108090000467 Interferon-beta Proteins 0.000 description 2
- TWRXJAOTZQYOKJ-UHFFFAOYSA-L Magnesium chloride Chemical compound [Mg+2].[Cl-].[Cl-] TWRXJAOTZQYOKJ-UHFFFAOYSA-L 0.000 description 2
- 101710185720 Putative ethidium bromide resistance protein Proteins 0.000 description 2
- FAPWRFPIFSIZLT-UHFFFAOYSA-M Sodium chloride Chemical compound [Na+].[Cl-] FAPWRFPIFSIZLT-UHFFFAOYSA-M 0.000 description 2
- 230000024932 T cell mediated immunity Effects 0.000 description 2
- 102000040945 Transcription factor Human genes 0.000 description 2
- 108091023040 Transcription factor Proteins 0.000 description 2
- GLNADSQYFUSGOU-GPTZEZBUSA-J Trypan blue Chemical compound [Na+].[Na+].[Na+].[Na+].C1=C(S([O-])(=O)=O)C=C2C=C(S([O-])(=O)=O)C(/N=N/C3=CC=C(C=C3C)C=3C=C(C(=CC=3)\N=N\C=3C(=CC4=CC(=CC(N)=C4C=3O)S([O-])(=O)=O)S([O-])(=O)=O)C)=C(O)C2=C1N GLNADSQYFUSGOU-GPTZEZBUSA-J 0.000 description 2
- 108020005202 Viral DNA Proteins 0.000 description 2
- JLCPHMBAVCMARE-UHFFFAOYSA-N [3-[[3-[[3-[[3-[[3-[[3-[[3-[[3-[[3-[[3-[[3-[[5-(2-amino-6-oxo-1H-purin-9-yl)-3-[[3-[[3-[[3-[[3-[[3-[[5-(2-amino-6-oxo-1H-purin-9-yl)-3-[[5-(2-amino-6-oxo-1H-purin-9-yl)-3-hydroxyoxolan-2-yl]methoxy-hydroxyphosphoryl]oxyoxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(5-methyl-2,4-dioxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxyoxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(5-methyl-2,4-dioxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(4-amino-2-oxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(5-methyl-2,4-dioxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(5-methyl-2,4-dioxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(4-amino-2-oxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(4-amino-2-oxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(4-amino-2-oxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(4-amino-2-oxopyrimidin-1-yl)oxolan-2-yl]methyl [5-(6-aminopurin-9-yl)-2-(hydroxymethyl)oxolan-3-yl] hydrogen phosphate Polymers Cc1cn(C2CC(OP(O)(=O)OCC3OC(CC3OP(O)(=O)OCC3OC(CC3O)n3cnc4c3nc(N)[nH]c4=O)n3cnc4c3nc(N)[nH]c4=O)C(COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3CO)n3cnc4c(N)ncnc34)n3ccc(N)nc3=O)n3cnc4c(N)ncnc34)n3ccc(N)nc3=O)n3ccc(N)nc3=O)n3ccc(N)nc3=O)n3cnc4c(N)ncnc34)n3cnc4c(N)ncnc34)n3cc(C)c(=O)[nH]c3=O)n3cc(C)c(=O)[nH]c3=O)n3ccc(N)nc3=O)n3cc(C)c(=O)[nH]c3=O)n3cnc4c3nc(N)[nH]c4=O)n3cnc4c(N)ncnc34)n3cnc4c(N)ncnc34)n3cnc4c(N)ncnc34)n3cnc4c(N)ncnc34)O2)c(=O)[nH]c1=O JLCPHMBAVCMARE-UHFFFAOYSA-N 0.000 description 2
- 230000003321 amplification Effects 0.000 description 2
- 230000019552 anatomical structure morphogenesis Effects 0.000 description 2
- 230000000840 anti-viral effect Effects 0.000 description 2
- 230000015572 biosynthetic process Effects 0.000 description 2
- 239000000872 buffer Substances 0.000 description 2
- 210000000234 capsid Anatomy 0.000 description 2
- 239000003795 chemical substances by application Substances 0.000 description 2
- 239000002299 complementary DNA Substances 0.000 description 2
- 230000009089 cytolysis Effects 0.000 description 2
- 230000007423 decrease Effects 0.000 description 2
- 108010048367 enhanced green fluorescent protein Proteins 0.000 description 2
- 239000003623 enhancer Substances 0.000 description 2
- 238000011156 evaluation Methods 0.000 description 2
- 238000010195 expression analysis Methods 0.000 description 2
- 231100000001 growth retardation Toxicity 0.000 description 2
- 230000005764 inhibitory process Effects 0.000 description 2
- 230000003993 interaction Effects 0.000 description 2
- 230000010468 interferon response Effects 0.000 description 2
- 229960001388 interferon-beta Drugs 0.000 description 2
- 230000003834 intracellular effect Effects 0.000 description 2
- 239000010410 layer Substances 0.000 description 2
- 239000002502 liposome Substances 0.000 description 2
- 239000006166 lysate Substances 0.000 description 2
- 239000013642 negative control Substances 0.000 description 2
- 238000003199 nucleic acid amplification method Methods 0.000 description 2
- 230000030648 nucleus localization Effects 0.000 description 2
- 238000005457 optimization Methods 0.000 description 2
- 239000013641 positive control Substances 0.000 description 2
- 230000035755 proliferation Effects 0.000 description 2
- 238000003753 real-time PCR Methods 0.000 description 2
- 230000004044 response Effects 0.000 description 2
- 230000035945 sensitivity Effects 0.000 description 2
- 239000002356 single layer Substances 0.000 description 2
- 238000010561 standard procedure Methods 0.000 description 2
- 238000006467 substitution reaction Methods 0.000 description 2
- 239000000758 substrate Substances 0.000 description 2
- 239000006228 supernatant Substances 0.000 description 2
- 230000008093 supporting effect Effects 0.000 description 2
- 238000012360 testing method Methods 0.000 description 2
- 239000012096 transfection reagent Substances 0.000 description 2
- 230000009466 transformation Effects 0.000 description 2
- 238000011144 upstream manufacturing Methods 0.000 description 2
- 238000002255 vaccination Methods 0.000 description 2
- 230000003442 weekly effect Effects 0.000 description 2
- HJCMDXDYPOUFDY-WHFBIAKZSA-N Ala-Gln Chemical compound C[C@H](N)C(=O)N[C@H](C(O)=O)CCC(N)=O HJCMDXDYPOUFDY-WHFBIAKZSA-N 0.000 description 1
- 102000002260 Alkaline Phosphatase Human genes 0.000 description 1
- 108020004774 Alkaline Phosphatase Proteins 0.000 description 1
- 108091093088 Amplicon Proteins 0.000 description 1
- 241000272814 Anser sp. Species 0.000 description 1
- 241000701802 Aviadenovirus Species 0.000 description 1
- 108091003079 Bovine Serum Albumin Proteins 0.000 description 1
- 241000283707 Capra Species 0.000 description 1
- 108091026890 Coding region Proteins 0.000 description 1
- 108020004635 Complementary DNA Proteins 0.000 description 1
- 241000699800 Cricetinae Species 0.000 description 1
- 102100028183 Cytohesin-interacting protein Human genes 0.000 description 1
- 102000053602 DNA Human genes 0.000 description 1
- 230000004543 DNA replication Effects 0.000 description 1
- 241000450599 DNA viruses Species 0.000 description 1
- 101150005326 EF2 gene Proteins 0.000 description 1
- 238000002965 ELISA Methods 0.000 description 1
- 101710088791 Elongation factor 2 Proteins 0.000 description 1
- 241000588724 Escherichia coli Species 0.000 description 1
- 241000710831 Flavivirus Species 0.000 description 1
- 241000701796 Fowl aviadenovirus 1 Species 0.000 description 1
- 230000005526 G1 to G0 transition Effects 0.000 description 1
- 108091006052 GFP-tagged proteins Proteins 0.000 description 1
- SXRSQZLOMIGNAQ-UHFFFAOYSA-N Glutaraldehyde Chemical compound O=CCCCC=O SXRSQZLOMIGNAQ-UHFFFAOYSA-N 0.000 description 1
- BCCRXDTUTZHDEU-VKHMYHEASA-N Gly-Ser Chemical compound NCC(=O)N[C@@H](CO)C(O)=O BCCRXDTUTZHDEU-VKHMYHEASA-N 0.000 description 1
- 208000031886 HIV Infections Diseases 0.000 description 1
- 208000037357 HIV infectious disease Diseases 0.000 description 1
- HTTJABKRGRZYRN-UHFFFAOYSA-N Heparin Chemical compound OC1C(NC(=O)C)C(O)OC(COS(O)(=O)=O)C1OC1C(OS(O)(=O)=O)C(O)C(OC2C(C(OS(O)(=O)=O)C(OC3C(C(O)C(O)C(O3)C(O)=O)OS(O)(=O)=O)C(CO)O2)NS(O)(=O)=O)C(C(O)=O)O1 HTTJABKRGRZYRN-UHFFFAOYSA-N 0.000 description 1
- 208000009889 Herpes Simplex Diseases 0.000 description 1
- 101000823116 Homo sapiens Alpha-1-antitrypsin Proteins 0.000 description 1
- 101000916686 Homo sapiens Cytohesin-interacting protein Proteins 0.000 description 1
- 241001428586 Human adenovirus D8 Species 0.000 description 1
- 206010061598 Immunodeficiency Diseases 0.000 description 1
- 102100034343 Integrase Human genes 0.000 description 1
- 108010014726 Interferon Type I Proteins 0.000 description 1
- 102000002227 Interferon Type I Human genes 0.000 description 1
- 108010005716 Interferon beta-1a Proteins 0.000 description 1
- ZQISRDCJNBUVMM-UHFFFAOYSA-N L-Histidinol Natural products OCC(N)CC1=CN=CN1 ZQISRDCJNBUVMM-UHFFFAOYSA-N 0.000 description 1
- ZQISRDCJNBUVMM-YFKPBYRVSA-N L-histidinol Chemical compound OC[C@@H](N)CC1=CNC=N1 ZQISRDCJNBUVMM-YFKPBYRVSA-N 0.000 description 1
- 201000005505 Measles Diseases 0.000 description 1
- 241000712079 Measles morbillivirus Species 0.000 description 1
- 101710134502 Mgp-operon protein 3 Proteins 0.000 description 1
- 241000711386 Mumps virus Species 0.000 description 1
- 239000012580 N-2 Supplement Substances 0.000 description 1
- 239000004677 Nylon Substances 0.000 description 1
- 241000283973 Oryctolagus cuniculus Species 0.000 description 1
- 238000012408 PCR amplification Methods 0.000 description 1
- 241000286209 Phasianidae Species 0.000 description 1
- ISWSIDIOOBJBQZ-UHFFFAOYSA-N Phenol Chemical compound OC1=CC=CC=C1 ISWSIDIOOBJBQZ-UHFFFAOYSA-N 0.000 description 1
- 102000011755 Phosphoglycerate Kinase Human genes 0.000 description 1
- 108010021757 Polynucleotide 5'-Hydroxyl-Kinase Proteins 0.000 description 1
- 102000008422 Polynucleotide 5'-hydroxyl-kinase Human genes 0.000 description 1
- 101710150451 Protein Bel-1 Proteins 0.000 description 1
- 238000010802 RNA extraction kit Methods 0.000 description 1
- 108010092799 RNA-directed DNA polymerase Proteins 0.000 description 1
- 101000702488 Rattus norvegicus High affinity cationic amino acid transporter 1 Proteins 0.000 description 1
- 108020004511 Recombinant DNA Proteins 0.000 description 1
- 241000283984 Rodentia Species 0.000 description 1
- 239000006146 Roswell Park Memorial Institute medium Substances 0.000 description 1
- 108091081024 Start codon Proteins 0.000 description 1
- 101710172711 Structural protein Proteins 0.000 description 1
- 101001099217 Thermotoga maritima (strain ATCC 43589 / DSM 3109 / JCM 10099 / NBRC 100826 / MSB8) Triosephosphate isomerase Proteins 0.000 description 1
- IQFYYKKMVGJFEH-XLPZGREQSA-N Thymidine Chemical group O=C1NC(=O)C(C)=CN1[C@@H]1O[C@H](CO)[C@@H](O)C1 IQFYYKKMVGJFEH-XLPZGREQSA-N 0.000 description 1
- 108020004440 Thymidine kinase Proteins 0.000 description 1
- 101710205823 Translation elongation factor 2 Proteins 0.000 description 1
- 239000007983 Tris buffer Substances 0.000 description 1
- 229920004890 Triton X-100 Polymers 0.000 description 1
- 206010000210 abortion Diseases 0.000 description 1
- 231100000176 abortion Toxicity 0.000 description 1
- 230000004913 activation Effects 0.000 description 1
- 230000006978 adaptation Effects 0.000 description 1
- 238000001042 affinity chromatography Methods 0.000 description 1
- 239000011543 agarose gel Substances 0.000 description 1
- 238000013019 agitation Methods 0.000 description 1
- 125000000539 amino acid group Chemical group 0.000 description 1
- 229960000723 ampicillin Drugs 0.000 description 1
- AVKUERGKIZMTKX-NJBDSQKTSA-N ampicillin Chemical compound C1([C@@H](N)C(=O)N[C@H]2[C@H]3SC([C@@H](N3C2=O)C(O)=O)(C)C)=CC=CC=C1 AVKUERGKIZMTKX-NJBDSQKTSA-N 0.000 description 1
- 230000003698 anagen phase Effects 0.000 description 1
- 238000004458 analytical method Methods 0.000 description 1
- 230000001064 anti-interferon Effects 0.000 description 1
- 230000006907 apoptotic process Effects 0.000 description 1
- 230000001580 bacterial effect Effects 0.000 description 1
- 229960002685 biotin Drugs 0.000 description 1
- 235000020958 biotin Nutrition 0.000 description 1
- 239000011616 biotin Substances 0.000 description 1
- 229930189065 blasticidin Natural products 0.000 description 1
- 210000004369 blood Anatomy 0.000 description 1
- 239000008280 blood Substances 0.000 description 1
- 238000009835 boiling Methods 0.000 description 1
- 108010006025 bovine growth hormone Proteins 0.000 description 1
- 210000004958 brain cell Anatomy 0.000 description 1
- 239000000969 carrier Substances 0.000 description 1
- 230000024245 cell differentiation Effects 0.000 description 1
- 239000013592 cell lysate Substances 0.000 description 1
- 210000003855 cell nucleus Anatomy 0.000 description 1
- 230000004663 cell proliferation Effects 0.000 description 1
- 230000003833 cell viability Effects 0.000 description 1
- 238000012512 characterization method Methods 0.000 description 1
- 239000003153 chemical reaction reagent Substances 0.000 description 1
- 238000010276 construction Methods 0.000 description 1
- 230000030944 contact inhibition Effects 0.000 description 1
- 238000011109 contamination Methods 0.000 description 1
- 238000001816 cooling Methods 0.000 description 1
- 239000013078 crystal Substances 0.000 description 1
- 230000000120 cytopathologic effect Effects 0.000 description 1
- 230000007711 cytoplasmic localization Effects 0.000 description 1
- 230000001086 cytosolic effect Effects 0.000 description 1
- 230000003247 decreasing effect Effects 0.000 description 1
- 230000002950 deficient Effects 0.000 description 1
- 229940009976 deoxycholate Drugs 0.000 description 1
- 230000001419 dependent effect Effects 0.000 description 1
- 230000004069 differentiation Effects 0.000 description 1
- 238000009792 diffusion process Methods 0.000 description 1
- 238000006073 displacement reaction Methods 0.000 description 1
- 238000010494 dissociation reaction Methods 0.000 description 1
- 230000005593 dissociations Effects 0.000 description 1
- 239000003814 drug Substances 0.000 description 1
- 235000013601 eggs Nutrition 0.000 description 1
- 238000012869 ethanol precipitation Methods 0.000 description 1
- 210000003527 eukaryotic cell Anatomy 0.000 description 1
- 239000013604 expression vector Substances 0.000 description 1
- 239000012894 fetal calf serum Substances 0.000 description 1
- 210000003754 fetus Anatomy 0.000 description 1
- 239000012737 fresh medium Substances 0.000 description 1
- 238000001502 gel electrophoresis Methods 0.000 description 1
- 238000010353 genetic engineering Methods 0.000 description 1
- 239000001963 growth medium Substances 0.000 description 1
- 238000003306 harvesting Methods 0.000 description 1
- 230000036541 health Effects 0.000 description 1
- 229960002897 heparin Drugs 0.000 description 1
- 229920000669 heparin Polymers 0.000 description 1
- 102000051631 human SERPINA1 Human genes 0.000 description 1
- 210000003917 human chromosome Anatomy 0.000 description 1
- 208000033519 human immunodeficiency virus infectious disease Diseases 0.000 description 1
- 238000003384 imaging method Methods 0.000 description 1
- 230000028993 immune response Effects 0.000 description 1
- 210000000987 immune system Anatomy 0.000 description 1
- 230000001771 impaired effect Effects 0.000 description 1
- 238000013101 initial test Methods 0.000 description 1
- 238000011081 inoculation Methods 0.000 description 1
- 239000002054 inoculum Substances 0.000 description 1
- 229930027917 kanamycin Natural products 0.000 description 1
- 229960000318 kanamycin Drugs 0.000 description 1
- SBUJHOSQTJFQJX-NOAMYHISSA-N kanamycin Chemical compound O[C@@H]1[C@@H](O)[C@H](O)[C@@H](CN)O[C@@H]1O[C@H]1[C@H](O)[C@@H](O[C@@H]2[C@@H]([C@@H](N)[C@H](O)[C@@H](CO)O2)O)[C@H](N)C[C@@H]1N SBUJHOSQTJFQJX-NOAMYHISSA-N 0.000 description 1
- 229930182823 kanamycin A Natural products 0.000 description 1
- 230000000670 limiting effect Effects 0.000 description 1
- 229910001629 magnesium chloride Inorganic materials 0.000 description 1
- 239000011159 matrix material Substances 0.000 description 1
- 230000007246 mechanism Effects 0.000 description 1
- 239000012528 membrane Substances 0.000 description 1
- 238000002941 microtiter virus yield reduction assay Methods 0.000 description 1
- 230000005012 migration Effects 0.000 description 1
- 238000013508 migration Methods 0.000 description 1
- 230000003278 mimic effect Effects 0.000 description 1
- 238000002703 mutagenesis Methods 0.000 description 1
- 231100000350 mutagenesis Toxicity 0.000 description 1
- 230000035772 mutation Effects 0.000 description 1
- 201000009240 nasopharyngitis Diseases 0.000 description 1
- 210000003061 neural cell Anatomy 0.000 description 1
- 230000001537 neural effect Effects 0.000 description 1
- 229920001778 nylon Polymers 0.000 description 1
- 239000002245 particle Substances 0.000 description 1
- 230000037361 pathway Effects 0.000 description 1
- 239000008188 pellet Substances 0.000 description 1
- BULVZWIRKLYCBC-UHFFFAOYSA-N phorate Chemical compound CCOP(=S)(OCC)SCSCC BULVZWIRKLYCBC-UHFFFAOYSA-N 0.000 description 1
- 230000008092 positive effect Effects 0.000 description 1
- 238000001556 precipitation Methods 0.000 description 1
- 239000013587 production medium Substances 0.000 description 1
- XJMOSONTPMZWPB-UHFFFAOYSA-M propidium iodide Chemical compound [I-].[I-].C12=CC(N)=CC=C2C2=CC=C(N)C=C2[N+](CCC[N+](C)(CC)CC)=C1C1=CC=CC=C1 XJMOSONTPMZWPB-UHFFFAOYSA-M 0.000 description 1
- 230000001681 protective effect Effects 0.000 description 1
- 238000000746 purification Methods 0.000 description 1
- 238000011002 quantification Methods 0.000 description 1
- 238000000163 radioactive labelling Methods 0.000 description 1
- 229940038850 rebif Drugs 0.000 description 1
- 230000009703 regulation of cell differentiation Effects 0.000 description 1
- 230000001105 regulatory effect Effects 0.000 description 1
- 238000010845 search algorithm Methods 0.000 description 1
- 230000028327 secretion Effects 0.000 description 1
- 238000012163 sequencing technique Methods 0.000 description 1
- 239000012679 serum free medium Substances 0.000 description 1
- 239000011780 sodium chloride Substances 0.000 description 1
- 239000000243 solution Substances 0.000 description 1
- 238000001228 spectrum Methods 0.000 description 1
- 230000010473 stable expression Effects 0.000 description 1
- 238000003153 stable transfection Methods 0.000 description 1
- 238000010186 staining Methods 0.000 description 1
- 230000000638 stimulation Effects 0.000 description 1
- 208000024891 symptom Diseases 0.000 description 1
- 230000008685 targeting Effects 0.000 description 1
- 230000001225 therapeutic effect Effects 0.000 description 1
- 238000004448 titration Methods 0.000 description 1
- 238000012546 transfer Methods 0.000 description 1
- 230000009261 transgenic effect Effects 0.000 description 1
- 238000003146 transient transfection Methods 0.000 description 1
- 230000014616 translation Effects 0.000 description 1
- LENZDBCJOHFCAS-UHFFFAOYSA-N tris Chemical compound OCC(N)(CO)CO LENZDBCJOHFCAS-UHFFFAOYSA-N 0.000 description 1
- 231100000588 tumorigenic Toxicity 0.000 description 1
- 230000000381 tumorigenic effect Effects 0.000 description 1
- 230000010472 type I IFN response Effects 0.000 description 1
- 241001529453 unidentified herpesvirus Species 0.000 description 1
- 229940125575 vaccine candidate Drugs 0.000 description 1
- 210000002845 virion Anatomy 0.000 description 1
- XLYOFNOQVPJJNP-UHFFFAOYSA-N water Substances O XLYOFNOQVPJJNP-UHFFFAOYSA-N 0.000 description 1
Images









Classifications
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K14/00—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof
- C07K14/005—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from viruses
- C07K14/01—DNA viruses
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12N—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA
- C12N7/00—Viruses; Bacteriophages; Compositions thereof; Preparation or purification thereof
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K14/00—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof
- C07K14/005—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from viruses
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K14/00—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof
- C07K14/005—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from viruses
- C07K14/01—DNA viruses
- C07K14/075—Adenoviridae
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K14/00—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof
- C07K14/435—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from animals; from humans
- C07K14/705—Receptors; Cell surface antigens; Cell surface determinants
- C07K14/70567—Nuclear receptors, e.g. retinoic acid receptor [RAR], RXR, nuclear orphan receptors
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12N—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA
- C12N5/00—Undifferentiated human, animal or plant cells, e.g. cell lines; Tissues; Cultivation or maintenance thereof; Culture media therefor
- C12N5/10—Cells modified by introduction of foreign genetic material
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12N—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA
- C12N5/00—Undifferentiated human, animal or plant cells, e.g. cell lines; Tissues; Cultivation or maintenance thereof; Culture media therefor
- C12N5/10—Cells modified by introduction of foreign genetic material
- C12N5/12—Fused cells, e.g. hybridomas
- C12N5/16—Animal cells
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2319/00—Fusion polypeptide
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2319/00—Fusion polypeptide
- C07K2319/01—Fusion polypeptide containing a localisation/targetting motif
- C07K2319/09—Fusion polypeptide containing a localisation/targetting motif containing a nuclear localisation signal
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2319/00—Fusion polypeptide
- C07K2319/60—Fusion polypeptide containing spectroscopic/fluorescent detection, e.g. green fluorescent protein [GFP]
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2319/00—Fusion polypeptide
- C07K2319/70—Fusion polypeptide containing domain for protein-protein interaction
- C07K2319/71—Fusion polypeptide containing domain for protein-protein interaction containing domain for transcriptional activaation, e.g. VP16
- C07K2319/715—Fusion polypeptide containing domain for protein-protein interaction containing domain for transcriptional activaation, e.g. VP16 containing a domain for ligand dependent transcriptional activation, e.g. containing a steroid receptor domain
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12N—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA
- C12N2510/00—Genetically modified cells
- C12N2510/02—Cells for production
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12N—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA
- C12N2710/00—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA dsDNA viruses
- C12N2710/00011—Details
- C12N2710/10011—Adenoviridae
- C12N2710/10311—Mastadenovirus, e.g. human or simian adenoviruses
- C12N2710/10322—New viral proteins or individual genes, new structural or functional aspects of known viral proteins or genes
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12N—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA
- C12N2710/00—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA dsDNA viruses
- C12N2710/00011—Details
- C12N2710/16011—Herpesviridae
- C12N2710/16611—Simplexvirus, e.g. human herpesvirus 1, 2
- C12N2710/16622—New viral proteins or individual genes, new structural or functional aspects of known viral proteins or genes
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12N—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA
- C12N2710/00—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA dsDNA viruses
- C12N2710/00011—Details
- C12N2710/16011—Herpesviridae
- C12N2710/16611—Simplexvirus, e.g. human herpesvirus 1, 2
- C12N2710/16651—Methods of production or purification of viral material
- C12N2710/16652—Methods of production or purification of viral material relating to complementing cells and packaging systems for producing virus or viral particles
Landscapes
- Health & Medical Sciences (AREA)
- Chemical & Material Sciences (AREA)
- Life Sciences & Earth Sciences (AREA)
- Organic Chemistry (AREA)
- Genetics & Genomics (AREA)
- General Health & Medical Sciences (AREA)
- Zoology (AREA)
- Biochemistry (AREA)
- Engineering & Computer Science (AREA)
- Medicinal Chemistry (AREA)
- Virology (AREA)
- Wood Science & Technology (AREA)
- Bioinformatics & Cheminformatics (AREA)
- Biophysics (AREA)
- Gastroenterology & Hepatology (AREA)
- Molecular Biology (AREA)
- Proteomics, Peptides & Aminoacids (AREA)
- Biotechnology (AREA)
- Biomedical Technology (AREA)
- Immunology (AREA)
- Cell Biology (AREA)
- Microbiology (AREA)
- General Engineering & Computer Science (AREA)
- High Energy & Nuclear Physics (AREA)
- Physics & Mathematics (AREA)
- Toxicology (AREA)
- Micro-Organisms Or Cultivation Processes Thereof (AREA)
- Preparation Of Compounds By Using Micro-Organisms (AREA)
- Peptides Or Proteins (AREA)
Abstract
FATOR PROTÉICO DE AUMENTO DE PRODUTIVIDADE, NOVAS LINHAS CELULARES E SEUS USOS. A presente invenção refere-se a um método para a preparação de um vírus alvo ou proteínas-alvo não adenovirais utilizando uma linhagem celular de expressão potente com, integrado de maneira estável em seu genoma, um gene que codifique uma proteína reguladora heteróloga específica.
Description
[0001] A presente invenção refere-se a um método para a preparação de um vírus alvo não adenoviral ou proteínas-alvo, utilizando uma linhagem celular de expressão potente apresentando um gene que codifica uma proteína reguladora heteróloga específica integrado de maneira estável em seu genoma.
[0002] Produtos biofarmacêuticos de células eucarióticas são uma parte integral da medicina moderna. Entretanto, maior produtividade e maior segurança são parâmetros importantes que ainda requerem otimização substancial. O gargalo mais crucial nos esforços de otimização é o próprio substrato celular. Um transgene seguro que possa ser introduzido em linhagens celulares já liberadas para uso em processos biofarmacêuticos para aumentar os rendimentos de produto dessas células manipuladas é extremamente valioso.
[0003] Adenovírus são vírus de DNA de filamento duplo sem invólucro (nus) que infectam um amplo espectro de animais. Entre os membros melhor caracterizados está o adenovírus humano sorotipo 5 (Ad5). Esse vírus é uma causa frequente de sintomas do resfriado comum, e a infecção frequentemente ocorre na infância.
[0004] Os adenovírus são passíveis de manipulação genética, e adenovírus incompetentes para replicação, incluindo Ad5 (número de acesso do GenBank para sequência: AC_000008), são usados como vetores em terapia genética e para vacinação terapêutica. Para se obterem vírus incompetentes para replicação, grandes regiões do DNA genômico são substituídas por sequências não virais. As funções virais faltantes são fornecidas em trans pelas linhagens celulares hospedeiras que tenham sido transfectadas de maneira estável com genes que estejam deletados no vetor. Um dos primeiros sistemas que foram desenvolvidos consiste em vetores adenovirais deletados na região E1 reguladora produzida em linhagens celulares que fornecem as proteínas E1 correspondentes.
[0005] A linhagem celular mais comum para essa finalidade é a linhagem celular 293. Essa linhagem foi gerada em 1977 por transfecção de DNA genômico adenoviral fragmentado em células humanas primárias (Graham et al., J. Gen. Virol. 36, 59-74 (1977)), muito antes de se reconhecer que adenovírus podem servir de vetores de terapia genética. Demonstrou-se subsequentemente que a linhagem celular resultante continha os nucleotídeos 1 a 4344 do DNA genômico (Louis et al., Virology 233, 423-429 (1997)), que inclui a região E1; essa caracterização demonstrou que a região E1 pode ser usada para imortalizar e transformar células primárias.
[0006] Adjacente à região E1, segue-se o gene para pIX ("poteína 9"; nucleotídeos 3609 a 4031 no DNA genômico). O promotor para pIX está incrustado dentro do componente E1B da região E1. Um mecanismo chamado de oclusão de promotor permite a expressão de pIX em um momento precoce retardado no ciclo de infecção viral no início da replicação de DNA viral, com números crescentes de cópias de DNA viral (Fessler e Young, J. Virol. 72, 4049-4056 (1998)). Embora o gene esteja presente dentro dos 4344 nucleotídeos integrados em células 293, a expressão de pIX não pode ser detectada, mesmo com métodos sensíveis de marcação radioativa (Spector et al., J. Virol. 36, 860-871 (1980)).
[0007] Conforme acima descrito, vetores adenovirais deficientes em replicação foram gerados por deleção da região E1 do genoma viral. Os produtos de E1 são essenciais para a replicação viral, e a função da região E1 tinha, portanto, de ser fornecida em trans mediante transgenes E1 estáveis na célula de empacotamento do adenovírus (como a linhagem celular 293). Por causa com a proximidade da região E1, o gene pIX causava frequente recombinação entre vetores adenovirais deletados e E1 no genoma do hospedeiro. Esse evento de recombinação gerava adenovírus competentes para replicação (RCA), uma contaminação séria em preparações de vetores. Para suprimir esse evento de recombinação, pIX era deletada do genoma do adenovírus. No decorrer desses experimentos, reconheceu-se que pIX estabiliza o capsídeo adenoviral contra estresse térmico e estérico mediante aumento da interação dos blocos de construção principais, os hexons (Colby e Shenk, J. Virol. 39, 977-980 (1981); Ghosh-Choudhury et al., EMBO J. 6, 1733-1739 (1987)). A morfogênese na ausência de pIX fornece vírus sensíveis à temperatura, que não podem destruir moléculas de DNA genômico maiores que 105% dos 35938 pares de bases do tipo selvagem. Para ainda permitir uma capacidade de empacotamento normal e a estabilidade térmica, a proteína pIX foi introduzida de maneira estável em linhagens celulares pretendidas como células de empacotamento para vetores adenovirais (Krougliak e Graham, Hum. Gene Ther. 6, 1575-1586 (1995); WO 99/57296 e Imler et al., Gene Therapy 3, 75-84 (1996)).
[0008] Também reconhecendo que pIX decora a superfície de vírions, proteínas de fusão com pIX foram geradas com a finalidade de expandir a faixa de hospedeiros de vetores adenovirais ou para seguir a morfogênese e a migração intracelular de partículas virais (revisado por Parks, Mol. Ther. 11, 19-25 (2005)).
[0009] Embora claramente uma proteína estrutural, pIX também está implicada como proteína reguladora para a replicação do adenovírus. Considera-se que PIX funcione como transativador da transcrição para aumentar a expressão de E1A, uma função possivelmente até exercida como uma virocina pela proteína PIX proveniente do capsídeo na etapa de infecção (revisado por Parks, Mol. Ther. 11, 19-25 (2005)). PIX, juntamente com a proteína precoce E4 Orf3, também é descrita como interagindo com inclusões subnucleares chamadas de corpúsculos PML (Puvion-Dutilleul et al., Exp. Cell. Res. 218, 9-16 (1995); Leppard e Everett, J. Gen. Virol. 80, 997-1008 (1999)). Esses são agregados dinâmicos de 250 nm a 500 nm de tamanho e que se propõe que estejam envolvidos na regulação da diferenciação celular (Wang et al., Science 279, 1547-1551 (1998)), controle da apoptose (Quignon et al., Nature Gen. 20, 259-265 (1998)) e resposta a infecções virais (Moller e Schmitz, Arch Immunol Ther Exp (Warz) 51, 295-300 (2003)).
[00010] Por causa de seus efeitos pleotrópicos, introduzidos a proteína PIX em linhagens celulares para examinar se PIX aumenta a proliferação celular ou as propriedades de produção de produtos biofarmacêuticos que não estejam relacionados a adenovírus ou vetores adenovirais. Há uma necessidade geral de fatores que modulem essas propriedades em linhagens celulares estabelecidas.
[00011] Por exemplo, vírus atenuados (enfraquecidos) são candidatos promissores a vacinas: com a inoculação, eles imitam uma infecção natural, mas permitem mais tempo para o estabelecimento da resposta imune protetora desejada pelo vacinado. Com números crescentes de pacientes imunocomprometidos (por exemplo, devido a infecção por HIV), são desejáveis cepas altamente atenuadas. Embora cepas atenuadas ainda prossigam até a infecção (normalmente benigna), cepas altamente atenuadas são bloqueadas em um nível celular, mesmo na ausência de um sistema imune funcional. Um método frequentemente usado para estabelecer e manter a atenuação é a passagem dos vírus em diferentes tecidos do hospedeiro. Por exemplo, vírus do sarampo e da caxumba destinados a vacinação humana são passados por células primárias, em ovos de galinha embrionados ou culturas derivadas delas. Uma nova geração de vacinas se baseia em vírus de varíola altamente atenuados, que também dependem de células primárias de galinha para produção. Uma linhagem celular que pode substituir células primárias de galinha e que, ao mesmo tempo, se proteja ainda menos eficientemente contra a infecção viral devido a manipulações secundárias, como introdução do transgene de PIX, fornece, consequentemente, um substrato altamente desejável.
[00012] Para outras finalidades, pode-se preferir uma linhagem celular de mamíferos (em vez de aves). Essas linhagens celulares preferidas já existem e passaram pelo exame de autoridades sanitárias com relação à segurança e a riscos apresentados pelos produtos biofarmacêuticos derivados. Aqui também uma manipulação secundária (como introdução do transgene de PIX) para aumentar o espectro de aplicações disponíveis ou as eficiências de produção, sem comprometer as características de segurança, é altamente desejável.
[00013] Quando se prepararam linhagens celulares que tenham sido transfectadas de maneira estável como o gene adenoviral pIX (ou seu análogo de fusão quimérico), observou-se inesperadamente que pIX exerce um efeito fenotípico em células de aves e humanas. Para células de aves, isso é particularmente surpreendente, porque as células de ave não podem ser infectadas por adenovírus humanos, aviadenovírus (como CELO ou adenovírus de pássaros do tipo 8) não codificam um homólogo de PIX (Ojkic e Nagy, J. Gen. Virol. 81, 1833-1837 (2000)). Além disso, observou-se que a presença estável de PIX aumenta a suscetibilidade da célula à indução pelo análogo de RNA de filamento duplo, provavelmente mediante o receptor do tipo Toll 3. Provavelmente nesse contexto, também observou-se inesperadamente que a presença da proteína PIX aumenta os rendimentos de vírus de varíola altamente atenuados em células hospedeiras de aves. Como células infectadas por vírus de varíola sofriam menos da indução por análogo de RNA de filamento duplo, podemos ter encontrado uma interação entre a proteína PIX e genes anti-interferon do vírus da varíola que não havia sido anteriormente descrita. Também observou-se um aumento surpreendente no rendimento de produto proteináceo (não apenas vírus) liberados por uma linhagem celular transfectada de maneira estável.
[00014] Assim, a presente invenção apresenta: (1) um método para a preparação de um vírus alvo não adenoviral ou uma ou mais proteínas-alvo, o método compreendendo: (a) o cultivo de uma célula de expressão obtenível por infecção ou transfecção de uma célula hospedeira, integrado de maneira estável em seu genoma, um gene que codifique uma PIX de Adenovírus ou sua variante funcional, como uma proteína reguladora heteróloga, e expressão estável da dita proteína reguladora ou sua variante funcional, com o dito vírus alvo, ou com um vetor veículo de sequências de ácidos nucléicos que codifiquem o dito vírus alvo, ou com um vetor veículo de sequências de ácidos nucléicos que codifiquem a dita uma ou mais proteínas-alvo (em que o vírus alvo não adenoviral não contenha a dita proteína reguladora e a(s) proteína(s) alvo difira(m) da dita proteína reguladora ou sua variante funcional), e (b) o isolamento do vírus alvo ou da(s) proteína(s) alvo; (2) uma modalidade preferida de (1) acima, em que a dita proteína PIX ou sua variante funcional coopere com fatores virais não cognatos, module a distribuição subcelular de fatores diferentes da dita proteína, module a transcrição e/ou crescimento celular e intensifique a produtividade da célula na produção de um vírus não contendo a dita proteína reguladora e na produção de uma proteína diferente da dita proteína reguladora ou sua variante funcional; (3) uma modalidade preferida de (1) e (2) acima, em que o adenovírus pIX é fornecido como uma proteína de fusão com outra proteína que module ou expanda a atividade ou a distribuição subcelular do adenovírus pIX, por exemplo, esteja fusionado a receptor alfa de ácido retinoico, de preferência seja uma proteína de fusão com a sequência mostrada em SEQ ID NO: 4 ou seja fusionada a um GFP e contenha um NLS, de preferência seja uma proteína com a sequência mostrada em SEQ ID NO: 23; (4) uma modalidade preferida de (1) a (3) acima, em que a célula hospedeira e de expressão seja uma célula de vertebrado, incluindo células de mamíferos e células de aves, de preferência a célula de mamífero seja uma célula derivada de cérebro humano, e a célula de ave seja uma célula derivada de retina de pato ou uma célula derivada de somito de pato; (5) uma modalidade preferida de (1) a (4) acima, em que a célula hospedeira e de expressão seja derivada de cérebro humano, de preferência de cérebro fetal e, mais preferivelmente, seja uma célula NC5T11, e a dita célula seja veículo de uma sequência de ácido nucléico que codifique PIX de Adenovírus ou sua variante funcional como uma proteína reguladora heteróloga, de preferência a dita proteína reguladora heteróloga seja codificada por um ácido nucléico mostrado na SEQ ID NO: 1, SEQ ID NO: 3 ou SEQ ID NO: 22; (6) uma modalidade preferida de (5) acima, em que a célula hospedeira seja uma célula NC5T11 n° 34, e a célula de expressão é derivada da célula NC5T11 n° 34, a dita célula NC5T11 n° 34, estando depositada no DSMZ sob o número de acesso DSM ACC2744; (7) uma modalidade preferida de (1) a (4) acima, em que a célula hospedeira e de expressão seja uma célula de ave, de preferência seja derivada de retina de pato ou de somito de pato, e a dita célula seja veículo de uma sequência de ácido nucléico que codifica PIX de Adenovírus ou sua variante funcional como uma proteína reguladora heteróloga, de preferência a dita proteína reguladora heteróloga seja codificada por um ácido nucléico mostrado na SEQ ID NO: 1, SEQ ID NO: 3 ou SEQ ID NO: 22; (8) uma modalidade preferida de (7) acima, em que a célula hospedeira seja uma célula CR.PIX (17a11b), e a célula de expressão seja derivada da célula CR.PIX (17a11b), a dita célula CR.PIX (17a11b) estando depositada no DSMZ sob o número de acesso DSM ACC2749; (9) uma célula de expressão para a produção de um vírus alvo ou uma ou mais proteínas-alvo conforme definido em (1) a (8) acima, de preferência a expressão sendo conforme definida em (5) a (8) acima; (10) um método para a preparação da célula de expressão conforme definida em (9) acima, que compreende a infecção ou transfecção de uma linhagem celular hospedeira conforme definida em (1) a (8) acima com um vírus, ou com um vetor veículo de sequências de ácidos nucléicos que codifiquem o dito vírus ou com um vetor veículo de sequências de ácidos nucléicos que codifiquem a dita uma ou mais proteínas-alvo; (11) uma célula hospedeira conforme definida em (5) a (8) acima; (12) um método para a preparação de uma célula hospedeira de acordo com (11) acima, que compreende a transfecção de uma célula de partida apropriada com um vetor veículo da dita proteína reguladora ou sua variante funcional; (13) o uso da célula de expressão conforme definida em (7) acima para a preparação de um vírus alvo ou de uma ou mais proteínas- alvo; (14) uma proteína de fusão compreendendo pelo menos um primeiro domínio compreendendo uma proteína reguladora e pelo menos um segundo domínio compreendendo uma proteína ou proteína que aja como modulador de transcrição e/ou como um sinal para direcionamento subcelular, conforme definido em (2) ou (3) acima; e (15) uma sequência de nucleotídeos que codifica a proteína de fusão conforme definida em (14) acima.
[00015] Figura 1: histórico da linhagem celular NC5T11. A: neuroesferas de células primárias cultivadas sob condições livres de soro. B: monocamada de células primárias cultivadas em DMEM/F12 com 5% de FCS. C: foco primário duas semanas após a transfecção com p79. As setas indicam a borda entre células primárias e imortais. D: cultura aderente homogênea de células imortalizadas em DMEM/F12 com 5% de FCS. E: cultura em suspensão de NC5T11 em tubos de agitação em Excell VPRO.
[00016] Figura 2: imunofluorescência detectando E1A e E1B em NC5T11. Depois da fixação com metanol, as células foram tratadas com anticorpos de rato dirigidos contra E1A e E1B 55k, respectivamente seguido por anticorpos anti-rato conjugados a vermelho Texas. Conforme mostrado na fig. 2, todas as células na amostra mostram coloração nuclear típica para E1A e coloração citoplasmática para E1B. Depois da fixação com metanol, as células foram tratadas com anticorpos de rato dirigidos contra E1A e E1B 55k, respectivamente seguido por anticorpos anti-rato conjugados a vermelho Texas. Conforme mostrado aqui, todas as células na amostra mostram coloração nuclear típica para E1A e coloração citoplasmática para E1B.
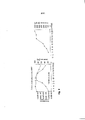
[00017] Figura 3: produtividade específica de clones aat selecionados. Clones celulares de NC5T11 transfectados com C55 e selecionados com puromicina foram semeados a 7 x 10⁴ células em placas de 12 cavidades, o número de células e o título de aat foram determinados nos dias 1, 2 e 3 após a semeadura, e se calculou a produtividade específica celular máxima por dia.
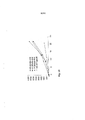
[00018] Figura 4: análise de expressão de NC5T11 puro n° 8 em cultura de lotes com agitação. As células foram semeadas em 12 mL de EXCELL VPRO a 6 x 10⁴ células/mL em tubos de agitação de polipropileno de 50 mL (TPP, Suíça) com e submetidos a rotação com um raio de 1 cm e uma velocidade de 160 rpm. Amostras de 200 μL foram tiradas nos dias 4, 7, 9, 11, 15, 18 e 21. A densidade e a viabilidade das células foram determinadas depois de tingir com azul de tripan usando um hemocitômetro.
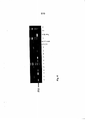
[00019] Figura 5: detecção de cDNA de pIX-RARA por PCR em clones reunidos. Clones reunidos veículos do gene pIXRARA foi gerada a partir de NC5T11 puro n° 8 por transfecção com F67 e seleção com higromicina. O RNA foi extraído usando-se um kit de extração de RNA (Machery Nagel, Alemanha), e cDNA foi sintetizado usando-se Transcriptase Reversa AMV (Invitrogen). cDNAs para apenas o fragmento pIX ou para todo o gene pIXRARA foram amplificados com iniciador 1 e 1 e 164, respectivamente.
[00020] Figura 6: detecção das sequências de pIXs como parte da proteína de fusão em subclones resistentes a higromicina de NC5T11 puro n° 8 e NC5T11 (n° 34, 35, 36, 37, 38) por PCR. O DNA foi isolado de clones de células cultivados em 6 cavidades por lise em SDS, seguido por extração com fenol e precipitação. O DNA foi amplificado com os iniciadores 1 e 2 durante 28 ciclos.
[00021] Figura 7: a estabilidade dos genes pIXRARA e pIX em NC5T11 transfectada de maneira estável foi determinada com relação a E1B: E1A+E1B e pIXRARA foram introduzidos em transfecções separadas e genes de E1 e foram mantidos na ausência de seleção durante > 2 anos e são, portanto, considerados integrados de maneira estável. O DNA genômico foi isolado de clones de células selecionadas em 2 momentos: imediatamente após parada por seleção com hyg (precoce); após 2 meses na ausência de pressão seletiva (tardia). Os níveis de DNA de PIX e E1B foram determinados por PCR de Tempo Real.
[00022] Figura 8: retardo de crescimento induzido por tratamento com RA em clones recombinantes de pIXRARA de NC5T11 e NC5T11 puro n° 8. As células foram semeadas a 2 x 10⁵ em placas de 6 cavidades, na presença ou ausência de 6 μg/mL de ácido retinoico. Fotos mostrando o retardo de crescimento nos clones tratados com RA n° 12 e n° 34, mas não em NC5T11, foram tiradas 4 dias após a semeadura usando-se imagem por contraste de fase a uma ampliação de 4x.
[00023] Figura 9: PIXRARA impede a inibição da replicação dos vírus por interferon. Células NC5T11 e NC5T11 n° 34 foram infectadas com EMCV, um vírus sensível a interferon, a uma MOI de 0,004, em células tratadas com interferon beta. Os lisados celulares foram submetidos a titulação por formação de placa em células A549.
[00024] Figura 10: análise de expressão da linhagem celular NC5T11 puro n° 8 que expressa alfa-1-antitripsina do vetor C55 e seus subclones n° 10, n° 12, n° 14, veículos do vetor F67 (pEFpIX-RARA) além de C55. As células foram semeadas em EXCELL VPRO (JRH Biosciences) a 6 x 10⁴ células/mL em tubos de agitação de polipropileno de 50 mL (TPP, Suíça), com um volume total de 12 mL, e submetidas a rotação com um raio de 1 cm e uma velocidade de 160 rpm.
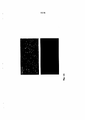
[00025] Figura 11: expressão de PIX em células CR de retina de pato. Painel esquerdo: reação de PCR contra o gene de PIX em DNA genômico de células pIX. Carga de gel da esquerda para a direita: marcador de 1 kb (Invitrogen); PCR em DNA genômico de CRpIX; controle sem molde; controle positivo com plasmídeo usado na transfecção de CrpIX. Painel direito: Western Blot para detecção de proteína pIX em células CRpIX. Raia 1: células 293; raia 2: proteína pIX em células CRpIX.
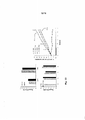
[00026] Figura 12: manutenção estável do transgene de PIX em células de retina de pato. Painel esquerdo superior: MCX e DXS são alíquotas independentes de um clone de CRpIX cultivado durante > 3 meses em paralelo e sem seleção. Após três meses, usou-se TaqMan para contar os números de cópias do transgene de E1B e PIX em MCX e DXS. Como o transgene de E1B é mantido independentemente do PIX, a razão dos dois genes é uma indicação da manutenção do transgene de PIX. A razão não se alterou entre MCX e DXS. Além disso, a razão de mRNA de PIX para mRNA de E1B também não se alterou, e o mRNA de PIX excedia o mRNA de E1B, indicando a expressão de PIX. Painel direito: MCX e células CR.HS de origem (negativas para PIX) foram cultivadas com ou sem pressão seletiva de higromicina durante 2 semanas (indicado pela barra preta no eixo x). Em vários momentos, o DNA genômico foi isolado (indicado por "A", "B" e "C") e submetido a quantificação por TaqMan (inferior esquerdo). Enquanto as células de origem foram mortas pela higromicina, as células MCX sobreviveram. A razão de transgenes permaneceu constante, novamente indicando a manutenção estável do transgene de PIX também na presença de pressão seletiva. O tempo de duplicação para as células de origem é de aproximadamente 32 h, mas de apenas 41 horas para células MCX.
[00027] Figura 13: efeito de PIX sobre a replicação de MVA em células CS. Células CS e CSpIX foram infectadas com MVA e ensaiadas quanto à replicação de MVA 48 h e 72 h após a infecção. O rendimento de MVA era significativamente maior em células CS positivas para PIX. Da mesma forma, conforme evidenciado na microimagem de contraste de fase, o efeito citopático pareceu retardado para células CSpIX em 48 horas. Entretanto, ambas as culturas são suscetíveis ao vírus em graus similares, pois a lise completa é evidente 72 horas após a infecção.
[00028] Figura 14: efeito de PIX sobre a replicação de MVA em células CR. Células CR e CRpIX em suspensão foram infectadas com várias multiplicidades e a várias densidades de células de semeadura. O rendimento de MVA foi ensaiado 48 h após a infecção e está mostrado no eixo y. O tamanho das bolhas apresenta as densidades de células de semeadura. As bolhas preenchidas mostram os valores para células CRpIX, bolhas brancas mostram os valores para as células de origem. Em todas as configurações, PIX confere um claro aumento nas taxas de amplificação de MVA.
[00029] Figura 15: distribuição subcelular de PIX-GFP em células de pato. PIX etiquetado com GFP aparece em poucos pontos brilhantes citoplasmáticos e coloração citoplasmática difusa, excluindo grandemente o núcleo. Outros clones exibem coloração citoplasmática difusa mais forte e acumulação mais intensa fora do núcleo.
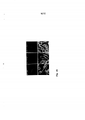
[00030] Figura 16: distribuição subcelular de variantes de PIX-GFP em células CHO. Para investigar alterações induzidas da distribuição de PIX dentro das células, variantes de fusão foram geradas, incluindo a inserção de um sítio de localização nuclear (NLS) e fusão ao receptor alfa retinoico, uma proteína celular que já contém um NLS. Mostram-se células CHO transitoriamente transfectadas com plasmídeos de expressão para variantes de PIX-GFP.
[00031] Figura 17: efeito de indução com interferon na presença de PIX. Células CSpIX e CRpIX foram tratadas com poli I:poli C, um indutor conhecido da resposta de interferon do tipo I, e comparadas a células de origem. As células CSpIX reagiram com maior sensibilidade a poli I:poli C do que as células CS. Células CRpIX e CR reagiram de maneira comparável e em menor medida que as células CS.
[00032] Figura 18: efeito da infecção com MVA e indução com interferon na presença de PIX-GFP. Células CSp9GFP e CRp9GFP foram tratadas com poli I:poli C e infectadas com MVA a uma M.O.I. de 0,1, conforme indicado. Mais uma vez, células derivadas de CS reagiram mais fortemente à indução com interferon. Surpreendentemente, corpúsculos de PIX brilhantes pareceram diminuir de número com a indução ou infecção em ambas as linhagens celulares, ao passo que a intensidade de sinal global de PIX-GFP aumenta. Além disso, o efeito da indução com poli I:poli C é melhorado por infecção paralela com MVA, conforme indicado por um número maior de células CS ainda aderentes 22 h após o tratamento.
[00033] O método da modalidade (1) da invenção utiliza uma célula de expressão com um gene que codifica uma proteína reguladora heteróloga, a saber, pIX, ou sua variante funcional, integrado em seu genoma. A dita proteína reguladora possui as seguintes propriedades: 1. Modula a transcrição e, particularmente se ligada a moduladores ou reguladores apropriados, também influencia o crescimento celular. 2. Intensifica a produtividade da linhagem celular com relação à produção de um vírus não contendo a dita proteína reguladora (isto é, a proteína reguladora não é um substituto para uma proteína deletada do vírus) e/ou com relação à produção de uma proteína diferente da dita proteína reguladora ou sua variante funcional.
[00034] De acordo com a invenção, a proteína reguladora heteróloga é a proteína pIX de adenovírus sorotipo 5 (por exemplo, aquela com a sequência de aa mostrada na SEQ ID NO: 2), seus mutantes (incluindo mutantes de adição, substituição e/ou deleção), suas variantes (por exemplo, variantes obtidas de um adenovírus de um sorotipo diferente) e similares.
[00035] "Variante funcional da proteína reguladora heteróloga", de acordo com a invenção, inclui homólogos do adenovírus além do sorotipo 5, todos os tipos de mutação (adição, substituição e/ou deleção) de resíduos de aminoácidos particulares da respectiva proteína reguladora de tipo selvagem, modificação por fusão com sequências de proteínas ou peptídeos ativos adicionais e outros. São particularmente preferidas as proteínas de fusão, a saber, proteínas de fusão compreendendo pelo menos um primeiro domínio que compreenda uma proteína reguladora, conforme acima definida, e pelo menos um segundo domínio compreendendo uma proteína ou peptídeo que aja como um modulador de transcrição. Em uma modalidade preferida da invenção, o dito modulador de transcrição é um fator de transcrição incluindo o receptor alfa de ácido retinoico, que pode estar presente em forma completa ou incompleta (isto é, truncado). O modulador também pode ser um peptídeo de trânsito, que inclui sequências NLF, por exemplo, aquelas mostrada em SEQ ID NO: 21. De acordo com a invenção, os primeiro e segundo domínios ligados covalentemente entre si diretamente ou mediante um elo peptídico. Elos peptídicos adequados incluem estruturas flexíveis e hidrofílicas, como poli Gly-Ser.
[00036] Os termos "células" e "linhagem celular", conforme usados na descrição detalhada a seguir, referem-se a células de expressão/linhagens celulares de expressão e células hospedeiras/linhagens celulares hospedeiras.
[00037] De acordo com a invenção, é preferível que a proteína reguladora heteróloga ou sua variante funcional seja expressada na célula em uma quantidade de pelo menos 1 pg/μg de proteína celular, de preferência em uma quantidade de pelo menos 10 pg/μg de proteína celular, de modo que sua expressão possa ser determinada por Western-Blotting.
[00038] Na célula da invenção, a proteína reguladora heteróloga ou sua variante funcional está, de preferência, sob controle de um promotor homólogo ou heterólogo estável. Promotores adequados são promotores celulares constitutivos ou suas variantes, como o promotor de fator 2 de translocação e alongamento humano. Uma variante particular do promotor de fator 2 de translocação e alongamento humano utilizado na invenção tem a sequência mostrada na SEQ ID NO: 12. A sequência mostrada representa uma versão "curta" do promotor, que está localizada no cromossomo humano 19:3.935.3253.936.638 (montagem de genoma humano, maio de 2004) e garante uma expressão de nível médio estável. Para uma expressão mais forte, pode-se usar uma versão "mais longa" do promotor localizada em chr19:3.935.349-3.938.957 (montagem de genoma humano, maio de 2004).
[00039] De acordo com a invenção, a célula é uma célula de vertebrado, incluindo células de mamíferos, células de aves e outras. Células de mamíferos adequadas são células humanas e células de roedores, incluindo de camundongo, rato, hamster, etc. Células de mamíferos particularmente preferidas de acordo com a invenção são células derivadas de cérebro humano, particularmente de cérebro humano fetal, uma célula NOS ou Sp2/0 de camundongo, uma célula BHk ou CHO. Células de aves adequadas são células de pato, galinha, codorna e ganso. Células de aves particularmente preferidas de acordo com a invenção são células derivadas de retina de pato ou derivadas de somito.
[00040] Por outro lado, a célula da invenção pode ser derivada de uma célula primária ou de uma célula previamente imortalizada. Além disso, a célula também pode ser veículo de genes imortalizadores (virais), incluindo uma proteína E1 de um adenovírus, como a proteína E1 de mastadenovírus grupo C tipo 5 e outros. É particularmente preferido de acordo com a presente invenção que a célula também seja veículo do gene de E1A e/ou E1B de adenovírus mostrado na SEQ ID NO: 5.
[00041] A célula utilizada no método da modalidade (1) da invenção também pode ser veículo de sequências funcionais, por exemplo, sequências requeridas para sua aplicação como célula de expressão, como sequências marcadoras de seleção, sítios doadores/receptores de união e/ou sequências de reconhecimento de recombinase, que permitam a integração de uma sequência de ácido nucléico alvo a ser expressada na célula, etc.
[00042] A "infecção", "transfecção" e "transformação" efetuadas no método das modalidades (1), (10) e (12) da invenção podem ser efetuadas de acordo com procedimentos padronizados conhecidos por aqueles versados na técnica. Os ditos métodos também podem englobar etapas de seleção, isolamento e expansão adequadas, caso requerido.
[00043] No método da modalidade (1), o vírus alvo inclui vírus do tipo selvagem, com mutação ou deletado, vírus adaptado ao frio ou atenuado, cepas de vacinas, vetores virais veículos de gene(s) heterólogo(s), vetores virais, como lentivírus, vírus da varíola, vírus adeno associados (aav), vírus da herpes, flavivírus e similares.
[00044] Além disso, no método da modalidade (1), a uma ou mais proteínas-alvo incluem anticorpos, proteínas recombinantes, como eritropoetina, alfa-1-antitripsina, fatores da coagulação sanguínea VIII e IX e interferons, antígenos virais, como influenza HA e NA, e M, HBV-S, proteína G de herpes e proteína G da raiva, hormônios peptídicos e similares. Embora o método permita a produção de células capazes de expressão contemporânea de mais de uma proteína-alvo, é particularmente preferido que codifique apenas uma proteína-alvo.
[00045] O cultivo e isolamento do método da modalidade (1) da invenção pode ser efetuado de acordo com procedimentos padronizados prontamente disponíveis para aqueles versados na técnica. O dito método também pode incluir etapas de purificação padronizadas, assim como etapas de modificação subsequentes do vírus alvo ou proteína(s) alvo.
[00046] Com relação às modalidades preferidas das linhagens celulares de expressão e hospedeiras das modalidades (9) e (11), respectivamente, assim como aos métodos de produção das ditas linhagens celulares das modalidades (10) e (12), faz-se referência à discussão detalhada apresentada acima com relação à modalidade (1).
[00047] De acordo com as modalidades (14) e (15), a invenção apresenta uma proteína de fusão compreendendo pelo menos um primeiro domínio que compreende uma proteína reguladora e pelo menos um segundo domínio que compreende uma proteína ou peptídeo que aja como um modulador da transcrição conforme acima definido, e uma sequência de nucleotídeos que codifica a dita proteína de fusão, respectivamente. A invenção também se refere ao uso da dita proteína de fusão (por exemplo, em aplicações diagnósticas ou farmacêuticas etc.) e da sequência de nucleotídeos que a codifica das modalidades (14) e (15), respectivamente, por exemplo, em todos os tipos de construtores de vetores, linhagens celulares, cultura de tecido, animais transgênicos etc.
[00048] A linhagem celular NC5T11 n° 34 foi depositada no DSMZ- Deutsche Sammlung von Mikroorganismen und Zellkulturen GmbH, Mascheroder Weg 1b, 38124 Braunschweig, Alemanha, em 4 de novembro de 2005, sob o número de acesso DSM ACC2744. A linhagem celular CR.PIX (17a11b) foi depositada no DSMZ-Deutsche Sammlung von Mikroorganismen und Zellkulturen GmbH, Mascheroder Weg 1b, 38124 Braunschweig, Alemanha, em 4 de novembro de 2005, sob o número de acesso DSM ACC2749.
[00049] A invenção será explicada em maiores detalhes por meio dos exemplos a seguir, que, entretanto, não devem ser tomados como limitando a invenção.
[00050] A linhagem celular foi desenvolvida a partir de uma mistura de células de cérebro fetais por imortalização com os genes E1A e B de adenovírus 5 por transfecção não viral.
[00051] Uma amostra de tecido foi tirada da zona periventricular do cérebro de um feto após abortamento induzido. Foi dissecada com tesouras e homogeneizada por aspiração com uma pipeta de cultura de tecido em meio de cultura neuronal, à base de DEMEM/F12 contendo 20 ng/mL de hFGF (Invitrogen, Carlsbad, CA 92008, EUA), 20 ng/mL de hEGF (Invitrogen), 1x suplemento N2 (Invitrogen) e 8 μg/mL de heparina (Sigma Aldrich, St. Louis, EUA). As células foram sedimentadas a 200 g durante 3 min. A viabilidade das células foi avaliada usando-se azul tripan e iodeto de propídio, usando-se um citômetro de fluxo (BD Biosciences, Jose, CA 95131, EUA). A viabilidade era de 75%. 0,5 x 10⁶ células foram semeadas em balões T25. As células foram incubadas a 37°C e 5% de CO2. As células formaram neuroesferas até o dia 5 de cultura. As neuroesferas são mostradas na Figura 1A. No dia 8, as células foram transferidas para DMEM/F12 suplementado com 5% de FCS, para permitir a fixação e para estimular a proliferação. As células formaram uma monocamada homogênea conforme mostrado na Figura 1B e foram passadas a 1:5 uma vez por semana. Essa cultura de células neurais primárias foi chamada de NC5.
[00052] Após 2 semanas em soro contendo meio, as células foram transfectadas com vetor p79 em placas de 6 cavidades subconfluentes usando-se Effectene (Qiagen, 40724 Hilden, Alemanha) como um reagente de transfecção, segundo as instruções dos fabricantes. O plasmídeo p79 contém os seguintes elementos: o pBluescript (Stratagene, EUA), serve de estrutura principal do plasmídeo, em que o marcador de resistência à ampicilina foi substituído pelo gene de resistência à canamicina acionado por um promotor bacteriano que permite o crescimento e seleção em E. coli. O vetor aloja um fragmento de adenovírus 5 do tipo selvagem (SEQ ID NO: 5) contendo os quadros de leitura abertos para E1A (variantes de união 13S e 12S, com ou sem o domínio CR3, respectivamente), e E1B 55k e 19k, assim como sequências a montante de E1A. O gene de E1A é precedido pelo promotor de fosfoglicerato quinase (camundongo). As sequências do adenovírus são seguidas pelo sinal de poliadenilação do gene de timidina quinase de herpes simples, servindo de substituto para o sinal de poliadenilação de E1B. Os elementos foram obtidos dos respectivos organismos ou de plasmídeos doadores por PCR e clonados usando-se técnicas convencionais de DNA recombinante e verificados por sequenciamento. Dois dias após a transfecção, as células foram tripsinizadas e transferidas para um disco de 10 cm. Duas semanas depois, focos de pequenas células com uma elevada razão de núcleo/citoplasma e bordas claramente distinguíveis se formaram (Figura 1C) em células transfectadas, mas não em tratadas de controle. A partir de 11a transfecção, oito focos independentes foram isolados tripsina usando-se cilindros de clonagem (Corning, EUA), semeados em cavidades de uma placa de 24 cavidades e expandidos mediante uma placa de 12 cavidades, placa de 6 cavidades e balão T25. Todos os focos isolados continham dois tipos de células: células pequenas com bordas nítidas e células do tipo fibroblasto estendidos.
[00053] Três semanas após a transfecção, 15 clones adicionais se tornaram visíveis na transfecção T11, alguns dos quais podendo se originar de células restantes de clones primários já isolados.
[00054] Os clones T11a.1 e T11a.6 mostraram o crescimento mais rápido e foram criopreservados em DMEM/F12, 10% de DMSO, 25% de soro 8 semanas após a transfecção. Nesse momento, todos os clones ainda continham uma fração de células com citoplasma aumentado, assemelhando-se ao fenótipo primário. Entretanto, com uma razão de divisão de 1:5 para T11a.1 e T11a.6, foram supercultivadas e eliminadas aproximadamente 3 meses após a transfecção. Experimentos de imunofluorescência foram realizados para associar a morfologia alterada com a expressão de E1A e E1B. Depois da fixação com metanol, as células foram tratadas com anticorpos de rato dirigidos contra E1A e E1B 55k, respectivamente seguido por anticorpos anti-rato conjugados com vermelho Texas. Conforme mostrado na figura 2, todas as células na amostram mostram coloração nuclear típica para E1A e coloração citoplasmática para E1B.
[00055] Três meses após a transfecção, os clones T11a.1 e T11a.6 foram transferidos para meio livre de soro ProPER (Cambrex, Bélgica) por semeadura de 1,6 x 10⁶ células após tratamento com tripsina. As células foram colhidas por centrifugação, e o meio foi trocado por centrifugação uma vez por semana. A população de células sobreviveu, mas, mesmo seis meses após a transfecção, as células ainda mostraram baixa viabilidade e cresciam com um elevado tempo de duplicação de 60 - 80 h.
[00056] Quando as células foram transferidas de volta para DMEM/F12 com 5% de FCS após 3 meses em meio ProPER, uma cultura homogênea e altamente viável com um tempo de duplicação de 40 h se formou para ambos os clones. T11a.1 foi escolhido como o clone celular mais robusto para experimentos adicionais e chamado de NC5T11 (figura 1D).
[00057] A produção de proteínas em uma linhagem celular depende de métodos eficientes de transfecção e seleção. A adequação de marcadores de seleção comumente usados G418, puromicina, higromicina, blasticidina, MTX, histidinol para NC5T11 era desconhecida. Em uma primeira etapa de avaliação, diferentes reagentes de transfecção comercialmente disponíveis Lipofectamine (Invitrogen), Fugene (Roche, Alemanha), Polyfect (Qiagen) e Effectene foram testados segundo os protocolos dos fabricantes. O plasmídeo pEGFP-N1 (Clonetech, EUA) que expressa GFP do promotor CMV humano foi usado para determinar a eficácia de transfecção transitória. A eficiência mais elevada foi obtida com Effectene (Qiagen), atingindo 20 - 50% dependendo da densidade celular, quando aplicado a células aderentes crescendo em DMEM/F12 10% de FCS.
[00058] Para testar os genes marcadores de seleção, foram construídos vetores de expressão contendo o gene de alfa-1-antitripsina (aat) humano, sob controle do promotor CMV humano, seguido pelo sinal PoliA do hormônio de crescimento bovino e o respectivo marcador de seleção controlado por um promotor fraco. Mais especificamente, para testar a seleção com puromicina, usou-se o vetor C55, que contém o gene de resistência à puromicina acionado pelo promotor PGK humano, seguido pelo sinal de poliadenilação precoce de SV40.
[00059] Depois da transfecção, as células foram semeadas em DMEM/F12 5% de FCS contendo 0,75 μg/mL de puromicina e selecionadas durante 3 semanas com troca semanal do meio. Geraram- se clones reunidos, e a expressão foi verificada por imunofluorescência usando-se um anticorpo anti-alfa-1-antitripsina policlonal de cabra (Innogenetics, EUA), seguido por um anticorpo anticabra de coelho secundário marcado com biotina e conjugado de estreptavidina- Vermelho Texas.
[00060] Para isolar clones celulares individuais, 10.000 células dos clones reunidos foram semeadas em um disco de 15 cm. Após 4 semanas, os clones foram isolados usando-se cilindros de clones (Corning), e os clones n° 1, 2, 7, 8, 9, 10 foram analisados quanto à expressão de aat. Mais especificamente, as células foram semeadas a 7 x 10⁶ células em placas de 12 cavidades, e o número de células e a expressão de aat foram determinados. As taxas de produtividade específica das células calculadas são dadas na Figura 3. O clone NC5T11 puro n° 8 mostra uma produtividade específica acima de 100 pg/célula/dia e foi escolhido para desenvolvimento adicional.
[00061] A taxa de crescimento tanto de NC5T11, quanto de NC5T11 puro n° 8 em meio ProPER (Cambrex) foi reduzida aproximadamente duas vezes em comparação com o meio contendo soro. Consequentemente, Xcell VPRO (JRH Biosciences) foi testado como uma alternativa. A adaptação foi feita por semeadura direta de 4,5 x 10⁶ células em 5 mL de EXCELL VPRO em um balão T25. Após 2 semanas, o crescimento celular foi reiniciado, e se estabeleceu uma razão de divisão semanal de 1:3. Como etapa seguinte, ambos os clones foram adaptados para crescerem na presença de tensão de cisalhamento. As células foram semeadas em 12 mL de EXCELL VPRO a 6 x 10⁴ células/mL em tubos de agitação de polipropileno de 50 mL (TPP, Suíça) com e submetidos a rotação com um raio de 1 cm e uma velocidade de 160 rpm. Após passagens repetidas, efetuaram-se ensaios por bateladas para determinar as densidades celulares máximas e a acumulação de produto durante as fases de crescimento exponencial e estacionário. Foram feitas as seguintes observações: o clone NC511puro mostrou uma elevada viabilidade, que foi mantida acima de 70% até o dia 18. A densidade celular máxima não excedeu 1 x 10⁶. A acumulação de produto continuou durante a fase estacionária (figura 5). Concluiu-se que o desenvolvimento de meios específicos ou aperfeiçoamento adicional das células serão requeridos para se conseguir uma elevada densidade celular, comparável à obtida com células CHO. Isso provavelmente resultará em títulos de produtos substancialmente aumentados.
[00062] As sequências para PIX de adenovírus e receptor alfa de ácido retinoico (RARA) foram obtidas por PCR de adenovírus tipo 5 e DNA genômico humano, respectivamente, usando-se os iniciadores: para PIX; e 3.CCAATGCGGTTGCCACCATTGAGACCCAGA(SEQ ID NO18) para RARA.
[00063] Ambos os fragmentos foram amplificados separadamente. Uma superposição entre os iniciadores 2 e 3 permitiu conectar ambos os fragmentos mediante PCR usando-se os iniciadores 3 e 4. O gene de fusão foi clonado no vetor pEFpromhyg, resultando em pEFpIXRARA. Esse vetor contém o fator 2 de alongamento humano localizado em chr19:3.935.325-3.936.638 (montagem de genoma humano, maio de 2004; SEQ ID NO: 12). Contém elementos a montante e o primeiro íntron do gene EF2. O códon de partida natural de EF2, localizado em 5’ com relação ao primeiro íntron, foi removido por mutagênese. No vetor, pEFpromhyg, a sequência de EF2 é seguida pelo sítio de restrição único (AfeI) usado para inserção de pIX-RARA. Um sítio de ligação a ribossomo interno após o sítio AF1 permite a expressão do gene de resistência a higromicina como um segundo quadro de leitura aberto em um RNA unido a pIX-RARA. Essa configuração suporta a expressão de pIX-RARA em todas as células resistentes a higromicina.
[00064] O gene para wt pIX foi amplificado usando-se os iniciadores AACC.-v I A-/ A •-Q:AGC<A,J.:G-(SEQ ID NO: 10) θ ..-•j.;:.:GAG! (r-; । i K,;, (SEQ ID NO: 11) e integrado no síto Afe de pEFpromhyg, em vez de pIX-RARA, para fornecer pEFpIX. Exemplo 5: Modificação das linhagens celulares NC5T11 e NC5T11 puro n° 8 com o gene de PIX e a proteína de fusão PIX-receptor de ácido retinoico
[00065] Os clones celulares NC5T11 e NC5T11 puro n° 8 foram preparados para transfecção em placas de 6 cavidades por semeadura de 1,3 x 10⁶ células/cavidade em DMEM/F12, 5% de FCS. O plasmídeo F67 (pEFpIXRARA) e o plasmídeo F76 (pEFpIX) foram linearizados com a enzima de restrição Asp700 (Roche) e transfectados após precipitação com etanol usando-se Effectene (Qiagen): o DNA foi misturado com 16 μL de intensificador e 200 μL de tampão EC. Após 2 min à temperatura ambiente, 18 μL de Effectene foram adicionados, e a formação de lipossomo foi deixada durante 10 min à temperatura ambiente. A mistura de transfecção foi adicionada a 1 mL de volume de cultura em células semeadas a 80% de confluência em placas de 6 cavidades no dia anterior. Uma alta eficiência de transfecção foi confirmada com uma transfecção paralela de pEGFP-N1 (Clontech, Palo Alto, CA 94303-4230, EUA). Um dia após a transfecção, o meio foi trocado para DMEM/F12 com 10% de FCS, e se adicionaram 75 ou 100 μg/mL (NC5T11) e 50 μg/mL (NC5T11 puro n° 8) de higromicina. O meio de seleção foi substituído duas vezes por semana. Após 18 dias, 15 - 20 clones claros se tornaram visíveis em cada uma das cavidades. Os clones reunidos foram tratados com tripsina, e a seleção continuou durante mais duas semanas. Os clones reunidos foram testados quanto à expressão de PIXRARA por RTPCR. Um sinal forte foi detectado com os iniciadores 1 e 2, um sinal mais fraco com os iniciadores 1 e 4 na maioria dos clones reunidos. Para isolar clones celulares individuais, 10.000 e 1.000 células dos clones reunidos foram semeadas em discos de 15 cm. Após 4 semanas, os clones foram isolados usando-se cilindros de clone (Corning). Para clones resultantes da transfecção de F76, aplicou-se uma estratégia diferente. Os clones reunidos foram tratados com tripsina, transferidos para um tubo de agitação de 50 mL em EXCELL VPRO contendo 75 μg/mL de higromicina e, após 2 semanas de cultura em suspensão, 2.000 células viáveis foram misturadas com 12 mL de matriz de clone (Genetix, RU), semeadas em uma placa de seis cavidades (Greiner) (2 mL/cavidade) e submetidas a recolhimento de colônias automatizado (clonepixFL, Genetics, RU). Clones originados de NC5T11 puro n° 8 receberam os números 10 - 21. Clones originados de NC5T11 receberam os n° 34 - 45. Clones transfectados com pEF1PIX foram chamados de NC5T11PIXA- NC5T11PIXE. Os clones foram testados quanto à presença do respectivo vetor por PCR. Um teste inicial usando os iniciadores 1 e 2 é apresentado na figura 6. Todos os clones mostrando um sinal positivo foram deslocados para crescimento em ExCell VPRO. A readaptação foi feita por semeadura direta de 4,5 x 10⁶ células em 5 mL de EXCELL VPRO em um balão T25. Após 6 semanas em cultura estacionária, as células foram transferidas para tubos de agitação de polipropileno de 50 mL (TPP, Suíça) a uma densidade de semeadura de 6 x 10⁴ células/mL em EXCELL VPRO, com um volume total de 12 mL, e submetidas a rotação com um raio de 1 cm e uma velocidade de 160 rpm. Os clones n° 10, 12, 14 (NC5T11 puro n° 8 pIXRARA) e n° 34, 43 (NC5T11pIXRARA) e NC5T11PIXB, NC5T11PIXC foram escolhidos pela maior viabilidade sob tensão de cisalhamento. Os clones n° 34, 43 e NC5T11PIXC foram reclonados e analisados quanto à estabilidade do DNA integrado. A estabilidade foi avaliada determinando-se a razão de genes entre PIX e E1B, porque E1A+E1B e pIXRARA foram introduzidos em transfecções separadas, e genes de E1 foram introduzidos e foram mantidos na ausência de seleção durante > 2 anos e são, consequentemente, considerados integrados de maneira estável. O DNA genômico foi isolado de clones celulares selecionados em 2 momentos: imediatamente após a parada de seleção com hyg (precoce); após 2 meses na ausência de pressão de seleção (tardia). Os níveis de DNA de PIX e E1B foram determinados por PCR em Tempo Real (ABI 7000, CYBR Green) a 2 concentrações de DNA. Exemplos dessa avaliação são mostrados na figura 7. O vetor pEF2PIXRARA é mantido de maneira estável nos suclones n° 34 e 43, com aproximadamente 0,4 - 0,6 cópia de PIXRARA por E1B. O clone NC5T11PIXC contém originalmente 4 cópias de pIX por E1B. Esse número é reduzido duas vezes no decorrer do experimento.
[00066] O ácido retinoico (RA) é um indutor da diferenciação celular. A diferenciação está tipicamente associada a um crescimento celular reduzido. A resposta a RA depende da expressão do receptor retinoico alfa, um fator de transcrição ativador por RA. RA tem um efeito profundo sobre PML (leucemia pró-mielocítica), revertendo o fenótipo transformado por parada do crescimento.
[00067] Conforme mostrado na figura 8, o tratamento com RA a uma concentração de 6 μg/mL não teve nenhum efeito sobre o crescimento de NC5T11 ou do clone que expressão alfa-1-antitripsina NC5T11 puro n° 8. Entretanto, o crescimento dos clones n° 14 (NC5T11 puro n° 8 pIXRARA) e n° 34 (NC5T11pIXRARA) foi interrompido pelo tratamento com 6 μg/mL durante 5 dias na cultura aderente em DMEM/F12 com 5% de FCS.
[00068] Células NC5T11 e NC5T11 n° 34 foram semeadas em placas de 6 cavidades a 8,0 x 10⁵ células/cavidade em DMEM/F12 5% de FCS. Após 12 h, adicionou-se interferon beta (rebif 44 da Serono) as cavidades a uma concentração de 1 e 8 UI/mL. Após 30 min, as células tratadas com interferon e as células de controle tanto de NC5T11, quanto de NC5T11 n° 34 foram infectadas com vírus de encefalomiocardite (EMCV) a uma multiplicidade de infecção (MOI) de 0,004. Após 24 h, as culturas foram colhidas e congeladas a -80°C para romper as células. Essa suspensão foi descongelada e clareada por centrifugação com 800 x g durante 10 min. Os lisados foram submetidos a titulação de vírus por ensaio em placa com células A549: em resumo, as células A549 foram semeadas em placas de 24 cavidades e cultivadas até atingir a confluência, incubadas durante 30 minutos com lisados clareados diluídos de 10 a 2 x 10⁸ vezes, superpostas com 0,2% de agarose de baixa formação de gel tipo VII em RPMI e 10% de FCS e incubadas a 37°C durante 24 h. A camada de agarose foi aspirada, as células foram fixadas com glutaraldeído a 2% em PBS durante 20 min a 20°C, lavadas com água e incubadas durante 30 min à temperatura ambiente com solução de 1% de violeta cristal em etanol a 50% para contar as placas de vírus. Os resultados mostrados na figura 9 demonstram que a replicação de EMCV é relativamente ineficaz em células NC5T11, e que é altamente sensível ao tratamento com interferon antes da infecção. A 8 UI/mL, nenhum vírus viável pode ser recuperado da cultura. Em contraste, a replicação de vírus em NC5T11 n° 34 é afetada apenas levemente pelo tratamento com interferon. Além disso, mesmo na ausência de IFN exógeno, títulos mais elevados são observados para NC5T11 n° 34. Os fenômenos mostrados modelam processos de vacina típicos, porque muitas cepas de vacina induzem uma resposta de IFN em células produtoras, com uma via de IFN intacta, infecção a baixa multiplicidade de infecção (MOI), preferida em processos de produção, pode causar secreção de IFN, resultando em um bloqueio da replicação de vírus em células que não foram inicialmente infectadas. Consequentemente, a expressão de PIX pode permitir uma produção de altos títulos de vírus, partindo-se de baixa MOI.
[00069] NC5T11 puro n° 8 pIXRARA veículo do vetor F67, assim como alfa-1-antitripsina, foram comparadas ao clone de partida NC5T11 puro n° 8 na capacidade de produzir alfa-1-antitripsina em um ensaio por bateladas com agitação. As células foram semeadas em EXCELL VPRO (JRH Biosciences) a 6 x 10⁴ células/mL em tubos de agitação de polipropileno de 50 mL (TPP, Suíça), com um volume total de 12 mL, e submetidas a rotação com um raio de 1 cm e uma velocidade de 160 rpm. A cultura foi continuada até o dia 22. Além das células em suspensão, formou-se um anel de aglomerados celulares aderidos à parede do tubo. As células nesses aglomerados preservaram uma viabilidade acima de 70% durante todo o processo. Como a dissociação desses aglomerados por tripsina ou acutase (PAA) não foi bem- sucedida, as cinéticas de crescimento e as densidades celulares máximas não foram determinadas. As amostras foram tiradas nos dias 9, 13 e 22, e os títulos foram determinados usando-se ELISA de alfa-1- antitripsina. Os resultados são mostrados na figura 10.
[00070] A linhagem celular CR, derivada de células de retina de pato primárias e imortalizadas de acordo com diretrizes de risco definidas, é descrita em outro lugar (pedido de patente WO 05042728, células de retina transfectadas com plasmídeo 60E). As células foram cultivadas em meio DMEM F12 (Invitrogen, Carlsbad, CA 92008, EUA) suplementado com 5% de soro de novilho fetal (Biochrom AG, 12213 Berlim, Alemanha) a 39°C e 7,5% de CO2. Para a passagem, as células foram brevemente tratadas com TrupLE Express (Invitrogen). O plasmídeo 76F pEFPIX1 foi linearizado com as enzimas de restrição Ssp I e Xmn I (ambas da New England Biolabs, Beverly, MA 019155599, EUA) e purificado a 400 ng/μL por cromatografia de afinidade (kit de extração em gel da Qiagen, 40724 Hilden, Alemanha). 5 μL (2 μg) do DNA purificado foram transfectados em células CR com os reagentes Effectene (Qiagen): o DNA foi misturado com 16 μL de intensificador e 200 μL de tampão EC. Depois de 2 min à temperatura ambiente, 18 μL de Effectene foram adicionados, e a formação de lipossomo foi deixada durante 10 min à temperatura ambiente. A mistura de transfecção foi adicionada a 1 mL de volume de cultura em células semeadas a 80% de confluência em placas de 6 cavidades no dia anterior. A alta eficiência de transfecção foi confirmada com transfecção paralela de pEGFP-N1 (Clontech, Palo Alto, CA 94303-4230, EUA).
[00071] As culturas transfectadas com pIX foram expandidas em balões T75 três dias após a transfecção, e a seleção foi iniciada com 25 μg/mL de higromicina B (Invitrogen). O meio foi substituído uma vez por semana com higromicina B elevada a 50 μg/mL. Após três semanas, um total de quatro grandes focos sobreviveram e foram ressemeados em um balão T25: as células foram destacadas com TrypLE e coletadas com 100 x g durante 10 min, ressuspendidas em meio fresco e plaqueadas em um balão T25.
[00072] Quatro semanas após a transfecção, as células e uma cultura subconfluente saudável em um balão T25 foram destacadas com TrypLE em 5 mL de DMEM F12, 5% de FCS. 2 mL dela foram misturados com meio n° 63032-1000M (JRH Biosciences, KS 66215, EUA), um meio livre de componentes derivados de animais destinado à manutenção de culturas em suspensão. Adicionou-se higromicina B a 50 μg/mL. O DNA genômico foi isolado de 2 mL da cultura e submetido a PCR contra o transgene pIX com os iniciadores V293 e V294. O controle negativo foi fornecido por uma reação paralela sem DNA, o controle positivo por uma reação paralela com plasmídeo 76F. O produto de PCR esperado na figura 11 (painel esquerdo) demonstra a inserção estável do transgene pIX nas células CR, agora chamadas de "CRpIX".
[00073] A expressão da proteína PIX foi confirmada por Western Blotting: 6 x 10⁵ células foram rompidas por ebulição em (20 mM de Tris, pH 7,4, 300 mM de NaCl, 1% de Na-desoxicolato, 1% de Triton® X-100, 0,1% de SDS), e a proteína foi separada por eletroforese em gel, então, transferida para uma membrana de náilon. PIX foi detectada com anticorpo primário para pIX (um presente do Dr. W. Seidel, Ernst-Moritz- Arndt-Universitat Greifswald, Alemanha), então, reagida com anticorpo secundário dirigido contra o primeiro anticorpo e marcado com fosfatase alcalina.
[00074] O sinal de tamanho esperado na figura 11 (painel direito) confirma a expressão de pIX em células CRpIX. Nenhum sinal estava presente no controle negativo das células 293 preparadas em uma reação paralela.
[00075] As células foram cultivadas em meio n° 63032-1000M por duas passagens adicionais, então, transferidas para meio n° 145611000M (também da JRH Biosciences) por duas passagens adicionais. Todos os meios JRH foram suplementados com 1 x Glutamax I (Invitrogen) e 100 μg/mL de higromicina B.
[00076] Com a segunda passagem em meio n° 14561-1000M, uma pequena fração (aproximadamente 2% de uma cultura em suspensão de 5 mL) foi ressuspendida completamente em DMEM:F12, meio FCS e plaqueada em uma placa de petri de 15 cm de diâmetro. Após 6 dias, onze focos foram removidos para cavidades individuais de uma placa de 12 cavidades e mantidos em DMEM F12, meio FCS. Para a transferência de clone, o meio foi aspirado, e placas de clonagem (Sigma, MO, EUA) foram embebidas em TrypLE, brevemente aplicado diretamente aos clones, então, transferido para as cavidades cheias de meio. Os clones individuais foram expandidos para experimentos adicionais e determinação de propriedades de crescimento.
[00077] Para analisar a manutenção de PIX nas células transfectadas de maneira estável, o DNA genômico foi isolado de 1 x 10⁶ células com o kit QIAamp DNA Sangue (Qiagen), e o número de moléculas de E1B e PIX foi determinado em 25 ng e 50 ng de DNA genômico, em uma reação ABI 7000 TaqMan com química de detecção SYBR Green (ABI). Os iniciadores usados para a quantificação foram gTggTTgCTTCATgCTAgTg (SEQ ID NO: 13) e TCTTCAgCAggTgACAgTTg (SEQ ID NO: 14) para E1B, ACCTACgAgACCgTgTCTg (SEQ ID NO: gAgCCgTCAACTTgTCATC (SEQ ID NO: 16) para PIX. Como o E1B foi introduzido independentemente e tem de ser mantido nas células para sobreviver, esse gene serve de marcador interno para padronizar o número de cópias de PIX e a força de expressão do gene.
[00078] A figura 12 demonstra a manutenção estável do transgene PIX em células CR em suspensão, mesmo na ausência de pressão de seleção. Também demonstra que células positivas para PIX sofrem de uma diminuição de crescimento. Observou-se consistentemente proliferação diminuída para todas as nossas células (células de aves e humanas) com a transfecção estável com o plasmídeo de expressão de PIX, demonstrando um impacto de PIX sobre a bioquímica da célula hospedeira. Além disso, observou-se uma tendência em células CR aderentes positivas para PIX de evitar o crescimento em camadas confluentes (inibição por contato aumentada).
[00079] A linhagem celular CS é derivada de somitos embrionários, também descritas no pedido de patente WO 05042728. A geração de células CS positivas para PIX foi realizada em paralelo ao procedimento acima descrito para a linha CR. Contrariamente a CRpIX, nenhuma cultura em suspensão foi estabelecida para CSpIX. A dependência de ancoragem estrita é uma característica de células CS. Uma célula que não se prolifera em suspensão pode ser considerada como sendo menos tumorigênica, pois o potencial de metastatizar é gravemente prejudicado. A proteína PIX não altera essa propriedade em células CS. Embora pleotrópica, essa proteína parece, portanto, não ter impacto sobre o fenótipo de transformação. Essa observação sustenta nossa consideração de que PIX pode ser aplicado com segurança em processos biofarmacêuticos.
[00080] Células CS transfectadas de maneira estável para expressão de PIX e células CS de origem como referência foram semeadas em uma placa de 6 cavidades a 2 x 10⁶ células/cavidade e infectadas com MVA a uma M.O.I. de 0,1 no dia seguinte. Fotografias para documentar as diferenças no avanço de CPE foram tiradas 48 h e 72 h após a infecção. O rendimento de vírus no sobrenadante 48 h após a infecção e o rendimento completo (sobrenadante mais pélete de células lisadas) 72 h após a infecção foram determinados em um ensaio de microfoco. Os resultados são mostrados na figura 13: a presença de PIX nas células CS parece retardar o início de CPE 48 h após a infecção, quando comparado com a referência de origem. 72 h após a infecção, ambas as culturas são lisadas completamente, sugerindo que as diferenças na extensão de CPE não é derivada a uma mistura de células refratárias a MVA e suscetíveis a MVA na população de CS.PIX.
[00081] Segundo nosso conhecimento, células positivas para PIX nunca foram testadas contra vírus diferentes de adenovírus cognatos.
[00082] O efeito positivo da proteína PIX também foi quantificado em células CR. Contrariamente às células CS, as células CR estão adaptadas à suspensão. As culturas em suspensão são preferíveis para muitas aplicações industriais. Consequentemente, determinamos o efeito de PIX nesse sistema, em oposição a uma cultura aderente.
[00083] Para células CR, o efeito de suporte de PIX não é tão pronunciado quanto em células CS, mas observou-se consistentemente títulos mais elevados para MVA. Os rendimentos de MVA foram otimizados em uma série de experimentos e se mostraram maiores 48 h após a infecção a densidades celulares médias. A figura 14 mostra uma comparação da suspensão de clone CR.HS (selecionado de vários clones como a linhagem celular com maiores rendimentos de MVA) e linhagem celular CR.MCX PIX(+). A abscissa indica M.O.I. (0,01, 0,05 ou 0,1, respectivamente), a ordenada indica o arrebentamento, e o tamanho das bolhas indica as densidades celulares (8, 2 ou 0,8 x 10⁶ células/mL, respectivamente). O arrebentamento é a razão de vírus de saída (ou rendimento) para vírus de entrada (o inóculo, dependendo do número de células e da M.O.I.) e, portanto, uma medida da eficiência de amplificação. Em todas as configurações, as linhagens celulares PIX(+) excedem a linhagem PIX(-) em desempenho.
[00084] Um gene de fusão PIX-GFP foi gerado para visualizar a distribuição da proteína PIX em células vivas e superar a atividade de ligação fraca do anticorpo disponível. Plasmídeo 76F pEFPIX1 foi tratado com as enzimas de restrição Acc I e Dra I, e as terminações foram embotadas com polimerase Klenow (todos da New England Biolabs, Beverly, MA 01915-5599, EUA). Do padrão de bandas complexo, o fragmento desejado de 447 pb contendo a sequência de codificação de PIX foi isolado por extração em gel de agarose (kit de extração em gel da Qiagen, 40724 Hilden, Alemanha). A enzima de restrição Dra I reconhece a sequência "TTTAAA", para cortar depois do último resíduo de timidina, em que o tripleto central "TAA" é o códon de parada do quadro de leitura aberto de PIX. O fragmento de 447 pb é, portanto, desprovido de um códon de parada. A fusão desse fragmento ao gene para EGFP no plasmídeo pEGFP-N1 aberto com Sma I (também da New England Biolabs) gera um gene de fusão contínuo de PIX seguido por EGFP. O plasmídeo resultante foi chamado de p9GFP, a proteína de fusão expressada sendo chamada de PIX-GFP neste texto.
[00085] Células CS e CR foram transfectadas com p9GFP e selecionadas com 300 μg/mL de geneticina (Invitrogen) para expressão estável de PIX-GFP. Duas populações de diferentes expressões de PIX- GFP foram observadas em até 2 semanas: uma população normalmente tinha 2 a 5 pontos brilhantes de PIX-GFP no citoplasma, a outra população tinha uma expressão mais uniforme de PIX-GFP no citoplasma e acumulação mais difusão do sinal de GFP em uma região proximal ao núcleo. Em ambos os casos, os núcleos das células pareciam uma região escura, sugerindo que nenhuma ou muito pouca proteína quimérica entra no núcleo. Exemplos representativos de ambos os tipos de clones em CRpIXGFP são mostrados na figura 15.
[00086] Consistente com esse resultado, descobriu-se uma sequência de exportação nuclear no quadro de leitura aberto de PIX por aplicação do algoritmo de pesquisa NetNES (Cour et al., Protein Eng. Des. Sel. 17, 527-536 (2004)) para a sequência primária de PIX. O NES identificado por esse programa é c^:Δ.\ccGC<iAA<-r-j4; (SEQ ID NO: 17) (traduzido: :i- RrJ SEQ ID NO: 18). Segundo nosso conhecimento, é a primeira vez que esse sinal foi descrito na proteína PIX. Inversamente, uma sequência de localização nuclear (NLS) não foi descrita na literatura para PIX, e não podemos detectar esse sinal (por exemplo, usando o algoritmo fornecido pela Universidade de Columbia em http://cubic.bioc.columbia.edu/cgi/var/nair/resonline.pl).
[00087] A localização citoplasmática de PIX-GFP em nossas células de pato é, portanto, consistente com a sequência primária de PIX.
[00088] A surpreendente exclusão nuclear de PIX GFP foi investigada com constructos de fusão com PIX adicionais. Um plasmídeo de expressão de PIX-GFP-NLS foi derivado do constructo p9GFP acima descrito por inserção dos oligonucleotídeos sintéticos i185 e i186. Esses oligos foram desnaturados a 80°C durante 5 min e deixados anelar em 10 mM de MgCl2 por resfriamento gradual à temperatura ambiente, para fornecer: 5' - G ATGTACAAAG ATCCG AAG AAG AACCGC A AAGGTT A ACG CGGCCG C AC - 3' (SEQ ID NO: 19) 3CT ACATGTTTCT AG GCTTCTTCTTGG CGTTT CCAATT G CG CCGG CGTG- 5' (SEQ ID NO: 20)
[00089] Esse oligonucleotídeo de filamento duplo foi digerido com BsrG I e Not I e inserido nos mesmos sítios de p9GFP. Traduzida, a inserção adiciona uma sequência NLS (PKKNRK; SEQ ID NO: 21) à proteína de fusão PIX-GFP que se assemelha ao vírus símio 40 NLS. Um novo sítio Hpa I introduzido com esse enxerto serve de marcador diagnóstico para confirmar uma clonagem bem-sucedida. O plasmídeo resultante é chamado de p9GFP NLS, a proteína expressada PIX-GFP- NLS, e o quadro de leitura aberto que codifica a proteína PIX-GFP-NLS são mostrados nas SEQ ID NOs: 23 e 22, respectivamente.
[00090] Uma proteína de fusão PIX-RARA etiquetada com GFP foi gerada mediante amplificação com PCR de um fragmento contendo PIX-RARA com os iniciadores EBR 44A (5’- r < -3’; SEQ D NO: 24), V293 (5’- .AAÍ-.C.AGCGC AC:/-GA-:.;cACCAAc.:':Gr-3’; SEQ ID NO: 25) e piasmídeo n° 67F pEF PIX RARA NEO como molde. O amplicon de 1.926 pb foi tratado com polinucleotídeo quinase e inserido em pEGFP-C2 (Clontech) linearizado com EcoR I e embotado com enzima Klenow (todas as enzimas da New England Biolabs). O plasmídeo resultante é chamado de p9 GFP RARA, a proteína expressada de PIX GFP RARA.
[00091] A figura 16 mostra a distribuição intracelular das várias proteínas etiquetadas com GFP em células CHO transitoriamente transfectadas.
[00092] Muitos vírus induzem a resposta imune celular inata mediante TLR-3 (receptor 3 do tipo Toll). TLR-3 reconhece RNA de filamento duplo, um padrão distintivo da replicação viral. Entre as funções de TLR-3 está a ativação de NFkB e interferon do tipo I (Alexopoulou et al., Nature 413, 732-738 (2001)). O interferon medeia um estado antiviral na célula hospedeira. O efeito da indução com interferon mediante um RNA de filamento duplo artificial, poli I:poli C (ácido poliinosínico-policitidílico, Sigma) foi examinado. Surpreendentemente, as células CR e CRpIX apresentavam sensibilidade muito baixa a poli I:poli C, ao passo que as células CS responderam claramente ao indutor. Inesperadamente, células CS positivas para PIX responderam mais rápido e a concentrações mais baixas do que células CS de origem (figura 17). Segundo nosso conhecimento, uma conexão entre PIX e interferon não havia sido descrita na atual literatura.
[00093] O efeito de suporte de PIX para MVA foi mais forte em células CS do que em células CR, e as células CS responderam ao substituto de RNA de filamento duplo melhor do que células CR. Sabe- se que MVA induz interferon, e que esse vírus também está equipado com proteínas que aliviam a resposta de interferon. O efeito do indutor poli I:poli C sobre MVA em células CRp9GFP e CSp9GFP foi, portanto, determinado. A figura 18 sugere que células infectadas com MVA sofrem menos com poli I:poli C do que o controle não infectado. Essa observação é consistente com o fato de que MVA tanto induz, quanto interfere com a resposta imune celular inata e se relaciona com nossa observação inesperada de que PIX de um adenovírus humano em células de aves coopera com proteínas antivirais de um vírus de varíola altamente atenuado para aumentar os rendimentos desse último vírus. SEQ ID NO Listagem de Sequência - Texto Livre SEQ ID NO Descrição 1, 2 proteína pIX adenoviral 3, 4 proteína de fusão pIX-RARA 5 Ad5 E1A + E1B 6 – 11 iniciador 12 promotor do fator 2 de alongamento da tradução humano "curto" 13 – 16 iniciador 17 – 18 NES 19 – 20 oligonucleotídeos sintéticos que codificam NLS 21 NLS 22 – 23 proteína de fusão pIX-GFP-NLS 24 – 25 iniciador
Claims (10)
1. Método para a preparação de um vírus alvo não adenoviral ou uma ou mais proteína(s) alvo que não é(são) relacionada(s) a Adenovírus, caracterizado pelo fato de que compreende: (a) o cultivo de uma célula de expressão de vertebrado imortalizada que possui integrado de maneira estável em seu genoma, um gene que codifica PIX de Adenovírus que apresenta uma sequência de aminoácidos de acordo com SEQ ID NO: 2, como uma proteína reguladora heteróloga, e expressa de forma estável a referida proteína reguladora, e é infectada ou transfectada com um vírus alvo não adenoviral, com um vetor portador de sequências de ácidos nucléicos que codificam o referido vírus, ou com um vetor portador de sequências de ácidos nucléicos que codificam a referida uma ou mais proteína(s) alvo que não é(são) relacionada(s) a Adenovírus, e (b) o isolamento do vírus alvo não adenoviral ou da(s) proteína(s) alvo que não é(são) relacionada(s) a Adenovírus.
2. Método, de acordo com a reivindicação 1, caracterizado pelo fato de que: (i) a proteína reguladora heteróloga é expressa na célula de expressão de vertebrado imortalizada em uma quantidade de pelo menos 1 pg/μg de proteína celular, de preferência em uma quantidade de pelo menos 10 pg/μg de proteína celular; e/ou (ii) a proteína reguladora heteróloga está sob controle de um promotor homólogo ou heterólogo estável, de preferência o referido promotor é um promotor celular constitutivo, mais preferivelmente é um promotor do fator 2 de alongamento de translocação humano.
3. Método, de acordo com a reivindicação 1 ou 2, caracterizado pelo fato de que: (i) a célula de expressão de vertebrado imortalizada é portadora de genes de imortalização (virais) adicionais, incluindo uma proteína E1 de adenovírus, de preferência do grupo C de mastadenovírus tipo 5, mais preferivelmente a célula é portadora do gene E1A e/ou E1B de adenovírus mostrado na SEQ ID NO: 5; e/ou (ii) a célula de expressão de vertebrado imortalizada também é portadora de sequências funcionais, como sequências marcadoras de seleção, sítios doadores/receptores de junção e/ou sequências de reconhecimento de recombinase, que permitam a integração de uma sequência de ácido nucléico alvo a ser expressada na célula.
4. Método, de acordo com qualquer uma das reivindicações 1 a 3, caracterizado pelo fato de que: (i) o vírus alvo é selecionado de vírus mutantes ou deletados de tipo selvagem, vírus adaptados ou atenuados do resfriado, cepas de vacina, vetores virais portadores de gene(s) heterólogo(s), vetores virais como lentivírus, vírus de varíola, incluindo um vírus de varíola bovina, como Varíola Bovina Ankara Modificada, varíola de aves ou vírus de varíola de canários, e um vírus adeno associado (aav); (ii) a uma ou mais proteínas alvo são selecionadas de anticorpos, proteínas recombinantes, como eritropoetina, alfa-1- antitripsina, fatores de coagulação sanguínea VIII e IX e interferons, antígenos virais, como HA e NA de influenza, HBV-S, proteína G de herpes e proteína G de raiva, e hormônios peptídicos.
5. Método, de acordo com qualquer uma das reivindicações 1 a 4, caracterizado pelo fato de que a célula de expressão de vertebrado imortalizada é derivada de um cérebro humano, de preferência de cérebro fetal humano e, mais preferivelmente, é uma célula NC5T11, e a referida célula é portadora de uma sequência de ácido nucléico que codifica PIX de Adenovírus como uma proteína reguladora heteróloga, em que a sequência de ácido nucléico é mostrada na SEQ ID NO: 1.
6. Método, de acordo com a reivindicação 5, caracterizado pelo fato de que a célula de expressão de vertebrado imortalizada é derivada da célula NC5T11 n° 34, a referida célula NC5T11 n° 34, estando depositada no DSMZ sob o número de acesso DSM ACC2744.
7. Método, de acordo com qualquer uma das reivindicações 1 a 4, caracterizado pelo fato de que a célula de expressão de vertebrado imortalizada é uma célula de ave, de preferência é derivada de retina de pato ou de somito de pato, e a referida célula é portadora de uma sequência de ácido nucléico que codifica PIX de Adenovírus como uma proteína reguladora heteróloga, em que a sequência de ácido nucléico é mostrada na SEQ ID NO: 1.
8. Método, de acordo com a reivindicação 7, caracterizado pelo fato de que a célula de expressão de vertebrado imortalizada é derivada da célula CR.PIX (17a11b), a referida célula CR.PIX (17a11b) estando depositada no DSMZ sob o número de acesso DSM ACC2749.
9. Método para a preparação de uma célula de expressão de vertebrado imortalizada, caracterizado pelo fato de que compreende as etapas de: (i) fornecer uma célula hospedeira de vertebrado imortalizada apresentando integrado de forma estável em seu genoma um gene que codifica para PIX de Adenovírus que apresenta uma sequência de aminoácidos de acordo com SEQ ID NO: 2 como uma proteína reguladora heteróloga e expressa de forma estável a referida proteína reguladora heteróloga, e (ii) infectar ou transfectar a célula hospedeira de vertebrado imortalizada com um vírus não adenoviral, ou com um vetor portador de sequências de ácidos nucléicos que codificam o referido vírus ou com um vetor portador de sequências de ácidos nucléicos que codificam a referida uma ou mais proteína(s) alvo que não é(são) relacionada(s) a Adenovírus.
10. Uso de uma célula de expressão de vertebrado imortalizada, caracterizado pelo fato de que é para a preparação de um vírus alvo não adenoviral ou de uma ou mais proteínas alvo que não é(são) relacionada(s) a Adenovírus, em que a referida célula de expressão de vertebrado imortalizada: (i) integrou de forma estável em seu genoma um gene que codifica para PIX de Adenovírus que apresenta uma sequência de aminoácidos de acordo com SEQ ID NO: 2 como uma proteína reguladora heteróloga e expressa de forma estável a referida proteína reguladora heteróloga, e (ii) é infectada ou transfectada com um vírus alvo não adenoviral, com um vetor portador de sequências de ácido nucleico que codificam o referido vírus, ou com um vetor portador de sequências de ácido nucleico que codificam uma ou mais proteína(s) alvo, que não é(são) relacionado ao Adenovírus.
Applications Claiming Priority (5)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| EP05110453.7 | 2005-11-08 | ||
| EP05110453A EP1783210A1 (en) | 2005-11-08 | 2005-11-08 | Productivity augmenting protein factors, novel cell lines and uses thereof |
| US75015605P | 2005-12-14 | 2005-12-14 | |
| US60/750,156 | 2005-12-14 | ||
| PCT/EP2006/068234 WO2007054516A1 (en) | 2005-11-08 | 2006-11-08 | Productivity augmenting protein factor, novel cell lines and uses thereof |
Publications (2)
| Publication Number | Publication Date |
|---|---|
| BRPI0618369A2 BRPI0618369A2 (pt) | 2011-08-30 |
| BRPI0618369B1 true BRPI0618369B1 (pt) | 2022-04-12 |
Family
ID=35985267
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| BRPI0618369-7A BRPI0618369B1 (pt) | 2005-11-08 | 2006-11-08 | Método para a preparação de um vírus alvo não adenoviral ou uma ou mais proteína(s) alvo que não é(são) relacionada(s) a adenovírus, método para a preparação de uma célula de expressão de vertebrado imortalizada e seu uso |
Country Status (20)
| Country | Link |
|---|---|
| US (1) | US8815540B2 (pt) |
| EP (2) | EP1783210A1 (pt) |
| JP (1) | JP5468780B2 (pt) |
| KR (1) | KR101311973B1 (pt) |
| CN (1) | CN101356265B (pt) |
| AT (1) | ATE542890T1 (pt) |
| AU (1) | AU2006310999B2 (pt) |
| BR (1) | BRPI0618369B1 (pt) |
| CA (1) | CA2628689C (pt) |
| CY (1) | CY1112734T1 (pt) |
| DK (1) | DK1945760T3 (pt) |
| ES (1) | ES2380975T3 (pt) |
| IL (1) | IL191327A (pt) |
| MY (1) | MY147959A (pt) |
| NZ (1) | NZ568482A (pt) |
| PL (1) | PL1945760T3 (pt) |
| PT (1) | PT1945760E (pt) |
| RU (1) | RU2449015C2 (pt) |
| SI (1) | SI1945760T1 (pt) |
| WO (1) | WO2007054516A1 (pt) |
Families Citing this family (5)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| EP2098590A1 (en) * | 2008-03-04 | 2009-09-09 | ProBioGen AG | Cell line from Rousettus as host cell for pathogen amplification |
| US8679839B2 (en) | 2008-03-04 | 2014-03-25 | Probiogen Ag | Cell line from rousettus as host cell for pathogen amplification |
| EP2199385A1 (en) * | 2008-12-16 | 2010-06-23 | ProBioGen AG | Specific and persistent activation of heat shock response in cell lines using a viral factor |
| CN108795983A (zh) * | 2018-06-28 | 2018-11-13 | 深圳市疾病预防控制中心(深圳市卫生检验中心、深圳市预防医学研究所) | 一种RXRα蛋白稳定高表达细胞系及其制备方法 |
| WO2026041811A1 (en) | 2024-08-23 | 2026-02-26 | Transgene | Recombinant poxvirus and method for regulating the expression of toxic conditional gene products of said recombinant poxvirus in a producing cell |
Family Cites Families (7)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| US5804413A (en) * | 1992-07-31 | 1998-09-08 | University Of Pittsburgh Of The Commonwealth System Of Higher Education | Herpes simplex virus strains for gene transfer |
| US5989805A (en) * | 1995-10-27 | 1999-11-23 | Board Of Trustees Operating Michigan State University | Immortal avian cell line to grow avian and animal viruses to produce vaccines |
| AU3877099A (en) * | 1998-05-01 | 1999-11-23 | Genzyme Corporation | Partially deleted adenoviral vectors |
| WO1999057296A1 (en) * | 1998-05-01 | 1999-11-11 | Genzyme Corporation | Partially deleted adenoviral vectors |
| WO2002096939A2 (en) * | 2001-05-30 | 2002-12-05 | Transgene S.A. | Adenovirus protein ix, its domains involved in capsid assembly, transcriptional activity and nuclear reorganization |
| EP1528101A1 (en) * | 2003-11-03 | 2005-05-04 | ProBioGen AG | Immortalized avian cell lines for virus production |
| KR101211386B1 (ko) * | 2005-11-04 | 2012-12-13 | 노바티스 백신즈 앤드 다이아그노스틱스 에스.알.엘. | 알루미늄 보조제에 즉석 흡착되는 인플루엔자 백신 |
-
2005
- 2005-11-08 EP EP05110453A patent/EP1783210A1/en not_active Withdrawn
-
2006
- 2006-11-08 CA CA2628689A patent/CA2628689C/en active Active
- 2006-11-08 AU AU2006310999A patent/AU2006310999B2/en active Active
- 2006-11-08 PL PL06807777T patent/PL1945760T3/pl unknown
- 2006-11-08 ES ES06807777T patent/ES2380975T3/es active Active
- 2006-11-08 CN CN2006800506905A patent/CN101356265B/zh active Active
- 2006-11-08 BR BRPI0618369-7A patent/BRPI0618369B1/pt active IP Right Grant
- 2006-11-08 WO PCT/EP2006/068234 patent/WO2007054516A1/en not_active Ceased
- 2006-11-08 SI SI200631265T patent/SI1945760T1/sl unknown
- 2006-11-08 DK DK06807777.5T patent/DK1945760T3/da active
- 2006-11-08 PT PT06807777T patent/PT1945760E/pt unknown
- 2006-11-08 AT AT06807777T patent/ATE542890T1/de active
- 2006-11-08 JP JP2008539429A patent/JP5468780B2/ja active Active
- 2006-11-08 EP EP06807777A patent/EP1945760B1/en active Active
- 2006-11-08 KR KR1020087013574A patent/KR101311973B1/ko active Active
- 2006-11-08 NZ NZ568482A patent/NZ568482A/en unknown
- 2006-11-08 MY MYPI20081500A patent/MY147959A/en unknown
- 2006-11-08 RU RU2008122920/10A patent/RU2449015C2/ru active
-
2008
- 2008-05-07 IL IL191327A patent/IL191327A/en active IP Right Grant
- 2008-05-08 US US12/117,475 patent/US8815540B2/en active Active
-
2012
- 2012-04-09 CY CY20121100350T patent/CY1112734T1/el unknown
Also Published As
| Publication number | Publication date |
|---|---|
| EP1945760B1 (en) | 2012-01-25 |
| DK1945760T3 (da) | 2012-03-05 |
| SI1945760T1 (sl) | 2012-03-30 |
| CN101356265A (zh) | 2009-01-28 |
| CN101356265B (zh) | 2013-04-03 |
| ATE542890T1 (de) | 2012-02-15 |
| RU2008122920A (ru) | 2009-12-20 |
| US8815540B2 (en) | 2014-08-26 |
| JP2009514544A (ja) | 2009-04-09 |
| KR101311973B1 (ko) | 2013-09-27 |
| CA2628689C (en) | 2014-02-25 |
| EP1783210A1 (en) | 2007-05-09 |
| PL1945760T3 (pl) | 2012-05-31 |
| RU2449015C2 (ru) | 2012-04-27 |
| AU2006310999B2 (en) | 2012-04-12 |
| PT1945760E (pt) | 2012-03-28 |
| WO2007054516A1 (en) | 2007-05-18 |
| MY147959A (en) | 2013-02-15 |
| EP1945760A1 (en) | 2008-07-23 |
| CY1112734T1 (el) | 2016-02-10 |
| ES2380975T3 (es) | 2012-05-22 |
| NZ568482A (en) | 2011-06-30 |
| US20120164727A1 (en) | 2012-06-28 |
| IL191327A (en) | 2013-03-24 |
| CA2628689A1 (en) | 2007-05-18 |
| AU2006310999A1 (en) | 2007-05-18 |
| JP5468780B2 (ja) | 2014-04-09 |
| BRPI0618369A2 (pt) | 2011-08-30 |
| KR20080068104A (ko) | 2008-07-22 |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| CN1934243B (zh) | 用于病毒生产的永生化的禽类细胞系 | |
| Lafemina et al. | Expression of the acidic nuclear immediate-early protein (IE1) of human cytomegalovirus in stable cell lines and its preferential association with metaphase chromosomes | |
| EP1226264B1 (en) | Cell lines and constructs useful in production of e1-deleted adenoviruses in absence of replication competent adenovirus | |
| JP2003535575A (ja) | 腫瘍崩壊性アデノウイルス | |
| Riley et al. | Tiny T antigen: an autonomous polyomavirus T antigen amino-terminal domain | |
| US8815540B2 (en) | Productivity augmenting protein factor, novel cell lines and uses thereof | |
| Spector et al. | Identification of a human cytomegalovirus virus DNA segment that complements an adenovirus 5 immediate early mutant | |
| CN111386126B (zh) | 真核细胞系 | |
| CN114450017A (zh) | 腺病毒多肽ix提高腺病毒基因治疗载体的生产率和感染性 | |
| MX2008005987A (en) | Productivity augmenting protein factor, novel cell lines and uses thereof | |
| Riley et al. | Maintenance of cellular proliferation by adenovirus early region 1A in fibroblasts conditionally immortalized by using simian virus 40 large T antigen requires conserved region 1 | |
| JP2009514544A5 (pt) | ||
| EP2199385A1 (en) | Specific and persistent activation of heat shock response in cell lines using a viral factor | |
| Sawada et al. | Identification of specific amino acid residues of adenovirus 12 E1A involved in transformation and p300 binding | |
| Sunstrom | Specific DNA binding by polyomavirus large T antigen | |
| Dufort | Correspondence between factor binding sites and replication activation in the polyomavirus enhancer | |
| Temperley | A study of the in vitro initiation of adenovirus DNA replication | |
| ADENOVIRUSES et al. | Hamilton, Ontario L8S 4K1, CANADA | |
| Wohl | Serotype specificity of adenovirus packaging |
Legal Events
| Date | Code | Title | Description |
|---|---|---|---|
| B06F | Objections, documents and/or translations needed after an examination request according [chapter 6.6 patent gazette] | ||
| B06H | Technical and formal requirements: requirement cancelled [chapter 6.8 patent gazette] |
Free format text: REF. A RPI NO 2153 DE 10/04/2012. ANULACAO DA EXIGENCIA 6.6 POR TER SIDO INDEVIDA. REQUERENTE NAO APRESENTOU RESPOSTA A EXIGENCIA CONFORME DISPOE A RESOLUCAO 207 DE 24/04/2009, ENTRETANTO, A RESPOSTA CONSTA NO FORMULARIO DE DEPOSITO. |
|
| B07D | Technical examination (opinion) related to article 229 of industrial property law [chapter 7.4 patent gazette] | ||
| B07E | Notification of approval relating to section 229 industrial property law [chapter 7.5 patent gazette] | ||
| B06U | Preliminary requirement: requests with searches performed by other patent offices: procedure suspended [chapter 6.21 patent gazette] | ||
| B06A | Patent application procedure suspended [chapter 6.1 patent gazette] | ||
| B09B | Patent application refused [chapter 9.2 patent gazette] | ||
| B12B | Appeal against refusal [chapter 12.2 patent gazette] | ||
| B16A | Patent or certificate of addition of invention granted [chapter 16.1 patent gazette] |
Free format text: PRAZO DE VALIDADE: 20 (VINTE) ANOS CONTADOS A PARTIR DE 08/11/2006, OBSERVADAS AS CONDICOES LEGAIS. PATENTE CONCEDIDA CONFORME ADI 5.529/DF, QUE DETERMINA A ALTERACAO DO PRAZO DE CONCESSAO. |