DE20121977U1 - Nukleinsäuren für die Diagnose von mit Tumor-Suppressorgenen und Onkogenen assoziierten Krankheiten - Google Patents
Nukleinsäuren für die Diagnose von mit Tumor-Suppressorgenen und Onkogenen assoziierten Krankheiten Download PDFInfo
- Publication number
- DE20121977U1 DE20121977U1 DE20121977U DE20121977U DE20121977U1 DE 20121977 U1 DE20121977 U1 DE 20121977U1 DE 20121977 U DE20121977 U DE 20121977U DE 20121977 U DE20121977 U DE 20121977U DE 20121977 U1 DE20121977 U1 DE 20121977U1
- Authority
- DE
- Germany
- Prior art keywords
- dna
- genes
- sequences
- seq
- oligomer
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Expired - Lifetime
Links
- 108090000623 proteins and genes Proteins 0.000 title claims abstract description 79
- 201000010099 disease Diseases 0.000 title claims abstract description 17
- 208000037265 diseases, disorders, signs and symptoms Diseases 0.000 title claims abstract description 17
- 239000000523 sample Substances 0.000 title abstract description 27
- 239000012634 fragment Substances 0.000 title abstract description 16
- 230000030933 DNA methylation on cytosine Effects 0.000 title abstract description 13
- 230000022131 cell cycle Effects 0.000 title abstract description 4
- 206010028980 Neoplasm Diseases 0.000 title description 22
- 201000011510 cancer Diseases 0.000 title description 11
- 206010003210 Arteriosclerosis Diseases 0.000 title 1
- 230000032683 aging Effects 0.000 title 1
- 208000011775 arteriosclerosis disease Diseases 0.000 title 1
- 206010003246 arthritis Diseases 0.000 title 1
- OPTASPLRGRRNAP-UHFFFAOYSA-N cytosine Chemical compound NC=1C=CNC(=O)N=1 OPTASPLRGRRNAP-UHFFFAOYSA-N 0.000 claims abstract description 52
- 108091034117 Oligonucleotide Proteins 0.000 claims abstract description 48
- 230000011987 methylation Effects 0.000 claims abstract description 40
- 238000007069 methylation reaction Methods 0.000 claims abstract description 40
- 230000000295 complement effect Effects 0.000 claims abstract description 27
- 229940104302 cytosine Drugs 0.000 claims abstract description 22
- 108091093037 Peptide nucleic acid Proteins 0.000 claims abstract description 21
- 108020004707 nucleic acids Proteins 0.000 claims abstract description 21
- 102000039446 nucleic acids Human genes 0.000 claims abstract description 21
- 150000007523 nucleic acids Chemical class 0.000 claims abstract description 20
- LSNNMFCWUKXFEE-UHFFFAOYSA-M Bisulfite Chemical compound OS([O-])=O LSNNMFCWUKXFEE-UHFFFAOYSA-M 0.000 claims abstract description 18
- 239000007790 solid phase Substances 0.000 claims abstract description 17
- 239000002773 nucleotide Substances 0.000 claims abstract description 14
- 125000003729 nucleotide group Chemical group 0.000 claims abstract description 14
- 239000003153 chemical reaction reagent Substances 0.000 claims abstract description 4
- WBZKQQHYRPRKNJ-UHFFFAOYSA-L disulfite Chemical compound [O-]S(=O)S([O-])(=O)=O WBZKQQHYRPRKNJ-UHFFFAOYSA-L 0.000 claims abstract description 4
- 229940079826 hydrogen sulfite Drugs 0.000 claims abstract description 4
- 239000012876 carrier material Substances 0.000 claims abstract description 3
- 108020004414 DNA Proteins 0.000 claims description 56
- 108700020796 Oncogene Proteins 0.000 claims description 52
- 102000043276 Oncogene Human genes 0.000 claims description 51
- 108700025716 Tumor Suppressor Genes Proteins 0.000 claims description 51
- 102000044209 Tumor Suppressor Genes Human genes 0.000 claims description 51
- JLCPHMBAVCMARE-UHFFFAOYSA-N [3-[[3-[[3-[[3-[[3-[[3-[[3-[[3-[[3-[[3-[[3-[[5-(2-amino-6-oxo-1H-purin-9-yl)-3-[[3-[[3-[[3-[[3-[[3-[[5-(2-amino-6-oxo-1H-purin-9-yl)-3-[[5-(2-amino-6-oxo-1H-purin-9-yl)-3-hydroxyoxolan-2-yl]methoxy-hydroxyphosphoryl]oxyoxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(5-methyl-2,4-dioxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxyoxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(5-methyl-2,4-dioxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(4-amino-2-oxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(5-methyl-2,4-dioxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(5-methyl-2,4-dioxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(4-amino-2-oxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(4-amino-2-oxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(4-amino-2-oxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(4-amino-2-oxopyrimidin-1-yl)oxolan-2-yl]methyl [5-(6-aminopurin-9-yl)-2-(hydroxymethyl)oxolan-3-yl] hydrogen phosphate Polymers Cc1cn(C2CC(OP(O)(=O)OCC3OC(CC3OP(O)(=O)OCC3OC(CC3O)n3cnc4c3nc(N)[nH]c4=O)n3cnc4c3nc(N)[nH]c4=O)C(COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3CO)n3cnc4c(N)ncnc34)n3ccc(N)nc3=O)n3cnc4c(N)ncnc34)n3ccc(N)nc3=O)n3ccc(N)nc3=O)n3ccc(N)nc3=O)n3cnc4c(N)ncnc34)n3cnc4c(N)ncnc34)n3cc(C)c(=O)[nH]c3=O)n3cc(C)c(=O)[nH]c3=O)n3ccc(N)nc3=O)n3cc(C)c(=O)[nH]c3=O)n3cnc4c3nc(N)[nH]c4=O)n3cnc4c(N)ncnc34)n3cnc4c(N)ncnc34)n3cnc4c(N)ncnc34)n3cnc4c(N)ncnc34)O2)c(=O)[nH]c1=O JLCPHMBAVCMARE-UHFFFAOYSA-N 0.000 claims description 25
- 238000004458 analytical method Methods 0.000 claims description 17
- 108091029430 CpG site Proteins 0.000 claims description 12
- 238000001514 detection method Methods 0.000 claims description 11
- 230000003321 amplification Effects 0.000 claims description 8
- 238000003199 nucleic acid amplification method Methods 0.000 claims description 8
- XEEYBQQBJWHFJM-UHFFFAOYSA-N Iron Chemical compound [Fe] XEEYBQQBJWHFJM-UHFFFAOYSA-N 0.000 claims description 6
- PXHVJJICTQNCMI-UHFFFAOYSA-N Nickel Chemical compound [Ni] PXHVJJICTQNCMI-UHFFFAOYSA-N 0.000 claims description 6
- 108091028043 Nucleic acid sequence Proteins 0.000 claims description 4
- RYGMFSIKBFXOCR-UHFFFAOYSA-N Copper Chemical compound [Cu] RYGMFSIKBFXOCR-UHFFFAOYSA-N 0.000 claims description 3
- 239000004793 Polystyrene Substances 0.000 claims description 3
- 229910000831 Steel Inorganic materials 0.000 claims description 3
- 229910052782 aluminium Inorganic materials 0.000 claims description 3
- XAGFODPZIPBFFR-UHFFFAOYSA-N aluminium Chemical compound [Al] XAGFODPZIPBFFR-UHFFFAOYSA-N 0.000 claims description 3
- 229910052802 copper Inorganic materials 0.000 claims description 3
- 239000010949 copper Substances 0.000 claims description 3
- 239000011521 glass Substances 0.000 claims description 3
- PCHJSUWPFVWCPO-UHFFFAOYSA-N gold Chemical compound [Au] PCHJSUWPFVWCPO-UHFFFAOYSA-N 0.000 claims description 3
- 229910052737 gold Inorganic materials 0.000 claims description 3
- 239000010931 gold Substances 0.000 claims description 3
- 229910052742 iron Inorganic materials 0.000 claims description 3
- 229910052759 nickel Inorganic materials 0.000 claims description 3
- 229920002223 polystyrene Polymers 0.000 claims description 3
- 239000010703 silicon Substances 0.000 claims description 3
- 229910052710 silicon Inorganic materials 0.000 claims description 3
- 229910052709 silver Inorganic materials 0.000 claims description 3
- 239000004332 silver Substances 0.000 claims description 3
- 239000010959 steel Substances 0.000 claims description 3
- 239000012071 phase Substances 0.000 claims description 2
- 102100020871 Forkhead box protein G1 Human genes 0.000 claims 3
- 101000931525 Homo sapiens Forkhead box protein G1 Proteins 0.000 claims 3
- 101150084967 EPCAM gene Proteins 0.000 claims 2
- 102100031940 Epithelial cell adhesion molecule Human genes 0.000 claims 2
- 101150057140 TACSTD1 gene Proteins 0.000 claims 2
- RITKWYDZSSQNJI-INXYWQKQSA-N (2s)-n-[(2s)-1-[[(2s)-4-amino-1-[[(2s)-1-[[(2s)-1-[[2-[[(2s)-1-[[(2s)-1-[[(2s)-1-amino-1-oxo-3-phenylpropan-2-yl]amino]-5-(diaminomethylideneamino)-1-oxopentan-2-yl]amino]-4-methyl-1-oxopentan-2-yl]amino]-2-oxoethyl]amino]-1-oxo-3-phenylpropan-2-yl]amino] Chemical compound C([C@@H](C(=O)NCC(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC=1C=CC=CC=1)C(N)=O)NC(=O)[C@H](CO)NC(=O)[C@H](CC(N)=O)NC(=O)[C@H](CC=1C2=CC=CC=C2NC=1)NC(=O)[C@H](CC(N)=O)NC(=O)[C@@H](N)CC=1C=CC(O)=CC=1)C1=CC=CC=C1 RITKWYDZSSQNJI-INXYWQKQSA-N 0.000 claims 1
- 102100031323 Anthrax toxin receptor 1 Human genes 0.000 claims 1
- 102100021569 Apoptosis regulator Bcl-2 Human genes 0.000 claims 1
- 108091012583 BCL2 Proteins 0.000 claims 1
- 108700020462 BRCA2 Proteins 0.000 claims 1
- 102100035755 BRD4-interacting chromatin-remodeling complex-associated protein Human genes 0.000 claims 1
- 102100037674 Bis(5'-adenosyl)-triphosphatase Human genes 0.000 claims 1
- 101150008921 Brca2 gene Proteins 0.000 claims 1
- 102100031629 COP9 signalosome complex subunit 1 Human genes 0.000 claims 1
- 102100034157 DNA mismatch repair protein Msh2 Human genes 0.000 claims 1
- 102100035275 E3 ubiquitin-protein ligase CBL-C Human genes 0.000 claims 1
- 102100033612 E3 ubiquitin-protein ligase makorin-2 Human genes 0.000 claims 1
- 102100032058 EARP and GARP complex-interacting protein 1 Human genes 0.000 claims 1
- 101150016325 EPHA3 gene Proteins 0.000 claims 1
- 102100039577 ETS translocation variant 5 Human genes 0.000 claims 1
- 102100038083 Endosialin Human genes 0.000 claims 1
- 108010055211 EphA1 Receptor Proteins 0.000 claims 1
- 102100030322 Ephrin type-A receptor 1 Human genes 0.000 claims 1
- 102100030324 Ephrin type-A receptor 3 Human genes 0.000 claims 1
- 102100028043 Fibroblast growth factor 3 Human genes 0.000 claims 1
- 102100028072 Fibroblast growth factor 4 Human genes 0.000 claims 1
- 102100023359 Forkhead box protein N3 Human genes 0.000 claims 1
- 102100030334 Friend leukemia integration 1 transcription factor Human genes 0.000 claims 1
- 102100037859 G1/S-specific cyclin-D3 Human genes 0.000 claims 1
- 102100030708 GTPase KRas Human genes 0.000 claims 1
- 108010085877 Guanine Nucleotide-Releasing Factor 2 Proteins 0.000 claims 1
- 101000796095 Homo sapiens Anthrax toxin receptor 1 Proteins 0.000 claims 1
- 101000802816 Homo sapiens BRD4-interacting chromatin-remodeling complex-associated protein Proteins 0.000 claims 1
- 101000940485 Homo sapiens COP9 signalosome complex subunit 1 Proteins 0.000 claims 1
- 101001134036 Homo sapiens DNA mismatch repair protein Msh2 Proteins 0.000 claims 1
- 101000737269 Homo sapiens E3 ubiquitin-protein ligase CBL-C Proteins 0.000 claims 1
- 101001018973 Homo sapiens E3 ubiquitin-protein ligase makorin-2 Proteins 0.000 claims 1
- 101000921326 Homo sapiens EARP and GARP complex-interacting protein 1 Proteins 0.000 claims 1
- 101000813745 Homo sapiens ETS translocation variant 5 Proteins 0.000 claims 1
- 101000812663 Homo sapiens Endoplasmin Proteins 0.000 claims 1
- 101000884275 Homo sapiens Endosialin Proteins 0.000 claims 1
- 101001060280 Homo sapiens Fibroblast growth factor 3 Proteins 0.000 claims 1
- 101001060274 Homo sapiens Fibroblast growth factor 4 Proteins 0.000 claims 1
- 101000907594 Homo sapiens Forkhead box protein N3 Proteins 0.000 claims 1
- 101001062996 Homo sapiens Friend leukemia integration 1 transcription factor Proteins 0.000 claims 1
- 101000738559 Homo sapiens G1/S-specific cyclin-D3 Proteins 0.000 claims 1
- 101000584612 Homo sapiens GTPase KRas Proteins 0.000 claims 1
- 101000993380 Homo sapiens Hypermethylated in cancer 1 protein Proteins 0.000 claims 1
- 101000840577 Homo sapiens Insulin-like growth factor-binding protein 7 Proteins 0.000 claims 1
- 101000916644 Homo sapiens Macrophage colony-stimulating factor 1 receptor Proteins 0.000 claims 1
- 101000645296 Homo sapiens Metalloproteinase inhibitor 2 Proteins 0.000 claims 1
- 101001091223 Homo sapiens Metastasis-suppressor KiSS-1 Proteins 0.000 claims 1
- 101001133056 Homo sapiens Mucin-1 Proteins 0.000 claims 1
- 101001133081 Homo sapiens Mucin-2 Proteins 0.000 claims 1
- 101000974343 Homo sapiens Nuclear receptor coactivator 4 Proteins 0.000 claims 1
- 101000869523 Homo sapiens Phosphatidylinositide phosphatase SAC2 Proteins 0.000 claims 1
- 101000689394 Homo sapiens Phospholipid scramblase 4 Proteins 0.000 claims 1
- 101000738776 Homo sapiens Pituitary tumor-transforming gene 1 protein-interacting protein Proteins 0.000 claims 1
- 101000872170 Homo sapiens Polycomb complex protein BMI-1 Proteins 0.000 claims 1
- 101001133941 Homo sapiens Prolyl 3-hydroxylase 1 Proteins 0.000 claims 1
- 101000876829 Homo sapiens Protein C-ets-1 Proteins 0.000 claims 1
- 101000893493 Homo sapiens Protein flightless-1 homolog Proteins 0.000 claims 1
- 101000615238 Homo sapiens Proto-oncogene DBL Proteins 0.000 claims 1
- 101000775749 Homo sapiens Proto-oncogene vav Proteins 0.000 claims 1
- 101000779418 Homo sapiens RAC-alpha serine/threonine-protein kinase Proteins 0.000 claims 1
- 101001047642 Homo sapiens Serine/threonine-protein kinase LATS1 Proteins 0.000 claims 1
- 101000832631 Homo sapiens Small ubiquitin-related modifier 3 Proteins 0.000 claims 1
- 101000654583 Homo sapiens Splicing factor, suppressor of white-apricot homolog Proteins 0.000 claims 1
- 101000712600 Homo sapiens Thyroid hormone receptor beta Proteins 0.000 claims 1
- 101000834937 Homo sapiens Tomoregulin-1 Proteins 0.000 claims 1
- 101000829436 Homo sapiens Transcription elongation factor SPT6 Proteins 0.000 claims 1
- 101000904152 Homo sapiens Transcription factor E2F1 Proteins 0.000 claims 1
- 101000813738 Homo sapiens Transcription factor ETV6 Proteins 0.000 claims 1
- 101000698001 Homo sapiens Transcription initiation protein SPT3 homolog Proteins 0.000 claims 1
- 101000796673 Homo sapiens Transformation/transcription domain-associated protein Proteins 0.000 claims 1
- 101000658574 Homo sapiens Transmembrane 4 L6 family member 1 Proteins 0.000 claims 1
- 101000830603 Homo sapiens Tumor necrosis factor ligand superfamily member 11 Proteins 0.000 claims 1
- 101000830598 Homo sapiens Tumor necrosis factor ligand superfamily member 12 Proteins 0.000 claims 1
- 101000830600 Homo sapiens Tumor necrosis factor ligand superfamily member 13 Proteins 0.000 claims 1
- 101000830596 Homo sapiens Tumor necrosis factor ligand superfamily member 15 Proteins 0.000 claims 1
- 101000597779 Homo sapiens Tumor necrosis factor ligand superfamily member 18 Proteins 0.000 claims 1
- 101000610604 Homo sapiens Tumor necrosis factor receptor superfamily member 10B Proteins 0.000 claims 1
- 101000610602 Homo sapiens Tumor necrosis factor receptor superfamily member 10C Proteins 0.000 claims 1
- 101000801228 Homo sapiens Tumor necrosis factor receptor superfamily member 1A Proteins 0.000 claims 1
- 101000611023 Homo sapiens Tumor necrosis factor receptor superfamily member 6 Proteins 0.000 claims 1
- 101000847156 Homo sapiens Tumor necrosis factor-inducible gene 6 protein Proteins 0.000 claims 1
- 101000610980 Homo sapiens Tumor protein D52 Proteins 0.000 claims 1
- 101000820294 Homo sapiens Tyrosine-protein kinase Yes Proteins 0.000 claims 1
- 102100031612 Hypermethylated in cancer 1 protein Human genes 0.000 claims 1
- 102100029228 Insulin-like growth factor-binding protein 7 Human genes 0.000 claims 1
- 229910020769 KISS1 Inorganic materials 0.000 claims 1
- 229910015837 MSH2 Inorganic materials 0.000 claims 1
- 102100028198 Macrophage colony-stimulating factor 1 receptor Human genes 0.000 claims 1
- 102100026262 Metalloproteinase inhibitor 2 Human genes 0.000 claims 1
- 102100034841 Metastasis-suppressor KiSS-1 Human genes 0.000 claims 1
- 102100025825 Methylated-DNA-protein-cysteine methyltransferase Human genes 0.000 claims 1
- 102100034256 Mucin-1 Human genes 0.000 claims 1
- 102100034263 Mucin-2 Human genes 0.000 claims 1
- 101001067395 Mus musculus Phospholipid scramblase 1 Proteins 0.000 claims 1
- 102100022927 Nuclear receptor coactivator 4 Human genes 0.000 claims 1
- 108091093018 PVT1 Proteins 0.000 claims 1
- 102100032287 Phosphatidylinositide phosphatase SAC2 Human genes 0.000 claims 1
- 102100024494 Phospholipid scramblase 4 Human genes 0.000 claims 1
- 102100037419 Pituitary tumor-transforming gene 1 protein-interacting protein Human genes 0.000 claims 1
- 102100033566 Polycomb complex protein BMI-1 Human genes 0.000 claims 1
- 102100034144 Prolyl 3-hydroxylase 1 Human genes 0.000 claims 1
- 102100035251 Protein C-ets-1 Human genes 0.000 claims 1
- 102100021384 Proto-oncogene DBL Human genes 0.000 claims 1
- 102100032190 Proto-oncogene vav Human genes 0.000 claims 1
- 102100033810 RAC-alpha serine/threonine-protein kinase Human genes 0.000 claims 1
- 102100022308 Ras-related protein Rab-3A Human genes 0.000 claims 1
- 102100039100 Ras-related protein Rab-5A Human genes 0.000 claims 1
- 102100027555 Ras-specific guanine nucleotide-releasing factor 2 Human genes 0.000 claims 1
- 108010038036 Receptor Activator of Nuclear Factor-kappa B Proteins 0.000 claims 1
- 102100029981 Receptor tyrosine-protein kinase erbB-4 Human genes 0.000 claims 1
- 101710100963 Receptor tyrosine-protein kinase erbB-4 Proteins 0.000 claims 1
- 102100024031 Serine/threonine-protein kinase LATS1 Human genes 0.000 claims 1
- 102100024534 Small ubiquitin-related modifier 3 Human genes 0.000 claims 1
- 102100032652 Splicing factor, suppressor of white-apricot homolog Human genes 0.000 claims 1
- 108010001288 T-Lymphoma Invasion and Metastasis-inducing Protein 1 Proteins 0.000 claims 1
- 102000002154 T-Lymphoma Invasion and Metastasis-inducing Protein 1 Human genes 0.000 claims 1
- 108091007178 TNFRSF10A Proteins 0.000 claims 1
- 102100033451 Thyroid hormone receptor beta Human genes 0.000 claims 1
- 102100026159 Tomoregulin-1 Human genes 0.000 claims 1
- 102100023690 Transcription elongation factor SPT6 Human genes 0.000 claims 1
- 102100024026 Transcription factor E2F1 Human genes 0.000 claims 1
- 102100039580 Transcription factor ETV6 Human genes 0.000 claims 1
- 102100027912 Transcription initiation protein SPT3 homolog Human genes 0.000 claims 1
- 102100034902 Transmembrane 4 L6 family member 1 Human genes 0.000 claims 1
- 102100024568 Tumor necrosis factor ligand superfamily member 11 Human genes 0.000 claims 1
- 102100024584 Tumor necrosis factor ligand superfamily member 12 Human genes 0.000 claims 1
- 102100024585 Tumor necrosis factor ligand superfamily member 13 Human genes 0.000 claims 1
- 102100024587 Tumor necrosis factor ligand superfamily member 15 Human genes 0.000 claims 1
- 102100035283 Tumor necrosis factor ligand superfamily member 18 Human genes 0.000 claims 1
- 102100040113 Tumor necrosis factor receptor superfamily member 10A Human genes 0.000 claims 1
- 102100040112 Tumor necrosis factor receptor superfamily member 10B Human genes 0.000 claims 1
- 102100040115 Tumor necrosis factor receptor superfamily member 10C Human genes 0.000 claims 1
- 102100028787 Tumor necrosis factor receptor superfamily member 11A Human genes 0.000 claims 1
- 102100033732 Tumor necrosis factor receptor superfamily member 1A Human genes 0.000 claims 1
- 102100040403 Tumor necrosis factor receptor superfamily member 6 Human genes 0.000 claims 1
- 102100032807 Tumor necrosis factor-inducible gene 6 protein Human genes 0.000 claims 1
- 102100027881 Tumor protein 63 Human genes 0.000 claims 1
- 101710140697 Tumor protein 63 Proteins 0.000 claims 1
- 102100040418 Tumor protein D52 Human genes 0.000 claims 1
- 102100021788 Tyrosine-protein kinase Yes Human genes 0.000 claims 1
- 108010005713 bis(5'-adenosyl)triphosphatase Proteins 0.000 claims 1
- 108040008770 methylated-DNA-[protein]-cysteine S-methyltransferase activity proteins Proteins 0.000 claims 1
- 108010046566 rab3A GTP Binding Protein Proteins 0.000 claims 1
- 108010032037 rab5 GTP-Binding Proteins Proteins 0.000 claims 1
- 238000000034 method Methods 0.000 abstract description 32
- 230000001973 epigenetic effect Effects 0.000 abstract description 19
- 238000009396 hybridization Methods 0.000 abstract description 18
- 230000002068 genetic effect Effects 0.000 abstract description 16
- 238000003745 diagnosis Methods 0.000 abstract description 15
- 238000002560 therapeutic procedure Methods 0.000 abstract description 13
- ISAKRJDGNUQOIC-UHFFFAOYSA-N Uracil Chemical compound O=C1C=CNC(=O)N1 ISAKRJDGNUQOIC-UHFFFAOYSA-N 0.000 abstract description 12
- 102000054765 polymorphisms of proteins Human genes 0.000 abstract description 6
- 229940035893 uracil Drugs 0.000 abstract description 6
- 238000004519 manufacturing process Methods 0.000 abstract description 5
- 230000000694 effects Effects 0.000 abstract description 4
- 239000000126 substance Substances 0.000 abstract description 3
- 239000013256 coordination polymer Substances 0.000 abstract 4
- 230000002456 anti-arthritic effect Effects 0.000 abstract 1
- 230000036436 anti-hiv Effects 0.000 abstract 1
- 230000000259 anti-tumor effect Effects 0.000 abstract 1
- 239000000824 cytostatic agent Substances 0.000 abstract 1
- 230000001085 cytostatic effect Effects 0.000 abstract 1
- 230000001506 immunosuppresive effect Effects 0.000 abstract 1
- 230000010534 mechanism of action Effects 0.000 abstract 1
- 230000000324 neuroprotective effect Effects 0.000 abstract 1
- 210000004027 cell Anatomy 0.000 description 10
- 239000011159 matrix material Substances 0.000 description 10
- LRSASMSXMSNRBT-UHFFFAOYSA-N 5-methylcytosine Chemical compound CC1=CNC(=O)N=C1N LRSASMSXMSNRBT-UHFFFAOYSA-N 0.000 description 9
- 230000007067 DNA methylation Effects 0.000 description 9
- 238000006243 chemical reaction Methods 0.000 description 9
- 230000035772 mutation Effects 0.000 description 7
- 210000001519 tissue Anatomy 0.000 description 7
- 108090000765 processed proteins & peptides Proteins 0.000 description 6
- 238000012163 sequencing technique Methods 0.000 description 6
- 238000011161 development Methods 0.000 description 5
- 230000018109 developmental process Effects 0.000 description 5
- 238000004949 mass spectrometry Methods 0.000 description 5
- 238000003752 polymerase chain reaction Methods 0.000 description 5
- 102000004196 processed proteins & peptides Human genes 0.000 description 5
- 230000035945 sensitivity Effects 0.000 description 5
- 206010003571 Astrocytoma Diseases 0.000 description 4
- 208000003174 Brain Neoplasms Diseases 0.000 description 4
- 102100024458 Cyclin-dependent kinase inhibitor 2A Human genes 0.000 description 4
- IQFYYKKMVGJFEH-XLPZGREQSA-N Thymidine Chemical compound O=C1NC(=O)C(C)=CN1[C@@H]1O[C@H](CO)[C@@H](O)C1 IQFYYKKMVGJFEH-XLPZGREQSA-N 0.000 description 4
- 238000003795 desorption Methods 0.000 description 4
- 230000014509 gene expression Effects 0.000 description 4
- RWQNBRDOKXIBIV-UHFFFAOYSA-N thymine Chemical compound CC1=CNC(=O)NC1=O RWQNBRDOKXIBIV-UHFFFAOYSA-N 0.000 description 4
- 238000005904 alkaline hydrolysis reaction Methods 0.000 description 3
- 239000012491 analyte Substances 0.000 description 3
- 210000004556 brain Anatomy 0.000 description 3
- 238000000816 matrix-assisted laser desorption--ionisation Methods 0.000 description 3
- 238000001840 matrix-assisted laser desorption--ionisation time-of-flight mass spectrometry Methods 0.000 description 3
- 108700042657 p16 Genes Proteins 0.000 description 3
- 102000004169 proteins and genes Human genes 0.000 description 3
- 238000012360 testing method Methods 0.000 description 3
- 208000009575 Angelman syndrome Diseases 0.000 description 2
- DWRXFEITVBNRMK-UHFFFAOYSA-N Beta-D-1-Arabinofuranosylthymine Natural products O=C1NC(=O)C(C)=CN1C1C(O)C(O)C(CO)O1 DWRXFEITVBNRMK-UHFFFAOYSA-N 0.000 description 2
- 208000005623 Carcinogenesis Diseases 0.000 description 2
- 230000006429 DNA hypomethylation Effects 0.000 description 2
- 238000000018 DNA microarray Methods 0.000 description 2
- 208000017604 Hodgkin disease Diseases 0.000 description 2
- 208000010747 Hodgkins lymphoma Diseases 0.000 description 2
- 206010058467 Lung neoplasm malignant Diseases 0.000 description 2
- 101150039798 MYC gene Proteins 0.000 description 2
- 239000000020 Nitrocellulose Substances 0.000 description 2
- 201000007286 Pilocytic astrocytoma Diseases 0.000 description 2
- 201000010769 Prader-Willi syndrome Diseases 0.000 description 2
- 206010040007 Sense of oppression Diseases 0.000 description 2
- BQCADISMDOOEFD-UHFFFAOYSA-N Silver Chemical compound [Ag] BQCADISMDOOEFD-UHFFFAOYSA-N 0.000 description 2
- 208000005718 Stomach Neoplasms Diseases 0.000 description 2
- 239000000654 additive Substances 0.000 description 2
- 230000002411 adverse Effects 0.000 description 2
- 238000003491 array Methods 0.000 description 2
- 230000008901 benefit Effects 0.000 description 2
- IQFYYKKMVGJFEH-UHFFFAOYSA-N beta-L-thymidine Natural products O=C1NC(=O)C(C)=CN1C1OC(CO)C(O)C1 IQFYYKKMVGJFEH-UHFFFAOYSA-N 0.000 description 2
- 230000033228 biological regulation Effects 0.000 description 2
- 239000008280 blood Substances 0.000 description 2
- 210000004369 blood Anatomy 0.000 description 2
- 210000000481 breast Anatomy 0.000 description 2
- 230000036952 cancer formation Effects 0.000 description 2
- 231100000504 carcinogenesis Toxicity 0.000 description 2
- 230000032823 cell division Effects 0.000 description 2
- 238000002512 chemotherapy Methods 0.000 description 2
- 230000002596 correlated effect Effects 0.000 description 2
- 230000003247 decreasing effect Effects 0.000 description 2
- 239000000032 diagnostic agent Substances 0.000 description 2
- 229940039227 diagnostic agent Drugs 0.000 description 2
- 238000009792 diffusion process Methods 0.000 description 2
- 239000003814 drug Substances 0.000 description 2
- 239000000975 dye Substances 0.000 description 2
- 238000002330 electrospray ionisation mass spectrometry Methods 0.000 description 2
- 206010017758 gastric cancer Diseases 0.000 description 2
- 210000001035 gastrointestinal tract Anatomy 0.000 description 2
- 230000012010 growth Effects 0.000 description 2
- 201000010536 head and neck cancer Diseases 0.000 description 2
- 208000014829 head and neck neoplasm Diseases 0.000 description 2
- 230000006607 hypermethylation Effects 0.000 description 2
- 230000002779 inactivation Effects 0.000 description 2
- 230000005764 inhibitory process Effects 0.000 description 2
- 150000002500 ions Chemical class 0.000 description 2
- 210000004072 lung Anatomy 0.000 description 2
- 229920001220 nitrocellulos Polymers 0.000 description 2
- 239000004033 plastic Substances 0.000 description 2
- 229920003023 plastic Polymers 0.000 description 2
- 239000000047 product Substances 0.000 description 2
- 238000001959 radiotherapy Methods 0.000 description 2
- 238000011160 research Methods 0.000 description 2
- 230000002441 reversible effect Effects 0.000 description 2
- 238000004611 spectroscopical analysis Methods 0.000 description 2
- 201000011549 stomach cancer Diseases 0.000 description 2
- 230000001629 suppression Effects 0.000 description 2
- 229940124597 therapeutic agent Drugs 0.000 description 2
- 230000001225 therapeutic effect Effects 0.000 description 2
- 229940104230 thymidine Drugs 0.000 description 2
- 229940113082 thymine Drugs 0.000 description 2
- 230000007704 transition Effects 0.000 description 2
- 210000004881 tumor cell Anatomy 0.000 description 2
- HWPZZUQOWRWFDB-UHFFFAOYSA-N 1-methylcytosine Chemical compound CN1C=CC(N)=NC1=O HWPZZUQOWRWFDB-UHFFFAOYSA-N 0.000 description 1
- XAUDJQYHKZQPEU-KVQBGUIXSA-N 5-aza-2'-deoxycytidine Chemical compound O=C1N=C(N)N=CN1[C@@H]1O[C@H](CO)[C@@H](O)C1 XAUDJQYHKZQPEU-KVQBGUIXSA-N 0.000 description 1
- 229920000936 Agarose Polymers 0.000 description 1
- 108091093088 Amplicon Proteins 0.000 description 1
- 206010006187 Breast cancer Diseases 0.000 description 1
- 208000026310 Breast neoplasm Diseases 0.000 description 1
- 206010009944 Colon cancer Diseases 0.000 description 1
- 108091029523 CpG island Proteins 0.000 description 1
- 102000053602 DNA Human genes 0.000 description 1
- 230000007118 DNA alkylation Effects 0.000 description 1
- 102000016928 DNA-directed DNA polymerase Human genes 0.000 description 1
- 108010014303 DNA-directed DNA polymerase Proteins 0.000 description 1
- 108090000790 Enzymes Proteins 0.000 description 1
- 102000004190 Enzymes Human genes 0.000 description 1
- 102000006947 Histones Human genes 0.000 description 1
- 108010033040 Histones Proteins 0.000 description 1
- 208000028018 Lymphocytic leukaemia Diseases 0.000 description 1
- 208000032818 Microsatellite Instability Diseases 0.000 description 1
- 241000699670 Mus sp. Species 0.000 description 1
- 102100038895 Myc proto-oncogene protein Human genes 0.000 description 1
- 102000048850 Neoplasm Genes Human genes 0.000 description 1
- 108700019961 Neoplasm Genes Proteins 0.000 description 1
- 208000015914 Non-Hodgkin lymphomas Diseases 0.000 description 1
- 239000004677 Nylon Substances 0.000 description 1
- 229910019142 PO4 Inorganic materials 0.000 description 1
- -1 Phosphorothioate nucleic acids Chemical class 0.000 description 1
- 206010036790 Productive cough Diseases 0.000 description 1
- 108700020978 Proto-Oncogene Proteins 0.000 description 1
- 102000052575 Proto-Oncogene Human genes 0.000 description 1
- 108700005075 Regulator Genes Proteins 0.000 description 1
- 241000270295 Serpentes Species 0.000 description 1
- 108020004682 Single-Stranded DNA Proteins 0.000 description 1
- 102100034803 Small nuclear ribonucleoprotein-associated protein N Human genes 0.000 description 1
- 108700025695 Suppressor Genes Proteins 0.000 description 1
- RYYWUUFWQRZTIU-UHFFFAOYSA-N Thiophosphoric acid Chemical group OP(O)(S)=O RYYWUUFWQRZTIU-UHFFFAOYSA-N 0.000 description 1
- 108091023040 Transcription factor Proteins 0.000 description 1
- 102000040945 Transcription factor Human genes 0.000 description 1
- 101710188297 Trehalose synthase/amylase TreS Proteins 0.000 description 1
- 230000005856 abnormality Effects 0.000 description 1
- 230000021736 acetylation Effects 0.000 description 1
- 238000006640 acetylation reaction Methods 0.000 description 1
- 230000029936 alkylation Effects 0.000 description 1
- 238000005804 alkylation reaction Methods 0.000 description 1
- 230000006907 apoptotic process Effects 0.000 description 1
- 239000007864 aqueous solution Substances 0.000 description 1
- 238000003556 assay Methods 0.000 description 1
- 108700041737 bcl-2 Genes Proteins 0.000 description 1
- 238000004166 bioassay Methods 0.000 description 1
- 230000015572 biosynthetic process Effects 0.000 description 1
- 230000010261 cell growth Effects 0.000 description 1
- 210000003850 cellular structure Anatomy 0.000 description 1
- 238000007385 chemical modification Methods 0.000 description 1
- 210000000349 chromosome Anatomy 0.000 description 1
- 238000004140 cleaning Methods 0.000 description 1
- 210000001072 colon Anatomy 0.000 description 1
- 238000011109 contamination Methods 0.000 description 1
- 230000000875 corresponding effect Effects 0.000 description 1
- 230000008878 coupling Effects 0.000 description 1
- 238000010168 coupling process Methods 0.000 description 1
- 238000005859 coupling reaction Methods 0.000 description 1
- 238000002425 crystallisation Methods 0.000 description 1
- 230000008025 crystallization Effects 0.000 description 1
- 208000035250 cutaneous malignant susceptibility to 1 melanoma Diseases 0.000 description 1
- 230000007423 decrease Effects 0.000 description 1
- 238000012217 deletion Methods 0.000 description 1
- 230000037430 deletion Effects 0.000 description 1
- 230000001419 dependent effect Effects 0.000 description 1
- 230000006326 desulfonation Effects 0.000 description 1
- 238000005869 desulfonation reaction Methods 0.000 description 1
- 238000000502 dialysis Methods 0.000 description 1
- 239000012636 effector Substances 0.000 description 1
- 210000003527 eukaryotic cell Anatomy 0.000 description 1
- 238000011156 evaluation Methods 0.000 description 1
- 238000002474 experimental method Methods 0.000 description 1
- 210000001508 eye Anatomy 0.000 description 1
- 239000012530 fluid Substances 0.000 description 1
- 239000007789 gas Substances 0.000 description 1
- 230000011365 genetic imprinting Effects 0.000 description 1
- 210000003128 head Anatomy 0.000 description 1
- 230000036541 health Effects 0.000 description 1
- 210000002216 heart Anatomy 0.000 description 1
- 230000014200 hypermethylation of CpG island Effects 0.000 description 1
- 238000002513 implantation Methods 0.000 description 1
- 239000003112 inhibitor Substances 0.000 description 1
- 230000000977 initiatory effect Effects 0.000 description 1
- 238000003780 insertion Methods 0.000 description 1
- 230000037431 insertion Effects 0.000 description 1
- 230000000968 intestinal effect Effects 0.000 description 1
- 210000000936 intestine Anatomy 0.000 description 1
- 238000000752 ionisation method Methods 0.000 description 1
- 210000003734 kidney Anatomy 0.000 description 1
- 238000001698 laser desorption ionisation Methods 0.000 description 1
- 210000004185 liver Anatomy 0.000 description 1
- 201000005202 lung cancer Diseases 0.000 description 1
- 201000005296 lung carcinoma Diseases 0.000 description 1
- 208000020816 lung neoplasm Diseases 0.000 description 1
- 208000003747 lymphoid leukemia Diseases 0.000 description 1
- 239000000463 material Substances 0.000 description 1
- 230000013011 mating Effects 0.000 description 1
- 230000007246 mechanism Effects 0.000 description 1
- 230000001404 mediated effect Effects 0.000 description 1
- 201000001441 melanoma Diseases 0.000 description 1
- 230000033607 mismatch repair Effects 0.000 description 1
- 239000000203 mixture Substances 0.000 description 1
- 230000004048 modification Effects 0.000 description 1
- 238000012986 modification Methods 0.000 description 1
- 238000010369 molecular cloning Methods 0.000 description 1
- 210000003739 neck Anatomy 0.000 description 1
- 230000009826 neoplastic cell growth Effects 0.000 description 1
- 229920001778 nylon Polymers 0.000 description 1
- 231100000590 oncogenic Toxicity 0.000 description 1
- 230000002246 oncogenic effect Effects 0.000 description 1
- 230000005868 ontogenesis Effects 0.000 description 1
- 108700025694 p53 Genes Proteins 0.000 description 1
- 239000012188 paraffin wax Substances 0.000 description 1
- 230000001717 pathogenic effect Effects 0.000 description 1
- 235000021317 phosphate Nutrition 0.000 description 1
- 150000003013 phosphoric acid derivatives Chemical class 0.000 description 1
- 229920001184 polypeptide Polymers 0.000 description 1
- 238000001556 precipitation Methods 0.000 description 1
- 230000008569 process Effects 0.000 description 1
- 238000004393 prognosis Methods 0.000 description 1
- 210000002307 prostate Anatomy 0.000 description 1
- 125000006239 protecting group Chemical group 0.000 description 1
- 239000002516 radical scavenger Substances 0.000 description 1
- 230000037425 regulation of transcription Effects 0.000 description 1
- 238000004153 renaturation Methods 0.000 description 1
- 239000011347 resin Substances 0.000 description 1
- 229920005989 resin Polymers 0.000 description 1
- 238000012552 review Methods 0.000 description 1
- 210000002966 serum Anatomy 0.000 description 1
- 108010039827 snRNP Core Proteins Proteins 0.000 description 1
- 239000002904 solvent Substances 0.000 description 1
- 230000002269 spontaneous effect Effects 0.000 description 1
- 210000003802 sputum Anatomy 0.000 description 1
- 208000024794 sputum Diseases 0.000 description 1
- 238000010561 standard procedure Methods 0.000 description 1
- 239000000758 substrate Substances 0.000 description 1
- 239000013589 supplement Substances 0.000 description 1
- 238000001356 surgical procedure Methods 0.000 description 1
- 238000013519 translation Methods 0.000 description 1
- 102000035160 transmembrane proteins Human genes 0.000 description 1
- 108091005703 transmembrane proteins Proteins 0.000 description 1
- 230000005740 tumor formation Effects 0.000 description 1
- 231100000588 tumorigenic Toxicity 0.000 description 1
- 230000000381 tumorigenic effect Effects 0.000 description 1
- 210000002700 urine Anatomy 0.000 description 1
- XLYOFNOQVPJJNP-UHFFFAOYSA-N water Substances O XLYOFNOQVPJJNP-UHFFFAOYSA-N 0.000 description 1
Classifications
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12Q—MEASURING OR TESTING PROCESSES INVOLVING ENZYMES, NUCLEIC ACIDS OR MICROORGANISMS; COMPOSITIONS OR TEST PAPERS THEREFOR; PROCESSES OF PREPARING SUCH COMPOSITIONS; CONDITION-RESPONSIVE CONTROL IN MICROBIOLOGICAL OR ENZYMOLOGICAL PROCESSES
- C12Q1/00—Measuring or testing processes involving enzymes, nucleic acids or microorganisms; Compositions therefor; Processes of preparing such compositions
- C12Q1/68—Measuring or testing processes involving enzymes, nucleic acids or microorganisms; Compositions therefor; Processes of preparing such compositions involving nucleic acids
- C12Q1/6876—Nucleic acid products used in the analysis of nucleic acids, e.g. primers or probes
- C12Q1/6883—Nucleic acid products used in the analysis of nucleic acids, e.g. primers or probes for diseases caused by alterations of genetic material
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K14/00—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof
- C07K14/435—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from animals; from humans
- C07K14/46—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from animals; from humans from vertebrates
- C07K14/47—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from animals; from humans from vertebrates from mammals
- C07K14/4701—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from animals; from humans from vertebrates from mammals not used
- C07K14/4702—Regulators; Modulating activity
- C07K14/4703—Inhibitors; Suppressors
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12Q—MEASURING OR TESTING PROCESSES INVOLVING ENZYMES, NUCLEIC ACIDS OR MICROORGANISMS; COMPOSITIONS OR TEST PAPERS THEREFOR; PROCESSES OF PREPARING SUCH COMPOSITIONS; CONDITION-RESPONSIVE CONTROL IN MICROBIOLOGICAL OR ENZYMOLOGICAL PROCESSES
- C12Q1/00—Measuring or testing processes involving enzymes, nucleic acids or microorganisms; Compositions therefor; Processes of preparing such compositions
- C12Q1/68—Measuring or testing processes involving enzymes, nucleic acids or microorganisms; Compositions therefor; Processes of preparing such compositions involving nucleic acids
- C12Q1/6876—Nucleic acid products used in the analysis of nucleic acids, e.g. primers or probes
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12Q—MEASURING OR TESTING PROCESSES INVOLVING ENZYMES, NUCLEIC ACIDS OR MICROORGANISMS; COMPOSITIONS OR TEST PAPERS THEREFOR; PROCESSES OF PREPARING SUCH COMPOSITIONS; CONDITION-RESPONSIVE CONTROL IN MICROBIOLOGICAL OR ENZYMOLOGICAL PROCESSES
- C12Q2600/00—Oligonucleotides characterized by their use
- C12Q2600/154—Methylation markers
Landscapes
- Chemical & Material Sciences (AREA)
- Life Sciences & Earth Sciences (AREA)
- Health & Medical Sciences (AREA)
- Organic Chemistry (AREA)
- Proteomics, Peptides & Aminoacids (AREA)
- Zoology (AREA)
- Analytical Chemistry (AREA)
- Engineering & Computer Science (AREA)
- Wood Science & Technology (AREA)
- Genetics & Genomics (AREA)
- General Health & Medical Sciences (AREA)
- Biochemistry (AREA)
- Biophysics (AREA)
- Molecular Biology (AREA)
- Microbiology (AREA)
- Immunology (AREA)
- Biotechnology (AREA)
- Physics & Mathematics (AREA)
- Bioinformatics & Cheminformatics (AREA)
- General Engineering & Computer Science (AREA)
- Pathology (AREA)
- Toxicology (AREA)
- Gastroenterology & Hepatology (AREA)
- Medicinal Chemistry (AREA)
- Measuring Or Testing Involving Enzymes Or Micro-Organisms (AREA)
Abstract
Nukleinsäure, umfassend einen mindestens 18 Basen langen Sequenzabschnitt der chemisch vorbehandelten DNA von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind, gemäß einer der Sequenzen ausgewählt aus der Gruppe von Seq. IDNo. 1 bis Seq. IDNo. 536 und dazu komplementärer Sequenzen.
Description
- Gebiet der Erfindung
- Die nach den methodischen Entwicklungen der letzten Jahre in der Molekularbiologie gut studierten Beobachtungsebenen sind die Gene selbst, die Übersetzung dieser Gene in RNA und die daraus entstehenden Proteine. Wann im Laufe der Entwicklung eines Individuums welches Gen angeschaltet wird und wie Aktivieren und Inhibieren bestimmter Gene in bestimmten Zellen und Geweben gesteuert wird, ist mit Ausmaß und Charakter der Methylierung der Gene bzw. des Genoms korrelierbar. Insofern äußern sich pathogene Zustände in einem veränderten Methylierungsmuster einzelner Gene oder des Genoms.
- Die vorliegende Erfindung betrifft Nukleinsäuren, Oligonukleotide, PNA-Oligomere und ein Verfahren zur Diagnose von Erkrankungen, die mit dem genetischen und/oder epigenetischen Parametern von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind und insbesondere deren Methylierungsstatus in Zusammenhang stehen.
- Stand der Technik
- Es besteht ein Bedarf für die Entwicklung von alternativen Verfahren der Behandlung und Diagnose von Krebspatienten. Augenblickliche Verfahren der Behandlung, wie zum Beispiel Radiotherapie und Chemotherapie, sind oft von unangenehmen Nebenwirkungen begleitet und gegen viele Formen von Krebs ineffektiv.
- Die Genetik von Krebs ist kompliziert und schließt viel dominante positive Regulatoren des transformierten Zustands (Onkogene) sowie viele rezessive negative Regulatoren (Tumorsuppressorgene) ein. Ungefähr 100 Onkogene wurden identifiziert. Die Onkogene fallen in mehrere Gruppen, die verschiedene Typen von Aktivitäten repräsentieren, die von Transmembranproteinen zu Transkriptionsfaktoren reichen. Im Augenblick sind ungefähr 10 Tumorsuppressorgene bekannt. Sie stellen den Verlust von Funktionen in Genen dar, die gewöhnlicher Weise einige Unterdrückung auf Tumorsuppressorgene und Onkogene oder das Zellwachstum ausüben, wobei ein Loslassen der Unterdrückung tumorigen ist. Zusätzlich zu den Verlust von Heterozygozität und spontaner Mutation in Genen existiert ein weiterer Mechanismus, der zu Tumorbildung führen kann. Von der epigenetischen Fehlregulation von Genen wurde gezeigt, dass sie an der Bildung von Tumoren beteiligt ist. Der am besten charakterisierte epigenetische Parameter ist der von genomischer Methylierung, der kovalenten Modifikation der CS-Position von Cytosin. Methylierungsanomalien bei Krebs schließen Punktmutationen, globale Hypomethylierung, Hypomethylierung von einzelnen Genen, Hypermethylierung von CpG Inseln und den Verlust von Imprinting ein.
- Die hohe Rate von Mutationen innerhalb der CpG Inseln kann zu Krebs führen. Methylierte Cytosinbasen können spontan deaminieren, um Uracil zu bilden. Die Mismatchreparatur kann dann durch DNA-MTase beeinträchtigt werden, was zu einer Cytosin zu Thiamidin Transition führt. Ein gutes Beispiel davon ist das p53 Gen. eine Mutationen in diesem Genen ist in mehr als 50 % aller Tumore vorhanden, von denen abgeschätzte 24 % Cytosin zu Thymidin Transitionen an CpG Dinucleotiden sind.
- Abnehmende Spiegel von globaler Methylierung ist in vielen Formen von Tumoren verbreitet. Eine Hypomethylierung von einzelnen Genen wurde auch beobachtet. Eine inverse Beziehung zwischen Spiegeln von Methylierung und der Zellteilung wurde in dem bcl-2 Gen (lymphocytische Leukämie) und dem k-ras Proto-Onkogen in Lungen- und Colonkarzinomen beobachtet.
- Das p16 Gen ist ein Schlüssel-Tumorsuppressorgene und Onkogene regulatorisches Gen. Das p16 Protein stoppt das Fortschreiten des Zellzyklus an der G1/S Grenze, und der Verlust der p16 Funktionen kann zum Fortschreiten von Krebs führen, durch ein Ermöglichen von nicht regulierter Zellteilung. Die Hypermethylierungs vermittelte Inaktivierung des p16 Gens wurde in Hirn-, Brust-, Colon-, Kopf- und Nacken-, und nicht-kleine Zellen Lungenkrebs und in hochgradigem nicht-Hodgkin's Lymphom gezeigt.
- Die Rolle der Methylierung bei der Tumorgenese wird durch Singal und Ginder 'DNA Methylation' Blood, Vol. 93 No. 12 (June 15), 1999: pp. 4059-4070 zusammenfassend beschrieben. Weitere Beispiele von Methylierungs-gekoppelter Onkogenese schließen ein:
- Kopf- und Nackenkrebs (Sanchez-Cespedes M et al. „Gene promoter hypermethylation in tumours and serum of head and neck cancer patients" Cancer Res. 2000 Feb. 15;60 (4):892-5).
- Hodgkin's Erkrankung (Garcia JF et al „Loss of p16 protein expression associated with methylation of the p16INK4A gene is a frequent finding in Hodgkin's disease" Lab invest 1999 Dec; 79 (12):1453-9):
- Magenkrebs (Yanagisawa Y et al. „ Methylation of the hMLH1 promoter in familial gastric cancer with microsatellite instability" Int J Cancer 2000 Jan 1; 85 (1):50-3).
- Die Identifizierung der Methylierungs-abhängigen Regulation von Krebsgenen hat die Möglichkeit eröffnet, alternativen Verfahren der Krebsbehandlung und Diagnose zu entwickeln. Von der Behandlung mit DNA Methylierungsinhibitoren wurde gezeigt, daß sie die Genexpression des Schlüssel-Tumorsuppressorgene and Onkogens Gen p16 wiederherstellen, Bender et. al. "Inhibition of DNA methylation by 5-aza-2'-deoxycytidine suppresses the growth of human tumor cell lines." Cancer research 58; 95-101 (1998). Dies führte zu erheblichen Spiegeln an Genexpression, was zur Suppression von Wachstum in Tumorzellinien führte.
- Methylierungs-basierte Therapien könnten beträchtliche Vorteile über die augenblicklichen Verfahren der Behandlung, wie z. B. Chemotherapie, Chirurgie und Radiotherapien aufweisen. Sie könnten sogar ein Mittel zur Verfügung stellen, Tumore zu behandeln, die gegenüber herkömmlichen Verfahren der Behandlung resistent sind, wie durch Soengas et al "Inactivation of the apoptosis effector Apaf-1 in malignant melanoma" Nature 409; 207-211(2001) gezeigt. Zusätzlich zu der Entwicklung von Methylierungs-spezifischen Therapien, haben Experimente mit Min-Mäusen gezeigt, daß die Inhibierung der DNA Methylierung die Tumorinitiation unterdrücken kann, Laird et. al. 'Suppression of intestinal neoplasia by DNA hypomethylation' Cell 81; 197-205 (1995). Weiterhin kann die DNA Methylierungsanalyse neue Mittel zur Krebsdiagnose zur Verfügung stellen.
- 5-Methylcytosin ist die häufigste kovalent modifizierte Base in der DNA eukaryontischer Zellen. Sie spielt beispielsweise eine Rolle in der Regulation der Transkription, beim genetischen Imprinting und in der Tumorgenese. Die Identifizierung von 5-Methylcytosin als Bestandteil genetischer Information ist daher von erheblichem Interesse. 5-Methylcytosin- Positionen können jedoch nicht durch Sequenzierung identifiziert werden, da 5-Methylcytosin das gleiche Basenpaarungsverhalten aufweist wie Cytosin. Darüber hinaus geht bei einer PCR-Amplifikation die epigenetische Information, welche die 5-Methylcytosine tragen, vollständig verloren.
- Eine relativ neue und die mittlerweile am häufigsten angewandte Methode zur Untersuchung von DNA auf 5-Methylcytosin beruht auf der spezifischen Reaktion von Bisulfit mit Cytosin, das nach anschließender alkalischer Hydrolyse in Uracil umgewandelt wird, welches in seinem Basenpaarungsverhalten dem Thymidin entspricht. 5-Methylcytosin wird dagegen unter diesen Bedingungen nicht modifiziert. Damit wird die ursprüngliche DNA so umgewandelt, daß Methylcytosin, welches ursprünglich durch sein Hybridisierungsverhalten vom Cytosin nicht unterschieden werden kann, jetzt durch „normale" molekularbiologische Techniken als einzig verbliebenes Cytosin beispielsweise durch Amplifikation und Hybridisierung oder Sequenzierung nachgewiesen werden kann. Alle diese Techniken beruhen auf Basenpaarung, welche jetzt voll ausgenutzt wird. Der Stand der Technik, was die Empfindlichkeit betrifft, wird durch ein Verfahren definiert, welches die zu untersuchende DNA in einer Agarose-Matrix einschließt, dadurch die Diffusion und Renaturierung der DNA (Bisulfit reagiert nur an einzelsträngiger DNA) verhindert und alle Fällungs- und Reinigungsschritte durch schnelle Dialyse ersetzt (Olek A, Oswald J, Walter J. A modified and improved method for bisulphite based cytosine methylation analysis. Nucleic Acids Res. 1996 Dec 15;24(24):5064-6). Mit dieser Methode können einzelne Zellen untersucht werden, was das Potential der Methode veranschaulicht. Allerdings werden bisher nur einzelne Regionen bis etwa 3000 Basenpaare Länge untersucht, eine globale Untersuchung von Zellen auf Tausenden von möglichen Methylierungsanalysen ist nicht möglich. Allerdings kann auch dieses Verfahren keine sehr kleinen Fragmente aus geringen Probenmengen zuverlässig analysieren. Diese gehen trotz Diffusionsschutz durch die Matrix verloren.
- Eine Übersicht über die weiteren bekannten Möglichkeiten, 5-Methylcytosine nachzuweisen, kann aus dem folgenden Übersichtsartikel entnommen werden: Rein, T., DePamphilis, M. L., Zorbas, H., Nucleic Acids Res. 1998, 26, 2255.
- Die Bisulfit-Technik wird bisher bis auf wenige Ausnahmen (z.B. Zeschnigk M, Lich C, Buiting K, Doerfler W, Horsthemke B. A single-tube PCR test for the diagnosis of Angelman and Prader-Willi syndrome based on allelic methylation differences at the SNRPN locus. Eur J Hum Genet. 1997 Mar-Apr;S(2):94-8) nur in der Forschung angewendet. Immer aber werden kurze, spezifische Stücke eines bekannten Gens nach einer Bisulfit-Behandlung amplifiziert und entweder komplett sequenziert (Olek A, Walter J. The pre-implantation ontogeny of the H19 methylation imprint. Nat Genet. 1997 Nov;17(3):275-6) oder einzelne Cytosin-Positionen durch eine „Primer-Extension-Reaktion" (Gonzalgo ML, Jones PA. Rapid quantitation of methylation differences at specific sites using methylation-sensitive single nucleotide primer extension (Ms-SNuPE). Nucleic Acids Res. 1997 Jun 15;25(12):2529-31, WO 95/00669) oder einen Enzymschnitt (Xiong Z, Laird PW. COBRA: a sensitive and quantitative DNA methylation assay. Nucleic Acids Res. 1997 Jun 15;25(12):2532-4) nachgewiesen. Zudem ist auch der Nachweis durch Hybridisierung beschrieben worden (Olek et al., WO 99/28498).
- Weitere Publikationen, die sich mit der Anwendung der Bisulfit-Technik zum Methylierungsnachweis bei einzelnen Genen befassen, sind: Grigg G, Clark S. Sequencing 5-methylcytosine residues in genomic DNA. Bioessays. 1994 Jun;16(6):431-6, 431; Zeschnigk M, Schmitz B, Dittrich B, Buiting K, Horsthemke B, Doerfler W. Imprinted segments in the human genome: different DNA methylation patterns in the Prader-Willi/Angelman syndrome region as determined by the genomic sequencing method. Hum Mol Genet. 1997 Mar;6(3):387-95; Feil R, Charlton J, Bird AP, Walter J, Reik W. Methylation analysis on individual chromosomes: improved protocol for bisulphite genomic sequencing. Nucleic Acids Res. 1994 Feb 25;22(4):695-6; Martin V, Ribieras S, Song-Wang X, Rio MC, Dante R. Genomic sequencing indicates a correlation between DNA hypomethylation in the 5' region of the pS2 gene and its expression in human breast cancer cell lines. Gene. 1995 May 19;157(1-2):261-4; WO 97/46705, WO 95/15373 und WO 98/45560.
- Eine Übersicht über den Stand der Technik in der Oligomer Array Herstellung läßt sich aus einer im Januar 1999 erschienenen Sonderausgabe von Nature Genetics (Nature Genetics Supplement, Volume 21, January 1999) und der dort zitierten Literatur entnehmen.
- Für die Abtastung eines immobilisierten DNA-Arrays sind vielfach fluoreszenzmarkierte Sonden verwendet worden. Besonders geeignet für Fluoreszenzmarkierungen ist das einfache Anbringen von Cy3 und Cy5 Farbstoffen am 5'-OH der jeweiligen Sonde. Die Detektion der Fluoreszenz der hybridisierten Sonden erfolgt beispielsweise über ein Konfokalmikroskop. Die Farbstoffe Cy3 und Cy5 sind, neben vielen anderen, kommerziell erhältlich.
- Matrix-assistierte Laser Desorptions/Ionisations-Massenspektrometrie (MALDI-TOF) ist eine sehr leistungsfähige Entwicklung für die Analyse von Biomolekülen (Karas M, Hillenkamp F. Laser desorption ionization of proteins with molecular masses exceeding 10,000 daltons. Anal Chem. 1988 Oct 15;60(20):2299-301). Ein Analyt wird in eine lichtabsorbierende Matrix eingebettet. Durch einen kurzen Laserpuls wird die Matrix verdampft und das Analytmolekül so unfragmentiert in die Gasphase befördert. Durch Stöße mit Matrixmolekülen wird die Ionisation des Analyten erreicht. Eine angelegte Spannung beschleunigt die Ionen in ein feldfreies Flugrohr. Auf Grund ihrer verschiedenen Massen werden Ionen unterschiedlich stark beschleunigt. Kleinere Ionen erreichen den Detektor früher als größere.
- MALDI-TOF Spektrometrie eignet sich ausgezeichnet zur Analyse von Peptiden und Proteinen. Die Analyse von Nukleinsäuren ist etwas schwieriger (Gut I G, Beck S. DNA and Matrix Assisted Laser Desorption Ionization Mass Spectrometry. Current Innovations and Future Trends. 1995, 1; 147-57). Für Nukleinsäuren ist die Empfindlichkeit etwa 100 mal schlechter als für Peptide und nimmt mit zunehmender Fragmentgröße überproportional ab. Für Nukleinsäuren, die ein vielfach negativ geladenes Rückgrat haben, ist der Ionisationsprozeß durch die Matrix wesentlich ineffizienter. In der MALDI-TOF Spektrometrie spielt die Wahl der Matrix eine eminent wichtige Rolle. Für die Desorption von Peptiden sind einige sehr leistungsfähige Matrizes gefunden worden, die eine sehr feine Kristallisation ergeben. Für DNA gibt es zwar mittlerweile einige ansprechende Matrizes, jedoch wurde dadurch der Empfindlichkeitsunterschied nicht verringert. Der Empfindlichkeitsunterschied kann verringert werden, indem die DNA chemisch so modifiziert wird, dass sie einem Peptid ähnlicher wird. Phosphorothioatnukleinsäuren, bei denen die gewöhnlichen Phosphate des Rückgrats durch Thiophosphate substituiert sind, lassen sich durch einfache Alkylierungschemie in eine ladungsneutrale DNA umwandeln (Gut IG, Beck S. A procedure for selective DNA alkylation and detection by mass spectrometry. Nucleic Acids Res. 1995 Apr 25;23(8):1367-73). Die Kopplung eines „charge tags" an diese modifizierte DNA resultiert in der Steigerung der Empfindlichkeit um den gleichen Betrag, wie er für Peptide gefunden wird. Ein weiterer Vorteil von „charge tagging" ist die erhöhte Stabilität der Analyse gegen Verunreinigungen, die den Nachweis unmodifizierter Substrate stark erschweren.
- Genomische DNA wird durch Standardmethoden aus DNA von Zell-, Gewebe- oder sonstigen Versuchsproben gewonnen. Diese Standardmethodik findet sich in Referenzen wie Fritsch und Maniatis eds., Molecular Cloning: A Laboratory Manual, 1989.
- Definition der Aufgabe
- Die vorliegende Erfindung ist dazu gedacht, Oligonukleotide und/oder PNA-Oligomere zur Detektion von Cytosin-Methylierungen sowie ein Verfahren bereitzustellen, welches sich zur Diagnose von genetischen und epigenetischen Parametern von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind, besonders eignet. Der Erfindung liegt die Erkenntnis zugrunde, daß sich die Cytosin-Methylierungsmuster zur Diagnose und/oder der Therapie von mit Tumor-Suppressorgenen und Onkogenen assoziierten Erkrankungen besonders eignen.
- Beschreibung
- Es ist die Aufgabe der vorliegenden Erfindung, die chemisch modifizierte DNA von Genen zur Verfügung zu stellen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind, sowie Oligonukleotide und/oder PNA-Oligomere zur Detektion von Cytosin-Methylierungen sowie ein Verfahren bereitzustellen, welches sich zur Diagnose und/oder der Therapie von genetischen und epigenetischen Parametern von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind, besonders eignet. Der Erfindung liegt die Erkenntnis zugrunde, daß genetische und epigenetische Parameter und insbesondere die Cytosin-Methylierungsmuster von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind, zur Diagnose und/oder der Therapie von mit Tumor-Suppressorgenen und Onkogenen assoziierten Erkrankungen besonders eignen.
- Diese Aufgabe wird erfindungsgemäß durch das zur Verfügung stellen einer Nukleinsäure, die einen mindestens 18 Basen langen Sequenzabschnitt der chemisch vorbehandelten DNA von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind gemäß einer der Seq. ID No. 1 bis Seq. ID No. 536 und dazu komplementären Sequenzen und/oder der chemisch vorbehandelten DNA von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind gemäß einer der Sequenzen der in Tabelle 1 aufgelisteten Gene enthält, gelöst. In der Tabelle sind nach den aufgelisteten Gen-Bezeichnungen die jeweiligen Datenban knummern (Zugangsnummern) angegeben, die die dazugehörigen Gensequenzen als einmalig definieren. GenBank am National Institute of Health wurde als die zu Grunde liegende Datenbank unter der Internet Adresse www.ncbi.nlm.nih.gov verwendet.
- Die chemisch modifizierte Nukleinsäure konnte bisher nicht in Zusammenhang mit der Ermittlung von genetischen und epigenetische Parametern gebracht werden.
- Die Aufgabe der vorliegenden Erfindung wird weiterhin durch ein Oligonukleotid oder Oligomer zur Detektion des Cytosin-Methylierungszustandes in chemisch vorbehandelter DNA, umfassend mindestens eine Basensequenz mit einer Länge von mindestens 13 Nukleotiden gelöst, die an eine chemisch vorbehandelte DNA von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind gemäß einer der Seq. ID No. 1 bis Seq. ID No. 536 und dazu komplementären Sequenzen und/oder der chemisch vorbehandelten DNA von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind gemäß einer der Sequenzen der in Tabelle 1 aufgelisteten Gene hybridisiert. Die erfindungsgemäßen Oligomersonden stellen wichtige und effektive Werkzeuge dar, welche die Ermittlung der genetischen und epigenetischen Parameter von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind, erst ermöglichen. Bevorzugterweise umfaßt die Basensequenz der Oligomere mindestens ein CpG Dinukleotid. Die Sonden können auch in Form einer PNA (Peptide Nucleic Acid) vorliegen, die besonders bevorzugte Paarungseigenschaften aufweist. Besonders bevorzugt sind erfindungsgemäße Oligonukleotide, bei denen das Cytosin des CpG Dinukleotids das 5. – 9. Nukleotid vom 5'-Ende des 13-mers ist, im Falle von PNA-Oligomeren ist es bevorzugt, dass das Cytosin des CpG Dinukleotids das 4. – 6. Nukleotid vom 5'-Ende des 9-mers ist.
- Die erfindungsgemäßen Oligomere werden normalerweise in sogenannten Sets eingesetzt, die für jedes der CpG Dinukleotide eine der Sequenzen der Seq. ID No. 1 bis Seq. ID No. 536 und dazu komplementären Sequenzen und/oder der chemisch vorbehandelten DNA von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind gemäß einer der Sequenzen der in Tabelle 1 aufgelisteten Gene mindestens ein Oligomer umfassen. Bevorzugt ist ein Set, das für jedes der CpG Dinukleotide aus einer der Seq ID No. 1 bis Seq ID No. 536 und dazu komplementären Sequenzen und/oder der chemisch vorbehandelten DNA von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind gemäß einer der Sequenzen der in Tabelle 1 aufgelisteten Gene mindestens ein Oligomer umfaßt.
- Darüber hinaus stellt die Erfindung ein Set von mindestens zwei Oligonukleotiden zur Verfügung, die als sogenannte „Primer-Oligonukleotide" zur Amplifikation von DNA-Sequenzen einer der Seq. ID No. 1 bis Seq. ID No. 536 und dazu komplementären Sequenzen und/oder der chemisch vorbehandelten DNA von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind gemäß einer der Sequenzen der in Tabelle 1 aufgelisteten Gene oder Abschnitten davon eingesetzt werden können.
- Im Falle der erfindungsgemäßen Sets von Oligonukleotiden ist es bevorzugt, daß mindestens ein Oligonukleotid an eine Festphase gebunden ist.
- Die vorliegende Erfindung betrifft weiterhin einen Satz von mindestens 10 n (Oligonukleotiden und/oder PNA-Oligomeren), die zur Detektion des Cytosin-Methylierungszustandes in chemisch vorbehandelter genomischer DNA (Seq. ID No. 1 bis Seq. ID No. 536 und dazu komplementären Sequenzen und/oder der chemisch vorbehandelten DNA von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind gemäß einer der Sequenzen der in Tabelle 1 aufgelisteten Gene) dienen. Mit diesen Sonden ist die Diagnose von genetischen und epigenetischen Parametern von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind möglich. Das Set von Oligomeren kann auch zur Detektion von Single Nucleotide Polymorphismen (SNPs) in der chemisch vorbehandelten DNA von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind gemäß einer der Seq. ID No. 1 bis Seq. ID No. 536 und dazu komplementären Sequenzen und/oder der chemisch vorbehandelten DNA von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind gemäß einer der Sequenzen der in Tabelle 1 aufgelisteten Gene verwendet werden.
- Erfindungsgemäß ist es bevorzugt, daß eine von der Erfindung zur Verfügung gestellte Anordnung aus unterschiedlichen Oligonukleotiden und/oder PNA-Oligomeren (ein sogenanntes "Array") ebenfalls an eine Festphase gebunden vorliegt. Dieses Array von unterschiedlichen Oligonukleotid- und/oder PNA-Oligomersequenzen kann dadurch gekennzeichnet sein, dass es auf der Festphase in Form eines rechtwinkligen oder hexagonalen Gitters angeordnet ist. Bevorzugterweise besteht die Festphasenoberfläche aus Silizium, Glas, Polystyrol, Aluminium, Stahl, Eisen, Kupfer, Nickel, Silber oder Gold. Möglich sind jedoch auch Nitrocellulose sowie Kunststoffe wie zum Beispiel Nylon, die in Form von Kugeln oder auch als Harz-Matrizes vorliegen können.
- Ein weiterer Gegenstand der Erfindung ist daher ein Verfahren zur Herstellung eines auf einem Trägermaterial fixierten Arrays zur Analyse in Zusammenhang mit Tumor-Suppressorgenen und Onkogenen assoziierten Erkrankungen, bei dem mindestens ein Oligomer gemäß der Erfindung an eine feste Phase gekoppelt wird. Verfahren zur Herstellung von solchen Arrays sind zum Beispiel aus der
US 5,744,305 mittels Festphasenchemie und photolabilen Schutzgruppen bekannt. - Ein weiterer Gegenstand der Erfindung betrifft einen DNA-Chip zur Analyse in Zusammenhang mit Tumor-Suppressorgenen und Onkogenen assoziierten Erkrankungen, der mindestens eine Nukleinsäure gemäß der vorliegenden Erfindung umfaßt. DNA-Chips sind zum Beispiel aus der
US 5,837,832 bekannt. - Gegenstand der vorliegenden Erfindung ist zudem ein Kit, das zum Beispiel aus einer Bisulfit enthaltenden Reagenz, einem Satz von Primeroligonukleotiden umfassend mindestens zwei Oligonukleotide, deren Sequenzen jeweils mindestens einen 18 Basenpaaren langen Abschnitt der im Anhang aufgeführten Basensequenzen (Seq. ID No. 1 bis Seq. ID No. 536 und dazu komplementären Sequenzen und/oder der chemisch vorbehandelten DNA von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind gemäß einer der Sequenzen der in Tabelle 1 aufgelisteten Gene), Oligonukleotiden und/oder PNA-Oligomeren sowie einer Anleitung zur Durchführung und Auswertung des beschriebenen Verfahrens bestehen kann. Ein Kit im Sinne der Erfindung kann jedoch auch nur Teile der vorgenannten Bestandteile enthalten.
- Die Erfindung stellt weiterhin ein Verfahren zur Ermittlung von genetischen und/oder epigenetischen Parametern von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind durch Analyse von Cytosin-Methylierungen und Single Nucleotide Polymorphismen zur Verfügung, das folgende Schritte umfaßt:
- In einem ersten Verfahrensschritt wird eine genomische DNA-Probe derart chemisch behandelt, daß an der 5'-Position nicht-methylierte Cytosinbasen in Uracil, Thymin oder eine andere vom Hybridisierungsverhalten her dem Cytosin unähnliche Base umgewandelt werden. Dies wird im folgenden unter „chemischer Vorbehandlung" verstanden.
- Die zu analysierende genomische DNA wird bevorzugt aus den üblichen Quellen für DNA erhalten, wie Zellen oder Zellbestandteilen, zum Beispiel Zellinien, Biopsine, Blut, Sputum, Stuhl, Urin, Gehirn-Rückenmarks-Flüssigkeit, in Paraffin eingebettetes Gewebe, beispielsweise Gewebe von Augen, Darm, Niere, Hirn, Herz, Prostata, Lunge, Brust oder Leber, histologische Objektträger oder Kombinationen davon.
- Bevorzugt wird dazu die oben beschriebene Behandlung genomischer DNA mit Bisulfit (Hydrogensulfit, Disulfit) und anschließender alkalischer Hydrolyse angewendet, die zu einer Umwandlung nicht methylierter Cytosin-Nukleobasen in Uracil oder eine andere vom Basenpaarungsverhalten her dem Cytosin unähnliche Base führt.
- Aus dieser chemisch vorbehandelten genomischen DNA werden Fragmente unter Verwendung von Sätzen von erfindungsgemäßen Primer-Oligonukleotiden und einer bevorzugterweise hitzestabilen Polymerase amplifiziert. Aus statistischen und praktikablen Erwägungen werden bevorzugterweise mehr als zehn unterschiedliche Fragmente amplifiziert, die 100 – 2000 Basenpaare lang sind. Die Amplifikation von mehreren DNA-Abschnitten kann simultan in ein und demselben Reaktionsgefäß durchgeführt werden. Üblicherweise wird die Amplifikation mittels der Polymerasekettenreaktion (PCR) durchgeführt.
- In einer bevorzugten Ausführungsform des Verfahrens umfaßt der Satz von Primer-Oligonukleotiden mindestens zwei Oligonukleotide, deren Sequenzen jeweils revers komplementär oder identisch zu einem mindestens 18 Basenpaare langen Abschnitt der im Anhang (Seq. ID No. 1 bis Seq. ID No. 536 und dazu komplementären Sequenzen und/oder der chemisch vorbehandelten DNA von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind gemäß einer der Sequenzen der in Tabelle 1 aufgelisteten Gene) aufgelisteten Basensequenzen sind. Die Primer-Oligonukleotide sind vorzugsweise dadurch gekennzeichnet, daß sie kein CpG Dinukleotid enthalten.
- Erfindungsgemäß bevorzugt ist es, daß bei der Amplifikation mindestens ein Primer-Oligonukleotid an eine Festphase gebunden ist. Die unterschiedlichen Oligonukleotid und/oder PNA-Oligomersequenzen können auf einer ebenen Festphase in Form eines rechtwinkligen oder hexagonalen Gitters angeordnet sein, wobei die Festphasenoberfläche bevorzugt aus Silizium, Glas, Polystyrol, Aluminium, Stahl, Eisen, Kupfer, Nickel, Silber oder Gold besteht, wobei auch andere Materialien, wie Nitrocellulose oder Kunststoffe verwendet werden können.
- Die mittels der Amplifikation erhaltenen Fragmente können eine direkt oder indirekt nachweisbare Markierung tragen. Bevorzugt sind Markierungen in Form von Fluoreszenzmarkierungen, Radionukliden oder ablösbaren Molekülfragmenten mit typischer Masse, die in einem Massenspektrometer nachgewiesen werden können, wobei bevorzugt ist, dass die erzeugten Fragmente zur besseren Detektierbarkeit im Massenspektrometer eine einzelne positive oder negative Nettoladung aufweisen. Der Nachweis kann mittels Matrix assistierter Laser Desorptions/Ionisations Massenspektrometrie (MALDI) oder mittels Elektrospray Massenspektrometrie (ESI) durchgeführt und visualisiert werden.
- Die im zweiten Verfahrensschritt erhaltenen Amplifikate werden anschließend an einen Satz von Oligonukleotiden und/oder PNA- Sonden der oder an ein Array hybridisiert. Die Hybridisierung erfolgt dabei auf die unten angegebene Art und Weise. Der bei der Hybridisierung verwendete Satz besteht bevorzugterweise aus mindestens 10 Oligonukleotid oder PNA-Oligomer Sonden. Die Amplifikate dienen dabei als Sonden, die an vorher an einer Festphase gebundene Oligonukleotide hybridisieren. Die nicht hybridisierten Fragmente werden anschließend entfernt. Die besagten Oligonukleotide umfassen mindestens eine Basensequenz mit einer Länge von 13 Nukleotiden, die revers komplementär oder identisch zu einem Abschnitt der im Anhang aufgeführten Basensequenzen ist, der mindestens ein CpG Dinukleotid enthält. Das Cytosin des CpG Dinukleotids ist das 5. bis 9. Nukleotid vom 5'-Ende des 13 mers aus betrachtet. Für jedes CpG Dinukleotid ist ein Oligonukleotid vorhanden. Die besagten PNA-Oligomere umfassen mindestens eine Basensequenz mit einer Länge von 9 Nukleotiden, die revers komplementär oder identisch zu einem Abschnitt der im Anhang aufgeführten Basensequenzen ist, der mindestens ein CpG Dinukleotid enthält. Das Cytosin des CpG Dinukleotids ist das 4. bis 6. Nukleotid vom 5'-Ende des 9-mers aus gesehen. Für jedes CpG Dinukleotid ist ein Oligonukleotid vorhanden.
- Im vierten Verfahrensschritt entfernt man die nicht hybridisierten Amplifikate.
- Im letzten Verfahrensschritt detektiert man die hybridisierten Amplifikate. Dabei ist bevorzugt, daß an den Amplifikaten angebrachte Markierungen an jeder Position der Festphase, an der sich eine Oligonukleotidsequenz befindet, identifizierbar sind.
- Erfindungsgemäß bevorzugt ist es, daß die Markierungen der Amplifikate Fluoreszenzmarkierungen, Radionuklide oder ablösbare Molekülfragmente mit typischer Masse sind, die in ei nem Massenspektrometer nachgewiesen werden können. Der Nachweis der Amplifikate, Fragmente der Amplifikate oder zu den Amplifikaten komplementäre Sonden im Massenspektrometer ist bevorzugt, wobei man die Detektion mittels Matrix assistierter Laser Desorptions/Ionisations Massenspektrometrie (MALDI) oder mittels Elektrospray Massenspektrometrie (ESI) durchführen und visualisieren kann.
- Zur besseren Detektierbarkeit im Massenspektrometer können die erzeugten Fragmente eine einzelne positive oder negative Nettoladung aufweisen. Bevorzugt wird das vorgenannte Verfahren zur Ermittlung von genetischen und/oder epigenetischen Parametern von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind, verwendet.
- Die erfindungsgemäßen Oligomere oder Arrays derselben sowie ein erfindungsgemäßes Kit sollen zur Diagnose und/oder Therapie einer mit Tumor-Suppressorgenen und Onkogenen assoziierten Krankheit durch Analyse von Methylierungsmustern von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind, verwendet werden. Erfindungsgemäss bevorzugt ist die Verwendung des Verfahrens zur Diagnose und/oder Therapie bedeutender genetischer und/oder epigenetischer Parameter innerhalb von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind.
- Das erfindungsgemäße Verfahren dient zum Beispiel der Diagnose und/oder der Therapie von soliden Tumoren und Krebsarten.
- Auch die erfindungsgemäßen Nukleinsäuren der Seq. ID No. 1 bis Seq. ID No. 536 und dazu komplementäre Sequenzen und/oder die chemisch vorbehandelte DNA von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind gemäß einer der Sequenzen der in Tabelle 1 aufgelisteten Gene können für die Diagnose und/oder der Therapie von genetischen und/oder epigenetischen Parametern von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind, verwendet werden.
- Die vorliegende Erfindung betrifft weiterhin ein Verfahren zur Herstellung eines Diagnostikums und/oder Therapeutikums zur Diagnose und/oder der Therapie von Krankheiten, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind durch Analyse von Methylierungsmustern von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind, wobei das Diagnostikum und/oder das Therapeutikum dadurch gekennzeichnet ist, dass mindestens eine Nukleinsäure, gemäß der vorliegenden Erfindung, gegebenenfalls zusammen mit geeigneten Zusatz- und Hilfsstoffen zu dessen Herstellung verwendet wird.
- Ein weiterer Gegenstand der vorliegenden Erfindung betrifft ein Diagnostikum und/oder Therapeutikum für Krankheiten, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind, durch Analyse von Methylierungsmustern von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind, wobei das Diagnostikum und/oder Therapeutikum dadurch gekennzeichnet ist, das es mindestens eine Nukleinsäure gemäß der Erfindung, gegebenenfalls zusammen mit geeigneten Zusatz- und Hilfsstoffen enthält.
- Die vorliegende Erfindung betrifft weiterhin die Diagnose und/oder Prognose nachteiliger Ereignisse für Patienten oder Individuen, bei dem die mittels der Erfindung erhaltenen bedeutenden genetischen und/oder epigenetischen Parameter innerhalb von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind mit einem anderen Satz genetischen und/oder epigenetischen Parameter verglichen werden können und die so erhaltenen Unterschiede als Basis für eine Diagnose und/oder Prognose nachteiliger Ereignisse für Patienten oder Individuen dienen.
- Unter dem Begriff "Hybridisierung" im Sinne der vorliegenden Erfindung ist eine Bindung unter Ausbildung einer Duplex-Struktur eines Oligonukleotids an eine vollständig komplementäre Sequenz im Sinne der Watson-Crick Basenpaarungen in der Proben DNA zu verstehen. Unter "stringenten Hybridisierungsbedingungen" sind solche Bedingungen zu verstehen, bei denen eine Hybridisierung bei 60°C in 2,5 x SSC-Puffer, gefolgt von mehreren Waschschritten bei 37°C in einer geringeren Pufferkonzentration erfolgt und stabil bleibt.
- Mit dem Begriff "funktionelle Varianten" sind alle DNA-Sequenzen bezeichnet, die komplementär zu einer DNA-Sequenz sind, die unter stringenten Bedingungen mit der Referenzsequenz hybridisieren und eine zu dem entsprechenden erfindungsgemäßen Polypeptid ähnliche Aktivität aufweisen.
- "Genetische Parameter" im Sinne dieser Erfindung sind Mutationen und Polymorphismen von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind und zu deren Regulation weiterhin erforderlicher Sequenzen. Insbesondere sind als Mutationen Insertionen, Dele tionen, Punktmutationen, Inversionen und Polymorphismen und besonders bevorzugt SNPs (Single Nucleotide Polymorphisms) zu bezeichnen.
- "Epigenetische Parameter" im Sinne dieser Erfindung sind insbesondere Cytosin-Methylierungen und weitere chemische Modifikationen von DNA-Basen von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind und zu deren Regulation weiterhin erforderliche Sequenzen. Weitere epigenetische Parameter sind beispielsweise die Acetylierung von Histonen, die jedoch mit dem beschriebenen Verfahren nicht direkt analysiert werden kann, sondern wiederum mit der DNA-Methylierung korreliert.
- Die Erfindung soll nun im folgenden anhand der Sequenzen und Beispiele unter Bezugnahme auf die beigefügte Figur weiter verdeutlicht werden, ohne daß die Erfindung hierauf eingeschränkt wird.
- Figur 1
-
1 zeigte die Hybridisierung von Fluoreszenz-markierten Amplifikaten an ein Oberflächen-gebundenes Oligonukleotid. Probe I stammt von pilocytischem Astrocytom (Hirntumor)-Gewebe und Probe II stammt von Astrocytom Grad II (Hirntumor)-Gewebe. Die Fluoreszenz an einem Punkt zeigt die Hybridisierung des Amplifikats an. Die Hybridisierung an ein CG Oligonukleotid zeigt an, daß die Methylierung an der Cytosin-Position analysiert wird, die Hybridisierung an ein TG Oligonukleotid zeigt an, daß keine Methylierung an der Cytosin-Position analysiert wird. - Seq ID No. 1 bis Seq ID No. 536
- Die Seq ID No. 1 bis Seq ID No. 536 zeigen Sequenzen der chemisch vorbehandelten genomischen DNAs von verschiedenen Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind, gemäß der Erfindung. Sequenzen, die ungerade Sequenznummern haben (z.B., Seq. ID No. 1, 3, 5,...) zeigen in jedem Fall Sequenzen der chemisch vorbehandelten genomischen DNAs von verschiedenen Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind. Sequenzen, die gerade Sequenznummern aufweisen (z.B., Seq. ID No. 2, 4, 6, ...) zeigen in jedem Fall Sequenzen der chemisch vorbehandelten genomischen DNAs von verschiedenen Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind, die komplementär zu den voranstehenden Sequenzen sind (z.B., die komplementäre Sequenz zu Seq. ID No. 1 ist Seq. ID No. 2, die komplementäre Sequenz zu Seq. ID No. 3 ist Seq. ID No. 4, usw.)
- Seg. ID No. 537 bis Seq. ID No. 540
- Seq. ID No. 537 bis Seq. ID No. 540 zeigen spezifische Oligonukleotid-Sequenzen, wie in Beispiel 1 verwendet.
- Das folgende Beispiel betrifft ein Fragment eines Gens, das mit Tumor-Suppressorgenen und Onkogenen assoziiert ist, in diesem Fall MYC, wobei eine spezifische CG-Position auf ihren Methylierungsstatus hin analysiert wird.
- Beispiel 1: Methylierungsanalyse in dem mit Tumor-Suppressorgenen und Onkogenen assoziierten Gen MYC
- Das folgende Beispiel betrifft ein Fragment des Gens MYC, worin eine spezifische CG-Position auf ihren Methylierungsstatus hin analysiert wird.
- Im ersten Schritt wird eine genomische Sequenz unter Verwendung von Bisulfit (Hydrogensulfit, Disulfit) derart behandelt, daß alle nicht an der 5-Position der Base methylierten Cytosine so verändert werden, daß eine hinsichtlich dem Basenpaarungsverhalten unterschiedliche Base entsteht, während die in 5-Position methylierten Cytosine unverändert bleiben.
- Wird für die Reaktion Bisulfit verwendet, so findet an den nicht methylierten Cytosinbasen eine Addition statt. Zudem müssen ein denaturierendes Reagenz oder Lösungsmittel sowie ein Radikalfänger zugegen sein. Eine anschließende alkalische Hydrolyse führt dann zur Umwandlung von nicht methylierten Cytosin-Nukleobasen in Uracil. Chemisch umgewandelte DNA dient dann dazu, methylierte Cytosine nachzuweisen. Im zweiten Verfahrensschritt verdünnt man die behandelte DNA-Probe mit Wasser oder einer wäßrigen Lösung. Bevorzugt wird anschließend eine Desulfonierung der DNA (10-30 min, 90-100 °C) bei alkalischem pH-Wert durchgeführt. Im dritten Schritt des Verfahrens amplifiziert man die DNA-Probe in einer Polymerasekettenreaktion, bevorzugt mit einer hitzebeständigen DNA-Polymerase. Im vorliegenden Fall werden Cytosine des Gens MYC analysiert. Dazu wird mit den spezifischen Primeroligonukleotiden TTTTGTGTGGAGGGTAGTTG (Seq. ID No. 537) und CCCCAAATAAACAAAATAACC (Seq. ID No. 538) ein definiertes Fragment der Länge 831 bp amplifiziert. Dieses Amplifikat dient als Probe, die an ein vorher an einer Festphase gebundenes Oligonukleotid unter Ausbildung einer Duplexstruktur hybridisiert, beispielsweise TAAGGATGCGGTTTGTTA (Seq. ID No. 539), wobei sich das nachzuweisende Cytosin an Position 60 des Amplifikats befindet. Der Nachweis des Hybridisierungsprodukts beruht auf Cy3 und Cy5 fluoreszenzmarkierten Primer-Oligonukleotiden, die für die Amplifikation verwendet wurden. Nur wenn in der Bisulfit behandelten DNA an dieser Stelle ein methyliertes Cytosin vorgelegen hat, kommt es zu einer Hybridisierungsreaktion der amplifizierten DNA mit dem Oligonukleotid. Somit kann der Methylierungsstatus des jeweiligen zu untersuchenden Cytosins über das Hybridisierungsprodukt abgeleitet werden.
- Um den Methylierungsstatus der Position zu überprüfen, wird eine Probe des Amplifikats weiterhin an ein anderes Oligonukleotid hybridisiert, das vorher an eine feste Phase gebunden wurde. Dieses Oligonukleotid ist identisch zu dem Oligonukleotid, das vorher benutzt wurde, um den Methylierungsstatus der Probe zu analysieren, mit der Ausnahme der fraglichen Position. An der zu analysierenden Position umfaßt das Oligonukleotid eine Thymin-Base, im Gegensatz zu einer Cytosin-Base d.h. die Sequenz TAAGGATGTGGTTTGTTA (Seq. ID No. 540). Daher findet die Hybridisierungsreaktion nur statt, falls ein nicht-methyliertes Cytosin an der zu analysierenden Positionen vorhanden ist.
- Die Analyse wurde an zwei Gewebeproben durchgeführt, Probe 1 aus pilocytischem Astrocytom (Hirntumor) und Probe 2 aus Astrocytom Grad II (Hirntumor). Aus den Ergebnissen (
1 ) kann gesehen werden, daß Probe 1 an Position 60 des Amplifikat nicht methyliert war, wohingegen im Vergleich Probe 2 ein Gemisch von sowohl methylierten als auch nicht-methylierten Zellen an derselben Position aufwies. - Beispiel 2: Diagnose von mit Tumor-Suppressorgenen und Onkogenen assoziierten Erkrankungen
- Um einen Bezug der Methylierungsmuster zu einer der mit Tumor-Suppressorgenen und Onkogenen assoziierten Erkrankungen herzustellen, bedarf es zunächst der Untersuchung der DNA-Methylierungsmuster einer Gruppe von erkrankten und einer Gruppe von gesunden Personen. Diese Untersuchungen werden zum Beispiel analog dem Beispiel 1 durchgeführt. Die so erhaltenen Ergebnisse werden in einer Datenbank abgespeichert und die CpG Dinukleotide identifiziert, die zwischen den beiden Gruppen unterschiedlich methyliert sind. Dies kann durch Bestimmung einzelner CpG Methylierungsraten erfolgen, wie dies z. B. durch Sequenzieren relativ ungenau oder aber durch eine Methylierungs-sensitive „Primer- Extension-Reaktion" sehr genau möglich ist. Auch gleichzeitige Analyse des gesamten Methylierungsstatus ist möglich, und die Muster können z.B. mittels Clustering-Analysen, die z.B. durch einen Rechner durchgeführt werden können, verglichen werden.
- Nachfolgend ist es möglich, untersuchte Patienten einer bestimmten Therapiegruppe zuzuordnen und diese Patienten gezielt mit einer individualisierten Therapie zu behandeln.
- Beispiel 2 kann zum Beispiel für die folgenden Erkrankungen durchgeführt werden: Soliden Tumoren und Krebsarten.
- Tabelle 1
- Auflistung von bevorzugten Genen der vorliegenden Erfindung, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind.
-

-
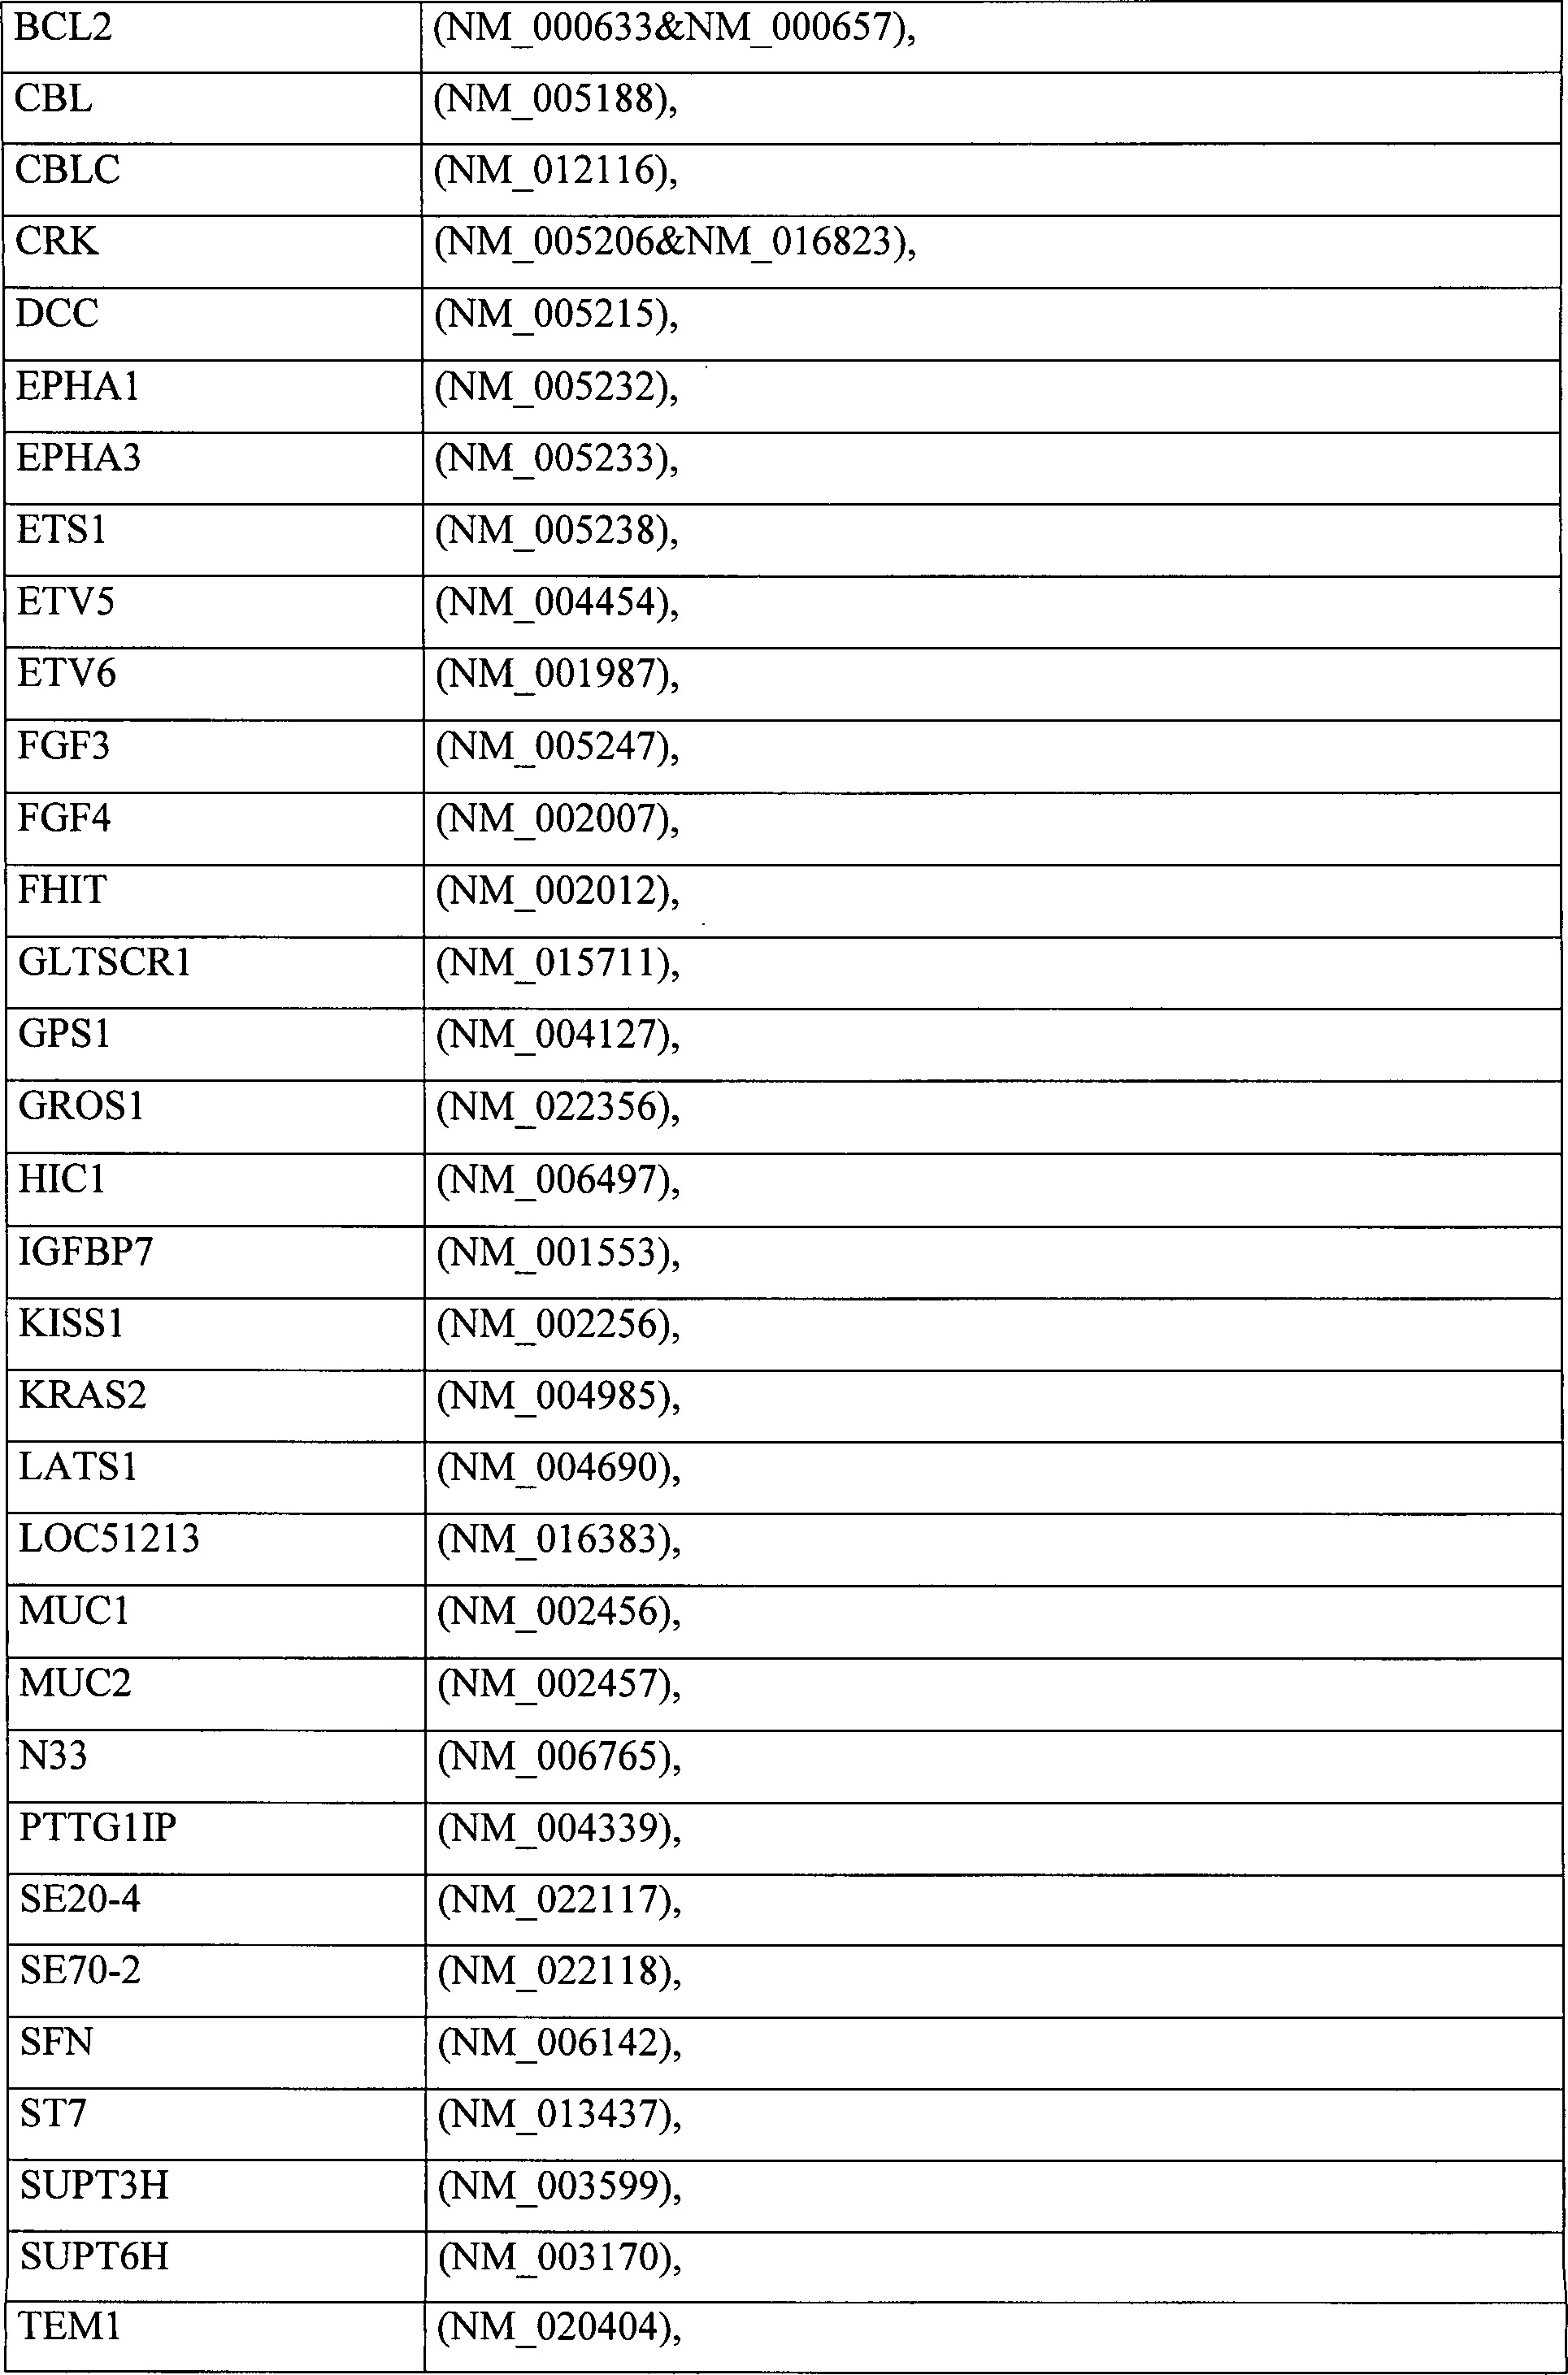
-

-

Claims (14)
- Nukleinsäure, umfassend einen mindestens 18 Basen langen Sequenzabschnitt der chemisch vorbehandelten DNA von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind, gemäß einer der Sequenzen ausgewählt aus der Gruppe von Seq. ID No. 1 bis Seq. ID No. 536 und dazu komplementärer Sequenzen.
- Nukleinsäure, umfassend einen mindestens 18 Basen langen Sequenzabschnitt der chemisch vorbehandelten DNA von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind, gemäß einer der Sequenzen gemäß einem der Gene BRCA2 (U43746), E2F1 (M96577), ELE1 (X71413), MN/CA9 (Z54349), PVT1 (M26714), SAC2 (AK001725), TEM8 (AK025429), TM4SF1 (X01394), TNFSF11 (AF053712), AXL (NM_021913&NM_001699), CCND3 (NM_001760), CSF1R (NM_005211), MGMT (NM_002412), NOV (NM_002514), SFRS8 (NM_004592), TNFRSF6 (NM_000043), TPD52 (NM_005079), AKT1 (NM_005163), BCL2 (NM_000633&NM_000657), CBL (NM_005188), CBLC (NM_012116), CRK (NM_005206&NM_016823), DCC (NM_005215), EPHA1 (NM_005232), EPHA3 (NM_005233), ETS1 (NM_005238), ETV5 (NM_004454), ETV6 (NM_001987), FGF3 (NM_005247), FGF4 (NM_002007), FHIT (NM_002012), GLTSCR1 (NM_015711), GPS1 (NM_004127), GROS1(NM_022356), HIC1 (NM_006497), IGFBP7 (NM_001553), KISS1 (NM_002256), KRAS2 (NM_004985), LATS1 (NM_004690), LOC51213 (NM_016383), MUC1 (NM_002456), MUC2 (NM_002457), N33 (NM_006765), PTTG1IP (NM_004339), SE20-4 (NM_022117), SE70-2 (NM_022118), SFN (NM _06142), ST7 (NM_013437), SUPT3H (NM_003599), SUPT6H (NM_003170), TEM1 (NM_020404), TERT (NM_003219), THRB NM_000461), TIMP2 (NM_003255), TMEFF1 (NM_003692), TNFAIP6 (NM_007115), TNFRSF10A (NM_003844), TNFRSF10B (NM_003842), TNFRSF10C (NM_003841), TNFRSF11A (NM_003840), TNFRSF1A (NM_001065), TNFSF12 (NM_003809), TNFSF13 (NM_003808), TNFSF15 (NM_005118), TNFSF18 (NM_005092), TP63 (NM_003722), TSSC1 (NM_003310), VDR (NM_000376), YES1 (NM_005433), FOXG1A (NM _04471), GRF2 (NM_005312), HSPC070 (NM_014160), RAB3A (NM_002866), RAB5A (NM_004162), APC ( NM_000038), BMI1 (NM_005180), CHES1 (NM_005197), SMT3H1 (NM_006936), TIAM1 (NM_003253), VAV1 (NM_005428), MCF2 (NM_005369), MSH2 (NM_000251), ERBB4 (NM_005235), FOXG1B (NM_005249), TACSTD1 (NM_002354), TRA1 (NM_003299), FOXG1B (NM_005249), TACSTD1 (NM_002354), FLI1 (NM_002017) und dazu komplementärer Sequenzen.
- Oligomer, insbesondere Oligonukleotid oder Peptide Nucleic Acid (PNA)-Oligomer, wobei das Oligomer in jedem Fall mindestens eine Basensequenz mit einer Länge von mindestens 9 Nukleotiden umfaßt, die an eine chemisch vorbehandelte DNA von Genen, die mit Tumor-Suppressorgenen und Onkogenen assoziiert sind gemäß einer der Seq. ID No. 1 bis Seq. ID No. 536 nach Anspruch 1 oder eine chemisch vorbehandelte DNA von Genen nach Anspruch 2 und dazu komplementären Sequenzen hybridisiert oder dazu identisch ist.
- Oligomer nach Anspruch 3, wobei die Basensequenz mindestens ein CpG Dinukleotid umfaßt.
- Oligomer nach Anspruch 4, dadurch gekennzeichnet, daß sich das Cytosin des CpG Dinukleotids in etwa im mittleren Drittel des Oligomers befindet.
- Satz von Oligomeren, umfassend mindestens zwei Oligomere nach einem der Ansprüche 3 bis 5.
- Satz von Oligomeren nach Anspruch 6, umfassend Oligomere zur Detektion des Methylierungszustandes aller CpG Dinukleotide von einer der Sequenzen gemäß einer der Seq. ID No. 1 bis Seq. ID No. 536 nach Anspruch 1 oder einer chemisch vorbehandelten DNA eines Gens nach Anspruch 2 und dazu komplementärer Sequenzen.
- Satz von mindestens zwei Oligonukleotiden nach Anspruch 3, die als Primer-Oligonukleotide zur Amplifikation von DNA-Sequenzen einer der Seq. ID No. 1 bis Seq. ID No. 536 und dazu komplementären Sequenzen oder einer chemisch vorbehandelten DNA eines Gens nach Anspruch 2 und dazu komplementären Sequenzen oder Abschnitten davon eingesetzt werden können.
- Satz von Oligonukleotiden nach Anspruch 8, dadurch gekennzeichnet, daß mindestens ein Oligonukleotid an eine Festphase gebunden ist.
- Auf einem Trägermaterial fixierten Anordnung von unterschiedlichen Oligomeren (Array) zur Analyse von in Zusammenhang mit dem Methylierungszustand der CpG Dinukleotide einer der Seq. ID No. 1 bis Seq. ID No. 536 und dazu komplementärer Sequenzen und/oder einer chemisch vorbehandelten DNA eines Gens nach Anspruch 2 stehenden Erkrankungen, bei dem mindestens ein Oligomer nach einem der Ansprüche 3 bis 5 an eine feste Phase gekoppelt vorliegt.
- Array von unterschiedlichen Oligonukleotid- und/oder PNA-Oligomersequenzen nach Anspruch 10, dadurch gekennzeichnet, daß diese auf einer ebenen Festphase in Form eines rechtwinkligen oder hexagonalen Gitters angeordnet sind.
- Array nach einem der Ansprüche 10 oder 11, dadurch gekennzeichnet, daß die Festphasenoberfläche aus Silizium, Glas, Polystyrol, Aluminium, Stahl, Eisen, Kupfer, Nickel, Silber oder Gold besteht.
- DNA- und/oder PNA-Array zur Analyse von in Zusammenhang mit dem Methylierungszustand von Genen stehenden Erkrankungen, der mindestens eine Nukleinsäure nach einem der voranstehenden Ansprüche umfaßt.
- Kit, umfassend ein Bisulfit (= Disulfit, Hydrogensulfit) Reagenz sowie Oligonukleotide und/oder PNA-Oligomere nach einem der Ansprüche 3 bis 5.
Priority Applications (1)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| DE20121977U DE20121977U1 (de) | 2000-03-15 | 2001-03-15 | Nukleinsäuren für die Diagnose von mit Tumor-Suppressorgenen und Onkogenen assoziierten Krankheiten |
Applications Claiming Priority (12)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| DE10013847A DE10013847A1 (de) | 2000-03-15 | 2000-03-15 | Oligonukleotide oder PNA-Oligomere und Verfahren zur parallelen Detektion des Methylierungszustandes genomischer DNA |
| DE10013847.0 | 2000-03-15 | ||
| DE10019058A DE10019058A1 (de) | 2000-04-06 | 2000-04-06 | Detektion von Variationen des DNA-Methylierungsprofils |
| DE10019058.8 | 2000-04-06 | ||
| DE10019173 | 2000-04-07 | ||
| DE10019173.8 | 2000-04-07 | ||
| DE10032529A DE10032529A1 (de) | 2000-06-30 | 2000-06-30 | Diagnose von bedeutenden genetischen Parametern innerhalb des Major Histocompatibility Complex (MHC) |
| DE10032529.7 | 2000-06-30 | ||
| DE10043826 | 2000-09-01 | ||
| DE10043826.1 | 2000-09-01 | ||
| DE20121977U DE20121977U1 (de) | 2000-03-15 | 2001-03-15 | Nukleinsäuren für die Diagnose von mit Tumor-Suppressorgenen und Onkogenen assoziierten Krankheiten |
| EP01923666A EP1268855A2 (de) | 2000-03-15 | 2001-03-15 | Diagnose von krankheiten, welche mit tmorsuppressorgenen assoziiert sind |
Publications (1)
| Publication Number | Publication Date |
|---|---|
| DE20121977U1 true DE20121977U1 (de) | 2003-12-24 |
Family
ID=30119469
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| DE20121977U Expired - Lifetime DE20121977U1 (de) | 2000-03-15 | 2001-03-15 | Nukleinsäuren für die Diagnose von mit Tumor-Suppressorgenen und Onkogenen assoziierten Krankheiten |
Country Status (1)
| Country | Link |
|---|---|
| DE (1) | DE20121977U1 (de) |
Cited By (2)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| EP1693468A1 (de) | 2005-02-16 | 2006-08-23 | Epigenomics AG | Verfahren zur Bestimmung des Methylierungsmusters einer Polynukleinsäure |
| EP2481810A1 (de) | 2005-04-15 | 2012-08-01 | Epigenomics AG | Verfahren zur Bereitstellung von DNA-Fragmenten, die von einer dezentralen Probe abgeleitet sind |
-
2001
- 2001-03-15 DE DE20121977U patent/DE20121977U1/de not_active Expired - Lifetime
Cited By (3)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| EP1693468A1 (de) | 2005-02-16 | 2006-08-23 | Epigenomics AG | Verfahren zur Bestimmung des Methylierungsmusters einer Polynukleinsäure |
| EP2481810A1 (de) | 2005-04-15 | 2012-08-01 | Epigenomics AG | Verfahren zur Bereitstellung von DNA-Fragmenten, die von einer dezentralen Probe abgeleitet sind |
| US10731215B2 (en) | 2005-04-15 | 2020-08-04 | Epigenomics Ag | Method for determining the presence or absence of methylation in a sample |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| DE60126593T2 (de) | Diagnose von mit apoptose assoziierten erkrankungen mittels ermittlung des methylierungszustandes von apoptose-assozierten genen | |
| US20040048254A1 (en) | Diagnosis of diseases associated with tumor supressor genes and oncogenes | |
| DE10151055B4 (de) | Verfahren zum Nachweis von Cytosin-Methylierung in CpG Inseln | |
| EP1294951A2 (de) | Diagnose von mit dem immunsystem assoziierten krankheiten | |
| DE10132212B4 (de) | Verfahren zum Nachweis von Cytosin-Methylierung durch vergleichende Analyse der Einzelstränge von Amplifikaten | |
| DE20121960U1 (de) | Nukleinsäuren für die Diagnose von mit Metastase assoziierten Krankheiten | |
| DE10161625A1 (de) | Verfahren und Nukleinsäuren für die Analyse einer Lungenzell-Zellteilungsstörung | |
| DE10128508A1 (de) | Verfahren und Nukleinsäuren für die Differenzierung von Prostata-Tumoren | |
| DE10061338A1 (de) | Diagnose von mit Angiogenese assoziierten Krankheiten | |
| EP1332228A2 (de) | Diagnose von mit cdk4 assoziierten krankheiten durch bestimmung des methylierungszustandes des cdk4 gens | |
| DE10037769A1 (de) | Diagnose von mit CD24 assoziierten Krankheiten | |
| EP1339873B1 (de) | Diagnose von mit humos assoziierten krankheiten | |
| DE10128509A1 (de) | Verfahren und Nukleinsäuren für die Differenzierung von Prostata- und Nierenkarzinomen | |
| EP1432827B1 (de) | Verfahren zum nachweis von dna-methylierung mittels markierten s-adenosylmethioninanaloga | |
| DE20121965U1 (de) | Nukleinsäuren für die Diagnose von mit DNA Addukten assoziierten Krankheiten | |
| DE20121968U1 (de) | Nukleinsäuren für die Diagnose von mit Apoptose assoziierten Krankheiten | |
| DE10230692A1 (de) | Verfahren und Nukleinsäuren für die Analyse von Methylierungsmustern innerhalb des DD3-Gens | |
| DE20121961U1 (de) | Nukleinsäuren für die Diagnose von mit der Signaltransduktion assoziierten Krankheiten | |
| DE20121967U1 (de) | Nukleinsäuren für die Diagnose von Verhaltensstörungen, neurologischen Erkrankungen und Krebs | |
| DE20121969U1 (de) | Nukleinsäuren für die Diagnose von mit DNA Reparatur assoziierten Krankheiten | |
| DE20121974U1 (de) | Nukleinsäuren für die Diagnose von mit DNA Replikation assoziierten Krankheiten | |
| DE20121973U1 (de) | Nukleinsäuren für die Diagnose von mit dem Zellzyklus assoziierten Krankheiten | |
| DE20121979U1 (de) | Nukleinsäuren für die Diagnose von mit der Zellsignalisierung assoziierten Krankheiten | |
| DE20121964U1 (de) | Nukleinsäuren für die Diagnose von mit dem Metabolismus assoziierten Krankheiten | |
| DE20121963U1 (de) | Nukleinsäuren für die Diagnose von mit Entwicklungsgenen assoziierten Krankheiten |
Legal Events
| Date | Code | Title | Description |
|---|---|---|---|
| R207 | Utility model specification |
Effective date: 20040205 |
|
| R150 | Term of protection extended to 6 years |
Effective date: 20040107 |
|
| R151 | Term of protection extended to 8 years |
Effective date: 20070430 |
|
| R152 | Term of protection extended to 10 years |
Effective date: 20090429 |
|
| R071 | Expiry of right |