EP0948237B1 - Verfahren zur Störbefreiung eines Mikrophonsignals - Google Patents
Verfahren zur Störbefreiung eines Mikrophonsignals Download PDFInfo
- Publication number
- EP0948237B1 EP0948237B1 EP99106123A EP99106123A EP0948237B1 EP 0948237 B1 EP0948237 B1 EP 0948237B1 EP 99106123 A EP99106123 A EP 99106123A EP 99106123 A EP99106123 A EP 99106123A EP 0948237 B1 EP0948237 B1 EP 0948237B1
- Authority
- EP
- European Patent Office
- Prior art keywords
- signal
- time
- filtering function
- microphone
- frequency domain
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Expired - Lifetime
Links
Images











Classifications
-
- G—PHYSICS
- G10—MUSICAL INSTRUMENTS; ACOUSTICS
- G10L—SPEECH ANALYSIS TECHNIQUES OR SPEECH SYNTHESIS; SPEECH RECOGNITION; SPEECH OR VOICE PROCESSING TECHNIQUES; SPEECH OR AUDIO CODING OR DECODING
- G10L21/00—Speech or voice signal processing techniques to produce another audible or non-audible signal, e.g. visual or tactile, in order to modify its quality or its intelligibility
- G10L21/02—Speech enhancement, e.g. noise reduction or echo cancellation
- G10L21/0208—Noise filtering
-
- H—ELECTRICITY
- H04—ELECTRIC COMMUNICATION TECHNIQUE
- H04R—LOUDSPEAKERS, MICROPHONES, GRAMOPHONE PICK-UPS OR LIKE ACOUSTIC ELECTROMECHANICAL TRANSDUCERS; ELECTRIC HEARING AIDS; PUBLIC ADDRESS SYSTEMS
- H04R3/00—Circuits for transducers
- H04R3/007—Protection circuits for transducers
-
- G—PHYSICS
- G10—MUSICAL INSTRUMENTS; ACOUSTICS
- G10L—SPEECH ANALYSIS TECHNIQUES OR SPEECH SYNTHESIS; SPEECH RECOGNITION; SPEECH OR VOICE PROCESSING TECHNIQUES; SPEECH OR AUDIO CODING OR DECODING
- G10L21/00—Speech or voice signal processing techniques to produce another audible or non-audible signal, e.g. visual or tactile, in order to modify its quality or its intelligibility
- G10L21/02—Speech enhancement, e.g. noise reduction or echo cancellation
- G10L21/0208—Noise filtering
- G10L21/0216—Noise filtering characterised by the method used for estimating noise
- G10L2021/02168—Noise filtering characterised by the method used for estimating noise the estimation exclusively taking place during speech pauses
Definitions
- the invention relates to a method for noise immunity of a microphone signal.
- a particular situation is often given in vehicles in that a playback device such as a radio, a cassette or CD player via a loudspeaker Sound environment generates, which superimposed as an interference signal recorded by a microphone voice signal, for example, for speech recognition or telephone transmission.
- a microphone voice signal for example, for speech recognition or telephone transmission.
- the microphone signal must be freed as much as possible of interference signal components.
- the interference signal emanating from a source of interference not only reaches the microphone on the shortest direct path, but also occurs via numerous reflections as a superposition of a plurality of echoes with different transit times in the microphone signal.
- the entire effect of the interference signal from the source of interference on the microphone signal can be described by an a priori unknown transfer function of the room, such as the passenger compartment of a motor vehicle.
- the transfer function changes depending on the occupation of the vehicle and the position of the individual persons.
- a compensation signal can be generated which, by subtraction from the microphone signal, delivers a signal freed from the interference signal, for example a pure speech signal.
- said replica represents a more or less good approximation to the unknown transfer function and the disturbance can not be completely eliminated.
- EP 0 250 048 A1 discloses a digital block adaptable filter which is adapted in the frequency domain.
- Object of the present invention is to provide a method for noise immunity of a microphone signal that has good characteristics hinsichltich the suppression with reasonable signal processing overhead.
- the compensation of the Störsignalanteils in the microphone signal is made by means of a generated from the reference signal on the replica of the transfer function compensation signal in the frequency domain, so that the microphone signal, compensation signal and output signal in the frequency range, i. in the form of spectra.
- the signal processing in this process step in the frequency domain requires a spectral transformation of the microphone signal, but takes into account that the reproduction of the transfer function in the frequency range is more advantageous and provides for a beneficial subsequent additional noise reduction of the output signal, which is typically also made in the frequency domain, already a particularly suitable Signal form ready.
- an advantageous development of the invention provides for a division of the replica filter into a plurality of sub-filters at time-shifted segments of the segmented reference signal whose coefficient update can be staggered over time, whereby the signal processing effort can be minimized.
- the division of the replica filter into a plurality of sub-filters and the noise removal on the basis of a filter setting obtained in a speech break are independent of the Störsignalkompensation in the frequency domain independently for the noise immunity of a microphone signal feasible and advantageous.
- Fig. 1 represents the principle of a device for (single-channel) radio signal compensation.
- the acoustic signal emitted by the loudspeaker reaches the microphone of the speech input system directly, but also via numerous reflections in the vehicle interior.
- the transmission path G thus represents a transversal filter with a weighted sum of time-delayed echoes
- the loudspeaker signal x is filtered by the a priori unknown transfer function G of the vehicle interior.
- the result is the noise component r, which adds to the speech signal s to the microphone signal y.
- an estimate r ⁇ is generated from the loudspeaker signal x by means of the filter simulation H.
- the speech signal may still contain disturbances in the form of, for example, engine noise or external noise, but which are not explicitly dealt with in this context.
- the H is an adaptive filter and works according to a standard method known in the literature, the LMS algorithm (Least Mean Squares).
- the error signal E is still required in order to accomplish the coefficient adaptation in the filter H.
- the output signal s ⁇ is fed to the determination of the filter coefficients.
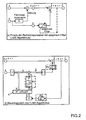
- Fig. 2a shows in another representation again the arrangement of Fig. 1 as a radio signal compensation.
- the adaptive system H can be realized, for example, in the time domain as an FIR filter (finite-impulse-response filter). For large impulse response lengths, as they often occur in practice, however, this requires a very high computational effort.
- FIR filter finite-impulse-response filter
- FLMS frequency domain
- Fig. 2b shows a block diagram of the FLMS algorithm.
- F is a spectral transformation FFT of a time signal into the frequency domain and F -1 is the inverse IFFT.
- the processing steps referred to as projections P1, P2 and P3 are used for the correct segmentation of the data by the block use with the FFT or IFFT and will be explained in more detail later.
- the operation of the filter is to multiply the reference spectrum X by the filter coefficient vector H.
- the spectrum of the filter output R ⁇ is transformed back into the time domain via F -1 .
- the signal r ⁇ is available.
- the projection P1 which is particularly complicated here with two spectral transformations, calculates from H 'the coefficient vector H required for the filtering.
- the spectrum S 1 of the output signal evaluated with P 3 is calculated to calculate the correction vector ⁇ H' s + r - r ⁇ needed.
- FIG. 3 A detailed block diagram of the in Fig. 2b shown FLMS algorithm Fig. 3 ,
- the samples of a signal and the nodes of the FFT are commonly referred to as samples. All spectral transforms and their inverses are to be segmented as 256-point FFTs, each overlapping 128 samples.
- the output signal s ⁇ in the time domain consists of 128 sample blocks. It arises from the difference of the second block halves (thus in each case the samples 129 to 256) of microphone signal and filtered compensation signal r ⁇ .
- the projection P1 which requires 2 FFTs and converts the vector H 'into the vector H, is elaborate.
- the first half (samples 1 to 128) is cut out of the complex 256-point result vector of the inverse transformation from the frequency to the time domain (IFFT) and the second half (samples 129 to 256) is set to zero.
- the transformation into the frequency domain takes place again by means of FFT.
- Simple is the projection P2. It consists of the above-described fragmentation of the last 128 samples, resulting in overlapping 256-sample blocks again resulting in non-overlapping 128-sample blocks.
- the projection P3 is also very simple, which, in turn, provides overlapping 256-sample blocks from non-overlapping 128-sample blocks of the output signal by preprogramming 128 null values.
- the adaptation of the filter coefficients H ' L + 1 for a cycle L + 1 consists of the addition of a renewal vector ⁇ H' L to the old coefficient vector H ' L.
- the operation of the LMS algorithm is significantly influenced by the adaptation constant ⁇ and the smoothing constant ⁇ . Latches in recursion loops are labeled Sp.
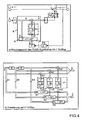
- the previously described arrangement of the FLMS algorithm allows filter emulations with a maximum impulse response length of half an FFT length, in the example case 128 samples. If longer impulse responses are to be compensated, the already known FLMS algorithm for a sub-filter ( Fig. 4a ) to n subfilters.
- the im Fig. 4a Block B with the input signals X and S ⁇ and the compensation spectrum R ⁇ as the output is denoted by the Fig. 4b to replace the extension shown.
- the spectrum X of the reference signal is delayed by latches D by 1 or 2 block lengths, and the instantaneous X1 and the two delayed spectra X2, X3 are separately multiplied by coefficient vectors H1, H2, H3 determined separately in an extended projection P1.
- the formation of the coefficient vectors is analogous to the case of only a sub-filter, wherein in K1, K2, K3 respectively the associated reference spectrum is linked to the spectrum S ⁇ of the output signal.
- the effort is considerably increased mainly by the tripling of the projection P1. Additional storage space is required to provide the spectra of the reference signal X which is older by 1 or 2 block lengths.
- Fig. 6 provides a more detailed block diagram of the frequency domain output FLMS algorithm and again allows comparison with Fig. 3 (Time domain output).
- the filter adaptation consisting of smoothing of the spectral power, power normalization and coefficient renewal has remained unchanged. What is new are the FFT in the microphone channel, the difference formation YR ⁇ in the frequency domain instead of in the time domain for output formation, and finally the newly defined projection P4, which differs from the projection P1 only by the complementary time domain window.
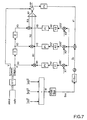
- Fig. 7 Shown is the FLMS algorithm with 3 sub-filters (384 sample impulse response), which provides sufficient suppression of the radio signal in the microphone channel of the speech input system.
- the projections P1 and P4 are shown simplified. It's already out Fig. 4b known additional effort in the form of the memory D and the tripling of the projection P1 visible.
- the filter output is now practically 3 times the smoothed spectral power is taken into account after the inverse by multiplying by the constant 6 ⁇ .
- the filter adaptation is now carried out separately for the 3 coefficient vectors of the 3 sub-filters.
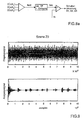
- FIG. 9 An example Z0 for the operation of the invention according to Fig. 7 shows Fig. 9 ,
- Microphone signal Y resulted from convolution of this noise signal with a likewise constructed 384 sample impulse response and the addition of an extremely weak speech signal. While listening to this in Fig. 9 recorded above signal y, the 10 spoken numbers are barely visible in the colored (because filtered) noise.
- the output signal of the estimator which was transformed back into the time domain, is freed after a transient of about 1 second (12,000 samples) very effective the speech input from noise and provides an undistorted but slightly reverberated speech signal S ⁇ ( Fig. 9 below).
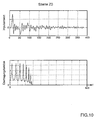
- the resulting 3 * 128 sample impulse response or the associated filter transfer function can be calculated at any time. So shows Fig. 10 above is the 384 sample impulse response as it appears at the very end of the scene, that is, after the digit "0" was spoken. It is a very accurate image of the impulse response that was used to convolve with white Gaussian noise and thus to synthetically generate the signal micro.
- White noise as the reference input signal and filtered "colored" noise as the microphone input signal are the simplest case in terms of the task of finding a replica of this filter. Since the reference signal contains all frequency components by definition, the filter adaptation succeeds fastest here.
- the additional additive speech input in the microphone input signal - ie the actual useful signal of the speech input system - represents a disturbance for the (F) LMS algorithm, which hinders the correct adaptation of the filter coefficients. In other words, the system is only able to correctly reproduce the room acoustics of the vehicle interior (distance between radio loudspeaker and microphone) during pauses in speech thereby causing a compensation of the radio playback.
- Fig. 9 This works very well, since the microphone input consists essentially of noise and only a very small part of speech input.
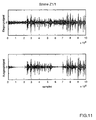
- the reference signal radio picked up from the radio speaker terminals and the signal micro recorded from the microphone of the voice input system came from the scene Z1.
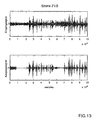
- This microphone signal is in Fig. 11 shown above, consists of 100000 samples and thus has a sampling time of 12 kHz a time duration of about 8.3 seconds. It is fluent and relatively fast spoken language of a vehicle occupant seated in the rear right of the car while at the same time sounding at normal volume from the car radio speaker.
- the hearing test results in a clear elaboration of the language portion or a notable especially in the short language breaks music suppression.
- a suitable feature is used together with a threshold as an indicator for a voice input. If the characteristic falls below the threshold, this is an indication of missing speech input. In this case, as already stated above, a largely undisturbed filter adaptation can take place.
- the filter coefficient set is used, which was stored immediately before the threshold was exceeded, ie at the end of the preceding speech break.
- these stored coefficients H10, H20, H30 provide significantly better radio signal compensation than the current coefficients H, H2, H3, which constantly change under the disturbing influence of the voice input.
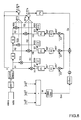
- Fig. 8 represents an embodiment with a further improved FLMS processing with 3 sub-filters.
- Fig. 7 existing current filter coefficient vectors H1, H2, H3, which were needed to form the continuously adopted output signal yR, there now exists an additional output signal (y-Ro) formed using stored coefficients H10, H20, H30.
- the current coefficient sets H1, H2, H3 represent a useful compensation filter in the frequency domain only in the absence of speech input in the steady state, however, provide insufficient filter characteristics in voice input, because the adaptation process in the control loop is constantly disturbed.
- the outputs (y-Ro) and (y-Ra) are identical. Inserting voice inputs cause the 3 switches, whereby the last located in the memories M1, M2, M3 coefficients H10, H20, H30 are no longer overwritten and remain unchanged. This state, in which the outputs (Y-Ro) and (Y-Ra) differ, is maintained until a speech break is detected again and the switches are closed.
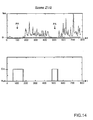
- a smoothing filter for example a 1st order recursive low-pass filter with the input feat, provides at its output the smoothed speech pause feature fea which, after comparison with a threshold value th, controls the coefficients transfer switches.
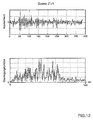
- the measured 384-sample impulse response with associated magnitude transfer function is in Fig. 15 represented as current impulse response (a) or current transfer function (b).
- an impulse response (c) and a high-quality transfer function (d) can be calculated from the stored coefficients H10, H20, H30.
- the impulse response from the stored coefficients has the typical zero samples at the beginning, which are caused by the transit time of the direct sound from the radio loudspeaker to the speech input microphone. From the dead time of about 40 samples to be read in the example, the distance between loudspeaker and microphone can be determined.
- the complex projection P4 (IFFT, window on the right in the time domain, FFT) can be replaced without noticeable loss of quality by a relatively simple convolution in the frequency domain, thus saving 2 FFTs.
- IFFT IFFT, window on the right in the time domain, FFT
- the "right-sided" 128-sample rectangle window in the time domain ( Fig. 16a ) in the ideal projection replaced by a 128 sample Hamming window ( Fig. 16b ).
- Fig. 16b the "right-sided" 128-sample rectangle window in the time domain in the ideal projection replaced by a 128 sample Hamming window ( Fig. 16b ).
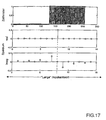
- Fig. 17 In the case of the rectangular window, the real part of the spectrum consists of a single line (DC component), whereas the antisymmetrical part of the imaginary spectrum consists of many slowly decreasing lines with alternating lines Zeroing exists.
- the projection P1 (IFFT - left-sided rectangular window - FFT) can be replaced by a corresponding convolution operation in the frequency domain with the conjugate complex 7-line spectrum.
- IFFT - left-sided rectangular window - FFT IFFT - left-sided rectangular window - FFT
- Fig. 8 cost-effective solutions can be achieved by following the LMS algorithm Fig. 8 the 3 projections P1 need not be processed simultaneously in a 256 sample input data block.
- the 128-sample overlapping input data blocks of length 256 are numbered beginning with "1" at random Fig. 19a outlined. For example, if the input data blocks are modulo-3, the 3 sub-filter projections are not possible in parallel ( Fig.
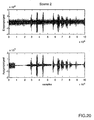
- the first of these scenes Z2 involves voice input of digits, with the radio loudspeaker emitting near-white noise at a relatively high volume.
- the corresponding 100000 sample microphone signal is in Fig. 20 above, the extracted output signal in Fig. 20 shown below.
- a clear noise exemption of the output signal compared to the microphone input is found by interception comparison.
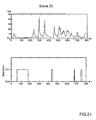
- the time course of the speech pause feature is together with the constant threshold th Fig. 21 pictured above and derived therefrom language pauses or the associated switch positions in Fig. 21 below.
- Fig. 22 in to Fig.
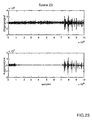
- the first 100000 samples of a measurement scene Z3 with POP music on the radio and fluent to fast spoken language of the person sitting on the right back are in the form of the microphone signal y in Fig. 23 recorded above.
- the radio signal is usefully suppressed ( Fig. 23 below).
- the POP music suppression is effectively maintained, whereby the speech intelligibility here is markedly improved over the microphone signal.
- Fig. 24 After a long linguistic break, there is no longer a threshold underrun because of the subsequent pause-free speech input ( Fig. 24 ). For this reason, the in Fig.
Landscapes
- Engineering & Computer Science (AREA)
- Signal Processing (AREA)
- Physics & Mathematics (AREA)
- Acoustics & Sound (AREA)
- Computational Linguistics (AREA)
- Quality & Reliability (AREA)
- Health & Medical Sciences (AREA)
- Audiology, Speech & Language Pathology (AREA)
- Human Computer Interaction (AREA)
- Multimedia (AREA)
- Fittings On The Vehicle Exterior For Carrying Loads, And Devices For Holding Or Mounting Articles (AREA)
- Soundproofing, Sound Blocking, And Sound Damping (AREA)
Description
- Die Erfindung betrifft ein Verfahren zur Störbefreiung eines Mikrophonsignals.
- Derartige Verfahren gewinnen insbesondere für die Spracheingabe von Kommandos und/oder für Freisprechtelefone zunehmend an Bedeutung, wobei insbesondere die Situation in einem Fahrzeug ein wichtiger Anwendungsfall ist.
- Eine besondere Situation ist in Fahrzeugen häufig dadurch gegeben, daß ein Wiedergabegerät wie z.B. ein Radio, ein Kassetten- oder CD-Abspieler über einen Lautsprecher eine Geräuschumgebung erzeugt, die als Störsignal ein von einem Mikrophon aufgenommenes Sprachsignal, beispielsweise für die Spracherkennung oder Telefonübertragung überlagert. Zur Erkennung von Spracheingaben in einem Spracherkenner oder zur verständlichen Sprachübertragung über Telefon ist das Mikrophonsignal soweit wie möglich von Störsignalanteilen zu befreien.
- Das von einer Störquelle, insbesondere einem Lautsprecher ausgehende Störsignal gelangt nicht nur auf direktem kürzestem Weg zum Mikrophon, sondern tritt auch noch über zahlreiche Reflexionen als eine Überlagerung einer Mehrzahl von Echos mit verschiedenen Laufzeiten im Mikrophonsignal in Erscheinung. Die gesamte Einwirkung des Störsignals von der Störquelle auf das Mikrophonsignal kann durch eine a priori unbekannte Übertragungsfunktion des Raumes, beispielsweise des Fahrgastraumes eines Kraftfahrzeugs beschrieben werden. Die Übertragungsfunktion ändert sich je nach Besetzung des Fahrzeugs und nach Position der einzelnen Personen. Durch Nachbildung dieser Übertragungsfunktion und Filterung eines Referenzsignals von der Störquelle mit dieser Nachbildung kann ein Kompensationssignal erzeugt werden, welches durch Subtraktion vom Mikrophonsignal ein vom Störsignal befreites Signal, beispielsweise ein reines Sprachsignal liefert. Im Realfall stellt die genannte Nachbildung eine mehr oder minder gute Annäherung an die unbekannte Übertragungsfunktion dar und die Störung kann nicht vollständig beseitigt werden.
-
EP 0 250 048 A1 offenbart einen digitalen blockadaptatierbaren Filter der im Frequenzbereich adaptiert wird. - Aufgabe der vorliegenden Erfindung ist es, ein Verfahren zur Störbefreiung eines Mikrophonsignals anzugeben, daß bei vertretbarem Signalverarbeitungsaufwand gute Eigenschaften hinsichltich der Entstörung aufweist.
- Die Erfindung ist im Patentanspruch 1 beschrieben. Die Unteransprüche enthalten vorteilhafte Ausgestaltungen und Weiterbildungen der Erfindung.
- Wesentlich an dem erfindungsgemäßen Verfahren ist, daß die Kompensation des Störsignalanteils im Mikrophonsignal mittels eines aus dem Referenzsignal über die Nachbildung der Übertragungsfunktion erzeugten Kompensationssignals im Frequenzbereich vorgenommen wird, so daß Mikrophonsignal, Kompensationssignal und Ausgangssignal im Frequenzbereich, d.h. in Form von Spektren vorliegen. Die Signalverarbeitung in diesem Verfahrensschritt im Frequenzbereich erfordert zwar eine spektrale Transformation des Mikrophonsignals, berücksichtigt aber, daß die Nachbildung der Übertragungsfunktion im Frequenzbereich vorteilhafter ist und stellt für eine vorteilhafte nachfolgende zusätzliche Geräuschreduktion des Ausgangssignals, die typischerweise gleichfalls im Frequenzbereich vorgenommen wird, bereits eine besonders geeignete Signalform bereit.
- Durch einfache Näherungen beim Ersatz eines Verarbeitungsschritts mit einem Zeitfenster kann durch Übergang zu einer Faltung im Frequenzbereich eine deutliche Reduzierung des Verarbeitungsaufwands reduziert werden.
- Für lange Impulsantworten der Übertragungsfunktion bzw. deren Nachbildung sieht eine vorteilhafte Weiterbildung der Erfindung eine Aufteilung des Nachbildungsfilters in mehrere Teilfilter zu zeitversetzten Segmenten des segmentierten Referenzsignals vor, deren Koeffizienten-Aktualisierung zeitlich gestaffelt sein kann, wodurch der Signalverarbeitungsaufwand gering gehalten werden kann.
- Als besonders vorteilhaft erweist es sich, die Entstörung eines Sprachsignals auf der Basis einer Einstellung des Nachbildungsfilters, die in einer vorhergehenden Sprachpause gewonnen und gespeichert wurde, vorzunehmen.
- Die Aufteilung des Nachbildungsfilters in mehrere Teilfilter und die Störbefreiung auf der Basis einer in einer Sprachpause gewonnenen Filtereinstellung sind auch unabhängig von der Störsignalkompensation im Frequenzbereich eigenständig für die Störbefreiung eines Mikrophonsignals realisierbar und vorteilhaft.
- Die Erfindung ist nachfolgend anhand von bevorzugten Ausführungsbeispielen unter Bezugnahme auf die Abbildungen noch eingehend veranschaulicht. Dabei zeigt:
- Fig. 1
- ein Prinzip der Kompensation eines Radiosignals
- Fig. 2a
- ein Blockschaltbild zu
Fig. 1 - Fig. 2b
- ein Blockschaltbild zur Filternachbildung
- Fig. 3
- ein detailliertes Beispiel zu
Fig. 2b - Fig. 4
- eine Erweiterung auf mehrere Teilfilter
- Fig. 5
- einen Übergang zur Kompensation im Frequenzbereich
- Fig. 6
- ein detailliertes Beispiel zu
Fig. 5b - Fig. 7
- ein Ausführungsbeispiel mit mehreren Teilfiltern
- Fig. 8
- ein Ausführungsbeispiel mit Speicherung der Filtereinstellungen
- Fig. 9
- Signale einer synthetischen Beispielsszene
- Fig. 10
- Impulsantwort und Übertragungsfunktion zu
Fig. 9 - Fig. 11
- Signal einer ersten Meßszene
- Fig. 12
- Impulsantwort und Übertragungsfunktion zu
Fig. 11 - Fig. 13
- das Beispiel nach
Fig. 11 mit Speicherung der Filtereinstellungen - Fig. 14
- eine Sprachpausendetektion zu
Fig. 13 - Fig. 15
- Impulsantworten und Übertragungsfunktionen zu
Fig. 11 undFig. 13 - Fig. 16
- Übergang von einem Zeitfenster zu einer Faltung im Frequenzbereich
- Fig. 17
- ein Rechteck-Zeitfenster mit Linienspektrum
- Fig. 18
- ein Hamming-Zeitfenster mit Linienspektrum
- Fig. 19
- Staffelung von Signalblöcken bei der Filterberechnung
- Fig. 20
- Signale einer zweiten Meßszene
- Fig. 21
- eine Sprachpausendetektion zu
Fig. 20 - Fig. 22
- Impulsantworten und Übertragungsfunktionen zu
Fig. 20 undFig. 21 - Fig. 23
- Signale einer dritten Meßszene
- Fig. 24
- eine Sprachpausendetektion zu
Fig. 23 - Fig. 25
- Impulsantworten und Übertragungsfunktionen zu
Fig. 23 undFig. 24 - Fig. 26
- Signale einer vierten Meßszene
- Fig. 27
- eine Sprachpausendetektion zu
Fig. 26 - Fig. 28
- Impulsantworten und Übertragungsfunktionen zu
Fig. 26 undFig. 27 . -
Fig. 1 stellt das Prinzip einer Einrichtung zur (einkanaligen) Radiosignalkompensation dar. Das vom Lautsprecher abgestrahlte akustische Signal gelangt auf direktem Wege, aber auch über zahlreiche Reflektionen im Fahrzeuginnenraum, auf das Mikrophon des Spracheingabesystems. Unter der Annahme, daß sich die Übertragungsstrecke G demnach als Transversalfilter mit einer gewichteten Summe zeitlich verzögerter Echos darstellt, läßt sich eine Filternachbildung H finden, die im Idealfall H=G eine vollständige Kompensation des Radiosignales ermöglicht. - Das Lautsprechersignal x wird durch die a priori unbekannte Übertragungsfunktion G des Fahrzeuginnenraumes gefiltert. Es entsteht die Störkomponente r, die sich mit dem Sprachsignal s zu dem Mikrophonsignal y addiert. Um die Störkomponente r zu kompensieren, wird mittels der Filternachbildung H ein Schätzwert r^ aus dem Lautsprechersignal x erzeugt. Der Ausgang der Schaltung liefert den Schätzwert für das Sprachsignal:
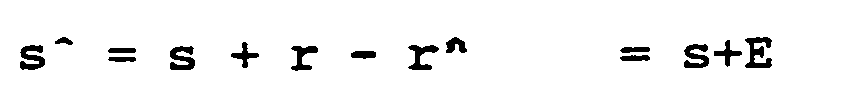
- Dem Sprachsignal s ist also am Ausgang der Schaltung noch das Fehlersignal

- H ist ein adaptives Filter und arbeitet nach einem in der Literatur bekannten Standardverfahren, dem LMS-Algorithmus (least mean squares). Neben dem Eingangssignal x wird noch das Fehlersignal E benötigt, um die Koeffizientenadaption im Filter H zu bewerkstelligen. Hierfür ist das Ausgangssignal s^ der Bestimmung der Filterkoeffizienten zugeführt.
-
Fig. 2a zeigt in anderer Darstellung nochmals die Anordnung vonFig. 1 als Radiosignalkompensation. Das adaptive System H kann z.B. im Zeitbereich als FIR-Filter (finite-impulse-response-Filter) realisiert werden. Bei großen Impulsantwortlängen, wie sie in der Praxis häufig auftreten, ist hierzu allerdings ein sehr hoher Rechenaufwand notwendig. Verschiedene Vorteile gegenüber einer Zeitbereichslösung bietet die Realisierung des LMS-Algorithmus im Frequenzbereich (FLMS). Wegen der blockweisen Verarbeitung von Daten in den als diskreten Fouriertransformationen realisierten spektralen Transformationen und der Filterrealisierung im Frequenzbereich durch Multiplikationen wird dieses Verfahren besonders rechenzeitgünstig. -
Fig. 2b zeigt ein Blockschaltbild des FLMS-Algorithmus. Die zugehörige Theorie ist an sich bekannt und daher an dieser Stelle nicht im Detail behandelt. Es bedeuten F eine spektrale Transformation FFT eines Zeitsignals in den Frequenzbereich und F-1 die inverse IFFT. Die als Projektionen P1, P2 und P3 bezeichneten Verarbeitungsschritte dienen der korrekten Segmentierung der Daten durch die blockweise Verwendung mit der FFT bzw. IFFT und werden später noch genauer erläutert. Die Arbeitsweise des Filters besteht in der Multiplikation des Referenzspektrums X mit dem Filter-Koeffizientenvektor H. Das Spektrum des Filterausgangs R^ wird über F-1 zurück in den Zeitbereich transformiert. Nach Anwendung der Projektion P2 auf den Realteil des so erhaltenen Kompensationssignals steht das Signal r^ zur Verfügung. Die Differenz der Signale
- Wesentlicher Bestandteil des adaptiven Filters ist die Koeffiiientenadaption im Block K, die im
Fig. 2b durch die Erneuerungsgleichung

- Ein detailliertes Blockschaltbild des in
Fig. 2b dargestellten FLMS-Algorithmus zeigtFig. 3 . Die Abtastwerte eines Signals und die Stützstellen der FFT seien in gebräuchlicher Weise als samples bezeichnet. Alle Spektraltransformationen und deren Inverse sind als 256-Punkte - FFT's, die jeweils um 128 samples überlappen, zu segmentieren. Zu beachten ist, daß sich das Ausgangssignal s^ im Zeitbereich aus 128-sample-Blöcken zusammensetzt. Es entsteht aus der Differenz der zweiten Blockhälften (also jeweils der samples 129 bis 256) von Mikrofonsignal und gefiltertem Kompensationssignal r^. Aufwendig ist die Projektion P1, die 2 FFT's benötigt und den Vektor H' in den Vektor H umrechnet. Hierbei wird aus dem komplexen 256-Punkte-Ergebnisvektor der Rücktransformation vom Frequenz-in den Zeitbereich (IFFT) die erste Hälfte (samples 1 bis 128) ausgeschnitten und die zweite Hälfte (samples 129 bis 256) zu Null gesetzt. Nach Anwendung dieses Rechteckfensters im Zeitbereich erfolgt wieder mittels FFT die Transformation in den Frequenzbereich. Einfach ist die Projektion P2. Sie besteht aus der oben schon beschriebenen Ausschnittsbildung der letzten 128 samples, wodurch aus überlappenden 256-sample-Blöcken wieder nicht überlappende 128-sample-Blöcke entstehen. Ebenfalls sehr einfach ist schließlich auch die Projektion P3, welche umgekehrt aus nicht überlappenden 128-sample-Blöcken des Ausgangssignales durch Voranstellen von 128 Nullwerten wiederum überlappende 256-sample-Blöcke bereitstellt. Die Adaption der Filterkoeffizienten H'L+1 für einen Zyklus L+1 besteht aus der Addition eines Erneuerungsvektors ΔH'L zum alten Koeffizientenvektor H'L. Diese Erneuerung errechnet sich aus dem Produkt zwischen dem Spektrum S^L des Ausgangssignals und dem konjugiert komplexen Spektrum X*L des Referenzsignales - gewichtet mit einer spektralen Leistungsnormierung 2µL,


- Die Arbeitsweise des LMS-Algorithmus wird erheblich von der Adaptionskonstante α und der Glättungskonstante β beeinflußt. Zwischenspeicher in Rekursionsschleifen sind mit Sp bezeichnet.
- Die bisher beschriebene Anordnung des FLMS-Algorithmus erlaubt Filternachbildungen mit einer maximalen Impulsantwortlänge von einer halben FFT-Länge, im Beispielsfall also 128 samples. Sollen längere Impulsantworten kompensiert werden, ist der schon bekannte FLMS-Algorithmus für einen Teilfilter (
Fig. 4a ) auf n Teilfilter zu erweitern. Eine 3-Teilfilter-Lösung mit einer Impulsantwortlänge von 3·128=384 samples hat sich bei der Radiosignalunterdrückung im Pkw mit einem Spracheingabesystem bewährt (Fig. 4b ). Der imFig. 4a mit B bezeichnete Block mit den Eingangssignalen X und S^ und dem Kompensations-Spektrum R^ als Ausgang ist durch die imFig. 4b dargestellte Erweiterung zu ersetzen. Das Spektrum X des Referenzsignals wird durch Zwischenspeicher D um 1 bzw. 2 Blocklängen verzögert und das unverzögerte X1 und die beiden verzögerten Spektren X2, X3 werden separat in mit in einer erweiterten Projektion P1 getrennt bestimmten Koeffizientenvektoren H1, H2, H3 multipliziert. Die Bildung der Koeffizientenvektoren erfolgt analog zum Fall nur eines Teilfilters, wobei in K1, K2, K3 jeweils das zugehörige Referenzspektrum mit dem Spektrum S^ des Ausgangssignals verknüpft wird. Der Aufwand wird hauptsächlich durch die Verdreifachung der Projektion P1 beträchtlich erhöht. Zusätzlicher Speicherplatzbedarf wird notwendig um die Spektren des um 1 bzw. 2 Blocklängen zeitlich älteren Referenzsignales X bereitzustellen. - Bei der beispielhaft angegebenen Aufgabenstellung der Unterdrückung des Radiosignales bei Spracheingabe im Kfz ist es vorteilhaft die Ausgangsdaten nicht im Zeit- sondern im Frequenzbereich auszugeben, da dadurch eine verbesserte Anpassung an eine nachgeschaltete Geräuschunterdrückung erreicht werden kann. Der bereits vorgestellte FLMS-Algorithmus mit einem Teilfilter benötigt gemäß
Fig. 5a insgesamt 5 FFT's bei einem Ausgangssignal im Zeitbereich. Wird dem Ausgang eine FFT nachgeschaltet, erhöht sich der Aufwand bei einem Frequenzbereichs-Ausgangssignal auf 6 FFT's. Die gleiche FFT-Anzahl ergibt sich zunächst auch bei einer äquivalenten Lösung nachFig. 5b . Diese Variante besitzt jedoch folgende Vorteile: - Bei der zeitgleichen Spektralanalyse der Signale x und y ist nur eine einzige 256-Punkte-FFT mit geringem Zusatzaufwand für eine spektrale Separation notwendig. Man erzielt eine Einsparung von 1 FFT.
- Die hier mit P4 gekennzeichnete und neu definierte Projektion ist bis auf das verwendete Zeitfenster formal identisch mit der Projektion P1. Wie später gezeigt wird, läßt sich P4 durch eine relativ einfache Faltungsoperation im Frequenzbereich ersetzten, ohne daß eine merkliche Einbuße an Qualität in Kauf genommen werden muß. Man erzielt eine Einsparung von 2 FFT's.
-
Fig. 6 stellt ein ausführlicheres Blockschaltbild des FLMS-Algorithmus mit Frequenzbereichs-Ausgangssignal dar und gestattet nochmals einen Vergleich mitFig. 3 (Zeitbereichs-Ausgang). Unverändert geblieben ist die Filteradaption bestehend aus Glättung der spektralen Leistung, Leistungsnormierung und Koeffizientenerneuerung. Neu sind die FFT im Mikrophonkanal, die Differenzbildung Y-R^ im Frequenz- anstatt im Zeitbereich zur Ausgangsbildung, und schließlich die neu definierte Projektion P4, welche sich lediglich durch das komplementäre Zeitbereichsfenster von der Projektion P1 unterscheidet. - Als Vorstufe einer nachfolgend beschriebenen bevorzugten Ausführung betrachte man
Fig. 7 . Dargestellt ist der FLMS-Algorithmus mit 3 Teilfiltern (384-sample-Impulsantwort), welcher eine ausreichende Unterdrückung des Radiosignales im Mikrophonkanal des Spracheingabesystems liefert. Die Projektionen P1 und P4 sind vereinfacht dargestellt. Es ist der schon ausFig. 4b bekannte zusätzliche Aufwand in Form der Speicher D sowie die Verdreifachung der Projektion P1 ersichtlich. Im Gegensatz zur 1-Teilfilter-Lösung nachFig. 6 wird die Summe W von gegenwärtigem und den beiden zeitlich vorausgegangenen Referenz-Leistungsspektren auf den Eingang des rekursiven Filters gegeben. Die Tatsache, daß am Filterausgang nun praktisch die 3-fache geglättete spektrale Leistung vorliegt, wird nach der Kehrwertbildung durch Multiplikation mit der Konstanten 6α berücksichtigt. Nach der spektralen Leistungsnormierung des in P4 modifizierten Ausgangsspektrums S^ wird die Filter-Adaption nun für die 3 Koeffizientenvektoren der 3 Teilfilter separat durchgeführt. - Ein Beispiel Z0 für die Wirkungsweise der Erfindung nach
Fig. 7 zeigtFig. 9 . Die Eingangsdaten wurden synthetisch generiert. Das Referenzsignal X stellt 100000 Abtastwerte eines weißen Gaußrauschens bei einer Abtastfolgefrequenz von fs=12 kHz dar. Das Mikrophonsignal Y entstand durch Faltung dieses Rauschsignales mit einer ebenfalls konstruierten 384-sample-Impulsantwort sowie der Addition eines äußerst schwachen Sprachsignales. Beim Abhören dieses inFig. 9 oben aufgezeichneten Signals y sind die 10 gesprochenen Ziffern gerade noch im farbigen (weil gefilterten) Rauschen zu erkennen. Das in den Zeitbereich zurücktransformierte Ausgangssignal des Schätzers befreit nach einem ca. 1 Sekunde (12000 samples) dauernden Einschwingvorgang sehr wirkungsvoll die Spracheingabe vom Rauschen und liefert ein unverzerrtes jedoch leicht verhalltes Sprachsignal S^ (Fig. 9 unten). Die verwendeten beiden Parameter waren α=0,05 und β=0,5, Werte, die sich auch bei den später vorgestellten Beispielen gut bewährt haben. - Aus den jeweils 129 samples langen Teilkoeffizientenvektoren H1, H2, H3 der 3 Teilfilter nach Bild7 läßt sich nun zu jedem Zeitpunkt die hieraus resultierende 3*128-sample-Impulsantwort bzw. die zugehörige Filterübertragungsfunktion berechnen. So zeigt
Fig. 10 oben die 384-sample-Impulsantwort, wie sie sich ganz am Ende der Szene- also nachdem die Ziffer "0" gesprochen wurde - ergibt. Sie ist ein sehr genaues Abbild derjenigen Impulsantwort, die zur Faltung mit weißem Gaußrauschen und damit zur synthetischen Generierung des Signales mikro benutzt wurde. Die zugehörige Betragsübertragungsfunktion (Fig. 10 unten) im Bereich zwischen den Frequenzen 0 und fs/2 = 6 kHz stellt einen mit zahlreichen schmalbandigen Resonanzüberhöhungen behafteten Tiefpaßfrequenzgang dar. - Weißes Rauschen als Referenzeingangssignal und gefiltertes "farbiges" Rauschen als Mikrophoneingangssignal stellen im Sinne der Aufgabenstellung, eine Nachbildung dieses Filters zu finden, den einfachsten Fall dar. Da das Referenzsignal per Definitionen alle Frequenzanteile enthält, gelingt die Filteradaption hier am schnellsten. Die zusätzliche additive Spracheingabe im Mikrophoneingangssignal - also das eigentliche Nutzsignal des Spracheingabesystems - stellt für den (F)LMS-Algorithmus eine Störung dar, welche die korrekte Adaption der Filterkoeffizienten behindert. Anders ausgedrückt: nur in Sprachpausen ist das System dazu in der Lage die Raumakustik des Fahrzeuginnenraums (Strecke Radiolautsprecher zum Mikrophon) richtig nachzubilden und dadurch eine Kompensation der Radiowiedergabe zu bewirken. Im oben demonstrierten Beispiel gemäß
Fig. 9 gelingt dies sehr gut, da der Mikrophon-eingang im wesentlichen aus Rauschen und nur zu einem sehr geringen Teil aus Spracheingabe besteht. - Aus echten Messungen im Fahrzeug hingegen entstammten das an den Radiolautsprecherklemmen abgegriffene Referenzsignal radio und das vom Mikrophon des Spracheingabesystem aufgezeichnete Signal mikro der Szene Z1. Dieses Mikrophonsignal ist in
Fig. 11 oben dargestellt, besteht aus 100000 samples und besitzt demnach bei einer Sampling-Frequenz von 12 kHz eine zeitliche Dauer von ca. 8,3 Sekunden. Es handelt sich um flüssig und relativ schnelle gesprochene Sprache eines hinten rechts im Auto sitzenden Fahrzeuginsassen, während gleichzeitig Musik mit normaler Lautstärke aus dem Autoradio-Lautsprecher erklingt. Nach Anwendung der Entstörmaßnahme gemäßFig. 7 und Umrechnung in den Zeitbereich ergibt sich das inFig. 11 unten dargestellte Ausgangssignal. Der Hörtest ergibt eine deutliche Herausarbeitung des Sprachanteils bzw. eine vor allem in den kurzen Sprachpausen bemerkenswerte Musikunterdrückung. Auffällig und von Nachteil ist jedoch, daß die erwünschte Radiosignalunterdrückung in starkem Maße davon abhängt, ob gerade gesprochen wird oder nicht. Die wieder am Szenenende ermittelte 384-sample-Impulsantwort mit zugehöriger Übertragungsfunktion ist ausFig. 12 ersichtlich. Eine korrekte Impulsantwort ist an den typischen Nullsamples (Totzeit) am Anfang zu erkennen, welche von der Laufzeit des Direktschalls vom Radiolautsprecher zum Mikrophon herrühren. Aus den hier vorhandenen starken Störungen am Anfang sowie am Ende der Impulsantwort läßt sich demnach der Schluß ziehen, daß die Filteradaption an dieser Stelle wegen vorhandener Spracheingabe äußerst unzureichend ist. - Die im folgenden anhand von
Fig. 8 beschriebene Ausführungsform beruht auf folgender Grundidee: ein geeignetes Merkmal dient zusammen mit einem Schwellenwert als Indikator für eine Spracheingabe. Unterschreitet das Merkmal die Schwelle, so ist dies ein Anzeichen für fehlende Spracheingabe. In diesem Fall kann - wie oben schon festgestellt - eine weitgehend ungestörte Filteradaption erfolgen. Bei Spracheingabe wird nun auf denjenigen Filterkoeffizientensatz zurückgegriffen, der unmittelbar vor der Schwellenüberschreitung - d.h. am Ende der vorangegangenen Sprachpause - abgespeichert wurde. Diese gespeicherten Koeffizienten H10, H20, H30 liefern im Regelfall eine deutlich bessere Radiosignal-Kompensation als die unter dem störenden Einfluß der Spracheingabe sich ständig ändernden aktuellen Koeffizienten H, H2, H3. -
Fig. 8 stellt eine Ausführung mit einer weiter verbesserten FLMS-Verarbeitung mit 3 Teilfiltern dar. Neben den schon inFig. 7 vorhandenen aktuellen Filterkoeffizientenvektoren H1, H2, H3, welche zur Bildung des fortlaufend adoptierten Ausgangssignals y-R benötigt wurden, existiert nun ein zusätzliches Ausgangssignal (y-Ro), das unter Verwendung gespeicherter Koeffizienten H10, H20, H30 gebildet ist. Die aktuellen Koeffizientensätze H1, H2, H3 stellen nur bei fehlender Spracheingabe im eingeschwungenen Zustand ein brauchbares Kompensationsfilter im Frequenzbereich dar, liefern hingegen bei Spracheingabe ungenügende Filtereigenschaften, weil der Adaptionsprozeß in der Regelschleife ständig gestört wird. Bei fehlender Spracheingabe d.h. hoher Filterqualität sind die drei Schalter geschlossen und es werden die aktuellen Koeffizientensätze in die Koeffizientenspeicher M1, M2, M3 geschrieben: H10=H1, H20=H2, H30=H3. Die Ausgänge (y-Ro) und (y-Ra) sind identisch. Einsetzende Spracheingaben bewirken ein Öffnen der 3 Schalter, wodurch die zuletzt in den Speichern M1, M2, M3 befindlichen Koeffizienten H10, H20, H30 nicht mehr überschrieben werden und unverändert bleiben. Dieser Zustand, in welchem sich die Ausgänge (Y-Ro) und (Y-Ra) unterschieden, wird solange beibehalten, bis wieder eine Sprachpause detektiert und die Schalter geschlossen werden. - Als Sprachpausenmerkmal fea hat sich die geglättete Summe aller Absolutwerte der Koeffizientenkorrekturvektoren ΔH1', ΔH2', ΔH3' bewährt (
Fig. 8a ). Diese Größe ist gleich Null bzw. weist kleine Zahlenwerte auf, wenn es keinen oder nur einen geringen Bedarf gibt, die Koeffizienten abzuändern. In Sprachpausen ist dies der Fall, der Regelkreis ist praktisch eingeschwungen. Störungen, wie sie durch Spracheingabe - aber auch durch Bewegungen der Fahrzeuginsassen - hervorgerufen werden, haben einen erhöhten Nachregelbedarf zur Folge, was sich durch entsprechend große Zahlenwerte bei ΔH1', ΔH2', ΔH3' und somit beim Merkmal fea bemerkbar macht. Ein Glättungsfilter beispielsweise ein rekursiver Tiefpaß 1. Ordnung mit dem Eingang feat stellt an seinem Ausgang das geglättete Sprachpausen-Merkmal fea zur Verfügung, welches nach Vergleich mit einem Schwellwert th die Schalter für die Koeffizientenübernahme steuert. - Die Wirkungsweise des verbesserten FLMS-Algorithmus nach
Fig. 8 demonstriertFig. 13 . Oben ist das aufgezeichnete Signal y der Szene Z1 (vgl.Fig. 11 oben) dargestellt, unten das gewonnene Ausgangssignal. Schon der visuelle Vergleich der Ausgangssignale vonFig. 13 undFig. 11 zeigt die verbesserte Herausarbeitung der Sprachpassagen. Der vergleichende Hörtest bestätigt dies: auch während der Spracheingabe ist die Musikunterdrückung deutlich besser. Den Verlauf des Sprachpausenmerkmals und der konstanten Schwelle über der Zeit (hier in FFT-Blöcken skaliert) zeigtFig. 14 oben. In den durch die Schwellenunterschreitung detektierten Sprachpausen (Fig. 14 unten) findet laufend die Übernahme der Koeffizienten in die Speicher wie beschrieben statt, um dort während der Spracheingabe als gespeicherte Koeffizienten zur Verfügung zu stehen. Die schon inFig. 12 am Szenenende gemessene 384-sample-Impulsantwort mit zugehöriger Betragsübertragungsfunktion ist inFig. 15 als aktuelle Impulsantwort (a) bzw. aktuelle Übertragungsfunktion (b) dargestellt. Im Gegensatz zu dieser infolge Spracheingabe stark gestörten Schätzung aus den aktuellen Koeffizienten H1, H2, H3 ist aus den gespeicherten Koeffizienten H10, H20, H30 eine Impulsantwort (c) und eine Übertragungsfunktion (d) hoher Qualität berechenbar. Die Impulsantwort aus den gespeicherten Koeffizienten weist die typischen Nullsamples am Anfang auf, welche durch die Laufzeit des Direktschalls vom Radiolautsprecher zum Spracheingabemikrophon verursacht werden. Aus der im Beispielsfall abzulesenden Totzeit von ca. 40 samples läßt sich die Entfernung zwischen Lautsprecher und Mikrophon bestimmen. - Wie vorstehend schon angedeutet läßt sich die aufwendige Projektion P4 (IFFT, Fenster rechts im Zeitbereich, FFT) ohne merkliche Einbuße an Qualität durch eine relativ einfache Faltung im Frequenzbereich ersetzten, wodurch 2 FFT's eingespart werden. Dazu betrachte man
Fig. 16 . In einem ersten Schritt wird das "rechtsseitige" 128-sample-Rechteckfenster im Zeitbereich (Fig. 16a ) bei der idealen Projektion ersetzt durch ein 128-sample-Hammingfenster (Fig. 16b ). Gegenüber dem Rechteckfenster besitzt dieses den Vorteil eines bedeutend schmaleren Spektrums. WieFig. 17 zeigt, besteht beim Rechteckfenster der Realteil des Spektrums aus einer einzigen Linie (Gleichanteil), während das zur Mitte antisymmetrische Imaginärteil-Spektrum aus vielen nach außen hin langsam abfallenden Linien mit alternierenden Nullstellen besteht. Im Gegensatz dazu beschränkt sich das komplexe Spektrum des Hammingfensters (Fig. 18 ) auf insgesamt 7 Linien, von denen im symmetrischen Realteil nur 3 und im antisymmetrischen Imaginärteil nur 4 Werte von Null verschieden sind. Sämtliche weiter außen liegenden Anteile sind vernachlässigbar gering. Diese spezielle Eigenschaft des Hammingfensters ermöglicht es vorteilhafterweise die Multiplikation im Zeitbereich (Fig. 16b ) zu ersetzen durch eine Faltung mit dem zugehörigen 7-sample-Spektrum im Frequenzbereich und damit eine IFFT und eine FFT einzusparen (Fig. 16c ). - Prinzipiell läßt sich natürlich auch die Projektion P1 (IFFT - linksseitiges Rechteckfenster - FFT) ersetzen durch eine entsprechende Faltungsoperation im Frequenzbereich mit dem konjugiert komplexen 7-Linien-Spektrum. Experimente haben jedoch gezeigt, daß Einsparungen an dieser Stelle erkauft werden mit einer deutlichen Verschlechterung des Einschwingverhaltens. Aufwandsgünstige Lösungen lassen sich trotzdem dadurch erzielen, daß in dem LMS-Algorithmus nach
Fig. 8 die 3 Projektionen P1 nicht gleichzeitig in einem 256-sample-Inputdatenblock abgearbeitet werden müssen. Die mit 128-samples überlappenden Inputdatenblöcke der Länge 256 sind mit einer willkürlich bei "1" beginnenden Nummerierung inFig. 19a skizziert. So ist es z.B. möglich bei modulo-3-Zählweise der Inputdatenblöcke die 3 Teilfilterprojektionen nicht parallel (Fig. 19b ) sondern sequentiell in aufeinanderfolgenden BlöckenFig. 19 zu berechnen. Dadurch sind bei idealer Projektion P1 pro Datenblock nicht 6 sondern nur noch 2 FFT's notwendig. Es hat sich gezeigt, daß die Kompensation des Radiosignales auch noch ausreichend funktioniert, wenn die Abstände zwischen den zu berechnenden Teilfilter-Projektionen noch größer gewählt werden. Zählt man die Blöcke z.B. modulo 6, so ist lediglich in jedem zweiten Block eine Projektion Zu berechnen (Fig. 19d ). Selbst eine Reduzierung auf einen Abstand von vier Blöcken zwischen zwei aufeinanderfolgenden P1 Berechnungen mittels modulo-12-Zählung führt noch zu brauchbaren Ergebnissen (Fig. 19e ). - Die Leistungsfähigkeit des FLMS-Algorithmus mit 3 Teilfiltern gemäß Blockschaltung
Fig. 8 und einer sequentiellen Berechnung der idealen Projektion P1 im Zeitraster nachFig. 19e sowie der Projektion P2 mittels Faltung im Frequenzbereich (Fig. 16c ) mit einem komplexen 7-Linien-Spektrum (Fig. 18 ) sei anhand von 3 Meßszenen demonstriert. - Die erste dieser Szenen Z2 beinhaltet Spracheingabe von Ziffern, wobei der Radiolautsprecher annähernd weißes Rauschen mit verhältnismäßig hoher Lautstärke abstrahlt. Das zugehörige 100000-sample-Mikrophonsignal ist in
Fig. 20 oben, das extrahierte Ausgangssignal inFig. 20 unten dargestellt. Eine deutliche Rauschbefreiung des Outputsignales gegenüber dem Mikrophoninput stellt man durch Abhörvergleich fest. Der zeitliche Verlauf des Sprachpausenmerkmals ist zusammen mit der konstanten Schwelle thFig. 21 oben abgebildet und die hieraus abgeleiteten Sprachpausen bzw. die zugeordneten Schalterstellungen inFig. 21 unten. Schließlich zeigtFig. 22 in zuFig. 15 analoger Weise die am Szenenende gefundene Impulsantwort (a) und Übertragungsfunktion (b) auf der Basis der aktuellen Koeffizienten und die entsprechenden Größen (c), (d) auf der Basis der Sprachpauseneinstellung. Es ist deutlich erkennbar, daß die am Szenenende gefundene aktuelle Impulsantwort ein infolge Spracheingabe gestörtes Ergebnis darstellt, während die aus der letzten Sprachpause stammende Impulsantwort aus den gespeicherten Koeffizientensätzen eine hohe Qualität aufweist. - Die ersten 100000 samples einer Meßszene Z3 mit POP-Musik im Radio und flüssig bis schnell gesprochener Sprache der rechts hinten sitzenden Person sind in Form des Mikrophonsignales y in
Fig. 23 oben aufgezeichnet. Nach ca. 10000 samples (0,83 s) wird das Radiosignal brauchbar unterdrückt (Fig. 23 unten). Auch bei der im letzten Drittel dieser Szene einsetzenden Spracheingabe bleibt die POP-Musikunterdrückung wirksam erhalten, wodurch die Sprachverständlichkeit hier gegenüber dem Mikrophonsignal merklich verbessert wird. Nach einer langen Sprachpause kommt es wegen der anschließenden pausenfreien Spracheingabe nicht mehr zu einer Schwellenunterschreitung (Fig. 24 ). Aus diesem Grunde ist die inFig. 25 unten am Ende der Szene festgehaltene Impulsantwort auf der Basis der gespeicherten Koeffizienten zeitlich relativ veraltet, weil sie bereits ca. 2,3 s vorher aktuell war (215 Blöcke * 10,7 ms). Wieder weist die aktuelle Impulsantwort (Fig. 25 oben) starke von der Spracheingabe herrührende Störungen auf. Wie ein Vergleich mit der ähnlichen Szene Z1 nachFiguren 11 bis 15 zeigt, ist trotz des stark verringerten Rechenaufwandes die Qualität der Störbefreiung unverändert hoch. - Die letzte Szene Z4 nach
Fig. 26 wurde ohne Spracheingabe erstellt und soll abschließend nochmals die Musikunterdrückungseigenschaften des beschriebenen FLMS-Algorithmus demonstrieren. Nach ca. 18000 samples bzw. 1,5 s wird - wie ausFig. 26 unten ersichtlich - die Musik wirksam unterdrückt. Diese Eigenschaft wird bis zum Szenenende mit unveränderter Qualität beibehalten.Fig. 27 zeigt auf, daß das Sprachpausen-Größe fea überwiegend unter der Schwelle th bleibt. Die Zeiten, in welchen auf die gespeicherten Koeffizienten zurückgegriffen wird, sind demnach nur sehr kurz. Impulsantwort und Übertragungsfunktion aus aktuellen Koeffizienten sind daher im wesentlichen mit den entsprechenden Verläufen aus Sprachpausen-Koeffizienten identisch.
Claims (10)
- Verfahren zur Störbefreiung eines Mikrophonsignals von Anteilen eines Quellsignals, das als Referenzsignal (x) vorliegt und nach Durchlaufen einer Übertragungsstrecke mit a priori unbekannter Übertragungsfunktion (G) sich im Mikrophonsignal als Störsignal (r) einem Sprachsignal (s) überlagert, durch adaptive Nachbildung des Störsignals und Kompensation des tatsächlichen und des nachgebildeten Störsignals in einem Ausgangssignal, wobei das Mikrophonsignal gleichfalls in den Frequenzbereich transformiert, die Kompensation an Signalen im Frequenzbereich vorgenommen und das im Frequenzbereich vorliegende Ausgangssignal zur Adaption der Nachbildung mit dem im Frequenzbereich vorliegenden Referenzsignal verknüpft wird, wobei zur Nachbildung des Störsignals eine adaptive Filterfunktion eines Nachbildungsfilters auf das Referenzsignal angewandt wird, dadurch gekennzeichnet, dass das Auftreten des Sprachsignals im Mikrophonsignal detektiert wird und bei Auftreten eines Sprachsignals die vor Auftreten des Sprachsignals eingestellte Filterfunktion zur Bildung des Ausgangssignals beibehalten wird.
- Verfahren nach Anspruch 1, in dem das Ausgangssignalspektrum in den Zeitbereich transformiert, das Zeitsignal durch Voranstellen von Nullwerten auf doppelte Länge gebracht, in den Frequenzbereich rücktransformiert und der Nachbildung der Übertragungsfunktion zugrundegelegt wird.
- Verfahren nach Anspruch 1, in dem das Ausgangssignalspektrum mit dem Spektrum eines Hamming-Zeitfensters gefaltet wird und der Nachbildung der Übertragungsfunktion zugrundegelegt wird.
- Verfahren nach Anspruch 1, in dem die Filterfunktion durch einen Koeffizientenvektor vorgegeben wird, dessen Koeffizienten adaptiv eingestellt werden.
- Verfahren nach Anspruch 1, in dem auch bei Detektion des Sprachsignals die adaptive Nachführung einer aktuellen Filterfunktion zusätzlich zur Bildung des Ausgangssignals fortgeführt wird.
- Verfahren nach Anspruch 5, in dem das Auftreten des Sprachsignals aus einer Veränderung der aktuellen Filterfunktion detektiert wird.
- Verfahren nach Anspruch 6, in dem die Veränderung der aktuellen Filterfunktion für die Detektion des Auftretens eines Sprachsignals zeitlich geglättet wird.
- Verfahren nach einem der vorhergehenden Ansprüche, in dem die Filterfunktion in mehrere Teilfilterfunktion zu aufeinanderfolgenden Abschnitten einer Gesamt-Impulsantwort aller Teilfilter aufgespalten ist und auf Referenzsignalspektren zu zeitlich versetzten Zeitsegmenten des segmentierten Referenz-Zeitsignals angewandt wird.
- Verfahren nach Anspruch 8, in dem die Adaption der Filterfunktion für die Teilfilter parallel durchgeführt wird.
- Verfahren nach Anspruch 9, in dem die Adaption der Filterfunktion für die einzelnen Teilfilter zeitsequentiell durchgeführt wird.
Applications Claiming Priority (2)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| DE19814971 | 1998-04-03 | ||
| DE19814971A DE19814971A1 (de) | 1998-04-03 | 1998-04-03 | Verfahren zur Störbefreiung eines Mikrophonsignals |
Publications (3)
| Publication Number | Publication Date |
|---|---|
| EP0948237A2 EP0948237A2 (de) | 1999-10-06 |
| EP0948237A3 EP0948237A3 (de) | 2006-02-08 |
| EP0948237B1 true EP0948237B1 (de) | 2008-06-11 |
Family
ID=7863491
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| EP99106123A Expired - Lifetime EP0948237B1 (de) | 1998-04-03 | 1999-04-01 | Verfahren zur Störbefreiung eines Mikrophonsignals |
Country Status (4)
| Country | Link |
|---|---|
| US (1) | US6895095B1 (de) |
| EP (1) | EP0948237B1 (de) |
| AT (1) | ATE398326T1 (de) |
| DE (2) | DE19814971A1 (de) |
Families Citing this family (34)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| DE19958836A1 (de) * | 1999-11-29 | 2001-05-31 | Deutsche Telekom Ag | Verfahren und Anordnung zur Verbesserung der Kommunikation in einem Fahrzeug |
| DE10041885A1 (de) * | 2000-08-25 | 2002-03-07 | Mueller Bbm Gmbh | Sprachsignalübertragungssystem für Fahrzeuge |
| DE10052991A1 (de) * | 2000-10-19 | 2002-05-02 | Deutsche Telekom Ag | Verfahren zur Ermittlung raumakustischer und elektroakustischer Parameter |
| DE10221990B4 (de) * | 2002-05-17 | 2006-10-12 | Audi Ag | Reduzierung von Störgeräuschen an Autoradios mit Busanschlüssen |
| US20040047475A1 (en) * | 2002-09-09 | 2004-03-11 | Ford Global Technologies, Inc. | Audio noise cancellation system for a sensor in an automotive vehicle |
| JP2005218010A (ja) * | 2004-02-02 | 2005-08-11 | Matsushita Electric Ind Co Ltd | 車両用データ伝送システム |
| US8170879B2 (en) | 2004-10-26 | 2012-05-01 | Qnx Software Systems Limited | Periodic signal enhancement system |
| US7716046B2 (en) * | 2004-10-26 | 2010-05-11 | Qnx Software Systems (Wavemakers), Inc. | Advanced periodic signal enhancement |
| US7949520B2 (en) | 2004-10-26 | 2011-05-24 | QNX Software Sytems Co. | Adaptive filter pitch extraction |
| US8543390B2 (en) | 2004-10-26 | 2013-09-24 | Qnx Software Systems Limited | Multi-channel periodic signal enhancement system |
| US8306821B2 (en) | 2004-10-26 | 2012-11-06 | Qnx Software Systems Limited | Sub-band periodic signal enhancement system |
| US7525440B2 (en) * | 2005-06-01 | 2009-04-28 | Bose Corporation | Person monitoring |
| ATE423433T1 (de) * | 2006-04-18 | 2009-03-15 | Harman Becker Automotive Sys | System und verfahren zur mehrkanal- echokompensation |
| ATE445966T1 (de) * | 2006-05-08 | 2009-10-15 | Harman Becker Automotive Sys | Echoverringerung für zeitvariante systeme |
| EP1855457B1 (de) * | 2006-05-10 | 2009-07-08 | Harman Becker Automotive Systems GmbH | Kompensation von Mehrkanalechos durch Dekorrelation |
| EP1879181B1 (de) * | 2006-07-11 | 2014-05-21 | Nuance Communications, Inc. | Verfahren zur Kompensation von Audiosignalkomponenten in einem Fahrzeugkommunikationssystem und Vorrichtung dafür |
| US20080063122A1 (en) * | 2006-09-07 | 2008-03-13 | Gwo-Jia Jong | Method for suppressing co-channel interference from different frequency |
| EP1936939B1 (de) * | 2006-12-18 | 2011-08-24 | Harman Becker Automotive Systems GmbH | Echokompensation mit geringer Komplexität |
| US7577257B2 (en) * | 2006-12-21 | 2009-08-18 | Verizon Services Operations, Inc. | Large scale quantum cryptographic key distribution network |
| US20080225688A1 (en) * | 2007-03-14 | 2008-09-18 | Kowalski John M | Systems and methods for improving reference signals for spatially multiplexed cellular systems |
| ATE524015T1 (de) * | 2007-05-22 | 2011-09-15 | Harman Becker Automotive Sys | Verfahren und vorrichtung zur verarbeitung mindestens zweier mikrofonsignale zur sendung eines ausgangssignals mit reduzierter interferenz |
| EP2018034B1 (de) * | 2007-07-16 | 2011-11-02 | Nuance Communications, Inc. | Verfahren und System zur Verarbeitung von Tonsignalen in einem Multimediasystem eines Fahrzeugs |
| US8850154B2 (en) | 2007-09-11 | 2014-09-30 | 2236008 Ontario Inc. | Processing system having memory partitioning |
| US8904400B2 (en) | 2007-09-11 | 2014-12-02 | 2236008 Ontario Inc. | Processing system having a partitioning component for resource partitioning |
| US8694310B2 (en) | 2007-09-17 | 2014-04-08 | Qnx Software Systems Limited | Remote control server protocol system |
| US8209514B2 (en) | 2008-02-04 | 2012-06-26 | Qnx Software Systems Limited | Media processing system having resource partitioning |
| EP2222091B1 (de) | 2009-02-23 | 2013-04-24 | Nuance Communications, Inc. | Verfahren zum Bestimmen eines Satzes von Filterkoeffizienten für ein Mittel zur Kompensierung von akustischem Echo |
| CN102043168B (zh) | 2010-10-15 | 2012-11-07 | 中国石油化工股份有限公司 | 一种对数字信号进行仿真加噪的处理方法 |
| WO2013051210A1 (ja) * | 2011-10-07 | 2013-04-11 | パナソニック株式会社 | 符号化装置及び符号化方法 |
| DE102014214143B4 (de) * | 2014-03-14 | 2015-12-31 | Fraunhofer-Gesellschaft zur Förderung der angewandten Forschung e.V. | Vorrichtung und Verfahren zum Verarbeiten eines Signals im Frequenzbereich |
| US20180166073A1 (en) * | 2016-12-13 | 2018-06-14 | Ford Global Technologies, Llc | Speech Recognition Without Interrupting The Playback Audio |
| EP3563561B1 (de) * | 2016-12-30 | 2025-04-02 | Harman Becker Automotive Systems GmbH | Unterdrückung von akustischem echo |
| DE102017101497B4 (de) * | 2017-01-26 | 2020-08-27 | Infineon Technologies Ag | Mikro-Elektro-Mechanisches-System (MEMS) -Schaltkreis und Verfahren zum Rekonstruieren einer Störgröße |
| DE102018204687B3 (de) * | 2018-03-27 | 2019-06-13 | Infineon Technologies Ag | MEMS Mikrofonmodul |
Family Cites Families (5)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| NL8601604A (nl) * | 1986-06-20 | 1988-01-18 | Philips Nv | Frequentie-domein blok-adaptief digitaal filter. |
| JP2748626B2 (ja) * | 1989-12-29 | 1998-05-13 | 日産自動車株式会社 | 能動型騒音制御装置 |
| US5649012A (en) * | 1995-09-15 | 1997-07-15 | Hughes Electronics | Method for synthesizing an echo path in an echo canceller |
| US5937060A (en) * | 1996-02-09 | 1999-08-10 | Texas Instruments Incorporated | Residual echo suppression |
| JP3654470B2 (ja) * | 1996-09-13 | 2005-06-02 | 日本電信電話株式会社 | サブバンド多チャネル音声通信会議用反響消去方法 |
-
1998
- 1998-04-03 DE DE19814971A patent/DE19814971A1/de not_active Withdrawn
-
1999
- 1999-04-01 EP EP99106123A patent/EP0948237B1/de not_active Expired - Lifetime
- 1999-04-01 DE DE59914782T patent/DE59914782D1/de not_active Expired - Lifetime
- 1999-04-01 AT AT99106123T patent/ATE398326T1/de not_active IP Right Cessation
- 1999-04-02 US US09/285,064 patent/US6895095B1/en not_active Expired - Lifetime
Also Published As
| Publication number | Publication date |
|---|---|
| ATE398326T1 (de) | 2008-07-15 |
| DE59914782D1 (de) | 2008-07-24 |
| EP0948237A2 (de) | 1999-10-06 |
| US6895095B1 (en) | 2005-05-17 |
| DE19814971A1 (de) | 1999-10-07 |
| EP0948237A3 (de) | 2006-02-08 |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| EP0948237A2 (de) | Verfahren zur Störbefreiung eines Mikrophonsignals | |
| DE19747885B4 (de) | Verfahren zur Reduktion von Störungen akustischer Signale mittels der adaptiven Filter-Methode der spektralen Subtraktion | |
| DE3118473C2 (de) | Verfahren zur Aufbereitung elektrischer Signale mit einer digitalen Filteranordnung | |
| DE69738288T2 (de) | Einrichtung zur unterdrückung einer störenden komponente eines eingangssignals | |
| DE2207141C3 (de) | Schaltungsanordnung zur Unterdrückung unerwünschter Sprachsignale mittels eines vorhersagenden Filters | |
| EP0747880B1 (de) | Spracherkennungssystem | |
| EP1143416A2 (de) | Geräuschunterdrückung im Zeitbereich | |
| EP0912974A1 (de) | Verfahren zur verringerung von störungen eines sprachsignals | |
| DE112007003625T5 (de) | Echounterdrückungsvorrichtung, echounterdrückungssystem, Echounterdrückungsverfahren und Computerprogramm | |
| EP2080197B1 (de) | Vorrichtung zur geräuschunterdrückung bei einem audiosignal | |
| EP1189419B1 (de) | Verfahren und Vorrichtung zur Elimination Lautsprecherinterferenzen aus Mikrofonsignalen | |
| DE102006027673A1 (de) | Signaltrenner, Verfahren zum Bestimmen von Ausgangssignalen basierend auf Mikrophonsignalen und Computerprogramm | |
| DE19956088A1 (de) | Einseiten-Unterband-Filter | |
| DE102015222105A1 (de) | Audiosignalverarbeitung in einem Fahrzeug | |
| EP3065417B1 (de) | Verfahren zur unterdrückung eines störgeräusches in einem akustischen system | |
| EP0623995B1 (de) | Anordnung zur geräuschabhängigen Regelung der Lautstärke eines Autoradios | |
| DE102013011761A1 (de) | Kraftfahrzeug mit einer Freisprecheinrichtung und Verfahren zur Erzeugung eines Frequenzganges für Freisprecheinrichtungen | |
| DE10137348A1 (de) | Verfahren und Schaltungsanordnung zur Geräuschreduktion bei der Sprachübertragung in Kommunikationssystemen | |
| DE3230391C2 (de) | ||
| EP0615226B1 (de) | Verfahren zur Geräuschreduktion für gestörte Sprachkanäle | |
| DE19729521A1 (de) | Verfahren und Vorrichtung zur Stör- und Echounterdrückung | |
| DE10140523B4 (de) | Vorrichtung zum Feedback Cancelling bei der Ausgabe von Mikrofonsignalen durch Lautsprecher | |
| DE10356063B4 (de) | Verfahren zur Entstörung von Audiosignalen | |
| EP1282297A2 (de) | Verfahren und Anordnung zur Echo- und Störgeräuschunterdrückung | |
| EP0909029B1 (de) | Verfahren zur Adaption von Filterkoeffizienten und adaptive Digitalfiltereinrichtung |
Legal Events
| Date | Code | Title | Description |
|---|---|---|---|
| PUAI | Public reference made under article 153(3) epc to a published international application that has entered the european phase |
Free format text: ORIGINAL CODE: 0009012 |
|
| AK | Designated contracting states |
Kind code of ref document: A2 Designated state(s): AT BE CH CY DE DK ES FI FR GB GR IE IT LI LU MC NL PT SE |
|
| AX | Request for extension of the european patent |
Free format text: AL;LT;LV;MK;RO;SI |
|
| RAP1 | Party data changed (applicant data changed or rights of an application transferred) |
Owner name: DAIMLERCHRYSLER AG |
|
| RAP1 | Party data changed (applicant data changed or rights of an application transferred) |
Owner name: HARMAN BECKER AUTOMOTIVE SYSTEMS (BECKER DIVISION) |
|
| RAP1 | Party data changed (applicant data changed or rights of an application transferred) |
Owner name: HARMAN BECKER AUTOMOTIVE SYSTEMS GMBH |
|
| PUAL | Search report despatched |
Free format text: ORIGINAL CODE: 0009013 |
|
| AK | Designated contracting states |
Kind code of ref document: A3 Designated state(s): AT BE CH CY DE DK ES FI FR GB GR IE IT LI LU MC NL PT SE |
|
| AX | Request for extension of the european patent |
Extension state: AL LT LV MK RO SI |
|
| 17P | Request for examination filed |
Effective date: 20060807 |
|
| AKX | Designation fees paid |
Designated state(s): AT CH DE ES FR GB IT LI NL SE |
|
| GRAP | Despatch of communication of intention to grant a patent |
Free format text: ORIGINAL CODE: EPIDOSNIGR1 |
|
| 17Q | First examination report despatched |
Effective date: 20070803 |
|
| RIC1 | Information provided on ipc code assigned before grant |
Ipc: H04R 3/00 20060101ALI20070927BHEP Ipc: G10L 21/02 20060101AFI20070927BHEP |
|
| GRAS | Grant fee paid |
Free format text: ORIGINAL CODE: EPIDOSNIGR3 |
|
| GRAA | (expected) grant |
Free format text: ORIGINAL CODE: 0009210 |
|
| AK | Designated contracting states |
Kind code of ref document: B1 Designated state(s): AT CH DE ES FR GB IT LI NL SE |
|
| REG | Reference to a national code |
Ref country code: GB Ref legal event code: FG4D Free format text: NOT ENGLISH |
|
| REG | Reference to a national code |
Ref country code: CH Ref legal event code: EP |
|
| REF | Corresponds to: |
Ref document number: 59914782 Country of ref document: DE Date of ref document: 20080724 Kind code of ref document: P |
|
| PG25 | Lapsed in a contracting state [announced via postgrant information from national office to epo] |
Ref country code: NL Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20080611 |
|
| NLV1 | Nl: lapsed or annulled due to failure to fulfill the requirements of art. 29p and 29m of the patents act | ||
| PG25 | Lapsed in a contracting state [announced via postgrant information from national office to epo] |
Ref country code: SE Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20080911 Ref country code: ES Free format text: LAPSE BECAUSE OF FAILURE TO SUBMIT A TRANSLATION OF THE DESCRIPTION OR TO PAY THE FEE WITHIN THE PRESCRIBED TIME-LIMIT Effective date: 20080922 |
|
| PLBE | No opposition filed within time limit |
Free format text: ORIGINAL CODE: 0009261 |
|
| STAA | Information on the status of an ep patent application or granted ep patent |
Free format text: STATUS: NO OPPOSITION FILED WITHIN TIME LIMIT |
|
| 26N | No opposition filed |
Effective date: 20090312 |
|
| PGFP | Annual fee paid to national office [announced via postgrant information from national office to epo] |
Ref country code: AT Payment date: 20090401 Year of fee payment: 11 |
|
| PGFP | Annual fee paid to national office [announced via postgrant information from national office to epo] |
Ref country code: CH Payment date: 20090427 Year of fee payment: 11 |
|
| REG | Reference to a national code |
Ref country code: CH Ref legal event code: PL |
|
| PG25 | Lapsed in a contracting state [announced via postgrant information from national office to epo] |
Ref country code: AT Free format text: LAPSE BECAUSE OF NON-PAYMENT OF DUE FEES Effective date: 20100401 |
|
| PG25 | Lapsed in a contracting state [announced via postgrant information from national office to epo] |
Ref country code: LI Free format text: LAPSE BECAUSE OF NON-PAYMENT OF DUE FEES Effective date: 20100430 Ref country code: CH Free format text: LAPSE BECAUSE OF NON-PAYMENT OF DUE FEES Effective date: 20100430 |
|
| REG | Reference to a national code |
Ref country code: DE Ref legal event code: R082 Ref document number: 59914782 Country of ref document: DE Representative=s name: GRUENECKER, KINKELDEY, STOCKMAIR & SCHWANHAEUS, DE |
|
| REG | Reference to a national code |
Ref country code: DE Ref legal event code: R082 Ref document number: 59914782 Country of ref document: DE Representative=s name: GRUENECKER PATENT- UND RECHTSANWAELTE PARTG MB, DE Effective date: 20120411 Ref country code: DE Ref legal event code: R082 Ref document number: 59914782 Country of ref document: DE Representative=s name: GRUENECKER, KINKELDEY, STOCKMAIR & SCHWANHAEUS, DE Effective date: 20120411 Ref country code: DE Ref legal event code: R081 Ref document number: 59914782 Country of ref document: DE Owner name: NUANCE COMMUNICATIONS, INC. (N.D.GES.D. STAATE, US Free format text: FORMER OWNER: HARMAN BECKER AUTOMOTIVE SYSTEMS GMBH, 76307 KARLSBAD, DE Effective date: 20120411 |
|
| REG | Reference to a national code |
Ref country code: FR Ref legal event code: TP Owner name: NUANCE COMMUNICATIONS, INC., US Effective date: 20120924 |
|
| REG | Reference to a national code |
Ref country code: FR Ref legal event code: PLFP Year of fee payment: 18 |
|
| REG | Reference to a national code |
Ref country code: FR Ref legal event code: PLFP Year of fee payment: 19 |
|
| REG | Reference to a national code |
Ref country code: FR Ref legal event code: PLFP Year of fee payment: 20 |
|
| PGFP | Annual fee paid to national office [announced via postgrant information from national office to epo] |
Ref country code: FR Payment date: 20180426 Year of fee payment: 20 Ref country code: IT Payment date: 20180420 Year of fee payment: 20 |
|
| PGFP | Annual fee paid to national office [announced via postgrant information from national office to epo] |
Ref country code: DE Payment date: 20180629 Year of fee payment: 20 Ref country code: GB Payment date: 20180427 Year of fee payment: 20 |
|
| REG | Reference to a national code |
Ref country code: DE Ref legal event code: R071 Ref document number: 59914782 Country of ref document: DE |
|
| REG | Reference to a national code |
Ref country code: GB Ref legal event code: PE20 Expiry date: 20190331 |
|
| PG25 | Lapsed in a contracting state [announced via postgrant information from national office to epo] |
Ref country code: GB Free format text: LAPSE BECAUSE OF EXPIRATION OF PROTECTION Effective date: 20190331 |