ES2889098T3 - Sumador de potencia variable eficiente en energía y métodos de uso del mismo - Google Patents
Sumador de potencia variable eficiente en energía y métodos de uso del mismo Download PDFInfo
- Publication number
- ES2889098T3 ES2889098T3 ES18719353T ES18719353T ES2889098T3 ES 2889098 T3 ES2889098 T3 ES 2889098T3 ES 18719353 T ES18719353 T ES 18719353T ES 18719353 T ES18719353 T ES 18719353T ES 2889098 T3 ES2889098 T3 ES 2889098T3
- Authority
- ES
- Spain
- Prior art keywords
- output
- adder
- stage
- generation
- serial
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Active
Links
Classifications
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F7/00—Methods or arrangements for processing data by operating upon the order or content of the data handled
- G06F7/38—Methods or arrangements for performing computations using exclusively denominational number representation, e.g. using binary, ternary, decimal representation
- G06F7/48—Methods or arrangements for performing computations using exclusively denominational number representation, e.g. using binary, ternary, decimal representation using non-contact-making devices, e.g. tube, solid state device; using unspecified devices
- G06F7/50—Adding; Subtracting
- G06F7/501—Half or full adders, i.e. basic adder cells for one denomination
- G06F7/502—Half adders; Full adders consisting of two cascaded half adders
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F7/00—Methods or arrangements for processing data by operating upon the order or content of the data handled
- G06F7/38—Methods or arrangements for performing computations using exclusively denominational number representation, e.g. using binary, ternary, decimal representation
- G06F7/48—Methods or arrangements for performing computations using exclusively denominational number representation, e.g. using binary, ternary, decimal representation using non-contact-making devices, e.g. tube, solid state device; using unspecified devices
- G06F7/50—Adding; Subtracting
- G06F7/505—Adding; Subtracting in bit-parallel fashion, i.e. having a different digit-handling circuit for each denomination
- G06F7/506—Adding; Subtracting in bit-parallel fashion, i.e. having a different digit-handling circuit for each denomination with simultaneous carry generation for, or propagation over, two or more stages
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F7/00—Methods or arrangements for processing data by operating upon the order or content of the data handled
- G06F7/38—Methods or arrangements for performing computations using exclusively denominational number representation, e.g. using binary, ternary, decimal representation
- G06F7/48—Methods or arrangements for performing computations using exclusively denominational number representation, e.g. using binary, ternary, decimal representation using non-contact-making devices, e.g. tube, solid state device; using unspecified devices
- G06F7/50—Adding; Subtracting
- G06F7/505—Adding; Subtracting in bit-parallel fashion, i.e. having a different digit-handling circuit for each denomination
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F2207/00—Indexing scheme relating to methods or arrangements for processing data by operating upon the order or content of the data handled
- G06F2207/506—Indexing scheme relating to groups G06F7/506 - G06F7/508
- G06F2207/5063—2-input gates, i.e. only using 2-input logical gates, e.g. binary carry look-ahead, e.g. Kogge-Stone or Ladner-Fischer adder
Landscapes
- Physics & Mathematics (AREA)
- General Physics & Mathematics (AREA)
- Engineering & Computer Science (AREA)
- Computational Mathematics (AREA)
- Mathematical Analysis (AREA)
- Pure & Applied Mathematics (AREA)
- Theoretical Computer Science (AREA)
- General Engineering & Computer Science (AREA)
- Mathematical Optimization (AREA)
- Computing Systems (AREA)
- Analogue/Digital Conversion (AREA)
- Advance Control (AREA)
- Compression, Expansion, Code Conversion, And Decoders (AREA)
- Design And Manufacture Of Integrated Circuits (AREA)
- Power Sources (AREA)
- Prostheses (AREA)
- Complex Calculations (AREA)
Abstract
Un sumador de múltiples bits que comprende: una etapa de sumador completo configurada para recibir al menos algunos de una pluralidad de bits menos significativos, LSBs, de primeros datos y segundos datos; una etapa de medio sumador configurada para recibir al menos algunos de una pluralidad de bits más significativos, MSBs, de los primeros datos y los segundos datos, en donde la etapa de medio sumador incluye al menos un medio sumador; una etapa de generación de transporte acoplada a la etapa de sumador completo y a la etapa de medio sumador, en donde la etapa de generación de transporte incluye al menos un componente de generación de propagación, PG, en serie acoplado a las salidas del al menos un medio sumador; y una etapa de postsuma acoplada a la etapa de generación de transporte y a la etapa de medio sumador y configurada para generar una salida de suma parcial de los primeros datos y los segundos datos, en donde un número de los al menos algunos de la pluralidad de LSBs es diferente de un número de los al menos algunos de la pluralidad de MSBs.
Description
DESCRIPCIÓN
Sumador de potencia variable eficiente en energía y métodos de uso del mismo
Campo técnico
Esta aplicación se relaciona con un circuito digital para realizar operaciones aritméticas y, más particularmente, con sumadores que tienen configuraciones variables para mejorar la eficiencia de energía.
Antecedentes
Los sumadores se usan ampliamente en subsistemas multimedia, tales como cámaras y procesadores gráficos ya que la adición es una función importante para muchas operaciones de procesamiento de señales digitales. Por ejemplo, el filtrado digital se puede implementar usando etapas repetitivas de operaciones de suma múltiple. Otras operaciones matemáticas tales como resta, inversión de signo, multiplicación, división, comparación, raíz cuadrada, logarítmica, hiperbólica, trigonométrica también pueden incluir diversas etapas de adiciones.
Las herramientas de software para síntesis de circuitos convencionales comúnmente se enfocan en optimizar el área y/o velocidad en lugar de la potencia, especialmente para sumadores y multiplicadores. Por ejemplo, una herramienta de software para síntesis de circuitos convencional puede sintetizar un sumador usando un sumador de transporte de ondulación (RCA). La herramienta de software puede optimizar los retrasos de procesamiento reemplazando el RCA con un sumador de transporte-salto, un sumador de transporte con anticipación, o un sumador de transporte-selección para cumplir con las restricciones de temporización. Sin embargo, los sumadores de transporte-salto, sumadores de transporte con anticipación, y sumadores de transporte-selección típicamente usan más lógicas que los RCAs, y de este modo consumen más potencia que los RCAs. Aunque algunas herramientas de software para síntesis de circuitos pueden proporcionar algunos controles para el consumo de potencia, los controles pueden no ser efectivos o suficientes para cumplir con las restricciones de potencia para ciertas aplicaciones. El alto consumo de potencia puede no ser una gran preocupación cuando el circuito sintetizado se usa en un sistema de anfitrión o una máquina de anfitrión, tal como un ordenador personal (PC). Sin embargo, los dispositivos móviles que se usan para aplicaciones multimedia pueden estar limitadas por la potencia. Por consiguiente, pueden ser deseables sistemas y técnicas mejorados para sintetizar sumadores que puedan equilibrar la velocidad, potencia, y/o área.
Resumen
Se proporcionan sumadores de múltiples bits eficientes en energía. Diversas realizaciones incluyen sumadores que usan circuitería de transporte en paralelo para algunas de las etapas de bit más significativo (MSB) para proporcionar una circuitería de transporte de aceleración y en serie o de ondulación para etapas de bits menos significativo para proporcionar ahorro de potencia. La aceleración se refiere a la reducción en retraso desde el momento en que se reciben las entradas hasta el momento en que se calculan las salidas. Específicamente, diversas realizaciones incluyen sumadores que tienen una división desigual entre el número de etapas de MSB paralelas y el número de etapas de bits menos significativos en serie.
De acuerdo con una realización, un aparato sumador de múltiples bits que incluye: una etapa de sumador completo configurada para recibir al menos algunos de una pluralidad de bits menos significativos (LSBs) de primeros datos y segundos datos; y una etapa de medio sumador configurada para recibir al menos algunos de una pluralidad de bits más significativos (MSBs) de los primeros datos y los segundos datos, en donde la etapa de medio sumador incluye al menos un medio sumador; una etapa de generación de transporte acoplada a la etapa de sumador completo y la etapa de medio sumador, en donde la etapa de generación de transporte incluye al menos un componente de generación de propagación (PG) en serie acoplado a las salidas del al menos un medio sumador; y una etapa de postsuma acoplada a la etapa de generación de transporte y la etapa de medio sumador y configurada para generar una salida de suma parcial de los primeros datos y los segundos datos, en donde un número de los al menos algunos de la pluralidad de LSBs es diferente de un número de los al menos algunos de la pluralidad de MSBs.
De acuerdo con una realización, un aparato que incluye: un componente de procesamiento que incluye un sumador de múltiples bits, en donde el sumador de múltiples bits incluye: una etapa de sumador completo configurada para recibir al menos algunos de una pluralidad de bits menos significativos (LSBs) de primeros datos y segundos datos; y una etapa de medio sumador configurada para recibir al menos algunos de una pluralidad de bits más significativos (MSBs) de los primeros datos y los segundos datos, en donde la etapa de medio sumador incluye al menos un medio sumador; una etapa de generación de transporte acoplada a la etapa de sumador completo y la etapa de medio sumador, en donde la etapa de generación de transporte incluye al menos un componente de generación de propagación (PG) en serie acoplado a las salidas del al menos un medio sumador; y una etapa de postsuma acoplada a la etapa de generación de transporte y la etapa de medio sumador y configurada para generar una salida de suma parcial de los primeros datos y los segundos datos, en donde un número de los al menos algunos de la pluralidad de LSBs es diferente de un número de los al menos algunos de la pluralidad de MSBs.
De acuerdo con otra realización, un método incluye: generar, a través de al menos un sumador completo, una salida de transporte intermedio con base en al menos algunos de una pluralidad de bits menos significativos (LSBs) de primeros datos y segundos datos; generar, a través de al menos un medio sumador, una salida de propagación actual y una salida de generación actual con base en al menos algunos de una pluralidad de bits más significativos (MSBs) de los primeros datos y los segundos datos, en donde un número de los al menos algunos de la pluralidad de MSBs es diferente de un número de los al menos algunos de la pluralidad de LSBs; generar, a través de al menos un componente de generación de propagación (PG) en serie, una salida de propagación en serie y una salida de generación en serie con base en al menos la salida de propagación actual y la salida de generación actual; y generar una salida de suma parcial con base en al menos la salida de propagación en serie, la salida de generación en serie, la salida de propagación actual, y la salida de transporte intermedio.
De acuerdo con otra realización, un aparato incluye: medios para generar una salida de transporte intermedio con base en al menos algunos de una pluralidad de bits menos significativos (LSBs) de primeros datos y segundos datos; medios para generar una salida de propagación actual y una salida de generación actual con base en al menos algunos de una pluralidad de bits más significativos (MSBs) de los primeros datos y los segundos datos, en donde un número de los al menos algunos de la pluralidad de MSBs es diferente de un número de los al menos algunos de la pluralidad de LSBs; medios para generar una salida de propagación en serie y una salida de generación en serie con base en al menos la salida de propagación actual y la salida de generación actual; y medios para generar una salida de suma parcial con base en al menos la salida de propagación en serie, la salida de generación en serie, la salida de propagación actual, y la salida de transporte intermedio.
Breve descripción de los dibujos
La figura 1 es una ilustración que muestra un sumador de transporte de ondulación (RCA), de acuerdo con una realización
La figura 2 es una ilustración que muestra una implementación de nivel de puerta lógica de un RCA, de acuerdo con una realización.
La figura 3 muestra un esquema de configuración de sumador de potencia variable, de acuerdo con una realización.
La figura 4 es una ilustración de un sumador de 4 bits de ejemplo que aplica aceleración a tres etapas de MSB, de acuerdo con una realización.
La figura 5 es una ilustración de un sumador de 4 bits de ejemplo que aplica aceleración a dos etapas de MSB, de acuerdo con una realización.
La figura 6 es una ilustración de un sumador de 4 bits de ejemplo que aplica aceleración a una etapa de MSB, de acuerdo con una realización.
La figura 7 es una ilustración de un componente de PG en serie de ejemplo, de acuerdo con una realización.
La figura 8 es una ilustración de un componente de PG en paralelo de ejemplo, de acuerdo con una realización.
La figura 9 es una ilustración de un componente de suma de ejemplo, de acuerdo con una realización.
La figura 10 es una ilustración de un dispositivo informático de ejemplo, de acuerdo con una realización.
La figura 11 es un diagrama de flujo para un método de ejemplo de realización de una adición de múltiples bits con base en una métrica de retraso de potencia predeterminada, de acuerdo con una realización.
Descripción detallada
Realizaciones de circuito de ejemplo
Diversas realizaciones proporcionan sumadores eficientes en energía variando el grado de paralelismo para los sumadores con base en una métrica de producto de retraso de potencia (PDP) en lugar de una métrica de potencia única o una métrica de retraso única. Por ejemplo, un sumador puede configurarse para usar circuitería de transporte en paralelo para algunas de las etapas de MSB y circuitería de transporte en serie para las etapas de bits menos significativas restantes. La circuitería en paralelo se conoce como circuitería de aceleración. El grado de paralelismo se ajusta durante el tiempo de diseño variando el número de etapas de MSB paralelas que usan la circuitería de aceleración. En una realización, un sumador incluye una etapa de sumador completo (FA), una etapa de medio sumador (HA), una etapa de generación de transporte, y una etapa de postsuma. La etapa de FA incluye circuitería de transporte en serie y opera en LSBs. La etapa de HA, la etapa de generación de transporte, y la etapa de postsuma incluyen circuitería de transporte en paralelo y operan en MSBs.
En la realización de ejemplo anterior, la etapa de FA está configurada para recibir LSBs de los primeros datos y segundos datos. La etapa de FA incluye uno o más FAs en serie configurados para generar sumas parciales y una salida de transporte intermedio desde los LSBs recibidos. La etapa de HA está configurada para recibir MSBs de los primeros datos y los segundos datos y realiza PG bit a bit. La etapa de HA incluye uno o más HAs en paralelo, cada uno configurado para generar una salida de suma y una salida de transporte para un par de entrada de MSB. Cada par de entrada se forma a partir de un bit de los primeros datos y un bit a partir de los segundos datos, donde los bits son del mismo orden de magnitud. La salida de suma puede ser análoga a una salida de propagación de una red de generación de propagación (PG). La salida de transporte puede ser análoga a una salida de generación de una red de PG. En algunas realizaciones, al menos una porción de la etapa de HA puede operar en paralelo con la etapa de FA.
Continuando con la realización de ejemplo anterior, la etapa de generación de transporte incluye una etapa de PG en serie y una etapa de PG en paralelo. La etapa de PG en serie incluye uno o más componentes de PG en serie. Cada componente de PG en serie está acoplado a las salidas de un HA y configurado para emitir las salidas de propagación y generación del HA o las salidas de propagación y generación de un siguiente orden de bits menor o un siguiente HA menos significativo con base en la salida de propagación del HA. En algunas realizaciones, al menos una porción de la etapa de PG en serie puede operar en paralelo con la etapa de FA. La etapa de PG en paralelo incluye uno o más componentes de PG en paralelo. Cada componente de PG en paralelo se acopla a las salidas de un componente de PG en serie y la etapa de FA y se configura para emitir la salida de generación del componente de PG en serie o la salida de transporte intermedio de la etapa de FA con base en la salida de propagación del componente de PG en serie. La salida del componente de PG en paralelo más significativo puede corresponder a una salida de transporte final para la suma de los primeros datos y los segundos datos.
Continuando con la realización de ejemplo anterior, la etapa de postsuma incluye uno o más componentes de suma paralelos. Cada componente de suma está acoplado a la salida del componente de PG en paralelo y configurado para agregar la salida de generación del componente de PG en paralelo a la salida de propagación de un HA del mismo orden de bits o del mismo significado para producir una suma parcial. Las sumas parciales producidas por los componentes de suma corresponden a MSBs de la suma de los primeros datos y los segundos datos.
Realizaciones adicionales pueden incluir el sumador descrito anteriormente en un dispositivo informático. Por ejemplo, el dispositivo informático puede incluir además un componente computacional acoplado al sumador. El componente computacional se puede configurar para realizar operaciones de punto fijo y/o operaciones de punto flotante, que pueden interactuar con el sumador para adiciones. En algunas realizaciones, el dispositivo informático puede incluir una multitud de sumadores con diferente grado de paralelismos.
Diversas realizaciones pueden incluir ventajas sobre los sistemas convencionales. Por ejemplo, se pueden usar diversas realizaciones durante una fase de diseño para permitir que un diseñador de circuitos seleccione sumadores que tengan una cantidad apropiada de paralelismo para satisfacer las restricciones de temporización pero aún tratar suficientes dígitos con mecanismos de transporte de ondulación para ahorrar potencia y espacio. Eso permite un diseño eficiente en energía que también se puede personalizar para cumplir con una restricción de temporización particular. Por ejemplo, el diseñador puede incrementar gradualmente el número de etapas de MSB con la circuitería de aceleración hasta que un sumador cumpla con una cierta restricción de PDP. Luego, el sumador puede compilarse usando celdas estándar y liberarse como una unidad o una bandeja. La bandeja puede mantener las celdas o circuitería del sumador físicamente cerca entre sí en un plano de planta, y de este modo puede mejorar además la velocidad, área, y consumo de potencia. Las diversas realizaciones pueden proporcionar un control preciso de aceleración versus la potencia en una granularidad fina (por ejemplo, en etapas de una etapa de bits) para el diseño de sumadores. Aunque las realizaciones divulgadas se describen en el contexto de sumadores de 4 bits, las realizaciones divulgadas se pueden aplicar a cualquier sumador de múltiples bits, tales como un sumador de 3 bits, un sumador de 8 bits, un sumador de 16 bits, y un sumador de 32 bits.
La figura 1 es una ilustración que muestra un RCA 100, de acuerdo con una realización. La figura 1 ilustra el RCA 100 como un sumador de 4 bits con el propósito de simplicidad de discusión, aunque se reconocerá que realizaciones de la presente divulgación pueden escalar para agregar más o menos número de bits. El RCA 100 incluye una pluralidad de sumadores completos (FAs) 110. Los FAs 110 se muestran como 110b0, 110b1, 110b2, y 110b3. Cada FA 110 incluye tres puertos de entrada, denotados como A, B, y Ci, y dos puertos de salida, denotados como S y Ci. Para cada FA 110, el puerto de entrada A está configurado para recibir un bit desde un primer operando y el puerto de entrada B está configurado para recibir un bit desde un segundo operando. Los bits de entrada recibidos en los puertos de entrada A y B son de igual magnitud o significado. El puerto de entrada Ci está configurado para recibir un bit de ejecución desde un siguiente FA 110 de orden de bits menos significativo o bajo. Cada FA 110 está configurado para agregar bits de entrada recibidos desde los puertos de entrada A, B, y Ci para producir una suma y una ejecución en los puertos de salida S y Ci, respectivamente. Los FAs 110 se pueden implementar usando cualquier configuración de circuito adecuada. En algunas realizaciones, se pueden aplicar técnicas de factorización Booleana y/o transformada Booleana para reducir el conteo de transistores, retraso, y/o potencia. Por ejemplo, los FAs 110 se pueden implementar usando puertas de paso, puertas de transmisión, puertas de paso, y/o puertas de dominó.
Como ejemplo, el RCA 100 agrega un primer operando A a un segundo operando B para producir un resultado o suma S y un bit de ejecución Csalida. El primer operando A incluye 4 bits, denotados como A<0>, A<1>, A<2>, y A<3> desde LSB a MSB. El segundo operando B incluye 4 bits, denotados como B<0>, B<1>, B<2>, y B<3> desde LSB a MSB. El resultado S incluye 4 bits, denotados como S<0>, S<1>, S<2>, y S<3> desde LSB a MSB. Durante un primer período, el FA 110b0 agrega un bit de arrastre, denotado como Centrada, a un LSB A<0> del primer operando A y un lSb B<0> del segundo operando B para producir un bit de resultado menos significativo S<0> del resultado S y un primer bit de ejecución, denotado como C1. Durante un período siguiente, el FA 110b1 agrega el bit de ejecución C1, un siguiente MSB A<1> del primer operando A, y un siguiente MSB B<1> del segundo operando B para producir un siguiente bit de resultado más significativo S<1> y un segundo bit de ejecución, denotado como C2. Este procedimiento se repite hasta que el bit de ejecución, denotado como C3, se agrega al MSB A<3> del primer operando A y al MSB B<3> del segundo operando B para producir un bit de resultado más significativo S<3> y una salida de postransporte o bit de ejecución final, denotado como Csalida.
Como se puede ver, el bit de ejecución de cada FA 110 es un arrastre de un siguiente FA 110 más significativo, y de este modo cada FA 110 puede no comenzar hasta la compleción de un FA 110 menos significativo previo. De este modo, hay un retraso de tiempo entre la generación del bit de resultado menos significativo S<0> y el bit de resultado más significativo S<3>. Como tal, el retraso de tiempo de un RCA de N bits es en el orden de N.
La figura 2 es una ilustración que muestra una implementación de nivel de puerta lógica de un RCA 200 similar al RCA 100, de acuerdo con una realización. El RCA 200 incluye una etapa 210 de generación de PG bit a bit, una etapa 220 de generación de PG de grupo, una etapa 230 de generación de postsuma, y etapas 202 de bits. El número de etapas 202 de bits depende de los anchos de bit de los operandos. Las etapas 202 de bits se extienden a través de la etapa 210 de generación de PG bit a bit, la etapa 220 de generación de PG de grupo, y la etapa 230 de generación de postsuma. Cada etapa 202 de bits corresponde a un FA 110 del RCA 100.
Para cada i-ésima etapa 202 de bits, la etapa 210 de generación de PG bit a bit está configurada para generar una salida de generación, denotada como Gi, y una salida de propagación, denotada como Pi, para cada par de bits de entrada, denotados como (Ai, Bi), donde Ai y Bi corresponden a un bit de operando A y un bit de operando B, respectivamente, de igual magnitud. La salida de generación Gi y la salida de propagación Pi se pueden implementar usando una puerta AND lógica y una puerta OR exclusiva, respectivamente, y se expresan como se muestra a continuación:
Gi = A i .B u (1)

donde i varía de 1 a N y N representa el número de etapas 202 de bits. La salida de generación Gi indica si se genera un transporte para la i-ésima etapa 202 de bits. Se genera un transporte cuando ambos bits de entrada Ai y Bi son verdaderos o tienen valores de unos. La salida de propagación Pi indica si el transporte Ci-1 recibido desde una etapa 202 de bits previa (i-1 )ésima se propaga a la etapa 202 de bits i-ésima actual. La salida de propagación Pi es verdadera cuando cualquiera Ai o Bi es verdadero. La etapa 210 de PG bit a bit puede generar las salidas de generación (por ejemplo, G0, G1, G2, y G3) y las salidas de propagación (por ejemplo, P0, P1, P2 , y P3) para todas las etapas 202 de bits en paralelo.
Para cada i-ésima etapa 202 de bit, la etapa 220 de generación de PG de grupo se configura para generar una salida de generación de grupo, denotada como Gi 0 o Ci, con base en la salida de generación Gi y la salida de propagación Pi de la i-ésima etapa 202 de bits y la salida de generación Gi-1 y la salida de propagación Pi-1 del siguiente orden de bits bajo o etapa 202 de bits significativa (i-1)ésima. Cuando la salida de propagación Pi es falsa, la etapa 220 de generación de PG de grupo emite la salida de generación Gi en el la salida de generación de grupo Gi0. Por el contrario, cuando la salida de propagación Pi es verdadera, la etapa 220 de generación de PG de grupo emite la salida de generación previa Gi-10 en la salida de generación de grupo Gi 0. La salida de generación de grupo Gi 0 se puede implementar usando puertas AND lógicas y puertas OR lógicas y se expresan como se muestra a continuación:
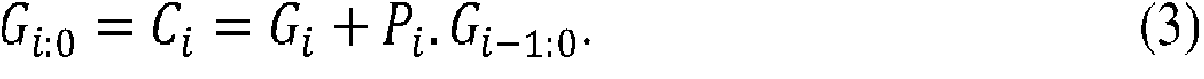
La etapa 220 de generación de PG de grupo genera la salida de generación de grupo (por ejemplo, G00 , G10 , G20 , y G3:q) en serie.
Para cada i-ésima etapa 202 de bits, la etapa 230 de generación de postsuma está configurada para generar una suma, denotada como Si. Además, la etapa 230 de generación de postsuma genera una ejecución final, denominada como Csalidao C4 , en la etapa 202 de bits más significativa. La suma Si se puede implementar usando puertas OR exclusivas y se expresa como se muestra a continuación:
La ejecución final Csalida se puede implementar usando una puerta AND lógica y una puerta OR lógica y se expresa como se muestra a continuación:
Cout = Cjy Pjy. C/y-i- (5)
Aunque el RCA 200 implementa adiciones usando operaciones de prefijo en paralelo, las salidas de generación de grupo (por ejemplo, el transporte) ondulan en serie desde el LSB al MSB, y de este modo pueden tener un rendimiento lento. Como tal, el RCA 200 puede no cumplir con las restricciones de temporización de algunas aplicaciones. Otros diseños de sumadores, tales como sumadores de transporte-salto, sumadores de transporte con anticipación, y/o sumadores de transporte-selección, pueden incluir cálculo paralelo para transportes, y de este modo pueden mejorar la velocidad de procesamiento o retraso de tiempo. Sin embargo, tales diseños de sumadores pueden usar más transistores y son menos eficientes en potencia y/o menos eficientes en área que el RCA 200.
La figura 3 muestra un esquema 300 de configuración de sumador de potencia variable, de acuerdo con una realización. El esquema 300 configura sumadores con base en una métrica de PDP objetivo en lugar de con base en una potencia objetivo o un retraso objetivo solo. La métrica de PDP es una medida de vatios por megahercio (MHz), y de este modo es indicativa de eficiencia de potencia. El esquema 300 emplea sumadores 310 basados en PG en paralelo con circuitería de transporte en paralelo para un número de MSBs y circuitería de transporte en serie, tales como los FAs 110, para el número restante de LSBs para compensar la velocidad por el ahorro de potencia. Aunque el esquema 300 se ilustra en el contexto de un sumador de 4 bits con tres configuraciones 306, 307, y 308 de aceleración, el esquema 300 se puede aplicar a un sumador de N bits con configuraciones de aceleración de 1 a N-1, donde N es un entero positivo mayor que 1.
Como ejemplo, cada configuración 306, 307, y 308 agrega un primer operando A a un segundo operando B para producir una suma S y un bit de ejecución Csalida. Las configuraciones 306, 307, y 308 proporcionan etapas incrementales de compensaciones de retraso de potencia. El primer operando A incluye 4 bits, denotados como A<0>, A<1>, A<2>, y A<3> desde LSB a MSB. El segundo operando B incluye 4 bits, denotados como B<0>, B<1>, B<2>, y B<3> desde LSB a MSB. El resultado S incluye 4 bits, denotados como S<0>, S<1>, S<2>, y S<3> desde LSB a MSB.
La configuración 306 usa un FA 110 para agregar el par de entrada de LSB (A<0>, B<0>) y sumadores 310 basados en PG en paralelo para proporcionar una aceleración para las tres etapas 302 de MSB. La configuración 306 se denomina como una configuración de aceleración tres. Los sumadores 310 basados en PG en paralelo pueden incluir diversas etapas de cálculos de PG como se describe con mayor detalle en este documento. Como se muestra, un primer sumador 310 basado en PG en paralelo opera en el par de entrada (A<1>, B<1>), un segundo sumador 310 basado en PG en paralelo opera en el par de entrada (A<2>, B<2>), y un tercer sumador 310 basado en PG en paralelo opera en el par de entrada (A<3>, B<3>). El primer, segundo, y tercer sumadores 310 basados en PG en paralelo operan en paralelo para calcular transportes intermedios como se muestra por la flecha 309. El primer, segundo, y tercer sumadores 310 basados en PG en paralelo pueden operar en paralelo con el FA 110. Aunque los sumadores 310 basados en PG en paralelo pueden proporcionar una aceleración o mejorar el retraso de tiempo, los sumadores 310 basados en PG en paralelo incluyen más lógicas de transistor, y de este modo pueden consumir más potencia que el uso de FAs 110.
La configuración 307 usa dos FAs 110 para agregar los dos pares de LSB (A<0>, B<0>) y (A<1>, B<1>) y usa sumadores 310 basados en PG en paralelo para proporcionar una aceleración en las siguientes dos etapas 302 de MSB. De este modo, la configuración 307 se denomina como una configuración de aceleración dos. Como se muestra, un primer sumador 310 basado en PG en paralelo opera en el par de entrada (A<2>, B<2>) y un segundo sumador 310 basado en PG en paralelo opera en el par de entrada (A<3>, B<3>). El primer y segundo sumadores 310 basados en PG en paralelo operan en paralelo para calcular transportes intermedios como se muestra por la flecha 309. Los FAs 110 operan en serie, pero pueden operar en paralelo con los sumadores 310 basados en PG en paralelo. Aunque la configuración 307 proporciona menos aceleración que la configuración 306, la configuración 307 es más eficiente en energía que la configuración 306.
La configuración 308 usa tres FAs 110 para operar en los tres pares de LSB (A<0>, B<0>), (A<1>, B<1>), y (A<2>, B<2>) y usa un sumador 310 basado en PG en paralelo para proporcionar una aceleración en la etapa 302 de MSB. De este modo, la configuración 308 se denomina como una configuración de aceleración uno. El sumador 310 basado en PG en paralelo opera en el par de entrada (A<3>, B<3>) para calcular un transporte intermedio como se muestra por la flecha 309. Similar a la configuración 307, los FAs 110 operan en serie, pero pueden operar en paralelo con el sumador 310 basado en PG en paralelo. Aunque la configuración 308 proporciona menos aceleración que las configuraciones 306 y 307, la configuración 308 puede ser más eficiente en energía que ambas configuraciones 306 y 307. El esquema 300 puede incluir además una configuración sin aceleración, por ejemplo, una configuración de aceleración cero, que degenera en la misma configuración que el RCA 100.
Para configurar un sumador con base en un PDP objetivo, en la acción 320, el esquema 300 determina un PDP objetivo, por ejemplo, con base en restricciones de temporización y potencia para una aplicación y/o dispositivo particular. En la acción 322, el esquema 300 selecciona una configuración de sumador de las configuraciones 306,
307, y 308 con base en el PDP objetivo determinado. Como se puede ver, las configuraciones 306, 307, y 308 proporcionan una compensación variable de potencia-velocidad en etapas de etapas 302 de bits. De este modo, el esquema 300 se puede usar en el diseño de sumadores para compensar velocidad por ahorro de potencia en etapas incrementales. Para mejorar además la eficiencia de energía, el esquema 300 puede generar los FAs 110 y los sumadores 310 basados en PG en paralelo para una configuración 306, 307, o 308 particular como una unidad o una bandeja. Como tal, los componentes o celdas de circuito para los FAs 110 y sumadores 310 basados en PG en paralelo pueden ubicarse cerca uno del otro en un plano de planta en lugar de estar dispersos.
La figura 4 es una ilustración de un sumador 400 de 4 bits de ejemplo que aplica aceleración a tres etapas 402 de MSB, de acuerdo con una realización. El sumador 400 tiene una configuración similar a la configuración 306 y proporciona una vista más detallada de los componentes internos e interconexiones de los sumadores 310 basados en PG en paralelo en la configuración 306. El sumador 400 incluye una etapa 410 de FA, una etapa 420 de HA, una etapa 430 de generación de transporte, y una etapa 440 de postsuma. La etapa 410 de FA opera en los LSBs de un operando A y un operando B. El operando A se puede representar desde lSb a MSB como A<0>, A<1>, A<2>, y A<3>. El operando B se puede representar desde LSB a m Sb como B<0>, B<1>, B<2>, y B<3>. La etapa 420 de HA, la etapa 430 de generación de transporte, y la etapa 440 de postsuma corresponden a los sumadores 310 basados en PG en paralelo y operan en los tres MSBs del operando A y los tres MSBs del operando B.
La etapa 410 de FA incluye un FA 110 en la etapa 404 de LSB. El FA 110 recibe A<0>, B<0>, y una entrada de transporte, denotada como Centrada, en los puertos de entrada A, B, y Ci, respectivamente. El fA 110 calcula una suma del par de entrada (A<0>, B<0>) y produce un bit de suma menos significativo, denotado como S<0>, en el puerto de salida S y un transporte intermedio de la suma en el puerto de salida Co.
La etapa 420 de HA está acoplada a la etapa 410 de FA. La etapa 420 de HA incluye una pluralidad de HAs 422 configurados para calcular PG bit a bit. Cada etapa 402 de MSB incluye un HA correspondiente que opera en un par de entrada (A<1>, B<1>), (A<2>, B<2>), o (A<3>, B<3>). La etapa 402 de MSB menos significativa incluye un HA 422 adicional que opera en el par de entrada (A<0>, B<0). Cada HA 422 incluye puertos de entrada, denotados como A y B, y puertos de salida, denotados como Co y S. El puerto de entrada A está configurado para recibir un bit desde el operando A. El puerto de entrada B está configurado para recibir un bit desde el operando B. Los bits de entrada recibidos en los puertos de entrada A y B son de igual magnitud o significado. Cada HA 422 está configurado para generar una salida de generación en el puerto de salida Co a partir de los bits de entrada recibidos de acuerdo con la ecuación (1) y generar una salida de propagación en el puerto de salida S a partir de los bits de entrada recibidos de acuerdo con la ecuación (2). Dado que las operaciones de los HAs 422 son independientes entre sí, los HAs 422 pueden configurarse como circuitería en paralelo. Además, las operaciones de los HAs 422 son independientes de la etapa 410 de FA. De este modo, los HAs 422 pueden configurarse para operar en paralelo con la etapa 410 de FA. Por ejemplo, los HAs 422 y el FA 110 pueden incluir componentes operacionales en paralelo.
La etapa 430 de generación de transporte está acoplada a la etapa 420 de HA y la etapa 410 de FA. La etapa 430 de generación de transporte incluye una etapa 432 de PG en serie y una etapa 436 de PG en paralelo. La etapa 432 de PG en serie incluye una pluralidad de componentes 434 de PG en serie, uno en cada etapa 402 de MSB. Cada componente 434 de PG en serie incluye puertos de entrada, denotados como Gi, Pi, Gi-1, y Pi-1, y puertos de salida, denotados como Go y Po. Los puertos de entrada Gi y Pi están acoplados a los puertos de salida Co y S, respectivamente, de un HA 422 de un orden de bits actuales o una etapa 402 de MSB actual. Los puertos de entrada Gi-1 y Pi-1 están acoplados a los puertos de salida Go y Po, respectivamente, de un componente 434 de PG en serie de un siguiente orden de bits menor o una etapa 402 de MSB previa. Sin embargo, los puertos de entrada Gi-1 y Pi-1 del componente 434 de PG en serie menos significativo están acoplados a los puertos de salida Co y S, respectivamente, del HA 422 menos significativo. Cada componente 434 de PG en serie está configurado para emitir la salida de generación y la salida de propagación del HA del orden de bits actuales o propagar la salida de generación y la salida de propagación de un componente 434 de PG en serie de un siguiente orden de bits menor con base en la entrada recibida en el puerto de entrada Pi. La circuitería interna de los componentes 434 de PG en serie se describe con mayor detalle en este documento. Dado que la operación de cada componente 434 de PG en serie es dependiente de un componente 434 de PG en serie de un siguiente orden de bits menor, los componentes 434 de PG en serie están configurados para operaren serie. Sin embargo, algunos de los componentes 434 de PG en serie pueden operar en paralelo con la etapa 410 de FA dependiendo de las temporizaciones de la etapa 410 de FA y la etapa 420 de HA.
La etapa 436 de PG en paralelo incluye una pluralidad de componentes 438 de PG en paralelo, uno en cada etapa 402 de MSB. Cada componente 438 de PG en paralelo incluye puertos de entrada, denotados como Gi, Pi, y Gi-1, y un puerto de salida, denotado como Go. Los puertos de entrada Gi y Pi están acoplados a los puertos de salida Go y Po respectivamente, de un componente 434 de PG en serie de un orden de bits actuales. Los puertos de entrada Gi-1 están acoplados al puerto de salida Co del FA 110. Cada componente 438 de PG en paralelo está configurado para emitir la salida de generación del componente de PG en serie del orden de bits actuales o la salida de transporte intermedio por el FA 110 con base en la entrada recibida en el puerto de entrada Pi. La circuitería interna de los componentes 438 de PG en paralelo se describe con mayor detalle en este documento. Dado que las operaciones de los componentes 438 de PG en paralelo son independientes entre sí, los componentes 438 de PG en paralelo pueden configurarse para operar en paralelo. La salida del componente 438 de PG en paralelo del orden de bits más alto corresponde a una salida de postransporte o salida de transporte final, denotada como Csalida.
La etapa 440 de postsuma está acoplada a la etapa 420 de HA y la etapa 430 de generación de transporte. La etapa 440 de postsuma incluye una pluralidad de componentes 442 de suma, uno en cada etapa 402 de MSB. Cada componente 442 de suma incluye puertos de entrada, denotados como Gi y Pi, y un puerto de salida, denotado como S. El puerto de entrada Gi está acoplado al puerto de salida Go de un componente 438 de PG en paralelo de un orden de bits actuales. El puerto de entrada Pi está acoplado al puerto de salida S de un HA 422 del orden de bits actuales. Cada componente 442 de suma está configurado para generar una salida de suma parcial en el puerto de salida S a partir de las entradas recibidas en los puertos de entrada Gi y Pi. Como se muestra, los componentes 442 de suma generan los tres bits de suma más significativos, denotados como S<1>, S<2>, y S<3>. La circuitería interna del componente 442 de suma se describe con mayor detalle en este documento.
Como se puede ver, la aceleración es proporcionada por las operaciones en paralelo entre los HAs 422, las operaciones en paralelo entre la etapa 410 de FA y la etapa 420 de HA, las operaciones en paralelo entre la etapa 410 de FA y la etapa 432 de PG en serie, las operaciones en paralelo entre los componentes 438 de PG en paralelo, y/o las operaciones en paralelo entre los componentes 442 de suma.
La figura 5 es una ilustración de un sumador 500 de 4 bits de ejemplo que aplica aceleración a dos etapas 502 de MSB, de acuerdo con una realización. El sumador 500 tiene una configuración similar como la configuración 307 y proporciona una vista más detallada de los componentes internos e interconexiones de los sumadores 310 basados en PG en paralelo en la configuración 307. El sumador 500 incluye una etapa 510 de FA, una etapa 520 de HA, una etapa 530 de generación de transporte, y una etapa 540 de postsuma, donde la etapa 530 de generación de transporte incluye una 532 etapa de PG en serie y una etapa 536 de PG en paralelo. La etapa 510 de FA, la etapa 520 de HA, la etapa 532 de PG en serie, la etapa 536 de PG en paralelo, y la etapa 540 de postsuma son sustancialmente similares a la etapa 410 de FA, la etapa 420 de HA, la etapa 432 de PG en serie, la etapa 436 de PG en paralelo, y la etapa 440 de postsuma. Sin embargo, la etapa 520 de Ha , la etapa 532 de PG en serie, la etapa 536 de PG en paralelo, y la etapa 540 de postsuma operan en dos etapas 502 de MSB para proporcionar una aceleración de 2 bits, y la etapa 510 de FA opera en las dos etapas 504 de lSb restantes para proporcionar ahorro de potencia.
La etapa 510 de FA incluye dos FAs 110 configurados para operar en los dos pares de entrada de LSB (A<0>, B<0>) y (A<1>, B<1>). El FA 110 en la etapa 504 de LSB más significativa produce un transporte intermedio en el puerto de salida Co.
La etapa 520 de HA incluye dos HAs 422 configurados para operar en los dos pares de entrada de MSB (A<2>, B<2>) y (A<3>, B<3>). La etapa 520 de HA incluye además un tercer HA 422 en la etapa 502 de MSB menos significativa configurada para operar en el par de LSB más significativo (A<1>, B<1>) operado por la etapa 510 de FA. Los HAs 422 son HAs en paralelo y pueden operar en paralelo con la etapa 510 de FA.
La etapa 532 de PG en serie incluye dos componentes 434 de PG en serie configurados para operar en los dos pares de entrada de MSB (A<2>, B<2>) y (A<3>, B<3>). Los componentes 434 de PG en serie pueden operar en paralelo con la etapa 510 de FA. La etapa 536 de PG en paralelo incluye dos componentes 438 de PG en paralelo configurados para operar en los dos pares de entrada de m Sb (A<2>, B<2>) y (A<3>, B<3>) y la salida de transporte intermedio por la etapa 510 de FA.
La etapa 540 de postsuma incluye dos componentes 442 de suma configurados para operar en los dos pares de entrada de MSB (A<2>, B<2>) y (A<3>, B<3>) y las salidas de propagación en los puertos de salida S de los HAs 422.
La figura 6 es una ilustración de un sumador 600 de 4 bits de ejemplo que aplica aceleración a una etapa 602 de MSB, de acuerdo con una realización. El sumador 600 tiene una configuración similar como la configuración 308 y proporciona una vista más detallada de los componentes internos e interconexiones de los sumadores 310 basados en PG en paralelo en la configuración 308. El sumador 600 incluye una etapa 610 de FA, una etapa 620 de HA, una etapa 630 de generación de transporte, y una etapa 640 de postsuma, donde la etapa 630 de generación de transporte incluye una etapa 632 de PG en serie y una etapa 636 de PG en paralelo. La etapa 610 de FA es sustancialmente similar a las etapas 410 y 510 de FA. La etapa 620 de HA es sustancialmente similar a las etapas 420 y 520 de HA. La etapa 632 de PG en serie es sustancialmente similar a las etapas 432 y 532 de PG en serie. La etapa 636 de PG en paralelo es sustancialmente similar a las etapas 436 y 536 de PG en paralelo. La etapa 640 de postsuma es sustancialmente similar a las etapas 440 y 540 de postsuma. Sin embargo, la etapa 620 de HA, la etapa 632 de PG en serie, la etapa 636 de PG en paralelo, y la etapa 640 de postsuma operan en la etapa 602 de MSB para proporcionar una aceleración de 1 bit, y la etapa 610 de FA opera en las tres etapas 604 de LSB restantes.
La etapa 610 de FA incluye tres FAs 110 configurados para operar en los tres pares de entrada de LSB (A<0>, B<0>), (A<1>, B<1>), (A<2>, B<2>). El FA 110 en las etapas 604 de LSB más significativas produce un transporte intermedio en el puerto de salida Co.
La etapa 620 de HA incluye un HA 422 configurado para operar en el par de entrada de MSB (A<3>, B<3>). La etapa 620 de HA incluye además un tercer HA 422 en la etapa 602 de MSB menos significativa configurada para operar en
el par de entrada de MSB (A<2>, B<2>) de los LSBs operados por la etapa 610 de FA. Los HAs 422 son HAs en paralelo y pueden operar en paralelo con la etapa 610 de FA.
La etapa 632 de PG en serie incluye unos componentes 434 de PG en serie configurados para operar en el par de entrada de MSB (A<3>, B<3>). Los componentes 434 de PG en serie pueden operar en paralelo con la etapa 610 de FA. La etapa 636 de PG en paralelo incluye unos componentes 438 de PG en paralelo configurados para operar en el par de entrada de MSB (A<3>, B<3>) y la salida de transporte intermedio por la etapa 610 de FA. La etapa 640 de postsuma incluye unos componentes 442 de suma configurados para operar en el par de entrada de m Sb (A<3>, B<3>) y las salidas de propagación en el puerto de salida S de los HAs 422.
La figura 7 es una ilustración de un componente 700 de PG en serie de ejemplo, de acuerdo con una realización. El componente 700 de PG en serie es similar al componente 434 de PG en serie y proporciona una vista más detallada de los componentes internos e interconexiones del componente 434 de PG en serie. El componente 700 de PG en serie incluye puertos de entrada, denotados como Gi, Pi, Gm , y Pm , y puertos de salida, denotados como Go y P0. El componente 700 de PG en serie genera una señal de salida en el puerto de salida Go con base en las señales de entrada recibidas desde los puertos de entrada Gi, Pi, y Gm usando una puerta AND lógica y una puerta OR lógica expresada como se muestra a continuación:
G0 = Gi Pi .Gi_ i. (6)
El componente 700 de PG en serie genera una señal de salida en el puerto de salida Po con base en las señales de entrada recibidas desde los puertos de entrada Gi, Pi, y Pi-1 usando una puerta AND lógica expresada como se muestra a continuación:
Po=P i P i-1- (7)
Como tal, cuando la señal de entrada en la entrada Pi es falsa, el componente 700 de PG en serie emite las señales de entrada recibidas desde los puertos de entrada Gi y Pi a los puertos de salida Go y Po, respectivamente. De lo contrario, el componente 700 de PG en serie emite las señales de entrada recibidas en los puertos de entrada Gm y Pi-1 a los puertos de salida Go y P0, respectivamente.
La figura 8 es una ilustración de un componente 800 de PG en paralelo de ejemplo, de acuerdo con una realización. El componente 800 de PG en paralelo es similar al componente 438 de PG en paralelo y proporciona una vista más detallada de los componentes internos e interconexiones del componente 438 de PG en paralelo. El componente 800 de PG en paralelo incluye puertos de entrada, denotados como Gi, Pi, y Gm , y un puerto de salida, denotado como Go. El componente 800 de PG en paralelo genera una señal de salida en el puerto de salida Go con base en las señales de entrada recibidas desde los puertos de entrada Gi, Pi, y Gm usando una puerta AND lógica y una puerta OR lógica expresada como se muestra a continuación:

Como tal, cuando la señal de entrada en la entrada Pi es falsa, el componente 800 de PG en paralelo emite la señal de entrada recibida desde los puertos de entrada Gi al puerto de salida Go. De lo contrario, el componente 800 de PG en paralelo emite la señal de entrada recibida en el puerto de entrada Gm a los puertos de salida Go.
La figura 9 es una ilustración de un componente 900 de suma de ejemplo, de acuerdo con una realización. El componente 900 de suma es similar al componente 442 de suma y proporciona una vista más detallada de los componentes internos e interconexiones del componente 442 de suma. El componente 900 de suma incluye puertos de entrada, denotados como Gi y Pi, y un puerto de salida, denotado como S. El componente 900 de suma genera una señal de salida en el puerto de salida S con base en las señales de entrada recibidas desde los puertos de entrada Gi y Pi usando una puerta OR exclusiva expresada como se muestra a continuación:
5 = Gt © Pt. (9)
La figura 10 es una ilustración de un dispositivo 1000 informático de ejemplo, de acuerdo con una realización. El dispositivo 1000 informático puede ser un dispositivo móvil, un dispositivo multimedia, o cualquier dispositivo que pueda ser de potencia limitada. El dispositivo 1000 informático incluye un componente 1010 de procesamiento. El componente 1010 de procesamiento incluye uno o más componentes 1012 computacionales y uno o más sumadores 1014 de múltiples bits. Los sumadores 1014 de múltiples bits pueden configurarse de acuerdo con el esquema 300 y pueden tener configuraciones similares como configuraciones 306, 307, y 308 y los sumadores 400, 500, y 600. En una realización, al menos un sumador 1014 de múltiples bits tiene una división desigual de etapas de MSB de aceleración y etapas de LSB de transporte de ondulación. Por ejemplo, el sumador 1014 de múltiples bits puede ser un sumador de K-bits y puede incluir N etapas de MSB de aceleración y (K-N) etapas de LSB de transporte de ondulación, donde N y (K-N) no son iguales. En algunas realizaciones, los sumadores 1014 de múltiples bits pueden
tener diferentes arquitecturas de aceleración. Por ejemplo, un sumador 1014 de múltiples bits puede tener tres etapas de aceleración de MSB, otro sumador 1014 de múltiples bits puede tener dos etapas de MSB de aceleración, y aún otro sumador 1014 de múltiples bits puede tener cero etapas de aceleración. El dispositivo 1000 informático puede incluir además memoria, puertos de entrada, puertos de salida, subsistema de bus, subsistema de reloj, subsistema de potencia, y cualquier subsistema de aplicación específica.
El componente 1012 computacional puede incluir lógicas y circuiterías configuradas para realizar operaciones de punto flotante y/o operaciones de punto fijo. Las operaciones de punto flotante y/o las operaciones de punto fijo pueden incluir resta, multiplicación, división, inversión de signo, y/o comparación. El componente 1012 computacional puede configurarse además para calcular funciones hiperbólicas, de raíz cuadrada, trigonométricas, logarítmicas, y/o cualquier función matemática avanzada.
El componente 1012 computacional está acoplado a los sumadores 1014 de múltiples bits. El componente 1012 computacional puede realizar al menos algunas de las operaciones usando adiciones calculadas por los sumadores 1014 de múltiples bits. Como ejemplo, el componente 1012 computacional puede configurarse para realizar multiplicación, donde un multiplicando se multiplica por un multiplicador. La multiplicación puede incluir multiplicar el multiplicando con cada dígito binario del multiplicador para producir productos parciales y sumar los productos parciales para producir un producto final. En una realización, los sumadores 1014 de múltiples bits pueden configurarse para agregar los productos parciales para producir el producto final. En otra realización, se agregan dígitos binarios de magnitudes iguales a través de los productos parciales para producir un conjunto de bits de transporte y un conjunto de bits de suma, por ejemplo, usando sumadores de transporte-ahorro. El conjunto de bits de transporte puede formar un vector y el conjunto de bits de suma puede formar otro vector. En tal realización, los sumadores 1014 de múltiples bits pueden configurarse para agregar el vector de bits de transporte al vector de bits de suma para producir el producto final.
Métodos de ejemplo de uso para los circuitos de las figuras 4-10 se discutirán ahora.
Métodos de ejemplo de uso
La figura 11 es un diagrama de flujo para un método 1100 de ejemplo de realización de una adición de múltiples bits con base en una métrica de retraso de potencia predeterminada, de acuerdo con una realización. El método 1100 puede ser realizado por los sumadores ilustrados en las figuras 3-6. En el método 1100 de ejemplo, las acciones se realizan con respecto a las configuraciones en las figuras 3-6. Específicamente, el sumador se configura de acuerdo con una métrica de PDP, por ejemplo, un PDP objetivo, usando el esquema 300. El número de etapas de MSB de aceleración se selecciona para cumplir con la métrica de PDP predeterminada. Por ejemplo, durante una fase de diseño de circuito, un diseñador de circuitos puede comenzar con un RCA eficiente en potencia tales como los RCAs 100 y 200 sin etapa de MSB de aceleración y aumentar gradualmente el número de etapas de MSB de aceleración hasta que el sumador cumpla tanto con la restricción de temporización como con la restricción de potencia de una métrica de retraso de potencia respectiva.
El sumador recibe los primeros datos y segundos datos. Cada primeros datos y segundos datos pueden incluir un número de bits binarios. Los primeros datos pueden corresponder al operando A y los segundos datos pueden corresponder al operando B en los ejemplos de las figuras 4-6. El sumador puede tener una división desigual entre el número de etapas de MSB de aceleración (por ejemplo, las etapas 402, 502, y 602 de MSB) y las etapas de LSB de transporte de ondulación (por ejemplo, las etapas 404, 504, y 604 de LSB). Las acciones descritas a continuación en los bloques 1110-1140 se realizan para los primeros datos y los segundos datos.
El método 1100 comienza en el bloque 1110, que incluye generar una salida de transporte intermedio con base en al menos algunos LSBs de los primeros datos y los segundos datos, por ejemplo, a través de al menos un FA tales como los FAs 110. La salida de transporte intermedio corresponde a la ejecución generada por el FA 110 más significativo.
En el bloque 1120, el método 1100 incluye generar una salida de propagación actual y una salida de generación actual con base en al menos algunos MSBs de los primeros datos y los segundos datos, por ejemplo, a través de al menos un HA tales como los HAs 422. La salida de propagación actual y la salida de generación actual pueden corresponder a las salidas en los puertos de salida S y Co, respectivamente, de un HA 422 en una iésima etapa de bits en los ejemplos de las figuras 4-6.
En el bloque 1130, el método 1100 incluye generar una salida de propagación en serie y una salida de generación en serie con base en al menos la salida de propagación actual y la salida de generación actual, por ejemplo, a través de un componente de PG en serie tales como los componentes 434 y 700 de PG en serie. La salida de propagación en serie y la salida de generación en serie pueden corresponder a las salidas en los puertos de salida Po y Go, respectivamente, de un componente 434 de PG en serie en la i-ésima etapa de bits en los ejemplos de las figuras 4-6.
La generación de la salida de propagación en serie y la salida de generación en serie incluye propagar la salida de propagación actual y la salida de generación actual a la salida de propagación en serie y la salida de generación en serie, respectivamente, cuando la salida de propagación actual es falsa. La generación de la salida de propagación
en serie y la salida de generación en serie incluye propagar la salida de propagación previa y la salida de generación previa a la salida de propagación en serie y la salida de generación en serie, respectivamente, cuando la salida de propagación actual es verdadera.
En una realización, la salida de generación previa y la salida de propagación previa corresponden a la salida de generación y la salida de propagación, respectivamente, de un componente de PG en serie en una (i-1 )ésima etapa de bits, por ejemplo, operando en los siguientes MSBs de orden de bits inferior de los primeros datos y los segundos datos. En otra realización, la salida de generación previa y la salida de propagación previa corresponden a la salida de transporte y la salida de suma, respectivamente, de un HA que opera en MSBs de los al menos algunos LSBs de los primeros datos y los segundos datos.
En el bloque 1140, el método 1100 incluye generar una salida de suma parcial con base en al menos la salida de propagación en serie, la salida de generación en serie, y la salida de transporte intermedio. La salida de suma parcial puede corresponder a la salida en el puerto de salida S de un componente 442 de suma en la i"ésima etapa de bits en los ejemplos de las figuras 4-6. Por ejemplo, se puede generar una salida de generación en paralelo con base en la salida de propagación en serie y la salida de generación en serie usando un componente de Pg en paralelo tal como el componente 438 de PG en paralelo y se puede generar la salida de suma parcial con base en la salida de generación en paralelo y la salida de propagación actual.
El alcance de realizaciones no está limitado al método específico mostrado en la figura 11. Otras realizaciones pueden agregar, omitir, redisponer, o modificar una o más acciones. Por ejemplo, las acciones del bloque 1110, en el cual se genera la salida de transporte intermedio, y las acciones del bloque 1120, en el cual se generan la salida de propagación actual y la salida de generación actual, pueden ocurrir simultáneamente. Alternativamente, las acciones del bloque 1110, en el cual se genera la salida de transporte intermedio, y las acciones del bloque 1130, en el cual se generan la salida de propagación en serie y la salida de generación en serie, pueden ocurrir simultáneamente. En otras palabras la disposición de los bloques en el método 1100 no está limitada a un orden específico de acciones.
Como apreciarán ahora aquellos de alguna experiencia en esta técnica y dependiendo de la aplicación particular en cuestión, se pueden hacer muchas modificaciones, sustituciones y variaciones en y a los materiales, aparatos, configuraciones y métodos de uso de los dispositivos de la presente divulgación sin apartarse del alcance de la misma. A la luz de esto, el alcance de la presente divulgación no debe limitarse al de las realizaciones particulares ilustradas y descritas en este documento, ya que son simplemente a modo de algunos ejemplos de las mismas, sino que más bien, debe ser totalmente conmensuradas con el de las reivindicaciones anexas de aquí en adelante y sus equivalentes funcionales.
Claims (15)
1. Un sumador de múltiples bits que comprende:
una etapa de sumador completo configurada para recibir al menos algunos de una pluralidad de bits menos significativos, LSBs, de primeros datos y segundos datos;
una etapa de medio sumador configurada para recibir al menos algunos de una pluralidad de bits más significativos, MSBs, de los primeros datos y los segundos datos, en donde la etapa de medio sumador incluye al menos un medio sumador;
una etapa de generación de transporte acoplada a la etapa de sumador completo y a la etapa de medio sumador, en donde la etapa de generación de transporte incluye al menos un componente de generación de propagación, PG, en serie acoplado a las salidas del al menos un medio sumador; y
una etapa de postsuma acoplada a la etapa de generación de transporte y a la etapa de medio sumador y configurada para generar una salida de suma parcial de los primeros datos y los segundos datos,
en donde un número de los al menos algunos de la pluralidad de LSBs es diferente de un número de los al menos algunos de la pluralidad de MSBs.
2. El sumador de múltiples bits de la reivindicación 1, en donde la etapa de sumador completo incluye al menos un sumador completo, y en donde el al menos un sumador completo y el al menos un medio sumador comprenden componentes operacionales paralelos.
3. El sumador de múltiples bits de la reivindicación 1, en donde la etapa de sumador completo incluye al menos un sumador completo, y en donde el al menos un sumador completo y el al menos un componente de PG en serie comprenden componentes operacionales paralelos.
4. El sumador de múltiples bits de la reivindicación 1, en donde la etapa de medio sumador incluye una pluralidad de medios sumadores que comprenden componentes operacionales paralelos.
5. El sumador de múltiples bits de la reivindicación 4, en donde un número de la pluralidad de medio sumadores está asociado con una métrica de producto de retraso de potencia objetivo, PDP.
6. El sumador de múltiples bits de la reivindicación 1, en donde las salidas del al menos un medio sumador incluyen una salida de propagación actual y una salida de generación actual, en donde la etapa de medio sumador incluye un segundo medio sumador que es un siguiente medio sumador de orden de bits alto del al menos un medio sumador, en donde el segundo medio sumador está configurado para producir una salida de propagación previa y una salida de generación previa con base en los al menos algunos de la pluralidad de MSBs, y en donde el componente de PG en serie se acopla además a la salida de propagación actual, la salida de generación actual, la salida de propagación previa, y la salida de generación previa.
7. El sumador de múltiples bits de la reivindicación 6, en donde el componente de PG en serie incluye:
una primera puerta AND lógica que incluye:
puertos de entrada acoplados a la salida de propagación actual y la salida de propagación previa; y
un puerto de salida que produce una salida de propagación en serie;
una segunda puerta AND lógica que incluye puertos de entrada acoplados a la salida de propagación actual y la salida de generación previa; y
una primera puerta OR lógica que incluye:
puertos de entrada acoplados a una salida de la segunda puerta AND lógica y la salida de generación actual; y un puerto de salida que produce una salida de generación en serie.
8. El sumador de múltiples bits de la reivindicación 7, en donde la etapa de sumador completo incluye al menos un sumador completo configurado para producir una salida de transporte intermedio con base en los al menos algunos de la pluralidad de LSBs, y en donde la etapa de generación de transporte incluye además al menos un componente de PG en paralelo que incluye:
una tercera puerta AND lógica que incluye puertos de entrada acoplados a la salida de propagación en serie y la salida de transporte intermedio; y
segunda puerta OR lógica que incluye:
puertos de entrada acoplados a una salida de la tercera puerta AND lógica y la salida de generación en serie; y un puerto de salida que produce una salida de postransporte.
9. El sumador de múltiples bits de la reivindicación 8, en donde la etapa de postsuma incluye una puerta OR exclusiva que incluye:
puertos de entrada acoplados a la salida de postransporte y la salida de propagación actual del al menos un medio sumador; y
un puerto de salida que produce la salida de suma parcial.
10. Un aparato que comprende:
un componente de procesamiento que incluye un sumador de múltiples bits de acuerdo con una cualquiera de las reivindicaciones 1 a 9.
11. El aparato de la reivindicación 10, en donde el componente de procesamiento incluye además al menos un componente computacional acoplado al sumador de múltiples bits, y en donde el al menos un componente computacional está asociado con al menos una de una operación de punto fijo o una operación de punto flotante.
12. El aparato de la reivindicación 11, en donde el al menos un componente computacional está asociado con una multiplicación, y en donde el componente computacional está configurado para generar al menos dos productos parciales que forman los primeros datos y los segundos datos.
13. Un método que comprende:
generar, a través de al menos un sumador completo, una salida de transporte intermedio con base en al menos algunos de una pluralidad de bits menos significativos, LSBs, de primeros datos y segundos datos;
generar, a través de al menos un medio sumador, una salida de propagación actual y una salida de generación actual con base en al menos algunos de una pluralidad de bits más significativos, MSBs, de los primeros datos y los segundos datos, en donde un número de los al menos algunos de la pluralidad de MSBs es diferente de un número de los al menos algunos de la pluralidad de LSBs;
generar, a través de al menos un componente de generación de propagación, PG, en serie una salida de propagación en serie y una salida de generación en serie con base en al menos la salida de propagación actual y la salida de generación actual; y
generar una salida de suma parcial con base en al menos la salida de propagación en serie, la salida de generación en serie, la salida de propagación actual, y la salida de transporte intermedio.
14. El método de la reivindicación 13, en donde la generación de la salida de propagación actual y la salida de generación actual es concurrente con la generación de la salida de transporte intermedio.
15. El método de la reivindicación 13, en donde la generación de la salida de propagación en serie y la salida de generación en serie es concurrente con la generación de la salida de transporte intermedio.
Applications Claiming Priority (2)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| US15/488,019 US10223071B2 (en) | 2017-04-14 | 2017-04-14 | Energy-efficient variable power adder and methods of use thereof |
| PCT/US2018/024785 WO2018191015A1 (en) | 2017-04-14 | 2018-03-28 | Energy-efficient variable power adder and methods of use thereof |
Publications (1)
| Publication Number | Publication Date |
|---|---|
| ES2889098T3 true ES2889098T3 (es) | 2022-01-11 |
Family
ID=62028112
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| ES18719353T Active ES2889098T3 (es) | 2017-04-14 | 2018-03-28 | Sumador de potencia variable eficiente en energía y métodos de uso del mismo |
Country Status (7)
| Country | Link |
|---|---|
| US (1) | US10223071B2 (es) |
| EP (1) | EP3610367B1 (es) |
| CN (1) | CN110506255B (es) |
| ES (1) | ES2889098T3 (es) |
| SG (1) | SG11201908404UA (es) |
| TW (1) | TWI679577B (es) |
| WO (1) | WO2018191015A1 (es) |
Families Citing this family (3)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| US10824692B2 (en) | 2018-10-12 | 2020-11-03 | Google Llc | Low-power adder circuit |
| US20220244912A1 (en) * | 2021-02-02 | 2022-08-04 | Efinix, Inc. | Dynamic block size carry-skip adder construction on fpgas by combining ripple carry adders with routable propagate/generate signals |
| WO2024159045A1 (en) * | 2023-01-25 | 2024-08-02 | Sehat Sutardja | High speed ripple adder |
Family Cites Families (16)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| GB2211966A (en) * | 1987-11-02 | 1989-07-12 | Philips Nv | Digital integrated circuit |
| US5204832A (en) | 1990-03-22 | 1993-04-20 | Matsushita Electric Industrial Co., Ltd. | Addition apparatus having round-off function |
| US5349676A (en) * | 1991-02-11 | 1994-09-20 | General Electric Company | Data acquisition systems with programmable bit-serial digital signal processors |
| US5278783A (en) | 1992-10-30 | 1994-01-11 | Digital Equipment Corporation | Fast area-efficient multi-bit binary adder with low fan-out signals |
| KR950004225B1 (ko) * | 1993-04-16 | 1995-04-27 | 현대전자산업주식회사 | 고속 캐리 증가 가산기 |
| US5619441A (en) * | 1994-10-14 | 1997-04-08 | International Business Machines Corporation | High speed dynamic binary incrementer |
| US5912832A (en) | 1996-09-12 | 1999-06-15 | Board Of Regents, The University Of Texas System | Fast n-bit by n-bit multipliers using 4-bit by 4-bit multipliers and cascaded adders |
| DE10215771A1 (de) * | 2002-04-10 | 2003-11-20 | Infineon Technologies Ag | Konfigurierbares Rechenwerk |
| US7213043B2 (en) | 2003-01-21 | 2007-05-01 | Lsi Logic Corporation | Sparce-redundant fixed point arithmetic modules |
| DE602005023614D1 (de) * | 2004-03-05 | 2010-10-28 | Sandbridge Technologies Inc | Arithmetische schaltung mit ausgeglichenen logikpegeln für betrieb mit niedriger stromaufnahme |
| US7516173B2 (en) * | 2004-08-04 | 2009-04-07 | Intel Corporation | Carry-skip adder having merged carry-skip cells with sum cells |
| US7424507B1 (en) | 2004-09-30 | 2008-09-09 | National Semiconductor Corporation | High speed, low power, pipelined zero crossing detector that utilizes carry save adders |
| US7546331B2 (en) * | 2005-03-17 | 2009-06-09 | Qualcomm Incorporated | Low power array multiplier |
| TWI335550B (en) * | 2006-02-06 | 2011-01-01 | Via Tech Inc | Stream processor with variable single instruction multiple data (simd) factor and common special function |
| US8521801B2 (en) | 2008-04-28 | 2013-08-27 | Altera Corporation | Configurable hybrid adder circuitry |
| US8661072B2 (en) | 2008-08-19 | 2014-02-25 | International Business Machines Corporation | Shared parallel adder tree for executing multiple different population count operations |
-
2017
- 2017-04-14 US US15/488,019 patent/US10223071B2/en active Active
-
2018
- 2018-03-28 ES ES18719353T patent/ES2889098T3/es active Active
- 2018-03-28 EP EP18719353.7A patent/EP3610367B1/en active Active
- 2018-03-28 CN CN201880024647.4A patent/CN110506255B/zh active Active
- 2018-03-28 SG SG11201908404U patent/SG11201908404UA/en unknown
- 2018-03-28 WO PCT/US2018/024785 patent/WO2018191015A1/en not_active Ceased
- 2018-04-02 TW TW107111571A patent/TWI679577B/zh active
Also Published As
| Publication number | Publication date |
|---|---|
| WO2018191015A1 (en) | 2018-10-18 |
| CN110506255B (zh) | 2023-06-09 |
| TW201842441A (zh) | 2018-12-01 |
| US10223071B2 (en) | 2019-03-05 |
| EP3610367B1 (en) | 2021-08-25 |
| EP3610367A1 (en) | 2020-02-19 |
| US20180300107A1 (en) | 2018-10-18 |
| CN110506255A (zh) | 2019-11-26 |
| TWI679577B (zh) | 2019-12-11 |
| SG11201908404UA (en) | 2019-10-30 |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| US9722629B2 (en) | Method and apparatus for converting from floating point to integer representation | |
| Kuang et al. | Low-cost high-performance VLSI architecture for Montgomery modular multiplication | |
| US9098332B1 (en) | Specialized processing block with fixed- and floating-point structures | |
| Bhardwaj et al. | ACMA: Accuracy-configurable multiplier architecture for error-resilient system-on-chip | |
| Chow et al. | A Karatsuba-based Montgomery multiplier | |
| Pajuelo-Holguera et al. | Fast Montgomery modular multiplier using FPGAs | |
| Anjana et al. | Synthesize of high speed floating-point multipliers based on Vedic mathematics | |
| Yan et al. | An implementation of Montgomery modular multiplication on FPGAs | |
| EP3767455A1 (en) | Apparatus and method for processing floating-point numbers | |
| CN110506255B (zh) | 节能型可变功率加法器及其使用方法 | |
| Ushasree et al. | VLSI implementation of a high speed single precision floating point unit using verilog | |
| Teja et al. | Design and performance analysis of different low-power multiply-accumulate (MAC) units | |
| EP3767454B1 (en) | Apparatus and method for processing floating-point numbers | |
| US20240111489A1 (en) | Bignum addition and/or subtraction with carry propagation | |
| US12079594B2 (en) | Fast precomputation for Montgomery multiplier | |
| Gayathree et al. | Design of High-Speed Adder with three operands for Image Blending Applications | |
| US12131132B2 (en) | Efficient montgomery multiplier | |
| Sivasankaran | Design and implementation of high speed and high accuracy fixed-width modified booth multiplier for DSP application | |
| Safa et al. | Parallel Prefix Adders Based Linear Congruential Generator | |
| Liang et al. | ALU Architecture with Dynamic Precision Support | |
| Santosh et al. | Complex Binary Number System-based Co-Processor Design for Signal Processing Applications | |
| Su et al. | A reconfigurable coprocessor for public-key cryptography | |
| HK40016533A (en) | Energy-efficient variable power adder and methods of use thereof | |
| ADEYINKA | ELECTRIC VLSI DESIGN AND SIMULATION OF A 16 BIT CARRY-LOOKAHEAD ADDER | |
| Zhou et al. | Implementing elliptic curve cryptography on Nios II processor |