JP2004334193A - 音声認識および自然言語理解のための複合統計/ルール・ベース文法モデルを有するシステム - Google Patents
音声認識および自然言語理解のための複合統計/ルール・ベース文法モデルを有するシステム Download PDFInfo
- Publication number
- JP2004334193A JP2004334193A JP2004127286A JP2004127286A JP2004334193A JP 2004334193 A JP2004334193 A JP 2004334193A JP 2004127286 A JP2004127286 A JP 2004127286A JP 2004127286 A JP2004127286 A JP 2004127286A JP 2004334193 A JP2004334193 A JP 2004334193A
- Authority
- JP
- Japan
- Prior art keywords
- model
- word
- statistical
- gram
- rule
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Pending
Links
Images


Classifications
-
- G—PHYSICS
- G10—MUSICAL INSTRUMENTS; ACOUSTICS
- G10L—SPEECH ANALYSIS TECHNIQUES OR SPEECH SYNTHESIS; SPEECH RECOGNITION; SPEECH OR VOICE PROCESSING TECHNIQUES; SPEECH OR AUDIO CODING OR DECODING
- G10L15/00—Speech recognition
- G10L15/08—Speech classification or search
- G10L15/18—Speech classification or search using natural language modelling
- G10L15/183—Speech classification or search using natural language modelling using context dependencies, e.g. language models
- G10L15/19—Grammatical context, e.g. disambiguation of the recognition hypotheses based on word sequence rules
-
- B—PERFORMING OPERATIONS; TRANSPORTING
- B01—PHYSICAL OR CHEMICAL PROCESSES OR APPARATUS IN GENERAL
- B01D—SEPARATION
- B01D39/00—Filtering material for liquid or gaseous fluids
- B01D39/08—Filter cloth, i.e. woven, knitted or interlaced material
-
- C—CHEMISTRY; METALLURGY
- C02—TREATMENT OF WATER, WASTE WATER, SEWAGE, OR SLUDGE
- C02F—TREATMENT OF WATER, WASTE WATER, SEWAGE, OR SLUDGE
- C02F1/00—Treatment of water, waste water, or sewage
- C02F1/44—Treatment of water, waste water, or sewage by dialysis, osmosis or reverse osmosis
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F40/00—Handling natural language data
- G06F40/30—Semantic analysis
-
- B—PERFORMING OPERATIONS; TRANSPORTING
- B01—PHYSICAL OR CHEMICAL PROCESSES OR APPARATUS IN GENERAL
- B01D—SEPARATION
- B01D2239/00—Aspects relating to filtering material for liquid or gaseous fluids
- B01D2239/06—Filter cloth, e.g. knitted, woven non-woven; self-supported material
- B01D2239/0604—Arrangement of the fibres in the filtering material
- B01D2239/0618—Non-woven
-
- C—CHEMISTRY; METALLURGY
- C02—TREATMENT OF WATER, WASTE WATER, SEWAGE, OR SLUDGE
- C02F—TREATMENT OF WATER, WASTE WATER, SEWAGE, OR SLUDGE
- C02F2103/00—Nature of the water, waste water, sewage or sludge to be treated
- C02F2103/007—Contaminated open waterways, rivers, lakes or ponds
Landscapes
- Engineering & Computer Science (AREA)
- Artificial Intelligence (AREA)
- Theoretical Computer Science (AREA)
- Chemical & Material Sciences (AREA)
- Physics & Mathematics (AREA)
- Audiology, Speech & Language Pathology (AREA)
- Health & Medical Sciences (AREA)
- Computational Linguistics (AREA)
- Hydrology & Water Resources (AREA)
- Acoustics & Sound (AREA)
- Water Supply & Treatment (AREA)
- Environmental & Geological Engineering (AREA)
- Life Sciences & Earth Sciences (AREA)
- Human Computer Interaction (AREA)
- Chemical Kinetics & Catalysis (AREA)
- Organic Chemistry (AREA)
- Multimedia (AREA)
- General Health & Medical Sciences (AREA)
- General Engineering & Computer Science (AREA)
- General Physics & Mathematics (AREA)
- Textile Engineering (AREA)
- Machine Translation (AREA)
- Telephonic Communication Services (AREA)
Abstract
【課題】 2パスのシステムに関連する効率の悪さを低減し、また、言語モデルにおける以前の知識を含んで、言語モデル・トレーニング・データの不足を補うこと。
【解決手段】 複合統計モデルおよびルール・ベース文法言語モデルを使用し、音声認識タスクおよび自然言語理解タスクの両方を実行をする。
【選択図】 図2A
【解決手段】 複合統計モデルおよびルール・ベース文法言語モデルを使用し、音声認識タスクおよび自然言語理解タスクの両方を実行をする。
【選択図】 図2A
Description
本発明は音声認識(speech recognition)および自然言語理解(natural language understanding)に関する。より詳細には、本発明は、統計モデル部およびルール・ベース文法部から形成される複合モデルを、同時の音声認識および自然言語理解の実行において言語モデルとして、使用することに関する。
発話された人間の音声を認識および理解することは、将来のコンピューティング環境に不可欠であると考えられている。現在まで、発話音声を認識および理解するタスクは、2つの異なるシステムによって対処されてきた。第1のシステムは音声認識システムであり、第2のシステムは自然言語理解システムである。
従来の音声認識システムは、発話言語入力を示す音声信号を受信する。音響特徴が音声信号内で識別され、音声信号が、音響モデルおよび言語モデルを使用して復号化されて、入力音声信号によって表現された語(words)を指し示す出力が提供される。
また、話し言葉の使用可能なアプリケーションおよびサービス(speech enabled applications and services)の開発を容易にするために、意味ベースの頑強な理解システム(semantic-based robust understanding systems)が現在開発下にある。このようなシステムは、会話型であり、リサーチ・システムにおいて幅広く使用されている。しかし、これらは特に、会話システムの実装において従来の開発者による使用に対しては実用的ではない。大体において、このような実装は、領域特有の文法(domain-specific grammars)の手動の開発に依拠している。このタスクには時間がかかり、エラーを起こしやすく、領域内で著しい量の専門知識(技術)が必要となる。
話し言葉の使用可能なアプリケーションおよびサービスの開発を進めるために、用例ベース文法オーサリング・ツール(example- based grammar authoring tool)が導入されている。このツールはSGStudioとして知られている(たとえば、非特許文献1および非特許文献2参照)。このツールは、以前の情報の多数の異なるソースを利用することによって、文法開発を大幅に容易にする。これは、言語知識をほとんど有していない通常の開発者が、発話言語理解のための意味文法を構築することを可能にする。このシステムは、少量のデータによる、比較的高品質な意味文法の半自動生成を容易にする。さらに、このツールは、文法開発に関係する労力を著しく削減するだけでなく、異なる領域に渡る理解の精度も向上させる。
しかし、NLUシステムにおける純粋にルール・ベースの文法は、なお頑強性に欠け、脆弱性を示す可能性がある。
加えて、全てではないが大部分の以前の手法は、理解を、別の問題として、音声認識とは無関係に扱う。2パスの手法がしばしば採用され、これにおいて、第1のパスとして、領域特有のn−グラム言語モデルが構築されて音声認識のために使用され、その語第2のパスとして、様々な学習アルゴリズムにより得られた理解モデルが音声認識装置からの出力を「理解」するために適用される。
Y. Wang, A. Acero, "GRAMMAR LEARNING FOR SPOKEN LANGUAGE UNDERSTANDING", IEEE Workshop on Automatic Speech Recognition and Understanding, Madonna D. Campiglio Italy, 2001
Y. Wang, A. Acero, "EVALUATION OF SPOKEN LANGUAGE GRAMMAR LEARNING IN ATIS DOMAIN", Proceedings of ICASSP, Orlando, FL 2002
Riccardi, G., et al., "STOCHASTIC AUTOMATA FOR LANGUAGE MODELING", Computer Speech and Language, 10: pages 265-293 (1996)
理解および音声認識を2つの別々の独立したタスクとして扱った以前のシステムは、いくつかの欠点を示すと考えられる。第1に、音声認識装置のためのn−グラム言語モデルを構築する際に最適化される目的関数は、テスト・データの混乱の低減であり、これは、音声認識語エラー率の低減に関係付けられる。これは必ずしも、全体の理解エラー率における低減につながるとは限らない。第2に、大量のトレーニング・データは、多数のスピーチ・アプリケーションの開発のためにめったに使用可能ではない。少量のデータでトレーニングされたn−グラムはしばしば、不十分な認識精度を生じる。
したがって、本発明は、複合統計モデルおよびルール・ベース文法言語モデルを使用し、音声認識タスクおよび自然言語理解タスクの両方を実行する。
本発明の一実施形態は、また、各未知語についてのループをあらゆるn−グラムに含むのではなく、バック−オフ状態上の共有分布を参照することによって、各n−グラムについてのすべての未知語を処理することによって、コンパクトな方法で複合モデルに対応する状態マシンを構築することも含む。
本発明は、音声認識および自然言語理解システムを扱う。具体的には、本発明は、音声認識および自然言語理解を実行するために使用される複合ルール・ベース文法および統計モデルを扱う。しかし、本発明をより詳細に論じるより先に、本発明を使用することができる1つの例示的環境を論じる。
図1は、本発明を実装することができる、適切なコンピューティング・システム環境100の一実施例を例示する。コンピューティング・システム環境100は適切なコンピューティング環境の一実施例でしかなく、本発明の使用または機能性の範囲についてのいかなる限定をも示唆するように意図されない。コンピューティング環境100は、例示的オペレーティング環境100において例示したコンポーネントのいずれか1つまたは組合せに関係するいかなる依存性も要件も有するものとして解釈されるべきではない。
本発明は、多数の他の汎用または専用コンピューティング・システム環境または構成と共に動作可能である。本発明と共に使用するために適切である可能性のある周知のコンピューティング・システム、環境および/または構成の例には、それだけに限定されないが、パーソナル・コンピュータ、サーバ・コンピュータ、ハンドヘルドまたはラップトップ・デバイス、マルチ・プロセッサ・システム、マイクロ・プロセッサ・ベースのシステム、セットトップボックス、プログラマブルなコンシューマ・エレクトロニクス、ネットワークPC、ミニ・コンピュータ、メインフレーム・コンピュータ、上記のシステムまたはデバイスのいずれかを含む分散コンピューティング環境などが含まれる。
本発明を一般に、プログラム・モジュールなど、コンピュータによって実行されるコンピュータ実行可能命令に関連して説明することができる。一般に、プログラム・モジュールには、ルーチン、プログラム、オブジェクト、コンポーネント、データ構造などが含まれ、これらは特定のタスクを実行するか、あるいは特定の抽象データ型を実施する。本発明をまた分散コンピューティング環境において実施することもでき、ここでは、通信ネットワークを通じてリンクされるリモート処理デバイスによってタスクが実行される。分散コンピューティング環境では、プログラム・モジュールは、メモリ・ストレージ・デバイスを含む、ローカルおよびリモートのコンピュータ・ストレージ・メディアに位置することができる。
図1を参照すると、本発明を実装するための例示的システムは、コンピュータ110の形態における汎用コンピューティング・デバイスを含む。コンピュータ110のコンポーネントは、それだけに限定されないが、処理装置120、システム・メモリ130、および、システム・メモリを含む様々なシステム・コンポーネントを処理装置120に結合するシステム・バス121を含むことができる。システム・バス121は、いくつかのタイプのバス構造のいずれかにすることができ、これには、様々なバス・アーキテクチャのいずれかを使用する、メモリ・バスまたはメモリ・コントローラ、周辺バスおよびローカル・バスが含まれる。例として、限定ではなく、このようなアーキテクチャには、業界標準アーキテクチャ(ISA)バス、マイクロ・チャネル・アーキテクチャ(MCA)バス、拡張ISA(EISA)バス、Video Electronics Standards Association(VESA)ローカル・バス、およびメザニン・バスとしても知られるPeripheral Component Interconnect(PCI)バスが含まれる。
コンピュータ110は通常、様々なコンピュータ可読媒体を含む。コンピュータ可読媒体は、コンピュータ110によってアクセスすることができるいかなる使用可能なメディアにすることもでき、これには、揮発性および不揮発性のメディア、リムーバブルおよび非リムーバブルのメディアが含まれる。例として、限定ではなく、コンピュータ可読媒体は、コンピュータ・ストレージ・メディアおよび通信メディアを含むことができる。コンピュータ・ストレージ・メディアは、揮発性および不揮発性、リムーバブルおよび非リムーバブルのメディアを含み、これらはコンピュータ可読命令、データ構造、プログラム・モジュールまたは他のデータなど、情報の格納のためのいずれかの方法または技術において実施される。コンピュータ・ストレージ・メディアには、それだけに限定されないが、RAM、ROM、EEPROM、フラッシュ・メモリもしくは他のメモリ技術、CD−ROM、デジタル多用途ディスク(DVD)もしくは他の光ディスク・ストレージ、磁気カセット、磁気テープ、磁気ディスク・ストレージもしくは他の磁気ストレージ・デバイス、または、所望の情報を格納するために使用することができ、コンピュータ110によってアクセスすることができる他のいかなるメディアもが含まれる。通信メディアは、通常、コンピュータ可読命令、データ構造、プログラム・モジュールまたは他のデータを、搬送波WAVまたは他の移送メカニズムなどの変調データ信号において具現化し、任意の情報配信メディアをも含む。「変調データ信号」という用語は、信号における情報を符号化するような方法でその特性の1つまたは複数が設定または変更されている信号を意味する。例として、限定ではなく、通信メディアには、有線ネットワークまたは直接有線接続などの有線メディア、ならびに、音響、RF、赤外線および他の無線メディアなどの無線メディアが含まれる。上記のいずれの組合せも、コンピュータ可読媒体の範囲内に含まれるべきである。
システム・メモリ130は、揮発性および/または不揮発性メモリの形態におけるコンピュータ・ストレージ・メディアを含み、これは読み取り専用メモリ(ROM)131およびランダム・アクセス・メモリ(RAM)132などである。基本入出力システム133(BIOS)は、起動中など、コンピュータ110内の複数の要素の間で情報を転送する助けとなる基本ルーチンを含み、通常はROM131に格納される。RAM132は通常、処理装置120によって即時アクセス可能および/または現在動作中であるデータおよび/またはプログラム・モジュールを含む。例として、限定ではなく、図1は、オペレーティング・システム134、アプリケーション・プログラム135、他のプログラム・モジュール136およびプログラム・データ137を例示する。
コンピュータ110はまた、他のリムーバブル/非リムーバブル、揮発性/不揮発性のコンピュータ・ストレージ・メディアも含むことができる。例としてのみ、図1は、非リムーバブル、不揮発性の磁気メディアに対する読み書きを行うハードディスク・ドライブ141、リムーバブル、不揮発性磁気ディスク152に対する読み書きを行う磁気ディスク・ドライブ151、および、CD ROMまたは他の光メディアなど、リムーバブル、不揮発性の光ディスク156に対する読み書きを行う光ディスク・ドライブ155を例示する。例示的オペレーティング環境で使用することができる他のリムーバブル/非リムーバブル、揮発性/不揮発性のコンピュータ・ストレージ・メディアには、それだけに限定されないが、磁気テープ・カセット、フラッシュ・メモリ・カード、デジタル多用途ディスク、デジタル・ビデオ・テープ、ソリッドステートRAM、ソリッドステートROMなどが含まれる。ハードディスク・ドライブ141は通常システム・バス121に、インターフェース140などの非リムーバブル・メモリ・インターフェースを通じて接続され、磁気ディスク・ドライブ151および光ディスク・ドライブ155は通常システム・バス121に、インターフェース150などのリムーバブル・メモリ・インターフェースによって接続される。
上述し、図1に例示したドライブおよびそれらの関連付けられたコンピュータ・ストレージ・メディアは、コンピュータ110用のコンピュータ可読命令、データ構造、プログラム・モジュールおよび他のデータのストレージを提供する。図1では、たとえば、ハードディスク・ドライブ141が、オペレーティング・システム144、アプリケーション・プログラム145、他のプログラム・モジュール146およびプログラム・データ147を格納するものとして例示される。これらのコンポーネントを、オペレーティング・システム134、アプリケーション・プログラム135、他のプログラム・モジュール136およびプログラム・データ137と同じものにも異なるものにもすることができることに留意されたい。オペレーティング・システム144、アプリケーション・プログラム145、他のプログラム・モジュール146およびプログラム・データ147にはここで異なる番号が与えられて、最低でも、それらが異なるコピーであることが例示される。
ユーザはコマンドおよび情報をコンピュータ110へ、キーボード162、マイクロフォン163、および、マウス、トラック・ボールまたはタッチ・パッドなどのポインティング・デバイス161などの入力デバイスを通じて、入力することができる。他の入力デバイス(図示せず)には、ジョイスティック、ゲームパッド、衛星放送受信アンテナ、スキャナなどが含まれる可能性がある。これらおよび他の入力デバイスがしばしば処理装置120へ、システム・バスに結合されるユーザ入力インターフェース160を通じて接続されるが、これを、パラレル・ポート、ゲームポートまたはユニバーサル・シリアル・バス(USB)など、他のインターフェースおよびバス構造によって接続することができる。モニタ191または他のタイプの表示デバイスもまたシステム・バス121へ、ビデオ・インターフェース190などのインターフェースを介して接続される。モニタに加えて、コンピュータはまた、スピーカ197およびプリンタ196など、出力周辺インターフェース195を通じて接続することができる他の周辺出力デバイスを含むこともできる。
コンピュータ110はネットワーク環境において、リモート・コンピュータ180など、1つまたは複数のリモート・コンピュータへの論理接続を使用して動作することができる。リモート・コンピュータ180は、パーソナル・コンピュータ、ハンドヘルド・デバイス、サーバ、ルーター、ネットワークPC、ピア・デバイスまたは他の共通ネットワーク・ノードにすることができ、通常は、コンピュータ110に関連して上述した要素の多数またはすべてを含む。図1に示す論理接続は、ローカル・エリア・ネットワーク(LAN)171およびワイド・エリア・ネットワーク(WAN)173を含むが、他のネットワークも含むことができる。このようなネットワーキング環境は、オフィス、企業全体のコンピュータ・ネットワーク、イントラネットおよびインターネットにおいて一般的である。
LANネットワーキング環境において使用するとき、コンピュータ110がLAN171へ、ネットワーク・インターフェースまたはアダプタ170を通じて接続される。WANネットワーキング環境において使用するとき、コンピュータ110は通常、モデム172、またはインターネットなどのWAN173を介して通信を確立するための他の手段を含む。モデム172を内部または外部にすることができ、システム・バス121へ、ユーザ入力インターフェース160または他の適切なメカニズムを介して接続することができる。ネットワーク環境では、コンピュータ110に関連して示したプログラム・モジュールまたはその一部を、リモート・メモリ・ストレージ・デバイスに格納することができる。例として、限定ではなく、図1はリモート・アプリケーション・プログラム185をリモート・コンピュータ180上に存在するものとして例示する。図示のネットワーク接続は例示的であり、複数のコンピュータの間で通信リンクを確立する他の手段を使用できることは理解されよう。
本発明を、図1に関して説明したものなど、コンピュータ・システム上で実行することができることに留意されたい。しかし、本発明を、サーバ、メッセージ・ハンドリング専用コンピュータ、または、本発明の異なる部分が分散コンピューティング・システムの異なる部分上で実行される分散システム上で実行することができる。
図2Aは、本発明の一実施形態によるモデル・オーサリング・システム200のブロック図である。モデル・オーサリング・システム200は、モデル・オーサリング・コンポーネント202およびオプショナルのユーザ・インターフェース204を含む。図2Aはまた、モデル・オーサリング・コンポーネント202が入力として、スキーマ206、トレーニング用例テキスト文字列のセット208、オプショナルの文法ライブラリ209を受信し、ルール・ベース文法(文脈自由文法またはCFG)210を出力することも示す。オプショナルの文法ライブラリ209は、日付および時間など、領域に依存しない概念、ならびに、都市名、航空路など、領域依存の概念についての定義を含み、これをアプリケーション・データベースから得ることができる。
システム200の詳細なオペレーションを以下でより詳細に説明する。しかし、簡単に言えば、ユーザはモデル・オーサリング・コンポーネント202に、スキーマ206およびトレーニング用例テキスト文字列208を提供する。これを、オプショナルのユーザ・インターフェース204を通じて、あるいはある他のユーザ入力メカニズムを通じて、あるいは自動手段を通じて行うことができる。モデル・オーサリング・コンポーネント202は入力を受信し、ルール・ベース文法210をこの入力に基づいて生成する。ルール・ベース文法の一実施例は、コンピュータが入力をテキストの意味表現にマップすることができるようにする文脈自由文法(またはCFG)である。
スキーマ206は、例示的には、モデリングされる領域の意味記述である。スキーマの1つの例示を図2Bに示す。図2Bは、開発者によってシステム200へ入力することができる、大幅に簡易化されたスキーマ212を例示する。スキーマ212は、異なる都市から出発して異なる都市に到着し、異なる出発および到着時間を有するフライトを示す、ユーザからの入力用の様々なテキスト文字列の意味を表現するスキーマである。スキーマ212は、フライト表示コマンド(ShowFlight)がフライトのための意味クラスをスロットとして含むことを示す。スキーマ212はまた、フライトのための意味クラスを、4つのスロットを有し、それぞれが、出発時間、到着時間、出発都市、到着都市に対応することを、より詳細に示している。
スキーマ212から、モデル・オーサリング・コンポーネント202は、図2Cに例示するルールのセットを生成することができる。ルール1は、ShowFlight文は、常に、プロパティ部ShowFlightPropertiesを後続するコマンド部ShowFlightCmdを有することを示す。
ルール2は、ShowFlightProperties部が1つまたは複数のプロパティをその中に有することができることを指し示す。たとえば、ルール2は、ShowFlightProperties部が、オプショナルのShowFlightProperties部を後続することができる少なくとも1つのShowFlightPropertyを含むことを指し示す。ShowFlightPropertiesのこの再帰的定義は、その表現を簡易化し、これが1つまたは複数のプロパティを有することを可能にする。
ルール3は、ShowFlightProperty部が、ShowFlightPreFlight部、Flight部、およびShowFlightPostFlight部を含むことを示す。これは、スキーマ内のスロットFlightがプレアンブルおよびポストアンブルを有することができることを指し示す。
第4のルールは、スキーマ内のオブジェクトFlightが、コマンド部を有していないけれども、properties部(FlightProperties)を有するのみであることを示し、これは、Flightはスキーマ内のオブジェクトであるが、ShowFlightはコマンドであるからである。ルール5は、FlightProperties部が再度再帰的に、オプショナルのFlightPropertiesを後続する少なくとも1つのFlightPropertyを含むように定義されることを示す。
ルール6〜9は、図2Bに示すスキーマ212の4つのスロットに対応する。ルール6は、第1のプロパティを、プリアンブル(FlightPreDepartureCity)が前に来て、後にポストアンブル(FlightPostDepartureCity)が続く、出発都市スロットを有する、として定義する。ルール7は到着都市を同じ方法で定義し、ルール8および9は、出発時間および到着時間を類似の方法でそれぞれ定義する。
図2Cで識別されたルールのすべてをスキーマ212から、モデル・オーサリング・コンポーネント202によって自動的に生成することができるという事実が与えられても、なお、何の特定の語が実際に特定のプレターミナル(コマンド意味クラスについてのコマンド、ならびに、スロットについてのプレアンブルおよびポストアンブル)にマップされるかを示す、書き換えルールはない。たとえば、「please show me the flights …」という句がShowFlightCmdにマップされることを示すであろうルールはない。同様に、どの語が、具体的に、たとえば、FlightPreArrivalCityプレアンブルにマップするかなどを示す書き換えルールはない。したがって、開発者は、また、モデル・オーサリング・コンポーネント202がこれらの書き換えルールも学習できるように、トレーニング用例テキスト文字列および注釈208も入力する。
図2Dは、用例テキスト文字列213の一実施例「Flight from Seattle to Boston」を、テキスト文字列213に対応する意味注釈214と共に例示する。意味注釈214は開発者によって提供され、文字列213の意味論的な意味を指し示す。意味注釈214はたとえば、入力テキスト文字列213がShowFlightコマンドに対応し、これはスロットFlightを有し、スロットFlight自体が2つのスロットを有し、その両方が都市であることを示す。Flightスロット内の2つのスロットの間の区別は、スロットの名前によってのみ行われる。一方は「Arrival」都市と呼ばれ、他方は「Departure」都市と呼ばれる。意味注釈214はまた、語「Boston」を「Arrival」都市スロットにマップし、語「Seattle」を「Departure」都市スロットにマップする。したがって、注釈214に基づいて、モデル・オーサリング・コンポーネント202は、どのスロットが語「Seattle」および「Boston」にマップするかを知るようになる。
注釈付き用例、および、図2Cのテンプレート文法ルールから、モデル・オーサリング・コンポーネント202は、図2Eに例示した解析木216などのルール・ベース文法(またはCFG)解析木を生成することができる。解析木216の第1のレベル218(ShowFlightがShowFlightCmdとその後に続くShowFlightPropertiesから形成されることを示す部分)は、図2Cのルール1から形成される。
第2のレベル220(ShowFlightPropertiesがShowFlightPropertyから形成されることを示す部分)はルール2から生成され、ここで、オプショナルのShowFlightProperties部は使用されない。
次のレベル222(ShowFlightPropertyがShowFlightPreFlightとその後に続くShowFlightPostFlightから形成されることを示す部分)は、図2Cのルール3から生成される。
次のレベル224(FlightオブジェクトがFlightPropertiesセクションから形成されることを示す)は、図2Cのルール4から生成される。
次のレベル226(FlightProperties部がFlightProperty部とその後に続くFlightProperties部から形成されることを示す部分)は、図2Cのルール5から生成される。
次のレベル228(FlightProperty部がFlightPreDepartureCity部とその後に続くCityスロットとその後に続くFlightPostDepartureCityポストアンブルから形成されることを示すレベル)は、ルール6から生成され、次のレベル230(FlightPropertiesがFlightPreArrivalCityプレアンブル、CityスロットおよびFlightPostArrivalCityポストアンブルから形成されることを示すレベル)は、ルール7から生成される。
最後に、語「Seattle」がCityスロットへレベル228の下でマップされること、語「Boston」がCityスロットへレベル230の下でマップされることを示すレベルは、意味注釈214から生成され、これもまたユーザによって入力される。したがって、モデル・オーサリング・コンポーネント202は、入力シーケンスにおける語「Seattle」および「Boston」からCFG解析木へ、また、図2Cにおいて生成されたルールへマップする方法を学習することができる。都市ルールもまた、注釈付きデータからではなくライブラリ文法(これは、データを領域特有のデータベースから取ることによって構築することができる)から得ることができることに留意されたい。
しかし、なお、まだツリーにマップされないいくつかの語が入力文において存在する。これらの語には、「Flight」、「from」および「to」が含まれる。語「Flight」および「from」は語「Seattle」の前に来るので、これらの語は解析木216において様々なプレターミナルにマップすることができ、これには、FlightCmd、ShowFlightPreFlightおよびFlightPreDepartureCityが含まれる。同様に、語「to」は入力テキスト文字列213における語「Seattle」と「Boston」の間に存在するので、語「to」はFlightPostDepartureCityにもFlightPreArrivalCityにもマップすることができる。
語「to」は前置詞であることが知られているので、これは、その後に来るものを修飾しなければならない。したがって、語「to」は解析木216においてFlightPreArrivalCityプレターミナルにマップすると決定することができる。
しかし、語「Flight」および「from」が解析木216においてどこに存在するべきであるかはなお知られていない。また、この2つの語のための特定の文節化は知られていない。たとえば、1つの代替方法では、語「Flight」をShowFlightCmdにマップすることができ、語「from」はShowFlightPreFlightにマップされる。その場合、プレターミナルFlightPreDepartureCityは空のセットにマップされる。
もう1つの代替方法によれば、語「Flight」および「from」はShowFlightCmdにマップされ、他のプレターミナルShowFlightPreFlightおよびFlightPreDepartureCityは共に空のセットにマップされる。
さらにもう1つの代替方法では、「Flight」はShowFlightCmdにマップされ、「from」はFlightPreDepartureCityにマップされ、その間に残りのプレターミナルShowFlightPreFlightは空のセットにマップされる。
これは文節化の曖昧性を表し、これは伝統的に、開発者からの追加の情報がなければ解決されていなかった。いくつかの以前のシステムでは、可能な文節化の各々が単にユーザに表示され、ユーザはこれらの文節化の1つを選択することを許可された。
しかし、このことは、結果としていくつかの問題を生じてきた。最初に、ユーザとのこのタイプの対話は、押しつけがましく、時間がかかる。また、より可能性のあるプレターミナルがあり、より多くの位置合わせされていない語が入力テキスト文字列内にあるとき、ユーザに提示されなければならない可能性の数は劇的に増す。すべてのこのような文節化の候補をユーザによる選択のために有効に表示することは、不可能でないけれども、非常に困難である。加えて、文節化がユーザによる選択のために適切に表示されたときでさえ、ユーザは、文節化において、しばしば、エラーを起こしたり、また、類似テキスト文字列を一貫性がなく、文節化したりする。
一実施形態によれば、期待値最大化(EM)アルゴリズムが、文節化の選択の曖昧性をなくすために、モデル・コンポーネント202における文節化の曖昧性に適用される。EMアルゴリズムは一般に、モデルが観測不可能な隠れ変数を含むとき、最尤推定量を有するモデル・パラメータを推定するためのアルゴリズムである。
図3Aは、モデル・オーサリング・コンポーネント202をより詳細に例示するブロック図である。図3Aは、モデル・オーサリング・コンポーネント202が例示的に、テンプレート文法ジェネレータ300、文節化EM適用コンポーネント302およびプルーニング(pruning:剪定)・コンポーネント304を含むことを示す。テンプレート文法ジェネレータ300は、スキーマ206、および、スキーマ206内の意味クラスによって(適切なタイプの単一化を通じて)参照されたオプショナルの文法ライブラリ209内のいかなるルールをも受信し、スキーマ206およびオプショナルの文法ライブラリ209から学習または収集することができるすべてのルールを含むテンプレート文法を生成する。次いで、テンプレート文法がEM文節化コンポーネントによって入力として、トレーニング用例(テキスト文字列およびそれらの注釈)と共に、取られる。EM文節化コンポーネント302はテンプレート文法を使用して、トレーニング用例内の文節化の曖昧性を発見する。次いで、コンポーネント302はいかなる文節化の曖昧性をもなくすように動作する。その曖昧性をなくすことに基づいて、文法から書き換えルールを、プルーニング・コンポーネント304を使用してプルーニング(剪定)して、ルール・ベース文法210を提供することができる。
EM文節化コンポーネント302のオペレーションをさらに例示するため、図2Fおよび2Gは例示的表を提供する。図2Fは、用例のセットを含む表である。そのうちの最初のものは、語「from」が場合によってはプレターミナルShowFlightCmdにもプレターミナルFlightPreDepartureCityにもマップすることができることを示す。この用例をコンポーネント302によって「from Seattle to Boston」のような用例文から取り入れることができる。第2の用例は、語「Flight from」をプレターミナルShowFlightCmdおよびFlightPreDepartureCityにマップすることができることを示す。この用例を、コンポーネント302によって「Flight from Seattle to Boston」のような用例文から、取り入れることができる。第3の用例は、語「Flight to」をプレターミナルShowFlightCmdおよびFlightPreArrivalCityにマップすることができることを例示し、これを同様にコンポーネント302によって「Flight to Boston on Tuesday」のような用例から得ることができる。しかし、用例の文節化は曖昧である。すなわち、第1の用例における語「from」がプレターミナルShowFlightCmdにマップされるべきであるか、プレターミナルFlightPreDepartureCityにマップされるべきであるかは、まだ知られていない。同様に、語「Flight from」がプレターミナルShowFlightCmdとFlightPreDepartureCityの間でどのようにマップされるべきであるかは、知られていない。加えて、言うまでもなく、「Flight to」が可能なプレターミナルShowFlightCmdとFlightPreArrivalCityでどのようにマップされるべきであるかは、知られていない。
図2Gは、EMアルゴリズム適用コンポーネント202のオペレーションをさらに例示する表である。図3Bは、コンポーネント202のオペレーションを例示する流れ図であり、これを図2Fおよび2Gと共に説明する。
最初に、コンポーネント302はすべての可能な文節化を列挙する。これを図2Gの左の列の、「可能な書き換えルール」というラベルが付けられた所に示す。図2Gに示す書き換えルールでは、プレターミナル名を形成する複数の語のいくつかが短縮される。したがって、例として、書き換えルールSFCmd→εは、ShowFlightCmd(SFCmdに短縮)プレターミナルが空のセットにマップされることを示す。同様に、書き換えルールSFCmd→fromは、語「from」がプレターミナルShowFlightCmdにマップされる文節化を表現する。さらに、FPDCity→εは、プレターミナルFlightPreDepartureCity(FPDCityに短縮)が空のセットにマップされる文節化を表現し、FPACity→εは、プレターミナルFlightPreArrivalCity(FPACityに短縮)が空のセットにマップされる文節化を表現する。これらの例から、図2Gに示す表の書き換えルール部における他の表意法は自明である。図2Fに示す用例についての各可能な文節化が列挙されると言えば十分であろう。
図2Fの第1の用例から、ある文節化は、語「from」がShowFlightCmdにマップされることを示し、別の文節化は、語「from」がFlightPreDepartureCityにマップされることを示す。
図2Fの第2の用例は、いくつかの異なる代替文節化もサポートする。たとえば、1つの代替文節化によれば、2語「Flight from」は両方ともプレターミナルShowFlightCmdにマップされ、プレターミナルFlightPreDepartureCityはεにマップされる。もう1つの代替文節化では、語「Flight from」は両方ともプレターミナルFlightPreDepartureCityにマップされ、プレターミナル「ShowFlightCmd」はεにマップされる。さらにもう1つの代替文節化では、語「Flight」および語「from」に分割され、語「Flight」はプレターミナルShowFlightCmdにマップされ、語「from」はプレターミナルFlightPreDepartureCityにマップされるようになる。これらの文節化の各々もまた、図2Gにおいて列挙された書き換えルールに示される。
第3の用例を、第2の用例に類似の方法で文節化することができ、これにおいて語「Flight to」をプレターミナルShowFlightCmdにもプレターミナルFlightPreArrivalCityにもマップすることができ、他のプレターミナルはεにマップされるか、あるいは2語「Flight to」をプレターミナルShowFlightCmdおよびFlightPreArrivalCityの間で分割することができる。再度、これらの文節化の各々は、図2Gに示す書き換えルールにおいて表現される。
すべての可能な文節化の列挙を、図3Bの流れ図におけるブロック306によって示す。
文節化をサポートする書き換えルールが列挙された後、これらにはそれぞれ確率が割り当てられる。最初に、図2Gに例示したすべての文節化には同じ確率が割り当てられる。これを図3Bのブロック308によって示す。
次に、コンポーネント302が、新たに期待カウントを、列挙された書き換えルールに、図2Fの用例におけるこれらのカウントの可能な生起(occurrences)に基づいて、割り当る。これをブロック310によって示す。たとえば、第1の用例から、2つの可能な文節化があり、一方は語「from」をShowFlightCmdにマップし、プレターミナルFlightPreDepartureCityをεにマップし、その他方はShowFlightCmdをεにマップし、語「from」をプレターミナルFlightPreDepartureCityにマップする。第1の書き換えルールは、ShowFlightCmdプレターミナルがε(空のセット)にマップすることを示す。したがって、用例1における文節化の半分は、図2Gの表に示す第1の書き換えルールをサポートする。したがって、第1の用例から、第1の書き換えルール(ShowFlightCmd→ε)に2分の1のカウントが割り当てられる。
上述のように、第2の用例は3つの異なる文節化をサポートし、その1つは両方の語「Flight from」をプレターミナルShowFlightCmdに割り当て、プレターミナルFlightPreDepartureCityをεに割り当て、もう1つの文節化は、語「Flight」をプレターミナルShowFlightCmdにマップし、語「from」をプレターミナルFlightPreDepartureCityにマップし、最後の文節化は、プレターミナルShowFlightCmdをεにマップし、両方の語「Flight from」をプレターミナルFlightPreDepartureCityにマップする。これらの3つの文節化のうち、1つは第1の書き換えルール(SFCmd→ε)をサポートする。したがって、第2の用例から、第1の書き換えルールに3分の1のカウントが割り当てられる。
同様に、第3の用例は3つの可能な文節化を有し、その1つはプレターミナルShowFlightCmdをεにマップする。したがって、第3の用例から、図2Gに示す第1の書き換えルールに再度3分の1のカウントが割り当てられる。
このタイプの解析を使用すると、第2の書き換えルール(SFCmd→from)が第1の用例によってサポートされるだけであることがわかる。したがって、第1の用例についての2つの可能な文節化があり、その一方は第2の書き換えルールをサポートしているので、第2の書き換えルール(SFCmd→from)に2分の1が割り当てられる。
第3の書き換えルール(SFCmd→Flight)は、図2Fに示す第2および第3の用例の各々からの文節化の1つによってサポートされる。したがって、これらの各用例は3つの可能な文節化を有するので、第3の書き換えルール(SFCmd→Flight)に、各用例から3分の1のカウントが割り当てられる。
コンポーネント302は、図2において列挙された各書き換えルールに対してカウントをこのような方法で割り当て、これらのカウントを図2Gに示す表の第2の列に例示する。これらのカウントはすべて、共通の分母を有するように変換され、次いでこれらが各プレターミナルについて正規化されて、確率が得られる。すなわち、ShowFlightCmdプレターミナルについての合計の確率量は合計で1にならなければならない。したがって、各書き換えルールについてのカウントが正規化係数によって乗算され、その書き換えルールに関連付けられた確率を得る。
たとえば、プレターミナルShowFlightCmdについてのカウントの総数が3であることがわかる。したがって、第1の書き換えルール(SFCmd→ε)の確率は7/18である。同様に、第2の書き換えルール(SFCmd→from)についての確率は3/18である、などとなる。コンポーネント302は、この確率を得るために、各書き換えルールおよび各プレターミナルについてのカウントを処理する。
このように、プレターミナルFPDCityでは、すべての異なるルールに渡るカウントの合計は2であり、したがって正規化係数は1/2である。最後のプレターミナルFPACityでは、1のカウント(3*1/3=1)しかなく、したがって正規化係数は1である。このように、コンポーネント302は、各書き換えルールに関連付けられた確率を1に再設定し、これは、用例によってサポートされた書き換えルールの生起をより正確に反映することがわかる。カウントを正規化して新しい確率を得ることを、図3Bのブロック312によって示す。
コンポーネント302はこのプロセス(各カウントを推定し、新しい確率を得ること)において、カウントおよび確率が収束するまで繰り返す。これをブロック314によって示す。たとえば、第1の書き換えルールについての新しいカウント
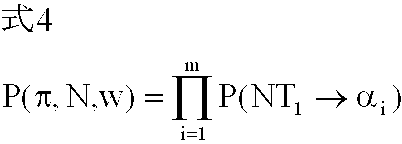
を得るために、コンポーネント302は式1を実装し、これは最初に、以下のようにノンターミナル・シーケンスShowFlightCmdおよびFPDCityが与えられると、語「from」を観測する合計の尤度を発見する。
式1
P(from|ShowFlightCmd FPDCity)
=P(ε|ShowFlightCmd)*P(from|FPDCity)
+P(from|ShowFlightCmd)*P(ε|FPDCity)
=[(7/18)×(5/12)]+[(3/18)×(5/12)]=50/216
この量から、空の文字列をShowFlightCmdに位置合わせし、「from」をFPDCityに位置合わせする文節化についての比率は、以下のように新しい期待カウント
式1
P(from|ShowFlightCmd FPDCity)
=P(ε|ShowFlightCmd)*P(from|FPDCity)
+P(from|ShowFlightCmd)*P(ε|FPDCity)
=[(7/18)×(5/12)]+[(3/18)×(5/12)]=50/216
この量から、空の文字列をShowFlightCmdに位置合わせし、「from」をFPDCityに位置合わせする文節化についての比率は、以下のように新しい期待カウント
になる。
同様に、第2の書き換えルール(SFCmd→from)についての新しいカウント
は、以下のように計算される。
このプロセスが各書き換えルールについて継続されて、各用例からのカウント
が収集される。次いで、新しいカウントが正規化係数によって乗算されて、新しい確率が得られる。図3Bに示すように、コンポーネント302はこのプロセスにおいて繰り返し、新しいカウントおよび新しい確率を、確率が収束するまで再推定する。
この繰り返しが完了した後、コンポーネント302は、算出された、列挙された各書き換えルールに関連付けられた、新しいカウントおよび新しい確率を有することになる。このことは、それ自体、トレーニング中に得られた異なる文節化に対応するルールに、各文節化への確率を割り当てているので、大変有用であるが、このことは、所望する最終結果ではない可能性がある。たとえば、いくつかのパーサーは確率を利用することができない。また、いくつかの構文解析コンポーネントでは、多数のルールがパーサーをそれほど有効でなくする。
したがって、1つの例示的実施形態によれば、コンポーネント302は、ルールおよび関連付けられた確率をプルーニング・コンポーネント304に提供し、ここでルールをプルーニング(剪定:)することができる。これを、図3Bのブロック316および318によって示す。プルーニング・コンポーネント304はルールを、いくつかの異なる方法の1つでプルーニングすることができる(ブロック320によって示す)。たとえば、プルーニング・コンポーネント304は単に、所望のしきい値レベルより下の確率を有するルールをプルーニングして除くことができる。次いで、コンポーネント304は残りのルールをルール・ベース文法210に導入する。
もう1つの例示的実施形態によれば、プルーニング・コンポーネント304は、各用例に対応する高い尤度を有する所定の数の文節化を除くすべてを取り除き、残りの文節化に従って文法に書き換えルールを提供するだけである。たとえば、コンポーネント304は、最高の確率を有するものを除く、各用例に対応するすべての文節化を取り除くことができる。このように、用例1では、語「from」をプレターミナルFlightPreDepartureCityにマップした文節化が、語「from」をプレターミナルShowFlightCmdに割り当てた文節化よりも高い確率を有したと仮定する。その場合、2番目の文節化(「from」をShowFlightCmdにマップしたもの)が取り除かれる。その場合、選択された文節化をサポートする2つの書き換えルールが文法に追加される。したがって、書き換えルール「SFCmd→ε」および書き換えルール「FPDCity→from」が両方とも文法に追加される。
同様に、すべての用例のうちの最良の文節化によってもはやサポートされないルールを、図2Gに示された列挙されたルールから除去することができる。したがって、ルール「SFCmd→from」は、それが、除去されている用例1についての文節化によってサポートされているだけであるので、除去することができる。
この方法におけるEMアルゴリズムの適用を、より形式的な数学的表現で、これより説明する。文節化の曖昧性の解決は、各ブロックがシーケンスN=NT1,NT2,…,NTmにおけるプレターミナルに位置合わせするように、語のシーケンスw=w1,,w2,…,wnについて、mブロック・パーティションπ=α1,α2,…,αmを発見する問題として公式化することができる。ブロックは、wからの0個またはそれ以上の語を含むことができる。
π、Nおよびwの結合確率をモデリングする場合、以下のようになる。
次いで、Nおよびwが与えられると、最も可能性の高い文節化を以下のように得ることができる。
このようなパーティションをビタビ探索により発見することができる。したがって、残された唯一の問題は、モデル・パラメータP(NT→α)を、あらゆるプレターミナル(または概念)NTおよび語のシーケンスα、について推定することである。トレーニング・データが、各プレターミナルについての語のシーケンスとペアにされたプレターミナルのリストである場合、このことを最尤(ML)推定により行うことができる。しかし、ユーザからオーサリング・ツールを介して得られたトレーニング用例は例示的に、プレターミナル・シーケンスおよびターミナル・シーケンスのペアである。パーティションまたは文節化は隠れ変数であり、ツールにとっては未知である。
EMアルゴリズムは最初に、モデルについてパラメータPΦを設定し、次いで、観測Dの尤度が増すように反復的にパラメータをPΦ’に修正する。
このようなPΦ’を発見するため、補助関数Qを式6に定義する。
このようなPΦ’を発見するため、補助関数Qを式6に定義する。
これは、L(D|PΦ’)−L(D|PΦ)の下限であり、2つのモデル・パラメータ化の間のトレーニング・データの対数尤度差である。EMアルゴリズムは、プレターミナルについてのすべての可能な書き換えルールの確率が合計で1にならなければならないという制約を受け、新しいパラメータ化によるトレーニング・サンプル尤度の増大を最大にするように、Qを最大化することにより、パラメータPΦ’を意欲的に再設定する。したがって、各ルールNT→αについて、その新しい確率を、以下の式を解くことによって得ることができる。
なので、以下のようになる。
したがって、確率は、期待カウントに正規化係数−1/λを掛けたものに再設定されるべきである。
期待カウントを計算するため、以下に留意されたい。
よって、以下の通りである。
が、プレターミナル・シーケンスNを語シーケンスwに書き換えるプロセスにおいて、ルールNT→αがNにおけるk番目のプレターミナルについて使用されてサブ・シーケンスα=wi,…,wjを生成するイベントであるとし、および
が、シーケンスNにおける位置sからtへのプレターミナルが、ターミナル語wP,…,wq=1を包含する確率であるとする。そうすると、以下のようになる。
したがって、仮に、
を計算することができる場合、式(9)、(11)および(13)を結合して、期待カウントを得て、モデル・パラメータを再設定することができる。実際には、
は、式14に従うダイナミック・プログラミングにより計算することができ、ただしεはヌル文字列である。
式11において、
を使用できることに留意されたい。
図4は、本発明の異なる態様によるモデル・オーサリング・コンポーネント350のもう1つの実施形態350を例示する。ルール・ベース文法210は、まだ、望まれるよりも頑強ではなく、より脆弱である可能性がある。たとえば、トレーニング中に、以下のルールが生成されて以下のプレターミナルがモデリングされると仮定する。
FlightPreArrivalCity→to
ShowFlightCmd→Show me the flight
さらに、ランタイム中に、入力された文が「Show flight to Boston」であると仮定する。この入力文は、「Show flight」がShowFlightCmdであることを示すルールがないので、理解されないことになる。
FlightPreArrivalCity→to
ShowFlightCmd→Show me the flight
さらに、ランタイム中に、入力された文が「Show flight to Boston」であると仮定する。この入力文は、「Show flight」がShowFlightCmdであることを示すルールがないので、理解されないことになる。
CFGは、高分解理解(high resolution understanding)について十分に機能する。高分解理解は、文を多数のスロットに分解する文法を表現する。スロットの数が多くなるほど、より高い分解理解が文法によって示される。CFGは、高分解の状況において十分に一般化する。
しかし、満たされるべき多数のスロットがない場合、多くの適用は、低い分解理解を必要とする。1つのこのような適用は、コマンドおよびコントロールである。たとえば、コマンドおよびコントロール適用では、認識されなければならないいくつかのコマンドには、「ChangePassword」、「ChangeBackground」および「ChangeLoginPicture」が含まれる。これらの場合では、満たされるべきスロットはなく、文全体がコマンドとして認識されなければならない。トレーニング中に、これは十分に結果として以下のようなルールを生じることができる。
ChangeLoginPictureCmd→Please change my login icon
「ChangeLoginPicture」はコマンドであるので、ルールへのプロパティ部はない。したがって、文法学習者は単に、それが獲得したルールにおいて全文を「記憶する」。ユーザが発行したコマンドを認識し、呼び出すために、このコマンドはトレーニング・データ内の全文にマッチしなければならない。汎用化はまったくない。
ChangeLoginPictureCmd→Please change my login icon
「ChangeLoginPicture」はコマンドであるので、ルールへのプロパティ部はない。したがって、文法学習者は単に、それが獲得したルールにおいて全文を「記憶する」。ユーザが発行したコマンドを認識し、呼び出すために、このコマンドはトレーニング・データ内の全文にマッチしなければならない。汎用化はまったくない。
テンプレート文法内のルールによりプレターミナル(コマンド、プレアンブル、ポストアンブルなど)をモデリングする代わりに、本発明の一実施形態が引き出され、統計モデル(n−グラムなど)がプレターミナルをモデリングするために使用される。一実施形態では、テンプレート文法におけるプレターミナルに対応する、列挙された文節化について生成されたテキストが、n−グラム(または他の統計モデル)についてのトレーニング・データとして使用される。したがって、上記の用例では、プレターミナルについて列挙された文節化に対応するテキスト文字列が、EMアルゴリズムの期待ステップにおいて収集されたその期待カウントと共に、プレターミナルについてのn−グラムをトレーニングするために使用される。このように、テキスト「Show me the flight」がトレーニング・データとして使用されて、ShowFlightCmdプレターミナルをモデリングするためのn−グラムがトレーニングされる。したがって、それにおける「Show flight」を有する文がShowFlightCmdとして認識されるであろう確率を、以下のように計算することができる。
式15
Pr(<s>ShowFlight</s>|ShowFlightCmd)=
Pr(show|<s>; ShowFlightCmd)*
Pr(flight|show;ShowFlightCmd)*
Pr(</s>|flight; ShowFlightCmd)
Pr(<s>ShowFlight</s>|ShowFlightCmd)=
Pr(show|<s>; ShowFlightCmd)*
Pr(flight|show;ShowFlightCmd)*
Pr(</s>|flight; ShowFlightCmd)
このルールは、ShowFlightCmdとして認識された「show flight」を有しないけれども、式15における上記のn−グラム確率はゼロにならない。式15における第1の係数および第3の係数は、これらの係数が、実際にトレーニング・データ内に存在するバイグラムに対応するので、ゼロではない(たとえば、[<s> show]および[flight </s>])。第2の係数は、トレーニング・データにおいて現れたバイグラムに対応しないが、バック−オフのような平滑化技術(後述)があるため、これもまたゼロでない確率を有するようになり、以下のように表現することができる。
式16
Pr(flight|show;ShowFlightCmd)=
backoff_weight*Pr(flight|ShowFlightCmd)
バック−オフ重みを経験的に、あるいはそうでない場合は望むように設定することができ、ユニグラム確率Pr(flight|ShowFlightCmd)は、「flight」がトレーニング・データ内の語であるので、ゼロではない。
Pr(flight|show;ShowFlightCmd)=
backoff_weight*Pr(flight|ShowFlightCmd)
バック−オフ重みを経験的に、あるいはそうでない場合は望むように設定することができ、ユニグラム確率Pr(flight|ShowFlightCmd)は、「flight」がトレーニング・データ内の語であるので、ゼロではない。
パーサーは、Pr(show flight</s>|ShowFlightCmd)>0なので、入力文をShowFlight候補として見なすようになる。入力文の最終的な解釈は、他の解釈候補との比較によって決まるようになる。
したがって、図4は、スロットおよび統計モデル部326(n−グラムなど)をモデリングするためのルールを含み、プレターミナル(コマンド、プレアンブルおよびポストアンブルなど)を識別する、文法部210(CFGなど)を含む複合モデル351を作成するモデル・オーサリング・コンポーネントのもう1つの実施形態350を示す。したがって、ランタイム中に、入力文は、統計モデル部326を使用して評価されてプレターミナルが識別され、ルール・ベース文法部210を使用して評価されてスロットが満たされる。
コンポーネント350は複合モデル351を、部分的には、上述のEMアルゴリズム技術を使用してトレーニングする。たとえば、図5が、異なるサンプル文節化に従ってShowFlightCmdについて列挙されたすべてのルールを示すと仮定する。
図2〜3Bに関して上述したモデルでは、EMアルゴリズムのE−ステップ中に、期待カウントが、図5に示す列挙された各ルールについて収集される。M−ステップ中に、カウントが正規化される。しかし、複合モデル351では、アルゴリズムのM−ステップ中にカウントを正規化する代わりに、列挙されたルールの右側におけるテキスト文字列、および、これらのルールに対応する、関連する期待カウントがトレーニング・データとして使用されて、ShowFlightCmdプレターミナルについてのn−グラムがトレーニングおよび平滑化される。
言い換えれば、n−グラムのトレーニングにおいて、フル・カウントが語シーケンスの各生起について追加される必要はない。その代わりに、トレーニング・シーケンスに関連付けられたルールについての期待カウントに対応する部分データ(図3Aで例示したEM適用コンポーネント302によって生成されたもの)が、語シーケンスの各生起について追加される。
図2〜3Bに関して文節化の曖昧性をなくすことについて説明した実施形態とのもう1つの違いは、EMアルゴリズムのE−ステップに関連する。確率を、列挙された各ルールに関連付けるのではなく、ルールの確率はルール内のすべてのn−グラムの積である。
たとえば、上述のルール・ベース文法では、ルール、ShowFlightCmd→Show me the flightは、それに関連付けられたアトミック確率を有する。しかし、複合モデル351では、ルールについての確率を以下のように計算することができる。
式17
Pr(ShowFlightCmd→Show me the flight)=
Pr(show|<s>; ShowFlightCmd)*
Pr(me|show; ShowFlightCmd)*
Pr(the|me; ShowFlightCmd)*
Pr(flight|the; ShowFlightCmd)*
Pr(</s>|flight; ShowFlightCmd)
式17
Pr(ShowFlightCmd→Show me the flight)=
Pr(show|<s>; ShowFlightCmd)*
Pr(me|show; ShowFlightCmd)*
Pr(the|me; ShowFlightCmd)*
Pr(flight|the; ShowFlightCmd)*
Pr(</s>|flight; ShowFlightCmd)
また、本発明の一実施形態によれば、プレターミナルについての統計モデルのトレーニングには、平滑化アルゴリズムを適用することが含まれる。たとえば、プレターミナルについての統計モデルをトレーニングするためのトレーニング・データは比較的疎(sparse)である可能性があり、これは、このトレーニング・データが、所与のプレターミナルに関連付けられた文節化について列挙されたテキスト文字列を含むだけであるからである。このことは、統計モデルによって対象とされない(カバーされない)比較的大量の言語表現を残し、したがって、統計モデルを比較的脆弱にさせる。このように、モデル確率は、より低いレベルのn−グラムを使用して、一様分布状態に平滑化される。すなわち、統計モデルがバイグラムを含む場合、これは、文脈(context)に関係なくモデリングされた語についての確率を提供するユニグラムにより平滑化される。加えて、統計モデルは、同じ確率を語彙内の各語に割り当てる一様分布により平滑化される。したがって、語が語彙内にある場合、これは統計モデルによって、ゼロ確率によりモデリングされないようになる。削除された補間が使用されて、平滑化のオペレーションにおいて各モデルについての重みが求められ、異なる次数のモデルが線形補間される。
コンポーネント350はまた、本発明の異なる実施形態による追加の統計モデル・コンポーネントをトレーニングすることもできる。これをより詳細に、図6に示すブロック図に例示する。たとえば、そのブロック図で、統計モデル部326を、プレターミナルについての統計モデル・コンポーネント340を含むだけでなく、複数の他の統計モデルも含むものとして示す。たとえば、統計モデル326は、一実施形態では、コンポーネント342および344を含み、これらは、タスクの事前確率をモデリングする統計モデル、および、スロット遷移についての統計モデルを含む。
たとえば、ランタイム入力文が「Show flights to Boston arriving on Tuesday, 11:00 a.m.」である場合、語「arriving on」は、「Tuesday」が到着日に対応することを示すものとして解析されるようになる。しかし、「11:00 a.m.」の前に、それが出発時間であるのか到着時間であるのかを示すための語はない。「到着時間」スロットが「到着日」スロットの後に続く確率は、「出発時間」スロットが「到着日」スロットの後に続く確率より高い可能性が高くなる。このようなスロット遷移がモデリングされる場合、スロット遷移モデルは、「11:00 a.m.」が「arrival time」スロットにマッチされる方を選ぶようになる。また、統計モデル(n−グラム・モデルなど)をトレーニングしてスロット遷移をモデリングすることは、統計モデル(n−グラムモデルなど)をトレーニングしてスロットの事前確率をモデリングすることと、nの次数が異なることを除いて同じであることにも留意されたい。スロットの事前確率では、ユニグラム・モデルがトレーニングされ、2つのスロットの間のスロット遷移をモデリングするために、バイグラム・モデルがトレーニングされるなどとなる。
さらに、いくつかのコマンドは、トレーニング・データにおいて他のものより頻繁に発生する。したがって、コマンドの事前確率はモデル342においてモデリングされる。
本発明を、これから、もう1つの実施例に関して、より詳細に説明する。図7は、アポイントメント・スケジューリング・コマンドNewApptについてのセマンティクスを定義する、スキーマにおける意味クラスの1つの例示的な簡易化された実施例を示す。
図8は、意味クラスNewApptについて自動的に生成することができるテンプレート・ルールを例示し、ただし中括弧(braces)内のシンボルはオプショナルである。図9は、注釈付き文の一実施形態「New meeting with Peter at 5:00」を例示する。図10は、文節化の曖昧性をなくすことが前述のように実行された後に追加することができる、2つのルールを例示する。
しかし、前述のように、純粋なルール・ベースの文法は頑強性に欠け、脆弱性を示す可能性がある。したがって、本発明の一態様は、CFGルールをn−グラムで置き換えて、テンプレート文法におけるコマンド、プレアンブルおよびポストアンブルの各々をモデリングし、スロット遷移をモデリングする。スロットn−グラムは、プレアンブルおよびポストアンブルを欠くスロットの解釈を制約する。結果として生じるモデルは、統計モデル(またはHMM)およびCFGの複合である。HMMはテンプレート・ルールおよびn−グラムプレターミナルをモデリングし、CFGはライブラリ文法をモデリングする。
このようなモデルの一実施例を図11に示す。語「Att」は、「Attendee」の省略形であり、「ST」は「StartTime」の省略形である。出力確率(emission probabilities)bはプレターミナル依存n−グラムであり(この図では、これらをユニグラムとして示すが、高位出力分布は結果として高位HMMを生じるようになる)、遷移確率aはスロット遷移バイグラムである。スロット・ノードからの出力τは、ライブラリCFGノンターミナルである。語はこれらから、CFGモデルPCFGに従って生成される。
図11に示すモデルでは、入力文sの意味を、以下(式18)を満たすビタビ意味クラスcおよび状態シーケンスσを発見することによって得ることができる。
新しいモデルはCFGモデルの制限を克服する。低分解理解(タスク分類)では、プロパティ・プレターミナルがテンプレート文法に導入されない。したがって、すべてのトレーニング・データが使用されて、コマンド・プレターミナルについてのn−グラムがトレーニングおよび平滑化される。このモデルは、式19によって表現されるn−グラム分類子に縮小する。
n−グラム・モデルは厳密なルールマッチを必要としない。ルール適用可能性について二分決定(binary decisions)を行うのではなく、これは観測された語シーケンスが状態(プレターミナル)シーケンスから生成される確率を比較して、最も可能性の高い解釈を発見する。したがって、モデル自体は頑強であり、頑強なパーサーの必要性がない。
これより、トレーニングをより詳細に、図7〜11に示す実施例に関して説明する。モデルをトレーニングするため、EMアルゴリズムは自動的に語シーケンスを文節化し、各文節αを、対応するペアのプレターミナル・シーケンスにおいて対応するプレターミナルNTに位置合わせする。EMアルゴリズムは、NTから生成する語の文字列に対して確率を割り当てるモデルP(NT→α)を構築し、これを初期一様分布によりパラメータ化する。次いで、これは、パラメータ化を反復的にリファインする。各反復において、これは、ルールNT→αについての期待カウントを、前の反復におけるモデルのパラメータ化に従って計算し(Eステップ)、次いで、確率P(NT→α)を、期待カウントを正規化することによって再推定する(Mステップ)。プレターミナルをn−グラムでモデリングする新しいモデルをトレーニングするため、E−ステップにおいて収集された期待カウントが使用されて、M−ステップにおいてn−グラムがトレーニングおよび平滑化され、このn−グラムはEMアルゴリズムによって使用されて、文節化についての期待カウントが収集される。このことは、結果として、図12に例示するトレーニング・アルゴリズムを生じる。
1つの例示的実施形態では、図12の最後の行において例示されたしきい値は0.01に設定される。言うまでもなく、他のしきい値も使用することができる。
本発明のもう1つのオプショナルの態様にも留意されたい。オプショナルの文法ライブラリ209(図2A、4および13に示す)をトレーニング・データ208に統計的に適合させることができる。たとえば、文法ライブラリ209が、大小の国内外の都市を含む、比較的大きい都市リストを含むと仮定する。しかし、さらに、モデルがトレーニングされている特定の適用(application)は国内の都市のみを参照する傾向があり、さらに、ニューヨークおよびロサンゼルスなどの国内の大都市は、より小さい都市よりも参照される可能性が高いと仮定する。コンポーネント202または350は、文法209を備えることができる確率文脈自由文法(PCFG)に関連付けられた確率を、注釈付きトレーニング・データ208から学習する。たとえば、ルールCityname→New Yorkについての確率は、ルールCityname→Tokyoについての確率より大きいことを学習することができる。このことは、上述の他の確率が学習されるのと同じ方法で行うことができる。
図13は、スロットについてのルール・ベース文法部およびプレターミナルについての統計モデル部を共に使用したランタイム・システムを例示する。このシステムは入力を受信し、文法部およびn−グラム部を使用し、出力402を出力する。
復号化をより詳細に、図14に関して説明する。図14は、入力「new meeting with Peter at five」についてのダイナミック・プログラミング・デコーダを表しているダイナミック・プログラミング・トレリス構造を例示している。
ダイナミック・プログラミング・デコーダは、上記の式18によって表現されたビタビ経路を発見する。入力を受信すると、デコーダは最初にボトムアップのチャート・パーサーを使用して、いくつかの入力スパンを包含するライブラリ文法ノン・ターミナルを発見する。この実施例では、これは「Peter」を<Person>、「five」を<time>または<num>と識別する。次いで、デコーダは第1の列の意味クラスノード(この実施例は意味クラスNewApptのみを示す)から開始して、トレリス中を探索する。各ノードで、これは、同じ列における他のノードへの遷移(異なるノン・ターミナルへの切り替え)、または同じ行における次のノードへの遷移(ノン・ターミナルによる入力語の消費)を行う。探索は左から右へ、これが一番右の列に達するまで継続する。これが遷移を行うとき、適切な対数確率を開始ノードのスコアに追加することによって、スコアが得られる。次いでこのスコアが、宛先ノードのスコアと比較され、新しいスコアの方が高い場合、スコアを置き換える。トレリスより下は、チャート・パーサーによって識別されたノン・ターミナルである。太い経路410は、ビタビ解釈を表現する。高い方の細い経路412は正しいタスクを識別するが、いずれのスロットも識別しない。低い方の細い経路414(ビタビ経路410の部分を共有する)は、出席者を識別するが開始タイム・スロットを識別しない。これは「at five」を出席者についてのポストアンブルとして扱う。図14に示す最初の9個の各遷移についての対数確率を以下にビタビ経路410についてリストする。
任意の所望のプルーニング・メカニズムも使用することができる。たとえば、あるプルーニング・メカニズムは、トレリスの各列で、ノードのスコアが同じ列における最大スコアより低いしきい値(5.0など)より小さい場合、そのノードから遷移が行われないことを規定する。すなわち、経路が同じ列におけるノードに通じる別の経路よりおそらく105倍低い場合、その経路は延長されない。デコーダは、プルーニングの後、頑強なパーサーより1桁速く実行する。
本発明の一実施形態によれば、複合モデル351は自然言語理解システムにおいて使用されるだけでなく、音声認識システムにおいても使用することができる。このような実施形態では、音声認識システムは音声認識および自然言語理解を単一のパスにおいて実行することができる。
図15は、複合モデル351が使用される1つの例示的音声認識システム500のブロック図を例示する。言うまでもなく、複合モデル351が、図15に示す音声認識システムにおいて実装されるので、システム500は、音声認識に加えて、自然言語理解も実行することができる。これをより詳細に説明する前に、システム500の全体のオペレーションの簡単な考察を提供する。
図15で、話者501はマイクロフォン504に向かって話す。マイクロフォン504によって検出されたオーディオ信号は電気信号に変換され、これがアナログ−デジタル(A−D)コンバータ506に提供される。
A−Dコンバータ506は、マイクロフォン504からのアナログ信号を一連のデジタル値に変換する。いくつかの実施形態では、A−Dコンバータ506はアナログ信号を16kHzおよびサンプル当たりに16ビットでサンプリングし、それにより毎秒32キロバイトの音声データを作成する。これらのデジタル値はフレーム・コンストラクタ507に提供され、これは一実施形態では、これらの値を10ミリ秒間隔で開始する25ミリ秒フレームにグループ化する。
フレーム・コンストラクタ507によって作成されたデータのフレームは、特徴抽出器(feature extractor)508に提供され、これが特徴を各フレームから抽出する。特徴抽出モジュールの例には、線形予測符号化(LPC)、LPC導出ケプストラム、知覚線形予想(PLP)、聴覚モデル特徴抽出、およびメル周波数ケプストラム係数(Mel-Frequency Cepstrum Coefficients:MFCC)特徴抽出を実行するためのモジュールが含まれる。本発明はこれらの特徴抽出モジュールに限定されず、本発明とのコンテクスト内で他のモジュールを使用できることに留意されたい。
特徴抽出モジュール508は、それぞれが音声信号のフレームに関連付けられている特徴ベクトルのストリームを生じる。この特徴ベクトルのストリームは、デコーダ512に提供され、そこで、最も可能性の高い語のシーケンスが、特徴ベクトルのストリーム、レキシコン514、言語モデル351および音響モデル518に基づいて、識別される。復号化のために使用される特定の方法は、本発明には重要ではない。
仮説語の最も確からしいシーケンスを、オプショナルの信頼性測定モジュール520に提供することができる。信頼測定モジュール520は、どの語が音声認識装置によって不適切に識別されている可能性が最も高いかを識別する。これを、部分的には2次音響モデル(図示せず)に基づかせることができる。次いで、信頼測定モジュール520は仮説語のシーケンスを出力モジュール522へ、どの語が不適切に識別されている可能性があるかを示す識別子と共に、提供する。信頼測定モジュール520は本発明の実施のために必要ではないことは、当業者には理解されよう。
トレーニング中に、トレーニング・テキスト526に対応する音声信号がトレーナ524[YW1]に、トレーニング・テキスト526の語彙表記(lexical transcription)と共に入力される。トレーナ524は音響モデル518を、トレーニング入力に基づいてトレーニングする。複合言語モデル351のトレーニングについては上述した。
同じく上述したように、モデル351は、(たとえば、隠れマルコフ・モデル技術を使用して実装される)統計部を使用して適用スキーマの構造情報を符号化し、(たとえば、CFG技術を使用して実装される)ルール・ベース部を使用して、いくつかのHMM状態の出力(emissions)をモデリングする。図16〜17Bは、モデルのトポロジを、それが未知語を説明するとしても、どのようにこのモデルを有限状態表現において、コンパクトな方法で、表現することができるかの考察を容易にするような方法で例示する。
図16は、もう1つの適用スキーマ600の1つの例示的実施形態である。スキーマ600は単に、この適用が2つのタイプの情報クエリ、すなわち、フライト情報についてのもの(ShowFlightタスク)、および、陸上輸送情報についてのもの(GroundTransportタスク)をサポートすることを示す。フライト情報を得るために、ユーザは到着都市(ACity)および/または出発都市(DCity)スロットについての情報を提供して、システムがユーザの仕様に従って情報を探索することができるようにしなければならない。スロットのタイプは、その「フィラー」についての要件を指定する。ACityおよびDCityスロットの両方について、フィラーは、タイプ「City」のオブジェクトを参照する文法ライブラリにおいてモデリングされた表現でなければならない。
図17Aおよび17Bは、スキーマ600の意味制約を自然言語理解ルール・ベース文法(CFGなど)に組み込む統計モデル部(HMM)を示す。図17Aは、最上位構造602を例示し、これは2つのブランチを有し、一方はShowFlightサブ・ネットワーク604につながり、他方はGroundTransportネットワーク606につながる。各ブランチにおける遷移重みは、2つのタスクについての確率である。したがって、S−ノードからShowFlightサブ・ネットワーク604への遷移重みは、ShowFlightタスク(またはコマンド)の確率に対応し、GroundTransportサブ・ネットワーク606への遷移重みは、GroundTransportタスクの確率に対応する。
図17Bは、ShowFlightサブ・ネットワーク604モデルをより詳細に例示し、このサブ・ネットワーク・モデルの使用を図17Cによって例示する。図17Bに示すShowFlightサブ・ネットワーク・モデルは、ユーザがShowFlightコマンドを発行するために使用することができる言語表現をモデリングする。このサブ・ネットワーク・モデルはコマンド部(「Show me the flight」など)により開始し、その後にスロットについての表現が続く。各スロットは、プレアンブルおよびポストアンブルによって一まとめに扱われ、プレアンブルおよびポストアンブルはスロットについての言語的文脈としての機能を果たす。たとえば、語「from」はDCityスロットについてのプレアンブルである。これは、その後に続くCityが出発都市である可能性が高いことを示唆する。これらのスロットは相互接続され、これらの接続はスロット遷移についてのバイグラム確率により重み付けされ、これはトレーニング・データから推定される。
サブ・ネットワーク・モデル604では、コマンド、プレアンブルおよびポストアンブルが統計n−グラム・モデルによりモデリングされる。これらをサブ・ネットワーク・モデル604における長円形の部分によって例示する。スロット・フィラーは、文法ライブラリからの確率的CFGルールによりモデリングされる。これらをサブ・ネットワーク・モデル604における長方形によって例示する。文法ライブラリにおけるルールについての確率は例示的に、領域特有のデータを使用して調節され、平滑化される。モデル604におけるn−グラムは、部分的にラベル付きのトレーニング・データによりトレーニングされる。上述のように、EMアルゴリズムを使用してネットワーク内のn−グラムをトレーニングすることができ、これらのアラインメントは隠れ変数として扱われる。
頑強なパーサーに依拠して、文法によって包含されない語をスキップした、以前の頑強な理解技術とは異なり、文法におけるプレターミナルについてのn−グラム・モデルの使用は、モデルをそれ自体で頑強にする。このことは、本発明の1つの特徴を可能とし、これは複合モデル351(図17Aおよび17Bに示す一実施形態)を自然言語理解のみにおいて使用するのではなく、音声認識においても使用する、ことを可能にする。このことは、以前のシステムにおいて音声認識および自然言語理解を実施するために使用された、最適状態とは言えない、2パスの手法に勝り、さらに、それは、以前のシステムよりよく例示的に汎用化することができるように、以前の知識を使用する。
しかし、音声認識システムにおけるモデル351(図15に示す言語モデルなど)を使用するために、このモデルは最初に、デコーダ512がその言語モデルとして受け入れることができるフォーマットに変換される。したがって、コマンド、プレアンブルおよびポストアンブルをモデリングするために使用された統計n−グラム・モデル(すなわち、CFG内のこれらのn−グラム)が、確率有限状態オートマトン(automata)に変換される。変換されたn−グラムおよび最上位のHMM構造(図17Aに示す602など)は、ライブラリ文法におけるルールと共に、確率文脈自由文法(PCFG)言語モデルを形成する。この変換は、周知の変換アルゴリズム(たとえば、非特許文献3参照。)に基づいて、実行することができる。
しかしながら、従来のアルゴリズムに対して、モデルのサイズを著しく縮小するために、1つの著しい修正が行われる。これを、図18の(a)、(b)および(c)によって例示する。図18の(a)および(c)は、2つのプレターミナルについてのバイグラム言語モデルの有限状態表現を例示し、各々は2つの観測語(それぞれa、bおよびc、dと示す)によりトレーニングされている。モデル内の各円弧におけるラベルは、重みおよび出力シンボルを例示する。文字Iは初期状態を表現し、文字Oはバック−オフ状態を表現し、文字Fは最終状態を表現する。図18の(b)は共有一様分布の有限状態表現であり、これが使用されて、バック−オフ確率が未知語(すなわち、図18の(a)に示すような特定のn−グラム・モデルについてのトレーニング・データにおいて見られなかった語)に割り当てられる。
図18の(a)に示すモデルのオペレーションを例示するため、語「a」の発声とその後に続く語「b」の発声に関連付けられた確率を考察する。これは、以下の確率の組合せに対応する。
P(a|<s>):a
P(b|a):b
Pr(</s>|b)
P(a|<s>):a
P(b|a):b
Pr(</s>|b)
第1の確率は、語「a」が文開始シンボルの後に続くn−グラム確率である。これは、初期状態Iから状態aへの遷移に対応する。第2の確率は、語「b」が語「a」の後に続く確率であり、これは状態aから状態bへの遷移においてラベル付けされる。第3の確率は、文終了シンボルが語「b」の後に続く確率であり、これは状態bから有限状態Fへの遷移においてラベル付けされる。この一連の遷移は、有限状態マシンにおいて、発声「a b」を受け入れる経路を形成し、この発声の確率を、この経路における遷移の確率を乗算することによって計算する。
トレーニング・データにおいて観測されない語シーケンスの発声では、有限状態マシンは0の確率をそれに割り当てない。その代わりに、経路は、バック−オフ状態を通じて、バック−オフ重みおよびユニグラム確率の積を、未知イベントのバイグラム確率として使用し、トラバースする。たとえば、発声「a a」の確率は、図18の(a)において以下の経路を介して計算される。
I→a P(a|<s>):a
a→O B(a):ε
O→a P(a):a
a→F P(</s>|a)
ここで、バイグラム「a a」がトレーニング・データにおいて観測されないとしても、P(a|a)=B(a)*P(a)>0である。
I→a P(a|<s>):a
a→O B(a):ε
O→a P(a):a
a→F P(</s>|a)
ここで、バイグラム「a a」がトレーニング・データにおいて観測されないとしても、P(a|a)=B(a)*P(a)>0である。
モデリング中の特定のn−グラムについてのトレーニング・データにおいて未知である語の発声では、その語が語彙内にある場合、その語には、一様確率への確率バック−オフ1/|V|が割り当てられ、ただし|V|は語彙サイズである。以前のシステムでは、これは結果として、あらゆる未知語についてのバック−オフ状態O上の自己ループとなる。複合モデル内の各n−グラムについてのトレーニング・データは比較的疎である可能性があるので、モデルに関連付けられた語彙における多数の語が、各n−グラムについてのトレーニング・データにおいて未知となる。モデル351は例示的に、多数の語(例示的には数百)を有する語彙をサポートするようになるので、また、モデルも多数のn−グラム(これも例示的には数百)を有するようになるので、複合モデル全体におけるバック−オフ状態Oを通じた自己ループの数は非常に大きくなる。
したがって、本発明の1つの例示的実施形態によれば、各未知語についてのループを追加するのではなく、複合モデル351におけるn−グラム・モデル(図18の(a)に示すものなど)は、バック−オフ状態Oを通じた単一のループ620[YW2]を含む。単一のループ620は、図18の(b)に示すような共有一様分布モデルを参照する。
図18の(b)に示す一様分布モデルでは、文字nは語彙内の語の数を指し、ただしw1は最初の語「a」を指し、w2は第2の語「b」を指すなどとなる。したがって、各未知語について、バック−オフ状態上をループするのではなく、モデルは、バック−オフ状態O上の一様分布によりラベルが付けられた自己ループによりほぼ平滑化される。図18の(b)に示す一様分布モデルは、複合モデル351におけるn−グラムのすべてについて共有される。各n−グラムは単に、図18の(a)に示すループ620に類似のループを有し、これは図18の(b)に示す一様分布モデルを参照する。これを図18の(c)に例示する。これは、モデル351における空間の相当の量を節約し、これを以前のシステムよりはるかにコンパクトにする。
このように、本発明の様々な実施形態は、プレターミナルについての統計モデル部を含むだけでなく、スロットを満たすためのルール・ベース文法部をも含み、この複合モデルは音声認識、または、音声認識および自然言語理解システムの組合せにおいて使用されることは理解されよう。これは実質的に、最適状態とは言えない2パスのシステムに関連する効率の悪さを低減し、また、言語モデルにおける以前の知識を含んで、言語モデル・トレーニング・データの不足を補う(すなわち、データの疎性に対処する)。この組み合わせた手法はまた、全体の理解エラー率も低減する。本発明のもう1つの実施形態はまた、n−グラム・モデルを平滑化することであって、これを、n−グラム・モデルにおいてバック−オフ状態に渡って自己ループを使用するのではなく、別のバック−オフ・モデル(一様分布モデルなど)を参照することによって行うことも含む。これはモデルのサイズを縮小し、よりコンパクトにする。
本発明を特定の実施形態を参照して説明したが、本発明の精神および範囲から逸脱することなく、形態および詳細において変更を行うことができることは、当業者には理解されよう。
200 モデル・オーサリング・システム
202 モデル・オーサリング・コンポーネント
204 ユーザ・インターフェース
206 スキーマ
208 トレーニング用例テキスト文字列のセット
209 文法ライブラリ
210 ルール・ベース文法
300 テンプレート文法ジェネレータ
302 文節化EM適用コンポーネント
304 プルーニング・コンポーネント
325 スロットについてのルール・ベース文法部
326 統計モデル部
340 プレターミナルについての統計モデル・コンポーネント
342 コンポーネント
344 コンポーネント
350 モデル・オーサリング・コンポーネント
351 複合モデル
400 自然言語入力文字列
402 出力
500 音声認識システム
501 話者
504 マイクロフォン
506 アナログ−デジタル(A−D)コンバータ
507 フレーム・コンストラクタ
508 特徴抽出器
512 デコーダ
514 レキシコン
518 音響モデル
520 信頼測定モジュール
522 出力モジュール
524 トレーナ
526 トレーニング・テキスト
202 モデル・オーサリング・コンポーネント
204 ユーザ・インターフェース
206 スキーマ
208 トレーニング用例テキスト文字列のセット
209 文法ライブラリ
210 ルール・ベース文法
300 テンプレート文法ジェネレータ
302 文節化EM適用コンポーネント
304 プルーニング・コンポーネント
325 スロットについてのルール・ベース文法部
326 統計モデル部
340 プレターミナルについての統計モデル・コンポーネント
342 コンポーネント
344 コンポーネント
350 モデル・オーサリング・コンポーネント
351 複合モデル
400 自然言語入力文字列
402 出力
500 音声認識システム
501 話者
504 マイクロフォン
506 アナログ−デジタル(A−D)コンバータ
507 フレーム・コンストラクタ
508 特徴抽出器
512 デコーダ
514 レキシコン
518 音響モデル
520 信頼測定モジュール
522 出力モジュール
524 トレーナ
526 トレーニング・テキスト
Claims (16)
- 音声処理システムであって、
音響モデルと、
ルール・ベース・モデル部および統計モデル部を含む複合言語モデルと、
前記音響モデルおよび前記複合言語モデルに結合され、自然言語音声入力の部分を、スキーマから導出されたプレターミナルおよびスロットに、前記音響モデルおよび前記複合言語モデルに基づいてマップするように構成されたデコーダと
を備えることを特徴とする音声処理システム。 - 前記デコーダは、前記自然言語音声入力の部分を前記スロットに、前記複合言語モデルの前記ルール・ベース・モデル部に基づいてマップするように構成されることを特徴とする請求項1に記載の音声処理システム。
- 前記デコーダは、前記自然言語音声入力の部分を前記プレターミナルに、前記複合言語モデルの前記統計モデル部に基づいてマップするように構成されることを特徴とする請求項1に記載の音声処理システム。
- 前記複合言語モデルの前記統計モデル部は、複数の統計n−グラム・モデルを備え、1つの統計n−グラム・モデルは各プレターミナルに対応することを特徴とする請求項1に記載の音声処理システム。
- 前記複合言語モデルは語の語彙をサポートし、前記統計n−グラム・モデルはトレーニング・データに基づいてトレーニングされ、前記語彙において、特定の統計n−グラム・モデルをトレーニングするために使用されない語は、前記特定の統計n−グラム・モデルについての未知語を備えることを特徴とする請求項4に記載の音声処理システム。
- 前記複合言語モデルの前記統計モデル部は、バック−オフ・モデル部をさらに備え、これはアクセスされるとき、バック−オフ・スコアを前記語彙における語に割り当てるように構成されることを特徴とする請求項5に記載の音声処理システム。
- 各統計n−グラム・モデルは、すべての未知語についての前記バック−オフ・モデル部への参照を含むことを特徴とする請求項6に記載の音声処理システム。
- 前記バック−オフ・モデル部は、一様スコアを前記語彙におけるあらゆる語に割り当てる、一様分布n−グラムを備えることを特徴とする請求項7に記載の音声処理システム。
- 前記ルール・ベース・モデル部は、文脈自由文法(CFG)を備えることを特徴とする請求項1に記載の音声処理システム。
- 音声処理中に確率を語仮説に割り当てる方法であって、
語仮説を受信すること、
複数の統計モデルおよび複数のルール・ベース・モデルを有する複合言語モデルにアクセスすること、
前記語仮説が、前記n−グラム・モデルのトレーニング中に知られた語に対応する場合、n−グラム確率を、n−グラム・モデルにより、前記語仮説に割り当てること、
前記語仮説が、前記n−グラム・モデルのトレーニング中に知られなかった語に対応する場合、前記語仮説のための別のバック−オフ・モデルを参照すること、および
バック−オフ確率を、未知語に対応する各語仮説に、前記バック−オフ・モデルにより割り当てること
を備えることを特徴とする方法。 - 前記語仮説を、入力スキーマから導出されたスロットに、前記複合言語モデル内の前記ルール・ベース・モデルに基づいて、マップすることをさらに備えることを特徴とする請求項10に記載の方法。
- 前記語仮説を、前記入力スキーマから導出されたプレターミナルに、前記複合言語モデル内の前記n−グラム・モデルおよび前記バック−オフ・モデルによって割り当てられた確率に基づいて、マップすることをさらに備えることを特徴とする請求項11に記載の方法。
- 前記別のバック−オフ・モデルを参照することは、一様分布n−グラムを参照することを備えることを特徴とする請求項12に記載の方法。
- 前記バック−オフ確率を割り当てることは、一様分布スコアを前記語彙におけるあらゆる語に割り当てることを備えることを特徴とする請求項13に記載の方法。
- 音声認識システムにおいて使用するための複合言語モデルであって、
入力音声信号の部分をスキーマから導出されたスロットにマップするためにアクセスされるルール・ベース・モデル部と、
前記入力音声信号の部分を前記スキーマから導出されたプレターミナルにマップするためにアクセスされる統計モデル部と
を備えることを特徴とする複合言語モデル。 - 前記統計モデル部は、複数の統計n−グラム・モデルを備え、1つの統計n−グラム・モデルは各プレターミナルに対応することを特徴とする請求項15に記載の複合言語モデル。
Applications Claiming Priority (2)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| US10/427,604 US7603267B2 (en) | 2003-05-01 | 2003-05-01 | Rules-based grammar for slots and statistical model for preterminals in natural language understanding system |
| US10/718,138 US20040220809A1 (en) | 2003-05-01 | 2003-11-20 | System with composite statistical and rules-based grammar model for speech recognition and natural language understanding |
Publications (1)
| Publication Number | Publication Date |
|---|---|
| JP2004334193A true JP2004334193A (ja) | 2004-11-25 |
Family
ID=32993987
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| JP2004127286A Pending JP2004334193A (ja) | 2003-05-01 | 2004-04-22 | 音声認識および自然言語理解のための複合統計/ルール・ベース文法モデルを有するシステム |
Country Status (6)
| Country | Link |
|---|---|
| EP (1) | EP1475779B1 (ja) |
| JP (1) | JP2004334193A (ja) |
| KR (1) | KR20040094642A (ja) |
| CN (1) | CN1551103B (ja) |
| AT (1) | ATE352086T1 (ja) |
| DE (1) | DE602004004310T2 (ja) |
Cited By (2)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP2021018797A (ja) * | 2019-07-23 | 2021-02-15 | バイドゥ オンライン ネットワーク テクノロジー (ベイジン) カンパニー リミテッド | 対話の交互方法、装置、コンピュータ可読記憶媒体、及びプログラム |
| JP2022006183A (ja) * | 2020-10-27 | 2022-01-12 | ベイジン バイドゥ ネットコム サイエンス テクノロジー カンパニー リミテッド | 言語モデルのトレーニング方法、装置、及び電子機器 |
Families Citing this family (18)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| CN100349206C (zh) * | 2005-09-12 | 2007-11-14 | 周运南 | 文字语音互转装置 |
| KR100784730B1 (ko) * | 2005-12-08 | 2007-12-12 | 한국전자통신연구원 | 태깅된 도메인 코퍼스 없이 새로운 도메인에 적용 가능한통계적 hmm 품사 태깅 장치 및 방법 |
| KR100718846B1 (ko) * | 2006-11-29 | 2007-05-16 | 인하대학교 산학협력단 | 음성 검출을 위한 통계 모델을 적응적으로 결정하는 방법 |
| US8494852B2 (en) * | 2010-01-05 | 2013-07-23 | Google Inc. | Word-level correction of speech input |
| US8484025B1 (en) * | 2012-10-04 | 2013-07-09 | Google Inc. | Mapping an audio utterance to an action using a classifier |
| US9786269B2 (en) | 2013-03-14 | 2017-10-10 | Google Inc. | Language modeling of complete language sequences |
| CZ307393B6 (cs) * | 2013-06-26 | 2018-07-25 | Speechtech, S.R.O. | Zařízení pro převod řeči do textu v reálném čase |
| US20160379630A1 (en) * | 2015-06-25 | 2016-12-29 | Intel Corporation | Speech recognition services |
| CN105786971B (zh) * | 2016-02-02 | 2019-06-11 | 宋继华 | 一种面向国际汉语教学的语法点识别方法 |
| CN108288467B (zh) * | 2017-06-07 | 2020-07-14 | 腾讯科技(深圳)有限公司 | 一种语音识别方法、装置及语音识别引擎 |
| CN108010526B (zh) * | 2017-12-08 | 2021-11-23 | 北京奇虎科技有限公司 | 语音处理方法及装置 |
| US10902211B2 (en) * | 2018-04-25 | 2021-01-26 | Samsung Electronics Co., Ltd. | Multi-models that understand natural language phrases |
| CN108962224B (zh) * | 2018-07-19 | 2020-06-26 | 苏州思必驰信息科技有限公司 | 口语理解和语言模型联合建模方法、对话方法及系统 |
| CN109087645B (zh) * | 2018-10-24 | 2021-04-30 | 科大讯飞股份有限公司 | 一种解码网络生成方法、装置、设备及可读存储介质 |
| CN111292751B (zh) * | 2018-11-21 | 2023-02-28 | 北京嘀嘀无限科技发展有限公司 | 语义解析方法及装置、语音交互方法及装置、电子设备 |
| CN109582776B (zh) * | 2018-12-04 | 2021-07-09 | 北京羽扇智信息科技有限公司 | 模型的生成方法及装置、电子设备及存储介质 |
| CN110517693B (zh) * | 2019-08-01 | 2022-03-04 | 出门问问(苏州)信息科技有限公司 | 语音识别方法、装置、电子设备和计算机可读存储介质 |
| CN114416948B (zh) * | 2022-01-18 | 2024-12-17 | 珠海大地软件科技有限公司 | 一种基于语义感知的一对多对话生成方法及装置 |
Citations (6)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JPH04195100A (ja) * | 1990-11-28 | 1992-07-15 | Nec Corp | 連続音声認識装置 |
| JPH08123471A (ja) * | 1994-10-28 | 1996-05-17 | Mitsubishi Electric Corp | 音声認識装置 |
| JPH1097535A (ja) * | 1996-05-16 | 1998-04-14 | Atr Onsei Honyaku Tsushin Kenkyusho:Kk | 音声言語解析装置 |
| JPH10116094A (ja) * | 1996-10-01 | 1998-05-06 | Lucent Technol Inc | 音声認識方法および音声認識装置 |
| WO2001093249A1 (en) * | 2000-06-01 | 2001-12-06 | Microsoft Corporation | Unified language model cfg and n-grams |
| WO2001093246A2 (en) * | 2000-06-01 | 2001-12-06 | Microsoft Corporation | Creating a unified task dependent language models with information retrieval techniques |
-
2004
- 2004-04-22 JP JP2004127286A patent/JP2004334193A/ja active Pending
- 2004-04-30 AT AT04010313T patent/ATE352086T1/de not_active IP Right Cessation
- 2004-04-30 EP EP04010313A patent/EP1475779B1/en not_active Expired - Lifetime
- 2004-04-30 CN CN2004100451835A patent/CN1551103B/zh not_active Expired - Fee Related
- 2004-04-30 KR KR1020040030526A patent/KR20040094642A/ko not_active Ceased
- 2004-04-30 DE DE602004004310T patent/DE602004004310T2/de not_active Expired - Lifetime
Patent Citations (6)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JPH04195100A (ja) * | 1990-11-28 | 1992-07-15 | Nec Corp | 連続音声認識装置 |
| JPH08123471A (ja) * | 1994-10-28 | 1996-05-17 | Mitsubishi Electric Corp | 音声認識装置 |
| JPH1097535A (ja) * | 1996-05-16 | 1998-04-14 | Atr Onsei Honyaku Tsushin Kenkyusho:Kk | 音声言語解析装置 |
| JPH10116094A (ja) * | 1996-10-01 | 1998-05-06 | Lucent Technol Inc | 音声認識方法および音声認識装置 |
| WO2001093249A1 (en) * | 2000-06-01 | 2001-12-06 | Microsoft Corporation | Unified language model cfg and n-grams |
| WO2001093246A2 (en) * | 2000-06-01 | 2001-12-06 | Microsoft Corporation | Creating a unified task dependent language models with information retrieval techniques |
Cited By (5)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP2021018797A (ja) * | 2019-07-23 | 2021-02-15 | バイドゥ オンライン ネットワーク テクノロジー (ベイジン) カンパニー リミテッド | 対話の交互方法、装置、コンピュータ可読記憶媒体、及びプログラム |
| JP7150770B2 (ja) | 2019-07-23 | 2022-10-11 | バイドゥ オンライン ネットワーク テクノロジー(ペキン) カンパニー リミテッド | 対話方法、装置、コンピュータ可読記憶媒体、及びプログラム |
| JP2022006183A (ja) * | 2020-10-27 | 2022-01-12 | ベイジン バイドゥ ネットコム サイエンス テクノロジー カンパニー リミテッド | 言語モデルのトレーニング方法、装置、及び電子機器 |
| JP7190017B2 (ja) | 2020-10-27 | 2022-12-14 | ベイジン バイドゥ ネットコム サイエンス テクノロジー カンパニー リミテッド | 言語モデルのトレーニング方法、装置、及び電子機器 |
| US11900918B2 (en) | 2020-10-27 | 2024-02-13 | Beijing Baidu Netcom Science Technology Co., Ltd. | Method for training a linguistic model and electronic device |
Also Published As
| Publication number | Publication date |
|---|---|
| CN1551103A (zh) | 2004-12-01 |
| DE602004004310D1 (de) | 2007-03-08 |
| ATE352086T1 (de) | 2007-02-15 |
| CN1551103B (zh) | 2010-06-23 |
| DE602004004310T2 (de) | 2007-05-10 |
| EP1475779A1 (en) | 2004-11-10 |
| EP1475779B1 (en) | 2007-01-17 |
| KR20040094642A (ko) | 2004-11-10 |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| US20040220809A1 (en) | System with composite statistical and rules-based grammar model for speech recognition and natural language understanding | |
| EP1475779B1 (en) | System with composite statistical and rules-based grammar model for speech recognition and natural language understanding | |
| Mohri et al. | Weighted finite-state transducers in speech recognition | |
| EP1447792B1 (en) | Method and apparatus for modeling a speech recognition system and for predicting word error rates from text | |
| US7529657B2 (en) | Configurable parameters for grammar authoring for speech recognition and natural language understanding | |
| EP1575030B1 (en) | New-word pronunciation learning using a pronunciation graph | |
| US8442828B2 (en) | Conditional model for natural language understanding | |
| JPH08278794A (ja) | 音声認識装置および音声認識方法並びに音声翻訳装置 | |
| US7076422B2 (en) | Modelling and processing filled pauses and noises in speech recognition | |
| EP1465155B1 (en) | Automatic resolution of segmentation ambiguities in grammar authoring | |
| Wang et al. | Combination of CFG and n-gram modeling in semantic grammar learning | |
| CN113421587A (zh) | 语音评测的方法、装置、计算设备及存储介质 | |
| Schwartz et al. | Hidden understanding models for statistical sentence understanding | |
| Roark | Robust garden path parsing | |
| Li | Low-resource speech recognition for thousands of languages | |
| Švec et al. | Semantic entity detection from multiple ASR hypotheses within the WFST framework | |
| Švec et al. | Word-semantic lattices for spoken language understanding | |
| Acero et al. | A semantically structured language model | |
| Watanabe et al. | Xinjian Li Carnegie Mellon University | |
| Lieb et al. | A flexible and integrated interface between speech recognition, speech interpretation and dialog management |
Legal Events
| Date | Code | Title | Description |
|---|---|---|---|
| A621 | Written request for application examination |
Free format text: JAPANESE INTERMEDIATE CODE: A621 Effective date: 20070330 |
|
| A131 | Notification of reasons for refusal |
Free format text: JAPANESE INTERMEDIATE CODE: A131 Effective date: 20100326 |
|
| A02 | Decision of refusal |
Free format text: JAPANESE INTERMEDIATE CODE: A02 Effective date: 20100903 |