JP2007014331A - インターフェロン様分子およびその使用 - Google Patents
インターフェロン様分子およびその使用 Download PDFInfo
- Publication number
- JP2007014331A JP2007014331A JP2006170738A JP2006170738A JP2007014331A JP 2007014331 A JP2007014331 A JP 2007014331A JP 2006170738 A JP2006170738 A JP 2006170738A JP 2006170738 A JP2006170738 A JP 2006170738A JP 2007014331 A JP2007014331 A JP 2007014331A
- Authority
- JP
- Japan
- Prior art keywords
- polypeptide
- seq
- ifn
- amino acid
- nucleotide sequence
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Pending
Links
- 108090000765 processed proteins & peptides Proteins 0.000 claims abstract description 786
- 102000004196 processed proteins & peptides Human genes 0.000 claims abstract description 773
- 229920001184 polypeptide Polymers 0.000 claims abstract description 760
- 238000000034 method Methods 0.000 claims abstract description 173
- 150000007523 nucleic acids Chemical class 0.000 claims abstract description 147
- 102000039446 nucleic acids Human genes 0.000 claims abstract description 135
- 108020004707 nucleic acids Proteins 0.000 claims abstract description 135
- 239000013598 vector Substances 0.000 claims abstract description 62
- 230000027455 binding Effects 0.000 claims abstract description 57
- 208000037265 diseases, disorders, signs and symptoms Diseases 0.000 claims abstract description 30
- 238000004519 manufacturing process Methods 0.000 claims abstract description 29
- 201000010099 disease Diseases 0.000 claims abstract description 23
- 208000035475 disorder Diseases 0.000 claims abstract description 7
- 210000004027 cell Anatomy 0.000 claims description 268
- 108090000623 proteins and genes Proteins 0.000 claims description 195
- 125000003275 alpha amino acid group Chemical group 0.000 claims description 113
- FWMNVWWHGCHHJJ-SKKKGAJSSA-N 4-amino-1-[(2r)-6-amino-2-[[(2r)-2-[[(2r)-2-[[(2r)-2-amino-3-phenylpropanoyl]amino]-3-phenylpropanoyl]amino]-4-methylpentanoyl]amino]hexanoyl]piperidine-4-carboxylic acid Chemical compound C([C@H](C(=O)N[C@H](CC(C)C)C(=O)N[C@H](CCCCN)C(=O)N1CCC(N)(CC1)C(O)=O)NC(=O)[C@H](N)CC=1C=CC=CC=1)C1=CC=CC=C1 FWMNVWWHGCHHJJ-SKKKGAJSSA-N 0.000 claims description 99
- 108020004414 DNA Proteins 0.000 claims description 99
- 239000002773 nucleotide Substances 0.000 claims description 92
- 125000003729 nucleotide group Chemical group 0.000 claims description 92
- 230000000694 effects Effects 0.000 claims description 88
- 230000014509 gene expression Effects 0.000 claims description 83
- 239000012634 fragment Substances 0.000 claims description 76
- 150000001413 amino acids Chemical class 0.000 claims description 74
- 102000004169 proteins and genes Human genes 0.000 claims description 67
- 239000000203 mixture Substances 0.000 claims description 49
- 239000011230 binding agent Substances 0.000 claims description 45
- -1 polypropylene Polymers 0.000 claims description 38
- 238000006467 substitution reaction Methods 0.000 claims description 38
- 241001465754 Metazoa Species 0.000 claims description 32
- 230000000295 complement effect Effects 0.000 claims description 31
- 150000001875 compounds Chemical class 0.000 claims description 31
- 125000000539 amino acid group Chemical group 0.000 claims description 25
- 238000012217 deletion Methods 0.000 claims description 22
- 230000037430 deletion Effects 0.000 claims description 22
- 230000008569 process Effects 0.000 claims description 21
- 125000002924 primary amino group Chemical group [H]N([H])* 0.000 claims description 19
- 238000009472 formulation Methods 0.000 claims description 17
- 230000004927 fusion Effects 0.000 claims description 17
- 230000004048 modification Effects 0.000 claims description 15
- 238000012986 modification Methods 0.000 claims description 15
- 230000004071 biological effect Effects 0.000 claims description 14
- 239000012528 membrane Substances 0.000 claims description 14
- 229920001223 polyethylene glycol Polymers 0.000 claims description 14
- 239000000126 substance Substances 0.000 claims description 14
- 239000002202 Polyethylene glycol Substances 0.000 claims description 13
- 230000009261 transgenic effect Effects 0.000 claims description 13
- 238000003780 insertion Methods 0.000 claims description 12
- 230000037431 insertion Effects 0.000 claims description 12
- 210000004899 c-terminal region Anatomy 0.000 claims description 11
- 230000001575 pathological effect Effects 0.000 claims description 11
- DNIAPMSPPWPWGF-UHFFFAOYSA-N Propylene glycol Chemical compound CC(O)CO DNIAPMSPPWPWGF-UHFFFAOYSA-N 0.000 claims description 9
- 239000013603 viral vector Substances 0.000 claims description 8
- 125000001360 methionine group Chemical group N[C@@H](CCSC)C(=O)* 0.000 claims description 7
- 229920002307 Dextran Polymers 0.000 claims description 6
- 210000004408 hybridoma Anatomy 0.000 claims description 6
- 229930182817 methionine Natural products 0.000 claims description 6
- 229920003169 water-soluble polymer Polymers 0.000 claims description 5
- 108020004635 Complementary DNA Proteins 0.000 claims description 4
- 241000124008 Mammalia Species 0.000 claims description 4
- 230000000890 antigenic effect Effects 0.000 claims description 4
- 238000012258 culturing Methods 0.000 claims description 4
- 201000006417 multiple sclerosis Diseases 0.000 claims description 4
- 229920001577 copolymer Polymers 0.000 claims description 3
- 210000003527 eukaryotic cell Anatomy 0.000 claims description 3
- 230000009931 harmful effect Effects 0.000 claims description 3
- 230000003053 immunization Effects 0.000 claims description 3
- 239000002904 solvent Substances 0.000 claims description 3
- 238000002054 transplantation Methods 0.000 claims description 3
- 102000001706 Immunoglobulin Fab Fragments Human genes 0.000 claims description 2
- 108010054477 Immunoglobulin Fab Fragments Proteins 0.000 claims description 2
- 239000002671 adjuvant Substances 0.000 claims description 2
- 239000003963 antioxidant agent Substances 0.000 claims description 2
- 239000001913 cellulose Substances 0.000 claims description 2
- 229920002678 cellulose Polymers 0.000 claims description 2
- 229920001519 homopolymer Polymers 0.000 claims description 2
- 229920001583 poly(oxyethylated polyols) Polymers 0.000 claims description 2
- 210000001236 prokaryotic cell Anatomy 0.000 claims description 2
- 230000003248 secreting effect Effects 0.000 claims description 2
- 108010047041 Complementarity Determining Regions Proteins 0.000 claims 1
- 239000004743 Polypropylene Substances 0.000 claims 1
- 239000004372 Polyvinyl alcohol Substances 0.000 claims 1
- 230000001668 ameliorated effect Effects 0.000 claims 1
- 230000003302 anti-idiotype Effects 0.000 claims 1
- 230000003078 antioxidant effect Effects 0.000 claims 1
- 230000002519 immonomodulatory effect Effects 0.000 claims 1
- 230000007170 pathology Effects 0.000 claims 1
- 229920000191 poly(N-vinyl pyrrolidone) Polymers 0.000 claims 1
- 229920001155 polypropylene Polymers 0.000 claims 1
- 229920002451 polyvinyl alcohol Polymers 0.000 claims 1
- 239000003381 stabilizer Substances 0.000 claims 1
- 238000011282 treatment Methods 0.000 abstract description 47
- 239000008194 pharmaceutical composition Substances 0.000 abstract description 22
- 230000001225 therapeutic effect Effects 0.000 abstract description 19
- 238000003745 diagnosis Methods 0.000 abstract description 7
- 230000008901 benefit Effects 0.000 abstract description 5
- 238000011321 prophylaxis Methods 0.000 abstract 1
- 235000001014 amino acid Nutrition 0.000 description 83
- 229940024606 amino acid Drugs 0.000 description 67
- 235000018102 proteins Nutrition 0.000 description 59
- 238000012360 testing method Methods 0.000 description 34
- 239000002299 complementary DNA Substances 0.000 description 27
- 150000002148 esters Chemical class 0.000 description 27
- 150000003839 salts Chemical class 0.000 description 26
- 238000003556 assay Methods 0.000 description 25
- 229940002612 prodrug Drugs 0.000 description 25
- 239000000651 prodrug Chemical class 0.000 description 25
- 238000013518 transcription Methods 0.000 description 25
- 230000035897 transcription Effects 0.000 description 25
- 108010076504 Protein Sorting Signals Proteins 0.000 description 24
- 102000005962 receptors Human genes 0.000 description 24
- 108020003175 receptors Proteins 0.000 description 24
- 210000001519 tissue Anatomy 0.000 description 24
- 108091026890 Coding region Proteins 0.000 description 23
- 108091028043 Nucleic acid sequence Proteins 0.000 description 23
- 241000700159 Rattus Species 0.000 description 23
- 239000005557 antagonist Substances 0.000 description 22
- 239000000523 sample Substances 0.000 description 22
- 229920000642 polymer Polymers 0.000 description 21
- 239000000556 agonist Substances 0.000 description 20
- 238000009396 hybridization Methods 0.000 description 20
- 230000001105 regulatory effect Effects 0.000 description 20
- 239000013612 plasmid Substances 0.000 description 19
- 230000001965 increasing effect Effects 0.000 description 18
- 238000001415 gene therapy Methods 0.000 description 17
- 239000003623 enhancer Substances 0.000 description 16
- 230000006801 homologous recombination Effects 0.000 description 16
- 238000002744 homologous recombination Methods 0.000 description 16
- 239000013604 expression vector Substances 0.000 description 15
- 238000001727 in vivo Methods 0.000 description 15
- 239000000463 material Substances 0.000 description 15
- 238000012216 screening Methods 0.000 description 15
- ZHNUHDYFZUAESO-UHFFFAOYSA-N Formamide Chemical compound NC=O ZHNUHDYFZUAESO-UHFFFAOYSA-N 0.000 description 14
- 238000002203 pretreatment Methods 0.000 description 14
- 241000894007 species Species 0.000 description 14
- FAPWRFPIFSIZLT-UHFFFAOYSA-M Sodium chloride Chemical compound [Na+].[Cl-] FAPWRFPIFSIZLT-UHFFFAOYSA-M 0.000 description 13
- 239000002253 acid Substances 0.000 description 13
- 230000000202 analgesic effect Effects 0.000 description 13
- 230000003110 anti-inflammatory effect Effects 0.000 description 13
- 230000007423 decrease Effects 0.000 description 13
- 239000003814 drug Substances 0.000 description 13
- 229940000406 drug candidate Drugs 0.000 description 13
- 230000006798 recombination Effects 0.000 description 13
- 238000005215 recombination Methods 0.000 description 13
- 239000000243 solution Substances 0.000 description 13
- 230000015572 biosynthetic process Effects 0.000 description 12
- 238000010367 cloning Methods 0.000 description 12
- 150000001720 carbohydrates Chemical class 0.000 description 11
- 239000003446 ligand Substances 0.000 description 11
- 238000003752 polymerase chain reaction Methods 0.000 description 11
- 238000003786 synthesis reaction Methods 0.000 description 11
- 102000004190 Enzymes Human genes 0.000 description 10
- 108090000790 Enzymes Proteins 0.000 description 10
- DHMQDGOQFOQNFH-UHFFFAOYSA-N Glycine Chemical compound NCC(O)=O DHMQDGOQFOQNFH-UHFFFAOYSA-N 0.000 description 10
- 239000004098 Tetracycline Substances 0.000 description 10
- 230000003321 amplification Effects 0.000 description 10
- 238000006243 chemical reaction Methods 0.000 description 10
- 230000006870 function Effects 0.000 description 10
- 210000004962 mammalian cell Anatomy 0.000 description 10
- 238000003199 nucleic acid amplification method Methods 0.000 description 10
- 239000000047 product Substances 0.000 description 10
- 235000019364 tetracycline Nutrition 0.000 description 10
- 150000003522 tetracyclines Chemical class 0.000 description 10
- YBJHBAHKTGYVGT-ZKWXMUAHSA-N (+)-Biotin Chemical compound N1C(=O)N[C@@H]2[C@H](CCCCC(=O)O)SC[C@@H]21 YBJHBAHKTGYVGT-ZKWXMUAHSA-N 0.000 description 9
- 108091032973 (ribonucleotides)n+m Proteins 0.000 description 9
- 108091034117 Oligonucleotide Proteins 0.000 description 9
- 240000004808 Saccharomyces cerevisiae Species 0.000 description 9
- 235000014680 Saccharomyces cerevisiae Nutrition 0.000 description 9
- 238000002347 injection Methods 0.000 description 9
- 239000007924 injection Substances 0.000 description 9
- 238000002955 isolation Methods 0.000 description 9
- 229940021182 non-steroidal anti-inflammatory drug Drugs 0.000 description 9
- 238000000746 purification Methods 0.000 description 9
- 229960002180 tetracycline Drugs 0.000 description 9
- 229930101283 tetracycline Natural products 0.000 description 9
- 108700028146 Genetic Enhancer Elements Proteins 0.000 description 8
- PEDCQBHIVMGVHV-UHFFFAOYSA-N Glycerine Chemical compound OCC(O)CO PEDCQBHIVMGVHV-UHFFFAOYSA-N 0.000 description 8
- 238000004458 analytical method Methods 0.000 description 8
- 239000002585 base Substances 0.000 description 8
- 235000014633 carbohydrates Nutrition 0.000 description 8
- 238000004113 cell culture Methods 0.000 description 8
- 230000008859 change Effects 0.000 description 8
- 239000003795 chemical substances by application Substances 0.000 description 8
- 235000018417 cysteine Nutrition 0.000 description 8
- 208000037765 diseases and disorders Diseases 0.000 description 8
- 238000000338 in vitro Methods 0.000 description 8
- 230000003993 interaction Effects 0.000 description 8
- 239000011159 matrix material Substances 0.000 description 8
- 239000002609 medium Substances 0.000 description 8
- 108020004999 messenger RNA Proteins 0.000 description 8
- 239000011734 sodium Substances 0.000 description 8
- 241000238631 Hexapoda Species 0.000 description 7
- 108010050904 Interferons Proteins 0.000 description 7
- 241000699670 Mus sp. Species 0.000 description 7
- 108091023040 Transcription factor Proteins 0.000 description 7
- 102000040945 Transcription factor Human genes 0.000 description 7
- 241000700605 Viruses Species 0.000 description 7
- 150000001242 acetic acid derivatives Chemical class 0.000 description 7
- 238000007792 addition Methods 0.000 description 7
- 239000000427 antigen Substances 0.000 description 7
- 108091007433 antigens Proteins 0.000 description 7
- 102000036639 antigens Human genes 0.000 description 7
- 230000001413 cellular effect Effects 0.000 description 7
- 238000003776 cleavage reaction Methods 0.000 description 7
- XUJNEKJLAYXESH-UHFFFAOYSA-N cysteine Natural products SCC(N)C(O)=O XUJNEKJLAYXESH-UHFFFAOYSA-N 0.000 description 7
- 238000001514 detection method Methods 0.000 description 7
- 238000005516 engineering process Methods 0.000 description 7
- 108020001507 fusion proteins Proteins 0.000 description 7
- 102000037865 fusion proteins Human genes 0.000 description 7
- 230000013595 glycosylation Effects 0.000 description 7
- 238000006206 glycosylation reaction Methods 0.000 description 7
- 210000003000 inclusion body Anatomy 0.000 description 7
- 230000035772 mutation Effects 0.000 description 7
- 102000040430 polynucleotide Human genes 0.000 description 7
- 108091033319 polynucleotide Proteins 0.000 description 7
- 239000002157 polynucleotide Substances 0.000 description 7
- 230000007017 scission Effects 0.000 description 7
- 150000003384 small molecules Chemical class 0.000 description 7
- 239000011780 sodium chloride Substances 0.000 description 7
- 238000012546 transfer Methods 0.000 description 7
- 230000009466 transformation Effects 0.000 description 7
- 239000003981 vehicle Substances 0.000 description 7
- 108020004705 Codon Proteins 0.000 description 6
- 102000014150 Interferons Human genes 0.000 description 6
- 241000829100 Macaca mulatta polyomavirus 1 Species 0.000 description 6
- 230000004988 N-glycosylation Effects 0.000 description 6
- PXHVJJICTQNCMI-UHFFFAOYSA-N Nickel Chemical compound [Ni] PXHVJJICTQNCMI-UHFFFAOYSA-N 0.000 description 6
- 108091005804 Peptidases Proteins 0.000 description 6
- 102000035195 Peptidases Human genes 0.000 description 6
- 108020005067 RNA Splice Sites Proteins 0.000 description 6
- 241000283984 Rodentia Species 0.000 description 6
- 239000003242 anti bacterial agent Substances 0.000 description 6
- 230000000692 anti-sense effect Effects 0.000 description 6
- 229940079593 drug Drugs 0.000 description 6
- 108010052621 fas Receptor Proteins 0.000 description 6
- 102000018823 fas Receptor Human genes 0.000 description 6
- RWSXRVCMGQZWBV-WDSKDSINSA-N glutathione Chemical compound OC(=O)[C@@H](N)CCC(=O)N[C@@H](CS)C(=O)NCC(O)=O RWSXRVCMGQZWBV-WDSKDSINSA-N 0.000 description 6
- 230000012010 growth Effects 0.000 description 6
- JYGXADMDTFJGBT-VWUMJDOOSA-N hydrocortisone Chemical compound O=C1CC[C@]2(C)[C@H]3[C@@H](O)C[C@](C)([C@@](CC4)(O)C(=O)CO)[C@@H]4[C@@H]3CCC2=C1 JYGXADMDTFJGBT-VWUMJDOOSA-N 0.000 description 6
- 210000000987 immune system Anatomy 0.000 description 6
- 238000002513 implantation Methods 0.000 description 6
- 238000002360 preparation method Methods 0.000 description 6
- 230000010076 replication Effects 0.000 description 6
- 229910052708 sodium Inorganic materials 0.000 description 6
- 229940083542 sodium Drugs 0.000 description 6
- 229940124597 therapeutic agent Drugs 0.000 description 6
- 238000001890 transfection Methods 0.000 description 6
- 230000003612 virological effect Effects 0.000 description 6
- XLYOFNOQVPJJNP-UHFFFAOYSA-N water Substances O XLYOFNOQVPJJNP-UHFFFAOYSA-N 0.000 description 6
- FFTVPQUHLQBXQZ-KVUCHLLUSA-N (4s,4as,5ar,12ar)-4,7-bis(dimethylamino)-1,10,11,12a-tetrahydroxy-3,12-dioxo-4a,5,5a,6-tetrahydro-4h-tetracene-2-carboxamide Chemical compound C1C2=C(N(C)C)C=CC(O)=C2C(O)=C2[C@@H]1C[C@H]1[C@H](N(C)C)C(=O)C(C(N)=O)=C(O)[C@@]1(O)C2=O FFTVPQUHLQBXQZ-KVUCHLLUSA-N 0.000 description 5
- 102000002260 Alkaline Phosphatase Human genes 0.000 description 5
- 108020004774 Alkaline Phosphatase Proteins 0.000 description 5
- 241000196324 Embryophyta Species 0.000 description 5
- 241000588724 Escherichia coli Species 0.000 description 5
- DGAQECJNVWCQMB-PUAWFVPOSA-M Ilexoside XXIX Chemical compound C[C@@H]1CC[C@@]2(CC[C@@]3(C(=CC[C@H]4[C@]3(CC[C@@H]5[C@@]4(CC[C@@H](C5(C)C)OS(=O)(=O)[O-])C)C)[C@@H]2[C@]1(C)O)C)C(=O)O[C@H]6[C@@H]([C@H]([C@@H]([C@H](O6)CO)O)O)O.[Na+] DGAQECJNVWCQMB-PUAWFVPOSA-M 0.000 description 5
- WHUUTDBJXJRKMK-VKHMYHEASA-N L-glutamic acid Chemical compound OC(=O)[C@@H](N)CCC(O)=O WHUUTDBJXJRKMK-VKHMYHEASA-N 0.000 description 5
- 241000699666 Mus <mouse, genus> Species 0.000 description 5
- 108020004511 Recombinant DNA Proteins 0.000 description 5
- 238000012300 Sequence Analysis Methods 0.000 description 5
- 230000004913 activation Effects 0.000 description 5
- 208000038016 acute inflammation Diseases 0.000 description 5
- 230000006022 acute inflammation Effects 0.000 description 5
- 239000003435 antirheumatic agent Substances 0.000 description 5
- 230000001580 bacterial effect Effects 0.000 description 5
- 239000011324 bead Substances 0.000 description 5
- 230000008827 biological function Effects 0.000 description 5
- 229960002685 biotin Drugs 0.000 description 5
- 235000020958 biotin Nutrition 0.000 description 5
- 239000011616 biotin Substances 0.000 description 5
- 239000002775 capsule Substances 0.000 description 5
- 125000003178 carboxy group Chemical group [H]OC(*)=O 0.000 description 5
- 239000013611 chromosomal DNA Substances 0.000 description 5
- 208000037976 chronic inflammation Diseases 0.000 description 5
- 230000006020 chronic inflammation Effects 0.000 description 5
- 229960002086 dextran Drugs 0.000 description 5
- 230000010354 integration Effects 0.000 description 5
- 229940047124 interferons Drugs 0.000 description 5
- 229960000318 kanamycin Drugs 0.000 description 5
- 229930027917 kanamycin Natural products 0.000 description 5
- SBUJHOSQTJFQJX-NOAMYHISSA-N kanamycin Chemical compound O[C@@H]1[C@@H](O)[C@H](O)[C@@H](CN)O[C@@H]1O[C@H]1[C@H](O)[C@@H](O[C@@H]2[C@@H]([C@@H](N)[C@H](O)[C@@H](CO)O2)O)[C@H](N)C[C@@H]1N SBUJHOSQTJFQJX-NOAMYHISSA-N 0.000 description 5
- 229930182823 kanamycin A Natural products 0.000 description 5
- 239000003550 marker Substances 0.000 description 5
- 238000002844 melting Methods 0.000 description 5
- 230000008018 melting Effects 0.000 description 5
- 229960004023 minocycline Drugs 0.000 description 5
- 239000000546 pharmaceutical excipient Substances 0.000 description 5
- 229960005205 prednisolone Drugs 0.000 description 5
- 150000005599 propionic acid derivatives Chemical class 0.000 description 5
- 230000002829 reductive effect Effects 0.000 description 5
- 108091008146 restriction endonucleases Proteins 0.000 description 5
- 150000003872 salicylic acid derivatives Chemical class 0.000 description 5
- 210000002966 serum Anatomy 0.000 description 5
- 239000001509 sodium citrate Substances 0.000 description 5
- 238000010561 standard procedure Methods 0.000 description 5
- 238000011144 upstream manufacturing Methods 0.000 description 5
- 239000004475 Arginine Substances 0.000 description 4
- 241000894006 Bacteria Species 0.000 description 4
- FBPFZTCFMRRESA-FSIIMWSLSA-N D-Glucitol Natural products OC[C@H](O)[C@H](O)[C@@H](O)[C@H](O)CO FBPFZTCFMRRESA-FSIIMWSLSA-N 0.000 description 4
- FBPFZTCFMRRESA-JGWLITMVSA-N D-glucitol Chemical compound OC[C@H](O)[C@@H](O)[C@H](O)[C@H](O)CO FBPFZTCFMRRESA-JGWLITMVSA-N 0.000 description 4
- 230000004568 DNA-binding Effects 0.000 description 4
- LYCAIKOWRPUZTN-UHFFFAOYSA-N Ethylene glycol Chemical compound OCCO LYCAIKOWRPUZTN-UHFFFAOYSA-N 0.000 description 4
- 239000004471 Glycine Substances 0.000 description 4
- ODKSFYDXXFIFQN-BYPYZUCNSA-P L-argininium(2+) Chemical compound NC(=[NH2+])NCCC[C@H]([NH3+])C(O)=O ODKSFYDXXFIFQN-BYPYZUCNSA-P 0.000 description 4
- DCXYFEDJOCDNAF-REOHCLBHSA-N L-asparagine Chemical compound OC(=O)[C@@H](N)CC(N)=O DCXYFEDJOCDNAF-REOHCLBHSA-N 0.000 description 4
- ZDXPYRJPNDTMRX-VKHMYHEASA-N L-glutamine Chemical compound OC(=O)[C@@H](N)CCC(N)=O ZDXPYRJPNDTMRX-VKHMYHEASA-N 0.000 description 4
- KDXKERNSBIXSRK-YFKPBYRVSA-N L-lysine Chemical compound NCCCC[C@H](N)C(O)=O KDXKERNSBIXSRK-YFKPBYRVSA-N 0.000 description 4
- KDXKERNSBIXSRK-UHFFFAOYSA-N Lysine Natural products NCCCCC(N)C(O)=O KDXKERNSBIXSRK-UHFFFAOYSA-N 0.000 description 4
- 206010028980 Neoplasm Diseases 0.000 description 4
- 108700026244 Open Reading Frames Proteins 0.000 description 4
- XSQUKJJJFZCRTK-UHFFFAOYSA-N Urea Chemical compound NC(N)=O XSQUKJJJFZCRTK-UHFFFAOYSA-N 0.000 description 4
- JLCPHMBAVCMARE-UHFFFAOYSA-N [3-[[3-[[3-[[3-[[3-[[3-[[3-[[3-[[3-[[3-[[3-[[5-(2-amino-6-oxo-1H-purin-9-yl)-3-[[3-[[3-[[3-[[3-[[3-[[5-(2-amino-6-oxo-1H-purin-9-yl)-3-[[5-(2-amino-6-oxo-1H-purin-9-yl)-3-hydroxyoxolan-2-yl]methoxy-hydroxyphosphoryl]oxyoxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(5-methyl-2,4-dioxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxyoxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(5-methyl-2,4-dioxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(4-amino-2-oxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(5-methyl-2,4-dioxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(5-methyl-2,4-dioxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(4-amino-2-oxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(4-amino-2-oxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(4-amino-2-oxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(4-amino-2-oxopyrimidin-1-yl)oxolan-2-yl]methyl [5-(6-aminopurin-9-yl)-2-(hydroxymethyl)oxolan-3-yl] hydrogen phosphate Polymers Cc1cn(C2CC(OP(O)(=O)OCC3OC(CC3OP(O)(=O)OCC3OC(CC3O)n3cnc4c3nc(N)[nH]c4=O)n3cnc4c3nc(N)[nH]c4=O)C(COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3CO)n3cnc4c(N)ncnc34)n3ccc(N)nc3=O)n3cnc4c(N)ncnc34)n3ccc(N)nc3=O)n3ccc(N)nc3=O)n3ccc(N)nc3=O)n3cnc4c(N)ncnc34)n3cnc4c(N)ncnc34)n3cc(C)c(=O)[nH]c3=O)n3cc(C)c(=O)[nH]c3=O)n3ccc(N)nc3=O)n3cc(C)c(=O)[nH]c3=O)n3cnc4c3nc(N)[nH]c4=O)n3cnc4c(N)ncnc34)n3cnc4c(N)ncnc34)n3cnc4c(N)ncnc34)n3cnc4c(N)ncnc34)O2)c(=O)[nH]c1=O JLCPHMBAVCMARE-UHFFFAOYSA-N 0.000 description 4
- 229960000723 ampicillin Drugs 0.000 description 4
- AVKUERGKIZMTKX-NJBDSQKTSA-N ampicillin Chemical compound C1([C@@H](N)C(=O)N[C@H]2[C@H]3SC([C@@H](N3C2=O)C(O)=O)(C)C)=CC=CC=C1 AVKUERGKIZMTKX-NJBDSQKTSA-N 0.000 description 4
- 229940111131 antiinflammatory and antirheumatic product propionic acid derivative Drugs 0.000 description 4
- ODKSFYDXXFIFQN-UHFFFAOYSA-N arginine Natural products OC(=O)C(N)CCCNC(N)=N ODKSFYDXXFIFQN-UHFFFAOYSA-N 0.000 description 4
- 150000004648 butanoic acid derivatives Chemical class 0.000 description 4
- 150000001732 carboxylic acid derivatives Chemical class 0.000 description 4
- 210000000170 cell membrane Anatomy 0.000 description 4
- 238000002659 cell therapy Methods 0.000 description 4
- 238000005119 centrifugation Methods 0.000 description 4
- 239000003153 chemical reaction reagent Substances 0.000 description 4
- 210000004978 chinese hamster ovary cell Anatomy 0.000 description 4
- 238000004590 computer program Methods 0.000 description 4
- 239000003246 corticosteroid Substances 0.000 description 4
- 229960001334 corticosteroids Drugs 0.000 description 4
- 210000000805 cytoplasm Anatomy 0.000 description 4
- 230000003247 decreasing effect Effects 0.000 description 4
- VHJLVAABSRFDPM-QWWZWVQMSA-N dithiothreitol Chemical compound SC[C@@H](O)[C@H](O)CS VHJLVAABSRFDPM-QWWZWVQMSA-N 0.000 description 4
- 238000003018 immunoassay Methods 0.000 description 4
- 230000002163 immunogen Effects 0.000 description 4
- 230000001939 inductive effect Effects 0.000 description 4
- 208000015181 infectious disease Diseases 0.000 description 4
- 239000003112 inhibitor Substances 0.000 description 4
- 150000002632 lipids Chemical class 0.000 description 4
- 239000002502 liposome Substances 0.000 description 4
- 230000001404 mediated effect Effects 0.000 description 4
- 239000002207 metabolite Substances 0.000 description 4
- 210000004940 nucleus Anatomy 0.000 description 4
- 210000000056 organ Anatomy 0.000 description 4
- OIGNJSKKLXVSLS-VWUMJDOOSA-N prednisolone Chemical compound O=C1C=C[C@]2(C)[C@H]3[C@@H](O)C[C@](C)([C@@](CC4)(O)C(=O)CO)[C@@H]4[C@@H]3CCC2=C1 OIGNJSKKLXVSLS-VWUMJDOOSA-N 0.000 description 4
- 238000000159 protein binding assay Methods 0.000 description 4
- JEXVQSWXXUJEMA-UHFFFAOYSA-N pyrazol-3-one Chemical compound O=C1C=CN=N1 JEXVQSWXXUJEMA-UHFFFAOYSA-N 0.000 description 4
- 229940058287 salicylic acid derivative anticestodals Drugs 0.000 description 4
- 230000028327 secretion Effects 0.000 description 4
- NLJMYIDDQXHKNR-UHFFFAOYSA-K sodium citrate Chemical compound O.O.[Na+].[Na+].[Na+].[O-]C(=O)CC(O)(CC([O-])=O)C([O-])=O NLJMYIDDQXHKNR-UHFFFAOYSA-K 0.000 description 4
- 229910001415 sodium ion Inorganic materials 0.000 description 4
- 239000007787 solid Substances 0.000 description 4
- 239000000600 sorbitol Substances 0.000 description 4
- 238000013268 sustained release Methods 0.000 description 4
- 239000012730 sustained-release form Substances 0.000 description 4
- 239000003826 tablet Substances 0.000 description 4
- 230000005030 transcription termination Effects 0.000 description 4
- 238000010361 transduction Methods 0.000 description 4
- 230000026683 transduction Effects 0.000 description 4
- 241000701161 unidentified adenovirus Species 0.000 description 4
- DCXYFEDJOCDNAF-UHFFFAOYSA-N Asparagine Natural products OC(=O)C(N)CC(N)=O DCXYFEDJOCDNAF-UHFFFAOYSA-N 0.000 description 3
- 108091003079 Bovine Serum Albumin Proteins 0.000 description 3
- 241000283707 Capra Species 0.000 description 3
- 102000004127 Cytokines Human genes 0.000 description 3
- 108090000695 Cytokines Proteins 0.000 description 3
- FBPFZTCFMRRESA-KVTDHHQDSA-N D-Mannitol Chemical compound OC[C@@H](O)[C@@H](O)[C@H](O)[C@H](O)CO FBPFZTCFMRRESA-KVTDHHQDSA-N 0.000 description 3
- 238000000018 DNA microarray Methods 0.000 description 3
- KCXVZYZYPLLWCC-UHFFFAOYSA-N EDTA Chemical compound OC(=O)CN(CC(O)=O)CCN(CC(O)=O)CC(O)=O KCXVZYZYPLLWCC-UHFFFAOYSA-N 0.000 description 3
- UPEZCKBFRMILAV-JNEQICEOSA-N Ecdysone Natural products O=C1[C@H]2[C@@](C)([C@@H]3C([C@@]4(O)[C@@](C)([C@H]([C@H]([C@@H](O)CCC(O)(C)C)C)CC4)CC3)=C1)C[C@H](O)[C@H](O)C2 UPEZCKBFRMILAV-JNEQICEOSA-N 0.000 description 3
- 108091029865 Exogenous DNA Proteins 0.000 description 3
- 108700024394 Exon Proteins 0.000 description 3
- WHUUTDBJXJRKMK-UHFFFAOYSA-N Glutamic acid Natural products OC(=O)C(N)CCC(O)=O WHUUTDBJXJRKMK-UHFFFAOYSA-N 0.000 description 3
- 208000009329 Graft vs Host Disease Diseases 0.000 description 3
- 241000282412 Homo Species 0.000 description 3
- 108010001336 Horseradish Peroxidase Proteins 0.000 description 3
- 108091092195 Intron Proteins 0.000 description 3
- QNAYBMKLOCPYGJ-REOHCLBHSA-N L-alanine Chemical compound C[C@H](N)C(O)=O QNAYBMKLOCPYGJ-REOHCLBHSA-N 0.000 description 3
- CKLJMWTZIZZHCS-REOHCLBHSA-N L-aspartic acid Chemical compound OC(=O)[C@@H](N)CC(O)=O CKLJMWTZIZZHCS-REOHCLBHSA-N 0.000 description 3
- AGPKZVBTJJNPAG-WHFBIAKZSA-N L-isoleucine Chemical compound CC[C@H](C)[C@H](N)C(O)=O AGPKZVBTJJNPAG-WHFBIAKZSA-N 0.000 description 3
- ROHFNLRQFUQHCH-YFKPBYRVSA-N L-leucine Chemical compound CC(C)C[C@H](N)C(O)=O ROHFNLRQFUQHCH-YFKPBYRVSA-N 0.000 description 3
- FFEARJCKVFRZRR-BYPYZUCNSA-N L-methionine Chemical compound CSCC[C@H](N)C(O)=O FFEARJCKVFRZRR-BYPYZUCNSA-N 0.000 description 3
- COLNVLDHVKWLRT-QMMMGPOBSA-N L-phenylalanine Chemical compound OC(=O)[C@@H](N)CC1=CC=CC=C1 COLNVLDHVKWLRT-QMMMGPOBSA-N 0.000 description 3
- QIVBCDIJIAJPQS-VIFPVBQESA-N L-tryptophane Chemical compound C1=CC=C2C(C[C@H](N)C(O)=O)=CNC2=C1 QIVBCDIJIAJPQS-VIFPVBQESA-N 0.000 description 3
- OUYCCCASQSFEME-QMMMGPOBSA-N L-tyrosine Chemical compound OC(=O)[C@@H](N)CC1=CC=C(O)C=C1 OUYCCCASQSFEME-QMMMGPOBSA-N 0.000 description 3
- ROHFNLRQFUQHCH-UHFFFAOYSA-N Leucine Natural products CC(C)CC(N)C(O)=O ROHFNLRQFUQHCH-UHFFFAOYSA-N 0.000 description 3
- 239000004472 Lysine Substances 0.000 description 3
- 229930195725 Mannitol Natural products 0.000 description 3
- 229930193140 Neomycin Natural products 0.000 description 3
- 241000283973 Oryctolagus cuniculus Species 0.000 description 3
- 238000012408 PCR amplification Methods 0.000 description 3
- JGSARLDLIJGVTE-MBNYWOFBSA-N Penicillin G Chemical compound N([C@H]1[C@H]2SC([C@@H](N2C1=O)C(O)=O)(C)C)C(=O)CC1=CC=CC=C1 JGSARLDLIJGVTE-MBNYWOFBSA-N 0.000 description 3
- 239000004365 Protease Substances 0.000 description 3
- 101710149951 Protein Tat Proteins 0.000 description 3
- 208000025747 Rheumatic disease Diseases 0.000 description 3
- MTCFGRXMJLQNBG-UHFFFAOYSA-N Serine Natural products OCC(N)C(O)=O MTCFGRXMJLQNBG-UHFFFAOYSA-N 0.000 description 3
- FKNQFGJONOIPTF-UHFFFAOYSA-N Sodium cation Chemical compound [Na+] FKNQFGJONOIPTF-UHFFFAOYSA-N 0.000 description 3
- 108010090804 Streptavidin Proteins 0.000 description 3
- 108700026226 TATA Box Proteins 0.000 description 3
- 108010022394 Threonine synthase Proteins 0.000 description 3
- QIVBCDIJIAJPQS-UHFFFAOYSA-N Tryptophan Natural products C1=CC=C2C(CC(N)C(O)=O)=CNC2=C1 QIVBCDIJIAJPQS-UHFFFAOYSA-N 0.000 description 3
- 230000002776 aggregation Effects 0.000 description 3
- 238000004220 aggregation Methods 0.000 description 3
- 235000004279 alanine Nutrition 0.000 description 3
- UPEZCKBFRMILAV-UHFFFAOYSA-N alpha-Ecdysone Natural products C1C(O)C(O)CC2(C)C(CCC3(C(C(C(O)CCC(C)(C)O)C)CCC33O)C)C3=CC(=O)C21 UPEZCKBFRMILAV-UHFFFAOYSA-N 0.000 description 3
- 229940051880 analgesics and antipyretics pyrazolones Drugs 0.000 description 3
- 239000012491 analyte Substances 0.000 description 3
- 229940088710 antibiotic agent Drugs 0.000 description 3
- 239000000074 antisense oligonucleotide Substances 0.000 description 3
- 238000012230 antisense oligonucleotides Methods 0.000 description 3
- 238000013459 approach Methods 0.000 description 3
- 235000009582 asparagine Nutrition 0.000 description 3
- 229960001230 asparagine Drugs 0.000 description 3
- 230000033228 biological regulation Effects 0.000 description 3
- 239000000872 buffer Substances 0.000 description 3
- 239000001506 calcium phosphate Substances 0.000 description 3
- 229910000389 calcium phosphate Inorganic materials 0.000 description 3
- 235000011010 calcium phosphates Nutrition 0.000 description 3
- 239000003638 chemical reducing agent Substances 0.000 description 3
- 210000000349 chromosome Anatomy 0.000 description 3
- 229940111134 coxibs Drugs 0.000 description 3
- 239000003255 cyclooxygenase 2 inhibitor Substances 0.000 description 3
- 125000000151 cysteine group Chemical group N[C@@H](CS)C(=O)* 0.000 description 3
- 210000000172 cytosol Anatomy 0.000 description 3
- 102000004419 dihydrofolate reductase Human genes 0.000 description 3
- 239000003085 diluting agent Substances 0.000 description 3
- 239000002988 disease modifying antirheumatic drug Substances 0.000 description 3
- UPEZCKBFRMILAV-JMZLNJERSA-N ecdysone Chemical compound C1[C@@H](O)[C@@H](O)C[C@]2(C)[C@@H](CC[C@@]3([C@@H]([C@@H]([C@H](O)CCC(C)(C)O)C)CC[C@]33O)C)C3=CC(=O)[C@@H]21 UPEZCKBFRMILAV-JMZLNJERSA-N 0.000 description 3
- 238000004520 electroporation Methods 0.000 description 3
- 238000001400 expression cloning Methods 0.000 description 3
- 229960002989 glutamic acid Drugs 0.000 description 3
- ZDXPYRJPNDTMRX-UHFFFAOYSA-N glutamine Natural products OC(=O)C(N)CCC(N)=O ZDXPYRJPNDTMRX-UHFFFAOYSA-N 0.000 description 3
- 229960003180 glutathione Drugs 0.000 description 3
- 235000011187 glycerol Nutrition 0.000 description 3
- 208000024908 graft versus host disease Diseases 0.000 description 3
- 239000003102 growth factor Substances 0.000 description 3
- 239000001963 growth medium Substances 0.000 description 3
- 229960000890 hydrocortisone Drugs 0.000 description 3
- 230000028993 immune response Effects 0.000 description 3
- 238000001114 immunoprecipitation Methods 0.000 description 3
- 238000000099 in vitro assay Methods 0.000 description 3
- 238000011534 incubation Methods 0.000 description 3
- 230000006698 induction Effects 0.000 description 3
- 238000001802 infusion Methods 0.000 description 3
- 108020001756 ligand binding domains Proteins 0.000 description 3
- 210000004185 liver Anatomy 0.000 description 3
- 210000004698 lymphocyte Anatomy 0.000 description 3
- 239000000594 mannitol Substances 0.000 description 3
- 235000010355 mannitol Nutrition 0.000 description 3
- MYWUZJCMWCOHBA-VIFPVBQESA-N methamphetamine Chemical compound CN[C@@H](C)CC1=CC=CC=C1 MYWUZJCMWCOHBA-VIFPVBQESA-N 0.000 description 3
- 238000010369 molecular cloning Methods 0.000 description 3
- 229960004927 neomycin Drugs 0.000 description 3
- 229910052759 nickel Inorganic materials 0.000 description 3
- 238000001668 nucleic acid synthesis Methods 0.000 description 3
- 235000015097 nutrients Nutrition 0.000 description 3
- 238000007911 parenteral administration Methods 0.000 description 3
- 230000006320 pegylation Effects 0.000 description 3
- 238000010647 peptide synthesis reaction Methods 0.000 description 3
- 230000003169 placental effect Effects 0.000 description 3
- 229920000036 polyvinylpyrrolidone Polymers 0.000 description 3
- 239000001267 polyvinylpyrrolidone Substances 0.000 description 3
- 235000013855 polyvinylpyrrolidone Nutrition 0.000 description 3
- 235000019833 protease Nutrition 0.000 description 3
- 235000019419 proteases Nutrition 0.000 description 3
- 150000003217 pyrazoles Chemical class 0.000 description 3
- 238000011160 research Methods 0.000 description 3
- 230000001177 retroviral effect Effects 0.000 description 3
- 238000012163 sequencing technique Methods 0.000 description 3
- 239000007790 solid phase Substances 0.000 description 3
- 229940124530 sulfonamide Drugs 0.000 description 3
- 230000002459 sustained effect Effects 0.000 description 3
- 108091006106 transcriptional activators Proteins 0.000 description 3
- 238000013519 translation Methods 0.000 description 3
- QORWJWZARLRLPR-UHFFFAOYSA-H tricalcium bis(phosphate) Chemical compound [Ca+2].[Ca+2].[Ca+2].[O-]P([O-])([O-])=O.[O-]P([O-])([O-])=O QORWJWZARLRLPR-UHFFFAOYSA-H 0.000 description 3
- 241001430294 unidentified retrovirus Species 0.000 description 3
- 210000005253 yeast cell Anatomy 0.000 description 3
- XSYUPRQVAHJETO-WPMUBMLPSA-N (2s)-2-[[(2s)-2-[[(2s)-2-[[(2s)-2-[[(2s)-2-[[(2s)-2-amino-3-(1h-imidazol-5-yl)propanoyl]amino]-3-(1h-imidazol-5-yl)propanoyl]amino]-3-(1h-imidazol-5-yl)propanoyl]amino]-3-(1h-imidazol-5-yl)propanoyl]amino]-3-(1h-imidazol-5-yl)propanoyl]amino]-3-(1h-imidaz Chemical compound C([C@H](N)C(=O)N[C@@H](CC=1NC=NC=1)C(=O)N[C@@H](CC=1NC=NC=1)C(=O)N[C@@H](CC=1NC=NC=1)C(=O)N[C@@H](CC=1NC=NC=1)C(=O)N[C@@H](CC=1NC=NC=1)C(O)=O)C1=CN=CN1 XSYUPRQVAHJETO-WPMUBMLPSA-N 0.000 description 2
- HPZMWTNATZPBIH-UHFFFAOYSA-N 1-methyladenine Chemical compound CN1C=NC2=NC=NC2=C1N HPZMWTNATZPBIH-UHFFFAOYSA-N 0.000 description 2
- RFLVMTUMFYRZCB-UHFFFAOYSA-N 1-methylguanine Chemical compound O=C1N(C)C(N)=NC2=C1N=CN2 RFLVMTUMFYRZCB-UHFFFAOYSA-N 0.000 description 2
- UFBJCMHMOXMLKC-UHFFFAOYSA-N 2,4-dinitrophenol Chemical group OC1=CC=C([N+]([O-])=O)C=C1[N+]([O-])=O UFBJCMHMOXMLKC-UHFFFAOYSA-N 0.000 description 2
- WXTMDXOMEHJXQO-UHFFFAOYSA-N 2,5-dihydroxybenzoic acid Chemical compound OC(=O)C1=CC(O)=CC=C1O WXTMDXOMEHJXQO-UHFFFAOYSA-N 0.000 description 2
- YSAJFXWTVFGPAX-UHFFFAOYSA-N 2-[(2,4-dioxo-1h-pyrimidin-5-yl)oxy]acetic acid Chemical compound OC(=O)COC1=CNC(=O)NC1=O YSAJFXWTVFGPAX-UHFFFAOYSA-N 0.000 description 2
- FZWGECJQACGGTI-UHFFFAOYSA-N 2-amino-7-methyl-1,7-dihydro-6H-purin-6-one Chemical compound NC1=NC(O)=C2N(C)C=NC2=N1 FZWGECJQACGGTI-UHFFFAOYSA-N 0.000 description 2
- LVYLCBNXHHHPSB-UHFFFAOYSA-N 2-hydroxyethyl salicylate Chemical compound OCCOC(=O)C1=CC=CC=C1O LVYLCBNXHHHPSB-UHFFFAOYSA-N 0.000 description 2
- DGVVWUTYPXICAM-UHFFFAOYSA-N 2-mercaptoethanol Substances OCCS DGVVWUTYPXICAM-UHFFFAOYSA-N 0.000 description 2
- WRMNZCZEMHIOCP-UHFFFAOYSA-N 2-phenylethanol Chemical compound OCCC1=CC=CC=C1 WRMNZCZEMHIOCP-UHFFFAOYSA-N 0.000 description 2
- WZRJTRPJURQBRM-UHFFFAOYSA-N 4-amino-n-(5-methyl-1,2-oxazol-3-yl)benzenesulfonamide;5-[(3,4,5-trimethoxyphenyl)methyl]pyrimidine-2,4-diamine Chemical compound O1C(C)=CC(NS(=O)(=O)C=2C=CC(N)=CC=2)=N1.COC1=C(OC)C(OC)=CC(CC=2C(=NC(N)=NC=2)N)=C1 WZRJTRPJURQBRM-UHFFFAOYSA-N 0.000 description 2
- FXUBHWHRMVGJOG-UHFFFAOYSA-N 4-benzoyl-2,3-dihydro-1h-indene-1-carboxylic acid Chemical compound OC(=O)C1CCC2=C1C=CC=C2C(=O)C1=CC=CC=C1 FXUBHWHRMVGJOG-UHFFFAOYSA-N 0.000 description 2
- OVONXEQGWXGFJD-UHFFFAOYSA-N 4-sulfanylidene-1h-pyrimidin-2-one Chemical compound SC=1C=CNC(=O)N=1 OVONXEQGWXGFJD-UHFFFAOYSA-N 0.000 description 2
- OIVLITBTBDPEFK-UHFFFAOYSA-N 5,6-dihydrouracil Chemical compound O=C1CCNC(=O)N1 OIVLITBTBDPEFK-UHFFFAOYSA-N 0.000 description 2
- DCPSTSVLRXOYGS-UHFFFAOYSA-N 6-amino-1h-pyrimidine-2-thione Chemical compound NC1=CC=NC(S)=N1 DCPSTSVLRXOYGS-UHFFFAOYSA-N 0.000 description 2
- JAJIPIAHCFBEPI-UHFFFAOYSA-N 9,10-dioxoanthracene-1-sulfonic acid Chemical compound O=C1C2=CC=CC=C2C(=O)C2=C1C=CC=C2S(=O)(=O)O JAJIPIAHCFBEPI-UHFFFAOYSA-N 0.000 description 2
- 108010088751 Albumins Proteins 0.000 description 2
- GUBGYTABKSRVRQ-XLOQQCSPSA-N Alpha-Lactose Chemical compound O[C@@H]1[C@@H](O)[C@@H](O)[C@@H](CO)O[C@H]1O[C@@H]1[C@@H](CO)O[C@H](O)[C@H](O)[C@H]1O GUBGYTABKSRVRQ-XLOQQCSPSA-N 0.000 description 2
- 108020000948 Antisense Oligonucleotides Proteins 0.000 description 2
- CIWBSHSKHKDKBQ-JLAZNSOCSA-N Ascorbic acid Chemical compound OC[C@H](O)[C@H]1OC(=O)C(O)=C1O CIWBSHSKHKDKBQ-JLAZNSOCSA-N 0.000 description 2
- 241000972773 Aulopiformes Species 0.000 description 2
- 108090001008 Avidin Proteins 0.000 description 2
- 208000020084 Bone disease Diseases 0.000 description 2
- QWOJMRHUQHTCJG-UHFFFAOYSA-N CC([CH2-])=O Chemical compound CC([CH2-])=O QWOJMRHUQHTCJG-UHFFFAOYSA-N 0.000 description 2
- VTYYLEPIZMXCLO-UHFFFAOYSA-L Calcium carbonate Chemical compound [Ca+2].[O-]C([O-])=O VTYYLEPIZMXCLO-UHFFFAOYSA-L 0.000 description 2
- 102000014914 Carrier Proteins Human genes 0.000 description 2
- 229930186147 Cephalosporin Chemical class 0.000 description 2
- HZZVJAQRINQKSD-UHFFFAOYSA-N Clavulanic acid Natural products OC(=O)C1C(=CCO)OC2CC(=O)N21 HZZVJAQRINQKSD-UHFFFAOYSA-N 0.000 description 2
- 241000699800 Cricetinae Species 0.000 description 2
- 241000701022 Cytomegalovirus Species 0.000 description 2
- 102000053602 DNA Human genes 0.000 description 2
- 230000004543 DNA replication Effects 0.000 description 2
- 108090000204 Dipeptidase 1 Proteins 0.000 description 2
- 239000006144 Dulbecco’s modified Eagle's medium Substances 0.000 description 2
- 238000002965 ELISA Methods 0.000 description 2
- ULGZDMOVFRHVEP-RWJQBGPGSA-N Erythromycin Chemical compound O([C@@H]1[C@@H](C)C(=O)O[C@@H]([C@@]([C@H](O)[C@@H](C)C(=O)[C@H](C)C[C@@](C)(O)[C@H](O[C@H]2[C@@H]([C@H](C[C@@H](C)O2)N(C)C)O)[C@H]1C)(C)O)CC)[C@H]1C[C@@](C)(OC)[C@@H](O)[C@H](C)O1 ULGZDMOVFRHVEP-RWJQBGPGSA-N 0.000 description 2
- 241000206602 Eukaryota Species 0.000 description 2
- 108010010803 Gelatin Proteins 0.000 description 2
- 108700039691 Genetic Promoter Regions Proteins 0.000 description 2
- ZRALSGWEFCBTJO-UHFFFAOYSA-N Guanidine Chemical compound NC(N)=N ZRALSGWEFCBTJO-UHFFFAOYSA-N 0.000 description 2
- 241000725303 Human immunodeficiency virus Species 0.000 description 2
- MHAJPDPJQMAIIY-UHFFFAOYSA-N Hydrogen peroxide Chemical compound OO MHAJPDPJQMAIIY-UHFFFAOYSA-N 0.000 description 2
- HEFNNWSXXWATRW-UHFFFAOYSA-N Ibuprofen Chemical compound CC(C)CC1=CC=C(C(C)C(O)=O)C=C1 HEFNNWSXXWATRW-UHFFFAOYSA-N 0.000 description 2
- 108060003951 Immunoglobulin Proteins 0.000 description 2
- 102000008394 Immunoglobulin Fragments Human genes 0.000 description 2
- 108010021625 Immunoglobulin Fragments Proteins 0.000 description 2
- KZSNJWFQEVHDMF-BYPYZUCNSA-N L-valine Chemical compound CC(C)[C@H](N)C(O)=O KZSNJWFQEVHDMF-BYPYZUCNSA-N 0.000 description 2
- GUBGYTABKSRVRQ-QKKXKWKRSA-N Lactose Natural products OC[C@H]1O[C@@H](O[C@H]2[C@H](O)[C@@H](O)C(O)O[C@@H]2CO)[C@H](O)[C@@H](O)[C@H]1O GUBGYTABKSRVRQ-QKKXKWKRSA-N 0.000 description 2
- HYVABZIGRDEKCD-UHFFFAOYSA-N N(6)-dimethylallyladenine Chemical compound CC(C)=CCNC1=NC=NC2=C1N=CN2 HYVABZIGRDEKCD-UHFFFAOYSA-N 0.000 description 2
- 230000004989 O-glycosylation Effects 0.000 description 2
- MITFXPHMIHQXPI-UHFFFAOYSA-N Oraflex Chemical compound N=1C2=CC(C(C(O)=O)C)=CC=C2OC=1C1=CC=C(Cl)C=C1 MITFXPHMIHQXPI-UHFFFAOYSA-N 0.000 description 2
- 229910019142 PO4 Inorganic materials 0.000 description 2
- 108010067372 Pancreatic elastase Proteins 0.000 description 2
- 241001631646 Papillomaviridae Species 0.000 description 2
- 241001494479 Pecora Species 0.000 description 2
- 229930182555 Penicillin Natural products 0.000 description 2
- 239000004698 Polyethylene Substances 0.000 description 2
- 108010040201 Polymyxins Proteins 0.000 description 2
- WCUXLLCKKVVCTQ-UHFFFAOYSA-M Potassium chloride Chemical compound [Cl-].[K+] WCUXLLCKKVVCTQ-UHFFFAOYSA-M 0.000 description 2
- 241000288906 Primates Species 0.000 description 2
- ONIBWKKTOPOVIA-UHFFFAOYSA-N Proline Natural products OC(=O)C1CCCN1 ONIBWKKTOPOVIA-UHFFFAOYSA-N 0.000 description 2
- NBBJYMSMWIIQGU-UHFFFAOYSA-N Propionic aldehyde Chemical compound CCC=O NBBJYMSMWIIQGU-UHFFFAOYSA-N 0.000 description 2
- KAESVJOAVNADME-UHFFFAOYSA-N Pyrrole Chemical compound C=1C=CNC=1 KAESVJOAVNADME-UHFFFAOYSA-N 0.000 description 2
- 102000018120 Recombinases Human genes 0.000 description 2
- 108010091086 Recombinases Proteins 0.000 description 2
- 229930189077 Rifamycin Natural products 0.000 description 2
- 108010071390 Serum Albumin Proteins 0.000 description 2
- 102000007562 Serum Albumin Human genes 0.000 description 2
- CDBYLPFSWZWCQE-UHFFFAOYSA-L Sodium Carbonate Chemical compound [Na+].[Na+].[O-]C([O-])=O CDBYLPFSWZWCQE-UHFFFAOYSA-L 0.000 description 2
- 238000002105 Southern blotting Methods 0.000 description 2
- 229930006000 Sucrose Natural products 0.000 description 2
- CZMRCDWAGMRECN-UGDNZRGBSA-N Sucrose Chemical compound O[C@H]1[C@H](O)[C@@H](CO)O[C@@]1(CO)O[C@@H]1[C@H](O)[C@@H](O)[C@H](O)[C@@H](CO)O1 CZMRCDWAGMRECN-UGDNZRGBSA-N 0.000 description 2
- 108010006785 Taq Polymerase Proteins 0.000 description 2
- AYFVYJQAPQTCCC-UHFFFAOYSA-N Threonine Natural products CC(O)C(N)C(O)=O AYFVYJQAPQTCCC-UHFFFAOYSA-N 0.000 description 2
- 239000004473 Threonine Substances 0.000 description 2
- 102000006601 Thymidine Kinase Human genes 0.000 description 2
- 108020004440 Thymidine kinase Proteins 0.000 description 2
- KZSNJWFQEVHDMF-UHFFFAOYSA-N Valine Natural products CC(C)C(N)C(O)=O KZSNJWFQEVHDMF-UHFFFAOYSA-N 0.000 description 2
- 241000251539 Vertebrata <Metazoa> Species 0.000 description 2
- 241000711975 Vesicular stomatitis virus Species 0.000 description 2
- 150000007513 acids Chemical class 0.000 description 2
- 238000005917 acylation reaction Methods 0.000 description 2
- 230000002411 adverse Effects 0.000 description 2
- 238000001261 affinity purification Methods 0.000 description 2
- 239000011543 agarose gel Substances 0.000 description 2
- 150000001299 aldehydes Chemical class 0.000 description 2
- 108010026331 alpha-Fetoproteins Proteins 0.000 description 2
- VREFGVBLTWBCJP-UHFFFAOYSA-N alprazolam Chemical compound C12=CC(Cl)=CC=C2N2C(C)=NN=C2CN=C1C1=CC=CC=C1 VREFGVBLTWBCJP-UHFFFAOYSA-N 0.000 description 2
- 229940126575 aminoglycoside Drugs 0.000 description 2
- 210000004102 animal cell Anatomy 0.000 description 2
- 229940111133 antiinflammatory and antirheumatic drug oxicams Drugs 0.000 description 2
- 239000007864 aqueous solution Substances 0.000 description 2
- 235000003704 aspartic acid Nutrition 0.000 description 2
- 229960001671 azapropazone Drugs 0.000 description 2
- WOIIIUDZSOLAIW-NSHDSACASA-N azapropazone Chemical compound C1=C(C)C=C2N3C(=O)[C@H](CC=C)C(=O)N3C(N(C)C)=NC2=C1 WOIIIUDZSOLAIW-NSHDSACASA-N 0.000 description 2
- 229960005149 bendazac Drugs 0.000 description 2
- BYFMCKSPFYVMOU-UHFFFAOYSA-N bendazac Chemical compound C12=CC=CC=C2C(OCC(=O)O)=NN1CC1=CC=CC=C1 BYFMCKSPFYVMOU-UHFFFAOYSA-N 0.000 description 2
- WPYMKLBDIGXBTP-UHFFFAOYSA-N benzoic acid Chemical compound OC(=O)C1=CC=CC=C1 WPYMKLBDIGXBTP-UHFFFAOYSA-N 0.000 description 2
- CNBGNNVCVSKAQZ-UHFFFAOYSA-N benzydamine Chemical compound C12=CC=CC=C2C(OCCCN(C)C)=NN1CC1=CC=CC=C1 CNBGNNVCVSKAQZ-UHFFFAOYSA-N 0.000 description 2
- 108010005774 beta-Galactosidase Proteins 0.000 description 2
- OQFSQFPPLPISGP-UHFFFAOYSA-N beta-carboxyaspartic acid Natural products OC(=O)C(N)C(C(O)=O)C(O)=O OQFSQFPPLPISGP-UHFFFAOYSA-N 0.000 description 2
- 102000006635 beta-lactamase Human genes 0.000 description 2
- 239000012620 biological material Substances 0.000 description 2
- 239000012472 biological sample Substances 0.000 description 2
- 210000001124 body fluid Anatomy 0.000 description 2
- RYYVLZVUVIJVGH-UHFFFAOYSA-N caffeine Chemical compound CN1C(=O)N(C)C(=O)C2=C1N=CN2C RYYVLZVUVIJVGH-UHFFFAOYSA-N 0.000 description 2
- 201000011510 cancer Diseases 0.000 description 2
- 239000004202 carbamide Substances 0.000 description 2
- 239000000969 carrier Substances 0.000 description 2
- 230000010261 cell growth Effects 0.000 description 2
- 230000004663 cell proliferation Effects 0.000 description 2
- 229940124587 cephalosporin Drugs 0.000 description 2
- 150000001780 cephalosporins Chemical class 0.000 description 2
- HVYWMOMLDIMFJA-DPAQBDIFSA-N cholesterol Chemical compound C1C=C2C[C@@H](O)CC[C@]2(C)[C@@H]2[C@@H]1[C@@H]1CC[C@H]([C@H](C)CCCC(C)C)[C@@]1(C)CC2 HVYWMOMLDIMFJA-DPAQBDIFSA-N 0.000 description 2
- 238000004587 chromatography analysis Methods 0.000 description 2
- 230000002759 chromosomal effect Effects 0.000 description 2
- MYSWGUAQZAJSOK-UHFFFAOYSA-N ciprofloxacin Chemical compound C12=CC(N3CCNCC3)=C(F)C=C2C(=O)C(C(=O)O)=CN1C1CC1 MYSWGUAQZAJSOK-UHFFFAOYSA-N 0.000 description 2
- HZZVJAQRINQKSD-PBFISZAISA-N clavulanic acid Chemical compound OC(=O)[C@H]1C(=C/CO)/O[C@@H]2CC(=O)N21 HZZVJAQRINQKSD-PBFISZAISA-N 0.000 description 2
- 229960003324 clavulanic acid Drugs 0.000 description 2
- CBGUOGMQLZIXBE-XGQKBEPLSA-N clobetasol propionate Chemical compound C1CC2=CC(=O)C=C[C@]2(C)[C@]2(F)[C@@H]1[C@@H]1C[C@H](C)[C@@](C(=O)CCl)(OC(=O)CC)[C@@]1(C)C[C@@H]2O CBGUOGMQLZIXBE-XGQKBEPLSA-N 0.000 description 2
- 229940047766 co-trimoxazole Drugs 0.000 description 2
- 238000004440 column chromatography Methods 0.000 description 2
- 238000012875 competitive assay Methods 0.000 description 2
- 239000000356 contaminant Substances 0.000 description 2
- 238000013270 controlled release Methods 0.000 description 2
- 230000001276 controlling effect Effects 0.000 description 2
- ORTQZVOHEJQUHG-UHFFFAOYSA-L copper(II) chloride Chemical compound Cl[Cu]Cl ORTQZVOHEJQUHG-UHFFFAOYSA-L 0.000 description 2
- 238000004132 cross linking Methods 0.000 description 2
- OPTASPLRGRRNAP-UHFFFAOYSA-N cytosine Chemical compound NC=1C=CNC(=O)N=1 OPTASPLRGRRNAP-UHFFFAOYSA-N 0.000 description 2
- RGWHQCVHVJXOKC-SHYZEUOFSA-J dCTP(4-) Chemical compound O=C1N=C(N)C=CN1[C@@H]1O[C@H](COP([O-])(=O)OP([O-])(=O)OP([O-])([O-])=O)[C@@H](O)C1 RGWHQCVHVJXOKC-SHYZEUOFSA-J 0.000 description 2
- 230000006378 damage Effects 0.000 description 2
- 230000002950 deficient Effects 0.000 description 2
- 238000011161 development Methods 0.000 description 2
- 229960000616 diflunisal Drugs 0.000 description 2
- HUPFGZXOMWLGNK-UHFFFAOYSA-N diflunisal Chemical compound C1=C(O)C(C(=O)O)=CC(C=2C(=CC(F)=CC=2)F)=C1 HUPFGZXOMWLGNK-UHFFFAOYSA-N 0.000 description 2
- 230000029087 digestion Effects 0.000 description 2
- 238000006471 dimerization reaction Methods 0.000 description 2
- 230000004064 dysfunction Effects 0.000 description 2
- 108010057988 ecdysone receptor Proteins 0.000 description 2
- 239000012636 effector Substances 0.000 description 2
- 238000011156 evaluation Methods 0.000 description 2
- 238000010195 expression analysis Methods 0.000 description 2
- MHMNJMPURVTYEJ-UHFFFAOYSA-N fluorescein-5-isothiocyanate Chemical compound O1C(=O)C2=CC(N=C=S)=CC=C2C21C1=CC=C(O)C=C1OC1=CC(O)=CC=C21 MHMNJMPURVTYEJ-UHFFFAOYSA-N 0.000 description 2
- 230000005714 functional activity Effects 0.000 description 2
- 210000001035 gastrointestinal tract Anatomy 0.000 description 2
- 239000000499 gel Substances 0.000 description 2
- 238000001502 gel electrophoresis Methods 0.000 description 2
- 229920000159 gelatin Polymers 0.000 description 2
- 239000008273 gelatin Substances 0.000 description 2
- 235000019322 gelatine Nutrition 0.000 description 2
- 235000011852 gelatine desserts Nutrition 0.000 description 2
- 230000002068 genetic effect Effects 0.000 description 2
- 235000013922 glutamic acid Nutrition 0.000 description 2
- 239000004220 glutamic acid Substances 0.000 description 2
- 239000010931 gold Substances 0.000 description 2
- 229910052737 gold Inorganic materials 0.000 description 2
- UYTPUPDQBNUYGX-UHFFFAOYSA-N guanine Chemical compound O=C1NC(N)=NC2=C1N=CN2 UYTPUPDQBNUYGX-UHFFFAOYSA-N 0.000 description 2
- 208000006454 hepatitis Diseases 0.000 description 2
- 231100000283 hepatitis Toxicity 0.000 description 2
- 238000004128 high performance liquid chromatography Methods 0.000 description 2
- HNDVDQJCIGZPNO-UHFFFAOYSA-N histidine Natural products OC(=O)C(N)CC1=CN=CN1 HNDVDQJCIGZPNO-UHFFFAOYSA-N 0.000 description 2
- 210000005260 human cell Anatomy 0.000 description 2
- 238000002169 hydrotherapy Methods 0.000 description 2
- WGCNASOHLSPBMP-UHFFFAOYSA-N hydroxyacetaldehyde Natural products OCC=O WGCNASOHLSPBMP-UHFFFAOYSA-N 0.000 description 2
- 238000002649 immunization Methods 0.000 description 2
- 102000018358 immunoglobulin Human genes 0.000 description 2
- 230000016784 immunoglobulin production Effects 0.000 description 2
- CGIGDMFJXJATDK-UHFFFAOYSA-N indomethacin Chemical compound CC1=C(CC(O)=O)C2=CC(OC)=CC=C2N1C(=O)C1=CC=C(Cl)C=C1 CGIGDMFJXJATDK-UHFFFAOYSA-N 0.000 description 2
- 230000008595 infiltration Effects 0.000 description 2
- 238000001764 infiltration Methods 0.000 description 2
- 230000002757 inflammatory effect Effects 0.000 description 2
- 230000002401 inhibitory effect Effects 0.000 description 2
- 230000005764 inhibitory process Effects 0.000 description 2
- NOESYZHRGYRDHS-UHFFFAOYSA-N insulin Chemical compound N1C(=O)C(NC(=O)C(CCC(N)=O)NC(=O)C(CCC(O)=O)NC(=O)C(C(C)C)NC(=O)C(NC(=O)CN)C(C)CC)CSSCC(C(NC(CO)C(=O)NC(CC(C)C)C(=O)NC(CC=2C=CC(O)=CC=2)C(=O)NC(CCC(N)=O)C(=O)NC(CC(C)C)C(=O)NC(CCC(O)=O)C(=O)NC(CC(N)=O)C(=O)NC(CC=2C=CC(O)=CC=2)C(=O)NC(CSSCC(NC(=O)C(C(C)C)NC(=O)C(CC(C)C)NC(=O)C(CC=2C=CC(O)=CC=2)NC(=O)C(CC(C)C)NC(=O)C(C)NC(=O)C(CCC(O)=O)NC(=O)C(C(C)C)NC(=O)C(CC(C)C)NC(=O)C(CC=2NC=NC=2)NC(=O)C(CO)NC(=O)CNC2=O)C(=O)NCC(=O)NC(CCC(O)=O)C(=O)NC(CCCNC(N)=N)C(=O)NCC(=O)NC(CC=3C=CC=CC=3)C(=O)NC(CC=3C=CC=CC=3)C(=O)NC(CC=3C=CC(O)=CC=3)C(=O)NC(C(C)O)C(=O)N3C(CCC3)C(=O)NC(CCCCN)C(=O)NC(C)C(O)=O)C(=O)NC(CC(N)=O)C(O)=O)=O)NC(=O)C(C(C)CC)NC(=O)C(CO)NC(=O)C(C(C)O)NC(=O)C1CSSCC2NC(=O)C(CC(C)C)NC(=O)C(NC(=O)C(CCC(N)=O)NC(=O)C(CC(N)=O)NC(=O)C(NC(=O)C(N)CC=1C=CC=CC=1)C(C)C)CC1=CN=CN1 NOESYZHRGYRDHS-UHFFFAOYSA-N 0.000 description 2
- 230000002452 interceptive effect Effects 0.000 description 2
- 230000003834 intracellular effect Effects 0.000 description 2
- 238000001990 intravenous administration Methods 0.000 description 2
- 229960000310 isoleucine Drugs 0.000 description 2
- AGPKZVBTJJNPAG-UHFFFAOYSA-N isoleucine Natural products CCC(C)C(N)C(O)=O AGPKZVBTJJNPAG-UHFFFAOYSA-N 0.000 description 2
- 229950000248 isonixin Drugs 0.000 description 2
- WJDDCFNFNAHLAF-UHFFFAOYSA-N isonixin Chemical compound CC1=CC=CC(C)=C1NC(=O)C1=CC=CNC1=O WJDDCFNFNAHLAF-UHFFFAOYSA-N 0.000 description 2
- 210000003734 kidney Anatomy 0.000 description 2
- 239000008101 lactose Substances 0.000 description 2
- 230000000670 limiting effect Effects 0.000 description 2
- 229940041028 lincosamides Drugs 0.000 description 2
- 239000000314 lubricant Substances 0.000 description 2
- 239000003120 macrolide antibiotic agent Substances 0.000 description 2
- 229940041033 macrolides Drugs 0.000 description 2
- HQKMJHAJHXVSDF-UHFFFAOYSA-L magnesium stearate Chemical compound [Mg+2].CCCCCCCCCCCCCCCCCC([O-])=O.CCCCCCCCCCCCCCCCCC([O-])=O HQKMJHAJHXVSDF-UHFFFAOYSA-L 0.000 description 2
- 238000012423 maintenance Methods 0.000 description 2
- 238000013507 mapping Methods 0.000 description 2
- 238000005259 measurement Methods 0.000 description 2
- GLVAUDGFNGKCSF-UHFFFAOYSA-N mercaptopurine Chemical compound S=C1NC=NC2=C1NC=N2 GLVAUDGFNGKCSF-UHFFFAOYSA-N 0.000 description 2
- 125000002496 methyl group Chemical group [H]C([H])([H])* 0.000 description 2
- LXCFILQKKLGQFO-UHFFFAOYSA-N methylparaben Chemical compound COC(=O)C1=CC=C(O)C=C1 LXCFILQKKLGQFO-UHFFFAOYSA-N 0.000 description 2
- 238000002493 microarray Methods 0.000 description 2
- 239000011859 microparticle Substances 0.000 description 2
- 239000004005 microsphere Substances 0.000 description 2
- VKHAHZOOUSRJNA-GCNJZUOMSA-N mifepristone Chemical compound C1([C@@H]2C3=C4CCC(=O)C=C4CC[C@H]3[C@@H]3CC[C@@]([C@]3(C2)C)(O)C#CC)=CC=C(N(C)C)C=C1 VKHAHZOOUSRJNA-GCNJZUOMSA-N 0.000 description 2
- 230000007935 neutral effect Effects 0.000 description 2
- 231100000252 nontoxic Toxicity 0.000 description 2
- 230000003000 nontoxic effect Effects 0.000 description 2
- 230000002018 overexpression Effects 0.000 description 2
- 239000008188 pellet Substances 0.000 description 2
- XKFIQZCHJUUSBA-UHFFFAOYSA-N perisoxal Chemical compound C1=C(C=2C=CC=CC=2)ON=C1C(O)CN1CCCCC1 XKFIQZCHJUUSBA-UHFFFAOYSA-N 0.000 description 2
- 229950005491 perisoxal Drugs 0.000 description 2
- 238000002823 phage display Methods 0.000 description 2
- ZQBAKBUEJOMQEX-UHFFFAOYSA-N phenyl salicylate Chemical compound OC1=CC=CC=C1C(=O)OC1=CC=CC=C1 ZQBAKBUEJOMQEX-UHFFFAOYSA-N 0.000 description 2
- COLNVLDHVKWLRT-UHFFFAOYSA-N phenylalanine Natural products OC(=O)C(N)CC1=CC=CC=C1 COLNVLDHVKWLRT-UHFFFAOYSA-N 0.000 description 2
- 235000021317 phosphate Nutrition 0.000 description 2
- 150000008300 phosphoramidites Chemical class 0.000 description 2
- OXNIZHLAWKMVMX-UHFFFAOYSA-N picric acid Chemical compound OC1=C([N+]([O-])=O)C=C([N+]([O-])=O)C=C1[N+]([O-])=O OXNIZHLAWKMVMX-UHFFFAOYSA-N 0.000 description 2
- 229920000747 poly(lactic acid) Polymers 0.000 description 2
- 230000008488 polyadenylation Effects 0.000 description 2
- 210000004896 polypeptide structure Anatomy 0.000 description 2
- 229960001917 prednylidene Drugs 0.000 description 2
- 238000012545 processing Methods 0.000 description 2
- 239000000044 progesterone antagonist Substances 0.000 description 2
- 230000009465 prokaryotic expression Effects 0.000 description 2
- 230000000069 prophylactic effect Effects 0.000 description 2
- QELSKZZBTMNZEB-UHFFFAOYSA-N propylparaben Chemical compound CCCOC(=O)C1=CC=C(O)C=C1 QELSKZZBTMNZEB-UHFFFAOYSA-N 0.000 description 2
- 230000002685 pulmonary effect Effects 0.000 description 2
- 238000000163 radioactive labelling Methods 0.000 description 2
- 230000004044 response Effects 0.000 description 2
- 230000002441 reversible effect Effects 0.000 description 2
- 238000012552 review Methods 0.000 description 2
- 229960003292 rifamycin Drugs 0.000 description 2
- HJYYPODYNSCCOU-ODRIEIDWSA-N rifamycin SV Chemical compound OC1=C(C(O)=C2C)C3=C(O)C=C1NC(=O)\C(C)=C/C=C/[C@H](C)[C@H](O)[C@@H](C)[C@@H](O)[C@@H](C)[C@H](OC(C)=O)[C@H](C)[C@@H](OC)\C=C\O[C@@]1(C)OC2=C3C1=O HJYYPODYNSCCOU-ODRIEIDWSA-N 0.000 description 2
- YGSDEFSMJLZEOE-UHFFFAOYSA-N salicylic acid Chemical compound OC(=O)C1=CC=CC=C1O YGSDEFSMJLZEOE-UHFFFAOYSA-N 0.000 description 2
- 235000019515 salmon Nutrition 0.000 description 2
- WVYADZUPLLSGPU-UHFFFAOYSA-N salsalate Chemical compound OC(=O)C1=CC=CC=C1OC(=O)C1=CC=CC=C1O WVYADZUPLLSGPU-UHFFFAOYSA-N 0.000 description 2
- 238000007423 screening assay Methods 0.000 description 2
- 238000000926 separation method Methods 0.000 description 2
- 238000004904 shortening Methods 0.000 description 2
- 230000019491 signal transduction Effects 0.000 description 2
- GEHJYWRUCIMESM-UHFFFAOYSA-L sodium sulfite Chemical compound [Na+].[Na+].[O-]S([O-])=O GEHJYWRUCIMESM-UHFFFAOYSA-L 0.000 description 2
- 238000005063 solubilization Methods 0.000 description 2
- 230000007928 solubilization Effects 0.000 description 2
- 230000009870 specific binding Effects 0.000 description 2
- 238000003860 storage Methods 0.000 description 2
- UCSJYZPVAKXKNQ-HZYVHMACSA-N streptomycin Chemical compound CN[C@H]1[C@H](O)[C@@H](O)[C@H](CO)O[C@H]1O[C@@H]1[C@](C=O)(O)[C@H](C)O[C@H]1O[C@@H]1[C@@H](NC(N)=N)[C@H](O)[C@@H](NC(N)=N)[C@H](O)[C@H]1O UCSJYZPVAKXKNQ-HZYVHMACSA-N 0.000 description 2
- 239000005720 sucrose Substances 0.000 description 2
- 235000000346 sugar Nutrition 0.000 description 2
- 150000008163 sugars Chemical class 0.000 description 2
- 150000003456 sulfonamides Chemical class 0.000 description 2
- 239000006228 supernatant Substances 0.000 description 2
- 239000004094 surface-active agent Substances 0.000 description 2
- 230000004083 survival effect Effects 0.000 description 2
- 239000000375 suspending agent Substances 0.000 description 2
- 230000008685 targeting Effects 0.000 description 2
- 238000002560 therapeutic procedure Methods 0.000 description 2
- RWQNBRDOKXIBIV-UHFFFAOYSA-N thymine Chemical compound CC1=CNC(=O)NC1=O RWQNBRDOKXIBIV-UHFFFAOYSA-N 0.000 description 2
- 229960004659 ticarcillin Drugs 0.000 description 2
- OHKOGUYZJXTSFX-KZFFXBSXSA-N ticarcillin Chemical compound C=1([C@@H](C(O)=O)C(=O)N[C@H]2[C@H]3SC([C@@H](N3C2=O)C(O)=O)(C)C)C=CSC=1 OHKOGUYZJXTSFX-KZFFXBSXSA-N 0.000 description 2
- 230000002103 transcriptional effect Effects 0.000 description 2
- 108091008578 transmembrane receptors Proteins 0.000 description 2
- 102000027257 transmembrane receptors Human genes 0.000 description 2
- 229960005294 triamcinolone Drugs 0.000 description 2
- GFNANZIMVAIWHM-OBYCQNJPSA-N triamcinolone Chemical compound O=C1C=C[C@]2(C)[C@@]3(F)[C@@H](O)C[C@](C)([C@@]([C@H](O)C4)(O)C(=O)CO)[C@@H]4[C@@H]3CCC2=C1 GFNANZIMVAIWHM-OBYCQNJPSA-N 0.000 description 2
- 229950002929 trinitrophenol Drugs 0.000 description 2
- LENZDBCJOHFCAS-UHFFFAOYSA-N tris Chemical compound OCC(N)(CO)CO LENZDBCJOHFCAS-UHFFFAOYSA-N 0.000 description 2
- OUYCCCASQSFEME-UHFFFAOYSA-N tyrosine Natural products OC(=O)C(N)CC1=CC=C(O)C=C1 OUYCCCASQSFEME-UHFFFAOYSA-N 0.000 description 2
- 241000701447 unidentified baculovirus Species 0.000 description 2
- 239000004474 valine Substances 0.000 description 2
- 238000005406 washing Methods 0.000 description 2
- 150000003952 β-lactams Chemical class 0.000 description 2
- SOOXXPIIPHUERK-UHFFFAOYSA-N (2-propan-2-yl-1h-indol-3-yl)-pyridin-3-ylmethanone Chemical compound CC(C)C=1NC2=CC=CC=C2C=1C(=O)C1=CC=CN=C1 SOOXXPIIPHUERK-UHFFFAOYSA-N 0.000 description 1
- KIUKXJAPPMFGSW-DNGZLQJQSA-N (2S,3S,4S,5R,6R)-6-[(2S,3R,4R,5S,6R)-3-Acetamido-2-[(2S,3S,4R,5R,6R)-6-[(2R,3R,4R,5S,6R)-3-acetamido-2,5-dihydroxy-6-(hydroxymethyl)oxan-4-yl]oxy-2-carboxy-4,5-dihydroxyoxan-3-yl]oxy-5-hydroxy-6-(hydroxymethyl)oxan-4-yl]oxy-3,4,5-trihydroxyoxane-2-carboxylic acid Chemical compound CC(=O)N[C@H]1[C@H](O)O[C@H](CO)[C@@H](O)[C@@H]1O[C@H]1[C@H](O)[C@@H](O)[C@H](O[C@H]2[C@@H]([C@@H](O[C@H]3[C@@H]([C@@H](O)[C@H](O)[C@H](O3)C(O)=O)O)[C@H](O)[C@@H](CO)O2)NC(C)=O)[C@@H](C(O)=O)O1 KIUKXJAPPMFGSW-DNGZLQJQSA-N 0.000 description 1
- RJMIEHBSYVWVIN-LLVKDONJSA-N (2r)-2-[4-(3-oxo-1h-isoindol-2-yl)phenyl]propanoic acid Chemical compound C1=CC([C@H](C(O)=O)C)=CC=C1N1C(=O)C2=CC=CC=C2C1 RJMIEHBSYVWVIN-LLVKDONJSA-N 0.000 description 1
- RDJGLLICXDHJDY-NSHDSACASA-N (2s)-2-(3-phenoxyphenyl)propanoic acid Chemical compound OC(=O)[C@@H](C)C1=CC=CC(OC=2C=CC=CC=2)=C1 RDJGLLICXDHJDY-NSHDSACASA-N 0.000 description 1
- VUAFHZCUKUDDBC-SCSAIBSYSA-N (2s)-2-[(2-methyl-2-sulfanylpropanoyl)amino]-3-sulfanylpropanoic acid Chemical compound CC(C)(S)C(=O)N[C@H](CS)C(O)=O VUAFHZCUKUDDBC-SCSAIBSYSA-N 0.000 description 1
- RJMIEHBSYVWVIN-NSHDSACASA-N (2s)-2-[4-(3-oxo-1h-isoindol-2-yl)phenyl]propanoic acid Chemical compound C1=CC([C@@H](C(O)=O)C)=CC=C1N1C(=O)C2=CC=CC=C2C1 RJMIEHBSYVWVIN-NSHDSACASA-N 0.000 description 1
- MDKGKXOCJGEUJW-VIFPVBQESA-N (2s)-2-[4-(thiophene-2-carbonyl)phenyl]propanoic acid Chemical compound C1=CC([C@@H](C(O)=O)C)=CC=C1C(=O)C1=CC=CS1 MDKGKXOCJGEUJW-VIFPVBQESA-N 0.000 description 1
- XMQUEQJCYRFIQS-YFKPBYRVSA-N (2s)-2-amino-5-ethoxy-5-oxopentanoic acid Chemical compound CCOC(=O)CC[C@H](N)C(O)=O XMQUEQJCYRFIQS-YFKPBYRVSA-N 0.000 description 1
- XIYOPDCBBDCGOE-IWVLMIASSA-N (4s,4ar,5s,5ar,12ar)-4-(dimethylamino)-1,5,10,11,12a-pentahydroxy-6-methylidene-3,12-dioxo-4,4a,5,5a-tetrahydrotetracene-2-carboxamide Chemical compound C=C1C2=CC=CC(O)=C2C(O)=C2[C@@H]1[C@H](O)[C@H]1[C@H](N(C)C)C(=O)C(C(N)=O)=C(O)[C@@]1(O)C2=O XIYOPDCBBDCGOE-IWVLMIASSA-N 0.000 description 1
- RNIADBXQDMCFEN-IWVLMIASSA-N (4s,4ar,5s,5ar,12ar)-7-chloro-4-(dimethylamino)-1,5,10,11,12a-pentahydroxy-6-methylidene-3,12-dioxo-4,4a,5,5a-tetrahydrotetracene-2-carboxamide Chemical compound C=C1C2=C(Cl)C=CC(O)=C2C(O)=C2[C@@H]1[C@H](O)[C@H]1[C@H](N(C)C)C(=O)C(C(N)=O)=C(O)[C@@]1(O)C2=O RNIADBXQDMCFEN-IWVLMIASSA-N 0.000 description 1
- MTCQOMXDZUULRV-ADOAZJKMSA-N (4s,4as,5ar,12ar)-4-(dimethylamino)-1,10,11,12a-tetrahydroxy-3,12-dioxo-4a,5,5a,6-tetrahydro-4h-tetracene-2-carboxamide Chemical compound C1C2=CC=CC(O)=C2C(O)=C2[C@@H]1C[C@H]1[C@H](N(C)C)C(=O)C(C(N)=O)=C(O)[C@@]1(O)C2=O MTCQOMXDZUULRV-ADOAZJKMSA-N 0.000 description 1
- NWXMGUDVXFXRIG-WESIUVDSSA-N (4s,4as,5as,6s,12ar)-4-(dimethylamino)-1,6,10,11,12a-pentahydroxy-6-methyl-3,12-dioxo-4,4a,5,5a-tetrahydrotetracene-2-carboxamide Chemical compound C1=CC=C2[C@](O)(C)[C@H]3C[C@H]4[C@H](N(C)C)C(=O)C(C(N)=O)=C(O)[C@@]4(O)C(=O)C3=C(O)C2=C1O NWXMGUDVXFXRIG-WESIUVDSSA-N 0.000 description 1
- GUXHBMASAHGULD-SEYHBJAFSA-N (4s,4as,5as,6s,12ar)-7-chloro-4-(dimethylamino)-1,6,10,11,12a-pentahydroxy-3,12-dioxo-4a,5,5a,6-tetrahydro-4h-tetracene-2-carboxamide Chemical compound C1([C@H]2O)=C(Cl)C=CC(O)=C1C(O)=C1[C@@H]2C[C@H]2[C@H](N(C)C)C(=O)C(C(N)=O)=C(O)[C@@]2(O)C1=O GUXHBMASAHGULD-SEYHBJAFSA-N 0.000 description 1
- FAMUIRDLAWWMCQ-AQFAATAFSA-N (4s,4as,5as,6s,12ar)-n-[[4-[n-(diaminomethylidene)carbamimidoyl]piperazin-1-yl]methyl]-4-(dimethylamino)-1,6,10,11,12a-pentahydroxy-6-methyl-3,12-dioxo-4,4a,5,5a-tetrahydrotetracene-2-carboxamide Chemical compound OC([C@@]1(O)C(=O)C=2[C@@H]([C@](C3=CC=CC(O)=C3C=2O)(C)O)C[C@H]1[C@@H](C1=O)N(C)C)=C1C(=O)NCN1CCN(C(=N)N=C(N)N)CC1 FAMUIRDLAWWMCQ-AQFAATAFSA-N 0.000 description 1
- 125000000027 (C1-C10) alkoxy group Chemical group 0.000 description 1
- WHBMMWSBFZVSSR-GSVOUGTGSA-N (R)-3-hydroxybutyric acid Chemical compound C[C@@H](O)CC(O)=O WHBMMWSBFZVSSR-GSVOUGTGSA-N 0.000 description 1
- QKDHBVNJCZBTMR-LLVKDONJSA-N (R)-temafloxacin Chemical compound C1CN[C@H](C)CN1C(C(=C1)F)=CC2=C1C(=O)C(C(O)=O)=CN2C1=CC=C(F)C=C1F QKDHBVNJCZBTMR-LLVKDONJSA-N 0.000 description 1
- WHTVZRBIWZFKQO-AWEZNQCLSA-N (S)-chloroquine Chemical compound ClC1=CC=C2C(N[C@@H](C)CCCN(CC)CC)=CC=NC2=C1 WHTVZRBIWZFKQO-AWEZNQCLSA-N 0.000 description 1
- HRKBEOWSWBHJNM-UHFFFAOYSA-N 1,1-dioxo-2h-1$l^{6},2-benzothiazin-4-ol Chemical compound C1=CC=C2C(O)=CNS(=O)(=O)C2=C1 HRKBEOWSWBHJNM-UHFFFAOYSA-N 0.000 description 1
- YUIOPHXTILULQC-UHFFFAOYSA-N 1,4-Dithiane-2,5-diol Chemical compound OC1CSC(O)CS1 YUIOPHXTILULQC-UHFFFAOYSA-N 0.000 description 1
- XOZLRRYPUKAKMU-UHFFFAOYSA-N 1,5-dimethyl-2-phenyl-4-(propan-2-ylamino)-3-pyrazolone Chemical compound O=C1C(NC(C)C)=C(C)N(C)N1C1=CC=CC=C1 XOZLRRYPUKAKMU-UHFFFAOYSA-N 0.000 description 1
- PDYZVPFJLHCRGG-UHFFFAOYSA-N 1,6-dimethyl-4-oxo-7,8,9,9a-tetrahydro-6h-pyrido[1,2-a]pyrimidine-3-carboxamide Chemical compound CN1C=C(C(N)=O)C(=O)N2C(C)CCCC21 PDYZVPFJLHCRGG-UHFFFAOYSA-N 0.000 description 1
- FMBVHKPWDJQLNO-UHFFFAOYSA-N 1-[(3-fluorophenyl)methyl]-5-nitroindazole Chemical compound N1=CC2=CC([N+](=O)[O-])=CC=C2N1CC1=CC=CC(F)=C1 FMBVHKPWDJQLNO-UHFFFAOYSA-N 0.000 description 1
- PMXICBGNGPDDAW-UHFFFAOYSA-N 1-[3-(aminomethyl)-5-tert-butyl-2-hydroxyphenyl]propan-1-one Chemical compound CCC(=O)C1=CC(C(C)(C)C)=CC(CN)=C1O PMXICBGNGPDDAW-UHFFFAOYSA-N 0.000 description 1
- UDJZTGMLYITLIQ-UHFFFAOYSA-N 1-ethenylpyrrolidine Chemical compound C=CN1CCCC1 UDJZTGMLYITLIQ-UHFFFAOYSA-N 0.000 description 1
- SATCOUWSAZBIJO-UHFFFAOYSA-N 1-methyladenine Natural products N=C1N(C)C=NC2=C1NC=N2 SATCOUWSAZBIJO-UHFFFAOYSA-N 0.000 description 1
- WJNGQIYEQLPJMN-IOSLPCCCSA-N 1-methylinosine Chemical compound C1=NC=2C(=O)N(C)C=NC=2N1[C@@H]1O[C@H](CO)[C@@H](O)[C@H]1O WJNGQIYEQLPJMN-IOSLPCCCSA-N 0.000 description 1
- VSNHCAURESNICA-NJFSPNSNSA-N 1-oxidanylurea Chemical compound N[14C](=O)NO VSNHCAURESNICA-NJFSPNSNSA-N 0.000 description 1
- IIZPXYDJLKNOIY-JXPKJXOSSA-N 1-palmitoyl-2-arachidonoyl-sn-glycero-3-phosphocholine Chemical compound CCCCCCCCCCCCCCCC(=O)OC[C@H](COP([O-])(=O)OCC[N+](C)(C)C)OC(=O)CCC\C=C/C\C=C/C\C=C/C\C=C/CCCCC IIZPXYDJLKNOIY-JXPKJXOSSA-N 0.000 description 1
- GZCWLCBFPRFLKL-UHFFFAOYSA-N 1-prop-2-ynoxypropan-2-ol Chemical compound CC(O)COCC#C GZCWLCBFPRFLKL-UHFFFAOYSA-N 0.000 description 1
- IDINUJSAMVOPCM-UHFFFAOYSA-N 15-Deoxyspergualin Natural products NCCCNCCCCNC(=O)C(O)NC(=O)CCCCCCN=C(N)N IDINUJSAMVOPCM-UHFFFAOYSA-N 0.000 description 1
- MPDGHEJMBKOTSU-YKLVYJNSSA-N 18beta-glycyrrhetic acid Chemical compound C([C@H]1C2=CC(=O)[C@H]34)[C@@](C)(C(O)=O)CC[C@]1(C)CC[C@@]2(C)[C@]4(C)CC[C@@H]1[C@]3(C)CC[C@H](O)C1(C)C MPDGHEJMBKOTSU-YKLVYJNSSA-N 0.000 description 1
- JNCSKMUPCTYDLO-UHFFFAOYSA-N 1h-imidazole;1h-pyridin-2-one Chemical class C1=CNC=N1.OC1=CC=CC=N1 JNCSKMUPCTYDLO-UHFFFAOYSA-N 0.000 description 1
- AZCOEIZFVQEQCU-UHFFFAOYSA-N 2-(1-benzoyl-2-methylindol-3-yl)acetic acid Chemical compound CC1=C(CC(O)=O)C2=CC=CC=C2N1C(=O)C1=CC=CC=C1 AZCOEIZFVQEQCU-UHFFFAOYSA-N 0.000 description 1
- ZAVJTSLIGAGALR-UHFFFAOYSA-N 2-(2,2,2-trifluoroacetyl)cyclooctan-1-one Chemical compound FC(F)(F)C(=O)C1CCCCCCC1=O ZAVJTSLIGAGALR-UHFFFAOYSA-N 0.000 description 1
- HLYBTPMYFWWNJN-UHFFFAOYSA-N 2-(2,4-dioxo-1h-pyrimidin-5-yl)-2-hydroxyacetic acid Chemical compound OC(=O)C(O)C1=CNC(=O)NC1=O HLYBTPMYFWWNJN-UHFFFAOYSA-N 0.000 description 1
- RYDUZJFCKYTEHX-UHFFFAOYSA-N 2-(2-propan-2-yl-2,3-dihydro-1h-inden-5-yl)propanoic acid Chemical compound C1=C(C(C)C(O)=O)C=C2CC(C(C)C)CC2=C1 RYDUZJFCKYTEHX-UHFFFAOYSA-N 0.000 description 1
- TXUGZLRUFAAHAO-LFIBNONCSA-N 2-(dimethylamino)ethyl 2-[(e)-1-(4-chlorophenyl)ethylideneamino]oxyacetate Chemical compound CN(C)CCOC(=O)CO\N=C(/C)C1=CC=C(Cl)C=C1 TXUGZLRUFAAHAO-LFIBNONCSA-N 0.000 description 1
- SGAKLDIYNFXTCK-UHFFFAOYSA-N 2-[(2,4-dioxo-1h-pyrimidin-5-yl)methylamino]acetic acid Chemical compound OC(=O)CNCC1=CNC(=O)NC1=O SGAKLDIYNFXTCK-UHFFFAOYSA-N 0.000 description 1
- SVBOROZXXYRWJL-UHFFFAOYSA-N 2-[(4-oxo-2-sulfanylidene-1h-pyrimidin-5-yl)methylamino]acetic acid Chemical compound OC(=O)CNCC1=CNC(=S)NC1=O SVBOROZXXYRWJL-UHFFFAOYSA-N 0.000 description 1
- ACTOXUHEUCPTEW-BWHGAVFKSA-N 2-[(4r,5s,6s,7r,9r,10r,11e,13e,16r)-6-[(2s,3r,4r,5s,6r)-5-[(2s,4r,5s,6s)-4,5-dihydroxy-4,6-dimethyloxan-2-yl]oxy-4-(dimethylamino)-3-hydroxy-6-methyloxan-2-yl]oxy-10-[(2s,5s,6r)-5-(dimethylamino)-6-methyloxan-2-yl]oxy-4-hydroxy-5-methoxy-9,16-dimethyl-2-o Chemical compound O([C@H]1/C=C/C=C/C[C@@H](C)OC(=O)C[C@@H](O)[C@@H]([C@H]([C@@H](CC=O)C[C@H]1C)O[C@H]1[C@@H]([C@H]([C@H](O[C@@H]2O[C@@H](C)[C@H](O)[C@](C)(O)C2)[C@@H](C)O1)N(C)C)O)OC)[C@@H]1CC[C@H](N(C)C)[C@@H](C)O1 ACTOXUHEUCPTEW-BWHGAVFKSA-N 0.000 description 1
- XLVXAUNDHWERBM-IVGWJTKZSA-N 2-[1-(4-chlorobenzoyl)-5-methoxy-2-methylindol-3-yl]-n-[(2r,3r,4s,5r)-3,4,5,6-tetrahydroxy-1-oxohexan-2-yl]acetamide Chemical compound CC1=C(CC(=O)N[C@@H](C=O)[C@@H](O)[C@H](O)[C@H](O)CO)C2=CC(OC)=CC=C2N1C(=O)C1=CC=C(Cl)C=C1 XLVXAUNDHWERBM-IVGWJTKZSA-N 0.000 description 1
- ANMLJLFWUCQGKZ-UHFFFAOYSA-N 2-[3-(trifluoromethyl)anilino]-3-pyridinecarboxylic acid (3-oxo-1H-isobenzofuran-1-yl) ester Chemical compound FC(F)(F)C1=CC=CC(NC=2C(=CC=CN=2)C(=O)OC2C3=CC=CC=C3C(=O)O2)=C1 ANMLJLFWUCQGKZ-UHFFFAOYSA-N 0.000 description 1
- XILVEPYQJIOVNB-UHFFFAOYSA-N 2-[3-(trifluoromethyl)anilino]benzoic acid 2-(2-hydroxyethoxy)ethyl ester Chemical compound OCCOCCOC(=O)C1=CC=CC=C1NC1=CC=CC(C(F)(F)F)=C1 XILVEPYQJIOVNB-UHFFFAOYSA-N 0.000 description 1
- TYCOFFBAZNSQOJ-UHFFFAOYSA-N 2-[4-(3-fluorophenyl)phenyl]propanoic acid Chemical compound C1=CC(C(C(O)=O)C)=CC=C1C1=CC=CC(F)=C1 TYCOFFBAZNSQOJ-UHFFFAOYSA-N 0.000 description 1
- XUDSQIDNHJMBBW-FOWTUZBSSA-N 2-[4-[(e)-n-hydroxy-c-methylcarbonimidoyl]phenoxy]-1-piperidin-1-ylethanone Chemical compound C1=CC(C(=N/O)/C)=CC=C1OCC(=O)N1CCCCC1 XUDSQIDNHJMBBW-FOWTUZBSSA-N 0.000 description 1
- WGDADRBTCPGSDG-UHFFFAOYSA-N 2-[[4,5-bis(4-chlorophenyl)-1,3-oxazol-2-yl]sulfanyl]propanoic acid Chemical compound O1C(SC(C)C(O)=O)=NC(C=2C=CC(Cl)=CC=2)=C1C1=CC=C(Cl)C=C1 WGDADRBTCPGSDG-UHFFFAOYSA-N 0.000 description 1
- XKSAJZSJKURQRX-UHFFFAOYSA-N 2-acetyloxy-5-(4-fluorophenyl)benzoic acid Chemical compound C1=C(C(O)=O)C(OC(=O)C)=CC=C1C1=CC=C(F)C=C1 XKSAJZSJKURQRX-UHFFFAOYSA-N 0.000 description 1
- JJBCTCGUOQYZHK-UHFFFAOYSA-N 2-acetyloxybenzoate;(5-amino-1-carboxypentyl)azanium Chemical compound OC(=O)C(N)CCCC[NH3+].CC(=O)OC1=CC=CC=C1C([O-])=O JJBCTCGUOQYZHK-UHFFFAOYSA-N 0.000 description 1
- QKNYBSVHEMOAJP-UHFFFAOYSA-N 2-amino-2-(hydroxymethyl)propane-1,3-diol;hydron;chloride Chemical compound Cl.OCC(N)(CO)CO QKNYBSVHEMOAJP-UHFFFAOYSA-N 0.000 description 1
- MSWZFWKMSRAUBD-IVMDWMLBSA-N 2-amino-2-deoxy-D-glucopyranose Chemical compound N[C@H]1C(O)O[C@H](CO)[C@@H](O)[C@@H]1O MSWZFWKMSRAUBD-IVMDWMLBSA-N 0.000 description 1
- MECVOSKQBMPUFG-UHFFFAOYSA-N 2-carboxyphenolate;morpholin-4-ium Chemical compound C1COCCN1.OC(=O)C1=CC=CC=C1O MECVOSKQBMPUFG-UHFFFAOYSA-N 0.000 description 1
- XMSMHKMPBNTBOD-UHFFFAOYSA-N 2-dimethylamino-6-hydroxypurine Chemical compound N1C(N(C)C)=NC(=O)C2=C1N=CN2 XMSMHKMPBNTBOD-UHFFFAOYSA-N 0.000 description 1
- SMADWRYCYBUIKH-UHFFFAOYSA-N 2-methyl-7h-purin-6-amine Chemical compound CC1=NC(N)=C2NC=NC2=N1 SMADWRYCYBUIKH-UHFFFAOYSA-N 0.000 description 1
- ZGUHNWLPPVJTOG-UHFFFAOYSA-N 2-propyl-2h-phenazin-1-one Chemical compound C1=CC=C2N=C(C(C(CCC)C=C3)=O)C3=NC2=C1 ZGUHNWLPPVJTOG-UHFFFAOYSA-N 0.000 description 1
- 108020005065 3' Flanking Region Proteins 0.000 description 1
- PLZMRGRLCWCLFW-UHFFFAOYSA-N 3-[5-(3-bromophenyl)tetrazol-2-yl]-1-piperidin-1-ylpropan-1-one Chemical compound BrC1=CC=CC(C2=NN(CCC(=O)N3CCCCC3)N=N2)=C1 PLZMRGRLCWCLFW-UHFFFAOYSA-N 0.000 description 1
- KOLPWZCZXAMXKS-UHFFFAOYSA-N 3-methylcytosine Chemical compound CN1C(N)=CC=NC1=O KOLPWZCZXAMXKS-UHFFFAOYSA-N 0.000 description 1
- XUOAKFNMJMYKBY-UHFFFAOYSA-N 4,5-bis(4-fluorophenyl)-2-(1,1,2,2-tetrafluoroethylsulfonyl)-1h-imidazole Chemical compound N1C(S(=O)(=O)C(F)(F)C(F)F)=NC(C=2C=CC(F)=CC=2)=C1C1=CC=C(F)C=C1 XUOAKFNMJMYKBY-UHFFFAOYSA-N 0.000 description 1
- TYNLGDBUJLVSMA-UHFFFAOYSA-N 4,5-diacetyloxy-9,10-dioxo-2-anthracenecarboxylic acid Chemical compound O=C1C2=CC(C(O)=O)=CC(OC(C)=O)=C2C(=O)C2=C1C=CC=C2OC(=O)C TYNLGDBUJLVSMA-UHFFFAOYSA-N 0.000 description 1
- MBKWNJVQSFBLQI-UHFFFAOYSA-N 4-(4-chlorophenyl)-5-methyl-1h-imidazole Chemical compound N1C=NC(C=2C=CC(Cl)=CC=2)=C1C MBKWNJVQSFBLQI-UHFFFAOYSA-N 0.000 description 1
- GJAKJCICANKRFD-UHFFFAOYSA-N 4-acetyl-4-amino-1,3-dihydropyrimidin-2-one Chemical compound CC(=O)C1(N)NC(=O)NC=C1 GJAKJCICANKRFD-UHFFFAOYSA-N 0.000 description 1
- KNKRHSVKIORZQB-UHFFFAOYSA-N 4-bromo-2-(hydroxymethyl)phenol Chemical compound OCC1=CC(Br)=CC=C1O KNKRHSVKIORZQB-UHFFFAOYSA-N 0.000 description 1
- IMKNHLPRDSWAHW-UHFFFAOYSA-N 4-butyl-1,2-diphenylpyrazolidine-3,5-dione;4,5-dihydro-1,3-thiazol-2-amine Chemical compound NC1=NCCS1.O=C1C(CCCC)C(=O)N(C=2C=CC=CC=2)N1C1=CC=CC=C1 IMKNHLPRDSWAHW-UHFFFAOYSA-N 0.000 description 1
- SYCHUQUJURZQMO-UHFFFAOYSA-N 4-hydroxy-2-methyl-1,1-dioxo-n-(1,3-thiazol-2-yl)-1$l^{6},2-benzothiazine-3-carboxamide Chemical compound OC=1C2=CC=CC=C2S(=O)(=O)N(C)C=1C(=O)NC1=NC=CS1 SYCHUQUJURZQMO-UHFFFAOYSA-N 0.000 description 1
- UACOJOVKHNAJPX-UHFFFAOYSA-N 5-(methoxyamino)-6-methyl-2-sulfanylidene-1H-pyrimidin-4-one Chemical compound CONC=1C(NC(NC=1C)=S)=O UACOJOVKHNAJPX-UHFFFAOYSA-N 0.000 description 1
- LQLQRFGHAALLLE-UHFFFAOYSA-N 5-bromouracil Chemical compound BrC1=CNC(=O)NC1=O LQLQRFGHAALLLE-UHFFFAOYSA-N 0.000 description 1
- DVEQCIBLXRSYPH-UHFFFAOYSA-N 5-butyl-1-cyclohexylbarbituric acid Chemical compound O=C1C(CCCC)C(=O)NC(=O)N1C1CCCCC1 DVEQCIBLXRSYPH-UHFFFAOYSA-N 0.000 description 1
- KELXHQACBIUYSE-UHFFFAOYSA-N 5-methoxy-1h-pyrimidine-2,4-dione Chemical compound COC1=CNC(=O)NC1=O KELXHQACBIUYSE-UHFFFAOYSA-N 0.000 description 1
- ZLAQATDNGLKIEV-UHFFFAOYSA-N 5-methyl-2-sulfanylidene-1h-pyrimidin-4-one Chemical compound CC1=CNC(=S)NC1=O ZLAQATDNGLKIEV-UHFFFAOYSA-N 0.000 description 1
- LRSASMSXMSNRBT-UHFFFAOYSA-N 5-methylcytosine Chemical compound CC1=CNC(=O)N=C1N LRSASMSXMSNRBT-UHFFFAOYSA-N 0.000 description 1
- HSPHKCOAUOJLIO-UHFFFAOYSA-N 6-(aziridin-1-ylamino)-1h-pyrimidin-2-one Chemical compound N1C(=O)N=CC=C1NN1CC1 HSPHKCOAUOJLIO-UHFFFAOYSA-N 0.000 description 1
- CKOMXBHMKXXTNW-UHFFFAOYSA-N 6-methyladenine Chemical compound CNC1=NC=NC2=C1N=CN2 CKOMXBHMKXXTNW-UHFFFAOYSA-N 0.000 description 1
- MYYIMZRZXIQBGI-HVIRSNARSA-N 6alpha-Fluoroprednisolone Chemical compound O=C1C=C[C@]2(C)[C@H]3[C@@H](O)C[C@](C)([C@@](CC4)(O)C(=O)CO)[C@@H]4[C@@H]3C[C@H](F)C2=C1 MYYIMZRZXIQBGI-HVIRSNARSA-N 0.000 description 1
- ANOGOQXCGBMIJV-UHFFFAOYSA-N 7-chloro-n-(3,4-dichlorophenyl)-5-hydroxy-1,1-dioxo-2,3-dihydro-1$l^{6}-benzothiepine-4-carboxamide Chemical compound C1CS(=O)(=O)C2=CC=C(Cl)C=C2C(O)=C1C(=O)NC1=CC=C(Cl)C(Cl)=C1 ANOGOQXCGBMIJV-UHFFFAOYSA-N 0.000 description 1
- SWJYOKZMYFJUOY-KQYNXXCUSA-N 9-[(2r,3r,4s,5r)-3,4-dihydroxy-5-(hydroxymethyl)oxolan-2-yl]-6-(methylamino)-7h-purin-8-one Chemical compound OC1=NC=2C(NC)=NC=NC=2N1[C@@H]1O[C@H](CO)[C@@H](O)[C@H]1O SWJYOKZMYFJUOY-KQYNXXCUSA-N 0.000 description 1
- GSDSWSVVBLHKDQ-UHFFFAOYSA-N 9-fluoro-3-methyl-10-(4-methylpiperazin-1-yl)-7-oxo-2,3-dihydro-7H-[1,4]oxazino[2,3,4-ij]quinoline-6-carboxylic acid Chemical compound FC1=CC(C(C(C(O)=O)=C2)=O)=C3N2C(C)COC3=C1N1CCN(C)CC1 GSDSWSVVBLHKDQ-UHFFFAOYSA-N 0.000 description 1
- QTBSBXVTEAMEQO-UHFFFAOYSA-M Acetate Chemical compound CC([O-])=O QTBSBXVTEAMEQO-UHFFFAOYSA-M 0.000 description 1
- 102000013563 Acid Phosphatase Human genes 0.000 description 1
- 108010051457 Acid Phosphatase Proteins 0.000 description 1
- 102000007469 Actins Human genes 0.000 description 1
- 108010085238 Actins Proteins 0.000 description 1
- 229920000936 Agarose Polymers 0.000 description 1
- 102000009027 Albumins Human genes 0.000 description 1
- 241000710929 Alphavirus Species 0.000 description 1
- 241001156002 Anthonomus pomorum Species 0.000 description 1
- WZPBZJONDBGPKJ-UHFFFAOYSA-N Antibiotic SQ 26917 Natural products O=C1N(S(O)(=O)=O)C(C)C1NC(=O)C(=NOC(C)(C)C(O)=O)C1=CSC(N)=N1 WZPBZJONDBGPKJ-UHFFFAOYSA-N 0.000 description 1
- 108020004491 Antisense DNA Proteins 0.000 description 1
- 108020005544 Antisense RNA Proteins 0.000 description 1
- 240000003291 Armoracia rusticana Species 0.000 description 1
- 235000011330 Armoracia rusticana Nutrition 0.000 description 1
- 206010003210 Arteriosclerosis Diseases 0.000 description 1
- BSYNRYMUTXBXSQ-UHFFFAOYSA-N Aspirin Chemical compound CC(=O)OC1=CC=CC=C1C(O)=O BSYNRYMUTXBXSQ-UHFFFAOYSA-N 0.000 description 1
- XHVAWZZCDCWGBK-WYRLRVFGSA-M Aurothioglucose Chemical compound OC[C@H]1O[C@H](S[Au])[C@H](O)[C@@H](O)[C@@H]1O XHVAWZZCDCWGBK-WYRLRVFGSA-M 0.000 description 1
- 241000713842 Avian sarcoma virus Species 0.000 description 1
- 208000032791 BCR-ABL1 positive chronic myelogenous leukemia Diseases 0.000 description 1
- JRLALOMYZVOMRI-UHFFFAOYSA-N BPPC Chemical compound BPPC JRLALOMYZVOMRI-UHFFFAOYSA-N 0.000 description 1
- 241000193830 Bacillus <bacterium> Species 0.000 description 1
- 235000014469 Bacillus subtilis Nutrition 0.000 description 1
- 108700003860 Bacterial Genes Proteins 0.000 description 1
- 239000005711 Benzoic acid Substances 0.000 description 1
- BVKZGUZCCUSVTD-UHFFFAOYSA-M Bicarbonate Chemical compound OC([O-])=O BVKZGUZCCUSVTD-UHFFFAOYSA-M 0.000 description 1
- BTBUEUYNUDRHOZ-UHFFFAOYSA-N Borate Chemical compound [O-]B([O-])[O-] BTBUEUYNUDRHOZ-UHFFFAOYSA-N 0.000 description 1
- 241000283690 Bos taurus Species 0.000 description 1
- 241000701822 Bovine papillomavirus Species 0.000 description 1
- 208000003174 Brain Neoplasms Diseases 0.000 description 1
- 206010006187 Breast cancer Diseases 0.000 description 1
- 208000026310 Breast neoplasm Diseases 0.000 description 1
- VOVIALXJUBGFJZ-KWVAZRHASA-N Budesonide Chemical compound C1CC2=CC(=O)C=C[C@]2(C)[C@@H]2[C@@H]1[C@@H]1C[C@H]3OC(CCC)O[C@@]3(C(=O)CO)[C@@]1(C)C[C@@H]2O VOVIALXJUBGFJZ-KWVAZRHASA-N 0.000 description 1
- AQILRUICKKFKCG-UHFFFAOYSA-N C(C)NCC=1C(NC(NC1)=O)=O Chemical compound C(C)NCC=1C(NC(NC1)=O)=O AQILRUICKKFKCG-UHFFFAOYSA-N 0.000 description 1
- OYPRJOBELJOOCE-UHFFFAOYSA-N Calcium Chemical compound [Ca] OYPRJOBELJOOCE-UHFFFAOYSA-N 0.000 description 1
- UXVMQQNJUSDDNG-UHFFFAOYSA-L Calcium chloride Chemical compound [Cl-].[Cl-].[Ca+2] UXVMQQNJUSDDNG-UHFFFAOYSA-L 0.000 description 1
- 241000282465 Canis Species 0.000 description 1
- 108010078791 Carrier Proteins Proteins 0.000 description 1
- UQLLWWBDSUHNEB-CZUORRHYSA-N Cefaprin Chemical compound N([C@H]1[C@@H]2N(C1=O)C(=C(CS2)COC(=O)C)C(O)=O)C(=O)CSC1=CC=NC=C1 UQLLWWBDSUHNEB-CZUORRHYSA-N 0.000 description 1
- GNWUOVJNSFPWDD-XMZRARIVSA-M Cefoxitin sodium Chemical compound [Na+].N([C@]1(OC)C(N2C(=C(COC(N)=O)CS[C@@H]21)C([O-])=O)=O)C(=O)CC1=CC=CS1 GNWUOVJNSFPWDD-XMZRARIVSA-M 0.000 description 1
- 241000282693 Cercopithecidae Species 0.000 description 1
- GHXZTYHSJHQHIJ-UHFFFAOYSA-N Chlorhexidine Chemical compound C=1C=C(Cl)C=CC=1NC(N)=NC(N)=NCCCCCCN=C(N)N=C(N)NC1=CC=C(Cl)C=C1 GHXZTYHSJHQHIJ-UHFFFAOYSA-N 0.000 description 1
- 239000004099 Chlortetracycline Substances 0.000 description 1
- UDKCHVLMFQVBAA-UHFFFAOYSA-M Choline salicylate Chemical compound C[N+](C)(C)CCO.OC1=CC=CC=C1C([O-])=O UDKCHVLMFQVBAA-UHFFFAOYSA-M 0.000 description 1
- 208000010833 Chronic myeloid leukaemia Diseases 0.000 description 1
- KRKNYBCHXYNGOX-UHFFFAOYSA-K Citrate Chemical compound [O-]C(=O)CC(O)(CC([O-])=O)C([O-])=O KRKNYBCHXYNGOX-UHFFFAOYSA-K 0.000 description 1
- OIRAEJWYWSAQNG-UHFFFAOYSA-N Clidanac Chemical compound ClC=1C=C2C(C(=O)O)CCC2=CC=1C1CCCCC1 OIRAEJWYWSAQNG-UHFFFAOYSA-N 0.000 description 1
- FBRAWBYQGRLCEK-AVVSTMBFSA-N Clobetasone butyrate Chemical compound C1CC2=CC(=O)C=C[C@]2(C)[C@]2(F)[C@@H]1[C@@H]1C[C@H](C)[C@@](C(=O)CCl)(OC(=O)CCC)[C@@]1(C)CC2=O FBRAWBYQGRLCEK-AVVSTMBFSA-N 0.000 description 1
- 101100007328 Cocos nucifera COS-1 gene Proteins 0.000 description 1
- 108700010070 Codon Usage Proteins 0.000 description 1
- 108010078777 Colistin Proteins 0.000 description 1
- 229910021592 Copper(II) chloride Inorganic materials 0.000 description 1
- 241000711573 Coronaviridae Species 0.000 description 1
- 229920000858 Cyclodextrin Polymers 0.000 description 1
- CMSMOCZEIVJLDB-UHFFFAOYSA-N Cyclophosphamide Chemical compound ClCCN(CCCl)P1(=O)NCCCO1 CMSMOCZEIVJLDB-UHFFFAOYSA-N 0.000 description 1
- PMATZTZNYRCHOR-CGLBZJNRSA-N Cyclosporin A Chemical compound CC[C@@H]1NC(=O)[C@H]([C@H](O)[C@H](C)C\C=C\C)N(C)C(=O)[C@H](C(C)C)N(C)C(=O)[C@H](CC(C)C)N(C)C(=O)[C@H](CC(C)C)N(C)C(=O)[C@@H](C)NC(=O)[C@H](C)NC(=O)[C@H](CC(C)C)N(C)C(=O)[C@H](C(C)C)NC(=O)[C@H](CC(C)C)N(C)C(=O)CN(C)C1=O PMATZTZNYRCHOR-CGLBZJNRSA-N 0.000 description 1
- 108010036949 Cyclosporine Proteins 0.000 description 1
- 102100025621 Cytochrome b-245 heavy chain Human genes 0.000 description 1
- IGXWBGJHJZYPQS-SSDOTTSWSA-N D-Luciferin Chemical compound OC(=O)[C@H]1CSC(C=2SC3=CC=C(O)C=C3N=2)=N1 IGXWBGJHJZYPQS-SSDOTTSWSA-N 0.000 description 1
- WQZGKKKJIJFFOK-QTVWNMPRSA-N D-mannopyranose Chemical compound OC[C@H]1OC(O)[C@@H](O)[C@@H](O)[C@@H]1O WQZGKKKJIJFFOK-QTVWNMPRSA-N 0.000 description 1
- VVNCNSJFMMFHPL-VKHMYHEASA-N D-penicillamine Chemical compound CC(C)(S)[C@@H](N)C(O)=O VVNCNSJFMMFHPL-VKHMYHEASA-N 0.000 description 1
- 230000004544 DNA amplification Effects 0.000 description 1
- 230000007023 DNA restriction-modification system Effects 0.000 description 1
- 102000052510 DNA-Binding Proteins Human genes 0.000 description 1
- 101710096438 DNA-binding protein Proteins 0.000 description 1
- MQJKPEGWNLWLTK-UHFFFAOYSA-N Dapsone Chemical compound C1=CC(N)=CC=C1S(=O)(=O)C1=CC=C(N)C=C1 MQJKPEGWNLWLTK-UHFFFAOYSA-N 0.000 description 1
- CYCGRDQQIOGCKX-UHFFFAOYSA-N Dehydro-luciferin Natural products OC(=O)C1=CSC(C=2SC3=CC(O)=CC=C3N=2)=N1 CYCGRDQQIOGCKX-UHFFFAOYSA-N 0.000 description 1
- FMTDIUIBLCQGJB-UHFFFAOYSA-N Demethylchlortetracyclin Natural products C1C2C(O)C3=C(Cl)C=CC(O)=C3C(=O)C2=C(O)C2(O)C1C(N(C)C)C(O)=C(C(N)=O)C2=O FMTDIUIBLCQGJB-UHFFFAOYSA-N 0.000 description 1
- 241000702421 Dependoparvovirus Species 0.000 description 1
- 208000013558 Developmental Bone disease Diseases 0.000 description 1
- 239000004375 Dextrin Substances 0.000 description 1
- 229920001353 Dextrin Polymers 0.000 description 1
- WYQPLTPSGFELIB-JTQPXKBDSA-N Difluprednate Chemical compound C1([C@@H](F)C2)=CC(=O)C=C[C@]1(C)[C@]1(F)[C@@H]2[C@@H]2CC[C@@](C(=O)COC(C)=O)(OC(=O)CCC)[C@@]2(C)C[C@@H]1O WYQPLTPSGFELIB-JTQPXKBDSA-N 0.000 description 1
- BWGNESOTFCXPMA-UHFFFAOYSA-N Dihydrogen disulfide Chemical compound SS BWGNESOTFCXPMA-UHFFFAOYSA-N 0.000 description 1
- JWCSIUVGFCSJCK-CAVRMKNVSA-N Disodium Moxalactam Chemical compound N([C@]1(OC)C(N2C(=C(CSC=3N(N=NN=3)C)CO[C@@H]21)C(O)=O)=O)C(=O)C(C(O)=O)C1=CC=C(O)C=C1 JWCSIUVGFCSJCK-CAVRMKNVSA-N 0.000 description 1
- 241000255581 Drosophila <fruit fly, genus> Species 0.000 description 1
- RHAXSHUQNIEUEY-UHFFFAOYSA-N Epirizole Chemical compound COC1=CC(C)=NN1C1=NC(C)=CC(OC)=N1 RHAXSHUQNIEUEY-UHFFFAOYSA-N 0.000 description 1
- 241001302160 Escherichia coli str. K-12 substr. DH10B Species 0.000 description 1
- 241000701959 Escherichia virus Lambda Species 0.000 description 1
- IMROMDMJAWUWLK-UHFFFAOYSA-N Ethenol Chemical compound OC=C IMROMDMJAWUWLK-UHFFFAOYSA-N 0.000 description 1
- 239000001116 FEMA 4028 Substances 0.000 description 1
- 108010087819 Fc receptors Proteins 0.000 description 1
- 102000009109 Fc receptors Human genes 0.000 description 1
- RBBWCVQDXDFISW-UHFFFAOYSA-N Feprazone Chemical compound O=C1C(CC=C(C)C)C(=O)N(C=2C=CC=CC=2)N1C1=CC=CC=C1 RBBWCVQDXDFISW-UHFFFAOYSA-N 0.000 description 1
- 229920001917 Ficoll Polymers 0.000 description 1
- 241000724791 Filamentous phage Species 0.000 description 1
- BJGNCJDXODQBOB-UHFFFAOYSA-N Fivefly Luciferin Natural products OC(=O)C1CSC(C=2SC3=CC(O)=CC=C3N=2)=N1 BJGNCJDXODQBOB-UHFFFAOYSA-N 0.000 description 1
- APQPGQGAWABJLN-UHFFFAOYSA-N Floctafenine Chemical compound OCC(O)COC(=O)C1=CC=CC=C1NC1=CC=NC2=C(C(F)(F)F)C=CC=C12 APQPGQGAWABJLN-UHFFFAOYSA-N 0.000 description 1
- UIOFUWFRIANQPC-JKIFEVAISA-N Floxacillin Chemical compound N([C@@H]1C(N2[C@H](C(C)(C)S[C@@H]21)C(O)=O)=O)C(=O)C1=C(C)ON=C1C1=C(F)C=CC=C1Cl UIOFUWFRIANQPC-JKIFEVAISA-N 0.000 description 1
- WJOHZNCJWYWUJD-IUGZLZTKSA-N Fluocinonide Chemical compound C1([C@@H](F)C2)=CC(=O)C=C[C@]1(C)[C@]1(F)[C@@H]2[C@@H]2C[C@H]3OC(C)(C)O[C@@]3(C(=O)COC(=O)C)[C@@]2(C)C[C@@H]1O WJOHZNCJWYWUJD-IUGZLZTKSA-N 0.000 description 1
- GHASVSINZRGABV-UHFFFAOYSA-N Fluorouracil Chemical compound FC1=CNC(=O)NC1=O GHASVSINZRGABV-UHFFFAOYSA-N 0.000 description 1
- 241000700662 Fowlpox virus Species 0.000 description 1
- CEAZRRDELHUEMR-URQXQFDESA-N Gentamicin Chemical compound O1[C@H](C(C)NC)CC[C@@H](N)[C@H]1O[C@H]1[C@H](O)[C@@H](O[C@@H]2[C@@H]([C@@H](NC)[C@@](C)(O)CO2)O)[C@H](N)C[C@@H]1N CEAZRRDELHUEMR-URQXQFDESA-N 0.000 description 1
- 229930182566 Gentamicin Natural products 0.000 description 1
- WQZGKKKJIJFFOK-GASJEMHNSA-N Glucose Natural products OC[C@H]1OC(O)[C@H](O)[C@@H](O)[C@@H]1O WQZGKKKJIJFFOK-GASJEMHNSA-N 0.000 description 1
- 108010024636 Glutathione Proteins 0.000 description 1
- 244000068988 Glycine max Species 0.000 description 1
- 235000010469 Glycine max Nutrition 0.000 description 1
- MPDGHEJMBKOTSU-UHFFFAOYSA-N Glycyrrhetinsaeure Natural products C12C(=O)C=C3C4CC(C)(C(O)=O)CCC4(C)CCC3(C)C1(C)CCC1C2(C)CCC(O)C1(C)C MPDGHEJMBKOTSU-UHFFFAOYSA-N 0.000 description 1
- 240000004670 Glycyrrhiza echinata Species 0.000 description 1
- 235000001453 Glycyrrhiza echinata Nutrition 0.000 description 1
- 235000006200 Glycyrrhiza glabra Nutrition 0.000 description 1
- 235000017382 Glycyrrhiza lepidota Nutrition 0.000 description 1
- YCISZOVUHXIOFY-HKXOFBAYSA-N Halopredone acetate Chemical compound C1([C@H](F)C2)=CC(=O)C(Br)=C[C@]1(C)[C@]1(F)[C@@H]2[C@@H]2CC[C@](OC(C)=O)(C(=O)COC(=O)C)[C@@]2(C)C[C@@H]1O YCISZOVUHXIOFY-HKXOFBAYSA-N 0.000 description 1
- 101710154606 Hemagglutinin Proteins 0.000 description 1
- 108091005904 Hemoglobin subunit beta Proteins 0.000 description 1
- 241000700721 Hepatitis B virus Species 0.000 description 1
- 108010070875 Human Immunodeficiency Virus tat Gene Products Proteins 0.000 description 1
- 241000701109 Human adenovirus 2 Species 0.000 description 1
- 241000700588 Human alphaherpesvirus 1 Species 0.000 description 1
- 241000701806 Human papillomavirus Species 0.000 description 1
- VEXZGXHMUGYJMC-UHFFFAOYSA-N Hydrochloric acid Chemical compound Cl VEXZGXHMUGYJMC-UHFFFAOYSA-N 0.000 description 1
- BGSOJVFOEQLVMH-UHFFFAOYSA-N Hydrocortisone phosphate Natural products O=C1CCC2(C)C3C(O)CC(C)(C(CC4)(O)C(=O)COP(O)(O)=O)C4C3CCC2=C1 BGSOJVFOEQLVMH-UHFFFAOYSA-N 0.000 description 1
- FNFPHNZQOKBKHN-UHFFFAOYSA-N Hydrocortisone tebutate Natural products C1CC2=CC(=O)CCC2(C)C2C1C1CCC(C(=O)COC(=O)CC(C)(C)C)(O)C1(C)CC2O FNFPHNZQOKBKHN-UHFFFAOYSA-N 0.000 description 1
- 208000037147 Hypercalcaemia Diseases 0.000 description 1
- XQFRJNBWHJMXHO-RRKCRQDMSA-N IDUR Chemical compound C1[C@H](O)[C@@H](CO)O[C@H]1N1C(=O)NC(=O)C(I)=C1 XQFRJNBWHJMXHO-RRKCRQDMSA-N 0.000 description 1
- ACEWLPOYLGNNHV-UHFFFAOYSA-N Ibuprofen piconol Chemical compound C1=CC(CC(C)C)=CC=C1C(C)C(=O)OCC1=CC=CC=N1 ACEWLPOYLGNNHV-UHFFFAOYSA-N 0.000 description 1
- 102000009786 Immunoglobulin Constant Regions Human genes 0.000 description 1
- 108010009817 Immunoglobulin Constant Regions Proteins 0.000 description 1
- 108700005091 Immunoglobulin Genes Proteins 0.000 description 1
- 206010061218 Inflammation Diseases 0.000 description 1
- 208000022559 Inflammatory bowel disease Diseases 0.000 description 1
- 229930010555 Inosine Natural products 0.000 description 1
- UGQMRVRMYYASKQ-KQYNXXCUSA-N Inosine Chemical compound O[C@@H]1[C@H](O)[C@@H](CO)O[C@H]1N1C2=NC=NC(O)=C2N=C1 UGQMRVRMYYASKQ-KQYNXXCUSA-N 0.000 description 1
- 108090001061 Insulin Proteins 0.000 description 1
- 102100023915 Insulin Human genes 0.000 description 1
- 102100034343 Integrase Human genes 0.000 description 1
- LPHGQDQBBGAPDZ-UHFFFAOYSA-N Isocaffeine Natural products CN1C(=O)N(C)C(=O)C2=C1N(C)C=N2 LPHGQDQBBGAPDZ-UHFFFAOYSA-N 0.000 description 1
- UETNIIAIRMUTSM-UHFFFAOYSA-N Jacareubin Natural products CC1(C)OC2=CC3Oc4c(O)c(O)ccc4C(=O)C3C(=C2C=C1)O UETNIIAIRMUTSM-UHFFFAOYSA-N 0.000 description 1
- 208000012659 Joint disease Diseases 0.000 description 1
- 241000235058 Komagataella pastoris Species 0.000 description 1
- LEVWYRKDKASIDU-IMJSIDKUSA-N L-cystine Chemical compound [O-]C(=O)[C@@H]([NH3+])CSSC[C@H]([NH3+])C([O-])=O LEVWYRKDKASIDU-IMJSIDKUSA-N 0.000 description 1
- FBOZXECLQNJBKD-ZDUSSCGKSA-N L-methotrexate Chemical compound C=1N=C2N=C(N)N=C(N)C2=NC=1CN(C)C1=CC=C(C(=O)N[C@@H](CCC(O)=O)C(O)=O)C=C1 FBOZXECLQNJBKD-ZDUSSCGKSA-N 0.000 description 1
- LRQKBLKVPFOOQJ-YFKPBYRVSA-N L-norleucine Chemical compound CCCC[C@H]([NH3+])C([O-])=O LRQKBLKVPFOOQJ-YFKPBYRVSA-N 0.000 description 1
- 125000000510 L-tryptophano group Chemical group [H]C1=C([H])C([H])=C2N([H])C([H])=C(C([H])([H])[C@@]([H])(C(O[H])=O)N([H])[*])C2=C1[H] 0.000 description 1
- 108090000942 Lactalbumin Proteins 0.000 description 1
- 102000004407 Lactalbumin Human genes 0.000 description 1
- 102100023981 Lamina-associated polypeptide 2, isoform alpha Human genes 0.000 description 1
- 101710163560 Lamina-associated polypeptide 2, isoform alpha Proteins 0.000 description 1
- 101710189385 Lamina-associated polypeptide 2, isoforms beta/gamma Proteins 0.000 description 1
- 241000713666 Lentivirus Species 0.000 description 1
- HLFSDGLLUJUHTE-SNVBAGLBSA-N Levamisole Chemical compound C1([C@H]2CN3CCSC3=N2)=CC=CC=C1 HLFSDGLLUJUHTE-SNVBAGLBSA-N 0.000 description 1
- OJMMVQQUTAEWLP-UHFFFAOYSA-N Lincomycin Natural products CN1CC(CCC)CC1C(=O)NC(C(C)O)C1C(O)C(O)C(O)C(SC)O1 OJMMVQQUTAEWLP-UHFFFAOYSA-N 0.000 description 1
- DDWFXDSYGUXRAY-UHFFFAOYSA-N Luciferin Natural products CCc1c(C)c(CC2NC(=O)C(=C2C=C)C)[nH]c1Cc3[nH]c4C(=C5/NC(CC(=O)O)C(C)C5CC(=O)O)CC(=O)c4c3C DDWFXDSYGUXRAY-UHFFFAOYSA-N 0.000 description 1
- 206010058467 Lung neoplasm malignant Diseases 0.000 description 1
- 239000006137 Luria-Bertani broth Substances 0.000 description 1
- MQHWFIOJQSCFNM-UHFFFAOYSA-L Magnesium salicylate Chemical compound [Mg+2].OC1=CC=CC=C1C([O-])=O.OC1=CC=CC=C1C([O-])=O MQHWFIOJQSCFNM-UHFFFAOYSA-L 0.000 description 1
- SBDNJUWAMKYJOX-UHFFFAOYSA-N Meclofenamic Acid Chemical compound CC1=CC=C(Cl)C(NC=2C(=CC=CC=2)C(O)=O)=C1Cl SBDNJUWAMKYJOX-UHFFFAOYSA-N 0.000 description 1
- 108010036176 Melitten Proteins 0.000 description 1
- 108090000157 Metallothionein Proteins 0.000 description 1
- AFVFQIVMOAPDHO-UHFFFAOYSA-N Methanesulfonic acid Chemical compound CS(O)(=O)=O AFVFQIVMOAPDHO-UHFFFAOYSA-N 0.000 description 1
- RJQXTJLFIWVMTO-TYNCELHUSA-N Methicillin Chemical compound COC1=CC=CC(OC)=C1C(=O)N[C@@H]1C(=O)N2[C@@H](C(O)=O)C(C)(C)S[C@@H]21 RJQXTJLFIWVMTO-TYNCELHUSA-N 0.000 description 1
- FQISKWAFAHGMGT-SGJOWKDISA-M Methylprednisolone sodium succinate Chemical compound [Na+].C([C@@]12C)=CC(=O)C=C1[C@@H](C)C[C@@H]1[C@@H]2[C@@H](O)C[C@]2(C)[C@@](O)(C(=O)COC(=O)CCC([O-])=O)CC[C@H]21 FQISKWAFAHGMGT-SGJOWKDISA-M 0.000 description 1
- 241000713333 Mouse mammary tumor virus Species 0.000 description 1
- 108010083674 Myelin Proteins Proteins 0.000 description 1
- 102000006386 Myelin Proteins Human genes 0.000 description 1
- 208000033761 Myelogenous Chronic BCR-ABL Positive Leukemia Diseases 0.000 description 1
- CHJJGSNFBQVOTG-UHFFFAOYSA-N N-methyl-guanidine Natural products CNC(N)=N CHJJGSNFBQVOTG-UHFFFAOYSA-N 0.000 description 1
- 238000005481 NMR spectroscopy Methods 0.000 description 1
- BLXXJMDCKKHMKV-UHFFFAOYSA-N Nabumetone Chemical compound C1=C(CCC(C)=O)C=CC2=CC(OC)=CC=C21 BLXXJMDCKKHMKV-UHFFFAOYSA-N 0.000 description 1
- 108091061960 Naked DNA Proteins 0.000 description 1
- CMWTZPSULFXXJA-UHFFFAOYSA-N Naproxen Natural products C1=C(C(C)C(O)=O)C=CC2=CC(OC)=CC=C21 CMWTZPSULFXXJA-UHFFFAOYSA-N 0.000 description 1
- 206010029260 Neuroblastoma Diseases 0.000 description 1
- JZFPYUNJRRFVQU-UHFFFAOYSA-N Niflumic acid Chemical compound OC(=O)C1=CC=CN=C1NC1=CC=CC(C(F)(F)F)=C1 JZFPYUNJRRFVQU-UHFFFAOYSA-N 0.000 description 1
- 239000000020 Nitrocellulose Substances 0.000 description 1
- 102000007399 Nuclear hormone receptor Human genes 0.000 description 1
- 239000004677 Nylon Substances 0.000 description 1
- 108020005187 Oligonucleotide Probes Proteins 0.000 description 1
- 208000010191 Osteitis Deformans Diseases 0.000 description 1
- 208000001132 Osteoporosis Diseases 0.000 description 1
- 101710093908 Outer capsid protein VP4 Proteins 0.000 description 1
- 101710135467 Outer capsid protein sigma-1 Proteins 0.000 description 1
- 206010033128 Ovarian cancer Diseases 0.000 description 1
- 206010061535 Ovarian neoplasm Diseases 0.000 description 1
- 102000004316 Oxidoreductases Human genes 0.000 description 1
- 108090000854 Oxidoreductases Proteins 0.000 description 1
- 208000027868 Paget disease Diseases 0.000 description 1
- 102000016387 Pancreatic elastase Human genes 0.000 description 1
- 229930195708 Penicillin V Natural products 0.000 description 1
- 108010087702 Penicillinase Proteins 0.000 description 1
- 102000007079 Peptide Fragments Human genes 0.000 description 1
- 108010033276 Peptide Fragments Proteins 0.000 description 1
- 229920000954 Polyglycolide Polymers 0.000 description 1
- 108010093965 Polymyxin B Proteins 0.000 description 1
- 241001505332 Polyomavirus sp. Species 0.000 description 1
- 229920001213 Polysorbate 20 Polymers 0.000 description 1
- TVQZAMVBTVNYLA-UHFFFAOYSA-N Pranoprofen Chemical compound C1=CC=C2CC3=CC(C(C(O)=O)C)=CC=C3OC2=N1 TVQZAMVBTVNYLA-UHFFFAOYSA-N 0.000 description 1
- HUMXXHTVHHLNRO-KAJVQRHHSA-N Prednisolone tebutate Chemical compound C1CC2=CC(=O)C=C[C@]2(C)[C@@H]2[C@@H]1[C@@H]1CC[C@@](C(=O)COC(=O)CC(C)(C)C)(O)[C@@]1(C)C[C@@H]2O HUMXXHTVHHLNRO-KAJVQRHHSA-N 0.000 description 1
- 206010060862 Prostate cancer Diseases 0.000 description 1
- 208000000236 Prostatic Neoplasms Diseases 0.000 description 1
- 101710176177 Protein A56 Proteins 0.000 description 1
- 108010029485 Protein Isoforms Proteins 0.000 description 1
- 102000001708 Protein Isoforms Human genes 0.000 description 1
- 241000125945 Protoparvovirus Species 0.000 description 1
- 241000589516 Pseudomonas Species 0.000 description 1
- 201000001263 Psoriatic Arthritis Diseases 0.000 description 1
- 208000036824 Psoriatic arthropathy Diseases 0.000 description 1
- WTKZEGDFNFYCGP-UHFFFAOYSA-N Pyrazole Chemical compound C=1C=NNC=1 WTKZEGDFNFYCGP-UHFFFAOYSA-N 0.000 description 1
- 108091034057 RNA (poly(A)) Proteins 0.000 description 1
- 108010092799 RNA-directed DNA polymerase Proteins 0.000 description 1
- 239000012980 RPMI-1640 medium Substances 0.000 description 1
- 102000009661 Repressor Proteins Human genes 0.000 description 1
- 108091027981 Response element Proteins 0.000 description 1
- 108010039491 Ricin Proteins 0.000 description 1
- 239000006146 Roswell Park Memorial Institute medium Substances 0.000 description 1
- 241000714474 Rous sarcoma virus Species 0.000 description 1
- MEFKEPWMEQBLKI-AIRLBKTGSA-N S-adenosyl-L-methioninate Chemical compound O[C@@H]1[C@H](O)[C@@H](C[S+](CC[C@H](N)C([O-])=O)C)O[C@H]1N1C2=NC=NC(N)=C2N=C1 MEFKEPWMEQBLKI-AIRLBKTGSA-N 0.000 description 1
- 206010039491 Sarcoma Diseases 0.000 description 1
- 241000700584 Simplexvirus Species 0.000 description 1
- 206010072610 Skeletal dysplasia Diseases 0.000 description 1
- UIIMBOGNXHQVGW-DEQYMQKBSA-M Sodium bicarbonate-14C Chemical compound [Na+].O[14C]([O-])=O UIIMBOGNXHQVGW-DEQYMQKBSA-M 0.000 description 1
- DWAQJAXMDSEUJJ-UHFFFAOYSA-M Sodium bisulfite Chemical compound [Na+].OS([O-])=O DWAQJAXMDSEUJJ-UHFFFAOYSA-M 0.000 description 1
- DBMJMQXJHONAFJ-UHFFFAOYSA-M Sodium laurylsulphate Chemical compound [Na+].CCCCCCCCCCCCOS([O-])(=O)=O DBMJMQXJHONAFJ-UHFFFAOYSA-M 0.000 description 1
- ABBQHOQBGMUPJH-UHFFFAOYSA-M Sodium salicylate Chemical compound [Na+].OC1=CC=CC=C1C([O-])=O ABBQHOQBGMUPJH-UHFFFAOYSA-M 0.000 description 1
- 239000004187 Spiramycin Substances 0.000 description 1
- 101000857870 Squalus acanthias Gonadoliberin Proteins 0.000 description 1
- 229920002472 Starch Polymers 0.000 description 1
- 108091081024 Start codon Proteins 0.000 description 1
- 235000021355 Stearic acid Nutrition 0.000 description 1
- 241000187747 Streptomyces Species 0.000 description 1
- 241000272534 Struthio camelus Species 0.000 description 1
- NHUHCSRWZMLRLA-UHFFFAOYSA-N Sulfisoxazole Chemical compound CC1=NOC(NS(=O)(=O)C=2C=CC(N)=CC=2)=C1C NHUHCSRWZMLRLA-UHFFFAOYSA-N 0.000 description 1
- 210000001744 T-lymphocyte Anatomy 0.000 description 1
- 208000024313 Testicular Neoplasms Diseases 0.000 description 1
- 206010057644 Testis cancer Diseases 0.000 description 1
- 241000534944 Thia Species 0.000 description 1
- WKDDRNSBRWANNC-UHFFFAOYSA-N Thienamycin Natural products C1C(SCCN)=C(C(O)=O)N2C(=O)C(C(O)C)C21 WKDDRNSBRWANNC-UHFFFAOYSA-N 0.000 description 1
- 239000000898 Thymopoietin Substances 0.000 description 1
- 108010034949 Thyroglobulin Proteins 0.000 description 1
- 102000009843 Thyroglobulin Human genes 0.000 description 1
- 108700009124 Transcription Initiation Site Proteins 0.000 description 1
- 108700029229 Transcriptional Regulatory Elements Proteins 0.000 description 1
- 108700019146 Transgenes Proteins 0.000 description 1
- 206010052779 Transplant rejections Diseases 0.000 description 1
- 239000007983 Tris buffer Substances 0.000 description 1
- 101710162629 Trypsin inhibitor Proteins 0.000 description 1
- 229940122618 Trypsin inhibitor Drugs 0.000 description 1
- JDLSRXWHEBFHNC-UHFFFAOYSA-N Ufenamate Chemical compound CCCCOC(=O)C1=CC=CC=C1NC1=CC=CC(C(F)(F)F)=C1 JDLSRXWHEBFHNC-UHFFFAOYSA-N 0.000 description 1
- IXKSXJFAGXLQOQ-XISFHERQSA-N WHWLQLKPGQPMY Chemical compound C([C@@H](C(=O)N[C@@H](CC=1C2=CC=CC=C2NC=1)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CC(C)C)C(=O)N1CCC[C@H]1C(=O)NCC(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CC(O)=O)C(=O)N1CCC[C@H]1C(=O)N[C@@H](CCSC)C(=O)N[C@@H](CC=1C=CC(O)=CC=1)C(O)=O)NC(=O)[C@@H](N)CC=1C2=CC=CC=C2NC=1)C1=CNC=N1 IXKSXJFAGXLQOQ-XISFHERQSA-N 0.000 description 1
- FBRAWBYQGRLCEK-UHFFFAOYSA-N [17-(2-chloroacetyl)-9-fluoro-10,13,16-trimethyl-3,11-dioxo-7,8,12,14,15,16-hexahydro-6h-cyclopenta[a]phenanthren-17-yl] butanoate Chemical compound C1CC2=CC(=O)C=CC2(C)C2(F)C1C1CC(C)C(C(=O)CCl)(OC(=O)CCC)C1(C)CC2=O FBRAWBYQGRLCEK-UHFFFAOYSA-N 0.000 description 1
- RACDDTQBAFEERP-PLTZVPCUSA-N [2-[(6s,8s,9s,10r,13s,14s,17r)-6-chloro-17-hydroxy-10,13-dimethyl-3,11-dioxo-6,7,8,9,12,14,15,16-octahydrocyclopenta[a]phenanthren-17-yl]-2-oxoethyl] acetate Chemical compound C1([C@@H](Cl)C2)=CC(=O)C=C[C@]1(C)[C@@H]1[C@@H]2[C@@H]2CC[C@@](C(=O)COC(=O)C)(O)[C@@]2(C)CC1=O RACDDTQBAFEERP-PLTZVPCUSA-N 0.000 description 1
- FNFPHNZQOKBKHN-KAJVQRHHSA-N [2-[(8s,9s,10r,11s,13s,14s,17r)-11,17-dihydroxy-10,13-dimethyl-3-oxo-2,6,7,8,9,11,12,14,15,16-decahydro-1h-cyclopenta[a]phenanthren-17-yl]-2-oxoethyl] 3,3-dimethylbutanoate Chemical compound C1CC2=CC(=O)CC[C@]2(C)[C@@H]2[C@@H]1[C@@H]1CC[C@@](C(=O)COC(=O)CC(C)(C)C)(O)[C@@]1(C)C[C@@H]2O FNFPHNZQOKBKHN-KAJVQRHHSA-N 0.000 description 1
- 230000002159 abnormal effect Effects 0.000 description 1
- 238000010521 absorption reaction Methods 0.000 description 1
- 229960004892 acemetacin Drugs 0.000 description 1
- FSQKKOOTNAMONP-UHFFFAOYSA-N acemetacin Chemical compound CC1=C(CC(=O)OCC(O)=O)C2=CC(OC)=CC=C2N1C(=O)C1=CC=C(Cl)C=C1 FSQKKOOTNAMONP-UHFFFAOYSA-N 0.000 description 1
- TWIIVLKQFJBFPW-UHFFFAOYSA-N acetaminosalol Chemical compound C1=CC(NC(=O)C)=CC=C1OC(=O)C1=CC=CC=C1O TWIIVLKQFJBFPW-UHFFFAOYSA-N 0.000 description 1
- 229950007008 acetaminosalol Drugs 0.000 description 1
- 239000008351 acetate buffer Substances 0.000 description 1
- 229960001138 acetylsalicylic acid Drugs 0.000 description 1
- WDSCBUNMANHPFH-UHFFFAOYSA-N acexamic acid Chemical compound CC(=O)NCCCCCC(O)=O WDSCBUNMANHPFH-UHFFFAOYSA-N 0.000 description 1
- 229960004582 acexamic acid Drugs 0.000 description 1
- 230000002378 acidificating effect Effects 0.000 description 1
- NIXOWILDQLNWCW-UHFFFAOYSA-N acrylic acid group Chemical group C(C=C)(=O)O NIXOWILDQLNWCW-UHFFFAOYSA-N 0.000 description 1
- 239000012190 activator Substances 0.000 description 1
- 230000002730 additional effect Effects 0.000 description 1
- 239000000654 additive Substances 0.000 description 1
- 229960001570 ademetionine Drugs 0.000 description 1
- 239000000443 aerosol Substances 0.000 description 1
- 238000001042 affinity chromatography Methods 0.000 description 1
- 230000001270 agonistic effect Effects 0.000 description 1
- 238000012867 alanine scanning Methods 0.000 description 1
- 229960005142 alclofenac Drugs 0.000 description 1
- ARHWPKZXBHOEEE-UHFFFAOYSA-N alclofenac Chemical compound OC(=O)CC1=CC=C(OCC=C)C(Cl)=C1 ARHWPKZXBHOEEE-UHFFFAOYSA-N 0.000 description 1
- 125000003172 aldehyde group Chemical group 0.000 description 1
- 229910001508 alkali metal halide Inorganic materials 0.000 description 1
- 150000008045 alkali metal halides Chemical class 0.000 description 1
- 125000003545 alkoxy group Chemical group 0.000 description 1
- 238000005804 alkylation reaction Methods 0.000 description 1
- 108010050122 alpha 1-Antitrypsin Proteins 0.000 description 1
- 102000013529 alpha-Fetoproteins Human genes 0.000 description 1
- 230000004075 alteration Effects 0.000 description 1
- 229940037003 alum Drugs 0.000 description 1
- 229950008930 amfenac Drugs 0.000 description 1
- SOYCMDCMZDHQFP-UHFFFAOYSA-N amfenac Chemical compound NC1=C(CC(O)=O)C=CC=C1C(=O)C1=CC=CC=C1 SOYCMDCMZDHQFP-UHFFFAOYSA-N 0.000 description 1
- 229960004821 amikacin Drugs 0.000 description 1
- LKCWBDHBTVXHDL-RMDFUYIESA-N amikacin Chemical compound O([C@@H]1[C@@H](N)C[C@H]([C@@H]([C@H]1O)O[C@@H]1[C@@H]([C@@H](N)[C@H](O)[C@@H](CO)O1)O)NC(=O)[C@@H](O)CCN)[C@H]1O[C@H](CN)[C@@H](O)[C@H](O)[C@H]1O LKCWBDHBTVXHDL-RMDFUYIESA-N 0.000 description 1
- ISRODTBNJUAWEJ-UHFFFAOYSA-N amixetrine Chemical compound C=1C=CC=CC=1C(OCCC(C)C)CN1CCCC1 ISRODTBNJUAWEJ-UHFFFAOYSA-N 0.000 description 1
- 229950001993 amixetrine Drugs 0.000 description 1
- 229940043312 ampicillin / sulbactam Drugs 0.000 description 1
- 235000020244 animal milk Nutrition 0.000 description 1
- 230000003042 antagnostic effect Effects 0.000 description 1
- 229940121363 anti-inflammatory agent Drugs 0.000 description 1
- 239000002260 anti-inflammatory agent Substances 0.000 description 1
- 239000002246 antineoplastic agent Substances 0.000 description 1
- 235000006708 antioxidants Nutrition 0.000 description 1
- 239000003816 antisense DNA Substances 0.000 description 1
- 239000002787 antisense oligonuctleotide Substances 0.000 description 1
- 239000013011 aqueous formulation Substances 0.000 description 1
- 208000011775 arteriosclerosis disease Diseases 0.000 description 1
- 206010003246 arthritis Diseases 0.000 description 1
- MDJRZSNPHZEMJH-MTMZYOSNSA-N artisone acetate Chemical compound C1C=C2C[C@@H](O)CC[C@]2(C)[C@@H]2[C@@H]1[C@@H]1CC[C@H](C(=O)COC(=O)C)[C@@]1(C)CC2 MDJRZSNPHZEMJH-MTMZYOSNSA-N 0.000 description 1
- 125000004104 aryloxy group Chemical group 0.000 description 1
- 235000010323 ascorbic acid Nutrition 0.000 description 1
- 229960005070 ascorbic acid Drugs 0.000 description 1
- 239000011668 ascorbic acid Substances 0.000 description 1
- 230000003190 augmentative effect Effects 0.000 description 1
- AUJRCFUBUPVWSZ-XTZHGVARSA-M auranofin Chemical compound CCP(CC)(CC)=[Au]S[C@@H]1O[C@H](COC(C)=O)[C@@H](OC(C)=O)[C@H](OC(C)=O)[C@H]1OC(C)=O AUJRCFUBUPVWSZ-XTZHGVARSA-M 0.000 description 1
- 229960005207 auranofin Drugs 0.000 description 1
- 229960002170 azathioprine Drugs 0.000 description 1
- LMEKQMALGUDUQG-UHFFFAOYSA-N azathioprine Chemical compound CN1C=NC([N+]([O-])=O)=C1SC1=NC=NC2=C1NC=N2 LMEKQMALGUDUQG-UHFFFAOYSA-N 0.000 description 1
- 229960004099 azithromycin Drugs 0.000 description 1
- MQTOSJVFKKJCRP-BICOPXKESA-N azithromycin Chemical compound O([C@@H]1[C@@H](C)C(=O)O[C@@H]([C@@]([C@H](O)[C@@H](C)N(C)C[C@H](C)C[C@@](C)(O)[C@H](O[C@H]2[C@@H]([C@H](C[C@@H](C)O2)N(C)C)O)[C@H]1C)(C)O)CC)[C@H]1C[C@@](C)(OC)[C@@H](O)[C@H](C)O1 MQTOSJVFKKJCRP-BICOPXKESA-N 0.000 description 1
- 150000003851 azoles Chemical class 0.000 description 1
- WZPBZJONDBGPKJ-VEHQQRBSSA-N aztreonam Chemical compound O=C1N(S([O-])(=O)=O)[C@@H](C)[C@@H]1NC(=O)C(=N/OC(C)(C)C(O)=O)\C1=CSC([NH3+])=N1 WZPBZJONDBGPKJ-VEHQQRBSSA-N 0.000 description 1
- 229960003644 aztreonam Drugs 0.000 description 1
- 210000003719 b-lymphocyte Anatomy 0.000 description 1
- PFOLLRNADZZWEX-FFGRCDKISA-N bacampicillin Chemical compound C1([C@@H](N)C(=O)N[C@H]2[C@@H]3N(C2=O)[C@H](C(S3)(C)C)C(=O)OC(C)OC(=O)OCC)=CC=CC=C1 PFOLLRNADZZWEX-FFGRCDKISA-N 0.000 description 1
- 229960002699 bacampicillin Drugs 0.000 description 1
- 229940092705 beclomethasone Drugs 0.000 description 1
- NBMKJKDGKREAPL-DVTGEIKXSA-N beclomethasone Chemical compound C1CC2=CC(=O)C=C[C@]2(C)[C@]2(Cl)[C@@H]1[C@@H]1C[C@H](C)[C@@](C(=O)CO)(O)[C@@]1(C)C[C@@H]2O NBMKJKDGKREAPL-DVTGEIKXSA-N 0.000 description 1
- 229960005430 benoxaprofen Drugs 0.000 description 1
- 229960000686 benzalkonium chloride Drugs 0.000 description 1
- 235000010233 benzoic acid Nutrition 0.000 description 1
- 229960004365 benzoic acid Drugs 0.000 description 1
- KMGARVOVYXNAOF-UHFFFAOYSA-N benzpiperylone Chemical compound C1CN(C)CCC1N1C(=O)C(CC=2C=CC=CC=2)=C(C=2C=CC=CC=2)N1 KMGARVOVYXNAOF-UHFFFAOYSA-N 0.000 description 1
- 229960000333 benzydamine Drugs 0.000 description 1
- CADWTSSKOVRVJC-UHFFFAOYSA-N benzyl(dimethyl)azanium;chloride Chemical compound [Cl-].C[NH+](C)CC1=CC=CC=C1 CADWTSSKOVRVJC-UHFFFAOYSA-N 0.000 description 1
- MSWZFWKMSRAUBD-UHFFFAOYSA-N beta-D-galactosamine Natural products NC1C(O)OC(CO)C(O)C1O MSWZFWKMSRAUBD-UHFFFAOYSA-N 0.000 description 1
- WQZGKKKJIJFFOK-FPRJBGLDSA-N beta-D-galactose Chemical compound OC[C@H]1O[C@@H](O)[C@H](O)[C@@H](O)[C@H]1O WQZGKKKJIJFFOK-FPRJBGLDSA-N 0.000 description 1
- WQZGKKKJIJFFOK-VFUOTHLCSA-N beta-D-glucose Chemical compound OC[C@H]1O[C@@H](O)[C@H](O)[C@@H](O)[C@@H]1O WQZGKKKJIJFFOK-VFUOTHLCSA-N 0.000 description 1
- 108010051210 beta-Fructofuranosidase Proteins 0.000 description 1
- 102000005936 beta-Galactosidase Human genes 0.000 description 1
- WHGYBXFWUBPSRW-FOUAGVGXSA-N beta-cyclodextrin Chemical compound OC[C@H]([C@H]([C@@H]([C@H]1O)O)O[C@H]2O[C@@H]([C@@H](O[C@H]3O[C@H](CO)[C@H]([C@@H]([C@H]3O)O)O[C@H]3O[C@H](CO)[C@H]([C@@H]([C@H]3O)O)O[C@H]3O[C@H](CO)[C@H]([C@@H]([C@H]3O)O)O[C@H]3O[C@H](CO)[C@H]([C@@H]([C@H]3O)O)O3)[C@H](O)[C@H]2O)CO)O[C@@H]1O[C@H]1[C@H](O)[C@@H](O)[C@@H]3O[C@@H]1CO WHGYBXFWUBPSRW-FOUAGVGXSA-N 0.000 description 1
- 235000011175 beta-cyclodextrine Nutrition 0.000 description 1
- 229960004853 betadex Drugs 0.000 description 1
- 229960002537 betamethasone Drugs 0.000 description 1
- UREBDLICKHMUKA-DVTGEIKXSA-N betamethasone Chemical compound C1CC2=CC(=O)C=C[C@]2(C)[C@]2(F)[C@@H]1[C@@H]1C[C@H](C)[C@@](C(=O)CO)(O)[C@@]1(C)C[C@@H]2O UREBDLICKHMUKA-DVTGEIKXSA-N 0.000 description 1
- 229960004311 betamethasone valerate Drugs 0.000 description 1
- SNHRLVCMMWUAJD-SUYDQAKGSA-N betamethasone valerate Chemical compound C1CC2=CC(=O)C=C[C@]2(C)[C@]2(F)[C@@H]1[C@@H]1C[C@H](C)[C@@](C(=O)CO)(OC(=O)CCCC)[C@@]1(C)C[C@@H]2O SNHRLVCMMWUAJD-SUYDQAKGSA-N 0.000 description 1
- 230000001588 bifunctional effect Effects 0.000 description 1
- 108091008324 binding proteins Proteins 0.000 description 1
- 238000010256 biochemical assay Methods 0.000 description 1
- 230000031018 biological processes and functions Effects 0.000 description 1
- 230000005540 biological transmission Effects 0.000 description 1
- 229920001222 biopolymer Polymers 0.000 description 1
- 150000001615 biotins Chemical class 0.000 description 1
- 108091006004 biotinylated proteins Proteins 0.000 description 1
- QRZAKQDHEVVFRX-UHFFFAOYSA-N biphenyl-4-ylacetic acid Chemical compound C1=CC(CC(=O)O)=CC=C1C1=CC=CC=C1 QRZAKQDHEVVFRX-UHFFFAOYSA-N 0.000 description 1
- UIDLJTHRRPMIQP-UHFFFAOYSA-L bis[2-[4-(2-methylpropyl)phenyl]propanoyloxy]aluminum;hydrate Chemical compound O.C1=CC(CC(C)C)=CC=C1C(C)C(=O)O[Al]OC(=O)C(C)C1=CC=C(CC(C)C)C=C1 UIDLJTHRRPMIQP-UHFFFAOYSA-L 0.000 description 1
- 239000002981 blocking agent Substances 0.000 description 1
- 239000010839 body fluid Substances 0.000 description 1
- 210000000988 bone and bone Anatomy 0.000 description 1
- 229940098773 bovine serum albumin Drugs 0.000 description 1
- 210000004556 brain Anatomy 0.000 description 1
- 210000005013 brain tissue Anatomy 0.000 description 1
- 210000000481 breast Anatomy 0.000 description 1
- 229960004272 bucillamine Drugs 0.000 description 1
- 229950005608 bucloxic acid Drugs 0.000 description 1
- IJTPQQVCKPZIMV-UHFFFAOYSA-N bucloxic acid Chemical compound ClC1=CC(C(=O)CCC(=O)O)=CC=C1C1CCCCC1 IJTPQQVCKPZIMV-UHFFFAOYSA-N 0.000 description 1
- 229950003872 bucolome Drugs 0.000 description 1
- 229960004436 budesonide Drugs 0.000 description 1
- 229960000962 bufexamac Drugs 0.000 description 1
- MXJWRABVEGLYDG-UHFFFAOYSA-N bufexamac Chemical compound CCCCOC1=CC=C(CC(=O)NO)C=C1 MXJWRABVEGLYDG-UHFFFAOYSA-N 0.000 description 1
- 239000007975 buffered saline Substances 0.000 description 1
- 239000004067 bulking agent Substances 0.000 description 1
- 229960003354 bumadizone Drugs 0.000 description 1
- FLWFHHFTIRLFPV-UHFFFAOYSA-N bumadizone Chemical compound C=1C=CC=CC=1N(C(=O)C(C(O)=O)CCCC)NC1=CC=CC=C1 FLWFHHFTIRLFPV-UHFFFAOYSA-N 0.000 description 1
- DQXBYHZEEUGOBF-UHFFFAOYSA-N but-3-enoic acid;ethene Chemical compound C=C.OC(=O)CC=C DQXBYHZEEUGOBF-UHFFFAOYSA-N 0.000 description 1
- 229960002973 butibufen Drugs 0.000 description 1
- UULSXYSSHHRCQK-UHFFFAOYSA-N butibufen Chemical compound CCC(C(O)=O)C1=CC=C(CC(C)C)C=C1 UULSXYSSHHRCQK-UHFFFAOYSA-N 0.000 description 1
- 125000000484 butyl group Chemical group [H]C([*])([H])C([H])([H])C([H])([H])C([H])([H])[H] 0.000 description 1
- ZTQSAGDEMFDKMZ-UHFFFAOYSA-N butyric aldehyde Natural products CCCC=O ZTQSAGDEMFDKMZ-UHFFFAOYSA-N 0.000 description 1
- 238000010804 cDNA synthesis Methods 0.000 description 1
- VJEONQKOZGKCAK-UHFFFAOYSA-N caffeine Natural products CN1C(=O)N(C)C(=O)C2=C1C=CN2C VJEONQKOZGKCAK-UHFFFAOYSA-N 0.000 description 1
- 229960001948 caffeine Drugs 0.000 description 1
- 239000011575 calcium Substances 0.000 description 1
- 229910052791 calcium Inorganic materials 0.000 description 1
- 229960005069 calcium Drugs 0.000 description 1
- 229910000019 calcium carbonate Inorganic materials 0.000 description 1
- 239000001110 calcium chloride Substances 0.000 description 1
- 229910001628 calcium chloride Inorganic materials 0.000 description 1
- 229960003669 carbenicillin Drugs 0.000 description 1
- FPPNZSSZRUTDAP-UWFZAAFLSA-N carbenicillin Chemical compound N([C@H]1[C@H]2SC([C@@H](N2C1=O)C(O)=O)(C)C)C(=O)C(C(O)=O)C1=CC=CC=C1 FPPNZSSZRUTDAP-UWFZAAFLSA-N 0.000 description 1
- 229960000717 carindacillin Drugs 0.000 description 1
- JIRBAUWICKGBFE-MNRDOXJOSA-N carindacillin Chemical group N([C@H]1[C@H]2SC([C@@H](N2C1=O)C(O)=O)(C)C)C(=O)C(C(=O)OC=1C=C2CCCC2=CC=1)C1=CC=CC=C1 JIRBAUWICKGBFE-MNRDOXJOSA-N 0.000 description 1
- 229960003184 carprofen Drugs 0.000 description 1
- IVUMCTKHWDRRMH-UHFFFAOYSA-N carprofen Chemical compound C1=CC(Cl)=C[C]2C3=CC=C(C(C(O)=O)C)C=C3N=C21 IVUMCTKHWDRRMH-UHFFFAOYSA-N 0.000 description 1
- 230000015556 catabolic process Effects 0.000 description 1
- QYIYFLOTGYLRGG-GPCCPHFNSA-N cefaclor Chemical compound C1([C@H](C(=O)N[C@@H]2C(N3C(=C(Cl)CS[C@@H]32)C(O)=O)=O)N)=CC=CC=C1 QYIYFLOTGYLRGG-GPCCPHFNSA-N 0.000 description 1
- 229960005361 cefaclor Drugs 0.000 description 1
- XIURVHNZVLADCM-IUODEOHRSA-N cefalotin Chemical compound N([C@H]1[C@@H]2N(C1=O)C(=C(CS2)COC(=O)C)C(O)=O)C(=O)CC1=CC=CS1 XIURVHNZVLADCM-IUODEOHRSA-N 0.000 description 1
- 229960000603 cefalotin Drugs 0.000 description 1
- OLVCFLKTBJRLHI-AXAPSJFSSA-N cefamandole Chemical compound CN1N=NN=C1SCC1=C(C(O)=O)N2C(=O)[C@@H](NC(=O)[C@H](O)C=3C=CC=CC=3)[C@H]2SC1 OLVCFLKTBJRLHI-AXAPSJFSSA-N 0.000 description 1
- 229960003012 cefamandole Drugs 0.000 description 1
- 229960004350 cefapirin Drugs 0.000 description 1
- 229960001139 cefazolin Drugs 0.000 description 1
- MLYYVTUWGNIJIB-BXKDBHETSA-N cefazolin Chemical compound S1C(C)=NN=C1SCC1=C(C(O)=O)N2C(=O)[C@@H](NC(=O)CN3N=NN=C3)[C@H]2SC1 MLYYVTUWGNIJIB-BXKDBHETSA-N 0.000 description 1
- 229960002129 cefixime Drugs 0.000 description 1
- OKBVVJOGVLARMR-QSWIMTSFSA-N cefixime Chemical compound S1C(N)=NC(C(=N\OCC(O)=O)\C(=O)N[C@@H]2C(N3C(=C(C=C)CS[C@@H]32)C(O)=O)=O)=C1 OKBVVJOGVLARMR-QSWIMTSFSA-N 0.000 description 1
- GCFBRXLSHGKWDP-XCGNWRKASA-N cefoperazone Chemical compound O=C1C(=O)N(CC)CCN1C(=O)N[C@H](C=1C=CC(O)=CC=1)C(=O)N[C@@H]1C(=O)N2C(C(O)=O)=C(CSC=3N(N=NN=3)C)CS[C@@H]21 GCFBRXLSHGKWDP-XCGNWRKASA-N 0.000 description 1
- 229960004682 cefoperazone Drugs 0.000 description 1
- 229960004261 cefotaxime Drugs 0.000 description 1
- AZZMGZXNTDTSME-JUZDKLSSSA-M cefotaxime sodium Chemical compound [Na+].N([C@@H]1C(N2C(=C(COC(C)=O)CS[C@@H]21)C([O-])=O)=O)C(=O)\C(=N/OC)C1=CSC(N)=N1 AZZMGZXNTDTSME-JUZDKLSSSA-M 0.000 description 1
- SRZNHPXWXCNNDU-RHBCBLIFSA-N cefotetan Chemical compound N([C@]1(OC)C(N2C(=C(CSC=3N(N=NN=3)C)CS[C@@H]21)C(O)=O)=O)C(=O)C1SC(=C(C(N)=O)C(O)=O)S1 SRZNHPXWXCNNDU-RHBCBLIFSA-N 0.000 description 1
- 229960005495 cefotetan Drugs 0.000 description 1
- 229960002682 cefoxitin Drugs 0.000 description 1
- 229960002588 cefradine Drugs 0.000 description 1
- 229960000484 ceftazidime Drugs 0.000 description 1
- ORFOPKXBNMVMKC-DWVKKRMSSA-N ceftazidime Chemical compound S([C@@H]1[C@@H](C(N1C=1C([O-])=O)=O)NC(=O)\C(=N/OC(C)(C)C(O)=O)C=2N=C(N)SC=2)CC=1C[N+]1=CC=CC=C1 ORFOPKXBNMVMKC-DWVKKRMSSA-N 0.000 description 1
- 229960001991 ceftizoxime Drugs 0.000 description 1
- NNULBSISHYWZJU-LLKWHZGFSA-N ceftizoxime Chemical compound N([C@@H]1C(N2C(=CCS[C@@H]21)C(O)=O)=O)C(=O)\C(=N/OC)C1=CSC(N)=N1 NNULBSISHYWZJU-LLKWHZGFSA-N 0.000 description 1
- RZEKVGVHFLEQIL-UHFFFAOYSA-N celecoxib Chemical compound C1=CC(C)=CC=C1C1=CC(C(F)(F)F)=NN1C1=CC=C(S(N)(=O)=O)C=C1 RZEKVGVHFLEQIL-UHFFFAOYSA-N 0.000 description 1
- 229960000590 celecoxib Drugs 0.000 description 1
- 108010015046 cell aggregation factors Proteins 0.000 description 1
- 238000000423 cell based assay Methods 0.000 description 1
- 239000006143 cell culture medium Substances 0.000 description 1
- 230000032823 cell division Effects 0.000 description 1
- 229940106164 cephalexin Drugs 0.000 description 1
- ZAIPMKNFIOOWCQ-UEKVPHQBSA-N cephalexin Chemical compound C1([C@@H](N)C(=O)N[C@H]2[C@@H]3N(C2=O)C(=C(CS3)C)C(O)=O)=CC=CC=C1 ZAIPMKNFIOOWCQ-UEKVPHQBSA-N 0.000 description 1
- RDLPVSKMFDYCOR-UEKVPHQBSA-N cephradine Chemical compound C1([C@@H](N)C(=O)N[C@H]2[C@@H]3N(C2=O)C(=C(CS3)C)C(O)=O)=CCC=CC1 RDLPVSKMFDYCOR-UEKVPHQBSA-N 0.000 description 1
- 210000001175 cerebrospinal fluid Anatomy 0.000 description 1
- 230000003196 chaotropic effect Effects 0.000 description 1
- 239000002738 chelating agent Substances 0.000 description 1
- 125000003636 chemical group Chemical group 0.000 description 1
- JCKYGMPEJWAADB-UHFFFAOYSA-N chlorambucil Chemical compound OC(=O)CCCC1=CC=C(N(CCCl)CCCl)C=C1 JCKYGMPEJWAADB-UHFFFAOYSA-N 0.000 description 1
- 229960004630 chlorambucil Drugs 0.000 description 1
- 229960003260 chlorhexidine Drugs 0.000 description 1
- 229950006229 chloroprednisone Drugs 0.000 description 1
- 229960003677 chloroquine Drugs 0.000 description 1
- WHTVZRBIWZFKQO-UHFFFAOYSA-N chloroquine Natural products ClC1=CC=C2C(NC(C)CCCN(CC)CC)=CC=NC2=C1 WHTVZRBIWZFKQO-UHFFFAOYSA-N 0.000 description 1
- CYDMQBQPVICBEU-UHFFFAOYSA-N chlorotetracycline Natural products C1=CC(Cl)=C2C(O)(C)C3CC4C(N(C)C)C(O)=C(C(N)=O)C(=O)C4(O)C(O)=C3C(=O)C2=C1O CYDMQBQPVICBEU-UHFFFAOYSA-N 0.000 description 1
- 229960004475 chlortetracycline Drugs 0.000 description 1
- CYDMQBQPVICBEU-XRNKAMNCSA-N chlortetracycline Chemical compound C1=CC(Cl)=C2[C@](O)(C)[C@H]3C[C@H]4[C@H](N(C)C)C(O)=C(C(N)=O)C(=O)[C@@]4(O)C(O)=C3C(=O)C2=C1O CYDMQBQPVICBEU-XRNKAMNCSA-N 0.000 description 1
- 235000019365 chlortetracycline Nutrition 0.000 description 1
- 229940099352 cholate Drugs 0.000 description 1
- 235000012000 cholesterol Nutrition 0.000 description 1
- BHQCQFFYRZLCQQ-OELDTZBJSA-N cholic acid Chemical compound C([C@H]1C[C@H]2O)[C@H](O)CC[C@]1(C)[C@@H]1[C@@H]2[C@@H]2CC[C@H]([C@@H](CCC(O)=O)C)[C@@]2(C)[C@@H](O)C1 BHQCQFFYRZLCQQ-OELDTZBJSA-N 0.000 description 1
- 229960002688 choline salicylate Drugs 0.000 description 1
- 210000001612 chondrocyte Anatomy 0.000 description 1
- 208000016532 chronic granulomatous disease Diseases 0.000 description 1
- 229960001265 ciclosporin Drugs 0.000 description 1
- 230000001886 ciliary effect Effects 0.000 description 1
- 229960003405 ciprofloxacin Drugs 0.000 description 1
- 229950010886 clidanac Drugs 0.000 description 1
- 229960002227 clindamycin Drugs 0.000 description 1
- KDLRVYVGXIQJDK-AWPVFWJPSA-N clindamycin Chemical compound CN1C[C@H](CCC)C[C@H]1C(=O)N[C@H]([C@H](C)Cl)[C@@H]1[C@H](O)[C@H](O)[C@@H](O)[C@@H](SC)O1 KDLRVYVGXIQJDK-AWPVFWJPSA-N 0.000 description 1
- 229960002842 clobetasol Drugs 0.000 description 1
- 229960004703 clobetasol propionate Drugs 0.000 description 1
- 229960001146 clobetasone Drugs 0.000 description 1
- 229960005465 clobetasone butyrate Drugs 0.000 description 1
- 238000012411 cloning technique Methods 0.000 description 1
- 229950009185 clopirac Drugs 0.000 description 1
- SJCRQMUYEQHNTC-UHFFFAOYSA-N clopirac Chemical compound CC1=CC(CC(O)=O)=C(C)N1C1=CC=C(Cl)C=C1 SJCRQMUYEQHNTC-UHFFFAOYSA-N 0.000 description 1
- 229960003326 cloxacillin Drugs 0.000 description 1
- LQOLIRLGBULYKD-JKIFEVAISA-N cloxacillin Chemical compound N([C@@H]1C(N2[C@H](C(C)(C)S[C@@H]21)C(O)=O)=O)C(=O)C1=C(C)ON=C1C1=CC=CC=C1Cl LQOLIRLGBULYKD-JKIFEVAISA-N 0.000 description 1
- 229950011057 cloximate Drugs 0.000 description 1
- 229960003346 colistin Drugs 0.000 description 1
- 239000003086 colorant Substances 0.000 description 1
- 230000024203 complement activation Effects 0.000 description 1
- 239000003184 complementary RNA Substances 0.000 description 1
- 230000009918 complex formation Effects 0.000 description 1
- 239000008139 complexing agent Substances 0.000 description 1
- 238000012790 confirmation Methods 0.000 description 1
- 238000010924 continuous production Methods 0.000 description 1
- NHRTVBMNRNCBLQ-UHFFFAOYSA-L copper;5,7-disulfoquinolin-8-olate;n-ethylethanamine Chemical compound [Cu+2].CCNCC.CCNCC.CCNCC.CCNCC.C1=CC=NC2=C([O-])C(S(=O)(=O)O)=CC(S(O)(=O)=O)=C21.C1=CC=NC2=C([O-])C(S(=O)(=O)O)=CC(S(O)(=O)=O)=C21 NHRTVBMNRNCBLQ-UHFFFAOYSA-L 0.000 description 1
- BMCQMVFGOVHVNG-TUFAYURCSA-N cortisol 17-butyrate Chemical compound C1CC2=CC(=O)CC[C@]2(C)[C@@H]2[C@@H]1[C@@H]1CC[C@@](C(=O)CO)(OC(=O)CCC)[C@@]1(C)C[C@@H]2O BMCQMVFGOVHVNG-TUFAYURCSA-N 0.000 description 1
- ALEXXDVDDISNDU-JZYPGELDSA-N cortisol 21-acetate Chemical compound C1CC2=CC(=O)CC[C@]2(C)[C@@H]2[C@@H]1[C@@H]1CC[C@@](C(=O)COC(=O)C)(O)[C@@]1(C)C[C@@H]2O ALEXXDVDDISNDU-JZYPGELDSA-N 0.000 description 1
- BGSOJVFOEQLVMH-VWUMJDOOSA-N cortisol phosphate Chemical compound O=C1CC[C@]2(C)[C@H]3[C@@H](O)C[C@](C)([C@@](CC4)(O)C(=O)COP(O)(O)=O)[C@@H]4[C@@H]3CCC2=C1 BGSOJVFOEQLVMH-VWUMJDOOSA-N 0.000 description 1
- 238000012136 culture method Methods 0.000 description 1
- 230000001186 cumulative effect Effects 0.000 description 1
- 229950009004 cuproxoline Drugs 0.000 description 1
- 229960004397 cyclophosphamide Drugs 0.000 description 1
- 229930182912 cyclosporin Natural products 0.000 description 1
- OOTFVKOQINZBBF-UHFFFAOYSA-N cystamine Chemical compound CCSSCCN OOTFVKOQINZBBF-UHFFFAOYSA-N 0.000 description 1
- 229940099500 cystamine Drugs 0.000 description 1
- 150000001945 cysteines Chemical class 0.000 description 1
- 229960003067 cystine Drugs 0.000 description 1
- 108091007930 cytoplasmic receptors Proteins 0.000 description 1
- 229940104302 cytosine Drugs 0.000 description 1
- 230000001086 cytosolic effect Effects 0.000 description 1
- 229940127089 cytotoxic agent Drugs 0.000 description 1
- SUYVUBYJARFZHO-RRKCRQDMSA-N dATP Chemical compound C1=NC=2C(N)=NC=NC=2N1[C@H]1C[C@H](O)[C@@H](COP(O)(=O)OP(O)(=O)OP(O)(O)=O)O1 SUYVUBYJARFZHO-RRKCRQDMSA-N 0.000 description 1
- SUYVUBYJARFZHO-UHFFFAOYSA-N dATP Natural products C1=NC=2C(N)=NC=NC=2N1C1CC(O)C(COP(O)(=O)OP(O)(=O)OP(O)(O)=O)O1 SUYVUBYJARFZHO-UHFFFAOYSA-N 0.000 description 1
- HAAZLUGHYHWQIW-KVQBGUIXSA-N dGTP Chemical compound C1=NC=2C(=O)NC(N)=NC=2N1[C@H]1C[C@H](O)[C@@H](COP(O)(=O)OP(O)(=O)OP(O)(O)=O)O1 HAAZLUGHYHWQIW-KVQBGUIXSA-N 0.000 description 1
- NHVNXKFIZYSCEB-XLPZGREQSA-N dTTP Chemical compound O=C1NC(=O)C(C)=CN1[C@@H]1O[C@H](COP(O)(=O)OP(O)(=O)OP(O)(O)=O)[C@@H](O)C1 NHVNXKFIZYSCEB-XLPZGREQSA-N 0.000 description 1
- 229960000860 dapsone Drugs 0.000 description 1
- 230000007812 deficiency Effects 0.000 description 1
- 238000006731 degradation reaction Methods 0.000 description 1
- 239000003405 delayed action preparation Substances 0.000 description 1
- 238000002716 delivery method Methods 0.000 description 1
- 229950001116 delmetacin Drugs 0.000 description 1
- 229960002398 demeclocycline Drugs 0.000 description 1
- 238000003936 denaturing gel electrophoresis Methods 0.000 description 1
- 238000013461 design Methods 0.000 description 1
- 229960003662 desonide Drugs 0.000 description 1
- WBGKWQHBNHJJPZ-LECWWXJVSA-N desonide Chemical compound C1CC2=CC(=O)C=C[C@]2(C)[C@@H]2[C@@H]1[C@@H]1C[C@H]3OC(C)(C)O[C@@]3(C(=O)CO)[C@@]1(C)C[C@@H]2O WBGKWQHBNHJJPZ-LECWWXJVSA-N 0.000 description 1
- JXMXDKHEZLKQPB-UHFFFAOYSA-N detomidine Chemical compound CC1=CC=CC(CC=2[N]C=NC=2)=C1C JXMXDKHEZLKQPB-UHFFFAOYSA-N 0.000 description 1
- 229960001894 detomidine Drugs 0.000 description 1
- 229960003957 dexamethasone Drugs 0.000 description 1
- UREBDLICKHMUKA-CXSFZGCWSA-N dexamethasone Chemical compound C1CC2=CC(=O)C=C[C@]2(C)[C@]2(F)[C@@H]1[C@@H]1C[C@@H](C)[C@@](C(=O)CO)(O)[C@@]1(C)C[C@@H]2O UREBDLICKHMUKA-CXSFZGCWSA-N 0.000 description 1
- 229950007331 dexindoprofen Drugs 0.000 description 1
- 229960000633 dextran sulfate Drugs 0.000 description 1
- 235000019425 dextrin Nutrition 0.000 description 1
- 206010012601 diabetes mellitus Diseases 0.000 description 1
- 229960004590 diacerein Drugs 0.000 description 1
- 229960004515 diclofenac potassium Drugs 0.000 description 1
- KXZOIWWTXOCYKR-UHFFFAOYSA-M diclofenac potassium Chemical compound [K+].[O-]C(=O)CC1=CC=CC=C1NC1=C(Cl)C=CC=C1Cl KXZOIWWTXOCYKR-UHFFFAOYSA-M 0.000 description 1
- 229960001193 diclofenac sodium Drugs 0.000 description 1
- YFAGHNZHGGCZAX-JKIFEVAISA-N dicloxacillin Chemical compound N([C@@H]1C(N2[C@H](C(C)(C)S[C@@H]21)C(O)=O)=O)C(=O)C1=C(C)ON=C1C1=C(Cl)C=CC=C1Cl YFAGHNZHGGCZAX-JKIFEVAISA-N 0.000 description 1
- 229960001585 dicloxacillin Drugs 0.000 description 1
- PCXMKBOWWVXEDT-UHFFFAOYSA-N difenamizole Chemical compound CN(C)C(C)C(=O)NC1=CC(C=2C=CC=CC=2)=NN1C1=CC=CC=C1 PCXMKBOWWVXEDT-UHFFFAOYSA-N 0.000 description 1
- 238000009792 diffusion process Methods 0.000 description 1
- 229960004875 difluprednate Drugs 0.000 description 1
- 239000000539 dimer Substances 0.000 description 1
- SWSQBOPZIKWTGO-UHFFFAOYSA-N dimethylaminoamidine Natural products CN(C)C(N)=N SWSQBOPZIKWTGO-UHFFFAOYSA-N 0.000 description 1
- XPPKVPWEQAFLFU-UHFFFAOYSA-J diphosphate(4-) Chemical compound [O-]P([O-])(=O)OP([O-])([O-])=O XPPKVPWEQAFLFU-UHFFFAOYSA-J 0.000 description 1
- 235000011180 diphosphates Nutrition 0.000 description 1
- 230000006806 disease prevention Effects 0.000 description 1
- NWOYIVRVSJDTLK-YSDBFZIDSA-L disodium;(2s,5r,6r)-6-[[(2r)-2-amino-2-phenylacetyl]amino]-3,3-dimethyl-7-oxo-4-thia-1-azabicyclo[3.2.0]heptane-2-carboxylate;(1r,4s)-3,3-dimethyl-2,2,6-trioxo-2$l^{6}-thiabicyclo[3.2.0]heptane-4-carboxylate Chemical compound [Na+].[Na+].O=S1(=O)C(C)(C)[C@H](C([O-])=O)C2C(=O)C[C@H]21.C1([C@@H](N)C(=O)N[C@H]2[C@H]3SC([C@@H](N3C2=O)C([O-])=O)(C)C)=CC=CC=C1 NWOYIVRVSJDTLK-YSDBFZIDSA-L 0.000 description 1
- 239000006185 dispersion Substances 0.000 description 1
- 238000010494 dissociation reaction Methods 0.000 description 1
- 230000005593 dissociations Effects 0.000 description 1
- 239000012153 distilled water Substances 0.000 description 1
- 229960005067 ditazole Drugs 0.000 description 1
- UUCMDZWCRNZCOY-UHFFFAOYSA-N ditazole Chemical compound O1C(N(CCO)CCO)=NC(C=2C=CC=CC=2)=C1C1=CC=CC=C1 UUCMDZWCRNZCOY-UHFFFAOYSA-N 0.000 description 1
- LOZWAPSEEHRYPG-UHFFFAOYSA-N dithiane Natural products C1CSCCS1 LOZWAPSEEHRYPG-UHFFFAOYSA-N 0.000 description 1
- 239000002552 dosage form Substances 0.000 description 1
- 231100000673 dose–response relationship Toxicity 0.000 description 1
- 230000003828 downregulation Effects 0.000 description 1
- OEHFRZLKGRKFAS-UHFFFAOYSA-N droxicam Chemical compound C12=CC=CC=C2S(=O)(=O)N(C)C(C2=O)=C1OC(=O)N2C1=CC=CC=N1 OEHFRZLKGRKFAS-UHFFFAOYSA-N 0.000 description 1
- 229960001850 droxicam Drugs 0.000 description 1
- 239000003937 drug carrier Substances 0.000 description 1
- 238000012377 drug delivery Methods 0.000 description 1
- 230000002900 effect on cell Effects 0.000 description 1
- 238000001962 electrophoresis Methods 0.000 description 1
- 239000003995 emulsifying agent Substances 0.000 description 1
- 239000000839 emulsion Substances 0.000 description 1
- 238000005538 encapsulation Methods 0.000 description 1
- 210000002472 endoplasmic reticulum Anatomy 0.000 description 1
- 229950010996 enfenamic acid Drugs 0.000 description 1
- HLNLBEFKHHCAMV-UHFFFAOYSA-N enfenamic acid Chemical compound OC(=O)C1=CC=CC=C1NCCC1=CC=CC=C1 HLNLBEFKHHCAMV-UHFFFAOYSA-N 0.000 description 1
- 230000002708 enhancing effect Effects 0.000 description 1
- 229950002107 enolicam Drugs 0.000 description 1
- 229960002549 enoxacin Drugs 0.000 description 1
- IDYZIJYBMGIQMJ-UHFFFAOYSA-N enoxacin Chemical compound N1=C2N(CC)C=C(C(O)=O)C(=O)C2=CC(F)=C1N1CCNCC1 IDYZIJYBMGIQMJ-UHFFFAOYSA-N 0.000 description 1
- 229960003720 enoxolone Drugs 0.000 description 1
- 230000002255 enzymatic effect Effects 0.000 description 1
- 238000001976 enzyme digestion Methods 0.000 description 1
- 229950003801 epirizole Drugs 0.000 description 1
- 210000003743 erythrocyte Anatomy 0.000 description 1
- 229960003276 erythromycin Drugs 0.000 description 1
- 125000004185 ester group Chemical group 0.000 description 1
- BEFDCLMNVWHSGT-UHFFFAOYSA-N ethenylcyclopentane Chemical compound C=CC1CCCC1 BEFDCLMNVWHSGT-UHFFFAOYSA-N 0.000 description 1
- 239000005038 ethylene vinyl acetate Substances 0.000 description 1
- 229960005293 etodolac Drugs 0.000 description 1
- XFBVBWWRPKNWHW-UHFFFAOYSA-N etodolac Chemical compound C1COC(CC)(CC(O)=O)C2=N[C]3C(CC)=CC=CC3=C21 XFBVBWWRPKNWHW-UHFFFAOYSA-N 0.000 description 1
- 229960001493 etofenamate Drugs 0.000 description 1
- 230000007717 exclusion Effects 0.000 description 1
- 238000002474 experimental method Methods 0.000 description 1
- 229960000192 felbinac Drugs 0.000 description 1
- ZWJINEZUASEZBH-UHFFFAOYSA-N fenamic acid Chemical class OC(=O)C1=CC=CC=C1NC1=CC=CC=C1 ZWJINEZUASEZBH-UHFFFAOYSA-N 0.000 description 1
- 229960001395 fenbufen Drugs 0.000 description 1
- ZPAKPRAICRBAOD-UHFFFAOYSA-N fenbufen Chemical compound C1=CC(C(=O)CCC(=O)O)=CC=C1C1=CC=CC=C1 ZPAKPRAICRBAOD-UHFFFAOYSA-N 0.000 description 1
- 229950006236 fenclofenac Drugs 0.000 description 1
- IDKAXRLETRCXKS-UHFFFAOYSA-N fenclofenac Chemical compound OC(=O)CC1=CC=CC=C1OC1=CC=C(Cl)C=C1Cl IDKAXRLETRCXKS-UHFFFAOYSA-N 0.000 description 1
- ITFWPRPSIAYKMV-UHFFFAOYSA-N fenflumizol Chemical compound C1=CC(OC)=CC=C1C1=C(C=2C=CC(OC)=CC=2)NC(C=2C(=CC(F)=CC=2)F)=N1 ITFWPRPSIAYKMV-UHFFFAOYSA-N 0.000 description 1
- 229960001419 fenoprofen Drugs 0.000 description 1
- 229960000489 feprazone Drugs 0.000 description 1
- 239000012894 fetal calf serum Substances 0.000 description 1
- 239000000945 filler Substances 0.000 description 1
- 238000001914 filtration Methods 0.000 description 1
- 239000012467 final product Substances 0.000 description 1
- 229960003240 floctafenine Drugs 0.000 description 1
- 238000000684 flow cytometry Methods 0.000 description 1
- 229960004273 floxacillin Drugs 0.000 description 1
- RFHAOTPXVQNOHP-UHFFFAOYSA-N fluconazole Chemical compound C1=NC=NN1CC(C=1C(=CC(F)=CC=1)F)(O)CN1C=NC=N1 RFHAOTPXVQNOHP-UHFFFAOYSA-N 0.000 description 1
- 229960004884 fluconazole Drugs 0.000 description 1
- 229960004369 flufenamic acid Drugs 0.000 description 1
- LPEPZBJOKDYZAD-UHFFFAOYSA-N flufenamic acid Chemical compound OC(=O)C1=CC=CC=C1NC1=CC=CC(C(F)(F)F)=C1 LPEPZBJOKDYZAD-UHFFFAOYSA-N 0.000 description 1
- 229950007979 flufenisal Drugs 0.000 description 1
- 239000012530 fluid Substances 0.000 description 1
- 229960003469 flumetasone Drugs 0.000 description 1
- WXURHACBFYSXBI-GQKYHHCASA-N flumethasone Chemical compound C1([C@@H](F)C2)=CC(=O)C=C[C@]1(C)[C@]1(F)[C@@H]2[C@@H]2C[C@@H](C)[C@@](C(=O)CO)(O)[C@@]2(C)C[C@@H]1O WXURHACBFYSXBI-GQKYHHCASA-N 0.000 description 1
- 229940042902 flumethasone pivalate Drugs 0.000 description 1
- JWRMHDSINXPDHB-OJAGFMMFSA-N flumethasone pivalate Chemical compound C1([C@@H](F)C2)=CC(=O)C=C[C@]1(C)[C@]1(F)[C@@H]2[C@@H]2C[C@@H](C)[C@@](C(=O)COC(=O)C(C)(C)C)(O)[C@@]2(C)C[C@@H]1O JWRMHDSINXPDHB-OJAGFMMFSA-N 0.000 description 1
- 229960000676 flunisolide Drugs 0.000 description 1
- NOOCSNJCXJYGPE-UHFFFAOYSA-N flunixin Chemical compound C1=CC=C(C(F)(F)F)C(C)=C1NC1=NC=CC=C1C(O)=O NOOCSNJCXJYGPE-UHFFFAOYSA-N 0.000 description 1
- 229960000588 flunixin Drugs 0.000 description 1
- 229960001321 flunoxaprofen Drugs 0.000 description 1
- ARPYQKTVRGFPIS-VIFPVBQESA-N flunoxaprofen Chemical compound N=1C2=CC([C@@H](C(O)=O)C)=CC=C2OC=1C1=CC=C(F)C=C1 ARPYQKTVRGFPIS-VIFPVBQESA-N 0.000 description 1
- FEBLZLNTKCEFIT-VSXGLTOVSA-N fluocinolone acetonide Chemical compound C1([C@@H](F)C2)=CC(=O)C=C[C@]1(C)[C@]1(F)[C@@H]2[C@@H]2C[C@H]3OC(C)(C)O[C@@]3(C(=O)CO)[C@@]2(C)C[C@@H]1O FEBLZLNTKCEFIT-VSXGLTOVSA-N 0.000 description 1
- 229960000785 fluocinonide Drugs 0.000 description 1
- GNBHRKFJIUUOQI-UHFFFAOYSA-N fluorescein Chemical compound O1C(=O)C2=CC=CC=C2C21C1=CC=C(O)C=C1OC1=CC(O)=CC=C21 GNBHRKFJIUUOQI-UHFFFAOYSA-N 0.000 description 1
- 239000007850 fluorescent dye Substances 0.000 description 1
- 229960001048 fluorometholone Drugs 0.000 description 1
- FAOZLTXFLGPHNG-KNAQIMQKSA-N fluorometholone Chemical compound C([C@@]12C)=CC(=O)C=C1[C@@H](C)C[C@@H]1[C@]2(F)[C@@H](O)C[C@]2(C)[C@@](O)(C(C)=O)CC[C@H]21 FAOZLTXFLGPHNG-KNAQIMQKSA-N 0.000 description 1
- 229960002949 fluorouracil Drugs 0.000 description 1
- 229960003590 fluperolone Drugs 0.000 description 1
- HHPZZKDXAFJLOH-QZIXMDIESA-N fluperolone Chemical compound C1CC2=CC(=O)C=C[C@]2(C)[C@]2(F)[C@@H]1[C@@H]1CC[C@@](C(=O)[C@@H](OC(C)=O)C)(O)[C@@]1(C)C[C@@H]2O HHPZZKDXAFJLOH-QZIXMDIESA-N 0.000 description 1
- 229960000618 fluprednisolone Drugs 0.000 description 1
- 229950001284 fluprofen Drugs 0.000 description 1
- 229960002390 flurbiprofen Drugs 0.000 description 1
- SYTBZMRGLBWNTM-UHFFFAOYSA-N flurbiprofen Chemical compound FC1=CC(C(C(O)=O)C)=CC=C1C1=CC=CC=C1 SYTBZMRGLBWNTM-UHFFFAOYSA-N 0.000 description 1
- 229960000671 formocortal Drugs 0.000 description 1
- QNXUUBBKHBYRFW-QWAPGEGQSA-N formocortal Chemical compound C1C(C=O)=C2C=C(OCCCl)CC[C@]2(C)[C@]2(F)[C@@H]1[C@@H]1C[C@H]3OC(C)(C)O[C@@]3(C(=O)COC(=O)C)[C@@]1(C)C[C@@H]2O QNXUUBBKHBYRFW-QWAPGEGQSA-N 0.000 description 1
- 238000004108 freeze drying Methods 0.000 description 1
- 238000010230 functional analysis Methods 0.000 description 1
- 238000001476 gene delivery Methods 0.000 description 1
- 238000003209 gene knockout Methods 0.000 description 1
- 238000003208 gene overexpression Methods 0.000 description 1
- 229960002518 gentamicin Drugs 0.000 description 1
- 229960005219 gentisic acid Drugs 0.000 description 1
- 239000011521 glass Substances 0.000 description 1
- 102000018146 globin Human genes 0.000 description 1
- 108060003196 globin Proteins 0.000 description 1
- 229960004410 glucametacin Drugs 0.000 description 1
- 229960002442 glucosamine Drugs 0.000 description 1
- 239000008103 glucose Substances 0.000 description 1
- 229960002389 glycol salicylate Drugs 0.000 description 1
- PCHJSUWPFVWCPO-UHFFFAOYSA-N gold Chemical compound [Au] PCHJSUWPFVWCPO-UHFFFAOYSA-N 0.000 description 1
- 229940015045 gold sodium thiomalate Drugs 0.000 description 1
- 229940083577 gold sodium thiosulfate Drugs 0.000 description 1
- 229950007488 guamecycline Drugs 0.000 description 1
- 150000002357 guanidines Chemical class 0.000 description 1
- 229940093915 gynecological organic acid Drugs 0.000 description 1
- 229960002475 halometasone Drugs 0.000 description 1
- GGXMRPUKBWXVHE-MIHLVHIWSA-N halometasone Chemical compound C1([C@@H](F)C2)=CC(=O)C(Cl)=C[C@]1(C)[C@]1(F)[C@@H]2[C@@H]2C[C@@H](C)[C@@](C(=O)CO)(O)[C@@]2(C)C[C@@H]1O GGXMRPUKBWXVHE-MIHLVHIWSA-N 0.000 description 1
- 229950004611 halopredone acetate Drugs 0.000 description 1
- 230000036541 health Effects 0.000 description 1
- 210000005003 heart tissue Anatomy 0.000 description 1
- 108010067006 heat stable toxin (E coli) Proteins 0.000 description 1
- 239000000185 hemagglutinin Substances 0.000 description 1
- 201000005787 hematologic cancer Diseases 0.000 description 1
- 208000024200 hematopoietic and lymphoid system neoplasm Diseases 0.000 description 1
- 229960003884 hetacillin Drugs 0.000 description 1
- DXVUYOAEDJXBPY-NFFDBFGFSA-N hetacillin Chemical compound C1([C@@H]2C(=O)N(C(N2)(C)C)[C@H]2[C@H]3SC([C@@H](N3C2=O)C(O)=O)(C)C)=CC=CC=C1 DXVUYOAEDJXBPY-NFFDBFGFSA-N 0.000 description 1
- 239000000833 heterodimer Substances 0.000 description 1
- FUZZWVXGSFPDMH-UHFFFAOYSA-N hexanoic acid Chemical compound CCCCCC(O)=O FUZZWVXGSFPDMH-UHFFFAOYSA-N 0.000 description 1
- 238000013537 high throughput screening Methods 0.000 description 1
- 210000003630 histaminocyte Anatomy 0.000 description 1
- 239000000710 homodimer Substances 0.000 description 1
- 238000000265 homogenisation Methods 0.000 description 1
- 229920002674 hyaluronan Polymers 0.000 description 1
- 229960003160 hyaluronic acid Drugs 0.000 description 1
- 229950000208 hydrocortamate Drugs 0.000 description 1
- FWFVLWGEFDIZMJ-FOMYWIRZSA-N hydrocortamate Chemical compound C1CC2=CC(=O)CC[C@]2(C)[C@@H]2[C@@H]1[C@@H]1CC[C@@](C(=O)COC(=O)CN(CC)CC)(O)[C@@]1(C)C[C@@H]2O FWFVLWGEFDIZMJ-FOMYWIRZSA-N 0.000 description 1
- 229960001067 hydrocortisone acetate Drugs 0.000 description 1
- 229960001524 hydrocortisone butyrate Drugs 0.000 description 1
- 229950000785 hydrocortisone phosphate Drugs 0.000 description 1
- 229950006240 hydrocortisone succinate Drugs 0.000 description 1
- VWQWXZAWFPZJDA-CGVGKPPMSA-N hydrocortisone succinate Chemical compound O=C1CC[C@]2(C)[C@H]3[C@@H](O)C[C@](C)([C@@](CC4)(O)C(=O)COC(=O)CCC(O)=O)[C@@H]4[C@@H]3CCC2=C1 VWQWXZAWFPZJDA-CGVGKPPMSA-N 0.000 description 1
- 239000000017 hydrogel Substances 0.000 description 1
- 229960002163 hydrogen peroxide Drugs 0.000 description 1
- MSYBLBLAMDYKKZ-UHFFFAOYSA-N hydron;pyridine-3-carbonyl chloride;chloride Chemical compound Cl.ClC(=O)C1=CC=CN=C1 MSYBLBLAMDYKKZ-UHFFFAOYSA-N 0.000 description 1
- 229920001477 hydrophilic polymer Polymers 0.000 description 1
- 229960004171 hydroxychloroquine Drugs 0.000 description 1
- XXSMGPRMXLTPCZ-UHFFFAOYSA-N hydroxychloroquine Chemical compound ClC1=CC=C2C(NC(C)CCCN(CCO)CC)=CC=NC2=C1 XXSMGPRMXLTPCZ-UHFFFAOYSA-N 0.000 description 1
- 229960002927 hydroxychloroquine sulfate Drugs 0.000 description 1
- 230000000148 hypercalcaemia Effects 0.000 description 1
- 208000030915 hypercalcemia disease Diseases 0.000 description 1
- 210000003016 hypothalamus Anatomy 0.000 description 1
- CYWFCPPBTWOZSF-UHFFFAOYSA-N ibufenac Chemical compound CC(C)CC1=CC=C(CC(O)=O)C=C1 CYWFCPPBTWOZSF-UHFFFAOYSA-N 0.000 description 1
- 229950009183 ibufenac Drugs 0.000 description 1
- 229960001680 ibuprofen Drugs 0.000 description 1
- 229950005954 ibuprofen piconol Drugs 0.000 description 1
- 229960002182 imipenem Drugs 0.000 description 1
- ZSKVGTPCRGIANV-ZXFLCMHBSA-N imipenem Chemical compound C1C(SCC\N=C\N)=C(C(O)=O)N2C(=O)[C@H]([C@H](O)C)[C@H]21 ZSKVGTPCRGIANV-ZXFLCMHBSA-N 0.000 description 1
- 230000003100 immobilizing effect Effects 0.000 description 1
- 230000001900 immune effect Effects 0.000 description 1
- 208000026278 immune system disease Diseases 0.000 description 1
- 230000005847 immunogenicity Effects 0.000 description 1
- 230000006872 improvement Effects 0.000 description 1
- 238000007901 in situ hybridization Methods 0.000 description 1
- 238000011503 in vivo imaging Methods 0.000 description 1
- 238000011065 in-situ storage Methods 0.000 description 1
- 230000002779 inactivation Effects 0.000 description 1
- 229960000905 indomethacin Drugs 0.000 description 1
- 229960004187 indoprofen Drugs 0.000 description 1
- 239000003701 inert diluent Substances 0.000 description 1
- 230000036512 infertility Effects 0.000 description 1
- 230000004054 inflammatory process Effects 0.000 description 1
- 239000004615 ingredient Substances 0.000 description 1
- 229940041682 inhalant solution Drugs 0.000 description 1
- 229960003786 inosine Drugs 0.000 description 1
- 229940125396 insulin Drugs 0.000 description 1
- 238000001361 intraarterial administration Methods 0.000 description 1
- 238000007918 intramuscular administration Methods 0.000 description 1
- 238000007912 intraperitoneal administration Methods 0.000 description 1
- 239000007928 intraperitoneal injection Substances 0.000 description 1
- 238000007914 intraventricular administration Methods 0.000 description 1
- 239000001573 invertase Substances 0.000 description 1
- 235000011073 invertase Nutrition 0.000 description 1
- 238000004255 ion exchange chromatography Methods 0.000 description 1
- 230000005865 ionizing radiation Effects 0.000 description 1
- 238000001155 isoelectric focusing Methods 0.000 description 1
- 229950004425 isofezolac Drugs 0.000 description 1
- LZRDDINFIHUVCX-UHFFFAOYSA-N isofezolac Chemical compound OC(=O)CC1=C(C=2C=CC=CC=2)C(C=2C=CC=CC=2)=NN1C1=CC=CC=C1 LZRDDINFIHUVCX-UHFFFAOYSA-N 0.000 description 1
- 229950000704 isoprofen Drugs 0.000 description 1
- 150000002540 isothiocyanates Chemical class 0.000 description 1
- 239000000644 isotonic solution Substances 0.000 description 1
- QFGMXJOBTNZHEL-UHFFFAOYSA-N isoxepac Chemical compound O1CC2=CC=CC=C2C(=O)C2=CC(CC(=O)O)=CC=C21 QFGMXJOBTNZHEL-UHFFFAOYSA-N 0.000 description 1
- 229950011455 isoxepac Drugs 0.000 description 1
- YYUAYBYLJSNDCX-UHFFFAOYSA-N isoxicam Chemical compound OC=1C2=CC=CC=C2S(=O)(=O)N(C)C=1C(=O)NC=1C=C(C)ON=1 YYUAYBYLJSNDCX-UHFFFAOYSA-N 0.000 description 1
- 229950002252 isoxicam Drugs 0.000 description 1
- DKYWVDODHFEZIM-UHFFFAOYSA-N ketoprofen Chemical compound OC(=O)C(C)C1=CC=CC(C(=O)C=2C=CC=CC=2)=C1 DKYWVDODHFEZIM-UHFFFAOYSA-N 0.000 description 1
- 229960000991 ketoprofen Drugs 0.000 description 1
- 229960004752 ketorolac Drugs 0.000 description 1
- OZWKMVRBQXNZKK-UHFFFAOYSA-N ketorolac Chemical compound OC(=O)C1CCN2C1=CC=C2C(=O)C1=CC=CC=C1 OZWKMVRBQXNZKK-UHFFFAOYSA-N 0.000 description 1
- 108010045069 keyhole-limpet hemocyanin Proteins 0.000 description 1
- 238000002372 labelling Methods 0.000 description 1
- 229960000433 latamoxef Drugs 0.000 description 1
- 239000000787 lecithin Substances 0.000 description 1
- 235000010445 lecithin Nutrition 0.000 description 1
- 229940067606 lecithin Drugs 0.000 description 1
- 229960000681 leflunomide Drugs 0.000 description 1
- VHOGYURTWQBHIL-UHFFFAOYSA-N leflunomide Chemical compound O1N=CC(C(=O)NC=2C=CC(=CC=2)C(F)(F)F)=C1C VHOGYURTWQBHIL-UHFFFAOYSA-N 0.000 description 1
- 208000032839 leukemia Diseases 0.000 description 1
- 229960001614 levamisole Drugs 0.000 description 1
- 229940010454 licorice Drugs 0.000 description 1
- OJMMVQQUTAEWLP-KIDUDLJLSA-N lincomycin Chemical compound CN1C[C@H](CCC)C[C@H]1C(=O)N[C@H]([C@@H](C)O)[C@@H]1[C@H](O)[C@H](O)[C@@H](O)[C@@H](SC)O1 OJMMVQQUTAEWLP-KIDUDLJLSA-N 0.000 description 1
- 229960005287 lincomycin Drugs 0.000 description 1
- 238000001638 lipofection Methods 0.000 description 1
- 239000007788 liquid Substances 0.000 description 1
- 238000002761 liquid phase assay Methods 0.000 description 1
- 229950005965 lofemizole Drugs 0.000 description 1
- 229960003768 lonazolac Drugs 0.000 description 1
- XVUQHFRQHBLHQD-UHFFFAOYSA-N lonazolac Chemical compound OC(=O)CC1=CN(C=2C=CC=CC=2)N=C1C1=CC=C(Cl)C=C1 XVUQHFRQHBLHQD-UHFFFAOYSA-N 0.000 description 1
- 229960002373 loxoprofen Drugs 0.000 description 1
- BAZQYVYVKYOAGO-UHFFFAOYSA-M loxoprofen sodium hydrate Chemical compound O.O.[Na+].C1=CC(C(C([O-])=O)C)=CC=C1CC1C(=O)CCC1 BAZQYVYVKYOAGO-UHFFFAOYSA-M 0.000 description 1
- 210000004072 lung Anatomy 0.000 description 1
- 201000005202 lung cancer Diseases 0.000 description 1
- 208000020816 lung neoplasm Diseases 0.000 description 1
- 206010025135 lupus erythematosus Diseases 0.000 description 1
- 239000008176 lyophilized powder Substances 0.000 description 1
- 229940072082 magnesium salicylate Drugs 0.000 description 1
- 235000019359 magnesium stearate Nutrition 0.000 description 1
- 230000014759 maintenance of location Effects 0.000 description 1
- 210000001161 mammalian embryo Anatomy 0.000 description 1
- 208000027202 mammary Paget disease Diseases 0.000 description 1
- 239000004579 marble Substances 0.000 description 1
- 238000013178 mathematical model Methods 0.000 description 1
- HAWPXGHAZFHHAD-UHFFFAOYSA-N mechlorethamine Chemical class ClCCN(C)CCCl HAWPXGHAZFHHAD-UHFFFAOYSA-N 0.000 description 1
- 229960004961 mechlorethamine Drugs 0.000 description 1
- 229960000826 meclocycline Drugs 0.000 description 1
- 229960003803 meclofenamic acid Drugs 0.000 description 1
- 229960003464 mefenamic acid Drugs 0.000 description 1
- HYYBABOKPJLUIN-UHFFFAOYSA-N mefenamic acid Chemical compound CC1=CC=CC(NC=2C(=CC=CC=2)C(O)=O)=C1C HYYBABOKPJLUIN-UHFFFAOYSA-N 0.000 description 1
- 201000001441 melanoma Diseases 0.000 description 1
- VDXZNPDIRNWWCW-JFTDCZMZSA-N melittin Chemical compound NCC(=O)N[C@@H]([C@@H](C)CC)C(=O)NCC(=O)N[C@@H](C)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H]([C@@H](C)O)C(=O)NCC(=O)N[C@@H](CC(C)C)C(=O)N1CCC[C@H]1C(=O)N[C@@H](C)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CO)C(=O)N[C@H](C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CCC(N)=O)C(N)=O)CC1=CNC2=CC=CC=C12 VDXZNPDIRNWWCW-JFTDCZMZSA-N 0.000 description 1
- 229960001810 meprednisone Drugs 0.000 description 1
- PIDANAQULIKBQS-RNUIGHNZSA-N meprednisone Chemical compound C1CC2=CC(=O)C=C[C@]2(C)[C@@H]2[C@@H]1[C@@H]1C[C@H](C)[C@@](C(=O)CO)(O)[C@@]1(C)CC2=O PIDANAQULIKBQS-RNUIGHNZSA-N 0.000 description 1
- 229960001428 mercaptopurine Drugs 0.000 description 1
- KBOPZPXVLCULAV-UHFFFAOYSA-N mesalamine Chemical compound NC1=CC=C(O)C(C(O)=O)=C1 KBOPZPXVLCULAV-UHFFFAOYSA-N 0.000 description 1
- 229960004963 mesalazine Drugs 0.000 description 1
- 229940042016 methacycline Drugs 0.000 description 1
- 150000002741 methionine derivatives Chemical class 0.000 description 1
- 229960000485 methotrexate Drugs 0.000 description 1
- IZAGSTRIDUNNOY-UHFFFAOYSA-N methyl 2-[(2,4-dioxo-1h-pyrimidin-5-yl)oxy]acetate Chemical compound COC(=O)COC1=CNC(=O)NC1=O IZAGSTRIDUNNOY-UHFFFAOYSA-N 0.000 description 1
- 150000004702 methyl esters Chemical class 0.000 description 1
- 235000010270 methyl p-hydroxybenzoate Nutrition 0.000 description 1
- 239000004292 methyl p-hydroxybenzoate Substances 0.000 description 1
- 229960002216 methylparaben Drugs 0.000 description 1
- 229960004584 methylprednisolone Drugs 0.000 description 1
- LMINNBXUMGNKMM-UHFFFAOYSA-N metiazinic acid Chemical compound C1=C(CC(O)=O)C=C2N(C)C3=CC=CC=C3SC2=C1 LMINNBXUMGNKMM-UHFFFAOYSA-N 0.000 description 1
- 229950005798 metiazinic acid Drugs 0.000 description 1
- 229960003085 meticillin Drugs 0.000 description 1
- 229960000198 mezlocillin Drugs 0.000 description 1
- YPBATNHYBCGSSN-VWPFQQQWSA-N mezlocillin Chemical compound N([C@@H](C(=O)N[C@H]1[C@H]2SC([C@@H](N2C1=O)C(O)=O)(C)C)C=1C=CC=CC=1)C(=O)N1CCN(S(C)(=O)=O)C1=O YPBATNHYBCGSSN-VWPFQQQWSA-N 0.000 description 1
- 230000000813 microbial effect Effects 0.000 description 1
- 239000003094 microcapsule Substances 0.000 description 1
- 238000000520 microinjection Methods 0.000 description 1
- 229960003248 mifepristone Drugs 0.000 description 1
- 235000013336 milk Nutrition 0.000 description 1
- 239000008267 milk Substances 0.000 description 1
- 210000004080 milk Anatomy 0.000 description 1
- 230000003278 mimic effect Effects 0.000 description 1
- 108091005573 modified proteins Proteins 0.000 description 1
- 102000035118 modified proteins Human genes 0.000 description 1
- 229960005285 mofebutazone Drugs 0.000 description 1
- REOJLIXKJWXUGB-UHFFFAOYSA-N mofebutazone Chemical compound O=C1C(CCCC)C(=O)NN1C1=CC=CC=C1 REOJLIXKJWXUGB-UHFFFAOYSA-N 0.000 description 1
- 230000009149 molecular binding Effects 0.000 description 1
- 238000001823 molecular biology technique Methods 0.000 description 1
- 239000002808 molecular sieve Substances 0.000 description 1
- WOFMFGQZHJDGCX-ZULDAHANSA-N mometasone furoate Chemical compound O([C@]1([C@@]2(C)C[C@H](O)[C@]3(Cl)[C@@]4(C)C=CC(=O)C=C4CC[C@H]3[C@@H]2C[C@H]1C)C(=O)CCl)C(=O)C1=CC=CO1 WOFMFGQZHJDGCX-ZULDAHANSA-N 0.000 description 1
- 229960002744 mometasone furoate Drugs 0.000 description 1
- 150000002772 monosaccharides Chemical class 0.000 description 1
- 229960002186 morpholine salicylate Drugs 0.000 description 1
- 238000002703 mutagenesis Methods 0.000 description 1
- 231100000350 mutagenesis Toxicity 0.000 description 1
- RTGDFNSFWBGLEC-SYZQJQIISA-N mycophenolate mofetil Chemical compound COC1=C(C)C=2COC(=O)C=2C(O)=C1C\C=C(/C)CCC(=O)OCCN1CCOCC1 RTGDFNSFWBGLEC-SYZQJQIISA-N 0.000 description 1
- 229960004866 mycophenolate mofetil Drugs 0.000 description 1
- 210000005012 myelin Anatomy 0.000 description 1
- 210000000066 myeloid cell Anatomy 0.000 description 1
- 108010065781 myosin light chain 2 Proteins 0.000 description 1
- XJVXMWNLQRTRGH-UHFFFAOYSA-N n-(3-methylbut-3-enyl)-2-methylsulfanyl-7h-purin-6-amine Chemical compound CSC1=NC(NCCC(C)=C)=C2NC=NC2=N1 XJVXMWNLQRTRGH-UHFFFAOYSA-N 0.000 description 1
- BLUYEPLOXLPVCJ-INIZCTEOSA-N n-[(1s)-2-[4-(3-aminopropylamino)butylamino]-1-hydroxyethyl]-7-(diaminomethylideneamino)heptanamide Chemical compound NCCCNCCCCNC[C@H](O)NC(=O)CCCCCCNC(N)=N BLUYEPLOXLPVCJ-INIZCTEOSA-N 0.000 description 1
- JORAUNFTUVJTNG-BSTBCYLQSA-N n-[(2s)-4-amino-1-[[(2s,3r)-1-[[(2s)-4-amino-1-oxo-1-[[(3s,6s,9s,12s,15r,18s,21s)-6,9,18-tris(2-aminoethyl)-3-[(1r)-1-hydroxyethyl]-12,15-bis(2-methylpropyl)-2,5,8,11,14,17,20-heptaoxo-1,4,7,10,13,16,19-heptazacyclotricos-21-yl]amino]butan-2-yl]amino]-3-h Chemical compound CC(C)CCCCC(=O)N[C@@H](CCN)C(=O)N[C@H]([C@@H](C)O)CN[C@@H](CCN)C(=O)N[C@H]1CCNC(=O)[C@H]([C@@H](C)O)NC(=O)[C@H](CCN)NC(=O)[C@H](CCN)NC(=O)[C@H](CC(C)C)NC(=O)[C@@H](CC(C)C)NC(=O)[C@H](CCN)NC1=O.CCC(C)CCCCC(=O)N[C@@H](CCN)C(=O)N[C@H]([C@@H](C)O)CN[C@@H](CCN)C(=O)N[C@H]1CCNC(=O)[C@H]([C@@H](C)O)NC(=O)[C@H](CCN)NC(=O)[C@H](CCN)NC(=O)[C@H](CC(C)C)NC(=O)[C@@H](CC(C)C)NC(=O)[C@H](CCN)NC1=O JORAUNFTUVJTNG-BSTBCYLQSA-N 0.000 description 1
- KWUZCAVKPCRJPO-UHFFFAOYSA-N n-ethyl-4-(6-methyl-1,3-benzothiazol-2-yl)aniline Chemical compound C1=CC(NCC)=CC=C1C1=NC2=CC=C(C)C=C2S1 KWUZCAVKPCRJPO-UHFFFAOYSA-N 0.000 description 1
- 229960004270 nabumetone Drugs 0.000 description 1
- 229960000210 nalidixic acid Drugs 0.000 description 1
- MHWLWQUZZRMNGJ-UHFFFAOYSA-N nalidixic acid Chemical compound C1=C(C)N=C2N(CC)C=C(C(O)=O)C(=O)C2=C1 MHWLWQUZZRMNGJ-UHFFFAOYSA-N 0.000 description 1
- CVRCFLFEGNKMEC-UHFFFAOYSA-N naphthalen-1-yl 2-hydroxybenzoate Chemical compound OC1=CC=CC=C1C(=O)OC1=CC=CC2=CC=CC=C12 CVRCFLFEGNKMEC-UHFFFAOYSA-N 0.000 description 1
- 229960002009 naproxen Drugs 0.000 description 1
- CMWTZPSULFXXJA-VIFPVBQESA-N naproxen Chemical compound C1=C([C@H](C)C(O)=O)C=CC2=CC(OC)=CC=C21 CMWTZPSULFXXJA-VIFPVBQESA-N 0.000 description 1
- 229960003940 naproxen sodium Drugs 0.000 description 1
- CDBRNDSHEYLDJV-FVGYRXGTSA-M naproxen sodium Chemical compound [Na+].C1=C([C@H](C)C([O-])=O)C=CC2=CC(OC)=CC=C21 CDBRNDSHEYLDJV-FVGYRXGTSA-M 0.000 description 1
- 229930014626 natural product Natural products 0.000 description 1
- 239000006199 nebulizer Substances 0.000 description 1
- 239000013642 negative control Substances 0.000 description 1
- 229960000808 netilmicin Drugs 0.000 description 1
- ZBGPYVZLYBDXKO-HILBYHGXSA-N netilmycin Chemical compound O([C@@H]1[C@@H](N)C[C@H]([C@@H]([C@H]1O)O[C@@H]1[C@]([C@H](NC)[C@@H](O)CO1)(C)O)NCC)[C@H]1OC(CN)=CC[C@H]1N ZBGPYVZLYBDXKO-HILBYHGXSA-N 0.000 description 1
- 210000002569 neuron Anatomy 0.000 description 1
- 230000000508 neurotrophic effect Effects 0.000 description 1
- 229960000916 niflumic acid Drugs 0.000 description 1
- 229960000965 nimesulide Drugs 0.000 description 1
- HYWYRSMBCFDLJT-UHFFFAOYSA-N nimesulide Chemical compound CS(=O)(=O)NC1=CC=C([N+]([O-])=O)C=C1OC1=CC=CC=C1 HYWYRSMBCFDLJT-UHFFFAOYSA-N 0.000 description 1
- 229920001220 nitrocellulos Polymers 0.000 description 1
- 229960001180 norfloxacin Drugs 0.000 description 1
- OGJPXUAPXNRGGI-UHFFFAOYSA-N norfloxacin Chemical compound C1=C2N(CC)C=C(C(O)=O)C(=O)C2=CC(F)=C1N1CCNCC1 OGJPXUAPXNRGGI-UHFFFAOYSA-N 0.000 description 1
- 210000000633 nuclear envelope Anatomy 0.000 description 1
- 238000007899 nucleic acid hybridization Methods 0.000 description 1
- 229920001778 nylon Polymers 0.000 description 1
- QIQXTHQIDYTFRH-UHFFFAOYSA-N octadecanoic acid Chemical compound CCCCCCCCCCCCCCCCCC(O)=O QIQXTHQIDYTFRH-UHFFFAOYSA-N 0.000 description 1
- OQCDKBAXFALNLD-UHFFFAOYSA-N octadecanoic acid Natural products CCCCCCCC(C)CCCCCCCCC(O)=O OQCDKBAXFALNLD-UHFFFAOYSA-N 0.000 description 1
- 229960001699 ofloxacin Drugs 0.000 description 1
- 210000004248 oligodendroglia Anatomy 0.000 description 1
- 238000006384 oligomerization reaction Methods 0.000 description 1
- 239000002751 oligonucleotide probe Substances 0.000 description 1
- QQBDLJCYGRGAKP-FOCLMDBBSA-N olsalazine Chemical compound C1=C(O)C(C(=O)O)=CC(\N=N\C=2C=C(C(O)=CC=2)C(O)=O)=C1 QQBDLJCYGRGAKP-FOCLMDBBSA-N 0.000 description 1
- 229960004110 olsalazine Drugs 0.000 description 1
- 238000005457 optimization Methods 0.000 description 1
- 150000007524 organic acids Chemical class 0.000 description 1
- 235000005985 organic acids Nutrition 0.000 description 1
- 230000003204 osmotic effect Effects 0.000 description 1
- 230000011164 ossification Effects 0.000 description 1
- 201000008482 osteoarthritis Diseases 0.000 description 1
- UWYHMGVUTGAWSP-JKIFEVAISA-N oxacillin Chemical compound N([C@@H]1C(N2[C@H](C(C)(C)S[C@@H]21)C(O)=O)=O)C(=O)C1=C(C)ON=C1C1=CC=CC=C1 UWYHMGVUTGAWSP-JKIFEVAISA-N 0.000 description 1
- 229960001019 oxacillin Drugs 0.000 description 1
- 229960000273 oxametacin Drugs 0.000 description 1
- AJRNYCDWNITGHF-UHFFFAOYSA-N oxametacin Chemical compound CC1=C(CC(=O)NO)C2=CC(OC)=CC=C2N1C(=O)C1=CC=C(Cl)C=C1 AJRNYCDWNITGHF-UHFFFAOYSA-N 0.000 description 1
- 229950004426 oxapadol Drugs 0.000 description 1
- 229960002739 oxaprozin Drugs 0.000 description 1
- OFPXSFXSNFPTHF-UHFFFAOYSA-N oxaprozin Chemical compound O1C(CCC(=O)O)=NC(C=2C=CC=CC=2)=C1C1=CC=CC=C1 OFPXSFXSNFPTHF-UHFFFAOYSA-N 0.000 description 1
- 230000003647 oxidation Effects 0.000 description 1
- 238000007254 oxidation reaction Methods 0.000 description 1
- 230000001590 oxidative effect Effects 0.000 description 1
- 229960000649 oxyphenbutazone Drugs 0.000 description 1
- HFHZKZSRXITVMK-UHFFFAOYSA-N oxyphenbutazone Chemical compound O=C1C(CCCC)C(=O)N(C=2C=CC=CC=2)N1C1=CC=C(O)C=C1 HFHZKZSRXITVMK-UHFFFAOYSA-N 0.000 description 1
- 230000000242 pagocytic effect Effects 0.000 description 1
- FJKROLUGYXJWQN-UHFFFAOYSA-N papa-hydroxy-benzoic acid Natural products OC(=O)C1=CC=C(O)C=C1 FJKROLUGYXJWQN-UHFFFAOYSA-N 0.000 description 1
- DXHYQIJBUNRPJT-UHFFFAOYSA-N parsalmide Chemical compound CCCCNC(=O)C1=CC(N)=CC=C1OCC#C DXHYQIJBUNRPJT-UHFFFAOYSA-N 0.000 description 1
- 239000002245 particle Substances 0.000 description 1
- 230000000149 penetrating effect Effects 0.000 description 1
- 230000035515 penetration Effects 0.000 description 1
- 229960001639 penicillamine Drugs 0.000 description 1
- 229940049954 penicillin Drugs 0.000 description 1
- 229940056360 penicillin g Drugs 0.000 description 1
- 229940056367 penicillin v Drugs 0.000 description 1
- 229950009506 penicillinase Drugs 0.000 description 1
- 150000002960 penicillins Chemical class 0.000 description 1
- 239000000816 peptidomimetic Substances 0.000 description 1
- 208000028169 periodontal disease Diseases 0.000 description 1
- 210000001322 periplasm Anatomy 0.000 description 1
- 239000012466 permeate Substances 0.000 description 1
- BPLBGHOLXOTWMN-MBNYWOFBSA-N phenoxymethylpenicillin Chemical compound N([C@H]1[C@H]2SC([C@@H](N2C1=O)C(O)=O)(C)C)C(=O)COC1=CC=CC=C1 BPLBGHOLXOTWMN-MBNYWOFBSA-N 0.000 description 1
- PSBAIJVSCTZDDB-UHFFFAOYSA-N phenyl acetylsalicylate Chemical compound CC(=O)OC1=CC=CC=C1C(=O)OC1=CC=CC=C1 PSBAIJVSCTZDDB-UHFFFAOYSA-N 0.000 description 1
- 229950009058 phenyl acetylsalicylate Drugs 0.000 description 1
- 229960000969 phenyl salicylate Drugs 0.000 description 1
- 229960002895 phenylbutazone Drugs 0.000 description 1
- VYMDGNCVAMGZFE-UHFFFAOYSA-N phenylbutazonum Chemical compound O=C1C(CCCC)C(=O)N(C=2C=CC=CC=2)N1C1=CC=CC=C1 VYMDGNCVAMGZFE-UHFFFAOYSA-N 0.000 description 1
- NBIIXXVUZAFLBC-UHFFFAOYSA-K phosphate Chemical compound [O-]P([O-])([O-])=O NBIIXXVUZAFLBC-UHFFFAOYSA-K 0.000 description 1
- 239000010452 phosphate Substances 0.000 description 1
- 150000003013 phosphoric acid derivatives Chemical class 0.000 description 1
- 230000026731 phosphorylation Effects 0.000 description 1
- 238000006366 phosphorylation reaction Methods 0.000 description 1
- 239000002504 physiological saline solution Substances 0.000 description 1
- 229950006452 pifoxime Drugs 0.000 description 1
- 229960001503 piketoprofen Drugs 0.000 description 1
- ASFKKFRSMGBFRO-UHFFFAOYSA-N piketoprofen Chemical compound C=1C=CC(C(=O)C=2C=CC=CC=2)=CC=1C(C)C(=O)NC1=CC(C)=CC=N1 ASFKKFRSMGBFRO-UHFFFAOYSA-N 0.000 description 1
- XGNKHIPCARGLGS-UHFFFAOYSA-N pipebuzone Chemical compound O=C1N(C=2C=CC=CC=2)N(C=2C=CC=CC=2)C(=O)C1(CCCC)CN1CCN(C)CC1 XGNKHIPCARGLGS-UHFFFAOYSA-N 0.000 description 1
- 229950004769 pipebuzone Drugs 0.000 description 1
- 229960002292 piperacillin Drugs 0.000 description 1
- WCMIIGXFCMNQDS-IDYPWDAWSA-M piperacillin sodium Chemical compound [Na+].O=C1C(=O)N(CC)CCN1C(=O)N[C@H](C=1C=CC=CC=1)C(=O)N[C@@H]1C(=O)N2[C@@H](C([O-])=O)C(C)(C)S[C@@H]21 WCMIIGXFCMNQDS-IDYPWDAWSA-M 0.000 description 1
- 229960002702 piroxicam Drugs 0.000 description 1
- QYSPLQLAKJAUJT-UHFFFAOYSA-N piroxicam Chemical compound OC=1C2=CC=CC=C2S(=O)(=O)N(C)C=1C(=O)NC1=CC=CC=N1 QYSPLQLAKJAUJT-UHFFFAOYSA-N 0.000 description 1
- 210000002826 placenta Anatomy 0.000 description 1
- 230000027086 plasmid maintenance Effects 0.000 description 1
- 229920001983 poloxamer Polymers 0.000 description 1
- 229920001200 poly(ethylene-vinyl acetate) Polymers 0.000 description 1
- 229920000728 polyester Polymers 0.000 description 1
- 239000004633 polyglycolic acid Substances 0.000 description 1
- 229920002704 polyhistidine Polymers 0.000 description 1
- 229920002338 polyhydroxyethylmethacrylate Polymers 0.000 description 1
- 239000004626 polylactic acid Substances 0.000 description 1
- 229920000024 polymyxin B Polymers 0.000 description 1
- XDJYMJULXQKGMM-UHFFFAOYSA-N polymyxin E1 Natural products CCC(C)CCCCC(=O)NC(CCN)C(=O)NC(C(C)O)C(=O)NC(CCN)C(=O)NC1CCNC(=O)C(C(C)O)NC(=O)C(CCN)NC(=O)C(CCN)NC(=O)C(CC(C)C)NC(=O)C(CC(C)C)NC(=O)C(CCN)NC1=O XDJYMJULXQKGMM-UHFFFAOYSA-N 0.000 description 1
- KNIWPHSUTGNZST-UHFFFAOYSA-N polymyxin E2 Natural products CC(C)CCCCC(=O)NC(CCN)C(=O)NC(C(C)O)C(=O)NC(CCN)C(=O)NC1CCNC(=O)C(C(C)O)NC(=O)C(CCN)NC(=O)C(CCN)NC(=O)C(CC(C)C)NC(=O)C(CC(C)C)NC(=O)C(CCN)NC1=O KNIWPHSUTGNZST-UHFFFAOYSA-N 0.000 description 1
- 229960005266 polymyxin b Drugs 0.000 description 1
- 229940041153 polymyxins Drugs 0.000 description 1
- 239000000256 polyoxyethylene sorbitan monolaurate Substances 0.000 description 1
- 235000010486 polyoxyethylene sorbitan monolaurate Nutrition 0.000 description 1
- 239000000244 polyoxyethylene sorbitan monooleate Substances 0.000 description 1
- 235000010482 polyoxyethylene sorbitan monooleate Nutrition 0.000 description 1
- 229920000136 polysorbate Polymers 0.000 description 1
- 229950008882 polysorbate Drugs 0.000 description 1
- 229940068977 polysorbate 20 Drugs 0.000 description 1
- 229920000053 polysorbate 80 Polymers 0.000 description 1
- 229940068968 polysorbate 80 Drugs 0.000 description 1
- 210000003240 portal vein Anatomy 0.000 description 1
- 239000013641 positive control Substances 0.000 description 1
- 230000023603 positive regulation of transcription initiation, DNA-dependent Effects 0.000 description 1
- 230000029279 positive regulation of transcription, DNA-dependent Effects 0.000 description 1
- 239000001103 potassium chloride Substances 0.000 description 1
- 235000011164 potassium chloride Nutrition 0.000 description 1
- 239000000843 powder Substances 0.000 description 1
- 229960003101 pranoprofen Drugs 0.000 description 1
- 239000002244 precipitate Substances 0.000 description 1
- 238000001556 precipitation Methods 0.000 description 1
- 239000002243 precursor Substances 0.000 description 1
- JDOZJEUDSLGTLU-VWUMJDOOSA-N prednisolone phosphate Chemical compound O=C1C=C[C@]2(C)[C@H]3[C@@H](O)C[C@](C)([C@@](CC4)(O)C(=O)COP(O)(O)=O)[C@@H]4[C@@H]3CCC2=C1 JDOZJEUDSLGTLU-VWUMJDOOSA-N 0.000 description 1
- 229960002943 prednisolone sodium phosphate Drugs 0.000 description 1
- APGDTXUMTIZLCJ-CGVGKPPMSA-N prednisolone succinate Chemical compound O=C1C=C[C@]2(C)[C@H]3[C@@H](O)C[C@](C)([C@@](CC4)(O)C(=O)COC(=O)CCC(O)=O)[C@@H]4[C@@H]3CCC2=C1 APGDTXUMTIZLCJ-CGVGKPPMSA-N 0.000 description 1
- 229950004597 prednisolone succinate Drugs 0.000 description 1
- 229960004259 prednisolone tebutate Drugs 0.000 description 1
- 229960004618 prednisone Drugs 0.000 description 1
- XOFYZVNMUHMLCC-ZPOLXVRWSA-N prednisone Chemical compound O=C1C=C[C@]2(C)[C@H]3C(=O)C[C@](C)([C@@](CC4)(O)C(=O)CO)[C@@H]4[C@@H]3CCC2=C1 XOFYZVNMUHMLCC-ZPOLXVRWSA-N 0.000 description 1
- WSVOMANDJDYYEY-CWNVBEKCSA-N prednylidene Chemical group O=C1C=C[C@]2(C)[C@H]3[C@@H](O)C[C@](C)([C@@](C(=C)C4)(O)C(=O)CO)[C@@H]4[C@@H]3CCC2=C1 WSVOMANDJDYYEY-CWNVBEKCSA-N 0.000 description 1
- 239000000955 prescription drug Substances 0.000 description 1
- 239000003755 preservative agent Substances 0.000 description 1
- 230000002335 preservative effect Effects 0.000 description 1
- 102000003998 progesterone receptors Human genes 0.000 description 1
- 108090000468 progesterone receptors Proteins 0.000 description 1
- 150000003146 progesterones Chemical class 0.000 description 1
- 230000001737 promoting effect Effects 0.000 description 1
- 230000001915 proofreading effect Effects 0.000 description 1
- 235000010232 propyl p-hydroxybenzoate Nutrition 0.000 description 1
- 239000004405 propyl p-hydroxybenzoate Substances 0.000 description 1
- 229960003415 propylparaben Drugs 0.000 description 1
- 150000003180 prostaglandins Chemical class 0.000 description 1
- 238000001742 protein purification Methods 0.000 description 1
- 230000002797 proteolythic effect Effects 0.000 description 1
- OLTAWOVKGWWERU-UHFFFAOYSA-N proxazole Chemical compound C=1C=CC=CC=1C(CC)C1=NOC(CCN(CC)CC)=N1 OLTAWOVKGWWERU-UHFFFAOYSA-N 0.000 description 1
- 229960001801 proxazole Drugs 0.000 description 1
- 239000002510 pyrogen Substances 0.000 description 1
- 229940048084 pyrophosphate Drugs 0.000 description 1
- MIXMJCQRHVAJIO-TZHJZOAOSA-N qk4dys664x Chemical compound O.C1([C@@H](F)C2)=CC(=O)C=C[C@]1(C)[C@@H]1[C@@H]2[C@@H]2C[C@H]3OC(C)(C)O[C@@]3(C(=O)CO)[C@@]2(C)C[C@@H]1O.C1([C@@H](F)C2)=CC(=O)C=C[C@]1(C)[C@@H]1[C@@H]2[C@@H]2C[C@H]3OC(C)(C)O[C@@]3(C(=O)CO)[C@@]2(C)C[C@@H]1O MIXMJCQRHVAJIO-TZHJZOAOSA-N 0.000 description 1
- 238000011002 quantification Methods 0.000 description 1
- 150000007660 quinolones Chemical class 0.000 description 1
- 230000005855 radiation Effects 0.000 description 1
- 230000002285 radioactive effect Effects 0.000 description 1
- 229950000385 ramifenazone Drugs 0.000 description 1
- ZAHRKKWIAAJSAO-UHFFFAOYSA-N rapamycin Natural products COCC(O)C(=C/C(C)C(=O)CC(OC(=O)C1CCCCN1C(=O)C(=O)C2(O)OC(CC(OC)C(=CC=CC=CC(C)CC(C)C(=O)C)C)CCC2C)C(C)CC3CCC(O)C(C3)OC)C ZAHRKKWIAAJSAO-UHFFFAOYSA-N 0.000 description 1
- 230000008707 rearrangement Effects 0.000 description 1
- 238000003259 recombinant expression Methods 0.000 description 1
- 238000010188 recombinant method Methods 0.000 description 1
- 230000009467 reduction Effects 0.000 description 1
- 238000006722 reduction reaction Methods 0.000 description 1
- 238000005932 reductive alkylation reaction Methods 0.000 description 1
- 230000022532 regulation of transcription, DNA-dependent Effects 0.000 description 1
- 208000037803 restenosis Diseases 0.000 description 1
- 206010039073 rheumatoid arthritis Diseases 0.000 description 1
- PYWVYCXTNDRMGF-UHFFFAOYSA-N rhodamine B Chemical compound [Cl-].C=12C=CC(=[N+](CC)CC)C=C2OC2=CC(N(CC)CC)=CC=C2C=1C1=CC=CC=C1C(O)=O PYWVYCXTNDRMGF-UHFFFAOYSA-N 0.000 description 1
- JQXXHWHPUNPDRT-WLSIYKJHSA-N rifampicin Chemical compound O([C@](C1=O)(C)O/C=C/[C@@H]([C@H]([C@@H](OC(C)=O)[C@H](C)[C@H](O)[C@H](C)[C@@H](O)[C@@H](C)\C=C\C=C(C)/C(=O)NC=2C(O)=C3C([O-])=C4C)C)OC)C4=C1C3=C(O)C=2\C=N\N1CC[NH+](C)CC1 JQXXHWHPUNPDRT-WLSIYKJHSA-N 0.000 description 1
- 229960001225 rifampicin Drugs 0.000 description 1
- LCXASZQUGJCXBG-SUMWQHHRSA-N s057 Chemical compound C1([C@]23OC[C@@H](O3)CN3C4=CC=CC=C4N=C23)=CC=CC=C1 LCXASZQUGJCXBG-SUMWQHHRSA-N 0.000 description 1
- JZWFDVDETGFGFC-UHFFFAOYSA-N salacetamide Chemical compound CC(=O)NC(=O)C1=CC=CC=C1O JZWFDVDETGFGFC-UHFFFAOYSA-N 0.000 description 1
- 229950009280 salacetamide Drugs 0.000 description 1
- RLISWLLILOTWGG-UHFFFAOYSA-N salamidacetic acid Chemical compound NC(=O)C1=CC=CC=C1OCC(O)=O RLISWLLILOTWGG-UHFFFAOYSA-N 0.000 description 1
- 229950000417 salamidacetic acid Drugs 0.000 description 1
- 229960001860 salicylate Drugs 0.000 description 1
- YGSDEFSMJLZEOE-UHFFFAOYSA-M salicylate Chemical compound OC1=CC=CC=C1C([O-])=O YGSDEFSMJLZEOE-UHFFFAOYSA-M 0.000 description 1
- 229960004889 salicylic acid Drugs 0.000 description 1
- 229960000953 salsalate Drugs 0.000 description 1
- 229950000614 sancycline Drugs 0.000 description 1
- 238000002864 sequence alignment Methods 0.000 description 1
- 230000035939 shock Effects 0.000 description 1
- 229960002930 sirolimus Drugs 0.000 description 1
- QFJCIRLUMZQUOT-HPLJOQBZSA-N sirolimus Chemical compound C1C[C@@H](O)[C@H](OC)C[C@@H]1C[C@@H](C)[C@H]1OC(=O)[C@@H]2CCCCN2C(=O)C(=O)[C@](O)(O2)[C@H](C)CC[C@H]2C[C@H](OC)/C(C)=C/C=C/C=C/[C@@H](C)C[C@@H](C)C(=O)[C@H](OC)[C@H](O)/C(C)=C/[C@@H](C)C(=O)C1 QFJCIRLUMZQUOT-HPLJOQBZSA-N 0.000 description 1
- 238000002741 site-directed mutagenesis Methods 0.000 description 1
- 210000002027 skeletal muscle Anatomy 0.000 description 1
- 229940126586 small molecule drug Drugs 0.000 description 1
- URGAHOPLAPQHLN-UHFFFAOYSA-N sodium aluminosilicate Chemical compound [Na+].[Al+3].[O-][Si]([O-])=O.[O-][Si]([O-])=O URGAHOPLAPQHLN-UHFFFAOYSA-N 0.000 description 1
- 229910000029 sodium carbonate Inorganic materials 0.000 description 1
- FQENQNTWSFEDLI-UHFFFAOYSA-J sodium diphosphate Chemical compound [Na+].[Na+].[Na+].[Na+].[O-]P([O-])(=O)OP([O-])([O-])=O FQENQNTWSFEDLI-UHFFFAOYSA-J 0.000 description 1
- 238000002415 sodium dodecyl sulfate polyacrylamide gel electrophoresis Methods 0.000 description 1
- 229940079827 sodium hydrogen sulfite Drugs 0.000 description 1
- 235000010267 sodium hydrogen sulphite Nutrition 0.000 description 1
- OGPIIGMUPMPMNT-UHFFFAOYSA-M sodium meclofenamate (anhydrous) Chemical compound [Na+].CC1=CC=C(Cl)C(NC=2C(=CC=CC=2)C([O-])=O)=C1Cl OGPIIGMUPMPMNT-UHFFFAOYSA-M 0.000 description 1
- 229940048086 sodium pyrophosphate Drugs 0.000 description 1
- 229960004025 sodium salicylate Drugs 0.000 description 1
- 235000010265 sodium sulphite Nutrition 0.000 description 1
- JGMJQSFLQWGYMQ-UHFFFAOYSA-M sodium;2,6-dichloro-n-phenylaniline;acetate Chemical compound [Na+].CC([O-])=O.ClC1=CC=CC(Cl)=C1NC1=CC=CC=C1 JGMJQSFLQWGYMQ-UHFFFAOYSA-M 0.000 description 1
- HFPGULMERUXXDW-UHFFFAOYSA-M sodium;2-carboxybenzenesulfonate Chemical compound [Na+].OS(=O)(=O)C1=CC=CC=C1C([O-])=O HFPGULMERUXXDW-UHFFFAOYSA-M 0.000 description 1
- AGHLUVOCTHWMJV-UHFFFAOYSA-J sodium;gold(3+);2-sulfanylbutanedioate Chemical compound [Na+].[Au+3].[O-]C(=O)CC(S)C([O-])=O.[O-]C(=O)CC(S)C([O-])=O AGHLUVOCTHWMJV-UHFFFAOYSA-J 0.000 description 1
- 239000007909 solid dosage form Substances 0.000 description 1
- 238000000527 sonication Methods 0.000 description 1
- 235000010199 sorbic acid Nutrition 0.000 description 1
- 239000004334 sorbic acid Substances 0.000 description 1
- 229940075582 sorbic acid Drugs 0.000 description 1
- 238000001179 sorption measurement Methods 0.000 description 1
- 229960004954 sparfloxacin Drugs 0.000 description 1
- DZZWHBIBMUVIIW-DTORHVGOSA-N sparfloxacin Chemical compound C1[C@@H](C)N[C@@H](C)CN1C1=C(F)C(N)=C2C(=O)C(C(O)=O)=CN(C3CC3)C2=C1F DZZWHBIBMUVIIW-DTORHVGOSA-N 0.000 description 1
- 229960001294 spiramycin Drugs 0.000 description 1
- 235000019372 spiramycin Nutrition 0.000 description 1
- 229930191512 spiramycin Natural products 0.000 description 1
- 239000008107 starch Substances 0.000 description 1
- 235000019698 starch Nutrition 0.000 description 1
- 239000008117 stearic acid Substances 0.000 description 1
- WNIFXKPDILJURQ-UHFFFAOYSA-N stearyl glycyrrhizinate Natural products C1CC(O)C(C)(C)C2CCC3(C)C4(C)CCC5(C)CCC(C(=O)OCCCCCCCCCCCCCCCCCC)(C)CC5C4=CC(=O)C3C21C WNIFXKPDILJURQ-UHFFFAOYSA-N 0.000 description 1
- 210000000130 stem cell Anatomy 0.000 description 1
- 238000011146 sterile filtration Methods 0.000 description 1
- 239000008223 sterile water Substances 0.000 description 1
- 230000001954 sterilising effect Effects 0.000 description 1
- 238000004659 sterilization and disinfection Methods 0.000 description 1
- 239000003270 steroid hormone Substances 0.000 description 1
- 102000005969 steroid hormone receptors Human genes 0.000 description 1
- 108020003113 steroid hormone receptors Proteins 0.000 description 1
- 238000013517 stratification Methods 0.000 description 1
- 229960005322 streptomycin Drugs 0.000 description 1
- 238000012916 structural analysis Methods 0.000 description 1
- 238000007920 subcutaneous administration Methods 0.000 description 1
- 239000007929 subcutaneous injection Substances 0.000 description 1
- 239000000758 substrate Substances 0.000 description 1
- 229950005175 sudoxicam Drugs 0.000 description 1
- 150000005846 sugar alcohols Chemical class 0.000 description 1
- 229960002673 sulfacetamide Drugs 0.000 description 1
- SKIVFJLNDNKQPD-UHFFFAOYSA-N sulfacetamide Chemical compound CC(=O)NS(=O)(=O)C1=CC=C(N)C=C1 SKIVFJLNDNKQPD-UHFFFAOYSA-N 0.000 description 1
- 229960004306 sulfadiazine Drugs 0.000 description 1
- SEEPANYCNGTZFQ-UHFFFAOYSA-N sulfadiazine Chemical compound C1=CC(N)=CC=C1S(=O)(=O)NC1=NC=CC=N1 SEEPANYCNGTZFQ-UHFFFAOYSA-N 0.000 description 1
- 229960000654 sulfafurazole Drugs 0.000 description 1
- 229960005404 sulfamethoxazole Drugs 0.000 description 1
- FDDDEECHVMSUSB-UHFFFAOYSA-N sulfanilamide Chemical compound NC1=CC=C(S(N)(=O)=O)C=C1 FDDDEECHVMSUSB-UHFFFAOYSA-N 0.000 description 1
- NCEXYHBECQHGNR-QZQOTICOSA-N sulfasalazine Chemical compound C1=C(O)C(C(=O)O)=CC(\N=N\C=2C=CC(=CC=2)S(=O)(=O)NC=2N=CC=CC=2)=C1 NCEXYHBECQHGNR-QZQOTICOSA-N 0.000 description 1
- 229960001940 sulfasalazine Drugs 0.000 description 1
- NCEXYHBECQHGNR-UHFFFAOYSA-N sulfasalazine Natural products C1=C(O)C(C(=O)O)=CC(N=NC=2C=CC(=CC=2)S(=O)(=O)NC=2N=CC=CC=2)=C1 NCEXYHBECQHGNR-UHFFFAOYSA-N 0.000 description 1
- JLKIGFTWXXRPMT-UHFFFAOYSA-N sulphamethoxazole Chemical compound O1C(C)=CC(NS(=O)(=O)C=2C=CC(N)=CC=2)=N1 JLKIGFTWXXRPMT-UHFFFAOYSA-N 0.000 description 1
- 239000013589 supplement Substances 0.000 description 1
- 229960004492 suprofen Drugs 0.000 description 1
- 238000002198 surface plasmon resonance spectroscopy Methods 0.000 description 1
- 239000000725 suspension Substances 0.000 description 1
- 230000002194 synthesizing effect Effects 0.000 description 1
- 230000009885 systemic effect Effects 0.000 description 1
- 239000000454 talc Substances 0.000 description 1
- 235000012222 talc Nutrition 0.000 description 1
- 229910052623 talc Inorganic materials 0.000 description 1
- 229960005262 talniflumate Drugs 0.000 description 1
- 229960004576 temafloxacin Drugs 0.000 description 1
- 229960002871 tenoxicam Drugs 0.000 description 1
- LZNWYQJJBLGYLT-UHFFFAOYSA-N tenoxicam Chemical compound OC=1C=2SC=CC=2S(=O)(=O)N(C)C=1C(=O)NC1=CC=CC=N1 LZNWYQJJBLGYLT-UHFFFAOYSA-N 0.000 description 1
- 238000010998 test method Methods 0.000 description 1
- 201000003120 testicular cancer Diseases 0.000 description 1
- 210000001550 testis Anatomy 0.000 description 1
- 108700020534 tetracycline resistance-encoding transposon repressor Proteins 0.000 description 1
- 229940040944 tetracyclines Drugs 0.000 description 1
- 235000019818 tetrasodium diphosphate Nutrition 0.000 description 1
- 239000001577 tetrasodium phosphonato phosphate Substances 0.000 description 1
- RTKIYNMVFMVABJ-UHFFFAOYSA-L thimerosal Chemical compound [Na+].CC[Hg]SC1=CC=CC=C1C([O-])=O RTKIYNMVFMVABJ-UHFFFAOYSA-L 0.000 description 1
- 229940033663 thimerosal Drugs 0.000 description 1
- 150000003573 thiols Chemical class 0.000 description 1
- 229960002175 thyroglobulin Drugs 0.000 description 1
- 229950000140 tiflamizole Drugs 0.000 description 1
- 229950006150 tioxaprofen Drugs 0.000 description 1
- 229960004631 tixocortol Drugs 0.000 description 1
- YWDBSCORAARPPF-VWUMJDOOSA-N tixocortol Chemical compound O=C1CC[C@]2(C)[C@H]3[C@@H](O)C[C@](C)([C@@](CC4)(O)C(=O)CS)[C@@H]4[C@@H]3CCC2=C1 YWDBSCORAARPPF-VWUMJDOOSA-N 0.000 description 1
- 229960000707 tobramycin Drugs 0.000 description 1
- NLVFBUXFDBBNBW-PBSUHMDJSA-N tobramycin Chemical compound N[C@@H]1C[C@H](O)[C@@H](CN)O[C@@H]1O[C@H]1[C@H](O)[C@@H](O[C@@H]2[C@@H]([C@@H](N)[C@H](O)[C@@H](CO)O2)O)[C@H](N)C[C@@H]1N NLVFBUXFDBBNBW-PBSUHMDJSA-N 0.000 description 1
- 229960002905 tolfenamic acid Drugs 0.000 description 1
- YEZNLOUZAIOMLT-UHFFFAOYSA-N tolfenamic acid Chemical compound CC1=C(Cl)C=CC=C1NC1=CC=CC=C1C(O)=O YEZNLOUZAIOMLT-UHFFFAOYSA-N 0.000 description 1
- 229960001017 tolmetin Drugs 0.000 description 1
- UPSPUYADGBWSHF-UHFFFAOYSA-N tolmetin Chemical compound C1=CC(C)=CC=C1C(=O)C1=CC=C(CC(O)=O)N1C UPSPUYADGBWSHF-UHFFFAOYSA-N 0.000 description 1
- 229960002044 tolmetin sodium Drugs 0.000 description 1
- 231100000419 toxicity Toxicity 0.000 description 1
- 230000001988 toxicity Effects 0.000 description 1
- 239000003053 toxin Substances 0.000 description 1
- 231100000765 toxin Toxicity 0.000 description 1
- 108700012359 toxins Proteins 0.000 description 1
- 230000014621 translational initiation Effects 0.000 description 1
- 230000032258 transport Effects 0.000 description 1
- ODLHGICHYURWBS-LKONHMLTSA-N trappsol cyclo Chemical compound CC(O)COC[C@H]([C@H]([C@@H]([C@H]1O)O)O[C@H]2O[C@@H]([C@@H](O[C@H]3O[C@H](COCC(C)O)[C@H]([C@@H]([C@H]3O)O)O[C@H]3O[C@H](COCC(C)O)[C@H]([C@@H]([C@H]3O)O)O[C@H]3O[C@H](COCC(C)O)[C@H]([C@@H]([C@H]3O)O)O[C@H]3O[C@H](COCC(C)O)[C@H]([C@@H]([C@H]3O)O)O3)[C@H](O)[C@H]2O)COCC(O)C)O[C@@H]1O[C@H]1[C@H](O)[C@@H](O)[C@@H]3O[C@@H]1COCC(C)O ODLHGICHYURWBS-LKONHMLTSA-N 0.000 description 1
- 229960002117 triamcinolone acetonide Drugs 0.000 description 1
- YNDXUCZADRHECN-JNQJZLCISA-N triamcinolone acetonide Chemical compound C1CC2=CC(=O)C=C[C@]2(C)[C@]2(F)[C@@H]1[C@@H]1C[C@H]3OC(C)(C)O[C@@]3(C(=O)CO)[C@@]1(C)C[C@@H]2O YNDXUCZADRHECN-JNQJZLCISA-N 0.000 description 1
- FYZXEMANQYHCFX-UHFFFAOYSA-K tripotassium;2-[2-[bis(carboxylatomethyl)amino]ethyl-(carboxymethyl)amino]acetate Chemical compound [K+].[K+].[K+].OC(=O)CN(CC([O-])=O)CCN(CC([O-])=O)CC([O-])=O FYZXEMANQYHCFX-UHFFFAOYSA-K 0.000 description 1
- FQCQGOZEWWPOKI-UHFFFAOYSA-K trisalicylate-choline Chemical compound [Mg+2].C[N+](C)(C)CCO.OC1=CC=CC=C1C([O-])=O.OC1=CC=CC=C1C([O-])=O.OC1=CC=CC=C1C([O-])=O FQCQGOZEWWPOKI-UHFFFAOYSA-K 0.000 description 1
- KZNBHWLDPGWJMM-UHFFFAOYSA-J trisodium;dioxido-oxo-sulfanylidene-$l^{6}-sulfane;gold(1+);dihydrate Chemical compound O.O.[Na+].[Na+].[Na+].[Au+].[O-]S([O-])(=O)=S.[O-]S([O-])(=O)=S KZNBHWLDPGWJMM-UHFFFAOYSA-J 0.000 description 1
- GPRLSGONYQIRFK-MNYXATJNSA-N triton Chemical compound [3H+] GPRLSGONYQIRFK-MNYXATJNSA-N 0.000 description 1
- 229960000281 trometamol Drugs 0.000 description 1
- 239000002753 trypsin inhibitor Substances 0.000 description 1
- 229920001664 tyloxapol Polymers 0.000 description 1
- MDYZKJNTKZIUSK-UHFFFAOYSA-N tyloxapol Chemical compound O=C.C1CO1.CC(C)(C)CC(C)(C)C1=CC=C(O)C=C1 MDYZKJNTKZIUSK-UHFFFAOYSA-N 0.000 description 1
- 229960004224 tyloxapol Drugs 0.000 description 1
- 108010087967 type I signal peptidase Proteins 0.000 description 1
- 229950010121 ufenamate Drugs 0.000 description 1
- 241000712461 unidentified influenza virus Species 0.000 description 1
- 230000002792 vascular Effects 0.000 description 1
- 235000015112 vegetable and seed oil Nutrition 0.000 description 1
- 239000008158 vegetable oil Substances 0.000 description 1
- OGWKCGZFUXNPDA-XQKSVPLYSA-N vincristine Chemical compound C([N@]1C[C@@H](C[C@]2(C(=O)OC)C=3C(=CC4=C([C@]56[C@H]([C@@]([C@H](OC(C)=O)[C@]7(CC)C=CCN([C@H]67)CC5)(O)C(=O)OC)N4C=O)C=3)OC)C[C@@](C1)(O)CC)CC1=C2NC2=CC=CC=C12 OGWKCGZFUXNPDA-XQKSVPLYSA-N 0.000 description 1
- OGWKCGZFUXNPDA-UHFFFAOYSA-N vincristine Natural products C1C(CC)(O)CC(CC2(C(=O)OC)C=3C(=CC4=C(C56C(C(C(OC(C)=O)C7(CC)C=CCN(C67)CC5)(O)C(=O)OC)N4C=O)C=3)OC)CN1CCC1=C2NC2=CC=CC=C12 OGWKCGZFUXNPDA-UHFFFAOYSA-N 0.000 description 1
- 229960004528 vincristine Drugs 0.000 description 1
- 239000011534 wash buffer Substances 0.000 description 1
- 239000001993 wax Substances 0.000 description 1
- 238000001262 western blot Methods 0.000 description 1
- 239000000080 wetting agent Substances 0.000 description 1
Images
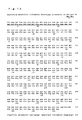
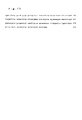
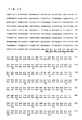
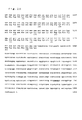
Classifications
-
- G—PHYSICS
- G01—MEASURING; TESTING
- G01N—INVESTIGATING OR ANALYSING MATERIALS BY DETERMINING THEIR CHEMICAL OR PHYSICAL PROPERTIES
- G01N33/00—Investigating or analysing materials by specific methods not covered by groups G01N1/00 - G01N31/00
- G01N33/48—Biological material, e.g. blood, urine; Haemocytometers
- G01N33/50—Chemical analysis of biological material, e.g. blood, urine; Testing involving biospecific ligand binding methods; Immunological testing
- G01N33/68—Chemical analysis of biological material, e.g. blood, urine; Testing involving biospecific ligand binding methods; Immunological testing involving proteins, peptides or amino acids
- G01N33/6863—Cytokines, i.e. immune system proteins modifying a biological response such as cell growth proliferation or differentiation, e.g. TNF, CNF, GM-CSF, lymphotoxin, MIF or their receptors
- G01N33/6866—Interferon
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61P—SPECIFIC THERAPEUTIC ACTIVITY OF CHEMICAL COMPOUNDS OR MEDICINAL PREPARATIONS
- A61P25/00—Drugs for disorders of the nervous system
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61P—SPECIFIC THERAPEUTIC ACTIVITY OF CHEMICAL COMPOUNDS OR MEDICINAL PREPARATIONS
- A61P37/00—Drugs for immunological or allergic disorders
- A61P37/02—Immunomodulators
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K14/00—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof
- C07K14/435—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from animals; from humans
- C07K14/52—Cytokines; Lymphokines; Interferons
- C07K14/555—Interferons [IFN]
-
- A—HUMAN NECESSITIES
- A01—AGRICULTURE; FORESTRY; ANIMAL HUSBANDRY; HUNTING; TRAPPING; FISHING
- A01K—ANIMAL HUSBANDRY; AVICULTURE; APICULTURE; PISCICULTURE; FISHING; REARING OR BREEDING ANIMALS, NOT OTHERWISE PROVIDED FOR; NEW BREEDS OF ANIMALS
- A01K2217/00—Genetically modified animals
- A01K2217/05—Animals comprising random inserted nucleic acids (transgenic)
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61K—PREPARATIONS FOR MEDICAL, DENTAL OR TOILETRY PURPOSES
- A61K38/00—Medicinal preparations containing peptides
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61K—PREPARATIONS FOR MEDICAL, DENTAL OR TOILETRY PURPOSES
- A61K48/00—Medicinal preparations containing genetic material which is inserted into cells of the living body to treat genetic diseases; Gene therapy
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2319/00—Fusion polypeptide
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2319/00—Fusion polypeptide
- C07K2319/01—Fusion polypeptide containing a localisation/targetting motif
- C07K2319/02—Fusion polypeptide containing a localisation/targetting motif containing a signal sequence
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2319/00—Fusion polypeptide
- C07K2319/30—Non-immunoglobulin-derived peptide or protein having an immunoglobulin constant or Fc region, or a fragment thereof, attached thereto
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12N—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA
- C12N2799/00—Uses of viruses
- C12N2799/02—Uses of viruses as vector
- C12N2799/021—Uses of viruses as vector for the expression of a heterologous nucleic acid
Landscapes
- Health & Medical Sciences (AREA)
- Life Sciences & Earth Sciences (AREA)
- Chemical & Material Sciences (AREA)
- Molecular Biology (AREA)
- Immunology (AREA)
- Engineering & Computer Science (AREA)
- Medicinal Chemistry (AREA)
- Organic Chemistry (AREA)
- General Health & Medical Sciences (AREA)
- Biomedical Technology (AREA)
- Biochemistry (AREA)
- Urology & Nephrology (AREA)
- Hematology (AREA)
- Cell Biology (AREA)
- Proteomics, Peptides & Aminoacids (AREA)
- Public Health (AREA)
- Food Science & Technology (AREA)
- Zoology (AREA)
- Gastroenterology & Hepatology (AREA)
- Veterinary Medicine (AREA)
- Animal Behavior & Ethology (AREA)
- Genetics & Genomics (AREA)
- Pharmacology & Pharmacy (AREA)
- Bioinformatics & Cheminformatics (AREA)
- Nuclear Medicine, Radiotherapy & Molecular Imaging (AREA)
- Biophysics (AREA)
- Biotechnology (AREA)
- General Chemical & Material Sciences (AREA)
- Microbiology (AREA)
- Chemical Kinetics & Catalysis (AREA)
- Toxicology (AREA)
- Physics & Mathematics (AREA)
- Analytical Chemistry (AREA)
- General Physics & Mathematics (AREA)
- Pathology (AREA)
- Neurology (AREA)
- Neurosurgery (AREA)
- Peptides Or Proteins (AREA)
- Micro-Organisms Or Cultivation Processes Thereof (AREA)
- Medicines That Contain Protein Lipid Enzymes And Other Medicines (AREA)
Abstract
【課題】診断的な利点または治療的な利点を有する、新規ポリペプチドおよびこれらをコードする核酸分子を提供する。
【解決手段】インターフェロン様(Interferon−Like)(IFN−L)ポリペプチドおよびこれをコードする核酸分子。IFN−Lポリペプチドを産生するための、選択的結合因子、ベクター、宿主細胞、および方法を提供する。さらに、IFN−Lポリペプチドに関連する疾患、障害、および状態の、診断、処置、改善、および/または予防のための方法及び薬学的組成物を提供する。
【選択図】なし
【解決手段】インターフェロン様(Interferon−Like)(IFN−L)ポリペプチドおよびこれをコードする核酸分子。IFN−Lポリペプチドを産生するための、選択的結合因子、ベクター、宿主細胞、および方法を提供する。さらに、IFN−Lポリペプチドに関連する疾患、障害、および状態の、診断、処置、改善、および/または予防のための方法及び薬学的組成物を提供する。
【選択図】なし
Description
本発明は、インターフェロン様(Interferon−Like)(IFN−L)ポリペプチドおよびこれをコードする核酸分子に関する。本発明はまた、IFN−Lポリペプチドを産生するための、選択的結合因子、ベクター、宿主細胞および方法に関する。本発明はさらに、IFN−Lポリペプチドと関連する疾患、障害、および状態の、診断、処置、改善、および/または予防のための薬学的組成物および方法に関する。
核酸分子の同定、クローニング、発現、および操作における技術進歩ならびにヒトゲノムの解読は、新規治療因子の発見を大きく加速した。現在、高速核酸配列決定技術は、前例のない速度で配列情報を作製し得、そしてコンピュータ分析と結合されて、ゲノムの一部および全体への重複配列の集合ならびにポリペプチドコード領域の同定を可能にする。既知アミノ酸配列のデータベース編集物に対する推定アミノ酸配列の比較によって、以前に同定された配列および/または構造の目印に対して相同性の程度を決定することが可能になる。核酸分子のポリペプチドコード領域のクローニングおよび発現は、構造分析および機能分析のためのポリペプチド産物を提供する。核酸分子およびコードされるポリペプチドの操作は、治療剤としての使用に関して生成物に対して有利な特性を与え得る。
過去10年間にわたるゲノム研究における大いなる技術進歩にも関わらず、ヒトゲノムに基づく新規治療剤の開発に対する可能性は、未だ広く理解されていない。潜在的に有利なポリペプチド治療剤をコードする多くの遺伝子またはこれらがコードするポリペプチド(これらは、治療分子に対して「標的」としてはたらき得る)は、未だ同定されていない。
従って、診断的な利点または治療的な利点を有する、新規ポリペプチドおよびこれらをコードする核酸分子を同定することが、本発明の目的である。
(発明の要旨)
本発明は、新規IFN−Lの核酸分子およびコードされるポリペプチドに関する。
本発明は、新規IFN−Lの核酸分子およびコードされるポリペプチドに関する。
本発明は、単離された核酸分子であって、以下:
(a)配列番号1または配列番号4のいずれかに示されるヌクレオチド配列;
(b)ATCC受託番号PTA−976中のDNAインサートのヌクレオチド配列;
(c)配列番号2または配列番号5のいずれかに示されるポリペプチドをコードするヌクレオチド配列;
(d)(a)〜(c)のいずれかの相補体に、中程度または高度にストリンジェントな条件下でハイブリダイズするヌクレオチド配列;および
(e)(a)〜(c)のいずれかに相補的なヌクレオチド配列、
からなる群より選択されるヌクレオチド配列を含む、単離された核酸分子を提供する。
(a)配列番号1または配列番号4のいずれかに示されるヌクレオチド配列;
(b)ATCC受託番号PTA−976中のDNAインサートのヌクレオチド配列;
(c)配列番号2または配列番号5のいずれかに示されるポリペプチドをコードするヌクレオチド配列;
(d)(a)〜(c)のいずれかの相補体に、中程度または高度にストリンジェントな条件下でハイブリダイズするヌクレオチド配列;および
(e)(a)〜(c)のいずれかに相補的なヌクレオチド配列、
からなる群より選択されるヌクレオチド配列を含む、単離された核酸分子を提供する。
本発明はまた、単離された核酸分子であって、以下:
(a)配列番号2または配列番号5のいずれかに示されるポリペプチドに少なくとも約70%同一であるポリペプチドをコードするヌクレオチド配列であって、ここで、上記コードされたポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、ヌクレオチド配列;
(b)配列番号1もしくは配列番号4のいずれかに示されるヌクレオチド配列、ATCC受託番号PTA−976中のDNAインサートのヌクレオチド配列、または(a)の、対立遺伝子改変体またはスプライス改変体をコードするヌクレオチド配列;
(c)少なくとも約25アミノ酸残基のポリペプチドフラグメントをコードする、配列番号1もしくは配列番号4のいずれかのヌクレオチド配列、ATCC受託番号PTA−976中のDNAインサート、(a)または(b)の領域であって、ここで、上記ポリペプチドフラグメントは、配列番号2もしくは配列番号5のいずれかに示されるコードされたポリペプチドの活性を有するか、または抗原性である、領域;
(d)少なくとも約16ヌクレオチドのフラグメントを含む、配列番号1、もしくは配列番号4のいずれかのヌクレオチド配列、ATCC受託番号PTA−976中のDNAインサート、または(a)〜(c)いずれかの領域;
(e)中程度または高度にストリンジェントな条件下で、(a)〜(d)のいずれかの相補体にハイブリダイズする、ヌクレオチド配列;ならびに
(f)(a)〜(d)のいずれかに相補的なヌクレオチド配列、
からなる群より選択されるヌクレオチド配列を含む、単離された核酸分子を提供する。
本発明はさらに、単離された核酸分子であって、以下;
(a)少なくとも1つの保存的アミノ酸置換を有する配列番号2または配列番号5のいずれかに示されるポリペプチドをコードするヌクレオチド配列であって、ここで、上記コードされたポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、ヌクレオチド配列;
(b)少なくとも1つのアミノ酸挿入を有する配列番号2または配列番号5のいずれかに示されるポリペプチドをコードするヌクレオチド配列であって、ここで、上記コードされたポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、ヌクレオチド配列;
(c)少なくとも1つのアミノ酸欠失を有する配列番号2または配列番号5のいずれかに示されるポリペプチドをコードするヌクレオチド配列であって、ここで、上記コードされたポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、ヌクレオチド配列;
(d)C末端短縮および/またはN末端短縮を有する配列番号2または配列番号5のいずれかに示されるポリペプチドをコードするヌクレオチド配列であって、ここで、上記コードされたポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、ヌクレオチド配列;
(e)アミノ酸置換、アミノ酸挿入、アミノ酸欠失、C末端短縮、およびN末端短縮からなる群より選択される少なくとも1つの改変を有する配列番号2または配列番号5のいずれかに示されるポリペプチドをコードするヌクレオチド配列であって、ここで、上記コードされたポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、ヌクレオチド配列;
(f)少なくとも約16ヌクレオチドのフラグメントを含む(a)〜(e)のいずれかのヌクレオチド配列;
(g)中程度または高度にストリンジェントな条件下で、(a)〜(f)のいずれかの相補体にハイブリダイズする、ヌクレオチド配列;ならびに
(h)(a)〜(e)のいずれかに相補的なヌクレオチド配列、
からなる群より選択されるヌクレオチド配列を含む、単離された核酸分子を提供する。
本発明は、単離されたポリペプチドであって、以下:
(a)配列番号2または配列番号5のいずれかに示されるアミノ酸配列;および
(b)ATCC受託番号PTA−976中のDNAインサートによってコードされるアミノ酸配列、
からなる群より選択されるアミノ酸配列を含む、単離されたポリペプチドを提供する。
(a)配列番号2または配列番号5のいずれかに示されるアミノ酸配列;および
(b)ATCC受託番号PTA−976中のDNAインサートによってコードされるアミノ酸配列、
からなる群より選択されるアミノ酸配列を含む、単離されたポリペプチドを提供する。
本発明はまた、単離されたポリペプチドであって、以下:
(a)配列番号3または配列番号6のいずれかに示されるアミノ酸配列であって、必要に応じてさらにアミノ末端メチオニンを含む、アミノ酸配列;
(b)配列番号2または配列番号5のいずれかのオルソログ(ortholog)に対するアミノ酸配列;
(c)配列番号2または配列番号5のいずれかのアミノ酸配列に少なくとも約70%同一であるアミノ酸配列であって、ここで、上記ポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、アミノ酸配列;
(d)少なくとも約25アミノ酸残基を含む配列番号2または配列番号5のいずれかに示されるアミノ酸配列のフラグメントであって、ここで、上記フラグメントは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有するか、または抗原性である、フラグメント;ならびに
(e)配列番号2、もしくは配列番号5のいずれかに示されるアミノ酸配列、ATCC受託番号PTA−976中のDNAインサートによってコードされるアミノ酸配列、(a)、または(b)の、対立遺伝子改変体またはスプライス改変体のアミノ酸配列、
からなる群より選択されるアミノ酸配列を含む、単離されたポリペプチドを提供する。
本発明はさらに、単離されたポリペプチドであって、以下:
(a)少なくとも1つの保存的アミノ酸置換を有する配列番号2または配列番号5のいずれかに示されるアミノ酸配列であって、ここで、上記ポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、アミノ酸配列;
(b)少なくとも1つのアミノ酸挿入を有する配列番号2または配列番号5のいずれかに示されるアミノ酸配列であって、ここで、上記ポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、アミノ酸配列;
(c)少なくとも1つのアミノ酸欠失を有する配列番号2または配列番号5のいずれかに示されるアミノ酸配列であって、ここで、上記ポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、アミノ酸配列;
(d)C末端短縮および/またはN末端短縮を有する配列番号2または配列番号5のいずれかに示されるアミノ酸配列であって、ここで、上記ポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、アミノ酸配列;ならびに
(e)アミノ酸置換、アミノ酸挿入、アミノ酸欠失、C末端短縮、およびN末端短縮からなる群より選択される少なくとも1つの改変を有する配列番号2または配列番号5のいずれかに示されるアミノ酸配列であって、ここで、上記ポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、アミノ酸配列、
からなる群より選択されるアミノ酸配列を含む、単離されたポリペプチドを提供する。
IFN−Lアミノ酸配列を含む融合ポリペプチドがまた、提供される。
本発明はまた、本明細書中に示されるような単離された核酸分子を含む発現ベクター、本明細書中に示されるような組換え核酸分子を含む組換え宿主細胞、およびIFN−Lポリペプチドを産生する方法を提供し、この方法は、この宿主細胞を培養する工程、必要に応じてそのように産生されたポリペプチドを単離する工程を包含する。
IFN−Lポリペプチドをコードする核酸分子を含むトランスジェニック非ヒト動物がまた、本発明に含まれる。IFN−L核酸分子は、IFN−Lポリペプチドの発現およびIFN−Lポリペプチドの増加したレベル(これは、増加した循環レベルを含み得る)を可能にする様式で、動物中に導入される。あるいは、IFN−L核酸分子は、内因性IFN−Lポリペプチドの発現を阻害する様式で動物に導入される(すなわち、IFN−Lポリペプチド遺伝子ノックアウトを保有するトランスジェニック動物を作製する)。トランスジェニック非ヒト動物は、好ましくは哺乳動物であり、より好ましくはげっ歯類(例えば、ラットまたはマウス)である。
本発明のIFN−Lポリペプチドの誘導体がまた、提供される。
本発明のIFN−Lポリペプチドに特異的に結合し得る選択的結合因子(例えば、抗体およびペプチド)が、さらに提供される。このような抗体およびペプチドは、アゴニストのものであってもアンタゴニストのものであってもよい。
本発明のヌクレオチド、ポリペプチド、もしくは選択的結合因子ならびに1つ以上の薬学的に受容可能な処方剤を含む薬学的組成物がまた、本発明によって包含される。この薬学的組成物は、治療的に有効な量の本発明のヌクレオチドまたはポリペプチドを提供するために使用される。本発明はまた、このポリペプチド、核酸分子、および選択的結合因子を使用する方法に関する。
本発明のIFN−LポリペプチドおよびIFN−L核酸分子は、疾患および障害(本明細書中に列挙されるものを含む)を処置、予防、改善、および/または検出するために使用され得る。
本発明はまた、IFN−Lポリペプチドに結合する試験分子を同定するために、試験分子をアッセイする方法を提供する。この方法は、IFN−Lポリペプチドを試験分子と接触させて、この試験分子のこのポリペプチドに対する結合の程度を決定する工程を包含する。この方法はさらに、このような試験分子が、IFN−Lポリペプチドのアゴニストまたはアンタゴニストであるか否かを決定する工程を包含する。本発明はさらに、IFN−Lポリペプチドの発現またはIFN−Lポリペプチドの活性に対する分子の影響を試験する方法を提供する。
IFN−Lポリペプチドの発現を調整する方法およびIFN−Lポリペプチドのレベルを調節する(すなわち、増加または減少する)方法がまた、本発明によって含まれる。1つの方法は、IFN−Lポリペプチドをコードする核酸分子を動物に投与する工程を包含する。別の方法において、IFN−Lポリペプチドの発現を調整または調節するエレメントを含む核酸分子が、投与され得る。これらの方法の例としては、本明細書中にさらに記載されるように、遺伝子治療、細胞治療、およびアンチセンス治療が挙げられる。
本発明の別の局面において、IFN−Lポリペプチドは、そのレセプター(「IFN−Lポリペプチドレセプター」)を同定するために使用され得る。種々の形態の「発現クローニング」は、タンパク質リガンドに対するレセプターをクローニングするために広範囲に使用されている。例えば、SimonsenおよびLodish、1994、Trends Pharmacol.Sci.15:437−41ならびにTartagliaら、1995、Cell 83:1263−71を参照のこと。IFN−Lポリペプチドレセプターの単離は、IFN−Lポリペプチドシグナル伝達経路の新規アゴニストおよびアンタゴニストの同定または開発に有用である。このようなアゴニストおよびアンタゴニストとしては、可溶性IFN−Lポリペプチドレセプター、抗IFN−Lポリペプチドレセ
プター−選択的結合因子(例えば、抗体またはその誘導体)、低分子、およびアンチセンスオリゴヌクレオチドが挙げられ、これらのうちのいずれかは、1つ以上の疾患または障害(本明細書中に開示されるものを含む)の処置に有用であり得る。
プター−選択的結合因子(例えば、抗体またはその誘導体)、低分子、およびアンチセンスオリゴヌクレオチドが挙げられ、これらのうちのいずれかは、1つ以上の疾患または障害(本明細書中に開示されるものを含む)の処置に有用であり得る。
(発明の詳細な説明)
本明細書中で使用される節の表題は、組織的な目的のみのためであり、そして記載される内容を限定するようには解釈されるべきではない。本願において列挙される全ての参考文献は、明確に本明細書中に参考として援用される。
本明細書中で使用される節の表題は、組織的な目的のみのためであり、そして記載される内容を限定するようには解釈されるべきではない。本願において列挙される全ての参考文献は、明確に本明細書中に参考として援用される。
(定義)
用語「IFN−L遺伝子」または「IFN−L核酸分子」あるいは「IFN−Lポリヌクレオチド」とは、配列番号1または配列番号4のいずれかに示されるヌクレオチド配列、配列番号2または配列番号5のいずれかに示されるポリペプチドをコードするヌクレオチド配列、ATCC受託番号PTA−976におけるDNAインサートのヌクレオチド配列、および本明細書中で定義される核酸分子を含むか、またはこれらからなる核酸分子をいう。
用語「IFN−L遺伝子」または「IFN−L核酸分子」あるいは「IFN−Lポリヌクレオチド」とは、配列番号1または配列番号4のいずれかに示されるヌクレオチド配列、配列番号2または配列番号5のいずれかに示されるポリペプチドをコードするヌクレオチド配列、ATCC受託番号PTA−976におけるDNAインサートのヌクレオチド配列、および本明細書中で定義される核酸分子を含むか、またはこれらからなる核酸分子をいう。
用語「IFN−Lポリペプチド対立遺伝子改変体」とは、生物体または生物体の集団の染色体の所定の遺伝子座を占める遺伝子の、天然に存在する可能ないくつかの交替形態のうちの1つをいう。
用語「IFN−Lポリペプチドスプライス改変体」とは、配列番号2または配列番号5のいずれかに示されるIFN−Lポリペプチドアミノ酸配列のRNA転写物中のイントロン配列の選択的プロセシングによって生成される、核酸分子(通常はRNA)をいう。
用語「単離された核酸分子」とは、(1)総核酸が供給源細胞から単離される場合に、これが天然で一緒に見出されるタンパク質、脂質、炭水化物、または他の物質のうち少なくとも約50パーセントから分離された本発明の核酸分子、(2)「単離された核酸分子」が天然で連結しているポリヌクレオチドの全てまたは一部に連結していない本発明の核酸分子、(3)天然では連結しないポリヌクレオチドに作動可能に連結した本発明の核酸分子、または(4)より大きなポリヌクレオチド配列の一部として天然には存在しない、本発明の核酸分子をいう。好ましくは、本発明の単離された核酸分子は、任意の他の混入核酸分子、または天然の環境において見出される他の混入物(これらは、ポリペプチド産生における使用、または治療的使用、診断的使用、予防的使用、または研究的使用に干渉する)を実質的に含まない。
用語「核酸配列」または「核酸分子」は、DNAまたはRNA配列をいう。この用語は、DNAおよびRNAの公知の塩基アナログのいずれかから形成される分子を含み、例えば、以下であるがこれらに限定されない:4−アセチルシトシン、8−ヒドロキシ−N6−メチルアデノシン、アジリジニル−シトシン、プソイドイソシトシン(pseudoisocytosine)、5−(カルボキシヒドロキシルメチル)ウラシル、5−フルオロウラシル、5−ブロモウラシル、5−カルボキシメチルアミノメチル−2−チオウラシル、5−カルボキシメチルアミノメチルウラシル、ジヒドロウラシル、イノシン、N6−イソ−ペンテニルアデニン、1−メチルアデニン、1−メチルプソイドウラシル、1−メチルグアニン、1−メチルイノシン、2,2−ジメチルグアニン、2−メチルアデニン、2−メチルグアニン、3−メチルシトシン、5−メチルシトシン、N6−メチルアデニン、7−メチルグアニン、5−エチルアミノメチルウラシル、5−メトキシアミノ−メチル−2−チオウラシル、β−D−マンノシルキューオシン、5’−メトキシカルボニル−メチルウラシル、5−メトキシウラシル、2−メチルチオ−N6−イソペンテニルアデニン、ウラシル−5−オキシ酢酸メチルエステル、ウラシル−5−オキシ酢酸、オキシブトキソシン、プソイドウラシル、キューオシン、2−チオシトシン、5−メチル−2−チオウラシル、2−チオウラシル、4−チオウラシル、5−メチルウラシル、N−ウラシル−5−オキシ酢酸メチルエステル、ウラシル−5−オキシ酢酸、プソイドウラシル、キューオシン、2−チオシトシン、および2,6−ジアミノプリン。
用語「ベクター」は、宿主細胞にコード情報を移すために使用される任意の分子(例えば、核酸、プラスミド、またはウイルス)をいうように使用される。
用語「発現ベクター」は、宿主細胞の形質転換に適切であり、そして挿入された異種核酸配列の発現を、指向および/または制御する核酸配列を含むベクターをいう。発現としては、転写、翻訳、およびRNAスプライシング(イントロンが存在する場合)のようなプロセスが挙げられるがこれらに限定されない。
用語「作動可能に連結された」を用いて、本明細書中では、隣接配列の配置をいい、ここで、このように記載される隣接配列は、その通常の機能を行うように構成または構築される。従って、コード配列に作動可能に連結した隣接配列は、このコード配列の複製、転写および/または翻訳を行うことが可能であり得る。
例えば、コード配列は、このプロモーターがコード配列の転写を指向し得る場合に、プロモーターに作動可能に連結される。隣接配列は、これが正確に機能する限り、コード配列と連続する必要はない。したがって、例えば、介在性非翻訳の、転写された配列は、プロモーター配列とコード配列との間に存在し得、そしてこのプロモーター配列は、依然としてこのコード配列に「作動可能に連結」されているとみなされ得る。
例えば、コード配列は、このプロモーターがコード配列の転写を指向し得る場合に、プロモーターに作動可能に連結される。隣接配列は、これが正確に機能する限り、コード配列と連続する必要はない。したがって、例えば、介在性非翻訳の、転写された配列は、プロモーター配列とコード配列との間に存在し得、そしてこのプロモーター配列は、依然としてこのコード配列に「作動可能に連結」されているとみなされ得る。
用語「宿主細胞」を用いて、核酸配列で形質転換されたか、または形質転換され得、次いで目的の選択された遺伝子を発現し得る細胞をいう。この用語には、選択された遺伝子が存在する限り、子孫が形態学または遺伝子構造において本来の親と同一であろうとなかろうと、親細胞の子孫を含む。
用語「IFN−Lポリペプチド」とは、配列番号2または配列番号5のいずれかのアミノ酸配列を含むポリペプチド、および関連するポリペプチドをいう。関連ポリペプチドとしては、IFN−Lポリペプチドフラグメント、IFN−Lポリペプチドオルソログ、IFN−Lポリペプチド改変体、およびIFN−Lポリペプチド誘導体が挙げられ、これらは、配列番号2または配列番号5のいずれかに示されるポリペプチドの少なくとも1つの活性を保有する。IFN−Lポリペプチドは、本明細書中で定義される成熟ポリペプチドであり得、そしてこれらが調製される方法に依存して、アミノ末端メチオニン残基を有しても有さなくてもよい。
用語「IFN−Lポリペプチドフラグメント」とは、配列番号2または配列番号5のいずれかに示されるポリペプチドの、アミノ末端(リーダー配列を有するかまたは有さない)での短縮化および/またはカルボキシ末端での短縮化を含むポリペプチドをいう。用語「IFN−Lポリペプチドフラグメント」はまた、IFN−Lポリペプチドオルソログ、IFN−Lポリペプチド誘導体、またはIFN−Lポリペプチド改変体のアミノ末端および/またはカルボキシ末端短縮化、あるいはIFN−Lポリペプチド対立遺伝子改変体またはIFN−Lポリペプチドスプライス改変体によってコードされるポリペプチドのアミノ末端および/またはカルボキシ末端短縮化をいう。IFN−Lポリペプチドフラグメントは、選択的RNAスプライシング、またはインビボプロテアーゼ活性から生じ得る。IFN−Lポリペプチドの膜結合形態もまた、本発明によって意図される。好ましい実施形態において、短縮化および/または欠失は、約10アミノ酸、または約20アミノ酸、または約50アミノ酸、または約75アミノ酸、または約100アミノ酸、または約100より多くのアミノ酸を含む。このように生成されるポリペプチドフラグメントは、約25個連続したアミノ酸、または約50アミノ酸、または約75アミノ酸、または約100アミノ酸、または約150アミノ酸、または約200アミノ酸を含む。このようなIFN−Lポリペプチドフラグメントは、必要に応じて、アミノ末端メチオニン残基を含み得る。このようなフラグメントは、例えば、IFN−Lポリペプチドに対する抗体を生成するために使用
され得ることが理解される。
され得ることが理解される。
用語「IFN−Lポリペプチドオルソログ」は、配列番号2または配列番号5のいずれかに示されるIFN−Lポリペプチドアミノ酸配列に対応する、別の種由来のポリペプチドをいう。例えば、マウスおよびヒトのIFN−Lポリペプチドは、互いにオルソログであるとみなされる。
用語「IFN−Lポリペプチド改変体」は、配列番号2または配列番号5(リーダー配列を有するかまたは有さない)のいずれかに示されるIFN−Lポリペプチドアミノ酸配列と比較して、1つ以上のアミノ酸配列の置換、欠失(例えば、内部欠失および/またはIFN−Lポリペプチドフラグメント)、および/または付加(例えば、内部付加および/またはIFN−L融合ポリペプチド)を有するアミノ酸配列を含むIFN−Lポリペプチドをいう。改変体は、天然に存在する(例えば、IFN−Lポリペプチド対立遺伝子改変体、IFN−Lポリペプチドオルソログ、およびIFN−Lポリペプチドスプライス改変体)か、または、人工的に構築され得る。このようなIFN−Lポリペプチド改変体は、配列番号1または配列番号4のいずれかに示されるDNA配列から変化するDNA配列を有する、対応する核酸分子から調製され得る。好ましい実施形態において、この改変体は、1〜3、または1〜5、または1〜10、または1〜15、または1〜20、または1〜25、または1〜50、または1〜75、または1〜100、または100より多くのアミノ酸の置換、挿入、付加、および/または欠失を有し、ここで、この置換は、保存的、または非保存的、あるいはその任意の組み合わせであり得る。
用語「IFN−Lポリペプチド誘導体」は、配列番号2または配列番号5のいずれかに示されるポリペプチド、本明細書中で定義されるIFN−Lポリペプチドフラグメント、IFN−Lポリペプチドオルソログ、またはIFN−Lポリペプチド改変体をいい、これらは、化学的に改変されている。用語「IFN−Lポリペプチド誘導体」はまた、本明細書中で定義されるIFN−Lポリペプチド対立遺伝子改変体またはIFN−Lポリペプチドスプライス改変体によってコードされるポリペプチドをいい、これは化学的に改変されている。
用語「成熟IFN−Lポリペプチド」は、リーダー配列を欠失したIFN−Lポリペプチドをいう。成熟IFN−Lポリペプチドはまた、他の改変(例えば、アミノ末端(リーダー配列を有するかまたは有さない)および/またはカルボキシ末端のタンパク質分解性プロセシング、より大きな前駆体からのより小さなポリペプチドの切断、N連結および/またはO連結グリコシル化など)を含み得る。
用語「IFN−L融合ポリペプチド」は、配列番号2または配列番号5のいずれかに示されるポリペプチド、本明細書中で定義されるIFN−Lポリペプチドフラグメント、IFN−Lポリペプチドオルソログ、IFN−Lポリペプチド改変体、またはIFN−L誘導体のアミノ末端またはカルボキシ末端での、1つ以上のアミノ酸の融合(例えば、異種タンパク質またはペプチド)をいう。用語「IFN−L融合ポリペプチド」はまた、本明細書中で定義されるIFN−Lポリペプチド対立遺伝子改変体またはIFN−Lポリペプチドスプライス改変体によってコードされるポリペプチドのアミノ末端またはカルボキシル末端での、1つ以上のアミノ酸の融合をいう。
用語「生物学的に活性なIFN−Lポリペプチド」とは、配列番号2または配列番号5のいずれかのアミノ酸配列を含むポリペプチドの、少なくとも1つの活性特徴を有するIFN−Lポリペプチドをいう。さらに、IFN−Lポリペプチドは、免疫原としての活性を有し得る;すなわち、このIFN−Lポリペプチドは、抗体が惹起され得る少なくとも1つのエピトープを含む。
用語「単離されたポリペプチド」とは、(1)供給源細胞から単離される場合に、天然で一緒に見出されるポリヌクレオチド、脂質、炭水化物、または他の物質の少なくとも約50%から単離された本発明のポリペプチド、(2)「単離されたポリペプチド」が天然で連結するポリペプチドの全てまたは一部に連結しない(共有結合的または非共有結合的相互作用によって)、本発明のポリペプチド、(3)天然には連結しないポリペプチドに作動可能に連結(共有結合的または非共有結合的相互作用によって)する、本発明のポリペプチド、または(4)天然には存在しない本発明のポリペプチドをいう。好ましくは、この単離されたポリペプチドは、任意の他の混入ポリペプチドまたは天然の環境において見出される他の混入物(これは、その治療的使用、診断的使用、予防的使用、または研究
的使用に干渉する)を実質的に含まない。
的使用に干渉する)を実質的に含まない。
用語「同一性」とは、当該分野で公知のように、配列の比較によって決定される、2つ以上のポリペプチド分子または2つ以上の核酸分子の配列間の関係をいう。当該分野において、「同一性」はまた、場合に応じて、2つ以上のヌクレオチドまたは2つ以上のアミノ酸配列間の一致によって決定されるように、核酸分子またはポリペプチド間の配列関連性の程度を意味する。「同一性」は、2つ以上の配列のうち小さなものと、特定の数理的モデルまたはコンピュータプログラム(すなわち、「アルゴリズム」)により取り扱われたギャップ整列(存在する場合)との間の一致の同一パーセントを評価する。
用語「類似性」は、関連した概念であるが、「同一性」とは対照的に、「類似性」は、同一的一致および保存的置換の一致の両方を含む関連性の基準をいう。2つのポリペプチド配列が、例えば10/20個同一のアミノ酸を有し、そして残りが全て非保存的置換である場合、パーセント同一性および類似性は、どちらも50%である。同じ例において、保存的置換であるさらに5つの位置が存在する場合、パーセント同一性は50%のままであるが、パーセント類似性は75%(15/20)である。したがって、保存的置換が存在する場合、2つのポリペプチド間のパーセント類似性は、これらの2つのポリペプチド間のパーセント同一性よりも高い。
用語「天然に存在する」または「ネイティブの」は、核酸分子、ポリペプチド、宿主細胞などのような生物学的物質と関連して使用される場合、天然において見出され、そしてヒトによって操作されていない物質をいう。同様に、「天然に存在しない」または「ネイティブではない」は、本明細書中で使用される場合、天然で見出されないか、またはヒトによって構造的に改変もしくは合成された物質をいう。
用語「有効量」および「治療有効量」は、各々、本明細書中に示されるIFN−Lポリペプチドの1つ以上の生物学的活性の観察可能なレベルを支持するために使用されるIFN−LポリペプチドまたはIFN−L核酸分子の量をいう。
用語「薬学的に受容可能なキャリア」または「生理学的に受容可能なキャリア」は、本明細書中で使用される場合、薬学的組成物としてのIFN−Lポリペプチド、IFN−L核酸分子、またはIFN−L選択的結合因子の送達の達成または増強に適切な1つ以上の処方物質をいう。
用語「抗原」とは、選択的結合因子(例えば、抗体)により結合され得、そしてさらに動物において使用されて、その抗原のエピトープに結合し得る抗体を産生じ得る分子または分子の一部をいう。抗原は、1つ以上のエピトープを有し得る。
用語「選択的結合因子」とは、IFN−Lポリペプチドに特異性を有する分子(単数または複数)をいう。本明細書中で使用される場合、用語「特異的」および「特異性」とは、選択的結合因子の、ヒトIFN−Lポリペプチドに結合し、かつ非IFN−Lポリペプチドに結合しない能力をいう。しかし、選択的結合因子がまた、配列番号2または配列番号5のいずれかに記載されるようなポリペプチドのオルソログ(すなわち、その種間変形(例えば、マウスIFN−LポリペプチドおよびラットIFN−Lポリペプチド))に結合し得ることが、理解される。
用語「形質導入」とは、通常はファージによる1つの細菌から別の細菌への遺伝子の伝達をいう。「形質導入」はまた、レトロウイルスによる真核生物細胞配列の獲得および伝達をいう。
用語「トランスフェクション」は、細胞による異種または外因性DNAの取り込みをいうために使用され、そして細胞は、外因性DNAが細胞膜内に導入された場合には「トランスフェクトされ」ている。多数のトランスフェクション技術は、当該分野で周知であり、そして本明細書中に開示される。例えば、Grahamら,1973,Virology 52:456;Sambrookら,Molecular Cloning,A Laboratory Manual (Cold Spring Harbor Laboratories,1989);Davisら,Basic Methods in Molecular Biology(Elsevier,1986);and Chuら,1981,Gene 13:197を参照のこと。このような技術を使用して、1つ以上の外因性DNA部分を適切な宿主細胞に導入し得る。
本明細書中で使用される場合、用語「形質転換」とは、細胞の遺伝的特徴における変化をいい、そして細胞は、新しいDNAを含有するように改変された場合に形質転換されている。例えば、細胞は、それがそのネイティブな状態から遺伝的に改変される場合に形質転換される。トランスフェクションまたは形質導入に続いて、DNAの形質転換は、物理的に細胞の染色体に組み込むことにより細胞のDNAと組換わり得るか、複製されることなしにエピソームエレメントとして一時的に維持され得るか、またはプラスミドとして独立的に複製し得る。DNAが細胞分裂と共に複製される場合に、細胞は、安定に形質転換されたとみなされる。
(核酸分子および/またはポリペプチドの関連性)
関連した核酸分子が、配列番号1または配列番号4のいずれかの核酸分子の対立遺伝子改変体またはスプライス改変体を包含すること、および上記のヌクレオチド配列のいずれかに相補的である配列を包含することが理解される。関連した核酸分子はまた、配列番号2または配列番号5のいずれかにおけるポリペプチドと比較して1以上のアミノ酸残基の置換、改変、付加および/または欠失を含むかまたは本質的にこれからなるポリペプチドをコードするヌクレオチド配列を包含する。このような関連したIFN−Lポリペプチドは、例えば、1以上のN結合型もしくはO結合型のグリコシル化部位の付加および/もしくは欠失、または1以上のシステイン残基の付加および/もしくは欠失を含み得る。
関連した核酸分子が、配列番号1または配列番号4のいずれかの核酸分子の対立遺伝子改変体またはスプライス改変体を包含すること、および上記のヌクレオチド配列のいずれかに相補的である配列を包含することが理解される。関連した核酸分子はまた、配列番号2または配列番号5のいずれかにおけるポリペプチドと比較して1以上のアミノ酸残基の置換、改変、付加および/または欠失を含むかまたは本質的にこれからなるポリペプチドをコードするヌクレオチド配列を包含する。このような関連したIFN−Lポリペプチドは、例えば、1以上のN結合型もしくはO結合型のグリコシル化部位の付加および/もしくは欠失、または1以上のシステイン残基の付加および/もしくは欠失を含み得る。
関連した核酸分子はまた、配列番号2または配列番号5のいずれかのIFN−Lポリペプチドの少なくとも約25個連続したアミノ酸、または少なくとも約50個のアミノ酸、または少なくとも約75個のアミノ酸、または少なくとも約100個のアミノ酸、または少なくとも約150個のアミノ酸、または少なくとも約200個のアミノ酸、または200個より多くのアミノ酸残基のポリペプチドをコードする、IFN−L核酸分子のフラグメントを包含する。
さらに、関連したIFN−L核酸分子はまた、本明細書中で定義したとおりの中程度または高度にストリンジェントな条件下で、配列番号1、もしくは配列番号4のいずれかのIFN−L核酸分子またはポリペプチドをコードする分子の十分に相補的な配列とハイブリダイズするヌクレオチド配列を含む分子を包含し、このポリペプチドは、配列番号2もしくは配列番号5、または本明細書中に定義したとおりの核酸フラグメント、または本明細書中に定義したとおりのポリペプチドをコードする核酸フラグメントのいずれかに示されるアミノ酸配列を含む。ハイブリダイゼーションプローブは、本明細書中に提供されるIFN−L配列を用いてcDNA、ゲノムDNAライブラリーまたは合成DNAライブラリーを関連した配列についてスクリーニングして調製され得る。IFN−LポリペプチドのDNA配列および/またはアミノ酸配列のうちの、既知配列に対して顕著な同一性を示す領域は、本明細書中に記載されるとおりの配列アラインメントアルゴリズムを用いて容易に決定され、そしてこれらの領域を用いて、スクリーニングのためのプローブを設計し得る。
用語「高度にストリンジェントな条件」とは、配列が非常に相補的であるDNA鎖のハイブリダイゼーションを許容し、かつ顕著に不一致のDNAのハイブリダイゼーションを排除するように設計された条件をいう。ハイブリダイゼーションのストリンジェンシーは、温度、イオン強度および変性剤(例えば、ホルムアミド)の濃度によって主に決定される。ハイブリダイゼーションおよび洗浄についての「高度にストリンジェントな条件」の例は、65〜68℃での0.015M塩化ナトリウム、0.0015Mクエン酸ナトリウムまたは42℃での0.015M塩化ナトリウム、0.0015Mクエン酸ナトリウムおよび50%ホルムアミドである。Sambrook,FritschおよびManiatis,Molecular Cloning:A Laboratory Manual(第2版,Cold Spring Harbor Laboratory,1989);Andersonら,Nucleic Acid Hybridisation:A Practical Approach第4章(IRL Press Limited)を参照のこと。
よりストリンジェントな条件(例えば、より高い温度、より低いイオン強度、より高いホルムアミドまたは他の変性剤)もまた用いられ得るが、ハイブリダイゼーションの速度が影響される。他の薬剤は、非特異的および/またはバックグラウンドのハイブリダイゼーションを減少させる目的のために、ハイブリダイゼーションおよび洗浄の緩衝液中に含まれ得る。例は、0.1%ウシ血清アルブミン、0.1%ポリビニルピロリドン、0.1%ピロリン酸ナトリウム、0.1%ドデシル硫酸ナトリウム、NaDodSO4、(SDS)、ficoll、デンハルト溶液、超音波処理サケ精子DNA(または別の非相補的DNA)および硫酸デキストランであるが、他の適切な薬剤もまた用いられ得る。これらの添加剤の濃度および種類は、ハイブリダイゼーション条件のストリンジェンシーに実質的に影響を与えることなく変更され得る。ハイブリダイゼーション実験は通常、pH6.8〜7.4で実施される;しかし、代表的なイオン強度の条件では、ハイブリダイゼーションの速度は、pHからほぼ独立する。Andersonら,Nucleic Acid Hybridisation:A Practical Approach第4章(IRL Press Limited)を参照のこと。
DNA二重鎖の安定性に影響を与える因子としては、塩基組成、長さおよび塩基対の不一致程度が挙げられる。ハイブリダイゼーション条件は、これらの変動要因を適応させ、そして異なる配列関連性のDNAがハイブリッドを形成するのを可能にするために当業者によって調整され得る。完全に一致したDNA二重鎖の融解温度は、以下の方程式によって評価され得る:
Tm(℃)=81.5+16.6(log[Na+])+0.41(%G+C)−600/N−0.72(%ホルムアミド)ここで、Nは、形成される二重鎖の長さであり、[Na+]は、ハイブリダイゼーション溶液または洗浄溶液中でのナトリウムイオンのモル濃度であり、%G+Cは、ハイブリッド中での(グアニン+シトシン)塩基の百分率である。不完全に一致したハイブリッドについては、融解温度は、1%の不一致毎に約1℃下げ
られる。
Tm(℃)=81.5+16.6(log[Na+])+0.41(%G+C)−600/N−0.72(%ホルムアミド)ここで、Nは、形成される二重鎖の長さであり、[Na+]は、ハイブリダイゼーション溶液または洗浄溶液中でのナトリウムイオンのモル濃度であり、%G+Cは、ハイブリッド中での(グアニン+シトシン)塩基の百分率である。不完全に一致したハイブリッドについては、融解温度は、1%の不一致毎に約1℃下げ
られる。
用語「中程度にストリンジェントな条件」とは、「高度にストリンジェントな条件」下で生じ得るよりも高い程度の塩基対不一致を有するDNA二重鎖が形成され得る条件をいう。代表的な「中程度にストリンジェントな条件」の例は、50〜65℃での0.015M塩化ナトリウム、0.0015Mクエン酸ナトリウムまたは37〜50℃での0.015M塩化ナトリウム、0.0015Mクエン酸ナトリウムおよび20%ホルムアミドである。例示として、0.015Mナトリウムイオン中での50℃という「中程度にストリンジェントな条件」は、約21%の不一致を可能にする。
「高度にストリンジェントな条件」と「中程度にストリンジェントな条件」との間に絶対的な区別が存在しないことが当業者によって認識される。例えば、0.015Mナトリウムイオン(ホルムアミドなし)では、完全に一致した長さのDNAの融解温度は、約71℃である。65℃で(同じイオン強度で)の洗浄を用いると、このことは、約6%の不一致を可能にする。より遠く関連した配列を捕獲するために、当業者は、単純に、温度を低くし得るかまたはイオン強度を高くし得る。
約20ntまでのオリゴヌクレオチドプローブについての1M NaCl*中での融解温度の良好な評価は、以下によって与えられる:
Tm=A−T塩基対あたり2℃ + G−C塩基対あたり4℃*6×塩クエン酸ナトリウム(SSC)中でのナトリウムイオン濃度は、1Mである。Suggsら,Developmental Biology Using Purified Genes 683(BrownおよびFox編,1981)を参照のこと。
Tm=A−T塩基対あたり2℃ + G−C塩基対あたり4℃*6×塩クエン酸ナトリウム(SSC)中でのナトリウムイオン濃度は、1Mである。Suggsら,Developmental Biology Using Purified Genes 683(BrownおよびFox編,1981)を参照のこと。
オリゴヌクレオチドについての高度ストリンジェンシー洗浄条件は通常、6×SSC、0.1% SDS中でのそのオリゴヌクレオチドのTmよりも0℃〜5℃低い温度においてである。
別の実施形態では、関連した核酸分子は、配列番号1もしくは配列番号4のいずれかに示されるとおりのヌクレオチド配列に対して少なくとも約70パーセント同一であるヌクレオチド配列を含むかもしくはこれからなるか、または配列番号2もしくは配列番号5のいずれかに示すとおりのポリペプチドに対して少なくとも約70パーセント同一であるポリペプチドをコードするヌクレオチド配列を含むかもしくは本質的にこれからなる。好ましい実施形態では、ヌクレオチド配列は、配列番号1もしくは配列番号4のいずれかに示されるとおりのヌクレオチド配列に対して約75パーセント、もしくは約80パーセント、もしくは約85パーセント、もしくは約90パーセント、もしくは約95、96、97、98、もしくは99パーセント同一であるか、またはヌクレオチド配列は、配列番号2、もしくは配列番号5のいずれかに示されるとおりのポリペプチド配列に対して約75パーセント、もしくは約80パーセント、もしくは約85パーセント、もしくは約90パーセント、もしくは約95、96、97、98、もしくは99パーセント同一であるポリペプチドをコードする。関連した核酸分子は、配列番号2または配列番号5のいずれかに示されるポリペプチドの少なくとも1つの活性を保有するポリペプチドをコードする。
核酸配列における相違は、配列番号2または配列番号5のいずれかのアミノ酸配列と比較して、アミノ酸配列の保存的および/または非保存的改変をもたらし得る。
配列番号2または配列番号5のいずれかのアミノ酸配列に対する保存的改変(およびコードするヌクレオチドに対する、対応する改変)は、IFN−Lポリペプチドの機能的特徴および化学的特徴と類似の機能的特徴および化学的特徴を有するポリペプチドを生じる。対照的に、IFN−Lポリペプチドの機能的特徴および/または化学的特徴における実質的な改変は、以下を維持することに対するその影響が顕著に異なる、配列番号2または配列番号5のいずれかのアミノ酸配列における置換を選択することによって達成され得る:(a)例えば、シートもしくはヘリックスコンホメーションのような、置換領域における分子骨格の構造、(b)標的部位での分子の電荷もしくは疎水性、または(c)側鎖のかさ。
例えば、「保存的アミノ酸置換」は、その位置でのアミノ酸残基の極性にも電荷にもほとんどまたは全く影響がないような、標準的残基によるネイティブなアミノ酸残基の置換を含み得る。さらに、ポリペプチド中の任意のネイティブな残基はまた、「アラニンスキャニング変異誘発」について以前に記載されたように、アラニンによって置換され得る。
保存的アミノ酸置換はまた、生物学的系における合成によるよりむしろ、化学的なペプチド合成によって代表的に組み込まれる、天然には存在しないアミノ酸残基を含む。これらとしては、ペプチド模倣物、およびアミノ酸部分の他の逆転形態または反転形態が挙げられる。
天然に存在する残基は、共通の側鎖特性に基づいて、複数のクラスに分割され得る:
1)疎水性:ノルロイシン、Met、Ala、Val、Leu、Ile;
2)中性親水性:Cys、Ser、Thr;
3)酸性:Asp、Glu;
4)塩基性:Asn、Gln、His、Lys、Arg;
5)鎖の配向に影響を与える残基:Gly、Pro;および
6)芳香族:Trp、Tyr、Phe。
1)疎水性:ノルロイシン、Met、Ala、Val、Leu、Ile;
2)中性親水性:Cys、Ser、Thr;
3)酸性:Asp、Glu;
4)塩基性:Asn、Gln、His、Lys、Arg;
5)鎖の配向に影響を与える残基:Gly、Pro;および
6)芳香族:Trp、Tyr、Phe。
例えば、非保存的置換は、これらのクラスのうちの1つのメンバーの、別のクラス由来のメンバーに対する交換を包含し得る。このような置換された残基は、非ヒトIFN−Lポリペプチドと相同なヒトIFN−Lポリペプチドの領域またはこの分子の非相同領域に導入され得る。
このような変化を行う際に、アミノ酸のヒドロパシー指数(hydropathic index)が考慮され得る。各アミノ酸は、その疎水性および電荷特性に基づいて、ヒドロパシー指数を割り当てられている。ヒドロパシー指数は、以下である:イソロイシン(+4.5);バリン(+4.2);ロイシン(+3.8);フェニルアラニン(+2.8);システイン/シスチン(+2.5);メチオニン(+1.9);アラニン(+1.8);グリシン(−0.4);スレオニン(−0.7);セリン(−0.8);トリプトファン(−0.9);チロシン(−1.3);プロリン(−1.6);ヒスチジン(−3.2);グルタミン酸(−3.5);グルタミン(−3.5);アスパラギン酸(−3.5);アスパラギン(−3.5);リジン(−3.9);およびアルギニン(−4.5)。
タンパク質に対する相互作用的な生物学的機能を確認する際の、ヒドロパシーアミノ酸指数の重要性は、当該分野において一般的に理解されている(Kyteら、1982,J.Mol.Biol.157:105−31)。特定のアミノ酸が類似のヒドロパシー指数またはスコアを有する他のアミノ酸の代わりに使用され得、そして依然として類似の生物学的活性を維持し得ることが、公知である。ヒドロパシー指数に基づいて変化を起こす際に、ヒドロパシー指数が±2以内であるアミノ酸の置換が好ましく、±1以内であるものが特に好ましく、そして±0.5以内であるものが、なおより特に好ましい。
類似のアミノ酸の置換が親水性に基づいて効果的になされ得る(特に、これによって作製された生物学的機能的に等価なタンパク質またはペプチドが、この場合においてと同様に、免疫学的実施形態における使用に関して考慮される場合)こともまた、当該分野において理解されている。タンパク質の最も大きな局所的平均親水性は、その隣接するアミノ酸の親水性によって支配される場合に、その免疫原性および抗原性、すなわち、そのタンパク質の生物学的特性に相関する。
以下の親水性の値が、これらのアミノ酸残基に割り当てられた:アルギニン(+3.0);リジン(+3.0);アスパラギン酸(+3.0±1);グルタミン酸(+3.0±1);セリン(+0.3);アスパラギン(+0.2);グルタミン(+0.2);グリシン(0);スレオニン(−0.4);プロリン(−0.5±1);アラニン(−0.5);ヒスチジン(−0.5);システイン(−1.0);メチオニン(−1.3);バリン(−1.5);ロイシン(−1.8);イソロイシン(−1.8);チロシン(−2.3);フェニルアラニン(−2.5);およびトリプトファン(−3.4)。類似の親水性の値に基づいて変化を行う際に、親水性値が±2以内であるアミノ酸の置換が好ましく、±1以内であるものが特に好ましく、そして±0.5以内であるものが、なおより特に好ましい。一次アミノ酸配列から、エピトープをまた、親水性に基づいて同定し得る。これらの領域はまた、「エピトープコア領域」と呼ばれる。
所望のアミノ酸置換(保存的であれ非保存的であれ)は、当業者によって、このような置換が所望される時点で決定され得る。例えば、アミノ酸置換を使用して、IFN−Lポリペプチドの重要な残基を同定し得るか、または本明細書中に記載されるIFN−Lポリペプチドの親和性を増加もしくは減少させ得る。例示的なアミノ酸置換は、表Iに記載される。
当業者は、周知技術を用いて配列番号2または配列番号5のいずれかに示されるポリペプチドの適切な改変体を決定し得る。活性を崩壊させずに変更され得るその分子の適切な領域を決定するために、当業者は、活性に関して重要であると考えらない領域を標的化し得る。例えば、同じ種由来または他の種由来の、類似した活性を有する類似したポリペプチドが既知の場合、当業者は、IFN−Lポリペプチドのアミノ酸配列をそのような類似したポリペプチドと比較し得る。そのような比較を用いて、当業者は、類似したポリペプチドの間で保存されているその分子の残基および部分を同定し得る。そのような類似したポリペプチドに対して保存されていないIFN−Lポリペプチドの領域における変化は、IFN−Lポリペプチドの生物学的活性および/または構造に逆の影響をおそらくほとんど与えないことが理解される。当業者はまた、たとえ比較的保存された領域においても、活性を維持しながら天然に存在する残基を化学的に類似したアミノ酸で代用し得る(保存的アミノ酸残基置換)ことを理解する。従って、生物学的活性または構造に対して重要であり得る領域でさえ、生物学的活性を崩壊させることなく、またはポリペプチド構造に逆の影響を与えることなく、保存的アミノ酸置換に供され得る。
さらに、活性または構造に重要である類似したポリペプチドにおける残基を同定する、構造−機能研究を当業者は、再検討し得る。そのような比較を考慮して、当業者は、類似したポリペプチドにおいて活性もしくは構造に重要であるアミノ酸残基に対応する、IFN−Lポリペプチドにおけるアミノ酸残基の重要性を予測し得る。当業者は、IFN−Lポリペプチドのそのような予測された重要なアミノ酸残基に関して、化学的に類似したアミノ酸置換を選択し得る。
当業者はまた、類似したポリペプチドにおける三次元構造に関連して、三次元構造およびアミノ酸配列を分析し得る。そのような情報を考慮して、当業者は、三次元構造についてIFN−Lポリペプチドのアミノ酸残基のアラインメントを推測し得る。当業者は、タンパク質の表面上であると推測されるアミノ酸残基に対して急激な変更を作製しないように選択し得る。なぜなら、そのような残基は、他の分子との重要な相互作用に関与し得るからである。さらに、当業者は、各アミノ酸残基において単一アミノ酸置換を含む試験改変体を作製し得る。この改変体は、当業者に公知の活性アッセイを用いてスクリーニングされ得る。そのような改変体を使用して、適切な改変体に関する情報を集め得る。例えば、当業者は、特定のアミノ酸残基に対する変更が、崩壊された活性、不適当に減少された活性、または不適切な活性を生じることを発見した場合、そのような変更を有する改変体は、回避される。言い換えると、そのような慣用的な実験から集められた情報に基づいて、当業者は、さらなる置換が単独または他の変異と組み合わせてかのいずれかで回避されるべきであるアミノ酸を、容易に決定し得る。
多数の科学刊行物が、二次構造の推測に向けられている。Moult、Curr.Opin. Biotechnol.、7:422−27、1996、Chouら、Biochemistry、13:222−45、1974;Chouら、Biochemistry、113:211−22、1974;Chouら、Adv.Enzymol.Relat.Areas Mol.Biol.、47:45−48,1978;Chouら、Ann.Rev.Biochem.、47:251−276およびChouら、Biophys.J.、26:367−84、1979を参照のこと)。さらに、コンピュータープログラムが、現在利用可能であり、二次構造の予測によって補助する。二次構造を推測する1つの方法は、相同性モデリングに基づく。例えば、30%よりも大きい配列同一性、または40%よりも大きい配列類似性を有する2つのポリペプチドまたはタンパク質は、しばしば、類似した構造トポロジーを有する。タンパク質構造データベース(PDB)の近年の成長により、二次構造の推測可能性(ポリペプチド構造またはタンパク質構造内の潜在的な折り畳みの数を含む)の促進がもたらされた。Holmら、Nucleic.Acids.Res.、27:244−47,1999を参照のこと。所定のポリペプチドもしくはタンパク質における限定された数の折り畳みが存在すること、および一旦構造の臨界の数が決定されると、構造予測が劇的により正確になること、が示唆されている(Brennerら、Curr.Opin.Struct.Biol.、7 369−76、1997)。
二次構造を予測するさらなる方法としては、「スレッディング(threading)」(Jones、Curr.Opin.Struct.Biol.、7:377−87、1997;Sipplら、Structure、4:15−9、1996)、「プロフィール分析」(Bowieら、Science.253:164−70、1991;Gribskovら、Methods.Enzymol.、183:146−59、1990;Gribskovら、Proc.Nat.Acad.Sci.U.S.A.、844355−58、1987)、および「進化的連鎖(evolutionary linkage)」(Homeら、前出、およびBrenner、前出を参照のこと)が、挙げられる。
好ましいIFN−Lポリペプチド改変体としては、グリコシル化改変体が挙げられ、ここで、グリコシル化部位の数および/または種類は、配列番号2または配列番号5のいずれかに記載されるアミノ酸配列と比較して変更されている。1つの実施形態において、IFN−Lポリペプチド改変体は、配列番号2または配列番号5のいずれかに記載のアミノ酸配列よりも多いかまたは少ない数のN結合型グリコシル化部位を含む。N結合型グリコシル化部位は、配列:Asn−X−SerまたはAsn−X−Thrによって特徴付けられ、ここで、Xとして示されるアミノ酸残基は、プロリン以外の任意のアミノ酸残基であり得る。この配列を作製するためのアミノ酸残基の置換は、N結合型炭水化物鎖の付加のための潜在的に新たな部位を提供する。あるいは、この配列を除去する置換は、存在するN結合型炭水化物鎖を除く。また、N結合型炭水化物鎖の再配列が提供され、ここで、一つ以上のN結合型グリコシル化部位(代表的には、天然にある部位)が除去されて一つ以上の新しいN結合型部位が作製される。さらに好ましいIFN−L改変体としては、システイン改変体が挙げられ、ここで、一つ以上のシステイン残基が、配列番号2または配列番号5のいずれかに記載されるアミノ酸と比較して、欠失されているか、または別のアミノ酸(例えば、セリン)を置換している。システイン改変体は、IFN−Lポリペプチドが、不溶性封入体の単離の後のように、生物学的に活性なコンフォメーションに折り畳まれなければならない場合に有用である。システイン改変体は、一般的に、ネイティブなタンパク質よりも少ないシステイン残基を有し、そして代表的には、不対システインから生じる相互作用を最少化するために偶数を有する。
他の実施形態において、関連する核酸分子は、少なくとも1つのアミノ酸の挿入を有する配列番号2または配列番号5のいずれかに記載されるポリペプチド(そして、ここで、このポリペプチドは、配列番号2または配列番号5のいずれかに記載されるポリペプチドの活性を有する)をコードするヌクレオチド配列から、あるいは、少なくとも1つのアミノ酸の欠失を有する配列番号2または配列番号5のいずれかに記載されるポリペプチド(そして、ここで、このポリペプチドは、配列番号2または配列番号5のいずれかに記載されるポリペプチドの活性を有する)をコードするヌクレオチド配列から構成される/成る。関連する核酸分子はまた、配列番号2または配列番号5のいずれかに記載されるポリペプチド(そして、ここで、このポリペプチドは、カルボキシ末端切断および/またはアミノ末端切断を有し、そして、さらに配列番号2または配列番号5のいずれかに記載されるポリペプチドの活性を有する)をコードするヌクレオチド配列から構成される/成る。関連する核酸分子はまた、アミノ酸置換、アミノ酸挿入、アミノ酸欠失、カルボキシ末端切断および/またはアミノ末端切断を有する配列番号2または配列番号5のいずれかに記載されるポリペプチド(そして、ここで、このポリペプチドは、配列番号2または配列番号5のいずれかに記載されるポリペプチドの活性を有する)をコードするヌクレオチド配列から構成される/成る。
さらに、配列番号2または配列番号5のいずれかのアミノ酸配列を含むポリペプチドまたは他のIFN−Lポリペプチド改変体は、相同なポリペプチドに融合されてホモダイマーを形成し得るか、または異種のポリペプチドに融合されてヘテロダイマーを形成し得る。異種のペプチドおよびポリペプチドとしては、以下が挙げられるが、これらに限定されない:IFN−L融合タンパク質の検出および/または単離を可能するためのエピトープ;膜貫通レセプタータンパク質またはその一部分(例えば、細胞外ドメインまたは膜貫通および細胞内ドメイン);膜貫通レセプタータンパク質に結合するリガンドまたはその一部分;触媒活性である酵素またはその一部分;オリゴマー化を促進するポリペプチドまたはペプチド(例えば、ロイシンジッパードメイン);安定性を増加するポリペプチドまたはペプチド(例えば、免疫グロブリン定常領域);ならびに配列番号2または配列番号5のいずれかに記載されるアミノ酸配列を含むポリペプチドまたはIFN−Lポリペプチド改変体とは異なる治療活性を有するポリペプチド。
融合は、配列番号2または配列番号5のいずれかに記載されるアミノ酸配列を含むポリペプチドまたは他のIFN−Lポリペプチド改変体のアミノ末端またはカルボキシ末端のいずれかでなされ得る。融合は、リンカー分子またはアダプター分子なしで直接的であり得るか、あるいはリンカー分子またはアダプター分子を使用して間接的であり得る。リンカー分子またはアダプター分子は、1つ以上のアミノ酸残基、代表的には約20〜約50個のアミノ酸残基であり得る。リンカー分子またはアダプター分子はまた、DNA制限エンドヌクレアーゼ、またはプロテアーゼの切断部位を有するように設計され得て融合部分の分離を可能にする。一旦構築されると、融合ポリペプチドは、本明細書中に記載される方法に従って誘導され得ることが理解される。
本発明のさらなる実施形態において、配列番号2または配列番号5のいずれかに記載されるアミノ酸配列を含むポリペプチドまたは他のIFN−Lポリペプチド改変体は、ヒトIgGのFc領域の一つ以上のドメインに融合される。抗体は、2つの機能的に独立した部分(「Fab」として公知の可変ドメイン(抗原に結合する)および「Fc」として公知の定常ドメイン(食細胞による攻撃および補体活性化のようなエフェクター機能に関係する)を含む。Fcは、長い血清半減期を有し、一方、Fabは短寿命である(Caponら、Nature、337:525−31、1989)。治療タンパク質と一緒に構築される場合、Fcドメインは、より長い半減期を提供し得るか、またはFcレセプター結合、プロテインA結合、補体固定およびおそらく胎盤輸送のような機能を組込み得る(同書)。表IIは、当該分野で公知の特定のFc機能の使用を要約する。
一つの例において、ヒトIgGヒンジ領域、CH2領域およびCH3領域の全てまたは一部は、当業者に公知の方法を使用してIFN−LポリペプチドのN末端またはC末端のいずれかに融合され得る。別の例において、ヒトIgGヒンジ領域、CH2およびCH3領域は、IFN−Lポリペプチドフラグメント(例えば、IFN−Lポリペプチドの予想される細胞外部分)のアミノ末端またはカルボキシ末端のいずれかと融合し得る。
得られるIFN−L融合ポリペプチドは、プロテインAアフィニティーカラムの使用によって精製され得る。Fc領域に融合されたペプチドおよびタンパク質は、融合されていない対応物よりも実質的に長い半減期を示すことが見出された。また、Fc領域への融合は、融合ポリペプチドの二量化/多量体化を可能にする。Fc領域は、天然に存在するFc領域であり得るか、または特定の質(例えば、治療的質、循環時間、凝集の減少など)を改善するために変更され得る。
関連する核酸分子およびペプチドの同一性および類似性は、公知の方法によって容易に計算され得る。このような方法としては、以下が挙げられるがこれらに限定されない:Computational Molecular Biology,Lesk,A.M.Lesk編,Oxford University Press1988;Biocomputing:Informatics and Genome Projects,D.W.Smith編,Academic Press,1993;Computer Analysis of Sequence Data,Part 1,Griffin,A.M.,およびGriffin,H.G.編,Humana Press,New Jersey,1994;Sequence Analysis in Molecular Biology,von Heinje,G.,Academic Press,1987;Sequence Analysis Primer,M.Gribskov,およびJ.Devereux編,M.Stockton Press,1991;ならびにCarillo編,SIAM J.Applied Math.,48:1073,1988に記載される方法。
同一性および/または類似性を決定するための好ましい方法は、試験される配列間に最も大きな一致を与えるように設計される。同一性および類似性を決定するための方法は、公に利用可能なコンピュータプログラムに記載される。2つの配列間の同一性および類似性を決定するための好ましいコンピュータプログラム方法としては、以下が挙げられるがこれらに限定されない:GCGプログラムパッケージ(GAP(Devereuxら、Nucleic.Acids.Res.,12:387,1984;Genetics Computer Group,University of Wisconsin,Madison,WI)を含む)、BLASTP、BLASTN、およびFASTA(Altschulら,J.Mol.Biol.,215:403−10,1990)。BLASTXプログラムは、National Center for Biotechnology Information(NCBI)および他の供給源(BLAST Manual,Altschulら、NCB/NLM/NIH Bethesda,MD;Altschulら,1990上記)から公に入手可能である。周知のSmith Watermanアルゴリズムもまた同一性を決定するために使用され得る。
2つのアミノ酸配列を整列させるための特定の整列スキームは、2つの配列の短い領域のみの一致を生じ得、この小さな整列された領域は、2つの全長配列間に有意な関係がないとしても非常に高い配列同一性を有し得る。従って、好ましい実施形態においては、選択された整列方法(GAPプログラム)は、標的ポリペプチドの少なくとも50個の連続するアミノ酸にわたる整列を生じる。
例えば、コンピュータアルゴリズムGAP(Genetics Computer Group,University of Wisconsin,Madison,WI)を使用して、配列同一性の割合が決定される2つのポリペプチドは、それらのそれぞれのアミノ酸の最適の一致(アルゴリズムによって決定される「一致したスパン(matched span)」)について整列される。ギャップオープニングペナルティー(gap opening penalty)(これは、平均ダイアゴナルの3倍として計算され;「平均ダイアゴナル」は、使用される比較マトリクスのダイアゴナルの平均であり;「ダイアゴナル」は、特定の比較マトリクスによってそれぞれの完全なアミノ酸一致に割り当てられるスコアまたは数である)およびギャップエクステンションペナルティー(これは、通常ギャップオープニングペナルティーの1/10である)、ならびにPAM250またはBLOSUM62のような比較マトリクスがアルゴリズムとともに使用される。標準比較マトリクス(PAM250比較マトリクスのついてDayhoffら、Atlas of Protein Sequence and Structure、第5巻、補遺35(3)、1978;BLOSUM62比較マトリクスについてHenikoffら、Proc.Natl.Acad.Sci USA、89:10915−10919、1992)もまたアルゴリズムによって使用される。
ポリペプチド配列の比較に好ましいパラメーターとしては、以下が挙げられる: アルゴリズム(Algorithm):NeedlemanおよびWunsch,J.Mol.Biol.48:443−53(1970)、 比較マトリクス(Comparison matrix):BLOSUM 62、Henikoffら、前出)
ギャップペナルティー(Gap Penalty):12 ギャップレングスペナルティー(Gap Length Penalty):4 類似性の閾値:0。
ギャップペナルティー(Gap Penalty):12 ギャップレングスペナルティー(Gap Length Penalty):4 類似性の閾値:0。
GAPプログラムは、上記パラメーターを用いて有用である。上記パラメーターは、GAPアルゴリズムを使用してポリペプチド比較についてのデフォルトパラメーター(末端ギャップについてペナルティーなしで)である。
核酸分子配列比較についての好ましいパラメーターとしては、以下が挙げられる: アルゴリズム:NeedlemanおよびWunsch,前出)
比較マトリクス:一致=+10、不一致=0 ギャップペナルティー:50 ギャップレングスペナルティー:3。
比較マトリクス:一致=+10、不一致=0 ギャップペナルティー:50 ギャップレングスペナルティー:3。
GAPプログラムはまた、上記パラメーターを用いて有用である。上記パラメーターは、核酸分子比較に付いてのデフォルトパラメーターである。
他の例示的なアルゴリズム、ギャップオープニングペナルティー、ギャップエクステンションペナルティー、比較マトリクス、同一性の閾値などが当業者によって使用され得、これには、Program Manual,Wisconsin Package,Version 9,September,1997に記載されるものを含む。なされる特定の選択は、当業者に明らかであり、なされる特定の比較(例えば、DNA−DNA間、タンパク質−タンパク質間、タンパク質−DNA間);さらに、比較が配列の対間である(この場合、GAPまたはBestFitが一般的に好ましい)か、一つの配列と配列の大きなデータベースとの間(この場合、FASTAまたはBLASTAが好ましい)であるか)に依存する。
(核酸分子)
核酸分子は、IFN−Lポリペプチドのアミノ酸配列を含むポリペプチドをコードし、種々の方法(化学合成、cDNAまたはゲノムライブラリースクリーニング、発現ライブラリースクリーニングおよび/またはcDNAのPCR増幅を含むがこれらに限定されない)で容易に得られ得る。
核酸分子は、IFN−Lポリペプチドのアミノ酸配列を含むポリペプチドをコードし、種々の方法(化学合成、cDNAまたはゲノムライブラリースクリーニング、発現ライブラリースクリーニングおよび/またはcDNAのPCR増幅を含むがこれらに限定されない)で容易に得られ得る。
本明細書中で使用される組換えDNA方法は、一般的に、Sambrookら(Molecular Cloning:A Laboratory Manual,Cold Spring Harbor Laboratory Press(1989))および/またはAusubelら編(Current Protocols in Molecular Biology,Green Publishers Inc. and Wiley and Sons,NY(1994))に記載される方法である。本発明は、本明細書中に記載される核酸分子およびこのような分子を得るための方法を用意する。
IFN−Lポリペプチドのアミノ酸配列をコードする遺伝子が一つの種から同定された場合、その遺伝子の全てまたは一部は、同じ種からのオーソロガス遺伝子または関連遺伝子を同定するためのプローブとして使用され得る。プローブまたはプライマーは、IFN−Lポリペプチドを発現すると考えられる種々の組織供給源からのcDNAライブラリーをスクリーニングするために使用され得る。
さらに、配列番号1または配列番号4のいずれかに記載される配列を有する核酸分子の一部または全てを使用してゲノムライブラリーをスクリーニングし、IFN−Lをコードする遺伝子を同定および単離し得る。代表的には、中程度または高いストリンジェンシーの条件は、スクリーニングのために使用されてスクリーニングから得られた偽陽性の数を最小にする。
IFN−Lポリペプチドのアミノ酸配列をコードする核酸分子はまた、発現クローニング(これは、発現されたタンパク質の性質に基づく陽性クローンの検出を使用する)によって同定され得る。代表的には、核酸ライブラリーは、宿主細胞表面において発現されそして示されるクローン化タンパク質への抗体または他の結合パートナー(例えば、レセプターまたはリガンド)の結合によってスクリーニングされる。抗体または結合パートナーは、検出可能な標識を用いて修飾されて所望のクローンを発現するそれらの細胞を同定する。
以下に記載される説明に従って行われる組換え発現技術は、これらのポリヌクレオチドを作製し、そしてコードされるポリペプチドを発現するために従われ得る。例えば、IFN−Lポリペプチドのアミノ酸配列をコードする核酸配列を適切なベクターに挿入することによって、当業者は、大量の所望のヌクレオチド配列を容易に作製し得る。次いで、この配列を使用して検出プローブまたは増幅プライマーを作製し得る。あるいは、IFN−Lポリペプチドのアミノ酸配列をコードするポリヌクレオチドを発現ベクターに挿入し得る。発現ベクターを適切な宿主に導入することによって、コードされるIFN−Lポリペプチドは、大量に作製され得る。
適切な核酸配列を得るための別の方法は、ポリメラーゼ連鎖反応(PCR)である。この方法において、cDNAは、酵素逆転写酵素を使用して、poly(A)+RNAまたは全RNAから調製される。次いで、2つのプライマー(代表的には、IFN−Lポリペプチドのアミノ酸配列をコードするcDNAの2つの別個の領域に対して相補的である)が、TaqポリメラーゼのようなポリメラーゼとともにこのcDNAに付加され、そしてこのポリメラーゼが、これら2つのプライマー間のこのcDNAの領域を増幅する。
IFN−Lポリペプチドのアミノ酸配列をコードする核酸分子を調製する別の手段は、Engelsら、1989,Angew.Chem.Intl.Ed.28:716−34によって記載されるもののような、当業者に周知の方法を使用する、化学合成である。これらの方法としては、とりわけ、核酸合成のためのリン酸トリエステル、ホスホルアミダイト、およびH−ホスホネート方法が挙げられる。このような化学合成のために好ましい方法は、標準的なホスホルアミダイト化学を使用する、ポリマーにより支持される合成である。代表的に、IFN−Lポリペプチドのアミノ酸配列をコードするDNAは、数百ヌクレオチド長である。約100ヌクレオチドより長い核酸は、これらの方法を使用して、いくつかのフラグメントとして合成され得る。次いで、これらのフラグメントが一緒に連結されて、IFN−L遺伝子の全長ヌクレオチド配列を形成し得る。通常、このポリペプチドのアミノ末端をコードするDNAフラグメントは、ATGを有し、これは、メチオニン残基をコードする。このメチオニンは、宿主細胞において産生されたポリペプチドがその細胞から分泌されるよう設計されるか否かに依存して、IFN−Lポリペプチドの成熟形態で存在してもそうでなくてもよい。当業者に公知の他の方法が、同様に使用され得る。
特定の実施形態において、核酸改変体は、所定の宿主細胞におけるIFN−Lポリペプチドの最適な発現のために変更されたコドンを含む。特定のコドン変更は、発現のために選択されるIFN−Lポリペプチドおよび宿主細胞に依存する。このような「コドン最適化」は、種々の方法によって(例えば、所定の宿主細胞において高度に発現される遺伝子における使用に好ましいコドンを選択することによって)実施され得る。高度に発現された細菌遺伝子のコドン優先性のための「Eco_high.Cod」のようなコドン度数表を組み込むコンピュータアルゴリズムが使用され得、そしてUniversity of Wisconsin Package Version 9.0(Genetics Computer Group,Madison,WI)によって提供される。他の有用なコドン度数表としては、「Celegans_high.cod」、「Celegans_low.cod」、「Drosophila_high.cod」、「Human_high.cod」、「Maize_high.cod」、および「Yeast_high.cod.」が挙げられる。
いくつかの場合において、IFN−Lポリペプチド改変体をコードする核酸分子を調製することが所望であり得る。改変体をコードする核酸分子は、プライマー(単数または複数)が所望の点変異を有する部位特異的変異誘発、PCR増幅、または他の適切な方法を使用して生成し得る(変異誘発技術の記載に関しては、Sambrookら、前出、およびAusubelら、前出を参照のこと)。Engelsら、前出によって記載される方法を使用する化学合成もまた、このような改変体を調製するために使用され得る。当業者に公知の他の方法が、同様に使用され得る。
(ベクターおよび宿主細胞)
IFN−Lポリペプチドのアミノ酸配列をコードする核酸分子を、標準的な連結技術を使用して適切な発現ベクターに挿入する。ベクターは、代表的に、使用される特定の宿主細胞において機能的であるように選択される(すなわち、ベクターは、遺伝子の増幅および/または遺伝子の発現が生じ得るように、宿主細胞機構と適合性である)。IFN−Lポリペプチドのアミノ酸配列をコードする核酸分子は、原核生物宿主細胞、酵母宿主細胞、昆虫(バキュロウイルス系)宿主細胞および/または真核生物宿主細胞において増幅/発現され得る。宿主細胞の選択は、IFN−Lポリペプチドが翻訳後修飾(例えば、グリコシル化および/またはホスホリル化)されるか否かに一部依存する。そうである場合、酵母宿主細胞、昆虫宿主細胞、または哺乳動物宿主細胞が好ましい。発現ベクターの総説について、Meth.Enz.,185巻(D.V.Goeddel,編,Academic Press 1990)を参照のこと。
IFN−Lポリペプチドのアミノ酸配列をコードする核酸分子を、標準的な連結技術を使用して適切な発現ベクターに挿入する。ベクターは、代表的に、使用される特定の宿主細胞において機能的であるように選択される(すなわち、ベクターは、遺伝子の増幅および/または遺伝子の発現が生じ得るように、宿主細胞機構と適合性である)。IFN−Lポリペプチドのアミノ酸配列をコードする核酸分子は、原核生物宿主細胞、酵母宿主細胞、昆虫(バキュロウイルス系)宿主細胞および/または真核生物宿主細胞において増幅/発現され得る。宿主細胞の選択は、IFN−Lポリペプチドが翻訳後修飾(例えば、グリコシル化および/またはホスホリル化)されるか否かに一部依存する。そうである場合、酵母宿主細胞、昆虫宿主細胞、または哺乳動物宿主細胞が好ましい。発現ベクターの総説について、Meth.Enz.,185巻(D.V.Goeddel,編,Academic Press 1990)を参照のこと。
代表的に、任意の宿主細胞に使用される発現ベクターは、プラスミド維持のためならびに外来性ヌクレオチド配列のクローニングおよび発現のために配列を含む。このような配列(集合的に、「隣接配列」と呼ばれる)は、特定の実施形態において、代表的に、以下のヌクレオチド配列の1つ以上を含む:プロモーター、1つ以上のエンハンサー配列、複製起点、転写終結配列、ドナーおよびアクセプタースプライス部位を含む完全なイントロン配列、ポリペプチド分泌のためのリーダー配列をコードする配列、リボソーム結合部位、ポリアデニル化配列、発現されるポリペプチドをコードする核酸を挿入するためのポリリンカー領域、ならびに選択マーカーエレメント。これらの配列のそれぞれが、以下に議論される。
必要に応じて、ベクターは、「タグ」コード配列(すなわち、IFN−Lポリペプチドコード配列の5’末端または3’末端に配置されるオリゴヌクレオチド分子)を含み得;オリゴヌクレオチド配列は、polyHis(例えば、hexaHis)、別の「タグ」(例えば、FLAG、HA(赤血球凝集素インフルエンザウイルス))または市販の抗体が存在するmycをコードする。このタグは、代表的には、ポリペプチドの発現の際にポリペプチドに融合され、宿主細胞からの、IFN−Lポリペプチドのアフィニティー精製のための手段として役立ち得る。アフィニティー精製は、例えば、アフィニティーマトリクスとしてタグに対して抗体を使用するカラムクロマトグラフィーによって達成され得る。必要に応じて、タグは、続いて、切断のために特定のペプチダーゼを使用するような種々の手段によって、精製されたIFN−Lポリペプチドから除去され得る。
隣接配列は、同種(すなわち、宿主細胞と同じ種および/または系統由来)であり得るか、異種(すなわち、宿主細胞種または系統以外の種由来)であり得るか、ハイブリッド(すなわち、1つより多くの供給源由来の隣接配列の組み合わせ)であり得るか、または合成であり得るか、あるいは隣接配列は、IFN−Lポリペプチド発現を調節するために正常に機能するネイティブな配列であり得る。このように、隣接配列の供給源は、任意の原核生物または真核生物、任意の脊椎生物または無脊椎生物、あるいは任意の植物であり得、但し、隣接配列は、宿主細胞の機構において機能的であり、そして宿主細胞の機構によって活性化され得る。
本発明のベクターに有用な隣接配列は、当該分野において周知である任意のいくつかの方法によって得られ得る。代表的には、IFN−L遺伝子隣接配列以外の、本明細書中で有用な隣接配列は、マッピングおよび/または制限エンドヌクレアーゼ消化によって以前に同定されており、従って、適切な制限エンドヌクレアーゼを使用して、適切な組織供給源から単離され得る。いくつかの場合において、隣接配列の全長ヌクレオチド配列は公知であり得る。ここで、隣接配列は、核酸合成またはクローニングのために本明細書中で記載される方法を使用して合成され得る。
隣接配列の全てまたは一部のみが公知である場合、PCRを使用して、そして/あるいは適切なオリゴヌクレオチドならびに/または同じもしくは別の種由来の隣接配列フラグメントを用いてゲノムライブラリーをスクリーニングすることによって得られ得る。隣接配列が公知でない場合、隣接配列を含むDNAのフラグメントは、例えば、コード配列または別の遺伝子(単数または複数)を含み得る大きな片のDNAから単離され得る。単離は、適切なDNAフラグメントを生成するための制限エンドヌクレアーゼ消化、続くアガロースゲル精製を使用する単離、Qiagen(登録商標)カラムクロマトグラフィー(Chatsworth、CA)、または当業者に公知の他の方法によって達成され得る。この目的を達成するための適切な酵素の選択は、当業者に容易に明かである。
複製起点は、代表的に、市販から購入された原核生物発現ベクターの一部であり、この起点は、宿主細胞においてベクターの増幅に役立つ。特定のコピー数に対するベクターの増幅は、いくつかの場合において、IFN−Lポリペプチドの最適な発現に重要であり得る。選択されたベクターが複製起点部位を含まない場合、公知の配列に基づいて化学的に合成され得、そしてベクターに連結され得る。例えば、プラスミドpBR322(New England Biolabs,Beverly,MA)からの複製起点は、大部分のグラム陰性細菌に適切であり、そして種々の起点(例えば、SV40、ポリオーマ、アデノウイルス、水疱性口内炎ウイルス(VSV)、またはHPVまたはBPVのようなパピローマウイルス)は、哺乳動物細胞におけるベクターのクローニングのために有用である。一般的に、複製成分の起点は、哺乳動物発現ベクター(例えば、SV40起点は、ただそれが初期プロモーターを含むので、しばしば、使用される)を必要としない。
転写終結配列は、代表的にポリペプチドコード領域の末端の3’側に配置され、そして転写を終結させるのに役立つ。通常、原核生物細胞における転写終結配列は、G−Cリッチフラグメント、続いてポリ−T配列である。この配列はライブラリーから容易にクローン化され得るか、またはベクターの一部として市販で購入され、これは、本明細書中に記載されるような核酸合成のための方法を使用して容易に合成され得る。
選択マーカー遺伝子エレメントは、選択培養培地において増殖される宿主細胞の生存および増殖に必要なタンパク質をコードする。代表的な選択マーカー遺伝子は、(a)原核生物宿主細胞に対して、抗生物質または他の毒素(例えば、アンピシリン、テトラサイクリン、またはカナマイシン)に対する耐性を与えるか;(b)細胞の栄養要求性の欠損を補うか;(c)あるいは複合培地から入手可能でない重要な栄養素を供給するタンパク質をコードする。好ましい選択マーカーは、カナマイシン耐性遺伝子、アンピシリン耐性遺伝子、およびテトラサイクリン耐性遺伝子である。ネオマイシン耐性遺伝子もまた、原核生物宿主細胞および真核生物宿主細胞における選択のために使用され得る。
他の選択遺伝子は、発現される遺伝子を増幅するために使用され得る。増幅は、増殖に重要なタンパク質の産生により大きく要求される遺伝子が、組換え細胞の連続的な生成の染色体内でタンデムに反復されるプロセスである。哺乳動物細胞に対する適切な選択マーカーの例としては、ジヒドロ葉酸レダクターゼ(DHFR)およびチミジンキナーゼが挙げられる。哺乳動物細胞形質転換体は、選択圧下に置かれ、ここで、形質転換体のみが、ベクターに存在する選択遺伝子によって生存するように独特に適合される。選択圧は、培地中の選択因子の濃度が連続的に変化し、それによって選択遺伝子とIFN−LポリペプチドをコードするDNAとの両方の増幅を導く条件下で、形質転換された細胞を培養することによって課される。結果として、増加した量のIFN−Lポリペプチドが、増幅されたDNAから合成される。
リボソーム結合部位は、通常、mRNAの翻訳開始に必要であり、そしてShine−Dalgarno配列(原核性物)またはKozak配列(真核生物)によって特徴付けられる。このエレメントは、代表的に、発現されるIFN−Lポリペプチドのプロモーターの3’側およびコード配列の5’側に配置される。Shine−Dalgarno配列は、可変であるが、代表的には、ポリプリン(すなわち、高いA−G含有量を有する)である。多くのShine−Dalgarno配列は、同定されており、それぞれが、本明細書中に記載の方法を使用して、原核生物ベクターを使用して容易に合成され得る。
リーダー配列、またはシグナル配列は、宿主細胞からIFN−Lポリペプチドを指向させるために使用され得る。代表的には、シグナル配列をコードするヌクレオチド配列は、IFN−L核酸分子のコード領域に位置するか、または直接IFN−Lポリペプチドコード領域の5’末端に位置する。多くのシグナル配列が同定されており、選択された宿主細胞において機能性であるシグナル配列の任意が、IFN−L核酸分子と組み合わせて使用され得る。従って、シグナル配列は、IFN−L核酸分子に対して同種(天然)または異種であり得る。さらに、シグナル配列は、本明細書中に記載される方法を使用して化学的に合成され得る。大部分において、シグナルペプチドの存在による宿主細胞からのIFN−Lポリペプチドの分泌は、分泌されたIFN−Lポリペプチドからのシグナルペプチドの除去を生じる。シグナル配列は、ベクターの成分であり得るか、またはベクターに挿入されたIFN−L核酸分子の一部であり得る。
IFN−Lポリペプチドコード領域に結合されたネイティブなIFN−Lポリペプチドシグナル配列をコードするヌクレオチド配列またはIFN−Lポリペプチドコード領域に結合された異種シグナル配列をコードするヌクレオチド配列のいずれかの使用が本発明の範囲内に含まれる。選択された異種シグナル配列は、宿主細胞によって認識され、プロセスされる(すなわち、シグナルペプチダーゼによって切断される)ものであるべきである。ネイティブなIFN−Lポリペプチドシグナル配列を認識せず、プロセスしない原核生物宿主細胞について、シグナル配列は、例えば、アルカリホスファターゼ、ペニシリナーゼ、または熱安定エンテロトキシンIIリーダーのグループから選択される原核生物シグナル配列によって置換される。酵母分泌について、ネイティブなIFN−Lポリペプチドシグナル配列は、酵母インベルターゼ、α因子、または酸ホスファターゼリーダーによって置換され得る。哺乳動物細胞発現において、ネイティブなシグナル配列が満足であるが、他の哺乳動物シグナル配列が適切であり得る。
グリコシル化が真核生物宿主細胞発現系において望ましいような、いくつかの場合において、グリコシル化または収量を改善するために種々のシグナルペプチド(presequence)が操作され得る。例えば、特定のシグナルペプチドのペプチダーゼ切断部位を変更し得るかまたはプロ配列(pro−sequence)を加え得、これはまた、グリコシル化に影響し得る。最後のタンパク質産物は、1位に(成熟タンパク質の最初のアミノ酸に対して)、発現に付随して1つ以上のさらなるアミノ酸を有し得、これは、完全に除去されないかもしれない。例えば、最終のタンパク質産物は、アミノ末端に結合される、ペプチダーゼ切断部位において見出される1つまたは2つのアミノ酸残基を有し得る。あるいは、いくつかの酵素切断部位は、酵素が成熟ポリペプチド内のこのような領域で切断する場合、所望のIFN−Lポリペプチドの少し短縮した形態を生じ得る。
多くの場合において、核酸分子の転写は、ベクター内の1つ以上のイントロンの存在によって増加する;これは、ポリペプチドが真核生物宿主細胞(特に、哺乳動物宿主細胞)において産生される場合、特に当てはまる。使用されるイントロンは、特に使用される遺伝子が全長ゲノム配列またはそのフラグメントである場合、IFN−L遺伝子内に天然に存在し得る。イントロンが遺伝子内に天然に存在しない(大部分のcDNAについて)場合、イントロンは、別の供給源から得られ得る。隣接配列およびIFN−L遺伝子に関してイントロンの位置は、イントロンが効果的に転写されなければならないので、一般的に重要である。従って、IFN−L cDNA分子が転写される場合、イントロンの好ましい位置は、転写開始部位の3’側で、poly−A転写終止配列の5’側である。好ましくは、イントロン(単数または複数)は、コード配列を妨害しないように、cDNAの1つの側または他の側(すなわち、5’側または3’側)に配置される。任意の供給源(ウイルス、原核生物および真核生物(植物または動物)を含む)由来の任意のイントロンを使用して本発明を実行し得るが、但し、このイントロンは、挿入される宿主細胞に適合性である。合成イントロンもまたここに含まれる。必要に応じて、1つより多くのイントロンがベクター内で使用され得る。
本発明の発現ベクターおよびクローニングベクターは、代表的には、宿主生物によって認識され、IFN−Lポリペプチドをコードする分子に作動可能に連結されたプロモーターを含む。プロモーターは、構造遺伝子の転写を制御する構造遺伝子(一般的に、約100〜1000bp)の開始コドンに対して上流(すなわち、5’側)に配置される非転写配列である。プロモーターは、通常、2つのクラス(誘導プロモーターおよび構成プロモーター)の1つにグループ化される。誘導プロモーターは、培養条件におけるいくらかの変化(例えば、栄養の存在または非存在、あるいは温度の変化)に応答してそれらの制御下で、DNAからの転写の増加したレベルを開始する。他方、構成プロモーターは、連続的な遺伝子産物の産生を開始する;すなわち、遺伝子発現に対してほとんど制御しないかまたは制御しない。多数のプロモーター(種々の潜在的な宿主細胞によって認識される)が周知である。適切なプロモーターは、供給源のDNAからプロモーターを制限酵素消化によって取り出し、そして所望のプロモーター配列をベクターに挿入することによって、IFN−LポリペプチドをコードするDNAに作動可能に連結される。ネイティブなIFN−Lプロモーター配列は、IFN−L核酸分子の増幅および/または発現に指向させるために使用され得る。しかし、ネイティブなプロモーターと比較して大きい転写および発現タンパク質のより高い産生が可能であり、そして使用のために選択された宿主細胞系と適合性である場合、異種プロモーターが好ましい。
原核生物宿主との使用に適切なプロモーターとしては、β−ラクタマーゼおよびラクトースプロモーター系;アルカリホスファターゼ;トリプトファン(trp)プロモーター系;およびハイブリッドプロモーター(例えば、tacプロモーター)が挙げられる。他の公知の細菌プロモーターもまた、適切である。これらの配列は、公開されており、その結果、当業者は、任意の有用な制限部位を供給するのに必要とされるリンカーまたはアダプターを使用して、所望のDNAにそれらの配列を連結し得る。
酵母宿主との使用に適切なプロモーターはまた、当該分野において周知である。酵母エンハンサーは、酵母プロモーターとの使用に有利に使用される。哺乳動物宿主細胞との使用に適切なプロモーターは周知であり、限定しないが、ポリオーマウイルス、鶏痘ウイルス、アデノウイルス(例えば、Adenovirus2)、ウシパピローマウイルス、鳥類肉腫ウイルス、サイトメガロウイルス、レトロウイルス、B型肝炎ウイルスおよび最も好ましいシミアンウイルス40(SV40)のようなウイルスのゲノムから得られるプロモーターが挙げられる。他の適切な哺乳動物プロモーターとしては、異種哺乳動物プロモーター(例えば、熱ショックプロモーターおよびアクチンプロモーター)が挙げられる。
IFN−L遺伝子発現を制御する際に関心があり得るさらなるプロモーターとしては、限定しないが、以下が挙げられる:SV40初期プロモータ領域(Bernoist and Chambon,1981,Nature 290:304−10);CMVプロモーター;ラウス肉腫ウイルスの3’側の長い終末反復に含まれるプロモーター(Yamamoto,et al.,1980,Cell 22 :787−97);ヘルペスチミジンキナーゼプロモーター(Wagner et al.,1981,Proc.Natl.Acad.Sci.U.S.A.78:1444−45);メタロチオネイン遺伝子の調節配列(Brinster et al.,1982,Nature 296:39−42);β−ラクタマーゼプロモーターのような原核生物発現ベクター(Villa−Kamaroff et al.,1978,Proc.Natl.Acad.Sci.U.S.A.,75:3727−31);またはtacプロモーター(DeBoer et al.,1983,Proc.Natl.Acad.Sci.U.S.A.,80:21−25)。組織特異性を示し、そしてトランスジェニック動物において利用されている以下の動物転写制御領域もまた関心がある:膵臓腺房細胞において活性なエラスターゼI遺伝子制御領域(Swift et al.,1984,Cell 38:639−46;Ornitz et al.,1986,Cold Spring Harbor Symp.Quant.Biol.50:399−409(1986);MacDonald,1987,Hepatology 7:425−515);膵臓β細胞において活性なインシュリン遺伝子制御領域(Hanahan,1985,Nature 315:115−22);リンパ球において活性な免疫グロブリン遺伝子制御領域(Grosschedl et al.,1984,Cell 38:647−58;Adames et al.,1985,Nature 318:533−38;Alexander et al.,1987,Mol.Cell.Biol.,7:1436−44);精巣、乳房、リンパ球、および肥満細胞において活性なマウス乳腺腫瘍ウイルス制御領域(Leder et al.,1986,Cell 45:485−95);肝臓において活性なアルブミン遺伝子制御領域(Pinkert et al.,1987,Genes and Devel.1:268−76);肝臓において活性なα−フェトプロテイン遺伝子制御領域(Krumlauf et al.,1985,Mol.Cell.Biol.,5:1639−48;Hammer et al.,1987,Science 235:53−58);肝臓において活性なα1−抗トリプシン遺伝子制御領域(Kelsey et al.,1987,Genes and Devel.1:161−71);骨髄性細胞において活性なβ−グロビン遺伝子制御領域(Mogram et al.,1985,Nature 315:338−40;Kollias et al.,1986,Cell 46:89−94);脳の稀突起神経膠細胞において活性なミエリンベースのタンパク質遺伝子制御領域(Readhead et al.,1987,Cell 48:703−12);骨格筋において活性なミオシン軽鎖−2遺伝子制御領域(Sani,1985,Nature 314:283−86);ならびに視床下部において活性なゴナドトロピン放出ホルモン遺伝子制御領域(Mason et al.,1986,Science 234:1372−78)。
エンハンサー配列は、より高等な真核生物によって本発明のIFN−LポリペプチドをコードするDNAの転写を増加するように、ベクターに挿入され得る。エンハンサーは、転写を増加させるためにプロモーターに作用する、通常約10〜300bpの長さのDNAのシスに作用するエレメントである。エンハンサーは、相対的な方向および位置に非依存性である。これらは、転写ユニットに対して5’側および3’側に見出された。哺乳動物遺伝子から入手可能ないくつかのエンハンサー配列が公知である(例えば、グロビン、エラスターゼ、アルブミン、α−フェトプロテインおよびインシュリン)。しかし、代表的には、ウイルス由来のエンハンサーが、使用される。SV40エンハンサー、サイトメガロウイルス初期プロモーターエンハンサー、ポリオーマエンハンサー、およびアデノウイルスエンハンサーは、真核生物プロモーターの活性化について例示的に増強するエレメントである。エンハンサーは、IFN−L核酸分子に対して5’位または3’位でベクターにスプライシングされ得るが、代表的には、プロモーターから5’位側に配置される。
本発明の発現ベクターは、市販のベクターのような開始ベクターから構築され得る。このようなベクターは、全ての所望な隣接配列を含んでも良いし、含まなくても良い。本明細書中に記載される隣接配列の1つ以上がすでにベクター内にない場合、これらは、個々に得られ得、ベクターに連結され得る。隣接配列のそれぞれを得るために使用される方法は、当業者に周知である。
本発明を実行するために好ましいベクターは、細菌宿主細胞、昆虫宿主細胞、および哺乳動物宿主細胞と適合性のベクターである。このようなベクターとしては、特に、pCRII、pCR3、およびpcDNA3.1(Invitrogen、San Diego、CA)、pBSII(Stratagene、La Jolla、CA)、pET15(Novagen、Madison、WI)、pGEX(Pharmacia Biotech、Piscataway、NJ)、pEGFP−N2(Clontech、Palo Alto、CA)、pETL(BlueBacII、Invitrogen)、pDSR−alpha(PCT公開番号WO 90/14363)ならびにpFastBacDual(Gibco−BRL、Grand Island、NY)が挙げられる。
さらなる適切なベクターとしては、限定しないが、コスミド、プラスミド、または改変ウイルスが挙げられるが、これらのベクター系は、選択された宿主細胞と適合性でなければならないことが理解される。このようなベクターとしては、限定しないが、Bluescript(登録商標)プラスミド誘導体(高コピー数ColEl−ベースのファージミド、Stratagene Cloning Systems,La Jolla CA)、Taq増幅PCR産物をクローニングするために設計されたPCRクローニングプラスミド(例えば、TOPOTM TA Cloning(登録商標)Kit、PCR2.1(登録商標)プラスミド誘導体、Invitrogen、Carlsbad、CA)、ならびにバキュロウイルス発現系のような哺乳動物ベクター、酵母ベクターまたはウイルスベクター(pBacPAKプラスミド誘導体、Clontech、Palo Alto、CA)が挙げられる。
ベクターが構築され、そしてIFN−Lポリペプチドをコードする核酸分子がベクターの適切な部位に挿入された後に、完全なベクターが増幅および/またはポリペプチド発現に適切な宿主細胞に挿入され得る。IFN−Lポリペプチドに対する発現ベクターの選択された宿主細胞への形質転換は、トランスフェクション、感染、塩化カルシウム、エレクトロポレーション、マイクロインジェクション、リポフェクション、DEAE−デキストラン法、または他の公知の技術のような方法を含む周知の方法によって達成され得る。選択される方法は、一部、使用される宿主細胞の種類の機能である。これらの方法および他の適切な方法は、当業者に周知であり、例えば、Sambrookら、前出に記載される。
宿主細胞は、原核生物宿主細胞(例えば、E.coli)または真核生物宿主細胞(例えば、酵母細胞、昆虫細胞、または脊椎動物細胞)であり得る。宿主細胞は、適切な条件下で培養される場合、IFN−Lポリペプチドを合成し、これは、続いて、培養培地から(宿主細胞がそのポリペプチドを培地に分泌する場合)収集され得るか、直接そのポリペプチドを産生する宿主細胞から収集される(そのポリペプチドが分泌されない場合)。適切な宿主細胞の選択は、所望の発現レベル、活性(例えば、グリコシル化またはリン酸化)に望ましいかまたは必要なポリペプチド修飾、および生物学的に活性な分子に折り畳まれる容易さなどの種々の因子に依存する。
多数の適切な宿主細胞が当該分野で公知であり、そして多くのものがAmerican Type Culture Collection(ATCC),Manassas,VAから入手可能である。例としては、哺乳動物細胞(例えば、チャイニーズハムスター卵巣細胞(CHO)、CHO DHFR(−)細胞(Urlaubら、1980、Proc.Natl.Acad.Sci.U.S.A,97:4216−20)、ヒト胎児腎臓(HEK)293細胞もしくは293T細胞または3T3細胞が挙げられるが、これらに限定されない。適切な哺乳動物宿主細胞の選択ならびに形質転換、培養、増幅、スクリーニング、産物産生および精製のための方法は、当該分野で公知である。他の適切な哺乳動物細胞株は、サルCOS−1細胞株およびCOS−7細胞株ならびにCV−1細胞株である。さらなる例示的な哺乳動物宿主細胞としては、形質転換された細胞株を含む、霊長類細胞株およびげっ歯類細胞株が挙げられる。正常な二倍体細胞、一次組織のインビトロ培養に由来する細胞株、ならびに一次外植片もまた適切である。候補細胞は、選択遺伝子が遺伝子型的に欠損していてもよいし、または優性に作用する選択遺伝子を含んでいてもよい。他の適切な哺乳動物細胞株としては、以下が挙げられるが、これらに限定されない:マウス神経芽細胞腫N2A細胞、HeLa細胞、マウスL−929細胞、Swiss、Balb−cもしくはNIHマウスに由来する3T3株、またはBHKハムスター細胞株もしくはHaKハムスター細胞株。各々これらの細胞株は、タンパク質発現の分野の当業者に公知であり、そしてタンパク質発現の分野の当業者にとって利用可能である。
本発明に適切な宿主細胞として同様に有用であるのは、細菌細胞である。例えば、E.coliの種々の株(例えば、HB101、DH5、DH10、およびMC1061)が、バイオテクノロジーの分野において宿主細胞として周知である。B.subtilis、Pseudomonas spp.、他のBacillus spp.、Streptomyces spp.などの種々の株もまた、本方法において使用され得る。
当業者に公知の酵母細胞の多くの株もまた、本発明のポリペプチドの発現のための宿主細胞として利用可能である。好ましい酵母細胞としては、例えば、Saccharomyces cerevisiaeおよびPichia pastorisが挙げられる。
さらに、所望される場合、昆虫細胞系が、本発明の方法において利用され得る。このような系は、例えば、Kittsら、1993、Biotechniques 14:810〜17;Lucklow、1993、Curr.Opin.Biotechnol.4:564〜72;およびLucklowら、1993、J.Virol.,67:4566〜79に記載される。好ましい昆虫細胞は、Sf−9およびHi5(Invitrogen)である。
グリコシル化IFN−Lポリペプチドを発現するためにトランスジェニック動物もまた使用し得る。例えば、トランスジェニック乳汁産生動物(例えば、ウシまたはヤギ)を使用し得、そしてその動物の乳汁中の本発明のグリコシル化ポリペプチドを入手し得る。IFN−Lポリペプチドを産生するために植物もまた使用し得るが、一般に、植物中で生じるグリコシル化は、哺乳動物細胞にて産生されるものと異なり、そしてヒト治療用途に適切でないグリコシル化産生物を生じ得る。
(ポリペプチド産生)
IFN−Lポリペプチド発現ベクターを含む宿主細胞が、当業者に周知の標準培地を使用して培養され得る。この培地は、通常、その細胞の増殖および生存に必要な栄養素すべてを含む。E.coli細胞を培養するのに適切な培地は、例えば、Luria Broth(LB)および/またはTerrific Broth(TB)である。真核生物細胞を培養するのに適切な培地は、ロズウェルパークメモリアル研究所培地1640(Roswll Park Memorial Institute medium 1640)(RPMI 1640)、最小必須培地(Minimal Essential Mediam)(MEM)および/またはダルベッコ改変イーグル培地(Dulbecco’s Modified Eagle Medium)(DMEM)が挙げられ、これら全ては、培養される特定の細胞株により必要とされる血清および/または増殖因子が補充され得る。昆虫培養に適切な培地は、必要な場合にはイーストレート(yeastolate)、ラクトアルブミン加水分解産物および/またはウシ胎仔血清を補充した、グレース培地である。
IFN−Lポリペプチド発現ベクターを含む宿主細胞が、当業者に周知の標準培地を使用して培養され得る。この培地は、通常、その細胞の増殖および生存に必要な栄養素すべてを含む。E.coli細胞を培養するのに適切な培地は、例えば、Luria Broth(LB)および/またはTerrific Broth(TB)である。真核生物細胞を培養するのに適切な培地は、ロズウェルパークメモリアル研究所培地1640(Roswll Park Memorial Institute medium 1640)(RPMI 1640)、最小必須培地(Minimal Essential Mediam)(MEM)および/またはダルベッコ改変イーグル培地(Dulbecco’s Modified Eagle Medium)(DMEM)が挙げられ、これら全ては、培養される特定の細胞株により必要とされる血清および/または増殖因子が補充され得る。昆虫培養に適切な培地は、必要な場合にはイーストレート(yeastolate)、ラクトアルブミン加水分解産物および/またはウシ胎仔血清を補充した、グレース培地である。
代表的には、トランスフェクトまたは形質転換された細胞の選択的増殖に有用な抗生物質または他の化合物が、この培地に補充物として添加される。使用される化合物は、宿主細胞が形質転換されたプラスミド上に存在する選択マーカーエレメントにより決定される。例えば、その選択マーカーエレメントがカナマイシン耐性である場合、培養培地に添加される化合物は、カナマイシンである。選択的増殖のための他の化合物としては、アンピシリン、テトラサイクリンおよびネオマイシンが挙げられる。
宿主細胞により産生されるIFN−Lポリペプチドの量は、当該分野で公知の標準的方法を使用して評価され得る。このような方法としては、限定はしないが、ウェスタンブロット分析、SDS−ポリアクリルアミドゲル電気泳動、非変性ゲル電気泳動、高速液体クロマトグラフィー(HPLC)分離、免疫沈降、および/または活性アッセイ(例えば、DNA結合ゲルシフトアッセイ)が挙げられる。
IFN−Lポリペプチドが宿主細胞から分泌されるように設計された場合、ポリペプチドの大部分は、細胞培養培地にて見出され得る。しかし、IFN−Lポリペプチドが宿主細胞から分泌されない場合、IFN−Lポリペプチドは細胞質および/または核(真核生物宿主細胞について)あるいは細胞質ゾル(グラム陰性細菌宿主細胞について)に存在する。
宿主細胞の細胞質および/または核(真核生物宿主細胞について)あるいは細胞質ゾル(グラム陰性細菌宿主細胞について)に存在するIFN−Lポリペプチドについては、細胞内物質(グラム陰性細菌についての封入体を含む)が、当業者に公知の任意の標準的技術を使用して宿主細胞から抽出され得る。例えば、宿主細胞は、フレンチプレス、ホモジナイゼーション、および/または超音波処理によって、ペリプラズム/細胞質の中身を放出するように溶解され得、それに続いて遠心分離され得る。
IFN−Lポリペプチドが細胞質ゾルにおいて封入体を形成した場合、その封入体は、しばしば、内側細胞膜および/または外側細胞膜に結合し得、従って、遠心分離後に、主にペレット物質中に見出される。次いで、このペレット物質は、極端なpH状態で処理され得るか、またはカオトロピック剤(例えば、界面活性剤、グアニジン、グアニジン誘導体、尿素、または尿素誘導体)を還元剤(例えば、ジチオスレイトール(アルカリ性pH)もしくはトリスカルボキシエチルホスフィン(酸性pH))の存在下で用いて処理されて、封入体を遊離、ばらばらにおよび可溶化し得る。可溶化形態のIFN−Lポリペプチドは、次いで、ゲル電気泳動、免疫沈降などを使用して分析され得る。IFN−Lポリペプチドを単離することが所望される場合、単離は、本明細書中に記載される方法およびMarstonら、1990、Meth.Enz.182:264−75に記載される方法のような、標準的方法を使用して達成され得る。
いくつかの場合において、IFN−Lポリペプチドは、単離の際に生物学的に活性でないかもしれない。そのポリペプチドを「リフォールディング」する、すなわち、その3次構造に変換してジスルフィド結合を生じるための種々の方法が、生物学的活性を回復するために使用され得る。このような方法は、可溶化されたポリペプチドを通常は7を超えるpHに、特定の濃度のカオトロープの存在下で曝すことを包含する。カオトロープの選択は、封入体可溶化のために使用される選択に非常に類似するが、通常このカオトロープは、より低い濃度で使用され、そして可溶化に使用されるカオトロープと必ずしも同じではない。ほとんどの場合、リフォールディング/酸化溶液はまた、還元剤を含むかまたは還元剤に加えてその酸化形態を特定の比で含んで、特定の酸化還元ポテンシャルを生じ、それによりそのタンパク質のシステイン架橋の形成を生じるようなジスルフィドシャッフリングを可能にする。一般的に使用される酸化還元カップルのいくつかとしては、システイン/シスタミン、グルタチオン(GSH)/ジチオビスGSH、塩化銅(II)、ジチオスレイトール(DTT)/ジチアンDTT、および2−2−メルカプトエタノール(bME)/ジチオ−b(ME)が挙げられる。多くの場合、共溶媒が、リフォールディングの効率を高めるために使用され得るかまたは必要であり得、そしてこの目的に使用されるさらに一般的な試薬としては、グリセロール、種々の分子量のポリエチレングリコール、アルギニンなどが挙げられる。
封入体が、IFN−Lポリペプチドの発現の際に有意な程度まで形成されない場合は、そのポリペプチドは、主に、細胞ホモジネートの遠心分離後に上清中に見出される。そのポリペプチドは、本明細書中に記載されるような方法を使用して、上清からさらに単離され得る。
溶液からのIFN−Lポリペプチドの精製は、種々の技術を使用して達成され得る。そのポリペプチドが、そのカルボキシル末端もしくはアミノ末端のいずれかに、ヘキサヒスチジンのようなタグを含む(IFN−Lポリペプチド/ヘキサHis)かまたはFLAG(Eastman Kodak Co.、New Haven、CT)もしくはmyc(Invitrogen,Carlsbad,CA)のような他の小さいペプチドを含むように合成されている場合、そのポリペプチドは、カラムマトリックスがそのタグに対して高い親和性を有するアフィニティーカラムにその溶液を通すことによって、1工程のプロセスで精製され得る。
例えば、ポリヒスチジンは、ニッケルに対して高い親和性および特異性で結合する。従って、ニッケルのアフィニティーカラム(例えば、Qiagen(登録商標)ニッケルカラム)が、IFN−Lポリペプチド/ポリHisの精製に使用され得る。例えば、Current Protocols in Molecular Biology、10.11.8節(Ausubelら編、Green Publishers Inc.and John Wiley and Sons 1993)を参照のこと。
さらに、IFN−Lポリペプチドは、IFN−Lポリペプチドを特異的に認識しそして結合し得る、モノクローナル抗体を使用して精製され得る。
精製のための他の適切な手段としては、限定はしないが、アフィニティークロマトグラフィー、免疫アフィニティークロマトグラフィー、イオン交換クロマトグラフィー、分子ふるいクロマトグラフィー、HPLC、電気泳動(ネイティブゲル電気泳動を含む)およびその後のゲル溶出、ならびに分取等電点電気泳動(「Isoprime」マシーン/技術、Hoefer Scientific、San Francisco,CA)が挙げられる。いくつかの場合、2つ以上のこれらの精製技術が、純度の上昇を達成するために組み合わされ得る。
IFN−Lポリペプチドはまた、当該分野で公知の技術を使用する、化学合成法(例えば、固相ペプチド合成)により調製され得、その公知技術は、例えば、Merrifieldら、1963、J.Am.Chem.Soc.85:2149;Houghtenら、1985、Proc Natl Acad.Sci.USA 82:5132、ならびにStewartおよびYoung Solid Phase Peptide Synthesis(Pierce Chemical Co.1984)に示される技術である。このようなポリペプチドは、アミノ末端にメチオニンを含んで合成され得るし、または含まずに合成され得る。化学的に合成されたIFN−Lポリペプチドは、これらの参考文献に示される方法を使用して、ジスルフィド架橋を形成するように酸化され得る。科学的に合成されたIFN−Lポリペプチドは、組換え産生されるかもしくは天然の供給源から精製された対応するIFN−Lポリペプチドに匹敵する生物学的活性を有すると予測され、従って、組換えIFN−Lポリペプチドもしくは天然のIFN−Lポリペプチドと交換可能に使用され得る。
IFN−Lポリペプチドを得る別の手段は、そのIFN−Lポリペプチドが天然で見出される生物学的サンプル(例えば、供給源組織および/または流体)からの精製を介する。このような精製は、本明細書中に記載のようなタンパク質精製のための方法を使用して実行され得る。精製の間のIFN−Lポリペプチドの存在は、例えば、組換え産生されたIFN−Lポリペプチドもしくはそのペプチドフラグメントに対して調製された抗体を使用して、モニターされ得る。
核酸およびポリペプチドを産生するためのさらなる多数の方法が、当該分野で公知であり、そしてその方法は、IFN−Lポリペプチドに対する特異性を有するポリペプチドを産生するために使用され得る。例えば、Robertsら、1997、Proc.Natl.Acad.Sci.USA、94:12297−12303、を参照のこと。これは、mRNAとそのコードされるペプチドとの間の融合タンパク質の産生を記載する。また、Roberts、1999、Curr.Opin.Chem.Biol.3:263−273も参照のこと。さらに、米国特許第5,824,469号は、特定の生物学的機能を果たし得るオリゴヌクレオチドを得る方法を記載する。この手順は、各々が5’ランダム配列、所定の中心配列、および3’ランダム配列を有する、オリゴヌクレオチドの不均質プールを産生することを包含する。生じた不均質プールは、所望の生物学的機能を示さない細胞集団に導入される。次いで、この細胞の部分集団が、所定の生物学的機能を示す部分集団についてスクリーニングされる。この部分集団から、所望の生物学的機能を果たし得るオリゴヌクレオチドが、単離される。
米国特許第5,763,192号、同第5,814,476号、同第5,723,323号および同第5,817,483号は、ペプチドもしくはポリペプチドを産生するためのプロセスを記載する。これは、確率的(stochastic)遺伝子もしくはそのフラグメントを産生すること、次いでこれらの遺伝子を、その確率的遺伝子によりコードされる1つ以上のタンパク質を産生する宿主細胞に導入することによって、なされる。次いで、この宿主細胞は、所望の活性を有するペプチドもしくはポリペプチドを産生するクローンを同定するためにスクリーニングされる。
ペプチドもしくはポリペプチドを産生するための別の方法は、「Random Activation of Gene Expression for Gene Discovery」(RAGE−GD)として公知である、Athersys,Inc.により出願されたPCT/US98/20094(WO99/15650)に記載され、このプロセスは、インサイチュ組換え方法による内因性遺伝子発現の活性化もしくは遺伝子の過剰発現を包含する。例えば、内因性遺伝子の発現は、非相同組換えもしくは非正統的(illegitimate)組換えによってその遺伝子の発現を活性化し得る標的細胞に調節配列を組み込むことによって、活性化もしくは増加される。標的DNAは、まず、放射線に供され、そして遺伝子プロモーターが挿入される。このプロモーターは、最終的には遺伝子の前の途切れ目に位置し、その遺伝子の転写を開始する。これは、所望のペプチドもしくはポリペプチドの発現を生じる。
これらの方法がまた、包括的IFN−Lポリペプチド発現ライブラリーを作製するために使用され得、このライブラリーが続いて種々のアッセイ(例えば、生化学的アッセイ、細胞アッセイ、および生物全体アッセイ(例えば、植物、マウスなど))における高スループット表現型スクリーニングに使用され得ることが、理解される。
(合成)
本明細書中に記載される核酸およびポリペプチド分子が組換え手段および他の手段によって産生され得ることが当業者に理解される。
本明細書中に記載される核酸およびポリペプチド分子が組換え手段および他の手段によって産生され得ることが当業者に理解される。
(選択的結合因子)
用語「選択的結合因子」とは、1以上のIFN−Lポリペプチドに対する特異性を有する分子をいう。適切な選択的結合因子としては、抗体およびその誘導体、ポリペプチド、ならびに小分子が挙げられるが、これらに限定されない。適切な選択的結合因子は、当該分野で公知の方法を使用して調製され得る。本発明の例示的IFN−Lポリペプチド選択的結合因子は、IFN−Lポリペプチドの特定の部分を結合し得、それによって、IFN−LポリペプチドレセプターへのIFN−Lポリペプチドの結合を阻害する。
用語「選択的結合因子」とは、1以上のIFN−Lポリペプチドに対する特異性を有する分子をいう。適切な選択的結合因子としては、抗体およびその誘導体、ポリペプチド、ならびに小分子が挙げられるが、これらに限定されない。適切な選択的結合因子は、当該分野で公知の方法を使用して調製され得る。本発明の例示的IFN−Lポリペプチド選択的結合因子は、IFN−Lポリペプチドの特定の部分を結合し得、それによって、IFN−LポリペプチドレセプターへのIFN−Lポリペプチドの結合を阻害する。
IFN−Lポリペプチドを結合する選択的結合因子(例えば、抗体および抗体フラグメント)は、本発明の範囲内にある。抗体は、ポリクローナル(単一特異的なポリクローナルを含む)抗体、モノクローナル抗体(mAb)、組換え抗体、キメラ抗体、ヒト化抗体(例えば、CDRグラフト化抗体)、ヒト抗体、単鎖抗体および/または二特異性抗体、ならびにそれらのフラグメント、改変体または誘導体であり得る。抗体フラグメントは、IFN−Lポリペプチドのエピトープに結合する抗体の部分を含む。このようなフラグメントの例としては、全長抗体の酵素的切断によって生成される、FabフラグメントおよびF(ab’)フラグメントが挙げられる。他の結合フラグメントとしては、組換えDNA技術(例えば、抗体可変領域をコードする核酸配列を含む組換えプラスミドの発現)によって精製されるフラグメントが挙げられる。
IFN−Lポリペプチドに対するポリクローナル抗体は、一般に、IFN−Lおよびアジュバントの複数回の皮下注射または腹腔内注射によって、動物(例えば、ウサギまたはマウス)において産生される。IFN−Lポリペプチドを、キャリアタンパク質に結合体化することが有用であり得、このキャリアタンパク質は、免疫される種において免疫原性である(例えば、キーホールリンペットヘモシアニン、血清、アルブミン、ウシサイログロブリンまたはダイズトリプシンインヒビター)。また、凝集因子(例えば、ミョウバン)も、免疫応答を増強するために使用される。免疫後、動物を採血し、そして血清を、抗IFN−L抗体力価についてアッセイする。
IFN−Lポリペプチドに対するモノクローナル抗体は、培養物中の継代細胞株による抗体分子の産生を提供する、任意の方法を使用して産生される。モノクローナル抗体を調製するための適切な方法の例としては、Kohlerら、1975、Nature 256:495−497のハイブリドーマ法、およびヒトB細胞ハイブリドーマ法(Kozbor、1984、J.Immunol.133:3001;Brodeurら、Monoclonal Antibody Production Techniques and Applications、51〜63頁(Marcel Dekker,Inc.,1987))が挙げられる。IFN−Lポリペプチドと反応性のモノクローナル抗体を産生するハイブリドーマ細胞株もまた、本発明によって提供される。
本発明のモノクローナル抗体は、治療剤としての使用のために改変され得る。1つの実施形態は、「キメラ」抗体であり、ここで、重鎖(H)および/または軽鎖(L)の一部が、特定の種に由来するかまたは特定の抗体のクラスもしくはサブクラスに属する抗体における対応する配列と、同一であるかまたは相同であり、鎖の残りの部分は、別の種に由来するかまたは別の抗体のクラスもしくはサブクラスに属する抗体における対応する配列と、同一であるかまたは相同である。このような抗体のフラグメントもまた、それらが、所望の生物学的活性を示す限り、含まれる。米国特許第4,816,567号;Morrisonら、1985、Proc.Natl.Acad.Sci.U.S.A.81:6851−6855を参照のこと。
別の実施形態において、本発明のモノクローナル抗体は、「ヒト化」抗体である。非ヒト抗体をヒト化するための方法は、当該分野で周知である。米国特許第5,585,089号および同第5,693,762号を参照のこと。一般に、ヒト化抗体は、非ヒト供給源由来のそのヒト化抗体に1以上のアミノ酸残基が導入されている。ヒト化は、例えば、齧歯目の相補的決定領域(CDR)の少なくとも一部を、ヒト抗体の対応する領域で置換することによる、当該分野で記載される方法(Jonesら、1986、Nature 321:522−52;Riechmannら、1988、Nature 332:323−327;Verhoeyenら、1988、Science 239:1534−1536)によって、行われ得る。
IFN−Lポリペプチドを結合する、ヒト抗体もまた、本発明に含まれる。内因性免疫グロブリン産生の非存在下でヒト抗体のレパートリーを産生し得るトランスジェニック動物(例えば、マウス)を使用して、このような抗体は、必要に応じてキャリアに結合体化されたIFN−Lポリペプチド抗原(すなわち、少なくとも6個連続するアミノ酸を有する)で免疫することによって産生される。例えば、Jakobovitsら、1993、Proc.Natl.Acad.Sci.U.S.A.90:2551−2555;Jakobovitsら、1993、Nature 362:255−258;Bruggermannら、1993、Year in Immuno.7:33を参照のこと。1つの方法において、このようなトランスジェニック動物は、免疫グロブリンの重鎖および軽鎖をその中でコードする内因性遺伝子座を不活化し、ヒト重鎖および軽鎖タンパク質をコードする遺伝子座を、そのゲノム内に導入することによって産生される。次いで、部分的に改変された動物(完全未満の補体の改変を有する)を交雑育種して、所望の免疫系の改変の全てを有する動物を得る。免疫原を投与した場合、これらのトランスジェニック動物は、これらの抗原に免疫特異的な可変領域を含む、(例えば、マウスよりもむしろ)ヒトのアミノ酸配列を有する抗体を産生する。PCT出願番号PCT/US96/05928およびPCT/US93/06926を参照のこと。さらなる方法は、米国特許第5,545,807号、PCT出願番号PCT/US91/245、PCT/GB89/01207、ならびにEP546073B1およびEP546073A1に記載される。ヒト抗体はまた、本明細書中に記載されるような、宿主細胞における組換えDNAの発現またはハイブリドーマ細胞における発現によって産生される。
代替的な実施形態において、ヒト抗体は、ファージディスプレイライブラリーにおいて生成され得る(Hoogenboomら,1991,J.Mol.Biol.227:381;Marksら,1991,J.Mol.Biol.222:581)。これらのプロセスは、糸状バクテリオファージの表面上での抗体レパートリーのディスプレイ、引き続いて、選択された抗原に対するそれらの結合によるファージの選択によって免疫選択を模倣する。1つのこのような技術は、PCT出願番号PCT/US98/17364(これは、このようなアプローチを用いたMPL−レセプターおよびmsk−レセプターに対する高親和性でかつ機能的アゴニスト抗体の単離を記載する)に記載される。
キメラ抗体、CDRグラフト化抗体、およびヒト化抗体は、代表的には、組換え方法により産生される。これらの抗体をコードする核酸は、宿主細胞に導入され、そして本明細書中に記載される材料および方法を用いて発現される。好ましい実施形態において、抗体は、哺乳動物宿主細胞(例えば、CHO細胞)において発現される。モノクローナル(例えば、ヒト)抗体は、宿主細胞における組換えDNAの発現によるか、または本明細書中に記載のハイブリドーマ細胞における発現により産生され得る。
本発明の抗IFN−L抗体は、IFN−Lポリペプチドの検出および定量について、任意の公知のアッセイ方法(例えば、競合結合アッセイ、直接的サンドイッチアッセイおよび間接的サンドイッチアッセイ、ならびに免疫沈降アッセイ(Sola,Monoclonal Antibodies:A Manual of Techniques,pp.147−158(CRC Press,Inc.,1987))において用いられ得る。抗体は、使用されるアッセイ方法に適切な親和性でIFN−Lポリペプチドを結合する。
診断適用に関しては、特定の実施形態において、抗IFN−L抗体は、代表的には検出可能な部分で標識され得る。この検出可能な部分は、直接的または間接的のいずれかで検出可能なシグナルを生じ得る任意の部分である。例えば、検出可能な部分は、放射性同位体(例えば、3H、14C、32P、35S、125I、99Tc、111Iまたは67Ga)、蛍光化合物もしくは化学発光化合物(例えば、フルオロセインイソチオシアネート、ローダミンもしくはルシフェリン);または酵素(例えば、アルカリホスファターゼ、β−ガラクトシダーゼまたは西洋ワサビベルオキシダーゼ)(Bayerら,1990,Meth.Enz.184:138−163)であり得る。
競合結合アッセイは、限定された量の抗IFN−L抗体との結合について試験サンプル分析物(IFN−Lポリペプチド)と競合する標識された標準物質(例えば、IFN−Lポリペプチドまたはその免疫学的に反応性の部分)の能力に依存する。試験サンプル中のIFN−Lポリペプチドの量は、この抗体に結合する標準物質の量に逆比例する。結合する標準物質の量の測定を容易にするために、抗体は、代表的には、競合の前または後に不溶化され、その結果、この抗体に結合する標準物質および分析物は、結合しないままの標準物質および分析物から簡単に分離され得る。
サンドイッチイムノアッセイは、代表的には、2つの抗体(各々、検出され、そして/または定量されるタンパク質の異なる免疫原性部分(すなわち、エピトープ)に結合し得る)の使用に関する。サンドイッチアッセイにおいて、この試験サンプル分析物は、代表的には、固体支持体に固定化された第1の抗体に結合され、その後、第2の抗体が分析物に結合し、このようにして不溶性の3部分で構成される複合体を形成する。例えば、米国特許第4,376,110号を参照のこと。第2の抗体は、それ自体検出可能な部分で標識され得るか(例えば、直接サンドイッチアッセイ)、または検出可能な部分で標識された抗免疫グロブリン抗体を用いて測定され得る(間接サンドイッチアッセイ)。例えば、サンドイッチアッセイの1つの型は、酵素結合イムノソルベントアッセイ(ELISA)であり、この場合、この検出可能な部分は酵素である。
抗IFN−L抗体を含む、選択的結合因子はまた、インビボイメージングのために有用である。検出可能な部分で標識した抗体は、動物に、好ましくは、血流に投与され得、そしてこの宿主においてこの標識した抗体の存在および位置がアッセイされる。この抗体は、核磁気共鳴、電離放射線、または当該分野で公知の他の検出手段のいずれかによって、動物中で検出可能である任意の部分で標識され得る。
抗体を含む、本発明の選択的結合因子は、治療剤として使用され得る。これらの治療剤は、一般に、アゴニストまたはアンタゴニストであり、これらは、IFN−Lポリペプチドの少なくとも1つの生物学的活性を、それぞれ増強または減少させるかのいずれかである。1つの実施形態において、本発明のアンタゴニスト抗体は、IFN−Lポリペプチドに特異的に結合し得、そしてインビボまたはインビトロでIFN−Lポリペプチドの機能活性を阻害または排除し得る、抗体またはその結合フラグメントである。好ましい実施形態において、選択的結合因子(例えば、アンタゴニスト抗体)は、少なくとも約50%、および好ましくは、少なくとも約80%で、IFN−Lポリペプチドの機能活性を阻害する。別の実施形態において、選択的結合因子は、IFN−Lポリペプチド結合パートナー(リガンドまたはレセプター)と相互作用し得、これにより、インビトロまたはインビボにおいてIFN−Lポリペプチド活性を阻害または排除し得る、抗IFN−Lポリペプチド抗体であり得る。アゴニストおよびアンタゴニストの抗IFN−Lポリペプチド抗体を含む、選択的結合因子は、当該分野で周知であるスクリーニングアッセイによって同定される。
本発明はまた、IFN−L選択的結合因子(例えば、抗体)を含むキットおよび生物学的サンプル中でIFN−Lポリペプチドレベルを検出するのに有用である他の試薬に関する。このような試薬としては、検出可能な標識、血清ブロック剤、ポジティブコントロールサンプルおよびネガティブコントロールサンプル、ならびに検出試薬が挙げられ得る。
(マイクロアレイ)
DNAマイクロアレイ技術は、本発明に従って利用され得ることが、理解される。DNAマイクロアレイは、固体支持体(例えば、ガラス)上に配置された核酸の小型高密度アレイである。このアレイ内の各細胞またはエレメントは、相補的核酸配列(例えば、mRNA)とハイブリダイゼーションするための標識として作用する、単一の核酸種の複数のコピーを含む。DNAマイクロアレイ技術を使用する発現プロファイリングにおいて、mRNAは、最初に細胞サンプルまたは組織サンプルから抽出され、次いで、酵素標識されたcDNAから蛍光標識されたcDNAに変換される。この材料は、マイクロアレイにハイブリダイズされ、そして未結合のcDNAは、洗浄により除去される。次いで、このアレイ上に示された個々の遺伝子の発現は、各標的核酸分子に特異的に結合する標識されたcDNAの量を定量することによって視覚化される。この方法において、数千の遺伝子の発現が、生物学的材料の単一サンプルから、ハイスループットの並行様式で定量され得る。
DNAマイクロアレイ技術は、本発明に従って利用され得ることが、理解される。DNAマイクロアレイは、固体支持体(例えば、ガラス)上に配置された核酸の小型高密度アレイである。このアレイ内の各細胞またはエレメントは、相補的核酸配列(例えば、mRNA)とハイブリダイゼーションするための標識として作用する、単一の核酸種の複数のコピーを含む。DNAマイクロアレイ技術を使用する発現プロファイリングにおいて、mRNAは、最初に細胞サンプルまたは組織サンプルから抽出され、次いで、酵素標識されたcDNAから蛍光標識されたcDNAに変換される。この材料は、マイクロアレイにハイブリダイズされ、そして未結合のcDNAは、洗浄により除去される。次いで、このアレイ上に示された個々の遺伝子の発現は、各標的核酸分子に特異的に結合する標識されたcDNAの量を定量することによって視覚化される。この方法において、数千の遺伝子の発現が、生物学的材料の単一サンプルから、ハイスループットの並行様式で定量され得る。
このハイスループット発現プロファイリングは、本発明のIFN−L分子に関連して広範の適用を有し、これには、以下が挙げられるが、これに限定されない:治療のための標的として、IFN−L疾患関連遺伝子の同定および確認;関連するIFN−L分子およびそのインヒビターの分子毒性;臨床試験のための集団の階層化および代替マーカーの生成;ならびにハイスループットスクリーニングにおいて、選択化合物の同定を援助することによって、関連するIFN−Lポリペプチド小分子薬物探索を増強すること。
(化学的誘導体)
IFN−Lポリペプチドの化学的に改変された誘導体は、開示が本明細書中に記載される場合、当業者によって調製され得る。IFN−Lポリペプチド誘導体は、このポリペプチドへ天然に結合する分子の型または位置のいずれかで、異なる様式で改変される。誘導体は、天然に結合した化学的な基の1以上の除去によって形成される分子を含み得る。配列番号2、もしくは配列番号5、または他のIFN−Lポリペプチドのいずれかのアミノ酸配列を含むポリペプチドは、1以上のポリマーの共有結合によって改変され得る。例えば、選択されたポリマーは、代表的に水溶性であり、その結果、結合するタンパク質は、水環境(例えば、生理学的な環境)下で沈殿しない。ポリマーの混合物が、適切なポリマーの範囲内に含まれる。好ましくは、最終生成物の調製の治療学的使用のために、このポリマーは、薬学的に受容可能である。
IFN−Lポリペプチドの化学的に改変された誘導体は、開示が本明細書中に記載される場合、当業者によって調製され得る。IFN−Lポリペプチド誘導体は、このポリペプチドへ天然に結合する分子の型または位置のいずれかで、異なる様式で改変される。誘導体は、天然に結合した化学的な基の1以上の除去によって形成される分子を含み得る。配列番号2、もしくは配列番号5、または他のIFN−Lポリペプチドのいずれかのアミノ酸配列を含むポリペプチドは、1以上のポリマーの共有結合によって改変され得る。例えば、選択されたポリマーは、代表的に水溶性であり、その結果、結合するタンパク質は、水環境(例えば、生理学的な環境)下で沈殿しない。ポリマーの混合物が、適切なポリマーの範囲内に含まれる。好ましくは、最終生成物の調製の治療学的使用のために、このポリマーは、薬学的に受容可能である。
このポリマーの各々は、任意の分子量を有し得、そして分枝または非分枝であり得る。このポリマーの各々は、代表的に、約2kDaと約100kDaとの間の平均分子量を有する(この用語「約(およそ)」は、水溶性ポリマーの調製の際に、上記の分子量より多いか、上記の分子量よりいくらか少ない重量を有することを示す)。各ポリマーの平均分子量は、好ましくは、約5kDaと約50kDaとの間、より好ましくは、約12kDaと約40kDaとの間、そして最も好ましくは、約20kDaと約35Daとの間である。
適切な水溶性ポリマーまたはその混合物としては、以下が挙げられるが、これらに限定されない:N連結炭水化物またはO連結炭水化物、糖、リン酸、ポリエチレングリコール(PEG)(これは、モノポリエチレングリコール(C1−C10)、アルコキシポリエチレングリコール、またはアリールオキシポリエチレングリコールを含む、タンパク質を誘導体化するために使用されたPEGの形態を含む)、モノメトキシ−ポリエチレングリコール、デキストラン(例えば、低分子量(例えば、約6kDのデキストラン))、セルロース、または他の炭水化物ベースのポリマー、ポリ−(N−ビニルピロリジン)ポリエチレングリコール、プロピレングリコールホモポリマー、ポリプロピレンオキシ/エチレンオキシドコポリマー、ポリオキシエチル化ポリオール(例えば、グリセロール)、およびビニルアルコール。共有結合したIFN−Lポリペプチドマルチマーを調製するために使用され得る、二官能性架橋分子もまた、本発明に含まれる。
一般に、化学的誘導は、活性化したポリマー分子とタンパク質を反応させるために使用される任意の適切な条件下で、実施され得る。ポリペプチドの化学的誘導体を調製するための方法は、一般的に、以下の工程を包含する:(a)配列番号2もしくは配列番号5、または他のIFN−Lポリペプチドのいずれかのアミノ酸配列を含むポリペプチドが、1以上のポリマー分子に結合する条件下で、活性化したポリマー分子(例えば、ポリマー分子の反応性エステルまたはアルデヒド誘導体)とポリペプチドを反応させる工程、ならびに(b)反応生成物を得る工程。最適の反応条件は、既知のパラメータおよび所望の結果に基づいて決定される。例えば、ポリマー分子のタンパク質に対する比が大きくなるほど、結合したポリマー分子の割合も大きくなる。1つの実施形態において、IFN−Lポリペプチド誘導体は、アミノ末端に単一ポリマー分子部分を有する。例えば、米国特許第5,234,784号を参照のこと。
ポリペプチドのペグ化(pegylation)は、当該分野で公知の任意のペグ化反応を使用して特異的に実施され得る。このような反応は、例えば、以下の参考文献に記載されている:Francisら,1992,Focus on Growth Factors 3:4−10;欧州特許第0154316号および0401384号;ならびに米国特許第4,179,337号。例えば、ペグ化は、本明細書中に記載されるように、反応性ポリエチレングリコール分子(または、類似の反応性水溶性ポリマー)とのアシル化反応またはアルキル化反応を介して実施され得る。アシル化反応のために、選択されたポリマーは、単一の反応性エステル基を有さねばならない。還元的アルキル化について、選択されたポリマーは、単一の反応性アルデヒド基を有さねばならない。例えば、反応性アルデヒドは、水溶性であるポリエチレングリコールプロピオンアルデヒドか、またはモノC1−C10アルコキシもしくはそのアリールオキシ誘導体である(米国特許第5,252,714号を参照のこと)。
別の実施形態において、IFN−Lポリペプチドは、ビオチンに化学的に結合され得る。次いで、このビオチン/IFN−Lポリペプチド分子は、アビジンに結合され得、その結果、4価のアビジン/ビオチン/IFN−Lポリペプチド分子が得られる。IFN−Lポリペプチドはまた、ジニトロフェノール(DNP)またはトリニトロフェノール(TNP)に共有結合され得、そして得られた結合体は、抗DNPまたは抗TNP−IgMで沈澱されて、10価の十量体の結合体を形成する。
一般に、本発明のIFN−Lポリペプチド誘導体の投与によって、緩和または調節され得る条件は、IFN−Lポリペプチドについて本明細書中に記載されたものを含む。しかし、本明細書中に開示されるIFN−Lポリペプチド誘導体は、非誘導体化分子と比較した場合、さらなる活性、増強もしくは減少した生物学的活性、または他の特徴(例えば、増加または減少した半減期)を有し得る。
(遺伝子操作された非ヒト動物)
マウス、ラット、または他のげっ歯類;ウサギ、ヤギ、ヒツジ、または他の家畜のような非ヒト動物が、さらに本発明の範囲内に含まれ、ここで、ネイティブなIFN−Lポリペプチドをコードする遺伝子は崩壊(すなわち「ノックアウト」)され、IFN−Lポリペプチドの発現レベルは、有意に減少するか、または完全に破壊される。このような動物は、米国特許第5,557,032号に記載されるような技術および方法を使用して調製され得る。
マウス、ラット、または他のげっ歯類;ウサギ、ヤギ、ヒツジ、または他の家畜のような非ヒト動物が、さらに本発明の範囲内に含まれ、ここで、ネイティブなIFN−Lポリペプチドをコードする遺伝子は崩壊(すなわち「ノックアウト」)され、IFN−Lポリペプチドの発現レベルは、有意に減少するか、または完全に破壊される。このような動物は、米国特許第5,557,032号に記載されるような技術および方法を使用して調製され得る。
本発明は、マウス、ラット、または他のげっ歯類;ウサギ、ヤギ、ヒツジ、または他の家畜のような非ヒト動物をさらに含み、この動物のネイティブな形態のIFN−L遺伝子または異種IFN−L遺伝子のいずれかが、これらの動物によって過剰発現され、これによって、「トランスジェニック」動物を作製する。このようなトランスジェニック動物は、米国特許第5,489,743号およびPCT公開番号WO94/28122号に記載されるような周知の方法を使用して調製され得る。
本発明は、非ヒト動物をさらに含み、ここで、本発明の1以上のIFN−Lポリペプチドのプロモーターは、(例えば、相同的な組換え方法を使用することによって)活性化されるかまたは不活性化されるかのいずれかであり、1以上のネイティブなIFN−Lポリペプチドの発現のレベルを改変する。
これらの非ヒト動物は、薬物候補物スクリーニングのために使用され得る。このようなスクリーニングにおいて、動物での薬物候補物の影響が測定され得る。例えば、薬物候補物は、IFN−L遺伝子の発現を減少または増加させ得る。特定の実施形態において、産生されるIFN−Lポリペプチドの量は、動物を薬物候補物に曝露した後に測定され得る。さらに、特定の実施形態において、動物での薬物候補物の実際の影響を検出し得る。例えば、特定の遺伝子の過剰発現により、疾患状態または病理学的状態を生じ得るか、あるいは疾患状態または病理学的状態と関連し得る。このような場合において、遺伝子の発現を減少させる薬物候補物の能力または病理学的状態を防止または阻害する能力を試験し得る。別の例において、ポリペプチドのフラグメントのような、特定の代謝産物の産生は、疾患状態または病理学的状態を生じるか、あるいは疾患状態または病理学的状態と関連する。このような場合、このような代謝産物の産生を減少させる薬物候補物の能力または病理学的状態を防止または阻害する能力を試験し得る。
(IFN−Lポリペプチド活性の他の調節因子についてのアッセイ)
いくつかの状態において、IFN−Lポリペプチドの活性の調節因子である分子(すなわち、アゴニストまたはアンタゴニスト)を同定することが所望され得る。IFN−Lポリペプチドを調節する天然または合成分子は、本明細書中に記載されるように、1以上のスクリーニングアッセイを使用して同定され得る。このような分子は、エキソビボ様式またはインビトロ様式のいずれかで、注射、または経口送達、移植デバイスなどによって投与され得る。
いくつかの状態において、IFN−Lポリペプチドの活性の調節因子である分子(すなわち、アゴニストまたはアンタゴニスト)を同定することが所望され得る。IFN−Lポリペプチドを調節する天然または合成分子は、本明細書中に記載されるように、1以上のスクリーニングアッセイを使用して同定され得る。このような分子は、エキソビボ様式またはインビトロ様式のいずれかで、注射、または経口送達、移植デバイスなどによって投与され得る。
「試験分子」とは、IFN−Lポリペプチドの活性を調節する(すなわち、増加または減少させる)能力に関する評価の下にある分子を言う。最も一般的に、試験分子は、IFN−Lポリペプチドと直接的に相互作用する。しかし、試験分子はまた、例えば、IFN−L遺伝子発現に影響を与えることによってか、またはIFN−Lポリペプチド結合パートナー(例えば、レセプターまたはリガンド)に結合することによって、IFN−Lポリペプチド活性を間接的に調節し得ることがまた、意図される。1つの実施形態において、試験分子は、少なくとも約10−6M、好ましくは、約10−8M、より好ましくは、約10−9M、そしてさらにより好ましくは約10−10Mの親和性定数でIFN−Lポリペプチドと結合する。
IFN−Lポリペプチドと相互作用する化合物を同定するための方法は、本発明によって包含される。特定の実施形態において、IFN−Lポリペプチドは、試験分子とIFN−Lポリペプチドとの相互作用が可能な条件下で、試験分子と共にインキュベートされ、そして相互作用の範囲が測定される。試験分子は、実質的に精製された形態または粗製の混合物中でスクリーニングされ得る。
特定の実施形態において、IFN−Lポリペプチドアゴニストまたはアンタゴニストは、タンパク質、ペプチド、炭水化物、脂質、または小分子量の分子であり得、これらは、IFN−Lポリペプチドと相互作用して、その活性を調節する。IFN−Lポリペプチドの発現を調節する分子は、IFN−Lポリペプチドをコードする核酸と相補的であるかまたはIFN−Lポリペプチドの発現を指向または制御する核酸配列に対して相補的である核酸分子を含み、そしてこの分子は、発現のアンチセンス調節因子として作用する。
一旦、試験化合物がIFN−Lポリペプチドと相互作用するとして同定されると、この分子は、IFN−Lポリペプチド活性を増加または減少させるその能力についてさらに評価され得る。試験分子とIFN−Lポリペプチドとの相互作用の測定は、いくつかの形式で実施され得、これには、細胞ベースの結合アッセイ、膜結合アッセイ、液相アッセイ、および免疫アッセイが挙げられる。一般に、試験分子は、特定の期間、IFN−Lポリペプチドと共にインキュベートされ、そしてIFN−Lポリペプチド活性が、生物学的活性を測定するための1つ以上のアッセイによって決定される。
試験分子とIFN−Lポリペプチドとの相互作用はまた、免疫アッセイにおいて、ポリクローナルまたはモノクローナル抗体を使用して直接的にアッセイされ得る。あるいは、本明細書中に記載されるようなエピトープタグを含むIFN−Lポリペプチドの改変形態は、溶液および免疫アッセイ中で使用され得る。
IFN−Lポリペプチドが、結合パートナー(例えば、レセプターまたはリガンド)との相互作用を介して、生物学的活性を示す場合、種々のインビトロアッセイが、対応する結合パートナー(例えば、選択的結合因子、レセプター、またはリガンド)へのIFN−Lポリペプチドの結合を測定するために使用され得る。これらのアッセイは、IFN−Lポリペプチドのその結合パートナーに対する結合の速度および/または程度を増加または減少させる試験分子の能力に関して、この試験分子をスクリーニングするために使用され得る。1アッセイにおいて、IFN−Lポリペプチドは、マイクロタイタープレートのウェル中で免疫化される。次いで、放射標識したIFN−Lポリペプチド結合パートナー(例えば、ヨウ素化したIFN−Lポリペプチド結合パートナー)および試験化合物は、このウェルに、一時に一方をか(いずれかの順序で)または同時に、添加され得る。インキュベーション後に、このウェルは洗浄され、そしてシンチレーション計数器を使用して、放射性が計数され、結合パートナーがIFN−Lポリペプチドに結合する程度が決定され得る。代表的に、分子は、濃度範囲にわたって試験され、そして試験アッセイの1以上のエレメントを欠く一連のコントロールウェルは、結果の評価の正確性のために使用され得る。この方法の代わりは、タンパク質の「位置」を逆にする工程を逆にする工程(すなわち、マイクロタイタープレートウェルに対してIFN−Lポリペプチド結合パートナーを固定化し、試験分子および放射標識したIFN−Lポリペプチドとともにインキュベートし、そしてIFN−Lポリペプチド結合の程度を決定する工程)を包含する。例えば、Current Protocols in Molecular Biology、第18章(Ausubelら、編、Green Publishers Inc.ならびにWileyおよびSons 1995)を参照のこと。
放射性標識に対する代替として、IFN−Lポリペプチドまたはその結合パートナーは、ビオチンと結合体化され得、そしてビオチン化されたタンパク質の存在が、次いで、酵素(例えば、西洋ワサビペルオキシダーゼ(HRP)またはアルカリホスファターゼ(AP)(これらは、比色定量的に検出され得る))に結合したストレプトアビジンを使用して検出され得るか、またはストレプトアビジンの蛍光タグ化によって検出され得る。IFN−LポリペプチドまたはIFN−Lポリペプチド結合パートナー(これらは、ビオチンに結合されている)に対する抗体はまた、APまたはHRPに連結した酵素連結ストレプトアビジンとの複合体のインキュベーション後に、検出目的のために使用され得る。
IFN−LポリペプチドまたはIFN−Lポリペプチド結合パートナーはまた、アガロースビーズ、アクリルビーズ、または他の型のこのような不活性な固相基材への付着によって固定化され得る。基材−タンパク質複合体は、相補タンパク質および試験化合物を含む溶液内に配置され得る。インキュベーション後、これらのビーズは、遠心分離によって沈澱され得、そしてIFN−Lポリペプチドとその結合パートナーとの間の結合の量が、本明細書中に記載の方法を使用して評価され得る。あるいは、基材−タンパク質複合体は、試験分子および相補タンパク質がカラムを通過されることによって、カラム内に固定化され得る。IFN−Lポリペプチドとその結合パートナーとの間の複合体の形成が、次いで、本明細書中に記載の技術(例えば、放射性標識または抗体結合)のいずれかを使用して評価され得る。
IFN−Lポリペプチド結合タンパク質とIFN−Lポリペプチド結合パートナーとの間の複合体の形成を増加または減少させる試験分子を同定するために有用な別のインビトロアッセイは、表面プラズモン共鳴検出器システム(例えば、BIAcoreアッセイシステム(Pharmacia,Piscataway,NJ))である。BIAcoreシステムは、製造業者によって特定されるように利用される。このアッセイは、本質的に、IFN−LポリペプチドまたはIFN−Lポリペプチド結合パートナーのいずれかの、デキストランでコートされたセンサーチップ(これは、検出器に位置する)への共有結合を含む。次いで、この試験化合物および他の相補タンパク質が、同時にかまたは連続的にかのいずれかで、センサーチップを含むチャンバーに注入され得る。結合する相補タンパク質の量は、センサーチップのデキストランコート側面と物理的に結合する分子量の変化に基づいて評価され得、この分子量の変化は、検出器システムによって測定される。
いくつかの場合において、2つ以上の試験化合物を一緒に、IFN−LポリペプチドとIFN−Lポリペプチド結合パートナーとの間の複合体の形成を増加または減少させるそれらの能力について評価することが望ましくあり得る。これらの場合において、本明細書中に記載のアッセイは、第一の試験化合物と同時にか、またはそれに続いてのいずれかで、このようなさらなる試験化合物を添加することによって容易に改変され得る。このアッセイにおける工程の残りは、本明細書中に記載される。
インビトロアッセイ(例えば、本明細書中に記載されるもの)は、IFN−LポリペプチドとIFN−Lポリペプチド結合パートナーとの間の複合体の形成に対する影響について、多数の化合物をスクリーニングするために、有利に使用され得る。これらのアッセイは、ファージディスプレイ、合成ペプチド、および化学合成ライブラリーにおいて生成された化合物をスクリーニングするために、自動化され得る。
IFN−LポリペプチドとIFN−Lポリペプチド結合パートナーとの間の複合体の形成を増加または減少する化合物はまた、IFN−LポリペプチドまたはIFN−Lポリペプチド結合パートナーのいずれかを発現する細胞および細胞株を使用して、細胞培養物においてスクリーニングされ得る。細胞および細胞株は、任意の哺乳動物から得ることができるが、好ましくは、ヒト、または他の霊長類、イヌ類またはげっ歯類の供給源由来である。IFN−Lポリペプチドの、IFN−Lポリペプチド結合パートナーを発現する細胞への、その表面での結合は、試験化合物の存在または非存在下で評価され、そして結合の程度が、例えば、IFN−Lポリペプチド結合パートナーに対するビオチン化抗体を使用するフローサイトメトリーによって決定され得る。細胞培養アッセイは、本明細書中に記載されるタンパク質結合アッセイにおいて、陽性であるとスコア付けされる化合物をさらに特徴付けするために有利に使用され得る。
細胞培養物はまた、薬物候補物の影響をスクリーニングするために使用され得る。例えば、薬物候補物は、IFN−L遺伝子の発現を減少または増加させ得る。特定の実施形態において、生成されるIFN−LポリペプチドまたはIFN−Lポリペプチドフラグメントの量は、細胞培養物の薬物候補物への曝露の後に測定され得る。特定の実施形態において、細胞培養物への薬物候補物の実質的な影響が検出され得る。例えば、特定の遺伝子の過剰発現は、細胞培養物への特定の影響を有し得る。このような場合に、遺伝子の発現を増加または減少させる薬物候補物の能力、または細胞培養物に対する特定の影響を防害または阻害するその能力が試験され得る。他の例において、特定の代謝産物(例えば、ポリペプチドのフラグメント)の生成が、疾患または病的状態を生じ得るか、またはそれらと関連し得る。このような場合、細胞培養物におけるこのような代謝産物の生成を減少する薬物候補物の能力が試験され得る。
(内部移行タンパク質)
tatタンパク質配列(HIV由来)が、タンパク質を細胞内に内部移行させるために、使用され得る。例えば、Falwellら、1994、Proc.Natl.Acad.Sci.U.S.A.91:664−68を参照のこと。例えば、HIV tatタンパク質の11アミノ酸の配列(Y−G−R−K−K−R−R−Q−R−R−R;配列番号18)(「タンパク質形質導入ドメイン」、またはTAT PDTを称される)は、細胞の細胞質膜および核膜を横切る送達を媒介するとして記載されている。Schwarzeら,1999,Science 285:1569−72;およびNagaharaら,1998,Nat.Med.4:1449−52を参照のこと。これらの手順において、FITC構築物(FITC標識G−G−G−G−Y−G−R−K−K−R−R−Q−R−R−R;配列番号19)(これは、腹腔内投与に続いて組織を貫通する)が調製され、そしてこのような構築物の細胞への結合が、蛍光活性化分類(FACS)分析によって検出される。tat−β−gal融合タンパク質で処置された細胞は、β−gal活性を示す。注入に続いて、このような構築物の発現が、多くの組織(肝臓、腎臓、肺、心臓および脳組織を含む)において検出され得る。このような構築物は、細胞に入るためにある程度広がり、そういうものとして、細胞内への移入に続いて、再折り畳みを必要とし得ると考えられる。
tatタンパク質配列(HIV由来)が、タンパク質を細胞内に内部移行させるために、使用され得る。例えば、Falwellら、1994、Proc.Natl.Acad.Sci.U.S.A.91:664−68を参照のこと。例えば、HIV tatタンパク質の11アミノ酸の配列(Y−G−R−K−K−R−R−Q−R−R−R;配列番号18)(「タンパク質形質導入ドメイン」、またはTAT PDTを称される)は、細胞の細胞質膜および核膜を横切る送達を媒介するとして記載されている。Schwarzeら,1999,Science 285:1569−72;およびNagaharaら,1998,Nat.Med.4:1449−52を参照のこと。これらの手順において、FITC構築物(FITC標識G−G−G−G−Y−G−R−K−K−R−R−Q−R−R−R;配列番号19)(これは、腹腔内投与に続いて組織を貫通する)が調製され、そしてこのような構築物の細胞への結合が、蛍光活性化分類(FACS)分析によって検出される。tat−β−gal融合タンパク質で処置された細胞は、β−gal活性を示す。注入に続いて、このような構築物の発現が、多くの組織(肝臓、腎臓、肺、心臓および脳組織を含む)において検出され得る。このような構築物は、細胞に入るためにある程度広がり、そういうものとして、細胞内への移入に続いて、再折り畳みを必要とし得ると考えられる。
従って、tatタンパク質配列は、所望のポリペプチドを細胞に内部移入させるために使用され得ることが理解される。例えば、tatタンパク質配列を使用して、IFN−Lアンタゴニスト(例えば、抗IFN−L選択的結合因子、低分子、可溶性レセプター、またはアンチセンスオリゴヌクレオチド)は、IFN−L分子の活性を阻害するために、細胞内投与され得る。本明細書中で使用される場合、用語「IFN−L分子」は、本明細書中に記載されるような、IFN−L核酸分子およびIFN−Lポリペプチドの両方をいう。所望ならば、IFN−Lタンパク質自体はまた、これらの手順を使用して、細胞に内部投与され得る。Straus,1999,Science 285:1466−67をまた参照のこと。
(IFN−Lポリペプチドを用いた細胞供給源の同定)
本発明の特定の実施形態に従って、IFN−Lポリペプチドと関連する特定の細胞型の供給源を決定し得ることが有用であり得る。例えば、適切な治療を選択する際の補助として疾患または病的状態の起源を決定することが有用であり得る。特定の実施形態において、IFN−Lポリペプチドをコードする核酸は、プローブとして使用されて、このようなプローブを用いて細胞の核酸をスクリーニングすることによって、本明細書中に記載の細胞を同定し得る。他の実施形態において、抗IFN−Lポリペプチド抗体を使用して、細胞におけるIFN−Lポリペプチドの存在について試験し得、従って、このような細胞が本明細書中に記載される型の細胞か否かを決定し得る。
本発明の特定の実施形態に従って、IFN−Lポリペプチドと関連する特定の細胞型の供給源を決定し得ることが有用であり得る。例えば、適切な治療を選択する際の補助として疾患または病的状態の起源を決定することが有用であり得る。特定の実施形態において、IFN−Lポリペプチドをコードする核酸は、プローブとして使用されて、このようなプローブを用いて細胞の核酸をスクリーニングすることによって、本明細書中に記載の細胞を同定し得る。他の実施形態において、抗IFN−Lポリペプチド抗体を使用して、細胞におけるIFN−Lポリペプチドの存在について試験し得、従って、このような細胞が本明細書中に記載される型の細胞か否かを決定し得る。
(IFN−Lポリペプチド組成物および投与)
治療組成物は、本発明の範囲内である。このようなIFN−Lポリペプチド薬学的組成物は、治療有効量のIFN−LポリペプチドまたはIFN−L核酸分子を、投与の様式と適合するように選択された薬学的にまたは生理学的に受容可能な処方剤との混合物中に、含み得る。薬学的組成物は、治療有効量の1以上のIFN−Lポリペプチド選択的結合因子を、投与の様式と適合するように選択された薬学的にまたは生理学的に受容可能な処方剤との混合物中に、含み得る。
治療組成物は、本発明の範囲内である。このようなIFN−Lポリペプチド薬学的組成物は、治療有効量のIFN−LポリペプチドまたはIFN−L核酸分子を、投与の様式と適合するように選択された薬学的にまたは生理学的に受容可能な処方剤との混合物中に、含み得る。薬学的組成物は、治療有効量の1以上のIFN−Lポリペプチド選択的結合因子を、投与の様式と適合するように選択された薬学的にまたは生理学的に受容可能な処方剤との混合物中に、含み得る。
受容可能な処方物材料は、好ましくは、使用される投薬量および濃度で、レシピエントに対して非毒性である。
薬学的組成物は、例えば、pH、浸透圧、粘度、清澄性、色、等張性、におい、無菌性、安定性、解離または放出の速度、吸着、または組成物の浸透を改変、維持または保存するための処方物材料を含み得る。適切な処方物材料としては、以下が挙げられるが、これらに限定されない:アミノ酸(例えば、グリシン、グルタミン、アスパラギン、アルギニン、またはリジン)、抗菌剤、抗酸化剤(例えば、アスコルビン酸、亜硫酸ナトリウム、または亜硫酸水素ナトリウム(sodium hydrogen−sulfite))、緩衝液(例えば、ホウ酸塩、炭酸水素塩、Tris−HCl、クエン酸塩、リン酸塩、または他の有機酸)、バルキング剤(例えば、マンニトールまたはグリシン)、キレート化剤(エチレンジアミン四酢酸(EDTA))、複合体化剤(例えば、カフェイン、ポリビニルピロリドン、β−シクロデキストリン、またはヒドロキシプロピル−β−シクロデキストリン)、フィラー、単糖類、二糖類、および他の炭水化物(例えば、グルコース、マンノースまたはデキストリン)、タンパク質(例えば、血清アルブミン、ゼラチン、または免疫グロブリン)、着色剤、味付け剤および希釈剤、乳化剤、親水性ポリマー(例えば、ポリビニルピロリドン)、低分子量ポリペプチド、塩形成対イオン(例えば、ナトリウム)、保存剤(例えば、塩化ベンザルコニウム、安息香酸、サリチル酸、チメロサール、フェネチルアルコール、メチルパラベン、プロピルパラベン、クロルヘキシジン、ソルビン酸、または過酸化水素)、溶媒(例えば、グリセリン、プロピレングリコール、またはポリエチレングリコール)、糖アルコール(例えば、マンニトールまたはソルビトール)、懸濁剤、表面活性剤または湿潤剤(例えば、プルオニック(pluronic);PEG;ソルビタンエステル;ポリソルビテート(例えば、polysorbate 20またはpolysorbate 80);トリトン;トロメタミン;レシチン;コレステロールまたはチロキサポール(tyloxapal))、安定性増強剤(例えば、スクロースまたはソルビトール)、張度増強剤(例えば、ハロゲン化アルカリ金属(好ましくは塩化ナトリウムまたは塩化カリウム)、またはマンニトール、ソルビトール)、送達ビヒクル、希釈剤、賦形剤および/または薬学的なアジュバント。Remington’s Pharmaceutical Sciences(第18版,A.R.Gennaro,編,Mack Publishing Company 1990を参照のこと。
最適な薬学的組成物は、当業者によって、例えば、意図される投与経路、送達形式、および所望の投薬量に依存して決定される。例えば、Remington’s Pharmaceutical Sciences,前出を参照のこと。このような組成物は、IFN−L分子の、物理的な状態、安定性、インビボ放出の速度、およびインビボクリアランスの速度に影響し得る。
薬学的組成物における主要なビヒクルまたはキャリアは、本来水性または非水性のいずれかであり得る。例えば、注入のための適切なビヒクルまたはキャリアは、水、生理学的な生理食塩水溶液、または人工脳脊髄液であり、おそらく非経口投与のための組成物において一般的な他の材料で補充されている。中性の緩衝化生理食塩水または血清アルブミンと混合された生理食塩水は、さらなる例示的なビヒクルである。他の例示的な薬学的組成物は、約pH7.0−8.5のTris緩衝液または約pH4.0−5.5の酢酸塩緩衝液を含み、これはさらに、ソルビトールまたは適切な置換物を含み得る。本発明の1つの実施形態において、IFN−Lポリペプチド組成物は、所望の程度の純度を有する選択された組成物を、任意の処方薬剤(Remington’s Pharmaceutical Sciences,前出)と混合することによって、凍結乾燥ケークまたは水溶液の形態で、保存のために調製され得る。さらに、IFN−Lポリペプチド産物は、スクロースのような適切な賦形剤を使用して凍結乾燥物として処方され得る。
このIFN−Lポリペプチドの薬学的組成物は、非経口送達のために選択され得る。あるいは、これらの組成物は、吸入または消化管を介する送達(例えば、経口的に)のために、選択され得る。このような薬学的に受容可能な組成物の調製は、当該分野の技術内にある。
処方成分が、投与の部位に受容可能な濃度で存在する。例えば、緩衝液は、生理学的pHまたは多少より低いpH(典型的に、約5〜約8のpH範囲内)にこの組成物を維持するために使用される。
非経口投与が意図される場合、本発明における使用のための治療組成物は、薬学的に受容可能なビヒクルに所望のIFN−L分子を含む発熱物質を含まない非経口的に受容可能な水溶液の形態であり得る。非経口注入のために特に適切なビヒクルは、滅菌蒸留水であり、ここで、IFN−L分子が、滅菌で、等張溶液として処方され、適切に保存される。なお別の調製は、所望の分子と、薬剤(例えば、注入可能なミクロスフィア、生体侵食(bio−erodible)薬剤、ポリマー化合物(ポリ乳酸またはポリグリコール酸のような)、ビーズまたはリポソーム)との処方物に関係し、これは、次いで蓄積注射を介して送達され得る産物の制御されたまたは持続された放出を提供する。ヒアルロン酸がまた、使用され得、そしてこれは、循環において、維持された持続時間を促進する効果を有し得る。所望の分子の導入のための他の適切な手段は、移植可能な薬物送達デバイスを含む。
1つの実施形態において、薬学的組成物は、吸入のために処方され得る。例えば、IFN−Lポリペプチドは、吸入のための乾燥粉末として処方され得る。IFN−Lポリペプチドまたは核酸分子の吸入溶液はまた、エアロゾル送達のための噴霧体と共に処方され得る。なお別の実施形態において、溶液は、噴霧され得る。肺投与が、PCT公開番号WO94/20069にさらに記載され、これは化学的に改変されたタンパク質の肺送達を記載する。
特定の処方物が、経口投与され得ることがまた意図される。本発明の1つの実施形態において、このよう様式で投与されるIFN−Lポリペプチドが、固体投薬形態(例えば、錠剤またはカプセル)の調合において慣用的に使用されるキャリアを伴うか、または伴わず処方され得る。例えば、カプセルは、バイオアベイラビリティーが最大化され、そして前全身分解が最小化される場合、胃腸管内での点で処方物の活性部分を放出するように設計され得る。さらなる薬剤が、IFN−Lポリペプチドの吸収を容易にするために含まれ得る。希釈剤、味付け剤、低融点ワックス、植物油、潤滑剤、懸濁剤、錠剤崩壊剤、およびバインダーがまた、使用され得る。
別の薬学的組成物は、錠剤の製造に適切な非毒性賦形剤との混合物中に、有効量のIFN−Lポリペプチドを含み得る。錠剤を滅菌水または別の適切なビヒクルに溶解することによって、溶液が、単位用量形態で調製され得る。適切な賦形剤としては以下を含むが、これらに限定されない:不活性な希釈剤(炭酸カルシウム、炭酸ナトリウムまたは炭酸水素ナトリウム、ラクトース、あるいはリン酸カルシウム);または結合剤(例えば、デンプン、ゼラチンまたはアラビアゴム);あるいは潤滑剤(例えば、ステアリン酸マグネシウム、ステアリン酸またはタルク)。
さらなるIFN−Lポリペプチドの薬学的組成物は、当業者に明らかであり、持続または制御送達処方物中にIFN−Lポリペプチドを含む処方物を含む。種々の他の持続または制御送達手段(例えば、リポソームキャリア、生体侵食マイクロスフィアあるいは多孔性ビーズおよび蓄積注射)を処方するための技術はまた、当業者に公知である。例えば、PCT/US93/00829(これは、薬学的組成物の送達のための多孔性ポリマー性ミクロ粒子の制御放出を記載する)を参照のこと。
徐放性調製物のさらなる例としては、成形された物品の形態(例えば、フィルム、またはマイクロカプセル)の半透過性ポリマーマトリックスを含む。徐放性マトリックスとしては、ポリエステル、ヒドロゲル、ポリラクチド(米国特許第3,773,919号および欧州特許第058481号)、L−グルタミン酸とγエチル−L−グルタメートとのコポリマー(Sidmanら,1983,Biopolymers 22:547−56)、ポリ(2−ヒドロキシエチル−メタクリレート)(Langerら,1981,J.Biomed.Mater.Res.15:167−277およびLanger,1982,Chem.Tech.12:98−105)、エチレンビニルアセテート(Langerら,前出)またはポリ−D(−)−3−ヒドロキシ酪酸(欧州特許第133988号)。徐放性組成物はまた、リポソームを含み得、これは、当該分野で公知のいくつかの方法のいずれかによって調製され得る。例えば、Eppsteinら,1985,Proc.Natl.Acad.Sci.USA 82:3688−92;および欧州特許第036676号、同第088046号、および同第143949号を参照のこと。
インビボ投与のために使用されるIFN−Lの薬学的組成物は、代表的に滅菌でなければならない。このことは、滅菌濾過膜を介する濾過によって達成され得る。組成物が、凍結乾燥される場合、この方法を使用する滅菌は、凍結乾燥および再構成の前に、またはそれに続いてのいずれかで実施され得る。非経口投与のための組成物は、凍結乾燥された形態または溶液で保存され得る。さらに、非経口組成物は、一般に、滅菌アクセスポートを有する容器(例えば、静脈内溶液バッグまたは皮下注射針によって貫通可能なストッパーを有するバイアル)内に配置される。
一旦、薬学的組成物が処方されると、それは、滅菌バイアル中に溶液、懸濁液、ゲル、エマルジョン、固体、または脱水和粉末または凍結乾燥粉末として保存され得る。このような処方物は、すぐに使用できる形態または投与の前に再構成を必要とする形態(凍結乾燥された形態)のいずれかで保存され得る。
特定の実施形態において、本発明は、単一用量投与単位を生成するためのキットに関する。このキットは、各々、乾燥タンパク質を有する第一の容器および水性処方物を有する第二の容器の両方を含み得る。また、本発明の範囲内には、単一および多チャンバーの予め充填されたシリンジ(例えば、液体シリンジおよび分散シリンジ(lyosyringe))を含むキットが含まれる。
治療的に使用されるIFN−Lの薬学的組成物の有効量は、例えば、治療の内容および目的に依存する。当業者は、処置のための適切な投薬レベルが、従って、送達される分子、IFN−L分子が使用されている指標、投与の経路、および患者のサイズ(体重、体表面、または器官の大きさ)および状態(年齢および一般的な健康)に、部分的に依存して変化することを理解する。従って、臨床家は、最適な治療効果を得るために、投薬量を力価決定し(titer)、投与経路を改変し得る。代表的な投薬量は、上記の因子に依存して、約0.1μg/kg〜約100mg/kg以上までの範囲であり得る。他の実施形態において、投薬量は、0.1μg/kg〜約100mg/kgまで;または1μg/kg〜約100mg/kgまで;または5μg/kg〜約100mg/kgまでの範囲であり得る。
投薬の頻度は、使用される処方物中でのIFN−L分子の薬物動態学のパラメーターに依存する。典型的に、臨床家は、所望の効果を達成する投薬量に達するまで組成物を投与する。従って、組成物は、経時的な単一用量として、2以上の用量(これは、同量の所望の分子を含んでも、含まなくてもよい)として、あるいは移植デバイスまたはカテーテルを介する連続的な注入として、投与され得る。適切な投薬量のさらなる改良は、当業者によって慣用的になされ、そしてそれらによって慣用的に実施される課題の範囲内である。適切な投薬量は、適切な用量−応答データの使用を介して確認され得る。
薬学的組成物の投与の経路は、以下のような公知の方法と一致する:経口的に;静脈内、腹腔内、脳内(実質内の)、脳室内、筋肉内、眼内、動脈内、門脈内、または病巣内の経路による注入を介して;徐放性系によって;または移植デバイスによって。所望される場合、これらの組成物は、ボーラス注射によって投与され得るか、または注入によって連続的に投与され得るか、または移植デバイスによって投与され得る。
あるいはまたはさらに、組成物は、その上に所望の分子が吸収されるかまたはカプセル化される膜、スポンジ、または他の適切な材料の移植を介して局所的に投与され得る。移植デバイスが使用される場合、このデバイスは、任意の適切な組織または器官に移植され得、そして所望の分子の送達は、拡散、時限放出ボーラスまたは連続的な投与を介し得る。
いくつかの場合において、エキソビボ様式において、IFN−Lポリペプチドの薬学的組成物を使用することが所望され得る。このような例において、患者から除去された細胞、組織、または器官は、これらの細胞、組織、または器官が引き続いて患者に移植して戻された後にIFN−Lポリペプチドの薬学的組成物に曝露される。
他の場合において、IFN−Lポリペプチドは、本明細書中に記載される方法を使用して、遺伝的に操作されて、IFN−Lポリペプチドを発現および分泌する特定の細胞を移植することによって送達され得る。このような細胞は、動物またはヒト細胞であり得、そして自己、異種、または外因性の細胞であり得る。必要に応じて、細胞は、不死化され得る。免疫学的応答の機会を減少するために、細胞は、周囲の組織の浸潤を回避するために、カプセル化され得る。カプセル化材料は、典型的に、生体適合性の半浸透性ポリマー性包囲物または膜であり、これらは、タンパク質産物の放出を可能にするが、患者の免疫系または周囲の組織からの他の有害な因子によって細胞の破壊を防止する。
本明細書中において議論されるように、単離された細胞集団(例えば、幹細胞、リンパ球、赤血球、軟骨細胞、ニューロンなど)を1つ以上のIFN−Lポリペプチドで処理することが、望ましくあり得る。このことは、細胞膜に対して透過性の形態である場合には、単離された細胞をこのポリペプチドに直接曝露することによって達成され得る。
本発明のさらなる実施形態は、治療ポリペプチドのインビトロ産生と、遺伝子治療または細胞治療による治療ポリペプチドの産生および送達との両方のための、細胞および方法(例えば、相同組換えおよび/または他の組換え産生方法)に関する。相同組換えおよび他の組換えの方法を使用して、通常は転写に対してサイレントなIFN−L遺伝子(すなわち、過少発現される遺伝子)を含む細胞を改変し得、これによって、治療有効量のIFN−Lポリペプチドを発現する細胞を産生し得る。
相同組換えは、もともとは、遺伝子を標的化して転写活性な遺伝子における変異を誘導するか、または修正するために開発された技術である。Kucherlapati,1989,Prog.in Nucl.Acid Res.& Mol.Biol.36:301。基本的な技術が、特定の変異を哺乳動物ゲノムの特定の領域に導入するため(Thomasら、1986,Cell 44:419−28;ThomasおよびCapecchi,1987,Cell 51:503−12;Doetschmanら、1988,Proc.Natl.Acad.Sci.U.S.A.85:8583−87)、または欠損遺伝子における特定の変異を修正するため(Doetschmanら、1987,Nature 330:576−78)の方法として、開発された。例示的な相同組換え技術は、米国特許第5,272,071号;欧州特許第9193051号および同第505500号;PCT/US90/07642、ならびにPCT公開番号WO 91/09955)に記載されている。
相同組換えによって、ゲノムに挿入されるべきDNA配列は、それを標的DNAに付着させることによって、目的の遺伝子の特定の領域に指向され得る。この標的DNAは、ゲノムDNAの領域に相補的(相同)であるヌクレオチド配列である。ゲノムの特定の領域に対して相補的な標的DNAの小さな断片は、DNA複製プロセスの間に、親鎖と接触される。これは、細胞に挿入されてハイブリダイズしたDNAの一般的な特性であり、そして従って、共有される相同領域を介して、内因性DNAの他の断片と組み換わる。この相補鎖が、変異または異なる配列またはさらなるヌクレオチドを含むオリゴヌクレオチドに付着される場合には、これはまた、この組換えの結果として新たに合成された鎖に組み込まれる。プルーフリーディング機能の結果として、DNAの新たな配列がテンプレートとして働くことが可能である。従って、移入されたDNAは、ゲノムに組み込まれる。
IFN−Lポリペプチドと相互作用し得るかまたはその発現を制御し得るDNAの領域(例えば、隣接配列)が、標的DNAのこれらの断片に付着する。例えば、プロモーター/エンハンサーエレメント、サプレッサ、または外因性転写調節エレメントが、意図される宿主細胞のゲノムに、所望のIFN−LポリペプチドをコードするDNAの転写に影響を与えるに十分な近さおよび配向で、挿入される。制御エレメントは、この宿主細胞ゲノムに存在するDNAの部分を制御する。従って、所望のIFN−Lポリペプチドの発現は、IFN−L遺伝子自体をコードするDNAのトランスフェクションによってではなく、むしろ、IFN−L遺伝子の転写のための認識可能なシグナルを有する内因性遺伝子配列を提供するDNA調節セグメントと結合した標的DNA(目的の内因性遺伝子と相同の領域を含む)の使用によって、達成され得る。
例示的な方法において、細胞における所望の標的遺伝子(すなわち、所望の内因性細胞遺伝子)の発現は、予め選択された部位における細胞ゲノムへの相同組換えを介して、少なくとも調節配列、エキソン、およびスプライスドナー部位を含むDNAの導入によって、変更される。これらの構成成分は、新たな転写ユニットの産生を実際に生じるような様式で、染色体(ゲノム)DNAに導入される(ここで、DNA構築物に存在する調節配列、エキソン、およびスプライスドナー部位は、内因性遺伝子に作動可能に連結する)。染色体DNAへのこれらの構成成分の導入の結果として、所望の内因性遺伝子の発現が変化する。
本明細書中で記載されるように、変化された遺伝子発現は、通常は得られたままの細胞においてサイレントな(発現されていない)遺伝子の活性化(または発現させる)、ならびに得られたままの細胞において生理学的に有意なレベルでは発現されない遺伝子の発現の増加を包含する。この実施形態はさらに、調節または誘導のパターンを変化させる工程を包含し、その結果、これは、得られたままの細胞において生じる調節または誘導のパターンとは異なり、そして得られたままの細胞において発現される遺伝子の発現を減少(排除を含む)させる。
細胞の内在性IFN−L遺伝子からのIFN−Lポリペプチドの産生を増加するかまたはこれを引き起こすために相同組換えが使用され得る1つの方法は、最初に、相同組換えを使用して、部位特異的組換え系由来の組換え配列(例えば、Cre/loxP、FLP/FRT)(Sauer,1994,Curr.Opin.Biotechnol.,5:521−27;Sauer,1993,Methods Enzymol.,225:890−900)を、細胞の内在性ゲノムIFN−Lポリペプチドコード領域の上流(すなわち、5’側)に配置する工程を包含する。ゲノムIFN−Lポリペプチドコード領域のすぐ上流に配置された部位に対して相同性の組換え部位を含むプラスミドは、適切なリコンビナーゼ酵素と共に、改変された細胞株に導入される。このリコンビナーゼによって、プラスミドは、このプラスミドの組換え部位を介して、この細胞株のゲノムIFN−Lポリペプチドコード領域のすぐ上流に位置する組換え部位に組込み得る(BaubonisおよびSauer、1993,Nucleic Acids Res.21:2025−29;O’Garmanら、1991,Science 251:1351−55)。転写を増加させることが知られている任意の側方配列(例えば、エンハンサー/プロモーター、イントロン、翻訳エンハンサー)は、このプラスミド中に適切に配置される場合、細胞の内在性IFN−L遺伝子からの新たなまたは増加したIFN−Lポリペプチド産生を生じる新たなまたは改変された転写単位を作製するような様式で一体化する。
部位特異的組換え配列が細胞の内在性ゲノムIFN−Lポリペプチドコード領域のすぐ上流に配置された細胞株を使用するさらなる方法は、細胞株のゲノムの他の位置に第2の組換え部位を導入するために相同組換えを使用することである。適切な組換え酵素は、次いで、二組換え部位細胞株に導入され、組換え事象(欠失、転化、および転移)を生じ(Sauer,1994,Curr.Opin.Biotechnol.,5:521−27;Sauer,1993,Methods Enxymol.,225:890−900)、これは、細胞の内在性IFN−L遺伝子からの新規なまたは増加したIFN−Lポリペプチド産生を生じる新しいかまたは改変された転写ユニットを作製する。
細胞の内在性IFN−L遺伝子からのIFN−Lポリペプチドの発現を増加するため、または引き起こすためのさらなるアプローチは、細胞の内在性IFN−L遺伝子からの新たなまたは増加したIFN−Lポリペプチドの産生を生じる様式で、遺伝子(単数または複数)(例えば、転写因子)の発現を増加するかまたは引き起こし、そして/または遺伝子(単数または複数)(例えば、転写リプレッサ)の発現を減少する工程を包含する。この方法は、天然に存在しないポリペプチド(例えば、転写因子ドメインに融合した部位特異的DNA結合ドメインを含むポリペプチド)を、細胞の内在性IFN−L遺伝子からの新たなまたは増加したIFN−Lポリペプチドの産生が起こるように、細胞に導入する工程を包含する。
本発明はさらに、標的遺伝子の発現を変化させる方法において有用なDNA構築物に関する。特定の実施形態において、例示的なDNA構築物は、以下を含む:(a)1つ以上の標的配列、(b)調節配列、(c)エキソン、および(d)不対スプライスドナー部位。DNA構築物中の標的配列は、エレメント(a)〜(d)の細胞中の標的遺伝子への組込みを指向し、その結果、これらのエレメント(b)〜(d)は、内在性標的遺伝子の配列に作動可能に連結される。別の実施形態において、DNA構築物は、以下を含む:(a)1つ以上の標的配列、(b)調節配列、(c)エキソン、(d)スプライスドナー部位、(e)イントロン、および(f)スプライスアクセプター部位。ここで、標的配列は、エレメント(a)〜(f)の組込みを指向し、その結果、(b)〜(f)のエレメントは、内在性遺伝子に作動可能に連結される。標的配列は、相同組換えが生じる細胞染色体DNAの予め選択された部位に対して相同性である。この構築物において、エキソンは、一般的に、調節配列の3’であり、そしてスプライスドナー部位は、このエキソンの3’である。
特定の遺伝子の配列(例えば、本明細書中で記載されるIFN−Lポリペプチドの核酸配列)が公知である場合、遺伝子の選択された領域に対して相補的なDNAの部分は、合成されるか、またはそうでなければ、例えば、目的の領域に結合している特定の認識部位におけるネイティブのDNAの適切な制限等によって得られ得る。この部分は、細胞に挿入された際に、標的配列として働き、そしてそのゲノム内の相同性領域にハイブリダイズする。このハイブリダイゼーションが、DNA複製の間に生じる場合、このDNAの部分、およびそれに結合した任意のさらなる配列は、Okazakiフラグメントとして作用し、そしてDNAの新たに合成された娘鎖に組み込まれる。従って、本発明は、IFN−Lポリペプチドをコードするヌクレオチドを含み、このヌクレオチドは、標的配列として使用され得る。
IFN−Lポリペプチド細胞治療(例えば、IFN−Lポリペプチドを産生する細胞の移植)もまた企図される。この実施形態は、生物学的に活性な形態のIFN−Lポリペプチドを合成および分泌し得る細胞を移植する工程を包含する。このようなIFN−Lポリペプチド産生細胞は、IFN−Lポリペプチドの天然産物である細胞であり得るか、または組換え細胞であって、そのIFN−Lポリペプチドを産生する能力が、所望のポリペプチドをコードする遺伝子またはIFN−Lポリペプチドの発現を増大する遺伝子で形質転換することによって増大された、組換え細胞であり得る。このような改変は、遺伝子を送達し、その発現および分泌を促進するために適切なベクターによって達成され得る。IFN−Lポリペプチドを投与されている患者における強力な免疫学的反応を最小化するために、異種のポリペプチドの投与と共に生じる場合、IFN−Lポリペプチドを産生する天然の細胞が、ヒト起源であり、そしてヒトIFN−Lポリペプチドを産生することが好ましい。同様に、IFN−Lポリペプチドを産生する組換え細胞が、ヒトIFN−Lポリペプチドをコードする遺伝子を含む発現ベクターで形質転換されることが好ましい。
移植細胞は、周辺組織の浸潤を回避するようにカプセル化され得る。ヒトまたは非ヒト動物細胞は、生体適合性の半透性ポリマー封入物または膜(これは、IFN−Lポリペプチドの放出を可能にするが、患者の免疫系または周辺組織からの他の有害な因子による細胞の崩壊を防止する)の形態で患者に移植され得る。あるいは、IFN−Lポリペプチドをエキソビボで産生するように形質転換された患者自身の細胞が、このようなカプセル化なしで、患者に直接移植され得る。
生きた細胞をカプセル化するための技術は当該分野で公知であり、そしてカプセル化された細胞の調製およびそれらの患者への移植は、慣用的に達成され得る。例えば、Baetgeら(PCT公開番号WO95/05452およびPCT/US94/09299)は、生物学的に活性な分子の効果的な送達のために遺伝子操作された細胞を含む膜カプセルを記載する。このカプセルは、生体適合性であり、そして容易に回収可能である。このカプセルは、哺乳動物宿主に移植された際に、インビボで下方制御に供されないプロモーターに作動可能に連結された生物学的に活性な分子をコードするDNA配列を含む組換えDNA分子でトランスフェクトされた細胞をカプセル化する。このデバイスは、生きた細胞由来の分子のレシピエント内の特定の部位への送達を提供する。さらに、米国特許第4,892,538号;同第5,011,472号;および同第5,106,627号を参照のこと。生きた細胞をカプセル化するためのシステムは、PCT公開番号WO91/10425(Aebischerら)に記載される。PCT公開番号WO91//10470(Aebischerら);Winnら、1991,Exper.Neurol.113:322−29;Aebischerら、1991,Exper.Neurol.111:269−75;およびTrescoら、1992,ASAIO 38:17−23もまた参照のこと。
IFN−Lポリペプチドのインビボおよびインビトロの遺伝子治療送達もまた想定される。遺伝子治療技術の一例は、構成的または誘発性プロモーターに作動可能に連結され得るIFN−LポリペプチドをコードするIFN−L遺伝子(ゲノムDNA、cDNAおよび/または合成DNAのいずれか)を使用して、「遺伝子治療DNA構築物」を形成することである。このプロモーターは、内在性IFN−L遺伝子に対してホモ接合性またはヘテロ接合性であり得る。ただし、これは、構築物が挿入される細胞または組織型において活性である。遺伝子治療DNA構築物の他の成分は、必要に応じて、部位特異的組込みのために設計されたDNA分子(例えば、相同組換えのために有用な内在性配列)、組織特異的プロモーター、エンハンサーまたはサイレンサー、親細胞に対する選択優位性を提供し得るDNA分子、形質転換された細胞を同定するための標識として有用なDNA分子、ネガティブ選択系、細胞特異的結合因子(例えば、細胞標的化のため)、細胞特異的内部移行因子、ベクターからの発現を増強させる転写因子、およびベクターの産生を可能にする因子を含み得る。
遺伝子治療DNA構築物は、次いで、ウイルスベクターまたは非ウイルスベクターを使用して細胞に導入され得る(エキソビボまたはインビボのいずれか)。遺伝子治療DNA構築物を導入するための1つの手段は、本明細書中に記載されるようなウイルスベクターの使用による。特定のベクター(例えば、レトロウイルスベクター)は、DNA構築物を細胞の染色体DNAに送達し、そしてこの遺伝子は、染色体DNAに組み込まれ得る。他のベクターは、エピソームとして機能し、そして遺伝子治療DNA構築物は、細胞質に残る。
さらに他の実施形態において、調節エレメントが、標的細胞におけるIFN−L遺伝子の制御された発現のために含められ得る。このようなエレメントは、適切なエフェクターに応答して作動状態にされる。このようにして、治療的ポリペプチドは、所望の場合に発現され得る。1つの従来の制御手段は、低分子結合ドメインおよび生物学的プロセスを開始し得るドメインを含むキメラタンパク質(例えば、DNA結合タンパク質または転写活性化タンパク質)を二量化する低分子二量化剤またはラパログ(rapalog)の使用を包含する(PCT公開番号WO96/41865、WO97/31898およびWO97/31899を参照のこと)。タンパク質の二量化は、導入遺伝子の転写を開始するために使用され得る。
代替の調節技術は、目的の遺伝子から発現されたタンパク質を、凝集体またはクラスターとして細胞の内側に貯蔵する方法を使用する。目的の遺伝子は、小胞体における凝集タンパク質の残留を生じる、条件的凝集ドメインを含む融合タンパク質として発現される。貯蔵されたタンパク質は安定であり、そして細胞の内側で不活性である。しかし、このタンパク質は、条件的凝集ドメインを除去し、それによって凝集体またはクラスターを特異的に破壊し、その結果、このタンパク質が細胞から分泌され得る、薬物(例えば、低分子リガンド)を投与することによって放出され得る。Aridorら、2000,Science 287:816−17およびRiveraら、2000,Science 287:826−30を参照のこと。
他の適切な制御手段または遺伝子スイッチとしては、本明細書中で記載される系が挙げられるが、これらに限定されない。Mifepristone(RU486)は、プロゲステロンアンタゴニストとして使用される。改変されたプロゲステロンレセプターリガンド結合ドメインのプロゲステロンアンタゴニストへの結合は、2つの転写因子のダイマーを形成することによって、転写を活性化し、次いで、核に至り、DNAに結合する。このリガンド結合ドメインは、レセプターが天然のリガンドに結合する能力を排除するように改変される。改変されたステロイドホルモンレセプター系はさらに、米国特許第5,364,791号、ならびにPCT公開番号WO96/40911およびWO97/10337に記載される。
さらに別の制御系は、エクジソンレセプター(細胞質レセプター)に結合し、そしてこれを活性化するエクジソン(ショウジョウバエステロイドホルモン)を使用する。次いで、このレセプターは核にトランスロケーションし、特異的なDNA応答エレメント(エクジソン応答性遺伝子由来のプロモーター)に結合する。エクジソンレセプターは、転写を開始するための、トランス活性化ドメイン、DNA結合ドメイン、およびリガンド結合ドメインを含む。エクジソン系はさらに、米国特許第5,514,578、およびPCT公開番号WO97/38117、WO96/37609、およびWO93/03162に記載される。
別の制御手段は、陽性テトラサイクリン制御可能トランス活性化因子を使用する。この系は、転写を活性化するポリペプチドに連結された変異したtetリプレッサータンパク質DNA結合ドメイン(逆テトラサイクリン調節製トランス活性化因子タンパク質を生じた変異したtet R−4アミノ酸の変化、すなわち、これは、テトラサイクリンの存在下でtetオペレーターに結合する)を含む。このような系は、米国特許第5,464,758号、同第5,650,298号、および同第5,654,168号に記載される。
さらなる発現制御系および核酸構築物は、米国特許第5,741,679号および同第5,834,186号(Innovir Laboratories Inc.)に記載される。
インビボ遺伝子治療は、IFN−Lポリペプチドをコードする遺伝子を、IFN−L核酸分子の局所注射によって、または他の適切なウイルス性もしくは非ウイルス性の送達ベクターによって、細胞に導入することにより達成され得る。Hefti,1994,Neurobiology 25:1418−35。例えば、IFN−Lポリペプチドをコードする核酸分子は、標的細胞への送達のためのアデノ随伴ウイルス(AAV)ベクターに含まれ得る(例えば、Johnson,PCT公開番号WO95/34670;PCT出願番号PCT/US95/07178を参照のこと)。組換えAAVゲノムは、典型的に、機能的プロモーターに作動可能に連結したIFN−LポリペプチドをコードするDNA配列およびポリアデニル化配列に隣接するAAV逆方向末端反復を含む。
代替の適切なウイルスベクターとしては、レトロウイルス、アデノウイルス、単純ヘルペスウイルス、レンチウイルス、肝炎ウイルス、パルボウイルス、パポバウイルス、ポックスウイルス、アルファウイルス、コロナウイルス、ラブドウイルス、パラミクソウイルス、および乳頭腫ウイルスベクターが挙げられるがこれらに限定されない。米国特許第5,672,344号は、組換え神経栄養性HSV−1ベクターを含むインビボウイルス媒介遺伝子転移系を記載する。米国特許第5,399,346号は、治療タンパク質をコードするDNAセグメントを挿入するためにインビトロで処理されたヒト細胞の送達によって、治療タンパク質を患者に提供するためのプロセスの例を提供する。遺伝子治療技術の実施のためのさらなる方法および材料は、米国特許第5,631,236号(アデノウイルスベクターを含む)、同第5,672,510号(レトロウイルスベクターを含む)、同第5,635,399号(サイトカインを発現するレトロウイルスベクターを含む)に記載される。
非ウイルス性送達法としては、リポソーム媒介移入、裸のDNA送達(直接注射)、レセプター媒介移入(リガンド−DNA複合体)、エレクトロポレーション、リン酸カルシウム沈澱、および微粒子ボンバードメント(例えば、遺伝子銃)が挙げられるが、これらに限定されない。遺伝子治療材料および方法はまた、誘導性プロモーター、組織特異的エンハンサー−プロモーター、部位特異的組込みのために設計されたDNA配列、親細胞に対する選択優位性を提供し得るDNA配列、形質転換された細胞を同定するための標識、ネガティブな選択系および発現制御系(安全性の指標)、細胞特異的結合因子(細胞標的化のため)、細胞特異的内部移行因子およびベクターによる発現を増強させる転写因子ならびにベクター製造の方法を含み得る。遺伝子治療技術の実施のためのこのようなさらなる方法および材料は、米国特許第4,970,154号(エレクトロポレーション技術を含む)、同第5,679,559号(遺伝子送達のためのリポタンパク質含有系を記載する)、同第5,676,954号(リポソームキャリアを含む)、同第5,593,875号(リン酸カルシウムトランスフェクションのための方法を記載する)、および同第4,945,050号(生物学的に活性な粒子がある速度で細胞に噴霧され、それによりこの粒子がこの細胞の表面を貫通し、そしてこの細胞の内側に組み込まれるプロセスを記載する)、およびPCT公開番号WO96/40958(核リガンドを含む)に記載される。
IFN−L遺伝子治療または細胞治療がさらに、同じか異なる細胞における1つ以上のさらなるポリペプチドの送達を含み得ることもまた企図される。このような細胞は、患者に別々に導入され得るか、この細胞は、単一の移植可能デバイス(例えば、上記のカプセル化膜)に含められ得るか、あるいはこの細胞は、ウイルスベクターによって別々に改変され得る。
遺伝子治療によって細胞における内在性IFN−Lポリペプチドの発現を増加させる手段は、IFN−Lポリペプチドプロモーターに1つ以上のエンハンサーエレメントを挿入することであり、ここでエンハンサーエレメントは、IFN−L遺伝子の転写活性を増加させるように働き得る。使用されるエンハンサーエレメントは、遺伝子を活性化することを所望する組織に基づいて選択される−その組織でプロモーター活性化を与えることが知られているエンハンサーエレメントが選択される。例えば、IFN−Lポリペプチドをコードする遺伝子がT細胞において「作動状態になる(turned on)」場合、lckプロモーターエンハンサーエレメントが使用され得る。ここで、付加される転写エレメントの機能的部分は、標準的なクローニング技術を使用して、IFN−Lポリペプチドプロモーターを含むDNAフラグメントに挿入され得る(そして必要に応じて、ベクターおよび/または5’および/または3’隣接配列に挿入され得る)。「相同組換え構築物」として公知のこの構築物は、次いで、エキソビボまたはインビボのいずれかで、所望の細胞に導入され得る。
遺伝子治療はまた、内在性プロモーターのヌクレオチド配列を改変することによって、IFN−Lポリペプチド発現を減少させるために使用され得る。このような改変は、典型的に、相同組換え方法によって達成される。例えば、不活性化のために選択されたIFN−L遺伝子のプロモーターの全てまたは一部を含むDNA分子は、転写を調節するプロモーターの断片を除去および/または置換するように操作され得る。例えば、プロモーターの転写活性化因子のTATAボックスおよび/または結合部位は、標準的な分子生物学的技術を使用して欠失され得;このような欠失は、プロモーター活性を阻害し得、それにより対応するIFN−L遺伝子の転写を抑制し得る。プロモーターにおけるTATAボックスまたは転写活性化因子結合部位の欠失は、IFN−Lポリペプチドプロモーター(調節されるIFN−L遺伝子と同じかまたは関連の種由来)のすべてまたは関連の部分を含むDNA構築物を生成することによって達成され得、ここで、1つ以上のTATAボックスおよび/または転写活性化因子結合部位のヌクレオチドは、1つ以上のヌクレオチドの置換、欠失、および/または挿入によって変異される。結果として、TATAボックスおよび/または活性化因子結合部位は、減少した活性を有するか、または完全に不活性にされる。この構築物(これはまた、典型的に、改変されたプロモーターセグメントに隣接したネイティブの(内在性)5’および3’DNA配列に対応する少なくとも約500塩基のDNAを含む)は、直接または本明細書中に記載されるようなウイルスベクターを介してのいずれかで、適切な細胞に(エキソビボまたはインビボのいずれかで)導入され得る。典型的に、細胞のゲノムDNAへのこの構築物の組込みは、相同組換えによってであり、ここで、このプロモーター構築物の5’および3’DNA配列は、内在性染色体DNAへのハイブリダイゼーションによって、改変プロモーター領域を組み込むのを助けるのに役立ち得る。
(治療的使用)
IFN−Lの核酸分子、ポリペプチド、ならびにそのアゴニストおよびアンタゴニストを使用して、本明細書中に記載の疾患、障害または状態を含む、多くの疾患、障害または状態を処置、診断、回復または予防し得る。
IFN−Lの核酸分子、ポリペプチド、ならびにそのアゴニストおよびアンタゴニストを使用して、本明細書中に記載の疾患、障害または状態を含む、多くの疾患、障害または状態を処置、診断、回復または予防し得る。
IFN−Lポリペプチドのアゴニストおよびアンタゴニストには、IFN−Lポリペプチド活性を調節し、そしてこのIFN−Lポリペプチドの成熟形態の少なくとも1つの活性を増加させるまたは減少させるかのいずれかの分子が含まれる。アゴニストまたはアンタゴニストは、IFN−Lポリペプチドと相互作用しそしてこれによってその活性を調節する、補因子(例えば、タンパク質、ペプチド、炭水化物、脂質または低分子量分子)であり得る。ポリペプチドの潜在的なアゴニストまたはアンタゴニストとしては、IFN−Lタンパク質の細胞外ドメインの一部または全てを含むIFN−Lポリペプチドの可溶性形態または膜結合形態のいずれかと反応する、抗体が挙げられる。IFN−Lポリペプチド発現を調節する分子としては、代表的に、発現のアンチセンスレギュレーターとして作用し得る、IFN−Lポリペプチドをコードする核酸が挙げられる。
IFN−Lポリペプチドは、公知のインターフェロンに対するIFN−Lポリペプチドの相同性に基づいて、癌細胞の増殖および維持を制御する際に役割を果たし得る。従って、IFN−Lの核酸分子、ポリペプチドならびにそれらのアゴニストおよびアンタゴニストは、癌の診断および/または処置のために有用であり得る。このような癌の例としては、慢性骨髄性白血病、毛様細胞性白血病、カポージ肉腫、黒色腫、肺癌、脳の癌、乳癌、造血系の癌、前立腺癌、卵巣癌および精巣癌が挙げられるがこれらに限定されない。他の癌は、本発明の範囲に包含される。
IFN−Lポリペプチドは、公知のインターフェロンに対するIFN−Lポリペプチドの相同性に基づいて、免疫系の調節に役割を果たし得る。従って、IFN−Lの核酸分子、ポリペプチドならびにそれらのアゴニストおよびアンタゴニストは、免疫系の機能不全の診断および/または処置のために有用であり得る。このような疾患の例としては、以下が挙げられるがこれらに限定されない:多発性硬化症、慢性関節リウマチ、乾癬性関節炎(psioriatic arthritis)、炎症性関節炎、変形性関節炎、炎症性関節疾患、自己免疫疾患、狼瘡、糖尿病、炎症性腸疾患、移植拒絶、および対宿主性移植片病。免疫系の機能不全によって影響を受ける他の疾患は、本発明の範囲に包含される。
IFN−Lポリペプチドは、公知のインターフェロンに対するIFN−Lポリペプチドの相同性に基づいて、ウイルス感染および微生物感染の制御に役割を果たし得る。従って、IFN−Lの核酸分子、ポリペプチドならびにそれらのアゴニストおよびアンタゴニストは、感染の診断および/または処置のために有用であり得る。このような疾患の例としては、以下が挙げられるがこれらに限定されない:肝炎、ヒト免疫不全ウイルス、ヒトパピローマウイルスおよび慢性肉芽腫症(granulamatous)。感染によって引き起こされる他の疾患は、本発明の範囲に包含される。
IFN−Lポリペプチドは、公知のインターフェロンに対するIFN−Lポリペプチドの相同性に基づいて、骨形成および骨維持の制御に役割を果たし得る。従って、IFN−Lの核酸分子、ポリペプチドならびにアゴニストおよびアンタゴニストは、骨の疾患の診断および/または処置のために有用であり得る。このような疾患の例としては、以下が挙げられるがこれらに限定されない:骨粗鬆症、大理石骨秒、骨形成不全、パジェット病、歯周病および高カルシウム血症。他の骨障害は、本発明の範囲に包含される。
IFN−Lポリペプチドは、公知のインターフェロンに対するIFN−Lポリペプチドの相同性に基づいて、不適切な細胞増殖に役割を果たし得る。従って、IFN−Lの核酸分子、ポリペプチドならびにアゴニストおよびアンタゴニストは、異常な細胞増殖が存在する疾患の診断および/または処置のために有用であり得る。このような疾患の例としては、以下が挙げられるがこれらに限定されない:動脈硬化症および血管再狭窄。不適切な細胞増殖によって影響を受ける他の疾患は、本発明の範囲に包含される。
特定の実施形態では、本発明は、分泌型もしくは可溶性のヒトfas抗原またはその組換え型(PCT公開番号WO 96/20206;Mountzら,1995,J.Immunol.,155:4829−37;および欧州特許第510691号)と組み合わせた(前処置、後処置または同時処置)IFN−Lポリペプチドの使用に関する。PCT公開番号WO 96/20206は、分泌型ヒトfas抗原(Ig融合タンパク質を含めて、ネイティブおよび組換え型)、可溶性組換え型ヒトfas抗原をコードするのを担う遺伝子を単離するための方法、この遺伝子を適切なベクターおよび細胞型にクローニングするための方法、ならびにこの遺伝子を発現してインヒビターを産生する方法を開示する。欧州特許第510691号は、可溶性fas抗原を含めて、ヒトfas抗原をコードする核酸、この核酸を発現するためのベクター、およびこのベクターでトランスフェクトされた形質転換体を教示する。非経口的に投与される場合、分泌型または可溶性fas抗原融合タンパク質の用量は各々、一般に、約1μg/kg〜約100μg/kgである。
本明細書中に引用される疾患および障害の処置は、疼痛および炎症の制御のための第1線の薬物の使用を包含し得る;これらの薬物は、非ステロイド性抗炎症薬物(NSAID)として分類される。第2の処置は、コルチコステロイド、徐作用性抗リウマチ薬物(SAARD)または疾患改変(DM)薬物を包含する。以下の化合物に関する情報は、The Merck Manual of Diagnosis and Therapy(第16版、1992)およびPharmaprojects(PJB Publications Ltd)に見出され得る。
特定の実施形態では、本発明は、本明細書中に引用される疾患および障害(急性および慢性の炎症(例えば、リウマチ病)ならびに対宿主性移植片病を包含する)の処置のための、IFN−Lポリペプチドおよび1以上のNSAIDのうちのいずれかの使用に関する。NSAIDは、その抗炎症作用を、少なくとも部分的に、プロスタグランジン合成の阻害に負う(GoodmanおよびGilman,The Pharmacological Basis of Therapeutics(第7版、1985))。NSAIDは、少なくとも9つの群に特徴付けられ得る:(1)サリチル酸誘導体、(2)プロピオン酸誘導体、(3)酢酸誘導体、(4)フェナム酸誘導体、(5)カルボン酸誘導体、(6)酪酸誘導体、(7)オキシカム(oxicam)、(8)ピラゾールおよび(9)ピラゾロン。
別の特定の実施形態では、本発明は、1以上のサリチル酸誘導体、プロドラッグエステル、または薬学的に受容可能なその塩のいずれかと組み合わせた(前処置、後処置または同時処置)IFN−Lポリペプチドの使用に関する。このようなサリチル酸誘導体、プロドラッグエステルおよび薬学的に受容可能なその塩は、以下を包含する:アセトアミノサロール、アロキシプリン、アスピリン、ベノリラート、ブロモサリゲニン、アセチルサリチル酸カルシウム、トリサリチル酸コリンマグネシウム、サリチル酸マグネシウム、サリチル酸コリン、ジフルニサル、エテルサラート、フェンドサール、ゲンチジン酸、サリチル酸グリコール、サリチル酸イミダゾール、アセチルサリチル酸リジン、メサラミン、サリチル酸モルホリン、サリチル酸1−ナフチル、オルサラジン、パルサルミド、アセチルサリチル酸フェニル、サリチル酸フェニル、サラセタミド、サリチルアミドO−酢酸、サルサラート、サリチル酸ナトリウムおよびスルファサラジン。類似の鎮痛特性および抗炎症特性を有する、構造的に関連したサリチル酸誘導体もまた、このグループによって包含されることが意図される。
さらなる特定の実施形態では、本発明は、1以上のプロピオン酸誘導体、プロドラッグエステル、または薬学的に受容可能なその塩のいずれかと組み合わせた(前処置、後処置または同時処置)IFN−Lポリペプチドの使用に関する。このようなプロピオン酸誘導体、プロドラッグエステルおよび薬学的に受容可能なその塩は、以下を包含する:アルミノプロフェン、ベノキサプロフェン、ブクロクス酸、カルプロフェン、デキスインドプロフェン、フェノプロフェン、フルノキサプロフェン、フルプロフェン、フルルビプロフェン、フルクロプロフェン、イブプロフェン、イブプロフェンアルミニウム、イブプロキサム、インドプロフェン、イソプロフェン、ケトプロフェン、ロキソプロフェン(loxoprofen)、ミロプロフェン、ナプロキセン、ナプロキセンナトリウム、オキサプロジン、ピケトプロフェン、ピメプロフェン、ピルプロフェン、プラノプロフェン、プロチジン酸、ピリドキシプロフェン(pyridoxiprofen)、スプロフェン、チアプロフェン酸およびチオキサプロフェン。類似の鎮痛特性および抗炎症特性を有する、構造的に関連したプロピオン酸誘導体もまた、このグループによって包含されることが意図される。
なお別の特定の実施形態では、本発明は、1以上の酢酸誘導体、プロドラッグエステル、または薬学的に受容可能なその塩のいずれかと組み合わせた(前処置、後処置または同時処置)IFN−Lポリペプチドの使用に関する。このような酢酸誘導体、プロドラッグエステルおよび薬学的に受容可能なその塩は、以下を包含する:アセメタシン、アルクロフェナク、アムフェナク、ブフェキサマック、シンメタシン、クロピラク、デルメタシン(delmetacin)、ジクロフェナクカリウム、ジクロフェナクナトリウム、エトドラク、フェルビナク、フェンクロフェナク、フェンクロラク、フェンクロジン酸、フェンチアザク、フロフェナク、グルカメタシン、イブフェナック、インドメタシン、イソフェゾラク、イソキセパック、ロナゾラク、メチアジン酸、オキサメタシン、オキシピナク(oxpinac)、ピメタシン、プログルメタシン、スリンダク、タルメタシン、チアラミド、チオピナク、トルメチン、トルメチンナトリウム、ジドメタシンおよびゾメピラク。類似の鎮痛特性および抗炎症特性を有する、構造的に関連した酢酸誘導体もまた、このグループによって包含されることが意図される。
別の特定の実施形態では、本発明は、1以上のフェナム酸誘導体、プロドラッグエステル、または薬学的に受容可能なその塩のいずれかと組み合わせた(前処置、後処置または同時処置)IFN−Lポリペプチドの使用に関する。このようなフェナム酸誘導体、プロドラッグエステルおよび薬学的に受容可能なその塩は、以下を包含する:エンフェナム酸、エトフェナマート、フルフェナム酸、イソニキシン、メクロフェナム酸、メクロフェナム酸ナトリウム、メトフェナム酸(medofenamic acid)、メフェナム酸、ニフルム酸、タルニフルマート、テロフェナマート、トルフェナム酸およびウフェナマート。類似の鎮痛特性および抗炎症特性を有する、構造的に関連したフェナム酸誘導体もまた、このグループによって包含されることが意図される。
さらなる特定の実施形態では、本発明は、1以上のカルボン酸誘導体、プロドラッグエステル、または薬学的に受容可能なその塩のいずれかと組み合わせた(前処置、後処置または同時処置)IFN−Lポリペプチドの使用に関する。使用され得るカルボン酸誘導体、プロドラッグエステルおよび薬学的に受容可能なその塩は、以下を包含する:クリダナク、ジフルニサル、フルフェニサール、イノリジン(inoridine)、ケトロラクおよびチノリジン。類似の鎮痛特性および抗炎症特性を有する、構造的に関連したカルボン酸誘導体もまた、このグループによって包含されることが意図される。
なお別の特定の実施形態では、本発明は、1以上の酪酸誘導体、プロドラッグエステル、または薬学的に受容可能なその塩のいずれかと組み合わせた(前処置、後処置または同時処置)IFN−Lポリペプチドの使用に関する。酪酸誘導体、プロドラッグエステルおよび薬学的に受容可能なその塩は、以下を包含する:ブマジゾン、ブチブフェン、フェンブフェンおよびキセンブシン。類似の鎮痛特性および抗炎症特性を有する、構造的に関連した酪酸誘導体もまた、このグループによって包含されることが意図される。
別の特定の実施形態では、本発明は、1以上のオキシカム、プロドラッグエステル、または薬学的に受容可能なその塩のいずれかと組み合わせた(前処置、後処置または同時処置)IFN−Lポリペプチドの使用に関する。オキシカム、プロドラッグエステルおよび薬学的に受容可能なその塩は、以下を包含する:ドロキシカム、エノリカム、イソキシカム、ピロキシカム、スドキシカム、テノキシカムおよび4−ヒドロキシル−1,2−ベンゾチアジン1,1−ジオキシド4−(N−フェニル)−カルボキサミド。類似の鎮痛特性および抗炎症特性を有する、構造的に関連したオキシカムもまた、このグループによって包含されることが意図される。
さらに別の特定の実施形態において、本発明は、IFN−Lポリペプチドの、任意の1つ以上のピラゾール、プロドラッグエステルまたは薬学的に受容可能なそれらの塩と組み合わせた(前処置、後処置、または同時処置)使用に関する。使用され得るピラゾール、プロドラッグエステルおよび薬学的に受容可能なそれらの塩には:ジフェナミゾールおよびエピリゾールが挙げられる。類似の鎮痛および抗炎症特性を有する、構造的に関連するピラゾールもまた、この群に包含されることが意図される。
さらなる特定の実施形態において、本発明は、IFN−Lポリペプチドの、任意の1つ以上のピラゾロン、プロドラッグエステルまたは薬学的に受容可能なそれらの塩と組み合わせた(前処置、後処置、または同時処置)使用に関する。使用され得るピラゾロン、プロドラッグエステルおよび薬学的に受容可能なそれらの塩には:アパゾン、アザプロパゾン、ベンズピペリロン、フェプラゾン、モフェブタゾン、モラゾン、オキシフェンブタゾン、フェニルブタゾン、ピペブゾン、プロピルフェナゾン、ラミフェナゾン、スキシブゾン、およびチアゾリノブタゾンが挙げられる。類似の鎮痛および抗炎症特性を有する、構造的に関連するピラゾロンもまた、この群に包含されることが意図される。
別の特定の実施形態において、本発明は、IFN−Lポリペプチドの、任意の以下の1つ以上のNSAIDと組み合わせた(前処置、後処置、または同時処置)使用に関する。ε−アセトアミドカプロン酸、S−アデノシルメチオニン、3−アミノ−4−ヒドロキシ酪酸、アミキセトリン、アニトラザフェン、アントラフェニン、ベンダザック、ベンダザックリシネート、ベンジダミン、ベプロジン、ブロペラモール、ブコローム、ブフェゾラク、シプロカゾン、クロキシマート、ダジダミン、デボキサメト、デトミジン、ジフェンピラミド(difenpiramide)、ジフェンピラミド(difenpyramide)、ジフィサラミン、ジタゾール、エモルファゾン、ファネチゾールメシラート、フェンフルミゾール、フロクタフェニン、フルミゾール、フルニキシン、フルプロカゾン、フォピルトリン、フォスフォサル、グアイメサール、グアイアゾレン、イソニキシン(isonixirn)、レフェタミンHCl、レフルノミド、ロフェミゾール、ロチファゾール、リシンクロニキシナート、メセクラゾン、ナブメトン、ニクチンドール、ニメスリド、オルゴテイン、オルパノキシン、オキサセプロール、オキサパドール、パラニリン、ペリソキサール、ペリソキサールクエン酸塩、ピフォキシム、ピプロキセン、ピラゾラク、ピルフェニドン、プロカゾン、プロキサゾール、チエラビンB,チフラミゾール、チメガジン、トレクチン、トルパドール、トリプトアミド、ならびに会社コード番号で称されるNSAID(例えば、480156S、AA861、AD1590、AFP802、AFP860、AI77B、AP504、AU8001、BPPC、BW540C、CHINOIN127、CN100、EB382、EL508、F1044、FK−506、GV3658、ITF182、KCNTEI6090、KME4、LA2851、MR714、MR897、MY309、ONO3144、PR823、PV102、PV108、R830、RS2131、SCR152、SH440、SIR133、SPAS510、SQ27239、ST281、SY6001、TA60、TAI−901(4−ベンゾイル−1−インダンカルボン酸)、TVX2706、U60257、UR2301、およびWY41770。NSAIDと類似の鎮痛および抗炎症特性を有する、構造的に関連するNSAIDもまた、この群に包含されることが意図される。
さらに別の特定の実施形態において、本発明は、本明細書中に記載の疾患および障害(リウマチ病、対宿主性移植片病、および多発性硬化症のような急性炎症および慢性炎症を含む)の処置のための、IFN−Lポリペプチドの、任意の1つ以上のコルチコステロイド、プロドラッグエステルまたは薬学的に受容可能なそれらの塩と組み合わせた(前処置、後処置、または同時処置)使用に関する。コルチコステロイド、プロドラッグエステルおよび薬学的に受容可能なそれらの塩には:ヒドロコルチゾンおよびヒドロコルチゾンに由来する以下のような化合物が挙げられる。21−アセトキシプレグネノロン、アルクロメラゾン、アルゲストン、アムシノニド、ベクロメタゾン、ベタメタゾン、吉草酸ベタメタゾン、ブデソニド、クロロプレドニゾン、クロベタゾール、プロピオン酸クロベタゾール、クロベタゾン、酪酸クロベタゾン、クロコルトロン、クロプレドノール、コルチコステロン、コルチゾン、コルチバゾール、デフラザコン、デソニド、デスオキシメラゾン、デキサメタゾン、ジフロラゾン、ジフロコルトロン、ジフルプレドナート、エノキソロン、フルアザコート、フルクロロニド、フルメタゾン、フルメタゾンピバレート、フルニソリド、フルシノロンアセトニド、フルオシノニド、フルオロシノロンアセトニド、フルオコルチンブチル、フルオコルトロン、ヘキサン酸フルオコルトロン、吉草酸ジフルコルトロン、フルオロメトロン、酢酸フルペロロン、酢酸フルプレドニデン、フルプレドニゾロン、フルランデノリド、フォルモコルタール、ハルシノニド、ハロメタゾン、酢酸ハロプレドン、ヒドロコルタメート、ヒドロコルチゾン、酢酸ヒドロコルチゾン、酪酸ヒドロコルチゾン、リン酸ヒドロコルチゾン、コハク酸ヒドロコルチゾン21−ナトリウム、ヒドロコルチゾンテブテート、マジプレドン、メドリゾン、メプレドニゾン、メチルプレドニゾロン、モメタゾンフロエート、パラメタゾン、プレドニカルバート、プレドニゾロン、21−ジエドリアミノ酢酸プレドニゾロン、リン酸プレドニゾロンナトリウム、コハク酸プレドニゾロンナトリウム、21−m−スルホ安息香酸プレドニゾロンナトリウム、21−ステアログリコレートプレドニゾロンナトリウム、プレドニゾロンテブテート、21−トリメチル酢酸プレドニゾロン、プレドニゾン、プレドニバール、プレドニリデン、21−ジエチルアミノ酢酸プレドニリデン、チキソコルトール、トリアムシノロン、トリアムシノロンアセトニド、トリアムシノロンベネトニド、およびトリアミシノロンヘキサセトニド。類似の鎮痛および抗炎症特性を有する、構造的に関連するコルチコステロイドもまた、この群に包含されることが意図される。
別の特定の実施形態において、本発明は、本明細書中に記載の疾患および障害(リウマチ病、宿主対移植片疾患、および多発性硬化症のような急性炎症および慢性炎症を含む)の処置のための、IFN−Lポリペプチドの、任意の1つ以上の遅効性の抗リウマチ薬物(SAARD)または疾患改変性抗リウマチ薬物(DMARD)、プロドラッグエステルまたは薬学的に受容可能なそれらの塩と組み合わせた(前処置、後処置、または同時処置)使用に関する。SAARDまたはDMARD、プロドラッグエステルおよび薬学的に受容可能なそれらの塩には:アロクプレイドナトリウム、オーラノフィン、金チオグルコース、金チオグリカニド、アザチオプリン、ブレキナルナトリウム、ブシラミン、3−金チオ−2−プロパノール−1−スルホン酸カルシウム、クロラムブシル、クロロキン、クロブザリト、クプロキソリン、シクロホスファミド、シクロスポリン、ダプソン、15−デオキシスペルグアリン、ジアセレイン、グルコサミン、金塩(例えば、シクロキン金塩、金チオリンゴ酸ナトリウム、金チオ硫酸ナトリウム)、ヒドロキシクロロキン、硫酸ヒドロキシクロロキン、ヒドロキシ尿素、ケブゾン、レバミゾール、ロベンザリト、メリチン、6−メルカプトプリン、メトトレキサート、ミゾリビン、ミコフェノール酸モフェチル、ミロラール、ナイトロジェンマスタード、D−ペニシラミン、ピリジノールイミダゾール(例えば、SKNF86002およびSB203580)、ラパマイシン、チオール類、チモポイエチン、およびビンクリスチン。類似の鎮痛および抗炎症特性を有する、構造的に関連するSAARDまたはDMARDもまた、この群に包含されることが意図される。
別の特定の実施形態において、本発明は、本明細書中に記載の疾患および障害(急性炎症および慢性炎症を含む)の処置のための、IFN−Lポリペプチドの、任意の1つ以上のCOX2インヒビター、プロドラッグエステルまたは薬学的に受容可能なそれらの塩と組み合わせた(前処置、後処置、または同時処置)使用に関する。COX2インヒビター、プロドラッグエステルおよび薬学的に受容可能なそれらの塩の例としては、例えば、セレコキシブが挙げられる。類似の鎮痛および抗炎症特性を有する、構造的に関連するCOX2インヒビターもまた、この群に包含されることが意図される。
さらに別の特定の実施形態において、本発明は、急性および慢性炎症を含む、本明細書中に記載される疾患および障害の処置のための、1つ以上の抗菌剤、プロドラッグエステル、またはその薬学的に受容可能な塩のいずれかと組み合わせた(前処置、後処置、または同時処置)、IFN−Lポリペプチドの使用に関する。抗菌剤としては、例えば、ペニシリン、セファロスポリンおよび他のβ−ラクタム、アミノ配糖体、アゾール、キロノン類、マクロライド、リファマイシン、テトラサイクリン、スルホンアミド、リンコサミド(lincosamide)およびポリミキシンの広範なクラスが挙げられる。ペニシリンは、以下を含むがこれらに限定されない:ペニシリンG、ペニシリンV、メチシリン、ナフシリン、オキサシリン、クロキサシリン、ジクロキサシリン、フロクサシリン、アンピシリン、アンピシリン/スルバクタム、アモキシリン、アモキシリン/クラブラン酸、ヘタシリン、シクラシリン(cyclacillin)、バカンピシリン、カルベニシリン、カルベニシリンインダニル(carbenicillin indanyl)、チカルシリン、チカルシリン/クラブラン酸、アズロシリン、メズロシリン、ピペラシリン(peperacillin)、およびメシリナム。セファロスポリンおよび他のβ−ラクタムとしては、以下を含むがこれらに限定されない:セファロチン、セファピリン、セファレキシン、セフラジン、セファゾリン、セファドロキシル、セファクロール、セファマンドール、セフォテタン、セフォキシチン、セルロキシム(ceruroxime)、セフォニシド、セフォラジン(ceforadine)、セフィキシム、セフォタキシム、モキサラクタム、セフチゾキシム、セトリアキソン(cetriaxone)、セフォペラゾン(cephoperazone)、セフタジジム、イミペネムおよびアズトレオナム。アミノ配糖体としては、以下を含むがこれらに限定されない:ストレプトマイシン、ゲンタマイシン、トブラマイシン、アミカシン、ネチルマイシン、カナマイシンおよびネオマイシン。アゾールとしては、フルコナゾールを含むがこれに限定されない。キノロン類としては、ナリジクス酸、ノルフロキサシン、エノキサシン、シプロフロキサシン、オフロキサシン、スパルフロキサシンおよびテマフロキサシンを含むがこれらに限定されない。マクロライドとしては、エリスロマイシン(erythomycin)、スピラマイシンおよびアジスロマイシンを含むがこれらに限定されない。リファマイシンとしては、リファンピンを含むがこれに限定されない。テトラサイクリンとしては、スピサイクリン(spicycline)、クロルテトラサイクリン、クロモサイクリン、デメクロサイクリン、デオキシサイクリン(deoxycycline)、グアメサイクリン(guamecycline)、リメサイクリン、メクロサイクリン、メタサイクリン、ミノサイクリン、オキシテトラサイクリン、ぺニメピサイクリン(penimepicycline)、ピパサイクリン、ロリテトラサイクリン、サンサイクリン、セノサイクリン(senociclin)およびテトラサイクリンを含むがこれらに限定されない。スルホンアミドとしては、スルファニルアミド、スルファメトキサゾール、スルファセタミド、スルファジアジン、スルフィソキサゾールおよびco−トリモキサゾール(トリメトプリム/スルファメトキサゾール)を含むがこれらに限定されない。リンコサミドとしては、クリンダマイシンおよびリンコマイシンを含むがこれらに限定されない。ポリミキシン(ポリペプチド)としては、ポリミキシンBおよびコリスチンを含むがこれらに限定されない。
IFN−Lポリペプチド機能のアゴニストまたはアンタゴニストは、処置される状態に適切であるように、1つ以上のサイトカイン、増殖因子、抗生物質、抗炎症剤および/または化学療法剤と組み合わせて(同時にかまたは連続的)使用され得る。
望ましくないレベルのIFN−Lポリペプチドによって引き起こされるかまたは媒介される他の疾患は、本発明の範囲内に含まれる。望ましくないレベルとしては、過剰レベルのIFN−Lポリペプチド、および正常以下(sub−normal)のレベルのIFN−Lポリペプチドが挙げられる。
(IFN−L核酸およびIFN−Lポリペプチドの使用)
本発明の核酸分子(それ自体は生物学的に活性なポリペプチドをコードしない核酸分子を含む)を使用して、IFN−L遺伝子および関連遺伝子の染色体上の位置をマッピングし得る。マッピングは、当該分野で公知の技術(例えば、PCR増幅およびインサイチュハイブリダイゼーション)により行われ得る。
本発明の核酸分子(それ自体は生物学的に活性なポリペプチドをコードしない核酸分子を含む)を使用して、IFN−L遺伝子および関連遺伝子の染色体上の位置をマッピングし得る。マッピングは、当該分野で公知の技術(例えば、PCR増幅およびインサイチュハイブリダイゼーション)により行われ得る。
IFN−L核酸分子(それ自体は生物学的に活性なポリペプチドをコードしない核酸分子を含む)は、哺乳動物組織または体液サンプル中のIFN−L核酸分子の存在について、定性的または定量的のいずれかで試験するための、診断アッセイにおけるハイブリダイゼーションプローブとして有用であり得る。
他の方法はまた、1つ以上のIFN−Lポリペプチドの活性を阻害することが所望される場合に使用され得る。このような阻害は、発現制御配列(三重らせん形成)またはIFN−L mRNAに対して、相補的かつハイブリダイズする核酸分子によりもたらされ得る。例えば、アンチセンスDNAまたはRNA分子(これらは、IFN−L遺伝子の少なくとも一部に相補的である配列を有する)は、細胞中に導入され得る。アンチセンスプローブは、本明細書中に開示されるIFN−L遺伝子の配列を使用して、利用可能な技術により設計され得る。代表的には、このようなアンチセンス分子の各々は、選択された各IFN−L遺伝子の開始部位(5’末端)に相補的である。このアンチセンス分子が次いで、対応するIFN−L mRNAにハイブリダイズする場合、このmRNAの翻訳は、防止されるかまたは低減される。アンチセンスインヒビターは、細胞または生物におけるIFN−Lポリペプチドの減少または不在に関連する情報を提供する。
あるいは、遺伝子治療を使用して、1つ以上のIFN−Lポリペプチドの優性ネガティブインヒビターを作製し得る。この状況において、各選択されたIFN−Lポリペプチドの変異体ポリペプチドをコードするDNAは、調製され得、そして本明細書中に記載されるウイルスまたは非ウイルスの方法のいずれかを使用して患者の細胞中に導入され得る。このような変異体の各々は、代表的にはその生物学的役割において内因性ポリペプチドと競合するように設計される。
さらに、IFN−Lポリペプチド(生物学的に活性でも活性でなくても)免疫原として使用され得、すなわち、これらのポリペプチドは、抗体が誘発され得る少なくとも1つのエピトープを含有する。IFN−Lポリペプチドに結合する選択的結合因子(本明細書中に記載されるような)は、インビボおよびインビトロでの診断目的のために使用され得、これらの目的としては、体液サンプルまたは細胞サンプル中のIFN−Lポリペプチドの存在を検出するための標識された形態での使用を含むが、これに限定されない。これらの抗体をまた使用して、本明細書中に列挙される疾患および障害を含む多数の疾患および障害を、予防、処置、または診断し得る。これらの抗体は、IFN−Lポリペプチドに特徴的な少なくとも1つの活性を低減するかまたは遮断するように、IFN−Lポリペプチドに結合し得るか、またはポリペプチドに結合してIFN−Lポリペプチドに特徴的な少なくとも1つの活性を増加し得る(IFN−Lポリペプチドの薬物動態を増加させることによるものを含む)。
本発明のIFN−Lポリペプチドは、発現クローニングストラテジーを使用して、IFN−Lポリペプチドレセプターをクローン化するために使用され得る。放射性標識(125I)IFN−Lポリペプチドまたはアフィニティ/活性−タグ化IFN−Lポリペプチド(例えば、Fc融合物またはアルカリホスファターゼ融合物)を、結合アッセイにおいて使用して、IFN−Lポリペプチドレセプターを発現する細胞型または細胞株または組織を同定し得る。このような細胞または組織から単離されたRNAは、cDNAに変換され得、哺乳動物発現ベクターにクローン化され、そして哺乳動物細胞(例えば、COSまたは293細胞)にトランスフェクトされて発現ライブラリーを作製する。放射性標識またはタグ化されたIFN−Lポリペプチドは、次いで、アフィニティリガンドとして使用されて、このライブラリーから、その表面上にIFN−Lポリペプチドレセプターを発現する細胞のサブセットを同定および単離し得る。DNAは、次いでこれらの細胞から単離され得、そして哺乳動物細胞にトランスフェクトされて二次発現ライブラリー(ここで、IFN−Lポリペプチドレセプターを発現する細胞の画分は、元のライブラリーよりも何倍も高い)を作製し得る。この富化プロセスは、IFN−Lポリペプチドレセプターを含有する単一の組換えクローンが単離されるまで繰り返し反復され得る。IFN−Lポリペプチドレセプターの単離は、IFN−Lポリペプチドシグナル伝達経路の新規なアゴニストおよびアンタゴニストを同定または開発するために有用である。このようなアゴニストおよびアンタゴニストとしては、可溶性IFN−Lポリペプチドレセプター、抗IFN−Lポリペプチドレセプター抗体、低分子またはアンチセンスオリゴヌクレオチドが含まれ、そしてこれらは、本明細書中に記載される疾患または障害の1つ以上を、処置、予防、または診断するために使用され得る。
pSPORT1(Gibco BRL)中にサブクローニングされ、そしてE.coli DH10B株にトランスフェクトされた、ヒトIFN−LポリペプチドをコードするcDNAの寄託(受託番号PTA−976を有する)を、1999年11月23日付けで、アメリカン タイプ カルチャー コレクション,バージニア 20110−2209,マナサス,ユニバーシティ ブールバード 10801に行った。
以下の実施例は、例示目的のみのために意図され、いかようにも、本発明の範囲を限定するとは解釈されるべきではない。
(実施例1:ラットIFN−Lポリペプチド遺伝子のクローニング)
概して、Sambrookら(前出)に記載されるような材料および方法を、ラットIFN−Lポリペプチドをコードする遺伝子をクローニングおよび分析するために使用した。
概して、Sambrookら(前出)に記載されるような材料および方法を、ラットIFN−Lポリペプチドをコードする遺伝子をクローニングおよび分析するために使用した。
ラットIFN−Lポリペプチドをコードする配列を、コンピューター支援分析(computer−assisted analysis)と組み合わせて大規模無作為cDNA配列決定によって、ラット胎盤cDNAライブラリーから単離した。ラット胎盤cDNAライブラリーを構築するために、ラット胚(17日齢)[E17]胎盤mRNAを、標準的な方法によって調製した(ChomczynskiおよびSacchi,1987,Anal.Biochem.162:156)。Superscript Plasmid cDNA kit(Gibco BRL)を使用して合成した後、ラットcDNAを、pSPORT1ベクター(Gibco BRL)のSalIおよびNotI部位にサブクローニングした。
ラットIFN−Lポリペプチドについての全長cDNAの配列分析によって、この遺伝子が、191アミノ酸のタンパク質をコードする573bpのオープンリーディングフレームを含むことが示された(図1A〜1B)。このラットIFN−Lポリペプチド配列は、シグナルペプチドを含むことが予測されている(図1A、下線によって示される推定シグナルペプチド)。ラットIFN−Lポリペプチド配列は、GenBankデータベースにおけるタンパク質配列とのラットIFN−Lポリペプチド配列の比較後に、インターフェロンタンパク質ファミリーの新規なメンバーであるとして同定された。
(実施例2:ヒトIFN−Lポリペプチド遺伝子のクローニング)
概して、Sambrookら(前出)に記載されるような材料および方法を、ヒトIFN−Lポリペプチドをコードする遺伝子をクローニングおよび分析するために使用した。
概して、Sambrookら(前出)に記載されるような材料および方法を、ヒトIFN−Lポリペプチドをコードする遺伝子をクローニングおよび分析するために使用した。
インターフェロン遺伝子ファミリーの既知のメンバーのゲノム構造を調べることによって、このファミリーのメンバーが、固有のイントロン不在(intronless)構造を共有することが明らかにされた。従って、ヒトIFN−Lポリペプチドをコードする配列を、ラットIFN−Lポリペプチド遺伝子由来のプローブを用いてヒトゲノムDNAライブラリーをスクリーニングすることによって単離した。
放射性ラットIFN−Lプローブを、ラットIFN−LポリペプチドcDNAのポリメラーゼ連鎖反応(PCR)増幅によって作製した。ポリメラーゼ連鎖反応(PCR)を、Perkin−Elmer 9600サーモサイクラー(PE Biosystems,Foster City,CA)および以下の反応条件を使用して実施した:20ngのラットIFN−LポリペプチドcDNA、各々20pmolのプライマー1795−01(5’−A−T−G−A−C−A−C−T−G−A−A−G−T−A−T−T−T−A−T−G−G−3’;配列番号20)および1795−02(5’−A−T−T−C−A−T−G−T−T−G−A−G−T−A−G−T−T−T−G−T−A−3’;配列番号21)、各々1mmolのdATP,dTTP,dGTP、0.01mmolのdCTP、100μCiの32P−dCTP、4mMのMgCl2、1×PCR緩衝液、ならびに5UのTaqポリメラーゼ(PE Biosystems)。「コールド(cold)」PCR反応(すなわち、放射性標識化dCTPの存在下において実施されず、かつ平衡状態のdNTP混合物を使用する反応)を、標識化反応と同時に調製した。増幅反応を、94℃で30秒間、60℃で30秒間、および72℃で1分間の45サイクルで実施した。プールされた標識化および非標識化のプローブを、Quick Spin G−50カラム(Qiagen)を使用して精製し、100℃で10分間煮沸し、そして氷上にて20分間冷却し、次いで、ハイブリダイゼーション溶液に添加した。少なくとも5×10⁵cpm/μLの特異的活性を有するプローブを、この方法を使用して作製した。
ヒトIFN−Lポリペプチドをコードする配列を、ヒトλゲノムDNAライブラリー(Stratagene,カタログ番号946206)をスクリーニングすることによって単離した。一次スクリーニングのために、1×10⁶個のクローンを、50,000コロニー/プレートの密度でプレーティングし、そして標準的な技術を使用して、ニトロセルロースフィルターに転写した。ポジティブクローンを、分析前に再スクリーニングした。
ラットIFN−Lプローブを、30%ホルムアミド、5×SSC、2×デンハルト溶液、10μg/mLのサケ精子DNA、0.2%SDS、2mM EDTA、および0.1%ピロリン酸塩中において42℃で一晩、このフィルターにハイブリダイズさせた。ハイブリダイゼーション後、フィルターを、1×SSCおよび0.1%SDS中において室温で30〜60分間洗浄し、次いで、0.2×SSCおよび0.1%SDS中において55℃で15分間洗浄した。
3個のポジティブクローンを、一次スクリーニングおよび二次スクリーニングの後に回収し、そして、λファージDNAを、固体プレート培養方法によって調製した。NotI挿入物を、このクローンから切り出し、そしてpSPORT1(GibcoBRL)中に連結し、そして引き続き、これらの連結物を使用して、E.coli DH10株を形質転換した。形質転換後、プラスミドを、Spin Column plasmid prep kit(Qiagen)を使用して回収した。
3個のポジティブゲノムDNAクローン由来のプラスミドを、ゲノムDNAライブラリースクリーニングにおいて利用したラットIFN−Lプローブを使用するサザンブロット分析によって分析した。回収したプラスミドDNAをHindIIIで消化した後、消化されたフラグメントを、アガロースゲルにおいて分解し、次いで、ナイロンメンブレンに転写した。ハイブリダイゼーション条件は、ゲノムDNAライブラリースクリーニングにおいて利用された条件と同一であった。サザンブロット分析によって、3個のポジティブゲノムクローンが、同一のゲノム挿入物を含む可能性が高いことが示された。ラットIFN−Lプローブとハイブリダイズするフラグメントを、引き続き、配列決定分析のために、pSPORT1中にサブクローニングした。この分析によって、3個のポジティブゲノムDNAクローンが、同一のゲノム挿入物を含むことが確認された。
ヒトIFN−Lポリペプチドをコードする配列を含む3個のゲノムクローンの配列分析によって、この遺伝子が、207アミノ酸のタンパク質をコードする621pbのオープンリーディングフレームを含むことが示された(図2A〜2B)。このヒトIFN−Lポリペプチド配列は、シグナルペプチドを含むことが予測された(図2A、下線によって示される推定シグナルペプチド)。IFN−Lポリペプチドの配列分析は、このタンパク質が、分泌されるサイトカイン分子であることを強く示唆している。
64%の類似性が、ヒトIFN−L遺伝子のオープンリーディングフレームとラットIFN−L cDNAのオープンリーディングフレームとの間で観察された。図3は、ヒトIFN−Lポリペプチド(配列番号2)と、ヒトIFN−β(配列番号7)と、ラットIFN−Lポリペプチド(配列番号4)とのアミノ酸配列アラインメントを示す。ヒトIFN−Lポリペプチドは、ヒトIFN−βに対して30%同一性である。ヒトIFN−Lポリペプチドは、ラットIFN−Lポリペプチドに対して40.5%同一性であり、そして50%類似性である。ヒトIFN−Lポリペプチド中の5つすべての推定システイン残基は、ラットIFN−Lポリペプチド中のそれらのシステイン残基と完全に一致する。
(実施例3:IFN−L mRNA発現)
IFN−L mRNAの発生的発現パターンを、いくつかの異なる段階のマウスおよびラットの胚においてIFN−Lポリペプチド転写物の存在を検出するための32P−標識化全長ラットcDNAプローブを使用するノーザンブロット分析によって決定した。ラット胎盤cDNAライブラリーの構築のために使用されたのと同じ技術を使用して、ラットおよびマウスの胚からRNAを単離した。ノーザンブロットを、40%ホルムアミド、5×SSC、1mM EDTA,および0.1%中において、42℃にて4時間、プレハイブリダイゼーションした。このブロットを、ラットIFN−Lプローブを添加したことを除いて同じ溶液中において、42℃にて一晩ハイブリダイズさせた。ハイブリダイゼーション後、ブロットを、1×SSCおよび0.1%SDS中において60℃にて30分間洗浄した。
IFN−L mRNAの発生的発現パターンを、いくつかの異なる段階のマウスおよびラットの胚においてIFN−Lポリペプチド転写物の存在を検出するための32P−標識化全長ラットcDNAプローブを使用するノーザンブロット分析によって決定した。ラット胎盤cDNAライブラリーの構築のために使用されたのと同じ技術を使用して、ラットおよびマウスの胚からRNAを単離した。ノーザンブロットを、40%ホルムアミド、5×SSC、1mM EDTA,および0.1%中において、42℃にて4時間、プレハイブリダイゼーションした。このブロットを、ラットIFN−Lプローブを添加したことを除いて同じ溶液中において、42℃にて一晩ハイブリダイズさせた。ハイブリダイゼーション後、ブロットを、1×SSCおよび0.1%SDS中において60℃にて30分間洗浄した。
IFN−L mRNAの発現を、標準的な技術を使用するRT−PCRによって、種々のヒト組織において試験した。ヒトIFN−L mRNAは、膵臓、小腸、前立腺、子宮、甲状腺および胎盤において検出された。
IFN−L mRNAの発現を、インサイチュハイブリダイゼーションによって局在化した。正常胚および成体マウス組織のパネルを4%パラホルムアミド中で固定し、パラフィンに包埋し、そして5μmに切片化した。切片化した組織を、0.2M HCl中で透過化処理し、プロテイナーゼKで消化し、そしてトリエタノールアミンおよび無水酢酸でアセチル化した。切片を、ハイブリダイゼーション溶液(300mM NaCl、20mM Tris−HCl、pH8.0,5mM EDTA、1×デンハルト溶液、0.2% SDS、10mM DTT、0.25mg/ml tRNA、25μg/ml ポリA,25μg/ml ポリCおよび50%ホルムアミド)中で1時間60℃でプレハイブリダイズし、次いで、10%デキストランおよび2×10⁴cpm/μlの33P−標識アンチセンスリボプローブ(ヒトIFN−L遺伝子に相補的)を含有する同じ溶液中で60℃で一晩ハイブリダイズする。標準的技術を用いて、ヒトIFN−L cDNA配列を含有するクローンのインビトロ転写によって、このリボプローブを得る。
ハイブリダイゼーション後、切片を、ハイブリダイゼーション溶液中でリンスし、RNaseAで処理してハイブリダイズしていないプローブを消化し、次いで0.1×SSC中で55℃で30分間洗浄する。次いで、切片をNTB−2エマルジョン(Kodak,Rochester,NY)に浸し、4℃に3週間曝し、発色させ、そしてヘマトキシリンおよびエオシンで対比染色する。組織形態学およびハイブリダイゼーションシグナルを、脳(矢状断面1つおよび冠状断面2つ)、胃腸管(食道、胃、十二指腸、空腸、回腸、近位結腸、および遠位結腸)、下垂体、肝臓、肺、心臓、脾臓、胸腺、リンパ節、腎臓、副腎、膀胱、膵臓、唾液腺、雄性および雌性生殖器(雌性の卵巣、卵管、および子宮;ならびに雄性の精巣、精巣上体、前立腺、精嚢および輸精管)、BATおよびWAT(皮下、腎臓周囲)、骨(大腿)、皮膚、乳房、および骨格筋についての暗野かつ標準のイルミネーションによって同時に分析する。
(実施例4:IFN−Lポリペプチドの生成)
(A.細菌におけるIFN−Lポリペプチドの発現)
PCRを用いて、ヒトまたはラットのいずれかのIFN−LポリペプチドをコードするテンプレートDNA配列を、この配列の5’および3’末端に対応するプライマー(表1)を用いて増幅し、これは、増幅したDNA産物の発現ベクター内への挿入を可能にするために制限酵素部位を組み込んだ。増幅後に、PCR産物をゲル精製し、適切な制限酵素で消化し、そして標準的な組換えDNA技術を用いて発現ベクターpAMG21(ATCC番号98113)へ連結した。PCRインサートとベクター配列の連結後、連結反応混合物を使用して、エレクトロポレーションによってE.coli宿主株(例えば、Amgen株番号2596)中に形質転換し、そして形質転換体をカナマイシン薬物耐性について選択した。選択したコロニー由来のプラスミドDNAを、単離し、そしてDNA配列決定に供して適切なインサート(挿入物)の存在を確認した。
ラットIFN−Lポリペプチド細菌発現ベクターを構築するために、IFN−L核酸配列をプライマー1825−22および1825−21を用いてcDNAテンプレートから増幅した。これらのプライマーによる増幅後に得られたPCR産物を、pAMG21のNde I部位およびBam HI部位に挿入し、次いで連結反応を細菌形質転換において用いた。得られた細菌クローンをAmgen株番号3729と名付けた。図4は、Amgen株番号3729のpAMG21インサートのヌクレオチド配列およびこのインサートによってコードされる予測アミノ酸配列を示す。
ラットIFN−Lポリペプチド細菌発現ベクター(ここでは、位置180のシステインがセリン残基で置換された)を、プライマー1825−22および1909−56を用いて構築した。これらのプライマーによる増幅後得られたPCR産物を、pAMG21のNde I部位およびBam HI部位に挿入し、次いで連結反応を細菌形質転換において用いた。
得られた細菌クローンをAmgen株番号3858と名付けた。図5は、Amgen株番号3858のpAMG21インサートのヌクレオチド配列およびこのインサートによってコードされる予測アミノ酸配列を示す。
ヒトIFN−Lポリペプチド細菌発現ベクターを構築するために、IFN−L核酸配列をプライマー1967−32および1982−14を用いてcDNAテンプレートから増幅した。これらのプライマーによる増幅後に得られたPCR産物を、pAMG21のXba I部位およびBam HI部位に挿入し、次いで連結反応を細菌形質転換において用いた。得られた細菌クローンをAmgen株番号4047と名付けた。図6は、Amgen株番号4047のpAMG21インサートのヌクレオチド配列およびこのインサートによってコードされる予測アミノ酸配列を示す。
ヒトIFN−Lポリペプチド細菌発現ベクター(ここでは、位置193のシステインがセリン残基で置換された)を、プライマー1967−32および1967−33を用いて構築した。これらのプライマーによる増幅後得られたPCR産物を、pAMG21のXba I部位およびBam HI部位に挿入し、次いで連結反応を細菌形質転換において用いた。得られた細菌クローンをAmgen株番号3969と名付けた。図7は、Amgen株番号3969のpAMG21インサートのヌクレオチド配列およびこのインサートによってコードされる予測アミノ酸配列を示す。
ヒトIFN−LポリペプチドのN末端改変を発現しているヒトIFN−Lポリペプチド細菌発現ベクターを、プライマー1967−32および1967−33によって株番号4047からプラスミドを増幅することによって構築した。これらのプライマーによる増幅後得られたPCR産物を、pAMG21のNde I部位およびBam HI部位に挿入し、次いで連結反応を細菌形質転換において用いた。得られた細菌クローンをAmgen株番号4182と名付けた。図8は、Amgen株番号4182のpAMG21インサートのヌクレオチド配列およびこのインサートによってコードされる予測アミノ酸配列を示す。
IFN−Lポリペプチドを生成するために、形質転換された宿主細胞を、まず、IFN−Lポリペプチドの導入前に、50μg/mLのカナマイシンを含有するTerrific Broth培地で30℃でインキュベートする。IFN−Lポリペプチドの発現を、30ng/mLのN−(3−オキソヘキサノイル)−dl−ホモセリンラクトンの添加、それに続く30℃かまたは37℃での6時間のインキュベーションによって、誘導した。IFN−Lポリペプチドの発現を、培養物、細菌ペレットの再懸濁および溶解物の遠心分離、ならびに、SDSポリアクリルアミドゲル電気泳動による宿主細胞タンパク質の分析によって評価した。
E.coliが産生したIFN−Lポリペプチドに相当する、SDSポリアクリルアミドゲル上の単一のバンドを、ゲルから切り出し、そしてN末端アミノ酸配列を、本質的にMatsudairaら、1987,J.Biol.Chem.262:10〜35に記載のように決定した。
IFN−Lポリペプチドを、以下の通り精製した。まず、細胞を高圧均質化によって、水中で溶解し、封入体を遠心分離によって収集した。次いで、可溶化した封入体を種々の折り畳み(refold)条件に供した。
(B.IFN−Lポリペプチド哺乳動物発現ベクターの構築)
ヒトとラットの両方のIFN−Lポリペプチドのネイティブタンパク質およびネイティブタンパク質Fc融合バージョンを、CHOか293のいずれかの哺乳動物発現系において生成した。IFN−LポリペプチドをコードするテンプレートDNA配列を、5’および3’末端に対応するプライマーを用いてPCRによって増幅した(表2)。
ヒトとラットの両方のIFN−Lポリペプチドのネイティブタンパク質およびネイティブタンパク質Fc融合バージョンを、CHOか293のいずれかの哺乳動物発現系において生成した。IFN−LポリペプチドをコードするテンプレートDNA配列を、5’および3’末端に対応するプライマーを用いてPCRによって増幅した(表2)。
IFN−Lポリペプチド発現ベクターを構築するために、IFN−L核酸配列を以下に記載するように増幅した。ラットIFN−L核酸配列を3つのプライマーの対の1つ(順方向プライマー1847−77、および1847−88、1896−56、または1896−57のいずれか)を用いて得た。ラットIFN−LポリペプチドFc融合構築物を、第1のセットのプライマー(これは、Hind IIIおよびNot Iクローニング部位を取り込み、そして終止コドンを取り込まなかった)で調製されたPCR産物をクローニングすることによって生成した。第2のセットのプライマー(これは、Hind IIIおよびSal Iクローニング部位ならびに2つの終止コドンを組み込んだ)で調製されたPCR産物を、pDSRαにクローニングすることによって、または第3のセットのプライマー(これは、Hind IIIおよびNot Iクローニング部位ならびに2つの終止コドンを組み込んだ)で調製されたPCR産物を、pDSR4にクローニングすることによって、ラットIFN−L可溶ポリペプチドを生成した。
ヒトIFN−L核酸配列を、3つのプライマーの対の1つ(順方向1854−48および1854−49、および順方向プライマー1855−44、および1854−45または1854−46のいずれか)を用いて得た。ヒトIFN−LポリペプチドFc融合構築物を、第1のセットのプライマー(これは、Not Iクローニング部位を取り込み、そして終止コドンを取り込まなかず、そして第Xa因子切断部位を取り込んだ)で調製されたPCR産物をクローニングすることによって生成した。第2のセットのプライマー(これは、Hind IIIおよびSal Iクローニング部位ならびに2つの終止コドンを組み込んだ)で調製されたPCR産物を、pDSRαにクローニングすることによって、または第3のセットのプライマー(これは、Hind IIIおよびNot Iクローニング部位ならびに2つの終止コドンを組み込んだ)で調製されたPCR産物を、pDSR4にクローニングすることによって、ヒトIFN−L可溶ポリペプチドを生成した。第2の順方向プライマー(1954−47)をまた、1955−44の代わりに使用し、2つの開始コドンを保有する構築物を生成した。
PCR増幅を、Perkin−Elmer 9600サーモサイクラーおよび以下の反応条件を用いて実施した:ラットまたはヒトIFN−LポリペプチドcDNA20ng、各適切なプライマー20pmol、dNTP 1mmol、MgCl2 4mM、1×PCR緩衝液、およびTaqポリメラーゼ 5U(PE Biosystems)。増幅反応を、94℃で30秒間、50℃で30秒間、および72℃で1分間4サイクルの間実施し、続いて94℃で30秒間、55℃で30秒間、そして72℃で1分間26サイクルの間実施した。
PCR産物をQiagen PCR精製スピンカラムを用いて精製し、次いで、適切な制限エンドヌクレアーゼによる消化に供した。消化後、フラグメントをアガロースゲル上で分離し、Qiagenゲル精製スピンカラムを用いて精製し、そして適切なベクターに連結した。連結物を、E.coli株DH10に形質転換した。選択された形質転換株の配列分析後、大規模なプラスミド貯蔵物を、組織培養トランスフェクションのために調製した。
(C.哺乳動物細胞におけるIFN−Lポリペプチドの発現および精製)
リポフェクチンまたはリン酸カルシウムプロトコールのいずれかを用いて、293 EBNA細胞またはCHO細胞中に、IFN−Lポリペプチド発現構築物を導入した。
リポフェクチンまたはリン酸カルシウムプロトコールのいずれかを用いて、293 EBNA細胞またはCHO細胞中に、IFN−Lポリペプチド発現構築物を導入した。
生成されるIFN−Lポリペプチドに対する機能的研究を行うため、ハイグロマイシン選択293 EBNAクローニングのプールから大量の馴化培地を生成した。この細胞を500cm Nunc Triple Flasks中で、80%コンフルエンスになるまで培養し、その後、培地を回収する1週間前に無血清培地に切り換えた。馴化培地を回収し、そして精製まで−20℃に凍結した。
馴化培地を下記のとおり、アフィニティークロマトグラフィーによって精製する。この培地を解凍し、次いで0.2μmフィルターに通した。プロテインGカラムをPBSでpH7.0に平衡化し、次いで濾過した培地をロードした。このカラムをA280の吸収がベースラインに達するまでPBSで洗浄した。0.1M Glycine−HClを用いてpH7.2でIFN−Lポリペプチドを、カラムから溶出し、直ちに1M Tris−HClを用いてpH8.5で中和した。IFN−Lポリペプチドを含有する画分をプールし、PBS中で透析し、そして−70℃で貯蔵した。
ヒトIFN−Lポリペプチド−Fc融合ポリペプチドの第Xa因子切断について、アフィニティークロマトグラフィー精製したタンパク質を、50mM Tris−HCl、100mM NaCl、2mM CaCl2中でpH8.0で透析する。制限プロテアーゼ第Xa因子を、透析したタンパク質に1/100(w/w)で添加し、そしてこのサンプルを室温で一晩消化した。
(実施例5:IFN−Lポリペプチドの生物学的活性)
IFN−Lポリペプチドのリン酸化を、以下のようにアッセイした。細胞株を、実施例4Cにおいて生成したラットIFN−L Fc融合ポリペプチド1μg/mLか、またはコントロール溶液に、37℃で15分間暴露した。IFN−Lポリペプチド暴露後、細胞を溶解し、そして細胞タンパク質を回収し、そしてSDS−PAGEによって分離した。次いで、分離したタンパク質を抗pTyr抗体を用いてウエスタンブロットによって分析した。いくつかの細胞株は、IFN−L Fc融合ポリペプチドへの暴露後、細胞タンパク質リン酸化において増加を示した。
IFN−Lポリペプチドのリン酸化を、以下のようにアッセイした。細胞株を、実施例4Cにおいて生成したラットIFN−L Fc融合ポリペプチド1μg/mLか、またはコントロール溶液に、37℃で15分間暴露した。IFN−Lポリペプチド暴露後、細胞を溶解し、そして細胞タンパク質を回収し、そしてSDS−PAGEによって分離した。次いで、分離したタンパク質を抗pTyr抗体を用いてウエスタンブロットによって分析した。いくつかの細胞株は、IFN−L Fc融合ポリペプチドへの暴露後、細胞タンパク質リン酸化において増加を示した。
(実施例6:抗IFN−Lポリペプチド抗体の生成)
IFN−Lポリペプチドに対する抗体を、生物学的合成または化学的合成によって生成した、精製タンパク質またはIFN−Lペプチドを用いて免疫することによって獲得し得る。抗体を生成するための適切な手順は、HudsonおよびBay、Practical Immunology(第二版、Blackwell Scientific Pubilication)に記載の手順を含む。
IFN−Lポリペプチドに対する抗体を、生物学的合成または化学的合成によって生成した、精製タンパク質またはIFN−Lペプチドを用いて免疫することによって獲得し得る。抗体を生成するための適切な手順は、HudsonおよびBay、Practical Immunology(第二版、Blackwell Scientific Pubilication)に記載の手順を含む。
抗体生成のための1つの手順において、動物(代表的には、マウスまたはウサギ)に、IFN−L抗原(例えば、IFN−Lポリペプチド)を注射し、そして、ハイブリドーマ産生のため、ELISAによって決定した十分な血清力価レベルを有する動物を、選択する。免疫した動物の脾臓を回収し、そして単一細胞懸濁液として調製し、これから脾臓細胞を回収する。脾臓細胞をマウスミエローマ細胞(例えば、Sp2/0−Ag14細胞)に融合し、DMEM(200U/mLペニシリン、200μg/mL硫酸ストレプトマイシン、および4mMグルタミン含有)中でまずインキュベートし、次いで、HAT選択培地(ヒポキサンチン、アミノプテリンおよびチミジン)中でインキュベートする。選択後、組織培養上清を各融合ウェルから取り出し、そしてELISAによって、抗IFN−L抗体産生について試験する。
抗IFN−Lを得るため、別の手順をまた、使用し得る。この手順は例えば、ヒト抗体の生成のためのヒトIg遺伝子座を保有するトランスジェニックマウスの免疫、および合成抗体ライブラリー(例えば、抗体可変ドメインの変異誘発によって生成されるライブラリーなど)のスクリーニングである。
(実施例7:トランスジェニックマウスにおけるIFN−Lポリペプチドの発現)
IFN−Lポリペプチドの生物学的活性を評価するため、肝臓特異的ApoEプロモーターの制御下で、IFN−Lポリペプチド/Fc融合タンパク質をコードする構築物を調製する。この構築物の送達により、IFN−Lポリペプチドの機能に関する情報である、病理的変化を生じることが期待される。同様に、βアクチンプロモーターの制御下で、全長IFN−Lポリペプチドを含む構築物を調製する。この構築物の送達により、偏在性発現を生じることが期待される。
IFN−Lポリペプチドの生物学的活性を評価するため、肝臓特異的ApoEプロモーターの制御下で、IFN−Lポリペプチド/Fc融合タンパク質をコードする構築物を調製する。この構築物の送達により、IFN−Lポリペプチドの機能に関する情報である、病理的変化を生じることが期待される。同様に、βアクチンプロモーターの制御下で、全長IFN−Lポリペプチドを含む構築物を調製する。この構築物の送達により、偏在性発現を生じることが期待される。
これらの構築物を生成するために、PCRを用いて、所望の配列の5’および3’末端に対応し、そしてプライマーを用いてIFN−LポリペプチドをコードするテンプレートDNA配列を増幅し、そしてこの配列は、発現ベクター内への増幅産物の挿入を可能にするために制限酵素部位を組み込む。増幅後、PCR産物をゲル精製し、適切な制限酵素で消化し、そして標準的組み換えDNA技術を用いて発現ベクター中に連結する。例えば、増幅したIFN−Lポリペプチド配列を、Grahamら、1997、Nature Genetics,17:272〜74およびRayら,1991 Genes Dev.5:2265〜73に記載のように、ヒトβアクチンプロモーターの制御下で発現ベクター中にクローニングし得る。
連結(ライゲーション)後、反応混合物を用いて、E.coli宿主株をエレクトロポレーションによって形質転換し、そして形質転換体を、薬物耐性について選択する。選択したコロニー由来のプラスミドDNAを単離して、DNA配列決定に供し、適切なインサートの存在および変異が存在しないことを確認する。IFN−Lポリペプチド発現ベクターを、2回のCsCl密度勾配遠心分離を通じて精製し、適切な制限酵素で切断し、そして、IFN−Lポリペプチド導入遺伝子を含有する直線フラグメントを、ゲル電気泳動によって精製する。精製したフラグメントを、5mM Tris(pH7.4)および0.2mM EDTA中で、2mg/mLの濃度で、再懸濁する。
BDF1×BDF1交配マウス由来の単一細胞胚を、記載(PCT公開番号WO97/23614)のように注射する。胚を、CO2インキュベーター中で一晩培養し、そして15〜20の2細胞胚を偽妊娠CD1雌性マウスの卵管に移す。マイクロインジェクションした胚の着床から得た子孫を、以下のように、ゲノムDNAサンプル中に取り込んだ導入遺伝子のPCR増幅でスクリーニングする。耳切片を20mLの耳緩衝液(20mM Tris,pH8.0,10mM EDTA、0.5% SDS、および500mg/mL プロテイナーゼK)中で、55℃で一晩消化する。次いで、このサンプルを200mLのTEで希釈し、そして2mLの耳サンプルを、適切なプライマーを用いるPCR反応中で用いる。
8週齢で、トランスジェニック創始動物およびコントロール動物を、剖検および病理分析のため、屠殺する。脾臓の一部を取り出し、そしてTotal RNA Extraction Kit(Qiagen)を用いて、脾臓から、総細胞RNAを単離し、そして導入遺伝子発現を、RT−PCRによって決定する。脾臓から回収したRNAを、以下のように、SuperScriptTMPreamplification System(Gibco−BRL)を用いてcDNAに変換する。適切なプライマー(発現ベクター配列に位置し、そしてIFN−Lポリペプチド導入遺伝子の3’側である)を用いて、導入遺伝子転写物からcDNA合成をプライムする。トランスジェニック創始動物およびコントロール由来の10mgの総脾臓RNAを、1mMのプライマーとともに、10分間70℃でインキュベートし、そして氷上に置く。次いで、反応物に、10mM Tris−HCl、pH8.3、50mM KCl、2.5mM MgCl2、10mMの各dNTP、0.1mM DTT、および200UのSuperScriptII逆転写酵素を補充する。42℃で50分間のインキュベーション後、72℃で15分間加熱することによって反応を停止し、2UのRNase Hを用いて20分間37℃で消化する。次いで、サンプルをIFN−Lポリペプチドに特異的なプライマーを用いるPCRによって増幅する。
(実施例8:トランスジェニックマウスにおけるIFN−Lポリペプチドの生物学的活性)
安楽死の前に、トランスジェニック動物を計量し、イソフルオロラン(isofluorane)によって麻酔し、そして心臓穿刺によって採血する。サンプルを、血液学および血清化学分析に供する。X線撮影を、最終的な放血後に行う。肉眼での解剖の際に、主な内臓器官を、重量分析に供する。
安楽死の前に、トランスジェニック動物を計量し、イソフルオロラン(isofluorane)によって麻酔し、そして心臓穿刺によって採血する。サンプルを、血液学および血清化学分析に供する。X線撮影を、最終的な放血後に行う。肉眼での解剖の際に、主な内臓器官を、重量分析に供する。
肉眼での解剖後、組織(すなわち、肝臓、脾臓、膵臓、胃、胃腸管全体、腎臓、生殖器官、皮膚および乳腺、骨、脳、心臓、肺、胸腺、気管、食道、甲状腺、副腎、膀胱、リンパ節および骨格筋)を取出し、そして10%緩衝化Zn−ホルマリン中で組織学的検査のために固定する。固定後、組織をパラフィンブロック中で処理し、そして3mmの切片を得る。全ての切片を、ヘマトキシリンおよびエオシンで染色し、次いで組織学的分析に供する。
トランスジェニックマウスおよびコントロールマウスの両方の脾臓、リンパ節およびパイアー斑を、以下の通りにB細胞特異的抗体およびT細胞特異的抗体による免疫組織学的分析に供する。ホルマリンで固定したパラフィン包埋切片を脱パラフィン処理し、そして脱イオン水中で水和する。切片を3%過酸化水素でクエンチし、Protein Block(Lipshaw,Pittsburgh,PA)でブロックし、そしてラットモノクローナル抗マウスB220およびCD3(Harlan,Indianapolis,IN)中でインキュベートする。抗体結合を、色素原(chromagen)としてDAB(BioTek,Santa Barbara,CA)を用いて、ビオチン化ウサギ抗ラット免疫グロブリンおよびペルオキシダーゼ結合体化ストレプトアビジン(BioGenex,San Ramon,CA)によって検出する。切片を、ヘマトキシリンで対比染色する。
剖検後、トランスジェニック動物およびコントロールの同腹仔由来の脾臓および胸腺のMLNおよび切片を取出す。シリンジの平らな末端を用いて100mmナイロン性細胞ストレーナー(Becton Dickinson,Franklin Lakes,NJ)の底に対してこの組織を穏やかに粉砕することによって単細胞懸濁物を調製する。細胞を2回洗浄し、計数し、次いで各組織由来の約1×10⁶細胞を、20μL容量において0.5μg CD16/32(FcγIII/II)Fcブロックで10分間インキュベートする。次いで、サンプルを、FITCまたはPEに結合体化した、CD90.2(Thy−1.2)、CD45R(B220)、CD11b(Mac−1)、Gr−1、CD4またはCD8に対するモノクローナル抗体(PharMingen,San Diego,CA)の0.5μg抗体を有する、100μL容量のPBS(Ca+およびMg+を欠く)、0.1%ウシ血清アルブミンおよび0.01%アジ化ナトリウム中で2〜8℃で30分間染色する。抗体結合後、細胞を洗浄し、次いでFACScan(Becton Dickinson)でのフローサイトメトリーによって分析する。
本発明を好ましい実施形態に関して記載してきたが、改変および修飾が当業者に思い浮かぶことが理解される。それゆえ、添付の特許請求の範囲が、特許請求される本願発明の範囲内に入る全てのこのような等価な改変物を包含することが意図される。
Claims (56)
- 単離された核酸分子であって、以下:
(a)配列番号1または配列番号4のいずれかに示されるヌクレオチド配列;
(b)ATCC受託番号PTA−976中のDNAインサートのヌクレオチド
配列;
(c)配列番号2または配列番号5のいずれかに示されるポリペプチドをコー
ドするヌクレオチド配列;
(d)(a)〜(c)のいずれかの相補体に、中程度または高度にストリンジェントな条件下でハイブリダイズするヌクレオチド配列;および
(e)(a)〜(c)のいずれかに相補的なヌクレオチド配列、
からなる群より選択されるヌクレオチド配列を含む、単離された核酸分子。 - 単離された核酸分子であって、以下:
(a)配列番号2または配列番号5のいずれかに示されるポリペプチドに少なくとも約70%同一であるポリペプチドをコードするヌクレオチド配列であって、ここで、該コードされたポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、ヌクレオチド配列;
(b)配列番号1、もしくは配列番号4のいずれかに示されるヌクレオチド配列、ATCC受託番号PTA−976中のDNAインサートのヌクレオチド配列、または(a)の、対立遺伝子改変体またはスプライス改変体をコードするヌクレオチド配列;
(c)少なくとも約25アミノ酸残基のポリペプチドフラグメントをコードする、配列番号1、もしくは配列番号4のいずれかのヌクレオチド配列、ATCC受託番号PTA−976中のDNAインサート、(a)または(b)の領域であって、ここで、該ポリペプチドフラグメントは、配列番号2、もしくは配列番号5のいずれかに示されるコードされたポリペプチドの活性を有するか、または抗原性である、領域;
(d)少なくとも約16ヌクレオチドのフラグメントを含む、配列番号1、もしくは配列番号4のいずれかのヌクレオチド配列、ATCC受託番号PTA−976中のDNAインサート、または(a)〜(c)いずれかの領域;
(e)中程度または高度にストリンジェントな条件下で、(a)〜(d)のいずれかの相補体にハイブリダイズする、ヌクレオチド配列;ならびに
(f)(a)〜(d)のいずれかに相補的なヌクレオチド配列、
からなる群より選択されるヌクレオチド配列を含む、単離された核酸分子。 - 単離された核酸分子であって、以下;
(a)少なくとも1つの保存的アミノ酸置換を有する配列番号2または配列番号5のいずれかに示されるポリペプチドをコードするヌクレオチド配列であって、ここで、該コードされたポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、ヌクレオチド配列;
(b)少なくとも1つのアミノ酸挿入を有する配列番号2または配列番号5のいずれかに示されるポリペプチドをコードするヌクレオチド配列であって、ここで、該コードされたポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、ヌクレオチド配列;
(c)少なくとも1つのアミノ酸欠失を有する配列番号2または配列番号5のいずれかに示されるポリペプチドをコードするヌクレオチド配列であって、ここで、該コードされたポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、ヌクレオチド配列;
(d)C末端短縮および/またはN末端短縮を有する配列番号2または配列番号5のいずれかに示されるポリペプチドをコードするヌクレオチド配列であって、ここで、該コードされたポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、ヌクレオチド配列;
(e)アミノ酸置換、アミノ酸挿入、アミノ酸欠失、C末端短縮、およびN末端短縮からなる群より選択される少なくとも1つの改変を有する配列番号2または配列番号5のいずれかに示されるポリペプチドをコードするヌクレオチド配列であって、ここで、該コードされたポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、ヌクレオチド配列;
(f)少なくとも約16ヌクレオチドのフラグメントを含む(a)〜(e)のいずれかのヌクレオチド配列;
(g)中程度または高度にストリンジェントな条件下で、(a)〜(f)のいずれかの相補体にハイブリダイズする、ヌクレオチド配列;ならびに
(h)(a)〜(e)のいずれかに相補的なヌクレオチド配列、
からなる群より選択されるヌクレオチド配列を含む、単離された核酸分子。 - 請求項1、請求項2または請求項3のいずれかに記載の核酸分子を含む、ベクター。
- 請求項4に記載のベクターを含む、宿主細胞。
- 真核生物細胞である、請求項5に記載の宿主細胞。
- 原核生物細胞である、請求項5に記載の宿主細胞。
- IFN−Lポリペプチドを産生するためのプロセスであって、該ポリペプチドを発現するために適切な条件下で請求項5に記載の宿主細胞を培養する工程、および必要に応じて、該培養物から該ポリペプチドを単離する工程を包含する、プロセス。
- 請求項8に記載のプロセスによって産生される、ポリペプチド。
- 請求項8に記載のプロセスであって、ここで、前記核酸分子が、IFN−LポリペプチドをコードするDNAに作動可能に連結された、ネイティブなIFN−Lポリペプチドに対するプロモーターDNA以外のプロモーターDNAを含む、プロセス。
- 請求項2に記載の単離された核酸分子であって、ここで、同一性パーセントは、GAP、BLASTN、FASTA、BLASTA、BLASTX、BestFit、およびSmith−Watermanアルゴリズムからなる群より選択されるコンピュータープログラムを用いて決定される、単離された核酸分子。
- 化合物がIFN−Lポリペプチド活性またはIFN−Lポリペプチド産生を阻害するか否かを決定するためのプロセスであって、請求項5、請求項6、または請求項7のいずれかに記載の細胞を該化合物に曝露する工程、および該細胞におけるIFN−Lポリペプチド活性またはIFN−Lポリペプチド産生を測定する工程を包含する、プロセス。
- 単離されたポリペプチドであって、以下:
(a)配列番号2または配列番号5のいずれかに示されるアミノ酸配列;および
(b)ATCC受託番号PTA−976中のDNAインサートによってコードされるアミノ酸配列、
からなる群より選択されるアミノ酸配列を含む、単離されたポリペプチド。 - 単離されたポリペプチドであって、以下:
(a)配列番号3または配列番号6のいずれかに示されるアミノ酸配列であって、必要に応じてアミノ末端メチオニンをさらに含む、アミノ酸配列;
(b)配列番号2または配列番号5のいずれかのオルソログに対するアミノ酸配列;
(c)配列番号2または配列番号5のいずれかのアミノ酸配列に少なくとも約70%同一であるアミノ酸配列であって、ここで、該ポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、アミノ酸配列;
(d)少なくとも約25アミノ酸残基を含む配列番号2または配列番号5のいずれかに示されるアミノ酸配列のフラグメントであって、ここで、該フラグメントは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有するか、または抗原性である、フラグメント;ならびに
(e)配列番号2、もしくは配列番号5のいずれかに示されるアミノ酸配列、ATCC受託番号PTA−976中のDNAインサートによってコードされるアミノ酸配列、または(a)〜(c)のいずれかの、対立遺伝子改変体またはスプライス改変体のアミノ酸配列、
からなる群より選択されるアミノ酸配列を含む、単離されたポリペプチド。 - 単離されたポリペプチドであって、以下:
(a)少なくとも1つの保存的アミノ酸置換を有する配列番号2または配列番号5のいずれかに示されるアミノ酸配列であって、ここで、該ポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、アミノ酸配列;
(b)少なくとも1つのアミノ酸挿入を有する配列番号2または配列番号5のいずれかに示されるアミノ酸配列であって、ここで、該ポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、アミノ酸配列;
(c)少なくとも1つのアミノ酸欠失を有する配列番号2または配列番号5のいずれかに示されるアミノ酸配列であって、ここで、該ポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、アミノ酸配列;
(d)C末端短縮および/またはN末端短縮を有する配列番号2または配列番号5のいずれかに示されるアミノ酸配列であって、ここで、該ポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、アミノ酸配列;ならびに
(e)アミノ酸置換、アミノ酸挿入、アミノ酸欠失、C末端短縮、およびN末端短縮からなる群より選択される少なくとも1つの改変を有する配列番号2または配列番号5のいずれかに示されるアミノ酸配列であって、ここで、該ポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、アミノ酸配列、からなる群より選択されるアミノ酸配列を含む、単離されたポリペプチド。 - 請求項1、請求項2、または請求項3のいずれかに記載の核酸分子によってコードされる単離されたポリペプチドであって、ここで、該ポリペプチドは、配列番号2または配列番号5のいずれかに示されるポリペプチドの活性を有する、単離されたポリペプチド。
- 請求項14に記載の単離されたポリペプチドであって、ここで、同一性パーセントは、GAP、BLASTP、FASTA、BLASTA、BLASTX、BestFit、およびSmith−Watermanアルゴリズムからなる群より選択されるコンピュータープログラムを用いて決定される、単離されたポリペプチド。
- 請求項13、請求項14、または請求項15のいずれかに記載のポリペプチドに特異的に結合する、選択的結合因子またはそのフラグメント。
- 配列番号2または配列番号5のいずれかに示されるアミノ酸配列を含むポリペプチドまたはそのフラグメントに特異的に結合する、請求項18に記載の選択的結合因子またはそのフラグメント。
- 抗体またはそのフラグメントである、請求項18に記載の選択的結合因子。
- ヒト化抗体である、請求項18に記載の選択的結合因子。
- ヒト抗体またはそのフラグメントである、請求項18に記載の選択的結合因子。
- ポリクローナル抗体またはそのフラグメントである、請求項18に記載の選択的結合因子。
- モノクローナル抗体またはそのフラグメントである、請求項18に記載の選択的結合因子。
- キメラ抗体またはそのフラグメントである、請求項18に記載の選択的結合因子。
- CDR移植抗体またはそのフラグメントである、請求項18に記載の選択的結合因子。
- 抗イディオタイプ抗体またはそのフラグメントである、請求項18に記載の選択的結合因子。
- 可変領域フラグメントである、請求項18記載の選択的結合因子。
- FabフラグメントまたはFab’フラグメントである、請求項28に記載の可変領域フラグメント。
- 配列番号2または配列番号5のいずれかのアミノ酸配列を有するポリペプチドに特異性を有する少なくとも1つの相補性決定領域を含む、選択的結合因子またはそのフラグメント。
- 検出可能標識に結合される、請求項18に記載の選択的結合因子。
- IFN−Lポリペプチドの生物学的活性を拮抗する、請求項18に記載の選択的結合因子。
- IFN−Lポリペプチド関連の疾患、状態、または障害を、処置、予防、または改善するための方法であって、有効量の請求項18に記載の選択的結合因子を患者に投与する工程を包含する、方法。
- 配列番号2または配列番号5のいずれかのアミノ酸配列を含むポリペプチドで動物を免疫することによって産生される、選択的結合因子。
- 請求項1、請求項2、または請求項3のいずれかに記載のポリペプチドを結合し得る選択的結合因子を産生する、ハイブリドーマ。
- 請求項18に記載の抗IFN−L抗体またはフラグメントを用いて、IFN−Lポリペプチドの量を検出または定量する方法。
- 請求項13、請求項14、または請求項15のいずれかに記載のポリペプチド、および薬学的に受容可能な処方剤を含む、組成物。
- 前記薬学的に受容可能な処方剤が、キャリア、アジュバント、溶解剤、安定剤、または抗酸化剤である、請求項37に記載の組成物。
- 前記ポリペプチドが、配列番号3または配列番号6のいずれかに示されるアミノ酸配列を含む、請求項37に記載の組成物。
- 請求項13、請求項14、または請求項15のいずれかに記載のポリペプチドの誘導体を含む、ポリペプチド。
- 水溶性ポリマーを用いて共有結合的に改変された、請求項40に記載のポリペプチド。
- 請求項41に記載のポリペプチドであって、ここで、前記水溶性ポリマーが、ポリエチレングリコール、モノメトキシポリエチレングリコール、デキストラン、セルロース、ポリ−(N−ビニルピロリドン)ポリエチレングリコール、プロピレングリコールホモポリマー、ポリプロピレンオキシド/エチレンオキシドコポリマー、ポリオキシエチル化ポリオール、およびポリビニルアルコールからなる群より選択される、ポリペプチド。
- 請求項1、請求項2または請求項3のいずれかに記載の核酸分子および薬学的に受容可能な処方剤を含む、組成物。
- 前記核酸分子が、ウイルスベクター中に含まれる、請求項43に記載の組成物。
- 請求項1、請求項2または請求項3のいずれかに記載の核酸分子を含む、ウイルスベクター。
- 異種アミノ酸配列に融合された、請求項13、請求項14、または請求項15のいずれかに記載のポリペプチドを含む、融合ポリペプチド。
- 前記異種アミノ酸配列が、IgG定常ドメインまたはそのフラグメントである、請求項46に記載の融合ポリペプチド。
- 医学的状態を、処置、予防、または改善するための方法であって、請求項13、請求項14、もしくは請求項15のいずれかに記載のポリペプチド、または請求項1、請求項2、もしくは請求項3のいずれかに記載の核酸によってコードされるポリペプチドを患者に投与する工程を包含する、方法。
- 処置、予防または改善されている前記医学的状態が、多発性硬化症または免疫調節を要する他の病理である、請求項48に記載の方法。
- 被験体において病的状態または病的状態に対する感受性を診断する方法であって、以下:
(a)サンプル中の、請求項13、請求項14、もしくは請求項15のいずれかに記載のポリペプチド、または請求項1、請求項2、もしくは請求項3のいずれかに記載の核酸分子によってコードされるポリペプチドの、発現の存在または発現量を決定する工程;および
(b)該ポリペプチドの発現の存在または発現量に基づいて、病的状態または病的状態に対する感受性を診断する工程、を包含する、方法。 - デバイスであって、以下:
(a)移植に適した膜;および
(b)該膜内にカプセル化された細胞であって、該細胞は、請求項13、請求項14、もしくは請求項15のいずれかに記載のタンパク質を分泌する、細胞;
を備え、
該膜は、該タンパク質に対して透過性であり、そして該細胞に有害な物質に対して不透過性である、デバイス。 - IFN−Lポリペプチドに結合する化合物を同定する方法であって、以下:
(a)請求項13、請求項14、もしくは請求項15のいずれかに記載のポリペプチドを、化合物と接触させる工程;および
(b)該化合物に対する該IFN−Lポリペプチドの結合の程度を決定する工程、
を包含する、方法。 - 前記化合物に結合した場合に、前記ポリペプチドの活性を決定する工程をさらに包含する、請求項52に記載の方法。
- 動物においてポリペプチドのレベルを調節する方法であって、請求項1、請求項2、または請求項3のいずれかに記載の核酸分子を該動物に投与する工程を包含する、方法。
- 請求項1、請求項2、または請求項3のいずれかに記載の核酸分子を含む、トランスジェニック非ヒト哺乳動物。
- 化合物がIFN−Lポリペプチド活性またはIFN−Lポリペプチド産生を阻害するか否かを決定するためのプロセスであって、請求項54に記載のトランスジェニック哺乳動物を該化合物に曝露する工程、および該哺乳動物におけるIFN−Lポリペプチド活性またはIFN−Lポリペプチド産生を測定する工程を包含する、プロセス。
Applications Claiming Priority (2)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| US16972099P | 1999-12-08 | 1999-12-08 | |
| US72486000A | 2000-11-28 | 2000-11-28 |
Related Parent Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| JP2001544347A Division JP2003520579A (ja) | 1999-12-08 | 2000-12-04 | インターフェロン様分子およびその使用 |
Publications (1)
| Publication Number | Publication Date |
|---|---|
| JP2007014331A true JP2007014331A (ja) | 2007-01-25 |
Family
ID=26865319
Family Applications (2)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| JP2001544347A Withdrawn JP2003520579A (ja) | 1999-12-08 | 2000-12-04 | インターフェロン様分子およびその使用 |
| JP2006170738A Pending JP2007014331A (ja) | 1999-12-08 | 2006-06-20 | インターフェロン様分子およびその使用 |
Family Applications Before (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| JP2001544347A Withdrawn JP2003520579A (ja) | 1999-12-08 | 2000-12-04 | インターフェロン様分子およびその使用 |
Country Status (10)
| Country | Link |
|---|---|
| US (4) | US20020137137A1 (ja) |
| EP (1) | EP1240327B1 (ja) |
| JP (2) | JP2003520579A (ja) |
| AT (1) | ATE385517T1 (ja) |
| CA (1) | CA2395408A1 (ja) |
| DE (1) | DE60037978T2 (ja) |
| ES (1) | ES2300280T3 (ja) |
| MX (1) | MXPA02005660A (ja) |
| TW (1) | TWI253470B (ja) |
| WO (1) | WO2001042474A2 (ja) |
Families Citing this family (14)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| US7390637B2 (en) | 1998-07-21 | 2008-06-24 | Human Genome Sciences, Inc. | Keratinocyte derived interferon |
| US6472512B1 (en) | 1998-07-21 | 2002-10-29 | Human Genome Sciences, Inc. | Keratinocyte derived interferon |
| US6433145B1 (en) | 1998-07-21 | 2002-08-13 | Human Genome Sciences, Inc. | Keratinocyte derived interferon |
| US7959910B2 (en) | 2000-07-31 | 2011-06-14 | Biolex Therapeutics, Inc. | C-terminally truncated interferon alpha variants |
| US20060024272A1 (en) * | 2004-07-29 | 2006-02-02 | Large Scale Biology Corporation | C-terminally truncated interferon |
| US9475974B2 (en) * | 2007-07-17 | 2016-10-25 | Schlumberger Technology Corporation | Controlling the stability of water in water emulsions |
| US20100179076A1 (en) * | 2009-01-15 | 2010-07-15 | Sullivan Philip F | Filled Systems From Biphasic Fluids |
| US7950459B2 (en) * | 2009-01-15 | 2011-05-31 | Schlumberger Technology Corporation | Using a biphasic solution as a recyclable coiled tubing cleanout fluid |
| IN2014CN02982A (ja) * | 2011-10-01 | 2015-07-03 | Glytech Inc | |
| SG11201402490XA (en) | 2011-11-23 | 2014-06-27 | Amgen Inc | Methods of treatment using an antibody against interferon gamma |
| US9678074B2 (en) * | 2012-03-28 | 2017-06-13 | The United States Of America, As Represented By The Secretary, Dept. Of Health And Human Services | Interferon-λ4 (IFNL4) protein, related nucleic acid molecules, and uses thereof |
| AU2014245917B2 (en) | 2013-03-29 | 2017-09-28 | Glytech, Inc. | Polypeptide having sialylated sugar chains attached thereto |
| BR112020025287A2 (pt) | 2018-06-25 | 2021-03-09 | University Of Washington | Projeto de novo de miméticos de interleucina potentes e seletivos |
| WO2023052541A1 (en) | 2021-09-30 | 2023-04-06 | Imcheck Therapeutics | Combination of an anti-btn3a activating antibody and an il-2 agonist for use in therapy |
Family Cites Families (8)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JPS60500864A (ja) | 1983-02-04 | 1985-06-06 | ワドリ、テクナラジズ、インコーパレイティド | 近縁関係にあるが別個のタンパク質間に存在する共通決定基に対して特異的なハイブリド−マ抗体の製造および特性づけ |
| ATE311895T1 (de) | 1992-05-26 | 2005-12-15 | Immunex Corp | Neue zytokine die cd30 binden |
| KR100688051B1 (ko) * | 1998-07-21 | 2007-02-28 | 휴먼 게놈 사이언시즈, 인코포레이티드 | 각질세포-유래된 인터페론 |
| US7390637B2 (en) | 1998-07-21 | 2008-06-24 | Human Genome Sciences, Inc. | Keratinocyte derived interferon |
| US6433145B1 (en) * | 1998-07-21 | 2002-08-13 | Human Genome Sciences, Inc. | Keratinocyte derived interferon |
| US6472512B1 (en) | 1998-07-21 | 2002-10-29 | Human Genome Sciences, Inc. | Keratinocyte derived interferon |
| AU3891600A (en) * | 1999-03-18 | 2000-10-04 | Zymogenetics Inc. | Murine interferon-alpha named also zcyto13 |
| AU2509900A (en) * | 1999-07-21 | 2001-02-13 | Human Genome Sciences, Inc. | Keratinocyte derived interferon |
-
2000
- 2000-12-04 WO PCT/US2000/032939 patent/WO2001042474A2/en not_active Ceased
- 2000-12-04 MX MXPA02005660A patent/MXPA02005660A/es not_active Application Discontinuation
- 2000-12-04 EP EP00982416A patent/EP1240327B1/en not_active Expired - Lifetime
- 2000-12-04 AT AT00982416T patent/ATE385517T1/de not_active IP Right Cessation
- 2000-12-04 ES ES00982416T patent/ES2300280T3/es not_active Expired - Lifetime
- 2000-12-04 CA CA002395408A patent/CA2395408A1/en not_active Abandoned
- 2000-12-04 JP JP2001544347A patent/JP2003520579A/ja not_active Withdrawn
- 2000-12-04 DE DE60037978T patent/DE60037978T2/de not_active Expired - Fee Related
- 2000-12-08 TW TW089126207A patent/TWI253470B/zh not_active IP Right Cessation
-
2001
- 2001-08-10 US US09/927,850 patent/US20020137137A1/en not_active Abandoned
-
2004
- 2004-10-29 US US10/977,680 patent/US7811791B2/en not_active Expired - Fee Related
-
2005
- 2005-08-08 US US11/200,389 patent/US8148109B2/en not_active Expired - Fee Related
-
2006
- 2006-06-20 JP JP2006170738A patent/JP2007014331A/ja active Pending
-
2012
- 2012-02-14 US US13/372,816 patent/US20120157666A1/en not_active Abandoned
Also Published As
| Publication number | Publication date |
|---|---|
| WO2001042474A3 (en) | 2002-02-28 |
| US7811791B2 (en) | 2010-10-12 |
| US8148109B2 (en) | 2012-04-03 |
| EP1240327B1 (en) | 2008-02-06 |
| EP1240327A2 (en) | 2002-09-18 |
| US20020137137A1 (en) | 2002-09-26 |
| US20050221344A1 (en) | 2005-10-06 |
| JP2003520579A (ja) | 2003-07-08 |
| US20060024795A1 (en) | 2006-02-02 |
| WO2001042474A2 (en) | 2001-06-14 |
| ATE385517T1 (de) | 2008-02-15 |
| DE60037978T2 (de) | 2008-05-21 |
| MXPA02005660A (es) | 2002-09-02 |
| DE60037978D1 (de) | 2008-03-20 |
| ES2300280T3 (es) | 2008-06-16 |
| CA2395408A1 (en) | 2001-06-04 |
| TWI253470B (en) | 2006-04-21 |
| US20120157666A1 (en) | 2012-06-21 |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| US20060078966A1 (en) | IL-17 receptor like polypeptides and uses thereof | |
| US20120157666A1 (en) | Interferon-like proteins and uses thereof | |
| AU2001259029B2 (en) | Il-17 receptor like molecules and uses thereof | |
| US20030166069A1 (en) | Interleukin-1 receptor antagonist-like molecules and uses thereof | |
| AU2001259029A1 (en) | Il-17 receptor like molecules and uses thereof | |
| WO2001042304A1 (en) | Interleukin-1 receptor antagonist-related molecules and uses thereof | |
| WO2001059120A2 (en) | Il-17 like molecules and uses thereof | |
| AU778676B2 (en) | Interleukin-1 receptor antagonist-like molecules and uses thereof | |
| JP3842647B2 (ja) | インターロイキン−1レセプターアンタゴニスト関連分子およびその使用 | |
| AU782554B2 (en) | Interleukin-1 receptor antagonist-like molecules and uses thereof | |
| JP2003516735A (ja) | インターロイキン−1レセプターアンタゴニスト様分子およびその使用 | |
| AU1944901A (en) | Interferon-like molecules and uses thereof | |
| AU2005201491A1 (en) | Interferon-Like Molecules and Uses Thereof |
Legal Events
| Date | Code | Title | Description |
|---|---|---|---|
| A621 | Written request for application examination |
Free format text: JAPANESE INTERMEDIATE CODE: A621 Effective date: 20071130 |
|
| A131 | Notification of reasons for refusal |
Free format text: JAPANESE INTERMEDIATE CODE: A131 Effective date: 20080805 |
|
| A02 | Decision of refusal |
Free format text: JAPANESE INTERMEDIATE CODE: A02 Effective date: 20090113 |