JP2012108576A - マルチコアプロセッサ、処理実行方法、プログラム - Google Patents
マルチコアプロセッサ、処理実行方法、プログラム Download PDFInfo
- Publication number
- JP2012108576A JP2012108576A JP2010254662A JP2010254662A JP2012108576A JP 2012108576 A JP2012108576 A JP 2012108576A JP 2010254662 A JP2010254662 A JP 2010254662A JP 2010254662 A JP2010254662 A JP 2010254662A JP 2012108576 A JP2012108576 A JP 2012108576A
- Authority
- JP
- Japan
- Prior art keywords
- progress status
- core
- processing
- processes
- execution
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Pending
Links
Images






Landscapes
- Debugging And Monitoring (AREA)
Abstract
【課題】既存のプログラムの変更によるコスト増を抑制し、既存のプログラムをマルチコアで実行しても適切に負荷分散できるマルチコアプロセッサを提供すること。
【解決手段】複数のコア51と、アプリケーション22が記憶された記憶手段57と、を有するマルチコアプロセッサ200であって、アプリケーションを複数の処理に区分した際の処理間の依存関係を登録した処理依存関係情報12と、各処理の進度状況が登録された進度状況登録テーブル11と、進度状況が実行待ちの処理と処理依存関係情報において依存関係がある処理の実行完了が前記進度状況登録テーブルに登録されている場合、実行待ちの処理の前記進度状況を実行可能に更新する進度状況更新手段31と、進度状況に実行可能と設定された処理を空きコアに割り当てる処理割り当て手段32と、を有する。
【選択図】図2
【解決手段】複数のコア51と、アプリケーション22が記憶された記憶手段57と、を有するマルチコアプロセッサ200であって、アプリケーションを複数の処理に区分した際の処理間の依存関係を登録した処理依存関係情報12と、各処理の進度状況が登録された進度状況登録テーブル11と、進度状況が実行待ちの処理と処理依存関係情報において依存関係がある処理の実行完了が前記進度状況登録テーブルに登録されている場合、実行待ちの処理の前記進度状況を実行可能に更新する進度状況更新手段31と、進度状況に実行可能と設定された処理を空きコアに割り当てる処理割り当て手段32と、を有する。
【選択図】図2
Description
本発明は、複数のコアが搭載されたマルチコアプロセッサに関し、特に、コアに処理を割り当てることで負荷分散できるマルチコアプロセッサに関する。
車両には数多くの電子制御装置が搭載されており、各電子制御装置が各種のプログラムを実行して様々な車載装置を制御している。電子制御装置はCPUを有しているが、電子制御装置においてもCPUのマルチコア化を図ることで処理効率を向上させようという試みがある。
マルチコアのCPUの処理効率の向上は、複数のタスクを各コアが並行に実行することを基本的な考え方にする。しかしながら、タスクには処理内容や重要度などに違いがあり全てのタスクを公平にコアに割り当てることはできないため、効率よくタスクをコアに割り当てる技術が考案されている(例えば、特許文献1参照。)。特許文献1には、複数個のプロセッサユニットにタスク割当を行なう際、プログラムの実行時間や実行タスク間の依存性を考慮するマルチプロセッサシステムが開示されている。
また、タスク単位でなくタスクが分割されたスレッド単位でコアに割り当てる技術も考案されている(例えば、特許文献2参照。)。特許文献2には、サブルーチンやスレッドにタグを付け、スレッドの実行特徴を連続して習得してスレッド性能データを生成し、スレッド特性データに基づきコアにスレッドを割り当てるマルチプロセッサシステムが提供されている。
ところで、車両ではすでに電子制御装置が多くのプログラムを実行しており、この既存のプログラムを変更することなく、マルチコアに適用することでコスト増を抑制することが検討されている。
図1は、従来のシングルコア用のプログラムを模式的に説明する図の一例である。このプログラムの特にメインタスクはシングルコア(図のCPU)用に開発されているため、最初から最後まで逐次実行される。また、CPUに割込みが生じると、CPUは例えば割込みタスクを実行する。
図1(a)のようなプログラムを、図1(b)のようにマルチコアの各コアに割り当てることを考えると、例えばOS(Operating System)が、タスクの起床毎にメインタスクと割込みタスクを各コアに割り当てることになる。したがって、図1(a)と図1(b)を比較すれば、コア1の処理負荷は割込みタスクを実行する必要がない分だけ低減されたことになる。
しかしながら、一般に、メインタスクと割込みタスクではメインタスクの方が処理負荷が大きく、メインタスクと割込みタスクを分散しただけでは、マルチコアによる処理負荷の低減・処理の高効率化の恩恵を十分には受けられない。
そこで、特許文献2に開示されているように、タスクをスレッドなどのより小さい粒度に分割して、各コアに割り当てることが考えられる。しかし、シングルコア用のプログラム(この場合はメインタスク)を分割することは容易ではなく、特許文献2にもスレッドへの分割方法は開示されていない。コンパイルされたプログラムには、例えばC言語の関数やサブルーチンに対応するラベルが記述されているので、ラベル毎にスレッドに分割することが考えられる。しかし、ラベル毎にスレッド化した場合、1つのスレッドで処理が完結しているという保証がなく、スレッド単位の取り扱いが不具合を引き起こすおそれがある。また、スレッドをあまり小さい粒度にするとコアへの割り当てのオーバーヘッドが目立つようになるため、ラベル毎に一律にスレッド化することは適切でない。
また、処理単位の適切な粒度にスレッド化できたとしても、スレッド間の依存関係を考慮せずに、OS等が単にスレッドを空いたコアに割り当てるだけでは、プログラムが正常に動作する保証がない。
本発明は、上記課題に鑑み、既存のプログラムの変更によるコスト増を抑制し、既存のプログラムをマルチコアで実行しても適切に負荷分散できるマルチコアプロセッサを提供することを目的とする。
本発明は、複数のコアと、アプリケーションが記憶された記憶手段と、を有するマルチコアプロセッサであって、前記アプリケーションを複数の処理に区分した際の処理間の依存関係を登録した処理依存関係情報と、各処理の進度状況が登録された進度状況登録テーブルと、前記進度状況が実行待ちの処理と前記処理依存関係情報において依存関係がある処理の実行完了が前記進度状況登録テーブルに登録されている場合、実行待ちの処理の前記進度状況を実行可能に更新する進度状況更新手段と、前記進度状況に実行可能と設定された処理を空きコアに割り当てる処理割り当て手段と、を有することを特徴とする。
既存のプログラムの変更によるコスト増を抑制し、既存のプログラムをマルチコアで実行しても適切に負荷分散できるマルチコアプロセッサを提供することができる。
以下、本発明を実施するための形態について図面を参照しながら説明する。
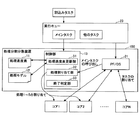
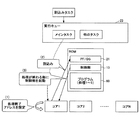
図2は、本実施形態のマルチコアプロセッサの概略的な特徴部を示す図の一例である。まず、マルチコアプロセッサには新たに処理分割分散装置100が配置される。処理分割分散装置100は処理進度表11と処理モデル12を有する。
・処理進度表11には、プログラムのメインタスクから抽出された複数の処理のステータス(Wait、Ready、Processing、Done)が登録されている。
・処理モデル12には、処理間の依存関係が登録されている。
図2は、本実施形態のマルチコアプロセッサの概略的な特徴部を示す図の一例である。まず、マルチコアプロセッサには新たに処理分割分散装置100が配置される。処理分割分散装置100は処理進度表11と処理モデル12を有する。
・処理進度表11には、プログラムのメインタスクから抽出された複数の処理のステータス(Wait、Ready、Processing、Done)が登録されている。
・処理モデル12には、処理間の依存関係が登録されている。
制御部13は、処理進度表11のステータスを監視し、Waitの処理があれば処理モデル12を参照して、Waitの処理が実行可能な状態になったか否かを判定する。制御部13は、実行可能になった処理のステータスをReadyに更新することで、コア1又はコア2が該処理を実行することができる。
処理進度表11には、既存のプログラムのメインタスクから適切な粒度の処理が抽出され、処理の先頭アドレス(後述の処理開始アドレス)と終了アドレス(後述の処理終了アドレス)が登録されている。制御部はこれらのアドレスを使用して処理を切り替えることで、既存のプログラムについてはほとんど変更することなく、マルチコアに負荷分散することが可能となる。このため、既存のプログラムを分割してマルチタスク用に再開発するのに比べて、小さい労力でマルチコア化に対応することができる。
〔構成〕
図3は、マルチコアプロセッサ200のハードウェア構成図の一例を示す。マルチコアプロセッサ200は、マルチレイヤーバス61を介して接続されたCPU50、DMAC54、SDRAM55、I/Oブリッジ56及びROM57を有する。
図3は、マルチコアプロセッサ200のハードウェア構成図の一例を示す。マルチコアプロセッサ200は、マルチレイヤーバス61を介して接続されたCPU50、DMAC54、SDRAM55、I/Oブリッジ56及びROM57を有する。
CPU50は2つの集積回路を有し、各集積回路が、コア51、INT52、及び、RAMを53有する(これらを区別する場合、コア1,コア2のように番号を付す)。コア1,2は、それぞれ、IFU(Instruction Fetch Unit)、DEC(DECoder)、RF(Register Fetch)、REG(REGister)、LSU(Load Store Unit)、SH(Shifter)、ALU、MUL及びFPU等の演算回路を有し、パイプライン制御により1クロックで1命令を実行することができる。
RAM1はコア1に専用のメモリ(一次キャッシュ)であり、RAM2はコア2に専用のメモリ(一次キャッシュ)である。INT1とINT2は、コア間割り込みを制御すると共に、コア1からコア2又はコア2からコア1に、パラメータ等の送受信を制御する。また、INT1,INT2は、RAM1、RAM2、又は、SDRAM55を共有の通信用メモリにしてパラメータ等を送受信することもできる。INT1とINT2を使用したコア間のパラメータ通信はハードウェア的な実装であり、この他、OSが提供するコア間通信のAPIを利用してもコア1とコア2は通信することができる。
DMAC54は、コア1及びコア2から要求を受けてプログラム60をSDRAM55、RAM1、RAM2に読み込んだり、周辺機器からのメモリアクセス要求を調停すると共に、I/Oブリッジ56からSDRAM55へ、又は、SDRAM55からI/Oブリッジ56へ、コア1、コア2を介することなくデータを転送する。SDRAM55は、コア1及びコア2がプログラム60を実行している間、RAM1又はRAM2にミスヒットするとプログラム60又はデータを提供するためのメモリ(二次キャッシュ)である。SDRAM55の少なくとも一部はコア1とコア2により共有される。
ROM57にはプログラム60及びタスク制御プログラム70が記憶されている。プログラム60は、少なくともメインタスクと割込みタスクが含まれている。タスク制御プログラム70は、処理分割分散装置100を制御するソフトウェアであるが、処理分割分散装置100がハード的に実装される場合には不要となる場合がある。なお、ROM57には、OSやデバイスドライバ(プラットフォーム)も記憶されている。
I/Oブリッジ56は、マルチレイヤーバス61とI/Oバス62の間で相互に周波数や電圧値などを変換する。I/Oバス62には種々のI/O58が接続されている。I/O58はプロセッサ100と外部の機器を接続するインタフェースであり、例えば、CANコントローラ、各種のアクチュエータ、センサ、スイッチ等が接続される。
ここで、マルチコアの態様として、それぞれのコアに決まったタスクを割り当てるAMP(Asymmetric Multi‐processing)、例えばOSがそれぞれのコアにタスクを動的に割り当てるSMP(Symmetric Multi‐processing)、又は、一部のコアにタスクを固定的に割り当て、残りのコアにタスクを動的に割り当てるBMP(Bound Multi‐processing)が知られている。本実施形態では、処理分割分散装置100が複数のコアに処理を動的に割り当てるのでSMPのマルチコアプロセッサ200とすることが自然である。だが、いくつかのコア51にだけ処理を割り当てると決めてそのコアの中だけで処理分割分散装置100が処理を動的に割り当てることもできる。したがって、SMP、AMP又はBMPのいずれかの実装態様でなければならないと言うことはない。
なお、SMPのマルチコアプロセッサ200の場合、複数の処理の処理結果をコア間で共有できるように、不図示のスヌープコントローラ(SNC)がRAM1とRAM2のデータの更新を監視して、更新データをRAM1とRAM2間で通信する。これによりRAM1とRAM2のキャッシュのコヒーレンシを維持することができる。また、コア間で1つの処理を再割り当てすることも容易になる。
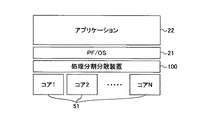
図4は、マルチコアプロセッサ200の実装例を示す図である。アプリケーション22は、メインタスクや割込みタスクのプログラム60、及び、別の既存のプログラムのメインタスク(区別するため他のタスクという)である。なお、別の既存のプログラムは、処理に分割されずに実行されるものとする。また、割込みタスクは2つ以上あってもよい。
PF/OS21はプラットフォームとオペレーティングシステムを意味するが両者が独立して存在してもそうでなくてもよく、図示するPF/OS21の意義は処理分割分散装置100と略一体になって、コア51にアプリケーション22の処理を割り当てる点にある。処理分割分散装置100は複数の処理を各コア1〜Nに割り当てるが、この機能はOSのスケジューリングと同系統の機能となる。一方、メインタスクは複数の処理に分割されたので、OSによるスケジューリングは困難になっている。
メインタスクを変更せずにOSによるスケジューリングを可能とするには、メインタスクが複数の処理に分割されていることをOSから遮蔽することが好ましい。このため、処理分割分散装置100は、PF/OS21がいずれかのコア51にメインタスクを割り当てるというディスパッチ処理をコア51の代わりに受け取り、各処理の実行を制御する。このように、処理分割分散装置100はPF/OS21に含まれる形態で実装されることがある。なお、上記のように処理分割分散装置100をハード的なICで実装することもできるが、この場合はOSのメインタスクに対するディスパッチ処理をコア51の代わりに、処理分割分散装置100が取得して、各処理の実行の制御を開始する。
図5は、処理分割分散装置100の機能ブロック図の一例を示す。処理分割分散装置100をソフト的に実装する場合、図5の処理分割分散装置100はいずれかのコア51により実行される。また、図5では処理分割分散装置100とPF/OS21を一体に図示した。
マルチタスクをサポートするOSでは、タスクの優先順位と状態に応じて、実行可能なタスクから順に実行キュー23に登録する。タスクの状態には、例えば、実行可能、実行中、実行待ちの状態がある。OSにとってタスクの優先順位は予め既知である。OSは、実行キュー23の中から最も優先順位の高いタスクをコア51に割り当てる。
また、プリエンプション(実行中のタスクの中断と再開)が可能なOSの場合、OSは実行キュー23の中で最も優先順位の高いタスクと、各コア51が実行中のタスクの優先順位を比較して、実行キュー23で最も優先順位の高いタスクが、各コア51が実行中のいずれかのタスクの優先順位よりも高くなると、そのコア51に実行キュー23で最も優先順位の高いタスクを割り当てる。
ここで、コア51が実行しているタスクを切り替える必要が生じるのは、タスク自身がタスク切り替えを引き起こすサービスコールをOSに要求した場合や、割り込みが起こり割り込み処理を実行していたコア51がサービスコールをOSに要求した場合などである。前者の場合は、自身を起床待ちにする場合や、優先度の高いタスクを呼び出す場合に生じる。
なお、メインタスクは既存のプログラムから変更がないので、メインタスクの各処理がサービスコールをOSに要求することはない。また、メインタスクの優先順位が最も高いのでメインタスクの各処理を実行しているコア51の全てが、例えば割込みタスクに切り替えられることは生じない。
本実施形態では、メインタスクの優先順位が最も高いが、割込みが生じ割込みタスクが起床された場合は、割込みタスクの優先順位の方が高くなるものとする。
ところで、OSから見てメインタスクとその他のタスクは優先順位の違いはあってもそれぞれは1つのタスクなので、発明の課題で説明したように、メインタスクに割り当てられるコア51は1つである。しかし、マルチコアプロセッサ200にメインタスク以外のタスクが同時に生起される数よりも2〜3個多いコアを用意しておけば、メインタスクに複数のコア51が割り当てられているのとみなすことができる。すなわちSMPでは、処理分割分散装置100がメインタスクの複数の処理を空いているコア(メインタスク以外のタスクを実行していないコア)51に割り当て並行に実行できる。
また、マルチコアプロセッサ200の実装をAMPとした場合、メインタスクに専用の複数のコア51が割り当てられるので、この場合も処理分割分散装置100がメインタスクの複数の処理を空いているコア51に割り当て並行に実行できる。しかし、実行可能なコア51の数を可変にできるという点(スケーラビリティ)ではSMPの方がより好ましい。
サービスコールが発生したり、プリエンプションが発生すると、OSはディスパッチ処理を開始する。本実施例では、OSがメインタスクを呼び出すディスパッチ処理を、制御部13が受け取る。
また、OSがメインタスク以外のタスクを呼び出すディスパッチ処理を実行した場合は、従来と同様に、制御部13を介することなくコア51が実行するタスクの切り替えが行われる。制御部13を介してタスクの切り替えが行われてもよい。
OSは、タスクをコア51に割り当てる際、まず、割り当て対象のコア51が実行しているタスクのコンテキスト(タスクの実行に必要な、汎用レジスタ,プログラムカウンタ、スタックポインタなど)を保存し、該コア51に割り当てるタスクのコンテキストを割り当て対象のコア51に設定する。
一方、いずれかのコア51にメインタスクが割り当てられた場合、メインタスクが実行中になる。実行中の間、制御部13は、処理進度表11の更新、各コア51への処理の割り当てを繰り返す。
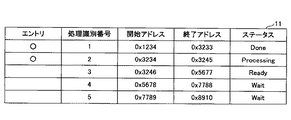
図6は処理進度表11の一例を示す図である。処理進度表11には、「エントリ」、「処理識別番号(1〜5)」、「処理開始アドレス」、「処理終了アドレス」、及び、「ステータス」が登録される。「エントリ」にフラグ「○」が設定された処理は、メインタスクにおいて処理の順番が最初の処理であることを示す。「エントリ」をなくし、処理割り当て部32が処理進度表11の最上位の処理からコア51に割り当てるとしてもよいが、この場合、処理1と並行に実行可能な処理(図では処理2)があっても、しばらくは実行されない状態が発生してしまう。また、後述するように「エントリ」があることで、メインタスクの全ての処理1〜5が完了した後に、メインタスクを再開するための最初の処理が明らかになる。
「処理識別番号」は処理分割分散装置100が処理を識別するための情報である。メインタスクから処理1〜5をどのように分割するかは後述する。
「処理開始アドレス」は処理1〜5の先頭アドレスであり、「処理終了アドレス」は処理1〜5の終了アドレスである。これらのアドレスは、ROM57に記憶された状態のプログラム60のアドレスである。図では処理終了アドレスは処理開始アドレスの直前になっているが、分岐先で終了する場合などはこのようにならない場合もあるし、また、条件分岐した場合に対応するため複数の処理終了アドレスが登録される場合もある。
「ステータス」は、各処理の状態(Ready、Processing、Wait、Done)を表す。Readyは処理に必要なデータや事象が全て揃っていて、コア51が割り当てられればいつでも実行可能な状態を、Processingはコア51が実行している状態を、Waitは他の処理による演算結果、入出力終了などの事象の終了を待っている状態を、Doneは処理が完了した状態を、それぞれ意味する。なお、処理のステータスは、OSが監視するタスクの状態とは別のものである。
図5の処理割り当て部32は、処理進度表11のステータスが“Ready”の処理を空いているコア51に割り当てる。具体的には、処理進度表11に登録された処理開始アドレスを、空いているコア51のPC(プログラムカウンタ)に設定する。割り当て対象の空いているコア51がそれまで別の処理を実行していた場合、処理割り当て部32はコンテキストを保存したり、複数の処理の処理結果を統合するなど、必要な処理を行う。
また、終了判定部33は、処理進度表11のステータスが“Processing”の処理を実行しているコア51のPCを監視して、処理終了アドレスに到達したか否かを判定する。これは、メインタスクは既存のプログラムから変更がないため、各コア51が処理の終了を判定することが困難なためである。このため、外部の終了判定部33が終了を判定する。
処理進度表更新部31は、処理進度表11のステータスを操作する手段であり、特に、Waitの処理をReadyに更新する処理を行う。
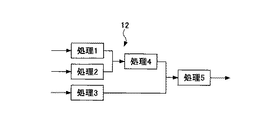
図7は、処理モデル12の一例を示す。処理モデル12は並行に実行可能な処理、及び、処理間の依存関係を示す情報を含む。図7では、処理1〜3は並列に処理が可能であることを示し、処理4は処理1及び処理2に対し依存関係を有し、処理5は処理3及び処理4に依存関係を有することをそれぞれ示している。依存関係とは、例えば、処理4は処理1及び2のいずれも完了しないと実行できないことを言う。
図7は、処理モデル12の一例を示す。処理モデル12は並行に実行可能な処理、及び、処理間の依存関係を示す情報を含む。図7では、処理1〜3は並列に処理が可能であることを示し、処理4は処理1及び処理2に対し依存関係を有し、処理5は処理3及び処理4に依存関係を有することをそれぞれ示している。依存関係とは、例えば、処理4は処理1及び2のいずれも完了しないと実行できないことを言う。
なお、図6の処理進度表11のステータスは、メインタスクが2つのコア51を使用している状態で、処理1と処理2が並行に実行され、その後、処理1が先に終了されたことで、処理3がReadyになった状態を示す。
処理進度表11の処理1〜5は、この処理モデル12を開発者が抽出する際に区分した一連の(ひとまとまりの)処理となる。処理の抽出について説明する。シングルタスクのプログラムはコードの上から順番に実行される。関数型のプログラムではmain関数から定義された関数j(j:1〜m)やマクロi(i:1〜n)が順番に呼び出されるようにして実行される。開発者は、関数jやマクロiで依存関係のある箇所を特定する。依存関係には、次のようにデータ依存と処理依存がある。
・データ依存
後の関数jやマクロiがそれよりも前の関数jやマクロiが使用する変数を使用する場合である。例えば、後の関数がそれよりも前の関数から「引数」を受け渡される場合や、後の関数と前の関数が共通のグローバル関数を使うような場合である。より具体的な例では、前の関数がクランク角を求める処理であり、後の関数がクランク角を用いて燃料噴射タイミングなどを決定する処理の場合、2つの処理にデータ依存関係があると言える。また、例えば、前の関数が圧縮されたデータを伸張する処理であり、後の関数がデータを表示したり出力する処理の場合、2つの処理にデータ依存関係があると言える。
・処理依存
後の関数jやマクロiの実行に、それよりも前の関数jやマクロiが実行した状況が必要となる場合である。例えば、後の関数がアクチュエータを元の状態に戻す処理であり、前提として前の関数がアクチュエータをある状態にする処理である場合、2つの処理に処理依存関係があると言える。また例えば、後の関数が入出力装置にデータを出力する処理であり、前の関数が入出力装置を初期化する処理である場合、2つの処理に処理依存関係があると言える。
・データ依存
後の関数jやマクロiがそれよりも前の関数jやマクロiが使用する変数を使用する場合である。例えば、後の関数がそれよりも前の関数から「引数」を受け渡される場合や、後の関数と前の関数が共通のグローバル関数を使うような場合である。より具体的な例では、前の関数がクランク角を求める処理であり、後の関数がクランク角を用いて燃料噴射タイミングなどを決定する処理の場合、2つの処理にデータ依存関係があると言える。また、例えば、前の関数が圧縮されたデータを伸張する処理であり、後の関数がデータを表示したり出力する処理の場合、2つの処理にデータ依存関係があると言える。
・処理依存
後の関数jやマクロiの実行に、それよりも前の関数jやマクロiが実行した状況が必要となる場合である。例えば、後の関数がアクチュエータを元の状態に戻す処理であり、前提として前の関数がアクチュエータをある状態にする処理である場合、2つの処理に処理依存関係があると言える。また例えば、後の関数が入出力装置にデータを出力する処理であり、前の関数が入出力装置を初期化する処理である場合、2つの処理に処理依存関係があると言える。
開発者は、このような依存関係を抽出し、メインタスクが使用可能なコア数を考慮して、適当な数の処理に区分する。例えば、メインタスクが使用可能なコア数が少ない(例えば2つしかない)のに、それよりもかなり多い数(例えば、50〜100)に処理を区分すると並列に実行可能な処理は増えるが、処理の切り替えのオーバーヘッドが処理効率を下げてしまう。一方、メインタスクが使用可能なコア数が十分にある(例えば10個ある)のに、区分後の処理の数が少ないと(例えば、10以下)、並列に実行可能な処理が少なくなり、マルチコアの有効性を活かせない。このため、開発者はある程度最適化しながら処理を適切な数に区分する。
〔動作手順〕
図8は、処理進度表更新部31が処理進度表11を更新する手順を示すフローチャート図の一例である。図8の手順は、マルチコアプロセッサ200が起動すると繰り返し実行される。なお、以下では、コア数は2つ(処理分散分割装置100を入れると3つ)であるとして説明する。
図8は、処理進度表更新部31が処理進度表11を更新する手順を示すフローチャート図の一例である。図8の手順は、マルチコアプロセッサ200が起動すると繰り返し実行される。なお、以下では、コア数は2つ(処理分散分割装置100を入れると3つ)であるとして説明する。
起動直後の処理進度表更新部31は処理進度表11を初期化する。例えば、RAM53に処理進度表11を生成し初期状態を設定する。「エントリ」「処理識別番号」「処理開始アドレス」「処理終了アドレス」については固定なので、処理進度表更新部31は既知のこれらの情報をRAM53に書き込む。
また、起動直後の各処理のステータスは、「エントリ」にフラグが設定された処理1,2が“Ready”でなければならないので(そうしないとどの処理も開始されない)、処理進度表更新部31は処理1,2のステータスをReadyに更新する。その他の処理3〜5のステータスは全てWaitに更新する。なお、処理モデル12により依存関係のないことが分かる処理3のステータスをReadyとしておいてもよい。
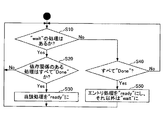
処理進度表更新部31は、処理進度表11のステータスがWaitの処理があるか否かを判定する(S10)。判定のタイミングは、例えば、クロックサイクル毎でもよいし、終了判定部33が、コア51が実行している処理が完了したと判定したタイミングでもよい。
ステータスがWaitの処理3,4、5がある場合(S10のYes)、処理進度表更新部31はステータスがWaitの処理3,4、5について1つずつ処理モデル12に基づき依存関係のある処理が全てDoneか否かを判定する(S20)。
処理モデル12によれば、処理3に対し依存関係のある処理はなく、処理4に対し依存関係のある処理は処理1,2なので、処理進度表更新部31は処理1,2がDoneとなったか否かを判定し、処理5に対し依存関係のある処理は処理3,4なので、処理進度表更新部31は処理3,4がDoneとなったか否かを判定する。ステータスがWaitの処理に関し依存関係のある処理が全てDoneになると、処理進度表更新部31はWaitであったステータスをReadyに更新する(S30)。
ステップS10に戻り、ステータスがWaitの処理がなくなると(S10のNo)、処理のステータスはReady、Done、又は、Processingということになるが、全てDoneになった場合に「エントリ」の処理1、2から再開する必要がある。
このため、処理進度表更新部31は処理進度表11の全てのステータスがDoneになったか否かを判定する(S40)。全てのステータスがDoneになっていない場合(S40のNo)、手順はS10に戻る。
全てのステータスがDoneになった場合(S40のYes)、処理進度表更新部31は「エントリ」にフラグが設定された処理1、2にReadyを設定する(S50)。メインタスクをシングルコアのプロセッサで実行する場合と同様に、本実施形態のマルチコアプロセッサ200はメインタスクを繰り返し実行することができる。
なお、ステップS40で全てのステータスがDoneになるまで待つのでなく、ステータスがDoneとProcessingだけになったら、「エントリ」にフラグが設定された処理1、2にReadyを設定することもできる。こうすることで、例えば、コア1が処理5を実行中(Processing)、処理1、2のステータスがReadyになるので、いずれか1つ以上のコア2が空き次第、そのコア2が処理1又は処理2を実行できるようになる。したがって、処理の並列度をさらに向上させることができる。
図9は、処理割り当て部32がコア51に処理1〜5を割り当てる手順を示すフローチャート図の一例である。図9の手順は、マルチコアプロセッサ200が起動すると繰り返し実行される。
まず、処理割り当て部32は、「エントリ」にフラグが設定された処理1、2のステータスがReadyか否かを判定する(S110)。こうすることで、マルチコアプロセッサ200はメインタスクで最初に行うべき処理から実行を開始できる。処理1、2のステータスがReadyでない場合(S110のNo)、処理進度表11の初期化が完了していないとして待機する。
処理1、2のステータスがReadyである場合(S110のYes)、処理割り当て部32は処理進度表11の処理1,2の処理開始アドレスを読み出す(S140)。そして、処理割り当て部32は、空いているコア1,2で処理1,2を実行する(S150)。すなわち、処理1の処理開始アドレスをコア1のPCに、処理2の処理開始アドレスをコア2のPCに、それぞれ設定する。
図10は、S140,S150の処理のフローチャート図の一例を示す。処理割り当て部32は、空いているコア1,2に割り当てた処理1,2の識別情報を処理進度表更新部31に通知するので、処理進度表更新部31は処理1,2のステータスをProcessingに更新する(S210)。
その後、コア1,2は処理1,2を実行する(S220)。コア1,2が処理1,2を実行している間、終了判定部33はコア1,2のPCをINT経由で監視したり、命令バッファを読み出すことで、コア1,2が処理終了アドレスまで処理を実行したことを検出する。終了判定部33は、コア1,2が処理終了アドレスまで処理を実行したことを検出すると、PCや命令バッファに処理を終了する命令(例えば、NOP、END等)を設定するなどして、処理1,2を強制的に終了させる。
そして、終了判定部33は処理1,2の識別情報と終了を処理進度表更新部31に通知する。これにより、処理進度表更新部31は処理1,2のステータスをDoneに更新する(S230)。
図11はコア1,2が処理1〜5を実行するタイムチャート図の一例である。初期状態の処理1,2のステータスはReadyであり、ステップS210の手順により処理1,2のステータスはProcessingになる。また、この後、処理1,2が実行中に処理3のステータスはReadyとなる。その後、コア1が処理1の処理終了アドレスまで実行すると、処理1のステータスはDoneとなり、コア2が処理2の処理終了アドレスまで実行すると、処理2のステータスはDoneとなる。
図9に戻り、処理割り当て部32は、定期的に又は処理進度表11が更新される毎に、ステータスがReadyの処理があるか否かを判定する(S130)。処理1,2の実行中は処理3のステータスがReadyであるので、処理割り当て部32は空きコアがあるか否かを判定する(S130)。空きコアの有無は、例えば、OSに問い合わせたり、フラグを参照することで判断できる。
例えば、処理1,2の実行中は空きコアがないので手順はステップS120に戻る。そして、コア1が処理1の実行を完了すると、コア1が空きコアとなるので(S130のYes)、処理割り当て部32はコア1に処理3を割り当て、コア1が処理3を実行する(S140、S150)。
これにより、処理進度表更新部31は処理3のステータスをProcessingに更新する(S210)。ここで、処理割り当て部32は、「エントリ」にフラグが設定された処理以外の処理を割り当てる際、コンテキスト管理を実行する。
まず、処理割り当て部32は、それまでコア1が実行していた処理1のコンテキストを保存する。次に、処理割り当て部32は、処理モデル12を参照して、割り当て対象の処理がデータ依存の関係を有する処理を探す。処理3の場合は、データ依存の関係にある処理はないので、処理割り当て部32は何もしない。
これに対し、例えば処理4が処理1と処理2に対しデータ依存の関係がある場合、処理割り当て部32は、保存してある処理1と処理2のコンテキストを読み出し、予め定められた処理を施して、コンテキストを復帰する。予め定められた処理は、処理1,2に対する処理4のデータ依存関係、処理3,4に対する処理5のデータ依存関係によって様々であるが、例えば、処理1、2のコンテキストのうち処理4が使用するデータが格納されたレジスタのみ取り出す処理、状態を示すフラグを取り出す処理等である。なお、処理4が処理1、2に対しデータ依存関係があっても、処理1,2のコンテキストを互いに演算するような処理は処理4内で行われる。
その後、コア1は処理3を実行するので(S220)、終了判定部33はコア1が処理終了アドレスまで処理を実行したことを検出する。終了判定部33は処理3の識別情報と終了を処理進度表更新部31に通知するので、処理進度表更新部31は処理3のステータスをDoneに更新する(S230)。
図11に示すように、コア1が処理3の処理終了アドレスまで実行すると、処理3のステータスはDoneとなる。処理4,処理5についても同様に割り当てられ実行される。
すなわち、処理4のステータスは、処理2がDoneになるとReadyになり、コア2が処理4の実行を完了するとDoneになる。すると、処理5のステータスがReadyになるので、コア1が処理5の実行を開始することができる。そして、コア1が処理5の実行を完了すると、処理1,2のステータスがReadyになる。上記のように、処理5のステータスがProcessingになった時点で処理1,2のステータスをReadyとすれば、空いているコア2が処理1を実行することができ、並列度が向上する。
〔メインタスクと他のタスクとの競合について〕
コア51の数に対し、OSが割り当てるタスクの数がある程度多いと、メインタスクを実行していたコア51が処理1〜5を途中で中断し、別のタスクを実行する必要も生じる。しかしこの場合でも、本実施形態のマルチコアプロセッサ200は有効である。
コア51の数に対し、OSが割り当てるタスクの数がある程度多いと、メインタスクを実行していたコア51が処理1〜5を途中で中断し、別のタスクを実行する必要も生じる。しかしこの場合でも、本実施形態のマルチコアプロセッサ200は有効である。
図12(a)は、コア1,2に対する処理1〜5と割込みタスクの割り当ての関係を示す図の一例である。処理分割分散装置100は、OSからの割り当てに関係なく、複数のコア1,2に処理を分散できるので、2つしかないコア1,2に処理1,2を割り当てることができる。コア1が処理1をコア2が処理2を実行している状態で、OSが割込みタスクを起床した場合、コア1又はコア2(図ではコア2に)に割込みタスクをディスパッチする。これによりコア2は割込みタスクを実行するが、コア1は処理1の実行後、処理2には依存関係のない処理3を実行できる。
そして、コア2が割込みタスクを終了したら、OSが処理2のコンテキストをコア2に復帰させるのでコア2は処理2を完了させることができる。なお、コア1が処理3を実行完了した後、処理2の実行が完了しないとコア1は処理4を実行できないが、換言すれば、処理3の後はコア1が空きコアになり、メインタスク以外のタスクをコア1が実行できるようになる。したがって、メインタスクと他のタスクとのリソースを共有しても、不都合は生じない。
なお、図12(a)ではコア2が処理2の完了後、コア1が処理4を実行しているが、2つのコア1,2が空いている場合にどちらのコアが処理2を実行するか(OSがどちらのコアに割り当てるか)は設計できる。
図12(b)は、コア1,2に対する処理1〜5と割込みタスクの割り当ての関係を示す図の別の一例である。コア2が割込みタスクを実行するところまでは図12(a)と同じであるが、図12(b)ではコア2が実行する割込みタスクの実行時間が長い。しかしながら、このような場合も、処理分割分散装置100が処理2をコア1に再割り当てすることで、処理を進行させることができる。
具体的には、処理分割分散装置100がOSの割込みタスクの割り当てを監視し、OSが退避したコンテキストを取得することで、処理2をコア1に再割り当てすることができる。再割り当てが可能であれば、以降は、処理分割分散装置100が処理進度表11に基づきReadyになった処理から順番にコア1に割り当てるので、シングルコアがメインタスクを実行する場合と同様に処理1〜5を完了させることができる。
〔処理分割分散装置を専用のコアに割り当てない場合〕
これまでは、固定のコアが処理分割分散装置100の機能を提供するとしたが、タスクを実行するコアが処理分割分散装置100の機能を提供することもできる。
図13は、処理分割分散装置100の機能ブロック図の一例を示す。図13において図5と同一部について説明を省略する。図13では機能ブロックの種類は図5と同じであるが、終了判定部33の機能が異なっている。
これまでは、固定のコアが処理分割分散装置100の機能を提供するとしたが、タスクを実行するコアが処理分割分散装置100の機能を提供することもできる。
図13は、処理分割分散装置100の機能ブロック図の一例を示す。図13において図5と同一部について説明を省略する。図13では機能ブロックの種類は図5と同じであるが、終了判定部33の機能が異なっている。
まず、マルチコアプロセッサ200の起動時に処理進度表更新部31が処理進度表11を初期化し、処理割り当て部32が処理1,2を空きコアに割り当てるのは、上述したとおりである。そして、終了判定部33は、コア自身が処理1〜5の終了を検出できるように、処理の直前に有効フラグと処理終了アドレスをコア1、2に設定する。コア1,2は、有効フラグがオンであることを条件に、PCが処理終了アドレスと一致すると、割込みを発生する。この割込みによって、コア1,2は処理分割分散装置100として起動する。
すると、終了判定部33は、終了した処理の識別番号を処理進度表更新部31に通知するので、処理進度表更新部31は処理進度表11の終了した処理のステータスをDoneに更新する。次に、処理進度表更新部31は図8の手順を実行するので、処理依存のなくなった処理があればステータスにReadyが更新されることになる。
処理割り当て部32は図9,10の手順を実行するので、ステータスにReadyが更新された処理があれば、空きコアに処理を割り当てることができる。なお、ステータスにReadyが更新された処理がない場合でも、後に別のコアが割込みを発生したいずれかのタイミングで、必ずステータスにReadyが更新される処理が生じる。
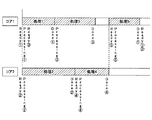
図14は、コア1,2が処理1〜5を実行するタイムチャート図の一例である。図14ではメッシュ部が、処理分割分散装置100がコアを占有したことを示し、丸数字は処理識別番号を示す。処理1,2の実行前に、処理分割分散装置100は処理進度表11を初期化すると共に処理1、2のステータスをReadyからProcessingに更新する。
コア1が処理1の処理終了アドレスまで実行すると、割込みによりコア1が処理分割分散装置100として起動するので、処理進度表更新部31は処理1のステータスをDoneに、依存関係のない処理3のステータスをReadyに更新する。また、処理割り当て部32が処理3をコア1に割り当てることで、処理進度表更新部31が処理3のステータスをProcessingに更新する。
コア2が処理2の処理終了アドレスまで実行すると、割込みによりコア2が処理分割分散装置100として起動するので、処理進度表更新部31は処理2のステータスをDoneに、依存関係のない処理4のステータスをReadyに更新する。また、処理割り当て部32が処理4をコア2に割り当てることで、処理進度表更新部31が処理4のステータスをProcessingに更新する。
次に、コア1が処理3の処理終了アドレスまで実行すると、割込みによりコア1が処理分割分散装置100として起動するので、処理進度表更新部31は処理3のステータスをDoneに更新する。しかし、処理3が終了した時点では処理4が終了していないので、処理進度表更新部31は処理5のステータスをReadyに更新できない。
このため、次に、コア2が処理4の処理終了アドレスまで実行すると、割込みによりコア2が処理分割分散装置100として起動するので、処理進度表更新部31は処理4のステータスをDoneに、依存関係のない処理5のステータスをReadyに更新する。また、処理割り当て部32が処理5をコア2に割り当てることで、処理進度表更新部31が処理5のステータスをProcessingに更新する。
なお、コア2が処理5の処理終了アドレスまで実行した場合、処理1,2のステータスがReadyからProcessingにそれぞれ更新される。
したがって、専用のコアに処理分割分散装置100が割り当てられない場合も、処理1〜5から処理分割分散装置100の切り替えへのオーバーヘッドが生じるものの、処理分割分散装置100がメインタスクの処理を分散させることができる。
以上説明したように、本実施形態のマルチコアプロセッサ200は、既存のプログラムから適切な粒度の処理と依存関係を抽出することで、既存のプログラムをそのままマルチコアに適用でき、1つのメインタスクをマルチコアに負荷分散することができる。
11 処理進度表
12 処理モデル
21 PF/OS
22 アプリケーション
31 処理進度表更新部
32 処理割り当て部
33 終了判定部
60 プログラム
70 タスク制御プログラム
100 処理分割分散装置
200 マルチコアプロセッサ
12 処理モデル
21 PF/OS
22 アプリケーション
31 処理進度表更新部
32 処理割り当て部
33 終了判定部
60 プログラム
70 タスク制御プログラム
100 処理分割分散装置
200 マルチコアプロセッサ
Claims (14)
- 複数のコアと、アプリケーションが記憶された記憶手段と、を有するマルチコアプロセッサであって、
前記アプリケーションを複数の処理に区分した際の処理間の依存関係を登録した処理依存関係情報と、
各処理の進度状況が登録された進度状況登録テーブルと、
前記進度状況が実行待ちの処理と前記処理依存関係情報において依存関係がある処理の実行完了が前記進度状況登録テーブルに登録されている場合、実行待ちの処理の前記進度状況を実行可能に更新する進度状況更新手段と、
前記進度状況に実行可能と設定された処理を空きコアに割り当てる処理割り当て手段と、を有するマルチコアプロセッサ。 - 各処理の処理終了アドレスが登録された処理終了アドレス情報と、
コアが前記処理終了アドレスの命令を実行した場合に、処理の終了を検出する終了判定手段と、を有し、
前記進度状況更新手段は、前記終了判定手段が終了を検出した処理の前記進度状況を実行完了に更新する、請求項1記載のマルチコアプロセッサ。 - 各処理の処理開始アドレスが登録された処理開始アドレス情報、を有し、
前記処理割り当て手段は、処理開始アドレスを割り当て対象のコアのプログラムカウンタに設定することで、処理を空きコアに割り当てる、
請求項1又は2記載のマルチコアプロセッサ。 - 前記進度状況登録テーブルには、複数のコアで並行に実行可能であり、かつ、前記アプリケーションの起動直後に実行される処理にエントリ情報が登録されている、
請求項1〜3いずれか1項記載のマルチコアプロセッサ。 - 前記進度状況更新手段は、全ての処理の前記進度状況が実行完了に設定された場合、前記エントリ情報が登録された処理の前記進度状況を実行可能に更新する、
請求項4記載のマルチコアプロセッサ。 - 前記進度状況更新手段は、全ての処理の前記進度状況が実行完了に設定される前であって、前記進度状況が実行中又は実行完了の処理のみになった場合、
前記エントリ情報が登録された処理の前記進度状況を実行可能に更新する、
請求項4記載のマルチコアプロセッサ。 - 前記依存関係は、後の処理が前の処理のデータを使用するデータ依存、又は、後の処理が前の処理の処理結果を前提とする処理依存、である、
請求項1〜6いずれか1項記載のマルチコアプロセッサ。 - 前記処理割り当て手段は、複数の処理を異なるコアに割り当て、各コアが時間的に並行にそれぞれ処理を実行する、
請求項7記載のマルチコアプロセッサ。 - 前記進度状況更新手段は、前記処理割り当て手段により処理が割り当てられたコアが該処理を実行している間に、該処理の前記進度状況を更新する、
請求項8記載のマルチコアプロセッサ。 - 前記進度状況更新手段は、1つの処理の実行完了毎に、該処理を実行していたコアに割り当てられることで実現され、該処理の前記進度状況を更新する、
請求項8記載のマルチコアプロセッサ。 - 前記進度状況は、コア毎に、実行待ち、実行可能、実行中、実行完了の順に遷移する、
請求項1〜10いずれか1項記載のマルチコアプロセッサ。 - 前記記憶手段にはアプリケーションの他にプログラムが記憶されており、
前記アプリケーションと前記プログラムの優先順位に応じて、前記アプリケーションと前記プログラムを動的に前記コアに割り当てるスケジュール手段を有する、
請求項1〜11いずれか1項記載のマルチコアプロセッサ。 - 複数のコアと、アプリケーションが記憶された記憶手段と、
前記アプリケーションを複数の処理に区分した際の処理間の依存関係を登録した処理依存関係情報と、
各処理の進度状況が登録された進度状況登録テーブルと、を有するマルチコアプロセッサの処理実行方法であって、
進度状況更新手段が、前記進度状況が実行待ちの処理と前記処理依存関係情報において依存関係がある処理の実行完了が前記進度状況登録テーブルに登録されている場合、実行待ちの処理の前記進度状況を実行可能に更新するステップと、
処理割り当て手段が、前記進度状況に実行可能と設定された処理を空きコアに割り当てるステップと、を有する処理実行方法。 - 複数のコアと、アプリケーションが記憶された記憶手段と、
前記アプリケーションを複数の処理に区分した際の処理間の依存関係を登録した処理依存関係情報と、
各処理の進度状況が登録された進度状況登録テーブルと、を有するマルチコアプロセッサに、
前記進度状況が実行待ちの処理と前記処理依存関係情報において依存関係がある処理の実行完了が前記進度状況登録テーブルに登録されている場合、実行待ちの処理の前記進度状況を実行可能に更新する進度状況更新ステップと、
前記進度状況に実行可能と設定された処理を空きコアに割り当てる処理割り当てステップと、を実行させるプログラム。
Priority Applications (1)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| JP2010254662A JP2012108576A (ja) | 2010-11-15 | 2010-11-15 | マルチコアプロセッサ、処理実行方法、プログラム |
Applications Claiming Priority (1)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| JP2010254662A JP2012108576A (ja) | 2010-11-15 | 2010-11-15 | マルチコアプロセッサ、処理実行方法、プログラム |
Publications (1)
| Publication Number | Publication Date |
|---|---|
| JP2012108576A true JP2012108576A (ja) | 2012-06-07 |
Family
ID=46494149
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| JP2010254662A Pending JP2012108576A (ja) | 2010-11-15 | 2010-11-15 | マルチコアプロセッサ、処理実行方法、プログラム |
Country Status (1)
| Country | Link |
|---|---|
| JP (1) | JP2012108576A (ja) |
Cited By (10)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| WO2014025145A1 (en) * | 2012-08-10 | 2014-02-13 | Samsung Techwin Co., Ltd | Method and apparatus for processing message between processors |
| WO2014109019A1 (ja) | 2013-01-09 | 2014-07-17 | 三菱電機株式会社 | プラントエンジニアリングシステム |
| KR20160004335A (ko) * | 2013-04-23 | 2016-01-12 | 아브 이니티오 테크놀로지 엘엘시 | 컴퓨팅 시스템에 의해 수행되는 태스크 제어 |
| JP2017073000A (ja) * | 2015-10-07 | 2017-04-13 | 株式会社デンソー | 並列化方法、並列化ツール、車載装置 |
| JP2017111662A (ja) * | 2015-12-17 | 2017-06-22 | 日立オートモティブシステムズ株式会社 | 電子制御装置 |
| JP2017182627A (ja) * | 2016-03-31 | 2017-10-05 | 株式会社デンソー | マイクロコンピュータ |
| CN110114732A (zh) * | 2016-12-27 | 2019-08-09 | 东芝三菱电机产业系统株式会社 | 可编程控制器、管理装置和控制系统 |
| JP2020501253A (ja) * | 2016-11-28 | 2020-01-16 | アマゾン テクノロジーズ インコーポレイテッド | 局所化されたデバイスコーディネータにおけるオンデマンドコード実行 |
| US10642658B2 (en) | 2014-05-26 | 2020-05-05 | Hitachi Automotive Systems, Ltd. | Vehicle control apparatus |
| JP2020197886A (ja) * | 2019-06-03 | 2020-12-10 | 日立オートモティブシステムズ株式会社 | 制御装置および制御方法 |
-
2010
- 2010-11-15 JP JP2010254662A patent/JP2012108576A/ja active Pending
Cited By (19)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| US9448864B2 (en) | 2012-08-10 | 2016-09-20 | Hanwha Techwin Co., Ltd. | Method and apparatus for processing message between processors |
| US20150242254A1 (en) * | 2012-08-10 | 2015-08-27 | Samsung Techwin Co., Ltd. | Method and apparatus for processing message between processors |
| KR101915198B1 (ko) | 2012-08-10 | 2018-11-05 | 한화테크윈 주식회사 | 프로세서간 메시지처리장치 및 방법 |
| WO2014025145A1 (en) * | 2012-08-10 | 2014-02-13 | Samsung Techwin Co., Ltd | Method and apparatus for processing message between processors |
| WO2014109019A1 (ja) | 2013-01-09 | 2014-07-17 | 三菱電機株式会社 | プラントエンジニアリングシステム |
| KR20160004335A (ko) * | 2013-04-23 | 2016-01-12 | 아브 이니티오 테크놀로지 엘엘시 | 컴퓨팅 시스템에 의해 수행되는 태스크 제어 |
| JP2016520912A (ja) * | 2013-04-23 | 2016-07-14 | アビニシオ テクノロジー エルエルシー | コンピューティングシステムによって実行されるタスクの制御 |
| US10565005B2 (en) | 2013-04-23 | 2020-02-18 | Ab Initio Technology Llc | Controlling tasks performed by a computing system |
| KR102305084B1 (ko) * | 2013-04-23 | 2021-09-24 | 아브 이니티오 테크놀로지 엘엘시 | 컴퓨팅 시스템에 의해 수행되는 태스크 제어 |
| US10489191B2 (en) | 2013-04-23 | 2019-11-26 | Ab Initio Technology Llc | Controlling tasks performed by a computing system using controlled process spawning |
| US10642658B2 (en) | 2014-05-26 | 2020-05-05 | Hitachi Automotive Systems, Ltd. | Vehicle control apparatus |
| JP2017073000A (ja) * | 2015-10-07 | 2017-04-13 | 株式会社デンソー | 並列化方法、並列化ツール、車載装置 |
| JP2017111662A (ja) * | 2015-12-17 | 2017-06-22 | 日立オートモティブシステムズ株式会社 | 電子制御装置 |
| JP2017182627A (ja) * | 2016-03-31 | 2017-10-05 | 株式会社デンソー | マイクロコンピュータ |
| JP2020501253A (ja) * | 2016-11-28 | 2020-01-16 | アマゾン テクノロジーズ インコーポレイテッド | 局所化されたデバイスコーディネータにおけるオンデマンドコード実行 |
| CN110114732A (zh) * | 2016-12-27 | 2019-08-09 | 东芝三菱电机产业系统株式会社 | 可编程控制器、管理装置和控制系统 |
| CN110114732B (zh) * | 2016-12-27 | 2022-02-25 | 东芝三菱电机产业系统株式会社 | 可编程控制器、管理装置和控制系统 |
| JP2020197886A (ja) * | 2019-06-03 | 2020-12-10 | 日立オートモティブシステムズ株式会社 | 制御装置および制御方法 |
| JP7236939B2 (ja) | 2019-06-03 | 2023-03-10 | 日立Astemo株式会社 | 制御装置および制御方法 |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| US8963933B2 (en) | Method for urgency-based preemption of a process | |
| US8230201B2 (en) | Migrating sleeping and waking threads between wake-and-go mechanisms in a multiple processor data processing system | |
| JP6294586B2 (ja) | 命令スレッドを組み合わせた実行の管理システムおよび管理方法 | |
| US7979861B2 (en) | Multi-processor system and program for causing computer to execute controlling method of multi-processor system | |
| JP5411587B2 (ja) | マルチスレッド実行装置、マルチスレッド実行方法 | |
| US10242420B2 (en) | Preemptive context switching of processes on an accelerated processing device (APD) based on time quanta | |
| JP2005284749A (ja) | 並列処理コンピュータ | |
| US10248456B2 (en) | Method and system for providing stack memory management in real-time operating systems | |
| US20130205058A1 (en) | Multi-thread processor and its interrupt processing method | |
| US10846092B2 (en) | Execution of micro-operations | |
| WO2009113034A1 (en) | Look-ahead task management | |
| US8973009B2 (en) | Allocation and control unit for controlling parallel execution of threads on auxiliary processing units | |
| CN103473135A (zh) | 虚拟化环境下自旋锁lhp现象的处理方法 | |
| CN101599009A (zh) | 一种异构多处理器上并行执行任务的方法 | |
| CN1926514B (zh) | 从处理器中的并发物理线程的数目中去耦合逻辑线程的数目 | |
| EP2235630A1 (en) | Data processing system and method of interrupt handling | |
| JP2009223842A (ja) | 仮想計算機制御プログラム及び仮想計算機システム | |
| US9367326B2 (en) | Multiprocessor system and task allocation method | |
| US7711925B2 (en) | Information-processing device with transaction processor for executing subset of instruction set where if transaction processor cannot efficiently execute the instruction it is sent to general-purpose processor via interrupt | |
| JPH07160656A (ja) | 外部割込み制御方法 | |
| US8595747B2 (en) | Efficient task scheduling by assigning fixed registers to scheduler | |
| US10360652B2 (en) | Wavefront resource virtualization | |
| US6311267B1 (en) | Just-in-time register renaming technique | |
| EP1913474B1 (en) | Dynamically modifying system parameters based on usage of specialized processing units | |
| JP7054688B2 (ja) | 同期制御システムおよび同期制御方法 |