JP2017167779A - 画像処理装置、表示装置、アニメーション生成方法、アニメーション表示方法及びプログラム - Google Patents
画像処理装置、表示装置、アニメーション生成方法、アニメーション表示方法及びプログラム Download PDFInfo
- Publication number
- JP2017167779A JP2017167779A JP2016051932A JP2016051932A JP2017167779A JP 2017167779 A JP2017167779 A JP 2017167779A JP 2016051932 A JP2016051932 A JP 2016051932A JP 2016051932 A JP2016051932 A JP 2016051932A JP 2017167779 A JP2017167779 A JP 2017167779A
- Authority
- JP
- Japan
- Prior art keywords
- facial expression
- animation
- voice
- facial
- data
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Granted
Links
Images
Classifications
-
- G—PHYSICS
- G10—MUSICAL INSTRUMENTS; ACOUSTICS
- G10L—SPEECH ANALYSIS TECHNIQUES OR SPEECH SYNTHESIS; SPEECH RECOGNITION; SPEECH OR VOICE PROCESSING TECHNIQUES; SPEECH OR AUDIO CODING OR DECODING
- G10L13/00—Speech synthesis; Text to speech systems
- G10L13/08—Text analysis or generation of parameters for speech synthesis out of text, e.g. grapheme to phoneme translation, prosody generation or stress or intonation determination
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F40/00—Handling natural language data
- G06F40/20—Natural language analysis
- G06F40/268—Morphological analysis
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F40/00—Handling natural language data
- G06F40/20—Natural language analysis
- G06F40/279—Recognition of textual entities
- G06F40/289—Phrasal analysis, e.g. finite state techniques or chunking
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F40/00—Handling natural language data
- G06F40/30—Semantic analysis
- G06F40/35—Discourse or dialogue representation
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06T—IMAGE DATA PROCESSING OR GENERATION, IN GENERAL
- G06T13/00—Animation
- G06T13/20—Three-dimensional [3D] animation
- G06T13/40—Three-dimensional [3D] animation of characters, e.g. humans, animals or virtual beings
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06V—IMAGE OR VIDEO RECOGNITION OR UNDERSTANDING
- G06V40/00—Recognition of biometric, human-related or animal-related patterns in image or video data
- G06V40/20—Movements or behaviour, e.g. gesture recognition
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F40/00—Handling natural language data
- G06F40/40—Processing or translation of natural language
- G06F40/42—Data-driven translation
- G06F40/47—Machine-assisted translation, e.g. using translation memory
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06T—IMAGE DATA PROCESSING OR GENERATION, IN GENERAL
- G06T13/00—Animation
-
- G—PHYSICS
- G10—MUSICAL INSTRUMENTS; ACOUSTICS
- G10L—SPEECH ANALYSIS TECHNIQUES OR SPEECH SYNTHESIS; SPEECH RECOGNITION; SPEECH OR VOICE PROCESSING TECHNIQUES; SPEECH OR AUDIO CODING OR DECODING
- G10L15/00—Speech recognition
- G10L15/26—Speech to text systems
-
- G—PHYSICS
- G10—MUSICAL INSTRUMENTS; ACOUSTICS
- G10L—SPEECH ANALYSIS TECHNIQUES OR SPEECH SYNTHESIS; SPEECH RECOGNITION; SPEECH OR VOICE PROCESSING TECHNIQUES; SPEECH OR AUDIO CODING OR DECODING
- G10L21/00—Speech or voice signal processing techniques to produce another audible or non-audible signal, e.g. visual or tactile, in order to modify its quality or its intelligibility
- G10L21/06—Transformation of speech into a non-audible representation, e.g. speech visualisation or speech processing for tactile aids
- G10L21/10—Transforming into visible information
- G10L2021/105—Synthesis of the lips movements from speech, e.g. for talking heads
Landscapes
- Engineering & Computer Science (AREA)
- Theoretical Computer Science (AREA)
- Physics & Mathematics (AREA)
- General Physics & Mathematics (AREA)
- Health & Medical Sciences (AREA)
- Computational Linguistics (AREA)
- Audiology, Speech & Language Pathology (AREA)
- General Health & Medical Sciences (AREA)
- Artificial Intelligence (AREA)
- General Engineering & Computer Science (AREA)
- Multimedia (AREA)
- Human Computer Interaction (AREA)
- Acoustics & Sound (AREA)
- Computer Vision & Pattern Recognition (AREA)
- Psychiatry (AREA)
- Social Psychology (AREA)
- Processing Or Creating Images (AREA)
Abstract
Description
音声の出力とともに表示される顔画像に前記音声に対応する表情を付加する表情付加手段と、
前記表情が付加された顔画像に含まれる口を前記音声に応じて動かすアニメーションを生成する生成手段と、
を備える。
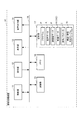
図1は、本実施形態に係る表示装置10の機能的構成を示すブロック図である。
表示装置10は、制御部11と、操作部12と、表示部13と、音声出力部14と、通信部15と、メモリ16と、記憶部17と、を備え、各部はバス18を介して接続されている。表示装置10は、映像加工が可能な画像処理装置を含んで構成される。
音声データAは、人が発した音声を録音して得られたデータであり、リップシンクさせたいキャラクター(人物も含む)の音声として用いられる。音声データAとしては、音声以外の音(ノイズ、BGM等)が含まれていないものとする。また、本実施形態において、音声データAには、その音声の言語の情報を含むヘッダ情報が付加されている。
顔画像データFは、リップシンクさせたいキャラクターの顔を含む画像のデータであり、例えば、2次元の静止画データ、又は、3次元のポリゴンデータである。
次に、表示装置10の動作について説明する。
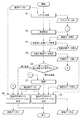
図2は、表示装置10において実行されるアニメーション生成処理を示すフローチャートである。アニメーション生成処理は、操作部12によりアニメーションの生成に使用する音声データA、顔画像データF及び生成するアニメーションの言語が指定され、アニメーションの生成が指示された際に、制御部11と記憶部17に記憶されているプログラムPとの協働により実行される。なお、言語としては、予め定められた複数の言語の中から指定が可能である。指定された音声データA、顔画像データF及び言語は、設定情報としてメモリ16に記憶される。
テキスト変換には、既存の音声認識技術を用いる。例えば、制御部11は、「ご来店ありがとうございます。」という音声データAを、「ごらいてんありがとうございます。」というテキストデータBに変換する。制御部11は、生成したテキストデータBをメモリ16に記憶させる。
単語の検出には、例えば、形態素解析等の既存の単語検出技術を用いる。例えば、制御部11は、「ごらいてんありがとうございます。」というテキストデータBから、「ご来店」、「ありがとう」、「ございます」の3つの単語を検出する。制御部11は、生成した単語データ群Cをメモリ16に記憶させる。
例えば、制御部11は、単語データ群Cに含まれる単語データを最初の単語から順番に読み込み、単語毎に、記憶部17に記憶されている単語・表情対応テーブルT1においてその単語に対応付けて記憶されている表情の情報を取得して、単語表情データ群Dを生成する。例えば、「ご来店」に対応する表情として「文脈次第」、「ありがとう」に対応する表情として「笑顔」、「ございます」に対応する表情として「文脈次第」が取得される。ここで、「文脈次第」とは、文脈に合わせた表情であることを示す。制御部11は、生成した単語表情データ群Dをメモリ16に記憶させる。
例えば、制御部11は、単語表情データ群Dを参照し、同一文内の単語に対応する表情のうち最も多い表情をその文の表情として決定する。例えば、上述の「ご来店ありがとうございます。」の場合、各単語に対応する表情は、「ご来店」→「文脈次第」、「ありがとう」→「笑顔」、「ございます」→「文脈次第」である。「文脈次第」は文脈に合わせた表情であることから無視し、「笑顔」をこの文の表情として決定する。制御部11は、生成した文表情データ群Eをメモリ16に記憶させる。
例えば、制御部11は、まず、顔画像データFにおける口の特徴点を取得する。例えば、画像認識により顔画像データFから口の輪郭を抽出し、輪郭上の特徴点の座標を取得する。次いで、制御部11は、音声データAの冒頭から順次フレーム1枚に相当する時間の音声データAtを取得する。ここで、生成するアニメーションのフレームレートをPf(フレーム/秒)、音声データAの再生時間をT(秒)とすると、1/Pf(秒/フレーム)ずつ音声データAtを取得する。次いで、制御部11は、各音声データAtを解析して母音を取得し、母音に応じた口の形状を、その音声データAtに対応するフレームの口の形状として決定する。そして、決定した口の形状となるように、顔画像データFの口の各特徴点の位置を変化させ、その変化させた各特徴点の座標を、その音声データAtに対応するフレームの口の形状データとしてフレーム番号に対応付けてメモリ16に記憶する。
まず、制御部11は、各フレームの顔画像に付加する表情を決定する。例えば、制御部11は、各フレームの音声データAtに対応する文を特定し、特定した文に対応する表情を文表情データ群Eに基づいて特定し、特定した表情を各フレームの顔画像に付加する表情として決定する。次いで、制御部11は、各フレームに対して決定された表情と記憶部17に記憶されている表情パラメータIに基づいて顔画像データFに表情を付加して各フレームの顔画像データを生成し、メモリ16に記憶させる。そして、制御部11は、各フレームの顔画像データの口を各フレームの口の形状データに基づいて変形することにより各フレームの静止画を生成し、生成した各フレームの静止画を結合してアニメーションを生成し、生成したアニメーションに音声データAを結合して映像データH1を生成し、映像データH1を記憶部17に記憶させる。
例えば、制御部11は、翻訳後のテキストデータである翻訳文データ群Gに基づいて、指定された言語の音声データ(音声データJと呼ぶ)を生成し、音声データJと顔画像データFに基づいて、ステップS6で説明したものと同様の手法(音声データAを音声データJに置き合えるところのみが異なる)によりアニメーションを構成する各フレームの口の形状データを生成する。なお、各フレームの音声データを音声データJtとする。
まず、制御部11は、各フレームの顔画像に付加する表情を決定する。例えば、制御部11は、各フレームの音声データJtに対応する文(翻訳後のテキスト文)を特定し、特定した文の翻訳前の文に対応する表情を文表情データ群Eに基づいて特定し、特定した表情を各フレームの顔画像に付加する表情として決定する。次いで、制御部11は、各フレームに対して決定された表情と記憶部17に記憶されている表情パラメータIに基づいて顔画像データFに表情を付加して各フレームの顔画像データを生成し、メモリ16に記憶させる。そして、制御部11は、各フレームの顔画像データの口を各フレームの口の形状データに基づいて変形することにより各フレームの静止画を生成し、生成した各フレームの静止画を結合してアニメーションを生成し、生成したアニメーションに音声データJを結合して映像データH2を生成し、映像データH2を記憶部17に記憶させる。
例えば、制御部11は、テキストデータBから単語を検出し、単語・表情対応テーブルT1を参照してテキストデータBに含まれる各文を構成する単語に予め対応付けられている表情の情報を取得し、取得した情報に基づいて、テキストデータBに含まれる各文に応じた表情を決定する。そして、決定した表情をその文に対応する音声の出力とともに表示される顔画像に付加し、表情が付加された顔画像に含まれる口を音声に応じて動かすアニメーションを生成する。
従って、音声に応じて表情を変え、音声に応じて口を動かすアニメーションを1枚の顔画像から自動的に生成するので、顔画像に基づいて生成されるリップシンクアニメーションの表現力を向上させることができる。また、例えば、音声を耳で聞きながらどのタイミングでどの表情を付加するのかをユーザが判断して手動で調整する等の煩雑な作業を行うことなく、容易に音声に応じた表情が付加されたリップシンクアニメーションを生成することが可能となる。
従って、もとの言語とは異なる言語(例えば、外国語)の音声に応じて表情を変え、その音声に応じて口を動かすアニメーションを1枚の顔画像から自動的に生成することができるので、音声の言語を理解できなくても、容易に音声に応じた表情が付加されたリップアニメーションを生成することが可能となる。
以下に、この出願の願書に最初に添付した特許請求の範囲に記載した発明を付記する。付記に記載した請求項の項番は、この出願の願書に最初に添付した特許請求の範囲の通りである。
〔付記〕
<請求項1>
音声の出力とともに表示される顔画像に前記音声に対応する表情を付加する表情付加手段と、
前記表情が付加された顔画像に含まれる口を前記音声に応じて動かすアニメーションを生成する生成手段と、
を備える画像処理装置。
<請求項2>
前記表情付加手段は、テキストデータに対応する音声の出力とともに表示される顔画像に前記音声に対応する表情を付加する請求項1に記載の画像処理装置。
<請求項3>
前記表情付加手段は、前記テキストデータに含まれる各文に応じた表情を決定し、決定した表情をその文に対応する音声の出力とともに表示される顔画像に付加する請求項2に記載の画像処理装置。
<請求項4>
前記表情付加手段は、前記テキストデータに含まれる各文を構成する単語に予め対応付けられている表情の情報を取得し、取得した情報に基づいて、前記テキストデータに含まれる各文に応じた表情を決定する請求項3に記載の画像処理装置。
<請求項5>
前記テキストデータに含まれる各文を前記テキストデータの言語とは異なる他の言語のテキストデータに翻訳する翻訳手段を備え、
前記表情付加手段は、翻訳前の前記テキストデータに含まれる各文に対して決定された表情を翻訳後の対応する各文に対応する音声の出力とともに表示される顔画像に付加し、
前記生成手段は、前記表情が付加された顔画像に含まれる口を前記翻訳後の前記テキストデータに対応する音声に応じて動かすアニメーションを生成する請求項3又は4に記載の画像処理装置。
<請求項6>
請求項1〜5の何れか一項に記載の画像処理装置と、
前記画像処理装置により生成されたアニメーションを表示する表示手段と、
を備える表示装置。
<請求項7>
音声とともに出力される顔画像に前記音声に対応する表情を付加する工程と、
前記表情が付加された顔画像に含まれる口を前記音声に応じて動かすアニメーションを生成する工程と、
を含むアニメーション生成方法。
<請求項8>
音声の出力とともに表示される顔画像に前記音声に対応する表情を付加する工程と、
前記表情が付加された顔画像に含まれる口を前記音声に応じて動かすアニメーションを生成する工程と、
前記生成されたアニメーションを表示する工程と、
を含むアニメーション表示方法。
<請求項9>
コンピュータを、
音声の出力とともに表示される顔画像に前記音声に対応する表情を付加する表情付加手段、
前記表情が付加された顔画像に含まれる口を前記音声に応じて動かすアニメーションを生成する生成手段、
として機能させるためのプログラム。
<請求項10>
コンピュータを、
音声の出力とともに表示される顔画像に前記音声に対応する表情を付加する表情付加手段、
前記表情が付加された顔画像に含まれる口を前記音声に応じて動かすアニメーションを生成する生成手段、
前記生成手段により生成されたアニメーションを表示する表示手段、
として機能させるためのプログラム。
11 制御部
12 操作部
13 表示部
14 音声出力部
15 通信部
16 メモリ
17 記憶部
A 音声データ
B テキストデータ
C 単語データ群
D 単語表情データ群
E 文表情データ群
F 顔画像データ
G 翻訳文データ群
H1 映像データ
H2 映像データ
I 表情パラメータ
P プログラム
T1 単語・表情対応テーブル
Claims (10)
- 音声の出力とともに表示される顔画像に前記音声に対応する表情を付加する表情付加手段と、
前記表情が付加された顔画像に含まれる口を前記音声に応じて動かすアニメーションを生成する生成手段と、
を備える画像処理装置。 - 前記表情付加手段は、テキストデータに対応する音声の出力とともに表示される顔画像に前記音声に対応する表情を付加する請求項1に記載の画像処理装置。
- 前記表情付加手段は、前記テキストデータに含まれる各文に応じた表情を決定し、決定した表情をその文に対応する音声の出力とともに表示される顔画像に付加する請求項2に記載の画像処理装置。
- 前記表情付加手段は、前記テキストデータに含まれる各文を構成する単語に予め対応付けられている表情の情報を取得し、取得した情報に基づいて、前記テキストデータに含まれる各文に応じた表情を決定する請求項3に記載の画像処理装置。
- 前記テキストデータに含まれる各文を前記テキストデータの言語とは異なる他の言語のテキストデータに翻訳する翻訳手段を備え、
前記表情付加手段は、翻訳前の前記テキストデータに含まれる各文に対して決定された表情を翻訳後の対応する各文に対応する音声の出力とともに表示される顔画像に付加し、
前記生成手段は、前記表情が付加された顔画像に含まれる口を前記翻訳後の前記テキストデータに対応する音声に応じて動かすアニメーションを生成する請求項3又は4に記載の画像処理装置。 - 請求項1〜5の何れか一項に記載の画像処理装置と、
前記画像処理装置により生成されたアニメーションを表示する表示手段と、
を備える表示装置。 - 音声とともに出力される顔画像に前記音声に対応する表情を付加する工程と、
前記表情が付加された顔画像に含まれる口を前記音声に応じて動かすアニメーションを生成する工程と、
を含むアニメーション生成方法。 - 音声の出力とともに表示される顔画像に前記音声に対応する表情を付加する工程と、
前記表情が付加された顔画像に含まれる口を前記音声に応じて動かすアニメーションを生成する工程と、
前記生成されたアニメーションを表示する工程と、
を含むアニメーション表示方法。 - コンピュータを、
音声の出力とともに表示される顔画像に前記音声に対応する表情を付加する表情付加手段、
前記表情が付加された顔画像に含まれる口を前記音声に応じて動かすアニメーションを生成する生成手段、
として機能させるためのプログラム。 - コンピュータを、
音声の出力とともに表示される顔画像に前記音声に対応する表情を付加する表情付加手段、
前記表情が付加された顔画像に含まれる口を前記音声に応じて動かすアニメーションを生成する生成手段、
前記生成手段により生成されたアニメーションを表示する表示手段、
として機能させるためのプログラム。
Priority Applications (3)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| JP2016051932A JP6711044B2 (ja) | 2016-03-16 | 2016-03-16 | 画像処理装置、表示装置、アニメーション生成方法及びプログラム |
| US15/388,053 US10304439B2 (en) | 2016-03-16 | 2016-12-22 | Image processing device, animation display method and computer readable medium |
| CN201710059946.9A CN107204027B (zh) | 2016-03-16 | 2017-01-24 | 图像处理装置、显示装置、动画生成方法以及动画显示方法 |
Applications Claiming Priority (1)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| JP2016051932A JP6711044B2 (ja) | 2016-03-16 | 2016-03-16 | 画像処理装置、表示装置、アニメーション生成方法及びプログラム |
Publications (2)
| Publication Number | Publication Date |
|---|---|
| JP2017167779A true JP2017167779A (ja) | 2017-09-21 |
| JP6711044B2 JP6711044B2 (ja) | 2020-06-17 |
Family
ID=59847052
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| JP2016051932A Active JP6711044B2 (ja) | 2016-03-16 | 2016-03-16 | 画像処理装置、表示装置、アニメーション生成方法及びプログラム |
Country Status (3)
| Country | Link |
|---|---|
| US (1) | US10304439B2 (ja) |
| JP (1) | JP6711044B2 (ja) |
| CN (1) | CN107204027B (ja) |
Cited By (1)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP2021033961A (ja) * | 2019-08-29 | 2021-03-01 | 株式会社鈴康 | 動画生成プログラム、動画生成装置及び動画生成方法 |
Families Citing this family (9)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| CN108174123A (zh) * | 2017-12-27 | 2018-06-15 | 北京搜狐新媒体信息技术有限公司 | 数据处理方法、装置及系统 |
| US10657972B2 (en) * | 2018-02-02 | 2020-05-19 | Max T. Hall | Method of translating and synthesizing a foreign language |
| CN108648251B (zh) * | 2018-05-15 | 2022-05-24 | 奥比中光科技集团股份有限公司 | 3d表情制作方法及系统 |
| CN108830917B (zh) * | 2018-05-29 | 2023-04-18 | 努比亚技术有限公司 | 一种信息生成方法、终端及计算机可读存储介质 |
| US10891969B2 (en) * | 2018-10-19 | 2021-01-12 | Microsoft Technology Licensing, Llc | Transforming audio content into images |
| CN111933136B (zh) * | 2020-08-18 | 2024-05-10 | 南京奥拓电子科技有限公司 | 一种辅助语音识别控制方法和装置 |
| CN113570686A (zh) * | 2021-02-07 | 2021-10-29 | 腾讯科技(深圳)有限公司 | 虚拟视频直播处理方法及装置、存储介质、电子设备 |
| US12602849B2 (en) | 2022-12-30 | 2026-04-14 | Samsung Electronics Co., Ltd. | Image generation using one-dimensional inputs |
| US12597175B2 (en) | 2023-07-10 | 2026-04-07 | Samsung Electronics Co., Ltd. | Avatar creation from natural language description |
Family Cites Families (13)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| EP0543329B1 (en) * | 1991-11-18 | 2002-02-06 | Kabushiki Kaisha Toshiba | Speech dialogue system for facilitating human-computer interaction |
| US6161083A (en) * | 1996-05-02 | 2000-12-12 | Sony Corporation | Example-based translation method and system which calculates word similarity degrees, a priori probability, and transformation probability to determine the best example for translation |
| US6279017B1 (en) * | 1996-08-07 | 2001-08-21 | Randall C. Walker | Method and apparatus for displaying text based upon attributes found within the text |
| US6250928B1 (en) * | 1998-06-22 | 2001-06-26 | Massachusetts Institute Of Technology | Talking facial display method and apparatus |
| JP2003085582A (ja) | 2001-09-11 | 2003-03-20 | Minolta Co Ltd | 通信システム、アニメーション生成装置、およびアニメーションの生成方法 |
| JP2003248837A (ja) * | 2001-11-12 | 2003-09-05 | Mega Chips Corp | 画像作成装置、画像作成システム、音声生成装置、音声生成システム、画像作成用サーバ、プログラム、および記録媒体 |
| JP2006127371A (ja) | 2004-11-01 | 2006-05-18 | Matsushita Electric Ind Co Ltd | アニメーション選択装置及び方法 |
| US20090132371A1 (en) * | 2007-11-20 | 2009-05-21 | Big Stage Entertainment, Inc. | Systems and methods for interactive advertising using personalized head models |
| US8224652B2 (en) * | 2008-09-26 | 2012-07-17 | Microsoft Corporation | Speech and text driven HMM-based body animation synthesis |
| CN102054287B (zh) * | 2009-11-09 | 2015-05-06 | 腾讯科技(深圳)有限公司 | 面部动画视频生成的方法及装置 |
| JP2011150221A (ja) | 2010-01-25 | 2011-08-04 | Seiko Epson Corp | 映像出力装置搭載機器、映像出力装置の投影方法 |
| US9293152B2 (en) * | 2012-01-25 | 2016-03-22 | International Business Machines Corporation | Abrasion test methods and devices |
| US20160110922A1 (en) * | 2014-10-16 | 2016-04-21 | Tal Michael HARING | Method and system for enhancing communication by using augmented reality |
-
2016
- 2016-03-16 JP JP2016051932A patent/JP6711044B2/ja active Active
- 2016-12-22 US US15/388,053 patent/US10304439B2/en active Active
-
2017
- 2017-01-24 CN CN201710059946.9A patent/CN107204027B/zh active Active
Cited By (2)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP2021033961A (ja) * | 2019-08-29 | 2021-03-01 | 株式会社鈴康 | 動画生成プログラム、動画生成装置及び動画生成方法 |
| WO2021039561A1 (ja) * | 2019-08-29 | 2021-03-04 | 株式会社鈴康 | 動画生成方法、動画生成装置及び記憶媒体 |
Also Published As
| Publication number | Publication date |
|---|---|
| US20170270701A1 (en) | 2017-09-21 |
| JP6711044B2 (ja) | 2020-06-17 |
| CN107204027B (zh) | 2021-03-12 |
| CN107204027A (zh) | 2017-09-26 |
| US10304439B2 (en) | 2019-05-28 |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| JP6711044B2 (ja) | 画像処理装置、表示装置、アニメーション生成方法及びプログラム | |
| US7844467B1 (en) | System and method of providing conversational visual prosody for talking heads | |
| US8131551B1 (en) | System and method of providing conversational visual prosody for talking heads | |
| US20030149569A1 (en) | Character animation | |
| CN113077537A (zh) | 一种视频生成方法、存储介质及设备 | |
| KR20210119441A (ko) | 텍스트 및 오디오 기반 실시간 얼굴 재연 | |
| JP5353835B2 (ja) | 情報処理プログラムおよび情報処理装置 | |
| KR20170034409A (ko) | 안면 구조에 기초한 음성 합성 방법 및 장치 | |
| KR20140146965A (ko) | 디스플레이 장치, 서버를 포함하는 변환 시스템 및 디스플레이 장치의 제어 방법 | |
| EP4404574A1 (en) | Video processing method and apparatus, and medium and program product | |
| US20200193961A1 (en) | System for synchronizing speech and motion of character | |
| WO2024174414A1 (zh) | 视频合成方法、装置、存储介质和电子设备 | |
| US10923106B2 (en) | Method for audio synthesis adapted to video characteristics | |
| CN113870828A (zh) | 音频合成方法、装置、电子设备和可读存储介质 | |
| JPWO2018079294A1 (ja) | 情報処理装置及び情報処理方法 | |
| JP6528484B2 (ja) | 画像処理装置、アニメーション生成方法及びプログラム | |
| WO2018198447A1 (ja) | 情報処理装置および情報処理方法 | |
| JP2024030802A (ja) | モデル学習装置、モデル学習方法、及びモデル学習プログラム。 | |
| US12327491B2 (en) | Information processing device and information processing method | |
| JP7756754B1 (ja) | 判定装置、判定方法及びコンピュータープログラム | |
| US20250173935A1 (en) | Device for synchronization of features of digital objects with audio contents | |
| CN117041645A (zh) | 基于数字人的视频播放方法、装置、电子设备及存储介质 | |
| CN121865054A (zh) | 数字人视频生成方法、装置、设备、介质及产品 | |
| CN121037650A (zh) | 一种多媒体数据生成方法、系统、电子设备及存储介质 | |
| CN121078292A (zh) | 视频生成方法、装置、电子设备、智能体及介质 |
Legal Events
| Date | Code | Title | Description |
|---|---|---|---|
| A621 | Written request for application examination |
Free format text: JAPANESE INTERMEDIATE CODE: A621 Effective date: 20190301 |
|
| A977 | Report on retrieval |
Free format text: JAPANESE INTERMEDIATE CODE: A971007 Effective date: 20200312 |
|
| A131 | Notification of reasons for refusal |
Free format text: JAPANESE INTERMEDIATE CODE: A131 Effective date: 20200324 |
|
| A521 | Request for written amendment filed |
Free format text: JAPANESE INTERMEDIATE CODE: A523 Effective date: 20200402 |
|
| TRDD | Decision of grant or rejection written | ||
| A01 | Written decision to grant a patent or to grant a registration (utility model) |
Free format text: JAPANESE INTERMEDIATE CODE: A01 Effective date: 20200428 |
|
| A61 | First payment of annual fees (during grant procedure) |
Free format text: JAPANESE INTERMEDIATE CODE: A61 Effective date: 20200511 |
|
| R150 | Certificate of patent or registration of utility model |
Ref document number: 6711044 Country of ref document: JP Free format text: JAPANESE INTERMEDIATE CODE: R150 |