JP4876329B2 - 対訳確率付与装置、対訳確率付与方法並びにそのプログラム - Google Patents
対訳確率付与装置、対訳確率付与方法並びにそのプログラム Download PDFInfo
- Publication number
- JP4876329B2 JP4876329B2 JP2001144337A JP2001144337A JP4876329B2 JP 4876329 B2 JP4876329 B2 JP 4876329B2 JP 2001144337 A JP2001144337 A JP 2001144337A JP 2001144337 A JP2001144337 A JP 2001144337A JP 4876329 B2 JP4876329 B2 JP 4876329B2
- Authority
- JP
- Japan
- Prior art keywords
- language
- word
- probability
- translation
- appearance
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Expired - Fee Related
Links
- 238000013519 translation Methods 0.000 title claims description 112
- 238000000034 method Methods 0.000 title claims description 26
- 238000004364 calculation method Methods 0.000 claims description 33
- 230000014509 gene expression Effects 0.000 claims description 16
- 230000001419 dependent effect Effects 0.000 claims description 3
- 230000014616 translation Effects 0.000 description 93
- 238000010586 diagram Methods 0.000 description 11
- 238000007796 conventional method Methods 0.000 description 6
- 238000003058 natural language processing Methods 0.000 description 3
- 238000004458 analytical method Methods 0.000 description 2
- 238000005516 engineering process Methods 0.000 description 2
- 230000010365 information processing Effects 0.000 description 2
- 150000001875 compounds Chemical class 0.000 description 1
- 230000000694 effects Effects 0.000 description 1
- 238000000605 extraction Methods 0.000 description 1
- 230000000877 morphologic effect Effects 0.000 description 1
- 230000003287 optical effect Effects 0.000 description 1
- 239000004065 semiconductor Substances 0.000 description 1
Images


Landscapes
- Machine Translation (AREA)
Description
【発明の属する技術分野】
機械翻訳、クロス言語テキスト検索など、異なる言語の間で言葉の対応をとることを課題とする自然言語処理技術に関する。
【0002】
【従来技術】
機械翻訳、クロス言語テキスト検索など、異なる言語の間で言葉の対応をとることを課題とする自然言語処理技術においては、一方の言語の単語を、もう一方の言語の適切な単語に対応させることは非常に重要な課題であり、訳語選択の問題と呼ばれている。この課題が重要な問題であることは、一般にどのような言語対の場合にも当てはまるが、以下では英語と日本語の場合を取り上げ、具体例を示して説明する。
【0003】
英語の単語は一般に複数の意味をもち、一般にはそれぞれ異なる日本語の単語に対応する。ところが、自然言語処理分野において元の英単語の使われている状況を正しく判断して適切な日本語の単語を選択することは、一般には非常に困難である。たとえば、英語の単語「term」には「期間」という意味の他に「専門用語」という意味があるが、どのような場合に「期間」という意味となり、どのような場合に「専門用語」という意味になるか、という訳語の選択条件を、あらかじめ明示的に記述することは非常に難しい。
【0004】
この問題を解決する方法として、言葉が実際に使用された例、すなわち実例文を大量に集めてそれを利用する方法が提案されている。
【0005】
たとえば「野上宏康、熊野明、田中克己、天野真家『既存目的言語文書からの訳語の自動学習方式』情報処理学会第42回全国大会(平成3年)」(先行技術文献1)では、以下のような方法が提案されている。
【0006】
まず、異なる言語(日本語と英語など)で、同じ分野の話題を述べている文例を大量に収集しておく。次に、一方の言語(たとえば英語)の単語が、相手言語(たとえば日本語)の訳語候補のうち、どの訳語に対応するかの確からしさを判定する際に、相手言語の文例集における、各訳語候補の出現確率の高さを用いる。たとえば、今、英語の「term」を「期間」と訳すのが確からしいか「専門用語」と訳すのが確からしいかを判断するのに、同じ分野の話題を述べている日本語の文例集の中に出現する「期間」という単語と「専門用語」という単語の頻度を計測し、その多い方を「term」の訳語とする、という手法である。この手法には、相手言語の文例集のみを分析すればよいという利点がある。
【0007】
また「中島弘之、梶博行『対訳テキストを利用した訳語選択のための共起関係の自動抽出』情報処理学会第39回全国大会(平成元年)」(先行技術文献2)では、以下のような方法が提案されている。
【0008】
まず、異なる言語(日本語と英語など)で、一方が他方の翻訳関係にあるような対訳文例集を用意する。さらに、二つの言語の間の対訳辞書を用意し、第1の言語の例文に含まれる単語に対して対訳辞書を引き、訳語候補を挙げる。その例文と対訳関係にある第2の言語の例文の中に出現する訳語候補の頻度を計測し、最も高頻度で現われる訳語候補を、元の単語に対する訳語とする、という手法である。この手法は、互いに翻訳関係にある対訳例文が利用できる場合には、高い精度で訳語を認定できるという利点がある。
【0009】
【発明が解決しようとする課題】
しかしながら、先行技術文献1の方法は、相手言語の単語の頻度だけを手がかりにしているため、相手言語で一般的に高頻度で出現する単語が訳語として採用されてしまいやすい、という欠点がある。
【0010】
たとえば、英語の単語「make」には「作る」という訳語の他にも多くの日本語の訳語が相当する。一例として「make a call」を「電話をする」と訳すためには「call」を「電話」に対応するものとし、「make」には「する」という動詞が対応するものとして辞書を構築するのが通常の手法である。このように辞書を作る時「make」には少なくとも「作る」と「する」という訳語候補が存在することになる。この場合、先行技術文献1の方法に従って、相手言語、つまり日本語の単語の出現頻度だけを計測すると、訳語「作る」よりも訳語「する」の方が一般に出現頻度が高いので、「make」の訳語候補として「する」が最も確からしいものとして選択されてしまう。先行技術文献1には、このように、本来の訳語として適切かどうかとは無関係に、相手言語で出現頻度の高い訳語が選択されやすい、という欠点がある。
【0011】
また、先行技術文献2の方法は、互いに翻訳関係にある対訳例文が大量に存在する場合に有効な方法であるが、実際には、互いに翻訳関係にある対訳例文の量は極めて限られている。先行技術文献2の方法は対訳例文が大量に存在しない場合には適用できない、という欠点がある。
【0012】
本願発明の目的は、従来の手法がもつ、上記のような問題点を解決し、より確からしい訳語候補を選択するための方法を提供するところにある。
【0013】
【課題を解決するための手段】
本発明の対訳確率付与装置は、第1の言語を第2の言語に翻訳する際に用いられる対訳確率付与装置であって、第1の言語の文例集と第2の言語の文例集とを有し、第1の言語の単語に対する第2の言語の訳語候補を単語対応対として格納した第1言語第2言語対訳辞書を有し、第1の言語の文例集における単語の出現に関する統計量を計算する第1言語統計量計算モジュールを有し、第2の言語の文例集における単語の出現に関する統計量を計算する第2言語統計量計算モジュールを有し、対訳辞書の各単語対応対に付与された対訳確率をパラメータとして、第1の言語の文例集から第1言語統計量計算モジュールによって求められる統計量から、第2の言語の単語の出現に関する統計量を推定する対訳確率モデルを有し、第2の言語の文例集から第2言語統計量計算モジュールによって求められた統計量と対訳確率モデルによって第1の言語から推定された第2の言語の統計量との差を最小にするようにパラメータを求める対訳確率付与部を有することを特徴とする。
【0014】
この場合、第1の言語の単語の出現に関する統計量から第2の言語の単語の出現に関する統計量を推定する対訳確率モデルとして、第1の言語の単語E(i)の出現確率E(i)とその単語E(i)が第2の言語の訳語J(n)に対応する対応確率S(i,n)との積を求め、第1の言語の各単語E(i)に関して上記の積を可算した和をとることによって第2の言語における単語J(n)の出現確率J(n)を計算する対訳確率モデルを用いてもよい。
【0015】
また、第1の言語の単語の出現に関する統計量から第2の言語の単語の出現に関する統計量を推定する対訳確率モデルとして、第1の言語で一つの文の中に出現する二つの単語のペアの共起確率P(E(i)^E(J))とその単語ペアを構成する各単語E(i)およびE(J)が第2の言語の訳語に対応する対応確率S(i,m)およびS(J,n)との積を求め、第1の言語の各単語ペアE(i)およびE(J)に関して上記の積を可算した和をとることによって第2の言語で一つの文の中に出現する二つの単語のペアの出現確率P(J(m)^J(n))を計算する対訳確率モデルを用いことにしてもよい。
【0016】
また、第1の言語の単語の出現に関する統計量から第2の言語の単語の出現に関する統計量を推定する対訳確率モデルとして、第1の言語で構文上の係り受け関係にある二つの単語のペアの共起確率P(E(i)^E(J))とその単語ペアを構成する各単語E(i)およびE(J)が第2の言語の訳語に対応する対応確率S(i,m)およびS(J,n)との積を求め、第1の言語の各単語ペアE(i)およびE(J)に関して上記の積を可算した和をとることによって第2の言語で構文上の係り受け関係にある二つの単語のペアの出現確率P(J(m)^J(n))を計算する対訳確率モデルを用いることにしてもよい。
【0017】
【発明の実施の形態】
本発明の実施の形態について図面を参照して説明する。図1は本発明の第1実施の形態の訳語選択システムの構成を示すブロック図である。
【0018】
本実施の形態は、第1言語の文例集1、第2言語の文例集2、第1の言語の単語に対する第2の言語の訳語候補を単語対応対として格納した第1言語第2言語対訳辞書3、第1言語の文例集における単語の出現に関する統計量を計算する第1言語統計量計算モジュール4、第2言語の文例集における単語の出現に関する統計量を計算する第2言語統計量計算モジュール5、対訳辞書の各単語対応対に付与された対訳確率をパラメータとして、第1の言語の文例集から第1言語統計量計算モジュールによって求められる統計量から、第2の言語の単語の出現に関する統計量を推定する対訳確率モデルを格納した対訳確率モデル格納部6、第2の言語の文例集から第2言語統計量計算モジュールによって求められた統計量と対訳確率モデルによって第1の言語から推定された第2の言語の統計量との差を最小にするようにパラメータを求める対訳確率付与部7とから構成されている。
【0019】
各ブロックの内容と動作について以下に説明する。第1言語の文例集1には、第1の言語、たとえば英語の実例文が格納されている。第2言語の文例集2には、第2の言語、たとえば日本語の実例文が格納されている。第1言語第2言語対訳辞書3には、第1の言語の各単語に対する第2の言語の訳語候補を単語対応対として格納してある。図2は、第1言語第2言語対訳辞書3の内容の例を示した図である。この図では、第1言語の単語E(i)に対応する第2言語の訳語候補として、J(k)、J(m)、J(n) が存在する場合を示している。
【0020】
この図でe(i)は、第1言語の単語E(i)の出現確率、j(k)、j(m)、j(n)はそれぞれ第2言語の単語J(k)、J(m)、J(n)の出現確率を表す。また、S(i,k)、S(i,m)、S(i,m)は、それぞれ、第1言語の単語E(i)が、第2言語の単語J(k)、J(m)、J(n)に翻訳される確率を表す。
【0021】
第1言語統計量計算モジュール4は、第1言語の文例集1における単語の出現に関する統計量を計算する。第2言語統計量計算モジュール5は、第2言語の文例集2における単語の出現に関する統計量を計算する。第1言語統計量計算モジュール4および第2言語統計量計算モジュール5は、必要に応じて、第1言語の文例集1および第2言語の文例集2に含まれる文を形態素解析したり構文解析したりして、そこに含まれる単語の出現に関する統計量を計算する。統計量の例としては、各単語の出現確率や二つの単語が同時に出現する共起確率などがある。
【0022】
対訳確率モデル格納部6には、第1の言語の単語の出現に関する統計量から第2の言語の単語の出現に関する統計量を推定する対訳確率モデルが格納してある。この対訳確率モデルは、対訳辞書の各単語対応対に付与された対訳確率をパラメータとして、第1の言語の文例集から第1言語統計量計算モジュールによって求められる統計量から、第2の言語の単語の出現に関する統計量を推定する。
【0023】
対訳確率付与部7は、第2の言語の文例集から第2言語統計量計算モジュールによって求められた統計量と対訳確率モデルによって第1の言語から推定された第2の言語の統計量との差を最小にするように、対訳辞書の各単語対応対に付与された対訳確率パラメータを調整する。
【0024】
図6は、本願発明の第2の実施の形態を説明する図である。
【0025】
図6において、本願発明の第2の実施の形態は、入力装置101と、コンピュータから構成されるデータ処理装置102と、出力装置103と、記憶装置104と、訳語選択プログラムを記録した記憶媒体105とを備える。記憶媒体105は、磁気ディスク、磁気テープ、光ディスク、半導体メモリその他の記憶媒体よりなる。
【0026】
訳語選択プログラムは、記憶媒体105からデータ処理装置102の主記憶装置に読み込まれ、データ処理装置102の動作を制御する。データ処理装置102は、訳語選択プログラムの制御により以下の処理を行なう。
【0027】
訳語の選択を行なうべき単語が入力装置101から入力されると、第1言語統計量計算モジュール4と第2言語統計量計算モジュール5とが起動される。第1言語統計量計算モジュール4は、第1言語の文例集1における単語の出現に関する統計量を計算する。第2言語統計量計算モジュール5は、第2言語の文例集2における単語の出現に関する統計量を計算する。
【0028】
次に、対訳確率付与部7が起動される。対訳確率付与部7は、第2の言語の文例集から第2言語統計量計算モジュールによって求められた統計量と対訳確率モデル格納部6に格納された対訳確率モデルによって第1の言語から推定された第2の言語の統計量との差を最小にするように、対訳辞書の各単語対応対に付与された対訳確率パラメータを調整する。
【0029】
結果として得られた対訳確率パラメータの値にしたがって、訳語が出力装置103から出力される。
【0030】
次に、図1に示した実施の形態における、対訳確率モデル格納部6に格納されている対訳確率モデルの例を用いて、本願発明の動作を説明する。次の式は、対訳確率モデルの一例を表す式である。
【0031】
【数1】
【0032】
この式1のS(i,m)が、この対訳確率モデルにおけるパラメータであり、第1言語の単語E(i)と第2言語の訳語候補J(m)との単語対応対に与えられた対訳確率である。このパラメータには、第1言語の単語は第2言語の単語に必ず対応するという仮定の下で、
【0033】
【数2】
【0034】
この対訳確率モデルによって各単語の対訳確率を求めるには、第1言語統計量計算モジュール4によって、第1言語の文例集1における単語の出現確率e(i) を計算し、第2言語統計量計算モジュール5によって、第2言語の文例集2における単語の出現確率j(m)を計算し、このようにして求めたe(i)およびj(m)を上記の対訳確率モデルの式に代入して上記の制約を満たすパラメータS(i,m)を定める。
【0035】
次に、図3、図4、図5を用いて、本願発明と従来方式の差異を説明する。ここでは、例として、英語の単語を日本語の単語に翻訳する場合を考える。
【0036】
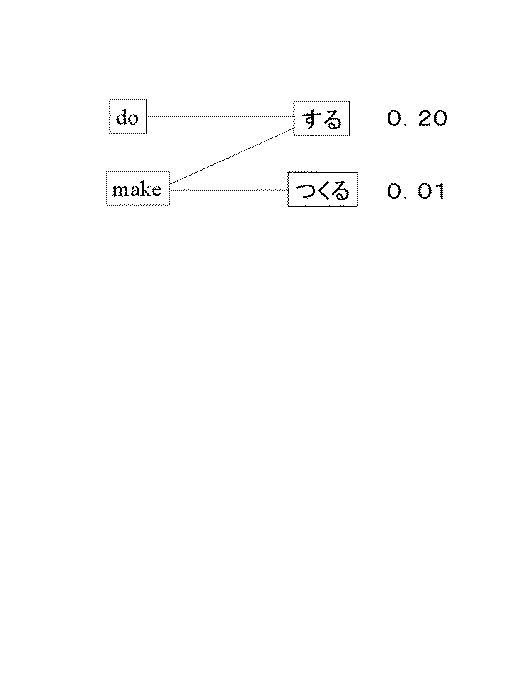
図3は、第1言語第2言語対訳辞書3の中の英単語「do」と「make」の単語対応対を示している。ここでは簡単のため、英単語「do」は日本語の単語「する」1語とだけ訳語候補としての単語対応対をなしており、英単語「make」は日本語の単語の「つくる」と「する」の2単語と、訳語候補としての単語対応対をなしている状況を想定する。
【0037】
図4は、先行技術文献1で示されているような、第2言語の文例集における単語の出現頻度だけを用いて、第1言語の単語の訳語選択を行なう従来方式の動作を、図3で示した単語対応対の構成をもった「do」と「make」を例に挙げて表した図である。図4は第2言語の文例集における「する」と「つくる」の出現確率が、仮にそれぞれ、0.20および0.01である状況を示している。この場合、先行技術文献1の従来方式では、「make」の訳語として、出現確率の高い単語「する」が単語「つくる」よりも優先されてしまう。
【0038】
図5は、本願発明の動作を、図3で示した単語対応対の構成をもった「do」と「make」を例に挙げて表した図である。図5では、第1言語の文例集における「do」と「make」の出現確率が、仮にそれぞれ、0.18および0.02である状況を示している。第2言語の文例集における「する」と「つくる」の出現確率は、図4の場合と同様に、それぞれ、0.20および0.01であるとする。
【0039】
本願発明では、上述の式で示したような対訳確率モデルを用いて、日本語の同じ単語を訳語としてもつ英単語の影響を考慮した計算を行なう。この方法で、英単語「make」が「する」に翻訳される確率および「つくる」に翻訳される確率を計算すると、この例のように「する」の頻度が高くても、その頻度の大部分は英単語「do」からの翻訳確率に対応するので、「make」から「する」への翻訳確率は低くなる。図5では「make」から「つくる」への翻訳確率が0.9、「make」から「する」への翻訳確率が0.1という結果が得られた場合を示している。
【0040】
次に、対訳確率モデル格納部6に格納されている対訳確率モデルの第2の例を用いて、本願発明の動作を説明する。次に挙げる式は、対訳確率モデルの一例を表す式である。
【0041】
【数3】
【0042】
この式のS(i,m)およびS(j,n)が、この対訳確率モデルにおけるパラメータであり、それぞれ、第1言語の単語 E(i) と第2言語の訳語候補J(m)との単語対応対に与えられた対訳確率、第1言語の単語E(J)と第2言語の訳語候補J(n)との単語対応対に与えられた対訳確率である。このパラメータには、第1言語の単語は第2言語の単語に必ず対応するという仮定の下で、
【0043】
【数4】
【0044】
この対訳確率モデルを使って各単語の対訳確率を求める場合、二つの単語の共起として、何種類かの共起が考えられる。共起の種類の一つとして、一つの文の中に二つの単語が共に出現する文内共起がある。
【0045】
この場合、第1言語統計量計算モジュール4によって、第1言語の文例集1における二つの単語の文内共起確率P(E(i)^E(J))を計算し、2言語統計量計算モジュール5によって、第2言語の文例集2における二つの単語の文内共起確率P(J(m)^J(n))を計算し、このようにして求めたP(E(i)^E(J))およびP(J(m)^J(n))を上記の対訳確率モデルの式に代入して、上記の制約を満たすパラメータS(i,m) を定める。
【0046】
もう一つの共起の種類として、二つの単語が、互いに構文的な係り受け関係にある係り受け共起がある。この場合、第1言語統計量計算モジュール4によって、第1言語の文例集1における二つの単語の係り受け共起確率P(E(i)^E(j))を計算し、第2言語統計量計算モジュール5によって、第2言語の文例集2における二つの単語の係り受け共起確率P(J(m)^J(n))を計算し、このようにして求めたP(E(i)^E(j))およびP(J(m)^J(n))を上記の対訳確率モデルの式に代入して、上記の制約を満たすパラメータS(i,m)を定める。
【0047】
【発明の効果】
本願発明によれば、第1言語の単語の訳語を定める際、先行技術文献1とは異なり、第1言語と第2言語の両方の全体の単語の対訳確率を考慮に入れるため、第2言語で出現確率の高い単語が訳語に選ばれやすいという先行技術文献1のもっていた欠点が解消されている。
【0048】
また、本願発明で用いる第1言語および第2言語の文例集は互いに翻訳関係にあることを仮定していないため、大量に収集することができる。互いに翻訳関係にある文例集が存在しないと適用できないという先行技術文献2のもっていた欠点が解消されている。
【0049】
さらに、本願発明では文内共起を用いて対訳確率を求めるため、単独の単語の対訳確率だけを用いる場合に比べて、複合語などの場合の翻訳の精度が向上する。
【0050】
また、本願発明では、係り受け共起を用いて対訳確率を求めるため、動詞とその格要素の名詞が組になって訳語が定まるような場合の翻訳の精度が向上する。
【図面の簡単な説明】
【図1】 本発明の第1の形態をなす訳語選択システムの構成を示すブロック図である。
【図2】 図1に示した実施例における、第1言語第2言語対訳辞書3の内容例を表す図である。
【図3】 従来法と本発明の動作を比較するための、第1言語第2言語対訳辞書3の内容例を示す図である。
【図4】 従来法の動作を説明するための第1言語第2言語対訳辞書3の内容例を示す図である。
【図5】 本発明の動作を説明するための第1言語第2言語対訳辞書3の内容例を示す図である。
【図6】 本発明の第2の実施の形態をなす訳語選択システムの構成を示すブロック図である。
【符号の説明】
1 第1言語の文例集
2 第2言語の文例集
3 第1言語第2言語対訳辞書
4 第1言語統計量計算モジュール
5 第2言語統計量計算モジュール
6 対訳確率モデル格納部
7 対訳確率付与部
101 入力装置
102 データ処理装置
103 出力装置
104 記憶装置
105 記録媒体
Claims (9)
- 第1の言語を第2の言語に翻訳する際に用いられる対訳確率付与装置であって、
第1の言語の文例集と第2の言語の文例集とを有し、
第1の言語の単語に対する第2の言語の訳語候補を単語対応対として格納した第1言語第2言語対訳辞書を有し、
第1の言語の文例集における単語の出現に関する統計量を計算する第1言語統計量計算モジュールを有し、
第2の言語の文例集における単語の出現に関する統計量を計算する第2言語統計量計算モジュールを有し、
前記第2言語統計量計算モジュールによって求められた統計量と、対訳辞書の各単語対応対に付与された対訳確率をパラメータとして、前記第1言語統計量計算モジュールによって求められる統計量から、対訳確率モデル格納部に格納された式に基づいて推定された第2の言語の単語の出現に関する統計量との差を最小にするようにパラメータを調整する対訳確率付与部を有すること
を特徴とする対訳確率付与装置。 - 請求項1記載の対訳確率付与装置において、前記対訳確率モデル格納部に格納された式として、第1の言語の単語E(i)の出現確率e(i)とその単語E(i)が第2の言語の訳語J(n)に対応する対応確率S(i,n)との積を求め、第1の言語の各単語E(i)に関して上記の積を可算した和をとることによって第2の言語における単語J(n)の出現確率j(n)を計算する式を用いることを特徴とする対訳確率付与装置。
- 請求項1記載の対訳確率付与装置において、前記対訳確率モデル格納部に格納された式として、第1の言語で一つの文の中に出現する二つの単語のペアの共起確率P(E(i)^E(j))とその単語ペアを構成する各単語E(i)および
E(j)が第2の言語の訳語に対応する対応確率S(i,m)およびS(j,n)との積を求め、第1の言語の各単語ペアE(i)およびE(j)に関して上記の積を可算した和をとることによって第2の言語で一つの文の中に出現する二つの単語のペアの出現確率P(J(m)^J(n))を計算する式を用いることを特徴とする対訳確率付与装置。 - 請求項1記載の対訳確率付与装置において、前記対訳確率モデル格納部に格納された式として、第1の言語で構文上の係り受け関係にある二つの単語のペアの共起確率P(E(i)^E(J))とその単語ペアを構成する各単語E(i)およびE(J)が第2の言語の訳語に対応する対応確率S(i,m)およびS(J,n)との積を求め、第1の言語の各単語ペアE(i)およびE(J)に関して上記の積を可算した和をとることによって第2の言語で構文上の係り受け関係にある二つの単語のペアの出現確率P(J(m)^J(n))を計算する式を用いることを特徴とする対訳確率付与装置。
- 第1の言語の文例集と第2の言語の文例集とを有し、
第1の言語の単語に対する第2の言語の訳語候補を単語対応対として格納した第1言語第2言語対訳辞書を有し、
(a)前記第1の言語の文例集における単語の出現に関する統計量を計算する処理、
(b)前記第2の言語の文例集における単語の出現に関する統計量を計算する処理、
(c)前記第1言語第2言語対訳辞書の各単語対応対に付与された対訳確率をパラメータとして、前記(a)によって計算される統計量に基づいて、第2の言語の単語の出現に関する統計量を推定する計算処理、
(d)前記(b)によって計算された統計量と、前記(c)によって推定された統計量との差を最小にするように前記パラメータを調整する処理、
を実行させることを特徴とするプログラム。 - 請求項5記載のプログラムにおいて、前記(c)の処理として、第1の言語の単語E(i)の出現確率E(i)と、その単語E(i)が第2の言語の訳語J(n)に対応する対応確率S(i,n)との積を求め、第1の言語の各単語E(i)に関して上記の積を可算した和をとることによって第2の言語における単語J(n)の出現確率J(n)を計算する処理を行なうことを特徴とするプログラム。
- 請求項5記載のプログラムにおいて、前記(c)の処理として、第1の言語で一つの文の中に出現する二つの単語のペアの共起確率P(E(i)^E(J))とその単語ペアを構成する各単語
E(i) および E(J)が第2の言語の訳語に対応する対応確率S(i,m)および
S(J,n)との積を求め、第1の言語の各単語ペアE(i)およびE(J)に関して上記の積を可算した和をとることによって第2の言語で一つの文の中に出現する二つの単語のペアの出現確率P(J(m)^J(n))を計算する処理を行なうことを特徴とするプログラム。 - 請求項5記載のプログラムにおいて、前記(c)の処理として、第1の言語で構文上の係り受け関係にある二つの単語のペアの共起確率P(E(i)^E(J))とその単語ペアを構成する各単語E(i)およびE(J)が第2の言語の訳語に対応する対応確率S(i,m)およびS(J,n)との積を求め、第1の言語の各単語ペアE(i)および
E(J)に関して上記の積を可算した和をとることによって第2の言語で構文上の係り受け関係にある二つの単語のペアの出現確率P(J(m)^J(n))を計算する処理を行なうことを特徴とするプログラム。 - 第1の言語の文例集と第2の言語の文例集と、
第1の言語の単語に対する第2の言語の訳語候補を単語対応対として格納した第1言語第2言語対訳辞書とを有する対訳確率付与装置が、
(a)前記第1の言語の文例集における単語の出現に関する統計量を計算し、
(b)前記第2の言語の文例集における単語の出現に関する統計量を計算し、
(c)前記第1言語第2言語対訳辞書の各単語対応対に付与された対訳確率をパラメータとして、前記(a)によって計算される統計量に基づいて、第2の言語の単語の出現に関する統計量を推定する計算処理をし、
(d)前記(b)によって計算された統計量と、前記(c)によって推定された統計量との差を最小にするように前記パラメータを調整すること
を特徴とする対訳確率付与方法。
Priority Applications (1)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| JP2001144337A JP4876329B2 (ja) | 2001-05-15 | 2001-05-15 | 対訳確率付与装置、対訳確率付与方法並びにそのプログラム |
Applications Claiming Priority (1)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| JP2001144337A JP4876329B2 (ja) | 2001-05-15 | 2001-05-15 | 対訳確率付与装置、対訳確率付与方法並びにそのプログラム |
Publications (2)
| Publication Number | Publication Date |
|---|---|
| JP2002342325A JP2002342325A (ja) | 2002-11-29 |
| JP4876329B2 true JP4876329B2 (ja) | 2012-02-15 |
Family
ID=18990301
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| JP2001144337A Expired - Fee Related JP4876329B2 (ja) | 2001-05-15 | 2001-05-15 | 対訳確率付与装置、対訳確率付与方法並びにそのプログラム |
Country Status (1)
| Country | Link |
|---|---|
| JP (1) | JP4876329B2 (ja) |
Families Citing this family (3)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP5380989B2 (ja) * | 2008-09-30 | 2014-01-08 | カシオ計算機株式会社 | 辞書機能を備えた電子装置およびプログラム |
| JP5555542B2 (ja) * | 2010-05-20 | 2014-07-23 | 日本電信電話株式会社 | 自動単語対応付け装置とその方法とプログラム |
| JP7251181B2 (ja) * | 2019-02-05 | 2023-04-04 | 富士通株式会社 | 対訳処理方法および対訳処理プログラム |
Family Cites Families (1)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| US6885985B2 (en) * | 2000-12-18 | 2005-04-26 | Xerox Corporation | Terminology translation for unaligned comparable corpora using category based translation probabilities |
-
2001
- 2001-05-15 JP JP2001144337A patent/JP4876329B2/ja not_active Expired - Fee Related
Also Published As
| Publication number | Publication date |
|---|---|
| JP2002342325A (ja) | 2002-11-29 |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| US7904291B2 (en) | Communication support apparatus and computer program product for supporting communication by performing translation between languages | |
| US5418717A (en) | Multiple score language processing system | |
| US7565281B2 (en) | Machine translation | |
| US6523000B1 (en) | Translation supporting apparatus and method and computer-readable recording medium, wherein a translation example useful for the translation task is searched out from within a translation example database | |
| US20080306728A1 (en) | Apparatus, method, and computer program product for machine translation | |
| EP1351158A1 (en) | Machine translation | |
| Karakanta | Experimental research in automatic subtitling: At the crossroads between machine translation and audiovisual translation | |
| US20090326912A1 (en) | Means and a method for training a statistical machine translation system | |
| US20070112553A1 (en) | System, method, and program for identifying the corresponding translation | |
| JP2008152760A (ja) | マシンアシスト翻訳ツール | |
| US20190147034A1 (en) | Predicting style breaches within textual content | |
| JP2004362249A (ja) | 翻訳知識最適化装置、翻訳知識最適化のためのコンピュータプログラム、コンピュータ及び記憶媒体 | |
| EP3832485A1 (en) | Question answering systems | |
| JP5002271B2 (ja) | 入力された原言語文を目的言語に機械翻訳する装置、方法およびプログラム | |
| Popowich et al. | Machine translation of closed captions | |
| Abdelrahman | Hallucination in low-resource languages: amplified risks and mitigation strategies for multilingual LLMs | |
| CN114661616B (zh) | 目标代码的生成方法及装置 | |
| KR100559472B1 (ko) | 영한 자동번역에서 의미 벡터와 한국어 국소 문맥 정보를사용한 대역어 선택시스템 및 방법 | |
| JP2960936B2 (ja) | 係り受け解析装置 | |
| US11288451B2 (en) | Machine based expansion of contractions in text in digital media | |
| JP2002342325A (ja) | 対訳確率付与装置、対訳確率付与方法並びにそのプログラム | |
| Lind et al. | Grounding the Comparative Turn in Communications: A Framework for ValidatingMultilingual Computational Text Analysis | |
| KR100617319B1 (ko) | 영한 자동번역을 위하여 동사구 패턴 및 의미 벡터를 사용하는 동사/명사 대역어 선택 장치 및 그 방법 | |
| Toole et al. | Time-constrained machine translation | |
| JPH05298349A (ja) | 共起関係知識学習方法、そのシステム、並びに共起関係辞書およびその利用方法 |
Legal Events
| Date | Code | Title | Description |
|---|---|---|---|
| RD01 | Notification of change of attorney |
Free format text: JAPANESE INTERMEDIATE CODE: A7421 Effective date: 20021204 |
|
| RD01 | Notification of change of attorney |
Free format text: JAPANESE INTERMEDIATE CODE: A7421 Effective date: 20050317 |
|
| RD01 | Notification of change of attorney |
Free format text: JAPANESE INTERMEDIATE CODE: A7421 Effective date: 20070118 |
|
| A621 | Written request for application examination |
Free format text: JAPANESE INTERMEDIATE CODE: A621 Effective date: 20080415 |
|
| RD01 | Notification of change of attorney |
Free format text: JAPANESE INTERMEDIATE CODE: A7421 Effective date: 20080612 |
|
| RD01 | Notification of change of attorney |
Free format text: JAPANESE INTERMEDIATE CODE: A7421 Effective date: 20090512 |
|
| A131 | Notification of reasons for refusal |
Free format text: JAPANESE INTERMEDIATE CODE: A131 Effective date: 20110215 |
|
| A521 | Written amendment |
Free format text: JAPANESE INTERMEDIATE CODE: A523 Effective date: 20110418 |
|
| RD01 | Notification of change of attorney |
Free format text: JAPANESE INTERMEDIATE CODE: A7421 Effective date: 20110705 |
|
| TRDD | Decision of grant or rejection written | ||
| A01 | Written decision to grant a patent or to grant a registration (utility model) |
Free format text: JAPANESE INTERMEDIATE CODE: A01 Effective date: 20111101 |
|
| A01 | Written decision to grant a patent or to grant a registration (utility model) |
Free format text: JAPANESE INTERMEDIATE CODE: A01 |
|
| A61 | First payment of annual fees (during grant procedure) |
Free format text: JAPANESE INTERMEDIATE CODE: A61 Effective date: 20111114 |
|
| R150 | Certificate of patent or registration of utility model |
Free format text: JAPANESE INTERMEDIATE CODE: R150 |
|
| FPAY | Renewal fee payment (event date is renewal date of database) |
Free format text: PAYMENT UNTIL: 20141209 Year of fee payment: 3 |
|
| LAPS | Cancellation because of no payment of annual fees |