JP5559352B2 - 知見抽出装置、知見更新装置、及びプログラム - Google Patents
知見抽出装置、知見更新装置、及びプログラム Download PDFInfo
- Publication number
- JP5559352B2 JP5559352B2 JP2012543372A JP2012543372A JP5559352B2 JP 5559352 B2 JP5559352 B2 JP 5559352B2 JP 2012543372 A JP2012543372 A JP 2012543372A JP 2012543372 A JP2012543372 A JP 2012543372A JP 5559352 B2 JP5559352 B2 JP 5559352B2
- Authority
- JP
- Japan
- Prior art keywords
- information
- knowledge
- unit
- concept
- word
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Expired - Fee Related
Links
Images















Classifications
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F40/00—Handling natural language data
- G06F40/20—Natural language analysis
- G06F40/205—Parsing
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06Q—INFORMATION AND COMMUNICATION TECHNOLOGY [ICT] SPECIALLY ADAPTED FOR ADMINISTRATIVE, COMMERCIAL, FINANCIAL, MANAGERIAL OR SUPERVISORY PURPOSES; SYSTEMS OR METHODS SPECIALLY ADAPTED FOR ADMINISTRATIVE, COMMERCIAL, FINANCIAL, MANAGERIAL OR SUPERVISORY PURPOSES, NOT OTHERWISE PROVIDED FOR
- G06Q40/00—Finance; Insurance; Tax strategies; Processing of corporate or income taxes
- G06Q40/04—Trading; Exchange, e.g. stocks, commodities, derivatives or currency exchange
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F16/00—Information retrieval; Database structures therefor; File system structures therefor
- G06F16/90—Details of database functions independent of the retrieved data types
- G06F16/93—Document management systems
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F16/00—Information retrieval; Database structures therefor; File system structures therefor
- G06F16/90—Details of database functions independent of the retrieved data types
- G06F16/95—Retrieval from the web
- G06F16/951—Indexing; Web crawling techniques
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F40/00—Handling natural language data
- G06F40/10—Text processing
- G06F40/166—Editing, e.g. inserting or deleting
- G06F40/177—Editing, e.g. inserting or deleting of tables; using ruled lines
- G06F40/18—Editing, e.g. inserting or deleting of tables; using ruled lines of spreadsheets
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F40/00—Handling natural language data
- G06F40/10—Text processing
- G06F40/197—Version control
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F16/00—Information retrieval; Database structures therefor; File system structures therefor
- G06F16/30—Information retrieval; Database structures therefor; File system structures therefor of unstructured textual data
- G06F16/31—Indexing; Data structures therefor; Storage structures
- G06F16/313—Selection or weighting of terms for indexing
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F40/00—Handling natural language data
- G06F40/20—Natural language analysis
- G06F40/205—Parsing
- G06F40/211—Syntactic parsing, e.g. based on context-free grammar [CFG] or unification grammars
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F40/00—Handling natural language data
- G06F40/20—Natural language analysis
- G06F40/279—Recognition of textual entities
- G06F40/289—Phrasal analysis, e.g. finite state techniques or chunking
- G06F40/295—Named entity recognition
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F40/00—Handling natural language data
- G06F40/30—Semantic analysis
Landscapes
- Engineering & Computer Science (AREA)
- Theoretical Computer Science (AREA)
- Physics & Mathematics (AREA)
- General Physics & Mathematics (AREA)
- Business, Economics & Management (AREA)
- General Engineering & Computer Science (AREA)
- Databases & Information Systems (AREA)
- Finance (AREA)
- Accounting & Taxation (AREA)
- Computational Linguistics (AREA)
- Artificial Intelligence (AREA)
- Audiology, Speech & Language Pathology (AREA)
- Health & Medical Sciences (AREA)
- General Health & Medical Sciences (AREA)
- General Business, Economics & Management (AREA)
- Data Mining & Analysis (AREA)
- Development Economics (AREA)
- Economics (AREA)
- Marketing (AREA)
- Strategic Management (AREA)
- Technology Law (AREA)
- Information Retrieval, Db Structures And Fs Structures Therefor (AREA)
- Financial Or Insurance-Related Operations Such As Payment And Settlement (AREA)
- Machine Translation (AREA)
Description
本発明の実施形態は、知見抽出装置、知見更新装置、及びプログラムに関する。
インターネットなどで提供される大量のデータを有効活用するために、ある概念に関する同義語や、概念間の関連を定義したシソーラスなどを用いて大量のデータからユーザに必要としている情報に関連する情報を選択して、もしくは選択した情報を組み合わせて知見情報を提供する技術がある。
例えば、株取引においては、株変動のきっかけとなるような知見情報を迅速に入手して判断し、取引内容に反映させることが有効である。例えば、通常とは異なる時期に新型のインフルエンザが流行した場合、感染予防に使われるマスクを製造する企業や消毒薬を製造する企業の需要が増加することが容易に予想され、該当企業の株価が上昇する。株取引を行うユーザは、「インフルエンザの通常とは異なる時期の流行」の情報から、需要の増える銘柄を推測し、取引に反映することが有効である。
これを踏まえ、従来、証券情報と合わせてニュースを提供する技術や、ユーザの検索要求に応じて関連ニュースを抽出し、知見情報として提供する技術がある。
上記のような技術として、例えば、株価チャートと関連ニュースを同一画面に表示する技術(第1の技術)や、注目している銘柄の関連銘柄(同業他社、取引先、メインバンク、資本関係あり、など予め設定したもの)のうち、注目している銘柄と同時期に同様の株価変動をした銘柄を関連銘柄として記憶する技術(第2の技術)がある。
また、ユーザの要求をトリガーとして記憶装置に保持されたニュース中の「〜関連株」「〜特需」などの手がかり語から注目銘柄検索のためのキーワード抽出と銘柄関連付けを行い、ユーザに提示する技術や、一般的なシソーラス構築等の分野において、単語の係り受けを、複数発生する構文解析結果のうちの出現数に応じた確信度で管理・更新する技術がある(第3の技術)。また、文書群から企業名と共起する関連語を取得してテーブルに保持するとともに、その共起対が株価変動に影響する度合いを予測係数テーブルで保持し、関連語の評価値と、予測係数を、それぞれ管理・更新し、株価予測を行う技術(第4の技術)もある。
しかしながら、株価チャートとニュースを同一画面でユーザに提示する第1の技術では、ニュースに予め銘柄などの知見情報を抽出する対象の語句(以下、知見情報抽出対象語という)が関連付けられていなければならないという問題がある。
また、注目している銘柄と同時期に同様の株価変動をした銘柄を関連銘柄として記憶する第2の技術では、同様の変動をしなかった銘柄が関連付けられないという問題がある。また、注目している銘柄に同業などの明示的な関連のある銘柄を予め設定するため、銘柄をグループ化する範囲が限定されてしまう。
第3の技術は、記憶装置に保持されたニュースからキーワード抽出と銘柄関連付けを実行するが、その活用方法や更新方法が開示されていない。
また、第3の技術は、単語の係り受けの確信度を評価し、以後に入手する新規コーパスで確信度を更新するが、情報源は単独(同種の情報)である。
第4の技術では、企業名の関連語を取得・管理し、その株価変動への影響も管理・更新しているが、株価変動で更新する対象は予測係数のみである。
本発明が解決しようとする課題は、知見情報抽出対象に関連付けられていない状態で随時配信される電子文書から、当該知見抽出対象語に関する知見情報を抽出する知見抽出装置、知見更新装置、及びプログラムを提供することである。
実施形態の知見抽出装置は、電子文書から知見情報を抽出する知見抽出装置であって、前記電子文書を受信する情報受信部と、前記知見情報を抽出する対象語と、前記知見情報を抽出する手掛かり語とに基づいて前記電子文書から概念を抽出し、抽出された当該概念と前記対象語を関連付けた知見情報を作成する知見抽出部と、前記抽出された知見情報を記憶する記憶部と、前記知見情報が記憶された後、前記電子文書を前記記憶部内の知見情報に基づいて分析する情報分析部と、前記電子文書に含まれる前記概念もしく前記対象語を検索する電子文書検索部と、前記検索部による検索の結果、前記電子文書に前記概念が規定数以上記載された場合に前記概念を抽出し、前記電子文書に前記対象語が規定数以上記載された場合に前記対象語に関連付けられた前記知見情報を前記記憶部から抽出する知見登録概念抽出部と、前記知見登録概念抽出部が抽出した前記対象語もしくは前記概念に関連する数値情報の大きさもしくは変動を評価する評価部と、前記数値情報の大きさもしくは変動の方向もしくは数値情報の変動の大きさに従って前記概念と前記対象語の関連性の評価数値である確信度を更新する確信度更新部と、前記確信度が規定値を下回った場合にユーザに判断を求め、ユーザの指示により選択中の前記概念間の関連を削除する知見更新部とを備える。
以下、各実施形態の知見抽出装置について図面を用いて説明する。なお、以下の各装置は、装置毎に、ハードウェア構成、又はハードウェア資源とソフトウェアとの組合せ構成のいずれでも実施可能となっている。組合せ構成のソフトウェアとしては、予めネットワーク又は記憶媒体から対応する装置のコンピュータにインストールされ、対応する装置の機能を実現させるためのプログラムが用いられる。
(第1の実施形態)
図1は、第1の実施形態に係る知見抽出装置の構成例を示すブロック図である。本実施形態の知見抽出装置1は、株取引を行うユーザや株取引判断を行うアルゴリズムトレードエンジンなどのシステム(複合イベント処理エンジン、CEPなどを組み込んだものを含む)への証券市場立会時間中の情報提供に使用可能なものであり、例えばインターネット等で配信されたニュース情報などの電子文書から株取引に関する知見情報を抽出する。抽出結果の、知見情報は情報提供などに使用可能となっている。
図1は、第1の実施形態に係る知見抽出装置の構成例を示すブロック図である。本実施形態の知見抽出装置1は、株取引を行うユーザや株取引判断を行うアルゴリズムトレードエンジンなどのシステム(複合イベント処理エンジン、CEPなどを組み込んだものを含む)への証券市場立会時間中の情報提供に使用可能なものであり、例えばインターネット等で配信されたニュース情報などの電子文書から株取引に関する知見情報を抽出する。抽出結果の、知見情報は情報提供などに使用可能となっている。
具体的には、この知見抽出装置1は、ニュース情報のうちの経済ニュースを受信した際に、例えば、キーワード「インフルエンザ」に関連する銘柄グルーピングの知識や、「インフルエンザ」関連銘柄で株価変動の材料となる「集団感染」「鳥インフルエンザ」の知識を獲得し、これらの知識を知見情報として保持するものである。また、知見抽出装置1は、経済ニュースを含むインターネット配信ニュース、企業情報を受信した際は、保持した知見情報を参照し、ニュース情報に「インフルエンザ」などのグループ、該当グループに所属する銘柄、該当グループの株価変動材料の有無の情報を付与し、アルゴリズムトレードエンジンなどのシステムもしくは株取引を行うユーザのユーザ端末装置に提供可能となっている。すなわち、知見抽出装置1は、銘柄などの知見抽出対象語のグルーピングをするための情報である概念(第1概念)や、第1概念に関連づける情報(第2概念)を含む知見情報を抽出する。
例えば、株取引に関する知見情報を抽出する場合、株の銘柄が所属する業界(例:金融、金属、広告など)が第1概念となるような手掛かり語(第1手掛かり語)を、知見抽出装置1に記憶させる。第1手掛かり語については後述する。第2概念は、第1概念と異なる概念であり、後述する第2手掛かり語に基づいて抽出される。
また、知見抽出装置1は、知見抽出システム1と呼んでもよい。
具体的には知見抽出装置1は、装置全体の制御を司る制御部10、記憶部11、情報受信部12、情報選択部13、知見抽出部14、情報分析部15および入出力インタフェース16を備え、各部11〜16がバス17を介して接続される。
記憶部11は、例えばハ−ドディスクドライブや不揮発性メモリ装置などのハードウェアで構成される。記憶部11は制御部10による実行対象のプログラムを記憶するのに加え、知見抽出部14で抽出した知見情報、受信し分析を行った電子文書などを保持する。また、記憶部11は、後述する第1手掛かり語辞書111、知見抽出対象語辞書112、第2手掛かり語辞書113及び処理途中のデータ等も保持する。
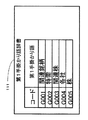
第1手掛かり語辞書111は、図2に一例を示すように、第1手掛かり語を識別するコードと、知見情報抽出対象をグルーピングする第1概念の手掛かりとなる第1手掛かり語とが関連付けられて記述されている。すなわち、本実施形態の電子文書はあらかじめ記憶された第1手掛かり語に基づいて第1概念名(グループ名)をつけられる。本実施形態の第1手掛かり語辞書はグループ定義語辞書111といえる。
知見抽出対象語辞書112は、図3に一例を示すように、本実施形態において電子文書から知見情報を抽出する対象語(知見抽出対象語)である銘柄を識別する証券コードと、銘柄の企業名と、銘柄の業種の大分類を示す東証業種1と、東証業種1内の小分類を示す東証業種2と、銘柄の企業名を表す企業名表現とが関連付けられて記述されている。企業名表現としては、企業名の正称、略称、通称、俗称、愛称などの様々な名称が使用可能となっている。なお、企業名表現は、名称に限らず、各企業の証券コードを用いてもよい。すなわち、本実施形態では知見抽出対象語辞書を銘柄辞書112といえる。
第2手掛かり語辞書113は、図4に一例を示すように、第2手掛かり語(材料表現手掛かり語)を識別するコードと、後述する知見抽出判定語の表現に対する手掛かり語とが関連付けられて記述されている。すなわち、本実施形態では第2手掛かり語辞書113を材料表現手掛かり語辞書113といえる。
情報受信部12は、インターネットで配信されるニュース情報を受信する。図5及び図6はインターネットで配信されるニュース情報の例である。ニュース情報の受信は、配信業者と契約を結び配信を受ける形態でも、一般に検索ロボットもしくはクローラと呼ばれるインターネット検索プログラムにより新規配信されたニュース情報を発見し入手する形態でもよい。本実施形態では、インターネットで配信されるニュース情報の構成要素のうち、図5及び図6に示す「タイムスタンプ」「ニュースソース」「ジャンル」「ニュース見出し」「ニュース本文」の5項目と、情報受信部12が付与する「ニュースID」を利用する。「タイムスタンプ」は、配信されたニュース情報に付与された配信日時情報である。「ニュースソース」は、その情報を提供した事業者の名称である。「ジャンル」は、ニュース情報に付与された「経済」「社会」「スポーツ」などのジャンル(分野)を示すタグ情報である。「ジャンル」は、ニュース受信時に付与されていなくてもよい。「ニュース見出し」は配信されたニュース情報の見出し部分の日本語列、「ニュース本文」は配信されたニュース情報の見出しを除く本文部分の日本語列である。
情報選択部13は、情報受信部12が受信したニュース情報から、ここでは経済ニュース(経済用語を含むニュース情報)を選択する。経済ニュースであることの判断は、例えば、受信したニュース情報に「ジャンル」が付与されている場合は、「ジャンル」が「経済」「市況」などの経済とその類義語のうちのいずれかの用語を含む表現であることにより判断する。受信したニュース情報に「ジャンル」が付与されていない場合は、例えば、ニュース見出しもしくはニュース本文に「東証」「大証」「日経平均」「株価」「株式市場」「高値」「終値」「出来高」などの経済用語、特に株取引に関する用語のいずれかを含むことにより判断する。すなわち、情報選択部13は、知見抽出対象語に関連の高い電子文書を選択する。
知見抽出部14は、情報入力部13によって選択されたニュース情報から知見情報を抽出するものであり、例えば、後述する知見抽出判定語チェック部141、第1手掛かり語チェック部142、第1概念抽出部143、知見抽出対象語抽出部144、第2概念抽出部145、組み合わせ作成部146及び第1概念チェック部147により、記憶部11内の各辞書111〜113を用い、知見情報抽出対象の経済ニュースから、知見抽出対象である銘柄をグループ分けする第1概念名、グループに所属する銘柄、株価変動の要因となる材料表現を抽出し、銘柄グルーピングや材料(イベント)の知見情報として記憶部11に書込む。ここで、知見情報としては、例えば、第1概念名、銘柄及び株価変動材料を含む情報、又は第1概念名及び銘柄からなる第1情報と株価変動材料からなる第2情報とを含む情報が使用可能となっているが、これらの組み合わせには限定されない。なお、知見抽出部14は情報選択部13によって選択された情報ではなく記憶部11に記憶された電子文書から知見情報を抽出することも可能である。
なお、知見抽出部14は、これら各部141〜147及び各辞書111〜113を用いる方法に限らず、例えば、構文解析、意味解析、文脈解析を用いて銘柄をグループ分けする方法により、知見情報を抽出してもよい。後者の方法では、例えば「インフルエンザの流行を受けて、XX社がランクイン」のように、図2に示したグループ定義語を含まないニュース情報からも知見情報を抽出可能となっている。
情報分析部15は、知見情報が記憶部11に記憶された後、情報受信部12に(新規に)受信された全てのニュース情報を記憶部11内の知見情報に基づいて分析するものであり、例えば、後述する知見抽出対象語・第1概念・第2概念抽出部151、電子文書割付部152及び知見抽出対象別判定部153を備えている。また、情報分析部15は、新規に受信したニュース情報にグルーピングや材料(イベント)の知見情報に該当する情報が存在する場合は、当該ニュース情報に当該知見情報を付与してもよい。情報分析部15はさらに、新規に受信したニュース情報を含めて一定時間に処理したニュース情報をグループや銘柄にわけ、それぞれのグループや銘柄で統計処理を行い、統計情報を付与してもよい。
一連の処理終了後、情報分析部15の出力が、ニュース情報の分析結果として入出力インタフェース16によりユーザ端末装置に提示される。
入出力インタフェース16は図示しない外部記憶装置とケーブルを介して接続可能であり、この外部記憶装置との間で記憶部11に記憶される知見情報や分析結果保存データベース(図示せず)にデータを入出力する。
図7は、以上のような知見抽出装置1に接続されるユーザ端末装置の構成例を示すブロック図である。ユーザ端末装置2は、知見抽出装置1を利用するユーザが取り扱う端末装置である。ユーザ端末装置2は、装置全体の処理を司る端末制御部21、端末記憶部22、表示部23、入力部24、通信インタフェース25を備え、それぞれがバス26を介して相互に接続される。
端末記憶部22は、例えばハ−ドディスクドライブや不揮発性メモリ装置などのハードウェアで構成された記憶装置である。端末記憶部22は、制御用のプログラムを記憶する。また、端末記憶部22は、端末制御部21による各種処理のワークメモリとしても機能する。
表示部23は、例えば液晶ディスプレイであり、情報分析部15の出力をユーザに向けて出力する。例えば、新規に受信したニュース情報の配信時刻(タイムスタンプ)、ニュースソース、ニュース情報で話題とされた企業名・第1概念名、ニュース情報に含まれる株取引材料(自己株取得、経営悪化、インフルエンザの集団感染、など)を表形式でユーザに提示する。
入力部24は例えばキーボードやマウスであり、知見抽出、情報分析およびシステム設定にかかる操作を受け付ける。
通信インタフェース25は、ケーブルを介して知見抽出装置1と接続され、ユーザ端末装置2においてユーザが指定した条件や知見抽出装置1の処理結果などのやり取りを行う。また、通信インタフェース25は外部記憶装置とケーブルを介して接続可能であり、この外部記憶装置との間で記憶部11に記憶する銘柄グルーピングや材料(イベント)の知見情報、分析結果を入出力することもできる。
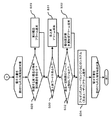
次に、以上のように構成された知見抽出装置1の動作について説明する。図8は、知見抽出部14の処理動作の詳細を示す模式図、図9は知見抽出部の処理動作の一例を説明するためのフローチャートである。
なお、以下の説明では、知見抽出部14の処理を、ニュース情報を受信する都度としているが、この処理は夜間などの情報分析処理を行わない時間帯に、受信済みのニュース情報に対してまとめて実施してもよい。
情報受信部12が、ニュース配信サイトからの配信を受けるか、ニュース配信サイトにアクセスすることにより、新規のニュース情報を受信する。例えば、図5及び図6のうち、図5に示すニュースID“1”に該当するニュース情報を受信する。
情報選択部13は、情報受信部12が受信した電子文書であるニュース情報から、知見情報を抽出する電子文書として経済ニュースを選択する(ステップS1)。経済ニュースであることの判断は、例えば、受信したニュース情報に「ジャンル」が付与されている場合は、「ジャンル」が「経済」「市況」などの経済とその類義語のうちのいずれかを含む表現であることにより判断する。
受信したニュース情報に「ジャンル」が付与されていない場合は、例えば、ニュース見出しもしくはニュース本文に「東証」「大証」「日経平均」「株価」「株式市場」「高値」「終値」「出来高」などの経済用語、特に株取引に関する用語のいずれかを含むことにより判断する。選択されたニュース情報は、情報選択部13から知見抽出部14に送出される。
知見抽出部14においては、知見抽出判定語チェック部141が、情報選択部13に選択されたニュース情報が知見情報を抽出する可能性のある電子文書かどうかを判定する知見抽出判定語を含むか否かを判定する(ステップS2)。
本実施形態では知見抽出判定語は株価変動を評価する株価変動評価語であるとする。すなわち、本実施形態では知見抽出判定語チェック部141を株価変動評価語チェック部141といえる。
例えば、知見抽出判定語チェック部141は、受信したニュース情報のニュース見出しもしくはニュース本文に、「高値更新」「強い動き」「反発」「急落」「続伸」「ランクイン」などの株価変動評価語が含まれるか否かを判定する。
ニュース情報に株価変動評価語が含まれる場合、知見抽出部14は、当該ニュース情報が知見情報を含むニュース情報であると判定して、ニュース情報を第1手掛かり語チェック部142に送信する。
なお、「株価変動評価語」は、株価の変動を評価する内容であれば、「株価変動表現語」、「株価変動語」又は「株価変動定義語」といった他の用語に言い換えてもよい。
第1手掛かり語チェック部142は、ステップS2の判定の結果、ニュース情報が株価変動評価語を含むとき、当該ニュース情報が銘柄の第1概念名を定義する第1手掛かり語(グループ定義語)を含むか否かを判定する(ステップS3)。すなわち、本実施形態の第1手掛かり語チェック部142はグループ定義語チェック部142といえる。
例えば、第1手掛かり語チェック部142は、第1手掛かり語辞書111を参照し、受信したニュース情報のニュース見出しもしくはニュース本文にグループ定義語の少なくとも1つが含まれるか否かを判定する。例えば図5に示すニュースID“1”のニュースは、グループ定義語「関連銘柄」を含む。
受信したニュース情報にグループ定義語が含まれない場合は第1概念抽出部143によるステップS4の処理を省略する。
受信したニュース情報にグループ定義語が含まれる場合は、第1手掛かり語チェック部142は、ニュース情報を第1概念抽出部143に送信する。
第1概念抽出部143は、ステップS3の判定の結果、ニュース情報がグループ定義語を含むとき、当該グループ定義語に基づいて当該ニュース情報から第1概念名を抽出する(ステップS4)。
例えば、第1概念抽出部143は、グループ定義語を含むニュース情報を受信すると、グループ定義語直前の名詞を第1概念名として抽出する。受信したニュース情報が例えば図5に示すニュースID“1”の場合は、グループ定義語「関連銘柄」の直前の名詞「インフルエンザ」を第1概念名として抽出する。
第1概念名は名詞としたが、「インフルエンザ」のような単語ではなくて、「新型インフルエンザ」「季節性インフルエンザ」のような複合名詞も抽出対象としてよい。また、グループ定義語を含むが直前が名詞でない場合は、第1概念名を含まないと判断する。
知見抽出対象語抽出部144は、知見抽出判定語チェック部141によるステップS2の判定の結果、ニュース情報が株価変動評価語を含むとき、当該ニュース情報から企業名及び証券コードを含む銘柄を抽出する。
具体的には、知見抽出対象語抽出部144は、例えば、ステップS3又はS4の後、第1概念抽出部143の処理を省略して送信されたニュース情報に対して、知見抽出対象語辞書112を参照し、ニュース見出しもしくはニュース本文に知見抽出対象名表現が含まれるか否かを判定し(ステップS5)、知見抽出対象名表現が含まれる場合に当該知見抽出対象名表現に対応する知見抽出対象語である銘柄を抽出する(ステップS6)。すなわち、本実施形態の知見抽出対象語抽出部144は銘柄抽出部144といえる。
ニュース見出しまたはニュース本文に、知見抽出対象語辞書112の「知見抽出対象名表現」列の表現がある場合は、その行の「証券コード」「企業名」に記された知見抽出対象語である銘柄が含まれると判断する。
知見抽出対象語辞書112は、1つの証券コードに対して複数行の定義を含んでよい。また、1件のニュース情報から複数の知見抽出対象名表現を抽出してよい。
例えば図5のニュースID“1”のニュース情報の場合、知見抽出対象名表現「RRボウ」「yyボウHD」「ホヘト薬品」が含まれるため、銘柄「証券コード 1031 企業名 RRボウ(株)」「証券コード 1033 企業名 yyボウホールディングス(株)」「証券コード 1041 企業名 ホヘト薬品(株)」が抽出される。
知見抽出対象語辞書112では知見抽出対象名表現を企業名称もしくは企業名の略称としているが、各企業の証券コードも知見抽出対象名表現の一例としてもよい。本実施形態の知見抽出対象語辞書112における知見抽出対象名表現は企業名表現といえる。
なお、知見抽出対象語抽出部144は、図10に示すように、ステップS2の結果、株価変動評価語を含む場合に銘柄を抽出すればよいので、ステップS3,S4の後に限らず、ステップS2の後からステップS9の前の間の任意の時点で銘柄を抽出可能である。
第2概念抽出部145は、知見抽出判定語チェック部141による判定の結果、ニュース情報が知見抽出判定語である株価変動評価語を含むとき、当該ニュース情報から第2概念として株価変動材料を抽出する。具体的には、第2概念抽出部145は、株価変動評価語を含むニュース情報のニュース見出しもしくはニュース本文に、第2手掛かり語辞書113内の第2手掛かり語の1つ以上が含まれるか否かを判定する(ステップS7)。
ステップS7およびステップS8の処理は、図9のフローチャートではステップS6の後としているが、ステップS3の処理の前、もしくはステップS3からステップS6の処理と並列で実施してもよい。
第2概念抽出部145は、受信したニュース情報のニュース見出しもしくはニュース本文に、第2手掛かり語辞書113内の第2手掛かり語が含まれる場合、その第2手掛かり語と係り受けしている名詞句を第2概念名として抽出する(ステップS8)。本実施形態では第2概念名を株価変動材料表現といえる。すなわち、本実施形態では第2概念抽出部145は材料抽出部145といえる。
例えば、図5に示すニュースID“1”のニュース本文では、第2文「○県が×市内の学生寮において、新型インフルエンザの集団感染が発生したと発表したことが手掛かり材料となっているようだ。」に第2手掛かり語「手掛かり材料」が含まれる。
第2手掛かり語「手掛かり材料」と係り受けしている名詞句は「新型インフルエンザの集団感染が発生したと発表したこと」である。この名詞句「新型インフルエンザの集団感染が発生したと発表したこと」が株価変動材料(イベント)表現として抽出される。
株価変動材料(イベント)表現は、抽出した名詞句を分析し、「新型インフルエンザの集団感染が発生した」もしくは「新型インフルエンザの集団感染」を抽出対象としてもよい。
また、ステップS6、ステップS7で抽出する第1概念名「インフルエンザ」を含む「新型インフルエンザ」とその付属語を消去し「集団感染」を抽出対象としてもよい。
さらに、該当のニュース本文が「○県が×市内の学生寮において、新型インフルエンザの集団感染が発生したと発表した。これが手掛かり材料となっているようだ。」のように2つの文にわかれている場合、手掛かり語「手掛かり材料」と係り受けしている代名詞「これ」を抽出した後で、文脈解析により「これ」を前文の「○県が×市内の学生寮において、新型インフルエンザの集団感染が発生したと発表した」に置き換え、置き換えた後の「○県が×市内の学生寮において、新型インフルエンザの集団感染が発生したと発表した」もしくはその分析結果から「新型インフルエンザの集団感染が発生した」、「新型インフルエンザの集団感染」、もしくは「集団感染」を抽出対象としてもよい。
ステップS3からステップS8の処理の終了後、組み合わせ作成部146は、処理中のニュース情報から抽出された第1概念名、知見抽出対象語である銘柄及び株価変動材料(第2概念名もしくはイベント)を組み合わせて知見情報を作成し、当該知見情報を記憶部に書き込む(ステップS9)。
ニュース情報から抽出された第1概念名が1つである場合は、その第1概念名に、抽出された全ての銘柄(知見抽出対象語)、及び抽出された全ての株価変動材料(第2概念名)を割り付ける。すなわち、1つの第1概念名に対して、知見抽出対象語である銘柄と第2概念である株価変動材料はそれぞれ1つまたは複数が割り付けられることを許容する。
分析対象のニュース情報が図6のニュースID“3”の場合は、図11に示すようにニュース本文から複数の6件の第1概念名、8件の銘柄、3件の株価変動材料が抽出される。
このように抽出された第1概念名が複数である場合、文脈解析などの高度な自然言語処理を用いて、第1概念名、第1概念名に係り受けしている銘柄、第1概念名もしくはその第1概念名に係り受けしている銘柄に係り受けしている株価変動材料を組み合せてもよい。
また、簡易的には、ニュース本文を文に区切り、文ごとに第1概念名、銘柄、株価変動材料を組み合せるとしてもよい。さらに、ニュース本文を1文ずつ取り出し、第1概念名と銘柄が揃った時にそこまでに抽出された第1概念名、銘柄、株価変動材料を組み合せて出力し、次の文から新たに第1概念名、銘柄、株価変動材料を組み合せるとしてもよい。 知見情報は第1概念名に対して銘柄と株価変動材料が割り付けられるとしているが、銘柄もしくは株価変動材料がない組み合せが作成されてもよい。
このような処理により、本実施形態では、第1概念名、銘柄(企業名表現)、株価変動材料のセットであるされた知見情報として以下の6セットが抽出される。
(1)第1概念名:石油 銘柄:○×△石〈1001〉、石油VV〈1002〉、
材料:10年4〜12月期で連結経常益2000億円強が報じられた。
材料:10年4〜12月期で連結経常益2000億円強が報じられた。
(2)第1概念名:商社 銘柄:HH商〈1080〉。
(3)第1概念名:非鉄金属 銘柄:SS鉱〈1050〉。
(4)第1概念名:繊維 銘柄:センイJJ〈1030〉。
(5)第1概念名:銀行 銘柄:HH銀〈1082〉。
(6)第1概念名:ハイテク 銘柄:ハイテクBB〈1060〉、QQメモリ〈1063〉、
材料:D証(D証券)が投資判断を引き上げ。
材料:D証(D証券)が投資判断を引き上げ。
組み合せは、第1概念名、銘柄、株価変動材料をセットにするとしたが、組み合わせは第1概念名と銘柄のみとし、株価変動材料は単独で知見情報として保持するとしてもよい。または、株価変動材料は第1概念名ではなく銘柄とセットにして知見情報として保持するとしてもよい。
組み合わせ作成部146の処理後、図12に一例を示す如き、抽出された知見情報は、記憶部11に書き込まれる(ステップS9)。なお、図12に示すように、本実施形態における第1概念の例として「インフルエンザ」、「石油」、「商社」、「非鉄金属」、「繊維」、「金属」、「ハイテク」などがある。
ステップS2で株価変動評価語がないと判定された経済ニュースは、第1概念チェック部147により、ニュース見出しもしくはニュース本文に、記憶部11に書き込まれた知見情報の第1概念名(既存第1概念名)を含むか否かを判定される(ステップS11)。本実施形態では第1概念名はグループ名であるため、第1概念チェック部147はグループ名チェック部といえる。
既存第1概念名を含む場合は、知見抽出対象語抽出部144が知見抽出対象語辞書112を用いて、ニュース見出しとニュース本文に知見抽出対象名表現が含まれるか否かを判定する(ステップS12)。
知見抽出対象名表現が含まれる場合、例えば「参入」「新事業」などの表現がある場合は、組み合せ作成部146が抽出された知見抽出対象名表現に対応する銘柄を既存グループに追加する処理のための組み合わせを作成する。
「撤退」などの表現がある場合は、組み合わせ作成部146が、既存第1概念に対して抽出された知見抽出対象名表現に対応する銘柄を取り除く処理のための組み合わせを作成する(ステップS13)。
ステップS13で既存第1概念と銘柄の追加もしくは削除処理の組み合わせが作成された場合は、その処理を記憶部11に対して実行する(ステップS9)。
次に、情報分析部15の動作を図13、図14及び図15によって説明する。
始めに、情報受信部12は、ニュース配信サイトからの配信を受けるか、ニュース配信サイトにアクセスすることにより、新規のニュース情報を受信する。例えば、図5のニュースID2に該当するニュース情報を受信する(ステップS21)。受信したニュース情報は知見抽出対象語・第1概念・第2概念抽出部151に送信される。
知見抽出対象語・第1概念・第2概念抽出部151は、まず、記憶部11に記憶された知見抽出対象語辞書112を参照し、受信したニュース情報のニュース見出しもしくはニュース本文に知見抽出対象名表現があるか否かを判定する(ステップS22)。
知見抽出対象名表現がある場合、知見抽出対象語・第1概念・第2概念抽出部151は、抽出された知見抽出対象名表現に対応する企業名・証券コードを抽出する。また、知見抽出対象語・第1概念・第2概念抽出部151は、図12に示す知見情報を参照し、抽出した企業名・証券コードが割り付けられた第1概念名を全て抽出する(ステップS23)。知見抽出対象語・第1概念・第2概念抽出部151及び電子文書割付部(ニュース割付部)152は、ニュース見出しとニュース本文から抽出された企業名ごとに、その企業が属する各グループに対して、ステップS24・ステップS25の処理を行う。
始めに、知見抽出対象語・第1概念・第2概念抽出部151は、図12に示す知見情報を参照し、その時点で処理中の企業名・その企業が属する第1概念名に割り付けられた第2概念(株価変動材料)を抽出し、ニュース見出し・ニュース本文中に該当の株価変動材料(表現)があるか否かを判定する(ステップS24)。
該当の株価変動材料(表現)がある場合は、処理中の受信ニュース情報にそのグループに関する情報があると判断し、電子文書割付部152が、処理中のニュース情報を、図12に示す知見情報でその第1概念名に対応付けられた企業に割り付ける(ステップS25)。
知見抽出対象語・第1概念・第2概念抽出部151は、ステップS22からステップS25の処理の後、もしくは、前、または並列で、受信したニュース情報のニュース見出しもしくはニュース本文に、図12に示す知見情報内の第1概念名が含まれるか否かを判定する(ステップS26)。
例えば、図6に示すニュースID“2”のニュース情報では、本文に第1概念名「インフルエンザ」が含まれる。
第1概念名が含まれる場合、知見抽出対象語・第1概念・第2概念抽出部151は、当該第1概念名を本文又は知見情報から抽出して電子文書割付部152に送出する。
第1概念名が抽出された場合、電子文書割付部152は、図12に示す知見情報でその第1概念名に対応付けられた知見抽出対象語である銘柄を取り出し、処理中の電子文書を該当知見抽出対象語全てに割り付ける(ステップS27)。
ステップS27までの処理でニュース情報を割り付けられた知見抽出対象語ごとに、知見抽出対象別判定部153は、以下に記載するステップS28からステップS34の処理を行う。
ステップS28では、ステップS24の第2概念、すなわち株価変動材料(表現)抽出結果を参照し、現在処理中の知見抽出対象語である銘柄が属する第1概念に特有の第2概念が抽出されているか否かを判定する。
処理中の知見抽出対象語において、当該知見抽出対象語の属する第1概念に関連づいて第2概念が抽出されている場合、当該知見抽出対象語に関する情報が変動する可能性があると判断し、当該知見抽出対象語と第2概念名のセットをアラームに追加する(ステップS29)。
具体的に記載すると、処理中の銘柄において、当該銘柄の所属グループに対応付けられた株価変動材料が抽出されている場合は、その銘柄の株価が変動する可能性があると判断し、その銘柄と株価変動材料のセットを株価変動材料アラームに追加する。
記憶部11に保持された知見情報が「第1概念名・知見抽出対象語」と第2概念名に分けられている場合は、ステップS28は、現在処理中の知見抽出対象語が属するか否かに関わらず記憶部11に保持された第2概念全てに関して抽出されているか否かを判定する。
この場合、ステップS29では、知見抽出対象語である銘柄と、ステップS28で抽出された第2概念である株価変動材料のセットを第2概念アラームに追加する。
知見抽出対象語である銘柄にニュース情報が割り付けられた後で、処理中の銘柄に割り付けられ、記憶部11に記憶された過去一定期間、例えば3日間のニュース見出し・ニュース本文を参照して急上昇ワードがあるかを判定し(ステップS30)、該当銘柄のニュース情報に急上昇ワードが存在する場合は、銘柄と急上昇ワードのセットを急上昇アラームに追加する(ステップS31)。
急上昇ワードは、近年、検索サイトなどで公開されているもので、出現単語の新しさ、急上昇を判定する技術が公知となっている。
さらに、同様に処理中の銘柄に割り付けられ、記憶部11に記憶された過去一定期間、例えば1時間のニュース情報のニュース見出し・ニュース本文を参照して処理中の受信ニュース情報が過去一定期間のニュース情報と類似・一致しているかを判定し(ステップS32)、類似ニュース情報もしくは一致するニュース情報がある場合は、そのニュース情報対の類似度を求め、多重配信アラームを追加する(ステップS33)。
以上の処理により出力された第2概念アラーム、急上昇アラーム、多重配信アラームは、情報分析部15から出力され、アルゴリズムトレードエンジンなどのシステムもしくは株取引を行うユーザ端末装置2に提供される(ステップS34)。
提供先がアルゴリズムトレードエンジンなどのシステムである場合、アルゴリズムトレードエンジンなどのシステムは、知見抽出装置1から提供されたニュース情報とニュース情報に付与された情報の他に、例えば該当銘柄の現在の株価、注文状況などを入力情報として、現時点で取るべき取引戦略を、株取引を行うユーザ端末装置2を介してユーザに提示する。
上述したように本実施形態によれば、受信されたニュース情報から経済用語を含むニュース情報を選択し、当該選択されたニュース情報から知見情報を抽出し、当該抽出された知見情報を記憶する構成により、銘柄に関連付けられていない状態で随時配信されるニュース情報から銘柄グルーピングや株価変動材料の知見情報を随時抽出することにより、知見情報を最新の状態にすることができる。
また、株価変動評価語を含むニュース情報が銘柄の第1概念名を定義するグループ定義語を含むとき、当該グループ定義語に基づいて当該ニュース情報から第1概念名を抽出し、株価変動評価語を含むニュース情報から企業名及び証券コードを含む銘柄を抽出し、株価変動評価語を含むニュース情報から株価変動材料を抽出し、当該抽出された第1概念名、銘柄及び株価変動材料を組み合わせて知見情報を作成し、当該作成された知見情報を記憶部11に書込む構成により、証券市場で使われる固定の業種ではないグルーピングの知見情報を活用できるので、株価変動予測を有効に支援できる。
さらに、知見情報が記憶された後、新規に受信された全てのニュース情報を記憶部11内の知見情報に基づいて分析する構成により、分析結果を、即時にアルゴリズムトレードエンジンなどのシステムもしくは株取引を行うユーザに提供することで、直近の株取引を有効に支援することができる。
また、提供先がアルゴリズムトレードエンジンなどのシステムである場合、現在の株価や注文状況などの数値情報のみを参照する場合と比較して、豊富な情報をもとにした判定を行うことが可能となる。
また、本実施形態及び以下の各実施形態は、対象をインターネット配信ニュースに限定しない。例えば、インターネットで配信される他の情報(ブログ、ミニブログ、マイクロブログ、企業発表情報)や、インターネット外に存在する電子文書を対象とすることも可能である。さらに、対象をニュース情報やブログなどの複数種類の情報の組み合わせとすることも可能である。
なお、ステップS32の類似ニュース情報もしくは一致するニュース情報の判定には、例えば、この出願の出願時に未公開である先願(特願2010−247518)の明細書に記載した処理[1]〜[3]を用いてもよい。以下の処理[1]〜[3]において「タイトル」の語は「ニュース本文」と読み替えてもよい。また、「ID付ニュース情報」の語は「ニュース情報」と読み替えてもよい。また、処理[1]〜[3]の主体は、前述したステップS32に合わせて「知見抽出対象別判定部153」に書き換えている。
[1]記憶部11は、単語解析辞書及び同一性判定基準などを予め記憶する。
同一性判定基準は、送信されるニュース情報における任意の2件のニュース情報が同一ニュースであるか否かを判定する基準を示しており、当該2件のニュース情報に含まれるニュースソース名が互いに一致することと、当該2件のニュース情報に含まれる配信日時の差分を示す配信時間差が基準値(最大の配信時間差)よりも小さいことと、当該2件のニュース情報における2件のタイトルの形態素解析結果から算出される類似度が規定値より高いことと、当該類似度は前記数値情報の有効数字の桁を四捨五入により合わせた後に算出されることとを含んでいる。
なお、類似度は、例えば、2件のタイトルの形態素解析結果に含まれる自立語の集合全体における当該自立語及び数値情報の個数に対し、当該2件のタイトルの形態素解析結果の両方に含まれる自立語及び数値情報の個数が占める割合である。また、類似度(0以上1以下)の規定値は、0.9程度の高い値が好ましい。また、「2件のタイトルの形態素解析結果から算出される類似度が規定値より高いこと」に代えて、「2件のタイトルの形態素解析結果から抽出される自立語が互いに一致すること」としてもよい。また、同一性判定基準は、同一性判定ルールと読み替えてもよい。
[2]知見抽出対象別判定部153は、記憶部11内の単語解析辞書を用い、ID付ニュース情報の単語解析処理を行なう。単語解析処理は例えば一例として、形態素解析技術(公知の技術)を用いる。換言すると、知見抽出対象別判定部153は、記憶部11内のID付ニュース情報に含まれるタイトルを形態素解析し、得られた形態素解析結果を当該ID付ニュース情報のニュースID及びタイトルに付加し、得られた解析結果情報を記憶部11に書き込む形態素解析機能をもっている。
なお、以下では形態素解析技術を一例として説明するが、知見抽出対象別判定部153での処理は、単語解析辞書を用いない、Nグラムなどの形態素解析ではない解析処理を用いて、単語に分解してもよい。つまり、本実施形態は、形態素解析に限定しない手法によりニュース情報を単語に分割し、単語の比較で類似度を判断するものである。
但し、例えば文字を単位としたNグラムの場合、品詞付けや自立語であるか否かの判定はできない。従って、形態素解析の他の手段で単語解析処理を行なうときは、「自立語」ではなく「単語」が処理対象となり得る。
[3]知見抽出対象別判定部153は、記憶部11内の同一性判定基準を満たすか否かに基づいて、記憶部11内の最新のID付ニュース情報と過去に書き込んだID付ニュース情報とが同一ニュースであるか否かを判定する。
例えば、知見抽出対象別判定部153は、最新のID付ニュース情報におけるタイトルの形態素解析結果から抽出された自立語及び数値情報と、過去に書き込まれたID付ニュース情報におけるタイトルの形態素解析結果から抽出された自立語及び数値情報とが一致する割合を示す類似度を算出する。但し、類似度を算出する前に、数値情報の有効数字の桁を四捨五入により合わせておく。この類似度が規定値(例、0.9)より高い場合、同一性判定部15は、ID付ニュース情報内のニュースソース名が一致し、さらに、各ニュースの配信時刻の差が基準値(例、5分)以内ならば、同一ニュースである旨を判定する。なお、類似度が高い旨の確認、ニュースソース名の一致確認、配信時刻の差の確認は、任意の順序で実行可能である。また、類似度が高い旨の確認に代えて、自立語が完全一致する旨を確認してもよい。
続いて、同一性判定の処理[3]について、ニュースID“38”のニュース情報と同一性判定対象のニュースID“3”のニュース情報とを例に挙げて述べる。
ニュースID“38”を含む最新のID付ニュース情報に対する形態素解析結果からは、数値情報「15.8%減」1種、自立語「米<名詞−固有名詞−国>」「商品販売<名詞−一般>」「A社<名詞−固有名詞−組織>」「1月<名詞−副詞可能>」「リコール<名詞−サ変接続>」「問題<名詞−ナイ形容詞語幹>」「響く<動詞−自立>」7種が抽出される。
同一性判定対象のニュースID“3”を含む過去のID付ニュース情報に対する形態素解析結果からは、数値情報「15%減<数値情報>」1種、自立語「A社<名詞−固有名詞−組織>」「1月<名詞−副詞可能>」「米<名詞−固有名詞−国>」「商品販売<名詞−一般>」4種が抽出される。
ここで、ニュースID“38”とニュースID“3”に対応する数値情報はそれぞれ「15.8%減」と「15%減」であり、値が一致しない。
自立語については、2件の形態素解析結果から抽出される自立語が全部で7種あるのに対して、2件の形態素解析結果の両方から抽出される自立語が4種である。
この場合、数値情報1種と自立語全7種の合計8種の情報のうち一致するものが4種であることに基づき、一致度が50%、類似度が0.5と算出される。
類似度の算出は、さらに「数値情報が含まれ、一致しない場合は類似度0とする」又は「数値情報の一致度と、自立語の一致度の平均を類似度とする」などとして実行してもよい。
なお、知見抽出対象別判定部153による自立語比較は、形態素解析結果をそのまま比較したが、これに限らず、形態素解析結果における動詞・形容詞・形容動詞を原形に変換して比較する処理や、否定の助動詞が続いていた場合には原形に戻す際に否定形の終止形とする処理、などの処理を加えるように変形してもよい。
(第2の実施形態)
次に、第2の実施形態について説明する。なお、第2の実施形態は、株取引に関する知見情報を抽出する第1の実施形態の知見抽出装置1に関する変形例である。
次に、第2の実施形態について説明する。なお、第2の実施形態は、株取引に関する知見情報を抽出する第1の実施形態の知見抽出装置1に関する変形例である。
株価変動の方向は、新たに得られた情報がポジティブかネガティブであるかとは必ずしも一致しない。株取引を行うユーザたちが事前に予測していた内容と比較して改善方向か改悪方向かが株価変動の方向を決める傾向がある。
したがって、第1の実施形態では、情報分析部15の処理において株価変動材料の有無とその表現のみをCEP(Complex Event Processing:複合イベント処理)もしくはユーザへの提供内容とした。しかし、一部の株価変動材料は、株価変動に一定の方向性を与える傾向がある。
そこで、第2の実施形態では、第2手掛かり語のうち、方向性が明らかであるものには、知見抽出部14内の材料抽出部145が、方向(ポジティブもしくはネガティブ)と、その強度を付与する形態としている。この強度は、例えば整数−5〜5の範囲で予め設定される。
これに伴い、第2概念抽出部145は、図4に示した第2手掛かり語辞書113に代えて、図16に示す第2手掛かり語辞書113aを用いる形態としている。
具体的には、第2概念抽出部145は、知見抽出判定語チェック部141による判定の結果、電子文書であるニュース情報が株価変動評価語を含むとき、当該ニュース情報から株価変動材料を抽出する前述した機能に加え、当該抽出された株価変動材料に基づいて、記憶部11内の第2手掛かり語辞書113aを検索し、当該検索された株価変動の方向及び強度を表す各情報を当該株価変動材料に付与する機能を更に備えている。
なお、第2手掛かり語辞書113aは、手掛かり語を識別するコードと、株価変動材料の表現に対する手掛かり語と、株価変動の方向を表す情報と、株価変動の強度を表す情報とが関連付けられて記述されている。
次に、以上のように構成された知見抽出装置1の動作を説明する。なお、第1の実施形態の知見抽出装置1と同様の構成・動作については説明を省略する
ステップS1〜S6までの動作は、前述同様に実行される。
ステップS1〜S6までの動作は、前述同様に実行される。
第2概念抽出部(以下、材料抽出部と記載する)145は、知見抽出判定語チェック部(以下、株価変動評価語チェック部と記載する)141による判定の結果、ニュース情報が株価変動評価語を含むとき、当該ニュース情報から株価変動材料を抽出する。具体的には、第2概念抽出部(以下、材料抽出部と記載する)145は、株価変動評価語を含むニュース情報のニュース見出しもしくはニュース本文に、第2手掛かり語辞書(以下、材料表現手掛かり語辞書と記載する)113a内の手掛かり語の1つ以上が含まれるか否かを判定する(ステップS7)。
ステップS7およびステップS8の処理は、図9のフローチャートではステップS6の後としているが、ステップS3の処理の前、もしくはステップS3からステップS6の処理と並列で実施してもよい。
材料抽出部145は、受信したニュース情報のニュース見出しもしくはニュース本文に、材料表現手掛かり語辞書113a内の手掛かり語が含まれる場合、その手掛かり語に係り受けしている名詞句を株価変動材料として抽出する(ステップS8)。
例えば図17に示すニュースID“4”からの知見抽出処理において、材料表現手掛かり語辞書113aに登録された手掛かり語「嫌気」を抽出し、手掛かり語「嫌気」に係り受けしている名詞句「業績下方修正」からなる株価変動材料に、手掛かり語「嫌気」に対応づけられた方向及び強度を付与し、株価変動材料「材料:業績下方修正 方向:ネガティブ 強度:2」が得られる。
組み合わせ作成部146は、前述同様に、知見情報を作成し、当該知見情報を記憶部11に書き込む(ステップS9)。図18は当該知見情報の一例である。ここで、知見情報は、方向及び強度が付与された株価変動材料「材料:業績下方修正 方向:ネガティブ 強度:2」を含んでいる。知見情報は、第1の実施形態と同様に、組み合せを、第1概念名、銘柄、株価変動材料をセットにしているが、組み合わせは第1概念名と銘柄のみとし、株価変動材料は単独で知見情報として保持するとしてもよい。または、株価変動材料は第1概念名ではなく銘柄とセットにして知見情報として保持するとしてもよい。
その後、図17に示すニュースID“5”を受信した際は、情報分析部15は、ニュース本文から株価変動材料「業績下方修正」を抽出した際に、「方向:ネガティブ 強度:2」の情報を、銘柄「1152: AA製鉄(株)」材料「業績下方修正」に加えてアルゴリズムトレードエンジンなどのシステムもしくは株取引を行うユーザ端末装置2に提供する。
上述したように本実施形態によれば、株取引に関する知見情報を抽出する知見抽出装置1によって抽出された株価変動材料に基づいて、第2手掛かり語辞書を検索し、当該検索された株価変動の方向及び強度を表す各情報を当該株価変動材料に付与する構成により、第1の実施形態の効果に加え、株価変動材料に方向と強度を加えた情報を提供することで、アルゴリズムトレードエンジンなどのシステムもしくは株取引を行うユーザの速やかな判断をさらに強く支援することができる。
(第3の実施形態)
次に、第3の実施形態について説明する。
次に、第3の実施形態について説明する。
第3の実施形態は、株取引に関する知見情を抽出する第1の実施形態の知見抽出装置1の変形例であり、知見抽出部14が抽出する知見情報をある対象に関する材料(イベント)とそのタイムスタンプとしている。
これに伴い、情報受信部12は、ニュース情報を受信する前述した機能に加え、ニュース情報を受信する際に、当該ニュース情報にタイムスタンプを付加する機能を更に備えている。
知見抽出部14は、情報選択部13により選択されたニュース情報から知見情報を抽出する前述した機能において、当該選択されたニュース情報から所定の対象を示す表現を含むイベント情報を抽出すると共に、当該イベント情報が抽出されたニュース情報から抽出し、当該抽出したイベント情報及びタイムスタンプを知見情報として記憶部11に書込む機能をもっている。
ここで、所定の対象を示す表現は、例えば、銘柄の企業名を表す企業名表現、又は銘柄の第1概念名を定義するグループ定義語の直前の名詞を表す表現である。なお、「銘柄の企業名を表す企業名表現」は、知見抽出対象語辞書(以下、銘柄辞書と記載する)112に記述されている。「銘柄の第1概念名を定義するグループ定義語」は、第1手掛かり語辞書(以下、グループ定義後辞書と記載する)111に記述されている。
次に、以上のように構成された知見抽出装置1の動作を説明する。図19は、知見抽出部14の処理動作の一例を示すフローチャートである。
情報受信部12がニュース情報を受信すると(ステップS41)、知見抽出部14はグループ定義語辞書111及び銘柄辞書112などを参照し、ユーザによって選択されている対象(企業が関連づけられた第1概念)を示す表現が含まれるか否かを判定する(ステップS42)。
ユーザによって選択されている対象を示す表現が含まれる場合、知見抽出部14は、その対象を示す表現を含む名詞句を、第2概念(イベント)として抽出する(ステップS43)。
知見抽出部14は、抽出した第2概念を、対象名、受信情報のタイムスタンプと合わせて記憶部11に追加的に書込む(ステップS44)。
以下、情報分析部15は、前述同様に、ステップS21〜S34の動作を実行する。
図20は、知見情報の一例を示す図である。図5に示すニュースID“1”,“2”から第1概念名「インフルエンザ」に関して処理を行った例である。
抽出する知識(第2概念)はユーザによって選択された対象表現を含む名詞句としたが、この名詞句中から複合名詞を選択したり、固有名詞(地名など)を選択したり、急上昇ワードを選択して第2概念とし、第2手掛かり語を「○県」「集団感染」「△市」やその組み合わせとしてもよい。
第1概念「インフルエンザ」で抽出した第2概念を、図12に示した如き、第1の実施形態で取得した知見情報にしたがって企業に展開し、図20に示す知見情報で「対象」を「インフルエンザ」から「1033:yyボウホールディングス(株)」に置き換えた情報を合わせて知見情報として書き込んでもよい。
さらに、図20に示すように、類似度の高いニュース情報の配信数を「類似情報数」として合わせて知見情報としてもよい。
上述したように本実施形態によれば、ニュース情報を受信する際に、ニュース情報にタイムスタンプを付加し、選択されたニュース情報から所定の対象を示す表現を含むイベント情報を抽出すると共に、当該抽出したイベント情報及びタイムスタンプを知見情報として記憶部11に書込む構成により、第1の実施形態の効果に加え、ある対象(第1概念)に関する第2概念をタイムスタンプ情報のある時系列で抽出し保持することで、同様の事象が発生した際に、近い将来の予想に有効な知見情報を保持しユーザ端末装置2に提示することができる。
なお、第3の実施形態は、受信する情報を電子メールとし、対象をプロジェクトとすることで、企業活動のうちのプロジェクトに関するリスクを示す知見情報を抽出することも可能である。さらに、受信する情報を情報機器のシステムログとし、対象をコンピュータネットワークシステムとすることで、コンピュータネットワークシステムの障害検知に関する知見情報の抽出をすることも可能である。
(第4の実施形態)
次に、第4の実施形態について説明する。
次に、第4の実施形態について説明する。
図21を参照して、第4の実施形態の知見抽出装置100の構成について説明する。なお、第1の実施形態乃至第3の実施形態に記載の構成については省略する。
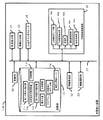
図21に示すように、本実施形態の知見抽出装置100は記憶部11の評価情報114と確信度更新ルール115、及び知見評価更新装置18を備える。評価情報114と確信度更新ルール115、及び確信度については後述する。
知見評価更新装置18は、上位概念チェック部181と、下位概念抽出部181と、評価部183と、確信度更新部184と、知見更新部185を備える。
上位概念チェック部181は、知見情報に含まれるグループ名毎に、あらかじめ設定した期間に記憶部11に新規登録されたニュース情報中で、当該グループ名が記載されたニュースの有無と配信数をチェックする。すなわち、本実施形態の知見情報は階層構造の情報であり、グループ名を上位概念とし、銘柄を下位概念とする。
下位概念抽出部182は、上位概念チェック部182によってチェックされたグループ名の下位概念である、知見情報に含まれる銘柄を全て抽出する。また、下位概念抽出部182は、上位概念チェック部181がチェックしたニュース情報から当該銘柄が記載されたニュースの有無と配信数をチェックする。
評価部183は、記憶部11に記憶された評価情報114に基づいて、下位概念抽出部182が抽出した銘柄毎に評価値を算出する。評価情報114は、例えば株価情報、ニュース、株の出来高、会社の業績や従業員数などである。
確信度更新部184は、評価部183が算出した評価値と、確信度更新ルール15とに基づいて、後述する確信度を更新する。
知見更新部185は、確信度更新部184による更新結果に基づいて、記憶部11に記憶された知見情報を更新する。
ここで、株価変動が、各銘柄が関連するニュースの発生の影響を受けることは前述のとおりであるが、影響の大きさは銘柄や、グループ名(キーワード)により異なる。したがって、グループ名と銘柄の組み合わせに加えて、その銘柄が該当グループ名のニュース発生時に受ける影響の強さ、すなわち、その銘柄が該当グループに所属する確信度の情報を合わせて保持することが有効である。
したがって、第4の実施形態では、図12に示した知見情報に代えて、図22に示すように、確信度と確信度更新履歴とを含む確信度情報を加えた知見情報を保持する形態としている。すなわち、本発明の確信度とは、下位概念が上位概念に帰属する(関連する)度合いを示す数値であり、背景技術に記載した第3の技術における確信度とは異なる。知見情報における確信度が高いほど、下位概念が上位概念に帰属する度合いが高い、すなわち関連性が強い情報であると判定できる。
なお、図22では図12の株価変動材料の情報を省略しているが、株価変動材料を加えた構成としてもよい。または、グループ名と株価変動材料の組合せを図22の知見情報とは別テーブルで管理する構成としてもよい。さらに、株価変動材料に加えて、第2の実施形態および図18に示すように、方向、強度を合わせて管理してもよい。また、確信度情報に含まれる情報は確信度のみでもよい。
図22の知見情報では、第1の実施形態、第2の実施形態、第3の実施形態で用いた図12の知見情報と同様にグループ名、銘柄の2種の情報を保持する。さらに、その銘柄が該当グループに所属する確信度の情報を加えた3種の情報を必須とする。これらに加えて、グループ名を細分化する下位グループ名、該当企業から発表された、該当事業(グループ)に参入予定の時期である事業参入時期、該当企業から発表された、該当事業から撤退予定の時期である事業撤退時期、過去一定回数までの確信度更新履歴、そのグループ名と銘柄の関係を新規抽出した際のグループ定義語を記録するグループ定義語、などの情報を合わせて保持してもよい。本実施形態では、確信度更新履歴を2つ前の履歴まで保持する。
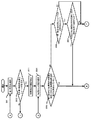
次に、図22の知見情報の確信度を保持し更新する知見評価更新装置18を備えた知見抽出装置100の動作を説明する。図23は、知見評価更新装置18の処理動作(以下、知見評価更新処理という)の詳細を示す模式図、図24及び図25は知見評価更新処理の一例を説明するためのフローチャートである。
以下、本実施形態の知見抽出装置100において、図22の4行目の知見情報に関する処理を行う場合について説明する。図22の4行目の知見情報は、「第1概念名:インフルエンザ、下位グループ名:インフルエンザ薬、銘柄:ff医薬<1042>、確信度:1、事業参入時期:2007年10月19日、確信度更新履歴1(前回の確信度更新履歴):2008年9月10日 +1、グループ定義後:関連」、である。
第1概念名(以下、グループ名と記載する)、銘柄(企業名表現)、株価変動材料のセットの抽出は、第1の実施例と同様に実行される。グループ名と銘柄の組み合わせが新規に抽出された際は、確信度の初期値として、例えば1.0を付与する。また、本実施形態の確信度の最小値は0とし、後述する確信度更新処理により、確信度が0を下回る結果となった場合は0に修正する。また、本実施形態の確信度の最大値は5.0とする。確信度更新処理により、確信度が5.0を超える結果となった場合は、例外処理により、5.0を大きく超えることがないように調整してもよい。例外処理は、例えば、前日の確信度が5.0より大、かつ、今回の更新でも確信度が増える状況の場合は、確信度を0.05のみ増やすこととし、前日の確信度が4.95未満、かつ今回の更新で確信度が5.0を超える場合に、更新後の確信度を5.0とする、という処理を行う。
なお、以下の説明では、知見評価更新処理を、証券市場終了後の夕方もしくは夜間に1回実行するとしているが、この処理は、1日1回ではなく、証券市場の前場と後場の終了時にそれぞれ実施してもよい。
知見評価更新処理が起動されると、上位概念チェック部181は図22の知見情報からグループ名を1つ選択する(ステップS51)。ここでは、グループ名「インフルエンザ」が選択される。続いて、上位概念チェック部181は、その日に記憶部11に新規登録されたニュース中で、ステップS51で選択されたグループ名が記載されたニュースの有無を確認する(ステップS52)。
なお、本実施形態では、ニュース件数の集計は、例えば営業日の15:00などの所定の時刻ごとに行う。休日に配信されたニュースは、翌営業日のニュースに加算してもよい。また、ステップS52においては、グループ名と下位グループ名の両方が記載されたニュースの有無を確認してもよい。
選択中のグループ名が記載されたニュースがない場合(ステップS52がNo)、ステップS53〜ステップS63の処理を省略し、ステップS64に進む。ステップS64については後述する。
選択中のグループ名が記載されたニュースがある場合(ステップS52がYes)、下位概念抽出部182は、図22の知見情報のうち、グループ名が選択中のものと同一である知見情報に含まれる銘柄を抽出する(ステップS53)。評価部183は、下位概念抽出部182によって選択された銘柄から1つを選ぶ(ステップS54)。ここでは銘柄「ff医薬<1042>」が選択される。
続いて、評価部183は、下位概念抽出部182によって選択された銘柄と、その銘柄に対応するグループ名と同時に含み、かつ事業撤退に関連するあらかじめ定めた語句(「撤退」「売却」など)がないニュースがあるか否かを判定する(ステップS55)。
下位概念抽出部182によって選択された銘柄と、その銘柄に対応するグループ名と同時に含み、かつ事業撤退に関連する語句がないニュースがない場合(ステップS55はNo)、ステップS56、S57の処理を省略し、ステップS58に進む。
下位概念抽出部182によって選択された銘柄と、その銘柄に対応するグループ名と同時に含み、かつ事業撤退に関連する語句がないニュースがある場合(ステップS55はYes)、評価部183は、当該グループ名を含むニュース件数が規定数以上かどうかを確認する(ステップS56)。本実施形態ではステップS56での規定数を3とする。
当該グループ名を含むニュース件数が規定数以上の場合(ステップS56がYes)、評価部183は、評価値として、当該銘柄の「出来高変化率」を算出し、算出した出来高変化率が後述する確信度の更新条件に合致するか否かを確認する(ステップS57)。
この場合、本実施形態の評価情報114には株の銘柄に関する日ごとの出来高が含まれる。銘柄がff医薬<1042>の出来高の一例を図26に示す。
ステップS57で評価部158は、この評価情報114を用いて「出来高変化率」を以下の式で算出する。
(1) 出来高変化率=(当日の出来高)/(直近5営業日の出来高の平均)
上記の式(1)では、直近5営業日の平均を用いているが、5営業日に限らないことは言うまでもない。
上記の式(1)では、直近5営業日の平均を用いているが、5営業日に限らないことは言うまでもない。
なお、ステップS57における更新条件は例えば「あらかじめ設定した閾値以上であれば更新する」である。また、更新条件は、当該知見抽出装置100に含まれる記憶部11に含まれる情報に基づいて動的に変化させてもよい。更新条件の動的な変化とは、例えば、評価情報114としてニュース情報を用いる場合、ニュース情報に含まれる当該銘柄の関連ニュースの件数が所定の数よりも多い場合に、更新条件に含まれる閾値を所定の単位で上昇させるようなことが考えられる。
本実施形態では、更新条件は「出来高変化率>1.1もしくは出来高変化率<1.0に当てはまるか否か」とする。
ステップS55〜ステップS57の判定は、確信度を更新するかを判定するための処理の一例であり、判定をさらに詳細に分けることや、判定基準として別の指標を用いることも考えられる。
当該グループ名を含むニュース件数が規定数未満の場合(ステップS56がNo)、もしくは評価部183が算出した評価値が、確信度の更新条件に合致しない場合(ステップS57がNo)、ステップS58〜ステップS62の処理を省略し、ステップS63の処理に進む。
評価部183が算出した評価値が、確信度の更新条件に合致する場合(ステップS57がYes)、確信度更新部184が当該銘柄と対応付けて記憶部11に記憶された確信度を更新する(ステップS58)。なお、確信度更新部184による確信度の更新は、記憶部11に確信度更新ルール115をあらかじめ設定しておき、このルールに従って更新する。
本実施形態における確信度更新ルール115の一例を図27に示す。図27に示す確信度更新ルール115は、記憶部11に格納されている。
図27の確信度更新ルール115は、「ステップS55の判定がYes、かつ出来高変化率≦1.1の場合、確信度に0.05を加える」,「ステップS55の判定がYes、かつ出来高変化率>1.1の場合、確信度に(出来高変化率−1.0)×0.5を確信度に加える」,「ステップS56がYes、かつ出来高変化率>1.1の場合、(ニュース変化率−出来高変化率)×0.5を確信度から減らす」,「ステップS56がYes、かつ出来高変化率<1.0の場合、(ニュース件数変化率−出来高変化率)×0.5を確信度に加える」である。
ニュース件数変化率は、以下の式に基づいて算出する。
(2) ニュース件数変化率=(当日の該当グループ名を含むニュース件数に当日の確信度を乗じたもの)/(直近5営業日の該当グループ名を含むニュース件数に該当日の確信度を乗じたものの平均)
また、本実施形態におけるインフルエンザが含まれるニュースの件数を日ごとに示したグラフを図28に示す。
また、本実施形態におけるインフルエンザが含まれるニュースの件数を日ごとに示したグラフを図28に示す。
本実施形態では、ステップS55のYesからステップS58に進んだ場合と、ステップS57のYesからステップS58に進んだ場合で更新ルールが異なる。また、例えば「出来高変化率<1.0の場合(1−出来高変化率)×0.5を前営業日の確信度から減らす」というような更新ルールでもよい。なお、確信度の前日値は例えば図22の知見情報に含まれる確信度更新履歴から算出する。または、確信度自体を履歴として保持してもよい。
図29に、本実施形態の確信度に関するグラフの一例を示す。
続いて、知見更新部185が、図22の知見情報を更新する。具体的には、知見更新部185は、更新後の確信度が、当該銘柄を含む知見情報を記憶部11から削除する条件(以下、削除条件という)を満たすか否かを判定する(ステップS59)。本実施形態では、例えば、確信度が0.3以下になった場合は、知見更新部185は、削除条件を満たすと判定する。なお、この判定は、最新の確信度の数値で判定するのではなく、更新履歴で例えば減少が5回連続した場合に削除条件を満たすとするとしてもよい。
更新後の確信度が0.3より大きい場合(ステップS59がNo)、すなわち、グループからの削除条件を満たさない場合、知見更新部185はステップS61〜ステップS62の処理省略し、ステップS63に進む。
更新後の確信度が0.3以下である場合(ステップS59がYes)、すなわち、グループからの削除条件を満たす場合、知見更新部185は、ユーザにアラームを提示する(ステップS60)。このアラームとは、ユーザに選択中の銘柄を選択中のグループから削除するか否かを確認するためのものであり、例えば入出力インタフェース16に表示される。
ユーザが、表示されたアラームを参照し、当該知見情報を削除するか否かを、入出力インタフェースを用いて入力すると、知見更新部185は、入力された情報が削除を指示する情報であるかを判定する(ステップS61)。
削除が指示されない場合(ステップS61がNo)、知見更新部185はステップS62の処理を省略し、ステップS63の処理に進む。
削除が指示された場合(ステップS61がYes)、知見更新部185は、選択された銘柄をグループから削除する(ステップS62)。すわなち、選択中のグループと選択中の銘柄の組み合わせに該当する知見情報を記憶部から削除する。なお、銘柄のグループからの削除は、この一連の処理のみで行うのではなく、図22の知見情報に記載された事業撤退時期の情報に従い、撤退時期に到達した銘柄を削除する処理を別途行ってもよい。
続いて、知見更新部185は、選択中のグループに未処理の銘柄があるか否かを判定する(ステップS63)。未処理の銘柄がある場合(ステップS63がYes)、ステップS54に戻って未処理の銘柄のうちの1つについて同様の処理を行う。
選択中のグループで未処理の銘柄がなくなった場合(ステップS63がNo)もしくは、ステップS52がNoの場合、知見更新部185は、知見情報に保持されたグループで未処理のものがあるか否かを判定する(ステップS64)。
未処理のグループがある場合(ステップS64がYes)、ステップS51に戻って未処理のグループのうちの1つについて同様の処理を行う。未処理のグループがない場合8ステップS64がNo)、処理を終了する。
上述したように本実施形態によれば、知見を抽出した情報源以外の情報(株価変動や出来高など)に基づいて、知見の有効性を評価し更新する構成により、第1の実施形態の効果に加え、知見の確かさを複数の情報源に基づき高く維持できる。
なお、第4の実施形態において、図24、図25の処理の判定基準は、前記に限定するものではない。例えば、ステップS52の選択中のグループ名を含むニュースがあるか否かの判定は、選択中のグループ名を含むニュース数が前日以上であるか否かの判定に置き換え、もしくは選択中のグループ名が急上昇ワードに該当するか否かの判定に置き換えてもよい。
また、ステップS57における選択中の銘柄の出来高変化率が更新条件を満たすか否かの判定は、選択中の銘柄の株価変動や売買代金、日経平均などの株式市場全体の傾向を示す指標と比較した株価変動傾向による判定に置き換えてもよい。
例えば、ステップS57において株価変動を用いて判定する場合、評価部183は、評価値としてその銘柄の直前の営業日の株価変動、例えばさらにその前の営業日からの株価変動の割合を求める。評価部183はこのとき、例えば株価変動が5%以上の上昇ならば選択中の銘柄が選択中のグループに帰属することは適切であると判定する。また、評価部183は、株価変動が5%未満の下落もしくは5%未満の上昇の場合は、銘柄のグループ帰属の適切判断を保留する。また、評価部183は、株価変動が5%以上の下落の場合は、選択中の銘柄が選択中のグループに帰属することは不適切であると判定する。この株価変動の判定は、第2の実施形態および図18に示したように、ニュースに記載された材料表現とその方向も加味し、上昇(ポジティブ)と下落(ネガティブ)のいずれがグループに帰属することの判断に適切であるかを決定した上で行ってもよい。
また、各銘柄に関する処理は、所属するグループごとに実施する形態としたが、ある銘柄が同日に複数のグループで処理対象となる場合は、例外的な処理を実施してもよい。例外的な処理とは、例えば、[4]もしくは[5]の処理である。
[4]同日に複数のグループで処理対象となる銘柄は、確信度更新を実施しない。
[5]同日に複数のグループで処理対象となる銘柄は、所属するグループごとに、他の所属銘柄の変動を参照する。他の銘柄と同じ方向・同程度の数値変動をした場合は、そのグループでの確信度更新処理を実施する。
また、本実施形態では、確信度による評価更新の対象をグループ名と銘柄の関係としたが、確信度は、図22の知見情報に保持されたグループ定義語の評価に用いてもよい。すなわち、知見情報に保持されたグループ定義語と対応する確信度の情報をグループ定義語ごとに整理し、確信度の平均や最大値が規定値未満となったグループ定義語を有効ではないと判定して図2のグループ定義語辞書(第1手掛かり語辞書)から削除してもよい。
また、確信度の情報は、知見情報もしくはグループ定義語の評価更新に用いるものではなく、一般ニュースに含まれるグループ名を数える際に重み付けに用いてもよい。すなわち、例えばグループ名「インフルエンザ」を含むニュースが50件ある場合、確信度が1.0の銘柄には50件、確信度が0.8の銘柄には40件のニュース配信があったものとして件数を割り付けるようにしてもよい。
図30は、本実施例の効果の一例を示す図である。図30には、ある東証一部上場銘柄について、その銘柄名を含むニュース件数(銘柄名のみ)、銘柄名もしくはその銘柄が所属するグループ名(図30の例では約200のグループがあるとする)の少なくとも一つを含むニュース件数(銘柄名ORグループ名(確信度なし))、グループ名を含むニュース件数をそのグループ名の確信度で補正した件数と銘柄名を含むニュース件数の合計(銘柄名ORグループ名(確信度補正なし))について、ニュース件数と該当銘柄の出来高の相関係数を求めたものが示されている。
相関係数とは、2つの確率変数の間の相関、すなわち類似度の度合いを示す統計学的指標であり、−1から+1の間の実数値をとる。1に近いときは2つの確率変数には正の相関があるといい、−1に近ければ負の相関があるという。0に近いときはもとの確率変数の相関は弱い。相関係数と相関関係は、例えば相関係数 が「0.0〜±0.2」であれば、相関関係は「ほとんど相関がない」、相関係数が「±0.2〜±0.4」であれば、相関関係は「やや相関がある」、相関係数が「±0.4〜±0.7」であれば、相関関係は「相関がある」、相関係数が「±0.7〜±0.9」であれば、相関関係は「強い相関がある」、相関係数が「±0.9〜±1.0」であれば、相関関係は「きわめて強い相関がある」、とみなせる。
図30に示した、本実施形態の知見評価更新処理を適用した「銘柄名ORグループ名(確信度補正あり)」の相関係数は、銘柄名のみ、および銘柄名ORグループ名(確信度なし)の相関係数よりも高い値になっており、より強い相関がある知見情報を得ることができていると言える。
なお、本実施形態の知見評価更新装置18では、株取引に関する知見情報以外の知見情報を評価・更新することも可能であり、例えば商品に関する知見情報(以下、商品知見情報という)の知見評価更新処理が可能である。
この場合、商品知見情報は、企業の告知、ブログ、マイクロブログ、などのインターネットで配信される情報から抽出される。また、このとき、商品知見情報に含まれる下位概念の情報を商品名とし、上位概念の情報をグループ名とし、さらに商品知見情報の評価値を商品の売り上げ情報の変化率とする。この売り上げ情報の変化率により商品知見情報を評価・更新することで、商品のグループ名と売り上げとの相関がより強い知見情報を抽出することも可能である。
(第5の実施形態)
次に、第5の実施形態について説明する。
次に、第5の実施形態について説明する。
第1の実施形態乃至第4の実施形態では、ニュース情報にグループの情報があるか否かを判定する際に、グループ名のみを抽出すべき表現としていた。しかし、一般ニュースでは、経済ニュースで用いられるグループ名ではない関連語が記載される場合がある。例えば、図29に示すような経済ニュースからは、グループ名「防衛(関連)」、銘柄「aa重工〈7191〉」、「bb重工業〈7192〉」、「cc工業〈7193〉」の組み合わせが抽出される。なお、社名の横に示されている各数字は、架空の証券コードである。
上記の場合、グループ名は「防衛」であるが、一般ニュースで報じられる内容は、図29の各経済ニュースの前半部分の「政府が自衛隊機の民間転用を進める方針を固めた」や「朝鮮半島情勢緊迫化」であり、グループ名「防衛」は記載されない可能性が高い。
そこで、第5の実施形態では、図12の知見情報に加えて、図32に示す関連語情報116を用いる。図32に示すように、本実施形態の関連語情報116は、知見No.とグループ名(第1概念名)と関連語とを対応付けたテーブルとして記憶部11に保持される。なお、関連語はあらかじめユーザが登録してもよいし、ニュース情報にグループ名と同時にでてくる単語を関連語として抽出して登録してもよい。
ここで、図33を参照して、第5の実施形態の知見抽出装置101の構成について説明する。第1の実施形態乃至第4の実施形態と同じ図番が付与されている各構成は、第1の実施形態乃至第4の実施形態と同じ動作を行なうものとする。
図33に示すように、第5の実施形態の知見抽出装置101は、第4の実施形態の知見抽出装置100に加えて、記憶部11に関連語情報116を保持する。なお、本実施形態の知見抽出装置101は、第1乃至第3の実施形態の知見抽出装置1に関連語情報116を加えた構成としてもよい。
本実施形態の知見抽出装置101の処理の一例について、図14、図24及び図25を参照して説明する。
本実施形態の知見抽出装置101は、図14もしくは図24及び図25に示す処理において、ニュース情報に含まれるグループ名の有無を判定する際に(図14のステップS24、もしくは図24のステップS52)、図32に示す関連語情報116に含まれる関連語をグループ名と同等の表現としてチェック対象に加える。すなわち本実施形態の知見抽出装置101は、ステップS51で選択されたグループ名と同一のグループ名が関連語情報116に保持されているか検索し、保持されている場合、このグループ名もしくはこのグループ名に対応する関連語がニュース情報に含まれるか否かを判定する。
このとき、1つのニュースにグループ名と関連語が記載されている場合は、グループ名が記載されたニュース1件相当と数える。関連語は、第1の実施形態で説明した株価変動材料から、他のグループには登録されていない表現を選んでもよい。また、グループ名を含むニュース群と他のニュース群で出現頻度に有意な差のある名詞句を抽出してもよい。さらに、図12の知見情報と図22の知見情報と図32の関連語情報116は、グループ名で結合できる範囲で、別の分割形態で保持してもよい。
本実施形態によれば、一般ニュースでは記載されることが少ないグループ名に加えて関連語を抽出対象とすることで、一般ニュースの銘柄への影響をさらに適切に評価することができる。
(第6の実施形態)
次に、第6の実施形態における知見抽出装置について説明する。第6の実施形態における知見抽出装置は、第3の実施形態と同様に、電子文書を受信する際に、当該電子文書にタイムスタンプを付加する機能を更に備え、知見抽出部14が抽出する知見情報をある対象に関する材料(イベント)とそのタイムスタンプとする。
次に、第6の実施形態における知見抽出装置について説明する。第6の実施形態における知見抽出装置は、第3の実施形態と同様に、電子文書を受信する際に、当該電子文書にタイムスタンプを付加する機能を更に備え、知見抽出部14が抽出する知見情報をある対象に関する材料(イベント)とそのタイムスタンプとする。
図34を参照して、第6の実施形態の知見抽出装置102の構成について説明する。なお、上述の実施形態に記載の構成については省略する。
図34に示すように、本実施形態の知見抽出装置102は知見評価更新装置19を備える。
知見評価更新装置19は、図21に示した知見抽出装置100の知見評価更新装置18における、上位概念チェック部181に変えて電子文書検索部186を備え、下位概念抽出部182に変えて知見登録概念抽出部187を備える。
電子文書検索部186は、知見情報に含まれる第1概念名に、あらかじめ設定した期間に記憶部11に新規登録された電子文書中で、当該第1概念名が記載された電子文書の有無と配信数をチェックする。
知見登録概念抽出部187は、電子文書検索部186によってチェックされた第1概念名と関連付けられた、知見情報に含まれる知見抽出対象語を全て抽出する。また、知見登録概念抽出部187は、電子文書検索部186がチェックした電子文書から当該知見抽出対象語が記載された電子文書の有無と配信数をチェックする。
第6の実施形態においては、電子文書をインターネットで配信されるマイクロブログ(ミニブログ、つぶやきブログとも称し、Twitter(登録商標)が代表例)の記事とし、第1概念をテレビ番組、知見抽出対象語をテレビ番組もしくはテレビ番組の登場人物もしくはテレビ番組の中のコーナーもしくはテレビ番組中で取り上げられる商品などの番組中に現れるもの、第2概念をテレビ番組もしくは知見抽出対象語に対する評価表現とする。すなわち、本実施形態では図21に示した第4の実施形態における知見抽出装置100のようにニュース情報から株取引に関する知見情報を抽出するのではなく、電子文書であるマイクロブログの記事のうち、テレビ番組に言及する内容のものを受信した際に、例えば、ドラマAに関連する知見抽出対象語(登場人物、取り上げられるもの、ストーリー展開、スタッフなど)をグルーピングする知識や、ドラマAもしくはその知見抽出対象語に関してよく使われる評価表現「ワロタ」「泣けた」「ぱねぇ」の知識を獲得し、これらの知識を知見情報として抽出する知見抽出装置102について説明する。
なお、「ワロタ」とは「笑った」、もしくは「笑える」という意味で使用される語句であり、「ぱねぇ」とは、「半端なことではない」の意味で使用される語句である。また、知見抽出装置102は、マイクロブログを含むインターネット配信の電子文書、例えばニュース、一般ブログ、テレビ局発表情報を受信した際は、保持した知見情報を参照し、電子文書に「ドラマA」などの番組名、該当番組に所属する知見抽出対象語、該当番組もしくは知見抽出対象語の評価表現の有無の情報を付与し、番組制作者などのユーザの端末装置に提供可能となっている。
すなわち、本実施形態の知見抽出装置102は、第4の実施形態に示した知見抽出装置101の変形例である。
図35に、本実施形態における第1手掛かり語辞書111の一例を示す。図35に示すように、第1手掛かり語を識別するコードと、第1概念名、本実施形態においては番組名を定義する第1手掛かり語とが、関連付けられて記述されている。
第1手掛かり語辞書111は、本実施形態においては、図35に一例を示すように、第1手掛かり語を識別するコードと、第1概念名、本実施形態においては番組名を定義する第1手掛かり語とが、関連付けられて記述されている。具体的には、番組名などの記事内容を定義する第1手掛かり語は、記事内容の先頭文字の「#」であるとする。
本実施形態における知見抽出対象語辞書112は、図36に一例を示すように、知見抽出対象語、本実施形態においてはテレビ番組中に現れるものについて、知見抽出対象語を識別するコードと、知見抽出対象語が関連付けられた番組名と、知見抽出対象語のマイクロブログ記事中に現れる別表記である知見抽出対象語表現とが関連付けられて記述されている。知見抽出対象語表現としては、知見抽出対象語名の正称、略称、通称、俗称、愛称などの様々な名称が使用可能となっている。知見抽出対象語辞書112は、まず、テレビ局の公開情報に基づいて構築してもよい。その際、他の番組にも登場する出演者に関しては番組名を特定せず、番組に固有の役名などについては番組名を記載するとしてもよい。さらに、知見抽出対象語辞書は、知見情報を抽出する際に、第1概念が記載されたマイクロブログ記事に現れる別の名詞もしくは複合名詞を知見抽出対象語候補として記録し、ユーザの確認後に知見抽出対象語として追加登録するものとしてもよい。
第2手掛かり語辞書113aは、図37に一例を示すように、第2手掛かり語を識別するコードと、第2概念、すなわち本実施形態においては知見抽出対象語表現に対す第2手掛かり語とが関連付けられて記述されている。本実施形態においては、第2手掛かり語は感情表現である顔文字およびそれに類する表現とする。第2手掛かり語辞書113aは、第2の実施形態と同様に、感情の方向と、その感情の強度が付与された形態とする。なお、強度は、感情が強いほど大きな値で示される。
図38に、本実施形態で情報受信部12が受信する電子文書であるマイクロブログの記事の一例を示す。図38に示すように、本実施形態では、インターネットで配信されるマイクロブログ記事の構成要素のうち、図38に示す「タイムスタンプ」「ユーザ」「引用情報」「本文」の4項目と、情報受信部12が付与する「記事ID」を利用する。
「タイムスタンプ」は、配信されたマイクロブログ記事に付与された発信日時情報である。「ユーザ」は、その情報を発信したユーザの識別名称である。「引用情報」は、他のユーザが発信したマイクロブログ記事をそのまま引用し再発信する際などに付与される、元の記事の発信ユーザの識別名称である。「記事本文」は配信されたマイクロブログ記事の本文の文字列である。
情報選択部13は、情報受信部12が受信したマイクロブログの記事から、知見抽出対象とする電子文書、すなわち本実施形態ではテレビ番組に関するマイクロブログ記事を選択する。テレビ番組に関するマイクロブログであることの判断は、例えば、マイクロブログの記事内容の先頭に第1手掛かり語「#」に続いてテレビ番組名もしくはテレビ局名が記載されていることで判断する。第1手掛かり語がないマイクロブログ記事の場合は、本文に、テレビ番組名、テレビ局名、もしくは図36の知見抽出対象語辞書112に記載された知見抽出対象語のいずれかが含まれることにより判断する。
次に、以上のように構成された知見抽出装置102の動作について説明する。図39は知見抽出装置102における知見抽出部14の処理動作の詳細を示す模式図である。知見抽出部の処理動作は、第1の実施形態と同様に、図9のフローチャートに従う。
なお、以下の説明では、知見抽出部14の処理を、電子文書を受信する都度としているが、この処理は夜間などの情報分析処理を行わない時間帯に、受信済みのマイクロブログの記事に対してまとめて実施してもよい。
情報受信部12が、マイクロブログの掲載されたサイトからの配信を受けるか、マイクロブログの掲載されたサイトにアクセスすることにより、新規のマイクロブログを受信する。例えば、図38に示す記事ID“3”に該当するマイクロブログを受信する。
情報選択部13は、情報受信部12が受信したマイクロブログの記事から、テレビ番組に関するマイクロブログ記事を選択する(ステップS1)。テレビ番組に関するマイクロブログであることの判断は、例えば、記事内容の先頭文字「#」に続いてにテレビ番組名もしくはテレビ局名が記載されていることで判断する。記事内容の先頭文字「#」がないマイクロブログ記事の場合は、本文に、テレビ番組名、テレビ局名、もしくは図36の知見抽出対象語辞書に記載された知見抽出対象語のいずれかが含まれることにより判断する。選択されたマイクロブログ記事は、情報選択部13から知見抽出部14に送出される。
知見抽出部14においては、知見抽出判定語チェック部141が、情報選択部13に選択されたマイクロブログ記事が知見抽出判定語を含むか否かを判定する(ステップS2)。本実施形態の場合は、ステップS1の処理とステップS2の処理の判断基準を同一とし、いずれかの処理ステップのみ実施するものとしてもよい。
知見抽出判定語が含まれる場合は、知見情報が含まれるマイクロブログ記事として、マイクロブログ記事を第1手掛かり語チェック部142に送信する。
第1手掛かり語チェック部142は、ステップS2の判定の結果、マイクロブログ記事が知見抽出判定語を含むとき、当該マイクロブログ記事が第1概念名、すなわち、本実施形態においては番組名を定義する第1手掛かり語を含むか否かを判定する(ステップS3)。
例えば、第1手掛かり語チェック部142は、第1手掛かり語辞書111を参照し、受信したマイクロブログ記事の本文に第1手掛かり語の少なくとも一つが含まれるか否かを判定する。例えば図38に示す記事ID“3”のニュースは、第1手掛かり語「#」を含む。
受信したマイクロブログ記事に第1手掛かり語が含まれない場合は第1概念抽出部143によるステップS4の処理を省略する。
受信したマイクロブログ記事に第1手掛かり語が含まれる場合は、第1手掛かり語チェック部142は、マイクロブログ記事を第1概念抽出部143に送信する。
第1概念抽出部143は、ステップS3の判定の結果、マイクロブログ記事が第1手掛かり語を含むとき、当該第1手掛かり語に基づいて当該マイクロブログ記事から番組名を抽出する(ステップS4)。
例えば、第1概念抽出部143は、第1手掛かり語を含むマイクロブログの記事を受信すると、第1手掛かり語直後の名詞もしくは複合名詞を番組名として抽出する。受信したマイクロブログの記事が例えば図38に示すニュースID“3”の場合は、第1手掛かり語「#」の直後の複合名詞「ドラマA」を番組名として抽出する。
本実施形態の場合は、例えば、番組名として手掛かり語直後の名詞もしくは複合名詞を抽出した後で、既存の番組名の一覧(図示せず)と比較し、抽出した名詞もしくは複合名詞が番組名の正式名称もしくは略称である場合のみ番組名として採用し、それ以外の場合は、番組名を含まないと判断してもよい。
一方、知見抽出対象語抽出部144は、知見抽出判定語チェック部141による判定の結果、マイクロブログの記事が知見抽出判定語を含むとき、当該マイクロブログ記事から知見抽出対象語名を抽出する。
具体的には、知見抽出対象語抽出部144は、例えば、ステップS3又はS4の後、第1概念抽出部143の処理を省略して送信されたマイクロブログ記事に対して、知見抽出対象語辞書112を参照し、マイクロブログ記事本文に知見抽出対象語表現が含まれるか否かを判定し(ステップS5)、知見抽出対象語表現が含まれる場合に当該知見抽出対象語表現に対応する知見抽出対象語を抽出する(ステップS6)。
マイクロブログ記事本文に、知見抽出対象語辞書112の「知見抽出対象語表現」列の表現がある場合は、その行の「知見抽出対象語名」に記された知見抽出対象語が含まれると判断する。
知見抽出対象語辞書112は、一つの知見抽出対象語に対して複数行の定義もしくは知見抽出対象語表現列に複数の表現を含んでよい。また、1件のマイクロブログ記事から複数の知見抽出対象語表現を抽出してよい。
例えば図38の記事ID“3”のマイクロブログ記事の場合、知見抽出対象語表現「mさん」が含まれるため、知見抽出対象語「コード B001 知見抽出対象語名 役名M」が抽出される。
第2概念抽出部145は、知見抽出判定語チェック部141による判定の結果、マイクロブログ記事が知見抽出判定語を含むとき、当該マイクロブログ記事から第2概念、すなわち、本実施形態においては評価表現を抽出する。具体的には、第2概念抽出部145は、知見抽出判定語を含むマイクロブログ記事本文に、第2手掛かり語辞書113a内の手掛かり語の一つ以上が含まれるか否かを判定する(ステップS7)。
ステップS7およびステップS8の処理は、図9のフローチャートではステップS6の後としているが、第1の実施形態と同様に、ステップS3の処理の前、もしくはステップS3からステップS6の処理と並列で実施してもよい。
第2概念抽出部145は、受信したマイクロブログ記事の見出しもしくは本文に、第2手掛かり語辞書113a内の第2手掛かり語が含まれる場合、その手掛かり語と共起している語句を評価表現として抽出する(ステップS8)。
例えば、図38に示す記事ID“3”の本文では、「mさん万能すぎワロタww#ドラマA」に第2手掛かり語「ww」が含まれる。
第2手掛かり語「ww」と共起している語句、例えば直前に置かれた語句は「ワロタ」(一般辞書にはない未知語)である。この未知語「ワロタ」が評価表現として抽出される。
評価表現は、処理中の1件の記事で手掛かり語直前の語句とせずに、同じ第2手掛かり語を含む多数のマイクロブログ記事から全ての単語を抽出し、該当の第2手掛かり語を含まない記事の集合と比較して統計的に共起する確率が高い語句を評価表現とするとしてもよい。例えば図38の記事ID7と記事ID8は、異なる第2手掛かり語「ww」および「(;_;)の直前の語句が「ヤバい」で一致し、どちらの第2手掛かり語と共起する確率も同じなので、評価表現としない。
抽出された評価表現「ワロタ」には、第2手掛かり語辞書113aに登録された第2手掛かり語「ww」に対応づけられた方向及び強度を付与し、評価表現「評価表現:ワロタ 方向:笑い 強度:1」が得られる。
ステップS3からステップS8の処理の終了後、組み合わせ作成部146は、処理中のマイクロブログ記事から抽出された番組名、知見抽出対象語及び評価表現を組み合わせて知見情報を作成し、当該知見情報を記憶部に書き込む(ステップS9)。ここで、知見情報は、方向及び強度が付与された評価表現「評価表現:ワロタ 方向:笑い 強度:1」を含んでいる。評価表現は、第1の実施形態と同様に、方向や強度が付与されない形式を選択してもよい。
マイクロブログ記事から抽出された番組名が1つである場合は、その番組名に、抽出された全ての知見抽出対象語、抽出された全ての評価表現を割り付ける。すなわち、1つの番組名に対して、知見抽出対象語と評価表現はそれぞれ1つまたは複数が割り付けられることを許容する。抽出された番組名が複数である場合は、第1の実施形態と同様に、文脈解析や簡易的な判別処理により、番組名、番組名に係り受けしている知見抽出対象語、番組名もしくはその番組名に係り受けしている知見抽出対象語である銘柄に係り受けしている評価表現を判別して組み合せてもよい。さらに、知見情報は番組名に対して知見抽出対象語と評価表現が割り付けられるとしているが、知見抽出対象語もしくは評価表現がない組み合せが作成されてもよい。
このような処理により、番組名、知見抽出対象語名、評価表現のセットとして以下の知見が抽出され、記憶部11に書き込まれる。
番組名 : ドラマA
番組に属する知見抽出対象語 : 役名M
評価表現 : ワロタ 方向 : 笑い 強度 : 1
組み合せは、番組名、知見抽出対象語、評価表現をセットにするとしたが、第1の実施形態と同様に、組み合わせは番組名と知見抽出対象語のみとし、評価表現は単独で知見情報として保持するとしてもよい。または、評価表現は番組名ではなく知見抽出対象語とセットにして知見情報として保持するとしてもよい。
番組に属する知見抽出対象語 : 役名M
評価表現 : ワロタ 方向 : 笑い 強度 : 1
組み合せは、番組名、知見抽出対象語、評価表現をセットにするとしたが、第1の実施形態と同様に、組み合わせは番組名と知見抽出対象語のみとし、評価表現は単独で知見情報として保持するとしてもよい。または、評価表現は番組名ではなく知見抽出対象語とセットにして知見情報として保持するとしてもよい。
ステップS2で知見抽出判定語がないと判定されたマイクロブログ本文は、第1概念チェック部147により、マイクロブログ記事本文に、記憶部11に書き込まれた知見情報の番組名を含むか否かを判定される(ステップS11)。
番組名を含む場合は、知見抽出対象語抽出部144が知見抽出対象語辞書112を用いて、マイクロブログ本文に知見抽出対象語表現が含まれるか否かを判定する(ステップS12)。
知見抽出対象語表現が含まれる場合、例えば「採用」「登場」などの表現がある場合は、組み合せ作成部146が抽出された知見抽出対象語表現に対応する知見抽出対象語を番組に追加する処理のための組み合せを作成する。
「降板」などの表現がある場合は、組み合わせ作成部146が、番組に対して抽出された知見抽出対象語表現に対応する知見抽出対象語を取り除く処理のための組合せを作成する(ステップS13)。
ステップS13で番組と知見抽出対象語の追加もしくは削除処理の組み合わせが作成された場合は、その処理を記憶部11に対して実行する(ステップS9)。
なお、知見抽出対象語の抽出は、知見抽出対象語辞書112を用いずに、番組名を含むマイクロブログ記事本文から名詞句を抽出し知見抽出対象語とするとしてもよい。この場合、抽出した名詞句は、新たに知見抽出対象語として知見抽出対象語辞書112に追加するものとしてもよい。さらに、ステップS11からS13の処理と判断は、1件のマイクロブログのみで行わずに、例えばある規定の数を超える発信があった場合にのみ記憶部11に対する実行対象としてもよい。または、ステップS11からS13までの処理は、マイクロブログ本文に対して行うのではなく、テレビ局やニュース配信業者から配信された電子文書のみに対して実行するものとしてもよい。
次に、情報分析部15の動作を図39、図14及び図15によって説明する。
始めに、情報受信部12は、マイクロブログの掲載されたサイトからの配信を受けるか、マイクロブログの掲載されたサイトにアクセスすることにより、新規のマイクロブログ記事を受信する。例えば、図38の記事ID“6”に該当するマイクロブログ記事を受信する(ステップS21)。受信したマイクロブログ記事は知見抽出対象語・第1概念・第2概念抽出部151に送信される。
知見抽出対象語・第1概念・第2概念抽出部151は、まず、記憶部11に記憶された知見抽出対象語辞書112を参照し、受信したマイクロブログ記事に知見抽出対象語表現があるか否かを判定する(ステップS22)。
知見抽出対象語表現がある場合、知見抽出対象語・第1概念・第2概念抽出部151は、抽出された知見抽出対象語表現に対応する知見抽出対象語名・コードを抽出する。また、知見抽出対象語・第1概念・第2概念抽出部151は、図36に示す知見抽出対象語辞書112を知見情報として参照し、抽出した知見抽出対象語名が割り付けられた第1概念、すなわち本実施形態においては番組名を全て抽出する(ステップS23)。知見抽出対象語・第1概念・第2概念抽出部151及び電子文書割付部152は、マイクロブログ記事本文から抽出された知見抽出対象語名ごとに、その知見抽出対象語が属する各番組に対して、ステップS24・ステップS25の処理を行う。
始めに、知見抽出対象語・第1概念・第2概念抽出部151は、これに先立つ処理によって抽出された、図40中に示す知見情報を参照し、その時点で処理中の知見抽出対象語名・その知見抽出対象語が属する番組名に割り付けられた第2概念、すなわち本実施形態においては評価表現を抽出し、マイクロブログ本文中に該当の評価表現があるか否かを判定する(ステップS24)。
該当の評価表現がある場合は、処理中の受信マイクロブログ記事にその番組に関する情報と評価があると判断し、電子文書割付部152が、処理中のマイクロブログ記事を、知見抽出対象語及び番組に割り付ける(ステップS25)。本実施形態においては、第1の実施形態とは異なり、番組名に属する全ての知見抽出対象語への展開はしないとしてもよい。
知見抽出対象語・第1概念・第2概念抽出部151は、ステップS22からステップS25の処理の後、もしくは、前、または並列で、受信したマイクロブログ記事本文に、図12に示す知見情報内の第1概念名が含まれるか否かを判定する(ステップS26)。
例えば、図38に示す記事ID“6”のマイクロブログ記事では、本文に番組名は含まれていない。この場合は、知見抽出対象語・第1概念・第2概念抽出部151は、抽出された知見抽出対象語「役名M」が図36の知見抽出対象語辞書12で関連付けられた番組名「ドラマA」を抽出して電子文書割付部152に送出する。
第1概念名が抽出された場合、電子文書割付部152は、図12に示す知見情報でその番組名に対応付けられた知見抽出対象語を取り出し、処理中のマイクロブログ記事を該当銘柄全てに割り付けることもできる(ステップS27)。本実施形態ではこの処理を省略し、マイクロブログ記事は、本文から抽出された知見抽出対象語のみに割り付けるものとする。
ステップS27までの処理でマイクロブログ記事を割り付けられた知見抽出対象語ごとに、知見抽出対象別判定部153は、以下に記載するステップS28からステップS34の処理を行う。
ステップS28では、ステップS24の第2概念、すなわち本実施形態では評価表現抽出結果を参照し、現在処理中の知見抽出対象語が属する番組の評価表現が抽出されているか否かを判定する。
処理中の知見抽出対象語で、処理中の所属番組に対応付けられた評価表現が抽出されている場合は、その知見抽出対象語もしくは番組への反応が変動する可能性があると判断し、その番組、知見抽出対象語と、評価表現のセットをアラームに追加する(ステップS29)。
記憶部11に保持された知見情報が「番組名・知見抽出対象語」と評価表現に分けられている場合は、ステップS28は、現在処理中の知見抽出対象語や番組が属するか否かに関わらず記憶部11に保持された評価表現全てに関して抽出されているか否かを判定する。
この場合、ステップS29では、知見抽出対象語と、ステップS28で抽出された評価表現のセットをアラームに追加する。
知見抽出対象語にマイクロブログ記事が割り付けられた後で、処理中の知見抽出対象語もしくは番組に割り付けられ、記憶部11に記憶された過去一定期間、例えば3日間のマイクロブログ本文を参照して急上昇ワードがあるかを判定し(ステップS30)、処理中の知見抽出対象語もしくは番組のマイクロブログ記事に急上昇ワードが存在する場合は、番組、知見抽出対象語と急上昇ワードのセットを急上昇アラームに追加する(ステップS31)。
さらに、同様に処理中の知見抽出対象語もしくは番組に割り付けられ、記憶部11に記憶された過去一定期間、例えば1時間のマイクロブログ記事本文を参照して処理中の受信マイクロブログ記事が過去一定期間のマイクロブログ記事と類似・一致しているかを判定し(ステップS32)、類似マイクロブログ記事もしくは一致するマイクロブログ記事がある場合は、そのマイクロブログ記事対の類似度を求め、多重配信アラームを追加する(ステップS33)。
以上の処理により出力されたアラーム、急上昇アラーム、多重配信アラームは、情報分析部15から出力され、ユーザ端末装置2に提供される(ステップS34)。
上述したように本実施形態によれば、受信されたマイクロブログ記事からテレビ番組、知見抽出対象語(番組に取り上げられるものなど)、評価表現の知見を抽出して保持することで、一般の辞書にはない表現も知見として活用できる。
さらに、知見情報が記憶された後、新規に受信された全てのマイクロブログ記事を記憶部11内の知見情報に基づいて分析する構成により、分析結果を、即時にユーザに提供することで、視聴者の反応の把握を有効に支援することができる。
さらに、知見抽出部14は、情報選択部13により選択されたマイクロブログ記事から知見情報を抽出する前述した機能において、第3の実施形態と同様に、当該選択されたマイクロブログ記事から所定の対象を示す表現を含むイベント情報を抽出すると共に、当該イベント情報が抽出されたマイクロブログ記事から抽出し、当該抽出したイベント情報及びタイムスタンプを知見情報として記憶部11に書込む機能をもっている。
ここで、所定の対象を示す表現は、例えば、知見抽出対象語、すなわち本実施形態においては知見抽出対象語辞書112に記述された知見抽出対象語表現、又は第1概念、すなわち本実施形態においては番組名を表す表現である。なお、「知見抽出対象語の番組名を定義する第1手掛かり語」は、第1手掛かり語辞書111に記述されている。
知見抽出部14の処理は、第3の実施形態と同様に、図18のフローチャートに従う。
情報受信部12がマイクロブログ記事を受信すると(ステップS41)、知見抽出部14は第1手掛かり語辞書111及び知見抽出対象語辞書112などを参照し、ユーザによって選択されている対象(知見抽出対象語、番組名など)を示す表現が含まれるか否かを判定する(ステップS42)。
ユーザによって選択されている対象を示す表現が含まれる場合、知見抽出部14は、その対象を示す表現を含む名詞句を、材料(イベント)として抽出する(ステップS43)。
知見抽出部14は、抽出した材料(イベント)を、対象名、受信情報のタイムスタンプと合わせて記憶部11に追加的に書込む(ステップS44)。
以下、情報分析部15は、前述同様に、ステップS21〜S34の動作を実行する。
図41は、知見情報の一例を示す図である。図38に示すニュースID“3”,“6”から知見抽出対象語名「役名M」に関して処理を行った例である。
抽出する知識はユーザによって選択された対象表現を含む名詞句としたが、この名詞句中から複合名詞を選択したり、固有名詞を選択したり、急上昇ワードを選択して材料(イベント)としてもよい。
知見抽出対象語名「役名M」で抽出した材料(イベント)を、図36の知見抽出対象語辞書112にしたがって番組に割り付け、図41に示す知見情報で「対象」を「役名M」から「ドラマA」に置き換えた情報を合わせて知見情報として書き込んでもよい。
さらに、図41に示すように、類似度の高いマイクロブログ記事の配信数を「類似情報数」として合わせて知見情報としてもよい。
上述したように本実施形態によれば、マイクロブログ記事を受信する際に、マイクロブログ記事にタイムスタンプを付加し、選択されたマイクロブログ記事から所定の対象を示す表現を含むイベント情報を抽出すると共に、当該イベント情報が抽出されたマイクロブログ記事から抽出し、当該抽出したイベント情報及びタイムスタンプを知見情報として記憶部11に書込む構成により、第3の実施形態と同様に、ある対象に関する材料(イベント)をタイムスタンプ情報のある時系列で抽出し保持することで、同様の事象が発生した際に、近い将来の予想に有効な知見情報を保持しユーザ端末装置2に提示することができる。
続いて、知見評価更新装置19の処理について説明する。
番組がコメディタッチである場合は「笑い」の評価は前向きととらえることができるが、番組がシリアスなドラマである場合は、「笑い」は失笑であり、低評価であることが推測される。したがって、番組ごとに、評価表現と、番組の評価の高さ、本実施形態では確信度の情報を合わせて保持することが有効である。
したがって、本実施形態では、図42に示すように、確信度と確信度更新履歴とを含む確信度情報を加えた知見情報を保持する形態としている。すなわち、本実施形態の確信度とは、第2概念と第1概念の関連する度合いを示す数値である。
なお、図42では第1概念である番組名、第2概念である評価表現、知見抽出対象語の情報を保持しているが、番組名もしくは知見抽出対象語のいずれかの情報は保持しないとしてもよい。
知見評価更新装置19の処理は、本願の出願時点で未公開である特願2012−15700の処理に従って行うことができる。本実施形態の場合、数値情報として、例えば番組の視聴率を用いることができる。知見評価更新処理は、マイクロブログ記事の配信が少ない時間帯に1日1回の頻度で実施しても、分析対象としている番組終了から一定時間を経た後にそれぞれ実施してもよい。
本実施形態によれば、知見を抽出した情報源以外の情報(視聴率など)に基づいて、第1概念と第2概念の組合せの有効性を評価し更新する構成により、知見の確かさや第1概念もしくは知見抽出対象語への影響度を複数の情報源に基づき高く維持できる。
確信度の情報は、知見情報もしくは第1手掛かり語もしくは第2手掛かり語の関連性の評価更新に用いるものではなく、マイクロブログ記事をはじめとする電子文書に含まれる番組名もしくは知見抽出対象語を数える際に重み付けに用いてもよい。すなわち、例えば番組名「ドラマA」に属する知見抽出対象語「登場人物X」を含むマイクロブログ記事が50件ある場合、確信度が1.0の場合は50件、確信度が0.8の場合は40件のマイクロブログ記事配信があったものとして件数を割り付けるようにしてもよい。または、確信度の低い評価表現の数が多くなった場合は、視聴者からの評価が下がっていると判断する知見としてもよい。
以上説明した少なくとも1つの実施形態の知見抽出装置によれば、知見抽出対象語に関連付けられていない状態で随時配信される電子文書から知見抽出対象語に関する知見情報を随時抽出することが可能である。また、上記実施形態の少なくとも1つの知見抽出装置は、知見情報を最新の状態にすることができる。
なお、上記の各実施形態に記載した手法は、コンピュータに実行させることのできるプログラムとして、磁気ディスク(フロッピー(登録商標)ディスク、ハードディスクなど)、光ディスク(CD−ROM、DVDなど)、光磁気ディスク(MO)、半導体メモリなどの記憶媒体に格納して頒布することもできる。
また、この記憶媒体としては、プログラムを記憶でき、かつコンピュータが読み取り可能な記憶媒体であれば、その記憶形式は何れの形態であってもよい。
また、記憶媒体からコンピュータにインストールされたプログラムの指示に基づきコンピュータ上で稼働しているOS(オペレーティングシステム)や、データベース管理ソフト、ネットワークソフト等のMW(ミドルウェア)等が上記実施形態を実現するための各処理の一部を実行してもよい。
さらに、各実施形態における記憶媒体は、コンピュータと独立した媒体に限らず、LANやインターネット等により伝送されたプログラムをダウンロードして記憶または一時記憶した記憶媒体も含まれる。
また、記憶媒体は1つに限らず、複数の媒体から上記の各実施形態における処理が実行される場合も本発明における記憶媒体に含まれ、媒体構成は何れの構成であってもよい。
なお、各実施形態におけるコンピュータは、記憶媒体に記憶されたプログラムに基づき、上記の各実施形態における各処理を実行するものであって、パソコン等の1つからなる装置、複数の装置がネットワーク接続されたシステム等の何れの構成であってもよい。
また、各実施形態におけるコンピュータとは、パソコンに限らず、情報処理機器に含まれる演算処理装置、マイコン等も含み、プログラムによって本発明の機能を実現することが可能な機器、装置を総称している。
なお、本発明のいくつかの実施形態を説明したが、これらの実施形態は、例として提示したものであり、発明の範囲を限定することは意図していない。これら新規な実施形態は、その他の様々な形態で実施されることが可能であり、発明の要旨を逸脱しない範囲で、種々の省略、置き換え、変更を行うことができる。これら実施形態やその変形は、発明の範囲や要旨に含まれるとともに、特許請求の範囲に記載された発明とその均等の範囲に含まれる。
1,100,101,102…知見抽出装置、2…ユーザ端末装置、10…制御部、11…記憶部、12…情報受信部、13…情報選択部、14…知見抽出部、15…情報分析部、16…入出力インタフェース、17,26…バス、21…端末制御部、22…端末記憶部、23…表示部、24…入力部、25…通信インタフェース、111…第1手掛かり語辞書、112…知見抽出対象語辞書、113,113a…第2手掛かり語辞書、141…知見抽出判定語チェック部、142…第1手掛かり語チェック部、143…第1概念抽出部、144…知見抽出対象語抽出部、145…第2概念抽出部、146…組み合わせ作成部、147…第1概念チェック部、151…知見抽出対象語・第1概念・第2概念抽出部、152…電子文書割付部、153…知見抽出対象別判定部、18、19…知見評価更新装置、181…電子文書検索部、182…知見登録概念抽出部、183…評価部、184…確信度更新部、185…知見更新部
Claims (16)
- 電子文書から知見情報を抽出する知見抽出装置であって、
前記電子文書を受信する情報受信部と、
前記知見情報を抽出する対象語と、前記知見情報を抽出する手掛かり語とに基づいて前記電子文書から概念を抽出し、抽出された当該概念と前記対象語を関連付けた知見情報を作成する知見抽出部と、
前記抽出された知見情報を記憶する記憶部と、
前記知見情報が記憶された後、前記電子文書を前記記憶部内の知見情報に基づいて分析する情報分析部と、
前記電子文書に含まれる前記概念もしく前記対象語を検索する電子文書検索部と、
前記検索部による検索の結果、前記電子文書に前記概念が規定数以上記載された場合に前記概念を抽出し、前記電子文書に前記対象語が規定数以上記載された場合に前記対象語に関連付けられた前記知見情報を前記記憶部から抽出する知見登録概念抽出部と、
前記知見登録概念抽出部が抽出した前記対象語もしくは前記概念に関連する数値情報の大きさもしくは変動を評価する評価部と、
前記数値情報の大きさもしくは変動の方向もしくは数値情報の変動の大きさに従って前記概念と前記対象語の関連性の評価数値である確信度を更新する確信度更新部と
を備える知見抽出装置。 - 請求項1に記載の知見抽出装置において、
前記確信度が規定値を下回った場合にユーザに判断を求め、ユーザの指示により選択中の前記概念間の関連を削除する知見更新部を備える知見抽出装置。 - 前記手掛かり語はあらかじめ強度が設定され
前記知見抽出部は、
前記手掛かり語の強度と前記抽出された概念と前記対象語を関連付けた知見情報関連付けた知見情報を作成する請求項1に記載の知見抽出装置。 - 配信されたニュース情報から株取引に関する知見情報を抽出する知見抽出装置であって、
前記ニュース情報を受信する情報受信部と、
前記受信されたニュース情報から経済用語を含むニュース情報を選択する情報選択部と、
前記選択されたニュース情報から前記知見情報を抽出する知見抽出部と、
前記抽出された知見情報を記憶する記憶部と、
前記知見情報が記憶された後、前記情報受信部に受信された全てのニュース情報を前記記憶部内の知見情報に基づいて分析する情報分析部と
を備え、
前記知見抽出部は、
前記選択されたニュース情報が株価変動を評価する株価変動評価語を含むか否かを判定する株価変動評価語判定部と、
前記判定の結果、前記ニュース情報が株価変動評価語を含むとき、当該ニュース情報が銘柄のグループ名を定義するグループ定義語を含むか否かを判定するグループ定義語判定部と、
この判定の結果、前記ニュース情報がグループ定義語を含むとき、当該グループ定義語に基づいて当該ニュース情報からグループ名を抽出するグループ名抽出部と、
前記株価変動評価語判定部による判定の結果、前記ニュース情報が株価変動評価語を含むとき、当該ニュース情報から企業名及び証券コードを含む銘柄を抽出する銘柄抽出部と、
前記株価変動評価語判定部による判定の結果、前記ニュース情報が株価変動評価語を含むとき、当該ニュース情報から株価変動材料を抽出する材料抽出部と、
前記抽出されたグループ名、銘柄及び株価変動材料を組み合わせて前記知見情報を作成する組み合わせ作成部と、
前記作成された知見情報を前記記憶部に書込む書込部と
を備え、
前記知見情報は、前記グループ名、前記銘柄及び前記株価変動材料を含む情報、又は前記グループ名及び前記銘柄からなる第1情報と前記株価変動材料からなる第2情報とを含む情報である知見抽出装置。 - 請求項4に記載の知見抽出装置において、
前記知見抽出部は、
前記株価変動材料の表現に対する手掛かり語と、前記株価変動の方向を表す情報と、前記株価変動の強度を表す情報とを関連付けて記憶した材料表現手掛かり辞書記憶部と、
前記抽出された株価変動材料に基づいて、前記材料表現手掛かり辞書を検索し、当該検索された株価変動の方向及び強度を表す各情報を当該株価変動材料に付与する情報付与部と
を更に備える知見抽出装置。 - 請求項4に記載の知見抽出装置において、
前記情報受信部は、前記ニュース情報を受信する際に、当該ニュース情報にタイムスタンプを付加し、
前記知見抽出部は、前記選択されたニュース情報から所定の対象を示す表現を含むイベント情報を抽出すると共に、当該イベント情報が抽出されたニュース情報から抽出し、当該抽出したイベント情報及びタイムスタンプを前記知見情報として前記記憶部に書込む処理を実行し、
前記所定の対象を示す表現は、銘柄の企業名を表す企業名表現、又は前記銘柄のグループ名を定義するグループ定義語の直前の名詞を表す表現である知見抽出装置。 - 請求項4に記載の知見抽出装置において、
前記知見情報は上位概念の情報と下位概念の情報とによって構成される階層構造であり、
前記記憶部は評価情報と、前記下位概念の情報が前記上位概念の情報に帰属する度合いを示す確信度とを記憶し、
前記評価情報から抽出された、前記上位概念の情報と前記下位概念の情報とに関連する評価情報に基づいて評価値を算出する評価部と、
前記評価値に基づいて、前記確信度を更新する確信度更新部と
を備える知見抽出装置。 - 請求項4に記載の知見抽出装置において、
前記記憶部はさらに、評価情報と、前記知見情報に含まれる前記銘柄が前記グループ名に帰属する度合いを示す確信度とを記憶し、
前記ニュース情報に含まれている前記グループ名を確認する確認部と、
前記確認部により、前記ニュース情報に含まれていると確認されたグループ名に基づいて前記知見情報から銘柄を抽出する抽出部と、
前記銘柄に関連する前記評価情報に基づいて評価値を算出する評価部と、
前記評価値に基づいて、前記確信度を更新する確信度更新部と
を備える知見抽出装置。 - 請求項7に記載の知見抽出装置において、
前記確信度が規定値を下回った場合に、前記下位概念の情報と前記上位概念の情報とを含む知見情報を前記記憶部から削除する知見更新部を備える知見抽出装置。 - 記憶部を備え、配信された電子文書から知見情報を抽出する知見抽出装置に用いられるプログラムであって、
前記知見抽出装置を、
前記電子文書を受信する情報受信部、
前記知見情報を抽出する対象語と、前記知見情報を抽出する手掛かり語とに基づいて前記電子文書から概念を抽出し、抽出された当該概念を関連付けた知見情報を作成する知見抽出部、
前記抽出された知見情報を記憶する記憶部、
前記知見情報が記憶された後、前記電子文書を前記記憶部内の知見情報に基づいて分析する情報分析部、
前記電子文書に含まれる前記概念もしく前記対象語を検索する電子文書検索部、
前記検索部による検索の結果、前記電子文書に前記概念が規定数以上記載された場合に前記概念を抽出し、前記電子文書に前記対象語が規定数以上記載された場合に前記対象語に関連付けられた前記知見情報を前記記憶部から抽出する知見登録概念抽出部、
前記知見登録概念抽出部が抽出した前記対象語もしくは前記概念に関連する数値情報の大きさもしくは変動を評価する評価部、
前記数値情報の大きさもしくは変動の方向もしくは数値情報の変動の大きさに従って前記概念と前記対象語の関連性の評価数値である確信度を更新する確信度更新部、
前記確信度が規定値を下回った場合にユーザに判断を求め、ユーザの指示により選択中の前記概念間の関連を削除する知見更新部、
として機能させるためのプログラム。 - 記憶部を備え、配信されたニュース情報から株取引に関する知見情報を抽出する知見抽出装置に用いられるプログラムであって、
前記知見抽出装置を、
前記ニュース情報を受信する情報受信部、
前記受信されたニュース情報から経済用語を含むニュース情報を選択する情報選択部、
前記選択されたニュース情報から前記知見情報を抽出し、当該知見情報を前記記憶部に書込む知見抽出部、
前記知見情報の書込み後、前記情報受信部に受信された全てのニュース情報を前記記憶部内の知見情報に基づいて分析する情報分析部、
として機能させるとともに、
前記知見抽出部を、
前記選択されたニュース情報が株価変動を評価する株価変動評価語を含むか否かを判定する株価変動評価語判定部、
前記判定の結果、前記ニュース情報が株価変動評価語を含むとき、当該ニュース情報が銘柄のグループ名を定義するグループ定義語を含むか否かを判定するグループ定義語判定部、
この判定の結果、前記ニュース情報がグループ定義語を含むとき、当該グループ定義語に基づいて当該ニュース情報からグループ名を抽出するグループ名抽出部、
前記株価変動評価語判定部による判定の結果、前記ニュース情報が株価変動評価語を含むとき、当該ニュース情報から企業名及び証券コードを含む銘柄を抽出する銘柄抽出部、
前記株価変動評価語判定部による判定の結果、前記ニュース情報が株価変動評価語を含むとき、当該ニュース情報から株価変動材料を抽出する材料抽出部と、
前記抽出されたグループ名、銘柄及び株価変動材料を組み合わせて前記知見情報を作成する組み合わせ作成部、
前記作成された知見情報を前記記憶部に書込む書込部と
として機能させ、
前記知見情報は、前記グループ名、前記銘柄及び前記株価変動材料を含む情報、又は前記グループ名及び前記銘柄からなる第1情報と前記株価変動材料からなる第2情報とを含む情報であるプログラム。 - 請求項11に記載のプログラムにおいて、
前記知見情報は上位概念の情報と下位概念の情報とによって構成される階層構造であり、
前記記憶部は評価情報と、前記下位概念の情報が前記上位概念の情報に帰属する度合いを示す確信度とを記憶し、
前記知見抽出装置を
前記評価情報から抽出された、前記上位概念の情報と前記下位概念の情報とに関連する評価情報に基づいて評価値を算出する評価部、
前記評価値に基づいて、前記確信度を更新する確信度更新部、
として機能させるためのプログラム。 - 上位概念の情報と下位概念の情報とによって構成される階層構造である知見情報と、前記知見情報の評価情報と、前記知見情報に含まれる前記下位概念の情報が前記上位概念の情報に帰属する度合いを示す確信度とを記憶する記憶部と、
前記評価情報から抽出された、前記上位概念の情報と前記下位概念の情報とに関連する評価情報に基づいて評価値を算出する評価部と、
前記評価値に基づいて、前記確信度を更新する確信度更新部と、
を備える知見更新装置。 - 請求項13に記載の知見更新装置において、
前記記憶部は前記確信度の更新ルールを記憶し、
前記確信度更新部は、前記評価値と前記更新ルールとに基づいて前記確信度を更新するか否かを判定する知見更新装置。 - 請求項13に記載の知見更新装置において、
前記確信度に基づいて前記知見情報を更新する知見更新部を備える知見更新装置。 - 上位概念の情報と下位概念の情報とによって構成される階層構造の知見情報と、前記知見情報の評価情報と、前記知見情報に含まれる前記下位概念の情報が前記上位概念の情報に帰属する度合いを示す確信度とを記憶する記憶部を備え、前記知見情報を更新する知見更新装置に用いられるプログラムであって、
前記知見更新装置を、
前記評価情報から抽出された、前記上位概念の情報と前記下位概念の情報とに関連する評価情報に基づいて評価値を算出する評価部、
前記評価値に基づいて、前記確信度を更新する確信度更新部、
として機能させるためのプログラム。
Applications Claiming Priority (1)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| PCT/JP2012/003586 WO2013179346A1 (ja) | 2012-05-31 | 2012-05-31 | 知見抽出装置、知見更新装置、及びプログラム |
Publications (2)
| Publication Number | Publication Date |
|---|---|
| JP5559352B2 true JP5559352B2 (ja) | 2014-07-23 |
| JPWO2013179346A1 JPWO2013179346A1 (ja) | 2016-01-14 |
Family
ID=49672605
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| JP2012543372A Expired - Fee Related JP5559352B2 (ja) | 2012-05-31 | 2012-05-31 | 知見抽出装置、知見更新装置、及びプログラム |
Country Status (6)
| Country | Link |
|---|---|
| US (1) | US10002122B2 (ja) |
| EP (1) | EP2857985A4 (ja) |
| JP (1) | JP5559352B2 (ja) |
| CN (1) | CN103582881B (ja) |
| SG (1) | SG11201407958PA (ja) |
| WO (1) | WO2013179346A1 (ja) |
Cited By (1)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP2016122383A (ja) * | 2014-12-25 | 2016-07-07 | 株式会社Quick | 情報提供システム、情報提供方法及び情報提供プログラム |
Families Citing this family (18)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| US9218322B2 (en) * | 2010-07-28 | 2015-12-22 | Hewlett-Packard Development Company, L.P. | Producing web page content |
| KR101854472B1 (ko) * | 2011-05-20 | 2018-05-03 | 오영주 | 야구용어 연계 증권정보 특성분석 시스템 및 특성제공 방법 |
| KR101913435B1 (ko) * | 2012-07-10 | 2018-12-28 | 오영주 | 야구용어 연계 투자평가 및 특성분석 방법 및 그 시스템 |
| US20180039927A1 (en) * | 2016-08-05 | 2018-02-08 | General Electric Company | Automatic summarization of employee performance |
| JP6727610B2 (ja) * | 2016-09-05 | 2020-07-22 | 国立研究開発法人情報通信研究機構 | 文脈解析装置及びそのためのコンピュータプログラム |
| US10740557B1 (en) | 2017-02-14 | 2020-08-11 | Casepoint LLC | Technology platform for data discovery |
| US11158012B1 (en) | 2017-02-14 | 2021-10-26 | Casepoint LLC | Customizing a data discovery user interface based on artificial intelligence |
| US11275794B1 (en) * | 2017-02-14 | 2022-03-15 | Casepoint LLC | CaseAssist story designer |
| US11461787B1 (en) * | 2017-02-27 | 2022-10-04 | United Services Automobile Association (Usaa) | Intention identification in electronic documents |
| JP6871759B2 (ja) * | 2017-02-28 | 2021-05-12 | 株式会社日立製作所 | 判断支援システム及び判断支援方法 |
| US11232260B2 (en) * | 2018-04-19 | 2022-01-25 | Entigenlogic Llc | Updating a document utilizing trusted new information |
| KR102618473B1 (ko) * | 2018-04-30 | 2023-12-27 | 안상선 | 로봇 저널리즘을 이용한 암호 화폐의 분석 뉴스 콘텐츠 서비스 시스템과 그 서비스 방법 |
| US10585922B2 (en) | 2018-05-23 | 2020-03-10 | International Business Machines Corporation | Finding a resource in response to a query including unknown words |
| JP6679705B1 (ja) * | 2018-12-25 | 2020-04-15 | ヤフー株式会社 | 情報処理装置、情報処理方法、及び情報処理プログラム |
| US20220174357A1 (en) * | 2020-11-30 | 2022-06-02 | At&T Intellectual Property I, L.P. | Simulating audience feedback in remote broadcast events |
| US11503090B2 (en) | 2020-11-30 | 2022-11-15 | At&T Intellectual Property I, L.P. | Remote audience feedback mechanism |
| JP7778401B2 (ja) * | 2021-06-29 | 2025-12-02 | イノフィン インコーポレイテッド | キーワード辞典を利用して投資キーワードを管理するサーバ及び方法 |
| US20240046039A1 (en) * | 2022-07-13 | 2024-02-08 | FiscalNote, Inc. | Method for News Mapping and Apparatus for Performing the Method |
Citations (3)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP2002251590A (ja) * | 2001-02-23 | 2002-09-06 | Fujitsu Ltd | 文書分析装置 |
| JP2011141833A (ja) * | 2010-01-08 | 2011-07-21 | Nifty Corp | 株価予測装置、方法及びプログラム |
| JP2012099001A (ja) * | 2010-11-04 | 2012-05-24 | Toshiba Corp | ニュース情報分析装置 |
Family Cites Families (28)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JPH09160915A (ja) | 1995-12-07 | 1997-06-20 | Meidensha Corp | 自然言語の文脈的処理方式 |
| US6076088A (en) * | 1996-02-09 | 2000-06-13 | Paik; Woojin | Information extraction system and method using concept relation concept (CRC) triples |
| JPH11134410A (ja) | 1997-11-04 | 1999-05-21 | Kokusai Electric Co Ltd | 証券情報の表示方法とその端末装置 |
| JP3266586B2 (ja) * | 1999-07-07 | 2002-03-18 | インターナショナル・ビジネス・マシーンズ・コーポレーション | データ分析システム |
| US6823331B1 (en) * | 2000-08-28 | 2004-11-23 | Entrust Limited | Concept identification system and method for use in reducing and/or representing text content of an electronic document |
| JP3813837B2 (ja) * | 2001-05-25 | 2006-08-23 | 株式会社東芝 | データ分析装置及びデータ分析方法並びにプログラム |
| JP4907806B2 (ja) | 2001-09-27 | 2012-04-04 | 富士通株式会社 | 情報処理装置 |
| KR100500329B1 (ko) * | 2001-10-18 | 2005-07-11 | 주식회사 핸디소프트 | 워크플로우 마이닝 시스템 및 방법 |
| JP2003162639A (ja) | 2001-11-28 | 2003-06-06 | Fujitsu Ltd | 銘柄選択支援装置 |
| WO2003067471A1 (fr) * | 2002-02-04 | 2003-08-14 | Celestar Lexico-Sciences, Inc. | Appareil et procede permettant de traiter des connaissances dans des documents |
| US7085771B2 (en) * | 2002-05-17 | 2006-08-01 | Verity, Inc | System and method for automatically discovering a hierarchy of concepts from a corpus of documents |
| JP2004252971A (ja) | 2003-01-30 | 2004-09-09 | Daiwa Securities Group Inc | 企業情報提供システム、方法及びプログラム、クライアントシステムの制御方法 |
| JP4372099B2 (ja) | 2003-05-15 | 2009-11-25 | オムロン株式会社 | 高周波加熱装置 |
| JP2005100221A (ja) | 2003-09-26 | 2005-04-14 | Nomura Research Institute Ltd | 投資判断支援情報提供装置および方法 |
| JP4081056B2 (ja) * | 2004-08-30 | 2008-04-23 | 株式会社東芝 | 情報処理装置、情報処理方法及びプログラム |
| US20070078889A1 (en) * | 2005-10-04 | 2007-04-05 | Hoskinson Ronald A | Method and system for automated knowledge extraction and organization |
| US20070192309A1 (en) * | 2005-10-12 | 2007-08-16 | Gordon Fischer | Method and system for identifying sentence boundaries |
| CN101042692B (zh) * | 2006-03-24 | 2010-09-22 | 富士通株式会社 | 基于语义预测的译文获取方法和设备 |
| CN101174273B (zh) * | 2007-12-04 | 2010-06-23 | 清华大学 | 基于元数据分析的新闻事件检测方法 |
| US11461785B2 (en) * | 2008-07-10 | 2022-10-04 | Ron M. Redlich | System and method to identify, classify and monetize information as an intangible asset and a production model based thereon |
| JP5238437B2 (ja) * | 2008-09-30 | 2013-07-17 | 株式会社東芝 | ウェブ閲覧目的分類装置、ウェブ閲覧目的分類方法、及びウェブ閲覧目的分類プログラム |
| CN101727451B (zh) * | 2008-10-22 | 2013-10-16 | 富士通株式会社 | 信息提取方法和装置 |
| US8346534B2 (en) * | 2008-11-06 | 2013-01-01 | University of North Texas System | Method, system and apparatus for automatic keyword extraction |
| JP2010247518A (ja) | 2009-03-26 | 2010-11-04 | Fuji Xerox Co Ltd | 画像形成装置、用紙管理プログラム |
| CN101593204A (zh) * | 2009-06-05 | 2009-12-02 | 北京大学 | 一种基于新闻评论网页的情感倾向性分析系统 |
| JP5621773B2 (ja) | 2009-07-06 | 2014-11-12 | 日本電気株式会社 | 分類階層再作成システム、分類階層再作成方法及び分類階層再作成プログラム |
| CN101661513B (zh) * | 2009-10-21 | 2011-04-06 | 上海交通大学 | 网络热点和舆情的检测方法 |
| JP2012015700A (ja) | 2010-06-30 | 2012-01-19 | Kyocera Mita Corp | 原稿読取装置及び画像形成装置 |
-
2012
- 2012-05-31 CN CN201280002603.4A patent/CN103582881B/zh not_active Expired - Fee Related
- 2012-05-31 SG SG11201407958PA patent/SG11201407958PA/en unknown
- 2012-05-31 WO PCT/JP2012/003586 patent/WO2013179346A1/ja not_active Ceased
- 2012-05-31 EP EP12877878.4A patent/EP2857985A4/en not_active Withdrawn
- 2012-05-31 JP JP2012543372A patent/JP5559352B2/ja not_active Expired - Fee Related
-
2014
- 2014-11-17 US US14/543,553 patent/US10002122B2/en active Active
Patent Citations (3)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP2002251590A (ja) * | 2001-02-23 | 2002-09-06 | Fujitsu Ltd | 文書分析装置 |
| JP2011141833A (ja) * | 2010-01-08 | 2011-07-21 | Nifty Corp | 株価予測装置、方法及びプログラム |
| JP2012099001A (ja) * | 2010-11-04 | 2012-05-24 | Toshiba Corp | ニュース情報分析装置 |
Non-Patent Citations (10)
| Title |
|---|
| CSNG199900793011; 小原和博、外2名: 'イベント知識と選択強調学習を用いたニューラル多変量予測' 電気学会論文誌C 第116-C巻,第7号, 19960620, p.802-808, 社団法人電気学会 * |
| CSNG200700136007; 酒井浩之、外1名: '経済新聞記事内容の個々の企業におけるインパクトの判定' 情報処理学会研究報告(2006-FI-84) 第2006巻,第94号, 20060913, p.43-50, 社団法人情報処理学会 * |
| CSNJ200610036047; 西村康成、外1名: '時系列データと文章データベースからの知識抽出に関する研究' FIT2005 第4回情報科学技術フォーラム 一般講演論文集 第2分冊 データベース 自然言語 人工 , 20050822, p.119-120 * |
| CSNJ200810065311; 中村健二、外5名: '株価情報と新聞記事を用いた企業の評判情報の抽出に関する研究' 第70回(平成20年)全国大会講演論文集(1) アーキテクチャ ソフトウェア科学・工学 データベース , 20080313, p.1-637〜1-638 * |
| CSNJ201010026059; 張へい、外1名: '株価データに基づく新聞記事の評価' 2008年度人工知能学会全国大会(第22回)論文集 [CD-ROM] , 2008, p.1-3(1E2-4) * |
| JPN6012037380; 酒井浩之、外1名: '経済新聞記事内容の個々の企業におけるインパクトの判定' 情報処理学会研究報告(2006-FI-84) 第2006巻,第94号, 20060913, p.43-50, 社団法人情報処理学会 * |
| JPN6012037381; 小原和博、外2名: 'イベント知識と選択強調学習を用いたニューラル多変量予測' 電気学会論文誌C 第116-C巻,第7号, 19960620, p.802-808, 社団法人電気学会 * |
| JPN6012037384; 西村康成、外1名: '時系列データと文章データベースからの知識抽出に関する研究' FIT2005 第4回情報科学技術フォーラム 一般講演論文集 第2分冊 データベース 自然言語 人工 , 20050822, p.119-120 * |
| JPN6012037386; 中村健二、外5名: '株価情報と新聞記事を用いた企業の評判情報の抽出に関する研究' 第70回(平成20年)全国大会講演論文集(1) アーキテクチャ ソフトウェア科学・工学 データベース , 20080313, p.1-637〜1-638 * |
| JPN6012037388; 張へい、外1名: '株価データに基づく新聞記事の評価' 2008年度人工知能学会全国大会(第22回)論文集 [CD-ROM] , 2008, p.1-3(1E2-4) * |
Cited By (1)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP2016122383A (ja) * | 2014-12-25 | 2016-07-07 | 株式会社Quick | 情報提供システム、情報提供方法及び情報提供プログラム |
Also Published As
| Publication number | Publication date |
|---|---|
| US20150066964A1 (en) | 2015-03-05 |
| EP2857985A1 (en) | 2015-04-08 |
| JPWO2013179346A1 (ja) | 2016-01-14 |
| US10002122B2 (en) | 2018-06-19 |
| WO2013179346A1 (ja) | 2013-12-05 |
| CN103582881B (zh) | 2017-05-03 |
| CN103582881A (zh) | 2014-02-12 |
| SG11201407958PA (en) | 2015-01-29 |
| EP2857985A4 (en) | 2016-08-03 |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| JPWO2013179346A1 (ja) | 知見抽出装置、知見更新装置、及びプログラム | |
| JP6043067B2 (ja) | 株取引知見抽出装置及びプログラム | |
| US11093467B2 (en) | Tools and techniques for extracting knowledge from unstructured data retrieved from personal data sources | |
| Welbers et al. | A gatekeeper among gatekeepers: News agency influence in print and online newspapers in the Netherlands | |
| Berend | Opinion expression mining by exploiting keyphrase extraction | |
| US20200320086A1 (en) | Method and system for content recommendation | |
| US10380626B2 (en) | System and method for evaluating search queries to identify titles for content production | |
| US9015182B2 (en) | Product placement engine and method | |
| US20160085742A1 (en) | Automated collective term and phrase index | |
| US20150186790A1 (en) | Systems and Methods for Automatic Understanding of Consumer Evaluations of Product Attributes from Consumer-Generated Reviews | |
| US20110196855A1 (en) | Real time content searching in social network | |
| US20160117591A1 (en) | Dynamic Business Rule Creation Using Scored Sentiments | |
| KR19990076970A (ko) | 다수 및/또는 복합 질의를 사용하여 데이터 세트의 내용을 평가하는 방법 및 시스템 | |
| AU2017355420A1 (en) | Systems and methods for event detection and clustering | |
| US8543578B2 (en) | Method and system for automatically identifying related content to an electronic text | |
| WO2010014082A1 (en) | Method and apparatus for relating datasets by using semantic vectors and keyword analyses | |
| US20160260166A1 (en) | Identification, curation and trend monitoring for uncorrelated information sources | |
| US11310539B1 (en) | Grouping a first set of video items to efficiently match against a second set of video items using embedding similarity | |
| JP5032645B2 (ja) | ニュース情報分析装置 | |
| US12204571B2 (en) | Content publisher recommender | |
| WO2006015878A2 (en) | Active relationship management | |
| Orimaye et al. | Performance and trends in recent opinion retrieval techniques | |
| Drury | A Text Mining System for Evaluating the Stock Market's Response To News | |
| Srinivasan et al. | Cross document person name disambiguation using entity profiles. | |
| Ajayi et al. | Classification of Social Media Users by Interests and Sentiments using Text Mining Techniques |
Legal Events
| Date | Code | Title | Description |
|---|---|---|---|
| TRDD | Decision of grant or rejection written | ||
| A01 | Written decision to grant a patent or to grant a registration (utility model) |
Free format text: JAPANESE INTERMEDIATE CODE: A01 Effective date: 20140509 |
|
| A61 | First payment of annual fees (during grant procedure) |
Free format text: JAPANESE INTERMEDIATE CODE: A61 Effective date: 20140605 |
|
| R150 | Certificate of patent or registration of utility model |
Ref document number: 5559352 Country of ref document: JP Free format text: JAPANESE INTERMEDIATE CODE: R150 |
|
| S533 | Written request for registration of change of name |
Free format text: JAPANESE INTERMEDIATE CODE: R313533 |
|
| R350 | Written notification of registration of transfer |
Free format text: JAPANESE INTERMEDIATE CODE: R350 |
|
| LAPS | Cancellation because of no payment of annual fees |