KR20140097529A - 항암 융합 단백질 - Google Patents
항암 융합 단백질 Download PDFInfo
- Publication number
- KR20140097529A KR20140097529A KR1020147018001A KR20147018001A KR20140097529A KR 20140097529 A KR20140097529 A KR 20140097529A KR 1020147018001 A KR1020147018001 A KR 1020147018001A KR 20147018001 A KR20147018001 A KR 20147018001A KR 20140097529 A KR20140097529 A KR 20140097529A
- Authority
- KR
- South Korea
- Prior art keywords
- seq
- domain
- sequence
- fusion protein
- protein
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Withdrawn
Links
- 108020001507 fusion proteins Proteins 0.000 title claims abstract description 607
- 102000037865 fusion proteins Human genes 0.000 title claims abstract description 607
- 230000001093 anti-cancer Effects 0.000 title description 7
- 108090000623 proteins and genes Proteins 0.000 claims abstract description 385
- 102000004169 proteins and genes Human genes 0.000 claims abstract description 379
- 108090000765 processed proteins & peptides Proteins 0.000 claims abstract description 217
- 239000012636 effector Substances 0.000 claims abstract description 157
- 150000001413 amino acids Chemical class 0.000 claims abstract description 119
- 206010028980 Neoplasm Diseases 0.000 claims abstract description 114
- 239000012634 fragment Substances 0.000 claims abstract description 58
- 238000011282 treatment Methods 0.000 claims abstract description 40
- 230000014616 translation Effects 0.000 claims abstract description 27
- 238000001243 protein synthesis Methods 0.000 claims abstract description 26
- 201000011510 cancer Diseases 0.000 claims abstract description 24
- 208000037265 diseases, disorders, signs and symptoms Diseases 0.000 claims abstract description 6
- 238000000034 method Methods 0.000 claims description 279
- 210000004027 cell Anatomy 0.000 claims description 156
- 241000588724 Escherichia coli Species 0.000 claims description 143
- 230000014509 gene expression Effects 0.000 claims description 122
- 108700012359 toxins Proteins 0.000 claims description 80
- 239000003053 toxin Substances 0.000 claims description 79
- 231100000765 toxin Toxicity 0.000 claims description 78
- 230000000694 effects Effects 0.000 claims description 60
- 238000003776 cleavage reaction Methods 0.000 claims description 53
- 230000007017 scission Effects 0.000 claims description 53
- 206010057190 Respiratory tract infections Diseases 0.000 claims description 48
- 241000589517 Pseudomonas aeruginosa Species 0.000 claims description 45
- 230000003197 catalytic effect Effects 0.000 claims description 45
- 102000004196 processed proteins & peptides Human genes 0.000 claims description 36
- 230000027455 binding Effects 0.000 claims description 28
- 241000589516 Pseudomonas Species 0.000 claims description 24
- 241000282414 Homo sapiens Species 0.000 claims description 22
- XKUKSGPZAADMRA-UHFFFAOYSA-N glycyl-glycyl-glycine Chemical compound NCC(=O)NCC(=O)NCC(O)=O XKUKSGPZAADMRA-UHFFFAOYSA-N 0.000 claims description 19
- 108091005804 Peptidases Proteins 0.000 claims description 17
- 239000004365 Protease Substances 0.000 claims description 17
- 239000013604 expression vector Substances 0.000 claims description 17
- 239000008194 pharmaceutical composition Substances 0.000 claims description 17
- 108091033319 polynucleotide Proteins 0.000 claims description 17
- 102000040430 polynucleotide Human genes 0.000 claims description 17
- 239000002157 polynucleotide Substances 0.000 claims description 17
- 102000005962 receptors Human genes 0.000 claims description 17
- 108020003175 receptors Proteins 0.000 claims description 17
- 108090000829 Ribosome Inactivating Proteins Proteins 0.000 claims description 15
- 108010053187 Diphtheria Toxin Proteins 0.000 claims description 14
- 102000016607 Diphtheria Toxin Human genes 0.000 claims description 14
- KDXKERNSBIXSRK-UHFFFAOYSA-N Lysine Natural products NCCCCC(N)C(O)=O KDXKERNSBIXSRK-UHFFFAOYSA-N 0.000 claims description 14
- 239000004472 Lysine Substances 0.000 claims description 13
- 210000000170 cell membrane Anatomy 0.000 claims description 13
- 108700004714 Gelonium multiflorum GEL Proteins 0.000 claims description 11
- 108010067216 glycyl-glycyl-glycine Proteins 0.000 claims description 11
- 108010044426 integrins Proteins 0.000 claims description 11
- 102000006495 integrins Human genes 0.000 claims description 11
- 108010086434 alanyl-seryl-glycine Proteins 0.000 claims description 10
- 210000002472 endoplasmic reticulum Anatomy 0.000 claims description 10
- 108010000449 TNF-Related Apoptosis-Inducing Ligand Receptors Proteins 0.000 claims description 8
- 102000002259 TNF-Related Apoptosis-Inducing Ligand Receptors Human genes 0.000 claims description 8
- 238000001784 detoxification Methods 0.000 claims description 8
- 108010001064 glycyl-glycyl-glycyl-glycine Proteins 0.000 claims description 8
- IYMAXBFPHPZYIK-BQBZGAKWSA-N Arg-Gly-Asp Chemical compound NC(N)=NCCC[C@H](N)C(=O)NCC(=O)N[C@@H](CC(O)=O)C(O)=O IYMAXBFPHPZYIK-BQBZGAKWSA-N 0.000 claims description 7
- TVYMKYUSZSVOAG-ZLUOBGJFSA-N Cys-Ala-Ala Chemical compound [H]N[C@@H](CS)C(=O)N[C@@H](C)C(=O)N[C@@H](C)C(O)=O TVYMKYUSZSVOAG-ZLUOBGJFSA-N 0.000 claims description 7
- FWMNVWWHGCHHJJ-SKKKGAJSSA-N 4-amino-1-[(2r)-6-amino-2-[[(2r)-2-[[(2r)-2-[[(2r)-2-amino-3-phenylpropanoyl]amino]-3-phenylpropanoyl]amino]-4-methylpentanoyl]amino]hexanoyl]piperidine-4-carboxylic acid Chemical compound C([C@H](C(=O)N[C@H](CC(C)C)C(=O)N[C@H](CCCCN)C(=O)N1CCC(N)(CC1)C(O)=O)NC(=O)[C@H](N)CC=1C=CC=CC=1)C1=CC=CC=C1 FWMNVWWHGCHHJJ-SKKKGAJSSA-N 0.000 claims description 6
- YBAFDPFAUTYYRW-UHFFFAOYSA-N N-L-alpha-glutamyl-L-leucine Natural products CC(C)CC(C(O)=O)NC(=O)C(N)CCC(O)=O YBAFDPFAUTYYRW-UHFFFAOYSA-N 0.000 claims description 6
- QMOQBVOBWVNSNO-UHFFFAOYSA-N 2-[[2-[[2-[(2-azaniumylacetyl)amino]acetyl]amino]acetyl]amino]acetate Chemical group NCC(=O)NCC(=O)NCC(=O)NCC(O)=O QMOQBVOBWVNSNO-UHFFFAOYSA-N 0.000 claims description 5
- YNCHFVRXEQFPBY-BQBZGAKWSA-N Asp-Gly-Arg Chemical compound OC(=O)C[C@H](N)C(=O)NCC(=O)N[C@H](C(O)=O)CCCN=C(N)N YNCHFVRXEQFPBY-BQBZGAKWSA-N 0.000 claims description 5
- 241000186216 Corynebacterium Species 0.000 claims description 5
- 108091036408 Toxin-antitoxin system Proteins 0.000 claims description 5
- 239000004480 active ingredient Substances 0.000 claims description 5
- 230000002255 enzymatic effect Effects 0.000 claims description 5
- 231100000654 protein toxin Toxicity 0.000 claims description 5
- JBFQOLHAGBKPTP-NZATWWQASA-N (2s)-2-[[(2s)-4-carboxy-2-[[3-carboxy-2-[[(2s)-2,6-diaminohexanoyl]amino]propanoyl]amino]butanoyl]amino]-4-methylpentanoic acid Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](CCC(O)=O)NC(=O)C(CC(O)=O)NC(=O)[C@@H](N)CCCCN JBFQOLHAGBKPTP-NZATWWQASA-N 0.000 claims description 4
- 102000009062 ADP Ribose Transferases Human genes 0.000 claims description 4
- 108010049290 ADP Ribose Transferases Proteins 0.000 claims description 4
- 108010066676 Abrin Proteins 0.000 claims description 4
- 102100038408 Kinesin-like protein KIF22 Human genes 0.000 claims description 4
- 241000124008 Mammalia Species 0.000 claims description 4
- 240000007643 Phytolacca americana Species 0.000 claims description 4
- 235000009074 Phytolacca americana Nutrition 0.000 claims description 4
- 102100034937 Poly(A) RNA polymerase, mitochondrial Human genes 0.000 claims description 4
- 108010008281 Recombinant Fusion Proteins Proteins 0.000 claims description 4
- 102000007056 Recombinant Fusion Proteins Human genes 0.000 claims description 4
- 102000006382 Ribonucleases Human genes 0.000 claims description 4
- 108010083644 Ribonucleases Proteins 0.000 claims description 4
- 101710183280 Topoisomerase Proteins 0.000 claims description 4
- 241000221012 Viscum Species 0.000 claims description 4
- OPTASPLRGRRNAP-UHFFFAOYSA-N cytosine Chemical compound NC=1C=CNC(=O)N=1 OPTASPLRGRRNAP-UHFFFAOYSA-N 0.000 claims description 4
- 201000010099 disease Diseases 0.000 claims description 4
- 108010089256 lysyl-aspartyl-glutamyl-leucine Proteins 0.000 claims description 4
- 238000007911 parenteral administration Methods 0.000 claims description 4
- 108010070643 prolylglutamic acid Proteins 0.000 claims description 4
- 210000003705 ribosome Anatomy 0.000 claims description 4
- UWQJHXKARZWDIJ-ZLUOBGJFSA-N Ala-Ala-Cys Chemical compound C[C@H](N)C(=O)N[C@@H](C)C(=O)N[C@@H](CS)C(O)=O UWQJHXKARZWDIJ-ZLUOBGJFSA-N 0.000 claims description 3
- 125000003440 L-leucyl group Chemical group O=C([*])[C@](N([H])[H])([H])C([H])([H])C(C([H])([H])[H])([H])C([H])([H])[H] 0.000 claims description 3
- 125000002842 L-seryl group Chemical group O=C([*])[C@](N([H])[H])([H])C([H])([H])O[H] 0.000 claims description 3
- 239000003937 drug carrier Substances 0.000 claims description 3
- 108020004999 messenger RNA Proteins 0.000 claims description 3
- 229920000724 poly(L-arginine) polymer Polymers 0.000 claims description 3
- 108010011110 polyarginine Proteins 0.000 claims description 3
- INOZZBHURUDQQR-AJNGGQMLSA-N (2s)-2-[[(2s)-2-[[(2s)-2-[[(2s)-2-amino-3-(1h-imidazol-5-yl)propanoyl]amino]-3-carboxypropanoyl]amino]-4-carboxybutanoyl]amino]-4-methylpentanoic acid Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](CCC(O)=O)NC(=O)[C@H](CC(O)=O)NC(=O)[C@@H](N)CC1=CN=CN1 INOZZBHURUDQQR-AJNGGQMLSA-N 0.000 claims description 2
- 241000567143 Adenia digitata Species 0.000 claims description 2
- 241001639638 Adenia volkensii Species 0.000 claims description 2
- 108010040956 Ala-Asp-Glu-Leu Proteins 0.000 claims description 2
- DECCMEWNXSNSDO-ZLUOBGJFSA-N Ala-Cys-Ala Chemical compound C[C@H](N)C(=O)N[C@@H](CS)C(=O)N[C@@H](C)C(O)=O DECCMEWNXSNSDO-ZLUOBGJFSA-N 0.000 claims description 2
- DDPXDCKYWDGZAL-BQBZGAKWSA-N Asn-Gly-Arg Chemical compound NC(=O)C[C@H](N)C(=O)NCC(=O)N[C@H](C(O)=O)CCCN=C(N)N DDPXDCKYWDGZAL-BQBZGAKWSA-N 0.000 claims description 2
- 241001316288 Bougainvillea spectabilis Species 0.000 claims description 2
- 102100039371 ER lumen protein-retaining receptor 1 Human genes 0.000 claims description 2
- 108050009340 Endothelin Proteins 0.000 claims description 2
- 102000002045 Endothelin Human genes 0.000 claims description 2
- 241000143456 Hirsutella thompsonii Species 0.000 claims description 2
- 101000812437 Homo sapiens ER lumen protein-retaining receptor 1 Proteins 0.000 claims description 2
- 125000002059 L-arginyl group Chemical group O=C([*])[C@](N([H])[H])([H])C([H])([H])C([H])([H])C([H])([H])N([H])C(=N[H])N([H])[H] 0.000 claims description 2
- 108010047562 NGR peptide Proteins 0.000 claims description 2
- SVWQEIRZHHNBIO-WHFBIAKZSA-N Ser-Gly-Cys Chemical compound [H]N[C@@H](CO)C(=O)NCC(=O)N[C@@H](CS)C(O)=O SVWQEIRZHHNBIO-WHFBIAKZSA-N 0.000 claims description 2
- 241000607768 Shigella Species 0.000 claims description 2
- 241000607764 Shigella dysenteriae Species 0.000 claims description 2
- 241000221019 Suregada multiflora Species 0.000 claims description 2
- 230000000118 anti-neoplastic effect Effects 0.000 claims description 2
- 108010072041 arginyl-glycyl-aspartic acid Proteins 0.000 claims description 2
- AGOYDEPGAOXOCK-KCBOHYOISA-N clarithromycin Chemical compound O([C@@H]1[C@@H](C)C(=O)O[C@@H]([C@@]([C@H](O)[C@@H](C)C(=O)[C@H](C)C[C@](C)([C@H](O[C@H]2[C@@H]([C@H](C[C@@H](C)O2)N(C)C)O)[C@H]1C)OC)(C)O)CC)[C@H]1C[C@@](C)(OC)[C@@H](O)[C@H](C)O1 AGOYDEPGAOXOCK-KCBOHYOISA-N 0.000 claims description 2
- 108010016616 cysteinylglycine Proteins 0.000 claims description 2
- 229940104302 cytosine Drugs 0.000 claims description 2
- ZUBDGKVDJUIMQQ-UBFCDGJISA-N endothelin-1 Chemical compound C([C@@H](C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CC=1C2=CC=CC=C2NC=1)C(O)=O)NC(=O)[C@H]1NC(=O)[C@H](CC=2C=CC=CC=2)NC(=O)[C@@H](CC=2C=CC(O)=CC=2)NC(=O)[C@H](C(C)C)NC(=O)[C@H]2CSSC[C@@H](C(N[C@H](CO)C(=O)N[C@@H](CO)C(=O)N[C@H](CC(C)C)C(=O)N[C@@H](CCSC)C(=O)N[C@H](CC(O)=O)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CCC(O)=O)C(=O)N2)=O)NC(=O)[C@@H](CO)NC(=O)[C@H](N)CSSC1)C1=CNC=N1 ZUBDGKVDJUIMQQ-UBFCDGJISA-N 0.000 claims description 2
- 108010084264 glycyl-glycyl-cysteine Proteins 0.000 claims description 2
- 108010041601 histidyl-aspartyl-glutamyl-leucine Proteins 0.000 claims description 2
- 239000004922 lacquer Substances 0.000 claims description 2
- 230000014759 maintenance of location Effects 0.000 claims description 2
- 230000001613 neoplastic effect Effects 0.000 claims description 2
- 239000001397 quillaja saponaria molina bark Substances 0.000 claims description 2
- 229930182490 saponin Natural products 0.000 claims description 2
- 150000007949 saponins Chemical class 0.000 claims description 2
- 229940007046 shigella dysenteriae Drugs 0.000 claims description 2
- GECHUMIMRBOMGK-UHFFFAOYSA-N sulfapyridine Chemical group C1=CC(N)=CC=C1S(=O)(=O)NC1=CC=CC=N1 GECHUMIMRBOMGK-UHFFFAOYSA-N 0.000 claims description 2
- 102100037486 Reverse transcriptase/ribonuclease H Human genes 0.000 claims 3
- 241000228254 Aspergillus restrictus Species 0.000 claims 1
- 208000006558 Dental Calculus Diseases 0.000 claims 1
- JVSBYEDSSRZQGV-GUBZILKMSA-N Glu-Asp-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](CC(O)=O)NC(=O)[C@@H](N)CCC(O)=O JVSBYEDSSRZQGV-GUBZILKMSA-N 0.000 claims 1
- 108010031186 Glycoside Hydrolases Proteins 0.000 claims 1
- 102000005744 Glycoside Hydrolases Human genes 0.000 claims 1
- 125000003412 L-alanyl group Chemical group [H]N([H])[C@@](C([H])([H])[H])(C(=O)[*])[H] 0.000 claims 1
- 206010065612 Loose tooth Diseases 0.000 claims 1
- 108010017898 Shiga Toxins Proteins 0.000 claims 1
- RTAQQCXQSZGOHL-UHFFFAOYSA-N Titanium Chemical compound [Ti] RTAQQCXQSZGOHL-UHFFFAOYSA-N 0.000 claims 1
- 102000004357 Transferases Human genes 0.000 claims 1
- 108090000992 Transferases Proteins 0.000 claims 1
- 108010076324 alanyl-glycyl-glycine Proteins 0.000 claims 1
- 239000003054 catalyst Substances 0.000 claims 1
- 201000003486 coccidioidomycosis Diseases 0.000 claims 1
- 108010057083 glutamyl-aspartyl-leucine Proteins 0.000 claims 1
- 108010018006 histidylserine Proteins 0.000 claims 1
- 229910052719 titanium Inorganic materials 0.000 claims 1
- 239000010936 titanium Substances 0.000 claims 1
- 230000002401 inhibitory effect Effects 0.000 abstract description 30
- 235000018102 proteins Nutrition 0.000 description 358
- 125000003275 alpha amino acid group Chemical group 0.000 description 171
- 230000002018 overexpression Effects 0.000 description 165
- 108020004414 DNA Proteins 0.000 description 147
- 235000001014 amino acid Nutrition 0.000 description 132
- HNDVDQJCIGZPNO-UHFFFAOYSA-N histidine Natural products OC(=O)C(N)CC1=CN=CN1 HNDVDQJCIGZPNO-UHFFFAOYSA-N 0.000 description 110
- KDCGOANMDULRCW-UHFFFAOYSA-N 7H-purine Chemical compound N1=CNC2=NC=NC2=C1 KDCGOANMDULRCW-UHFFFAOYSA-N 0.000 description 101
- 108091026890 Coding region Proteins 0.000 description 101
- 239000013612 plasmid Substances 0.000 description 89
- 108091028043 Nucleic acid sequence Proteins 0.000 description 84
- 238000001962 electrophoresis Methods 0.000 description 84
- 108020004705 Codon Proteins 0.000 description 81
- 108700012411 TNFSF10 Proteins 0.000 description 79
- 241000699670 Mus sp. Species 0.000 description 62
- 238000002474 experimental method Methods 0.000 description 61
- PEDCQBHIVMGVHV-UHFFFAOYSA-N Glycerine Chemical compound OCC(O)CO PEDCQBHIVMGVHV-UHFFFAOYSA-N 0.000 description 57
- 230000004614 tumor growth Effects 0.000 description 55
- FAPWRFPIFSIZLT-UHFFFAOYSA-M Sodium chloride Chemical compound [Na+].[Cl-] FAPWRFPIFSIZLT-UHFFFAOYSA-M 0.000 description 48
- 239000000203 mixture Substances 0.000 description 47
- 230000005764 inhibitory process Effects 0.000 description 43
- 210000004900 c-terminal fragment Anatomy 0.000 description 40
- 241001198387 Escherichia coli BL21(DE3) Species 0.000 description 37
- 230000035772 mutation Effects 0.000 description 37
- 230000008859 change Effects 0.000 description 34
- 241000699666 Mus <mouse, genus> Species 0.000 description 32
- 239000002609 medium Substances 0.000 description 32
- RWSXRVCMGQZWBV-WDSKDSINSA-N glutathione Chemical compound OC(=O)[C@@H](N)CCC(=O)N[C@@H](CS)C(=O)NCC(O)=O RWSXRVCMGQZWBV-WDSKDSINSA-N 0.000 description 30
- 239000012981 Hank's balanced salt solution Substances 0.000 description 27
- 238000002360 preparation method Methods 0.000 description 27
- 239000000872 buffer Substances 0.000 description 25
- 230000001472 cytotoxic effect Effects 0.000 description 24
- 239000011780 sodium chloride Substances 0.000 description 24
- OTLLEIBWKHEHGU-UHFFFAOYSA-N 2-[5-[[5-(6-aminopurin-9-yl)-3,4-dihydroxyoxolan-2-yl]methoxy]-3,4-dihydroxy-6-(hydroxymethyl)oxan-2-yl]oxy-3,5-dihydroxy-4-phosphonooxyhexanedioic acid Chemical compound C1=NC=2C(N)=NC=NC=2N1C(C(C1O)O)OC1COC1C(CO)OC(OC(C(O)C(OP(O)(O)=O)C(O)C(O)=O)C(O)=O)C(O)C1O OTLLEIBWKHEHGU-UHFFFAOYSA-N 0.000 description 20
- 230000037430 deletion Effects 0.000 description 20
- 238000012217 deletion Methods 0.000 description 20
- 101100284354 Mus musculus Hr gene Proteins 0.000 description 19
- 230000006378 damage Effects 0.000 description 19
- 238000010586 diagram Methods 0.000 description 19
- 210000000278 spinal cord Anatomy 0.000 description 19
- 206010009944 Colon cancer Diseases 0.000 description 18
- 239000012537 formulation buffer Substances 0.000 description 18
- RAXXELZNTBOGNW-UHFFFAOYSA-N imidazole Natural products C1=CNC=N1 RAXXELZNTBOGNW-UHFFFAOYSA-N 0.000 description 18
- 230000004565 tumor cell growth Effects 0.000 description 18
- 208000029742 colonic neoplasm Diseases 0.000 description 17
- 108010082117 matrigel Proteins 0.000 description 17
- 108010024636 Glutathione Proteins 0.000 description 15
- 206010058467 Lung neoplasm malignant Diseases 0.000 description 15
- 108090000435 Urokinase-type plasminogen activator Proteins 0.000 description 15
- 238000009472 formulation Methods 0.000 description 15
- 229960003180 glutathione Drugs 0.000 description 15
- 201000005202 lung cancer Diseases 0.000 description 15
- 208000020816 lung neoplasm Diseases 0.000 description 15
- 230000032258 transport Effects 0.000 description 15
- 102000035195 Peptidases Human genes 0.000 description 14
- 229930006000 Sucrose Natural products 0.000 description 14
- CZMRCDWAGMRECN-UGDNZRGBSA-N Sucrose Chemical compound O[C@H]1[C@H](O)[C@@H](CO)O[C@@]1(CO)O[C@@H]1[C@H](O)[C@@H](O)[C@H](O)[C@@H](CO)O1 CZMRCDWAGMRECN-UGDNZRGBSA-N 0.000 description 14
- 102000046283 TNF-Related Apoptosis-Inducing Ligand Human genes 0.000 description 14
- 230000006907 apoptotic process Effects 0.000 description 14
- 235000013681 dietary sucrose Nutrition 0.000 description 14
- 229960004793 sucrose Drugs 0.000 description 14
- 101000610605 Homo sapiens Tumor necrosis factor receptor superfamily member 10A Proteins 0.000 description 13
- 239000006228 supernatant Substances 0.000 description 13
- 231100000057 systemic toxicity Toxicity 0.000 description 13
- 102000003990 Urokinase-type plasminogen activator Human genes 0.000 description 12
- 230000004913 activation Effects 0.000 description 12
- 230000037396 body weight Effects 0.000 description 12
- LENZDBCJOHFCAS-UHFFFAOYSA-N tris Chemical compound OCC(N)(CO)CO LENZDBCJOHFCAS-UHFFFAOYSA-N 0.000 description 12
- 210000004881 tumor cell Anatomy 0.000 description 12
- 229960005356 urokinase Drugs 0.000 description 12
- 239000000284 extract Substances 0.000 description 11
- 230000008569 process Effects 0.000 description 11
- XLYOFNOQVPJJNP-UHFFFAOYSA-N water Substances O XLYOFNOQVPJJNP-UHFFFAOYSA-N 0.000 description 11
- DHMQDGOQFOQNFH-UHFFFAOYSA-N Glycine Chemical compound NCC(O)=O DHMQDGOQFOQNFH-UHFFFAOYSA-N 0.000 description 10
- 230000001965 increasing effect Effects 0.000 description 10
- 238000012360 testing method Methods 0.000 description 10
- 108091003079 Bovine Serum Albumin Proteins 0.000 description 9
- 102000004142 Trypsin Human genes 0.000 description 9
- 108090000631 Trypsin Proteins 0.000 description 9
- 102100040113 Tumor necrosis factor receptor superfamily member 10A Human genes 0.000 description 9
- 239000012091 fetal bovine serum Substances 0.000 description 9
- ZDXPYRJPNDTMRX-UHFFFAOYSA-N glutamine Natural products OC(=O)C(N)CCC(N)=O ZDXPYRJPNDTMRX-UHFFFAOYSA-N 0.000 description 9
- 230000005847 immunogenicity Effects 0.000 description 9
- 238000002513 implantation Methods 0.000 description 9
- 230000004048 modification Effects 0.000 description 9
- 238000012986 modification Methods 0.000 description 9
- 239000012588 trypsin Substances 0.000 description 9
- 230000004580 weight loss Effects 0.000 description 9
- 206010061902 Pancreatic neoplasm Diseases 0.000 description 8
- 239000002095 exotoxin Substances 0.000 description 8
- 231100000776 exotoxin Toxicity 0.000 description 8
- 238000001990 intravenous administration Methods 0.000 description 8
- 239000003446 ligand Substances 0.000 description 8
- 208000015486 malignant pancreatic neoplasm Diseases 0.000 description 8
- 239000012528 membrane Substances 0.000 description 8
- 201000002528 pancreatic cancer Diseases 0.000 description 8
- 208000008443 pancreatic carcinoma Diseases 0.000 description 8
- CSCPPACGZOOCGX-UHFFFAOYSA-N Acetone Chemical compound CC(C)=O CSCPPACGZOOCGX-UHFFFAOYSA-N 0.000 description 7
- 101710082714 Exotoxin A Proteins 0.000 description 7
- 241000219745 Lupinus Species 0.000 description 7
- 102100040112 Tumor necrosis factor receptor superfamily member 10B Human genes 0.000 description 7
- 125000000539 amino acid group Chemical group 0.000 description 7
- 230000000259 anti-tumor effect Effects 0.000 description 7
- 239000002246 antineoplastic agent Substances 0.000 description 7
- 210000004369 blood Anatomy 0.000 description 7
- 239000008280 blood Substances 0.000 description 7
- 239000007853 buffer solution Substances 0.000 description 7
- 229920001184 polypeptide Polymers 0.000 description 7
- 238000000746 purification Methods 0.000 description 7
- 239000000126 substance Substances 0.000 description 7
- 208000037965 uterine sarcoma Diseases 0.000 description 7
- 108090001090 Lectins Proteins 0.000 description 6
- 102000004856 Lectins Human genes 0.000 description 6
- 230000001580 bacterial effect Effects 0.000 description 6
- 230000015556 catabolic process Effects 0.000 description 6
- 238000006731 degradation reaction Methods 0.000 description 6
- -1 for example Chemical compound 0.000 description 6
- 201000007270 liver cancer Diseases 0.000 description 6
- 208000014018 liver neoplasm Diseases 0.000 description 6
- 239000011347 resin Substances 0.000 description 6
- 229920005989 resin Polymers 0.000 description 6
- 238000007920 subcutaneous administration Methods 0.000 description 6
- 108010049207 Death Domain Receptors Proteins 0.000 description 5
- 102000009058 Death Domain Receptors Human genes 0.000 description 5
- 239000004471 Glycine Substances 0.000 description 5
- 206010060862 Prostate cancer Diseases 0.000 description 5
- 208000000236 Prostatic Neoplasms Diseases 0.000 description 5
- 101000762949 Pseudomonas aeruginosa (strain ATCC 15692 / DSM 22644 / CIP 104116 / JCM 14847 / LMG 12228 / 1C / PRS 101 / PAO1) Exotoxin A Proteins 0.000 description 5
- 239000012980 RPMI-1640 medium Substances 0.000 description 5
- 229920002684 Sepharose Polymers 0.000 description 5
- 230000009471 action Effects 0.000 description 5
- 235000014633 carbohydrates Nutrition 0.000 description 5
- 229910002091 carbon monoxide Inorganic materials 0.000 description 5
- 230000001413 cellular effect Effects 0.000 description 5
- 238000002983 circular dichroism Methods 0.000 description 5
- 239000003085 diluting agent Substances 0.000 description 5
- 125000003630 glycyl group Chemical group [H]N([H])C([H])([H])C(*)=O 0.000 description 5
- 230000001939 inductive effect Effects 0.000 description 5
- 238000002347 injection Methods 0.000 description 5
- 239000007924 injection Substances 0.000 description 5
- 239000002523 lectin Substances 0.000 description 5
- 108010004914 prolylarginine Proteins 0.000 description 5
- 239000011734 sodium Substances 0.000 description 5
- 238000002415 sodium dodecyl sulfate polyacrylamide gel electrophoresis Methods 0.000 description 5
- 230000001988 toxicity Effects 0.000 description 5
- 231100000419 toxicity Toxicity 0.000 description 5
- 238000013518 transcription Methods 0.000 description 5
- 230000035897 transcription Effects 0.000 description 5
- 239000013598 vector Substances 0.000 description 5
- LRFVTYWOQMYALW-UHFFFAOYSA-N 9H-xanthine Chemical compound O=C1NC(=O)NC2=C1NC=N2 LRFVTYWOQMYALW-UHFFFAOYSA-N 0.000 description 4
- AOJJSUZBOXZQNB-TZSSRYMLSA-N Doxorubicin Chemical compound O([C@H]1C[C@@](O)(CC=2C(O)=C3C(=O)C=4C=CC=C(C=4C(=O)C3=C(O)C=21)OC)C(=O)CO)[C@H]1C[C@H](N)[C@H](O)[C@H](C)O1 AOJJSUZBOXZQNB-TZSSRYMLSA-N 0.000 description 4
- 239000006144 Dulbecco’s modified Eagle's medium Substances 0.000 description 4
- 241000196324 Embryophyta Species 0.000 description 4
- 241001465754 Metazoa Species 0.000 description 4
- 101900161471 Pseudomonas aeruginosa Exotoxin A Proteins 0.000 description 4
- 108090000190 Thrombin Proteins 0.000 description 4
- XSQUKJJJFZCRTK-UHFFFAOYSA-N Urea Chemical compound NC(N)=O XSQUKJJJFZCRTK-UHFFFAOYSA-N 0.000 description 4
- 230000033115 angiogenesis Effects 0.000 description 4
- 230000005775 apoptotic pathway Effects 0.000 description 4
- 238000003556 assay Methods 0.000 description 4
- 238000004364 calculation method Methods 0.000 description 4
- 239000000969 carrier Substances 0.000 description 4
- 231100000263 cytotoxicity test Toxicity 0.000 description 4
- 230000007547 defect Effects 0.000 description 4
- SNRUBQQJIBEYMU-UHFFFAOYSA-N dodecane Chemical compound CCCCCCCCCCCC SNRUBQQJIBEYMU-UHFFFAOYSA-N 0.000 description 4
- 239000003814 drug Substances 0.000 description 4
- 239000000499 gel Substances 0.000 description 4
- 238000000338 in vitro Methods 0.000 description 4
- 238000001727 in vivo Methods 0.000 description 4
- 229930027917 kanamycin Natural products 0.000 description 4
- SBUJHOSQTJFQJX-NOAMYHISSA-N kanamycin Chemical compound O[C@@H]1[C@@H](O)[C@H](O)[C@@H](CN)O[C@@H]1O[C@H]1[C@H](O)[C@@H](O[C@@H]2[C@@H]([C@@H](N)[C@H](O)[C@@H](CO)O2)O)[C@H](N)C[C@@H]1N SBUJHOSQTJFQJX-NOAMYHISSA-N 0.000 description 4
- 229960000318 kanamycin Drugs 0.000 description 4
- 229930182823 kanamycin A Natural products 0.000 description 4
- 239000007788 liquid Substances 0.000 description 4
- 239000003550 marker Substances 0.000 description 4
- 238000005259 measurement Methods 0.000 description 4
- 230000003287 optical effect Effects 0.000 description 4
- 230000037361 pathway Effects 0.000 description 4
- 238000010647 peptide synthesis reaction Methods 0.000 description 4
- YBYRMVIVWMBXKQ-UHFFFAOYSA-N phenylmethanesulfonyl fluoride Chemical compound FS(=O)(=O)CC1=CC=CC=C1 YBYRMVIVWMBXKQ-UHFFFAOYSA-N 0.000 description 4
- 230000010287 polarization Effects 0.000 description 4
- 230000003389 potentiating effect Effects 0.000 description 4
- 150000003212 purines Chemical class 0.000 description 4
- 239000000243 solution Substances 0.000 description 4
- 238000006467 substitution reaction Methods 0.000 description 4
- 238000003786 synthesis reaction Methods 0.000 description 4
- 229960004072 thrombin Drugs 0.000 description 4
- 238000002054 transplantation Methods 0.000 description 4
- DGVVWUTYPXICAM-UHFFFAOYSA-N β‐Mercaptoethanol Chemical compound OCCS DGVVWUTYPXICAM-UHFFFAOYSA-N 0.000 description 4
- MTCFGRXMJLQNBG-REOHCLBHSA-N (2S)-2-Amino-3-hydroxypropansäure Chemical compound OC[C@H](N)C(O)=O MTCFGRXMJLQNBG-REOHCLBHSA-N 0.000 description 3
- ZEAYJGRKRUBDOB-GARJFASQSA-N Arg-Gln-Pro Chemical compound C1C[C@@H](N(C1)C(=O)[C@H](CCC(=O)N)NC(=O)[C@H](CCCN=C(N)N)N)C(=O)O ZEAYJGRKRUBDOB-GARJFASQSA-N 0.000 description 3
- IAZDPXIOMUYVGZ-UHFFFAOYSA-N Dimethylsulphoxide Chemical compound CS(C)=O IAZDPXIOMUYVGZ-UHFFFAOYSA-N 0.000 description 3
- 102000004190 Enzymes Human genes 0.000 description 3
- 108090000790 Enzymes Proteins 0.000 description 3
- LFQSCWFLJHTTHZ-UHFFFAOYSA-N Ethanol Chemical compound CCO LFQSCWFLJHTTHZ-UHFFFAOYSA-N 0.000 description 3
- 235000014066 European mistletoe Nutrition 0.000 description 3
- 102000016359 Fibronectins Human genes 0.000 description 3
- 108010067306 Fibronectins Proteins 0.000 description 3
- WQZGKKKJIJFFOK-GASJEMHNSA-N Glucose Natural products OC[C@H]1OC(O)[C@H](O)[C@@H](O)[C@@H]1O WQZGKKKJIJFFOK-GASJEMHNSA-N 0.000 description 3
- WHUUTDBJXJRKMK-UHFFFAOYSA-N Glutamic acid Natural products OC(=O)C(N)CCC(O)=O WHUUTDBJXJRKMK-UHFFFAOYSA-N 0.000 description 3
- 101000830565 Homo sapiens Tumor necrosis factor ligand superfamily member 10 Proteins 0.000 description 3
- FADYJNXDPBKVCA-UHFFFAOYSA-N L-Phenylalanyl-L-lysin Natural products NCCCCC(C(O)=O)NC(=O)C(N)CC1=CC=CC=C1 FADYJNXDPBKVCA-UHFFFAOYSA-N 0.000 description 3
- DNIAPMSPPWPWGF-UHFFFAOYSA-N Propylene glycol Chemical compound CC(O)CO DNIAPMSPPWPWGF-UHFFFAOYSA-N 0.000 description 3
- 235000012300 Rhipsalis cassutha Nutrition 0.000 description 3
- MTCFGRXMJLQNBG-UHFFFAOYSA-N Serine Natural products OCC(N)C(O)=O MTCFGRXMJLQNBG-UHFFFAOYSA-N 0.000 description 3
- 238000001042 affinity chromatography Methods 0.000 description 3
- 239000003963 antioxidant agent Substances 0.000 description 3
- WQZGKKKJIJFFOK-VFUOTHLCSA-N beta-D-glucose Chemical compound OC[C@H]1O[C@@H](O)[C@H](O)[C@@H](O)[C@@H]1O WQZGKKKJIJFFOK-VFUOTHLCSA-N 0.000 description 3
- 230000000903 blocking effect Effects 0.000 description 3
- 238000005119 centrifugation Methods 0.000 description 3
- 150000001875 compounds Chemical class 0.000 description 3
- 239000013078 crystal Substances 0.000 description 3
- 125000000151 cysteine group Chemical group N[C@@H](CS)C(=O)* 0.000 description 3
- 229940088598 enzyme Drugs 0.000 description 3
- 239000008103 glucose Substances 0.000 description 3
- 230000012010 growth Effects 0.000 description 3
- 201000005787 hematologic cancer Diseases 0.000 description 3
- 208000024200 hematopoietic and lymphoid system neoplasm Diseases 0.000 description 3
- 102000044949 human TNFSF10 Human genes 0.000 description 3
- 238000010348 incorporation Methods 0.000 description 3
- 239000004615 ingredient Substances 0.000 description 3
- 230000003834 intracellular effect Effects 0.000 description 3
- UWKQSNNFCGGAFS-XIFFEERXSA-N irinotecan Chemical compound C1=C2C(CC)=C3CN(C(C4=C([C@@](C(=O)OC4)(O)CC)C=4)=O)C=4C3=NC2=CC=C1OC(=O)N(CC1)CCC1N1CCCCC1 UWKQSNNFCGGAFS-XIFFEERXSA-N 0.000 description 3
- 108010044348 lysyl-glutamyl-aspartic acid Proteins 0.000 description 3
- 230000007246 mechanism Effects 0.000 description 3
- 238000010369 molecular cloning Methods 0.000 description 3
- VMGAPWLDMVPYIA-HIDZBRGKSA-N n'-amino-n-iminomethanimidamide Chemical compound N\N=C\N=N VMGAPWLDMVPYIA-HIDZBRGKSA-N 0.000 description 3
- 230000006320 pegylation Effects 0.000 description 3
- 239000008188 pellet Substances 0.000 description 3
- 229920001223 polyethylene glycol Polymers 0.000 description 3
- 229920002704 polyhistidine Polymers 0.000 description 3
- 230000009467 reduction Effects 0.000 description 3
- 230000001105 regulatory effect Effects 0.000 description 3
- BOLDJAUMGUJJKM-LSDHHAIUSA-N renifolin D Natural products CC(=C)[C@@H]1Cc2c(O)c(O)ccc2[C@H]1CC(=O)c3ccc(O)cc3O BOLDJAUMGUJJKM-LSDHHAIUSA-N 0.000 description 3
- 230000010076 replication Effects 0.000 description 3
- 239000007787 solid Substances 0.000 description 3
- 239000002904 solvent Substances 0.000 description 3
- 235000000346 sugar Nutrition 0.000 description 3
- 230000008685 targeting Effects 0.000 description 3
- 231100000331 toxic Toxicity 0.000 description 3
- 230000009466 transformation Effects 0.000 description 3
- 239000008215 water for injection Substances 0.000 description 3
- HKZAAJSTFUZYTO-LURJTMIESA-N (2s)-2-[[2-[[2-[[2-[(2-aminoacetyl)amino]acetyl]amino]acetyl]amino]acetyl]amino]-3-hydroxypropanoic acid Chemical compound NCC(=O)NCC(=O)NCC(=O)NCC(=O)N[C@@H](CO)C(O)=O HKZAAJSTFUZYTO-LURJTMIESA-N 0.000 description 2
- 108091032973 (ribonucleotides)n+m Proteins 0.000 description 2
- QZDDFQLIQRYMBV-UHFFFAOYSA-N 2-[3-nitro-2-(2-nitrophenyl)-4-oxochromen-8-yl]acetic acid Chemical compound OC(=O)CC1=CC=CC(C(C=2[N+]([O-])=O)=O)=C1OC=2C1=CC=CC=C1[N+]([O-])=O QZDDFQLIQRYMBV-UHFFFAOYSA-N 0.000 description 2
- QKNYBSVHEMOAJP-UHFFFAOYSA-N 2-amino-2-(hydroxymethyl)propane-1,3-diol;hydron;chloride Chemical compound Cl.OCC(N)(CO)CO QKNYBSVHEMOAJP-UHFFFAOYSA-N 0.000 description 2
- 230000005730 ADP ribosylation Effects 0.000 description 2
- 102100022749 Aminopeptidase N Human genes 0.000 description 2
- YBIAYFFIVAZXPK-AVGNSLFASA-N Arg-His-Arg Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC1=CNC=N1)C(=O)N[C@@H](CCCNC(N)=N)C(O)=O YBIAYFFIVAZXPK-AVGNSLFASA-N 0.000 description 2
- 239000004475 Arginine Substances 0.000 description 2
- IJGRMHOSHXDMSA-UHFFFAOYSA-N Atomic nitrogen Chemical compound N#N IJGRMHOSHXDMSA-UHFFFAOYSA-N 0.000 description 2
- 244000063299 Bacillus subtilis Species 0.000 description 2
- 235000014469 Bacillus subtilis Nutrition 0.000 description 2
- 241000894006 Bacteria Species 0.000 description 2
- 108010049990 CD13 Antigens Proteins 0.000 description 2
- 101100283604 Caenorhabditis elegans pigk-1 gene Proteins 0.000 description 2
- 102000004091 Caspase-8 Human genes 0.000 description 2
- 108090000538 Caspase-8 Proteins 0.000 description 2
- 102000011727 Caspases Human genes 0.000 description 2
- 108010076667 Caspases Proteins 0.000 description 2
- 102000004127 Cytokines Human genes 0.000 description 2
- 108090000695 Cytokines Proteins 0.000 description 2
- 102000004163 DNA-directed RNA polymerases Human genes 0.000 description 2
- 108090000626 DNA-directed RNA polymerases Proteins 0.000 description 2
- 102100035233 Furin Human genes 0.000 description 2
- 101150111025 Furin gene Proteins 0.000 description 2
- XUMFMAVDHQDATI-DCAQKATOSA-N Gln-Pro-Arg Chemical compound NC(=O)CC[C@H](N)C(=O)N1CCC[C@H]1C(=O)N[C@@H](CCCN=C(N)N)C(O)=O XUMFMAVDHQDATI-DCAQKATOSA-N 0.000 description 2
- YOBGUCWZPXJHTN-BQBZGAKWSA-N Gly-Ser-Arg Chemical compound NCC(=O)N[C@@H](CO)C(=O)N[C@H](C(O)=O)CCCN=C(N)N YOBGUCWZPXJHTN-BQBZGAKWSA-N 0.000 description 2
- NIOPEYHPOBWLQO-KBPBESRZSA-N Gly-Trp-Glu Chemical compound NCC(=O)N[C@@H](Cc1c[nH]c2ccccc12)C(=O)N[C@@H](CCC(O)=O)C(O)=O NIOPEYHPOBWLQO-KBPBESRZSA-N 0.000 description 2
- 108010010369 HIV Protease Proteins 0.000 description 2
- 108010042918 Integrin alpha5beta1 Proteins 0.000 description 2
- 108010002350 Interleukin-2 Proteins 0.000 description 2
- 102000000588 Interleukin-2 Human genes 0.000 description 2
- 241000235058 Komagataella pastoris Species 0.000 description 2
- PMGDADKJMCOXHX-UHFFFAOYSA-N L-Arginyl-L-glutamin-acetat Natural products NC(=N)NCCCC(N)C(=O)NC(CCC(N)=O)C(O)=O PMGDADKJMCOXHX-UHFFFAOYSA-N 0.000 description 2
- QNAYBMKLOCPYGJ-REOHCLBHSA-N L-alanine Chemical compound C[C@H](N)C(O)=O QNAYBMKLOCPYGJ-REOHCLBHSA-N 0.000 description 2
- ODKSFYDXXFIFQN-BYPYZUCNSA-N L-arginine Chemical compound OC(=O)[C@@H](N)CCCN=C(N)N ODKSFYDXXFIFQN-BYPYZUCNSA-N 0.000 description 2
- WNGVUZWBXZKQES-YUMQZZPRSA-N Leu-Ala-Gly Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H](C)C(=O)NCC(O)=O WNGVUZWBXZKQES-YUMQZZPRSA-N 0.000 description 2
- 241000204031 Mycoplasma Species 0.000 description 2
- PXHVJJICTQNCMI-UHFFFAOYSA-N Nickel Chemical compound [Ni] PXHVJJICTQNCMI-UHFFFAOYSA-N 0.000 description 2
- FXGIMYRVJJEIIM-UWVGGRQHSA-N Pro-Leu-Gly Chemical compound OC(=O)CNC(=O)[C@H](CC(C)C)NC(=O)[C@@H]1CCCN1 FXGIMYRVJJEIIM-UWVGGRQHSA-N 0.000 description 2
- 108010076504 Protein Sorting Signals Proteins 0.000 description 2
- 108010026552 Proteome Proteins 0.000 description 2
- 108700008625 Reporter Genes Proteins 0.000 description 2
- 206010038669 Respiratory arrest Diseases 0.000 description 2
- 240000004808 Saccharomyces cerevisiae Species 0.000 description 2
- 235000014680 Saccharomyces cerevisiae Nutrition 0.000 description 2
- IOVBCLGAJJXOHK-SRVKXCTJSA-N Ser-His-His Chemical compound C([C@H](NC(=O)[C@H](CO)N)C(=O)N[C@@H](CC=1NC=NC=1)C(O)=O)C1=CN=CN1 IOVBCLGAJJXOHK-SRVKXCTJSA-N 0.000 description 2
- 239000007983 Tris buffer Substances 0.000 description 2
- LCHZBEUVGAVMKS-RHYQMDGZSA-N Val-Thr-Leu Chemical compound CC(C)C[C@H](NC(=O)[C@@H](NC(=O)[C@@H](N)C(C)C)[C@@H](C)O)C(O)=O LCHZBEUVGAVMKS-RHYQMDGZSA-N 0.000 description 2
- RTJPAGFXOWEBAI-SRVKXCTJSA-N Val-Val-Arg Chemical compound CC(C)[C@H](N)C(=O)N[C@@H](C(C)C)C(=O)N[C@H](C(O)=O)CCCN=C(N)N RTJPAGFXOWEBAI-SRVKXCTJSA-N 0.000 description 2
- 108700022368 Whn Proteins 0.000 description 2
- 238000009825 accumulation Methods 0.000 description 2
- 239000002253 acid Substances 0.000 description 2
- GFFGJBXGBJISGV-UHFFFAOYSA-N adenyl group Chemical group N1=CN=C2N=CNC2=C1N GFFGJBXGBJISGV-UHFFFAOYSA-N 0.000 description 2
- 239000000443 aerosol Substances 0.000 description 2
- 239000000556 agonist Substances 0.000 description 2
- 235000004279 alanine Nutrition 0.000 description 2
- 125000003295 alanine group Chemical group N[C@@H](C)C(=O)* 0.000 description 2
- 238000004458 analytical method Methods 0.000 description 2
- 239000003242 anti bacterial agent Substances 0.000 description 2
- 239000003429 antifungal agent Substances 0.000 description 2
- 229940121375 antifungal agent Drugs 0.000 description 2
- ODKSFYDXXFIFQN-UHFFFAOYSA-N arginine Natural products OC(=O)C(N)CCCNC(N)=N ODKSFYDXXFIFQN-UHFFFAOYSA-N 0.000 description 2
- 235000009697 arginine Nutrition 0.000 description 2
- 108010008355 arginyl-glutamine Proteins 0.000 description 2
- 108010068380 arginylarginine Proteins 0.000 description 2
- 108010047857 aspartylglycine Proteins 0.000 description 2
- 108010092854 aspartyllysine Proteins 0.000 description 2
- 230000015572 biosynthetic process Effects 0.000 description 2
- 210000004899 c-terminal region Anatomy 0.000 description 2
- 239000004202 carbamide Substances 0.000 description 2
- 230000004663 cell proliferation Effects 0.000 description 2
- 230000003833 cell viability Effects 0.000 description 2
- 230000036755 cellular response Effects 0.000 description 2
- 239000003795 chemical substances by application Substances 0.000 description 2
- OSASVXMJTNOKOY-UHFFFAOYSA-N chlorobutanol Chemical compound CC(C)(O)C(Cl)(Cl)Cl OSASVXMJTNOKOY-UHFFFAOYSA-N 0.000 description 2
- 238000004587 chromatography analysis Methods 0.000 description 2
- 235000019504 cigarettes Nutrition 0.000 description 2
- 238000001142 circular dichroism spectrum Methods 0.000 description 2
- 230000000295 complement effect Effects 0.000 description 2
- 229940127089 cytotoxic agent Drugs 0.000 description 2
- 230000007812 deficiency Effects 0.000 description 2
- 239000008367 deionised water Substances 0.000 description 2
- 229910021641 deionized water Inorganic materials 0.000 description 2
- 230000001419 dependent effect Effects 0.000 description 2
- 229960004679 doxorubicin Drugs 0.000 description 2
- 239000003623 enhancer Substances 0.000 description 2
- 238000011156 evaluation Methods 0.000 description 2
- 239000003102 growth factor Substances 0.000 description 2
- 239000002596 immunotoxin Substances 0.000 description 2
- 230000001976 improved effect Effects 0.000 description 2
- 230000006698 induction Effects 0.000 description 2
- 238000001802 infusion Methods 0.000 description 2
- 230000003993 interaction Effects 0.000 description 2
- 230000009545 invasion Effects 0.000 description 2
- BPHPUYQFMNQIOC-NXRLNHOXSA-N isopropyl beta-D-thiogalactopyranoside Chemical compound CC(C)S[C@@H]1O[C@H](CO)[C@H](O)[C@H](O)[C@H]1O BPHPUYQFMNQIOC-NXRLNHOXSA-N 0.000 description 2
- 230000000670 limiting effect Effects 0.000 description 2
- 210000004185 liver Anatomy 0.000 description 2
- 210000004962 mammalian cell Anatomy 0.000 description 2
- 239000000463 material Substances 0.000 description 2
- 231100000252 nontoxic Toxicity 0.000 description 2
- 239000002773 nucleotide Substances 0.000 description 2
- 125000003729 nucleotide group Chemical group 0.000 description 2
- 238000011275 oncology therapy Methods 0.000 description 2
- 238000012261 overproduction Methods 0.000 description 2
- 239000012071 phase Substances 0.000 description 2
- 239000003755 preservative agent Substances 0.000 description 2
- 239000000047 product Substances 0.000 description 2
- 108700042769 prolyl-leucyl-glycine Proteins 0.000 description 2
- 238000011160 research Methods 0.000 description 2
- 238000012163 sequencing technique Methods 0.000 description 2
- 108010026333 seryl-proline Proteins 0.000 description 2
- 230000019491 signal transduction Effects 0.000 description 2
- 239000007790 solid phase Substances 0.000 description 2
- 238000001228 spectrum Methods 0.000 description 2
- 239000003381 stabilizer Substances 0.000 description 2
- 238000011255 standard chemotherapy Methods 0.000 description 2
- 238000003756 stirring Methods 0.000 description 2
- 239000004094 surface-active agent Substances 0.000 description 2
- 208000011580 syndromic disease Diseases 0.000 description 2
- 125000003831 tetrazolyl group Chemical group 0.000 description 2
- 230000001225 therapeutic effect Effects 0.000 description 2
- 238000002560 therapeutic procedure Methods 0.000 description 2
- 210000001519 tissue Anatomy 0.000 description 2
- 230000002588 toxic effect Effects 0.000 description 2
- 238000000539 two dimensional gel electrophoresis Methods 0.000 description 2
- 230000002792 vascular Effects 0.000 description 2
- 229940075420 xanthine Drugs 0.000 description 2
- NWONKYPBYAMBJT-UHFFFAOYSA-L zinc sulfate Chemical compound [Zn+2].[O-]S([O-])(=O)=O NWONKYPBYAMBJT-UHFFFAOYSA-L 0.000 description 2
- 229960001763 zinc sulfate Drugs 0.000 description 2
- 229910000368 zinc sulfate Inorganic materials 0.000 description 2
- JNTMAZFVYNDPLB-PEDHHIEDSA-N (2S,3S)-2-[[[(2S)-1-[(2S,3S)-2-amino-3-methyl-1-oxopentyl]-2-pyrrolidinyl]-oxomethyl]amino]-3-methylpentanoic acid Chemical compound CC[C@H](C)[C@H](N)C(=O)N1CCC[C@H]1C(=O)N[C@@H]([C@@H](C)CC)C(O)=O JNTMAZFVYNDPLB-PEDHHIEDSA-N 0.000 description 1
- QVVDVENEPNODSI-BTNSXGMBSA-N (2s)-2-[[(2s)-2-[[(2s)-2-[[(2s)-2-[[(2s)-2-[[(2s)-2-amino-5-(diaminomethylideneamino)pentanoyl]amino]-5-(diaminomethylideneamino)pentanoyl]amino]-5-(diaminomethylideneamino)pentanoyl]amino]-5-(diaminomethylideneamino)pentanoyl]amino]-5-(diaminomethylidene Chemical compound NC(N)=NCCC[C@H](N)C(=O)N[C@@H](CCCN=C(N)N)C(=O)N[C@@H](CCCN=C(N)N)C(=O)N[C@@H](CCCN=C(N)N)C(=O)N[C@@H](CCCN=C(N)N)C(=O)N[C@@H](CCCN=C(N)N)C(O)=O QVVDVENEPNODSI-BTNSXGMBSA-N 0.000 description 1
- IIZPXYDJLKNOIY-JXPKJXOSSA-N 1-palmitoyl-2-arachidonoyl-sn-glycero-3-phosphocholine Chemical compound CCCCCCCCCCCCCCCC(=O)OC[C@H](COP([O-])(=O)OCC[N+](C)(C)C)OC(=O)CCC\C=C/C\C=C/C\C=C/C\C=C/CCCCC IIZPXYDJLKNOIY-JXPKJXOSSA-N 0.000 description 1
- FBFNMTGUOBUGFQ-UHFFFAOYSA-M 2-(2,5-diphenyltetrazol-1-ium-1-yl)-4,5-dimethyl-1,3-thiazole;bromide Chemical compound [Br-].S1C(C)=C(C)N=C1[N+]1=C(C=2C=CC=CC=2)N=NN1C1=CC=CC=C1 FBFNMTGUOBUGFQ-UHFFFAOYSA-M 0.000 description 1
- GOJUJUVQIVIZAV-UHFFFAOYSA-N 2-amino-4,6-dichloropyrimidine-5-carbaldehyde Chemical group NC1=NC(Cl)=C(C=O)C(Cl)=N1 GOJUJUVQIVIZAV-UHFFFAOYSA-N 0.000 description 1
- 108020005096 28S Ribosomal RNA Proteins 0.000 description 1
- UMCMPZBLKLEWAF-BCTGSCMUSA-N 3-[(3-cholamidopropyl)dimethylammonio]propane-1-sulfonate Chemical compound C([C@H]1C[C@H]2O)[C@H](O)CC[C@]1(C)[C@@H]1[C@@H]2[C@@H]2CC[C@H]([C@@H](CCC(=O)NCCC[N+](C)(C)CCCS([O-])(=O)=O)C)[C@@]2(C)[C@@H](O)C1 UMCMPZBLKLEWAF-BCTGSCMUSA-N 0.000 description 1
- 229930024421 Adenine Natural products 0.000 description 1
- 101000854353 Agrocybe aegerita Ribonuclease ageritin Proteins 0.000 description 1
- 240000000254 Agrostemma githago Species 0.000 description 1
- 235000009899 Agrostemma githago Nutrition 0.000 description 1
- YWWATNIVMOCSAV-UBHSHLNASA-N Ala-Arg-Phe Chemical compound NC(=N)NCCC[C@H](NC(=O)[C@@H](N)C)C(=O)N[C@H](C(O)=O)CC1=CC=CC=C1 YWWATNIVMOCSAV-UBHSHLNASA-N 0.000 description 1
- WXERCAHAIKMTKX-ZLUOBGJFSA-N Ala-Asp-Asp Chemical compound [H]N[C@@H](C)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CC(O)=O)C(O)=O WXERCAHAIKMTKX-ZLUOBGJFSA-N 0.000 description 1
- JEPNLGMEZMCFEX-QSFUFRPTSA-N Ala-His-Ile Chemical compound CC[C@H](C)[C@@H](C(=O)O)NC(=O)[C@H](CC1=CN=CN1)NC(=O)[C@H](C)N JEPNLGMEZMCFEX-QSFUFRPTSA-N 0.000 description 1
- NMXKFWOEASXOGB-QSFUFRPTSA-N Ala-Ile-His Chemical compound C[C@H](N)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@H](C(O)=O)CC1=CN=CN1 NMXKFWOEASXOGB-QSFUFRPTSA-N 0.000 description 1
- SUMYEVXWCAYLLJ-GUBZILKMSA-N Ala-Leu-Gln Chemical compound [H]N[C@@H](C)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCC(N)=O)C(O)=O SUMYEVXWCAYLLJ-GUBZILKMSA-N 0.000 description 1
- MNZHHDPWDWQJCQ-YUMQZZPRSA-N Ala-Leu-Gly Chemical compound C[C@H](N)C(=O)N[C@@H](CC(C)C)C(=O)NCC(O)=O MNZHHDPWDWQJCQ-YUMQZZPRSA-N 0.000 description 1
- MDNAVFBZPROEHO-UHFFFAOYSA-N Ala-Lys-Val Natural products CC(C)C(C(O)=O)NC(=O)C(NC(=O)C(C)N)CCCCN MDNAVFBZPROEHO-UHFFFAOYSA-N 0.000 description 1
- RTZCUEHYUQZIDE-WHFBIAKZSA-N Ala-Ser-Gly Chemical compound C[C@H](N)C(=O)N[C@@H](CO)C(=O)NCC(O)=O RTZCUEHYUQZIDE-WHFBIAKZSA-N 0.000 description 1
- DHONNEYAZPNGSG-UBHSHLNASA-N Ala-Val-Phe Chemical compound C[C@H](N)C(=O)N[C@@H](C(C)C)C(=O)N[C@H](C(O)=O)CC1=CC=CC=C1 DHONNEYAZPNGSG-UBHSHLNASA-N 0.000 description 1
- 102100021569 Apoptosis regulator Bcl-2 Human genes 0.000 description 1
- 241001489705 Aquarius Species 0.000 description 1
- GIVATXIGCXFQQA-FXQIFTODSA-N Arg-Ala-Ser Chemical compound OC[C@@H](C(O)=O)NC(=O)[C@H](C)NC(=O)[C@@H](N)CCCN=C(N)N GIVATXIGCXFQQA-FXQIFTODSA-N 0.000 description 1
- HQIZDMIGUJOSNI-IUCAKERBSA-N Arg-Gly-Arg Chemical compound N[C@@H](CCCNC(N)=N)C(=O)NCC(=O)N[C@@H](CCCNC(N)=N)C(O)=O HQIZDMIGUJOSNI-IUCAKERBSA-N 0.000 description 1
- MJINRRBEMOLJAK-DCAQKATOSA-N Arg-Lys-Asp Chemical compound OC(=O)C[C@@H](C(O)=O)NC(=O)[C@H](CCCCN)NC(=O)[C@@H](N)CCCN=C(N)N MJINRRBEMOLJAK-DCAQKATOSA-N 0.000 description 1
- BNYNOWJESJJIOI-XUXIUFHCSA-N Arg-Lys-Ile Chemical compound CC[C@H](C)[C@@H](C(=O)O)NC(=O)[C@H](CCCCN)NC(=O)[C@H](CCCN=C(N)N)N BNYNOWJESJJIOI-XUXIUFHCSA-N 0.000 description 1
- YNDLOUMBVDVALC-ZLUOBGJFSA-N Asn-Ala-Ala Chemical compound C[C@@H](C(=O)N[C@@H](C)C(=O)O)NC(=O)[C@H](CC(=O)N)N YNDLOUMBVDVALC-ZLUOBGJFSA-N 0.000 description 1
- JRVABKHPWDRUJF-UBHSHLNASA-N Asn-Asn-Trp Chemical compound C1=CC=C2C(=C1)C(=CN2)C[C@@H](C(=O)O)NC(=O)[C@H](CC(=O)N)NC(=O)[C@H](CC(=O)N)N JRVABKHPWDRUJF-UBHSHLNASA-N 0.000 description 1
- OLGCWMNDJTWQAG-GUBZILKMSA-N Asn-Glu-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@H](CCC(O)=O)NC(=O)[C@@H](N)CC(N)=O OLGCWMNDJTWQAG-GUBZILKMSA-N 0.000 description 1
- WONGRTVAMHFGBE-WDSKDSINSA-N Asn-Gly-Gln Chemical compound C(CC(=O)N)[C@@H](C(=O)O)NC(=O)CNC(=O)[C@H](CC(=O)N)N WONGRTVAMHFGBE-WDSKDSINSA-N 0.000 description 1
- HDHZCEDPLTVHFZ-GUBZILKMSA-N Asn-Leu-Glu Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCC(O)=O)C(O)=O HDHZCEDPLTVHFZ-GUBZILKMSA-N 0.000 description 1
- WIDVAWAQBRAKTI-YUMQZZPRSA-N Asn-Leu-Gly Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CC(C)C)C(=O)NCC(O)=O WIDVAWAQBRAKTI-YUMQZZPRSA-N 0.000 description 1
- NLDNNZKUSLAYFW-NHCYSSNCSA-N Asn-Lys-Val Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](C(C)C)C(O)=O NLDNNZKUSLAYFW-NHCYSSNCSA-N 0.000 description 1
- UGXYFDQFLVCDFC-CIUDSAMLSA-N Asn-Ser-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@H](CO)NC(=O)[C@@H](N)CC(N)=O UGXYFDQFLVCDFC-CIUDSAMLSA-N 0.000 description 1
- XHTUGJCAEYOZOR-UBHSHLNASA-N Asn-Ser-Trp Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CO)C(=O)N[C@@H](CC1=CNC2=C1C=CC=C2)C(O)=O XHTUGJCAEYOZOR-UBHSHLNASA-N 0.000 description 1
- RKXVTTIQNKPCHU-KKHAAJSZSA-N Asp-Val-Thr Chemical compound C[C@@H](O)[C@@H](C(O)=O)NC(=O)[C@H](C(C)C)NC(=O)[C@@H](N)CC(O)=O RKXVTTIQNKPCHU-KKHAAJSZSA-N 0.000 description 1
- JGLWFWXGOINXEA-YDHLFZDLSA-N Asp-Val-Tyr Chemical compound OC(=O)C[C@H](N)C(=O)N[C@@H](C(C)C)C(=O)N[C@H](C(O)=O)CC1=CC=C(O)C=C1 JGLWFWXGOINXEA-YDHLFZDLSA-N 0.000 description 1
- 241000228212 Aspergillus Species 0.000 description 1
- 108700000712 BH3 Interacting Domain Death Agonist Proteins 0.000 description 1
- 102000055105 BH3 Interacting Domain Death Agonist Human genes 0.000 description 1
- 108091007065 BIRCs Proteins 0.000 description 1
- 231100000699 Bacterial toxin Toxicity 0.000 description 1
- 206010005003 Bladder cancer Diseases 0.000 description 1
- 238000009010 Bradford assay Methods 0.000 description 1
- 208000003174 Brain Neoplasms Diseases 0.000 description 1
- 206010006187 Breast cancer Diseases 0.000 description 1
- 208000026310 Breast neoplasm Diseases 0.000 description 1
- 102100025752 CASP8 and FADD-like apoptosis regulator Human genes 0.000 description 1
- BHPQYMZQTOCNFJ-UHFFFAOYSA-N Calcium cation Chemical compound [Ca+2] BHPQYMZQTOCNFJ-UHFFFAOYSA-N 0.000 description 1
- KLWPJMFMVPTNCC-UHFFFAOYSA-N Camptothecin Natural products CCC1(O)C(=O)OCC2=C1C=C3C4Nc5ccccc5C=C4CN3C2=O KLWPJMFMVPTNCC-UHFFFAOYSA-N 0.000 description 1
- 102000014914 Carrier Proteins Human genes 0.000 description 1
- 108010070951 CcdBET2 Proteins 0.000 description 1
- 102000000844 Cell Surface Receptors Human genes 0.000 description 1
- 108010001857 Cell Surface Receptors Proteins 0.000 description 1
- 102000019034 Chemokines Human genes 0.000 description 1
- 108010012236 Chemokines Proteins 0.000 description 1
- 108010035563 Chloramphenicol O-acetyltransferase Proteins 0.000 description 1
- 108010035532 Collagen Proteins 0.000 description 1
- 102000008186 Collagen Human genes 0.000 description 1
- 208000001333 Colorectal Neoplasms Diseases 0.000 description 1
- 101800004637 Communis Proteins 0.000 description 1
- 102000003903 Cyclin-dependent kinases Human genes 0.000 description 1
- 108090000266 Cyclin-dependent kinases Proteins 0.000 description 1
- CVOZXIPULQQFNY-ZLUOBGJFSA-N Cys-Ala-Cys Chemical compound C[C@H](NC(=O)[C@@H](N)CS)C(=O)N[C@@H](CS)C(O)=O CVOZXIPULQQFNY-ZLUOBGJFSA-N 0.000 description 1
- NAPULYCVEVVFRB-HEIBUPTGSA-N Cys-Thr-Thr Chemical compound C[C@@H](O)[C@@H](C(O)=O)NC(=O)[C@H]([C@@H](C)O)NC(=O)[C@@H](N)CS NAPULYCVEVVFRB-HEIBUPTGSA-N 0.000 description 1
- 102100030497 Cytochrome c Human genes 0.000 description 1
- 108010075031 Cytochromes c Proteins 0.000 description 1
- 230000007023 DNA restriction-modification system Effects 0.000 description 1
- BWGNESOTFCXPMA-UHFFFAOYSA-N Dihydrogen disulfide Chemical compound SS BWGNESOTFCXPMA-UHFFFAOYSA-N 0.000 description 1
- MWWSFMDVAYGXBV-RUELKSSGSA-N Doxorubicin hydrochloride Chemical compound Cl.O([C@H]1C[C@@](O)(CC=2C(O)=C3C(=O)C=4C=CC=C(C=4C(=O)C3=C(O)C=21)OC)C(=O)CO)[C@H]1C[C@H](N)[C@H](O)[C@H](C)O1 MWWSFMDVAYGXBV-RUELKSSGSA-N 0.000 description 1
- 102100037024 E3 ubiquitin-protein ligase XIAP Human genes 0.000 description 1
- 102100031780 Endonuclease Human genes 0.000 description 1
- 108010042407 Endonucleases Proteins 0.000 description 1
- 102100030013 Endoribonuclease Human genes 0.000 description 1
- 108010093099 Endoribonucleases Proteins 0.000 description 1
- 108010037362 Extracellular Matrix Proteins Proteins 0.000 description 1
- 102000010834 Extracellular Matrix Proteins Human genes 0.000 description 1
- 108700007698 Genetic Terminator Regions Proteins 0.000 description 1
- ZBKUIQNCRIYVGH-SDDRHHMPSA-N Gln-Leu-Pro Chemical compound CC(C)C[C@@H](C(=O)N1CCC[C@@H]1C(=O)O)NC(=O)[C@H](CCC(=O)N)N ZBKUIQNCRIYVGH-SDDRHHMPSA-N 0.000 description 1
- RWCBJYUPAUTWJD-NHCYSSNCSA-N Gln-Met-Val Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H](CCSC)C(=O)N[C@@H](C(C)C)C(O)=O RWCBJYUPAUTWJD-NHCYSSNCSA-N 0.000 description 1
- UEILCTONAMOGBR-RWRJDSDZSA-N Gln-Thr-Ile Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O UEILCTONAMOGBR-RWRJDSDZSA-N 0.000 description 1
- KBKGRMNVKPSQIF-XDTLVQLUSA-N Glu-Ala-Tyr Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](C)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(O)=O KBKGRMNVKPSQIF-XDTLVQLUSA-N 0.000 description 1
- ZWABFSSWTSAMQN-KBIXCLLPSA-N Glu-Ile-Ala Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](C)C(O)=O ZWABFSSWTSAMQN-KBIXCLLPSA-N 0.000 description 1
- HVYWQYLBVXMXSV-GUBZILKMSA-N Glu-Leu-Ala Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](C)C(O)=O HVYWQYLBVXMXSV-GUBZILKMSA-N 0.000 description 1
- ATVYZJGOZLVXDK-IUCAKERBSA-N Glu-Leu-Gly Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(C)C)C(=O)NCC(O)=O ATVYZJGOZLVXDK-IUCAKERBSA-N 0.000 description 1
- OCJRHJZKGGSPRW-IUCAKERBSA-N Glu-Lys-Gly Chemical compound NCCCC[C@@H](C(=O)NCC(O)=O)NC(=O)[C@@H](N)CCC(O)=O OCJRHJZKGGSPRW-IUCAKERBSA-N 0.000 description 1
- QCMVGXDELYMZET-GLLZPBPUSA-N Glu-Thr-Glu Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCC(O)=O)C(O)=O QCMVGXDELYMZET-GLLZPBPUSA-N 0.000 description 1
- KXRORHJIRAOQPG-SOUVJXGZSA-N Glu-Tyr-Pro Chemical compound C1C[C@@H](N(C1)C(=O)[C@H](CC2=CC=C(C=C2)O)NC(=O)[C@H](CCC(=O)O)N)C(=O)O KXRORHJIRAOQPG-SOUVJXGZSA-N 0.000 description 1
- XBWMTPAIUQIWKA-BYULHYEWSA-N Gly-Asp-Ile Chemical compound CC[C@H](C)[C@@H](C(O)=O)NC(=O)[C@H](CC(O)=O)NC(=O)CN XBWMTPAIUQIWKA-BYULHYEWSA-N 0.000 description 1
- CEXINUGNTZFNRY-BYPYZUCNSA-N Gly-Cys-Gly Chemical compound [NH3+]CC(=O)N[C@@H](CS)C(=O)NCC([O-])=O CEXINUGNTZFNRY-BYPYZUCNSA-N 0.000 description 1
- YYPFZVIXAVDHIK-IUCAKERBSA-N Gly-Glu-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](CCC(O)=O)NC(=O)CN YYPFZVIXAVDHIK-IUCAKERBSA-N 0.000 description 1
- IDOGEHIWMJMAHT-BYPYZUCNSA-N Gly-Gly-Cys Chemical compound NCC(=O)NCC(=O)N[C@@H](CS)C(O)=O IDOGEHIWMJMAHT-BYPYZUCNSA-N 0.000 description 1
- AFWYPMDMDYCKMD-KBPBESRZSA-N Gly-Leu-Tyr Chemical compound NCC(=O)N[C@@H](CC(C)C)C(=O)N[C@H](C(O)=O)CC1=CC=C(O)C=C1 AFWYPMDMDYCKMD-KBPBESRZSA-N 0.000 description 1
- BCCRXDTUTZHDEU-VKHMYHEASA-N Gly-Ser Chemical compound NCC(=O)N[C@@H](CO)C(O)=O BCCRXDTUTZHDEU-VKHMYHEASA-N 0.000 description 1
- JSLVAHYTAJJEQH-QWRGUYRKSA-N Gly-Ser-Phe Chemical compound NCC(=O)N[C@@H](CO)C(=O)N[C@H](C(O)=O)CC1=CC=CC=C1 JSLVAHYTAJJEQH-QWRGUYRKSA-N 0.000 description 1
- 102000003886 Glycoproteins Human genes 0.000 description 1
- 108090000288 Glycoproteins Proteins 0.000 description 1
- 102000001398 Granzyme Human genes 0.000 description 1
- 108060005986 Granzyme Proteins 0.000 description 1
- 108010043121 Green Fluorescent Proteins Proteins 0.000 description 1
- 102000004144 Green Fluorescent Proteins Human genes 0.000 description 1
- JBCLFWXMTIKCCB-UHFFFAOYSA-N H-Gly-Phe-OH Natural products NCC(=O)NC(C(O)=O)CC1=CC=CC=C1 JBCLFWXMTIKCCB-UHFFFAOYSA-N 0.000 description 1
- 241000238631 Hexapoda Species 0.000 description 1
- SKYULSWNBYAQMG-IHRRRGAJSA-N His-Leu-Arg Chemical compound [H]N[C@@H](CC1=CNC=N1)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCCNC(N)=N)C(O)=O SKYULSWNBYAQMG-IHRRRGAJSA-N 0.000 description 1
- 241000282412 Homo Species 0.000 description 1
- 101000971171 Homo sapiens Apoptosis regulator Bcl-2 Proteins 0.000 description 1
- 101000914211 Homo sapiens CASP8 and FADD-like apoptosis regulator Proteins 0.000 description 1
- 101000611183 Homo sapiens Tumor necrosis factor Proteins 0.000 description 1
- 101000610602 Homo sapiens Tumor necrosis factor receptor superfamily member 10C Proteins 0.000 description 1
- 229920002153 Hydroxypropyl cellulose Polymers 0.000 description 1
- UKTUOMWSJPXODT-GUDRVLHUSA-N Ile-Asn-Pro Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CC(=O)N)C(=O)N1CCC[C@@H]1C(=O)O)N UKTUOMWSJPXODT-GUDRVLHUSA-N 0.000 description 1
- YBGTWSFIGHUWQE-MXAVVETBSA-N Ile-His-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@@H](NC(=O)[C@@H](N)[C@@H](C)CC)CC1=CN=CN1 YBGTWSFIGHUWQE-MXAVVETBSA-N 0.000 description 1
- NURNJECQNNCRBK-FLBSBUHZSA-N Ile-Thr-Thr Chemical compound CC[C@H](C)[C@H](N)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H]([C@@H](C)O)C(O)=O NURNJECQNNCRBK-FLBSBUHZSA-N 0.000 description 1
- 108060003951 Immunoglobulin Proteins 0.000 description 1
- 102000015696 Interleukins Human genes 0.000 description 1
- 108010063738 Interleukins Proteins 0.000 description 1
- 208000008839 Kidney Neoplasms Diseases 0.000 description 1
- 229930064664 L-arginine Natural products 0.000 description 1
- 235000014852 L-arginine Nutrition 0.000 description 1
- ODKSFYDXXFIFQN-BYPYZUCNSA-P L-argininium(2+) Chemical compound NC(=[NH2+])NCCC[C@H]([NH3+])C(O)=O ODKSFYDXXFIFQN-BYPYZUCNSA-P 0.000 description 1
- CKLJMWTZIZZHCS-REOHCLBHSA-N L-aspartic acid Chemical compound OC(=O)[C@@H](N)CC(O)=O CKLJMWTZIZZHCS-REOHCLBHSA-N 0.000 description 1
- 125000000415 L-cysteinyl group Chemical group O=C([*])[C@@](N([H])[H])([H])C([H])([H])S[H] 0.000 description 1
- WHUUTDBJXJRKMK-VKHMYHEASA-N L-glutamic acid Chemical compound OC(=O)[C@@H](N)CCC(O)=O WHUUTDBJXJRKMK-VKHMYHEASA-N 0.000 description 1
- HNDVDQJCIGZPNO-YFKPBYRVSA-N L-histidine Chemical compound OC(=O)[C@@H](N)CC1=CN=CN1 HNDVDQJCIGZPNO-YFKPBYRVSA-N 0.000 description 1
- ROHFNLRQFUQHCH-YFKPBYRVSA-N L-leucine Chemical compound CC(C)C[C@H](N)C(O)=O ROHFNLRQFUQHCH-YFKPBYRVSA-N 0.000 description 1
- KDXKERNSBIXSRK-YFKPBYRVSA-N L-lysine Chemical compound NCCCC[C@H](N)C(O)=O KDXKERNSBIXSRK-YFKPBYRVSA-N 0.000 description 1
- 125000000174 L-prolyl group Chemical group [H]N1C([H])([H])C([H])([H])C([H])([H])[C@@]1([H])C(*)=O 0.000 description 1
- KZSNJWFQEVHDMF-BYPYZUCNSA-N L-valine Chemical group CC(C)[C@H](N)C(O)=O KZSNJWFQEVHDMF-BYPYZUCNSA-N 0.000 description 1
- 108010085895 Laminin Proteins 0.000 description 1
- 102000007547 Laminin Human genes 0.000 description 1
- HBJZFCIVFIBNSV-DCAQKATOSA-N Leu-Arg-Asn Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H](CCCN=C(N)N)C(=O)N[C@@H](CC(N)=O)C(O)=O HBJZFCIVFIBNSV-DCAQKATOSA-N 0.000 description 1
- MYGQXVYRZMKRDB-SRVKXCTJSA-N Leu-Asp-Lys Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@H](C(O)=O)CCCCN MYGQXVYRZMKRDB-SRVKXCTJSA-N 0.000 description 1
- LAGPXKYZCCTSGQ-JYJNAYRXSA-N Leu-Glu-Phe Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC1=CC=CC=C1)C(O)=O LAGPXKYZCCTSGQ-JYJNAYRXSA-N 0.000 description 1
- HRTRLSRYZZKPCO-BJDJZHNGSA-N Leu-Ile-Ser Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CO)C(O)=O HRTRLSRYZZKPCO-BJDJZHNGSA-N 0.000 description 1
- JKSIBWITFMQTOA-XUXIUFHCSA-N Leu-Ile-Val Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](C(C)C)C(O)=O JKSIBWITFMQTOA-XUXIUFHCSA-N 0.000 description 1
- QNTJIDXQHWUBKC-BZSNNMDCSA-N Leu-Lys-Phe Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CC1=CC=CC=C1)C(O)=O QNTJIDXQHWUBKC-BZSNNMDCSA-N 0.000 description 1
- BRTVHXHCUSXYRI-CIUDSAMLSA-N Leu-Ser-Ser Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H](CO)C(=O)N[C@@H](CO)C(O)=O BRTVHXHCUSXYRI-CIUDSAMLSA-N 0.000 description 1
- CGHXMODRYJISSK-NHCYSSNCSA-N Leu-Val-Asp Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H](C(C)C)C(=O)N[C@H](C(O)=O)CC(O)=O CGHXMODRYJISSK-NHCYSSNCSA-N 0.000 description 1
- ROHFNLRQFUQHCH-UHFFFAOYSA-N Leucine Natural products CC(C)CC(N)C(O)=O ROHFNLRQFUQHCH-UHFFFAOYSA-N 0.000 description 1
- 108060001084 Luciferase Proteins 0.000 description 1
- 239000005089 Luciferase Substances 0.000 description 1
- 235000010689 Lufa Nutrition 0.000 description 1
- 244000302544 Luffa aegyptiaca Species 0.000 description 1
- 235000009814 Luffa aegyptiaca Nutrition 0.000 description 1
- 239000006142 Luria-Bertani Agar Substances 0.000 description 1
- WALVCOOOKULCQM-ULQDDVLXSA-N Lys-Arg-Phe Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC1=CC=CC=C1)C(O)=O WALVCOOOKULCQM-ULQDDVLXSA-N 0.000 description 1
- FLCMXEFCTLXBTL-DCAQKATOSA-N Lys-Asp-Arg Chemical compound C(CCN)C[C@@H](C(=O)N[C@@H](CC(=O)O)C(=O)N[C@@H](CCCN=C(N)N)C(=O)O)N FLCMXEFCTLXBTL-DCAQKATOSA-N 0.000 description 1
- CANPXOLVTMKURR-WEDXCCLWSA-N Lys-Gly-Thr Chemical compound C[C@@H](O)[C@@H](C(O)=O)NC(=O)CNC(=O)[C@@H](N)CCCCN CANPXOLVTMKURR-WEDXCCLWSA-N 0.000 description 1
- XIZQPFCRXLUNMK-BZSNNMDCSA-N Lys-Leu-Phe Chemical compound CC(C)C[C@@H](C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)O)NC(=O)[C@H](CCCCN)N XIZQPFCRXLUNMK-BZSNNMDCSA-N 0.000 description 1
- LJADEBULDNKJNK-IHRRRGAJSA-N Lys-Leu-Val Chemical compound CC(C)C[C@H](NC(=O)[C@@H](N)CCCCN)C(=O)N[C@@H](C(C)C)C(O)=O LJADEBULDNKJNK-IHRRRGAJSA-N 0.000 description 1
- IPTUBUUIFRZMJK-ACRUOGEOSA-N Lys-Phe-Phe Chemical compound C([C@H](NC(=O)[C@@H](N)CCCCN)C(=O)N[C@@H](CC=1C=CC=CC=1)C(O)=O)C1=CC=CC=C1 IPTUBUUIFRZMJK-ACRUOGEOSA-N 0.000 description 1
- OBZHNHBAAVEWKI-DCAQKATOSA-N Lys-Pro-Asn Chemical compound NCCCC[C@H](N)C(=O)N1CCC[C@H]1C(=O)N[C@@H](CC(N)=O)C(O)=O OBZHNHBAAVEWKI-DCAQKATOSA-N 0.000 description 1
- SBQDRNOLGSYHQA-YUMQZZPRSA-N Lys-Ser-Gly Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CO)C(=O)NCC(O)=O SBQDRNOLGSYHQA-YUMQZZPRSA-N 0.000 description 1
- DLCAXBGXGOVUCD-PPCPHDFISA-N Lys-Thr-Ile Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O DLCAXBGXGOVUCD-PPCPHDFISA-N 0.000 description 1
- VHTOGMKQXXJOHG-RHYQMDGZSA-N Lys-Thr-Val Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](C(C)C)C(O)=O VHTOGMKQXXJOHG-RHYQMDGZSA-N 0.000 description 1
- KTINOHQFVVCEGQ-XIRDDKMYSA-N Lys-Trp-Asp Chemical compound NCCCC[C@H](N)C(=O)N[C@@H](Cc1c[nH]c2ccccc12)C(=O)N[C@@H](CC(O)=O)C(O)=O KTINOHQFVVCEGQ-XIRDDKMYSA-N 0.000 description 1
- IMDJSVBFQKDDEQ-MGHWNKPDSA-N Lys-Tyr-Ile Chemical compound CC[C@H](C)[C@@H](C(=O)O)NC(=O)[C@H](CC1=CC=C(C=C1)O)NC(=O)[C@H](CCCCN)N IMDJSVBFQKDDEQ-MGHWNKPDSA-N 0.000 description 1
- VWPJQIHBBOJWDN-DCAQKATOSA-N Lys-Val-Ala Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](C)C(O)=O VWPJQIHBBOJWDN-DCAQKATOSA-N 0.000 description 1
- QLFAPXUXEBAWEK-NHCYSSNCSA-N Lys-Val-Asp Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CC(O)=O)C(O)=O QLFAPXUXEBAWEK-NHCYSSNCSA-N 0.000 description 1
- 231100000002 MTT assay Toxicity 0.000 description 1
- 238000000134 MTT assay Methods 0.000 description 1
- 102100021760 Magnesium transporter protein 1 Human genes 0.000 description 1
- 102000018697 Membrane Proteins Human genes 0.000 description 1
- 108010052285 Membrane Proteins Proteins 0.000 description 1
- SLQDSYZHHOKQSR-QXEWZRGKSA-N Met-Gly-Ile Chemical compound CC[C@H](C)[C@@H](C(O)=O)NC(=O)CNC(=O)[C@@H](N)CCSC SLQDSYZHHOKQSR-QXEWZRGKSA-N 0.000 description 1
- 102000005741 Metalloproteases Human genes 0.000 description 1
- 108010006035 Metalloproteases Proteins 0.000 description 1
- 206010027476 Metastases Diseases 0.000 description 1
- 241000551546 Minerva Species 0.000 description 1
- 235000009815 Momordica Nutrition 0.000 description 1
- 241000218984 Momordica Species 0.000 description 1
- 244000302512 Momordica charantia Species 0.000 description 1
- 235000009811 Momordica charantia Nutrition 0.000 description 1
- 208000003445 Mouth Neoplasms Diseases 0.000 description 1
- 231100000678 Mycotoxin Toxicity 0.000 description 1
- SITLTJHOQZFJGG-UHFFFAOYSA-N N-L-alpha-glutamyl-L-valine Natural products CC(C)C(C(O)=O)NC(=O)C(N)CCC(O)=O SITLTJHOQZFJGG-UHFFFAOYSA-N 0.000 description 1
- KZNQNBZMBZJQJO-UHFFFAOYSA-N N-glycyl-L-proline Natural products NCC(=O)N1CCCC1C(O)=O KZNQNBZMBZJQJO-UHFFFAOYSA-N 0.000 description 1
- 238000011785 NMRI mouse Methods 0.000 description 1
- 206010067482 No adverse event Diseases 0.000 description 1
- 108010038807 Oligopeptides Proteins 0.000 description 1
- 102000015636 Oligopeptides Human genes 0.000 description 1
- 206010033128 Ovarian cancer Diseases 0.000 description 1
- 206010061535 Ovarian neoplasm Diseases 0.000 description 1
- 108090000854 Oxidoreductases Proteins 0.000 description 1
- 229930012538 Paclitaxel Natural products 0.000 description 1
- 108010033276 Peptide Fragments Proteins 0.000 description 1
- 102000007079 Peptide Fragments Human genes 0.000 description 1
- 244000137852 Petrea volubilis Species 0.000 description 1
- MIICYIIBVYQNKE-QEWYBTABSA-N Phe-Ile-Gln Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CCC(=O)N)C(=O)O)NC(=O)[C@H](CC1=CC=CC=C1)N MIICYIIBVYQNKE-QEWYBTABSA-N 0.000 description 1
- GPSMLZQVIIYLDK-ULQDDVLXSA-N Phe-Lys-Val Chemical compound [H]N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](C(C)C)C(O)=O GPSMLZQVIIYLDK-ULQDDVLXSA-N 0.000 description 1
- KIQUCMUULDXTAZ-HJOGWXRNSA-N Phe-Tyr-Tyr Chemical compound N[C@@H](Cc1ccccc1)C(=O)N[C@@H](Cc1ccc(O)cc1)C(=O)N[C@@H](Cc1ccc(O)cc1)C(O)=O KIQUCMUULDXTAZ-HJOGWXRNSA-N 0.000 description 1
- 101000582927 Photorhabdus laumondii subsp. laumondii (strain DSM 15139 / CIP 105565 / TT01) Lectin A Proteins 0.000 description 1
- 241001149098 Phytolacca dodecandra Species 0.000 description 1
- 231100000742 Plant toxin Toxicity 0.000 description 1
- 206010035226 Plasma cell myeloma Diseases 0.000 description 1
- 229920001213 Polysorbate 20 Polymers 0.000 description 1
- NMELOOXSGDRBRU-YUMQZZPRSA-N Pro-Glu-Gly Chemical compound OC(=O)CNC(=O)[C@H](CCC(=O)O)NC(=O)[C@@H]1CCCN1 NMELOOXSGDRBRU-YUMQZZPRSA-N 0.000 description 1
- HAEGAELAYWSUNC-WPRPVWTQSA-N Pro-Gly-Val Chemical compound [H]N1CCC[C@H]1C(=O)NCC(=O)N[C@@H](C(C)C)C(O)=O HAEGAELAYWSUNC-WPRPVWTQSA-N 0.000 description 1
- STGVYUTZKGPRCI-GUBZILKMSA-N Pro-Val-Cys Chemical compound SC[C@@H](C(O)=O)NC(=O)[C@H](C(C)C)NC(=O)[C@@H]1CCCN1 STGVYUTZKGPRCI-GUBZILKMSA-N 0.000 description 1
- 108700033844 Pseudomonas aeruginosa toxA Proteins 0.000 description 1
- 108010003201 RGH 0205 Proteins 0.000 description 1
- 206010038389 Renal cancer Diseases 0.000 description 1
- 108091007602 SLC58A1 Proteins 0.000 description 1
- 241000235070 Saccharomyces Species 0.000 description 1
- 241000293871 Salmonella enterica subsp. enterica serovar Typhi Species 0.000 description 1
- 241001136712 Sambucus ebulus Species 0.000 description 1
- 240000006028 Sambucus nigra Species 0.000 description 1
- 235000003142 Sambucus nigra Nutrition 0.000 description 1
- 240000003946 Saponaria officinalis Species 0.000 description 1
- YQHZVYJAGWMHES-ZLUOBGJFSA-N Ser-Ala-Ser Chemical compound OC[C@H](N)C(=O)N[C@@H](C)C(=O)N[C@@H](CO)C(O)=O YQHZVYJAGWMHES-ZLUOBGJFSA-N 0.000 description 1
- LTFSLKWFMWZEBD-IMJSIDKUSA-N Ser-Asn Chemical compound OC[C@H](N)C(=O)N[C@H](C(O)=O)CC(N)=O LTFSLKWFMWZEBD-IMJSIDKUSA-N 0.000 description 1
- FIDMVVBUOCMMJG-CIUDSAMLSA-N Ser-Asn-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](CC(N)=O)NC(=O)[C@@H](N)CO FIDMVVBUOCMMJG-CIUDSAMLSA-N 0.000 description 1
- UGJRQLURDVGULT-LKXGYXEUSA-N Ser-Asn-Thr Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H]([C@@H](C)O)C(O)=O UGJRQLURDVGULT-LKXGYXEUSA-N 0.000 description 1
- KNZQGAUEYZJUSQ-ZLUOBGJFSA-N Ser-Asp-Ala Chemical compound C[C@@H](C(=O)O)NC(=O)[C@H](CC(=O)O)NC(=O)[C@H](CO)N KNZQGAUEYZJUSQ-ZLUOBGJFSA-N 0.000 description 1
- YPUSXTWURJANKF-KBIXCLLPSA-N Ser-Gln-Ile Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O YPUSXTWURJANKF-KBIXCLLPSA-N 0.000 description 1
- SMIDBHKWSYUBRZ-ACZMJKKPSA-N Ser-Glu-Ala Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](C)C(O)=O SMIDBHKWSYUBRZ-ACZMJKKPSA-N 0.000 description 1
- IXCHOHLPHNGFTJ-YUMQZZPRSA-N Ser-Gly-His Chemical compound C1=C(NC=N1)C[C@@H](C(=O)O)NC(=O)CNC(=O)[C@H](CO)N IXCHOHLPHNGFTJ-YUMQZZPRSA-N 0.000 description 1
- DJACUBDEDBZKLQ-KBIXCLLPSA-N Ser-Ile-Glu Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CCC(O)=O)C(O)=O DJACUBDEDBZKLQ-KBIXCLLPSA-N 0.000 description 1
- UPLYXVPQLJVWMM-KKUMJFAQSA-N Ser-Phe-Leu Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CC(C)C)C(O)=O UPLYXVPQLJVWMM-KKUMJFAQSA-N 0.000 description 1
- PJIQEIFXZPCWOJ-FXQIFTODSA-N Ser-Pro-Asp Chemical compound [H]N[C@@H](CO)C(=O)N1CCC[C@H]1C(=O)N[C@@H](CC(O)=O)C(O)=O PJIQEIFXZPCWOJ-FXQIFTODSA-N 0.000 description 1
- WNDUPCKKKGSKIQ-CIUDSAMLSA-N Ser-Pro-Gln Chemical compound OC[C@H](N)C(=O)N1CCC[C@H]1C(=O)N[C@@H](CCC(N)=O)C(O)=O WNDUPCKKKGSKIQ-CIUDSAMLSA-N 0.000 description 1
- KQNDIKOYWZTZIX-FXQIFTODSA-N Ser-Ser-Arg Chemical compound OC[C@H](N)C(=O)N[C@@H](CO)C(=O)N[C@H](C(O)=O)CCCNC(N)=N KQNDIKOYWZTZIX-FXQIFTODSA-N 0.000 description 1
- VEVYMLNYMULSMS-AVGNSLFASA-N Ser-Tyr-Gln Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CCC(N)=O)C(O)=O VEVYMLNYMULSMS-AVGNSLFASA-N 0.000 description 1
- 102220599431 Serum amyloid A-1 protein_V70A_mutation Human genes 0.000 description 1
- 101710154250 Small basic protein Proteins 0.000 description 1
- 108091007178 TNFRSF10A Proteins 0.000 description 1
- IRKWVRSEQFTGGV-VEVYYDQMSA-N Thr-Asn-Arg Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CCCNC(N)=N)C(O)=O IRKWVRSEQFTGGV-VEVYYDQMSA-N 0.000 description 1
- KBBRNEDOYWMIJP-KYNKHSRBSA-N Thr-Gly-Thr Chemical compound C[C@H]([C@@H](C(=O)NCC(=O)N[C@@H]([C@@H](C)O)C(=O)O)N)O KBBRNEDOYWMIJP-KYNKHSRBSA-N 0.000 description 1
- WYLAVUAWOUVUCA-XVSYOHENSA-N Thr-Phe-Asp Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CC(O)=O)C(O)=O WYLAVUAWOUVUCA-XVSYOHENSA-N 0.000 description 1
- IQPWNQRRAJHOKV-KATARQTJSA-N Thr-Ser-Lys Chemical compound C[C@@H](O)[C@H](N)C(=O)N[C@@H](CO)C(=O)N[C@H](C(O)=O)CCCCN IQPWNQRRAJHOKV-KATARQTJSA-N 0.000 description 1
- 102000004338 Transferrin Human genes 0.000 description 1
- 108090000901 Transferrin Proteins 0.000 description 1
- 240000006567 Trichosanthes anguina Species 0.000 description 1
- 235000008326 Trichosanthes anguina Nutrition 0.000 description 1
- 240000006023 Trichosanthes kirilowii Species 0.000 description 1
- 235000009818 Trichosanthes kirilowii Nutrition 0.000 description 1
- MXKUGFHWYYKVDV-SZMVWBNQSA-N Trp-Val-Val Chemical compound CC(C)[C@H](NC(=O)[C@@H](NC(=O)[C@@H](N)Cc1c[nH]c2ccccc12)C(C)C)C(O)=O MXKUGFHWYYKVDV-SZMVWBNQSA-N 0.000 description 1
- 108060008682 Tumor Necrosis Factor Proteins 0.000 description 1
- 108060008683 Tumor Necrosis Factor Receptor Proteins 0.000 description 1
- 102100040247 Tumor necrosis factor Human genes 0.000 description 1
- 102100040115 Tumor necrosis factor receptor superfamily member 10C Human genes 0.000 description 1
- 108010061360 Type 1 Ribosome Inactivating Proteins Proteins 0.000 description 1
- ZNFPUOSTMUMUDR-JRQIVUDYSA-N Tyr-Asn-Thr Chemical compound [H]N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H]([C@@H](C)O)C(O)=O ZNFPUOSTMUMUDR-JRQIVUDYSA-N 0.000 description 1
- NGALWFGCOMHUSN-AVGNSLFASA-N Tyr-Gln-Asp Chemical compound [H]N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CC(O)=O)C(O)=O NGALWFGCOMHUSN-AVGNSLFASA-N 0.000 description 1
- 208000007097 Urinary Bladder Neoplasms Diseases 0.000 description 1
- SLLKXDSRVAOREO-KZVJFYERSA-N Val-Ala-Thr Chemical compound C[C@H]([C@@H](C(=O)O)NC(=O)[C@H](C)NC(=O)[C@H](C(C)C)N)O SLLKXDSRVAOREO-KZVJFYERSA-N 0.000 description 1
- XQVRMLRMTAGSFJ-QXEWZRGKSA-N Val-Asp-Arg Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CC(=O)O)C(=O)N[C@@H](CCCN=C(N)N)C(=O)O)N XQVRMLRMTAGSFJ-QXEWZRGKSA-N 0.000 description 1
- KNYHAWKHFQRYOX-PYJNHQTQSA-N Val-Ile-His Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CC1=CN=CN1)C(=O)O)NC(=O)[C@H](C(C)C)N KNYHAWKHFQRYOX-PYJNHQTQSA-N 0.000 description 1
- MIKHIIQMRFYVOR-RCWTZXSCSA-N Val-Pro-Thr Chemical compound C[C@H]([C@@H](C(=O)O)NC(=O)[C@@H]1CCCN1C(=O)[C@H](C(C)C)N)O MIKHIIQMRFYVOR-RCWTZXSCSA-N 0.000 description 1
- QZKVWWIUSQGWMY-IHRRRGAJSA-N Val-Ser-Phe Chemical compound CC(C)[C@H](N)C(=O)N[C@@H](CO)C(=O)N[C@H](C(O)=O)CC1=CC=CC=C1 QZKVWWIUSQGWMY-IHRRRGAJSA-N 0.000 description 1
- RLVTVHSDKHBFQP-ULQDDVLXSA-N Val-Tyr-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@@H](NC(=O)[C@@H](N)C(C)C)CC1=CC=C(O)C=C1 RLVTVHSDKHBFQP-ULQDDVLXSA-N 0.000 description 1
- AEFJNECXZCODJM-UWVGGRQHSA-N Val-Val-Gly Chemical compound CC(C)[C@H]([NH3+])C(=O)N[C@@H](C(C)C)C(=O)NCC([O-])=O AEFJNECXZCODJM-UWVGGRQHSA-N 0.000 description 1
- KZSNJWFQEVHDMF-UHFFFAOYSA-N Valine Natural products CC(C)C(N)C(O)=O KZSNJWFQEVHDMF-UHFFFAOYSA-N 0.000 description 1
- 102000005789 Vascular Endothelial Growth Factors Human genes 0.000 description 1
- 108010019530 Vascular Endothelial Growth Factors Proteins 0.000 description 1
- 241000700605 Viruses Species 0.000 description 1
- 241000221013 Viscum album Species 0.000 description 1
- 108700031544 X-Linked Inhibitor of Apoptosis Proteins 0.000 description 1
- 238000002835 absorbance Methods 0.000 description 1
- 230000003213 activating effect Effects 0.000 description 1
- 239000012190 activator Substances 0.000 description 1
- 229960000643 adenine Drugs 0.000 description 1
- 230000001464 adherent effect Effects 0.000 description 1
- 150000001298 alcohols Chemical class 0.000 description 1
- 206010002224 anaplastic astrocytoma Diseases 0.000 description 1
- 230000006481 angiogenic pathway Effects 0.000 description 1
- 239000005557 antagonist Substances 0.000 description 1
- 230000000844 anti-bacterial effect Effects 0.000 description 1
- 238000011319 anticancer therapy Methods 0.000 description 1
- 229940034982 antineoplastic agent Drugs 0.000 description 1
- 229940041181 antineoplastic drug Drugs 0.000 description 1
- 230000003078 antioxidant effect Effects 0.000 description 1
- 239000003443 antiviral agent Substances 0.000 description 1
- 230000001640 apoptogenic effect Effects 0.000 description 1
- 239000012736 aqueous medium Substances 0.000 description 1
- 239000007864 aqueous solution Substances 0.000 description 1
- 125000000637 arginyl group Chemical group N[C@@H](CCCNC(N)=N)C(=O)* 0.000 description 1
- 108010062796 arginyllysine Proteins 0.000 description 1
- 108010010430 asparagine-proline-alanine Proteins 0.000 description 1
- 235000003704 aspartic acid Nutrition 0.000 description 1
- 239000010426 asphalt Substances 0.000 description 1
- 238000000376 autoradiography Methods 0.000 description 1
- VSRXQHXAPYXROS-UHFFFAOYSA-N azanide;cyclobutane-1,1-dicarboxylic acid;platinum(2+) Chemical compound [NH2-].[NH2-].[Pt+2].OC(=O)C1(C(O)=O)CCC1 VSRXQHXAPYXROS-UHFFFAOYSA-N 0.000 description 1
- 239000000688 bacterial toxin Substances 0.000 description 1
- PXXJHWLDUBFPOL-UHFFFAOYSA-N benzamidine Chemical compound NC(=N)C1=CC=CC=C1 PXXJHWLDUBFPOL-UHFFFAOYSA-N 0.000 description 1
- OQFSQFPPLPISGP-UHFFFAOYSA-N beta-carboxyaspartic acid Natural products OC(=O)C(N)C(C(O)=O)C(O)=O OQFSQFPPLPISGP-UHFFFAOYSA-N 0.000 description 1
- 108091008324 binding proteins Proteins 0.000 description 1
- 230000003115 biocidal effect Effects 0.000 description 1
- 230000029918 bioluminescence Effects 0.000 description 1
- 238000005415 bioluminescence Methods 0.000 description 1
- 230000033558 biomineral tissue development Effects 0.000 description 1
- 235000015895 biscuits Nutrition 0.000 description 1
- 210000004204 blood vessel Anatomy 0.000 description 1
- 210000001124 body fluid Anatomy 0.000 description 1
- 239000010839 body fluid Substances 0.000 description 1
- OQUUTERJWTYTHP-UHFFFAOYSA-N butanedioate;1h-tetrazol-1-ium Chemical compound [NH2+]1C=NN=N1.[NH2+]1C=NN=N1.[O-]C(=O)CCC([O-])=O OQUUTERJWTYTHP-UHFFFAOYSA-N 0.000 description 1
- 229910001424 calcium ion Inorganic materials 0.000 description 1
- VSJKWCGYPAHWDS-FQEVSTJZSA-N camptothecin Chemical compound C1=CC=C2C=C(CN3C4=CC5=C(C3=O)COC(=O)[C@]5(O)CC)C4=NC2=C1 VSJKWCGYPAHWDS-FQEVSTJZSA-N 0.000 description 1
- 229940127093 camptothecin Drugs 0.000 description 1
- 208000035269 cancer or benign tumor Diseases 0.000 description 1
- 150000001720 carbohydrates Chemical class 0.000 description 1
- 229960004562 carboplatin Drugs 0.000 description 1
- 125000003178 carboxy group Chemical group [H]OC(*)=O 0.000 description 1
- 239000006143 cell culture medium Substances 0.000 description 1
- 230000022131 cell cycle Effects 0.000 description 1
- 239000006285 cell suspension Substances 0.000 description 1
- 230000007248 cellular mechanism Effects 0.000 description 1
- 239000000919 ceramic Substances 0.000 description 1
- 238000012512 characterization method Methods 0.000 description 1
- 229960004926 chlorobutanol Drugs 0.000 description 1
- 239000011248 coating agent Substances 0.000 description 1
- 238000000576 coating method Methods 0.000 description 1
- 229920001436 collagen Polymers 0.000 description 1
- 238000007398 colorimetric assay Methods 0.000 description 1
- 238000002648 combination therapy Methods 0.000 description 1
- 230000021615 conjugation Effects 0.000 description 1
- 239000000470 constituent Substances 0.000 description 1
- 238000011254 conventional chemotherapy Methods 0.000 description 1
- 238000012258 culturing Methods 0.000 description 1
- 231100000433 cytotoxic Toxicity 0.000 description 1
- 230000003013 cytotoxicity Effects 0.000 description 1
- 231100000135 cytotoxicity Toxicity 0.000 description 1
- 238000002784 cytotoxicity assay Methods 0.000 description 1
- 238000007405 data analysis Methods 0.000 description 1
- 101150047356 dec-1 gene Proteins 0.000 description 1
- 108010025198 decaglycine Proteins 0.000 description 1
- 230000018044 dehydration Effects 0.000 description 1
- 238000006297 dehydration reaction Methods 0.000 description 1
- 238000004925 denaturation Methods 0.000 description 1
- 230000036425 denaturation Effects 0.000 description 1
- 230000030609 dephosphorylation Effects 0.000 description 1
- 238000006209 dephosphorylation reaction Methods 0.000 description 1
- 238000013461 design Methods 0.000 description 1
- 238000001514 detection method Methods 0.000 description 1
- 230000001627 detrimental effect Effects 0.000 description 1
- 238000000502 dialysis Methods 0.000 description 1
- 206010013023 diphtheria Diseases 0.000 description 1
- 239000006185 dispersion Substances 0.000 description 1
- 239000002612 dispersion medium Substances 0.000 description 1
- VSJKWCGYPAHWDS-UHFFFAOYSA-N dl-camptothecin Natural products C1=CC=C2C=C(CN3C4=CC5=C(C3=O)COC(=O)C5(O)CC)C4=NC2=C1 VSJKWCGYPAHWDS-UHFFFAOYSA-N 0.000 description 1
- 239000002552 dosage form Substances 0.000 description 1
- 229960002918 doxorubicin hydrochloride Drugs 0.000 description 1
- 229940079593 drug Drugs 0.000 description 1
- 230000009977 dual effect Effects 0.000 description 1
- 229950000317 dulanermin Drugs 0.000 description 1
- 230000005684 electric field Effects 0.000 description 1
- 238000005516 engineering process Methods 0.000 description 1
- 238000011067 equilibration Methods 0.000 description 1
- BEFDCLMNVWHSGT-UHFFFAOYSA-N ethenylcyclopentane Chemical compound C=CC1CCCC1 BEFDCLMNVWHSGT-UHFFFAOYSA-N 0.000 description 1
- 210000003527 eukaryotic cell Anatomy 0.000 description 1
- 235000008995 european elder Nutrition 0.000 description 1
- 230000001747 exhibiting effect Effects 0.000 description 1
- 210000002744 extracellular matrix Anatomy 0.000 description 1
- 235000013305 food Nutrition 0.000 description 1
- 230000002538 fungal effect Effects 0.000 description 1
- 230000004927 fusion Effects 0.000 description 1
- 239000010437 gem Substances 0.000 description 1
- 238000010353 genetic engineering Methods 0.000 description 1
- 235000013922 glutamic acid Nutrition 0.000 description 1
- 239000004220 glutamic acid Substances 0.000 description 1
- 108010049041 glutamylalanine Proteins 0.000 description 1
- 238000006206 glycosylation reaction Methods 0.000 description 1
- XBGGUPMXALFZOT-UHFFFAOYSA-N glycyl-L-tyrosine hemihydrate Natural products NCC(=O)NC(C(O)=O)CC1=CC=C(O)C=C1 XBGGUPMXALFZOT-UHFFFAOYSA-N 0.000 description 1
- 108010028188 glycyl-histidyl-serine Proteins 0.000 description 1
- 108010050475 glycyl-leucyl-tyrosine Proteins 0.000 description 1
- 108010074027 glycyl-seryl-phenylalanine Proteins 0.000 description 1
- 108010087823 glycyltyrosine Proteins 0.000 description 1
- 239000005090 green fluorescent protein Substances 0.000 description 1
- 230000009036 growth inhibition Effects 0.000 description 1
- 210000003494 hepatocyte Anatomy 0.000 description 1
- 231100000304 hepatotoxicity Toxicity 0.000 description 1
- 239000000833 heterodimer Substances 0.000 description 1
- 238000004896 high resolution mass spectrometry Methods 0.000 description 1
- 231100000086 high toxicity Toxicity 0.000 description 1
- 108010040030 histidinoalanine Proteins 0.000 description 1
- 125000000487 histidyl group Chemical group [H]N([H])C(C(=O)O*)C([H])([H])C1=C([H])N([H])C([H])=N1 0.000 description 1
- 108010036413 histidylglycine Proteins 0.000 description 1
- 230000007062 hydrolysis Effects 0.000 description 1
- 238000006460 hydrolysis reaction Methods 0.000 description 1
- 125000001165 hydrophobic group Chemical group 0.000 description 1
- 239000001863 hydroxypropyl cellulose Substances 0.000 description 1
- 235000010977 hydroxypropyl cellulose Nutrition 0.000 description 1
- 210000000987 immune system Anatomy 0.000 description 1
- 102000018358 immunoglobulin Human genes 0.000 description 1
- 229940051026 immunotoxin Drugs 0.000 description 1
- 231100000608 immunotoxin Toxicity 0.000 description 1
- 230000002637 immunotoxin Effects 0.000 description 1
- 230000000415 inactivating effect Effects 0.000 description 1
- 230000002779 inactivation Effects 0.000 description 1
- 239000003978 infusion fluid Substances 0.000 description 1
- 238000003780 insertion Methods 0.000 description 1
- 230000037431 insertion Effects 0.000 description 1
- 108010078376 interleukin 2-diphtheria toxin Proteins 0.000 description 1
- 238000007918 intramuscular administration Methods 0.000 description 1
- 238000007912 intraperitoneal administration Methods 0.000 description 1
- 230000002601 intratumoral effect Effects 0.000 description 1
- 230000002427 irreversible effect Effects 0.000 description 1
- 238000002955 isolation Methods 0.000 description 1
- 239000007951 isotonicity adjuster Substances 0.000 description 1
- 201000010982 kidney cancer Diseases 0.000 description 1
- 230000002147 killing effect Effects 0.000 description 1
- 239000000787 lecithin Substances 0.000 description 1
- 235000010445 lecithin Nutrition 0.000 description 1
- 229940067606 lecithin Drugs 0.000 description 1
- 208000032839 leukemia Diseases 0.000 description 1
- 208000012987 lip and oral cavity carcinoma Diseases 0.000 description 1
- 150000002632 lipids Chemical class 0.000 description 1
- 239000002502 liposome Substances 0.000 description 1
- 230000007056 liver toxicity Effects 0.000 description 1
- 239000008176 lyophilized powder Substances 0.000 description 1
- 230000002132 lysosomal effect Effects 0.000 description 1
- 230000010874 maintenance of protein location Effects 0.000 description 1
- 208000030883 malignant astrocytoma Diseases 0.000 description 1
- 238000004519 manufacturing process Methods 0.000 description 1
- 244000005700 microbiome Species 0.000 description 1
- 239000002480 mineral oil Substances 0.000 description 1
- 235000010446 mineral oil Nutrition 0.000 description 1
- 210000003470 mitochondria Anatomy 0.000 description 1
- 230000002438 mitochondrial effect Effects 0.000 description 1
- 238000010172 mouse model Methods 0.000 description 1
- 239000002636 mycotoxin Substances 0.000 description 1
- 201000000050 myeloid neoplasm Diseases 0.000 description 1
- 230000007935 neutral effect Effects 0.000 description 1
- 229910052759 nickel Inorganic materials 0.000 description 1
- HYWYRSMBCFDLJT-UHFFFAOYSA-N nimesulide Chemical compound CS(=O)(=O)NC1=CC=C([N+]([O-])=O)C=C1OC1=CC=CC=C1 HYWYRSMBCFDLJT-UHFFFAOYSA-N 0.000 description 1
- 229910052757 nitrogen Inorganic materials 0.000 description 1
- 208000002154 non-small cell lung carcinoma Diseases 0.000 description 1
- 230000009871 nonspecific binding Effects 0.000 description 1
- 230000003000 nontoxic effect Effects 0.000 description 1
- 102000039446 nucleic acids Human genes 0.000 description 1
- 108020004707 nucleic acids Proteins 0.000 description 1
- 150000007523 nucleic acids Chemical class 0.000 description 1
- 230000005693 optoelectronics Effects 0.000 description 1
- 210000000056 organ Anatomy 0.000 description 1
- 230000003647 oxidation Effects 0.000 description 1
- 238000007254 oxidation reaction Methods 0.000 description 1
- 229960001592 paclitaxel Drugs 0.000 description 1
- 239000002245 particle Substances 0.000 description 1
- 244000052769 pathogen Species 0.000 description 1
- 238000002823 phage display Methods 0.000 description 1
- 239000000546 pharmaceutical excipient Substances 0.000 description 1
- 108010073101 phenylalanylleucine Proteins 0.000 description 1
- 108010051242 phenylalanylserine Proteins 0.000 description 1
- 239000000902 placebo Substances 0.000 description 1
- 229940068196 placebo Drugs 0.000 description 1
- 239000003123 plant toxin Substances 0.000 description 1
- 229920002401 polyacrylamide Polymers 0.000 description 1
- 229920005862 polyol Polymers 0.000 description 1
- 150000003077 polyols Chemical class 0.000 description 1
- 239000000256 polyoxyethylene sorbitan monolaurate Substances 0.000 description 1
- 235000010486 polyoxyethylene sorbitan monolaurate Nutrition 0.000 description 1
- 229920000136 polysorbate Polymers 0.000 description 1
- 229950008882 polysorbate Drugs 0.000 description 1
- 239000000843 powder Substances 0.000 description 1
- 238000001556 precipitation Methods 0.000 description 1
- 230000002335 preservative effect Effects 0.000 description 1
- 125000002924 primary amino group Chemical group [H]N([H])* 0.000 description 1
- 210000001236 prokaryotic cell Anatomy 0.000 description 1
- 230000002035 prolonged effect Effects 0.000 description 1
- 230000000644 propagated effect Effects 0.000 description 1
- 210000002307 prostate Anatomy 0.000 description 1
- 230000007065 protein hydrolysis Effects 0.000 description 1
- 239000012460 protein solution Substances 0.000 description 1
- 125000000561 purinyl group Chemical group N1=C(N=C2N=CNC2=C1)* 0.000 description 1
- 239000001047 purple dye Substances 0.000 description 1
- 239000010453 quartz Substances 0.000 description 1
- 230000003439 radiotherapeutic effect Effects 0.000 description 1
- 238000001959 radiotherapy Methods 0.000 description 1
- 238000003259 recombinant expression Methods 0.000 description 1
- 230000002829 reductive effect Effects 0.000 description 1
- 230000008261 resistance mechanism Effects 0.000 description 1
- 108091008146 restriction endonucleases Proteins 0.000 description 1
- 102220319377 rs769687105 Human genes 0.000 description 1
- 102200111189 rs906807 Human genes 0.000 description 1
- 230000028327 secretion Effects 0.000 description 1
- 239000006152 selective media Substances 0.000 description 1
- 230000035945 sensitivity Effects 0.000 description 1
- 238000000926 separation method Methods 0.000 description 1
- 125000003607 serino group Chemical group [H]N([H])[C@]([H])(C(=O)[*])C(O[H])([H])[H] 0.000 description 1
- 230000035939 shock Effects 0.000 description 1
- 230000011664 signaling Effects 0.000 description 1
- VYPSYNLAJGMNEJ-UHFFFAOYSA-N silicon dioxide Inorganic materials O=[Si]=O VYPSYNLAJGMNEJ-UHFFFAOYSA-N 0.000 description 1
- 238000009097 single-agent therapy Methods 0.000 description 1
- 239000002195 soluble material Substances 0.000 description 1
- 229940075582 sorbic acid Drugs 0.000 description 1
- 235000010199 sorbic acid Nutrition 0.000 description 1
- 239000004334 sorbic acid Substances 0.000 description 1
- 230000003595 spectral effect Effects 0.000 description 1
- 238000002798 spectrophotometry method Methods 0.000 description 1
- 239000007921 spray Substances 0.000 description 1
- 239000012899 standard injection Substances 0.000 description 1
- 239000008223 sterile water Substances 0.000 description 1
- 150000008163 sugars Chemical class 0.000 description 1
- 239000013589 supplement Substances 0.000 description 1
- 239000000725 suspension Substances 0.000 description 1
- 230000002195 synergetic effect Effects 0.000 description 1
- 238000007910 systemic administration Methods 0.000 description 1
- RCINICONZNJXQF-MZXODVADSA-N taxol Chemical compound O([C@@H]1[C@@]2(C[C@@H](C(C)=C(C2(C)C)[C@H](C([C@]2(C)[C@@H](O)C[C@H]3OC[C@]3([C@H]21)OC(C)=O)=O)OC(=O)C)OC(=O)[C@H](O)[C@@H](NC(=O)C=1C=CC=CC=1)C=1C=CC=CC=1)O)C(=O)C1=CC=CC=C1 RCINICONZNJXQF-MZXODVADSA-N 0.000 description 1
- 108010072986 threonyl-seryl-lysine Proteins 0.000 description 1
- FUSNMLFNXJSCDI-UHFFFAOYSA-N tolnaftate Chemical compound C=1C=C2C=CC=CC2=CC=1OC(=S)N(C)C1=CC=CC(C)=C1 FUSNMLFNXJSCDI-UHFFFAOYSA-N 0.000 description 1
- 230000000699 topical effect Effects 0.000 description 1
- 230000008359 toxicosis Effects 0.000 description 1
- 230000005026 transcription initiation Effects 0.000 description 1
- 238000001890 transfection Methods 0.000 description 1
- 239000012581 transferrin Substances 0.000 description 1
- 238000013519 translation Methods 0.000 description 1
- 150000003626 triacylglycerols Chemical class 0.000 description 1
- YNJBWRMUSHSURL-UHFFFAOYSA-N trichloroacetic acid Chemical compound OC(=O)C(Cl)(Cl)Cl YNJBWRMUSHSURL-UHFFFAOYSA-N 0.000 description 1
- 108010038745 tryptophylglycine Proteins 0.000 description 1
- 102000003390 tumor necrosis factor Human genes 0.000 description 1
- 102000003298 tumor necrosis factor receptor Human genes 0.000 description 1
- 208000029729 tumor suppressor gene on chromosome 11 Diseases 0.000 description 1
- 201000005112 urinary bladder cancer Diseases 0.000 description 1
- 239000004474 valine Substances 0.000 description 1
- 108010073969 valyllysine Proteins 0.000 description 1
- 235000015112 vegetable and seed oil Nutrition 0.000 description 1
- 239000008158 vegetable oil Substances 0.000 description 1
- 230000003612 virological effect Effects 0.000 description 1
- 238000009941 weaving Methods 0.000 description 1
- 238000005303 weighing Methods 0.000 description 1
- 239000012224 working solution Substances 0.000 description 1
- 238000002689 xenotransplantation Methods 0.000 description 1
Images


Classifications
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K14/00—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof
- C07K14/435—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from animals; from humans
- C07K14/52—Cytokines; Lymphokines; Interferons
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K14/00—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof
- C07K14/81—Protease inhibitors
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61P—SPECIFIC THERAPEUTIC ACTIVITY OF CHEMICAL COMPOUNDS OR MEDICINAL PREPARATIONS
- A61P35/00—Antineoplastic agents
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K14/00—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof
- C07K14/435—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from animals; from humans
- C07K14/52—Cytokines; Lymphokines; Interferons
- C07K14/525—Tumour necrosis factor [TNF]
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12N—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA
- C12N9/00—Enzymes; Proenzymes; Compositions thereof; Processes for preparing, activating, inhibiting, separating or purifying enzymes
- C12N9/14—Hydrolases (3)
- C12N9/24—Hydrolases (3) acting on glycosyl compounds (3.2)
- C12N9/2402—Hydrolases (3) acting on glycosyl compounds (3.2) hydrolysing O- and S- glycosyl compounds (3.2.1)
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61K—PREPARATIONS FOR MEDICAL, DENTAL OR TOILETRY PURPOSES
- A61K38/00—Medicinal preparations containing peptides
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2319/00—Fusion polypeptide
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2319/00—Fusion polypeptide
- C07K2319/01—Fusion polypeptide containing a localisation/targetting motif
- C07K2319/04—Fusion polypeptide containing a localisation/targetting motif containing an ER retention signal such as a C-terminal HDEL motif
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2319/00—Fusion polypeptide
- C07K2319/20—Fusion polypeptide containing a tag with affinity for a non-protein ligand
- C07K2319/21—Fusion polypeptide containing a tag with affinity for a non-protein ligand containing a His-tag
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2319/00—Fusion polypeptide
- C07K2319/50—Fusion polypeptide containing protease site
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2319/00—Fusion polypeptide
- C07K2319/55—Fusion polypeptide containing a fusion with a toxin, e.g. diphteria toxin
Landscapes
- Chemical & Material Sciences (AREA)
- Health & Medical Sciences (AREA)
- Life Sciences & Earth Sciences (AREA)
- Organic Chemistry (AREA)
- Genetics & Genomics (AREA)
- Medicinal Chemistry (AREA)
- General Health & Medical Sciences (AREA)
- Zoology (AREA)
- Biochemistry (AREA)
- Molecular Biology (AREA)
- Gastroenterology & Hepatology (AREA)
- Biophysics (AREA)
- Proteomics, Peptides & Aminoacids (AREA)
- Wood Science & Technology (AREA)
- Engineering & Computer Science (AREA)
- Bioinformatics & Cheminformatics (AREA)
- Toxicology (AREA)
- General Engineering & Computer Science (AREA)
- Biomedical Technology (AREA)
- Microbiology (AREA)
- Biotechnology (AREA)
- Veterinary Medicine (AREA)
- Animal Behavior & Ethology (AREA)
- Public Health (AREA)
- Pharmacology & Pharmacy (AREA)
- Nuclear Medicine, Radiotherapy & Molecular Imaging (AREA)
- General Chemical & Material Sciences (AREA)
- Chemical Kinetics & Catalysis (AREA)
- Peptides Or Proteins (AREA)
- Medicines That Contain Protein Lipid Enzymes And Other Medicines (AREA)
- Enzymes And Modification Thereof (AREA)
- Micro-Organisms Or Cultivation Processes Thereof (AREA)
Abstract
본 발명은 hTRAIL95보다 낮지 않은 위치에 있는 아미노산으로 개시하는 가용성 hTRAIL 단백질 서열의 기능적 단편이거나, 70% 이상의 서열 동일성, 바람직하게는 85%의 서열 동일성을 가지며 아미노산 hTRAIL281로 종결하는 상기 기능적 단편의 동족체인 도메인 (a) 및 단백질 합성을 억제하는 효과기 펩타이드의 서열인 도메인 (b)를 포함하는 융합 단백질에 관한 것으로, 상기 도메인 (b)의 서열은 상기 도메인 (a)의 C-말단 또는 N-말단에 부착되어 있다. 상기 융합 단백질은 암 질환이 치료를 위해 사용될 수 있다.
Description
본 발명은 치료학적 융합 단백질, 특히 재조합 융합 단백질 분야에 관한 것이다. 보다 구체적으로, 본 발명은 가용성 인간 TRAIL 단백질의 서열 및 단백질 합성을 억제하는 펩타이드 독소의 서열의 단편을 함유하는 융합 단백질, 이를 함유하는 약학적 조성물, 치료, 특히 항암제로서의 이의 용도, 및 상기 융합 단백질을 암호화하는 폴리뉴클레오타이드 서열, 상기 폴리뉴클레오타이드 서열을 함유하는 발현 벡터 및 상기 발현 벡터를 함유하는 숙주 세포에 관한 것이다.
Apo2L (Apo2-리간드)로도 공지되어 있는 사이토카인 계열(종양 괴사 인자-관련된 아폽토시스 유도 리간드)의 구성원인 TRAIL 단백질은, 바이러스에 의해 감염된 세포 및 종양 세포에서 아폽토시스의 강력한 활성제이다. TRAIL은 체내에서 자연적으로 발생하는 리간드이다. TRAIL 단백질, 이의 아미노산 서열, 암호성 DNA 서열 및 단백질 발현 시스템은 EP 0 835 305 A1호에 최초로 개시되어 있다.
TRAIL 단백질은 아폽토시스 유발성 표면 TRAIL 수용체 1 및 2 (TRAIL-R1/R2)에 결합하고 후속적으로 이들 수용체를 활성화시킴으로써 이의 항암 활성을 나타낸다. DR4 및 DR5로도 공지되어 있는 이들 수용체(사멸 수용체 4 및 사멸 수용체 5)는 TNF 수용체 계열의 구성원이며 상이한 유형의 암세포에 의해 과발현된다. 이들 수용체의 활성화는, 활성화된 카스파제-8에 의해 실행성 카스파제의 활성화 및 이로 인한 핵산의 분해를 초래하는 억제 유전자 p53-독립적인 아폽토시스의 외부 신호전달 경로를 유도할 수 있다. TRAIL 활성화시에 방출된 카스파제-8은 또한 절단된 Bid 단백질의 방출을 유도할 수 있고, 이러한 Bid 단백질은 미토콘드리아로 전위되고, 이것은 시토크롬 c의 방출을 자극하여, 사멸 수용체로부터 아폽토시스 신호를 간접적으로 증폭시킨다.
TRAIL은 이러한 단백질에 대해 내성을 나타내는 건강한 세포 내에서 아폽토시스를 필수적으로 유도하지 않고 종양 세포에 선택적으로 작용한다. 그러므로, TRAIL의 엄청난 잠재성은 혈액암 및 고형 종양을 포함한 광범위하고 상이한 유형의 종양 세포에 작용하며 동시에 정상 세포에는 영향을 주지 않으며 잠재적으로 비교적 작은 부작용을 나타내는 항암제로서 인식되었다.
TRAIL 단백질은 281개의 아미노산 길이를 갖는 유형 II 막 단백질이며, 프로테아제에 의한 절단시 아미노산 잔기 114-281을 포함하는 이의 세포외 영역은 생물학적으로도 또한 활성인 20 kDa 크기의 가용성 sTRAIL 분자를 형성한다. TRAIL 및 sTRAIL의 두 형태는 표적 세포 상에 존재하는 TRAIL 수용체와의 상호 작용을 통해 아폽토시스를 촉발할 수 있다. TRAIL 분자의 가용성 부분의 강한 항종양 활성 및 매우 낮은 전신 독성은 세포주 시험을 사용하여 입증되었다. 또한, INN 둘라너민(dulanermin)으로 알려진 hTRAIL의 아미노산 114-281에 상응하는 아미노산 서열을 갖는 재조합 인간 가용성 TRAIL(rhTRAIL)에 관한 예비 인간 임상 연구는 이의 양호한 내성 및 독성 제한 용량의 부재를 보여주었다. 예를 들면, EP 1 688 498에서 122-281hTRAIL의 재조합 원형 과변이된 돌연변이체에 대해 최근 보고된 바와 같이, 114-284보다 짧은 TRAIL의 단편도 또한 막 사멸 수용체와 결합하고, 이들 수용체를 통해 아폽토시스를 유도할 수 있다.
현재까지 보고된 간 세포 상의 재조합 TRAIL 단백질의 독성 효과는 변형, 즉 폴리히스티딘 태그의 존재와 관련되는 것으로 나타나며, 태그되지 않은 TRAIL은 어떠한 전신 독성도 나타내지 않았다.
그러나, 환자에 대한 추가의 임상 시험에서, 단일요법으로서의 TRAIL의 실제 효능은 낮은 것으로 입증되었다. 또한, 다수의 암세포에 의해 나타난 TRAIL에 대한 원발성 또는 후천성 내성은 문제가 있었다(예를 들면, WO 2007/022214호 참조). 내성은 각종 메커니즘으로 인한 것일 수 있으며, 암 유형에 특이적이거나 환자-의존적일 수 있다[Thorburn A, Behbakht K, Ford H. TRAIL receptor-targeted therapeutics: resistance mechanisms and strategies to avoid them. Drug Resist Updat 2008; 11: 17-24]. 이러한 내성은 항암제로서의 TRAIL의 유용성을 제한한다. TRAIL에 대한 내성의 메커니즘이 완전하게 이해되진 않았지만, 세포 표면 수용체의 수준으로부터 신호 전달 경로 내의 실행성 카스파제까지의 범위의 TRAIL-유도 아폽토시스 경로의 상이한 수준에서, 그 자체는 명백할 수 있는 것으로 믿어진다.
TRAIL에 대한 종양의 이러한 낮은 효능 및 내성을 극복하기 위해, 방사선요법제 및 화학요법제를 사용하는 각종 조합 요법이 설계되었으며, 이는 상승적인 아폽토시스 효과를 유발하였다(WO 2009/002947호; [A. Almasan and A. Ashkenazi, Cytokine Growth Factor Reviews 14(2003) 337-348; RK Srivastava, Neoplasis, Vol 3, No 6, 2001, 535-546, Soria JC et al., J. Clin. Oncology, Vol 28, No 9(2010), p.1527-1533]). 선택된 통상의 화학요법제(파클리탁셀, 카보플라틴) 및 단일클론 항-VEGF 항체와의 조합에 의한 암치료를 위한 rhTRAIL의 용도는 WO 2009/140469호에 개시되어 있다. 그러나, 이러한 조합은 종래의 화학요법 또는 방사선요법의 잘 공지된 결함을 필수적으로 내포한다. 그러나, 종래 기술은 TRAIL 단백질을 다른 단백질 또는 이의 단편과 융합시켜 수득된 TRAIL에 대한 세포 내성의 폐기를 제안하는 임의의 데이터에 대하여 침묵하고 있다.
더욱이, TRAIL 요법과 관련된 문제는 이의 낮은 안정성 및 투여 후 신체로부터의 신속한 제거인 것으로 입증되었다.
또한, 항암 요법은 종양 세포 단백질 합성의 억제에 관한 것일 수 있다. 세포내 단백질 합성을 억제함으로써 종양 세포 증식을 억제하는 유익한 효과는 공지되어 있다. 암 치료와 보완적인 암 치료 둘 다로서, 단백질 합성의 과정을 억제 또는 조절하는 물질의 임상적 사용에 대한 시도가 이루어지고 있다.
세포 단백질의 합성을 억제하는 물질은 세균, 진균 또는 식물 기원의 촉매 펩타이드 또는 단백질 독소이다. 촉매 도메인만을 가지고 결합 도메인을 갖지 않은 단일쇄 독소(헤미톡신으로도 공지되어 있음)는 통상적으로 세포에 대하여 실제로 무독성인 유리 천연 형태이다. 2개 이상의 쇄로 이루어진 독소(할로톡신으로도 공지되어 있음)는 촉매 도메인에 추가하여 결합 도메인을 가지지만 세포 선택성을 가지지 않아서 전신 투여 후 건강한 조직에 대한 바람직하지 못한 독성 및 광범위한 부작용을 나타낸다.
보다 높은 특이성을 달성하기 위해, 독소 또는 단백질 독소의 촉매 도메인은 캐리어 - 종양 세포 상에 존재하는 마커에 선택적으로 결합하는 리간드에 대하여 결합된다. 도메인 또는 리간드 표적화 단백질의 사용은 단질질의 독성 도메인을 세포로 특이적으로 전달할 수 있게 한다. 면역독소는, 독소가 결합 리간드에 연결되어 있는 융합 단백질 또는 접합체이며, 상기 결합 리간드는 항체, 성장 인자, 인터류킨 및 종양 괴사 인자와 같은 면역계 단백질이다. 성장인자 VEGF, FGF 및 PDGF와 리보솜 불활성화 단백질(ribosome inactivating protein: RIP)로 이루어진 그룹으로부터의 독소의 접합체, TNF와 RIP 독소의 접합체, IL-2와 슈도모나스(Pseudomonas) 외독소의 접합체, IL-13와 슈도모나스 외독소의 접합체는 공지되어 있을 뿐만 아니라, 접합체 IL2-디프테리아 독소를 함유하는 치료제 Ontake®에 사용된다. 다른 예로는 겔로닌 및 아브린과 같은 독소와 인테그린, 피브로넥틴, I-CAM 및 그랜자임 B의 접합체 뿐만 아니라, 에불린과 트랜스페린의 접합체가 있다[Hall, W. A., Targeted toxin therapy for malignant astrocytoma. Neurosurgery 2000, 46, 544-551]. WO 2002/069886 및 US2003176331에서, 겔로닌 RIP 독소와 상기 독소의 표적화 전달을 위한 2차 폴리펩타이드의 접합화의 가능성이 언급되어 있다. 이러한 2차 폴리펩타이드의 다수의 가능한 유형 중에서도 TRAIL 단백질이 언급되어 있지만, 이러한 유형의 키메라의 구조 및 특성에 관한 어떠한 상세한 내용도 개시되어 있지 않다.
WO 2008052322에서, RIP 독소의 캐리어로서 세포 표면 구조에 결합하는 비-면역글로불린 폴리펩타이드 의 가능성이 언급되어 있다. WO 2008080218에서, 다수 열거된 TRAIL 중의 하나로 포함하는 사이토카인이 변형된 독소에 대한 캐리어로서 작용할 수 있는 것으로 언급되어 있지만, 상세한 설명은 TRAIL 및 독소를 포함하는 치료 효과적인 분자 및 이의 특성을 규정하는 어떠한 정보도 포함하지 않는다.
U.S. 6,627,197은 단백질 합성 불활성화 독소, HIV 프로테아제에 의해 절단가능한 펩타이드, 세포 표면에 결합하는 요소로서의 렉틴, 항바이러스제로서 적용되는 표적화 단편 및 소수성화제를 포함하는 작제물을 개시하고 있다.
종래 기술에서, 종양 환경에서 독소의 방출 및 그 결과 종양 세포로의 내지화를 가능하게 하는 특이적인 프로테아제에 의해 인식되는 절단 부위의 키메라 단백질에서의 용도도 또한 공지되어 있다. 예를 들면, US 7,252,993은 HIV 프로테아제에 의해 인식되는 링커를 통해 연결되는, 리신 및 표적화 펩타이드 - DP178 케모카인의 독성 단편을 포함하는 키메라 단백질을 개시하고 있다. 그러나, 이의 상세한 설명은 TRAIL-독소 키메라의 구조, 특성 및 적용에 대한 상세한 정보를 제공하지 않는다.
본 발명은 효과기 펩타이드로서의 펩타이드 독소의 독성 특성과 아폽토시스 유발성 특성을 조합하고 TRAIL 단백질의 암 세포 상에 존재하는 구조에 대하여 특이적으로 표적화하는 신규한 융합 단백질을 제공한다. 본 발명의 융합 단백질은 TRAIL로부터 유래된 결합 도메인 및 단백질 합성 억제 특성을 갖는 효과기 펩타이드로서의 펩타이드 독소 도메인을 포함한다.
hTRAIL로부터 유래된 도메인의 존재로 인해, 본 발명에 따른 단백질은 암 세포에 선택적으로 유도되며, 단백질의 요소는 효과를 나타낸다.
특히, 효과기 펩타이드로서의 펩타이드 독소는 암 세포에서 단백질 합성 과정을 억제한다. 종양 환경에 대한 본 발명의 단백질의 전달은 체내에서 건강한 세포에 대하여 독성 및 부작용 뿐만 아니라, 투여 빈도의 감소를 최소화할 수 있게 한다. 추가로, 본 발명에 따른 단백질을 사용하는 표적화 치료는 고독성 및 고용량 투여의 필요성에 의해 유발되는 단백질 합성 억제에 기초하여 이전에 공지된 비특이적인 치료의 저효율성의 문제를 극복할 수 있게 한다.
다수의 경우에서, 본 발명의 융합 단백질은 서열의 단편을 포함하는 가용성 hTRAIL 및 이의 변이체 보다 더욱 강력한 것으로 밝혀졌다. 지금까지, 본 발명의 융합 단백질에 사용된 효과기 펩타이드는 바람직하지 못한 동력학, 비특이적인 프로테아제에 의한 신속한 분해, 또는 표적 부위에서 효과기 펩타이드의 적절한 작용을 가능하게 하는데 필요한 적절한 경로 활성화 서열의 결핍에 의해 유발되는 체내 축적 때문에 의약에 사용되지 않았다. 융합 단백질에 대한 효과기 펩타이드의 혼입은 작용이 바람직한 부위에 선택적으로 전달할 수 있게 한다. 더욱이, 효과기 펩타이드의 부착은 단백질의 질량을 증가시켜 종양에서 반감기 연장 및 단백질의 보유 증가 및 이의 효율성 향상을 야기한다. 추가로, 다수의 경우에서, 신규한 융합 단백질은 또한 TRAIL에 대한 천연 또는 유발 내성을 극복한다.
본 발명은 지금부터 하기 도면을 참고로 하여 상세히 기술한다.
도 1은 rhTRAIL114-281과 비교한 실시예 18a, 실시예 25a, 실시예 37a 및 실시예 42a의 본 발명의 융합 단백질로 처리된 대장암 Colo 205를 갖는 HsdCpb:NMRI-Foxn1 nin 마우스에서의 종양 체적 변화(초기 단계의 %)를 도시한 것이다.
도 2는 rhTRAIL114-281과 비교한 실시예 18a, 실시예 25a, 실시예 37a 및 실시예 42a의 본 발명의 융합 단백질로 처리된 대장암 Colo 205를 갖는 HsdCpb:NMRI-Foxn1 nin 마우스에서의 종양 성장 억제 값(%TGI)을 도시한 것이다.
도 3은 rhTRAIL114-281과 비교한 실시예 18a 및 실시예 35a의 본 발명의 융합 단백질로 처리된 폐암 A549를 갖는 Cby.Cg-foxn1(nu)/J 마우스에서의 종양 체적 변화(초기 단계의 %)를 도시한 것이다.
도 4는 rhTRAIL114-281과 비교한 실시예 18a 및 실시예 35a의 본 발명의 융합 단백질로 처리된 폐암 A549를 갖는 Cby.Cg-foxn1(nu)/J 마우스에서의 종양 성장 억제 값(%TGI)을 도시한 것이다.
도 5는 rhTRAIL114-281과 비교한 실시예 18a 및 실시예 50a의 본 발명의 융합 단백질로 처리된 폐암 A549를 갖는 Cby.Cg-foxn1(nu)/J 마우스에서의 종양 체적 변화(초기 단계의 %)를 도시한 것이다.
도 6은 rhTRAIL114-281과 비교한 실시예 18a 및 실시예 50a의 본 발명의 융합 단백질로 처리된 폐암 A549를 갖는 Cby.Cg-foxn1(nu)/J 마우스에서의 종양 성장 억제 값(%TGI)을 도시한 것이다.
도 7은 rhTRAIL114-281과 비교한 실시예 2a, 실시예 18a 및 실시예 44a의 본 발명의 융합 단백질로 처리된 폐암 A549를 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 체적 변화(초기 단계의 %)를 도시한 것이다.
도 8은 rhTRAIL114-281과 비교한 실시예 2a, 실시예 18a 및 실시예 44a의 본 발명의 융합 단백질로 처리된 폐암 A549를 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 성장 억제 값(%TGI)을 도시한 것이다.
도 9는 rhTRAIL114-281과 비교한 실시예 20a, 실시예 26a, 실시예 43a 및 실시예 47a의 본 발명의 융합 단백질로 처리된 폐암 A549를 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 체적 변화(초기 단계의 %)를 도시한 것이다.
도 10은 rhTRAIL114-281과 비교한 실시예 20a, 실시예 26a, 실시예 43a 및 실시예 47a의 본 발명의 융합 단백질로 처리된 폐암 A549를 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 성장 억제 값(%TGI)을 도시한 것이다.
도 11은 rhTRAIL114-281과 비교한 실시예 20a, 실시예 51a 및 실시예 52a의 본 발명의 융합 단백질로 처리된 췌장암 PANC-1을 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 체적 변화(초기 단계의 %)를 도시한 것이다.
도 12는 rhTRAIL114-281과 비교한 실시예 20a, 실시예 51a 및 실시예 52a의 본 발명의 융합 단백질로 처리된 췌장암 PANC-1을 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 성장 억제 값(%TGI)을 도시한 것이다.
도 13은 rhTRAIL114-281과 비교한 실시예 18a 및 실시예 44a의 본 발명의 융합 단백질로 처리된 췌장암 PANC-1을 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 체적 변화(초기 단계의 %)를 도시한 것이다.
도 14는 rhTRAIL114-281과 비교한 실시예 18a 및 실시예 44a의 본 발명의 융합 단백질로 처리된 췌장암 PANC-1을 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 성장 억제 값(%TGI)을 도시한 것이다.
도 15는 실시예 18a의 본 발명의 융합 단백질로 처리된 전립선암 PC3을 갖는 Cby.Cg-foxn1(nu)/J 마우스에서의 종양 체적 변화(초기 단계의 %)를 도시한 것이다.
도 16은 실시예 18a의 본 발명의 융합 단백질로 처리된 전립선암 PC3을 갖는 Cby.Cg-foxn1(nu)/J 마우스에서의 종양 성장 억제 값(%TGI)을 도시한 것이다.
도 17은 rhTRAIL114-281과 비교한 실시예 51a의 본 발명의 융합 단백질로 처리된 간암 PCL/PRF/5를 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 체적 변화(초기 단계의 %)를 도시한 것이다.
도 18은 rhTRAIL114-281과 비교한 실시예 51a의 본 발명의 융합 단백질로 처리된 간암 PCL/PRF/5를 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 성장 억제 값(%TGI)을 도시한 것이다.
도 19는 rhTRAIL114-281과 비교한 실시예 18b 및 실시예 2b의 본 발명의 융합 단백질로 처리된 대장암 HCT116을 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 체적 변화(초기 단계의 %)를 도시한 것이다.
도 19a는 rhTRAIL114-281과 비교한 실시예 18b의 본 발명의 융합 단백질로 처리된 대장암 HCT116을 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 체적 변화(초기 단계의 %)를 도시한 것이다.
도 20은 rhTRAIL114-281과 비교한 실시예 18b 및 실시예 2b의 본 발명의 융합 단백질로 처리된 대장암 HCT116을 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 성장 억제 값(%TGI)을 도시한 것이다.
도 20a는 rhTRAIL114-281과 비교한 실시예 18b의 본 발명의 융합 단백질로 처리된 대장암 HCT116을 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 성장 억제 값(%TGI)을 도시한 것이다.
도 21은 rhTRAIL114-281과 비교한 실시예 18b, 실시예 2b 및 실시예 54b의 본 발명의 융합 단백질로 처리된 대장암 SW620을 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 체적 변화(초기 단계의 %)를 도시한 것이다.
도 21a는 rhTRAIL114-281과 비교한 실시예 18b의 본 발명의 융합 단백질로 처리된 대장암 SW620을 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 체적 변화(초기 단계의 %)를 도시한 것이다.
도 22는 rhTRAIL114-281과 비교한 실시예 18b, 실시예 2b 및 실시예 54b의 본 발명의 융합 단백질로 처리된 대장암 HCT116을 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 성장 억제 값(%TGI)을 도시한 것이다.
도 22a는 rhTRAIL114-281과 비교한 실시예 18b의 본 발명의 융합 단백질로 처리된 대장암 HCT116을 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 성장 억제 값(%TGI)을 도시한 것이다.
도 23은 rhTRAIL114-281과 비교한 실시예 18b 및 실시예 51b의 본 발명의 융합 단백질로 처리된 대장암 HT-29를 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 체적 변화(초기 단계의 %)를 도시한 것이다.
도 24는 rhTRAIL114-281과 비교한 실시예 18b 및 실시예 51b의 본 발명의 융합 단백질로 처리된 대장암 HT-29를 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 성장 억제 값(%TGI)을 도시한 것이다.
도 25는 rhTRAIL114-281과 비교한 실시예 18b의 본 발명의 융합 단백질로 처리된 간암 HepG2를 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 체적 변화(초기 단계의 %)를 도시한 것이다.
도 26은 rhTRAIL114-281과 비교한 실시예 18b의 본 발명의 융합 단백질로 처리된 간암 HepG2를 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 성장 억제 값(%TGI)을 도시한 것이다.
도 27은 rhTRAIL114-281과 비교한 실시예 18b 및 실시예 2b의 본 발명의 융합 단백질로 처리된 폐암 A549를 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 체적 변화(초기 단계의 %)를 도시한 것이다.
도 28은 rhTRAIL114-281과 비교한 실시예 18b 및 실시예 2b의 본 발명의 융합 단백질로 처리된 폐암 A549를 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 성장 억제 값(%TGI)을 도시한 것이다.
도 29는 rhTRAIL114-281과 비교한 실시예 18b의 본 발명의 융합 단백질로 처리된 자궁 육종 MES-SA/Dx5를 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 체적 변화(초기 단계의 %)를 도시한 것이다.
도 29a는 rhTRAIL114-281과 비교한 실시예 18b, 실시예 2b 및 실시예 51b의 본 발명의 융합 단백질로 처리된 자궁 육종 MES-SA/Dx5를 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 체적 변화(초기 단계의 %)를 도시한 것이다.
도 30은 rhTRAIL114-281과 비교한 실시예 18b의 본 발명의 융합 단백질로 처리된 자궁 육종 MES-SA/Dx5를 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 성장 억제 값(%TGI)을 도시한 것이다.
도 30a는 rhTRAIL114-281과 비교한 실시예 18b, 실시예 2b 및 실시예 51b의 본 발명의 융합 단백질로 처리된 자궁 육종 MES-SA/Dx5를 갖는 Crl:SHO-PrkdcscidHrhr 마우스에서의 종양 성장 억제 값(%TGI)을 도시한 것이다.
본 발명은
- hTRAIL95보다 낮지 않은 위치에 있는 아미노산으로 개시하는 가용성 hTRAIL 단백질 서열의 기능적 단편이거나, 70% 이상의 서열 동일성, 바람직하게는 85%의 서열 동일성을 가지며 아미노산 hTRAIL281로 종결하는 상기 기능적 단편의 동족체인 도메인 (a), 및
- 단백질 합성을 억제하는 효과기 펩타이드의 서열인 하나 이상의 도메인 (b)
를 포함하는 융합 단백질에 관한 것으로,
상기 도메인 (b)의 서열은 상기 도메인 (a)의 C-말단 및/또는 N-말단에 부착되어 있고,
상기 융합 단백질은 세포 표면 상의 탄수화물 수용체에 결합하는 도메인을 함유하지 않는다.
용어 "가용성 hTRAIL 서열의 기능적 가용성 단편"이란, 즉 세포의 표면에 있는 이의 수용체에 결합시 포유동물 세포에서 아폽토시스 신호를 유발할 수 있는 임의의 이러한 가용성 hTRAIL의 단편을 나타내는 것으로 이해되어야 한다.
TRAIL 서열의 70% 이상 또는 85% 이상의 상동성의 존재는 당업계에 공지되어 있는 것으로 당업자에게 또한 이해될 것이다.
본 발명의 융합 단백질에서 효과기 펩타이드의 도메인 (b)는 hTRAIL 단백질도 아니고 hTRAIL 단백질의 일부나 단편도 아닌 것으로 이해되어야 한다.
본 발명에 따른 용어 "펩타이드"란, 펩타이드 결합을 통해 함께 연결된 복수의 아미노산으로부터 축조된 분자로 이해되어야 한다. 따라서, 본 발명에 따른 용어 "펩타이드"는 올리고펩타이드, 폴리펩타이드 및 단백질을 포함한다.
본 발명에서, 펩타이드의 아미노산 서열은 펩타이드의 N-말단(N-종결)에서 이의 C-말단(C-종결) 쪽으로의 방향으로 당업계에서 채택되는 통상의 방식으로 제시될 것이다. 그러므로, 임의의 서열은 이의 선형 제시(presentation)의 좌측 상에 이의 N-말단 및 우측 상에 이의 C-말단을 가질 것이다.
숫자보다 선행하는 용어 TRAIL은 hTRAIL의 공지된 서열에서 이러한 숫자를 갖는 아미노산을 나타내기 위해 본 명세서에서 사용된다.
본 발명의 융합 단백질은 도메인 (a)의 C-말단 및/또는 N-말단에 부착된, 효과기 펩타이드의 하나 이상의 도메인 (b)를 혼입한다.
특정 실시형태에서, 도메인 (a)는 hTRAIL95 내지 hTRAIL121 범위의 아미노산으로 개시하여 아미노산 hTRAIL281로 종결하는 hTRAIL 서열의 단편이다.
특히, 도메인 (a)는 hTRAIL95-281, hTRAIL114-281, hTRAIL116-281, hTRAIL119-281, hTRAIL120-281 및 hTRAIL121-281에 상응하는 서열로 이루어진 군으로부터 선택될 수 있다. hTRAIL95-281, hTRAIL114-281, hTRAIL116-281, hTRAIL119-281, hTRAIL120-281 및 hTRAIL121-281이 수탁 번호 P50591로 ZenBank에 공개되고 서열 번호 141로서 본 발명의 서열 목록에 제시된 hTRAIL의 공지된 서열에서 각각 번호 95, 114, 116, 119, 120 및 121로 표시된 아미노산으로 개시하고 마지막 아미노산 281로 종결하는 인간 TRAIL 단백질의 단편을 나타낸다는 것은 당업자에게 명백할 것이다.
다른 특정 실시형태에서, 도메인 (a)는 hTRAIL95보다 낮지 않은 아미노산 위치에서 개시하고 아미노산 hTRAIL281에서 종결하는 가용성 hTRAIL 단백질 서열의 기능적 단편의 동족체로서, 그 서열은 본래의 서열과 70% 이상, 바람직하게는 85% 이상 동일하다.
이러한 실시형태의 특정 변형에서, 도메인 (a)는 hTRAIL95-281, hTRAIL114-281, hTRAIL116-281, hTRAIL119-281, hTRAIL120-281 및 hTRAIL121-281에 상응하는 서열로 이루어진 군으로부터 선택된 단편의 동족체이다.
hTRAIL 단편의 동족체가 이러한 단편의 아미노산 서열의 변경/변형이며, 여기서 1개의 아미노산, 2개의 아미노산, 3개의 아미노산, 4개의 아미노산, 5개의 아미노산, 6개의 아미노산 및 아미노산 중의 15% 이하를 포함한 하나 이상의 아미노산이 변화되고, 변형된 서열의 단편이 hTRAIL 서열의 기능성, 즉 세포 표면 사멸 수용체에 결합하고 포유동물 세포에서 아폽토시스를 유발하는 능력을 보존한다는 것은 이해되어야 한다. 아미노산 서열의 변형은, 예를 들면, 아미노산의 치환, 결손 및/또는 부가를 포함할 수 있다.
바람직하게는, 변형된 서열을 갖는 hTRAIL 단편의 동족체는 hTRAIL의 본래의 단편과 비교하여 사멸 수용체 DR4 (TRAIL-R1) 또는 DR5 (TRAIL-R2)에 대한 변형된 친화성을 나타낸다.
용어 "변형된 친화성"이란 증가된 친화성 및/또는 변경된 수용체 선택성을 갖는 친화성을 의미한다.
바람직하게는, 변형된 서열을 갖는 hTRAIL 단편의 동족체는 hTRAIL의 본래의 단편과 비교하여 사멸 수용체 DR4 또는 DR5에 대한 증가된 친화성을 나타낸다.
특히 바람직하게는, 변형된 서열을 갖는 hTRAIL 단편의 동족체는 사멸 수용체 DR4와 비교하여 사멸 수용체 DR5에 대한 증가된 친화성, 즉 증가된 선택성 DR5/DR4를 나타낸다.
또한 바람직하게는, 변형된 서열을 갖는 hTRAIL 단편의 동족체는 수용체 DR1 (TRAIL-R3) 및/또는 DR2 (TRAIL-R4)에 대한 친화성과 관련하여 사멸 수용체 DR4 및/또는 DR5에 대한 증가된 선택성을 나타낸다.
사멸 수용체 DR4 및 DR5에 대한 증가된 친화성 및/또는 선택성을 초래하는 hTRAIL의 변형은 당업자에게 공지되어 있으며, 예를 들면, DR4에 대한 증가된 선택성을 갖는 D218H 돌연변이를 개시하고 있는 문헌[Tur V, van der Sloot AM, Reis CR, Szegezdi E, Cool RH, Samali A, Serrano L, Quax WJ. DR4-selective tumor necrosis factor-related apoptosis-inducing ligand (TRAIL) variants obtained by structure-based design. J. Biol. Chem. 2008 Jul 18; 283(29): 20560-8] 또는 DR4에 대한 감소된 친화성을 갖는 D269H 돌연변이를 개시하고 있는 문헌[Gasparian ME, Chernyak BV, Dolgikh DA, Yagolovich AV, Popova EN, Sycheva AM, Moshkovskii SA, Kirpichnikov MP. Generation of new TRAIL mutants DR5-A 및 DR5-B with improved selectivity to death receptor 5, Apoptosis. 2009 Jun; 14(6): 778-87]을 참조한다. DR1 및 DR2 수용체와 비교하여 DR4 및 DR5로부터 선택된 하나의 수용체에 대한 증가된 친화성 및 DR4와 비교하여 수용체 DR5에 대한 증가된 친화성을 초래하는 hTRAIL 돌연변이체는 또한 WO 2009077857 및 WO 2009066174에 개시되어 있다.
적절한 돌연변이는 131, 149, 159, 193, 199, 201, 204, 204, 212, 215, 218 및 251로 이루어진 군으로부터 선택된 천연 hTRAL의 위치에 있는 하나 이상의 돌연변이이며, 특히 라이신, 히스티딘 또는 아르기닌과 같은 염기성 아미노산, 또는 글루탐산 또는 아스파라긴산과 같은 아미노산으로의 아미노산의 치환을 포함하는 돌연변이이다. 특히, WO 2009066174에 개시된 바와 같은 G131R, G131K, R149I, R149M, R149N, R149K, S159R, Q193H, Q193K, N199H, N199R, K201H, K201R, K204E, K204D, K204L, K204Y, K212R, S215E, S215H, S215K, S215D, D218Y, D218H, K251D, K251E 및 K251Q로 이루어진 군으로부터 선택된 하나 이상의 돌연변이를 명시할 수 있다.
적절한 돌연변이는 또한 195, 269 및 214로 이루어진 군으로부터 선택된 천연 hTRAIL의 위치에 있는 하나 이상의 돌연변이이며, 특히 라이신, 히스티딘 또는 아르기닌과 같은 염기성 아미노산으로의 아미노산의 치환을 포함하는 돌연변이이다. 특히, WO 2009077857에 기재된 바와 같은 269H, E195R 및 T214R로 이루어진 군으로부터 선택된 하나 이상의 돌연변이를 명시할 수 있다.
특정 실시형태에서, hTRAIL 단편의 동족체인 도메인 (a)는, WO 2009066174에 기재된 바와 같은 천연 TRAIL 서열의 D218H 돌연변이체, 또는 문헌[Gasparian ME et al. Generation of new TRAIL mutants DR5-A and DR5-B with improved selectivity to death receptor 5, Apoptosis. 2009 Jun; 14(6): 778-87]에 기재된 바와 같은 천연 TRAIL 서열의 Y189N-R191K-Q193R-H264R-I266R-D269H 돌연변이체로부터 선택된다.
도메인 (a), 즉 TRAIL 단편은 세포의 표면 상의 사멸 수용체에 대한 융합 단백질의 작제물의 결합을 담당하는 도메인이다. 더욱이, 결합시의 도메인 (a)는 이의 공지된 작용제 활성, 즉 아폽토시스의 외인성 경로의 활성화를 나타낸다.
본 발명의 융합 단백질은 세포 표면 상의 탄수화물 수용체에 결합할 수 있는 도메인의 서열을 포함하지 않는다. 세포 표면 상의 탄수화물 수용체에 대한 결합은 비-특이적 결합이다.
특히, 본 발명의 융합 단백질은 세포 표면 상의 슈가(sugar) 수용체에 결합할 수 있는 렉틴 도메인(당단백질)의 서열을 포함하지 않는다. 세포 표면 상의 탄수화물 수용체에 결합할 수 있는 렉틴 도메인은 특히 단백질 독소의 서브유닛(쇄)과 이의 단편 둘 다 뿐만 아니라, 효소적 기능성을 포함한 상이한 기능성의 도메인을 동반하지 않고 홀로 생성되는 렉틴 단백질로 이해되어야 한다.
또 다른 실시형태에서, 도메인 (a)를 제외한 본 발명의 융합 단백질은 세포 표면 상의 수용체에 결합하는 어떠한 다른 도메인도 포함하지 않는다. 본 발명의 융합 단백질의 도메인 (b)는 효과기 펩타이드 - 세포 내의 단백질 합성 과정을 억제하는 펩타이드 독소의 도메인이다.
본 발명의 융합 단백질의 도메인 (b)의 효과기 펩타이드는 세포에서 단백질 합성 과정의 해독 단계를 억제하여 단백질 합성을 억제하는 독소일 수 있다.
본 발명의 융합 단백질의 도메인 (b)의 효과기 펩타이드는 세포에서 단백질 합성 과정의 전사 및 RNA 생성을 억제하여 단백질 합성을 억제하는 독소일 수 있다.
하나의 실시형태에서, 펩타이드 독소는 리보솜 수준에서 단백질의 해독을 효소적으로 억제하는 펩타이드이다. 본 발명의 이러한 실시형태에서, 하나의 변이체에서의 펩타이드 독소는 N-글리코시다제, 리보뉴클레아제 및 ADP-리보실트랜스퍼라제의 활성으로부터 선택된 효소적 촉매 활성을 가진다.
효과기 펩타이드로서의 이의 주요 활성에 추가하여, 펩타이드 독소가, 예를 들면, 문헌[W. J. Pneumans et al., The FASEB Journal, 2001, Vol. 15, str. 1493-1506]에 개시된 바와 같이, 세포에서 단백질 합성을 억제할 수 있는 하나 이상의 다른 활성을 가질 수 있다는 것은 당업자에게 자명할 것이므로 이해되어야 한다.
N-글리코시다제 활성을 갖는 효과기 펩타이드는 28S rRNA의 서브유닛 60에서 하나의 특이적인 아데닌 잔기의 절단에 의해 리보솜의 변형(탈퓨린화)을 수행한다. 이러한 변형은 비가역적이며, 리보솜과 해독 인자 EF의 결합을 방지하고, 따라서 해독을 차단한다.
N-글리코시다제의 촉매 활성을 갖는 효과기 펩타이드는 유형 1 리보솜 불활성화 단백질 (RIP) (헤미톡신) 및 유형 2 RIP 단백질의 촉매 서브유닛(쇄) A 및 본래의 서열과 85% 이상의 서열 동일성의 보존된 N-글리코시다제 활성을 가지는 이들의 변형물로 이루어진 군으로부터 선택될 수 있다.
N-글리코시다제 활성을 갖는 유형 1 RIP 독소는 단일-쇄 단백질이며, 촉매 도메인만을 가진다.
다음의 식물 기원의 공지된 독소는 단일-쇄 유형 1 RIP 독소: 겔로닌 (겔 로니움 멀티플로룸: Gelonium multiflorum 유래), 모모르딘 (Momordica 속의 식물로부터 분리된 단백질), 사포린 (사포나리아 오피시날리스: Saponaria Officinalis 유래), 도데칸드린 (파이토라카 도데칸드라: Phytolacca dodecandra 유래), 부가닌 (부가인빌레아 스펙타빌리스: Bougainvillea spectabilis 유래), 미국자리공 (파이토라카 아메리카나: Phytolacca Americana) 유래의 PAP 단백질, 트리코산틴 (트리코산테스 키릴로위이: Trichosanthes kirilowii 유래), 트리코안구인 (트리코산테스 안구이나: Trichosanthes anguina 유래), 아그로스틴 (아그로스테마 기타고: Agrostemma githago 유래), 디안트린, 루핀 P1 (루파 실린드리카: Luffa cylindrica 유래), 모모르카린 (모모르디카 카란티아: Momordica charantia 유래) 및 트리틴의 군으로부터의 특이적인 효과기 단백질로서 언급될 수 있다.
이러한 실시형태에서의 효과기 단백질 서열의 예는 서열 번호 55 (부가닌), 서열 번호 58 (PAP 독소 동족체), 서열 번호 59 (사포린의 단편), 서열 번호 60 (트리코산틴), 서열 번호 61 (트리코안구인), 서열 번호 65 (루핀 P1), 서열 번호 67 (모모르카린) 및 서열 번호 78 (겔로닌의 촉매 도메인)로서 표시된다.
이러한 실시형태에서의 효과기 단백질 서열의 추가 예는 겔로닌 (서열 번호 198)의 유사체 및 본래의 서열이 변형된 트리코산틴의 유사체 (서열 번호 199 및 서열 번호 200)이다.
변형된 트리코산틴의 하나의 예는 서열 번호 199이며, 트리코산틴의 공지된 서열은 독소의 면역원성을 낮추도록 변형된다. 즉, 트리코산틴의 공지된 서열에서, "YFF" 81-83 모티프는 "ACS"로 치환되고, 유사하게 "KR" 173-174 아미노산은 "CG" 잔기로 치환된다(상기 아미노산 잔기 번호는 GenBank에 공개된 서열: AAB22585.1과 일치한다)[An Q, Wei S, Mu S, Zhang X, Lei Y, Zhang W, Jia N, Cheng X, Fan A, Li Z, Xu Z. J Biomed Sci. 2006 Sep; 13(5): 637-43].
변형된 트리코산틴의 추가 예는 서열 번호 200이며, 트리코산틴의 공지된 서열은 다음의 방식으로 변형된다. 즉, "YFF" 81-83 모티프는 독소의 면역원성을 낮추기 위해 "ACS"로 치환되고, "KR" 173-174 아미노산은 혈관 누출 증후군 (vascular leak syndrome: VLS) 문제를 감소시키기 위해 "CG" 잔기로 치환되고[An Q, Wei S, Mu S, Zhang X, Lei Y, Zhang W, Jia N, Cheng X, Fan A, Li Z, Xu Z. J Biomed Sci.2006 Sep; 13(5): 637-43], 발린 잔기 - 2 및 66은 알라닌으로 치환되고, 류신 132는 글라이신으로 치환된다(상기 아미노산 잔기 번호는 GenBank에 공개된 서열: AAB22585.1과 일치한다)[Baluna R, Rizo J, Gordon BE, Ghetie V, Vitetta ES. Proc Natl Acad Sci. U S A. 1999 Mar 30; 96(7): 3957-62].
서열 번호 198의 돌연변이 V70A를 갖는 겔로닌 유사체는 공지되어 있으며, 문헌[Baluna et al. Proc. Natl. Acad. Sci. USA, Vol. 96, pp. 3957-3962, March 1999]에 개시되어 있다.
서열 번호 199로 지정된 트리코산틴 유사체는 공지되어 있으며, 문헌[An Q, et al. J Biomed Sci. 2006 Sep; 13(5): 637-43]에 개시되어 있다.
서열 번호 200으로 지정된 트리코산틴 유사체는 신규하며, 문헌에 개시되어 있지 않다.
N-글리코시다제 활성을 갖는 유형 2 RIP 독소는 2개의 쇄 단백질이며, 세포 표면 상에 존재하는 탄수화물(슈가) 수용체에 결합할 수 있는 렉틴 결합 도메인 (서브유닛 B) 및 촉매 도메인 (서브유닛 A)을 갖는다. 본 발명에 따르면, 렉틴 결합 도메인이 없는 유형 2 RIP 독소의 촉매 서브유닛 A는 효과기 펩타이드로서 사용될 수 있다.
이러한 유형의 효과기 펩타이드로서, 다음 식물 독소의 촉매 서브유닛 A가 언급될 수 있다: 리신 (리시누스 코뮤니스: Ricinnus communis 유래), 아브린 (아브루스 프레카트리우스: Abbrus precatrius 유래), 모데신 (아데니아 디지타타: Adenia digitata 유래), 비스쿠민 (겨우살이 비스쿰 알붐: Viscum album 유래의 독소), 볼켄신 (아데니아 볼켄시이: Adenia volkensii 유래), 에불린 1 (삼부쿠스 에불루스: Sambucus ebulus 유래), 니그린 b (삼부쿠스 니그 라: Sambucus nigra 유래) 및 세균성 독소 시가 (시겔라 다이센테리애: Shigella dysenteriae 유래), 또는 본래의 서열과 85% 이상의 서열 동일성의 보존된 N-글리코시다제 활성을 가지는 이들의 변형물.
이러한 실시형태에서의 효과기 펩타이드 서열의 예는 서열 번호 56 및 서열 번호 57 (리신의 서브유닛 A 및 리신의 변이체 서브유닛 A), 서열 번호 195 (리신의 변형된 서브유닛 A), 서열 번호 62 (겨우살이 독소의 서브유닛 A), 서열 번호 63 (에불린 1의 서브유닛 A), 서열 번호 64 (니그린 b의 서브유닛 A), 서열 번호 66 (볼켄신의 서브유닛 A), 서열 번호 70 (시가 독소 서브유닛 A의 변이체), 서열 번호 82 (아브린의 서브유닛 A), 서열 번호 194 (돌연변이 V71A, G115A 및 S232Q를 갖는 문헌[Baluna et al. Proc. Natl. Acad. Sci. USA, Vol. 96, pp. 3957-3962, March 1999]에 개시된 바와 같은 아브린의 변형된 서브유닛 A, 상기 아미노산 잔기 번호는 GenBank CAA38655.1에 공개된 서열과 일치한다)로서 지정된다.
이러한 실시형태에서의 효과기 펩타이드 서열의 예는 서열 번호 56 및 서열 번호 57 (리신의 서브유닛 A 및 리신의 변이체 서브유닛 A), 서열 번호 195 (결손 78 LDV 80을 갖는 문헌[Baluna et al. Proc. Natl. Acad. Sci. USA, Vol. 96, pp. 3957-3962, March 1999]에 개시된 바와 같은 리신의 변형된 서브유닛 A, 상기 아미노산 잔기 번호는 GenBank ABG65738.1에 공개된 서열과 일치한다), 서열 번호 62 (겨우살이 독소의 서브유닛 A), 서열 번호 63 (에불린 1의 서브유닛 A), 서열 번호 64 (니그린 b의 서브유닛 A), 서열 번호 66 (볼켄신의 서브유닛 A), 서열 번호 70 (시가 독소 서브유닛 A의 변이체), 서열 번호 82 (아브린의 서브유닛 A), 서열 번호 194 (돌연변이 V71A, G115A 및 S233Q를 갖는 문헌[Baluna et al. Proc. Natl. Acad. Sci. USA Vol. 96, pp. 3957-3962, March 1999]에 개시된 바와 같은 아브린의 변형된 서브유닛 A, 상기 아미노산 잔기 번호는 GenBank CAA38655.1에 공개된 서열과 일치한다)로서 지정된다.
리보뉴클레아제의 촉매 활성을 갖는 효과기 펩타이드(리보톡신으로도 언급됨)는 엔도뉴클레아제에 속하며, 28S rRNA에서 포스포디에스테르 결합을 절단하고, 이에 의해 리보솜을 억제하고 해독을 중단시킨다. 이러한 그룹의 효과기 펩타이드로서 진균 독소 알파-사크린, 미토-길린, 아스퍼질루스 레스트릭투스(Aspergillus restrictus) 유래의 레스트릭토신 및 히르수텔린 (히르수텔라 톰소니이: Hirsutella thompsonii 유래)이 언급될 수 있다.
이러한 실시형태에서의 효과기 펩타이드 서열의 예는 서열 번호 71 (레스트릭토신) 및 서열 번호 72 (히르수텔린)로서 지정된다.
ADP-리보실트랜스퍼라제의 촉매 활성을 갖는 효과기 펩타이드는 ADP-리보실화를 유발하고, 따라서 단백질 합성 기구의 성분의 불활성화, 주로 신장/해독 인자 EF-2, 및 해독의 억제를 유발한다. 효과기 펩타이드의 이러한 그룹에는 코리네박테리움 디프테리애 (Corynebacterium diphteriae) 유래의 디프테리아 독소, 슈도모나스 아에루기노사 (Pseudomonas aeruginosa) 유래의 외독소 A 및 본래의 서열과 85% 이상의 서열 동일성의 보존된 ADP-리보실트랜스퍼라제 활성을 가지는 이들의 변형물의 촉매 도메인이 속한다.
슈도모나스 아에루기노사 외독소 A 및 디프테리아 독소의 촉매 도메인의 변형물의 예는 펩타이드의 말단 단편의 절단 뿐만 아니라, 촉매 도메인 또는 이의 단편에서의 치환 또는 결손을 포함한다. 적절한 치환 및 결손의 일부는 문헌[Weldon JE et al.. Blood. 2009 Apr 16; 113(16): 3792-800; 및 Onda M et al.. Proc Natl Acad Sci U S A. 2011 Apr 5; 108(14): 5742-7]에 개시되어 있다.
이러한 실시형태에서의 효과기 펩타이드 서열의 예는 서열 번호 69 (촉매 도메인 A의 천연 서열)로서 지정된 공지된 슈도모나스 아에루기노사 외독소 촉매 도메인 A, 및 서열 번호 68, 서열 번호 83, 서열 번호 84, 서열 번호 201, 서열 번호 202, 서열 번호 203, 서열 번호 204, 서열 번호 205, 서열 번호 206 및 서열 번호 207로서 지정된 이의 돌연변이형 유사체이다.
이러한 실시형태에서의 효과기 펩타이드 서열의 예는 서열 번호 68로 지정된 공지된 슈도모나스 아에루기노사 외독소 A, 및 서열 번호 69, 서열 번호 83, 서열 번호 84, 서열 번호 201, 서열 번호 202, 서열 번호 203, 서열 번호 204, 서열 번호 205, 서열 번호 206 및 서열 번호 207로서 지정된 이의 유사체이다.
서열 번호 69, 서열 번호 83, 서열 번호 84, 서열 번호 203 및 서열 번호 206으로서 지정된 슈도모나스 아에루기노사 외독소 A의 유사체는 공지되어 있으며, 문헌에 개시되어 있다.
서열 번호 201, 서열 번호 202, 서열 번호 204, 서열 번호 205 및 서열 번호 207로서 지정된 슈도모나스 아에루기노사 외독소 A의 유사체는 신규하며, 문헌에 개시되어 있지 않다.
공지된 서열 번호 203은 면역원성을 감소시키는 8개의 돌연변이를 갖는 문헌[Onda M et al.. Proc Natl Acad Sci U S A. 2011 Apr 5; 108(14): 5742-7]에 개시된 바와 같은 슈도모나스 아에루기노사 외독소 A의 HA22-LR-8M 변이체이다.
공지된 서열 번호 206은 문헌[Weldon JE et al.. Blood. 2009 Apr 16; 113(16): 3792-800]에 개시된 바와 같은 슈도모나스 아에루기노사 외독소 A의 결손 변이체 HA22-LR이다.
신규한 서열 번호 201은 외독소 A의 슈도모나스 아에루기노사 촉매 도메인의 유사체이며, 여기서 3개의 점 돌연변이 R318K, N441Q 및 R601K는 공지된 서열에 도입되어 면역원성을 감소시킨다(상기 아미노산 잔기 번호는 GenBank AAB59097.1에 공개된 서열과 일치한다).
신규한 서열 번호 202는 문헌[Choe M, Webber KO, Pastan I. Cancer Res. 1994 Jul 1; 54(13): 3460-7]에 개시된 바와 같은 면역원성을 낮추는 추가의 돌연변이 및 WO 2007/016150에 개시된 바와 같은 다른 돌연변이를 도입한 문헌[Weldon JE et al., Blood. 2009 Apr 16; 113(16): 3792-800]에 개시된 바와 같은 외독소 A의 슈도모나스 아에루기노사 촉매 도메인의 결손 변이체 A2-LR이다.
신규한 서열 번호 204는 문헌[Weldon JE et al.. Blood. 2009 Apr 16; 113(16): 3792-800]에 개시된 바와 같은 변이체 HA22 M3 (결손 및 돌연변이 C312S)과 문헌[Onda M et al.k Proc Natl Acad Sci. U S A. 2011 Apr 5; 108(14): 5742-7]에 개시된 바와 같은 면역원성을 감소시키는 8개의 돌연변이를 갖는 변이체 HA22 8M의 조합인 외독소 A의 슈도모나스 아에루기노사 촉매 도메인의 변이체이다.
신규한 서열 번호 205는 문헌[Weldon JE et al.. Blood. 2009 Apr 16; 113(16): 3792-800]에 개시된 바와 같은 변이체 HA22 M3, 즉 결손 및 돌연변이 C312S와 천연 슈도모나스 아에루기노사 독소에 존재하는 푸린에 의해 인식되는 절단 부위의 영역의 추가 결손을 갖는 문헌[Onda M et al.. Proc Natl Acad Sci U S A. 2011 Apr 5; 108(14): 5742-7]에 개시된 바와 같은 면역원성을 감소시키는 8개의 돌연변이의 조합인 외독소 A의 슈도모나스 아에루기노사 촉매 도메인의 변이체이다.
신규한 서열 번호 207은 문헌[Weldon JE et al., Blood. 2009 Apr 16; 113(16): 3792-800]에 개시된 바와 같은 변이체 HA22 M3, 즉 결손 및 돌연변이 C312S, 문헌[Onda M et al., Proc Natl Acad Sci. USA. 2011 Apr 5; 108(14): 5742-7]에 개시된 바와 같은 변이체 HA22 8M, 즉 면역원성을 감소시키는 8개의 돌연변이 및 추가의 돌연변이 R601K의 조합인 외독소 A의 슈도모나스 아에루기노사 촉매 도메인의 변이체이다.
이러한 실시형태에서의 효과기 펩타이드 서열의 다른 예는 디프테리아 독소의 공지된 서브유닛 A (촉매 도메인), 및 서열 번호 79, 서열 번호 80, 서열 번호 81, 서열 번호 196 (2개의 돌연변이 V7A 및 V27A의 도입에 의해 변형된 디프테리아 독소의 서브유닛 A)으로 지정된 이의 공지된 활성 단편이다. 변형은 문헌[Baluna R, Rizo J, Gordon BE, Ghetie V, Vitetta ES. Proc Natl Acad Sci USA. 1999 Mar 30; 96(7): 3957-62] 및 서열 번호 197로 인한 VLS (혈관 누출 증후군)를 제거하기 위해 선택된다(디프테리아 독소는 문헌[Baluna R, Rizo J, Gordon BE, Ghetie V, Vitetta ES. Proc. Natl. Acad Sci USA. 1999 Mar 30; 96(7): 3957-62]로 인한 VLS (혈관 누출 증후군)를 제거하기 위해 3개의 아미노산 6VDS9의 결손 및 돌연변이 V29A를 도입하여 변형된다).
본 발명의 융합 단백질의 도메인 (b)의 효과기 펩타이드는, 예를 들면, 세균에서 공지된 독소-항독소 시스템에 속하는 단백질 합성을 억제하는 펩타이드 독소일 수 있다. 이러한 독소는 다음과 같은 상이한 기작을 통해 작용하는 단백질 합성을 차단할 수 있다: 세포막과의 결합 및 이에 따른 막 전위의 신속한 붕괴 및 수반성 호흡 정지의 유발; 토포아이소머라제에 대한 결합에 의한 폴리마라제(DNA 및 RNA)의 억제; 또는 엔도리보뉴클레아제(RNase)로서의 작용.
mRNase 활성을 갖는 독소-항독소 시스템의 구성성분인 독소의 예는 다음과 같다: 서열 번호 77로서 지정된 RNase 활성을 갖는 StaB 단백질[Szymanik M., Doctoral thesis. 2006. Warsaw University, Warsaw]; 살모넬라 타이피(Salmonella typhi) 유래의 Kid 독소[Bravo A, de Torrontegui G, Diaz R. Identification of components of a new stability system of plasmid R1, ParD, that is close to the origin of replication of this plasmid. Mol Gen Genet. 1987 Nov; 210(1):101-10]; 및 서열 번호 73 (Kid 단백질) 및 서열 번호 76 (RelE 단백질)으로서 지정된 대장균(Escherichia coli) 유래의 RelE 독소[Gotfredsen M, Gerdes K. The Escherichia coli relBE genes belong to a New toxin-antitoxin gene family. Mol Microbiol. 1998 Aug; 29(4): 1065-7].
토포아이소머라제에 대한 결합에 의해 폴리머라제를 억제하는 독소-항독소 시스템의 구성성분인 독소의 예는 CcdB 계열 대장균 단백질 유래의 독소와 DNA 분해 및 RNA 폴리머라제 억제의 보존된 활성을 갖는 이의 변이체, 예를 들면, CcdBET2 독소이다[E. Trovatti et al, Bioorg Med Chem Lett. 2008 Dec 1; 18(23): 6161-4].
이러한 실시형태에서의 효과기 펩타이드 서열의 예는 서열 번호 74 (CcdB 단백질) 및 서열 번호 75 (CcdB 단백질 변이체)로서 지정된다.
세포막과 결합하고 이에 따라 막 전위의 신속한 붕괴 및 수반성 호흡 정지를 유발하는 독소-항독소 시스템의 구성성분인 독소의 예는 세포질 막 TisB 및 Hok에 삽입되는 소수성 잔기의 긴 스트레치(stretch)를 함유하는 소형 염기성 단백질이다. Hok 또는 TisB의 막 삽입은 전기화학 전위의 손실을 유발하는데, 이는 세포내 ATP의 감소를 설명한다. 따라서, TisB와 Hok 둘 다는 세균 막을 손상시킴으로써 세포를 사멸한다[Unoson C, Wagner EG. A small SOS-induced toxin is targeted against the inner membrane in Escherichia coli. Mol Microbiol. 2008 Oct; 70(1): 258-70. Epub 2008 Aug 29]. 이러한 실시형태에서의 효과기 펩타이드 서열의 예는 서열 번호 208로서 지정된다.
상기에서 언급한 바와 같이, 일부 효과기 펩타이드는 신규하며, 이전에 개시되어 있지 않았다.
따라서, 본 발명은 서열 번호 200의 트리코산틴의 돌연변이형 변이체, 서열 번호 201의 슈도모나스 아에루기노사 독소의 촉매 서브유닛 A의 돌연변이형 변이체, 서열 번호 202의 슈도모나스 아에루기노사 독소의 촉매 서브유닛 A의 돌연변이형 변이체, 서열 번호 204의 슈도모나스 아에루기노사 독소의 촉매 서브유닛 A의 돌연변이형 변이체, 서열 번호 205의 슈도모나스 아에루기노사 독소의 촉매 서브유닛 A의 돌연변이형 변이체 및 서열 번호 207의 슈도모나스 아에루기노사 독소의 촉매 서브유닛 A의 돌연변이형 변이체로 이루어진 군으로부터 선택된 신규한 펩타이드에 관한 것이다.
이러한 신규 펩타이드는 특히 본 발명의 항암 융합 단백질의 도메인 (b)의 효과기 펩타이드로서의 용도를 발견하였다.
이러한 신규한 펩타이드는 모 펩타이드의 면역원성을 낮추도록 특별히 설계된다.
따라서, 이러한 신규한 펩타이드의 특별한 특징은 낮은 면역원성이다.
서열 번호 200의 트리코산틴의 돌연변이형 변이체로 이루어진 군으로부터 선택된 펩타이드는 유리하다.
서열 번호 201의 슈도모나스 아에루기노사 독소의 촉매 서브유닛 A의 돌연변이형 변이체로 이루어진 군으로부터 선택된 펩타이드도 또한 유리하다.
서열 번호 202의 슈도모나스 아에루기노사 독소의 촉매 서브유닛 A의 돌연변이형 변이체로 이루어진 군으로부터 선택된 펩타이드도 또한 유리하다.
서열 번호 204의 슈도모나스 아에루기노사 독소의 촉매 서브유닛 A의 돌연변이형 변이체, 서열 번호 205의 슈도모나스 아에루기노사 독소의 촉매 서브유닛 A의 돌연변이형 변이체 및 서열 번호 207의 슈도모나스 아에루기노사 독소의 촉매 서브유닛 A의 돌연변이형 변이체로 이루어진 군으로부터 선택된 펩타이드도 또한 유리하다.
암 세포의 표면 상에 존재하는 TRAIL 수용체에 대한 결합시, 융합 단백질은 이중 효과를 나타낸다. TRAIL의 기능적 단편 또는 보존된 기능성을 갖는 이의 유사체인 도메인 (a)는 이의 공지된 작용제 활성, 즉 세포 표면 상의 사멸 수용체에 대한 결합 및 아폽토시스의 외인성 경로의 활성화를 나타낸다. 융합 단백질의 도메인 (b)의 효과기 펩타이드는 종양 세포에서 단백질 합성의 억제에 의해 TRAIL 도메인의 활성과 병행하여 세포내에서 이의 작용을 잠재적으로 나타낼 수 있을 것이다.
세포에 대한 융합 단백질의 내재화 후 효과기 펩타이드 - 기능적 도메인 (b)의 활성화는 리소좀(lisosomal) 효소(비특이적 프로테아제)에 의한 본 발명의 융합 단백질의 도메인 (b)로부터 도메인 (a)의 절단에 의해 비특이적으로 발생할 수 있다.
하지만, 바람직하게는 융합 단백질은 세포 환경에서 존재하는 프로테아제에 의해 인식되는 절단 부위의 도메인을 포함한다.
따라서, 본 발명의 바람직한 실시형태에서, 도메인 (a) 및 도메인 (b)는 세포 환경, 특히 종양 세포 환경에서 존재하는 프로테아제, 예를 들면, 메탈로프로테아제, 유로키나제 또는 푸린에 의해 인식되는 절단 부위의 서열을 포함하는 하나 이상의 도메인 (c)에 의해 연결되어 있다.
프로테아제에 의해 인식되는 서열은,
- 메탈로프로테아제 MMP Pro Leu Gly Leu Ala Gly Glu Pro/ PLGLAGEP에 의해 인식되는 서열, 또는 부착되는 서열의 마지막 아미노산에 의해 메탈로프로테아제 MMP에 의해 인식되는 서열을 형성하는 이의 단편,
- 유로키나제 uPA Arg Val Val Arg/RVVR에 의해 인식되는 서열, 또는 부착되는 서열의 마지막 아미노산에 의해 유로키나제에 의해 인식되는 서열을 형성하는 이의 단편, 및
이들의 조합, 또는
- 푸린 Arg Gln Pro Arg/RQPR, Arg Gln Pro Arg Gly/RQPRG, Arg Lys Lys Arg/RKKR에 의해 인식되는 서열, 문헌[M. Gordon et al., In Inf. and Immun, 1995, 63, No. 1, p. 82-87]에 개시된 푸린에 의해 인식되는 다른 이례적인 서열 또는 푸린 Arg His Arg Gln Pro Arg Gly Trp Glu Gln Leu (RHRQPRGWEQL)에 의해 인식되는 천연 서열.
본 발명의 하나의 실시형태에서, 프로테아제 절단 부위는 메탈로프로테아제 MMP에 의해 인식되는 서열 및/또는 유로키나제 uPA에 의해 인식되는 서열 및/또는 임의의 순서로 서로 옆에 위치하는 푸린에 의해 인식되는 서열의 조합이다.
바람직하게는, 하나의 실시형태에서의 도메인 (c)는 Arg Gln Pro Arg/RQPR, Arg Gln Pro Arg Gly/RQPRG, Arg Val Lys Arg/RVKR 및 Arg Lys Lys Arg/RKKR로부터 선택된 푸린에 의해 인식되는 서열이다.
프로테아제인 메탈로프로테아제 MMP, 유로키나제 uPA 및 푸린은 종양 환경에서 과발현된다. 프로테아제에 의해 인식되는 서열의 존재는 도메인 (a) 및 도메인 (b)의 절단, 즉 기능적 도메인 (b)의 방출 및 이에 따른 이의 가속화된 활성화를 가능하게 한다.
프로테아제 절단 부위의 존재는 효과기 펩타이드의 신속한 방출을 가능하게 함으로써, 비특이적인 프로테아제에 의한 융합 단백질의 무작위 분해가 일어나기 전에 종양 환경에서 과발현된 프로테아제에 의한 hTRAIL 단편으로부터의 절단의 결과로서 펩타이드를 이의 작용 부위까지 운반하는 기회를 증가시킨다.
이와 관련하여, 바람직한 효과기 펩타이드는 디프테리아 독소 및 슈도모나스 외독소이며, 이들은 푸린 Arg Val Arg Arg/RVRR (디프테리아 독소) 및 Arg Gln Pro Arg Gly/RQPRG (슈도모나스 외독소)에 의해 인식되는 절단 부위의 저연 발생 서열을 함유한다.
추가로, 운반 도메인 (d)는 본 발명의 융합 단백질의 효과기 펩타이드의 도메인 (b)에 부착될 수 있다.
도메인 (d)는,
- (d1) 슈도모나스 아에루기노사로부터 유래하는, 세포막을 통해 운반하는 도메인;
- (d2) 소포체로 표적화하는, 상기 세포막을 통해 운반하는 도메인;
- (d3) 6, 7, 8, 9, 10 또는 11 (Arg/R) 잔기로 이루어진, 상기 세포막을 통해 운반하는 폴리아르기닌 서열, 또는 부착되는 서열의 마지막 아미노산에 의해 운반 도메인 (d1), (d2) 또는 (d3)의 서열을 형성하는 이들의 단편; 및
- 이들의 조합으로 이루어진 군으로부터 선택될 수 있다.
도메인 (d1), (d2) 및 (d3)의 조합은 특히 (d1)/(d2), (d1)/(d3) 또는 (d1)/(d2)/(d3)의 조합을 포함할 수 있다.
더욱이, 도메인 (d1), (d2) 및 (d3)의 조합은 서로 옆에 위치하고 도메인 (b)의 하나의 말단에 연결된 도메인 및/또는 도메인 (b)의 상이한 말단에 연결된 도메인을 포함할 수 있다.
융합 단백질이 도메인 (b)에 부착된 운반 도메인 (d)와 도메인 (a) 및 도메인 (b) 사이의 절단 부위의 도메인 (c) 둘 다를 가지는 경우, 작제물의 절단 후 운반 도메인 (d)가 여전히 도메인 (b)에 부착되어 있는 방식으로 도메인 (c)가 위치된다 것은 이해되어야 한다. 즉, 융합 단백질이 운반 도메인 (d)와 절단 부위 도메인 (c) 둘 다를 함유하는 경우, 도메인 (d)는 도메인 (b)와 도메인 (c) 사이에 위치되어 있거나, 도메인 (d)의 부착 부위에 대향하는 도메인 (b)의 말단에 위치되어 있다.
본 발명은 또한 도메인 (d), 바람직하게는 전위 슈도모나스 아에루기노사 도메인이 2개의 도메인 (c) 사이에 위치되어 있는 변이체, 즉 작제물의 절단 후 운반 도메인, 바람직하게는 전위 슈도모나스 아에루기노사 도메인이 TRAIL 도메인에도 효과기 펩타이드 도메인에도 부착되어 있지 않은 변이체를 포함한다.
본 발명은 도메인 (d)가 도메인 (c)와 도메인 (a) 사이에 위치되어 있는 변이체, 즉 작제물의 절단 후 운반 도메인이 여전히 TRAIL 도메인에 부착되어 있는 변이체를 포함하지 않는다.
슈도모나스 아에루기노사 독소의 전위 도메인인 운반 도메인 또는 슈도모나스 아에루기노사 독소로부터 유래하는 리소좀 막을 통해 운반하는 도메인의 다른 단편은 세포막을 가로질러 전위하는 능력을 가지며, 효과기 펩타이드를 종양 세포의 구획에 도입하는데 사용될 수 있다. 슈도모나스 아에루기노사 전위 도메인의 서열은 잘 공지되어 있으며, 서열 번호 139로 지정된다.
바람직하게는, 슈도모나스 아에루기노사 전위 도메인은 도메인 (a)와 도메인 (b) 사이에 위치되어 있고 추가로 도메인 (c)에 의해 분리되어 있다.
또한, 바람직하게는 소포체에 운반하는 도메인 (d2)는 효과기 펩타이드의 C-말단에 부착되어 있고 본 발명의 융합 단백질의 C-말단에 위치되어 있다.
또한, 바람직하게는 세포막을 통해 운반하는 폴리아르기닌 서열은 효과기 펩타이드의 C-말단에 부착되어 있고 효과기 펩타이드와 도메인 (a) 사이에 위치되어 있고, 바람직하게는 추가로 도메인 (c)에 의해 도메인 (d)와 분리되어 있다.
소포체로 유도하는 서열 (d2)는 소포체에 유도하는 당업계에 공지된 임의의 신호 서열일 수 있으며, 예를 들면, Lys Asp Glu Leu/KDEL, His Asp Glu Leu/HDEL, Arg Asp Glu Leu/RDEL, Asp Asp Glu Leu/DDEL, Ala Asp Glu Leu/ADEL, Ser Asp Glu Leu/SDEL 및 Lys Glu Asp Leu/KEDL이 있지만, 이에 한정되지는 않는다.
도메인 (d2)는 바람직하게는 Lys Asp Glu Leu/KDEL 및 Lys Glu Asp Leu/KEDL로부터 선택된다.
바람직하게는, 운반 서열 (d2)는 본 발명의 융합 단백질의 C-말단에 위치되어 있다.
또 다른 실시형태에서, 융합 단백질에 대한 PEG 분자의 부착에 적절한 서열을 포함하는 도메인 (e)(페길화 링커)가 추가로 도메인 (a)와 도메인 (b) 사이에 위치되어 있다. 이러한 링커는 공지된 서열인 Ala Ser Gly Cys Gly Pro Glu/ASGCGPE일 수 있다. 페길화 링커는 또한 다음으로 이루어진 군으로부터 선택될 수 있다:
Ala Ala Cys Ala Ala/AACAA,
Ser Gly Gly Cys Gly Gly Ser/SGGCGGS 및
Ser Gly Cys Gly Ser/SGCGS.
바람직하게는, 페길화 링커의 서열은 Ala Ser Gly Cys Gly Pro Glu/ ASGCGPE이다.
융합 단백질의 주요 기능적 요소 및 절단 부위 도메인(들) 이외에도, 본 발명의 융합 단백질은 가요성 입체 링커의 중립(neutral) 서열/서열들을 함유할 수 있다. 이러한 입체 링커는 잘 공지되어 있으며, 문헌에 기재되어 있다. 융합 단백질에 대한 이들의 혼입은 숙주 세포에서 이의 과발현의 과정에 의해 생성된 단백질의 정확한 접기(folding)를 제공하는 것으로 의도된다. 특히, 입체 링커는 글라이신, 글라이신-세린 또는 글라이신-시스테인-알라닌 링커일 수 있다.
특히, 입체 링커는 글라이신과 세린 잔기의 조합, 예를 들면, Gly Gly Gly Gly Ser/GGGGS, 또는 입체 링커로서 작용하는 임의의 이의 단편, 예를 들면, 단편 Gly Gly Gly Ser/GGGS, Gly Gly Gly/GGG 또는 Gly Gly Gly Gly/GGGG일 수 있다. 다른 실시형태에서, 입체 링커는 글라이신, 세린 및 알라닌 잔기의 조합의 임의의 조합, 예를 들면, Ala Ser Gly Gly/ASGG, 또는 입체 링커로서 작용하는 임의의 이의 단편, 예를 들면, AlaSerGly/ASG일 수 있다. 입체 링커, 예를 들면, 서열 Gly Gly Gly Ser Gly/ GGGGS, 또는 입체 링커로서 작용하는 임의의 이의 단편, 예를 들면, 단편 Gly Gly Gly/GGG와 입체 링커로서 작용하는 또 다른 단편의 조합을 사용하는 것도 또한 가능하다. 이러한 경우, 입체 링커는 글라이신, 세린 및 알라닌 잔기의 조합, 예를 들면, Gly Gly Gly Ser Ala Ser Gly Gly/GGGSASGG일 수 있다. 또 다른 실시형태에서, 입체 링커는 세린과 히스티딘 잔기의 조합, 예를 들면, Ser His His Ser/SHHS 또는 Ser His His Ala Ser/SHHAS일 수 있다.
또 다른 실시형태에서, 입체 링커는 알라닌과 시스테인 잔기이 조합, 예를 들면, CAAACAAC (Cys Ala Ala Ala Cys Ala Ala Cys), CAACAAAC (Cys Ala Ala Cys Ala Ala Ala Cys) 또는 이들의 단편일 수 있다.
또 다른 실시형태에서, 적절한 입체 링커는 위에서 언급된 바와 같은 임의의 유형의 입체 링커의 조합에 의해 형성된다. 이러한 조합의 예는 다름과 같이 표시된다: Gly Gly Gly Gly Gly Ser Gly Gly Gly Gly Ser (GGGGGSGGGGS), Gly Gly Gly Cys Ala Ala Ala Cys Ala Ala Cys (GGGCAAACAAC) 및 Gly Gly Gly Gly Ser Gly Gly Gly Gly Cys Ala Ala Ala Ala Ala Cys (GGGGSGGGCAAACAAC).
하나의 양태에서, 입체 링커는 또한 단일 아미노산 잔기, 예를 들면, 단일 시스테인 잔기로부터 선택될 수 있다.
또한, 입체 링커는 또한 비특이적 방식으로 발생하는 기능적 도메인 (b)의 활성화에 유용할 수 있다. 비특이적 방식에서의 도메인 (b)의 활성화는 입체 링커의 pH-의존적 가수분해로 인해 본 발명에 따른 융합 단백질의 도메인 (b)로부터 도메인 (a)를 절단함으로써 수행될 수 있다.
더욱이, 본 발명의 융합 단백질은 인테그린에 대한 모티브 결합을 함유하는 링커를 포함할 수 있다. 이러한 링커는 세포 표면에 대한 추가의 결합을 제공하고 전신성 독성을 감소시킬 수 있다.
인테그린은 다수의 세포 유형의 표면 상에 존재하는 알파-베타 이질이합체이다. 인테그린에 대한 리간드는 피브로넥틴, 콜라겐 및 라미닌과 같은 세포외 매트릭스 유착 단백질이다. 피브로넥틴 및 일부 다른 리간드의 경우, RGD 모티브는 인테그린과의 상호작용을 담당한다. 이러한 모티브를 함유하는 펩타이드는 인테그린 알파 5 베타 1을 특이적으로 인식하고, 전이를 형성하는 이의 능력을 제한함으로써 종양 세포의 침입에 대하여 억제 효과를 가진다[Ghelsen et al., (1988) J. Cell Biol. 106, 925-930]. 파지 디스플레이 방식을 사용하여, 6-아미노산 펩타이드의 라이브러리로부터 NGR 모티브를 포함하는 서열을 분리하고, 이는 인테그린 알파 5 베타 1에 결합하고 이를 특이적으로 인식한다[Koivunen et al.., J Biol Chem. 1993 Sep 25; 268(27): 20205-10]. 2개의 모티브 (NGR 및 RGD)는 혈관신생에 관련된 다른 인자에 대하여 길항제로서 결합하는 것으로 또한 입증되었다. RGD는 또한 혈관신생의 과정에서 특이적으로 과제시된 인테그린과 상호작용하는 반면[Friedlander et al. Definition of two angiogenic pathways by distinct αv integrins. Science (Washington DC), 270: 1500-1502, 1995], NGR은 암의 침입에도 또한 관련된 단백질이고 특히 종양 및 강렬한 혈관신생을 겪는 다른 세포의 혈관에 강하게 노출된 아미노펩티다제 N과 상호작용한다[Pasqualini et al., Aminopeptidase N is a receptor for tumor-homing peptides 및 a target for inhibiting angiogenesis. Cancer Res. 2000 Feb 1; 60(3): 722-7].
인테그린과 결합할 수 있는 본 발명의 융합 단백질로부터의 링커는 모티브 Asn Gly Arg (NGR), Asp Gly Arg (DGR) 또는 Arg Gly Asp (RGD)를 포함한다.
본 발명의 융합 단백질의 바람직한 실시형태에서, 인테그린과 결합하는 모티브를 포함하는 링커는 서열 번호 140으로 지정된다.
서열 번호 140 (Cys Phe Cys Asp Gly Arg Cys Asp Cys Ala/CFCDGRCDCA)은 시스테인 서열에 의해 안정화된 모티브 Asp Gly Arg (DGR)을 포함하며, 공지되어 있으며, 문헌[Wang H, Yan Z, Shi J, Han W, Zhang Y Protein Expr Purif. 2006 Jan; 45(1): 60-5]에 개시되어 있다.
본 발명의 융합 단백질의 특정 실시형태는 해독 과정의 억제에 의해 세포내에서 작용하는 펩타이드를 포함하는 융합 단백질이며, 서열 번호 55, 서열 번호 56, 서열 번호 57, 서열 번호 58, 서열 번호 59, 서열 번호 60, 서열 번호 61, 서열 번호 62, 서열 번호 63, 서열 번호 64, 서열 번호 65, 서열 번호 66, 서열 번호 67, 서열 번호 68, 서열 번호 69, 서열 번호 70, 서열 번호 71, 서열 번호 72, 서열 번호 73, 서열 번호 74, 서열 번호 75, 서열 번호 76, 서열 번호 77, 서열 번호 78, 서열 번호 79, 서열 번호 80, 서열 번호 81, 서열 번호 82, 서열 번호 83, 서열 번호 84, 서열 번호 144, 서열 번호 145, 서열 번호 146, 서열 번호 147, 서열 번호 148, 서열 번호 149, 서열 번호 150, 서열 번호 151, 서열 번호 152, 서열 번호 153, 서열 번호 154, 서열 번호 155, 서열 번호 156, 서열 번호 157, 서열 번호 158, 서열 번호 159, 서열 번호 160, 서열 번호 161, 서열 번호 162, 서열 번호 163, 서열 번호 164, 서열 번호 165, 서열 번호 166, 서열 번호 167 및 서열 번호 168의 지정된 펩타이드의 군으로부터 선택된다.
본 발명에 따른 융합 단백질에서의 TRAIL의 항암 활성은, 단백질 합성을 억제하는 다른 성분의 활성화(예를 들면, 28S rRNA에서 아데닌의 탈퓨린화, 인자 EF2의 ADP-리보실화, 28SRNA에서 아데닌의 N-글리코실화, 28S RNA의 절단, mRNA의 절단 또는 DNA 분해)를 수행하고, 이에 따라 프로테옴의 수준에서 세포의 반응을 차단하고, 아폽토시스 경로를 차단하는 단백질의 과생성을 감소시키고, 마지막으로 아폽토시스 경로를 재확립함으로써 잠재적으로 증가할 수 있다. 추가로, 세포의 단백질 합성 과정의 차단은 DR 시리즈의 기능적 세포 수용체에 대한 TRAIL의 부착으로부터 야기되는 신호와 상승작용하는 내부 유도된 아폽토시스를 세포 주기의 제어점 (예를 들면, 사이클린-의존적 키나제)에 의해 활성화시킬 수 있다.
본 발명의 융합 단백질은 다수의 경우에서 가용성 TRAIL 및 서열의 단편을 포함하는 이의 변이체 보다 더 강력한 활성을 나타내는 것으로 밝혀졌다.
지금까지, 본 발명의 융합 단백질에서 사용된 공지된 효과기 펩타이드 중에서도, 인터류킨-2에 융합된 디프테리아(Ontake®)만이 의약에서 사용되었다. 본 발명의 융합 단백질에 사용된 다른 효과기 펩타이드는 부적합한 동력학, 비특이적 프로테아제에 의한 신속한 분해, 및 표적 부위에서 효과기 펩타이드의 작용을 가능하게 하는데 필요한 적절한 활성화 경로의 서열의 결핍에 의해 유발되는 체내 축적 때문에 의약에 적용되지 않았다. 융합 단백질의 혼입은 이의 작용이 원해지는 부위로 이의 선택적인 전달을 가능하게 한다.
더욱이, 효과기 펩타이드의 부착은 단백질의 중량을 증가시키며, 이는 반감기를 연장시키고, 종양에서 단백질의 보유를 증가시키고, 그 결과 이의 효능을 증가시킨다. 추가적으로, 다수의 경우에서, 신규한 융합 단백질은 아마 단백질 합성을 담당하는 세포 기구의 불안정을 통해 TRAIL에 대한 자연 또는 유도 내성을 극복한다. 암 세포는 그 중에서도 아폽토시스 경로를 차단하는 단백질 (Bcl-2, IAP, XIAP 또는 cFLIP)의 과생성에 의해 TRAIL의 세포독성 활성에 대한 내성을 획득할 수 있기 때문에, 단백질 합성의 세포 기작의 차단은 프로테옴 수준에서 세포 반응을 봉쇄하고, 이에 따라 아폽토시스 경로를 해제할 수 있다.
상기에서 언급된 대표적인 융합 단백질의 구조에 대한 상세한 설명은 하기에 제시된 실시예에 나타낸다.
본 발명에 따르면, 융합 단백질은 2개 이상의 단백질을 함유하는 단일 단백질 분자 또는 이의 단편을 의미하며, 이는 추가의 화학 링커를 사용하지 않고 이의 각각의 펩타이드 쇄 내의 펩타이드 결합을 통해 공유결합되어 있다.
융합 단백질은 또한 대안적으로 단백질 작제물 또는 키메라 단백질로서 개시될 수도 있다. 본 발명에 따르면, 용어 "작제물" 또는 "키메라 단백질"은, 사용된다면, 상기에서 정의된 바와 같은 융합 단백질을 의미하는 것으로 이해되어야 한다.
이와 같이 정의된 융합 단백질이 펩타이드 및 단백질의 공지된 화학 합성 방법에 의해 합성될 수 있다는 것은 당업자에게 명백할 것이다.
융합 단백질은 화학 펩타이드 합성 방법, 특히 캐리어로서 적절한 수지를 사용하는 고체상에서의 펩타이드 합성 기술을 사용하여 합성될 수 있다. 이러한 기술은 당업계에 통상적으로 공지되어 있는 것이며, 그 중에서도 특히 논문, 예를 들면, [Bodanszky, The Practice of Peptide Synthesis, 1984, Springer-Verlag, New York; 및 Stewart et al., Solid Phase Peptide Synthesis, 2nd Edition, 1984, Pierce Chemical Company]에 개시되어 있다.
융합 단백질은 연속 단백질로서 펩타이드의 화학 합성 방법에 의해 합성될 수 있다. 대안적으로, 단백질의 각 단편(도메인)을 별개로 합성하고, 이어서 제2 펩타이드의 카복실 말단으로부터 하나의 펩타이드 단편의 아미노 말단을 축합함으로써, 펩타이드 결합을 통해 하나의 연속 펩타이드에서 함께 조합할 수 있다. 이러한 기술은 통상적으로 잘 공지되어 있다.
그러나, 바람직하게는 본 발명의 융합 단백질은 숙주 세포 내의 융합 단백질을 암호화하는 폴리뉴클레오타이드 서열의 유전자 발현 방법에 의해 생성된 재조합 단백질이다.
생성된 펩타이드의 구조를 증명하기 위해, 고분해능 질량 분석법과 같은 펩타이드의 아미노산 조성의 공지된 분석 방법을 사용하여 펩타이드의 분자량을 결정할 수 있다. 펩타이드 서열을 확인하기 위해, 순차적으로 펩타이드를 분해하고 아미노산의 서열을 식별하는 단백질 서열 분석기도 또한 사용할 수 있다.
본 발명의 추가의 측면은 상기에서 정의된 바와 같은 융합 단백질을 암호화하는 폴리뉴클레오타이드 서열, 특히 DNA 서열이다.
바람직하게는, 상기에서 정의된 바와 같은 융합 단백질을 암호화하는 본 발명에 따른 폴리뉴클레오타이드 서열, 특히 DNA는 대장균(E. coli)에서의 발현에 최적화된 서열이다.
본 발명의 또 다른 측면은 또한 상기에서 정의된 바와 같은 본 발명의 폴리뉴클레오타이드 서열, 특히 DNA 서열을 함유하는 발현 벡터이다.
본 발명의 또 다른 측면은 상기에서 정의된 바와 같은 발현 벡터를 포함하는 숙주 세포이다.
본 발명의 융합 단백질의 발현을 위한 바람직한 숙주 세포는 대장균 세포이다.
융합 단백질을 포함하는 재조합 단백질의 생성 방법은 잘 공지되어 있다. 간단히 말하자면, 이러한 기술은 폴리뉴클레오타이드 분자, 예를 들면, 표적 단백질의 아미노산 서열을 암호화하고 숙주에서 표적 단백질의 발현을 지시하는 DNA 분자의 생성에 있다. 이어서, 폴리뉴클레오타이드 분자를 암호화하는 표적 단백질을 적절한 발현 벡터에 혼입하는데, 이 발현 벡터는 폴리펩타이드의 효율적 발현을 보장한다. 이어서, 형질 감염/형질 전환을 위해 재조합 발현 벡터를 숙주 세포에 도입하고, 그 결과로서 형질 전환된 숙주 세포가 생성된다. 이후, 형질 전환된 세포를 배양하여 표적 단백질을 과발현시키고, 수득된 단백질을 정제하고, 임의로 단백질을 발현하거나 정제하는데 사용된 태그 서열을 절단하여 자른다.
발현 및 정제의 적절한 기술은, 예를 들면, 논문[Goeddel, Gene Expression Technology, Methods in Enzymology 185, Academic Press, San Diego, CA (1990); 및 A. Staron et al., Advances Mikrobiol., 2008, 47, 2, 1983-1995]에 개시되어 있다.
숙주 세포에서 DNA 서열의 도입 및 복제를 위한 발현 벡터로서, 코스미드, 플라스미드 또는 변형된 바이러스를 사용할 수 있다. 전형적으로 플라스미드를 발현 벡터로서 사용한다. 적절한 플라스미드는 잘 공지되어 있으며, 상업적으로 입수 가능하다.
본 발명의 발현 벡터는 본 발명의 융합 단백질을 암호화하는 폴리뉴클레오타이드 분자 및 적절한 숙주 세포에 혼입된 암호화 서열의 전사 및 해독을 위한 필수 조절 서열을 포함한다. 조절 서열의 선택은 숙주 세포의 유형에 의존하며 당업자에 의해 용이하게 수행될 수 있다. 이러한 조절 서열의 예는 전사 프로모터 및 인핸서 또는 RNA 폴리머라제 결합 서열, 암호화 서열 전에 삽입된 전사 개시 신호를 함유하는 리보솜 결합 서열, 및 암호화 서열 후에 삽입된 전사 종결자 서열이다. 더욱이, 사용되는 숙주 세포 및 벡터에 따라, 복제 원점, 추가적인 DNA 제한 부위, 인핸서, 및 전사의 유도를 허용하는 서열과 같은 기타 서열을 발현 벡터에 도입할 수 있다.
발현 벡터는 또한 형질전환된 세포에 정의된 표현형을 부여하고 형질전환된 세포의 특이적인 선택을 할 수 있게 하는 마커 유전자 서열을 포함할 것이다. 더욱이, 벡터는 또한 삽입되지 않은 플라스미드를 취한 세포와 표적 단백질의 삽입된 암호화 서열을 함유하는 재조합 플라스미드로 형질전환된 세포를 구별하도록 허용하는 제2 마커 서열을 함유할 수 있다. 가장 종종, 전형적인 항생제 내성 마커를 사용하지만, 세포내(생체내)의 존재가 자가방사선 기술, 분광광도법, 생체발광 또는 화학발광을 사용하여 용이하게 결정될 수 있는 당업계에 공지된 임의의 다른 리포터 유전자를 사용할 수 있다. 예를 들면, 숙주 세포에 따라, β-갈락토시다제, β-글루쿠로니다제, 루시페라제, 클로람페니콜 아세틸트랜스퍼라제 또는 녹색 형광 단백질과 같은 리포터 유전자를 사용할 수 있다.
더욱이, 발현 벡터는 접기를 용이하게 하는 적절한 세포 구획, 예를 들면, 주변세포질(periplasma)로 단백질을 운반하는 신호 서열을 함유할 수 있다. 추가로, N-말단에 부착된 HisTag 또는 C-말단에 부착된 GST와 같은 라벨/태그를 암호화하는 서열이 존재할 수 있으며, 이는 니켈 컬럼 상에서 친화성 크로마토그래피를 통해, 친화성의 원리를 사용하여 생성된 단백질의 후속 정제를 용이하게 한다. 숙주 세포 내에서 단백질 가수분해에 대항하여 단백질을 보호하는 추가의 서열 뿐만 아니라, 이의 용해도를 향상시키는 서열도 또한 존재할 수 있다.
표적 단백질의 서열에 부착된 보조 요소는 이의 활성을 차단하거나, 예를 들면, 독성으로 인한 것과 같은 또 다른 이유로 유해할 수 있다. 이러한 요소를 제거해야 하는데, 이는 효소 절단 또는 화학 절단에 의해 달성될 수 있다. 특히, 6-히스해딘 태그 HisTag 또는 친화성 크로마토그래피에 의해 단백질 정제를 허용하도록 부착된 이러한 유형의 다른 마커를 제거해야 하는데, 그 이유는 가용성 TRAIL 단백질의 간 독성에 대한 이의 기술된 효과 때문이다. 원핵 세포(대장균 또는 바실러스 서브틸리스(Bacillus subtilis)와 같은 세균, 사카로마이세스 세르비지애(Saccharomyces cervisiae) 또는 피키아 파스토리스(Pichia pastoris)와 같은 효모) 및 진핵 세포주(곤충, 포유동물, 식물)를 포함한 공지된 각종 숙주 세포를 기반으로 하는 이종 발현 시스템을 사용할 수 있다.
바람직하게는, 배양 및 유전자 조작의 용이성 및 다량의 수득 생성물로 인해, 대장균 발현 시스템을 사용한다. 따라서, 본 발명의 융합 단백질을 암호화하는 표적 서열을 함유하는 폴리뉴클레오타이드 서열은 대장균에서의 발현을 위해 최적화될 것이고, 즉 당업계에 공지된 가능한 서열 변이체로부터 선택된 대장균에서의 발현에 최적인 코돈을 암호화 서열에 함유할 것이다. 더욱이, 발현 벡터는 암호화 서열에 부착된 대장균에 적절한 상기에서 개시된 요소를 함유할 것이다.
따라서, 본 발명의 바람직한 실시형태에서, 대장균에서의 발현을 위해 최적화된 본 발명의 융합 단백질을 암호화하는 서열을 포함하는 폴리뉴클레오타이드 서열은 서열 번호 85, 서열 번호 86, 서열 번호 87, 서열 번호 88, 서열 번호 89, 서열 번호 90, 서열 번호 91, 서열 번호 92, 서열 번호 93, 서열 번호 94, 서열 번호 95, 서열 번호 96, 서열 번호 97, 서열 번호 98, 서열 번호 99, 서열 번호 100, 서열 번호 101, 서열 번호 102, 서열 번호 103, 서열 번호 104, 서열 번호 105, 서열 번호 106, 서열 번호 107, 서열 번호 108, 서열 번호 109, 서열 번호 110, 서열 번호 111, 서열 번호 112, 서열 번호 113, 서열 번호 114, 서열 번호 115, 서열 번호 116, 서열 번호 117, 서열 번호 118, 서열 번호 119, 서열 번호 120, 서열 번호 121, 서열 번호 122, 서열 번호 123, 서열 번호 124, 서열 번호 125, 서열 번호 126, 서열 번호 127, 서열 번호 128, 서열 번호 129, 서열 번호 130, 서열 번호 131, 서열 번호 132, 서열 번호 133, 서열 번호 134, 서열 번호 135, 서열 번호 136, 서열 번호 137, 서열 번호 138, 서열 번호 169, 서열 번호 170, 서열 번호 171, 서열 번호 172, 서열 번호 173, 서열 번호 174, 서열 번호 175, 서열 번호 176, 서열 번호 177, 서열 번호 178, 서열 번호 179, 서열 번호 180, 서열 번호 181, 서열 번호 182, 서열 번호 183, 서열 번호 184, 서열 번호 185, 서열 번호 186, 서열 번호 187, 서열 번호 188, 서열 번호 189, 서열 번호 190, 서열 번호 191, 서열 번호 192 및 서열 번호 193으로 이루어진 폴리뉴클레오타이드 서열의 군으로부터 선택되며; 이들은 각각 서열 번호 1, 서열 번호 2, 서열 번호 3, 서열 번호 4, 서열 번호 5, 서열 번호 6, 서열 번호 7, 서열 번호 8, 서열 번호 9, 서열 번호 10, 서열 번호 11, 서열 번호 12, 서열 번호 13, 서열 번호 14, 서열 번호 15, 서열 번호 16, 서열 번호 17, 서열 번호 18, 서열 번호 19, 서열 번호 20, 서열 번호 21, 서열 번호 22, 서열 번호 23, 서열 번호 24, 서열 번호 25, 서열 번호 26, 서열 번호 27, 서열 번호 28, 서열 번호 29, 서열 번호 30, 서열 번호 31, 서열 번호 32, 서열 번호 33, 서열 번호 34, 서열 번호 35, 서열 번호 36, 서열 번호 37, 서열 번호 38, 서열 번호 39, 서열 번호 40, 서열 번호 41, 서열 번호 42, 서열 번호 43, 서열 번호 44, 서열 번호 45, 서열 번호 46, 서열 번호 47, 서열 번호 48, 서열 번호 49, 서열 번호 50, 서열 번호 51, 서열 번호 52, 서열 번호 53, 서열 번호 54, 서열 번호 144, 서열 번호 145, 서열 번호 146, 서열 번호 147, 서열 번호 148, 서열 번호 149, 서열 번호 150, 서열 번호 151, 서열 번호 152, 서열 번호 153, 서열 번호 154, 서열 번호 155, 서열 번호 156, 서열 번호 157, 서열 번호 158, 서열 번호 159, 서열 번호 160, 서열 번호 161, 서열 번호 162, 서열 번호 163, 서열 번호 164, 서열 번호 165, 서열 번호 166, 서열 번호 167 및 서열 번호 168의 아미노산 서열로 이루어진 군으로부터 선택된 아미노산 서열에 상응하는 아미노산 서열을 갖는 융합 단백질을 암호화한다.
바람직한 실시형태에서, 본 발명은 또한 상기에서 나타낸 폴리뉴클레오타이드 서열인 서열 번호 85 내지 서열 번호 138 및 서열 번호 169 내지 서열 번호 193의 군으로부터 선택된 폴리뉴클레오타이드 서열을 포함하는 대장균의 형질 전환에 적절한 발현 벡터 뿐만 아니라, 이러한 발현 벡터로 형질전환된 대장균 세포를 제공한다.
형질 전환, 즉 세균성 숙주 세포, 특히 대장균에 대한 DNA 서열의 도입은, 예를 들면, 저온(4℃)에서 칼슘 이온으로 처리하고, 이어서 열 충격(37℃ 내지 42℃에서)을 수행하거나 전기천공법에 의해 DNA를 취하도록 제조된 적격 세포 상에서 일반적으로 수행된다. 이러한 기술은 잘 공지되어 있으며, 일반적으로 발현 시스템의 제조업자에 의해 결정되거나, 문헌 및 실험 작업을 위한 매뉴얼[Maniatis et al., Molecular Cloning. Cold Spring Harbor, N.Y., 1982]에 개시되어 있다.
대장균 발현 시스템에서의 본 발명의 융합 단백질의 과발현의 절차는 하기에서 더 개시될 것이다.
본 발명은 또한 활성 성분으로서 상기에서 정의된 바와 같은 본 발명의 융합 단백질 및 적절한 약제학적으로 허용가능한 담체, 희석제 및 통상의 보조 성분을 함유하는 약학적 조성물을 제공한다. 약학적 조성물은 담체 또는 희석제에 용해 또는 분산된 유효량의 본 발명의 융합 단백질 및 약제학적으로 허용 가능한 보조 성분을 함유할 것이며, 바람직하게는 단위 투여 형태로 제형화된 약학적 조성물 또는 복수의 용량을 함유하는 제형의 형태일 것이다. 약학적 형태 및 이의 제형화 방법 뿐만 아니라, 다른 성분, 담체 및 희석제는 당업자에게 공지되어 있으며, 문헌에 개시되어 있다. 예를 들면, 이들은 논문[Remington's Pharmaceutical Sciences, ed. 20, 2000, Mack Publishing Company, Easton, USA]에 개시되어 있다.
용어 "약제학적으로 허용가능한 담체, 희석제 및 보조 성분"은 당업계에 공지된 임의의 용매, 분산매, 계면활성제, 항산화제, 안정화제, 보존제(예를 들면, 항세균제, 항진균제) 및 등장제를 포함한다. 본 발명의 약학적 조성물은 선택된 투여 경로 및 목적하는 투여 형태, 예를 들면, 경구, 비경구, 흡입, 국소용 액체, 고체 및 에어로졸 형태에 따라 각종 유형의 담체, 희석제 및 부형제를 함유할 수 있으며, 이러한 선택된 형태는 주사와 같은 투여 경로를 위해 멸균 상태이어야 한다. 본 발명에 따른 약학적 조성물의 바람직한 투여 경로는 정맥내, 근육내, 피하, 복강내, 종양내와 같은 주사 경로, 또는 단일 또는 지속 정맥내 주입을 포함한 비경구이다.
하나의 실시형태에서, 본 발명의 약학적 조성물은 종양에 직접 주사하여 투여될 수 있다. 또 다른 실시형태에서, 본 발명의 약학적 조성물은 정맥내 투여될 수 있다. 또 다른 실시형태에서, 본 발명의 약학적 조성물은 피하로 또는 복강내로 투여될 수 있다. 비경구 투여를 위한 약학적 조성물은, 필요에 따라, 적절한 pH로 완충되고 체액과 등삼투성인 약제학적으로 허용 가능한 수성 또는 비수성 매질 중의 용액 또는 분산액일 수 있으며, 또한 수용자의 조직 또는 혈액과 상용가능한 조성물을 만드는 항산화제, 완충액, 정균제, 가용성 물질도 함유할 수 있다. 조성물에 포함될 수 있는 기타 성분은, 예를 들면, 물, 알콜, 예를 들면, 에탄올, 폴리올, 예를 들면, 글리세롤, 프로필렌 글리콜, 액체 폴리에틸렌 글리콜, 지질, 예를 들면, 트리글리세라이드, 식물성 오일, 리포솜을 포함할 수 있다. 상기 물질의 적절한 유동성 및 입자 크기는 코팅 물질, 예를 들면, 레시틴, 및 계면활성제, 예를 들면, 하이드록시프로필셀룰로스 폴리소르베이트 등에 의해 제공될 수 있다.
액체 비경구 조성물을 위한 적절한 등장제는, 예를 들면, 글루코스와 같은 슈가, 염화 나트륨 및 이들의 조합이다.
대안적으로 주사 또는 주입 투여를 위한 약학적 조성물은, 예를 들면, 발열원 없는 멸균수와 같은 적절한 캐리어에서 사용되기 직전에 재구성하기 위한 분말 형태, 예를 들면, 동결 건조된 분말일 수 있다.
비경구 투여를 위한 본 발명의 약학적 조성물은 용액, 스프레이 또는 에어로졸을 포함하는 비강 투여의 형태도 또한 가질 수 있다. 바람직하게는 비내 투여를 위한 형태는 수용액일 것이며, 코 분비물과 유사한 특성을 유지하기 위해 약 5.5 내지 약 6.5의 pH를 유지하도록 완충되거나 등장성일 것이다. 더욱이, 이는 잘 공지된 비내 제제에서와 같이 보존제 또는 안정화제를 함유할 것이다.
조성물은 하나 이상의 성분의 산화를 지연시키는 각종 항산화제를 함유할 수 있다. 더욱이, 미생물의 작용을 방지하기 위해, 조성물은, 예를 들면, 파라벤, 클로로부탄올, 히메로살, 소르브산 및 이러한 유형의 공지된 유사 물질을 포함하지만 이에 한정되지 않는 각종 항세균제 및 항진균제를 함유할 수 있다. 일반적으로, 본 발명의 약학적 조성물은, 예를 들면, 약 0.01 중량% 이상의 활성 성분을 포함할 수 있다. 보다 특히, 조성물은 조성물 단위에 대하여 활성 성분을 1 중량% 내지 75 중량%의 양으로 또는, 예를 들면, 25 중량% 내지 60 중량%의 양으로 함유할 수 있으나, 지정된 값으로 한정되는 것은 아니다. 인간을 포함한 환자에게 투여되는 본 발명에 따른 조성물의 실제 복용량은 체중, 병태의 심각성, 치료될 질환의 유형, 선행 또는 수반되는 치료적 개입, 투여 환자 및 투여 경로와 같은 육체적 및 생리적 요인에 의해 결정될 것이다. 적절한 단위 복용량, 전체 복용량 및 조성물 중 활성 성분의 농도는 치료하는 의사에 의해 결정된다.
조성물은, 예를 들면, 환자의 체중 1kg 당 약 1μg 내지 약 1000mg의 복용량으로, 예를 들면, 환자의 체중 1kg 당 5mg 내지 100mg의 범위 또는 5mg 내지 500mg의 범위로 투여될 수 있다. 융합 단백질 및 이를 함유하는 조성물은 항암 또는 항종양을 나타내며, 암 질환의 치료를 위해 사용될 수 있다. 본 발명은 또한 인간을 포함한 포유 동물에서 암 질환을 치료하기 위한 상기에서 정의된 바와 같은 본 발명의 융합 단백질의 용도도 제공한다. 본 발명은 또한 신생물/암 질환의 치료가 필요한 대상에게 상기에서 정의된 바와 같은 본 발명의 융합 단백질을 항신생물/항암 유효량으로, 임의로 적절한 약학적 조성물의 형태로 투여하는 것을 포함하는, 인간을 포함한 포유 동물에서 신생물/암 질환을 치료하는 방법도 제공한다.
본 발명의 융합 단백질은 백혈병, 육아종증, 골수종 및 기타 혈액암과 같은 혈액암의 치료를 위해 사용될 수 있다. 융합 단백질은 또한 유방암, 비소세포 폐암을 포함한 폐암, 대장암, 췌장암, 난소암, 방광암, 전립선암, 신장암, 뇌암 등과 같은 고형 종양의 치료를 위해 사용될 수 있다. 암의 치료에서 융합 단백질의 적절한 투여 경로는 특히 비경구 경로일 것이며, 이는 본 발명의 융합 단백질을 주사액 또는 주입액의 형태로, 이러한 투여 경로에 적절한 조성물 및 형태로 투여하는데에 있다. 본 발명은 하기의 특정 융합 단백질의 일반 절차 및 실시예에서 더 상세히 개시될 것이다.
융합 단백질의 과발현을 위한 일반 절차
플라스미드의 제조
대장균에서의 발현을 위해 최적화된 코돈을 포함하는 표적 융합 단백질의 아미노산 서열은 이를 암호화하는 DNA 서열을 생성하기 위해 주형으로서 사용하였다. 이러한 절차는 대장균에서의 표적 단백질 합성의 추가 단계의 효율을 향상시키는 것을 가능하게 한다. 이어서, 생성된 뉴클레오타이드 서열은 자동적으로 합성되었다. 추가로, 제한 효소 Ndel (선도 가닥의 5'-말단에서) 및 Xhol (선도 가닥의 3'-말단에서)의 절단 부위를 표적 단백질을 암호화하는 생성된 유전자에 첨가하였다. 이들을 사용하여 벡터 pET28a(Novagen)에 유전자를 클로닝하였다. 이들은 또한 다른 벡터에 단백질을 암호화하는 유전자를 클로닝하기 위해 사용될 수 있다. 이러한 작제물로부터 발현된 표적 단백질은 트롬빈에 의해 인식된 부위에 후행하는 폴리히스티딘 태그(6개의 히스티딘)가 N-말단에 임의로 설치되며, 이는 후속하여 친화성 크로마토그래피를 통해 정제를 위해 제공되었다. 일부 표적은 어떠한 태그도 없이, 특히 히스티딘 태그 없이 발현되었고, 이들을 후속하여 SP 세파로스 상에서 정제하였다. 생성된 작제물의 정확성을 효소 Ndel 및 Xhol을 사용하여 분리된 플라스미드의 제한 분석에 의해 우선적으로 확인한 후, 표적 단백질의 전체 해독틀의 자동 서열분석에 의해 확인하였다. 서열분석을 위해 사용된 프라이머는 벡터에 존재하는 T7 프로모터 (5'-TAATACGACTCACTATAGG-3') 및 T7 종결자 (5'-GCTAGTTATTGCTCAGCGG-3')의 서열에 상보적이다. 생성된 플라스미드는 제조업자의 추천에 따라 형질전환된 시판용 대장균 균주에서의 표적 융합 단백질의 과발현을 위해 사용되었다. 선택 배지(LB 한천, 카나마이신 50 μg/ml, 1% 글루코스) 상에서 수득된 콜로니는 카나마이신(50μg/ml) 및 1% 글루코스가 보충된 LB 액체 배지에서 밤새 배양하기 위해 사용되었다. 진탕 배양기에서 약 15시간의 성장 후, 배양물을 사용하여 적절한 배양물에 접종하였다.
융합 단백질의 과발현 및 정제 - 일반 절차 A
카나마이신(30μg/ml) 및 100μM 황산아연을 포함하는 LB 배지에 밤새 배양물을 접종하였다. 배양물은 600nm에서의 광학 밀도(OD)가 0.60-0.80에 도달될 때까지 37℃에서 배양하였다. 이어서, IPTG를 0.25mM 내지 1mM 범위의 최종 농도까지 첨가하였다. 25℃에서의 진탕 배양 (3.5시간 내지 20시간) 후, 배양물을 25분간 6,000g에서 원심분리하였다. 세균 펠릿은 50mM KH2PO4, 0.5M NaCl, 10mM 이미다졸을 함유하는 pH 7.4의 완충액에 재현탁시켰다. 현탁액을 8분 동안 얼음 상에서 초음파처리하였다(40% 진폭, 15초 펄스, 10초 간격). 생성된 추출물을 20,000g, 4℃에서 40분 동안 원심분리하여 맑게 하였다. Ni-세파로스(GE Healthcare) 수지를 세균 세포 추출물의 제조를 위해 사용된 완충액으로 평형화시켜 전처리하였다. 이어서, 수지를 추출물의 원심 분리 후 수득된 상청액과 함께 4℃에서 밤새 배양하였다. 이어서, 이를 크로마토그래피 컬럼에 주입하고, 50mM KH2PO4, 0.5M NaCl, 20mM 이미다졸의 pH 7.4의 완충액 15용적 내지 50용적으로 세정하였다. 수득된 단백질을 0.5M NaCl 및 50mM KH2PO4의 pH 7.4의 완충액에서 이미다졸 구배를 사용하여 컬럼으로부터 용출시켰다. 수득된 분획은 SDS-PAGE로 분석하였다. 적절한 분획을 합하고, 50mM 트리스 완충액, pH 7.2, 150mM NaCl, 500mM L-아르기닌, 0.1mM ZnSO4, 0.01% Tween 20에 대하여 4℃에서 밤새 투석하고, 동시에, 존재하는 경우, Histag를 트롬빈(1:50)으로 절단하였다. 절단 후, 벤즈아미딘 세파로스 TM 수지를 사용하여 정제에 의해 Histag와 함께 발현된 표적 융합 단백질로부터 트롬빈을 분리하였다. Histag 없이 발현된 표적 융합 단백질의 정제는 SP 세파로스 상에서 수행하였다. 생성물의 순도를 SDS-PAGE 전기영동에 의해 분석하였다[Maniatis et al, Molecular Cloning. Cold Spring Harbor, NY, 1982].
융합 단백질의 과발현 및 정제 - 일반 절차 B
카나마이신(30μg/ml) 및 100μM 황산아연을 포함하는 LB 배지에 밤새 배양물을 접종하였다. 배양물은 600nm에서의 광학 밀도(OD)가 0.60-0.80에 도달될 때까지 37℃에서 배양하였다. 이어서, IPTG를 0.5mM 내지 1mM 범위의 최종 농도까지 첨가하였다. 25℃에서의 진탕 배양 20시간 후, 배양물을 25분 동안 6000g에서 원심분리하였다. 과발현 후 세균 세포는 50mM KH2PO4, 0.5M NaCl, 10mM 이미다졸, 5mM 베타-머캅토에탄올, 0.5mM PMSF(페닐메틸설포닐 플루오라이드)를 함유하는 pH 7.8의 완충액에서 프렌치 프레스(French Press)로 파괴하였다. 생성된 추출물을 8,000g에서 50분 동안 원심분리하여 맑게 하였다. Ni-세파로스 수지를 수득된 상청액과 함께 밤새 배양하였다. 이어서, 결합 단백질을 포함하는 수지를 크로마토그래피 컬럼에 충전하였다. 비결합 단백질을 함유하는 분획을 세정 제거하기 위해, 컬럼을 50mM KH2PO4, 0.5M NaCl, 10mM 이미다졸, 5mM 베타-머캅토에탄올, 0.5mM PMSF(페닐메틸설포닐 플루오라이드)의 pH7.8의 완충액 15용적 내지 50용적으로 세정하였다. 이어서, 층(bed)과 특이적으로 결합하는 대부분의 단백질을 세정 제거하기 위해, 컬럼을 50mM KH2PO4, 0.5M NaCl, 500mM 이미다졸, 10% 글리세롤, 0,5mM PMSF를 함유하는의 pH 7.5의 완충액으로 세정하였다. 수득된 분획을 SDS-PAGE로 분석하였다[Maniatis et al, Molecular Cloning. Cold Spring Harbor, NY, 1982]. 표적 단백질을 함유하는 분획을 합하고, 단백질이 히스티딘 태그와 함께 발현된 경우, 트롬빈으로 절단하여(1U/4mg의 단백질, 16℃에서 8시간) 폴리히스티딘 태그를 제거하였다. 이어서, 분획을 제형 완충액(500mM L-아르기닌, 50mM 트리스, 2.5mM ZnSO4, pH 7.4)에 대하여 투석하였다.
본 상세한 설명에서, 후속하여 제거된 히스티딘 태그와 함께 최초로 발현된 단백질의 실시예는 실시예 번호 옆에 위첨자 a)로 지정된다. 히스티딘 태그 없이 최초로 발현된 단백질은 실시예 번호 옆에 위첨자 b)로 지정된다.
2-D 전기영동에 의한 융합 단백질의 특성화
수득된 단백질을 더 특성화하고 크로마토그래피 조건을 정확하게 선택하기 위해, 단백질의 등전점을 결정하였다. 이러한 목적을 위해, 하기 계획에 따라 2단계로 2차원 전기영동(2-D) 방법을 사용하였다.
단계 1. pH 구배 및 변성 조건에서 단백질의 등전점전기영동(isoelectrofocusing)
1mg/ml 내지 2mg/ml 농도의 단백질 제제를 아세톤 중의 10% 트리클로로아세트산 및 0.07% 베타-머캅토에탄올을 함유하는 침전 용액과 1:1 비율로 혼합하여 침전시켰다. 혼합물을 -20℃에서 30분 동안 배양하고, 이어서 15,000g 및 4℃에서 25분 동안 원심분리하였다. 상청액을 제거하고, 펠릿을 0.07% 베타-머캅토에탄올을 함유하는 냉 아세톤으로 2회 세정하였다. 이어서, 탐지 가능한 냄새가 검출되지 않을 때까지 아세톤 잔기를 증발시켰다. 후속하여 사용된 띠(strip)에 따라, 단백질 펠릿을 pH 3 내지 pH 11 또는 pH 6 내지 pH 11의 프로파일을 갖는 8M 우레아, 1% CHAPS, 15mM DTT, 0.5% 양쪽성 물질(GE Healthcare)의 재수화 완충액 250ml에 현탁시켰다. 단백질 용액을 등전점전기영동을 위해 세라믹 챔버에 넣은 후, 적절한 pH 프로파일(3-11 또는 6-11)을 갖는 13cm DryStrip(GE Healthcare)에 넣었다. 전체를 미네랄 오일 층으로 덮었다. 챔버를 Ettan IPGphor III 장치에 넣고, 등전점전기영동을 띠의 치수 및 pH 프로파일에 할당된 하기 프로그램에 따라 수행하였다:
20℃에서의 16시간 탈수
고정된 pH 구배로 전기장에서의 등전점전기영동

이어서, 등전점전기영동된 단백질을 함유하는 띠를 탈이온수에서 1분간 세정하고, Coomassie Brilliant로 염색하고, 이어서 탈색하고, 단백질의 위치를 표시하기 위해 이미지 파일로 보관하였다. 변색된 띠를 다음 조성의 완충액으로 15분 동안 2회 평형화시켰다: 50mM 트리스-HCl pH 8.8, 6M 우레아, 1% DTT, 2% SDS, 30% 글리세롤.
단계 2. SDS-PAGE에 의한 제2 방향에서의 분리
띠를 표준 크기 당 단일 웰을 함유하는 12.5% 폴리아크릴아미드 겔 상에 놓고, 이어서 3시간 동안 200V의 전압에서 SDS-PAGE를 위한 장치로 분리를 수행하였다. 겔을 Coomassie Brilliant로 염색하고, 이어서 적용된 스케일로 보관하였다. 단백질은 크기의 표준을 기준으로 이의 중량을 측정하여 확인되었고, 이의 IPI는 제조업자(GE Healthcare)에 의해 제공된 곡선(애노드로 표시된 말단으로부터 띠 길이의 %에 대한 pH의 비율)을 기준으로 하여 6-11의 규모로 판독되거나 등전점전기영동 캘리브레이션 키트(GE Healthcare)에 의해 실험적으로 측정된 곡선을 기준으로 3-11의 규모로 판독되었다.
본 발명의 융합 단백질의 대표적인 실시예는 하기 실시예에 개시된다.
하기 아미노산 서열 성분의 명칭이 사용된다:
LINKER1: 입체 링커 서열 (Gly Gly Gly Gly Ser / GGGGS)
LINKER2: 입체 링커 서열 (Gly Gly Gly Gly / GGGG)
LINKER3: 입체 링커 서열 (Ala Ser Gly Gly / ASGG)
LINKER4: 입체 링커 서열 (Gly Gly Gly Ser / GGGS)
LINKER5: 입체 링커 서열 (Ser His Ala Ser / SHAS)
FURIN: 푸린에 의해 절단된 서열 (Arg Lys Lys Arg / RKKR)
UROKIN: 유로키나제에 의해 절단된 서열 (Arg Val Val Arg / RVVR)
PEG: 페길화 링커 서열 (Ala Ser Gly Cys Gly Pro Glu / ASGCGPE)
TRANS1: 운반 서열 (Lys Asp Glu Leu / KDEL)
TRANS2: 운반 서열 (Arg Arg Arg Arg Arg Arg Arg Arg / RRRRRRRR)
TRANS3: (Lys Glu Asp Leu /KEDL)
LINKER6: (Cys Ala Ala Ala Cys Ala Ala Cys / CAAACAAC)
LINKER7: (Gly Gly Gly / GGG)
MMP: (Pro Leu Gly Leu Ala Gly / PLGLAG)
FURIN.NAT: (Arg His Arg Gln Pro Arg Gly Trp Glu Gln Leu / RHRQPRGWEQL)
실시예 1. 서열 번호 1의 융합 단백질
서열 번호 1의 단백질은 430개의 아미노산의 길이 및 48.3 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281의 서열에 의해 형성되고, 효과기 펩타이드의 도메인 (b)는 248-아미노산 부가닌 도메인 A (서열 번호 55)이고 도메인 (a)의 N-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b)의 사이에 입체 링커 서열 (GGGGS), 푸린에 의해 절단된 서열 (RKKR), 페길화 링커 서열 (ASGCGPE) 및 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 55)-LINKER1-FURIN-PEG-LINKER1-(TRAIL121-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 1 및 서열 번호 85이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 1을 이의 암호화 DNA 서열인 서열 번호 85를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 2. 서열 번호 2의 융합 단백질
서열 번호 2의 단백질은 267개의 아미노산의 길이 및 50.8 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 리신 A의 267-아미노산 도메인 (서열 번호 56)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)는 입체 링커 서열 (GGGGS), 페길화 서열 (ASGCGPE) 및 푸린에 의해 인식되는 절단 부위의 서열 (RKKR)에 의해 도메인 (b)와 분리되어 있다. 추가로, 도메인 (b)의 C-말단에서, 전체 작제물의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER1-PEG-FURIN-LINKER1-(서열 번호 56)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 2 및 서열 번호 86이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 2를 이의 암호화 DNA 서열인 서열 번호 86을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 2a)과 히스티딘 태그를 갖지 않는 단백질(실시예 2b) 둘 다가 발현되었다.
실시예 3. 서열 번호 3의 융합 단백질
서열 번호 3의 단백질은 378개의 아미노산의 길이 및 42 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 리신 A 도메인의 267-아미노산 변이체 (서열 번호 57)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)는 순차적으로 입체 링커 서열 (GGGGS), 페길화 서열 (ASGCGPE), 푸린에 의해 인식되는 절단 부위의 서열 (RKKR) 및 입체 링커 서열 (GGGGS)에 의해 도메인 (b)와 분리되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 작제물의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER1-PEG-FURIN-LINKER1-(서열 번호 57)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 3 및 서열 번호 87이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 3을 이의 암호화 DNA 서열인 서열 번호 87을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 4. 서열 번호 4의 융합 단백질
서열 번호 4의 단백질은 473개의 아미노산의 길이 및 53.2 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 PAP 독소의 290-아미노산 동족체 (서열 번호 58)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)는 순차적으로 입체 링커 서열 (GGGGS), 페길화 서열 (ASGCGPE) 및 입체 링커 서열 (GGGGS)에 의해 도메인 (b)와 분리되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 작제물의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 (KDEL)이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER1-PEG-LINKER1-(서열 번호 58)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 4 및 서열 번호 88이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 4를 이의 암호화 DNA 서열인 서열 번호 88을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 5. 서열 번호 5의 융합 단백질
서열 번호 5의 단백질은 430개의 아미노산의 길이 및 48.3 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 사포린의 252-아미노산 단편 (서열 번호 59)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)는 순차적으로 입체 링커 서열 (GGGGS), 페길화 서열 (ASGCGPE) 및 입체 링커 서열 (GGGGS)에 의해 도메인 (b)와 분리되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER1-PEG-LINKER1-(서열 번호 59)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 5 및 서열 번호 89이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 5를 이의 암호화 DNA 서열인 서열 번호 89를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 6. 서열 번호 6의 융합 단백질
서열 번호 6의 단백질은 442개의 아미노산의 길이 및 49.7 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 사포린의 252-아미노산 단편 (서열 번호 59)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 페길화 링커 서열 (ASGCGPE), 2개의 입체 링커 서열 (GGGGS) 및 푸린에 의해 절단된 서열 (RKKR)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-PEG-LINKER1-LINKER1-FURIN-(서열 번호 59)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 6 및 서열 번호 90이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 6을 이의 암호화 DNA 서열인 서열 번호 90을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 7. 서열 번호 7의 융합 단백질
서열 번호 7의 단백질은 429개의 아미노산의 길이 및 47.5 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 247-아미노산 펩타이드 트리코산틴 (서열 번호 60)이고 도메인 (a)의 N-말단에서 부착되어 있다.
추가로, 도메인 (b)와 도메인 (a) 사이에 입체 링커 서열 (GGGGS), 푸린에 의해 절단된 서열 (RKKR), 페길화 링커 서열 (ASGCGPE) 및 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 60)-LINKER1-FURIN-PEG-LINKER1-(TRAIL121-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 7 및 서열 번호 91이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 7을 이의 암호화 DNA 서열인 서열 번호 91을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 8. 서열 번호 8의 융합 단백질
서열 번호 8의 단백질은 427개의 아미노산의 길이 및 47.5 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 247-아미노산 펩타이드 트리코안구인 (서열 번호 61)이고 도메인 (a)의 N-말단에서 부착되어 있다.
추가로, 도메인 (b)와 도메인 (a) 사이에 입체 링커 서열 (GGGGS), 푸린에 의해 절단된 서열 (RKKR), 페길화 링커 서열 (ASGCGPE) 및 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 61)-LINKER1-FURIN-PEG-LINKER1-(TRAIL121-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 8 및 서열 번호 92이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 8을 이의 암호화 DNA 서열인 서열 번호 92를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 9. 서열 번호 9의 융합 단백질
서열 번호 9의 단백질은 427개의 아미노산의 길이 및 47.7 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 겨우살이 렉틴 A의 249-아미노산 쇄 (서열 번호 62)이고 도메인 (a)의 N-말단에서 부착되어 있다.
추가로, 도메인 (b)와 도메인 (a) 사이에 입체 링커 서열 (GGGGS), 페길화 링커 서열 (ASGCGPE) 및 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 62)-LINKER1-PEG-LINKER1-(TRAIL121-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 9 및 서열 번호 93이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 9를 이의 암호화 DNA 서열인 서열 번호 93을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 10. 서열 번호 10의 융합 단백질
서열 번호 10의 단백질은 462개의 아미노산의 길이 및 51.9 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 에불린의 273-아미노산 서브유닛 A (서열 번호 63)이고 도메인 (a)의 N-말단에서 부착되어 있다.
추가로, 도메인 (b)와 도메인 (a) 사이에 입체 링커 서열 (GGGGS), 페길화 링커 서열 (ASGCGPE), 푸린에 의해 절단된 서열 (RKKR) 및 입체 링커 서열 (GGGG)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 63)-LINKER1-PEG-FURIN-LINK2-(TRAIL114-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 10 및 서열 번호 94이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 10을 이의 암호화 DNA 서열인 서열 번호 94를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 11. 서열 번호 11의 융합 단백질
서열 번호 11의 단백질은 454개의 아미노산의 길이 및 50.7 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 니그린의 272-아미노산 서브유닛 A (서열 번호 64)이고 도메인 (a)의 N-말단에서 부착되어 있다.
추가로, 도메인 (b)와 도메인 (a) 사이에 입체 링커 서열 (GGGGS), 푸린에 의해 절단된 서열 (RKKR), 페길화 링커 서열 (ASGCGPE) 및 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 64)-LINKER1-FURIN-PEG-LINKER1-(TRAIL121-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 11 및 서열 번호 95이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 11을 이의 암호화 DNA 서열인 서열 번호 95를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 12. 서열 번호 12의 융합 단백질
서열 번호 12의 단백질은 221개의 아미노산의 길이 및 25.7 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 47-아미노산 루핀 P1 펩타이드 (서열 번호 65)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGGS) 및 푸린에 의해 절단된 서열 (RKKR)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER1-FURIN-(서열 번호 65)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 12 및 서열 번호 96이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 12를 이의 암호화 DNA 서열인 서열 번호 96을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 13. 서열 번호 13의 융합 단백질
서열 번호 13의 단백질은 221개의 아미노산의 길이 및 26 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 47-아미노산 루핀 P1 펩타이드 (서열 번호 65)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (ASGG) 및 (GGGS), 페길화 링커 서열 (ASGCGPE), 푸린에 의해 절단된 서열 (RKKR) 및 입체 링커 서열 (ASGG)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER4-PEG-FURIN-LINKER3-(서열 번호 65)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 13 및 서열 번호 97이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 13을 이의 암호화 DNA 서열인 서열 번호 97을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 14. 서열 번호 14의 융합 단백질
서열 번호 14의 단백질은 254개의 아미노산의 길이 및 29.2 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL95-281이고, 효과기 펩타이드의 도메인 (b)는 47-아미노산 루핀 P1 펩타이드 (서열 번호 65)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGGS), 페길화 링커 서열 (ASGCGPE) 및 푸린에 의해 절단된 서열 (RKKR)이 순차적으로 혼입되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 작제물의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL95-281)-LINKER1-PEG-FURIN-(서열 번호 65)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 14 및 서열 번호 98이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 14를 이의 암호화 DNA 서열인 서열 번호 98을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 14a)과 히스티딘 태그를 갖지 않는 단백질(실시예 14b) 둘 다가 발현되었다.
실시예 15. 서열 번호 15의 융합 단백질
서열 번호 15의 단백질은 438개의 아미노산의 길이 및 49 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281 서열이고, 효과기 펩타이드의 도메인 (b)는 볼켄신의 244-아미노산 서브유닛 A (서열 번호 66)이고 도메인 (a)의 N-말단에서 부착되어 있다.
추가로, 도메인 (b)와 도메인 (a) 사이에 입체 링커 서열 (GGGGS), 푸린에 의해 절단된 서열 (RKKR), 페길화 링커 서열 (ASGCGPE) 및 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 66)-LINKER1-FURIN-PEG-LINKER1-(TRAIL121-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 15 및 서열 번호 99이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 15를 이의 암호화 DNA 서열인 서열 번호 99를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 15a)과 히스티딘 태그를 갖지 않는 단백질(실시예 15b) 둘 다가 발현되었다.
실시예 16. 서열 번호 16의 융합 단백질
서열 번호 16의 단백질은 431개의 아미노산의 길이 및 48.3 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281 서열이고, 효과기 펩타이드의 도메인 (b)는 볼켄신의 244-아미노산 서브유닛 A (서열 번호 66)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGGS), 페길화 링커 서열 (ASGCGPE) 및 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
추가로, 도메인 (b)의 C-말단에, 전체 작제물의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER1-PEG-LINKER1-(서열 번호 66)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 16 및 서열 번호 100이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 15를 이의 암호화 DNA 서열인 서열 번호 99를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 17. 서열 번호 17의 융합 단백질
서열 번호 17의 단백질은 428개의 아미노산의 길이 및 47.8 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281 서열이고, 효과기 펩타이드의 도메인 (b)는 볼켄신의 246-아미노산 서브유닛 A (서열 번호 67)이고 도메인 (a)의 N-말단에서 부착되어 있다.
추가로, 도메인 (b)와 도메인 (a) 사이에 입체 링커 서열 (GGGGS), 푸린에 의해 절단된 서열 (RKKR), 페길화 링커 서열 (ASGCGPE) 및 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 67)-LINKER1-FURIN-PEG-LINKER1-(TRAIL121-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 17 및 서열 번호 101이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 17을 이의 암호화 DNA 서열인 서열 번호 101을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 18. 서열 번호 18의 융합 단백질
서열 번호 18의 단백질은 515개의 아미노산의 길이 및 55.9 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281 서열이고, 효과기 펩타이드의 도메인 (b)는 슈도모나스 아에루기노사 외독소의 변형된 서열의 단편의 342-아미노산 동족체 (서열 번호 68)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGS) 및 입체 링커 서열 (ASGG)이 순차적으로 혼입되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 작제물의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 (KDEL)이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER4-LINKER3-(서열 번호 68)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 18 및 서열 번호 102이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 18을 이의 암호화 DNA 서열인 서열 번호 102를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 18a)과 히스티딘 태그를 갖지 않는 단백질(실시예 18b) 둘 다가 발현되었다.
실시예 19. 서열 번호 19의 융합 단백질
서열 번호 19의 단백질은 526개의 아미노산의 길이 및 57.1 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL119-281이고, 효과기 펩타이드의 도메인 (b)는 변형된 슈도모나스 아에루기노사 외독소 서열의 단편의 342-아미노산 동족체 (서열 번호 68)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGS), 페길화 링커 서열 (ASGCGPE), 푸린에 의해 절단된 서열 (RKKR) 및 입체 링커 서열 (ASGG)이 순차적으로 혼입되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 (KDEL)이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL119-281)-LINKER4-PEG-FURIN-LINKER3-(서열 번호 68)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 19 및 서열 번호 103이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 19를 이의 암호화 DNA 서열인 서열 번호 103을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 20. 서열 번호 20의 융합 단백질
서열 번호 20의 단백질은 526개의 아미노산의 길이 및 57.2 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281 서열이고, 효과기 펩타이드의 도메인 (b)는 변형된 슈도모나스 아에루기노사 외독소 서열의 단편의 354-아미노산 동족체 (서열 번호 84)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGS), 페길화 링커 서열 (ASGCGPE), 푸린에 의해 절단된 서열 (RKKR) 및 입체 링커 서열 (ASGG)이 순차적으로 혼입되어 있다.
추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER4-PEG-FURIN-LINKER3-(서열 번호 84)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 20 및 서열 번호 104이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 20을 이의 암호화 DNA 서열인 서열 번호 104를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 20a)과 히스티딘 태그를 갖지 않는 단백질(실시예 20b) 둘 다가 발현되었다.
실시예 21. 서열 번호 21의 융합 단백질
서열 번호 21의 단백질은 534개의 아미노산의 길이 및 58.5 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281 서열이고, 효과기 펩타이드의 도메인 (b)는 변형된 슈도모나스 아에루기노사 외독소 서열의 단편의 354-아미노산 동족체 (서열 번호 69)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGS), 페길화 링커 서열 (ASGCGPE), 푸린에 의해 절단된 서열 (RKKR) 및 입체 링커 서열 (ASGG)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER4-PEG-FURIN-LINKER3-(서열 번호 69)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 21 및 서열 번호 105이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 21을 이의 암호화 DNA 서열인 서열 번호 105를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 22. 서열 번호 22의 융합 단백질
서열 번호 22의 단백질은 534개의 아미노산의 길이 및 56.1 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281 서열이고, 효과기 펩타이드의 도메인 (b)는 변형된 슈도모나스 아에루기노사 외독소 서열의 342-아미노산 단편 (서열 번호 83)이고 도메인 (a)의 C-말단에서 부착되어 있다. 추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGS)이 혼입되어 있다. 따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER4-(서열 번호 83)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 22 및 서열 번호 106이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 22를 이의 암호화 DNA 서열인 서열 번호 106를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 23. 서열 번호 23의 융합 단백질
서열 번호 23의 단백질은 526개의 아미노산의 길이 및 57.2 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL119-281이고, 효과기 펩타이드의 도메인 (b)는 변형된 슈도모나스 아에루기노사 외독소 서열의 342-아미노산 단편 (서열 번호 83)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGS), 페길화 링커 서열 (ASGCGPE), 푸린에 의해 절단된 서열 (RKKR) 및 입체 링커 서열 (ASGG)이 순차적으로 혼입되어 있다.
추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL119-281)-LINKER4-PEG-FURIN-LINKER3-(서열 번호 83)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 23 및 서열 번호 107이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 23을 이의 암호화 DNA 서열인 서열 번호 107을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 24. 서열 번호 24의 융합 단백질
서열 번호 24의 단백질은 526개의 아미노산의 길이 및 57.2 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281 서열이고, 효과기 펩타이드의 도메인 (b)는 변형된 슈도모나스 아에루기노사 외독소 서열의 342-아미노산 단편 (서열 번호 83)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGS), 페길화 링커 서열 (ASGCGPE), 푸린에 의해 절단된 서열 (RKKR) 및 입체 링커 서열 (ASGG)이 순차적으로 혼입되어 있다.
추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL119-281)-LINKER4-PEG-FURIN-LINKER3-(서열 번호 83)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 24 및 서열 번호 108이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 24를 이의 암호화 DNA 서열인 서열 번호 108을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 25. 서열 번호 25의 융합 단백질
서열 번호 25의 단백질은 423개의 아미노산의 길이 및 47.3 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL114-281 서열이고, 효과기 펩타이드의 도메인 (b)는 시가 독소 stx의 239-아미노산 변이체 (서열 번호 70)이고 도메인 (a)의 N-말단에서 부착되어 있다.
추가로, 도메인 (b)와 도메인 (a) 사이에 입체 링커 서열 (SHHAS), 푸린에 의해 절단된 서열 (RKKR) 및 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 70)-LINKER5-FURIN-LINKER1-(TRAIL114-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 25 및 서열 번호 109이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 25를 이의 암호화 DNA 서열인 서열 번호 109를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 26. 서열 번호 26의 융합 단백질
서열 번호 26의 단백질은 432개의 아미노산의 길이 및 47.9 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL120-281 서열이고, 효과기 펩타이드의 도메인 (b)는 시가 독소 stx의 239-아미노산 변이체 (서열 번호 70)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGS), 페길화 서열 (ASGCGPE), 푸린에 의해 절단된 서열 (RKKR) 및 입체 링커 서열 (GGGS)이 순차적으로 혼입되어 있다.
추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL120-281)-LINKER4-PEG-FURIN-LINKER4-(서열 번호 70)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 26 및 서열 번호 110이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 26을 이의 암호화 DNA 서열인 서열 번호 110을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 26a)과 히스티딘 태그를 갖지 않는 단백질(실시예 26b) 둘 다가 발현되었다.
실시예 27. 서열 번호 27의 융합 단백질
서열 번호 27의 단백질은 526개의 아미노산의 길이 및 38 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL114-281이고, 효과기 펩타이드의 도메인 (b)는 149-아미노산 레스트릭토신 펩타이드 (서열 번호 71)이고 도메인 (a)의 N-말단에서 부착되어 있다. 추가로, 도메인 (b)와 도메인 (a) 사이에 2개의 입체 링커 서열 (GGGGS), 푸린에 의해 절단된 서열 (RKKR) 및 페길화 링커 서열 (ASGCGPE)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 71)-LINKER1-LINKER1-FURIN-PEG-(TRAIL114-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 27 및 서열 번호 111이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 27을 이의 암호화 DNA 서열인 서열 번호 111을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 27a)과 히스티딘 태그를 갖지 않는 단백질(실시예 27b) 둘 다가 발현되었다.
실시예 28. 서열 번호 28의 융합 단백질
서열 번호 28의 단백질은 335개의 아미노산의 길이 및 37.7 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281 서열이고, 효과기 펩타이드의 도메인 (b)는 149-아미노산 레스트릭토신 펩타이드 (서열 번호 71)이고 도메인 (a)의 C-말단에서 부착되어 있다. 추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGGS), 페길화 링커 서열 (ASGCGPE), 푸린에 의해 절단된 서열 (RKKR) 및 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER1-PEG-FURIN-LINKER1-(서열 번호 71)-TR2
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 28 및 서열 번호 112이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 28을 이의 암호화 DNA 서열인 서열 번호 112를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 28a)과 히스티딘 태그를 갖지 않는 단백질(실시예 28b) 둘 다가 발현되었다.
실시예 29. 서열 번호 29의 융합 단백질
서열 번호 29의 단백질은 319개의 아미노산의 길이 및 35.7 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL114-281 서열이고, 효과기 펩타이드의 도메인 (b)는 130-아미노산 히르수텔린 펩타이드 (서열 번호 72)이고 도메인 (a)의 N-말단에서 부착되어 있다. 추가로, 도메인 (b)와 도메인 (a) 사이에 2개의 입체 링커 서열 (GGGGS), 푸린에 의해 절단된 서열 (RKKR) 및 페길화 링커 서열 (ASGCGPE)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 72)-LINKER1-LINKER1-FURIN-PEG-(TRAIL114-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 29 및 서열 번호 113이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 29를 이의 암호화 DNA 서열인 서열 번호 113을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 29a)과 히스티딘 태그를 갖지 않는 단백질(실시예 29b) 둘 다가 발현되었다.
실시예 30. 서열 번호 30의 융합 단백질
서열 번호 30의 단백질은 290개의 아미노산의 길이 및 32.3 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281 서열이고, 효과기 펩타이드의 도메인 (b)는 109-아미노산 Kid 단백질 (서열 번호 73)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGGS), 페길화 링커 서열 (ASGCGPE) 및 푸린에 의해 절단된 서열 (RKKR)이 순차적으로 혼입되어 있다.
추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER1-PEG-FURIN-(서열 번호 73)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 30 및 서열 번호 114이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 30을 이의 암호화 DNA 서열인 서열 번호 114를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 31. 서열 번호 31의 융합 단백질
서열 번호 31의 단백질은 277개의 아미노산의 길이 및 31.7 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281 서열이고, 효과기 펩타이드의 도메인 (b)는 100-아미노산 CcdB 단백질 (서열 번호 74)이고 도메인 (a)의 C-말단에서 부착되어 있다. 추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGGS), 페길화 링커 서열 (ASGCGPE) 및 푸린에 의해 절단된 서열 (RKKR)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER1-PEG-FURIN-(서열 번호74)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 31 및 서열 번호 115이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 31을 이의 암호화 DNA 서열인 서열 번호 115를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 32. 서열 번호 32의 융합 단백질
서열 번호 32의 단백질은 228개의 아미노산의 길이 및 25.7 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 CcdB 단백질의 47-아미노산 변이체 (서열 번호 75)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGGS), 페길화 링커 서열 (ASGCGPE) 및 푸린에 의해 절단된 서열 (RKKR)이 순차적으로 혼입되어 있다.
추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER1-PEG-FURIN-(서열 번호 75)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 32 및 서열 번호 116이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 32를 이의 암호화 DNA 서열인 서열 번호 116을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 32a)과 히스티딘 태그를 갖지 않는 단백질(실시예 32b) 둘 다가 발현되었다.
실시예 33. 서열 번호 33의 융합 단백질
서열 번호 33의 단백질은 275개의 아미노산의 길이 및 31.7 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 94-아미노산 RelE 단백질 (서열 번호 76)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGGS), 페길화 링커 서열 (ASGCGPE) 및 푸린에 의해 절단된 서열 (RKKR)이 순차적으로 혼입되어 있다.
추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER1-PEG-FURIN-(서열 번호 76)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 33 및 서열 번호 117이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 33을 이의 암호화 DNA 서열인 서열 번호 117을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 34. 서열 번호 34의 융합 단백질
서열 번호 34의 단백질은 271개의 아미노산의 길이 및 30.7 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 90-아미노산 StaB 단백질 (서열 번호 77)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGGS), 페길화 링커 서열 (ASGCGPE) 및 푸린에 의해 절단된 서열 (RKKR)이 순차적으로 혼입되어 있다.
추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER1-PEG-FURIN-(서열 번호 77)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 34 및 서열 번호 118이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 34를 이의 암호화 DNA 서열인 서열 번호 118을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 35. 서열 번호 35의 융합 단백질
서열 번호 35의 단백질은 429개의 아미노산의 길이 및 48.2 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL114-281이고, 효과기 펩타이드의 도메인 (b)는 251-아미노산 겔로닌 펩타이드 (서열 번호 78)이고 도메인 (a)의 N-말단에서 부착되어 있다. 추가로, 도메인 (b)와 도메인 (a) 사이에 2개의 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 78)-LINKER1-LINKER1-(TRAIL114-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 35 및 서열 번호 119이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 35를 이의 암호화 DNA 서열인 서열 번호 119를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 36. 서열 번호 36의 융합 단백질
서열 번호 36의 단백질은 434개의 아미노산의 길이 및 48.6 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL120-281이고, 효과기 펩타이드의 도메인 (b)는 251-아미노산 겔로닌 펩타이드 (서열 번호 78)이고 도메인 (a)의 N-말단에서 부착되어 있다.
추가로, 도메인 (b)와 도메인 (a) 사이에 입체 링커 서열 (GGGGS), 푸린에 의해 절단된 서열 (RKKR), 페길화 링커 서열 (ASGCGPE) 및 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 78)-LINKER1-FURIN-PEG-LINKER1-(TRAIL120-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 36 및 서열 번호 120이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 36을 이의 암호화 DNA 서열인 서열 번호 120을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 37. 서열 번호 37의 융합 단백질
서열 번호 37의 단백질은 427개의 아미노산의 길이 및 48 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 251-아미노산 겔로닌 펩타이드 (서열 번호 78)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 페길화 링커 서열 (ASGCGPE) 및 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-PEG-LINKER1-(서열 번호 78)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 37 및 서열 번호 121이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 37을 이의 암호화 DNA 서열인 서열 번호 121을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 38. 서열 번호 38의 융합 단백질
서열 번호 38의 단백질은 433개의 아미노산의 길이 및 48.5 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 251-아미노산 겔로닌 펩타이드 (서열 번호 78)이고 도메인 (a)의 N-말단에서 부착되어 있다.
추가로, 도메인 (b)와 도메인 (a) 사이에 입체 링커 서열 (GGGGS), 푸린에 의해 절단된 서열 (RKKR), 페길화 링커 서열 (ASGCGPE) 및 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 78)-LINKER1-FURIN-PEG-LINKER1-(TRAIL121-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 38 및 서열 번호 122이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 38을 이의 암호화 DNA 서열인 서열 번호 122를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 39. 서열 번호 39의 융합 단백질
서열 번호 39의 단백질은 558개의 아미노산의 길이 및 61.4 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 디프테리아 독소의 387-아미노산 서브유닛 A (서열 번호 79)이고 도메인 (a)의 N-말단에서 부착되어 있다.
추가로, 도메인 (b)와 도메인 (a) 사이에 2개의 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 79)-LINKER1-LINKER1-(TRAIL121-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 39 및 서열 번호 123이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 39를 이의 암호화 DNA 서열인 서열 번호 123을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 40. 서열 번호 40의 융합 단백질
서열 번호 40의 단백질은 481개의 아미노산의 길이 및 53.2 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 디프테리아 독소의 193-아미노산 촉매 도메인 (서열 번호 80)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGGS), 푸린에 의해 절단된 서열 (RKKR), 슈도모나스 독소로부터 유래된 운반 도메인 서열 (서열 번호 139) 및 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER1-FURIN-(서열 번호 139)-LINKER1-(서열 번호 80)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 40 및 서열 번호 124이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 40을 이의 암호화 DNA 서열인 서열 번호 124를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 40a)과 히스티딘 태그를 갖지 않는 단백질(실시예 40b) 둘 다가 발현되었다.
실시예 41. 서열 번호 41의 융합 단백질
서열 번호 41의 단백질은 481개의 아미노산의 길이 및 53.2 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 디프테리아 독소의 189-아미노산 촉매 도메인 (서열 번호 81)이고 도메인 (a)의 N-말단에서 부착되어 있다.
추가로, 도메인 (b)와 도메인 (a) 사이에 푸린에 의해 절단된 서열 (RKKR), 입체 링커 서열 (GGGGS), 슈도모나스 독소로부터 유래된 운반 도메인 서열 (서열 번호 139), 푸린에 의해 절단된 서열 (RKKR) 및 2개의 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 81)-FURIN-LINKER1-(서열 번호 139)-FURIN-LINKER1-LINKER1-(TRAIL121-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 41 및 서열 번호 125이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 41을 이의 암호화 DNA 서열인 서열 번호 125를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 42. 서열 번호 42의 융합 단백질
서열 번호 42의 단백질은 432개의 아미노산의 길이 및 48.7 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL114-281이고, 효과기 펩타이드의 도메인 (b)는 아브린의 251-아미노산 도메인 A (서열 번호 82)이고 도메인 (a)의 N-말단에서 부착되어 있다. 추가로, 도메인 (b)와 도메인 (a) 사이에 2개의 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 82)-LINKER1-LINKER1-(TRAIL114-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 42 및 서열 번호 126이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 42를 이의 암호화 DNA 서열인 서열 번호 126을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 42a)과 히스티딘 태그를 갖지 않는 단백질(실시예 42b) 둘 다가 발현되었다.
실시예 43. 서열 번호 43의 융합 단백질
서열 번호 43의 단백질은 443개의 아미노산의 길이 및 49.7 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL114-281이고, 효과기 펩타이드의 도메인 (b)는 아브린의 251-아미노산 도메인 A (서열 번호 82)이고 도메인 (a)의 N-말단에서 부착되어 있다. 추가로, 도메인 (b)와 도메인 (a) 사이에 입체 링커 서열 (GGGGS), 인테그린 리간드 서열 (서열 번호 140), 유로키나제에 의해 절단된 서열 (RVVR) 및 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 82)-LINKER1-(서열 번호 140)-UROKIN-LINKER1-(TRAIL114-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 43 및 서열 번호 127이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 43을 이의 암호화 DNA 서열인 서열 번호 127을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 43a)과 히스티딘 태그를 갖지 않는 단백질(실시예 43b) 둘 다가 발현되었다.
실시예 44. 서열 번호 44의 융합 단백질
서열 번호 44의 단백질은 433개의 아미노산의 길이 및 48.7 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL114-281이고, 효과기 펩타이드의 도메인 (b)는 아브린의 251-아미노산 도메인 A (서열 번호 82)이고 도메인 (a)의 N-말단에서 부착되어 있다. 추가로, 도메인 (b)와 도메인 (a) 사이에 2개의 입체 링커 서열 (GGGGS) 및 유로키나제에 의해 절단된 서열 (RVVR)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 82)-LINKER1-LINKER1-UROKIN-(TRAIL114-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 44 및 서열 번호 128이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 44를 이의 암호화 DNA 서열인 서열 번호 128을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 44a)과 히스티딘 태그를 갖지 않는 단백질(실시예 44b) 둘 다가 발현되었다.
실시예 45. 서열 번호 45의 융합 단백질
서열 번호 45의 단백질은 441개의 아미노산의 길이 및 50 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL114-281이고, 효과기 펩타이드의 도메인 (b)는 아브린의 251-아미노산 도메인 A (서열 번호 82)이고 도메인 (a)의 N-말단에서 부착되어 있다. 추가로, 도메인 (b)와 도메인 (a) 사이에 8개의 아르기닌 잔기로 이루어진 운반 서열 (RRRRRRRR), 유로키나제에 의해 절단된 서열 (RVVR) 및 순차적으로 2개의 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 82)-TRANS2-UROKIN-LINKER1-LINKER1-(TRAIL114-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 45 및 서열 번호 129이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 45를 이의 암호화 DNA 서열인 서열 번호 129를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 46. 서열 번호 46의 융합 단백질
서열 번호 46의 단백질은 550개의 아미노산의 길이 및 61.3 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL114-281이고, 효과기 펩타이드의 도메인 (b)는 아브린의 251-아미노산 도메인 A (서열 번호 82)이고 도메인 (a)의 C-말단에서 부착되어 있다. 추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGGS), 유로키나제에 의해 절단된 서열 (RVVR), 슈도모나스로부터 유래된 운반 도메인 서열 (서열 번호 139), 입체 링커 서열 (GGGGS) 및 유로키나제에 의해 절단된 서열 (RVVR)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL114-281)-LINKER1-UROKIN-(서열 번호 139)-LINKER1-UROKIN-(서열 번호 82)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 46 및 서열 번호 130이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 46을 이의 암호화 DNA 서열인 서열 번호 130을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 46a)과 히스티딘 태그를 갖지 않는 단백질(실시예 46b) 둘 다가 발현되었다.
실시예 47. 서열 번호 47의 융합 단백질
서열 번호 47의 단백질은 459개의 아미노산의 길이 및 51.5 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL95-281이고, 효과기 펩타이드의 도메인 (b)는 아브린의 251-아미노산 도메인 A (서열 번호 82)이고 도메인 (a)의 N-말단에서 부착되어 있다. 추가로, 도메인 (b)와 도메인 (a) 사이에 2개의 입체 링커 서열 (GGGGS), 유로키나제에 의해 절단된 서열 (RVVR) 및 페길화 링커 서열 (ASGCGPE)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 82)-LINKER1-LINKER1-UROKIN-PEG-(TRAIL95-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 47 및 서열 번호 131이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 47을 이의 암호화 DNA 서열인 서열 번호 131을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 47a)과 히스티딘 태그를 갖지 않는 단백질(실시예 47b) 둘 다가 발현되었다.
실시예 48. 서열 번호 48의 융합 단백질
서열 번호 48의 단백질은 443개의 아미노산의 길이 및 49.7 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281 서열이고, 효과기 펩타이드의 도메인 (b)는 아브린의 251-아미노산 도메인 A (서열 번호 82)이고 도메인 (a)의 C-말단에서 부착되어 있다. 추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGGS), 페길화 링커 서열 (ASGCGPE), 유로키나제에 의해 절단된 서열 (RVVR) 및 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER1-PEG-UROKIN-LINKER1-(서열 번호 82)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 48 및 서열 번호 132이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 48을 이의 암호화 DNA 서열인 서열 번호 132를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 49. 서열 번호 49의 융합 단백질
서열 번호 49의 단백질은 447개의 아미노산의 길이 및 50.2 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 아브린의 251-아미노산 도메인 A (서열 번호 82)이고 도메인 (a)의 C-말단에서 부착되어 있다. 추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGGS), 페길화 링커 서열 (ASGCGPE), 유로키나제에 의해 절단된 서열 (RVVR) 및 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다. 추가로, 도메인 (b)의 C-말단 상에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER1-PEG-UROKIN-LINKER1-(서열 번호 82)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 49 및 서열 번호 133이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 49를 이의 암호화 DNA 서열인 서열 번호 133을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 49a)과 히스티딘 태그를 갖지 않는 단백질(실시예 49b) 둘 다가 발현되었다.
실시예 50. 서열 번호 50의 융합 단백질
서열 번호 50의 단백질은 441개의 아미노산의 길이 및 49.4 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL114-281이고, 효과기 펩타이드의 도메인 (b)는 아브린의 251-아미노산 도메인 A (서열 번호 82)이고 도메인 (a)의 N-말단에서 부착되어 있다. 추가로, 도메인 (a)와 도메인 (b) 사이에 2개의 입체 링커 서열 (GGGGS), 유로키나제에 의해 절단된 서열 (RVVR) 및 페길화 링커 서열 (ASGCGPE)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 82)-LINKER1- LINKER1-UROKIN-PEG-(TRAIL114-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 50 및 서열 번호 134이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 50을 이의 암호화 DNA 서열인 서열 번호 134를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 50a)과 히스티딘 태그를 갖지 않는 단백질(실시예 50b) 둘 다가 발현되었다.
실시예 51. 서열 번호 51의 융합 단백질
서열 번호 51의 단백질은 515개의 아미노산의 길이 및 55.9 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 D218H 돌연변이 (서열 번호 142)를 함유하는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 변형된 슈도모나스 아에루기노사 외독소 서열의 단편의 342-아미노산 동족체 (서열 번호 68)이고 도메인 (a)의 C-말단에서 부착되어 있다. 추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGS) 및 (ASGG)이 순차적으로 혼입되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 142)-LINKER4-LINKER3-(서열 번호 68)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 51 및 서열 번호 135이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 51을 이의 암호화 DNA 서열인 서열 번호 135를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 51a)과 히스티딘 태그를 갖지 않는 단백질(실시예 51b) 둘 다가 발현되었다.
실시예 52. 서열 번호 52의 융합 단백질
서열 번호 52의 단백질은 515개의 아미노산의 길이 및 55.9 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 돌연변이 Y189N/R191K/Q193R/H264R/I266R/D269H를 함유하는 TRAIL121-281 (서열 번호 143)이고, 효과기 펩타이드의 도메인 (b)는 변형된 슈도모나스 아에루기노사 외독소 서열의 단편의 342-아미노산 동족체 (서열 번호 68)이고 도메인 (a)의 C-말단에서 부착되어 있다. 추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGS) 및 (ASGG)이 순차적으로 혼입되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 143)-LINKER4-LINKER3-(서열 번호 68)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 52 및 서열 번호 136이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 52를 이의 암호화 DNA 서열인 서열 번호 136을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 53. 서열 번호 53의 융합 단백질
서열 번호 53의 단백질은 515개의 아미노산의 길이 및 55.9 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 돌연변이 D218H를 함유하는 TRAIL121-281 (서열 번호 142)이고, 효과기 펩타이드의 도메인 (b)는 변형된 슈도모나스 아에루기노사 외독소 서열의 단편의 342-아미노산 동족체 (서열 번호 83)이고 도메인 (a)의 C-말단에서 부착되어 있다. 추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGS) 및 페길화 링커 서열 (ASGCGPE)이 순차적으로 혼입되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 142)-LINKER4-PEG-(서열 번호 83)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 53 및 서열 번호 137이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 53을 이의 암호화 DNA 서열인 서열 번호 137을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 A에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질이 발현되었다.
실시예 54. 서열 번호 54의 융합 단백질
서열 번호 54의 단백질은 515개의 아미노산의 길이 및 55.9 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 돌연변이 Y189N/R191K/Q193R/H264R/I266R/D269H를 함유하는 TRAIL121-281 (서열 번호 143)이고, 효과기 펩타이드의 도메인 (b)는 변형된 슈도모나스 아에루기노사 외독소 서열의 단편의 342-아미노산 동족체 (서열 번호 83)이고 도메인 (a)의 C-말단에서 부착되어 있다. 추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGS) 및 (ASGG)이 순차적으로 혼입되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 143)-LINKER4-LINKER3-(서열 번호 83)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 54 및 서열 번호 138이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 54를 이의 암호화 DNA 서열인 서열 번호 138을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 54a)과 히스티딘 태그를 갖지 않는 단백질(실시예 54b) 둘 다가 발현되었다.
실시예 55. 서열 번호 144의 융합 단백질
서열 번호 144의 단백질은 433개의 아미노산의 길이 및 48.8 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL114-281이고, 효과기 펩타이드의 도메인 (b)는 도메인 (a)의 N-말단에서 부착되어 있고 아브린 A 도메인의 251-아미노산 변이체 (서열 번호 194)이다. 추가로, 도메인 (b)와 도메인 (a) 사이에 2개의 입체 링커 서열 (GGGGS) 및 푸린에 의해 인식되는 절단 부위 (RKKR)이 순차적으로 혼입되어 있다. 따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 194)-LINKER1-LINKER1-FURIN-(TRAIL114-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 144 및 서열 번호 169이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 144를 이의 암호화 DNA 서열인 서열 번호 169를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖지 않는 단백질이 발현되었다.
실시예 56. 서열 번호 145의 융합 단백질
서열 번호 145의 단백질은 450개의 아미노산의 길이 및 50.5 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 도메인 (a)의 C-말단에서 부착되어 있고 리신 A 도메인의 264-아미노산 결손 변이체 (서열 번호 195)이다.
추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGGS), 페길화 링커 서열 (ASGCGPE), 푸린에 의해 인식되는 서열 및 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER1-PEG-FURIN-LINKER1-(서열 번호 195)-TRANS3
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 145 및 서열 번호 170이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 145를 이의 암호화 DNA 서열인 서열 번호 170을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖지 않는 단백질이 발현되었다.
실시예 57. 서열 번호 146의 융합 단백질
서열 번호 146의 단백질은 481개의 아미노산의 길이 및 53 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 도메인 (a)의 N-말단에서 부착되어 있고 디프테리아 독소의 189-아미노산 돌연변이형 활성 도메인 (서열 번호 196)이다.
추가로, 도메인 (b)와 도메인 (a) 사이에 푸린에 의해 인식되는 절단 부위 서열 (RKKR), 입체 링커 서열 (GGGGS), 슈도모나스 독소로부터 유래된 운반 도메인 서열 (서열 번호 139), 또 다른 푸린에 의해 인식되는 절단 부위 서열 (RKKR), 이어서 2개의 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 196)-FURIN-LINKER1-서열 번호 139-FURIN-LINKER1-LINKER1-(TRAIL121-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 146 및 서열 번호 171이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 146을 이의 암호화 DNA 서열인 서열 번호 171을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖지 않는 단백질이 발현되었다.
실시예 58. 서열 번호 147의 융합 단백질
서열 번호 147의 단백질은 478개의 아미노산의 길이 및 52.7 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 도메인 (a)의 N-말단에서 부착되어 있고 디프테리아 독소의 186-아미노산 돌연변이형 활성 도메인 (서열 번호 197)이다.
추가로, 도메인 (b)와 도메인 (a) 사이에 푸린에 의해 인식되는 절단 부위 서열 (RKKR), 입체 링커 서열 (GGGGS), 슈도모나스 독소로부터 유래된 운반 도메인 서열 (서열 번호 139), 또 다른 푸린에 의해 인식되는 절단 부위 서열 (RKKR), 이어서 2개의 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 197)-FURIN-LINKER1-서열 번호 139-FURIN-LINKER1-LINKER1-(TRAIL121-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 147 및 서열 번호 172이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 147을 이의 암호화 DNA 서열인 서열 번호 172를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖지 않는 단백질이 발현되었다.
실시예 59. 서열 번호 148의 융합 단백질
서열 번호 148의 단백질은 433개의 아미노산의 길이 및 48.5 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 도메인 (a)의 N-말단에서 부착되어 있고 겔로닌의 251-아미노산 돌연변이형 변이체 (서열 번호 198)이다.
추가로, 도메인 (b)와 도메인 (a) 사이에 입체 링커 서열 (GGGGS), 푸린에 의해 인식되는 절단 부위 서열 (RKKR), 페길화 링커 (ASGCGPE) 및 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 198)-LINKER1-FURIN-PEG-LINKER1-(TRAIL121-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 148 및 서열 번호 173이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 148을 이의 암호화 DNA 서열인 서열 번호 173을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 59a)과 히스티딘 태그를 갖지 않는 단백질(실시예 59b) 둘 다가 발현되었다.
실시예 60. 서열 번호 149의 융합 단백질
서열 번호 149의 단백질은 258개의 아미노산의 길이 및 29.5 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL95-281이고, 효과기 펩타이드의 도메인 (b)는 도메인 (a)의 C-말단에서 부착되어 있고 47-아미노산 P1 루핀 펩타이드 (서열 번호 65)이다.
추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGGS), (GGG) 및 (CAAACAAC), 이어서 푸린에 의해 인식되는 절단 부위 서열 (RKKR)이 순차적으로 혼입되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL95-281)-LINKER1-LINKER7-LINKER6-FURIN-(서열 번호 65)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 149 및 서열 번호 174이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 149를 이의 암호화 DNA 서열인 서열 번호 174를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖지 않는 단백질이 발현되었다.
실시예 61. 서열 번호 150의 융합 단백질
서열 번호 150의 단백질은 253개의 아미노산의 길이 및 29.2 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL95-281이고, 효과기 펩타이드의 도메인 (b)는 도메인 (a)의 N-말단에서 부착되어 있고 47-아미노산 P1 루핀 펩타이드 (서열 번호 65)이다.
추가로, 도메인 (b)와 도메인 (a) 사이에 푸린에 의해 인식되는 절단 부위 서열 (RKKR) 및 입체 링커 서열 (GGG) 및 (CAAACAAC)이 순차적으로 혼입되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 65)-TRANS1-FURIN-LINKER7-LINKER6-(TRAIL95-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 150 및 서열 번호 175이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 150을 이의 암호화 DNA 서열인 서열 번호 175를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖지 않는 단백질이 발현되었다.
실시예 62. 서열 번호 151의 융합 단백질
서열 번호 151의 단백질은 539개의 아미노산의 길이 및 59.3 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 도메인 (a)의 N-말단에서 부착되어 있고 트리코산틴의 247-아미노산 돌연변이형 변이체 (서열 번호 199)이다.
추가로, 도메인 (b)와 도메인 (a) 사이에 푸린에 의해 인식되는 절단 부위 서열 (RKKR) 및 입체 링커 서열 (GGGGS), 이어서 슈도모나스 독소로부터 유래된 운반 도메인 서열 (서열 번호 139), 또 다른 푸린에 의해 인식되는 절단 부위 (RKKR) 및 2개의 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 199)-FURIN-LINKER1-서열 번호 139-FURIN-LINKER1-LINKER1-(TRAIL121-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 151 및 서열 번호 176이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 151을 이의 암호화 DNA 서열인 서열 번호 176을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖지 않는 단백질이 발현되었다.
실시예 63. 서열 번호 152의 융합 단백질
서열 번호 152의 단백질은 429개의 아미노산의 길이 및 47.2 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 도메인 (a)의 N-말단에서 부착되어 있고 트리코산틴의 247-아미노산 돌연변이형 변이체 (서열 번호 200)이다.
추가로, 도메인 (b)와 도메인 (a) 사이에 입체 링커 서열 (GGGGS) 및 푸린에 의해 인식되는 절단 부위 서열 (RKKR), 이어서 페길화 서열 (ASGCGPE) 및 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 200)-LINKER1-FURIN-PEG-LINKER1-(TRAIL121-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 152 및 서열 번호 177이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 152를 이의 암호화 DNA 서열인 서열 번호 177을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖지 않는 단백질이 발현되었다.
실시예 64. 서열 번호 153의 융합 단백질
서열 번호 153의 단백질은 515개의 아미노산의 길이 및 55.9 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 점 돌연변이 R318K, N441Q 및 R601K를 갖는 342-아미노산 변형된 슈도모나스 아에루기노사 외독소 서열 (서열 번호 201)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 2개의 입체 링커 서열 (GGGS) 및 (ASGG)이 순차적으로 혼입되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER4-LINKER3-서열 번호 201-(TRANS1)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 153 및 서열 번호 178이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 153을 이의 암호화 DNA 서열인 서열 번호 178을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖지 않는 단백질이 발현되었다.
실시예 65. 서열 번호 154의 융합 단백질
서열 번호 154의 단백질은 402개의 아미노산의 길이 및 43.3 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 슈도모나스 아에루기노사 외독소 서열의 225-아미노산 결손 변이체 (서열 번호 202)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 2개의 입체 링커 서열 (GGGS) 및 (GGGG) 및 푸린에 의해 인식되는 절단 부위 서열 (RKKR)이 순차적으로 혼입되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER4-LINKER2-FURIN-(서열 번호 202)-TRANS3
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 154 및 서열 번호 179이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 154를 이의 암호화 DNA 서열인 서열 번호 179를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 65a)과 히스티딘 태그를 갖지 않는 단백질(실시예 65b) 둘 다가 발현되었다.
실시예 66. 서열 번호 155의 융합 단백질
서열 번호 155의 단백질은 403개의 아미노산의 길이 및 44.3 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 몇 개의 점 돌연변이를 갖는 슈도모나스 아에루기노사 외독소 서열의 226-아미노산 결손 변이체 (서열 번호 203)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 2개의 입체 링커 서열 (GGGGS) 및 (GGGG) 및 푸린에 의해 인식되는 절단 부위 서열 (RKKR)이 순차적으로 혼입되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
TRAIL121-281-LINKER1-LINKER2-FURIN-서열 번호 203-TRANS3
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 155 및 서열 번호 180이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 155를 이의 암호화 DNA 서열인 서열 번호 180을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 66a)과 히스티딘 태그를 갖지 않는 단백질(실시예 66b) 둘 다가 발현되었다.
실시예 67. 서열 번호 156의 융합 단백질
서열 번호 156의 단백질은 470개의 아미노산의 길이 및 51.5 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 몇 개의 점 돌연변이를 갖는 슈도모나스 아에루기노사 외독소 서열의 279-아미노산 결손 변이체 (서열 번호 204)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGGS) 및 페길화 링커 (ASGCGPE), 이어서 푸린에 의해 인식되는 서열 (RKKR) 및 푸린에 의해 인식되는 절단 부위의 천연 서열 (RHRQPRGWEQL)이 순차적으로 혼입되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER1-PEG-FURIN-푸린.NAT-(서열 번호 204)-TRANS3
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 156 및 서열 번호 181이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 156을 이의 암호화 DNA 서열인 서열 번호 181을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 67a)과 히스티딘 태그를 갖지 않는 단백질(실시예 67b) 둘 다가 발현되었다.
실시예 68. 서열 번호 157의 융합 단백질
서열 번호 157의 단백질은 478개의 아미노산의 길이 및 51.8 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 몇 개의 점 돌연변이를 갖는 슈도모나스 아에루기노사 외독소 서열의 279-아미노산 결손 변이체 (서열 번호 205)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 반복되는 입체 링커 서열 (GGGGS), 이어서 푸린에 의해 인식되는 절단 부위 (RKKR), 푸린에 의해 인식되는 절단 부위의 천연 서열 (RHRQPRGWEQL) 및 반복되는 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER1-LINKER1-FURIN-푸린.NAT-LINKER1-LINKER1-(서열 번호 205)-TRANS3
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 157 및 서열 번호 182이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 157을 이의 암호화 DNA 서열인 서열 번호 182를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 68a)과 히스티딘 태그를 갖지 않는 단백질(실시예 68b) 둘 다가 발현되었다.
실시예 69. 서열 번호 158의 융합 단백질
서열 번호 158의 단백질은 402개의 아미노산의 길이 및 44.7 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 슈도모나스 아에루기노사 외독소 서열의 214-아미노산 돌연변이형 결손 변이체 (서열 번호 206)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGGS), 이어서 입체 링커 서열 (GGGG), 푸린에 의해 인식되는 절단 부위 (RKKR) 및 푸린에 의해 인식되는 절단 부위의 천연 서열 (RHRQPRGWEQL)이 순차적으로 혼입되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER1-LINKER2-FURIN-푸린.NAT-(서열 번호 206)-TRANS3
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 158 및 서열 번호 183이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 158을 이의 암호화 DNA 서열인 서열 번호 183을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖지 않는 단백질이 발현되었다.
실시예 70. 서열 번호 159의 융합 단백질
서열 번호 159의 단백질은 467개의 아미노산의 길이 및 50.4 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 몇 개의 점 돌연변이를 갖는 슈도모나스 아에루기노사 외독소 서열의 279-아미노산 돌연변이형 결손 변이체 (서열 번호 205)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 반복되는 입체 링커 서열 (GGGGS), 이어서 푸린에 의해 인식되는 절단 부위 (RKKR) 및 또 다른 반복되는 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER1-LINKER1-FURIN-LINKER1-LINKER1-(서열 번호 205)-TRANS3
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 159 및 서열 번호 184이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 159를 이의 암호화 DNA 서열인 서열 번호 184를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖지 않는 단백질이 발현되었다.
실시예 71. 서열 번호 160의 융합 단백질
서열 번호 160의 단백질은 474개의 아미노산의 길이 및 51.3 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 몇 개의 점 돌연변이를 갖는 슈도모나스 아에루기노사 외독소 서열의 279-아미노산 돌연변이형 결손 변이체 (서열 번호 205)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 반복되는 입체 링커 서열 (GGGGS), 이어서 푸린에 의해 인식되는 절단 부위의 천연 서열 (RHRQPRGWEQL) 및 또 다른 반복되는 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
TRAIL121-281-LINKER1-LINKER1-푸린.NAT-LINKER1-LINKER1-서열 번호 205-TRANS3
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 160 및 서열 번호 185이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 160을 이의 암호화 DNA 서열인 서열 번호 185를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 71a)과 히스티딘 태그를 갖지 않는 단백질(실시예 71b) 둘 다가 발현되었다.
실시예 72. 서열 번호 161의 융합 단백질
서열 번호 161의 단백질은 474개의 아미노산의 길이 및 51.3 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 몇 개의 점 돌연변이를 갖는 슈도모나스 아에루기노사 외독소 서열의 279-아미노산 돌연변이형 결손 변이체 (서열 번호 205)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 반복되는 입체 링커 서열 (GGGGS), 이어서 푸린에 의해 인식되는 절단 부위의 천연 서열 (RHRQPRGWEQL) 및 또 다른 반복되는 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER1-LINKER1-푸린.NAT-LINKER1-LINKER1-(서열 번호 205)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 161 및 서열 번호 186이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 161을 이의 암호화 DNA 서열인 서열 번호 186을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖지 않는 단백질이 발현되었다.
실시예 73. 서열 번호 162의 융합 단백질
서열 번호 162의 단백질은 474개의 아미노산의 길이 및 51.2 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 돌연변이를 갖는 슈도모나스 아에루기노사 외독소 서열의 279-아미노산 결손 변이체 (서열 번호 207)이고 도메인 (a)의 C-말단에서 부착되어 있다.
추가로, 도메인 (a)와 도메인 (b) 사이에 반복되는 입체 링커 서열 (GGGGS), 이어서 푸린에 의해 인식되는 절단 부위의 천연 서열 (RHRQPRGWEQL) 및 또 다른 반복되는 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER1-LINKER1-푸린.NAT-LINKER1-LINKER1-(서열 번호 207)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 162 및 서열 번호 187이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 162를 이의 암호화 DNA 서열인 서열 번호 187을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖지 않는 단백질이 발현되었다.
실시예 74. 서열 번호 163의 융합 단백질
서열 번호 163의 단백질은 515개의 아미노산의 길이 및 55.9 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 돌연변이 D218H를 함유하는 TRAIL121-281 (서열 번호 142)이고, 효과기 펩타이드의 도메인 (b)는 3개의 점 돌연변이 R318K, N441Q 및 R601K를 갖는 342-아미노산 변형된 슈도모나스 아에 루기노사 외독소 서열 (서열 번호 201)이고 도메인 (a)의 C-말단에서 부착되어 있다. 추가로, 도메인 (a)와 도메인 (b) 사이에 입체 링커 서열 (GGGS) 및 (ASGG)이 순차적으로 혼입되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 142)-LINKER4-LINKER3-(서열 번호 201)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 163 및 서열 번호 188이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 163을 이의 암호화 DNA 서열인 서열 번호 188을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖지 않는 단백질이 발현되었다.
실시예 75. 서열 번호 164의 융합 단백질
서열 번호 164의 단백질은 475개의 아미노산의 길이 및 51.4 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 돌연변이 D218H를 함유하는 TRAIL121-281 (서열 번호 142)이고, 효과기 펩타이드의 도메인 (b)는 몇 개의 점 돌연변이를 갖는 슈도모나스 아에루기노사 외독소 서열의 279-아미노산 돌연변이형 결손 변이체 (서열 번호 205)이고 도메인 (a)의 C-말단에서 부착되어 있다. 추가로, 도메인 (a)와 도메인 (b) 사이에 반복되는 입체 링커 서열 (GGGGS), 이어서 푸린에 의해 인식되는 절단 부위의 천연 서열 (RHRQPRGWEQL) 및 또 다른 반복되는 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 142)-LINKER1-LINKER1-푸린.NAT-LINKER1-LINKER1-(서열 번호 205)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 164 및 서열 번호 189이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 164를 이의 암호화 DNA 서열인 서열 번호 189를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖지 않는 단백질이 발현되었다.
실시예 76. 서열 번호 165의 융합 단백질
서열 번호 165의 단백질은 463개의 아미노산의 길이 및 50.6 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 돌연변이 D218H를 함유하는 TRAIL121-281 (서열 번호 142)이고, 효과기 펩타이드의 도메인 (b)는 몇 개의 점 돌연변이를 갖는 슈도모나스 아에루기노사 외독소 서열의 279-아미노산 결손 변이체 (서열 번호 204)이고 도메인 (a)의 C-말단에서 부착되어 있다. 추가로, 도메인 (a)와 도메인 (b) 사이에 2개의 입체 링커 서열 (GGGS), 이어서 푸린에 의해 인식되는 절단 부위의 천연 서열 (RHRQPRGWEQL)이 순차적으로 혼입되어 있다. 추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 142)-LINKER4-LINKER4-푸린.NAT-(서열 번호 204)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 165 및 서열 번호 190이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 165를 이의 암호화 DNA 서열인 서열 번호 190을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖지 않는 단백질이 발현되었다.
실시예 77. 서열 번호 166의 융합 단백질
서열 번호 166의 단백질은 475개의 아미노산의 길이 및 51.4 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 돌연변이 Y189N/R191K/Q193R/H264R/I266R/D269H를 함유하는 TRAIL121-281 (서열 번호 143)이고, 효과기 펩타이드의 도메인 (b)는 몇 개의 점 돌연변이를 갖는 슈도모나스 아에루기노사 외독소 서열의 279-아미노산 돌연변이형 결손 변이체 (서열 번호 205)이고 도메인 (a)의 C-말단에서 부착되어 있다. 추가로, 도메인 (a)와 도메인 (b) 사이에 2개의 입체 링커 서열 (GGGGS), 이어서 푸린에 의해 인식되는 절단 부위의 천연 서열 (RHRQPRGWEQL) 및 2개의 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 143)-LINKER1-LINKER1-푸린.NAT-LINKER1-LINKER1-(서열 번호 205)-TRANS1
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 166 및 서열 번호 191이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 166을 이의 암호화 DNA 서열인 서열 번호 191을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖지 않는 단백질이 발현되었다.
실시예 78. 서열 번호 167의 융합 단백질
서열 번호 167의 단백질은 474개의 아미노산의 길이 및 51.24 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 점 돌연변이를 갖는 슈도모나스 아에루기노사 외독소 A 서열의 279-아미노산 결손 변이체 (서열 번호 207)이고 도메인 (a)의 C-말단에서 부착되어 있다. 추가로, 도메인 (a)와 도메인 (b) 사이에 2개의 입체 링커 서열 (GGGGS), 이어서 푸린에 의해 인식되는 절단 부위의 천연 서열 (RHRQPRGWEQL) 및 2개의 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
추가로, 도메인 (b)의 C-말단에, 전체 융합 단백질의 C-말단 단편을 형성하는, 효과기 펩타이드를 소포체로 유도하는 운반 서열 KDEL이 부착되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(TRAIL121-281)-LINKER1-LINKER1-푸린.NAT-LINKER1-LINKER1-(서열 번호 207)-TRANS3
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 167 및 서열 번호 192이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 167을 이의 암호화 DNA 서열인 서열 번호 192를 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
히스티딘 태그를 갖는 단백질(실시예 78a)과 히스티딘 태그를 갖지 않는 단백질(실시예 78b) 둘 다가 발현되었다.
실시예 79. 서열 번호 168의 융합 단백질
서열 번호 168의 단백질은 232개의 아미노산의 길이 및 26.2 kDa의 질량을 갖는 융합 단백질로서, 여기서 도메인 (a)는 TRAIL121-281이고, 효과기 펩타이드의 도메인 (b)는 51 아미노산 Hok 단백질 서열 (서열 번호 208)이고 도메인 (a)의 C-말단에서 부착되어 있다. 추가로, 도메인 (b)와 도메인 (a) 사이에 입체 링커 서열 (GGGGS), 이어서 유로키나제에 의해 인식되는 절단 부위의 서열 (RVVR) 및 메탈로프로테아제 MMP (PLGLAG) 및 a 입체 링커 서열 (GGGGS)이 순차적으로 혼입되어 있다.
따라서, 본 발명의 융합 단백질의 구조는 하기와 같다:
(서열 번호 208)-LINKER1-UROKIN-MMP-LINKER1-(TRAIL121-281)
아미노산 서열 및 대장균에서 발현을 위해 최적화된 코돈을 포함하는 DNA 암호화 서열은 첨부된 서열 목록에서 나타낸 바와 같이 각각 서열 번호 168 및 서열 번호 193이다.
아미노산 서열인 상기에서 개시된 구조의 서열 번호 168을 이의 암호화 DNA 서열인 서열 번호 193을 생성하기 위한 주형으로서 사용하였다. DNA의 암호화 서열을 함유하는 플라스미드를 생성하고, 융합 단백질의 과발현을 상기에서 개시된 일반 절차에 따라 수행하였다. Novagen으로부터 입수한 대장균 BL21 (DE3) 또는 Tuner (DE3) 균주를 사용하여 과발현을 일반 절차 B에 따라 수행하였다. 단백질을 상기에서 개시된 일반 절차에 따라 전기영동으로 분리하였다.
실시예 80. 융합 단백질의 항종양 활성의 검사
종양 세포주에 대한 세포독성 분석법으로 시험관내 및 마우스 생체 내에서 융합 단백질의 항종양 활성의 검사를 수행하였다. 비교를 위해서, rhTRAIL114-281 단백질 및 위약(placebo)을 사용하였다.
1.
원편광
이색성(Circular Dichroism: CD)의
측정
실시예 2a, 실시예 11a, 실시예 12a, 실시예 13a, 실시예 14a, 실시예 15a, 실시예 18a, 실시예 20a, 실시예 26a, 실시예 29a, 실시예 42a, 실시예 43a, 실시예 44a, 실시예 50a, 실시예 51a 및 실시예 52a의 융합 단백질에 대하여 원편광 이색성(CD)에 의해 이들의 구조의 관점에서 융합 단백질 제제의 품질을 측정하였다. 단백질의 2차 구조 및 입체형태의 측정을 위해 원편광 이색성을 이용하였다. CD 방법은 타원 편광의 외관 및 빛의 편광면 회전으로 명백해지는 단백질 구조의 광학 활성을 이용한다. 원자외선(far UV)에서 단백질의 CD 스펙트럼은 주요 폴리펩타이드 쇄의 입체형태에 대한 정확한 데이터를 제공한다.
분석될 단백질의 샘플을 50 mM Tris-HCl pH 8.0, 100 mM NaCl, 10% 글리세롤, 0,1 mM ZnCl2, 80 mM 사카로스, 5mM DTT로 이루어진 완충액으로 제형화한 후 컷 오프 12 kDa의 투석 백(Sigma-Aldrich)에서 투석하였다. 4℃에서 몇 시간 동안 교반하면서, 단백질 제제를 100배 과량 (v/v)의 완충액에 대하여 투석을 수행하였다. 투석을 완료한 후, 각각의 제제를 원심분리하고(25,000 rpm, 10분, 4℃), 상청액을 수집하였다.
상기와 같이 수득된 샘플 중 단백질 농도를 브래드포드(Bradford) 법에 의해 측정하였다.
0.1 mg/ml 내지 2.7 mg/ml의 농도 범위의 단백질에 대한 원편광 이색성의 측정을, 0.2mm 또는 1mm의 광로를 갖는 석영 큐벳트에서 Jasco J-710 분광편광계로 수행하였다. 7 L/분의 질소의 흐름 하에서 측정을 수행하였으며, 이는 195nm 내지 250nm의 파장 범위에서 측정을 수행할 수 있게 한다. 측정 파라미터: 스펙트럼 해상도 - 1nm; 광선의 반치폭 1nm; 감도 20mdeg, 1파장에 대한 평균 시간 - 8초, 스캔 속도 10 nm/분. CDPro 소프트웨어를 사용하여, 수득된 스펙트럼을 193nm 내지 250nm의 범위에서 수치로 분석하였다. 이러한 파장 범위에서 너무 낮은 신호 대 노이즈 비율 때문에, 광전자증배관에서의 전압이 700 V를 초과하는 포인트는 생략하였다.
CDPro 소프트웨어를 사용하여 수득된 데이터는 분석된 단백질에서의 특정한 2차 구조 함량의 산출을 제공한다(표 1 참조).
[표 1] 분석된 단백질에서의 2차 구조 함량
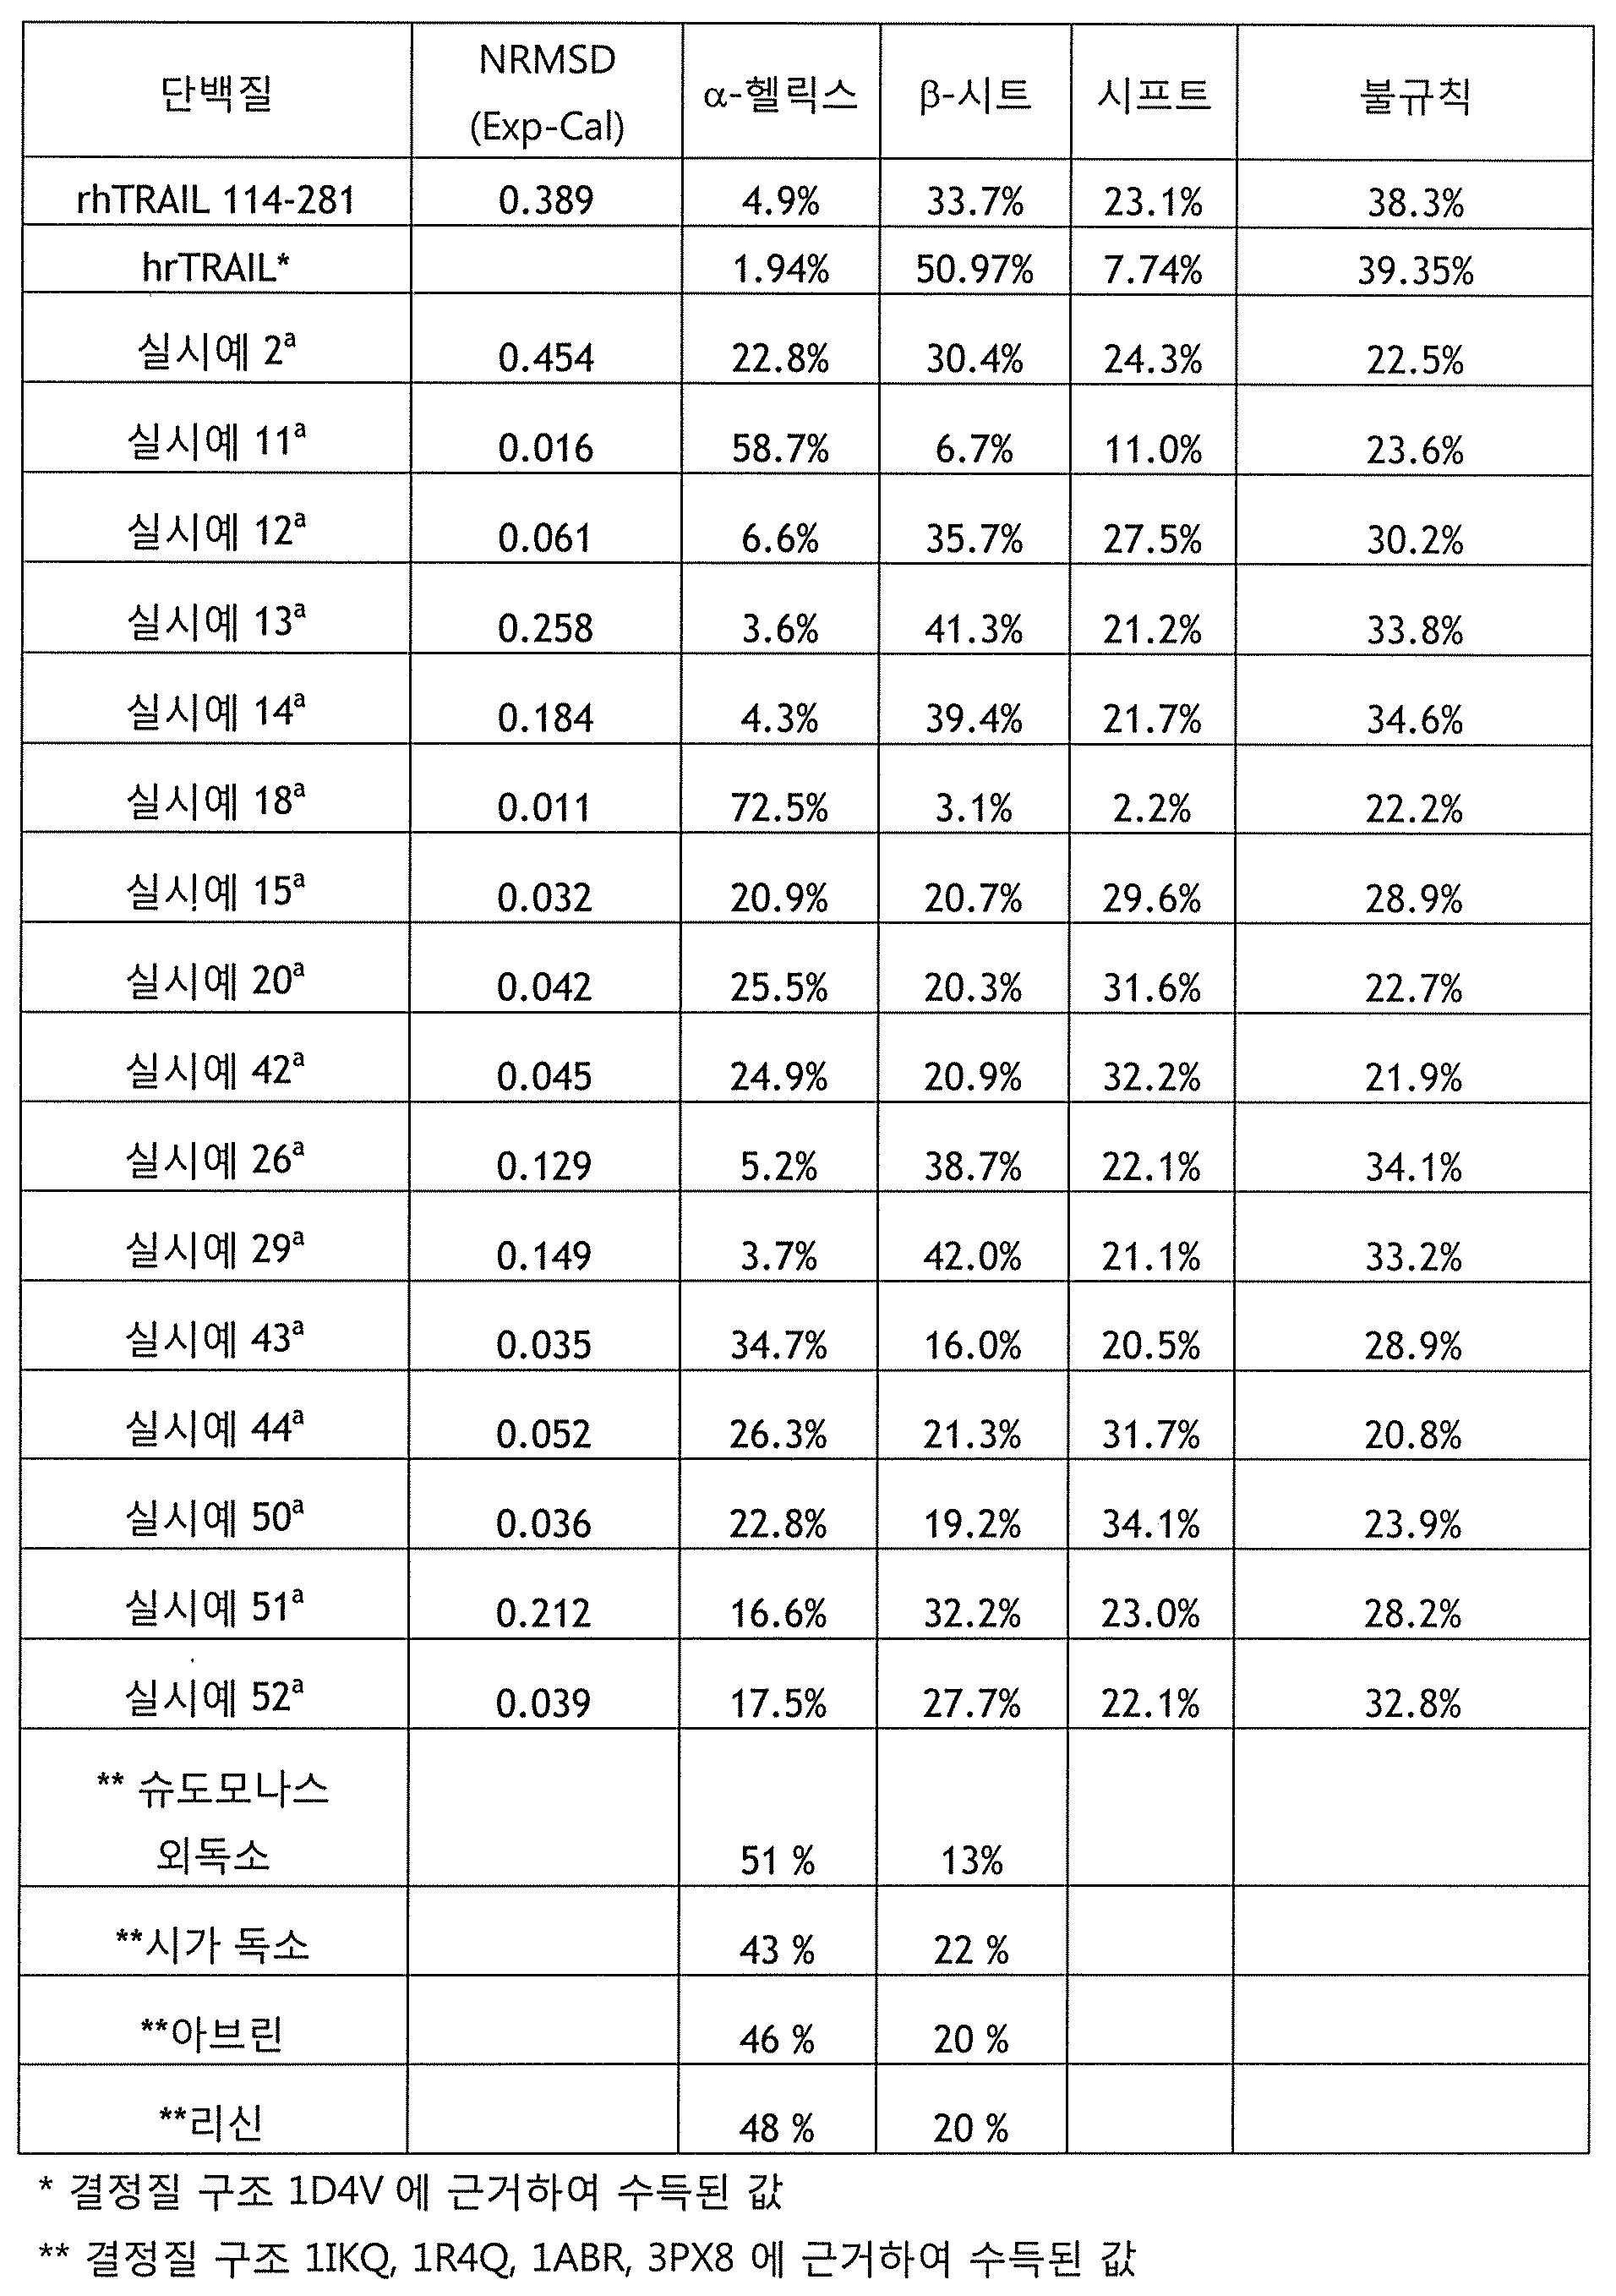
대조군 분자 (rhTRAIL114-281)은 주로 β-시트형 구조를 갖는 단백질에 대해 특징적인 CD 스펙트럼을 나타낸다(220nm 파장에서 급격한 윤곽의 타원률 최소치). 이는 2차 구조 성분의 산출을 확인해 주며, 미미한 수치의 α-헬릭스 요소를 제시한다. 수득된 결과는 또한 hTRAIL 단백질의 결정 구조로부터의 데이터와 일치하고, 본 발명의 융합 단백질(실시예 12a, 실시예 13a, 실시예 14a 및 실시예 29a)에 대해 특징적이며, 여기서 베타 성분은 그 구조의 32% 내지 44%를 구성한다. 모든 실시예의 경우, 이색성 스펙트럼은 파장 220nm에서 1개의 최소값을 특징으로 한다. TRAIL에 부착된 소형 펩타이드는 단백질의 작은 부분을 구성하고 정의된 2차 구조를 생성할 필요성이 없기 때문에, 분석된 단백질은 출발 단백질과 유의하게 상이해서는 안된다.
실시예 2a, 실시예 11a, 실시예 15a, 실시예 20a, 실시예 26a, 실시예 42a, 실시예 43a, 실시예 44a, 실시예 50a, 실시예 51a 및 실시예 52a의 작제물의 경우, 알파/베타 2차 구조의 혼합 함량을 관찰하였으며, 이는 공지된 효과기 펩타이드 도메인의 결정 구조에 근거한 예상치와 일치한다. 이들 벌키한(bulky) 도메인의 경우에서의 50% 수준의 알파 구조의 함량은 융합 단백질의 구조에 대하여 유의한 영향을 미친다.
실시예 18a의 단백질만은 알파-헬릭스 함량이 70%를 초과하고 베타 구조의 함량은 낮았다.
2.
시험관내에서의
세포주에 대한 시험
세포주
세포주를 ATCC 및 CLS로부터 입수하고, 이어서 Laboratory of Biology Adamed's Cell Line Bank에서 번식시키고 보관하였다. 실험 동안, Venor®GeM Mycoplasma PCR Detection Kit (Minerva Biolabs, Berlin, Germany) 키트를 사용하여, 마이코플라스마의 존재에 대하여 PCR 기술에 의해 관례대로 세포를 확인하였다. 배양물을 다음의 표준 조건으로 유지하였다: 37℃, 5% CO2 (DMEM의 경우 - 10% CO2) 및 85% 상대 습도. 특정 세포주를 ATTC에 의해 추천된 적절한 배지에서 배양하였다.
[표 2] 부착 세포주
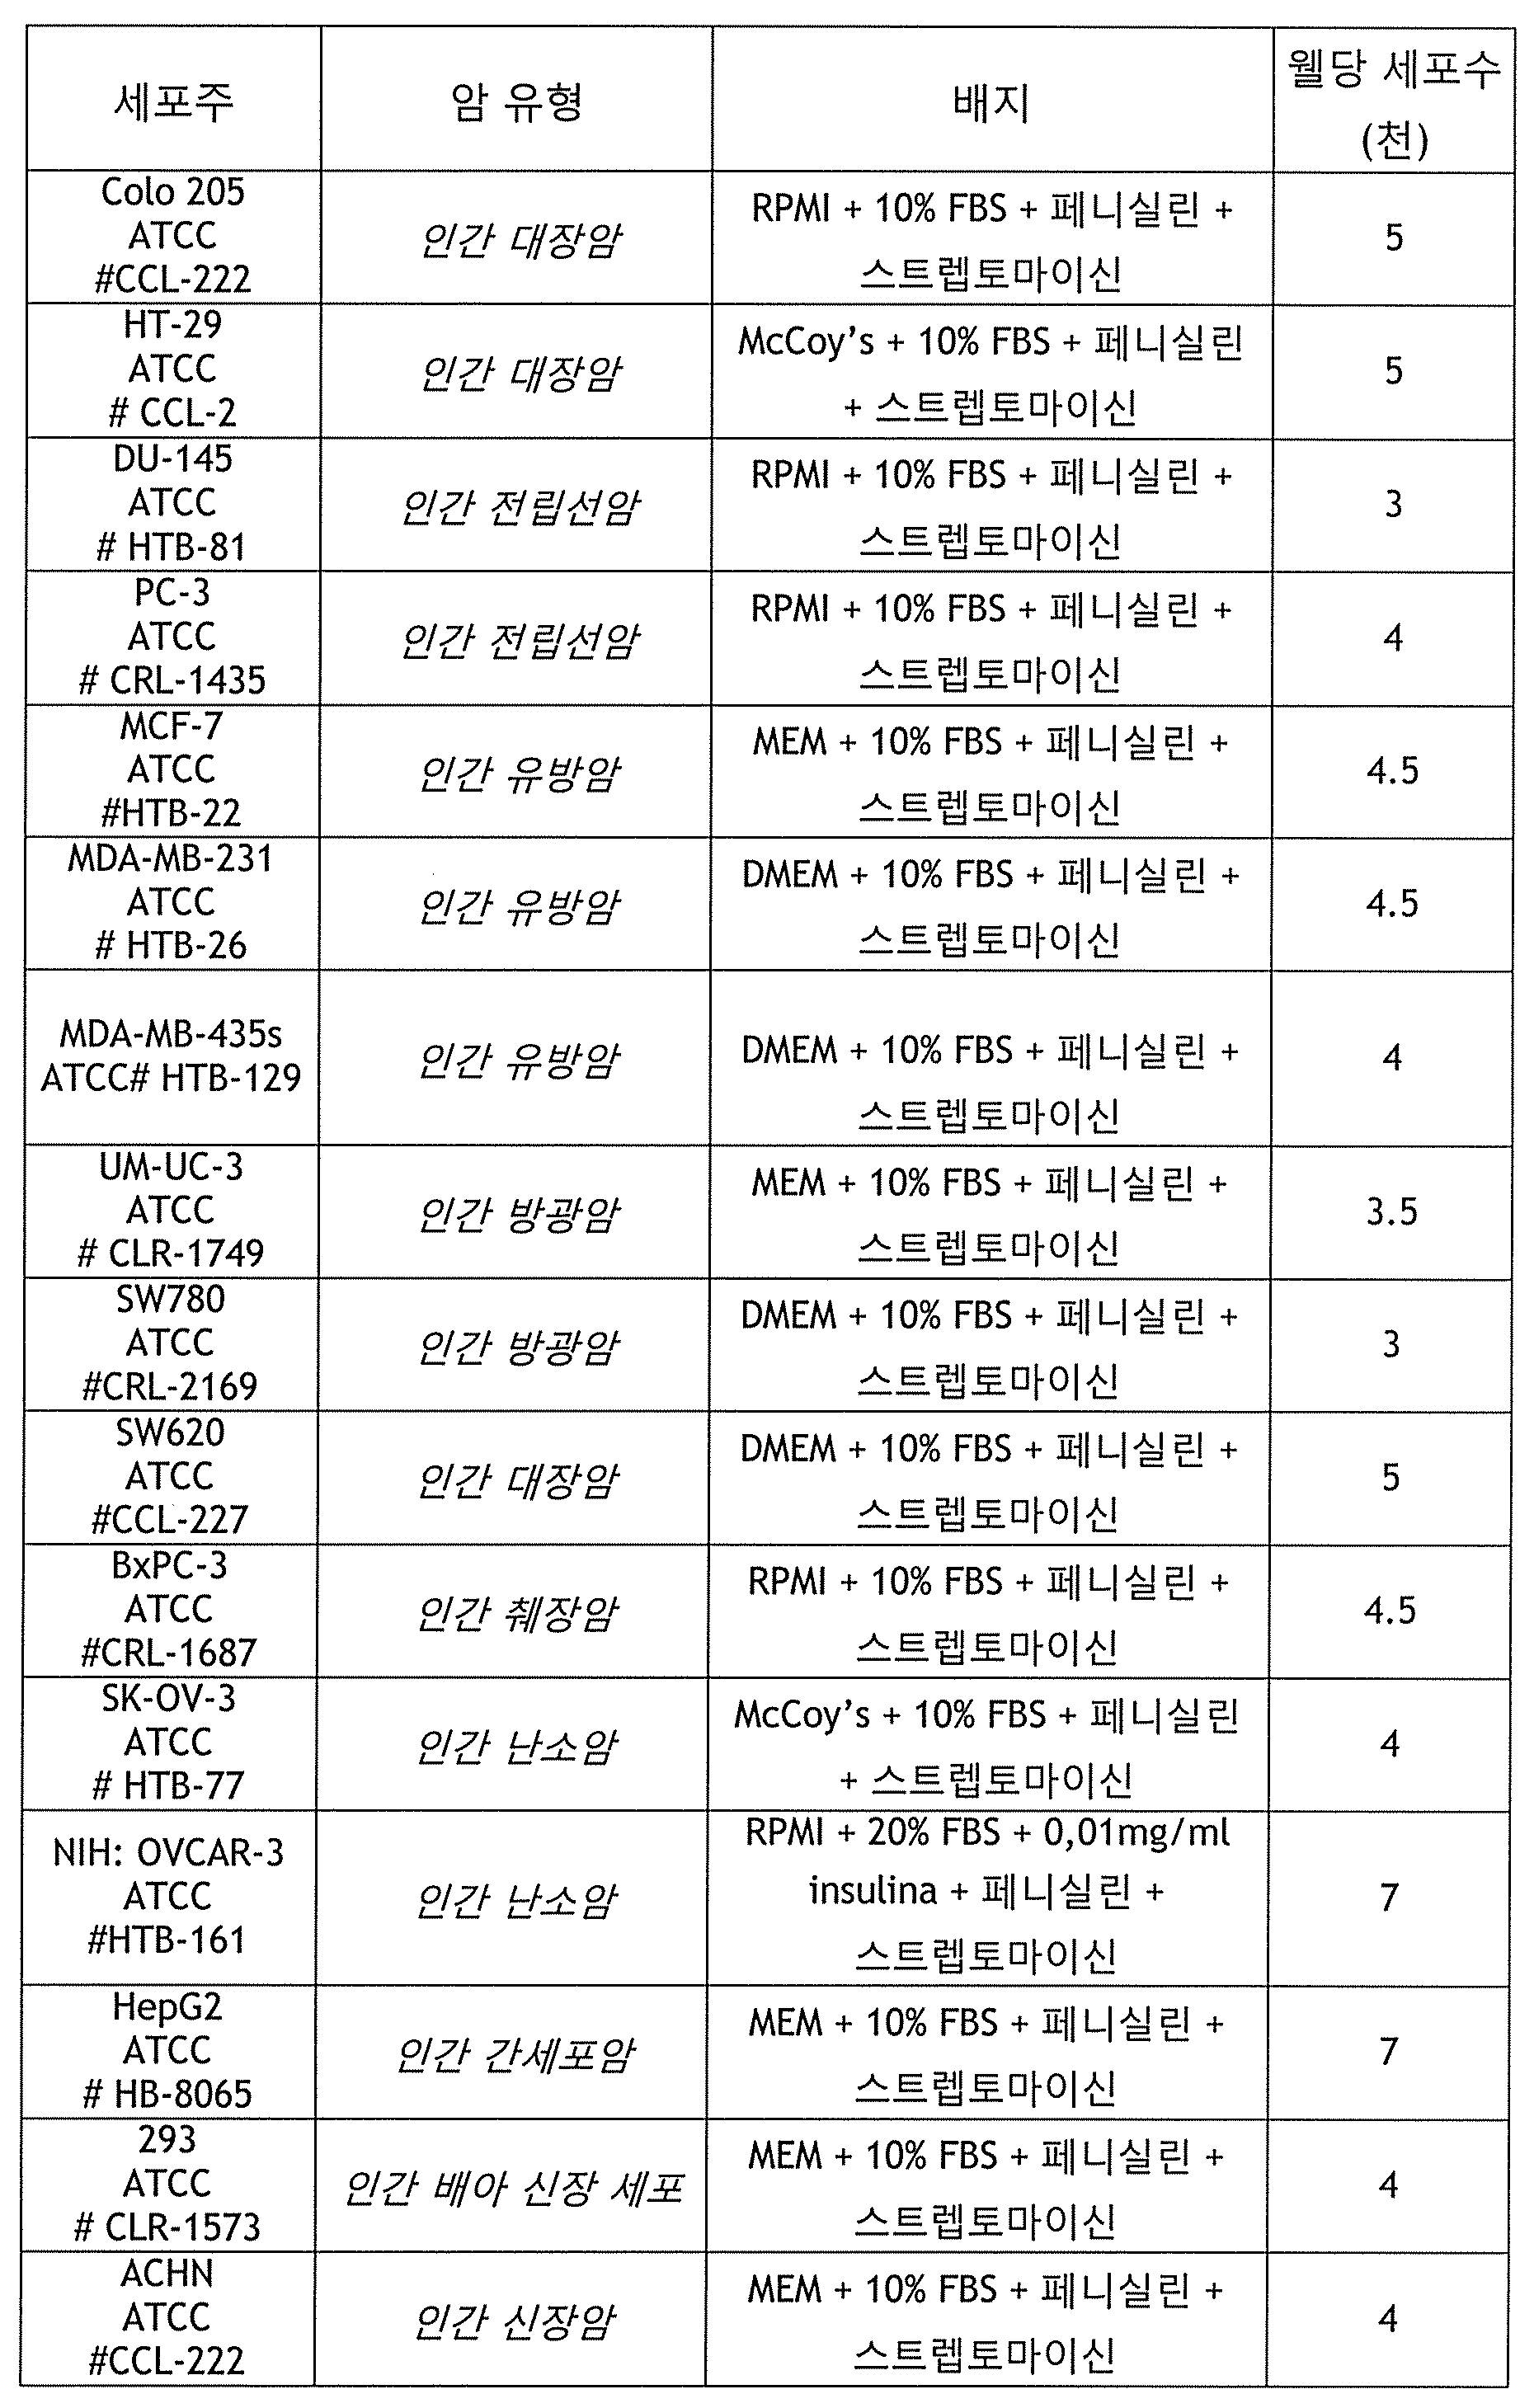


[표 3] 비부착 세포주
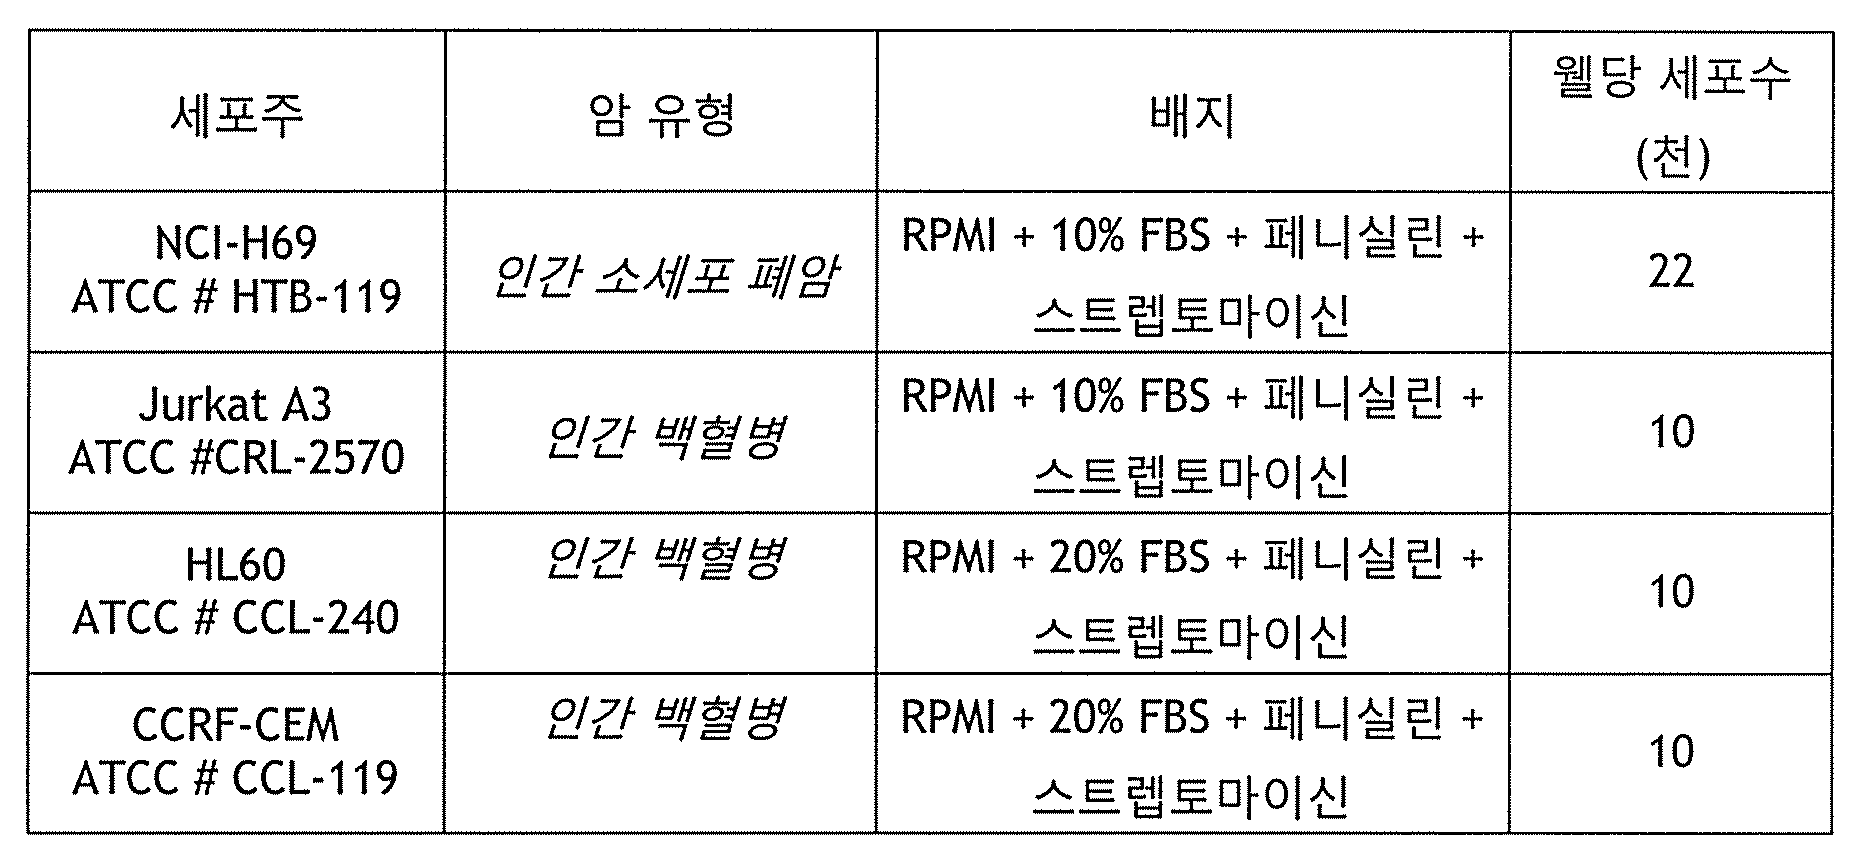
MTT
세포독성 시험
MTT 분석법은 세포의 증식, 생존성 및 세포독성을 측정하기 위해 사용되는 비색분석법이다. 이는 미토콘드리아 효소 석시네이트-테트라졸륨 리덕타제 1에 의해 황색 테트라졸륨 염 MTT (4,5-디메틸-2-티아졸릴)-2,5-디페닐테트라졸륨 브로마이드)를 수불용성 자색 염료인 포르마잔으로 분해하는 데에 있다. MTT 환원은 살아있는 세포에서만 일어난다. 데이터 분석은 단백질의 IC50 농도(ng/ml)의 측정에 있으며, 여기에서 세포수의 50% 환원은 대조군과 비교하여 처리된 집단에서 발생한다. 결과는 GraphPad Prism 5.0 소프트웨어를 사용하여 분석하였다. 시험은 문헌[Celis, JE, (1998). Cell Biology, a Laboratory Handbook, second edition, Academic Press, San Diego; Yang, Y., Koh, LW, Tsai, JH., (2004); Involvement of viral and chemical factors with oral cancer in Taiwan, Jpn J Clin Oncol, 34 (4), 176-183]의 상세한 설명에 따라 수행하였다.
세포 배양 배지를 소정의 밀도(100μl 당 104 내지 105 세포)로 희석하였다. 이어서, 적절하게 희석된 세포 현탁액 100μl를 96웰 플레이트에 3번씩 적용하였다. 이와 같이 제조된 세포를 사용된 배지에 따라 5% CO2 또는 10% CO2에서 24시간 동안 37에서 배양하고, 이어서 상기 세포(100μl의 배지 중)에 다양한 농도의 시험된 단백질을 함유하는 배지 100μl를 추가로 첨가하였다. 3회 내지 4회의 세포 분열에 상당하는 다음 72시간에 걸쳐 시험된 단백질과 함께 세포를 배양한 후, 시험 단백질을 포함하는 배지에 MTT의 작업 용액[5 mg/ml] 20 ml를 가하고, 5% CO2에서 3시간 동안 37에서 계속 배양하였다. 이어서, MTT 용액을 포함하는 배지를 제거하고, DMSO 100μl를 가하여 포르마잔 결정을 용해하였다. 교반한 후, 570nm에서 흡광도를 측정하였다(기준 필터 690nm).
EZ4U
세포독성 시험
비부착 세포주에서 단백질의 세포독성 활성을 시험하기 위하여 EZ4U (Biomedica) 시험을 이용하였다. 본 시험은 MTT 방법의 변형이며, 여기서 테트라졸륨 염의 환원시에 형성된 포르마잔은 수용성이다. 단백질(7개 농도의 단백질, 각각 3번씩)과 함께 세포를 72 시간 연속 배양한 후 세포 생존성 연구를 수행하였다. 이에 기초하여, GraphPad Prism 5 소프트웨어를 사용하여 IC50 값을 (2개의 독립적인 실험의 평균으로서) 측정하였다. 대조군 세포는 용매만으로 배양하였다.
시험관내 세포독성 시험의 결과를 IC50 값 (ng/ml)으로서 요약하였으며, 이는 용매만으로 처리된 대조군 세포에 대하여 융합 단백질의 세포독성 효과가 50% 수준으로 관찰되는 단백질 농도에 상응한다. 각각의 실험은 3번씩 수행된 2개 이상의 독립적인 실험의 평균값을 나타낸다. 단백질 제제의 활성 결여의 기준으로는 2000 ng/ml의 IC50 한도를 채택하였다. 2000을 초과하는 IC50 값을 갖는 융합 단백질은 비활성인 것으로 간주하였다.
본 시험을 위한 세포는 종래의 항암제에 대해 내성인 암 세포주로서 독소루비신 라인 MES-SA/DX5에 대해 내성이고 TRAIL 단백질에 대해 민감한 종양 세포주 뿐만 아니라, TRAIL 단백질에 대해 자연 내성(TRAIL에 대한 자연 내성의 기준: TRAIL 단백질에 대한 IC50 > 2000)인 종양 세포주를 포함한다.
비-암세포에서 융합 단백질의 효능/독성의 평가를 위해 분화되지 않은 HUVEC 세포주를 건강한 대조군 세포주로서 사용하였다.
TRAIL에 대해 자연 내성인 세포에 본 발명의 특정 융합 단백질을 투여함으로써 TRAIL에 대한 세포주의 내성을 극복할 가능성을 수득된 결과로 확인하였다. TRAIL에 대해 민감한 세포에 본 발명의 융합 단백질을 투여할 때, 일부의 경우 효능의 분명하고 강력한 강화 작용이 관찰되었으며, TRAIL 단독에 대한 IC50과의 비교하여 융합 단백질의 IC50 값의 감소가 명백하였다. 더욱이, 고전적인 항암제 독소루비신에 대해 내성인 세포에서 본 발명의 융합 단백질의 세포독성 활성이 수득되었고, 일부의 경우 TRAIL 단독의 활성보다 더 강력했다.
비-암세포주에 대해 수득된 2000 초과의 IC50 값은 건강한 세포에 대한 본 발명의 단백질의 사용과 관련된 독성 작용이 없음을 나타내며, 이는 단백질의 전신 독성 가능성이 낮음을 나타낸다.
확장된 패널의 종양 세포주에 대해 선택된 단백질 제제의 세포독성 활성의 측정
표 4는 광범위하고 가장 흔한 암에 상응하는, 상이한 장기로부터의 광범위한 패널의 종양 세포에 대해 선택된 본 발명의 융합 단백질의 시험관내 세포독성 활성에 대한 시험 결과를 나타낸다.
실험 결과는 평균값 ± 표준 편차(SD)로 제시된다. 모든 계산 및 그래프는 GraphPad Prism 5.0 소프트웨어를 사용하여 작성하였다.
수득된 IC50 값에 의해, 융합 단백질의 높은 세포독성 활성과 이에 따른 암 치료에서의 잠재적 유용성을 확인하였다.
[표 4] 본 발명의 융합 단백질의 세포독성 활성
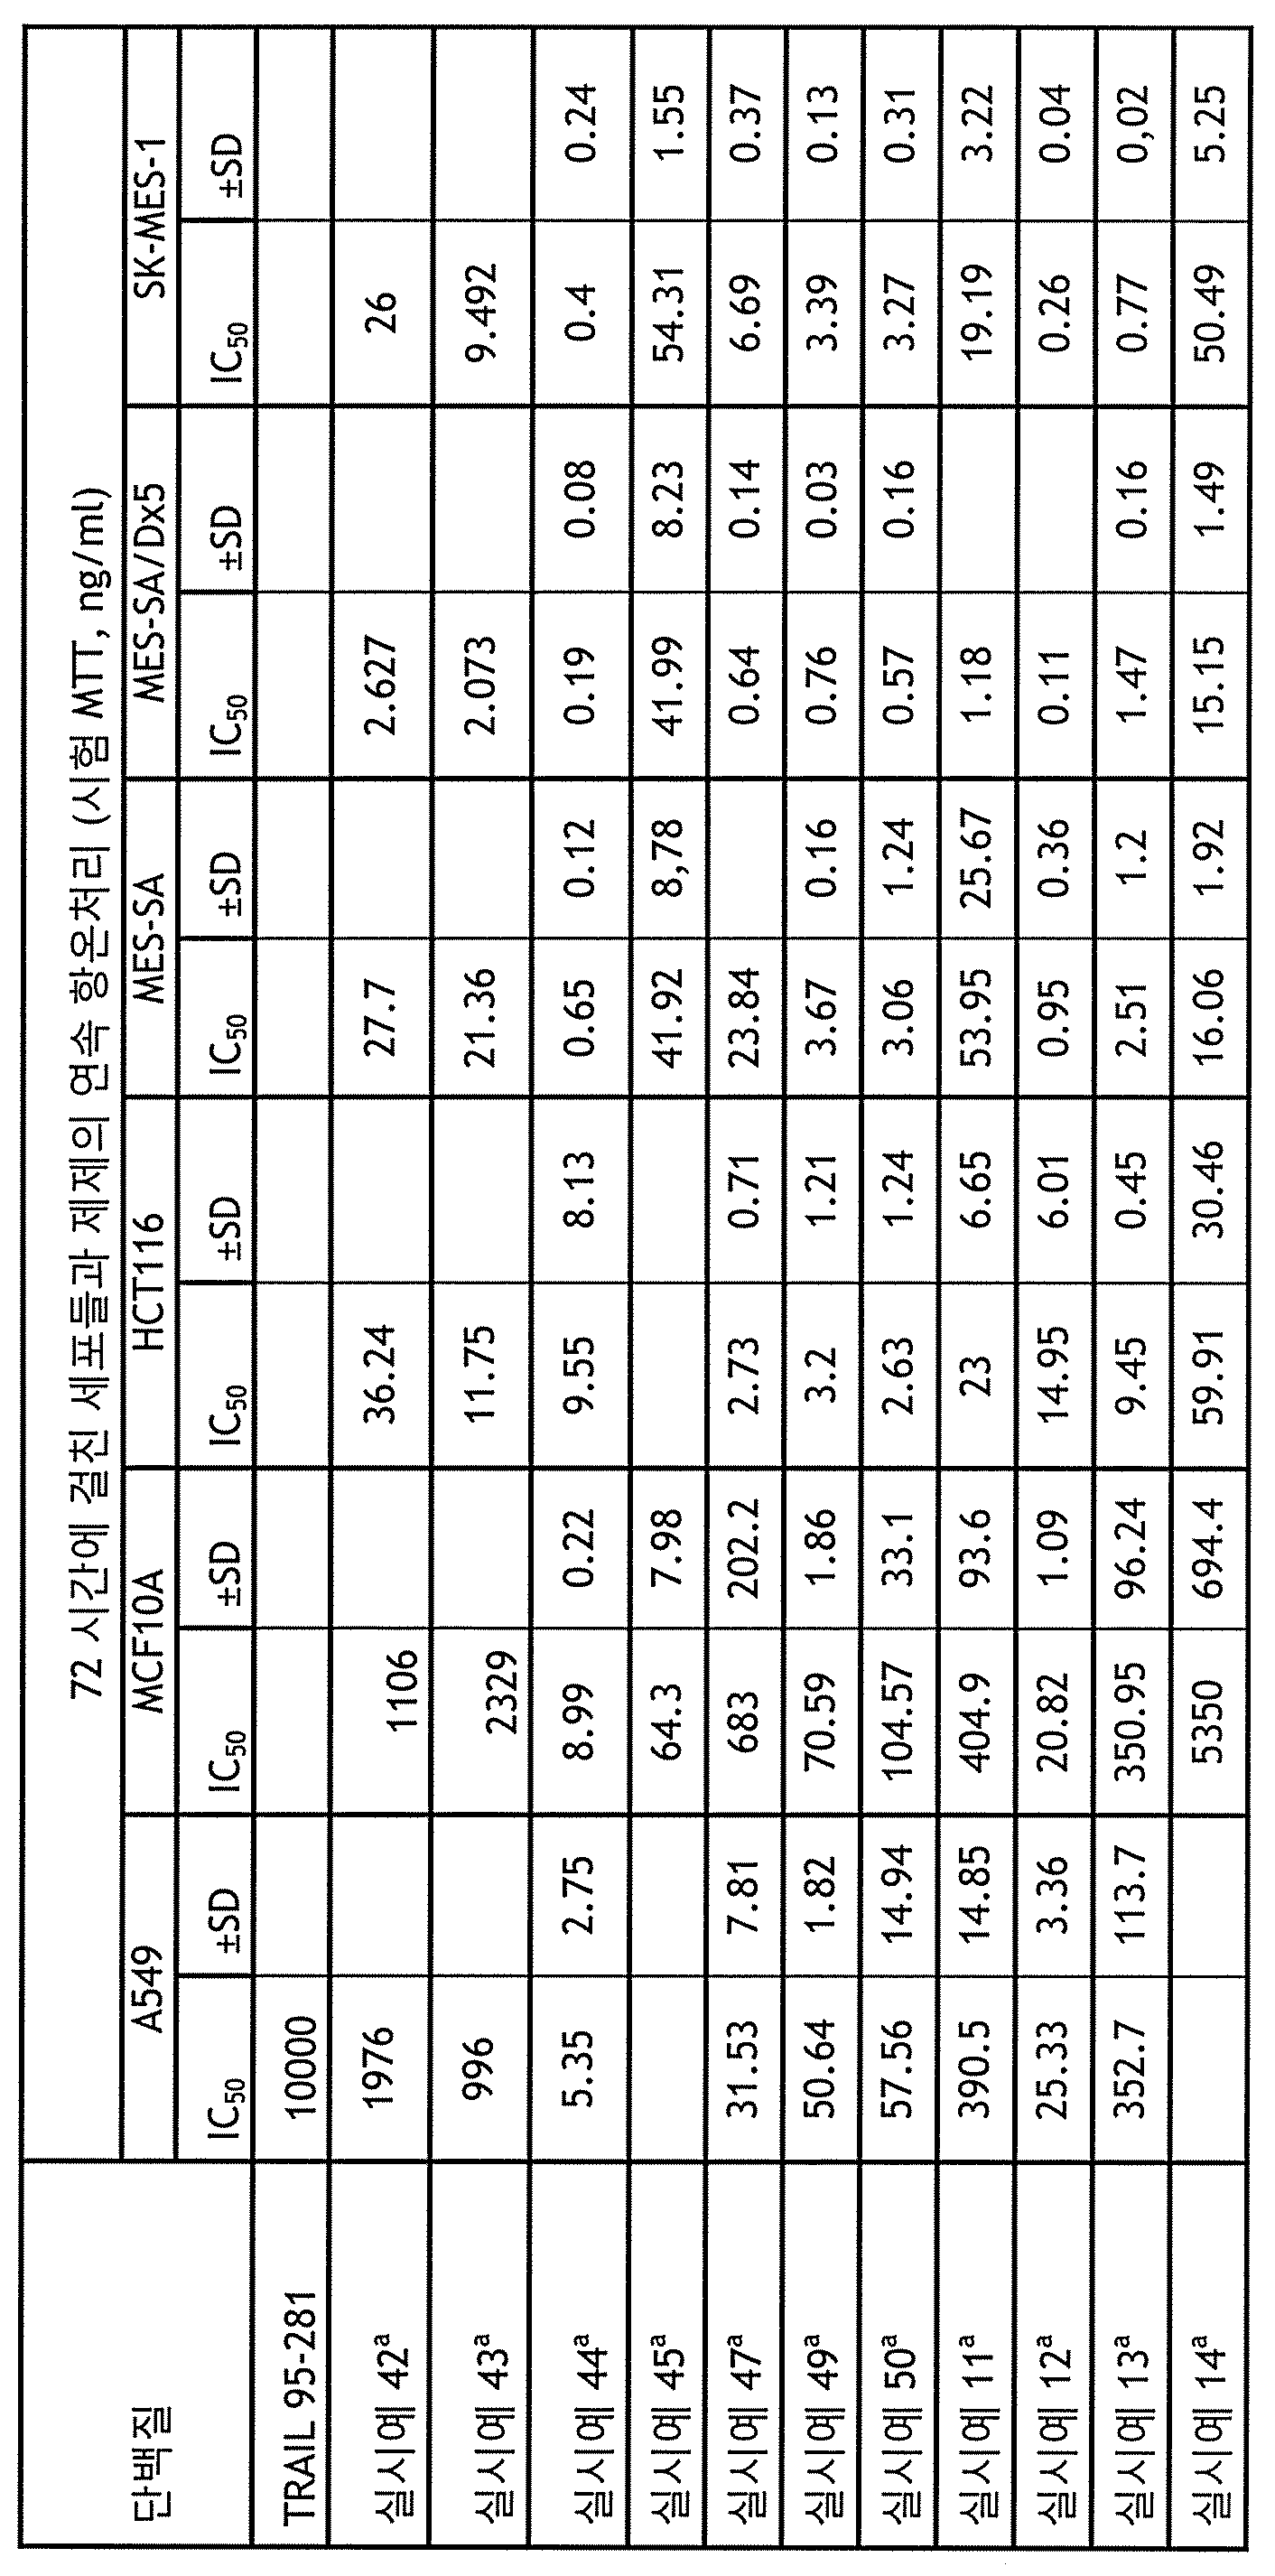
[표 4a] 본 발명의 융합 단백질의 세포독성 활성
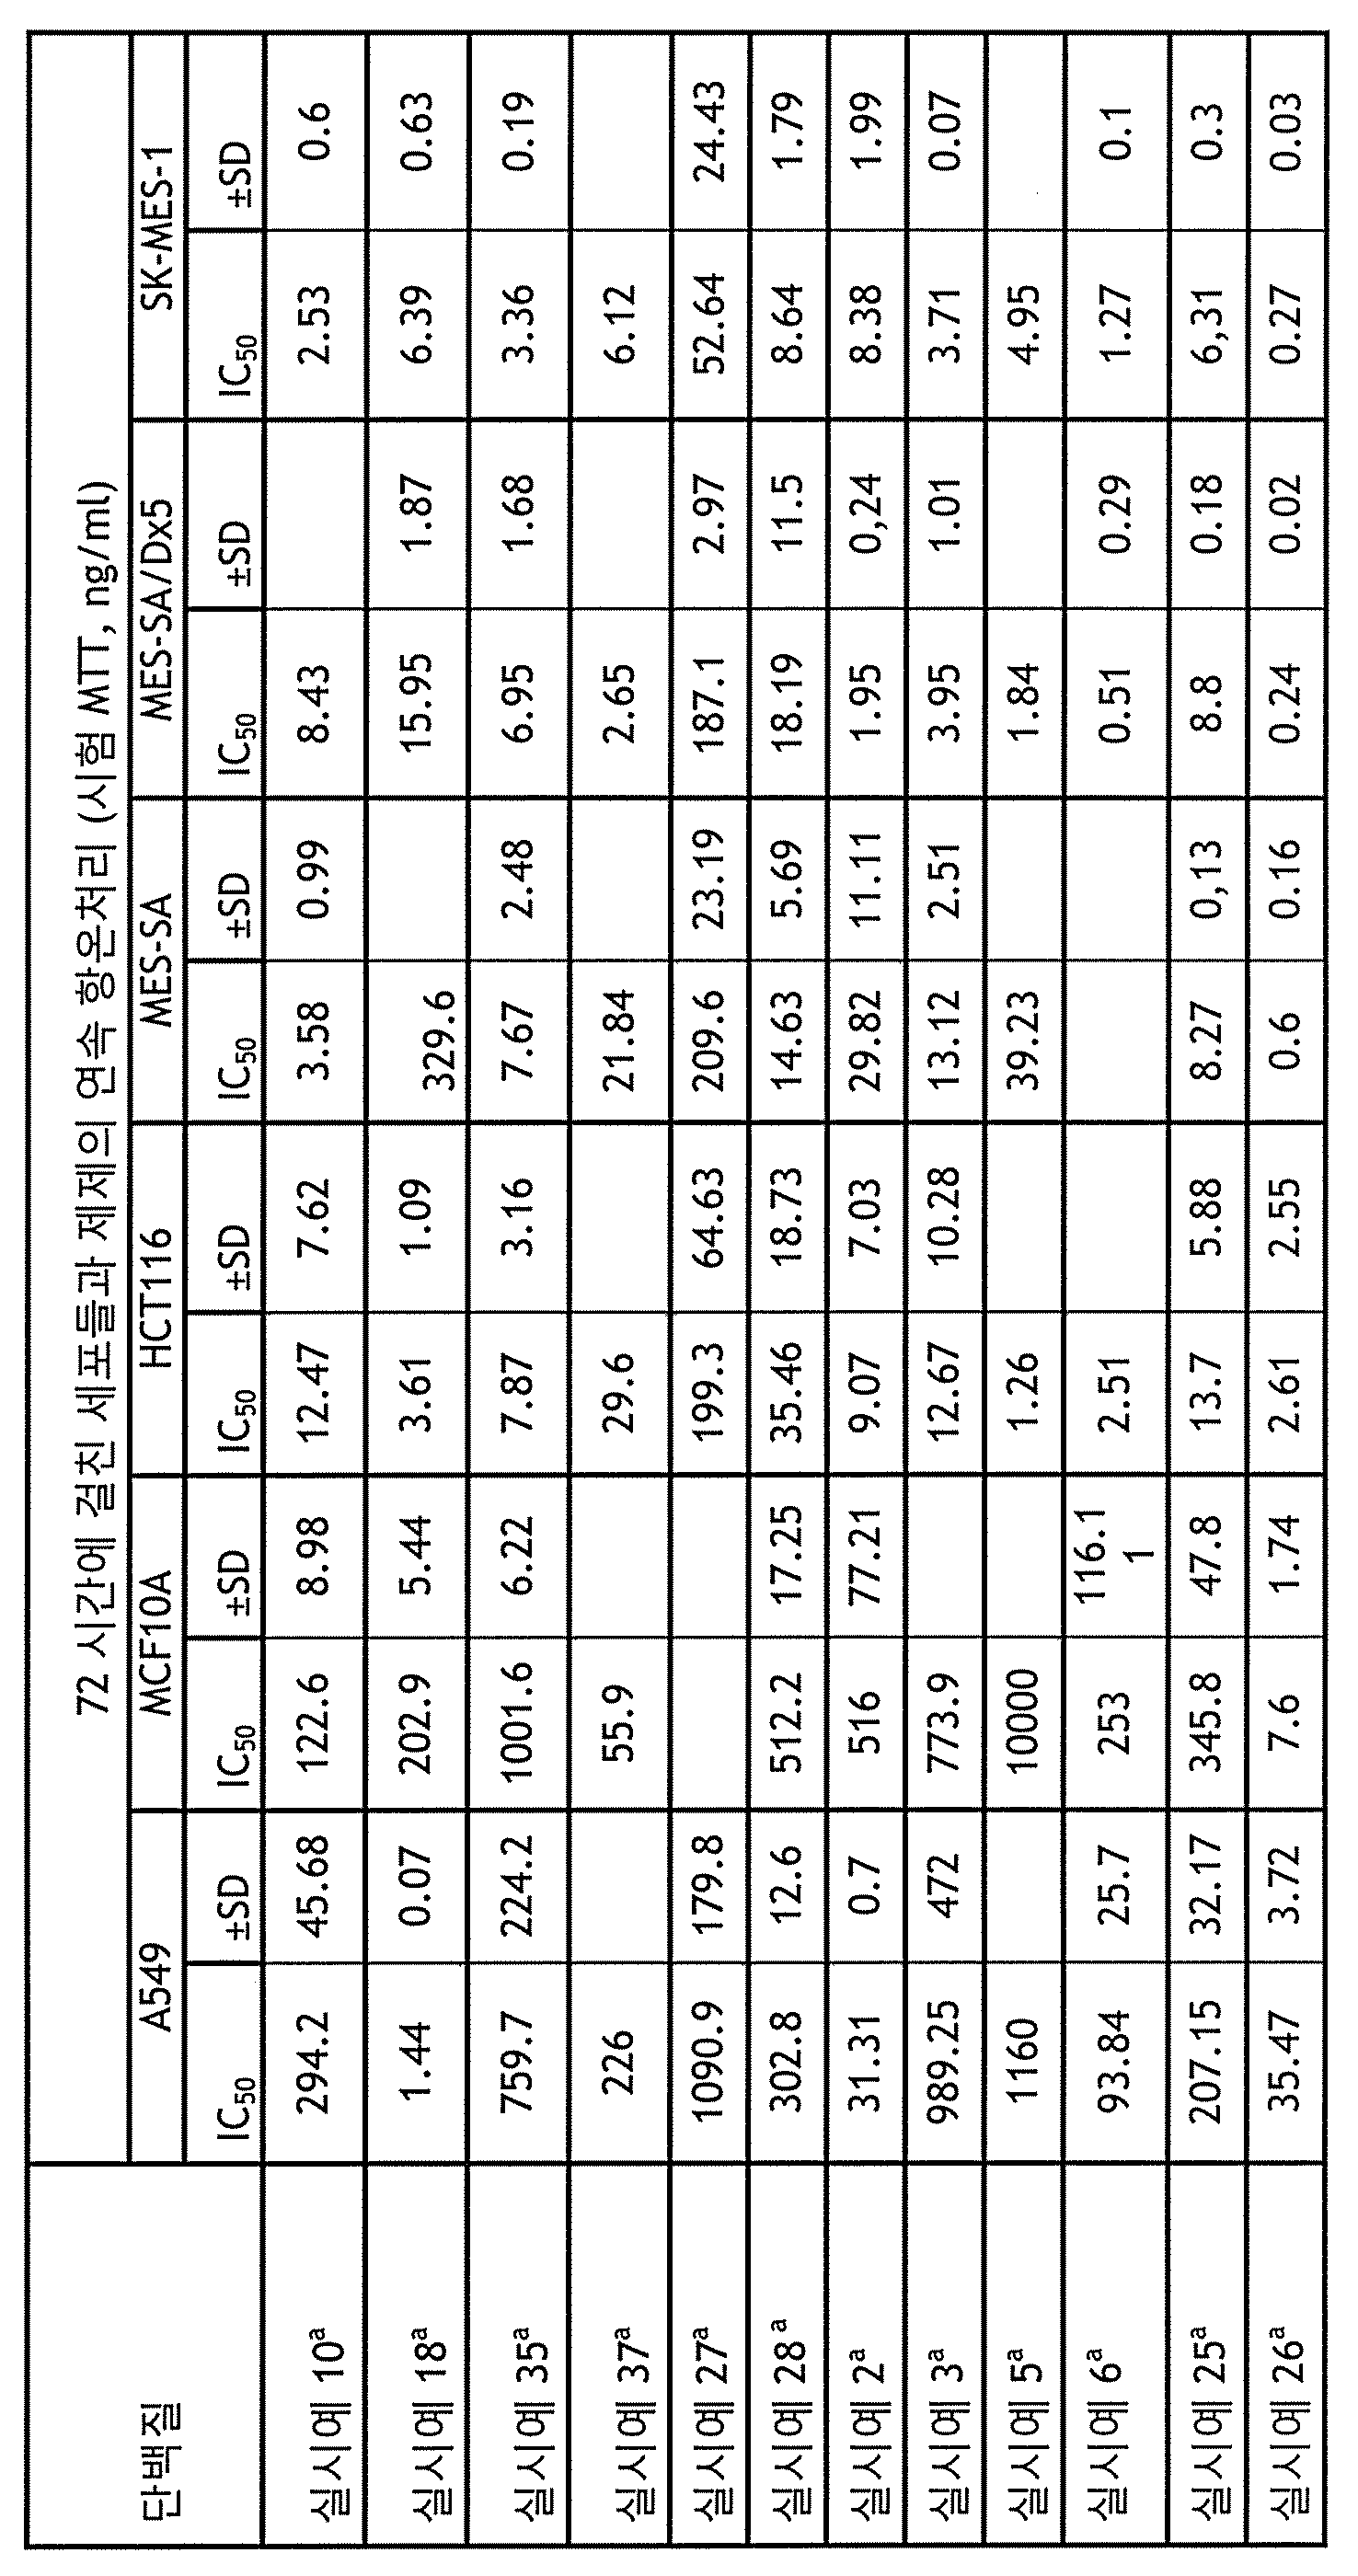
[표 4b] 본 발명의 융합 단백질의 세포독성 활성
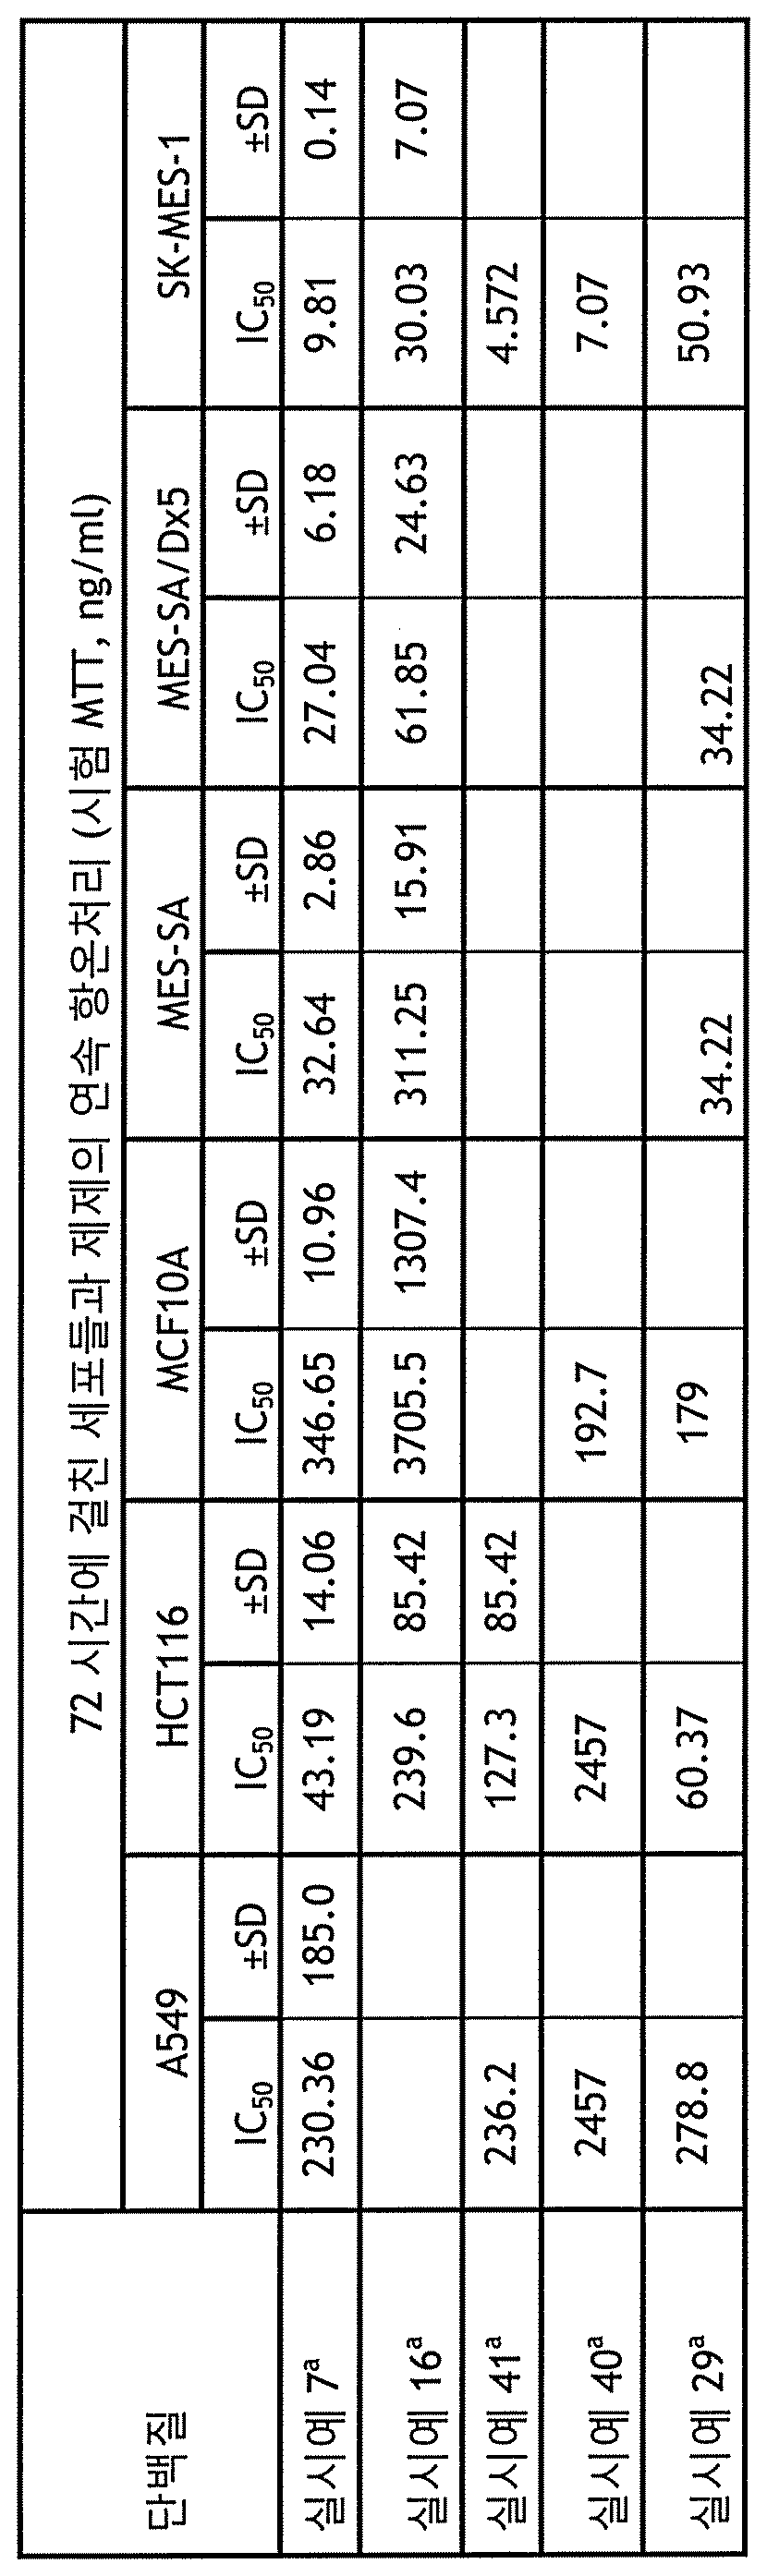
[표 4c] 본 발명의 융합 단백질의 세포독성 활성

[표 4d] 본 발명의 융합 단백질의 세포독성 활성
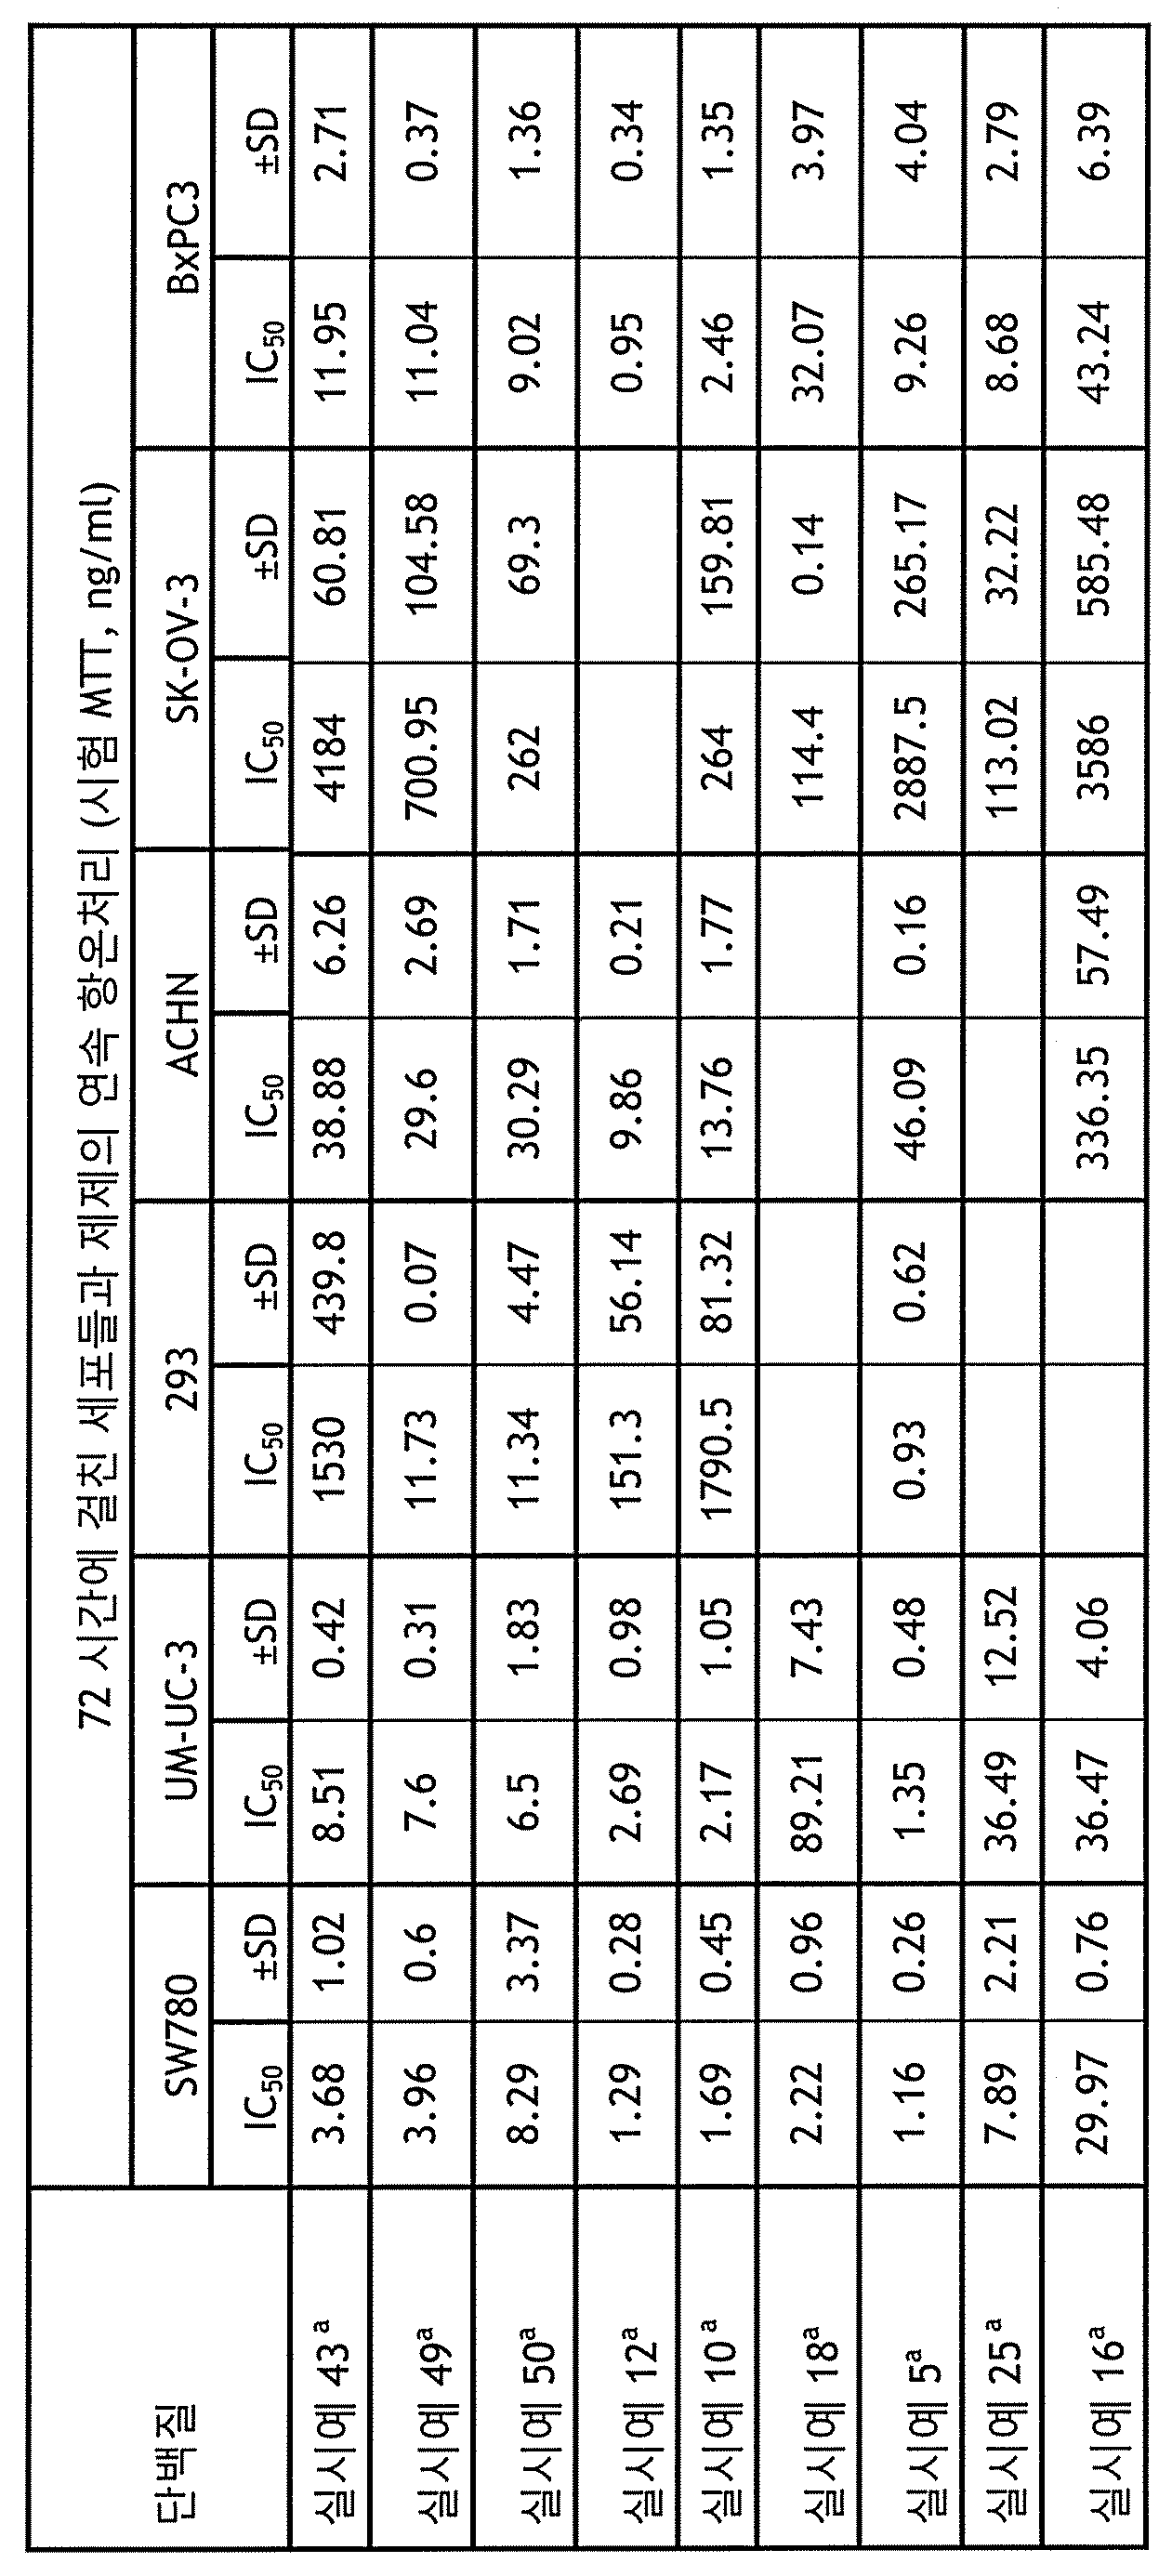
[표 4e] 본 발명의 융합 단백질의 세포독성 활성
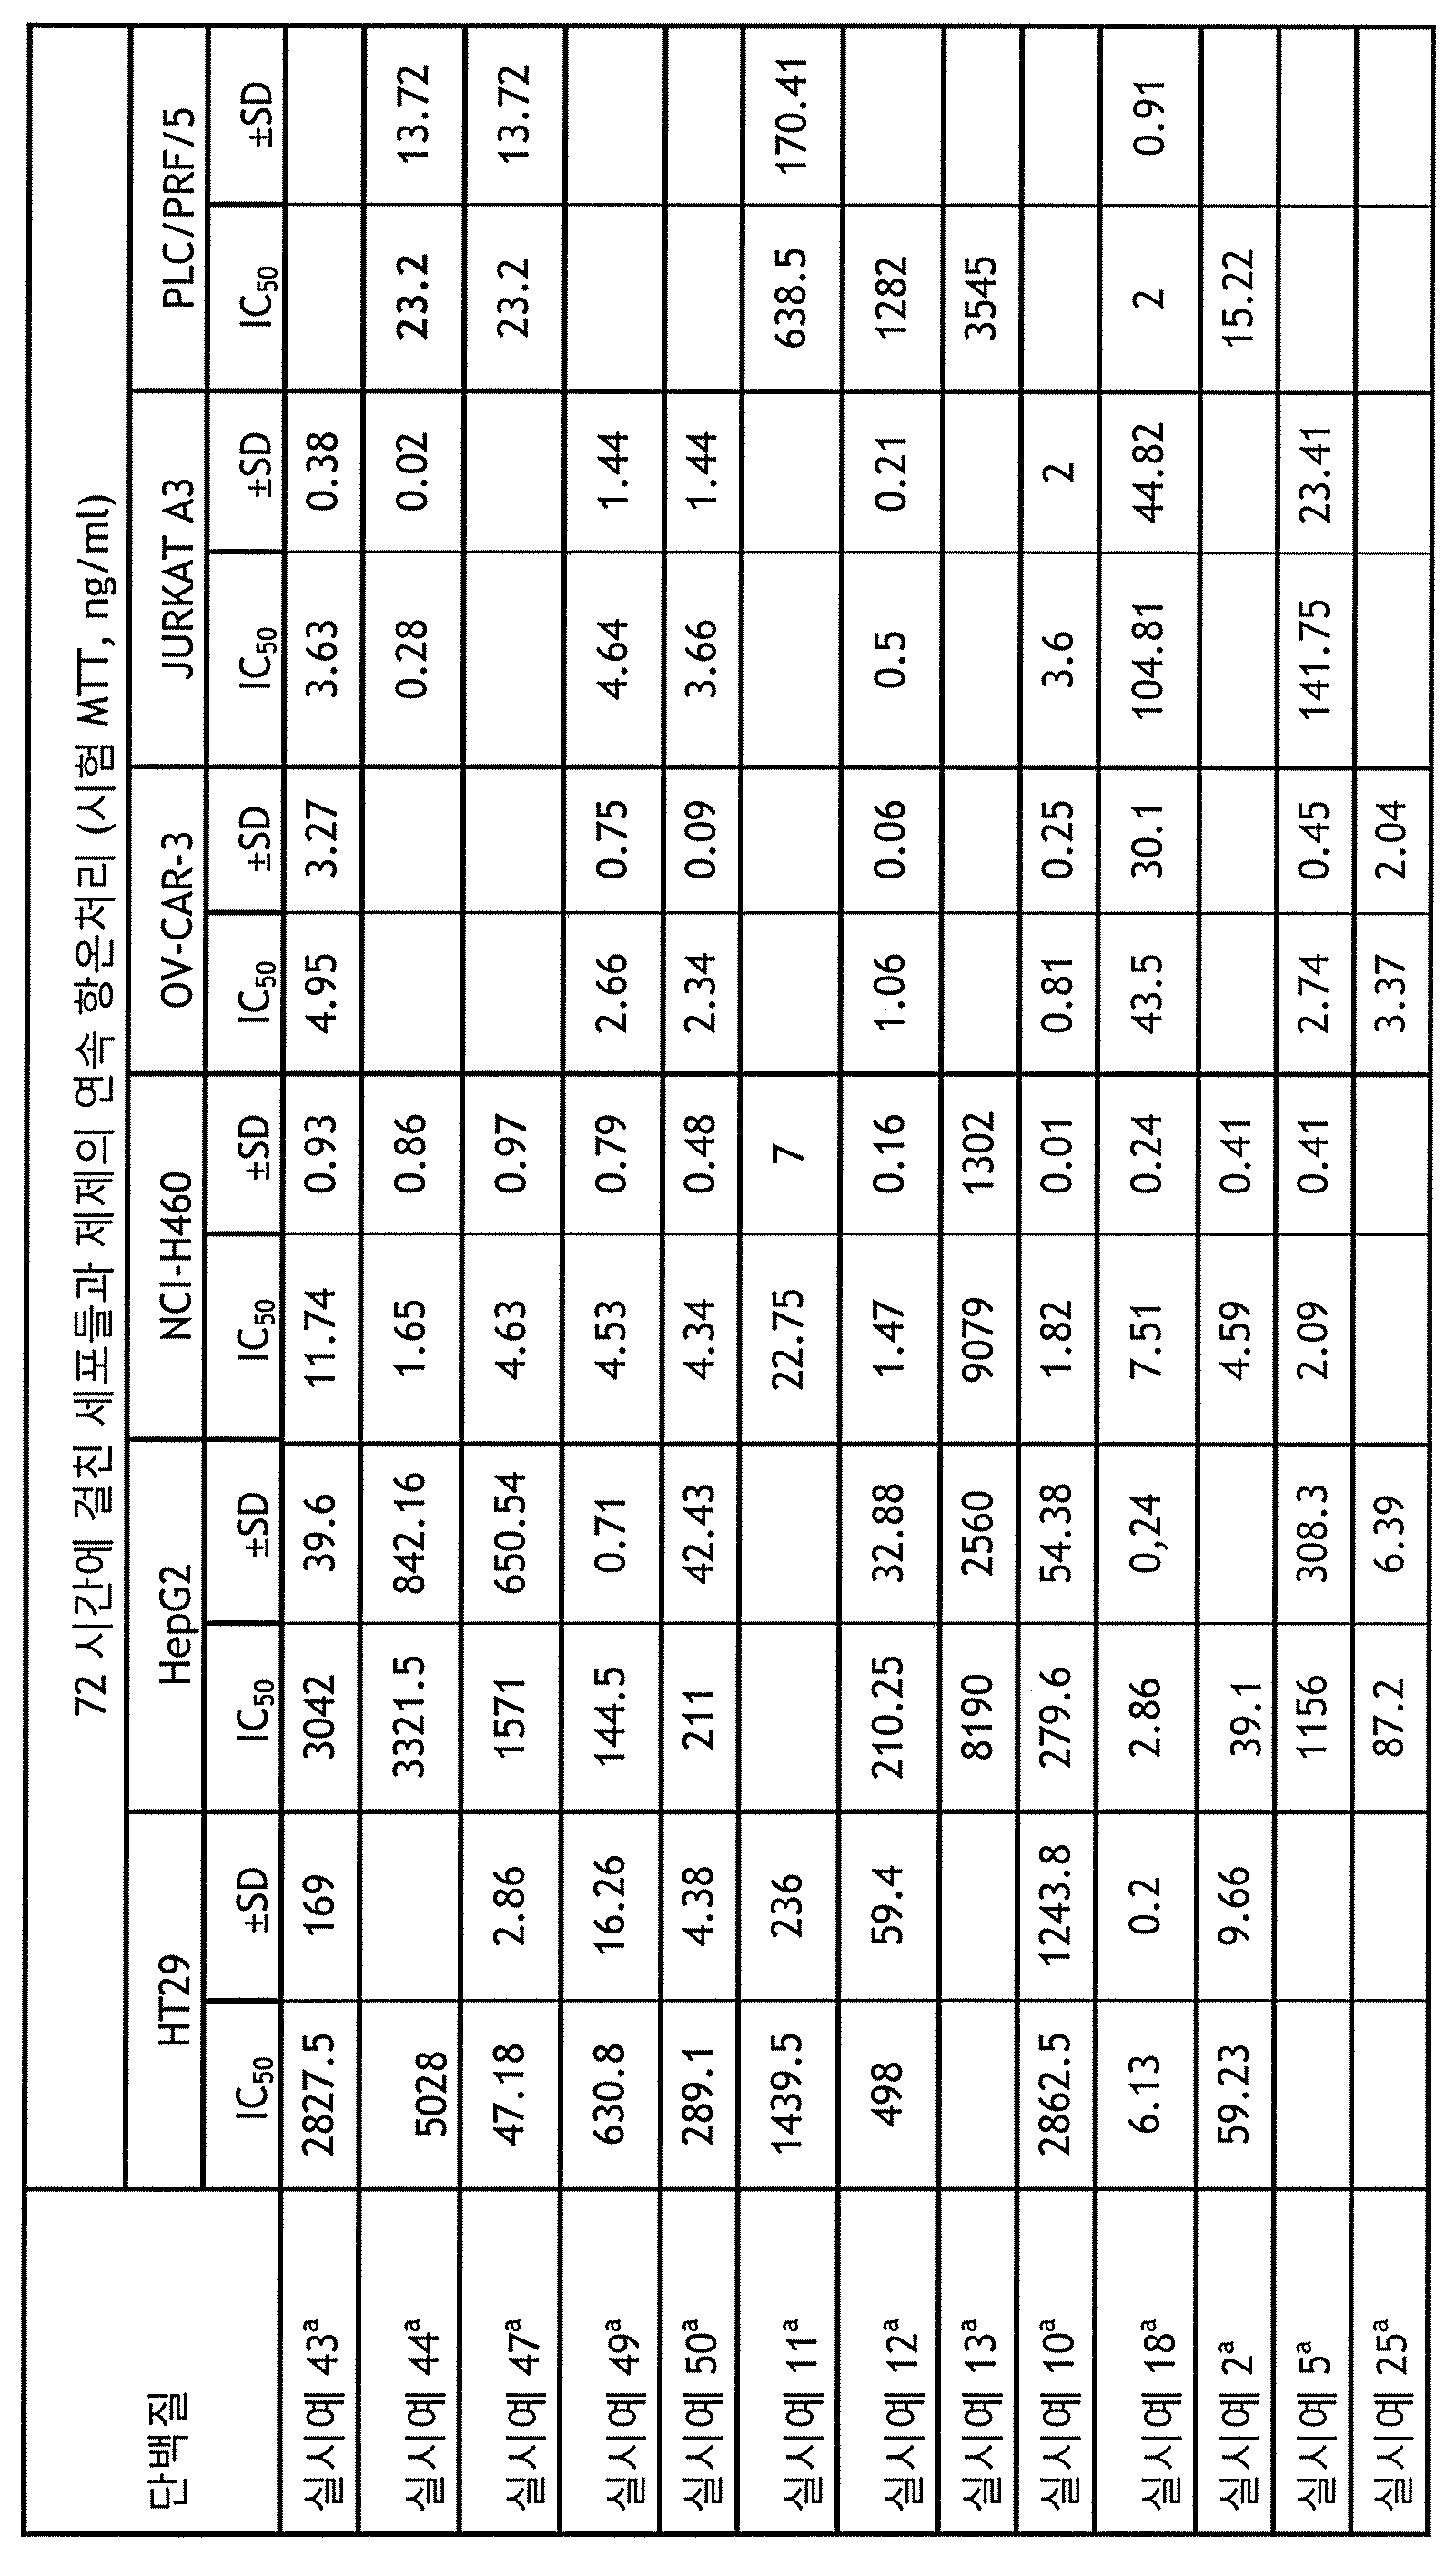
[표 4f] 본 발명의 융합 단백질의 세포독성 활성
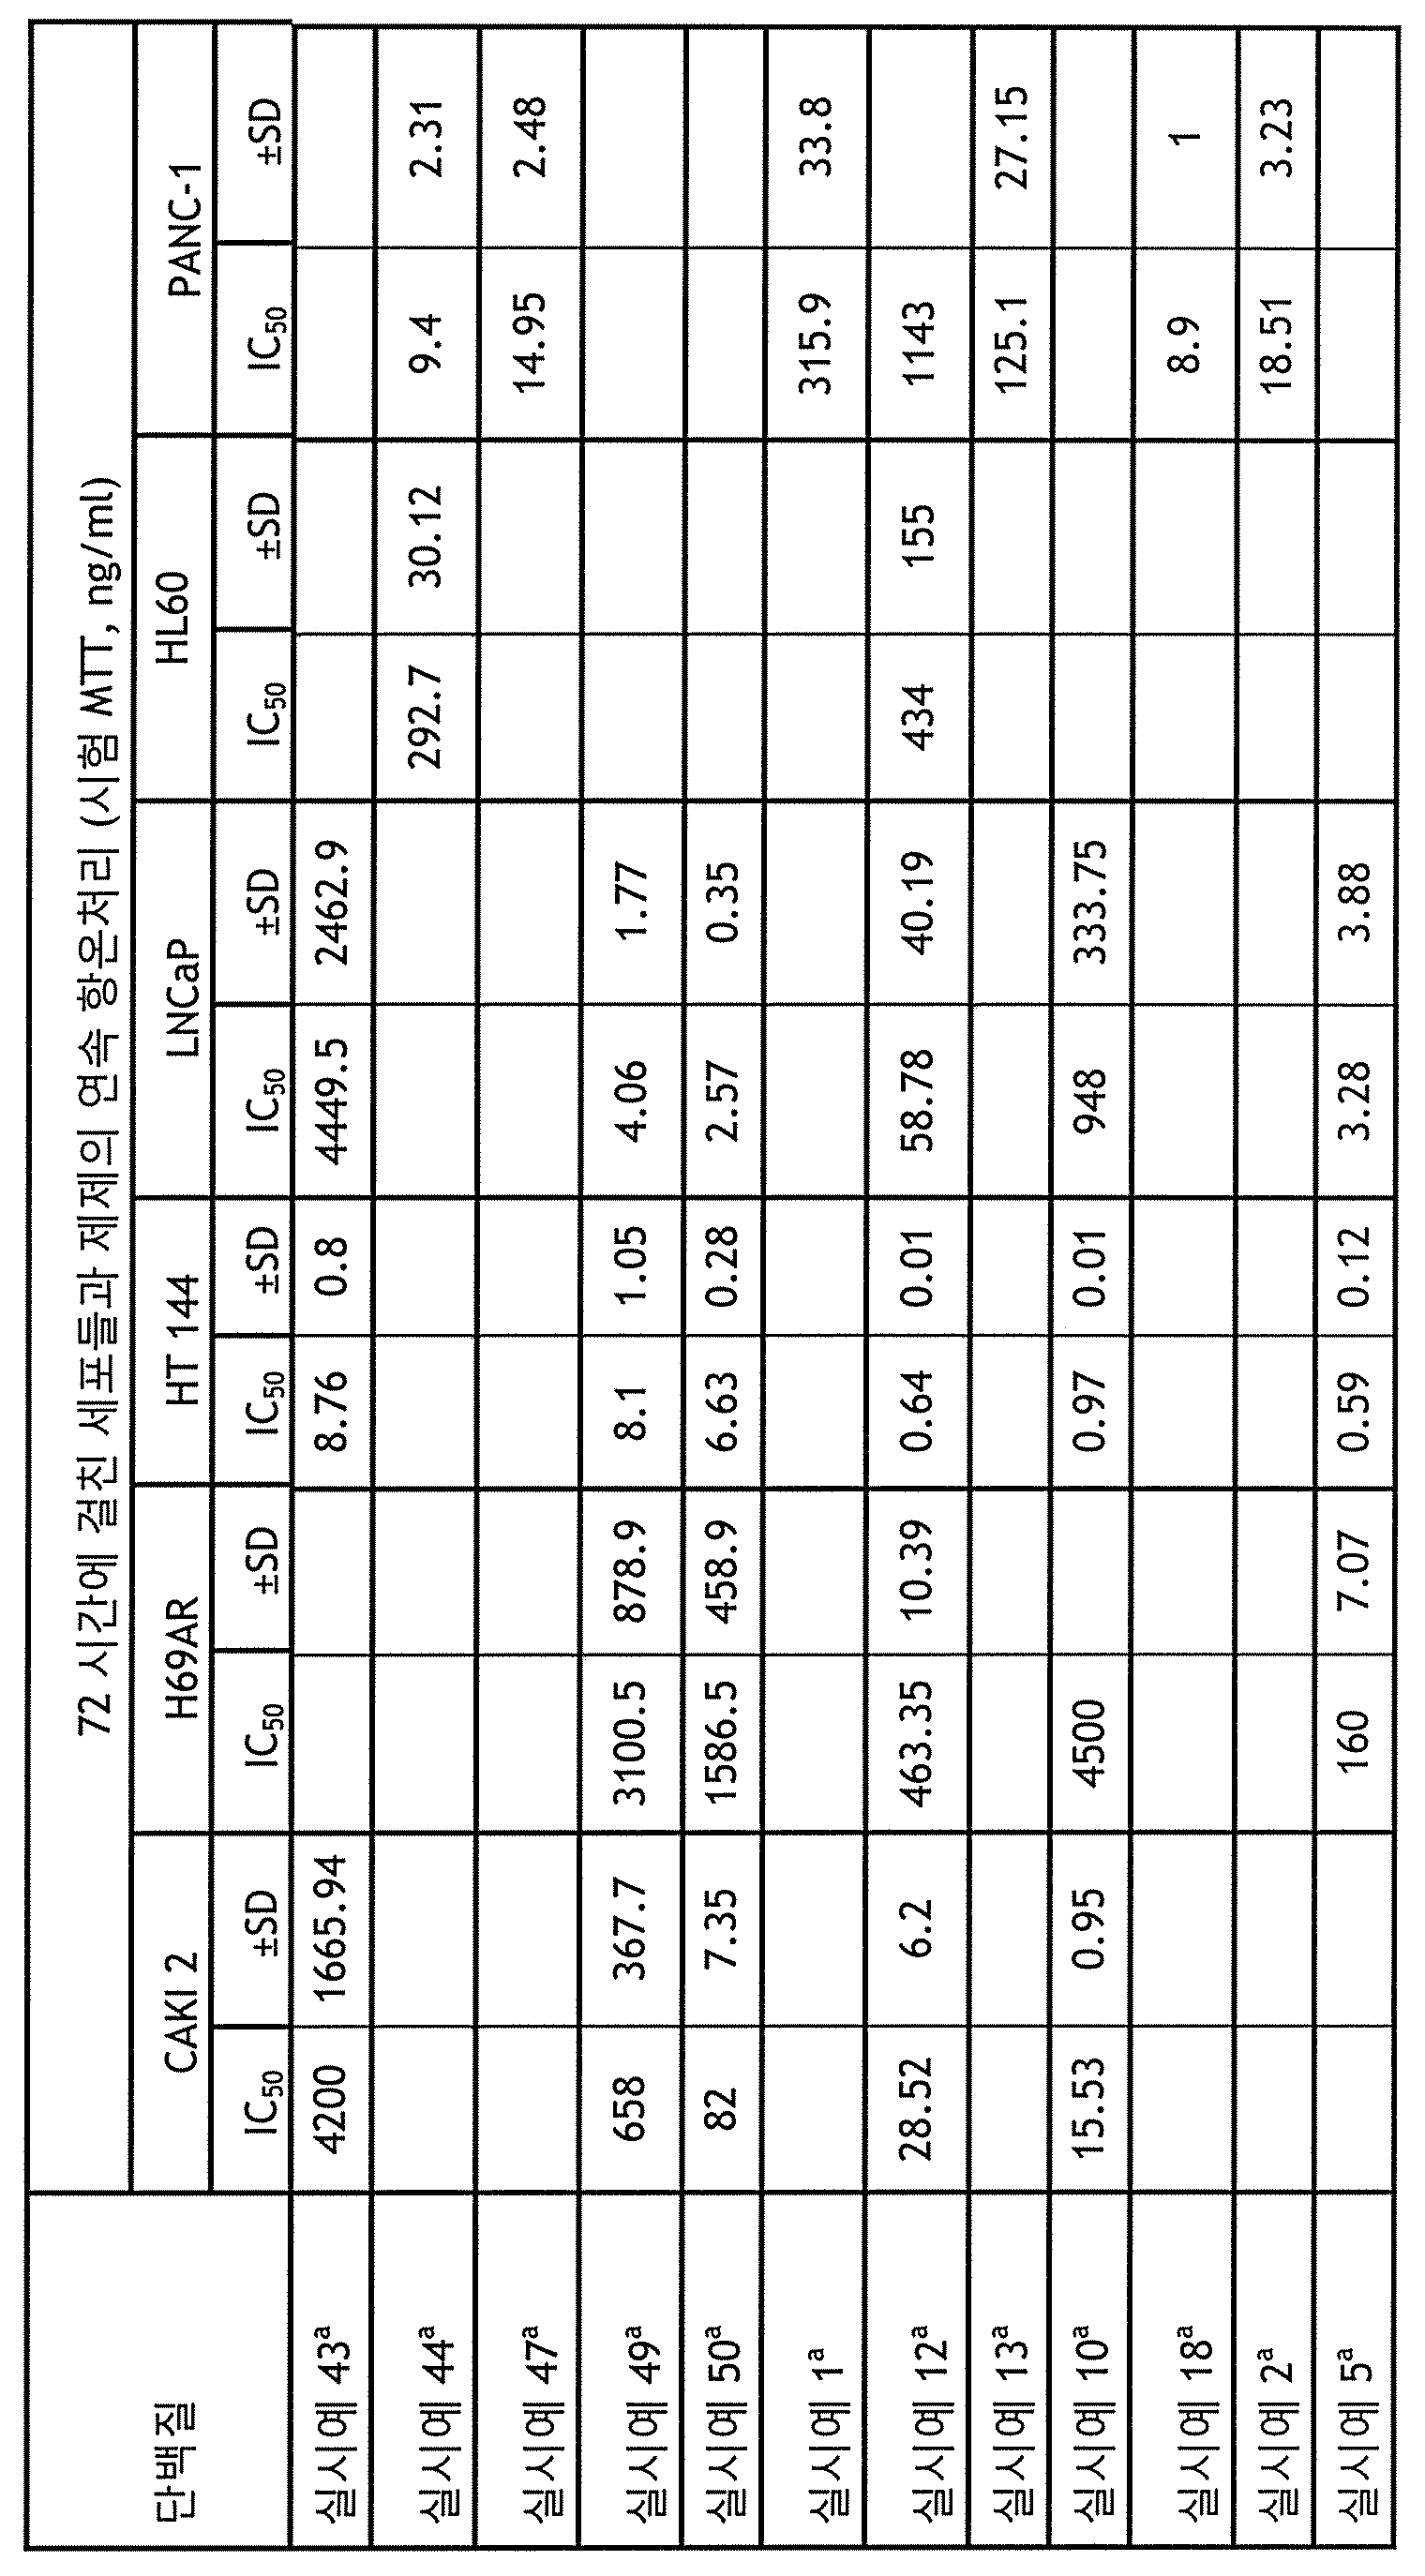
[표 4g] 본 발명의 융합 단백질의 세포독성 활성
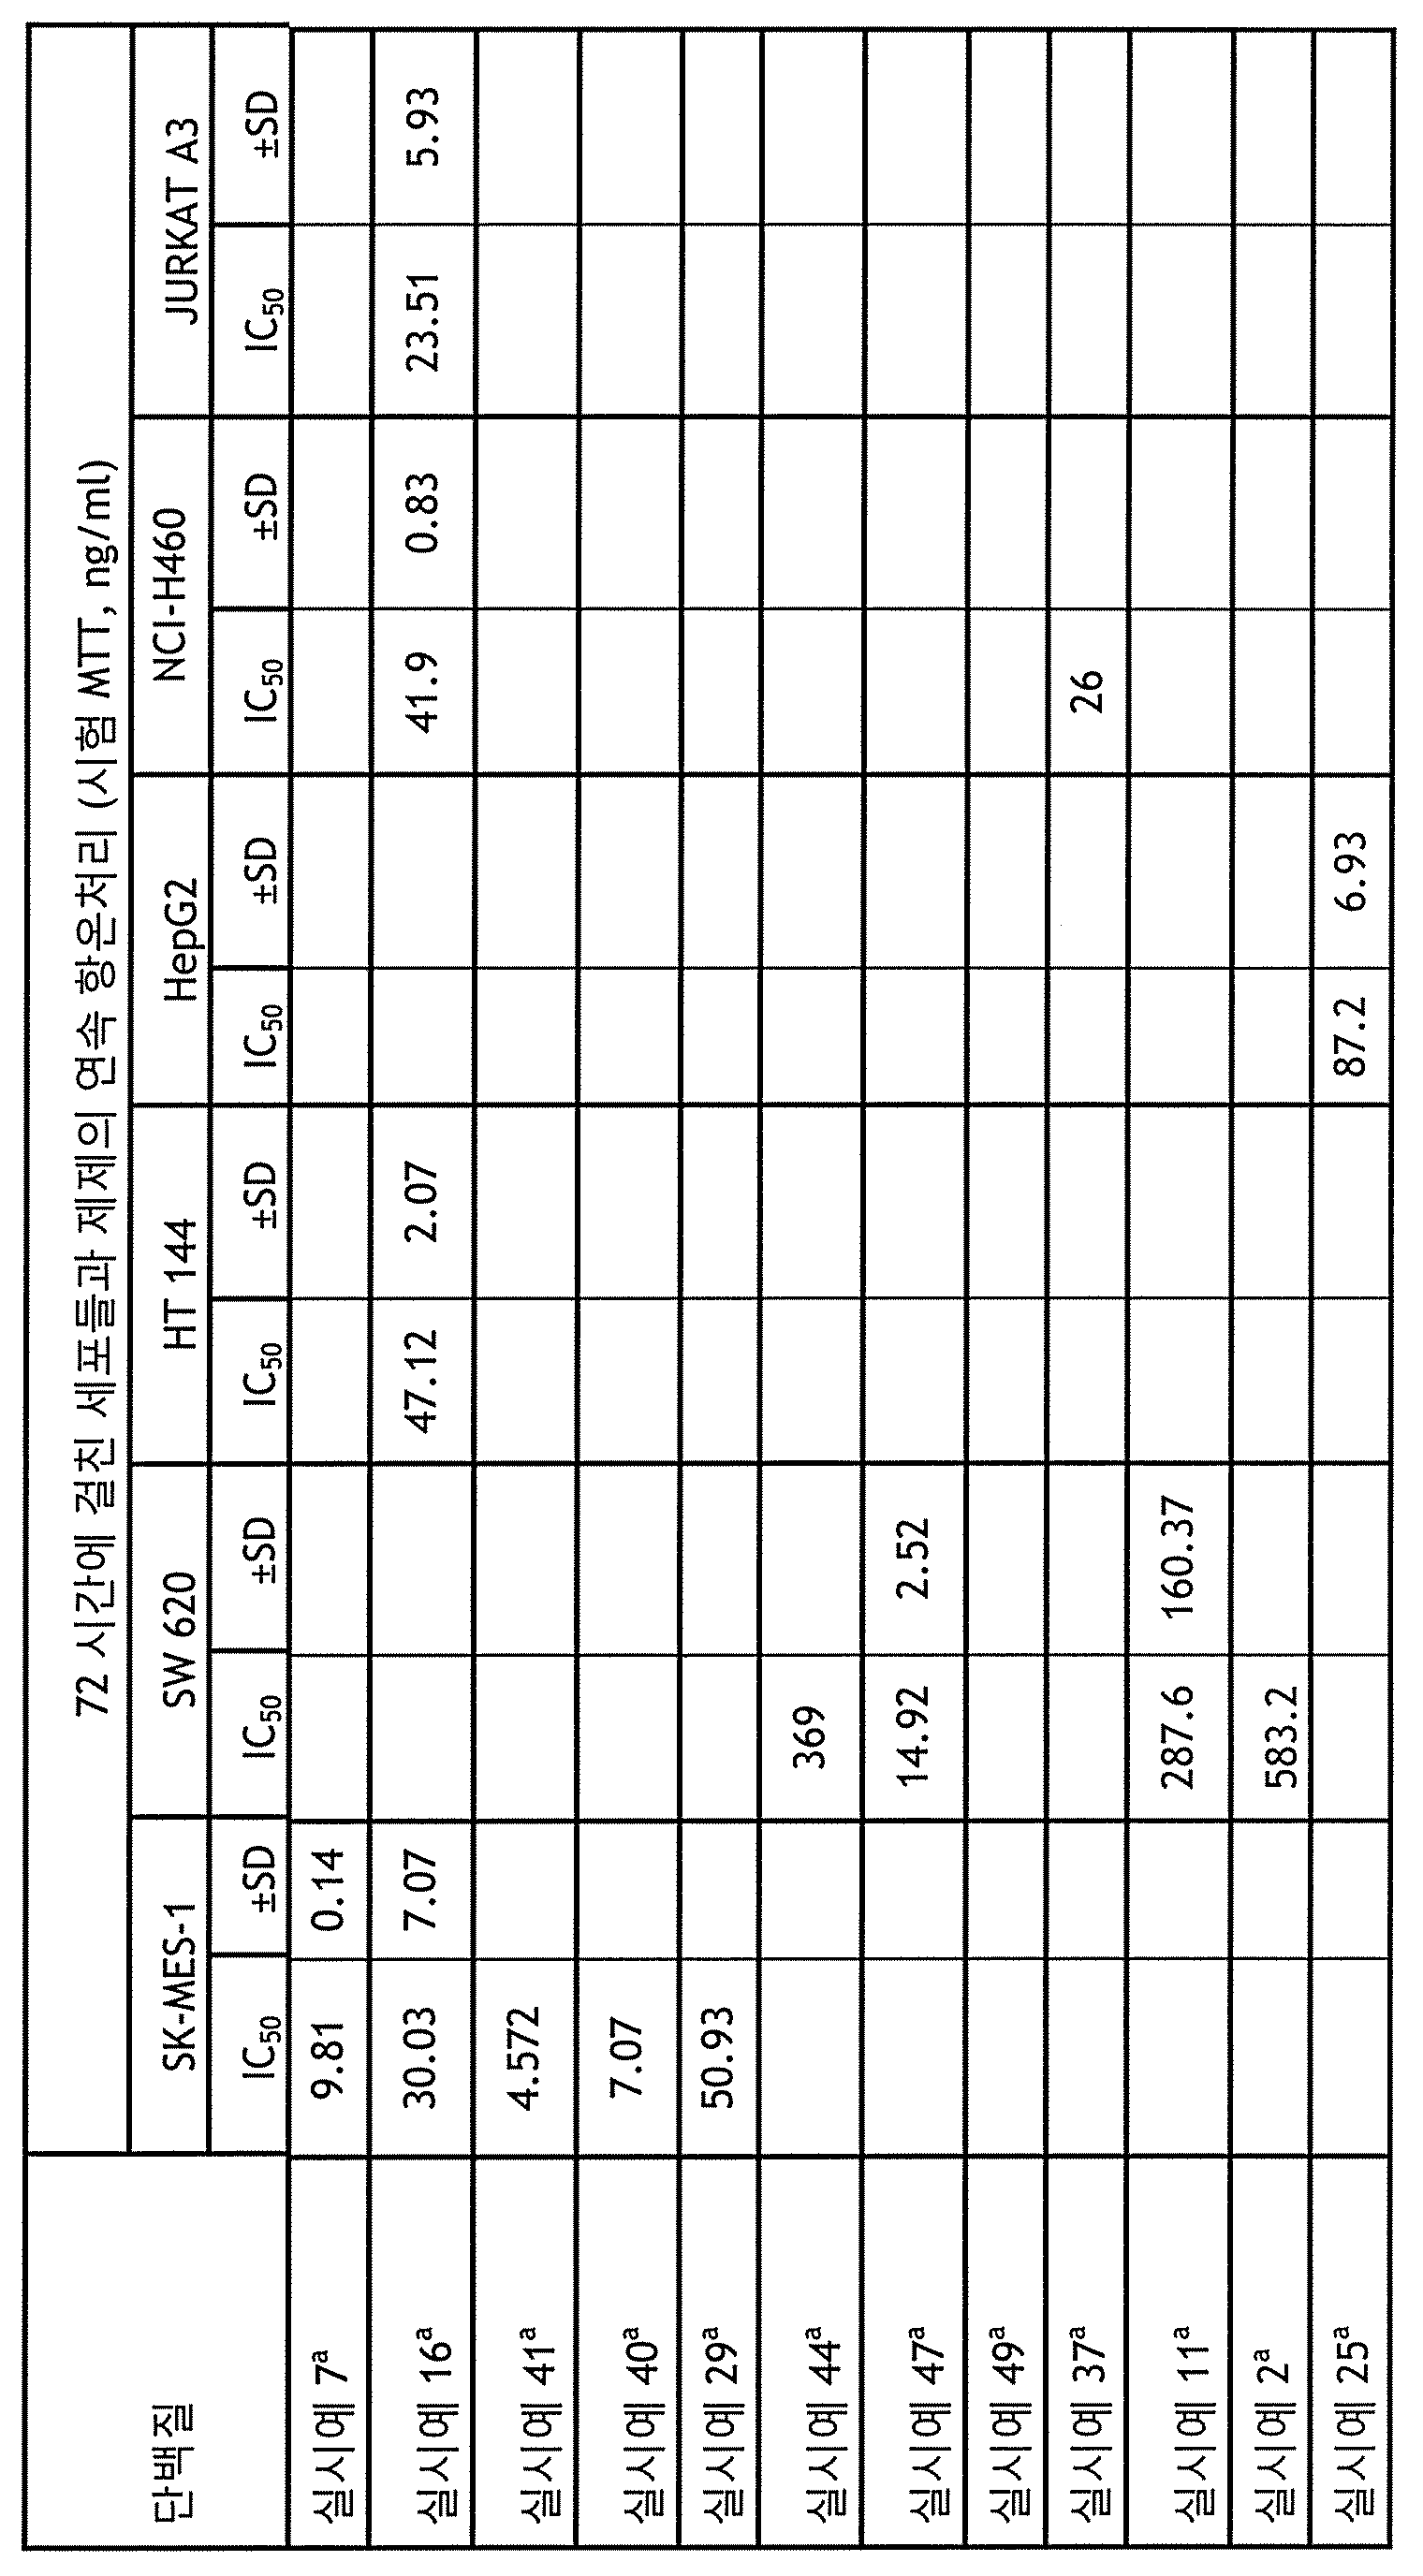
[표 4h] 본 발명의 융합 단백질의 세포독성 활성

[표 4i] 본 발명의 융합 단백질의 세포독성 활성

[표 4j] 본 발명의 융합 단백질의 세포독성 활성

[표 4k] 본 발명의 융합 단백질의 세포독성 활성
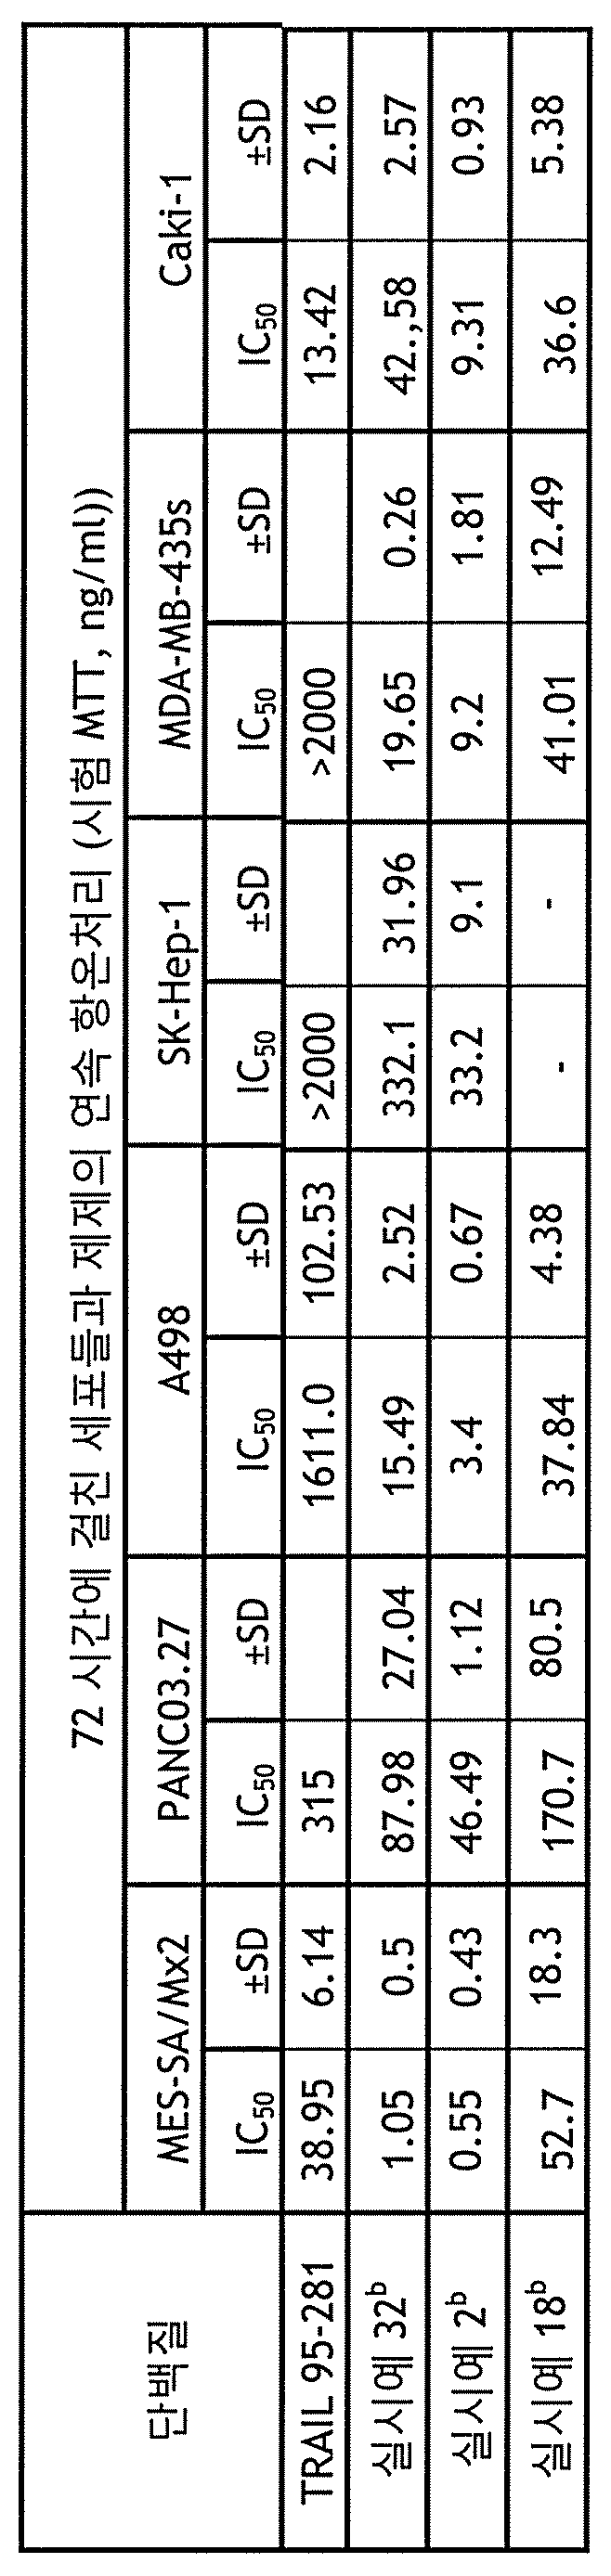
[표 4l] 본 발명의 융합 단백질의 세포독성 활성
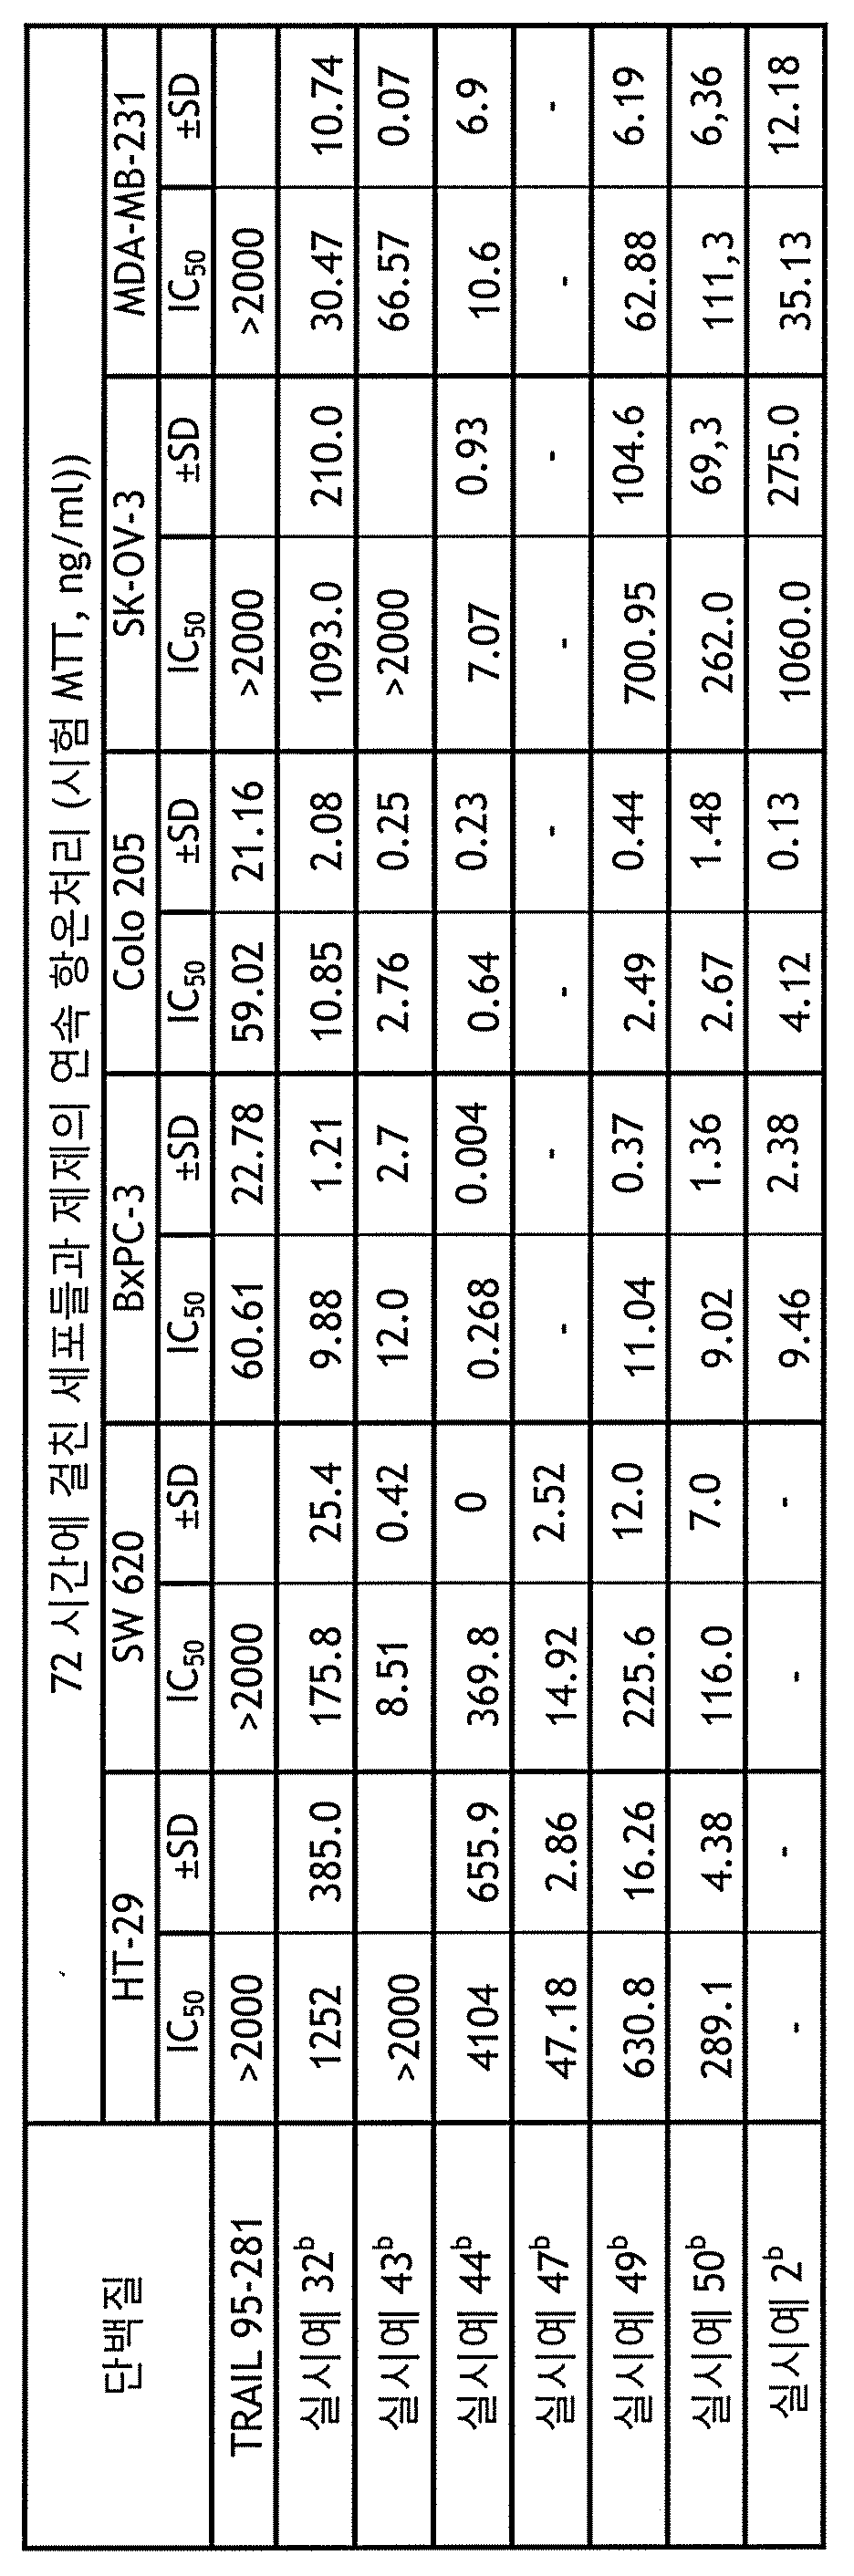
[표 4m] 본 발명의 융합 단백질의 세포독성 활성
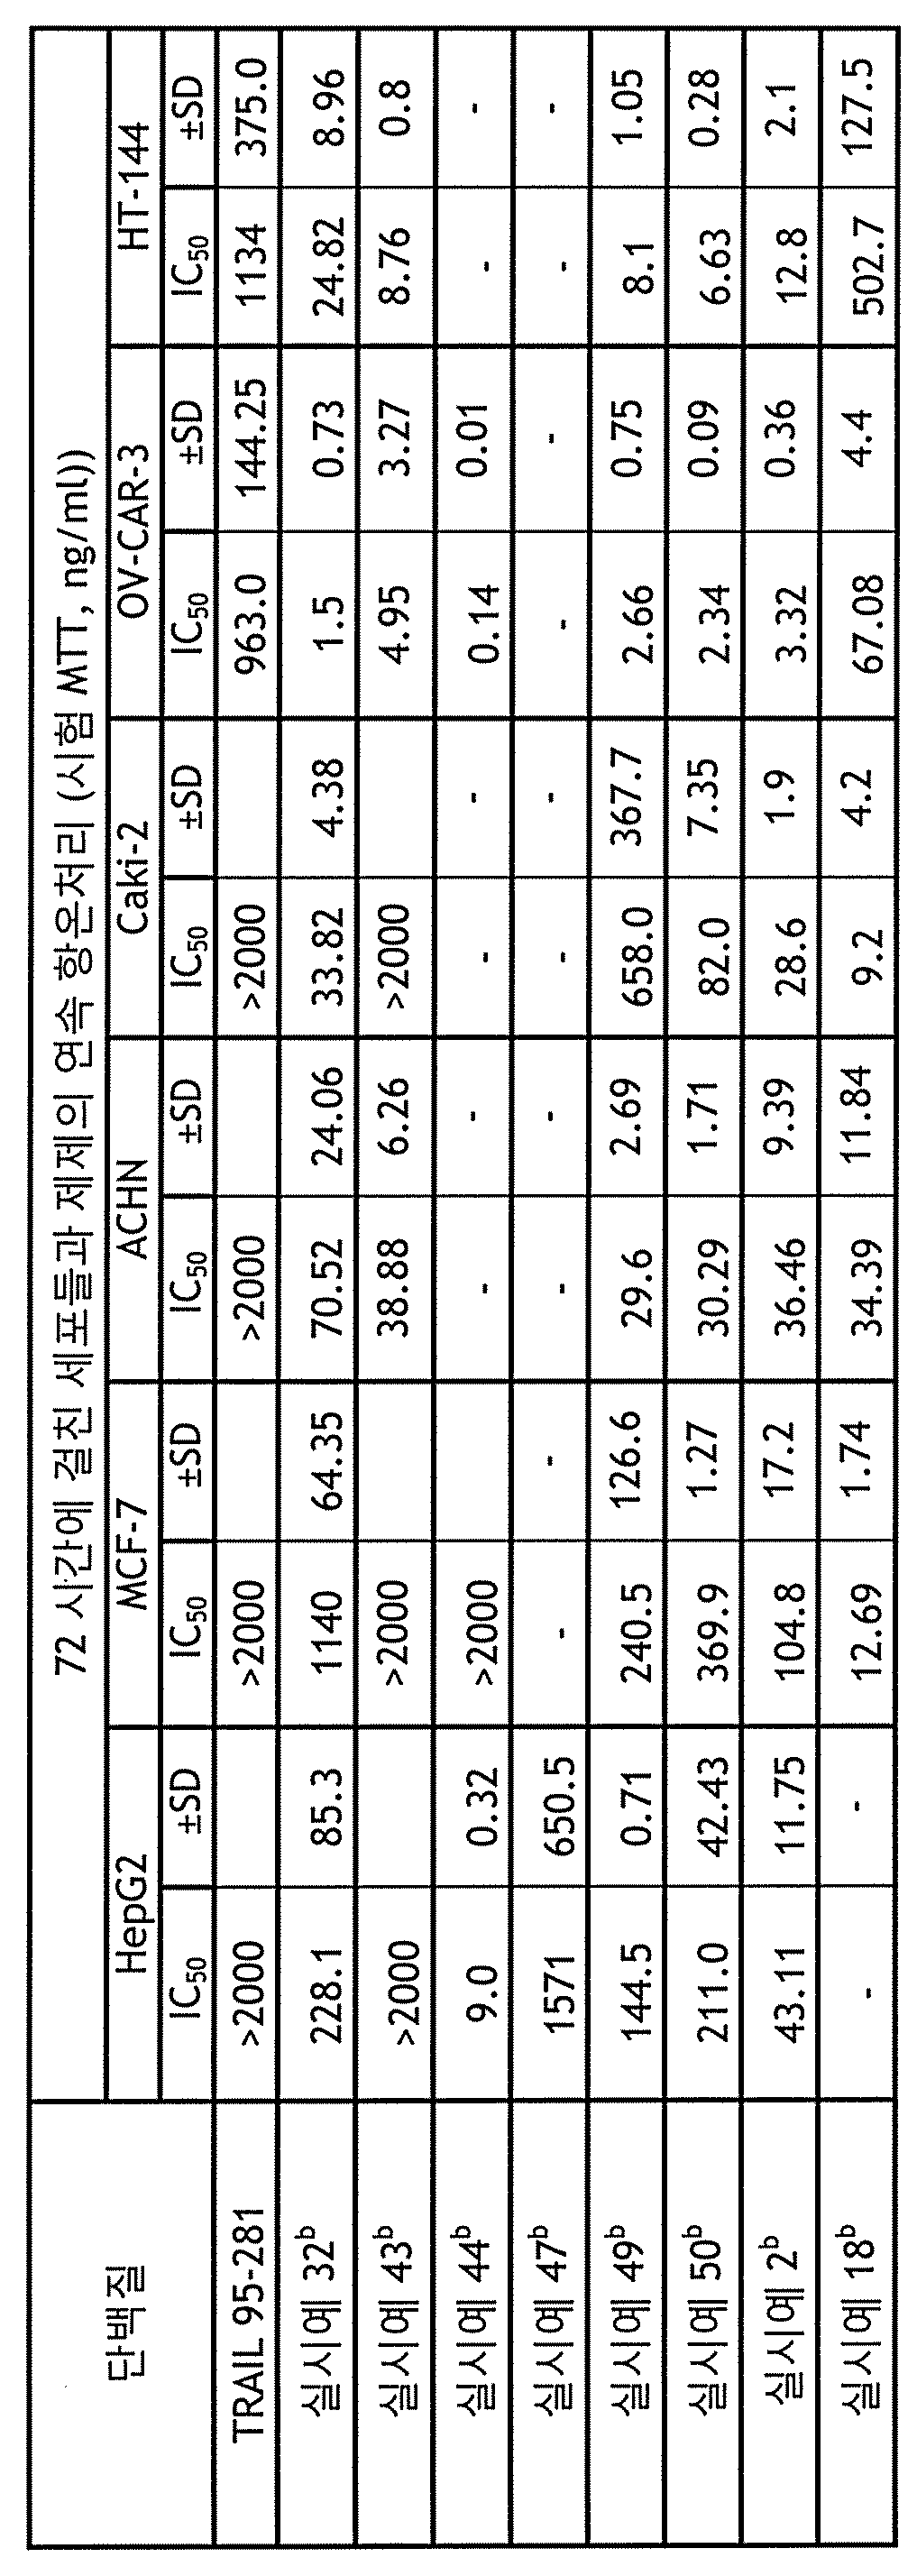
[표 4n] 본 발명의 융합 단백질의 세포독성 활성
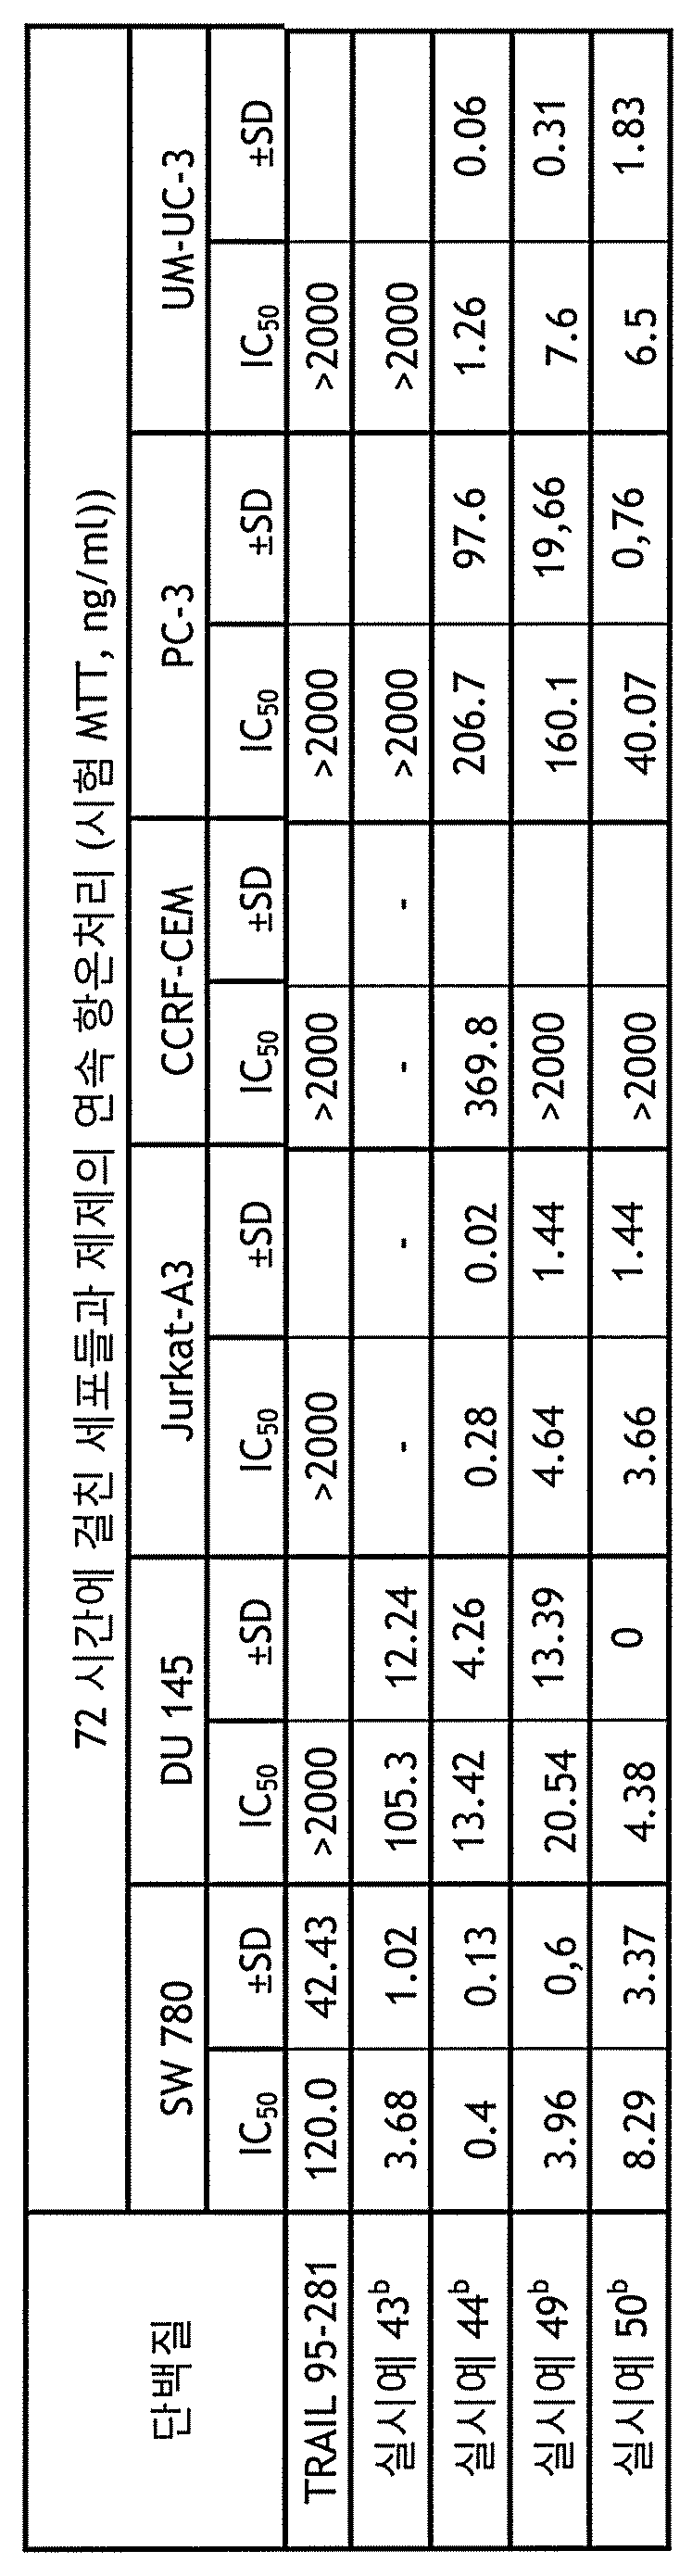
[표 4o] 본 발명의 융합 단백질의 세포독성 활성

[표 4p] 본 발명의 융합 단백질의 세포독성 활성
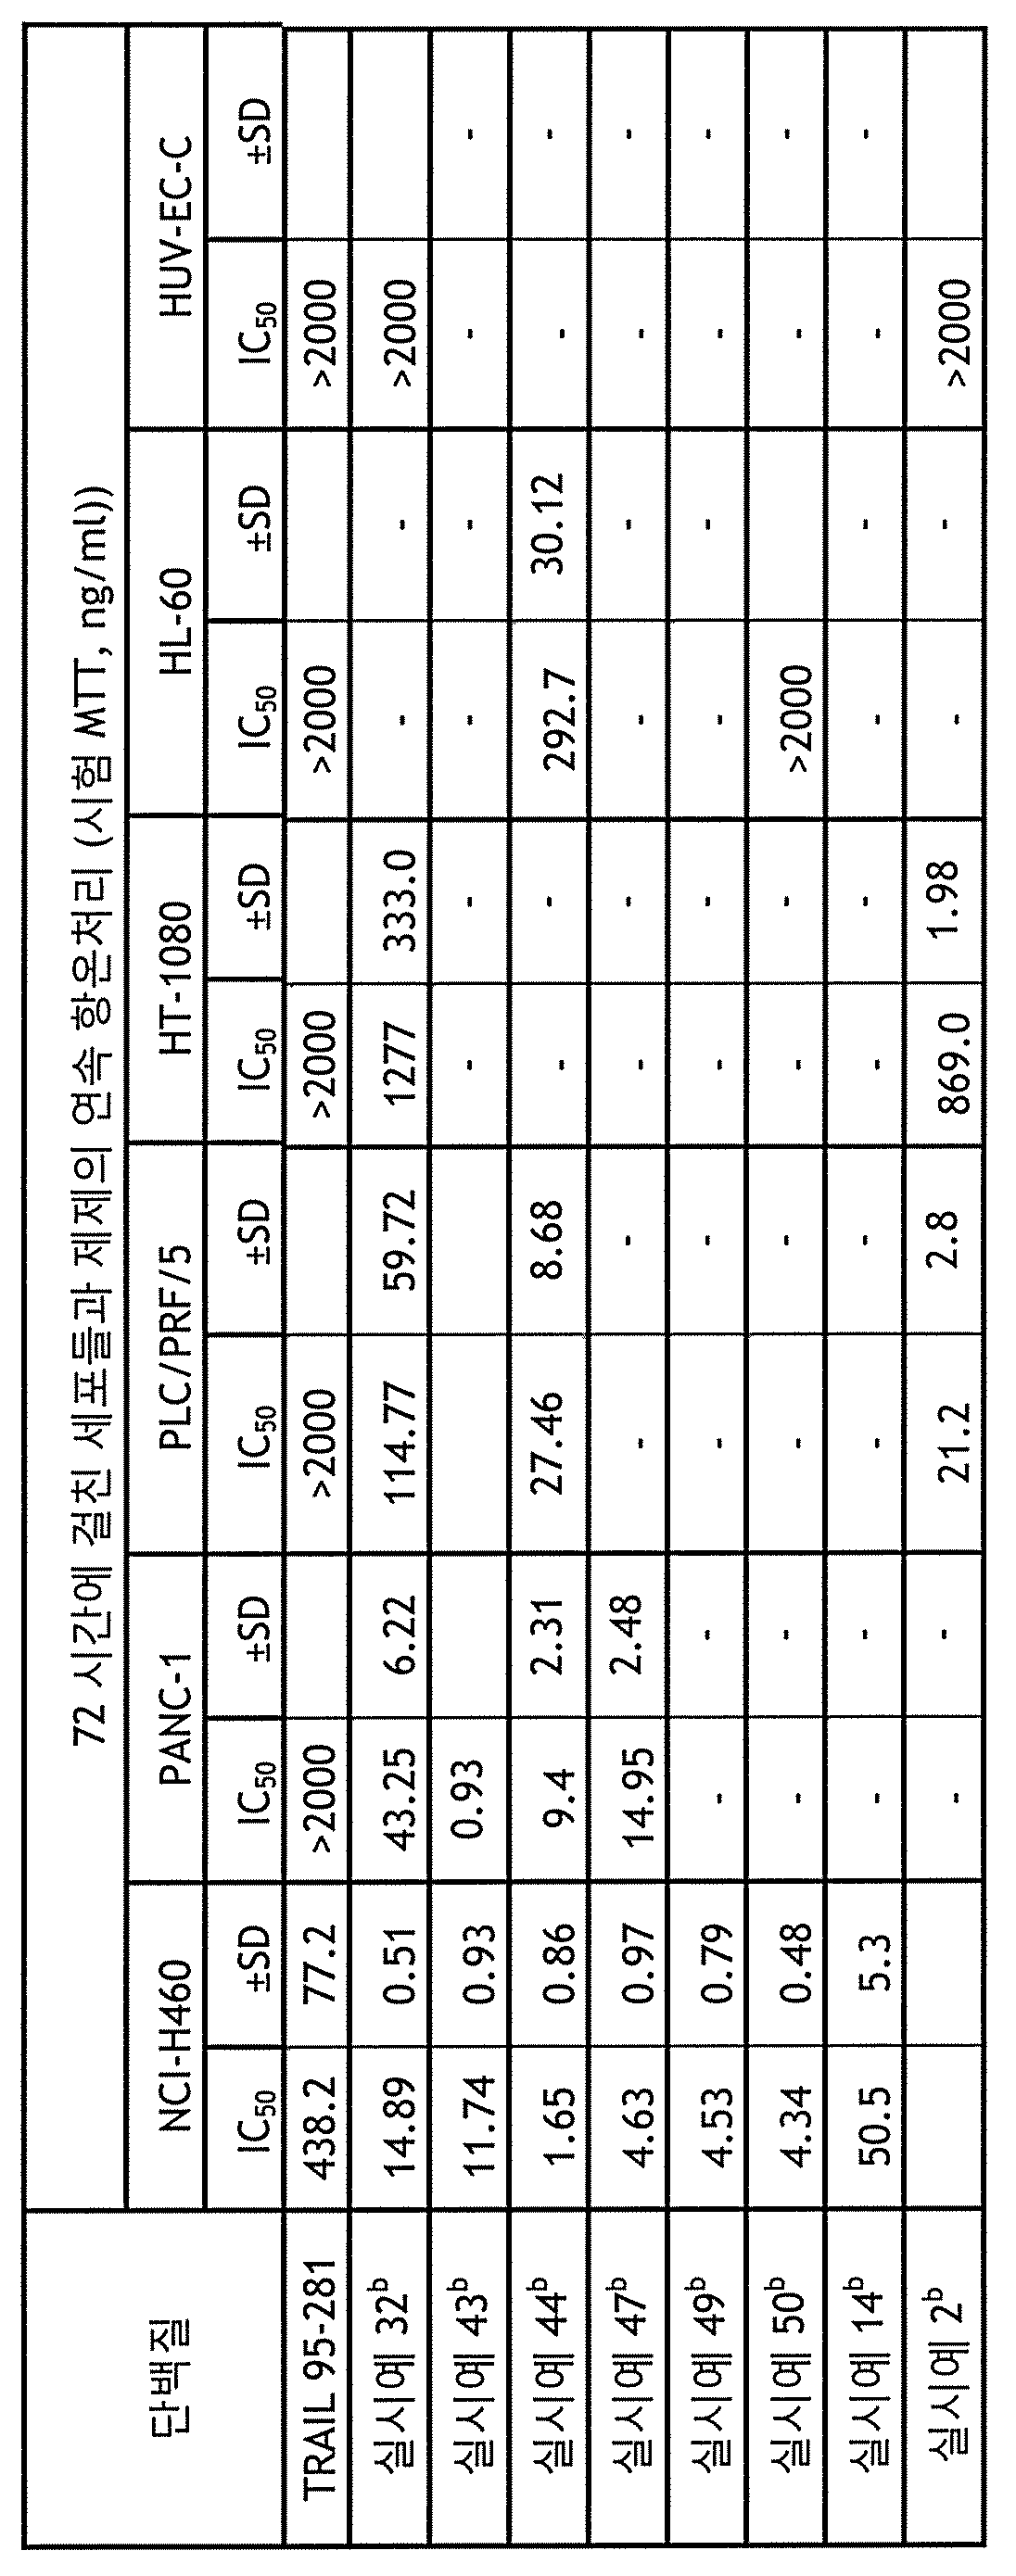
3. 이종이식에서 생체 내 융합 단백질의 항암 효능
인간 대장암 Colo 205 및 HCT-116, SW620, 인간 폐암 A549, 인간 전립선암 PC-3, 인간 췌장암 Panc-1, 인간 간암 PCL/PRF/5, HT-29, HepG2 및 인간 자궁 육종 MES-SA.Dx5의 마우스 모델에서 단백질 제제의 항종양 활성을 시험하였다.
세포
인간 대장암 Colo 205 세포를 10% 우태아 혈청 및 2mM 글루타민으로 보충된 RPMI1640 배지 (HyClone, Logan, UT, USA) (임의로 Opto-MEM (Invitrogen, Cat.22600-134)과 1:1 비율로 혼합함)에서 유지하였다. 마우스 이식일에, 트립신(Invitrogen)으로 세포를 세척하여 지지체로부터 세포를 분리하고, 이어서 세포를 1300 rpm, 4℃에서, 8분 동안 원심분리하고, HBSS 완충액 (Hanks 배지)에 현탁하였다.
인간 폐암 A549 세포를 10% 우태아 혈청 및 2mM 글루타민으로 보충된 RPMI1640 배지 (HyClone, Logan, UT, USA)에서 유지하였다. 마우스 이식일에, 트립신(Invitrogen)으로 세포를 세척하여 지지체로부터 세포를 분리하고, 이어서 세포를 1300 rpm, 4℃에서, 8분 동안 원심분리하고, HBSS 완충액 (Hanks 배지)에 현탁하였다.
인간 폐암 A549 세포를 10% 우태아 혈청 및 2mM 글루타민으로 보충된 RPMI1640 배지 (HyClone, Logan, UT, USA)에서 유지하였다. 마우스 이식일에, 트립신(Invitrogen)으로 세포를 세척하여 지지체로부터 세포를 분리하고, 이어서 세포를 1300 rpm, 4℃에서, 8분 동안 원심분리하고, HBSS 완충액 (Hanks 배지)에 현탁하였다.
인간 전립선암 PC3 세포를 10% 우태아 혈청 및 2mM 글루타민으로 보충된 RPMI1640 배지 (HyClone, Logan, UT, USA)에서 유지하였다. 마우스 이식일에, 트립신(Invitrogen)으로 세포를 세척하여 지지체로부터 세포를 분리하고, 이어서 세포를 1300 rpm, 4℃에서, 8분 동안 원심분리하고, HBSS 완충액 (Hanks 배지)에 현탁하였다.
인간 췌장암 PANC-1 세포를 10% 우태아 혈청 및 2mM 글루타민으로 보충된 DMEM 배지 (HyClone, Logan, UT, USA)에서 유지하였다. 마우스 이식일에, 트립신(Invitrogen)으로 세포를 세척하여 지지체로부터 세포를 분리하고, 이어서 세포를 1300 rpm, 4℃에서, 8분 동안 원심분리하고, HBSS 완충액 (Hanks 배지)에 현탁하였다.
인간 간암 PCL/PRF/5 (CLS) 및 인간 대장암 SW-620 세포를 10% 우태아 혈청 및 2mM 글루타민으로 보충된 DMEM 배지 (HyClone, Logan, UT, USA)에서 유지하였다. 마우스 이식일에, 트립신(Invitrogen)으로 세포를 세척하여 지지체로부터 세포를 분리하고, 이어서 세포를 1300 rpm, 4℃에서, 8분 동안 원심분리하고, HBSS 완충액 (Hanks 배지)에 현탁하였다.
인간 대장암 HCT-116 및 HT-29 세포를 10% 우태아 혈청 및 2mM 글루타민으로 보충된 McCoy 배지 (HyClone, Logan, UT, USA)에서 유지하였다. 마우스 이식일에, 트립신(Invitrogen)으로 세포를 세척하여 지지체로부터 세포를 분리하고, 이어서 세포를 1300 rpm, 4℃에서, 8분 동안 원심분리하고, HBSS 완충액 (Hanks 배지)에 현탁하였다.
인간 간암 HepG2 세포를 10% 우태아 혈청 및 2mM 글루타민으로 보충된 DMEM 배지 (HyClone, Logan, UT, USA)에서 유지하였다. 마우스 이식일에, 트립신(Invitrogen)으로 세포를 세척하여 지지체로부터 세포를 분리하고, 이어서 세포를 1300 rpm, 4℃에서, 8분 동안 원심분리하고, HBSS 완충액 (Hanks 배지)에 현탁하였다.
다중약물 내성 인간 자궁 육종 MES-SA.Dx5 세포를 10% 우태아 혈청, 2mM 글루타민 및 1μM 독소루비신 하이드로클로라이드 (Sigma, Cat. No. D1515-10MG)로 보충된 McCoy 배지 (HyClone, Logan, UT, USA)에서 유지하였다. 세포 이식 3일 전에, 세포를 독소루비신이 없는 배지에서 배양하였다. 마우스 이식일에, 트립신(Invitrogen)으로 세포를 세척하여 지지체로부터 세포를 분리하고, 이어서 세포를 1300 rpm, 4℃에서, 8분 동안 원심분리하고, HBSS 완충액 (Hanks 배지)에 현탁하였다.
마우스
본 발명의 단백질의 항종양 활성의 검사는 Centrum Medycyny Doswiadczalnej in Bialystok로부터 입수한 7주령 내지 9주령의 CD-누드 (Crl:CD1-Foxn1 nu 1) 마우스, Harlan UK로부터 입수한 7주령 내지 8주령의 Hsd:Athymic-Nude-Foxn1nu 마우스 (암컷), Harlan UK로부터 입수한 8주령 내지 10주령의 HsdCpb:NMRI-Foxn1nu 마우스, Centrum Medycyny Doswiadczalnej in Bialystok로부터 입수한 8주령 내지 10주령의 암컷 Cby.Cg-foxn1(nu)/J 마우스 및 Charles River Germany로부터 입수한 4주령 내지 5주령의 암컷 Crl:SHO-PrkdcscidHrhr 마우스에 대하여 수행하였다. 마우스를 음식물과 탈이온수에 대한 자유로운 접근(임의로)과 함께 특정 병원체가 없는 조건 하에 유지하였다. 동물에 대한 모든 실험은 다음의 지침서에 따라 수행하였다: New York Academy of Sciences' Ad Hoc Committee on Animal Research에 의해 발행되고, IV Local Ethics Committee on Animal Experimentation in Warsaw (No. 71/2009)에 의해 승인된 "Interdisciplinary Principles and Guidelines for the Use of Animals in Research, Marketing and Education".
실험 과정 및 평가
전자 캘리퍼를 사용하여 종양 크기를 측정하고, 다음 식을 사용하여 종양 체적을 산출하였다: (a2 x b)/2, 여기서 a = 종양의 짧은 대각선 (mm) 및 b = 종양의 긴 대각선 (mm). 다음 식을 사용하여 종양 성장 억제값을 산출하였다:
TGI [%] (종양 성장 억제값) = (WT/WC) x 100 - 100%
여기서, WT는 처리군에서의 평균 종양 체적이고, WC는 대조군에서의 평균 종양 체적이다.
실험 결과는 평균값 ± 표준 편차(SD)로 제시된다. 모든 계산 및 그래프는 GraphPad Prism 5.0 소프트웨어를 사용하여 작성하였다.
인간 대장암 모델
A.
Colo
205
0일째에, 마우스에 0.5mm x 25mm의 바늘(Bogmark)을 갖는 주사기로 0.15ml RPMI1640 배지에 현탁된 5x10⁶의 Colo 205 세포를 우측에 피하로(s.c.) 이식하였다. 실험 10일째에, 마우스를 무작위로 추출하여 약 100 mm3의 그룹의 종양의 평균 크기를 수득하고, 처리군으로 할당하였다. 처리군에 실시예 18a (3 mg/kg), 실시예 25a (3 mg/kg), 실시예 37a (5 mg/kg) 및 실시예 42a (10 mg/kg)의 본 발명의 융합 단백질의 제제를, 비교 기준으로서 rhTRAIL114-281 (10 mg/kg)을, 대조군으로서 주사용수를 투여하였다. 2일마다 제제를 6회 정맥내(i.v.) 투여하였다. 실험 27일째에, 척수 파괴를 통해 마우스를 희생시켰다.
실험 결과는 도 1 및 도 2에 도시되며, 도 1은 종양 체적 변화의 다이어그램을 도시한 것이고, 도 2는 대조군의 백분율로서의 종양 성장 억제값(% TGI)을 도시한 것이다.
도 1 및 도 2에 제시된 실험 결과는 실시예 18a, 실시예 25a, 실시예 37a 및 실시예 42a의 본 발명의 융합 단백질의 투여가 실험 27일째에 대조군에 비하여 종양 Colo 205 성장을 각각 TGI 30.5%, 37%, 29% 및 60.2%로 억제하였음을 나타낸다. 비교 기준으로서 사용된 rhTRAIL114-281의 경우, 대조군에 비하여 종양 세포 성장에 대한 약간의 억제 효과를 12% 수준의 TGI로 수득하였다. 따라서, 본 발명의 융합 단백질은 TRAIL 단독과 비교하여 훨씬 더 강력한 효과를 발휘한다.
시험된 융합 단백질은 마우스의 체중 감소 (즉, 기준선 체중의 10% 미만)에 의해 나타나는 유의한 부작용을 일으키지 않았다. 이는 단백질의 전신 독성이 낮음을 나타낸다.
B.
HCT
-116
0일째에, 마우스 Crl:SHO-Prkdc scid Hr hr 에 0.5mm x 25mm의 바늘(Bogmark)을 갖는 주사기로 HBSS 완충액:Matrigel의 3:1 혼합물 0.1ml에 현탁된 5x10⁶의 HCT116 세포를 우측에 피하로(s.c.) 이식하였다. 종양이 71mm3 내지 432mm3의 크기에 도달할 때(13일), 마우스를 무작위로 추출하여 약 180mm3의 그룹의 종양의 평균 크기를 수득하고, 처리군으로 할당하였다. 처리군에 실시예 18b (3 mg/kg) 및 실시예 2b (5 mg/kg)의 본 발명의 융합 단백질의 제제를, 비교 기준으로서 rhTRAIL114-281 (65 mg/kg)을, 대조군으로서 제형 완충액 (50mM Trizma Base, 200mM NaCl, 5mM 글루타티온, 0.1mM ZnCl2, 10% 글리세롤, 80mM 사카로스, pH 8.0)을 투여하였다. 2일마다 rhTRAIL114-281 및 실시예 2b에 6회 정맥내(i.v.) 투여하고, 실험 13일째, 15일째, 21일째, 24일째에 실시예 18b에 정맥내(i.v.) 투여하였다. 대조군에 제형 완충액을 투여하였다. 실험 24일째에, 척수 파괴를 통해 마우스를 희생시켰다.
실험 결과는 도 19 및 도 20에 도시되며, 도 19는 종양 체적 변화의 다이어그램을 도시한 것이고, 도 20은 대조군의 백분율로서의 종양 성장 억제값(% TGI)을 도시한 것이다.
도 19 및 도 20에 제시된 실험 결과는 실시예 18b 및 실시예 2b의 본 발명의 융합 단백질의 투여가 실험 24일째에 대조군에 비하여 HCT116 종양 성장을 각각 TGI 81% 및 67%로 억제하였음을 나타낸다. 비교 기준으로서 사용된 rhTRAIL114-281의 경우, 대조군에 비하여 종양 세포 성장에 대한 약간의 억제 효과를 38% 수준의 TGI로 수득하였다. 따라서, 본 발명의 융합 단백질은 TRAIL 단독과 비교하여 훨씬 더 강력한 효과를 발휘한다.
B1.
HCT116
0일째에, 마우스 Crl:SHO-Prkdc scid Hr hr 에 0.5mm x 25mm의 바늘(Bogmark)을 갖는 주사기로 HBSS 완충액:Matrigel의 3:1 혼합물 0.1ml에 현탁된 5x10⁶의 HCT116 세포를 우측에 피하로(s.c.) 이식하였다. 종양이 63mm3 내지 370mm3의 크기에 도달할 때(17일), 마우스를 무작위로 추출하여 약 190mm3의 그룹의 종양의 평균 크기를 수득하고, 처리군으로 할당하였다. 처리군에 실시예 18b (3 mg/kg)의 본 발명의 융합 단백질의 제제를, 비교 기준으로서 rhTRAIL114-281 (70 mg/kg)을, 대조군으로서 제형 완충액 (50mM Trizma Base, 200mM NaCl, 5mM 글루타티온, 0.1mM ZnCl2, 10% 글리세롤, 80mM 사카로스, pH 8.0)을 투여하였다. 2일마다 rhTRAIL114-281에 6회 정맥내(i.v.) 투여하고, 4일마다 실시예 18b에 6회 정맥내(i.v.) 투여하였다. 대조군에 제형 완충액을 투여하였다. 실험 47일째에, 척수 파괴를 통해 마우스를 희생시켰다.
실험 결과는 도 19a 및 도 20a에 도시되며, 도 19a는 종양 체적 변화의 다이어그램을 도시한 것이고, 도 20a은 대조군의 백분율로서의 종양 성장 억제값(% TGI)을 도시한 것이다.
도 19a 및 도 20a에 제시된 실험 결과는 실시예 18b의 본 발명의 융합 단백질의 투여가 실험 47일째에 대조군에 비하여 HCT116 종양 성장을 TGI 85%로 억제하였음을 나타낸다. 비교 기준으로서 사용된 rhTRAIL114-281의 경우, 대조군에 비하여 종양 세포 성장에 대한 약간의 억제 효과를 37% 수준의 TGI로 수득하였다. 따라서, 본 발명의 융합 단백질은 TRAIL 단독과 비교하여 훨씬 더 강력한 효과를 발휘한다.
C.
SW620
TAZD
0일째에, 마우스 Crl:SHO-Prkdc scid Hr hr 에 0.5mm x 25mm의 바늘(Bogmark)을 갖는 주사기로 HBSS 완충액:Matrigel의 3:1 혼합물 0.1ml에 현탁된 5x10⁶의 SW620 세포를 우측에 피하로(s.c.) 이식하였다. 종양이 92mm3 내지 348mm3의 크기에 도달할 때(13일), 마우스를 무작위로 추출하여 약 207mm3의 그룹의 종양의 평균 크기를 수득하고, 처리군으로 할당하였다. 처리군에 실시예 2b (5 mg/kg), 실시예 18b (3 mg/kg) 및 실시예 51b (5 mg/kg)의 본 발명의 융합 단백질의 제제를, 비교 기준으로서 rhTRAIL114-281 (50 mg/kg)을, 대조군으로서 제형 완충액 (50mM Trizma Base, 200mM NaCl, 5mM 글루타티온, 0.1mM ZnCl2, 10% 글리세롤, 80mM 사카로스, pH 8.0)을 투여하였다. 제제를 2일마다 6회 정맥내(i.v.) 투여하였다. 대조군에 제형 완충액 [f25]을 투여하였다.
실험 26일째에, 척수 파괴를 통해 마우스를 희생시켰다.
실험 결과는 도 21 및 도 22에 도시되며, 도 21은 종양 체적 변화의 다이어그램을 도시한 것이고, 도 22는 대조군의 백분율로서의 종양 성장 억제값(% TGI)을 도시한 것이다.
도 21 및 도 22에 제시된 실험 결과는 실시예 18b, 실시예 51b 및 실시예 2b의 본 발명의 융합 단백질의 투여가 실험 34일째에 대조군에 비하여 SW620 종양 성장을 각각 TGI 62.6%, 39% 및 54%로 억제하였음을 나타낸다. 비교 기준으로서 사용된 rhTRAIL114-281의 경우, 대조군에 비하여 종양 세포 성장에 대한 약간의 억제 효과를 23% 수준의 TGI로 수득하였다. 따라서, 본 발명의 융합 단백질은 TRAIL 단독과 비교하여 훨씬 더 강력한 효과를 발휘한다.
C1
.
SW620
0일째에, 마우스 Crl:SHO-Prkdc scid Hr hr 에 0.5mm x 25mm의 바늘(Bogmark)을 갖는 주사기로 HBSS 완충액:Matrigel의 3:1 혼합물 0.1ml에 현탁된 5x10⁶의 SW620 세포를 우측에 피하로(s.c.) 이식하였다. 종양이 126mm3 내지 300mm3의 크기에 도달할 때(11일), 마우스를 무작위로 추출하여 약 210mm3의 그룹의 종양의 평균 크기를 수득하고, 처리군으로 할당하였다. 처리군에 실시예 18b (5 mg/kg)의 본 발명의 융합 단백질의 제제를, 비교 기준으로서 rhTRAIL114-281 (50 mg/kg)을, 대조군으로서 제형 완충액 (50mM Trizma Base, 200mM NaCl, 5mM 글루타티온, 0.1mM ZnCl2, 10% 글리세롤, 80mM 사카로스, pH 8.0)을 투여하였다. 제제를 3일마다 5회 정맥내(i.v.) 투여하였다. 대조군에 제형 완충액 [f25]을 투여하였다.
실험 31일째에, 척수 파괴를 통해 마우스를 희생시켰다.
실험 결과는 도 21a 및 도 22a에 도시되며, 도 21a는 종양 체적 변화의 다이어그램을 도시한 것이고, 도 22a는 대조군의 백분율로서의 종양 성장 억제값(% TGI)을 도시한 것이다.
도 21a 및 도 22a에 제시된 실험 결과는 실시예 18b의 본 발명의 융합 단백질의 투여가 실험 31일째에 대조군에 비하여 SW620 종양 성장을 TGI 73%로 억제하였음을 나타낸다. 비교 기준으로서 사용된 rhTRAIL114-281의 경우, 대조군에 비하여 종양 세포 성장에 대한 약간의 억제 효과를 27.6% 수준의 TGI로 수득하였다. 따라서, 본 발명의 융합 단백질은 TRAIL 단독과 비교하여 훨씬 더 강력한 효과를 발휘한다.
D.
HT
-29
0일째에, 마우스 Crl:SHO-Prkdc scid Hr hr 에 0.5mm x 25mm의 바늘(Bogmark)을 갖는 주사기로 HBSS 완충액:Matrigel의 3:1 혼합물 0.1ml에 현탁된 5x10⁶의 HT-29 세포를 우측에 피하로(s.c.) 이식하였다. 종양이 80mm3 내지 348mm3의 크기에 도달할 때(12일), 마우스를 무작위로 추출하여 약 188mm3의 그룹의 종양의 평균 크기를 수득하고, 처리군으로 할당하였다. 처리군에 실시예 18b (4회 용량 3 mg/kg, 나머지 2회 용량 6 mg/kg) 및 실시예 51b (5 mg/kg)의 본 발명의 융합 단백질의 제제를, 비교 기준으로서 rhTRAIL114-281 (50 mg/kg)을, 대조군으로서 제형 완충액 [f25]을 투여하였다. 제제를 2일마다 6회 정맥내(i.v.) 투여하였다. 대조군에 제형 완충액 (50mM Trizma Base, 200mM NaCl, 5mM 글루타티온, 0.1mM ZnCl2, 10% 글리세롤, 80mM 사카로스, pH 8.0)을 투여하였다. 실험 26일째에, 척수 파괴를 통해 마우스를 희생시켰다.
실험 결과는 도 23 및 도 24에 도시되며, 도 23은 종양 체적 변화의 다이어그램을 도시한 것이고, 도 24는 대조군의 백분율로서의 종양 성장 억제값(% TGI)을 도시한 것이다.
도 23 및 도 24에 제시된 실험 결과는 실시예 18b 및 실시예 51b의 본 발명의 융합 단백질의 투여가 실험 26일째에 대조군에 비하여 HT-29 종양 성장을 각각 TGI 53% 및 67%로 억제하였음을 나타낸다. 비교 기준으로서 사용된 rhTRAIL114-281의 경우, 대조군에 비하여 종양 세포 성장에 대한 약간의 억제 효과를 17.5% 수준의 TGI로 수득하였다. 따라서, 본 발명의 융합 단백질은 TRAIL 단독과 비교하여 훨씬 더 강력한 효과를 발휘한다.
폐암 모델
A. 0일째에, Cby.Cg-foxn1(nu)/J 마우스에 0.5mm x 25mm의 바늘(Bogmark)을 갖는 주사기로 HBSS 배지 0.15ml에 현탁된 5x10⁶의 A549 세포를 우측에 피하로(s.c.) 이식하였다. 실험 20일째에, 마우스를 무작위로 추출하여 약 45mm3의 그룹의 종양의 평균 크기를 수득하고, 처리군으로 할당하였다. 처리군에 실시예 18a (5 mg/kg) 및 실시예 35a (5 mg/kg)의 본 발명의 융합 단백질의 제제를, 비교 기준으로서 rhTRAIL114-281 (15 mg/kg)을, 대조군으로서 주사용수를 투여하였다. 제제를 다음과 같이 투여하였다: 투여 (1일째), 하루 휴식, 3일째, 4일째, 5일째 매일 투여, 하루 휴식, 투여 (7일째), 하루 휴식, 투여 (9일째). 실험 38일째에, 척수 파괴를 통해 마우스를 희생시켰다.
실험 결과는 도 3 및 도 4에 도시되며, 도 3은 종양 체적 변화의 다이어그램을 도시한 것이고, 도 4는 대조군의 백분율로서의 종양 성장 억제값(% TGI)을 도시한 것이다.
도 3 및 도 4에 제시된 실험 결과는 실시예 18a 및 실시예 35a의 본 발명의 융합 단백질의 투여가 실험 38일째에 대조군에 비하여 A549 종양 성장을 각각 TGI 73.3% 및 20.7%로 억제하였음을 나타낸다. 비교 기준으로서 사용된 rhTRAIL114-281의 경우, 대조군에 비하여 종양 세포 성장에 대한 약간의 억제 효과를 16% 수준의 TGI로 수득하였다. 따라서, 본 발명의 융합 단백질은 TRAIL 단독과 비교하여 훨씬 더 강력한 효과를 발휘한다.
시험된 융합 단백질은 마우스의 체중 감소 (즉, 기준선 체중의 10% 미만)에 의해 나타나는 유의한 부작용을 일으키지 않았다. 이는 단백질의 전신 독성이 낮음을 나타낸다.
B. 0일째에, Cby.Cg-foxn1(nu)/J 마우스에 0.5mm x 25mm의 바늘(Bogmark)을 갖는 주사기로 HBSS 배지와 Matrigel (4:1)의 혼합물 0.10ml에 현탁된 5x10⁶의 A549 세포를 우측에 피하로(s.c.) 이식하였다. 실험 19일째에, 마우스를 무작위로 추출하여 약 75mm3의 그룹의 종양의 평균 크기를 수득하고, 처리군으로 할당하였다. 처리군에 실시예 18a (5 mg/kg) 및 실시예 50a (20 mg/kg)의 본 발명의 융합 단백질의 제제를, 비교 기준으로서 rhTRAIL114-281 (15 mg/kg)을, 대조군으로서 주사용수를 투여하였다. 제제를 2일마다 6회 정맥내(i.v.) 투여하였다. 실험 35일째에, 척수 파괴를 통해 마우스를 희생시켰다.
실험 결과는 도 5 및 도 6에 도시되며, 도 5는 종양 체적 변화의 다이어그램을 도시한 것이고, 도 6은 대조군의 백분율로서의 종양 성장 억제값(% TGI)을 도시한 것이다.
실험 결과는 실시예 18a 및 실시예 50a의 본 발명의 융합 단백질의 투여가 실험 35일째에 대조군에 비하여 A549 종양 성장을 각각 TGI 26% 및 45%로 억제하였음을 나타낸다. 비교 기준으로서 사용된 rhTRAIL114-281의 경우, 대조군에 비하여 종양 세포 성장에 대한 억제 효과를 0% 수준의 TGI로 수득하지 못하였다. 따라서, 본 발명의 융합 단백질은 TRAIL 단독과 비교하여 훨씬 더 강력한 효과를 발휘한다.
시험된 융합 단백질은 마우스의 체중 감소 (즉, 기준선 체중의 10% 미만)에 의해 나타나는 유의한 부작용을 일으키지 않았다. 이는 단백질의 전신 독성이 낮음을 나타낸다.
C. 0일째에, 마우스에 0.5mm x 25mm의 바늘(Bogmark)을 갖는 주사기로 HBSS 배지와 Matrigel (3:1)의 혼합물 0.10ml에 현탁된 5x10⁶의 A549 세포를 우측에 피하로(s.c.) 이식하였다. 실험 17일째에, 마우스를 무작위로 추출하여 약 100mm3 내지 120mm3의 그룹의 종양의 평균 크기를 수득하고, 처리군으로 할당하였다. 처리군에 실시예 2a (5 mg/kg), 실시예 18a (3 mg/kg) 및 실시예 44a (20 mg/kg)의 본 발명의 융합 단백질의 제제를, 비교 기준으로서 rhTRAIL114-281 (20 mg/kg)을, 대조군으로서 제형 완충액 (19mM NaH2PO4, 81mM Na2HPO4, 50mM NaCl, 5mM 글루타티온, 0.1mM ZnCl2, 10% 글리세롤, pH 7.4)을 투여하였다. 제제를 2일마다 6회 정맥내(i.v.) 투여하였다. 실험 34일째에, 척수 파괴를 통해 마우스를 희생시켰다.
실험 결과는 도 7 및 도 8에 도시되며, 도 7은 종양 체적 변화의 다이어그램을 도시한 것이고, 도 8은 대조군의 백분율로서의 종양 성장 억제값(% TGI)을 도시한 것이다.
실험 결과는 실시예 2a, 실시예 18a 및 실시예 44a의 본 발명의 융합 단백질의 투여가 실험 34일째에 대조군에 비하여 A549 종양 성장을 각각 TGI 83.5%, 80% 및 47%로 억제하였음을 나타낸다. 비교 기준으로서 사용된 rhTRAIL114-281의 경우, 대조군에 비하여 종양 세포 성장에 대한 약간의 억제 효과를 21.8% 수준의 TGI로 수득하였다. 따라서, 본 발명의 융합 단백질은 TRAIL 단독과 비교하여 훨씬 더 강력한 효과를 발휘한다.
시험된 융합 단백질은 마우스의 체중 감소 (즉, 기준선 체중의 10% 미만)에 의해 나타나는 유의한 부작용을 일으키지 않았다. 이는 단백질의 전신 독성이 낮음을 나타낸다.
D. 0일째에, 마우스에 0.5mm x 25mm의 바늘(Bogmark)을 갖는 주사기로 HBSS 배지와 Matrigel (3:1)의 혼합물 0.10ml에 현탁된 7x10⁶의 A549 세포를 우측에 피하로(s.c.) 이식하였다. 실험 21일째에, 마우스를 무작위로 추출하여 약 160mm3 내지 180mm3의 그룹의 종양의 평균 크기를 수득하고, 처리군으로 할당하였다. 처리군에 실시예 20a (15 mg/kg), 실시예 26a (6 mg/kg), 실시예 43a (10 mg/kg) 및 실시예 47a (5 mg/kg)의 본 발명의 융합 단백질의 제제를, 비교 기준으로서 rhTRAIL114-281 (40 mg/kg)을, 대조군으로서 제형 완충액 (5mM NaH2PO4, 95mM Na2HPO4, 200mM NaCl, 5mM 글루타티온, 0.1mM ZnCl2, 10% 글리세롤, 80mM 사카로스, pH 7.4)을 투여하였다. 제제를 2일마다 6회 정맥내(i.v.) 투여하였다. 실험 35일째에, 척수 파괴를 통해 마우스를 희생시켰다.
실험 결과는 도 9 및 도 10에 도시되며, 도 9는 종양 체적 변화의 다이어그램을 도시한 것이고, 도 10은 대조군의 백분율로서의 종양 성장 억제값(% TGI)을 도시한 것이다.
실험 결과는 실시예 20a, 실시예 26a, 실시예 43a 및 실시예 47a의 본 발명의 융합 단백질의 투여가 실험 35일째에 대조군에 비하여 A549 종양 성장을 각각 TGI 49.5 %, 64%, 40.2% 및 49.5%로 억제하였음을 나타낸다. 비교 기준으로서 사용된 rhTRAIL114-281의 경우, 대조군에 비하여 종양 세포 성장에 대한 약간의 억제 효과를 15% 수준의 TGI로 수득하였다. 따라서, 본 발명의 융합 단백질은 TRAIL 단독과 비교하여 훨씬 더 강력한 효과를 발휘한다.
E. A549 - 종양의 재성장
0일째에, 마우스 Crl:SHO-Prkdc scid Hr hr 에 0.5mm x 25mm의 바늘(Bogmark)을 갖는 주사기로 HBSS 완충액:Matrigel의 3:1 혼합물 0.1ml에 현탁된 7x10⁶의 A549 세포를 우측에 피하로(s.c.) 이식하였다. 종양이 85mm3 내지 302mm3의 크기에 도달할 때(17일째), 마우스를 무작위로 추출하여 약 177mm3의 그룹의 종양의 평균 크기를 수득하고, 처리군으로 할당하였다. 처리군에 실시예 2b (5 mg/kg) 및 실시예 18b (3 mg/kg)의 본 발명의 융합 단백질의 제제를, 비교 기준으로서 rhTRAIL114-281 (90 mg/kg)을, 대조군으로서 제형 완충액 (50mM Trizma Base, 200mM NaCl, 5mM 글루타티온, 0.1mM ZnCl2, 10% 글리세롤, 80mM 사카로스, pH 8.0)을 투여하였다. rhTRAIL114-281에 2일마다 12회 정맥내(i.v.) 투여하고, 실시예 2b에 2일마다 7회 정맥내(i.v.) 투여하고, 실시예 18b에 실험 17일째, 20일째, 25일째 및 29일째에 정맥내(i.v.) 투여하였다. 대조군은 제형 완충액을 투여하였다. 실험 45일째에, 척수 파괴를 통해 마우스를 희생시켰다.
실험 결과는 도 27 및 도 28에 도시되며, 도 27은 종양 체적 변화의 다이어그램을 도시한 것이고, 도 28은 대조군의 백분율로서의 종양 성장 억제값(% TGI)을 도시한 것이다.
도 27 및 도 28에 제시된 실험 결과는 실시예 18b 및 실시예 2b의 본 발명의 융합 단백질의 투여가 실험 45일째에 대조군에 비하여 A549 종양 성장을 각각 TGI 71% 및 44%로 억제하였음을 나타낸다. 비교 기준으로서 사용된 rhTRAIL114-281의 경우, 대조군에 비하여 종양 세포 성장에 대한 약간의 억제 효과를 10.6% 수준의 TGI로 수득하였다. 따라서, 본 발명의 융합 단백질은 TRAIL 단독과 비교하여 훨씬 더 강력한 효과를 발휘한다.
췌장암 모델
A. 0일째에, 마우스에 0.5mm x 25mm의 바늘(Bogmark)을 갖는 주사기로 HBSS 배지와 Matrigel (3:1)의 혼합물 0.10ml에 현탁된 7x10⁶의 PANC-1 세포를 우측에 피하로(s.c.) 이식하였다. 실험 27일째에, 마우스를 무작위로 추출하여 약 95mm3의 그룹의 종양의 평균 크기를 수득하고, 처리군으로 할당하였다. 처리군에 실시예 20a(5 mg/kg), 실시예 51a (10 mg/kg) 및 실시예 52a (10 mg/kg)의 본 발명의 융합 단백질의 제제를, 비교 기준으로서 rhTRAIL114-281 (20 mg/kg)을, 대조군으로서 제형 완충액 (5mM NaH2PO4, 95mM Na2HPO4, 200mM NaCl, 5mM 글루타티온, 0.1mM ZnCl2, 10% 글리세롤, 80mM 사카로스, pH 7.4)을 투여하였다. 제제를 2일마다 6회 정맥내(i.v.) 투여하였다. 실험 40일째에, 척수 파괴를 통해 마우스를 희생시켰다.
실험 결과는 도 11 및 도 12에 도시되며, 도 11은 종양 체적 변화의 다이어그램을 도시한 것이고, 도 12는 대조군의 백분율로서의 종양 성장 억제값(% TGI)을 도시한 것이다.
실험 결과는 실시예 20a, 실시예 51a 및 실시예 52a의 본 발명의 융합 단백질의 투여가 실험 40일째에 대조군에 비하여 PANC-1 종양 성장을 각각 TGI 19%, 38% 및 34%로 억제하였음을 나타낸다. 비교 기준으로서 사용된 rhTRAIL114-281의 경우, 대조군에 비하여 종양 세포 성장에 대한 약간의 억제 효과를 12% 수준의 TGI로 수득하였다. 따라서, 본 발명의 융합 단백질은 TRAIL 단독과 비교하여 훨씬 더 강력한 효과를 발휘한다.
시험된 융합 단백질은 마우스의 체중 감소 (즉, 기준선 체중의 10% 미만)에 의해 나타나는 유의한 부작용을 일으키지 않았다. 이는 단백질의 전신 독성이 낮음을 나타낸다.
B. 0일째에, 마우스에 0.5mm x 25mm의 바늘(Bogmark)을 갖는 주사기로 HBSS 배지와 Matrigel (3:1)의 혼합물 0.10ml에 현탁된 5x10⁶의 PANC-1 세포를 우측에 피하로(s.c.) 이식하였다. 실험 31일째에, 마우스를 무작위로 추출하여 약 110mm3의 그룹의 종양의 평균 크기를 수득하고, 처리군으로 할당하였다. 처리군에 실시예 18a (3 mg/kg) 및 실시예 44a (20 mg/kg)의 본 발명의 융합 단백질의 제제를, 비교 기준으로서 rhTRAIL114-281 (20 mg/kg)을, 대조군으로서 제형 완충액 (19mM NaH2PO4, 81mM Na2HPO4, 50mM NaCl, 5mM 글루타티온, 0.1mM ZnCl2, 10% 글리세롤, pH 7.4)을 투여하였다. 제제를 2일마다 6회 정맥내(i.v.) 투여하였다. 실험 42일째에, 척수 파괴를 통해 마우스를 희생시켰다.
실험 결과는 도 13 및 도 14에 도시되며, 도 13은 종양 체적 변화의 다이어그램을 도시한 것이고, 도 14는 대조군의 백분율로서의 종양 성장 억제값(% TGI)을 도시한 것이다.
실험 결과는 실시예 18a 및 실시예 44a의 본 발명의 융합 단백질의 투여가 실험 42일째에 대조군에 비하여 PANC-1 종양 성장을 각각 TGI 56% 및 43%로 억제하였음을 나타낸다. 비교 기준으로서 사용된 rhTRAIL114-281의 경우, 대조군에 비하여 종양 세포 성장에 대한 약간의 억제 효과를 27.5% 수준의 TGI로 수득하였다. 따라서, 본 발명의 융합 단백질은 TRAIL 단독과 비교하여 훨씬 더 강력한 효과를 발휘한다.
시험된 융합 단백질은 마우스의 체중 감소 (즉, 기준선 체중의 10% 미만)에 의해 나타나는 유의한 부작용을 일으키지 않았다. 이는 단백질의 전신 독성이 낮음을 나타낸다.
전립선암 모델
0일째에, 마우스에 0.5mm x 25mm의 바늘(Bogmark)을 갖는 주사기로 HBSS 배지와 Matrigel (9:1)의 혼합물 0.20ml에 현탁된 5x10⁶의 PC3 세포를 우측에 피하로(s.c.) 이식하였다. 실험 29일째에, 마우스를 무작위로 추출하여 약 90mm3의 그룹의 종양의 평균 크기를 수득하고, 처리군으로 할당하였다. 처리군에 실시예 18a(5 mg/kg)의 본 발명의 융합 단백질의 제제를, 대조군으로서 주사용수를 투여하였다. 제제를 2일마다 6회 정맥내(i.v.) 투여하였다. 실험 60일째에, 척수 파괴를 통해 마우스를 희생시켰다.
실험 결과는 도 15 및 도 16에 도시되며, 도 15는 종양 체적 변화의 다이어그램을 도시한 것이고, 도 16은 대조군의 백분율로서의 종양 성장 억제값(% TGI)을 도시한 것이다.
실험 결과는 실시예 18a의 본 발명의 융합 단백질의 투여가 실험 60일째에 대조군에 비하여 PC3 종양 성장을 TGI 30.8%로 억제하였음을 나타낸다.
시험된 융합 단백질은 마우스의 체중 감소 (즉, 기준선 체중의 10% 미만)에 의해 나타나는 유의한 부작용을 일으키지 않았다. 이는 단백질의 전신 독성이 낮음을 나타낸다.
간암 모델
A. PCL/PRF/5
0일째에, 마우스 Crl:SHO-PrkdcscidHrhr에 0.5mm x 25mm의 바늘(Bogmark)을 갖는 주사기로 HBSS 배지와 Matrigel (3:1)의 혼합물 0.10ml에 현탁된 7x10⁶의 PCL/PRF/5 세포를 우측에 피하로(s.c.) 이식하였다. 실험 31일째에, 마우스를 무작위로 추출하여 약 200mm3의 그룹의 종양의 평균 크기를 수득하고, 처리군으로 할당하였다. 처리군에 실시예 51a (10 mg/kg)a의 본 발명의 융합 단백질의 제제를, 비교 기준으로서 rhTRAIL114-281 (30 mg/kg)을, 대조군으로서 제형 완충액 (5mM NaH2PO4, 95mM Na2HPO4, 200mM NaCl, 5mM 글루타티온, 0.1mM ZnCl2, 10% 글리세롤, 80mM 사카로스, pH 7.4)을 투여하였다. 제제를 2일마다 6회 정맥내(i.v.) 투여하였다. 실험 49일째에, 척수 파괴를 통해 마우스를 희생시켰다.
실험 결과는 도 17 및 도 18에 도시되며, 도 17은 종양 체적 변화의 다이어그램을 도시한 것이고, 도 18은 대조군의 백분율로서의 종양 성장 억제값(% TGI)을 도시한 것이다.
실험 결과는 실시예 51a의 본 발명의 융합 단백질의 투여가 실험 49일째에 대조군에 비하여 PCL/PRF/5 종양 성장을 TGI 88.5%로 억제하였음을 나타낸다. 비교 기준으로서 사용된 rhTRAIL114-281의 경우, 대조군에 비하여 종양 세포 성장에 대한 약간의 억제 효과를 18% 수준의 TGI로 수득하였다. 따라서, 본 발명의 융합 단백질은 TRAIL 단독과 비교하여 훨씬 더 강력한 효과를 발휘한다.
시험된 융합 단백질은 마우스의 체중 감소 (즉, 기준선 체중의 10% 미만)에 의해 나타나는 유의한 부작용을 일으키지 않았다. 이는 단백질의 전신 독성이 낮음을 나타낸다.
E. A549 - 종양의 재성장
0일째에, 마우스 Crl:SHO-Prkdc scid Hr hr 에 0.5mm x 25mm의 바늘(Bogmark)을 갖는 주사기로 HBSS 완충액:Matrigel의 3:1 혼합물 0.1ml에 현탁된 7x10⁶의 A549 세포를 우측에 피하로(s.c.) 이식하였다. 종양이 85mm3 내지 302mm3의 크기에 도달할 때(17일째), 마우스를 무작위로 추출하여 약 177mm3의 그룹의 종양의 평균 크기를 수득하고, 처리군으로 할당하였다. 처리군에 실시예 2b (5 mg/kg) 및 실시예 18b (3 mg/kg)의 본 발명의 융합 단백질의 제제를, 비교 기준으로서 rhTRAIL114-281 (90 mg/kg)을, 대조군으로서 제형 완충액 (50mM Trizma Base, 200mM NaCl, 5mM 글루타티온, 0.1mM ZnCl2, 10% 글리세롤, 80mM 사카로스, pH 8.0)을 투여하였다. rhTRAIL114-281에 2일마다 12회 정맥내(i.v.) 투여하고, 실시예 2b에 2일마다 7회 정맥내(i.v.) 투여하고, 실시예 18b에 실험 17일째, 20일째, 25일째 및 29일째에 정맥내(i.v.) 투여하였다. 대조군은 제형 완충액을 투여하였다. 실험 45일째에, 척수 파괴를 통해 마우스를 희생시켰다.
실험 결과는 도 27 및 도 28에 도시되며, 도 27은 종양 체적 변화의 다이어그램을 도시한 것이고, 도 28은 대조군의 백분율로서의 종양 성장 억제값(% TGI)을 도시한 것이다.
도 27 및 도 28에 제시된 실험 결과는 실시예 18b 및 실시예 2b의 본 발명의 융합 단백질의 투여가 실험 45일째에 대조군에 비하여 A549 종양 성장을 각각 TGI 71% 및 44%로 억제하였음을 나타낸다. 비교 기준으로서 사용된 rhTRAIL114-281의 경우, 대조군에 비하여 종양 세포 성장에 대한 약간의 억제 효과를 10.6% 수준의 TGI로 수득하였다. 따라서, 본 발명의 융합 단백질은 TRAIL 단독과 비교하여 훨씬 더 강력한 효과를 발휘한다.
B. HepG2
0일째에, 마우스 Crl:SHO-Prkdc scid Hr hr 에 0.5mm x 25mm의 바늘(Bogmark)을 갖는 주사기로 HBSS 완충액:Matrigel의 3:1 혼합물 0.1ml에 현탁된 7x10⁶의 HepG2 세포를 우측에 피하로(s.c.) 이식하였다. 종양이 64mm3 내지 530mm3의 크기에 도달할 때(25일째), 마우스를 무작위로 추출하여 약 228mm3의 그룹의 종양의 평균 크기를 수득하고, 처리군으로 할당하였다. 처리군에 실시예 18b (5 mg/kg) 및 실시예 18b (10 mg/kg HSA로 보충된 5 mg/kg)의 본 발명의 융합 단백질의 제제를, 비교 기준으로서 rhTRAIL114-281 (50 mg/kg)을, 대조군으로서 제형 완충액 (50mM Trizma Base, 200mM NaCl, 5mM 글루타티온, 0.1mM ZnCl2, 10% 글리세롤, 80mM 사카로스, pH 8.0) 및 기준 화합물 5FU (20 mg/kg)를 투여하였다. rhTRAIL114-281에 2일마다 12회 정맥내(i.v.) 투여하고, 실시예 18b에 실험 25일째, 27일째, 29일째, 37일째 및 42일째에 정맥내(i.v.) 투여하였다. 5FU (20 mg/kg)를 2일마다 6회 복강내(i.p.) 투여하였다. 대조군은 제형 완충액을 투여하였다. 실험 49일째에, 척수 파괴를 통해 마우스를 희생시켰다.
실험 결과는 도 25 및 도 26에 도시되며, 도 25는 종양 체적 변화의 다이어그램을 도시한 것이고, 도 26은 대조군의 백분율로서의 종양 성장 억제값(% TGI)을 도시한 것이다.
도 25 및 도 26에 제시된 실험 결과는 실시예 18b의 본 발명의 융합 단백질의 투여가 실험 49일째에 대조군에 비하여 HepG2 종양 성장을 TGI 82.5%로 억제하였음을 나타낸다. 비교 기준으로서 사용된 rhTRAIL114-281 및 5FU의 경우, 대조군에 비하여 종양 세포 성장에 대한 약간의 억제 효과를 각각 31% 및 -4.7% 수준의 TGI로 수득하였다. 따라서, 본 발명의 융합 단백질은 TRAIL 단독 및 표준 화학요법과 비교하여 훨씬 더 강력한 효과를 발휘한다.
시험된 융합 단백질은 마우스의 체중 감소 (즉, 기준선 체중의 10% 미만)에 의해 나타나는 유의한 부작용을 일으키지 않았다. 이는 단백질의 전신 독성이 낮음을 나타낸다.
다중약물 내성 자궁 육종 모델
MES-SA.Dx5
0일째에, 마우스 Crl:SHO-Prkdc scid Hr hr 에 0.5mm x 25mm의 바늘(Bogmark)을 갖는 주사기로 HBSS 완충액:Matrigel의 3:1 혼합물 0.1ml에 현탁된 7x10⁶의 MES-SA.Dx5 세포를 우측에 피하로(s.c.) 이식하였다. 종양이 64mm3 내지 323mm3의 크기에 도달할 때(13일째), 마우스를 무작위로 추출하여 약 180mm3의 그룹의 종양의 평균 크기를 수득하고, 처리군으로 할당하였다. 처리군에 실시예 18b (5 mg/kg)의 본 발명의 융합 단백질의 제제를, 비교 기준으로서 rhTRAIL114-281 (50 mg/kg)을, 대조군으로서 제형 완충액 (50mM Trizma Base, 200mM NaCl, 5mM 글루타티온, 0.1mM ZnCl2, 10% 글리세롤, 80mM 사카로스, pH 8.0) 및 기준 화합물 CPT-11 (camptothecin, Pfeizer) (30 mg/kg)을 투여하였다. rhTRAIL114-281 및 실시예 18b에 2일마다 6회 정맥내(i.v.) 투여하였다. CPT-11을 2일마다 6회 복강내(i.p.) 투여하였다. 대조군은 제형 완충액을 투여하였다. 실험 34일째에, 척수 파괴를 통해 마우스를 희생시켰다.
실험 결과는 도 29 및 도 30에 도시되며, 도 25는 종양 체적 변화의 다이어그램을 도시한 것이고, 도 26은 대조군의 백분율로서의 종양 성장 억제값(% TGI)을 도시한 것이다.
도 29 및 도 30에 제시된 실험 결과는 실시예 18b의 본 발명의 융합 단백질의 투여가 실험 34일째에 대조군에 비하여 MES-SA/Dx5 종양 성장을 TGI 85%로 억제하였음을 나타낸다. 비교 기준으로서 사용된 rhTRAIL114-281 및 CPT-11의 경우, 대조군에 비하여 종양 세포 성장에 대한 약간의 억제 효과를 각각 51% 및 57% 수준의 TGI로 수득하였다. 따라서, 본 발명의 융합 단백질은 TRAIL 단독 및 표준 화학요법과 비교하여 훨씬 더 강력한 효과를 발휘한다.
MES-SA.Dx5
0일째에, 마우스 Crl:SHO-Prkdc scid Hr hr 에 0.5mm x 25mm의 바늘(Bogmark)을 갖는 주사기로 HBSS 완충액:Matrigel의 3:1 혼합물 0.1ml에 현탁된 7x10⁶의 MES-SA.Dx5 세포를 우측에 피하로(s.c.) 이식하였다. 종양이 26mm3 내지 611mm3의 크기에 도달할 때(19일째), 마우스를 무작위로 추출하여 약 180mm3의 그룹의 종양의 평균 크기를 수득하고, 처리군으로 할당하였다. 처리군에 실시예 2b (3 mg/kg), 실시예 18b (3 mg/kg) 및 실시예 51b (7,5 mg/kg)의 본 발명의 융합 단백질의 제제를, 비교 기준으로서 rhTRAIL114-281 (60 mg/kg)을, 대조군으로서 제형 완충액 (50mM Trizma Base, 200mM NaCl, 5mM 글루타티온, 0.1mM ZnCl2, 10% 글리세롤, 80mM 사카로스, pH 8.0)을 투여하였다. rhTRAIL114-281, 실시예 2b 및 실시예 51b에 2일마다 6회 정맥내(i.v.) 투여하였다. 실시예 18b에 2일마다 4회 정맥내(i.v.) 투여하였다. 대조군은 제형 완충액을 투여하였다.
실험 33일째, 척수 파괴를 통해 마우스를 희생시켰다.
실험 결과는 도 29a 및 도 30a에 도시되며, 도 29a는 종양 체적 변화의 다이어그램을 도시한 것이며, 도 30a는 대조군의 백분율로서의 종양 성장 억제값(%TGI)을 도시한 것이다.
도 29a 및 도 30a에서 그래프로 제시된 실험 결과는 실시예 2b, 실시예 18b 및 실시예 51b의 본 발명의 융합 단백질의 투여가 실험 33일째에 대조군에 비하여 MES-SA/Dx5 종양 성장을 각각 TGI 84%, 67.5% 및 58.6%로 억제하였음을 나타낸다. 비교 기준으로서 사용된 rhTRAIL114-281의 경우, 대조군에 비하여 종양 세포 성장에 대한 약간의 억제 효과를 25.8% 수준의 TGI로 수득하였다. 따라서, 본 발명의 융합 단백질은 TRAIL 단독과 비교하여 훨씬 더 강력한 효과를 발휘한다.
SEQUENCE LISTING
<110> Adamed Sp. z o.o.
<120> Anticancer fusion protein
<130> PL
<150> PL397167
<151> 2011-11-28
<160> 208
<170> PatentIn version 3.5
<210> 1
<211> 430
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 1
Tyr Asn Thr Val Ser Phe Asn Leu Gly Glu Ala Tyr Glu Tyr Pro Thr
1 5 10 15
Phe Ile Gln Asp Leu Arg Asn Glu Leu Ala Lys Gly Thr Pro Val Cys
20 25 30
Gln Leu Pro Val Thr Leu Gln Thr Ile Ala Asp Asp Lys Arg Phe Val
35 40 45
Leu Val Asp Ile Thr Thr Thr Ser Lys Lys Thr Val Lys Val Ala Ile
50 55 60
Asp Val Thr Asp Val Tyr Val Val Gly Tyr Gln Asp Lys Trp Asp Gly
65 70 75 80
Lys Asp Arg Ala Val Phe Leu Asp Lys Val Pro Thr Val Ala Thr Ser
85 90 95
Lys Leu Phe Pro Gly Val Thr Asn Arg Val Thr Leu Thr Phe Asp Gly
100 105 110
Ser Tyr Gln Lys Leu Val Asn Ala Ala Lys Val Asp Arg Lys Asp Leu
115 120 125
Glu Leu Gly Val Tyr Lys Leu Glu Phe Ser Ile Glu Ala Ile His Gly
130 135 140
Lys Thr Ile Asn Gly Gln Glu Ile Ala Lys Phe Phe Leu Ile Val Ile
145 150 155 160
Gln Met Val Ser Glu Ala Ala Arg Phe Lys Tyr Ile Glu Thr Glu Val
165 170 175
Val Asp Arg Gly Leu Tyr Gly Ser Phe Lys Pro Asn Phe Lys Val Leu
180 185 190
Asn Leu Glu Asn Asn Trp Gly Asp Ile Ser Asp Ala Ile His Lys Ser
195 200 205
Ser Pro Gln Cys Thr Thr Ile Asn Pro Ala Leu Gln Leu Ile Ser Pro
210 215 220
Ser Asn Asp Pro Trp Val Val Asn Lys Val Ser Gln Ile Ser Pro Asp
225 230 235 240
Met Gly Ile Leu Lys Phe Lys Ser Gly Gly Gly Gly Ser Arg Lys Lys
245 250 255
Arg Ala Ser Gly Cys Gly Pro Glu Gly Gly Gly Gly Ser Arg Val Ala
260 265 270
Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu Ser Ser Pro
275 280 285
Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn Ser Trp Glu
290 295 300
Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His Leu Arg Asn
305 310 315 320
Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile Tyr Ser Gln
325 330 335
Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr Lys Asn Asp
340 345 350
Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr Pro Asp Pro
355 360 365
Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser Lys Asp Ala
370 375 380
Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe Glu Leu Lys
385 390 395 400
Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His Leu Ile Asp
405 410 415
Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val Gly
420 425 430
<210> 2
<211> 453
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 2
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Gly Ser Ala Ser Gly Cys Gly Pro Glu Arg Lys Lys
165 170 175
Arg Gly Gly Gly Gly Ser Glu Asp Asn Asn Ile Phe Pro Lys Gln Tyr
180 185 190
Pro Ile Ile Asn Phe Thr Thr Ala Gly Ala Thr Val Gln Ser Tyr Thr
195 200 205
Asn Phe Ile Arg Ala Val Arg Gly Arg Leu Thr Thr Gly Ala Asp Val
210 215 220
Arg His Glu Ile Pro Val Leu Pro Asn Arg Val Gly Leu Pro Ile Asn
225 230 235 240
Gln Arg Phe Ile Leu Val Glu Leu Ser Asn His Ala Glu Leu Ser Val
245 250 255
Thr Leu Ala Leu Asp Val Thr Asn Ala Tyr Val Val Gly Tyr Arg Ala
260 265 270
Gly Asn Ser Ala Tyr Phe Phe His Pro Asp Asn Gln Glu Asp Ala Glu
275 280 285
Ala Ile Thr His Leu Phe Thr Asp Val Gln Asn Arg Tyr Thr Phe Ala
290 295 300
Phe Gly Gly Asn Tyr Asp Arg Leu Glu Gln Leu Ala Gly Ser Leu Arg
305 310 315 320
Glu Asn Ile Glu Leu Gly Asn Gly Pro Leu Glu Glu Ala Ile Ser Ala
325 330 335
Leu Tyr Tyr Tyr Ser Thr Gly Gly Thr Gln Leu Pro Thr Leu Ala Arg
340 345 350
Ser Phe Ile Val Cys Ile Gln Met Ile Ser Glu Ala Ala Arg Phe Gln
355 360 365
Tyr Ile Glu Gly Glu Met Arg Thr Arg Ile Arg Tyr Asn Arg Arg Ser
370 375 380
Ala Pro Asp Pro Ser Val Ile Thr Leu Glu Asn Ser Trp Gly Arg Leu
385 390 395 400
Ser Thr Ala Ile Gln Glu Ser Asn Gln Gly Ala Phe Ala Ser Pro Ile
405 410 415
Gln Leu Gln Arg Arg Asn Gly Ser Lys Phe Ser Val Tyr Asp Val Ser
420 425 430
Ile Leu Ile Pro Ile Ile Ala Leu Met Val Tyr Arg Cys Ala Pro Pro
435 440 445
Pro Lys Asp Glu Leu
450
<210> 3
<211> 378
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 3
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Gly Ser Ala Ser Gly Cys Gly Pro Glu Arg Lys Lys
165 170 175
Arg Gly Gly Gly Gly Ser Gly Pro Gly Pro Lys Gln Tyr Pro Ile Ile
180 185 190
Asn Phe Thr Thr Ala Gly Ala Thr Val Gln Ser Tyr Thr Asn Phe Ile
195 200 205
Arg Ala Val Arg Gly Arg Leu Thr Thr Gly Ala Asp Val Arg His Glu
210 215 220
Ile Pro Val Leu Pro Asn Arg Val Gly Leu Pro Ile Asn Gln Arg Phe
225 230 235 240
Ile Leu Val Glu Leu Ser Asn His Ala Glu Leu Ser Val Thr Leu Ala
245 250 255
Leu Asp Val Thr Asn Ala Tyr Val Val Gly Tyr Arg Ala Gly Asn Ser
260 265 270
Ala Tyr Phe Phe His Pro Asp Asn Gln Glu Asp Ala Glu Ala Ile Thr
275 280 285
His Leu Phe Thr Asp Val Gln Asn Arg Tyr Thr Phe Ala Phe Gly Gly
290 295 300
Asn Tyr Asp Arg Leu Glu Gln Leu Ala Gly Asn Leu Arg Glu Asn Ile
305 310 315 320
Glu Leu Gly Asn Gly Pro Leu Glu Glu Ala Ile Ser Ala Leu Tyr Tyr
325 330 335
Tyr Ser Thr Gly Gly Thr Gln Leu Pro Thr Leu Ala Arg Ser Phe Ile
340 345 350
Ile Cys Ile Gln Met Ile Ser Glu Ala Ala Arg Phe Gln Tyr Ile Glu
355 360 365
Gly Glu Met Arg Val Pro Lys Asp Glu Leu
370 375
<210> 4
<211> 473
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 4
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Gly Ser Ala Ser Gly Cys Gly Pro Glu Gly Gly Gly
165 170 175
Gly Ser Ala Ile Asn Thr Ile Thr Phe Asp Ala Gly Asn Ala Thr Ile
180 185 190
Asn Lys Tyr Ala Thr Phe Met Glu Ser Leu Arg Asn Gln Ala Lys Asp
195 200 205
Pro Lys Leu Lys Cys Tyr Gly Ile Pro Met Leu Pro Asp Thr Asn Ser
210 215 220
Thr Pro Lys Tyr Leu Leu Val Lys Leu Gln Gly Ala Asn Leu Lys Thr
225 230 235 240
Ile Thr Leu Met Leu Arg Arg Asn Asn Leu Tyr Val Met Gly Tyr Ser
245 250 255
Asp Pro Phe Asn Gly Asn Lys Cys Arg Tyr His Ile Phe Asn Asp Ile
260 265 270
Thr Ser Thr Glu Arg Thr Asp Val Glu Asn Thr Leu Cys Ser Ser Ser
275 280 285
Ser Ser Arg Val Ala Met Ser Ile Asn Tyr Asn Ser Leu Tyr Pro Thr
290 295 300
Met Glu Lys Lys Ala Glu Val Asn Ser Arg Asn Gln Val Gln Leu Gly
305 310 315 320
Ile Gln Ile Leu Ser Ser Asp Ile Gly Lys Ile Ser Gly Val Asp Ser
325 330 335
Phe Pro Val Lys Thr Glu Ala Phe Phe Leu Leu Val Ala Ile Gln Met
340 345 350
Val Ser Glu Ala Ala Arg Phe Lys Tyr Ile Glu Asn Gln Val Lys Thr
355 360 365
Asn Phe Asn Arg Ala Phe Tyr Pro Asp Pro Lys Val Ile Asn Leu Glu
370 375 380
Glu Lys Trp Gly Lys Ile Ser Glu Ala Ile His Asn Ala Lys Asn Gly
385 390 395 400
Ala Leu Pro Lys Pro Leu Glu Leu Val Asp Ala Lys Gly Thr Lys Trp
405 410 415
Ile Val Leu Arg Val Asp Glu Ile Asn Arg Asp Val Ala Leu Leu Lys
420 425 430
Tyr Val Asn Gly Thr Cys Gln Thr Thr Tyr Gln Asn Ala Met Phe Ser
435 440 445
Gln Val Ile Ile Ser Thr Tyr Tyr Asn Tyr Met Ser Asn Leu Gly Asp
450 455 460
Leu Phe Glu Gly Phe Lys Asp Glu Leu
465 470
<210> 5
<211> 430
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 5
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Gly Ser Ala Ser Gly Cys Gly Pro Glu Gly Gly Gly
165 170 175
Gly Ser Val Thr Ser Ile Thr Leu Asp Leu Val Asn Pro Thr Ala Gly
180 185 190
Gln Tyr Ser Ser Phe Val Asp Lys Ile Arg Asn Asn Val Lys Asp Pro
195 200 205
Asn Leu Lys Tyr Gly Gly Thr Asp Ile Ala Val Ile Gly Pro Pro Ser
210 215 220
Lys Asp Lys Phe Leu Arg Ile Asn Phe Gln Ser Ser Arg Gly Thr Val
225 230 235 240
Ser Leu Gly Leu Lys Arg Asp Asn Leu Tyr Val Val Ala Tyr Leu Ala
245 250 255
Met Asp Asn Thr Asn Val Asn Arg Ala Tyr Tyr Phe Lys Ser Glu Ile
260 265 270
Thr Ser Ala Glu Leu Thr Ala Leu Phe Pro Glu Ala Thr Thr Ala Asn
275 280 285
Gln Lys Ala Leu Glu Tyr Thr Glu Asp Tyr Gln Ser Ile Glu Lys Asn
290 295 300
Ala Gln Ile Thr Gln Gly Asp Lys Ser Arg Lys Glu Leu Gly Leu Gly
305 310 315 320
Ile Asp Leu Leu Leu Thr Phe Met Glu Ala Val Asn Lys Lys Ala Arg
325 330 335
Val Val Lys Asn Glu Ala Arg Phe Leu Leu Ile Ala Ile Gln Met Thr
340 345 350
Ala Glu Val Ala Arg Phe Arg Tyr Ile Gln Asn Leu Val Thr Lys Asn
355 360 365
Phe Pro Asn Lys Phe Asp Ser Asp Asn Lys Val Ile Gln Phe Glu Val
370 375 380
Ser Trp Arg Lys Ile Ser Thr Ala Ile Tyr Gly Asp Ala Lys Asn Gly
385 390 395 400
Val Phe Asn Lys Asp Tyr Asp Phe Gly Phe Gly Lys Val Arg Gln Val
405 410 415
Lys Asp Leu Gln Met Gly Leu Leu Met Tyr Leu Gly Lys Pro
420 425 430
<210> 6
<211> 442
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 6
Val Arg Glu Arg Gly Pro Gln Arg Val Ala Ala His Ile Thr Gly Thr
1 5 10 15
Arg Gly Arg Ser Asn Thr Leu Ser Ser Pro Asn Ser Lys Asn Glu Lys
20 25 30
Ala Leu Gly Arg Lys Ile Asn Ser Trp Glu Ser Ser Arg Ser Gly His
35 40 45
Ser Phe Leu Ser Asn Leu His Leu Arg Asn Gly Glu Leu Val Ile His
50 55 60
Glu Lys Gly Phe Tyr Tyr Ile Tyr Ser Gln Thr Tyr Phe Arg Phe Gln
65 70 75 80
Glu Glu Ile Lys Glu Asn Thr Lys Asn Asp Lys Gln Met Val Gln Tyr
85 90 95
Ile Tyr Lys Tyr Thr Ser Tyr Pro Asp Pro Ile Leu Leu Met Lys Ser
100 105 110
Ala Arg Asn Ser Cys Trp Ser Lys Asp Ala Glu Tyr Gly Leu Tyr Ser
115 120 125
Ile Tyr Gln Gly Gly Ile Phe Glu Leu Lys Glu Asn Asp Arg Ile Phe
130 135 140
Val Ser Val Thr Asn Glu His Leu Ile Asp Met Asp His Glu Ala Ser
145 150 155 160
Phe Phe Gly Ala Phe Leu Val Gly Ala Ser Gly Cys Gly Pro Glu Gly
165 170 175
Gly Gly Gly Gly Ser Gly Gly Gly Gly Ser Arg Lys Lys Arg Val Thr
180 185 190
Ser Ile Thr Leu Asp Leu Val Asn Pro Thr Ala Gly Gln Tyr Ser Ser
195 200 205
Phe Val Asp Lys Ile Arg Asn Asn Val Lys Asp Pro Asn Leu Lys Tyr
210 215 220
Gly Gly Thr Asp Ile Ala Val Ile Gly Pro Pro Ser Lys Asp Lys Phe
225 230 235 240
Leu Arg Ile Asn Phe Gln Ser Ser Arg Gly Thr Val Ser Leu Gly Leu
245 250 255
Lys Arg Asp Asn Leu Tyr Val Val Ala Tyr Leu Ala Met Asp Asn Thr
260 265 270
Asn Val Asn Arg Ala Tyr Tyr Phe Lys Ser Glu Ile Thr Ser Ala Glu
275 280 285
Leu Thr Ala Leu Phe Pro Glu Ala Thr Thr Ala Asn Gln Lys Ala Leu
290 295 300
Glu Tyr Thr Glu Asp Tyr Gln Ser Ile Glu Lys Asn Ala Gln Ile Thr
305 310 315 320
Gln Gly Asp Lys Ser Arg Lys Glu Leu Gly Leu Gly Ile Asp Leu Leu
325 330 335
Leu Thr Phe Met Glu Ala Val Asn Lys Lys Ala Arg Val Val Lys Asn
340 345 350
Glu Ala Arg Phe Leu Leu Ile Ala Ile Gln Met Thr Ala Glu Val Ala
355 360 365
Arg Phe Arg Tyr Ile Gln Asn Leu Val Thr Lys Asn Phe Pro Asn Lys
370 375 380
Phe Asp Ser Asp Asn Lys Val Ile Gln Phe Glu Val Ser Trp Arg Lys
385 390 395 400
Ile Ser Thr Ala Ile Tyr Gly Asp Ala Lys Asn Gly Val Phe Asn Lys
405 410 415
Asp Tyr Asp Phe Gly Phe Gly Lys Val Arg Gln Val Lys Asp Leu Gln
420 425 430
Met Gly Leu Leu Met Tyr Leu Gly Lys Pro
435 440
<210> 7
<211> 429
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 7
Asp Val Ser Phe Arg Leu Ser Gly Ala Thr Ser Ser Ser Tyr Gly Val
1 5 10 15
Phe Ile Ser Asn Leu Arg Lys Ala Leu Pro Asn Glu Arg Lys Leu Tyr
20 25 30
Asp Ile Pro Leu Leu Arg Ser Ser Leu Pro Gly Ser Gln Arg Tyr Ala
35 40 45
Leu Ile His Leu Thr Asn Tyr Ala Asp Glu Thr Ile Ser Val Ala Ile
50 55 60
Asp Val Thr Asn Val Tyr Ile Met Gly Tyr Arg Ala Gly Asp Thr Ser
65 70 75 80
Tyr Phe Phe Asn Glu Ala Ser Ala Thr Glu Ala Ala Lys Tyr Val Phe
85 90 95
Lys Asp Ala Met Arg Lys Val Thr Leu Pro Tyr Ser Gly Asn Tyr Glu
100 105 110
Arg Leu Gln Thr Ala Ala Gly Lys Ile Arg Glu Asn Ile Pro Leu Gly
115 120 125
Leu Pro Ala Leu Asp Ser Ala Ile Thr Thr Leu Phe Tyr Tyr Asn Ala
130 135 140
Asn Ser Ala Ala Ser Ala Leu Met Val Leu Ile Gln Ser Thr Ser Glu
145 150 155 160
Ala Ala Arg Tyr Lys Phe Ile Glu Gln Gln Ile Gly Lys Arg Val Asp
165 170 175
Lys Thr Phe Leu Pro Ser Leu Ala Ile Ile Ser Leu Glu Asn Ser Trp
180 185 190
Ser Ala Leu Ser Lys Gln Ile Gln Ile Ala Ser Thr Asn Asn Gly Gln
195 200 205
Phe Glu Ser Pro Val Val Leu Ile Asn Ala Gln Asn Gln Arg Val Thr
210 215 220
Ile Thr Asn Val Asp Ala Gly Val Val Thr Ser Asn Ile Ala Leu Leu
225 230 235 240
Leu Asn Arg Asn Asn Met Ala Gly Gly Gly Gly Ser Arg Lys Lys Arg
245 250 255
Ala Ser Gly Cys Gly Pro Glu Gly Gly Gly Gly Ser Arg Val Ala Ala
260 265 270
His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu Ser Ser Pro Asn
275 280 285
Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn Ser Trp Glu Ser
290 295 300
Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His Leu Arg Asn Gly
305 310 315 320
Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile Tyr Ser Gln Thr
325 330 335
Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr Lys Asn Asp Lys
340 345 350
Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr Pro Asp Pro Ile
355 360 365
Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser Lys Asp Ala Glu
370 375 380
Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe Glu Leu Lys Glu
385 390 395 400
Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His Leu Ile Asp Met
405 410 415
Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val Gly
420 425
<210> 8
<211> 427
<212> PRT
<213> Artificial Sequence
<220>
<223> brak
<400> 8
Asp Val Ser Phe Asp Leu Ser Thr Ala Thr Lys Lys Ser Tyr Ser Ser
1 5 10 15
Phe Ile Thr Gln Leu Arg Asp Ala Leu Pro Thr Gln Gly Thr Val Cys
20 25 30
Gly Ile Pro Leu Leu Pro Ser Thr Ala Ser Gly Ser Gln Trp Phe Arg
35 40 45
Phe Phe Asn Leu Thr Asn Tyr Asn Asp Glu Thr Val Thr Val Ala Val
50 55 60
Asn Val Thr Asn Val Tyr Ile Val Ala Tyr Arg Ala Asp Ala Val Ser
65 70 75 80
Tyr Phe Phe Glu Asp Thr Pro Ala Glu Ala Phe Lys Leu Ile Phe Ala
85 90 95
Gly Thr Lys Thr Val Lys Leu Pro Tyr Ser Gly Asn Tyr Asp Lys Leu
100 105 110
Gln Ser Val Val Gly Lys Gln Arg Asp Met Ile Glu Leu Gly Ile Pro
115 120 125
Ala Leu Ser Ser Ala Ile Thr Asn Met Val Tyr Tyr Asp Tyr Gln Ser
130 135 140
Thr Ala Ala Ala Leu Leu Val Leu Ile Gln Cys Thr Ala Glu Ala Ala
145 150 155 160
Arg Tyr Lys Tyr Ile Glu Gln Gln Val Ser Ser His Ile Ser Ser Asn
165 170 175
Phe Tyr Pro Asn Gln Ala Val Ile Ser Leu Glu Asn Lys Trp Gly Ala
180 185 190
Leu Ser Lys Gln Ile Gln Ile Ala Asn Arg Thr Gly His Gly Gln Phe
195 200 205
Glu Asn Pro Val Glu Leu Tyr Asn Pro Asp Gly Thr Arg Phe Ser Val
210 215 220
Thr Asn Thr Ser Ala Gly Val Val Lys Gly Asn Ile Lys Leu Leu Leu
225 230 235 240
Tyr Tyr Lys Ala Ser Gly Gly Gly Gly Ser Arg Lys Lys Arg Ala Ser
245 250 255
Gly Cys Gly Pro Glu Gly Gly Gly Gly Ser Arg Val Ala Ala His Ile
260 265 270
Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu Ser Ser Pro Asn Ser Lys
275 280 285
Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn Ser Trp Glu Ser Ser Arg
290 295 300
Ser Gly His Ser Phe Leu Ser Asn Leu His Leu Arg Asn Gly Glu Leu
305 310 315 320
Val Ile His Glu Lys Gly Phe Tyr Tyr Ile Tyr Ser Gln Thr Tyr Phe
325 330 335
Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr Lys Asn Asp Lys Gln Met
340 345 350
Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr Pro Asp Pro Ile Leu Leu
355 360 365
Met Lys Ser Ala Arg Asn Ser Cys Trp Ser Lys Asp Ala Glu Tyr Gly
370 375 380
Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe Glu Leu Lys Glu Asn Asp
385 390 395 400
Arg Ile Phe Val Ser Val Thr Asn Glu His Leu Ile Asp Met Asp His
405 410 415
Glu Ala Ser Phe Phe Gly Ala Phe Leu Val Gly
420 425
<210> 9
<211> 427
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 9
Tyr Glu Arg Leu Arg Leu Arg Val Thr His Gln Thr Thr Gly Glu Glu
1 5 10 15
Tyr Phe Arg Phe Ile Thr Leu Leu Arg Asp Tyr Val Ser Ser Gly Ser
20 25 30
Phe Ser Asn Glu Ile Pro Leu Leu Arg Gln Ser Thr Ile Pro Val Ser
35 40 45
Asp Ala Gln Arg Phe Val Leu Val Glu Leu Thr Asn Glu Gly Gly Asp
50 55 60
Ser Ile Thr Ala Ala Ile Asp Val Thr Asn Leu Tyr Val Val Ala Tyr
65 70 75 80
Gln Ala Gly Asp Gln Ser Tyr Phe Leu Arg Asp Ala Pro Arg Gly Ala
85 90 95
Glu Thr His Leu Phe Thr Gly Thr Thr Arg Ser Ser Leu Pro Phe Asn
100 105 110
Gly Ser Tyr Pro Asp Leu Glu Arg Tyr Ala Gly His Arg Asp Gln Ile
115 120 125
Pro Leu Gly Ile Asp Gln Leu Ile Gln Ser Val Thr Ala Leu Arg Phe
130 135 140
Pro Gly Gly Ser Thr Arg Thr Gln Ala Arg Ser Ile Leu Ile Leu Ile
145 150 155 160
Gln Met Ile Ser Glu Ala Ala Arg Phe Asn Pro Ile Leu Trp Arg Ala
165 170 175
Arg Gln Tyr Ile Asn Ser Gly Ala Ser Phe Leu Pro Asp Val Tyr Met
180 185 190
Leu Glu Leu Glu Thr Ser Trp Gly Gln Gln Ser Thr Gln Val Gln Gln
195 200 205
Ser Thr Asp Gly Val Phe Asn Asn Pro Ile Arg Leu Ala Ile Pro Pro
210 215 220
Gly Asn Phe Val Thr Leu Thr Asn Val Arg Asp Val Ile Ala Ser Leu
225 230 235 240
Ala Ile Met Leu Phe Val Cys Gly Glu Gly Gly Gly Gly Gly Ser Ala
245 250 255
Ser Gly Cys Gly Pro Glu Gly Gly Gly Gly Ser Arg Val Ala Ala His
260 265 270
Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu Ser Ser Pro Asn Ser
275 280 285
Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn Ser Trp Glu Ser Ser
290 295 300
Arg Ser Gly His Ser Phe Leu Ser Asn Leu His Leu Arg Asn Gly Glu
305 310 315 320
Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile Tyr Ser Gln Thr Tyr
325 330 335
Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr Lys Asn Asp Lys Gln
340 345 350
Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr Pro Asp Pro Ile Leu
355 360 365
Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser Lys Asp Ala Glu Tyr
370 375 380
Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe Glu Leu Lys Glu Asn
385 390 395 400
Asp Arg Ile Phe Val Ser Val Thr Asn Glu His Leu Ile Asp Met Asp
405 410 415
His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
420 425
<210> 10
<211> 462
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 10
Ile Asp Tyr Pro Ser Val Ser Phe Asn Leu Ala Gly Ala Lys Ser Thr
1 5 10 15
Thr Tyr Arg Asp Phe Leu Lys Asn Leu Arg Asp Arg Val Ala Thr Gly
20 25 30
Thr Tyr Glu Val Asn Gly Leu Pro Val Leu Arg Arg Glu Ser Glu Val
35 40 45
Gln Val Lys Asn Arg Phe Val Leu Val Arg Leu Thr Asn Tyr Asn Gly
50 55 60
Asp Thr Val Thr Ser Ala Val Asp Val Thr Asn Leu Tyr Leu Val Ala
65 70 75 80
Phe Ser Ala Asn Gly Asn Ser Tyr Phe Phe Lys Asp Ala Thr Glu Leu
85 90 95
Gln Lys Ser Asn Leu Phe Leu Gly Thr Thr Gln His Thr Leu Ser Phe
100 105 110
Thr Gly Asn Tyr Asp Asn Leu Glu Thr Ala Ala Gly Thr Arg Arg Glu
115 120 125
Ser Ile Glu Leu Gly Pro Asn Pro Leu Asp Gly Ala Ile Thr Ser Leu
130 135 140
Trp Tyr Asp Gly Gly Val Ala Arg Ser Leu Leu Val Leu Ile Gln Met
145 150 155 160
Val Pro Glu Ala Ala Arg Phe Arg Tyr Ile Glu Gln Glu Val Arg Arg
165 170 175
Ser Leu Gln Gln Leu Thr Ser Phe Thr Pro Asn Ala Leu Met Leu Ser
180 185 190
Met Glu Asn Asn Trp Ser Ser Met Ser Leu Glu Val Gln Leu Ser Gly
195 200 205
Asp Asn Val Ser Pro Phe Ser Gly Thr Val Gln Leu Gln Asn Tyr Asp
210 215 220
His Thr Pro Arg Leu Val Asp Asn Phe Glu Glu Leu Tyr Lys Ile Thr
225 230 235 240
Gly Ile Ala Ile Leu Leu Phe Arg Cys Val Ala Thr Lys Thr Thr His
245 250 255
Asn Ala Ile Arg Met Pro His Val Leu Val Gly Glu Asp Asn Lys Phe
260 265 270
Asn Gly Gly Gly Gly Ser Ala Ser Gly Cys Gly Pro Glu Arg Lys Lys
275 280 285
Arg Gly Gly Gly Gly Val Arg Glu Arg Gly Pro Gln Arg Arg Val Ala
290 295 300
Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu Ser Ser Pro
305 310 315 320
Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn Ser Trp Glu
325 330 335
Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His Leu Arg Asn
340 345 350
Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile Tyr Ser Gln
355 360 365
Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr Lys Asn Asp
370 375 380
Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr Pro Asp Pro
385 390 395 400
Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser Lys Asp Ala
405 410 415
Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe Glu Leu Lys
420 425 430
Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His Leu Ile Asp
435 440 445
Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val Gly
450 455 460
<210> 11
<211> 454
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 11
Ile Asp Tyr Pro Ser Val Ser Phe Asn Leu Asp Gly Ala Lys Ser Ala
1 5 10 15
Thr Tyr Arg Asp Phe Leu Ser Asn Leu Arg Lys Thr Val Ala Thr Gly
20 25 30
Thr Tyr Glu Val Asn Gly Leu Pro Val Leu Arg Arg Glu Ser Glu Val
35 40 45
Gln Val Lys Ser Arg Phe Val Leu Val Pro Leu Thr Asn Tyr Asn Gly
50 55 60
Asn Thr Val Thr Leu Ala Val Asp Val Thr Asn Leu Tyr Val Val Ala
65 70 75 80
Phe Ser Gly Asn Ala Asn Ser Tyr Phe Phe Lys Asp Ala Thr Glu Val
85 90 95
Gln Lys Ser Asn Leu Phe Val Gly Thr Lys Gln Asn Thr Leu Ser Phe
100 105 110
Thr Gly Asn Tyr Asp Asn Leu Glu Thr Ala Ala Asn Thr Arg Arg Glu
115 120 125
Ser Ile Glu Leu Gly Pro Ser Pro Leu Asp Gly Ala Ile Thr Ser Leu
130 135 140
Tyr His Gly Asp Ser Val Ala Arg Ser Leu Leu Val Val Ile Gln Met
145 150 155 160
Val Ser Glu Ala Ala Arg Phe Arg Tyr Ile Glu Gln Glu Val Arg Arg
165 170 175
Ser Leu Gln Gln Ala Thr Ser Phe Thr Pro Asn Ala Leu Met Leu Ser
180 185 190
Met Glu Asn Asn Trp Ser Ser Met Ser Leu Glu Ile Gln Gln Ala Gly
195 200 205
Asn Asn Val Ser Pro Phe Phe Gly Thr Val Gln Leu Leu Asn Tyr Asp
210 215 220
His Thr His Arg Leu Val Asp Asn Phe Glu Glu Leu Tyr Lys Ile Thr
225 230 235 240
Gly Ile Ala Ile Leu Leu Phe Arg Cys Ser Ser Pro Ser Asn Asp Asn
245 250 255
Ala Ile Arg Met Pro Leu Asp Leu Ala Gly Glu Asp Asn Lys Tyr Asn
260 265 270
Gly Gly Gly Gly Ser Arg Lys Lys Arg Ala Ser Gly Cys Gly Pro Glu
275 280 285
Gly Gly Gly Gly Ser Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly
290 295 300
Arg Ser Asn Thr Leu Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu
305 310 315 320
Gly Arg Lys Ile Asn Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe
325 330 335
Leu Ser Asn Leu His Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys
340 345 350
Gly Phe Tyr Tyr Ile Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu
355 360 365
Ile Lys Glu Asn Thr Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr
370 375 380
Lys Tyr Thr Ser Tyr Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg
385 390 395 400
Asn Ser Cys Trp Ser Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr
405 410 415
Gln Gly Gly Ile Phe Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser
420 425 430
Val Thr Asn Glu His Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe
435 440 445
Gly Ala Phe Leu Val Gly
450
<210> 12
<211> 221
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 12
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Gly Ser Arg Lys Lys Arg Pro Arg Gly Ser Pro Arg
165 170 175
Thr Glu Tyr Glu Ala Cys Arg Val Arg Cys Gln Val Ala Glu His Gly
180 185 190
Val Glu Arg Gln Arg Arg Cys Gln Gln Val Cys Glu Lys Arg Leu Arg
195 200 205
Glu Arg Glu Gly Arg Arg Glu Val Asp Lys Asp Glu Leu
210 215 220
<210> 13
<211> 227
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 13
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Ser Ala Ser Gly Cys Gly Pro Glu Arg Lys Lys Arg
165 170 175
Ala Ser Gly Gly Pro Arg Gly Ser Pro Arg Thr Glu Tyr Glu Ala Cys
180 185 190
Arg Val Arg Cys Gln Val Ala Glu His Gly Val Glu Arg Gln Arg Arg
195 200 205
Cys Gln Gln Val Cys Glu Lys Arg Leu Arg Glu Arg Glu Gly Arg Arg
210 215 220
Glu Val Asp
225
<210> 14
<211> 254
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 14
Thr Ser Glu Glu Thr Ile Ser Thr Val Gln Glu Lys Gln Gln Asn Ile
1 5 10 15
Ser Pro Leu Val Arg Glu Arg Gly Pro Gln Arg Val Ala Ala His Ile
20 25 30
Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu Ser Ser Pro Asn Ser Lys
35 40 45
Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn Ser Trp Glu Ser Ser Arg
50 55 60
Ser Gly His Ser Phe Leu Ser Asn Leu His Leu Arg Asn Gly Glu Leu
65 70 75 80
Val Ile His Glu Lys Gly Phe Tyr Tyr Ile Tyr Ser Gln Thr Tyr Phe
85 90 95
Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr Lys Asn Asp Lys Gln Met
100 105 110
Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr Pro Asp Pro Ile Leu Leu
115 120 125
Met Lys Ser Ala Arg Asn Ser Cys Trp Ser Lys Asp Ala Glu Tyr Gly
130 135 140
Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe Glu Leu Lys Glu Asn Asp
145 150 155 160
Arg Ile Phe Val Ser Val Thr Asn Glu His Leu Ile Asp Met Asp His
165 170 175
Glu Ala Ser Phe Phe Gly Ala Phe Leu Val Gly Gly Gly Gly Gly Ser
180 185 190
Ala Ser Gly Cys Gly Pro Glu Arg Lys Lys Arg Pro Arg Gly Ser Pro
195 200 205
Arg Thr Glu Tyr Glu Ala Cys Arg Val Arg Cys Gln Val Ala Glu His
210 215 220
Gly Val Glu Arg Gln Arg Arg Cys Gln Gln Val Cys Glu Lys Arg Leu
225 230 235 240
Arg Glu Arg Glu Gly Arg Arg Glu Val Asp Lys Asp Glu Leu
245 250
<210> 15
<211> 438
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 15
Val Phe Pro Lys Val Pro Phe Asp Val Pro Lys Ala Thr Val Glu Ser
1 5 10 15
Tyr Thr Arg Phe Ile Arg Val Leu Arg Asp Glu Leu Ala Gly Gly Val
20 25 30
Ser Pro Gln Gly Ile Arg Arg Leu Arg Asn Pro Ala Glu Ile Gln Pro
35 40 45
Ser Gln Gly Phe Ile Leu Ile Gln Leu Thr Gly Tyr Val Gly Ser Val
50 55 60
Thr Leu Ile Met Asp Val Arg Asn Ala Tyr Leu Leu Gly Tyr Leu Ser
65 70 75 80
His Asn Val Leu Tyr His Phe Asn Asp Val Ser Ala Ser Ser Ile Ala
85 90 95
Ser Val Phe Pro Asp Ala Gln Arg Arg Gln Leu Pro Phe Gly Gly Gly
100 105 110
Tyr Pro Ser Met Arg Asn Tyr Ala Pro Glu Arg Asp Gln Ile Asp His
115 120 125
Gly Ile Val Glu Leu Ala Tyr Ala Val Asp Arg Leu Tyr Tyr Ser Gln
130 135 140
Asn Asn Asn Gln Ile Ala Leu Gly Leu Val Ile Cys Ala Gly Met Val
145 150 155 160
Ala Glu Ala Ser Arg Phe Arg Tyr Ile Glu Gly Leu Val Arg Gln Ser
165 170 175
Ile Val Gly Pro Gly Asp Tyr Arg Thr Phe Arg Pro Asp Ala Leu Met
180 185 190
Tyr Ser Ile Val Thr Gln Trp Gln Thr Leu Ser Glu Arg Ile Gln Gly
195 200 205
Ser Phe Asn Gly Ala Phe Gln Pro Val Gln Leu Gly Tyr Ala Ser Asp
210 215 220
Pro Phe Tyr Trp Asp Asn Val Ala Gln Ala Ile Thr Arg Leu Ser Leu
225 230 235 240
Met Leu Phe Val Ser Arg Ser Thr Asp Gly Gly Gly Gly Ser Arg Val
245 250 255
Lys Arg Ala Ser Gly Cys Gly Pro Glu Gly Gly Gly Gly Ser Val Arg
260 265 270
Glu Arg Gly Pro Gln Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly
275 280 285
Arg Ser Asn Thr Leu Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu
290 295 300
Gly Arg Lys Ile Asn Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe
305 310 315 320
Leu Ser Asn Leu His Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys
325 330 335
Gly Phe Tyr Tyr Ile Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu
340 345 350
Ile Lys Glu Asn Thr Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr
355 360 365
Lys Tyr Thr Ser Tyr Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg
370 375 380
Asn Ser Cys Trp Ser Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr
385 390 395 400
Gln Gly Gly Ile Phe Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser
405 410 415
Val Thr Asn Glu His Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe
420 425 430
Gly Ala Phe Leu Val Gly
435
<210> 16
<211> 431
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 16
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Gly Ser Ala Ser Gly Cys Gly Pro Glu Gly Gly Gly
165 170 175
Gly Ser Val Phe Pro Lys Val Pro Phe Asp Val Pro Lys Ala Thr Val
180 185 190
Glu Ser Tyr Thr Arg Phe Ile Arg Val Leu Arg Asp Glu Leu Ala Gly
195 200 205
Gly Val Ser Pro Gln Gly Ile Arg Arg Leu Arg Asn Pro Ala Glu Ile
210 215 220
Gln Pro Ser Gln Gly Phe Ile Leu Ile Gln Leu Thr Gly Tyr Val Gly
225 230 235 240
Ser Val Thr Leu Ile Met Asp Val Arg Asn Ala Tyr Leu Leu Gly Tyr
245 250 255
Leu Ser His Asn Val Leu Tyr His Phe Asn Asp Val Ser Ala Ser Ser
260 265 270
Ile Ala Ser Val Phe Pro Asp Ala Gln Arg Arg Gln Leu Pro Phe Gly
275 280 285
Gly Gly Tyr Pro Ser Met Arg Asn Tyr Ala Pro Glu Arg Asp Gln Ile
290 295 300
Asp His Gly Ile Val Glu Leu Ala Tyr Ala Val Asp Arg Leu Tyr Tyr
305 310 315 320
Ser Gln Asn Asn Asn Gln Ile Ala Leu Gly Leu Val Ile Cys Ala Gly
325 330 335
Met Val Ala Glu Ala Ser Arg Phe Arg Tyr Ile Glu Gly Leu Val Arg
340 345 350
Gln Ser Ile Val Gly Pro Gly Asp Tyr Arg Thr Phe Arg Pro Asp Ala
355 360 365
Leu Met Tyr Ser Ile Val Thr Gln Trp Gln Thr Leu Ser Glu Arg Ile
370 375 380
Gln Gly Ser Phe Asn Gly Ala Phe Gln Pro Val Gln Leu Gly Tyr Ala
385 390 395 400
Ser Asp Pro Phe Tyr Trp Asp Asn Val Ala Gln Ala Ile Thr Arg Leu
405 410 415
Ser Leu Met Leu Phe Val Ser Arg Ser Thr Asp Lys Asp Glu Leu
420 425 430
<210> 17
<211> 428
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 17
Asp Val Ser Phe Arg Leu Ser Gly Ala Asp Pro Arg Ser Tyr Gly Met
1 5 10 15
Phe Ile Lys Asp Leu Arg Asn Ala Leu Pro Phe Arg Glu Lys Val Tyr
20 25 30
Asn Ile Pro Leu Leu Leu Pro Ser Val Ser Gly Ala Gly Arg Tyr Leu
35 40 45
Leu Met His Leu Phe Asn Tyr Asp Gly Lys Thr Ile Thr Val Ala Leu
50 55 60
Asp Val Thr Asn Val Tyr Ile Met Gly Tyr Leu Ala Asp Thr Thr Ser
65 70 75 80
Tyr Phe Phe Asn Glu Pro Ala Ala Glu Leu Ala Ser Gln Tyr Val Phe
85 90 95
Arg Asp Ala Arg Arg Lys Ile Thr Leu Pro Tyr Ser Gly Asn Tyr Glu
100 105 110
Arg Leu Gln Ile Ala Ala Gly Lys Pro Arg Glu Lys Ile Pro Ile Gly
115 120 125
Leu Pro Ala Leu Asp Ser Ala Ile Ser Thr Leu Leu His Tyr Asp Ser
130 135 140
Thr Ala Ala Ala Gly Ala Leu Leu Val Leu Ile Gln Thr Thr Ala Glu
145 150 155 160
Ala Ala Arg Phe Lys Tyr Ile Glu Gln Gln Ile Gln Glu Arg Ala Tyr
165 170 175
Arg Asp Glu Val Pro Ser Leu Ala Thr Ile Ser Leu Glu Asn Ser Trp
180 185 190
Ser Gly Leu Ser Lys Gln Ile Gln Leu Ala Gln Gly Asn Asn Gly Ile
195 200 205
Phe Arg Thr Pro Ile Val Leu Val Asp Asn Lys Gly Asn Arg Val Gln
210 215 220
Ile Thr Asn Val Thr Ser Lys Val Val Thr Ser Asn Ile Gln Leu Leu
225 230 235 240
Leu Asn Thr Arg Asn Ile Gly Gly Gly Gly Ser Arg Lys Lys Arg Ala
245 250 255
Ser Gly Cys Gly Pro Glu Gly Gly Gly Gly Ser Arg Val Ala Ala His
260 265 270
Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu Ser Ser Pro Asn Ser
275 280 285
Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn Ser Trp Glu Ser Ser
290 295 300
Arg Ser Gly His Ser Phe Leu Ser Asn Leu His Leu Arg Asn Gly Glu
305 310 315 320
Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile Tyr Ser Gln Thr Tyr
325 330 335
Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr Lys Asn Asp Lys Gln
340 345 350
Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr Pro Asp Pro Ile Leu
355 360 365
Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser Lys Asp Ala Glu Tyr
370 375 380
Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe Glu Leu Lys Glu Asn
385 390 395 400
Asp Arg Ile Phe Val Ser Val Thr Asn Glu His Leu Ile Asp Met Asp
405 410 415
His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val Gly
420 425
<210> 18
<211> 515
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 18
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Ser Ala Ser Gly Gly Pro Glu Gly Gly Ser Leu Ala
165 170 175
Ala Leu Thr Ala His Gln Ala Cys His Leu Pro Leu Glu Thr Phe Thr
180 185 190
Arg His Arg Gln Pro Arg Gly Trp Glu Gln Leu Glu Gln Cys Gly Tyr
195 200 205
Pro Val Gln Arg Leu Val Ala Leu Tyr Leu Ala Ala Arg Leu Ser Trp
210 215 220
Asn Gln Val Asp Gln Val Ile Ala Asn Ala Leu Ala Ser Pro Gly Ser
225 230 235 240
Gly Gly Asp Leu Gly Glu Ala Ile Arg Glu Ser Pro Glu Gln Ala Arg
245 250 255
Leu Ala Leu Thr Leu Ala Ala Ala Glu Ser Glu Arg Phe Val Arg Gln
260 265 270
Gly Thr Gly Asn Asp Glu Ala Gly Ala Ala Asn Gly Pro Ala Asp Ser
275 280 285
Gly Asp Ala Leu Leu Glu Arg Asn Tyr Pro Thr Gly Ala Glu Phe Leu
290 295 300
Gly Asp Gly Gly Asp Val Ser Phe Ser Thr Arg Gly Thr Gln Asn Trp
305 310 315 320
Thr Val Glu Arg Leu Leu Gln Ala His Arg Gln Leu Glu Glu Ala Gly
325 330 335
Tyr Val Phe Val Gly Tyr His Gly Thr Phe Leu Glu Ala Ala Gln Ser
340 345 350
Ile Val Phe Gly Gly Val Arg Ala Arg Ser Gln Asp Leu Asp Ala Ile
355 360 365
Trp Ala Gly Phe Tyr Ile Ala Gly Asp Pro Ala Leu Ala Tyr Gly Tyr
370 375 380
Ala Gln Asp Gln Glu Pro Asp Ala Ala Gly Arg Ile Arg Asn Gly Ala
385 390 395 400
Leu Leu Arg Val Tyr Val Pro Arg Ser Ser Leu Pro Gly Phe Tyr Ala
405 410 415
Thr Ser Leu Thr Leu Ala Ala Pro Glu Ala Ala Gly Glu Val Glu Arg
420 425 430
Leu Ile Gly His Pro Leu Pro Leu Arg Leu Asp Ala Ile Thr Gly Pro
435 440 445
Glu Glu Ser Gly Gly Arg Leu Glu Thr Ile Leu Gly Trp Pro Leu Ala
450 455 460
Glu Arg Thr Val Val Ile Pro Ser Ala Ile Pro Thr Asp Pro Arg Asn
465 470 475 480
Val Gly Gly Asp Leu Asp Pro Ser Ser Ile Pro Asp Ser Glu Gln Ala
485 490 495
Ile Ser Ala Leu Pro Asp Tyr Ala Ser Gln Pro Gly Lys Pro Pro Lys
500 505 510
Asp Glu Leu
515
<210> 19
<211> 528
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 19
Pro Gln Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn
1 5 10 15
Thr Leu Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys
20 25 30
Ile Asn Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn
35 40 45
Leu His Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr
50 55 60
Tyr Ile Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu
65 70 75 80
Asn Thr Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr
85 90 95
Ser Tyr Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys
100 105 110
Trp Ser Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly
115 120 125
Ile Phe Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn
130 135 140
Glu His Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe
145 150 155 160
Leu Val Gly Gly Gly Gly Ser Ala Ser Gly Cys Gly Pro Glu Arg Lys
165 170 175
Lys Arg Ala Ser Gly Gly Pro Glu Gly Gly Ser Leu Ala Ala Leu Thr
180 185 190
Ala His Gln Ala Cys His Leu Pro Leu Glu Thr Phe Thr Arg His Arg
195 200 205
Gln Pro Arg Gly Trp Glu Gln Leu Glu Gln Cys Gly Tyr Pro Val Gln
210 215 220
Arg Leu Val Ala Leu Tyr Leu Ala Ala Arg Leu Ser Trp Asn Gln Val
225 230 235 240
Asp Gln Val Ile Arg Asn Ala Leu Ala Ser Pro Gly Ser Gly Gly Asp
245 250 255
Leu Gly Glu Ala Ile Arg Glu Gln Pro Glu Gln Ala Arg Leu Ala Leu
260 265 270
Thr Leu Ala Ala Ala Glu Ser Glu Arg Phe Val Arg Gln Gly Thr Gly
275 280 285
Asn Asp Glu Ala Gly Ala Ala Asn Gly Pro Ala Asp Ser Gly Asp Ala
290 295 300
Leu Leu Glu Arg Asn Tyr Pro Thr Gly Ala Glu Phe Leu Gly Asp Gly
305 310 315 320
Gly Asp Val Ser Phe Ser Thr Arg Gly Thr Gln Asn Trp Thr Val Glu
325 330 335
Arg Leu Leu Gln Ala His Arg Gln Leu Glu Glu Ala Gly Tyr Val Phe
340 345 350
Val Gly Tyr His Gly Thr Phe Leu Glu Ala Ala Gln Ser Ile Val Phe
355 360 365
Gly Gly Val Arg Ala Arg Ser Gln Asp Leu Asp Ala Ile Trp Ala Gly
370 375 380
Phe Tyr Ile Ala Gly Asp Pro Ala Leu Ala Tyr Gly Tyr Ala Gln Asp
385 390 395 400
Gln Glu Pro Asp Ala Ala Gly Arg Ile Arg Asn Gly Ala Leu Leu Arg
405 410 415
Val Tyr Val Pro Arg Ser Ser Leu Pro Gly Phe Tyr Ala Thr Ser Leu
420 425 430
Thr Leu Ala Ala Pro Glu Ala Ala Gly Glu Val Glu Arg Leu Ile Gly
435 440 445
His Pro Leu Pro Leu Arg Leu Asp Ala Ile Thr Gly Pro Glu Glu Ser
450 455 460
Gly Gly Arg Leu Glu Thr Ile Leu Gly Trp Pro Leu Ala Glu Arg Thr
465 470 475 480
Val Val Ile Pro Ser Ala Ile Pro Thr Asp Pro Arg Asn Val Gly Gly
485 490 495
Asp Leu Asp Pro Ser Ser Ile Pro Asp Ser Glu Gln Ala Ile Ser Ala
500 505 510
Leu Pro Asp Tyr Ala Ser Gln Pro Gly Lys Pro Pro Lys Asp Glu Leu
515 520 525
<210> 20
<211> 526
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 20
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Ser Ala Ser Gly Cys Gly Pro Glu Arg Lys Lys Arg
165 170 175
Ala Ser Gly Gly Pro Glu Gly Gly Ser Leu Ala Ala Leu Thr Ala His
180 185 190
Gln Ala Cys His Leu Pro Leu Glu Thr Phe Thr Arg His Arg Gln Pro
195 200 205
Arg Gly Trp Glu Gln Leu Glu Gln Cys Gly Tyr Pro Val Gln Arg Leu
210 215 220
Val Ala Leu Tyr Leu Ala Ala Arg Leu Ser Trp Asn Gln Val Asp Gln
225 230 235 240
Val Ile Ala Asn Ala Leu Ala Ser Pro Gly Ser Gly Gly Asp Leu Gly
245 250 255
Glu Ala Ile Arg Glu Ser Pro Glu Gln Ala Arg Leu Ala Leu Thr Leu
260 265 270
Ala Ala Ala Glu Ser Glu Arg Phe Val Arg Gln Gly Thr Gly Asn Asp
275 280 285
Glu Ala Gly Ala Ala Asn Gly Pro Ala Asp Ser Gly Asp Ala Leu Leu
290 295 300
Glu Arg Asn Tyr Pro Thr Gly Ala Glu Phe Leu Gly Asp Gly Gly Asp
305 310 315 320
Val Ser Phe Ser Thr Arg Gly Thr Gln Asn Trp Thr Val Glu Arg Leu
325 330 335
Leu Gln Ala His Arg Gln Leu Glu Glu Ala Gly Tyr Val Phe Val Gly
340 345 350
Tyr His Gly Thr Phe Leu Glu Ala Ala Gln Ser Ile Val Phe Gly Gly
355 360 365
Val Arg Ala Arg Ser Gln Asp Leu Asp Ala Ile Trp Ala Gly Phe Tyr
370 375 380
Ile Ala Gly Asp Pro Ala Leu Ala Tyr Gly Tyr Ala Gln Asp Gln Glu
385 390 395 400
Pro Asp Ala Ala Gly Arg Ile Arg Asn Gly Ala Leu Leu Arg Val Tyr
405 410 415
Val Pro Arg Ser Ser Leu Pro Gly Phe Tyr Ala Thr Ser Leu Thr Leu
420 425 430
Ala Ala Pro Glu Ala Ala Gly Glu Val Glu Arg Leu Ile Gly His Pro
435 440 445
Leu Pro Leu Arg Leu Asp Ala Ile Thr Gly Pro Glu Glu Ser Gly Gly
450 455 460
Arg Leu Glu Thr Ile Leu Gly Trp Pro Leu Ala Glu Arg Thr Val Val
465 470 475 480
Ile Pro Ser Ala Ile Pro Thr Asp Pro Arg Asn Val Gly Gly Asp Leu
485 490 495
Asp Pro Ser Ser Ile Pro Asp Ser Glu Gln Ala Ile Ser Ala Leu Pro
500 505 510
Asp Tyr Ala Ser Gln Pro Gly Lys Pro Pro Lys Asp Glu Leu
515 520 525
<210> 21
<211> 534
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 21
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Ser Ala Ser Gly Cys Gly Pro Glu Arg Lys Lys Arg
165 170 175
Ala Ser Gly Gly Pro Glu Gly Gly Ser Leu Ala Ala Leu Thr Ala His
180 185 190
Gln Ala Cys His Leu Pro Leu Glu Thr Phe Thr Arg His Arg Gln Pro
195 200 205
Arg Gly Trp Glu Gln Leu Glu Gln Cys Gly Tyr Pro Val Gln Arg Leu
210 215 220
Val Ala Leu Tyr Leu Ala Ala Arg Leu Ser Trp Asn Gln Val Asp Gln
225 230 235 240
Val Ile Arg Asn Ala Leu Ala Ser Pro Gly Ser Gly Gly Asp Leu Gly
245 250 255
Glu Ala Ile Arg Glu Gln Pro Glu Gln Ala Arg Leu Ala Leu Thr Leu
260 265 270
Ala Ala Ala Glu Ser Glu Arg Phe Val Arg Gln Gly Thr Gly Asn Val
275 280 285
Val Ser Leu Thr Cys Pro Val Ala Ala Gly Glu Cys Ala Gly Pro Ala
290 295 300
Asp Ser Gly Asp Ala Leu Leu Glu Arg Asn Tyr Pro Thr Gly Ala Glu
305 310 315 320
Phe Leu Gly Asp Gly Gly Asp Val Ser Phe Ser Thr Arg Gly Thr Gln
325 330 335
Asn Trp Thr Val Glu Arg Leu Leu Gln Ala His Arg Gln Leu Glu Glu
340 345 350
Arg Gly Tyr Val Phe Val Gly Tyr His Gly Thr Phe Leu Glu Ala Ala
355 360 365
Gln Ser Ile Val Phe Gly Gly Val Arg Ala Arg Ser Gln Asp Leu Asp
370 375 380
Ala Ile Trp Arg Gly Phe Tyr Ile Ala Gly Asp Pro Ala Leu Ala Tyr
385 390 395 400
Gly Tyr Ala Gln Asp Gln Glu Pro Asp Ala Arg Gly Arg Ile Arg Asn
405 410 415
Gly Ala Leu Leu Arg Val Tyr Val Pro Arg Ser Ser Leu Pro Gly Phe
420 425 430
Tyr Arg Thr Ser Leu Thr Leu Ala Ala Pro Glu Ala Ala Gly Glu Val
435 440 445
Glu Arg Leu Ile Gly His Pro Leu Pro Leu Arg Leu Asp Ala Ile Thr
450 455 460
Gly Pro Glu Glu Glu Gly Gly Arg Leu Glu Thr Ile Leu Gly Trp Pro
465 470 475 480
Leu Ala Glu Arg Thr Val Val Ile Pro Ser Ala Ile Pro Thr Asp Pro
485 490 495
Arg Asn Val Gly Gly Asp Leu Asp Pro Ser Ser Ile Pro Asp Lys Glu
500 505 510
Gln Ala Ile Ser Ala Leu Pro Asp Tyr Ala Ser Gln Pro Gly Lys Pro
515 520 525
Pro Arg Glu Asp Leu Lys
530
<210> 22
<211> 515
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 22
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Asn Phe Lys Phe Arg Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu Arg
130 135 140
Leu Arg Asp Met His His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Ser Ala Ser Gly Gly Pro Glu Gly Gly Ser Leu Ala
165 170 175
Ala Leu Thr Ala His Gln Ala Cys His Leu Pro Leu Glu Thr Phe Thr
180 185 190
Arg His Arg Gln Pro Arg Gly Trp Glu Gln Leu Glu Gln Cys Gly Tyr
195 200 205
Pro Val Gln Arg Leu Val Ala Leu Tyr Leu Ala Ala Arg Leu Ser Trp
210 215 220
Asn Gln Val Asp Gln Val Ile Ala Asn Ala Leu Ala Ser Pro Gly Ser
225 230 235 240
Gly Gly Asp Leu Gly Glu Ala Ile Arg Glu Ser Pro Glu Gln Ala Arg
245 250 255
Leu Ala Leu Thr Leu Ala Ala Ala Glu Ser Glu Arg Phe Val Arg Gln
260 265 270
Gly Thr Gly Asn Asp Glu Ala Gly Ala Ala Asn Gly Pro Ala Asp Ser
275 280 285
Gly Asp Ala Leu Leu Glu Arg Asn Tyr Pro Thr Gly Ala Glu Phe Leu
290 295 300
Gly Asp Gly Gly Asp Val Ser Phe Ser Thr Arg Gly Thr Gln Asn Trp
305 310 315 320
Thr Val Glu Arg Leu Leu Gln Ala His Arg Gln Leu Glu Glu Arg Gly
325 330 335
Tyr Val Phe Val Gly Tyr His Gly Thr Phe Leu Glu Ala Ala Gln Ser
340 345 350
Ile Val Phe Gly Gly Val Arg Ala Arg Ser Gln Asp Leu Asp Ala Ile
355 360 365
Trp Ala Gly Phe Tyr Ile Ala Gly Asp Pro Ala Leu Ala Tyr Gly Tyr
370 375 380
Ala Gln Asp Gln Glu Pro Asp Ala Ala Gly Arg Ile Arg Asn Gly Ala
385 390 395 400
Leu Leu Arg Val Tyr Val Pro Arg Ser Ser Leu Pro Gly Phe Tyr Ala
405 410 415
Thr Ser Leu Thr Leu Ala Ala Pro Glu Ala Ala Gly Glu Val Glu Arg
420 425 430
Leu Ile Gly His Pro Leu Pro Leu Arg Leu Asp Ala Ile Thr Gly Pro
435 440 445
Glu Glu Ser Gly Gly Arg Leu Glu Thr Ile Leu Gly Trp Pro Leu Ala
450 455 460
Glu Arg Thr Val Val Ile Pro Ser Ala Ile Pro Thr Asp Pro Arg Asn
465 470 475 480
Val Gly Gly Asp Leu Asp Pro Ser Ser Ile Pro Asp Ser Glu Gln Ala
485 490 495
Ile Ser Ala Leu Pro Asp Tyr Ala Ser Gln Pro Gly Lys Pro Pro Lys
500 505 510
Asp Glu Leu
515
<210> 23
<211> 528
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 23
Pro Gln Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn
1 5 10 15
Thr Leu Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys
20 25 30
Ile Asn Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn
35 40 45
Leu His Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr
50 55 60
Tyr Ile Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu
65 70 75 80
Asn Thr Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr
85 90 95
Ser Tyr Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys
100 105 110
Trp Ser Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly
115 120 125
Ile Phe Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn
130 135 140
Glu His Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe
145 150 155 160
Leu Val Gly Gly Gly Gly Ser Ala Ser Gly Cys Gly Pro Glu Arg Lys
165 170 175
Lys Arg Ala Ser Gly Gly Pro Glu Gly Gly Ser Leu Ala Ala Leu Thr
180 185 190
Ala His Gln Ala Cys His Leu Pro Leu Glu Thr Phe Thr Arg His Arg
195 200 205
Gln Pro Arg Gly Trp Glu Gln Leu Glu Gln Cys Gly Tyr Pro Val Gln
210 215 220
Arg Leu Val Ala Leu Tyr Leu Ala Ala Arg Leu Ser Trp Asn Gln Val
225 230 235 240
Asp Gln Val Ile Ala Asn Ala Leu Ala Ser Pro Gly Ser Gly Gly Asp
245 250 255
Leu Gly Glu Ala Ile Arg Glu Ser Pro Glu Gln Ala Arg Leu Ala Leu
260 265 270
Thr Leu Ala Ala Ala Glu Ser Glu Arg Phe Val Arg Gln Gly Thr Gly
275 280 285
Asn Asp Glu Ala Gly Ala Ala Asn Gly Pro Ala Asp Ser Gly Asp Ala
290 295 300
Leu Leu Glu Arg Asn Tyr Pro Thr Gly Ala Glu Phe Leu Gly Asp Gly
305 310 315 320
Gly Asp Val Ser Phe Ser Thr Arg Gly Thr Gln Asn Trp Thr Val Glu
325 330 335
Arg Leu Leu Gln Ala His Arg Gln Leu Glu Glu Arg Gly Tyr Val Phe
340 345 350
Val Gly Tyr His Gly Thr Phe Leu Glu Ala Ala Gln Ser Ile Val Phe
355 360 365
Gly Gly Val Arg Ala Arg Ser Gln Asp Leu Asp Ala Ile Trp Ala Gly
370 375 380
Phe Tyr Ile Ala Gly Asp Pro Ala Leu Ala Tyr Gly Tyr Ala Gln Asp
385 390 395 400
Gln Glu Pro Asp Ala Ala Gly Arg Ile Arg Asn Gly Ala Leu Leu Arg
405 410 415
Val Tyr Val Pro Arg Ser Ser Leu Pro Gly Phe Tyr Ala Thr Ser Leu
420 425 430
Thr Leu Ala Ala Pro Glu Ala Ala Gly Glu Val Glu Arg Leu Ile Gly
435 440 445
His Pro Leu Pro Leu Arg Leu Asp Ala Ile Thr Gly Pro Glu Glu Ser
450 455 460
Gly Gly Arg Leu Glu Thr Ile Leu Gly Trp Pro Leu Ala Glu Arg Thr
465 470 475 480
Val Val Ile Pro Ser Ala Ile Pro Thr Asp Pro Arg Asn Val Gly Gly
485 490 495
Asp Leu Asp Pro Ser Ser Ile Pro Asp Ser Glu Gln Ala Ile Ser Ala
500 505 510
Leu Pro Asp Tyr Ala Ser Gln Pro Gly Lys Pro Pro Lys Asp Glu Leu
515 520 525
<210> 24
<211> 526
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 24
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Ser Ala Ser Gly Cys Gly Pro Glu Arg Lys Lys Arg
165 170 175
Ala Ser Gly Gly Pro Glu Gly Gly Ser Leu Ala Ala Leu Thr Ala His
180 185 190
Gln Ala Cys His Leu Pro Leu Glu Thr Phe Thr Arg His Arg Gln Pro
195 200 205
Arg Gly Trp Glu Gln Leu Glu Gln Cys Gly Tyr Pro Val Gln Arg Leu
210 215 220
Val Ala Leu Tyr Leu Ala Ala Arg Leu Ser Trp Asn Gln Val Asp Gln
225 230 235 240
Val Ile Ala Asn Ala Leu Ala Ser Pro Gly Ser Gly Gly Asp Leu Gly
245 250 255
Glu Ala Ile Arg Glu Ser Pro Glu Gln Ala Arg Leu Ala Leu Thr Leu
260 265 270
Ala Ala Ala Glu Ser Glu Arg Phe Val Arg Gln Gly Thr Gly Asn Asp
275 280 285
Glu Ala Gly Ala Ala Asn Gly Pro Ala Asp Ser Gly Asp Ala Leu Leu
290 295 300
Glu Arg Asn Tyr Pro Thr Gly Ala Glu Phe Leu Gly Asp Gly Gly Asp
305 310 315 320
Val Ser Phe Ser Thr Arg Gly Thr Gln Asn Trp Thr Val Glu Arg Leu
325 330 335
Leu Gln Ala His Arg Gln Leu Glu Glu Arg Gly Tyr Val Phe Val Gly
340 345 350
Tyr His Gly Thr Phe Leu Glu Ala Ala Gln Ser Ile Val Phe Gly Gly
355 360 365
Val Arg Ala Arg Ser Gln Asp Leu Asp Ala Ile Trp Ala Gly Phe Tyr
370 375 380
Ile Ala Gly Asp Pro Ala Leu Ala Tyr Gly Tyr Ala Gln Asp Gln Glu
385 390 395 400
Pro Asp Ala Ala Gly Arg Ile Arg Asn Gly Ala Leu Leu Arg Val Tyr
405 410 415
Val Pro Arg Ser Ser Leu Pro Gly Phe Tyr Ala Thr Ser Leu Thr Leu
420 425 430
Ala Ala Pro Glu Ala Ala Gly Glu Val Glu Arg Leu Ile Gly His Pro
435 440 445
Leu Pro Leu Arg Leu Asp Ala Ile Thr Gly Pro Glu Glu Ser Gly Gly
450 455 460
Arg Leu Glu Thr Ile Leu Gly Trp Pro Leu Ala Glu Arg Thr Val Val
465 470 475 480
Ile Pro Ser Ala Ile Pro Thr Asp Pro Arg Asn Val Gly Gly Asp Leu
485 490 495
Asp Pro Ser Ser Ile Pro Asp Ser Glu Gln Ala Ile Ser Ala Leu Pro
500 505 510
Asp Tyr Ala Ser Gln Pro Gly Lys Pro Pro Lys Asp Glu Leu
515 520 525
<210> 25
<211> 423
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 25
Lys Glu Phe Thr Leu Asp Phe Ser Thr Ala Lys Thr Tyr Val Asp Ser
1 5 10 15
Leu Asn Val Ile Arg Ser Ala Ile Gly Thr Pro Leu Gln Thr Ile Ser
20 25 30
Ser Gly Gly Thr Ser Leu Leu Met Ile Asp Ser Gly Thr Gly Asp Asn
35 40 45
Leu Phe Ala Val Asp Val Arg Gly Ile Asp Pro Glu Glu Gly Arg Phe
50 55 60
Asn Asn Leu Arg Leu Ile Val Glu Arg Asn Asn Leu Tyr Val Thr Gly
65 70 75 80
Phe Val Asn Arg Thr Asn Asn Val Phe Tyr Arg Phe Ala Asp Phe Ser
85 90 95
His Val Thr Phe Pro Gly Thr Thr Ala Val Thr Leu Ser Gly Asp Ser
100 105 110
Ser Tyr Thr Thr Leu Gln Arg Val Ala Gly Ile Ser Arg Thr Gly Met
115 120 125
Gln Ile Asn Arg His Ser Leu Thr Thr Ser Tyr Leu Asp Leu Met Ser
130 135 140
His Ser Gly Thr Ser Leu Thr Gln Ser Val Ala Arg Ala Met Leu Arg
145 150 155 160
Phe Val Thr Val Thr Ala Glu Ala Leu Arg Phe Arg Gln Ile Gln Arg
165 170 175
Gly Phe Arg Thr Thr Leu Asp Asp Leu Ser Gly Arg Ser Tyr Val Met
180 185 190
Thr Ala Glu Asp Val Asp Leu Thr Leu Asn Trp Gly Arg Leu Ser Ser
195 200 205
Val Leu Pro Asp Tyr His Gly Gln Asp Ser Val Arg Val Gly Arg Ile
210 215 220
Ser Phe Gly Ser Ile Asn Ala Ile Leu Gly Ser Val Ala Leu Ile Leu
225 230 235 240
Asn Ser His His Ala Ser Gly Gly Gly Gly Ser Arg Val Lys Arg Val
245 250 255
Arg Glu Arg Gly Pro Gln Arg Val Ala Ala His Ile Thr Gly Thr Arg
260 265 270
Gly Arg Ser Asn Thr Leu Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala
275 280 285
Leu Gly Arg Lys Ile Asn Ser Trp Glu Ser Ser Arg Ser Gly His Ser
290 295 300
Phe Leu Ser Asn Leu His Leu Arg Asn Gly Glu Leu Val Ile His Glu
305 310 315 320
Lys Gly Phe Tyr Tyr Ile Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu
325 330 335
Glu Ile Lys Glu Asn Thr Lys Asn Asp Lys Gln Met Val Gln Tyr Ile
340 345 350
Tyr Lys Tyr Thr Ser Tyr Pro Asp Pro Ile Leu Leu Met Lys Ser Ala
355 360 365
Arg Asn Ser Cys Trp Ser Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile
370 375 380
Tyr Gln Gly Gly Ile Phe Glu Leu Lys Glu Asn Asp Arg Ile Phe Val
385 390 395 400
Ser Val Thr Asn Glu His Leu Ile Asp Met Asp His Glu Ala Ser Phe
405 410 415
Phe Gly Ala Phe Leu Val Gly
420
<210> 26
<211> 432
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 26
Gln Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr
1 5 10 15
Leu Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile
20 25 30
Asn Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu
35 40 45
His Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr
50 55 60
Ile Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn
65 70 75 80
Thr Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser
85 90 95
Tyr Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp
100 105 110
Ser Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile
115 120 125
Phe Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu
130 135 140
His Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu
145 150 155 160
Val Gly Gly Gly Gly Ser Ala Ser Gly Cys Gly Pro Glu Arg Lys Lys
165 170 175
Arg Gly Gly Gly Gly Ser Lys Glu Phe Thr Leu Asp Phe Ser Thr Ala
180 185 190
Lys Thr Tyr Val Asp Ser Leu Asn Val Ile Arg Ser Ala Ile Gly Thr
195 200 205
Pro Leu Gln Thr Ile Ser Ser Gly Gly Thr Ser Leu Leu Met Ile Asp
210 215 220
Ser Gly Thr Gly Asp Asn Leu Phe Ala Val Asp Val Arg Gly Ile Asp
225 230 235 240
Pro Glu Glu Gly Arg Phe Asn Asn Leu Arg Leu Ile Val Glu Arg Asn
245 250 255
Asn Leu Tyr Val Thr Gly Phe Val Asn Arg Thr Asn Asn Val Phe Tyr
260 265 270
Arg Phe Ala Asp Phe Ser His Val Thr Phe Pro Gly Thr Thr Ala Val
275 280 285
Thr Leu Ser Gly Asp Ser Ser Tyr Thr Thr Leu Gln Arg Val Ala Gly
290 295 300
Ile Ser Arg Thr Gly Met Gln Ile Asn Arg His Ser Leu Thr Thr Ser
305 310 315 320
Tyr Leu Asp Leu Met Ser His Ser Gly Thr Ser Leu Thr Gln Ser Val
325 330 335
Ala Arg Ala Met Leu Arg Phe Val Thr Val Thr Ala Glu Ala Leu Arg
340 345 350
Phe Arg Gln Ile Gln Arg Gly Phe Arg Thr Thr Leu Asp Asp Leu Ser
355 360 365
Gly Arg Ser Tyr Val Met Thr Ala Glu Asp Val Asp Leu Thr Leu Asn
370 375 380
Trp Gly Arg Leu Ser Ser Val Leu Pro Asp Tyr His Gly Gln Asp Ser
385 390 395 400
Val Arg Val Gly Arg Ile Ser Phe Gly Ser Ile Asn Ala Ile Leu Gly
405 410 415
Ser Val Ala Leu Ile Leu Asn Ser His His Ala Ser Lys Asp Glu Leu
420 425 430
<210> 27
<211> 338
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 27
Ala Thr Trp Thr Cys Ile Asn Gln Gln Leu Asn Pro Lys Thr Asn Lys
1 5 10 15
Trp Glu Asp Lys Arg Leu Leu Tyr Ser Gln Ala Lys Ala Glu Ser Asn
20 25 30
Ser His His Ala Pro Leu Ser Asp Gly Lys Thr Gly Ser Ser Tyr Pro
35 40 45
His Trp Phe Thr Asn Gly Tyr Asp Gly Asn Gly Lys Leu Ile Lys Gly
50 55 60
Arg Thr Pro Ile Lys Phe Gly Lys Ala Asp Cys Asp Arg Pro Pro Lys
65 70 75 80
His Ser Gln Asn Gly Met Gly Lys Asp Asp His Tyr Leu Leu Glu Phe
85 90 95
Pro Thr Phe Pro Asp Gly His Asp Tyr Lys Phe Asp Ser Lys Lys Pro
100 105 110
Lys Glu Asp Pro Gly Pro Ala Arg Val Ile Tyr Thr Tyr Pro Asn Lys
115 120 125
Val Phe Cys Gly Ile Val Ala His Gln Arg Gly Asn Gln Gly Asp Leu
130 135 140
Arg Leu Cys Ser His Gly Gly Gly Gly Ser Gly Gly Gly Gly Ser Arg
145 150 155 160
Lys Lys Arg Ala Ser Gly Cys Gly Pro Glu Val Arg Glu Arg Gly Pro
165 170 175
Gln Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr
180 185 190
Leu Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile
195 200 205
Asn Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu
210 215 220
His Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr
225 230 235 240
Ile Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn
245 250 255
Thr Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser
260 265 270
Tyr Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp
275 280 285
Ser Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile
290 295 300
Phe Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu
305 310 315 320
His Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu
325 330 335
Val Gly
<210> 28
<211> 335
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 28
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Gly Ser Ala Ser Gly Cys Gly Pro Glu Arg Lys Lys
165 170 175
Arg Gly Gly Gly Gly Ser Ala Thr Trp Thr Cys Ile Asn Gln Gln Leu
180 185 190
Asn Pro Lys Thr Asn Lys Trp Glu Asp Lys Arg Leu Leu Tyr Ser Gln
195 200 205
Ala Lys Ala Glu Ser Asn Ser His His Ala Pro Leu Ser Asp Gly Lys
210 215 220
Thr Gly Ser Ser Tyr Pro His Trp Phe Thr Asn Gly Tyr Asp Gly Asn
225 230 235 240
Gly Lys Leu Ile Lys Gly Arg Thr Pro Ile Lys Phe Gly Lys Ala Asp
245 250 255
Cys Asp Arg Pro Pro Lys His Ser Gln Asn Gly Met Gly Lys Asp Asp
260 265 270
His Tyr Leu Leu Glu Phe Pro Thr Phe Pro Asp Gly His Asp Tyr Lys
275 280 285
Phe Asp Ser Lys Lys Pro Lys Glu Asp Pro Gly Pro Ala Arg Val Ile
290 295 300
Tyr Thr Tyr Pro Asn Lys Val Phe Cys Gly Ile Val Ala His Gln Arg
305 310 315 320
Gly Asn Gln Gly Asp Leu Arg Leu Cys Ser His Lys Asp Glu Leu
325 330 335
<210> 29
<211> 319
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 29
Ala Pro Ile Val Thr Cys Arg Pro Lys Leu Asp Gly Arg Glu Lys Pro
1 5 10 15
Phe Lys Val Asp Val Ala Thr Ala Gln Ala Gln Ala Arg Lys Ala Gly
20 25 30
Leu Thr Thr Gly Lys Ser Gly Asp Pro His Arg Tyr Phe Ala Gly Asp
35 40 45
His Ile Arg Trp Gly Val Asn Asn Cys Asp Lys Ala Asp Ala Ile Leu
50 55 60
Trp Glu Tyr Pro Ile Tyr Trp Val Gly Lys Asn Ala Glu Trp Ala Lys
65 70 75 80
Asp Val Lys Thr Ser Gln Gln Lys Gly Gly Pro Thr Pro Ile Arg Val
85 90 95
Val Tyr Ala Asn Ser Arg Gly Ala Val Gln Tyr Cys Gly Val Met Thr
100 105 110
His Ser Lys Val Asp Lys Asn Asn Gln Gly Lys Glu Phe Phe Glu Lys
115 120 125
Cys Asp Gly Gly Gly Gly Ser Gly Gly Gly Gly Ser Arg Lys Lys Arg
130 135 140
Ala Ser Gly Cys Gly Pro Glu Val Arg Glu Arg Gly Pro Gln Arg Val
145 150 155 160
Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu Ser Ser
165 170 175
Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn Ser Trp
180 185 190
Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His Leu Arg
195 200 205
Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile Tyr Ser
210 215 220
Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr Lys Asn
225 230 235 240
Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr Pro Asp
245 250 255
Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser Lys Asp
260 265 270
Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe Glu Leu
275 280 285
Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His Leu Ile
290 295 300
Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val Gly
305 310 315
<210> 30
<211> 290
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 30
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Gly Ser Ala Ser Gly Cys Gly Pro Glu Arg Lys Lys
165 170 175
Arg Glu Arg Gly Glu Ile Trp Leu Val Ser Leu Asp Pro Thr Ala Gly
180 185 190
His Glu Gln Gln Gly Thr Arg Pro Val Leu Ile Val Thr Pro Ala Ala
195 200 205
Phe Asn Arg Val Thr Arg Leu Pro Val Val Val Pro Val Thr Ser Gly
210 215 220
Gly Asn Phe Ala Arg Thr Ala Gly Phe Ala Val Ser Leu Asp Gly Val
225 230 235 240
Gly Ile Arg Thr Thr Gly Val Val Arg Cys Asp Gln Pro Arg Thr Ile
245 250 255
Asp Met Lys Ala Arg Gly Gly Lys Arg Leu Glu Arg Val Pro Glu Thr
260 265 270
Ile Met Asn Glu Val Leu Gly Arg Leu Ser Thr Ile Leu Thr Lys Asp
275 280 285
Glu Leu
290
<210> 31
<211> 277
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 31
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Gly Ser Ala Ser Gly Cys Gly Pro Glu Arg Lys Lys
165 170 175
Arg Gln Phe Lys Val Tyr Thr Tyr Lys Arg Glu Ser Arg Tyr Arg Leu
180 185 190
Phe Val Asp Val Gln Ser Asp Ile Ile Asp Thr Pro Gly Arg Arg Met
195 200 205
Val Ile Pro Leu Ala Ser Ala Arg Leu Leu Ser Asp Lys Val Ser Arg
210 215 220
Glu Leu Tyr Pro Val Val His Ile Gly Asp Glu Ser Trp Arg Met Met
225 230 235 240
Thr Thr Asp Met Ala Ser Val Pro Val Ser Val Ile Gly Glu Glu Val
245 250 255
Ala Asp Leu Ser His Arg Glu Asn Asp Ile Lys Asn Ala Ile Asn Leu
260 265 270
Met Phe Trp Gly Ile
275
<210> 32
<211> 228
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 32
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Gly Ser Ala Ser Gly Cys Gly Pro Glu Arg Lys Lys
165 170 175
Arg Gln Phe Lys Val Tyr Thr Tyr Lys Gly Gly Ser Gly Gly Arg Leu
180 185 190
Leu Ser Asp Lys Val Ser Arg Glu Leu Gly Gly Ser Gly Gly Ser His
195 200 205
Arg Glu Asn Asp Ile Lys Asn Ala Ile Asn Leu Met Phe Trp Gly Ile
210 215 220
Lys Asp Glu Leu
225
<210> 33
<211> 275
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 33
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Gly Ser Ala Ser Gly Cys Gly Pro Glu Arg Lys Lys
165 170 175
Arg Ala Tyr Phe Leu Asp Phe Asp Glu Arg Ala Leu Lys Glu Trp Arg
180 185 190
Lys Leu Gly Ser Thr Val Arg Glu Gln Leu Lys Lys Lys Leu Val Glu
195 200 205
Val Leu Glu Ser Pro Arg Ile Glu Ala Asn Lys Leu Arg Gly Met Pro
210 215 220
Asp Cys Tyr Lys Ile Lys Leu Arg Ser Ser Gly Tyr Arg Leu Val Tyr
225 230 235 240
Gln Val Ile Asp Glu Lys Val Val Val Phe Val Ile Ser Val Gly Lys
245 250 255
Arg Glu Arg Ser Glu Val Tyr Ser Glu Ala Val Lys Arg Ile Leu Lys
260 265 270
Asp Glu Leu
275
<210> 34
<211> 271
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 34
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Gly Ser Ala Ser Gly Cys Gly Pro Glu Arg Lys Lys
165 170 175
Arg Pro Glu Leu Glu Trp Lys Ala Ala Ala Val Ala Asp Leu Leu Ala
180 185 190
Ile Val Asp Tyr Ile Ser Asp Asp Asn Pro Asp Ala Ala Phe Ala Leu
195 200 205
Met Glu Glu Ile Gln Asp Lys Val Ala Gln Leu Pro Ala His Pro Lys
210 215 220
Arg Cys Arg Pro Gly Arg Val Glu Gly Thr Arg Glu Leu Val Val Arg
225 230 235 240
Pro Asn Tyr Leu Val Val Tyr Ala Glu Thr Pro Ala Val Val Thr Ile
245 250 255
Leu Arg Val Leu His Ala Ala Gln Met Trp Pro Lys Asp Glu Leu
260 265 270
<210> 35
<211> 429
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 35
Gly Leu Asp Thr Val Ser Phe Ser Thr Lys Gly Ala Thr Tyr Ile Thr
1 5 10 15
Tyr Val Asn Phe Leu Asn Glu Leu Arg Val Lys Leu Lys Pro Glu Gly
20 25 30
Asn Ser His Gly Ile Pro Leu Leu Arg Lys Lys Ala Asp Asp Pro Gly
35 40 45
Lys Ala Phe Val Leu Val Ala Leu Ser Asn Asp Asn Gly Gln Leu Ala
50 55 60
Glu Ile Ala Ile Asp Val Thr Ser Val Tyr Val Val Gly Tyr Gln Val
65 70 75 80
Arg Asn Arg Ser Tyr Phe Phe Lys Asp Ala Pro Asp Ala Ala Tyr Glu
85 90 95
Gly Leu Phe Lys Asn Thr Ile Lys Thr Arg Leu His Phe Gly Gly Ser
100 105 110
Tyr Pro Ser Leu Glu Gly Glu Lys Ala Tyr Arg Glu Thr Thr Asp Leu
115 120 125
Gly Ile Glu Pro Leu Arg Ile Gly Ile Lys Lys Leu Asp Glu Asn Ala
130 135 140
Ile Asp Asn Tyr Lys Pro Thr Glu Ile Ala Ser Ser Leu Leu Val Val
145 150 155 160
Ile Gln Met Val Ser Glu Ala Ala Arg Phe Thr Phe Ile Glu Asn Gln
165 170 175
Ile Arg Asn Asn Phe Gln Gln Arg Ile Arg Pro Ala Asn Asn Thr Ile
180 185 190
Ser Leu Glu Asn Lys Trp Gly Lys Leu Ser Phe Gln Ile Arg Thr Ser
195 200 205
Gly Ala Asn Gly Met Phe Ser Glu Ala Val Glu Leu Glu Arg Ala Asn
210 215 220
Gly Lys Lys Tyr Tyr Val Thr Ala Val Asp Gln Val Lys Pro Lys Ile
225 230 235 240
Ala Leu Leu Lys Phe Val Asp Lys Asp Pro Lys Gly Gly Gly Gly Ser
245 250 255
Gly Gly Gly Gly Ser Val Arg Glu Arg Gly Pro Gln Arg Val Ala Ala
260 265 270
His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu Ser Ser Pro Asn
275 280 285
Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn Ser Trp Glu Ser
290 295 300
Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His Leu Arg Asn Gly
305 310 315 320
Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile Tyr Ser Gln Thr
325 330 335
Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr Lys Asn Asp Lys
340 345 350
Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr Pro Asp Pro Ile
355 360 365
Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser Lys Asp Ala Glu
370 375 380
Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe Glu Leu Lys Glu
385 390 395 400
Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His Leu Ile Asp Met
405 410 415
Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val Gly
420 425
<210> 36
<211> 434
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 36
Gly Leu Asp Thr Val Ser Phe Ser Thr Lys Gly Ala Thr Tyr Ile Thr
1 5 10 15
Tyr Val Asn Phe Leu Asn Glu Leu Arg Val Lys Leu Lys Pro Glu Gly
20 25 30
Asn Ser His Gly Ile Pro Leu Leu Arg Lys Lys Ala Asp Asp Pro Gly
35 40 45
Lys Ala Phe Val Leu Val Ala Leu Ser Asn Asp Asn Gly Gln Leu Ala
50 55 60
Glu Ile Ala Ile Asp Val Thr Ser Val Tyr Val Val Gly Tyr Gln Val
65 70 75 80
Arg Asn Arg Ser Tyr Phe Phe Lys Asp Ala Pro Asp Ala Ala Tyr Glu
85 90 95
Gly Leu Phe Lys Asn Thr Ile Lys Thr Arg Leu His Phe Gly Gly Ser
100 105 110
Tyr Pro Ser Leu Glu Gly Glu Lys Ala Tyr Arg Glu Thr Thr Asp Leu
115 120 125
Gly Ile Glu Pro Leu Arg Ile Gly Ile Lys Lys Leu Asp Glu Asn Ala
130 135 140
Ile Asp Asn Tyr Lys Pro Thr Glu Ile Ala Ser Ser Leu Leu Val Val
145 150 155 160
Ile Gln Met Val Ser Glu Ala Ala Arg Phe Thr Phe Ile Glu Asn Gln
165 170 175
Ile Arg Asn Asn Phe Gln Gln Arg Ile Arg Pro Ala Asn Asn Thr Ile
180 185 190
Ser Leu Glu Asn Lys Trp Gly Lys Leu Ser Phe Gln Ile Arg Thr Ser
195 200 205
Gly Ala Asn Gly Met Phe Ser Glu Ala Val Glu Leu Glu Arg Ala Asn
210 215 220
Gly Lys Lys Tyr Tyr Val Thr Ala Val Asp Gln Val Lys Pro Lys Ile
225 230 235 240
Ala Leu Leu Lys Phe Val Asp Lys Asp Pro Lys Gly Gly Gly Gly Ser
245 250 255
Arg Lys Lys Arg Ala Ser Gly Cys Gly Pro Glu Gly Gly Gly Gly Ser
260 265 270
Gln Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr
275 280 285
Leu Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile
290 295 300
Asn Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu
305 310 315 320
His Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr
325 330 335
Ile Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn
340 345 350
Thr Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser
355 360 365
Tyr Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp
370 375 380
Ser Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile
385 390 395 400
Phe Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu
405 410 415
His Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu
420 425 430
Val Gly
<210> 37
<211> 427
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 37
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Ala Ser Gly Cys Gly Pro Glu Gly Gly Gly Gly Ser Gly Leu Asp
165 170 175
Thr Val Ser Phe Ser Thr Lys Gly Ala Thr Tyr Ile Thr Tyr Val Asn
180 185 190
Phe Leu Asn Glu Leu Arg Val Lys Leu Lys Pro Glu Gly Asn Ser His
195 200 205
Gly Ile Pro Leu Leu Arg Lys Lys Ala Asp Asp Pro Gly Lys Ala Phe
210 215 220
Val Leu Val Ala Leu Ser Asn Asp Asn Gly Gln Leu Ala Glu Ile Ala
225 230 235 240
Ile Asp Val Thr Ser Val Tyr Val Val Gly Tyr Gln Val Arg Asn Arg
245 250 255
Ser Tyr Phe Phe Lys Asp Ala Pro Asp Ala Ala Tyr Glu Gly Leu Phe
260 265 270
Lys Asn Thr Ile Lys Thr Arg Leu His Phe Gly Gly Ser Tyr Pro Ser
275 280 285
Leu Glu Gly Glu Lys Ala Tyr Arg Glu Thr Thr Asp Leu Gly Ile Glu
290 295 300
Pro Leu Arg Ile Gly Ile Lys Lys Leu Asp Glu Asn Ala Ile Asp Asn
305 310 315 320
Tyr Lys Pro Thr Glu Ile Ala Ser Ser Leu Leu Val Val Ile Gln Met
325 330 335
Val Ser Glu Ala Ala Arg Phe Thr Phe Ile Glu Asn Gln Ile Arg Asn
340 345 350
Asn Phe Gln Gln Arg Ile Arg Pro Ala Asn Asn Thr Ile Ser Leu Glu
355 360 365
Asn Lys Trp Gly Lys Leu Ser Phe Gln Ile Arg Thr Ser Gly Ala Asn
370 375 380
Gly Met Phe Ser Glu Ala Val Glu Leu Glu Arg Ala Asn Gly Lys Lys
385 390 395 400
Tyr Tyr Val Thr Ala Val Asp Gln Val Lys Pro Lys Ile Ala Leu Leu
405 410 415
Lys Phe Val Asp Lys Asp Pro Lys Asp Glu Leu
420 425
<210> 38
<211> 433
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 38
Gly Leu Asp Thr Val Ser Phe Ser Thr Lys Gly Ala Thr Tyr Ile Thr
1 5 10 15
Tyr Val Asn Phe Leu Asn Glu Leu Arg Val Lys Leu Lys Pro Glu Gly
20 25 30
Asn Ser His Gly Ile Pro Leu Leu Arg Lys Lys Ala Asp Asp Pro Gly
35 40 45
Lys Ala Phe Val Leu Val Ala Leu Ser Asn Asp Asn Gly Gln Leu Ala
50 55 60
Glu Ile Ala Ile Asp Val Thr Ser Val Tyr Val Val Gly Tyr Gln Val
65 70 75 80
Arg Asn Arg Ser Tyr Phe Phe Lys Asp Ala Pro Asp Ala Ala Tyr Glu
85 90 95
Gly Leu Phe Lys Asn Thr Ile Lys Thr Arg Leu His Phe Gly Gly Ser
100 105 110
Tyr Pro Ser Leu Glu Gly Glu Lys Ala Tyr Arg Glu Thr Thr Asp Leu
115 120 125
Gly Ile Glu Pro Leu Arg Ile Gly Ile Lys Lys Leu Asp Glu Asn Ala
130 135 140
Ile Asp Asn Tyr Lys Pro Thr Glu Ile Ala Ser Ser Leu Leu Val Val
145 150 155 160
Ile Gln Met Val Ser Glu Ala Ala Arg Phe Thr Phe Ile Glu Asn Gln
165 170 175
Ile Arg Asn Asn Phe Gln Gln Arg Ile Arg Pro Ala Asn Asn Thr Ile
180 185 190
Ser Leu Glu Asn Lys Trp Gly Lys Leu Ser Phe Gln Ile Arg Thr Ser
195 200 205
Gly Ala Asn Gly Met Phe Ser Glu Ala Val Glu Leu Glu Arg Ala Asn
210 215 220
Gly Lys Lys Tyr Tyr Val Thr Ala Val Asp Gln Val Lys Pro Lys Ile
225 230 235 240
Ala Leu Leu Lys Phe Val Asp Lys Asp Pro Lys Gly Gly Gly Gly Ser
245 250 255
Arg Lys Lys Arg Ala Ser Gly Cys Gly Pro Glu Gly Gly Gly Gly Ser
260 265 270
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
275 280 285
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
290 295 300
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
305 310 315 320
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
325 330 335
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
340 345 350
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
355 360 365
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
370 375 380
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
385 390 395 400
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
405 410 415
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
420 425 430
Gly
<210> 39
<211> 558
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 39
Gly Ala Asp Asp Val Val Asp Ser Ser Lys Ser Phe Val Met Glu Asn
1 5 10 15
Phe Ser Ser Tyr His Gly Thr Lys Pro Gly Tyr Val Asp Ser Ile Gln
20 25 30
Lys Gly Ile Gln Lys Pro Lys Ser Gly Thr Gln Gly Asn Tyr Asp Asp
35 40 45
Asp Trp Lys Gly Phe Tyr Ser Thr Asp Asn Lys Tyr Asp Ala Ala Gly
50 55 60
Tyr Ser Val Asp Asn Glu Asn Pro Leu Ser Gly Lys Ala Gly Gly Val
65 70 75 80
Val Lys Val Thr Tyr Pro Gly Leu Thr Lys Val Leu Ala Leu Lys Val
85 90 95
Asp Asn Ala Glu Thr Ile Lys Lys Glu Leu Gly Leu Ser Leu Thr Glu
100 105 110
Pro Leu Met Glu Gln Val Gly Thr Glu Glu Phe Ile Lys Arg Phe Gly
115 120 125
Asp Gly Ala Ser Arg Val Val Leu Ser Leu Pro Phe Ala Glu Gly Ser
130 135 140
Ser Ser Val Glu Tyr Ile Asn Asn Trp Glu Gln Ala Lys Ala Leu Ser
145 150 155 160
Val Glu Leu Glu Ile Asn Phe Glu Thr Arg Gly Lys Arg Gly Gln Asp
165 170 175
Ala Met Tyr Glu Tyr Met Ala Gln Ala Cys Ala Gly Asn Arg Val Arg
180 185 190
Arg Ser Val Gly Ser Ser Leu Ser Cys Ile Asn Leu Asp Trp Asp Val
195 200 205
Ile Arg Asp Lys Thr Lys Thr Lys Ile Glu Ser Leu Lys Glu His Gly
210 215 220
Pro Ile Lys Asn Lys Met Ser Glu Ser Pro Asn Lys Thr Val Ser Glu
225 230 235 240
Glu Lys Ala Lys Gln Tyr Leu Glu Glu Phe His Gln Thr Ala Leu Glu
245 250 255
His Pro Glu Leu Ser Glu Leu Lys Thr Val Thr Gly Thr Asn Pro Val
260 265 270
Phe Ala Gly Ala Asn Tyr Ala Ala Trp Ala Val Asn Val Ala Gln Val
275 280 285
Ile Asp Ser Glu Thr Ala Asp Asn Leu Glu Lys Thr Thr Ala Ala Leu
290 295 300
Ser Ile Leu Pro Gly Ile Gly Ser Val Met Gly Ile Ala Asp Gly Ala
305 310 315 320
Val His His Asn Thr Glu Glu Ile Val Ala Gln Ser Ile Ala Leu Ser
325 330 335
Ser Leu Met Val Ala Gln Ala Ile Pro Leu Val Gly Glu Leu Val Asp
340 345 350
Ile Gly Phe Ala Ala Tyr Asn Phe Val Glu Ser Ile Ile Asn Leu Phe
355 360 365
Gln Val Val His Asn Ser Tyr Asn Arg Pro Ala Tyr Ser Pro Gly His
370 375 380
Lys Thr His Gly Gly Gly Gly Ser Gly Gly Gly Gly Ser Arg Val Ala
385 390 395 400
Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu Ser Ser Pro
405 410 415
Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn Ser Trp Glu
420 425 430
Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His Leu Arg Asn
435 440 445
Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile Tyr Ser Gln
450 455 460
Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr Lys Asn Asp
465 470 475 480
Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr Pro Asp Pro
485 490 495
Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser Lys Asp Ala
500 505 510
Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe Glu Leu Lys
515 520 525
Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His Leu Ile Asp
530 535 540
Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val Gly
545 550 555
<210> 40
<211> 481
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 40
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Ser Gly Gly Gly Gly Ser Arg Lys Lys Arg Pro Glu
165 170 175
Gly Gly Ser Leu Ala Ala Leu Thr Ala His Gln Ala Cys His Leu Pro
180 185 190
Leu Glu Thr Phe Thr Arg His Arg Gln Pro Arg Gly Trp Glu Gln Leu
195 200 205
Glu Gln Cys Gly Tyr Pro Val Gln Arg Leu Val Ala Leu Tyr Leu Ala
210 215 220
Ala Arg Leu Ser Trp Asn Gln Val Asp Gln Val Ile Arg Asn Ala Leu
225 230 235 240
Ala Ser Pro Gly Ser Gly Gly Asp Leu Gly Glu Ala Ile Arg Glu Gln
245 250 255
Pro Glu Gln Ala Arg Leu Ala Leu Thr Leu Ala Ala Ala Glu Ser Glu
260 265 270
Arg Phe Val Arg Gln Gly Thr Gly Asn Gly Gly Gly Gly Ala Asp Asp
275 280 285
Val Val Asp Ser Ser Lys Ser Phe Val Met Glu Asn Phe Ser Ser Tyr
290 295 300
His Gly Thr Lys Pro Gly Tyr Val Asp Ser Ile Gln Lys Gly Ile Gln
305 310 315 320
Lys Pro Lys Ser Gly Thr Gln Gly Asn Tyr Asp Asp Asp Trp Lys Gly
325 330 335
Phe Tyr Ser Thr Asp Asn Lys Tyr Asp Ala Ala Gly Tyr Ser Val Asp
340 345 350
Asn Glu Asn Pro Leu Ser Gly Lys Ala Gly Gly Val Val Lys Val Thr
355 360 365
Tyr Pro Gly Leu Thr Lys Val Leu Ala Leu Lys Val Asp Asn Ala Glu
370 375 380
Thr Ile Lys Lys Glu Leu Gly Leu Ser Leu Thr Glu Pro Leu Met Glu
385 390 395 400
Gln Val Gly Thr Glu Glu Phe Ile Lys Arg Phe Gly Asp Gly Ala Ser
405 410 415
Arg Val Val Leu Ser Leu Pro Phe Ala Glu Gly Ser Ser Ser Val Glu
420 425 430
Tyr Ile Asn Asn Trp Glu Gln Ala Lys Ala Leu Ser Val Glu Leu Glu
435 440 445
Ile Asn Phe Glu Thr Arg Gly Lys Arg Gly Gln Asp Ala Met Tyr Glu
450 455 460
Tyr Met Ala Gln Ala Cys Ala Gly Asn Arg Val Arg Arg Lys Asp Glu
465 470 475 480
Leu
<210> 41
<211> 481
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 41
Gly Ala Asp Asp Val Val Asp Ser Ser Lys Ser Phe Val Met Glu Asn
1 5 10 15
Phe Ser Ser Tyr His Gly Thr Lys Pro Gly Tyr Val Asp Ser Ile Gln
20 25 30
Lys Gly Ile Gln Lys Pro Lys Ser Gly Thr Gln Gly Asn Tyr Asp Asp
35 40 45
Asp Trp Lys Gly Phe Tyr Ser Thr Asp Asn Lys Tyr Asp Ala Ala Gly
50 55 60
Tyr Ser Val Asp Asn Glu Asn Pro Leu Ser Gly Lys Ala Gly Gly Val
65 70 75 80
Val Lys Val Thr Tyr Pro Gly Leu Thr Lys Val Leu Ala Leu Lys Val
85 90 95
Asp Asn Ala Glu Thr Ile Lys Lys Glu Leu Gly Leu Ser Leu Thr Glu
100 105 110
Pro Leu Met Glu Gln Val Gly Thr Glu Glu Phe Ile Lys Arg Phe Gly
115 120 125
Asp Gly Ala Ser Arg Val Val Leu Ser Leu Pro Phe Ala Glu Gly Ser
130 135 140
Ser Ser Val Glu Tyr Ile Asn Asn Trp Glu Gln Ala Lys Ala Leu Ser
145 150 155 160
Val Glu Leu Glu Ile Asn Phe Glu Thr Arg Gly Lys Arg Gly Gln Asp
165 170 175
Ala Met Tyr Glu Tyr Met Ala Gln Ala Cys Ala Gly Asn Arg Lys Lys
180 185 190
Arg Gly Gly Gly Gly Ser Pro Glu Gly Gly Ser Leu Ala Ala Leu Thr
195 200 205
Ala His Gln Ala Cys His Leu Pro Leu Glu Thr Phe Thr Arg His Arg
210 215 220
Gln Pro Arg Gly Trp Glu Gln Leu Glu Gln Cys Gly Tyr Pro Val Gln
225 230 235 240
Arg Leu Val Ala Leu Tyr Leu Ala Ala Arg Leu Ser Trp Asn Gln Val
245 250 255
Asp Gln Val Ile Arg Asn Ala Leu Ala Ser Pro Gly Ser Gly Gly Asp
260 265 270
Leu Gly Glu Ala Ile Arg Glu Gln Pro Glu Gln Ala Arg Leu Ala Leu
275 280 285
Thr Leu Ala Ala Ala Glu Ser Glu Arg Phe Val Arg Gln Gly Thr Gly
290 295 300
Asn Gly Arg Lys Lys Arg Gly Gly Gly Gly Ser Gly Gly Gly Gly Ser
305 310 315 320
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
325 330 335
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
340 345 350
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
355 360 365
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
370 375 380
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
385 390 395 400
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
405 410 415
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
420 425 430
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
435 440 445
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
450 455 460
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
465 470 475 480
Gly
<210> 42
<211> 433
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 42
Ala Arg His Met Glu Asp Arg Pro Ile Lys Phe Ser Thr Glu Gly Ala
1 5 10 15
Thr Ser Gln Ser Tyr Lys Gln Phe Ile Glu Ala Leu Arg Glu Arg Leu
20 25 30
Arg Gly Gly Leu Ile His Asp Ile Pro Val Leu Pro Asp Pro Thr Thr
35 40 45
Leu Gln Glu Arg Asn Arg Tyr Ile Thr Val Glu Leu Ser Asn Ser Asp
50 55 60
Thr Glu Ser Ile Glu Val Gly Ile Asp Val Thr Asn Ala Tyr Val Val
65 70 75 80
Ala Tyr Arg Ala Gly Thr Gln Ser Tyr Phe Leu Arg Asp Ala Pro Ser
85 90 95
Ser Ala Ser Asp Tyr Leu Phe Thr Gly Thr Asp Gln His Ser Leu Pro
100 105 110
Phe Tyr Gly Thr Tyr Gly Asp Leu Glu Arg Trp Ala His Gln Ser Arg
115 120 125
Gln Gln Ile Pro Leu Gly Leu Gln Ala Leu Thr His Gly Ile Ser Phe
130 135 140
Phe Arg Ser Gly Gly Asn Asp Asn Glu Glu Lys Ala Arg Thr Leu Ile
145 150 155 160
Val Ile Ile Gln Met Val Ala Glu Ala Ala Arg Phe Arg Tyr Ile Ser
165 170 175
Asn Arg Val Arg Val Ser Ile Gln Thr Gly Thr Ala Phe Gln Pro Asp
180 185 190
Ala Ala Met Ile Ser Leu Glu Asn Asn Trp Asp Asn Leu Ser Arg Gly
195 200 205
Val Gln Glu Ser Val Gln Asp Thr Phe Pro Asn Gln Val Thr Leu Thr
210 215 220
Asn Ile Arg Asn Glu Pro Val Ile Val Asp Ser Leu Ser His Pro Thr
225 230 235 240
Val Ala Val Leu Ala Leu Met Leu Phe Val Cys Asn Pro Pro Asn Gly
245 250 255
Gly Gly Gly Ser Gly Gly Gly Gly Ser Val Arg Glu Arg Gly Pro Gln
260 265 270
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
275 280 285
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
290 295 300
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
305 310 315 320
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
325 330 335
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
340 345 350
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
355 360 365
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
370 375 380
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
385 390 395 400
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
405 410 415
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
420 425 430
Gly
<210> 43
<211> 447
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 43
Ala Arg His Met Glu Asp Arg Pro Ile Lys Phe Ser Thr Glu Gly Ala
1 5 10 15
Thr Ser Gln Ser Tyr Lys Gln Phe Ile Glu Ala Leu Arg Glu Arg Leu
20 25 30
Arg Gly Gly Leu Ile His Asp Ile Pro Val Leu Pro Asp Pro Thr Thr
35 40 45
Leu Gln Glu Arg Asn Arg Tyr Ile Thr Val Glu Leu Ser Asn Ser Asp
50 55 60
Thr Glu Ser Ile Glu Val Gly Ile Asp Val Thr Asn Ala Tyr Val Val
65 70 75 80
Ala Tyr Arg Ala Gly Thr Gln Ser Tyr Phe Leu Arg Asp Ala Pro Ser
85 90 95
Ser Ala Ser Asp Tyr Leu Phe Thr Gly Thr Asp Gln His Ser Leu Pro
100 105 110
Phe Tyr Gly Thr Tyr Gly Asp Leu Glu Arg Trp Ala His Gln Ser Arg
115 120 125
Gln Gln Ile Pro Leu Gly Leu Gln Ala Leu Thr His Gly Ile Ser Phe
130 135 140
Phe Arg Ser Gly Gly Asn Asp Asn Glu Glu Lys Ala Arg Thr Leu Ile
145 150 155 160
Val Ile Ile Gln Met Val Ala Glu Ala Ala Arg Phe Arg Tyr Ile Ser
165 170 175
Asn Arg Val Arg Val Ser Ile Gln Thr Gly Thr Ala Phe Gln Pro Asp
180 185 190
Ala Ala Met Ile Ser Leu Glu Asn Asn Trp Asp Asn Leu Ser Arg Gly
195 200 205
Val Gln Glu Ser Val Gln Asp Thr Phe Pro Asn Gln Val Thr Leu Thr
210 215 220
Asn Ile Arg Asn Glu Pro Val Ile Val Asp Ser Leu Ser His Pro Thr
225 230 235 240
Val Ala Val Leu Ala Leu Met Leu Phe Val Cys Asn Pro Pro Asn Gly
245 250 255
Gly Gly Gly Ser Cys Phe Cys Asp Gly Arg Cys Asp Cys Ala Arg Val
260 265 270
Val Arg Gly Gly Gly Gly Ser Val Arg Glu Arg Gly Pro Gln Arg Val
275 280 285
Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu Ser Ser
290 295 300
Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn Ser Trp
305 310 315 320
Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His Leu Arg
325 330 335
Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile Tyr Ser
340 345 350
Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr Lys Asn
355 360 365
Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr Pro Asp
370 375 380
Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser Lys Asp
385 390 395 400
Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe Glu Leu
405 410 415
Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His Leu Ile
420 425 430
Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val Gly
435 440 445
<210> 44
<211> 433
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 44
Glu Asp Arg Pro Ile Lys Phe Ser Thr Glu Gly Ala Thr Ser Gln Ser
1 5 10 15
Tyr Lys Gln Phe Ile Glu Ala Leu Arg Glu Arg Leu Arg Gly Gly Leu
20 25 30
Ile His Asp Ile Pro Val Leu Pro Asp Pro Thr Thr Leu Gln Glu Arg
35 40 45
Asn Arg Tyr Ile Thr Val Glu Leu Ser Asn Ser Asp Thr Glu Ser Ile
50 55 60
Glu Val Gly Ile Asp Val Thr Asn Ala Tyr Val Val Ala Tyr Arg Ala
65 70 75 80
Gly Thr Gln Ser Tyr Phe Leu Arg Asp Ala Pro Ser Ser Ala Ser Asp
85 90 95
Tyr Leu Phe Thr Gly Thr Asp Gln His Ser Leu Pro Phe Tyr Gly Thr
100 105 110
Tyr Gly Asp Leu Glu Arg Trp Ala His Gln Ser Arg Gln Gln Ile Pro
115 120 125
Leu Gly Leu Gln Ala Leu Thr His Gly Ile Ser Phe Phe Arg Ser Gly
130 135 140
Gly Asn Asp Asn Glu Glu Lys Ala Arg Thr Leu Ile Val Ile Ile Gln
145 150 155 160
Met Val Ala Glu Ala Ala Arg Phe Arg Tyr Ile Ser Asn Arg Val Arg
165 170 175
Val Ser Ile Gln Thr Gly Thr Ala Phe Gln Pro Asp Ala Ala Met Ile
180 185 190
Ser Leu Glu Asn Asn Trp Asp Asn Leu Ser Arg Gly Val Gln Glu Ser
195 200 205
Val Gln Asp Thr Phe Pro Asn Gln Val Thr Leu Thr Asn Ile Arg Asn
210 215 220
Glu Pro Val Ile Val Asp Ser Leu Ser His Pro Thr Val Ala Val Leu
225 230 235 240
Ala Leu Met Leu Phe Val Cys Asn Pro Pro Asn Gly Gly Gly Gly Ser
245 250 255
Gly Gly Gly Gly Ser Arg Val Val Arg Val Arg Glu Arg Gly Pro Gln
260 265 270
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
275 280 285
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
290 295 300
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
305 310 315 320
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
325 330 335
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
340 345 350
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
355 360 365
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
370 375 380
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
385 390 395 400
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
405 410 415
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
420 425 430
Gly
<210> 45
<211> 441
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 45
Glu Asp Arg Pro Ile Lys Phe Ser Thr Glu Gly Ala Thr Ser Gln Ser
1 5 10 15
Tyr Lys Gln Phe Ile Glu Ala Leu Arg Glu Arg Leu Arg Gly Gly Leu
20 25 30
Ile His Asp Ile Pro Val Leu Pro Asp Pro Thr Thr Leu Gln Glu Arg
35 40 45
Asn Arg Tyr Ile Thr Val Glu Leu Ser Asn Ser Asp Thr Glu Ser Ile
50 55 60
Glu Val Gly Ile Asp Val Thr Asn Ala Tyr Val Val Ala Tyr Arg Ala
65 70 75 80
Gly Thr Gln Ser Tyr Phe Leu Arg Asp Ala Pro Ser Ser Ala Ser Asp
85 90 95
Tyr Leu Phe Thr Gly Thr Asp Gln His Ser Leu Pro Phe Tyr Gly Thr
100 105 110
Tyr Gly Asp Leu Glu Arg Trp Ala His Gln Ser Arg Gln Gln Ile Pro
115 120 125
Leu Gly Leu Gln Ala Leu Thr His Gly Ile Ser Phe Phe Arg Ser Gly
130 135 140
Gly Asn Asp Asn Glu Glu Lys Ala Arg Thr Leu Ile Val Ile Ile Gln
145 150 155 160
Met Val Ala Glu Ala Ala Arg Phe Arg Tyr Ile Ser Asn Arg Val Arg
165 170 175
Val Ser Ile Gln Thr Gly Thr Ala Phe Gln Pro Asp Ala Ala Met Ile
180 185 190
Ser Leu Glu Asn Asn Trp Asp Asn Leu Ser Arg Gly Val Gln Glu Ser
195 200 205
Val Gln Asp Thr Phe Pro Asn Gln Val Thr Leu Thr Asn Ile Arg Asn
210 215 220
Glu Pro Val Ile Val Asp Ser Leu Ser His Pro Thr Val Ala Val Leu
225 230 235 240
Ala Leu Met Leu Phe Val Cys Asn Pro Pro Asn Arg Arg Arg Arg Arg
245 250 255
Arg Arg Arg Arg Val Val Arg Gly Gly Gly Gly Ser Gly Gly Gly Gly
260 265 270
Ser Val Arg Glu Arg Gly Pro Gln Arg Val Ala Ala His Ile Thr Gly
275 280 285
Thr Arg Gly Arg Ser Asn Thr Leu Ser Ser Pro Asn Ser Lys Asn Glu
290 295 300
Lys Ala Leu Gly Arg Lys Ile Asn Ser Trp Glu Ser Ser Arg Ser Gly
305 310 315 320
His Ser Phe Leu Ser Asn Leu His Leu Arg Asn Gly Glu Leu Val Ile
325 330 335
His Glu Lys Gly Phe Tyr Tyr Ile Tyr Ser Gln Thr Tyr Phe Arg Phe
340 345 350
Gln Glu Glu Ile Lys Glu Asn Thr Lys Asn Asp Lys Gln Met Val Gln
355 360 365
Tyr Ile Tyr Lys Tyr Thr Ser Tyr Pro Asp Pro Ile Leu Leu Met Lys
370 375 380
Ser Ala Arg Asn Ser Cys Trp Ser Lys Asp Ala Glu Tyr Gly Leu Tyr
385 390 395 400
Ser Ile Tyr Gln Gly Gly Ile Phe Glu Leu Lys Glu Asn Asp Arg Ile
405 410 415
Phe Val Ser Val Thr Asn Glu His Leu Ile Asp Met Asp His Glu Ala
420 425 430
Ser Phe Phe Gly Ala Phe Leu Val Gly
435 440
<210> 46
<211> 550
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 46
Val Arg Glu Arg Gly Pro Gln Arg Val Ala Ala His Ile Thr Gly Thr
1 5 10 15
Arg Gly Arg Ser Asn Thr Leu Ser Ser Pro Asn Ser Lys Asn Glu Lys
20 25 30
Ala Leu Gly Arg Lys Ile Asn Ser Trp Glu Ser Ser Arg Ser Gly His
35 40 45
Ser Phe Leu Ser Asn Leu His Leu Arg Asn Gly Glu Leu Val Ile His
50 55 60
Glu Lys Gly Phe Tyr Tyr Ile Tyr Ser Gln Thr Tyr Phe Arg Phe Gln
65 70 75 80
Glu Glu Ile Lys Glu Asn Thr Lys Asn Asp Lys Gln Met Val Gln Tyr
85 90 95
Ile Tyr Lys Tyr Thr Ser Tyr Pro Asp Pro Ile Leu Leu Met Lys Ser
100 105 110
Ala Arg Asn Ser Cys Trp Ser Lys Asp Ala Glu Tyr Gly Leu Tyr Ser
115 120 125
Ile Tyr Gln Gly Gly Ile Phe Glu Leu Lys Glu Asn Asp Arg Ile Phe
130 135 140
Val Ser Val Thr Asn Glu His Leu Ile Asp Met Asp His Glu Ala Ser
145 150 155 160
Phe Phe Gly Ala Phe Leu Val Gly Gly Gly Gly Gly Ser Gly Gly Gly
165 170 175
Gly Ser Arg Lys Lys Arg Pro Glu Gly Gly Ser Leu Ala Ala Leu Thr
180 185 190
Ala His Gln Ala Cys His Leu Pro Leu Glu Thr Phe Thr Arg His Arg
195 200 205
Gln Pro Arg Gly Trp Glu Gln Leu Glu Gln Cys Gly Tyr Pro Val Gln
210 215 220
Arg Leu Val Ala Leu Tyr Leu Ala Ala Arg Leu Ser Trp Asn Gln Val
225 230 235 240
Asp Gln Val Ile Arg Asn Ala Leu Ala Ser Pro Gly Ser Gly Gly Asp
245 250 255
Leu Gly Glu Ala Ile Arg Glu Gln Pro Glu Gln Ala Arg Leu Ala Leu
260 265 270
Thr Leu Ala Ala Ala Glu Ser Glu Arg Phe Val Arg Gln Gly Thr Gly
275 280 285
Asn Gly Gly Gly Gly Gly Ser Arg Lys Lys Arg Glu Asp Arg Pro Ile
290 295 300
Lys Phe Ser Thr Glu Gly Ala Thr Ser Gln Ser Tyr Lys Gln Phe Ile
305 310 315 320
Glu Ala Leu Arg Glu Arg Leu Arg Gly Gly Leu Ile His Asp Ile Pro
325 330 335
Val Leu Pro Asp Pro Thr Thr Leu Gln Glu Arg Asn Arg Tyr Ile Thr
340 345 350
Val Glu Leu Ser Asn Ser Asp Thr Glu Ser Ile Glu Val Gly Ile Asp
355 360 365
Val Thr Asn Ala Tyr Val Val Ala Tyr Arg Ala Gly Thr Gln Ser Tyr
370 375 380
Phe Leu Arg Asp Ala Pro Ser Ser Ala Ser Asp Tyr Leu Phe Thr Gly
385 390 395 400
Thr Asp Gln His Ser Leu Pro Phe Tyr Gly Thr Tyr Gly Asp Leu Glu
405 410 415
Arg Trp Ala His Gln Ser Arg Gln Gln Ile Pro Leu Gly Leu Gln Ala
420 425 430
Leu Thr His Gly Ile Ser Phe Phe Arg Ser Gly Gly Asn Asp Asn Glu
435 440 445
Glu Lys Ala Arg Thr Leu Ile Val Ile Ile Gln Met Val Ala Glu Ala
450 455 460
Ala Arg Phe Arg Tyr Ile Ser Asn Arg Val Arg Val Ser Ile Gln Thr
465 470 475 480
Gly Thr Ala Phe Gln Pro Asp Ala Ala Met Ile Ser Leu Glu Asn Asn
485 490 495
Trp Asp Asn Leu Ser Arg Gly Val Gln Glu Ser Val Gln Asp Thr Phe
500 505 510
Pro Asn Gln Val Thr Leu Thr Asn Ile Arg Asn Glu Pro Val Ile Val
515 520 525
Asp Ser Leu Ser His Pro Thr Val Ala Val Leu Ala Leu Met Leu Phe
530 535 540
Val Cys Asn Pro Pro Asn
545 550
<210> 47
<211> 459
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 47
Glu Asp Arg Pro Ile Lys Phe Ser Thr Glu Gly Ala Thr Ser Gln Ser
1 5 10 15
Tyr Lys Gln Phe Ile Glu Ala Leu Arg Glu Arg Leu Arg Gly Gly Leu
20 25 30
Ile His Asp Ile Pro Val Leu Pro Asp Pro Thr Thr Leu Gln Glu Arg
35 40 45
Asn Arg Tyr Ile Thr Val Glu Leu Ser Asn Ser Asp Thr Glu Ser Ile
50 55 60
Glu Val Gly Ile Asp Val Thr Asn Ala Tyr Val Val Ala Tyr Arg Ala
65 70 75 80
Gly Thr Gln Ser Tyr Phe Leu Arg Asp Ala Pro Ser Ser Ala Ser Asp
85 90 95
Tyr Leu Phe Thr Gly Thr Asp Gln His Ser Leu Pro Phe Tyr Gly Thr
100 105 110
Tyr Gly Asp Leu Glu Arg Trp Ala His Gln Ser Arg Gln Gln Ile Pro
115 120 125
Leu Gly Leu Gln Ala Leu Thr His Gly Ile Ser Phe Phe Arg Ser Gly
130 135 140
Gly Asn Asp Asn Glu Glu Lys Ala Arg Thr Leu Ile Val Ile Ile Gln
145 150 155 160
Met Val Ala Glu Ala Ala Arg Phe Arg Tyr Ile Ser Asn Arg Val Arg
165 170 175
Val Ser Ile Gln Thr Gly Thr Ala Phe Gln Pro Asp Ala Ala Met Ile
180 185 190
Ser Leu Glu Asn Asn Trp Asp Asn Leu Ser Arg Gly Val Gln Glu Ser
195 200 205
Val Gln Asp Thr Phe Pro Asn Gln Val Thr Leu Thr Asn Ile Arg Asn
210 215 220
Glu Pro Val Ile Val Asp Ser Leu Ser His Pro Thr Val Ala Val Leu
225 230 235 240
Ala Leu Met Leu Phe Val Cys Asn Pro Pro Asn Gly Gly Gly Gly Ser
245 250 255
Gly Gly Gly Gly Ser Arg Lys Lys Arg Ala Ser Gly Cys Gly Pro Glu
260 265 270
Thr Ser Glu Glu Thr Ile Ser Thr Val Gln Glu Lys Gln Gln Asn Ile
275 280 285
Ser Pro Leu Val Arg Glu Arg Gly Pro Gln Arg Val Ala Ala His Ile
290 295 300
Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu Ser Ser Pro Asn Ser Lys
305 310 315 320
Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn Ser Trp Glu Ser Ser Arg
325 330 335
Ser Gly His Ser Phe Leu Ser Asn Leu His Leu Arg Asn Gly Glu Leu
340 345 350
Val Ile His Glu Lys Gly Phe Tyr Tyr Ile Tyr Ser Gln Thr Tyr Phe
355 360 365
Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr Lys Asn Asp Lys Gln Met
370 375 380
Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr Pro Asp Pro Ile Leu Leu
385 390 395 400
Met Lys Ser Ala Arg Asn Ser Cys Trp Ser Lys Asp Ala Glu Tyr Gly
405 410 415
Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe Glu Leu Lys Glu Asn Asp
420 425 430
Arg Ile Phe Val Ser Val Thr Asn Glu His Leu Ile Asp Met Asp His
435 440 445
Glu Ala Ser Phe Phe Gly Ala Phe Leu Val Gly
450 455
<210> 48
<211> 443
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 48
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Gly Ser Ala Ser Gly Cys Gly Pro Glu Arg Lys Lys
165 170 175
Arg Gly Gly Gly Gly Ser Ala Arg His Met Glu Asp Arg Pro Ile Lys
180 185 190
Phe Ser Thr Glu Gly Ala Thr Ser Gln Ser Tyr Lys Gln Phe Ile Glu
195 200 205
Ala Leu Arg Glu Arg Leu Arg Gly Gly Leu Ile His Asp Ile Pro Val
210 215 220
Leu Pro Asp Pro Thr Thr Leu Gln Glu Arg Asn Arg Tyr Ile Thr Val
225 230 235 240
Glu Leu Ser Asn Ser Asp Thr Glu Ser Ile Glu Val Gly Ile Asp Val
245 250 255
Thr Asn Ala Tyr Val Val Ala Tyr Arg Ala Gly Thr Gln Ser Tyr Phe
260 265 270
Leu Arg Asp Ala Pro Ser Ser Ala Ser Asp Tyr Leu Phe Thr Gly Thr
275 280 285
Asp Gln His Ser Leu Pro Phe Tyr Gly Thr Tyr Gly Asp Leu Glu Arg
290 295 300
Trp Ala His Gln Ser Arg Gln Gln Ile Pro Leu Gly Leu Gln Ala Leu
305 310 315 320
Thr His Gly Ile Ser Phe Phe Arg Ser Gly Gly Asn Asp Asn Glu Glu
325 330 335
Lys Ala Arg Thr Leu Ile Val Ile Ile Gln Met Val Ala Glu Ala Ala
340 345 350
Arg Phe Arg Tyr Ile Ser Asn Arg Val Arg Val Ser Ile Gln Thr Gly
355 360 365
Thr Ala Phe Gln Pro Asp Ala Ala Met Ile Ser Leu Glu Asn Asn Trp
370 375 380
Asp Asn Leu Ser Arg Gly Val Gln Glu Ser Val Gln Asp Thr Phe Pro
385 390 395 400
Asn Gln Val Thr Leu Thr Asn Ile Arg Asn Glu Pro Val Ile Val Asp
405 410 415
Ser Leu Ser His Pro Thr Val Ala Val Leu Ala Leu Met Leu Phe Val
420 425 430
Cys Asn Pro Pro Asn Val Arg Glu Arg Gly Pro
435 440
<210> 49
<211> 447
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 49
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Gly Ser Ala Ser Gly Cys Gly Pro Glu Arg Lys Lys
165 170 175
Arg Gly Gly Gly Gly Ser Ala Arg His Met Glu Asp Arg Pro Ile Lys
180 185 190
Phe Ser Thr Glu Gly Ala Thr Ser Gln Ser Tyr Lys Gln Phe Ile Glu
195 200 205
Ala Leu Arg Glu Arg Leu Arg Gly Gly Leu Ile His Asp Ile Pro Val
210 215 220
Leu Pro Asp Pro Thr Thr Leu Gln Glu Arg Asn Arg Tyr Ile Thr Val
225 230 235 240
Glu Leu Ser Asn Ser Asp Thr Glu Ser Ile Glu Val Gly Ile Asp Val
245 250 255
Thr Asn Ala Tyr Val Val Ala Tyr Arg Ala Gly Thr Gln Ser Tyr Phe
260 265 270
Leu Arg Asp Ala Pro Ser Ser Ala Ser Asp Tyr Leu Phe Thr Gly Thr
275 280 285
Asp Gln His Ser Leu Pro Phe Tyr Gly Thr Tyr Gly Asp Leu Glu Arg
290 295 300
Trp Ala His Gln Ser Arg Gln Gln Ile Pro Leu Gly Leu Gln Ala Leu
305 310 315 320
Thr His Gly Ile Ser Phe Phe Arg Ser Gly Gly Asn Asp Asn Glu Glu
325 330 335
Lys Ala Arg Thr Leu Ile Val Ile Ile Gln Met Val Ala Glu Ala Ala
340 345 350
Arg Phe Arg Tyr Ile Ser Asn Arg Val Arg Val Ser Ile Gln Thr Gly
355 360 365
Thr Ala Phe Gln Pro Asp Ala Ala Met Ile Ser Leu Glu Asn Asn Trp
370 375 380
Asp Asn Leu Ser Arg Gly Val Gln Glu Ser Val Gln Asp Thr Phe Pro
385 390 395 400
Asn Gln Val Thr Leu Thr Asn Ile Arg Asn Glu Pro Val Ile Val Asp
405 410 415
Ser Leu Ser His Pro Thr Val Ala Val Leu Ala Leu Met Leu Phe Val
420 425 430
Cys Asn Pro Pro Asn Val Arg Glu Arg Gly Pro Lys Asp Glu Leu
435 440 445
<210> 50
<211> 441
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 50
Glu Asp Arg Pro Ile Lys Phe Ser Thr Glu Gly Ala Thr Ser Gln Ser
1 5 10 15
Tyr Lys Gln Phe Ile Glu Ala Leu Arg Glu Arg Leu Arg Gly Gly Leu
20 25 30
Ile His Asp Ile Pro Val Leu Pro Asp Pro Thr Thr Leu Gln Glu Arg
35 40 45
Asn Arg Tyr Ile Thr Val Glu Leu Ser Asn Ser Asp Thr Glu Ser Ile
50 55 60
Glu Val Gly Ile Asp Val Thr Asn Ala Tyr Val Val Ala Tyr Arg Ala
65 70 75 80
Gly Thr Gln Ser Tyr Phe Leu Arg Asp Ala Pro Ser Ser Ala Ser Asp
85 90 95
Tyr Leu Phe Thr Gly Thr Asp Gln His Ser Leu Pro Phe Tyr Gly Thr
100 105 110
Tyr Gly Asp Leu Glu Arg Trp Ala His Gln Ser Arg Gln Gln Ile Pro
115 120 125
Leu Gly Leu Gln Ala Leu Thr His Gly Ile Ser Phe Phe Arg Ser Gly
130 135 140
Gly Asn Asp Asn Glu Glu Lys Ala Arg Thr Leu Ile Val Ile Ile Gln
145 150 155 160
Met Val Ala Glu Ala Ala Arg Phe Arg Tyr Ile Ser Asn Arg Val Arg
165 170 175
Val Ser Ile Gln Thr Gly Thr Ala Phe Gln Pro Asp Ala Ala Met Ile
180 185 190
Ser Leu Glu Asn Asn Trp Asp Asn Leu Ser Arg Gly Val Gln Glu Ser
195 200 205
Val Gln Asp Thr Phe Pro Asn Gln Val Thr Leu Thr Asn Ile Arg Asn
210 215 220
Glu Pro Val Ile Val Asp Ser Leu Ser His Pro Thr Val Ala Val Leu
225 230 235 240
Ala Leu Met Leu Phe Val Cys Asn Pro Pro Asn Gly Gly Gly Gly Ser
245 250 255
Gly Gly Gly Gly Ser Arg Lys Lys Arg Ala Ser Gly Cys Gly Pro Glu
260 265 270
Cys Val Arg Glu Arg Gly Pro Gln Arg Val Ala Ala His Ile Thr Gly
275 280 285
Thr Arg Gly Arg Ser Asn Thr Leu Ser Ser Pro Asn Ser Lys Asn Glu
290 295 300
Lys Ala Leu Gly Arg Lys Ile Asn Ser Trp Glu Ser Ser Arg Ser Gly
305 310 315 320
His Ser Phe Leu Ser Asn Leu His Leu Arg Asn Gly Glu Leu Val Ile
325 330 335
His Glu Lys Gly Phe Tyr Tyr Ile Tyr Ser Gln Thr Tyr Phe Arg Phe
340 345 350
Gln Glu Glu Ile Lys Glu Asn Thr Lys Asn Asp Lys Gln Met Val Gln
355 360 365
Tyr Ile Tyr Lys Tyr Thr Ser Tyr Pro Asp Pro Ile Leu Leu Met Lys
370 375 380
Ser Ala Arg Asn Ser Cys Trp Ser Lys Asp Ala Glu Tyr Gly Leu Tyr
385 390 395 400
Ser Ile Tyr Gln Gly Gly Ile Phe Glu Leu Lys Glu Asn Asp Arg Ile
405 410 415
Phe Val Ser Val Thr Asn Glu His Leu Ile Asp Met Asp His Glu Ala
420 425 430
Ser Phe Phe Gly Ala Phe Leu Val Gly
435 440
<210> 51
<211> 515
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 51
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro His Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Ser Ala Ser Gly Gly Pro Glu Gly Gly Ser Leu Ala
165 170 175
Ala Leu Thr Ala His Gln Ala Cys His Leu Pro Leu Glu Thr Phe Thr
180 185 190
Arg His Arg Gln Pro Arg Gly Trp Glu Gln Leu Glu Gln Cys Gly Tyr
195 200 205
Pro Val Gln Arg Leu Val Ala Leu Tyr Leu Ala Ala Arg Leu Ser Trp
210 215 220
Asn Gln Val Asp Gln Val Ile Ala Asn Ala Leu Ala Ser Pro Gly Ser
225 230 235 240
Gly Gly Asp Leu Gly Glu Ala Ile Arg Glu Ser Pro Glu Gln Ala Arg
245 250 255
Leu Ala Leu Thr Leu Ala Ala Ala Glu Ser Glu Arg Phe Val Arg Gln
260 265 270
Gly Thr Gly Asn Asp Glu Ala Gly Ala Ala Asn Gly Pro Ala Asp Ser
275 280 285
Gly Asp Ala Leu Leu Glu Arg Asn Tyr Pro Thr Gly Ala Glu Phe Leu
290 295 300
Gly Asp Gly Gly Asp Val Ser Phe Ser Thr Arg Gly Thr Gln Asn Trp
305 310 315 320
Thr Val Glu Arg Leu Leu Gln Ala His Arg Gln Leu Glu Glu Arg Gly
325 330 335
Tyr Val Phe Val Gly Tyr His Gly Thr Phe Leu Glu Ala Ala Gln Ser
340 345 350
Ile Val Phe Gly Gly Val Arg Ala Arg Ser Gln Asp Leu Asp Ala Ile
355 360 365
Trp Ala Gly Phe Tyr Ile Ala Gly Asp Pro Ala Leu Ala Tyr Gly Tyr
370 375 380
Ala Gln Asp Gln Glu Pro Asp Ala Ala Gly Arg Ile Arg Asn Gly Ala
385 390 395 400
Leu Leu Arg Val Tyr Val Pro Arg Ser Ser Leu Pro Gly Phe Tyr Ala
405 410 415
Thr Ser Leu Thr Leu Ala Ala Pro Glu Ala Ala Gly Glu Val Glu Arg
420 425 430
Leu Ile Gly His Pro Leu Pro Leu Arg Leu Asp Ala Ile Thr Gly Pro
435 440 445
Glu Glu Ser Gly Gly Arg Leu Glu Thr Ile Leu Gly Trp Pro Leu Ala
450 455 460
Glu Arg Thr Val Val Ile Pro Ser Ala Ile Pro Thr Asp Pro Arg Asn
465 470 475 480
Val Gly Gly Asp Leu Asp Pro Ser Ser Ile Pro Asp Ser Glu Gln Ala
485 490 495
Ile Ser Ala Leu Pro Asp Tyr Ala Ser Gln Pro Gly Lys Pro Pro Lys
500 505 510
Asp Glu Leu
515
<210> 52
<211> 515
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 52
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Asn Phe Lys Phe Arg Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu Arg
130 135 140
Leu Arg Asp Met His His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Ser Ala Ser Gly Gly Pro Glu Gly Gly Ser Leu Ala
165 170 175
Ala Leu Thr Ala His Gln Ala Cys His Leu Pro Leu Glu Thr Phe Thr
180 185 190
Arg His Arg Gln Pro Arg Gly Trp Glu Gln Leu Glu Gln Cys Gly Tyr
195 200 205
Pro Val Gln Arg Leu Val Ala Leu Tyr Leu Ala Ala Arg Leu Ser Trp
210 215 220
Asn Gln Val Asp Gln Val Ile Ala Asn Ala Leu Ala Ser Pro Gly Ser
225 230 235 240
Gly Gly Asp Leu Gly Glu Ala Ile Arg Glu Ser Pro Glu Gln Ala Arg
245 250 255
Leu Ala Leu Thr Leu Ala Ala Ala Glu Ser Glu Arg Phe Val Arg Gln
260 265 270
Gly Thr Gly Asn Asp Glu Ala Gly Ala Ala Asn Gly Pro Ala Asp Ser
275 280 285
Gly Asp Ala Leu Leu Glu Arg Asn Tyr Pro Thr Gly Ala Glu Phe Leu
290 295 300
Gly Asp Gly Gly Asp Val Ser Phe Ser Thr Arg Gly Thr Gln Asn Trp
305 310 315 320
Thr Val Glu Arg Leu Leu Gln Ala His Arg Gln Leu Glu Glu Arg Gly
325 330 335
Tyr Val Phe Val Gly Tyr His Gly Thr Phe Leu Glu Ala Ala Gln Ser
340 345 350
Ile Val Phe Gly Gly Val Arg Ala Arg Ser Gln Asp Leu Asp Ala Ile
355 360 365
Trp Ala Gly Phe Tyr Ile Ala Gly Asp Pro Ala Leu Ala Tyr Gly Tyr
370 375 380
Ala Gln Asp Gln Glu Pro Asp Ala Ala Gly Arg Ile Arg Asn Gly Ala
385 390 395 400
Leu Leu Arg Val Tyr Val Pro Arg Ser Ser Leu Pro Gly Phe Tyr Ala
405 410 415
Thr Ser Leu Thr Leu Ala Ala Pro Glu Ala Ala Gly Glu Val Glu Arg
420 425 430
Leu Ile Gly His Pro Leu Pro Leu Arg Leu Asp Ala Ile Thr Gly Pro
435 440 445
Glu Glu Ser Gly Gly Arg Leu Glu Thr Ile Leu Gly Trp Pro Leu Ala
450 455 460
Glu Arg Thr Val Val Ile Pro Ser Ala Ile Pro Thr Asp Pro Arg Asn
465 470 475 480
Val Gly Gly Asp Leu Asp Pro Ser Ser Ile Pro Asp Ser Glu Gln Ala
485 490 495
Ile Ser Ala Leu Pro Asp Tyr Ala Ser Gln Pro Gly Lys Pro Pro Lys
500 505 510
Asp Glu Leu
515
<210> 53
<211> 519
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 53
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro His Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Ser Gly Ala Ser Gly Cys Gly Pro Glu Pro Glu Gly
165 170 175
Gly Ser Leu Ala Ala Leu Thr Ala His Gln Ala Cys His Leu Pro Leu
180 185 190
Glu Thr Phe Thr Arg His Arg Gln Pro Arg Gly Trp Glu Gln Leu Glu
195 200 205
Gln Cys Gly Tyr Pro Val Gln Arg Leu Val Ala Leu Tyr Leu Ala Ala
210 215 220
Arg Leu Ser Trp Asn Gln Val Asp Gln Val Ile Ala Asn Ala Leu Ala
225 230 235 240
Ser Pro Gly Ser Gly Gly Asp Leu Gly Glu Ala Ile Arg Glu Ser Pro
245 250 255
Glu Gln Ala Arg Leu Ala Leu Thr Leu Ala Ala Ala Glu Ser Glu Arg
260 265 270
Phe Val Arg Gln Gly Thr Gly Asn Asp Glu Ala Gly Ala Ala Asn Gly
275 280 285
Pro Ala Asp Ser Gly Asp Ala Leu Leu Glu Arg Asn Tyr Pro Thr Gly
290 295 300
Ala Glu Phe Leu Gly Asp Gly Gly Asp Val Ser Phe Ser Thr Arg Gly
305 310 315 320
Thr Gln Asn Trp Thr Val Glu Arg Leu Leu Gln Ala His Arg Gln Leu
325 330 335
Glu Glu Arg Gly Tyr Val Phe Val Gly Tyr His Gly Thr Phe Leu Glu
340 345 350
Ala Ala Gln Ser Ile Val Phe Gly Gly Val Arg Ala Arg Ser Gln Asp
355 360 365
Leu Asp Ala Ile Trp Ala Gly Phe Tyr Ile Ala Gly Asp Pro Ala Leu
370 375 380
Ala Tyr Gly Tyr Ala Gln Asp Gln Glu Pro Asp Ala Ala Gly Arg Ile
385 390 395 400
Arg Asn Gly Ala Leu Leu Arg Val Tyr Val Pro Arg Ser Ser Leu Pro
405 410 415
Gly Phe Tyr Ala Thr Ser Leu Thr Leu Ala Ala Pro Glu Ala Ala Gly
420 425 430
Glu Val Glu Arg Leu Ile Gly His Pro Leu Pro Leu Arg Leu Asp Ala
435 440 445
Ile Thr Gly Pro Glu Glu Ser Gly Gly Arg Leu Glu Thr Ile Leu Gly
450 455 460
Trp Pro Leu Ala Glu Arg Thr Val Val Ile Pro Ser Ala Ile Pro Thr
465 470 475 480
Asp Pro Arg Asn Val Gly Gly Asp Leu Asp Pro Ser Ser Ile Pro Asp
485 490 495
Ser Glu Gln Ala Ile Ser Ala Leu Pro Asp Tyr Ala Ser Gln Pro Gly
500 505 510
Lys Pro Pro Lys Asp Glu Leu
515
<210> 54
<211> 515
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<400> 54
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Asn Phe Lys Phe Arg Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu Arg
130 135 140
Leu Arg Asp Met His His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Ser Ala Ser Gly Gly Pro Glu Gly Gly Ser Leu Ala
165 170 175
Ala Leu Thr Ala His Gln Ala Cys His Leu Pro Leu Glu Thr Phe Thr
180 185 190
Arg His Arg Gln Pro Arg Gly Trp Glu Gln Leu Glu Gln Cys Gly Tyr
195 200 205
Pro Val Gln Arg Leu Val Ala Leu Tyr Leu Ala Ala Arg Leu Ser Trp
210 215 220
Asn Gln Val Asp Gln Val Ile Ala Asn Ala Leu Ala Ser Pro Gly Ser
225 230 235 240
Gly Gly Asp Leu Gly Glu Ala Ile Arg Glu Ser Pro Glu Gln Ala Arg
245 250 255
Leu Ala Leu Thr Leu Ala Ala Ala Glu Ser Glu Arg Phe Val Arg Gln
260 265 270
Gly Thr Gly Asn Asp Glu Ala Gly Ala Ala Asn Gly Pro Ala Asp Ser
275 280 285
Gly Asp Ala Leu Leu Glu Arg Asn Tyr Pro Thr Gly Ala Glu Phe Leu
290 295 300
Gly Asp Gly Gly Asp Val Ser Phe Ser Thr Arg Gly Thr Gln Asn Trp
305 310 315 320
Thr Val Glu Arg Leu Leu Gln Ala His Arg Gln Leu Glu Glu Arg Gly
325 330 335
Tyr Val Phe Val Gly Tyr His Gly Thr Phe Leu Glu Ala Ala Gln Ser
340 345 350
Ile Val Phe Gly Gly Val Arg Ala Arg Ser Gln Asp Leu Asp Ala Ile
355 360 365
Trp Ala Gly Phe Tyr Ile Ala Gly Asp Pro Ala Leu Ala Tyr Gly Tyr
370 375 380
Ala Gln Asp Gln Glu Pro Asp Ala Ala Gly Arg Ile Arg Asn Gly Ala
385 390 395 400
Leu Leu Arg Val Tyr Val Pro Arg Ser Ser Leu Pro Gly Phe Tyr Ala
405 410 415
Thr Ser Leu Thr Leu Ala Ala Pro Glu Ala Ala Gly Glu Val Glu Arg
420 425 430
Leu Ile Gly His Pro Leu Pro Leu Arg Leu Asp Ala Ile Thr Gly Pro
435 440 445
Glu Glu Ser Gly Gly Arg Leu Glu Thr Ile Leu Gly Trp Pro Leu Ala
450 455 460
Glu Arg Thr Val Val Ile Pro Ser Ala Ile Pro Thr Asp Pro Arg Asn
465 470 475 480
Val Gly Gly Asp Leu Asp Pro Ser Ser Ile Pro Asp Ser Glu Gln Ala
485 490 495
Ile Ser Ala Leu Pro Asp Tyr Ala Ser Gln Pro Gly Lys Pro Pro Lys
500 505 510
Asp Glu Leu
515
<210> 55
<211> 248
<212> PRT
<213> Bougainvillea spectabilis
<300>
<308> GenBank/AAL35962.1
<309> 2001-11-29
<313> (27)..(247)
<400> 55
Tyr Asn Thr Val Ser Phe Asn Leu Gly Glu Ala Tyr Glu Tyr Pro Thr
1 5 10 15
Phe Ile Gln Asp Leu Arg Asn Glu Leu Ala Lys Gly Thr Pro Val Cys
20 25 30
Gln Leu Pro Val Thr Leu Gln Thr Ile Ala Asp Asp Lys Arg Phe Val
35 40 45
Leu Val Asp Ile Thr Thr Thr Ser Lys Lys Thr Val Lys Val Ala Ile
50 55 60
Asp Val Thr Asp Val Tyr Val Val Gly Tyr Gln Asp Lys Trp Asp Gly
65 70 75 80
Lys Asp Arg Ala Val Phe Leu Asp Lys Val Pro Thr Val Ala Thr Ser
85 90 95
Lys Leu Phe Pro Gly Val Thr Asn Arg Val Thr Leu Thr Phe Asp Gly
100 105 110
Ser Tyr Gln Lys Leu Val Asn Ala Ala Lys Val Asp Arg Lys Asp Leu
115 120 125
Glu Leu Gly Val Tyr Lys Leu Glu Phe Ser Ile Glu Ala Ile His Gly
130 135 140
Lys Thr Ile Asn Gly Gln Glu Ile Ala Lys Phe Phe Leu Ile Val Ile
145 150 155 160
Gln Met Val Ser Glu Ala Ala Arg Phe Lys Tyr Ile Glu Thr Glu Val
165 170 175
Val Asp Arg Gly Leu Tyr Gly Ser Phe Lys Pro Asn Phe Lys Val Leu
180 185 190
Asn Leu Glu Asn Asn Trp Gly Asp Ile Ser Asp Ala Ile His Lys Ser
195 200 205
Ser Pro Gln Cys Thr Thr Ile Asn Pro Ala Leu Gln Leu Ile Ser Pro
210 215 220
Ser Asn Asp Pro Trp Val Val Asn Lys Val Ser Gln Ile Ser Pro Asp
225 230 235 240
Met Gly Ile Leu Lys Phe Lys Ser
245
<210> 56
<211> 267
<212> PRT
<213> Ricinus communis
<300>
<308> GenBank/ABG65738.1
<309> 2006-07-16
<313> (1)..(267)
<400> 56
Glu Asp Asn Asn Ile Phe Pro Lys Gln Tyr Pro Ile Ile Asn Phe Thr
1 5 10 15
Thr Ala Gly Ala Thr Val Gln Ser Tyr Thr Asn Phe Ile Arg Ala Val
20 25 30
Arg Gly Arg Leu Thr Thr Gly Ala Asp Val Arg His Glu Ile Pro Val
35 40 45
Leu Pro Asn Arg Val Gly Leu Pro Ile Asn Gln Arg Phe Ile Leu Val
50 55 60
Glu Leu Ser Asn His Ala Glu Leu Ser Val Thr Leu Ala Leu Asp Val
65 70 75 80
Thr Asn Ala Tyr Val Val Gly Tyr Arg Ala Gly Asn Ser Ala Tyr Phe
85 90 95
Phe His Pro Asp Asn Gln Glu Asp Ala Glu Ala Ile Thr His Leu Phe
100 105 110
Thr Asp Val Gln Asn Arg Tyr Thr Phe Ala Phe Gly Gly Asn Tyr Asp
115 120 125
Arg Leu Glu Gln Leu Ala Gly Ser Leu Arg Glu Asn Ile Glu Leu Gly
130 135 140
Asn Gly Pro Leu Glu Glu Ala Ile Ser Ala Leu Tyr Tyr Tyr Ser Thr
145 150 155 160
Gly Gly Thr Gln Leu Pro Thr Leu Ala Arg Ser Phe Ile Val Cys Ile
165 170 175
Gln Met Ile Ser Glu Ala Ala Arg Phe Gln Tyr Ile Glu Gly Glu Met
180 185 190
Arg Thr Arg Ile Arg Tyr Asn Arg Arg Ser Ala Pro Asp Pro Ser Val
195 200 205
Ile Thr Leu Glu Asn Ser Trp Gly Arg Leu Ser Thr Ala Ile Gln Glu
210 215 220
Ser Asn Gln Gly Ala Phe Ala Ser Pro Ile Gln Leu Gln Arg Arg Asn
225 230 235 240
Gly Ser Lys Phe Ser Val Tyr Asp Val Ser Ile Leu Ile Pro Ile Ile
245 250 255
Ala Leu Met Val Tyr Arg Cys Ala Pro Pro Pro
260 265
<210> 57
<211> 192
<212> PRT
<213> Ricinus communis
<300>
<308> GenBank/ACZ56254.1
<309> 2009-12-05
<313> (1)..(192)
<400> 57
Gly Pro Gly Pro Lys Gln Tyr Pro Ile Ile Asn Phe Thr Thr Ala Gly
1 5 10 15
Ala Thr Val Gln Ser Tyr Thr Asn Phe Ile Arg Ala Val Arg Gly Arg
20 25 30
Leu Thr Thr Gly Ala Asp Val Arg His Glu Ile Pro Val Leu Pro Asn
35 40 45
Arg Val Gly Leu Pro Ile Asn Gln Arg Phe Ile Leu Val Glu Leu Ser
50 55 60
Asn His Ala Glu Leu Ser Val Thr Leu Ala Leu Asp Val Thr Asn Ala
65 70 75 80
Tyr Val Val Gly Tyr Arg Ala Gly Asn Ser Ala Tyr Phe Phe His Pro
85 90 95
Asp Asn Gln Glu Asp Ala Glu Ala Ile Thr His Leu Phe Thr Asp Val
100 105 110
Gln Asn Arg Tyr Thr Phe Ala Phe Gly Gly Asn Tyr Asp Arg Leu Glu
115 120 125
Gln Leu Ala Gly Asn Leu Arg Glu Asn Ile Glu Leu Gly Asn Gly Pro
130 135 140
Leu Glu Glu Ala Ile Ser Ala Leu Tyr Tyr Tyr Ser Thr Gly Gly Thr
145 150 155 160
Gln Leu Pro Thr Leu Ala Arg Ser Phe Ile Ile Cys Ile Gln Met Ile
165 170 175
Ser Glu Ala Ala Arg Phe Gln Tyr Ile Glu Gly Glu Met Arg Val Pro
180 185 190
<210> 58
<211> 290
<212> PRT
<213> Phytolacca americana
<300>
<308> GenBank/CAA66702.1
<309> 2005-04-18
<313> (25)..(314)
<400> 58
Ile Asn Thr Ile Thr Phe Asp Ala Gly Asn Ala Thr Ile Asn Lys Tyr
1 5 10 15
Ala Thr Phe Met Glu Ser Leu Arg Asn Gln Ala Lys Asp Pro Lys Leu
20 25 30
Lys Cys Tyr Gly Ile Pro Met Leu Pro Asp Thr Asn Ser Thr Pro Lys
35 40 45
Tyr Leu Leu Val Lys Leu Gln Gly Ala Asn Leu Lys Thr Ile Thr Leu
50 55 60
Met Leu Arg Arg Asn Asn Leu Tyr Val Met Gly Tyr Ser Asp Pro Phe
65 70 75 80
Asn Gly Asn Lys Cys Arg Tyr His Ile Phe Asn Asp Ile Thr Ser Thr
85 90 95
Glu Arg Thr Asp Val Glu Asn Thr Leu Cys Ser Ser Ser Ser Ser Arg
100 105 110
Val Ala Met Ser Ile Asn Tyr Asn Ser Leu Tyr Pro Thr Met Glu Lys
115 120 125
Lys Ala Glu Val Asn Ser Arg Asn Gln Val Gln Leu Gly Ile Gln Ile
130 135 140
Leu Ser Ser Asp Ile Gly Lys Ile Ser Gly Val Asp Ser Phe Pro Val
145 150 155 160
Lys Thr Glu Ala Phe Phe Leu Leu Val Ala Ile Gln Met Val Ser Glu
165 170 175
Ala Ala Arg Phe Lys Tyr Ile Glu Asn Gln Val Lys Thr Asn Phe Asn
180 185 190
Arg Ala Phe Tyr Pro Asp Pro Lys Val Ile Asn Leu Glu Glu Lys Trp
195 200 205
Gly Lys Ile Ser Glu Ala Ile His Asn Ala Lys Asn Gly Ala Leu Pro
210 215 220
Lys Pro Leu Glu Leu Val Asp Ala Lys Gly Thr Lys Trp Ile Val Leu
225 230 235 240
Arg Val Asp Glu Ile Asn Arg Asp Val Ala Leu Leu Lys Tyr Val Asn
245 250 255
Gly Thr Cys Gln Thr Thr Tyr Gln Asn Ala Met Phe Ser Gln Val Ile
260 265 270
Ile Ser Thr Tyr Tyr Asn Tyr Met Ser Asn Leu Gly Asp Leu Phe Glu
275 280 285
Gly Phe
290
<210> 59
<211> 252
<212> PRT
<213> Saponaria officinalis
<300>
<308> GenBank/CAA48886.1
<309> 2005-04-18
<313> (1)..(251)
<400> 59
Val Thr Ser Ile Thr Leu Asp Leu Val Asn Pro Thr Ala Gly Gln Tyr
1 5 10 15
Ser Ser Phe Val Asp Lys Ile Arg Asn Asn Val Lys Asp Pro Asn Leu
20 25 30
Lys Tyr Gly Gly Thr Asp Ile Ala Val Ile Gly Pro Pro Ser Lys Asp
35 40 45
Lys Phe Leu Arg Ile Asn Phe Gln Ser Ser Arg Gly Thr Val Ser Leu
50 55 60
Gly Leu Lys Arg Asp Asn Leu Tyr Val Val Ala Tyr Leu Ala Met Asp
65 70 75 80
Asn Thr Asn Val Asn Arg Ala Tyr Tyr Phe Lys Ser Glu Ile Thr Ser
85 90 95
Ala Glu Leu Thr Ala Leu Phe Pro Glu Ala Thr Thr Ala Asn Gln Lys
100 105 110
Ala Leu Glu Tyr Thr Glu Asp Tyr Gln Ser Ile Glu Lys Asn Ala Gln
115 120 125
Ile Thr Gln Gly Asp Lys Ser Arg Lys Glu Leu Gly Leu Gly Ile Asp
130 135 140
Leu Leu Leu Thr Phe Met Glu Ala Val Asn Lys Lys Ala Arg Val Val
145 150 155 160
Lys Asn Glu Ala Arg Phe Leu Leu Ile Ala Ile Gln Met Thr Ala Glu
165 170 175
Val Ala Arg Phe Arg Tyr Ile Gln Asn Leu Val Thr Lys Asn Phe Pro
180 185 190
Asn Lys Phe Asp Ser Asp Asn Lys Val Ile Gln Phe Glu Val Ser Trp
195 200 205
Arg Lys Ile Ser Thr Ala Ile Tyr Gly Asp Ala Lys Asn Gly Val Phe
210 215 220
Asn Lys Asp Tyr Asp Phe Gly Phe Gly Lys Val Arg Gln Val Lys Asp
225 230 235 240
Leu Gln Met Gly Leu Leu Met Tyr Leu Gly Lys Pro
245 250
<210> 60
<211> 247
<212> PRT
<213> Trichosanthes kirilowii
<300>
<308> GenBank/AAB22585.1
<309> 1993-05-08
<313> (1)..(247)
<400> 60
Asp Val Ser Phe Arg Leu Ser Gly Ala Thr Ser Ser Ser Tyr Gly Val
1 5 10 15
Phe Ile Ser Asn Leu Arg Lys Ala Leu Pro Asn Glu Arg Lys Leu Tyr
20 25 30
Asp Ile Pro Leu Leu Arg Ser Ser Leu Pro Gly Ser Gln Arg Tyr Ala
35 40 45
Leu Ile His Leu Thr Asn Tyr Ala Asp Glu Thr Ile Ser Val Ala Ile
50 55 60
Asp Val Thr Asn Val Tyr Ile Met Gly Tyr Arg Ala Gly Asp Thr Ser
65 70 75 80
Tyr Phe Phe Asn Glu Ala Ser Ala Thr Glu Ala Ala Lys Tyr Val Phe
85 90 95
Lys Asp Ala Met Arg Lys Val Thr Leu Pro Tyr Ser Gly Asn Tyr Glu
100 105 110
Arg Leu Gln Thr Ala Ala Gly Lys Ile Arg Glu Asn Ile Pro Leu Gly
115 120 125
Leu Pro Ala Leu Asp Ser Ala Ile Thr Thr Leu Phe Tyr Tyr Asn Ala
130 135 140
Asn Ser Ala Ala Ser Ala Leu Met Val Leu Ile Gln Ser Thr Ser Glu
145 150 155 160
Ala Ala Arg Tyr Lys Phe Ile Glu Gln Gln Ile Gly Lys Arg Val Asp
165 170 175
Lys Thr Phe Leu Pro Ser Leu Ala Ile Ile Ser Leu Glu Asn Ser Trp
180 185 190
Ser Ala Leu Ser Lys Gln Ile Gln Ile Ala Ser Thr Asn Asn Gly Gln
195 200 205
Phe Glu Ser Pro Val Val Leu Ile Asn Ala Gln Asn Gln Arg Val Thr
210 215 220
Ile Thr Asn Val Asp Ala Gly Val Val Thr Ser Asn Ile Ala Leu Leu
225 230 235 240
Leu Asn Arg Asn Asn Met Ala
245
<210> 61
<211> 245
<212> PRT
<213> Trichosanthes anguina
<300>
<308> GenBank/AAD02686.1
<309> 1999-03-03
<313> (20)..(264)
<400> 61
Asp Val Ser Phe Asp Leu Ser Thr Ala Thr Lys Lys Ser Tyr Ser Ser
1 5 10 15
Phe Ile Thr Gln Leu Arg Asp Ala Leu Pro Thr Gln Gly Thr Val Cys
20 25 30
Gly Ile Pro Leu Leu Pro Ser Thr Ala Ser Gly Ser Gln Trp Phe Arg
35 40 45
Phe Phe Asn Leu Thr Asn Tyr Asn Asp Glu Thr Val Thr Val Ala Val
50 55 60
Asn Val Thr Asn Val Tyr Ile Val Ala Tyr Arg Ala Asp Ala Val Ser
65 70 75 80
Tyr Phe Phe Glu Asp Thr Pro Ala Glu Ala Phe Lys Leu Ile Phe Ala
85 90 95
Gly Thr Lys Thr Val Lys Leu Pro Tyr Ser Gly Asn Tyr Asp Lys Leu
100 105 110
Gln Ser Val Val Gly Lys Gln Arg Asp Met Ile Glu Leu Gly Ile Pro
115 120 125
Ala Leu Ser Ser Ala Ile Thr Asn Met Val Tyr Tyr Asp Tyr Gln Ser
130 135 140
Thr Ala Ala Ala Leu Leu Val Leu Ile Gln Cys Thr Ala Glu Ala Ala
145 150 155 160
Arg Tyr Lys Tyr Ile Glu Gln Gln Val Ser Ser His Ile Ser Ser Asn
165 170 175
Phe Tyr Pro Asn Gln Ala Val Ile Ser Leu Glu Asn Lys Trp Gly Ala
180 185 190
Leu Ser Lys Gln Ile Gln Ile Ala Asn Arg Thr Gly His Gly Gln Phe
195 200 205
Glu Asn Pro Val Glu Leu Tyr Asn Pro Asp Gly Thr Arg Phe Ser Val
210 215 220
Thr Asn Thr Ser Ala Gly Val Val Lys Gly Asn Ile Lys Leu Leu Leu
225 230 235 240
Tyr Tyr Lys Ala Ser
245
<210> 62
<211> 249
<212> PRT
<213> Viscum album
<300>
<308> GenBank/AAL87006.1
<309> 2002-03-17
<313> (1)..(249)
<400> 62
Tyr Glu Arg Leu Arg Leu Arg Val Thr His Gln Thr Thr Gly Glu Glu
1 5 10 15
Tyr Phe Arg Phe Ile Thr Leu Leu Arg Asp Tyr Val Ser Ser Gly Ser
20 25 30
Phe Ser Asn Glu Ile Pro Leu Leu Arg Gln Ser Thr Ile Pro Val Ser
35 40 45
Asp Ala Gln Arg Phe Val Leu Val Glu Leu Thr Asn Glu Gly Gly Asp
50 55 60
Ser Ile Thr Ala Ala Ile Asp Val Thr Asn Leu Tyr Val Val Ala Tyr
65 70 75 80
Gln Ala Gly Asp Gln Ser Tyr Phe Leu Arg Asp Ala Pro Arg Gly Ala
85 90 95
Glu Thr His Leu Phe Thr Gly Thr Thr Arg Ser Ser Leu Pro Phe Asn
100 105 110
Gly Ser Tyr Pro Asp Leu Glu Arg Tyr Ala Gly His Arg Asp Gln Ile
115 120 125
Pro Leu Gly Ile Asp Gln Leu Ile Gln Ser Val Thr Ala Leu Arg Phe
130 135 140
Pro Gly Gly Ser Thr Arg Thr Gln Ala Arg Ser Ile Leu Ile Leu Ile
145 150 155 160
Gln Met Ile Ser Glu Ala Ala Arg Phe Asn Pro Ile Leu Trp Arg Ala
165 170 175
Arg Gln Tyr Ile Asn Ser Gly Ala Ser Phe Leu Pro Asp Val Tyr Met
180 185 190
Leu Glu Leu Glu Thr Ser Trp Gly Gln Gln Ser Thr Gln Val Gln Gln
195 200 205
Ser Thr Asp Gly Val Phe Asn Asn Pro Ile Arg Leu Ala Ile Pro Pro
210 215 220
Gly Asn Phe Val Thr Leu Thr Asn Val Arg Asp Val Ile Ala Ser Leu
225 230 235 240
Ala Ile Met Leu Phe Val Cys Gly Glu
245
<210> 63
<211> 273
<212> PRT
<213> Sambucus ebulus L
<300>
<308> GenBank/CAC33178.1
<309> 2001-02-17
<313> (26)..(298)
<400> 63
Ile Asp Tyr Pro Ser Val Ser Phe Asn Leu Ala Gly Ala Lys Ser Thr
1 5 10 15
Thr Tyr Arg Asp Phe Leu Lys Asn Leu Arg Asp Arg Val Ala Thr Gly
20 25 30
Thr Tyr Glu Val Asn Gly Leu Pro Val Leu Arg Arg Glu Ser Glu Val
35 40 45
Gln Val Lys Asn Arg Phe Val Leu Val Arg Leu Thr Asn Tyr Asn Gly
50 55 60
Asp Thr Val Thr Ser Ala Val Asp Val Thr Asn Leu Tyr Leu Val Ala
65 70 75 80
Phe Ser Ala Asn Gly Asn Ser Tyr Phe Phe Lys Asp Ala Thr Glu Leu
85 90 95
Gln Lys Ser Asn Leu Phe Leu Gly Thr Thr Gln His Thr Leu Ser Phe
100 105 110
Thr Gly Asn Tyr Asp Asn Leu Glu Thr Ala Ala Gly Thr Arg Arg Glu
115 120 125
Ser Ile Glu Leu Gly Pro Asn Pro Leu Asp Gly Ala Ile Thr Ser Leu
130 135 140
Trp Tyr Asp Gly Gly Val Ala Arg Ser Leu Leu Val Leu Ile Gln Met
145 150 155 160
Val Pro Glu Ala Ala Arg Phe Arg Tyr Ile Glu Gln Glu Val Arg Arg
165 170 175
Ser Leu Gln Gln Leu Thr Ser Phe Thr Pro Asn Ala Leu Met Leu Ser
180 185 190
Met Glu Asn Asn Trp Ser Ser Met Ser Leu Glu Val Gln Leu Ser Gly
195 200 205
Asp Asn Val Ser Pro Phe Ser Gly Thr Val Gln Leu Gln Asn Tyr Asp
210 215 220
His Thr Pro Arg Leu Val Asp Asn Phe Glu Glu Leu Tyr Lys Ile Thr
225 230 235 240
Gly Ile Ala Ile Leu Leu Phe Arg Cys Val Ala Thr Lys Thr Thr His
245 250 255
Asn Ala Ile Arg Met Pro His Val Leu Val Gly Glu Asp Asn Lys Phe
260 265 270
Asn
<210> 64
<211> 272
<212> PRT
<213> Sambucus nigra
<300>
<308> GenBank/AAB39475.1
<309> 1996-12-13
<313> (26)..(297)
<400> 64
Ile Asp Tyr Pro Ser Val Ser Phe Asn Leu Asp Gly Ala Lys Ser Ala
1 5 10 15
Thr Tyr Arg Asp Phe Leu Ser Asn Leu Arg Lys Thr Val Ala Thr Gly
20 25 30
Thr Tyr Glu Val Asn Gly Leu Pro Val Leu Arg Arg Glu Ser Glu Val
35 40 45
Gln Val Lys Ser Arg Phe Val Leu Val Pro Leu Thr Asn Tyr Asn Gly
50 55 60
Asn Thr Val Thr Leu Ala Val Asp Val Thr Asn Leu Tyr Val Val Ala
65 70 75 80
Phe Ser Gly Asn Ala Asn Ser Tyr Phe Phe Lys Asp Ala Thr Glu Val
85 90 95
Gln Lys Ser Asn Leu Phe Val Gly Thr Lys Gln Asn Thr Leu Ser Phe
100 105 110
Thr Gly Asn Tyr Asp Asn Leu Glu Thr Ala Ala Asn Thr Arg Arg Glu
115 120 125
Ser Ile Glu Leu Gly Pro Ser Pro Leu Asp Gly Ala Ile Thr Ser Leu
130 135 140
Tyr His Gly Asp Ser Val Ala Arg Ser Leu Leu Val Val Ile Gln Met
145 150 155 160
Val Ser Glu Ala Ala Arg Phe Arg Tyr Ile Glu Gln Glu Val Arg Arg
165 170 175
Ser Leu Gln Gln Ala Thr Ser Phe Thr Pro Asn Ala Leu Met Leu Ser
180 185 190
Met Glu Asn Asn Trp Ser Ser Met Ser Leu Glu Ile Gln Gln Ala Gly
195 200 205
Asn Asn Val Ser Pro Phe Phe Gly Thr Val Gln Leu Leu Asn Tyr Asp
210 215 220
His Thr His Arg Leu Val Asp Asn Phe Glu Glu Leu Tyr Lys Ile Thr
225 230 235 240
Gly Ile Ala Ile Leu Leu Phe Arg Cys Ser Ser Pro Ser Asn Asp Asn
245 250 255
Ala Ile Arg Met Pro Leu Asp Leu Ala Gly Glu Asp Asn Lys Tyr Asn
260 265 270
<210> 65
<211> 47
<212> PRT
<213> Luffa cylindrica
<300>
<308> Swiss-Prot/P56568.1
<309> 2011-06-28
<313> (1)..(47)
<400> 65
Pro Arg Gly Ser Pro Arg Thr Glu Tyr Glu Ala Cys Arg Val Arg Cys
1 5 10 15
Gln Val Ala Glu His Gly Val Glu Arg Gln Arg Arg Cys Gln Gln Val
20 25 30
Cys Glu Lys Arg Leu Arg Glu Arg Glu Gly Arg Arg Glu Val Asp
35 40 45
<210> 66
<211> 249
<212> PRT
<213> Adenia volkensii
<300>
<308> GenBank/CAD61022.1
<309> 2005-04-15
<313> (1)..(244)
<400> 66
Val Phe Pro Lys Val Pro Phe Asp Val Pro Lys Ala Thr Val Glu Ser
1 5 10 15
Tyr Thr Arg Phe Ile Arg Val Leu Arg Asp Glu Leu Ala Gly Gly Val
20 25 30
Ser Pro Gln Gly Ile Arg Arg Leu Arg Asn Pro Ala Glu Ile Gln Pro
35 40 45
Ser Gln Gly Phe Ile Leu Ile Gln Leu Thr Gly Tyr Val Gly Ser Val
50 55 60
Thr Leu Ile Met Asp Val Arg Asn Ala Tyr Leu Leu Gly Tyr Leu Ser
65 70 75 80
His Asn Val Leu Tyr His Phe Asn Asp Val Ser Ala Ser Ser Ile Ala
85 90 95
Ser Val Phe Pro Asp Ala Gln Arg Arg Gln Leu Pro Phe Gly Gly Gly
100 105 110
Tyr Pro Ser Met Arg Asn Tyr Ala Pro Glu Arg Asp Gln Ile Asp His
115 120 125
Gly Ile Val Glu Leu Ala Tyr Ala Val Asp Arg Leu Tyr Tyr Ser Gln
130 135 140
Asn Asn Asn Gln Ile Ala Leu Gly Leu Val Ile Cys Ala Gly Met Val
145 150 155 160
Ala Glu Ala Ser Arg Phe Arg Tyr Ile Glu Gly Leu Val Arg Gln Ser
165 170 175
Ile Val Gly Pro Gly Asp Tyr Arg Thr Phe Arg Pro Asp Ala Leu Met
180 185 190
Tyr Ser Ile Val Thr Gln Trp Gln Thr Leu Ser Glu Arg Ile Gln Gly
195 200 205
Ser Phe Asn Gly Ala Phe Gln Pro Val Gln Leu Gly Tyr Ala Ser Asp
210 215 220
Pro Phe Tyr Trp Asp Asn Val Ala Gln Ala Ile Thr Arg Leu Ser Leu
225 230 235 240
Met Leu Phe Val Ser Arg Ser Thr Asp
245
<210> 67
<211> 246
<212> PRT
<213> Momordica charantia
<300>
<308> GenBank/AAB22586.1
<309> 1993-05-08
<313> (1)..(246)
<400> 67
Asp Val Ser Phe Arg Leu Ser Gly Ala Asp Pro Arg Ser Tyr Gly Met
1 5 10 15
Phe Ile Lys Asp Leu Arg Asn Ala Leu Pro Phe Arg Glu Lys Val Tyr
20 25 30
Asn Ile Pro Leu Leu Leu Pro Ser Val Ser Gly Ala Gly Arg Tyr Leu
35 40 45
Leu Met His Leu Phe Asn Tyr Asp Gly Lys Thr Ile Thr Val Ala Leu
50 55 60
Asp Val Thr Asn Val Tyr Ile Met Gly Tyr Leu Ala Asp Thr Thr Ser
65 70 75 80
Tyr Phe Phe Asn Glu Pro Ala Ala Glu Leu Ala Ser Gln Tyr Val Phe
85 90 95
Arg Asp Ala Arg Arg Lys Ile Thr Leu Pro Tyr Ser Gly Asn Tyr Glu
100 105 110
Arg Leu Gln Ile Ala Ala Gly Lys Pro Arg Glu Lys Ile Pro Ile Gly
115 120 125
Leu Pro Ala Leu Asp Ser Ala Ile Ser Thr Leu Leu His Tyr Asp Ser
130 135 140
Thr Ala Ala Ala Gly Ala Leu Leu Val Leu Ile Gln Thr Thr Ala Glu
145 150 155 160
Ala Ala Arg Phe Lys Tyr Ile Glu Gln Gln Ile Gln Glu Arg Ala Tyr
165 170 175
Arg Asp Glu Val Pro Ser Leu Ala Thr Ile Ser Leu Glu Asn Ser Trp
180 185 190
Ser Gly Leu Ser Lys Gln Ile Gln Leu Ala Gln Gly Asn Asn Gly Ile
195 200 205
Phe Arg Thr Pro Ile Val Leu Val Asp Asn Lys Gly Asn Arg Val Gln
210 215 220
Ile Thr Asn Val Thr Ser Lys Val Val Thr Ser Asn Ile Gln Leu Leu
225 230 235 240
Leu Asn Thr Arg Asn Ile
245
<210> 68
<211> 342
<212> PRT
<213> Pseudomonas aeruginosa
<400> 68
Pro Glu Gly Gly Ser Leu Ala Ala Leu Thr Ala His Gln Ala Cys His
1 5 10 15
Leu Pro Leu Glu Thr Phe Thr Arg His Arg Gln Pro Arg Gly Trp Glu
20 25 30
Gln Leu Glu Gln Cys Gly Tyr Pro Val Gln Arg Leu Val Ala Leu Tyr
35 40 45
Leu Ala Ala Arg Leu Ser Trp Asn Gln Val Asp Gln Val Ile Ala Asn
50 55 60
Ala Leu Ala Ser Pro Gly Ser Gly Gly Asp Leu Gly Glu Ala Ile Arg
65 70 75 80
Glu Ser Pro Glu Gln Ala Arg Leu Ala Leu Thr Leu Ala Ala Ala Glu
85 90 95
Ser Glu Arg Phe Val Arg Gln Gly Thr Gly Asn Asp Glu Ala Gly Ala
100 105 110
Ala Asn Gly Pro Ala Asp Ser Gly Asp Ala Leu Leu Glu Arg Asn Tyr
115 120 125
Pro Thr Gly Ala Glu Phe Leu Gly Asp Gly Gly Asp Val Ser Phe Ser
130 135 140
Thr Arg Gly Thr Gln Asn Trp Thr Val Glu Arg Leu Leu Gln Ala His
145 150 155 160
Arg Gln Leu Glu Glu Ala Gly Tyr Val Phe Val Gly Tyr His Gly Thr
165 170 175
Phe Leu Glu Ala Ala Gln Ser Ile Val Phe Gly Gly Val Arg Ala Arg
180 185 190
Ser Gln Asp Leu Asp Ala Ile Trp Ala Gly Phe Tyr Ile Ala Gly Asp
195 200 205
Pro Ala Leu Ala Tyr Gly Tyr Ala Gln Asp Gln Glu Pro Asp Ala Ala
210 215 220
Gly Arg Ile Arg Asn Gly Ala Leu Leu Arg Val Tyr Val Pro Arg Ser
225 230 235 240
Ser Leu Pro Gly Phe Tyr Ala Thr Ser Leu Thr Leu Ala Ala Pro Glu
245 250 255
Ala Ala Gly Glu Val Glu Arg Leu Ile Gly His Pro Leu Pro Leu Arg
260 265 270
Leu Asp Ala Ile Thr Gly Pro Glu Glu Ser Gly Gly Arg Leu Glu Thr
275 280 285
Ile Leu Gly Trp Pro Leu Ala Glu Arg Thr Val Val Ile Pro Ser Ala
290 295 300
Ile Pro Thr Asp Pro Arg Asn Val Gly Gly Asp Leu Asp Pro Ser Ser
305 310 315 320
Ile Pro Asp Ser Glu Gln Ala Ile Ser Ala Leu Pro Asp Tyr Ala Ser
325 330 335
Gln Pro Gly Lys Pro Pro
340
<210> 69
<211> 354
<212> PRT
<213> Pseudomonas aeruginosa
<400> 69
Pro Glu Gly Gly Ser Leu Ala Ala Leu Thr Ala His Gln Ala Cys His
1 5 10 15
Leu Pro Leu Glu Thr Phe Thr Arg His Arg Gln Pro Arg Gly Trp Glu
20 25 30
Gln Leu Glu Gln Cys Gly Tyr Pro Val Gln Arg Leu Val Ala Leu Tyr
35 40 45
Leu Ala Ala Arg Leu Ser Trp Asn Gln Val Asp Gln Val Ile Arg Asn
50 55 60
Ala Leu Ala Ser Pro Gly Ser Gly Gly Asp Leu Gly Glu Ala Ile Arg
65 70 75 80
Glu Gln Pro Glu Gln Ala Arg Leu Ala Leu Thr Leu Ala Ala Ala Glu
85 90 95
Ser Glu Arg Phe Val Arg Gln Gly Thr Gly Asn Val Val Ser Leu Thr
100 105 110
Cys Pro Val Ala Ala Gly Glu Cys Ala Gly Pro Ala Asp Ser Gly Asp
115 120 125
Ala Leu Leu Glu Arg Asn Tyr Pro Thr Gly Ala Glu Phe Leu Gly Asp
130 135 140
Gly Gly Asp Val Ser Phe Ser Thr Arg Gly Thr Gln Asn Trp Thr Val
145 150 155 160
Glu Arg Leu Leu Gln Ala His Arg Gln Leu Glu Glu Arg Gly Tyr Val
165 170 175
Phe Val Gly Tyr His Gly Thr Phe Leu Glu Ala Ala Gln Ser Ile Val
180 185 190
Phe Gly Gly Val Arg Ala Arg Ser Gln Asp Leu Asp Ala Ile Trp Arg
195 200 205
Gly Phe Tyr Ile Ala Gly Asp Pro Ala Leu Ala Tyr Gly Tyr Ala Gln
210 215 220
Asp Gln Glu Pro Asp Ala Arg Gly Arg Ile Arg Asn Gly Ala Leu Leu
225 230 235 240
Arg Val Tyr Val Pro Arg Ser Ser Leu Pro Gly Phe Tyr Arg Thr Ser
245 250 255
Leu Thr Leu Ala Ala Pro Glu Ala Ala Gly Glu Val Glu Arg Leu Ile
260 265 270
Gly His Pro Leu Pro Leu Arg Leu Asp Ala Ile Thr Gly Pro Glu Glu
275 280 285
Glu Gly Gly Arg Leu Glu Thr Ile Leu Gly Trp Pro Leu Ala Glu Arg
290 295 300
Thr Val Val Ile Pro Ser Ala Ile Pro Thr Asp Pro Arg Asn Val Gly
305 310 315 320
Gly Asp Leu Asp Pro Ser Ser Ile Pro Asp Lys Glu Gln Ala Ile Ser
325 330 335
Ala Leu Pro Asp Tyr Ala Ser Gln Pro Gly Lys Pro Pro Arg Glu Asp
340 345 350
Leu Lys
<210> 70
<211> 241
<212> PRT
<213> Shigella dysentarie
<300>
<308> GenBank/ABR09970.1
<309> 2007-12-21
<313> (6)..(244)
<400> 70
Lys Glu Phe Thr Leu Asp Phe Ser Thr Ala Lys Thr Tyr Val Asp Ser
1 5 10 15
Leu Asn Val Ile Arg Ser Ala Ile Gly Thr Pro Leu Gln Thr Ile Ser
20 25 30
Ser Gly Gly Thr Ser Leu Leu Met Ile Asp Ser Gly Thr Gly Asp Asn
35 40 45
Leu Phe Ala Val Asp Val Arg Gly Ile Asp Pro Glu Glu Gly Arg Phe
50 55 60
Asn Asn Leu Arg Leu Ile Val Glu Arg Asn Asn Leu Tyr Val Thr Gly
65 70 75 80
Phe Val Asn Arg Thr Asn Asn Val Phe Tyr Arg Phe Ala Asp Phe Ser
85 90 95
His Val Thr Phe Pro Gly Thr Thr Ala Val Thr Leu Ser Gly Asp Ser
100 105 110
Ser Tyr Thr Thr Leu Gln Arg Val Ala Gly Ile Ser Arg Thr Gly Met
115 120 125
Gln Ile Asn Arg His Ser Leu Thr Thr Ser Tyr Leu Asp Leu Met Ser
130 135 140
His Ser Gly Thr Ser Leu Thr Gln Ser Val Ala Arg Ala Met Leu Arg
145 150 155 160
Phe Val Thr Val Thr Ala Glu Ala Leu Arg Phe Arg Gln Ile Gln Arg
165 170 175
Gly Phe Arg Thr Thr Leu Asp Asp Leu Ser Gly Arg Ser Tyr Val Met
180 185 190
Thr Ala Glu Asp Val Asp Leu Thr Leu Asn Trp Gly Arg Leu Ser Ser
195 200 205
Val Leu Pro Asp Tyr His Gly Gln Asp Ser Val Arg Val Gly Arg Ile
210 215 220
Ser Phe Gly Ser Ile Asn Ala Ile Leu Gly Ser Val Ala Leu Ile Leu
225 230 235 240
Asn
<210> 71
<211> 149
<212> PRT
<213> Aspergillus restrictus
<300>
<308> GenBank/AAA32707.1
<309> 1993-04-27
<313> (28)..(176)
<400> 71
Ala Thr Trp Thr Cys Ile Asn Gln Gln Leu Asn Pro Lys Thr Asn Lys
1 5 10 15
Trp Glu Asp Lys Arg Leu Leu Tyr Ser Gln Ala Lys Ala Glu Ser Asn
20 25 30
Ser His His Ala Pro Leu Ser Asp Gly Lys Thr Gly Ser Ser Tyr Pro
35 40 45
His Trp Phe Thr Asn Gly Tyr Asp Gly Asn Gly Lys Leu Ile Lys Gly
50 55 60
Arg Thr Pro Ile Lys Phe Gly Lys Ala Asp Cys Asp Arg Pro Pro Lys
65 70 75 80
His Ser Gln Asn Gly Met Gly Lys Asp Asp His Tyr Leu Leu Glu Phe
85 90 95
Pro Thr Phe Pro Asp Gly His Asp Tyr Lys Phe Asp Ser Lys Lys Pro
100 105 110
Lys Glu Asp Pro Gly Pro Ala Arg Val Ile Tyr Thr Tyr Pro Asn Lys
115 120 125
Val Phe Cys Gly Ile Val Ala His Gln Arg Gly Asn Gln Gly Asp Leu
130 135 140
Arg Leu Cys Ser His
145
<210> 72
<211> 130
<212> PRT
<213> Hirsutella thompsonii var thompsonii
<300>
<308> GenBank/AAB47280.1
<309> 2003-01-15
<313> (35)..(164)
<400> 72
Ala Pro Ile Val Thr Cys Arg Pro Lys Leu Asp Gly Arg Glu Lys Pro
1 5 10 15
Phe Lys Val Asp Val Ala Thr Ala Gln Ala Gln Ala Arg Lys Ala Gly
20 25 30
Leu Thr Thr Gly Lys Ser Gly Asp Pro His Arg Tyr Phe Ala Gly Asp
35 40 45
His Ile Arg Trp Gly Val Asn Asn Cys Asp Lys Ala Asp Ala Ile Leu
50 55 60
Trp Glu Tyr Pro Ile Tyr Trp Val Gly Lys Asn Ala Glu Trp Ala Lys
65 70 75 80
Asp Val Lys Thr Ser Gln Gln Lys Gly Gly Pro Thr Pro Ile Arg Val
85 90 95
Val Tyr Ala Asn Ser Arg Gly Ala Val Gln Tyr Cys Gly Val Met Thr
100 105 110
His Ser Lys Val Asp Lys Asn Asn Gln Gly Lys Glu Phe Phe Glu Lys
115 120 125
Cys Asp
130
<210> 73
<211> 109
<212> PRT
<213> Salmonella typhi
<300>
<308> GenBank/ACJ63596.1
<309> 2010-04-22
<313> (28)..(136)
<400> 73
Glu Arg Gly Glu Ile Trp Leu Val Ser Leu Asp Pro Thr Ala Gly His
1 5 10 15
Glu Gln Gln Gly Thr Arg Pro Val Leu Ile Val Thr Pro Ala Ala Phe
20 25 30
Asn Arg Val Thr Arg Leu Pro Val Val Val Pro Val Thr Ser Gly Gly
35 40 45
Asn Phe Ala Arg Thr Ala Gly Phe Ala Val Ser Leu Asp Gly Val Gly
50 55 60
Ile Arg Thr Thr Gly Val Val Arg Cys Asp Gln Pro Arg Thr Ile Asp
65 70 75 80
Met Lys Ala Arg Gly Gly Lys Arg Leu Glu Arg Val Pro Glu Thr Ile
85 90 95
Met Asn Glu Val Leu Gly Arg Leu Ser Thr Ile Leu Thr
100 105
<210> 74
<211> 100
<212> PRT
<213> Escherichia coli
<300>
<308> GenBank/AAL77580.1
<309> 2005-06-29
<313> (27)..(126)
<400> 74
Gln Phe Lys Val Tyr Thr Tyr Lys Arg Glu Ser Arg Tyr Arg Leu Phe
1 5 10 15
Val Asp Val Gln Ser Asp Ile Ile Asp Thr Pro Gly Arg Arg Met Val
20 25 30
Ile Pro Leu Ala Ser Ala Arg Leu Leu Ser Asp Lys Val Ser Arg Glu
35 40 45
Leu Tyr Pro Val Val His Ile Gly Asp Glu Ser Trp Arg Met Met Thr
50 55 60
Thr Asp Met Ala Ser Val Pro Val Ser Val Ile Gly Glu Glu Val Ala
65 70 75 80
Asp Leu Ser His Arg Glu Asn Asp Ile Lys Asn Ala Ile Asn Leu Met
85 90 95
Phe Trp Gly Ile
100
<210> 75
<211> 47
<212> PRT
<213> Escherichia coli
<300>
<301> Trovatti E, Cotrim CA, Garrido SS, Barros RS, Marchetto R.
<302> Peptides based on CcdB protein as novel inhibitors of bacterial
topoisomerases
<303> Bioorg Med Chem Lett.
<304> 18
<305> 23
<306> 6161-6164
<307> 2008-10-07
<400> 75
Gln Phe Lys Val Tyr Thr Tyr Lys Gly Gly Ser Gly Gly Arg Leu Leu
1 5 10 15
Ser Asp Lys Val Ser Arg Glu Leu Gly Gly Ser Gly Gly Ser His Arg
20 25 30
Glu Asn Asp Ile Lys Asn Ala Ile Asn Leu Met Phe Trp Gly Ile
35 40 45
<210> 76
<211> 94
<212> PRT
<213> Escherichia coli
<300>
<308> NCBI Reference Sequence/NP_416081.1
<309> 2011-02-13
<313> (2)..(95)
<400> 76
Ala Tyr Phe Leu Asp Phe Asp Glu Arg Ala Leu Lys Glu Trp Arg Lys
1 5 10 15
Leu Gly Ser Thr Val Arg Glu Gln Leu Lys Lys Lys Leu Val Glu Val
20 25 30
Leu Glu Ser Pro Arg Ile Glu Ala Asn Lys Leu Arg Gly Met Pro Asp
35 40 45
Cys Tyr Lys Ile Lys Leu Arg Ser Ser Gly Tyr Arg Leu Val Tyr Gln
50 55 60
Val Ile Asp Glu Lys Val Val Val Phe Val Ile Ser Val Gly Lys Arg
65 70 75 80
Glu Arg Ser Glu Val Tyr Ser Glu Ala Val Lys Arg Ile Leu
85 90
<210> 77
<211> 90
<212> PRT
<213> Paracoccus methylutens
<300>
<308> NCBI Reference Sequence/YP_001429553.1
<309> 2010-11-03
<313> (2)..(91)
<400> 77
Pro Glu Leu Glu Trp Lys Ala Ala Ala Val Ala Asp Leu Leu Ala Ile
1 5 10 15
Val Asp Tyr Ile Ser Asp Asp Asn Pro Asp Ala Ala Phe Ala Leu Met
20 25 30
Glu Glu Ile Gln Asp Lys Val Ala Gln Leu Pro Ala His Pro Lys Arg
35 40 45
Cys Arg Pro Gly Arg Val Glu Gly Thr Arg Glu Leu Val Val Arg Pro
50 55 60
Asn Tyr Leu Val Val Tyr Ala Glu Thr Pro Ala Val Val Thr Ile Leu
65 70 75 80
Arg Val Leu His Ala Ala Gln Met Trp Pro
85 90
<210> 78
<211> 251
<212> PRT
<213> Gelonium multoflorum
<300>
<301> Veenendaal LM, Jin H, Ran S, Cheung L, Navone N, Marks JW,
Waltenberger J,
<302> In vitro and in vivo studies of a VEGF121/rGelonin
<303> Proc Natl Acad Sci U S A.
<304> 99
<305> 12
<306> 7866-71
<307> 2001-06-11
<400> 78
Gly Leu Asp Thr Val Ser Phe Ser Thr Lys Gly Ala Thr Tyr Ile Thr
1 5 10 15
Tyr Val Asn Phe Leu Asn Glu Leu Arg Val Lys Leu Lys Pro Glu Gly
20 25 30
Asn Ser His Gly Ile Pro Leu Leu Arg Lys Lys Ala Asp Asp Pro Gly
35 40 45
Lys Ala Phe Val Leu Val Ala Leu Ser Asn Asp Asn Gly Gln Leu Ala
50 55 60
Glu Ile Ala Ile Asp Val Thr Ser Val Tyr Val Val Gly Tyr Gln Val
65 70 75 80
Arg Asn Arg Ser Tyr Phe Phe Lys Asp Ala Pro Asp Ala Ala Tyr Glu
85 90 95
Gly Leu Phe Lys Asn Thr Ile Lys Thr Arg Leu His Phe Gly Gly Ser
100 105 110
Tyr Pro Ser Leu Glu Gly Glu Lys Ala Tyr Arg Glu Thr Thr Asp Leu
115 120 125
Gly Ile Glu Pro Leu Arg Ile Gly Ile Lys Lys Leu Asp Glu Asn Ala
130 135 140
Ile Asp Asn Tyr Lys Pro Thr Glu Ile Ala Ser Ser Leu Leu Val Val
145 150 155 160
Ile Gln Met Val Ser Glu Ala Ala Arg Phe Thr Phe Ile Glu Asn Gln
165 170 175
Ile Arg Asn Asn Phe Gln Gln Arg Ile Arg Pro Ala Asn Asn Thr Ile
180 185 190
Ser Leu Glu Asn Lys Trp Gly Lys Leu Ser Phe Gln Ile Arg Thr Ser
195 200 205
Gly Ala Asn Gly Met Phe Ser Glu Ala Val Glu Leu Glu Arg Ala Asn
210 215 220
Gly Lys Lys Tyr Tyr Val Thr Ala Val Asp Gln Val Lys Pro Lys Ile
225 230 235 240
Ala Leu Leu Lys Phe Val Asp Lys Asp Pro Lys
245 250
<210> 79
<211> 387
<212> PRT
<213> Corynobacterium diptheriae
<300>
<308> GenBank/AAA72359.1
<309> 1993-02-23
<313> (2)..(388)
<400> 79
Gly Ala Asp Asp Val Val Asp Ser Ser Lys Ser Phe Val Met Glu Asn
1 5 10 15
Phe Ser Ser Tyr His Gly Thr Lys Pro Gly Tyr Val Asp Ser Ile Gln
20 25 30
Lys Gly Ile Gln Lys Pro Lys Ser Gly Thr Gln Gly Asn Tyr Asp Asp
35 40 45
Asp Trp Lys Gly Phe Tyr Ser Thr Asp Asn Lys Tyr Asp Ala Ala Gly
50 55 60
Tyr Ser Val Asp Asn Glu Asn Pro Leu Ser Gly Lys Ala Gly Gly Val
65 70 75 80
Val Lys Val Thr Tyr Pro Gly Leu Thr Lys Val Leu Ala Leu Lys Val
85 90 95
Asp Asn Ala Glu Thr Ile Lys Lys Glu Leu Gly Leu Ser Leu Thr Glu
100 105 110
Pro Leu Met Glu Gln Val Gly Thr Glu Glu Phe Ile Lys Arg Phe Gly
115 120 125
Asp Gly Ala Ser Arg Val Val Leu Ser Leu Pro Phe Ala Glu Gly Ser
130 135 140
Ser Ser Val Glu Tyr Ile Asn Asn Trp Glu Gln Ala Lys Ala Leu Ser
145 150 155 160
Val Glu Leu Glu Ile Asn Phe Glu Thr Arg Gly Lys Arg Gly Gln Asp
165 170 175
Ala Met Tyr Glu Tyr Met Ala Gln Ala Cys Ala Gly Asn Arg Val Arg
180 185 190
Arg Ser Val Gly Ser Ser Leu Ser Cys Ile Asn Leu Asp Trp Asp Val
195 200 205
Ile Arg Asp Lys Thr Lys Thr Lys Ile Glu Ser Leu Lys Glu His Gly
210 215 220
Pro Ile Lys Asn Lys Met Ser Glu Ser Pro Asn Lys Thr Val Ser Glu
225 230 235 240
Glu Lys Ala Lys Gln Tyr Leu Glu Glu Phe His Gln Thr Ala Leu Glu
245 250 255
His Pro Glu Leu Ser Glu Leu Lys Thr Val Thr Gly Thr Asn Pro Val
260 265 270
Phe Ala Gly Ala Asn Tyr Ala Ala Trp Ala Val Asn Val Ala Gln Val
275 280 285
Ile Asp Ser Glu Thr Ala Asp Asn Leu Glu Lys Thr Thr Ala Ala Leu
290 295 300
Ser Ile Leu Pro Gly Ile Gly Ser Val Met Gly Ile Ala Asp Gly Ala
305 310 315 320
Val His His Asn Thr Glu Glu Ile Val Ala Gln Ser Ile Ala Leu Ser
325 330 335
Ser Leu Met Val Ala Gln Ala Ile Pro Leu Val Gly Glu Leu Val Asp
340 345 350
Ile Gly Phe Ala Ala Tyr Asn Phe Val Glu Ser Ile Ile Asn Leu Phe
355 360 365
Gln Val Val His Asn Ser Tyr Asn Arg Pro Ala Tyr Ser Pro Gly His
370 375 380
Lys Thr His
385
<210> 80
<211> 300
<212> PRT
<213> Corynobacterium diptheriae
<300>
<308> GenBank/AAA72359.1
<309> 1993-07-23
<313> (2)..(194)
<400> 80
Ala Asp Asp Val Val Asp Ser Ser Lys Ser Phe Val Met Glu Asn Phe
1 5 10 15
Ser Ser Tyr His Gly Thr Lys Pro Gly Tyr Val Asp Ser Ile Gln Lys
20 25 30
Gly Ile Gln Lys Pro Lys Ser Gly Thr Gln Gly Asn Tyr Asp Asp Asp
35 40 45
Trp Lys Gly Phe Tyr Ser Thr Asp Asn Lys Tyr Asp Ala Ala Gly Tyr
50 55 60
Ser Val Asp Asn Glu Asn Pro Leu Ser Gly Lys Ala Gly Gly Val Val
65 70 75 80
Lys Val Thr Tyr Pro Gly Leu Thr Lys Val Leu Ala Leu Lys Val Asp
85 90 95
Asn Ala Glu Thr Ile Lys Lys Glu Leu Gly Leu Ser Leu Thr Glu Pro
100 105 110
Leu Met Glu Gln Val Gly Thr Glu Glu Phe Ile Lys Arg Phe Gly Asp
115 120 125
Gly Ala Ser Arg Val Val Leu Ser Leu Pro Phe Ala Glu Gly Ser Ser
130 135 140
Ser Val Glu Tyr Ile Asn Asn Trp Glu Gln Ala Lys Ala Leu Ser Val
145 150 155 160
Glu Leu Glu Ile Asn Phe Glu Thr Arg Gly Lys Arg Gly Gln Asp Ala
165 170 175
Met Tyr Glu Tyr Met Ala Gln Ala Cys Ala Gly Asn Arg Val Arg Arg
180 185 190
Pro Glu Gly Gly Ser Leu Ala Ala Leu Thr Ala His Gln Ala Cys His
195 200 205
Leu Pro Leu Glu Thr Phe Thr Arg His Arg Gln Pro Arg Gly Trp Glu
210 215 220
Gln Leu Glu Gln Cys Gly Tyr Pro Val Gln Arg Leu Val Ala Leu Tyr
225 230 235 240
Leu Ala Ala Arg Leu Ser Trp Asn Gln Val Asp Gln Val Ile Arg Asn
245 250 255
Ala Leu Ala Ser Pro Gly Ser Gly Gly Asp Leu Gly Glu Ala Ile Arg
260 265 270
Glu Gln Pro Glu Gln Ala Arg Leu Ala Leu Thr Leu Ala Ala Ala Glu
275 280 285
Ser Glu Arg Phe Val Arg Gln Gly Thr Gly Asn Gly
290 295 300
<210> 81
<211> 297
<212> PRT
<213> Corynobacterium diptheriae
<300>
<308> GenBank/AAA72359.1
<309> 1993-07-23
<313> (2)..(190)
<400> 81
Gly Ala Asp Asp Val Val Asp Ser Ser Lys Ser Phe Val Met Glu Asn
1 5 10 15
Phe Ser Ser Tyr His Gly Thr Lys Pro Gly Tyr Val Asp Ser Ile Gln
20 25 30
Lys Gly Ile Gln Lys Pro Lys Ser Gly Thr Gln Gly Asn Tyr Asp Asp
35 40 45
Asp Trp Lys Gly Phe Tyr Ser Thr Asp Asn Lys Tyr Asp Ala Ala Gly
50 55 60
Tyr Ser Val Asp Asn Glu Asn Pro Leu Ser Gly Lys Ala Gly Gly Val
65 70 75 80
Val Lys Val Thr Tyr Pro Gly Leu Thr Lys Val Leu Ala Leu Lys Val
85 90 95
Asp Asn Ala Glu Thr Ile Lys Lys Glu Leu Gly Leu Ser Leu Thr Glu
100 105 110
Pro Leu Met Glu Gln Val Gly Thr Glu Glu Phe Ile Lys Arg Phe Gly
115 120 125
Asp Gly Ala Ser Arg Val Val Leu Ser Leu Pro Phe Ala Glu Gly Ser
130 135 140
Ser Ser Val Glu Tyr Ile Asn Asn Trp Glu Gln Ala Lys Ala Leu Ser
145 150 155 160
Val Glu Leu Glu Ile Asn Phe Glu Thr Arg Gly Lys Arg Gly Gln Asp
165 170 175
Ala Met Tyr Glu Tyr Met Ala Gln Ala Cys Ala Gly Asn Pro Glu Gly
180 185 190
Gly Ser Leu Ala Ala Leu Thr Ala His Gln Ala Cys His Leu Pro Leu
195 200 205
Glu Thr Phe Thr Arg His Arg Gln Pro Arg Gly Trp Glu Gln Leu Glu
210 215 220
Gln Cys Gly Tyr Pro Val Gln Arg Leu Val Ala Leu Tyr Leu Ala Ala
225 230 235 240
Arg Leu Ser Trp Asn Gln Val Asp Gln Val Ile Arg Asn Ala Leu Ala
245 250 255
Ser Pro Gly Ser Gly Gly Asp Leu Gly Glu Ala Ile Arg Glu Gln Pro
260 265 270
Glu Gln Ala Arg Leu Ala Leu Thr Leu Ala Ala Ala Glu Ser Glu Arg
275 280 285
Phe Val Arg Gln Gly Thr Gly Asn Gly
290 295
<210> 82
<211> 251
<212> PRT
<213> Abrus precatorius
<300>
<308> GenBank/CAA38655.1
<309> 2005-04-18
<313> (2)..(252)
<400> 82
Glu Asp Arg Pro Ile Lys Phe Ser Thr Glu Gly Ala Thr Ser Gln Ser
1 5 10 15
Tyr Lys Gln Phe Ile Glu Ala Leu Arg Glu Arg Leu Arg Gly Gly Leu
20 25 30
Ile His Asp Ile Pro Val Leu Pro Asp Pro Thr Thr Leu Gln Glu Arg
35 40 45
Asn Arg Tyr Ile Thr Val Glu Leu Ser Asn Ser Asp Thr Glu Ser Ile
50 55 60
Glu Val Gly Ile Asp Val Thr Asn Ala Tyr Val Val Ala Tyr Arg Ala
65 70 75 80
Gly Thr Gln Ser Tyr Phe Leu Arg Asp Ala Pro Ser Ser Ala Ser Asp
85 90 95
Tyr Leu Phe Thr Gly Thr Asp Gln His Ser Leu Pro Phe Tyr Gly Thr
100 105 110
Tyr Gly Asp Leu Glu Arg Trp Ala His Gln Ser Arg Gln Gln Ile Pro
115 120 125
Leu Gly Leu Gln Ala Leu Thr His Gly Ile Ser Phe Phe Arg Ser Gly
130 135 140
Gly Asn Asp Asn Glu Glu Lys Ala Arg Thr Leu Ile Val Ile Ile Gln
145 150 155 160
Met Val Ala Glu Ala Ala Arg Phe Arg Tyr Ile Ser Asn Arg Val Arg
165 170 175
Val Ser Ile Gln Thr Gly Thr Ala Phe Gln Pro Asp Ala Ala Met Ile
180 185 190
Ser Leu Glu Asn Asn Trp Asp Asn Leu Ser Arg Gly Val Gln Glu Ser
195 200 205
Val Gln Asp Thr Phe Pro Asn Gln Val Thr Leu Thr Asn Ile Arg Asn
210 215 220
Glu Pro Val Ile Val Asp Ser Leu Ser His Pro Thr Val Ala Val Leu
225 230 235 240
Ala Leu Met Leu Phe Val Cys Asn Pro Pro Asn
245 250
<210> 83
<211> 342
<212> PRT
<213> Pseudomonas aeruginosa
<400> 83
Pro Glu Gly Gly Ser Leu Ala Ala Leu Thr Ala His Gln Ala Cys His
1 5 10 15
Leu Pro Leu Glu Thr Phe Thr Arg His Arg Gln Pro Arg Gly Trp Glu
20 25 30
Gln Leu Glu Gln Cys Gly Tyr Pro Val Gln Arg Leu Val Ala Leu Tyr
35 40 45
Leu Ala Ala Arg Leu Ser Trp Asn Gln Val Asp Gln Val Ile Ala Asn
50 55 60
Ala Leu Ala Ser Pro Gly Ser Gly Gly Asp Leu Gly Glu Ala Ile Arg
65 70 75 80
Glu Ser Pro Glu Gln Ala Arg Leu Ala Leu Thr Leu Ala Ala Ala Glu
85 90 95
Ser Glu Arg Phe Val Arg Gln Gly Thr Gly Asn Asp Glu Ala Gly Ala
100 105 110
Ala Asn Gly Pro Ala Asp Ser Gly Asp Ala Leu Leu Glu Arg Asn Tyr
115 120 125
Pro Thr Gly Ala Glu Phe Leu Gly Asp Gly Gly Asp Val Ser Phe Ser
130 135 140
Thr Arg Gly Thr Gln Asn Trp Thr Val Glu Arg Leu Leu Gln Ala His
145 150 155 160
Arg Gln Leu Glu Glu Arg Gly Tyr Val Phe Val Gly Tyr His Gly Thr
165 170 175
Phe Leu Glu Ala Ala Gln Ser Ile Val Phe Gly Gly Val Arg Ala Arg
180 185 190
Ser Gln Asp Leu Asp Ala Ile Trp Ala Gly Phe Tyr Ile Ala Gly Asp
195 200 205
Pro Ala Leu Ala Tyr Gly Tyr Ala Gln Asp Gln Glu Pro Asp Ala Ala
210 215 220
Gly Arg Ile Arg Asn Gly Ala Leu Leu Arg Val Tyr Val Pro Arg Ser
225 230 235 240
Ser Leu Pro Gly Phe Tyr Ala Thr Ser Leu Thr Leu Ala Ala Pro Glu
245 250 255
Ala Ala Gly Glu Val Glu Arg Leu Ile Gly His Pro Leu Pro Leu Arg
260 265 270
Leu Asp Ala Ile Thr Gly Pro Glu Glu Ser Gly Gly Arg Leu Glu Thr
275 280 285
Ile Leu Gly Trp Pro Leu Ala Glu Arg Thr Val Val Ile Pro Ser Ala
290 295 300
Ile Pro Thr Asp Pro Arg Asn Val Gly Gly Asp Leu Asp Pro Ser Ser
305 310 315 320
Ile Pro Asp Ser Glu Gln Ala Ile Ser Ala Leu Pro Asp Tyr Ala Ser
325 330 335
Gln Pro Gly Lys Pro Pro
340
<210> 84
<211> 342
<212> PRT
<213> Pseudomonas aeruginosa
<400> 84
Pro Glu Gly Gly Ser Leu Ala Ala Leu Thr Ala His Gln Ala Cys His
1 5 10 15
Leu Pro Leu Glu Thr Phe Thr Arg His Arg Gln Pro Arg Gly Trp Glu
20 25 30
Gln Leu Glu Gln Cys Gly Tyr Pro Val Gln Arg Leu Val Ala Leu Tyr
35 40 45
Leu Ala Ala Arg Leu Ser Trp Asn Gln Val Asp Gln Val Ile Ala Asn
50 55 60
Ala Leu Ala Ser Pro Gly Ser Gly Gly Asp Leu Gly Glu Ala Ile Arg
65 70 75 80
Glu Ser Pro Glu Gln Ala Arg Leu Ala Leu Thr Leu Ala Ala Ala Glu
85 90 95
Ser Glu Arg Phe Val Arg Gln Gly Thr Gly Asn Asp Glu Ala Gly Ala
100 105 110
Ala Asn Gly Pro Ala Asp Ser Gly Asp Ala Leu Leu Glu Arg Asn Tyr
115 120 125
Pro Thr Gly Ala Glu Phe Leu Gly Asp Gly Gly Asp Val Ser Phe Ser
130 135 140
Thr Arg Gly Thr Gln Asn Trp Thr Val Glu Arg Leu Leu Gln Ala His
145 150 155 160
Arg Gln Leu Glu Glu Ala Gly Tyr Val Phe Val Gly Tyr His Gly Thr
165 170 175
Phe Leu Glu Ala Ala Gln Ser Ile Val Phe Gly Gly Val Arg Ala Arg
180 185 190
Ser Gln Asp Leu Asp Ala Ile Trp Ala Gly Phe Tyr Ile Ala Gly Asp
195 200 205
Pro Ala Leu Ala Tyr Gly Tyr Ala Gln Asp Gln Glu Pro Asp Ala Ala
210 215 220
Gly Arg Ile Arg Asn Gly Ala Leu Leu Arg Val Tyr Val Pro Arg Ser
225 230 235 240
Ser Leu Pro Gly Phe Tyr Ala Thr Ser Leu Thr Leu Ala Ala Pro Glu
245 250 255
Ala Ala Gly Glu Val Glu Arg Leu Ile Gly His Pro Leu Pro Leu Arg
260 265 270
Leu Asp Ala Ile Thr Gly Pro Glu Glu Ser Gly Gly Arg Leu Glu Thr
275 280 285
Ile Leu Gly Trp Pro Leu Ala Glu Arg Thr Val Val Ile Pro Ser Ala
290 295 300
Ile Pro Thr Asp Pro Arg Asn Val Gly Gly Asp Leu Asp Pro Ser Ser
305 310 315 320
Ile Pro Asp Ser Glu Gln Ala Ile Ser Ala Leu Pro Asp Tyr Ala Ser
325 330 335
Gln Pro Gly Lys Pro Pro
340
<210> 85
<211> 1290
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 85
tataacaccg tgtcatttaa tctgggcgaa gcctatgaat atccgacctt tattcaggat 60
ctgcgtaatg aactggcaaa aggtacaccg gtttgtcagc tgccggttac cctgcagacc 120
attgcagatg ataaacgttt tgttctggtg gatatcacca ccaccagtaa aaaaaccgtt 180
aaagttgcca tcgatgtgac cgatgtttat gttgttggct atcaggataa atgggatggt 240
aaagatcgtg ccgtttttct ggataaagtt ccgaccgttg caaccagcaa actgtttccg 300
ggtgttacca atcgtgttac cctgaccttt gatggtagct atcagaaact ggttaatgca 360
gccaaagtgg atcgtaaaga tctggaactg ggcgtttata aactggaatt cagcattgaa 420
gccatccatg gtaaaaccat taacggccaa gaaatcgcca aatttttcct gattgtgatt 480
cagatggtta gcgaagccgc acgctttaaa tacattgaaa ccgaagttgt ggatcgcggt 540
ctgtatggta gctttaaacc gaactttaaa gtgctgaacc tggaaaataa ctggggtgat 600
attagcgacg caattcataa aagcagtccg cagtgtacca ccattaatcc ggcactgcag 660
ctgattagcc cgagcaatga tccgtgggtt gttaataaag ttagccagat tagtccggac 720
atgggcattc tgaaattcaa aagcggtggt ggtggtagcc gtaaaaaacg tgcaagcggt 780
tgtggtccgg aaggtggtgg cggtagtcgt gttgcagcac atattaccgg cacccgtggt 840
cgtagcaata ccctgagcag cccgaatagc aaaaatgaaa aagccctggg tcgcaaaatt 900
aacagctggg aaagcagccg tagcggtcat agctttctga gcaatctgca tctgcgcaat 960
ggtgaactgg tgattcacga aaaaggcttc tattatatct acagccagac ctatttccgc 1020
ttccaagaag agatcaaaga gaacaccaaa aacgacaaac aaatggtgca gtacatctat 1080
aaatacacca gctatccgga tccgattctg ctgatgaaaa gcgcacgtaa tagctgttgg 1140
agcaaagatg cagaatatgg cctgtatagc atctatcagg gtggcatttt tgaactgaaa 1200
gaaaacgatc gcatctttgt gagcgtgacc aatgaacatc tgattgatat ggatcacgaa 1260
gccagctttt ttggtgcctt tctggttggt 1290
<210> 86
<211> 1359
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 86
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaatagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gacctatttt cgctttcagg aagaaattaa agaaaatacc 240
aaaaatgata aacaaatggt gcagtacatc tataaatata ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggtctgtat 360
agcatttatc agggtggcat ttttgaactg aaagaaaatg atcgcatttt tgtgagcgtg 420
accaatgaac atctgattga tatggatcat gaagccagct tttttggtgc atttctggtt 480
ggtggtggtg gcggtagcgc aagcggttgt ggtccggaac gtaaaaaacg cggtggtggt 540
ggtagtgaag ataataatat ttttccgaaa cagtacccga ttattaattt taccaccgca 600
ggcgcaaccg ttcagagcta taccaatttt attcgtgcag ttcgtggtcg tctgacaacc 660
ggtgcggatg ttcgtcatga aattccggtt ctgccgaatc gtgttggtct gccgattaat 720
cagcgtttta ttctggttga actgagcaat catgcagaac tgagcgttac cctggcactg 780
gatgttacca atgcctatgt tgttggttat cgtgcaggta atagcgccta tttttttcat 840
ccggataatc aggaagatgc agaagcaatt acccacctgt ttaccgatgt gcagaatcgt 900
tatacctttg catttggtgg caattatgat cgtctggaac agctggcagg tagcctgcgt 960
gaaaatattg aactgggtaa tggtccgctg gaagaagcaa ttagcgcact gtattattat 1020
agcaccggtg gcacccagct gccgaccctg gcacgtagct ttattgtttg tattcagatg 1080
attagcgaag cagcccgttt tcagtatatt gaaggtgaaa tgcgtacccg cattcgttat 1140
aatcgtcgta gcgcaccgga tccgagcgtt attaccctgg aaaatagctg gggtcgtctg 1200
agtaccgcaa ttcaggaatc aaatcaggga gcatttgcaa gcccgattca gctgcagcgt 1260
cgtaatggta gcaaatttag cgtttatgat gtgagcattc tgattccgat tattgccctg 1320
atggtttatc gttgtgcacc gcctccgaaa gaagatctg 1359
<210> 87
<211> 1134
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 87
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaatagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gacctatttt cgctttcagg aagaaattaa agaaaatacc 240
aaaaatgata aacaaatggt gcagtacatc tataaatata ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggtctgtat 360
agcatttatc agggtggcat ttttgaactg aaagaaaatg atcgcatttt tgtgagcgtg 420
accaatgaac atctgattga tatggatcat gaagccagct tttttggtgc atttctggtt 480
ggtggtggtg gcggtagcgc aagcggttgt ggtccggaac gtaaaaaacg cggtggtggt 540
ggtagtggtc cgggtccgaa acagtacccg attattaatt ttaccaccgc aggcgcaacc 600
gttcagagct ataccaattt tattcgtgca gttcgtggtc gtctgacaac cggtgcggat 660
gttcgtcatg aaattccggt tctgccgaat cgtgttggtc tgccgattaa tcagcgtttt 720
attctggttg aactgagcaa tcatgcagaa ctgagcgtta ccctggcact ggatgttacc 780
aatgcctatg ttgttggtta tcgtgcaggt aatagcgcct atttttttca tccggataat 840
caggaagatg cagaagcaat tacccacctg tttaccgatg tgcagaatcg ttataccttt 900
gcatttggtg gcaattatga tcgtctggaa cagctggcag gtaatctgcg tgaaaatatt 960
gaactgggta atggtccgct ggaagaagca attagcgcac tgtattatta tagcaccggt 1020
ggcacccagc tgccgaccct ggcacgtagc tttattattt gtattcagat gattagcgaa 1080
gccgcacgct ttcagtatat tgaaggtgaa atgcgtgtgc cgaaagaaga tctg 1134
<210> 88
<211> 1419
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 88
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaatagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gacctatttt cgctttcaag aagaaattaa agaaaacacc 240
aaaaatgata aacaaatggt gcagtacatt tataaatata ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggtctgtat 360
agcatttatc agggtggcat ttttgaactg aaagaaaatg atcgcatttt tgtgagcgtg 420
accaatgaac atctgattga tatggatcat gaagccagct tttttggtgc atttctggtt 480
ggtggtggtg gcggtagcgc aagcggttgt ggtccggaag gtggtggtgg tagtgcaatt 540
aataccatta cctttgatgc aggcaatgcc accattaata aatatgccac ctttatggaa 600
agcctgcgta atcaggcaaa agatccgaaa ctgaaatgct atggtattcc gatgctgccg 660
gataccaata gcaccccgaa atatctgctg gttaaactgc agggtgcaaa tctgaaaacc 720
attaccctga tgctgcgtcg taataatctg tatgttatgg gttatagcga tccgtttaat 780
ggtaataaat gccgctatca tatttttaat gatattacca gcaccgaacg caccgatgtt 840
gaaaataccc tgtgtagcag cagcagcagt cgtgttgcaa tgagcattaa ttataatagc 900
ctgtatccga ccatggaaaa aaaagcagaa gtgaatagcc gtaatcaggt tcagctgggt 960
attcagattc tgagcagcga tattggtaaa atcagcggtg ttgatagctt tccggttaaa 1020
accgaagcat tttttctgct ggttgccatt cagatggtta gcgaagcagc acgctttaaa 1080
tatattgaaa atcaggtgaa aaccaatttt aatcgtgcct tttatccgga tccgaaagtg 1140
attaatctgg aagaaaaatg gggcaaaatt agcgaagcca ttcataatgc aaaaaatggt 1200
gcactgccga aaccgctgga actggttgat gcaaaaggca ccaaatggat tgttctgcgt 1260
gtggatgaaa ttaatcgtga tgttgccctg ctgaaatatg ttaatggcac ctgtcagacc 1320
acctatcaga atgcaatgtt tagccaggtg attattagca cctattataa ttatatgagc 1380
aatctgggcg acctgtttga aggctttaaa gatgaactg 1419
<210> 89
<211> 1290
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 89
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa atcaatagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gacctatttt cgctttcaag aagagattaa agaaaatacc 240
aaaaatgata aacaaatggt gcagtacatt tataaatata ccagctatcc ggacccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggtctgtat 360
agcatttatc agggtggcat ctttgagctg aaagaaaatg atcgcatctt tgttagcgtg 420
accaacgaac atctgatcga tatggatcat gaagccagct tttttggtgc atttctggtt 480
ggtggtggtg gcggtagcgc aagcggttgt ggtccggaag gtggtggtgg tagtgttacc 540
agcattaccc tggatctggt taatccgacc gcaggtcagt atagcagctt tgttgataaa 600
attcgcaata acgtgaaaga tccgaatctg aaatatggtg gcaccgatat tgcagttatt 660
ggtccgccta gcaaagataa atttctgcgc attaactttc agagcagccg tggcaccgtt 720
agcctgggtc tgaaacgtga taatctgtat gttgttgcat atctggccat ggataatacc 780
aatgttaacc gtgcctatta ttttaaaagc gaaatcacca gcgcagaact gaccgcactg 840
tttccggaag caaccaccgc aaatcagaaa gcactggaat ataccgaaga ttatcagagc 900
atcgaaaaaa atgcccagat tacccagggt gataaaagcc gtaaagaact gggtctgggt 960
attgatctgc tgctgacctt tatggaagcc gttaataaaa aagcccgtgt ggttaaaaac 1020
gaagcacgtt ttctgctgat tgcaattcag atgaccgcag aagttgcacg ttttcgttat 1080
attcagaacc tggtgaccaa aaactttccg aacaaattcg acagcgataa caaagtgatc 1140
cagtttgaag ttagctggcg taaaatttcc accgcaattt atggtgatgc caaaaatggc 1200
gtgtttaaca aagattatga cttcggtttt ggcaaagtgc gtcaggttaa agatctgcag 1260
atgggtctgc tgatgtatct gggtaaaccg 1290
<210> 90
<211> 1326
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 90
gttcgtgaac gtggtccgca gcgtgttgca gcacatatta ccggcacccg tggtcgtagc 60
aataccctga gcagcccgaa tagcaaaaat gaaaaagcac tgggtcgcaa aatcaatagc 120
tgggaaagca gccgtagcgg tcatagcttt ctgagcaatc tgcatctgcg taatggtgaa 180
ctggtgattc atgaaaaagg cttttattat atctatagcc agacctattt tcgctttcaa 240
gaagagatta aagaaaatac caaaaatgat aaacaaatgg tgcagtatat ctataaatat 300
accagctatc cggacccgat tctgctgatg aaaagcgcac gtaatagctg ttggagcaaa 360
gatgcagaat atggtctgta tagcatttat cagggtggca tctttgagct gaaagaaaat 420
gatcgcatct ttgttagcgt gaccaacgaa catctgatcg atatggatca tgaagccagc 480
ttttttggtg catttctggt tggtgcaagc ggttgtggtc cggaaggtgg tggtggtggc 540
agcggtggtg gcggtagccg taaaaaacgt gttaccagca ttaccctgga tctggttaat 600
ccgaccgcag gtcagtatag cagctttgtt gataaaattc gcaataacgt gaaagatccg 660
aatctgaaat atggtggcac cgatattgca gttattggtc cgcctagcaa agataaattt 720
ctgcgcatta actttcagag cagccgtggc accgttagcc tgggtctgaa acgtgataat 780
ctgtatgttg ttgcatatct ggccatggat aataccaatg ttaaccgtgc ctattatttt 840
aaaagcgaaa tcaccagcgc agaactgacc gcactgtttc cggaagcaac caccgcaaat 900
cagaaagcac tggaatatac cgaagattat cagagcatcg aaaaaaatgc ccagattacc 960
cagggtgata aaagccgtaa agaactgggt ctgggtattg atctgctgct gacctttatg 1020
gaagccgtta ataaaaaagc ccgtgtggtt aaaaacgaag cacgttttct gctgattgca 1080
attcagatga ccgcagaagt tgcacgtttt cgttatattc agaacctggt gaccaaaaac 1140
tttccgaaca aattcgacag cgataacaaa gtgatccagt ttgaagttag ctggcgtaaa 1200
atttccaccg caatttatgg tgatgccaaa aatggcgtgt ttaacaaaga ttatgacttc 1260
ggttttggca aagtgcgtca ggttaaagat ctgcagatgg gtctgctgat gtatctgggt 1320
aaaccg 1326
<210> 91
<211> 1287
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 91
gatgttagct ttcgtctgag cggtgcaacc agcagcagct atggtgtttt tattagcaat 60
ctgcgtaaag cactgccgaa tgaacgtaaa ctgtatgata ttccgctgct gcgtagcagc 120
ctgcctggta gccagcgtta tgcactgatt catctgacca attatgccga tgaaaccatt 180
agcgttgcca ttgatgtgac caatgtgtat attatgggtt atcgtgcagg cgataccagc 240
tattttttta atgaagcaag cgcaaccgaa gcagccaaat atgtttttaa agatgccatg 300
cgtaaagtga ccctgccgta tagcggtaat tatgaacgtc tgcagaccgc agcaggtaaa 360
attcgtgaaa atattccgct gggtctgcct gcactggata gcgcaattac caccctgttt 420
tattataatg caaatagcgc agcaagcgca ctgatggttc tgattcagag caccagcgaa 480
gcagcacgtt ataaatttat tgaacagcag attggcaaac gcgtggataa aacctttctg 540
ccgagcctgg caattattag cctggaaaat agctggtcag cactgagcaa acaaattcag 600
attgcaagca ccaataatgg ccagtttgaa agtccggttg ttctgattaa tgcacagaat 660
cagcgtgtga ccattaccaa tgttgatgcc ggtgttgtta ccagcaatat tgcactgctg 720
ctgaatcgta ataatatggc aggcggtggt ggtagccgta aaaaacgtgc aagcggttgt 780
ggtccggaag gtggtggtgg tagtcgtgtt gcagcacata ttaccggcac ccgtggtcgt 840
agcaataccc tgagcagccc gaatagcaaa aatgaaaaag cactgggtcg caaaattaat 900
agctgggaaa gcagccgtag cggtcatagc tttctgagca atctgcatct gcgtaatggt 960
gaactggtga ttcatgaaaa aggcttttat tatatttata gccagaccta ttttcgcttt 1020
caggaagaaa ttaaagaaaa taccaaaaac gataaacaaa tggtgcagta tatctataaa 1080
tataccagct atccggatcc gattctgctg atgaaaagcg cacgtaatag ctgttggagc 1140
aaagatgcag aatatggtct gtatagcatt tatcagggtg gcatttttga actgaaagaa 1200
aatgatcgca tttttgtgag cgtgaccaat gaacatctga ttgatatgga tcatgaagcc 1260
agcttttttg gtgcatttct ggtgggt 1287
<210> 92
<211> 1281
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 92
gatgtgtcat ttgatctgag caccgcaacc aaaaaaagct atagcagctt tattacccag 60
ctgcgtgatg cactgccgac ccagggcacc gtttgtggta ttccgctgct gccgagcacc 120
gcaagcggta gccagtggtt tcgttttttt aatctgacca attataatga tgaaaccgtt 180
accgtggccg ttaatgttac caatgtttat attgttgcct atcgtgcaga tgccgtgagc 240
tatttttttg aagatacacc ggcagaagcc tttaaactga tttttgcagg caccaaaacc 300
gttaaactgc cgtatagcgg caattatgat aaactgcaga gcgttgttgg taaacagcgt 360
gatatgattg aactgggtat tccggcactg agcagcgcaa ttaccaatat ggtgtattat 420
gattatcaga gcaccgcagc agcactgctg gttctgattc agtgtaccgc agaagcagca 480
cgctataaat atattgaaca gcaggttagc agccatatta gcagcaattt ttatccgaat 540
caggccgtta ttagcctgga aaataaatgg ggtgcactga gcaaacaaat tcagattgca 600
aatcgtaccg gtcatggcca gtttgaaaat ccggttgaac tgtataatcc ggatggcacc 660
cgttttagcg ttaccaatac cagtgccggt gttgttaaag gcaatattaa actgctgctg 720
tattataaag ccagcggtgg tggtggtagc cgtaaaaaac gtgcaagcgg ttgtggtccg 780
gaaggtggtg gtggcagtcg tgttgcagca catattaccg gcacccgtgg tcgtagcaat 840
accctgagca gcccgaatag caaaaatgaa aaagcactgg gtcgcaaaat taatagctgg 900
gaaagcagcc gtagcggtca tagctttctg agcaatctgc atctgcgtaa tggtgaactg 960
gtgattcatg aaaaaggctt ttattatatt tatagccaga cctattttcg ctttcaggaa 1020
gaaattaaag aaaataccaa aaacgataaa caaatggtgc agtatatcta taaatatacc 1080
agctatccgg atccgattct gctgatgaaa agcgcacgta atagctgttg gagcaaagat 1140
gcagaatatg gtctgtatag catttatcag ggtggcattt ttgaactgaa agaaaatgat 1200
cgcatttttg tgagcgtgac caatgaacat ctgattgata tggatcatga agccagcttt 1260
tttggtgcat ttctggtggg t 1281
<210> 93
<211> 1281
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 93
tatgaacgtc tgcgtctgcg tgttacccat cagaccaccg gtgaagaata ttttcgtttt 60
attaccctgc tgcgcgatta tgttagcagc ggtagcttta gcaatgaaat tccgctgctg 120
cgtcagagca ccattccggt tagtgatgca cagcgttttg ttctggttga actgaccaat 180
gaaggtggtg atagcattac cgcagcaatt gatgttacca atctgtatgt tgttgcatat 240
caggcaggcg atcagagcta ttttctgcgt gatgcaccgc gtggtgcaga aacccacctg 300
tttaccggca ccacccgtag cagcctgccg tttaatggta gctatccgga tctggaacgt 360
tatgcaggtc atcgtgatca gattccgctg ggtattgatc agctgattca gagcgttacc 420
gcactgcgtt ttccgggtgg tagcacccgt acccaggcac gtagcattct gattctgatt 480
cagatgatta gcgaagcagc acgttttaat ccgattctgt ggcgtgcacg tcagtatatt 540
aatagcggtg ccagctttct gccggatgtt tatatgctgg aactggaaac cagctggggt 600
cagcagagca cccaggttca gcagagtacc gatggtgttt ttaataatcc gattcgtctg 660
gcaattccgc ctggtaattt tgttaccctg accaatgttc gtgatgttat tgcaagcctg 720
gccattatgc tgtttgtttg tggtgaaggt ggtggtggtg gcagcgcaag cggttgtggt 780
ccggaaggtg gtggcggtag ccgtgttgca gcacatatta ccggcacccg tggtcgtagc 840
aataccctga gcagcccgaa tagcaaaaat gaaaaagcac tgggtcgcaa aattaatagc 900
tgggaaagca gccgtagcgg tcatagcttt ctgagcaatc tgcatctgcg taatggtgaa 960
ctggtgattc atgaaaaagg cttttattat atttatagcc agacctattt tcgctttcag 1020
gaagaaatca aagaaaatac caaaaatgat aaacaaatgg tgcagtatat ctataaatat 1080
accagttatc cggatccgat tctgctgatg aaaagcgcac gtaatagctg ttggagcaaa 1140
gatgcagaat atggtctgta tagcatttat cagggtggca tttttgaact gaaagaaaat 1200
gatcgcattt ttgtgagcgt gaccaatgaa catctgattg atatggatca tgaagccagc 1260
ttttttggtg catttctggt t 1281
<210> 94
<211> 1386
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 94
attgattatc cgagcgtgtc ctttaatctg gcaggcgcaa aaagcaccac ctatcgtgat 60
tttctgaaaa atctgcgtga tcgtgttgca accggcacct atgaagttaa tggtctgccg 120
gttctgcgtc gtgaaagcga agttcaggtt aaaaatcgtt ttgttctggt gcgcctgacc 180
aattataatg gtgataccgt taccagcgca gttgatgtta ccaatctgta tctggttgca 240
tttagcgcaa atggcaatag ctattttttt aaagatgcca ccgaactgca gaaaagcaac 300
ctgtttctgg gcaccaccca gcataccctg agctttaccg gtaattatga taatctggaa 360
accgcagcag gcacccgtcg tgaaagtatt gaactgggtc cgaatccgct ggatggtgca 420
attaccagcc tgtggtatga tggtggtgtt gcacgtagcc tgctggttct gattcagatg 480
gttccggaag cagcacgttt tcgttatatt gaacaggaag ttcgtcgtag cctgcagcag 540
ctgaccagct ttaccccgaa tgcactgatg ctgagcatgg aaaataattg gagcagcatg 600
agcctggaag ttcagctgag cggtgataat gttagcccgt ttagcggcac cgttcagctg 660
cagaattatg atcatacacc gcgtctggtg gataattttg aagaactgta taaaattacc 720
ggcattgcca ttctgctgtt tcgttgtgtt gcaaccaaaa ccacccataa tgcaattcgt 780
atgccgcatg ttctggttgg tgaagataat aaatttaatg gtggtggtgg tagcgcaagc 840
ggttgtggtc cggaacgtaa aaaacgtggt ggtggcggtg ttcgtgaacg tggtccgcag 900
cgtcgtgttg cagcacatat taccggcacc cgtggtcgta gcaataccct gagcagcccg 960
aatagcaaaa atgaaaaagc actgggtcgc aaaattaata gctgggaaag cagccgtagc 1020
ggtcatagct ttctgagcaa tctgcatctg cgtaatggtg aactggtgat tcatgaaaaa 1080
ggcttttatt atatttatag ccagacctat tttcgctttc aggaagaaat taaagaaaat 1140
accaaaaatg ataaacaaat ggtgcagtat atctataaat ataccagcta tccggatccg 1200
attctgctga tgaaaagcgc acgtaatagc tgttggagca aagatgcaga atatggtctg 1260
tatagcattt atcagggtgg catttttgaa ctgaaagaaa atgatcgcat ttttgtgagc 1320
gtgaccaatg aacatctgat tgatatggat catgaagcca gcttttttgg tgcctttctg 1380
gttggt 1386
<210> 95
<211> 1362
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 95
attgattatc cgagcgtgtc ttttaatctg gatggtgcaa aaagcgcaac ctatcgtgat 60
tttctgagca atctgcgtaa aaccgttgca accggcacct atgaagttaa tggtctgccg 120
gttctgcgtc gtgaaagcga agttcaggtt aaaagccgtt ttgttctggt tccgctgacc 180
aattataatg gtaataccgt taccctggcc gttgatgtta ccaatctgta tgttgttgcc 240
tttagcggta atgccaatag ctattttttt aaagatgcca ccgaagtgca gaaaagcaac 300
ctgtttgttg gcaccaaaca gaataccctg agctttaccg gcaattatga taatctggaa 360
accgcagcaa atacccgtcg tgaaagtatt gaactgggtc cgagtccgct ggatggtgcc 420
attaccagcc tgtatcatgg tgatagcgtt gcacgtagcc tgctggttgt tattcagatg 480
gttagcgaag cagcacgttt tcgttatatt gaacaggaag ttcgtcgtag cctgcagcag 540
gcaaccagct ttaccccgaa tgcactgatg ctgagcatgg aaaataattg gagcagcatg 600
agcctggaaa ttcagcaggc aggtaataat gttagcccgt tttttggcac cgttcagctg 660
ctgaattatg atcataccca tcgtctggtg gataattttg aagaactgta taaaattacc 720
ggcattgcca ttctgctgtt tcgttgtagc agcccgagca atgataatgc aattcgtatg 780
ccgctggatc tggcaggcga agataataaa tataatggtg gtggtggcag ccgcaaaaaa 840
cgtgcaagcg gttgtggtcc ggaaggtggt ggtggtagtc gtgttgcagc acatattacc 900
ggcacccgtg gtcgtagcaa taccctgagt agcccgaata gcaaaaatga aaaagcactg 960
ggtcgcaaaa ttaatagctg ggaaagcagc cgtagcggtc atagctttct gtcaaatctg 1020
catctgcgta atggtgaact ggtgattcat gaaaaaggct tttattatat ttatagccag 1080
acctattttc gctttcagga agaaattaaa gaaaatacca aaaatgataa acaaatggtg 1140
cagtatatct ataaatatac cagctatccg gatccgattc tgctgatgaa aagcgcacgt 1200
aatagctgtt ggagcaaaga tgcagaatat ggtctgtata gcatttatca gggtggcatt 1260
tttgaactga aagaaaatga tcgcattttt gtgagcgtga ccaatgaaca tctgattgat 1320
atggatcatg aagccagctt ttttggtgca tttctggttg gt 1362
<210> 96
<211> 663
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 96
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa atcaatagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gacctatttt cgctttcaag aagagattaa agaaaatacc 240
aaaaatgata aacaaatggt gcagtacatt tataaataca ccagctatcc ggacccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggtctgtat 360
agcatttatc agggtggcat ctttgagctg aaagaaaatg atcgcatctt tgttagcgtg 420
accaacgaac atctgatcga tatggatcat gaagccagct tttttggtgc atttctggtt 480
ggtggtggtg gcggtagccg taaaaaacgt ccgcgtggta gtccgcgtac cgaatatgaa 540
gcatgtcgtg ttcgttgtca ggttgcagaa catggtgttg aacgtcagcg tcgttgtcag 600
caggtttgtg aaaaacgtct gcgtgaacgt gaaggtcgtc gtgaagttga taaagatgaa 660
ctg 663
<210> 97
<211> 681
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 97
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaatagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gacctatttt cgctttcaag aagaaattaa agaaaacacc 240
aaaaatgata aacaaatggt gcagtatatc tataaatata ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggtctgtat 360
agcatttatc agggtggcat ttttgaactg aaagaaaatg atcgcatttt tgtgagcgtg 420
accaatgaac atctgattga tatggatcat gaagccagct tttttggtgc atttctggtt 480
ggtggtggtg gtagcgcaag cggttgtggt ccggaacgta aaaaacgtgc aagcggtggt 540
ccgcgtggta gtccgcgtac cgaatatgaa gcatgtcgtg ttcgttgtca ggttgcagaa 600
catggtgttg aacgtcagcg tcgttgtcag caggtttgtg aaaaacgtct gcgtgaacgt 660
gaaggtcgtc gtgaagttga t 681
<210> 98
<211> 762
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 98
accagcgaag aaaccattag caccgttcaa gaaaaacagc agaatattag tccgctggtt 60
cgtgaacgtg gtccgcagcg tgttgcagca catattaccg gcacccgtgg tcgtagcaat 120
accctgagca gcccgaatag caaaaatgaa aaagcactgg gtcgcaaaat caatagctgg 180
gaaagcagcc gtagcggtca tagctttctg agcaatctgc atctgcgtaa tggtgaactg 240
gtgattcatg aaaaaggctt ctactatatc tacagccaga cctattttcg cttccaagaa 300
gaaatcaaag agaacaccaa aaacgacaaa caaatggtgc agtacatcta caaatatacc 360
agctatccgg atccgattct gctgatgaaa agcgcacgta atagctgttg gagcaaagat 420
gcagaatatg gtctgtatag catttatcag ggtggcatct ttgagctgaa agaaaatgat 480
cgcatctttg ttagcgtgac caacgaacat ctgatcgata tggatcatga agccagcttt 540
tttggtgcat ttctggttgg tggtggtggc ggtagcgcaa gcggttgtgg tccggaacgt 600
aaaaaacgtc cgcgtggtag tccgcgtacc gaatatgaag catgtcgtgt tcgttgtcag 660
gttgcagaac atggtgttga acgtcagcgt cgttgtcagc aggtttgtga aaaacgtctg 720
cgtgaacgtg aaggtcgtcg tgaagttgat aaagatgaac tg 762
<210> 99
<211> 1314
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 99
gtttttccga aagtgccgtt tgatgttccg aaagcaaccg ttgaaagcta tacccgtttt 60
attcgtgttc tgcgtgatga actggcaggc ggtgtttctc cgcagggtat tcgtcgtctg 120
cgtaatccgg cagaaattca gccgagccag ggttttattc tgattcagct gaccggttat 180
gttggtagcg ttaccctgat tatggatgtg cgtaatgcat atctgctggg ttatctgagc 240
cataatgtgc tgtatcattt taatgatgtt agcgcaagca gcattgcaag cgtttttccg 300
gatgcacagc gtcgtcagct gccgtttggt ggtggttatc cgagcatgcg taattatgca 360
ccggaacgcg atcagattga tcatggtatt gtggaactgg cctatgcagt tgatcgtctg 420
tattatagcc agaataacaa tcagattgcc ctgggtctgg ttatttgtgc aggtatggtt 480
gcagaagcaa gccgttttcg ttatattgaa ggtctggtgc gtcagagcat tgttggtccg 540
ggtgattatc gtacctttcg tcctgatgca ctgatgtata gcattgttac ccagtggcag 600
accctgagcg aacgtattca gggtagcttt aatggtgcat ttcagccggt tcagctgggt 660
tatgcaagcg atccgtttta ttgggataat gttgcacagg caattacccg tctgagcctg 720
atgctgtttg ttagccgtag caccgatggt ggtggtggta gccgtgttaa acgtgcgtct 780
ggttgcggcc cggaaggcgg cggtggcagc gttcgtgaac gtggtccgca gcgtgttgca 840
gcacatatta ccggcacccg tggtcgtagc aataccctga gcagcccgaa tagcaaaaat 900
gaaaaagccc tgggtcgcaa aattaatagc tgggaaagca gccgtagcgg tcatagcttt 960
ctgagcaatc tgcatctgcg taatggtgaa ctggtgattc atgaaaaagg cttttattat 1020
atttatagcc agacctattt tcgctttcag gaagaaatta aagaaaatac caaaaatgat 1080
aaacaaatgg tgcagtatat ctataaatat accagctatc cggatccgat tctgctgatg 1140
aaaagcgcac gtaatagctg ttggagcaaa gatgcagaat atggcctgta tagcatttat 1200
cagggtggca tttttgaact gaaagaaaat gatcgcattt ttgtgagcgt gaccaatgaa 1260
catctgattg atatggatca tgaagccagc ttttttggtg catttctggt gggc 1314
<210> 100
<211> 1293
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 100
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaatagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gacctatttt cgctttcaag aagaaattaa agaaaatacc 240
aaaaatgata agcagatggt gcagtatatc tataaatata ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggtctgtat 360
agcatttatc agggtggcat ttttgaactg aaagaaaatg atcgcatttt tgtgagcgtg 420
accaatgaac atctgattga tatggatcat gaagccagct tttttggtgc atttctggtt 480
ggtggtggtg gcggtagcgc aagcggttgt ggtccggaag gtggtggtgg tagtgttttt 540
ccgaaagttc cgtttgatgt tccgaaagca accgttgaaa gctatacccg ttttattcgt 600
gttctgcgtg atgaactggc aggcggtgtt agtccgcagg gtattcgtcg tctgcgtaat 660
ccggcagaaa ttcagccgag ccagggtttt attctgattc agctgaccgg ttatgttggt 720
agcgttaccc tgattatgga tgttcgtaat gcatatctgc tgggttatct gagccataat 780
gtgctgtatc attttaatga tgttagcgca agcagcattg caagcgtttt tccggatgca 840
cagcgtcgtc agctgccgtt tggtggtggt tatccgagca tgcgtaatta tgcaccggaa 900
cgtgatcaga ttgatcatgg tattgttgaa ctggcctatg cagttgatcg tctgtattat 960
agccagaata acaatcagat tgccctgggt ctggttattt gtgcaggtat ggttgcagaa 1020
gcaagccgtt ttcgttatat tgaaggtctg gttcgtcaga gcattgttgg tccgggtgat 1080
tatcgtacct ttcgtccgga tgcactgatg tatagcattg ttacccagtg gcagaccctg 1140
agcgaacgta ttcagggtag ctttaatggt gcatttcagc cggttcagct gggttatgca 1200
agcgatccgt tttattggga taatgttgca caggcaatta cccgtctgag cctgatgctg 1260
tttgttagcc gtagcaccga taaagaagat ctg 1293
<210> 101
<211> 1284
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 101
gatgttagct ttcgtctgag cggtgcagat ccgcgtagct atggtatgtt tattaaagat 60
ctgcgtaacg cactgccgtt tcgtgaaaaa gtttacaata ttccgctgct gctgccgagc 120
gttagcggtg caggtcgtta tctgctgatg cacctgttta attatgacgg taaaaccatt 180
accgttgcac tggatgttac caacgtgtat attatgggtt atctggcaga taccacgagc 240
tattttttta atgaaccggc agcagaactg gcaagccagt atgtttttcg tgatgcacgt 300
cgtaaaatca ccctgccgta tagcggtaat tatgaacgtc tgcagattgc agcaggtaaa 360
ccgcgtgaaa aaattccgat tggtctgcct gcactggata gcgcaattag caccctgctg 420
cattatgata gcaccgcagc agccggtgca ctgctggttc tgattcagac caccgcagaa 480
gcagcacgtt ttaaatatat tgagcagcag attcaagagc gtgcatatcg tgatgaagtt 540
ccgagcctgg caaccattag cctggaaaat agctggtcag gtctgagcaa acaaattcag 600
ctggcacagg gtaataatgg tatttttcgt accccgattg tgctggttga taataaaggt 660
aatcgcgtgc agattaccaa tgttaccagc aaagttgtga ccagcaatat ccagctgctg 720
ctgaataccc gtaatattgg tggtggtggt agccgtaaaa aacgtgcaag cggttgtggt 780
ccggaaggtg gtggtggcag tcgtgttgca gcacatatta ccggcacccg tggtcgtagc 840
aataccctga gcagcccgaa tagcaaaaat gaaaaagcac tgggtcgcaa aatcaatagc 900
tgggaaagca gccgtagcgg tcatagcttt ctgagcaatc tgcatctgcg taatggtgaa 960
ctggtgattc atgaaaaagg cttttattat atttatagcc agacctattt tcgctttcaa 1020
gaagagatta aagaaaatac caaaaatgat aaacaaatgg tgcagtatat ctataaatat 1080
accagctatc cggacccgat tctgctgatg aaaagcgcac gtaatagctg ttggagcaaa 1140
gatgcagaat atggtctgta tagcatttat cagggtggca tctttgagct gaaagaaaat 1200
gatcgcatct ttgttagcgt gaccaacgaa catctgatcg atatggatca tgaagccagc 1260
ttttttggtg catttctggt gggt 1284
<210> 102
<211> 1545
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 102
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagccct gggtcgcaaa attaatagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gacctatttt cgctttcagg aagaaattaa agaaaacacc 240
aaaaatgata aacaaatggt gcagtatatc tataaatata ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggcctgtat 360
agcatttatc agggtggcat ttttgaactg aaagaaaatg atcgcatttt tgtgagcgtg 420
accaatgaac atctgattga tatggatcat gaagccagct tttttggtgc atttctggtt 480
ggtggtggtg gtagcgcaag cggtggtccg gaaggtggta gcctggcagc actgaccgca 540
catcaggcat gtcatctgcc gctggaaacc tttacccgtc atcgtcagcc tcgtggttgg 600
gaacagctgg aacagtgtgg ttatccggtt cagcgtctgg ttgcactgta tctggcagca 660
cgtctgagct ggaatcaggt tgatcaggtt attgcaaatg cactggcatc tccgggtagc 720
ggtggtgatc tgggtgaagc aattcgtgaa tctccggaac aggcacgtct ggcactgacc 780
ctggcagcag cagaaagcga acgttttgtt cgtcagggca ccggtaatga tgaagccggt 840
gcagcaaatg gtccggcaga tagcggtgat gcactgctgg aacgtaatta tccgaccggt 900
gcagaatttc tgggtgatgg cggtgatgtt agctttagca cccgtggcac ccagaattgg 960
accgttgaac gtctgctgca ggcacatcgt cagctggaag aagccggtta cgtttttgtg 1020
ggttatcatg gcacctttct ggaagcagca cagagcattg tttttggtgg tgttcgtgca 1080
cgtagccagg atctggatgc aatttgggca ggcttttata ttgccggtga tccggcactg 1140
gcatatggtt atgcacagga tcaggaaccg gacgcagccg gtcgtattcg taatggtgca 1200
ctgctgcgtg tttatgttcc gcgtagcagc ctgcctggtt tttatgcaac cagcctgacc 1260
ctggctgcac cggaagcagc gggtgaagtg gaacgtctga ttggtcatcc gctgccgctg 1320
cgtctggatg ccattaccgg tccggaagaa tctggtggtc gtctggaaac cattctgggt 1380
tggcctctgg cagaacgcac cgttgttatt ccgagcgcaa ttccgaccga tccgcgtaat 1440
gttggtggcg atctggatcc gagcagcatt ccggatagcg aacaggcaat tagcgcactg 1500
ccggattatg ccagccagcc tggtaaacct ccgaaagatg aactg 1545
<210> 103
<211> 1578
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 103
cgtgtggcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaatagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gacctatttt cgctttcagg aagaaattaa agaaaatacc 240
aaaaatgata aacaaatggt gcagtatatc tataaatata ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggtctgtat 360
agcatttatc agggtggcat ttttgaactg aaagaaaatg atcgcatttt tgtgagcgtg 420
accaatgaac atctgattga tatggatcat gaagccagct tttttggtgc atttctggtt 480
ggtggtggtg gtagcgcaag cggttgtggt ccggaacgta aaaaacgtgc aagcggtggt 540
ccggaaggtg gtagcctggc agcactgacc gcacatcagg catgtcatct gccgctggaa 600
acctttaccc gtcatcgtca gcctcgtggt tgggaacagc tggaacagtg tggttatccg 660
gttcagcgtc tggttgcact gtatctggca gcacgtctga gctggaatca ggttgatcag 720
gttattgcaa atgcactggc aagtccgggt agcggtggtg atctgggtga agcaattcgt 780
gaaagtccgg aacaggcacg tctggcactg accctggcag cagcagaaag cgaacgtttt 840
gttcgtcagg gcaccggtaa tgatgaagcc ggtgcagcaa atggtccggc agatagcggt 900
gatgcactgc tggaacgtaa ttatccgacc ggtgcagaat ttctgggtga tggcggtgat 960
gttagcttta gcacccgtgg cacccagaat tggaccgttg aacgtctgct gcaggcacat 1020
cgtcagctgg aagaagcagg ttacgttttt gttggttatc atggcacctt tctggaagca 1080
gcacagagca ttgtttttgg tggtgttcgt gcacgtagcc aggatctgga tgcaatttgg 1140
gcaggttttt atattgccgg tgatccggca ctggcttatg gttatgcaca ggatcaggaa 1200
ccggacgcag caggtcgtat tcgtaatggt gcactgctgc gtgtttatgt tccgcgtagc 1260
agcctgcctg gtttttatgc aaccagcctg accctggctg caccggaagc agccggtgaa 1320
gtggaacgtc tgattggtca tccgctgccg ctgcgtctgg atgccattac cggtccggaa 1380
gaaagcggtg gtcgtctgga aaccattctg ggttggcctc tggcagaacg taccgttgtt 1440
attccgagcg caattccgac cgatccgcgt aatgttggtg gcgatctgga tccgagcagc 1500
attccggata gcgaacaggc aattagcgca ctgccggatt atgcaagcca gcctggtaaa 1560
cctccgaaag atgaactg 1578
<210> 104
<211> 1578
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 104
cgtgtggcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaatagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gacctatttt cgctttcagg aagaaattaa agaaaatacc 240
aaaaatgata aacaaatggt gcagtatatc tataaatata ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggtctgtat 360
agcatttatc agggtggcat ttttgaactg aaagaaaatg atcgcatttt tgtgagcgtg 420
accaatgaac atctgattga tatggatcat gaagccagct tttttggtgc atttctggtt 480
ggtggtggtg gtagcgcaag cggttgtggt ccggaacgta aaaaacgtgc aagcggtggt 540
ccggaaggtg gtagtctggc agcactgacc gcacatcagg catgtcatct gccgctggaa 600
acctttaccc gtcatcgtca gcctcgtggt tgggaacagc tggaacagtg tggttatccg 660
gttcagcgtc tggttgcact gtatctggca gctcgtctga gctggaatca ggttgatcag 720
gttattcgta atgcactggc aagtccgggt agcggtggcg atctgggtga agcaattcgt 780
gaacagccgg aacaggcacg tctggcactg accctggcag cagcagaaag cgaacgtttt 840
gttcgtcagg gcaccggtaa tgatgaagcc ggtgcagcaa atggtccggc agatagcggt 900
gatgcactgc tggaacgtaa ttatccgacc ggtgcagaat ttctgggtga tggcggtgat 960
gttagcttta gcacccgtgg cacccagaat tggaccgttg aacgtctgct gcaggcacat 1020
cgtcagctgg aagaagccgg ttacgttttt gtgggttatc atggcacctt tctggaagca 1080
gcacagagca ttgtttttgg tggtgttcgt gcacgtagcc aggatctgga tgcaatttgg 1140
gcaggctttt atattgccgg tgatccggca ctggcatacg gttatgcaca ggatcaggaa 1200
ccggacgcag ccggtcgtat tcgtaatggt gcactgctgc gtgtttatgt tccgcgtagc 1260
agcctgcctg gtttttatgc aaccagcctg accctggctg caccggaagc agcgggtgaa 1320
gtggaacgtc tgattggtca tccgctgccg ctgcgtctgg atgccattac cggtccggaa 1380
gaatctggtg gtcgtctgga aaccattctg ggttggcctc tggcagaacg caccgttgtt 1440
attccgagcg caattccgac cgatccgcgt aatgttggtg gcgatctgga tccgagcagc 1500
attccggata gcgaacaggc aattagcgca ctgccggatt atgccagcca gcctggtaaa 1560
cctccgaaag atgaactg 1578
<210> 105
<211> 1602
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 105
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaacagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttctactata tctacagcca gacctatttt cgcttccaag aagagattaa agaaaacacc 240
aaaaacgata aacaaatggt gcagtacatc tataaataca ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggcctgtat 360
agcatttatc agggtggcat ctttgaactg aaagaaaacg atcgtatttt cgtgagcgtg 420
accaatgaac atctgatcga tatggatcat gaagccagct tttttggtgc atttctggtg 480
ggtggtggtg gtagcgcaag cggttgtggt ccggaacgta aaaaacgtgc aagtggcggt 540
ccggaaggtg gtagcctggc agcactgacc gcacatcagg catgtcatct gccgctggaa 600
acctttaccc gtcatcgtca gcctcgtggt tgggaacagc tggaacagtg tggttatccg 660
gttcagcgtc tggttgcact gtatctggca gcccgtctga gctggaatca ggttgatcag 720
gttattcgta atgcactggc aagtccgggt agcggtggtg atctgggtga agcaattcgt 780
gaacagcctg aacaggcacg tctggcactg accctggcag ccgcagaaag cgaacgtttt 840
gttcgtcagg gcaccggtaa tgttgttagc ctgacctgtc cggttgcagc cggtgaatgt 900
gcaggtccgg cagatagcgg tgatgcactg ctggaacgta attatccgac cggtgcagaa 960
tttctgggtg atggcggtga tgttagcttt agtacccgtg gcacccagaa ttggaccgtt 1020
gaacgtctgc tgcaggcaca ccgtcagctg gaagaacgtg gttatgtttt tgttggttat 1080
catggcacct ttctggaagc agcacagagc attgtgtttg gtggtgttcg tgcacgtagc 1140
caggatctgg atgcaatttg gcgtggtttc tatattgccg gtgatccggc actggcctat 1200
ggttatgcac aggatcaaga accggatgca cgtggtcgca ttcgcaatgg tgccctgctg 1260
cgtgtttatg ttccgcgtag cagcctgcct ggtttttatc gtaccagcct gacactggct 1320
gcaccggaag cagcgggtga agtggaacgt ctgattggtc atccgctgcc gctgcgtctg 1380
gatgcgatta ccggtcctga agaagaaggc ggtcgtctgg aaaccattct gggttggcct 1440
ctggcagaac gtaccgttgt tattccgagc gcaattccga ccgatccgcg taatgttggt 1500
ggcgatctgg atccgagcag cattccggat aaagaacagg caattagcgc actgccggat 1560
tatgcaagcc agcctggtaa accgcctcgt gaagatctga aa 1602
<210> 106
<211> 1545
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 106
cgtgtggcgg cgcatattac cggcacccgt ggccgtagca acaccctgag cagcccgaac 60
agcaaaaacg aaaaagcgct gggccgtaaa attaacagct gggaaagcag ccgtagcggc 120
catagctttc tgagcaacct gcatctgcgt aacggcgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gaccaacttt aaatttcgtg aagaaattaa agaaaacacc 240
aaaaacgata aacagatggt gcagtatatt tataaatata ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcgcg taacagctgc tggagcaaag atgcggaata tggcctgtat 360
agcatttatc agggcggcat ttttgaactg aaagaaaacg atcgtatttt tgtgagcgtg 420
accaacgaac gtctgcgtga tatgcatcat gaagcgagct tttttggcgc gtttctggtg 480
ggcggcggcg gcagcgcgag cggcggcccg gaaggcggca gcctggcggc gctgaccgcg 540
catcaggcgt gccatctgcc gctggaaacc tttacccgtc atcgtcagcc gcgtggctgg 600
gaacagctgg aacagtgcgg ctatccggtg cagcgtctgg tggcgctgta tctggcggcg 660
cgtctgagct ggaaccaggt ggatcaggtg attgcgaacg cgctggcgag cccgggcagc 720
ggcggcgatc tgggcgaagc gattcgtgaa agcccggaac aggcgcgtct ggcgctgacc 780
ctggcggcgg cggaaagcga acgttttgtg cgtcagggca ccggcaacga tgaagcgggc 840
gcggcgaacg gcccggcgga tagcggcgat gcgctgctgg aacgtaacta tccgaccggc 900
gcggaatttc tgggcgatgg cggcgatgtg agctttagca cccgtggcac ccagaactgg 960
accgtggaac gtctgctgca ggcgcatcgt cagctggaag aacgtggcta tgtgtttgtg 1020
ggctatcatg gcacctttct ggaagcggcg cagagcattg tgtttggcgg cgtgcgtgcg 1080
cgtagccagg atctggatgc gatttgggcg ggcttttata ttgcgggcga tccggcgctg 1140
gcgtatggct atgcgcagga tcaggaaccg gatgcggcgg gccgtattcg taacggcgcg 1200
ctgctgcgtg tgtatgtgcc gcgtagcagc ctgccgggct tttatgcgac cagcctgacc 1260
ctggcggcgc cggaagcggc gggcgaagtg gaacgtctga ttggccatcc gctgccgctg 1320
cgtctggatg cgattaccgg cccggaagaa agcggcggcc gtctggaaac cattctgggc 1380
tggccgctgg cggaacgtac cgtggtgatt ccgagcgcga ttccgaccga tccgcgtaac 1440
gtgggcggcg atctggatcc gagcagcatt ccggatagcg aacaggcgat tagcgcgctg 1500
ccggattatg cgagccagcc gggcaaaccg ccgaaagatg aactg 1545
<210> 107
<211> 1578
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 107
agagtggcag cacatataac aggaacaaga ggaagatcaa atacattatc atcaccaaat 60
tcaaagaatg aaaaggcatt aggaagaaag ataaattcat gggaatcatc aagatcagga 120
cattcatttt tatcaaattt acatttaaga aatggagaat tagtgataca tgaaaaggga 180
ttttattata tatattcaca aacatatttt agatttcaag aagaaataaa ggaaaataca 240
aagaatgata agcaaatggt gcaatatata tataagtata catcatatcc agatccaata 300
ttattaatga agtcagcaag aaattcatgt tggtcaaagg atgcagaata tggattatat 360
tcaatatatc aaggaggaat atttgaatta aaggaaaatg atagaatatt tgtgtcagtg 420
acaaatgaac atttaataga tatggatcat gaagcatcat tttttggagc atttttagtg 480
ggaggaggag gatcagcatc aggatgtgga ccagaaagaa agaagagagc atcaggagga 540
ccagaaggag gatcattagc agcattaaca gcacatcaag catgtcattt accattagaa 600
acatttacaa gacatagaca accaagagga tgggaacaat tagaacaatg tggatatcca 660
gtgcaaagat tagtggcatt atatttagca gcaagattat catggaatca agtggatcaa 720
gtgatagcaa atgcattagc atcaccagga tcaggaggag atttaggaga agcaataaga 780
gaatcaccag aacaagcaag attagcatta acattagcag cagcagaatc agaaagattt 840
gtgagacaag gaacaggaaa tgatgaagca ggagcagcaa atggaccagc agattcagga 900
gatgcattat tagaaagaaa ttatccaaca ggagcagaat ttttaggaga tggaggagat 960
gtgtcatttt caacaagagg aacacaaaat tggacagtgg aaagattatt acaagcacat 1020
agacaattag aagaaagagg atatgtgttt gtgggatatc atggaacatt tttagaagca 1080
gcacaatcaa tagtgtttgg aggagtgaga gcaagatcac aagatttaga tgcaatatgg 1140
gcaggatttt atatagcagg agatccagca ttagcatatg gatatgcaca agatcaagaa 1200
ccagatgcag caggaagaat aagaaatgga gcattattaa gagtgtatgt gccaagatca 1260
tcattaccag gattttatgc aacatcatta acattagcag caccagaagc agcaggagaa 1320
gtggaaagat taataggaca tccattacca ttaagattag atgcaataac aggaccagaa 1380
gaatcaggag gaagattaga aacaatatta ggatggccat tagcagaaag aacagtggtg 1440
ataccatcag caataccaac agatccaaga aatgtgggag gagatttaga tccatcatca 1500
ataccagatt cagaacaagc aatatcagca ttaccagatt atgcatcaca accaggaaag 1560
ccaccaaagg atgaatta 1578
<210> 108
<211> 1578
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 108
cgtgtggcgg cgcatattac cggcacccgt ggccgtagca acaccctgag cagcccgaac 60
agcaaaaacg aaaaagcgct gggccgtaaa attaacagct gggaaagcag ccgtagcggc 120
catagctttc tgagcaacct gcatctgcgt aacggcgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gacctatttt cgttttcagg aagaaattaa agaaaacacc 240
aaaaacgata aacagatggt gcagtatatt tataaatata ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcgcg taacagctgc tggagcaaag atgcggaata tggcctgtat 360
agcatttatc agggcggcat ttttgaactg aaagaaaacg atcgtatttt tgtgagcgtg 420
accaacgaac atctgattga tatggatcat gaagcgagct tttttggcgc gtttctggtg 480
ggcggcggcg gcagcgcgag cggctgcggc ccggaacgta aaaaacgtgc gagcggcggc 540
ccggaaggcg gcagcctggc ggcgctgacc gcgcatcagg cgtgccatct gccgctggaa 600
acctttaccc gtcatcgtca gccgcgtggc tgggaacagc tggaacagtg cggctatccg 660
gtgcagcgtc tggtggcgct gtatctggcg gcgcgtctga gctggaacca ggtggatcag 720
gtgattgcga acgcgctggc gagcccgggc agcggcggcg atctgggcga agcgattcgt 780
gaaagcccgg aacaggcgcg tctggcgctg accctggcgg cggcggaaag cgaacgtttt 840
gtgcgtcagg gcaccggcaa cgatgaagcg ggcgcggcga acggcccggc ggatagcggc 900
gatgcgctgc tggaacgtaa ctatccgacc ggcgcggaat ttctgggcga tggcggcgat 960
gtgagcttta gcacccgtgg cacccagaac tggaccgtgg aacgtctgct gcaggcgcat 1020
cgtcagctgg aagaacgtgg ctatgtgttt gtgggctatc atggcacctt tctggaagcg 1080
gcgcagagca ttgtgtttgg cggcgtgcgt gcgcgtagcc aggatctgga tgcgatttgg 1140
gcgggctttt atattgcggg cgatccggcg ctggcgtatg gctatgcgca ggatcaggaa 1200
ccggatgcgg cgggccgtat tcgtaacggc gcgctgctgc gtgtgtatgt gccgcgtagc 1260
agcctgccgg gcttttatgc gaccagcctg accctggcgg cgccggaagc ggcgggcgaa 1320
gtggaacgtc tgattggcca tccgctgccg ctgcgtctgg atgcgattac cggcccggaa 1380
gaaagcggcg gccgtctgga aaccattctg ggctggccgc tggcggaacg taccgtggtg 1440
attccgagcg cgattccgac cgatccgcgt aacgtgggcg gcgatctgga tccgagcagc 1500
attccggata gcgaacaggc gattagcgcg ctgccggatt atgcgagcca gccgggcaaa 1560
ccgccgaaag atgaactg 1578
<210> 109
<211> 1269
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 109
aaagaattta ccctggattt tagcaccgca aaaacctatg ttgatagcct gaatgttatt 60
cgtagcgcaa ttggtacacc gctgcagacc attagcagcg gtggcaccag cctgctgatg 120
attgatagcg gcaccggtga taacctgttt gcagttgatg tgcgtggtat tgatccggaa 180
gaaggtcgct ttaataatct gcgcctgatt gtggaacgta ataatctgta tgtgaccggt 240
tttgtgaatc gtaccaataa tgtgttttat cgctttgccg attttagcca tgttaccttt 300
ccgggtacaa ccgcagttac cctgagcggt gatagcagct ataccaccct gcagcgtgtt 360
gcaggtatta gccgtaccgg tatgcagatt aatcgtcata gcctgaccac ctcttatctg 420
gatctgatga gccatagcgg tacaagcctg acccagagcg ttgcacgtgc aatgctgcgt 480
tttgttaccg ttaccgcaga agcactgcgt tttcgtcaga ttcagcgtgg ttttcgtacc 540
accctggatg atctgagcgg tcgtagctat gttatgaccg cagaagatgt tgatctgacc 600
ctgaattggg gtcgtctgag cagcgttctg ccggattatc atggtcagga tagcgttcgt 660
gttggtcgta ttagctttgg tagcattaat gcaattctgg gtagcgttgc actgattctg 720
aatagccatc atgcaagcgg tggtggtggt agccgtgtta aacgtgttcg tgaacgtggt 780
ccgcagcgtg tggcagcaca tattaccggc acccgtggtc gtagcaatac cctgagcagc 840
ccgaatagca aaaatgaaaa agccctgggt cgcaaaatta atagctggga aagcagccgt 900
agcggtcata gctttctgag caatctgcat ctgcgtaatg gtgaactggt gattcatgaa 960
aaaggctttt attatattta tagccagacc tattttcgct ttcaggaaga aattaaagaa 1020
aataccaaaa atgataaaca aatggtgcag tatatttata aatacaccag ctatccggat 1080
ccgattctgc tgatgaaaag cgcacgtaat agctgttgga gcaaagatgc agaatatggc 1140
ctgtatagca tttatcaggg tggcattttt gaactgaaag aaaatgatcg catttttgtg 1200
agcgtgacca atgaacatct gattgatatg gatcatgaag ccagcttttt tggtgcattt 1260
ctggtgggc 1269
<210> 110
<211> 1296
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 110
cagcgtgttg cagcacatat taccggcacc cgtggtcgta gcaataccct gagcagcccg 60
aatagcaaaa atgaaaaagc actgggtcgc aaaattaata gctgggaaag cagccgtagc 120
ggtcatagct ttctgagcaa tctgcatctg cgtaatggtg aactggtgat tcatgaaaaa 180
ggcttttatt atatttatag ccagacctat tttcgctttc aggaagaaat taaagaaaat 240
accaaaaatg ataaacaaat ggtgcagtac atctataaat ataccagcta tccggatccg 300
attctgctga tgaaaagcgc acgtaatagc tgttggagca aagatgcaga atatggtctg 360
tatagcattt atcagggtgg catttttgaa ctgaaagaaa atgatcgcat ttttgtgagc 420
gtgaccaatg aacatctgat tgatatggat catgaagcca gcttttttgg tgcatttctg 480
gttggtggtg gtggtagcgc aagcggttgt ggtccggaac gtaaaaaacg tggtggtggc 540
ggtagtaaag aatttaccct ggattttagc accgccaaaa cctatgttga tagcctgaat 600
gttattcgta gcgcaattgg tacaccgctg cagaccatta gcagcggtgg caccagcctg 660
ctgatgattg atagcggcac cggtgataac ctgtttgcag ttgatgttcg tggtattgat 720
ccggaagaag gtcgttttaa taatctgcgt ctgattgtgg aacgcaataa tctgtatgtt 780
accggttttg tgaatcgcac caataatgtg ttttatcgct ttgccgattt tagccatgtt 840
acctttccgg gtacaaccgc agttaccctg agcggtgata gcagctatac caccctgcag 900
cgtgtggcag gtattagccg taccggtatg cagattaatc gtcatagcct gaccaccagt 960
tatctggatc tgatgagcca tagcggtaca agcctgaccc agagcgttgc acgcgctatg 1020
ctgcgttttg ttaccgttac cgcagaagca ctgcgttttc gtcagattca gcgtggtttt 1080
cgtaccaccc tggatgatct gagcggtcgt agctatgtta tgaccgcaga agatgttgat 1140
ctgaccctga attggggtcg tctgagcagc gttctgccgg attatcatgg tcaggatagc 1200
gttcgtgttg gtcgtattag ctttggtagc attaatgcaa ttctgggtag cgttgcactg 1260
attctgaata gccatcatgc aagcaaagaa gatctg 1296
<210> 111
<211> 1076
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 111
gcaacctgga cctgtattaa tcagcagctg aatccgaaaa ccaacaaatg ggaagataaa 60
cgtctgctgt atagccaggc aaaagcagaa agcaatagcc atcatgcacc gctgagtgat 120
ggtaaaaccg gtagcagcta tccgcattgg tttaccaatg gttatgatgg taacggcaaa 180
ctgattaaag gtcgtacccc gattaaattt ggtaaagcag attgtgatcg ccctccgaaa 240
cattcacaga atggtatggg taaagatgat cactatctgc tggaatttcc gacctttccg 300
gatggtcacg attataaatt tgatagcaaa aaaccgaaag aggatccggg tccggcacgt 360
gttatttata cctatccgaa taaagtgttc tgcggtattg ttgcacatca gcgtggtaat 420
cagggtgatc tgcgtctgtg tagccatggt ggtggtggta gcggtggtgg tggcagccgt 480
aaaaaacgtg caagcggttg tggtccggaa gttcgtgaac gtggtccgca gcgtgttgca 540
gcacatatta ccggcacccg tggtcgtagc aataccctga gcagcccgaa tagcaaaaat 600
gaaaaagcac tgggtcgcaa aatcaatagc tgggaaagca gccgtagcgg tcatagcttt 660
ctgagcaatc tgcatctgcg taatggtgaa ctggtgattc atgaaaaagg cttttattat 720
atttatagcc agacctattt tcgctttcaa gaagagatta aagaaaatac caaaaatgat 780
aaacaaatgg tgcagtacat ctataaatat accagctatc cggacccgat tctgctgatg 840
aaaagcgcac gtaatagctg ttggagcaaa gatgcagaat atggtctgta tagcatttat 900
cagggtggca tctttgagct gaaagaaaat gatcgcatct ttgttagcgt gaccaacgaa 960
catctgatcg atatggatca tgaagccagc ttttttggtg catttctggt tggtaagctt 1020
tagtaactcg agattatgag ctctggagca caagactggc ctcatgggcc ttccgc 1076
<210> 112
<211> 1005
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 112
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa atcaatagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gacctatttt cgctttcaag aagagattaa agaaaatacc 240
aaaaatgata aacaaatggt gcagtacatc tataaatata ccagctatcc ggacccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggtctgtat 360
agcatttatc agggtggcat ctttgagctg aaagaaaatg atcgcatctt tgttagcgtg 420
accaacgaac atctgatcga tatggatcat gaagccagct tttttggtgc atttctggtt 480
ggtggtggtg gcggtagcgc aagcggttgt ggtccggaac gtaaaaaacg cggtggtggt 540
ggtagtgcaa cctggacctg tattaatcag cagctgaatc cgaaaaccaa caaatgggaa 600
gataaacgtc tgctgtatag ccaggcaaaa gcagaaagca atagccatca tgcaccgctg 660
agtgatggta aaaccggtag cagctatccg cattggttta ccaatggtta tgatggtaac 720
ggcaaactga ttaaaggtcg taccccgatt aaatttggta aagcagattg tgatcgccct 780
ccgaaacatt cacagaatgg tatgggtaaa gatgatcact atctgctgga atttccgacc 840
tttccggatg gtcacgatta taaatttgat agcaaaaaac cgaaagagga tccgggtccg 900
gcacgtgtta tttataccta tccgaataaa gtgttctgcg gtattgttgc acatcagcgt 960
ggtaatcagg gtgatctgcg tctgtgtagc cataaagaag atctg 1005
<210> 113
<211> 957
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 113
gcaccgattg ttacctgtcg tccgaaactg gatggtcgtg aaaaaccgtt taaagttgat 60
gttgcaaccg cacaggcaca ggcacgtaaa gcaggtctga ccaccggtaa aagcggtgat 120
ccgcatcgtt attttgccgg tgatcatatt cgttggggtg ttaataattg cgataaagca 180
gatgccatcc tgtgggaata tccgatttat tgggttggta aaaatgccga atgggccaaa 240
gatgttaaaa ccagccagca gaaaggtggt ccgaccccga ttcgtgttgt ttatgcaaat 300
agccgtggtg cagttcagta ttgtggtgtt atgacccata gcaaagtgga taaaaacaac 360
cagggcaaag aattttttga aaaatgtgat ggtggtggtg gtagcggtgg tggtggcagc 420
cgtaaaaaac gtgcaagcgg ttgtggtccg gaagttcgtg aacgtggtcc gcagcgtgtt 480
gcagcacata ttaccggcac ccgtggtcgt agcaataccc tgagcagccc gaatagcaaa 540
aatgaaaaag cactgggtcg caaaatcaat agctgggaaa gcagccgtag cggtcatagc 600
tttctgagca atctgcatct gcgtaatggt gaactggtga ttcatgaaaa aggcttttat 660
tatatttata gccagaccta ttttcgcttt caagaagaga ttaaagaaaa taccaaaaat 720
gataaacaaa tggtgcagta catctataaa tataccagct atccggaccc gattctgctg 780
atgaaaagcg cacgtaatag ctgttggagc aaagatgcag aatatggtct gtatagcatt 840
tatcagggtg gcatctttga gctgaaagaa aatgatcgca tctttgttag cgtgaccaac 900
gaacatctga tcgatatgga tcatgaagcc agcttttttg gtgcatttct ggtgggt 957
<210> 114
<211> 870
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 114
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaatagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gacctatttt cgctttcaag aagaaatcaa agaaaatacc 240
aaaaatgata aacaaatggt gcagtatatt tacaaatata ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggtctgtat 360
agcatttatc agggtggcat ttttgaactg aaagaaaatg atcgcatttt tgtgagcgtg 420
accaatgaac atctgattga tatggatcat gaagccagct tttttggtgc atttctggtt 480
ggtggtggtg gcggtagcgc aagcggttgt ggtccggaac gtaaaaaacg tgaacgtggt 540
gaaatttggc tggttagcct ggatccgacc gcaggtcatg aacagcaggg cacccgtccg 600
gttctgattg ttacaccggc agcatttaat cgtgttaccc gtctgccggt tgttgttccg 660
gttaccagcg gtggtaattt tgcacgtacc gcaggttttg cagtgagcct ggatggtgtt 720
ggtattcgta ccaccggtgt tgttcgttgt gatcagcctc gtaccattga tatgaaagca 780
cgtggtggta aacgtctgga acgtgttccg gaaaccatta tgaatgaagt tctgggtcgt 840
ctgagcacca ttctgaccaa agaagatctg 870
<210> 115
<211> 831
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 115
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaatagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gacctatttt cgctttcaag aagaaatcaa agaaaatacc 240
aaaaatgata aacaaatggt gcagtatatt tacaaatata ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggtctgtat 360
agcatttatc agggtggcat ttttgaactg aaagaaaatg atcgcatttt tgtgagcgtg 420
accaatgaac atctgattga tatggatcat gaagccagct tttttggtgc atttctggtt 480
ggtggtggtg gcggtagcgc aagcggttgt ggtccggaac gtaaaaaacg tcagtttaaa 540
gtgtatacct ataaacgcga aagccgttat cgtctgtttg ttgatgttca gagcgatatt 600
attgatacac cgggtcgtcg tatggttatt ccgctggcaa gcgcacgtct gctgagcgat 660
aaagttagcc gtgaactgta tccggttgtt catattggtg atgaaagctg gcgtatgatg 720
accaccgata tggcaagcgt tccggttagc gttattggtg aagaagttgc agatctgagc 780
catcgtgaaa atgatattaa aaatgccatt aatctgatgt tttggggcat t 831
<210> 116
<211> 684
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 116
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaatagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gacctatttt cgctttcaag aagaaatcaa agaaaatacc 240
aaaaatgata aacaaatggt gcagtatatt tacaaatata ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggtctgtat 360
agcatttatc agggtggcat ttttgaactg aaagaaaatg atcgcatttt tgtgagcgtg 420
accaatgaac atctgattga tatggatcat gaagccagct tttttggtgc atttctggtt 480
ggtggtggtg gcggtagcgc aagcggttgt ggtccggaac gtaaaaaacg tcagtttaaa 540
gtgtatacct ataaaggtgg tagcggtggt cgtctgctga gcgataaagt tagccgtgaa 600
ctgggtggta gtggaggtag ccatcgtgaa aatgatatta aaaatgccat taatctgatg 660
ttttggggca ttaaagaaga tctg 684
<210> 117
<211> 825
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 117
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaatagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gacctatttt cgctttcaag aagaaatcaa agaaaatacc 240
aaaaatgata aacaaatggt gcagtatatc tataaatata ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggtctgtat 360
agcatttatc agggtggcat ttttgaactg aaagaaaatg atcgcatttt tgtgagcgtg 420
accaatgaac atctgattga tatggatcat gaagccagct tttttggtgc atttctggtt 480
ggtggtggtg gcggtagcgc aagcggttgt ggtccggaac gtaaaaaacg tgcatatttt 540
ctggattttg atgaacgtgc cctgaaagaa tggcgtaaac tgggtagcac cgttcgtgaa 600
cagctgaaaa aaaaactggt tgaagttctg gaaagtccgc gtattgaagc aaataaactg 660
cgtggtatgc cggattgcta taaaattaaa ctgcgtagca gcggctatcg tctggtttat 720
caggttattg atgaaaaagt ggtggtgttt gtgattagcg ttggtaaacg tgaacgtagc 780
gaagtttata gcgaagcagt taaacgcatt ctgaaagaag atctg 825
<210> 118
<211> 813
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 118
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaatagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gacctatttt cgctttcaag aagaaatcaa agaaaatacc 240
aaaaatgata aacaaatggt gcagtatatt tacaaatata ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggtctgtat 360
agcatttatc agggtggcat ttttgaactg aaagaaaatg atcgcatttt tgtgagcgtg 420
accaatgaac atctgattga tatggatcat gaagccagct tttttggtgc atttctggtt 480
ggtggtggtg gcggtagcgc aagcggttgt ggtccggaac gtaaaaaacg tccggaactg 540
gaatggaaag cagcagcagt tgcagatctg ctggcaattg ttgattatat tagtgatgat 600
aatccggatg cagcatttgc actgatggaa gaaattcagg ataaagttgc acagctgcct 660
gcacatccga aacgttgtcg tccgggtcgt gttgaaggca cccgtgaact ggttgttcgt 720
ccgaattatc tggttgttta tgcagaaaca ccggcagttg ttaccattct gcgtgttctg 780
catgcagcac agatgtggcc gaaagaagat ctg 813
<210> 119
<211> 1287
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 119
ggcctggata ccgttagctt tagcaccaaa ggtgcaacct atattaccta tgtgaatttt 60
ctgaatgaac tgcgcgttaa actgaaaccg gaaggtaata gccatggtat tccgctgctg 120
cgtaaaaaag cagatgatcc gggtaaagca tttgttctgg ttgcactgag caatgataat 180
ggtcagctgg ccgaaattgc aattgatgtg accagcgttt atgtggttgg ttatcaggtt 240
cgtaatcgca gctatttttt taaagatgca ccggatgcag cctatgaagg cctgtttaaa 300
aataccatta aaacccgtct gcattttggt ggtagctatc cgagcctgga aggtgaaaaa 360
gcatatcgtg aaaccaccga tctgggtatt gaaccgctgc gtattggcat taaaaaactg 420
gatgaaaatg ccattgataa ttataaaccg accgaaattg cctctagcct gctggttgtt 480
attcagatgg ttagcgaagc agcacgtttt acctttattg aaaatcagat tcgcaataat 540
tttcagcagc gtattcgtcc ggcaaataat accattagcc tggaaaataa atggggcaaa 600
ctgagctttc agattcgtac cagcggtgca aatggtatgt ttagcgaagc cgttgaactg 660
gaacgtgcca atggcaaaaa atactatgtg accgcagtgg atcaggttaa accgaaaatt 720
gccctgctga aatttgttga taaagatccg aaaggtggtg gtggtagcgg tggcggtggc 780
tctgttcgtg aacgtggtcc gcagcgtgtt gcagcacata ttaccggcac ccgtggtcgt 840
agcaataccc tgagcagccc gaatagcaaa aatgaaaaag ccctgggtcg caaaattaat 900
agctgggaaa gcagccgtag cggtcatagc tttctgagca atctgcatct gcgtaatggt 960
gaactggtga ttcatgaaaa aggcttttat tatatttata gccagaccta ttttcgcttt 1020
caggaagaaa ttaaagaaaa caccaaaaat gataaacaaa tggtgcagta tatctataaa 1080
tataccagct atccggatcc gattctgctg atgaaaagcg cacgtaatag ctgttggagc 1140
aaagatgcag aatatggcct gtatagcatt tatcagggtg gcatttttga actgaaagaa 1200
aatgatcgca tttttgtgag cgtgaccaat gaacatctga ttgatatgga tcatgaagcc 1260
agcttttttg gtgcatttct ggtgggc 1287
<210> 120
<211> 1302
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 120
ggcctggata ccgttagctt tagcaccaaa ggtgcaacct atattaccta tgtgaatttt 60
ctgaatgaac tgcgcgttaa actgaaaccg gaaggtaata gccatggtat tccgctgctg 120
cgtaaaaaag cagatgatcc gggtaaagca tttgttctgg ttgcactgag caatgataat 180
ggtcagctgg ccgaaattgc aattgatgtg accagcgttt atgtggttgg ttatcaggtt 240
cgtaatcgca gctatttttt taaagatgca ccggatgcag cctatgaagg cctgtttaaa 300
aataccatta aaacccgtct gcattttggt ggtagctatc cgagcctgga aggtgaaaaa 360
gcatatcgtg aaaccaccga tctgggtatt gaaccgctgc gtattggcat taaaaaactg 420
gatgaaaatg ccattgataa ttataaaccg accgaaattg cctctagcct gctggttgtt 480
attcagatgg ttagcgaagc agcacgtttt acctttattg aaaatcagat tcgcaataat 540
tttcagcagc gtattcgtcc ggcaaataat accattagcc tggaaaataa atggggcaaa 600
ctgagctttc agattcgtac cagcggtgca aatggtatgt ttagcgaagc cgttgaactg 660
gaacgtgcca atggcaaaaa atactatgtg accgcagtgg atcaggttaa accgaaaatt 720
gccctgctga aatttgttga taaagatccg aaaggtggtg gtggcagccg taaaaaacgt 780
gcaagcggtt gtggtccgga aggtggtggt ggtagccagc gtgttgcagc acatattacc 840
ggcacccgtg gtcgtagcaa taccctgagc agcccgaata gcaaaaatga aaaagccctg 900
ggtcgcaaaa ttaatagctg ggaaagcagc cgtagcggtc atagctttct gagcaatctg 960
catctgcgta atggtgaact ggtgattcat gaaaaaggct tttattatat ttatagccag 1020
acctattttc gctttcagga agaaattaaa gaaaacacca aaaatgataa acaaatggtg 1080
cagtatatct ataaatatac cagctatccg gatccgattc tgctgatgaa aagcgcacgt 1140
aatagctgtt ggagcaaaga tgcagaatat ggcctgtata gcatttatca gggtggcatt 1200
tttgaactga aagaaaatga tcgcattttt gtgagcgtga ccaatgaaca tctgattgat 1260
atggatcatg aagccagctt ttttggtgca tttctggtgg gc 1302
<210> 121
<211> 1281
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 121
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaatagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gacctatttt cgctttcaag aagaaattaa agaaaacacc 240
aaaaatgata aacaaatggt gcagtacatt tataaatata ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggtctgtat 360
agcatttatc agggtggcat ttttgaactg aaagaaaatg atcgcatttt tgtgagcgtg 420
accaatgaac atctgattga tatggatcat gaagccagct tttttggtgc atttctggtt 480
ggtgcaagcg gttgtggtcc ggaaggtggt ggtggtagcg gtctggatac cgttagcttt 540
agcaccaaag gtgcaaccta tattacctat gtgaattttc tgaatgaact gcgcgtgaaa 600
ctgaaaccgg aaggtaatag ccatggtatt ccgctgctgc gtaaaaaagc agatgatccg 660
ggtaaagcat ttgttctggt tgcactgagc aatgataatg gtcagctggc agaaattgcc 720
attgatgtta ccagcgttta tgttgttggt tatcaggttc gtaatcgcag ctattttttt 780
aaagatgcac cggatgcagc ctatgaaggt ctgtttaaaa ataccattaa aacccgtctg 840
cattttggtg gtagctatcc gagcctggaa ggtgaaaaag catatcgtga aaccaccgat 900
ctgggtattg aaccgctgcg tattggtatt aaaaaactgg atgaaaatgc cattgataat 960
tataaaccga ccgaaattgc aagcagcctg ctggttgtta ttcagatggt tagcgaagca 1020
gcacgcttta cctttattga aaatcagatt cgcaataatt ttcagcagcg tattcgtccg 1080
gcaaataata ccattagcct ggaaaataaa tggggcaaac tgagctttca gattcgtacc 1140
agcggtgcaa atggtatgtt tagcgaagcc gttgaactgg aacgtgccaa tggcaaaaaa 1200
tactatgtta ccgcagtgga tcaggtgaaa ccgaaaattg cactgctgaa atttgtggat 1260
aaagatccga aagatgaact g 1281
<210> 122
<211> 1299
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 122
ggtctggata ccgtgtcctt tagcaccaaa ggtgcaacct atattaccta tgtgaatttt 60
ctgaatgaac tgcgcgtgaa actgaaaccg gaaggtaata gccatggtat tccgctgctg 120
cgtaaaaaag cagatgatcc gggtaaagca tttgttctgg ttgcactgag caatgataat 180
ggtcagctgg cagaaattgc cattgatgtt accagcgttt atgttgttgg ttatcaggtt 240
cgtaatcgca gctatttttt taaagatgca ccggatgcag cctatgaagg tctgtttaaa 300
aataccatta aaacccgtct gcattttggt ggtagctatc cgagcctgga aggtgaaaaa 360
gcatatcgtg aaaccaccga tctgggtatt gaaccgctgc gtattggtat taaaaaactg 420
gatgaaaatg ccattgataa ttataaaccg accgaaattg caagcagcct gctggttgtt 480
attcagatgg ttagcgaagc agcacgcttt acctttattg aaaatcagat tcgcaataat 540
tttcagcagc gtattcgtcc ggcaaataat accattagcc tggaaaataa atggggcaaa 600
ctgagctttc agattcgtac cagcggtgca aatggtatgt ttagcgaagc cgttgaactg 660
gaacgtgcca atggcaaaaa gtattatgtt accgcagtgg atcaggtaaa accgaaaatt 720
gcactgctga aatttgtgga taaagatccg aaaggtggtg gtggtagccg taaaaaacgt 780
gcaagcggtt gtggtccgga aggtggtggc ggttcacgtg ttgcagcaca tattaccggc 840
acccgtggtc gtagcaatac cctgagcagc ccgaatagca aaaatgaaaa agcactgggt 900
cgcaaaatta atagctggga aagcagccgt agcggtcata gctttctgag caatctgcat 960
ctgcgtaatg gtgaactggt gattcatgaa aaaggctttt attatattta tagccagacc 1020
tattttcgct ttcaggaaga aattaaagaa aataccaaaa atgataaaca aatggtgcag 1080
tatatctata aatataccag ctatccggat ccgattctgc tgatgaaaag cgcacgtaat 1140
agctgttgga gcaaagatgc agaatatggt ctgtatagca tttatcaggg tggcattttt 1200
gaactgaaag aaaatgatcg catttttgtg agcgtgacca atgaacatct gattgatatg 1260
gatcatgaag ccagcttttt tggtgcattt ctggttggt 1299
<210> 123
<211> 1674
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 123
ggtgcagatg atgttgttga tagcagcaaa tcctttgtga tggaaaattt tagcagctat 60
catggcacca aaccgggtta tgttgatagc attcagaaag gcattcagaa accgaaaagc 120
ggcacccagg gtaattatga tgatgattgg aaaggctttt atagcaccga taataaatat 180
gatgccgcag gctatagcgt tgataatgaa aatccgctgt ctggtaaagc cggtggtgtt 240
gttaaagtta cctatccggg tctgaccaaa gttctggcac tgaaagttga taatgccgaa 300
accattaaaa aagaactggg tctgtctctg accgaaccgc tgatggaaca ggttggcacc 360
gaagaattta ttaaacgctt tggtgatggt gcaagccgtg ttgttctgag cctgccgttt 420
gcagaaggta gcagcagcgt tgaatatatt aataattggg aacaggccaa agcactgagc 480
gttgaactgg aaattaattt tgaaacccgt ggcaaacgtg gtcaggatgc catgtatgaa 540
tatatggcac aggcatgtgc aggcaatcgt gttcgtcgta gcgttggtag cagcctgagc 600
tgtattaatc tggattggga tgtgattcgc gataaaacca aaaccaaaat tgaaagcctg 660
aaagaacatg gtccgattaa aaataaaatg agcgaaagcc cgaataaaac cgtgagcgaa 720
gaaaaagcaa aacagtatct ggaagaattt catcagaccg cactggaaca tccggaactg 780
agcgaactga aaaccgttac cggcaccaat ccggtttttg ccggtgcaaa ttatgcagca 840
tgggcagtta atgttgccca ggtgattgat agcgaaaccg cagataatct ggaaaaaacc 900
accgcagcac tgagcattct gcctggtatt ggtagcgtta tgggtattgc agatggtgca 960
gtgcatcata ataccgaaga aattgtggca cagagcattg cactgagcag cctgatggtt 1020
gcacaggcaa ttccgctggt tggtgaactg gttgatatcg gctttgcagc ctataatttt 1080
gtggaaagca ttatcaacct gtttcaggtg gtgcataata gctataatcg tccggcatat 1140
tctccgggtc ataaaaccca tggtggtggt ggtagcggtg gtggtggcag ccgtgttgca 1200
gcacatatta ccggcacccg tggtcgtagc aataccctga gcagcccgaa tagcaaaaat 1260
gaaaaagccc tgggtcgcaa aattaatagc tgggaaagca gccgtagcgg tcatagcttt 1320
ctgagcaatc tgcatctgcg taatggcgaa ctggtgattc atgaaaaagg tttttattat 1380
atttatagcc agacctattt tcgctttcag gaagaaatta aagaaaacac caaaaatgat 1440
aaacaaatgg ttcagtacat ctataaatat accagctatc cggatccgat tctgctgatg 1500
aaaagcgcac gtaatagctg ttggagcaaa gatgcagaat atggcctgta tagcatttat 1560
cagggtggca tttttgaact gaaagaaaat gatcgcattt ttgtgagcgt gaccaatgaa 1620
catctgattg atatggatca tgaagccagc ttttttggtg catttctggt gggt 1674
<210> 124
<211> 1443
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 124
cgtgtggcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa atcaatagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttctactata tctatagcca gacctatttc cgcttccaag aagaaatcaa agaaaatacc 240
aaaaacgata aacaaatggt gcagtatatc tataaataca ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggtctgtat 360
agcatttatc agggtggcat ctttgagctg aaagaaaatg atcgcatctt tgttagcgtg 420
accaacgaac atctgatcga tatggatcat gaagccagct tttttggtgc atttctggtt 480
ggtggtggtg gtagcggtgg tggtggcagc cgtaaaaaac gtccggaagg tggtagcctg 540
gcagcactga ccgcacatca ggcatgtcat ctgccgctgg aaacctttac ccgtcatcgt 600
cagcctcgtg gttgggaaca gctggaacag tgtggttatc cggttcagcg tctggttgca 660
ctgtatctgg cagcacgtct gagctggaat caggttgatc aggttattcg taatgcactg 720
gcaagtccgg gtagtggtgg tgatctgggt gaagcaattc gtgaacagcc ggaacaggca 780
cgtctggcac tgaccctggc agcagcagaa agcgaacgtt ttgttcgtca gggcaccggt 840
aatggtggtg gcggtgcaga tgatgttgtt gatagcagca aaagttttgt gatggaaaac 900
ttcagcagct atcatggcac caaaccgggt tatgttgata gcattcagaa aggtattcag 960
aaaccgaaaa gcggcaccca gggtaattat gatgatgatt ggaaaggctt ctatagcacc 1020
gataacaaat atgatgcagc cggttatagc gtggataatg aaaatccgct gagcggtaaa 1080
gccggtggtg ttgttaaagt tacctatccg ggtctgacca aagttctggc actgaaagtt 1140
gataatgccg aaaccatcaa aaaagaactg ggtctgagcc tgaccgaacc gctgatggaa 1200
caggttggca ccgaagaatt tatcaaacgt tttggtgatg gtgcaagccg tgttgttctg 1260
agtctgccgt ttgcagaagg tagcagcagc gttgaatata tcaataattg ggaacaggca 1320
aaagccctga gcgttgaact ggaaatcaat tttgaaaccc gtggtaaacg tggtcaggat 1380
gcaatgtatg aatatatggc acaggcatgt gcaggcaatc gtgttcgtcg taaagaagat 1440
ctg 1443
<210> 125
<211> 1443
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 125
ggcgcggatg atgtggtgga tagcagcaaa agctttgtga tggaaaactt tagcagctat 60
catggcacca aaccgggcta tgtggatagc attcagaaag gcattcagaa accgaaaagc 120
ggcacccagg gcaactatga tgatgattgg aaaggctttt atagcaccga taacaaatat 180
gatgcggcgg gctatagcgt ggataacgaa aacccgctga gcggcaaagc gggcggcgtg 240
gtgaaagtga cctatccggg cctgaccaaa gtgctggcgc tgaaagtgga taacgcggaa 300
accattaaaa aagaactggg cctgagcctg accgaaccgc tgatggaaca ggtgggcacc 360
gaagaattta ttaaacgctt tggcgatggc gcgagccgcg tggtgctgag cctgccgttt 420
gcggaaggca gcagcagcgt ggaatatatt aacaactggg aacaggcgaa agcgctgagc 480
gtggaactgg aaattaactt tgaaacccgc ggcaaacgcg gccaggatgc gatgtatgaa 540
tatatggcgc aggcgtgcgc gggcaaccgc aaaaaacgcg gcggcggcgg cagcccggaa 600
ggcggcagcc tggcggcgct gaccgcgcat caggcgtgcc atctgccgct ggaaaccttt 660
acccgccatc gccagccgcg cggctgggaa cagctggaac agtgcggcta tccggtgcag 720
cgcctggtgg cgctgtatct ggcggcgcgc ctgagctgga accaggtgga tcaggtgatt 780
cgcaacgcgc tggcgagccc gggcagcggc ggcgatctgg gcgaagcgat tcgcgaacag 840
ccggaacagg cgcgcctggc gctgaccctg gcggcggcgg aaagcgaacg ctttgtgcgc 900
cagggcaccg gcaacggccg caaaaaacgc ggcggcggcg gcagcggcgg cggcggcagc 960
cgcgtggcgg cgcatattac cggcacccgc ggccgcagca acaccctgag cagcccgaac 1020
agcaaaaacg aaaaagcgct gggccgcaaa attaacagct gggaaagcag ccgcagcggc 1080
catagctttc tgagcaacct gcatctgcgc aacggcgaac tggtgattca tgaaaaaggc 1140
ttttattata tttatagcca gacctatttt cgctttcagg aagaaattaa agaaaacacc 1200
aaaaacgata aacagatggt gcagtatatt tataaatata ccagctatcc ggatccgatt 1260
ctgctgatga aaagcgcgcg caacagctgc tggagcaaag atgcggaata tggcctgtat 1320
agcatttatc agggcggcat ttttgaactg aaagaaaacg atcgcatttt tgtgagcgtg 1380
accaacgaac atctgattga tatggatcat gaagcgagct tttttggcgc gtttctggtg 1440
ggc 1443
<210> 126
<211> 1104
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 126
gcgcgccata tggaagatcg tccgattaaa tttagcaccg aaggtgccac ctcccagtct 60
tataaacagt ttattgaagc gctgcgtgaa cgtctgcgtg gcggtctgat tcatgatatt 120
ccggttctgc cggatccgac aactctgcag gaacgcaatc gttatattac cgtggaactg 180
agtaattccg atacagaatc tattgaagtg ggcattgtga cgcatggtat ttcttttttt 240
cgtagtggcg gtaatgataa tgaagaaaaa gcgcgtaccc tgattgttat tattcagatg 300
gttgctgaag ccgctcgctt tcgttatatt tccaatcgtg tgcgtgtgtc tattcagact 360
ggtactgcct ttcagccgga tgcagctatg atttccctgg aaaataattg ggataatctg 420
tctcgtggtg ttcaggaatc cgttcaggat acctttccga atcaggttac cctgaccaat 480
attcgtaatg aaccggttat tgttgatagc ctgtctcatc cgaccgttgc tgttctggcc 540
ctgatgctgt ttgtttgcaa tcctccgaat ggtggtggtg gttctggtgg cggtggttca 600
gtgcgtgaac gtggtccgca gcgtgttgcc gctcatatta ccggtactcg tggtcgttct 660
aataccctgt ctagcccgaa tagtaaaaat gaaaaagccc tgggtcgcaa aattaatagt 720
tgggaatcta gtcgtagtgg ccattctttt ctgagcaatc tgcatctgcg taatggtgaa 780
ctggtgattc atgaaaaagg tttttattat atctattccc agacttattt tcgttttcag 840
gaagaaatta aagaaaacac gaaaaatgat aaacagatgg tgcagtatat ctataaatat 900
acctcttatc cggatccgat tctgctgatg aaaagtgccc gtaattcttg ttggagtaaa 960
gatgcggaat atggcctgta ttctatttat cagggtggta tttttgaact gaaagaaaat 1020
gatcgcattt ttgtgtctgt gaccaatgaa catctgattg atatggatca tgaagcatct 1080
ttttttggtg cctttctggt gggc 1104
<210> 127
<211> 1359
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 127
gcacgccaca tggaagatcg tccgattaaa tttagcaccg aaggtgcaac cagccagagc 60
tataaacagt ttattgaagc actgcgtgaa cgtctgcgtg gtggtctgat tcatgatatt 120
ccggttctgc cggatccgac caccctgcag gaacgtaatc gttatattac cgttgaactg 180
agcaatagcg ataccgaaag cattgaagtt ggtattgatg tgaccaatgc ctatgttgtt 240
gcatatcgtg caggcaccca gagctatttt ctgcgtgatg caccgagcag cgcaagcgat 300
tacctgttta ccggcaccga tcagcatagc ctgccgtttt atggcaccta tggtgatctg 360
gaacgttggg cacatcagag ccgtcagcag attccgctgg gtctgcaggc actgacccat 420
ggtattagct tttttcgtag cggtggcaat gataatgaag aaaaagcacg taccctgatt 480
gtgattattc agatggttgc agaagcagca cgctttcgtt atatttcaaa tcgtgttcgt 540
gtgagcattc agaccggcac cgcatttcag ccggatgcag caatgattag cctggaaaat 600
aattgggata atctgagccg tggtgttcag gaaagcgttc aggatacctt tccgaatcag 660
gttaccctga ccaatattcg taatgaaccg gttattgttg atagcctgag ccatccgacc 720
gttgcagttc tggcactgat gctgtttgtt tgtaatcctc cgaatgttcg tgaacgtggt 780
ccgggtggtg gtggttcttg tttttgtgat ggtcgctgtg attgtgcacg taagaaacgc 840
ggtggtggtg gttctgtgcg tgaacgtggt ccgcagcgtg ttgccgctca tattaccggt 900
actcgtggtc gttctaatac cctgtctagc ccgaatagta aaaatgaaaa agccctgggt 960
cgcaaaatta atagttggga atctagtcgt agtggccatt cttttctgag caatctgcat 1020
ctgcgtaatg gtgaactggt gattcatgaa aaaggttttt attatatcta ttcccagact 1080
tattttcgtt ttcaggaaga aattaaagaa aacacgaaaa atgataaaca gatggtgcag 1140
tatatctata aatatacctc ttatccggat ccgattctgc tgatgaaaag tgcccgtaat 1200
tcttgttgga gtaaagatgc ggaatatggc ctgtattcta tttatcaggg tggtattttt 1260
gaactgaaag aaaatgatcg catttttgtg tctgtgacca atgaacatct gattgatatg 1320
gatcatgaag catctttttt tggtgccttt ctggtgggc 1359
<210> 128
<211> 1302
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 128
atggaagatc gtccgattaa atttagcacc gaaggtgcca cctcccagtc ttataaacag 60
tttattgaag cgctgcgtga acgtctgcgt ggcggtctga ttcatgatat tccggttctg 120
ccggatccga caactctgca ggaacgcaat cgttatatta ccgtggaact gagtaattcc 180
gatacagaat ctattgaagt gggcattgat gttaccaatg cttatgtggt tgcttatcgc 240
gctggcaccc agagttattt tctgcgtgat gctccgtcat ctgccagtga ttacctgttt 300
accggtacgg atcagcattc cctgccgttt tatggtactt atggtgatct ggaacgctgg 360
gctcatcagt ctcgtcagca gattccgctg ggtctgcagg ctctgacgca tggtatttct 420
ttttttcgta gtggcggtaa tgataatgaa gaaaaagcgc gtaccctgat tgttattatt 480
cagatggttg ctgaagccgc tcgctttcgt tatatttcca atcgtgtgcg tgtgtctatt 540
cagactggta ctgcctttca gccggatgca gctatgattt ccctggaaaa taattgggat 600
aatctgtctc gtggtgttca ggaatccgtt caggatacct ttccgaatca ggttaccctg 660
accaatattc gtaatgaacc ggttattgtt gatagcctgt ctcatccgac cgttgctgtt 720
ctggccctga tgctgtttgt ttgcaatcct ccgaatggtg gtggtggttc tggtggcggt 780
ggttcacgta agaaacgcgt gcgtgaacgt ggtccgcagc gtgttgccgc tcatattacc 840
ggtactcgtg gtcgttctaa taccctgtct agcccgaata gtaaaaatga aaaagccctg 900
ggtcgcaaaa ttaatagttg ggaatctagt cgtagtggcc attcttttct gagcaatctg 960
catctgcgta atggtgaact ggtgattcat gaaaaaggtt tttattatat ctattcccag 1020
acttattttc gttttcagga agaaattaaa gaaaacacga aaaatgataa acagatggtg 1080
cagtatatct ataaatatac ctcttatccg gatccgattc tgctgatgaa aagtgcccgt 1140
aattcttgtt ggagtaaaga tgcggaatat ggcctgtatt ctatttatca gggtggtatt 1200
tttgaactga aagaaaatga tcgcattttt gtgtctgtga ccaatgaaca tctgattgat 1260
atggatcatg aagcatcttt ttttggtgcc tttctggtgg gc 1302
<210> 129
<211> 1320
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 129
gaagatcgtc cgattaaatt tagcaccgaa ggtgccacct cccagtctta taaacagttt 60
attgaagcgc tgcgtgaacg tctgcgtggc ggtctgattc atgatattcc ggttctgccg 120
gatccgacaa ctctgcagga acgcaatcgt tatattaccg tggaactgag taattccgat 180
acagaatcta ttgaagtggg cattgatgtt accaatgctt atgtggttgc ttatcgcgct 240
ggcacccaga gttattttct gcgtgatgct ccgtcatctg ccagtgatta cctgtttacc 300
ggtacggatc agcattccct gccgttttat ggtacttatg gtgatctgga acgctgggct 360
catcagtctc gtcagcagat tccgctgggt ctgcaggctc tgacgcatgg tatttctttt 420
tttcgtagtg gcggtaatga taatgaagaa aaagcgcgta ccctgattgt tattattcag 480
atggttgctg aagccgctcg ctttcgttat atttccaatc gtgtgcgtgt gtctattcag 540
actggtactg cctttcagcc ggatgcagct atgatttccc tggaaaataa ttgggataat 600
ctgtctcgtg gtgttcagga atccgttcag gatacctttc cgaatcaggt taccctgacc 660
aatattcgta atgaaccggt tattgttgat agcctgtctc atccgaccgt tgctgttctg 720
gccctgatgc tgtttgtttg caatcctccg aatcgtcgtc gtcgtcgccg tcgtcgtaag 780
aaacgcggtg gtggtggttc tggtggcggt ggttcagtgc gtgaacgtgg tccgcagcgt 840
gttgccgctc atattaccgg tactcgtggt cgttctaata ccctgtctag cccgaatagt 900
aaaaatgaaa aagccctggg tcgcaaaatt aatagttggg aatctagtcg tagtggccat 960
tcttttctga gcaatctgca tctgcgtaat ggtgaactgg tgattcatga aaaaggtttt 1020
tattatatct attcccagac ttattttcgt tttcaggaag aaattaaaga aaacacgaaa 1080
aatgataaac agatggtgca gtatatctat aaatatacct cttatccgga tccgattctg 1140
ctgatgaaaa gtgcccgtaa ttcttgttgg agtaaagatg cggaatatgg cctgtattct 1200
atttatcagg gtggtatttt tgaactgaaa gaaaatgatc gcatttttgt gtctgtgacc 1260
aatgaacatc tgattgatat ggatcatgaa gcatcttttt ttggtgcctt tctggtgggc 1320
<210> 130
<211> 1671
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 130
gtgcgtgaac gtggtccgca gcgtgttgcc gctcatatta ccggtactcg tggtcgttct 60
aataccctgt ctagcccgaa tagtaaaaat gaaaaagccc tgggtcgcaa aattaatagt 120
tgggaatcta gtcgtagtgg ccattctttt ctgagcaatc tgcatctgcg taatggtgaa 180
ctggtgattc atgaaaaagg tttttattat atctattccc agacttattt tcgttttcag 240
gaagaaatta aagaaaacac gaaaaatgat aaacagatgg tgcagtatat ctataaatat 300
acctcttatc cggatccgat tctgctgatg aaaagtgccc gtaattcttg ttggagtaaa 360
gatgcggaat atggcctgta ttctatttat cagggtggta tttttgaact gaaagaaaat 420
gatcgcattt ttgtgtctgt gaccaatgaa catctgattg atatggatca tgaagcatct 480
ttttttggtg cctttctggt gggcggtggt ggtggttctg gtggcggtgg ttcacgtaag 540
aaacgcccgg aaggcggcag cctggcggcg ctgaccgcgc atcaggcgtg ccatctgccg 600
ctggaaacct ttacccgcca tcgccagccg cgcggctggg aacagctgga acagtgcggc 660
tatccggtgc agcgcctggt ggcgctgtat ctggcggcgc gcctgagctg gaaccaggtg 720
gatcaggtga ttcgcaacgc gctggcgagc ccgggcagcg gcggcgatct gggcgaagcg 780
attcgcgaac agccggaaca ggcgcgcctg gcgctgaccc tggcggcggc ggaaagcgaa 840
cgctttgtgc gccagggcac cggcaacggc ggtggcggtg gttcacgtaa gaaacgcgaa 900
gatcgtccga ttaaatttag caccgaaggt gccacctccc agtcttataa acagtttatt 960
gaagcgctgc gtgaacgtct gcgtggcggt ctgattcatg atattccggt tctgccggat 1020
ccgacaactc tgcaggaacg caatcgttat attaccgtgg aactgagtaa ttccgataca 1080
gaatctattg aagtgggcat tgatgttacc aatgcttatg tggttgctta tcgcgctggc 1140
acccagagtt attttctgcg tgatgctccg tcatctgcca gtgattacct gtttaccggt 1200
acggatcagc attccctgcc gttttatggt acttatggtg atctggaacg ctgggctcat 1260
cagtctcgtc agcagattcc gctgggtctg caggctctga cgcatggtat ttcttttttt 1320
cgtagtggcg gtaatgataa tgaagaaaaa gcgcgtaccc tgattgttat tattcagatg 1380
gttgctgaag ccgctcgctt tcgttatatt tccaatcgtg tgcgtgtgtc tattcagact 1440
ggtactgcct ttcagccgga tgcagctatg atttccctgg aaaataattg ggataatctg 1500
tctcgtggtg ttcaggaatc cgttcaggat acctttccga atcaggttac cctgaccaat 1560
attcgtaatg aaccggttat tgttgatagc ctgtctcatc cgaccgttgc tgttctggcc 1620
ctgatgctgt ttgtttgcaa tcctccgaat cgtcgtcgtc gtcgccgtcg t 1671
<210> 131
<211> 1377
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 131
gaagatcgtc cgattaaatt tagcaccgaa ggtgcaacca gccagagcta taaacagttt 60
attgaagcac tgcgtgaacg tctgcgtggt ggtctgattc atgatattcc ggttctgccg 120
gatccgacca ccctgcaaga acgtaatcgt tatattaccg tggaactgag caatagcgat 180
accgaaagca ttgaagttgg tattgatgtg accaatgcct atgttgttgc atatcgtgca 240
ggcacccaga gctattttct gcgtgatgca ccgagcagcg caagcgatta cctgtttacc 300
ggcaccgatc agcatagcct gccgttttat ggcacctatg gtgatctgga acgttgggca 360
catcagagcc gtcagcagat tccgctgggt ctgcaggcac tgacccatgg tattagcttt 420
tttcgtagcg gtggcaatga caatgaagaa aaagcacgta ccctgattgt gattattcag 480
atggttgcag aagcagcacg ctttcgttat atttcaaatc gtgttcgtgt gagcattcag 540
accggaaccg catttcagcc ggatgcagca atgattagcc tggaaaataa ttgggataat 600
ctgagccgtg gtgttcaaga aagcgttcag gatacctttc cgaatcaggt taccctgacc 660
aatattcgta atgaaccggt tattgttgat agcctgagcc atccgaccgt tgcagttctg 720
gcactgatgc tgtttgtttg taatccgcct aatggtggtg gtggtagcgg tggtggtggc 780
agccgtaaaa aacgtgcaag cggttgtggt ccggaaacca gcgaagaaac cattagcacc 840
gttcaagaaa aacagcagaa tattagtccg ctggttcgtg aacgtggtcc gcagcgtgtt 900
gcagcacata ttaccggaac ccgtggtcgt agcaataccc tgagcagccc gaatagcaaa 960
aatgaaaaag cactgggtcg caaaatcaat agctgggaaa gcagccgtag cggtcatagc 1020
tttctgagca atctgcatct gcgtaatggt gaactggtga ttcatgaaaa aggcttttat 1080
tatatttata gccagaccta ttttcgcttt caagaagaga ttaaagaaaa taccaaaaat 1140
gataaacaaa tggtgcagta tatctataaa tataccagct atccggatcc gatcctgctg 1200
atgaaaagcg cacgtaatag ctgttggagc aaagatgcag aatatggtct gtatagcatt 1260
tatcagggtg gcatctttga gctgaaagaa aatgatcgca tctttgttag cgtgaccaac 1320
gaacatctga tcgatatgga tcatgaagcc agcttttttg gtgcatttct ggtgggt 1377
<210> 132
<211> 1329
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 132
cgtgtggcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaatagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gacctatttt cgctttcagg aagaaattaa agaaaatacc 240
aaaaatgata aacaaatggt gcagtatatc tataaatata ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggtctgtat 360
agcatttatc agggtggcat ttttgaactg aaagaaaatg atcgcatttt tgtgagcgtg 420
accaatgaac atctgattga tatggatcat gaagccagct tttttggtgc atttctggtt 480
ggtggtggtg gcggtagcgc aagcggttgt ggtccggaac gtaaaaaacg cggtggtggt 540
ggtagtgcac gccacatgga agatcgtccg attaaattta gcaccgaagg tgcaaccagc 600
cagagctata aacagtttat tgaagcactg cgtgaacgtc tgcgtggtgg tctgattcat 660
gatattccgg ttctgccgga tccgaccacc ctgcaggaac gtaatcgtta tattaccgtt 720
gaactgagca atagcgatac cgaaagcatt gaagttggta ttgatgtgac caatgcctat 780
gttgttgcat atcgtgcagg cacccagagc tattttctgc gtgatgcacc gagcagcgca 840
agcgattacc tgtttaccgg caccgatcag catagcctgc cgttttatgg cacctatggt 900
gatctggaac gttgggcaca tcagagccgt cagcagattc cgctgggtct gcaggcactg 960
acccatggta ttagcttttt tcgtagcggt ggcaatgata atgaagaaaa agcacgtacc 1020
ctgattgtga ttattcagat ggttgcagaa gcagcacgct ttcgttatat ttcaaatcgt 1080
gttcgtgtga gcattcagac cggcaccgca tttcagccgg atgcagcaat gattagcctg 1140
gaaaataatt gggataatct gagccgtggt gttcaggaaa gcgttcagga tacctttccg 1200
aatcaggtta ccctgaccaa tattcgtaat gaaccggtta ttgttgatag cctgagccat 1260
ccgaccgttg cagttctggc actgatgctg tttgtttgta atcctccgaa tgttcgtgaa 1320
cgtggtccg 1329
<210> 133
<211> 1341
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 133
cgtgtggcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaatagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gacctatttt cgctttcagg aagaaattaa agaaaatacc 240
aaaaatgata aacaaatggt gcagtatatc tataaatata ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggtctgtat 360
agcatttatc agggtggcat ttttgaactg aaagaaaatg atcgcatttt tgtgagcgtg 420
accaatgaac atctgattga tatggatcat gaagccagct tttttggtgc atttctggtt 480
ggtggtggtg gcggtagcgc aagcggttgt ggtccggaac gtaaaaaacg cggtggtggt 540
ggtagtgcac gccacatgga agatcgtccg attaaattta gcaccgaagg tgcaaccagc 600
cagagctata aacagtttat tgaagcactg cgtgaacgtc tgcgtggtgg tctgattcat 660
gatattccgg ttctgccgga tccgaccacc ctgcaggaac gtaatcgtta tattaccgtt 720
gaactgagca atagcgatac cgaaagcatt gaagttggta ttgatgtgac caatgcctat 780
gttgttgcat atcgtgcagg cacccagagc tattttctgc gtgatgcacc gagcagcgca 840
agcgattacc tgtttaccgg caccgatcag catagcctgc cgttttatgg cacctatggt 900
gatctggaac gttgggcaca tcagagccgt cagcagattc cgctgggtct gcaggcactg 960
acccatggta ttagcttttt tcgtagcggt ggcaatgata atgaagaaaa agcacgtacc 1020
ctgattgtga ttattcagat ggttgcagaa gcagcacgct ttcgttatat ttcaaatcgt 1080
gttcgtgtga gcattcagac cggcaccgca tttcagccgg atgcagcaat gattagcctg 1140
gaaaataatt gggataatct gagccgtggt gttcaggaaa gcgttcagga tacctttccg 1200
aatcaggtta ccctgaccaa tattcgtaat gaaccggtta ttgttgatag cctgagccat 1260
ccgaccgttg cagttctggc actgatgctg tttgtttgta atcctccgaa tgttcgtgaa 1320
cgtggtccga aagaagatct g 1341
<210> 134
<211> 1323
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 134
gaagatcgtc cgattaaatt tagcaccgaa ggtgcaacca gccagagcta taaacagttt 60
attgaagcac tgcgtgaacg tctgcgtggt ggtctgattc atgatattcc ggttctgccg 120
gatccgacca ccctgcagga acgtaatcgt tatattaccg ttgaactgag caatagcgat 180
accgaaagca ttgaagttgg tattgatgtg accaatgcct atgttgttgc atatcgtgca 240
ggcacccaga gctattttct gcgtgatgca ccgagcagcg caagcgatta cctgtttacc 300
ggcaccgatc agcatagcct gccgttttat ggcacctatg gtgatctgga acgttgggca 360
catcagagcc gtcagcagat tccgctgggt ctgcaggcac tgacccatgg tattagcttt 420
tttcgtagcg gtggcaatga taatgaagaa aaagcacgta ccctgattgt gattattcag 480
atggttgcag aagcagcacg ctttcgttat atttcaaatc gtgttcgtgt gagcattcag 540
accggcaccg catttcagcc ggatgcagca atgattagcc tggaaaataa ttgggataat 600
ctgagccgtg gtgttcagga aagcgttcag gatacctttc cgaatcaggt taccctgacc 660
aatattcgta atgaaccggt tattgttgat agcctgagcc atccgaccgt tgcagttctg 720
gcactgatgc tgtttgtttg taatccgccg aatggtggtg gtggtagcgg tggtggtggc 780
agccgtaaaa aacgtgcaag cggttgtggt ccggaatgtg ttcgtgaacg tggtccgcag 840
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 900
agcaaaaatg aaaaagcact gggtcgcaaa attaatagct gggaaagcag ccgtagcggt 960
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 1020
ttttattata tttatagcca gacctatttt cgctttcagg aagaaattaa agaaaatacc 1080
aaaaatgata aacaaatggt gcagtatatc tataaataca ccagctatcc ggatccgatt 1140
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggtctgtat 1200
agcatttatc agggtggcat ttttgaactg aaagaaaatg atcgcatttt tgtgagcgtg 1260
accaatgaac atctgattga tatggatcat gaagccagct tttttggtgc atttctggtt 1320
ggt 1323
<210> 135
<211> 1545
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 135
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagccct gggtcgcaaa attaatagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gacctatttt cgctttcagg aagaaattaa agaaaacacc 240
aaaaatgata aacaaatggt gcagtatatc tataaatata ccagctatcc gcatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggcctgtat 360
agcatttatc agggtggcat ttttgaactg aaagaaaatg atcgcatttt tgtgagcgtg 420
accaatgaac atctgattga tatggatcat gaagccagct tttttggtgc atttctggtt 480
ggtggtggtg gtagcgcaag cggtggtccg gaaggtggta gcctggcagc actgaccgca 540
catcaggcat gtcatctgcc gctggaaacc tttacccgtc atcgtcagcc tcgtggttgg 600
gaacagctgg aacagtgtgg ttatccggtt cagcgtctgg ttgcactgta tctggcagca 660
cgtctgagct ggaatcaggt tgatcaggtt attgcaaatg cactggcatc tccgggtagc 720
ggtggtgatc tgggtgaagc aattcgtgaa tctccggaac aggcacgtct ggcactgacc 780
ctggcagcag cagaaagcga acgttttgtt cgtcagggca ccggtaatga tgaagccggt 840
gcagcaaatg gtccggcaga tagcggtgat gcactgctgg aacgtaatta tccgaccggt 900
gcagaatttc tgggtgatgg cggtgatgtt agctttagca cccgtggcac ccagaattgg 960
accgttgaac gtctgctgca ggcacatcgt cagctggaag aagccggtta cgtttttgtg 1020
ggttatcatg gcacctttct ggaagcagca cagagcattg tttttggtgg tgttcgtgca 1080
cgtagccagg atctggatgc aatttgggca ggcttttata ttgccggtga tccggcactg 1140
gcatatggtt atgcacagga tcaggaaccg gacgcagccg gtcgtattcg taatggtgca 1200
ctgctgcgtg tttatgttcc gcgtagcagc ctgcctggtt tttatgcaac cagcctgacc 1260
ctggctgcac cggaagcagc gggtgaagtg gaacgtctga ttggtcatcc gctgccgctg 1320
cgtctggatg ccattaccgg tccggaagaa tctggtggtc gtctggaaac cattctgggt 1380
tggcctctgg cagaacgcac cgttgttatt ccgagcgcaa ttccgaccga tccgcgtaat 1440
gttggtggcg atctggatcc gagcagcatt ccggatagcg aacaggcaat tagcgcactg 1500
ccggattatg ccagccagcc tggtaaacct ccgaaagatg aactg 1545
<210> 136
<211> 1545
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 136
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagccct gggtcgcaaa attaatagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gaccaatttt aagtttaggg aagaaattaa agaaaacacc 240
aaaaatgata aacaaatggt gcagtatatc tataaatata ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggcctgtat 360
agcatttatc agggtggcat ttttgaactg aaagaaaatg atcgcatttt tgtgagcgtg 420
accaatgaac gtctgaggga tatgcatcat gaagccagct tttttggtgc atttctggtt 480
ggtggtggtg gtagcgcaag cggtggtccg gaaggtggta gcctggcagc actgaccgca 540
catcaggcat gtcatctgcc gctggaaacc tttacccgtc atcgtcagcc tcgtggttgg 600
gaacagctgg aacagtgtgg ttatccggtt cagcgtctgg ttgcactgta tctggcagca 660
cgtctgagct ggaatcaggt tgatcaggtt attgcaaatg cactggcatc tccgggtagc 720
ggtggtgatc tgggtgaagc aattcgtgaa tctccggaac aggcacgtct ggcactgacc 780
ctggcagcag cagaaagcga acgttttgtt cgtcagggca ccggtaatga tgaagccggt 840
gcagcaaatg gtccggcaga tagcggtgat gcactgctgg aacgtaatta tccgaccggt 900
gcagaatttc tgggtgatgg cggtgatgtt agctttagca cccgtggcac ccagaattgg 960
accgttgaac gtctgctgca ggcacatcgt cagctggaag aagccggtta cgtttttgtg 1020
ggttatcatg gcacctttct ggaagcagca cagagcattg tttttggtgg tgttcgtgca 1080
cgtagccagg atctggatgc aatttgggca ggcttttata ttgccggtga tccggcactg 1140
gcatatggtt atgcacagga tcaggaaccg gacgcagccg gtcgtattcg taatggtgca 1200
ctgctgcgtg tttatgttcc gcgtagcagc ctgcctggtt tttatgcaac cagcctgacc 1260
ctggctgcac cggaagcagc gggtgaagtg gaacgtctga ttggtcatcc gctgccgctg 1320
cgtctggatg ccattaccgg tccggaagaa tctggtggtc gtctggaaac cattctgggt 1380
tggcctctgg cagaacgcac cgttgttatt ccgagcgcaa ttccgaccga tccgcgtaat 1440
gttggtggcg atctggatcc gagcagcatt ccggatagcg aacaggcaat tagcgcactg 1500
ccggattatg ccagccagcc tggtaaacct ccgaaagatg aactg 1545
<210> 137
<211> 1557
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 137
cgtgtggcgg cgcatattac cggcacccgt ggccgtagca acaccctgag cagcccgaac 60
agcaaaaacg aaaaagcgct gggccgtaaa attaacagct gggaaagcag ccgtagcggc 120
catagctttc tgagcaacct gcatctgcgt aacggcgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gacctatttt cgttttcagg aagaaattaa agaaaacacc 240
aaaaacgata aacagatggt gcagtatatt tataaatata ccagctatcc gcatccgatt 300
ctgctgatga aaagcgcgcg taacagctgc tggagcaaag atgcggaata tggcctgtat 360
agcatttatc agggcggcat ttttgaactg aaagaaaacg atcgtatttt tgtgagcgtg 420
accaacgaac atctgattga tatggatcat gaagcgagct tttttggcgc gtttctggtg 480
ggcggcggcg gcagcggcgc gagcggctgc ggcccggaac cggaaggcgg cagcctggcg 540
gcgctgaccg cgcatcaggc gtgccatctg ccgctggaaa cctttacccg tcatcgtcag 600
ccgcgtggct gggaacagct ggaacagtgc ggctatccgg tgcagcgtct ggtggcgctg 660
tatctggcgg cgcgtctgag ctggaaccag gtggatcagg tgattgcgaa cgcgctggcg 720
agcccgggca gcggcggcga tctgggcgaa gcgattcgtg aaagcccgga acaggcgcgt 780
ctggcgctga ccctggcggc ggcggaaagc gaacgttttg tgcgtcaggg caccggcaac 840
gatgaagcgg gcgcggcgaa cggcccggcg gatagcggcg atgcgctgct ggaacgtaac 900
tatccgaccg gcgcggaatt tctgggcgat ggcggcgatg tgagctttag cacccgtggc 960
acccagaact ggaccgtgga acgtctgctg caggcgcatc gtcagctgga agaacgtggc 1020
tatgtgtttg tgggctatca tggcaccttt ctggaagcgg cgcagagcat tgtgtttggc 1080
ggcgtgcgtg cgcgtagcca ggatctggat gcgatttggg cgggctttta tattgcgggc 1140
gatccggcgc tggcgtatgg ctatgcgcag gatcaggaac cggatgcggc gggccgtatt 1200
cgtaacggcg cgctgctgcg tgtgtatgtg ccgcgtagca gcctgccggg cttttatgcg 1260
accagcctga ccctggcggc gccggaagcg gcgggcgaag tggaacgtct gattggccat 1320
ccgctgccgc tgcgtctgga tgcgattacc ggcccggaag aaagcggcgg ccgtctggaa 1380
accattctgg gctggccgct ggcggaacgt accgtggtga ttccgagcgc gattccgacc 1440
gatccgcgta acgtgggcgg cgatctggat ccgagcagca ttccggatag cgaacaggcg 1500
attagcgcgc tgccggatta tgcgagccag ccgggcaaac cgccgaaaga tgaactg 1557
<210> 138
<211> 1545
<212> DNA
<213> Artificial Sequence
<220>
<223> none
<400> 138
cgtgtggcgg cgcatattac cggcacccgt ggccgtagca acaccctgag cagcccgaac 60
agcaaaaacg aaaaagcgct gggccgtaaa attaacagct gggaaagcag ccgtagcggc 120
catagctttc tgagcaacct gcatctgcgt aacggcgaac tggtgattca tgaaaaaggc 180
ttttattata tttatagcca gaccaacttt aaatttcgtg aagaaattaa agaaaacacc 240
aaaaacgata aacagatggt gcagtatatt tataaatata ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcgcg taacagctgc tggagcaaag atgcggaata tggcctgtat 360
agcatttatc agggcggcat ttttgaactg aaagaaaacg atcgtatttt tgtgagcgtg 420
accaacgaac gtctgcgtga tatgcatcat gaagcgagct tttttggcgc gtttctggtg 480
ggcggcggcg gcagcgcgag cggcggcccg gaaggcggca gcctggcggc gctgaccgcg 540
catcaggcgt gccatctgcc gctggaaacc tttacccgtc atcgtcagcc gcgtggctgg 600
gaacagctgg aacagtgcgg ctatccggtg cagcgtctgg tggcgctgta tctggcggcg 660
cgtctgagct ggaaccaggt ggatcaggtg attgcgaacg cgctggcgag cccgggcagc 720
ggcggcgatc tgggcgaagc gattcgtgaa agcccggaac aggcgcgtct ggcgctgacc 780
ctggcggcgg cggaaagcga acgttttgtg cgtcagggca ccggcaacga tgaagcgggc 840
gcggcgaacg gcccggcgga tagcggcgat gcgctgctgg aacgtaacta tccgaccggc 900
gcggaatttc tgggcgatgg cggcgatgtg agctttagca cccgtggcac ccagaactgg 960
accgtggaac gtctgctgca ggcgcatcgt cagctggaag aacgtggcta tgtgtttgtg 1020
ggctatcatg gcacctttct ggaagcggcg cagagcattg tgtttggcgg cgtgcgtgcg 1080
cgtagccagg atctggatgc gatttgggcg ggcttttata ttgcgggcga tccggcgctg 1140
gcgtatggct atgcgcagga tcaggaaccg gatgcggcgg gccgtattcg taacggcgcg 1200
ctgctgcgtg tgtatgtgcc gcgtagcagc ctgccgggct tttatgcgac cagcctgacc 1260
ctggcggcgc cggaagcggc gggcgaagtg gaacgtctga ttggccatcc gctgccgctg 1320
cgtctggatg cgattaccgg cccggaagaa agcggcggcc gtctggaaac cattctgggc 1380
tggccgctgg cggaacgtac cgtggtgatt ccgagcgcga ttccgaccga tccgcgtaac 1440
gtgggcggcg atctggatcc gagcagcatt ccggatagcg aacaggcgat tagcgcgctg 1500
ccggattatg cgagccagcc gggcaaaccg ccgaaagatg aactg 1545
<210> 139
<211> 108
<212> PRT
<213> Pseudomonas aeruginosa
<400> 139
Pro Glu Gly Gly Ser Leu Ala Ala Leu Thr Ala His Gln Ala Cys His
1 5 10 15
Leu Pro Leu Glu Thr Phe Thr Arg His Arg Gln Pro Arg Gly Trp Glu
20 25 30
Gln Leu Glu Gln Cys Gly Tyr Pro Val Gln Arg Leu Val Ala Leu Tyr
35 40 45
Leu Ala Ala Arg Leu Ser Trp Asn Gln Val Asp Gln Val Ile Arg Asn
50 55 60
Ala Leu Ala Ser Pro Gly Ser Gly Gly Asp Leu Gly Glu Ala Ile Arg
65 70 75 80
Glu Gln Pro Glu Gln Ala Arg Leu Ala Leu Thr Leu Ala Ala Ala Glu
85 90 95
Ser Glu Arg Phe Val Arg Gln Gly Thr Gly Asn Gly
100 105
<210> 140
<211> 10
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<300>
<301> Wang H, Yan Z, Shi J, Han W, Zhang Y.
<302> Expression, purification, and characterization of a
neovasculature targeted rmhTNF-alpha in Escherichia coli
<303> Protein Expr Purif.
<304> 45
<305> 1
<306> 60-5
<307> 2005-07-21
<400> 140
Cys Phe Cys Asp Gly Arg Cys Asp Cys Ala
1 5 10
<210> 141
<211> 281
<212> PRT
<213> Homo sapiens
<400> 141
Met Ala Met Met Glu Val Gln Gly Gly Pro Ser Leu Gly Gln Thr Cys
1 5 10 15
Val Leu Ile Val Ile Phe Thr Val Leu Leu Gln Ser Leu Cys Val Ala
20 25 30
Val Thr Tyr Val Tyr Phe Thr Asn Glu Leu Lys Gln Met Gln Asp Lys
35 40 45
Tyr Ser Lys Ser Gly Ile Ala Cys Phe Leu Lys Glu Asp Asp Ser Tyr
50 55 60
Trp Asp Pro Asn Asp Glu Glu Ser Met Asn Ser Pro Cys Trp Gln Val
65 70 75 80
Lys Trp Gln Leu Arg Gln Leu Val Arg Lys Met Ile Leu Arg Thr Ser
85 90 95
Glu Glu Thr Ile Ser Thr Val Gln Glu Lys Gln Gln Asn Ile Ser Pro
100 105 110
Leu Val Arg Glu Arg Gly Pro Gln Arg Val Ala Ala His Ile Thr Gly
115 120 125
Thr Arg Gly Arg Ser Asn Thr Leu Ser Ser Pro Asn Ser Lys Asn Glu
130 135 140
Lys Ala Leu Gly Arg Lys Ile Asn Ser Trp Glu Ser Ser Arg Ser Gly
145 150 155 160
His Ser Phe Leu Ser Asn Leu His Leu Arg Asn Gly Glu Leu Val Ile
165 170 175
His Glu Lys Gly Phe Tyr Tyr Ile Tyr Ser Gln Thr Tyr Phe Arg Phe
180 185 190
Gln Glu Glu Ile Lys Glu Asn Thr Lys Asn Asp Lys Gln Met Val Gln
195 200 205
Tyr Ile Tyr Lys Tyr Thr Ser Tyr Pro Asp Pro Ile Leu Leu Met Lys
210 215 220
Ser Ala Arg Asn Ser Cys Trp Ser Lys Asp Ala Glu Tyr Gly Leu Tyr
225 230 235 240
Ser Ile Tyr Gln Gly Gly Ile Phe Glu Leu Lys Glu Asn Asp Arg Ile
245 250 255
Phe Val Ser Val Thr Asn Glu His Leu Ile Asp Met Asp His Glu Ala
260 265 270
Ser Phe Phe Gly Ala Phe Leu Val Gly
275 280
<210> 142
<211> 161
<212> PRT
<213> Artificial Sequence
<220>
<223> none
<300>
<302> IMPROVED CYTOKINE DESIGN
<310> WO2009066174
<311> 2008-11-21
<312> 2009-05-28
<400> 142
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro His Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly
<210> 143
<211> 161
<212> PRT
<213> Artificial Sequence
<220>
<223> brak
<300>
<301> Gasparian ME,
<302> DR4-selective tumor necrosis factor-related apoptosis-inducing
ligand(TRAIL) variants obtained by structure-based design
<303> J Biol Chem
<304> 283
<305> 29
<306> 20560-8
<307> 2008-07-18
<400> 143
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Asn Phe Lys Phe Arg Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu Arg
130 135 140
Leu Arg Asp Met His His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly
<210> 144
<211> 433
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 144
Glu Asp Arg Pro Ile Lys Phe Ser Thr Glu Gly Ala Thr Ser Gln Ser
1 5 10 15
Tyr Lys Gln Phe Ile Glu Ala Leu Arg Glu Arg Leu Arg Gly Gly Leu
20 25 30
Ile His Asp Ile Pro Val Leu Pro Asp Pro Thr Thr Leu Gln Glu Arg
35 40 45
Asn Arg Tyr Ile Thr Val Glu Leu Ser Asn Ser Asp Thr Glu Ser Ile
50 55 60
Glu Val Gly Ile Asp Ala Thr Asn Ala Tyr Val Val Ala Tyr Arg Ala
65 70 75 80
Gly Thr Gln Ser Tyr Phe Leu Arg Asp Ala Pro Ser Ser Ala Ser Asp
85 90 95
Tyr Leu Phe Thr Gly Thr Asp Gln His Ser Leu Pro Phe Tyr Gly Thr
100 105 110
Tyr Ala Asp Leu Glu Arg Trp Ala His Gln Ser Arg Gln Gln Ile Pro
115 120 125
Leu Gly Leu Gln Ala Leu Thr His Gly Ile Ser Phe Phe Arg Ser Gly
130 135 140
Gly Asn Asp Asn Glu Glu Lys Ala Arg Thr Leu Ile Val Ile Ile Gln
145 150 155 160
Met Val Ala Glu Ala Ala Arg Phe Arg Tyr Ile Ser Asn Arg Val Arg
165 170 175
Val Ser Ile Gln Thr Gly Thr Ala Phe Gln Pro Asp Ala Ala Met Ile
180 185 190
Ser Leu Glu Asn Asn Trp Asp Asn Leu Ser Arg Gly Val Gln Glu Ser
195 200 205
Val Gln Asp Thr Phe Pro Asn Gln Val Thr Leu Thr Asn Ile Arg Asn
210 215 220
Glu Pro Val Ile Val Asp Gln Leu Ser His Pro Thr Val Ala Val Leu
225 230 235 240
Ala Leu Met Leu Phe Val Cys Asn Pro Pro Asn Gly Gly Gly Gly Ser
245 250 255
Gly Gly Gly Gly Ser Arg Lys Lys Arg Val Arg Glu Arg Gly Pro Gln
260 265 270
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
275 280 285
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
290 295 300
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
305 310 315 320
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
325 330 335
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
340 345 350
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
355 360 365
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
370 375 380
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
385 390 395 400
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
405 410 415
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
420 425 430
Gly
<210> 145
<211> 450
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 145
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Gly Ser Ala Ser Gly Cys Gly Pro Glu Arg Lys Lys
165 170 175
Arg Gly Gly Gly Gly Ser Glu Asp Asn Asn Ile Phe Pro Lys Gln Tyr
180 185 190
Pro Ile Ile Asn Phe Thr Thr Ala Gly Ala Thr Val Gln Ser Tyr Thr
195 200 205
Asn Phe Ile Arg Ala Val Arg Gly Arg Leu Thr Thr Gly Ala Asp Val
210 215 220
Arg His Glu Ile Pro Val Leu Pro Asn Arg Val Gly Leu Pro Ile Asn
225 230 235 240
Gln Arg Phe Ile Leu Val Glu Leu Ser Asn His Ala Glu Leu Ser Val
245 250 255
Thr Leu Ala Thr Asn Ala Tyr Val Val Gly Tyr Arg Ala Gly Asn Ser
260 265 270
Ala Tyr Phe Phe His Pro Asp Asn Gln Glu Asp Ala Glu Ala Ile Thr
275 280 285
His Leu Phe Thr Asp Val Gln Asn Arg Tyr Thr Phe Ala Phe Gly Gly
290 295 300
Asn Tyr Asp Arg Leu Glu Gln Leu Ala Gly Ser Leu Arg Glu Asn Ile
305 310 315 320
Glu Leu Gly Asn Gly Pro Leu Glu Glu Ala Ile Ser Ala Leu Tyr Tyr
325 330 335
Tyr Ser Thr Gly Gly Thr Gln Leu Pro Thr Leu Ala Arg Ser Phe Ile
340 345 350
Val Cys Ile Gln Met Ile Ser Glu Ala Ala Arg Phe Gln Tyr Ile Glu
355 360 365
Gly Glu Met Arg Thr Arg Ile Arg Tyr Asn Arg Arg Ser Ala Pro Asp
370 375 380
Pro Ser Val Ile Thr Leu Glu Asn Ser Trp Gly Arg Leu Ser Thr Ala
385 390 395 400
Ile Gln Glu Ser Asn Gln Gly Ala Phe Ala Ser Pro Ile Gln Leu Gln
405 410 415
Arg Arg Asn Gly Ser Lys Phe Ser Val Tyr Asp Val Ser Ile Leu Ile
420 425 430
Pro Ile Ile Ala Leu Met Val Tyr Arg Cys Ala Pro Pro Pro Lys Glu
435 440 445
Asp Leu
450
<210> 146
<211> 481
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 146
Gly Ala Asp Asp Val Ala Asp Ser Ser Lys Ser Phe Val Met Glu Asn
1 5 10 15
Phe Ser Ser Tyr His Gly Thr Lys Pro Gly Tyr Ala Asp Ser Ile Gln
20 25 30
Lys Gly Ile Gln Lys Pro Lys Ser Gly Thr Gln Gly Asn Tyr Asp Asp
35 40 45
Asp Trp Lys Gly Phe Tyr Ser Thr Asp Asn Lys Tyr Asp Ala Ala Gly
50 55 60
Tyr Ser Val Asp Asn Glu Asn Pro Leu Ser Gly Lys Ala Gly Gly Val
65 70 75 80
Val Lys Val Thr Tyr Pro Gly Leu Thr Lys Val Leu Ala Leu Lys Val
85 90 95
Asp Asn Ala Glu Thr Ile Lys Lys Glu Leu Gly Leu Ser Leu Thr Glu
100 105 110
Pro Leu Met Glu Gln Val Gly Thr Glu Glu Phe Ile Lys Arg Phe Gly
115 120 125
Asp Gly Ala Ser Arg Val Val Leu Ser Leu Pro Phe Ala Glu Gly Ser
130 135 140
Ser Ser Val Glu Tyr Ile Asn Asn Trp Glu Gln Ala Lys Ala Leu Ser
145 150 155 160
Val Glu Leu Glu Ile Asn Phe Glu Thr Arg Gly Lys Arg Gly Gln Asp
165 170 175
Ala Met Tyr Glu Tyr Met Ala Gln Ala Cys Ala Gly Asn Arg Lys Lys
180 185 190
Arg Gly Gly Gly Gly Ser Pro Glu Gly Gly Ser Leu Ala Ala Leu Thr
195 200 205
Ala His Gln Ala Cys His Leu Pro Leu Glu Thr Phe Thr Arg His Arg
210 215 220
Gln Pro Arg Gly Trp Glu Gln Leu Glu Gln Cys Gly Tyr Pro Val Gln
225 230 235 240
Arg Leu Val Ala Leu Tyr Leu Ala Ala Arg Leu Ser Trp Asn Gln Val
245 250 255
Asp Gln Val Ile Arg Asn Ala Leu Ala Ser Pro Gly Ser Gly Gly Asp
260 265 270
Leu Gly Glu Ala Ile Arg Glu Gln Pro Glu Gln Ala Arg Leu Ala Leu
275 280 285
Thr Leu Ala Ala Ala Glu Ser Glu Arg Phe Val Arg Gln Gly Thr Gly
290 295 300
Asn Gly Arg Lys Lys Arg Gly Gly Gly Gly Ser Gly Gly Gly Gly Ser
305 310 315 320
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
325 330 335
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
340 345 350
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
355 360 365
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
370 375 380
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
385 390 395 400
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
405 410 415
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
420 425 430
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
435 440 445
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
450 455 460
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
465 470 475 480
Gly
<210> 147
<211> 478
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 147
Gly Ala Asp Asp Val Ser Lys Ser Phe Val Met Glu Asn Phe Ser Ser
1 5 10 15
Tyr His Gly Thr Lys Pro Gly Tyr Ala Asp Ser Ile Gln Lys Gly Ile
20 25 30
Gln Lys Pro Lys Ser Gly Thr Gln Gly Asn Tyr Asp Asp Asp Trp Lys
35 40 45
Gly Phe Tyr Ser Thr Asp Asn Lys Tyr Asp Ala Ala Gly Tyr Ser Val
50 55 60
Asp Asn Glu Asn Pro Leu Ser Gly Lys Ala Gly Gly Val Val Lys Val
65 70 75 80
Thr Tyr Pro Gly Leu Thr Lys Val Leu Ala Leu Lys Val Asp Asn Ala
85 90 95
Glu Thr Ile Lys Lys Glu Leu Gly Leu Ser Leu Thr Glu Pro Leu Met
100 105 110
Glu Gln Val Gly Thr Glu Glu Phe Ile Lys Arg Phe Gly Asp Gly Ala
115 120 125
Ser Arg Val Val Leu Ser Leu Pro Phe Ala Glu Gly Ser Ser Ser Val
130 135 140
Glu Tyr Ile Asn Asn Trp Glu Gln Ala Lys Ala Leu Ser Val Glu Leu
145 150 155 160
Glu Ile Asn Phe Glu Thr Arg Gly Lys Arg Gly Gln Asp Ala Met Tyr
165 170 175
Glu Tyr Met Ala Gln Ala Cys Ala Gly Asn Arg Lys Lys Arg Gly Gly
180 185 190
Gly Gly Ser Pro Glu Gly Gly Ser Leu Ala Ala Leu Thr Ala His Gln
195 200 205
Ala Cys His Leu Pro Leu Glu Thr Phe Thr Arg His Arg Gln Pro Arg
210 215 220
Gly Trp Glu Gln Leu Glu Gln Cys Gly Tyr Pro Val Gln Arg Leu Val
225 230 235 240
Ala Leu Tyr Leu Ala Ala Arg Leu Ser Trp Asn Gln Val Asp Gln Val
245 250 255
Ile Arg Asn Ala Leu Ala Ser Pro Gly Ser Gly Gly Asp Leu Gly Glu
260 265 270
Ala Ile Arg Glu Gln Pro Glu Gln Ala Arg Leu Ala Leu Thr Leu Ala
275 280 285
Ala Ala Glu Ser Glu Arg Phe Val Arg Gln Gly Thr Gly Asn Gly Arg
290 295 300
Lys Lys Arg Gly Gly Gly Gly Ser Gly Gly Gly Gly Ser Arg Val Ala
305 310 315 320
Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu Ser Ser Pro
325 330 335
Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn Ser Trp Glu
340 345 350
Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His Leu Arg Asn
355 360 365
Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile Tyr Ser Gln
370 375 380
Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr Lys Asn Asp
385 390 395 400
Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr Pro Asp Pro
405 410 415
Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser Lys Asp Ala
420 425 430
Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe Glu Leu Lys
435 440 445
Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His Leu Ile Asp
450 455 460
Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val Gly
465 470 475
<210> 148
<211> 433
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 148
Gly Leu Asp Thr Val Ser Phe Ser Thr Lys Gly Ala Thr Tyr Ile Thr
1 5 10 15
Tyr Val Asn Phe Leu Asn Glu Leu Arg Val Lys Leu Lys Pro Glu Gly
20 25 30
Asn Ser His Gly Ile Pro Leu Leu Arg Lys Lys Ala Asp Asp Pro Gly
35 40 45
Lys Ala Phe Val Leu Val Ala Leu Ser Asn Asp Asn Gly Gln Leu Ala
50 55 60
Glu Ile Ala Ile Asp Ala Thr Ser Val Tyr Val Val Gly Tyr Gln Val
65 70 75 80
Arg Asn Arg Ser Tyr Phe Phe Lys Asp Ala Pro Asp Ala Ala Tyr Glu
85 90 95
Gly Leu Phe Lys Asn Thr Ile Lys Thr Arg Leu His Phe Gly Gly Ser
100 105 110
Tyr Pro Ser Leu Glu Gly Glu Lys Ala Tyr Arg Glu Thr Thr Asp Leu
115 120 125
Gly Ile Glu Pro Leu Arg Ile Gly Ile Lys Lys Leu Asp Glu Asn Ala
130 135 140
Ile Asp Asn Tyr Lys Pro Thr Glu Ile Ala Ser Ser Leu Leu Val Val
145 150 155 160
Ile Gln Met Val Ser Glu Ala Ala Arg Phe Thr Phe Ile Glu Asn Gln
165 170 175
Ile Arg Asn Asn Phe Gln Gln Arg Ile Arg Pro Ala Asn Asn Thr Ile
180 185 190
Ser Leu Glu Asn Lys Trp Gly Lys Leu Ser Phe Gln Ile Arg Thr Ser
195 200 205
Gly Ala Asn Gly Met Phe Ser Glu Ala Val Glu Leu Glu Arg Ala Asn
210 215 220
Gly Lys Lys Tyr Tyr Val Thr Ala Val Asp Gln Val Lys Pro Lys Ile
225 230 235 240
Ala Leu Leu Lys Phe Val Asp Lys Asp Pro Lys Gly Gly Gly Gly Ser
245 250 255
Arg Lys Lys Arg Ala Ser Gly Cys Gly Pro Glu Gly Gly Gly Gly Ser
260 265 270
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
275 280 285
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
290 295 300
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
305 310 315 320
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
325 330 335
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
340 345 350
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
355 360 365
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
370 375 380
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
385 390 395 400
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
405 410 415
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
420 425 430
Gly
<210> 149
<211> 258
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 149
Thr Ser Glu Glu Thr Ile Ser Thr Val Gln Glu Lys Gln Gln Asn Ile
1 5 10 15
Ser Pro Leu Val Arg Glu Arg Gly Pro Gln Arg Val Ala Ala His Ile
20 25 30
Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu Ser Ser Pro Asn Ser Lys
35 40 45
Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn Ser Trp Glu Ser Ser Arg
50 55 60
Ser Gly His Ser Phe Leu Ser Asn Leu His Leu Arg Asn Gly Glu Leu
65 70 75 80
Val Ile His Glu Lys Gly Phe Tyr Tyr Ile Tyr Ser Gln Thr Tyr Phe
85 90 95
Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr Lys Asn Asp Lys Gln Met
100 105 110
Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr Pro Asp Pro Ile Leu Leu
115 120 125
Met Lys Ser Ala Arg Asn Ser Cys Trp Ser Lys Asp Ala Glu Tyr Gly
130 135 140
Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe Glu Leu Lys Glu Asn Asp
145 150 155 160
Arg Ile Phe Val Ser Val Thr Asn Glu His Leu Ile Asp Met Asp His
165 170 175
Glu Ala Ser Phe Phe Gly Ala Phe Leu Val Gly Gly Gly Gly Gly Ser
180 185 190
Gly Gly Gly Cys Ala Ala Ala Cys Ala Ala Cys Arg Lys Lys Arg Pro
195 200 205
Arg Gly Ser Pro Arg Thr Glu Tyr Glu Ala Cys Arg Val Arg Cys Gln
210 215 220
Val Ala Glu His Gly Val Glu Arg Gln Arg Arg Cys Gln Gln Val Cys
225 230 235 240
Glu Lys Arg Leu Arg Glu Arg Glu Gly Arg Arg Glu Val Asp Lys Asp
245 250 255
Glu Leu
<210> 150
<211> 253
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 150
Pro Arg Gly Ser Pro Arg Thr Glu Tyr Glu Ala Cys Arg Val Arg Cys
1 5 10 15
Gln Val Ala Glu His Gly Val Glu Arg Gln Arg Arg Cys Gln Gln Val
20 25 30
Cys Glu Lys Arg Leu Arg Glu Arg Glu Gly Arg Arg Glu Val Asp Lys
35 40 45
Asp Glu Leu Arg Lys Lys Arg Gly Gly Gly Cys Ala Ala Ala Cys Ala
50 55 60
Ala Cys Thr Ser Glu Glu Thr Ile Ser Thr Val Gln Glu Lys Gln Gln
65 70 75 80
Asn Ile Ser Pro Leu Val Arg Glu Arg Gly Pro Gln Arg Val Ala Ala
85 90 95
His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu Ser Ser Pro Asn
100 105 110
Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn Ser Trp Glu Ser
115 120 125
Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His Leu Arg Asn Gly
130 135 140
Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile Tyr Ser Gln Thr
145 150 155 160
Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr Lys Asn Asp Lys
165 170 175
Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr Pro Asp Pro Ile
180 185 190
Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser Lys Asp Ala Glu
195 200 205
Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe Glu Leu Lys Glu
210 215 220
Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His Leu Ile Asp Met
225 230 235 240
Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val Gly
245 250
<210> 151
<211> 539
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 151
Asp Val Ser Phe Arg Leu Ser Gly Ala Thr Ser Ser Ser Tyr Gly Val
1 5 10 15
Phe Ile Ser Asn Leu Arg Lys Ala Leu Pro Asn Glu Arg Lys Leu Tyr
20 25 30
Asp Ile Pro Leu Leu Arg Ser Ser Leu Pro Gly Ser Gln Arg Tyr Ala
35 40 45
Leu Ile His Leu Thr Asn Tyr Ala Asp Glu Thr Ile Ser Val Ala Ile
50 55 60
Asp Val Thr Asn Val Tyr Ile Met Gly Tyr Arg Ala Gly Asp Thr Ser
65 70 75 80
Ala Cys Ser Asn Glu Ala Ser Ala Thr Glu Ala Ala Lys Tyr Val Phe
85 90 95
Lys Asp Ala Met Arg Lys Val Thr Leu Pro Tyr Ser Gly Asn Tyr Glu
100 105 110
Arg Leu Gln Thr Ala Ala Gly Lys Ile Arg Glu Asn Ile Pro Leu Gly
115 120 125
Leu Pro Ala Leu Asp Ser Ala Ile Thr Thr Leu Phe Tyr Tyr Asn Ala
130 135 140
Asn Ser Ala Ala Ser Ala Leu Met Val Leu Ile Gln Ser Thr Ser Glu
145 150 155 160
Ala Ala Arg Tyr Lys Phe Ile Glu Gln Gln Ile Gly Cys Gly Val Asp
165 170 175
Lys Thr Phe Leu Pro Ser Leu Ala Ile Ile Ser Leu Glu Asn Ser Trp
180 185 190
Ser Ala Leu Ser Lys Gln Ile Gln Ile Ala Ser Thr Asn Asn Gly Gln
195 200 205
Phe Glu Ser Pro Val Val Leu Ile Asn Ala Gln Asn Gln Arg Val Thr
210 215 220
Ile Thr Asn Val Asp Ala Gly Val Val Thr Ser Asn Ile Ala Leu Leu
225 230 235 240
Leu Asn Arg Asn Asn Met Ala Arg Lys Lys Arg Gly Gly Gly Gly Ser
245 250 255
Pro Glu Gly Gly Ser Leu Ala Ala Leu Thr Ala His Gln Ala Cys His
260 265 270
Leu Pro Leu Glu Thr Phe Thr Arg His Arg Gln Pro Arg Gly Trp Glu
275 280 285
Gln Leu Glu Gln Cys Gly Tyr Pro Val Gln Arg Leu Val Ala Leu Tyr
290 295 300
Leu Ala Ala Arg Leu Ser Trp Asn Gln Val Asp Gln Val Ile Arg Asn
305 310 315 320
Ala Leu Ala Ser Pro Gly Ser Gly Gly Asp Leu Gly Glu Ala Ile Arg
325 330 335
Glu Gln Pro Glu Gln Ala Arg Leu Ala Leu Thr Leu Ala Ala Ala Glu
340 345 350
Ser Glu Arg Phe Val Arg Gln Gly Thr Gly Asn Gly Arg Lys Lys Arg
355 360 365
Gly Gly Gly Gly Ser Gly Gly Gly Gly Ser Arg Val Ala Ala His Ile
370 375 380
Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu Ser Ser Pro Asn Ser Lys
385 390 395 400
Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn Ser Trp Glu Ser Ser Arg
405 410 415
Ser Gly His Ser Phe Leu Ser Asn Leu His Leu Arg Asn Gly Glu Leu
420 425 430
Val Ile His Glu Lys Gly Phe Tyr Tyr Ile Tyr Ser Gln Thr Tyr Phe
435 440 445
Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr Lys Asn Asp Lys Gln Met
450 455 460
Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr Pro Asp Pro Ile Leu Leu
465 470 475 480
Met Lys Ser Ala Arg Asn Ser Cys Trp Ser Lys Asp Ala Glu Tyr Gly
485 490 495
Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe Glu Leu Lys Glu Asn Asp
500 505 510
Arg Ile Phe Val Ser Val Thr Asn Glu His Leu Ile Asp Met Asp His
515 520 525
Glu Ala Ser Phe Phe Gly Ala Phe Leu Val Gly
530 535
<210> 152
<211> 429
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 152
Asp Ala Ser Phe Arg Leu Ser Gly Ala Thr Ser Ser Ser Tyr Gly Val
1 5 10 15
Phe Ile Ser Asn Leu Arg Lys Ala Leu Pro Asn Glu Arg Lys Leu Tyr
20 25 30
Asp Ile Pro Leu Leu Arg Ser Ser Leu Pro Gly Ser Gln Arg Tyr Ala
35 40 45
Leu Ile His Leu Thr Asn Tyr Ala Asp Glu Thr Ile Ser Val Ala Ile
50 55 60
Asp Ala Thr Asn Val Tyr Ile Met Gly Tyr Arg Ala Gly Asp Thr Ser
65 70 75 80
Ala Cys Ser Asn Glu Ala Ser Ala Thr Glu Ala Ala Lys Tyr Val Phe
85 90 95
Lys Asp Ala Met Arg Lys Val Thr Leu Pro Tyr Ser Gly Asn Tyr Glu
100 105 110
Arg Leu Gln Thr Ala Ala Gly Lys Ile Arg Glu Asn Ile Pro Leu Gly
115 120 125
Leu Pro Ala Gly Asp Ser Ala Ile Thr Thr Leu Phe Tyr Tyr Asn Ala
130 135 140
Asn Ser Ala Ala Ser Ala Leu Met Val Leu Ile Gln Ser Thr Ser Glu
145 150 155 160
Ala Ala Arg Tyr Lys Phe Ile Glu Gln Gln Ile Gly Cys Gly Val Asp
165 170 175
Lys Thr Phe Leu Pro Ser Leu Ala Ile Ile Ser Leu Glu Asn Ser Trp
180 185 190
Ser Ala Leu Ser Lys Gln Ile Gln Ile Ala Ser Thr Asn Asn Gly Gln
195 200 205
Phe Glu Ser Pro Val Val Leu Ile Asn Ala Gln Asn Gln Arg Val Thr
210 215 220
Ile Thr Asn Val Asp Ala Gly Val Val Thr Ser Asn Ile Ala Leu Leu
225 230 235 240
Leu Asn Arg Asn Asn Met Ala Gly Gly Gly Gly Ser Arg Lys Lys Arg
245 250 255
Ala Ser Gly Cys Gly Pro Glu Gly Gly Gly Gly Ser Arg Val Ala Ala
260 265 270
His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu Ser Ser Pro Asn
275 280 285
Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn Ser Trp Glu Ser
290 295 300
Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His Leu Arg Asn Gly
305 310 315 320
Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile Tyr Ser Gln Thr
325 330 335
Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr Lys Asn Asp Lys
340 345 350
Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr Pro Asp Pro Ile
355 360 365
Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser Lys Asp Ala Glu
370 375 380
Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe Glu Leu Lys Glu
385 390 395 400
Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His Leu Ile Asp Met
405 410 415
Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val Gly
420 425
<210> 153
<211> 515
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 153
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Ser Ala Ser Gly Gly Pro Glu Gly Gly Ser Leu Ala
165 170 175
Ala Leu Thr Ala His Gln Ala Cys His Leu Pro Leu Glu Thr Phe Thr
180 185 190
Arg His Arg Gln Pro Arg Gly Trp Glu Gln Leu Glu Gln Cys Gly Tyr
195 200 205
Pro Val Gln Lys Leu Val Ala Leu Tyr Leu Ala Ala Arg Leu Ser Trp
210 215 220
Asn Gln Val Asp Gln Val Ile Ala Asn Ala Leu Ala Ser Pro Gly Ser
225 230 235 240
Gly Gly Asp Leu Gly Glu Ala Ile Arg Glu Ser Pro Glu Gln Ala Arg
245 250 255
Leu Ala Leu Thr Leu Ala Ala Ala Glu Ser Glu Arg Phe Val Arg Gln
260 265 270
Gly Thr Gly Asn Asp Glu Ala Gly Ala Ala Asn Gly Pro Ala Asp Ser
275 280 285
Gly Asp Ala Leu Leu Glu Arg Asn Tyr Pro Thr Gly Ala Glu Phe Leu
290 295 300
Gly Asp Gly Gly Asp Val Ser Phe Ser Thr Arg Gly Thr Gln Gln Trp
305 310 315 320
Thr Val Glu Arg Leu Leu Gln Ala His Arg Gln Leu Glu Glu Ala Gly
325 330 335
Tyr Val Phe Val Gly Tyr His Gly Thr Phe Leu Glu Ala Ala Gln Ser
340 345 350
Ile Val Phe Gly Gly Val Arg Ala Arg Ser Gln Asp Leu Asp Ala Ile
355 360 365
Trp Ala Gly Phe Tyr Ile Ala Gly Asp Pro Ala Leu Ala Tyr Gly Tyr
370 375 380
Ala Gln Asp Gln Glu Pro Asp Ala Ala Gly Arg Ile Arg Asn Gly Ala
385 390 395 400
Leu Leu Arg Val Tyr Val Pro Arg Ser Ser Leu Pro Gly Phe Tyr Ala
405 410 415
Thr Ser Leu Thr Leu Ala Ala Pro Glu Ala Ala Gly Glu Val Glu Arg
420 425 430
Leu Ile Gly His Pro Leu Pro Leu Arg Leu Asp Ala Ile Thr Gly Pro
435 440 445
Glu Glu Ser Gly Gly Arg Leu Glu Thr Ile Leu Gly Trp Pro Leu Ala
450 455 460
Glu Arg Thr Val Val Ile Pro Ser Ala Ile Pro Thr Asp Pro Lys Asn
465 470 475 480
Val Gly Gly Asp Leu Asp Pro Ser Ser Ile Pro Asp Ser Glu Gln Ala
485 490 495
Ile Ser Ala Leu Pro Asp Tyr Ala Ser Gln Pro Gly Lys Pro Pro Lys
500 505 510
Asp Glu Leu
515
<210> 154
<211> 402
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 154
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Ser Gly Gly Gly Gly Arg Lys Lys Arg Arg His Arg
165 170 175
Gln Pro Arg Gly Trp Glu Gln Leu Pro Thr Gly Ala Glu Phe Leu Gly
180 185 190
Asp Gly Gly Asp Val Ser Phe Ser Thr Arg Gly Thr Gln Asn Trp Thr
195 200 205
Val Glu Arg Leu Leu Gln Ala His Arg Gln Leu Glu Glu Ala Gly Tyr
210 215 220
Val Phe Val Gly Tyr His Gly Thr Phe Leu Glu Ala Ala Gln Ser Ile
225 230 235 240
Val Phe Gly Gly Val Arg Ala Arg Ser Gln Asp Leu Asp Ala Ile Trp
245 250 255
Ala Gly Phe Tyr Ile Ala Gly Asp Pro Ala Leu Ala Tyr Gly Tyr Ala
260 265 270
Gln Asp Gln Glu Pro Asp Ala Ala Gly Arg Ile Arg Asn Gly Ala Leu
275 280 285
Leu Arg Val Tyr Val Pro Arg Ser Ser Leu Pro Gly Phe Tyr Ala Thr
290 295 300
Ser Leu Thr Leu Ala Ala Pro Glu Ala Ala Gly Glu Val Glu Arg Leu
305 310 315 320
Ile Gly His Pro Leu Pro Leu Arg Leu Asp Ala Ile Thr Gly Pro Glu
325 330 335
Glu Ser Gly Gly Arg Leu Glu Thr Ile Leu Gly Trp Pro Leu Ala Glu
340 345 350
Arg Thr Val Val Ile Pro Ser Ala Ile Pro Thr Asp Pro Arg Asn Val
355 360 365
Gly Gly Asp Leu Asp Pro Ser Ser Ile Pro Asp Ser Glu Gln Ala Ile
370 375 380
Ser Ala Leu Pro Asp Tyr Ala Ser Gln Pro Gly Lys Pro Pro Lys Glu
385 390 395 400
Asp Leu
<210> 155
<211> 403
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 155
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Ser Gly Gly Gly Gly Arg Lys Lys Arg Arg His Arg
165 170 175
Gln Pro Arg Gly Trp Glu Gln Leu Tyr Pro Thr Gly Ala Glu Phe Leu
180 185 190
Gly Asp Gly Gly Ala Val Ser Phe Ser Thr Arg Gly Thr Gln Asn Trp
195 200 205
Thr Val Glu Arg Leu Leu Gln Ala His Arg Gln Leu Glu Glu Gly Gly
210 215 220
Tyr Val Phe Val Gly Tyr His Gly Thr Phe Leu Glu Ala Ala Gln Ser
225 230 235 240
Ile Val Phe Gly Gly Val Arg Ala Arg Ser Gln Asp Leu Asp Ala Ile
245 250 255
Trp Ala Gly Phe Tyr Ile Ala Gly Asp Pro Ala Leu Ala Tyr Gly Tyr
260 265 270
Ala Gln Asp Gln Glu Pro Asp Ala Ala Gly Arg Ile Arg Asn Gly Ala
275 280 285
Leu Leu Arg Val Tyr Val Pro Arg Ser Ser Leu Pro Gly Phe Tyr Ala
290 295 300
Thr Ser Leu Thr Leu Ala Ala Pro Glu Ala Ala Gly Glu Val Glu Arg
305 310 315 320
Leu Ile Gly His Pro Leu Pro Leu Arg Leu Asp Ala Ile Thr Gly Pro
325 330 335
Glu Glu Ala Gly Gly Arg Leu Glu Thr Ile Leu Gly Trp Pro Leu Ala
340 345 350
Glu Arg Thr Val Val Ile Pro Ser Ala Ile Pro Thr Asp Pro Arg Asn
355 360 365
Val Gly Gly Asp Leu Asp Pro Ser Ser Ile Pro Asp Ala Glu Ala Ala
370 375 380
Ile Ser Ala Leu Pro Asp Tyr Ala Ser Gln Pro Gly Lys Pro Pro Lys
385 390 395 400
Glu Asp Leu
<210> 156
<211> 470
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 156
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Ser Ala Ser Gly Cys Gly Pro Glu Arg Lys Lys Arg
165 170 175
Arg His Arg Gln Pro Arg Gly Trp Glu Gln Leu Glu Gln Ser Gly Tyr
180 185 190
Pro Val Gln Arg Leu Val Ala Leu Tyr Leu Ala Ala Arg Leu Ser Trp
195 200 205
Asn Gln Val Asp Gln Val Ile Arg Asn Ala Leu Ala Ser Pro Gly Ser
210 215 220
Gly Gly Asp Leu Gly Glu Ala Ile Arg Glu Gln Pro Glu Gln Ala Arg
225 230 235 240
Leu Ala Leu Thr Leu Ala Ala Ala Glu Ser Glu Tyr Pro Thr Gly Ala
245 250 255
Glu Phe Leu Gly Asp Gly Gly Ala Val Ser Phe Ser Thr Arg Gly Thr
260 265 270
Gln Asn Trp Thr Val Glu Arg Leu Leu Gln Ala His Arg Gln Leu Glu
275 280 285
Glu Gly Gly Tyr Val Phe Val Gly Tyr His Gly Thr Phe Leu Glu Ala
290 295 300
Ala Gln Ser Ile Val Phe Gly Gly Val Arg Ala Arg Ser Gln Asp Leu
305 310 315 320
Asp Ala Ile Trp Ala Gly Phe Tyr Ile Ala Gly Asp Pro Ala Leu Ala
325 330 335
Tyr Gly Tyr Ala Gln Asp Gln Glu Pro Asp Ala Ala Gly Arg Ile Arg
340 345 350
Asn Gly Ala Leu Leu Arg Val Tyr Val Pro Arg Ser Ser Leu Pro Gly
355 360 365
Phe Tyr Ala Thr Ser Leu Thr Leu Ala Ala Pro Glu Ala Ala Gly Glu
370 375 380
Val Glu Arg Leu Ile Gly His Pro Leu Pro Leu Arg Leu Asp Ala Ile
385 390 395 400
Thr Gly Pro Glu Glu Ala Gly Gly Arg Leu Glu Thr Ile Leu Gly Trp
405 410 415
Pro Leu Ala Glu Arg Thr Val Val Ile Pro Ser Ala Ile Pro Thr Asp
420 425 430
Pro Arg Asn Val Gly Gly Asp Leu Asp Pro Ser Ser Ile Pro Asp Ala
435 440 445
Glu Ala Ala Ile Ser Ala Leu Pro Asp Tyr Ala Ser Gln Pro Gly Lys
450 455 460
Pro Pro Lys Glu Asp Leu
465 470
<210> 157
<211> 478
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 157
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Ser Gly Gly Gly Gly Ser Arg Lys Lys Arg Arg His
165 170 175
Arg Gln Pro Arg Gly Trp Glu Gln Leu Gly Gly Gly Gly Ser Gly Gly
180 185 190
Gly Gly Ser Glu Gln Ser Gly Tyr Pro Val Gln Arg Leu Val Ala Leu
195 200 205
Tyr Leu Ala Ala Arg Leu Ser Trp Asn Gln Val Asp Gln Val Ile Arg
210 215 220
Asn Ala Leu Ala Ser Pro Gly Ser Gly Gly Asp Leu Gly Glu Ala Ile
225 230 235 240
Arg Glu Gln Pro Glu Gln Ala Arg Leu Ala Leu Thr Leu Ala Ala Ala
245 250 255
Glu Ser Glu Tyr Pro Thr Gly Ala Glu Phe Leu Gly Asp Gly Gly Ala
260 265 270
Val Ser Phe Ser Thr Arg Gly Thr Gln Asn Trp Thr Val Glu Arg Leu
275 280 285
Leu Gln Ala His Arg Gln Leu Glu Glu Gly Gly Tyr Val Phe Val Gly
290 295 300
Tyr His Gly Thr Phe Leu Glu Ala Ala Gln Ser Ile Val Phe Gly Gly
305 310 315 320
Val Arg Ala Arg Ser Gln Asp Leu Asp Ala Ile Trp Ala Gly Phe Tyr
325 330 335
Ile Ala Gly Asp Pro Ala Leu Ala Tyr Gly Tyr Ala Gln Asp Gln Glu
340 345 350
Pro Asp Ala Ala Gly Arg Ile Arg Asn Gly Ala Leu Leu Arg Val Tyr
355 360 365
Val Pro Arg Ser Ser Leu Pro Gly Phe Tyr Ala Thr Ser Leu Thr Leu
370 375 380
Ala Ala Pro Glu Ala Ala Gly Glu Val Glu Arg Leu Ile Gly His Pro
385 390 395 400
Leu Pro Leu Arg Leu Asp Ala Ile Thr Gly Pro Glu Glu Ala Gly Gly
405 410 415
Arg Leu Glu Thr Ile Leu Gly Trp Pro Leu Ala Glu Arg Thr Val Val
420 425 430
Ile Pro Ser Ala Ile Pro Thr Asp Pro Arg Asn Val Gly Gly Asp Leu
435 440 445
Asp Pro Ser Ser Ile Pro Asp Ala Glu Ala Ala Ile Ser Ala Leu Pro
450 455 460
Asp Tyr Ala Ser Gln Pro Gly Lys Pro Pro Lys Glu Asp Leu
465 470 475
<210> 158
<211> 402
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 158
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Ser Gly Gly Gly Gly Arg Lys Lys Arg Arg His Arg
165 170 175
Gln Pro Arg Gly Trp Glu Gln Leu Pro Thr Gly Ala Glu Phe Leu Gly
180 185 190
Asp Gly Gly Asp Val Ser Phe Ser Thr Arg Gly Thr Gln Asn Trp Thr
195 200 205
Val Glu Arg Leu Leu Gln Ala His Arg Gln Leu Glu Glu Arg Gly Tyr
210 215 220
Val Phe Val Gly Tyr His Gly Thr Phe Leu Glu Ala Ala Gln Ser Ile
225 230 235 240
Val Phe Gly Gly Val Arg Ala Arg Ser Gln Asp Leu Asp Ala Ile Trp
245 250 255
Arg Gly Phe Tyr Ile Ala Gly Asp Pro Ala Leu Ala Tyr Gly Tyr Ala
260 265 270
Gln Asp Gln Glu Pro Asp Ala Arg Gly Arg Ile Arg Asn Gly Ala Leu
275 280 285
Leu Arg Val Tyr Val Pro Arg Ser Ser Leu Pro Gly Phe Tyr Arg Thr
290 295 300
Ser Leu Thr Leu Ala Ala Pro Glu Ala Ala Gly Glu Val Glu Arg Leu
305 310 315 320
Ile Gly His Pro Leu Pro Leu Arg Leu Asp Ala Ile Thr Gly Pro Glu
325 330 335
Glu Glu Gly Gly Arg Leu Glu Thr Ile Leu Gly Trp Pro Leu Ala Glu
340 345 350
Arg Thr Val Val Ile Pro Ser Ala Ile Pro Thr Asp Pro Arg Asn Val
355 360 365
Gly Gly Asp Leu Asp Pro Ser Ser Ile Pro Asp Lys Glu Gln Ala Ile
370 375 380
Ser Ala Leu Pro Asp Tyr Ala Ser Gln Pro Gly Lys Pro Pro Lys Glu
385 390 395 400
Asp Leu
<210> 159
<211> 467
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 159
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Ser Gly Gly Gly Gly Ser Arg Lys Lys Arg Gly Gly
165 170 175
Gly Gly Ser Gly Gly Gly Gly Ser Glu Gln Ser Gly Tyr Pro Val Gln
180 185 190
Arg Leu Val Ala Leu Tyr Leu Ala Ala Arg Leu Ser Trp Asn Gln Val
195 200 205
Asp Gln Val Ile Arg Asn Ala Leu Ala Ser Pro Gly Ser Gly Gly Asp
210 215 220
Leu Gly Glu Ala Ile Arg Glu Gln Pro Glu Gln Ala Arg Leu Ala Leu
225 230 235 240
Thr Leu Ala Ala Ala Glu Ser Glu Tyr Pro Thr Gly Ala Glu Phe Leu
245 250 255
Gly Asp Gly Gly Ala Val Ser Phe Ser Thr Arg Gly Thr Gln Asn Trp
260 265 270
Thr Val Glu Arg Leu Leu Gln Ala His Arg Gln Leu Glu Glu Gly Gly
275 280 285
Tyr Val Phe Val Gly Tyr His Gly Thr Phe Leu Glu Ala Ala Gln Ser
290 295 300
Ile Val Phe Gly Gly Val Arg Ala Arg Ser Gln Asp Leu Asp Ala Ile
305 310 315 320
Trp Ala Gly Phe Tyr Ile Ala Gly Asp Pro Ala Leu Ala Tyr Gly Tyr
325 330 335
Ala Gln Asp Gln Glu Pro Asp Ala Ala Gly Arg Ile Arg Asn Gly Ala
340 345 350
Leu Leu Arg Val Tyr Val Pro Arg Ser Ser Leu Pro Gly Phe Tyr Ala
355 360 365
Thr Ser Leu Thr Leu Ala Ala Pro Glu Ala Ala Gly Glu Val Glu Arg
370 375 380
Leu Ile Gly His Pro Leu Pro Leu Arg Leu Asp Ala Ile Thr Gly Pro
385 390 395 400
Glu Glu Ala Gly Gly Arg Leu Glu Thr Ile Leu Gly Trp Pro Leu Ala
405 410 415
Glu Arg Thr Val Val Ile Pro Ser Ala Ile Pro Thr Asp Pro Arg Asn
420 425 430
Val Gly Gly Asp Leu Asp Pro Ser Ser Ile Pro Asp Ala Glu Ala Ala
435 440 445
Ile Ser Ala Leu Pro Asp Tyr Ala Ser Gln Pro Gly Lys Pro Pro Lys
450 455 460
Glu Asp Leu
465
<210> 160
<211> 474
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 160
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Ser Gly Gly Gly Gly Ser Arg His Arg Gln Pro Arg
165 170 175
Gly Trp Glu Gln Leu Gly Gly Gly Gly Ser Gly Gly Gly Gly Ser Glu
180 185 190
Gln Ser Gly Tyr Pro Val Gln Arg Leu Val Ala Leu Tyr Leu Ala Ala
195 200 205
Arg Leu Ser Trp Asn Gln Val Asp Gln Val Ile Arg Asn Ala Leu Ala
210 215 220
Ser Pro Gly Ser Gly Gly Asp Leu Gly Glu Ala Ile Arg Glu Gln Pro
225 230 235 240
Glu Gln Ala Arg Leu Ala Leu Thr Leu Ala Ala Ala Glu Ser Glu Tyr
245 250 255
Pro Thr Gly Ala Glu Phe Leu Gly Asp Gly Gly Ala Val Ser Phe Ser
260 265 270
Thr Arg Gly Thr Gln Asn Trp Thr Val Glu Arg Leu Leu Gln Ala His
275 280 285
Arg Gln Leu Glu Glu Gly Gly Tyr Val Phe Val Gly Tyr His Gly Thr
290 295 300
Phe Leu Glu Ala Ala Gln Ser Ile Val Phe Gly Gly Val Arg Ala Arg
305 310 315 320
Ser Gln Asp Leu Asp Ala Ile Trp Ala Gly Phe Tyr Ile Ala Gly Asp
325 330 335
Pro Ala Leu Ala Tyr Gly Tyr Ala Gln Asp Gln Glu Pro Asp Ala Ala
340 345 350
Gly Arg Ile Arg Asn Gly Ala Leu Leu Arg Val Tyr Val Pro Arg Ser
355 360 365
Ser Leu Pro Gly Phe Tyr Ala Thr Ser Leu Thr Leu Ala Ala Pro Glu
370 375 380
Ala Ala Gly Glu Val Glu Arg Leu Ile Gly His Pro Leu Pro Leu Arg
385 390 395 400
Leu Asp Ala Ile Thr Gly Pro Glu Glu Ala Gly Gly Arg Leu Glu Thr
405 410 415
Ile Leu Gly Trp Pro Leu Ala Glu Arg Thr Val Val Ile Pro Ser Ala
420 425 430
Ile Pro Thr Asp Pro Arg Asn Val Gly Gly Asp Leu Asp Pro Ser Ser
435 440 445
Ile Pro Asp Ala Glu Ala Ala Ile Ser Ala Leu Pro Asp Tyr Ala Ser
450 455 460
Gln Pro Gly Lys Pro Pro Lys Glu Asp Leu
465 470
<210> 161
<211> 474
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 161
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Ser Gly Gly Gly Gly Ser Arg His Arg Gln Pro Arg
165 170 175
Gly Trp Glu Gln Leu Gly Gly Gly Gly Ser Gly Gly Gly Gly Ser Glu
180 185 190
Gln Ser Gly Tyr Pro Val Gln Arg Leu Val Ala Leu Tyr Leu Ala Ala
195 200 205
Arg Leu Ser Trp Asn Gln Val Asp Gln Val Ile Arg Asn Ala Leu Ala
210 215 220
Ser Pro Gly Ser Gly Gly Asp Leu Gly Glu Ala Ile Arg Glu Gln Pro
225 230 235 240
Glu Gln Ala Arg Leu Ala Leu Thr Leu Ala Ala Ala Glu Ser Glu Tyr
245 250 255
Pro Thr Gly Ala Glu Phe Leu Gly Asp Gly Gly Ala Val Ser Phe Ser
260 265 270
Thr Arg Gly Thr Gln Asn Trp Thr Val Glu Arg Leu Leu Gln Ala His
275 280 285
Arg Gln Leu Glu Glu Gly Gly Tyr Val Phe Val Gly Tyr His Gly Thr
290 295 300
Phe Leu Glu Ala Ala Gln Ser Ile Val Phe Gly Gly Val Arg Ala Arg
305 310 315 320
Ser Gln Asp Leu Asp Ala Ile Trp Ala Gly Phe Tyr Ile Ala Gly Asp
325 330 335
Pro Ala Leu Ala Tyr Gly Tyr Ala Gln Asp Gln Glu Pro Asp Ala Ala
340 345 350
Gly Arg Ile Arg Asn Gly Ala Leu Leu Arg Val Tyr Val Pro Arg Ser
355 360 365
Ser Leu Pro Gly Phe Tyr Ala Thr Ser Leu Thr Leu Ala Ala Pro Glu
370 375 380
Ala Ala Gly Glu Val Glu Arg Leu Ile Gly His Pro Leu Pro Leu Arg
385 390 395 400
Leu Asp Ala Ile Thr Gly Pro Glu Glu Ala Gly Gly Arg Leu Glu Thr
405 410 415
Ile Leu Gly Trp Pro Leu Ala Glu Arg Thr Val Val Ile Pro Ser Ala
420 425 430
Ile Pro Thr Asp Pro Arg Asn Val Gly Gly Asp Leu Asp Pro Ser Ser
435 440 445
Ile Pro Asp Ala Glu Ala Ala Ile Ser Ala Leu Pro Asp Tyr Ala Ser
450 455 460
Gln Pro Gly Lys Pro Pro Lys Asp Glu Leu
465 470
<210> 162
<211> 474
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 162
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Ser Gly Gly Gly Gly Ser Arg His Arg Gln Pro Arg
165 170 175
Gly Trp Glu Gln Leu Gly Gly Gly Gly Ser Gly Gly Gly Gly Ser Glu
180 185 190
Gln Ser Gly Tyr Pro Val Gln Lys Leu Val Ala Leu Tyr Leu Ala Ala
195 200 205
Arg Leu Ser Trp Asn Gln Val Asp Gln Val Ile Arg Asn Ala Leu Ala
210 215 220
Ser Pro Gly Ser Gly Gly Asp Leu Gly Glu Ala Ile Arg Glu Gln Pro
225 230 235 240
Glu Gln Ala Arg Leu Ala Leu Thr Leu Ala Ala Ala Glu Ser Glu Tyr
245 250 255
Pro Thr Gly Ala Glu Phe Leu Gly Asp Gly Gly Ala Val Ser Phe Ser
260 265 270
Thr Arg Gly Thr Gln Asn Trp Thr Val Glu Arg Leu Leu Gln Ala His
275 280 285
Arg Gln Leu Glu Glu Gly Gly Tyr Val Phe Val Gly Tyr His Gly Thr
290 295 300
Phe Leu Glu Ala Ala Gln Ser Ile Val Phe Gly Gly Val Arg Ala Arg
305 310 315 320
Ser Gln Asp Leu Asp Ala Ile Trp Ala Gly Phe Tyr Ile Ala Gly Asp
325 330 335
Pro Ala Leu Ala Tyr Gly Tyr Ala Gln Asp Gln Glu Pro Asp Ala Ala
340 345 350
Gly Arg Ile Arg Asn Gly Ala Leu Leu Arg Val Tyr Val Pro Arg Ser
355 360 365
Ser Leu Pro Gly Phe Tyr Ala Thr Ser Leu Thr Leu Ala Ala Pro Glu
370 375 380
Ala Ala Gly Glu Val Glu Arg Leu Ile Gly His Pro Leu Pro Leu Arg
385 390 395 400
Leu Asp Ala Ile Thr Gly Pro Glu Glu Ala Gly Gly Arg Leu Glu Thr
405 410 415
Ile Leu Gly Trp Pro Leu Ala Glu Arg Thr Val Val Ile Pro Ser Ala
420 425 430
Ile Pro Thr Asp Pro Lys Asn Val Gly Gly Asp Leu Asp Pro Ser Ser
435 440 445
Ile Pro Asp Ala Glu Ala Ala Ile Ser Ala Leu Pro Asp Tyr Ala Ser
450 455 460
Gln Pro Gly Lys Pro Pro Lys Asp Glu Leu
465 470
<210> 163
<211> 515
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 163
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro His Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Ser Ala Ser Gly Gly Pro Glu Gly Gly Ser Leu Ala
165 170 175
Ala Leu Thr Ala His Gln Ala Cys His Leu Pro Leu Glu Thr Phe Thr
180 185 190
Arg His Arg Gln Pro Arg Gly Trp Glu Gln Leu Glu Gln Cys Gly Tyr
195 200 205
Pro Val Gln Lys Leu Val Ala Leu Tyr Leu Ala Ala Arg Leu Ser Trp
210 215 220
Asn Gln Val Asp Gln Val Ile Ala Asn Ala Leu Ala Ser Pro Gly Ser
225 230 235 240
Gly Gly Asp Leu Gly Glu Ala Ile Arg Glu Ser Pro Glu Gln Ala Arg
245 250 255
Leu Ala Leu Thr Leu Ala Ala Ala Glu Ser Glu Arg Phe Val Arg Gln
260 265 270
Gly Thr Gly Asn Asp Glu Ala Gly Ala Ala Asn Gly Pro Ala Asp Ser
275 280 285
Gly Asp Ala Leu Leu Glu Arg Asn Tyr Pro Thr Gly Ala Glu Phe Leu
290 295 300
Gly Asp Gly Gly Asp Val Ser Phe Ser Thr Arg Gly Thr Gln Gln Trp
305 310 315 320
Thr Val Glu Arg Leu Leu Gln Ala His Arg Gln Leu Glu Glu Ala Gly
325 330 335
Tyr Val Phe Val Gly Tyr His Gly Thr Phe Leu Glu Ala Ala Gln Ser
340 345 350
Ile Val Phe Gly Gly Val Arg Ala Arg Ser Gln Asp Leu Asp Ala Ile
355 360 365
Trp Ala Gly Phe Tyr Ile Ala Gly Asp Pro Ala Leu Ala Tyr Gly Tyr
370 375 380
Ala Gln Asp Gln Glu Pro Asp Ala Ala Gly Arg Ile Arg Asn Gly Ala
385 390 395 400
Leu Leu Arg Val Tyr Val Pro Arg Ser Ser Leu Pro Gly Phe Tyr Ala
405 410 415
Thr Ser Leu Thr Leu Ala Ala Pro Glu Ala Ala Gly Glu Val Glu Arg
420 425 430
Leu Ile Gly His Pro Leu Pro Leu Arg Leu Asp Ala Ile Thr Gly Pro
435 440 445
Glu Glu Ser Gly Gly Arg Leu Glu Thr Ile Leu Gly Trp Pro Leu Ala
450 455 460
Glu Arg Thr Val Val Ile Pro Ser Ala Ile Pro Thr Asp Pro Lys Asn
465 470 475 480
Val Gly Gly Asp Leu Asp Pro Ser Ser Ile Pro Asp Ser Glu Gln Ala
485 490 495
Ile Ser Ala Leu Pro Asp Tyr Ala Ser Gln Pro Gly Lys Pro Pro Lys
500 505 510
Asp Glu Leu
515
<210> 164
<211> 475
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 164
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro His Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Gly Ser Gly Gly Gly Gly Ser Arg His Arg Gln Pro
165 170 175
Arg Gly Trp Glu Gln Leu Gly Gly Gly Gly Ser Gly Gly Gly Gly Ser
180 185 190
Glu Gln Ser Gly Tyr Pro Val Gln Arg Leu Val Ala Leu Tyr Leu Ala
195 200 205
Ala Arg Leu Ser Trp Asn Gln Val Asp Gln Val Ile Arg Asn Ala Leu
210 215 220
Ala Ser Pro Gly Ser Gly Gly Asp Leu Gly Glu Ala Ile Arg Glu Gln
225 230 235 240
Pro Glu Gln Ala Arg Leu Ala Leu Thr Leu Ala Ala Ala Glu Ser Glu
245 250 255
Tyr Pro Thr Gly Ala Glu Phe Leu Gly Asp Gly Gly Ala Val Ser Phe
260 265 270
Ser Thr Arg Gly Thr Gln Asn Trp Thr Val Glu Arg Leu Leu Gln Ala
275 280 285
His Arg Gln Leu Glu Glu Gly Gly Tyr Val Phe Val Gly Tyr His Gly
290 295 300
Thr Phe Leu Glu Ala Ala Gln Ser Ile Val Phe Gly Gly Val Arg Ala
305 310 315 320
Arg Ser Gln Asp Leu Asp Ala Ile Trp Ala Gly Phe Tyr Ile Ala Gly
325 330 335
Asp Pro Ala Leu Ala Tyr Gly Tyr Ala Gln Asp Gln Glu Pro Asp Ala
340 345 350
Ala Gly Arg Ile Arg Asn Gly Ala Leu Leu Arg Val Tyr Val Pro Arg
355 360 365
Ser Ser Leu Pro Gly Phe Tyr Ala Thr Ser Leu Thr Leu Ala Ala Pro
370 375 380
Glu Ala Ala Gly Glu Val Glu Arg Leu Ile Gly His Pro Leu Pro Leu
385 390 395 400
Arg Leu Asp Ala Ile Thr Gly Pro Glu Glu Ala Gly Gly Arg Leu Glu
405 410 415
Thr Ile Leu Gly Trp Pro Leu Ala Glu Arg Thr Val Val Ile Pro Ser
420 425 430
Ala Ile Pro Thr Asp Pro Arg Asn Val Gly Gly Asp Leu Asp Pro Ser
435 440 445
Ser Ile Pro Asp Ala Glu Ala Ala Ile Ser Ala Leu Pro Asp Tyr Ala
450 455 460
Ser Gln Pro Gly Lys Pro Pro Lys Asp Glu Leu
465 470 475
<210> 165
<211> 463
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 165
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro His Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Ser Gly Gly Gly Ser Arg His Arg Gln Pro Arg Gly
165 170 175
Trp Glu Gln Leu Glu Gln Ser Gly Tyr Pro Val Gln Arg Leu Val Ala
180 185 190
Leu Tyr Leu Ala Ala Arg Leu Ser Trp Asn Gln Val Asp Gln Val Ile
195 200 205
Arg Asn Ala Leu Ala Ser Pro Gly Ser Gly Gly Asp Leu Gly Glu Ala
210 215 220
Ile Arg Glu Gln Pro Glu Gln Ala Arg Leu Ala Leu Thr Leu Ala Ala
225 230 235 240
Ala Glu Ser Glu Tyr Pro Thr Gly Ala Glu Phe Leu Gly Asp Gly Gly
245 250 255
Ala Val Ser Phe Ser Thr Arg Gly Thr Gln Asn Trp Thr Val Glu Arg
260 265 270
Leu Leu Gln Ala His Arg Gln Leu Glu Glu Gly Gly Tyr Val Phe Val
275 280 285
Gly Tyr His Gly Thr Phe Leu Glu Ala Ala Gln Ser Ile Val Phe Gly
290 295 300
Gly Val Arg Ala Arg Ser Gln Asp Leu Asp Ala Ile Trp Ala Gly Phe
305 310 315 320
Tyr Ile Ala Gly Asp Pro Ala Leu Ala Tyr Gly Tyr Ala Gln Asp Gln
325 330 335
Glu Pro Asp Ala Ala Gly Arg Ile Arg Asn Gly Ala Leu Leu Arg Val
340 345 350
Tyr Val Pro Arg Ser Ser Leu Pro Gly Phe Tyr Ala Thr Ser Leu Thr
355 360 365
Leu Ala Ala Pro Glu Ala Ala Gly Glu Val Glu Arg Leu Ile Gly His
370 375 380
Pro Leu Pro Leu Arg Leu Asp Ala Ile Thr Gly Pro Glu Glu Ala Gly
385 390 395 400
Gly Arg Leu Glu Thr Ile Leu Gly Trp Pro Leu Ala Glu Arg Thr Val
405 410 415
Val Ile Pro Ser Ala Ile Pro Thr Asp Pro Arg Asn Val Gly Gly Asp
420 425 430
Leu Asp Pro Ser Ser Ile Pro Asp Ala Glu Ala Ala Ile Ser Ala Leu
435 440 445
Pro Asp Tyr Ala Ser Gln Pro Gly Lys Pro Pro Lys Asp Glu Leu
450 455 460
<210> 166
<211> 475
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 166
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Asn Phe Lys Phe Arg Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu Arg
130 135 140
Leu Arg Asp Met His His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Gly Ser Gly Gly Gly Gly Ser Arg His Arg Gln Pro
165 170 175
Arg Gly Trp Glu Gln Leu Gly Gly Gly Gly Ser Gly Gly Gly Gly Ser
180 185 190
Glu Gln Ser Gly Tyr Pro Val Gln Arg Leu Val Ala Leu Tyr Leu Ala
195 200 205
Ala Arg Leu Ser Trp Asn Gln Val Asp Gln Val Ile Arg Asn Ala Leu
210 215 220
Ala Ser Pro Gly Ser Gly Gly Asp Leu Gly Glu Ala Ile Arg Glu Gln
225 230 235 240
Pro Glu Gln Ala Arg Leu Ala Leu Thr Leu Ala Ala Ala Glu Ser Glu
245 250 255
Tyr Pro Thr Gly Ala Glu Phe Leu Gly Asp Gly Gly Ala Val Ser Phe
260 265 270
Ser Thr Arg Gly Thr Gln Asn Trp Thr Val Glu Arg Leu Leu Gln Ala
275 280 285
His Arg Gln Leu Glu Glu Gly Gly Tyr Val Phe Val Gly Tyr His Gly
290 295 300
Thr Phe Leu Glu Ala Ala Gln Ser Ile Val Phe Gly Gly Val Arg Ala
305 310 315 320
Arg Ser Gln Asp Leu Asp Ala Ile Trp Ala Gly Phe Tyr Ile Ala Gly
325 330 335
Asp Pro Ala Leu Ala Tyr Gly Tyr Ala Gln Asp Gln Glu Pro Asp Ala
340 345 350
Ala Gly Arg Ile Arg Asn Gly Ala Leu Leu Arg Val Tyr Val Pro Arg
355 360 365
Ser Ser Leu Pro Gly Phe Tyr Ala Thr Ser Leu Thr Leu Ala Ala Pro
370 375 380
Glu Ala Ala Gly Glu Val Glu Arg Leu Ile Gly His Pro Leu Pro Leu
385 390 395 400
Arg Leu Asp Ala Ile Thr Gly Pro Glu Glu Ala Gly Gly Arg Leu Glu
405 410 415
Thr Ile Leu Gly Trp Pro Leu Ala Glu Arg Thr Val Val Ile Pro Ser
420 425 430
Ala Ile Pro Thr Asp Pro Arg Asn Val Gly Gly Asp Leu Asp Pro Ser
435 440 445
Ser Ile Pro Asp Ala Glu Ala Ala Ile Ser Ala Leu Pro Asp Tyr Ala
450 455 460
Ser Gln Pro Gly Lys Pro Pro Lys Asp Glu Leu
465 470 475
<210> 167
<211> 474
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 167
Arg Val Ala Ala His Ile Thr Gly Thr Arg Gly Arg Ser Asn Thr Leu
1 5 10 15
Ser Ser Pro Asn Ser Lys Asn Glu Lys Ala Leu Gly Arg Lys Ile Asn
20 25 30
Ser Trp Glu Ser Ser Arg Ser Gly His Ser Phe Leu Ser Asn Leu His
35 40 45
Leu Arg Asn Gly Glu Leu Val Ile His Glu Lys Gly Phe Tyr Tyr Ile
50 55 60
Tyr Ser Gln Thr Tyr Phe Arg Phe Gln Glu Glu Ile Lys Glu Asn Thr
65 70 75 80
Lys Asn Asp Lys Gln Met Val Gln Tyr Ile Tyr Lys Tyr Thr Ser Tyr
85 90 95
Pro Asp Pro Ile Leu Leu Met Lys Ser Ala Arg Asn Ser Cys Trp Ser
100 105 110
Lys Asp Ala Glu Tyr Gly Leu Tyr Ser Ile Tyr Gln Gly Gly Ile Phe
115 120 125
Glu Leu Lys Glu Asn Asp Arg Ile Phe Val Ser Val Thr Asn Glu His
130 135 140
Leu Ile Asp Met Asp His Glu Ala Ser Phe Phe Gly Ala Phe Leu Val
145 150 155 160
Gly Gly Gly Gly Ser Gly Gly Gly Gly Ser Arg His Arg Gln Pro Arg
165 170 175
Gly Trp Glu Gln Leu Gly Gly Gly Gly Ser Gly Gly Gly Gly Ser Glu
180 185 190
Gln Ser Gly Tyr Pro Val Gln Lys Leu Val Ala Leu Tyr Leu Ala Ala
195 200 205
Arg Leu Ser Trp Asn Gln Val Asp Gln Val Ile Arg Asn Ala Leu Ala
210 215 220
Ser Pro Gly Ser Gly Gly Asp Leu Gly Glu Ala Ile Arg Glu Gln Pro
225 230 235 240
Glu Gln Ala Arg Leu Ala Leu Thr Leu Ala Ala Ala Glu Ser Glu Tyr
245 250 255
Pro Thr Gly Ala Glu Phe Leu Gly Asp Gly Gly Ala Val Ser Phe Ser
260 265 270
Thr Arg Gly Thr Gln Asn Trp Thr Val Glu Arg Leu Leu Gln Ala His
275 280 285
Arg Gln Leu Glu Glu Gly Gly Tyr Val Phe Val Gly Tyr His Gly Thr
290 295 300
Phe Leu Glu Ala Ala Gln Ser Ile Val Phe Gly Gly Val Arg Ala Arg
305 310 315 320
Ser Gln Asp Leu Asp Ala Ile Trp Ala Gly Phe Tyr Ile Ala Gly Asp
325 330 335
Pro Ala Leu Ala Tyr Gly Tyr Ala Gln Asp Gln Glu Pro Asp Ala Ala
340 345 350
Gly Arg Ile Arg Asn Gly Ala Leu Leu Arg Val Tyr Val Pro Arg Ser
355 360 365
Ser Leu Pro Gly Phe Tyr Ala Thr Ser Leu Thr Leu Ala Ala Pro Glu
370 375 380
Ala Ala Gly Glu Val Glu Arg Leu Ile Gly His Pro Leu Pro Leu Arg
385 390 395 400
Leu Asp Ala Ile Thr Gly Pro Glu Glu Ala Gly Gly Arg Leu Glu Thr
405 410 415
Ile Leu Gly Trp Pro Leu Ala Glu Arg Thr Val Val Ile Pro Ser Ala
420 425 430
Ile Pro Thr Asp Pro Lys Asn Val Gly Gly Asp Leu Asp Pro Ser Ser
435 440 445
Ile Pro Asp Ala Glu Ala Ala Ile Ser Ala Leu Pro Asp Tyr Ala Ser
450 455 460
Gln Pro Gly Lys Pro Pro Lys Glu Asp Leu
465 470
<210> 168
<211> 232
<212> PRT
<213> Artificial Sequence
<220>
<223> fusion protein
<400> 168
Lys Leu Pro Arg Ser Ser Leu Val Trp Cys Val Leu Ile Val Cys Leu
1 5 10 15
Thr Leu Leu Ile Phe Thr Tyr Leu Thr Arg Lys Ser Leu Cys Glu Ile
20 25 30
Arg Tyr Arg Asp Gly His Arg Glu Val Ala Ala Phe Met Ala Tyr Glu
35 40 45
Ser Gly Lys Gly Gly Gly Gly Ser Arg Val Val Arg Pro Leu Gly Leu
50 55 60
Ala Gly Gly Gly Gly Gly Ser Arg Val Ala Ala His Ile Thr Gly Thr
65 70 75 80
Arg Gly Arg Ser Asn Thr Leu Ser Ser Pro Asn Ser Lys Asn Glu Lys
85 90 95
Ala Leu Gly Arg Lys Ile Asn Ser Trp Glu Ser Ser Arg Ser Gly His
100 105 110
Ser Phe Leu Ser Asn Leu His Leu Arg Asn Gly Glu Leu Val Ile His
115 120 125
Glu Lys Gly Phe Tyr Tyr Ile Tyr Ser Gln Thr Tyr Phe Arg Phe Gln
130 135 140
Glu Glu Ile Lys Glu Asn Thr Lys Asn Asp Lys Gln Met Val Gln Tyr
145 150 155 160
Ile Tyr Lys Tyr Thr Ser Tyr Pro Asp Pro Ile Leu Leu Met Lys Ser
165 170 175
Ala Arg Asn Ser Cys Trp Ser Lys Asp Ala Glu Tyr Gly Leu Tyr Ser
180 185 190
Ile Tyr Gln Gly Gly Ile Phe Glu Leu Lys Glu Asn Asp Arg Ile Phe
195 200 205
Val Ser Val Thr Asn Glu His Leu Ile Asp Met Asp His Glu Ala Ser
210 215 220
Phe Phe Gly Ala Phe Leu Val Gly
225 230
<210> 169
<211> 1299
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 169
gaagatcgtc cgatcaaatt tagcaccgaa ggtgcaacca gccagagcta taaacagttt 60
attgaagcac tgcgtgaacg tctgcgtggt ggtctgattc atgatattcc ggttctgccg 120
gatccgacca ccctgcaaga acgtaatcgt tatattaccg ttgaactgag caatagcgat 180
accgaaagca ttgaagttgg tattgatgca accaatgcct atgttgttgc atatcgtgca 240
ggtacacaga gctattttct gcgtgatgca ccgagcagcg caagcgatta cctgtttacc 300
ggcaccgatc agcatagcct gccgttttat ggcacctatg cagatctgga acgttgggca 360
catcagagcc gtcagcagat tccgctgggt ctgcaggcac tgacccatgg tattagcttt 420
tttcgtagcg gtggcaatga taacgaagaa aaagcacgta ccctgattgt gattattcag 480
atggttgcag aagcagcccg ttttcgctat atttcaaatc gtgttcgtgt tagcattcag 540
accggtacag catttcagcc ggatgcagca atgattagcc tggaaaataa ctgggataat 600
ctgagccgtg gtgttcaaga aagcgttcag gatacctttc cgaatcaggt taccctgacc 660
aatattcgta atgaaccggt tattgttgat cagctgagcc atccgaccgt tgcagttctg 720
gcactgatgc tgtttgtttg taatccgcct aatggtggtg gtggcagcgg tggtggcggt 780
agccgtaaaa aacgcgttcg tgaacgtggt ccgcagcgtg ttgcagcaca tattaccggt 840
acacgtggtc gtagcaatac cctgagcagc ccgaatagca aaaatgaaaa agccctgggt 900
cgtaaaatca atagctggga aagcagccgt agcggtcata gctttctgag caatctgcat 960
ctgcgtaatg gtgaactggt tattcatgag aaaggcttct actatatcta cagccagacc 1020
tattttcgct tccaagaaga gattaaagaa aacaccaaaa acgataaaca aatggtgcag 1080
tacatctata aatacaccag ctatccggat cctatcctgc tgatgaaaag cgcacgtaat 1140
agctgttgga gcaaagatgc agaatatggc ctgtatagca tttatcaggg tggcatcttt 1200
gaactgaaag aaaacgatcg tattttcgtg agcgtgacca atgaacatct gatcgatatg 1260
gatcatgaag ccagcttttt tggtgcattt ctggtgggt 1299
<210> 170
<211> 1350
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 170
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaacagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttctactata tctacagcca gacctatttt cgcttccaag aagagattaa agaaaacacc 240
aaaaacgata aacaaatggt gcagtacatc tataaataca ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggcctgtat 360
agcatttatc agggtggcat ctttgaactg aaagaaaacg atcgtatttt cgtgagcgtg 420
accaatgaac atctgatcga tatggatcat gaagccagct tttttggtgc atttctggtg 480
ggtggtggtg gcggtagcgc aagcggttgt ggtccggaac gtaaaaaacg tggcggtggt 540
ggtagtgaag ataataacat ttttccgaaa cagtacccga tcatcaattt taccaccgca 600
ggcgcaaccg ttcagagcta taccaacttt attcgtgcag ttcgtggtcg tctgaccacc 660
ggtgcagatg ttcgtcatga aattccggtt ctgccgaatc gtgttggtct gccgattaat 720
cagcgtttta ttctggttga actgagcaac catgcagaac tgagcgttac cctggcaacc 780
aatgcctatg tggttggtta tcgtgcaggt aatagcgcct attttttcca tccggataat 840
caagaagatg ccgaagcaat tacccacctg tttaccgatg ttcagaatcg ttataccttt 900
gcctttggtg gtaattatga tcgtctggaa cagctggcag gtagcctgcg tgaaaatatt 960
gaactgggta atggtccgct ggaagaagcc attagcgcac tgtattatta cagtaccggt 1020
ggcacccagc tgccgaccct ggcacgtagc tttattgttt gtattcagat gattagcgaa 1080
gccgcacgct ttcagtatat tgaaggtgaa atgcgtaccc gcattcgtta taatcgtcgt 1140
agcgcaccgg atccgtcagt tattaccctg gaaaatagct ggggtcgtct gtcaaccgca 1200
attcaagaaa gcaatcaggg tgcatttgca agcccgattc agctgcagcg tcgtaatggt 1260
agcaaattta gcgtttatga tgtgagcatt ctgatcccga ttattgccct gatggtgtat 1320
cgttgtgcac cgcctccgaa agaagatctg 1350
<210> 171
<211> 1443
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 171
ggtgcagatg atgttgcaga tagcagcaaa agctttgtga tggaaaactt tagcagctat 60
catggcacca aaccgggtta tgccgatagc attcagaaag gtattcagaa accgaaaagc 120
ggcacccagg gtaattatga tgatgattgg aaaggcttct atagcaccga taacaaatat 180
gatgcagccg gttatagcgt ggataatgaa aatccgctga gcggtaaagc cggtggtgtt 240
gttaaagtta cctatccggg tctgaccaaa gttctggcac tgaaagttga taatgccgaa 300
accatcaaaa aagaactggg tctgagcctg accgaaccgc tgatggaaca ggttggcacc 360
gaagaattta tcaaacgttt tggtgatggt gcaagccgtg ttgtgctgag cctgccgttt 420
gcagaaggta gcagcagcgt tgaatatatc aataattggg aacaggcaaa agccctgagc 480
gttgaactgg aaatcaattt tgaaacccgt ggtaaacgtg gtcaggatgc aatgtatgaa 540
tacatggcac aggcatgtgc aggtaatcgt aaaaaacgcg gtggtggtgg tagtccggaa 600
ggtggtagcc tggcagcact gaccgcacat caggcatgtc atctgccgct ggaaaccttt 660
acccgtcatc gtcagcctcg tggctgggaa cagctggaac agtgtggtta tccggttcag 720
cgtctggttg cactgtatct ggcagcccgt ctgagctgga atcaggttga tcaggttatt 780
cgtaatgcac tggcaagtcc gggtagcggt ggtgatctgg gtgaagcaat tcgtgaacag 840
cctgaacagg cacgtctggc cctgaccctg gcagccgcag aaagcgaacg ttttgttcgt 900
cagggcaccg gtaatggtcg caaaaaacgt ggcggtggcg gttcaggggg tggtggttca 960
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 1020
agcaaaaatg aaaaagcgct gggtcgtaaa atcaatagct gggaaagcag ccgtagcggt 1080
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgagaaaggc 1140
ttttattata tctatagcca gacctacttt cgcttccaag aagagattaa agaaaacacc 1200
aaaaacgata aacaaatggt gcagtacatc tataaataca ccagctatcc ggatccgatt 1260
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggcctgtat 1320
agcatttatc agggtggcat ctttgaactg aaagaaaacg atcgtatttt cgtgagcgtg 1380
accaatgaac atctgatcga tatggatcat gaagccagct tttttggtgc atttctggtg 1440
ggt 1443
<210> 172
<211> 1434
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 172
ggtgcagatg atgtgagcaa aagctttgtg atggaaaact ttagcagcta tcatggcacc 60
aaaccgggtt atgcagatag cattcagaaa ggtattcaga aaccgaaaag cggcacccag 120
ggtaattatg atgatgattg gaaaggcttc tatagcaccg ataacaaata tgatgcagcc 180
ggttatagcg tggataatga aaatccgctg agcggtaaag ccggtggtgt tgttaaagtt 240
acctatccgg gtctgaccaa agttctggca ctgaaagttg ataatgccga aaccatcaaa 300
aaagaactgg gtctgagcct gaccgaaccg ctgatggaac aggttggcac cgaagaattt 360
atcaaacgtt ttggtgatgg tgcaagccgt gttgtgctga gcctgccgtt tgcagaaggt 420
agcagcagcg ttgaatatat caataattgg gaacaggcaa aagccctgag cgttgaactg 480
gaaatcaatt ttgaaacccg tggtaaacgt ggtcaggatg caatgtatga atacatggca 540
caggcatgtg caggtaatcg taaaaaacgc ggtggtggtg gtagtccgga aggtggtagc 600
ctggcagcac tgaccgcaca tcaggcatgt catctgccgc tggaaacctt tacccgtcat 660
cgtcagcctc gtggctggga acagctggaa cagtgtggtt atccggttca gcgtctggtt 720
gcactgtatc tggcagcccg tctgagctgg aatcaggttg atcaggttat tcgtaatgca 780
ctggcaagtc cgggtagcgg tggtgatctg ggtgaagcaa ttcgtgaaca gcctgaacag 840
gcacgtctgg ccctgaccct ggcagccgca gaaagcgaac gttttgttcg tcagggcacc 900
ggtaatggtc gcaaaaaacg tggcggtggc ggttcagggg gtggtggttc acgtgttgca 960
gcacatatta ccggcacccg tggtcgtagc aataccctga gcagcccgaa tagcaaaaat 1020
gaaaaagcgc tgggtcgtaa aatcaatagc tgggaaagca gccgtagcgg tcatagcttt 1080
ctgagcaatc tgcatctgcg taatggtgaa ctggtgattc atgagaaagg cttttattat 1140
atctatagcc agacctactt tcgcttccaa gaagagatta aagaaaacac caaaaacgat 1200
aaacaaatgg tgcagtacat ctataaatac accagctatc cggatccgat tctgctgatg 1260
aaaagcgcac gtaatagctg ttggagcaaa gatgcagaat atggcctgta tagcatttat 1320
cagggtggca tctttgaact gaaagaaaac gatcgtattt tcgtgagcgt gaccaatgaa 1380
catctgatcg atatggatca tgaagccagc ttttttggtg catttctggt gggt 1434
<210> 173
<211> 1299
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 173
ggtctggata ccgttagctt tagcaccaaa ggtgcaacct atattaccta tgtgaacttt 60
ctgaatgagc tgcgcgttaa actgaaaccg gaaggtaata gccatggtat tccgctgctg 120
cgtaaaaaag cagatgatcc gggtaaagca tttgttctgg ttgcactgag caatgataat 180
ggtcagctgg cagaaattgc cattgatgca accagcgttt atgttgttgg ttatcaggtt 240
cgtaatcgca gctatttctt caaagatgca ccggatgcag cctatgaagg tctgtttaaa 300
aacaccatta aaacccgtct gcatttcggt ggtagctatc cgagcctgga aggtgaaaaa 360
gcatatcgtg aaaccaccga tctgggtatt gaaccgctgc gtattggtat caaaaaactg 420
gatgaaaacg ccatcgataa ctataaaccg accgaaattg caagcagcct gctggttgtt 480
attcagatgg ttagcgaagc agcacgcttt acctttattg aaaatcagat ccgcaacaac 540
tttcagcagc gtattcgtcc ggcaaataat accattagcc tggaaaacaa atggggcaaa 600
ctgagctttc agattcgtac cagcggtgca aatggtatgt ttagtgaagc agttgaactg 660
gaacgtgcca atggcaaaaa atactatgtt accgcagttg atcaggtgaa accgaaaatt 720
gcactgctga aattcgttga caaagatccg aaaggtggtg gtggtagccg taaaaaacgt 780
gcaagcggtt gtggtccgga aggcggtggc ggtagtcgtg ttgcagcaca tattaccggc 840
acccgtggtc gtagcaatac cctgagcagc ccgaatagca aaaatgaaaa agccctgggt 900
cgtaaaatca atagctggga aagcagccgt agcggtcata gctttctgag caatctgcat 960
ctgcgtaatg gtgaactggt gattcatgaa aaaggcttct actatatcta cagccagacc 1020
tattttcgct tccaagaaga gattaaagaa aacaccaaaa acgataaaca aatggtgcag 1080
tacatctata aatacaccag ctatccggat ccgattctgc tgatgaaaag cgcacgtaat 1140
agctgttgga gcaaagatgc cgaatatggt ctgtatagca tttatcaggg tggcatcttc 1200
gaactgaaag aaaacgatcg tatttttgtg agcgtgacca acgaacatct gatcgatatg 1260
gatcatgaag ccagcttttt tggtgcattt ctggttggc 1299
<210> 174
<211> 759
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 174
cctcgtggta gtccgcgtac cgaatatgaa gcatgtcgtg ttcgttgtca ggttgcagaa 60
catggtgttg aacgtcagcg tcgttgccag caggtttgtg aaaaacgtct gcgtgaacgt 120
gaaggtcgtc gtgaagttga taaagatgaa ctgcgtaaaa aacgtggtgg tggttgtgca 180
gcagcatgtg cagcctgtac cagcgaagaa accattagca ccgttcaaga aaaacagcag 240
aatattagtc cgctggttcg tgaacgcggt ccgcagcgtg ttgcagcaca tattaccggc 300
acccgtggtc gtagcaatac cctgagcagc ccgaatagca aaaatgaaaa agcactgggt 360
cgcaaaatta acagctggga aagcagccgt agcggtcata gctttctgag caatctgcat 420
ctgcgtaatg gtgaactggt gattcatgaa aaaggcttct actatatcta cagccagacc 480
tattttcgct tccaagaaga gattaaagaa aacaccaaaa acgataaaca aatggtgcag 540
tacatctata aatacaccag ctatccggat ccgattctgc tgatgaaaag cgcacgtaat 600
agctgttgga gcaaagatgc agaatatggc ctgtatagca tttatcaggg tggcatcttt 660
gaactgaaag aaaacgatcg tattttcgtg agcgtgacca atgaacatct gatcgatatg 720
gatcatgaag ccagcttttt tggtgcattt ctggtgggt 759
<210> 175
<211> 759
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 175
cctcgtggta gtccgcgtac cgaatatgaa gcatgtcgtg ttcgttgtca ggttgcagaa 60
catggtgttg aacgtcagcg tcgttgccag caggtttgtg aaaaacgtct gcgtgaacgt 120
gaaggtcgtc gtgaagttga taaagatgaa ctgcgtaaaa aacgtggtgg tggttgtgca 180
gcagcatgtg cagcctgtac cagcgaagaa accattagca ccgttcaaga aaaacagcag 240
aatattagtc cgctggttcg tgaacgcggt ccgcagcgtg ttgcagcaca tattaccggc 300
acccgtggtc gtagcaatac cctgagcagc ccgaatagca aaaatgaaaa agcactgggt 360
cgcaaaatta acagctggga aagcagccgt agcggtcata gctttctgag caatctgcat 420
ctgcgtaatg gtgaactggt gattcatgaa aaaggcttct actatatcta cagccagacc 480
tattttcgct tccaagaaga gattaaagaa aacaccaaaa acgataaaca aatggtgcag 540
tacatctata aatacaccag ctatccggat ccgattctgc tgatgaaaag cgcacgtaat 600
agctgttgga gcaaagatgc agaatatggc ctgtatagca tttatcaggg tggcatcttt 660
gaactgaaag aaaacgatcg tattttcgtg agcgtgacca atgaacatct gatcgatatg 720
gatcatgaag ccagcttttt tggtgcattt ctggtgggt 759
<210> 176
<211> 1617
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 176
gatgttagct ttcgtctgag cggtgcaacc agcagcagct atggtgtgtt tattagcaat 60
ctgcgtaaag cactgccgaa tgaacgtaaa ctgtatgata ttccgctgct gcgtagcagc 120
ctgcctggta gccagcgtta tgcactgatt catctgacca attatgccga tgaaaccatt 180
agcgttgcaa ttgatgttac caacgtgtat atcatgggtt atcgtgccgg tgataccagc 240
gcatgtagca atgaagcaag cgcaaccgaa gcagcaaaat atgtttttaa agatgccatg 300
cgcaaagtga ccctgccgta tagcggtaat tatgaacgcc tgcagaccgc agcaggtaaa 360
attcgtgaaa acattccgct gggtctgcct gcactggata gcgcaattac caccctgttt 420
tattacaatg caaatagcgc agccagcgca ctgatggttc tgattcagag caccagcgaa 480
gcagctcgct ataaattcat tgaacagcag attggttgcg gtgtggataa aacctttctg 540
ccgagcctgg caattattag cctggaaaat agctggtcag cactgagcaa acaaattcag 600
attgcaagca ccaataacgg ccagtttgaa agtccggttg ttctgattaa tgcacagaat 660
cagcgtgtga ccattaccaa tgttgatgcc ggtgttgtta ccagtaatat tgcactgctg 720
ctgaatcgca ataatatggc acgtaaaaaa cgcggtggtg gtggtagtcc ggaaggtggt 780
agcctggcag ccctgaccgc acatcaggca tgtcatctgc cgctggaaac ctttacccgt 840
catcgtcagc ctcgtggttg ggaacagctg gaacagtgtg gttatccggt tcagcgtctg 900
gttgccctgt atctggcagc acgtctgagc tggaatcagg ttgatcaggt tattcgtaat 960
gcactggcaa gtccgggtag cggtggtgat ctgggtgaag ccattcgtga acagcctgaa 1020
caggcacgtc tggcactgac cctggcagca gcagaaagcg aacgttttgt tcgtcagggc 1080
accggtaacg gtcgcaaaaa acgtggcggt ggcggttcag ggggtggtgg ttcacgtgtt 1140
gcagcacata ttaccggcac ccgtggtcgt agcaataccc tgagcagccc gaatagcaaa 1200
aatgaaaaag cactgggtcg taaaatcaac agctgggaaa gcagccgtag cggtcatagc 1260
tttctgagta atctgcatct gcgcaatggt gaactggtga ttcatgaaaa aggcttctac 1320
tatatctaca gccagaccta ttttcgcttc caagaagaga ttaaagaaaa caccaaaaac 1380
gataaacaaa tggtgcagta catctataaa tacaccagct atccggatcc gattctgctg 1440
atgaaaagcg cacgtaatag ctgttggagc aaagatgcag aatatggcct gtatagcatt 1500
tatcagggtg gcatttttga gctgaaagaa aacgatcgta ttttcgtgag cgtgaccaat 1560
gaacatctga tcgatatgga tcatgaagcc agcttttttg gtgcatttct ggtgggt 1617
<210> 177
<211> 1287
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 177
gatgcaagct ttcgtctgag cggtgcaacc agcagcagct atggtgtgtt tattagcaat 60
ctgcgtaaag cactgccgaa tgaacgtaaa ctgtatgata ttccgctgct gcgtagcagc 120
ctgcctggta gccagcgtta tgcactgatt catctgacca attatgccga tgaaaccatt 180
agcgttgcaa ttgatgcaac caacgtgtat atcatgggtt atcgtgccgg tgataccagc 240
gcatgtagca atgaagcaag cgcaaccgaa gcagcaaaat atgtttttaa agatgccatg 300
cgcaaagtga ccctgccgta tagcggtaat tatgaacgcc tgcagaccgc agcaggtaaa 360
attcgtgaaa acattccgct gggtctgcct gcgggtgata gcgcaattac caccctgttt 420
tattacaatg caaatagcgc agccagcgca ctgatggttc tgattcagag caccagcgaa 480
gcagctcgct ataaattcat tgaacagcag attggttgcg gtgtggataa aacctttctg 540
ccgagcctgg caattattag cctggaaaat agctggtcag cactgagcaa acaaattcag 600
attgcaagca ccaataacgg ccagtttgaa agtccggttg ttctgattaa tgcacagaat 660
cagcgtgtga ccattaccaa tgttgatgcc ggtgttgtta ccagtaatat tgcactgctg 720
ctgaatcgca ataatatggc aggcggtggt ggtagccgta aaaaacgtgc aagcggttgt 780
ggtccggaag gtggtggtgg ttcacgtgtt gcagcacata ttaccggcac ccgtggtcgt 840
agcaataccc tgagcagccc gaatagcaaa aatgaaaaag cactgggtcg caaaattaac 900
agctgggaaa gcagccgtag cggtcatagc tttctgagta atctgcatct gcgcaatggt 960
gaactggtga ttcatgaaaa aggcttctac tatatctaca gccagaccta ttttcgcttc 1020
caagaagaga ttaaagaaaa caccaaaaac gataaacaaa tggtgcagta catctataaa 1080
tacaccagct atccggatcc gattctgctg atgaaaagcg cacgtaatag ctgttggagc 1140
aaagatgcag aatatggcct gtatagcatt tatcagggtg gcatttttga gctgaaagaa 1200
aacgatcgta ttttcgtgag cgtgaccaat gaacatctga tcgatatgga tcatgaagcc 1260
agcttttttg gtgcatttct ggtgggt 1287
<210> 178
<211> 1545
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 178
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaacagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttctactata tctacagcca gacctatttt cgcttccaag aagagattaa agaaaacacc 240
aaaaacgata aacaaatggt gcagtacatc tataaataca ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggcctgtat 360
agcatttatc agggtggcat ctttgaactg aaagaaaacg atcgtatttt cgtgagcgtg 420
accaatgaac atctgatcga tatggatcat gaagccagct tttttggtgc atttctggtg 480
ggtggtggtg gtagcgcaag cggtggtccg gaaggtggta gcctggcagc actgaccgca 540
catcaggcat gtcatctgcc gctggaaacc tttacccgtc atcgtcagcc tcgtggttgg 600
gaacagctgg aacagtgtgg ttatccggtt cagaaactgg ttgcactgta tctggcagcc 660
cgtctgagct ggaatcaggt tgatcaggtt attgcaaatg cactggcaag tccgggtagc 720
ggtggtgatc tgggtgaagc aattcgtgaa agtccggaac aggcacgtct ggcactgacc 780
ctggcagccg cagaaagcga acgttttgtt cgtcagggca ccggtaatga tgaagccggt 840
gcagcaaatg gtccggcaga tagcggtgat gcactgctgg aacgtaatta tccgaccggt 900
gcagaatttc tgggtgatgg cggtgatgtt agctttagta cccgtggcac ccagcagtgg 960
accgttgaac gtctgctgca ggcacaccgt cagctggaag aggcaggtta tgtttttgtt 1020
ggttatcatg gcacctttct ggaagcagca cagagcattg tgtttggtgg tgttcgtgca 1080
cgtagccagg atctggatgc aatttgggca ggtttctata ttgccggtga tccggcactg 1140
gcctatggtt atgcacagga tcaagaaccg gatgcagcag gtcgtattcg caatggtgcc 1200
ctgctgcgtg tttatgttcc gcgtagcagc ctgcctggtt tttatgcaac cagcctgaca 1260
ctggctgcac ctgaagcagc cggtgaagtg gaacgtctga ttggtcatcc gctgccgctg 1320
cgtctggatg cgattaccgg tcctgaagaa agtggtggtc gtctggaaac cattctgggt 1380
tggcctctgg cagaacgtac cgttgttatt ccgagcgcaa ttccgaccga tccgaaaaat 1440
gttggtggcg atctggatcc gagcagcatt ccggatagtg aacaggcaat tagcgcactg 1500
ccggattatg ccagccagcc tggtaaaccg cctaaagatg aactg 1545
<210> 179
<211> 1206
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 179
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaacagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttctactata tctacagcca gacctatttt cgcttccaag aagagattaa agaaaacacc 240
aaaaacgata aacaaatggt gcagtacatc tataaataca ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggcctgtat 360
agcatttatc agggtggcat ctttgaactg aaagaaaacg atcgtatttt cgtgagcgtg 420
accaatgaac atctgatcga tatggatcat gaagccagct tttttggtgc atttctggtg 480
ggtggtggtg gtagcggtgg tggcggtcgt aaaaaacgtc gtcatcgtca gcctcgtggt 540
tgggaacagc tgccgaccgg tgcagaattt ctgggtgatg gcggtgatgt tagctttagt 600
acccgtggca cccagaattg gaccgttgaa cgtctgctgc aggcacaccg tcagctggaa 660
gaggcaggtt atgtttttgt tggttatcat ggcacctttc tggaagcagc acagagcatt 720
gtgtttggtg gtgttcgtgc acgtagccag gatctggatg caatttgggc aggtttctat 780
attgccggtg atccggcact ggcctatggt tatgcacagg atcaagaacc ggatgcagca 840
ggtcgtattc gcaatggtgc actgctgcgt gtttatgttc cgcgtagcag cctgcctggt 900
ttttatgcaa ccagcctgac cctggcagca ccggaagcag ccggtgaagt ggaacgtctg 960
attggtcatc cgctgccgct gcgtctggat gccattaccg gtccggaaga aagcggtggt 1020
cgtctggaaa ccattctggg ttggcctctg gcagaacgta ccgttgttat tccgagcgca 1080
attccgaccg atccgcgtaa tgttggtggt gatctggatc cgagcagcat tccggatagt 1140
gaacaggcaa ttagcgcact gccggattat gccagccagc ctggtaaacc gcctaaagaa 1200
gatctg 1206
<210> 180
<211> 1209
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 180
cagatcttct ttaggcggtt taccaggctg gctggcataa tccggcagtg cgctaattgc 60
tgcttcggca tccggaatgc tgctcggatc cagatcacca ccaacattac gcggatcggt 120
cggaattgcg ctcggaataa caacggtacg ttctgccaga ggccaaccca gaatggtttc 180
cagacgaccg cctgcttctt ccggaccggt aatggcatcc agacgcagcg gcagcggatg 240
accaatcaga cgttccactt caccggctgc ttccggtgct gccagggtca ggctggttgc 300
ataaaaacca ggcaggctgc tacgcggaac ataaacacgc agcagtgcac cattgcgaat 360
acgacctgct gcatccggtt cttgatcctg tgcataacca taggccagtg ccggatcacc 420
ggcaatatag aaacctgccc aaattgcatc cagatcctgg ctacgtgcac gaacaccacc 480
aaacacaatg ctctgtgctg cttccagaaa ggtgccatga taaccaacaa aaacataacc 540
accctcttcc agctgacggt gtgcctgcag cagacgttca acggtccaat tctgggtgcc 600
acgggtacta aagctaactg cgccaccatc acccagaaat tctgcaccgg tcggatacag 660
ctgttcccaa ccacgaggct gacgatgacg acgtttttta cgaccgccac caccgctacc 720
accaccaccc accagaaatg caccaaaaaa gctggcttca tgatccatat cgatcagatg 780
ttcattggtc acgctcacga aaatacgatc gttttctttc agttcaaaga tgccaccctg 840
ataaatgcta tacaggccat attctgcatc tttgctccaa cagctattac gtgcgctttt 900
catcagcaga atcggatccg gatagctggt gtatttatag atgtactgca ccatttgttt 960
atcgtttttg gtgttttctt taatctcttc ttggaagcga aaataggtct ggctgtagat 1020
atagtagaag cctttttcat gaatcaccag ttcaccatta cgcagatgca gattgctcag 1080
aaagctatga ccgctacggc tgctttccca gctgttaatt ttgcgaccca gtgctttttc 1140
atttttgcta ttcgggctgc tcagggtatt gctacgacca cgggtgccgg taatatgtgc 1200
tgcaacacg 1209
<210> 181
<211> 1410
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 181
cagatcttct ttaggcggtt taccaggctg gctggcataa tccggcagtg cgctaattgc 60
tgcttcggca tccggaatgc tgctcggatc cagatcgcca ccaacattac gcggatcggt 120
cggaattgcg ctcggaataa caacggtacg ttctgccaga ggccaaccca gaatggtttc 180
cagacgaccg cctgcttctt ccggaccggt aatggcatcc agacgcagcg gcagcggatg 240
accaatcaga cgttccactt caccggctgc ttccggtgca gccagtgtca ggctggttgc 300
ataaaaacca ggcaggctgc tacgcggaac ataaacacgc agcagtgcac cattgcgaat 360
acgacctgct gcatccggtt cttgatcctg tgcataacca taggccagtg ccggatcacc 420
ggcaatatag aaacctgccc aaattgcatc cagatcctgg ctacgtgcac gaacaccacc 480
aaacacaatg ctctgtgctg cttccagaaa ggtgccatga taaccaacaa aaacataacc 540
accctcttcc agctgacggt gtgcctgcag cagacgttca acggtccaat tctgggtgcc 600
acgggtacta aagctaactg cgccaccatc acccagaaat tctgcaccgg tcggatattc 660
gctttctgct gctgccaggg tcagtgccag acgtgcctgt tcaggctgtt cacgaattgc 720
ttcacccaga tcaccaccgc tacccggact tgccagtgca ttacgaataa cctgatcaac 780
ctgattccag ctcagacgtg ctgccagata cagtgcaacc agacgctgaa ccggataacc 840
gctctgttcc agctgttccc aaccacgagg ctgacgatga cgacgttttt tacgttccgg 900
accacaaccg cttgcgctac caccaccacc caccagaaat gcaccaaaaa agctggcttc 960
atgatccata tcgatcagat gttcattggt cacgctcacg aaaatacgat cgttttcttt 1020
cagttcaaag atgccaccct gataaatgct atacaggcca tattctgcat ctttgctcca 1080
acagctatta cgtgcgcttt tcatcagcag aatcggatcc ggatagctgg tgtatttata 1140
gatgtactgc accatttgtt tatcgttttt ggtgttttct ttaatctctt cttggaagcg 1200
aaaataggtc tggctgtaga tatagtagaa gcctttttca tgaatcacca gttcaccatt 1260
acgcagatgc agattgctca gaaagctatg accgctacgg ctgctttccc agctgttaat 1320
tttgcgaccc agtgcttttt catttttgct attcgggctg ctcagggtat tgctacgacc 1380
acgggtgccg gtaatatgtg ctgcaacacg 1410
<210> 182
<211> 1434
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 182
cagatcttct ttaggcggtt taccaggctg gctggcataa tccggcagtg cgctaattgc 60
tgcttcggca tccggaatgc tgctcggatc cagatctccg ccaacattac gcggatcggt 120
cggaattgcg ctcggaataa caacggtacg ttctgccaga ggccaaccca gaatggtttc 180
cagacgaccg cctgcttctt ccggaccggt aatggcatcc agacgcagcg gcagcggatg 240
accaatcaga cgttccactt caccggctgc ttccggtgca gccagtgtca ggctggttgc 300
ataaaaacca ggcaggctgc tacgcggaac ataaacacgc agcagtgcac cattgcgaat 360
acgacctgct gcatccggtt cttgatcctg tgcataacca taggccagtg ccggatcacc 420
ggcaatatag aaacctgccc aaattgcatc cagatcctgg ctacgtgcac gaacaccacc 480
aaacacaatg ctctgtgctg cttccagaaa ggtgccatga taaccaacaa aaacataacc 540
accctcttcc agctgacggt gtgcctgcag cagacgttca acggtccaat tctgggtgcc 600
acgggtacta aagctaactg cgccaccatc acccagaaat tctgcaccgg tcggatattc 660
gctttctgct gctgccaggg tcagtgccag acgtgcctgt tccggctgtt cacgaattgc 720
ttcacccaga tcaccaccac tacccggact tgccagtgca ttacgaataa cctgatcaac 780
ctgattccag ctcagacgtg ctgccagata cagtgcaacc agacgctgaa ccggataacc 840
gctctgttct gaaccacccc cacctgagcc accgccaccc agctgctccc aaccacgagg 900
ctgacgatga cgacgttttt tacgtgaacc gccaccaccg ctaccaccac cacccaccag 960
aaatgcacca aaaaagctgg cttcatgatc catatcgatc agatgttcat tggtcacgct 1020
cacgaaaata cgatcgtttt ctttcagttc aaagatgcca ccctgataaa tgctatacag 1080
gccatattct gcatctttgc tccaacagct attacgtgcg cttttcatca gcagaatcgg 1140
atccggatag ctggtgtatt tatagatgta ctgcaccatt tgtttatcgt ttttggtgtt 1200
ttctttaatc tcttcttgga agcgaaaata ggtctggctg tagatatagt agaagccttt 1260
ttcatgaatc accagttcac cattacgcag atgcagattg ctcagaaagc tatgaccgct 1320
acggctgctt tcccagctgt taattttgcg acccagtgct ttttcatttt tgctattcgg 1380
gctgctcagg gtattgctac gaccacgggt gccggtaata tgtgctgcaa cacg 1434
<210> 183
<211> 1206
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 183
cagatcttct ttaggcggtt taccaggctg gcttgcataa tccggcagtg cgctaattgc 60
ctgttcttta tccggaatgc tgctcggatc cagatcacca ccaacattac gcggatcggt 120
cggaattgcg ctcggaataa caacggtacg ttctgccaga ggccaaccca gaatggtttc 180
cagacgaccg ccttcttctt ccggaccggt aatggcatcc agacgcagcg gcagcggatg 240
accaatcaga cgttccactt caccggctgc ttccggtgct gccagggtca ggctggtacg 300
ataaaaacca ggcaggctgc tacgcggaac ataaacacgc agcagtgcac cattgcgaat 360
gcgaccacgt gcatccggtt cttgatcctg tgcataacca taggccagtg ccggatcacc 420
ggcaatatag aaaccacgcc aaattgcatc cagatcctgg ctacgtgcac gaacaccacc 480
aaacacaatg ctctgtgctg cttccagaaa ggtgccatga taaccaacaa aaacataacc 540
acgttcttcc agctgacggt gtgcctgcag cagacgttca acggtccaat tctgggtgcc 600
acgggtacta aagctaacat caccgccatc acccagaaat tctgcaccgg tcggcagctg 660
ttcccaacca cgaggctgac gatgacgacg ttttttacga ccgccaccac cgctaccacc 720
accacccacc agaaatgcac caaaaaagct ggcttcatga tccatatcga tcagatgttc 780
attggtcacg ctcacgaaaa tacgatcgtt ttctttcagt tcaaagatgc caccctgata 840
aatgctatac aggccatatt ctgcatcttt gctccaacag ctattacgtg cgcttttcat 900
cagcagaatc ggatccggat agctggtgta tttatagatg tactgcacca tttgtttatc 960
gtttttggtg ttttctttaa tctcttcttg gaagcgaaaa taggtctggc tgtagatata 1020
gtagaagcct ttttcatgaa tcaccagttc accattacgc agatgcagat tgctcagaaa 1080
gctatgaccg ctacggctgc tttcccagct gttaattttg cgacccagtg ctttttcatt 1140
tttgctattc gggctgctca gggtattgct acgaccacgg gtgccggtaa tatgtgctgc 1200
aacacg 1206
<210> 184
<211> 1401
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 184
cagatcttct ttaggcggtt taccaggctg gctggcataa tccggcagtg cgctaattgc 60
tgcttcggca tccggaatgc tgctcggatc cagatctccg ccaacattac gcggatcggt 120
cggaattgcg ctcggaataa caacggtacg ttctgccaga ggccaaccca gaatggtttc 180
cagacgaccg cctgcttctt ccggaccggt aatggcatcc agacgcagcg gcagcggatg 240
accaatcaga cgttccactt caccggctgc ttccggtgca gccagtgtca ggctggttgc 300
ataaaaacca ggcaggctgc tacgcggaac ataaacacgc agcagtgcac cattgcgaat 360
acgacctgct gcatccggtt cttgatcctg tgcataacca taggccagtg ccggatcacc 420
ggcaatatag aaacctgccc aaattgcatc cagatcctgg ctacgtgcac gaacaccacc 480
aaacacaatg ctctgtgctg cttccagaaa ggtgccatga taaccaacaa aaacataacc 540
accctcttcc agctgacgat gtgcctgcag cagacgttca acggtccaat tctgggtgcc 600
acgggtacta aagctaactg cgccaccatc acccagaaat tctgcaccgg tcggatattc 660
gctttctgct gctgccaggg tcagtgccag acgtgcctgt tccggctgtt cacgaattgc 720
ttcacccaga tcaccaccac tacccggact tgccagtgca ttacgaataa cctgatcaac 780
ctgattccag ctcagacgtg ctgccagata cagtgcaacc agacgctgaa ccggataacc 840
gctctgttcg ctacctccgc cacctgaacc accgccaccg cgttttttac gtgaaccgcc 900
accaccgcta ccaccaccac ccaccagaaa tgcaccaaaa aagctggctt catgatccat 960
atcgatcaga tgttcattgg tcacgctcac gaaaatacga tcgttttctt tcagttcaaa 1020
gatgccaccc tgataaatgc tatacaggcc atattctgca tctttgctcc aacagctatt 1080
acgtgcgctt ttcatcagca gaatcggatc cggatagctg gtgtatttat agatgtactg 1140
caccatttgt ttatcgtttt tggtgttttc tttaatctct tcttggaagc gaaaataggt 1200
ctggctgtag atatagtaga agcctttttc atgaatcacc agttcaccat tacgcagatg 1260
cagattgctc agaaagctat gaccgctacg gctgctttcc cagctgttaa ttttgcgacc 1320
cagtgctttt tcatttttgc tattcgggct gctcagggta ttgctacgac cacgggtgcc 1380
ggtaatatgt gctgcaacac g 1401
<210> 185
<211> 1422
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 185
cagatcttct ttaggcggtt taccaggctg gctggcataa tccggcagtg cgctaattgc 60
tgcttcggca tccggaatgc tgctcggatc cagatctccg ccaacattac gcggatcggt 120
cggaattgcg ctcggaataa caacggtacg ttctgccaga ggccaaccca gaatggtttc 180
cagacgaccg cctgcttctt ccggaccggt aatggcatcc agacgcagcg gcagcggatg 240
accaatcaga cgttccactt caccggctgc ttccggtgca gccagtgtca ggctggttgc 300
ataaaaacca ggcaggctgc tacgcggaac ataaacacgc agcagtgcac cattgcgaat 360
acgacctgct gcatccggtt cttgatcctg tgcataacca taggccagtg ccggatcacc 420
ggcaatatag aaacctgccc aaattgcatc cagatcctgg ctacgtgcac gaacaccacc 480
aaacacaatg ctctgtgctg cttccagaaa ggtgccatga taaccaacaa aaacataacc 540
accctcttcc agctgacggt gtgcctgcag cagacgttca acggtccaat tctgggtgcc 600
acgggtacta aagctaactg cgccaccatc acccagaaat tctgcaccgg tcggatattc 660
gctttctgct gctgccaggg tcagtgccag acgtgcctgt tccggctgtt cacgaattgc 720
ttcacccaga tcaccaccac tacccggact tgccagtgca ttacgaataa cctgatcaac 780
ctgattccag ctcagacgtg ctgccagata cagtgcaacc agacgctgaa ccggataacc 840
gctctgttct gaaccacccc cacctgagcc accgccaccc agctgctccc aaccacgagg 900
ctgacgatga cgtgaaccgc caccaccgct accaccacca cccaccagaa atgcaccaaa 960
aaagctggct tcatgatcca tatcgatcag atgttcattg gtcacgctca cgaaaatacg 1020
atcgttttct ttcagttcaa agatgccacc ctgataaatg ctatacaggc catattctgc 1080
atctttgctc caacagctat tacgtgcgct tttcatcagc agaatcggat ccggatagct 1140
ggtgtattta tagatgtact gcaccatttg tttatcgttt ttggtgtttt ctttaatctc 1200
ttcttggaag cgaaaatagg tctggctgta gatatagtag aagccttttt catgaatcac 1260
cagttcacca ttacgcagat gcagattgct cagaaagcta tgaccgctac ggctgctttc 1320
ccagctgtta attttgcgac ccagtgcttt ttcatttttg ctattcgggc tgctcagggt 1380
attgctacga ccacgggtgc cggtaatatg tgctgcaaca cg 1422
<210> 186
<211> 1422
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 186
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaacagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttctactata tctacagcca gacctatttt cgcttccaag aagagattaa agaaaacacc 240
aaaaacgata aacaaatggt gcagtacatc tataaataca ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggcctgtat 360
agcatttatc agggtggcat ctttgaactg aaagaaaacg atcgtatttt cgtgagcgtg 420
accaatgaac atctgatcga tatggatcat gaagccagct tttttggtgc atttctggtg 480
ggtggtggtg gtagcggtgg tggcggttca cgtcatcgtc agcctcgtgg ttgggagcag 540
ctgggtggcg gtggctcagg tgggggtggt tcagaacaga gcggttatcc ggttcagcgt 600
ctggttgcac tgtatctggc agcacgtctg agctggaatc aggttgatca ggttattcgt 660
aatgcactgg caagtccggg tagtggtggt gatctgggtg aagcaattcg tgaacagccg 720
gaacaggcac gtctggcact gaccctggca gcagcagaaa gcgaatatcc gaccggtgca 780
gaatttctgg gtgatggtgg cgcagttagc tttagtaccc gtggcaccca gaattggacc 840
gttgaacgtc tgctgcaggc acaccgtcag ctggaagagg gtggttatgt ttttgttggt 900
tatcatggca cctttctgga agcagcacag agcattgtgt ttggtggtgt tcgtgcacgt 960
agccaggatc tggatgcaat ttgggcaggt ttctatattg ccggtgatcc ggcactggcc 1020
tatggttatg cacaggatca agaaccggat gcagcaggtc gtattcgcaa tggtgcactg 1080
ctgcgtgttt atgttccgcg tagcagcctg cctggttttt atgcaaccag cctgacactg 1140
gctgcaccgg aagcagccgg tgaagtggaa cgtctgattg gtcatccgct gccgctgcgt 1200
ctggatgcca ttaccggtcc ggaagaagca ggcggtcgtc tggaaaccat tctgggttgg 1260
cctctggcag aacgtaccgt tgttattccg agcgcaattc cgaccgatcc gcgtaatgtt 1320
ggcggagatc tggatccgag cagcattccg gatgccgaag cagcaattag cgcactgccg 1380
gattatgcca gccagcctgg taaaccgcct aaagatgaac tg 1422
<210> 187
<211> 1422
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 187
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaacagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttctactata tctacagcca gacctatttt cgcttccaag aagagattaa agaaaacacc 240
aaaaacgata aacaaatggt gcagtacatc tataaataca ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggcctgtat 360
agcatttatc agggtggcat ctttgaactg aaagaaaacg atcgtatttt cgtgagcgtg 420
accaatgaac atctgatcga tatggatcat gaagccagct tttttggtgc atttctggtg 480
ggtggtggtg gtagcggtgg tggcggttca cgtcatcgtc agcctcgtgg ttgggagcag 540
ctgggtggcg gtggctcagg tgggggtggt tcagaacaga gcggttatcc ggttcagaaa 600
ctggttgcac tgtatctggc agcacgtctg agctggaatc aggttgatca ggttattcgt 660
aatgcactgg caagtccggg tagtggtggt gatctgggtg aagcaattcg tgaacagccg 720
gaacaggcac gtctggcact gaccctggca gcagcagaaa gcgaatatcc gaccggtgca 780
gaatttctgg gtgatggtgg cgcagttagc tttagtaccc gtggcaccca gaattggacc 840
gttgaacgtc tgctgcaggc acaccgtcag ctggaagagg gtggttatgt ttttgttggt 900
tatcatggca cctttctgga agcagcacag agcattgtgt ttggtggtgt tcgtgcacgt 960
agccaggatc tggatgcaat ttgggcaggt ttctatattg ccggtgatcc ggcactggcc 1020
tatggttatg cacaggatca agaaccggat gcagcaggtc gtattcgcaa tggtgcactg 1080
ctgcgtgttt atgttccgcg tagcagcctg cctggttttt atgcaaccag cctgacactg 1140
gctgcaccgg aagcagccgg tgaagtggaa cgtctgattg gtcatccgct gccgctgcgt 1200
ctggatgcca ttaccggtcc ggaagaagca ggcggtcgtc tggaaaccat tctgggttgg 1260
cctctggcag aacgtaccgt tgttattccg agcgcaattc cgaccgatcc gaaaaatgtt 1320
ggcggagatc tggatccgag cagcattccg gatgccgaag cagcaattag cgcactgccg 1380
gattatgcca gccagcctgg taaaccgcct aaagatgaac tg 1422
<210> 188
<211> 1545
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 188
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaacagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttctactata tctacagcca gacctatttt cgcttccaag aagagattaa agaaaacacc 240
aaaaacgata aacaaatggt gcagtacatc tataaataca ccagctatcc gcatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggcctgtat 360
agcatttatc agggtggcat ctttgaactg aaagaaaacg atcgtatttt cgtgagcgtg 420
accaatgaac atctgatcga tatggatcat gaagccagct tttttggtgc atttctggtg 480
ggtggtggtg gtagcgcaag cggtggtccg gaaggtggta gcctggcagc actgaccgca 540
catcaggcat gtcatctgcc gctggaaacc tttacccgtc atcgtcagcc tcgtggttgg 600
gaacagctgg aacagtgtgg ttatccggtt cagaaactgg ttgcactgta tctggcagcc 660
cgtctgagct ggaatcaggt tgatcaggtt attgcaaatg cactggcaag tccgggtagc 720
ggtggtgatc tgggtgaagc aattcgtgaa agtccggaac aggcacgtct ggcactgacc 780
ctggcagccg cagaaagcga acgttttgtt cgtcagggca ccggtaatga tgaagccggt 840
gcagcaaatg gtccggcaga tagcggtgat gcactgctgg aacgtaatta tccgaccggt 900
gcagaatttc tgggtgatgg cggtgatgtt agctttagta cccgtggcac ccagcagtgg 960
accgttgaac gtctgctgca ggcacaccgt cagctggaag aggcaggtta tgtttttgtt 1020
ggttatcatg gcacctttct ggaagcagca cagagcattg tgtttggtgg tgttcgtgca 1080
cgtagccagg atctggatgc aatttgggca ggtttctata ttgccggtga tccggcactg 1140
gcctatggtt atgcacagga tcaagaaccg gatgcagcag gtcgtattcg caatggtgcc 1200
ctgctgcgtg tttatgttcc gcgtagcagc ctgcctggtt tttatgcaac cagcctgaca 1260
ctggctgcac ctgaagcagc cggtgaagtg gaacgtctga ttggtcatcc gctgccgctg 1320
cgtctggatg cgattaccgg tcctgaagaa agtggtggtc gtctggaaac cattctgggt 1380
tggcctctgg cagaacgtac cgttgttatt ccgagcgcaa ttccgaccga tccgaaaaat 1440
gttggtggcg atctggatcc gagcagcatt ccggatagcg aacaggcaat tagcgcactg 1500
ccggattatg ccagccagcc tggtaaaccg cctaaagatg aactg 1545
<210> 189
<211> 1425
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 189
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaacagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttctactata tctacagcca gacctatttt cgcttccaag aagagattaa agaaaacacc 240
aaaaacgata aacaaatggt gcagtacatc tataaataca ccagctatcc gcatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggcctgtat 360
agcatttatc agggtggcat ctttgaactg aaagaaaacg atcgtatttt cgtgagcgtg 420
accaatgaac atctgatcga tatggatcat gaagccagct tttttggtgc atttctggtg 480
ggtggtggtg gcggtagtgg cggtggtggt agccgtcatc gtcagcctcg tggttgggag 540
cagctgggag gtggtggttc aggcggtggc ggttcagaac agagcggtta tccggttcag 600
cgtctggttg cactgtatct ggcagcacgt ctgagctgga atcaggttga tcaggttatt 660
cgtaatgcac tggcaagtcc gggtagcggt ggtgatctgg gtgaagcaat tcgtgaacag 720
ccggaacagg cacgtctggc actgaccctg gcagcagcag aaagcgaata tccgaccggt 780
gcagaatttc tgggtgatgg tggtgcagtt agctttagta cccgtggcac ccagaattgg 840
accgttgaac gtctgctgca ggcacaccgt cagctggaag agggtggtta tgtttttgtt 900
ggttatcatg gcacctttct ggaagcagca cagagcattg tgtttggtgg tgttcgtgca 960
cgtagccagg atctggatgc aatttgggca ggtttctata ttgccggtga tccggcactg 1020
gcctatggtt atgcacagga tcaagaaccg gatgcagcag gtcgtattcg caatggtgca 1080
ctgctgcgtg tttatgttcc gcgtagcagc ctgcctggtt tttatgcaac cagcctgaca 1140
ctggctgcac cggaagcagc cggtgaagtg gaacgtctga ttggtcatcc gctgccgctg 1200
cgtctggatg ccattaccgg tccggaagaa gcaggcggtc gtctggaaac cattctgggt 1260
tggcctctgg cagaacgtac cgttgttatt ccgagcgcaa ttccgaccga tccgcgtaat 1320
gttggtggcg atctggatcc gagcagcatt ccggatgccg aagcagcaat tagcgcactg 1380
ccggattatg ccagccagcc tggtaaaccg cctaaagatg aactg 1425
<210> 190
<211> 1389
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 190
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaacagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttctactata tctacagcca gacctatttt cgcttccaag aagagattaa agaaaacacc 240
aaaaacgata aacaaatggt gcagtacatc tataaataca ccagctatcc gcatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggcctgtat 360
agcatttatc agggtggcat ctttgaactg aaagaaaacg atcgtatttt cgtgagcgtg 420
accaatgaac atctgatcga tatggatcat gaagccagct tttttggtgc atttctggtg 480
ggtggtggtg gtagcggtgg tggttcacgt catcgtcagc ctcgtggttg ggaacagctg 540
gaacagagcg gttatccggt tcagcgtctg gttgcactgt atctggcagc acgtctgagc 600
tggaatcagg ttgatcaggt tattcgtaat gcactggcaa gtccgggtag tggtggtgat 660
ctgggtgaag caattcgtga acagcctgaa caggcacgtc tggcactgac cctggcagca 720
gcagaaagcg aatatccgac cggtgcagaa tttctgggtg atggtggcgc agttagcttt 780
agtacccgtg gcacccagaa ttggaccgtt gaacgtctgc tgcaggcaca ccgtcagctg 840
gaagagggtg gttatgtttt tgttggttat catggcacct ttctggaagc agcacagagc 900
attgtgtttg gtggtgttcg tgcacgtagc caggatctgg atgcaatttg ggcaggtttc 960
tatattgccg gtgatccggc actggcctat ggttatgcac aggatcaaga accggatgca 1020
gcaggtcgta ttcgcaatgg tgcactgctg cgtgtttatg ttccgcgtag cagcctgcct 1080
ggtttttatg caaccagcct gacactggct gcaccggaag cagccggtga agtggaacgt 1140
ctgattggtc atccgctgcc gctgcgtctg gatgccatta ccggtccgga agaagcaggc 1200
ggtcgtctgg aaaccattct gggttggcct ctggcagaac gtaccgttgt tattccgagc 1260
gcaattccga ccgatccgcg taatgttggc ggagatctgg atccgagcag cattccggat 1320
gccgaagcag caattagcgc actgccggat tatgccagcc agcctggtaa accgcctaaa 1380
gatgaactg 1389
<210> 191
<211> 1425
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 191
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaacagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttctattaca tctacagcca gaccaacttc aaatttcgcg aagagattaa agaaaacacc 240
aaaaacgata aacaaatggt gcagtatatc tataaataca ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggcctgtat 360
agcatttatc agggtggcat ctttgaactg aaagaaaacg atcgtatttt cgtgagcgtt 420
accaatgaac gtctgcgtga tatgcatcat gaagcaagct tttttggtgc atttctggtg 480
ggtggtggtg gcggtagtgg cggtggtggt agccgtcatc gtcagcctcg tggttgggag 540
cagctgggag gtggtggttc aggcggtggc ggttcagaac agagcggtta tccggttcag 600
cgtctggttg cactgtatct ggcagcacgt ctgagctgga atcaggttga tcaggttatt 660
cgtaatgcac tggcaagtcc gggtagcggt ggtgatctgg gtgaagcaat tcgtgaacag 720
ccggaacagg cacgtctggc actgaccctg gcagcagcag aaagcgaata tccgaccggt 780
gcagaatttc tgggtgatgg tggtgcagtt agctttagta cccgtggcac ccagaattgg 840
accgttgaac gcctgctgca ggcacaccgt cagctggaag agggtggtta tgtttttgtt 900
ggttatcatg gcacctttct ggaagcagca cagagcattg tgtttggtgg tgttcgtgca 960
cgtagccagg atctggatgc aatttgggca ggtttctata ttgccggtga tccggcactg 1020
gcctatggtt atgcacagga tcaagaaccg gatgcagcag gtcgtattcg caatggtgca 1080
ctgctgcgtg tttatgttcc gcgtagcagc ctgcctggtt tttatgcaac cagcctgaca 1140
ctggctgcac cggaagcagc cggtgaagtg gaacgtctga ttggtcatcc gctgccgctg 1200
cgtctggatg ccattaccgg tccggaagaa gcaggcggtc gtctggaaac cattctgggt 1260
tggcctctgg cagaacgtac cgttgttatt ccgagcgcaa ttccgaccga tccgcgtaat 1320
gttggtggcg atctggatcc gagcagcatt ccggatgccg aagcagcaat tagcgcactg 1380
ccggattatg ccagccagcc tggtaaaccg cctaaagatg aactg 1425
<210> 192
<211> 1422
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 192
cgtgttgcag cacatattac cggcacccgt ggtcgtagca ataccctgag cagcccgaat 60
agcaaaaatg aaaaagcact gggtcgcaaa attaacagct gggaaagcag ccgtagcggt 120
catagctttc tgagcaatct gcatctgcgt aatggtgaac tggtgattca tgaaaaaggc 180
ttctactata tctacagcca gacctatttt cgcttccaag aagagattaa agaaaacacc 240
aaaaacgata aacaaatggt gcagtacatc tataaataca ccagctatcc ggatccgatt 300
ctgctgatga aaagcgcacg taatagctgt tggagcaaag atgcagaata tggcctgtat 360
agcatttatc agggtggcat ctttgaactg aaagaaaacg atcgtatttt cgtgagcgtg 420
accaatgaac atctgatcga tatggatcat gaagccagct tttttggtgc atttctggtg 480
ggtggtggtg gtagcggtgg tggcggttca cgtcatcgtc agcctcgtgg ttgggagcag 540
ctgggtggcg gtggctcagg tgggggtggt tcagaacaga gcggttatcc ggttcagaaa 600
ctggttgcac tgtatctggc agcacgtctg agctggaatc aggttgatca ggttattcgt 660
aatgcactgg caagtccggg tagtggtggt gatctgggtg aagcaattcg tgaacagccg 720
gaacaggcac gtctggcact gaccctggca gcagcagaaa gcgaatatcc gaccggtgca 780
gaatttctgg gtgatggtgg cgcagttagc tttagtaccc gtggcaccca gaattggacc 840
gttgaacgtc tgctgcaggc acaccgtcag ctggaagagg gtggttatgt ttttgttggt 900
tatcatggca cctttctgga agcagcacag agcattgtgt ttggtggtgt tcgtgcacgt 960
agccaggatc tggatgcaat ttgggcaggt ttctatattg ccggtgatcc ggcactggcc 1020
tatggttatg cacaggatca agaaccggat gcagcaggtc gtattcgcaa tggtgcactg 1080
ctgcgtgttt atgttccgcg tagcagcctg cctggttttt atgcaaccag cctgacactg 1140
gctgcaccgg aagcagccgg tgaagtggaa cgtctgattg gtcatccgct gccgctgcgt 1200
ctggatgcca ttaccggtcc ggaagaagca ggcggtcgtc tggaaaccat tctgggttgg 1260
cctctggcag aacgtaccgt tgttattccg agcgcaattc cgaccgatcc gaaaaatgtt 1320
ggcggagatc tggatccgag cagcattccg gatgccgaag cagcaattag cgcactgccg 1380
gattatgcca gccagcctgg taaaccgcct aaagaagatc tg 1422
<210> 193
<211> 696
<212> DNA
<213> Artificial Sequence
<220>
<223> -
<400> 193
aaactgcctc gtagcagcct ggtttggtgt gttctgattg tttgtctgac cctgctgatt 60
tttacctatc tgacccgtaa aagcctgtgc gaaattcgtt atcgtgatgg tcatcgtgaa 120
gttgcagcat ttatggccta tgaaagcggt aaaggtggtg gtggtagccg tgttgttcgt 180
ccgctgggtc tggcaggcgg tggtggcggt tcacgtgttg cagcacatat taccggcacc 240
cgtggtcgta gcaataccct gagcagcccg aatagcaaaa atgaaaaagc actgggtcgc 300
aaaattaaca gctgggaaag cagccgtagc ggtcatagct ttctgagcaa tctgcatctg 360
cgtaatggtg aactggtgat tcatgaaaaa ggcttctact atatctacag ccagacctat 420
tttcgcttcc aagaagagat taaagaaaac accaaaaacg ataaacaaat ggtgcagtac 480
atctataaat acaccagcta tccggatccg attctgctga tgaaaagcgc acgtaatagc 540
tgttggagca aagatgcaga atatggcctg tatagcattt atcagggtgg catctttgaa 600
ctgaaagaaa acgatcgtat tttcgtgagc gtgaccaatg aacatctgat cgatatggat 660
catgaagcca gcttttttgg tgcatttctg gtgggt 696
<210> 194
<211> 251
<212> PRT
<213> Abrus precatorius
<300>
<308> genbank/CAA38655.1
<309> 2005-04-18
<313> (2)..(251)
<400> 194
Glu Asp Arg Pro Ile Lys Phe Ser Thr Glu Gly Ala Thr Ser Gln Ser
1 5 10 15
Tyr Lys Gln Phe Ile Glu Ala Leu Arg Glu Arg Leu Arg Gly Gly Leu
20 25 30
Ile His Asp Ile Pro Val Leu Pro Asp Pro Thr Thr Leu Gln Glu Arg
35 40 45
Asn Arg Tyr Ile Thr Val Glu Leu Ser Asn Ser Asp Thr Glu Ser Ile
50 55 60
Glu Val Gly Ile Asp Ala Thr Asn Ala Tyr Val Val Ala Tyr Arg Ala
65 70 75 80
Gly Thr Gln Ser Tyr Phe Leu Arg Asp Ala Pro Ser Ser Ala Ser Asp
85 90 95
Tyr Leu Phe Thr Gly Thr Asp Gln His Ser Leu Pro Phe Tyr Gly Thr
100 105 110
Tyr Ala Asp Leu Glu Arg Trp Ala His Gln Ser Arg Gln Gln Ile Pro
115 120 125
Leu Gly Leu Gln Ala Leu Thr His Gly Ile Ser Phe Phe Arg Ser Gly
130 135 140
Gly Asn Asp Asn Glu Glu Lys Ala Arg Thr Leu Ile Val Ile Ile Gln
145 150 155 160
Met Val Ala Glu Ala Ala Arg Phe Arg Tyr Ile Ser Asn Arg Val Arg
165 170 175
Val Ser Ile Gln Thr Gly Thr Ala Phe Gln Pro Asp Ala Ala Met Ile
180 185 190
Ser Leu Glu Asn Asn Trp Asp Asn Leu Ser Arg Gly Val Gln Glu Ser
195 200 205
Val Gln Asp Thr Phe Pro Asn Gln Val Thr Leu Thr Asn Ile Arg Asn
210 215 220
Glu Pro Val Ile Val Asp Gln Leu Ser His Pro Thr Val Ala Val Leu
225 230 235 240
Ala Leu Met Leu Phe Val Cys Asn Pro Pro Asn
245 250
<210> 195
<211> 264
<212> PRT
<213> Ricinus communis
<300>
<301> Baluna et al.
<302> -
<303> Proc. Natl. Acad. Sci. USA
<304> 96
<306> 3957?962
<307> 1999-03-01
<400> 195
Glu Asp Asn Asn Ile Phe Pro Lys Gln Tyr Pro Ile Ile Asn Phe Thr
1 5 10 15
Thr Ala Gly Ala Thr Val Gln Ser Tyr Thr Asn Phe Ile Arg Ala Val
20 25 30
Arg Gly Arg Leu Thr Thr Gly Ala Asp Val Arg His Glu Ile Pro Val
35 40 45
Leu Pro Asn Arg Val Gly Leu Pro Ile Asn Gln Arg Phe Ile Leu Val
50 55 60
Glu Leu Ser Asn His Ala Glu Leu Ser Val Thr Leu Ala Thr Asn Ala
65 70 75 80
Tyr Val Val Gly Tyr Arg Ala Gly Asn Ser Ala Tyr Phe Phe His Pro
85 90 95
Asp Asn Gln Glu Asp Ala Glu Ala Ile Thr His Leu Phe Thr Asp Val
100 105 110
Gln Asn Arg Tyr Thr Phe Ala Phe Gly Gly Asn Tyr Asp Arg Leu Glu
115 120 125
Gln Leu Ala Gly Ser Leu Arg Glu Asn Ile Glu Leu Gly Asn Gly Pro
130 135 140
Leu Glu Glu Ala Ile Ser Ala Leu Tyr Tyr Tyr Ser Thr Gly Gly Thr
145 150 155 160
Gln Leu Pro Thr Leu Ala Arg Ser Phe Ile Val Cys Ile Gln Met Ile
165 170 175
Ser Glu Ala Ala Arg Phe Gln Tyr Ile Glu Gly Glu Met Arg Thr Arg
180 185 190
Ile Arg Tyr Asn Arg Arg Ser Ala Pro Asp Pro Ser Val Ile Thr Leu
195 200 205
Glu Asn Ser Trp Gly Arg Leu Ser Thr Ala Ile Gln Glu Ser Asn Gln
210 215 220
Gly Ala Phe Ala Ser Pro Ile Gln Leu Gln Arg Arg Asn Gly Ser Lys
225 230 235 240
Phe Ser Val Tyr Asp Val Ser Ile Leu Ile Pro Ile Ile Ala Leu Met
245 250 255
Val Tyr Arg Cys Ala Pro Pro Pro
260
<210> 196
<211> 189
<212> PRT
<213> Corynebacterium diphtheriae
<400> 196
Gly Ala Asp Asp Val Ala Asp Ser Ser Lys Ser Phe Val Met Glu Asn
1 5 10 15
Phe Ser Ser Tyr His Gly Thr Lys Pro Gly Tyr Ala Asp Ser Ile Gln
20 25 30
Lys Gly Ile Gln Lys Pro Lys Ser Gly Thr Gln Gly Asn Tyr Asp Asp
35 40 45
Asp Trp Lys Gly Phe Tyr Ser Thr Asp Asn Lys Tyr Asp Ala Ala Gly
50 55 60
Tyr Ser Val Asp Asn Glu Asn Pro Leu Ser Gly Lys Ala Gly Gly Val
65 70 75 80
Val Lys Val Thr Tyr Pro Gly Leu Thr Lys Val Leu Ala Leu Lys Val
85 90 95
Asp Asn Ala Glu Thr Ile Lys Lys Glu Leu Gly Leu Ser Leu Thr Glu
100 105 110
Pro Leu Met Glu Gln Val Gly Thr Glu Glu Phe Ile Lys Arg Phe Gly
115 120 125
Asp Gly Ala Ser Arg Val Val Leu Ser Leu Pro Phe Ala Glu Gly Ser
130 135 140
Ser Ser Val Glu Tyr Ile Asn Asn Trp Glu Gln Ala Lys Ala Leu Ser
145 150 155 160
Val Glu Leu Glu Ile Asn Phe Glu Thr Arg Gly Lys Arg Gly Gln Asp
165 170 175
Ala Met Tyr Glu Tyr Met Ala Gln Ala Cys Ala Gly Asn
180 185
<210> 197
<211> 186
<212> PRT
<213> Corynebacterium diphtheriae
<300>
<301> Baluna et al.
<302> -
<303> Proc. Natl. Acad. Sci. USA
<304> 96
<306> 3957?962
<307> 1999-03-01
<400> 197
Gly Ala Asp Asp Val Ser Lys Ser Phe Val Met Glu Asn Phe Ser Ser
1 5 10 15
Tyr His Gly Thr Lys Pro Gly Tyr Ala Asp Ser Ile Gln Lys Gly Ile
20 25 30
Gln Lys Pro Lys Ser Gly Thr Gln Gly Asn Tyr Asp Asp Asp Trp Lys
35 40 45
Gly Phe Tyr Ser Thr Asp Asn Lys Tyr Asp Ala Ala Gly Tyr Ser Val
50 55 60
Asp Asn Glu Asn Pro Leu Ser Gly Lys Ala Gly Gly Val Val Lys Val
65 70 75 80
Thr Tyr Pro Gly Leu Thr Lys Val Leu Ala Leu Lys Val Asp Asn Ala
85 90 95
Glu Thr Ile Lys Lys Glu Leu Gly Leu Ser Leu Thr Glu Pro Leu Met
100 105 110
Glu Gln Val Gly Thr Glu Glu Phe Ile Lys Arg Phe Gly Asp Gly Ala
115 120 125
Ser Arg Val Val Leu Ser Leu Pro Phe Ala Glu Gly Ser Ser Ser Val
130 135 140
Glu Tyr Ile Asn Asn Trp Glu Gln Ala Lys Ala Leu Ser Val Glu Leu
145 150 155 160
Glu Ile Asn Phe Glu Thr Arg Gly Lys Arg Gly Gln Asp Ala Met Tyr
165 170 175
Glu Tyr Met Ala Gln Ala Cys Ala Gly Asn
180 185
<210> 198
<211> 251
<212> PRT
<213> Gelonium multiflorum
<300>
<301> Baluna et al.
<303> Proc. Natl. Acad. Sci. USA
<304> 96
<306> 3957?962
<307> 1999-03-01
<400> 198
Gly Leu Asp Thr Val Ser Phe Ser Thr Lys Gly Ala Thr Tyr Ile Thr
1 5 10 15
Tyr Val Asn Phe Leu Asn Glu Leu Arg Val Lys Leu Lys Pro Glu Gly
20 25 30
Asn Ser His Gly Ile Pro Leu Leu Arg Lys Lys Ala Asp Asp Pro Gly
35 40 45
Lys Ala Phe Val Leu Val Ala Leu Ser Asn Asp Asn Gly Gln Leu Ala
50 55 60
Glu Ile Ala Ile Asp Ala Thr Ser Val Tyr Val Val Gly Tyr Gln Val
65 70 75 80
Arg Asn Arg Ser Tyr Phe Phe Lys Asp Ala Pro Asp Ala Ala Tyr Glu
85 90 95
Gly Leu Phe Lys Asn Thr Ile Lys Thr Arg Leu His Phe Gly Gly Ser
100 105 110
Tyr Pro Ser Leu Glu Gly Glu Lys Ala Tyr Arg Glu Thr Thr Asp Leu
115 120 125
Gly Ile Glu Pro Leu Arg Ile Gly Ile Lys Lys Leu Asp Glu Asn Ala
130 135 140
Ile Asp Asn Tyr Lys Pro Thr Glu Ile Ala Ser Ser Leu Leu Val Val
145 150 155 160
Ile Gln Met Val Ser Glu Ala Ala Arg Phe Thr Phe Ile Glu Asn Gln
165 170 175
Ile Arg Asn Asn Phe Gln Gln Arg Ile Arg Pro Ala Asn Asn Thr Ile
180 185 190
Ser Leu Glu Asn Lys Trp Gly Lys Leu Ser Phe Gln Ile Arg Thr Ser
195 200 205
Gly Ala Asn Gly Met Phe Ser Glu Ala Val Glu Leu Glu Arg Ala Asn
210 215 220
Gly Lys Lys Tyr Tyr Val Thr Ala Val Asp Gln Val Lys Pro Lys Ile
225 230 235 240
Ala Leu Leu Lys Phe Val Asp Lys Asp Pro Lys
245 250
<210> 199
<211> 247
<212> PRT
<213> Trichosanthes kirilowii
<300>
<301> An Q, et a
<302> -
<303> J Biomed Sci.
<304> 13
<305> 5
<306> 637-43
<307> 2005-09-01
<400> 199
Asp Val Ser Phe Arg Leu Ser Gly Ala Thr Ser Ser Ser Tyr Gly Val
1 5 10 15
Phe Ile Ser Asn Leu Arg Lys Ala Leu Pro Asn Glu Arg Lys Leu Tyr
20 25 30
Asp Ile Pro Leu Leu Arg Ser Ser Leu Pro Gly Ser Gln Arg Tyr Ala
35 40 45
Leu Ile His Leu Thr Asn Tyr Ala Asp Glu Thr Ile Ser Val Ala Ile
50 55 60
Asp Val Thr Asn Val Tyr Ile Met Gly Tyr Arg Ala Gly Asp Thr Ser
65 70 75 80
Ala Cys Ser Asn Glu Ala Ser Ala Thr Glu Ala Ala Lys Tyr Val Phe
85 90 95
Lys Asp Ala Met Arg Lys Val Thr Leu Pro Tyr Ser Gly Asn Tyr Glu
100 105 110
Arg Leu Gln Thr Ala Ala Gly Lys Ile Arg Glu Asn Ile Pro Leu Gly
115 120 125
Leu Pro Ala Leu Asp Ser Ala Ile Thr Thr Leu Phe Tyr Tyr Asn Ala
130 135 140
Asn Ser Ala Ala Ser Ala Leu Met Val Leu Ile Gln Ser Thr Ser Glu
145 150 155 160
Ala Ala Arg Tyr Lys Phe Ile Glu Gln Gln Ile Gly Cys Gly Val Asp
165 170 175
Lys Thr Phe Leu Pro Ser Leu Ala Ile Ile Ser Leu Glu Asn Ser Trp
180 185 190
Ser Ala Leu Ser Lys Gln Ile Gln Ile Ala Ser Thr Asn Asn Gly Gln
195 200 205
Phe Glu Ser Pro Val Val Leu Ile Asn Ala Gln Asn Gln Arg Val Thr
210 215 220
Ile Thr Asn Val Asp Ala Gly Val Val Thr Ser Asn Ile Ala Leu Leu
225 230 235 240
Leu Asn Arg Asn Asn Met Ala
245
<210> 200
<211> 247
<212> PRT
<213> Trichosanthes kirilowii
<400> 200
Asp Ala Ser Phe Arg Leu Ser Gly Ala Thr Ser Ser Ser Tyr Gly Val
1 5 10 15
Phe Ile Ser Asn Leu Arg Lys Ala Leu Pro Asn Glu Arg Lys Leu Tyr
20 25 30
Asp Ile Pro Leu Leu Arg Ser Ser Leu Pro Gly Ser Gln Arg Tyr Ala
35 40 45
Leu Ile His Leu Thr Asn Tyr Ala Asp Glu Thr Ile Ser Val Ala Ile
50 55 60
Asp Ala Thr Asn Val Tyr Ile Met Gly Tyr Arg Ala Gly Asp Thr Ser
65 70 75 80
Ala Cys Ser Asn Glu Ala Ser Ala Thr Glu Ala Ala Lys Tyr Val Phe
85 90 95
Lys Asp Ala Met Arg Lys Val Thr Leu Pro Tyr Ser Gly Asn Tyr Glu
100 105 110
Arg Leu Gln Thr Ala Ala Gly Lys Ile Arg Glu Asn Ile Pro Leu Gly
115 120 125
Leu Pro Ala Gly Asp Ser Ala Ile Thr Thr Leu Phe Tyr Tyr Asn Ala
130 135 140
Asn Ser Ala Ala Ser Ala Leu Met Val Leu Ile Gln Ser Thr Ser Glu
145 150 155 160
Ala Ala Arg Tyr Lys Phe Ile Glu Gln Gln Ile Gly Cys Gly Val Asp
165 170 175
Lys Thr Phe Leu Pro Ser Leu Ala Ile Ile Ser Leu Glu Asn Ser Trp
180 185 190
Ser Ala Leu Ser Lys Gln Ile Gln Ile Ala Ser Thr Asn Asn Gly Gln
195 200 205
Phe Glu Ser Pro Val Val Leu Ile Asn Ala Gln Asn Gln Arg Val Thr
210 215 220
Ile Thr Asn Val Asp Ala Gly Val Val Thr Ser Asn Ile Ala Leu Leu
225 230 235 240
Leu Asn Arg Asn Asn Met Ala
245
<210> 201
<211> 342
<212> PRT
<213> Pseudomonas aeruginosa
<400> 201
Pro Glu Gly Gly Ser Leu Ala Ala Leu Thr Ala His Gln Ala Cys His
1 5 10 15
Leu Pro Leu Glu Thr Phe Thr Arg His Arg Gln Pro Arg Gly Trp Glu
20 25 30
Gln Leu Glu Gln Cys Gly Tyr Pro Val Gln Lys Leu Val Ala Leu Tyr
35 40 45
Leu Ala Ala Arg Leu Ser Trp Asn Gln Val Asp Gln Val Ile Ala Asn
50 55 60
Ala Leu Ala Ser Pro Gly Ser Gly Gly Asp Leu Gly Glu Ala Ile Arg
65 70 75 80
Glu Ser Pro Glu Gln Ala Arg Leu Ala Leu Thr Leu Ala Ala Ala Glu
85 90 95
Ser Glu Arg Phe Val Arg Gln Gly Thr Gly Asn Asp Glu Ala Gly Ala
100 105 110
Ala Asn Gly Pro Ala Asp Ser Gly Asp Ala Leu Leu Glu Arg Asn Tyr
115 120 125
Pro Thr Gly Ala Glu Phe Leu Gly Asp Gly Gly Asp Val Ser Phe Ser
130 135 140
Thr Arg Gly Thr Gln Gln Trp Thr Val Glu Arg Leu Leu Gln Ala His
145 150 155 160
Arg Gln Leu Glu Glu Ala Gly Tyr Val Phe Val Gly Tyr His Gly Thr
165 170 175
Phe Leu Glu Ala Ala Gln Ser Ile Val Phe Gly Gly Val Arg Ala Arg
180 185 190
Ser Gln Asp Leu Asp Ala Ile Trp Ala Gly Phe Tyr Ile Ala Gly Asp
195 200 205
Pro Ala Leu Ala Tyr Gly Tyr Ala Gln Asp Gln Glu Pro Asp Ala Ala
210 215 220
Gly Arg Ile Arg Asn Gly Ala Leu Leu Arg Val Tyr Val Pro Arg Ser
225 230 235 240
Ser Leu Pro Gly Phe Tyr Ala Thr Ser Leu Thr Leu Ala Ala Pro Glu
245 250 255
Ala Ala Gly Glu Val Glu Arg Leu Ile Gly His Pro Leu Pro Leu Arg
260 265 270
Leu Asp Ala Ile Thr Gly Pro Glu Glu Ser Gly Gly Arg Leu Glu Thr
275 280 285
Ile Leu Gly Trp Pro Leu Ala Glu Arg Thr Val Val Ile Pro Ser Ala
290 295 300
Ile Pro Thr Asp Pro Lys Asn Val Gly Gly Asp Leu Asp Pro Ser Ser
305 310 315 320
Ile Pro Asp Ser Glu Gln Ala Ile Ser Ala Leu Pro Asp Tyr Ala Ser
325 330 335
Gln Pro Gly Lys Pro Pro
340
<210> 202
<211> 225
<212> PRT
<213> Pseudomonas aeruginosa
<400> 202
Arg His Arg Gln Pro Arg Gly Trp Glu Gln Leu Pro Thr Gly Ala Glu
1 5 10 15
Phe Leu Gly Asp Gly Gly Asp Val Ser Phe Ser Thr Arg Gly Thr Gln
20 25 30
Asn Trp Thr Val Glu Arg Leu Leu Gln Ala His Arg Gln Leu Glu Glu
35 40 45
Ala Gly Tyr Val Phe Val Gly Tyr His Gly Thr Phe Leu Glu Ala Ala
50 55 60
Gln Ser Ile Val Phe Gly Gly Val Arg Ala Arg Ser Gln Asp Leu Asp
65 70 75 80
Ala Ile Trp Ala Gly Phe Tyr Ile Ala Gly Asp Pro Ala Leu Ala Tyr
85 90 95
Gly Tyr Ala Gln Asp Gln Glu Pro Asp Ala Ala Gly Arg Ile Arg Asn
100 105 110
Gly Ala Leu Leu Arg Val Tyr Val Pro Arg Ser Ser Leu Pro Gly Phe
115 120 125
Tyr Ala Thr Ser Leu Thr Leu Ala Ala Pro Glu Ala Ala Gly Glu Val
130 135 140
Glu Arg Leu Ile Gly His Pro Leu Pro Leu Arg Leu Asp Ala Ile Thr
145 150 155 160
Gly Pro Glu Glu Ser Gly Gly Arg Leu Glu Thr Ile Leu Gly Trp Pro
165 170 175
Leu Ala Glu Arg Thr Val Val Ile Pro Ser Ala Ile Pro Thr Asp Pro
180 185 190
Arg Asn Val Gly Gly Asp Leu Asp Pro Ser Ser Ile Pro Asp Ser Glu
195 200 205
Gln Ala Ile Ser Ala Leu Pro Asp Tyr Ala Ser Gln Pro Gly Lys Pro
210 215 220
Pro
225
<210> 203
<211> 226
<212> PRT
<213> Pseudomonas aeruginosa
<300>
<301> Onda M et al.
<302> -
<303> Proc Natl Acad Sci U S A.
<304> 108
<305> 14
<306> 5742-7
<307> 2011-04-05
<400> 203
Arg His Arg Gln Pro Arg Gly Trp Glu Gln Leu Tyr Pro Thr Gly Ala
1 5 10 15
Glu Phe Leu Gly Asp Gly Gly Ala Val Ser Phe Ser Thr Arg Gly Thr
20 25 30
Gln Asn Trp Thr Val Glu Arg Leu Leu Gln Ala His Arg Gln Leu Glu
35 40 45
Glu Gly Gly Tyr Val Phe Val Gly Tyr His Gly Thr Phe Leu Glu Ala
50 55 60
Ala Gln Ser Ile Val Phe Gly Gly Val Arg Ala Arg Ser Gln Asp Leu
65 70 75 80
Asp Ala Ile Trp Ala Gly Phe Tyr Ile Ala Gly Asp Pro Ala Leu Ala
85 90 95
Tyr Gly Tyr Ala Gln Asp Gln Glu Pro Asp Ala Ala Gly Arg Ile Arg
100 105 110
Asn Gly Ala Leu Leu Arg Val Tyr Val Pro Arg Ser Ser Leu Pro Gly
115 120 125
Phe Tyr Ala Thr Ser Leu Thr Leu Ala Ala Pro Glu Ala Ala Gly Glu
130 135 140
Val Glu Arg Leu Ile Gly His Pro Leu Pro Leu Arg Leu Asp Ala Ile
145 150 155 160
Thr Gly Pro Glu Glu Ala Gly Gly Arg Leu Glu Thr Ile Leu Gly Trp
165 170 175
Pro Leu Ala Glu Arg Thr Val Val Ile Pro Ser Ala Ile Pro Thr Asp
180 185 190
Pro Arg Asn Val Gly Gly Asp Leu Asp Pro Ser Ser Ile Pro Asp Ala
195 200 205
Glu Ala Ala Ile Ser Ala Leu Pro Asp Tyr Ala Ser Gln Pro Gly Lys
210 215 220
Pro Pro
225
<210> 204
<211> 279
<212> PRT
<213> Pseudomonas aeruginosa
<400> 204
Glu Gln Ser Gly Tyr Pro Val Gln Arg Leu Val Ala Leu Tyr Leu Ala
1 5 10 15
Ala Arg Leu Ser Trp Asn Gln Val Asp Gln Val Ile Arg Asn Ala Leu
20 25 30
Ala Ser Pro Gly Ser Gly Gly Asp Leu Gly Glu Ala Ile Arg Glu Gln
35 40 45
Pro Glu Gln Ala Arg Leu Ala Leu Thr Leu Ala Ala Ala Glu Ser Glu
50 55 60
Tyr Pro Thr Gly Ala Glu Phe Leu Gly Asp Gly Gly Ala Val Ser Phe
65 70 75 80
Ser Thr Arg Gly Thr Gln Asn Trp Thr Val Glu Arg Leu Leu Gln Ala
85 90 95
His Arg Gln Leu Glu Glu Gly Gly Tyr Val Phe Val Gly Tyr His Gly
100 105 110
Thr Phe Leu Glu Ala Ala Gln Ser Ile Val Phe Gly Gly Val Arg Ala
115 120 125
Arg Ser Gln Asp Leu Asp Ala Ile Trp Ala Gly Phe Tyr Ile Ala Gly
130 135 140
Asp Pro Ala Leu Ala Tyr Gly Tyr Ala Gln Asp Gln Glu Pro Asp Ala
145 150 155 160
Ala Gly Arg Ile Arg Asn Gly Ala Leu Leu Arg Val Tyr Val Pro Arg
165 170 175
Ser Ser Leu Pro Gly Phe Tyr Ala Thr Ser Leu Thr Leu Ala Ala Pro
180 185 190
Glu Ala Ala Gly Glu Val Glu Arg Leu Ile Gly His Pro Leu Pro Leu
195 200 205
Arg Leu Asp Ala Ile Thr Gly Pro Glu Glu Ala Gly Gly Arg Leu Glu
210 215 220
Thr Ile Leu Gly Trp Pro Leu Ala Glu Arg Thr Val Val Ile Pro Ser
225 230 235 240
Ala Ile Pro Thr Asp Pro Arg Asn Val Gly Gly Asp Leu Asp Pro Ser
245 250 255
Ser Ile Pro Asp Ala Glu Ala Ala Ile Ser Ala Leu Pro Asp Tyr Ala
260 265 270
Ser Gln Pro Gly Lys Pro Pro
275
<210> 205
<211> 279
<212> PRT
<213> Pseudomonas aeruginosa
<400> 205
Glu Gln Ser Gly Tyr Pro Val Gln Arg Leu Val Ala Leu Tyr Leu Ala
1 5 10 15
Ala Arg Leu Ser Trp Asn Gln Val Asp Gln Val Ile Arg Asn Ala Leu
20 25 30
Ala Ser Pro Gly Ser Gly Gly Asp Leu Gly Glu Ala Ile Arg Glu Gln
35 40 45
Pro Glu Gln Ala Arg Leu Ala Leu Thr Leu Ala Ala Ala Glu Ser Glu
50 55 60
Tyr Pro Thr Gly Ala Glu Phe Leu Gly Asp Gly Gly Ala Val Ser Phe
65 70 75 80
Ser Thr Arg Gly Thr Gln Asn Trp Thr Val Glu Arg Leu Leu Gln Ala
85 90 95
His Arg Gln Leu Glu Glu Gly Gly Tyr Val Phe Val Gly Tyr His Gly
100 105 110
Thr Phe Leu Glu Ala Ala Gln Ser Ile Val Phe Gly Gly Val Arg Ala
115 120 125
Arg Ser Gln Asp Leu Asp Ala Ile Trp Ala Gly Phe Tyr Ile Ala Gly
130 135 140
Asp Pro Ala Leu Ala Tyr Gly Tyr Ala Gln Asp Gln Glu Pro Asp Ala
145 150 155 160
Ala Gly Arg Ile Arg Asn Gly Ala Leu Leu Arg Val Tyr Val Pro Arg
165 170 175
Ser Ser Leu Pro Gly Phe Tyr Ala Thr Ser Leu Thr Leu Ala Ala Pro
180 185 190
Glu Ala Ala Gly Glu Val Glu Arg Leu Ile Gly His Pro Leu Pro Leu
195 200 205
Arg Leu Asp Ala Ile Thr Gly Pro Glu Glu Ala Gly Gly Arg Leu Glu
210 215 220
Thr Ile Leu Gly Trp Pro Leu Ala Glu Arg Thr Val Val Ile Pro Ser
225 230 235 240
Ala Ile Pro Thr Asp Pro Arg Asn Val Gly Gly Asp Leu Asp Pro Ser
245 250 255
Ser Ile Pro Asp Ala Glu Ala Ala Ile Ser Ala Leu Pro Asp Tyr Ala
260 265 270
Ser Gln Pro Gly Lys Pro Pro
275
<210> 206
<211> 214
<212> PRT
<213> Pseudomonas aeruginosa
<300>
<301> Weldon JE et al.
<303> Blood
<304> 113
<305> 16
<306> 3792-3800
<307> 2009-04-16
<400> 206
Pro Thr Gly Ala Glu Phe Leu Gly Asp Gly Gly Asp Val Ser Phe Ser
1 5 10 15
Thr Arg Gly Thr Gln Asn Trp Thr Val Glu Arg Leu Leu Gln Ala His
20 25 30
Arg Gln Leu Glu Glu Arg Gly Tyr Val Phe Val Gly Tyr His Gly Thr
35 40 45
Phe Leu Glu Ala Ala Gln Ser Ile Val Phe Gly Gly Val Arg Ala Arg
50 55 60
Ser Gln Asp Leu Asp Ala Ile Trp Arg Gly Phe Tyr Ile Ala Gly Asp
65 70 75 80
Pro Ala Leu Ala Tyr Gly Tyr Ala Gln Asp Gln Glu Pro Asp Ala Arg
85 90 95
Gly Arg Ile Arg Asn Gly Ala Leu Leu Arg Val Tyr Val Pro Arg Ser
100 105 110
Ser Leu Pro Gly Phe Tyr Arg Thr Ser Leu Thr Leu Ala Ala Pro Glu
115 120 125
Ala Ala Gly Glu Val Glu Arg Leu Ile Gly His Pro Leu Pro Leu Arg
130 135 140
Leu Asp Ala Ile Thr Gly Pro Glu Glu Glu Gly Gly Arg Leu Glu Thr
145 150 155 160
Ile Leu Gly Trp Pro Leu Ala Glu Arg Thr Val Val Ile Pro Ser Ala
165 170 175
Ile Pro Thr Asp Pro Arg Asn Val Gly Gly Asp Leu Asp Pro Ser Ser
180 185 190
Ile Pro Asp Lys Glu Gln Ala Ile Ser Ala Leu Pro Asp Tyr Ala Ser
195 200 205
Gln Pro Gly Lys Pro Pro
210
<210> 207
<211> 279
<212> PRT
<213> Pseudomonas aeruginosa
<400> 207
Glu Gln Ser Gly Tyr Pro Val Gln Lys Leu Val Ala Leu Tyr Leu Ala
1 5 10 15
Ala Arg Leu Ser Trp Asn Gln Val Asp Gln Val Ile Arg Asn Ala Leu
20 25 30
Ala Ser Pro Gly Ser Gly Gly Asp Leu Gly Glu Ala Ile Arg Glu Gln
35 40 45
Pro Glu Gln Ala Arg Leu Ala Leu Thr Leu Ala Ala Ala Glu Ser Glu
50 55 60
Tyr Pro Thr Gly Ala Glu Phe Leu Gly Asp Gly Gly Ala Val Ser Phe
65 70 75 80
Ser Thr Arg Gly Thr Gln Asn Trp Thr Val Glu Arg Leu Leu Gln Ala
85 90 95
His Arg Gln Leu Glu Glu Gly Gly Tyr Val Phe Val Gly Tyr His Gly
100 105 110
Thr Phe Leu Glu Ala Ala Gln Ser Ile Val Phe Gly Gly Val Arg Ala
115 120 125
Arg Ser Gln Asp Leu Asp Ala Ile Trp Ala Gly Phe Tyr Ile Ala Gly
130 135 140
Asp Pro Ala Leu Ala Tyr Gly Tyr Ala Gln Asp Gln Glu Pro Asp Ala
145 150 155 160
Ala Gly Arg Ile Arg Asn Gly Ala Leu Leu Arg Val Tyr Val Pro Arg
165 170 175
Ser Ser Leu Pro Gly Phe Tyr Ala Thr Ser Leu Thr Leu Ala Ala Pro
180 185 190
Glu Ala Ala Gly Glu Val Glu Arg Leu Ile Gly His Pro Leu Pro Leu
195 200 205
Arg Leu Asp Ala Ile Thr Gly Pro Glu Glu Ala Gly Gly Arg Leu Glu
210 215 220
Thr Ile Leu Gly Trp Pro Leu Ala Glu Arg Thr Val Val Ile Pro Ser
225 230 235 240
Ala Ile Pro Thr Asp Pro Lys Asn Val Gly Gly Asp Leu Asp Pro Ser
245 250 255
Ser Ile Pro Asp Ala Glu Ala Ala Ile Ser Ala Leu Pro Asp Tyr Ala
260 265 270
Ser Gln Pro Gly Lys Pro Pro
275
<210> 208
<211> 51
<212> PRT
<213> Salmonella typhi
<300>
<308> GenBank/1209200A
<309> 1996-10-01
<313> (2)..(52)
<400> 208
Lys Leu Pro Arg Ser Ser Leu Val Trp Cys Val Leu Ile Val Cys Leu
1 5 10 15
Thr Leu Leu Ile Phe Thr Tyr Leu Thr Arg Lys Ser Leu Cys Glu Ile
20 25 30
Arg Tyr Arg Asp Gly His Arg Glu Val Ala Ala Phe Met Ala Tyr Glu
35 40 45
Ser Gly Lys
50
Claims (41)
- - hTRAIL95보다 낮지 않은 위치에 있는 아미노산으로 개시하는, 가용성 hTRAIL 단백질 서열의 기능적 단편이거나, 70% 이상의 서열 동일성, 바람직하게는 85%의 서열 동일성을 가지며 아미노산 hTRAIL281로 종결하는 상기 기능적 단편의 동족체인 도메인 (a), 및
- 단백질 합성을 억제하는 효과기 펩타이드의 서열인 하나 이상의 도메인 (b)
를 포함하는 융합 단백질로서,
상기 도메인 (b)의 서열은 상기 도메인 (a)의 C-말단 및/또는 N-말단에 부착되어 있고,
상기 융합 단백질은 세포 표면 상의 탄수화물 수용체에 결합하는 도메인을 함유하지 않는 것인, 융합 단백질. - 청구항 1에 있어서, 상기 도메인 (a)는 hTRAIL95 내지 hTRAIL121 범위의 아미노산으로 개시하고, 아미노산 281로 종결하는 가용성 hTRAIL 단백질 서열의 단편을 포함하는 것인, 융합 단백질.
- 청구항 1 또는 청구항 2에 있어서, 상기 도메인 (a)는 hTRAIL95-281, hTRAIL114-281, hTRAIL116-281, hTRAIL119-281, hTRAIL120-281 및 hTRAIL121-281로 이루어진 군으로부터 선택되는 것인, 융합 단백질.
- 청구항 1 내지 청구항 3 중 어느 한 항에 있어서, 상기 도메인 (a)는 DR4 및/또는 DR5 수용체에 대하여 변형된 친화성을 갖는 hTRAIL의 상기 기능적 단편의 동족체인, 융합 단백질.
- 청구항 4에 있어서, 상기 동족체는 서열 번호 142 및 서열 번호 143으로 이루어진 군으로부터 선택되는 것인, 융합 단백질.
- 청구항 1 내지 청구항 5 중 어느 한 항에 있어서, 상기 도메인 (b)의 상기 효과기 펩타이드는 리보솜의 수준에서 단백질 해독을 효소적으로 억제하는 펩타이드인, 융합 단백질.
- 청구항 6에 있어서, 상기 효과기 펩타이드는 N-글리코시다제의 효소 활성을 갖는 펩타이드인, 융합 단백질.
- 청구항 7에 있어서, 상기 효과기 펩타이드는 리보솜을 불활성화하는 단백질 독소 RIP 유형 1 및 리보솜을 불활성화하는 단백질 독소의 촉매 서브유닛 A RIP 유형 2, 또는 본래의 서열과 85% 이상의 서열 동일성의 보존된 N-글리코시다제 활성을 가지는 이들의 변형물로 이루어진 군으로부터 선택되는 것인, 융합 단백질.
- 청구항 8에 있어서, 상기 효과기 펩타이드는 겔로닌 (겔로니움 멀티플로 룸: Gelonium multiflorum 유래), 돌연변이형 겔로닌, 모모르딘, 사포린, 브리오딘 I, 도데칸드린, 부가닌 (부가인빌레아 스펙타빌리스: Bougainvillea spectabilis 유래) 및 미국자리공 (파이토라카 아메리카나: Phytolacca Americana) 유래의 PAP 단백질을 포함하는 RIP 유형 1 독소의 군으로부터 선택되거나, 리신의 서브유닛 A, 돌연변이형 리신 변이체, 아브린 (아브루스 프레카 트리우스: Abbrus precatrius 유래), 돌연변이형 아브린 변이체, 모데신 (아데 니아 디지타타: Adenia digitata 유래), 비스쿠민 (비스쿰 알붐: Viscum album 유래의 독소 MLI), 볼켄신 (아데니아 볼켄시이: Adenia volkensii 유래), 시가 독소 (시겔라 다이센테리애: Shigella dysenteriae 유래), 트리코산틴 및 돌연변이형 트리코산틴 변이체를 포함하는 RIP 유형 2 독소의 촉매 서브유닛의 군으로부터 선택되거나, 본래의 서열과 85% 이상의 서열 동일성의 보존된 N-글리코시다제 활성을 가지는 이들의 변형물의 군으로부터 선택되는 것인, 융합 단백질.
- 청구항 7 내지 청구항 9 중 어느 한 항에 있어서, 상기 효과기 펩타이드는 서열 번호 55, 서열 번호 56, 서열 번호 57, 서열 번호 58, 서열 번호 59, 서열 번호 60, 서열 번호 61, 서열 번호 62, 서열 번호 63, 서열 번호 64, 서열 번호 65, 서열 번호 66, 서열 번호 67, 서열 번호 70, 서열 번호 78, 서열 번호 82, 서열 번호 194, 서열 번호 195, 서열 번호 198, 서열 번호 199 및 서열 번호 200으로 이루어진 군으로부터 선택되는 것인, 융합 단백질.
- 청구항 6에 있어서, 상기 효과기 펩타이드는 리보뉴클레아제 효소 활성을 가지는 펩타이드인, 융합 단백질.
- 청구항 11에 있어서, 상기 효과기 펩타이드는 단백질 독소인 알파-사크린, 미토질린, 히르수텔린 (히르수텔라 톰소니이: Hirsutella thompsonii 유래), 레스트릭토신 (아스퍼질루스 레스트릭투스: Aspergillus restrictus 유래) 및 본래의 서열과 85% 이상의 서열 동일성의 보존된 리보뉴클레아제 활성을 가지는 이들의 변형물로부터 선택되는 것인, 융합 단백질.
- 청구항 12에 있어서, 상기 효과기 펩타이드는 서열 번호 71 및 서열 번호 72로 이루어진 군으로부터 선택되는 것인, 융합 단백질.
- 청구항 6에 있어서, 상기 효과기 펩타이드는 ADP-리보실트랜스퍼라제의 효소 활성을 가지는 것인, 융합 단백질.
- 청구항 14에 있어서, 상기 효과기 펩타이드는 슈도모나스 아에루기노사 (Pseudomonas aeruginosa)의 촉매 서브유닛 A 또는 슈도모나스 아에루기노사 독소의 돌연변이형 촉매 서브유닛 A 및 코리네박테리움 디프테리애 (Corynebacterium diphteriae)의 디프테리아 독소 또는 코리네박테리움 디프테리애의 돌연변이형 디프테리아 독소 및 본래의 서열과 85% 이상의 서열 동일성의 보존된 ADP-리보실트랜스퍼라제 활성을 가지는 이들의 변형물로 이루어진 군으로부터 선택되는 것인, 융합 단백질.
- 청구항 15에 있어서, 상기 효과기 펩타이드는 서열 번호 79, 서열 번호 80, 서열 번호 81, 서열 번호 83, 서열 번호 84, 서열 번호 196, 서열 번호 197, 서열 번호 201, 서열 번호 202, 서열 번호 203, 서열 번호 204, 서열 번호 205, 서열 번호 206 및 서열 번호 207로 이루어진 군으로부터 선택되는 것인, 융합 단백질.
- 청구항 1 내지 청구항 5 중 어느 한 항에 있어서, 상기 도메인 (b)의 효과기 펩타이드는 독소-항독소 시스템에 속하는 단백질 합성을 억제하는 독소인, 융합 단백질.
- 청구항 17에 있어서, 상기 효과기 펩타이드는 토포아이소머라제 활성, mRNAse 활성 또는 세포막과의 결합을 가지는 펩타이드인, 융합 단백질.
- 청구항 18에 있어서, 상기 효과기 펩타이드는 서열 번호 74의 CcdB 단백질, 서열 번호 75의 CcdB 단백질, 서열 번호 73의 Kid 단백질, 서열 번호 76의 RelE 단백질, 서열 번호 77의 StaB 단백질, 서열 번호 208의 Hok 단백질 및 본래의 서열과 85% 이상의 서열 동일성의 보존된 토포아이소머라제 활성, mRNAse 활성 또는 세포막과의 결합 활성을 가지는 이들의 변형물로 이루어진 군으로부터 선택되는 것인, 융합 단백질.
- 청구항 1 내지 청구항 19 중 어느 한 항에 있어서, 상기 도메인 (a)와 상기 도메인 (b) 사이에 또는 상기 도메인 (b) 사이에 프로테아제 절단 부위를 함유하는 도메인 (c)를 함유하는, 융합 단백질.
- 청구항 20에 있어서, 상기 도메인 (c)는 종양 환경에 존재하는 프로테아제에 의해 인식되는 프로테아제 절단 부위를 함유하는 것인, 융합 단백질.
- 청구항 1 내지 청구항 21 중 어느 한 항에 있어서, 상기 도메인 (b)의 효과기 펩타이드는
- 서열 번호 139의 슈도모나스 유래하는, 세포막을 통해 운반하는 도메인 (d1);
- Lys Asp Glu Leu/KDEL, His Asp Glu Leu/HDEL, Arg Asp Glu Leu/RDEL, Asp Asp Glu Leu/DDEL, Ala Asp Glu Leu/ADEL, Ser Asp Glu Leu/SDEL 및 Glu Asp Leu/KEDL로부터 선택된 소포체로 유도하는, 상기 세포막을 통해 운반하는 도메인 (d2);
- 6, 7, 8, 9, 10 또는 11 Arg 잔기로 이루어진, 상기 세포막을 통해 운반하는 폴리아르기닌 서열 (d3); 및
이들의 조합
으로 이루어진 군으로부터 선택된 운반 도메인 (d)와 더 연결되어 있고,
상기 운반 도메인 (d)는 상기 도메인 (b)의 효과기 펩타이드의 C-말단 및/또는 N-말단에 위치되어 있는 것인, 융합 단백질. - 청구항 22에 있어서, 상기 운반 도메인 (d)는 상기 도메인 (b)와 도메인 (c) 사이에, 상기 도메인 (a)와 도메인 (c) 사이에, 또는 2개의 도메인 (c) 사이에 위치되어 있는 것인, 융합 단백질.
- 청구항 22에 있어서, 상기 서열 (d)는 상기 융합 단백질의 C-말단에 위치되어 있는 것인, 융합 단백질.
- 청구항 20 내지 청구항 24 중 어느 한 항에 있어서, 상기 융합 단백질은 상기 도메인 (a), 상기 도메인 (b), 상기 도메인 (c) 및/또는 상기 도메인 (d) 사이에 가요성 입체 링커를 더 포함하는 것인, 융합 단백질.
- 청구항 25에 있어서, 상기 입체 링커는 Gly Gly Gly Gly Ser/GGGGS, Gly Gly Gly Ser/GGGS, Gly Gly Gly/GGG, Gly Gly Gly Gly/GGGG, Ala Ser Gly Gly/ASGG, Ala Ser Gly/ASG, Gly Gly Gly Ser Gly/GGGSG, Gly Gly Gly/GGG, Gly Gly Gly Ser Ala Ser Gly Gly/GGGSASGG, Ser His His Ser/SHHS, CAAACAAC (Cys Ala Ala Ala Cys Ala Ala Cys), CAACAAAC (Cys Ala Ala Cys Ala Ala Ala Cys) 및 이들의 조합으로부터 선택되는 것인, 융합 단백질.
- 청구항 20 내지 청구항 26 중 어느 한 항에 있어서, 상기 융합 단백질은 상기 도메인 (a), 상기 도메인 (b) 및/또는 상기 도메인 (c) 사이에 Ala Ser Gly Cys Gly Pro Glu/ASGCGPE, Ala Ala Cys Ala Ala/AACAA, Ser Gly Gly Cys Gly Gly Ser/SGGCGGS 또는 Ser Gly Cys Gly Ser/SGCGS로부터 선택된, PEG 분자의 부착을 위한 링커인 도메인 (e)를 함유하는 것인, 융합 단백질.
- 청구항 20 내지 청구항 27 중 어느 한 항에 있어서, 상기 융합 단백질은 상기 도메인 (b)와 상기 도메인 (c) 사이에 Asn Gly Arg/NGR, Asp Gly Arg/DGR 또는 Arg Gly Asp/RGD로 이루어진 군으로부터 선택된 인테그린과 결합하는 모티브를 더 함유하는 것인, 융합 단백질.
- 청구항 1에 있어서, 상기 융합 단백질은 서열 번호 1, 서열 번호 2, 서열 번호 3, 서열 번호 4, 서열 번호 5, 서열 번호 6, 서열 번호 7, 서열 번호 8, 서열 번호 9, 서열 번호 10, 서열 번호 11, 서열 번호 12, 서열 번호 13, 서열 번호 14, 서열 번호 15, 서열 번호 16, 서열 번호 17, 서열 번호 18, 서열 번호 19, 서열 번호 20, 서열 번호 21, 서열 번호 22, 서열 번호 23, 서열 번호 24, 서열 번호 25, 서열 번호 26, 서열 번호 27, 서열 번호 28, 서열 번호 29, 서열 번호 30, 서열 번호 31, 서열 번호 32, 서열 번호 33, 서열 번호 34, 서열 번호 35, 서열 번호 36, 서열 번호 37, 서열 번호 38, 서열 번호 39, 서열 번호 40, 서열 번호 41, 서열 번호 42, 서열 번호 43, 서열 번호 44, 서열 번호 45, 서열 번호 46, 서열 번호 47, 서열 번호 48, 서열 번호 49, 서열 번호 50, 서열 번호 51, 서열 번호 52, 서열 번호 53. 서열 번호 54, 서열 번호 144, 서열 번호 145, 서열 번호 146, 서열 번호 147, 서열 번호 148, 서열 번호 149, 서열 번호 150, 서열 번호 151, 서열 번호 152, 서열 번호 153, 서열 번호 154, 서열 번호 155, 서열 번호 156, 서열 번호 157, 서열 번호 158, 서열 번호 159, 서열 번호 160, 서열 번호 161, 서열 번호 162, 서열 번호 163, 서열 번호 164, 서열 번호 165, 서열 번호 166, 서열 번호 167 및 서열 번호 168로 이루어진 군으로부터 선택된 아미노산 서열을 가지는 것인, 융합 단백질.
- 청구항 1 내지 청구항 29 중 어느 한 항에 있어서, 상기 융합 단백질은 재조합 단백질인, 융합 단백질.
- 청구항 1 내지 청구항 29 중 어느 한 항에 기재된 융합 단백질을 암호화하는 폴리뉴클레오타이드 서열.
- 청구항 31에 있어서, 상기 폴리뉴클레오타이드 서열은 대장균(E. coli)에서의 유전자 발현에 최적화되어 있는 것인, 폴리뉴클레오타이드 서열.
- 청구항 32에 있어서, 상기 폴리뉴클레오타이드 서열은 서열 번호 85, 서열 번호 86, 서열 번호 87, 서열 번호 88, 서열 번호 89, 서열 번호 90, 서열 번호 91, 서열 번호 92, 서열 번호 93, 서열 번호 94, 서열 번호 95, 서열 번호 96, 서열 번호 97, 서열 번호 98, 서열 번호 99, 서열 번호 100, 서열 번호 101, 서열 번호 102, 서열 번호 103, 서열 번호 104, 서열 번호 105, 서열 번호 106, 서열 번호 107, 서열 번호 108, 서열 번호 109, 서열 번호 110, 서열 번호 111, 서열 번호 111, 서열 번호 113, 서열 번호 114, 서열 번호 115, 서열 번호 116, 서열 번호 117, 서열 번호 118, 서열 번호 119, 서열 번호 120, 서열 번호 121, 서열 번호 122, 서열 번호 123, 서열 번호 124, 서열 번호 125, 서열 번호 126, 서열 번호 127, 서열 번호 128, 서열 번호 129, 서열 번호 130, 서열 번호 131, 서열 번호 132, 서열 번호 133, 서열 번호 134, 서열 번호 135, 서열 번호 136, 서열 번호 137, 서열 번호 138, 서열 번호169, 서열 번호 170, 서열 번호 171, 서열 번호 172, 서열 번호 173, 서열 번호 174, 서열 번호 175, 서열 번호 176, 서열 번호 177, 서열 번호 178, 서열 번호 179, 서열 번호 180, 서열 번호 181, 서열 번호 182, 서열 번호 183, 서열 번호 184, 서열 번호 185, 서열 번호 186, 서열 번호 187, 서열 번호 188, 서열 번호 189, 서열 번호 190, 서열 번호 191, 서열 번호 192 및 서열 번호 193으로 이루어진 군으로부터 선택되는 것인, 폴리뉴클레오타이드 서열.
- 청구항 31 내지 청구항 33 중 어느 한 항에 기재된 폴리뉴클레오타이드 서열을 포함하는 발현 벡터.
- 청구항 34에 기재된 발현 벡터를 포함하는 숙주 세포.
- 청구항 35에 있어서, 상기 숙주 세포는 대장균 세포인, 숙주 세포.
- 활성 성분으로서의 청구항 1 내지 청구항 30 중 어느 한 항에 기재된 융합 단백질 및 약학적으로 허용가능한 담체를 포함하는 약학적 조성물.
- 청구항 37에 있어서, 상기 약학적 조성물은 비경구 투여를 위한 형태인, 약학적 조성물.
- 청구항 1 내지 청구항 30 중 어느 한 항에 있어서, 상기 융합 단백질은 인간을 포함한 포유동물에서 신생물성 질환의 치료에 사용하기 위한 것인, 융합 단백질.
- 인간을 포함한 포유동물에서 암 질환의 치료 방법으로서,
상기 치료 방법은 청구항 1 내지 청구항 30 중 어느 한 항에 기재된 융합 단백질이나 청구항 37 또는 청구항 38에 기재된 약학적 조성물을 항신생물성 유효량으로 치료를 필요로 하는 대상에게 투여하는 단계를 포함하는 것인 암 질환의 치료 방법. - 서열 번호 200의 트리코산틴의 돌연변이형 변이체, 서열 번호 201의 슈도모나스 아에루기노사 독소의 촉매 서브유닛 A의 돌연변이형 변이체, 서열 번호 202의 슈도모나스 아에루기노사 독소의 촉매 서브유닛 A의 돌연변이형 변이체, 서열 번호 204의 슈도모나스 아에루기노사 독소의 촉매 서브유닛 A의 돌연변이형 변이체, 서열 번호 205의 슈도모나스 아에루기노사 독소의 촉매 서브유닛 A의 돌연변이형 변이체 및 서열 번호 207의 슈도모나스 아에루기노사 독소의 촉매 서브유닛 A의 돌연변이형 변이체로 이루어진 군으로부터 선택되는 펩타이드.
Applications Claiming Priority (3)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| PLP.397167 | 2011-11-28 | ||
| PL397167A PL397167A1 (pl) | 2011-11-28 | 2011-11-28 | Przeciwnowotworowe bialko fuzyjne |
| PCT/IB2012/056806 WO2013080147A2 (en) | 2011-11-28 | 2012-11-28 | Anticancer fusion protein |
Publications (1)
| Publication Number | Publication Date |
|---|---|
| KR20140097529A true KR20140097529A (ko) | 2014-08-06 |
Family
ID=47561689
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| KR1020147018001A Withdrawn KR20140097529A (ko) | 2011-11-28 | 2012-11-28 | 항암 융합 단백질 |
Country Status (18)
| Country | Link |
|---|---|
| US (1) | US20150044162A1 (ko) |
| EP (1) | EP2785362A2 (ko) |
| JP (1) | JP2015500228A (ko) |
| KR (1) | KR20140097529A (ko) |
| CN (1) | CN103974711A (ko) |
| AU (1) | AU2012345494A1 (ko) |
| BR (1) | BR112014012808A2 (ko) |
| CA (1) | CA2856480A1 (ko) |
| EA (1) | EA201491049A1 (ko) |
| HK (1) | HK1201727A1 (ko) |
| IL (1) | IL232743A0 (ko) |
| IN (1) | IN2014CN04498A (ko) |
| MX (1) | MX2014006369A (ko) |
| PH (1) | PH12014501083A1 (ko) |
| PL (1) | PL397167A1 (ko) |
| SG (1) | SG11201402312WA (ko) |
| WO (1) | WO2013080147A2 (ko) |
| ZA (1) | ZA201404667B (ko) |
Cited By (1)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| KR20170010896A (ko) * | 2014-06-11 | 2017-02-01 | 몰레큘러 템플레이츠, 인코퍼레이션. | 프로테아제-절단 저항성의 시가 독소 a 서브유닛 작동체 폴리펩티드 및 이를 포함하는 세포-표적화 분자 |
Families Citing this family (23)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| US10450354B2 (en) | 2013-03-12 | 2019-10-22 | Molecular Templates, Inc. | CD20-binding immunotoxins for inducing cellular internalization and methods using same |
| WO2014141094A1 (en) | 2013-03-14 | 2014-09-18 | Adamed Sp. Z O.O. | Anticancer conjugate |
| IL285403B2 (en) | 2014-01-27 | 2023-10-01 | Molecular Templates Inc | Polypeptides that remove an epitope for MHC group I |
| JP6935195B2 (ja) * | 2014-03-11 | 2021-09-15 | モレキュラー テンプレーツ, インク.Molecular Templates, Inc. | 結合領域、志賀毒素aサブユニットのエフェクター領域、及びカルボキシ末端小胞体局在化シグナルモチーフを含むタンパク質 |
| US11142584B2 (en) | 2014-03-11 | 2021-10-12 | Molecular Templates, Inc. | CD20-binding proteins comprising Shiga toxin A subunit effector regions for inducing cellular internalization and methods using same |
| KR20170110601A (ko) | 2015-02-05 | 2017-10-11 | 몰레큘러 템플레이츠, 인코퍼레이션. | 시가 독소 a 서브유닛 작동체 영역을 포함하는 다가 cd20 결합 분자 및 이들의 강화된 조성물 |
| US10428132B2 (en) | 2015-02-11 | 2019-10-01 | West China Hospital, Sichuan University | Tumor necrosis factor-related apoptosis-inducing ligand variant, as well as a preparation method and use thereof |
| HUE051246T2 (hu) * | 2015-05-30 | 2021-03-01 | Molecular Templates Inc | Deimmunizált shigatoxin alegység vázak és azokat tartalmazó, sejthez irányító molekulák |
| CN112574316A (zh) | 2015-07-02 | 2021-03-30 | 博际生物医药科技(杭州)有限公司 | 用于肿瘤靶向治疗的白细胞介素-15融合蛋白 |
| KR101732126B1 (ko) | 2015-11-05 | 2017-05-02 | 한국생명공학연구원 | 췌장암 치료용 융합 단백질 및 이의 용도 |
| PL233352B1 (pl) * | 2016-09-15 | 2019-10-31 | Adamed Spolka Z Ograniczona Odpowiedzialnoscia | Przeciwnowotworowe białko fuzyjne |
| JP7075134B2 (ja) | 2016-12-07 | 2022-05-25 | モレキュラー テンプレーツ,インク. | 部位特異的コンジュゲーションのための志賀毒素aサブユニットエフェクターポリペプチド、志賀毒素エフェクター足場、及び細胞標的化分子 |
| CN106632680A (zh) * | 2016-12-27 | 2017-05-10 | 上海交通大学 | 植物体系表达人源化抗agr2单克隆抗体18a4的质粒构建 |
| JP7082424B2 (ja) | 2017-01-25 | 2022-06-08 | モレキュラー テンプレーツ,インク. | 脱免疫化された志賀毒素aサブユニットエフェクター及びcd8+t細胞エピトープを含む細胞標的化分子 |
| US12186376B2 (en) * | 2018-03-06 | 2025-01-07 | The Johns Hopkins University | Methods of treating or preventing cancer with an agent that depletes tregs and a checkpoint inhibitor |
| KR20200143634A (ko) | 2018-04-17 | 2020-12-24 | 몰레큘러 템플레이츠, 인코퍼레이션. | 탈면역된 시가 독소 a 서브유닛 스캐폴드를 포함하는 her2-표적화 분자 |
| US20220211872A1 (en) * | 2019-05-15 | 2022-07-07 | Universidad De Granada | Gene therapy with the genes hokd and ldrb for cancer treatments |
| CN113354738B (zh) * | 2020-03-05 | 2022-09-09 | 绍兴德方华生物技术有限公司 | 融合毒素VEGF165b/mGEL及其编码基因与应用 |
| JP7818834B2 (ja) * | 2020-08-17 | 2026-02-24 | エーティービー セラピューティクス | リボトキシンまたはRNAseを含む組換え免疫毒素 |
| CN114681599B (zh) * | 2020-12-31 | 2024-07-02 | 中国科学院上海药物研究所 | 一种阳离子脂质体疫苗及其制备方法和用途 |
| AU2022321271A1 (en) * | 2021-08-06 | 2024-02-29 | Kao Corporation | Nucleic acid structure utilizing snare |
| CN117384859B (zh) * | 2023-12-13 | 2024-03-22 | 北京翊博生物集团有限公司 | 一种树突状细胞来源的外泌体的制备方法及应用 |
| CN118792375B (zh) * | 2024-06-25 | 2025-09-23 | 华南农业大学 | 一种具有补肾壮阳功效的瓜蒌多肽及其制备方法和应用 |
Family Cites Families (16)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| KR100510234B1 (ko) | 1995-06-29 | 2005-11-25 | 임뮤넥스 코포레이션 | 세포소멸을 유도하는 시토킨 |
| AU2001238501A1 (en) | 2000-02-16 | 2001-08-27 | Bechtel Bwxt Idaho, Llc | Selective destruction of cells infected with human immunodeficiency virus |
| ZA200305980B (en) | 2001-02-12 | 2007-01-31 | Res Dev Foundation | Modified proteins, designer toxins, and methods of making thereof |
| CN1257187C (zh) * | 2003-10-22 | 2006-05-24 | 上海恰尔生物技术有限公司 | 钙网蛋白-肿瘤坏死因子相关凋亡诱导配体的融合蛋白及其制法和用途 |
| JP4688678B2 (ja) | 2003-11-03 | 2011-05-25 | 北京沙東生物技術有限公司 | 抗癌作用を有する組換えタンパク質、それをコードする遺伝子、及びそれらの使用 |
| US7252993B2 (en) | 2004-03-12 | 2007-08-07 | Battelle Energy Alliance, Llc | Plasmids encoding therapeutic agents |
| WO2007016150A2 (en) | 2005-07-29 | 2007-02-08 | THE GOVERNMENT OF THE UNITED STATES OF AMERICA, as represented by THE SECRETARY OF HEALTH AND HUMAN SERVICES NATIONAL INSTITUTES OF HEALTH | Mutated pseudomonas exotoxins with reduced antigenicity |
| AU2006279618A1 (en) | 2005-08-16 | 2007-02-22 | Genentech, Inc. | Apoptosis sensitivity to Apo2L/TRAIL by testing for 'GalNac-T14 expression in cells/tissues |
| EP2079840A4 (en) | 2006-10-30 | 2010-06-30 | Viventia Biotech Inc | IMMUNOTOXIN FUSIONS COMPRISING PROTEASEPLATABLE LINKER-ASSOCIATED ANTIBODY FRAGMENT AND PLANT TOXIN |
| EP2097529A4 (en) | 2006-12-29 | 2010-03-24 | Osprey Pharmaceuticals Usa Inc | METHOD FOR SELECTION AND PRODUCTION OF MODIFIED TOXINS, MODIFIED TOXINE CONJUGATES AND USES THEREOF |
| US20090131317A1 (en) | 2007-06-22 | 2009-05-21 | Affymax, Inc. | Compounds and peptides that bind the trail receptor |
| GB0723059D0 (en) | 2007-11-23 | 2008-01-02 | Nat Univ Ireland | Improved cytokine design |
| GB0724532D0 (en) | 2007-12-17 | 2008-01-30 | Nat Univ Ireland | Trail variants for treating cancer |
| KR101863136B1 (ko) * | 2008-01-24 | 2018-05-31 | 에스퍼란스 파마슈티컬스, 인코포레이티드 | 용해 도메인 융합 구성물 및 이를 제조하고 사용하는 방법 |
| TW200950778A (en) | 2008-05-14 | 2009-12-16 | Genentech Inc | Methods of using Apo2L/TRAIL to treat cancer |
| EP2460827A1 (en) * | 2008-06-30 | 2012-06-06 | The Trustees Of The University Of Pennsylvania | Fusion proteins comprising Fn14 and an inhibitory protein |
-
2011
- 2011-11-28 PL PL397167A patent/PL397167A1/pl unknown
-
2012
- 2012-11-28 JP JP2014544020A patent/JP2015500228A/ja active Pending
- 2012-11-28 SG SG11201402312WA patent/SG11201402312WA/en unknown
- 2012-11-28 BR BR112014012808A patent/BR112014012808A2/pt not_active IP Right Cessation
- 2012-11-28 CN CN201280058346.6A patent/CN103974711A/zh active Pending
- 2012-11-28 IN IN4498CHN2014 patent/IN2014CN04498A/en unknown
- 2012-11-28 KR KR1020147018001A patent/KR20140097529A/ko not_active Withdrawn
- 2012-11-28 HK HK15102260.2A patent/HK1201727A1/xx unknown
- 2012-11-28 EP EP12816127.0A patent/EP2785362A2/en not_active Withdrawn
- 2012-11-28 EA EA201491049A patent/EA201491049A1/ru unknown
- 2012-11-28 CA CA2856480A patent/CA2856480A1/en not_active Abandoned
- 2012-11-28 WO PCT/IB2012/056806 patent/WO2013080147A2/en not_active Ceased
- 2012-11-28 MX MX2014006369A patent/MX2014006369A/es unknown
- 2012-11-28 AU AU2012345494A patent/AU2012345494A1/en not_active Abandoned
- 2012-11-28 US US14/361,279 patent/US20150044162A1/en not_active Abandoned
-
2014
- 2014-05-14 PH PH12014501083A patent/PH12014501083A1/en unknown
- 2014-05-21 IL IL232743A patent/IL232743A0/en unknown
- 2014-06-25 ZA ZA2014/04667A patent/ZA201404667B/en unknown
Cited By (1)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| KR20170010896A (ko) * | 2014-06-11 | 2017-02-01 | 몰레큘러 템플레이츠, 인코퍼레이션. | 프로테아제-절단 저항성의 시가 독소 a 서브유닛 작동체 폴리펩티드 및 이를 포함하는 세포-표적화 분자 |
Also Published As
| Publication number | Publication date |
|---|---|
| IL232743A0 (en) | 2014-07-31 |
| JP2015500228A (ja) | 2015-01-05 |
| EA201491049A1 (ru) | 2014-10-30 |
| AU2012345494A1 (en) | 2014-07-10 |
| WO2013080147A3 (en) | 2014-02-13 |
| US20150044162A1 (en) | 2015-02-12 |
| CN103974711A (zh) | 2014-08-06 |
| PH12014501083A1 (en) | 2014-08-04 |
| EP2785362A2 (en) | 2014-10-08 |
| BR112014012808A2 (pt) | 2019-09-24 |
| CA2856480A1 (en) | 2013-06-06 |
| ZA201404667B (en) | 2015-09-30 |
| PL397167A1 (pl) | 2013-06-10 |
| SG11201402312WA (en) | 2014-06-27 |
| WO2013080147A2 (en) | 2013-06-06 |
| MX2014006369A (es) | 2014-07-09 |
| IN2014CN04498A (ko) | 2015-09-11 |
| HK1201727A1 (en) | 2015-09-11 |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| KR101861872B1 (ko) | 항암 융합 단백질 | |
| KR101952460B1 (ko) | 항암 융합 단백질 | |
| KR101950043B1 (ko) | 항암 융합 단백질 | |
| JP2015500228A (ja) | 抗がん融合タンパク質 | |
| KR20140110017A (ko) | 항암 융합 단백질 | |
| KR20140019828A (ko) | 항암 융합 단백질 | |
| CN102140473A (zh) | 抗肿瘤的核酸与多肽及其应用 | |
| HK1186209A (en) | Anticancer fusion protein | |
| HK1186209B (en) | Anticancer fusion protein | |
| NZ627445B2 (en) | Anticancer fusion protein | |
| HK1201848B (en) | Anticancer fusion protein |
Legal Events
| Date | Code | Title | Description |
|---|---|---|---|
| PA0105 | International application |
Patent event date: 20140627 Patent event code: PA01051R01D Comment text: International Patent Application |
|
| PG1501 | Laying open of application | ||
| PC1203 | Withdrawal of no request for examination | ||
| WITN | Application deemed withdrawn, e.g. because no request for examination was filed or no examination fee was paid |