KR20200024263A - 고혈당증의 치료 및 예방을 위한 펩타이드 - Google Patents
고혈당증의 치료 및 예방을 위한 펩타이드 Download PDFInfo
- Publication number
- KR20200024263A KR20200024263A KR1020207002727A KR20207002727A KR20200024263A KR 20200024263 A KR20200024263 A KR 20200024263A KR 1020207002727 A KR1020207002727 A KR 1020207002727A KR 20207002727 A KR20207002727 A KR 20207002727A KR 20200024263 A KR20200024263 A KR 20200024263A
- Authority
- KR
- South Korea
- Prior art keywords
- seq
- peptide
- ekrvla
- sequence
- leu
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Granted
Links
- 108090000765 processed proteins & peptides Proteins 0.000 title claims abstract description 298
- 102000004196 processed proteins & peptides Human genes 0.000 title claims abstract description 97
- 201000001421 hyperglycemia Diseases 0.000 title claims description 23
- 238000011282 treatment Methods 0.000 title abstract description 21
- 230000002265 prevention Effects 0.000 title abstract description 4
- 206010012601 diabetes mellitus Diseases 0.000 claims abstract description 47
- NOESYZHRGYRDHS-UHFFFAOYSA-N insulin Chemical compound N1C(=O)C(NC(=O)C(CCC(N)=O)NC(=O)C(CCC(O)=O)NC(=O)C(C(C)C)NC(=O)C(NC(=O)CN)C(C)CC)CSSCC(C(NC(CO)C(=O)NC(CC(C)C)C(=O)NC(CC=2C=CC(O)=CC=2)C(=O)NC(CCC(N)=O)C(=O)NC(CC(C)C)C(=O)NC(CCC(O)=O)C(=O)NC(CC(N)=O)C(=O)NC(CC=2C=CC(O)=CC=2)C(=O)NC(CSSCC(NC(=O)C(C(C)C)NC(=O)C(CC(C)C)NC(=O)C(CC=2C=CC(O)=CC=2)NC(=O)C(CC(C)C)NC(=O)C(C)NC(=O)C(CCC(O)=O)NC(=O)C(C(C)C)NC(=O)C(CC(C)C)NC(=O)C(CC=2NC=NC=2)NC(=O)C(CO)NC(=O)CNC2=O)C(=O)NCC(=O)NC(CCC(O)=O)C(=O)NC(CCCNC(N)=N)C(=O)NCC(=O)NC(CC=3C=CC=CC=3)C(=O)NC(CC=3C=CC=CC=3)C(=O)NC(CC=3C=CC(O)=CC=3)C(=O)NC(C(C)O)C(=O)N3C(CCC3)C(=O)NC(CCCCN)C(=O)NC(C)C(O)=O)C(=O)NC(CC(N)=O)C(O)=O)=O)NC(=O)C(C(C)CC)NC(=O)C(CO)NC(=O)C(C(C)O)NC(=O)C1CSSCC2NC(=O)C(CC(C)C)NC(=O)C(NC(=O)C(CCC(N)=O)NC(=O)C(CC(N)=O)NC(=O)C(NC(=O)C(N)CC=1C=CC=CC=1)C(C)C)CC1=CN=CN1 NOESYZHRGYRDHS-UHFFFAOYSA-N 0.000 claims description 132
- 150000001413 amino acids Chemical class 0.000 claims description 89
- 102000004877 Insulin Human genes 0.000 claims description 66
- 108090001061 Insulin Proteins 0.000 claims description 66
- 229940125396 insulin Drugs 0.000 claims description 66
- 210000001789 adipocyte Anatomy 0.000 claims description 55
- 238000006467 substitution reaction Methods 0.000 claims description 54
- 108090000315 Protein Kinase C Proteins 0.000 claims description 53
- 102000003923 Protein Kinase C Human genes 0.000 claims description 52
- 238000012217 deletion Methods 0.000 claims description 51
- 230000037430 deletion Effects 0.000 claims description 51
- 239000000203 mixture Substances 0.000 claims description 50
- 208000001072 type 2 diabetes mellitus Diseases 0.000 claims description 40
- 238000000034 method Methods 0.000 claims description 38
- 239000008194 pharmaceutical composition Substances 0.000 claims description 35
- 206010022489 Insulin Resistance Diseases 0.000 claims description 32
- 208000008589 Obesity Diseases 0.000 claims description 23
- 235000020824 obesity Nutrition 0.000 claims description 22
- 239000003472 antidiabetic agent Substances 0.000 claims description 19
- 239000004475 Arginine Substances 0.000 claims description 16
- ODKSFYDXXFIFQN-UHFFFAOYSA-N arginine Natural products OC(=O)C(N)CCCNC(N)=N ODKSFYDXXFIFQN-UHFFFAOYSA-N 0.000 claims description 16
- FFEARJCKVFRZRR-BYPYZUCNSA-N L-methionine Chemical compound CSCC[C@H](N)C(O)=O FFEARJCKVFRZRR-BYPYZUCNSA-N 0.000 claims description 15
- 229930182817 methionine Natural products 0.000 claims description 15
- 206010012689 Diabetic retinopathy Diseases 0.000 claims description 14
- 208000007342 Diabetic Nephropathies Diseases 0.000 claims description 13
- 208000032131 Diabetic Neuropathies Diseases 0.000 claims description 13
- ONIBWKKTOPOVIA-UHFFFAOYSA-N Proline Natural products OC(=O)C1CCCN1 ONIBWKKTOPOVIA-UHFFFAOYSA-N 0.000 claims description 13
- 208000033679 diabetic kidney disease Diseases 0.000 claims description 13
- 206010060378 Hyperinsulinaemia Diseases 0.000 claims description 12
- 208000031226 Hyperlipidaemia Diseases 0.000 claims description 12
- 208000029078 coronary artery disease Diseases 0.000 claims description 12
- 230000003451 hyperinsulinaemic effect Effects 0.000 claims description 12
- 201000008980 hyperinsulinism Diseases 0.000 claims description 12
- FWMNVWWHGCHHJJ-SKKKGAJSSA-N 4-amino-1-[(2r)-6-amino-2-[[(2r)-2-[[(2r)-2-[[(2r)-2-amino-3-phenylpropanoyl]amino]-3-phenylpropanoyl]amino]-4-methylpentanoyl]amino]hexanoyl]piperidine-4-carboxylic acid Chemical compound C([C@H](C(=O)N[C@H](CC(C)C)C(=O)N[C@H](CCCCN)C(=O)N1CCC(N)(CC1)C(O)=O)NC(=O)[C@H](N)CC=1C=CC=CC=1)C1=CC=CC=C1 FWMNVWWHGCHHJJ-SKKKGAJSSA-N 0.000 claims description 9
- 230000007812 deficiency Effects 0.000 claims description 8
- 230000003820 β-cell dysfunction Effects 0.000 claims description 7
- 230000006377 glucose transport Effects 0.000 claims description 6
- -1 incretin mimetic Proteins 0.000 claims description 6
- 229940125708 antidiabetic agent Drugs 0.000 claims description 5
- 238000010382 chemical cross-linking Methods 0.000 claims description 5
- 229940124213 Dipeptidyl peptidase 4 (DPP IV) inhibitor Drugs 0.000 claims description 4
- 229940100389 Sulfonylurea Drugs 0.000 claims description 4
- 229940123464 Thiazolidinedione Drugs 0.000 claims description 4
- 239000003603 dipeptidyl peptidase IV inhibitor Substances 0.000 claims description 4
- SWLAMJPTOQZTAE-UHFFFAOYSA-N 4-[2-[(5-chloro-2-methoxybenzoyl)amino]ethyl]benzoic acid Chemical class COC1=CC=C(Cl)C=C1C(=O)NCCC1=CC=C(C(O)=O)C=C1 SWLAMJPTOQZTAE-UHFFFAOYSA-N 0.000 claims description 3
- 229940077274 Alpha glucosidase inhibitor Drugs 0.000 claims description 3
- 108010088406 Glucagon-Like Peptides Proteins 0.000 claims description 3
- 102000036770 Islet Amyloid Polypeptide Human genes 0.000 claims description 3
- 108010041872 Islet Amyloid Polypeptide Proteins 0.000 claims description 3
- 239000003888 alpha glucosidase inhibitor Substances 0.000 claims description 3
- 125000002887 hydroxy group Chemical group [H]O* 0.000 claims description 3
- 150000002632 lipids Chemical class 0.000 claims description 3
- 229950004994 meglitinide Drugs 0.000 claims description 3
- XZWYZXLIPXDOLR-UHFFFAOYSA-N metformin Chemical compound CN(C)C(=N)NC(N)=N XZWYZXLIPXDOLR-UHFFFAOYSA-N 0.000 claims description 3
- 229960003105 metformin Drugs 0.000 claims description 3
- 229910052698 phosphorus Inorganic materials 0.000 claims description 3
- 150000001467 thiazolidinediones Chemical class 0.000 claims description 3
- 239000011734 sodium Substances 0.000 claims description 2
- YROXIXLRRCOBKF-UHFFFAOYSA-N sulfonylurea Chemical compound OC(=N)N=S(=O)=O YROXIXLRRCOBKF-UHFFFAOYSA-N 0.000 claims description 2
- 102000018711 Facilitative Glucose Transport Proteins Human genes 0.000 claims 1
- 108091052347 Glucose transporter family Proteins 0.000 claims 1
- DGAQECJNVWCQMB-PUAWFVPOSA-M Ilexoside XXIX Chemical compound C[C@@H]1CC[C@@]2(CC[C@@]3(C(=CC[C@H]4[C@]3(CC[C@@H]5[C@@]4(CC[C@@H](C5(C)C)OS(=O)(=O)[O-])C)C)[C@@H]2[C@]1(C)O)C)C(=O)O[C@H]6[C@@H]([C@H]([C@@H]([C@H](O6)CO)O)O)O.[Na+] DGAQECJNVWCQMB-PUAWFVPOSA-M 0.000 claims 1
- 229940123993 Incretin mimetic Drugs 0.000 claims 1
- 239000003112 inhibitor Substances 0.000 claims 1
- 125000002496 methyl group Chemical group [H]C([H])([H])* 0.000 claims 1
- 229910052708 sodium Inorganic materials 0.000 claims 1
- 208000037265 diseases, disorders, signs and symptoms Diseases 0.000 abstract description 7
- 235000001014 amino acid Nutrition 0.000 description 79
- 229940024606 amino acid Drugs 0.000 description 79
- 238000007792 addition Methods 0.000 description 49
- 241000699670 Mus sp. Species 0.000 description 48
- WQZGKKKJIJFFOK-GASJEMHNSA-N Glucose Natural products OC[C@H]1OC(O)[C@H](O)[C@@H](O)[C@@H]1O WQZGKKKJIJFFOK-GASJEMHNSA-N 0.000 description 45
- WQZGKKKJIJFFOK-VFUOTHLCSA-N beta-D-glucose Chemical compound OC[C@H]1O[C@@H](O)[C@H](O)[C@@H](O)[C@@H]1O WQZGKKKJIJFFOK-VFUOTHLCSA-N 0.000 description 44
- 239000008103 glucose Substances 0.000 description 44
- 102100032360 Alstrom syndrome protein 1 Human genes 0.000 description 38
- 101000797795 Homo sapiens Alstrom syndrome protein 1 Proteins 0.000 description 37
- 210000000577 adipose tissue Anatomy 0.000 description 31
- 108090000623 proteins and genes Proteins 0.000 description 30
- 241000282414 Homo sapiens Species 0.000 description 28
- 230000004190 glucose uptake Effects 0.000 description 26
- 235000018102 proteins Nutrition 0.000 description 23
- 102000004169 proteins and genes Human genes 0.000 description 23
- 210000004027 cell Anatomy 0.000 description 22
- MYGQXVYRZMKRDB-SRVKXCTJSA-N Leu-Asp-Lys Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@H](C(O)=O)CCCCN MYGQXVYRZMKRDB-SRVKXCTJSA-N 0.000 description 20
- SJJHXJDSNQJMMW-SRVKXCTJSA-N Glu-Lys-Arg Chemical compound OC(=O)CC[C@H](N)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CCCN=C(N)N)C(O)=O SJJHXJDSNQJMMW-SRVKXCTJSA-N 0.000 description 19
- 230000000694 effects Effects 0.000 description 19
- AERCCJGORROTKW-QMMMGPOBSA-N (2s)-2-amino-2-methylhept-6-enoic acid Chemical compound OC(=O)[C@](N)(C)CCCC=C AERCCJGORROTKW-QMMMGPOBSA-N 0.000 description 18
- NAIPAPCKKRCMBL-JYJNAYRXSA-N Pro-Pro-Phe Chemical compound C([C@@H](C(=O)O)NC(=O)[C@H]1N(CCC1)C(=O)[C@H]1NCCC1)C1=CC=CC=C1 NAIPAPCKKRCMBL-JYJNAYRXSA-N 0.000 description 18
- 239000003814 drug Substances 0.000 description 18
- JWZFECWHKQLRGK-LLVKDONJSA-N (2r)-2-amino-2-methyldec-9-enoic acid Chemical compound OC(=O)[C@@](N)(C)CCCCCCC=C JWZFECWHKQLRGK-LLVKDONJSA-N 0.000 description 16
- 238000002347 injection Methods 0.000 description 15
- 239000007924 injection Substances 0.000 description 15
- AHHJARQXFFGOKF-NRPADANISA-N Val-Glu-Cys Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CCC(=O)O)C(=O)N[C@@H](CS)C(=O)O)N AHHJARQXFFGOKF-NRPADANISA-N 0.000 description 14
- 229940079593 drug Drugs 0.000 description 14
- 201000005932 Alstrom Syndrome Diseases 0.000 description 13
- 239000008280 blood Substances 0.000 description 13
- 210000004369 blood Anatomy 0.000 description 13
- 238000007446 glucose tolerance test Methods 0.000 description 13
- 241000699666 Mus <mouse, genus> Species 0.000 description 12
- 210000001519 tissue Anatomy 0.000 description 12
- 239000000872 buffer Substances 0.000 description 11
- LCNASHSOFMRYFO-WDCWCFNPSA-N Leu-Thr-Gln Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@H](C(O)=O)CCC(N)=O LCNASHSOFMRYFO-WDCWCFNPSA-N 0.000 description 10
- 239000003795 chemical substances by application Substances 0.000 description 10
- 230000006698 induction Effects 0.000 description 10
- 238000003032 molecular docking Methods 0.000 description 10
- FAPWRFPIFSIZLT-UHFFFAOYSA-M Sodium chloride Chemical compound [Na+].[Cl-] FAPWRFPIFSIZLT-UHFFFAOYSA-M 0.000 description 9
- 229940127003 anti-diabetic drug Drugs 0.000 description 9
- 238000012360 testing method Methods 0.000 description 9
- OYQUOLRTJHWVSQ-SRVKXCTJSA-N Leu-His-Ser Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CC1=CNC=N1)C(=O)N[C@@H](CO)C(O)=O OYQUOLRTJHWVSQ-SRVKXCTJSA-N 0.000 description 8
- KDXKERNSBIXSRK-UHFFFAOYSA-N Lysine Natural products NCCCCC(N)C(O)=O KDXKERNSBIXSRK-UHFFFAOYSA-N 0.000 description 8
- 230000002503 metabolic effect Effects 0.000 description 8
- 101800005149 Peptide B Proteins 0.000 description 7
- 238000004458 analytical method Methods 0.000 description 7
- 238000000338 in vitro Methods 0.000 description 7
- 230000001965 increasing effect Effects 0.000 description 7
- 238000005259 measurement Methods 0.000 description 7
- 108010091748 peptide A Proteins 0.000 description 7
- RDFMDVXONNIGBC-UHFFFAOYSA-N (+-)-2-amino-heptanoic acid Natural products CCCCCC(N)C(O)=O RDFMDVXONNIGBC-UHFFFAOYSA-N 0.000 description 6
- DHMQDGOQFOQNFH-UHFFFAOYSA-N Glycine Chemical compound NCC(O)=O DHMQDGOQFOQNFH-UHFFFAOYSA-N 0.000 description 6
- FADYJNXDPBKVCA-UHFFFAOYSA-N L-Phenylalanyl-L-lysin Natural products NCCCCC(C(O)=O)NC(=O)C(N)CC1=CC=CC=C1 FADYJNXDPBKVCA-UHFFFAOYSA-N 0.000 description 6
- 239000004480 active ingredient Substances 0.000 description 6
- 230000037396 body weight Effects 0.000 description 6
- 150000001875 compounds Chemical class 0.000 description 6
- 150000001982 diacylglycerols Chemical class 0.000 description 6
- 235000005911 diet Nutrition 0.000 description 6
- 230000037213 diet Effects 0.000 description 6
- 201000010099 disease Diseases 0.000 description 6
- 108010050848 glycylleucine Proteins 0.000 description 6
- 238000000126 in silico method Methods 0.000 description 6
- 108010009298 lysylglutamic acid Proteins 0.000 description 6
- 238000004519 manufacturing process Methods 0.000 description 6
- 239000000546 pharmaceutical excipient Substances 0.000 description 6
- VRYALKFFQXWPIH-PBXRRBTRSA-N (3r,4s,5r)-3,4,5,6-tetrahydroxyhexanal Chemical compound OC[C@@H](O)[C@@H](O)[C@H](O)CC=O VRYALKFFQXWPIH-PBXRRBTRSA-N 0.000 description 5
- OVVUNXXROOFSIM-SDDRHHMPSA-N Arg-Arg-Pro Chemical compound C1C[C@@H](N(C1)C(=O)[C@H](CCCN=C(N)N)NC(=O)[C@H](CCCN=C(N)N)N)C(=O)O OVVUNXXROOFSIM-SDDRHHMPSA-N 0.000 description 5
- WHUUTDBJXJRKMK-UHFFFAOYSA-N Glutamic acid Natural products OC(=O)C(N)CCC(O)=O WHUUTDBJXJRKMK-UHFFFAOYSA-N 0.000 description 5
- 208000013016 Hypoglycemia Diseases 0.000 description 5
- 241001465754 Metazoa Species 0.000 description 5
- 108010029485 Protein Isoforms Proteins 0.000 description 5
- 102000001708 Protein Isoforms Human genes 0.000 description 5
- MTCFGRXMJLQNBG-UHFFFAOYSA-N Serine Natural products OCC(N)C(O)=O MTCFGRXMJLQNBG-UHFFFAOYSA-N 0.000 description 5
- 125000000539 amino acid group Chemical group 0.000 description 5
- 210000000170 cell membrane Anatomy 0.000 description 5
- 235000019197 fats Nutrition 0.000 description 5
- 238000009472 formulation Methods 0.000 description 5
- 150000002303 glucose derivatives Chemical class 0.000 description 5
- 229940126904 hypoglycaemic agent Drugs 0.000 description 5
- 230000002218 hypoglycaemic effect Effects 0.000 description 5
- 108010091871 leucylmethionine Proteins 0.000 description 5
- 230000004048 modification Effects 0.000 description 5
- 238000012986 modification Methods 0.000 description 5
- 210000003205 muscle Anatomy 0.000 description 5
- 108010070643 prolylglutamic acid Proteins 0.000 description 5
- 239000003826 tablet Substances 0.000 description 5
- 230000001225 therapeutic effect Effects 0.000 description 5
- XZFONYMRYTVLPL-NHCYSSNCSA-N Asn-Val-His Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CC1=CN=CN1)C(=O)O)NC(=O)[C@H](CC(=O)N)N XZFONYMRYTVLPL-NHCYSSNCSA-N 0.000 description 4
- WSFSSNUMVMOOMR-UHFFFAOYSA-N Formaldehyde Chemical compound O=C WSFSSNUMVMOOMR-UHFFFAOYSA-N 0.000 description 4
- OGNJZUXUTPQVBR-BQBZGAKWSA-N Glu-Gly-Glu Chemical compound OC(=O)CC[C@H](N)C(=O)NCC(=O)N[C@@H](CCC(O)=O)C(O)=O OGNJZUXUTPQVBR-BQBZGAKWSA-N 0.000 description 4
- WNGHUXFWEWTKAO-YUMQZZPRSA-N Gly-Ser-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](CO)NC(=O)CN WNGHUXFWEWTKAO-YUMQZZPRSA-N 0.000 description 4
- 241000282412 Homo Species 0.000 description 4
- ROHFNLRQFUQHCH-YFKPBYRVSA-N L-leucine Chemical compound CC(C)C[C@H](N)C(O)=O ROHFNLRQFUQHCH-YFKPBYRVSA-N 0.000 description 4
- AYFVYJQAPQTCCC-GBXIJSLDSA-N L-threonine Chemical compound C[C@@H](O)[C@H](N)C(O)=O AYFVYJQAPQTCCC-GBXIJSLDSA-N 0.000 description 4
- ROHFNLRQFUQHCH-UHFFFAOYSA-N Leucine Natural products CC(C)CC(N)C(O)=O ROHFNLRQFUQHCH-UHFFFAOYSA-N 0.000 description 4
- FJVJLMZUIGMFFU-BQBZGAKWSA-N Met-Asp-Gly Chemical compound CSCC[C@H](N)C(=O)N[C@@H](CC(O)=O)C(=O)NCC(O)=O FJVJLMZUIGMFFU-BQBZGAKWSA-N 0.000 description 4
- IHRFZLQEQVHXFA-RHYQMDGZSA-N Met-Thr-Lys Chemical compound CSCC[C@H](N)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@H](C(O)=O)CCCCN IHRFZLQEQVHXFA-RHYQMDGZSA-N 0.000 description 4
- YBAFDPFAUTYYRW-UHFFFAOYSA-N N-L-alpha-glutamyl-L-leucine Natural products CC(C)CC(C(O)=O)NC(=O)C(N)CCC(O)=O YBAFDPFAUTYYRW-UHFFFAOYSA-N 0.000 description 4
- 102100024924 Protein kinase C alpha type Human genes 0.000 description 4
- YASAKCUCGLMORW-UHFFFAOYSA-N Rosiglitazone Chemical compound C=1C=CC=NC=1N(C)CCOC(C=C1)=CC=C1CC1SC(=O)NC1=O YASAKCUCGLMORW-UHFFFAOYSA-N 0.000 description 4
- XKFJENWJGHMDLI-QWRGUYRKSA-N Ser-Phe-Gly Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)NCC(O)=O XKFJENWJGHMDLI-QWRGUYRKSA-N 0.000 description 4
- RKDFEMGVMMYYNG-WDCWCFNPSA-N Thr-Gln-Leu Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CC(C)C)C(O)=O RKDFEMGVMMYYNG-WDCWCFNPSA-N 0.000 description 4
- UGFSAPWZBROURT-IXOXFDKPSA-N Thr-Phe-Cys Chemical compound C[C@H]([C@@H](C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CS)C(=O)O)N)O UGFSAPWZBROURT-IXOXFDKPSA-N 0.000 description 4
- AYFVYJQAPQTCCC-UHFFFAOYSA-N Threonine Natural products CC(O)C(N)C(O)=O AYFVYJQAPQTCCC-UHFFFAOYSA-N 0.000 description 4
- 239000004473 Threonine Substances 0.000 description 4
- JAIZPWVHPQRYOU-ZJDVBMNYSA-N Val-Thr-Thr Chemical compound C[C@H]([C@@H](C(=O)N[C@@H]([C@@H](C)O)C(=O)O)NC(=O)[C@H](C(C)C)N)O JAIZPWVHPQRYOU-ZJDVBMNYSA-N 0.000 description 4
- 238000010521 absorption reaction Methods 0.000 description 4
- 210000000593 adipose tissue white Anatomy 0.000 description 4
- 108010005233 alanylglutamic acid Proteins 0.000 description 4
- 238000012512 characterization method Methods 0.000 description 4
- 108010016616 cysteinylglycine Proteins 0.000 description 4
- 239000003937 drug carrier Substances 0.000 description 4
- 238000005516 engineering process Methods 0.000 description 4
- 238000002474 experimental method Methods 0.000 description 4
- 230000014101 glucose homeostasis Effects 0.000 description 4
- 108010066198 glycyl-leucyl-phenylalanine Proteins 0.000 description 4
- 210000001596 intra-abdominal fat Anatomy 0.000 description 4
- 108010017391 lysylvaline Proteins 0.000 description 4
- 239000000463 material Substances 0.000 description 4
- HYAFETHFCAUJAY-UHFFFAOYSA-N pioglitazone Chemical compound N1=CC(CC)=CC=C1CCOC(C=C1)=CC=C1CC1C(=O)NC(=O)S1 HYAFETHFCAUJAY-UHFFFAOYSA-N 0.000 description 4
- 239000000843 powder Substances 0.000 description 4
- 238000002360 preparation method Methods 0.000 description 4
- 230000002441 reversible effect Effects 0.000 description 4
- 108010026333 seryl-proline Proteins 0.000 description 4
- 238000010254 subcutaneous injection Methods 0.000 description 4
- 239000007929 subcutaneous injection Substances 0.000 description 4
- 230000009885 systemic effect Effects 0.000 description 4
- 230000008685 targeting Effects 0.000 description 4
- MTCFGRXMJLQNBG-REOHCLBHSA-N (2S)-2-Amino-3-hydroxypropansäure Chemical compound OC[C@H](N)C(O)=O MTCFGRXMJLQNBG-REOHCLBHSA-N 0.000 description 3
- QWCKQJZIFLGMSD-UHFFFAOYSA-N 2-Aminobutanoic acid Natural products CCC(N)C(O)=O QWCKQJZIFLGMSD-UHFFFAOYSA-N 0.000 description 3
- FWBHETKCLVMNFS-UHFFFAOYSA-N 4',6-Diamino-2-phenylindol Chemical compound C1=CC(C(=N)N)=CC=C1C1=CC2=CC=C(C(N)=N)C=C2N1 FWBHETKCLVMNFS-UHFFFAOYSA-N 0.000 description 3
- 101150005161 ALMS1 gene Proteins 0.000 description 3
- GGNHBHYDMUDXQB-KBIXCLLPSA-N Ala-Glu-Ile Chemical compound CC[C@H](C)[C@@H](C(O)=O)NC(=O)[C@H](CCC(O)=O)NC(=O)[C@H](C)N GGNHBHYDMUDXQB-KBIXCLLPSA-N 0.000 description 3
- MOGMYRUNTKYZFB-UNQGMJICSA-N Arg-Thr-Phe Chemical compound NC(N)=NCCC[C@H](N)C(=O)N[C@@H]([C@H](O)C)C(=O)N[C@H](C(O)=O)CC1=CC=CC=C1 MOGMYRUNTKYZFB-UNQGMJICSA-N 0.000 description 3
- VPSHHQXIWLGVDD-ZLUOBGJFSA-N Asp-Asp-Asp Chemical compound OC(=O)C[C@H](N)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CC(O)=O)C(O)=O VPSHHQXIWLGVDD-ZLUOBGJFSA-N 0.000 description 3
- SKSJPIBFNFPTJB-NKWVEPMBSA-N Cys-Gly-Pro Chemical compound C1C[C@@H](N(C1)C(=O)CNC(=O)[C@H](CS)N)C(=O)O SKSJPIBFNFPTJB-NKWVEPMBSA-N 0.000 description 3
- QWCKQJZIFLGMSD-GSVOUGTGSA-N D-alpha-aminobutyric acid Chemical compound CC[C@@H](N)C(O)=O QWCKQJZIFLGMSD-GSVOUGTGSA-N 0.000 description 3
- YDJOULGWHQRPEV-SRVKXCTJSA-N Glu-His-Met Chemical compound CSCC[C@@H](C(=O)O)NC(=O)[C@H](CC1=CN=CN1)NC(=O)[C@H](CCC(=O)O)N YDJOULGWHQRPEV-SRVKXCTJSA-N 0.000 description 3
- MYXNLWDWWOTERK-BHNWBGBOSA-N Gly-Thr-Pro Chemical compound C[C@H]([C@@H](C(=O)N1CCC[C@@H]1C(=O)O)NC(=O)CN)O MYXNLWDWWOTERK-BHNWBGBOSA-N 0.000 description 3
- 239000004471 Glycine Substances 0.000 description 3
- WKEABZIITNXXQZ-CIUDSAMLSA-N His-Ser-Cys Chemical compound C1=C(NC=N1)C[C@@H](C(=O)N[C@@H](CO)C(=O)N[C@@H](CS)C(=O)O)N WKEABZIITNXXQZ-CIUDSAMLSA-N 0.000 description 3
- 101100162491 Homo sapiens ALMS1 gene Proteins 0.000 description 3
- LJKDGRWXYUTRSH-YVNDNENWSA-N Ile-Gln-Gln Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CCC(=O)N)C(=O)N[C@@H](CCC(=O)N)C(=O)O)N LJKDGRWXYUTRSH-YVNDNENWSA-N 0.000 description 3
- FFAUOCITXBMRBT-YTFOTSKYSA-N Ile-Lys-Ile Chemical compound CC[C@H](C)[C@H](N)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O FFAUOCITXBMRBT-YTFOTSKYSA-N 0.000 description 3
- 102100023915 Insulin Human genes 0.000 description 3
- ONIBWKKTOPOVIA-BYPYZUCNSA-N L-Proline Chemical compound OC(=O)[C@@H]1CCCN1 ONIBWKKTOPOVIA-BYPYZUCNSA-N 0.000 description 3
- ODKSFYDXXFIFQN-BYPYZUCNSA-P L-argininium(2+) Chemical compound NC(=[NH2+])NCCC[C@H]([NH3+])C(O)=O ODKSFYDXXFIFQN-BYPYZUCNSA-P 0.000 description 3
- NTSPQIONFJUMJV-AVGNSLFASA-N Lys-Arg-Val Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](C(C)C)C(O)=O NTSPQIONFJUMJV-AVGNSLFASA-N 0.000 description 3
- GQFDWEDHOQRNLC-QWRGUYRKSA-N Lys-Gly-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)CNC(=O)[C@@H](N)CCCCN GQFDWEDHOQRNLC-QWRGUYRKSA-N 0.000 description 3
- AZOFEHCPMBRNFD-BZSNNMDCSA-N Lys-Phe-Lys Chemical compound NCCCC[C@H](N)C(=O)N[C@H](C(=O)N[C@@H](CCCCN)C(O)=O)CC1=CC=CC=C1 AZOFEHCPMBRNFD-BZSNNMDCSA-N 0.000 description 3
- 239000004472 Lysine Substances 0.000 description 3
- 241000124008 Mammalia Species 0.000 description 3
- IZLCDZDNZFEDHB-DCAQKATOSA-N Met-Cys-Lys Chemical compound CSCC[C@@H](C(=O)N[C@@H](CS)C(=O)N[C@@H](CCCCN)C(=O)O)N IZLCDZDNZFEDHB-DCAQKATOSA-N 0.000 description 3
- TWEWRDAAIYBJTO-ULQDDVLXSA-N Met-Tyr-His Chemical compound CSCC[C@@H](C(=O)N[C@@H](CC1=CC=C(C=C1)O)C(=O)N[C@@H](CC2=CN=CN2)C(=O)O)N TWEWRDAAIYBJTO-ULQDDVLXSA-N 0.000 description 3
- FSTWDRPCQQUJIT-NHCYSSNCSA-N Met-Val-Glu Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CCC(=O)O)C(=O)O)NC(=O)[C@H](CCSC)N FSTWDRPCQQUJIT-NHCYSSNCSA-N 0.000 description 3
- OKKJLVBELUTLKV-UHFFFAOYSA-N Methanol Chemical compound OC OKKJLVBELUTLKV-UHFFFAOYSA-N 0.000 description 3
- ZMXDDKWLCZADIW-UHFFFAOYSA-N N,N-Dimethylformamide Chemical compound CN(C)C=O ZMXDDKWLCZADIW-UHFFFAOYSA-N 0.000 description 3
- XZFYRXDAULDNFX-UHFFFAOYSA-N N-L-cysteinyl-L-phenylalanine Natural products SCC(N)C(=O)NC(C(O)=O)CC1=CC=CC=C1 XZFYRXDAULDNFX-UHFFFAOYSA-N 0.000 description 3
- 229930193140 Neomycin Natural products 0.000 description 3
- 101100342977 Neurospora crassa (strain ATCC 24698 / 74-OR23-1A / CBS 708.71 / DSM 1257 / FGSC 987) leu-1 gene Proteins 0.000 description 3
- NKLDZIPTGKBDBB-HTUGSXCWSA-N Phe-Gln-Thr Chemical compound C[C@H]([C@@H](C(=O)O)NC(=O)[C@H](CCC(=O)N)NC(=O)[C@H](CC1=CC=CC=C1)N)O NKLDZIPTGKBDBB-HTUGSXCWSA-N 0.000 description 3
- QTDBZORPVYTRJU-KKXDTOCCSA-N Phe-Tyr-Ala Chemical compound [H]N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](C)C(O)=O QTDBZORPVYTRJU-KKXDTOCCSA-N 0.000 description 3
- 101800001357 Potential peptide Proteins 0.000 description 3
- 102400000745 Potential peptide Human genes 0.000 description 3
- DNIAPMSPPWPWGF-UHFFFAOYSA-N Propylene glycol Chemical compound CC(O)CO DNIAPMSPPWPWGF-UHFFFAOYSA-N 0.000 description 3
- 101710109947 Protein kinase C alpha type Proteins 0.000 description 3
- HEMHJVSKTPXQMS-UHFFFAOYSA-M Sodium hydroxide Chemical compound [OH-].[Na+] HEMHJVSKTPXQMS-UHFFFAOYSA-M 0.000 description 3
- 229920002472 Starch Polymers 0.000 description 3
- XQVRMLRMTAGSFJ-QXEWZRGKSA-N Val-Asp-Arg Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CC(=O)O)C(=O)N[C@@H](CCCN=C(N)N)C(=O)O)N XQVRMLRMTAGSFJ-QXEWZRGKSA-N 0.000 description 3
- WNZSAUMKZQXHNC-UKJIMTQDSA-N Val-Ile-Gln Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CCC(=O)N)C(=O)O)NC(=O)[C@H](C(C)C)N WNZSAUMKZQXHNC-UKJIMTQDSA-N 0.000 description 3
- 230000004913 activation Effects 0.000 description 3
- 238000013459 approach Methods 0.000 description 3
- 108010043240 arginyl-leucyl-glycine Proteins 0.000 description 3
- 108010059459 arginyl-threonyl-phenylalanine Proteins 0.000 description 3
- 125000003178 carboxy group Chemical group [H]OC(*)=O 0.000 description 3
- 230000001413 cellular effect Effects 0.000 description 3
- 238000004132 cross linking Methods 0.000 description 3
- XUJNEKJLAYXESH-UHFFFAOYSA-N cysteine Natural products SCC(N)C(O)=O XUJNEKJLAYXESH-UHFFFAOYSA-N 0.000 description 3
- 235000018417 cysteine Nutrition 0.000 description 3
- 230000007547 defect Effects 0.000 description 3
- 238000011156 evaluation Methods 0.000 description 3
- 108010015792 glycyllysine Proteins 0.000 description 3
- 239000001963 growth medium Substances 0.000 description 3
- 108010018006 histidylserine Proteins 0.000 description 3
- MGXWVYUBJRZYPE-YUGYIWNOSA-N incretin Chemical class C([C@@H](C(=O)N[C@@H](CO)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](C)C(=O)N[C@@H](CCSC)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CC=1NC=NC=1)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CC=1C=CC=CC=1)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CC=1C2=CC=CC=C2NC=1)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](C)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CCCCN)C(=O)NCC(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CC=1C2=CC=CC=C2NC=1)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CC=1NC=NC=1)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCC(N)=O)C(O)=O)NC(=O)[C@H](CC(O)=O)NC(=O)[C@H](CO)NC(=O)[C@@H](NC(=O)[C@H](CC=1C=CC=CC=1)NC(=O)[C@@H](NC(=O)CNC(=O)[C@H](CCC(O)=O)NC(=O)[C@H](C)NC(=O)[C@@H](N)CC=1C=CC(O)=CC=1)[C@@H](C)O)[C@@H](C)CC)C1=CC=C(O)C=C1 MGXWVYUBJRZYPE-YUGYIWNOSA-N 0.000 description 3
- 239000000859 incretin Substances 0.000 description 3
- 230000003993 interaction Effects 0.000 description 3
- 230000003834 intracellular effect Effects 0.000 description 3
- 108010012058 leucyltyrosine Proteins 0.000 description 3
- 239000002609 medium Substances 0.000 description 3
- 108020004999 messenger RNA Proteins 0.000 description 3
- 108010085203 methionylmethionine Proteins 0.000 description 3
- 229960004927 neomycin Drugs 0.000 description 3
- 229920001223 polyethylene glycol Polymers 0.000 description 3
- 108010077112 prolyl-proline Proteins 0.000 description 3
- 239000011780 sodium chloride Substances 0.000 description 3
- 239000000243 solution Substances 0.000 description 3
- 239000008107 starch Substances 0.000 description 3
- 235000019698 starch Nutrition 0.000 description 3
- 235000000346 sugar Nutrition 0.000 description 3
- 238000002560 therapeutic procedure Methods 0.000 description 3
- XUFXOAAUWZOOIT-SXARVLRPSA-N (2R,3R,4R,5S,6R)-5-[[(2R,3R,4R,5S,6R)-5-[[(2R,3R,4S,5S,6R)-3,4-dihydroxy-6-methyl-5-[[(1S,4R,5S,6S)-4,5,6-trihydroxy-3-(hydroxymethyl)-1-cyclohex-2-enyl]amino]-2-oxanyl]oxy]-3,4-dihydroxy-6-(hydroxymethyl)-2-oxanyl]oxy]-6-(hydroxymethyl)oxane-2,3,4-triol Chemical compound O([C@H]1O[C@H](CO)[C@H]([C@@H]([C@H]1O)O)O[C@H]1O[C@@H]([C@H]([C@H](O)[C@H]1O)N[C@@H]1[C@@H]([C@@H](O)[C@H](O)C(CO)=C1)O)C)[C@@H]1[C@@H](CO)O[C@@H](O)[C@H](O)[C@H]1O XUFXOAAUWZOOIT-SXARVLRPSA-N 0.000 description 2
- QUTFFEUUGHUPQC-ILWYWAAHSA-N (2r,3r,4s,5r)-3,4,5,6-tetrahydroxy-2-[(4-nitro-2,1,3-benzoxadiazol-7-yl)amino]hexanal Chemical compound OC[C@@H](O)[C@@H](O)[C@H](O)[C@H](C=O)NC1=CC=C([N+]([O-])=O)C2=NON=C12 QUTFFEUUGHUPQC-ILWYWAAHSA-N 0.000 description 2
- LWUWMHIOBPTZBA-DCAQKATOSA-N Ala-Arg-Lys Chemical compound NC(=N)NCCC[C@H](NC(=O)[C@@H](N)C)C(=O)N[C@@H](CCCCN)C(O)=O LWUWMHIOBPTZBA-DCAQKATOSA-N 0.000 description 2
- XEXJJJRVTFGWIC-FXQIFTODSA-N Ala-Asn-Arg Chemical compound C[C@@H](C(=O)N[C@@H](CC(=O)N)C(=O)N[C@@H](CCCN=C(N)N)C(=O)O)N XEXJJJRVTFGWIC-FXQIFTODSA-N 0.000 description 2
- PBAMJJXWDQXOJA-FXQIFTODSA-N Ala-Asp-Arg Chemical compound C[C@H](N)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@H](C(O)=O)CCCN=C(N)N PBAMJJXWDQXOJA-FXQIFTODSA-N 0.000 description 2
- AJBVYEYZVYPFCF-CIUDSAMLSA-N Ala-Lys-Asn Chemical compound [H]N[C@@H](C)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CC(N)=O)C(O)=O AJBVYEYZVYPFCF-CIUDSAMLSA-N 0.000 description 2
- PMQXMXAASGFUDX-SRVKXCTJSA-N Ala-Lys-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@@H](NC(=O)[C@H](C)N)CCCCN PMQXMXAASGFUDX-SRVKXCTJSA-N 0.000 description 2
- IORKCNUBHNIMKY-CIUDSAMLSA-N Ala-Pro-Glu Chemical compound C[C@H](N)C(=O)N1CCC[C@H]1C(=O)N[C@@H](CCC(O)=O)C(O)=O IORKCNUBHNIMKY-CIUDSAMLSA-N 0.000 description 2
- 108700028369 Alleles Proteins 0.000 description 2
- GUBGYTABKSRVRQ-XLOQQCSPSA-N Alpha-Lactose Chemical compound O[C@@H]1[C@@H](O)[C@@H](O)[C@@H](CO)O[C@H]1O[C@@H]1[C@@H](CO)O[C@H](O)[C@H](O)[C@H]1O GUBGYTABKSRVRQ-XLOQQCSPSA-N 0.000 description 2
- 206010068783 Alstroem syndrome Diseases 0.000 description 2
- 239000004114 Ammonium polyphosphate Substances 0.000 description 2
- VXXHDZKEQNGXNU-QXEWZRGKSA-N Arg-Asp-Val Chemical compound CC(C)[C@@H](C(O)=O)NC(=O)[C@H](CC(O)=O)NC(=O)[C@@H](N)CCCN=C(N)N VXXHDZKEQNGXNU-QXEWZRGKSA-N 0.000 description 2
- OANWAFQRNQEDSY-DCAQKATOSA-N Arg-Cys-His Chemical compound C1=C(NC=N1)C[C@@H](C(=O)O)NC(=O)[C@H](CS)NC(=O)[C@H](CCCN=C(N)N)N OANWAFQRNQEDSY-DCAQKATOSA-N 0.000 description 2
- OBFTYSPXDRROQO-SRVKXCTJSA-N Arg-Gln-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@H](CCC(N)=O)NC(=O)[C@@H](N)CCCN=C(N)N OBFTYSPXDRROQO-SRVKXCTJSA-N 0.000 description 2
- YKBHOXLMMPZPHQ-GMOBBJLQSA-N Arg-Ile-Asp Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CC(O)=O)C(O)=O YKBHOXLMMPZPHQ-GMOBBJLQSA-N 0.000 description 2
- FNXCAFKDGBROCU-STECZYCISA-N Arg-Ile-Tyr Chemical compound NC(N)=NCCC[C@H](N)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@H](C(O)=O)CC1=CC=C(O)C=C1 FNXCAFKDGBROCU-STECZYCISA-N 0.000 description 2
- YBZMTKUDWXZLIX-UWVGGRQHSA-N Arg-Leu-Gly Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC(C)C)C(=O)NCC(O)=O YBZMTKUDWXZLIX-UWVGGRQHSA-N 0.000 description 2
- RIIVUOJDDQXHRV-SRVKXCTJSA-N Arg-Lys-Gln Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CCC(N)=O)C(O)=O RIIVUOJDDQXHRV-SRVKXCTJSA-N 0.000 description 2
- MNBHKGYCLBUIBC-UFYCRDLUSA-N Arg-Phe-Phe Chemical compound C([C@H](NC(=O)[C@H](CCCNC(N)=N)N)C(=O)N[C@@H](CC=1C=CC=CC=1)C(O)=O)C1=CC=CC=C1 MNBHKGYCLBUIBC-UFYCRDLUSA-N 0.000 description 2
- WOZDCBHUGJVJPL-AVGNSLFASA-N Arg-Val-Lys Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CCCCN)C(=O)O)NC(=O)[C@H](CCCN=C(N)N)N WOZDCBHUGJVJPL-AVGNSLFASA-N 0.000 description 2
- JZRLLSOWDYUKOK-SRVKXCTJSA-N Asn-Asp-Phe Chemical compound C1=CC=C(C=C1)C[C@@H](C(=O)O)NC(=O)[C@H](CC(=O)O)NC(=O)[C@H](CC(=O)N)N JZRLLSOWDYUKOK-SRVKXCTJSA-N 0.000 description 2
- NNMUHYLAYUSTTN-FXQIFTODSA-N Asn-Gln-Glu Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CCC(O)=O)C(O)=O NNMUHYLAYUSTTN-FXQIFTODSA-N 0.000 description 2
- HYQYLOSCICEYTR-YUMQZZPRSA-N Asn-Gly-Leu Chemical compound [H]N[C@@H](CC(N)=O)C(=O)NCC(=O)N[C@@H](CC(C)C)C(O)=O HYQYLOSCICEYTR-YUMQZZPRSA-N 0.000 description 2
- ANPFQTJEPONRPL-UGYAYLCHSA-N Asn-Ile-Asp Chemical compound NC(=O)C[C@H](N)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CC(O)=O)C(O)=O ANPFQTJEPONRPL-UGYAYLCHSA-N 0.000 description 2
- BXUHCIXDSWRSBS-CIUDSAMLSA-N Asn-Leu-Asp Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CC(O)=O)C(O)=O BXUHCIXDSWRSBS-CIUDSAMLSA-N 0.000 description 2
- HMUKKNAMNSXDBB-CIUDSAMLSA-N Asn-Met-Glu Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CCSC)C(=O)N[C@@H](CCC(O)=O)C(O)=O HMUKKNAMNSXDBB-CIUDSAMLSA-N 0.000 description 2
- LSJQOMAZIKQMTJ-SRVKXCTJSA-N Asn-Phe-Asp Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CC(O)=O)C(O)=O LSJQOMAZIKQMTJ-SRVKXCTJSA-N 0.000 description 2
- HZZIFFOVHLWGCS-KKUMJFAQSA-N Asn-Phe-Leu Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CC(C)C)C(O)=O HZZIFFOVHLWGCS-KKUMJFAQSA-N 0.000 description 2
- XMHFCUKJRCQXGI-CIUDSAMLSA-N Asn-Pro-Gln Chemical compound C1C[C@H](N(C1)C(=O)[C@H](CC(=O)N)N)C(=O)N[C@@H](CCC(=O)N)C(=O)O XMHFCUKJRCQXGI-CIUDSAMLSA-N 0.000 description 2
- SYZWMVSXBZCOBZ-QXEWZRGKSA-N Asn-Val-Met Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CCSC)C(=O)O)NC(=O)[C@H](CC(=O)N)N SYZWMVSXBZCOBZ-QXEWZRGKSA-N 0.000 description 2
- PQKSVQSMTHPRIB-ZKWXMUAHSA-N Asn-Val-Ser Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CO)C(O)=O PQKSVQSMTHPRIB-ZKWXMUAHSA-N 0.000 description 2
- GVPSCJQLUGIKAM-GUBZILKMSA-N Asp-Arg-Arg Chemical compound OC(=O)C[C@H](N)C(=O)N[C@@H](CCCN=C(N)N)C(=O)N[C@@H](CCCN=C(N)N)C(O)=O GVPSCJQLUGIKAM-GUBZILKMSA-N 0.000 description 2
- HRGGPWBIMIQANI-GUBZILKMSA-N Asp-Gln-Leu Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CC(C)C)C(O)=O HRGGPWBIMIQANI-GUBZILKMSA-N 0.000 description 2
- KHBLRHKVXICFMY-GUBZILKMSA-N Asp-Glu-Lys Chemical compound N[C@@H](CC(=O)O)C(=O)N[C@@H](CCC(=O)O)C(=O)N[C@@H](CCCCN)C(=O)O KHBLRHKVXICFMY-GUBZILKMSA-N 0.000 description 2
- CMCIMCAQIULNDJ-CIUDSAMLSA-N Asp-His-Cys Chemical compound C1=C(NC=N1)C[C@@H](C(=O)N[C@@H](CS)C(=O)O)NC(=O)[C@H](CC(=O)O)N CMCIMCAQIULNDJ-CIUDSAMLSA-N 0.000 description 2
- ODNWIBOCFGMRTP-SRVKXCTJSA-N Asp-His-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@@H](NC(=O)[C@@H](N)CC(O)=O)CC1=CN=CN1 ODNWIBOCFGMRTP-SRVKXCTJSA-N 0.000 description 2
- RKNIUWSZIAUEPK-PBCZWWQYSA-N Asp-His-Thr Chemical compound C[C@H]([C@@H](C(=O)O)NC(=O)[C@H](CC1=CN=CN1)NC(=O)[C@H](CC(=O)O)N)O RKNIUWSZIAUEPK-PBCZWWQYSA-N 0.000 description 2
- LBOVBQONZJRWPV-YUMQZZPRSA-N Asp-Lys-Gly Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](CCCCN)C(=O)NCC(O)=O LBOVBQONZJRWPV-YUMQZZPRSA-N 0.000 description 2
- QJHOOKBAHRJPPX-QWRGUYRKSA-N Asp-Phe-Gly Chemical compound OC(=O)C[C@H](N)C(=O)N[C@H](C(=O)NCC(O)=O)CC1=CC=CC=C1 QJHOOKBAHRJPPX-QWRGUYRKSA-N 0.000 description 2
- PCJOFZYFFMBZKC-PCBIJLKTSA-N Asp-Phe-Ile Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O PCJOFZYFFMBZKC-PCBIJLKTSA-N 0.000 description 2
- ZKAOJVJQGVUIIU-GUBZILKMSA-N Asp-Pro-Arg Chemical compound OC(=O)C[C@H](N)C(=O)N1CCC[C@H]1C(=O)N[C@@H](CCCNC(N)=N)C(O)=O ZKAOJVJQGVUIIU-GUBZILKMSA-N 0.000 description 2
- GGRSYTUJHAZTFN-IHRRRGAJSA-N Asp-Pro-Tyr Chemical compound C1C[C@H](N(C1)C(=O)[C@H](CC(=O)O)N)C(=O)N[C@@H](CC2=CC=C(C=C2)O)C(=O)O GGRSYTUJHAZTFN-IHRRRGAJSA-N 0.000 description 2
- OTKUAVXGMREHRX-CFMVVWHZSA-N Asp-Tyr-Ile Chemical compound CC[C@H](C)[C@@H](C(O)=O)NC(=O)[C@@H](NC(=O)[C@@H](N)CC(O)=O)CC1=CC=C(O)C=C1 OTKUAVXGMREHRX-CFMVVWHZSA-N 0.000 description 2
- DCXYFEDJOCDNAF-UHFFFAOYSA-N Asparagine Natural products OC(=O)C(N)CC(N)=O DCXYFEDJOCDNAF-UHFFFAOYSA-N 0.000 description 2
- 102100021277 Beta-secretase 2 Human genes 0.000 description 2
- 125000001433 C-terminal amino-acid group Chemical group 0.000 description 2
- RKWGIWYCVPQPMF-UHFFFAOYSA-N Chloropropamide Chemical compound CCCNC(=O)NS(=O)(=O)C1=CC=C(Cl)C=C1 RKWGIWYCVPQPMF-UHFFFAOYSA-N 0.000 description 2
- 108091026890 Coding region Proteins 0.000 description 2
- 108010069514 Cyclic Peptides Proteins 0.000 description 2
- 102000001189 Cyclic Peptides Human genes 0.000 description 2
- QYKJOVAXAKTKBR-FXQIFTODSA-N Cys-Asp-Met Chemical compound CSCC[C@@H](C(=O)O)NC(=O)[C@H](CC(=O)O)NC(=O)[C@H](CS)N QYKJOVAXAKTKBR-FXQIFTODSA-N 0.000 description 2
- ASHTVGGFIMESRD-LKXGYXEUSA-N Cys-Asp-Thr Chemical compound C[C@H]([C@@H](C(=O)O)NC(=O)[C@H](CC(=O)O)NC(=O)[C@H](CS)N)O ASHTVGGFIMESRD-LKXGYXEUSA-N 0.000 description 2
- ZQHQTSONVIANQR-BQBZGAKWSA-N Cys-Gly-Met Chemical compound CSCC[C@@H](C(=O)O)NC(=O)CNC(=O)[C@H](CS)N ZQHQTSONVIANQR-BQBZGAKWSA-N 0.000 description 2
- OXOQBEVULIBOSH-ZDLURKLDSA-N Cys-Gly-Thr Chemical compound [H]N[C@@H](CS)C(=O)NCC(=O)N[C@@H]([C@@H](C)O)C(O)=O OXOQBEVULIBOSH-ZDLURKLDSA-N 0.000 description 2
- YYLBXQJGWOQZOU-IHRRRGAJSA-N Cys-Phe-Val Chemical compound CC(C)[C@@H](C(=O)O)NC(=O)[C@H](CC1=CC=CC=C1)NC(=O)[C@H](CS)N YYLBXQJGWOQZOU-IHRRRGAJSA-N 0.000 description 2
- 108010090461 DFG peptide Proteins 0.000 description 2
- 108020004414 DNA Proteins 0.000 description 2
- JVHXJTBJCFBINQ-ADAARDCZSA-N Dapagliflozin Chemical compound C1=CC(OCC)=CC=C1CC1=CC([C@H]2[C@@H]([C@@H](O)[C@H](O)[C@@H](CO)O2)O)=CC=C1Cl JVHXJTBJCFBINQ-ADAARDCZSA-N 0.000 description 2
- IAZDPXIOMUYVGZ-UHFFFAOYSA-N Dimethylsulphoxide Chemical compound CS(C)=O IAZDPXIOMUYVGZ-UHFFFAOYSA-N 0.000 description 2
- JSYULGSPLTZDHM-NRPADANISA-N Gln-Ala-Val Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H](C)C(=O)N[C@@H](C(C)C)C(O)=O JSYULGSPLTZDHM-NRPADANISA-N 0.000 description 2
- VUVKKXPCKILIBD-AVGNSLFASA-N Gln-Leu-His Chemical compound CC(C)C[C@@H](C(=O)N[C@@H](CC1=CN=CN1)C(=O)O)NC(=O)[C@H](CCC(=O)N)N VUVKKXPCKILIBD-AVGNSLFASA-N 0.000 description 2
- WLRYGVYQFXRJDA-DCAQKATOSA-N Gln-Pro-Pro Chemical compound NC(=O)CC[C@H](N)C(=O)N1CCC[C@H]1C(=O)N1[C@H](C(O)=O)CCC1 WLRYGVYQFXRJDA-DCAQKATOSA-N 0.000 description 2
- DCWNCMRZIZSZBL-KKUMJFAQSA-N Gln-Pro-Tyr Chemical compound C1C[C@H](N(C1)C(=O)[C@H](CCC(=O)N)N)C(=O)N[C@@H](CC2=CC=C(C=C2)O)C(=O)O DCWNCMRZIZSZBL-KKUMJFAQSA-N 0.000 description 2
- YPFFHGRJCUBXPX-NHCYSSNCSA-N Gln-Pro-Val Chemical compound CC(C)[C@H](NC(=O)[C@@H]1CCCN1C(=O)[C@@H](N)CCC(N)=O)C(O)=O YPFFHGRJCUBXPX-NHCYSSNCSA-N 0.000 description 2
- KUBFPYIMAGXGBT-ACZMJKKPSA-N Gln-Ser-Ala Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H](CO)C(=O)N[C@@H](C)C(O)=O KUBFPYIMAGXGBT-ACZMJKKPSA-N 0.000 description 2
- UTOQQOMEJDPDMX-ACZMJKKPSA-N Gln-Ser-Asp Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H](CO)C(=O)N[C@@H](CC(O)=O)C(O)=O UTOQQOMEJDPDMX-ACZMJKKPSA-N 0.000 description 2
- SXFPZRRVWSUYII-KBIXCLLPSA-N Gln-Ser-Ile Chemical compound CC[C@H](C)[C@@H](C(=O)O)NC(=O)[C@H](CO)NC(=O)[C@H](CCC(=O)N)N SXFPZRRVWSUYII-KBIXCLLPSA-N 0.000 description 2
- KHHDJQRWIFHXHS-NRPADANISA-N Gln-Val-Cys Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CS)C(=O)O)NC(=O)[C@H](CCC(=O)N)N KHHDJQRWIFHXHS-NRPADANISA-N 0.000 description 2
- NCWOMXABNYEPLY-NRPADANISA-N Glu-Ala-Val Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](C)C(=O)N[C@@H](C(C)C)C(O)=O NCWOMXABNYEPLY-NRPADANISA-N 0.000 description 2
- XXCDTYBVGMPIOA-FXQIFTODSA-N Glu-Asp-Glu Chemical compound OC(=O)CC[C@H](N)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CCC(O)=O)C(O)=O XXCDTYBVGMPIOA-FXQIFTODSA-N 0.000 description 2
- SJPMNHCEWPTRBR-BQBZGAKWSA-N Glu-Glu-Gly Chemical compound OC(=O)CC[C@H](N)C(=O)N[C@@H](CCC(O)=O)C(=O)NCC(O)=O SJPMNHCEWPTRBR-BQBZGAKWSA-N 0.000 description 2
- MUSGDMDGNGXULI-DCAQKATOSA-N Glu-Glu-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](CCC(O)=O)NC(=O)[C@@H](N)CCC(O)=O MUSGDMDGNGXULI-DCAQKATOSA-N 0.000 description 2
- MTAOBYXRYJZRGQ-WDSKDSINSA-N Glu-Gly-Asp Chemical compound OC(=O)CC[C@H](N)C(=O)NCC(=O)N[C@@H](CC(O)=O)C(O)=O MTAOBYXRYJZRGQ-WDSKDSINSA-N 0.000 description 2
- CAVMESABQIKFKT-IUCAKERBSA-N Glu-Gly-His Chemical compound C1=C(NC=N1)C[C@@H](C(=O)O)NC(=O)CNC(=O)[C@H](CCC(=O)O)N CAVMESABQIKFKT-IUCAKERBSA-N 0.000 description 2
- VXQOONWNIWFOCS-HGNGGELXSA-N Glu-His-Ala Chemical compound C[C@@H](C(=O)O)NC(=O)[C@H](CC1=CN=CN1)NC(=O)[C@H](CCC(=O)O)N VXQOONWNIWFOCS-HGNGGELXSA-N 0.000 description 2
- WVYJNPCWJYBHJG-YVNDNENWSA-N Glu-Ile-Gln Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CCC(N)=O)C(O)=O WVYJNPCWJYBHJG-YVNDNENWSA-N 0.000 description 2
- WNRZUESNGGDCJX-JYJNAYRXSA-N Glu-Leu-Phe Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CC1=CC=CC=C1)C(O)=O WNRZUESNGGDCJX-JYJNAYRXSA-N 0.000 description 2
- BXSZPACYCMNKLS-AVGNSLFASA-N Glu-Ser-Phe Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](CO)C(=O)N[C@@H](CC1=CC=CC=C1)C(O)=O BXSZPACYCMNKLS-AVGNSLFASA-N 0.000 description 2
- KIEICAOUSNYOLM-NRPADANISA-N Glu-Val-Ala Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](C)C(O)=O KIEICAOUSNYOLM-NRPADANISA-N 0.000 description 2
- ZYRXTRTUCAVNBQ-GVXVVHGQSA-N Glu-Val-Lys Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CCCCN)C(=O)O)NC(=O)[C@H](CCC(=O)O)N ZYRXTRTUCAVNBQ-GVXVVHGQSA-N 0.000 description 2
- 208000002705 Glucose Intolerance Diseases 0.000 description 2
- 206010018429 Glucose tolerance impaired Diseases 0.000 description 2
- VSVZIEVNUYDAFR-YUMQZZPRSA-N Gly-Ala-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](C)NC(=O)CN VSVZIEVNUYDAFR-YUMQZZPRSA-N 0.000 description 2
- AIJAPFVDBFYNKN-WHFBIAKZSA-N Gly-Asn-Asp Chemical compound C([C@@H](C(=O)N[C@@H](CC(=O)O)C(=O)O)NC(=O)CN)C(=O)N AIJAPFVDBFYNKN-WHFBIAKZSA-N 0.000 description 2
- OCDLPQDYTJPWNG-YUMQZZPRSA-N Gly-Asn-Lys Chemical compound C(CCN)C[C@@H](C(=O)O)NC(=O)[C@H](CC(=O)N)NC(=O)CN OCDLPQDYTJPWNG-YUMQZZPRSA-N 0.000 description 2
- FZQLXNIMCPJVJE-YUMQZZPRSA-N Gly-Asp-Leu Chemical compound [H]NCC(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CC(C)C)C(O)=O FZQLXNIMCPJVJE-YUMQZZPRSA-N 0.000 description 2
- AAHSHTLISQUZJL-QSFUFRPTSA-N Gly-Ile-Ile Chemical compound [H]NCC(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O AAHSHTLISQUZJL-QSFUFRPTSA-N 0.000 description 2
- FHQRLHFYVZAQHU-IUCAKERBSA-N Gly-Lys-Gln Chemical compound [H]NCC(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CCC(N)=O)C(O)=O FHQRLHFYVZAQHU-IUCAKERBSA-N 0.000 description 2
- PDUHNKAFQXQNLH-ZETCQYMHSA-N Gly-Lys-Gly Chemical compound NCCCC[C@H](NC(=O)CN)C(=O)NCC(O)=O PDUHNKAFQXQNLH-ZETCQYMHSA-N 0.000 description 2
- MHZXESQPPXOING-KBPBESRZSA-N Gly-Lys-Phe Chemical compound [H]NCC(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CC1=CC=CC=C1)C(O)=O MHZXESQPPXOING-KBPBESRZSA-N 0.000 description 2
- NTBOEZICHOSJEE-YUMQZZPRSA-N Gly-Lys-Ser Chemical compound [H]NCC(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CO)C(O)=O NTBOEZICHOSJEE-YUMQZZPRSA-N 0.000 description 2
- ZWRDOVYMQAAISL-UWVGGRQHSA-N Gly-Met-Lys Chemical compound CSCC[C@H](NC(=O)CN)C(=O)N[C@H](C(O)=O)CCCCN ZWRDOVYMQAAISL-UWVGGRQHSA-N 0.000 description 2
- GGLIDLCEPDHEJO-BQBZGAKWSA-N Gly-Pro-Ala Chemical compound OC(=O)[C@H](C)NC(=O)[C@@H]1CCCN1C(=O)CN GGLIDLCEPDHEJO-BQBZGAKWSA-N 0.000 description 2
- IROABALAWGJQGM-OALUTQOASA-N Gly-Trp-Tyr Chemical compound C1=CC=C2C(=C1)C(=CN2)C[C@@H](C(=O)N[C@@H](CC3=CC=C(C=C3)O)C(=O)O)NC(=O)CN IROABALAWGJQGM-OALUTQOASA-N 0.000 description 2
- BAYQNCWLXIDLHX-ONGXEEELSA-N Gly-Val-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](C(C)C)NC(=O)CN BAYQNCWLXIDLHX-ONGXEEELSA-N 0.000 description 2
- JBCLFWXMTIKCCB-UHFFFAOYSA-N H-Gly-Phe-OH Natural products NCC(=O)NC(C(O)=O)CC1=CC=CC=C1 JBCLFWXMTIKCCB-UHFFFAOYSA-N 0.000 description 2
- UJWYPUUXIAKEES-CUJWVEQBSA-N His-Cys-Thr Chemical compound [H]N[C@@H](CC1=CNC=N1)C(=O)N[C@@H](CS)C(=O)N[C@@H]([C@@H](C)O)C(O)=O UJWYPUUXIAKEES-CUJWVEQBSA-N 0.000 description 2
- GJMHMDKCJPQJOI-IHRRRGAJSA-N His-Lys-Arg Chemical compound NC(N)=NCCC[C@@H](C(O)=O)NC(=O)[C@H](CCCCN)NC(=O)[C@@H](N)CC1=CN=CN1 GJMHMDKCJPQJOI-IHRRRGAJSA-N 0.000 description 2
- ZVKDCQVQTGYBQT-LSJOCFKGSA-N His-Pro-Ala Chemical compound [H]N[C@@H](CC1=CNC=N1)C(=O)N1CCC[C@H]1C(=O)N[C@@H](C)C(O)=O ZVKDCQVQTGYBQT-LSJOCFKGSA-N 0.000 description 2
- 108700000788 Human immunodeficiency virus 1 tat peptide (47-57) Proteins 0.000 description 2
- 206010020880 Hypertrophy Diseases 0.000 description 2
- NULSANWBUWLTKN-NAKRPEOUSA-N Ile-Arg-Ser Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CCCN=C(N)N)C(=O)N[C@@H](CO)C(=O)O)N NULSANWBUWLTKN-NAKRPEOUSA-N 0.000 description 2
- QIHJTGSVGIPHIW-QSFUFRPTSA-N Ile-Asn-Val Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CC(=O)N)C(=O)N[C@@H](C(C)C)C(=O)O)N QIHJTGSVGIPHIW-QSFUFRPTSA-N 0.000 description 2
- OVPYIUNCVSOVNF-ZPFDUUQYSA-N Ile-Gln-Pro Natural products CC[C@H](C)[C@H](N)C(=O)N[C@@H](CCC(N)=O)C(=O)N1CCC[C@H]1C(O)=O OVPYIUNCVSOVNF-ZPFDUUQYSA-N 0.000 description 2
- NYEYYMLUABXDMC-NHCYSSNCSA-N Ile-Gly-Leu Chemical compound CC[C@H](C)[C@@H](C(=O)NCC(=O)N[C@@H](CC(C)C)C(=O)O)N NYEYYMLUABXDMC-NHCYSSNCSA-N 0.000 description 2
- URWXDJAEEGBADB-TUBUOCAGSA-N Ile-His-Thr Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CC1=CN=CN1)C(=O)N[C@@H]([C@@H](C)O)C(=O)O)N URWXDJAEEGBADB-TUBUOCAGSA-N 0.000 description 2
- WIZPFZKOFZXDQG-HTFCKZLJSA-N Ile-Ile-Ala Chemical compound CC[C@H](C)[C@H](N)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](C)C(O)=O WIZPFZKOFZXDQG-HTFCKZLJSA-N 0.000 description 2
- TVYWVSJGSHQWMT-AJNGGQMLSA-N Ile-Leu-Lys Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCCCN)C(=O)O)N TVYWVSJGSHQWMT-AJNGGQMLSA-N 0.000 description 2
- HZVRQFKRALAMQS-SLBDDTMCSA-N Ile-Trp-Asp Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CC1=CNC2=CC=CC=C21)C(=O)N[C@@H](CC(=O)O)C(=O)O)N HZVRQFKRALAMQS-SLBDDTMCSA-N 0.000 description 2
- XUJNEKJLAYXESH-REOHCLBHSA-N L-Cysteine Chemical compound SC[C@H](N)C(O)=O XUJNEKJLAYXESH-REOHCLBHSA-N 0.000 description 2
- QNAYBMKLOCPYGJ-REOHCLBHSA-N L-alanine Chemical compound C[C@H](N)C(O)=O QNAYBMKLOCPYGJ-REOHCLBHSA-N 0.000 description 2
- DCXYFEDJOCDNAF-REOHCLBHSA-N L-asparagine Chemical compound OC(=O)[C@@H](N)CC(N)=O DCXYFEDJOCDNAF-REOHCLBHSA-N 0.000 description 2
- CKLJMWTZIZZHCS-REOHCLBHSA-N L-aspartic acid Chemical compound OC(=O)[C@@H](N)CC(O)=O CKLJMWTZIZZHCS-REOHCLBHSA-N 0.000 description 2
- AGPKZVBTJJNPAG-WHFBIAKZSA-N L-isoleucine Chemical compound CC[C@H](C)[C@H](N)C(O)=O AGPKZVBTJJNPAG-WHFBIAKZSA-N 0.000 description 2
- LHSGPCFBGJHPCY-UHFFFAOYSA-N L-leucine-L-tyrosine Natural products CC(C)CC(N)C(=O)NC(C(O)=O)CC1=CC=C(O)C=C1 LHSGPCFBGJHPCY-UHFFFAOYSA-N 0.000 description 2
- SENJXOPIZNYLHU-UHFFFAOYSA-N L-leucyl-L-arginine Natural products CC(C)CC(N)C(=O)NC(C(O)=O)CCCN=C(N)N SENJXOPIZNYLHU-UHFFFAOYSA-N 0.000 description 2
- COLNVLDHVKWLRT-QMMMGPOBSA-N L-phenylalanine Chemical compound OC(=O)[C@@H](N)CC1=CC=CC=C1 COLNVLDHVKWLRT-QMMMGPOBSA-N 0.000 description 2
- QIVBCDIJIAJPQS-VIFPVBQESA-N L-tryptophane Chemical compound C1=CC=C2C(C[C@H](N)C(O)=O)=CNC2=C1 QIVBCDIJIAJPQS-VIFPVBQESA-N 0.000 description 2
- OUYCCCASQSFEME-QMMMGPOBSA-N L-tyrosine Chemical compound OC(=O)[C@@H](N)CC1=CC=C(O)C=C1 OUYCCCASQSFEME-QMMMGPOBSA-N 0.000 description 2
- KZSNJWFQEVHDMF-BYPYZUCNSA-N L-valine Chemical compound CC(C)[C@H](N)C(O)=O KZSNJWFQEVHDMF-BYPYZUCNSA-N 0.000 description 2
- GUBGYTABKSRVRQ-QKKXKWKRSA-N Lactose Natural products OC[C@H]1O[C@@H](O[C@H]2[C@H](O)[C@@H](O)C(O)O[C@@H]2CO)[C@H](O)[C@@H](O)[C@H]1O GUBGYTABKSRVRQ-QKKXKWKRSA-N 0.000 description 2
- 241000880493 Leptailurus serval Species 0.000 description 2
- WNGVUZWBXZKQES-YUMQZZPRSA-N Leu-Ala-Gly Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H](C)C(=O)NCC(O)=O WNGVUZWBXZKQES-YUMQZZPRSA-N 0.000 description 2
- GRZSCTXVCDUIPO-SRVKXCTJSA-N Leu-Arg-Gln Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CCC(N)=O)C(O)=O GRZSCTXVCDUIPO-SRVKXCTJSA-N 0.000 description 2
- WGNOPSQMIQERPK-UHFFFAOYSA-N Leu-Asn-Pro Natural products CC(C)CC(N)C(=O)NC(CC(=O)N)C(=O)N1CCCC1C(=O)O WGNOPSQMIQERPK-UHFFFAOYSA-N 0.000 description 2
- PVMPDMIKUVNOBD-CIUDSAMLSA-N Leu-Asp-Ser Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CO)C(O)=O PVMPDMIKUVNOBD-CIUDSAMLSA-N 0.000 description 2
- YVKSMSDXKMSIRX-GUBZILKMSA-N Leu-Glu-Asn Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(N)=O)C(O)=O YVKSMSDXKMSIRX-GUBZILKMSA-N 0.000 description 2
- KVOFSTUWVSQMDK-KKUMJFAQSA-N Leu-His-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@@H](NC(=O)[C@@H](N)CC(C)C)CC1=CN=CN1 KVOFSTUWVSQMDK-KKUMJFAQSA-N 0.000 description 2
- SGIIOQQGLUUMDQ-IHRRRGAJSA-N Leu-His-Val Chemical compound CC(C)C[C@@H](C(=O)N[C@@H](CC1=CN=CN1)C(=O)N[C@@H](C(C)C)C(=O)O)N SGIIOQQGLUUMDQ-IHRRRGAJSA-N 0.000 description 2
- JFSGIJSCJFQGSZ-MXAVVETBSA-N Leu-Ile-His Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CC1=CN=CN1)C(=O)O)NC(=O)[C@H](CC(C)C)N JFSGIJSCJFQGSZ-MXAVVETBSA-N 0.000 description 2
- OMHLATXVNQSALM-FQUUOJAGSA-N Leu-Ile-Pro Chemical compound CC[C@H](C)[C@@H](C(=O)N1CCC[C@@H]1C(=O)O)NC(=O)[C@H](CC(C)C)N OMHLATXVNQSALM-FQUUOJAGSA-N 0.000 description 2
- ZRHDPZAAWLXXIR-SRVKXCTJSA-N Leu-Lys-Ala Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](C)C(O)=O ZRHDPZAAWLXXIR-SRVKXCTJSA-N 0.000 description 2
- RTIRBWJPYJYTLO-MELADBBJSA-N Leu-Lys-Pro Chemical compound CC(C)C[C@@H](C(=O)N[C@@H](CCCCN)C(=O)N1CCC[C@@H]1C(=O)O)N RTIRBWJPYJYTLO-MELADBBJSA-N 0.000 description 2
- IBSGMIPRBMPMHE-IHRRRGAJSA-N Leu-Met-Lys Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H](CCSC)C(=O)N[C@@H](CCCCN)C(O)=O IBSGMIPRBMPMHE-IHRRRGAJSA-N 0.000 description 2
- AMSSKPUHBUQBOQ-SRVKXCTJSA-N Leu-Ser-Lys Chemical compound CC(C)C[C@@H](C(=O)N[C@@H](CO)C(=O)N[C@@H](CCCCN)C(=O)O)N AMSSKPUHBUQBOQ-SRVKXCTJSA-N 0.000 description 2
- KLSUAWUZBMAZCL-RHYQMDGZSA-N Leu-Thr-Pro Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H]([C@@H](C)O)C(=O)N1CCC[C@H]1C(O)=O KLSUAWUZBMAZCL-RHYQMDGZSA-N 0.000 description 2
- WFCKERTZVCQXKH-KBPBESRZSA-N Leu-Tyr-Gly Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)NCC(O)=O WFCKERTZVCQXKH-KBPBESRZSA-N 0.000 description 2
- RDFIVFHPOSOXMW-ACRUOGEOSA-N Leu-Tyr-Phe Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CC1=CC=CC=C1)C(O)=O RDFIVFHPOSOXMW-ACRUOGEOSA-N 0.000 description 2
- LTXREWYXXSTFRX-QGZVFWFLSA-N Linagliptin Chemical compound N=1C=2N(C)C(=O)N(CC=3N=C4C=CC=CC4=C(C)N=3)C(=O)C=2N(CC#CC)C=1N1CCC[C@@H](N)C1 LTXREWYXXSTFRX-QGZVFWFLSA-N 0.000 description 2
- 108010019598 Liraglutide Proteins 0.000 description 2
- YSDQQAXHVYUZIW-QCIJIYAXSA-N Liraglutide Chemical compound C([C@@H](C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCC(O)=O)C(=O)NCC(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](C)C(=O)N[C@@H](C)C(=O)N[C@@H](CCCCNC(=O)CC[C@H](NC(=O)CCCCCCCCCCCCCCC)C(O)=O)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC=1C=CC=CC=1)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](C)C(=O)N[C@@H](CC=1C2=CC=CC=C2NC=1)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CCCNC(N)=N)C(=O)NCC(=O)N[C@@H](CCCNC(N)=N)C(=O)NCC(O)=O)NC(=O)[C@H](CO)NC(=O)[C@H](CO)NC(=O)[C@@H](NC(=O)[C@H](CC(O)=O)NC(=O)[C@H](CO)NC(=O)[C@@H](NC(=O)[C@H](CC=1C=CC=CC=1)NC(=O)[C@@H](NC(=O)CNC(=O)[C@H](CCC(O)=O)NC(=O)[C@H](C)NC(=O)[C@@H](N)CC=1NC=NC=1)[C@@H](C)O)[C@@H](C)O)C(C)C)C1=CC=C(O)C=C1 YSDQQAXHVYUZIW-QCIJIYAXSA-N 0.000 description 2
- QYOXSYXPHUHOJR-GUBZILKMSA-N Lys-Asn-Glu Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CCC(O)=O)C(O)=O QYOXSYXPHUHOJR-GUBZILKMSA-N 0.000 description 2
- GKFNXYMAMKJSKD-NHCYSSNCSA-N Lys-Asp-Val Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](C(C)C)C(O)=O GKFNXYMAMKJSKD-NHCYSSNCSA-N 0.000 description 2
- GUYHHBZCBQZLFW-GUBZILKMSA-N Lys-Gln-Cys Chemical compound C(CCN)C[C@@H](C(=O)N[C@@H](CCC(=O)N)C(=O)N[C@@H](CS)C(=O)O)N GUYHHBZCBQZLFW-GUBZILKMSA-N 0.000 description 2
- QQUJSUFWEDZQQY-AVGNSLFASA-N Lys-Gln-Lys Chemical compound NCCCC[C@H](N)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@H](C(O)=O)CCCCN QQUJSUFWEDZQQY-AVGNSLFASA-N 0.000 description 2
- MQMIRLVJXQNTRJ-SDDRHHMPSA-N Lys-Gln-Pro Chemical compound C1C[C@@H](N(C1)C(=O)[C@H](CCC(=O)N)NC(=O)[C@H](CCCCN)N)C(=O)O MQMIRLVJXQNTRJ-SDDRHHMPSA-N 0.000 description 2
- PAMDBWYMLWOELY-SDDRHHMPSA-N Lys-Glu-Pro Chemical compound C1C[C@@H](N(C1)C(=O)[C@H](CCC(=O)O)NC(=O)[C@H](CCCCN)N)C(=O)O PAMDBWYMLWOELY-SDDRHHMPSA-N 0.000 description 2
- ITWQLSZTLBKWJM-YUMQZZPRSA-N Lys-Gly-Ala Chemical compound OC(=O)[C@H](C)NC(=O)CNC(=O)[C@@H](N)CCCCN ITWQLSZTLBKWJM-YUMQZZPRSA-N 0.000 description 2
- CANPXOLVTMKURR-WEDXCCLWSA-N Lys-Gly-Thr Chemical compound C[C@@H](O)[C@@H](C(O)=O)NC(=O)CNC(=O)[C@@H](N)CCCCN CANPXOLVTMKURR-WEDXCCLWSA-N 0.000 description 2
- MUXNCRWTWBMNHX-SRVKXCTJSA-N Lys-Leu-Asp Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CC(O)=O)C(O)=O MUXNCRWTWBMNHX-SRVKXCTJSA-N 0.000 description 2
- WVJNGSFKBKOKRV-AJNGGQMLSA-N Lys-Leu-Ile Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O WVJNGSFKBKOKRV-AJNGGQMLSA-N 0.000 description 2
- AIRZWUMAHCDDHR-KKUMJFAQSA-N Lys-Leu-Leu Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CC(C)C)C(O)=O AIRZWUMAHCDDHR-KKUMJFAQSA-N 0.000 description 2
- IPTUBUUIFRZMJK-ACRUOGEOSA-N Lys-Phe-Phe Chemical compound C([C@H](NC(=O)[C@@H](N)CCCCN)C(=O)N[C@@H](CC=1C=CC=CC=1)C(O)=O)C1=CC=CC=C1 IPTUBUUIFRZMJK-ACRUOGEOSA-N 0.000 description 2
- LUTDBHBIHHREDC-IHRRRGAJSA-N Lys-Pro-Lys Chemical compound NCCCC[C@H](N)C(=O)N1CCC[C@H]1C(=O)N[C@@H](CCCCN)C(O)=O LUTDBHBIHHREDC-IHRRRGAJSA-N 0.000 description 2
- VHGIWFGJIHTASW-FXQIFTODSA-N Met-Ala-Asp Chemical compound CSCC[C@H](N)C(=O)N[C@@H](C)C(=O)N[C@H](C(O)=O)CC(O)=O VHGIWFGJIHTASW-FXQIFTODSA-N 0.000 description 2
- DNDVVILEHVMWIS-LPEHRKFASA-N Met-Asp-Pro Chemical compound CSCC[C@@H](C(=O)N[C@@H](CC(=O)O)C(=O)N1CCC[C@@H]1C(=O)O)N DNDVVILEHVMWIS-LPEHRKFASA-N 0.000 description 2
- PQPMMGQTRQFSDA-SRVKXCTJSA-N Met-Glu-His Chemical compound [H]N[C@@H](CCSC)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC1=CNC=N1)C(O)=O PQPMMGQTRQFSDA-SRVKXCTJSA-N 0.000 description 2
- STTRPDDKDVKIDF-KKUMJFAQSA-N Met-Glu-Tyr Chemical compound CSCC[C@H](N)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@H](C(O)=O)CC1=CC=C(O)C=C1 STTRPDDKDVKIDF-KKUMJFAQSA-N 0.000 description 2
- VQILILSLEFDECU-GUBZILKMSA-N Met-Pro-Ala Chemical compound [H]N[C@@H](CCSC)C(=O)N1CCC[C@H]1C(=O)N[C@@H](C)C(O)=O VQILILSLEFDECU-GUBZILKMSA-N 0.000 description 2
- QAVZUKIPOMBLMC-AVGNSLFASA-N Met-Val-Leu Chemical compound CSCC[C@H](N)C(=O)N[C@@H](C(C)C)C(=O)N[C@H](C(O)=O)CC(C)C QAVZUKIPOMBLMC-AVGNSLFASA-N 0.000 description 2
- 108010085220 Multiprotein Complexes Proteins 0.000 description 2
- 102000007474 Multiprotein Complexes Human genes 0.000 description 2
- WYBVBIHNJWOLCJ-UHFFFAOYSA-N N-L-arginyl-L-leucine Natural products CC(C)CC(C(O)=O)NC(=O)C(N)CCCN=C(N)N WYBVBIHNJWOLCJ-UHFFFAOYSA-N 0.000 description 2
- KZNQNBZMBZJQJO-UHFFFAOYSA-N N-glycyl-L-proline Natural products NCC(=O)N1CCCC1C(O)=O KZNQNBZMBZJQJO-UHFFFAOYSA-N 0.000 description 2
- 125000001429 N-terminal alpha-amino-acid group Chemical group 0.000 description 2
- 108091005804 Peptidases Proteins 0.000 description 2
- CSYVXYQDIVCQNU-QWRGUYRKSA-N Phe-Asp-Gly Chemical compound [H]N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CC(O)=O)C(=O)NCC(O)=O CSYVXYQDIVCQNU-QWRGUYRKSA-N 0.000 description 2
- WFDAEEUZPZSMOG-SRVKXCTJSA-N Phe-Cys-Ser Chemical compound [H]N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CS)C(=O)N[C@@H](CO)C(O)=O WFDAEEUZPZSMOG-SRVKXCTJSA-N 0.000 description 2
- ZFVWWUILVLLVFA-AVGNSLFASA-N Phe-Gln-Cys Chemical compound C1=CC=C(C=C1)C[C@@H](C(=O)N[C@@H](CCC(=O)N)C(=O)N[C@@H](CS)C(=O)O)N ZFVWWUILVLLVFA-AVGNSLFASA-N 0.000 description 2
- FIRWJEJVFFGXSH-RYUDHWBXSA-N Phe-Glu-Gly Chemical compound OC(=O)CNC(=O)[C@H](CCC(O)=O)NC(=O)[C@@H](N)CC1=CC=CC=C1 FIRWJEJVFFGXSH-RYUDHWBXSA-N 0.000 description 2
- PSKRILMFHNIUAO-JYJNAYRXSA-N Phe-Glu-Lys Chemical compound C1=CC=C(C=C1)C[C@@H](C(=O)N[C@@H](CCC(=O)O)C(=O)N[C@@H](CCCCN)C(=O)O)N PSKRILMFHNIUAO-JYJNAYRXSA-N 0.000 description 2
- VZFPYFRVHMSSNA-JURCDPSOSA-N Phe-Ile-Ala Chemical compound OC(=O)[C@H](C)NC(=O)[C@H]([C@@H](C)CC)NC(=O)[C@@H](N)CC1=CC=CC=C1 VZFPYFRVHMSSNA-JURCDPSOSA-N 0.000 description 2
- OXKJSGGTHFMGDT-UFYCRDLUSA-N Phe-Phe-Arg Chemical compound C([C@H](N)C(=O)N[C@@H](CC=1C=CC=CC=1)C(=O)N[C@@H](CCCNC(N)=N)C(O)=O)C1=CC=CC=C1 OXKJSGGTHFMGDT-UFYCRDLUSA-N 0.000 description 2
- AXIOGMQCDYVTNY-ACRUOGEOSA-N Phe-Phe-Leu Chemical compound C([C@@H](C(=O)N[C@@H](CC(C)C)C(O)=O)NC(=O)[C@@H](N)CC=1C=CC=CC=1)C1=CC=CC=C1 AXIOGMQCDYVTNY-ACRUOGEOSA-N 0.000 description 2
- IIEOLPMQYRBZCN-SRVKXCTJSA-N Phe-Ser-Cys Chemical compound N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CO)C(=O)N[C@@H](CS)C(=O)O IIEOLPMQYRBZCN-SRVKXCTJSA-N 0.000 description 2
- FXEKNHAJIMHRFJ-ULQDDVLXSA-N Phe-Val-His Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CC1=CN=CN1)C(=O)O)NC(=O)[C@H](CC2=CC=CC=C2)N FXEKNHAJIMHRFJ-ULQDDVLXSA-N 0.000 description 2
- MWQXFDIQXIXPMS-UNQGMJICSA-N Phe-Val-Thr Chemical compound C[C@H]([C@@H](C(=O)O)NC(=O)[C@H](C(C)C)NC(=O)[C@H](CC1=CC=CC=C1)N)O MWQXFDIQXIXPMS-UNQGMJICSA-N 0.000 description 2
- 239000002202 Polyethylene glycol Substances 0.000 description 2
- FYQSMXKJYTZYRP-DCAQKATOSA-N Pro-Ala-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@H](C)NC(=O)[C@@H]1CCCN1 FYQSMXKJYTZYRP-DCAQKATOSA-N 0.000 description 2
- YFNOUBWUIIJQHF-LPEHRKFASA-N Pro-Asp-Pro Chemical compound C1C[C@H](NC1)C(=O)N[C@@H](CC(=O)O)C(=O)N2CCC[C@@H]2C(=O)O YFNOUBWUIIJQHF-LPEHRKFASA-N 0.000 description 2
- SFECXGVELZFBFJ-VEVYYDQMSA-N Pro-Asp-Thr Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H]([C@@H](C)O)C(O)=O SFECXGVELZFBFJ-VEVYYDQMSA-N 0.000 description 2
- JFNPBBOGGNMSRX-CIUDSAMLSA-N Pro-Gln-Ala Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](C)C(O)=O JFNPBBOGGNMSRX-CIUDSAMLSA-N 0.000 description 2
- YSUZKYSRAFNLRB-ULQDDVLXSA-N Pro-Gln-Trp Chemical compound N([C@@H](CCC(=O)N)C(=O)N[C@@H](CC=1C2=CC=CC=C2NC=1)C(O)=O)C(=O)[C@@H]1CCCN1 YSUZKYSRAFNLRB-ULQDDVLXSA-N 0.000 description 2
- CLNJSLSHKJECME-BQBZGAKWSA-N Pro-Gly-Ala Chemical compound OC(=O)[C@H](C)NC(=O)CNC(=O)[C@@H]1CCCN1 CLNJSLSHKJECME-BQBZGAKWSA-N 0.000 description 2
- VZKBJNBZMZHKRC-XUXIUFHCSA-N Pro-Ile-Leu Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CC(C)C)C(O)=O VZKBJNBZMZHKRC-XUXIUFHCSA-N 0.000 description 2
- FKVNLUZHSFCNGY-RVMXOQNASA-N Pro-Ile-Pro Chemical compound CC[C@H](C)[C@@H](C(=O)N1CCC[C@@H]1C(=O)O)NC(=O)[C@@H]2CCCN2 FKVNLUZHSFCNGY-RVMXOQNASA-N 0.000 description 2
- OWQXAJQZLWHPBH-FXQIFTODSA-N Pro-Ser-Asn Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H](CO)C(=O)N[C@@H](CC(N)=O)C(O)=O OWQXAJQZLWHPBH-FXQIFTODSA-N 0.000 description 2
- LNICFEXCAHIJOR-DCAQKATOSA-N Pro-Ser-Leu Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H](CO)C(=O)N[C@@H](CC(C)C)C(O)=O LNICFEXCAHIJOR-DCAQKATOSA-N 0.000 description 2
- 239000004365 Protease Substances 0.000 description 2
- 102000001253 Protein Kinase Human genes 0.000 description 2
- 108010079005 RDV peptide Proteins 0.000 description 2
- 102100037486 Reverse transcriptase/ribonuclease H Human genes 0.000 description 2
- 108091006300 SLC2A4 Proteins 0.000 description 2
- BYIROAKULFFTEK-CIUDSAMLSA-N Ser-Asp-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@H](CC(O)=O)NC(=O)[C@@H](N)CO BYIROAKULFFTEK-CIUDSAMLSA-N 0.000 description 2
- ULVMNZOKDBHKKI-ACZMJKKPSA-N Ser-Gln-Asp Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CC(O)=O)C(O)=O ULVMNZOKDBHKKI-ACZMJKKPSA-N 0.000 description 2
- HJEBZBMOTCQYDN-ACZMJKKPSA-N Ser-Glu-Asp Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(O)=O)C(O)=O HJEBZBMOTCQYDN-ACZMJKKPSA-N 0.000 description 2
- DLPXTCTVNDTYGJ-JBDRJPRFSA-N Ser-Ile-Cys Chemical compound OC[C@H](N)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CS)C(O)=O DLPXTCTVNDTYGJ-JBDRJPRFSA-N 0.000 description 2
- SRKMDKACHDVPMD-SRVKXCTJSA-N Ser-Lys-His Chemical compound C1=C(NC=N1)C[C@@H](C(=O)O)NC(=O)[C@H](CCCCN)NC(=O)[C@H](CO)N SRKMDKACHDVPMD-SRVKXCTJSA-N 0.000 description 2
- XJDMUQCLVSCRSJ-VZFHVOOUSA-N Ser-Thr-Ala Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](C)C(O)=O XJDMUQCLVSCRSJ-VZFHVOOUSA-N 0.000 description 2
- HAYADTTXNZFUDM-IHRRRGAJSA-N Ser-Tyr-Val Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](C(C)C)C(O)=O HAYADTTXNZFUDM-IHRRRGAJSA-N 0.000 description 2
- BEBVVQPDSHHWQL-NRPADANISA-N Ser-Val-Glu Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CCC(O)=O)C(O)=O BEBVVQPDSHHWQL-NRPADANISA-N 0.000 description 2
- 102100040257 TBC1 domain family member 4 Human genes 0.000 description 2
- 101710107476 TBC1 domain family member 4 Proteins 0.000 description 2
- TWLMXDWFVNEFFK-FJXKBIBVSA-N Thr-Arg-Gly Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCCNC(N)=N)C(=O)NCC(O)=O TWLMXDWFVNEFFK-FJXKBIBVSA-N 0.000 description 2
- KRPKYGOFYUNIGM-XVSYOHENSA-N Thr-Asp-Phe Chemical compound C[C@H]([C@@H](C(=O)N[C@@H](CC(=O)O)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)O)N)O KRPKYGOFYUNIGM-XVSYOHENSA-N 0.000 description 2
- IMDMLDSVUSMAEJ-HJGDQZAQSA-N Thr-Leu-Asn Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CC(N)=O)C(O)=O IMDMLDSVUSMAEJ-HJGDQZAQSA-N 0.000 description 2
- JWQNAFHCXKVZKZ-UVOCVTCTSA-N Thr-Lys-Thr Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H]([C@@H](C)O)C(O)=O JWQNAFHCXKVZKZ-UVOCVTCTSA-N 0.000 description 2
- GUHLYMZJVXUIPO-RCWTZXSCSA-N Thr-Met-Val Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCSC)C(=O)N[C@@H](C(C)C)C(O)=O GUHLYMZJVXUIPO-RCWTZXSCSA-N 0.000 description 2
- VGYVVSQFSSKZRJ-OEAJRASXSA-N Thr-Phe-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@@H](NC(=O)[C@@H](N)[C@H](O)C)CC1=CC=CC=C1 VGYVVSQFSSKZRJ-OEAJRASXSA-N 0.000 description 2
- QYDKSNXSBXZPFK-ZJDVBMNYSA-N Thr-Thr-Arg Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCCNC(N)=N)C(O)=O QYDKSNXSBXZPFK-ZJDVBMNYSA-N 0.000 description 2
- JLRGJRBPOGGCBT-UHFFFAOYSA-N Tolbutamide Chemical compound CCCCNC(=O)NS(=O)(=O)C1=CC=C(C)C=C1 JLRGJRBPOGGCBT-UHFFFAOYSA-N 0.000 description 2
- NIWAGRRZHCMPOY-GMVOTWDCSA-N Trp-Ala-Tyr Chemical compound C[C@@H](C(=O)N[C@@H](CC1=CC=C(C=C1)O)C(=O)O)NC(=O)[C@H](CC2=CNC3=CC=CC=C32)N NIWAGRRZHCMPOY-GMVOTWDCSA-N 0.000 description 2
- GKUROEIXVURAAO-BPUTZDHNSA-N Trp-Asp-Arg Chemical compound [H]N[C@@H](CC1=CNC2=C1C=CC=C2)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CCCNC(N)=N)C(O)=O GKUROEIXVURAAO-BPUTZDHNSA-N 0.000 description 2
- OBAMASZCXDIXSS-SZMVWBNQSA-N Trp-Glu-Lys Chemical compound C1=CC=C2C(=C1)C(=CN2)C[C@@H](C(=O)N[C@@H](CCC(=O)O)C(=O)N[C@@H](CCCCN)C(=O)O)N OBAMASZCXDIXSS-SZMVWBNQSA-N 0.000 description 2
- NOFFAYIYPAUNRM-HKUYNNGSSA-N Trp-Gly-Phe Chemical compound C1=CC=C(C=C1)C[C@@H](C(=O)O)NC(=O)CNC(=O)[C@H](CC2=CNC3=CC=CC=C32)N NOFFAYIYPAUNRM-HKUYNNGSSA-N 0.000 description 2
- QIVBCDIJIAJPQS-UHFFFAOYSA-N Tryptophan Natural products C1=CC=C2C(CC(N)C(O)=O)=CNC2=C1 QIVBCDIJIAJPQS-UHFFFAOYSA-N 0.000 description 2
- NSOMQRHZMJMZIE-GVARAGBVSA-N Tyr-Ala-Ile Chemical compound CC[C@H](C)[C@@H](C(O)=O)NC(=O)[C@H](C)NC(=O)[C@@H](N)CC1=CC=C(O)C=C1 NSOMQRHZMJMZIE-GVARAGBVSA-N 0.000 description 2
- MICSYKFECRFCTJ-IHRRRGAJSA-N Tyr-Arg-Asp Chemical compound C1=CC(=CC=C1C[C@@H](C(=O)N[C@@H](CCCN=C(N)N)C(=O)N[C@@H](CC(=O)O)C(=O)O)N)O MICSYKFECRFCTJ-IHRRRGAJSA-N 0.000 description 2
- FMOSEWZYZPMJAL-KKUMJFAQSA-N Tyr-Glu-Met Chemical compound CSCC[C@@H](C(=O)O)NC(=O)[C@H](CCC(=O)O)NC(=O)[C@H](CC1=CC=C(C=C1)O)N FMOSEWZYZPMJAL-KKUMJFAQSA-N 0.000 description 2
- AZGZDDNKFFUDEH-QWRGUYRKSA-N Tyr-Gly-Ser Chemical compound OC[C@@H](C(O)=O)NC(=O)CNC(=O)[C@@H](N)CC1=CC=C(O)C=C1 AZGZDDNKFFUDEH-QWRGUYRKSA-N 0.000 description 2
- FGVFBDZSGQTYQX-UFYCRDLUSA-N Tyr-Phe-Val Chemical compound [H]N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](C(C)C)C(O)=O FGVFBDZSGQTYQX-UFYCRDLUSA-N 0.000 description 2
- MNWINJDPGBNOED-ULQDDVLXSA-N Tyr-Pro-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@@H]1CCCN1C(=O)[C@@H](N)CC1=CC=C(O)C=C1 MNWINJDPGBNOED-ULQDDVLXSA-N 0.000 description 2
- GZWPQZDVTBZVEP-BZSNNMDCSA-N Tyr-Tyr-Asn Chemical compound [H]N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CC(N)=O)C(O)=O GZWPQZDVTBZVEP-BZSNNMDCSA-N 0.000 description 2
- XSQUKJJJFZCRTK-UHFFFAOYSA-N Urea Chemical compound NC(N)=O XSQUKJJJFZCRTK-UHFFFAOYSA-N 0.000 description 2
- NMANTMWGQZASQN-QXEWZRGKSA-N Val-Arg-Asp Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CCCN=C(N)N)C(=O)N[C@@H](CC(=O)O)C(=O)O)N NMANTMWGQZASQN-QXEWZRGKSA-N 0.000 description 2
- UDNYEPLJTRDMEJ-RCOVLWMOSA-N Val-Asn-Gly Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CC(=O)N)C(=O)NCC(=O)O)N UDNYEPLJTRDMEJ-RCOVLWMOSA-N 0.000 description 2
- XKVXSCHXGJOQND-ZOBUZTSGSA-N Val-Asp-Trp Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CC(=O)O)C(=O)N[C@@H](CC1=CNC2=CC=CC=C21)C(=O)O)N XKVXSCHXGJOQND-ZOBUZTSGSA-N 0.000 description 2
- FPCIBLUVDNXPJO-XPUUQOCRSA-N Val-Cys-Gly Chemical compound CC(C)[C@H](N)C(=O)N[C@@H](CS)C(=O)NCC(O)=O FPCIBLUVDNXPJO-XPUUQOCRSA-N 0.000 description 2
- UPJONISHZRADBH-XPUUQOCRSA-N Val-Glu Chemical compound CC(C)[C@H](N)C(=O)N[C@H](C(O)=O)CCC(O)=O UPJONISHZRADBH-XPUUQOCRSA-N 0.000 description 2
- CHWRZUGUMAMTFC-IHRRRGAJSA-N Val-His-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@@H](NC(=O)[C@@H](N)C(C)C)CC1=CNC=N1 CHWRZUGUMAMTFC-IHRRRGAJSA-N 0.000 description 2
- CPGJELLYDQEDRK-NAKRPEOUSA-N Val-Ile-Ala Chemical compound CC[C@H](C)[C@H](NC(=O)[C@@H](N)C(C)C)C(=O)N[C@@H](C)C(O)=O CPGJELLYDQEDRK-NAKRPEOUSA-N 0.000 description 2
- OVBMCNDKCWAXMZ-NAKRPEOUSA-N Val-Ile-Ser Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CO)C(=O)O)NC(=O)[C@H](C(C)C)N OVBMCNDKCWAXMZ-NAKRPEOUSA-N 0.000 description 2
- ZRSZTKTVPNSUNA-IHRRRGAJSA-N Val-Lys-Leu Chemical compound CC(C)C[C@H](NC(=O)[C@H](CCCCN)NC(=O)[C@@H](N)C(C)C)C(O)=O ZRSZTKTVPNSUNA-IHRRRGAJSA-N 0.000 description 2
- RQOMPQGUGBILAG-AVGNSLFASA-N Val-Met-Leu Chemical compound CC(C)[C@H](N)C(=O)N[C@@H](CCSC)C(=O)N[C@@H](CC(C)C)C(O)=O RQOMPQGUGBILAG-AVGNSLFASA-N 0.000 description 2
- VCIYTVOBLZHFSC-XHSDSOJGSA-N Val-Phe-Pro Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N2CCC[C@@H]2C(=O)O)N VCIYTVOBLZHFSC-XHSDSOJGSA-N 0.000 description 2
- VIKZGAUAKQZDOF-NRPADANISA-N Val-Ser-Glu Chemical compound CC(C)[C@H](N)C(=O)N[C@@H](CO)C(=O)N[C@H](C(O)=O)CCC(O)=O VIKZGAUAKQZDOF-NRPADANISA-N 0.000 description 2
- KZSNJWFQEVHDMF-UHFFFAOYSA-N Valine Natural products CC(C)C(N)C(O)=O KZSNJWFQEVHDMF-UHFFFAOYSA-N 0.000 description 2
- 229960002632 acarbose Drugs 0.000 description 2
- XUFXOAAUWZOOIT-UHFFFAOYSA-N acarviostatin I01 Natural products OC1C(O)C(NC2C(C(O)C(O)C(CO)=C2)O)C(C)OC1OC(C(C1O)O)C(CO)OC1OC1C(CO)OC(O)C(O)C1O XUFXOAAUWZOOIT-UHFFFAOYSA-N 0.000 description 2
- 229960001466 acetohexamide Drugs 0.000 description 2
- VGZSUPCWNCWDAN-UHFFFAOYSA-N acetohexamide Chemical compound C1=CC(C(=O)C)=CC=C1S(=O)(=O)NC(=O)NC1CCCCC1 VGZSUPCWNCWDAN-UHFFFAOYSA-N 0.000 description 2
- 235000004279 alanine Nutrition 0.000 description 2
- 108010047495 alanylglycine Proteins 0.000 description 2
- KOSRFJWDECSPRO-UHFFFAOYSA-N alpha-L-glutamyl-L-glutamic acid Natural products OC(=O)CCC(N)C(=O)NC(CCC(O)=O)C(O)=O KOSRFJWDECSPRO-UHFFFAOYSA-N 0.000 description 2
- 108010038850 arginyl-isoleucyl-tyrosine Proteins 0.000 description 2
- 108010062796 arginyllysine Proteins 0.000 description 2
- 235000009582 asparagine Nutrition 0.000 description 2
- 229960001230 asparagine Drugs 0.000 description 2
- 235000003704 aspartic acid Nutrition 0.000 description 2
- 108010069205 aspartyl-phenylalanine Proteins 0.000 description 2
- 108010038633 aspartylglutamate Proteins 0.000 description 2
- 108010092854 aspartyllysine Proteins 0.000 description 2
- 238000003556 assay Methods 0.000 description 2
- OQFSQFPPLPISGP-UHFFFAOYSA-N beta-carboxyaspartic acid Natural products OC(=O)C(N)C(C(O)=O)C(O)=O OQFSQFPPLPISGP-UHFFFAOYSA-N 0.000 description 2
- 239000011230 binding agent Substances 0.000 description 2
- 230000033228 biological regulation Effects 0.000 description 2
- 210000004899 c-terminal region Anatomy 0.000 description 2
- 239000011575 calcium Substances 0.000 description 2
- 229910052799 carbon Inorganic materials 0.000 description 2
- 239000000969 carrier Substances 0.000 description 2
- 238000004113 cell culture Methods 0.000 description 2
- 239000001913 cellulose Substances 0.000 description 2
- 229920002678 cellulose Polymers 0.000 description 2
- 235000010980 cellulose Nutrition 0.000 description 2
- 229960001761 chlorpropamide Drugs 0.000 description 2
- HVYWMOMLDIMFJA-DPAQBDIFSA-N cholesterol Chemical compound C1C=C2C[C@@H](O)CC[C@]2(C)[C@@H]2[C@@H]1[C@@H]1CC[C@H]([C@H](C)CCCC(C)C)[C@@]1(C)CC2 HVYWMOMLDIMFJA-DPAQBDIFSA-N 0.000 description 2
- 238000002983 circular dichroism Methods 0.000 description 2
- 239000007979 citrate buffer Substances 0.000 description 2
- 108010004073 cysteinylcysteine Proteins 0.000 description 2
- 108010060199 cysteinylproline Proteins 0.000 description 2
- 229960003834 dapagliflozin Drugs 0.000 description 2
- 230000001934 delay Effects 0.000 description 2
- 238000013461 design Methods 0.000 description 2
- 239000007884 disintegrant Substances 0.000 description 2
- 229960003345 empagliflozin Drugs 0.000 description 2
- OBWASQILIWPZMG-QZMOQZSNSA-N empagliflozin Chemical compound O[C@@H]1[C@@H](O)[C@H](O)[C@@H](CO)O[C@H]1C1=CC=C(Cl)C(CC=2C=CC(O[C@@H]3COCC3)=CC=2)=C1 OBWASQILIWPZMG-QZMOQZSNSA-N 0.000 description 2
- 238000001917 fluorescence detection Methods 0.000 description 2
- 108010063718 gamma-glutamylaspartic acid Proteins 0.000 description 2
- 235000013922 glutamic acid Nutrition 0.000 description 2
- 239000004220 glutamic acid Substances 0.000 description 2
- ZDXPYRJPNDTMRX-UHFFFAOYSA-N glutamine Natural products OC(=O)C(N)CCC(N)=O ZDXPYRJPNDTMRX-UHFFFAOYSA-N 0.000 description 2
- 108010078144 glutaminyl-glycine Proteins 0.000 description 2
- 108010055341 glutamyl-glutamic acid Proteins 0.000 description 2
- ZNNLBTZKUZBEKO-UHFFFAOYSA-N glyburide Chemical compound COC1=CC=C(Cl)C=C1C(=O)NCCC1=CC=C(S(=O)(=O)NC(=O)NC2CCCCC2)C=C1 ZNNLBTZKUZBEKO-UHFFFAOYSA-N 0.000 description 2
- 230000002641 glycemic effect Effects 0.000 description 2
- 108010000434 glycyl-alanyl-leucine Proteins 0.000 description 2
- 108010010147 glycylglutamine Proteins 0.000 description 2
- 108010081551 glycylphenylalanine Proteins 0.000 description 2
- 108010077515 glycylproline Proteins 0.000 description 2
- 108010037850 glycylvaline Proteins 0.000 description 2
- 210000002216 heart Anatomy 0.000 description 2
- HNDVDQJCIGZPNO-UHFFFAOYSA-N histidine Natural products OC(=O)C(N)CC1=CN=CN1 HNDVDQJCIGZPNO-UHFFFAOYSA-N 0.000 description 2
- 108010085325 histidylproline Proteins 0.000 description 2
- 229910052739 hydrogen Inorganic materials 0.000 description 2
- 239000001257 hydrogen Substances 0.000 description 2
- 238000003384 imaging method Methods 0.000 description 2
- 230000001771 impaired effect Effects 0.000 description 2
- 238000001727 in vivo Methods 0.000 description 2
- 230000001939 inductive effect Effects 0.000 description 2
- 238000007918 intramuscular administration Methods 0.000 description 2
- 238000007912 intraperitoneal administration Methods 0.000 description 2
- 238000001990 intravenous administration Methods 0.000 description 2
- AGPKZVBTJJNPAG-UHFFFAOYSA-N isoleucine Natural products CCC(C)C(N)C(O)=O AGPKZVBTJJNPAG-UHFFFAOYSA-N 0.000 description 2
- 229960000310 isoleucine Drugs 0.000 description 2
- 108010044374 isoleucyl-tyrosine Proteins 0.000 description 2
- 239000008101 lactose Substances 0.000 description 2
- 108010034529 leucyl-lysine Proteins 0.000 description 2
- 108010090333 leucyl-lysyl-proline Proteins 0.000 description 2
- 229960002397 linagliptin Drugs 0.000 description 2
- 229960002701 liraglutide Drugs 0.000 description 2
- 210000004185 liver Anatomy 0.000 description 2
- 230000007774 longterm Effects 0.000 description 2
- 239000000314 lubricant Substances 0.000 description 2
- 108010057952 lysyl-phenylalanyl-lysine Proteins 0.000 description 2
- 108010038320 lysylphenylalanine Proteins 0.000 description 2
- HQKMJHAJHXVSDF-UHFFFAOYSA-L magnesium stearate Chemical compound [Mg+2].CCCCCCCCCCCCCCCCCC([O-])=O.CCCCCCCCCCCCCCCCCC([O-])=O HQKMJHAJHXVSDF-UHFFFAOYSA-L 0.000 description 2
- 238000004949 mass spectrometry Methods 0.000 description 2
- 210000002901 mesenchymal stem cell Anatomy 0.000 description 2
- 125000001360 methionine group Chemical group N[C@@H](CCSC)C(=O)* 0.000 description 2
- 238000010172 mouse model Methods 0.000 description 2
- 230000035772 mutation Effects 0.000 description 2
- 229960000698 nateglinide Drugs 0.000 description 2
- OELFLUMRDSZNSF-BRWVUGGUSA-N nateglinide Chemical compound C1C[C@@H](C(C)C)CC[C@@H]1C(=O)N[C@@H](C(O)=O)CC1=CC=CC=C1 OELFLUMRDSZNSF-BRWVUGGUSA-N 0.000 description 2
- 229910052757 nitrogen Inorganic materials 0.000 description 2
- COLNVLDHVKWLRT-UHFFFAOYSA-N phenylalanine Natural products OC(=O)C(N)CC1=CC=CC=C1 COLNVLDHVKWLRT-UHFFFAOYSA-N 0.000 description 2
- 239000008363 phosphate buffer Substances 0.000 description 2
- 108010025488 pinealon Proteins 0.000 description 2
- 229960005095 pioglitazone Drugs 0.000 description 2
- 230000008569 process Effects 0.000 description 2
- 230000000750 progressive effect Effects 0.000 description 2
- 108010004914 prolylarginine Proteins 0.000 description 2
- 108010029020 prolylglycine Proteins 0.000 description 2
- 108060006633 protein kinase Proteins 0.000 description 2
- 238000011002 quantification Methods 0.000 description 2
- 230000007420 reactivation Effects 0.000 description 2
- 238000003753 real-time PCR Methods 0.000 description 2
- 230000001105 regulatory effect Effects 0.000 description 2
- 229960004586 rosiglitazone Drugs 0.000 description 2
- 108010033693 saxagliptin Proteins 0.000 description 2
- 229960004937 saxagliptin Drugs 0.000 description 2
- QGJUIPDUBHWZPV-SGTAVMJGSA-N saxagliptin Chemical compound C1C(C2)CC(C3)CC2(O)CC13[C@H](N)C(=O)N1[C@H](C#N)C[C@@H]2C[C@@H]21 QGJUIPDUBHWZPV-SGTAVMJGSA-N 0.000 description 2
- 108010048818 seryl-histidine Proteins 0.000 description 2
- 238000007920 subcutaneous administration Methods 0.000 description 2
- 210000004003 subcutaneous fat Anatomy 0.000 description 2
- 239000000126 substance Substances 0.000 description 2
- 229910052717 sulfur Inorganic materials 0.000 description 2
- 239000006228 supernatant Substances 0.000 description 2
- 239000000454 talc Substances 0.000 description 2
- 235000012222 talc Nutrition 0.000 description 2
- 229910052623 talc Inorganic materials 0.000 description 2
- 229960002277 tolazamide Drugs 0.000 description 2
- OUDSBRTVNLOZBN-UHFFFAOYSA-N tolazamide Chemical compound C1=CC(C)=CC=C1S(=O)(=O)NC(=O)NN1CCCCCC1 OUDSBRTVNLOZBN-UHFFFAOYSA-N 0.000 description 2
- 229960005371 tolbutamide Drugs 0.000 description 2
- 108010045269 tryptophyltryptophan Proteins 0.000 description 2
- OUYCCCASQSFEME-UHFFFAOYSA-N tyrosine Natural products OC(=O)C(N)CC1=CC=C(O)C=C1 OUYCCCASQSFEME-UHFFFAOYSA-N 0.000 description 2
- 108010051110 tyrosyl-lysine Proteins 0.000 description 2
- 239000004474 valine Substances 0.000 description 2
- 238000005406 washing Methods 0.000 description 2
- XLYOFNOQVPJJNP-UHFFFAOYSA-N water Substances O XLYOFNOQVPJJNP-UHFFFAOYSA-N 0.000 description 2
- 230000004580 weight loss Effects 0.000 description 2
- YBJHBAHKTGYVGT-ZKWXMUAHSA-N (+)-Biotin Chemical compound N1C(=O)N[C@@H]2[C@H](CCCCC(=O)O)SC[C@@H]21 YBJHBAHKTGYVGT-ZKWXMUAHSA-N 0.000 description 1
- CWFMWBHMIMNZLN-NAKRPEOUSA-N (2s)-1-[(2s)-2-[[(2s,3s)-2-amino-3-methylpentanoyl]amino]propanoyl]pyrrolidine-2-carboxylic acid Chemical compound CC[C@H](C)[C@H](N)C(=O)N[C@@H](C)C(=O)N1CCC[C@H]1C(O)=O CWFMWBHMIMNZLN-NAKRPEOUSA-N 0.000 description 1
- QVVDVENEPNODSI-BTNSXGMBSA-N (2s)-2-[[(2s)-2-[[(2s)-2-[[(2s)-2-[[(2s)-2-[[(2s)-2-amino-5-(diaminomethylideneamino)pentanoyl]amino]-5-(diaminomethylideneamino)pentanoyl]amino]-5-(diaminomethylideneamino)pentanoyl]amino]-5-(diaminomethylideneamino)pentanoyl]amino]-5-(diaminomethylidene Chemical compound NC(N)=NCCC[C@H](N)C(=O)N[C@@H](CCCN=C(N)N)C(=O)N[C@@H](CCCN=C(N)N)C(=O)N[C@@H](CCCN=C(N)N)C(=O)N[C@@H](CCCN=C(N)N)C(=O)N[C@@H](CCCN=C(N)N)C(O)=O QVVDVENEPNODSI-BTNSXGMBSA-N 0.000 description 1
- RAVVEEJGALCVIN-AGVBWZICSA-N (2s)-2-[[(2s)-2-[[(2s)-2-[[(2s)-5-amino-2-[[(2s)-2-[[(2s)-2-[[(2s)-6-amino-2-[[(2s)-6-amino-2-[[(2s)-2-[[2-[[(2s)-2-amino-3-(4-hydroxyphenyl)propanoyl]amino]acetyl]amino]-5-(diaminomethylideneamino)pentanoyl]amino]hexanoyl]amino]hexanoyl]amino]-5-(diamino Chemical compound NC(N)=NCCC[C@@H](C(O)=O)NC(=O)[C@H](CCCN=C(N)N)NC(=O)[C@H](CCCN=C(N)N)NC(=O)[C@H](CCC(N)=O)NC(=O)[C@H](CCCN=C(N)N)NC(=O)[C@H](CCCN=C(N)N)NC(=O)[C@H](CCCCN)NC(=O)[C@H](CCCCN)NC(=O)[C@H](CCCN=C(N)N)NC(=O)CNC(=O)[C@@H](N)CC1=CC=C(O)C=C1 RAVVEEJGALCVIN-AGVBWZICSA-N 0.000 description 1
- TZCPCKNHXULUIY-RGULYWFUSA-N 1,2-distearoyl-sn-glycero-3-phosphoserine Chemical compound CCCCCCCCCCCCCCCCCC(=O)OC[C@H](COP(O)(=O)OC[C@H](N)C(O)=O)OC(=O)CCCCCCCCCCCCCCCCC TZCPCKNHXULUIY-RGULYWFUSA-N 0.000 description 1
- ZOBPZXTWZATXDG-UHFFFAOYSA-N 1,3-thiazolidine-2,4-dione Chemical compound O=C1CSC(=O)N1 ZOBPZXTWZATXDG-UHFFFAOYSA-N 0.000 description 1
- LLJFMFZYVVLQKT-UHFFFAOYSA-N 1-cyclohexyl-3-[4-[2-(7-methoxy-4,4-dimethyl-1,3-dioxo-2-isoquinolinyl)ethyl]phenyl]sulfonylurea Chemical compound C=1C(OC)=CC=C(C(C2=O)(C)C)C=1C(=O)N2CCC(C=C1)=CC=C1S(=O)(=O)NC(=O)NC1CCCCC1 LLJFMFZYVVLQKT-UHFFFAOYSA-N 0.000 description 1
- MBPFNOMGYSRGQZ-PBXRRBTRSA-N 2-deoxy-D-glucose 6-phosphate Chemical compound OP(=O)(O)OC[C@@H](O)[C@@H](O)[C@H](O)CC=O MBPFNOMGYSRGQZ-PBXRRBTRSA-N 0.000 description 1
- 102100031786 Adiponectin Human genes 0.000 description 1
- 108010076365 Adiponectin Proteins 0.000 description 1
- YLTKNGYYPIWKHZ-ACZMJKKPSA-N Ala-Ala-Glu Chemical compound C[C@H](N)C(=O)N[C@@H](C)C(=O)N[C@H](C(O)=O)CCC(O)=O YLTKNGYYPIWKHZ-ACZMJKKPSA-N 0.000 description 1
- 101710198494 Alstrom syndrome protein 1 Proteins 0.000 description 1
- 108700031308 Antennapedia Homeodomain Proteins 0.000 description 1
- JCAISGGAOQXEHJ-ZPFDUUQYSA-N Arg-Gln-Ile Chemical compound CC[C@H](C)[C@@H](C(=O)O)NC(=O)[C@H](CCC(=O)N)NC(=O)[C@H](CCCN=C(N)N)N JCAISGGAOQXEHJ-ZPFDUUQYSA-N 0.000 description 1
- RFXXUWGNVRJTNQ-QXEWZRGKSA-N Arg-Gly-Ile Chemical compound CC[C@H](C)[C@@H](C(=O)O)NC(=O)CNC(=O)[C@H](CCCN=C(N)N)N RFXXUWGNVRJTNQ-QXEWZRGKSA-N 0.000 description 1
- COXMUHNBYCVVRG-DCAQKATOSA-N Arg-Leu-Ser Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CO)C(O)=O COXMUHNBYCVVRG-DCAQKATOSA-N 0.000 description 1
- PZBSKYJGKNNYNK-ULQDDVLXSA-N Arg-Leu-Tyr Chemical compound CC(C)C[C@H](NC(=O)[C@@H](N)CCCN=C(N)N)C(=O)N[C@@H](Cc1ccc(O)cc1)C(O)=O PZBSKYJGKNNYNK-ULQDDVLXSA-N 0.000 description 1
- NGTYEHIRESTSRX-UWVGGRQHSA-N Arg-Lys-Gly Chemical compound NCCCC[C@@H](C(=O)NCC(O)=O)NC(=O)[C@@H](N)CCCN=C(N)N NGTYEHIRESTSRX-UWVGGRQHSA-N 0.000 description 1
- NYDIVDKTULRINZ-AVGNSLFASA-N Arg-Met-Lys Chemical compound CSCC[C@@H](C(=O)N[C@@H](CCCCN)C(=O)O)NC(=O)[C@H](CCCN=C(N)N)N NYDIVDKTULRINZ-AVGNSLFASA-N 0.000 description 1
- IXIWEFWRKIUMQX-DCAQKATOSA-N Asp-Arg-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](CCCN=C(N)N)NC(=O)[C@@H](N)CC(O)=O IXIWEFWRKIUMQX-DCAQKATOSA-N 0.000 description 1
- FTNVLGCFIJEMQT-CIUDSAMLSA-N Asp-Cys-Leu Chemical compound CC(C)C[C@@H](C(=O)O)NC(=O)[C@H](CS)NC(=O)[C@H](CC(=O)O)N FTNVLGCFIJEMQT-CIUDSAMLSA-N 0.000 description 1
- CJUKAWUWBZCTDQ-SRVKXCTJSA-N Asp-Leu-Lys Chemical compound OC(=O)C[C@H](N)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCCCN)C(O)=O CJUKAWUWBZCTDQ-SRVKXCTJSA-N 0.000 description 1
- 101710150190 Beta-secretase 2 Proteins 0.000 description 1
- 229940123208 Biguanide Drugs 0.000 description 1
- XNCOSPRUTUOJCJ-UHFFFAOYSA-N Biguanide Chemical compound NC(N)=NC(N)=N XNCOSPRUTUOJCJ-UHFFFAOYSA-N 0.000 description 1
- 101100512078 Caenorhabditis elegans lys-1 gene Proteins 0.000 description 1
- 101100283604 Caenorhabditis elegans pigk-1 gene Proteins 0.000 description 1
- 101100315624 Caenorhabditis elegans tyr-1 gene Proteins 0.000 description 1
- OYPRJOBELJOOCE-UHFFFAOYSA-N Calcium Chemical compound [Ca] OYPRJOBELJOOCE-UHFFFAOYSA-N 0.000 description 1
- BHPQYMZQTOCNFJ-UHFFFAOYSA-N Calcium cation Chemical compound [Ca+2] BHPQYMZQTOCNFJ-UHFFFAOYSA-N 0.000 description 1
- BVKZGUZCCUSVTD-UHFFFAOYSA-L Carbonate Chemical compound [O-]C([O-])=O BVKZGUZCCUSVTD-UHFFFAOYSA-L 0.000 description 1
- 206010007559 Cardiac failure congestive Diseases 0.000 description 1
- 241000700199 Cavia porcellus Species 0.000 description 1
- 241000700112 Chinchilla Species 0.000 description 1
- 108020004705 Codon Proteins 0.000 description 1
- 241000699800 Cricetinae Species 0.000 description 1
- GFAPBMCRSMSGDZ-XGEHTFHBSA-N Cys-Thr-Met Chemical compound C[C@H]([C@@H](C(=O)N[C@@H](CCSC)C(=O)O)NC(=O)[C@H](CS)N)O GFAPBMCRSMSGDZ-XGEHTFHBSA-N 0.000 description 1
- FBPFZTCFMRRESA-KVTDHHQDSA-N D-Mannitol Chemical compound OC[C@@H](O)[C@@H](O)[C@H](O)[C@H](O)CO FBPFZTCFMRRESA-KVTDHHQDSA-N 0.000 description 1
- 206010012735 Diarrhoea Diseases 0.000 description 1
- 241000255348 Drosophila sp. (in: Insecta) Species 0.000 description 1
- 241000283074 Equus asinus Species 0.000 description 1
- 241000283073 Equus caballus Species 0.000 description 1
- 241000282326 Felis catus Species 0.000 description 1
- 108091006094 GTPase-accelerating proteins Proteins 0.000 description 1
- 108010010803 Gelatin Proteins 0.000 description 1
- 208000034826 Genetic Predisposition to Disease Diseases 0.000 description 1
- 241000699694 Gerbillinae Species 0.000 description 1
- QKWBEMCLYTYBNI-GVXVVHGQSA-N Gln-Lys-Val Chemical compound CC(C)[C@@H](C(O)=O)NC(=O)[C@H](CCCCN)NC(=O)[C@@H](N)CCC(N)=O QKWBEMCLYTYBNI-GVXVVHGQSA-N 0.000 description 1
- HLRLXVPRJJITSK-IFFSRLJSSA-N Gln-Thr-Val Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](C(C)C)C(O)=O HLRLXVPRJJITSK-IFFSRLJSSA-N 0.000 description 1
- QGWXAMDECCKGRU-XVKPBYJWSA-N Gln-Val-Gly Chemical compound CC(C)[C@H](NC(=O)[C@@H](N)CCC(N)=O)C(=O)NCC(O)=O QGWXAMDECCKGRU-XVKPBYJWSA-N 0.000 description 1
- ZCOJVESMNGBGLF-GRLWGSQLSA-N Glu-Ile-Ile Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O ZCOJVESMNGBGLF-GRLWGSQLSA-N 0.000 description 1
- QJVZSVUYZFYLFQ-CIUDSAMLSA-N Glu-Pro-Ala Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N1CCC[C@H]1C(=O)N[C@@H](C)C(O)=O QJVZSVUYZFYLFQ-CIUDSAMLSA-N 0.000 description 1
- HBMRTXJZQDVRFT-DZKIICNBSA-N Glu-Tyr-Val Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](C(C)C)C(O)=O HBMRTXJZQDVRFT-DZKIICNBSA-N 0.000 description 1
- 102000058061 Glucose Transporter Type 4 Human genes 0.000 description 1
- UFPXDFOYHVEIPI-BYPYZUCNSA-N Gly-Gly-Asp Chemical compound NCC(=O)NCC(=O)N[C@H](C(O)=O)CC(O)=O UFPXDFOYHVEIPI-BYPYZUCNSA-N 0.000 description 1
- TVUWMSBGMVAHSJ-KBPBESRZSA-N Gly-Leu-Phe Chemical compound NCC(=O)N[C@@H](CC(C)C)C(=O)N[C@H](C(O)=O)CC1=CC=CC=C1 TVUWMSBGMVAHSJ-KBPBESRZSA-N 0.000 description 1
- ZWZWYGMENQVNFU-UHFFFAOYSA-N Glycerophosphorylserin Natural products OC(=O)C(N)COP(O)(=O)OCC(O)CO ZWZWYGMENQVNFU-UHFFFAOYSA-N 0.000 description 1
- AEMRFAOFKBGASW-UHFFFAOYSA-M Glycolate Chemical compound OCC([O-])=O AEMRFAOFKBGASW-UHFFFAOYSA-M 0.000 description 1
- 206010019280 Heart failures Diseases 0.000 description 1
- WJGSTIMGSIWHJX-HVTMNAMFSA-N His-Ile-Gln Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CCC(=O)N)C(=O)O)NC(=O)[C@H](CC1=CN=CN1)N WJGSTIMGSIWHJX-HVTMNAMFSA-N 0.000 description 1
- 101000743845 Homo sapiens Ras-related protein Rab-10 Proteins 0.000 description 1
- 101000620576 Homo sapiens Ras-related protein Rab-14 Proteins 0.000 description 1
- 101001132279 Homo sapiens Ras-related protein Rab-2A Proteins 0.000 description 1
- 101000712571 Homo sapiens Ras-related protein Rab-8A Proteins 0.000 description 1
- 108010070875 Human Immunodeficiency Virus tat Gene Products Proteins 0.000 description 1
- 241000725303 Human immunodeficiency virus Species 0.000 description 1
- AGGIYSLVUKVOPT-HTFCKZLJSA-N Ile-Ser-Ile Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CO)C(=O)N[C@@H]([C@@H](C)CC)C(=O)O)N AGGIYSLVUKVOPT-HTFCKZLJSA-N 0.000 description 1
- HQLSBZFLOUHQJK-STECZYCISA-N Ile-Tyr-Arg Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CC1=CC=C(C=C1)O)C(=O)N[C@@H](CCCN=C(N)N)C(=O)O)N HQLSBZFLOUHQJK-STECZYCISA-N 0.000 description 1
- 108010044467 Isoenzymes Proteins 0.000 description 1
- RDFMDVXONNIGBC-LURJTMIESA-N L-2-aminoheptanoic acid Chemical compound CCCCC[C@H](N)C(O)=O RDFMDVXONNIGBC-LURJTMIESA-N 0.000 description 1
- WHUUTDBJXJRKMK-VKHMYHEASA-N L-glutamic acid Chemical compound OC(=O)[C@@H](N)CCC(O)=O WHUUTDBJXJRKMK-VKHMYHEASA-N 0.000 description 1
- ZDXPYRJPNDTMRX-VKHMYHEASA-N L-glutamine Chemical compound OC(=O)[C@@H](N)CCC(N)=O ZDXPYRJPNDTMRX-VKHMYHEASA-N 0.000 description 1
- HNDVDQJCIGZPNO-YFKPBYRVSA-N L-histidine Chemical compound OC(=O)[C@@H](N)CC1=CN=CN1 HNDVDQJCIGZPNO-YFKPBYRVSA-N 0.000 description 1
- KDXKERNSBIXSRK-YFKPBYRVSA-N L-lysine Chemical compound NCCCC[C@H](N)C(O)=O KDXKERNSBIXSRK-YFKPBYRVSA-N 0.000 description 1
- JVTAAEKCZFNVCJ-UHFFFAOYSA-M Lactate Chemical compound CC(O)C([O-])=O JVTAAEKCZFNVCJ-UHFFFAOYSA-M 0.000 description 1
- ZURHXHNAEJJRNU-CIUDSAMLSA-N Leu-Asp-Asn Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CC(N)=O)C(O)=O ZURHXHNAEJJRNU-CIUDSAMLSA-N 0.000 description 1
- KPYAOIVPJKPIOU-KKUMJFAQSA-N Leu-Lys-Lys Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CCCCN)C(O)=O KPYAOIVPJKPIOU-KKUMJFAQSA-N 0.000 description 1
- LQUIENKUVKPNIC-ULQDDVLXSA-N Leu-Met-Tyr Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CCSC)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(O)=O LQUIENKUVKPNIC-ULQDDVLXSA-N 0.000 description 1
- MJWVXZABPOKJJF-ACRUOGEOSA-N Leu-Phe-Phe Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CC1=CC=CC=C1)C(O)=O MJWVXZABPOKJJF-ACRUOGEOSA-N 0.000 description 1
- MUCIDQMDOYQYBR-IHRRRGAJSA-N Leu-Pro-His Chemical compound CC(C)C[C@@H](C(=O)N1CCC[C@H]1C(=O)N[C@@H](CC2=CN=CN2)C(=O)O)N MUCIDQMDOYQYBR-IHRRRGAJSA-N 0.000 description 1
- RIHIGSWBLHSGLV-CQDKDKBSSA-N Leu-Tyr-Ala Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](C)C(O)=O RIHIGSWBLHSGLV-CQDKDKBSSA-N 0.000 description 1
- VJGQRELPQWNURN-JYJNAYRXSA-N Leu-Tyr-Glu Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CCC(O)=O)C(O)=O VJGQRELPQWNURN-JYJNAYRXSA-N 0.000 description 1
- YNNPKXBBRZVIRX-IHRRRGAJSA-N Lys-Arg-Leu Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC(C)C)C(O)=O YNNPKXBBRZVIRX-IHRRRGAJSA-N 0.000 description 1
- GFWLIJDQILOEPP-HSCHXYMDSA-N Lys-Ile-Trp Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CC1=CNC2=CC=CC=C21)C(=O)O)NC(=O)[C@H](CCCCN)N GFWLIJDQILOEPP-HSCHXYMDSA-N 0.000 description 1
- FYYHWMGAXLPEAU-UHFFFAOYSA-N Magnesium Chemical compound [Mg] FYYHWMGAXLPEAU-UHFFFAOYSA-N 0.000 description 1
- 229930195725 Mannitol Natural products 0.000 description 1
- HUURTRNKPBHHKZ-JYJNAYRXSA-N Met-Phe-Val Chemical compound CSCC[C@H](N)C(=O)N[C@H](C(=O)N[C@@H](C(C)C)C(O)=O)CC1=CC=CC=C1 HUURTRNKPBHHKZ-JYJNAYRXSA-N 0.000 description 1
- IBAQFPQHRJAVAV-ULAWRXDQSA-N Miglitol Chemical compound OCCN1C[C@H](O)[C@@H](O)[C@H](O)[C@H]1CO IBAQFPQHRJAVAV-ULAWRXDQSA-N 0.000 description 1
- 241000282341 Mustela putorius furo Species 0.000 description 1
- FXHOOIRPVKKKFG-UHFFFAOYSA-N N,N-Dimethylacetamide Chemical compound CN(C)C(C)=O FXHOOIRPVKKKFG-UHFFFAOYSA-N 0.000 description 1
- 206010028813 Nausea Diseases 0.000 description 1
- 206010030124 Oedema peripheral Diseases 0.000 description 1
- 241000283973 Oryctolagus cuniculus Species 0.000 description 1
- 208000001164 Osteoporotic Fractures Diseases 0.000 description 1
- 229930040373 Paraformaldehyde Natural products 0.000 description 1
- 208000018262 Peripheral vascular disease Diseases 0.000 description 1
- 241000009328 Perro Species 0.000 description 1
- UMKYAYXCMYYNHI-AVGNSLFASA-N Phe-Gln-Asn Chemical compound C1=CC=C(C=C1)C[C@@H](C(=O)N[C@@H](CCC(=O)N)C(=O)N[C@@H](CC(=O)N)C(=O)O)N UMKYAYXCMYYNHI-AVGNSLFASA-N 0.000 description 1
- CMHTUJQZQXFNTQ-OEAJRASXSA-N Phe-Leu-Thr Chemical compound C[C@H]([C@@H](C(=O)O)NC(=O)[C@H](CC(C)C)NC(=O)[C@H](CC1=CC=CC=C1)N)O CMHTUJQZQXFNTQ-OEAJRASXSA-N 0.000 description 1
- WLYPRKLMRIYGPP-JYJNAYRXSA-N Phe-Lys-Glu Chemical compound OC(=O)CC[C@@H](C(O)=O)NC(=O)[C@H](CCCCN)NC(=O)[C@@H](N)CC1=CC=CC=C1 WLYPRKLMRIYGPP-JYJNAYRXSA-N 0.000 description 1
- GNZCMRRSXOBHLC-JYJNAYRXSA-N Phe-Val-Met Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CCSC)C(=O)O)NC(=O)[C@H](CC1=CC=CC=C1)N GNZCMRRSXOBHLC-JYJNAYRXSA-N 0.000 description 1
- 239000004698 Polyethylene Substances 0.000 description 1
- DEDANIDYQAPTFI-IHRRRGAJSA-N Pro-Asp-Tyr Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(O)=O DEDANIDYQAPTFI-IHRRRGAJSA-N 0.000 description 1
- WHNJMTHJGCEKGA-ULQDDVLXSA-N Pro-Phe-Leu Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CC(C)C)C(O)=O WHNJMTHJGCEKGA-ULQDDVLXSA-N 0.000 description 1
- 101800001295 Putative ATP-dependent helicase Proteins 0.000 description 1
- 101800001006 Putative helicase Proteins 0.000 description 1
- 102100031426 Ras GTPase-activating protein 1 Human genes 0.000 description 1
- 102100039103 Ras-related protein Rab-10 Human genes 0.000 description 1
- 102100022288 Ras-related protein Rab-14 Human genes 0.000 description 1
- 102100034485 Ras-related protein Rab-2A Human genes 0.000 description 1
- 102100033480 Ras-related protein Rab-8A Human genes 0.000 description 1
- 241000700159 Rattus Species 0.000 description 1
- XSYJDGIDKRNWFX-SRVKXCTJSA-N Ser-Cys-Phe Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CS)C(=O)N[C@@H](CC1=CC=CC=C1)C(O)=O XSYJDGIDKRNWFX-SRVKXCTJSA-N 0.000 description 1
- IFPBAGJBHSNYPR-ZKWXMUAHSA-N Ser-Ile-Gly Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H]([C@@H](C)CC)C(=O)NCC(O)=O IFPBAGJBHSNYPR-ZKWXMUAHSA-N 0.000 description 1
- UKKROEYWYIHWBD-ZKWXMUAHSA-N Ser-Val-Asp Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CC(O)=O)C(O)=O UKKROEYWYIHWBD-ZKWXMUAHSA-N 0.000 description 1
- SGZVZUCRAVSPKQ-FXQIFTODSA-N Ser-Val-Cys Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CS)C(=O)O)NC(=O)[C@H](CO)N SGZVZUCRAVSPKQ-FXQIFTODSA-N 0.000 description 1
- VYPSYNLAJGMNEJ-UHFFFAOYSA-N Silicium dioxide Chemical compound O=[Si]=O VYPSYNLAJGMNEJ-UHFFFAOYSA-N 0.000 description 1
- HVUMOYIDDBPOLL-XWVZOOPGSA-N Sorbitan monostearate Chemical compound CCCCCCCCCCCCCCCCCC(=O)OC[C@@H](O)[C@H]1OC[C@H](O)[C@H]1O HVUMOYIDDBPOLL-XWVZOOPGSA-N 0.000 description 1
- 235000021355 Stearic acid Nutrition 0.000 description 1
- 208000006011 Stroke Diseases 0.000 description 1
- 229930006000 Sucrose Natural products 0.000 description 1
- CZMRCDWAGMRECN-UGDNZRGBSA-N Sucrose Chemical compound O[C@H]1[C@H](O)[C@@H](CO)O[C@@]1(CO)O[C@@H]1[C@H](O)[C@@H](O)[C@H](O)[C@@H](CO)O1 CZMRCDWAGMRECN-UGDNZRGBSA-N 0.000 description 1
- UDQBCBUXAQIZAK-GLLZPBPUSA-N Thr-Glu-Glu Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CCC(O)=O)C(O)=O UDQBCBUXAQIZAK-GLLZPBPUSA-N 0.000 description 1
- SPVHQURZJCUDQC-VOAKCMCISA-N Thr-Lys-Leu Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CC(C)C)C(O)=O SPVHQURZJCUDQC-VOAKCMCISA-N 0.000 description 1
- APIDTRXFGYOLLH-VQVTYTSYSA-N Thr-Met Chemical compound CSCC[C@@H](C(O)=O)NC(=O)[C@@H](N)[C@@H](C)O APIDTRXFGYOLLH-VQVTYTSYSA-N 0.000 description 1
- 229920004890 Triton X-100 Polymers 0.000 description 1
- 239000013504 Triton X-100 Substances 0.000 description 1
- UUIYFDAWNBSWPG-IHPCNDPISA-N Trp-Lys-Lys Chemical compound C1=CC=C2C(=C1)C(=CN2)C[C@@H](C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CCCCN)C(=O)O)N UUIYFDAWNBSWPG-IHPCNDPISA-N 0.000 description 1
- CUHBVKUVJIXRFK-DVXDUOKCSA-N Trp-Trp-Ala Chemical compound C1=CC=C2C(C[C@H](N)C(=O)N[C@@H](CC=3C4=CC=CC=C4NC=3)C(=O)N[C@@H](C)C(O)=O)=CNC2=C1 CUHBVKUVJIXRFK-DVXDUOKCSA-N 0.000 description 1
- CKHQKYHIZCRTAP-SOUVJXGZSA-N Tyr-Gln-Pro Chemical compound C1C[C@@H](N(C1)C(=O)[C@H](CCC(=O)N)NC(=O)[C@H](CC2=CC=C(C=C2)O)N)C(=O)O CKHQKYHIZCRTAP-SOUVJXGZSA-N 0.000 description 1
- JKUZFODWJGEQAP-KBPBESRZSA-N Tyr-Gly-Lys Chemical compound C1=CC(=CC=C1C[C@@H](C(=O)NCC(=O)N[C@@H](CCCCN)C(=O)O)N)O JKUZFODWJGEQAP-KBPBESRZSA-N 0.000 description 1
- CTDPLKMBVALCGN-JSGCOSHPSA-N Tyr-Gly-Val Chemical compound [H]N[C@@H](CC1=CC=C(O)C=C1)C(=O)NCC(=O)N[C@@H](C(C)C)C(O)=O CTDPLKMBVALCGN-JSGCOSHPSA-N 0.000 description 1
- SYOMXKPPFZRELL-ONGXEEELSA-N Val-Gly-Lys Chemical compound CC(C)[C@@H](C(=O)NCC(=O)N[C@@H](CCCCN)C(=O)O)N SYOMXKPPFZRELL-ONGXEEELSA-N 0.000 description 1
- AIWLHFZYOUUJGB-UFYCRDLUSA-N Val-Phe-Tyr Chemical compound C([C@H](NC(=O)[C@@H](N)C(C)C)C(=O)N[C@@H](CC=1C=CC(O)=CC=1)C(O)=O)C1=CC=CC=C1 AIWLHFZYOUUJGB-UFYCRDLUSA-N 0.000 description 1
- 208000021017 Weight Gain Diseases 0.000 description 1
- 230000002159 abnormal effect Effects 0.000 description 1
- 230000005856 abnormality Effects 0.000 description 1
- TUCNEACPLKLKNU-UHFFFAOYSA-N acetyl Chemical compound C[C]=O TUCNEACPLKLKNU-UHFFFAOYSA-N 0.000 description 1
- 239000002253 acid Substances 0.000 description 1
- 230000009471 action Effects 0.000 description 1
- 239000008186 active pharmaceutical agent Substances 0.000 description 1
- 239000013543 active substance Substances 0.000 description 1
- 230000001154 acute effect Effects 0.000 description 1
- 239000000654 additive Substances 0.000 description 1
- 230000009815 adipogenic differentiation Effects 0.000 description 1
- 230000002411 adverse Effects 0.000 description 1
- 238000001261 affinity purification Methods 0.000 description 1
- 230000002776 aggregation Effects 0.000 description 1
- 238000004220 aggregation Methods 0.000 description 1
- 239000000556 agonist Substances 0.000 description 1
- 150000001408 amides Chemical class 0.000 description 1
- 125000003277 amino group Chemical group 0.000 description 1
- 238000002266 amputation Methods 0.000 description 1
- 238000003975 animal breeding Methods 0.000 description 1
- 230000003178 anti-diabetic effect Effects 0.000 description 1
- 239000000883 anti-obesity agent Substances 0.000 description 1
- 108010068380 arginylarginine Proteins 0.000 description 1
- 239000007640 basal medium Substances 0.000 description 1
- 210000000227 basophil cell of anterior lobe of hypophysis Anatomy 0.000 description 1
- 230000008901 benefit Effects 0.000 description 1
- 230000002146 bilateral effect Effects 0.000 description 1
- 229920002988 biodegradable polymer Polymers 0.000 description 1
- 239000004621 biodegradable polymer Substances 0.000 description 1
- 230000004071 biological effect Effects 0.000 description 1
- 229920001222 biopolymer Polymers 0.000 description 1
- 230000000740 bleeding effect Effects 0.000 description 1
- 210000004556 brain Anatomy 0.000 description 1
- 229910052791 calcium Inorganic materials 0.000 description 1
- 229910001424 calcium ion Inorganic materials 0.000 description 1
- 229960001713 canagliflozin Drugs 0.000 description 1
- VHOFTEAWFCUTOS-TUGBYPPCSA-N canagliflozin hydrate Chemical compound O.CC1=CC=C([C@H]2[C@@H]([C@@H](O)[C@H](O)[C@@H](CO)O2)O)C=C1CC(S1)=CC=C1C1=CC=C(F)C=C1.CC1=CC=C([C@H]2[C@@H]([C@@H](O)[C@H](O)[C@@H](CO)O2)O)C=C1CC(S1)=CC=C1C1=CC=C(F)C=C1 VHOFTEAWFCUTOS-TUGBYPPCSA-N 0.000 description 1
- 239000002775 capsule Substances 0.000 description 1
- 239000004202 carbamide Substances 0.000 description 1
- 150000001720 carbohydrates Chemical class 0.000 description 1
- 235000014633 carbohydrates Nutrition 0.000 description 1
- 230000015556 catabolic process Effects 0.000 description 1
- 230000008727 cellular glucose uptake Effects 0.000 description 1
- 230000030570 cellular localization Effects 0.000 description 1
- 230000004700 cellular uptake Effects 0.000 description 1
- 230000008859 change Effects 0.000 description 1
- BHONFOAYRQZPKZ-LCLOTLQISA-N chembl269478 Chemical compound C([C@H](NC(=O)[C@H](CC=1C2=CC=CC=C2NC=1)NC(=O)[C@H]([C@@H](C)CC)NC(=O)[C@H](CCCCN)NC(=O)[C@@H](NC(=O)[C@H](CCC(N)=O)NC(=O)[C@@H](N)CCCNC(N)=N)[C@@H](C)CC)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CCSC)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CC=1C2=CC=CC=C2NC=1)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CCCCN)C(O)=O)C1=CC=CC=C1 BHONFOAYRQZPKZ-LCLOTLQISA-N 0.000 description 1
- 235000012000 cholesterol Nutrition 0.000 description 1
- 208000020832 chronic kidney disease Diseases 0.000 description 1
- 208000022831 chronic renal failure syndrome Diseases 0.000 description 1
- 239000004927 clay Substances 0.000 description 1
- 238000010367 cloning Methods 0.000 description 1
- 229940110456 cocoa butter Drugs 0.000 description 1
- 235000019868 cocoa butter Nutrition 0.000 description 1
- 229940075614 colloidal silicon dioxide Drugs 0.000 description 1
- 238000007398 colorimetric assay Methods 0.000 description 1
- 230000001447 compensatory effect Effects 0.000 description 1
- 239000007891 compressed tablet Substances 0.000 description 1
- 239000006071 cream Substances 0.000 description 1
- 229920006037 cross link polymer Polymers 0.000 description 1
- 239000013078 crystal Substances 0.000 description 1
- 229940068840 d-biotin Drugs 0.000 description 1
- 229920006237 degradable polymer Polymers 0.000 description 1
- 238000006731 degradation reaction Methods 0.000 description 1
- 230000003111 delayed effect Effects 0.000 description 1
- 230000002939 deleterious effect Effects 0.000 description 1
- 230000001419 dependent effect Effects 0.000 description 1
- 238000001514 detection method Methods 0.000 description 1
- 238000011161 development Methods 0.000 description 1
- UREBDLICKHMUKA-CXSFZGCWSA-N dexamethasone Chemical compound C1CC2=CC(=O)C=C[C@]2(C)[C@]2(F)[C@@H]1[C@@H]1C[C@@H](C)[C@@](C(=O)CO)(O)[C@@]1(C)C[C@@H]2O UREBDLICKHMUKA-CXSFZGCWSA-N 0.000 description 1
- 229960003957 dexamethasone Drugs 0.000 description 1
- 239000008121 dextrose Substances 0.000 description 1
- 239000003085 diluting agent Substances 0.000 description 1
- 229940113088 dimethylacetamide Drugs 0.000 description 1
- 238000004090 dissolution Methods 0.000 description 1
- 239000002552 dosage form Substances 0.000 description 1
- 238000012377 drug delivery Methods 0.000 description 1
- 230000004064 dysfunction Effects 0.000 description 1
- 230000002124 endocrine Effects 0.000 description 1
- 230000002708 enhancing effect Effects 0.000 description 1
- 238000011067 equilibration Methods 0.000 description 1
- 239000012467 final product Substances 0.000 description 1
- 238000002073 fluorescence micrograph Methods 0.000 description 1
- 238000000799 fluorescence microscopy Methods 0.000 description 1
- 239000012634 fragment Substances 0.000 description 1
- 238000004108 freeze drying Methods 0.000 description 1
- 125000000524 functional group Chemical group 0.000 description 1
- 239000000499 gel Substances 0.000 description 1
- 239000008273 gelatin Substances 0.000 description 1
- 229920000159 gelatin Polymers 0.000 description 1
- 235000019322 gelatine Nutrition 0.000 description 1
- 235000011852 gelatine desserts Nutrition 0.000 description 1
- 238000003205 genotyping method Methods 0.000 description 1
- 239000011521 glass Substances 0.000 description 1
- 229960004580 glibenclamide Drugs 0.000 description 1
- 229960000346 gliclazide Drugs 0.000 description 1
- BOVGTQGAOIONJV-UHFFFAOYSA-N gliclazide Chemical compound C1=CC(C)=CC=C1S(=O)(=O)NC(=O)NN1CC2CCCC2C1 BOVGTQGAOIONJV-UHFFFAOYSA-N 0.000 description 1
- 229960004346 glimepiride Drugs 0.000 description 1
- WIGIZIANZCJQQY-RUCARUNLSA-N glimepiride Chemical compound O=C1C(CC)=C(C)CN1C(=O)NCCC1=CC=C(S(=O)(=O)NC(=O)N[C@@H]2CC[C@@H](C)CC2)C=C1 WIGIZIANZCJQQY-RUCARUNLSA-N 0.000 description 1
- 229960001381 glipizide Drugs 0.000 description 1
- ZJJXGWJIGJFDTL-UHFFFAOYSA-N glipizide Chemical compound C1=NC(C)=CN=C1C(=O)NCCC1=CC=C(S(=O)(=O)NC(=O)NC2CCCCC2)C=C1 ZJJXGWJIGJFDTL-UHFFFAOYSA-N 0.000 description 1
- 229960003468 gliquidone Drugs 0.000 description 1
- 239000003877 glucagon like peptide 1 receptor agonist Substances 0.000 description 1
- 235000001727 glucose Nutrition 0.000 description 1
- 108010079547 glutamylmethionine Proteins 0.000 description 1
- 230000002414 glycolytic effect Effects 0.000 description 1
- 230000000305 glycosuric effect Effects 0.000 description 1
- 125000003630 glycyl group Chemical group [H]N([H])C([H])([H])C(*)=O 0.000 description 1
- 108010089804 glycyl-threonine Proteins 0.000 description 1
- 239000008187 granular material Substances 0.000 description 1
- 230000036541 health Effects 0.000 description 1
- 208000019622 heart disease Diseases 0.000 description 1
- 210000005260 human cell Anatomy 0.000 description 1
- 229940084769 humulin r Drugs 0.000 description 1
- 238000010191 image analysis Methods 0.000 description 1
- 238000001114 immunoprecipitation Methods 0.000 description 1
- 238000012744 immunostaining Methods 0.000 description 1
- 230000001976 improved effect Effects 0.000 description 1
- 230000006872 improvement Effects 0.000 description 1
- 230000002779 inactivation Effects 0.000 description 1
- 239000004615 ingredient Substances 0.000 description 1
- 238000003780 insertion Methods 0.000 description 1
- 230000037431 insertion Effects 0.000 description 1
- PBGKTOXHQIOBKM-FHFVDXKLSA-N insulin (human) Chemical compound C([C@@H](C(=O)N[C@@H](CC(C)C)C(=O)N[C@H]1CSSC[C@H]2C(=O)N[C@H](C(=O)N[C@@H](CO)C(=O)N[C@H](C(=O)N[C@H](C(N[C@@H](CO)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CC=3C=CC(O)=CC=3)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CC=3C=CC(O)=CC=3)C(=O)N[C@@H](CSSC[C@H](NC(=O)[C@H](C(C)C)NC(=O)[C@H](CC(C)C)NC(=O)[C@H](CC=3C=CC(O)=CC=3)NC(=O)[C@H](CC(C)C)NC(=O)[C@H](C)NC(=O)[C@H](CCC(O)=O)NC(=O)[C@H](C(C)C)NC(=O)[C@H](CC(C)C)NC(=O)[C@H](CC=3NC=NC=3)NC(=O)[C@H](CO)NC(=O)CNC1=O)C(=O)NCC(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CCCNC(N)=N)C(=O)NCC(=O)N[C@@H](CC=1C=CC=CC=1)C(=O)N[C@@H](CC=1C=CC=CC=1)C(=O)N[C@@H](CC=1C=CC(O)=CC=1)C(=O)N[C@@H]([C@@H](C)O)C(=O)N1[C@@H](CCC1)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H]([C@@H](C)O)C(O)=O)C(=O)N[C@@H](CC(N)=O)C(O)=O)=O)CSSC[C@@H](C(N2)=O)NC(=O)[C@H](CCC(N)=O)NC(=O)[C@H](CCC(O)=O)NC(=O)[C@H](C(C)C)NC(=O)[C@@H](NC(=O)CN)[C@@H](C)CC)[C@@H](C)CC)[C@@H](C)O)NC(=O)[C@H](CCC(N)=O)NC(=O)[C@H](CC(N)=O)NC(=O)[C@@H](NC(=O)[C@@H](N)CC=1C=CC=CC=1)C(C)C)C1=CN=CN1 PBGKTOXHQIOBKM-FHFVDXKLSA-N 0.000 description 1
- 238000012528 insulin ELISA Methods 0.000 description 1
- 230000003914 insulin secretion Effects 0.000 description 1
- 230000002452 interceptive effect Effects 0.000 description 1
- 238000011813 knockout mouse model Methods 0.000 description 1
- 101150066555 lacZ gene Proteins 0.000 description 1
- 239000007788 liquid Substances 0.000 description 1
- 108010003700 lysyl aspartic acid Proteins 0.000 description 1
- 108010043322 lysyl-tryptophyl-alpha-lysine Proteins 0.000 description 1
- 239000011777 magnesium Substances 0.000 description 1
- 229910052749 magnesium Inorganic materials 0.000 description 1
- 235000019359 magnesium stearate Nutrition 0.000 description 1
- 239000000594 mannitol Substances 0.000 description 1
- 235000010355 mannitol Nutrition 0.000 description 1
- 238000002844 melting Methods 0.000 description 1
- 230000008018 melting Effects 0.000 description 1
- 239000012528 membrane Substances 0.000 description 1
- 208000030159 metabolic disease Diseases 0.000 description 1
- 150000002741 methionine derivatives Chemical class 0.000 description 1
- 108010063431 methionyl-aspartyl-glycine Proteins 0.000 description 1
- 108010056582 methionylglutamic acid Proteins 0.000 description 1
- 239000004005 microsphere Substances 0.000 description 1
- 229960001110 miglitol Drugs 0.000 description 1
- 108091005601 modified peptides Proteins 0.000 description 1
- 238000000302 molecular modelling Methods 0.000 description 1
- 239000007922 nasal spray Substances 0.000 description 1
- 230000008693 nausea Effects 0.000 description 1
- 231100000252 nontoxic Toxicity 0.000 description 1
- 230000003000 nontoxic effect Effects 0.000 description 1
- 235000021590 normal diet Nutrition 0.000 description 1
- 108020004707 nucleic acids Proteins 0.000 description 1
- 102000039446 nucleic acids Human genes 0.000 description 1
- 150000007523 nucleic acids Chemical class 0.000 description 1
- 238000013116 obese mouse model Methods 0.000 description 1
- 108010054103 octa-arginine peptide Proteins 0.000 description 1
- QIQXTHQIDYTFRH-UHFFFAOYSA-N octadecanoic acid Chemical compound CCCCCCCCCCCCCCCCCC(O)=O QIQXTHQIDYTFRH-UHFFFAOYSA-N 0.000 description 1
- OQCDKBAXFALNLD-UHFFFAOYSA-N octadecanoic acid Natural products CCCCCCCC(C)CCCCCCCCC(O)=O OQCDKBAXFALNLD-UHFFFAOYSA-N 0.000 description 1
- 239000002674 ointment Substances 0.000 description 1
- 238000005457 optimization Methods 0.000 description 1
- 239000003538 oral antidiabetic agent Substances 0.000 description 1
- 239000006186 oral dosage form Substances 0.000 description 1
- 229940127209 oral hypoglycaemic agent Drugs 0.000 description 1
- 210000000056 organ Anatomy 0.000 description 1
- 210000000496 pancreas Anatomy 0.000 description 1
- 206010033675 panniculitis Diseases 0.000 description 1
- 229920002866 paraformaldehyde Polymers 0.000 description 1
- 238000007911 parenteral administration Methods 0.000 description 1
- 230000007170 pathology Effects 0.000 description 1
- 108010043655 penetratin Proteins 0.000 description 1
- 230000035515 penetration Effects 0.000 description 1
- 230000035699 permeability Effects 0.000 description 1
- 150000003904 phospholipids Chemical class 0.000 description 1
- 230000026731 phosphorylation Effects 0.000 description 1
- 238000006366 phosphorylation reaction Methods 0.000 description 1
- 229920001606 poly(lactic acid-co-glycolic acid) Polymers 0.000 description 1
- 229920000573 polyethylene Polymers 0.000 description 1
- 229920000642 polymer Polymers 0.000 description 1
- 239000012254 powdered material Substances 0.000 description 1
- 230000001376 precipitating effect Effects 0.000 description 1
- 239000002243 precursor Substances 0.000 description 1
- 239000000047 product Substances 0.000 description 1
- 108010079317 prolyl-tyrosine Proteins 0.000 description 1
- 230000000069 prophylactic effect Effects 0.000 description 1
- 238000002331 protein detection Methods 0.000 description 1
- 230000006916 protein interaction Effects 0.000 description 1
- 230000017854 proteolysis Effects 0.000 description 1
- 239000003586 protic polar solvent Substances 0.000 description 1
- 230000002685 pulmonary effect Effects 0.000 description 1
- 238000011084 recovery Methods 0.000 description 1
- 239000006215 rectal suppository Substances 0.000 description 1
- 230000009467 reduction Effects 0.000 description 1
- 238000011160 research Methods 0.000 description 1
- 238000007363 ring formation reaction Methods 0.000 description 1
- CVHZOJJKTDOEJC-UHFFFAOYSA-N saccharin Chemical compound C1=CC=C2C(=O)NS(=O)(=O)C2=C1 CVHZOJJKTDOEJC-UHFFFAOYSA-N 0.000 description 1
- 150000003839 salts Chemical class 0.000 description 1
- 238000012216 screening Methods 0.000 description 1
- 230000019491 signal transduction Effects 0.000 description 1
- 229960004034 sitagliptin Drugs 0.000 description 1
- MFFMDFFZMYYVKS-SECBINFHSA-N sitagliptin Chemical compound C([C@H](CC(=O)N1CC=2N(C(=NN=2)C(F)(F)F)CC1)N)C1=CC(F)=C(F)C=C1F MFFMDFFZMYYVKS-SECBINFHSA-N 0.000 description 1
- 239000012064 sodium phosphate buffer Substances 0.000 description 1
- 239000007787 solid Substances 0.000 description 1
- 239000002904 solvent Substances 0.000 description 1
- 239000001587 sorbitan monostearate Substances 0.000 description 1
- 235000011076 sorbitan monostearate Nutrition 0.000 description 1
- 229940035048 sorbitan monostearate Drugs 0.000 description 1
- 210000005070 sphincter Anatomy 0.000 description 1
- 210000000952 spleen Anatomy 0.000 description 1
- 238000010186 staining Methods 0.000 description 1
- 239000008117 stearic acid Substances 0.000 description 1
- 230000004936 stimulating effect Effects 0.000 description 1
- 239000005720 sucrose Substances 0.000 description 1
- 150000008163 sugars Chemical class 0.000 description 1
- 125000000472 sulfonyl group Chemical group *S(*)(=O)=O 0.000 description 1
- 239000002511 suppository base Substances 0.000 description 1
- 238000002198 surface plasmon resonance spectroscopy Methods 0.000 description 1
- 230000002459 sustained effect Effects 0.000 description 1
- 238000013268 sustained release Methods 0.000 description 1
- 239000012730 sustained-release form Substances 0.000 description 1
- 239000006188 syrup Substances 0.000 description 1
- 235000020357 syrup Nutrition 0.000 description 1
- 108010048573 taspoglutide Proteins 0.000 description 1
- 229950007151 taspoglutide Drugs 0.000 description 1
- WRGVLTAWMNZWGT-VQSPYGJZSA-N taspoglutide Chemical compound C([C@@H](C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](C)C(=O)N[C@@H](CC=1C2=CC=CC=C2NC=1)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CCCCN)C(=O)NC(C)(C)C(=O)N[C@@H](CCCNC(N)=N)C(N)=O)NC(=O)[C@H](CCC(O)=O)NC(=O)[C@H](CCCCN)NC(=O)[C@H](C)NC(=O)[C@H](C)NC(=O)[C@H](CCC(N)=O)NC(=O)CNC(=O)[C@H](CCC(O)=O)NC(=O)[C@H](CC(C)C)NC(=O)[C@H](CC=1C=CC(O)=CC=1)NC(=O)[C@H](CO)NC(=O)[C@H](CO)NC(=O)[C@@H](NC(=O)[C@H](CC(O)=O)NC(=O)[C@H](CO)NC(=O)[C@@H](NC(=O)[C@H](CC=1C=CC=CC=1)NC(=O)[C@@H](NC(=O)CNC(=O)[C@H](CCC(O)=O)NC(=O)C(C)(C)NC(=O)[C@@H](N)CC=1NC=NC=1)[C@@H](C)O)[C@@H](C)O)C(C)C)C1=CC=CC=C1 WRGVLTAWMNZWGT-VQSPYGJZSA-N 0.000 description 1
- 238000011287 therapeutic dose Methods 0.000 description 1
- 230000000699 topical effect Effects 0.000 description 1
- 230000026683 transduction Effects 0.000 description 1
- 238000010361 transduction Methods 0.000 description 1
- 230000005945 translocation Effects 0.000 description 1
- 230000032258 transport Effects 0.000 description 1
- 230000001960 triggered effect Effects 0.000 description 1
- 210000000689 upper leg Anatomy 0.000 description 1
- 239000006216 vaginal suppository Substances 0.000 description 1
- 210000003462 vein Anatomy 0.000 description 1
- WQAJKOXBERTWBK-UHFFFAOYSA-N verdine Natural products CC1CNC2C(C1)OC3(CCC4C5CCC6(O)CC(O)CC(O)C6(C)C5C(=O)C4=C3C)C2C WQAJKOXBERTWBK-UHFFFAOYSA-N 0.000 description 1
- 229960001254 vildagliptin Drugs 0.000 description 1
- SYOKIDBDQMKNDQ-XWTIBIIYSA-N vildagliptin Chemical compound C1C(O)(C2)CC(C3)CC1CC32NCC(=O)N1CCC[C@H]1C#N SYOKIDBDQMKNDQ-XWTIBIIYSA-N 0.000 description 1
- 230000000007 visual effect Effects 0.000 description 1
- 238000012800 visualization Methods 0.000 description 1
- 230000004584 weight gain Effects 0.000 description 1
- 235000019786 weight gain Nutrition 0.000 description 1
Images


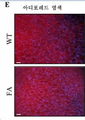
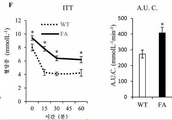
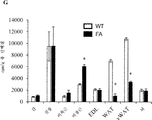

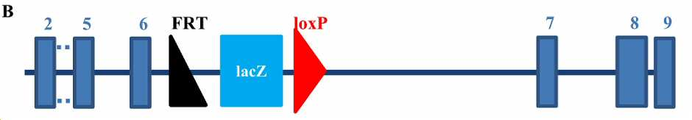

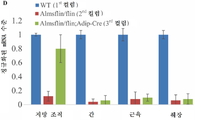


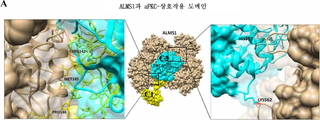

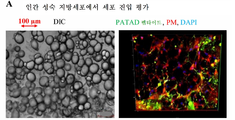
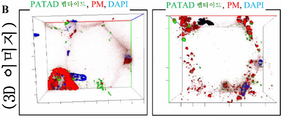

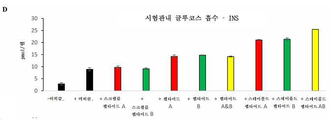
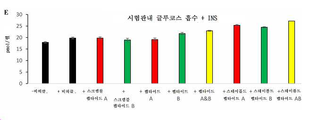
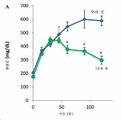


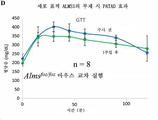
Classifications
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K14/00—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof
- C07K14/435—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from animals; from humans
- C07K14/46—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from animals; from humans from vertebrates
- C07K14/47—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from animals; from humans from vertebrates from mammals
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61K—PREPARATIONS FOR MEDICAL, DENTAL OR TOILETRY PURPOSES
- A61K31/00—Medicinal preparations containing organic active ingredients
- A61K31/13—Amines
- A61K31/155—Amidines (), e.g. guanidine (H2N—C(=NH)—NH2), isourea (N=C(OH)—NH2), isothiourea (—N=C(SH)—NH2)
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61K—PREPARATIONS FOR MEDICAL, DENTAL OR TOILETRY PURPOSES
- A61K38/00—Medicinal preparations containing peptides
- A61K38/16—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof
- A61K38/17—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from animals; from humans
- A61K38/22—Hormones
- A61K38/26—Glucagons
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61K—PREPARATIONS FOR MEDICAL, DENTAL OR TOILETRY PURPOSES
- A61K38/00—Medicinal preparations containing peptides
- A61K38/16—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof
- A61K38/17—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from animals; from humans
- A61K38/22—Hormones
- A61K38/28—Insulins
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61P—SPECIFIC THERAPEUTIC ACTIVITY OF CHEMICAL COMPOUNDS OR MEDICINAL PREPARATIONS
- A61P3/00—Drugs for disorders of the metabolism
- A61P3/08—Drugs for disorders of the metabolism for glucose homeostasis
- A61P3/10—Drugs for disorders of the metabolism for glucose homeostasis for hyperglycaemia, e.g. antidiabetics
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K7/00—Peptides having 5 to 20 amino acids in a fully defined sequence; Derivatives thereof
- C07K7/04—Linear peptides containing only normal peptide links
- C07K7/06—Linear peptides containing only normal peptide links having 5 to 11 amino acids
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K7/00—Peptides having 5 to 20 amino acids in a fully defined sequence; Derivatives thereof
- C07K7/04—Linear peptides containing only normal peptide links
- C07K7/08—Linear peptides containing only normal peptide links having 12 to 20 amino acids
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12N—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA
- C12N9/00—Enzymes; Proenzymes; Compositions thereof; Processes for preparing, activating, inhibiting, separating or purifying enzymes
- C12N9/10—Transferases (2.)
- C12N9/12—Transferases (2.) transferring phosphorus containing groups, e.g. kinases (2.7)
- C12N9/1205—Phosphotransferases with an alcohol group as acceptor (2.7.1), e.g. protein kinases
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12Y—ENZYMES
- C12Y207/00—Transferases transferring phosphorus-containing groups (2.7)
- C12Y207/11—Protein-serine/threonine kinases (2.7.11)
- C12Y207/11013—Protein kinase C (2.7.11.13)
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61K—PREPARATIONS FOR MEDICAL, DENTAL OR TOILETRY PURPOSES
- A61K38/00—Medicinal preparations containing peptides
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61K—PREPARATIONS FOR MEDICAL, DENTAL OR TOILETRY PURPOSES
- A61K45/00—Medicinal preparations containing active ingredients not provided for in groups A61K31/00 - A61K41/00
- A61K45/06—Mixtures of active ingredients without chemical characterisation, e.g. antiphlogistics and cardiaca
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2319/00—Fusion polypeptide
Landscapes
- Health & Medical Sciences (AREA)
- Chemical & Material Sciences (AREA)
- Life Sciences & Earth Sciences (AREA)
- Organic Chemistry (AREA)
- General Health & Medical Sciences (AREA)
- Medicinal Chemistry (AREA)
- Zoology (AREA)
- Genetics & Genomics (AREA)
- Engineering & Computer Science (AREA)
- Bioinformatics & Cheminformatics (AREA)
- Molecular Biology (AREA)
- Biochemistry (AREA)
- Proteomics, Peptides & Aminoacids (AREA)
- Wood Science & Technology (AREA)
- Veterinary Medicine (AREA)
- Gastroenterology & Hepatology (AREA)
- Public Health (AREA)
- Animal Behavior & Ethology (AREA)
- Pharmacology & Pharmacy (AREA)
- Biophysics (AREA)
- Epidemiology (AREA)
- Diabetes (AREA)
- General Engineering & Computer Science (AREA)
- Endocrinology (AREA)
- Microbiology (AREA)
- Biotechnology (AREA)
- Biomedical Technology (AREA)
- Toxicology (AREA)
- Immunology (AREA)
- Emergency Medicine (AREA)
- Hematology (AREA)
- Obesity (AREA)
- Chemical Kinetics & Catalysis (AREA)
- General Chemical & Material Sciences (AREA)
- Nuclear Medicine, Radiotherapy & Molecular Imaging (AREA)
- Medicines That Contain Protein Lipid Enzymes And Other Medicines (AREA)
- Peptides Or Proteins (AREA)
Abstract
Description
(A) 6-월령 수컷 마우스의 평균 체중이다.
(B) 아디포-레드(Adipo-red)로 염색한, 6-월령 수컷 마우스의 내장 지방 조직이다. 기준자(scale bar): 25 μM.
(C) 6-월령 수컷 마우스로부터의 인슐린 관용 시험(ITT), 및 곡선 아래 면적(A.U.C.; area under the curve) p<0.001)을 보여주는 상응하는 히스토그램이다.
(D) 2-월령 수컷 마우스의 평균 체중이다.
(E) 아디포-레드로 염색한, 2-월령 수컷 마우스의 내장 지방 조직이다. 기준자: 25 μM.
(F) 2-월령 수컷 마우스의 ITT 및 A.U.C.를 보여주는 히스토그램이다.
(G) 2-월령 마우스의 상이한 기관에서 인슐린-자극 데옥시글루코스 흡수 수준의 측정이다: 간, 심장, 비복근, 비장근, EDL(장지신근(extensor digitorum longus muscle)), WAT(백색 지방 조직), vWAT(내장 WAT), 뇌(n = 1개 유전자형 당 6 내지 8 마리 마우스).
도 2: ALMS1( Alms flin/flin )의 특이적인 지방 조직 재활성화의 발생 및 이의 대사 특징화
(A) ALMS 유전자의 인트론 영역에 도입되고 측면에 2개의 LoxP 부위를 갖는 네오마이신 유전자 (NEO box) 의 정지서열을 갖는 Cre 활성을 통해 표적화된 조직에서 ALMS 활성의 특이적인 재도입을 발생시키기 위한 클로닝 전략을 나타내는 도식도이다.
(B) Cre 활성 시, 플록세드(floxed) 영역은 제거되어, 단지 1개의 LoxP 부위만 남게 되며, 어떠한 정지 코돈도 ALMS 1 발현을 재활성화시키지 않는다.
(C) 지방세포 단독에 대한 아디포넥틴-Cre 마우스주(mouse line)의 특이성 평가이다. 아디포넥틴-Cre를 RosaTomatoeGFP 수용체주(reporter line)와 교차시킴으로써, 형광을 띄는 조직만 Cre 활성을 나타낸다.
(D) 주어진 유전자형을 갖는 상이한 표적 조직에서 Alms1 발현 수준의 정량적 PCR 분석이다. WT 마우스에서, 모든 시험된 조직은 ALMS1을 발현하고 있고, Alms1 flin/flin 에서 어떠한 발현 수준도 검출되지 않는 반면, Alms1flin/flin;아디포넥틴-Cre+/-에서, 지방 조직만 ALMS1을 발현하고 있다.
(E) Alms1 flin/flin 을 보여주는 지시된 유전자형을 갖고 있으며 비만이 되어 가고 있는 수컷 마우스에 대한 성장 곡선이다.
(F) 지시된 유전자형을 갖는 수컷 마우스에서 글루코스 관용 시험으로서, Alms flin/flin 이 글루코스 비관용(intolerant)이지만 지방 조직에서만 ALMS1을 회복시키는 것이 글루코스 관용을 회복시키기에 충분함을 도시한다.
도 3: 인간 αPKC 이소형 ( isoform ) 유래의 잠재적인 펩타이드 서열의 식별과 함께 ALMS1 및 αPKC 결합의 인 실리코 (In silico ) 모델링이다 .
(A) 3개의 주요 아미노산: 아르기닌, 메티오닌 및 프롤린의 식별과 함께 ALMS1 및 αPKC 결합의 인 실리코 모델링이다.
(B) 인간 αPKC 이소형 서열 유래 잠재적인 펩타이드의 식별이다. 이들 펩타이드는, Peptide of APKC Targeting ALMS for Diavetes 의 약어로 PATAD 펩타이드로 지칭할 수 있다.
도 4: 펩타이드 서열의 글루코스 흡수 유발력에 대한, 2개의 펩타이드 서열의 시험관내 특징화이다.
(A) 인간 지방세포에서 FAM-표지 스테이플드 펩타이드 A(서열 번호: 9)와 B(서열 번호: 11)의 혼합물의 세포 진입 평가를 도시하는 대표적인 사진이다. DIC: 좌측 패널에서 살아 있는 세포 취득(acquisition)에 대한 차등 간섭 대비 모드(differential interference contrast mode)이다. 우측 패널에서, 표지된 형질막(PM)과 함께 FAM-표지 펩타이드의 형광 검출이다.
(B) 도 3에서 식별된 PATAD 펩타이드의 세포 흡수의 3D 이미지이다; 펩타이드 A(좌측 패널) 또는 펩타이드 B(우측 패널)로 처리된 지방세포는 상기 지방세포 내부에서 펩타이드 내부의 스팟을 보여준다.
(C) 스테이플드 펩타이드 A와 B의 조합을 이용한 치료 후, 지방세포에서 INS의 부재 하에 2-NBDG의 흡수를 보여주는 사진이다.
(D) 지시된 펩타이드 치료 후(1개 그룹 당 n = 8), 지방세포에서 INS의 부재 하에 세포내 글루코스 유사체 2-NB의 정량화이다.
(E) 지시된 펩타이드 치료 후(1개 그룹 당 n = 8), 지방세포에서 INS의 존재 하에 세포내 글루코스 유사체 2-NB의 정량화이다.
도 5: 지방 조직-관련 내분비 양태 및 이들의 전신 영향이다.
(A) 스테이플드 펩타이드 A와 B의 조합의 피하 주사 전, 및 펩타이드 주사 후 1주 뒤에, 식단 유도 비만(DIO; diet induced obese) 및 당뇨병 마우스에서 글루코스 관용 시험(GTT)이다.
(B) DIO 마우스에서 펩타이드 치료에 대한 실험 설정의 도식도이다.
(C) 주사 부위로부터 수득된 지방 조직 내부에서 표지된 형질막(PM)과 함께 FAM-표지 펩타이드 A 및 B(화살표로 표시됨)의 형광 검출이다.
(D) 스테이플드 펩타이드 A와 B의 조합의 피하 주사 전, 및 펩타이드 피하 주사 후 1주 뒤에, 기능적 ALMS1이 결여된 Almsfoz/foz 마우스에서 GTT이다.

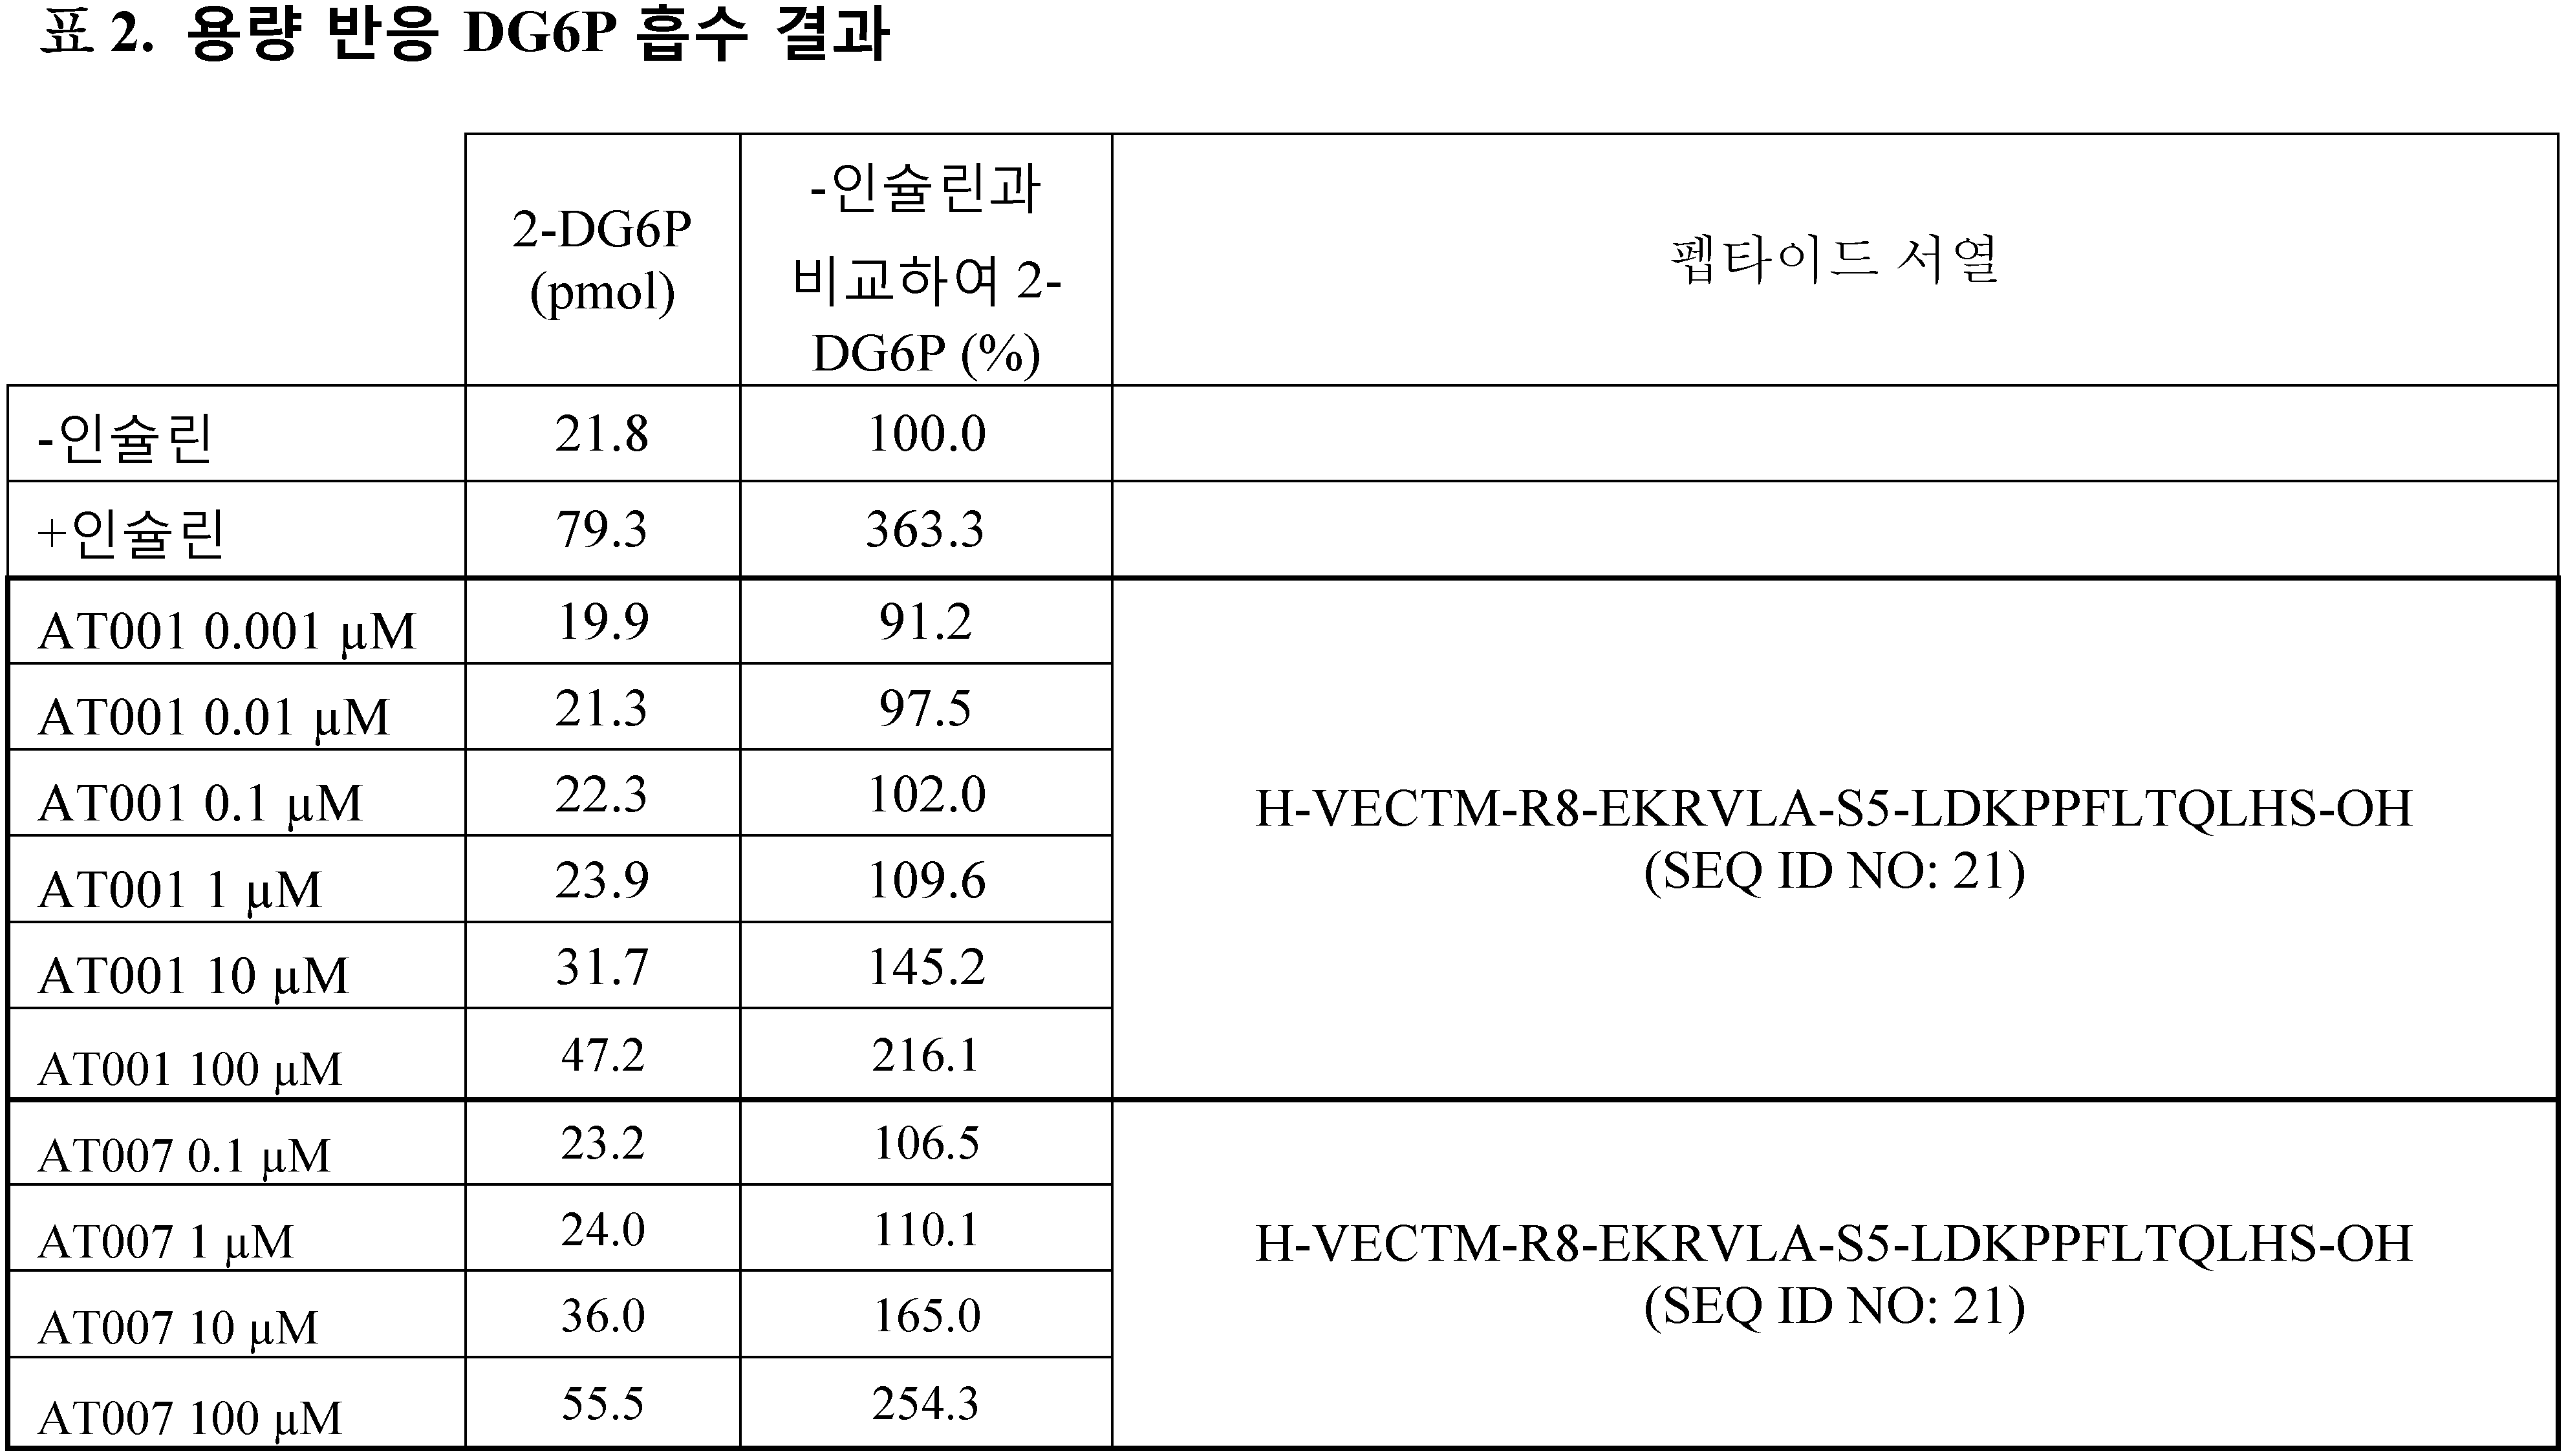

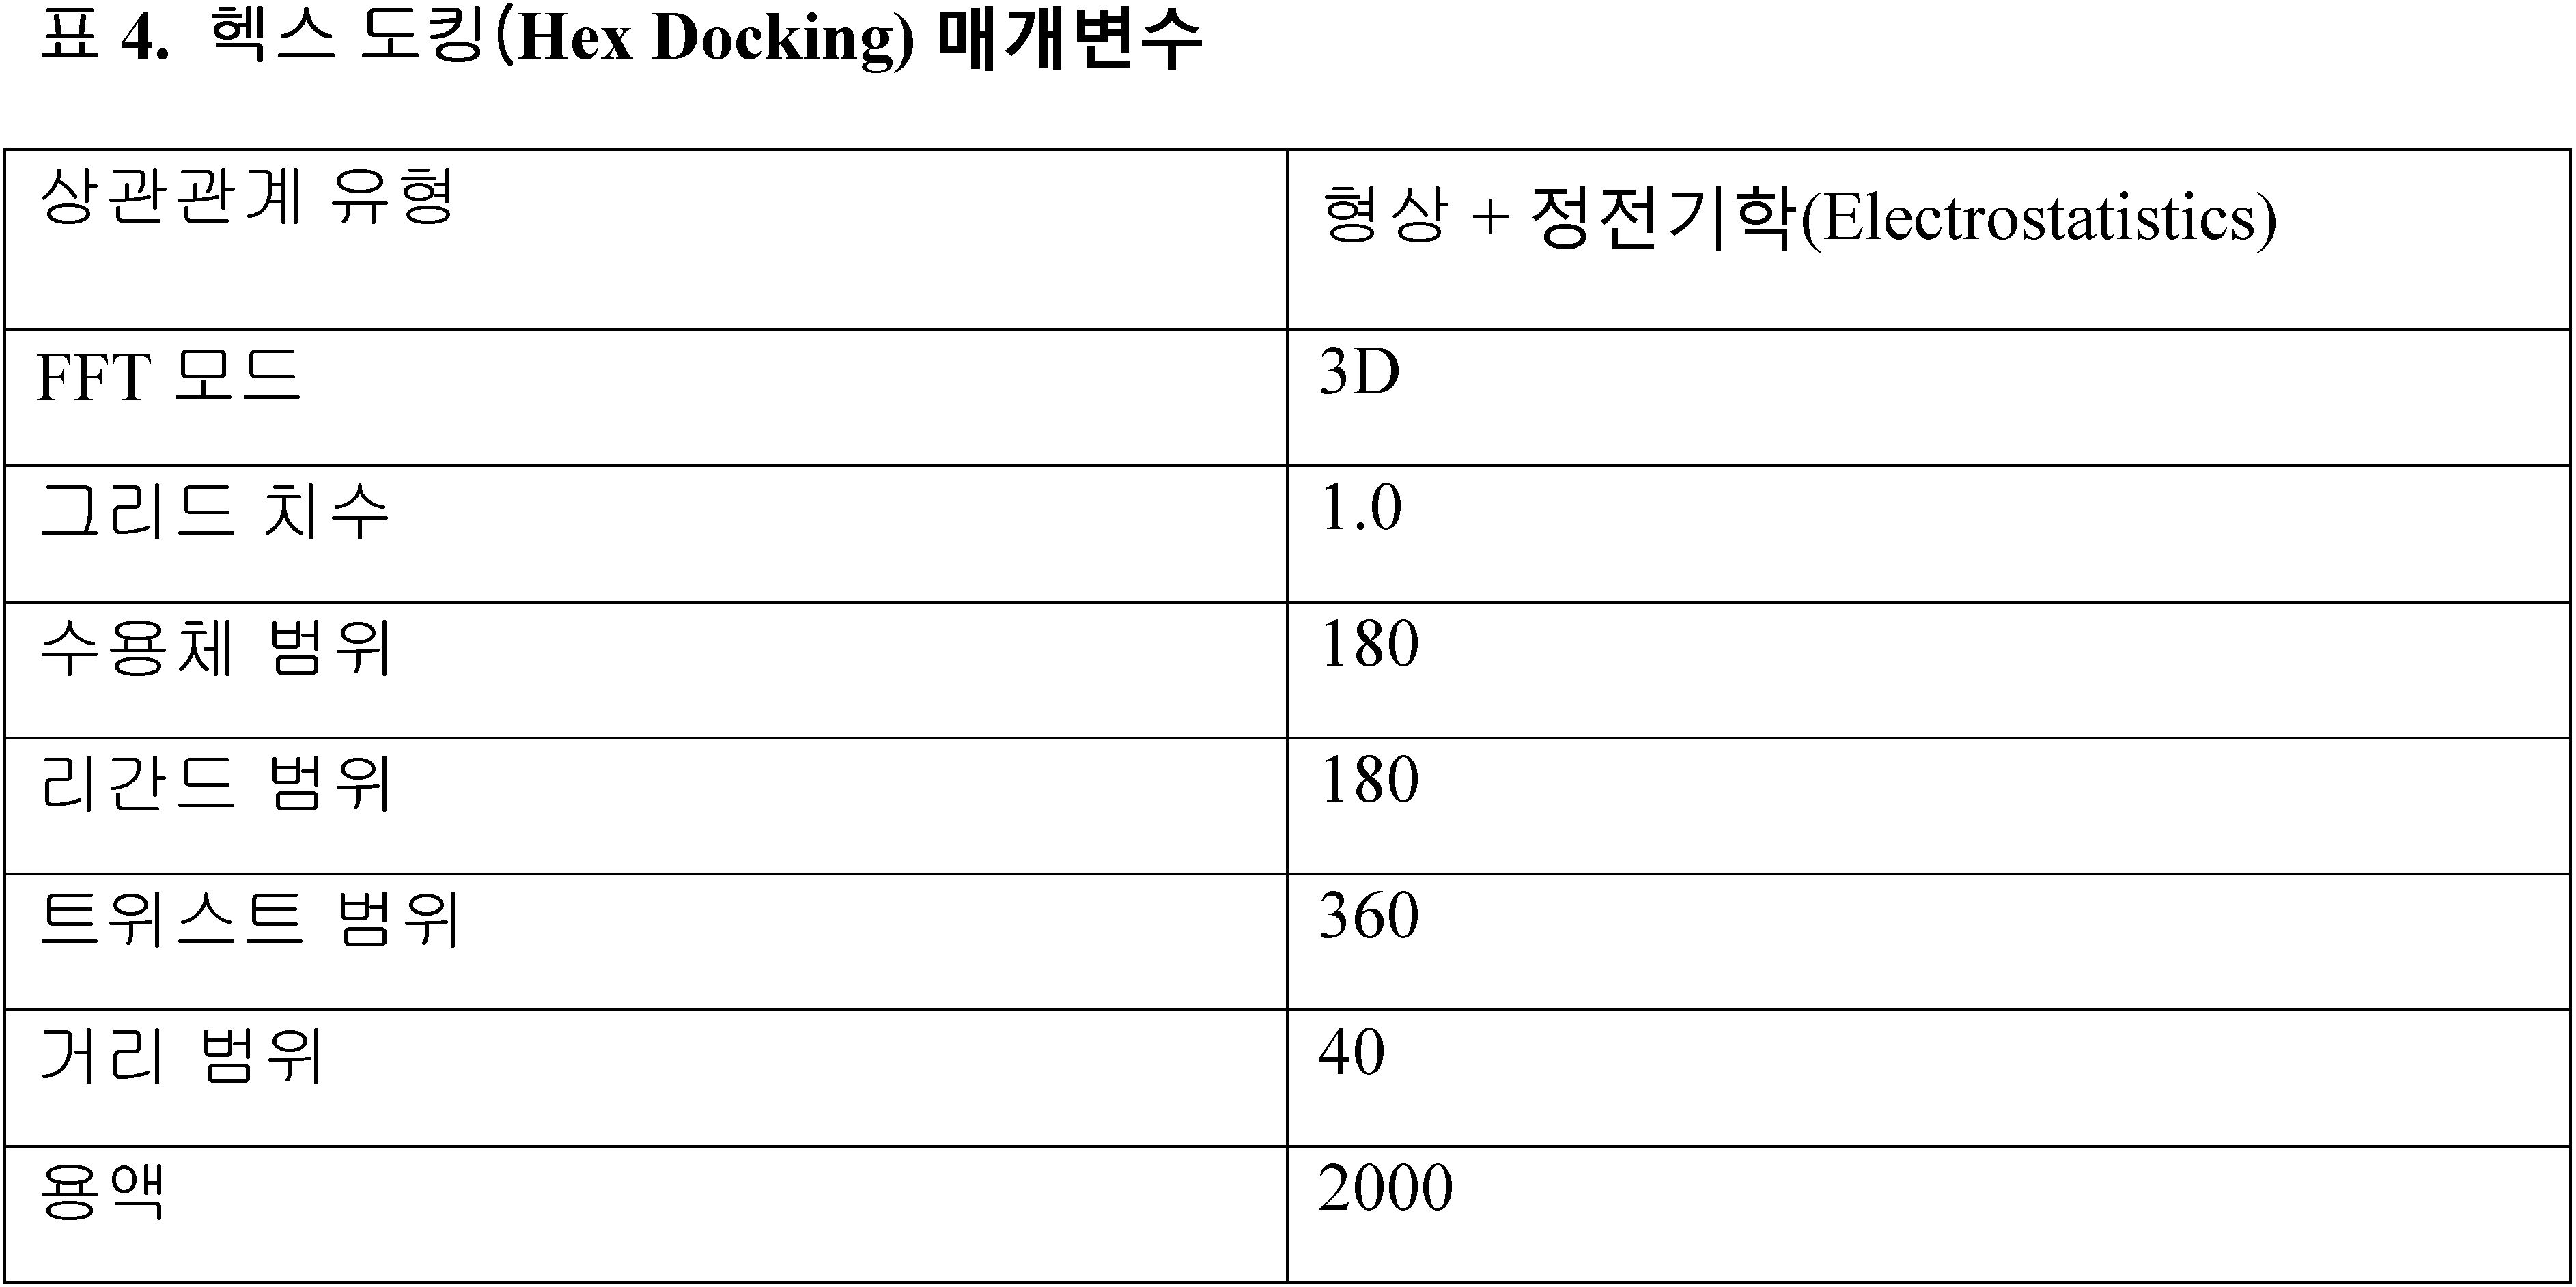
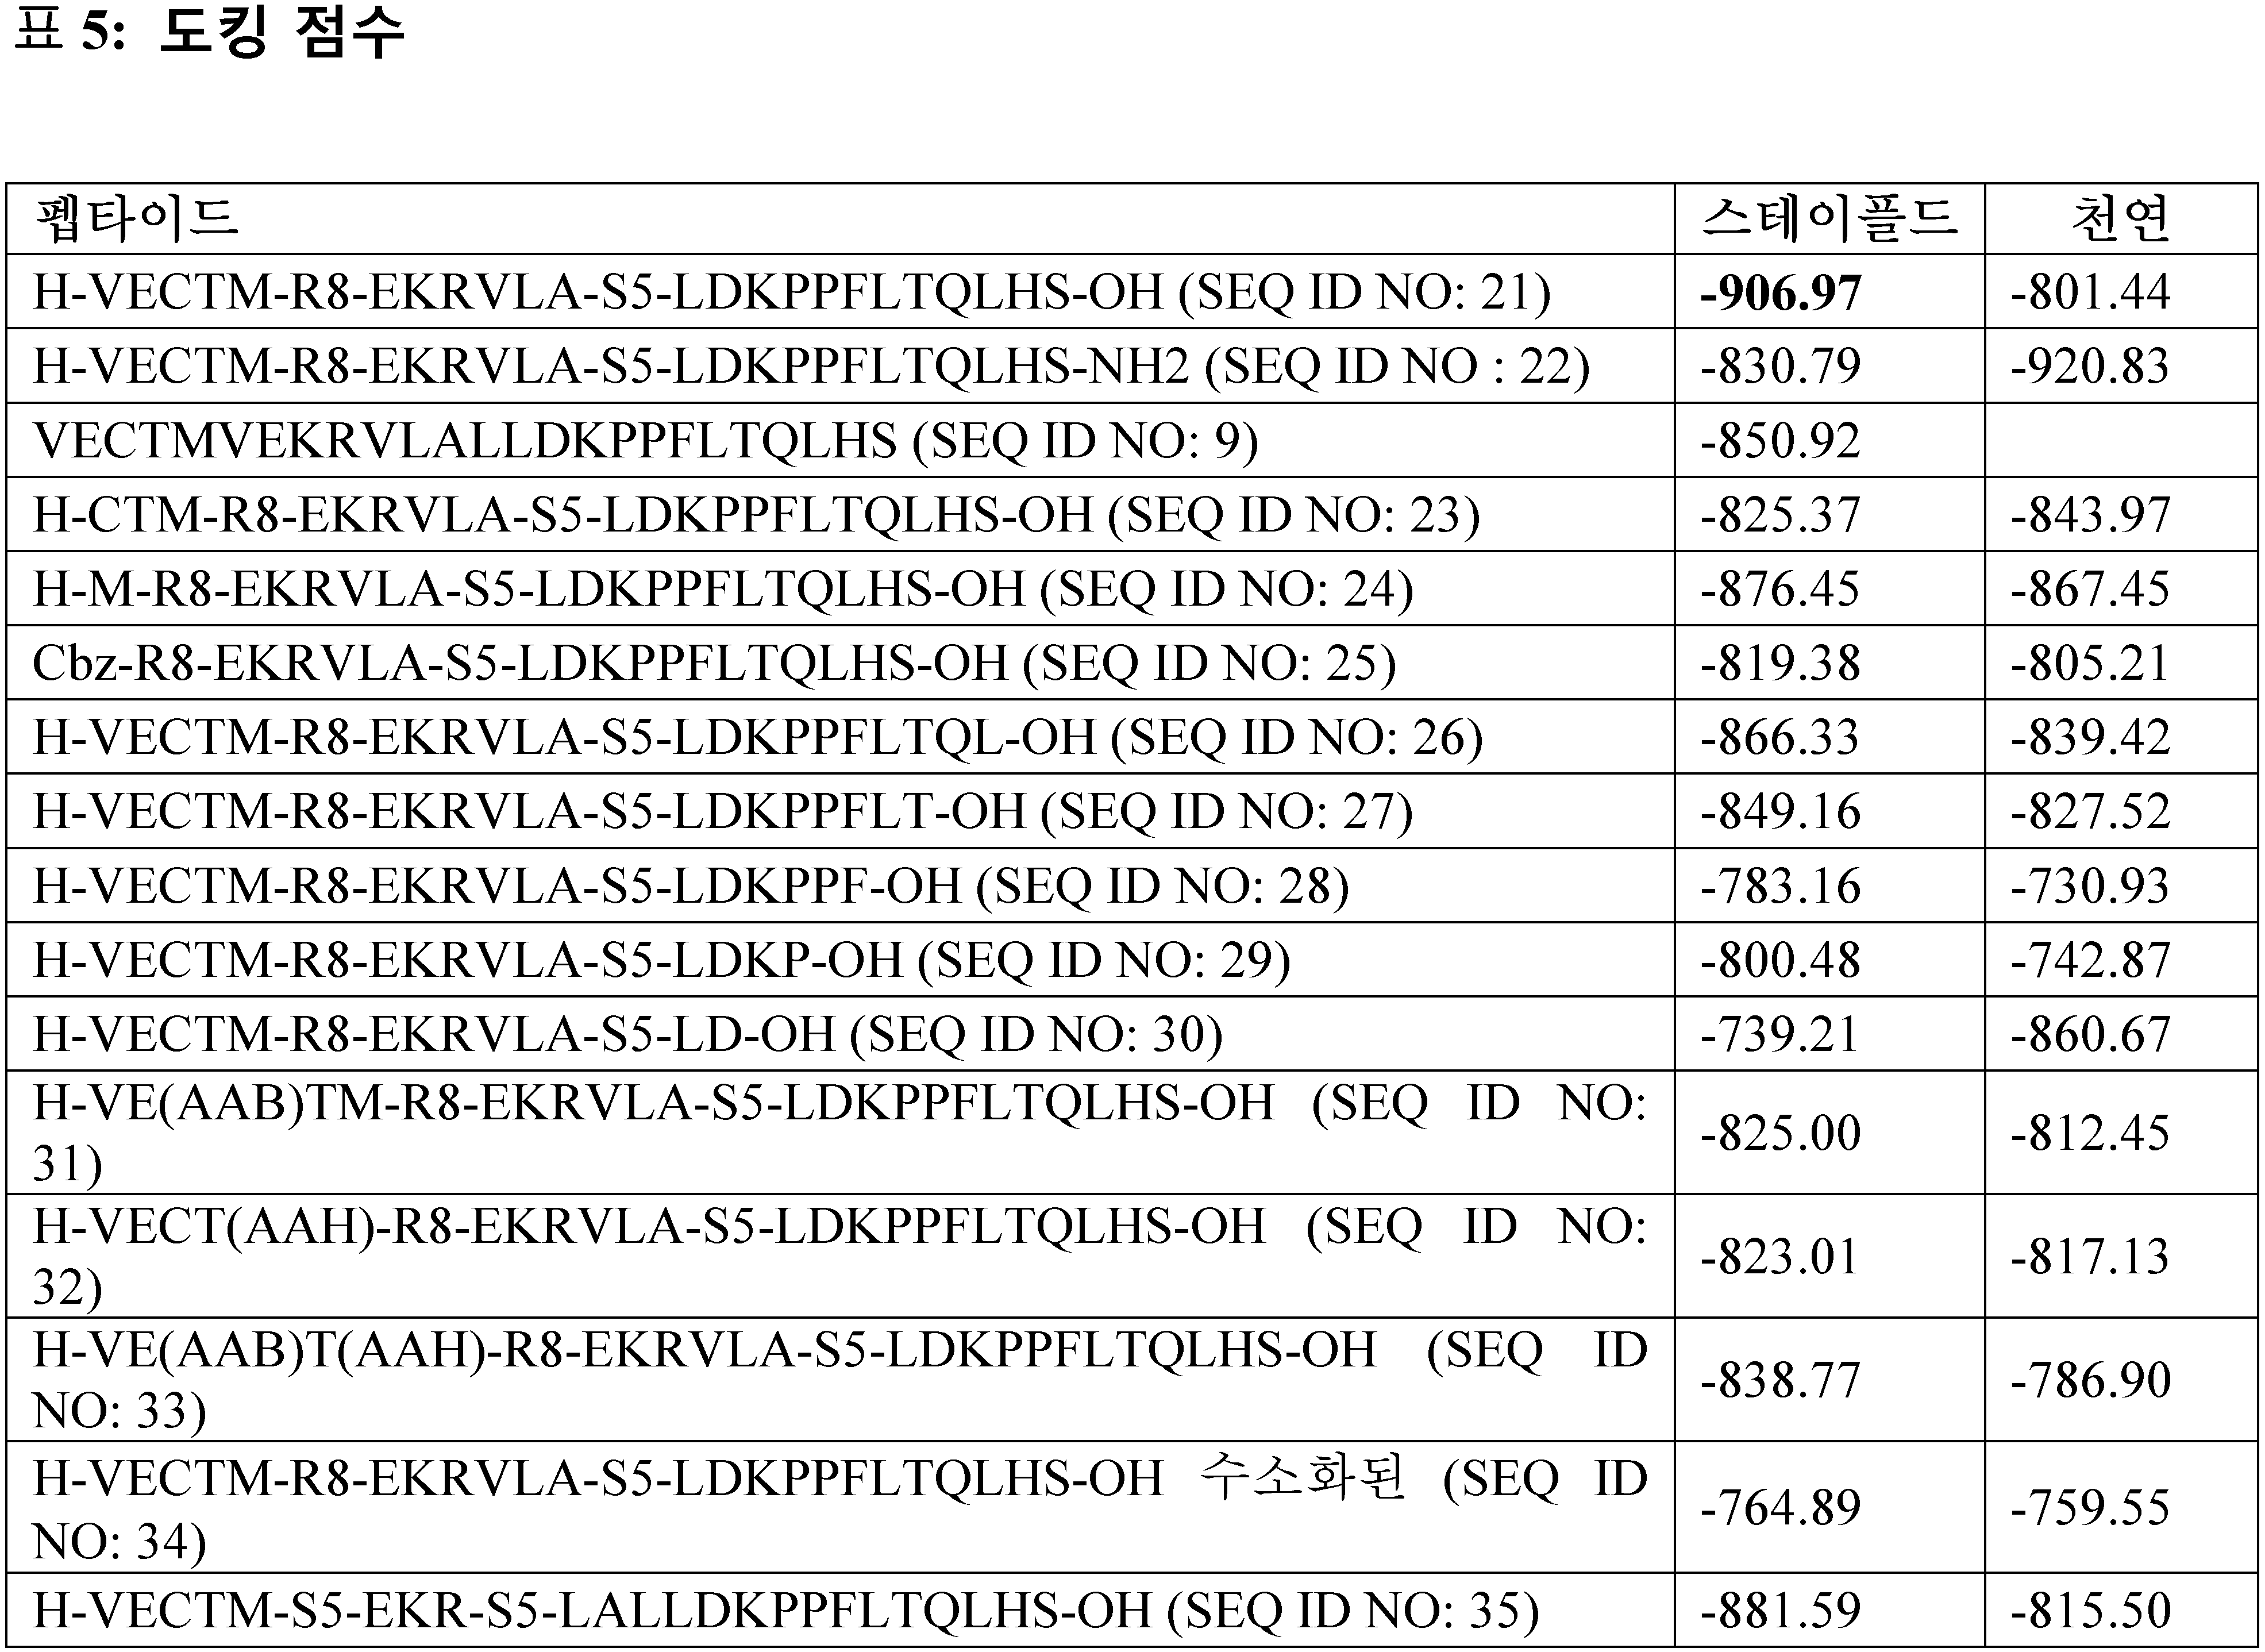
Claims (17)
- 인슐린-독립적 지방세포 글루코스 수송을 유도하는 펩타이드로서,
- 상기 펩타이드는 단백질 키나제 C(PKC)의 분절의 서열을 포함하며;
- 상기 펩타이드는 적어도 하나의 메티오닌, 하나의 프롤린 및 하나의 아르기닌을 포함하며;
- 상기 펩타이드는 적어도 8개 아미노산 내지 40개 미만의 아미노산 길이, 바람직하게는 적어도 10개 아미노산 내지 30개 미만의 아미노산 길이; 보다 바람직하게는 적어도 12개 아미노산 내지 25개 미만의 아미노산 길이를 가지고;
- 상기 펩타이드는 PKC의 분절의 상기 서열 내에 1, 2, 3, 4 또는 5개의 치환(들), 결실(들), 첨가(들) 또는 이들의 혼합을 포함할 수 있는,
펩타이드. - 제1항에 있어서, 상기 펩타이드는 바람직하게는, 알파 나선형 형태(conformation)를 채택하는, 펩타이드.
- 제1항 또는 제2항에 있어서, 상기 펩타이드는 스테이플링(stapling)과 같은 화학적 가교에 의해 변형되는, 펩타이드.
- 제1항 내지 제3항 중 어느 한 항에 있어서, 펩타이드 서열은 하기 식:
M-(X)m-P-(X)n-R 또는 M-(X)m-R-(X)n-P 또는 P-(X)m-M-(X)n-R 또는 P-(X)m-R-(X)n-M 또는 R-(X)m-P-(X)n-M 또는 R-(X)m-M-(X)n-P
중 하나에 따른 서열을 포함하고,
상기 m 및 n은 1 내지 20의 정수이며, m + n은 30 미만이고, X는 임의의 아미노산인, 펩타이드. - 제1항 내지 제4항 중 어느 한 항에 있어서, 상기 펩타이드는 하기 식:
M-(X)m-R-(X)n-P 또는 P-(X)m-R-(X)n-M 또는 R-(X)m-M-(X)n-P 또는 M-(X)m-P-(X)n-R
중 하나에 따른 서열을 포함하고,
상기 m, n 및 X는 제2항에서 정의된 바와 같은, 펩타이드. - 제1항 내지 제5항 중 어느 한 항에 있어서, m + n은 20 미만이고, m 및 n은 2 내지 15, 바람직하게는 2 내지 7의 정수인, 펩타이드.
- 제1항 내지 제6항 중 어느 한 항에 있어서, 상기 PKC는 알파-PKC(αPKC), βI 및 βII PKC를 포함하는 베타-PKC(βPKC), 델타-PKC, 세타-PKC, 에타(eta)-PKC 및 입실론-PKC로 구성된 군으로부터 선택되는, 펩타이드.
- 제7항에 있어서, 상기 PKC는 서열 번호: 1의 αPKC인, 펩타이드.
- 제1항 내지 제8항 중 어느 한 항에 있어서, 상기 펩타이드 서열은
- MVEKRVLALLDKP(서열 번호: 2);
- PFLTQLHSCFQTVDRLYFVM(서열 번호: 3);
- RLYFVMEYVNGGDLMYHIQQVGKFKEP(서열 번호: 4);
- MYHIQQVGKFKEPQAVFYAAEISIGLFFLHKR(서열 번호: 5);
- PQAVFYAAEISIGLFFLHKRGIIYRDLKLDNVM(서열 번호: 6);
- MDGVTTRTFCGTP(서열 번호: 7); 및
- MTKHPAKR(서열 번호: 8)
로 구성된 군으로부터 선택되는 서열을 포함하고,
선택적으로, 상기 펩타이드 서열은 1, 2, 3, 4 또는 5개의 치환(들), 결실(들), 첨가(들) 또는 이들의 혼합을 포함하는, 펩타이드. - 제9항에 있어서, 상기 펩타이드 서열은
- MVEKRVLALLDKP(서열 번호: 2);
- MDGVTTRTFCGTP(서열 번호: 7);
- MTKHPAKR(서열 번호: 8)
로 구성된 군으로부터 선택되는 서열을 포함하고,
선택적으로, 상기 펩타이드 서열은 1, 2, 3, 4 또는 5개의 치환(들), 결실(들), 첨가(들) 또는 이들의 혼합을 포함하는, 펩타이드. - 제1항 내지 제10항 중 어느 한 항에 있어서, 상기 펩타이드 서열은
- VECTMVEKRVLALLDKPPFLTQLHS(서열 번호: 9);
- MCKEHMMDGVTTRTFCGTPD(서열 번호: 10);
- SICKGLMTKHPAKRLGCGPEG(서열 번호: 11);
- H-VECTM-R8-EKRVLA-S5-LDKPPFLTQLHS-OH(서열 번호: 21);
- H-VECTM-R8-EKRVLA-S5-LDKPPFLTQLHS-NH2 (서열 번호: 22);
- H-CTM-R8-EKRVLA-S5-LDKPPFLTQLHS-OH(서열 번호: 23);
- H-M-R8-EKRVLA-S5-LDKPPFLTQLHS-OH(서열 번호: 24);
- Cbz-R8-EKRVLA-S5-LDKPPFLTQLHS-OH(서열 번호: 25);
- H-VECTM-R8-EKRVLA-S5-LDKPPFLTQL-OH(서열 번호: 26);
- H-VECTM-R8-EKRVLA-S5-LDKPPFLT-OH(서열 번호: 27);
- H-VECTM-R8-EKRVLA-S5-LDKPPF-OH(서열 번호: 28);
- H-VECTM-R8-EKRVLA-S5-LDKP-OH(서열 번호: 29);
- H-VECTM-R8-EKRVLA-S5-LD-OH(서열 번호: 30);
- H-VE(AAB)TM-R8-EKRVLA-S5-LDKPPFLTQLHS-OH(서열 번호: 31);
- H-VECT(AAH)-R8-EKRVLA-S5-LDKPPFLTQLHS-OH(서열 번호: 32);
- H-VE(AAB)T(AAH)-R8-EKRVLA-S5-LDKPPFLTQLHS-OH(서열 번호: 33);
- H-VECTM-R8-EKRVLA-S5-LDKPPFLTQLHS-OH 수소화된(서열 번호: 34);
- H-VECTM-S5-EKR-S5-LALLDKPPFLTQLHS-OH (서열 번호: 35); 및
- H-LPHET-R8-RLSQKV-S5-TKLDCLMFVEPA-OH(서열 번호: 36)
로 구성된 군으로부터 선택되는 서열을 포함하거나 이러한 서열로 구성되고,
선택적으로, 상기 펩타이드 서열은 1, 2, 3, 4 또는 5개의 치환(들), 결실(들), 첨가(들) 또는 이들의 혼합을 포함하는, 펩타이드. - 제1항 내지 제11항 중 어느 한 항에 있어서, 상기 펩타이드는
- VECTM V EKRVLA L LDKPPFLTQLHS(서열 번호: 9);
- MC K EHMMDG V TTRTFCGTPD(서열 번호: 10); 및
- S I CKGLMT K HPAKRLGCGPEG(서열 번호: 11);
- H-VECTM-R8-EKRVLA-S5-LDKPPFLTQLHS-OH(서열 번호: 21);
- H-VECTM-R8-EKRVLA-S5-LDKPPFLTQLHS-NH2 (서열 번호: 22);
- H-CTM-R8-EKRVLA-S5-LDKPPFLTQLHS-OH(서열 번호: 23);
- H-M-R8-EKRVLA-S5-LDKPPFLTQLHS-OH(서열 번호: 24);
- Cbz-R8-EKRVLA-S5-LDKPPFLTQLHS-OH(서열 번호: 25);
- H-VECTM-R8-EKRVLA-S5-LDKPPFLTQL-OH(서열 번호: 26);
- H-VECTM-R8-EKRVLA-S5-LDKPPFLT-OH(서열 번호: 27);
- H-VECTM-R8-EKRVLA-S5-LDKPPF-OH(서열 번호: 28);
- H-VECTM-R8-EKRVLA-S5-LDKP-OH(서열 번호: 29);
- H-VECTM-R8-EKRVLA-S5-LD-OH(서열 번호: 30);
- H-VE(AAB)TM-R8-EKRVLA-S5-LDKPPFLTQLHS-OH(서열 번호: 31);
- H-VECT(AAH)-R8-EKRVLA-S5-LDKPPFLTQLHS-OH(서열 번호: 32);
- H-VE(AAB)T(AAH)-R8-EKRVLA-S5-LDKPPFLTQLHS-OH(서열 번호: 33);
- H-VECTM-R8-EKRVLA-S5-LDKPPFLTQLHS-OH 수소화된(서열 번호: 34);
- H-VECTM-S5-EKR-S5-LALLDKPPFLTQLHS-OH (서열 번호: 35); 및
- H-LPHET-R8-RLSQKV-S5-TKLDCLMFVEPA-OH(서열 번호: 36)
로 구성된 군으로부터 선택되는 서열로 구성되고,
볼드체로 되어 있고 밑줄이 그어진 잔기는 스테이플링을 수행하고, 선택적으로 상기 잔기는 1, 2, 3, 4 또는 5개의 치환(들), 결실(들), 첨가(들) 또는 이들의 혼합을 포함하는, 펩타이드. - 제1항 내지 제11항 중 어느 한 항에 있어서, 상기 펩타이드는 하이드록실 말단 기를 갖는, 펩타이드.
- 제1항 내지 제11항 중 어느 한 항에 있어서, 상기 펩타이드는 메틸 말단 기를 갖는, 펩타이드.
- 제1항 내지 제14항 중 어느 한 항에 따른 펩타이드를 포함하는, 약제학적 조성물.
- 진성 당뇨병, 고혈당, 인슐린 내성, 고지혈증, 관상심장병(coronary heart disease), 당뇨병성 망막병증, 당뇨병성 신경병증, 당뇨병성 신장병증, 비만, 지질이영양증, 인슐린 결핍, 베타 세포 기능장애 또는 고인슐린혈증의 진행 또는 발병(onset)을 치료하거나 지연시키는 데 사용하기 위한, 제1항 내지 제14항 중 어느 한 항에 따른 펩타이드 또는 제15항에 따른 약제학적 조성물의 용도.
- 제1항 내지 제14항 중 어느 한 항의 펩타이드, 또는 제15항에 따른 약제학적 조성물, 또는 제16항의 용도에 있어서, 상기 펩타이드는 또 다른 항-당뇨병제, 바람직하게는 인슐린, 메트포르민, 설포닐우레아, 알파-글루코시다제 저해제, 티아졸리딘디온, 메글리티나이드(meglitinide), 인크레틴 모방체(incretin mimetic), 글루카곤-유사 펩타이드 유사체, 디펩티딜 펩티다제-4 저해제, 아밀린 유사체, 소듐 글루코스 수송체 저해제 및 이들의 임의의 조합으로 구성된 군으로부터 선택되는 또 다른 항-당뇨병제 (anti-diabetic agent) 와 조합되는, 펩타이드, 또는 약제학적 조성물, 또는 용도.
Applications Claiming Priority (3)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| EP17305843.9 | 2017-06-30 | ||
| EP17305843.9A EP3421485A1 (en) | 2017-06-30 | 2017-06-30 | Peptides for treatment and prevention of hyperglycaemia |
| PCT/EP2018/067657 WO2019002583A1 (en) | 2017-06-30 | 2018-06-29 | PEPTIDES FOR THE TREATMENT AND PREVENTION OF HYPERGLYCEMIA |
Publications (2)
| Publication Number | Publication Date |
|---|---|
| KR20200024263A true KR20200024263A (ko) | 2020-03-06 |
| KR102696075B1 KR102696075B1 (ko) | 2024-08-19 |
Family
ID=59363054
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| KR1020207002727A Active KR102696075B1 (ko) | 2017-06-30 | 2018-06-29 | 고혈당증의 치료 및 예방을 위한 펩타이드 |
Country Status (5)
| Country | Link |
|---|---|
| US (1) | US11332503B2 (ko) |
| EP (2) | EP3421485A1 (ko) |
| JP (1) | JP7471824B2 (ko) |
| KR (1) | KR102696075B1 (ko) |
| WO (1) | WO2019002583A1 (ko) |
Families Citing this family (6)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| BR112016017444A2 (pt) | 2014-01-29 | 2017-10-10 | Inst Nat Sante Rech Med | molécula e método |
| LT3723782T (lt) * | 2017-12-14 | 2026-02-10 | Université De Strasbourg | Peptidai, skirti nealkoholinės kepenų suriebėjimo ligos gydymui ir profilaktikai |
| RS64265B1 (sr) * | 2018-12-21 | 2023-07-31 | Univ Strasbourg | Peptidi za lečenje i prevenciju dijabetesa i povezanih poremećaja |
| CN111394339B (zh) * | 2020-03-18 | 2020-10-20 | 华东师范大学 | 一种基于酵母二肽基肽酶ⅲ的抗体模拟物及其应用 |
| CN116003511B (zh) * | 2023-01-30 | 2026-02-17 | 安徽科技学院 | 羊肚菌源降血糖肽及其应用 |
| CN117700489B (zh) * | 2023-12-19 | 2024-08-20 | 深圳泰华赛尔生物科技有限公司 | 脂肪干细胞在治疗糖尿病的药物中的应用 |
Citations (3)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP2007530000A (ja) * | 2003-07-17 | 2007-11-01 | ユニヴァーシティー オブ ダンディー | Lkb1/strad7m025複合体の使用方法 |
| WO2015114062A1 (en) * | 2014-01-29 | 2015-08-06 | Universite De Strasbourg | New target for diabetes treatment and prevention |
| WO2018005445A1 (en) * | 2016-06-27 | 2018-01-04 | The Broad Institute, Inc. | Compositions and methods for detecting and treating diabetes |
Family Cites Families (26)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| US4946778A (en) | 1987-09-21 | 1990-08-07 | Genex Corporation | Single polypeptide chain binding molecules |
| ES2188985T3 (es) | 1996-08-30 | 2003-07-01 | Jens Peter Furste | Seleccion enantiomerica y evolucion enantiomerica de acidos nucleicos. |
| US6225120B1 (en) | 1997-05-15 | 2001-05-01 | The General Hospital Corporation | Therapeutic and diagnostic tools for impaired glucose tolerance conditions |
| JP2003516760A (ja) | 1999-12-02 | 2003-05-20 | ユニヴァーシティー オブ ダンディー | プロテインキナーゼ調節 |
| US7029892B1 (en) | 2000-07-19 | 2006-04-18 | Amgen, Inc. | Serine threonine kinase member, h2520-59 |
| US20020162127A1 (en) | 2001-01-30 | 2002-10-31 | Yizhong Gu | Human protein kinase domain-containing protein |
| AU2002330649A1 (en) | 2001-10-15 | 2003-04-28 | University Of Southampton | Diagnosis and therapy of conditions involving alms1 |
| DE10244453A1 (de) | 2002-09-24 | 2004-04-01 | Phenomiques Gmbh | Hemmung der Proteinkinase C-alpha zur Behandlung von Krankheiten |
| WO2005079300A2 (en) | 2004-02-13 | 2005-09-01 | Albert Einstein College Of Medicine Of Yeshiva University | Protein kinase inhibitors and methods for identifying same |
| PL1768650T3 (pl) | 2004-06-04 | 2009-01-30 | Camurus Ab | Ciekłe formulacje depot |
| US7265092B2 (en) | 2004-09-30 | 2007-09-04 | Kai Pharmaceuticals, Inc. | Pharmaceutical formulation |
| KR100983746B1 (ko) | 2005-01-14 | 2010-09-24 | 카무러스 에이비 | 소마토스타틴 유사 제형 |
| AU2006263332B2 (en) | 2005-06-29 | 2012-02-23 | Hadasit Medical Research Services & Development Ltd. | Protein kinase C inhibitors for prevention of insulin resistance and type 2 diabetes |
| AU2007257650A1 (en) | 2006-06-15 | 2007-12-21 | Boehringer Ingelheim International Gmbh | 2-anilino-4-(heterocyclic)amino-pyrimidines as inhibitors of protein kinase C-alpha |
| US20090081786A1 (en) | 2006-06-30 | 2009-03-26 | Viktoria Kheifets | Peptide sequences for modulation of protein kinase C |
| KR20100040912A (ko) | 2007-07-30 | 2010-04-21 | 힐로 리미티드 | 약제학적 조성물 및 관련 방법 |
| EP2356139A4 (en) | 2008-07-23 | 2013-01-09 | Harvard College | LIGURE COMBINED POLYPEPTIDES |
| US8586707B2 (en) | 2008-09-16 | 2013-11-19 | The Research Foundation Of State University Of New York | Stapled peptides and method of synthesis |
| US20120208750A1 (en) | 2009-09-29 | 2012-08-16 | Joslin Diabetes Center, Inc. | Use of protein kinase c delta (pkcd) inhibitors to treat diabetes, obesity, and hepatic steatosis |
| WO2011057063A2 (en) | 2009-11-06 | 2011-05-12 | The Board Of Trustees Of The University Of Illinois | Compositions and methods for quantitatively monitoring lipids |
| GB201103631D0 (en) | 2011-03-03 | 2011-04-13 | Univ Leeds | Identification of candidate therapeutics |
| US8580769B2 (en) | 2011-03-10 | 2013-11-12 | The United States Of America As Represented By The Department Of Veterans Affairs | Treatment of obesity, metabolic syndrome, and diabetes with protein kinase C inhibitors |
| US9260484B2 (en) | 2011-06-15 | 2016-02-16 | Ohio State Innovation Foundation | Small molecule composite surfaces as inhibitors of protein-protein interactions |
| US9321763B2 (en) | 2012-04-04 | 2016-04-26 | Rigel Pharmaceuticals, Inc. | Protein kinase C inhibitors and uses thereof |
| EP3437651A1 (en) | 2017-08-03 | 2019-02-06 | Université de Strasbourg | Peptides for treatment and prevention of nonalcoholic fatty liver disease |
| LT3723782T (lt) | 2017-12-14 | 2026-02-10 | Université De Strasbourg | Peptidai, skirti nealkoholinės kepenų suriebėjimo ligos gydymui ir profilaktikai |
-
2017
- 2017-06-30 EP EP17305843.9A patent/EP3421485A1/en not_active Withdrawn
-
2018
- 2018-06-29 JP JP2019572518A patent/JP7471824B2/ja active Active
- 2018-06-29 KR KR1020207002727A patent/KR102696075B1/ko active Active
- 2018-06-29 US US16/627,389 patent/US11332503B2/en active Active
- 2018-06-29 WO PCT/EP2018/067657 patent/WO2019002583A1/en not_active Ceased
- 2018-06-29 EP EP18733884.3A patent/EP3645556A1/en active Pending
Patent Citations (3)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP2007530000A (ja) * | 2003-07-17 | 2007-11-01 | ユニヴァーシティー オブ ダンディー | Lkb1/strad7m025複合体の使用方法 |
| WO2015114062A1 (en) * | 2014-01-29 | 2015-08-06 | Universite De Strasbourg | New target for diabetes treatment and prevention |
| WO2018005445A1 (en) * | 2016-06-27 | 2018-01-04 | The Broad Institute, Inc. | Compositions and methods for detecting and treating diabetes |
Also Published As
| Publication number | Publication date |
|---|---|
| US11332503B2 (en) | 2022-05-17 |
| WO2019002583A1 (en) | 2019-01-03 |
| US20200216504A1 (en) | 2020-07-09 |
| EP3645556A1 (en) | 2020-05-06 |
| JP7471824B2 (ja) | 2024-04-22 |
| KR102696075B1 (ko) | 2024-08-19 |
| EP3421485A1 (en) | 2019-01-02 |
| JP2020525504A (ja) | 2020-08-27 |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| KR102696075B1 (ko) | 고혈당증의 치료 및 예방을 위한 펩타이드 | |
| US11382956B2 (en) | Amylin analogues | |
| JP6391589B2 (ja) | 官能基化されたエキセンディン−4誘導体 | |
| JP7362611B2 (ja) | 非アルコール性脂肪肝疾患及び線維症の治療及び予防のためのペプチド | |
| CN112566655B (zh) | 具有优化的活性比率的fgf21化合物/glp-1r激动剂组合 | |
| JP5485876B2 (ja) | 代謝疾患の治療における治療剤としての非アシル化グレリン | |
| JP6605467B2 (ja) | Vegf−cおよびccbe1の治療的使用 | |
| TW201625668A (zh) | 作為胜肽性雙重glp-1/昇糖素受體激動劑之艾塞那肽-4衍生物 | |
| TW201609800A (zh) | 做為雙重glp-1/升糖素受體促效劑之艾塞那肽-4胜肽類似物 | |
| TW201625669A (zh) | 衍生自艾塞那肽-4(Exendin-4)之肽類雙重GLP-1/升糖素受體促效劑 | |
| US11826403B2 (en) | Target for diabetes treatment and prevention | |
| US9821031B2 (en) | Methods and compositions for treating hypoglycemic disorders | |
| US20070218504A1 (en) | Human leptin-derived polypeptides and uses thereof | |
| JP7553115B2 (ja) | 糖尿病治療のためのペプチド断片 | |
| KR102555817B1 (ko) | 당뇨병 및 관련 질환의 치료 및 예방을 위한 펩타이드 | |
| KR20240134891A (ko) | Gip, glp-1 및 glp-2의 펩티드 삼중 작용제 | |
| CN107530401B (zh) | 作为代谢病症的治疗剂的皮连蛋白 |
Legal Events
| Date | Code | Title | Description |
|---|---|---|---|
| PA0105 | International application |
Patent event date: 20200129 Patent event code: PA01051R01D Comment text: International Patent Application |
|
| PG1501 | Laying open of application | ||
| A201 | Request for examination | ||
| PA0201 | Request for examination |
Patent event code: PA02012R01D Patent event date: 20210629 Comment text: Request for Examination of Application |
|
| E902 | Notification of reason for refusal | ||
| PE0902 | Notice of grounds for rejection |
Comment text: Notification of reason for refusal Patent event date: 20230523 Patent event code: PE09021S01D |
|
| E701 | Decision to grant or registration of patent right | ||
| PE0701 | Decision of registration |
Patent event code: PE07011S01D Comment text: Decision to Grant Registration Patent event date: 20240522 |
|
| GRNT | Written decision to grant | ||
| PR0701 | Registration of establishment |
Comment text: Registration of Establishment Patent event date: 20240813 Patent event code: PR07011E01D |
|
| PR1002 | Payment of registration fee |
Payment date: 20240813 End annual number: 3 Start annual number: 1 |
|
| PG1601 | Publication of registration |