KR20200032935A - 음성인식장치 및 음성인식방법 - Google Patents
음성인식장치 및 음성인식방법 Download PDFInfo
- Publication number
- KR20200032935A KR20200032935A KR1020180112204A KR20180112204A KR20200032935A KR 20200032935 A KR20200032935 A KR 20200032935A KR 1020180112204 A KR1020180112204 A KR 1020180112204A KR 20180112204 A KR20180112204 A KR 20180112204A KR 20200032935 A KR20200032935 A KR 20200032935A
- Authority
- KR
- South Korea
- Prior art keywords
- voice
- speech
- speaker
- word
- characteristic
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Granted
Links
Images



Classifications
-
- G—PHYSICS
- G10—MUSICAL INSTRUMENTS; ACOUSTICS
- G10L—SPEECH ANALYSIS TECHNIQUES OR SPEECH SYNTHESIS; SPEECH RECOGNITION; SPEECH OR VOICE PROCESSING TECHNIQUES; SPEECH OR AUDIO CODING OR DECODING
- G10L17/00—Speaker identification or verification techniques
- G10L17/06—Decision making techniques; Pattern matching strategies
- G10L17/14—Use of phonemic categorisation or speech recognition prior to speaker recognition or verification
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F21/00—Security arrangements for protecting computers, components thereof, programs or data against unauthorised activity
- G06F21/30—Authentication, i.e. establishing the identity or authorisation of security principals
- G06F21/31—User authentication
- G06F21/32—User authentication using biometric data, e.g. fingerprints, iris scans or voiceprints
-
- G—PHYSICS
- G10—MUSICAL INSTRUMENTS; ACOUSTICS
- G10L—SPEECH ANALYSIS TECHNIQUES OR SPEECH SYNTHESIS; SPEECH RECOGNITION; SPEECH OR VOICE PROCESSING TECHNIQUES; SPEECH OR AUDIO CODING OR DECODING
- G10L17/00—Speaker identification or verification techniques
- G10L17/02—Preprocessing operations, e.g. segment selection; Pattern representation or modelling, e.g. based on linear discriminant analysis [LDA] or principal components; Feature selection or extraction
-
- G—PHYSICS
- G10—MUSICAL INSTRUMENTS; ACOUSTICS
- G10L—SPEECH ANALYSIS TECHNIQUES OR SPEECH SYNTHESIS; SPEECH RECOGNITION; SPEECH OR VOICE PROCESSING TECHNIQUES; SPEECH OR AUDIO CODING OR DECODING
- G10L25/00—Speech or voice analysis techniques not restricted to a single one of groups G10L15/00 - G10L21/00
- G10L25/03—Speech or voice analysis techniques not restricted to a single one of groups G10L15/00 - G10L21/00 characterised by the type of extracted parameters
- G10L25/12—Speech or voice analysis techniques not restricted to a single one of groups G10L15/00 - G10L21/00 characterised by the type of extracted parameters the extracted parameters being prediction coefficients
-
- G—PHYSICS
- G10—MUSICAL INSTRUMENTS; ACOUSTICS
- G10L—SPEECH ANALYSIS TECHNIQUES OR SPEECH SYNTHESIS; SPEECH RECOGNITION; SPEECH OR VOICE PROCESSING TECHNIQUES; SPEECH OR AUDIO CODING OR DECODING
- G10L25/00—Speech or voice analysis techniques not restricted to a single one of groups G10L15/00 - G10L21/00
- G10L25/03—Speech or voice analysis techniques not restricted to a single one of groups G10L15/00 - G10L21/00 characterised by the type of extracted parameters
- G10L25/15—Speech or voice analysis techniques not restricted to a single one of groups G10L15/00 - G10L21/00 characterised by the type of extracted parameters the extracted parameters being formant information
-
- G—PHYSICS
- G10—MUSICAL INSTRUMENTS; ACOUSTICS
- G10L—SPEECH ANALYSIS TECHNIQUES OR SPEECH SYNTHESIS; SPEECH RECOGNITION; SPEECH OR VOICE PROCESSING TECHNIQUES; SPEECH OR AUDIO CODING OR DECODING
- G10L25/00—Speech or voice analysis techniques not restricted to a single one of groups G10L15/00 - G10L21/00
- G10L25/03—Speech or voice analysis techniques not restricted to a single one of groups G10L15/00 - G10L21/00 characterised by the type of extracted parameters
- G10L25/24—Speech or voice analysis techniques not restricted to a single one of groups G10L15/00 - G10L21/00 characterised by the type of extracted parameters the extracted parameters being the cepstrum
-
- G—PHYSICS
- G10—MUSICAL INSTRUMENTS; ACOUSTICS
- G10L—SPEECH ANALYSIS TECHNIQUES OR SPEECH SYNTHESIS; SPEECH RECOGNITION; SPEECH OR VOICE PROCESSING TECHNIQUES; SPEECH OR AUDIO CODING OR DECODING
- G10L25/00—Speech or voice analysis techniques not restricted to a single one of groups G10L15/00 - G10L21/00
- G10L25/48—Speech or voice analysis techniques not restricted to a single one of groups G10L15/00 - G10L21/00 specially adapted for particular use
- G10L25/51—Speech or voice analysis techniques not restricted to a single one of groups G10L15/00 - G10L21/00 specially adapted for particular use for comparison or discrimination
-
- G—PHYSICS
- G10—MUSICAL INSTRUMENTS; ACOUSTICS
- G10L—SPEECH ANALYSIS TECHNIQUES OR SPEECH SYNTHESIS; SPEECH RECOGNITION; SPEECH OR VOICE PROCESSING TECHNIQUES; SPEECH OR AUDIO CODING OR DECODING
- G10L25/00—Speech or voice analysis techniques not restricted to a single one of groups G10L15/00 - G10L21/00
- G10L25/90—Pitch determination of speech signals
Landscapes
- Engineering & Computer Science (AREA)
- Physics & Mathematics (AREA)
- Acoustics & Sound (AREA)
- Multimedia (AREA)
- Health & Medical Sciences (AREA)
- Audiology, Speech & Language Pathology (AREA)
- Human Computer Interaction (AREA)
- Signal Processing (AREA)
- Computational Linguistics (AREA)
- Computer Vision & Pattern Recognition (AREA)
- Computer Security & Cryptography (AREA)
- Theoretical Computer Science (AREA)
- Business, Economics & Management (AREA)
- Game Theory and Decision Science (AREA)
- Computer Hardware Design (AREA)
- Software Systems (AREA)
- General Engineering & Computer Science (AREA)
- General Physics & Mathematics (AREA)
- Information Retrieval, Db Structures And Fs Structures Therefor (AREA)
Abstract
Description
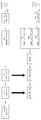
도 2는 일반적인 화자 확인 시, 음성에 대한 평준화 방법을 설명하기 위한 도면이다.
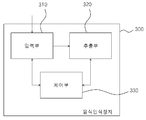
도 3은 본 발명의 일 실시 예에 의한 음성인식장치의 구성을 도시한 블록도이다.
도 4는 본 발명의 일 실시 예에 의한 음성인식장치에 포함되는 제어부의 상세 구성을 도시한 블록도이다.
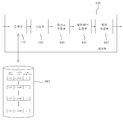
도 5는 본 발명의 일 실시 예에 의한 음성인식 과정을 도시한 도면이다.
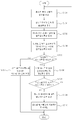
도 6은 본 발명의 일 실시 예에 의한 음성인식방법과 관련하여 화자에 대한 발화 패턴을 결정하는 과정을 도시한 도면이다.
도 7은 본 발명의 일 실시 예에 의한 음성인식방법과 관련하여 화자에 대한 발화 패턴을 결정하는 상세 과정을 도시한 도면이다.
도 8은 본 발명의 일 실시 예에 의한 음성인식방법을 설명하기 위한 도면이다.
320: 추출부 330: 제어부
410: 검색부 420: 비교부
430: 유사도 추정부 440: 발화 패턴 결정부
450: 화자 식별부 460: 데이터베이스
Claims (19)
- 음성인식장치에 있어서,
음성을 입력 받는 입력부;
상기 음성을 음소 단위로 분할하여 각 음소별로 음성특성을 추출하는 추출부; 및
상기 음성특성을 참조음성특성과 비교하고 유사도에 기초하여 상기 음성을 인증하는 제어부를 포함하되,
상기 추출부는,
사전에 입력된 복수개의 참조음성을 발화 상태를 반영한 복수개의 그룹으로 분류하고 상기 복수개의 그룹 각각으로부터 상기 참조음성특성을 추출하는 음성인식장치. - 제1항에 있어서,
상기 발화 상태는,
신체 상태, 감정 상태 및 주변 환경 중 적어도 하나를 포함하는 음성인식장치. - 제1항에 있어서,
상기 추출부는,
상기 복수개의 참조음성 각각에 대하여 상기 발화 상태와 관련된 특징 벡터를 추출하고, 추출된 상기 특징 벡터의 유사도에 기초하여 상기 복수개의 참조음성을 그룹화하여 상기 복수개의 그룹으로 분류하고, 상기 복수개의 그룹 각각에 대하여 상기 참조음성특성을 추출하는 음성인식장치. - 제1항에 있어서,
상기 음성특성과 상기 참조음성특성 각각은,
음성 주파수, 피치(pitch), 포먼트(formant), 발화시간 및 발화속도 중 적어도 하나를 포함하는 음성인식장치. - 제1항에 있어서,
상기 추출부는,
상기 음성특성 및 상기 참조음성특성 중 적어도 하나를 추출하는 경우, 상기 복수개의 그룹 각각에 대하여 서로 다른 추출방식을 적용하는 음성인식장치. - 제5항에 있어서,
상기 추출방식은,
PLP(Perceptual Linear Predictive Analysis), LPC(Linear Predictive Coding), MFCC(Mel-Frequency Cepstrum Coefficients) 및 켑스트럼(Cepstrum) 중 적어도 하나를 포함하는 음성인식장치. - 제1항에 있어서,
상기 제어부는,
상기 음성이 특정화자가 특정단어를 발화한 복수개의 제1음성을 포함하는 경우, 상기 제1음성의 상기 음성특성을 상기 참조음성특성과 비교하여, 소정 값 이상의 유사도가 소정 횟수 이상이면 상기 참조음성특성을 상기 특정화자의 상기 특정단어에 대한 발화 패턴으로 결정하는 음성인식장치. - 제1항에 있어서,
상기 제어부는,
상기 음성에 포함되는 단어 및 상기 단어의 상기 음성특성을 추출하여 데이터베이스에 포함되는 적어도 하나의 참조 단어와 비교하되, 상기 음성과 관련된 데이터를 기준으로 난수를 생성하고 소정 기준에 따라 상기 데이터베이스 상에서 상기 난수에 대응하는 상기 참조 단어를 검출하는 음성인식장치. - 제8항에 있어서,
상기 음성과 관련된 데이터는 상기 음성의 인증이 요청된 시간이고,
상기 제어부는,
상기 음성의 인증이 요청된 시간을 기준으로 상기 난수를 생성하고, 소정 행렬 구조로 구성되는 상기 데이터베이스 상에서 상기 난수의 소정 자리 숫자에 해당하는 행과 열에 해당하는 상기 참조 단어를 검출하는 음성인식장치. - 음성인식방법에 있어서,
음성을 입력 받는 단계;
상기 음성을 음소 단위로 분할하여 각 음소별로 음성특성을 추출하는 단계; 및
상기 음성특성을 참조음성특성과 비교하고 유사도에 기초하여 상기 음성을 인증하는 단계를 포함하되,
상기 참조음성특성은,
사전에 입력된 복수개의 참조음성을 발화 상태를 반영한 복수개의 그룹으로 분류하고 상기 복수개의 그룹 각각으로부터 추출되는 음성인식방법. - 제10항에 있어서,
상기 발화 상태는,
신체 상태, 감정 상태 및 주변 환경 중 적어도 하나를 포함하는 음성인식방법. - 제10항에 있어서,
상기 복수개의 참조음성 각각에 대하여 상기 발화 상태와 관련된 특징 벡터를 추출하고, 추출된 상기 특징 벡터의 유사도에 기초하여 상기 복수개의 참조음성을 그룹화하여 상기 복수개의 그룹으로 분류하고, 상기 복수개의 그룹 각각에 대하여 상기 참조음성특성을 추출하는 음성인식방법. - 제10항에 있어서,
상기 음성특성과 상기 참조음성특성 각각은,
음성 주파수, 피치(pitch), 포먼트(formant), 발화시간 및 발화속도 중 적어도 하나를 포함하는 음성인식방법. - 제10항에 있어서,
상기 음성특성 및 상기 참조음성특성 중 적어도 하나를 추출하는 경우, 상기 복수개의 그룹 각각에 대하여 서로 다른 추출방식을 적용하는 음성인식방법. - 제14항에 있어서,
상기 추출방식은,
PLP(Perceptual Linear Predictive Analysis), LPC(Linear Predictive Coding), MFCC(Mel-Frequency Cepstrum Coefficients) 및 켑스트럼(Cepstrum) 중 적어도 하나를 포함하는 음성인식방법. - 제10항에 있어서,
상기 음성이 특정화자가 특정단어를 발화한 복수개의 제1음성을 포함하는 경우, 상기 제1음성의 상기 음성특성을 상기 참조음성특성과 비교하여, 소정 값 이상의 유사도가 소정 횟수 이상이면 상기 참조음성특성을 상기 특정화자의 상기 특정단어에 대한 발화 패턴으로 결정하는 음성인식방법. - 제10항에 있어서,
상기 음성에 포함되는 단어 및 상기 단어의 상기 음성특성을 추출하여 데이터베이스에 포함되는 적어도 하나의 참조 단어와 비교하되, 상기 음성과 관련된 데이터를 기준으로 난수를 생성하고 소정 기준에 따라 상기 데이터베이스 상에서 상기 난수에 대응하는 상기 참조 단어를 검출하는 음성인식방법. - 제17항에 있어서,
상기 음성과 관련된 데이터는 상기 음성의 인증이 요청된 시간이고,
상기 음성의 인증이 요청된 시간을 기준으로 상기 난수를 생성하고, 소정 행렬 구조로 구성되는 상기 데이터베이스 상에서 상기 난수의 소정 자리 숫자에 해당하는 행과 열에 해당하는 상기 참조 단어를 검출하는 음성인식방법. - 제10항 내지 제18항 중 어느 한 항의 방법을 구현하기 위한 프로그램이 기록된 컴퓨터로 판독 가능한 기록 매체.
Priority Applications (1)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| KR1020180112204A KR102098956B1 (ko) | 2018-09-19 | 2018-09-19 | 음성인식장치 및 음성인식방법 |
Applications Claiming Priority (1)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| KR1020180112204A KR102098956B1 (ko) | 2018-09-19 | 2018-09-19 | 음성인식장치 및 음성인식방법 |
Publications (2)
| Publication Number | Publication Date |
|---|---|
| KR20200032935A true KR20200032935A (ko) | 2020-03-27 |
| KR102098956B1 KR102098956B1 (ko) | 2020-04-09 |
Family
ID=69959152
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| KR1020180112204A Expired - Fee Related KR102098956B1 (ko) | 2018-09-19 | 2018-09-19 | 음성인식장치 및 음성인식방법 |
Country Status (1)
| Country | Link |
|---|---|
| KR (1) | KR102098956B1 (ko) |
Cited By (2)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| WO2022086196A1 (ko) * | 2020-10-22 | 2022-04-28 | 가우디오랩 주식회사 | 기계 학습 모델을 이용하여 복수의 신호 성분을 포함하는 오디오 신호 처리 장치 |
| CN115836345A (zh) * | 2020-05-29 | 2023-03-21 | 雷诺股份公司 | 用于识别说话者的方法 |
Families Citing this family (1)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| KR20210154483A (ko) | 2020-06-12 | 2021-12-21 | 주식회사 싸우스이스트 | 보안 음성비밀번호 운용 음성인식장치 |
Citations (3)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP2006113546A (ja) * | 2004-09-14 | 2006-04-27 | Honda Motor Co Ltd | 情報伝達装置 |
| KR101812022B1 (ko) * | 2017-10-20 | 2017-12-26 | 주식회사 공훈 | 음성 인증 시스템 |
| KR101888058B1 (ko) * | 2018-02-09 | 2018-08-13 | 주식회사 공훈 | 발화된 단어에 기초하여 화자를 식별하기 위한 방법 및 그 장치 |
-
2018
- 2018-09-19 KR KR1020180112204A patent/KR102098956B1/ko not_active Expired - Fee Related
Patent Citations (3)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP2006113546A (ja) * | 2004-09-14 | 2006-04-27 | Honda Motor Co Ltd | 情報伝達装置 |
| KR101812022B1 (ko) * | 2017-10-20 | 2017-12-26 | 주식회사 공훈 | 음성 인증 시스템 |
| KR101888058B1 (ko) * | 2018-02-09 | 2018-08-13 | 주식회사 공훈 | 발화된 단어에 기초하여 화자를 식별하기 위한 방법 및 그 장치 |
Cited By (4)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| CN115836345A (zh) * | 2020-05-29 | 2023-03-21 | 雷诺股份公司 | 用于识别说话者的方法 |
| WO2022086196A1 (ko) * | 2020-10-22 | 2022-04-28 | 가우디오랩 주식회사 | 기계 학습 모델을 이용하여 복수의 신호 성분을 포함하는 오디오 신호 처리 장치 |
| US11714596B2 (en) | 2020-10-22 | 2023-08-01 | Gaudio Lab, Inc. | Audio signal processing method and apparatus |
| JP2023546700A (ja) * | 2020-10-22 | 2023-11-07 | ガウディオ・ラボ・インコーポレイテッド | 機械学習モデルを用いて複数の信号成分を含むオーディオ信号処理装置 |
Also Published As
| Publication number | Publication date |
|---|---|
| KR102098956B1 (ko) | 2020-04-09 |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| JP6350148B2 (ja) | 話者インデキシング装置、話者インデキシング方法及び話者インデキシング用コンピュータプログラム | |
| US6029124A (en) | Sequential, nonparametric speech recognition and speaker identification | |
| KR101888058B1 (ko) | 발화된 단어에 기초하여 화자를 식별하기 위한 방법 및 그 장치 | |
| US20170140761A1 (en) | Automatic speaker identification using speech recognition features | |
| CN114303186B (zh) | 用于在语音合成中适配人类说话者嵌入的系统和方法 | |
| JPWO2005013263A1 (ja) | 音声認証システム | |
| KR20010102549A (ko) | 화자 인식 방법 및 장치 | |
| Pawar et al. | Review of various stages in speaker recognition system, performance measures and recognition toolkits | |
| JP6481939B2 (ja) | 音声認識装置および音声認識プログラム | |
| US20100063817A1 (en) | Acoustic model registration apparatus, talker recognition apparatus, acoustic model registration method and acoustic model registration processing program | |
| JP4237713B2 (ja) | 音声処理装置 | |
| KR102098956B1 (ko) | 음성인식장치 및 음성인식방법 | |
| CN108091340B (zh) | 声纹识别方法、声纹识别系统和计算机可读存储介质 | |
| Ozaydin | Design of a text independent speaker recognition system | |
| JP5315976B2 (ja) | 音声認識装置、音声認識方法、および、プログラム | |
| KR20210052563A (ko) | 문맥 기반의 음성인식 서비스를 제공하기 위한 방법 및 장치 | |
| Jayamaha et al. | Voizlock-human voice authentication system using hidden markov model | |
| KR102113879B1 (ko) | 참조 데이터베이스를 활용한 화자 음성 인식 방법 및 그 장치 | |
| JP2003263193A (ja) | 音声認識システムで話者の交代を自動検出する方法 | |
| KR101925248B1 (ko) | 음성 인증 최적화를 위해 음성 특징벡터를 활용하는 방법 및 장치 | |
| Dustor et al. | Influence of feature dimensionality and model complexity on speaker verification performance | |
| Nair et al. | A reliable speaker verification system based on LPCC and DTW | |
| Lazam et al. | Development of academic attendance system using voice verification | |
| Rosenberg et al. | Overview of S | |
| JP4807261B2 (ja) | 音声処理装置およびプログラム |
Legal Events
| Date | Code | Title | Description |
|---|---|---|---|
| A201 | Request for examination | ||
| PA0109 | Patent application |
St.27 status event code: A-0-1-A10-A12-nap-PA0109 |
|
| PA0201 | Request for examination |
St.27 status event code: A-1-2-D10-D11-exm-PA0201 |
|
| D13-X000 | Search requested |
St.27 status event code: A-1-2-D10-D13-srh-X000 |
|
| D14-X000 | Search report completed |
St.27 status event code: A-1-2-D10-D14-srh-X000 |
|
| E902 | Notification of reason for refusal | ||
| PE0902 | Notice of grounds for rejection |
St.27 status event code: A-1-2-D10-D21-exm-PE0902 |
|
| T11-X000 | Administrative time limit extension requested |
St.27 status event code: U-3-3-T10-T11-oth-X000 |
|
| T11-X000 | Administrative time limit extension requested |
St.27 status event code: U-3-3-T10-T11-oth-X000 |
|
| T11-X000 | Administrative time limit extension requested |
St.27 status event code: U-3-3-T10-T11-oth-X000 |
|
| P11-X000 | Amendment of application requested |
St.27 status event code: A-2-2-P10-P11-nap-X000 |
|
| P13-X000 | Application amended |
St.27 status event code: A-2-2-P10-P13-nap-X000 |
|
| R17-X000 | Change to representative recorded |
St.27 status event code: A-3-3-R10-R17-oth-X000 |
|
| PG1501 | Laying open of application |
St.27 status event code: A-1-1-Q10-Q12-nap-PG1501 |
|
| E701 | Decision to grant or registration of patent right | ||
| PE0701 | Decision of registration |
St.27 status event code: A-1-2-D10-D22-exm-PE0701 |
|
| GRNT | Written decision to grant | ||
| PR0701 | Registration of establishment |
St.27 status event code: A-2-4-F10-F11-exm-PR0701 |
|
| PR1002 | Payment of registration fee |
St.27 status event code: A-2-2-U10-U11-oth-PR1002 Fee payment year number: 1 |
|
| PG1601 | Publication of registration |
St.27 status event code: A-4-4-Q10-Q13-nap-PG1601 |
|
| R18-X000 | Changes to party contact information recorded |
St.27 status event code: A-5-5-R10-R18-oth-X000 |
|
| P14-X000 | Amendment of ip right document requested |
St.27 status event code: A-5-5-P10-P14-nap-X000 |
|
| P14-X000 | Amendment of ip right document requested |
St.27 status event code: A-5-5-P10-P14-nap-X000 |
|
| P14-X000 | Amendment of ip right document requested |
St.27 status event code: A-5-5-P10-P14-nap-X000 |
|
| R18-X000 | Changes to party contact information recorded |
St.27 status event code: A-5-5-R10-R18-oth-X000 |
|
| PR1001 | Payment of annual fee |
St.27 status event code: A-4-4-U10-U11-oth-PR1001 Fee payment year number: 4 |
|
| PC1903 | Unpaid annual fee |
St.27 status event code: A-4-4-U10-U13-oth-PC1903 Not in force date: 20240403 Payment event data comment text: Termination Category : DEFAULT_OF_REGISTRATION_FEE |
|
| PC1903 | Unpaid annual fee |
St.27 status event code: N-4-6-H10-H13-oth-PC1903 Ip right cessation event data comment text: Termination Category : DEFAULT_OF_REGISTRATION_FEE Not in force date: 20240403 |