BRPI0701826B1 - proteínas da teia de aranha nephilengys cruentata, avicularia juruensis e parawixia bistriata isoladas da biodiversidade brasileira - Google Patents
proteínas da teia de aranha nephilengys cruentata, avicularia juruensis e parawixia bistriata isoladas da biodiversidade brasileira Download PDFInfo
- Publication number
- BRPI0701826B1 BRPI0701826B1 BRPI0701826-6A BRPI0701826A BRPI0701826B1 BR PI0701826 B1 BRPI0701826 B1 BR PI0701826B1 BR PI0701826 A BRPI0701826 A BR PI0701826A BR PI0701826 B1 BRPI0701826 B1 BR PI0701826B1
- Authority
- BR
- Brazil
- Prior art keywords
- seq
- promoter
- proteins
- gene
- sequences
- Prior art date
Links
- 108090000623 proteins and genes Proteins 0.000 title claims abstract description 428
- 102000004169 proteins and genes Human genes 0.000 title claims abstract description 300
- 241000239290 Araneae Species 0.000 title abstract description 139
- 241000742192 Nephilengys cruentata Species 0.000 title abstract description 18
- 241001216760 Parawixia bistriata Species 0.000 title abstract description 15
- 241000175331 Avicularia juruensis Species 0.000 title abstract description 14
- 150000007523 nucleic acids Chemical class 0.000 claims abstract description 92
- 229920001872 Spider silk Polymers 0.000 claims abstract description 90
- 239000013604 expression vector Substances 0.000 claims abstract description 64
- 102000039446 nucleic acids Human genes 0.000 claims abstract description 63
- 108020004707 nucleic acids Proteins 0.000 claims abstract description 63
- 238000000034 method Methods 0.000 claims abstract description 59
- 239000000203 mixture Substances 0.000 claims abstract description 35
- 102000007056 Recombinant Fusion Proteins Human genes 0.000 claims abstract description 30
- 108010008281 Recombinant Fusion Proteins Proteins 0.000 claims abstract description 30
- 235000003869 genetically modified organism Nutrition 0.000 claims abstract description 5
- 210000004027 cell Anatomy 0.000 claims description 123
- 241000196324 Embryophyta Species 0.000 claims description 81
- 238000004519 manufacturing process Methods 0.000 claims description 35
- 241001465754 Metazoa Species 0.000 claims description 33
- 210000002257 embryonic structure Anatomy 0.000 claims description 28
- 210000001519 tissue Anatomy 0.000 claims description 28
- 241000894006 Bacteria Species 0.000 claims description 26
- 108091026890 Coding region Proteins 0.000 claims description 25
- 238000013518 transcription Methods 0.000 claims description 25
- 230000035897 transcription Effects 0.000 claims description 25
- 241000233866 Fungi Species 0.000 claims description 23
- 244000005700 microbiome Species 0.000 claims description 23
- 241000238631 Hexapoda Species 0.000 claims description 22
- 108091028043 Nucleic acid sequence Proteins 0.000 claims description 22
- 230000001939 inductive effect Effects 0.000 claims description 20
- 229920000642 polymer Polymers 0.000 claims description 14
- 229920000742 Cotton Polymers 0.000 claims description 13
- 206010020649 Hyperkeratosis Diseases 0.000 claims description 13
- 241000700605 Viruses Species 0.000 claims description 13
- 230000003641 microbiacidal effect Effects 0.000 claims description 13
- 239000003981 vehicle Substances 0.000 claims description 13
- 238000010367 cloning Methods 0.000 claims description 11
- 210000000056 organ Anatomy 0.000 claims description 11
- 240000008042 Zea mays Species 0.000 claims description 10
- 210000001161 mammalian embryo Anatomy 0.000 claims description 9
- 239000003550 marker Substances 0.000 claims description 9
- XLYOFNOQVPJJNP-UHFFFAOYSA-N water Substances O XLYOFNOQVPJJNP-UHFFFAOYSA-N 0.000 claims description 9
- 235000005824 Zea mays ssp. parviglumis Nutrition 0.000 claims description 8
- 235000002017 Zea mays subsp mays Nutrition 0.000 claims description 8
- 235000005822 corn Nutrition 0.000 claims description 8
- 241000589158 Agrobacterium Species 0.000 claims description 7
- 108090000104 Actin-related protein 3 Proteins 0.000 claims description 6
- 229920001222 biopolymer Polymers 0.000 claims description 6
- PEDCQBHIVMGVHV-UHFFFAOYSA-N glycerol group Chemical group OCC(O)CO PEDCQBHIVMGVHV-UHFFFAOYSA-N 0.000 claims description 6
- -1 polyethylene Polymers 0.000 claims description 6
- 230000001131 transforming effect Effects 0.000 claims description 6
- 108010021809 Alcohol dehydrogenase Proteins 0.000 claims description 5
- FAPWRFPIFSIZLT-UHFFFAOYSA-M Sodium chloride Chemical compound [Na+].[Cl-] FAPWRFPIFSIZLT-UHFFFAOYSA-M 0.000 claims description 5
- 239000000284 extract Substances 0.000 claims description 5
- 150000003839 salts Chemical class 0.000 claims description 5
- 239000011780 sodium chloride Substances 0.000 claims description 5
- 239000003937 drug carrier Substances 0.000 claims description 4
- BRZYSWJRSDMWLG-CAXSIQPQSA-N geneticin Chemical compound O1C[C@@](O)(C)[C@H](NC)[C@@H](O)[C@H]1O[C@@H]1[C@@H](O)[C@H](O[C@@H]2[C@@H]([C@@H](O)[C@H](O)[C@@H](C(C)O)O2)N)[C@@H](N)C[C@H]1N BRZYSWJRSDMWLG-CAXSIQPQSA-N 0.000 claims description 4
- 239000003960 organic solvent Substances 0.000 claims description 4
- 230000010076 replication Effects 0.000 claims description 4
- UCSJYZPVAKXKNQ-HZYVHMACSA-N streptomycin Chemical compound CN[C@H]1[C@H](O)[C@@H](O)[C@H](CO)O[C@H]1O[C@@H]1[C@](C=O)(O)[C@H](C)O[C@H]1O[C@@H]1[C@@H](NC(N)=N)[C@H](O)[C@@H](NC(N)=N)[C@H](O)[C@H]1O UCSJYZPVAKXKNQ-HZYVHMACSA-N 0.000 claims description 4
- 241000351920 Aspergillus nidulans Species 0.000 claims description 3
- 108010066133 D-octopine dehydrogenase Proteins 0.000 claims description 3
- 241001508381 Subterranean clover stunt virus Species 0.000 claims description 3
- 108010043934 Sucrose synthase Proteins 0.000 claims description 3
- 241000219793 Trifolium Species 0.000 claims description 3
- 239000000654 additive Substances 0.000 claims description 3
- 230000006154 adenylylation Effects 0.000 claims description 3
- 239000004599 antimicrobial Substances 0.000 claims description 3
- 239000003906 humectant Substances 0.000 claims description 3
- 108010058731 nopaline synthase Proteins 0.000 claims description 3
- 101150016309 trpC gene Proteins 0.000 claims description 3
- ZBMRKNMTMPPMMK-UHFFFAOYSA-N 2-amino-4-[hydroxy(methyl)phosphoryl]butanoic acid;azane Chemical compound [NH4+].CP(O)(=O)CCC(N)C([O-])=O ZBMRKNMTMPPMMK-UHFFFAOYSA-N 0.000 claims description 2
- RSWGJHLUYNHPMX-UHFFFAOYSA-N Abietic-Saeure Natural products C12CCC(C(C)C)=CC2=CCC2C1(C)CCCC2(C)C(O)=O RSWGJHLUYNHPMX-UHFFFAOYSA-N 0.000 claims description 2
- YQYJSBFKSSDGFO-UHFFFAOYSA-N Epihygromycin Natural products OC1C(O)C(C(=O)C)OC1OC(C(=C1)O)=CC=C1C=C(C)C(=O)NC1C(O)C(O)C2OCOC2C1O YQYJSBFKSSDGFO-UHFFFAOYSA-N 0.000 claims description 2
- OTMSDBZUPAUEDD-UHFFFAOYSA-N Ethane Chemical compound CC OTMSDBZUPAUEDD-UHFFFAOYSA-N 0.000 claims description 2
- 239000005562 Glyphosate Substances 0.000 claims description 2
- 229930193140 Neomycin Natural products 0.000 claims description 2
- 229910019142 PO4 Inorganic materials 0.000 claims description 2
- IAJOBQBIJHVGMQ-UHFFFAOYSA-N Phosphinothricin Natural products CP(O)(=O)CCC(N)C(O)=O IAJOBQBIJHVGMQ-UHFFFAOYSA-N 0.000 claims description 2
- 239000004698 Polyethylene Substances 0.000 claims description 2
- 239000004372 Polyvinyl alcohol Substances 0.000 claims description 2
- KHPCPRHQVVSZAH-HUOMCSJISA-N Rosin Natural products O(C/C=C/c1ccccc1)[C@H]1[C@H](O)[C@@H](O)[C@@H](O)[C@@H](CO)O1 KHPCPRHQVVSZAH-HUOMCSJISA-N 0.000 claims description 2
- 229960000723 ampicillin Drugs 0.000 claims description 2
- AVKUERGKIZMTKX-NJBDSQKTSA-N ampicillin Chemical compound C1([C@@H](N)C(=O)N[C@H]2[C@H]3SC([C@@H](N3C2=O)C(O)=O)(C)C)=CC=CC=C1 AVKUERGKIZMTKX-NJBDSQKTSA-N 0.000 claims description 2
- 239000003963 antioxidant agent Substances 0.000 claims description 2
- 229960005091 chloramphenicol Drugs 0.000 claims description 2
- WIIZWVCIJKGZOK-RKDXNWHRSA-N chloramphenicol Chemical compound ClC(Cl)C(=O)N[C@H](CO)[C@H](O)C1=CC=C([N+]([O-])=O)C=C1 WIIZWVCIJKGZOK-RKDXNWHRSA-N 0.000 claims description 2
- 239000003995 emulsifying agent Substances 0.000 claims description 2
- IAJOBQBIJHVGMQ-BYPYZUCNSA-N glufosinate-P Chemical compound CP(O)(=O)CC[C@H](N)C(O)=O IAJOBQBIJHVGMQ-BYPYZUCNSA-N 0.000 claims description 2
- XDDAORKBJWWYJS-UHFFFAOYSA-N glyphosate Chemical compound OC(=O)CNCP(O)(O)=O XDDAORKBJWWYJS-UHFFFAOYSA-N 0.000 claims description 2
- 229940097068 glyphosate Drugs 0.000 claims description 2
- 229920000591 gum Polymers 0.000 claims description 2
- 229960000318 kanamycin Drugs 0.000 claims description 2
- 229930027917 kanamycin Natural products 0.000 claims description 2
- SBUJHOSQTJFQJX-NOAMYHISSA-N kanamycin Chemical compound O[C@@H]1[C@@H](O)[C@H](O)[C@@H](CN)O[C@@H]1O[C@H]1[C@H](O)[C@@H](O[C@@H]2[C@@H]([C@@H](N)[C@H](O)[C@@H](CO)O2)O)[C@H](N)C[C@@H]1N SBUJHOSQTJFQJX-NOAMYHISSA-N 0.000 claims description 2
- 229930182823 kanamycin A Natural products 0.000 claims description 2
- 239000004816 latex Substances 0.000 claims description 2
- 229920000126 latex Polymers 0.000 claims description 2
- 125000002496 methyl group Chemical group [H]C([H])([H])* 0.000 claims description 2
- 229960004927 neomycin Drugs 0.000 claims description 2
- 150000007524 organic acids Chemical class 0.000 claims description 2
- 235000005985 organic acids Nutrition 0.000 claims description 2
- 235000021317 phosphate Nutrition 0.000 claims description 2
- 150000003013 phosphoric acid derivatives Chemical class 0.000 claims description 2
- 229920000573 polyethylene Polymers 0.000 claims description 2
- 229920002689 polyvinyl acetate Polymers 0.000 claims description 2
- 239000011118 polyvinyl acetate Substances 0.000 claims description 2
- 229920002451 polyvinyl alcohol Polymers 0.000 claims description 2
- 229920000915 polyvinyl chloride Polymers 0.000 claims description 2
- 239000004800 polyvinyl chloride Substances 0.000 claims description 2
- 239000001267 polyvinylpyrrolidone Substances 0.000 claims description 2
- 229920000036 polyvinylpyrrolidone Polymers 0.000 claims description 2
- 235000013855 polyvinylpyrrolidone Nutrition 0.000 claims description 2
- 239000003755 preservative agent Substances 0.000 claims description 2
- 229960005322 streptomycin Drugs 0.000 claims description 2
- 239000002562 thickening agent Substances 0.000 claims description 2
- KHPCPRHQVVSZAH-UHFFFAOYSA-N trans-cinnamyl beta-D-glucopyranoside Natural products OC1C(O)C(O)C(CO)OC1OCC=CC1=CC=CC=C1 KHPCPRHQVVSZAH-UHFFFAOYSA-N 0.000 claims description 2
- 230000003389 potentiating effect Effects 0.000 claims 2
- 239000003242 anti bacterial agent Substances 0.000 claims 1
- 229940088710 antibiotic agent Drugs 0.000 claims 1
- 230000000007 visual effect Effects 0.000 claims 1
- 230000014509 gene expression Effects 0.000 abstract description 69
- 238000012512 characterization method Methods 0.000 abstract description 12
- 239000012634 fragment Substances 0.000 abstract description 10
- 238000009795 derivation Methods 0.000 abstract description 3
- 241000742168 Nephilengys Species 0.000 abstract 1
- 235000018102 proteins Nutrition 0.000 description 290
- 150000001413 amino acids Chemical class 0.000 description 70
- 210000004907 gland Anatomy 0.000 description 61
- 235000001014 amino acid Nutrition 0.000 description 54
- 239000000835 fiber Substances 0.000 description 53
- 239000013598 vector Substances 0.000 description 47
- 241000238902 Nephila clavipes Species 0.000 description 38
- 108020004414 DNA Proteins 0.000 description 36
- 108010022355 Fibroins Proteins 0.000 description 36
- 239000000047 product Substances 0.000 description 23
- 125000003275 alpha amino acid group Chemical group 0.000 description 22
- 230000001105 regulatory effect Effects 0.000 description 22
- 241000894007 species Species 0.000 description 22
- 230000015572 biosynthetic process Effects 0.000 description 21
- 230000003252 repetitive effect Effects 0.000 description 20
- 108090000765 processed proteins & peptides Proteins 0.000 description 19
- 241001134453 Lista Species 0.000 description 17
- 239000000463 material Substances 0.000 description 17
- 102000004196 processed proteins & peptides Human genes 0.000 description 17
- 238000010276 construction Methods 0.000 description 16
- 230000000295 complement effect Effects 0.000 description 15
- 238000003786 synthesis reaction Methods 0.000 description 15
- 230000009261 transgenic effect Effects 0.000 description 15
- 230000000694 effects Effects 0.000 description 14
- 239000002773 nucleotide Substances 0.000 description 14
- 125000003729 nucleotide group Chemical group 0.000 description 14
- 238000000746 purification Methods 0.000 description 14
- 239000000523 sample Substances 0.000 description 14
- 238000011161 development Methods 0.000 description 13
- 230000018109 developmental process Effects 0.000 description 13
- 229920001184 polypeptide Polymers 0.000 description 13
- 238000004458 analytical method Methods 0.000 description 12
- 108010028203 spidroin 2 Proteins 0.000 description 12
- 102000011632 Caseins Human genes 0.000 description 11
- 108010076119 Caseins Proteins 0.000 description 11
- 108091034117 Oligonucleotide Proteins 0.000 description 11
- 230000001580 bacterial effect Effects 0.000 description 11
- 239000000243 solution Substances 0.000 description 11
- 238000009987 spinning Methods 0.000 description 11
- 210000004899 c-terminal region Anatomy 0.000 description 10
- 238000012545 processing Methods 0.000 description 10
- 230000009466 transformation Effects 0.000 description 10
- 108091032973 (ribonucleotides)n+m Proteins 0.000 description 9
- 241000255789 Bombyx mori Species 0.000 description 9
- LFQSCWFLJHTTHZ-UHFFFAOYSA-N Ethanol Chemical compound CCO LFQSCWFLJHTTHZ-UHFFFAOYSA-N 0.000 description 9
- 241001123483 Tetragnathidae Species 0.000 description 9
- 238000006243 chemical reaction Methods 0.000 description 9
- 230000006870 function Effects 0.000 description 9
- 238000002955 isolation Methods 0.000 description 9
- 235000013336 milk Nutrition 0.000 description 9
- 239000008267 milk Substances 0.000 description 9
- 210000004080 milk Anatomy 0.000 description 9
- 241000238901 Araneidae Species 0.000 description 8
- 241000193935 Araneus diadematus Species 0.000 description 8
- 241000588724 Escherichia coli Species 0.000 description 8
- 108010076504 Protein Sorting Signals Proteins 0.000 description 8
- 239000002299 complementary DNA Substances 0.000 description 8
- 239000003623 enhancer Substances 0.000 description 8
- 108020004999 messenger RNA Proteins 0.000 description 8
- 238000010369 molecular cloning Methods 0.000 description 8
- 244000052769 pathogen Species 0.000 description 8
- 239000000126 substance Substances 0.000 description 8
- 101710191899 Actin-depolymerizing factor 3 Proteins 0.000 description 7
- 102000053602 DNA Human genes 0.000 description 7
- DHMQDGOQFOQNFH-UHFFFAOYSA-N Glycine Chemical compound NCC(O)=O DHMQDGOQFOQNFH-UHFFFAOYSA-N 0.000 description 7
- 240000002024 Gossypium herbaceum Species 0.000 description 7
- 235000004341 Gossypium herbaceum Nutrition 0.000 description 7
- 208000027418 Wounds and injury Diseases 0.000 description 7
- 238000007792 addition Methods 0.000 description 7
- 230000002441 reversible effect Effects 0.000 description 7
- 230000028327 secretion Effects 0.000 description 7
- 238000012360 testing method Methods 0.000 description 7
- 238000011282 treatment Methods 0.000 description 7
- 244000068988 Glycine max Species 0.000 description 6
- 235000010469 Glycine max Nutrition 0.000 description 6
- 244000299507 Gossypium hirsutum Species 0.000 description 6
- 210000004102 animal cell Anatomy 0.000 description 6
- 230000006378 damage Effects 0.000 description 6
- 210000002308 embryonic cell Anatomy 0.000 description 6
- 238000004128 high performance liquid chromatography Methods 0.000 description 6
- RAXXELZNTBOGNW-UHFFFAOYSA-N imidazole Natural products C1=CNC=N1 RAXXELZNTBOGNW-UHFFFAOYSA-N 0.000 description 6
- 208000014674 injury Diseases 0.000 description 6
- 210000004962 mammalian cell Anatomy 0.000 description 6
- BDAGIHXWWSANSR-UHFFFAOYSA-N methanoic acid Natural products OC=O BDAGIHXWWSANSR-UHFFFAOYSA-N 0.000 description 6
- 230000001717 pathogenic effect Effects 0.000 description 6
- 238000006116 polymerization reaction Methods 0.000 description 6
- 230000008569 process Effects 0.000 description 6
- 238000012163 sequencing technique Methods 0.000 description 6
- 230000014616 translation Effects 0.000 description 6
- 241000219194 Arabidopsis Species 0.000 description 5
- 241000235058 Komagataella pastoris Species 0.000 description 5
- QNAYBMKLOCPYGJ-REOHCLBHSA-N L-alanine Chemical compound C[C@H](N)C(O)=O QNAYBMKLOCPYGJ-REOHCLBHSA-N 0.000 description 5
- 230000003115 biocidal effect Effects 0.000 description 5
- 230000001276 controlling effect Effects 0.000 description 5
- 238000013461 design Methods 0.000 description 5
- 230000007613 environmental effect Effects 0.000 description 5
- 210000003527 eukaryotic cell Anatomy 0.000 description 5
- 210000004602 germ cell Anatomy 0.000 description 5
- 239000001963 growth medium Substances 0.000 description 5
- 238000009396 hybridization Methods 0.000 description 5
- 230000028993 immune response Effects 0.000 description 5
- 238000000338 in vitro Methods 0.000 description 5
- 230000000977 initiatory effect Effects 0.000 description 5
- 238000003780 insertion Methods 0.000 description 5
- 230000037431 insertion Effects 0.000 description 5
- 239000007788 liquid Substances 0.000 description 5
- 230000007246 mechanism Effects 0.000 description 5
- 238000000520 microinjection Methods 0.000 description 5
- 239000013612 plasmid Substances 0.000 description 5
- 230000008488 polyadenylation Effects 0.000 description 5
- 102000040430 polynucleotide Human genes 0.000 description 5
- 108091033319 polynucleotide Proteins 0.000 description 5
- 239000002157 polynucleotide Substances 0.000 description 5
- 230000008929 regeneration Effects 0.000 description 5
- 238000011069 regeneration method Methods 0.000 description 5
- 125000006850 spacer group Chemical group 0.000 description 5
- 230000035882 stress Effects 0.000 description 5
- 239000004753 textile Substances 0.000 description 5
- 239000013603 viral vector Substances 0.000 description 5
- 235000021247 β-casein Nutrition 0.000 description 5
- MTCFGRXMJLQNBG-REOHCLBHSA-N (2S)-2-Amino-3-hydroxypropansäure Chemical compound OC[C@H](N)C(O)=O MTCFGRXMJLQNBG-REOHCLBHSA-N 0.000 description 4
- 101710191900 Actin-depolymerizing factor 4 Proteins 0.000 description 4
- 241000239223 Arachnida Species 0.000 description 4
- 241001157789 Araneus bicentenarius Species 0.000 description 4
- 241000283690 Bos taurus Species 0.000 description 4
- 108020004635 Complementary DNA Proteins 0.000 description 4
- 102000000541 Defensins Human genes 0.000 description 4
- 108010002069 Defensins Proteins 0.000 description 4
- ZHNUHDYFZUAESO-UHFFFAOYSA-N Formamide Chemical compound NC=O ZHNUHDYFZUAESO-UHFFFAOYSA-N 0.000 description 4
- 108700037728 Glycine max beta-conglycinin Proteins 0.000 description 4
- VEXZGXHMUGYJMC-UHFFFAOYSA-N Hydrochloric acid Chemical compound Cl VEXZGXHMUGYJMC-UHFFFAOYSA-N 0.000 description 4
- KFZMGEQAYNKOFK-UHFFFAOYSA-N Isopropanol Chemical compound CC(C)O KFZMGEQAYNKOFK-UHFFFAOYSA-N 0.000 description 4
- 241000208125 Nicotiana Species 0.000 description 4
- ZRWPUFFVAOMMNM-UHFFFAOYSA-N Patulin Chemical compound OC1OCC=C2OC(=O)C=C12 ZRWPUFFVAOMMNM-UHFFFAOYSA-N 0.000 description 4
- 241000709992 Potato virus X Species 0.000 description 4
- 101000611441 Solanum lycopersicum Pathogenesis-related leaf protein 6 Proteins 0.000 description 4
- 108700019146 Transgenes Proteins 0.000 description 4
- XSQUKJJJFZCRTK-UHFFFAOYSA-N Urea Chemical compound NC(N)=O XSQUKJJJFZCRTK-UHFFFAOYSA-N 0.000 description 4
- JLCPHMBAVCMARE-UHFFFAOYSA-N [3-[[3-[[3-[[3-[[3-[[3-[[3-[[3-[[3-[[3-[[3-[[5-(2-amino-6-oxo-1H-purin-9-yl)-3-[[3-[[3-[[3-[[3-[[3-[[5-(2-amino-6-oxo-1H-purin-9-yl)-3-[[5-(2-amino-6-oxo-1H-purin-9-yl)-3-hydroxyoxolan-2-yl]methoxy-hydroxyphosphoryl]oxyoxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(5-methyl-2,4-dioxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxyoxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(5-methyl-2,4-dioxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(4-amino-2-oxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(5-methyl-2,4-dioxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(5-methyl-2,4-dioxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(4-amino-2-oxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(4-amino-2-oxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(4-amino-2-oxopyrimidin-1-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(6-aminopurin-9-yl)oxolan-2-yl]methoxy-hydroxyphosphoryl]oxy-5-(4-amino-2-oxopyrimidin-1-yl)oxolan-2-yl]methyl [5-(6-aminopurin-9-yl)-2-(hydroxymethyl)oxolan-3-yl] hydrogen phosphate Polymers Cc1cn(C2CC(OP(O)(=O)OCC3OC(CC3OP(O)(=O)OCC3OC(CC3O)n3cnc4c3nc(N)[nH]c4=O)n3cnc4c3nc(N)[nH]c4=O)C(COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3COP(O)(=O)OC3CC(OC3CO)n3cnc4c(N)ncnc34)n3ccc(N)nc3=O)n3cnc4c(N)ncnc34)n3ccc(N)nc3=O)n3ccc(N)nc3=O)n3ccc(N)nc3=O)n3cnc4c(N)ncnc34)n3cnc4c(N)ncnc34)n3cc(C)c(=O)[nH]c3=O)n3cc(C)c(=O)[nH]c3=O)n3ccc(N)nc3=O)n3cc(C)c(=O)[nH]c3=O)n3cnc4c3nc(N)[nH]c4=O)n3cnc4c(N)ncnc34)n3cnc4c(N)ncnc34)n3cnc4c(N)ncnc34)n3cnc4c(N)ncnc34)O2)c(=O)[nH]c1=O JLCPHMBAVCMARE-UHFFFAOYSA-N 0.000 description 4
- 235000004279 alanine Nutrition 0.000 description 4
- 125000000539 amino acid group Chemical group 0.000 description 4
- 230000008901 benefit Effects 0.000 description 4
- 235000013399 edible fruits Nutrition 0.000 description 4
- 102000034240 fibrous proteins Human genes 0.000 description 4
- 108091005899 fibrous proteins Proteins 0.000 description 4
- 230000002538 fungal effect Effects 0.000 description 4
- 230000002068 genetic effect Effects 0.000 description 4
- 208000015181 infectious disease Diseases 0.000 description 4
- 230000010354 integration Effects 0.000 description 4
- AMXOYNBUYSYVKV-UHFFFAOYSA-M lithium bromide Chemical compound [Li+].[Br-] AMXOYNBUYSYVKV-UHFFFAOYSA-M 0.000 description 4
- 239000011159 matrix material Substances 0.000 description 4
- 239000000137 peptide hydrolase inhibitor Substances 0.000 description 4
- 238000002360 preparation method Methods 0.000 description 4
- 210000001236 prokaryotic cell Anatomy 0.000 description 4
- 210000001938 protoplast Anatomy 0.000 description 4
- 238000013519 translation Methods 0.000 description 4
- 235000021249 α-casein Nutrition 0.000 description 4
- BYEAHWXPCBROCE-UHFFFAOYSA-N 1,1,1,3,3,3-hexafluoropropan-2-ol Chemical compound FC(F)(F)C(O)C(F)(F)F BYEAHWXPCBROCE-UHFFFAOYSA-N 0.000 description 3
- OSWFIVFLDKOXQC-UHFFFAOYSA-N 4-(3-methoxyphenyl)aniline Chemical compound COC1=CC=CC(C=2C=CC(N)=CC=2)=C1 OSWFIVFLDKOXQC-UHFFFAOYSA-N 0.000 description 3
- 241000192700 Cyanobacteria Species 0.000 description 3
- YMWUJEATGCHHMB-UHFFFAOYSA-N Dichloromethane Chemical compound ClCCl YMWUJEATGCHHMB-UHFFFAOYSA-N 0.000 description 3
- 241001334263 Euprosthenops Species 0.000 description 3
- 238000005033 Fourier transform infrared spectroscopy Methods 0.000 description 3
- 239000004471 Glycine Substances 0.000 description 3
- 108091092195 Intron Proteins 0.000 description 3
- 229920000271 Kevlar® Polymers 0.000 description 3
- OKKJLVBELUTLKV-UHFFFAOYSA-N Methanol Chemical compound OC OKKJLVBELUTLKV-UHFFFAOYSA-N 0.000 description 3
- 235000002637 Nicotiana tabacum Nutrition 0.000 description 3
- 239000004677 Nylon Substances 0.000 description 3
- 241000209094 Oryza Species 0.000 description 3
- 241000124665 Pisaurina mira Species 0.000 description 3
- 244000061456 Solanum tuberosum Species 0.000 description 3
- 235000002595 Solanum tuberosum Nutrition 0.000 description 3
- 108700005078 Synthetic Genes Proteins 0.000 description 3
- 108090000848 Ubiquitin Proteins 0.000 description 3
- 102000044159 Ubiquitin Human genes 0.000 description 3
- 241000251539 Vertebrata <Metazoa> Species 0.000 description 3
- 239000002253 acid Substances 0.000 description 3
- 244000193174 agave Species 0.000 description 3
- 230000004071 biological effect Effects 0.000 description 3
- 239000012620 biological material Substances 0.000 description 3
- 238000004364 calculation method Methods 0.000 description 3
- 239000003153 chemical reaction reagent Substances 0.000 description 3
- 210000004978 chinese hamster ovary cell Anatomy 0.000 description 3
- 238000004587 chromatography analysis Methods 0.000 description 3
- 150000001875 compounds Chemical class 0.000 description 3
- 239000002537 cosmetic Substances 0.000 description 3
- 239000013078 crystal Substances 0.000 description 3
- 201000010099 disease Diseases 0.000 description 3
- 208000037265 diseases, disorders, signs and symptoms Diseases 0.000 description 3
- 238000001962 electrophoresis Methods 0.000 description 3
- 238000004520 electroporation Methods 0.000 description 3
- 238000000605 extraction Methods 0.000 description 3
- 235000019253 formic acid Nutrition 0.000 description 3
- 230000002363 herbicidal effect Effects 0.000 description 3
- 239000004009 herbicide Substances 0.000 description 3
- 239000004761 kevlar Substances 0.000 description 3
- 238000004949 mass spectrometry Methods 0.000 description 3
- 230000005226 mechanical processes and functions Effects 0.000 description 3
- 229910052751 metal Inorganic materials 0.000 description 3
- 239000002184 metal Substances 0.000 description 3
- 150000002739 metals Chemical class 0.000 description 3
- 238000007479 molecular analysis Methods 0.000 description 3
- 229920001778 nylon Polymers 0.000 description 3
- 230000000704 physical effect Effects 0.000 description 3
- 238000011002 quantification Methods 0.000 description 3
- 238000011160 research Methods 0.000 description 3
- 239000011347 resin Substances 0.000 description 3
- 229920005989 resin Polymers 0.000 description 3
- 239000011734 sodium Substances 0.000 description 3
- 210000000130 stem cell Anatomy 0.000 description 3
- 238000012546 transfer Methods 0.000 description 3
- 210000002700 urine Anatomy 0.000 description 3
- 230000003612 virological effect Effects 0.000 description 3
- 239000002023 wood Substances 0.000 description 3
- FQVLRGLGWNWPSS-BXBUPLCLSA-N (4r,7s,10s,13s,16r)-16-acetamido-13-(1h-imidazol-5-ylmethyl)-10-methyl-6,9,12,15-tetraoxo-7-propan-2-yl-1,2-dithia-5,8,11,14-tetrazacycloheptadecane-4-carboxamide Chemical compound N1C(=O)[C@@H](NC(C)=O)CSSC[C@@H](C(N)=O)NC(=O)[C@H](C(C)C)NC(=O)[C@H](C)NC(=O)[C@@H]1CC1=CN=CN1 FQVLRGLGWNWPSS-BXBUPLCLSA-N 0.000 description 2
- 241000580482 Acidobacteria Species 0.000 description 2
- 241001133760 Acoelorraphe Species 0.000 description 2
- 241001156739 Actinobacteria <phylum> Species 0.000 description 2
- 102000007469 Actins Human genes 0.000 description 2
- 108010085238 Actins Proteins 0.000 description 2
- 101150021974 Adh1 gene Proteins 0.000 description 2
- 244000198134 Agave sisalana Species 0.000 description 2
- 241000589155 Agrobacterium tumefaciens Species 0.000 description 2
- 108050008874 Annexin Proteins 0.000 description 2
- 102000000412 Annexin Human genes 0.000 description 2
- 241001142141 Aquificae <phylum> Species 0.000 description 2
- 241001157788 Araneus Species 0.000 description 2
- 241001318880 Araneus gemmoides Species 0.000 description 2
- 241000326710 Argiope lobata Species 0.000 description 2
- 108010000241 Arthropod Proteins Proteins 0.000 description 2
- 241000209134 Arundinaria Species 0.000 description 2
- 241000235349 Ascomycota Species 0.000 description 2
- 241000228212 Aspergillus Species 0.000 description 2
- IJGRMHOSHXDMSA-UHFFFAOYSA-N Atomic nitrogen Chemical compound N#N IJGRMHOSHXDMSA-UHFFFAOYSA-N 0.000 description 2
- 241000193830 Bacillus <bacterium> Species 0.000 description 2
- 235000017166 Bambusa arundinacea Nutrition 0.000 description 2
- 235000017491 Bambusa tulda Nutrition 0.000 description 2
- 241000221198 Basidiomycota Species 0.000 description 2
- 101100263837 Bovine ephemeral fever virus (strain BB7721) beta gene Proteins 0.000 description 2
- 241000701822 Bovine papillomavirus Species 0.000 description 2
- UXVMQQNJUSDDNG-UHFFFAOYSA-L Calcium chloride Chemical compound [Cl-].[Cl-].[Ca+2] UXVMQQNJUSDDNG-UHFFFAOYSA-L 0.000 description 2
- 101100507655 Canis lupus familiaris HSPA1 gene Proteins 0.000 description 2
- 244000025254 Cannabis sativa Species 0.000 description 2
- 235000012766 Cannabis sativa ssp. sativa var. sativa Nutrition 0.000 description 2
- 235000012765 Cannabis sativa ssp. sativa var. spontanea Nutrition 0.000 description 2
- 108010022172 Chitinases Proteins 0.000 description 2
- 102000012286 Chitinases Human genes 0.000 description 2
- 241001185363 Chlamydiae Species 0.000 description 2
- 241001142109 Chloroflexi Species 0.000 description 2
- 241001143290 Chrysiogenetes <phylum> Species 0.000 description 2
- 240000000491 Corchorus aestuans Species 0.000 description 2
- 235000011777 Corchorus aestuans Nutrition 0.000 description 2
- 235000010862 Corchorus capsularis Nutrition 0.000 description 2
- 101710190853 Cruciferin Proteins 0.000 description 2
- 241000701022 Cytomegalovirus Species 0.000 description 2
- ZAQJHHRNXZUBTE-NQXXGFSBSA-N D-ribulose Chemical compound OC[C@@H](O)[C@@H](O)C(=O)CO ZAQJHHRNXZUBTE-NQXXGFSBSA-N 0.000 description 2
- ZAQJHHRNXZUBTE-UHFFFAOYSA-N D-threo-2-Pentulose Natural products OCC(O)C(O)C(=O)CO ZAQJHHRNXZUBTE-UHFFFAOYSA-N 0.000 description 2
- 241001143296 Deferribacteres <phylum> Species 0.000 description 2
- 101710088194 Dehydrogenase Proteins 0.000 description 2
- 241000192095 Deinococcus-Thermus Species 0.000 description 2
- 241000970811 Dictyoglomi Species 0.000 description 2
- 101100316840 Enterobacteria phage P4 Beta gene Proteins 0.000 description 2
- 241000701832 Enterobacteria phage T3 Species 0.000 description 2
- 102000004190 Enzymes Human genes 0.000 description 2
- 108090000790 Enzymes Proteins 0.000 description 2
- 241000588722 Escherichia Species 0.000 description 2
- 241000206602 Eukaryota Species 0.000 description 2
- 108050000194 Expansin Proteins 0.000 description 2
- 241000192125 Firmicutes Species 0.000 description 2
- 241001453172 Fusobacteria Species 0.000 description 2
- 241001265526 Gemmatimonadetes <phylum> Species 0.000 description 2
- 241000952335 Gloeobacteria Species 0.000 description 2
- 108010068370 Glutens Proteins 0.000 description 2
- 102000002812 Heat-Shock Proteins Human genes 0.000 description 2
- 108010004889 Heat-Shock Proteins Proteins 0.000 description 2
- 240000005979 Hordeum vulgare Species 0.000 description 2
- 235000007340 Hordeum vulgare Nutrition 0.000 description 2
- 206010021143 Hypoxia Diseases 0.000 description 2
- OUYCCCASQSFEME-QMMMGPOBSA-N L-tyrosine Chemical compound OC(=O)[C@@H](N)CC1=CC=C(O)C=C1 OUYCCCASQSFEME-QMMMGPOBSA-N 0.000 description 2
- 102000004407 Lactalbumin Human genes 0.000 description 2
- 108090000942 Lactalbumin Proteins 0.000 description 2
- 241000023953 Latrodectus geometricus Species 0.000 description 2
- 101150050813 MPI gene Proteins 0.000 description 2
- 241000124008 Mammalia Species 0.000 description 2
- 101000763602 Manilkara zapota Thaumatin-like protein 1 Proteins 0.000 description 2
- 101000763586 Manilkara zapota Thaumatin-like protein 1a Proteins 0.000 description 2
- 101100409013 Mesembryanthemum crystallinum PPD gene Proteins 0.000 description 2
- 241000699670 Mus sp. Species 0.000 description 2
- 101000966653 Musa acuminata Glucan endo-1,3-beta-glucosidase Proteins 0.000 description 2
- 101710197341 Myb-like transcription factor Proteins 0.000 description 2
- PXHVJJICTQNCMI-UHFFFAOYSA-N Nickel Chemical compound [Ni] PXHVJJICTQNCMI-UHFFFAOYSA-N 0.000 description 2
- 241000121237 Nitrospirae Species 0.000 description 2
- 241000192522 Nostocales Species 0.000 description 2
- 108700026244 Open Reading Frames Proteins 0.000 description 2
- 235000007164 Oryza sativa Nutrition 0.000 description 2
- 241000192494 Oscillatoriales Species 0.000 description 2
- 101710091688 Patatin Proteins 0.000 description 2
- 101710096342 Pathogenesis-related protein Proteins 0.000 description 2
- 244000046052 Phaseolus vulgaris Species 0.000 description 2
- 235000010627 Phaseolus vulgaris Nutrition 0.000 description 2
- 244000082204 Phyllostachys viridis Species 0.000 description 2
- 235000015334 Phyllostachys viridis Nutrition 0.000 description 2
- 241000235648 Pichia Species 0.000 description 2
- 241001180199 Planctomycetes Species 0.000 description 2
- 108020005120 Plant DNA Proteins 0.000 description 2
- 108010059820 Polygalacturonase Proteins 0.000 description 2
- ONIBWKKTOPOVIA-UHFFFAOYSA-N Proline Chemical compound OC(=O)C1CCCN1 ONIBWKKTOPOVIA-UHFFFAOYSA-N 0.000 description 2
- XBDQKXXYIPTUBI-UHFFFAOYSA-N Propionic acid Substances CCC(O)=O XBDQKXXYIPTUBI-UHFFFAOYSA-N 0.000 description 2
- 241000192142 Proteobacteria Species 0.000 description 2
- 108020004511 Recombinant DNA Proteins 0.000 description 2
- 108010003581 Ribulose-bisphosphate carboxylase Proteins 0.000 description 2
- 101150087119 SAG gene Proteins 0.000 description 2
- 241000235070 Saccharomyces Species 0.000 description 2
- 108010013296 Sericins Proteins 0.000 description 2
- 241001180364 Spirochaetes Species 0.000 description 2
- 241001143138 Thermodesulfobacteria <phylum> Species 0.000 description 2
- 241001143310 Thermotogae <phylum> Species 0.000 description 2
- 108090000704 Tubulin Proteins 0.000 description 2
- 108010061861 Uroplakins Proteins 0.000 description 2
- 241001261005 Verrucomicrobia Species 0.000 description 2
- 239000005862 Whey Substances 0.000 description 2
- 102000007544 Whey Proteins Human genes 0.000 description 2
- 108010046377 Whey Proteins Proteins 0.000 description 2
- 241000607479 Yersinia pestis Species 0.000 description 2
- 210000001015 abdomen Anatomy 0.000 description 2
- 230000036579 abiotic stress Effects 0.000 description 2
- 230000009471 action Effects 0.000 description 2
- 239000000427 antigen Substances 0.000 description 2
- 108091007433 antigens Proteins 0.000 description 2
- 102000036639 antigens Human genes 0.000 description 2
- 238000004630 atomic force microscopy Methods 0.000 description 2
- 239000011425 bamboo Substances 0.000 description 2
- 108010019077 beta-Amylase Proteins 0.000 description 2
- 230000004790 biotic stress Effects 0.000 description 2
- 125000005340 bisphosphate group Chemical group 0.000 description 2
- 239000000872 buffer Substances 0.000 description 2
- 238000010804 cDNA synthesis Methods 0.000 description 2
- 239000001110 calcium chloride Substances 0.000 description 2
- 229910001628 calcium chloride Inorganic materials 0.000 description 2
- 159000000007 calcium salts Chemical class 0.000 description 2
- 235000009120 camo Nutrition 0.000 description 2
- 238000003981 capillary liquid chromatography Methods 0.000 description 2
- 239000004202 carbamide Substances 0.000 description 2
- 230000015556 catabolic process Effects 0.000 description 2
- 108010040093 cellulose synthase Proteins 0.000 description 2
- 230000008859 change Effects 0.000 description 2
- 235000005607 chanvre indien Nutrition 0.000 description 2
- 239000003795 chemical substances by application Substances 0.000 description 2
- 230000008645 cold stress Effects 0.000 description 2
- 230000009089 cytolysis Effects 0.000 description 2
- 230000023753 dehiscence Effects 0.000 description 2
- 238000001514 detection method Methods 0.000 description 2
- 239000003814 drug Substances 0.000 description 2
- 235000013601 eggs Nutrition 0.000 description 2
- 230000013020 embryo development Effects 0.000 description 2
- 229940088598 enzyme Drugs 0.000 description 2
- 238000011156 evaluation Methods 0.000 description 2
- 238000002474 experimental method Methods 0.000 description 2
- 238000001125 extrusion Methods 0.000 description 2
- 210000002950 fibroblast Anatomy 0.000 description 2
- 238000001298 force spectroscopy Methods 0.000 description 2
- 238000010353 genetic engineering Methods 0.000 description 2
- 230000000762 glandular Effects 0.000 description 2
- 230000008642 heat stress Effects 0.000 description 2
- 239000011487 hemp Substances 0.000 description 2
- 125000000487 histidyl group Chemical group [H]N([H])C(C(=O)O*)C([H])([H])C1=C([H])N([H])C([H])=N1 0.000 description 2
- 239000005556 hormone Substances 0.000 description 2
- 229940088597 hormone Drugs 0.000 description 2
- 239000001257 hydrogen Substances 0.000 description 2
- 229910052739 hydrogen Inorganic materials 0.000 description 2
- 230000002209 hydrophobic effect Effects 0.000 description 2
- 230000007954 hypoxia Effects 0.000 description 2
- 230000001965 increasing effect Effects 0.000 description 2
- 230000002401 inhibitory effect Effects 0.000 description 2
- 238000011081 inoculation Methods 0.000 description 2
- 230000003993 interaction Effects 0.000 description 2
- 230000000670 limiting effect Effects 0.000 description 2
- 239000002502 liposome Substances 0.000 description 2
- ZJZXSOKJEJFHCP-UHFFFAOYSA-M lithium;thiocyanate Chemical compound [Li+].[S-]C#N ZJZXSOKJEJFHCP-UHFFFAOYSA-M 0.000 description 2
- 244000144972 livestock Species 0.000 description 2
- 229920002521 macromolecule Polymers 0.000 description 2
- 238000013507 mapping Methods 0.000 description 2
- 238000005259 measurement Methods 0.000 description 2
- 239000002609 medium Substances 0.000 description 2
- 239000012528 membrane Substances 0.000 description 2
- 229940124561 microbicide Drugs 0.000 description 2
- 238000002887 multiple sequence alignment Methods 0.000 description 2
- 239000002121 nanofiber Substances 0.000 description 2
- 229910052757 nitrogen Inorganic materials 0.000 description 2
- 230000008520 organization Effects 0.000 description 2
- 210000001672 ovary Anatomy 0.000 description 2
- 210000003101 oviduct Anatomy 0.000 description 2
- 230000036961 partial effect Effects 0.000 description 2
- 239000002245 particle Substances 0.000 description 2
- 239000000825 pharmaceutical preparation Substances 0.000 description 2
- 229920005862 polyol Polymers 0.000 description 2
- 150000003077 polyols Chemical class 0.000 description 2
- 229910001414 potassium ion Inorganic materials 0.000 description 2
- 101150063097 ppdK gene Proteins 0.000 description 2
- 238000001556 precipitation Methods 0.000 description 2
- 239000002243 precursor Substances 0.000 description 2
- 235000019260 propionic acid Nutrition 0.000 description 2
- IUVKMZGDUIUOCP-BTNSXGMBSA-N quinbolone Chemical compound O([C@H]1CC[C@H]2[C@H]3[C@@H]([C@]4(C=CC(=O)C=C4CC3)C)CC[C@@]21C)C1=CCCC1 IUVKMZGDUIUOCP-BTNSXGMBSA-N 0.000 description 2
- 230000004044 response Effects 0.000 description 2
- 108091008146 restriction endonucleases Proteins 0.000 description 2
- 238000012552 review Methods 0.000 description 2
- 235000009566 rice Nutrition 0.000 description 2
- 238000004626 scanning electron microscopy Methods 0.000 description 2
- 238000012216 screening Methods 0.000 description 2
- 238000000926 separation method Methods 0.000 description 2
- 238000002864 sequence alignment Methods 0.000 description 2
- MTCFGRXMJLQNBG-UHFFFAOYSA-N serine Chemical compound OCC(N)C(O)=O MTCFGRXMJLQNBG-UHFFFAOYSA-N 0.000 description 2
- 239000007787 solid Substances 0.000 description 2
- 238000006467 substitution reaction Methods 0.000 description 2
- 229920002994 synthetic fiber Polymers 0.000 description 2
- 239000012209 synthetic fiber Substances 0.000 description 2
- 230000009885 systemic effect Effects 0.000 description 2
- 230000002123 temporal effect Effects 0.000 description 2
- 230000005030 transcription termination Effects 0.000 description 2
- 230000002103 transcriptional effect Effects 0.000 description 2
- 230000010474 transient expression Effects 0.000 description 2
- OUYCCCASQSFEME-UHFFFAOYSA-N tyrosine Natural products OC(=O)C(N)CC1=CC=C(O)C=C1 OUYCCCASQSFEME-UHFFFAOYSA-N 0.000 description 2
- 241001515965 unidentified phage Species 0.000 description 2
- 241001430294 unidentified retrovirus Species 0.000 description 2
- 208000007089 vaccinia Diseases 0.000 description 2
- 238000010200 validation analysis Methods 0.000 description 2
- 230000002792 vascular Effects 0.000 description 2
- 238000001262 western blot Methods 0.000 description 2
- 235000021241 α-lactalbumin Nutrition 0.000 description 2
- 235000021246 κ-casein Nutrition 0.000 description 2
- JKMHFZQWWAIEOD-UHFFFAOYSA-N 2-[4-(2-hydroxyethyl)piperazin-1-yl]ethanesulfonic acid Chemical compound OCC[NH+]1CCN(CCS([O-])(=O)=O)CC1 JKMHFZQWWAIEOD-UHFFFAOYSA-N 0.000 description 1
- 241000238876 Acari Species 0.000 description 1
- 241001236783 Afrotheria Species 0.000 description 1
- 229920000936 Agarose Polymers 0.000 description 1
- 241000883320 Amblypygi Species 0.000 description 1
- 244000296825 Amygdalus nana Species 0.000 description 1
- 235000003840 Amygdalus nana Nutrition 0.000 description 1
- 235000001271 Anacardium Nutrition 0.000 description 1
- 241000693997 Anacardium Species 0.000 description 1
- 102000014133 Antimicrobial Cationic Peptides Human genes 0.000 description 1
- 108010050820 Antimicrobial Cationic Peptides Proteins 0.000 description 1
- 108700042778 Antimicrobial Peptides Proteins 0.000 description 1
- 102000044503 Antimicrobial Peptides Human genes 0.000 description 1
- 235000003911 Arachis Nutrition 0.000 description 1
- 244000105624 Arachis hypogaea Species 0.000 description 1
- 241000238897 Araneomorphae Species 0.000 description 1
- 241000356504 Argiope Species 0.000 description 1
- 241000023936 Argiope aurantia Species 0.000 description 1
- 241000238421 Arthropoda Species 0.000 description 1
- 244000018217 Artocarpus elasticus Species 0.000 description 1
- 235000005340 Asparagus officinalis Nutrition 0.000 description 1
- 241001106067 Atropa Species 0.000 description 1
- 235000005781 Avena Nutrition 0.000 description 1
- 244000075850 Avena orientalis Species 0.000 description 1
- CKPVBENLCULNNP-UHFFFAOYSA-N BCCC Chemical compound BCCC CKPVBENLCULNNP-UHFFFAOYSA-N 0.000 description 1
- 241000605059 Bacteroidetes Species 0.000 description 1
- 241000971519 Bacteroidetes/Chlorobi group Species 0.000 description 1
- 241000219198 Brassica Species 0.000 description 1
- 235000011331 Brassica Nutrition 0.000 description 1
- 101100029891 Caenorhabditis elegans pkd-2 gene Proteins 0.000 description 1
- 241000283707 Capra Species 0.000 description 1
- 235000002566 Capsicum Nutrition 0.000 description 1
- 240000008574 Capsicum frutescens Species 0.000 description 1
- 244000132069 Carica monoica Species 0.000 description 1
- 235000014649 Carica monoica Nutrition 0.000 description 1
- 241001466804 Carnivora Species 0.000 description 1
- WLYGSPLCNKYESI-RSUQVHIMSA-N Carthamin Chemical compound O[C@@H]1[C@@H](O)[C@H](O)[C@@H](CO)O[C@H]1[C@@]1(O)C(O)=C(C(=O)\C=C\C=2C=CC(O)=CC=2)C(=O)C(\C=C\2C([C@](O)([C@H]3[C@@H]([C@@H](O)[C@H](O)[C@@H](CO)O3)O)C(O)=C(C(=O)\C=C\C=3C=CC(O)=CC=3)C/2=O)=O)=C1O WLYGSPLCNKYESI-RSUQVHIMSA-N 0.000 description 1
- 241000208809 Carthamus Species 0.000 description 1
- 102100035882 Catalase Human genes 0.000 description 1
- 108010053835 Catalase Proteins 0.000 description 1
- 241000283153 Cetacea Species 0.000 description 1
- VEXZGXHMUGYJMC-UHFFFAOYSA-M Chloride anion Chemical compound [Cl-] VEXZGXHMUGYJMC-UHFFFAOYSA-M 0.000 description 1
- 241000191368 Chlorobi Species 0.000 description 1
- 241000219109 Citrullus Species 0.000 description 1
- 241000207199 Citrus Species 0.000 description 1
- 241000737241 Cocos Species 0.000 description 1
- 108020004705 Codon Proteins 0.000 description 1
- 241000723377 Coffea Species 0.000 description 1
- 108091035707 Consensus sequence Proteins 0.000 description 1
- 241000699800 Cricetinae Species 0.000 description 1
- 241000699802 Cricetulus griseus Species 0.000 description 1
- 244000024469 Cucumis prophetarum Species 0.000 description 1
- 235000010071 Cucumis prophetarum Nutrition 0.000 description 1
- 241000219122 Cucurbita Species 0.000 description 1
- 241000208175 Daucus Species 0.000 description 1
- 238000002965 ELISA Methods 0.000 description 1
- 241000512897 Elaeis Species 0.000 description 1
- 235000001942 Elaeis Nutrition 0.000 description 1
- 241001153950 Ephebopus Species 0.000 description 1
- 241000283086 Equidae Species 0.000 description 1
- 241001272171 Euarchontoglires Species 0.000 description 1
- 241000923108 Fibrobacteres Species 0.000 description 1
- 241000220223 Fragaria Species 0.000 description 1
- 108700028146 Genetic Enhancer Elements Proteins 0.000 description 1
- 241000219146 Gossypium Species 0.000 description 1
- 235000009438 Gossypium Nutrition 0.000 description 1
- 235000009432 Gossypium hirsutum Nutrition 0.000 description 1
- 239000007995 HEPES buffer Substances 0.000 description 1
- 241000208818 Helianthus Species 0.000 description 1
- 101710154606 Hemagglutinin Proteins 0.000 description 1
- 241000209219 Hordeum Species 0.000 description 1
- UFHFLCQGNIYNRP-UHFFFAOYSA-N Hydrogen Chemical compound [H][H] UFHFLCQGNIYNRP-UHFFFAOYSA-N 0.000 description 1
- 206010053317 Hydrophobia Diseases 0.000 description 1
- 241000759252 Hypsiboas punctatus Species 0.000 description 1
- 238000004971 IR microspectroscopy Methods 0.000 description 1
- DGAQECJNVWCQMB-PUAWFVPOSA-M Ilexoside XXIX Chemical compound C[C@@H]1CC[C@@]2(CC[C@@]3(C(=CC[C@H]4[C@]3(CC[C@@H]5[C@@]4(CC[C@@H](C5(C)C)OS(=O)(=O)[O-])C)C)[C@@H]2[C@]1(C)O)C)C(=O)O[C@H]6[C@@H]([C@H]([C@@H]([C@H](O6)CO)O)O)O.[Na+] DGAQECJNVWCQMB-PUAWFVPOSA-M 0.000 description 1
- 206010061598 Immunodeficiency Diseases 0.000 description 1
- 208000029462 Immunodeficiency disease Diseases 0.000 description 1
- 108060003951 Immunoglobulin Proteins 0.000 description 1
- 241000289658 Insectivora Species 0.000 description 1
- ONIBWKKTOPOVIA-BYPYZUCNSA-N L-Proline Chemical compound OC(=O)[C@@H]1CCCN1 ONIBWKKTOPOVIA-BYPYZUCNSA-N 0.000 description 1
- FFEARJCKVFRZRR-BYPYZUCNSA-N L-methionine Chemical compound CSCC[C@H](N)C(O)=O FFEARJCKVFRZRR-BYPYZUCNSA-N 0.000 description 1
- 241000208822 Lactuca Species 0.000 description 1
- 241000283953 Lagomorpha Species 0.000 description 1
- 241001272173 Laurasiatheria Species 0.000 description 1
- 241000208204 Linum Species 0.000 description 1
- 241000209082 Lolium Species 0.000 description 1
- 241000219745 Lupinus Species 0.000 description 1
- 241000227653 Lycopersicon Species 0.000 description 1
- 235000002262 Lycopersicon Nutrition 0.000 description 1
- 241000121629 Majorana Species 0.000 description 1
- 108020004687 Malate Synthase Proteins 0.000 description 1
- 241000220225 Malus Species 0.000 description 1
- 240000003183 Manihot esculenta Species 0.000 description 1
- 108091027974 Mature messenger RNA Proteins 0.000 description 1
- 241000219823 Medicago Species 0.000 description 1
- 241000347336 Melichthys niger Species 0.000 description 1
- 241000596014 Mesothelae Species 0.000 description 1
- 241000289419 Metatheria Species 0.000 description 1
- 238000010629 Molecular evolutionary genetics analysis Methods 0.000 description 1
- 241000289390 Monotremata Species 0.000 description 1
- 241000699666 Mus <mouse, genus> Species 0.000 description 1
- 241000699660 Mus musculus Species 0.000 description 1
- 241000239289 Mygalomorphae Species 0.000 description 1
- 241000238903 Nephila Species 0.000 description 1
- 241000207746 Nicotiana benthamiana Species 0.000 description 1
- 239000000020 Nitrocellulose Substances 0.000 description 1
- 241000795633 Olea <sea slug> Species 0.000 description 1
- 108020005187 Oligonucleotide Probes Proteins 0.000 description 1
- 241000168255 Opiliones Species 0.000 description 1
- 101710093908 Outer capsid protein VP4 Proteins 0.000 description 1
- 101710135467 Outer capsid protein sigma-1 Proteins 0.000 description 1
- 241000017103 Palpigradi Species 0.000 description 1
- 241001494479 Pecora Species 0.000 description 1
- 102000035195 Peptidases Human genes 0.000 description 1
- 108091005804 Peptidases Proteins 0.000 description 1
- 108010033276 Peptide Fragments Proteins 0.000 description 1
- 102000007079 Peptide Fragments Human genes 0.000 description 1
- 241000219833 Phaseolus Species 0.000 description 1
- 241000219843 Pisum Species 0.000 description 1
- 241000511381 Pleurocapsales Species 0.000 description 1
- 239000002202 Polyethylene glycol Substances 0.000 description 1
- 108010076039 Polyproteins Proteins 0.000 description 1
- 241000288906 Primates Species 0.000 description 1
- 241000192135 Prochloraceae Species 0.000 description 1
- 101710176177 Protein A56 Proteins 0.000 description 1
- 108010029485 Protein Isoforms Proteins 0.000 description 1
- 102000001708 Protein Isoforms Human genes 0.000 description 1
- 108010026552 Proteome Proteins 0.000 description 1
- 235000011432 Prunus Nutrition 0.000 description 1
- 241000500625 Pseudoscorpiones Species 0.000 description 1
- 241000508269 Psidium Species 0.000 description 1
- 241000220324 Pyrus Species 0.000 description 1
- 206010037742 Rabies Diseases 0.000 description 1
- 241000220259 Raphanus Species 0.000 description 1
- 108700008625 Reporter Genes Proteins 0.000 description 1
- 241000592840 Ricinulei Species 0.000 description 1
- 235000003846 Ricinus Nutrition 0.000 description 1
- 241000322381 Ricinus <louse> Species 0.000 description 1
- 235000004443 Ricinus communis Nutrition 0.000 description 1
- 241000283984 Rodentia Species 0.000 description 1
- 240000004808 Saccharomyces cerevisiae Species 0.000 description 1
- 241001466077 Salina Species 0.000 description 1
- 241000239226 Scorpiones Species 0.000 description 1
- 241000209056 Secale Species 0.000 description 1
- 241000780602 Senecio Species 0.000 description 1
- 229920002684 Sepharose Polymers 0.000 description 1
- 241000220261 Sinapis Species 0.000 description 1
- 108020004682 Single-Stranded DNA Proteins 0.000 description 1
- 235000002634 Solanum Nutrition 0.000 description 1
- 241000207763 Solanum Species 0.000 description 1
- 241000131853 Solifugae Species 0.000 description 1
- 240000006394 Sorghum bicolor Species 0.000 description 1
- 235000011684 Sorghum saccharatum Nutrition 0.000 description 1
- 238000002105 Southern blotting Methods 0.000 description 1
- 241000256251 Spodoptera frugiperda Species 0.000 description 1
- 108091081024 Start codon Proteins 0.000 description 1
- 229910000831 Steel Inorganic materials 0.000 description 1
- 101710172711 Structural protein Proteins 0.000 description 1
- 241001312519 Trigonella Species 0.000 description 1
- 235000021307 Triticum Nutrition 0.000 description 1
- 241000209140 Triticum Species 0.000 description 1
- 241000592845 Uropygi Species 0.000 description 1
- 241000219873 Vicia Species 0.000 description 1
- 241000219977 Vigna Species 0.000 description 1
- 235000009392 Vitis Nutrition 0.000 description 1
- 241000219095 Vitis Species 0.000 description 1
- 241000289690 Xenarthra Species 0.000 description 1
- 241000209149 Zea Species 0.000 description 1
- HMNZFMSWFCAGGW-XPWSMXQVSA-N [3-[hydroxy(2-hydroxyethoxy)phosphoryl]oxy-2-[(e)-octadec-9-enoyl]oxypropyl] (e)-octadec-9-enoate Chemical compound CCCCCCCC\C=C\CCCCCCCC(=O)OCC(COP(O)(=O)OCCO)OC(=O)CCCCCCC\C=C\CCCCCCCC HMNZFMSWFCAGGW-XPWSMXQVSA-N 0.000 description 1
- 150000007513 acids Chemical class 0.000 description 1
- 239000000853 adhesive Substances 0.000 description 1
- 230000001070 adhesive effect Effects 0.000 description 1
- 210000001943 adrenal medulla Anatomy 0.000 description 1
- 239000011543 agarose gel Substances 0.000 description 1
- 238000013019 agitation Methods 0.000 description 1
- 150000001408 amides Chemical class 0.000 description 1
- 238000003277 amino acid sequence analysis Methods 0.000 description 1
- BFNBIHQBYMNNAN-UHFFFAOYSA-N ammonium sulfate Chemical compound N.N.OS(O)(=O)=O BFNBIHQBYMNNAN-UHFFFAOYSA-N 0.000 description 1
- 229910052921 ammonium sulfate Inorganic materials 0.000 description 1
- 235000011130 ammonium sulphate Nutrition 0.000 description 1
- 238000010171 animal model Methods 0.000 description 1
- 230000002547 anomalous effect Effects 0.000 description 1
- 210000000612 antigen-presenting cell Anatomy 0.000 description 1
- 239000007864 aqueous solution Substances 0.000 description 1
- 238000004166 bioassay Methods 0.000 description 1
- 238000012742 biochemical analysis Methods 0.000 description 1
- 230000008033 biological extinction Effects 0.000 description 1
- 239000001506 calcium phosphate Substances 0.000 description 1
- 229910000389 calcium phosphate Inorganic materials 0.000 description 1
- 235000011010 calcium phosphates Nutrition 0.000 description 1
- 238000004422 calculation algorithm Methods 0.000 description 1
- 229940027138 cambia Drugs 0.000 description 1
- 239000001390 capsicum minimum Substances 0.000 description 1
- 238000004113 cell culture Methods 0.000 description 1
- 230000032823 cell division Effects 0.000 description 1
- 239000013592 cell lysate Substances 0.000 description 1
- 238000005119 centrifugation Methods 0.000 description 1
- 230000003196 chaotropic effect Effects 0.000 description 1
- 238000002512 chemotherapy Methods 0.000 description 1
- 210000001612 chondrocyte Anatomy 0.000 description 1
- 238000002983 circular dichroism Methods 0.000 description 1
- 235000020971 citrus fruits Nutrition 0.000 description 1
- 238000003776 cleavage reaction Methods 0.000 description 1
- 238000012761 co-transfection Methods 0.000 description 1
- 238000005345 coagulation Methods 0.000 description 1
- 230000015271 coagulation Effects 0.000 description 1
- 230000000052 comparative effect Effects 0.000 description 1
- 230000008876 conformational transition Effects 0.000 description 1
- 239000000470 constituent Substances 0.000 description 1
- 239000000356 contaminant Substances 0.000 description 1
- 238000007796 conventional method Methods 0.000 description 1
- 238000002425 crystallisation Methods 0.000 description 1
- 230000008025 crystallization Effects 0.000 description 1
- 239000012228 culture supernatant Substances 0.000 description 1
- UQHKFADEQIVWID-UHFFFAOYSA-N cytokinin Natural products C1=NC=2C(NCC=C(CO)C)=NC=NC=2N1C1CC(O)C(CO)O1 UQHKFADEQIVWID-UHFFFAOYSA-N 0.000 description 1
- 239000004062 cytokinin Substances 0.000 description 1
- 230000007423 decrease Effects 0.000 description 1
- 230000003247 decreasing effect Effects 0.000 description 1
- 230000007123 defense Effects 0.000 description 1
- 238000006731 degradation reaction Methods 0.000 description 1
- 238000012217 deletion Methods 0.000 description 1
- 230000037430 deletion Effects 0.000 description 1
- 210000004443 dendritic cell Anatomy 0.000 description 1
- 239000005547 deoxyribonucleotide Substances 0.000 description 1
- 125000002637 deoxyribonucleotide group Chemical group 0.000 description 1
- 230000001419 dependent effect Effects 0.000 description 1
- 238000000151 deposition Methods 0.000 description 1
- 239000003599 detergent Substances 0.000 description 1
- GUJOJGAPFQRJSV-UHFFFAOYSA-N dialuminum;dioxosilane;oxygen(2-);hydrate Chemical compound O.[O-2].[O-2].[O-2].[Al+3].[Al+3].O=[Si]=O.O=[Si]=O.O=[Si]=O.O=[Si]=O GUJOJGAPFQRJSV-UHFFFAOYSA-N 0.000 description 1
- 235000005911 diet Nutrition 0.000 description 1
- 230000037213 diet Effects 0.000 description 1
- 238000001085 differential centrifugation Methods 0.000 description 1
- 230000029087 digestion Effects 0.000 description 1
- 239000003085 diluting agent Substances 0.000 description 1
- 235000021186 dishes Nutrition 0.000 description 1
- 239000006185 dispersion Substances 0.000 description 1
- 238000004090 dissolution Methods 0.000 description 1
- 239000012153 distilled water Substances 0.000 description 1
- 229940079593 drug Drugs 0.000 description 1
- 239000012636 effector Substances 0.000 description 1
- 229920002549 elastin Polymers 0.000 description 1
- 238000001493 electron microscopy Methods 0.000 description 1
- 239000012149 elution buffer Substances 0.000 description 1
- 238000005538 encapsulation Methods 0.000 description 1
- 238000005516 engineering process Methods 0.000 description 1
- 230000007515 enzymatic degradation Effects 0.000 description 1
- 238000001976 enzyme digestion Methods 0.000 description 1
- 150000002148 esters Chemical class 0.000 description 1
- 230000007717 exclusion Effects 0.000 description 1
- 239000004744 fabric Substances 0.000 description 1
- YYJNOYZRYGDPNH-MFKUBSTISA-N fenpyroximate Chemical compound C=1C=C(C(=O)OC(C)(C)C)C=CC=1CO/N=C/C=1C(C)=NN(C)C=1OC1=CC=CC=C1 YYJNOYZRYGDPNH-MFKUBSTISA-N 0.000 description 1
- 238000009472 formulation Methods 0.000 description 1
- 238000005194 fractionation Methods 0.000 description 1
- 230000004927 fusion Effects 0.000 description 1
- 239000000499 gel Substances 0.000 description 1
- 238000007429 general method Methods 0.000 description 1
- 239000011521 glass Substances 0.000 description 1
- 150000002334 glycols Chemical class 0.000 description 1
- 229960000789 guanidine hydrochloride Drugs 0.000 description 1
- PJJJBBJSCAKJQF-UHFFFAOYSA-N guanidinium chloride Chemical compound [Cl-].NC(N)=[NH2+] PJJJBBJSCAKJQF-UHFFFAOYSA-N 0.000 description 1
- 230000036541 health Effects 0.000 description 1
- 239000000185 hemagglutinin Substances 0.000 description 1
- 229920006253 high performance fiber Polymers 0.000 description 1
- HNDVDQJCIGZPNO-UHFFFAOYSA-N histidine Natural products OC(=O)C(N)CC1=CN=CN1 HNDVDQJCIGZPNO-UHFFFAOYSA-N 0.000 description 1
- 230000001744 histochemical effect Effects 0.000 description 1
- 238000007654 immersion Methods 0.000 description 1
- 230000001900 immune effect Effects 0.000 description 1
- 210000000987 immune system Anatomy 0.000 description 1
- 238000003119 immunoblot Methods 0.000 description 1
- 230000007813 immunodeficiency Effects 0.000 description 1
- 230000002163 immunogen Effects 0.000 description 1
- 102000018358 immunoglobulin Human genes 0.000 description 1
- 229940072221 immunoglobulins Drugs 0.000 description 1
- 239000007943 implant Substances 0.000 description 1
- 239000012535 impurity Substances 0.000 description 1
- 238000001764 infiltration Methods 0.000 description 1
- 238000002329 infrared spectrum Methods 0.000 description 1
- 239000002198 insoluble material Substances 0.000 description 1
- 238000011835 investigation Methods 0.000 description 1
- BPHPUYQFMNQIOC-NXRLNHOXSA-N isopropyl beta-D-thiogalactopyranoside Chemical compound CC(C)S[C@@H]1O[C@H](CO)[C@H](O)[C@H](O)[C@H]1O BPHPUYQFMNQIOC-NXRLNHOXSA-N 0.000 description 1
- 238000011031 large-scale manufacturing process Methods 0.000 description 1
- 210000003041 ligament Anatomy 0.000 description 1
- 238000004811 liquid chromatography Methods 0.000 description 1
- 238000012006 liquid chromatography with tandem mass spectrometry Methods 0.000 description 1
- 239000004973 liquid crystal related substance Substances 0.000 description 1
- 210000004698 lymphocyte Anatomy 0.000 description 1
- 239000012139 lysis buffer Substances 0.000 description 1
- 210000002540 macrophage Anatomy 0.000 description 1
- 235000005739 manihot Nutrition 0.000 description 1
- 230000008774 maternal effect Effects 0.000 description 1
- 238000001840 matrix-assisted laser desorption--ionisation time-of-flight mass spectrometry Methods 0.000 description 1
- 230000001404 mediated effect Effects 0.000 description 1
- 229940127554 medical product Drugs 0.000 description 1
- 230000000442 meristematic effect Effects 0.000 description 1
- 229910001092 metal group alloy Inorganic materials 0.000 description 1
- 229930182817 methionine Natural products 0.000 description 1
- 125000001360 methionine group Chemical class N[C@@H](CCSC)C(=O)* 0.000 description 1
- 244000000010 microbial pathogen Species 0.000 description 1
- 210000003632 microfilament Anatomy 0.000 description 1
- 230000011278 mitosis Effects 0.000 description 1
- 230000004048 modification Effects 0.000 description 1
- 238000012986 modification Methods 0.000 description 1
- 235000013379 molasses Nutrition 0.000 description 1
- 238000001823 molecular biology technique Methods 0.000 description 1
- 238000000302 molecular modelling Methods 0.000 description 1
- 229910052759 nickel Inorganic materials 0.000 description 1
- LGQLOGILCSXPEA-UHFFFAOYSA-L nickel sulfate Chemical compound [Ni+2].[O-]S([O-])(=O)=O LGQLOGILCSXPEA-UHFFFAOYSA-L 0.000 description 1
- 229910000363 nickel(II) sulfate Inorganic materials 0.000 description 1
- 235000001968 nicotinic acid Nutrition 0.000 description 1
- 229920001220 nitrocellulos Polymers 0.000 description 1
- 238000001668 nucleic acid synthesis Methods 0.000 description 1
- 239000002777 nucleoside Substances 0.000 description 1
- 239000002751 oligonucleotide probe Substances 0.000 description 1
- 238000002515 oligonucleotide synthesis Methods 0.000 description 1
- 210000000287 oocyte Anatomy 0.000 description 1
- 238000005457 optimization Methods 0.000 description 1
- 230000008775 paternal effect Effects 0.000 description 1
- 238000012567 pattern recognition method Methods 0.000 description 1
- 239000008188 pellet Substances 0.000 description 1
- 239000012071 phase Substances 0.000 description 1
- 150000003904 phospholipids Chemical class 0.000 description 1
- 150000008300 phosphoramidites Chemical class 0.000 description 1
- 230000000243 photosynthetic effect Effects 0.000 description 1
- 230000004962 physiological condition Effects 0.000 description 1
- 229930195732 phytohormone Natural products 0.000 description 1
- 239000000419 plant extract Substances 0.000 description 1
- 229920002401 polyacrylamide Polymers 0.000 description 1
- 238000002264 polyacrylamide gel electrophoresis Methods 0.000 description 1
- 108010054442 polyalanine Proteins 0.000 description 1
- 229920001223 polyethylene glycol Polymers 0.000 description 1
- 230000001124 posttranscriptional effect Effects 0.000 description 1
- 244000062645 predators Species 0.000 description 1
- 230000007425 progressive decline Effects 0.000 description 1
- 230000035755 proliferation Effects 0.000 description 1
- ZMRUPTIKESYGQW-UHFFFAOYSA-N propranolol hydrochloride Chemical compound [H+].[Cl-].C1=CC=C2C(OCC(O)CNC(C)C)=CC=CC2=C1 ZMRUPTIKESYGQW-UHFFFAOYSA-N 0.000 description 1
- 230000012846 protein folding Effects 0.000 description 1
- 238000001742 protein purification Methods 0.000 description 1
- 230000030788 protein refolding Effects 0.000 description 1
- 239000012460 protein solution Substances 0.000 description 1
- 230000002797 proteolythic effect Effects 0.000 description 1
- 229940024999 proteolytic enzymes for treatment of wounds and ulcers Drugs 0.000 description 1
- 235000014774 prunus Nutrition 0.000 description 1
- 239000013014 purified material Substances 0.000 description 1
- 239000002994 raw material Substances 0.000 description 1
- 238000003259 recombinant expression Methods 0.000 description 1
- 238000011084 recovery Methods 0.000 description 1
- 230000002787 reinforcement Effects 0.000 description 1
- 230000003362 replicative effect Effects 0.000 description 1
- 239000002336 ribonucleotide Substances 0.000 description 1
- 125000002652 ribonucleotide group Chemical group 0.000 description 1
- 230000007017 scission Effects 0.000 description 1
- 230000003248 secreting effect Effects 0.000 description 1
- 239000013606 secretion vector Substances 0.000 description 1
- 238000010206 sensitivity analysis Methods 0.000 description 1
- 230000035939 shock Effects 0.000 description 1
- 239000000344 soap Substances 0.000 description 1
- 229910052708 sodium Inorganic materials 0.000 description 1
- 239000007790 solid phase Substances 0.000 description 1
- 230000007928 solubilization Effects 0.000 description 1
- 238000005063 solubilization Methods 0.000 description 1
- 239000002904 solvent Substances 0.000 description 1
- 230000000392 somatic effect Effects 0.000 description 1
- 239000004334 sorbic acid Substances 0.000 description 1
- 238000001228 spectrum Methods 0.000 description 1
- 150000003408 sphingolipids Chemical class 0.000 description 1
- 108010028210 spidroin 1 Proteins 0.000 description 1
- 238000005507 spraying Methods 0.000 description 1
- 239000003381 stabilizer Substances 0.000 description 1
- 238000010561 standard procedure Methods 0.000 description 1
- 230000003068 static effect Effects 0.000 description 1
- 239000010959 steel Substances 0.000 description 1
- 238000003756 stirring Methods 0.000 description 1
- 235000000346 sugar Nutrition 0.000 description 1
- 150000008163 sugars Chemical class 0.000 description 1
- 239000006228 supernatant Substances 0.000 description 1
- 230000004083 survival effect Effects 0.000 description 1
- 230000005469 synchrotron radiation Effects 0.000 description 1
- 230000002194 synthesizing effect Effects 0.000 description 1
- 229920001059 synthetic polymer Polymers 0.000 description 1
- 230000009897 systematic effect Effects 0.000 description 1
- 210000002435 tendon Anatomy 0.000 description 1
- 238000004154 testing of material Methods 0.000 description 1
- QGHREAKMXXNCOA-UHFFFAOYSA-N thiophanate-methyl Chemical compound COC(=O)NC(=S)NC1=CC=CC=C1NC(=S)NC(=O)OC QGHREAKMXXNCOA-UHFFFAOYSA-N 0.000 description 1
- 230000000699 topical effect Effects 0.000 description 1
- 230000005026 transcription initiation Effects 0.000 description 1
- 238000012250 transgenic expression Methods 0.000 description 1
- 238000011830 transgenic mouse model Methods 0.000 description 1
- 230000007704 transition Effects 0.000 description 1
- QORWJWZARLRLPR-UHFFFAOYSA-H tricalcium bis(phosphate) Chemical compound [Ca+2].[Ca+2].[Ca+2].[O-]P([O-])([O-])=O.[O-]P([O-])([O-])=O QORWJWZARLRLPR-UHFFFAOYSA-H 0.000 description 1
- 239000001226 triphosphate Substances 0.000 description 1
- 235000011178 triphosphate Nutrition 0.000 description 1
- 241000701447 unidentified baculovirus Species 0.000 description 1
- 235000015112 vegetable and seed oil Nutrition 0.000 description 1
- 239000008158 vegetable oil Substances 0.000 description 1
- 230000029812 viral genome replication Effects 0.000 description 1
- 230000001018 virulence Effects 0.000 description 1
- 238000002424 x-ray crystallography Methods 0.000 description 1
Images
Classifications
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K14/00—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof
- C07K14/435—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from animals; from humans
- C07K14/43504—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from animals; from humans from invertebrates
- C07K14/43513—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from animals; from humans from invertebrates from arachnidae
- C07K14/43518—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from animals; from humans from invertebrates from arachnidae from spiders
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61P—SPECIFIC THERAPEUTIC ACTIVITY OF CHEMICAL COMPOUNDS OR MEDICINAL PREPARATIONS
- A61P17/00—Drugs for dermatological disorders
- A61P17/02—Drugs for dermatological disorders for treating wounds, ulcers, burns, scars, keloids, or the like
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61P—SPECIFIC THERAPEUTIC ACTIVITY OF CHEMICAL COMPOUNDS OR MEDICINAL PREPARATIONS
- A61P31/00—Antiinfectives, i.e. antibiotics, antiseptics, chemotherapeutics
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61K—PREPARATIONS FOR MEDICAL, DENTAL OR TOILETRY PURPOSES
- A61K38/00—Medicinal preparations containing peptides
Landscapes
- Health & Medical Sciences (AREA)
- Life Sciences & Earth Sciences (AREA)
- Chemical & Material Sciences (AREA)
- Organic Chemistry (AREA)
- Insects & Arthropods (AREA)
- Medicinal Chemistry (AREA)
- General Health & Medical Sciences (AREA)
- Biochemistry (AREA)
- Genetics & Genomics (AREA)
- Proteomics, Peptides & Aminoacids (AREA)
- Molecular Biology (AREA)
- Biophysics (AREA)
- Gastroenterology & Hepatology (AREA)
- Zoology (AREA)
- Toxicology (AREA)
- Tropical Medicine & Parasitology (AREA)
- General Chemical & Material Sciences (AREA)
- Nuclear Medicine, Radiotherapy & Molecular Imaging (AREA)
- Public Health (AREA)
- Pharmacology & Pharmacy (AREA)
- Animal Behavior & Ethology (AREA)
- Chemical Kinetics & Catalysis (AREA)
- Veterinary Medicine (AREA)
- Communicable Diseases (AREA)
- Engineering & Computer Science (AREA)
- Bioinformatics & Cheminformatics (AREA)
- Dermatology (AREA)
- Oncology (AREA)
- Micro-Organisms Or Cultivation Processes Thereof (AREA)
- Peptides Or Proteins (AREA)
- Preparation Of Compounds By Using Micro-Organisms (AREA)
Abstract
Description
- a. Os primeiros estudos para utilização industrial da seda se concentraram principalmente na análise de proteínas de duas espécies: Nephila clavipes e Araneus diadematus. A seda linha de segurança, isolada dessas duas espécies é a mais estudada entre todas as fibras sintetizadas por aranhas. A linha de segurança é formada por dois tipos de proteínas produzidas pela glândula “major ampullate”, denominadas de MaSp1 e MaSp 2 (Major Ampullate Spidroin) na N. clavipes, e ADF-3 e ADF-4 na A. diadematus (Araneus Diadematus Fibroin) (Hinman M.B., Lewis, R.V. 1992. Isolation of a clone encoding a second dragline silk fibroin, Nephila clavipes dragline silk is a two protein fiber. J. Biol. Chem. 267:19320-19324; Guerette P., Ginzinger D., Weber B., Gosline J. 1996. Silk properties determined by gland-specific expression of a spider fibroin gene family. Science 272:112-115; Beckwitt R., Arcidiacono S. 1994. Sequence conservation in the C- terminal region of spider silk proteins (Spidroin) from Nephila clavipes (Tetragnathidae) and Araneus bicentenarius (Araneidae). J. Biol. Chem. 269:6661-6663, Beckwit R., Arcidiacono S., Stote R. 1998. Evolution of repetitive proteins: spider silks from Nephila clavipes (Tetragnathidae) and Araneus bicentarius (Araneidae). Insect. Biochem. Molec. 28:121-130). As proteínas da linha de segurança possuem massa molecular entre 180 kDa e 720 kDa, dependendo das condições de análise (Mello C.M., Senecal K. Yeung B., Vouros P., Kaplan D.I. 1994. Initial characterization of Nephila clavipes dragline protein. In: Kaplan D. L. Adams W.W Farmer B. Viney C. (Eds.). Silk Polymers: Materials Science and Biotechnology. American Chemical Society Symposium Series. 544:67-79). De acordo com a composição de aminoácidos destas proteínas, acredita-se que a proporção molecular entre MaSp1 e MaSp2, e entre ADF-4 e ADF-3 seja de aproximadamente 3:1 na fibra linha de segurança (Hinman M.B., Lewis, R.V. 1992. Isolation of a clone encoding a second dragline silk fibroin, Nephila clavipes dragline silk is a two protein fiber. J. Biol. Chem. 267:19320-19324; Lombardi S.J., Kaplan D.L. 1990. The amino acid composition of major ampullate gland silk (dragline) of Nephila clavipes (Araneae, Tetragnathidae). J. Arachnol. 18:297-306; Guerette P., Ginzinger D., Weber B., Gosline J. 1996. Silk properties determined by gland-specific expression of a spider fibroin gene family. Science 272:112-115). Embora produzidas em espécies diferentes, as proteínas da glândula “major ampullate” possuem em sua composição um alto número de repetições dos mesmos aminoácidos. Em MaSp2 e ADF-3, por exemplo, glicina, alanina, prolina, serina e tirosina são responsáveis por até 99% dos aminoácidos presentes na sua estrutura (Hayashi C.Y., Lewis R.V. 1998. Evidence from flagelliform silk. cDNA for the structural basis of elasticity and modular nature of spider silks. J. Mol. Biol. 275:773-784).
- a. seqüências substancialmente similares a qualquer uma das seqüências selecionadas do grupo identificado como SEQ ID NO 1-19;
- b. complementos das seqüências descritas em SEQ ID NO1-19;
- c. complementos reversos das seqüências descritas em SEQ ID NO1-19;
- d. seqüências reversas das seqüências descritas em SEQ ID NO1-19.
um promotor opcionalmente ligado a uma seqüência líder e operacionalmente ligado a; uma seqüência codificadora substancialmente similar à qualquer uma das seqüências identificadas como SEQ ID NO1-19.
- a. um promotor opcionalmente ligado a uma seqüência líder e operacionalmente ligado a;
- b. uma seqüência codificadora substancialmente similar à qualquer uma das seqüências identificadas como SEQ ID NO1-19 operacionalmente ligada a;
- c. um sinal de terminação;
- d. uma origem de replicação;
- e. um marcador seletivo; e
- f. um sítio de clonagem.
- a. transformar uma célula, tecido, órgão ou embrião com um gene quimérico de acordo com qualquer uma das reivindicações 3 a 11 ou um vetor de expressão de acordo com qualquer uma das reivindicações 12 a 23;
- b. selecionar células transformadas, calos de células, embriões ou sementes;
- c. regenerar plantas maduras, embriões maduros ou microorganismos de células transformadas, calos de células, embriões ou sementes selecionados na etapa (b);
- d. selecionar plantas maduras, embriões maduros ou células de microorganismos da etapa (c) contendo o gene quimérico ou vetor de expressão com as seqüências de nucleotídeos que codificam a proteína da seda da aranha.
- a. transformar uma célula, tecido, órgão ou embrião com um vetor de expressão de acordo com qualquer uma das reivindicações 12 a 23;
- b. selecionar células transformadas, calos de células, embriões ou sementes;
- c. regenerar plantas maduras, embriões maduros ou microorganismos de células transformadas, calos de células, embriões ou sementes selecionados na etapa (b);
- d. selecionar plantas maduras, embriões maduros ou células de microorganismos da etapa (c) contendo vetor de expressão com as seqüências de nucleotídeos que codificam a proteína da seda da aranha;
- e. Fazer a extração da proteína recombinante da seda de aranha produzida nos organismos selecionados na etapa (d).
- a. Proteína recombinante de acordo com a reivindicação 42;
- b. Veículo farmaceuticamente aceitável.
- a. Proteína recombinante de acordo com a reivindicação 43;
- b. Veículo agriculturalmente aceitável e, opcionalmente,
- c. Aditivos.
- a. Tm = 81,5ºC + 16,6 Log [Na+] + 0,41 (%G+C) – 0,63 (% formamida)-600/pb no duplex (sonda)
- b. Como ilustração da fórmula acima, usando [Na+] = [0,368] e 50% de formamida, com conteúdo de GC de 42% e um tamanho de sonda médio de 200 bases, a Tm será de 57ºC.
- a. “Microorganismos” referem-se a organismos microscópicos tais como bactérias, vírus, fungos e protozoários. Preferencialmente a presente invenção tem como microorganismos os organismos escolhidos do grupo das bactérias e fungos. “Bactérias” referem-se a organismos procariotos, com exceção das cianofíceas. Os ácidos nucleicos da invenção podem ser utilizados para conferir tratos desejados em essencialmente qualquer bacteria. Então, a invenção possui uso sobre várias espécies de bacterias, que incluem mas não estão limitadas ao grupo das Actinobacteria, Aquificae, Bacteroidetes/grupo Chlorobi, Chlamydiae/ grupo Verrucomicrobia, Chloroflexi, Chrysiogenetes, Cyanobacteria, Gloeobacteria, Nostocales, Oscillatoriales, Pleurocapsales, Prochlorales, Stigonematales, Deferribacteres, Deinococcus-Thermus, Dictyoglomi, Fibrobacteres/grupo Acidobacteria, Firmicutes, Fusobacteria, Gemmatimonadetes, Nitrospirae, Planctomycetes, Proteobacteria, Spirochaetes, Thermodesulfobacteria, Thermotogae. “Fungos” referem-se a organismos do reino Fungi que podem ser unicelulares ou pluricelulares. Os ácidos nucleicos da invenção podem ser utilizados para conferir tratos desejados em essencialmente qualquer fungo. Então, a invenção possui uso sobre várias espécies de fungos, que incluem mas não estão limitadas ao grupo dos Ascomycota e Basidiomycota. Preferencialmente a presente invenção utiliza espécies de microorganismos selecionadas dos gêneros Aspergillus, Bacillus, Escherichia, Pichia, Saccharomyces ou Estreptomyces.
- a. Em um aspecto particular da invenção, são providas seqüências de ácidos nucleicos que codificam proteínas da seda relacionadas principalmente, mas não limitando-se à glândula Minor Ampullate. Exemplos de seqüências de ácidos nucleicos que estão relacionadas com essa glândula compreendem SEQ ID NOs 4, 5, 6 e 16.
- a. A invenção também discorre sobre composições dermatológicas caracterizadas por apresentarem:
- b. Proteína recombinante de seda de aranha;
- c. Veículo farmaceuticamente aceitável.
- a. Proteína recombinante de seda de aranha;
- b. Veículo agriculturalmente aceitável e, opcionalmente,
- c. Aditivos
- a. transformar uma célula, tecido, órgão ou embrião com uma construção gênica de acordo com qualquer uma das reivindicações 3 a 11 ou um vetor de expressão de acordo com qualquer uma das reivindicações 12 a 23;
- b. selecionar células transformadas, calos de células, embriões ou sementes;
- c. regenerar plantas maduras, embriões maduros ou microorganismos de células transformadas, calos de células, embriões ou sementes selecionados na etapa (b);
- d. selecionar plantas maduras, embriões maduros ou células de microorganismos da etapa (c) contendo a construção gênica ou vetor de expressão com as seqüências de nucleotídeos que codificam a proteína da seda da aranha.
- a. transformar uma célula, tecido, órgão ou embrião com um vetor de expressão de acordo com qualquer uma das reivindicações 12 a 23;
- b. selecionar células transformadas, calos de células, embriões ou sementes;
- c. regenerar plantas maduras, embriões maduros ou microorganismos de células transformadas, calos de células, embriões ou sementes selecionados na etapa (b);
- d. selecionar plantas maduras, embriões maduros ou células de microorganismos da etapa (c) contendo vetor de expressão com as seqüências de nucleotídeos que codificam a proteína da seda da aranha;
- e. Fazer a extração da proteína recombinante da seda de aranha produzida nos organismos selecionados na etapa (d).
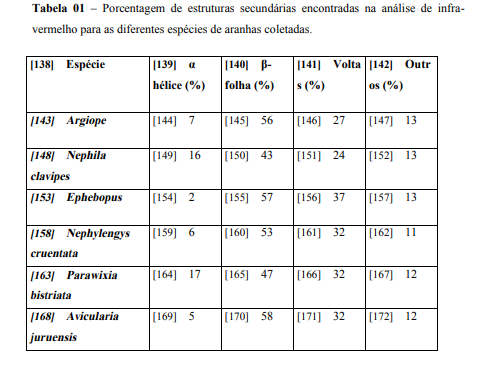
σ (stress)=F/A, onde F é a força aplicada e A área da secção transversal.
ε (strain)=ΔL/L0, onde ΔL é a mudança no comprimento da fibra e L0 é o comprimento inicial.
Y (stiffness or Young’s modulus)= σ/ ε
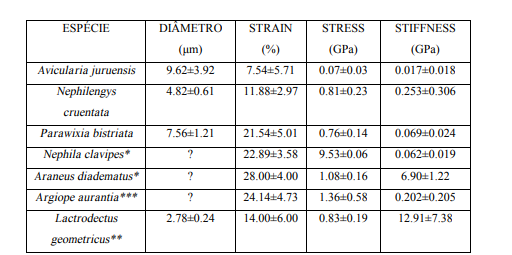
- 1. gi|7106228|gb|AAF36091.1
- 2. gi|7106224|gb|AAF36090.1
- 3. gi|2833649|gb|AAC38847.1
- 4. gi|13561982|gb|AAK30594.1
- 5. gi|2833647|gb|AAC38846.1
- 6. gi|70913024|gb|AAZ15322.1
- 7. gi|13562004|gb|AAK30605.1
- 8. gi|93138993|gb|ABE99838.1
- 9. gi|7106229|gb|AAF36092.1
- 10. gi|89276819|gb|ABD66603.1
Tabela 1: Porcentagem de discrepância de aminoácidos entre os alinhamentos par a-par de 11 seqüências relacionadas à SEQ ID NO 1. “SI 1” indica a SEQ ID NO 1. Os números que identificam linhas e colunas correspondem aos números da lista das seqüências encontradas no estado da técnica descritos anteriormente. O número encontrado no cruzamento de uma linha com uma coluna representa o percentual de discrepância observado no alinhamento das duas seqüências. Destacado com asterisco encontra-se a maior semelhança observada entre SEQ ID NO 1 e seqüências já descritas.
Valores sublinhados representam semelhanças entre seqüências já descritas maiores que a encontrada para SEQ ID NO 1. Apenas metade da tabela está preenchida porque os valores são recíprocos.
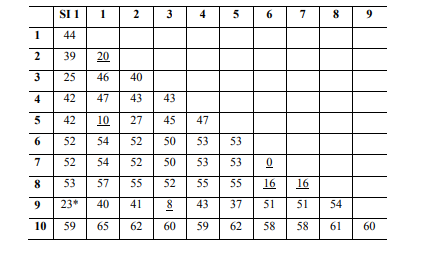
- 1. gi|83758427
- 2. gi|68342501
- 3. gi|89365776
- 4. gi|89365774
- 5. gi|63054329
- 6. gi|61387244
- 7. gi|70927654
- 8. gi|63054327
- 9. gi|61387237
- 10. gi|61387234
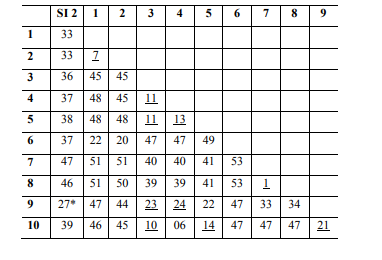
- 1. gi|83758427
- 2. gi|68342501
- 3. gi|89365776
- 4. gi|89365774
- 5. gi|63054329
- 6. gi|61387244
- 7. gi|70927654
- 8. gi|63054327
- 9. gi|61387237
- 10. gi|61387234

- 1. gi|2605800|
- 2. gi|85680899
- 3. gi|2605798|
- 4. gi|50363143
- 5. gi|50363141
- 6. gi|50363145
- 7. gi|2911274|
- 8. gi|50363137
- 9. gi|13561992
- 10. gi|50363139
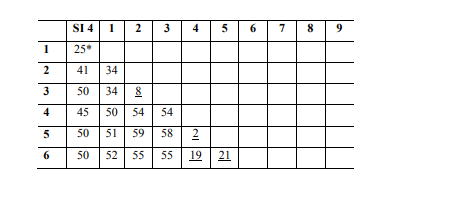

- 1. gi|2605798
- 2. gi|8572061
- 3. gi|765323
- 4. gi|27228959
- 5. gi|47007923
- 6. gi|47007963
- 7. gi|13561992
- 8. gi|108707764
- 9. gi|89276817
- 10. gi|2914731

- 1. gi|85680899
- 2. gi|2605798|
- 3. gi|89113992
- 4. gi|13562018
- 5. gi|63054333
- 6. gi|63054353
- 7. gi|63054329
- 8. gi|61387237
- 9. gi|13561994
- 10. gi|89365776
O número encontrado no cruzamento de uma linha com uma coluna representa o percentual de discrepância observado no alinhamento das duas seqüências. Destacado com asterisco encontra-se a maior semelhança observada entre SEQ ID NO 6 e seqüências já descritas. Os valores sublinhados representam as semelhanças entre seqüências já descritas maiores que a encontrada para SEQ ID NO 6. Apenas metade da tabela está preenchida porque os valores são recíprocos.

- 1. gi|63054331
- 2. gi|6984160|
- 3. gi|70905642
- 4. gi|89365776
- 5. gi|70905641
- 6. gi|63054329
- 7. gi|70905643
- 8. gi|14973269
- 9. gi|13562018
- 10. gi|8885520|
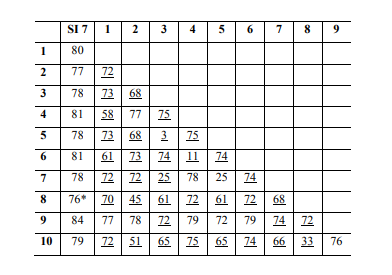
- 1. gi|89512121
- 2. gi|41019463
- 3. gi|41019465
- 4. gi|77158011
- 5. gi|90192368
- 6. gi|33348850
- 7. gi|62275780
- 8. gi|57792507
- 9. gi|49458046
- 10. gi|49458052

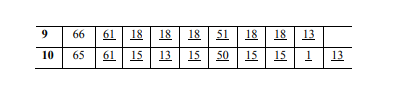
- 1. gi|17536963
- 2. gi|50548483
- 3. gi|76580883
- 4. gi|52428273
- 5. gi|52209673
- 6. gi|71416355
- 7. gi|89276819
- 8. gi|13562018
- 9. gi|71654760
- 10. gi|109511662

- 1. gi|68171564
- 2. gi|17536963
- 3. gi|89276819
- 4. gi|38197745
- 5. gi|13562020
- 6. gi|38197743
- 7. gi|83758429
- 8. gi|71416355
- 9. gi|70913022
- 10. gi|1263289
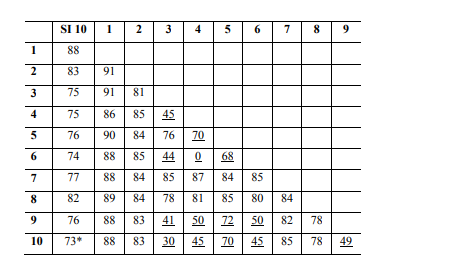
- 1. gi|1405387
- 2. gi|38197749
- 3. gi|38197751
- 4. gi|38197745
- 5. gi|50309199
- 6. gi|38197755
- 7. gi|38197759
- 8. gi|38197747
- 9. gi|50423563
- 10. gi|38197757

Tabela 12: Porcentagem de discrepância de aminoácidos entre os alinhamentos para-par de 11 seqüências relacionadas à SEQ ID NO 12. “SI 12” indica a SEQ ID NO 12. Os números que identificam linhas e colunas correspondem aos números da lista acima. O número encontrado no cruzamento de uma linha com uma coluna representa o percentual de discrepância observado no alinhamento das duas seqüências. Destacado com asterisco encontra-se a maior semelhança observada entre SEQ ID NO 12 e seqüências já descritas. Os valores sublinhados representam as semelhanças entre seqüências já descritas maiores que a encontrada para SEQ ID NO 12. Apenas metade da tabela está preenchida porque os valores são recíprocos.
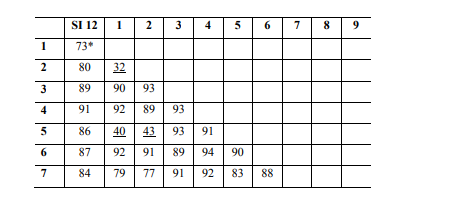
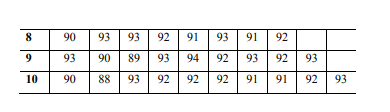
- 1. gi|22074292
- 2. gi|15021422
- 3. gi|88713113
- 4. gi|55593156
- 5. gi|82539404
- 6. gi|109467082
- 7. gi|3236370
- 8. gi|6677817
- 9. gi|71992048
- 10. gi|62175305|
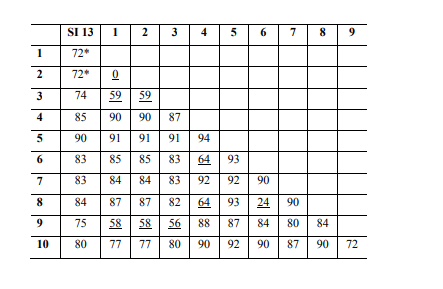
- 1. gi|49871101
- 2. gi|89114010
- 3. gi|44980633
- 4. gi|40787372
- 5. gi|58864899
- 6. gi|82936154
- 7. gi|16741397
- 8. gi|7243103
- 9. gi|11596144
- 10. gi|45439370
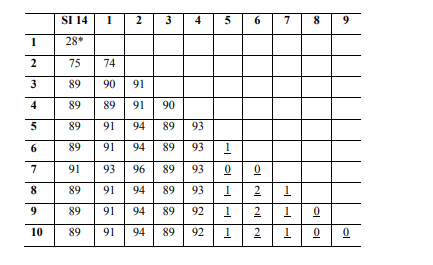
- 1. gi|62465589
- 2. gi|27228957
- 3. gi|13561980
- 4. gi|109500095
- 5. gi|47606845
- 6. gi|5921193
- 7. gi|51975245
- 8. gi|3236370
- 9. gi|109487472
- 10. gi|47219204
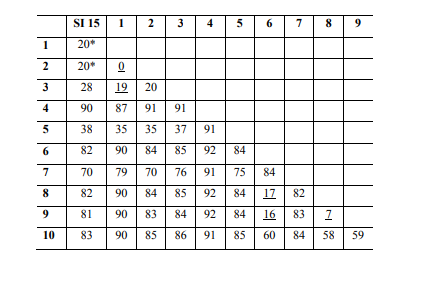
- 1. gi|1405387
- 2. gi|88175701
- 3. gi|17507879
- 4. gi|55619549
- 5. gi|71026577
- 6. gi|50902080
- 7. gi|66805291
- 8. gi|71408138
- 9. gi|50931795
- 10. gi|55274106
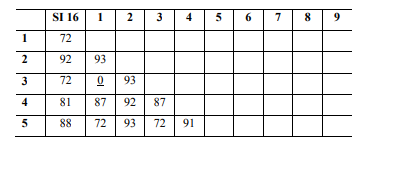
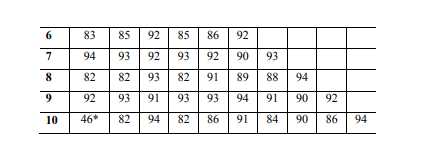
- 1. gi|47569234
- 2. gi|32815671
- 3. gi|49329892
- 4. gi|51975246
- 5. gi|42782789
- 6. gi|109500095
- 7. gi|55274104
- 8. gi|55274084
- 9. gi|50363145
- 10. gi|1263285
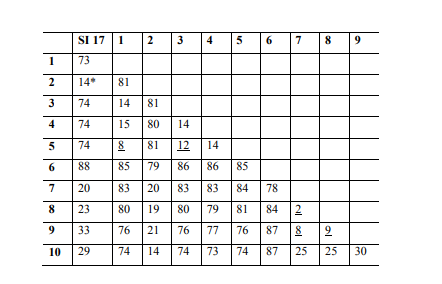
- 1. gi|70913022
- 2. gi|32815671
- 3. gi|55274104
- 4. gi|55274080
- 5. gi|55274092
- 6. gi|55274136
- 7. gi|55274128
- 8. gi|55274086
- 9. gi|38197745
- 10. gi|55274082
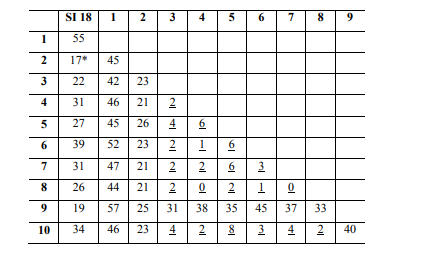
- 1. gi|1399945
- 2. gi|70913022
- 3. gi|17507879
- 4. gi|55274080
- 5. gi|55274086
- 6. gi|55274136
- 7. gi|55274128
- 8. gi|55274112
- 9. gi|55274138
- 10. gi|55274092
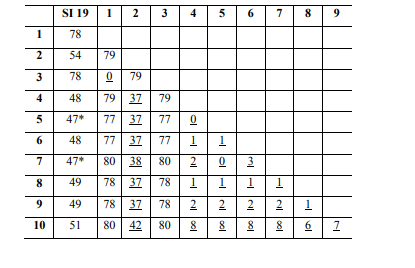
Claims (32)
- Gene quimérico caracterizado por compreender:
- a) um promotor opcionalmente ligado a uma seqüência líder e operacionalmente ligado a;
- b) uma seqüência codificadora selecionada do grupo SEQ ID NO 1 a 19.
- Gene quimérico de acordo com a reivindicação 1 caracterizado pelo fato de o promotor ser selecionado do grupo consistindo de constitutivos, induzíveis e tecidoespecíficos.
- Gene quimérico de acordo com a reivindicação 2 caracterizado pelo fato de o promotor tecido-específico ser selecionado entre promotores de genes de fibra de algodão.
- Gene quimérico de acordo com a reivindicação 3 caracterizado pelo fato de os promotores de genes de fibra de algodão serem selecionados do grupo consistindo de E6, H6S, Rac13, LTP, ACP, Expansina, CAP, Anexina, FbL2A e actina 2.
- Gene quimérico de acordo com a reivindicação 1 caracterizado pelo fato de o promotor conter elementos potencializadores.
- Gene quimérico de acordo com a reivindicação 1 caracterizado pelo fato de o promotor poder ser expresso em plantas, animais, bactérias, fungos ou insetos.
- Gene quimérico de acordo com a reivindicação 1 caracterizado pelo fato de a seqüência líder ser obtida do mesmo gene que o promotor utilizado para dirigir a transcrição da molécula isolada de ácido nucleico.
- Vetor de expressão caracterizado por conter um gene quimérico de acordo com qualquer uma das reivindicações 1 a 7.
- Vetor de expressão caracterizado por compreender:
- a) um promotor opcionalmente ligado a uma seqüência líder e operacionalmente ligado a;
- b) uma sequência codificadora selecionada do grupo SEQ ID NO 1 a 19 operacionalmente ligada a;
- c) um sinal de terminação;
- d) uma origem de replicação;
- e) um marcador seletivo; e
- f) um sítio de clonagem
- Vetor de expressão de acordo com a reivindicação 9 caracterizado pelo fato de o promotor ser selecionado do grupo consistindo de constitutivos, induzíveis e tecidoespecíficos.
- Vetor de expressão de acordo com a reivindicação 10 caracterizado pelo fato de o promotor tecido-específico ser selecionado entre promotores de genes de fibra de algodão.
- Vetor de expressão de acordo com a reivindicação 11 caracterizado pelo fato de os promotores de genes de fibra de algodão serem selecionados do grupo consistindo de E6, H6S, Rac13, LTP, ACP, Expansina, CAP, Anexina, FbL2A e actina 2.
- Vetor de expressão de acordo com qualquer uma das reivindicações 8 a 12 caracterizado pelo fato de o promotor conter elementos potencializadores.
- Vetor de expressão de acordo com a reivindicação 9 caracterizado pelo fato de a sequência líder ser obtida do mesmo gene que o promotor utilizado para dirigir a transcrição da molécula isolada de ácido nucleico.
- Vetor de expressão de acordo com a revindicação 14 caracterizado pelo fato de a seqüência líder ser obtida do mesmo gene que o promotor utilizado para dirigir a transcrição da molécula de ácido nucleico.
- Vetor de expressão de acordo com a reivindicação 9 caracterizado pelo fato de o promotor poder ser expresso em plantas, animais, bactérias, fungos ou insetos.
- Vetor de expressão de acordo com a reivindicação 9 caracterizado pelo fato de o sinal de terminação ser selecionado do grupo sinal de terminação de SV40, sinal de adenilação de HSV TK, sinal de terminação do gene da nopalina sintetase de Agrobacterium tumefasciens (NOS), sinal de terminação do gene da octopina sintetase, sinal de terminação do gene 19S e 35S do CaMV, sinal de terminação do gene da álcool desidrogenase de milho, sinal de terminação do gene da manopina sintetase, sinal de terminação do gene da beta-faseolina, sinal de terminação do gene da ssRUBISCO, sinal de terminação do gene da sucrose sintetase, sinal de terminação do vírus que ataca o Trifolium subterranean (SCSV), sinal de terminação do gene trpC de Aspergillus nidulans e outros semelhantes.
- Vetor de expressão de acordo com a reivindicação 9 caracterizado pelo fato de o marcador seletivo ser selecionado entre seqüências que conferem resistência a antibióticos ou marcadores visuais.
- Vetor de expressão de acordo com a reivindicação 18 caracterizado pelo fato de o marcador seletivo ser selecionado entre as seqüências codificadoras dos genes canamicina, neomicina, ampicilina, cloranfenicol, estreptomicina, higromicina, geneticina, fosfinotricina, glifosato, glufosinato de amônio, AHAS, BAR e GUS.
- Célula transformada oriunda de qualquer um dos grupos consistindo de bactérias ou fungos caracterizada pelo fato de conter um gene quimérico de acordo com qualquer uma das reivindicações 1 a 7.
- Célula transformada oriunda de qualquer um dos grupos consistindo de bactérias ou fungos caracterizada pelo fato de conter um vetor de expressão de acordo com qualquer uma das reivindicações 9 a 20.
- Célula transformada oriunda de qualquer um dos grupos consistindo de bactérias ou fungos caracterizada pelo fato de conter uma molécula de proteína recombinante compreendendo qualquer uma das sequências selecionadas do grupo identificado como SEQ ID NO 20 a 38.
- Microrganismo ou uma parte do mesmo caracterizado por compreender um gene quimérico de acordo com qualquer uma das reivindicações 1 a 8.
- Microrganismo ou uma parte do mesmo caracterizado por compreender um vetor de expressão de acordo com qualquer uma das reivindicações 8 a 19.
- Método para produzir um organismo geneticamente modificado caracterizado pelo fato de compreender as seguintes etapas:
- a) transformar uma célula, tecido, órgão ou embrião com um gene quimérico de acordo com qualquer uma das reivindicações 1 a 7 ou um vetor de expressão de acordo com qualquer uma das reivindicações 8 a 19;
- b) selecionar células transformadas, calos de células, embriões ou sementes;
- c) regenerar plantas maduras, embriões maduros ou microorganismos de células transformadas, calos de células, embriões ou sementes selecionados na etapa (b);
- d) selecionar plantas maduras, embriões maduros ou células de microorganismos da etapa (c) contendo o gene quimérico ou vetor de expressão com as seqüências de nucleotídeos que codificam a proteína da seda da aranha.
- Método para produção de proteína recombinante caracterizado pelo fato de compreender as seguintes etapas:
- a) transformar uma célula, tecido, órgão ou embrião com um vetor de expressão de acordo com qualquer uma das reivindicações 8 a 19;
- b) selecionar células transformadas, calos de células, embriões ou sementes;
- c) regenerar plantas maduras, embriões maduros ou microorganismos de células transformadas, calos de células, embriões ou sementes selecionados na etapa (b);
- d) selecionar plantas maduras, embriões maduros ou células de microorganismos da etapa (c) contendo vetor de expressão com as seqüências de nucleotídeos que codificam a proteína da seda da aranha;
- e) Fazer a extração da proteína recombinante da seda de aranha produzida nos organismos selecionados na etapa (d).
- Composição dermatológica caracterizada pelo fato de compreender:
- a) Proteína recombinante obtida pelo método descrito na reivindicação 26;
- b) Veículo farmaceuticamente aceitável.
- Composição dermatológica de acordo com a reivindicação 27 caracterizada pelo fato de o veículo farmaceuticamente aceitável ser selecionado do grupo consistindo de glicerol, água, solução salina, etano, solução com fosfatos e sais de ácidos orgânicos.
- Composição microbicida caracterizada pelo fato de compreender:
- a) Proteína recombinante obtida pelo método descrito na reivindicação 26 com atividade microbicida;
- b) Veículo agriculturalmente aceitável e, opcionalmente,
- c) Aditivos
- Composição microbicida de acordo com a reivindicação 29 caracterizada pelo fato de o veículo agriculturalmente aceitável ser selecionado do grupo consistindo de água, solventes orgânicos, umectantes, preservativos, espessantes, agentes antimicrobianos, antioxidantes, emulsificadores, polímeros formadores de filme e misturas destes.
- Composição microbicida de acordo com a reivindicação 30 caracterizada pelo fato de os aditivos serem selecionados do grupo consistindo de goma rosina, látex, pirrolidona polivinil, álcool polivinil, cloreto polivinil, polietileno, acetato de polivinil, metil, metalcrilato, e misturas destes.
- Biopolímeros produzidos a partir da proteína recombinante obtida de acordo com o método descrito na reivindicação 26.
Priority Applications (10)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| BRPI0701826-6A BRPI0701826B1 (pt) | 2007-03-16 | 2007-03-16 | proteínas da teia de aranha nephilengys cruentata, avicularia juruensis e parawixia bistriata isoladas da biodiversidade brasileira |
| PCT/BR2008/000072 WO2008113145A1 (en) | 2007-03-16 | 2008-03-13 | Proteins from the webs of nephilengys cruentata, avicularia juruensis and parawixia bistriata spiders |
| EP18178559.3A EP3434768A1 (en) | 2007-03-16 | 2008-03-13 | Proteins from the webs of nephilengys cruentata, avicularia juruensis and parawixia bistriata spiders |
| EP08714519A EP2126076A4 (en) | 2007-03-16 | 2008-03-13 | PROTEINS FROM THE NETWORKS OF SPIDERS NEPHILENGYS CRUENTATA, AVICULARIA JURUENSIS AND PARAWIXIA BISTRIATA |
| CN201711245428.2A CN108218972B (zh) | 2007-03-16 | 2008-03-13 | 来自Nephilengys Cruentata蜘蛛的网的蛋白 |
| CN200880015224A CN101679975A (zh) | 2007-03-16 | 2008-03-13 | 来自Nephilengys Cruentata蜘蛛、黄带粉趾食鸟蛛和Parawixia Bistriata蜘蛛的网的蛋白 |
| US12/531,664 US20100311645A1 (en) | 2007-03-16 | 2008-03-13 | Proteins from the webs of nephilengys cruentata, avicularia juruensis and parawixia bistriata spiders isolated from brazilian biodiversity |
| ARP080101091A AR065777A1 (es) | 2007-03-16 | 2008-03-14 | Proteinas de la telarana de nephilengys cruentata, avicularia juruensis y parawixia bistriata aisladas de la biodiversidad brasilera |
| US13/749,601 US10889624B2 (en) | 2007-03-16 | 2013-01-24 | Proteins from the webs of nephilengys cruentata, a vicularia juruensis and parawixia bistriata spiders isolated from brazilian biodiversity |
| HK18116693.6A HK1257458B (en) | 2007-03-16 | 2018-12-28 | Proteins from the webs of nephilengys cruentata spiders |
Applications Claiming Priority (1)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| BRPI0701826-6A BRPI0701826B1 (pt) | 2007-03-16 | 2007-03-16 | proteínas da teia de aranha nephilengys cruentata, avicularia juruensis e parawixia bistriata isoladas da biodiversidade brasileira |
Publications (2)
| Publication Number | Publication Date |
|---|---|
| BRPI0701826A BRPI0701826A (pt) | 2008-11-04 |
| BRPI0701826B1 true BRPI0701826B1 (pt) | 2021-02-17 |
Family
ID=39765310
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| BRPI0701826-6A BRPI0701826B1 (pt) | 2007-03-16 | 2007-03-16 | proteínas da teia de aranha nephilengys cruentata, avicularia juruensis e parawixia bistriata isoladas da biodiversidade brasileira |
Country Status (6)
| Country | Link |
|---|---|
| US (2) | US20100311645A1 (pt) |
| EP (2) | EP2126076A4 (pt) |
| CN (2) | CN101679975A (pt) |
| AR (1) | AR065777A1 (pt) |
| BR (1) | BRPI0701826B1 (pt) |
| WO (1) | WO2008113145A1 (pt) |
Families Citing this family (12)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| CA2759465C (en) | 2009-04-22 | 2017-12-12 | Spiber Technologies Ab | Method of producing polymers of spider silk proteins |
| EP3168229B1 (en) | 2010-03-18 | 2019-06-19 | Spiber Technologies AB | Production of proteins and polypeptides |
| CN107190017A (zh) * | 2010-09-28 | 2017-09-22 | 圣母大学 | 嵌合蜘蛛丝及其用途 |
| BRPI1102841B1 (pt) * | 2011-06-08 | 2018-11-21 | Empresa Brasileira De Pesquisa Agropecuaria Embrapa | MUTANTES DE INIBIDORES DE ALFA AMILASES ISOLADOS DE Phaseolus vulgaris COM PROPRIEDADES DE CONTROLAR INSETOS-PRAGA, COMPOSIÇÕES CONTENDO TAIS MUTANTES E MÉTODOS DE OBTENÇÃODOS MESMOS E DE LINHAGENS TRANSGÊNICAS |
| WO2014026345A1 (zh) * | 2012-08-16 | 2014-02-20 | 东华大学 | 一种提取大腹园蛛MiSp全长基因及全长基因表达的方法 |
| WO2017115005A1 (en) | 2015-12-29 | 2017-07-06 | Teknologian Tutkimuskeskus Vtt Oy | Production of fusion proteins in trichoderma |
| CN105777885B (zh) * | 2016-04-11 | 2019-07-09 | 中南大学 | 一种新疆穴居狼蛛Lycosa singoriensis抗菌肽及应用 |
| CN107805283B (zh) * | 2017-11-10 | 2021-01-15 | 井冈山大学 | 一种拟蛛丝蛋白及其生物合成方法 |
| EP4544912A3 (en) * | 2018-08-17 | 2025-06-25 | AMSilk GmbH | Use of a structural polypeptide for plant coating |
| WO2020158877A1 (ja) * | 2019-01-31 | 2020-08-06 | Spiber株式会社 | 組換えタンパク質の製造方法 |
| CN110317252B (zh) * | 2019-06-10 | 2021-01-26 | 华南师范大学 | 云斑蛛牵引丝性能及其丝蛋白基因序列 |
| WO2020262602A1 (ja) * | 2019-06-28 | 2020-12-30 | Spiber株式会社 | 合成皮革及びその製造方法、並びに合成皮革用接着剤 |
Family Cites Families (23)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| US576677A (en) | 1897-02-09 | Abel ken worthy | ||
| WO1989003887A1 (en) | 1987-10-20 | 1989-05-05 | Plant Genetic Systems N.V. | A process for the production of biologically active peptide via the expression of modified storage seed protein genes in transgenic plants |
| GB8810120D0 (en) | 1988-04-28 | 1988-06-02 | Plant Genetic Systems Nv | Transgenic nuclear male sterile plants |
| WO1991016351A1 (en) | 1990-04-19 | 1991-10-31 | The United States Of America, Secretary Of The Army, The Pentagon | Recombinant spider silk proteins through genetic engineering |
| US5989894A (en) | 1990-04-20 | 1999-11-23 | University Of Wyoming | Isolated DNA coding for spider silk protein, a replicable vector and a transformed cell containing the DNA |
| US5639948A (en) | 1991-02-08 | 1997-06-17 | Plant Genetic Systems, N.V. | Stamen-specific promoters from rice |
| WO1994029450A2 (en) | 1993-06-15 | 1994-12-22 | E.I. Du Pont De Nemours And Company | Novel, recombinantly produced spider silk analogs |
| US5733771A (en) | 1994-03-14 | 1998-03-31 | University Of Wyoming | cDNAs encoding minor ampullate spider silk proteins |
| DE69636288T2 (de) | 1995-10-06 | 2007-07-26 | Bayer Bioscience N.V. | Samenstrenung resistenz |
| US5994099A (en) | 1997-12-31 | 1999-11-30 | The University Of Wyoming | Extremely elastic spider silk protein and DNA coding therefor |
| FR2774588B1 (fr) * | 1998-02-11 | 2000-05-05 | Oreal | Composition cosmetique ou dermatologique contenant au moins une proteine de soie d'arachnides naturelle, recombinante ou un analogue |
| US7157615B2 (en) | 1998-03-17 | 2007-01-02 | Nexia Biotechnologies, Inc. | Production of biofilaments in transgenic animals |
| US7029917B2 (en) | 1998-05-01 | 2006-04-18 | The Regents Of The University Of California | Nucleic acids that control seed and fruit development in plants |
| US6608242B1 (en) | 2000-05-25 | 2003-08-19 | E. I. Du Pont De Nemours And Company | Production of silk-like proteins in plants |
| EP1287139B1 (de) | 2000-06-09 | 2010-08-25 | Leibniz-Institut für Pflanzengenetik und Kulturpflanzenforschung (IPK) | Synthetische spinnenseidenproteine und deren expression in transgenen pflanzen |
| US6412261B1 (en) | 2001-03-21 | 2002-07-02 | The Forman School | Method of reinforcing a fiber with spider silk |
| WO2002099082A2 (en) | 2001-06-06 | 2002-12-12 | University Of Wyoming | Expression of spider silk proteins in higher plants |
| JP2005502347A (ja) | 2001-08-29 | 2005-01-27 | ユニバーシティ オブ ワイオミング | クモ糸タンパク質をコードする核酸、ポリペプチド、抗体とそれらの使用方法 |
| CN1380418A (zh) | 2002-01-24 | 2002-11-20 | 中国科学院遗传与发育生物学研究所 | 蜘蛛丝基因的棉纤维细胞表达载体质粒 |
| ES2346645T3 (es) | 2002-03-14 | 2010-10-19 | Commonwealth Scientific And Industrial Research Organisation | Procedimientos y medios de supervision y modulacion del silenciamiento genico. |
| US20040102608A1 (en) * | 2002-05-13 | 2004-05-27 | Cornell Research Foundation, Inc. | Multiblock copolymers having improved mechanical properties |
| GB0218977D0 (en) | 2002-08-15 | 2002-09-25 | Univ York | Polypeptide |
| AU2005263622B2 (en) * | 2004-07-22 | 2012-04-26 | Amsilk Gmbh | Recombinant spider silk proteins |
-
2007
- 2007-03-16 BR BRPI0701826-6A patent/BRPI0701826B1/pt active IP Right Grant
-
2008
- 2008-03-13 EP EP08714519A patent/EP2126076A4/en not_active Ceased
- 2008-03-13 WO PCT/BR2008/000072 patent/WO2008113145A1/en not_active Ceased
- 2008-03-13 CN CN200880015224A patent/CN101679975A/zh active Pending
- 2008-03-13 US US12/531,664 patent/US20100311645A1/en not_active Abandoned
- 2008-03-13 CN CN201711245428.2A patent/CN108218972B/zh active Active
- 2008-03-13 EP EP18178559.3A patent/EP3434768A1/en active Pending
- 2008-03-14 AR ARP080101091A patent/AR065777A1/es not_active Application Discontinuation
-
2013
- 2013-01-24 US US13/749,601 patent/US10889624B2/en active Active
Also Published As
| Publication number | Publication date |
|---|---|
| BRPI0701826A (pt) | 2008-11-04 |
| EP2126076A1 (en) | 2009-12-02 |
| CN108218972A (zh) | 2018-06-29 |
| CN101679975A (zh) | 2010-03-24 |
| US10889624B2 (en) | 2021-01-12 |
| EP3434768A1 (en) | 2019-01-30 |
| CN108218972B (zh) | 2021-10-15 |
| EP2126076A4 (en) | 2010-06-16 |
| US20100311645A1 (en) | 2010-12-09 |
| AR065777A1 (es) | 2009-07-01 |
| WO2008113145A1 (en) | 2008-09-25 |
| HK1257458A1 (zh) | 2019-10-18 |
| WO2008113145A8 (en) | 2009-11-26 |
| US20140206851A1 (en) | 2014-07-24 |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| US10889624B2 (en) | Proteins from the webs of nephilengys cruentata, a vicularia juruensis and parawixia bistriata spiders isolated from brazilian biodiversity | |
| Chaw et al. | Complete gene sequence of spider attachment silk protein (PySp1) reveals novel linker regions and extreme repeat homogenization | |
| TRYSELIUS et al. | CecC, a cecropin gene expressed during metamorphosis in Drosophila pupae | |
| Sehnal et al. | Construction of silk fiber core in Lepidoptera | |
| Kikawada et al. | Dehydration-inducible changes in expression of two aquaporins in the sleeping chironomid, Polypedilum vanderplanki | |
| Yonemura et al. | Protein composition of silk filaments spun under water by caddisfly larvae | |
| US20050010035A1 (en) | Spider silk protein encoding nucleic acids, polypeptides, antibodies and methods of use thereof | |
| CA2624667A1 (en) | Silk proteins containing coiled coil region | |
| Zurovec et al. | Sericin composition in the silk of Antheraea yamamai | |
| CN110551190B (zh) | 一种利用家蚕生产蜘蛛丝的方法 | |
| KR20160093727A (ko) | 딱정벌레류 및/또는 노린재류 해충에 대한 저항성을 부여하는 ras 오포지트 (rop) 및 관련 핵산 분자 | |
| Gaines IV et al. | Identification and characterization of multiple Spidroin 1 genes encoding major ampullate silk proteins in Nephila clavipes | |
| Wei et al. | A male accessory gland specific gene takeout2 regulates male mating success in Bactrocera dorsalis. | |
| Zhang et al. | Identification and functional study of fhx-L1, a major silk component in Bombyx mori | |
| Yu et al. | A strategy for improving the mechanical properties of silk fibers through the combination of genetic manipulation and zinc ion crosslinking | |
| US20150038680A1 (en) | Spider silk dragline polynucleotides, polypeptides and methods of use thereof | |
| Lu et al. | How do butterflies use silk to attach their pupae to trees? | |
| CN109055386B (zh) | 家蚕BmSCP1基因及其重组表达载体和应用 | |
| WO2004016651A2 (en) | Spider silk polypeptide | |
| Hull et al. | Identification and characterization of a sex peptide receptor‐like transcript from the western tarnished plant bug L ygus hesperus | |
| Li et al. | Genome-wide investigation of the OR gene family in Helicoverpa armigera and functional analysis of OR48 and OR75 in metamorphosis development | |
| CN112695045B (zh) | 一种鳞翅目昆虫Hpx12基因及应用 | |
| CN114057855B (zh) | 一种高温引起蚜虫跌落的蛋白及其应用 | |
| HK1257458B (en) | Proteins from the webs of nephilengys cruentata spiders | |
| AU2013239320B2 (en) | Silk polypeptides |
Legal Events
| Date | Code | Title | Description |
|---|---|---|---|
| B03A | Publication of a patent application or of a certificate of addition of invention [chapter 3.1 patent gazette] | ||
| B06F | Objections, documents and/or translations needed after an examination request according [chapter 6.6 patent gazette] | ||
| B25C | Requirement related to requested transfer of rights |
Owner name: EMBRAPA - EMPRESA BRASILEIRA DE PESQUISA AGROPECUA Free format text: A FIM DE ATENDER A TRANSFERENCIA SOLICITADA ATRAVES DA PETICAO NO 12070000768-DF, DE 19/07/2007, E NECESSARIO APRESENTAR DOCUMENTO DE CESSAO ASSINADO PELOS REPRESENTANTES DAS PARTES ENVOLVIDAS E SUAS FIRMAS RECONHECIDAS. ALEM DISSO, E MISTER INDICAR, NO DOCUMENTO DE CESSAO, O NUMERO DO DEPOSITO. POR FIM, A CEDENTE DEVE APRESENTAR DOCUMENTO QUE COMPROVE A EXTENSAO DOS PODERES DE SEU REPRESENTANTE PARA QUE SE VERIFIQUE SE ELE ESTA APTO A ALIENAR BENS. |
|
| B07D | Technical examination (opinion) related to article 229 of industrial property law [chapter 7.4 patent gazette] | ||
| B08E | Application fees: payment of additional fee required [chapter 8.5 patent gazette] | ||
| B08H | Application fees: decision cancelled [chapter 8.8 patent gazette] | ||
| B25B | Requested transfer of rights rejected |
Owner name: EMBRAPA - EMPRESA BRASILEIRA DE PESQUISA AGROPECUA |
|
| B07G | Grant request does not fulfill article 229-c lpi (prior consent of anvisa) [chapter 7.7 patent gazette] |
Free format text: NOTIFICACAO DE DEVOLUCAO DO PEDIDO POR NAO SE ENQUADRAR NO ART. 229-C DA LPI. |
|
| B06F | Objections, documents and/or translations needed after an examination request according [chapter 6.6 patent gazette] | ||
| B06U | Preliminary requirement: requests with searches performed by other patent offices: procedure suspended [chapter 6.21 patent gazette] | ||
| B07A | Application suspended after technical examination (opinion) [chapter 7.1 patent gazette] | ||
| B06A | Patent application procedure suspended [chapter 6.1 patent gazette] | ||
| B09A | Decision: intention to grant [chapter 9.1 patent gazette] | ||
| B16A | Patent or certificate of addition of invention granted [chapter 16.1 patent gazette] |
Free format text: PRAZO DE VALIDADE: 10 (DEZ) ANOS CONTADOS A PARTIR DE 17/02/2021, OBSERVADAS AS CONDICOES LEGAIS. |