ES2777901T3 - Método de modificación de polipéptidos para purificar multímeros polipeptídicos - Google Patents
Método de modificación de polipéptidos para purificar multímeros polipeptídicos Download PDFInfo
- Publication number
- ES2777901T3 ES2777901T3 ES10839561T ES10839561T ES2777901T3 ES 2777901 T3 ES2777901 T3 ES 2777901T3 ES 10839561 T ES10839561 T ES 10839561T ES 10839561 T ES10839561 T ES 10839561T ES 2777901 T3 ES2777901 T3 ES 2777901T3
- Authority
- ES
- Spain
- Prior art keywords
- polypeptide
- antigen
- antibody
- binding activity
- amino acid
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Active
Links
Classifications
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K1/00—General methods for the preparation of peptides, i.e. processes for the organic chemical preparation of peptides or proteins of any length
- C07K1/14—Extraction; Separation; Purification
- C07K1/16—Extraction; Separation; Purification by chromatography
- C07K1/22—Affinity chromatography or related techniques based upon selective absorption processes
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K14/00—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof
- C07K14/435—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from animals; from humans
- C07K14/705—Receptors; Cell surface antigens; Cell surface determinants
- C07K14/70503—Immunoglobulin superfamily
- C07K14/70535—Fc-receptors, e.g. CD16, CD32, CD64 (CD2314/705F)
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K16/00—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies
- C07K16/18—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies against material from animals or humans
- C07K16/28—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies against material from animals or humans against receptors, cell surface antigens or cell surface determinants
- C07K16/2803—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies against material from animals or humans against receptors, cell surface antigens or cell surface determinants against the immunoglobulin superfamily
- C07K16/2809—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies against material from animals or humans against receptors, cell surface antigens or cell surface determinants against the immunoglobulin superfamily against the T-cell receptor (TcR)-CD3 complex
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K16/00—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies
- C07K16/18—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies against material from animals or humans
- C07K16/28—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies against material from animals or humans against receptors, cell surface antigens or cell surface determinants
- C07K16/2866—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies against material from animals or humans against receptors, cell surface antigens or cell surface determinants against receptors for cytokines, lymphokines, interferons
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K16/00—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies
- C07K16/18—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies against material from animals or humans
- C07K16/28—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies against material from animals or humans against receptors, cell surface antigens or cell surface determinants
- C07K16/30—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies against material from animals or humans against receptors, cell surface antigens or cell surface determinants from tumour cells
- C07K16/303—Liver or Pancreas
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K16/00—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies
- C07K16/18—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies against material from animals or humans
- C07K16/36—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies against material from animals or humans against blood coagulation factors
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K16/00—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies
- C07K16/46—Hybrid immunoglobulins
- C07K16/468—Immunoglobulins having two or more different antigen binding sites, e.g. multifunctional antibodies
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/50—Immunoglobulins specific features characterized by immunoglobulin fragments
- C07K2317/52—Constant or Fc region; Isotype
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/50—Immunoglobulins specific features characterized by immunoglobulin fragments
- C07K2317/52—Constant or Fc region; Isotype
- C07K2317/526—CH3 domain
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/50—Immunoglobulins specific features characterized by immunoglobulin fragments
- C07K2317/56—Immunoglobulins specific features characterized by immunoglobulin fragments variable (Fv) region, i.e. VH and/or VL
- C07K2317/567—Framework region [FR]
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/60—Immunoglobulins specific features characterized by non-natural combinations of immunoglobulin fragments
- C07K2317/62—Immunoglobulins specific features characterized by non-natural combinations of immunoglobulin fragments comprising only variable region components
- C07K2317/622—Single chain antibody (scFv)
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/60—Immunoglobulins specific features characterized by non-natural combinations of immunoglobulin fragments
- C07K2317/66—Immunoglobulins specific features characterized by non-natural combinations of immunoglobulin fragments comprising a swap of domains, e.g. CH3-CH2, VH-CL or VL-CH1
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/90—Immunoglobulins specific features characterized by (pharmaco)kinetic aspects or by stability of the immunoglobulin
- C07K2317/94—Stability, e.g. half-life, pH, temperature or enzyme-resistance
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2319/00—Fusion polypeptide
- C07K2319/30—Non-immunoglobulin-derived peptide or protein having an immunoglobulin constant or Fc region, or a fragment thereof, attached thereto
Landscapes
- Health & Medical Sciences (AREA)
- Chemical & Material Sciences (AREA)
- Immunology (AREA)
- Organic Chemistry (AREA)
- Life Sciences & Earth Sciences (AREA)
- Molecular Biology (AREA)
- Biophysics (AREA)
- General Health & Medical Sciences (AREA)
- Genetics & Genomics (AREA)
- Medicinal Chemistry (AREA)
- Biochemistry (AREA)
- Proteomics, Peptides & Aminoacids (AREA)
- Gastroenterology & Hepatology (AREA)
- Cell Biology (AREA)
- Toxicology (AREA)
- Zoology (AREA)
- Analytical Chemistry (AREA)
- Hematology (AREA)
- Peptides Or Proteins (AREA)
- Preparation Of Compounds By Using Micro-Organisms (AREA)
- Micro-Organisms Or Cultivation Processes Thereof (AREA)
- Medicines Containing Antibodies Or Antigens For Use As Internal Diagnostic Agents (AREA)
Abstract
Un método para producir un multímero polipeptídico que comprende un primer polipéptido que tiene una actividad de unión a antígeno y un segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, que comprende las etapas de: (a) expresar un ADN que codifica el primer polipéptido y un ADN que codifica el segundo polipéptido; y (b) recoger el producto de expresión de la etapa (a) por cromatografía de afinidad con proteína A, en donde el primer polipéptido y el segundo polipéptido comprenden una secuencia de aminoácidos de un dominio Fc de anticuerpo o una secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo; en donde el dominio Fc de anticuerpo o la región constante de cadena pesada de anticuerpo deriva de IgG humana; en donde el resto de aminoácido en la posición 435, de acuerdo con la numeración EU, en la secuencia de aminoácidos del dominio Fc o de la región constante de cadena pesada es histidina o arginina en el primer polipéptido y arginina o histidina respectivamente en el segundo polipéptido; en donde la combinación de aminoácidos en las posiciones 356 y 439 en la secuencia de aminoácidos de la región Fc o de la región constante de cadena pesada del primer polipéptido se ha modificado a aminoácidos con la misma carga eléctrica; y en donde la combinación de aminoácidos en las posiciones 356 y 439 en la secuencia de aminoácidos de la región Fc o de la región constante de cadena pesada del segundo polipéptido se ha modificado a aminoácidos con una carga eléctrica opuesta a aquella de las posiciones 356 y 439 del primer polipéptido.
Description
DESCRIPCIÓN
Método de modificación de polipéptidos para purificar multímeros polipeptídicos
Campo técnico
La presente invención se refiere a métodos para producir o purificar multímeros polipeptídicos, multímeros polipeptídicos con una capacidad de unión a proteína A alterada y similares.
Técnica anterior
Existen algunos métodos previamente indicados para producir un anticuerpo biespecífico de tipo IgG que tiene una región constante humana (anticuerpo de tipo IgG que tiene una región constante humana y en el que uno de los brazos tiene una actividad de unión específica al antígeno A y el otro tiene una actividad de unión específica al antígeno B). En general, un anticuerpo biespecífico de tipo IgG está compuesto por dos tipos de cadenas H (es decir, cadena H contra el antígeno A y cadena H contra el antígeno B) y dos tipos de cadenas L (es decir, cadena L contra el antígeno A y cadena L contra el antígeno B). Cuando se expresa dicho anticuerpo biespecífico de tipo IgG, se expresan dos tipos de cadenas H y dos tipos de cadenas L, y hay diez combinaciones posibles para la combinación H2L2. De estas, solamente una combinación tiene la especificidad de interés (un brazo tiene actividad de unión específica para el antígeno A y el otro tiene actividad de unión específica para el antígeno B). Por lo tanto, para obtener un anticuerpo biespecífico de interés, es necesario purificar un solo anticuerpo de interés de los diez tipos de anticuerpos. Este es un proceso extremadamente ineficaz y difícil.
Existen métodos indicados para resolver este problema que utilizan una cadena L común para que la cadena L contra el antígeno A y la cadena L contra el antígeno B tengan una secuencia de aminoácidos idéntica (Documentos de Patente 1 y 2). Cuando se expresa un anticuerpo biespecífico de tipo IgG que tiene una cadena L común, se expresan dos tipos de cadenas H y un tipo de cadena L común, y existen tres combinaciones posibles para la combinación H2L2. Una de estas combinaciones es un anticuerpo biespecífico de interés. Estas tres combinaciones son: anticuerpo monoespecífico contra el antígeno A (anticuerpo de cadena H homomérico contra el antígeno A), anticuerpo biespecífico contra tanto el antígeno A como el antígeno B (anticuerpo heteromérico con una cadena H contra el antígeno A y una cadena H contra el antígeno B), y un anticuerpo monoespecífico contra el antígeno B (anticuerpo de cadena H homomérico contra el antígeno B). Debido a que su relación es en general 1:2:1, la eficacia de expresión del anticuerpo biespecífico deseado es aproximadamente del 50 %. Se ha indicado un método para mejorar aún más esta eficacia que permite dos tipos de cadenas H asociadas heteroméricamente (Documento de Patente 3). Esto puede aumentar la eficacia de expresión del anticuerpo biespecífico deseado hasta aproximadamente un 90-95 %. Entre tanto, se ha indicado de un método para eliminar eficazmente los dos tipos de anticuerpos homoméricos que son impurezas, en el que se introducen sustituciones de aminoácidos en las regiones variables de los dos tipos de cadenas H para darles diferentes puntos isoeléctricos de modo que los dos tipos de anticuerpos homoméricos y el anticuerpo biespecífico de interés (anticuerpo heteromérico) puedan purificarse por cromatografía de intercambio iónico (Documento de Patente 4). Una combinación de los métodos mencionados anteriormente ha permitido producir eficazmente un anticuerpo biespecífico (anticuerpo heteromérico) que tiene una región constante humana de tipo IgG.
Por otro lado, en la producción industrial de anticuerpos de tipo IgG, se debe usar una etapa de purificación por cromatografía con proteína A, pero no se usa necesariamente la cromatografía de intercambio iónico en la etapa de purificación. Por lo tanto, el uso de la cromatografía de intercambio iónico para producir un anticuerpo biespecífico altamente puro conduce a un aumento de los costes de producción. Además, como la cromatografía de intercambio iónico por sí sola puede no garantizar un método de purificación fuerte para productos farmacéuticos, es preferible realizar más de una etapa cromatográfica para eliminar las impurezas.
En cualquier caso, es preferible que los anticuerpos biespecíficos también se puedan purificar altamente mediante una etapa cromatográfica que tenga un modo de separación diferente al de la cromatografía de intercambio iónico. Es deseable que, como uno de dichos modos de separación, la cromatografía con proteína A, que debe usarse en la producción industrial de anticuerpos de tipo IgG, pueda purificar anticuerpos biespecíficos a alta pureza.
Un método previamente indicado para purificar un anticuerpo biespecífico (anticuerpo heteromérico) usando proteína A es usar un anticuerpo biespecífico que tiene una cadena H de IgG2a de ratón que se une a la proteína A y una cadena H de IgG2b de rata que no se une a la proteína A. Se ha indicado que este método permite que un anticuerpo biespecífico de interés se purifique a una pureza del 95 % mediante la etapa de purificación basada en proteína A sola (Documento no de Patente 1 y Documento de Patente 5). Sin embargo, este método también utiliza la cromatografía de intercambio iónico para mejorar la pureza del anticuerpo biespecífico. En otras palabras, la purificación de un anticuerpo biespecífico altamente puro no se puede lograr mediante la etapa de purificación utilizando solamente cromatografía con proteína A. Además, catumaxomab, un anticuerpo biespecífico producido por el método descrito anteriormente y que tiene una cadena H de IgG2a de ratón y una cadena H de IgG2b de rata, tiene una semivida de aproximadamente 2,1 días en seres humanos, que es extremadamente más corta que la de la IgG1 humana normal (2 a 3 semanas) (Documento no de Patente 2). Además de tener una semivida corta, catumaxomab es altamente inmunogénico debido a sus regiones constantes de ratón y rata (Documento 3 no de Patente). Por lo tanto, un
anticuerpo biespecífico obtenido por tales métodos se considera inapropiado como un producto farmacéutico.
Por otro lado, se ha sugerido que desde el punto de vista de la inmunogenicidad, se puede usar una región constante de IgG3 humana como una región constante de no unión a proteína A (Documento no de Patente 1). Sin embargo, como se sabe que las cadenas H de IgG1 humana e IgG3 humana apenas se asocian entre sí (documento no de Patente 1), es imposible producir un anticuerpo biespecífico de interés usando una cadena H de IgG1 humana y una cadena H de IgG3 humana por el mismo método utilizado para el anticuerpo biespecífico que tiene una cadena H de IgG2a de ratón y una cadena H de IgG2b de rata. Asimismo, se ha indicado que la semivida de la IgG3 humana en seres humanos es generalmente más corta que la de la IgG1 humana, IgG2 humana e IgG4 humana (Documentos no de Patente 4 y 5). En consecuencia, al igual que el anticuerpo biespecífico que usa una IgG2a de ratón y una IgG2b de rata, un anticuerpo biespecífico que usa IgG3 humana también podría tener una semivida corta en seres humanos. Se sugiere que la razón por la cual la asociación de las cadenas H rara vez se produce entre la IgG1 humana y la IgG3 humana es la secuencia bisagra de la IgG3 humana (Documento no de Patente 1). Entre tanto, la razón de la corta semivida de la región constante de IgG3 humana aún no se ha aclarado por completo. Por lo tanto, no se ha indicado hasta ahora con respecto a los anticuerpos biespecíficos que usan una región constante de IgG3 humana como una región constante de no unión a proteína A. Además, tampoco hay un informe sobre los métodos para producir o purificar eficazmente anticuerpos biespecíficos altamente puros que tienen una región constante humana y muestran una semivida similar a la IgG1 humana.
Asimismo, el Documento de Patente 6, p. ej., divulga proteínas heterodiméricas de unión a antígeno biespecíficas, el Documento de Patente 7, p.ej., divulga métodos para preparar anticuerpos biespecíficos heterólogos, el Documento de Patente 8, p. ej., divulga métodos para producir un polipéptido que comprende una mutación en un resto de aminoácido que forma una interfaz polipeptídica de modo que se regule la asociación de polipéptidos, y el Documento no de Patente 6, p. ej., postula que todas las proteínas IgG que se unen a la proteína A tienen His en la posición 435, mientras que las que no, tienen Arg en esa posición.
Documentos de la técnica anterior
Documentos de Patente
Documento de Patente 1: WO98050431
Documento de Patente 2: WO2006109592
Documento de Patente 3: WO2006106905
Documento de Patente 4: WO2007114325
Documento de Patente 5: WO95033844
Documento de Patente 6: WO2010151792
Documento de Patente 7: US5945311
Documento de Patente 8: EP1870459
Documentos no de Patente
Documento no de Patente 1: The Journal of Immunology, 1995, 155:219-225
Documento no de Patente 2: J Clin Oncol 26: 2008 (supl 20 de Mayo; abstr 14006)
Documento no de Patente 3: Clin Cancer Res 2007 13:3899-3905
Documento no de Patente 4: Nat Biotechnol. Dic de 2007; 25(12):1369-72
Documento no de Patente 5: J. Clin Invest 1970; 49:673-80
Documento no de Patente 6: Scandinavian Journal of Immunology 1982; 15(3):275-78
Divulgación de la invención
[Problemas a Resolver por la Invención]
En general, se puede producir eficazmente un anticuerpo de tipo IgG normal como una IgG altamente pura a través de una etapa de purificación basada en proteína A. Sin embargo, la producción de un anticuerpo biespecífico altamente puro requiere una etapa de purificación adicional usando cromatografía de intercambio iónico. La adición de dicha etapa de purificación por cromatografía de intercambio iónico puede complicar la producción y aumentar el coste de producción. Por lo tanto, es preferible producir un anticuerpo biespecífico altamente puro mediante una etapa de purificación basada en proteína A sola. Un objetivo de la presente invención es proporcionar métodos que usan solamente una etapa de purificación basada en proteína A para producir o purificar eficazmente un anticuerpo biespecífico de tipo IgG altamente puro que tiene una región constante de cadena pesada de anticuerpo humano.
Entre tanto, como el sitio de unión a proteína A en el dominio Fc es idéntico al sitio de unión a FcRn en el dominio Fc, se espera que sea difícil ajustar la actividad de unión a proteína A mientras se conserva la unión al FcRn humano. La conservación de la capacidad de unión a FcRn humano es muy importante para la retención plasmática larga (semivida larga) en seres humanos, que es característica de los anticuerpos de tipo IgG. La presente invención proporciona métodos que usan solamente una etapa de purificación basada en proteína A para producir o purificar eficazmente un anticuerpo biespecífico altamente puro que mantiene un tiempo de retención en plasma comparable a o más largo que
el de IgG1 humana.
[Medios para Resolver los Problemas]
Los presentes inventores descubrieron métodos que usan solamente una etapa de purificación basada en proteína A para purificar o producir eficazmente un multímero polipeptídico altamente puro capaz de unirse a dos o más antígenos, en particular, un anticuerpo multiespecífico de tipo IgG que tiene una región constante humana, alterando su capacidad de unión a proteína A.
Asimismo, estos métodos se combinaron con métodos para regular la asociación entre un primer polipéptido que tiene una actividad de unión a antígeno y un segundo polipéptido que tiene una actividad de unión a antígeno modificando los aminoácidos que constituyen la interfaz formada tras la asociación de los polipéptidos. Mediante esta combinación, la presente invención permite la producción o purificación eficaz de un multímero polipeptídico altamente puro de interés.
Los presentes inventores también descubrieron que modificando el resto de aminoácido en la posición 435 (numeración EU) en la región constante de cadena pesada, la capacidad de unión a proteína A podría ajustarse manteniendo su retención en plasma comparable a o más larga que la de IgG1 humana. Basándose en este hallazgo, se puede producir o purificar un anticuerpo biespecífico altamente puro con un tiempo de retención en plasma comparable a o más largo que el de IgG1 humana.
La presente invención se basa en los hallazgos descritos anteriormente, y proporciona el tema en cuestión tal como se define en las reivindicaciones.
De manera específica, la presente invención proporciona [1] a [5] a continuación:
[1] Un método para producir un multímero polipeptídico que comprende un primer polipéptido que tiene una actividad de unión a antígeno y un segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, que comprende las etapas de:
(a) expresar un ADN que codifica el primer polipéptido que tiene una actividad de unión a antígeno y un ADN que codifica el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno; y
(b) recoger el producto de expresión de la etapa (a) por cromatografía de afinidad con proteína A, en donde el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno comprenden una secuencia de aminoácidos de un dominio Fc de anticuerpo o una secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo;
en donde el dominio Fc de anticuerpo o la región constante de cadena pesada de anticuerpo deriva de IgG humana; en donde el resto de aminoácido en la posición 435 (numeración EU) en la secuencia de aminoácidos del dominio Fc o de la región constante de cadena pesada es histidina o arginina en el primer polipéptido que tiene una actividad de unión a antígeno y arginina o histidina respectivamente en el segundo polipéptido que tiene o no tiene una actividad de unión a antígeno;
en donde la combinación de aminoácidos en las posiciones 356 y 439 en la secuencia de aminoácidos de la región Fc o región constante de cadena pesada del primer polipéptido que tiene una actividad de unión a antígeno se ha modificado a aminoácidos con la misma carga eléctrica; y
en donde la combinación de aminoácidos en las posiciones 356 y 439 en la secuencia de aminoácidos de la región Fc o región constante de cadena pesada del segundo polipéptido que tiene o no tiene una actividad de unión a antígeno se ha modificado a aminoácidos con una carga eléctrica opuesta a la del primer polipéptido que tiene una actividad de unión a antígeno.
[2] El método de [1],
i) en donde la pureza del multímero polipeptídico recogido es del 95 % o más;
y/o
ii) en donde el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno comprenden una secuencia de aminoácidos de una región variable de cadena pesada de anticuerpo,
particularmente en donde se ha modificado al menos un resto de aminoácido en las secuencias de aminoácidos de FR1, CDR2 y FR3 de la región variable de cadena pesada de anticuerpo; y/o
iii) en donde el multímero polipeptídico comprende uno o dos terceros polipéptidos que tienen una actividad de unión a antígeno, y la etapa (a) comprende expresar un ADN que codifica el tercer polipéptido que tiene una actividad de unión a antígeno, particularmente
a) en donde el tercer polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de
aminoácidos de una cadena ligera de anticuerpo,
y/o
b) en donde el multímero polipeptídico comprende adicionalmente un cuarto polipéptido que tiene una actividad de unión a antígeno, y la etapa (a) comprende expresar un ADN que codifica el cuarto polipéptido que tiene una actividad de unión a antígeno,
especialmente
b1) en donde al menos uno de los polipéptidos tercero y cuarto que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena ligera de anticuerpo,
o
b2) en donde el primer polipéptido que tiene una actividad de unión a antígeno comprende secuencias de aminoácidos de una región variable de cadena ligera de anticuerpo y de una región constante de cadena pesada de anticuerpo; el segundo polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena pesada de anticuerpo; el tercer polipéptido que tiene una actividad de unión a antígeno comprende secuencias de aminoácidos de una región variable de cadena pesada de anticuerpo y de una región constante de cadena ligera de anticuerpo; y el cuarto polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena ligera de anticuerpo;
y/o
iv) en donde el multímero polipeptídico es un anticuerpo multiespecífico, particularmente en donde el anticuerpo multiespecífico es un anticuerpo biespecífico.
[3] El método de uno cualquiera de [1] y [2] i) a [2] iv), que comprende el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que no tiene actividad de unión a antígeno, y en donde el primer polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de un dominio de unión a antígeno de un receptor y una secuencia de aminoácidos de un dominio Fc de anticuerpo, y el segundo polipéptido que no tiene actividad de unión a antígeno comprende una secuencia de aminoácidos de un dominio Fc de anticuerpo.
[4] Un método para purificar un multímero polipeptídico que comprende un primer polipéptido que tiene una actividad de unión a antígeno y un segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, que comprende las etapas de:
(a) expresar un ADN que codifica el primer polipéptido que tiene una actividad de unión a antígeno y un ADN que codifica el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno; y
(b) recoger el producto de expresión de la etapa (a) por cromatografía de afinidad con proteína A, en donde el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno comprenden una secuencia de aminoácidos de un dominio Fc de anticuerpo o una secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo;
en donde el dominio Fc de anticuerpo o la región constante de cadena pesada de anticuerpo deriva de IgG humana; en donde el resto de aminoácido en la posición 435 (numeración EU) en la secuencia de aminoácidos del dominio Fc o de la región constante de cadena pesada es histidina o arginina en el primer polipéptido que tiene una actividad de unión a antígeno y arginina o histidina respectivamente en el segundo polipéptido que tiene o no tiene una actividad de unión a antígeno;
en donde la combinación de aminoácidos en las posiciones 356 y 439 en la secuencia de aminoácidos de la región Fc o región constante de cadena pesada del primer polipéptido que tiene una actividad de unión a antígeno se ha modificado a aminoácidos con la misma carga eléctrica; y
en donde la combinación de aminoácidos en las posiciones 356 y 439 en la secuencia de aminoácidos de la región Fc o región constante de cadena pesada del segundo polipéptido que tiene o no tiene una actividad de unión a antígeno se ha modificado a aminoácidos con una carga eléctrica opuesta a la del primer polipéptido que tiene una actividad de unión a antígeno.
[5] El método de [4],
i) en donde la pureza del multímero polipeptídico recogido es del 95 % o más;
y/o
ii) en donde el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno comprenden una secuencia de aminoácidos de una región variable de cadena pesada de anticuerpo,
particularmente en donde se ha modificado al menos un resto de aminoácido en las secuencias de aminoácidos de FR1, CDR2 y FR3 de la región variable de cadena pesada de anticuerpo; y/o
iii) en donde el multímero polipeptídico comprende uno o dos terceros polipéptidos que tienen una actividad de unión a antígeno, y la etapa (a) comprende expresar un ADN que codifica el tercer polipéptido que tiene una actividad de unión a antígeno, particularmente
a) en donde el tercer polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena ligera de anticuerpo,
y/o
b) en donde el multímero polipeptídico comprende adicionalmente un cuarto polipéptido que tiene una actividad de unión a antígeno, y la etapa (a) comprende expresar un ADN que codifica el cuarto polipéptido que tiene una actividad de unión a antígeno,
especialmente
b1) en donde al menos uno de los polipéptidos tercero y cuarto que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena ligera de anticuerpo, o
b2) en donde el primer polipéptido que tiene una actividad de unión a antígeno comprende secuencias de aminoácidos de una región variable de cadena ligera de anticuerpo y de una región constante de cadena pesada de anticuerpo; el segundo polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena pesada de anticuerpo; el tercer polipéptido que tiene una actividad de unión a antígeno comprende secuencias de aminoácidos de una región variable de cadena pesada de anticuerpo y de una región constante de cadena ligera de anticuerpo; y el cuarto polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena ligera de anticuerpo;
y/o
iv) en donde el multímero polipeptídico es un anticuerpo multiespecífico,
particularmente en donde el anticuerpo multiespecífico es un anticuerpo biespecífico.
En el presente documento se divulgan adicionalmente los siguientes elementos [1] a [55]:
[1] Un método para producir un multímero polipeptídico que comprende un primer polipéptido que tiene una actividad de unión a antígeno y un segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, que comprende las etapas de:
(a) expresar un ADN que codifica el primer polipéptido que tiene una actividad de unión a antígeno y un ADN que codifica el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno; y
(b) recoger el producto de expresión de la etapa (a),
en donde se han modificado uno o más restos de aminoácidos en uno o ambos del primer polipéptido que tiene una actividad de unión a antígeno y del segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, de modo que existe una mayor diferencia de capacidad de unión a proteína A entre el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno.
[2] El método de [1], en donde el producto de expresión se recoge usando cromatografía de afinidad con proteína A en la etapa (b).
[3] El método de [1] o [2], en donde se han modificado uno o más restos de aminoácidos en uno o ambos del primer polipéptido que tiene una actividad de unión a antígeno y del segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, de modo que existe una mayor diferencia entre el pH del disolvente para eluir el primer polipéptido que tiene una actividad de unión a antígeno de la proteína A y aquel para eluir el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno de la proteína A.
[4] El método de uno cualquiera de [1] a [3], en donde se han modificado uno o más restos de aminoácidos en el primer polipéptido que tiene una actividad de unión a antígeno o en el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, para aumentar o reducir la capacidad de unión a proteína A de cualquiera de los dos del primer polipéptido que tiene una actividad de unión a antígeno y del segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno.
[5] El método de uno cualquiera de [1] a [4], en donde se han modificado uno o más restos de aminoácidos en el primer polipéptido que tiene una actividad de unión a antígeno y en el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, para aumentar la capacidad de unión a proteína A de cualquiera de los dos del primer polipéptido que tiene una actividad de unión a antígeno y del segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, y reducir la capacidad de unión a proteína A del otro polipéptido.
[6] El método de uno cualquiera de [1] a [5], en donde la pureza del multímero polipeptídico recogido es del 95 % o más.
[7] El método de uno cualquiera de [1] a [6], en donde el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno comprenden una secuencia de aminoácidos de un dominio Fc de anticuerpo o una secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo.
[8] El método de [7], en donde se ha modificado al menos un resto de aminoácido seleccionado de los restos de aminoácidos de las posiciones 250 a 255, 308 a 317 y 430 a 436 (numeración EU) en la secuencia de aminoácidos del dominio Fc de anticuerpo o de la región constante de la cadena pesada de anticuerpo.
[9] El método de uno cualquiera de [1] a [8], en donde el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno comprenden una secuencia de aminoácidos de una región variable de cadena pesada de anticuerpo.
[10] El método de [9], en donde se ha modificado al menos un resto de aminoácido en las secuencias de aminoácidos de FR1, CDR2 y FR3 de la región variable de cadena pesada de anticuerpo.
[11] El método de uno cualquiera de [1] a [10], en donde el multímero polipeptídico comprende uno o dos terceros polipéptidos que tienen una actividad de unión a antígeno, y la etapa (a) comprende expresar un ADN que codifica el tercer polipéptido que tiene una actividad de unión a antígeno.
[12] El método de [11], en donde el tercer polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena ligera de anticuerpo.
[13] El método de [11] o [12], en donde el multímero polipeptídico comprende adicionalmente un cuarto polipéptido que tiene una actividad de unión a antígeno y la etapa (a) comprende expresar un ADN que codifica el cuarto polipéptido que tiene una actividad de unión a antígeno.
[14] El método de [13], en donde al menos uno de los polipéptidos tercero y cuarto que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena ligera de anticuerpo.
[15] El método de [13], en donde el primer polipéptido que tiene una actividad de unión a antígeno comprende secuencias de aminoácidos de una región variable de cadena ligera de anticuerpo y de una región constante de cadena pesada de anticuerpo; el segundo polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena pesada de anticuerpo; el tercer polipéptido que tiene una actividad de unión a antígeno comprende secuencias de aminoácidos de una región variable de cadena pesada de anticuerpo y de una región constante de cadena ligera de anticuerpo; y el cuarto polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena ligera de anticuerpo.
[16] El método de uno cualquiera de [1] a [15], en donde el multímero polipeptídico es un anticuerpo multiespecífico.
[17] El método de [16], en donde el anticuerpo multiespecífico es un anticuerpo biespecífico.
[18] El método de uno cualquiera de [1] a [8], que comprende el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que no tiene actividad de unión a antígeno, y en donde el primer polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de un dominio de unión a antígeno de un receptor y una secuencia de aminoácidos de un dominio Fc de anticuerpo, y el segundo polipéptido que no tiene actividad de unión a antígeno comprende una secuencia de aminoácidos de un dominio Fc de anticuerpo.
[19] El método de uno cualquiera de [7] a [18], en donde el dominio Fc de anticuerpo o la región constante de cadena pesada de anticuerpo deriva de IgG humana.
[20] Un multímero polipeptídico producido por el método de uno cualquiera de [1] a [19].
[21] Un método para purificar un multímero polipeptídico que comprende un primer polipéptido que tiene una actividad de unión a antígeno y un segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, que comprende las etapas de:
(a) expresar un ADN que codifica el primer polipéptido que tiene una actividad de unión a antígeno y un ADN que codifica el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno; y
(b) recoger el producto de expresión de la etapa (a) por cromatografía de afinidad con proteína A,
en donde se han modificado uno o más restos de aminoácidos en uno o ambos del primer polipéptido que tiene una actividad de unión a antígeno y del segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, de modo que existe una mayor diferencia de capacidad de unión a proteína A entre el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno.
[22] El método de [21], en donde se han modificado uno o más restos de aminoácidos en el primer polipéptido que tiene una actividad de unión a antígeno o en el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, para aumentar o reducir la capacidad de unión a proteína A del primer polipéptido que tiene una actividad de unión a antígeno o del segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno.
[23] El método de [20] o [21], en donde se han modificado uno o más restos de aminoácidos en el primer polipéptido que tiene una actividad de unión a antígeno y en el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, para aumentar la capacidad de unión a proteína A de cualquiera de los dos del primer polipéptido que tiene una actividad de unión a antígeno y del segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno y reducir la capacidad de unión a proteína A del otro polipéptido.
[24] El método de uno cualquiera de [21] a [23], en donde la pureza del multímero polipeptídico recogido es del
95 % o más.
[25] El método de uno cualquiera de [21] a [24], en donde el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno comprenden una secuencia de aminoácidos de un dominio Fc de anticuerpo o una secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo.
[26] El método de [25], en donde se ha modificado al menos un resto de aminoácido seleccionado de los restos de aminoácidos de las posiciones 250 a 255, 308 a 317 y 430 a 436 (numeración EU) en la secuencia de aminoácidos del dominio Fc de anticuerpo o de la región constante de la cadena pesada de anticuerpo.
[27] El método de uno cualquiera de [21] a [26], en donde el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno comprenden una secuencia de aminoácidos de una región variable de cadena pesada de anticuerpo.
[28] El método de [27], en donde se ha modificado al menos un resto de aminoácido en las secuencias de aminoácidos de FR1, CDR2 y FR3 de la región variable de cadena pesada de anticuerpo.
[29] El método de uno cualquiera de [21] a [28], en donde el multímero polipeptídico comprende uno o dos terceros polipéptidos que tienen una actividad de unión a antígeno, y la etapa (a) comprende expresar un ADN que codifica el tercer polipéptido que tiene una actividad de unión a antígeno.
[30] El método de [29], en donde el tercer polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena ligera de anticuerpo.
[31] El método de [29] o [30], en donde el multímero polipeptídico comprende adicionalmente un cuarto polipéptido que tiene una actividad de unión a antígeno y la etapa (a) comprende expresar un ADN que codifica el cuarto polipéptido que tiene una actividad de unión a antígeno.
[32] El método de [31], en donde al menos uno de los polipéptidos tercero y cuarto que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena ligera de anticuerpo.
[33] El método de [31], en donde el primer polipéptido que tiene una actividad de unión a antígeno comprende secuencias de aminoácidos de una región variable de cadena ligera de anticuerpo y de una región constante de cadena pesada de anticuerpo; el segundo polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena pesada de anticuerpo; el tercer polipéptido que tiene una actividad de unión a antígeno comprende secuencias de aminoácidos de una región variable de cadena pesada de anticuerpo y de una región constante de cadena ligera de anticuerpo; y el cuarto polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena ligera de anticuerpo.
[34] El método de uno cualquiera de [21] a [33], en donde el multímero polipeptídico es un anticuerpo multiespecífico.
[35] El método de [34], en donde el anticuerpo multiespecífico es un anticuerpo biespecífico.
[36] El método de uno cualquiera de [25] a [35], en donde el dominio Fc de anticuerpo o la región constante de cadena pesada de anticuerpo deriva de IgG humana.
[37] Un multímero polipeptídico que comprende un primer polipéptido que tiene una actividad de unión a antígeno y un segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, en donde la capacidad de unión a la proteína A es diferente para el primer polipéptido que tiene una actividad de unión a antígeno y para el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno.
[38] El multímero polipeptídico de [37], en donde existe una diferencia entre el pH del disolvente para eluir el primer polipéptido que tiene una actividad de unión a antígeno de la proteína A y aquel para eluir el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno de la proteína A.
[39] El multímero polipeptídico de [37] o [38], en donde el primer polipéptido que tiene una actividad de unión a antígeno o el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno comprende una secuencia de aminoácidos de un dominio Fc de anticuerpo o una secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo, y en donde al menos se ha modificado un resto de aminoácido seleccionado de los restos de aminoácidos de las posiciones 250 a 255, 308 a 317 y 430 a 436 (numeración EU) en la secuencia de aminoácidos del dominio Fc de anticuerpo o de la región constante de cadena pesada de anticuerpo.
[40] El multímero polipeptídico de uno cualquiera de [37] a [39], en donde el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno comprenden una secuencia de aminoácidos de un dominio Fc de anticuerpo o una secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo;
en donde el resto de aminoácido de la posición 435 (numeración EU) en la secuencia de aminoácidos del dominio Fc de anticuerpo o de la región constante de cadena pesada de anticuerpo es histidina o arginina en cualquiera de los dos del primer polipéptido que tiene una actividad de unión a antígeno y del segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno; y
en donde el resto de aminoácido de la posición 435 (numeración EU) en la secuencia de aminoácidos del dominio Fc de anticuerpo o de la región constante de cadena pesada de anticuerpo en cualquiera de dichos polipéptidos es diferente de aquel en el otro polipéptido.
[41] El multímero polipeptídico de uno cualquiera de [37] a [40], en donde el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno comprenden una secuencia de aminoácidos de un dominio Fc de anticuerpo o una secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo;
en donde el resto de aminoácido de la posición 435 (numeración EU) en la secuencia de aminoácidos del dominio
Fc de anticuerpo o de la región constante de cadena pesada de anticuerpo es histidina en cualquiera de los dos del primer polipéptido que tiene una actividad de unión a antígeno y del segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno; y
en donde el resto de aminoácido de la posición 435 (numeración EU) en la secuencia de aminoácidos del dominio Fc de anticuerpo o de la región constante de cadena pesada de anticuerpo es arginina en el otro polipéptido.
[42] El multímero polipeptídico de uno cualquiera de [37] a [41], en donde el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno comprenden una secuencia de aminoácidos de una región variable de cadena pesada de anticuerpo y se ha modificado al menos un resto de aminoácido en las secuencias de aminoácidos de FR1, CDR2 y FR3 de la región variable de cadena pesada.
[43] El multímero polipeptídico de uno cualquiera de [37] a [42], que además comprende uno o dos terceros polipéptidos que tienen una actividad de unión a antígeno.
[44] El multímero polipeptídico de [43], en donde el tercer polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena ligera de anticuerpo.
[45] El multímero polipeptídico de [43] o [44], que además comprende uno cuarto polipéptido que tiene una actividad de unión a antígeno.
[46] El multímero polipeptídico de [45], en donde al menos uno de los polipéptidos tercero y cuarto que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena ligera de anticuerpo.
[47] El multímero polipeptídico de [45], en donde el primer polipéptido que tiene una actividad de unión a antígeno comprende secuencias de aminoácidos de una región variable de cadena ligera de anticuerpo y de una región constante de cadena pesada de anticuerpo; el segundo polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena pesada de anticuerpo; el tercer polipéptido que tiene una actividad de unión a antígeno comprende secuencias de aminoácidos de una región variable de cadena pesada de anticuerpo y de una región constante de cadena ligera de anticuerpo; y el cuarto polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena ligera de anticuerpo.
[48] El multímero polipeptídico de uno cualquiera de [37] a [47], que es un anticuerpo multiespecífico.
[49] El multímero polipeptídico de [48], en donde el anticuerpo multiespecífico es un anticuerpo biespecífico.
[50] El multímero polipeptídico de uno cualquiera de [37] a [41], que comprende el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que no tiene actividad de unión a antígeno, y en donde el primer polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de un dominio de unión a antígeno de un receptor y una secuencia de aminoácidos de un dominio Fc de anticuerpo, y el segundo polipéptido que no tiene actividad de unión a antígeno comprende una secuencia de aminoácidos de un dominio Fc de anticuerpo.
[51] El multímero polipeptídico de uno cualquiera de [39] a [50], en donde el dominio Fc de anticuerpo o la región constante de cadena pesada de anticuerpo deriva de IgG humana.
[52] Un ácido nucleico que codifica un polipéptido que constituye el multímero polipeptídico de uno cualquiera de [20] y [37] a [51].
[53] Un vector insertado con el ácido nucleico de [52].
54] Una célula que comprende el ácido nucleico de [52] o el vector de [53].
[55] Una composición farmacéutica que comprende el multímero polipeptídico de uno cualquiera de [20] y [37] a [51] como principio activo.
[Efectos de la invención]
La presente invención proporciona métodos que usan solamente una etapa de purificación basada en proteína A para purificar o producir eficazmente un multímero polipeptídico altamente puro que tiene actividad de unión contra dos o más antígenos (anticuerpo multiespecífico), alterando su capacidad de unión a proteína A. Los métodos de la presente invención permiten la purificación o producción eficaz de un multímero polipeptídico altamente puro de interés sin afectar los efectos de otras modificaciones de aminoácidos de interés. En particular, al combinar estos métodos con un método para regular la asociación entre dos dominios proteicos, los multímeros polipeptídicos de interés pueden producirse o purificarse de manera más eficaz a una mayor pureza.
Los métodos de la presente invención para producir o purificar anticuerpos multiespecíficos se caracterizan porque los restos de aminoácidos en su región constante de cadena pesada de anticuerpo y/o región variable de cadena pesada de anticuerpo se modifican como se define en las reivindicaciones. Las modificaciones de aminoácidos en contexto con la presente invención se introducen en estas regiones para modificar su capacidad de unión a la proteína A. Además, también se pueden obtener otros efectos de la modificación de aminoácidos de interés, por ejemplo, un tiempo de retención en plasma comparable o mayor que el de IgG1 humana. Los métodos de la presente invención permiten la preparación eficaz de anticuerpos multiespecíficos altamente puros que tienen tales efectos por modificación de aminoácidos.
En general, la producción de anticuerpos multiespecíficos de tipo IgG altamente puros requiere una etapa de purificación usando cromatografía de intercambio iónico. Sin embargo, la adición de esta etapa de purificación complica la producción y aumenta el coste de producción. Por otro lado, la purificación que usa solo cromatografía de intercambio iónico puede no ser lo suficientemente fuerte como método de purificación para productos farmacéuticos. Por lo tanto, es una tarea desarrollar un método para producir un anticuerpo biespecífico de tipo IgG usando solamente
una etapa de purificación basada en proteína A, o desarrollar un método de producción fuerte usando una etapa de purificación basada en proteína A y una etapa de cromatografía de intercambio iónico.
Breve descripción de los dibujos
La figura 1 es un gráfico que muestra una evaluación del tiempo de retención en plasma de MRA-IgG1 y MRA-z106/z107k en ratones transgénicos con FcRn humano.
La figura 2 es un diagrama que muestra que la misma región en el dominio Fc de anticuerpo se une a la proteína A y a FcRn.
La figura 3 muestra un curso temporal de las concentraciones en plasma de Q499-z1 18/J339-z1 19/l377-k y Q499-z121/J339-z119/l377-k después de la administración a ratones transgénicos con FcRn humano.
La figura 4 es un diagrama esquemático de una molécula GC33-IgG1-CD3-scFv que se une de forma divalente al antígeno específico de cáncer glipicano-3(GPC3) y se une de forma monovalente al antígeno CD3 de linfocitos T. La figura 5 muestra el resultado del análisis de cromatografía de exclusión por tamaño de NTA1L/NTAIR/GC33-k0 y NTA2L/NTA2R/GC33-k0 purificados con proteína A.
La figura 6 es un diagrama esquemático de una molécula de anticuerpo IgG anti-GPC3 que se une de forma monovalente a glipicano-3.
La figura 7 muestra el resultado del análisis de cromatografía de exclusión por tamaño de NTA4L-cont/NTA4R-cont/GC33-k0, NTA4L-G3/NTA4R-cont/GC33-k0 y NTA4L/NTA4R/GC33-k0 purificados con proteína A.
La figura 8 muestra cromatogramas de NTA4L-cont/NTA4R-cont/GC33-k0, NTA4L-G3/NTA4R-cont/GC33-k0 y NTA4L/NTA4R/GC33-k0 sometidos a purificación por cromatografía en columna con proteína A con elución de gradiente de pH.
La figura 9 es un diagrama esquemático de una molécula de proteína de fusión receptor Fc alfa-Fc que se une de forma monovalente a IgA.
La figura 10 muestra el resultado del análisis de cromatografía de exclusión por tamaño de IAL-cont/IAR-cont e IAL/IAR purificados con proteína A.
La figura 11 es un diagrama esquemático de no1, un anticuerpo biespecífico anti-receptor de IL-6/anti-GPC3 de origen natural.
La figura 12 es un diagrama esquemático de no2, que se obtuvo intercambiando el dominio VH y el dominio VL del anticuerpo anti-GPC3 en no1.
La figura 13 es un diagrama esquemático de no3, que se obtuvo modificando no2 para alterar el punto isoeléctrico de cada cadena.
La figura 14 es un diagrama esquemático de no5, que se obtuvo modificando no3 para potenciar la asociación heteromérica de las cadenas H y para purificar el anticuerpo asociado de forma heteromérica utilizando la proteína A.
La figura 15 es un diagrama esquemático de no6, que se obtuvo modificando no5 para potenciar la asociación entre la cadena H de interés y la cadena L de interés.
La figura 16 es cromatogramas de anticuerpos biespecíficos anti-receptor de IL-6/anti-GPC3 no1, no2, no3, no5 y no6 en cromatografía de intercambio catiónico para evaluar sus patrones de expresión.
La figura 17 es un cromatograma de no6 CM eluido con un gradiente de pH de una columna HiTrap protein A HP (GE Healthcare).
La figura 18 es un cromatograma de análisis de cromatografía de intercambio catiónico para evaluar una fracción máxima principal obtenida por purificación de una fracción purificada de proteína A de no6 usando una columna SP Sepharose HP (GE Healthcare).
Modo de llevar a cabo la invención
La presente invención proporciona métodos para producir un multímero polipeptídico que comprende un primer polipéptido que tiene una actividad de unión a antígeno y un segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno como se define en las reivindicaciones. Los métodos de la presente invención para producir un multímero polipeptídico comprenden las etapas de:
(a) expresar un ADN que codifica un primer polipéptido que tiene una actividad de unión a antígeno y un ADN que codifica un segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno; y
(b) recoger los productos de expresión de la etapa (a) por cromatografía de afinidad con proteína A, como se define adicionalmente en las reivindicaciones.
Los métodos de la presente invención para producir un multímero polipeptídico también pueden expresarse como métodos para producir un multímero polipeptídico con una capacidad de unión a proteína A alterada.
En la presente invención, "un polipéptido que tiene una primera actividad de unión a antígeno" puede denominarse "un primer polipéptido que tiene una actividad de unión a antígeno". "Un polipéptido que tiene una segunda actividad de unión a antígeno o que no tiene actividad de unión a antígeno" puede denominarse "un segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno". Lo mismo se aplica a "un polipéptido que tiene una tercera actividad de unión a antígeno" y a "un polipéptido que tiene una cuarta actividad de
unión a antígeno" descritos a continuación.
En la presente invención, el término "comprende" significa tanto "comprende" como "consiste en".
La presente invención también proporciona métodos para purificar un multímero polipeptídico que comprende un primer polipéptido que tiene una actividad de unión a antígeno y un segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno como se define en las reivindicaciones. Los métodos de la presente invención para purificar un multímero polipeptídico comprenden las etapas de:
(a) expresar un ADN que codifica un primer polipéptido que tiene una actividad de unión a antígeno y un ADN que codifica un segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno; y
(b) recoger los productos de expresión de la etapa (a) por cromatografía de afinidad con proteína A, como se define adicionalmente en las reivindicaciones.
Se puede obtener un polipéptido que tiene una actividad de unión a antígeno en el que se han modificado uno o más restos de aminoácidos: preparando un ADN que codifica un polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno,
modificando uno o más nucleótidos en el ADN;
introduciendo el ADN resultante en células conocidas por los expertos en la materia;
cultivando las células para expresar el ADN; y
recogiendo el producto de expresión.
Por lo tanto, los métodos de la presente divulgación para producir un multímero polipeptídico también pueden expresarse como métodos correspondientes que comprenden las etapas de:
(a) proporcionar un ADN que codifica un primer polipéptido que tiene una actividad de unión a antígeno y un ADN que codifica un segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno;
(b) alterar uno o más nucleótidos en uno o ambos ADN de la etapa (a) que codifican los polipéptidos primero y segundo de modo que exista una mayor diferencia de capacidad de unión a proteína A entre el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno;
(c) introducir los ADN de la etapa (b) en células hospedadoras y cultivar las células hospedadoras para expresar los ADN; y
(d) recoger los productos de expresión de la etapa (c) del cultivo de células hospedadoras.
Los métodos de la presente divulgación para purificar un multímero polipeptídico también pueden expresarse como métodos correspondientes que comprenden las etapas de:
(a) proporcionar un ADN que codifica un primer polipéptido que tiene una actividad de unión a antígeno y un ADN que codifica un segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno;
(b) alterar uno o más nucleótidos en uno o ambos ADN de la etapa (a) que codifican los polipéptidos primero y segundo de modo que exista una mayor diferencia de capacidad de unión a proteína A entre el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno;
(c) introducir los ADN de la etapa (b) en células hospedadoras y cultivar las células hospedadoras para expresar los ADN; y
(d) recoger los productos de expresión de la etapa (c) del cultivo de células hospedadoras mediante cromatografía de afinidad con proteína A.
En la presente invención, un multímero polipeptídico se refiere a un multímero heteromérico que contiene los polipéptidos primero y segundo. Es preferible que los polipéptidos primero y segundo tengan, cada uno, una actividad de unión a un antígeno diferente. los polipéptidos primero y segundo, que tienen, cada uno, una actividad de unión a antígeno diferente, no están particularmente limitados siempre que uno de los polipéptidos tenga un dominio (secuencia de aminoácidos) de unión a antígeno diferente de aquel del otro polipéptido. Por ejemplo, como se muestra en la Figura 4 descrita a continuación, un polipéptido puede fusionarse con un dominio de unión a antígeno que es diferente de aquel del otro polipéptido. De manera alternativa, como se muestra en las Figuras 4, 6 y 9 descritas a continuación, un polipéptido puede ser un polipéptido que se une de forma monovalente a un antígeno y que no tiene el dominio de unión a antígeno que posee el otro polipéptido. Los multímeros polipeptídicos que contienen dichos primer y segundo polipéptidos también se incluyen en los multímeros polipeptídicos en contexto con la presente invención.
Los multímeros incluyen dímeros, trímeros y tretrámeros, pero no se limitan a los mismos.
En la presente invención, un primer polipéptido y/o un segundo polipéptido pueden formar un multímero con uno o dos terceros polipéptidos.
Por lo tanto, la presente divulgación proporciona métodos correspondientes para producir un multímero polipeptídico que comprende un primer polipéptido que tiene una actividad de unión a antígeno, un segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, y uno o dos terceros polipéptidos que tienen una actividad de unión a antígeno, que comprenden las etapas de:
(a) expresar un ADN que codifica un primer polipéptido que tiene una actividad de unión a antígeno, un ADN que codifica un segundo polipéptido que tiene una actividad de unión a antígeno y un ADN que codifica dos terceros polipéptidos que tienen una actividad de unión a antígeno; y
(b) recoger los productos de expresión de la etapa (a);
o
(a) expresar un ADN que codifica un primer polipéptido que tiene una actividad de unión a antígeno, un ADN que codifica un segundo polipéptido que no tiene actividad de unión a antígeno y un ADN que codifica un tercer polipéptido que tiene una actividad de unión a antígeno; y
(b) recoger los productos de expresión de la etapa (a);
en donde se han modificado uno o más restos de aminoácidos en uno o ambos del primer polipéptido que tiene una actividad de unión a antígeno y del segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno de modo que existe una mayor diferencia de capacidad de unión a proteína A entre el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno.
Los métodos descritos anteriormente también pueden expresarse como métodos que comprenden las etapas de:
(a) proporcionar un ADN que codifica un primer polipéptido que tiene una actividad de unión a antígeno, un ADN que codifica un segundo polipéptido que tiene una actividad de unión a antígeno y un ADN que codifica dos terceros polipéptidos que tienen una actividad de unión a antígeno;
(b) alterar uno o más nucleótidos en uno o ambos ADN de la etapa (a) que codifican los polipéptidos primero y segundo de modo que exista una mayor diferencia de capacidad de unión a proteína A entre el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno; (c) introducir los ADN que codifican los polipéptidos primero, segundo y dos terceros en células hospedadoras y cultivar las células hospedadoras para expresar los ADN; y
(d) recoger los productos de expresión de la etapa (c) del cultivo de células hospedadoras;
o
(a) proporcionar un ADN que codifica un primer polipéptido que tiene una actividad de unión a antígeno, un ADN que codifica un segundo polipéptido que no tiene actividad de unión a antígeno y un ADN que codifica un tercer polipéptido que tiene una actividad de unión a antígeno;
(b) alterar uno o más nucleótidos en uno o ambos ADN de la etapa (a) que codifican los polipéptidos primero y segundo de modo que exista una mayor diferencia de actividad de unión a proteína A entre el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que no tiene actividad de unión a antígeno; (c) introducir los ADN que codifican los polipéptidos primero, segundo y tercero en células hospedadoras y cultivar las células hospedadoras para expresar los ADN; y
(d) recoger los productos de expresión de la etapa (c) del cultivo de células hospedadoras.
Asimismo, en la presente invención, los polipéptidos primero y segundo pueden formar un multímero con polipéptidos tercero y cuarto.
Por lo tanto, la presente divulgación proporciona métodos correspondientes para producir un multímero polipeptídico que comprende un primer polipéptido que tiene una actividad de unión a antígeno, un segundo polipéptido que tiene una actividad de unión a antígeno, un tercer polipéptido que tiene una actividad de unión a antígeno y un cuarto polipéptido que tiene una actividad de unión a antígeno, que comprenden las etapas de:
(a) expresar un ADN que codifica un primer polipéptido que tiene una actividad de unión a antígeno, un ADN que codifica un segundo polipéptido que tiene una actividad de unión a antígeno y un ADN que codifica un tercer polipéptido que tiene una actividad de unión a antígeno y un cuarto polipéptido que tiene una actividad de unión a antígeno; y
(b) recoger los productos de expresión de la etapa (a);
en donde se han modificado uno o más restos de aminoácidos en uno o ambos del primer polipéptido que tiene una
actividad de unión a antígeno y del segundo polipéptido que tiene una actividad de unión a antígeno de modo que existe una mayor diferencia de capacidad de unión a proteína A entre el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno.
Los métodos descritos anteriormente también pueden expresarse como métodos que comprenden las etapas de:
(a) proporcionar un ADN que codifica un primer polipéptido que tiene una actividad de unión a antígeno, un ADN que codifica un segundo polipéptido que tiene una actividad de unión a antígeno y un ADN que codifica un tercer polipéptido que tiene una actividad de unión a antígeno y un cuarto polipéptido que tiene una actividad de unión a antígeno;
(b) alterar uno o más nucleótidos en uno o ambos ADN de la etapa (a) que codifican los polipéptidos primero y segundo de modo que exista una mayor diferencia de capacidad de unión a proteína A entre el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno; (c) introducir los ADN que codifican los polipéptidos primero, segundo, tercero y cuarto en células hospedadoras y cultivar las células hospedadoras para expresar los ADN; y
(d) recoger los productos de expresión de la etapa (c) del cultivo de células hospedadoras.
La presente divulgación proporciona métodos correspondientes para purificar un multímero polipeptídico que comprende un primer polipéptido que tiene una actividad de unión a antígeno, un segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, y uno o dos terceros polipéptidos que tienen una actividad de unión a antígeno, que comprenden las etapas de:
(a) expresar un ADN que codifica un primer polipéptido que tiene una actividad de unión a antígeno, un ADN que codifica un segundo polipéptido que tiene una actividad de unión a antígeno y un ADN que codifica dos terceros polipéptidos que tienen una actividad de unión a antígeno; y
(b) recoger los productos de expresión de la etapa (a);
o
(a) expresar un ADN que codifica un primer polipéptido que tiene una actividad de unión a antígeno, un ADN que codifica un segundo polipéptido que no tiene actividad de unión a antígeno y un ADN que codifica un tercer polipéptido que tiene una actividad de unión a antígeno; y
(b) recoger los productos de expresión de la etapa (a);
en donde se han modificado uno o más restos de aminoácidos en uno o ambos del primer polipéptido que tiene una actividad de unión a antígeno y del segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno de modo que existe una mayor diferencia de capacidad de unión a proteína A entre el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno.
Los métodos descritos anteriormente también pueden expresarse como métodos que comprenden las etapas de:
(a) proporcionar un ADN que codifica un primer polipéptido que tiene una actividad de unión a antígeno, un ADN que codifica un segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno y un ADN que codifica dos terceros polipéptidos que tienen una actividad de unión a antígeno;
(b) alterar uno o más nucleótidos en uno o ambos ADN de la etapa (a) que codifican los polipéptidos primero y segundo de modo que exista una mayor diferencia de capacidad de unión a proteína A entre el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno; (c) introducir los ADN que codifican los polipéptidos primero, segundo y dos terceros en células hospedadoras y cultivar las células hospedadoras para expresar los ADN; y
(d) recoger los productos de expresión de la etapa (c) del cultivo de células hospedadoras;
o
(a) proporcionar un ADN que codifica un primer polipéptido que tiene una actividad de unión a antígeno, un ADN que codifica un segundo polipéptido que no tiene actividad de unión a antígeno y un ADN que codifica un tercer polipéptido que tiene una actividad de unión a antígeno;
(b) alterar uno o más nucleótidos en uno o ambos ADN de la etapa (a) que codifican los polipéptidos primero y segundo de modo que exista una mayor diferencia de capacidad de unión a proteína A entre el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que no tiene actividad de unión a antígeno; (c) introducir los ADN que codifican los polipéptidos primero, segundo y tercero en células hospedadoras y cultivar las células hospedadoras para expresar los ADN; y
(d) recoger los productos de expresión de la etapa (c) del cultivo de células hospedadoras.
La presente divulgación también proporciona métodos correspondientes para purificar un multímero polipeptídico que comprende un primer polipéptido que tiene una actividad de unión a antígeno, un segundo polipéptido que tiene una
actividad de unión a antígeno, un tercer polipéptido que tiene una actividad de unión a antígeno y un cuarto polipéptido que tiene una actividad de unión a antígeno, que comprenden las etapas de:
(a) expresar un ADN que codifica un primer polipéptido que tiene una actividad de unión a antígeno, un ADN que codifica un segundo polipéptido que tiene una actividad de unión a antígeno, un ADN que codifica un tercer polipéptido que tiene una actividad de unión a antígeno y un ADN que codifica un cuarto polipéptido que tiene una actividad de unión a antígeno; y
(b) recoger los productos de expresión de la etapa (a) por cromatografía de afinidad con proteína A;
en donde se han modificado uno o más restos de aminoácidos en uno o ambos del primer polipéptido que tiene una actividad de unión a antígeno y del segundo polipéptido que tiene una actividad de unión a antígeno de modo que existe una mayor diferencia de capacidad de unión a proteína A entre el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno.
Los métodos descritos anteriormente también pueden expresarse como métodos correspondientes que comprenden las etapas de:
(a) proporcionar un ADN que codifica un primer polipéptido que tiene una actividad de unión a antígeno, un ADN que codifica un segundo polipéptido que tiene una actividad de unión a antígeno, un ADN que codifica un tercer polipéptido que tiene una actividad de unión a antígeno y un ADN que codifica un cuarto polipéptido que tiene una actividad de unión a antígeno;
(b) alterar uno o más nucleótidos en uno o ambos ADN de la etapa (a) que codifican los polipéptidos primero y segundo de modo que exista una mayor diferencia de capacidad de unión a proteína A entre el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno; (c) introducir los ADN que codifican los polipéptidos primero, segundo, tercero y cuarto en células hospedadoras y cultivar las células hospedadoras para expresar los ADN; y
(d) recoger los productos de expresión de la etapa (c) del cultivo de células hospedadoras mediante cromatografía de afinidad con proteína A.
En un multímero polipeptídico en contexto con la presente invención que contiene un primer polipéptido, un segundo polipéptido y uno o dos terceros polipéptidos, los polipéptidos primero y segundo pueden formar, cada un,o un multímero (dímero) con el tercer polipéptido. Asimismo, los dos dímeros resultantes pueden formar un multímero entre sí. Los dos terceros polipéptidos pueden tener completamente la misma secuencia de aminoácidos (pueden tener una actividad de unión al mismo antígeno). De manera alternativa, los terceros polipéptidos pueden tener la misma secuencia de aminoácidos y dos o más actividades (por ejemplo, pueden tener actividades de unión a dos o más antígenos diferentes). Cuando solo está presente un tercer polipéptido, el tercer polipéptido puede formar un multímero polipeptídico mediante dimerización bien con el primer polipéptido o con el segundo polipéptido.
En un multímero polipeptídico en contexto con la presente invención, los polipéptidos primero y segundo tienen preferentemente actividad de unión a diferentes antígenos. Entre tanto, el tercer polipéptido puede tener actividad de unión al mismo antígeno que aquel de uno o ambos polipéptidos primero y segundo. De manera alternativa, el tercer polipéptido puede tener actividad de unión a un antígeno diferente de aquellos de los polipéptidos primero y segundo.
De manera alternativa, un multímero polipeptídico en contexto con la presente invención puede contener un primer polipéptido, segundo polipéptido, tercer polipéptido y cuarto polipéptido. En dicho multímero polipeptídico, el primer polipéptido y el segundo polipéptido pueden formar un multímero (dímero) con el tercer polipéptido y el cuarto polipéptido, respectivamente. Por ejemplo, a través de la formación de enlaces disulfuro en medio, el primer polipéptido y el tercer polipéptido pueden formar un dímero y el segundo polipéptido y el cuarto polipéptido pueden formar un dímero.
En un multímero polipeptídico en contexto con la presente invención, los polipéptidos primero y segundo tienen preferentemente actividad de unión a diferentes antígenos. Entre tanto, el tercer polipéptido puede tener actividad de unión al mismo antígeno que aquel de uno o ambos polipéptidos primero y segundo. De manera alternativa, el tercer polipéptido puede tener actividad de unión a un antígeno diferente de aquellos de los polipéptidos primero y segundo. Asimismo, el cuarto polipéptido puede tener actividad de unión al mismo antígeno que aquel de uno o ambos polipéptidos primero y segundo. De manera alternativa, el cuarto polipéptido puede tener actividad de unión a un antígeno diferente de aquellos de los polipéptidos primero y segundo.
De manera específica, por ejemplo, cuando los polipéptidos primero y segundo contienen la secuencia de aminoácidos de una cadena pesada de anticuerpo contra el antígeno A y la secuencia de aminoácidos de una cadena pesada de anticuerpo contra el antígeno B, respectivamente, los polipéptidos tercero y cuarto pueden contener la secuencia de aminoácidos de una cadena ligera de anticuerpo contra el antígeno A y la secuencia de aminoácidos de una cadena ligera de anticuerpo contra el antígeno B, respectivamente. Cuando un multímero polipeptídico en contexto con la presente invención tiene polipéptidos tercero y cuarto que contienen dos secuencias de aminoácidos de cadena ligera de anticuerpo diferentes, se puede producir o purificar eficazmente un multímero polipéptido de interés altamente puro haciendo los valores del pI del tercer y cuarto polipéptido diferente usando los métodos descritos a continuación, o
diferenciando su capacidad de unión a proteína L, diferenciando, además, la capacidad de unión a proteína A entre los polipéptidos primero y segundo.
De manera alternativa, por ejemplo, cuando el primer polipéptido tiene la secuencia de aminoácidos de una cadena pesada de anticuerpo contra el antígeno A, el segundo polipéptido tiene la secuencia de aminoácidos de una región variable de cadena ligera de anticuerpo contra el antígeno B y la secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo, el tercer polipéptido tiene la secuencia de aminoácidos de una cadena ligera de anticuerpo contra el antígeno A y el cuarto polipéptido tiene la secuencia de aminoácidos de una región variable de cadena pesada de anticuerpo contra el antígeno B y la secuencia de aminoácidos de una región constante de cadena ligera de anticuerpo, también puede producirse o purificarse eficazmente un multímero polipeptídico de interés altamente puro que tiene los polipéptidos primero, segundo, tercero y cuarto usando la presente invención. En este caso, como se descritos en el Ejemplo 12 a continuación, la introducción de mutaciones de aminoácidos para alterar el valor del pI de un polipéptido o la introducción de mutaciones de aminoácidos para promover la asociación de polipéptidos de interés (documento WO2006/106905) permite una purificación o producción más eficaz de un multímero polipeptídico de interés que tiene los polipéptidos primero, segundo, tercero y cuarto a mayor pureza. Las mutaciones de aminoácidos a introducir para promover la asociación de polipéptidos pueden ser las utilizadas en los métodos descritos en Protein Eng. julio de 1996, 9(7):617-21; Protein Eng Des Sel. abril de 2010, 23(4):195-202; J Biol Chem. 18 de junio de 2010, 285(25):19637-46; documento WO2009080254; y similares, en los que dos polipéptidos que tienen una región constante de cadena pesada se asocian de forma heteromérica modificando el dominio CH3 de la región constante de cadena pesada; y las utilizadas en los métodos descritos en los documentos WO2009080251, WO2009080252, WO2009080253, y similares, mediante las cuales se promueve la asociación de un par particular de cadena pesada y cadena ligera.
En la presente invención, "polipéptido que tiene una actividad de unión a antígeno" se refiere a un péptido o proteína de cinco o más aminoácidos de longitud que tiene un dominio (región) capaz de unirse a una proteína o péptido tal como un antígeno o ligando, por ejemplo, una región variable de cadena pesada o de cadena ligera, receptor, péptido de fusión receptor- dominio Fc, armazón de anticuerpo o un fragmento de los mismos. De manera específica, un polipéptido que tiene una actividad de unión a antígeno puede contener la secuencia de aminoácidos de una región variable, receptor, péptido de fusión receptor- dominio Fc, armazón de anticuerpos o un fragmento de los mismos.
El armazón puede ser cualquier polipéptido siempre que sea un polipéptido conformacionalmente estable capaz de unirse a al menos un antígeno. Tales polipéptidos incluyen, pero sin limitación, por ejemplo, fragmentos de región variable de anticuerpos, fibronectina, dominios de proteína A, dominios del receptor A de LDL, lipocalinas y las moléculas mencionadas en Nygren et al. (Current Opinion in Structural Biology, 7:463-469 (1997); Journal of Immunol. Methods, 290:3-28 (2004)), Binz et al. (Nature Biotech 23:1257-1266 (2005)), y Hosse et al. (Protein Science 15:14-27 (2006)).
Los expertos en la materia conocen métodos para obtener regiones variables, receptores, péptidos de fusión receptordominio Fc, armazón de anticuerpo y fragmentos de los mismos.
Dichos polipéptidos que tienen una actividad de unión a antígeno pueden derivar de un organismo vivo o diseñarse artificialmente. Los polipéptidos pueden derivar de proteínas naturales, proteínas sintéticas, proteínas recombinantes y similares. Asimismo, los polipéptidos pueden ser péptidos o fragmentos de proteínas de 10 o más aminoácidos de longitud que tienen un dominio (región) capaz de unirse a una proteína o péptido tal como un antígeno o ligando, siempre que tengan la capacidad de unirse a un antígeno. Los polipéptidos pueden tener más de un dominio capaz de unirse a un antígeno (incluyendo el ligando).
Un polipéptido que tiene una actividad de unión a antígeno también puede denominarse un polipéptido que tiene un dominio o dominios proteicos de unión a antígeno.
En la presente invención, "polipéptido que no tiene actividad de unión a antígeno" se refiere a un péptido o proteína de cinco o más aminoácidos de longitud, tal como un fragmento que no tiene actividad de unión a antígeno, dominio Fc, armazón de anticuerpo o un fragmento de los mismos. De manera específica, un polipéptido que no tiene actividad de unión a antígeno puede contener la secuencia de aminoácidos de una región constante, dominio Fc, armazón de anticuerpo o un fragmento de los mismos, pero la secuencia de aminoácidos no se limita a los ejemplos anteriores. Un polipéptido que no tiene actividad de unión a antígeno puede combinarse con un polipéptido que tiene una actividad de unión a antígeno para producir un multímero polipeptídico que se une de forma monovalente a un antígeno.
En la presente invención, el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno puede contener la secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo o la secuencia de aminoácidos de un dominio Fc de anticuerpo. La secuencia de aminoácidos de un dominio Fc de anticuerpo o de una región constante de cadena pesada de anticuerpo incluye aquellas de regiones constantes y dominios Fc de tipo IgG humana. Las regiones constantes o los dominios Fc de tipo IgG pueden ser del isotipo IgG1, IgG2, IgG3 o IgG4 natural, o pueden ser variantes de los mismos.
Entre tanto, en la presente invención, el tercer polipéptido que tiene una actividad de unión a antígeno y el cuarto polipéptido que tiene una actividad de unión a antígeno pueden contener la secuencia de aminoácidos de una región constante de cadena ligera de anticuerpo. La secuencia de aminoácidos de una región constante de cadena ligera de anticuerpo incluye, pero sin limitación, las regiones constantes de tipo kappa humana y lambda humana y variantes de las mismas.
Asimismo, en la presente invención, los polipéptidos que tienen una actividad de unión a antígeno pueden contener la secuencia de aminoácidos de una región variable de anticuerpo (por ejemplo, las secuencias de aminoácidos de CDR1, CDR2, CDR3, FR1, FR2, FR3 y FR4).
Además, en la presente invención, los polipéptidos que tienen una actividad de unión a antígeno pueden contener la secuencia de aminoácidos de una cadena pesada de anticuerpo o de una cadena ligera de anticuerpo. De manera más específica, el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno puede contener la secuencia de aminoácidos de una cadena pesada de anticuerpo. Entre tanto, el tercer polipéptido que tiene una actividad de unión a antígeno y el cuarto polipéptido que tiene una actividad de unión a antígeno pueden contener la secuencia de aminoácidos de una cadena ligera de anticuerpo.
Cuando un multímero polipeptídico de interés es un tetrámero que se forma por multimerización entre un dímero formado por los polipéptidos primero y tercero y un dímero formado por los polipéptidos segundo y cuarto, por ejemplo, un polipéptido en el que los polipéptidos primero y segundo que tienen una actividad de unión a antígeno contiene la secuencia de aminoácidos de una cadena pesada de anticuerpo, y un polipéptido en el que los polipéptidos tercero y cuarto que tienen una actividad de unión a antígeno contienen la secuencia de aminoácidos de una cadena ligera de anticuerpo, se puede usar para el multímero polipeptídico en contexto con la presente invención. De manera alternativa, también se puede usar un polipéptido en el que el primer polipéptido que tiene una actividad de unión a antígeno contiene la secuencia de aminoácidos de una cadena pesada de anticuerpo, un polipéptido en el que el segundo polipéptido que tiene una actividad de unión a antígeno contiene la secuencia de aminoácidos de una región variable de cadena ligera de anticuerpo y la secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo, un polipéptido en el que el tercer polipéptido que tiene una actividad de unión a antígeno contiene la secuencia de aminoácidos de una cadena ligera de anticuerpo, y un polipéptido en el que el cuarto polipéptido que tiene una actividad de unión a antígeno contiene la secuencia de aminoácidos de una región variable de cadena pesada de anticuerpo.
De manera específica, un multímero polipeptídico en contexto con la presente invención puede ser un anticuerpo multiespecífico.
En la presente invención, un "anticuerpo multiespecífico" se refiere a un anticuerpo capaz de unirse específicamente a al menos dos antígenos diferentes.
En la presente invención, "antígenos diferentes" se refiere no solo a diferentes moléculas de antígeno per se, sino también a diferentes determinantes antigénicos presentes en las mismas moléculas de antígeno. En consecuencia, por ejemplo, diferentes determinantes antigénicos presentes dentro de una sola molécula se incluyen en los "antígenos diferentes" en contexto con la presente invención. En la presente invención, los anticuerpos que reconocen diversos determinantes antigénicos diferentes en una sola molécula se consideran "anticuerpos capaces de unirse específicamente a antígenos diferentes".
En la presente invención, loa anticuerpos multiespecíficos incluyen, pero sin limitación, anticuerpos biespecíficos capaces de unirse específicamente a dos tipos de antígenos. Los anticuerpos biespecíficos preferidos de la presente invención incluyen anticuerpos IgG de tipo H2L2 (compuestos de dos tipos de cadenas H y dos tipos de cadenas L) que tienen una región constante de IgG humana. De manera más específica, dichos anticuerpos incluyen, pero sin limitación, por ejemplo, anticuerpos quiméricos de tipo IgG, anticuerpos humanizados y anticuerpos humanos.
Además, un polipéptido que tiene una actividad de unión a antígeno puede ser, por ejemplo, una molécula en la que al menos dos de una región variable de cadena pesada, región variable de cadena ligera, región constante de cadena pesada y región constante de cadena ligera, están unidas entre sí como una cadena simple. De manera alternativa, el polipéptido puede ser un anticuerpo en el que al menos dos de una región variable de cadena pesada, región variable de cadena ligera, dominio Fc (región constante sin dominio CH1) y región constante de cadena ligera, están unidas entre sí como una cadena simple.
En la presente divulgación, la frase "existe una mayor diferencia en la capacidad de unión a proteína A entre polipéptidos que tienen una actividad de unión a antígeno" significa que la capacidad de unión a proteína A no es la misma (es diferente) entre dos o más polipéptidos como resultado de modificaciones de aminoácidos en la superficie de polipéptidos que tienen una actividad de unión a antígeno. De manera más específica, esta frase significa que, por ejemplo, la capacidad de unión a proteína A del primer polipéptido que tiene una actividad de unión a antígeno es diferente de la del segundo polipéptido que tiene una actividad de unión a antígeno. La diferencia de la capacidad de unión a proteína A puede examinarse, por ejemplo, usando cromatografía de afinidad con proteína A.
La fuerza de la capacidad de unión a proteína A de un polipéptido que tiene una actividad de unión a antígeno está correlacionada con el pH del disolvente utilizado para la elución. Cuanto mayor sea la capacidad de unión a proteína A del polipéptido, menor será el pH del disolvente utilizado para la elución. Por lo tanto, la frase "existe una mayor diferencia en la capacidad de unión a proteína A entre los polipéptidos que tienen una actividad de unión a antígeno" también se puede expresar como "cuando dos o más polipéptidos que tienen una actividad de unión a antígeno se eluyen usando la cromatografía de afinidad con proteína A, cada polipéptido se eluye a un pH de disolvente diferente ". La diferencia en el pH del disolvente de elución es 0,1 o más, preferentemente 0,5 o más, y aún más preferentemente 1,0 o más, pero sin limitación a esto.
Asimismo, en la presente divulgación, es preferible alterar la capacidad de unión a proteína A sin disminuir otras actividades (por ejemplo, retención en plasma) de los polipéptidos que tienen una actividad de unión a antígeno.
Un multímero polipeptídico de interés que comprende el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno puede producirse o purificarse usando cromatografía de afinidad con proteína A basándose en la diferencia de capacidad de unión a proteína A entre el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno. De manera específica, por ejemplo, cuando el multímero polipeptídico en contexto con la presente invención es un anticuerpo biespecífico que tiene una cadena L común (es decir, la misma secuencia de aminoácidos en los polipéptidos tercero y cuarto), el multímero polipeptídico puede producirse o purificarse mediante el método descrito a continuación. En primer lugar, las células hospedadoras se introducen con lo siguiente: un ácido nucleico que codifica el primer polipéptido que tiene una actividad de unión a antígeno (más específicamente, la primera cadena pesada del anticuerpo) cuyo aminoácido en la posición 435 (numeración EU) en la secuencia de aminoácidos de la región constante de la cadena pesada de anticuerpo es arginina (R); un ácido nucleico que codifica el segundo polipéptido que tiene una actividad de unión a antígeno (más específicamente, la segunda cadena pesada del anticuerpo) cuyo aminoácido en la posición 435 (numeración EU) en la secuencia de aminoácidos de la región constante de la cadena pesada del anticuerpo es histidina (H ); y un ácido nucleico que codifica el tercer polipéptido que tiene una actividad de unión a antígeno (cadena L común). Las células se cultivan para expresar los ADN de forma transitoria. Después, los productos de expresión resultantes se cargan en una columna de proteína A. Después del lavado, la elución se realiza primero con una solución de elución de pH alto y después con una solución de elución de pH bajo. Un anticuerpo homomérico que comprende dos unidades de la primera cadena pesada del anticuerpo y dos unidades de la cadena L común no tiene ningún sitio de unión a proteína A en su región constante de cadena pesada. Entre tanto, un anticuerpo biespecífico que comprende la primera cadena pesada del anticuerpo, la segunda cadena pesada del anticuerpo, y dos unidades de la cadena L común tienen un único sitio de unión a la proteína A en su región constante de cadena pesada. Un anticuerpo homomérico que comprende dos unidades de la segunda cadena pesada del anticuerpo y dos unidades de la cadena L común tiene dos sitios de unión a proteína A en su región constante de cadena pesada. Tal como se ha descrito anteriormente, la capacidad de unión a proteína A de un polipéptido se correlaciona con el pH del disolvente para eluir el polipéptido en la cromatografía de afinidad con proteína A. Cuanto mayor sea la capacidad de unión a la proteína A, menor será el pH del disolvente para la elución. Por lo tanto, cuando la elución se lleva a cabo primero con una solución de elución de pH alto y después con una solución de elución de pH bajo, los anticuerpos se eluyen en el siguiente orden:
- un anticuerpo homomérico que comprende dos unidades de la primera cadena pesada de anticuerpo y dos unidades de la cadena L común
- un anticuerpo biespecífico que comprende la primera cadena pesada de anticuerpo, la segunda cadena pesada de anticuerpo y dos unidades de la cadena L común
- un anticuerpo homomérico que comprende dos unidades de la segunda cadena pesada de anticuerpo y dos unidades de la cadena L común
Esto permite la producción o purificación de los multímeros polipeptídicos (anticuerpos biespecíficos) de interés.
La pureza de los multímeros polipeptídicos obtenidos por los métodos de producción o purificación de la presente invención es preferentemente al menos del 95 % o mayor (por ejemplo, 96 %, 97 %, 98 %, 99 % o mayor).
Las modificaciones de los restos de aminoácidos para crear una diferencia en la capacidad de unión a proteína A entre el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno incluyen, pero sin limitación:
(1) modificación de uno o más restos de aminoácidos en la secuencia de aminoácidos de uno cualquiera del primer polipéptido que tiene una actividad de unión a antígeno y del segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, de modo que aumenta la capacidad de unión a proteína A de uno de los polipéptidos;
(2) modificación de uno o más restos de aminoácidos en la secuencia de aminoácidos de uno cualquiera del primer polipéptido que tiene una actividad de unión a antígeno y del segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, de modo que disminuye la capacidad de unión a proteína
A de uno de los polipéptidos; y
(3) modificación de uno o más restos de aminoácidos en el primer polipéptido que tiene una actividad de unión a antígeno y en el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, de modo que aumenta la capacidad de unión a proteína A de uno cualquiera del primer polipéptido que tiene una actividad de unión a antígeno y del segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, y disminuye la capacidad de unión a proteína A del otro polipéptido.
En la presente divulgación, se prefiere que se modifiquen los aminoácidos en la superficie de un polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno. Asimismo, también se prefiere considerar reducir la influencia de la modificación en otras actividades del polipéptido.
En consecuencia, en la presente divulgación, se prefiere modificar, por ejemplo, los restos de aminoácidos en las siguientes posiciones (numeración EU) en el dominio Fc del anticuerpo o en la región constante de cadena pesada:
TLMISR en las posiciones 250-255, VLHQDWLNGK en las posiciones 308-317 y EALHNHY en las posiciones 430 436;
preferentemente, TLMIS en las posiciones 250-254, LHQD en las posiciones 309-312, LN en las posiciones 314 y 315, E en la posición 430 y LHNHY en las posiciones 432-436;
más preferentemente, LMIS en las posiciones 251-254, LHQ en las posiciones 309-311, L en la posición 314 y LHNH en las posiciones 432-435; y en particular, MIS en las posiciones 252-254, L en la posición 309, Q en la posición 311 y NHY en las posiciones 434-436.
En cuanto a las modificaciones de aminoácidos de la región variable de cadena pesada de anticuerpo, los sitios de mutación preferidos incluyen FR1, CDR2 y FR3. Los sitios de mutación más preferidos incluyen, por ejemplo, las posiciones H15-H23, H56-H59, H63-H72 y H79-H83 (numeración EU).
De las modificaciones de aminoácidos anteriores, se prefieren más las modificaciones que no reducen la unión a FcRn o la retención en plasma en ratones transgénicos con FcRn humano.
De manera más específica, las modificaciones que aumentan la capacidad de unión a la proteína A de un polipéptido incluyen, pero sin limitación, sustitución de histidina (His) por el resto de aminoácido en la posición 435 (numeración EU) en la secuencia de aminoácidos de un dominio Fc de anticuerpo o una región constante de cadena pesada de anticuerpo.
Entre tanto, las modificaciones que reducen la capacidad de unión a la proteína A de un polipéptido incluyen, pero sin limitación, sustitución de arginina por el resto de aminoácido en la posición 435 (numeración EU) en la secuencia de aminoácidos de un dominio Fc de anticuerpo o una región constante de cadena pesada de anticuerpo.
En cuanto a la región variable de cadena pesada de anticuerpo, la región variable de la cadena pesada de la subclase VH3 tiene actividad de unión a proteína A. Por lo tanto, para aumentar la capacidad de unión a proteína A, las secuencias de aminoácidos en los sitios de modificación anteriores son preferentemente idénticas a las de la región variable de la cadena pesada de la subclase VH3. Para reducir la capacidad de unión a proteína A, las secuencias de aminoácidos son preferentemente idénticas a las de la región variable de cadena pesada de otra subclase.
Como se describe a continuación, la modificación de los restos de aminoácidos se puede lograr alterando uno o más nucleótidos en un ADN que codifica un polipéptido y expresando el ADN en las células hospedadoras. Los expertos en la materia pueden determinar fácilmente el número, el sitio y el tipo de nucleótidos alterados dependiendo del tipo de restos de aminoácidos después de la modificación.
En el presente documento, la modificación (alteración) se refiere a la sustitución, eliminación, adición o inserción, o combinaciones de las mismas.
El polipéptido que tiene una actividad de unión a antígeno puede comprender otras modificaciones además de las modificaciones anteriores de restos de aminoácidos. Dichas modificaciones adicionales se pueden seleccionar de, por ejemplo, sustituciones, eliminaciones y modificaciones de aminoácidos, y combinaciones de las mismas. De manera específica, todos los polipéptidos cuyas secuencias de aminoácidos comprenden una modificación descrita a continuación se incluyen en la presente invención:
- modificación de aminoácidos para aumentar la tasa de asociación heteromérica de dos tipos de cadenas H en un anticuerpo biespecífico
- modificación de aminoácidos para estabilizar los enlaces disulfuro entre el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno
- modificación de aminoácidos para mejorar la retención en plasma de un anticuerpo
- modificación para aumentar la estabilidad en condiciones ácidas
- modificación para reducir la heterogeneidad
- modificación para suprimir la reacción de desamidación
- modificación para introducir una diferencia entre los puntos isoeléctricos de dos tipos de polipéptidos
- modificación para alterar la capacidad de unión al receptor Fcy
Estas modificaciones de aminoácidos se describen a continuación.
Modificación de aminoácidos para aumentar la tasa de asociación heteromérica de dos tipos de cadenas H en un anticuerpo biespecífico
Las modificaciones de aminoácidos en contexto con la presente invención se pueden combinar con las modificaciones de aminoácidos descritas en el documento WO2006106905. No hay limitación en los sitios de modificación siempre que los aminoácidos formen la interfaz entre dos polipéptidos que tienen una actividad de unión a antígeno. De manera específica, por ejemplo, cuando se modifica una región constante de cadena pesada, tales modificaciones incluyen modificaciones que hacen que los aminoácidos de al menos una de las combinaciones de las posiciones 356 y 439, las posiciones 357 y 370 y las posiciones 399 y 409 (numeración EU) en la secuencia de aminoácidos de la región constante de cadena pesada del primer polipéptido que tiene una actividad de unión a antígeno tengan la misma carga eléctrica; y los aminoácidos de al menos una de las combinaciones de las posiciones 356 y 439, las posiciones 357 y 370, y las posiciones 399 y 409 (numeración EU) en la región constante de cadena pesada del segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene una actividad de unión a antígeno tengan una carga eléctrica opuesta a la del primer polipéptido que tiene una actividad de unión a antígeno. De manera más específica, dichas modificaciones incluyen, por ejemplo, introducción de una mutación que sustituye la Glu en la posición 356 (numeración EU) con Lys en la secuencia de aminoácidos de la región constante de cadena pesada de uno cualquiera del primer polipéptido que tiene una actividad de unión a antígeno y del segundo polipéptido que tiene una actividad de unión a antígeno y una mutación que sustituye la Lys en la posición 439 (numeración EU) con Glu en la secuencia de aminoácidos de la región constante de cadena pesada del otro polipéptido. Cuando estas modificaciones se combinan con las modificaciones en contexto con la presente invención, el polipéptido de interés se puede obtener con una pureza más alta por purificación basada en proteína A sola.
De manera alternativa, el multímero polipeptídico de interés que comprende los polipéptidos primero, segundo, tercero y cuarto que tienen una actividad de unión a antígeno puede producirse o purificarse eficazmente a una pureza superior, cuando se realiza una modificación para hacer que los aminoácidos en la posición 39 (numeración de Kabat) en la región variable de cadena pesada y/o en la posición 213 (numeración EU) en la región constante de cadena pesada del primer polipéptido que tiene una actividad de unión a antígeno tengan un carga eléctrica opuesta a la del aminoácido en la posición 39 (numeración de Kabat) en la región variable de cadena pesada y/o el aminoácido en la posición 213 (numeración EU) en la región constante de cadena pesada del segundo polipéptido que tiene una unión a antígeno actividad o que no tiene actividad de unión a antígeno y el aminoácido en la posición 38 (numeración de Kabat) y/o el aminoácido en la posición 123 (numeración EU) en la región variable de cadena ligera del tercer polipéptido que tiene una actividad de unión a antígeno tenga una carga eléctrica opuesto al del aminoácido en la posición 38 (numeración de Kabat) y/o al aminoácido en la posición 123 (numeración EU) en la región variable de cadena ligera del cuarto polipéptido que tiene una actividad de unión a antígeno.
Modificación de aminoácidos para estabilizar los enlaces disulfuro entre el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno
Como se describe en los documentos publicados (Mol. Immunol. 1993, 30, 105-108; y Mol. Immunol. 2001, 38, 1-8), se elimina la heterogeneidad de IgG4 y se puede mantener su estructura estable sustituyendo Pro por Ser en la posición 228 (numeración EU) en la secuencia de aminoácidos de la región constante de cadena pesada de IgG4.
Modificación de aminoácidos para mejorar la retención en plasma de un anticuerpo
Para regular la retención de plasma, es posible combinar las modificaciones de aminoácidos en contexto con la presente invención con modificaciones de aminoácidos que alteran el valor del pI del anticuerpo. Las modificaciones en regiones constantes incluyen, por ejemplo, modificaciones de aminoácidos en las posiciones 250 y 428 (numeración EU) y las descritas en documentos publicados (J. Immunol. 2006, 176 (1 ):346-356; y Nat. Biotechnol. 199715 (7):637-640). Las modificaciones a las regiones variables incluyen las modificaciones de aminoácidos descritas en los documentos WO2007/114319 y WO2009/041643. Los aminoácidos a modificar se exponen preferentemente en la superficie de un polipéptido que tiene una actividad de unión a antígeno. Las modificaciones incluyen, por ejemplo, la sustitución de aminoácidos en la posición 196 (numeración EU) en la secuencia de aminoácidos de una región constante de cadena pesada. En el caso de la región constante de la cadena pesada de IgG4, la retención en plasma se puede potenciar, por ejemplo, sustituyendo glutamina por lisina en la posición 196, reduciendo así el valor del pI.
Asimismo, la retención en plasma se puede regular alterando la capacidad de unión a FcRn. Las modificaciones de aminoácidos que alteran la capacidad de unión a FcRn incluyen, por ejemplo, las sustituciones de aminoácidos en la región constante de cadena pesada de anticuerpo descritas en documentos publicados (The Journal of Biological Chemistry vol.276, N.° 9 6591-6604, 2001; Molecular Cell, Vol.7, 867-877, 2001; Curr Opin Biotechnol. 2009, 20
(6):685-91). Dichas sustituciones de aminoácidos incluyen, por ejemplo, sustituciones en las posiciones 233, 238, 253, 254, 255, 256, 258, 265, 272, 276, 280, 285, 288, 290, 292, 293, 295, 296, 297, 298, 301, 303, 305, 307, 309, 311, 312, 315, 317, 329, 331, 338, 360, 362, 376, 378, 380, 382, 415, 424, 433, 434, 435 y 436 (numeración EU).
Modificación para mejorar la estabilidad en condiciones ácidas
Cuando se usa la región constante de cadena pesada de IgG4, la estructura estable de cuatro cadenas (estructura H2L2) se mantiene preferentemente suprimiendo la conversión de IgG4 en la forma de media molécula en condiciones ácidas. Por lo tanto, la arginina en la posición de aminoácidos 409 (sistema de numeración EU) que desempeña un papel importante en el mantenimiento de la estructura de cuatro cadenas (Immunology 2002, 105, 9-19) se sustituye preferentemente con lisina del tipo IgG1 que mantiene una estructura de cuatro cadenas estable incluso en condiciones ácidas. Asimismo, para mejorar la estabilidad ácida de la IgG2, la metionina en la posición de aminoácido 397 (sistema de numeración EU) puede sustituirse con valina. Estas modificaciones pueden usarse en combinación con las modificaciones de aminoácidos en contexto con la presente invención.
Modificación para reducir la heterogeneidad
Las modificaciones de aminoácidos en contexto con la presente invención pueden combinarse con los métodos descritos en el documento WO2009041613. De manera específica, por ejemplo, la modificación en la que se eliminan los dos aminoácidos en el extremo C de la región constante de cadena pesada de IgG1 (es decir, glicina y lisina en las posiciones 446 y 447 [numeración EU], respectivamente) se puede combinar con las modificaciones de aminoácidos descritas en los Ejemplos en el presente documento.
Modificación para suprimir la reacción de desamidación
Las modificaciones de aminoácidos en contexto con la presente invención pueden combinarse con modificaciones de aminoácidos para suprimir la reacción de desamidación. Se ha indicado que la reacción de desamidación e produce con mayor frecuencia en un sitio donde la asparagina (N) y la glicina (G) están adyacentes entre sí (— NG —) (Geiger et al., J. Bio. Chem. (1987) 262:785-794). Cuando un multímero polipeptídico (anticuerpo multiespecífico) en contexto con la presente invención tiene un sitio donde la asparagina y la glicina son adyacentes entre sí, la reacción de desamidación puede suprimirse modificando la secuencia de aminoácidos. De manera específica, por ejemplo, una o ambas de asparagina y glicina se sustituyen con otros aminoácidos. De manera más específica, por ejemplo, la asparagina se sustituye con ácido aspártico.
Modificación para introducir una diferencia en el punto isoeléctrico entre dos tipos de polipéptidos
Las modificaciones de aminoácidos en contexto con la presente invención pueden combinarse con modificaciones de aminoácidos para introducir una diferencia en el punto isoeléctrico. Se describen métodos específicos, por ejemplo, en el documento WO2007/114325. Además de las modificaciones en contexto con la presente invención, las secuencias de aminoácidos del primer polipéptido que tiene una actividad de unión a antígeno y del segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno se modifican para que haya una mayor diferencia en el punto isoeléctrico entre estos polipéptidos. Esto permite la producción o purificación eficaz del polipéptido de interés a una mayor pureza. Asimismo, se puede producir una diferencia mayor en el punto isoeléctrico entre el tercer polipéptido que tiene una actividad de unión a antígeno y el cuarto polipéptido que tiene una actividad de unión a antígeno. Esto permite que el multímero polipeptídico de interés que comprende los polipéptidos primero, segundo, tercero y cuarto se produzca o purifique de manera eficaz a una pureza superior. De manera específica, cuando los polipéptidos primero y segundo comprenden cada uno una secuencia de aminoácidos de una cadena pesada de anticuerpo, los sitios de modificación incluyen, por ejemplo, las posiciones 1, 3, 5, 8, 10, 12, 13, 15, 16, 19, 23, 25, 26, 39, 42, 43, 44, 46, 68, 71, 72, 73, 75, 76, 81, 82b, 83, 85, 86, 105, 108, 110 y 112 (numeración de Kabat). cuando los polipéptidos tercero y cuarto comprenden cada uno una secuencia de aminoácidos de una cadena ligera de anticuerpo, los sitios de modificación incluyen, por ejemplo, las posiciones 1, 3, 7, 8, 9, 11, 12, 16, 17, 18, 20, 22, 38, 39, 41, 42, 43, 45, 46, 49, 57, 60, 63, 65, 66, 68, 69, 70, 74, 76, 77, 79, 80, 81, 85, 100, 103, 105, 106, 107 y 108 (numeración de Kabat). Se puede producir una diferencia mayor en el punto isoeléctrico modificando al menos uno de los restos de aminoácidos en las posiciones anteriores en un polipéptido para que tenga una carga eléctrica, y modificando al menos uno de los restos de aminoácidos en las posiciones anteriores en el otro polipéptido para que no tenga carga o que tenga carga eléctrica opuesta a la anterior.
Modificación para alterar la capacidad de unión al receptor Fcv
Las modificaciones de aminoácidos en contexto con la presente invención pueden combinarse con modificaciones de aminoácidos que alteran (aumentan o reducen) la capacidad de unión al receptor de Fcy. Las modificaciones para alterar la capacidad de unión al receptor Fcy incluyen, pero sin limitación, las modificaciones descritas en Curr Opin Biotechnol. 2009, 20(6):685-91. De manera específica, la capacidad de unión al receptor Fcy se puede alterar, por ejemplo, combinando las modificaciones en contexto con la presente invención con una modificación que sustituye la leucina en las posiciones 234 y 235 y la asparagina en la posición 272 (numeración EU) de una región constante de cadena pesada de IgG1 con otros aminoácidos. Los aminoácidos después de la sustitución incluyen, pero sin
limitación, alanina.
A continuación se describe la preparación de ADN que codifican polipéptidos que tienen una actividad de unión a antígeno, la modificación de uno o más nucleótidos, la expresión de los ADN y la recuperación de productos de expresión
Preparación de ADN que codifican polipéptidos que tienen actividad de unión a antígeno
En la presente invención, un ADN que codifica un polipéptido que tiene una actividad de unión a antígeno o un polipéptido que no tiene actividad de unión a antígeno puede ser la totalidad o una parte de una secuencia conocida (secuencia de origen natural o artificial), o sus combinaciones. Tales ADN se pueden obtener por métodos conocidos por los expertos en la materia. Los ADN pueden aislarse, por ejemplo, de bibliotecas de anticuerpos, o clonando genes que codifican anticuerpos a partir de hibridomas que producen anticuerpos monoclonales.
Con respecto a las bibliotecas de anticuerpos, muchas ya son bien conocidas, y los expertos en la materia pueden obtener apropiadamente bibliotecas de anticuerpos ya que se conocen métodos para producir bibliotecas de anticuerpos. Por ejemplo, con respecto a las bibliotecas de fagos de anticuerpos, se puede consultar la bibliografía tal como Clackson et al., Nature 1991, 352: 624-8; Marks et al., J. Mol. Biol. 1991, 222: 581-97; Waterhouses et al., Nucleic Acids Res. 1993, 21: 2265-6; Griffiths et al., EMBO J. 1994, 13: 3245-60; Vaughan et al., Nature Biotechnology 1996, 14: 309-14; o la publicación de Patente Japonesa Kohyo N.° (JP-A) H20-504970 (publicación en fase nacional japonesa no examinada correspondiente a una publicación internacional no japonesa). Además, pueden usarse métodos conocidos tales como métodos que usan células eucariotas como bibliotecas (WO95/15393) y métodos de presentación en ribosomas. Asimismo, Además, también se conocen técnicas para obtener anticuerpos humanos mediante la selección usando bibliotecas de anticuerpos humanos. Por ejemplo, las regiones variables de anticuerpos humanos se pueden expresar en la superficie de los fagos como anticuerpos de cadena sencilla (scFv) usando métodos de presentación en fagos y se pueden seleccionar fagos que se unen a antígenos. El análisis genético de los fagos seleccionados puede determinar las secuencias de ADN que codifican las regiones variables de los anticuerpos humanos que se unen a los antígenos. Una vez que se revelan las secuencias de ADN de scFv que se unen a los antígenos, se pueden producir vectores de expresión adecuados basándose en estas secuencias para obtener anticuerpos humanos. Estos métodos ya son bien conocidos, y se pueden consultar los documentos WO92/01047, WO92/20791, WO93/06213, WO93/11236, WO93/19172, WO95/01438 y WO95/15388.
En cuanto a los métodos para obtener genes que codifican anticuerpos a partir de hibridomas, básicamente, se pueden usar técnicas conocidas. De manera específica, los antígenos deseados o las células que expresan los antígenos deseados se usan como antígenos sensibilizantes para la inmunización según los métodos de inmunización convencionales. Las células inmunitarias así obtenidas se fusionan con células precursoras conocidas por métodos de fusión celular ordinarios, y las células productoras de anticuerpos monoclonales (hibridomas) se exploran por métodos de exploración ordinarios. Los ADNc de las regiones variables de anticuerpo (regiones V) se pueden obtener mediante la transcripción inversa de los ARNm de los hibridomas obtenidos utilizando la transcriptasa inversa. Los genes que codifican los anticuerpos se pueden obtener uniéndolos con los ADN que codifican las regiones constantes de anticuerpos (regiones C) deseadas.
De manera más específica, sin limitaciones, los siguientes métodos son ejemplos.
Los antígenos sensibilizantes para obtener los genes de anticuerpos que codifican las cadenas pesadas y ligeras del anticuerpo incluyen tanto antígenos completos con inmunogenicidad como antígenos incompletos compuestos de haptenos y tales que no muestran antigenicidad. Por ejemplo, se pueden usar proteínas de longitud completa y péptidos parciales de proteínas de interés. Además, se sabe que las sustancias compuestas de polisacáridos, ácidos nucleicos, lípidos y similares pueden convertirse en antígenos. Por lo tanto, no hay limitaciones particulares sobre los antígenos en la presente invención. Los antígenos pueden prepararse por métodos conocidos por los expertos en la materia, y pueden prepararse, por ejemplo, por los siguientes métodos usando baculovirus (por ejemplo, el documento WO98/46777). Se pueden producir hibridomas, por ejemplo, los siguientes métodos de Milstein et al. (G. Kohler y C. Milstein, Métodos Enzymol. 1981, 73: 3-46) y similares. Cuando la inmunogenicidad de un antígeno es baja, se puede unir a una macromolécula que tiene inmunogenicidad, tal como la albúmina y después se usa para la inmunización. Asimismo, al unir los antígenos con otras moléculas si es necesario, se pueden convertir en antígenos solubles. Cuando las moléculas transmembrana, tal como los receptores, se usan como antígenos, las porciones de las regiones extracelulares de los receptores pueden usarse como un fragmento, o las células que expresan moléculas transmembrana en su superficie celular pueden usarse como inmunógenos.
Las células productoras de anticuerpos pueden obtenerse inmunizando animales usando los antígenos sensibilizantes adecuados descritos anteriormente. De manera alternativa, las células productoras de anticuerpos pueden prepararse mediante inmunización in vitro de linfocitos que pueden producir anticuerpos. Se pueden usar varios mamíferos como animales para la inmunización, donde generalmente se usan roedores, lagomorfos y primates. Ejemplos de tales animales incluyen ratones, ratas y hámsters para roedores, conejos para lagomorfos y monos, incluidos el mono cynomolgus, el mono rhesus, los hamadríades y los chimpancés para primates. Además, también se conocen animales transgénicos que portan repertorios de genes de anticuerpos humanos, y se pueden obtener anticuerpos
humanos usando estos animales (véanse los documentos WO96/34096; Mendez et al., Nat. Genet. 1997, 15: 146 56). En lugar de usar tales animales transgénicos, por ejemplo, los anticuerpos humanos deseados que tienen actividad de unión contra antígenos pueden obtenerse mediante la sensibilización in vitro de linfocitos humanos con antígenos deseados o células que expresan los antígenos deseados, y fusionando, después, los linfocitos sensibilizados con células de mieloma humano tales como U266 (véase la Solicitud de Patente Japonesa Kokoku N.° de Publicación (JP-B) H1-59878 (solicitud de patente japonesa aprobada y examinada,publicada para oposición)). Asimismo, los anticuerpos humanos deseados pueden obtenerse inmunizando animales transgénicos que portan un repertorio completo de genes de anticuerpos humanos, con los antígenos deseados (véase los documentos WO93/12227, WO92/03918, WO94/02602, WO96/34096 y WO96/33735).
La inmunización animal se puede llevar a cabo diluyendo y suspendiendo adecuadamente un antígeno sensibilizante en Solución Salina Tamponada con Fosfato (PBS), solución salina fisiológica o similares, y formando una emulsión mezclando un adyuvante si es necesario, seguido de una inyección intraperitoneal o subcutánea en los animales. Después de eso, el antígeno sensibilizante mezclado con el adyuvante incompleto de Freund se administra preferentemente varias veces cada cuatro a 21 días. La producción de anticuerpos puede confirmarse midiendo el título de anticuerpos diana en sueros animales usando métodos convencionales.
Las células productoras de anticuerpos obtenidas de linfocitos o animales inmunizados con un antígeno deseado pueden fusionarse con células de mieloma para generar hibridomas usando agentes de fusión convencionales (por ejemplo, polietilenglicol) (Goding, Monoclonal Antibodies: Principles and Practice, Academic Press, 1986, 59-103). Cuando sea necesario, las células de hibridoma se pueden cultivar y hacer crecer, y la especificidad de unión del anticuerpo producido a partir de estos hibridomas se puede medir utilizando métodos de análisis conocidos, tal como inmunoprecipitación, radioinmunoensayo (RIA) y ensayo de inmunoabsorción ligado a enzimas (ELISA). Después de eso, los hibridomas que producen anticuerpos de interés cuya especificidad, afinidad o actividad se han determinado pueden subclonarse mediante métodos tal como dilución limitante.
A continuación, los genes que codifican los anticuerpos seleccionados pueden clonarse a partir de hibridomas o células productoras de anticuerpos (linfocitos sensibilizados, y similares) utilizando sondas que pueden unirse específicamente a los anticuerpos (por ejemplo, oligonucleótidos complementarios a las secuencias que codifican las regiones constantes de anticuerpo). También es posible la clonación a partir de ARNm usando RT-PCR. Las inmunoglobulinas se clasifican en cinco clases diferentes, IgA, IgD, IgE, IgG e IgM. Estas clases se dividen en varias subclases (isotipos) (por ejemplo, IgG-1, IgG-2, IgG-3 e IgG-4; IgA-1 e IgA-2; y similares). Las cadenas pesadas y las cadenas ligeras usadas en la presente invención para producir anticuerpos no están particularmente limitadas y pueden derivar de anticuerpos que pertenecen a cualquiera de estas clases o subclases; sin embargo, se prefiere particularmente IgG.
En el presente documento, es posible modificar genes que codifican cadenas pesadas y genes que codifican cadenas ligeras utilizando técnicas de ingeniería genética. Los anticuerpos genéticamente modificados, tal como los anticuerpos quiméricos, los anticuerpos humanizados que se han modificado artificialmente con el fin de disminuir la antigenicidad heteróloga y contra los humanos, se pueden producir de manera apropiada si es necesario para anticuerpos tales como anticuerpos de ratón, anticuerpos de rata, anticuerpos de conejo, anticuerpos de hámster, anticuerpos de oveja y anticuerpos de camello. Los anticuerpos quiméricos son anticuerpos compuestos de regiones variables de cadena pesada y cadena ligera de anticuerpo de mamífero no humano, tal como anticuerpo de ratón, y las regiones constantes de cadena pesada y cadena ligera de anticuerpo humano. Se pueden obtener uniendo el ADN que codifica una región variable de un anticuerpo de ratón al ADN que codifica una región constante de un anticuerpo humano, incorporándolos en un vector de expresión e introduciendo el vector en un hospedador para la producción del anticuerpo. Un anticuerpo humanizado, que también se denomina anticuerpo humano reformado, se puede sintetizar mediante PCR a partir de una serie de oligonucleótidos producidos para que tengan partes solapantes en los extremos de las secuencias de ADN diseñadas para unir las regiones determinantes de la complementariedad (CDR) de un anticuerpo de un mamífero no humano tal como un ratón. El ADN obtenido puede unirse a un ADN que codifica una región constante de anticuerpo humano. El ADN unido puede incorporarse en un vector de expresión, y el vector puede introducirse en un hospedador para producir el anticuerpo (véase los documentos EP239400 y WO96/02576). Las FR de anticuerpos humanos que se unen a través de la CDR se seleccionan cuando la CDR forma un sitio de unión a antígeno favorable. Si es necesario, los aminoácidos en la región marco de una región variable de anticuerpo pueden sustituirse de modo que la CDR del anticuerpo humano reformado forme un sitio de unión a antígeno apropiado (K. Sato et al., Cancer Res. 1993, 53: 851-856). Los anticuerpos monoclonales en contexto con la presente invención incluyen tales anticuerpos humanizados y anticuerpos quiméricos.
Cuando los anticuerpos en contexto con la presente invención son anticuerpos quiméricos o anticuerpos humanizados, las regiones constantes de estos anticuerpos derivan preferentemente de anticuerpos humanos. Por ejemplo, se pueden usar Cy1, Cy2, Cy3 y Cy4 para la cadena pesada, mientras que se pueden usar Ck y CA para la cadena ligera. Asimismo, la región constante del anticuerpo humano puede modificarse según sea necesario para mejorar el anticuerpo o su estabilidad de producción. Un anticuerpo quimérico en contexto con la presente invención comprende preferentemente una región variable de un anticuerpo derivado de un mamífero no humano y una región constante de un anticuerpo humano. Entre tanto, un anticuerpo humanizado en contexto con la presente invención comprende preferentemente CDR de un anticuerpo derivado de un mamífero no humano, y regiones FR y C de un anticuerpo
humano. Las regiones constantes derivadas de los anticuerpos humanos comprenden secuencias de aminoácidos específicas, que varían según el isotipo, tal como IgG (IgG1, IgG2, IgG3 e IgG4), IgM, IgA, IgD e IgE. Las regiones constantes usadas para preparar los anticuerpos humanizados en contexto con la presente invención pueden ser regiones constantes de anticuerpos de cualquier isotipo. Se usa preferentemente una región constante de IgG humana, pero las regiones constantes no están limitadas a las mismas. Entre tanto, no existe una limitación particular en las FR derivadas de anticuerpos humanos que se usan para preparar anticuerpos humanizados, y pueden derivar de un anticuerpo de cualquier isotipo.
Las regiones variables y constantes de anticuerpos quiméricos o humanizados en contexto con la presente invención pueden modificarse por eliminación, sustitución, inserción y/o adición, siempre que los anticuerpos muestren la misma especificidad de unión que los anticuerpos originales.
Se espera que los anticuerpos quiméricos y humanizados que usan secuencias derivadas de humanos sean útiles cuando se administran a seres humanos con fines terapéuticos o similares, ya que su antigenicidad en el cuerpo humano se ha atenuado.
En la presente divulgación, los aminoácidos pueden modificarse para alterar las propiedades biológicas de un anticuerpo.
Los minicuerpos (anticuerpos de bajo peso molecular) son útiles como anticuerpos debido a sus propiedades cinéticas in vivo y a su bajo coste de producción utilizando E. coli, células vegetales o similares.
Los fragmentos de anticuerpos son un tipo de minicuerpo. Los minicuerpos incluyen anticuerpos que comprenden un fragmento de anticuerpo como su estructura parcial. Los minicuerpos en contexto con la presente invención no están particularmente limitados por su estructura o método de producción, siempre que tengan capacidad de unión a antígeno. Algunos minicuerpos tienen una actividad mayor que la de un anticuerpo completo (Orita et al., Blood (2005) 105: 562-566). En el presente documento, "los fragmentos de anticuerpos" no están particularmente limitados siempre que sean una parte de un anticuerpo completo (por ejemplo, IgG completa). Sin embargo, los fragmentos de anticuerpos comprenden preferentemente una región variable de cadena pesada (VH) o una región variable de cadena ligera (VL). Los fragmentos de anticuerpos preferidos incluyen, por ejemplo, Fab, F(ab')2, Fab' y Fv. La secuencia de aminoácidos de una región variable de cadena pesada (VH) o de una región variable de cadena ligera (VL) en un fragmento de anticuerpo puede modificarse mediante sustitución, eliminación, adición y/o inserción. Asimismo, pueden eliminarse algunas partes de una región variable de cadena pesada (VH) o de una región variable de cadena ligera (VL), siempre que los fragmentos conserven su capacidad de unión a antígeno. Por ejemplo, de los fragmentos de anticuerpos anteriores, "Fv" es un fragmento de anticuerpo mínimo que comprende los sitios completos de reconocimiento y unión a antígeno. "Fv" es un dímero (dímero VH-VL) en el que una región variable de cadena pesada (VH) y una región variable de cadena ligera (VL) están estrechamente unidas por enlaces no covalentes. Las tres regiones determinantes de complementariedad (CDR) de cada región variable forman un sitio de unión a antígeno en la superficie del dímero VH-VL. Seis CDR confieren un sitio de unión a antígeno al anticuerpo. Sin embargo, incluso una región variable (o la mitad de un Fv que comprende solo tres CDR específicas de antígeno) tiene la capacidad de reconocer y unirse a un antígeno, aunque su afinidad es menor que la del sitio de unión completo. Por lo tanto, tales moléculas que son más pequeñas que Fv también se incluyen en los fragmentos de anticuerpos en contexto con la presente invención. Asimismo, las regiones variables de un fragmento de anticuerpo pueden estar quimerizadas o humanizadas.
Es preferible que los minicuerpos comprendan tanto una región variable de cadena pesada (VH) como una región variable de cadena ligera (VL). Los minicuerpos incluyen, por ejemplo, fragmentos de anticuerpos tales como fragmentos Fab, Fab', F(ab')2 y Fv, y scFv (Fv de cadena sencilla) que pueden prepararse usando fragmentos de anticuerpos (Huston et al., Proc. Natl Acad. Sci. USA (1988) 85: 5879-83; Plickthun "The Pharmacology of Monoclonal Antibodies" Vol. 113, Resenburg y Moore (eds.), Springer Verlag, Nueva York, págs. 269-315, (1994)); diacuerpos (Holliger et al., Proc. Natl. Acad. Sci. USA (1993) 90:6444-8; los documentos EP 404097; WO93/11161; Johnson et al., Method in Enzymology (1991) 203: 88-98; Holliger et al., Protein Engineering (1996) 9:299-305; Perisic et al., Structure (1994) 2:1217-26; John et al., Protein Engineering (1999) 12(7):597-604; Atwell et al., Mol. Immunol. (1996) 33:1301-12); sc(Fv)2 (Hudson et al., J Immunol. Methods (1999) 231:177-89; Orita et al., Blood (2005) 105:562-566); triacuerpos (Journal of Immunological Methods (1999) 231: 177-89); y diacuerpos en tándem (Cancer Research (2000) 60:4336-41).
Se puede preparar un fragmento de anticuerpo tratando un anticuerpo con una enzima, por ejemplo, una proteasa tal como papaína y pepsina (véase Morimoto et al., J. Biochem. Biophys. Methods (1992) 24:107-17; Brennan et al., Science (1985) 229:81). De manera alternativa, también se puede producir un fragmento de anticuerpo mediante recombinación genética basándose en su secuencia de aminoácidos.
Un minicuerpo que comprende una estructura que es el resultado de la modificación de un fragmento de anticuerpo puede construirse usando un fragmento de anticuerpo obtenido mediante tratamiento enzimático o recombinación genética. De manera alternativa, después de construir un gen que codifica un minicuerpo completo e introducirlo en un vector de expresión, el minicuerpo puede expresarse en células hospedadoras apropiadas (véanse, por ejemplo,
Co et al., J. Immunol. (1994) 152:2968-76; Better y Horwitz, Methods Enzymol. (1989) 178:476-96; Pluckthun y Skerra, Methods Enzymol. (1989) 178: 497-515; Lamoyi, Methods Enzymol. (1986) 121:652-63; Rousseaux et al., Methods Enzymol. (1986) 121:663-9; Bird y Walker, Trends Biotechnol. (1991) 9:132-7).
El scFv anterior es un polipéptido de cadena sencilla que comprende dos regiones variables unidas entre sí a través de un enlazador o similares, según sea necesario. Las dos regiones variables contenidas en un scFv son generalmente una VH y una VL, pero un scFv puede tener dos VH o dos VL. En general, los polipéptidos scFv comprenden un enlazador entre los dominios VH y VL, formando así una porción emparejada de Vh y VL necesaria para la unión a antígeno. Un enlazador peptídico de diez o más aminoácidos se usa generalmente como el enlazador entre VH y VL para formar una porción emparejada intramolecularmente entre VH y VL. Sin embargo, los enlazadores del scFv en contexto con la presente invención no se limitan a dichos enlazadores peptídicos, siempre que no inhiban la formación de scFv. Para revisar scFv, véase Pluckthun "The Pharmacology of Monoclonal Antibody", Vol. 113 (Rosenburg y Moore ed., Springer Verlag, NY, págs. 269-315 (1994)).
Entre tanto, "diacuerpos (Db)" se refiere a fragmentos de anticuerpos divalentes construidos por fusión génica (P. Holliger et al., Proc. Natl. Acad. Sci. USA 90: 6444-6448 (1993); los documentos EP 404.097; WO93/11161; etc.). Los diacuerpos son dímeros que comprenden dos cadenas de polipéptidos, en las que cada cadena de polipéptidos comprende dentro de la misma cadena una región variable de cadena ligera (VL) y una región variable de cadena pesada (VH) unidas a través de un enlazador lo suficientemente corto como para evitar la interacción de estos dos dominios, por ejemplo, un enlazador de aproximadamente cinco restos. VL y VH codificadas en la misma cadena polipeptídica formarán un dímero porque el enlazador entre VL y VH es demasiado corto para formar un fragmento de región V de cadena sencilla. Por lo tanto, los diacuerpos tienen dos sitios de unión a antígeno. En este caso, cuando VL y VH dirigidas contra dos epítopos diferentes (a y b) se expresan simultáneamente como combinaciones de VLa-VHb y VLb-VHa conectadas con un enlazador de aproximadamente cinco restos, se secretan como Db biespecíficos.
Los diacuerpos comprenden dos moléculas de scFv y, por lo tanto, tienen cuatro regiones variables. Como resultado, los diacuerpos tienen dos sitios de unión a antígeno. A diferencia de las situaciones en las que scFv no forma dímeros, en la formación de diacuerpos, la longitud del enlazador entre la VH y la VL en cada molécula scFv es generalmente de aproximadamente cinco aminoácidos cuando el enlazador es un enlazador peptídico. Sin embargo, el enlazador de scFv que forma un diacuerpo no se limita a dicho enlazador peptídico, siempre que no inhiba la expresión de scFv y la formación de diacuerpos.
Asimismo, es preferible que los minicuerpos y fragmentos de anticuerpos en contexto con la presente invención comprendan adicionalmente una secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo y/o una secuencia de aminoácidos de una región constante de cadena ligera.
Alteración de uno o más nucleótidos
En el presente documento, "alteración de nucleótidos" significa que la manipulación genética o mutagénesis se realiza para insertar, eliminar o sustituir al menos un nucleótido en un ADN de modo que el polipéptido codificado por el ADN tenga restos de aminoácidos de interés. De manera específica, esto significa que el codón que codifica el resto de aminoácido original está sustituido con un codón que codifica el resto de aminoácido de interés. Dichas alteraciones de nucleótidos pueden introducirse usando métodos tales como mutagénesis dirigida al sitio (véase, por ejemplo, Kunkel (1985) Proc. Natl. Acad. Sci. USA 82: 488), mutagénesis por PCR y mutagénesis en casete. En general, los anticuerpos mutantes cuyas propiedades biológicas se han mejorado muestran una homología y/o similitud de secuencia de aminoácidos del 70 % o mayor, más preferentemente del 80 % o mayor, e incluso más preferentemente del 90 % o mayor (por ejemplo, 95 % o mayor, 97 %, 98 %, 99 %, etc.), en comparación con la secuencia de aminoácidos de la región variable del anticuerpo original. En el presente documento, la homología y/o similitud de secuencia se define como la proporción de restos de aminoácidos que son homólogos (el mismo resto) o similares (restos de aminoácidos clasificados en el mismo grupo basándose en las propiedades generales de las cadenas laterales de aminoácidos) a los restos de aminoácidos originales, después de maximizar el valor de la homología de secuencia realizando la alineación de secuencia y la introducción de huecos según sea necesario. En general, los restos de aminoácidos de origen natural se clasifican en los siguientes grupos basándose en las características de sus cadenas laterales: (1) hidrófobos: alanina, isoleucina, valina, metionina y leucina; (2) hidrófilos neutros: asparagina, glutamina, cisteína, treonina y serina; (3) ácidos: ácido aspártico y ácido glutámico; (4) básicos: arginina, histidina y lisina; (5) restos que tienen influencia en la conformación de la cadena: glicina y prolina; y (6) aromáticos: tirosina, triptófano y fenilalanina. El número de aminoácidos modificados es, por ejemplo, diez, nueve, ocho, siete, seis, cinco, cuatro, tres, dos o uno, pero sin limitación a esto.
En general, un total de seis regiones determinantes de complementariedad (CDR; regiones hipervariables) presentes en las regiones variables de cadena pesada y de cadena ligera interactúan para formar el sitio o los sitios de unión a antígeno de un anticuerpo. Se sabe que una de estas regiones variables tiene la capacidad de reconocer y unirse al antígeno, aunque la afinidad será menor que cuando se incluyen todos los sitios de unión. Por lo tanto, los polipéptidos en contexto con la presente invención que tienen una actividad de unión a antígeno pueden codificar porciones de fragmentos que contienen los sitios de unión a antígeno correspondientes de cadena pesada y cadena ligera de anticuerpo siempre que mantengan la actividad de unión a antígeno deseada.
Los métodos de la presente invención permiten la preparación eficaz de, por ejemplo, multímeros polipeptídicos deseados que realmente tienen la actividad descrita anteriormente.
En una realización preferida de la presente divulgación, los restos de aminoácidos apropiados para ser "modificados" pueden seleccionarse de, por ejemplo, las secuencias de aminoácidos de las regiones variables de cadena pesada y cadena ligera de anticuerpo y las secuencias de aminoácidos de la región variable de cadena ligera y la cadena ligera del anticuerpo.
Expresión de ADN
Los ADN que codifican los polipéptidos modificados se clonan (insertan) en un vector apropiado y después se introducen en las células hospedadoras. No hay una limitación particular en los vectores siempre que porten de manera estable los ácidos nucleicos insertados. Por ejemplo, cuando se usa E. coli como hospedador, los vectores incluyen vectores de clonación. Los vectores de clonación preferidos incluyen vectores pBluescript (Stratagene). Es posible usar distintos vectores disponibles comercialmente. Los vectores de expresión son particularmente útiles como vectores para producir los multímeros polipeptídicos o polipéptidos en contexto con la presente invención. No existe una limitación particular en los vectores de expresión siempre que expresen polipéptidos in vitro, en E. coli, en células de cultivo o en organismos. Los vectores preferidos incluyen, por ejemplo, vectores pBEST (Promega) para expresión in vitro; vectores pET (Invitrogen) para expresión en E. coli; el vector pME18S-FL3 (número de acceso de GenBank AB009864) para la expresión en células de cultivo; y el vector pME18S (Mol. Cell. Biol. 8:466-472 (1988)) para la expresión en organismos. Los ADN se pueden insertar en vectores mediante métodos convencionales, como la reacción con ligasa, utilizando sitios de enzimas de restricción (Current protocols in Molecular Biology edit. Ausubel et al. (1987) Publish. John Wiley & Sons. Sección 11.4-11.11).
No hay limitación particular en las células hospedadoras anteriores, y se pueden usar diferentes células hospedadoras dependiendo del fin. Las células para expresar polipéptidos incluyen, por ejemplo, células bacterianas (por ejemplo, Streptococcus, Staphylococcus, E. coli, Streptomyces y Bacillus subtilis), células fúngicas (p. ej., levadura y Aspergillus), células de insectos (p. ej., Drosophila S2 y Spodoptera SF9), células animales (p. ej., CHO, COS, HeLa, C127, 3T3, BHK, HEK293, Células de melanoma de Bowes) y células vegetales. Los vectores se pueden introducir en las células hospedadoras utilizando métodos conocidos, tal como el método de precipitación con fosfato de calcio, el método de electroporación (Current protocols in Molecular Biology edit. Ausubel et al. (1987) Publish. John Wiley & Sons. Sección 9.1-9.9), método de lipofección y método de microinyección.
Para secretar polipéptidos expresados en células hospedadoras en el lumen del retículo endoplasmático, el espacio periplásmico o el entorno extracelular, se pueden incorporar señales de secreción apropiadas en los polipéptidos de interés. Estas señales pueden ser intrínsecas o extrañas a los polipéptidos de interés.
Los vectores de expresión para los polipéptidos primero, segundo, tercero y cuarto pueden construirse insertando ADN que codifican los polipéptidos individualmente en vectores separados. De manera alternativa, algunos de los ADN que codifican los polipéptidos primero, segundo, tercero y cuarto (por ejemplo, un ADN que codifica el primer polipéptido y un ADN que codifica el segundo polipéptido) pueden insertarse en un único vector para construir vectores de expresión. Cuando se construye un vector de expresión insertando múltiples ADN en un único vector, no hay limitación en la combinación de ADN que codifican el polipéptido a insertar.
Recuperación de productos de expresión
Cuando los polipéptidos se secretan a un medio de cultivo, los productos de expresión se recuperan recogiendo el medio. Cuando los polipéptidos se producen en células, primero se lisan las células y después se recogen los polipéptidos.
Los polipéptidos pueden recogerse y purificarse a partir de un cultivo de células recombinantes mediante métodos conocidos que incluyen precipitación con sulfato de amonio o con etanol, extracción con ácido, cromatografía de intercambio aniónico o catiónico, cromatografía de fosfocelulosa, cromatografía de interacción hidrófoba, cromatografía de afinidad, cromatografía con hidroxilapatita y cromatografía con lectina.
En la presente invención, se usa cromatografía de afinidad con proteína A.
Las columnas de proteína A incluyen, pero sin limitación, Hyper D (PALL), POROS (Applied Biosystems), Sepharose F. F. (GE) y ProSep (Millipore). De manera alternativa, la cromatografía de afinidad con proteína A se puede realizar usando una resina unida por un ligando que imita la capacidad de unión a IgG de la proteína A. Además, cuando se usa un mimético de proteína A, se pueden aislar y purificar multímeros polipeptídicos de interés creando una diferencia en la capacidad de unión como resultado de las modificaciones de aminoácidos en contexto con la presente invención. Tales miméticos de proteína A incluyen, pero sin limitación, por ejemplo, mabSelect SuRE (GE Healthcare).
Asimismo, la presente invención proporciona multímeros polipeptídicos obtenidos por los métodos de producción o
purificación de la presente invención.
La presente invención también contempla multímeros polipeptídicos que comprenden el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, en donde la capacidad de unión a proteína A es diferente entre el primer y el segundo polipéptido.
Dichos multímeros polipeptídicos se pueden obtener por los métodos descritos en el presente documento. Las estructuras y propiedades de los multímeros polipeptídicos son como se describen anteriormente y se resumen a continuación.
En comparación con la modificación previa de los aminoácidos, se ha alterado la capacidad de unión a proteína A de los multímeros polipeptídicos en contexto con la presente invención. De manera más específica, la capacidad de unión a proteína A se ha alterado en uno o ambos del primer polipéptido que tiene una actividad de unión a antígeno y del segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno. En un multímero polipeptídico en contexto con la presente invención, la capacidad de unión a proteína A del primer polipéptido que tiene una actividad de unión a antígeno es diferente de la del segundo polipéptido que tiene una actividad de unión a antígeno que no tiene actividad de unión a antígeno. En consecuencia, el pH del disolvente para la elución de la proteína A es diferente para el primer polipéptido y para el segundo polipéptido en la cromatografía de afinidad.
Asimismo, el primer polipéptido y/o el segundo polipéptido pueden formar un multímero con uno o dos terceros polipéptidos.
Por lo tanto, la presente invención contempla multímeros polipeptídicos que comprenden el primer polipéptido que tiene una actividad de unión a antígeno, el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, y uno o dos terceros polipéptidos que tienen una actividad de unión a antígeno, en donde la capacidad de unión a proteína A es diferente para los polipéptidos primero y segundo. Dichos multímeros polipeptídicos también se pueden obtener por los métodos descritos en el presente documento.
Los multímeros polipeptídicos pueden comprender adicionalmente un cuarto polipéptido. Uno cualquiera del primer polipéptido y el segundo polipéptido pueden formar un multímero con el tercer polipéptido, mientras que el otro puede formar otro multímero con el cuarto polipéptido.
Por lo tanto, la presente invención contempla multímeros polipeptídicos que comprenden el primer polipéptido que tiene una actividad de unión a antígeno, el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, el tercer polipéptido que tiene una actividad de unión a antígeno y el cuarto polipéptido que tiene una actividad de unión a antígeno, en donde la capacidad de unión a proteína A es diferente para los polipéptidos primero y segundo. Dichos multímeros polipeptídicos también se pueden obtener por los métodos descritos en el presente documento.
El primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno anteriores pueden comprender una secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo o una secuencia de aminoácidos de un dominio Fc de anticuerpo. La secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo o un dominio Fc de anticuerpo incluye, pero sin limitación, una secuencia de aminoácidos de una región constante derivada de IgG humana.
Entre tanto, el tercer polipéptido que tiene una actividad de unión a antígeno y el cuarto polipéptido que tiene una actividad de unión a antígeno anteriores pueden comprender una secuencia de aminoácidos de una región constante de cadena ligera de anticuerpo.
Asimismo, los polipéptidos que tienen una actividad de unión a antígeno pueden comprender una secuencia de aminoácidos de una región variable de anticuerpo (por ejemplo, secuencias de aminoácidos de CDR1, CDR2, CDR3, FR1, FR2, FR3 y FR4).
El primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno anteriores pueden comprender una secuencia de aminoácidos de una cadena pesada de anticuerpo, o una secuencia de aminoácidos que comprende una región variable de cadena ligera de anticuerpo y una región constante de cadena pesada de anticuerpo. El tercer polipéptido que tiene una actividad de unión a antígeno y el cuarto polipéptido que tiene una actividad de unión a antígeno anteriores pueden comprender una secuencia de aminoácidos de una cadena ligera de anticuerpo, o una secuencia de aminoácidos que comprende una región variable de cadena pesada de anticuerpo y una región constante de cadena ligera de anticuerpo.
Un multímero polipeptídico en contexto con la presente invención puede ser un anticuerpo multiespecífico. Los
anticuerpos multiespecíficos en contexto con la presente invención incluyen, pero sin limitación, anticuerpos biespecíficos capaces de unirse específicamente a dos tipos de antígenos.
En un multímero polipeptídico en contexto con la presente divulgación, se han modificado uno o más restos de aminoácidos para que haya una diferencia (mayor) de la capacidad de unión a proteína A entre el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno. Tal como se ha descrito anteriormente, los sitios de modificación incluyen, pero sin limitación, por ejemplo, los siguientes restos de aminoácidos: TLMISR en las posiciones 250-255, VLHQDWLNGK en las posiciones 308-317, EALHNHY en las posiciones 430-436, preferentemente TLMIS en las posiciones 250-254, Lh Qd en las posiciones 309-312, LN en las posiciones 314-315, E en la posición 430, LHNHY en las posiciones 432-436, más preferentemente LMIS en las posiciones 251-254, LHQ en las posiciones 309-311, L en la posición 314, LHNH en las posiciones 432-435 y particularmente LMIS en las posiciones 252-254, L en la posición 309, Q en la posición 311 y n Hy en las posiciones 434-436 (numeración EU ) en un dominio Fc o en una región constante de cadena pesada de anticuerpo. Entre tanto, en cuanto a las modificaciones de aminoácidos de una región variable de cadena pesada de anticuerpo, los sitios de modificación preferidos incluyen FR1, CDR2 y FR3.
De manera más específica, los multímeros polipeptídicos de la presente divulgación, incluyen, pero sin limitación, multímeros polipeptídicos en los que el resto de aminoácido en la posición 435 (numeración EU) en la secuencia de aminoácidos de un dominio Fc de anticuerpo o región constante de cadena pesada de anticuerpo es histidina o arginina en uno cualquiera del primer polipéptido que tiene una actividad de unión a antígeno y del segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, mientras que el otro polipéptido tiene un resto de aminoácido diferente en la posición 435 (numeración EU) en la secuencia de aminoácidos de un dominio Fc de anticuerpo o región constante de cadena pesada de anticuerpo.
En los métodos de la presente invención, el resto de aminoácido en la posición 435 (numeración EU) en la secuencia de aminoácidos del dominio Fc o la región constante de cadena pesada es histidina o arginina en el primer polipéptido que tiene una actividad de unión a antígeno y arginina o histidina respectivamente en el segundo polipéptido que tiene o que no tiene una actividad de unión a antígeno.
Asimismo, los multímeros polipeptídicos en contexto con la presente invención incluyen, pero sin limitación, multímeros polipeptídicos en los que el resto de aminoácido en la posición 435 (numeración EU) en la secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo es histidina en uno cualquiera del primer polipéptido que tiene una actividad de unión a antígeno y del segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, mientras que el resto de aminoácido en la posición 435 (numeración EU) en la secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo es arginina en el otro polipéptido.
Asimismo, los multímeros polipeptídicos de la presente divulgación, que comprende los polipéptidos primero y segundo incluyen, pero sin limitación, los ejemplos a continuación.
(1) multímeros polipeptídicos que comprenden el primer o segundo polipéptido que comprende una secuencia de aminoácidos en la que los restos de aminoácidos en las posiciones 435 y 436 (numeración EU) en la secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo derivada de una IgG humana se han modificado a histidina (His) y tirosina (Tyr), respectivamente. Dichos multímeros polipeptídicos incluyen, pero sin limitación, por ejemplo, multímeros polipeptídicos que comprenden el primer o segundo polipéptido que comprende la secuencia de aminoácidos de la Se Q ID NO: 9, 11, 13 o 15.
(2) multímeros polipeptídicos que comprenden el primer o segundo polipéptido que comprende una secuencia de aminoácidos en la que los restos de aminoácidos en las posiciones 435 y 436 (numeración EU) en la secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo derivada de una IgG humana se han modificado a arginina (Arg) y fenilalanina (Phe), respectivamente.
Dichos multímeros polipeptídicos incluyen, pero sin limitación, por ejemplo, multímeros polipeptídicos que comprenden el primer o segundo polipéptido que comprende la secuencia de aminoácidos de la SEQ ID NO: 10 o 12.
(3) multímeros polipeptídicos que comprenden el primer o segundo polipéptido que comprende una secuencia de aminoácidos en la que los restos de aminoácidos en las posiciones 435 y 436 (numeración EU) en la secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo derivada de una IgG humana se han modificado a arginina (Arg) y tirosina (Tyr), respectivamente. Dichos multímeros polipeptídicos incluyen, pero sin limitación, por ejemplo, multímeros polipeptídicos que comprenden el primer o segundo polipéptido que comprende la secuencia de aminoácidos de la SEQ ID NO: 14.
(4) multímeros polipeptídicos que comprenden los polipéptidos primero y segundo, en donde uno cualquiera de los polipéptidos comprende una secuencia de aminoácidos en la que los restos de aminoácidos en las posiciones 435 y 436 (numeración EU) en la secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo derivada de una IgG humana se han modificado a histidina (His) y tirosina (Tyr), respectivamente; y el otro polipéptido comprende una secuencia de aminoácidos en la que los restos de aminoácidos en las posiciones 435 y 436 (numeración EU) en la secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo se han modificado a arginina (Arg) y fenilalanina (Phe), respectivamente.
Dichos multímeros polipeptídicos incluyen, pero sin limitación, por ejemplo, multímeros polipeptídicos que
comprenden el primer polipéptido que comprende la secuencia de aminoácidos de la SEQ ID NO: 9, 11, 13 o 15 y el segundo polipéptido que comprende la secuencia de aminoácidos de la SEQ ID NO: 10 o 12.
(5) multímeros polipeptídicos que comprenden los polipéptidos primero y segundo, en donde uno cualquiera de los polipéptidos comprende una secuencia de aminoácidos en la que los restos de aminoácidos en las posiciones 435 y 436 (numeración EU) en la secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo derivada de una IgG humana se han modificado a histidina (His) y tirosina (Tyr), respectivamente; y el otro polipéptido comprende una secuencia de aminoácidos en la que los restos de aminoácidos en las posiciones 435 y 436 (numeración EU) en la secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo se han modificado a arginina (Arg) y tirosina (Tyr), respectivamente.
Dichos multímeros polipeptídicos incluyen, pero sin limitación, por ejemplo, multímeros polipeptídicos que comprenden el primer polipéptido que comprende la secuencia de aminoácidos de la SEQ ID NO: 9, 11, 13 o 15 y el segundo polipéptido que comprende la secuencia de aminoácidos de la SEQ ID NO: 14.
(6) multímeros polipeptídicos que comprenden los polipéptidos primero y segundo, en donde uno cualquiera de los polipéptidos comprende una secuencia de aminoácidos en la que los restos de aminoácidos en las posiciones 435 y 436 (numeración EU) en la secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo derivada de una IgG humana se han modificado a arginina (Arg) y fenilalanina (Phe), respectivamente; y el otro polipéptido comprende una secuencia de aminoácidos en la que los restos de aminoácidos en las posiciones 435 y 436 (numeración EU) en la secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo se han modificado a arginina (Arg) y tirosina (Tyr), respectivamente.
Dichos multímeros polipeptídicos incluyen, pero sin limitación, por ejemplo, multímeros polipeptídicos que comprenden el primer polipéptido que comprende la secuencia de aminoácidos de la SEQ ID NO: 10 o 12 y el segundo polipéptido que comprende la secuencia de aminoácidos de la SEQ ID NO: 14.
Los polipéptidos primero y segundo anteriores pueden comprender adicionalmente una región variable de cadena pesada de anticuerpo. Los multímeros polipeptídicos de (1) a (6) anteriores también pueden comprender el tercer polipéptido y/o el cuarto polipéptido.
Asimismo, la presente invención contempla variantes de polipéptidos que comprenden un polipéptido que comprende una mutación en el resto de aminoácido en la posición 435 o 436 (numeración EU). Dichas variantes de polipéptidos incluyen, pero sin limitación, variantes de polipéptidos que comprenden un polipéptido descrito en los Ejemplos.
Asimismo, la presente invención contempla ácidos nucleicos que codifican un polipéptido (polipéptido que tiene una actividad de unión a antígeno) que constituye un multímero polipeptídico en el contexto de la presente invención. La presente invención también contempla vectores que portan tales ácidos nucleicos.
La presente invención también contempla células hospedadoras que comprenden los ácidos nucleicos o vectores anteriores. No existe limitación particular en las células hospedadoras, e incluyen, por ejemplo, E. coli y diferentes células vegetales y animales. Las células hospedadoras pueden usarse, por ejemplo, como un sistema de producción para producir y expresar los multímeros polipeptídicos o polipéptidos en contexto con la presente invención. Existen sistemas de producción in vitro e in vivo para producir los multímeros polipeptídicos o polipéptidos. Los sistemas de producción in vitro incluyen aquellos que usan células eucariotas y células procariotas.
Las células eucariotas que pueden usarse como células hospedadoras incluyen, por ejemplo, células animales, células vegetales y células fúngicas. Las células animales incluyen: células de mamíferos, por ejemplo, CHO (J. Exp. Med. (1995) 108, 945), COS, HEK293, 3T3, mieloma, BHK (riñón de hámster recién nacido), HeLa y Vero; células de anfibios tales como ovocitos de Xenopus laevis (Valle, et al., Nature (1981) 291: 338-340); y células de insectos tales como Sf9, Sf21 y Tn5. Para expresar los multímeros polipeptídicos o polipéptidos en contexto con la presente invención, se pueden usar de forma adecuada CHO-DG44, CHO-DX11B, células COS7, células HEK293 y células BHK. De las células animales, las células CHO son particularmente preferentes para la expresión a gran escala. Los vectores pueden introducirse en una célula hospedadora mediante, por ejemplo, métodos con fosfato de calcio, métodos DEAE-dextrano, métodos que usan liposoma catiónico DOTAP (Boehringer-Mannheim), métodos de electroporación o métodos de lipofección.
Se sabe que las células vegetales tales como las células derivadas de Nicotiana tabacum y las células de Lemna minor son sistemas de producción de proteínas, y estas células pueden usarse para producir multímeros polipeptídicos o polipéptidos en contexto con la presente invención mediante métodos que cultivan callos de estas células. Los sistemas de expresión de proteínas que usan células fúngicas, incluidas las células de levaduras, por ejemplo, las células del género Saccharomyces (Saccharomyces cerevisiae, Saccharomyces pombe, etc.) y las células de hongos filamentosos, por ejemplo, el género Aspergillus (Aspergillus niger, etc.) son conocidas, y estas células pueden usarse como un hospedador para producir multímeros polipeptídicos o polipéptidos en contexto con la presente invención.
Cuando se usan células procariotas, están disponibles los sistemas de producción que usan células bacterianas. Se conocen sistemas de producción que usan células bacterianas que incluyen Bacillus subtilis así como E. coli descritas anteriormente, y pueden usarse para producir multímeros polipeptídicos o polipéptidos en contexto con la presente invención.
Cuando se produce un multímero polipeptídico o polipéptido usando una célula hospedadora contemplada en la presente invención, un polinucleótido que codifica el multímero polipeptídico o polipéptido en contexto con la presente invención puede expresarse cultivando la célula hospedadora transformada con un vector de expresión que comprende el polinucleótido. El cultivo se puede realizar de acuerdo con métodos conocidos. Por ejemplo, cuando se usan células animales como células hospedadoras, se puede usar DMEM, MEM, RPMI 1640, o IMDm como el medio de cultivo. El medio de cultivo puede usarse con soluciones con complementos de suero tales como FBS o suero de ternera fetal (FCS). De manera alternativa, las células pueden cultivarse en cultivos sin suero. El pH preferido es de aproximadamente 6 a 8 durante el curso del cultivo. La incubación se lleva a cabo generalmente a aproximadamente 30 a 40 ° C durante aproximadamente 15 a 200 horas. El medio se intercambia, airea o agita, según sea necesario.
Por otro lado, los sistemas para producir polipéptidos in vivo incluyen, por ejemplo, aquellos que usan animales y aquellos que usan plantas. Se introduce un polinucleótido de interés en un animal o planta para producir el polipéptido en el cuerpo del animal o la planta, y después se recoge el polipéptido. El "hospedador" contemplado en la presente invención incluye tales animales y plantas.
Cuando se usan animales, están disponibles los sistemas de producción que usan mamíferos o insectos. Se pueden utilizar mamíferos tales como cabras, cerdos, ovejas, ratones y vacas (Vicki Glaser, SPECTRUM Biotechnology Applications (1993)). Cuando se usan mamíferos, se pueden usar animales transgénicos.
Por ejemplo, un polinucleótido que codifica un multímero polipeptídico o polipéptido en contexto con la presente invención puede prepararse como un gen de fusión con un gen que codifica un polipéptido producido específicamente en la leche, tal como la p-caseína de cabra. A continuación, los fragmentos de polinucleótidos que contienen este gen de fusión se inyectan en embriones de cabra, que después se introducen nuevamente en cabras hembras. El anticuerpo de interés puede obtenerse de la leche producida por las cabras transgénicas, que nacen de las cabras que recibieron los embriones, o por sus crías. Se pueden administrar hormonas apropiadas a las cabras transgénicas para aumentar el volumen de leche que contiene el anticuerpo producido por las cabras transgénicas (Ebert et al., Bio/Technology (1994) 12: 699-702).
Se pueden usar insectos tales como gusanos de seda para producir multímeros polipeptídicos o polipéptidos en contexto con la presente invención. Cuando se usan gusanos de seda, los baculovirus que portan un polinucleótido que codifica un multímero polipeptídico o polipéptido de interés pueden usarse para infectar gusanos de seda, de modo que el multímero polipeptídico o polipéptido de interés pueda obtenerse de los fluidos corporales de estos gusanos de seda (Susumu et al., Nature (1985) 315:592-594).
Las plantas usadas para producir multímeros polipeptídicos o polipéptidos en contexto con la presente invención incluyen, por ejemplo, tabaco. Cuando se usa tabaco, se inserta un polinucleótido que codifica un multímero polipeptídico o polipéptido de interés en un vector de expresión vegetal, por ejemplo, por ejemplo, pMON 530, y después el vector se introduce en una bacteria tal como Agrobacterium tumefaciens. Después, las bacterias se usan para infectar tabaco, tal como Nicotiana tabacum, y el multímero polipeptídico o polipéptido deseado se puede obtener de las hojas del tabaco (Ma et al., Eur. J. Immunol. (1994) 24: 131-138). De manera alternativa, se puede usar la misma bacteria para infectar a Lemna minor, y después de la clonación, se puede obtener el multímero polipeptídico o polipéptido deseado de las células de Lemna minor (Cox K.M. et al., Nat. Biotechnol. Dic de 2006; 24(12):1591-1597).
El multímero polipeptídico o polipéptido así obtenido puede aislarse del interior o del exterior (tal como el medio y la leche) de las células hospedadoras, y purificarse como un multímero polipeptídico o polipéptido sustancialmente puro y homogéneo. Los métodos utilizados para separar y purificar un polipéptido multímero o polipéptido no están limitados, y se pueden aplicar métodos utilizados en la purificación convencional de polipéptidos. Los anticuerpos pueden aislarse y purificarse seleccionando una combinación apropiada de, por ejemplo, columnas cromatográficas, filtración, ultrafiltración, precipitación de proteínas por adición de sal, precipitación con disolvente, extracción con disolvente, destilación, inmunoprecipitación, electroforesis en gel de poliacrilamida con SDS, isoelectroenfoque, diálisis, recristalización y similares.
Las cromatografías incluyen, por ejemplo, cromatografía de afinidad, cromatografía de intercambio iónico, cromatografía hidrófoba, filtración en gel, cromatografía de fase inversa y cromatografía de adsorción (Strategies for Protein Purification and Characterization: A Laboratory Course Manual. Ed Daniel R. Marshak et al., (1996) Cold Spring Harbor Laboratory Press). Estas cromatografías pueden llevarse a cabo utilizando cromatografía en fase líquida como HPLC y FPLC. Ejemplos de columnas para cromatografía de afinidad incluyen columnas de proteína A y columnas de proteína G. Ejemplos de las columnas que usan proteína A incluyen, pero sin limitación, Hyper D, POROS y Sepharose F. F. (Pharmacia).
Según sea necesario, se pueden añadir modificaciones y los péptidos se pueden eliminar a partir de un multímero polipeptídico o polipéptido arbitrariamente mediante tratamiento con una enzima de modificación de proteínas apropiada antes o después de la purificación del multímero polipeptídico o polipéptido. Dichas enzimas de modificación de proteínas incluyen, por ejemplo, tripsina, quimiotripsina, lisil endopeptidasa, proteína cinasa y glucosidasa.
Otra realización preferida de la presente invención incluye un método correspondiente para producir un multímero polipeptídico o polipéptido de la presente invención, que comprende las etapas de cultivar las células hospedadoras de la presente invención como se describe anteriormente y recoger el polipéptido del cultivo celular.
Asimismo, la presente divulgación contempla composiciones farmacéuticas (agentes) que comprenden un multímero polipeptídico o polipéptido de la presente divulgación y un transportador farmacéuticamente aceptable. En el presente documento, "composiciones farmacéuticas" generalmente se refiere a agentes para tratar o prevenir, o probar y diagnosticar enfermedades.
Las composiciones farmacéuticas contempladas en la presente divulgación pueden formularse mediante métodos conocidos por los expertos en la materia. Por ejemplo, tales composiciones farmacéuticas pueden usarse por vía parenteral en forma de inyecciones, que son soluciones o suspensiones estériles preparadas con agua u otro líquido farmacéuticamente aceptable. Por ejemplo, tales composiciones se pueden formular combinando apropiadamente con un transportador o medio farmacéuticamente aceptable, de manera específica, agua estéril, solución salina fisiológica, aceite vegetal, emulsionante, suspensión, tensioactivo, estabilizante, agente aromatizante, excipiente, vehículo, conservante, aglutinante o similares y mezclado en una forma de dosis unitaria que cumple los requisitos generalmente aceptados para la preparación de productos farmacéuticos. En tales preparaciones, la cantidad de principio activo se ajusta de modo que se obtenga una cantidad adecuada dentro de un intervalo especificado.
Las composiciones estériles para inyección pueden formularse usando vehículos tales como agua destilada para inyección, de acuerdo con protocolos convencionales para la formulación.
Las soluciones acuosas para inyección incluyen, por ejemplo, soluciones salinas fisiológicas e isotónicas que contienen glucosa u otros adyuvantes (por ejemplo, D-sorbitol, D-manosa, D-manitol y cloruro sódico). Pueden usarse en combinación solubilizantes apropiados, por ejemplo, alcoholes (etanol y similares), polialcoholes (propilenglicol, polietilenglicol y similares), tensioactivos no iónicos (polisorbato 80™, HCO-50 y similares).
Los aceites incluyen aceites de sésamo y soja. El benzoato de bencilo y/o el alcohol bencílico se pueden usar en combinación como solubilizantes. También se pueden combinar tampones (por ejemplo, el tampón fosfato y el tampón acetato de sodio), agentes suavizantes (por ejemplo, clorhidrato de procaína), estabilizantes (por ejemplo, alcohol bencílico y fenol) y/o antioxidantes. Las inyecciones preparadas generalmente se introducen en ampollas apropiadas.
Las composiciones farmacéuticas contempladas en la presente divulgación se administran preferentemente por vía parenteral. Por ejemplo, las composiciones pueden estar en forma de inyecciones, agentes transnasales, agentes transpulmonares o agentes transdérmicos. Por ejemplo, tales composiciones pueden administrarse sistémicamente o localmente mediante inyección intravenosa, inyección intramuscular, inyección intraperitoneal, inyección subcutánea, o similares.
Los métodos de administración pueden seleccionarse de manera apropiada teniendo en cuenta la edad y los síntomas del paciente. La dosificación de una composición farmacéutica que comprende un multímero polipeptídico o polipéptido o un polinucleótido que codifica un multímero polipeptídico o polipéptido puede establecerse, por ejemplo, dentro del intervalo de 0,0001 a 1000 mg/kg de peso para cada administración. De manera alternativa, la dosis puede ser, por ejemplo, de 0,001 a 100.000 mg por paciente. Sin embargo, en el presente documento, la dosificación no se limita necesariamente a los intervalos descritos anteriormente. Aunque el método de dosificación y de administración varían según el peso, la edad, los síntomas y similares del paciente, los expertos en la materia pueden seleccionar métodos de dosificación y de administración apropiados en consideración de estos factores.
Los anticuerpos multiespecíficos en contexto con la presente invención pueden formularse combinándolos con otros componentes farmacéuticos según sea necesario.
Ejemplos
A continuación, en el presente documento, la presente invención se describirá de manera específica haciendo referencia a los Ejemplos, pero no debe interpretarse como limitada a los mismos.
[Ejemplo 1] Construcción de vectores de expresión para genes de anticuerpos y expresión de los anticuerpos correspondientes
Las regiones variables de cadena H de anticuerpo utilizadas fueron:
Q153 (la región variable de cadena H de un anticuerpo anti-F.IX humano, SEQ ID NO: 1), Q407 (la región variable de cadena H de un anticuerpo anti-F.IX humano, SEQ ID NO: 2), J142 (la región variable de cadena H de un anticuerpo anti-F.X humano, SEQ ID NO: 3), J300 (la región variable de cadena H de un anticuerpo anti-F.X humano, SEQ ID NO: 4), y MRA-VH (la región variable de cadena H de un anticuerpo anti-receptor de interleucina-6 humano, SEQ ID NO: 5).
Las regiones variables de cadena L de anticuerpo utilizadas fueron:
L180-k (una cadena L común a un anticuerpo anti-F.IX humano y a un anticuerpo anti-F.X humano, SEQ ID NO: 6), L210-k (una cadena L común a un anticuerpo anti-F.IX humano/anticuerpo anti-F.X humano, SEQ ID NO: 7), y MRA-k (la cadena L de un anticuerpo anti-receptor de interleucina-6 humano, SEQ ID NO: 8).
Las regiones constantes de cadena H de anticuerpo utilizadas fueron:
G4d (SEQ ID NO: 9), que se construyó a partir de IgG4 mediante la introducción de una mutación por sustitución de Pro por Ser en la posición 228 (numeración EU) y eliminando la Gly y Lys C-terminales; z72 (SEQ ID NO: 10), que se construyó a partir de G4d mediante la introducción de las siguientes mutaciones: una mutación por sustitución de Arg por His en la posición 435 (numeración EU); una mutación por sustitución de Phe por Tyr en la posición 436 (numeración EU); y una mutación por sustitución de Pro por Leu en la posición 445 (numeración EU); z7 (SEQ ID NO: 11), que se construyó a partir de G4d mediante la introducción de una mutación por sustitución de Lys por Glu en la posición 356 (numeración EU); z73 (SEQ ID NO: 12), que se construyó a partir de Gz72 mediante la introducción de una mutación por sustitución de Glu por Lys en la posición 439 (numeración EU); z106 (SEQ ID NO: 13), que se construyó a partir de z7 mediante la introducción de las siguientes mutaciones: una mutación por sustitución de Gln por Lys en la posición 196 (numeración EU); una mutación por sustitución de Tyr por Phe en la posición 296 (numeración EU); y una mutación por sustitución de Lys por Arg en la posición 409 (numeración EU); z107 (SEQ ID NO: 14), que se construyó a partir de z73 mediante la introducción de las siguientes mutaciones: una mutación por sustitución de Gln por Lys en la posición 196 (numeración EU); una mutación por sustitución de Tyr por Phe en la posición 296 (numeración EU); una mutación por sustitución de Lys por Arg en la posición 409 (numeración EU); y una mutación por sustitución de Tyr por Phe en la posición 436 (numeración EU); y G1d (SEQ ID NO: 15), que se construyó eliminando la Gly y Lys de IgG1 C-terminales. Se introdujeron mutaciones por sustitución de Lys por Glu en la posición 356 (numeración EU) y Glu por Lys en la posición 439 (numeración EU) para la formación eficaz de moléculas heteroméricas a partir de las cadenas H correspondientes en la producción de anticuerpos heteroméricos ((documento WO 2006/106905) PROCESS FOR PRODUCTION OF POLYPEPTIDE BY REGULATION OF ASSEMBLY).
Los genes Q153-G4d y Q153-z7 de la cadena H del anticuerpo anti-F.IX humano se construyeron uniendo respectivamente G4d y z7 cadena abajo de Q153. El gen Q407-z106 de la cadena H del anticuerpo anti-F.IX humano se construyó uniendo z106 cadena abajo de Q407. Los genes J142-G4d, J142-z72 y J142-z73 de la cadena H del anticuerpo anti-F.X humano, se construyeron uniendo respectivamente G4d, z72 y z73 cadena abajo de J142. El gen J300-z107 de la cadena H del anticuerpo anti-F.X humano se construyó uniendo z107 cadena abajo de J300. Los genes MRA-G1d, MRA-z106 y MRA-z107 de la cadena H del anticuerpo anti-receptor de interleucina-6 humano se construyeron uniendo respectivamente G1d, z106 y z107 cadena abajo de MRA-VH.
Los genes de los anticuerpos correspondientes (Q153-G4d, Q153-z7, Q407-z106, J142-G4d, J142-z72, J142-z73, J300-z106, MRA-G1d, MRA-z106, MRA-z107, L180-k, L210-k y MRA-k) se insertaron en vectores de expresión de células animales.
Los siguientes anticuerpos se expresaron transitoriamente en células FreeStyle293 (Invitrogen) mediante transfección usando los vectores de expresión construidos. Como se muestra a continuación, los anticuerpos se nombraron usando las combinaciones de genes de anticuerpos transfectados.
MRA-G1d/MRA-k
MRA-z106/MRA-z107/MRA-k
Q153-G4d/J142-G4d/l180-k
Q153-G4d/J142-z72/l 180-k
Q153-z7/J142-z73/l180-k
Q407-z106/J300-z107/l210-k
[Ejemplo 2] Evaluación de las condiciones de elución para cromatografía de afinidad con proteína A
Q153-G4d/J142-G4d/l180-k y Q153-G4d/J142-z72/l180-k se expresaron de forma transitoria, y el medio del cultivo de células FreeStyle293 resultante (en adelante en el presente documento abreviado como CM) se usó como muestra para evaluar las condiciones de elución para cromatografía de afinidad con proteína A. Las muestras de CM se filtraron a través de un filtro con un tamaño de poro de 0,22 pm, y se cargaron en una columna rProtein A Sepharose de Flujo Rápido (GE Healthcare) equilibrada con D-PBS. La columna se sometió a lavados 1 y 2 y a eluciones de 1 a 5 de manera gradual como se muestra en la Tabla 1. El volumen de CM a cargar en la columna se ajustó a 20 mg de anticuerpo/ml de resina. Se recogieron las fracciones eluidas en cada condición, y las fracciones eluidas correspondientes se analizaron por cromatografía de intercambio catiónico para identificar sus componentes. Para preparar los controles, cada CM se cargó en resina rProtein G Sepharose de flujo Rápido (GE Healthcare). Las muestras purificadas por elución de forma discontinua se usaron como controles. Debido a que la proteína G se une al dominio Fab de un anticuerpo, todas las especies de anticuerpos (un anticuerpo biespecífico de interés en el que dos tipos de cadenas H están asociadas de manera heteromérica (anticuerpo heteromérico) y como impureza, los anticuerpos homoméricos monoespecíficos en los que las cadenas H de tipo sencillo están asociadas homoméricamente) en CM pueden purificarse utilizando proteína G, independientemente de su afinidad de unión a proteína A.
T l 11

El CM en el que se habían expresado Q153-G4d/J142-G4d/l180-k o Q153-G4d/J142-z72/l180-k se eluyó de una columna de proteína A (elución 1 a 5), y se analizaron las fracciones eluidas correspondientes por cromatografía de intercambio catiónico. En cuanto a Q153-G4d/J142-G4d/l180-k, el análisis reveló que a medida que la condición de elución se modificó de 1 a 5, es decir, a medida que se redujo el pH del tampón de elución, la composición de anticuerpos de las fracciones eluidas cambió gradualmente en el orden del anticuerpo homomérico J142-G4d/l180-k al anticuerpo heteromérico.
Q153-G4d/J142-G4d/l180-k, y después al anticuerpo homomérico Q153-G4d/l180-k. Se entiende que el orden de elución está de acuerdo con la capacidad de unión para la proteína A. Esto implica que el anticuerpo homomérico Q153-G4d/l180-k, que permaneció unido hasta que estuvo expuesto a un pH bajo, tiene una mayor capacidad de unión para la proteína A que la especie homomérica J142-G4d/l180-k (un anticuerpo homomérico contra FX) eluida a un pH alto. Se sabe que la región variable J142 es una secuencia incapaz de unirse a la proteína A. De manera específica, la especie homomérica J142-G4d/l180-k (un anticuerpo homomérico contra FX) tiene dos sitios de unión a proteína A; el anticuerpo heteromérico Q153- G4d/J142-G4d/l180-k tiene tres; y el anticuerpo homomérico Q153-G4d/l180-k (anticuerpo homomérico contra FX) tiene cuatro sitios de unión a proteína A. Por lo tanto, se reveló que más sitios de unión a proteína A dieron como resultado una unión más fuerte a la proteína A y, por lo tanto, se necesitó un pH más bajo para la elución.
Entre tanto, en cuanto a Q153-G4d/J142-z72/l180-k, se reveló que a medida que la condición de elución se alteró de 1 a 5, la composición del anticuerpo en la fracción eluida cambió del anticuerpo heteromérico Q153-G4d/J142-z72/l180 -k al anticuerpo homomérico Q153-G4d/l180-k. El anticuerpo homomérico J142-z72/l180-k (un anticuerpo homomérico contra FX) era casi indetectable en cualquier fracción eluida. Esto sugiere que J142-z72/l180-k no tiene capacidad de unión a proteína A. Se cree que la falta de capacidad de unión a proteína A de J142-z72 podría deberse a la mutación por sustitución introducida de Arg por His en la posición 435 (numeración EU). El anticuerpo homomérico J142-z72/l180-k (un anticuerpo homomérico contra FX) no tiene sitio de unión a proteína A, mientras que el anticuerpo heteromérico Q153-G4d/J142-z72/l180-k tiene dos sitios de unión a proteína A y el anticuerpo homomérico Q153-G4d/l180-k (un anticuerpo homomérico contra FIX) tiene cuatro. El anticuerpo homomérico J142-z72/l180-k (un anticuerpo homomérico contra FX) pasa a través de la columna porque no se une a la proteína A. Esta es la razón por la cual J142-z72/l180-k era indetectable en las fracciones eluidas. Asimismo, en ambos casos de Q153-G4d/J142-G4d/l180-k y Q153-G4d/J142-z72/l180-k, se sugirió que el anticuerpo heteromérico y el anticuerpo homomérico Q153-G4d/l180-k (un anticuerpo homomérico contra FIX) fueron separables entre sí a pH 3,6 o a un pH más bajo.
[Ejemplo 3] Aislamiento y purificación de anticuerpos heteroméricos por cromatografía con proteína A
Se usaron muestras de CM que contenían los siguientes anticuerpos:
Q153-G4d/J142-G4d/l180-k
Q153-G4d/J142-z72/l 180-k
Q153-z7/J142-z73/l180-k
Q407-z106/J300-z107/l210-k
Las muestras de CM se filtraron a través de un filtro con un tamaño de poro de 0,22 pm, y se cargaron en una columna rProtein A Sepharose de Flujo Rápido (GE Healthcare) equilibrada con D-PBS. La columna se sometió a lavados 1 y 2 y a las eluciones 1 y 2 como se muestra en la Tabla 2 (excepto que Q407-z106/J300-z107/l210-k se sometió a la elución 1 solamente). Las condiciones de elución se determinaron basándose en el resultado descrito en el Ejemplo 2. El volumen de CM a cargar en la columna se ajustó a 20 mg de anticuerpo/ml de resina. Se recogieron fracciones correspondientes eluidas en cada condición y se analizaron mediante cromatografía de intercambio catiónico para identificar sus componentes. Para preparar los controles, cada CM se cargó en la resina rProtein G Sepharose de Flujo Rápido (GE Healthcare) de la misma manera que se describe en el Ejemplo 2. Las muestras purificadas por elución de forma discontinua se usaron como controles.

El resultado del análisis de cromatografía de intercambio catiónico para cada fracción eluida se muestra en la Tabla 3 a continuación. Los valores representan el área del pico de elución expresada en porcentaje. Excepto para el anticuerpo Q153-G4d/J142-G4d/l180-k, los anticuerpos homoméricos contra FX eran casi indetectables en cualquier fracción eluida. Por lo tanto, se reveló que no solo el anticuerpo homomérico J142-z72 (un anticuerpo homomérico contra FX) descrito en el Ejemplo 2 sino también los anticuerpos homoméricos J142-z73 y J300-z107 (un anticuerpo homomérico contra FX) eran incapaces de unirse a la proteína A. Se cree que la falta de capacidad de unión a proteína A en el anticuerpo homomérico contra FX se debió a la mutación por sustitución de Arg por His en la posición 435 (numeración EU), que se introdujo en la región constante de la cadena H del anticuerpo contra FX. El anticuerpo heteromérico, que es un anticuerpo biespecífico de interés, se detectó principalmente en la fracción de elución 1. Entre tanto, la mayoría de los anticuerpos homoméricos contra FIX se eluyeron mediante la elución 2, aunque también se detectaron a un nivel muy bajo en la fracción de elución 1. En comparación con Q153-G4d/J142-z72/l180-k, en los casos de Q153-z7/J142-z73/l180-k y Q407-z106/J300-z107/l210-k, la proporción del anticuerpo heteromérico ( anticuerpo biespecífico de interés) aumentó considerablemente en la fracción eluida a pH 3,6. Por lo tanto, se demostró que, cuando se introdujeron las mutaciones por sustitución de Lys por Glu en la posición 356 (numeración EU) y de Glu por Lys en la posición 439 (numeración EU) para la formación eficaz de moléculas heteroméricas a partir de las cadenas H correspondientes en combinación con la mutación por sustitución de Arg por His en la posición 435 (numeración EU), el anticuerpo heteromérico (anticuerpo biespecífico de interés) podría purificarse a una pureza del 98 % o mayor a través de la etapa de purificación basada en proteína A sola.
Tal como se ha descrito anteriormente, los presentes inventores revelaron que, basándose en las diferencias en el número de sitios de unión a proteína A entre el anticuerpo heteromérico y los anticuerpos homoméricos, el anticuerpo heteromérico podría aislarse y purificarse a alta pureza a través de la etapa de cromatografía con proteína A sola.
T l

T l 4


T l 1

[Ejemplo 4] Evaluación de la farmacocinética en ratones transgénicos con FcRn humano
Como se describe en el Ejemplo 3 anterior, los presentes inventores demostraron que al usar z106 (SEQ ID NO: 13) y z107 (SEQ ID NO: 14) para las regiones constantes de cadena H correspondientes del anticuerpo biespecífico, el anticuerpo heteromérico (anticuerpo biespecífico de interés) podría purificarse a una pureza del 98 % o mayor a través de la etapa de proteína A sola. Entre tanto, la pérdida de la afinidad de unión a proteína A probablemente da como resultado la pérdida de la actividad de unión a FcRn humano porque la proteína A y el FcRn humano reconocen el mismo sitio en un anticuerpo IgG (J Immunol. 2000, 164(10):5313-8). Actualmente, hay un método indicado para purificar un anticuerpo biespecífico a una pureza del 95 % usando la proteína A. El método usa una cadena H de IgG2b de rata que no se une a la proteína A. Catumaxomab (un anticuerpo biespecífico) purificado por este método tiene una semivida de aproximadamente 2,1 días en seres humanos. Su semivida es significativamente más corta que la semivida de una IgG1 humana normal, que es de 2 a 3 semanas (Documento no de Patente 2). En este contexto, se evaluaron los anticuerpos que tienen z106 (SEQ ID NO: 13) y z107 (SEQ ID NO: 14) descritos en el Ejemplo 3 como regiones constantes para determinar su farmacocinética.
En un experimento farmacocinético para calcular la semivida en seres humanos, la farmacocinética en ratones transgénicos con FcRn humano (ratones B6.mFcRn -/-. HFcRn Tg línea 276+/+, Jackson Laboratories) se evaluó mediante el siguiente procedimiento. se administraron MRA-Gld/MRA-k (de ahora en adelante en el presente documento, abreviado como MRA-IgG1) que tiene la región constante de IgG1 y MRA-z106/MRA-z107/MRA-k (de ahora en adelante en el presente documento, abreviado como MRA-z106/z107) que tiene z106/z107 como región constante, cada uno, por vía intravenosa a los ratones una vez a una dosis de 1 mg/kg y se recogió sangre en los puntos de tiempo apropiados. La sangre recogida se centrifugó inmediatamente a 15.000 rpm y 4°°C durante 15 minutos para obtener plasma sanguíneo. El plasma separado se almacenó en un congelador a -20°°C o menos hasta su uso. La concentración en plasma se determinó por ELISA.
Se evaluaron MRA-IgG1 y MRA-z106/z107k para determinar su retención en plasma en ratones transgénicos con FcRn humano. Como se muestra en la Fig. 1, el resultado indica que la retención de MRA-z106/z107 en plasma fue comparable a o más duradera que la de MRA-IgG1. Tal como se ha descrito anteriormente, se demostró que z106/z107, una región constante que permite la producción o purificación eficaz del anticuerpo heteromérico a alta pureza mediante la etapa de purificación basada en proteína A sola, es comparable o superior a la IgG1 humana en términos de retención en plasma.
[Ejemplo 5] Construcción de vectores de expresión para genes de anticuerpos y expresión de los anticuerpos correspondientes
Las regiones variables de cadena H de anticuerpo utilizadas fueron:
Q499 (la región variable de cadena H de un anticuerpo anti-F.IX humano, SEQ ID NO: 16).
J339 (la región variable de cadena H de un anticuerpo anti-F.X humano, SEQ ID NO: 17).
La cadena L del anticuerpo usada fue:
L377-k (la cadena L común a un anticuerpo anti-F.IX humano y a un anticuerpo anti-F.X humano, SEQ ID NO: 18).
Las regiones constantes de cadena H de anticuerpo utilizadas fueron:
z118 (SEQ ID NO: 19), que se construyó a partir de z106 descrito en el Ejemplo 1, introduciendo una mutación por sustitución de Phe por Leu en la posición 405 (numeración EU);
z121 (SEQ ID NO: 20), que se construyó a partir de z118 introduciendo una mutación por sustitución de Arg por His en la posición 435 (numeración EU); y
z119 (SEQ ID NO: 21),que se construyó a partir de z118 introduciendo mutaciones por sustitución de Glu por Lys en la posición 356 (numeración EU) y en la posición 439 (numeración EU).
Los genes Q499-z118 y Q499-z121 de la cadena H del anticuerpo anti-F.IX humano se construyeron uniendo respectivamente z118 y z121 cadena abajo de Q499. El gen J339-zl 19 de la cadena H del anticuerpo anti-F.X humano se construyó uniendo z119 cadena abajo de J339.
Cada uno de los genes de anticuerpos (Q499-z118, Q499-z121, J339-z119 y L377-k) se insertó en un vector de expresión de células animales.
Los siguientes anticuerpos se expresaron transitoriamente en células FreeStyle293 (Invitrogen) mediante transfección usando los vectores de expresión construidos. Como se muestra a continuación, los anticuerpos se nombraron usando las combinaciones de genes de anticuerpos transfectados.
Q499-z118/J339-z119/l377-k
Q499-z121/J339-z119/l377-k
Los dos anticuerpos anteriores solo son diferentes en el aminoácido de la posición 435 en el sistema de numeración EU en la cadena H del anticuerpo anti-F.IX humano. z118 tiene His en la posición 435 y tiene afinidad de unión a proteína A. Entre tanto, z121 tiene Arg en la posición 435, y se predice que no tendrá actividad de unión a proteína A basándose en el hallazgo descrito en el Ejemplo 2. Se predice que Q499 se une a la proteína A basándose en su secuencia. Por lo tanto, en cuanto a Q499-z118/J339-z119/l377-k, la especie homomérica J339-z119/l377-k (un anticuerpo homomérico contra FX) tiene dos sitios de unión a proteína A; el anticuerpo heteromérico Q499-z118/J339-z119/l377-k tiene tres; y el anticuerpo homomérico Q499-z118/l377-k (anticuerpo homomérico contra FIX) tiene cuatro sitios de unión a proteína A. Entre tanto, en cuanto a Q499-z121/J339-z119/l377-k introducido con una modificación que conduce a la pérdida de la afinidad de unión a proteína A, la especie homomérica J339-z119/l377-k tiene dos sitios de unión a proteína A; el anticuerpo heteromérico Q499 -z121/J339-z119/l377-k tiene dos; y el anticuerpo homomérico Q499-z121/l377-k tiene dos. De manera específica, incluso si se introdujera una modificación que conduce a la pérdida de la afinidad de unión a proteína A (por ejemplo, una modificación que sustituye a Arg por el aminoácido en la posición 435, numeración EU) solamente en la cadena H que se une a la proteína A a través de su región variable, no produciría el efecto que permite el aislamiento/purificación eficaz del anticuerpo heteromérico a alta pureza por la etapa de purificación basada en proteína A sola. Sin embargo, la modificación que conduce a la pérdida de la capacidad de unión a proteína A puede producir el efecto cuando se utiliza MabSelct SuRe (GE Healthcare). MabSelect SuRe es una proteína A modificada incapaz de unirse a Q499 y un transportador cromatográfico para su uso en la purificación de anticuerpos. El transportador se desarrolló para cumplir con los requisitos industriales. El ligando es una proteína A recombinante que se ha modificado por ingeniería genética para ser resistente a condiciones alcalinas. La gran estabilidad del pH permite un lavado con NaOH eficaz y de bajo coste.
Asimismo, el transportador es característico porque no se une a la región variable de cadena pesada de la subclase VH3, tal como Q499. Con respecto a Q499-z118J339-z119/l377-k, la especie homomérica J339-z119/l377-k tiene dos sitios de unión a MabSelect SuRe; el anticuerpo heteromérico Q499 -z118/J339-z119/l377-k tiene dos; y el anticuerpo homomérico Q499-z118/l377-k tiene dos. Entre tanto, en cuanto a Q499-z121/J339-z119/l377-k, la especie homomérica J339-z119/l377-k tiene dos sitios de unión a MabSelect SuRe; el anticuerpo heteromérico Q499-z121/J339-z119/l377-k tiene un único sitio; y el anticuerpo homomérico Q499-z121 /l377-k no tienen ningún sitio de unión a MabSelect SuRe. De manera específica, se entiende que al combinar una proteína A modificada incapaz de unirse a la región variable del anticuerpo, tal como MabSelect SuRe, con una modificación que conduce a la pérdida de la afinidad de unión a proteína A, el anticuerpo heteromérico puede aislarse y purificarse eficazmente a alta pureza mediante la etapa de purificación basada en la proteína A sola,independientemente de la actividad de unión a proteína A de la región variable de cadena pesada.
[Ejemplo 6] Aislamiento y purificación de anticuerpos heteroméricos por cromatografía de afinidad usando proteína A modificada
El CM en el que se habían expresado Q499-z118/J339-z119/l377-k o Q499-z121/J339-z119/l377-k se sometió a cromatografía usando proteína A modificada. Las muestras de CM se filtraron a través de un filtro con un tamaño de poro de 0,22 pm, y se cargaron en una columna Mab Select SuRe (GE Healthcare) equilibrada con D-PBS. La columna se sometió a lavados 1 y 2 y elución como se muestra en la Tabla 7. La proteína A recombinante consta de cinco dominios (A a E) que tienen actividad de unión a IgG. En Mab Select SuRe, el dominio B se ha modificado por ingeniería genética para tener una estructura tetramérica. Mab Select SuRe carece de afinidad por la región variable del anticuerpo, y es ventajoso porque permite la elución del anticuerpo incluso en condiciones más suaves en comparación con la proteína A recombinante convencional. Además, la resina tiene una resistencia alcalina mejorada y permite la limpieza en el lugar usando NaOH 0,1 a 0,5 M,y por lo tanto es más adecuado para la producción. En el experimento descrito en este Ejemplo, como se muestra en la Tabla 7, se usó ácido acético 50 mM (el pH no se ajustó y el pH medido fue de alrededor de 3,0) para la elución en lugar de la elución gradual a pH 3,6 y pH 2,7 descrita en el Ejemplo 3. Las fracciones correspondientes eluidas se recogieron y analizaron por cromatografía de intercambio catiónico para identificar sus componentes. Para preparar los controles, cada CM se cargó en la resina rProtein G Sepharose de Flujo Rápido (GE Healthcare) de la misma manera que se describe en el Ejemplo 2. Las muestras purificadas por elución de forma discontinua se usaron como controles.
A continuación, las fracciones eluidas de la proteína A se sometieron a cromatografía de intercambio iónico. Se equilibró una columna de alto rendimiento SP Sepharose (GE Healthcare) con un tampón de equilibrio (tampón de fosfato de sodio 20 mM, pH 6,0). Después, las fracciones eluidas de la proteína A se neutralizaron con Tris-HCl 1,5 M, (pH 7,4), se diluyeron tres veces con tampón de equilibrio y se cargaron. Los anticuerpos unidos a la columna se
eluyeron con 25 volúmenes de columna (VC) de un gradiente de concentración de NaCl de 50 a 350 mM. Las fracciones eluidas que contenían el anticuerpo heteromérico se purificaron por cromatografía de filtración en gel usando superdex200. Las fracciones de monómeros resultantes se recogieron y se usaron en la evaluación de la farmacocinética en ratones transgénicos con FcRn humano descritos en el Ejemplo 7.
T l 71

El resultado del análisis de cromatografía de intercambio catiónico de cada fracción eluida se muestra en las Tablas 8 y 9. Como se muestra en la Tabla 8, con respecto a Q499-z118/J339-z119/l377-k, la relación de componentes de cada fracción eluida no es muy diferente de la del control. La razón es probablemente que las tres especies J339-z119/l377-k (un anticuerpo homomérico contra FX), Q499-z118/l377-k (un anticuerpo homomérico contra F.IX) y Q499-z118/J339-z1l9/l377 -k (un anticuerpo heteromérico) tenían dos sitios de unión para la proteína modificada, y por lo tanto no hubo diferencia en términos de asociación/disociación durante la etapa de purificación basada en proteína A.
Entre tanto, en el caso de Q499-z121/J339-z119/l377-k, la relación de Q499-z121/l377-k (un anticuerpo homomérico contra F.IX) en la fracción eluida se redujo relación en comparación con el control como se muestra en Tabla 9. Por el contrario, las relaciones de J339-z119/l377-k (un anticuerpo homomérico contra FX) y Q499-z121/J339-z119/l377-k (un anticuerpo heteromérico) en la fracción eluida aumentaron relativamente en comparación con el control junto con una disminución de Q499-z121/l377-k. Se creía que esto se debía a que J339-z119/l377-k (un anticuerpo homomérico contra F.X) tiene dos sitios de unión para la proteína A modificada y Q499-z121/J339-z119/l377-k (un anticuerpo heteromérico) tiene uno. Sin embargo, Q499-z121/l377-k (un anticuerpo homomérico contra F.IX) no tiene sitio de unión y, en consecuencia, la mayoría de Q499-z121/l377-k pasó a través de la columna sin unirse a la proteína A modificada.
Tal como se ha descrito anteriormente, la presente invención también demuestra que con respecto a los anticuerpos cuyas regiones variables tienen actividad de unión a proteína A, cuando la proteína A modificada se combina con una modificación que conduce a la pérdida de afinidad de unión a proteína A, uno de los anticuerpos homoméricos puede disminuir significativamente y, como resultado, la pureza del anticuerpo heteromérico aumenta por la etapa de purificación basada en proteína A sola.
T l 1

T l 1

[Ejemplo 71 Evaluación de la farmacocinética en ratones transgénicos con FcRn humano Se evaluaron Q499-z118/J339-z119/l377-k y Q499-z121/J339-z119/l377-k preparados como se describe en el Ejemplo 6 por determinar su farmacocinética.
Es probable que sea difícil ajustar la actividad de unión a proteína A sin pérdida de la unión a FcRn humano, porque la proteína A y el FcRn humano reconocen el mismo sitio en un anticuerpo IgG (J Immunol. 2000 164 (10):5313-8) como se muestra en la figura 2. Conservar la afinidad de unión por FcRn humano es muy importante para la retención en plasma larga (semivida larga) en seres humanos, que es característica de los anticuerpos de tipo IgG. En este
contexto, la farmacocinética se comparó entre Q499-z118/J339-z119/l377-k y Q499-z121/J339-z119/l377-k preparados como se describe en el Ejemplo 6.
En un experimento farmacocinético para predecir la semivida en seres humanos, la farmacocinética en ratones transgénicos con FcRn humano (ratones B6.mFcRn -/-. HFcRn Tg línea 276+/+, Jackson Laboratories) se evaluó mediante el siguiente procedimiento. Q499-z118/J339-z119/l377-k y Q499-z121/J339-z119/l377-k se administraron cada uno por vía intravenosa una vez a una dosis de 5 mg/kg a los ratones, y se recogió sangre en los puntos de tiempo apropiados. La sangre recogida se centrifugó inmediatamente a 15.000 rpm y 4°°C durante 15 minutos para obtener plasma sanguíneo. El plasma separado se almacenó en un congelador a -20°°C o menos hasta su uso. La concentración en sangre se determinó por ELISA.
Como se muestra en la Fig. 3, el resultado indica que Q499-z118/J339-z119/l377-k y Q499-z121/J339-z119/l377-k fueron comparables entre sí en términos de retención en plasma. Por lo tanto, se demostró que, z121/z119, una región constante en la que cualquiera de las cadenas H se introduce con una modificación que conduce a la pérdida de la capacidad de unión a proteína A es comparable en términos de retención en plasma a z118/z119, que no tiene la modificación que conduce a la pérdida de afinidad de unión a proteína A. Tal como se ha descrito anteriormente, los presentes inventores revelaron una modificación (por ejemplo, una mutación por sustitución de Arg por el aminoácido en la posición 435, numeración EU) que conduce a la pérdida de la capacidad de unión a proteína A pero no tiene influencia en la farmacocinética, y que permite un aislamiento/purificación eficaces del anticuerpo heteromérico a alta pureza a través de la etapa de purificación basada en proteína A sola, independientemente de la región variable.
[Ejemplo 8] Introducción de mutaciones en el dominio CH3 de GC33-IgG1-CD3-scFv y preparación de moléculas diseñadas a través de la etapa de purificación basada en proteína A sola
Introducción de mutaciones para la purificación basada en proteína A de la molécula GC33-IgG1-CD3-scFv
Los inventores diseñaron una molécula de anticuerpo IgG anti-GPC3 en la que un anticuerpo scFv anti-CD3 está unido a una de las dos cadenas H (Fig. 4). Se esperaba que esta molécula fuera capaz de destruir células cancerosas reclutando linfocitos T a células cancerosas a través de la unión divalente a glipicano-3(GPC3), un antígeno específico de cáncer, y de la unión monovalente a CD3, un antígeno de linfocitos T. Un anticuerpo scFv anti-CD3 debe estar unido a únicamente una de las dos cadenas H para lograr la unión monovalente a CD3. En este caso, es necesario purificar la molécula formada por asociación heteromérica de los dos tipos de cadenas H.
Por lo tanto, usando el mismo método descrito en el Ejemplo 3, se introdujo una mutación por sustitución de Arg por His en la posición 435 (numeración EU) en una de las cadenas H. Asimismo, la mutación anterior se combinó con las mutaciones (se introduce una sustitución de Lys por Asp en la posición 356, numeración EU, en una cadena H y se introduce una sustitución de Glu por Lys en la posición 439, numeración EU, en la otra cadena H) descritas en el documento WO 2006/106905 (PROCESS FOR PRODUCTION OF POLYPEPTIDE BY REGULATION OF ASSEMBLY) como una modificación para potenciar la asociación heteromérica de las dos cadenas H. Los presentes inventores probaron si era posible, con las mutaciones combinadas, purificar la molécula de interés por cromatografía con proteína A sola.
Construcción de vectores de expresión para genes de anticuerpos y expresión de anticuerpos correspondientes
Se construyó el gen que codifica GPC3 (región variable de la cadena H del anticuerpo anti-glipicano-3 humano, SEQ ID NO: 22) como una región variable de la cadena H del anticuerpo mediante un método conocido por los expertos en la materia. Asimismo, se construyó el gen que codifica Gc33-k0 (cadena L del anticuerpo anti-glipicano-3 humano, SEQ ID NO: 23) como una cadena L del anticuerpo mediante un método conocido por los expertos en la materia. Además, los genes descritos a continuación se construyeron como una región constante de cadena H de anticuerpo mediante un método conocido por los expertos en la materia.
LALA-G1d (SEQ ID NO: 24), que se construyó a partir de IgG1 sustituyendo Ala por Leu en las posiciones 234 y 235 (numeración EU), y Ala por Asn en la posición 297 (numeración EU), y eliminando las Gly y Lys C-terminales LALA-G1d-CD3 (Se Q ID NO: 25), que se construyó a partir de LALA-G1d mediante la unión de un scFv anti-CD3 (en el que la región variable de la cadena H del anticuerpo anti-CD3 humano se une mediante un enlazador peptídico al extremos C de la región variable de la cadena L del anticuerpo anti-CD3 humano)
LALA-G3S3E-G1d (SEQ ID NO: 26), que se construyó a partir de LALA-G1d sustituyendo Arg por His en la posición 435 (numeración EU) y Glu por Lys en la posición 439 (numeración EU); y
LALA-S3K-G1d-CD3 (SEQ ID n O: 27), que se construyó a partir de LALA-G1d-CD3 sustituyendo Lys por Asp en la posición 356 (numeración EU).
Los genes NTA1L y NTA1R de la cadena H del anticuerpo anti-GPC3 humano se construyeron uniendo respectivamente LALA-G1d-CD3 (en el que un anticuerpo scFv anti-CD3 se une a la región constante de la cadena H) y LALA-G1d (una región constante de cadena H) cadena abajo de GPC3, que es la región variable de la cadena H de un anticuerpo anti-glipicano-3 humano. Asimismo, los genes NTA2L y NTA2R de la cadena H del anticuerpo anti-GPC3 humano se construyeron uniendo un anticuerpo scFv anti-CD3 cadena abajo de GPC3 como una región
constante de cadena H, y uniendo LALA-S3K-G1d-CD3 introducido con una mutación por sustitución de Lys por Asp en la posición 356 (Numeración EU) o LALA-G3S3E-G1d introducido con mutaciones por sustitución de Arg para His en la posición 435 (numeración EU) y de Glu para Lys en la posición 439 (numeración EU). Los genes construidos se enumeraron a continuación.
Cadena H
NTA1L: GPC3-LALA-G1d-CD3
NTA1R: GPC3-LALA-G1d
NTA2L: GPC3-LALA-S3K-G1d-CD3
NTA2R: GPC3-LALA-G3S3E-G1d
Cadena L
GC33-k0 Cada uno de los genes de anticuerpos (cadenas H: NTA1L, NTA1R, NTA2L y NTA2R; Cadena L: GC33-k0) se insertó en un vector de expresión de células animales. Usando un método conocido por los expertos en la materia, los anticuerpos enumerados a continuación se expresaron transitoriamente en células FreeStyle293 (Invitrogen) mediante la transfección de las células con los vectores de expresión construidos. Como se muestra a continuación, los anticuerpos se nombraron usando las combinaciones de genes de anticuerpos transfectados (primera cadena H/segunda cadena H /cadena L).
NTA1L/NTA1R/GC33-k0
NTA2L/NTA2R/GC33-k0
Purificación de proteínas de las muestras expresadas y evaluación del rendimiento del heterodímero
Se usaron como muestra sobrenadantes de cultivo de células FreeStyle293 (CM) que contenían los siguientes anticuerpos.
NTA1L/NTA1R/GC33-k0
NTA2L/NTA2R/GC33-k0
Las muestras de CM se filtraron a través de un filtro con un tamaño de poro de 0,22 |jm, y se cargaron en una columna rProtein A Sepharose de Flujo Rápido (GE Healthcare) equilibrada con D-PBS. La columna se sometió a lavados 1 y 2 y elución 1 como se muestra en la Tabla 10. El volumen de CM a cargar en la columna se ajustó a 20 mg de anticuerpo/ml de resina. Se recogieron fracciones correspondientes eluidas en cada condición y se analizaron mediante cromatografía de exclusión por tamaño para identificar sus componentes.

El resultado de la cromatografía de exclusión por tamaño de cada fracción eluida se muestra en la Fig. 5 y en la Tabla 11 a continuación. Los valores representan el área del pico de elución expresada en porcentaje. Para NTA1L/NTA1R/GC33-k0 y NTA2L/NTA2R/GC33-k0, los anticuerpos homoméricos (anticuerpos con NTA1L homomérico o NTA2L homomérico) que tienen el anticuerpo scFv anti-CD3 en ambas cadenas eran casi indetectables. Se cree que esto se debe al nivel de expresión extremadamente bajo de las cadenas H que contienen el anticuerpo scFv anti-CD3 porque el nivel de expresión de una molécula scFv es generalmente bajo. En cuanto a los anticuerpos homoméricos que no contienen el anticuerpo scFv anti-CD3 en sus dos cadenas, se observó aproximadamente el 76 % del anticuerpo homomérico NTA1R en el caso de NTA1L/NTA1R/GC33-k0, mientras que solo se observó aproximadamente el 2 % del anticuerpo NTA2R homomérico en el caso de NTA2L/NTA2R/GC33-k0. Por lo tanto, la presente invención demostró que cuando las mutaciones por sustitución de Lys por Glu en la posición 356 (numeración EU) y de Glu por Lys en la posición 439 (numeración EU) para la formación eficaz de moléculas heteroméricas a partir de las cadenas H correspondientes, se combinaban con la mutación por sustitución de Arg por His en la posición 435 (numeración EU), el anticuerpo heteromérico (anticuerpo biespecífico de interés) podría purificarse eficazmente a una pureza del 98 % o mayor a través de la etapa de purificación basada en proteína A sola.
T l 111

[Ejemplo 9] Introducción de mutaciones en el dominio CH3 de anticuerpos monovalentes y preparación de moléculas diseñadas a través de la etapa de purificación basada en proteína A sola
Introducción de mutaciones para la purificación de moléculas de anticuerpos monovalentes utilizando la proteína A
Un anticuerpo IgG anti-GPC3 normal se une de forma divalente a través de las dos cadenas H al glipicano-3 (GPC3), un antígeno específico del cáncer. En el experimento descrito en este Ejemplo, los inventores diseñaron y evaluaron una molécula de anticuerpo IgG anti-GPC3 (Fig. 6) que se une de forma monovalente a glipicano-3. Se cree que, en comparación con los anticuerpos divalentes normales, la unión monovalente de la molécula a glipicano-3 (GPC3), un antígeno específico del cáncer, se basó en la afinidad y no en la avidez. Por lo tanto, se esperaba que la molécula fuera capaz de unirse al antígeno sin entrecruzamiento. Para lograr la unión monovalente de las dos cadenas H a glipicano-3 (GPC3), una debe ser una cadena H que consiste en un dominio bisagra-Fc que carece de la región variable y del dominio CH1, mientras que la otra es una cadena H normal. En este caso, es necesario purificar la molécula que es el resultado de la asociación heteromérica de los dos tipos de cadenas H.
Por lo tanto, usando el mismo método como se describe en el Ejemplo 3, se introdujo una mutación por sustitución de Arg por His en la posición 435 (numeración EU) en una de las cadenas H. Asimismo, la mutación anterior se combinó con las mutaciones (se introduce una sustitución de Lys por Asp en la posición 356, numeración EU, en una cadena H y se introduce una sustitución de Glu por Lys en la posición 439, numeración EU, en la otra cadena H) descritas en el documento WO 2006/106905 (PROCESS FOR PRODUCTION OF POLYPEPTIDE BY REGULATION OF ASSEMBLY) como una modificación para potenciar la asociación heteromérica de las dos cadenas H. Los presentes inventores evaluaron si era posible, con las mutaciones combinadas, purificar la molécula de interés por cromatografía con proteína A sola.
Construcción de vectores de expresión para genes de anticuerpos y expresión de anticuerpos correspondientes
La región variable de cadena H del anticuerpo utilizada fue:
GPC3 (la región variable de la cadena H de un anticuerpo anti-glipicano-3 humano, SEQ ID NO: 22). La cadena L del anticuerpo usada fue: GC33-k0 (la cadena L de un anticuerpo anti-glipicano-3 humano, SEQ ID NO: 23).
Las regiones constantes de cadena H de anticuerpo utilizadas fueron:
LALA-G1d (SEQ ID NO: 24), que se construyó a partir de IgG1 introduciendo mutaciones por sustitución de Ala por Leu en las posiciones 234 y 235 (numeración EU), y de Ala por Asn en la posición 297 (numeración EU), y eliminando las Gly y Lys C-terminales;
LALA-G3-G1d (SEQ iD NO: 28), que se construyó a partir de LALA-G1d introduciendo una mutación por sustitución de Arg por His en la posición 435 (numeración EU);
LALA-G3S3E-G1d (Se Q ID NO: 26), que se construyó a partir de LALA-G3-G1d introduciendo una mutación por sustitución de Glu por Lys en la posición 439 (numeración EU);
LALA-G1Fc (SEQ ID NO: 29), que se construyó a partir de LALA-G1d eliminando la región de las posiciones 1 a 215 (numeración EU); y
LALA-G1Fc-S3K (SEQ ID NO: 30), que se construyó a partir de G1Fc introduciendo una mutación por sustitución de Lys por Asp en la posición 356 (numeración EU).
Los genes NTA4L-cont, NTL4L-G3 y NTA4L de la cadena H del anticuerpo anti-GPC3 humano, se construyeron uniendo cadena abajo de GPC3 (la región variable de la cadena H de un anticuerpo anti-glipicano-3 humano), respectivamente, LALA-G1d (una región constante de cadena H), LALA-G3-G1d introducido con una mutación por sustitución de Arg por His en la posición 435 (numeración EU), y LALA-G3S3E-G1d introducido con mutaciones por sustitución de Arg por His en la posición 435 (numeración EU) y de Glu para Lys en la posición 439 (numeración EU). Asimismo, Los genes Fc NTA4R-cont y NTA4R se construyeron usando LALA-G1Fc (un dominio anti-Fc bisagra humano) y LALA-G1Fc-S3K (un dominio Fc bisagra introducido con una mutación por sustitución de Lys por Asp en la posición 356, numeración EU). Los genes construidos son:
Cadena H
NTA4L-cont: GPC3-LALA-G1d
NTA4L-G3: GPC3-LALA-G3-G1d
NTA4L: GPC3-LALA-G3S3E-G1d
NTA4R-cont: LALA-G1Fc
NTA4R: LALA-G1Fc-S3K
Cadena L
GC33-k0
Los genes de anticuerpos (NTA4L, NTA4L-cont, NTA4L-G3, NTA4R, NTA4R-cont y Gc33-k0) se insertaron cada uno en un vector de expresión de células animales.
Los siguientes anticuerpos se expresaron transitoriamente en células FreeStyle293 (Invitrogen) mediante transfección usando los vectores de expresión construidos. Como se muestra a continuación, los anticuerpos se nombraron usando las combinaciones de genes de anticuerpos transfectados.
NTA4L-cont/NTA4R-cont/GC33-k0
NTA4L-G3/NTA4R-cont/GC33-k0
NTA4L/NTA4R/GC33-k0
Purificación de proteínas de las muestras expresadas y evaluación del rendimiento del heterodímero
El CM que contiene el siguiente anticuerpo se utilizó como muestra:
NTA4L-cont/NTA4R-cont/GC33-k0
NTA4L-G3/NTA4R-cont/GC33-k0
NTA4L/NTA4R/GC33-k0
Las muestras de CM se filtraron a través de un filtro con un tamaño de poro de 0,22 |jm, y se cargaron en una columna rProtein A Sepharose de Flujo Rápido (GE Healthcare) equilibrada con D-PBS. La columna se sometió a lavados 1 y 2 y elución 1 como se muestra en la Tabla 12. El volumen de CM a cargar en la columna se ajustó a 20 mg de anticuerpo/ml de resina. Se recogieron fracciones correspondientes eluidas en cada condición y se analizaron mediante cromatografía de exclusión por tamaño para identificar sus componentes.
T l 121

El resultado de la cromatografía de exclusión por tamaño de cada fracción eluida se muestra en la Fig. 7 y en la Tabla 13 a continuación. Los valores representan el área del pico de elución expresada en porcentaje.
En cuanto a NTA4L-cont/NTA4R-cont/GC33-k0, se eluyeron el anticuerpo homomérico que se une de forma divalente a GPC3 (anticuerpo homomérico NTA4L-cont) y la molécula homomérica que no tiene dominio de unión a GPC3 (anticuerpo homomérico NTA4R-cont), mientras que el anticuerpo heteromérico de interés, NTA4L-cont/NTA4R-cont, representó solamente el 46,5 %.
En el caso de NTA4L-G3/NTA4R-cont/GC33-k0, el anticuerpo homomérico que se une de forma divalente a GPC3 (anticuerpo homomérico NTA4L-G3) fue casi indetectable, mientras que la molécula homomérica que no tiene dominio de unión a GPC3 (anticuerpo homomérico NTA4R-cont) fue abundante. El anticuerpo heteromérico de interés, NTA4L-G3/NTA4R-cont, representó el 66,7 %. En el caso de NTA4L/NTA4R/GC33-k0, el anticuerpo homomérico que se une de forma divalente a GPC3 (anticuerpo homomérico NTA4L) fue casi indetectable, y la proporción de la molécula homomérica que no tiene dominio de unión a GPC3 (NTA4R) se redujo considerablemente, lo que dio como resultado un aumento significativo de hasta un 93,0 % en la proporción del anticuerpo heteromérico de interés, NTA4L/NTA4R. Por lo tanto, la presente invención demostró que cuando se introdujeron las mutaciones por sustitución de Lys por Asp en la posición 356 (numeración EU) y de Glu por Lys en la posición 439 (numeración e U) para la formación eficaz de moléculas heteroméricas a partir de las cadenas H correspondientes en combinación con la mutación por sustitución de Arg por His en la posición 435 (numeración EU), el anticuerpo heteromérico (un anticuerpo biespecífico de interés) podría purificarse eficazmente a una pureza del 93 % o mayor a través de la etapa de purificación basada en proteína A sola.
T l 11
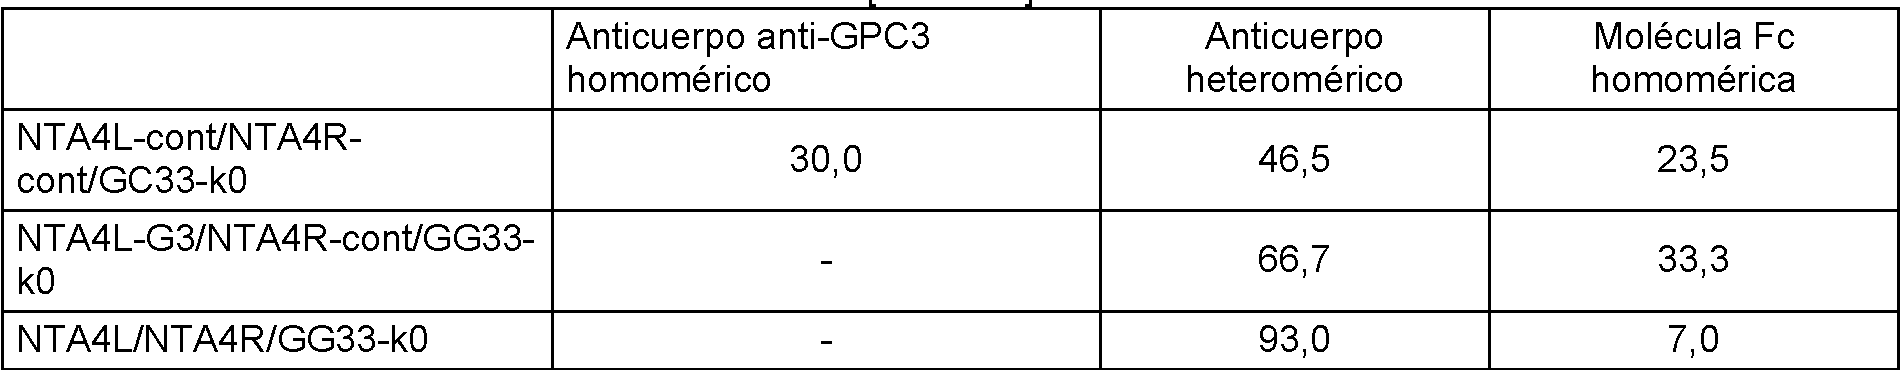
[Ejemplo 10] Preparación de anticuerpos heteroméricos a través de una etapa de purificación por cromatografía en columna con proteína A usando elución con gradiente de pH
Como se describe en el Ejemplo 9, los presentes inventores demostraron que en el caso de un anticuerpo que tiene la región variable únicamente en un brazo, el anticuerpo heteromérico podría purificarse eficientemente a través de la etapa de purificación basada en proteína A sola combinando la mutación por sustitución de Arg por His en la posición 435 (numeración EU) con las mutaciones (se introduce una sustitución de Lys por Asp en la posición 356, numeración EU, en una cadena H y se introduce una sustitución de Glu por Lys en la posición 439, numeración EU, en la otra cadena H) descritas en el documento WO 2006/106905 (PROCESS FOR PRODUCTION OF POLYPEPTIDE BY REGULATION OF ASSEMBLY). Sin embargo, el anticuerpo heteromérico no se purifica a una pureza suficientemente alta con la elución 1 (tampón de elución: HCl 2 mM, pH 2,7) solamente. Se necesita una etapa de purificación adicional.
Después, en este ejemplo, los presentes inventores evaluaron si el anticuerpo heteromérico puede aislarse y purificarse a alta pureza mediante cromatografía en columna con proteína A usando elución con un gradiente de pH. Esto se basó en el supuesto de que más sitios de unión a proteína A conducen a una unión más fuerte del anticuerpo heteromérico a la proteína A, y como resultado se necesita un pH más bajo para la elución. La purificación se puede lograr de manera más eficaz a un coste menor cuando la pureza del anticuerpo heteromérico se puede aumentar a casi el 100 % usando dicha elución con gradiente de pH.
Se usaron muestras de CM que contenían los siguientes anticuerpos:
NTA4L-cont/NTA4R-cont/GC33-k0
NTA4L-G3/NTA4R-cont/GC33-k0
NTA4L/NTA4R/GC33-k0
Las muestras de CM se filtraron a través de un filtro con un tamaño de poro de 0,22 pm, y se cargaron en una columna HP de proteína A HiTrap (GE Healthcare) equilibrada con D-PBS. La columna se sometió secuencialmente a lavados 1 y 2 y después se eluyó con un gradiente de pH usando elución A y B como se muestra en la Tabla 14. La elución con gradiente de pH se logró con el siguiente gradiente lineal: elución A/elución B = (100:0) ^ (30:70) durante 35 minutos. Las fracciones eluidas se recogieron y analizaron mediante análisis de cromatografía de exclusión por tamaño para identificar sus componentes.
T l 141

NTA4L-cont/NTA4R-cont/GC33-k0, NTA4L-G3/NTA4R-cont/GC33-k0 y NTA4L/NTA4R/GC33-k0 se purificaron por cromatografía en columna con proteína A en condiciones de elución con gradiente de pH. Los cromatogramas resultantes se muestran en la Fig. 8. La elución de NTA4L-cont/NTA4R-cont/GC33-k0 dio como resultado un pico amplio. Entre tanto, la elución con gradiente de pH de NTA4L-G3/NTA4R-cont/GC33-k0 dio dos picos de elución. Los picos de pH alto y bajo se marcaron como "elución 1" y "elución 2", respectivamente. El resultado para NTA4L/NTA4R/GC33-k0 fue aproximadamente el mismo que para NTA4L-G3/NTA4R-cont/GC33-k0, excepto que el área del pico de elución 2 fue menor.
El resultado del análisis de cromatografía de exclusión por tamaño de cada pico se muestra en la Tabla 15. NTA4L-cont/NTA4R-cont/GC33-k0 dio tres componentes eluidos en este orden: un anticuerpo homomérico que se une de forma divalente a GPC3 (anticuerpo homomérico NTA4L-cont), un anticuerpo heteromérico que se une de forma monovalente a GPC3 (anticuerpo heteromérico NTA4L-cont/NTA4R-conc) y una molécula homomérica que no tiene dominio de unión a GPC3 (anticuerpo homomérico NTA4R-cont). Se cree que la razón por la cual estos componentes no se separaron por elución con gradiente de pH es que tienen el mismo número (dos) de sitios de unión a proteína
A. Entre tanto, se reveló que en la elución 1 de NTA4L-G3/NTA4R-cont/GC33-k0, los niveles de anticuerpo homomérico que se une de forma divalente a GPC3 (anticuerpo homomérico NTA4L-G3) y a la molécula homomérica que no tiene dominio de unión a GPC3 (anticuerpo homomérico NTA4R -cont) estaban por debajo del límite de detección, mientras que el anticuerpo heteromérico que se une de forma monovalente a GPC3 (anticuerpo heteromérico NTA4L-G3/NTA4R-conc) representaba el 99,6 %. En la elución 2, se descubrió que la molécula homomérica que no tiene dominio de unión a GPC3 (anticuerpo homomérico NTA4R-cont) representaba el 98,8 %. El anticuerpo homomérico NTA4L-G3 pasa a través de la columna con proteína A porque no puede unirse a la proteína A debido a la mutación por sustitución de Arg por His en la posición 435 (numeración EU). Entre tanto, el anticuerpo heteromérico NTA4L-G3/NTA4R-conc tiene un único sitio de unión a proteína A, mientras que el anticuerpo homomérico NTA4R-cont tiene dos. Más sitios de unión a proteína A significa una unión más fuerte a la proteína A, y como resultado se requirió un pH más bajo para la elución. Se cree que esta es la razón por la cual el anticuerpo homomérico NTA4R-cont se eluyó a un pH más bajo que el anticuerpo heteromérico NTA4L-G3/NTA4R-conc. Se obtuvo casi el mismo resultado para NTA4L/NTA4R/GC33-k0. El resultado del análisis de cromatografía de exclusión por tamaño muestra que la relación de componentes era comparable a la de NTA4L-G3/NTA4R-cont/GC33-k0. Hubo una diferencia entre los cromatogramas con proteína A, y la relación de las áreas del pico de elución 2 a elución 1 fue menor en NTA4L/NTA4R/GC33-k0. La relación de la expresión del anticuerpo homomérico NTA4R-cont, que es el componente principal de la elución 2, se redujo debido a las mutaciones introducidas para la generación eficaz del anticuerpo heteromérico NTA4L-G3/NTA4R-conc. Las mutaciones de aminoácidos descritas anteriormente mejoraron el rendimiento de purificación del anticuerpo heteromérico y la fuerza de la purificación por cromatografía en columna con proteína A con elución con gradiente de pH.
Tal como se ha descrito anteriormente, los presentes inventores demostraron que el anticuerpo heteromérico podía aislarse y purificarse eficazmente a una alta pureza mediante la etapa de purificación usando cromatografía en columna con proteína A sola con elución con gradiente de pH.
T l 11

[Ejemplo 11] Introducción de mutación en el dominio CH3 de la proteína de fusión receptor Fc alfa-Fc y preparación de moléculas diseñadas a través de la etapa de purificación basada en proteína A sola
Introducción de la mutación en el dominio CH3 y preparación de la proteína de fusión monovalente del receptor Fc alfa-Fc a través de la etapa de purificación basada en la proteína A
Las proteínas de fusión convencionales del receptor Fc-Fc como Eternercept y Abatacept son homodímeros que pueden unirse de forma divalente a los ligandos. En el experimento descrito en este Ejemplo, los inventores diseñaron y evaluaron una proteína de fusión receptor Fc-Fc que se une de forma monovalente a IgA como ligando (Fig. 9). Para lograr la unión monovalente del receptor Fc alfa a IgA, una de las dos cadenas H de la proteína de fusión receptor Fc-Fc debe ser la cadena H completa que tiene el dominio bisagra-Fc. En este caso, es necesario purificar la molécula que es el resultado de la asociación heteromérica de los dos tipos de cadenas H
Por lo tanto, usando el mismo método descrito en el Ejemplo 6, se introdujo una mutación por sustitución de Arg por His en la posición 435 (numeración EU) en las dos cadenas H. Asimismo, la mutación anterior se combinó con las mutaciones (se introduce una sustitución de Lys por Asp en la posición 356, numeración EU, en una cadena H y se introduce una sustitución de Glu por Lys en la posición 439, numeración EU, en la otra cadena H) descritas en el documento WO 2006/106905 (PROCESS FOR PRODUCTION OF POLYPEPTIDE BY REGULATION OF ASSEMBLY) como una modificación para potenciar la asociación heteromérica de los dos tipos de cadenas H. Los presentes inventores evaluaron si era posible, con las mutaciones combinadas, purificar la molécula de interés por
cromatografía con proteína A sola.
Construcción de vectores de expresión para genes de anticuerpos y expresión de anticuerpos correspondientes
El receptor de Fc utilizado fue FcalfaR (receptor de IgA1 humano, SEQ ID NO: 31). Las regiones constantes de la cadena H de fusión utilizadas fueron:
G1Fc (SEQ ID NO: 32), que es un dominio humano bisagra-Fc construido a partir de IgG1 eliminando las Gly y Lys C-terminales, y los restos de las posiciones 1 a 223 (numeración EU);
G1Fc-G3S3K (SEQ ID NO: 33), que se construyó a partir de G1Fc mediante la introducción de mutaciones por sustitución de Lys por Asp en la posición 356 (numeración EU) y de Arg por His en la posición 435 (numeración EU); y
G1Fc-S3E (SEQ ID NO: 34), que se construyó a partir de G1Fc mediante la introducción de una mutación por sustitución de Glu por Lys en la posición 439 (numeración EU).
Las proteínas de fusión FcalfaR-Fc, IAL-cont e IAL, se construyeron uniendo cadena abajo de FcalfaR a través de un enlazador polipeptídico (SEQ ID NO: 35), G1Fc (una región constante de cadena H) y G1Fc-G3S3K introducidos con mutaciones por sustitución de Lys por Asp en posición 356 (numeración EU) y de Arg por His en la posición 435 (numeración EU).
Asimismo, los genes IAR-cont e IAR de Fc se construyeron para codificar G1Fc (un dominio bisagra-Fc humano) y G1Fc-S3E (un dominio Fc bisagra introducido con una mutación por sustitución de Glu por Lys en la posición 439, numeración EU), respectivamente. Los genes construidos fueron:
Cadena H
IAL-cont: FcalfaR-G1Fc
IAL: FcalfaR-G1Fc-G3S3K
IAR-cont: G1Fc
IAR: G1Fc-S3E
Los genes de los anticuerpos (IAL-cont, IAL, lAR-cont, and IAR) se insertaron cada uno en un vector de expresión de células animales.
Los siguientes anticuerpos se expresaron transitoriamente en células FreeStyle293 (Invitrogen) mediante transfección usando los vectores de expresión construidos. Como se muestra a continuación, los anticuerpos se nombraron usando las combinaciones de genes de anticuerpos transfectados.
IAL-cont/IAR-cont
IAL/IAR
Purificación de proteínas de la muestra expresada y evaluación del rendimiento del heterodímero
Se usaron muestras de CM que contenían el siguiente anticuerpo:
IAL-cont/IAR-cont
IAL/IAR
Las muestras de CM se filtraron a través de un filtro con un tamaño de poro de 0,22 pm, y se cargaron en una columna rProtein A Sepharose de Flujo Rápido (GE Healthcare) equilibrada con D-PBS. La columna se sometió a lavados 1 y 2 y elución 1 como se muestra en la Tabla 16. El volumen de CM a cargar en la columna se ajustó a 20 mg de anticuerpo/ml de resina. Se recogieron fracciones correspondientes eluidas en cada condición y se analizaron mediante cromatografía de exclusión por tamaño para identificar sus componentes.
T l 11
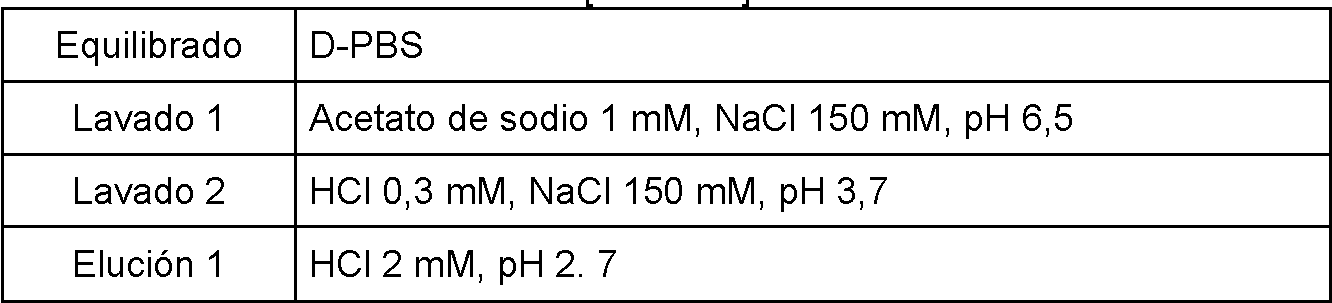
El resultado del análisis de la cromatografía de exclusión por tamaño de cada fracción eluida se muestra en la Fig. 10 y en la Tabla 17 a continuación. Los valores representan el área del pico de elución expresada en porcentaje. En cuanto a IAL-cont/IAR-cont, se eluyeron un anticuerpo homomérico que se une de forma divalente a IgA (anticuerpo
homomérico lAL-cont) y una molécula homomérica que no tiene sitio de unión a IgA (anticuerpo homomérico IAR-cont), mientras que el anticuerpo heteromérico IAL -cont/IAR-cont de interés representó solamente el 30 %. En el caso de IAL/IAR, el anticuerpo homomérico que se une de forma divalente a IgA (anticuerpo homomérico IAL) no fue detectable, y la proporción de la molécula homomérica que no tiene sitio de unión a IgA (anticuerpo homomérico IAR) se redujo considerablemente; por lo tanto, el anticuerpo heteromérico IAL/IAR de interés aumentó significativamente hasta aproximadamente el 96 %. Por lo tanto, la presente invención demostró que cuando se introdujeron las mutaciones por sustitución de Lys por Asp en la posición 356 (numeración EU) y de Glu por Lys en la posición 439 (numeración EU) para la formación eficaz de moléculas heteroméricas a partir de las cadenas H correspondientes en combinación con la mutación por sustitución de Arg por His en la posición 435 (numeración EU), el anticuerpo heteromérico, un anticuerpo biespecífico de interés, podría purificarse eficazmente a una pureza del 95 % o mayor a través de la etapa de purificación basada en proteína A sola.
T l 171

[Ejemplo 12] Construcción de un anticuerpo biespecífico del tipo IgG de cuatro cadenas
Construcción de vectores de expresión para genes de anticuerpos y expresión de anticuerpos correspondientes
El anticuerpo biespecífico contra F.IX humano y F.X humano, que se diseñó como se describe en el Ejemplo 1, consiste en una cadena L común y dos tipos de cadenas H que reconocen cada una un antígeno diferente. Obtener un anticuerpo biespecífico con dicha cadena L tan común no es fácil, porque es difícil para una secuencia de cadena L común reconocer dos tipos diferentes de antígenos. Tal como se ha descrito anteriormente, obtener una cadena L tan común es extremadamente difícil. Por lo tanto, se puede sospechar que una opción más preferida es un anticuerpo biespecífico que consiste en dos tipos de cadenas H y dos tipos de cadenas L que reconocen dos tipos de antígenos. Si se expresan dos tipos de cadenas H y dos tipos de cadenas L, forman diez tipos de moléculas de IgG H2L2 en combinaciones aleatorias. Es muy difícil purificar el anticuerpo biespecífico de interés de los diez tipos de anticuerpos.
En el experimento descrito en este Ejemplo, los presentes inventores prepararon y evaluaron anticuerpos biespecíficos que consisten en dos tipos de cadenas H y dos tipos de cadenas L contra el receptor de IL-6 humano y el glipicano-3 humano (GPC3). Para preparar eficazmente los anticuerpos biespecíficos que consisten en dos tipos de cadenas H y dos tipos de cadenas L, es necesario potenciar la asociación de cadenas H y cadenas L contra el mismo antígeno, así como la asociación heteromérica de dos tipos de cadenas H. Además, es esencial que el anticuerpo biespecífico con la combinación correcta pueda purificarse de los productos de expresión obtenidos.
Para potenciar la asociación entre las cadenas H y las cadenas L contra el mismo antígeno, la región variable (VH) de la cadena H (GC33-VH-CH1-bisagra-CH2-CH3) y la región variable (VL) de la cadena L (GC33- VL-CL) de g C33 (un anticuerpo anti-GPC3) se intercambiaron entre sí para producir la cadena H GC33-VL-CH1-bisagra-CH2-CH3 y la cadena L (GC33-VH-CL) (el dominio VH y el dominio VL se intercambiaron entre sí). GC33-VL-CH1-bisagra-CH2-CH3 está asociado con GC33-VH-CL; sin embargo, su asociación con la cadena L (MRA-VL-CL) del anticuerpo anti receptor de IL-6 se inhibe debido a la inestabilidad de la interacción VL/VL. De manera análoga, la cadena H (MRA-VH-CH1-bisagra-CH2-CH3) del anticuerpo anti-receptor de IL-6 está asociada con MRA-VL-CL; sin embargo, su asociación con la cadena L (GC33-VH-CL) del anticuerpo anti-GPC3 se inhibe debido a la inestabilidad de la interacción VH/VH. Tal como se ha descrito anteriormente, es posible potenciar la asociación entre las cadenas H y las cadenas L contra el mismo antígeno. Sin embargo, la interacción VH/VH y la interacción VL/VL también se producen aunque son menos estables que la interacción VH/VL (para VH/VH, véanse: FEBS Lett. 20 de noviembre de 2003, 554(3):323-9; J Mol Biol. 17 de octubre de 2003, 333(2):355-65; para VL/VL, véanse: J Struct Biol. junio de 2002, 138(3):171-86; Proc Natl Acad Sci USA. julio de 1985, 82(14):4592-6), y así, aunque con poca frecuencia, también se produce una autoasociación desfavorable de las cadenas H y de las cadenas L. Por lo tanto, aunque el porcentaje del anticuerpo biespecífico de interés aumenta simplemente intercambiando el dominio VH y el dominio VL entre sí, los productos expresados aún contienen aproximadamente diez tipos de combinaciones.
En general, es extremadamente difícil purificar el anticuerpo biespecífico de interés de los diez tipos de anticuerpos. Sin embargo, es posible mejorar la separación de los diez tipos de componentes en la cromatografía de intercambio iónico mediante la introducción de una modificación para que los diez tipos de componentes tengan cada uno un punto isoeléctrico diferente. En este contexto, MRA-VH, que es la región variable de la cadena H de un anticuerpo anti receptor de IL-6, se modificó para bajar el punto isoeléctrico, y esto produjo H54-VH con un punto isoeléctrico más bajo. De la misma manera, MRA-VL, que es la región variable de la cadena L de un anticuerpo anti-receptor de IL-6, se modificó para bajar el punto isoeléctrico, y esto produjo L28-VL con un punto isoeléctrico más bajo. Asimismo, GC33-VH, que es la región variable de la cadena H de un anticuerpo anti-GPC3, se modificó para aumentar el punto isoeléctrico. Esto produjo Hu22-VH con un punto isoeléctrico aumentado.
La combinación de las cadenas H y L de interés se mejoró intercambiando la VH y VL entre las cadenas H y las cadenas L de un anticuerpo anti-GPC3. Sin embargo, aunque con poca frecuencia, la asociación desfavorable de la cadena H /L se produce porque es imposible suprimir completamente la interacción H54-VH/Hu22-VH y la interacción L28-VL/GC33-VL. Una secuencia de anticuerpo normal tiene glutamina en la posición 39 en VH. En la interacción VH/VH, se cree que las glutaminas forman enlaces de hidrógeno en la interfaz Vh /VH. Después, la lisina se sustituyó por la glutamina en la posición 39 (numeración de Kabat) para alterar la interacción H54-VH/Hu22-VH. Por lo tanto, se esperaba que la interacción VH/VH se viera significativamente alterada debido a la repulsión electrostática entre dos lisinas en la interfaz VH/VH. A continuación, H54-VH-Q39K y Hu22-VH-Q39K se construyeron sustituyendo lisina por glutamina en la posición 39 (numeración de Kabat) en las secuencias de H54-VH y Hu22-VH. De manera análoga, una secuencia de anticuerpo normal tiene glutamina en la posición 38 en VL. En la interacción VL/VL, se espera que las glutaminas formen enlaces de hidrógeno en la interfaz VL/VL. Después, el ácido glutámico se sustituyó por la glutamina en la posición 38 (numeración de Kabat) para alterar la interacción L28-VL/GC33-VL. Por lo tanto, se esperaba que la interacción VL/VL se viera significativamente alterada debido a la repulsión electrostática entre dos ácidos glutámicos en la interfaz VL/VL. A continuación, L28-VL-Q38E y GC33-VL-Q38E se construyeron sustituyendo el ácido glutámico por la glutamina en la posición 39 (numeración de Kabat) en las secuencias de L28-VL y GC33-VL.
Para mejorar adicionalmente la eficacia de la expresión/purificación del anticuerpo biespecífico de interés, se introdujo una mutación por sustitución de Arg por His en la posición 435 (numeración e U) en una cadena H usando el mismo método descrito en el Ejemplo 3. Asimismo, la mutación anterior se combinó con las mutaciones (se introduce una sustitución de Lys por Asp en la posición 356, numeración EU, en una cadena H y se introduce una sustitución de Glu por Lys en la posición 439, numeración EU, en la otra cadena H) descritas en el documento WO 2006/106905 (PROCESS FOR PRODUCTION OF POLYPEPTIDE BY REGULATION OF ASSEMBLY) como una modificación para potenciar la asociación heteromérica de los dos tipos de cadenas H. Las mutaciones combinadas permiten la purificación de la molécula resultante de la asociación heteromérica de los dos tipos de cadenas H por cromatografía con proteína A sola.
De manera específica, las regiones variables de cadena H de anticuerpo utilizadas fueron:
MRA-VH (la región variable de la cadena H de un anticuerpo anti-receptor de interleucina-6 humano, SEQ ID NO: 36);
GC33-VH (la región variable de la cadena H de un anticuerpo anti-GPC3, SEQ ID NO: 37);
H54-VH (la región variable de la cadena H de un anticuerpo anti-receptor de interleucina-6 humano, SEQ ID NO: 38) con un punto isoeléctrico más bajo que el de MRA-VH;
Hu22-VH (la región variable de la cadena H de un anticuerpo anti-GPC3, SEQ ID NO: 39) con un punto isoeléctrico mayor que el de GC33-VH;
H54-VH-Q39K (SEQ ID NO: 40) donde la Lys está sustituida por Gln en la posición 39 (numeración de Kabat) en la secuencia de H54-VH; y
Hu22-VH-Q39K (SEQ ID NO: 41) donde la Lys está sustituida por Gln en la posición 39 en la secuencia de Hu22-VH.
También se usaron las siguientes regiones constantes de cadena H de anticuerpo:
IgG1-LALA-N297A-CH (SEQ ID NO: 42) donde la Ala está sustituida por Leu en las posiciones 234 y 235 (numeración EU) y la Ala está sustituida por Asn en la posición 297 (numeración EU), y las Gly y Lys C-terminales se eliminan en la secuencia de la región constante de la cadena H de IgG1;
IgG1-LALA-N297A-CHr (SEQ ID NO: 43) donde la secuencia de IgG1-LALA-N297A-CH tiene dos restos adicionales de Ser en el extremo N;
IgG1-LALA-N297A-s3-CH (SEQ ID NO: 44) donde el Glu está sustituido por Lys en la posición 439 (numeración EU) en la secuencia de IgG1-LALA-N297A-CH; e IgG1-LALA-N297A-G3s3-CHr (SEQ ID NO: 45) donde la Lys está sustituida por Asp en la posición 356 (numeración EU) y la Arg está sustituida por His en la posición 435 (numeración e U) en la secuencia de IgG1-LALA -N297A-CHr.
Entre tanto, las regiones variables de cadena L de anticuerpo utilizadas fueron:
MRA-VL (la región variable de la cadena L de un anticuerpo anti-receptor de interleucina-6 humano, SEQ ID NO: 46);
GC33-VL (la región variable de la cadena L de un anticuerpo anti-GPC3, SEQ ID NO: 47);
L28-VL (la región variable de la cadena L de un anticuerpo anti-receptor de interleucina-6 humano, SEQ ID NO: 48) con un punto isoeléctrico más bajo que el de MRA-VL;
L28-VL-Q38E (SEQ ID NO: 49) donde el Glu está sustituido por Gln en la posición 38 (numeración de Kabat) en la secuencia de L28-VL; y
GC33-VL-Q38E (SEQ ID NO: 50) donde el Glu está sustituido por Gln en la posición 38 (numeración de Kabat) en la secuencia de GC33-VL.
También se usaron las siguientes regiones constantes de cadena L de anticuerpo.
IgG1-CL (la región constante de la cadena L de IgG1, SEQ ID NO: 51).
IgG1-CLr (SEQ ID NO: 52), que se construyó sustituyendo Arg y Thr por las Ala y Ser C-terminales, respectivamente, en la secuencia de IgG1-CL.
El gen no1-Mh-H se construyó uniendo IgG1-LALA-N297A-CH cadena abajo de MRA-VH. El gen nol-Mh-L se construyó uniendo IgG1-CL cadena abajo de MRA-VL. El gen no1-Gh-H se construyó uniendo IgG1-LALA-N297A-CH cadena abajo de GC33-VH. El gen nol-Gh-L se construyó uniendo IgG1-CL cadena abajo de GC33-VL. El gen no2-Gh-H se construyó uniendo IgG1-LALA-N297A-CHr cadena abajo deGC33-VL. El gen no2-Gh-L se construyó uniendo IgG1-CLr cadena abajo de GC33-VH. El gen no3-MI-H se construyó uniendo IgG1-LALA-N297A-CH cadena abajo de H54-VH. El gen no3-MI-L se construyó uniendo IgG1-CL cadena abajo de L28-VL. El gen no3-Ghh-L se construyó uniendo IgG1-CLr cadena abajo de Hu22-VH.
El gen no5-MI-H se construyó uniendo IgG1-LALA-N297A-s3-CH cadena abajo de H54-VH. El gen no5-Gh-H se construyó uniendo IgG1-LALA-N297A-G3s3-CHr cadena abajo de GC33-VL.
El gen no6-MI-H se construyó uniendo IgG1-LALA-N297A-s3-CH cadena abajo de H54-VH-Q39K. El gen no6-MI-L se construyó uniendo IgG1-CL cadena abajo de L28-VL-Q38E. El gen no6-Gh-H se construyó uniendo IgG1-LALA-N297A-G3s3-CHr cadena abajo de GC33-VL-Q38E. El gen no6-Ghh-L se construyó uniendo IgG1-CLr cadena abajo de Hu22-VH-Q39K.
Los genes correspondientes (no1-Mh-H, no1-Mh-L, no1-Gh-H, no1-Gh-L, no2-Gh-H, no2-Gh-L, no3-Ml-H, no3-Ml-L, no3-Ghh-L, no5-Ml-H, no5-Gh-H, no6-Ml-H, no6-Ml-L, no6-Gh-H y no6-Ghh-L) se insertaron en vectores de expresión de células animales.
Las siguientes combinaciones de vectores de expresión se introdujeron en células FreeStyle293-F para expresar transitoriamente cada molécula diseñada.
A. Molécula diseñada: no1 (Fig. 11)
Descripción: anticuerpo biespecífico anti-receptor de IL-6 /anti-GPC3 natural.
Polipéptidos codificados por polinucleótidos insertados en el vector de expresión: no1-Mh-H (SEQ ID NO: 53), nol-Mh-L (SEQ ID NO: 54), no1-Gh-H (SEQ ID NO: 55) y nol-Gh-L (SEQ ID NO: 56).
B. Molécula diseñada: no2 (Fig. 12)
Descripción: construida a partir de no1 intercambiando los dominios VH y VL del anticuerpo anti-GPC3. Polipéptidos codificados por polinucleótidos insertados en el vector de expresión: no1-Mh-H, no1-Mh-L, no2-Gh-H (SEQ ID NO: 57) y no2-Gh-L (SEQ ID NO: 58).
C. Molécula diseñada: no3 (Fig. 13)
Descripción: construida a partir de no2 mediante la introducción de modificaciones en cada cadena para alterar su punto isoeléctrico. Polipéptidos codificados por polinucleótidos insertados en el vector de expresión: no3-Ml-H (SEQ ID NO: 59), no3-Ml-L (SEQ ID NO: 60) y no2-Gh-H y no3-Ghh-L (SEQ ID NO: 61).
D. Molécula diseñada: no5 (Fig. 14)
Descripción: construida a partir de no3 mediante la introducción de una modificación para potenciar la asociación de la cadena H heteromérica y una modificación que permite la purificación de anticuerpos basada en la proteína A generada a través de la asociación heteromérica. Polipéptidos codificados por polinucleótidos insertados en el vector de expresión: no5-Ml-H (SEQ ID NO: 62), no3-Ml-L, no5-Gh-H (SEQ ID NO: 63) y no3-Ghh-L.
E. Molécula diseñada: no6 (Fig. 15)
Descripción: construida a partir de no5 mediante la introducción de una modificación para mejorar la asociación entre una cadena de interés H y una cadena de interés L.
Polipéptidos codificados por polinucleótidos insertados en el vector de expresión: no6-Ml-H (SEQ ID NO: 64), no6-Ml-L (SEQ ID NO: 65), no6-Gh-H (SEQ ID NO: 66) y no6-Ghh-L (SEQ ID NO: 67).
Los sobrenadantes de cultivo filtrados a través de un filtro con un tamaño de poro de 0,22 pm se cargaron en la resina rProtein A Sepharose de flujo rápido (GE Healthcare) equilibrada con el medio. La resina se eluyó de manera discontinua para purificar las moléculas. Debido a que la proteína G se une al dominio Fab de un anticuerpo, todas las especies de anticuerpos en CM se pueden purificar con proteína G independientemente de la afinidad por la proteína A.
Los anticuerpos diseñados (no1, no2, no3, no5 y no6) se evaluaron para determinar su expresión por cromatografía de intercambio catiónico (IEC, por sus siglas en inglés) usando una columna ProPac WCX-10 (Dionex), una columna
Claims (5)
1. Un método para producir un multímero polipeptídico que comprende un primer polipéptido que tiene una actividad de unión a antígeno y un segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, que comprende las etapas de:
(a) expresar un ADN que codifica el primer polipéptido y un ADN que codifica el segundo polipéptido; y
(b) recoger el producto de expresión de la etapa (a) por cromatografía de afinidad con proteína A, en donde el primer polipéptido y el segundo polipéptido comprenden una secuencia de aminoácidos de un dominio Fc de anticuerpo o una secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo;
en donde el dominio Fc de anticuerpo o la región constante de cadena pesada de anticuerpo deriva de IgG humana; en donde el resto de aminoácido en la posición 435, de acuerdo con la numeración EU, en la secuencia de aminoácidos del dominio Fc o de la región constante de cadena pesada es histidina o arginina en el primer polipéptido y arginina o histidina respectivamente en el segundo polipéptido; en donde la combinación de aminoácidos en las posiciones 356 y 439 en la secuencia de aminoácidos de la región Fc o de la región constante de cadena pesada del primer polipéptido se ha modificado a aminoácidos con la misma carga eléctrica; y
en donde la combinación de aminoácidos en las posiciones 356 y 439 en la secuencia de aminoácidos de la región Fc o de la región constante de cadena pesada del segundo polipéptido se ha modificado a aminoácidos con una carga eléctrica opuesta a aquella de las posiciones 356 y 439 del primer polipéptido.
2. El método de la reivindicación 1,
i) en donde la pureza del multímero polipeptídico recogido es del 95 % o más;
y/o
ii) en donde el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno comprenden una secuencia de aminoácidos de una región variable de cadena pesada de anticuerpo,
particularmente en donde se ha modificado al menos un resto de aminoácido en las secuencias de aminoácidos de FR1, CDR2 y FR3 de la región variable de cadena pesada de anticuerpo;
y/o
iii) en donde el multímero polipeptídico comprende uno o dos terceros polipéptidos que tienen una actividad de unión a antígeno, y la etapa (a) comprende expresar un ADN que codifica el tercer polipéptido que tiene una actividad de unión a antígeno, particularmente
a) en donde el tercer polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena ligera de anticuerpo,
y/o
b) en donde el multímero polipeptídico comprende adicionalmente un cuarto polipéptido que tiene una actividad de unión a antígeno, y la etapa (a) comprende expresar un ADN que codifica el cuarto polipéptido que tiene una actividad de unión a antígeno,
especialmente
b1) en donde al menos uno de los polipéptidos tercero y cuarto que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena ligera de anticuerpo,
o
b2) en donde el primer polipéptido que tiene una actividad de unión a antígeno comprende secuencias de aminoácidos de una región variable de cadena ligera de anticuerpo y de una región constante de cadena pesada de anticuerpo; el segundo polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena pesada de anticuerpo; el tercer polipéptido que tiene una actividad de unión a antígeno comprende secuencias de aminoácidos de una región variable de cadena pesada de anticuerpo y de una región constante de cadena ligera de anticuerpo; y el cuarto polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena ligera de anticuerpo;
y/o
iv) en donde el multímero polipeptídico es un anticuerpo multiespecífico,
particularmente en donde el anticuerpo multiespecífico es un anticuerpo biespecífico.
3. El método de una cualquiera de las reivindicaciones 1 y 2 i) a 2 iv), que comprende el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que no tiene actividad de unión a antígeno, y en donde el primer polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de un dominio de unión a antígeno de un receptor y una secuencia de aminoácidos de un dominio Fc de anticuerpo, y el segundo polipéptido que no tiene actividad de unión a antígeno comprende una secuencia de aminoácidos de un dominio Fc de anticuerpo.
4. Un método para purificar un multímero polipeptídico que comprende un primer polipéptido que tiene una actividad de unión a antígeno y un segundo polipéptido que tiene una actividad de unión a antígeno o que no tiene actividad de unión a antígeno, que comprende las etapas de:
(a) expresar un ADN que codifica el primer polipéptido y un ADN que codifica el segundo polipéptido; y
(b) recoger el producto de expresión de la etapa (a) por cromatografía de afinidad con proteína A, en donde el primer polipéptido y el segundo polipéptido comprenden una secuencia de aminoácidos de un dominio Fc de anticuerpo o una secuencia de aminoácidos de una región constante de cadena pesada de anticuerpo;
en donde el dominio Fc de anticuerpo o la región constante de cadena pesada de anticuerpo deriva de IgG humana; en donde el resto de aminoácido en la posición 435, de acuerdo con la numeración EU, en la secuencia de aminoácidos del dominio Fc o de la región constante de cadena pesada es histidina o arginina en el primer polipéptido y arginina o histidina respectivamente en el segundo polipéptido; en donde la combinación de aminoácidos en las posiciones 356 y 439 en la secuencia de aminoácidos de la región Fc o de la región constante de cadena pesada del primer polipéptido se ha modificado a aminoácidos con la misma carga eléctrica; y
en donde la combinación de aminoácidos en las posiciones 356 y 439 en la secuencia de aminoácidos de la región Fc o de la región constante de cadena pesada del segundo polipéptido se ha modificado a aminoácidos con una carga eléctrica opuesta a aquella de las posiciones 356 y 439 del primer polipéptido.
5. El método de la reivindicación 4,
i) en donde la pureza del multímero polipeptídico recogido es del 95 % o más;
y/o
ii) en donde el primer polipéptido que tiene una actividad de unión a antígeno y el segundo polipéptido que tiene una actividad de unión a antígeno comprenden una secuencia de aminoácidos de una región variable de cadena pesada de anticuerpo,
particularmente en donde se ha modificado al menos un resto de aminoácido en las secuencias de aminoácidos de FR1, CDR2 y FR3 de la región variable de cadena pesada de anticuerpo; y/o
iii) en donde el multímero polipeptídico comprende uno o dos terceros polipéptidos que tienen una actividad de unión a antígeno, y la etapa (a) comprende expresar un ADN que codifica el tercer polipéptido que tiene una actividad de unión a antígeno, particularmente
a) en donde el tercer polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena ligera de anticuerpo,
y/o
b) en donde el multímero polipeptídico comprende adicionalmente un cuarto polipéptido que tiene una actividad de unión a antígeno, y la etapa (a) comprende expresar un ADN que codifica el cuarto polipéptido que tiene una actividad de unión a antígeno, especialmente
b1) en donde al menos uno de los polipéptidos tercero y cuarto que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena ligera de anticuerpo,
o
b2) en donde el primer polipéptido que tiene una actividad de unión a antígeno comprende secuencias de aminoácidos de una región variable de cadena ligera de anticuerpo y de una región constante de cadena pesada de anticuerpo; el segundo polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena pesada de anticuerpo; el tercer polipéptido que tiene una actividad de unión a antígeno comprende secuencias de aminoácidos de una región variable de cadena pesada de anticuerpo y de una región constante de cadena ligera de anticuerpo; y el cuarto polipéptido que tiene una actividad de unión a antígeno comprende una secuencia de aminoácidos de una cadena ligera de anticuerpo;
y/o
iv) en donde el multímero polipeptídico es un anticuerpo multiespecífico,
particularmente en donde el anticuerpo multiespecífico es un anticuerpo biespecífico.
Applications Claiming Priority (2)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| JP2009294391 | 2009-12-25 | ||
| PCT/JP2010/073361 WO2011078332A1 (ja) | 2009-12-25 | 2010-12-24 | ポリペプチド多量体を精製するためのポリペプチドの改変方法 |
Publications (1)
| Publication Number | Publication Date |
|---|---|
| ES2777901T3 true ES2777901T3 (es) | 2020-08-06 |
Family
ID=44195857
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| ES10839561T Active ES2777901T3 (es) | 2009-12-25 | 2010-12-24 | Método de modificación de polipéptidos para purificar multímeros polipeptídicos |
Country Status (15)
| Country | Link |
|---|---|
| US (14) | US20130018174A1 (es) |
| EP (1) | EP2522724B1 (es) |
| JP (1) | JP6087054B2 (es) |
| KR (3) | KR102103093B1 (es) |
| CN (1) | CN102770537A (es) |
| AU (1) | AU2010336277B2 (es) |
| BR (1) | BR112012017124C1 (es) |
| CA (1) | CA2785414C (es) |
| ES (1) | ES2777901T3 (es) |
| HR (1) | HRP20200464T1 (es) |
| MX (1) | MX2012007497A (es) |
| PL (1) | PL2522724T3 (es) |
| RU (1) | RU2606264C2 (es) |
| SI (1) | SI2522724T1 (es) |
| WO (1) | WO2011078332A1 (es) |
Families Citing this family (104)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| US20090137416A1 (en) | 2001-01-16 | 2009-05-28 | Regeneron Pharmaceuticals, Inc. | Isolating Cells Expressing Secreted Proteins |
| WO2004111233A1 (ja) | 2003-06-11 | 2004-12-23 | Chugai Seiyaku Kabushiki Kaisha | 抗体の製造方法 |
| CN101198698B (zh) * | 2005-03-31 | 2014-03-19 | 中外制药株式会社 | 通过调节多肽缔合制备多肽的方法 |
| CN104761637B (zh) | 2006-03-31 | 2021-10-15 | 中外制药株式会社 | 调控抗体血液动力学的方法 |
| EP2009101B1 (en) | 2006-03-31 | 2017-10-25 | Chugai Seiyaku Kabushiki Kaisha | Antibody modification method for purifying bispecific antibody |
| EP3415529B1 (en) * | 2007-09-26 | 2020-11-04 | Chugai Seiyaku Kabushiki Kaisha | Modified antibody constant region |
| CN101874042B9 (zh) | 2007-09-26 | 2019-01-01 | 中外制药株式会社 | 利用cdr的氨基酸取代来改变抗体等电点的方法 |
| EP2275443B1 (en) | 2008-04-11 | 2015-12-02 | Chugai Seiyaku Kabushiki Kaisha | Antigen-binding molecule capable of binding to two or more antigen molecules repeatedly |
| WO2010107110A1 (ja) | 2009-03-19 | 2010-09-23 | 中外製薬株式会社 | 抗体定常領域改変体 |
| TWI682995B (zh) | 2009-03-19 | 2020-01-21 | 日商中外製藥股份有限公司 | 抗體恆定區域改變體 |
| WO2011028952A1 (en) | 2009-09-02 | 2011-03-10 | Xencor, Inc. | Compositions and methods for simultaneous bivalent and monovalent co-engagement of antigens |
| JP5837821B2 (ja) | 2009-09-24 | 2015-12-24 | 中外製薬株式会社 | 抗体定常領域改変体 |
| AR080428A1 (es) | 2010-01-20 | 2012-04-11 | Chugai Pharmaceutical Co Ltd | Formulaciones liquidas estabilizadas contentivas de anticuerpos |
| US10435458B2 (en) | 2010-03-04 | 2019-10-08 | Chugai Seiyaku Kabushiki Kaisha | Antibody constant region variants with reduced Fcgammar binding |
| CA2806252C (en) | 2010-07-29 | 2019-05-14 | Xencor, Inc. | Antibodies with modified isoelectric points |
| KR101962483B1 (ko) * | 2010-11-17 | 2019-03-29 | 추가이 세이야쿠 가부시키가이샤 | 혈액응고 제viii 인자의 기능을 대체하는 기능을 갖는 다중특이성 항원 결합 분자 |
| TWI638833B (zh) | 2010-11-30 | 2018-10-21 | 中外製藥股份有限公司 | 細胞傷害誘導治療劑 |
| TWI654204B (zh) | 2010-11-30 | 2019-03-21 | Chugai Seiyaku Kabushiki Kaisha | 具有鈣依存性的抗原結合能力之抗體 |
| US12466897B2 (en) | 2011-10-10 | 2025-11-11 | Xencor, Inc. | Heterodimeric human IgG1 polypeptides with isoelectric point modifications |
| ES2732712T3 (es) | 2011-10-31 | 2019-11-25 | Chugai Pharmaceutical Co Ltd | Molécula de unión a antígeno que tiene una conjugación regulada entre la cadena pesada y la cadena ligera |
| EP4310191A3 (en) | 2012-06-14 | 2024-05-15 | Chugai Seiyaku Kabushiki Kaisha | Antigen-binding molecule containing modified fc region |
| HK1215950A1 (zh) * | 2012-09-25 | 2016-09-30 | 艾科诺斯科技股份有限公司 | 异源二聚免疫球蛋白的纯化 |
| EP2905290B1 (en) * | 2012-10-05 | 2019-12-04 | Kyowa Kirin Co., Ltd. | Heterodimeric protein composition |
| TW202423993A (zh) * | 2012-11-14 | 2024-06-16 | 美商再生元醫藥公司 | 重組細胞表面捕捉蛋白質 |
| CA2898100C (en) | 2013-01-14 | 2023-10-10 | Xencor, Inc. | Novel heterodimeric proteins |
| US11053316B2 (en) | 2013-01-14 | 2021-07-06 | Xencor, Inc. | Optimized antibody variable regions |
| US9701759B2 (en) | 2013-01-14 | 2017-07-11 | Xencor, Inc. | Heterodimeric proteins |
| US10487155B2 (en) | 2013-01-14 | 2019-11-26 | Xencor, Inc. | Heterodimeric proteins |
| US9605084B2 (en) | 2013-03-15 | 2017-03-28 | Xencor, Inc. | Heterodimeric proteins |
| US10131710B2 (en) | 2013-01-14 | 2018-11-20 | Xencor, Inc. | Optimized antibody variable regions |
| US10968276B2 (en) | 2013-03-12 | 2021-04-06 | Xencor, Inc. | Optimized anti-CD3 variable regions |
| CA2897987A1 (en) | 2013-01-15 | 2014-07-24 | Xencor, Inc. | Rapid clearance of antigen complexes using novel antibodies |
| US10519242B2 (en) | 2013-03-15 | 2019-12-31 | Xencor, Inc. | Targeting regulatory T cells with heterodimeric proteins |
| EP2970486B1 (en) | 2013-03-15 | 2018-05-16 | Xencor, Inc. | Modulation of t cells with bispecific antibodies and fc fusions |
| US10858417B2 (en) | 2013-03-15 | 2020-12-08 | Xencor, Inc. | Heterodimeric proteins |
| US10106624B2 (en) | 2013-03-15 | 2018-10-23 | Xencor, Inc. | Heterodimeric proteins |
| EP3936521B1 (en) * | 2013-03-15 | 2026-02-11 | Xencor, Inc. | Heterodimeric proteins |
| US11261262B2 (en) | 2013-09-03 | 2022-03-01 | Novimmune Sa | Readily isolated bispecific binding molecules with native format having mutated constant regions |
| CN105764922B (zh) * | 2013-09-27 | 2020-07-17 | 中外制药株式会社 | 多肽异源多聚体的制备方法 |
| BR112016006502A2 (pt) | 2013-09-30 | 2017-09-19 | Chugai Pharmaceutical Co Ltd | Método para a produção de molécula de ligação de antígeno usando-se fago auxiliar modificado |
| WO2015063339A1 (en) * | 2013-11-04 | 2015-05-07 | Glenmark Pharmaceuticals S.A. | Production of t cell retargeting hetero-dimeric immunoglobulins |
| JP6775422B2 (ja) | 2014-03-28 | 2020-10-28 | ゼンコー・インコーポレイテッドXencor、 Inc. | Cd38及びcd3に結合する二重特異性抗体 |
| AR101262A1 (es) * | 2014-07-26 | 2016-12-07 | Regeneron Pharma | Plataforma de purificación para anticuerpos biespecíficos |
| TWI701435B (zh) | 2014-09-26 | 2020-08-11 | 日商中外製藥股份有限公司 | 測定fviii的反應性之方法 |
| TWI700300B (zh) | 2014-09-26 | 2020-08-01 | 日商中外製藥股份有限公司 | 中和具有第viii凝血因子(fviii)機能替代活性的物質之抗體 |
| MA40764A (fr) | 2014-09-26 | 2017-08-01 | Chugai Pharmaceutical Co Ltd | Agent thérapeutique induisant une cytotoxicité |
| MA40894A (fr) * | 2014-11-04 | 2017-09-12 | Glenmark Pharmaceuticals Sa | Immunoglobulines hétéro-dimères reciblant des lymphocytes t cd3/cd38 et leurs procédés de production |
| US11773166B2 (en) | 2014-11-04 | 2023-10-03 | Ichnos Sciences SA | CD3/CD38 T cell retargeting hetero-dimeric immunoglobulins and methods of their production |
| SG11201704283PA (en) | 2014-11-26 | 2017-06-29 | Xencor Inc | Heterodimeric antibodies that bind cd3 and tumor antigens |
| US10259887B2 (en) | 2014-11-26 | 2019-04-16 | Xencor, Inc. | Heterodimeric antibodies that bind CD3 and tumor antigens |
| JP2017536830A (ja) | 2014-11-26 | 2017-12-14 | ゼンコー・インコーポレイテッドXencor、 Inc. | Cd3及びcd38に結合するヘテロ二量体抗体 |
| WO2016105450A2 (en) | 2014-12-22 | 2016-06-30 | Xencor, Inc. | Trispecific antibodies |
| US10227411B2 (en) | 2015-03-05 | 2019-03-12 | Xencor, Inc. | Modulation of T cells with bispecific antibodies and FC fusions |
| US11142587B2 (en) | 2015-04-01 | 2021-10-12 | Chugai Seiyaku Kabushiki Kaisha | Method for producing polypeptide hetero-oligomer |
| EP3286227A2 (en) * | 2015-04-24 | 2018-02-28 | F. Hoffmann-La Roche AG | Multispecific antigen-binding proteins |
| ES2973885T3 (es) | 2015-07-09 | 2024-06-24 | Genmab As | Anticuerpos biespecíficos y multiespecíficos y método para aislarlos |
| JP7058219B2 (ja) | 2015-12-07 | 2022-04-21 | ゼンコア インコーポレイテッド | Cd3及びpsmaに結合するヘテロ二量体抗体 |
| WO2017110980A1 (ja) | 2015-12-25 | 2017-06-29 | 中外製薬株式会社 | 増強された活性を有する抗体及びその改変方法 |
| SG11201803989WA (en) * | 2015-12-28 | 2018-06-28 | Chugai Pharmaceutical Co Ltd | Method for promoting efficiency of purification of fc region-containing polypeptide |
| JP2019506158A (ja) | 2016-01-22 | 2019-03-07 | ヤンセン バイオテツク,インコーポレーテツド | 抗ror1抗体、ror1×cd3二重特異性抗体、及びそれらの使用法 |
| GB201602156D0 (en) * | 2016-02-05 | 2016-03-23 | Jones Philip C And Boku University Of Natural Resources And Life Sciences | Heterodimers and purification thereof |
| CA3016424A1 (en) | 2016-03-14 | 2017-09-21 | Chugai Seiyaku Kabushiki Kaisha | Cell injury inducing therapeutic drug for use in cancer therapy |
| ES3055961T3 (en) | 2016-04-28 | 2026-02-17 | Chugai Pharmaceutical Co Ltd | Antibody-containing preparation |
| MA45255A (fr) | 2016-06-14 | 2019-04-17 | Xencor Inc | Anticorps inhibiteurs de points de contrôle bispécifiques |
| KR20190020341A (ko) | 2016-06-28 | 2019-02-28 | 젠코어 인코포레이티드 | 소마토스타틴 수용체 2에 결합하는 이종이량체 항체 |
| CN109415444B (zh) | 2016-07-29 | 2024-03-01 | 中外制药株式会社 | 显示增加的备选fviii辅因子功能活性的双特异性抗体 |
| US10793632B2 (en) | 2016-08-30 | 2020-10-06 | Xencor, Inc. | Bispecific immunomodulatory antibodies that bind costimulatory and checkpoint receptors |
| EP3509637B1 (en) | 2016-09-06 | 2024-11-27 | Chugai Seiyaku Kabushiki Kaisha | Methods of using a bispecific antibody that recognizes coagulation factor ix and/or activated coagulation factor ix and coagulation factor x and/or activated coagulation factor x |
| BR112019007281A2 (pt) | 2016-10-14 | 2019-07-09 | Xencor Inc | proteína heterodimérica, composições de ácido nucleico e de vetor de expressão, vetor de expressão, célula hospedeira, e, métodos para produzir proteína heterodimérica e para tratar câncer em um paciente |
| EP3603670A4 (en) | 2017-03-31 | 2021-03-10 | Public University Corporation Nara Medical University | MEDICAL COMPOSITION FOR THE PREVENTION AND / OR TREATMENT OF BLOOD CLOG FACTOR IX ANOMALY WITH A MULTI-SPECIFIC ANTIGIBINDING MOLECULAR FUNCTION OF BLOOD CLOTHING FACTOR VIII |
| US20180371088A1 (en) * | 2017-06-22 | 2018-12-27 | Development Center For Biotechnology | TARGET CELL-DEPENDENT T CELL ENGAGING AND ACTIVATION ASYMMETRIC HETERODIMERIC Fc-ScFv FUSION ANTIBODY FORMAT AND USES THEREOF IN CANCER THERAPY |
| CN111201242A (zh) * | 2017-06-22 | 2020-05-26 | 财团法人生物技术开发中心 | 不对称异二聚fc-scfv融合抗globo h及抗cd3双特异性抗体及其在癌症治疗上的用途 |
| AU2018291497A1 (en) | 2017-06-30 | 2020-01-16 | Xencor, Inc. | Targeted heterodimeric Fc fusion proteins containing IL-15/IL-15Ra and antigen binding domains |
| JP6496095B1 (ja) | 2017-09-29 | 2019-04-03 | 中外製薬株式会社 | 血液凝固第viii因子(fviii)補因子機能代替活性を有する多重特異性抗原結合分子および当該分子を有効成分として含有する薬学的製剤 |
| TW202600611A (zh) | 2017-11-01 | 2026-01-01 | 日商中外製藥股份有限公司 | 生物活性降低之抗體變異體與同功型 |
| AU2018366199A1 (en) | 2017-11-08 | 2020-05-28 | Xencor, Inc. | Bispecific and monospecific antibodies using novel anti-PD-1 sequences |
| US10981992B2 (en) | 2017-11-08 | 2021-04-20 | Xencor, Inc. | Bispecific immunomodulatory antibodies that bind costimulatory and checkpoint receptors |
| AU2018390418B2 (en) | 2017-12-19 | 2023-12-21 | Xencor, Inc. | Engineered IL-2 Fc fusion proteins |
| WO2019183334A1 (en) | 2018-03-21 | 2019-09-26 | Waters Technologies Corporation | Non-antibody high-affinity-based sample preparation, sorbents, devices and methods |
| AU2019247415A1 (en) | 2018-04-04 | 2020-10-22 | Xencor, Inc. | Heterodimeric antibodies that bind fibroblast activation protein |
| JP2021520829A (ja) | 2018-04-18 | 2021-08-26 | ゼンコア インコーポレイテッド | IL−15/IL−15RA Fc融合タンパク質およびTIM−3抗原結合ドメインを含む、TIM−3標的化ヘテロ二量体融合タンパク質 |
| CA3097593A1 (en) | 2018-04-18 | 2019-10-24 | Xencor, Inc. | Pd-1 targeted heterodimeric fusion proteins containing il-15/il-15ra fc-fusion proteins and pd-1 antigen binding domains and uses thereof |
| SG11202103192RA (en) | 2018-10-03 | 2021-04-29 | Xencor Inc | Il-12 heterodimeric fc-fusion proteins |
| US20220064327A1 (en) * | 2018-12-21 | 2022-03-03 | Kymab Limited | Fixaxfx bispecific antibody with common light chain |
| MA54601A (fr) | 2018-12-24 | 2022-03-30 | Sanofi Sa | Nouvelles protéines de liaison multi-spécifiques à base de pseudofab |
| JP7375027B2 (ja) * | 2019-02-14 | 2023-11-07 | メルス ナムローゼ フェンノートシャップ | 2つ以上の抗体を含む組成物の製造 |
| CN114409798A (zh) * | 2019-02-14 | 2022-04-29 | 美勒斯公司 | 制备包含两种或更多种抗体的组合物 |
| WO2020180726A1 (en) | 2019-03-01 | 2020-09-10 | Xencor, Inc. | Heterodimeric antibodies that bind enpp3 and cd3 |
| CN113840837A (zh) | 2019-03-14 | 2021-12-24 | 詹森生物科技公司 | 用于产生抗tnf抗体组合物的方法 |
| JP7635137B2 (ja) * | 2019-03-14 | 2025-02-25 | ヤンセン バイオテツク,インコーポレーテツド | 抗tnf抗体組成物を産生するための方法 |
| EP4023245A4 (en) * | 2019-08-28 | 2023-08-30 | Azusapharma Sciences, Inc. | BIFIDOBACTERIUM SPP. THE INVENTION RELATES TO THE EXPRESSION AND SECRETION OF BSAB OF THE DIABODY TYPE |
| US11743719B2 (en) | 2019-10-07 | 2023-08-29 | Denso Corporation | System and method for authenticating an occupant of a vehicle |
| CN113121677B (zh) * | 2019-12-31 | 2023-06-27 | 周易 | 一种得到高纯度异源抗体的方法 |
| WO2021231976A1 (en) | 2020-05-14 | 2021-11-18 | Xencor, Inc. | Heterodimeric antibodies that bind prostate specific membrane antigen (psma) and cd3 |
| CA3192204A1 (en) | 2020-08-19 | 2022-02-24 | Xencor, Inc. | Anti-cd28 and/or anti-b7h3 compositions |
| TW202241947A (zh) * | 2020-12-18 | 2022-11-01 | 比利時商艾伯霖克斯公司 | 包含靶向磷脂醯肌醇蛋白聚糖—3和t細胞受體的免疫球蛋白單可變結構域的多肽 |
| KR20230156079A (ko) | 2021-03-09 | 2023-11-13 | 젠코어 인코포레이티드 | Cd3과 cldn6에 결합하는 이종이량체 항체 |
| US11859012B2 (en) | 2021-03-10 | 2024-01-02 | Xencor, Inc. | Heterodimeric antibodies that bind CD3 and GPC3 |
| CN118139883A (zh) * | 2021-07-09 | 2024-06-04 | 詹森生物科技公司 | 用于生产抗tnf抗体组合物的制造方法 |
| CN119212716A (zh) * | 2022-05-09 | 2024-12-27 | 杭州微诺迈博生物科技有限公司 | 包含多特异性抗体的治疗剂及其在肿瘤治疗中的应用 |
| WO2024071008A1 (ja) * | 2022-09-26 | 2024-04-04 | 愛知県 | 抗原分子の単離方法 |
| CN121532432A (zh) * | 2023-05-10 | 2026-02-13 | 麦克法兰布奈特医疗研究与公共健康研究所有限公司 | 免疫治疗蛋白 |
| WO2026006492A2 (en) | 2024-06-25 | 2026-01-02 | Ypsilon Therapeutics, Inc. | Anti-prame/hla-a2 antibodies and uses thereof |
| WO2026006495A1 (en) | 2024-06-25 | 2026-01-02 | Alloy Therapeutics, Inc. | Anti-wt1/hla-a2 antibody and uses thereof |
Family Cites Families (13)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| UA40577C2 (uk) * | 1993-08-02 | 2001-08-15 | Мерк Патент Гмбх | Біспецифічна молекула, що використовується для лізису пухлинних клітин, спосіб її одержання, моноклональне антитіло (варіанти), фармацевтичний препарат, фармацевтичний набір (варіанти), спосіб видалення пухлинних клітин |
| US5945311A (en) * | 1994-06-03 | 1999-08-31 | GSF--Forschungszentrumfur Umweltund Gesundheit | Method for producing heterologous bi-specific antibodies |
| DE122009000068I2 (de) * | 1994-06-03 | 2011-06-16 | Ascenion Gmbh | Verfahren zur Herstellung von heterologen bispezifischen Antikörpern |
| DK0979281T3 (da) | 1997-05-02 | 2005-11-21 | Genentech Inc | Fremgangsmåde til fremstilling af multispecifikke antistoffer med heteromultimere og fælles bestanddele |
| WO2007024249A2 (en) * | 2004-11-10 | 2007-03-01 | Macrogenics, Inc. | Engineering fc antibody regions to confer effector function |
| CN101198698B (zh) | 2005-03-31 | 2014-03-19 | 中外制药株式会社 | 通过调节多肽缔合制备多肽的方法 |
| CA2603264C (en) | 2005-04-08 | 2017-03-21 | Chugai Seiyaku Kabushiki Kaisha | Antibody substituting for function of blood coagulation factor viii |
| ZA200710599B (en) * | 2005-04-15 | 2009-08-26 | Genentech Inc | HGF Beta chain variants |
| EP2009101B1 (en) * | 2006-03-31 | 2017-10-25 | Chugai Seiyaku Kabushiki Kaisha | Antibody modification method for purifying bispecific antibody |
| EP2107115A1 (en) * | 2007-01-24 | 2009-10-07 | Kyowa Hakko Kirin Co., Ltd. | Genetically recombinant antibody composition capable of binding specifically to ganglioside gm2 |
| LT2975051T (lt) * | 2009-06-26 | 2021-07-12 | Regeneron Pharmaceuticals, Inc. | Lengvai išskiriami bispecifiniai antikūnai su natyvios formos imunoglobulinu |
| KR101962483B1 (ko) * | 2010-11-17 | 2019-03-29 | 추가이 세이야쿠 가부시키가이샤 | 혈액응고 제viii 인자의 기능을 대체하는 기능을 갖는 다중특이성 항원 결합 분자 |
| BR112015022119A2 (pt) * | 2013-03-15 | 2017-08-29 | Abbvie Biotherapeutics Inc | Polipeptídeo, composto conjugado, composição farmacêutica, ácido nucleico, vetor, células hospedeiras procariótica e eucariótica, método de produção de um polipeptídeo, e, método de tratamento |
-
2010
- 2010-12-24 EP EP10839561.7A patent/EP2522724B1/en active Active
- 2010-12-24 MX MX2012007497A patent/MX2012007497A/es active IP Right Grant
- 2010-12-24 CN CN2010800647721A patent/CN102770537A/zh active Pending
- 2010-12-24 KR KR1020187012542A patent/KR102103093B1/ko active Active
- 2010-12-24 SI SI201031988T patent/SI2522724T1/sl unknown
- 2010-12-24 CA CA2785414A patent/CA2785414C/en active Active
- 2010-12-24 JP JP2011547650A patent/JP6087054B2/ja active Active
- 2010-12-24 BR BR112012017124A patent/BR112012017124C1/pt active Search and Examination
- 2010-12-24 PL PL10839561T patent/PL2522724T3/pl unknown
- 2010-12-24 US US13/518,861 patent/US20130018174A1/en not_active Abandoned
- 2010-12-24 KR KR1020207009446A patent/KR102380315B1/ko active Active
- 2010-12-24 ES ES10839561T patent/ES2777901T3/es active Active
- 2010-12-24 RU RU2012131671A patent/RU2606264C2/ru active
- 2010-12-24 HR HRP20200464TT patent/HRP20200464T1/hr unknown
- 2010-12-24 AU AU2010336277A patent/AU2010336277B2/en active Active
- 2010-12-24 WO PCT/JP2010/073361 patent/WO2011078332A1/ja not_active Ceased
- 2010-12-24 KR KR1020127019119A patent/KR101856792B1/ko active Active
-
2017
- 2017-06-08 US US15/617,008 patent/US20170275332A1/en not_active Abandoned
-
2018
- 2018-01-19 US US15/875,847 patent/US20180162902A1/en not_active Abandoned
- 2018-10-09 US US16/155,673 patent/US20190062368A1/en not_active Abandoned
-
2019
- 2019-06-21 US US16/448,088 patent/US20190352334A1/en not_active Abandoned
-
2020
- 2020-03-11 US US16/815,089 patent/US20200207805A1/en not_active Abandoned
- 2020-10-22 US US17/076,938 patent/US20210040147A1/en not_active Abandoned
-
2021
- 2021-06-02 US US17/336,538 patent/US20210292360A1/en not_active Abandoned
-
2022
- 2022-01-13 US US17/574,614 patent/US20220135618A1/en not_active Abandoned
- 2022-08-23 US US17/821,494 patent/US20220389054A1/en not_active Abandoned
-
2023
- 2023-03-31 US US18/193,697 patent/US20230227498A1/en not_active Abandoned
- 2023-11-09 US US18/505,180 patent/US20240083939A1/en not_active Abandoned
-
2024
- 2024-06-20 US US18/748,951 patent/US20240391952A1/en not_active Abandoned
-
2025
- 2025-08-29 US US19/314,060 patent/US20250382327A1/en active Pending
Also Published As
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| US20230227498A1 (en) | Polypeptide modification method for purifying polypeptide multimers | |
| CN109111524B (zh) | 控制了重链与轻链的缔合的抗原结合分子 | |
| EP2409991B1 (en) | Antibody constant region variant | |
| BR112017006061B1 (pt) | Anticorpo biespecífico, e composição farmacêutica que o compreende | |
| WO2007114325A1 (ja) | 二重特異性抗体を精製するための抗体改変方法 | |
| CN101460622A (zh) | 用于纯化双特异性抗体的抗体修饰方法 | |
| TW202607021A (zh) | 結合tslp之抗體及使用方法 | |
| HK1174663A (en) | Polypeptide modification method for purifying polypeptide multimers | |
| HK1259058B (en) | Antigen-binding molecule having regulated conjugation between heavy-chain and light-chain | |
| HK1259059B (en) | Antigen-binding molecule having regulated conjugation between heavy-chain and light-chain | |
| HK1197429A (en) | Antigen-binding molecule having regulated conjugation between heavy-chain and light-chain |