ES2916998T3 - Análogos del EGF(A) con sustituyentes de ácidos grasos - Google Patents
Análogos del EGF(A) con sustituyentes de ácidos grasos Download PDFInfo
- Publication number
- ES2916998T3 ES2916998T3 ES17701078T ES17701078T ES2916998T3 ES 2916998 T3 ES2916998 T3 ES 2916998T3 ES 17701078 T ES17701078 T ES 17701078T ES 17701078 T ES17701078 T ES 17701078T ES 2916998 T3 ES2916998 T3 ES 2916998T3
- Authority
- ES
- Spain
- Prior art keywords
- ethoxy
- peptide
- egf
- amino
- acetyl
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Active
Links
- 125000005313 fatty acid group Chemical group 0.000 title claims description 24
- 108090000765 processed proteins & peptides Proteins 0.000 claims abstract description 549
- 150000001875 compounds Chemical class 0.000 claims abstract description 259
- 125000001301 ethoxy group Chemical group [H]C([H])([H])C([H])([H])O* 0.000 claims description 896
- 125000002924 primary amino group Chemical group [H]N([H])* 0.000 claims description 470
- 125000002777 acetyl group Chemical group [H]C([H])([H])C(*)=O 0.000 claims description 444
- ZWQVYZXPYSYPJD-RYUDHWBXSA-N Glu-Gly-Phe Chemical class OC(=O)CC[C@H](N)C(=O)NCC(=O)N[C@H](C(O)=O)CC1=CC=CC=C1 ZWQVYZXPYSYPJD-RYUDHWBXSA-N 0.000 claims description 253
- 125000001424 substituent group Chemical group 0.000 claims description 248
- 125000004063 butyryl group Chemical group O=C([*])C([H])([H])C([H])([H])C([H])([H])[H] 0.000 claims description 235
- 238000006467 substitution reaction Methods 0.000 claims description 129
- 125000003275 alpha amino acid group Chemical group 0.000 claims description 95
- 150000001413 amino acids Chemical class 0.000 claims description 68
- 230000027455 binding Effects 0.000 claims description 36
- IJGRMHOSHXDMSA-UHFFFAOYSA-N Atomic nitrogen Chemical compound N#N IJGRMHOSHXDMSA-UHFFFAOYSA-N 0.000 claims description 35
- -1 methylsulfonylcarbamoylamino moiety Chemical group 0.000 claims description 32
- 229910052757 nitrogen Inorganic materials 0.000 claims description 21
- 230000002860 competitive effect Effects 0.000 claims description 10
- 125000001997 phenyl group Chemical group [H]C1=C([H])C([H])=C(*)C([H])=C1[H] 0.000 claims description 7
- LSNNMFCWUKXFEE-UHFFFAOYSA-M Bisulfite Chemical compound OS([O-])=O LSNNMFCWUKXFEE-UHFFFAOYSA-M 0.000 claims description 5
- 238000002965 ELISA Methods 0.000 claims description 5
- 238000013357 binding ELISA Methods 0.000 claims description 5
- 150000001732 carboxylic acid derivatives Chemical class 0.000 claims description 4
- 150000003536 tetrazoles Chemical group 0.000 claims description 4
- 125000003178 carboxy group Chemical group [H]OC(*)=O 0.000 claims description 3
- MAYZWDRUFKUGGP-VIFPVBQESA-N (3s)-1-[5-tert-butyl-3-[(1-methyltetrazol-5-yl)methyl]triazolo[4,5-d]pyrimidin-7-yl]pyrrolidin-3-ol Chemical compound CN1N=NN=C1CN1C2=NC(C(C)(C)C)=NC(N3C[C@@H](O)CC3)=C2N=N1 MAYZWDRUFKUGGP-VIFPVBQESA-N 0.000 claims description 2
- IRPVABHDSJVBNZ-RTHVDDQRSA-N 5-[1-(cyclopropylmethyl)-5-[(1R,5S)-3-(oxetan-3-yl)-3-azabicyclo[3.1.0]hexan-6-yl]pyrazol-3-yl]-3-(trifluoromethyl)pyridin-2-amine Chemical compound C1=C(C(F)(F)F)C(N)=NC=C1C1=NN(CC2CC2)C(C2[C@@H]3CN(C[C@@H]32)C2COC2)=C1 IRPVABHDSJVBNZ-RTHVDDQRSA-N 0.000 claims description 2
- KCBWAFJCKVKYHO-UHFFFAOYSA-N 6-(4-cyclopropyl-6-methoxypyrimidin-5-yl)-1-[[4-[1-propan-2-yl-4-(trifluoromethyl)imidazol-2-yl]phenyl]methyl]pyrazolo[3,4-d]pyrimidine Chemical compound C1(CC1)C1=NC=NC(=C1C1=NC=C2C(=N1)N(N=C2)CC1=CC=C(C=C1)C=1N(C=C(N=1)C(F)(F)F)C(C)C)OC KCBWAFJCKVKYHO-UHFFFAOYSA-N 0.000 claims description 2
- IDRGFNPZDVBSSE-UHFFFAOYSA-N OCCN1CCN(CC1)c1ccc(Nc2ncc3cccc(-c4cccc(NC(=O)C=C)c4)c3n2)c(F)c1F Chemical compound OCCN1CCN(CC1)c1ccc(Nc2ncc3cccc(-c4cccc(NC(=O)C=C)c4)c3n2)c(F)c1F IDRGFNPZDVBSSE-UHFFFAOYSA-N 0.000 claims description 2
- LXRZVMYMQHNYJB-UNXOBOICSA-N [(1R,2S,4R)-4-[[5-[4-[(1R)-7-chloro-1,2,3,4-tetrahydroisoquinolin-1-yl]-5-methylthiophene-2-carbonyl]pyrimidin-4-yl]amino]-2-hydroxycyclopentyl]methyl sulfamate Chemical compound CC1=C(C=C(S1)C(=O)C1=C(N[C@H]2C[C@H](O)[C@@H](COS(N)(=O)=O)C2)N=CN=C1)[C@@H]1NCCC2=C1C=C(Cl)C=C2 LXRZVMYMQHNYJB-UNXOBOICSA-N 0.000 claims description 2
- 239000002131 composite material Substances 0.000 claims 7
- FUOSTELFLYZQCW-UHFFFAOYSA-N 1,2-oxazol-3-one Chemical group OC=1C=CON=1 FUOSTELFLYZQCW-UHFFFAOYSA-N 0.000 claims 1
- BGGALFIXXQOTPY-NRFANRHFSA-N C1(=C(C2=C(C=C1)N(C(C#N)=C2)C[C@@H](N1CCN(CC1)S(=O)(=O)C)C)C)CN1CCC(CC1)NC1=NC(=NC2=C1C=C(S2)CC(F)(F)F)NC Chemical compound C1(=C(C2=C(C=C1)N(C(C#N)=C2)C[C@@H](N1CCN(CC1)S(=O)(=O)C)C)C)CN1CCC(CC1)NC1=NC(=NC2=C1C=C(S2)CC(F)(F)F)NC BGGALFIXXQOTPY-NRFANRHFSA-N 0.000 claims 1
- 238000011282 treatment Methods 0.000 abstract description 34
- HVYWMOMLDIMFJA-DPAQBDIFSA-N cholesterol Chemical compound C1C=C2C[C@@H](O)CC[C@]2(C)[C@@H]2[C@@H]1[C@@H]1CC[C@H]([C@H](C)CCCC(C)C)[C@@]1(C)CC2 HVYWMOMLDIMFJA-DPAQBDIFSA-N 0.000 abstract description 20
- 208000024172 Cardiovascular disease Diseases 0.000 abstract description 10
- 235000012000 cholesterol Nutrition 0.000 abstract description 9
- 239000003814 drug Substances 0.000 abstract description 8
- 208000032928 Dyslipidaemia Diseases 0.000 abstract description 6
- 208000017170 Lipid metabolism disease Diseases 0.000 abstract description 6
- 239000008194 pharmaceutical composition Substances 0.000 abstract description 6
- 235000014113 dietary fatty acids Nutrition 0.000 abstract 1
- 229930195729 fatty acid Natural products 0.000 abstract 1
- 239000000194 fatty acid Substances 0.000 abstract 1
- 150000004665 fatty acids Chemical class 0.000 abstract 1
- YMWUJEATGCHHMB-UHFFFAOYSA-N Dichloromethane Chemical compound ClCCl YMWUJEATGCHHMB-UHFFFAOYSA-N 0.000 description 188
- 238000007429 general method Methods 0.000 description 163
- 102100033237 Pro-epidermal growth factor Human genes 0.000 description 149
- KDXKERNSBIXSRK-UHFFFAOYSA-N Lysine Natural products NCCCCC(N)C(O)=O KDXKERNSBIXSRK-UHFFFAOYSA-N 0.000 description 145
- ZMXDDKWLCZADIW-UHFFFAOYSA-N N,N-Dimethylformamide Chemical compound CN(C)C=O ZMXDDKWLCZADIW-UHFFFAOYSA-N 0.000 description 133
- 235000001014 amino acid Nutrition 0.000 description 132
- OKKJLVBELUTLKV-UHFFFAOYSA-N Methanol Chemical compound OC OKKJLVBELUTLKV-UHFFFAOYSA-N 0.000 description 79
- 108010001831 LDL receptors Proteins 0.000 description 78
- 102000000853 LDL receptors Human genes 0.000 description 78
- 101710180553 Proprotein convertase subtilisin/kexin type 9 Proteins 0.000 description 75
- 102100038955 Proprotein convertase subtilisin/kexin type 9 Human genes 0.000 description 75
- 125000000539 amino acid group Chemical group 0.000 description 69
- 239000000243 solution Substances 0.000 description 64
- 239000011347 resin Substances 0.000 description 60
- 229920005989 resin Polymers 0.000 description 60
- 239000000203 mixture Substances 0.000 description 55
- JGFZNNIVVJXRND-UHFFFAOYSA-N N,N-Diisopropylethylamine (DIPEA) Chemical compound CCN(C(C)C)C(C)C JGFZNNIVVJXRND-UHFFFAOYSA-N 0.000 description 36
- KFZMGEQAYNKOFK-UHFFFAOYSA-N Isopropanol Chemical compound CC(C)O KFZMGEQAYNKOFK-UHFFFAOYSA-N 0.000 description 33
- 238000000034 method Methods 0.000 description 32
- XLYOFNOQVPJJNP-UHFFFAOYSA-N water Substances O XLYOFNOQVPJJNP-UHFFFAOYSA-N 0.000 description 32
- WEVYAHXRMPXWCK-UHFFFAOYSA-N Acetonitrile Chemical compound CC#N WEVYAHXRMPXWCK-UHFFFAOYSA-N 0.000 description 26
- RTZKZFJDLAIYFH-UHFFFAOYSA-N Diethyl ether Chemical compound CCOCC RTZKZFJDLAIYFH-UHFFFAOYSA-N 0.000 description 25
- 102000004196 processed proteins & peptides Human genes 0.000 description 25
- 108010007622 LDL Lipoproteins Proteins 0.000 description 24
- 102000007330 LDL Lipoproteins Human genes 0.000 description 24
- 102000004169 proteins and genes Human genes 0.000 description 23
- 108090000623 proteins and genes Proteins 0.000 description 23
- 238000004895 liquid chromatography mass spectrometry Methods 0.000 description 22
- 235000018102 proteins Nutrition 0.000 description 22
- SECXISVLQFMRJM-UHFFFAOYSA-N N-Methylpyrrolidone Chemical compound CN1CCCC1=O SECXISVLQFMRJM-UHFFFAOYSA-N 0.000 description 21
- 210000004899 c-terminal region Anatomy 0.000 description 21
- 108010028554 LDL Cholesterol Proteins 0.000 description 20
- DTQVDTLACAAQTR-UHFFFAOYSA-N trifluoroacetic acid Substances OC(=O)C(F)(F)F DTQVDTLACAAQTR-UHFFFAOYSA-N 0.000 description 19
- XEKOWRVHYACXOJ-UHFFFAOYSA-N Ethyl acetate Chemical compound CCOC(C)=O XEKOWRVHYACXOJ-UHFFFAOYSA-N 0.000 description 18
- VHYFNPMBLIVWCW-UHFFFAOYSA-N 4-Dimethylaminopyridine Chemical compound CN(C)C1=CC=NC=C1 VHYFNPMBLIVWCW-UHFFFAOYSA-N 0.000 description 16
- 239000004472 Lysine Substances 0.000 description 16
- 125000001429 N-terminal alpha-amino-acid group Chemical group 0.000 description 16
- 230000014509 gene expression Effects 0.000 description 16
- IAZDPXIOMUYVGZ-UHFFFAOYSA-N Dimethylsulphoxide Chemical compound CS(C)=O IAZDPXIOMUYVGZ-UHFFFAOYSA-N 0.000 description 15
- VEXZGXHMUGYJMC-UHFFFAOYSA-N Hydrochloric acid Chemical compound Cl VEXZGXHMUGYJMC-UHFFFAOYSA-N 0.000 description 15
- 125000003088 (fluoren-9-ylmethoxy)carbonyl group Chemical group 0.000 description 14
- HEDRZPFGACZZDS-MICDWDOJSA-N Trichloro(2H)methane Chemical compound [2H]C(Cl)(Cl)Cl HEDRZPFGACZZDS-MICDWDOJSA-N 0.000 description 14
- 238000003556 assay Methods 0.000 description 14
- 238000006243 chemical reaction Methods 0.000 description 13
- 125000002496 methyl group Chemical group [H]C([H])([H])* 0.000 description 13
- 238000000425 proton nuclear magnetic resonance spectrum Methods 0.000 description 13
- 230000002829 reductive effect Effects 0.000 description 13
- 241000699800 Cricetinae Species 0.000 description 12
- 238000008214 LDL Cholesterol Methods 0.000 description 12
- HEMHJVSKTPXQMS-UHFFFAOYSA-M Sodium hydroxide Chemical compound [OH-].[Na+] HEMHJVSKTPXQMS-UHFFFAOYSA-M 0.000 description 12
- 238000004458 analytical method Methods 0.000 description 12
- 239000003112 inhibitor Substances 0.000 description 12
- 230000015572 biosynthetic process Effects 0.000 description 11
- 230000002401 inhibitory effect Effects 0.000 description 11
- 125000003588 lysine group Chemical group [H]N([H])C([H])([H])C([H])([H])C([H])([H])C([H])([H])C([H])(N([H])[H])C(*)=O 0.000 description 11
- 239000002904 solvent Substances 0.000 description 11
- 238000003786 synthesis reaction Methods 0.000 description 11
- NQRYJNQNLNOLGT-UHFFFAOYSA-N Piperidine Chemical compound C1CCNCC1 NQRYJNQNLNOLGT-UHFFFAOYSA-N 0.000 description 10
- VYPSYNLAJGMNEJ-UHFFFAOYSA-N Silicium dioxide Chemical compound O=[Si]=O VYPSYNLAJGMNEJ-UHFFFAOYSA-N 0.000 description 10
- 238000005516 engineering process Methods 0.000 description 10
- 239000000543 intermediate Substances 0.000 description 10
- BDAGIHXWWSANSR-UHFFFAOYSA-N methanoic acid Natural products OC=O BDAGIHXWWSANSR-UHFFFAOYSA-N 0.000 description 10
- 239000011541 reaction mixture Substances 0.000 description 10
- 229940127355 PCSK9 Inhibitors Drugs 0.000 description 9
- 241000700159 Rattus Species 0.000 description 9
- 230000000694 effects Effects 0.000 description 9
- 238000002360 preparation method Methods 0.000 description 9
- 238000000746 purification Methods 0.000 description 9
- QTBSBXVTEAMEQO-UHFFFAOYSA-N Acetic acid Chemical compound CC(O)=O QTBSBXVTEAMEQO-UHFFFAOYSA-N 0.000 description 8
- WFDIJRYMOXRFFG-UHFFFAOYSA-N Acetic anhydride Chemical compound CC(=O)OC(C)=O WFDIJRYMOXRFFG-UHFFFAOYSA-N 0.000 description 8
- 241000282472 Canis lupus familiaris Species 0.000 description 8
- WYURNTSHIVDZCO-UHFFFAOYSA-N Tetrahydrofuran Chemical compound C1CCOC1 WYURNTSHIVDZCO-UHFFFAOYSA-N 0.000 description 8
- 239000008186 active pharmaceutical agent Substances 0.000 description 8
- 238000007792 addition Methods 0.000 description 8
- 125000003277 amino group Chemical group 0.000 description 8
- HOPRXXXSABQWAV-UHFFFAOYSA-N anhydrous collidine Natural products CC1=CC=NC(C)=C1C HOPRXXXSABQWAV-UHFFFAOYSA-N 0.000 description 8
- 210000004369 blood Anatomy 0.000 description 8
- 239000008280 blood Substances 0.000 description 8
- UTBIMNXEDGNJFE-UHFFFAOYSA-N collidine Natural products CC1=CC=C(C)C(C)=N1 UTBIMNXEDGNJFE-UHFFFAOYSA-N 0.000 description 8
- 210000004185 liver Anatomy 0.000 description 8
- 230000036470 plasma concentration Effects 0.000 description 8
- 239000007787 solid Substances 0.000 description 8
- GFYHSKONPJXCDE-UHFFFAOYSA-N sym-collidine Natural products CC1=CN=C(C)C(C)=C1 GFYHSKONPJXCDE-UHFFFAOYSA-N 0.000 description 8
- FPIRBHDGWMWJEP-UHFFFAOYSA-N 1-hydroxy-7-azabenzotriazole Chemical compound C1=CN=C2N(O)N=NC2=C1 FPIRBHDGWMWJEP-UHFFFAOYSA-N 0.000 description 7
- KCXVZYZYPLLWCC-UHFFFAOYSA-N EDTA Chemical compound OC(=O)CN(CC(O)=O)CCN(CC(O)=O)CC(O)=O KCXVZYZYPLLWCC-UHFFFAOYSA-N 0.000 description 7
- 241001465754 Metazoa Species 0.000 description 7
- 210000004027 cell Anatomy 0.000 description 7
- 230000008878 coupling Effects 0.000 description 7
- 238000010168 coupling process Methods 0.000 description 7
- 238000005859 coupling reaction Methods 0.000 description 7
- 230000007423 decrease Effects 0.000 description 7
- 230000003828 downregulation Effects 0.000 description 7
- 238000009472 formulation Methods 0.000 description 7
- 230000002440 hepatic effect Effects 0.000 description 7
- 125000005647 linker group Chemical group 0.000 description 7
- 239000012669 liquid formulation Substances 0.000 description 7
- 239000002244 precipitate Substances 0.000 description 7
- 239000000047 product Substances 0.000 description 7
- 238000007920 subcutaneous administration Methods 0.000 description 7
- 239000000126 substance Substances 0.000 description 7
- 125000000999 tert-butyl group Chemical group [H]C([H])([H])C(*)(C([H])([H])[H])C([H])([H])[H] 0.000 description 7
- 238000004704 ultra performance liquid chromatography Methods 0.000 description 7
- GOPWHXPXSPIIQZ-FQEVSTJZSA-N (4s)-4-(9h-fluoren-9-ylmethoxycarbonylamino)-5-[(2-methylpropan-2-yl)oxy]-5-oxopentanoic acid Chemical compound C1=CC=C2C(COC(=O)N[C@@H](CCC(O)=O)C(=O)OC(C)(C)C)C3=CC=CC=C3C2=C1 GOPWHXPXSPIIQZ-FQEVSTJZSA-N 0.000 description 6
- XQPYRJIMPDBGRW-UHFFFAOYSA-N 2-[2-[2-(9h-fluoren-9-ylmethoxycarbonylamino)ethoxy]ethoxy]acetic acid Chemical compound C1=CC=C2C(COC(=O)NCCOCCOCC(=O)O)C3=CC=CC=C3C2=C1 XQPYRJIMPDBGRW-UHFFFAOYSA-N 0.000 description 6
- CSCPPACGZOOCGX-UHFFFAOYSA-N Acetone Chemical compound CC(C)=O CSCPPACGZOOCGX-UHFFFAOYSA-N 0.000 description 6
- 229940121710 HMGCoA reductase inhibitor Drugs 0.000 description 6
- 101001051093 Homo sapiens Low-density lipoprotein receptor Proteins 0.000 description 6
- 125000003338 L-glutaminyl group Chemical group O=C([*])[C@](N([H])[H])([H])C([H])([H])C([H])([H])C(=O)N([H])[H] 0.000 description 6
- 241000699670 Mus sp. Species 0.000 description 6
- 125000000729 N-terminal amino-acid group Chemical group 0.000 description 6
- YXFVVABEGXRONW-UHFFFAOYSA-N Toluene Chemical compound CC1=CC=CC=C1 YXFVVABEGXRONW-UHFFFAOYSA-N 0.000 description 6
- 238000010521 absorption reaction Methods 0.000 description 6
- 230000010933 acylation Effects 0.000 description 6
- 238000005917 acylation reaction Methods 0.000 description 6
- 150000001299 aldehydes Chemical group 0.000 description 6
- 150000001408 amides Chemical class 0.000 description 6
- KRKNYBCHXYNGOX-UHFFFAOYSA-N citric acid Chemical compound OC(=O)CC(O)(C(O)=O)CC(O)=O KRKNYBCHXYNGOX-UHFFFAOYSA-N 0.000 description 6
- NKLCHDQGUHMCGL-UHFFFAOYSA-N cyclohexylidenemethanone Chemical group O=C=C1CCCCC1 NKLCHDQGUHMCGL-UHFFFAOYSA-N 0.000 description 6
- 238000003818 flash chromatography Methods 0.000 description 6
- 238000004128 high performance liquid chromatography Methods 0.000 description 6
- 230000001404 mediated effect Effects 0.000 description 6
- 239000000546 pharmaceutical excipient Substances 0.000 description 6
- 239000012071 phase Substances 0.000 description 6
- 239000002953 phosphate buffered saline Substances 0.000 description 6
- 230000002265 prevention Effects 0.000 description 6
- 238000011002 quantification Methods 0.000 description 6
- 239000000741 silica gel Substances 0.000 description 6
- 229910002027 silica gel Inorganic materials 0.000 description 6
- 229960001866 silicon dioxide Drugs 0.000 description 6
- YPTNAIDIXCOZAJ-LHEWISCISA-N (2s)-2-(9h-fluoren-9-ylmethoxycarbonylamino)-6-[[(4-methylphenyl)-diphenylmethyl]amino]hexanoic acid Chemical compound C1=CC(C)=CC=C1C(C=1C=CC=CC=1)(C=1C=CC=CC=1)NCCCC[C@@H](C(O)=O)NC(=O)OCC1C2=CC=CC=C2C2=CC=CC=C21 YPTNAIDIXCOZAJ-LHEWISCISA-N 0.000 description 5
- OSWFIVFLDKOXQC-UHFFFAOYSA-N 4-(3-methoxyphenyl)aniline Chemical compound COC1=CC=CC(C=2C=CC(N)=CC=2)=C1 OSWFIVFLDKOXQC-UHFFFAOYSA-N 0.000 description 5
- CURLTUGMZLYLDI-UHFFFAOYSA-N Carbon dioxide Chemical compound O=C=O CURLTUGMZLYLDI-UHFFFAOYSA-N 0.000 description 5
- 239000004606 Fillers/Extenders Substances 0.000 description 5
- 108010023302 HDL Cholesterol Proteins 0.000 description 5
- PIWKPBJCKXDKJR-UHFFFAOYSA-N Isoflurane Chemical compound FC(F)OC(Cl)C(F)(F)F PIWKPBJCKXDKJR-UHFFFAOYSA-N 0.000 description 5
- 102000004895 Lipoproteins Human genes 0.000 description 5
- 108090001030 Lipoproteins Proteins 0.000 description 5
- FAPWRFPIFSIZLT-UHFFFAOYSA-M Sodium chloride Chemical compound [Na+].[Cl-] FAPWRFPIFSIZLT-UHFFFAOYSA-M 0.000 description 5
- VORIUEAZEKLUSJ-UHFFFAOYSA-M [(6-chlorobenzotriazol-1-yl)oxy-(dimethylamino)methylidene]-dimethylazanium;trifluoroborane;fluoride Chemical compound [F-].FB(F)F.C1=C(Cl)C=C2N(OC(N(C)C)=[N+](C)C)N=NC2=C1 VORIUEAZEKLUSJ-UHFFFAOYSA-M 0.000 description 5
- 239000013543 active substance Substances 0.000 description 5
- 230000037396 body weight Effects 0.000 description 5
- 238000004364 calculation method Methods 0.000 description 5
- 235000011089 carbon dioxide Nutrition 0.000 description 5
- 239000012043 crude product Substances 0.000 description 5
- 235000018417 cysteine Nutrition 0.000 description 5
- 239000003480 eluent Substances 0.000 description 5
- 238000010828 elution Methods 0.000 description 5
- 235000019253 formic acid Nutrition 0.000 description 5
- 125000000524 functional group Chemical group 0.000 description 5
- 239000002471 hydroxymethylglutaryl coenzyme A reductase inhibitor Substances 0.000 description 5
- 229960002725 isoflurane Drugs 0.000 description 5
- 150000002632 lipids Chemical class 0.000 description 5
- 238000011068 loading method Methods 0.000 description 5
- CMWYAOXYQATXSI-UHFFFAOYSA-N n,n-dimethylformamide;piperidine Chemical compound CN(C)C=O.C1CCNCC1 CMWYAOXYQATXSI-UHFFFAOYSA-N 0.000 description 5
- 239000000843 powder Substances 0.000 description 5
- 230000009467 reduction Effects 0.000 description 5
- 238000006722 reduction reaction Methods 0.000 description 5
- 238000005932 reductive alkylation reaction Methods 0.000 description 5
- 230000002441 reversible effect Effects 0.000 description 5
- FIWQZURFGYXCEO-UHFFFAOYSA-M sodium;decanoate Chemical compound [Na+].CCCCCCCCCC([O-])=O FIWQZURFGYXCEO-UHFFFAOYSA-M 0.000 description 5
- 238000010254 subcutaneous injection Methods 0.000 description 5
- 239000007929 subcutaneous injection Substances 0.000 description 5
- WDUQJXKBWRNMKI-UHFFFAOYSA-N 18-[(2-methylpropan-2-yl)oxy]-18-oxooctadecanoic acid Chemical compound CC(C)(C)OC(=O)CCCCCCCCCCCCCCCCC(O)=O WDUQJXKBWRNMKI-UHFFFAOYSA-N 0.000 description 4
- FUOOLUPWFVMBKG-UHFFFAOYSA-N 2-Aminoisobutyric acid Chemical compound CC(C)(N)C(O)=O FUOOLUPWFVMBKG-UHFFFAOYSA-N 0.000 description 4
- 229960000549 4-dimethylaminophenol Drugs 0.000 description 4
- 108010088751 Albumins Proteins 0.000 description 4
- 102000009027 Albumins Human genes 0.000 description 4
- 206010002091 Anaesthesia Diseases 0.000 description 4
- 102100040214 Apolipoprotein(a) Human genes 0.000 description 4
- 101710115418 Apolipoprotein(a) Proteins 0.000 description 4
- QOSSAOTZNIDXMA-UHFFFAOYSA-N Dicylcohexylcarbodiimide Chemical compound C1CCCCC1N=C=NC1CCCCC1 QOSSAOTZNIDXMA-UHFFFAOYSA-N 0.000 description 4
- 108010010234 HDL Lipoproteins Proteins 0.000 description 4
- 102000015779 HDL Lipoproteins Human genes 0.000 description 4
- 125000000010 L-asparaginyl group Chemical group O=C([*])[C@](N([H])[H])([H])C([H])([H])C(=O)N([H])[H] 0.000 description 4
- CSNNHWWHGAXBCP-UHFFFAOYSA-L Magnesium sulfate Chemical compound [Mg+2].[O-][S+2]([O-])([O-])[O-] CSNNHWWHGAXBCP-UHFFFAOYSA-L 0.000 description 4
- 239000003875 Wang resin Substances 0.000 description 4
- KPFBUSLHFFWMAI-HYRPPVSQSA-N [(8r,9s,10r,13s,14s,17r)-17-acetyl-6-formyl-3-methoxy-10,13-dimethyl-1,2,7,8,9,11,12,14,15,16-decahydrocyclopenta[a]phenanthren-17-yl] acetate Chemical compound C1C[C@@H]2[C@](CCC(OC)=C3)(C)C3=C(C=O)C[C@H]2[C@@H]2CC[C@](OC(C)=O)(C(C)=O)[C@]21C KPFBUSLHFFWMAI-HYRPPVSQSA-N 0.000 description 4
- 239000002253 acid Substances 0.000 description 4
- 230000009471 action Effects 0.000 description 4
- 230000001154 acute effect Effects 0.000 description 4
- 230000037005 anaesthesia Effects 0.000 description 4
- 206010003119 arrhythmia Diseases 0.000 description 4
- 238000010241 blood sampling Methods 0.000 description 4
- 239000000872 buffer Substances 0.000 description 4
- 230000008859 change Effects 0.000 description 4
- 125000003636 chemical group Chemical group 0.000 description 4
- 239000003795 chemical substances by application Substances 0.000 description 4
- 208000029078 coronary artery disease Diseases 0.000 description 4
- 231100000673 dose–response relationship Toxicity 0.000 description 4
- 150000002148 esters Chemical class 0.000 description 4
- 125000001495 ethyl group Chemical group [H]C([H])([H])C([H])([H])* 0.000 description 4
- 125000000031 ethylamino group Chemical group [H]C([H])([H])C([H])([H])N([H])[*] 0.000 description 4
- 230000005764 inhibitory process Effects 0.000 description 4
- 239000003921 oil Substances 0.000 description 4
- 239000002245 particle Substances 0.000 description 4
- 230000036515 potency Effects 0.000 description 4
- 125000002572 propoxy group Chemical group [*]OC([H])([H])C(C([H])([H])[H])([H])[H] 0.000 description 4
- 125000006308 propyl amino group Chemical group 0.000 description 4
- 108010004034 stable plasma protein solution Proteins 0.000 description 4
- 238000012360 testing method Methods 0.000 description 4
- YLQBMQCUIZJEEH-UHFFFAOYSA-N tetrahydrofuran Natural products C=1C=COC=1 YLQBMQCUIZJEEH-UHFFFAOYSA-N 0.000 description 4
- 210000003462 vein Anatomy 0.000 description 4
- 239000003643 water by type Substances 0.000 description 4
- OJBNDXHENJDCBA-QFIPXVFZSA-N (2s)-2-(9h-fluoren-9-ylmethoxycarbonylamino)-6-(prop-2-enoxycarbonylamino)hexanoic acid Chemical compound C1=CC=C2C(COC(=O)N[C@@H](CCCCNC(=O)OCC=C)C(=O)O)C3=CC=CC=C3C2=C1 OJBNDXHENJDCBA-QFIPXVFZSA-N 0.000 description 3
- NDKDFTQNXLHCGO-UHFFFAOYSA-N 2-(9h-fluoren-9-ylmethoxycarbonylamino)acetic acid Chemical compound C1=CC=C2C(COC(=O)NCC(=O)O)C3=CC=CC=C3C2=C1 NDKDFTQNXLHCGO-UHFFFAOYSA-N 0.000 description 3
- RUVRGYVESPRHSZ-UHFFFAOYSA-N 2-[2-(2-azaniumylethoxy)ethoxy]acetate Chemical compound NCCOCCOCC(O)=O RUVRGYVESPRHSZ-UHFFFAOYSA-N 0.000 description 3
- JKMHFZQWWAIEOD-UHFFFAOYSA-N 2-[4-(2-hydroxyethyl)piperazin-1-yl]ethanesulfonic acid Chemical compound OCC[NH+]1CCN(CCS([O-])(=O)=O)CC1 JKMHFZQWWAIEOD-UHFFFAOYSA-N 0.000 description 3
- FPQQSJJWHUJYPU-UHFFFAOYSA-N 3-(dimethylamino)propyliminomethylidene-ethylazanium;chloride Chemical compound Cl.CCN=C=NCCCN(C)C FPQQSJJWHUJYPU-UHFFFAOYSA-N 0.000 description 3
- 125000001433 C-terminal amino-acid group Chemical group 0.000 description 3
- LFQSCWFLJHTTHZ-UHFFFAOYSA-N Ethanol Chemical compound CCO LFQSCWFLJHTTHZ-UHFFFAOYSA-N 0.000 description 3
- 125000000570 L-alpha-aspartyl group Chemical group [H]OC(=O)C([H])([H])[C@]([H])(N([H])[H])C(*)=O 0.000 description 3
- 102100024640 Low-density lipoprotein receptor Human genes 0.000 description 3
- 241000699673 Mesocricetus auratus Species 0.000 description 3
- PMZURENOXWZQFD-UHFFFAOYSA-L Sodium Sulfate Chemical compound [Na+].[Na+].[O-]S([O-])(=O)=O PMZURENOXWZQFD-UHFFFAOYSA-L 0.000 description 3
- ZMANZCXQSJIPKH-UHFFFAOYSA-N Triethylamine Chemical compound CCN(CC)CC ZMANZCXQSJIPKH-UHFFFAOYSA-N 0.000 description 3
- 239000007983 Tris buffer Substances 0.000 description 3
- ALFJRGAXCQIFQW-UHFFFAOYSA-N [(6-chlorobenzotriazol-1-yl)oxy-(dimethylamino)methylidene]-dimethylazanium Chemical compound C1=C(Cl)C=C2N(OC(N(C)C)=[N+](C)C)N=NC2=C1 ALFJRGAXCQIFQW-UHFFFAOYSA-N 0.000 description 3
- 230000029936 alkylation Effects 0.000 description 3
- 238000005804 alkylation reaction Methods 0.000 description 3
- 239000012131 assay buffer Substances 0.000 description 3
- 239000012911 assay medium Substances 0.000 description 3
- 230000000923 atherogenic effect Effects 0.000 description 3
- 238000011953 bioanalysis Methods 0.000 description 3
- 230000015556 catabolic process Effects 0.000 description 3
- 238000012512 characterization method Methods 0.000 description 3
- 238000003776 cleavage reaction Methods 0.000 description 3
- 229910052681 coesite Inorganic materials 0.000 description 3
- 229910052906 cristobalite Inorganic materials 0.000 description 3
- XUJNEKJLAYXESH-UHFFFAOYSA-N cysteine Natural products SCC(N)C(O)=O XUJNEKJLAYXESH-UHFFFAOYSA-N 0.000 description 3
- 238000006731 degradation reaction Methods 0.000 description 3
- 238000001514 detection method Methods 0.000 description 3
- IJKVHSBPTUYDLN-UHFFFAOYSA-N dihydroxy(oxo)silane Chemical compound O[Si](O)=O IJKVHSBPTUYDLN-UHFFFAOYSA-N 0.000 description 3
- 238000002474 experimental method Methods 0.000 description 3
- 238000004108 freeze drying Methods 0.000 description 3
- 230000002496 gastric effect Effects 0.000 description 3
- 239000011521 glass Substances 0.000 description 3
- 125000003630 glycyl group Chemical group [H]N([H])C([H])([H])C(*)=O 0.000 description 3
- 102000043555 human LDLR Human genes 0.000 description 3
- 238000001802 infusion Methods 0.000 description 3
- 238000002347 injection Methods 0.000 description 3
- 239000007924 injection Substances 0.000 description 3
- 239000007788 liquid Substances 0.000 description 3
- 238000004519 manufacturing process Methods 0.000 description 3
- 230000035772 mutation Effects 0.000 description 3
- 125000004433 nitrogen atom Chemical group N* 0.000 description 3
- 239000012074 organic phase Substances 0.000 description 3
- 230000001590 oxidative effect Effects 0.000 description 3
- CHKVPAROMQMJNQ-UHFFFAOYSA-M potassium bisulfate Chemical compound [K+].OS([O-])(=O)=O CHKVPAROMQMJNQ-UHFFFAOYSA-M 0.000 description 3
- 229910000343 potassium bisulfate Inorganic materials 0.000 description 3
- 230000002035 prolonged effect Effects 0.000 description 3
- 238000010242 retro-orbital bleeding Methods 0.000 description 3
- 150000003839 salts Chemical class 0.000 description 3
- 239000000523 sample Substances 0.000 description 3
- 238000005070 sampling Methods 0.000 description 3
- 230000007017 scission Effects 0.000 description 3
- 210000002966 serum Anatomy 0.000 description 3
- 239000000377 silicon dioxide Substances 0.000 description 3
- 235000012239 silicon dioxide Nutrition 0.000 description 3
- 239000007790 solid phase Substances 0.000 description 3
- 229910052682 stishovite Inorganic materials 0.000 description 3
- 239000006228 supernatant Substances 0.000 description 3
- 230000001225 therapeutic effect Effects 0.000 description 3
- 229910052905 tridymite Inorganic materials 0.000 description 3
- 229910021642 ultra pure water Inorganic materials 0.000 description 3
- 239000012498 ultrapure water Substances 0.000 description 3
- 239000003039 volatile agent Substances 0.000 description 3
- 238000005406 washing Methods 0.000 description 3
- 238000001262 western blot Methods 0.000 description 3
- KLBPUVPNPAJWHZ-UMSFTDKQSA-N (2r)-2-(9h-fluoren-9-ylmethoxycarbonylamino)-3-tritylsulfanylpropanoic acid Chemical compound C([C@@H](C(=O)O)NC(=O)OCC1C2=CC=CC=C2C2=CC=CC=C21)SC(C=1C=CC=CC=1)(C=1C=CC=CC=1)C1=CC=CC=C1 KLBPUVPNPAJWHZ-UMSFTDKQSA-N 0.000 description 2
- ZPGDWQNBZYOZTI-SFHVURJKSA-N (2s)-1-(9h-fluoren-9-ylmethoxycarbonyl)pyrrolidine-2-carboxylic acid Chemical compound OC(=O)[C@@H]1CCCN1C(=O)OCC1C2=CC=CC=C2C2=CC=CC=C21 ZPGDWQNBZYOZTI-SFHVURJKSA-N 0.000 description 2
- XXMYDXUIZKNHDT-QNGWXLTQSA-N (2s)-2-(9h-fluoren-9-ylmethoxycarbonylamino)-3-(1-tritylimidazol-4-yl)propanoic acid Chemical compound C([C@@H](C(=O)O)NC(=O)OCC1C2=CC=CC=C2C2=CC=CC=C21)C(N=C1)=CN1C(C=1C=CC=CC=1)(C=1C=CC=CC=1)C1=CC=CC=C1 XXMYDXUIZKNHDT-QNGWXLTQSA-N 0.000 description 2
- REITVGIIZHFVGU-IBGZPJMESA-N (2s)-2-(9h-fluoren-9-ylmethoxycarbonylamino)-3-[(2-methylpropan-2-yl)oxy]propanoic acid Chemical compound C1=CC=C2C(COC(=O)N[C@@H](COC(C)(C)C)C(O)=O)C3=CC=CC=C3C2=C1 REITVGIIZHFVGU-IBGZPJMESA-N 0.000 description 2
- ADOHASQZJSJZBT-SANMLTNESA-N (2s)-2-(9h-fluoren-9-ylmethoxycarbonylamino)-3-[1-[(2-methylpropan-2-yl)oxycarbonyl]indol-3-yl]propanoic acid Chemical compound C12=CC=CC=C2N(C(=O)OC(C)(C)C)C=C1C[C@@H](C(O)=O)NC(=O)OCC1C2=CC=CC=C2C2=CC=CC=C21 ADOHASQZJSJZBT-SANMLTNESA-N 0.000 description 2
- JAUKCFULLJFBFN-VWLOTQADSA-N (2s)-2-(9h-fluoren-9-ylmethoxycarbonylamino)-3-[4-[(2-methylpropan-2-yl)oxy]phenyl]propanoic acid Chemical compound C1=CC(OC(C)(C)C)=CC=C1C[C@@H](C(O)=O)NC(=O)OCC1C2=CC=CC=C2C2=CC=CC=C21 JAUKCFULLJFBFN-VWLOTQADSA-N 0.000 description 2
- UGNIYGNGCNXHTR-SFHVURJKSA-N (2s)-2-(9h-fluoren-9-ylmethoxycarbonylamino)-3-methylbutanoic acid Chemical compound C1=CC=C2C(COC(=O)N[C@@H](C(C)C)C(O)=O)C3=CC=CC=C3C2=C1 UGNIYGNGCNXHTR-SFHVURJKSA-N 0.000 description 2
- SJVFAHZPLIXNDH-QFIPXVFZSA-N (2s)-2-(9h-fluoren-9-ylmethoxycarbonylamino)-3-phenylpropanoic acid Chemical compound C([C@@H](C(=O)O)NC(=O)OCC1C2=CC=CC=C2C2=CC=CC=C21)C1=CC=CC=C1 SJVFAHZPLIXNDH-QFIPXVFZSA-N 0.000 description 2
- FODJWPHPWBKDON-IBGZPJMESA-N (2s)-2-(9h-fluoren-9-ylmethoxycarbonylamino)-4-[(2-methylpropan-2-yl)oxy]-4-oxobutanoic acid Chemical compound C1=CC=C2C(COC(=O)N[C@@H](CC(=O)OC(C)(C)C)C(O)=O)C3=CC=CC=C3C2=C1 FODJWPHPWBKDON-IBGZPJMESA-N 0.000 description 2
- CBPJQFCAFFNICX-IBGZPJMESA-N (2s)-2-(9h-fluoren-9-ylmethoxycarbonylamino)-4-methylpentanoic acid Chemical compound C1=CC=C2C(COC(=O)N[C@@H](CC(C)C)C(O)=O)C3=CC=CC=C3C2=C1 CBPJQFCAFFNICX-IBGZPJMESA-N 0.000 description 2
- KJYAFJQCGPUXJY-UMSFTDKQSA-N (2s)-2-(9h-fluoren-9-ylmethoxycarbonylamino)-4-oxo-4-(tritylamino)butanoic acid Chemical compound C([C@@H](C(=O)O)NC(=O)OCC1C2=CC=CC=C2C2=CC=CC=C21)C(=O)NC(C=1C=CC=CC=1)(C=1C=CC=CC=1)C1=CC=CC=C1 KJYAFJQCGPUXJY-UMSFTDKQSA-N 0.000 description 2
- OTKXCALUHMPIGM-FQEVSTJZSA-N (2s)-2-(9h-fluoren-9-ylmethoxycarbonylamino)-5-[(2-methylpropan-2-yl)oxy]-5-oxopentanoic acid Chemical compound C1=CC=C2C(COC(=O)N[C@@H](CCC(=O)OC(C)(C)C)C(O)=O)C3=CC=CC=C3C2=C1 OTKXCALUHMPIGM-FQEVSTJZSA-N 0.000 description 2
- WDGICUODAOGOMO-DHUJRADRSA-N (2s)-2-(9h-fluoren-9-ylmethoxycarbonylamino)-5-oxo-5-(tritylamino)pentanoic acid Chemical compound C([C@@H](C(=O)O)NC(=O)OCC1C2=CC=CC=C2C2=CC=CC=C21)CC(=O)NC(C=1C=CC=CC=1)(C=1C=CC=CC=1)C1=CC=CC=C1 WDGICUODAOGOMO-DHUJRADRSA-N 0.000 description 2
- UMRUUWFGLGNQLI-QFIPXVFZSA-N (2s)-2-(9h-fluoren-9-ylmethoxycarbonylamino)-6-[(2-methylpropan-2-yl)oxycarbonylamino]hexanoic acid Chemical compound C1=CC=C2C(COC(=O)N[C@@H](CCCCNC(=O)OC(C)(C)C)C(O)=O)C3=CC=CC=C3C2=C1 UMRUUWFGLGNQLI-QFIPXVFZSA-N 0.000 description 2
- QWXZOFZKSQXPDC-NSHDSACASA-N (2s)-2-(9h-fluoren-9-ylmethoxycarbonylamino)propanoic acid Chemical compound C1=CC=C2C(COC(=O)N[C@@H](C)C(O)=O)C3=CC=CC=C3C2=C1 QWXZOFZKSQXPDC-NSHDSACASA-N 0.000 description 2
- HNICLNKVURBTKV-NDEPHWFRSA-N (2s)-5-[[amino-[(2,2,4,6,7-pentamethyl-3h-1-benzofuran-5-yl)sulfonylamino]methylidene]amino]-2-(9h-fluoren-9-ylmethoxycarbonylamino)pentanoic acid Chemical compound C12=CC=CC=C2C2=CC=CC=C2C1COC(=O)N[C@H](C(O)=O)CCCN=C(N)NS(=O)(=O)C1=C(C)C(C)=C2OC(C)(C)CC2=C1C HNICLNKVURBTKV-NDEPHWFRSA-N 0.000 description 2
- JYEVQYFWINBXJU-QFIPXVFZSA-N (2s)-6-(9h-fluoren-9-ylmethoxycarbonylamino)-2-[(2-methylpropan-2-yl)oxycarbonylamino]hexanoic acid Chemical compound C1=CC=C2C(COC(=O)NCCCC[C@H](NC(=O)OC(C)(C)C)C(O)=O)C3=CC=CC=C3C2=C1 JYEVQYFWINBXJU-QFIPXVFZSA-N 0.000 description 2
- LZOLWEQBVPVDPR-VLIAUNLRSA-N (2s,3r)-2-(9h-fluoren-9-ylmethoxycarbonylamino)-3-[(2-methylpropan-2-yl)oxy]butanoic acid Chemical compound C1=CC=C2C(COC(=O)N[C@@H]([C@H](OC(C)(C)C)C)C(O)=O)C3=CC=CC=C3C2=C1 LZOLWEQBVPVDPR-VLIAUNLRSA-N 0.000 description 2
- QXVFEIPAZSXRGM-DJJJIMSYSA-N (2s,3s)-2-(9h-fluoren-9-ylmethoxycarbonylamino)-3-methylpentanoic acid Chemical compound C1=CC=C2C(COC(=O)N[C@@H]([C@@H](C)CC)C(O)=O)C3=CC=CC=C3C2=C1 QXVFEIPAZSXRGM-DJJJIMSYSA-N 0.000 description 2
- BYEAHWXPCBROCE-UHFFFAOYSA-N 1,1,1,3,3,3-hexafluoropropan-2-ol Chemical compound FC(F)(F)C(O)C(F)(F)F BYEAHWXPCBROCE-UHFFFAOYSA-N 0.000 description 2
- BDNKZNFMNDZQMI-UHFFFAOYSA-N 1,3-diisopropylcarbodiimide Chemical compound CC(C)N=C=NC(C)C BDNKZNFMNDZQMI-UHFFFAOYSA-N 0.000 description 2
- QAPSNMNOIOSXSQ-YNEHKIRRSA-N 1-[(2r,4s,5r)-4-[tert-butyl(dimethyl)silyl]oxy-5-(hydroxymethyl)oxolan-2-yl]-5-methylpyrimidine-2,4-dione Chemical compound O=C1NC(=O)C(C)=CN1[C@@H]1O[C@H](CO)[C@@H](O[Si](C)(C)C(C)(C)C)C1 QAPSNMNOIOSXSQ-YNEHKIRRSA-N 0.000 description 2
- JFLSOKIMYBSASW-UHFFFAOYSA-N 1-chloro-2-[chloro(diphenyl)methyl]benzene Chemical compound ClC1=CC=CC=C1C(Cl)(C=1C=CC=CC=1)C1=CC=CC=C1 JFLSOKIMYBSASW-UHFFFAOYSA-N 0.000 description 2
- VXDOXXIFGWRBSB-UHFFFAOYSA-N 13-(methylsulfonylcarbamoylamino)tridecanoic acid Chemical compound CS(=O)(=O)NC(=O)NCCCCCCCCCCCCC(=O)O VXDOXXIFGWRBSB-UHFFFAOYSA-N 0.000 description 2
- MNMGREKTJAQGNV-UHFFFAOYSA-N 14-[(2-methylpropan-2-yl)oxy]-14-oxotetradecanoic acid Chemical compound CC(C)(C)OC(=O)CCCCCCCCCCCCC(O)=O MNMGREKTJAQGNV-UHFFFAOYSA-N 0.000 description 2
- BWZVCCNYKMEVEX-UHFFFAOYSA-N 2,4,6-Trimethylpyridine Chemical compound CC1=CC(C)=NC(C)=C1 BWZVCCNYKMEVEX-UHFFFAOYSA-N 0.000 description 2
- HKRVTTAGPORXSX-UHFFFAOYSA-N 4-(aminomethyl)benzaldehyde hydrochloride Chemical compound Cl.NCC1=CC=C(C=O)C=C1 HKRVTTAGPORXSX-UHFFFAOYSA-N 0.000 description 2
- FWMNVWWHGCHHJJ-SKKKGAJSSA-N 4-amino-1-[(2r)-6-amino-2-[[(2r)-2-[[(2r)-2-[[(2r)-2-amino-3-phenylpropanoyl]amino]-3-phenylpropanoyl]amino]-4-methylpentanoyl]amino]hexanoyl]piperidine-4-carboxylic acid Chemical group C([C@H](C(=O)N[C@H](CC(C)C)C(=O)N[C@H](CCCCN)C(=O)N1CCC(N)(CC1)C(O)=O)NC(=O)[C@H](N)CC=1C=CC=CC=1)C1=CC=CC=C1 FWMNVWWHGCHHJJ-SKKKGAJSSA-N 0.000 description 2
- 206010002383 Angina Pectoris Diseases 0.000 description 2
- 108010071619 Apolipoproteins Proteins 0.000 description 2
- 102000007592 Apolipoproteins Human genes 0.000 description 2
- 201000001320 Atherosclerosis Diseases 0.000 description 2
- 108091003079 Bovine Serum Albumin Proteins 0.000 description 2
- 201000006474 Brain Ischemia Diseases 0.000 description 2
- 206010007556 Cardiac failure acute Diseases 0.000 description 2
- 206010007558 Cardiac failure chronic Diseases 0.000 description 2
- 208000031229 Cardiomyopathies Diseases 0.000 description 2
- 206010008120 Cerebral ischaemia Diseases 0.000 description 2
- HEDRZPFGACZZDS-UHFFFAOYSA-N Chloroform Chemical compound ClC(Cl)Cl HEDRZPFGACZZDS-UHFFFAOYSA-N 0.000 description 2
- 229920000858 Cyclodextrin Polymers 0.000 description 2
- XDTMQSROBMDMFD-UHFFFAOYSA-N Cyclohexane Chemical compound C1CCCCC1 XDTMQSROBMDMFD-UHFFFAOYSA-N 0.000 description 2
- LEVWYRKDKASIDU-QWWZWVQMSA-N D-cystine Chemical compound OC(=O)[C@H](N)CSSC[C@@H](N)C(O)=O LEVWYRKDKASIDU-QWWZWVQMSA-N 0.000 description 2
- 206010052337 Diastolic dysfunction Diseases 0.000 description 2
- XTHFKEDIFFGKHM-UHFFFAOYSA-N Dimethoxyethane Chemical compound COCCOC XTHFKEDIFFGKHM-UHFFFAOYSA-N 0.000 description 2
- IAZDPXIOMUYVGZ-WFGJKAKNSA-N Dimethyl sulfoxide Chemical compound [2H]C([2H])([2H])S(=O)C([2H])([2H])[2H] IAZDPXIOMUYVGZ-WFGJKAKNSA-N 0.000 description 2
- 102000016622 Dipeptidyl Peptidase 4 Human genes 0.000 description 2
- 208000007530 Essential hypertension Diseases 0.000 description 2
- 101000930822 Giardia intestinalis Dipeptidyl-peptidase 4 Proteins 0.000 description 2
- 229940089838 Glucagon-like peptide 1 receptor agonist Drugs 0.000 description 2
- 206010019280 Heart failures Diseases 0.000 description 2
- 108091006905 Human Serum Albumin Proteins 0.000 description 2
- 102000008100 Human Serum Albumin Human genes 0.000 description 2
- WTDHULULXKLSOZ-UHFFFAOYSA-N Hydroxylamine hydrochloride Chemical compound Cl.ON WTDHULULXKLSOZ-UHFFFAOYSA-N 0.000 description 2
- 206010020772 Hypertension Diseases 0.000 description 2
- 206010058179 Hypertensive emergency Diseases 0.000 description 2
- 108010046315 IDL Lipoproteins Proteins 0.000 description 2
- 206010022562 Intermittent claudication Diseases 0.000 description 2
- 208000007177 Left Ventricular Hypertrophy Diseases 0.000 description 2
- 108010033266 Lipoprotein(a) Proteins 0.000 description 2
- 102000057248 Lipoprotein(a) Human genes 0.000 description 2
- 208000004302 Microvascular Angina Diseases 0.000 description 2
- 208000026018 Microvascular coronary artery disease Diseases 0.000 description 2
- YNAVUWVOSKDBBP-UHFFFAOYSA-N Morpholine Chemical compound C1COCCN1 YNAVUWVOSKDBBP-UHFFFAOYSA-N 0.000 description 2
- 241000283973 Oryctolagus cuniculus Species 0.000 description 2
- 208000030831 Peripheral arterial occlusive disease Diseases 0.000 description 2
- 241000233805 Phoenix Species 0.000 description 2
- JUJWROOIHBZHMG-UHFFFAOYSA-N Pyridine Chemical compound C1=CC=NC=C1 JUJWROOIHBZHMG-UHFFFAOYSA-N 0.000 description 2
- 206010038563 Reocclusion Diseases 0.000 description 2
- 206010063837 Reperfusion injury Diseases 0.000 description 2
- CDBYLPFSWZWCQE-UHFFFAOYSA-L Sodium Carbonate Chemical compound [Na+].[Na+].[O-]C([O-])=O CDBYLPFSWZWCQE-UHFFFAOYSA-L 0.000 description 2
- PXIPVTKHYLBLMZ-UHFFFAOYSA-N Sodium azide Chemical compound [Na+].[N-]=[N+]=[N-] PXIPVTKHYLBLMZ-UHFFFAOYSA-N 0.000 description 2
- UIIMBOGNXHQVGW-UHFFFAOYSA-M Sodium bicarbonate Chemical compound [Na+].OC([O-])=O UIIMBOGNXHQVGW-UHFFFAOYSA-M 0.000 description 2
- 208000006011 Stroke Diseases 0.000 description 2
- 206010071436 Systolic dysfunction Diseases 0.000 description 2
- RHQDFWAXVIIEBN-UHFFFAOYSA-N Trifluoroethanol Chemical compound OCC(F)(F)F RHQDFWAXVIIEBN-UHFFFAOYSA-N 0.000 description 2
- NERFNHBZJXXFGY-UHFFFAOYSA-N [4-[(4-methylphenyl)methoxy]phenyl]methanol Chemical compound C1=CC(C)=CC=C1COC1=CC=C(CO)C=C1 NERFNHBZJXXFGY-UHFFFAOYSA-N 0.000 description 2
- 239000004480 active ingredient Substances 0.000 description 2
- 229960004539 alirocumab Drugs 0.000 description 2
- 230000006793 arrhythmia Effects 0.000 description 2
- 239000011230 binding agent Substances 0.000 description 2
- 230000036772 blood pressure Effects 0.000 description 2
- NNTOJPXOCKCMKR-UHFFFAOYSA-N boron;pyridine Chemical compound [B].C1=CC=NC=C1 NNTOJPXOCKCMKR-UHFFFAOYSA-N 0.000 description 2
- 239000012267 brine Substances 0.000 description 2
- 150000007516 brønsted-lowry acids Chemical group 0.000 description 2
- 238000011088 calibration curve Methods 0.000 description 2
- 230000000747 cardiac effect Effects 0.000 description 2
- 206010008118 cerebral infarction Diseases 0.000 description 2
- 239000003638 chemical reducing agent Substances 0.000 description 2
- 238000011284 combination treatment Methods 0.000 description 2
- 150000001945 cysteines Chemical class 0.000 description 2
- 229960003067 cystine Drugs 0.000 description 2
- 230000002950 deficient Effects 0.000 description 2
- 238000009795 derivation Methods 0.000 description 2
- 239000003085 diluting agent Substances 0.000 description 2
- 229940079593 drug Drugs 0.000 description 2
- 239000013020 final formulation Substances 0.000 description 2
- 230000004927 fusion Effects 0.000 description 2
- 230000010005 growth-factor like effect Effects 0.000 description 2
- 208000019622 heart disease Diseases 0.000 description 2
- 238000003119 immunoblot Methods 0.000 description 2
- 238000001727 in vivo Methods 0.000 description 2
- 238000011534 incubation Methods 0.000 description 2
- NOESYZHRGYRDHS-UHFFFAOYSA-N insulin Chemical compound N1C(=O)C(NC(=O)C(CCC(N)=O)NC(=O)C(CCC(O)=O)NC(=O)C(C(C)C)NC(=O)C(NC(=O)CN)C(C)CC)CSSCC(C(NC(CO)C(=O)NC(CC(C)C)C(=O)NC(CC=2C=CC(O)=CC=2)C(=O)NC(CCC(N)=O)C(=O)NC(CC(C)C)C(=O)NC(CCC(O)=O)C(=O)NC(CC(N)=O)C(=O)NC(CC=2C=CC(O)=CC=2)C(=O)NC(CSSCC(NC(=O)C(C(C)C)NC(=O)C(CC(C)C)NC(=O)C(CC=2C=CC(O)=CC=2)NC(=O)C(CC(C)C)NC(=O)C(C)NC(=O)C(CCC(O)=O)NC(=O)C(C(C)C)NC(=O)C(CC(C)C)NC(=O)C(CC=2NC=NC=2)NC(=O)C(CO)NC(=O)CNC2=O)C(=O)NCC(=O)NC(CCC(O)=O)C(=O)NC(CCCNC(N)=N)C(=O)NCC(=O)NC(CC=3C=CC=CC=3)C(=O)NC(CC=3C=CC=CC=3)C(=O)NC(CC=3C=CC(O)=CC=3)C(=O)NC(C(C)O)C(=O)N3C(CCC3)C(=O)NC(CCCCN)C(=O)NC(C)C(O)=O)C(=O)NC(CC(N)=O)C(O)=O)=O)NC(=O)C(C(C)CC)NC(=O)C(CO)NC(=O)C(C(C)O)NC(=O)C1CSSCC2NC(=O)C(CC(C)C)NC(=O)C(NC(=O)C(CCC(N)=O)NC(=O)C(CC(N)=O)NC(=O)C(NC(=O)C(N)CC=1C=CC=CC=1)C(C)C)CC1=CN=CN1 NOESYZHRGYRDHS-UHFFFAOYSA-N 0.000 description 2
- 208000021156 intermittent vascular claudication Diseases 0.000 description 2
- 238000006317 isomerization reaction Methods 0.000 description 2
- 230000000670 limiting effect Effects 0.000 description 2
- 201000005857 malignant hypertension Diseases 0.000 description 2
- 239000012528 membrane Substances 0.000 description 2
- BMTXISFUJUHYJF-UHFFFAOYSA-N methyl 13-(3-oxo-1,2-oxazol-5-yl)tridecanoate Chemical compound OC1=NOC(=C1)CCCCCCCCCCCCC(=O)OC BMTXISFUJUHYJF-UHFFFAOYSA-N 0.000 description 2
- 125000000250 methylamino group Chemical group [H]N(*)C([H])([H])[H] 0.000 description 2
- 230000004048 modification Effects 0.000 description 2
- 238000012986 modification Methods 0.000 description 2
- 208000010125 myocardial infarction Diseases 0.000 description 2
- WWZKQHOCKIZLMA-UHFFFAOYSA-N octanoic acid Chemical compound CCCCCCCC(O)=O WWZKQHOCKIZLMA-UHFFFAOYSA-N 0.000 description 2
- 238000005897 peptide coupling reaction Methods 0.000 description 2
- 239000004033 plastic Substances 0.000 description 2
- 229920000136 polysorbate Polymers 0.000 description 2
- 238000013105 post hoc analysis Methods 0.000 description 2
- BWHMMNNQKKPAPP-UHFFFAOYSA-L potassium carbonate Chemical compound [K+].[K+].[O-]C([O-])=O BWHMMNNQKKPAPP-UHFFFAOYSA-L 0.000 description 2
- 238000001556 precipitation Methods 0.000 description 2
- 238000002953 preparative HPLC Methods 0.000 description 2
- 101150002764 purA gene Proteins 0.000 description 2
- 230000001105 regulatory effect Effects 0.000 description 2
- 230000000250 revascularization Effects 0.000 description 2
- 238000004007 reversed phase HPLC Methods 0.000 description 2
- 229920006395 saturated elastomer Polymers 0.000 description 2
- HFHDHCJBZVLPGP-UHFFFAOYSA-N schardinger α-dextrin Chemical compound O1C(C(C2O)O)C(CO)OC2OC(C(C2O)O)C(CO)OC2OC(C(C2O)O)C(CO)OC2OC(C(O)C2O)C(CO)OC2OC(C(C2O)O)C(CO)OC2OC2C(O)C(O)C1OC2CO HFHDHCJBZVLPGP-UHFFFAOYSA-N 0.000 description 2
- 239000011780 sodium chloride Substances 0.000 description 2
- 229910052938 sodium sulfate Inorganic materials 0.000 description 2
- 235000011152 sodium sulphate Nutrition 0.000 description 2
- HPALAKNZSZLMCH-UHFFFAOYSA-M sodium;chloride;hydrate Chemical compound O.[Na+].[Cl-] HPALAKNZSZLMCH-UHFFFAOYSA-M 0.000 description 2
- 206010042772 syncope Diseases 0.000 description 2
- 230000035488 systolic blood pressure Effects 0.000 description 2
- 125000004213 tert-butoxy group Chemical group [H]C([H])([H])C(O*)(C([H])([H])[H])C([H])([H])[H] 0.000 description 2
- KYZNKZCLBLLEAN-UHFFFAOYSA-N tert-butyl 13-(methylsulfonylcarbamoylamino)tridecanoate Chemical compound CS(=O)(=O)NC(NCCCCCCCCCCCCC(=O)OC(C)(C)C)=O KYZNKZCLBLLEAN-UHFFFAOYSA-N 0.000 description 2
- LZGRTFZVKPFWEO-UHFFFAOYSA-N tert-butyl 14-azido-14-oxotetradecanoate Chemical compound N(=[N+]=[N-])C(CCCCCCCCCCCCC(=O)OC(C)(C)C)=O LZGRTFZVKPFWEO-UHFFFAOYSA-N 0.000 description 2
- GYDJEQRTZSCIOI-LJGSYFOKSA-N tranexamic acid Chemical compound NC[C@H]1CC[C@H](C(O)=O)CC1 GYDJEQRTZSCIOI-LJGSYFOKSA-N 0.000 description 2
- 229960000401 tranexamic acid Drugs 0.000 description 2
- 150000003626 triacylglycerols Chemical class 0.000 description 2
- SZHOJFHSIKHZHA-UHFFFAOYSA-N tridecanoic acid Chemical compound CCCCCCCCCCCCC(O)=O SZHOJFHSIKHZHA-UHFFFAOYSA-N 0.000 description 2
- LENZDBCJOHFCAS-UHFFFAOYSA-N tris Chemical compound OCC(N)(CO)CO LENZDBCJOHFCAS-UHFFFAOYSA-N 0.000 description 2
- 125000002221 trityl group Chemical group [H]C1=C([H])C([H])=C([H])C([H])=C1C([*])(C1=C(C(=C(C(=C1[H])[H])[H])[H])[H])C1=C([H])C([H])=C([H])C([H])=C1[H] 0.000 description 2
- VCGRFBXVSFAGGA-UHFFFAOYSA-N (1,1-dioxo-1,4-thiazinan-4-yl)-[6-[[3-(4-fluorophenyl)-5-methyl-1,2-oxazol-4-yl]methoxy]pyridin-3-yl]methanone Chemical compound CC=1ON=C(C=2C=CC(F)=CC=2)C=1COC(N=C1)=CC=C1C(=O)N1CCS(=O)(=O)CC1 VCGRFBXVSFAGGA-UHFFFAOYSA-N 0.000 description 1
- BUBGAUHBELNDEW-SFHVURJKSA-N (2s)-2-(9h-fluoren-9-ylmethoxycarbonylamino)-4-methylsulfanylbutanoic acid Chemical compound C1=CC=C2C(COC(=O)N[C@@H](CCSC)C(O)=O)C3=CC=CC=C3C2=C1 BUBGAUHBELNDEW-SFHVURJKSA-N 0.000 description 1
- MOWXJLUYGFNTAL-DEOSSOPVSA-N (s)-[2-chloro-4-fluoro-5-(7-morpholin-4-ylquinazolin-4-yl)phenyl]-(6-methoxypyridazin-3-yl)methanol Chemical compound N1=NC(OC)=CC=C1[C@@H](O)C1=CC(C=2C3=CC=C(C=C3N=CN=2)N2CCOCC2)=C(F)C=C1Cl MOWXJLUYGFNTAL-DEOSSOPVSA-N 0.000 description 1
- VYMPLPIFKRHAAC-UHFFFAOYSA-N 1,2-ethanedithiol Chemical compound SCCS VYMPLPIFKRHAAC-UHFFFAOYSA-N 0.000 description 1
- RYHBNJHYFVUHQT-UHFFFAOYSA-N 1,4-Dioxane Chemical compound C1COCCO1 RYHBNJHYFVUHQT-UHFFFAOYSA-N 0.000 description 1
- APWRZPQBPCAXFP-UHFFFAOYSA-N 1-(1-oxo-2H-isoquinolin-5-yl)-5-(trifluoromethyl)-N-[2-(trifluoromethyl)pyridin-4-yl]pyrazole-4-carboxamide Chemical compound O=C1NC=CC2=C(C=CC=C12)N1N=CC(=C1C(F)(F)F)C(=O)NC1=CC(=NC=C1)C(F)(F)F APWRZPQBPCAXFP-UHFFFAOYSA-N 0.000 description 1
- ASOKPJOREAFHNY-UHFFFAOYSA-N 1-Hydroxybenzotriazole Chemical compound C1=CC=C2N(O)N=NC2=C1 ASOKPJOREAFHNY-UHFFFAOYSA-N 0.000 description 1
- GOAHQZUKXDERCY-UHFFFAOYSA-N 1-O-ethyl 16-O-methyl 3-oxohexadecanedioate Chemical compound O=C(CC(=O)OCC)CCCCCCCCCCCCC(=O)OC GOAHQZUKXDERCY-UHFFFAOYSA-N 0.000 description 1
- ABDDQTDRAHXHOC-QMMMGPOBSA-N 1-[(7s)-5,7-dihydro-4h-thieno[2,3-c]pyran-7-yl]-n-methylmethanamine Chemical compound CNC[C@@H]1OCCC2=C1SC=C2 ABDDQTDRAHXHOC-QMMMGPOBSA-N 0.000 description 1
- BSXPDVKSFWQFRT-UHFFFAOYSA-N 1-hydroxytriazolo[4,5-b]pyridine Chemical compound C1=CC=C2N(O)N=NC2=N1 BSXPDVKSFWQFRT-UHFFFAOYSA-N 0.000 description 1
- JZYMWJSQUPKHRL-UHFFFAOYSA-N 13-(2H-tetrazol-5-yl)hexadecanoic acid Chemical compound N1N=NN=C1C(CCCCCCCCCCCC(=O)O)CCC JZYMWJSQUPKHRL-UHFFFAOYSA-N 0.000 description 1
- DXAHTGDKFBUUTG-UHFFFAOYSA-N 13-(3-oxo-1,2-oxazol-5-yl)tridecanoic acid Chemical compound OC1=NOC(=C1)CCCCCCCCCCCCC(=O)O DXAHTGDKFBUUTG-UHFFFAOYSA-N 0.000 description 1
- KECYRSJSKVUNLS-UHFFFAOYSA-N 14-sulfohexadecanoic acid Chemical compound CCC(CCCCCCCCCCCCC(O)=O)S(O)(=O)=O KECYRSJSKVUNLS-UHFFFAOYSA-N 0.000 description 1
- QAAFNMQOMNTKDD-UHFFFAOYSA-N 16-(2h-tetrazol-5-yl)hexadecanoic acid Chemical compound OC(=O)CCCCCCCCCCCCCCCC1=NN=NN1 QAAFNMQOMNTKDD-UHFFFAOYSA-N 0.000 description 1
- PDOKYQVQWZCYFH-UHFFFAOYSA-N 16-[2,2-dimethyl-4-[(2-methylpropan-2-yl)oxycarbonylamino]butoxy]sulfonylhexadecanoic acid Chemical compound C(C)(C)(C)OC(=O)NCCC(COS(=O)(=O)CCCCCCCCCCCCCCCC(=O)O)(C)C PDOKYQVQWZCYFH-UHFFFAOYSA-N 0.000 description 1
- DVGUZQKRMQLDDD-HKBQPEDESA-N 18-[[(1s)-1-carboxy-4-[2-[2-[2-[2-[2-[2-(2,5-dioxopyrrolidin-1-yl)oxy-2-oxoethoxy]ethoxy]ethylamino]-2-oxoethoxy]ethoxy]ethylamino]-4-oxobutyl]amino]-18-oxooctadecanoic acid Chemical compound OC(=O)CCCCCCCCCCCCCCCCC(=O)N[C@H](C(O)=O)CCC(=O)NCCOCCOCC(=O)NCCOCCOCC(=O)ON1C(=O)CCC1=O DVGUZQKRMQLDDD-HKBQPEDESA-N 0.000 description 1
- GOJUJUVQIVIZAV-UHFFFAOYSA-N 2-amino-4,6-dichloropyrimidine-5-carbaldehyde Chemical group NC1=NC(Cl)=C(C=O)C(Cl)=N1 GOJUJUVQIVIZAV-UHFFFAOYSA-N 0.000 description 1
- HCDMJFOHIXMBOV-UHFFFAOYSA-N 3-(2,6-difluoro-3,5-dimethoxyphenyl)-1-ethyl-8-(morpholin-4-ylmethyl)-4,7-dihydropyrrolo[4,5]pyrido[1,2-d]pyrimidin-2-one Chemical compound C=1C2=C3N(CC)C(=O)N(C=4C(=C(OC)C=C(OC)C=4F)F)CC3=CN=C2NC=1CN1CCOCC1 HCDMJFOHIXMBOV-UHFFFAOYSA-N 0.000 description 1
- BYHQTRFJOGIQAO-GOSISDBHSA-N 3-(4-bromophenyl)-8-[(2R)-2-hydroxypropyl]-1-[(3-methoxyphenyl)methyl]-1,3,8-triazaspiro[4.5]decan-2-one Chemical compound C[C@H](CN1CCC2(CC1)CN(C(=O)N2CC3=CC(=CC=C3)OC)C4=CC=C(C=C4)Br)O BYHQTRFJOGIQAO-GOSISDBHSA-N 0.000 description 1
- XUQZKSCQPMNDEY-UHFFFAOYSA-N 3-[2-[2-(2-aminoethoxy)ethoxy]ethoxy]propanoic acid Chemical compound NCCOCCOCCOCCC(O)=O XUQZKSCQPMNDEY-UHFFFAOYSA-N 0.000 description 1
- WNEODWDFDXWOLU-QHCPKHFHSA-N 3-[3-(hydroxymethyl)-4-[1-methyl-5-[[5-[(2s)-2-methyl-4-(oxetan-3-yl)piperazin-1-yl]pyridin-2-yl]amino]-6-oxopyridin-3-yl]pyridin-2-yl]-7,7-dimethyl-1,2,6,8-tetrahydrocyclopenta[3,4]pyrrolo[3,5-b]pyrazin-4-one Chemical compound C([C@@H](N(CC1)C=2C=NC(NC=3C(N(C)C=C(C=3)C=3C(=C(N4C(C5=CC=6CC(C)(C)CC=6N5CC4)=O)N=CC=3)CO)=O)=CC=2)C)N1C1COC1 WNEODWDFDXWOLU-QHCPKHFHSA-N 0.000 description 1
- VSRXCXMAKRXNAO-UHFFFAOYSA-N 4-[16-(2h-tetrazol-5-yl)hexadecanoylsulfamoyl]butanoic acid Chemical compound OC(=O)CCCS(=O)(=O)NC(=O)CCCCCCCCCCCCCCCC1=NN=NN1 VSRXCXMAKRXNAO-UHFFFAOYSA-N 0.000 description 1
- KVCQTKNUUQOELD-UHFFFAOYSA-N 4-amino-n-[1-(3-chloro-2-fluoroanilino)-6-methylisoquinolin-5-yl]thieno[3,2-d]pyrimidine-7-carboxamide Chemical compound N=1C=CC2=C(NC(=O)C=3C4=NC=NC(N)=C4SC=3)C(C)=CC=C2C=1NC1=CC=CC(Cl)=C1F KVCQTKNUUQOELD-UHFFFAOYSA-N 0.000 description 1
- CYJRNFFLTBEQSQ-UHFFFAOYSA-N 8-(3-methyl-1-benzothiophen-5-yl)-N-(4-methylsulfonylpyridin-3-yl)quinoxalin-6-amine Chemical compound CS(=O)(=O)C1=C(C=NC=C1)NC=1C=C2N=CC=NC2=C(C=1)C=1C=CC2=C(C(=CS2)C)C=1 CYJRNFFLTBEQSQ-UHFFFAOYSA-N 0.000 description 1
- 102000007469 Actins Human genes 0.000 description 1
- 108010085238 Actins Proteins 0.000 description 1
- 229940127438 Amylin Agonists Drugs 0.000 description 1
- 241000512290 Antalis Species 0.000 description 1
- 208000034048 Asymptomatic disease Diseases 0.000 description 1
- XUKUURHRXDUEBC-KAYWLYCHSA-N Atorvastatin Chemical compound C=1C=CC=CC=1C1=C(C=2C=CC(F)=CC=2)N(CC[C@@H](O)C[C@@H](O)CC(O)=O)C(C(C)C)=C1C(=O)NC1=CC=CC=C1 XUKUURHRXDUEBC-KAYWLYCHSA-N 0.000 description 1
- XUKUURHRXDUEBC-UHFFFAOYSA-N Atorvastatin Natural products C=1C=CC=CC=1C1=C(C=2C=CC(F)=CC=2)N(CCC(O)CC(O)CC(O)=O)C(C(C)C)=C1C(=O)NC1=CC=CC=C1 XUKUURHRXDUEBC-UHFFFAOYSA-N 0.000 description 1
- 238000009020 BCA Protein Assay Kit Methods 0.000 description 1
- 241000283690 Bos taurus Species 0.000 description 1
- 101800001415 Bri23 peptide Proteins 0.000 description 1
- LFRVVIWQLPSCSS-YTTGMZPUSA-N C(C)(C)(C)OC(=O)[C@H](CCC(NCCOCCOCC(NCCOCCOCC(=O)O)=O)=O)NC(=O)CCCCCCCCCCCCCCCCC(=O)O Chemical compound C(C)(C)(C)OC(=O)[C@H](CCC(NCCOCCOCC(NCCOCCOCC(=O)O)=O)=O)NC(=O)CCCCCCCCCCCCCCCCC(=O)O LFRVVIWQLPSCSS-YTTGMZPUSA-N 0.000 description 1
- 102400000107 C-terminal peptide Human genes 0.000 description 1
- 101800000655 C-terminal peptide Proteins 0.000 description 1
- 241000283707 Capra Species 0.000 description 1
- 239000005635 Caprylic acid (CAS 124-07-2) Substances 0.000 description 1
- OKTJSMMVPCPJKN-UHFFFAOYSA-N Carbon Chemical group [C] OKTJSMMVPCPJKN-UHFFFAOYSA-N 0.000 description 1
- KDXKERNSBIXSRK-RXMQYKEDSA-N D-lysine Chemical compound NCCCC[C@@H](N)C(O)=O KDXKERNSBIXSRK-RXMQYKEDSA-N 0.000 description 1
- GSNUFIFRDBKVIE-UHFFFAOYSA-N DMF Natural products CC1=CC=C(C)O1 GSNUFIFRDBKVIE-UHFFFAOYSA-N 0.000 description 1
- BWGNESOTFCXPMA-UHFFFAOYSA-N Dihydrogen disulfide Chemical compound SS BWGNESOTFCXPMA-UHFFFAOYSA-N 0.000 description 1
- 101100166531 Drosophila melanogaster CycC gene Proteins 0.000 description 1
- 101100346152 Drosophila melanogaster modSP gene Proteins 0.000 description 1
- 239000006144 Dulbecco’s modified Eagle's medium Substances 0.000 description 1
- 238000012286 ELISA Assay Methods 0.000 description 1
- 102400001368 Epidermal growth factor Human genes 0.000 description 1
- 101800003838 Epidermal growth factor Proteins 0.000 description 1
- 206010015719 Exsanguination Diseases 0.000 description 1
- WQZGKKKJIJFFOK-GASJEMHNSA-N Glucose Natural products OC[C@H]1OC(O)[C@H](O)[C@@H](O)[C@@H]1O WQZGKKKJIJFFOK-GASJEMHNSA-N 0.000 description 1
- 239000007821 HATU Substances 0.000 description 1
- 239000007995 HEPES buffer Substances 0.000 description 1
- 101001098868 Homo sapiens Proprotein convertase subtilisin/kexin type 9 Proteins 0.000 description 1
- LENZDBCJOHFCAS-UHFFFAOYSA-O Htris Chemical compound OCC([NH3+])(CO)CO LENZDBCJOHFCAS-UHFFFAOYSA-O 0.000 description 1
- DGAQECJNVWCQMB-PUAWFVPOSA-M Ilexoside XXIX Chemical compound C[C@@H]1CC[C@@]2(CC[C@@]3(C(=CC[C@H]4[C@]3(CC[C@@H]5[C@@]4(CC[C@@H](C5(C)C)OS(=O)(=O)[O-])C)C)[C@@H]2[C@]1(C)O)C)C(=O)O[C@H]6[C@@H]([C@H]([C@@H]([C@H](O6)CO)O)O)O.[Na+] DGAQECJNVWCQMB-PUAWFVPOSA-M 0.000 description 1
- 108090001061 Insulin Proteins 0.000 description 1
- 102000004877 Insulin Human genes 0.000 description 1
- FYZPCMFQCNBYCY-WIWKJPBBSA-N Insulin degludec Chemical compound CC[C@H](C)[C@H](NC(=O)CN)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@H]1CSSC[C@@H]2NC(=O)[C@@H](NC(=O)[C@H](CO)NC(=O)[C@@H](NC(=O)[C@H](CSSC[C@H](NC(=O)[C@H](CC(C)C)NC(=O)[C@H](Cc3c[nH]cn3)NC(=O)[C@H](CCC(N)=O)NC(=O)[C@H](CC(N)=O)NC(=O)[C@@H](NC(=O)[C@@H](N)Cc3ccccc3)C(C)C)C(=O)NCC(=O)N[C@@H](CO)C(=O)N[C@@H](Cc3c[nH]cn3)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](C)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](Cc3ccc(O)cc3)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CSSC[C@H](NC(=O)[C@H](Cc3ccc(O)cc3)NC(=O)[C@H](CC(N)=O)NC(=O)[C@H](CCC(O)=O)NC(=O)[C@H](CC(C)C)NC(=O)[C@H](CCC(N)=O)NC(=O)[C@H](Cc3ccc(O)cc3)NC(=O)[C@H](CC(C)C)NC(=O)[C@H](CO)NC2=O)C(=O)N[C@@H](CC(N)=O)C(O)=O)C(=O)NCC(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CCCNC(N)=N)C(=O)NCC(=O)N[C@@H](Cc2ccccc2)C(=O)N[C@@H](Cc2ccccc2)C(=O)N[C@@H](Cc2ccc(O)cc2)C(=O)N[C@@H]([C@@H](C)O)C(=O)N2CCC[C@H]2C(=O)N[C@@H](CCCCNC(=O)CC[C@H](NC(=O)CCCCCCCCCCCCCCC(O)=O)C(O)=O)C(O)=O)NC1=O)[C@@H](C)O)[C@@H](C)CC FYZPCMFQCNBYCY-WIWKJPBBSA-N 0.000 description 1
- 108010029660 Intrinsically Disordered Proteins Proteins 0.000 description 1
- SNDPXSYFESPGGJ-BYPYZUCNSA-N L-2-aminopentanoic acid Chemical compound CCC[C@H](N)C(O)=O SNDPXSYFESPGGJ-BYPYZUCNSA-N 0.000 description 1
- 125000003440 L-leucyl group Chemical group O=C([*])[C@](N([H])[H])([H])C([H])([H])C(C([H])([H])[H])([H])C([H])([H])[H] 0.000 description 1
- SNDPXSYFESPGGJ-UHFFFAOYSA-N L-norVal-OH Natural products CCCC(N)C(O)=O SNDPXSYFESPGGJ-UHFFFAOYSA-N 0.000 description 1
- LRQKBLKVPFOOQJ-YFKPBYRVSA-N L-norleucine Chemical compound CCCC[C@H]([NH3+])C([O-])=O LRQKBLKVPFOOQJ-YFKPBYRVSA-N 0.000 description 1
- 101150013552 LDLR gene Proteins 0.000 description 1
- YSDQQAXHVYUZIW-QCIJIYAXSA-N Liraglutide Chemical compound C([C@@H](C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCC(O)=O)C(=O)NCC(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](C)C(=O)N[C@@H](C)C(=O)N[C@@H](CCCCNC(=O)CC[C@H](NC(=O)CCCCCCCCCCCCCCC)C(O)=O)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC=1C=CC=CC=1)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](C)C(=O)N[C@@H](CC=1C2=CC=CC=C2NC=1)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CCCNC(N)=N)C(=O)NCC(=O)N[C@@H](CCCNC(N)=N)C(=O)NCC(O)=O)NC(=O)[C@H](CO)NC(=O)[C@H](CO)NC(=O)[C@@H](NC(=O)[C@H](CC(O)=O)NC(=O)[C@H](CO)NC(=O)[C@@H](NC(=O)[C@H](CC=1C=CC=CC=1)NC(=O)[C@@H](NC(=O)CNC(=O)[C@H](CCC(O)=O)NC(=O)[C@H](C)NC(=O)[C@@H](N)CC=1NC=NC=1)[C@@H](C)O)[C@@H](C)O)C(C)C)C1=CC=C(O)C=C1 YSDQQAXHVYUZIW-QCIJIYAXSA-N 0.000 description 1
- 108010019598 Liraglutide Proteins 0.000 description 1
- AYCPARAPKDAOEN-LJQANCHMSA-N N-[(1S)-2-(dimethylamino)-1-phenylethyl]-6,6-dimethyl-3-[(2-methyl-4-thieno[3,2-d]pyrimidinyl)amino]-1,4-dihydropyrrolo[3,4-c]pyrazole-5-carboxamide Chemical compound C1([C@H](NC(=O)N2C(C=3NN=C(NC=4C=5SC=CC=5N=C(C)N=4)C=3C2)(C)C)CN(C)C)=CC=CC=C1 AYCPARAPKDAOEN-LJQANCHMSA-N 0.000 description 1
- JAWPDOVYRPCTQV-UHFFFAOYSA-N N-[4-[2-[2-[2-[2-[2-[2-[(4-formylphenyl)methylamino]-2-oxoethoxy]ethoxy]ethylamino]-2-oxoethoxy]ethoxy]ethylamino]-4-oxobutyl]sulfonyl-16-(2H-tetrazol-5-yl)hexadecanamide Chemical compound C(=O)C1=CC=C(C=C1)CNC(COCCOCCNC(COCCOCCNC(CCCS(=O)(=O)NC(CCCCCCCCCCCCCCCC1=NN=NN1)=O)=O)=O)=O JAWPDOVYRPCTQV-UHFFFAOYSA-N 0.000 description 1
- AHVYPIQETPWLSZ-UHFFFAOYSA-N N-methyl-pyrrolidine Natural products CN1CC=CC1 AHVYPIQETPWLSZ-UHFFFAOYSA-N 0.000 description 1
- 238000011785 NMRI mouse Methods 0.000 description 1
- 239000000020 Nitrocellulose Substances 0.000 description 1
- 208000008589 Obesity Diseases 0.000 description 1
- 229910019142 PO4 Inorganic materials 0.000 description 1
- NFHFRUOZVGFOOS-UHFFFAOYSA-N Pd(PPh3)4 Substances [Pd].C1=CC=CC=C1P(C=1C=CC=CC=1)C1=CC=CC=C1.C1=CC=CC=C1P(C=1C=CC=CC=1)C1=CC=CC=C1.C1=CC=CC=C1P(C=1C=CC=CC=1)C1=CC=CC=C1.C1=CC=CC=C1P(C=1C=CC=CC=1)C1=CC=CC=C1 NFHFRUOZVGFOOS-UHFFFAOYSA-N 0.000 description 1
- 102000004160 Phosphoric Monoester Hydrolases Human genes 0.000 description 1
- 108090000608 Phosphoric Monoester Hydrolases Proteins 0.000 description 1
- 229920001213 Polysorbate 20 Polymers 0.000 description 1
- 239000004793 Polystyrene Substances 0.000 description 1
- DLSWIYLPEUIQAV-UHFFFAOYSA-N Semaglutide Chemical compound CCC(C)C(NC(=O)C(Cc1ccccc1)NC(=O)C(CCC(O)=O)NC(=O)C(CCCCNC(=O)COCCOCCNC(=O)COCCOCCNC(=O)CCC(NC(=O)CCCCCCCCCCCCCCCCC(O)=O)C(O)=O)NC(=O)C(C)NC(=O)C(C)NC(=O)C(CCC(N)=O)NC(=O)CNC(=O)C(CCC(O)=O)NC(=O)C(CC(C)C)NC(=O)C(Cc1ccc(O)cc1)NC(=O)C(CO)NC(=O)C(CO)NC(=O)C(NC(=O)C(CC(O)=O)NC(=O)C(CO)NC(=O)C(NC(=O)C(Cc1ccccc1)NC(=O)C(NC(=O)CNC(=O)C(CCC(O)=O)NC(=O)C(C)(C)NC(=O)C(N)Cc1cnc[nH]1)C(C)O)C(C)O)C(C)C)C(=O)NC(C)C(=O)NC(Cc1c[nH]c2ccccc12)C(=O)NC(CC(C)C)C(=O)NC(C(C)C)C(=O)NC(CCCNC(N)=N)C(=O)NCC(=O)NC(CCCNC(N)=N)C(=O)NCC(O)=O DLSWIYLPEUIQAV-UHFFFAOYSA-N 0.000 description 1
- 229910000831 Steel Inorganic materials 0.000 description 1
- 102000008079 Sterol Regulatory Element Binding Protein 2 Human genes 0.000 description 1
- 108010074438 Sterol Regulatory Element Binding Protein 2 Proteins 0.000 description 1
- DTQVDTLACAAQTR-UHFFFAOYSA-M Trifluoroacetate Chemical compound [O-]C(=O)C(F)(F)F DTQVDTLACAAQTR-UHFFFAOYSA-M 0.000 description 1
- 238000002835 absorbance Methods 0.000 description 1
- 230000006978 adaptation Effects 0.000 description 1
- 150000001412 amines Chemical class 0.000 description 1
- 230000006229 amino acid addition Effects 0.000 description 1
- 238000000540 analysis of variance Methods 0.000 description 1
- 239000000883 anti-obesity agent Substances 0.000 description 1
- 239000003472 antidiabetic agent Substances 0.000 description 1
- 229940125708 antidiabetic agent Drugs 0.000 description 1
- 239000002220 antihypertensive agent Substances 0.000 description 1
- 229940030600 antihypertensive agent Drugs 0.000 description 1
- 239000003524 antilipemic agent Substances 0.000 description 1
- 229940125710 antiobesity agent Drugs 0.000 description 1
- 230000036528 appetite Effects 0.000 description 1
- 235000019789 appetite Nutrition 0.000 description 1
- 238000013459 approach Methods 0.000 description 1
- 239000013011 aqueous formulation Substances 0.000 description 1
- 239000008346 aqueous phase Substances 0.000 description 1
- 239000007864 aqueous solution Substances 0.000 description 1
- 239000012300 argon atmosphere Substances 0.000 description 1
- 229960005370 atorvastatin Drugs 0.000 description 1
- 239000011324 bead Substances 0.000 description 1
- 230000009286 beneficial effect Effects 0.000 description 1
- 229960000074 biopharmaceutical Drugs 0.000 description 1
- 230000000903 blocking effect Effects 0.000 description 1
- 229940098773 bovine serum albumin Drugs 0.000 description 1
- 238000004422 calculation algorithm Methods 0.000 description 1
- JHRWWRDRBPCWTF-OLQVQODUSA-N captafol Chemical compound C1C=CC[C@H]2C(=O)N(SC(Cl)(Cl)C(Cl)Cl)C(=O)[C@H]21 JHRWWRDRBPCWTF-OLQVQODUSA-N 0.000 description 1
- 125000004432 carbon atom Chemical group C* 0.000 description 1
- 125000002843 carboxylic acid group Chemical group 0.000 description 1
- 150000001735 carboxylic acids Chemical group 0.000 description 1
- 230000007211 cardiovascular event Effects 0.000 description 1
- 230000001413 cellular effect Effects 0.000 description 1
- 238000005119 centrifugation Methods 0.000 description 1
- 239000002738 chelating agent Substances 0.000 description 1
- 238000007385 chemical modification Methods 0.000 description 1
- FZFAMSAMCHXGEF-UHFFFAOYSA-N chloro formate Chemical compound ClOC=O FZFAMSAMCHXGEF-UHFFFAOYSA-N 0.000 description 1
- 239000012230 colorless oil Substances 0.000 description 1
- 238000004440 column chromatography Methods 0.000 description 1
- 238000004891 communication Methods 0.000 description 1
- 230000009137 competitive binding Effects 0.000 description 1
- GHVNFZFCNZKVNT-UHFFFAOYSA-M decanoate Chemical compound CCCCCCCCCC([O-])=O GHVNFZFCNZKVNT-UHFFFAOYSA-M 0.000 description 1
- 230000003247 decreasing effect Effects 0.000 description 1
- 238000012217 deletion Methods 0.000 description 1
- 230000037430 deletion Effects 0.000 description 1
- 238000000326 densiometry Methods 0.000 description 1
- 238000010511 deprotection reaction Methods 0.000 description 1
- 206010012601 diabetes mellitus Diseases 0.000 description 1
- 235000005911 diet Nutrition 0.000 description 1
- 230000037213 diet Effects 0.000 description 1
- AJDPNPAGZMZOMN-UHFFFAOYSA-N diethyl (4-oxo-1,2,3-benzotriazin-3-yl) phosphate Chemical compound C1=CC=C2C(=O)N(OP(=O)(OCC)OCC)N=NC2=C1 AJDPNPAGZMZOMN-UHFFFAOYSA-N 0.000 description 1
- BGRWYRAHAFMIBJ-UHFFFAOYSA-N diisopropylcarbodiimide Natural products CC(C)NC(=O)NC(C)C BGRWYRAHAFMIBJ-UHFFFAOYSA-N 0.000 description 1
- 125000002147 dimethylamino group Chemical group [H]C([H])([H])N(*)C([H])([H])[H] 0.000 description 1
- GMLFPSKPTROTFV-UHFFFAOYSA-N dimethylborane Chemical compound CBC GMLFPSKPTROTFV-UHFFFAOYSA-N 0.000 description 1
- ZPWVASYFFYYZEW-UHFFFAOYSA-L dipotassium hydrogen phosphate Chemical compound [K+].[K+].OP([O-])([O-])=O ZPWVASYFFYYZEW-UHFFFAOYSA-L 0.000 description 1
- 229910000396 dipotassium phosphate Inorganic materials 0.000 description 1
- 235000019797 dipotassium phosphate Nutrition 0.000 description 1
- LOKCTEFSRHRXRJ-UHFFFAOYSA-I dipotassium trisodium dihydrogen phosphate hydrogen phosphate dichloride Chemical compound P(=O)(O)(O)[O-].[K+].P(=O)(O)([O-])[O-].[Na+].[Na+].[Cl-].[K+].[Cl-].[Na+] LOKCTEFSRHRXRJ-UHFFFAOYSA-I 0.000 description 1
- 229940042399 direct acting antivirals protease inhibitors Drugs 0.000 description 1
- 208000037265 diseases, disorders, signs and symptoms Diseases 0.000 description 1
- 208000035475 disorder Diseases 0.000 description 1
- 239000012153 distilled water Substances 0.000 description 1
- 230000008030 elimination Effects 0.000 description 1
- 238000003379 elimination reaction Methods 0.000 description 1
- 229940116977 epidermal growth factor Drugs 0.000 description 1
- 238000006345 epimerization reaction Methods 0.000 description 1
- VFRSADQPWYCXDG-LEUCUCNGSA-N ethyl (2s,5s)-5-methylpyrrolidine-2-carboxylate;2,2,2-trifluoroacetic acid Chemical compound OC(=O)C(F)(F)F.CCOC(=O)[C@@H]1CC[C@H](C)N1 VFRSADQPWYCXDG-LEUCUCNGSA-N 0.000 description 1
- LCFXLZAXGXOXAP-UHFFFAOYSA-N ethyl 2-cyano-2-hydroxyiminoacetate Chemical compound CCOC(=O)C(=NO)C#N LCFXLZAXGXOXAP-UHFFFAOYSA-N 0.000 description 1
- PQVSTLUFSYVLTO-UHFFFAOYSA-N ethyl n-ethoxycarbonylcarbamate Chemical compound CCOC(=O)NC(=O)OCC PQVSTLUFSYVLTO-UHFFFAOYSA-N 0.000 description 1
- 238000001704 evaporation Methods 0.000 description 1
- 230000008020 evaporation Effects 0.000 description 1
- 229960002027 evolocumab Drugs 0.000 description 1
- 239000000284 extract Substances 0.000 description 1
- 239000012091 fetal bovine serum Substances 0.000 description 1
- 230000001605 fetal effect Effects 0.000 description 1
- 239000011152 fibreglass Substances 0.000 description 1
- 239000000706 filtrate Substances 0.000 description 1
- 239000012467 final product Substances 0.000 description 1
- 239000000499 gel Substances 0.000 description 1
- 230000002068 genetic effect Effects 0.000 description 1
- 239000003365 glass fiber Substances 0.000 description 1
- 239000008103 glucose Substances 0.000 description 1
- 230000009716 hepatic expression Effects 0.000 description 1
- 102000053786 human PCSK9 Human genes 0.000 description 1
- NPZTUJOABDZTLV-UHFFFAOYSA-N hydroxybenzotriazole Substances O=C1C=CC=C2NNN=C12 NPZTUJOABDZTLV-UHFFFAOYSA-N 0.000 description 1
- 239000005457 ice water Substances 0.000 description 1
- 238000010348 incorporation Methods 0.000 description 1
- 239000004615 ingredient Substances 0.000 description 1
- 229940125396 insulin Drugs 0.000 description 1
- 108010050259 insulin degludec Proteins 0.000 description 1
- 229960004225 insulin degludec Drugs 0.000 description 1
- 230000003993 interaction Effects 0.000 description 1
- 230000002452 interceptive effect Effects 0.000 description 1
- 239000013067 intermediate product Substances 0.000 description 1
- 238000007918 intramuscular administration Methods 0.000 description 1
- 238000007912 intraperitoneal administration Methods 0.000 description 1
- 238000001990 intravenous administration Methods 0.000 description 1
- 238000010253 intravenous injection Methods 0.000 description 1
- SRJOCJYGOFTFLH-UHFFFAOYSA-N isonipecotic acid Chemical compound OC(=O)C1CCNCC1 SRJOCJYGOFTFLH-UHFFFAOYSA-N 0.000 description 1
- 210000004731 jugular vein Anatomy 0.000 description 1
- 102000005861 leptin receptors Human genes 0.000 description 1
- 108010019813 leptin receptors Proteins 0.000 description 1
- 238000004811 liquid chromatography Methods 0.000 description 1
- 229960002701 liraglutide Drugs 0.000 description 1
- GLXDVVHUTZTUQK-UHFFFAOYSA-M lithium hydroxide monohydrate Substances [Li+].O.[OH-] GLXDVVHUTZTUQK-UHFFFAOYSA-M 0.000 description 1
- 229940040692 lithium hydroxide monohydrate Drugs 0.000 description 1
- FZRNJOXQNWVMIH-UHFFFAOYSA-N lithium;hydrate Chemical compound [Li].O FZRNJOXQNWVMIH-UHFFFAOYSA-N 0.000 description 1
- 210000005228 liver tissue Anatomy 0.000 description 1
- 239000012139 lysis buffer Substances 0.000 description 1
- 229910052943 magnesium sulfate Inorganic materials 0.000 description 1
- 235000019341 magnesium sulphate Nutrition 0.000 description 1
- 238000012423 maintenance Methods 0.000 description 1
- 230000014759 maintenance of location Effects 0.000 description 1
- 238000004949 mass spectrometry Methods 0.000 description 1
- GXHFUVWIGNLZSC-UHFFFAOYSA-N meldrum's acid Chemical compound CC1(C)OC(=O)CC(=O)O1 GXHFUVWIGNLZSC-UHFFFAOYSA-N 0.000 description 1
- HNQIVZYLYMDVSB-UHFFFAOYSA-N methanesulfonimidic acid Chemical compound CS(N)(=O)=O HNQIVZYLYMDVSB-UHFFFAOYSA-N 0.000 description 1
- 239000003068 molecular probe Substances 0.000 description 1
- 125000000896 monocarboxylic acid group Chemical group 0.000 description 1
- PSHKMPUSSFXUIA-UHFFFAOYSA-N n,n-dimethylpyridin-2-amine Chemical compound CN(C)C1=CC=CC=N1 PSHKMPUSSFXUIA-UHFFFAOYSA-N 0.000 description 1
- 229920001220 nitrocellulos Polymers 0.000 description 1
- 235000020824 obesity Nutrition 0.000 description 1
- WWZKQHOCKIZLMA-UHFFFAOYSA-M octanoate Chemical compound CCCCCCCC([O-])=O WWZKQHOCKIZLMA-UHFFFAOYSA-M 0.000 description 1
- 229960002446 octanoic acid Drugs 0.000 description 1
- 238000001543 one-way ANOVA Methods 0.000 description 1
- 230000003287 optical effect Effects 0.000 description 1
- 238000003305 oral gavage Methods 0.000 description 1
- 150000002923 oximes Chemical class 0.000 description 1
- 238000010979 pH adjustment Methods 0.000 description 1
- 238000007911 parenteral administration Methods 0.000 description 1
- 239000000137 peptide hydrolase inhibitor Substances 0.000 description 1
- 238000010647 peptide synthesis reaction Methods 0.000 description 1
- 102000013415 peroxidase activity proteins Human genes 0.000 description 1
- 108040007629 peroxidase activity proteins Proteins 0.000 description 1
- 230000003285 pharmacodynamic effect Effects 0.000 description 1
- 230000000144 pharmacologic effect Effects 0.000 description 1
- NBIIXXVUZAFLBC-UHFFFAOYSA-K phosphate Chemical compound [O-]P([O-])([O-])=O NBIIXXVUZAFLBC-UHFFFAOYSA-K 0.000 description 1
- 239000010452 phosphate Substances 0.000 description 1
- 239000000256 polyoxyethylene sorbitan monolaurate Substances 0.000 description 1
- 235000010486 polyoxyethylene sorbitan monolaurate Nutrition 0.000 description 1
- 229920001184 polypeptide Polymers 0.000 description 1
- 229950008882 polysorbate Drugs 0.000 description 1
- 229920005990 polystyrene resin Polymers 0.000 description 1
- 230000004481 post-translational protein modification Effects 0.000 description 1
- 229910000027 potassium carbonate Inorganic materials 0.000 description 1
- 230000003389 potentiating effect Effects 0.000 description 1
- 229940028952 praluent Drugs 0.000 description 1
- 239000002243 precursor Substances 0.000 description 1
- 239000003755 preservative agent Substances 0.000 description 1
- 230000001737 promoting effect Effects 0.000 description 1
- UMJSCPRVCHMLSP-UHFFFAOYSA-N pyridine Natural products COC1=CC=CN=C1 UMJSCPRVCHMLSP-UHFFFAOYSA-N 0.000 description 1
- 238000003908 quality control method Methods 0.000 description 1
- 238000004445 quantitative analysis Methods 0.000 description 1
- 229940044601 receptor agonist Drugs 0.000 description 1
- 239000000018 receptor agonist Substances 0.000 description 1
- 229940017164 repatha Drugs 0.000 description 1
- 230000010076 replication Effects 0.000 description 1
- 238000011160 research Methods 0.000 description 1
- 230000004044 response Effects 0.000 description 1
- 238000004366 reverse phase liquid chromatography Methods 0.000 description 1
- 239000012723 sample buffer Substances 0.000 description 1
- 108010060325 semaglutide Proteins 0.000 description 1
- 229950011186 semaglutide Drugs 0.000 description 1
- 238000000926 separation method Methods 0.000 description 1
- XGVXKJKTISMIOW-ZDUSSCGKSA-N simurosertib Chemical compound N1N=CC(C=2SC=3C(=O)NC(=NC=3C=2)[C@H]2N3CCC(CC3)C2)=C1C XGVXKJKTISMIOW-ZDUSSCGKSA-N 0.000 description 1
- 239000011734 sodium Substances 0.000 description 1
- 229910052708 sodium Inorganic materials 0.000 description 1
- 235000017557 sodium bicarbonate Nutrition 0.000 description 1
- 229910000030 sodium bicarbonate Inorganic materials 0.000 description 1
- 229910000029 sodium carbonate Inorganic materials 0.000 description 1
- 238000002415 sodium dodecyl sulfate polyacrylamide gel electrophoresis Methods 0.000 description 1
- 239000001488 sodium phosphate Substances 0.000 description 1
- 239000011343 solid material Substances 0.000 description 1
- 241000894007 species Species 0.000 description 1
- 238000013222 sprague-dawley male rat Methods 0.000 description 1
- 239000003381 stabilizer Substances 0.000 description 1
- 238000010186 staining Methods 0.000 description 1
- 238000007619 statistical method Methods 0.000 description 1
- 239000010959 steel Substances 0.000 description 1
- 239000011550 stock solution Substances 0.000 description 1
- 230000001629 suppression Effects 0.000 description 1
- 239000000725 suspension Substances 0.000 description 1
- 230000002194 synthesizing effect Effects 0.000 description 1
- 239000008399 tap water Substances 0.000 description 1
- 235000020679 tap water Nutrition 0.000 description 1
- YNRRKPWXRKSLIS-UHFFFAOYSA-N tert-butyl 14-(2,2-dimethyl-4,6-dioxo-1,3-dioxan-5-yl)-14-oxotetradecanoate Chemical compound CC1(OC(C(C(O1)=O)C(CCCCCCCCCCCCC(=O)OC(C)(C)C)=O)=O)C YNRRKPWXRKSLIS-UHFFFAOYSA-N 0.000 description 1
- BLWUWWOYRPYJFM-UHFFFAOYSA-N tert-butyl 14-isocyanato-14-oxotetradecanoate Chemical compound N(=C=O)C(CCCCCCCCCCCCC(=O)OC(C)(C)C)=O BLWUWWOYRPYJFM-UHFFFAOYSA-N 0.000 description 1
- XFEWLFGFBHIHHI-UHFFFAOYSA-N tert-butyl 2-(aminomethyl)-3-formylbenzoate Chemical compound CC(C)(OC(=O)C=1C(=C(C=O)C=CC1)CN)C XFEWLFGFBHIHHI-UHFFFAOYSA-N 0.000 description 1
- HRJJBEIFHFVBRT-UHFFFAOYSA-N tert-butyl n-[(4-formylphenyl)methyl]carbamate Chemical compound CC(C)(C)OC(=O)NCC1=CC=C(C=O)C=C1 HRJJBEIFHFVBRT-UHFFFAOYSA-N 0.000 description 1
- 229940124597 therapeutic agent Drugs 0.000 description 1
- 210000001519 tissue Anatomy 0.000 description 1
- 238000012546 transfer Methods 0.000 description 1
- ZGYICYBLPGRURT-UHFFFAOYSA-N tri(propan-2-yl)silicon Chemical compound CC(C)[Si](C(C)C)C(C)C ZGYICYBLPGRURT-UHFFFAOYSA-N 0.000 description 1
- PIEPQKCYPFFYMG-UHFFFAOYSA-N tris acetate Chemical compound CC(O)=O.OCC(N)(CO)CO PIEPQKCYPFFYMG-UHFFFAOYSA-N 0.000 description 1
- 239000003656 tris buffered saline Substances 0.000 description 1
- RYFMWSXOAZQYPI-UHFFFAOYSA-K trisodium phosphate Chemical compound [Na+].[Na+].[Na+].[O-]P([O-])([O-])=O RYFMWSXOAZQYPI-UHFFFAOYSA-K 0.000 description 1
- 229910000406 trisodium phosphate Inorganic materials 0.000 description 1
- 235000019801 trisodium phosphate Nutrition 0.000 description 1
- 238000007492 two-way ANOVA Methods 0.000 description 1
- 238000001195 ultra high performance liquid chromatography Methods 0.000 description 1
- VBEQCZHXXJYVRD-GACYYNSASA-N uroanthelone Chemical compound C([C@@H](C(=O)N[C@H](C(=O)N[C@@H](CS)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CS)C(=O)N[C@H](C(=O)N[C@@H]([C@@H](C)CC)C(=O)NCC(=O)N[C@@H](CC=1C=CC(O)=CC=1)C(=O)N[C@@H](CO)C(=O)NCC(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CS)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC=1C2=CC=CC=C2NC=1)C(=O)N[C@@H](CC=1C2=CC=CC=C2NC=1)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCCNC(N)=N)C(O)=O)C(C)C)[C@@H](C)O)NC(=O)[C@H](CO)NC(=O)[C@H](CC(O)=O)NC(=O)[C@H](CC(C)C)NC(=O)[C@H](CO)NC(=O)[C@H](CCC(O)=O)NC(=O)[C@@H](NC(=O)[C@H](CC=1NC=NC=1)NC(=O)[C@H](CCSC)NC(=O)[C@H](CS)NC(=O)[C@@H](NC(=O)CNC(=O)CNC(=O)[C@H](CC(N)=O)NC(=O)[C@H](CC(C)C)NC(=O)[C@H](CS)NC(=O)[C@H](CC=1C=CC(O)=CC=1)NC(=O)CNC(=O)[C@H](CC(O)=O)NC(=O)[C@H](CC=1C=CC(O)=CC=1)NC(=O)[C@H](CO)NC(=O)[C@H](CO)NC(=O)[C@H]1N(CCC1)C(=O)[C@H](CS)NC(=O)CNC(=O)[C@H]1N(CCC1)C(=O)[C@H](CC=1C=CC(O)=CC=1)NC(=O)[C@H](CO)NC(=O)[C@@H](N)CC(N)=O)C(C)C)[C@@H](C)CC)C1=CC=C(O)C=C1 VBEQCZHXXJYVRD-GACYYNSASA-N 0.000 description 1
- 238000011179 visual inspection Methods 0.000 description 1
- 238000005303 weighing Methods 0.000 description 1
- 230000004584 weight gain Effects 0.000 description 1
- 235000019786 weight gain Nutrition 0.000 description 1
Classifications
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61K—PREPARATIONS FOR MEDICAL, DENTAL OR TOILETRY PURPOSES
- A61K38/00—Medicinal preparations containing peptides
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61K—PREPARATIONS FOR MEDICAL, DENTAL OR TOILETRY PURPOSES
- A61K38/00—Medicinal preparations containing peptides
- A61K38/16—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof
- A61K38/17—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from animals; from humans
- A61K38/177—Receptors; Cell surface antigens; Cell surface determinants
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61P—SPECIFIC THERAPEUTIC ACTIVITY OF CHEMICAL COMPOUNDS OR MEDICINAL PREPARATIONS
- A61P3/00—Drugs for disorders of the metabolism
- A61P3/06—Antihyperlipidemics
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61P—SPECIFIC THERAPEUTIC ACTIVITY OF CHEMICAL COMPOUNDS OR MEDICINAL PREPARATIONS
- A61P9/00—Drugs for disorders of the cardiovascular system
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K14/00—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof
- C07K14/435—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from animals; from humans
- C07K14/475—Growth factors; Growth regulators
- C07K14/485—Epidermal growth factor [EGF], i.e. urogastrone
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K14/00—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof
- C07K14/435—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from animals; from humans
- C07K14/705—Receptors; Cell surface antigens; Cell surface determinants
Landscapes
- Health & Medical Sciences (AREA)
- Life Sciences & Earth Sciences (AREA)
- Chemical & Material Sciences (AREA)
- Organic Chemistry (AREA)
- General Health & Medical Sciences (AREA)
- Medicinal Chemistry (AREA)
- Gastroenterology & Hepatology (AREA)
- Proteomics, Peptides & Aminoacids (AREA)
- Animal Behavior & Ethology (AREA)
- Engineering & Computer Science (AREA)
- Public Health (AREA)
- Veterinary Medicine (AREA)
- Pharmacology & Pharmacy (AREA)
- Bioinformatics & Cheminformatics (AREA)
- Zoology (AREA)
- Immunology (AREA)
- Toxicology (AREA)
- Molecular Biology (AREA)
- Genetics & Genomics (AREA)
- Biochemistry (AREA)
- Biophysics (AREA)
- Cell Biology (AREA)
- General Chemical & Material Sciences (AREA)
- Nuclear Medicine, Radiotherapy & Molecular Imaging (AREA)
- Chemical Kinetics & Catalysis (AREA)
- Epidemiology (AREA)
- Heart & Thoracic Surgery (AREA)
- Cardiology (AREA)
- Diabetes (AREA)
- Hematology (AREA)
- Obesity (AREA)
- Medicines That Contain Protein Lipid Enzymes And Other Medicines (AREA)
- Peptides Or Proteins (AREA)
- Medicinal Preparation (AREA)
Abstract
La invención se relaciona con compuestos derivados del dominio EGF (a) de LDL-R, en particular compuestos que comprenden una secuencia de péptido de tipo salvaje EGF (A) (LDL-R (293-332)) y al menos un sustituyente comprende al menos un grupo de ácidos grasos. La invención también se relaciona con una composición farmacéutica de la misma y usa un medicamento. Los nuevos compuestos EGF (a) de la invención son útiles como tratamiento, p. En el campo de la disminución del colesterol, la dislipidemia y la enfermedad cardiovascular. (Traducción automática con Google Translate, sin valor legal)
Description
DESCRIPCIÓN
Análogos del EGF(A) con sustituyentes de ácidos grasos
Campo técnico de la invención
La presente invención se refiere a análogos del EGF(A) y derivados de los mismos, más particularmente a análogos peptídicos del EGF(A) con un sustituyente de ácido graso.
Antecedentes
Los niveles altos de LDL-C (colesterol asociado a lipoproteínas de baja densidad) y la dislipidemia son promotores bien reconocidos de una enfermedad cardiovascular.
Se han aprobado las estatinas para el tratamiento de la dislipidemia durante 25 años. Esta clase ha demostrado una reducción sustancial y consistente de eventos cardiovasculares con un perfil de seguridad aceptable. La estatina más vendida, atorvastatina (Lipitor™) fue el fármaco más vendido del mundo en todo momento, con más de 125 mil millones USD en ventas del 1996 al 2012.
A pesar de la disponibilidad y el amplio uso de las estatinas y otros agentes reductores de lípidos, muchos pacientes no logran sus niveles objetivos de LDL-C y mantienen un riesgo alto de desarrollar una enfermedad cardiovascular. La PCSK9 (Proproteína Convertasa Subtilisina/Kexina tipo 9) promueve la degradación del LDL-R (receptor de LDL) hepático, lo que reduce de esta manera la expresión superficial del LDL-R hepático y, en consecuencia, la eliminación de las partículas de LDL. Por el contrario, el bloqueo de PCSK9 aumenta la eliminación de LDL-C así como también de otras lipoproteínas aterogénicas. De hecho, los receptores de LDL contribuyen a la eliminación de lipoproteínas aterogénicas diferentes de LDL, tales como lipoproteínas de densidad intermedia y partículas remanentes. El aumento de la eliminación de las lipoproteínas de densidad intermedia y de partículas remanentes puede tener beneficios terapéuticos más allá de los proporcionados por la reducción de LDL.
Las estatinas aumentan la expresión tanto del LDL-R como de PCSK9 mediante el factor de transcripción SREBP2. El aumento de la expresión de PCSK9 puede disminuir el efecto de las estatinas en la eliminación de LDL-C de la circulación. Al inhibir la unión de PCSK9 al LDL-R y prevenir de esta manera la degradación del LDL-R se mejora la eficacia de las estatinas. En conjunto, la inhibición de PCSK9 ofrece un enfoque novedoso para el manejo de lípidos. Dos anticuerpos anti-PCSK9, alirocumab/Praluent® y evolocumab/Repatha®, se han aprobado recientemente para el tratamiento de los niveles altos de LDL-C. Estos se administran mediante inyecciones subcutáneas de 1 ml cada dos semanas. Sin embargo, podría cuestionarse el cumplimiento de este régimen de dosificación de un fármaco administrado por vía subcutánea, especialmente para una afección asintomática.
La secuencia del EGF(A) (dominio A similar al factor de crecimiento epidérmico) (40 aminoácidos) del LDL-R (LDL-R-(293-332)) es bien reconocida como el sitio para la unión a PCSK9. Se ha demostrado que el péptido del EGF(A) natural aislado inhibe la unión de PCSK9 al LDL-R con una IC50 en el intervalo bajo en pM (Biochemical and Biophysical Research Communications 375 (2008) 69-73). Esta potencia baja impedirá un uso farmacéutico práctico del péptido EGF(A). Además, puede esperarse que la semivida de tales péptidos sea demasiado corta para ser de uso terapéutico.
El documento WO2012177741 y J. Mol. Biol. (2012) 422, 685-696 describen análogos del EGF(A) y la fusión a Fc de los mismos.
Todavía existe la necesidad de mejorar el tratamiento de los pacientes, por ejemplo, en términos de eficacia, también o alternativamente, en términos de conveniencia, comodidad para los pacientes, tal como comodidad y conveniencia del modo de administración y de esta manera su cumplimiento.
Resumen
La presente invención se refiere a novedosos compuestos del EGF(A) que tienen potencial para mejorar los tratamientos de los pacientes, particularmente en el campo de la disminución del colesterol, la dislipidemia y las enfermedades cardiovasculares.
La invención en un aspecto se refiere a derivados del EGF(A) que comprenden un análogo peptídico del EGF(A) que comprende 301Leu y un sustituyente que comprende al menos un grupo de ácido graso, en donde el análogo peptídico del EGF(A) tiene 1-8 sustituciones de aminoácidos en comparación con el dominio EGF(A), aminoácidos 293-332 del LDL-R, definido mediante la SEQ ID NO: 1 y en donde el derivado tiene una Ki por debajo de 5 nM cuando se mide en el ELISA competitivo de unión de PCSK9-LDL-R descrito en la sección D1.1 en la presente descripción.
La invención proporciona compuestos con mejores propiedades farmacocinéticas (PK). En particular, los compuestos de la invención tienen tiempos de vida media largos y todavía muestran buena capacidad para inhibir la unión de PCSK9 al LDL-R.
En una modalidad, la invención proporciona compuestos del EGF (A) con una capacidad mejorada para inhibir la unión de PCSK9 al LDL-R. En una modalidad, la invención proporciona compuestos con una capacidad de unión mejorada a PCSK9. En una modalidad, la invención proporciona compuestos del EGF (A) con semivida prolongada. En una modalidad la invención proporciona compuestos del EGF(A) con semivida prolongada y sin pérdida o sin pérdida sustancial de la capacidad para inhibir la unión de PCSK9 al LDL-R. En una modalidad la invención proporciona compuestos del EGF(A) con semivida prolongada y preservación de la capacidad de unión. En una modalidad la invención proporciona compuestos del EGF(A) con una alta estabilidad líquida, adecuados para formulaciones líquidas. En una modalidad la invención proporciona compuestos del EGF(A) con una alta estabilidad in vivo. En una modalidad, la invención proporciona compuestos con potencial para la administración oral. En una modalidad, la invención proporciona compuestos del EGF (A) con potencial para un tratamiento más conveniente para el paciente. En una modalidad, la invención proporciona compuestos con potencial para mejorar el cumplimiento del paciente. La invención puede también resolver problemas adicionales que resultarán evidentes a partir de la descripción de las modalidades ilustrativas.
La invención se refiere a un compuesto que comprende un análogo peptídico del EGF(A) del péptido EGF(A) definido mediante la secuencia SeQ ID NO: 1: Gly-Thr-Asn-Glu-Cys-Leu-Asp-Asn-Asn-Gly-Gly-Cys-Ser-His-Val-Cys-Asn-Asp-Leu-Lys-Ile-Gly-Tyr-Glu-Cys-Leu-Cys-Pro-Asp-Gly-Phe-Gln-Leu-Val-Ala-Gln-Arg-Arg-Cys-Glu, en donde el análogo peptídico comprende 301Leu. La invención se refiere a un derivado del EGF(A) que comprende un análogo peptídico del EGF(A) que comprende 301Leu y al menos un sustituyente que comprende al menos un grupo de ácido graso.
En una modalidad, el derivado del EGF(A), comprende un análogo peptídico del EGF(A) en donde, como se describió más arriba, el aminoácido 301 es Leu (L), a la vez que el péptido comprende además el/los residuo(s) naturales(s) en una o más de las posiciones 295 (Asn/N), 296 (Glu/E), 298 (Leu/L), 302 (Gly/G) y 310 (Asp/D). En modalidades adicionales el análogo peptídico del EGF(A) del derivado del EGF(A) tiene 1-15 sustituciones de aminoácidos en comparación con la SEQ ID NO: 1.
En una modalidad adicional el sustituyente del derivado del EGF(A) no se une al análogo peptídico del EGF(A) por medio de un residuo de aminoácido en ninguna de las posiciones 295, 298, 301, 302, 307 ni 310.
En una modalidad adicional el sustituyente se une al análogo peptídico del EGF(A) por medio de un residuo de aminoácido distinto de las posiciones 295, 298, 301, 302, 307 y 310.
En un aspecto, la invención se refiere a un análogo peptídico del EGF(A) que tiene 1-8 sustituciones de aminoácidos en comparación con el dominio EGF(A), los aminoácidos 293-332 del LDL-R, definidos mediante la SEQ ID NO 1, en donde el análogo peptídico del EGF(A) comprende 301Leu y 310Asp y en donde el péptido no tiene una sustitución de 299Asp por Glu, Val o His y en donde el análogo tiene una Ki por debajo de 5 nM cuando se mide en un ELISA competitivo de unión de PCSK9-LDL-R, como se describió en la sección D1.1 en la presente descripción.
En un aspecto adicional, la invención se refiere a un análogo peptídico del EGF(A) que tiene 1-8 sustituciones de aminoácidos en comparación con el dominio EGF(A), los aminoácidos 293-332 del LDL-R, definidos mediante la SEQ ID NO 1, en donde el análogo peptídico del EGF(A) comprende 301Leu, 310Asp y una sustitución de aminoácidos de 312Lys y en donde el análogo tiene una Ki por debajo de 5 nM cuando se mide en un ELISA competitivo de unión de PCSK9-LDL-R, como se describió en la sección D1.1 en la presente descripción.
En modalidades adicionales los análogos peptídicos del EGF(A) tienen uno, dos, tres, cuatro o cinco de los siguientes residuos de aminoácidos (naturales) 295Asn, 296Glu, 298Leu, 302Gly y 310Asp/D).
En una modalidad adicional dicho análogo peptídico comprende tres puentes disulfuro en las posiciones 297Cys-308Cys, 304Cys-317Cys y 319Cys-331Cys.
En otro aspecto, la descripción se refiere a una composición farmacéutica que comprende un compuesto de acuerdo con la invención.
En otro aspecto, la descripción se refiere a un compuesto de acuerdo con la invención para su uso como un medicamento.
En otro aspecto, la descripción se refiere al uso médico de los compuestos de acuerdo con la invención.
Breve descripción de las figuras
La figura 1 muestra los niveles de expresión hepática del LDL-R en ratones, medidos por inmunoelectrotransferencia, presentados como diagrama de dispersión para los animales individuales.
La figura 2 muestra el colesterol LDL plasmático en hámsteres tratados con vehículo o con compuestos del EGF(A) prolongadores del ejemplo 2.
La figura 3 muestra la expresión hepática del LDL-R en hígados de hámsteres tratados con vehículo o con compuestos del EGF(A) prolongadores del ejemplo 2, medida por inmunoelectrotransferencia.
Breve descripción del listado de secuencias
La secuencia de aminoácidos del EGF(A) natural (LDL-R(293-332)) se incluye en el listado de secuencias como la SEQ ID NO: 1. Las SEQ ID NO 2-78 son las secuencias de aminoácidos de los péptidos del EGF(A) de los compuestos del EGF(A) específicos de la invención.
Descripción
En lo que sigue, las letras griegas pueden representarse por sus símbolo o el nombre escrito correspondiente, por ejemplo: a = alfa; p = beta; s = épsilon; y = gamma; 8 = delta; o = omega; etcétera. También, la letra griega de p puede representarse por "u", por ejemplo, en pl = ul, o en pM = uM.
En lo que sigue, “un(una)” significa “uno o más”. A menos que se indique de otra forma en la especificación, los términos presentados en forma singular incluyen, también, la situación en plural.
Un asterisco (*) en una fórmula química designa i) un punto de unión, ii) un radical y/o iii) un electrón no compartido. Características estructurales
Compuesto del EGF(A)
El término "compuesto del EGF(A)" se usa en la presente descripción para referirse generalmente a un compuesto que comprende un péptido del EGF(A), que abarca el LDL-R(293-332) en peso como se define mediante la SEQ ID NO: 1 y análogos de los mismos. El término compuesto del EGF(A) abarca derivados del péptido del EGF-(A) y análogos de los mismos, es decir, los análogos peptídicos del EGF(A) con un sustituyente como se describió en la presente descripción, es un típico ejemplo de un compuesto del EGF(A).
Péptidos del EGF(A)
El término “péptido”, como se usa, por ejemplo, en el contexto de la invención, se refiere a un compuesto que comprende una serie de aminoácidos interconectados mediante enlaces amida (o peptídicos). En una modalidad particular el péptido consiste en aminoácidos interconectados mediante enlaces peptídicos.
El péptido de la invención comprende al menos 35, tal como 36, 37, 38, 39 o al menos 40 aminoácidos. En una modalidad particular el péptido está compuesto por 36, tal como 38 o 40 aminoácidos. En una modalidad particular adicional, el péptido consiste en 35, 36, 37, 38, 39 o 40 aminoácidos.
En presencia de adiciones de aminoácidos, denominadas en la presente descripción como alargamientos N-terminal y C-terminal, el péptido de la invención puede comprender hasta 140 aminoácidos. En una modalidad, el péptido de la invención puede comprender o consistir en residuos de 41 aminoácidos. En una modalidad particular, este comprende 40-140, 40-120, 40-100, 40-80, 40-60 o 40-50 aminoácidos.
Las expresiones “dominio EGF(A) del LDL-R”, “LDL-R (293-332)”, “LDL-R nativo (293-332), “EGF(A) (293-332)”, “EGF(A) natural", “EGF(A) en peso” o “EGF(A) nativo” como se usan en la presente, se refieren a un péptido que consiste de la secuencia SEQ ID NO: 1.
La SEQ ID NO: 1 es :
Gly-Thr-Asn-Glu-Cys-Leu-Asp-Asn-Asn-Gly-Gly-Cys-Ser-His-Val-Cys-Asn-Asp-Leu-Lys-Ile-Gly-Tyr-Glu-Cys-Leu-Cys-Pro-Asp-Gly-Phe-Gln-Leu-Val-Ala-Gln-Arg-Arg-Cys-Glu.
En esta fórmula la numeración de los residuos de aminoácidos sigue la numeración para el dominio EGF(A) del LDL-R (LDL-R-(293-332)), en donde el primer residuo de aminoácido (N-terminal) se numera o se concede la posición núm. 293, y los residuos de aminoácidos subsecuentes hacia el extremo C se numeran 294, 295, 296 y así sucesivamente, hasta el último residuo de aminoácido (C-terminal), que en el dominio EGF(A) del LDL-R es Glu con el número 332.
La numeración se realiza de manera diferente en el listado de secuencias, donde el primer residuo de aminoácido de SEQ ID NO: 1 (Gly) se asigna núm. 1 y el último (Glu) núm. 40. Lo mismo se aplica para las otras secuencias del listado de secuencias, es decir, el aminoácido N-terminal asignado es el núm. 1 independientemente de su posición
con relación a 293Gly o el residuo de aminoácido que sustituye el 293 con referencia a LDL-R(293-332). Sin embargo, en la presente descripción la numeración de las posiciones de aminoácidos es con referencia a LDL-R(293-332), como se explicó más arriba.
Se describen en la presente descripción los análogos peptídicos del EGF(A) identificados mediante la SEQ ID NO: 1 y los derivados de tales análogos peptídicos del EGF(A) del dominio EGF(A) natural del LDLR definido mediante la SEQ ID NO: 1.
El término “análogo” generalmente se refiere a un péptido, cuya secuencia tiene uno o más cambios de aminoácidos cuando se compara con una secuencia de aminoácidos de referencia.
Los términos “análogo de la invención”, “análogo peptídico de la invención”, “análogo del LDL-R(293-332)”, “análogo del EGF(A)” o “análogo de SEQ ID NO: 1” como se usan en la presente pueden referirse como un péptido, cuya secuencia comprende sustituciones de aminoácidos, es decir, reemplazos de aminoácidos con relación a la secuencia SEQ ID NO: 1. Un “análogo” también puede incluir alargamientos de aminoácidos en las posiciones N-terminal y/o C-terminal y/o truncamientos en las posiciones N-terminal y/o C-terminal.
El nivel de identidad con la SEQ ID NO: 1 puede calcularse mediante la determinación del número de aminoácidos que no se cambian con relación a la SEQ ID NO 1. La SEQ ID NO: 1 consiste en 40 residuos de aminoácidos y si se introducen tres sustituciones de aminoácidos el nivel de identidad es 37/40 %= 92,5 %. Si se cambian 5 residuos de aminoácidos el nivel de identidad es 87,5 %. Si el péptido se alarga en dirección N-terminal o C-terminal esa parte usualmente no se incluye en la comparación, mientras que una deleción de uno o más aminoácidos acorta el comparador. Por ejemplo, en los ejemplos mencionados más arriba, si el aminoácido N-terminal se elimina el nivel de identidad se reduce ligeramente a 36/39X100 % y 34/39X100 %, respectivamente. Al analizar la identidad de la secuencia de la cadena principal de un derivado del residuo de aminoácido del sustituyente, por ejemplo, el residuo al cual se une el sustituyente, también denominado el residuo de aminoácido del sustituyente, puede ser un aminoácido ya sea natural (wt) o sustituido. Si el residuo de aminoácido del sustituyente es un residuo de natural, tal como la Gly N-terminal o 312K este residuo se incluye en el cálculo del nivel de identidad, mientras que una Lys en cualquier otra posición de 293 a 332 sería una sustitución de aminoácidos y no se incluye cuando se calcula la identidad de aminoácidos con la SEQ ID NO:1.
En una modalidad, el análogo peptídico del EGF(A) tiene de 1-8 sustituciones de aminoácidos en comparación con la SEQ ID NO: 1, tal como 1-7, 1-6, 1-5 sustituciones de aminoácidos en comparación con la SEQ ID NO: 1. En una modalidad particular, pueden estar presentes hasta 7 sustituciones de aminoácidos, por ejemplo hasta 6, 5, 4, 3, 2 o 1 sustituciones de aminoácidos en el análogo peptídico del EGF-1.
En una modalidad el análogo de la invención tiene al menos un 75 % de identidad, tal como 80 %, tal como 85, tal como 90 o incluso 95 % de identidad con la SEQ ID NO:1 lo que se corresponde con hasta 10, 8, 6, 4 y 2 sustituciones de aminoácidos con relación a la SEQ ID NO 1, respectivamente en caso de no truncamiento.
Cada uno de los análogos peptídicos de la invención pueden describirse como referencia i) al número del residuo de aminoácido en EGF(A) nativo (LDL-R(293-332)) que corresponde al residuo de aminoácido que se cambia (es decir, la posición correspondiente en el EGF(A) LDL-R(293-332)) nativo, y ii) al cambio real.
En otras palabras, los análogos peptídicos de la invención pueden describirse como referencia al péptido del EGF(A) LDL-R(293-332) nativo, específicamente como una variante del mismo, en el cual se ha cambiado una cantidad de residuos de aminoácidos cuando se compara con el EGF(A) LDL-R(293-332) nativo (SEQ ID NO: 1). Estos cambios pueden representar, independientemente, una o más sustituciones de aminoácidos.
Los siguientes son ejemplos no limitantes de la nomenclatura adecuada de los análogos:
El péptido del EGF(A) incorporado en el derivado del Ejemplo 2 en la presente descripción puede referirse como el siguiente análogo del EGF(A) del LDL-R(293-332): (301Leu, 309Arg) LDL-R(293-332) EGF(A), o (Leu301, Arg309)-LDL-R(293-332) EGF(A) o (301L,309R) LDL-R(293-332) o (L301,R309) LDL-R(293-332). Esto significa que cuando este análogo se alinea con el LDL-R(293-332) nativo, tiene i) una Leu en el posición en el análogo que corresponde, de acuerdo con la alineación, a la posición 301 en el EGF(A) LDL-R(293-332) nativo, ii) una Arg en la posición en el análogo que corresponde a la posición 309 en el EGF(A) LDL-R(293-332) nativo.
Los análogos “que comprenden” determinados cambios especificados pueden comprender otros cambios, cuando se comparan con la SEQ ID NO: 1.
En una modalidad particular, el análogo "tiene" o “comprende” los cambios especificados. En una modalidad particular, el análogo “consiste en” los cambios. Cuando el término “consiste” o “que consiste” se usa en relación con un análogo, por ejemplo, un análogo consiste o que consiste de un grupo de sustituciones de aminoácidos especificadas, debe entenderse que las sustituciones de aminoácidos especificadas son las únicas sustituciones de aminoácidos en el análogo peptídico. Por el contrario un análogo “que comprende” un grupo de sustituciones de aminoácidos especificadas puede tener sustituciones adicionales.
Como es evidente a partir de los ejemplos mencionados más arriba, los residuos de aminoácidos pueden identificarse por su nombre completo, su código de una letra y/o su código de tres letras. Estas tres maneras son completamente equivalentes.
Las expresiones “un posición equivalente a” o "posición correspondiente" pueden usarse para caracterizar el sitio de cambio en una variante de secuencia del EGF(A) LDL-R(293-332) en referencia a la secuencia de referencia nativa del EGF(A) LDL-R(293-332) (SEQ ID NO: 1). Las posiciones equivalentes o correspondientes, así como también la cantidad de cambios, se deducen fácilmente, por ejemplo mediante simple escritura e inspección visual; y/o puede usarse un programa estándar de alineamiento de proteínas o péptidos, tal como "align" que se basa en un algoritmo de Needleman-Wunsch.
En lo que sigue, puede ocurrir que se defina una fórmula química de manera que dos grupos químicos subsecuentes puedan seleccionarse para ser “un enlace”. En tales casos, los dos grupos químicos subsecuentes realmente estarían ausentes, y solo un enlace conectaría los grupos químicos circundantes.
Los aminoácidos son moléculas que contienen un grupo amino y un grupo ácido carboxílico y, opcionalmente, uno o más grupos adicionales, frecuentemente denominados cadena lateral.
El término "aminoácido" incluye aminoácidos proteinogénicos (o naturales) (entre ellos los 20 aminoácidos estándar), así como también aminoácidos no proteinogénicos (o no naturales). Los aminoácidos proteinogénicos son aquellos que se incorporan naturalmente en las proteínas. Los aminoácidos estándar son los codificados por el código genético. Los aminoácidos no proteinogénicos o no se encuentran en proteínas, o no se producen por la maquinaria celular estándar (por ejemplo, pueden haberse sometido a modificación postraduccional). Los ejemplos no limitantes de aminoácidos no proteinogénicos son Aib (ácidoa-aminoisobutírico, o ácido 2-aminoisobutírico), norleucina, norvalina, así como también los isómeros D de los aminoácidos proteinogénicos.
En lo que sigue, cada aminoácido de los péptidos de la invención para los cuales no se indica el isómero óptico debe entenderse que se refiere al isómero L (a menos que se especifique de cualquier otra manera).
Análogos peptídicos
Los análogos peptídicos se definen como péptidos que comprenden una secuencia de aminoácidos que es un análogo de s Eq ID NO: 1. Los análogos peptídicos tienen la capacidad de unirse a la PCSK9 y tienen una capacidad mejorada de unirse a la PCSK9, por ejemplo en comparación con el LDL-R(293-332) nativo (EGF-(A) nativo) o con otros compuestos de unión a la PCSK9. Los análogos peptídicos tienen además la capacidad de inhibir la unión de PCSK9 al LDL-R. Los análogos peptídicos inhiben la unión de PCSK9 al Receptor de lipoproteínas de baja densidad (LDL-R) humano y dicha unión puede evaluarse mediante el uso del ensayo descrito en el Ejemplo D.1.1 en la presente descripción.
Un aspecto de la invención se refiere a un análogo peptídico del EGF(A) que tiene 1-8 sustituciones de aminoácidos en comparación con el dominio EGF(A), los aminoácidos 293-332 del LDL-R, definido mediante la SEQ ID NO 1, en donde el análogo peptídico del EGF(A) comprende 301Leu y 310Asp y en donde el péptido no tiene una sustitución de 299Asp por Glu, Val o His y en donde el análogo tiene una Ki por debajo de 5 nM cuando se mide en un ELISA competitivo de unión de PCSK9-LDL-R como se describió en la sección D1.1 en la presente descripción.
Un aspecto de la invención se refiere a un análogo peptídico del EGF(A) que tiene 1-8 sustituciones de aminoácidos en comparación con el dominio EGF(A), los aminoácidos 293-332 del LDL-R, definidos mediante la SEQ ID NO 1, en donde el análogo peptídico del EGF(A) comprende 301Leu, 310Asp y una sustitución de aminoácidos de 312Lys y en donde el análogo tiene una Ki por debajo de 5 nM cuando se mide en un ELISA competitivo de unión de PCSK9-LDL-R, como se describió en la sección D1.1 en la presente descripción.
En una modalidad los análogos peptídicos y los derivados peptídicos de la invención son péptidos inhibidores de PCSK9 o simplemente inhibidores de PCSK9. En una modalidad la invención se refiere a un análogo peptídico de SEQ ID NO:1, en donde el análogo peptídico es capaz de inhibir la unión de PCSK9 al receptor humano de la lipoproteína de baja densidad (LDL-R).
En una modalidad los análogos peptídicos, compuestos o inhibidores de PCSK9 de la invención tienen una capacidad mejorada de unirse a PCSK9 en comparación con EGF(A), LDL-R(293-332) (SEQ ID 1).
En una modalidad, los análogos peptídicos, compuestos o inhibidores de PCSK9 de la invención tienen una capacidad mejorada para unirse a PCSK9 en comparación con el Ej. 48 (SEQ ID 2).
En una modalidad, la Ki de los análogos peptídicos, compuestos o inhibidores de PCSK9 como se describió en la presente descripción, cuando se mide en el ensayo de ELISA competitivo de unión de PCSK9-LDL-R, está por debajo de 10 nM, tal como por debajo de 8 nM o tal como por debajo de 5 nM.
La funcionalidad de los análogos del EGF-(A) y los derivados de los mismos puede caracterizarse adicionalmente por sus capacidades para mejorar la captación de LDL, como se describió en el Ejemplo D1.2 en la presente descripción. En una modalidad, los análogos peptídicos, compuestos o inhibidores de PCSK9 de la invención aumentan la captación de LDL en presencia de PCSK9. En una modalidad, los análogos peptídicos, compuestos o inhibidores de PCSK9 de la invención son capaces de revertir o reducir la reducción de la captación de LDL mediada por PCSK9.
En una modalidad, los análogos peptídicos, compuestos o inhibidores de PCSK9 de la invención tienen una EC50 según se mide en el ensayo de captación de LDL, por debajo de 1500 nM, tal como por debajo de 1000 nM o tal como por debajo de 500 nM.
En una modalidad, un análogo peptídico de la invención puede definirse como que comprende al menos 1 sustitución de aminoácidos en comparación con la SEQ ID NO: 1, y opcionalmente un alargamiento. En una modalidad, un análogo peptídico de la invención puede definirse como que comprende hasta 15, hasta 14, hasta 13, hasta 12, hasta 11, hasta 10, hasta 9, hasta 8, hasta 7, hasta 6, hasta 5, hasta 4, hasta 3, hasta 2 o 1 sustitución(ciones) de aminoácido(s) en comparación con la SEQ ID NO: 1, y opcionalmente un alargamiento. Esto significa que un péptido que comprende un alargamiento en el N-terminal y/o en el C-terminal puede comprender hasta 15 sustituciones de aminoácidos en las posiciones 293 a 332 además de dicho alargamiento.
Un “alargamiento” de aminoácidos también puede denominarse “extensión”. En una modalidad, los análogos peptídicos de la invención comprenden un alargamiento. Dicho alargamiento puede ser una adición de hasta 50 residuos de aminoácidos en la posición N-terminal de la SEQ ID NO: 1 o un análogo de la misma, denominado también como un alargamiento N-terminal, lo que significa que un péptido de la invención puede comprender hasta 50 aminoácidos desde la posición 292 hacia abajo, por ejemplo, la posición 242. Adicionalmente o alternativamente, dicho alargamiento puede ser una adición de hasta 50 residuos de aminoácidos en la posición C-terminal de la SEQ ID NO: 1 o un análogo de la misma, denominado también como un alargamiento C-terminal, lo que significa que un péptido de la invención puede comprender hasta 50 aminoácidos desde la posición 333 hacia arriba, por ejemplo, la posición 383.
Dicho alargamiento puede estar presente ya sea en el N-terminal, en el C-terminal o ambos. Dicho alargamiento puede ser también de cualquier longitud entre 0 y 50 aminoácidos en cada lado, independientemente entre sí. En una modalidad, los análogos peptídicos de la invención comprenden un alargamiento N-terminal de 1-50, 1-40, 10 40, 1-30, 10-30, 20-30, 20-40, 20-50, 30-50, 1-10, 11-20, 21-30, 31-40 o 41-50 de residuos de aminoácidos o de 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 19, 20, 21, 22, 23, 24, 25, 26, 27, 28, 29, 30, 31, 32, 33, 34, 35, 36, 37, 38, 39, 40, 41, 42, 43, 44, 45, 46, 47, 48, 49 o 50 residuos de aminoácidos. Además o alternativamente, los análogos peptídicos de la invención pueden comprender un alargamiento del C-terminal de 1-50, 1-40, 10-40, 1 30, 10-30, 20-30, 20-40, 20-50, 30-50, 1-10, 11-20, 21-30, 31-40 o 41-50 residuos de aminoácidos o de 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 19, 20, 21, 22, 23, 24, 25, 26, 27, 28, 29, 30, 31, 32, 33, 34, 35, 36, 37, 38, 39, 40, 41, 42, 43, 44, 45, 46, 47, 48, 49 o 50 residuos de aminoácidos.
Un alargamiento puede referirse, en alguna situación, a una sustitución a medida que se introduce un nuevo residuo de aminoácido, tal como el 292A, 292Lys o 333Lys ejemplificado en la presente descripción.
Los truncamientos menores en el N-terminal y/o C-terminal del péptido del EGF(A) pueden estar presentes en el análogo peptídico del EGF(A).
En una modalidad el péptido del EGF(A) comprende al menos 35 residuos de aminoácidos, tal como 36 residuos de aminoácidos, tal como 37 residuos de aminoácidos, tal como 38 residuos de aminoácidos o tal como 39 residuos de aminoácidos. En una modalidad el análogo peptídico del EGF(A) de acuerdo con, comprende un truncamiento N-terminal de 1-2 residuos de aminoácidos. En una modalidad se eliminan uno o dos residuos de aminoácidos en el N-terminal. En modalidades adicionales el análogo peptídico del EGF(A) comprende en consecuencia un truncamiento N-terminal que elimina al menos o específicamente el aminoácido 293Gly.
En modalidades adicionales el análogo peptídico del EGF(A) comprende un truncamiento N-terminal que elimina al menos o específicamente 293Gly-294Thr.
En una modalidad el análogo peptídico del EGF(A) comprende un truncamiento C-terminal de 1 residuo de aminoácido. En una modalidad se elimina un único residuo de aminoácido C-terminal. En una modalidad el análogo peptídico comprende un truncamiento C-terminal que elimina específicamente el aminoácido 332Glu.
Además o alternativamente, un análogo peptídico de la invención puede comprender al menos un alargamiento de aminoácidos en el N-terminal o el C-terminal por ejemplo en la posición 292 y/o 333.
El análogo peptídico del EGF(A) de la invención comprende la sustitución de aminoácidos del residuo de aminoácido 301 de Asn por Leu, descrita también como Asn301Leu, o simplemente 301Leu. En una modalidad específica, el análogo peptídico del EGF(A) comprende la sustitución 301Leu.
Además, o alternativamente el análogo peptídico del EGF(A) comprende los residuos de aminoácidos 297Cys, 304Cys, 308Cys, 317Cys, 319Cys y 331Cys. Esos residuos de Cys son residuos naturales que pueden estar acoplados en puentes disulfuro, tales como los puentes disulfuro entre 297Cys y 308Cys, entre 304Cys y 317Cys y entre 319Cys y 331Cys.
En una modalidad, el análogo peptídico del EGF(A) comprende 301Leu y una cantidad de sustituciones de aminoácidos adicionales, como se describió anteriormente.
En una modalidad el análogo peptídico del EGF(A) comprende 301Leu, 310Asp y una sustitución de aminoácidos de 312Lys.
En una modalidad, el análogo peptídico del EGF(A) comprende 301Leu y 310Asp y en donde el análogo peptídico no tiene una sustitución de 299Asp por Glu, Val o His.
En una modalidad el análogo peptídico del EGF(A) comprende 301Leu, 309Arg y 312Glu.
En una modalidad el análogo peptídico del EGF(A) comprende 301Leu y 309Arg con la condición de que el análogo peptídico no tenga una sustitución de 310Asp por 310Lys o
En una modalidad el análogo peptídico del EGF(A) comprende 301Leu y 309Arg con la condición de que el análogo peptídico no tenga una sustitución de 299Asp por Glu, Val o His.
En una modalidad adicional el análogo peptídico no tiene ninguna de las sustituciones D310K, D310N, D310Q, D310Q, D310R y D310A o incluso cualquier sustitución de 310Asp.
En una modalidad el análogo peptídico del EGF(A) comprende uno, dos, tres o los cuatro residuos naturales: 295Asn, 296Glu, 298Leu y 302Gly.
En una modalidad el análogo peptídico del EGF(A) comprende uno, dos, tres, cuatro o los cinco residuos naturales: 295Asn, 296Glu, 298Leu, 302Gly y 310Asp.
En una modalidad el péptido tiene 295Asn.
En una modalidad el análogo peptídico tiene 296Glu. En una modalidad el análogo peptídico tiene 298Leu. En una modalidad el análogo peptídico tiene 302Gly. En una modalidad el análogo peptídico tiene 310Asp.
En una modalidad el análogo peptídico tiene dos o más de 310Asp, 295Asn y 296Glu. En una modalidad el análogo peptídico tiene los tres de 310Asp, 295Asn y 296Glu.
El análogo peptídico del EGF(A) puede comprender sustituciones de aminoácidos adicionales como se describió en la presente descripción. En una modalidad el análogo de la invención puede comprender además una o más sustituciones de aminoácidos en una(s) posición(ciones) seleccionada(s) del grupo de posiciones: 293, 294, 296, 299, 300, 303, 305, 306, 309, 311, 312, 313, 314, 315, 316, 318, 320, 321, 322, 323, 324, 325, 326, 328, 329, 330 y 332.
En una modalidad el análogo de la invención puede comprender además una o más sustituciones de aminoácidos en una(s) posición(ciones) seleccionada(s) del grupo de posiciones: 293, 294, 299, 300, 303, 305, 306, 309, 311, 312, 313, 314, 316, 318, 321, 322, 323, 324, 325, 326, 328, 329, 330, 331 y 332.
En una modalidad el análogo de la invención puede comprender además una o más sustituciones de aminoácidos en una(s) posición(ciones) seleccionada(s) de 294, 299, 300, 303, 309, 312, 313, 314, 316, 318, 321, 322, 323, 324, 325, 326, 328, 329, 330 y 332.
En una modalidad el análogo de la invención puede comprender además una o más sustituciones de aminoácidos en una(s) posición(ciones) seleccionada(s) de 299, 300, 309, 313, 316, 318, 321, 322, 323, 324, 326, 328, 329, 330 y 332.
En una modalidad el análogo de la invención puede comprender además una o más sustituciones de aminoácidos adicionales en una(s) posición(ciones) seleccionada(s) del grupo de posiciones: 309, 312, 313, 321, 324, 328 y 332. En una modalidad adicional el análogo peptídico comprende ya sea el residuo de aminoácido wt o un residuo diferente, es decir, una sustitución de aminoácidos, en determinados posiciones específicas, en adición a los residuos de aminoácidos especificados más arriba en la presente descripción.
En una modalidad tal el análogo de la invención comprende el residuo de aminoácido Gly(G) o Asn(N) en la posición 293.
En una modalidad tal el análogo de la invención comprende el residuo de aminoácido Trp (W), Thr(T) o Gly(G) en la posición 294.
En una modalidad tal el análogo de la invención comprende el residuo de aminoácido Asp(D), Gly(G), Pro(P), Arg(R), Lys(K), Ser(S), Thr(T), Asn(N), Gln(Q), Ala(A), Ile(I), Leu(L), Met(M), Phe(F), Tyr(Y) o Trp(W) en la posición 299.
En una modalidad tal el análogo de la invención comprende el residuo de aminoácido Asp(D), Gly(G), Pro (P), Arg(R), Lys(K), Ser(S), Thr(T), Asn(N), Gln(Q), Ala(A), Met(M), Phe(F), Tyr(Y) o Trp(W) en la posición 299.
En una modalidad tal el análogo de la invención comprende el residuo de aminoácido Asp(D), Ser (S), Arg(R), Leu (L), Ala (A), Lys(K) o Tyr(Y) en la posición 299.
En una modalidad tal el análogo de la invención comprende el residuo de aminoácido Asp(D) o Ala(A) en la posición 299.
En una modalidad tal el análogo de la invención comprende el residuo de aminoácido His(H) o Asn(N) en la posición 300.
En una modalidad tal el análogo de la invención comprende el residuo de aminoácido Val(V), Ser(S), Thr (T) o Ile (I) en la posición 307.
En una modalidad tal el análogo de la invención comprende el residuo de aminoácido Val(V), o Ile (I) en la posición 307.
En una modalidad tal el análogo de la invención comprende Ser(S), Thr (T) o Ile (I) en la posición 307.
En una modalidad tal el análogo de la invención comprende Ile (I) en la posición 307.
En una modalidad tal el análogo de la invención comprende el residuo de aminoácido Asn(N), Glu (E), His (H,) Arg (R), Ser (S) o Lys (K) en la posición 309.
En una modalidad tal el análogo de la invención comprende el residuo de aminoácido Asn(N), Arg (R), Ser (S) o Lys (K) en la posición 309.
En una modalidad tal el análogo de la invención comprende el residuo de aminoácido Asn(N), Arg (R), o Ser (S) en la posición 309.
En una modalidad tal el análogo de la invención comprende el residuo de aminoácido Asn(N) o Arg (R) en la posición 309.
En una modalidad tal el análogo de la invención comprende el residuo de aminoácido Lys(K) o Arg (R) en la posición 309.
El análogo peptídico del EGF(A) puede comprender varias sustituciones de aminoácidos como se describió en la presente descripción, tal como una o más sustituciones de aminoácidos seleccionadas del grupo de: 299Ala, 307Ile y 321Glu.
En modalidades adicionales, el análogo peptídico del EGF(A) comprende el residuo de aminoácido Asp(D), Lys (K) o Glu(E) en la posición 321.
En modalidades adicionales, el análogo peptídico del EGF(A) comprende el residuo de aminoácido Asp(D) o Glu(E) en la posición 321.
En modalidades adicionales, el análogo peptídico del EGF(A) comprende el residuo de aminoácido Glu(E) en la posición 321.
En modalidades adicionales, el análogo peptídico del EGF(A) comprende el residuo de aminoácido Gln (Q) o Gly (G) en la posición 324.
En modalidades adicionales, el análogo peptídico del EGF(A) comprende el residuo de aminoácido Arg (R) o His (H) en la posición 329.
En modalidades adicionales, el análogo peptídico del EGF(A) no tiene una sustitución de 300Asn(N) por Pro(P).
El dominio EGF(A) del LDL-R incluye una Lisina en la posición 312 que puede usarse para la sustitución como se describió en la presente descripción. En modalidades donde la unión del sustituyente a 312 no se desea 312Lys puede sustituirse por otro aminoácido como se describió en la presente descripción.
En una modalidad, la Lys en la posición 312 se sustituye por un residuo de aminoácido seleccionado de: Gly, Pro, Asp, Glu, Arg, His, Ser, Thr, Asn, Gln, Ala, Val, Ile, Leu, Met, Phe y Tyr. En una modalidad, la Lys en la posición 312 se sustituye por un residuo de aminoácido seleccionado de: Gly, Asp, Glu, Ser, Thr, Asn, Ala, Val, Ile, Leu, Phe y Tyr. En una modalidad, la Lys en la posición 312 se sustituye por un residuo de aminoácido seleccionado de: Asp, Glu, Thr, Asn, Ile, Leu, Phe y Tyr. En una modalidad, 312Lys se sustituye por 312Asp, 312Glu, 312Thr, 312Asn, 312Ile o 312Phe. En una modalidad, 312Lys se sustituye por 312Glu, 312Asp, 312Gln o 312Arg.
En una modalidad, 312Lys se sustituye por 312Glu, 312Thr, 312Asn, 312Ile, 312Phe o 312Tyr. En una modalidad, 312Lys se sustituye por 312Glu, 312Asn o 312Ile,
En una modalidad, 312Lys se sustituye por 312Glu o 312Arg. En una modalidad, 312Lys se sustituye por 312Arg. En una modalidad, 312Lys se sustituye por 312Glu.
Para incluir una opción para unir el sustituyente en diversas posiciones (ver en detalle más abajo), una Lys puede introducirse por la sustitución de aminoácidos de un residuo natural de SEQ ID NO: 1 o por un alargamiento peptídica de SEQ ID NO: 1, tal como una 292Lys o una 333Lys.
En los casos donde se desea más de un sustituyente, uno puede ser por medio de 312Lys mientras que el segundo es por medio de una Lys introducida por alargamiento o sustitución peptídica en la SEQ ID NO: 1.
En una modalidad el análogo peptídico de SEQ ID NO: 1 comprende al menos un residuo de Lys en una posición seleccionada del grupo de: 292Lys, 293Lys, 294Lys, 296Lys, 299Lys, 300Lys, 303Lys, 305Lys, 306Lys, 309Lys, 311Lys, 312Lys, 313Lys, 314Lys, 315Lys, 316Lys, 318Lys, 320Lys, 321Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 327Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys.
En una modalidad el análogo peptídico de SEQ ID NO: 1 comprende al menos un residuo de Lys en una posición seleccionada del grupo de: 292Lys, 293Lys, 294Lys, 299Lys, 300Lys, 303Lys, 305Lys, 306Lys, 309Lys, 311Lys, 312Lys, 313Lys, 314Lys, 315Lys, 316Lys, 318Lys, 320Lys, 321Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 327Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys.
En una modalidad el análogo peptídico de SEQ ID NO: 1 comprende al menos un residuo de Lys en una posición seleccionada del grupo de: 292Lys, 293Lys, 294Lys, 300Lys, 303Lys, 305Lys, 306Lys, 309Lys, 311 Lys, 312Lys, 313Lys, 314Lys, 316Lys, 318Lys, 321Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 327Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys.
En una modalidad el análogo peptídico de SEQ ID NO: 1 comprende al menos un residuo de Lys en una posición seleccionada del grupo de: 292Lys, 293Lys, 294Lys, 300Lys, 303Lys, 305Lys, 306Lys, 311Lys, 312Lys, 313Lys, 314Lys, 316Lys, 318Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 327Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys.
En una modalidad el análogo peptídico de SEQ ID NO: 1 comprende al menos un residuo de Lys en una posición seleccionada del grupo de: 292Lys, 293Lys, 294Lys, 300Lys, 303Lys, 305Lys, 306Lys, 311Lys, 313Lys, 314Lys, 316Lys, 318Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 327Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys. Además o alternativamente, el análogo peptídico de la invención comprende al menos una sustitución de aminoácidos seleccionada de 292Lys, 293Lys, 294Lys, 295Lys, 296Lys, 298Lys, 299Lys, 301Lys, 302Lys, 303Lys, 305Lys, 306Lys, 307Lys, 309Lys, 310Lys, 311Lys, 313Lys, 314Lys, 315Lys, 316Lys, 318Lys, 320Lys, 321Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 327Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys.
En una modalidad adicional, el análogo peptídico del EGF(A) de la invención comprende al menos una sustitución de aminoácidos seleccionada de:292Lys, 293Lys, 294Lys, 295Lys, 296Lys, 298Lys, 299Lys, 302Lys, 303Lys, 305Lys, 306Lys, 307Lys, 309Lys, 311Lys, 313Lys, 314Lys, 315Lys, 316Lys, 318Lys, 320Lys, 321Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 327Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys.
En una modalidad adicional, el análogo peptídico del EGF(A) de la invención comprende al menos una sustitución de aminoácidos seleccionada de 292Lys, 293Lys, 294Lys, 295Lys, 296Lys, 298Lys, 299Lys, 303Lys, 305Lys, 306Lys, 309Lys, 311Lys, 313Lys, 314Lys, 315Lys, 316Lys, 318Lys, 320Lys, 321Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 327Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys.
En una modalidad adicional, el análogo peptídico del EGF(A) de la invención comprende al menos una sustitución de aminoácidos seleccionada de 292Lys, 293Lys, 294Lys, 295Lys, 296Lys, 299Lys, 303Lys, 305Lys, 306Lys,
309Lys, 311 Lys, 313Lys, 314Lys, 315Lys, 316Lys, 318Lys, 320Lys, 321Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 327Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys.
En una modalidad adicional, el análogo peptídico del EGF(A) de la invención comprende al menos una sustitución de aminoácidos seleccionada de 292Lys, 293Lys, 294Lys, 296Lys, 299Lys, 303Lys, 305Lys, 306Lys, 309Lys, 311Lys, 313Lys, 314Lys, 315Lys, 316Lys, 318Lys, 320Lys, 321Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 327Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys.
En una modalidad adicional, el análogo peptídico del EGF(A) de la invención comprende al menos una sustitución de aminoácidos seleccionada de 292Lys, 293Lys, 294Lys, 299Lys, 303Lys, 305Lys, 306Lys, 309Lys, 311Lys, 313Lys, 314Lys, 315Lys, 316Lys, 318Lys, 320Lys, 321Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 327Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys.
En una modalidad adicional, el análogo peptídico del EGF(A) de la invención comprende al menos una sustitución de aminoácidos seleccionada de 292Lys, 293Lys, 294Lys, 299Lys, 303Lys, 305Lys, 306Lys, 309Lys, 311Lys, 313Lys, 314Lys, 315Lys, 316Lys, 318Lys, 320Lys, 321Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 327Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys.
En una modalidad adicional, el análogo peptídico del EGF(A) de la invención comprende al menos una sustitución de aminoácidos seleccionada de 292Lys, 293Lys, 294Lys, 299Lys, 303Lys, 305Lys, 306Lys, 310Lys, 311Lys, 313Lys, 314Lys, 315Lys, 316Lys, 318Lys, 320Lys, 321Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 327Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys.
En una modalidad adicional, el análogo peptídico del EGF(A) de la invención comprende al menos una sustitución de aminoácidos seleccionada de 292Lys, 293Lys, 294Lys, 299Lys, 303Lys, 305Lys, 306Lys, 309Lys, 310Lys, 311Lys, 313Lys, 314Lys, 315Lys, 316Lys, 318Lys, 321Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 327Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys.
En una modalidad adicional, el análogo peptídico del EGF(A) de la invención comprende al menos una sustitución de aminoácidos seleccionada de 292Lys, 293Lys, 294Lys, 303Lys, 305Lys, 306Lys, 310Lys, 311Lys, 313Lys, 314Lys, 315Lys, 316Lys, 318Lys, 321Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 327Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys. En una modalidad, los análogos peptídicos de la invención no comprenden ninguna de las siguientes sustituciones: 296K, 298K, 301K, 302K y 307K.
En una modalidad, los análogos peptídicos de la invención no comprenden ninguna de las siguientes sustituciones: 296K, 298K, 301K, 302K, 307K y 310K.
En una modalidad, los análogos peptídicos de la invención no comprenden ninguna de las siguientes sustituciones: 296K, 298K, 301K, 302K, 307, y 295K.
En una modalidad, los análogos peptídicos de la invención no comprenden ninguna de las siguientes sustituciones: 296K, 298K, 301K, 302K, 307K y 295D.
En una modalidad particular, el análogo peptídico de la invención comprende 1 o 2, de tales sustituciones de Lys. Además o alternativamente, el péptido de la invención puede comprender 312Lys.
En una modalidad el análogo peptídico de la invención comprende dos residuos de Lys. En una modalidad el análogo peptídico de la invención comprende dos residuos de Lys seleccionados de los pares que consisten en:
293K y 294K xiv. 313Ky 321K
ii. 293K y 312K xv. 313Ky324K
iii. 293K y 333K xvi. 313Ky328K
iv. 309K y 313K xvii. 313Ky332K
v. 309K y 324K xviii. 313Ky333K
vi. 309K y 328K xix. 314K y 333K
vii. 309K y 332K xx. 321K y 332K
viii. 309K y 333K xxi. 321Ky333K
ix. 311K y 313K xxii. 324K y 333K
x. 312K y 333K xxiii. 324K y 328K
xi. 312K y 313K xxiv. 328K y 333K
xii. 312K y 314K xxv. 330K y 333K y
xiii. 313K y 314K xxvi. 332K y 333K.
Como se observa más arriba, en la presente descripción, se proporcionan diversos análogos peptídicos por la presente invención. En una modalidad adicional el análogo peptídico del EGF(A) de acuerdo con la invención
comprende al menos dos sustituciones de aminoácidos identificadas mediante cualquiera de los grupos i-xxiv mostrados más abajo en comparación con la SEQ ID NO:1.
Todavía en una modalidad adicional, el análogo peptídico del EGF(A) de la invención consiste en las sustituciones de aminoácidos identificadas mediante cualquiera de los grupos i-xxiv como se muestra más abajo.
En una modalidad adicional el análogo peptídico del EGF(A) de acuerdo con la invención comprende al menos dos sustituciones de aminoácidos identificadas mediante cualquiera de los grupos i-xvi mostrados más abajo en comparación con la SEQ ID NO.:1.
Todavía en una modalidad adicional, el análogo peptídico del EGF(A) de la invención consiste en las sustituciones de aminoácidos identificadas mediante cualquiera de los grupos i-xvi como se muestra más abajo.
i. 301Leu y 309Arg
ii. 301Leu, 309Arg, 312Glu
iii. 301 Leu, 307Ile y 309Arg
iv. 301Leu, 307Ile, 309Arg y 312Glu
v. 301 Leu, 309Arg y 321 Glu
vi. 301Leu, 309Arg, 321Glu y 312Glu
vii. 301Leu, 307Ile, 309Arg y 299Ala
viii. 301Leu, 307Ile, 309Arg, 299Ala y 312Glu
ix. 301 Leu y 309Arg y al menos una sustitución de Lys
x. 301Leu, 309Arg, 312Glu y al menos una sustitución de Lys
xi. 301Leu, 307Ile y 309Arg y al menos una sustitución de Lys
xii. 301Leu, 307Ile, 309Arg y 312Glu y al menos una sustitución de Lys
xiii. 301Leu, 309Arg y 321Glu y al menos una sustitución de Lys
xiv. 301Leu, 309Arg, 321Glu y 312Glu y al menos una sustitución de Lys
xv. 301 Leu, 307Ile, 309Arg y 299Ala y al menos una sustitución de Lys o
xvi. 301Leu, 307Ile, 309Arg, 299Ala y 312Glu y al menos una sustitución de Lys.
En una modalidad adicional el análogo peptídico del EGF(A) de acuerdo con la invención comprende al menos dos sustituciones de aminoácidos identificadas mediante cualquiera de los grupos xvii-xx mostrados más abajo en comparación con la SEQ ID NO: 1.
Todavía en una modalidad adicional, el análogo peptídico del EGF(A) de la invención consiste en las sustituciones de aminoácidos identificadas mediante cualquiera de los grupos xvii-xx como se muestra más abajo.
xvii. 301Leu y 309Lys
xviii. 301Leu, 309Lys y 312Glu
xix. 301 Leu y 309Lys y al menos una sustitución de Lys adicional
xx. 301Leu, 309Lys y 312Glu y al menos una sustitución de Lys adicional.
En una modalidad adicional el análogo peptídico del EGF(A) de acuerdo con la invención comprende al menos dos sustituciones de aminoácidos identificadas mediante cualquiera de los grupos xxi-xxiv mostrados más abajo en comparación con la SEQ ID NO: 1.
Todavía en una modalidad adicional, el análogo peptídico del EGF(A) de la invención consiste en la sustitución de aminoácidos identificada mediante cualquiera de los grupos xxi-xxiv como se muestra más abajo
xxi. 301Leu y 307Ile,
xxii. 301Leu, 307Ile y 312Glu
xxiii. 301Leu y 307Ile y al menos una sustitución de Lys adicional y
xxiv. 301Leu, 3307Ile y 312Glu y al menos una sustitución de Lys adicional.
En modalidades específicas adicionales el análogo peptídico o el análogo peptídico de los compuestos de acuerdo con la invención comprenden o consisten en cualquiera de las secuencias de aminoácidos identificadas mediante las SEQ ID 1 a 106.
En una modalidad el análogo peptídico comprende o consiste en cualquiera de las secuencias de aminoácidos identificadas mediante las SEQ ID NO: 2-106.
En una modalidad el análogo peptídico comprende o consiste en cualquiera de las secuencias de aminoácidos identificadas mediante las SEQ ID NO: 2-47 and 49-106.
En una modalidad el análogo peptídico comprende o consiste en cualquiera de las secuencias de aminoácidos identificadas mediante cualquiera de las secuencias de aminoácidos SEQ Id NO: 2-44, 46, 47 y 49-106.
En una modalidad el análogo peptídico comprende o consiste en cualquiera de las secuencias de aminoácidos identificadas mediante las SEQ ID NO: 2-44, 46, 47, 49-53, 55, 58-106.
En una modalidad el análogo peptídico comprende o consiste en cualquiera de las secuencias de aminoácidos identificadas mediante las SEQ ID NO: 2-4, 6-44, 46, 47, 49-53, 55, 58-106.
En una modalidad el análogo peptídico comprende o consiste en cualquiera de las secuencias de aminoácidos identificadas mediante las SEQ ID NO: 2-4, 6-19, 21-44, 46, 47, 49-53, 55, 58-106.
Compuestos intermedios
La presente invención también se refiere a análogos peptídicos que pueden incorporarse en los derivados de la invención. Tales análogos peptídicos pueden denominarse “producto intermedio” o “compuesto intermedio”. Están en forma de análogos del LDL-R(293-332) novedosos, que como se describió anteriormente pueden incorporarse en los derivados del EGF(A) de la invención como se describe en más detalle más abajo. Tales análogos peptídicos son como se definió en la sección mencionada más arriba.
Particularmente, un análogo peptídico, o péptido intermedio, de acuerdo con la presente invención puede denominarse un análogo peptídico de la secuencia SEQ ID NO: 1.
En un aspecto la invención se refiere a un análogo peptídico del EGF(A) como se describió en la presente descripción para su uso en la fabricación de un compuesto del EGF(A), tal como un derivado del EGF(A).
Otras características, definiciones, aspectos y modalidades descritas en la presente descripción en relación con los análogos peptídicos de la invención pueden aplicarse también a los productos intermedios de la invención.
Derivados del EGF(A)
Los análogos peptídicos pueden comprender además un sustituyente y de esta manera se convierten en compuestos derivados.
El término “derivado” generalmente se refiere a un compuesto que puede prepararse a partir de un péptido nativo o un análogo del mismo mediante modificación química, en particular mediante unión covalente de uno o dos sustituyentes.
Las expresiones “derivado de la invención”, “derivado del EGF(A)”, “derivado del EGF(A) o “derivado del LDL-R(293-332)” o “derivado de un análogo del LDL-R(293-332)” como se usa en la presente se refieren a un péptido al cual se unen uno o dos sustituyentes. Cada uno de estos puede denominarse, también o alternativamente, una cadena lateral. En otras palabras, un “derivado de la invención” comprende un péptido, es decir, una secuencia peptídica, que en la presente descripción es un análogo peptídico del eGf(A), y al menos uno, que incluye tal como uno o dos, sustituyente(s).
El término “sustituyente” se usa para describir un resto unido covalentemente al péptido del EGF(A), por ejemplo, el sustituyente es un resto que no es parte del péptido del EGF(A) en sí.
En una modalidad el uno o más sustituyente(s) está(n) unido(s) a un átomo de nitrógeno del análogo peptídico del EGF(A). En una modalidad el uno o más sustituyente(s) está(n) unido(s) a un grupo amino del análogo peptídico del EGF(A). En una modalidad el uno o más sustituyente(s) está(n) unido(s) al aminoácido N-terminal del análogo peptídico del EGF(A) o a un residuo de Lys del análogo peptídico del EGF(A). En una modalidad el uno o más sustituyente(s) está(n) unido(s) al aminoácido N-terminal del análogo peptídico del EGF(A). En una modalidad, el uno o más sustituyente(s) se une(n) al nitrógeno alfa del residuo de aminoácido N-terminal del análogo peptídico del EGF(A). En una modalidad, el uno o más sustituyente(s) se une(n) a un residuo de Lys en el análogo peptídico del EGF(A). En una modalidad el uno o más sustituyente(s) está(n) unido(s) al nitrógeno-épsilon de un residuo de Lys en el análogo peptídico del EGF(A).
Los ejemplos de sustituyentes son diversos y se describen en más detalle más abajo.
Un aspecto de la invención se refiere a los derivados del EGF(A) que comprenden un análogo peptídico del EGF(A) que comprende 301Leu y un sustituyente que comprende al menos un grupo de ácido graso, en donde el análogo peptídico del EGF(A) tiene 1-8 sustituciones de aminoácidos en comparación con el dominio EGF(A), aminoácidos 293-332 del LDL-R, definido mediante la SEQ ID NO: 1, y en donde el derivado tiene una Ki por debajo de 5 nM cuando se mide en el ELISA competitivo de unión de PCSK9-LDL-R descrito en la sección D1.1 en la presente descripción.
Para todas las modalidades el término derivado del EGF(A) abarca, también, cualquier sal, amida o éster farmacéuticamente aceptable del mismo.
Sustituyentes
Un sustituyente es un resto unido a un análogo peptídico del EGF(A). De acuerdo con la invención se prefiere que el resto, por ejemplo, el sustituyente no tenga efecto o tenga un efecto mínimo sobre la funcionalidad del péptido del EGF(A) mientras se añaden otras propiedades beneficiosas, tales como una semivida más larga y/o una mejor exposición después de la dosificación oral.
Sigue que los derivados, así como también los análogos de la invención descritos más arriba, tienen la capacidad de unirse a PCSK9. Tal unión a PCSK9 inhibe la unión de PCSK9 a LDL-R, lo que previene de esta manera la degradación del LDL-R lo que aumenta la eliminación de LDL-C y lipoproteínas aterogénicas.
En una modalidad específica, los derivados y análogos de la invención tienen una capacidad mejorada para unirse a PCSK9, por ejemplo, en comparación con el LDL-R(293-332) nativo o con otros compuestos de unión a PCSK9. Los análogos y derivados de la invención pueden, por ejemplo, probarse en cuanto a su capacidad para inhibir la unión de PCSK9 al LDL-R mediante el uso del ensayo descrito en el ejemplo D.1.1 en la presente descripción.
En una modalidad el sustituyente tiene como objetivo mejorar la funcionalidad de los péptidos.
En una modalidad, el sustituyente aumenta la semivida del análogo peptídico de manera que la semivida plasmática de un derivado que comprende una cadena principal del péptido y un sustituyente tiene un aumento de la semivida en comparación con la semivida de la cadena principal del péptido, como se ilustra en el Ejemplo 1 y 48 (Sección D2, tabla 7). Los métodos para determinar la semivida en diferentes especies se conocen bien en la técnica y se ejemplifican en la presente descripción para ratones y perros (Secciones D2 y D5).
En una modalidad el derivado del EGF(A) de acuerdo con la invención tiene una semivida más arriba de 4 horas. En una modalidad el derivado del EGF(A) de acuerdo con la invención tiene una semivida más arriba de 6 horas, tal como más arriba de 8 horas o tal como más arriba de 10 horas en ratones medida después de una dosificación ya sea por vía subcutánea o intravenosa.
En una modalidad el derivado del EGF(A) de acuerdo con la invención tiene una semivida más arriba de 25 horas en perros.
En una modalidad el derivado del EGF(A) de acuerdo con la invención tiene una semivida más arriba de 50 horas, tal como más arriba de 100 horas o tal como más arriba de 150 horas en perros.
En una modalidad, un sustituyente de extensión de semivida es un resto proteico. En una modalidad tal adicional el resto proteico puede incluir albúmina humana, un dominio Fc o una extensión de proteína no estructurada. En una modalidad adicional el resto proteico puede fusionarse al análogo peptídico. En una modalidad adicional, el resto proteico es el dominio Fc y el dominio Fc se fusiona al análogo peptídico. Cuando se prepara una fusión de Fc el compuesto resultante usualmente será divalente ya que dos polipéptidos Fc formarán un dominio Fc.
En una modalidad el sustituyente no es un resto proteico. En una modalidad el sustituyente no es un resto proteico fusionado al análogo peptídico del EGF(A). En una modalidad el resto proteico no es un dominio Fc.
En otra modalidad el sustituyente es un resto no proteico.
En una modalidad particular, el sustituyente es capaz de formar complejos no covalentes con albúmina, lo que promueve de esta manera la circulación del derivado dentro de la corriente sanguínea, y también tiene el efecto de prolongar el tiempo de acción del derivado. En una modalidad particular, el sustituyente es capaz de prolongar el tiempo de acción del compuesto EGF(A) sin reducir sustancialmente su capacidad de unión a PCSK9.
En una modalidad el derivado del EGF(A) comprende un sustituyente de extensión de semivida. Diversos sustituyentes de extensión de semivida se conocen bien en la técnica e incluyen en particular aglutinantes de albúmina que comprenden un grupo de ácido graso como se describió en más detalle más abajo, y tales aglutinantes de albúmina son sustituyentes no proteicos.
El sustituyente comprende al menos un grupo de ácido graso.
En una modalidad particular, el grupo de ácido graso comprende una cadena de carbono que contiene al menos 8 grupos -CH2- consecutivos. En una modalidad el grupo de ácido graso comprende al menos 10 grupos -CH2-consecutivos, tales como al menos 12 grupos -CH2- consecutivos, al menos 14 grupos -CH2- consecutivos, al menos 16 grupos -CH2- consecutivos, al menos 18 grupos -CH2- consecutivos.
En una modalidad el grupo de ácido graso comprende 8-20 grupos -CH2- consecutivos. En una modalidad el grupo de ácido graso comprende 10-18 grupos -CH2- consecutivos. En una modalidad el grupo de ácido graso comprende
12-18 grupos -CH2- consecutivos. En una modalidad el grupo de ácido graso comprende 14-18 grupos -CH2-consecutivos.
En situaciones donde el derivado comprende dos sustituyentes, puede obtenerse un aumento de la semivida con grupos de ácidos grasos más cortos, por lo tanto en una modalidad donde el derivado comprende dos sustituyentes, los grupos de ácido graso pueden comprender al menos 8 grupos -CH2- consecutivos, tal como al menos 10 grupos -CH2- consecutivos, tal como al menos 12 grupos -CH2- consecutivos, al menos 14 grupos -CH2- consecutivos, al menos 16 grupos -CH2- consecutivos.
En una modalidad adicional donde el derivado comprende dos sustituyentes, cada uno de los sustituyentes comprende un grupo de ácido graso que comprende 8-18 grupos -CH2- consecutivos. En tales modalidades adicionales los grupos de ácido graso comprenden 10-18 grupos -CH2- consecutivos, tal como 12-18 grupos -CH2-consecutivos, tal como 14-18 grupos -CH2- consecutivos.
El término “grupo de ácido graso” como se usa en la presente puede referirse como grupo químico que comprende al menos un grupo funcional que es un ácido de Bronsted-Lowry con un pKa < 7. Los ejemplos no limitantes de tales grupos funcionales que son ácidos de Bronsted-Lowry incluyen un ácido carboxílico (que incluye también carboxifenoxi), un ácido sulfónico, un resto de tetrazol.
En una modalidad dicho grupo de ácido graso comprende un grupo funcional seleccionado de un ácido carboxílico, un ácido sulfónico, un resto de tetrazol, un resto de metilsulfonilcarbamoilamino (MSU) y un resto de 3-hidroxiisoxazolisoxazol. En consecuencia, el sustituyente de extensión de semivida de la invención en una modalidad comprende un ácido carboxílico, un ácido sulfónico, un resto de tetrazol, un resto de metilsulfonilcarbamoilamino o un resto de hidroxi-isoxazolisoxazol que incluye además 8-20 grupos -CH2- consecutivos según se define por: Quím. 1: HOOC-(CH2)n-CO-* en donde n es un número entero en el intervalo de 8-20, que también puede denominarse como un diácido C(n+2) o como
Quím. 1b: 
, en donde n es un número entero en el intervalo de 8-20,
Quím. 2: 5-tetrazolil-(CH2)n-CO-* en donde n es un número entero en el intervalo de 8-20, que también puede denominarse

Quím. 2b:
, en donde n es un número entero en el intervalo de 8-20.
Quím. 3: HOOC-(C6H4)-O-(CH2)m-CO-* en donde n es un número entero en el intervalo de 8-20, que también puede denominarse
Quím. 3b: 
en donde el grupo carboxi está en la posición 2, 3 o 4 del grupo (C6H4) de Quím. 3 y en donde m es un número entero en el intervalo de 8-11
Quím. 4: HO-S(O)2-(CH2)n-CO-* en donde n es un número entero en el intervalo de 8-20, que también puede denominarse

Quím. 4b:
, en donde n es un número entero en el intervalo de 8-20,
Quím. 5: MeS(O)2NH(CO)NH-(CH2)n-CO-* en donde n es un número entero en el intervalo de 8-20, que también puede denominarse.

Quím. 5b:
, en donde n es un número entero en el intervalo de 8-20,
Quím. 6: 3-HO-Isoxazol-(CH2)n-CO-* en donde n es un número entero en el intervalo de 8-20, que también puede denominarse

Quím. 6b:
, en donde n es un número entero en el intervalo de 8-20.
El término grupo funcional en su forma ácida se denomina FG-H y su forma como base conjugada se denomina FG-. El término “grupo funcional con un pKa < 7” como se usa en la presente puede denominarse un ácido de Bnansted-Lowry que en la forma de su derivado de metilo (CH3-FG-H) en solución acuosa tiene un pKa en equilibrio por debajo de 7, en donde el pKa es el -log de la constante de equilibrio (Ka) del equilibrio mostrado más abajo:

Los métodos para la determinación de pKa se conocen bien en la técnica. Un método tal, por ejemplo, fue descrito por Reijenga y otros en Anal Chem Insights 2013 (2013; 8:53-71).
Los sustituyentes de acuerdo con la invención en una modalidad comprenden uno o más elementos enlazadores. Los elementos enlazadores pueden unirse al grupo de ácido graso por uniones amida y denominarse Z2-Z10. Como se define adicionalmente en la presente descripción más abajo, la cantidad de elementos enlazadores puede ser a lo máximo 10.
En una modalidad específica, el sustituyente es de la Fórmula I:
Z1-Z2-Z3-Z4-Z5-Z6-Z7-Z8-Z9-Z10- [I]
en donde Z1 se selecciona de:
Quím. 1: HOOC-(CH2)n-CO-* o
Quím. 1b: 
Quím. 2: 5-tetrazolil-(CH2)n-CO-* o

Quím. 2b:
Quím. 3: HOOC-(C6H4)-O-(CH2)m-CO-* o
Quím. 3b: 
, en donde el grupo carboxi está en la posición 2, 3 o 4 de -(C6H4)-Quím. 4: HOS(O)2-(CH2)n-CO-* o

Quím. 4b:
Quím. 5: MeS(O)2NH2N(CO)NHN-(CH2)n-CO-* o

Quím. 5b:
y
Quím. 6: 3-HO-lsoxazole-(CH2)n-CO-* o

Quím. 6b:
en donde n es un número entero en el intervalo de 8-20 y m es un entero en el intervalo de 8-11.
En una modalidad particular, n es 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 19 o 20 en Quím. 1 o 1b. En una modalidad particular, n es 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 19 o 20 en Quím. 2 o 2b. En una modalidad particular, n es 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 19 o 20 en Quím. 4 o 4b. En una modalidad particular, m es 8, 9, 10 u 11 en Quím. 3 o 3b.
En una modalidad particular, n es 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 19 o 20 en Quím.5 o 5b.
En una modalidad particular, n es 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 19 o 20 en Quím.6 o 6b.
En una modalidad particular, el símbolo * indica el punto de unión al nitrógeno en Z2. En otra modalidad, donde Z2 es un enlace, el símbolo * indica el punto de unión al nitrógeno del elemento vecino Z.
El término “unión” como se usa en el contexto de la Fórmula I significa un enlace covalente. Cuando un componente de la Fórmula I (Z1-Z10) se define como un enlace, es equivalente a una fórmula I en donde dicho componente está ausente.
En la presente descripción más abajo se indica que cualquiera de Z2-Z10 es un enlace y también puede leerse como que cualquiera de Z2-Z10 está ausente. Lógicamente “un enlace” no puede seguir a “un enlace”. La indicación “un enlace” aquí significa, por lo tanto, que el elemento Z anterior se une covalente mente al siguiente elemento Z que no es “un enlace” (o está ausente).
Los elementos enlazadores Z2-Z10 se seleccionan a partir de los restos químicos que son capaces de formar enlaces amida, que incluyen restos similares a aminoácidos, tales como Glu, yGIu (denominada también Glu gammal o gGlu y definida por *-Nh-CH-(COOH)-CH2-CH2-CO-*), Gly, Ser, Ala, Thr, Ado, Aeep, Aeeep y TtdSuc y restos adicionales definidos más abajo.
Z2 se selecciona de
Quím. 7: *-NH-SO2-(CH2)3-CO-* o

Quím. 7b:
Quím. 8: *-NH-CH2-(C6H10)-CO-* o
Quím. 8b: 
, y
un enlace.
Z3 se selecciona de yGIu, Glu, o un enlace.
Z3 se selecciona de yGIu, Glu, o un enlace cuando Z2 es Quím. 7 o Quím. 7b.
Z3 se selecciona de yGIu, Glu, o un enlace, siempre y cuando Z3 se selecciona de yGIu, Glu cuando Z2 es Quím. 8. Z3 se selecciona de yGIu y Glu cuando Z2 es Quím. 8.
Z4, Z5, Z6, Z7, Z8, Z9 se seleccionan, independientemente entre sí, de Glu, yGIu, Gly, Ser, Ala, Thr, Ado, Aeep, Aeeep, TtdSuc y un enlace.
Glu, Gly, Ser, Ala, Thr son residuos de aminoácidos conocidos en la técnica.
YGIu es de la fórmula Quím. 9: *-NH-CH(COOH)-(CH2)2-CO-* que es el mismo que
Quím.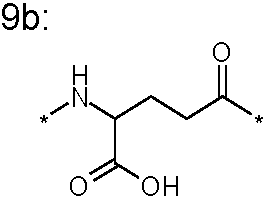
y también puede denominarse gGlu.
TtdSuc es de fórmula Quím. 10:
*-NH-(CH2)3-O-(CH2)2-O-(CH2)2O-(CH2)3-NHCO* o
*-NH-CH2CH2CH2OCH2CH2OCH2CH2OCH2CH2CH2NHCO* que es el mismo que

Quím. 10b:
Ado es de fórmula Quím. 11: *-NH-(CH2)2-O-(CH2)2-O-CH2-CO-* también puede denominarse ácido 8-amino-3,6-dioxaoctanoico y el cual es el mismo que

Quím. b 11b:
Aeep es de fórmula Quím. 12: *NH-CH2CH2OCH2CH2OCH2CH2CO*, que también puede denominarse
Quím. 12b: 
Aeeep es de fórmula Quím. 13: *NH-CH2CH2OCH2CH2OCH2CH2OCH2CH2CO*, que también puede denominarse

Quím. 13b:
Z10 se selecciona de un enlace, y Quím. 14: *-NH-CH2-(C6H4)-CH2-*, que también puede denominarse

Quím. 14b:
En una modalidad particular, cuando Z10 es Quím. 14, el sustituyente se une al grupo amino N-terminal de dicho péptido.
En otra modalidad, cuando Z10 es un enlace, dicho sustituyente se une a la posición épsilon de un residuo de Lys presente en dicho péptido o al residuo de aminoácido N-terminal de dicho péptido.
En una modalidad el derivado comprende dos sustituyentes. En una modalidad tal los dos sustituyentes son idénticos. En una modalidad tal los dos sustituyentes son diferentes. En una modalidad los dos sustituyentes se unen a átomos de nitrógeno del análogo peptídico del EGF(A). En una modalidad los dos sustituyentes están unidos a grupos amino del análogo peptídico del EGF(A). En una modalidad los dos sustituyentes están unidos al aminoácido N-terminal del EGF(A) y a un residuo de Lys del análogo peptídico del EGF(A). En una modalidad, un sustituyente se une al nitrógeno alfa del residuo de aminoácido N-terminal del análogo peptídico del EGF(A) y un sustituyente se une a un residuo de Lys del análogo peptídico del EGF(A). En una modalidad los dos sustituyentes están unidos a un aminoácido N-terminal del análogo peptídico del EGF(A). En una modalidad los dos sustituyentes están unidos a residuos de Lys diferentes del análogo peptídico del EGF(A). En una modalidad, los dos sustituyentes se unen al nitrógeno épsilon de diferentes residuos de Lys en el análogo peptídico del EGF(A).
En una modalidad donde están presentes dos sustituyentes, Z10 es Quím. 14 en un sustituyente que se une al grupo amino N-terminal de un análogo peptídico y Z10 es un enlace en el otro sustituyente que se une a la posición épsilon de un residuo de Lys presente en dicho análogo peptídico.
En otra modalidad donde están presentes dos sustituyentes, Z10 es un enlace en un sustituyente que se une al grupo amino N-terminal de un análogo peptídico y Z10 es un enlace en el otro sustituyente que se une a la posición épsilon de un residuo de Lys presente en dicho análogo peptídico.
En otra modalidad donde están presentes dos sustituyentes, Z10 es un enlace en ambos sustituyentes y cada uno de los dos sustituyentes se une a la posición épsilon de residuos de Lys diferentes presentes en un análogo peptídico. En una modalidad particular, los derivados de la invención pueden prepararse a partir de un análogo peptídico del EGF(A) mediante la unión covalente de uno o dos sustituyentes.
En una modalidad particular, los dos sustituyentes son de la Fórmula I: Z1-Z2-Z3-Z4-Z5-Z6-Z7-Z8-Z9-Z10-[I]. Z1 a Z10 son como se definió más arriba. En una modalidad particular, los dos sustituyentes son de la fórmula I y son idénticos, lo que significa que los Z1 a Z10 seleccionados son iguales en ambos sustituyentes. En otra modalidad, los dos sustituyentes son de la fórmula I y son diferentes, lo que significa que uno o más de los Z1 a Z10 seleccionados son diferentes entre un sustituyente y el otro.
Sustituyentes específicos
Como se observa, diversos sustituyentes mencionados más arriba, pueden prepararse por los expertos en la técnica. Los sustituyentes incluidos en la presente solicitud no deben considerarse limitantes de la invención.
En una modalidad el uno o dos sustituyente(s) se selecciona(n) del grupo de sustituyentes que consiste de:
HOOC-(CH2)18-CO-gGlu-2xADO
HOOC-(CH2)18-CO-NH-CH2-(C6H10)-CO-gGlu-2xADO
HOOC-(CH2)16-CO-gGlu-2xADO
HOOC-(CH2)16-CO-gGlu-2xADO-NH-CH2-(C6H4)-CH2
HOOC-(CH2)16-CO-gGlu
HOOC-(CH2)16-CO-NH-CH2-(C6H10)-CO-gGlu-2xADO
HOOC-(CH2)14-CO-gGlu-2xADO
HOOC-(CH2)14-CO-gGlu-HOOC-(CH2)14-CO-gGlu-2xADO-HOOC-(CH2)12-CO-gGlu-2xADO
4-HOOC-(C6H4)-O-(CH2)10-CO-gGlu-2xADO
4-HOOC-(C6H4)-O-(CH2)10-CO-gGlu-3xADO
4-HOOC-(C6H4)-O-(CH2)10-CO-gGlu
4-HOOC-(C6H4)-O-(CH2)10-CO-2xgGlu
4-HOOC-(C6H4)-O-(CH2)10-CO-gGlu-3xGly
4-HOOC-(C6H4)-O-(CH2)10-CO-2xgGlu-2xADO
4-HOOC-(C6H4)-O-(CH2)10-CO-gGlu-TtdSuc
4-HOOC-(C6H4)-O-(CH2)9-CO
4-HOOC-(C6H4)-O-(CH2)10-CO-gGlu-4xADO
4-HOOC-(C6H4)-O-(CH2)10-CO-NH-CH2-(C6H10)-CO-gGlu-2xADO
4-HOOC-(C6H4)-O-(CH2)9-CO-gGlu-2xADO
3-HOOC-(C6H4)-O-(CH2)9-CO-gGlu-2xADO
3-HO-Isoxazol-(CH2)12-CO-gGlu-2xADO
HOS(O)2-(CH2)15-CO-gGlu-2xADO-NH-CH2-(C6H4)-CH2
HOS(O)2-(CH2)13-CO-gGlu-2xADO
Tetrazolil-(CH2)15-CO-NH-SO2-(CH2)3-CO-ADO-ADO-NH-CH2-(C6H4)-CH2
Tetrazolil-(CH2)12-CO-gGlu-2xADO
Tetrazolil-(CH2)15-CO-gGlu-2xADO y
MeS(O)2NH(CO)NH-(CH2)12-CO-gGlu-2xADO.
En una modalidad, el sustituyente es de la Fórmula I en donde Z1 es Quím. 1: HOOC-(CH2)n-CO-*, en donde n es
16; Z2 es un enlace; Z3 es yGIu; dos de Z4, Z5, Z6, Z7, Z8, Z9 son Ado y los cuatro restantes son enlaces; Z10 es Quím.
14: *-NH-CH2-(C6H4)-CH2-*.
En una modalidad, el sustituyente es de la Fórmula I en donde Z1 es Quím. 1: HOOC-(CH2)n-CO-*, en donde n es
16; Z2 es un enlace; Z3 es yGIu; dos de Z4, Z5, Z6, Z7, Z8, y Z9 son Ado y los cuatro restantes son enlaces; Z10 es un enlace.
En una modalidad, el sustituyente es de la Fórmula I en donde Z1 es Quím. 1: HOOC-(CH2)n-CO-*, en donde n es 14 o 16; Z2 es un enlace; Z3 es yGIu; y todos Z4, Z5, Z6, Z7, Z8 y Z9 son enlaces; Z10 es un enlace.
En una modalidad, el sustituyente es de la Fórmula I en donde Z1 es Quím. 1: HOOC-(CH2)n-CO-*, en donde n es 16 o 18; Z2 es Quím. 8 (Trx); Z3 es yGIu; dos de Z4, Z5, Z6, Z7, Z8 y Z9 son Ado y los cuatro restantes son enlaces; Z10 es un enlace.
En una modalidad, el sustituyente es de la Fórmula I en donde Z1 es Quím. 2: Tetrazolil-(CH2)n-CO- *, en donde n es
15; Z2 es Quím. 7 (sulfonimida); Z3 es un enlace; dos de Z4, Z5, Z6, Z7, Z8 y Z9 son Ado y los cuatro restantes son enlaces; Z10 es Quím. 14: *-NH-CH2-(C6H4)-CH2-*.
En una modalidad, el sustituyente es de la Fórmula I en donde Z1 es Quím. 2: Tetrazolil-(CH2)n-CO- *, en donde n es
15; Z2 es un enlace; Z3 es yGIu; dos de Z4, Z5, Z6, Z7, Z8 y Z9 son Ado y los cuatro restantes son enlaces; Z10 es un enlace.
En una modalidad, el sustituyente es de la Fórmula I en donde Z1 es Quím. 2: Tetrazolil-(CH2)n-CO- *, en donde n es
12; Z2 es un enlace; Z3 es yGIu; dos de Z4, Z5, Z6, Z7, Z8 y Z9 son Ado y los cuatro restantes enlace.
En una modalidad, el sustituyente es de la Fórmula I en donde Z1 es Quím. 3: HOOC-(C6H4)-O-(CH2)m-CO-*, en donde m es 10; Z2 es un enlace; Z3 es un enlace; y todos de Z4, Z5, Z6, Z7, Z8 y Z9 son enlaces; Z10 es un enlace.
En una modalidad, el sustituyente es de la Fórmula I en donde Zi es Quím. 3: HOOC-(C6H4)-O-(CH2)m-CO-*, en donde m es 10; Z2 es un enlace; Z3 es una yGIu; y todos de Z4, Z5, Z6, Z7, Z8 y Z9 son enlaces; Z10 es un enlace.
En una modalidad, el sustituyente es de la Fórmula I en donde Z1 es Quím. 3: HOOC-(C6H4)-O-(CH2)m-CO-*, en donde m es 10; Z2 es un enlace; Z3 es una yGIu; y uno de Z4, Z5, Z6, Z7, Z8 y Z9 es una yGIu y los cinco restantes son enlaces; Z10 es un enlace.
En una modalidad, el sustituyente es de la Fórmula I en donde Z1 es Quím. 3: HOOC-(C6H4)-O-(CH2)m-CO-*, en donde m es 10; Z2 es un enlace; Z3 es una yGIu; y uno de Z4, Z5, Z6, Z7, Z8 y Z9 es una yGIu y dos son Ado y los tres restantes son enlaces; Z10 es un enlace.
En una modalidad, el sustituyente es de la Fórmula I en donde Z1 es Quím. 3: HOOC-(C6H4)-O-(CH2)m-CO-*, en donde m es 10; Z2 es un enlace; Z3 es una yGIu; y tres de Z4, Z5, Z6, Z7, Z8 y Z9 son Glu y los tres restantes son enlaces; Z10 es un enlace.
En una modalidad, el sustituyente es de la Fórmula I en donde Z1 es Quím. 3: HOOC-(C6H4)-O-(CH2)m-CO-*, en donde m es 10; Z2 es un enlace; Z3 es una yGIu; y dos de Z4, Z5, Z6, Z7, Z8 y Z9 son Ado y los cuatro restantes son enlaces; Z10 es un enlace.
En una modalidad, el sustituyente es de la Fórmula I en donde Z1 es Quím. 3: HOOC-(C6H4)-O-(CH2)m-CO-*, en donde m es 10; Z2 es un enlace; Z3 es una yGIu; y tres de Z4, Z5, Z6, Z7, Z8 y Z9 son Ado y los tres restantes son enlaces; Z10 es un enlace.
En una modalidad, el sustituyente es de la Fórmula I en donde Z1 es Quím. 3: HOOC-(C6H4)-O-(CH2)m-CO-*, en donde m es 10; Z2 es un enlace; Z3 es una yGIu; y cuatro de Z4, Z5, Z6, Z7, Z8 y Z9 son enlaces; Z10 es un enlace.
En una modalidad, el sustituyente es de la Fórmula I en donde Z1 es Quím. 3: HOOC-(C6H4)-O-(CH2)m-CO-*, en donde m es 10; Z2 es un enlace; Z3 es una yGIu; y uno de Z4, Z5, Z6, Z7, Z8 y Z9 es un TtdSuc y los cinco restantes son enlaces; Z10 es un enlace.
En una modalidad, el sustituyente es de la Fórmula I en donde Z1 es Quím. 3: HOOC-(C6H4)-O-(CH2)m-CO-*, en donde m es 10; Z2 es Quím. 8 (Trx); ; Z3 es una yGIu; y dos de Z4, Z5, Z6, Z7, Z8 y Z9 son Ado y los cuatro restantes son enlaces; Z10 es un enlace.
En una modalidad, el sustituyente es de la Fórmula I en donde Z1 es Quím. 3: HOOC-(C6H4)-O-(CH2)m-CO-*, en donde m es 9; Z2 es un enlace; Z3 es una yGIu; y uno de Z4, Z5, Z6, Z7, Z8 y Z9 es un TtdSuc y los cinco restantes son enlaces; Z10 es un enlace.
En una modalidad, el sustituyente es de la Fórmula I en donde Z1 es Quím. 3: HOOC-(C6H4)-O-(CH2)m-CO-*, en donde m es 10; Z2 es un enlace; Z3 es yGIu; dos de Z4, Z5, Z6, Z7, Z8 y Z9 son Ado, los cuatro restantes son enlaces;
Z10 es un enlace.
En una modalidad, el sustituyente es de la Fórmula I en donde Z1 es Quím. 3: HOOC-(C6H4)-O-(CH2)m-CO-*, en donde m es 10; Z2 es un enlace; Z3 es yGIu; dos de Z4, Z5, Z6, Z7, Z8 y Z9 son Ado, los cuatro restantes son enlaces;
Z10 es un enlace.
En una modalidad, el sustituyente es de la Fórmula I en donde Z1 es Quím. 4: HO-S(O)2-(CH2)n-CO- *, en donde n es
15; Z2 es un enlace; Z3 es yGIu; dos de Z4, Z5, Z6, Z7, Z8 y Z9 son Ado, los cuatro restantes son enlaces; Z10 es un enlace.
En una modalidad, el sustituyente es de la Fórmula I en donde Z1 es Quím. 4: HO-S(O)2-(CH2)n-CO-*, en donde n es
15; Z2 es un enlace; Z3 es yGIu; dos de Z4, Z5, Z6, Z7, Z8 y Z9 son Ado, los cuatro restantes son enlaces; Z10 es Quím.
14: *-NH-CH2-(C6H4)-CH2-*.
En una modalidad, el sustituyente es de la Fórmula I en donde Z1 es Quím. 5: MeS(O)2NH(CO)NH-(CH2)n-CO -*, en donde n es 12; Z2 es un enlace; Z3 es yGIu; dos de Z4, Z5, Za, Z7, Z8 y Z9 son Ado, los cuatro restantes son enlaces;
Z10 es un enlace.
En una modalidad, el sustituyente es de la Fórmula I en donde Z1 es Quím. 6: 3-OH-Isoxazol-(CH2)12-CO-*, en donde n es 12; Z2 es un enlace; Z3 es yGIu; dos de Z4, Z5, Z6, Z7, Z8 y Z9 son Ado, los cuatro restantes son enlaces; Z10 es un enlace.
Combinaciones de sustituyentes específicos:
En una modalidad, el compuesto de la invención comprende o tiene dos sustituyentes de la Fórmula I en donde Zi es Quím. 1: HOOC-(CH2)n-CO-*, en donde n es 16; Z2 es un enlace; Z3 es yGIu; dos de Z4, Z5, Z6, Z7, y los cuatro restantes son enlaces; Z10 es un enlace.
En una modalidad, el compuesto de la invención comprende o tiene dos sustituyentes de la Fórmula I en donde Z1 es Quím. 1: HOOC-(CH2)n-CO-*, en donde n es 14; Z2 es un enlace; Z3 es yGIu; dos de Z4, Z5, Z6, Z7, y los cuatro restantes son enlaces; Z10 es un enlace.
En una modalidad, el compuesto de la invención comprende o tiene dos sustituyentes de la Fórmula I en donde Z1 es Quím. 1: HOOC-(CH2)n-CO-*, en donde n es 14; Z2 es un enlace; Z3 es yGIu; los cuatro de Z4, Z5, Z6, Z7, Z8, Z9 son enlaces; Z10 es un enlace.
En una modalidad, el compuesto de la invención comprende o tiene dos sustituyentes de la Fórmula I en donde Z1 es Quím. 3: HOOC-(C6H4)-O-(CH2)m-CO-*, en donde m es 10; Z2 es un enlace; Z3 es yGIu; dos de Z4, Z5, Z9 son Ado, los cuatro restantes son enlaces; Z10 es un enlace.
En una modalidad, el compuesto de la invención comprende o tiene dos sustituyentes, donde uno es de la Fórmula I en donde Z1 es Quím. 1: HOOC-(CH2)n-CO-*, en donde n es 16; Z2 es un enlace; Z3 es yGIu; dos de Z4, Z5, Z6, Z7,
Z8, Z9 son Ado y los cuatro restantes son enlaces; Z10 es Quím. 14: *-NH-CH2-(C6H4)-CH2-*; donde el otro sustituyente es de Fórmula I en donde Z1 es Quím. 1: HOOC-(CH2)n-CO-*, en donde n es 16; Z2 es un enlace; Z3 es YGIu; dos de Z4, Z5, Z6, Z7, Z8, Z9 son Ado y los cuatro restantes son enlaces; Z10 es un enlace.
En una modalidad, el compuesto de la invención comprende o tiene dos sustituyentes, donde uno es de la Fórmula I en donde Z1 es Quím. 1: HOOC-(CH2)n-CO-*, en donde n es 16; Z2 es un enlace; Z3 es yGIu; dos de Z4, Z5, Z6, Z7,
Z8, Z9 son Ado y los cuatro restantes son enlaces; Z10 es Quím. 14: *-NH-CH2-(C6H4)-CH2-*; donde el otro sustituyente es de Fórmula I en donde Z1 es Quím. 3: HOOC-(C6H4)-O-(CH2)m-CO-*, en donde m es 10; Z2 es un enlace; Z3 es yGIu; dos de Z4, Z5, Z6, Z7, Z8 y Z9 son Ado, los cuatro restantes son enlaces; Z10 es un enlace.
En una modalidad, el compuesto de la invención comprende o tiene dos sustituyentes, donde uno es de la Fórmula I en donde Z1 es Quím. 1: HOOC-(CH2)n-CO-*, en donde n es 16; Z2 es un enlace; Z3 es yGIu; dos de Z4, Z5, Z6, Z7,
Z8, Z9 son Ado y los cuatro restantes son enlaces; Z10 es un enlace; donde el otro sustituyente es de la Fórmula I en donde Z1 es Quím. 3: HOOC-(C6H4)-O-(CH2)m-CO-*, en donde m es 10; Z2 es un enlace; Z3 es yGIu; dos de Z4, Z5,
Z6, Z7, Z8 y Z9 son Ado, los cuatro restantes son enlaces; Z10 es un enlace.
En una modalidad, el compuesto de la invención comprende o tiene dos sustituyentes, donde uno es de la Fórmula I en donde Z1 es Quím. 1: HOOC-(CH2)n-CO-*, en donde n es 16; Z2 es un enlace; Z3 es yGIu; dos de Z4, Z5, Z6, Z7,
Z8, Z9 son Ado y los cuatro restantes son enlaces; Z10 es un enlace; y el otro sustituyente es de la Fórmula I en donde Z1 es Quím. 4: HOS(O)2-(CH2)n-CO-*, en donde m es 15; Z2 es un enlace; Z3 es yGIu; dos de Z4, Z5, Z6, Z7, Z8 y Z9 son Ado, los cuatro restantes son enlaces; Z10 es Quím. 14: *-NH-CH2-(C6H4)-CH2-*.
En una modalidad, el compuesto de la invención comprende o tiene dos sustituyentes, donde uno es de la Fórmula I en donde Z1 es Quím. 3: HOOC-(C6H4)-O-(CH2)m-CO-*, en donde m es 10; Z2 es un enlace; Z3 es yGIu; dos de Z4,
Z5, Z6, Z7, Z8 y Z9 son Ado y los cuatro restantes son enlaces; Z10 es un enlace; donde el otro sustituyente es de la Fórmula I en donde Z1 es Quím. 4: HOS(O)2-(CH2)n-CO-*, en donde m es 15; Z2 es un enlace; Z3 es yGIu; dos de Z4,
Z5, Z6, Z7, Z8 y Z9 son Ado, los cuatro restantes son enlaces; Z10 es Quím. 14: *-NH-CH2-(C6H4)-CH2-*.
Péptido y sitio de unión
Un compuesto o derivado del EGF(A) de acuerdo con la invención comprende un análogo peptídico del EGF(A) del dominio EGF(A) del LDL-R como se definió mediante la SEQ ID NO: 1. Tal secuencia peptídica se describió más arriba en detalles en la presente descripción y el péptido del derivado o compuesto de la invención puede describirse y definirse mediante términos idénticos. El derivado o compuesto del EGF(A) tiene además al menos un sustituyente como se describió más arriba, en la presente descripción, que se une a la secuencia peptídica.
En los compuestos de la invención, el sustituyente se une covalentemente al péptido, lo que significa un residuo de aminoácido de la secuencia peptídica.
En una modalidad el derivado del EGF(A) de la invención, comprende un sustituyente que no se une a ninguna de las siguientes posiciones: 295, 296, 298, 301, 302 y 307. En una modalidad adicional el sustituyente no se une a ninguna de las siguientes posiciones: 295, 296, 298, 301, 302, 307 y 310. En tales modalidades adicionales, este no se une tampoco a ninguna de las siguientes posiciones: 299 y 320.
En una modalidad particular un sustituyente se une a través de cualquier posición de 292 a 333 excepto en cualquiera de las posiciones 297, 304, 308, 317, 319 y 331.
En una modalidad particular un sustituyente se une a través de cualquier posición de 292 a 333 excepto en cualquiera de las posiciones 297, 298, 301, 302, 304, 307, 308, 317, 319 y 331.
En una modalidad particular un sustituyente se une a través de cualquier posición de 292 a 333 excepto en cualquiera de las posiciones 295, 296, 297, 298, 301, 302, 304, 307, 308, 317, 319 y 331. En una modalidad particular un sustituyente unido a través de cualquier posición de 292 a 333 excepto en cualquiera de las posiciones 295, 296, 297, 298, 301, 302, 304, 307, 308, 310, 317, 319, 320 y 331. En una modalidad particular un sustituyente unido a través de cualquier posición de 292 a 333 excepto en cualquiera de las posiciones 295, 296, 297, 298, 301, 302, 304, 307, 308, 309, 310, 317, 319, 320 y 331.
En una modalidad, el(los) sustituyente(s) se une(n) a cualquiera o dos de las posiciones 292, 293, 294, 299, 300, 303, 305, 306, 309, 311, 312, 313, 314, 315, 316, 318, 320, 321, 322, 323, 324, 325, 326, 327, 328, 329, 330, 332 y 333 del análogo peptídico del EGF(A).
En una modalidad, la(s) sustitución(ciones) se une(n) a cualquiera o dos de las posiciones 292, 293, 294, 300, 303, 305, 306, 309, 311, 312, 313, 314, 315, 316, 318, 321, 322, 323, 324, 325, 326, 327, 328, 329, 330, 332 y 333 del análogo peptídico del EGF(A).
En una modalidad, la(s) sustitución(ciones) se une(n) a cualquiera o dos de las posiciones 292, 293, 294, 300, 303, 305, 306, 311, 312, 313, 314, 315, 316, 318, 321, 322, 323, 324, 325, 326, 327, 328, 329, 330, 332 y 333 del análogo peptídico del EGF(A).
En una modalidad, el sustituyente se une al aminoácido N-terminal de la secuencia peptídico. En una modalidad particular, el aminoácido N-terminal es Gly. En una modalidad particular, el aminoácido N-terminal es 293Gly. En una modalidad particular, el aminoácido N-terminal es 293Lys. En una modalidad particular, el aminoácido N-terminal es 292Lys. También puede ser una Lys o una Gly u otro residuo de aminoácido en la posición N-terminal que puede ser 293 o cualquier posición más lejos del extremo N, tal como 294Thr, 294Gly o 294Lys o 295Asn. En una modalidad particular, el sustituyente se une al nitrógeno alfa del residuo de aminoácido N-terminal del análogo peptídico. En otra modalidad, si el residuo de aminoácido N-terminal es Lys, el sustituyente puede enlazarse covalentemente al nitrógeno alfa o al grupo épsilon amino del residuo de lisina.
En una modalidad particular, el sustituyente se une al grupo £-amino de un residuo de Lys presente en el péptido. En otra modalidad, un sustituyente se une a una Lys en la posición C-terminal que puede ser la posición 332, 333 o cualquier posición hacia el extremo C.
En modalidades en donde los péptidos de la invención comprenden un alargamiento, ya sea en N-terminal o en C-terminal, el(los) sustituyente(s) puede(n) unirse a un residuo de aminoácido de dicho(s) alargamiento(s). En presencia de un alargamiento N-terminal, un sustituyente puede unirse al aminoácido N-terminal de dicho alargamiento o a una Lys presente dentro de la secuencia de alargamiento. En presencia de un alargamiento C-terminal, un sustituyente puede unirse a un residuo Lys en la posición C-terminal o a una Lys presente dentro de la secuencia de alargamiento.
Aún en otra modalidad, el sustituyente se une a un aminoácido presente en la secuencia peptídica. En una modalidad particular, el sustituyente se enlaza a un residuo de lisina presente en el péptido. En una modalidad particular, el sustituyente se enlaza al grupo épsilon amino de un residuo de lisina presente en el péptido. El residuo de lisina al que se enlaza el sustituyente puede localizarse en cualquier posición del análogo del EGF(A) LDL-R(293-332) que incluye la posición N-terminal o la posición C-terminal del péptido, cualquier posición dentro de o en el residuo del extremo N-terminal de un alargamiento N-terminal si está presente, cualquier posición dentro de o en el residuo del extremo C-terminal de un alargamiento C-terminal si está presente.
Como se describió anteriormente en la presente descripción el análogo peptídico del EGF(A) puede tener uno o más residuos de Lys; y esos residuos son útiles para la unión de los sustituyentes.
En una modalidad particular, la(s) lisina(s) a la(s) que se enlaza(n) el(los) sustituyente(s) se selecciona(n) del grupo de: 292Lys, 293Lys, 294Lys, 299Lys, 300Lys, 303Lys, 305Lys, 306Lys, 309Lys, 311Lys, 312Lys, 313Lys, 314Lys, 315Lys, 316Lys, 318Lys, 320Lys, 321Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 327Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys.
En una modalidad particular, la(s) lisina(s) a la(s) que se enlaza(n) el(los) sustituyente(s) se selecciona(n) de 293Lys, 294Lys, 295Lys, 296Lys, 298Lys, 299Lys, 301Lys, 302Lys, 303Lys, 305Lys, 306Lys, 307Lys, 309Lys, 310Lys, 311Lys, 312Lys, 313Lys, 314Lys, 315Lys, 316Lys, 318Lys, 320Lys, 321Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 327Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys.
En una modalidad particular, la(s) lisina(s) a la(s) que se enlaza(n) el(los) sustituyente(s) se selecciona(n) de 293Lys, 294Lys, 300Lys, 303Lys, 306Lys, 309Lys, 311Lys, 312Lys, 313Lys, 314Lys, 315Lys, 316Lys, 318Lys, 321Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys.
En otra modalidad, la(s) lisina(s) a la(s) que se enlaza(n) el(los) sustituyente(s) se selecciona(n) de 293Lys, 294Lys, 298Lys, 299Lys, 303Lys, 305Lys, 306Lys, 309Lys, 311Lys, 312Lys, 313Lys, 314Lys, 315Lys, 316Lys, 318Lys, 320Lys, 321Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 327Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys. En otra modalidad, la(s) lisina(s) a la(s) que se enlaza(n) el(los) sustituyente(s) se selecciona(n) de: 292Lys, 293Lys, 294Lys, 299Lys, 300Lys, 303Lys, 305Lys, 306Lys, 309Lys, 311Lys, 313Lys, 314Lys, 315Lys, 316Lys, 318Lys, 320Lys, 321Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 327Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys. En otra modalidad, la(s) lisina(s) a la(s) que se enlaza(n) el(los) sustituyente(s) se selecciona(n) de: 292Lys, 293Lys, 294Lys, 300Lys, 303Lys, 305Lys, 306Lys, 309Lys, 311Lys, 313Lys, 314Lys, 316Lys, 318Lys, 321Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 327Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys.
En otra modalidad, la(s) lisina(s) a la(s) que se enlaza(n) el(los) sustituyente(s) se selecciona(n) de: 293Lys, 294Lys, 300Lys, 303Lys, 305Lys, 306Lys, 309Lys, 311Lys, 313Lys, 314Lys, 316Lys, 318Lys, 321Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 327Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys.
En otra modalidad, la(s) lisina(s) a la(s) que se enlaza(n) el(los) sustituyente(s) se selecciona(n) de: 293Lys, 294Lys, 300Lys, 303Lys, 305Lys, 306Lys, 311Lys, 313Lys, 314Lys, 316Lys, 318Lys, 321Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 327Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys.
En modalidades donde el sustituyente se une a un alargamiento C-terminal, la lisina a la cual se enlaza el sustituyente puede seleccionarse de cualquiera de la posición 333Lys a 242Lys y/o a cualquiera de la posición 333Lys a 383Lys.
En modalidades donde los compuestos de la invención tienen dos sustituyentes, los sustituyentes pueden enlazarse independientemente entre sí como se definió anteriormente, lo que significa que cualquiera puede unirse al aminoácido N-terminal del péptido, al aminoácido C-terminal del péptido, o a un aminoácido dentro de la secuencia de aminoácidos del péptido.
En modalidades donde una Lys está presente en la posición N-terminal, dos sustituyentes pueden estar ambos enlazados a la Lys N-terminal del péptido. Uno puede enlazarse a la amina alfa N-terminal de dicha Lys mientras que el otro puede enlazarse al nitrógeno épsilon de dicha Lys. Cuando dos sustituyentes están presentes, uno puede enlazarse al aminoácido N-terminal del péptido mientras que el otro sustituyente se enlaza a un aminoácido, tal como una Lys, dentro del péptido. Alternativamente, un sustituyente puede enlazarse a una Lys en la posición C-terminal del péptido mientras que el otro sustituyente se enlaza a un aminoácido, tal como una Lys, en el péptido. Alternativamente, un sustituyente puede enlazarse a un residuo de aminoácido, tal como una Lys, dentro del péptido, que incluye alargamientos, el otro sustituyente se une a otro residuo de aminoácido, tal como una Lys, dentro del péptido, que incluye alargamientos.
En una modalidad, los compuestos de la invención tienen un sustituyente, dicho sustituyente se enlaza al péptido en el N-terminal; o dicho sustituyente se enlaza al péptido en la posición 292Lys; o dicho sustituyente se enlaza al péptido en la posición 293Lys; o dicho sustituyente se enlaza al péptido en la posición 299Lys; o dicho sustituyente se enlaza al péptido en la posición 300Lys; o dicho sustituyente se enlaza al péptido en la posición 309Lys; o dicho sustituyente se enlaza al péptido en la posición 311Lys; o dicho sustituyente se enlaza al péptido en la posición 312Lys; o dicho sustituyente se enlaza al péptido en la posición 313Lys; o dicho sustituyente se enlaza al péptido en la posición 314Lys; o dicho sustituyente se enlaza al péptido en la posición 315Lys; o dicho sustituyente se enlaza al péptido en la posición 316Lys; o dicho sustituyente se enlaza al péptido en la posición 318Lys; o dicho sustituyente se enlaza al péptido en la posición 320Lys; o dicho sustituyente se enlaza al péptido en la posición 321Lys; o dicho sustituyente se enlaza al péptido en la posición 322Lys; o dicho sustituyente se enlaza al péptido en la posición 323Lys; o dicho sustituyente se enlaza al péptido en la posición 324Lys; o dicho sustituyente se enlaza al péptido en la posición 325Lys; o dicho sustituyente se enlaza al péptido en la posición 326Lys; o dicho sustituyente se enlaza al péptido en la posición 328Lys; o dicho sustituyente se enlaza al péptido en la posición 329Lys; o dicho sustituyente se enlaza al péptido en la posición 330Lys; o dicho sustituyente se enlaza al péptido en la posición 332Lys; o dicho sustituyente se enlaza al péptido en la posición 333Lys.
En una modalidad donde el derivado de la invención tiene dos sustituyentes, dichos sustituyentes pueden enlazarse al péptido por medio del N-terminal y cualquiera de las posiciones de Lys mencionadas más arriba, tales como 293Lys, 309Lys, 313Lys, 324Lys, 328Lys, 330Lys, 332Lys y 333Lys.
En modalidades adicionales donde el derivado comprende dos sustituyentes, estos pueden enlazarse a dos residuos de Lys diferentes, tales como cualquiera de los siguientes pares de residuos de Lys
293K y 294K xiv. 313Ky 321K
ii. 293K y 312K xv. 313Ky324K
iii. 293K y 333K xvi. 313Ky328K
iv. 309K y 313K xvii. 313Ky332K
v. 309K y 324K xviii.
vi. 309K y 328K xix. 3K
vii. 309K y 332K xx. 2K
viii. 309K y 333K xxi. 3K
ix. 311K y 313K xxii.
x. 312K y 333K xxiii.
xi. 312K y 313K xxiv.
xii. 312K y 314K xxv.
xiii. 313K y 314K xxvi. 
En una modalidad los dos sustituyentes se unen a través de 333Lys y una Lys seleccionada de 293Lys, 309Lys, 312Lys, 313Lys, 314Lys, 321Lys, 324Lys, 328Lys, 330Lys y 332Lys.
En una modalidad los dos sustituyentes se unen a través de 333Lys y una Lys seleccionada de 312Lys, 313Lys, 314Lys, 321Lys, 324Lys, 328Lys y 330Lys.
En una modalidad los dos sustituyentes se unen a través de 333Lys y una Lys seleccionada de 313Lys, 324Lys y 328Lys.
Como se describió anteriormente el péptido puede tener una o más sustituciones de aminoácidos que pueden combinarse con residuos de aminoácidos específicos en posiciones específicas como se describió en la presente descripción. Tales residuos de aminoácidos específicos pueden ser residuos de aminoácidos wt que deben mantenerse, tal como las cisteínas que en una serie de modalidades preferidas, por ejemplo, en combinación con otras características descritas en la presente descripción, están presentes en el análogo peptídico. En tales modalidades el análogo peptídico comprende tres puentes disulfuro en las posiciones 297Cys-308Cys, 304Cys-317Cys y 319Cys-331Cys. En un ejemplo adicional de tales modalidades el análogo peptídico de un derivado peptídico comprende tres puentes disulfuro en las posiciones 297Cys-308Cys, 304Cys-317Cys y 319Cys-331Cys y al menos un sustituyente, en donde el(los) sustituyente(s) no se une(n) a una posición seleccionada de 295, 296, 298, 301, 302 y 307 de dicho análogo peptídico. El experto comprenderá que las combinaciones de la información de secuencia peptídica pueden combinarse con la información sobre la posición e identidad del sustituyente para definir diversas modalidades específicas de la presente invención.
En una modalidad, el análogo peptídico no comprende Lys en otras posiciones que las posiciones a las que se enlaza un sustituyente.
En una modalidad, los compuestos de la invención tienen un sustituyente, dicho sustituyente se enlaza ya sea en la posición N-terminal o a una Lys en cualquier posición, y el análogo peptídico no comprende Lys en todas las otras posiciones. En una modalidad, los compuestos de la invención tienen un sustituyente, dicho sustituyente se une a una Lys en cualquier posición distinta de la posición 312, y el análogo peptídico comprende una Arg en la posición 312Arg.
En una modalidad, los compuestos de la invención tienen dos sustituyentes, y el análogo peptídico no comprende Lys en posiciones distintas de las posiciones a las que se enlazan los sustituyentes.
En una modalidad el derivado del EGF(A) de acuerdo con la invención se selecciona del grupo de derivado del EGF(A) que consiste de: Ejemplos 1-47, 51-102 y 106-159.
En modalidades adicionales el derivado del EGF(A) de acuerdo con la invención se selecciona individualmente del grupo de derivado del EGF(A) que consiste de: Ejemplos 1-47, 51-102 y 106-159.
En una modalidad el derivado del EGF(A) de acuerdo con la invención se selecciona del grupo de derivado del EGF(A) que consiste de: Los ejemplos 1-44, 46-47, 51-55, 57, 60-64, 66-69, 71-102 y 106-159.
En una modalidad el derivado del EGF(A) de acuerdo con la invención se selecciona del grupo de derivado del EGF(A) que consiste de: Los ejemplos 31, 95, 128, 133, 143, 144, 150, 151, 152 y 153.
Composición farmacéutica
La descripción se refiere, también, a composiciones farmacéuticas que comprenden un compuesto de la invención, que incluye por ejemplo un análogo peptídico de la invención, o una sal, amida o éster farmacéuticamente aceptable del mismo, y un excipiente farmacéuticamente aceptable. Tales composiciones pueden prepararse como se conoce en la técnica.
El término "excipiente" se refiere, en un sentido amplio, a cualquier componente aparte del (de los) ingrediente(s) terapéutico(s) activo(s). El excipiente puede ser una sustancia inerte, una sustancia inactiva, y/o una sustancia no activa medicinalmente. El excipiente puede servir para varios fines, por ejemplo, como portador, vehículo, diluyente,
auxiliar para comprimidos, y/o para mejorar la administración, y/o la absorción de la sustancia activa. Los ejemplos no limitantes de los excipientes son: solventes, diluyentes, amortiguadores, conservantes, agentes reguladores de la tonicidad, agentes quelantes y estabilizadores. En la técnica se conoce la formulación de ingredientes activos farmacéuticamente con diversos excipientes, véase, por ejemplo, Remington: The Science and Practice of Pharmacy (por ejemplo, 19na edición (1995) y cualquiera de las ediciones posteriores).
Una composición puede estar en la forma de una formulación líquida, es decir una formulación acuosa que comprende agua. Una formulación líquida puede ser una solución o una suspensión. Alternativamente, esta puede ser una formulación sólida, por ejemplo una composición secada por congelación o secada por pulverización.
Una composición farmacéutica puede comprender además, un segundo ingrediente activo, tal como un agente terapéutico, que puede simplificar la administración en el caso de tratamientos de combinación.
Una composición puede ser una composición oral, y la vía de administración es oral. Los compuestos y en particular los compuestos de prolongación, es decir los compuestos derivados, son adecuados para la administración oral. Los péptidos y los compuestos están comprendidos en una formulación oral, es decir, una composición adecuada para la administración oral y capaz de proporcionar un nivel adecuado de biodisponibilidad. Pueden usarse tecnologías de formulaciones orales conocidas en la técnica. Esto incluye el uso de sales del ácido N-(8-(2-hidroxibenzoil)amino)caprílico, en particular el N-(8-(2-hidroxibenzoil)amino)caprilato de sodio (SNAC), como se describió en los documentos WO96/30036 y WO2008/028859, y las formulaciones de GIPET que incluyen caprato de sodio, tal como se describió en los documentos EP1154761 y US 8053429.
Para proporcionar compuestos para composiciones orales, los inventores confirmaron que los derivados del péptido EGF(A) de acuerdo con la invención presentan una absorción gastrointestinal en ratas (Tabla 10).
Alternativamente, una composición puede ser para administración parenteral, por ejemplo, realizada por inyección subcutánea, intramuscular, intraperitoneal o intravenosa. Naturalmente, los compuestos destinados a la administración subcutánea pueden no necesitar presentar una absorción gastrointestinal, mientras que pueden desearse otras características tales como una alta estabilidad en la formulación líquida.
Tratamiento de combinación
El tratamiento con un análogo o derivado peptídico del EGF(A) también puede combinarse con una o más sustancias farmacológicamente activas adicionales, por ejemplo, seleccionadas entre agentes antidiabéticos, agentes antiobesidad, agentes reguladores del apetito, agentes antihipertensivos, agentes para el tratamiento y/o la prevención de complicaciones resultantes de la diabetes o asociadas a ella y agentes para el tratamiento y/o la prevención de complicaciones y trastornos resultantes de la obesidad o asociados a ella.
Ejemplos de estas sustancias farmacológicamente activas son: agonistas del receptor GLP-1, insulina, inhibidores de DPP-IV (dipeptidil peptidasa-IV), agonistas de amilina y agonistas del receptor de leptina. Ejemplos particulares de tales sustancias activas son los agonistas del receptor GLP-1 liraglutida y semaglutida y el insulina degludec. Indicaciones farmacéuticas
En un aspecto, la descripción se refiere al uso de un análogo peptídico del EGF(A) o un derivado del EGF(A) como se describió en la presente descripción para su uso en la fabricación de un medicamento.
La descripción se refiere, también, a un compuesto de la invención, por ejemplo un análogo peptídico o un derivado de acuerdo con la invención, o una composición farmacéutica del mismo para usar como un medicamento o en la fabricación de un medicamento.
Un compuesto de la invención o una composición de la misma puede usarse para (i) mejorar los parámetros lipídicos, tales como la prevención y/o el tratamiento de la dislipidemia, disminuir los lípidos séricos totales; disminuir el LDL-C, aumentar el HDL; disminuir las LDL pequeñas y densas; disminuir las v Ld L; disminuir los triglicéridos; disminuir el colesterol; disminuir los niveles plasmáticos de lipoproteína a (Lp(a)); inhibir la generación de apolipoproteína A (apo(A)); (ii) la prevención y/o el tratamiento de enfermedades cardiovasculares, tales como el síndrome cardíaco X, la aterosclerosis, el infarto del miocardio, la cardiopatía coronaria, la lesión por reperfusión, el accidente cerebrovascular, la isquemia cerebral, una enfermedad cardíaca o cardiovascular precoz, la hipertrofia ventricular izquierda, la enfermedad arterial coronaria, la hipertensión, la hipertensión esencial, la emergencia hipertensiva aguda, la cardiomiopatía, la insuficiencia cardíaca, la intolerancia al ejercicio, la insuficiencia cardíaca aguda y/o crónica, la arritmia, la disritmia cardíaca, el síncope, la angina de pecho, la revascularización cardíaca y/o la reoclusión de la endoprótesis, la claudicación intermitente (aterosclerosis obliterante), la disfunción diastólica y/o la disfunción sistólica; y/o la reducción de la presión arterial, tal como la reducción de la presión arterial sistólica; el tratamiento de la enfermedad cardiovascular.
La descripción también se refiere a un método para (i) mejorar los parámetros lipídicos, tales como la prevención y/o el tratamiento de la dislipidemia, disminuir los lípidos séricos totales; aumentar el HDL-C; disminuir la LDL-C, disminuir la LDL-C pequeña y densa; disminuir la VLDL-C; disminuir los triglicéridos; disminuir el colesterol; disminuir los niveles plasmáticos de lipoproteína a (Lp(a)); inhibir la generación de apolipoproteína A (apo(A)); (ii) la prevención y/o el tratamiento de enfermedades cardiovasculares, tales como el síndrome cardíaco X, la aterosclerosis, el infarto del miocardio, la enfermedad cardíaca coronaria, la lesión por reperfusión, el accidente cerebrovascular, la isquemia cerebral, una enfermedad cardíaca o cardiovascular precoz, la hipertrofia ventricular izquierda, la enfermedad arterial coronaria, la hipertensión, la hipertensión esencial, la emergencia hipertensiva aguda, la cardiomiopatía, la insuficiencia cardíaca, la intolerancia al ejercicio, la insuficiencia cardíaca aguda y/o crónica, la arritmia, la disritmia cardíaca, el síncope, la angina de pecho, la revascularización cardíaca y/o la reoclusión de la endoprótesis, la claudicación intermitente (aterosclerosis obliterante), la disfunción diastólica y/o la disfunción sistólica; y/o reducción de la presión arterial, tal como la reducción de la presión arterial sistólica; el tratamiento de enfermedades cardiovasculares; en donde se administra una cantidad farmacéuticamente activa de un compuesto de acuerdo con la invención, por ejemplo, un análogo peptídico o un derivado de acuerdo con la invención.
Aunque determinadas características de la invención se ilustran y describen en la presente descripción, muchas modificaciones, sustituciones, cambios y equivalentes serán evidentes para los expertos en la técnica. Por lo tanto, debe entenderse que las reivindicaciones adjuntas pretenden cubrir todas esas modificaciones y cambios.
Ejemplos
Esta parte experimental comienza con una lista de abreviaturas y le continúa una sección que incluye los métodos generales para sintetizar y caracterizar los análogos y derivados de la invención. Después sigue un número de ejemplos que se refieren a la preparación de compuestos específicos del EGF(A) de la invención, que incluyen análogos y derivados, y al final se incluye un número de ejemplos relacionados con la actividad y las propiedades de estos compuestos (sección titulada métodos farmacológicos).
Los ejemplos sirven para ilustrar la invención.
Lista de abreviaturas
AcOH: ácido acético
Ado: ácido 8-amino-3,6-dioxaoctanoico
Aeep: ácido 9-amino-4,7-dioxanonanoico
Aeeep: ácido 12-amino-4,7,10-trioxa-dodecanoico
Alloc: Aliloxicarbonilo
API: Ingrediente Farmacéutico Activo
AUC: Área Bajo la Curva
BG: Glucosa en Sangre
Boc: í-butiloxicarbonilo
BSA: Albúmina sérica bovina
Clt: 2-clorotritilo
colidina: 2,4,6-trimetilpiridina
DCM: diclorometano
Dde: 1-(4,4-dimetil-2,6-dioxociclohexilideno)etilo
DIC: diisopropilcarbodiimida
DIPEA: diisopropiletilamina
DMAP: 4-dimetilaminopiridina
EGF: Similar al factor de crecimiento epidérmico
EGF(A): Dominio A similar al factor de crecimiento epidérmico
F (Tabla 5): Biodisponibilidad
Fmoc: 9-fluorenilmetiloxicarbonilo
HDL: Lipoproteína de alta densidad
HEPES: ácido 4-(2-hidroxietil)-1-piperazinetanosulfónico
HFIP 1,1,1,3,3,3-hexafluoro-2-propanol o hexafluoroisopropanol
HOAt: 1-hidroxi-7-azabenzotriazol
HOBt: 1-hidroxibenzotriazol
hPCKS9: PCSK9 humano
HPLC: Cromatografía líquida de alto rendimiento
HSA: Albúmina sérica humana
IC50: concentración inhibitoria máxima media
Inp: ácido isonipecótico
i.v. por vía intravenosa
ivDde: 1-(4,4-dimetil-2,6-dioxociclohexilideno)-3-metilbutilo
LCMS: Cromatografía líquida acoplada a espectroscopía de masas
LDL-R o LDLr: Receptor de la LDL
LDL: lipoproteína de baja densidad
LDL-C: Colesterol LDL
MeOH: metanol
Mmt: 4-metoxitritilo
Mtt: 4-metiltritilo
MRT: Tiempo medio de residencia
MSU: Metilsulfonilcarbamoilamino
NMP: N-metil pirrolidona
OBz: éster de benzoilo
Ado: ácido 8-amino-3,6-dioxaoctanoico
OSu: Ésteres de O-succinimidilo (ésteres de hidroxisuccinimida)
OtBu: éster terc butílico
Oxyma Pure®: Éster etílico de ácido ciano-hidroxiimino-acético
Pbf: 2,2,4,6,7-pentametildihidrobenzofuran-5-sulfonilo
PBS: Solución salina tamponada con fosfato
PD: Farmacodinámica
PK: Farmacocinética
QC: Control de calidad
RP: Fase inversa
RP-HPLC: Cromatografía líquida de alto rendimiento de fase inversa
RT: Temperatura ambiente
Rt: Tiempo de retención
s.c.: Vía subcutánea
SD: Desviación estándar
SEM: Error estándar de la media
SPPS: Síntesis de péptidos en fase sólida
tBu: terc butilo
TFA: ácido trifluoroacético
TIS o TIPS: triisopropilsilano
Tmáx: tiempo para alcanzar la Cmáx
Tris: tris(hidroximetil)aminometano o 2-amino-2-hidroximetil-propano-1,3-diol
Trt: trifenilmetilo (tritilo)
Trx: ácido tranexámico
UPLC: Cromatografía líquida de ultra alto rendimiento
TBS-T: Solución salina tamponada con Tris
Métodos químicos
Esta sección se divide en tres: La sección A, relacionada con los métodos generales de preparación de los compuestos de la invención, la sección B, relacionada con la preparación de un número de compuestos específicos de la invención, y la sección C, relacionada con los métodos de detección y caracterización de los compuestos de la invención y los resultados de un número de compuestos específicos de los ejemplos.
A. Métodos de preparación
Los compuestos de la invención pueden prepararse mediante el método descrito más abajo.
Preparación del péptido, es decir el péptido EGF(A) de la SEQ ID NO: 1 o análogos del mismo:
Métodos Generales de SPPS:
Los aminoácidos protegidos con Fmoc a usar pueden ser el estándar recomendado: Fmoc-Ala-OH, Fmoc-Arg(Pbf)-OH, Fmoc-Asn(Trt)-OH, Fmoc-Asp(OtBu)-OH, Fmoc-Cys(Trt)-OH, Fmoc-Gln(Trt)-OH, Fmoc-Glu(OtBu)-OH, Fmoc-Gly-OH, Fmoc-His(Trt)-OH, Fmoc-Ile-OH, Fmoc-Leu-OH, Fmoc-Lys(BOC)-OH, Fmoc-Met-OH, Fmoc-Phe-OH, Fmoc-Pro-OH, Fmoc-Ser(tBu)-OH, Fmoc-Thr(tBu)-OH, Fmoc-Trp(BOC)-OH, Fmoc-Tyr(tBu)-OH, Fmoc-Val-OH y Fmoc-Lys(Mtt)-OH o Fmoc-Lys(Alloc)-OH suministrados, por ejemplo, por Anaspec, Bachem, Iris Biotech o NovabioChem. La SPPS puede realizarse mediante el uso de química basada en Fmoc en un sintetizador de péptidos en fase sólida Prelude de Protein Technologies (Tucson, AZ 85714 EE.UU.). Una resina adecuada para la preparación de los ácidos carboxílicos C-terminales es una resina Wang precargada con un aminoácido tal como Fmoc-Glu(tBu)-resina Wang (Carga Baja, 0,35 mmol/g). En casos donde el sustituyente se une a una lisina C-terminal, una resina adecuada es una Fmoc-Lys(Mtt)-Wang pre-cargada. Una resina adecuada para la preparación de amidas peptídicas C-terminales es la resina H-Rink Amide-ChemMatrix (que carga, por ejemplo, 0,52 nmol/g) o la resina de poliestireno Rink Amide AM (Novabiochem, que carga, por ejemplo, 0,62 mmol/g) o similares. La eliminación de la protección con Fmoc se logra con piperidina al 20 % en NMP. Los acoplamientos de los péptidos se realizan mediante el uso de DIC/HOAt/colidina o DIC/Oxyma Pure con o sin colidina con o sin preactivación o mediante el uso de DEPBt (3
(dietoxifosforiloxi)-1,2,3-benzotriazin-4(3H)-ona) /DIPEA para la supresión de la epimerización de, por ejemplo, la His durante el acoplamiento. Las soluciones de aminoácido/HOAt o aminoácido/Oxima Pura (0,3 M/0,3 M en NMP a un exceso molar de 3-10 veces) se añadieron a la resina seguido por el mismo equivalente molar de DIC (3 M en NMP) seguido por colidina (3 M en NMP). Por ejemplo, pueden usarse las cantidades siguientes de solución de aminoácido/HOAt 0,3 M por acoplamiento para las siguientes reacciones en escala: Escala/ml, 0,05 mmol/1,5 ml, 0,10 mmol/3,0 ml, 0,25 mmol/7,5 ml.
Si se usa Fmoc-Lys(Mtt)-OH, el grupo Mtt puede retirarse mediante lavado de la resina con HFIP/DCM (75:25) (2 x 2 min), lavado con DCM y suspensión de la resina en HFIP/DCM (75:25)(2 x 20 min) y lavado subsecuente antes de que el sustituyente pueda introducirse en la posición épsilon del resto de lisina.
Si se usa Fmoc-Lys(Alloc)-OH, el grupo Alloc puede retirarse mediante tratamiento de la resina con Pd(PPh3)4 (0,02 equiv.) en presencia de uno o más limpiadores en combinación con, por ejemplo morfolina (6,0 equiv.) y/o complejo de dimetil borano (18,0 equiv.) (30 min). La resina se lava después con MeOH, NMP o DMF e IPA (alcohol isopropílico), respectivamente, antes de que el sustituyente pueda introducirse en la posición épsilon del resto de lisina.
Unión del sustituyente (Acilación)
El sustituyente puede introducirse en un procedimiento por etapas en el sintetizador de péptidos Prelude como se describió anteriormente mediante el uso de bloques constitutivos protegidos adecuadamente, tal como los aminoácidos estándar descritos más arriba, ácido Fmoc-8-amino-3,6-dioxaoctanoico o Fmoc-Glu-OtBu. La introducción del sustituyente puede lograrse mediante el uso de un bloque constitutivo, tal como éster mono-tercbutílico del ácido octadecanodioico. Después de cada etapa de acoplamiento, el intermedio peptídico sin reaccionar puede taponarse mediante el uso de anhídrido de ácido acético y colidina en exceso (> 10 eq.).
La introducción de un sustituyente en el nitrógeno épsilon de una lisina se logra mediante el uso de una lisina protegida con Mtt (Fmoc-Lys(Mtt)-OH), Alloc (Fmoc-Lys(Alloc)-OH) o un grupo ivDde (Fmoc-Lys(ivDde)-OH). La incorporación de restos de yGIu en el sustituyente puede lograrse mediante el acoplamiento con el aminoácido Fmoc-Glu-OtBu.
La introducción de cada resto en el sustituyente puede lograrse mediante el uso de un tiempo de acoplamiento prolongado (1 x 6 horas), seguido del taponado con anhídrido acético o, alternativamente, con ácido acético/DIC/HOAt/colidina.
Escisión de la resina
Después de la síntesis la resina se lava con DCM, y el péptido se escinde de la resina mediante un tratamiento de 2 3 horas con TFA/TIPS/agua (95/2,5/2,5) o TFA/EDT (1,2-etanoditiol)/agua (90/5/5) seguido por precipitación con Et2O (éter dietílico). El precipitado se lava con Et2O.
Plegamiento oxidativo
El precipitado de la etapa más arriba se disuelve en DMSO y se añade a una solución que consiste de:
TRIS 50 mM
CaCl25 mM
Cisteína 3 mM
Cistina 0,3 mM
en agua MQ, pH 8 a 8,8
La mezcla de reacción se mantiene durante toda la noche a temperatura ambiente o hasta que LCMS muestre que la reacción se completó.
Purificación y cuantificación
El péptido bruto (derivado) se acidifica con TFA a pH 2-3 y se purifica mediante HPLC preparativa de fase inversa (Waters Deltaprep 4000 o Gilson) en una columna que comprende gel de sílice C8- o C18-. La elución se realiza con un gradiente en aumento de MeCN en agua que comprende TFA al 0,1 %. Las fracciones relevantes se revisan mediante HPLC o UPLC analítica. Las fracciones que comprenden el derivado peptídico objetivo puro se mezclan. Una etapa de purificación adicional puede introducirse mediante el uso de otro gradiente, por ejemplo que contiene NH4HCO30,05 M. La solución resultante se analiza (HPLC, LCMS) y el producto (es decir, el derivado) se cuantifica mediante el uso de un detector de quimioluminiscencia específico para nitrógeno de HPLC (Antek 8060 HPLC-CLND) o mediante la medición de la absorción UV a 280 nm. El producto se dispensa en frascos de vidrio. Los frascos se taponan con prefiltros de fibra de vidrio Millipore. El secado por congelación proporciona el trifluoroacetato peptídico como un sólido blanco.
Unión del sustituyente (Alquilación reductiva)
El análogo peptídico purificado puede someterse a alquilación reductiva mediante el uso de un sustituyente adecuado de unión a la albúmina derivatizado con una funcionalidad aldehído.
El análogo peptídico se disuelve en ácido cítrico pH = 5,5 y un aldehído adecuado se disuelve en agua que puede contener ciclodextrina para aumentar la solubilidad. Se añade un agente reductor tal como el complejo de borano piridina disuelto en MeOH y la mezcla se agita suavemente durante toda la noche. Puede requerirse una adición subsecuente de un exceso del aldehído y el agente reductor para un rendimiento óptimo. La mezcla se purifica mediante el uso del procedimiento descrito más arriba.
B. Síntesis de compuestos de la invención
Los compuestos de la invención se prepararon mediante un método no esencialmente diferente de los métodos generales descritos más abajo.
Método A
Síntesis de análogos peptídicos del LDL-R(293-332) (sin sustituyente)
Los aminoácidos protegidos con Fmoc usados fueron los estándares recomendados: Fmoc-Ala-OH, Fmoc-Arg(Pbf)-OH, Fmoc-Asn(Trt)-OH, Fmoc-Asp(OtBu)-OH, Fmoc-Cys(Trt)-OH, Fmoc-Gln(Trt)-OH, Fmoc-Glu(OtBu)-OH, Fmoc-Gly-OH, Fmoc-His(Trt)-OH, Fmoc-Ile-OH, Fmoc-Leu-OH, Fmoc-Lys(BOC)-OH, BOC-Lys(Fmoc)-OH Fmoc-Phe-OH, Fmoc-Pro-OH, Fmoc-Ser(tBu)-OH, Fmoc-Thr(tBu)-OH, Fmoc-Trp(BOC)-OH, Fmoc-Tyr(tBu)-OH, Fmoc-Val-OH y Fmoc-Lys(Mtt)-OH suministrados, por ejemplo, por Anaspec, Bachem, Iris Biotech, o NovabioChem. La SPPS se realizó mediante el uso de química basada en Fmoc en un sintetizador de péptidos en fase sólida Prelude de Protein Technologies (Tucson, AZ 85714 EE.UU.). Se usó una resina Wang precargada con un aminoácido tal como Fmoc-Glu(tBu)-resina Wang (Carga Baja, 0,35 mmol/g) o similares. La desprotección del Fmoc se logró con piperidina al 20 % en NMP. Los acoplamientos de los péptidos se realizaron mediante el uso de DIC/Oxyma Pura con colidina. Las soluciones de aminoácido/Oxyma Pura (0,3 M/0,3 M en DMF a un exceso molar de 3-10 veces) se añadió a la resina seguido por el mismo equivalente molar de DIC (3 M en NMP) seguido por colidina (3 M en NMP).
Escisión de la resina
Después de la síntesis la resina se lavó con DCM, y el péptido se escindió de la resina mediante un tratamiento de 2-3 horas con TFA/TIPS/DTT/agua (92,5/2,5/2,5/2,5) seguido por precipitación con éter dietílico. El precipitado se lavó subsecuentemente con éter dietílico.
Plegamiento oxidativo
El precipitado de la etapa más arriba se disolvió en DMSO y se añadió a una solución que consistió de:
TRIS 50 mM
CaCl25 mM
Cisteína 3 mM
Cistina 0,3 mM
en agua MQ, pH 8,0 a 8,8
La mezcla de reacción se mantuvo durante toda la noche a temperatura ambiente o hasta que LCMS mostró que la reacción se completó.
Purificación y cuantificación
El péptido bruto se acidificó con TFA a pH 2-3 y se purificó mediante HPLC preparativa de fase inversa (Waters Deltaprep 4000 o Gilson) en una columna que comprende gel de sílice C8- o C18-. La elución se realizó con un gradiente en aumento de MeCN en agua que comprende TFA al 0,1 %. Las fracciones relevantes se analizaron mediante el uso de UPLC. Las fracciones que comprenden el péptido objetivo puro se combinaron. La solución resultante se analizó (UPLC, LCMS) y el derivado peptídico se cuantificó mediante el uso de un detector de HPLC específico de nitrógeno quimioluminiscente (Antek 8060 HPLC-CLND) o mediante la medición de la absorción UV a 280 nm. El producto se dispensó en frascos de vidrio. Los frascos se taponaron con prefiltros de fibra de vidrio Millipore. El secado por congelación proporcionó la sal de trifluoroacetato peptídico como un sólido blanco.
Método B
Síntesis de los derivados de análogos del EGF(A) del LDL-R(293-332) (con sustituyente) (en resina)
La síntesis del péptido EGF(A) unido a la resina procedió como se describió anteriormente.
La introducción de un sustituyente en el nitrógeno épsilon de una lisina en el N-terminal de la secuencia se logró mediante el uso de Boc-Lys(Fmoc)-OH. La introducción del sustituyente en la posición alfa del aminoácido N-terminal se llevó a cabo mediante el uso de un aminoácido protegido con Fmoc estándar, es decir, Fmoc-Gly-OH. Para la introducción de un sustituyente en el nitrógeno épsilon de una lisina en otras posiciones, se usó Fmoc-Lys(Mtt)-OH. El grupo Mtt se retiró mediante tratamiento con HFIP/DCM (75:25) (2 x 2 min), seguido por un lavado con DCM. La resina se resuspendió después en HFIP/DCM (75:25)(2x20 min o 2x30 min) y subsecuentemente se lavó con DCM antes que el sustituyente se introdujera en la posición épsilon del resto de lisina.
Los restos del sustituyente se introdujeron en un procedimiento por etapas mediante un sintetizador de péptidos Prelude como se describió en el método A, mediante el uso de bloques constitutivos protegidos adecuadamente, tal como los aminoácidos protegidos con Fmoc estándar descritos en el método A, ácido Fmoc-8-amino-3,6-dioxaoctanoico o Fmoc-Glu-OtBu. La introducción del grupo de ácido graso se logró mediante el uso del bloque constitutivo adecuado, tal como el éster mono-terc-butílico del ácido octadecanodioico. En algunos casos se aumentó el tiempo de acoplamiento o se repitió la etapa de acoplamiento para cada bloque constitutivo.
La escisión, el plegamiento oxidativo, la purificación y la cuantificación se realizaron como se describió en el método A.
Método C
Unión del sustituyente en solución (por medio de alquilación reductiva)
El péptido purificado obtenido del método A se sometió a alquilación reductiva mediante el uso de un sustituyente adecuado derivatizado con una funcionalidad aldehído.
El polvo del péptido secado por congelación se disolvió en un tampón de ácido cítrico (40 mM, pH 5,55; concentración del péptido: 4 mg/ml). Una solución que comprende el sustituyente seleccionado (10 eq., 10 mg/ml) en ciclodextrina acuosa al 40 % (p/v) se añadió a la solución del péptido y se mezcló suavemente mediante inversión del frasco de reacción. A esta solución se añadió el complejo de borano piridina (100 eq., solución de 80 mg/ml en MeOH) en alícuotas pequeñas, seguido por inversión suave del frasco de reacción. La solución de reacción se agitó suavemente a temperatura ambiente durante toda la noche. El progreso de la reacción se monitoreó mediante LC-MS. A la mañana siguiente, la solución de reacción se acidificó a pH 2-3 mediante el uso de TFA y se purificó mediante el uso del procedimiento descrito más arriba en el método A.
Método D
Unión del sustituyente (acilación del N-terminal del péptido plegado en solución)
El polvo del péptido secado por congelación se disolvió en tampón K2HPO4 (20 mM, pH 8,15) a una concentración objetivo de 5 mg/ml. Una solución del ácido 18-[[(1S)-1-carboxi-4-[2-[2-[2-[2-[2-[2-(2,5-dioxopirrolidin-1-il)oxi-2-oxoetoxi]etoxi]etilamino]-2-oxo-etoxi]etoxi]etilamino]-4-oxo-butil]amino]-18-oxo-octadecanoico en DMSO (4 eq.; 4 mg/ml) se añadió en cuatro alícuotas. Después de la adición de cada alícuota la solución del péptido se mezcló suavemente mediante inversión del frasco de reacción. Subsecuentemente, el valor de pH de la solución de reacción se midió y se ajustó a pH 8,0-8,3 mediante la adición de porciones pequeñas de N,N-diisopropiletilamina, después de lo cual la solución se dejó en reposo a temperatura ambiente. La progresión de la reacción se siguió por LC-MS. Después de tres horas la solución se acidificó a pH 5,9 con TFA y se purificó mediante el uso del procedimiento descrito más arriba.
B. 1. Síntesis de prolongadores y elementos enlazadores
Para la síntesis del éster mono-terc-butílico del ácido octadecanodioico: véase la solicitud de patente WO 2010102886. Los ésteres mono-terc-butílicos correspondientes de diácido de C14-, C16- y C20 pueden prepararse en consecuencia. Para la síntesis del ácido 14-sulfo-hexadecanoico o ácido 16-sulfo-hexadecanoico sulfónico véase el documento WO2015071355. Para la síntesis del ácido 16-(1H-tetrazol-5-il)hexadecanoico y ácido 13-(1H-tetrazol-5-il)hexadecanoico véase el documento WO2006005667.
Ácido 13-(metilsulfonilcarbamoilamino)tridecanoico.
Quím. 6-OH, en donde n=12:

Esta molécula se hizo mediante el uso de un procedimiento modificado de Luckhurst y otros. Tetrahedron Letters, volumen 48, número 50, 2007, páginas 8878-8882 http://dx.doi.org/10.10167j.tetlet.2007.10.046 Subsecuentemente se añadieron trietilamina (4,46 ml, 32,0 mmol) y cloroformiato de etilo (3,05 ml, 32,0 mmol) a una solución del ácido 14-(terc-butoxi)-14-oxotetradecanoico (1, C14(OtBu)-OH, 6,29 g, 20,0 mmol) en acetona (176 ml) a 0 °C. Después de 30 minutos a 0 °C, se añadió una solución de azida de sodio (2,60 g, 40,0 mmol) en agua (12 ml) y la mezcla se agitó durante 2 horas a 0 °C. La mezcla se concentró al vacío (a 30 °C) y se vertió en agua con hielo (300 ml). La mezcla resultante se extrajo con acetato de etilo (3 x 250 ml); los extractos orgánicos se combinaron y lavaron con agua (200 ml), solución acuosa al 10 % de hidrogenocarbonato de sodio (200 ml) y agua (200 ml); se secaron sobre sulfato de magnesio anhidro y se evaporaron hasta la sequedad para dar una mezcla de 14-azido-14-oxotetradecanoato de terc-butilo y 14-isocianato-14-oxotetradecanoato de terc-butilo como un aceite amarillo pálido.
Se añadieron metanosulfonamida (1,52 g, 16,0 mmol), carbonato de potasio (6,63 g, 48,0 mmol) a una solución de la mezcla de 14-azido-14-oxotetradecanoato de terc-butilo y 14-isocianato-14-oxotetradecanoato de terc-butilo (5,43 g, 16,0 mmol) en tolueno seco (50 ml). La mezcla de reacción se calentó a 85 °C durante toda la noche. Se añadió agua (100 ml) seguido por ácido clorhídrico acuoso 1 M (el pH se ajustó a pH=4). La mezcla se extrajo con éter dietílico (4 x 150 ml), se secó sobre sulfato de magnesio anhidro y se evaporó al vacío para dar 13-(3-(metilsulfonil)ureido)tridecanoato de terc-butilo.
Espectro de RMN 1H (300 MHz, DMSO, dH): 10,01 (s, 1 H); 6,42 (t, J=4,7 Hz, 1 H); 3,20 (s, 3 H); 3,02 (q, J=6,7 Hz, 2 H); 2,16 (t, J=7,3 Hz, 2 H); 1,52-1,33 (m, 13 H); 1,30-1,11 (m, 16 H).
Se añadieron ácido trifluoroacético (21,0 ml) y agua (2,50 ml) por goteo a una solución de 13-(3-(metilsulfonil)ureido)tridecanoato de terc-butilo (3, 6,30 g, 15,5 mmol) en diclorometano (30 ml). La mezcla de reacción se agitó durante 3 horas a temperatura ambiente. El solvente se evaporó a presión reducida, para producir ácido 13-(3-(metilsulfonil)ureido)tridecanoico.
Espectro de RMN 1H (300 MHz, DMSO, dH): 10,02 (s, 1 H); 6,43 (t, J=4,5 Hz, 1 H); 3,20 (s, 3 H); 3,02 (q, J=6,6 Hz, 2 H); 2,18 (t, J=7,3 Hz, 2 H); 1,56-1,33 (m, 4 H); 1,24 (s, 16 H).
Ácido 13-(3-hidroiisoxazol-5-il)tridecanoico
Quím. 5-OH, en donde n=12:

Esta molécula se hizo mediante el uso de un procedimiento modificado de Sorensen y otros. J. Org. Chem., 2000, 65 (4), pp 1003-1007. DOI: 10.1021/jo991409d
Se disolvieron ácido 14-(terc-butoxi)-14-oxotetradecanoico (1, 30,0 g, 95,4 mmol), N,N'-diciclohexilcarbodiimida (43,3 g, 209 mmol) y 4-dimetilaminopiridina (25,6 g, 20,9 mmol) en diclorometano anhidro (700 ml) y se añadió 2,2-dimetil-1,3-dioxano-4,6-diona (2, 20,6 g, 143 mmol) a la solución. La mezcla de reacción se agitó a temperatura ambiente durante 16 horas. Los compuestos volátiles se evaporaron después y la mezcla se diluyó con éter dietílico (500 ml) y se filtró un precipitado blanco. El filtrado se concentró a presión reducida, se diluyó con éter dietílico (300 ml) y se extrajo con ácido clorhídrico acuoso 1 M (3 x 100 ml) y salmuera (1 x 100 ml). La porción orgánica se secó con sulfato de sodio y se evaporó a presión reducida para dar 14-(2,2-dimetil-4,6-dioxo-1,3-dioxan-5-il)-14-oxotetradecanoato de terc-butilo como un aceite amarillo. El producto bruto se usó para la próxima etapa sin purificación adicional.
Espectro de RMN 1H (300 MHz, CDCl3, dH): 3,07 (t, J=7,5 Hz, 2 H); 2,20 (t, J=7,5 Hz, 2 H); 1,74 (s, 6 H); 1,71-1,51 (m, 4 H); 1,45 (s, 9 H); 1,36-1,23 (m, 16 H).
El producto bruto mencionado más arriba se disolvió en etanol (300 ml) y la solución resultante se agitó a 80 °C durante 3 horas y después durante toda la noche a temperatura ambiente. El solvente se retiró a presión reducida y el residuo se purificó mediante cromatografía rápida en columna (Silicagel 60, 0,040-0,063 mm; eluyente: ciclohexano/acetato de etilo 9:1) para dar 1-etil 16-metil 3-oxohexadecanodioato como un aceite incoloro Espectro de RMN 1H (300 MHz, CDCl3, dH): 4,21 (q, J=7,2 Hz, 2 H); 3,44 (s, 2 H); 2,54 (t, J=7,5 Hz, 2 H); 2,21 (t, J=7,5 Hz, 2 H); 1,67-1,51 (m, 4 H); 1,45 (s, 9 H); 1,38-1,21 (m, 19 H).
El hidróxido de sodio (1,09 g, 27,3 mmol) se disolvió en metanol (40,0 ml) y agua (10,0 ml) a - 30 °C bajo atmósfera de argón. El éster mencionado más arriba (4, 10,0 g, 26,0 mmol) se disolvió en metanol (40 ml) y dimetoxietano (50 ml) y se añadió gota a gota a la mezcla de reacción a - 30 °C. Después de 20 minutos, se añadió gota a gota una solución de clorhidrato de hidroxilamina (3,61 g, 52,0 mmol) e hidróxido de sodio (2,18 g, 54,6 mmol) en dimetoxietano (10 ml) y agua (10,0 ml) y la mezcla de reacción se agitó durante 3 horas a - 30 °C. Después la mezcla se inactivó con acetona (5 ml) y después de 5 minutos se vertió de una vez en ácido clorhídrico concentrado (70 ml) y se calentó a 80 °C durante 70 minutos. Después se retiraron todos los volátiles a presión reducida, se disolvieron los sólidos con diclorometano (400 ml) y se extrajeron con agua destilada (100 ml) y salmuera (70 ml). La porción orgánica se secó con sulfato de sodio. El producto bruto se purificó mediante cromatografía rápida en columna (Silicagel 60, 0,040-0,063 mm; eluyente: ciclohexano/acetato de etilo 3:1) para dar 13-(3-hidroxiisoxazol-5-il)tridecanoato de metilo como un sólido blanco.
Espectro de RMN 1H (300 MHz, CDCl3, dH): 5,66 (s, 1 H); 3,67 (s, 3 H); 2,63 (t, J=7,6 Hz, 2 H); 2,31 (t, J=7,6 Hz, 1 H); 1,72-1,55 (m, 4 H); 1,40-1,19 (m, 16 H).
Se disolvió 13-(3-hidroxiisoxazol-5-il)tridecanoato de metilo (5, 6,20 g, 19,9 mmol) en metanol (60,0 ml) y agua (20,0 ml), se añadió hidróxido de litio monohidratado (4,04 g, 96,3 mmol) y la mezcla de reacción se agitó durante 16 horas a temperatura ambiente. Después se retiraron los volátiles a presión reducida y se añadió agua (50,0 ml) seguida de ácido clorhídrico acuoso 1 M (50,0 ml). El precipitado se filtró y se lavó con agua (2 x 100 ml) y después se secó a presión reducida para dar ácido 13-(3-hidroxiisoxazol-5-il)tridecanoico como un sólido beige.
Espectro de RMN 1H (300 MHz, DMSO-d6, dH): 5,74 (s, 1 H); 2,57 (t, J=7,5 Hz, 2 H); 2,18 (t, J=7,5 Hz, 2 H); 1,63 1,41 (m, 4 H); 1,34-1,14 (m, 16 H).
B.2 Síntesis de precursores de sustituyentes intermedios para la alquilación reductiva
Ácido 18-[[(1S)-1-carboxi-4-[2-[2-[2-[2-[2-[2-[(4-formilfenil)methilamino]-2-oxo-etoxi]etoxi]etilamino]-2-oxoetoxi]etoxi]etilamino]-4-oxo-butil]amino]-18-oxo-octadecanoico

La resina de 2-clorotritilo de malla 100-200 (42,6 g, 42,6 mmol) se dejó inflar en diclorometano seco (205 ml) durante 20 minutos. Se añadió a la resina una solución de ácido {2-[2-(9H-fluoren-9-ilmetoxicarbonilamino)-etoxi]-etoxi}-acético (13,7 g, 35,5 mmol) y N,N-diisopropiletilamina (23,5 ml, 135 mmol) en diclorometano seco (30 ml) y se agitó la mezcla durante 3 horas. La resina se filtró y se trató con una solución de N,N-diisopropiletilamina (12,4 ml, 70.9 mmol) en una mezcla de metanol/diclorometano (4:1, 250 ml, 2 x 5 min). Después la resina se lavó con N,N-dimetilformamida (2 x 150 ml), diclorometano (3 x 150 ml) y N,N-dimetilformamida (3 x 150 ml). El grupo Fmoc se retiró mediante tratamiento con piperidina al 20 % en dimetilformamida (1 x 5 min, 1 x 30 min, 2 x 150 ml). La resina se lavó con N,N-dimetilformamida (3 x 150 ml), 2-propanol (2 x 150 ml) y diclorometano (200 ml, 2 x 150 ml). La solución de ácido {2-[2-(9H-fluoren-9-ilmetoxicarbonilamino)-etoxi]-etoxi}-acético (20,5 g, 53,2 mmol), tetrafluoroborato de O-(6-cloro-benzotriazol-1-il)-N,N,N',N'-tetrametiluronio (TcTU, 18. 9 g, 53,2 mmol) y N,N-diisopropiletilamina (16,7 ml, 95,7 mmol) en N,N-dimetilformamida (100 ml) y diclorometano (50 ml) se añadió a la resina y la mezcla se agitó durante 1 hora. La resina se filtró y lavó con N,N-dimetilformamida (2 x 150 ml), diclorometano (3 x 150 ml) y N,N-dimetilformamida (155 ml). El grupo Fmoc se retiró mediante tratamiento con piperidina al 20 % en dimetilformamida (1 x 5 min, 1 x 30 min, 2 x 150 ml). La resina se lavó con N,N-dimetilformamida (3 x 150 ml), 2-propanol (2 x 150 ml) y diclorometano (200 ml, 2 x 150 ml). La solución de Fmoc-Glu-OtBu (22,6 g, 53,2 mmol), tetrafluoroborato de O-(6-cloro-benzotriazol-1-il)-N,N,N',N'-tetrametiluronio (TCTU, 18.9 g, 53,2 mmol) y N,N-diisopropiletilamina (16,7 ml, 95,7 mmol) en N,N-dimetilformamida (155 ml) se añadió a la
resina y la mezcla se agitó durante 1 hora. La resina se filtró y lavó con N,N-dimetilformamida (2 x 150 ml), diclorometano (2 x 150 ml) y N,N-dimetilformamida (150 ml). El grupo Fmoc se retiró mediante tratamiento con piperidina al 20 % en dimetilformamida (1 x 5 min, 1 x 30 min, 2 x 150 ml). La resina se lavó con N,N-dimetilformamida (3 x 150 ml), 2-propanol (2 x 150 ml) y diclorometano (200 ml, 2 x 150 ml). La solución de éster mono-terc-butílico del ácido octadecanodioico (19,7 g, 53,2 mmol), tetrafluoroborato de O-(6-cloro-benzotriazol-1-il)-N,N,N',N'-tetrametiluronio (TCTU, 18,9 g, 53,2 mmol) y N,N-diisopropiletilamina (16,7 ml, 95,7 mmol) en mezcla de N, N-dimetilformamida/diclorometano (1:4, 200 ml) se añadió a la resina. La resina se agitó durante 2 horas, se filtró y lavó con N,N-dimetilformamida (3 x 150 ml), diclorometano (2 x 150 ml), metanol (2 x 150 ml) y diclorometano (300 ml, 6 x 150 ml). El producto se escindió de la resina mediante tratamiento con 2,2,2-trifluoroetanol (200 ml) durante 19 horas. La resina se filtró y lavó con diclorometano (2 x 150 ml), mezcla de 2-propanol/diclorometano (1:1, 2 x 150 ml), 2-propanol (150 ml) y diclorometano (2 x 150 ml). Las soluciones se combinaron; el solvente se evaporó y el producto bruto se purificó mediante cromatografía en columna rápida (Silicagel 60, 0,040-0,060 mm; eluyente: diclorometano/metanol 1:0-9:1). El producto puro se secó al vacío y se obtuvo como un aceite amarillo.
Rendimiento del éster terc-butílico del ácido 17-{(S)-1-terc-butoxicarbonil-3-[2-(2-{[2-(2-carboximetoxi-etoxi)-etilcarbamoil]-metoxi}-etoxi)-etilcarbamoil]-propilcarbamoil}-heptadecanoico: 25,85 g (86 %).
RF (SiO2, cloroformo/metanol, 85:15): 0,25.
Espectro de RMN 1H (300 MHz, CDCl3, dH): 7,38 (bs, 1 H); 7,08 (bs, 1 H); 6,61 (d, J=7,5 Hz, 1 H); 4,43 (m, 1 H); 4,15 (s, 2 H); 4,01 (s, 2 H); 3,78-3,39 (m, 16 H); 2,31 (t, J=6,9 Hz, 2 H); 2,27-2,09 (m, 5 H); 2,01-1,84 (m, 1 H); 1,69 1,50 (m, 4 H); 1,46 (s, 9 H); 1,43 (s, 9 H); 1,24 (bs, 24 H).
LC-MS m/z: 846,6 (M+H)+.
El éster terc-butílico del ácido (4-formil-bencil)-carbámico (Boc-aminometilbenzaldehído, 1,54 g, 6,60 mmol) se disolvió en diclorometano (50 ml) y se añadió una solución de ácido clorhídrico en dioxano (3,8 M, 20 ml, 76 mmol). La mezcla se agitó durante 16 horas y un material sólido precipitó de la solución. Todos los solventes se retiraron mediante evaporación. Se añadieron éster terc-butílico del ácido 17-{(S)-1-terc-butoxicarbonil-3-[2-(2-{[2-(2-carboximetoxi-etoxi)-etilcarbamoil]-metoxi}-etoxi)-etilcarbamoil]-propilcarbamoil}-heptadecanoico (5,08 g, 6,00 mmol), clorhidrato de etil-(N',N'-dimetilamino)propilcarbodiimida. (EDC, 1,73 g, 9,00 mmol), N,N-dimetilaminopiridina (DMAP, O, 037 g, 0,30 mmol) y diclorometano (50 ml). La mezcla se agitó y se añadió diisopropiletilamina (2 ml, 11,6 mmol) en 3 porciones. La mezcla de reacción se agitó durante 2 horas y los solventes se evaporaron. El residuo se disolvió en diclorometano (10 ml) y una solución de ácido clorhídrico se añadió gota a gota hasta que el pH fue menor que 5. La solución se sometió a cromatografía en columna (Silicagel 60, 0,040-0,060 mm; eluyente: diclorometano/metanol 95:5) para proporcionar el sustituyente como un aceite amarillo.
Rendimiento: 3,15 g (54 %).
Espectro de RMN 1H (300 MHz, CDCl3, dH): 9,99 (s, 1 H); 7,85 (d, J=7,9 Hz, 2 H); 7,54-7,43 (m, 3 H); 7,06 (t, J=5,5 Hz, 1 H); 6,86 (t, J=5,6 Hz, 1 H); 6,48 (d, J=7,7 Hz, 1 H); 4,58 (d, J=6,2 Hz, 2 H); 4,45-4,36 (m, 1 H); 4,09 (s, 2 H); 3,94 (s, 2 H); 3,73-3,37 (m, 16 H); 2,32-2,05 (m, 7 H); 1,99-1,80 (m, 1 H); 1,69-1,51 (m, 4 H); 1,45 (s, 9 H); 1,44 (s, 9 H); 1,33-1,20 (m, 24 H).
LC-MS m/z: 963,5 (M+H)+.
Ácido (2S)-5-[2-[2-[2-[2-[2-[2-[(4-formilfenil)metilamino]-2-oxo-etoxi]etoxi]etilamino]-2-oxo-etoxi]etoxi]etilamino]-5-oxo-2-(16-sulfohexadecanoilamino entanoico
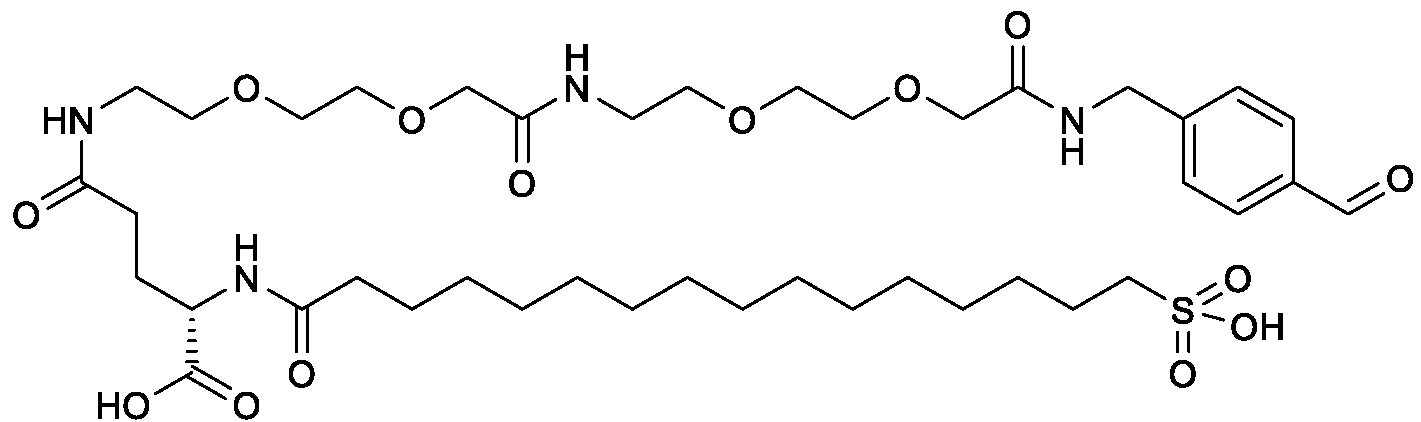
La resina de 2-clorotritilo de malla 100-200 1,8 mmol/g (1, 8,40 g, 14,3 mmol) se dejó inflar en diclorometano seco (150 ml) durante 30 minutos. Una solución de Fmoc-Ado-OH (2,82 g, 9,50 mmol) y N,N-diisopropiletilamina (6,30 ml, 36,1 mmol) en diclorometano seco (~150 ml) se añadió a la resina y la mezcla se agitó durante 24 horas. La resina se filtró y trató con una solución de N,N-diisopropiletilamina (3,30 ml, 19,0 mmol) en mezcla de metanol/diclorometano (4:1, 2 x 150 ml, 2 x 5 min). Después la resina se lavó con N,N-dimetilformamida (3 x 150 ml), diclorometano (3 x 150 ml) y N,N-dimetilformamida (3 x 150 ml). El grupo Fmoc se retiró mediante el tratamiento con piperidina al 20 % en N,N-dimetilformamida (1 x 5 min, 1 x 30 min, 2 x 150 ml). La resina se lavó con N,Ndimetilformamida (3 x 150 ml), 2-propanol (3 x 150 ml) y diclorometano (3 x 150 ml). La solución de ácido {2-[2-(9H-fluoren-9-ilmetoxicarbonilamino)-etoxi]-etoxi}-acético (Fmoc-Ado-OH, 4,80 g, 16,2 mmol), tetrafluoroborato de O-(6-cloro-benzotriazol-1-il)-N,N,N',N'-tetrametiluronio (TCTU, 5,74 g, 16,2 mmol) y N,N-diisopropiletilamina (4,47 ml, 25,7 mmol) en N,N-dimetilformamida (150 ml) se añadió a la resina y la mezcla se agitó durante 2 horas. La resina se filtró y se lavó con N,N-dimetilformamida (3 x 150 ml), diclorometano (3 x 150 ml) y N,N-dimetilformamida (3 x 150 ml). El grupo Fmoc se retiró mediante el tratamiento con piperidina al 20 % en N,N-dimetilformamida (1 x 5 min, 1 x 30 min, 2 x 150 ml). La resina se lavó con N,N-dimetilformamida (3 x 150 ml), 2-propanol (3 x 150 ml) y diclorometano (3 x 150 ml). La solución del éster 1 -terc-butílico del ácido (S)-2-(9H-fluoren-9-ilmetoxicarbonilamino)-pentanodioico (Fmoc-Glu-OtBu, 6,87 g, 16,2 mmol), tetrafluoroborato de O-(6-cloro-benzotriazol-1-il)-N,N,N',N'-tetrametiluronio (TCTU, 5,74 g, 16,2 mmol) y N,N-diisopropiletilamina (4,47 ml, 25,7 mmol) en N,N-dimetilformamida (150 ml) se añadió a la resina y la mezcla se agitó durante 2 horas. La resina se filtró y se lavó con N,N-dimetilformamida (3 x 150 ml), diclorometano (3 x 150 ml) y N,N-dimetilformamida (3 x 150 ml). El grupo Fmoc se retiró mediante el tratamiento con piperidina al 20 % en N,N-dimetilformamida (1 x 5 min, 1 x 30 min, 2 x 150 ml). La resina se lavó con N,N-dimetilformamida (3 x 150 ml), 2-propanol (3 x 150 ml) y diclorometano (3 x 150 ml). Una solución de ácido 16-((4-((terc-butoxicarbonil)amino)-2,2-dimetilbutoxi)sulfonil)hexadecanoico (6,62 g, 12,4 mmol), tetrafluoroborato de O-(6-cloro-benzotriazol-1-il)-N,N,N',N'-tetrametiluronio (Tc TU, 4,39 g, 12,4 mmol) y N,N-diisopropiletilamina (4,47 ml, 25,7 mmol) en mezcla de N,N-dimetilformamida/diclorometano (1/1, 150 ml) se añadió a la resina y la mezcla se agitó durante 2 horas. La resina se filtró y lavó con N,N-dimetilformamida (3 x 150 ml), metanol (5 x 150 ml) y diclorometano (10 x 150 ml). El producto se escindió de la resina mediante el tratamiento con 2,2,2-trifluoroetanol (150 ml) durante 24 horas. La resina se filtró y se lavó con diclorometano (3 x 150 ml). Las soluciones se combinaron, los solventes se evaporaron y el producto bruto (7,80 g) se purificó mediante cromatografía en columna rápida (Silicagel 60, 0,040-0,060 mm; eluyente: diclorometano/metanol 100:2 a diclorometano/metanol 100:10) para dar los compuestos intermedios como un sólido blanco.
Rendimiento: 4,00 g (42 %).
RF (SiO2, diclorometano/metanol 8:1): 0,50.
Espectro de RMN 1H (300 MHz, CDCl3, dH): 7,79-7,65 (m, 1 H); 7,36-7,20 (m, 1 H); 6,86 (d, J=7,5 Hz, 1 H); 4,49 4,63 (m, 1 H); 4,44-4,29 (m, 1 H); 4,07-3,93 (m, 4 H); 3,90 (s, 2 H); 3,77-3,35 (m, 16 H); 3,25-3,02 (m, 4 H); 2,44-1,75 (m, 8 H); 1,72-1,38 (m, 22 H); 1,38-1,18 (m, 22 H); 1,00 (m, 6 H).
LC-MS m/z: 1012,3 (M+H)+.
El compuesto intermedio mencionado más arriba (3,77 g, 3,73 mmol), N,N-diisopropiletilamina (1,75 ml, 10,1 mmol), [1,2,3]triazolo[4,5-b]piridin-1-ol (HOAt, 0,51 g, 3,73 mmol), clorhidrato de N-(3-dimetilaminopropil)-N'-etilcarbodiimida (EDC-HCl, 1,43 g, 7,46 mmol) se disolvieron en diclorometano (120 ml). Se añadió cloruro de 4-formil-bencil-amonio (5, 0,77 g, 4,48 mmol). La mezcla se agitó a temperatura ambiente durante 24 horas. Después de este tiempo la mezcla de reacción se evaporó, se disolvió en acetato de etilo (300 ml) y se lavó con solución acuosa 0,5 M de ácido clorhídrico (200 ml). La fase orgánica se separó, se lavó con agua (200 ml) y se secó sobre sulfato de magnesio. El acetato de etilo se evaporó y la mezcla bruta se purificó mediante cromatografía en columna rápida (Silicagel 60, 0,040-0,060 mm; eluyente: diclorometano a diclorometano/metanol 100:5) para dar el aldehído protegido como un sólido blanco.
Rendimiento: 3,00 g (71 %).
RF (SiO2, diclorometano/metanol 10:1): 0,70.
Espectro de RMN 1H (300 MHz, CDCl3, dH): 9,99 (s, 1 H); 7,85 (d, J=8,1 Hz, 2 H); 7,64-7,38 (m, 3 H); 7,14-6,97 (m, 1 H); 6,91-6,76 (m, 1 H); 6,54-6,43 (m, 1 H); 4,58 (d, J=6,2 Hz, 2 H); 4,47-4,32 (m, 1 H); 4,09 (s, 2 H); 3,88 (s, 2 H); 3,81-3,30 (m, 16 H); 3,22-3,02 (m, 4 H); 2,38-2,08 (m, 4 H); 1,96-1,71 (m, 5 H); 1,71-1,16 (m, 41 H); 0,99 (m, 6 H). LC-MS m/z: 1129,5 (M+H)+.
El aldehído protegido mencionado más arriba (3,00 g, 2,66 mmol) se agitó con mezcla de ácido trifluoroacético (15 ml) y agua (1 ml) durante 3 horas. Después de este tiempo la mezcla se evaporó varias veces con diclorometano y tolueno a presión reducida. El residuo se vertió en mezcla de agua/acetonitrilo (1/1, 15 ml). El pH se ajustó a 8,0 con solución acuosa saturada de fosfato trisódico y la solución resultante se agitó durante 20 minutos a 50 °C. El pH se ajustó a 6,0 con solución acuosa saturada de hidrogenosulfato de potasio. El residuo se desalinizó mediante cromatografía en fase inversa (DeltaPak, C18, 15 mm 50 mm x 500 mm, acetonitrilo/agua 5-15 %/15 min, 5 55 %/180 min TFA al 0,05 %). Los solventes se eliminaron mediante secado por congelación para dar el sustituyente como un polvo blanco.
Rendimiento: 0,66 g (28 %).
Espectro de RMN 1H (300 MHz, D2O, dH): 9,81 (s, 1 H); 7,79 (d, J=7,7 Hz, 2 H); 7,41 (d, J=7,9 Hz, 2 H); 4,44 (s, 2 H); 4,32-4,19 (m, 1 H); 4,05 (s, 2 H); 3,90 (s, 2 H); 3,74-3,43 (m, 12 H); 3,38-3,18 (m, 4 H); 2,83-2,60 (m, 2 H); 2,37-1,76 (m, 6 H); 1,76-1,37 (m, 4 H); 1,34-0,91 (m, 22 H).
LC-MS m/z: 873,8 (M+H)+.
N-((1-(4-Formilfenil)-3,12,21-trioxo-5,8,14,17-tetraoxa-2,11,20-triazatetracosan-24-il)sulfonil)-16-(1H-tetrazol-5-il)hexadecanamida

La resina Wang 0,68 mmol/g (20,5 g, 13,9 mmol) se dejó inflar en tetrahidrofurano (200 ml) durante 20 minutos. Una solución de ácido {2-[2-(9H-fluoren-9-ilmetoxicarbonilamino)-etoxi]-etoxi}-acético (Fmoc-Ado-OH, 16,1 g, 41,8 mmol) y 4-dimetilaminopiridina (DMAP, 0,17 g, 1,39 mmol) y N,N'-diisopropilcarbodiimida (DIC, 6,47 ml, 41,8 mmol) en tetrahidrofurano (200 ml) se añadió a la resina y la mezcla se agitó durante 18 horas. Después la resina se filtró y lavó con N,N-dimetilformamida (2 x 180 ml), diclorometano (2 x 180 ml) y N,N-dimetilformamida (2 x 180 ml). La resina se trató con una solución de anhídrido acético (13,2 ml, 139 mmol) y piridina (11,3 ml, 139 mmol) en N,N-dimetilformamida (180 ml). Después la resina se filtró y lavó con N,N-dimetilformamida (2 x 180 ml), diclorometano (2 x 180 ml) y N,N-dimetilformamida (2 x 180 ml). El grupo Fmoc se retiró mediante el tratamiento con piperidina al 20 % en N,N-dimetilformamida (1 x 5 min, 1 x 30 min, 2 x 180 ml). La resina se filtró y lavó con N,N-dimetilformamida (2 x 180 ml), diclorometano (2 x 180 ml) y N,N-dimetilformamida (2 x 180 ml). Una solución de ácido {2-[2-(9H-fluoren-9-ilmetoxicarbonilamino)-etoxi]-etoxi}-acético (Fmoc-Ado-OH, 10,8 g, 27,9 mmol), tetrafluoroborato de 3-óxido de 5-cloro-1-((dimetilamino)(dimetiliminio)metil)-1H-benzo[d][1,2,3]triazol (TCTU, 9,91 g, 27,9 mmol) y N,N-diisopropiletilamina (7,28 ml, 41,8 mmol) en N,N-dimetilformamida (180 ml) se añadió a la resina y la mezcla se agitó durante 2 horas. Después la resina se filtró y lavó con N,N-dimetilformamida (2 x 180 ml), diclorometano (2 x 180 ml) y N,N-dimetilformamida (2 x 180 ml). El grupo Fmoc se retiró mediante el tratamiento con piperidina al 20 % en N,N-dimetilformamida (1 x 5 min, 1 x 30 min, 2 x 180 ml). La resina se filtró y lavó con N,N-dimetilformamida (2 x 180 ml), diclorometano (2 x 180 ml) y N,N-dimetilformamida (2 x 180 ml). La solución de ácido 4-(N-(16-(1H-tetrazol-5-il)hexadecanoil)sulfamoil)butanoico (THA-SBA-OH, 8,91 g, 18,8 mmol), 1-((dimetilamino)(dimetiliminio)metil)-1H-[1,2,3]triazolo[4,5-b]piridina 3-óxido hexafluorofosfato (HATU, 7,16 g, 18,8 mmol) y N,N-diisopropiletilamina (5,71 ml, 32,8 mmol) en mezcla de N,N-dimetilformamida (90 ml) y diclorometano (90 ml) se añadió a la resina y la mezcla se agitó durante 18 horas.
La resina se filtró y lavó con N,N-dimetilformamida (2 x 180 ml), diclorometano (2 x 180 ml), 2-propanol (2 x 180 ml) y diclorometano (10 x 180 ml). El producto se escindió de la resina mediante el tratamiento con mezcla de ácido trifluoroacético (150 ml) y agua (7.5 ml) durante 1 hora. La resina se filtró y lavó con diclorometano (2 x 150 ml). El solvente se retiró a presión reducida y el residuo se trató con éter dietílico (100 ml). A una solución del intermedio
(7,90 g, 10,3 mmol) en tetrahidrofurano (100 ml) se añadió monohidrato de hidróxido de litio (1.74 g, 41.4 mmol) en agua (100 ml). La solución se agitó durante 18 horas. La solución se acidificó mediante solución acuosa al 10 % de hidrogenosulfato de potasio hasta lograr pH=3, seguido mediante saturación con cloruro de sodio. La fase orgánica se retiró, la fase acuosa se extrajo mediante acetato de etilo (1 x 300 ml). Las fases orgánicas combinadas se secaron sobre sulfato de sodio anhidro. El solvente se eliminó a presión reducida para dar el intermedio como un polvo blanco.
Rendimiento: 5,50 g (52 %).
Espectro de RMN 1H (300 MHz, AcOD-d4, dH): 4,22 (s, 2 H); 4,12 (s, 2 H); 3,83-3,61 (m, 12 H); 3,59-3,43 (m, 6 H); 3,02 (t, J=7,4 Hz, 2 H); 2,49 (t, J=7,3 Hz, 2 H); 2,41 (t, J=7,5 Hz, 2 H); 2,22-2,09 (m, 2 H); 1,89-1,75 (m, 2 H); 1,74 1,60 (m, 2 H); 1,47-1,26 (m, 22 H).
Una solución del compuesto mencionado más arriba (2,90 g, 3,80 mmol), clorhidrato de 4-aminometilbenzaldehído (0,78 g, 4,56 mmol), N,N'-diclohexilcarbodiimida (DCC, 0,78 g, 3,80 mmol) y 4-dimetilaminopiridina (DMAP, 1,02 g, 8,35 mmol) en diclorometano seco (100 ml) se agitó durante 18 horas. El precipitado se filtró y la solución se lavó con una solución acuosa de hidrogenosulfato de potasio al 10 % (2 x 100 ml). El solvente se retiró bajo presión reducida y el residuo se cristalizó a partir de tetrahidrofurano (30 ml). La purificación mediante cromatografía en columna rápida (Silicagel 60, 0,040-0,063 mm; eluyente: diclorometano/metanol, 20:1-5:1) dio el producto final como polvo amarillo pálido.
Rendimiento: 1,51 g (45 %).
Espectro RMN 1 H (300 MHz, AcOD-d4, dH): 9,96 (s, 1H); 7,91 (d, J=7,9 Hz, 2 H); 7,92 (d, J=7,9 Hz, 2 H); 4,63 (s, 2 H); 4,21 (s, 2 H); 4,08 (s, 2 H); 3,81-3,57 (m, 12 H); 3,54-3,41 (m, 6 H); 3,02 (t, J=7,4 Hz, 2 H); 2,47 (t, J=7,3 Hz, 2 H); 2,38 (t, J=7,4 Hz, 2 H); 2,19-2,07 (m, 2 H); 1,86-1,72 (m, 2 H); 1,70-1,57 (m, 2 H); 1,43-1,23 (m, 22 H).
Pureza por LC-MS: 100 %.
LC-MS Rt (Kinetex 4,6 mm x 50 mm, acetonitrilo/agua 20:50 a 100:0 0,1% FA): 3,58 min.
LC-MS m/z: 882,0 (M+H)+.
Se prepararon un total de 29 sustituyentes que se enumeran más abajo en la presente descripción, que especifica los elementos Z1-Z10 de cada uno de los sustituyentes individuales.


Métodos para la detección y caracterización
Métodos de LCMS
LCMS01 (véase la Tabla 1)
Tabla 1: Sistema de LC: Ac uit UPLC de Waters. Gradiente lineal: 5 % a 95 % de B.


LCMS027 (véase la Tabla 2)
Tabla 2: UPLC serie A ilent 1290 infinit LC/MSD TOF 6 min 5 % a 95 % de B 100 - 3200 amu C18

LCMS029 (véase la Tabla 3):
Tabla 3: Sistema Ac uit UPLC de Waters 6 min 35 min 5- 15-35 -100-100-5 % de B

C. Ejemplos de compuestos
C.1. Preparación de los ejemplos de compuestos
Ejemplo 1
N{293}-[4-[[[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]amino]metil]fenil]metil-[Ala299,Leu301,Ile307,Arg309,Lys310]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 2.
Compuesto preparado mediante el método general A y C
LCMS029: m/3 encontrada = 1743,9; m/4 encontrada = 1308,1; m/5 encontrada = 1046,7; masa calc. = 5229,1; masa encontrada = 5229,6
Ejemplo 2
N{293}-[4-[[[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]amino]metil]fenil]metil-[Leu301,Arg309]-LDL-R-(293-332)-péptido
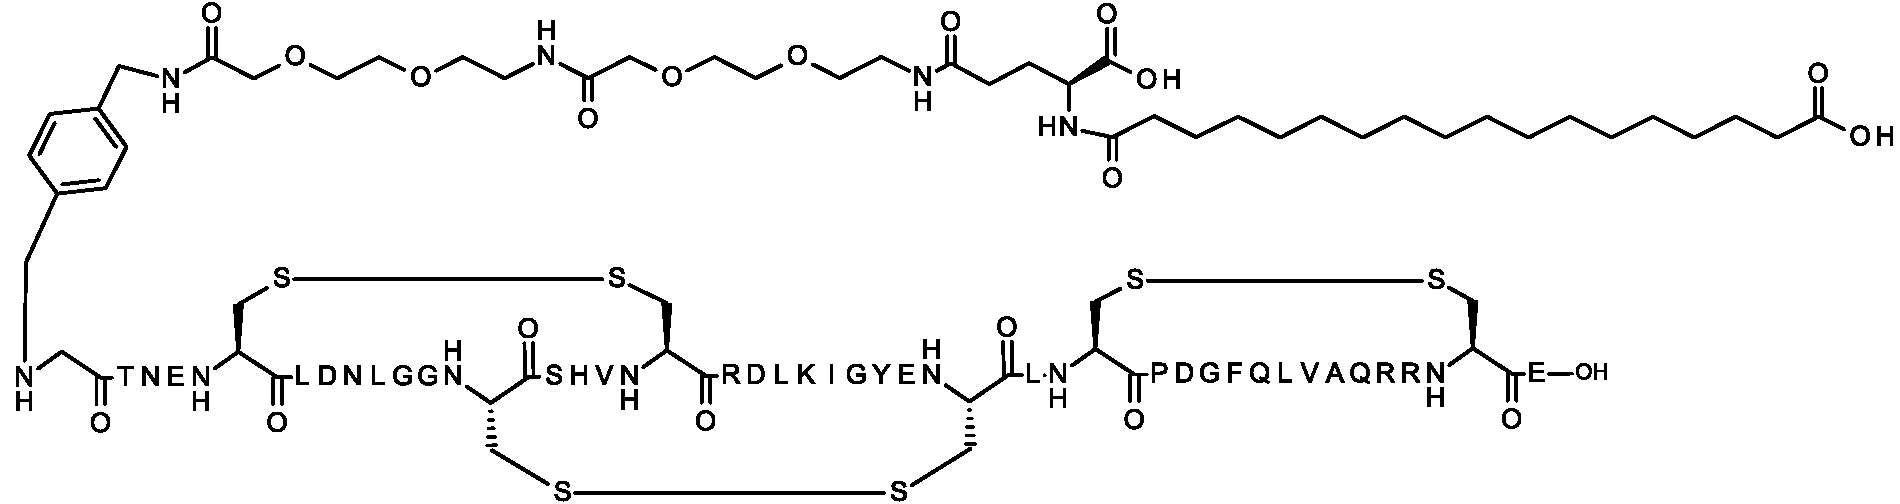
El péptido es la SEQ ID NO: 3.
Compuesto preparado mediante el método general A y C
LCMS029: m/3 encontrada = 1749,5; m/4 encontrada = 1312,4; m/5 encontrada = 1050,1; masa calc. = 5246,0; masa encontrada = 5246,4
Ejemplo 3
N{alfa}([Leu301,Arg309,Glu312]-LDL-R-(293-332)-péptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 4.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1314,6; m/5 encontrada = 1052,1; masa calc. = 5255,9
Ejemplo 4
N{épsilon-312}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 3.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1282,3; m/5 encontrada = 1026,3; masa calc. = 5126,8
Ejemplo 5
N{293}-[4-[[[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]amino]metil]fenil]metil-[Leu301,Arg309,Glu312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 6.
Compuesto preparado mediante el método general A y C
LCMS029: Masa calc. = 5246,92; masa encontrada = 5247,37
Ejemplo 6
N{épsilon-299}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Lys299,Leu301,Arg309,Glu312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 7.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1714,2; m/4 encontrada = 1286,1; masa calc. = 5140,85
Ejemplo 7
N{épsilon-330}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301 ,Arg309,Glu312,Lys330]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 8.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1700,8; m/4 encontrada = 1275,8; m/5 encontrada = 1020,9, masa calc. 5099,7; masa encontrada = 5099,75
Ejemplo 8
N{293}-[4-[[[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(16-sulfohexadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]amino]metil]fenil]metil-[Leu301 ,Arg309,Glu312]-LDL-R-(293-332)-péptido

23: El péptido es la SEQ ID NO: 6.
Compuesto preparado mediante el método general A y C
LCMS029: m/3 encontrada = 1757,1; m/4 encontrada = 1318,04; masa calc. = 5268,95; masa encontrada = 5269,39 Ejemplo 9
N{293}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-330}-[2-[2-[2-[[2-[2-[2
[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301 ,Arg309,Glu312,Lys330]-LDL-R-(293-332)-péptido

24: El péptido es la SEQ ID NO: 8.
Compuesto preparado mediante el método general B
LCMS029: m/3 encontrada = 1939,2; m/4 encontrada = 1454,2; masa calc. = 5815,6; masa encontrada = 5816,1 Ejemplo 10
N{épsilon-332}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301 ,Arg309,Glu312,Lys332]-LDL-R-(293-332)-péptido
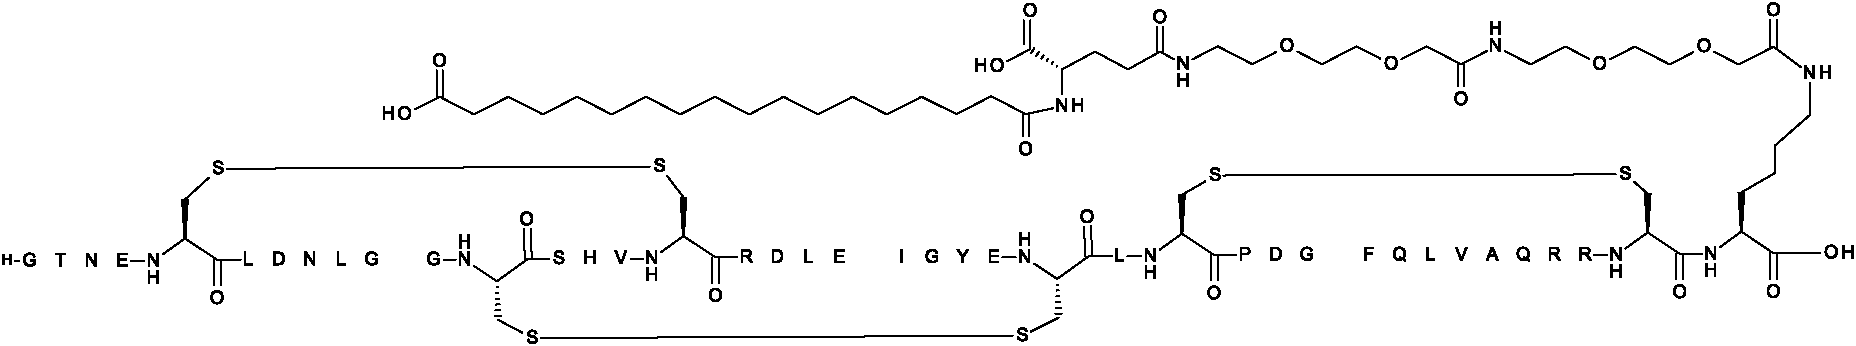
El péptido es la SEQ ID NO: 11.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1282,6; m/5 encontrada = 1026,3; masa calc. = 5126,8
Ejemplo 11
N{épsilon-293}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Lys293,Leu301 ,Arg309,Glu312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 12.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1300,6; m/5 encontrada = 1040,5; masa calc. = 5198,9
Ejemplo 12
N{alfa}(N{épsilon-293}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Lys293,Leu301,Arg309,Glu312]-LDL-R-(293-332)-péptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 13.
Compuesto preparado mediante el método general B
LCMS029: m/2 encontrada = 3022,4; m/3 encontrada = 2015,3; m/4 encontrada = 1511,8; m/5 encontrada = 1209,6; masa encontrada = 6043,6; masa calc. = 6042,9
Ejemplo 13
N{alfa}(N{épsilon-293}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Lys293,Leu301 ,Arg309,Glu312]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 13.
Compuesto preparado mediante el método general B
LCMS029: m/2 encontrada = 3030,4; m/3 encontrada = 2020,7; m/4 encontrada = 1515,7; m/5 encontrada = 1212,8; masa encontrada = 6059,7; masa calc. = 6058,8
Ejemplo 14
N{alfa}(N{épsilon-332}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino"]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301 ,Arg309,Glu312,Lys332]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 15.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1497,4; m/5 encontrada = 1198,3; masa calc. = 5986,7
Ejemplo 15
N{alfa}(N{épsilon-330}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino~]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys330]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 16.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1987,7; m/4 encontrada = 1491,0; m/5 encontrada = 1193,0; masa calc. = 5959,7 Ejemplo 16
N{alfa}(N{épsilon-321}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys321]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1500,9; m/5 encontrada = 1201,2; masa calc. = 6000,8
Ejemplo 17
N{alfa}(N{épsilon-312}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilaminojbutanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1498,2; m/5 encontrada = 1198,7; masa calc. = 5986,7
Ejemplo 18
N{alfa}([Leu301 ,Arg309,Glu312,Glu321]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 19.
Compuesto preparado mediante el método general B
LCMS027: m/2 encontrada = 2635,7; m/3 encontrada = 1757,5; m/4 encontrada = 1318,4; m/5 encontrada = 1054,9; masa calc. = 5270,0; masa encontrada = 5270,5
Ejemplo 19
N{293}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 6.
Compuesto preparado mediante el método general A y D
LCMS01: m/1 encontrada = 5127,8; m/3 encontrada = 1710,0; m/4 encontrada = 1282,3; m/5 encontrada = 1026,5; masa calc. = 5127,8
Ejemplo 20
N{épsilon-321}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys321]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 21.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1286.1; m/5 encontrada = 1029.1; masa calc. = 5140.9
Ejemplo 21
N{épsilon-324}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys324]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 22.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1282,9; m/5 encontrada = 1026,5; masa calc. = 5127,8
Ejemplo 22
N{293}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Gln312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 23.
Compuesto preparado mediante el método general B
LCMS029: m/3 encontrada = 1709,8; m/4 encontrada = 1282,6; masa calc. = 5126,8; masa encontrada = 5127,3 Ejemplo 23
N{épsilon-332}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Glu321,Lys332]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 24.
Compuesto preparado mediante el método general B
LCMS029: m/2 encontrada = 2571,2; m/3 encontrada = 1714,5; m/4 encontrada = 1286,1; m/z encontrada = 5141,4; masa calc. = 5140,9
Ejemplo 24
N{épsilon-293}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Lys293,Leu301,Arg309,Glu312,Glu321]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 25.
Compuesto preparado mediante el método general B
LCMS029: m/2 encontrada = 2607,2; m/3 encontrada = 1738,5; m/4 encontrada = 1304,1; masa encontrada = 5213,5; masa calc. = 5212,9
Ejemplo 25
N{alfa-293}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-293}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Lys293,Leu301,Arg309,Glu312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 26.
Compuesto preparado mediante el método general B
LCMS029: m/4 encontrada = 1479,7; masa calc. = 5914,8 Da; masa encontrada = 5914,3
Ejemplo 26
N{épsilon-300}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Lys300,Leu301,Arg309,Glu312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 27.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1286,9; m/5 encontrada = 1029,7; masa calc. = 5141,8
Ejemplo 27
N{épsilon-293}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-294}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Lys293,Lys294,Leu301,Arg309,Glu312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 28.
Compuesto preparado mediante el método general B
LCMS01: m/1 encontrada = 5957,6; m/4 encontrada = 1490,4; m/5 encontrada = 1192,3; m/1 calc. = 5957,7 Ejemplo 28
N{épsilon-293}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-312}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Lys293,Leu301,Arg309]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 29.
Compuesto preparado mediante el método general B
LCMS01: m/1 encontrada = 5929,4; m/4 encontrada = 1483,3; m/5 encontrada = 1186,8; m/1 calc. = 5929,7 Ejemplo 29
N{épsilon-309}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Lys309,Glu312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 30.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1700,8; m/4 encontrada = 1275,8; m/5 encontrada = 1020,9; masa calc. = 5099,8 (1A) Ejemplo 30
N{épsilon-318}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys318]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 31.
LCMS01: m/4 encontrada = 1286,5; m/5 encontrada = 1029,5; masa calc. = 5142,8
Ejemplo 31
N{alfa}(N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys313]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 32.
Compuesto preparado mediante el método general B
LCMS01: m/1 encontrada = 6002,8; m/4 encontrada = 1501,6; m/5 encontrada = 1201,5; m/1 calc. = 6002,7 Ejemplo 32
N{épsilon-326}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys326]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 33.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1719,8; m/4 encontrada = 1290,1; m/5 encontrada = 1032,3; masa calc. = 5156,8 Ejemplo 33
N{épsilon-325}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys325]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 34.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1715,1; m/4 encontrada = 1286,6; m/5 encontrada = 1029,5; masa calc. = 5142,8 Ejemplo 34
N{épsilon-323}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys323]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 35.
Compuesto preparado mediante el método general B
LCMS01: m/1 encontrada = 5108,8; m/3 encontrada = 1703,8; m/4 encontrada = 1278,1; m/5 encontrada = 1022,5 Ejemplo 35
N{épsilon-322}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys322]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 36.
Compuesto preparado mediante el método general B
LCMS01: m/1 encontrada = 5198,9; m/3 encontrada = 1733,8; m/4 encontrada = 1300,6; m/5 encontrada = 1040,7 Ejemplo 36
N{épsilon-320}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys320]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 37.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1720,4; m/4 encontrada = 1290,3; m/5 encontrada = 1032,5; masa calc. = 5158,8 Ejemplo 37
N{épsilon-329}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys329]-LDL-R-(293-332)-péptido
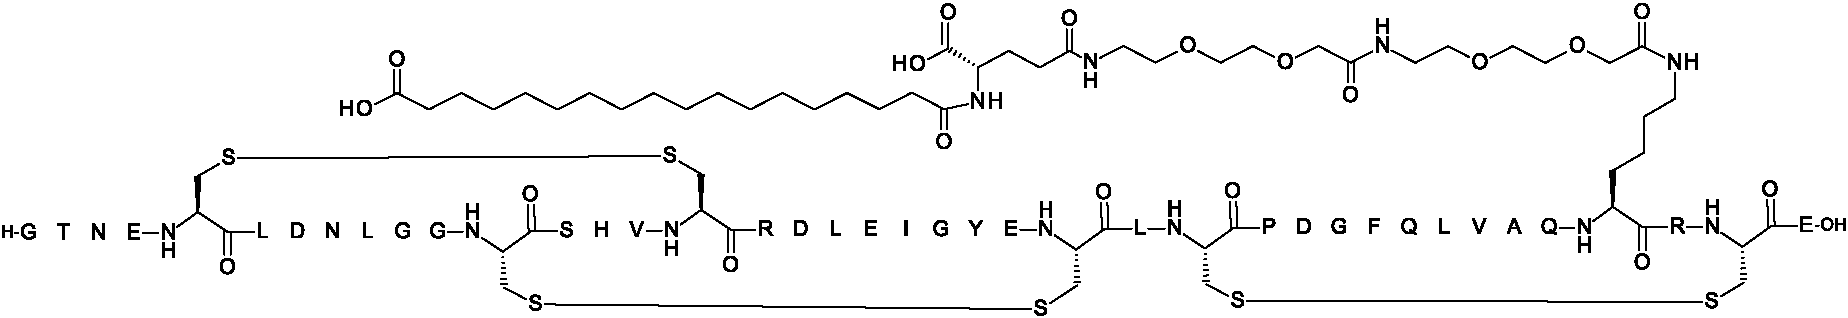
El péptido es la SEQ ID NO: 38.
Compuesto preparado mediante el método general B
LCMS029: m/2 encontrada = 2550,7; m/3 encontrada = 1700,8; m/4 encontrada = 1275,9; masa calc. = 5099,8; masa encontrada = 5100,5
Ejemplo 38
N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys313]-LDL-R-(293-332)-péptido
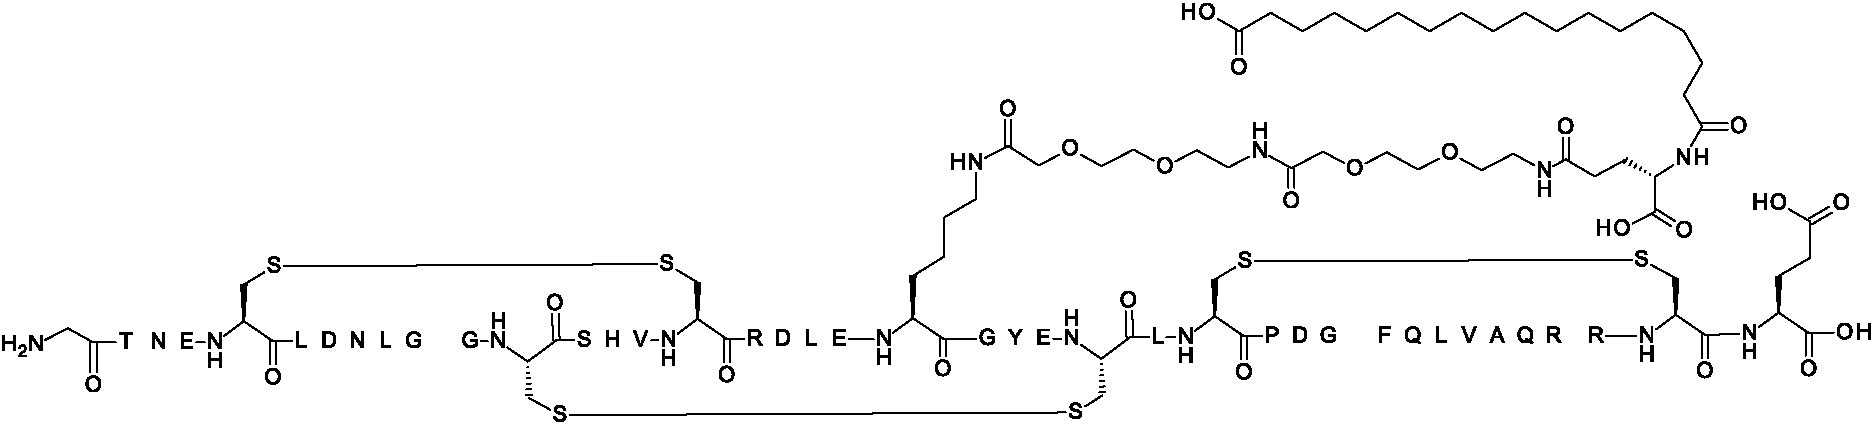
El péptido es la SEQ ID NO: 39.
Compuesto preparado mediante el método general B
LCMS01: m/1 encontrada = 5143,0; m/4 encontrada = 1286,0; m/5 encontrada = 1029,0; m/1 calc. = 5142,8 Ejemplo 39
N{épsilon-328}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys328]-LDL-R-(293-332)-péptido
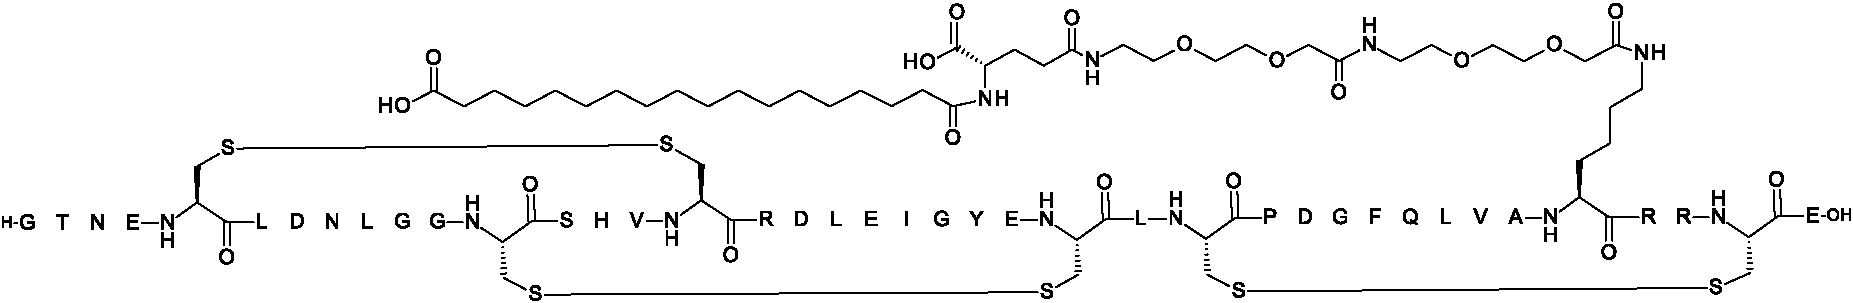
El péptido es la SEQ ID NO: 40.
Compuesto preparado mediante el método general B
LCMS029: m/2 encontrada = 2564,7; m/3 encontrada = 1710,2; m/4 encontrada = 1282,9; encontrada 5127,8; masa calc. = 5128,5
Ejemplo 40
N{épsilon-316}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys316]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 41.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1709,7; m/4 encontrada = 1282,3; m/5 encontrada = 1026,1; masa calc. = 5126,8 Ejemplo 41
N{épsilon-315}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys315]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 42.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1698,3; m/4 encontrada = 1273,8; m/5 encontrada = 1019,3; m/1 calc. = 5092,8 Ejemplo 42
N{alfaX[His300,Leu301,Arg309,Arg312]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 43.
Compuesto preparado mediante el método general B
LCMS01: m/1 encontrada = 5306,3; m/3 encontrada = 1768,7; m/4 encontrada = 1327,1; m/5 encontrada = 1061,7 Ejemplo 43
N{épsilon-314}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys314]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 44.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1300,2; m/5 encontrada = 1040,2; masa calc. = 5198,9
Ejemplo 44
N{épsilon-311}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301 ,Arg309,Lys311,Glu312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 45.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1714,9; m/4 encontrada = 1286,2; m/5 encontrada = 1029,2; masa calc. = 5142,8 Ejemplo 45 (comparador, no de acuerdo con las reivindicaciones)
N{épsilon-307}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Lys307,Arg309,Glu312]-LDL-R-(293-332)-péptido
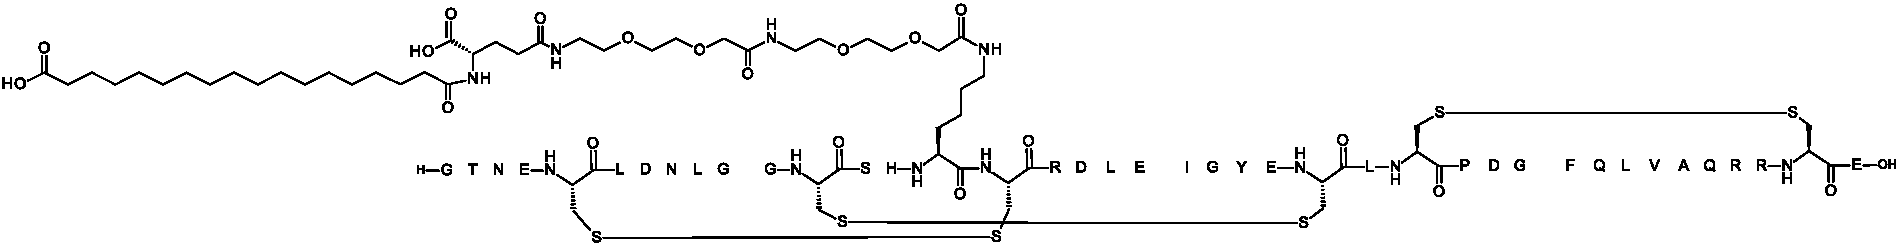
El péptido es la SEQ ID NO: 46.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1919,8; m/4 encontrada = 1290,1; m/5 encontrada = 1032,3; masa calc. = 5156,8 Ejemplo 46
N{alfa}([Leu301,Ser309,Arg312]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 47.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1738,8; m/4 encontrada = 1304,1; m/5 encontrada = 1043,5; masa encontrada = 5214,3 Ejemplo 47
N{alfa}([Leu301,Ser309,Glu312]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 48.
Compuesto preparado mediante el método general B
LCMS01: m/1 encontrada = 5187,2; m/3 encontrada = 1729,7; m/4 encontrada = 1297,2; m/5 encontrada = 1038,4; m/1 calc. = 5186,8
Ejemplo 48
Ala299,Leu301,Ile307,Arg309,Lys310]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 2.
Compuesto preparado mediante el método general A
LCMS01: m/3 encontrada = 1465,3; m/4 encontrada = 1099,3; m/5 encontrada = 879,6; calc. = 4391,0
Ejemplo 49
[Leu301,Arg309]-LDL-R-(293-332)-péptido
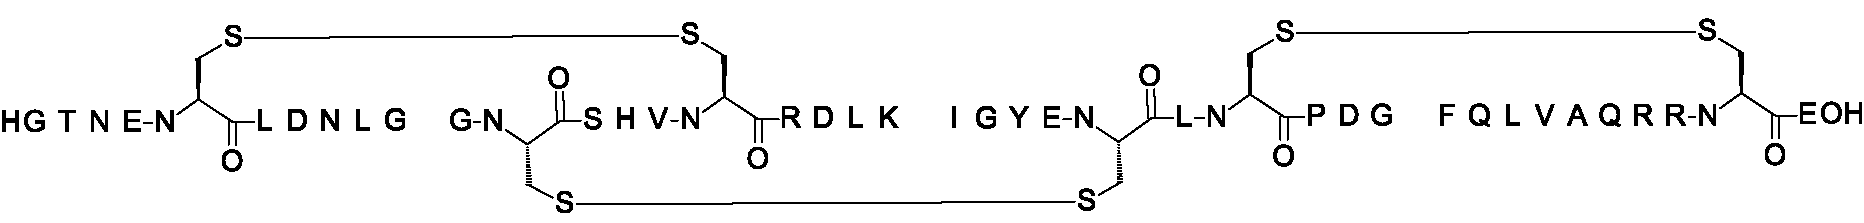
El péptido es la SEQ ID NO: 3.
Compuesto preparado mediante el método general A.
LCMS01: m/3 encontrada = 1470,3; m/4 encontrada = 1103,0; m/5 encontrada = 882,6; calc. = 4407,9
Ejemplo 50
[Leu301,Arg309,Glu312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 6.
Compuesto preparado mediante el método general A.
LCMS01: m/3 encontrada = 1471,3; m/4 encontrada = 1103,7; m/5 encontrada = 883,2; calc. = 4411,9 Ejemplo 51
N{293}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Tyr306,Ser309,Glu312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 49.
Compuesto preparado mediante el método general B
LCMS029: m/3 encontrada = 1695,8; masa calc. = 5085,1
Ejemplo 52
N{alfa-293}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Asn293,Leu301,Ser309,Glu312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 50.
LCMS29: m/3 encontrada = 1706,1, masa calc. = 5115,7
Compuesto preparado mediante el método general B
Ejemplo 53
N{épsilon-306}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Lys306,Arg309,Glu312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 51.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1707,0; m/4 encontrada = 1280,3; m/5 encontrada = 1024,4; masa calc. = 5118,8
Ejemplo 54
N{épsilon-305}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Lys305,Arg309,Glu312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 52.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1723,8; m/4 encontrada = 1292,8; m/5 encontrada = 1034,4; masa calc. = 5168,8 Ejemplo 55
N{épsilon-303}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Lys303,Arg309,Glu312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 53.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1733,7; m/4 encontrada = 1300,3; m/5 encontrada = 1040,5; masa calc. = 5198,9 Ejemplo 56 (comparador, no de acuerdo con las reivindicaciones)
N{épsilon-302}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Lys302,Arg309,Glu312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 54.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1733,7; m/4 encontrada = 1300,3; m/5 encontrada = 1040,5; masa calc. = 5198,9 Ejemplo 57
N{alfa}([Asn293,His300,Leu301 ,Arg309,Arg312]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys;

El péptido es la SEQ ID NO: 55.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1341,5; m/5 encontrada = 1073,3; masa calc. = 5363
Ejemplo 58 (comparador, no de acuerdo con las reivindicaciones)
N{épsilon-301}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Lys301,Arg309,Glu312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 56.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1715,2; m/4 encontrada = 1286,6; m/5 encontrada = 1029,5; masa calc. = 5142,8 Ejemplo 59 (comparador, no de acuerdo con las reivindicaciones)
N{épsilon-298}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Lys298,Leu301,Arg309,Glu312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 57.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1715,1; m/4 encontrada = 1286,3; m/5 encontrada = 1029,3; m/z calc. = 5142,8 Ejemplo 60
N{alfa}([Asn293,Leu301,Arg309,Arg312]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 58.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1780,7; m/4 encontrada = 1335,5; m/5 encontrada = 1068,4; masa calc. = 5340,1 Ejemplo 61
N{épsilon-332}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Ile307,Lys332]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 59.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1700,0; m/4 encontrada = 1275,1; m/5 encontrada = 1020,3; masa calc. = 5097,8 Ejemplo 62
N{épsilon-332}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Tyr306,Glu312,Lys332]-LDL-R-(293-332)-péptido;

El péptido es la SEQ ID NO: 60.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1704,3; m/4 encontrada = 1278,5; m/5 encontrada = 1030,4; m/z calc. = 5110,8 Ejemplo 63
N{épsilon-332}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Ile307,Glu312,Lys332]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 61.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1700,3; m/4 encontrada = 1275,2; m/5 encontrada = masa calc. = 5098,8 Ejemplo 64
N{293}-[4-[[[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]amino]metil]fenil]metil-[His300,Leu301,Arg309]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 62.
Compuesto preparado mediante el método general A C
LCMS01: m/3 encontrada = 1757,1; m/4 encontrada = 1318,1; m/5 encontrada = 1054,2; masa calc. = 5269,0 Ejemplo 65 (comparador, no de acuerdo con las reivindicaciones)
N{293}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Pro300,Leu301,Ile307,Arg309,Glu312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 5.
Compuesto preparado mediante el método general B
LCMS029: m/3 encontrada = 1709,1; masa calc. = 5124,8
Ejemplo 66
N{alfa}([Asn293,Leu301,Ile307,Arg309,Asp312]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 9.
Compuesto preparado mediante el método general B
LCMS029: m/4 encontrada = 1329,1; masa calc. = 5313,0
Ejemplo 67
N{alfa}([Asn293,Leu301,Arg309,Asp312]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 10.
Compuesto preparado mediante el método general B
LCMS029: m/4 encontrada = 1325,6; masa calc. = 5299,0
Ejemplo 68
N{293}-[4-[[[2-[2-[2-[[2-[2-[2-[4-[16-(1 H-tetrazol-5-il)hexadecanoilsulfamoil]butanoilamino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]amino]metil]fenil]metil-[Leu301,Arg309,Glu312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 6.
Compuesto preparado mediante el método general C
LCMS029: m/4 encontrada = 1320,1; masa calc. = 5276,98
Ejemplo 69
N{épsilon-328}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys328,His329]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 6.
Compuesto preparado mediante el método general B
LCMS029: m/4 encontrada = 1278,09; masa calc. = 5108,8 Da
Ejemplo 70 (comparador, no de acuerdo con las reivindicaciones)
N{épsilon-332}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Asp295,Leu301,Arg309,Glu312,Lys332]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 20.
Compuesto preparado mediante el método general B
LCMS029: m/4 encontrada = 1282,84; masa calc. = 5127,8 Da
Ejemplo 71
N{épsilon-312}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[His300,Leu301,Arg309]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 62.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1717,5 m/4 encontrada = 1288,2 m/5 encontrada = 1030,4 - masa calc. = 5149,9 -Ejemplo 72
N{293}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[His300,Leu301,Ile307,Arg309,Glu312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 26.
Compuesto preparado mediante el método general B
LCMS029: m/4 encontrada = 1292,1; masa calc. = 5164,8 Da
Ejemplo 73
N{épsilon-296}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Lys296,Leu301 ,Arg309,Glu312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 63.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1709,9; m/4 encontrada = 1282,6; masa calc. 5126,8
Ejemplo 74
N{épsilon-294}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Lys294,Leu301 ,Arg309,Glu312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 64.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1289,7; m/5 encontrada = 1031,7; masa calc. = 5154,8
Ejemplo 75
N{épsilon}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys[Leu301,Arg309,Glu312]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 65.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1752,9; m/4 encontrada = 1315,0; masa calc. = 5255,9
Ejemplo 76
N{épsilon-328}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Gly294,Leu301,Arg309,Glu312,Lys328],des-Gly293-LDL-R-(294-332)-péptido

El péptido es la SEQ ID NO: 66.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1676,6 m/4 encontrada = 1257,7 m/5 encontrada = 1006 )
-Masa calc. = 5026,7
Ejemplo 77
N{alfaH[Leu301,Asp306,Arg309,Glu312,Gly324]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 67.
Compuesto preparado mediante el método general B
LCMS029: m/3 encontrada = 1721,8; masa calc. = 5162,8 Da
Ejemplo 78
N{alfa}(N{293}-[2-[2-[2-[[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Asp306,Arg309,Glu312]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 68.
Compuesto preparado mediante el método general B
LCMS029: m/3 encontrada = 1528,7; masa calc. = 6110,8 Da
Ejemplo 79
N{alfa}(N{épsilon-321H2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[10-(4-carboxifenoxi)decanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301 ,Arg309,Glu312,Lys321]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[10-(4-carboxifenoxi)decanoilamino]butanoil]amino]etoxi]etoxi]acetil]ammo]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 17.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1493,9; m/5 encontrada = 1195,5; masa calc. = 5972,7
Ejemplo 80
N{alfa}([Leu301,Arg309,Glu312]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(15-carboxipentadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 4.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1743,6; m/4 encontrada = 1307,9; m/5 encontrada = 1046,4 masa calc. = 5227,9 Ejemplo 81
N{alfa}([Leu301,Arg309,Glu312]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(19-carboxinonadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 4.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1762,3; m/4 encontrada = 1321,7; m/5 encontrada = 1057,8; masa calc. = 5284,0 Ejemplo 82
N{alfa}([Leu301,Arg309,Glu312]-LDL-R-(293-332)-peptidil)-N{épsilon}[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]Lys

El péptido es la SEQ ID NO: 4.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1656,2; m/4 encontrada = 1242,4; m/5 encontrada = 994,0; masa calc. = 4965,6 Ejemplo 83
N{alfa}(N{épsilon-321}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(13-carboxitridecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys321]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(13-carboxitridecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 17.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1958,5; m/4 encontrada = 1468,9; m/5 encontrada = 1175,3; masa calc. = 5872,7 Ejemplo 84
N{alfa}(N{épsilon-321}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(15-carboxipentadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys321]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(15-carboxipentadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 17
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1483,1; m/5 encontrada = 1186,6; masa calc. = 5928,8
Ejemplo 85
N{alfa}(N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[10-(4-carboxifenoxi)decanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[His300,Leu301,Arg309,Glu312,Lys313]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[10-(4-carboxifenoxi)decanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 69.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1500,1 m/5 encontrada = 1200,3 m/z encontrada = 1000. masa calc. = 5997,7 Ejemplo 86
N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-328}-[2-[2-[2-[[2-[2
[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301 ,Arg309,Glu312,Lys313,Lys328]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 70.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1469,3; m/5 encontrada = 1175,8; masa calc. = 5874,6
Ejemplo 87
N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-324}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301 ,Arg309,Glu312,Lys313,Lys324]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO:71.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1469,1; m/5 encontrada = 1175,5; masa calc. = 5874,6
Ejemplo 88
N{293}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301 ,Arg309,Glu312,Lys313]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 39.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1469,3; m/5 encontrada = 1175,7; masa calc. = 5874,5
Ejemplo 89
N{alfa}(N{épsilon-324}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino"]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys324]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO:72.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1497,6; m/5 encontrada = 1198,3; masa calc. = 5987,7
Ejemplo 90
N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-321}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys313,Lys321]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 73.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1472,6; m/5 encontrada = 1178,3; masa calc. = 5887,6
Ejemplo 91
N{alfa}(N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[10-(4-carboxifenoxi)decanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[His300,Leu301,Arg309,Glu312,Lys313],des-Gly293-LDL-R-(294-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[10-(4-carboxifenoxi)decanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 74.
Compuesto preparado mediante el método general B
LC-MS: m/3 encontrada = 1981, m/4 = 1486: Masa calculada = 5940,6
Ejemplo 92
N{alfa}(N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[His300,Leu301,Arg309,Glu312,Lys313]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 39.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1507,3 m/5 encontrada = 1205,9 masa calc. = 6025,7
Ejemplo 93
N{292}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-Ala[Leu301,Arg309,Glu312,Lys313]-LDL-R-(293-332)-péptido
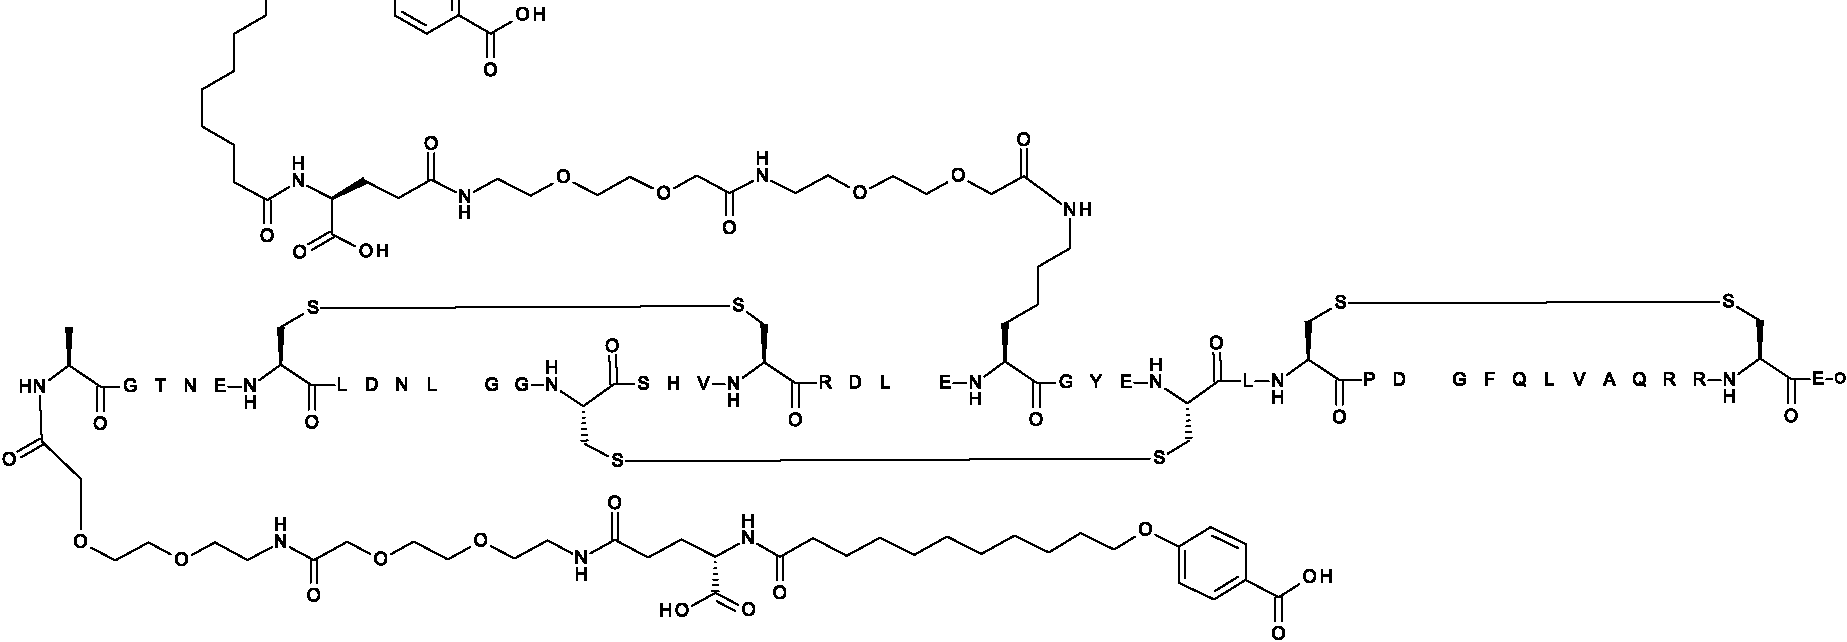
El péptido es la SEQ ID NO: 75.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1487,1; m/5 encontrada = 1190,0; masa calc. =5945,6
Ejemplo 94
N{294}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys313],des-Gly293-LDL-R-(294-332)-péptido

El péptido es la SEQ ID NO: 76.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1455,1; masa calc. = 5817,5
Ejemplo 95
N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys313],des-Gly293-LDL-R-(294-332)-péptido
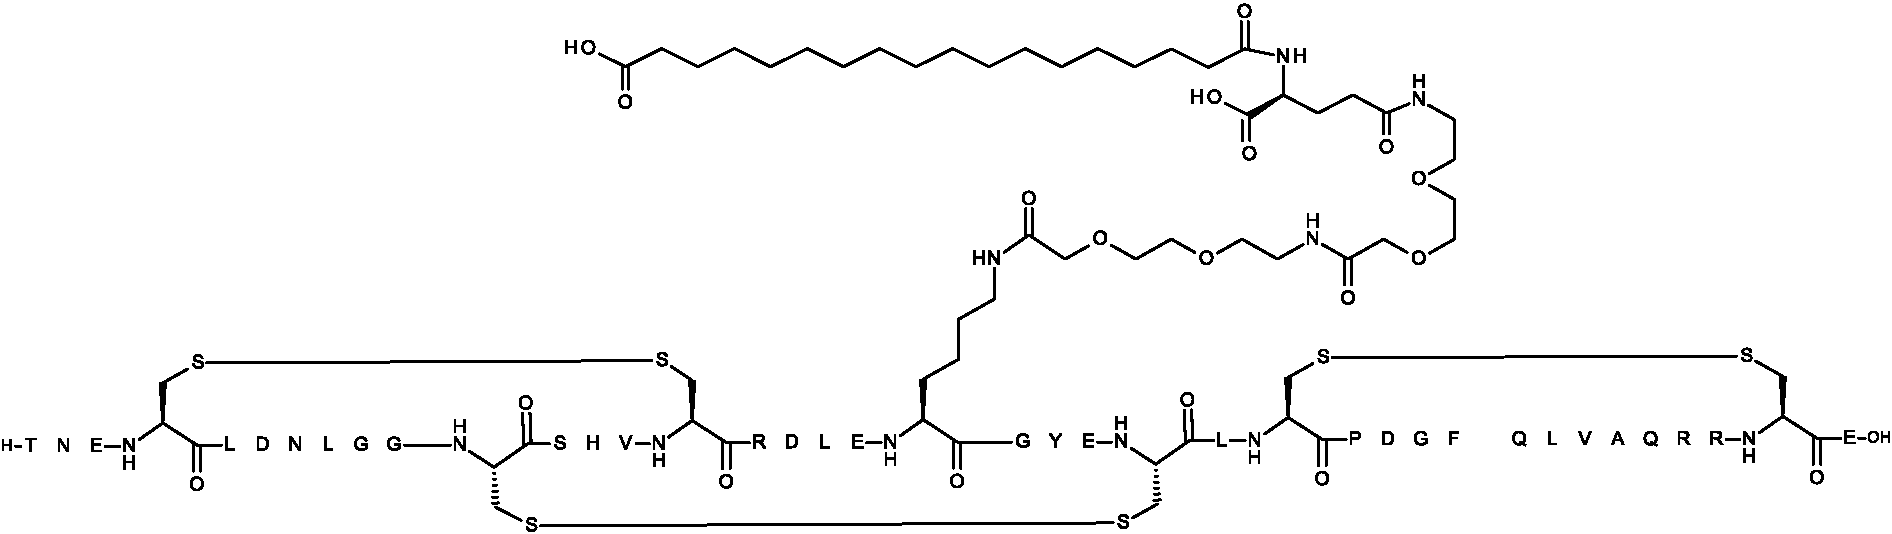
El péptido es la SEQ ID NO: 76.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1272,4; m/5 encontrada = 1017,9; masa calc. = 5085,7
Ejemplo 96
N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-332}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys313,Lys332]-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 77.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1469,1; m/5 encontrada = 1175,5; masa calc. =5873,6
Ejemplo 97
N{alfa}(N{épsilon-328}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino"]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys328]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 78.
Compuesto preparado mediante el método general B
LCMS28: m/3 encontrada = 1996,9; m/4 encontrada = 1497,9; masa calc. = 5987,7
Ejemplo 98
N{alfa}(N{épsilon-313}-[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]-[Leu301,Arg309,Glu312,Lys313]-LDL-R-(293-332)-peptidil)-N{épsilon}[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]Lys

El péptido es la SEQ ID NO:32.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1808,1; m/4 encontrada = 1356,4; m/5 encontrada = 1085,3; masa calc. = 5422,1 Ejemplo 99
N{Alpha}(N{Epsilon-313H(4S)-4-carboxi-4-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]butanoil][Leu301,Arg309,Glu312,Lys313]-LDL-R(293-332)--peptidil)-N{épsilon}[(4S)-4-carboxi-4-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]butanoil]Lys

El péptido es la SEQ ID NO: 32.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1894,2; m/4 encontrada = 1420,9; m/5 encontrada = 1136,9; masa calc. = 5680,3 Ejemplo 100
N{alfa}(N{épsilon-313}-[2-[[2-[[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]acetil]amino]acetil]amino]acetil]-[Leu301,Arg309,Glu312,Lys313]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[[2-[[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]acetil]amino]acetil]amino]acetil]Lys

El péptido es la SEQ ID NO: 32.
Compuesto preparado mediante el método general B
LCMS01: m/3 encontrada = 1922,2; m/4 encontrada = 1441,9; m/5 encontrada = 1153,7; masa calc. = 5764,4 Ejemplo 101
N{alfa}(N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys313]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 32.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1566,2; m/5 encontrada = 1252,9; masa calc. = 6260,9
Ejemplo 102
N{alfa}(N{épsilon-313H2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[10-(3-carboxifenoxi)decanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301 ,Arg309,Glu312,Lys313]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[10-(3-carboxifenoxi)decanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

El péptido es la SEQ ID NO: 32.
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada=1494,6; m/5= 1195,9 masa calc. = 5974,6
Ejemplo 103
Ala299,Leu301,Ile307,Arg309-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 79.
Compuesto preparado mediante el método general A.
LCMS01: m/2 encontrada = 2191,4; m/3 encontrada = 1461,0; Cale = 4381,0
Ejemplo 104 (comparador, no de acuerdo con las reivindicaciones)
Leu301,Arg309,Lys310-LDL-R-(293-332)-péptido
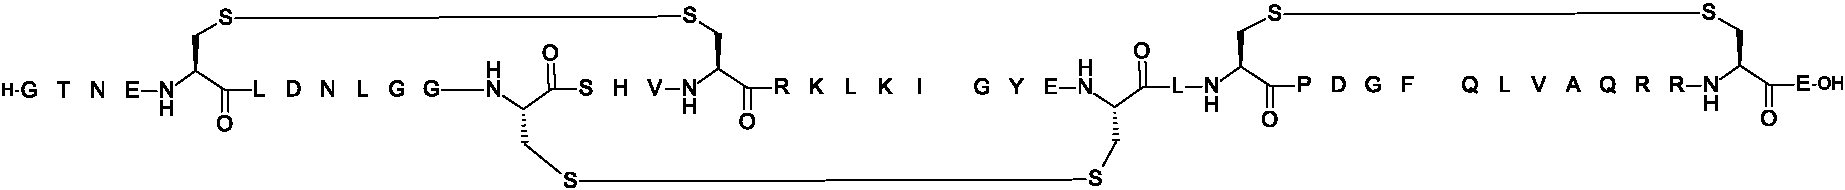
El péptido es la SEQ ID NO: 80.
Compuesto preparado mediante el método general A
LCMS01: m/3 encontrada = 1475,3; m/4 encontrada = 1107,0; Calc = 4424,0
Ejemplo 105
Leu301-LDL-R-(293-332)-péptido

El péptido es la SEQ ID NO: 81.
Compuesto preparado mediante el método general A
LCMS01: m/3 encontrada = 1456,3; m/4 encontrada = 1217,0; Calc = 4368,9
Ejemplo 106
N{alfa}([His300,Leu301,Arg309,Glu312]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

La cadena principal del péptido es la SEQ ID NO: 82.
Compuesto preparado mediante el método general B
LCMS027: m/3 encontrada = 1760,5; m/4 encontrada = 1320,6; m/5 encontrada = 1056,7; masa calc. = 5279,0 Ejemplo 107
N{alfa}(N{293}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

La cadena principal del péptido es la SEQ ID NO: 4
Compuesto preparado mediante el método general B
LCMS29: m/3 encontrada = 1996,9; m/4 encontrada = 1497,9; m/5 encontrada = 1198,6; masa calc. = 5987,7 Ejemplo 108
N{alfa}(N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[10-(4-carboxifenoxi)decanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[His300,Leu301,Arg309,Glu312,Lys313]-LDL-R-(295-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[10-(4-carboxifenoxi)decanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

La cadena principal del péptido es la SEQ ID NO: 83
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1460,8; m/5 encontrada = 1168,7; masa calc. = 5839,5
Ejemplo 109
N{alfa}(N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[13-(3-hidroxi-1,2-oxazol-5-il)tridecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[His300,Leu301,Arg309,Glu312,Lys313]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[13-(3-hidroxi-1,2-oxazol-5-il)tridecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

La cadena principal del péptido es la SEQ ID NO: 69
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1495,0; m/5 encontrada = 1196,0; masa calc. = 5975,7
Ejemplo 110
N{alfa}(N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[13-(3-hidroxi-1,2-oxazol-5-il)tridecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys313]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[13-(3-hidroxM,2-oxazol-5-il)tridecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

La cadena principal del péptido es la SEQ ID NO: 32
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1489,0; m/5 encontrada = 1191,0; masa calc. = 5952,7
Ejemplo 111
N{alfa}(N{épsilon-309}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilaminojbutanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Lys309,Glu312]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys
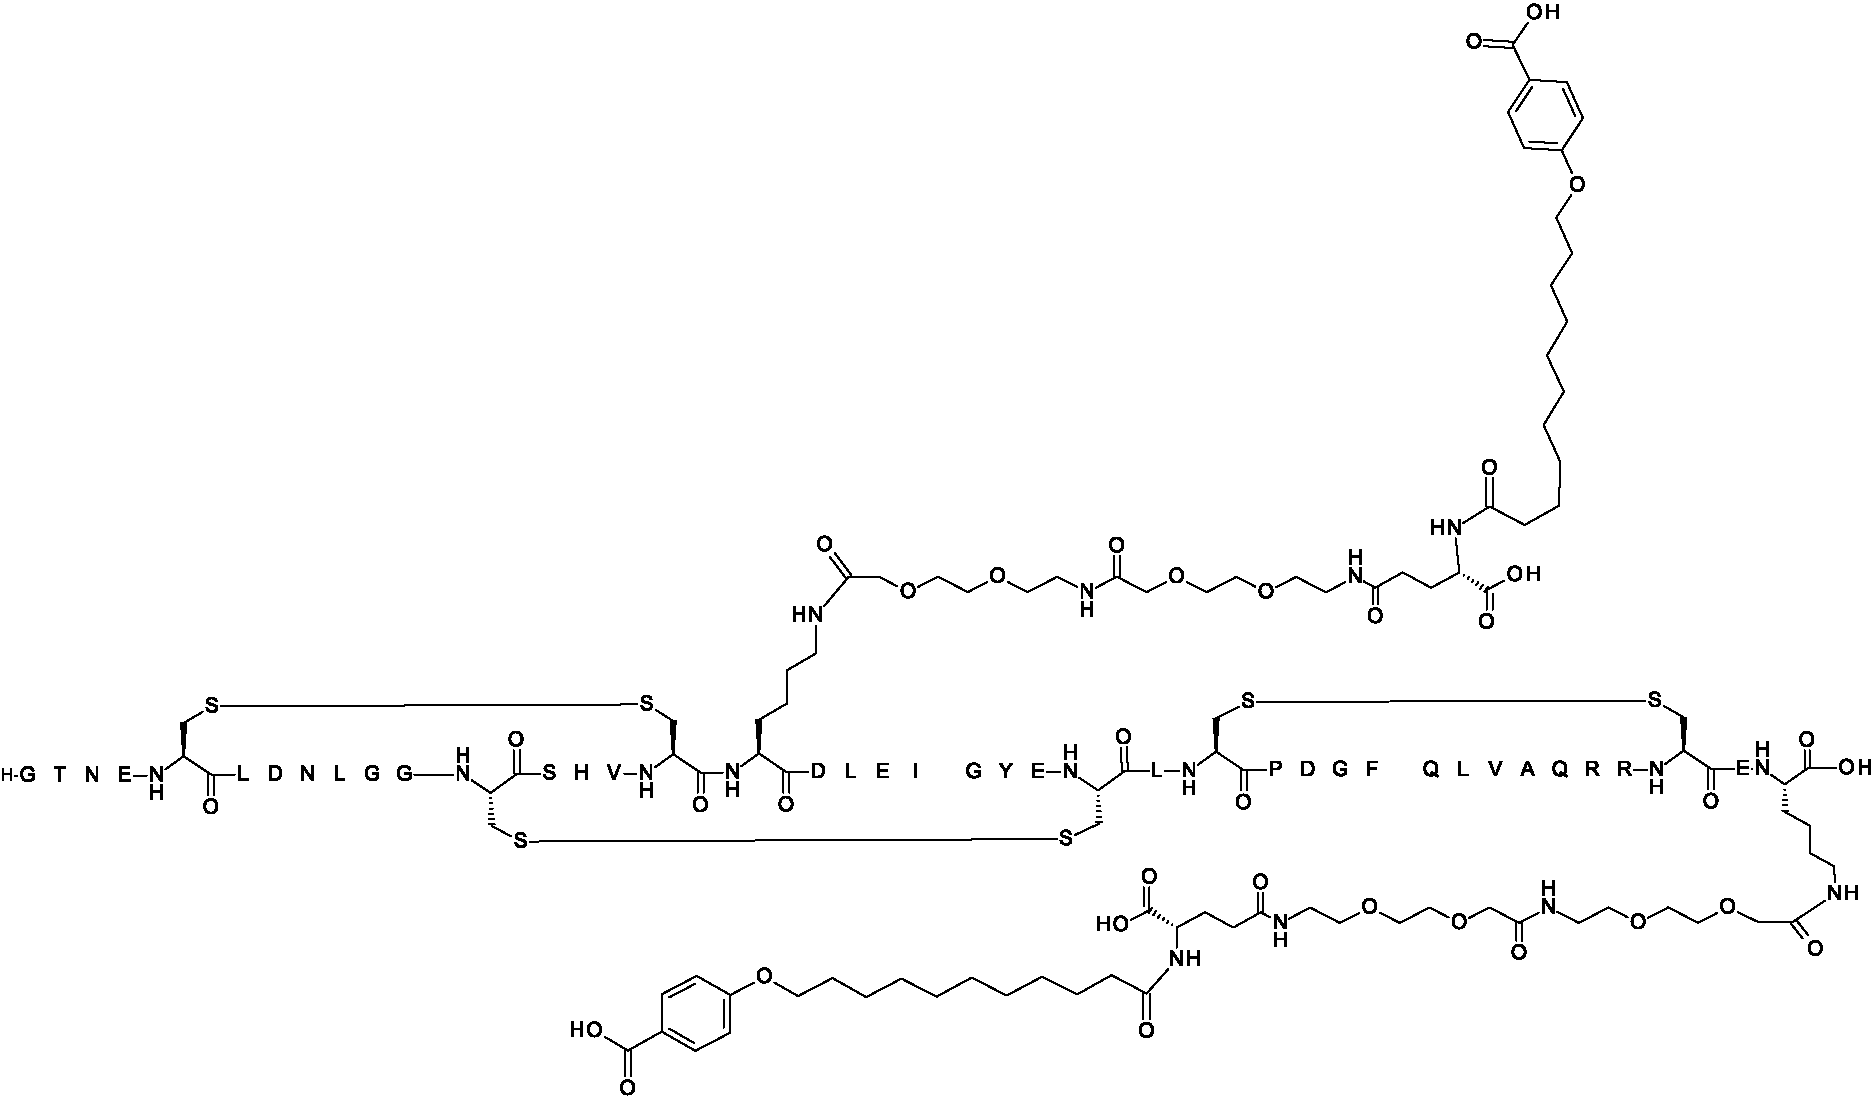
La cadena principal del péptido es la SEQ ID NO:84
Compuesto preparado mediante el método general B
LCMS29: m/3 encontrada = 1987,6; m/4 encontrada = 1490,9; m/5 encontrada = 1193,0; masa calc. = 5959,7 Ejemplo 112
N{alfa}(N{épsilon-324}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino"]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Tyr306,Glu312,Lys324]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino"]etoxi]etoxi]acetil]Lys

La cadena principal del péptido es la SEQ ID NO: 85
Compuesto preparado mediante el método general B
LCMS29: m/3 encontrada = 1991,6; m/4 encontrada = 1493,9; m/5 encontrada = 1195,1; masa calc. = 5971,7 Ejemplo 113
N{alfa}(N{épsilon-314}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[His300,Leu301,Arg309,Glu312,Lys314]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys
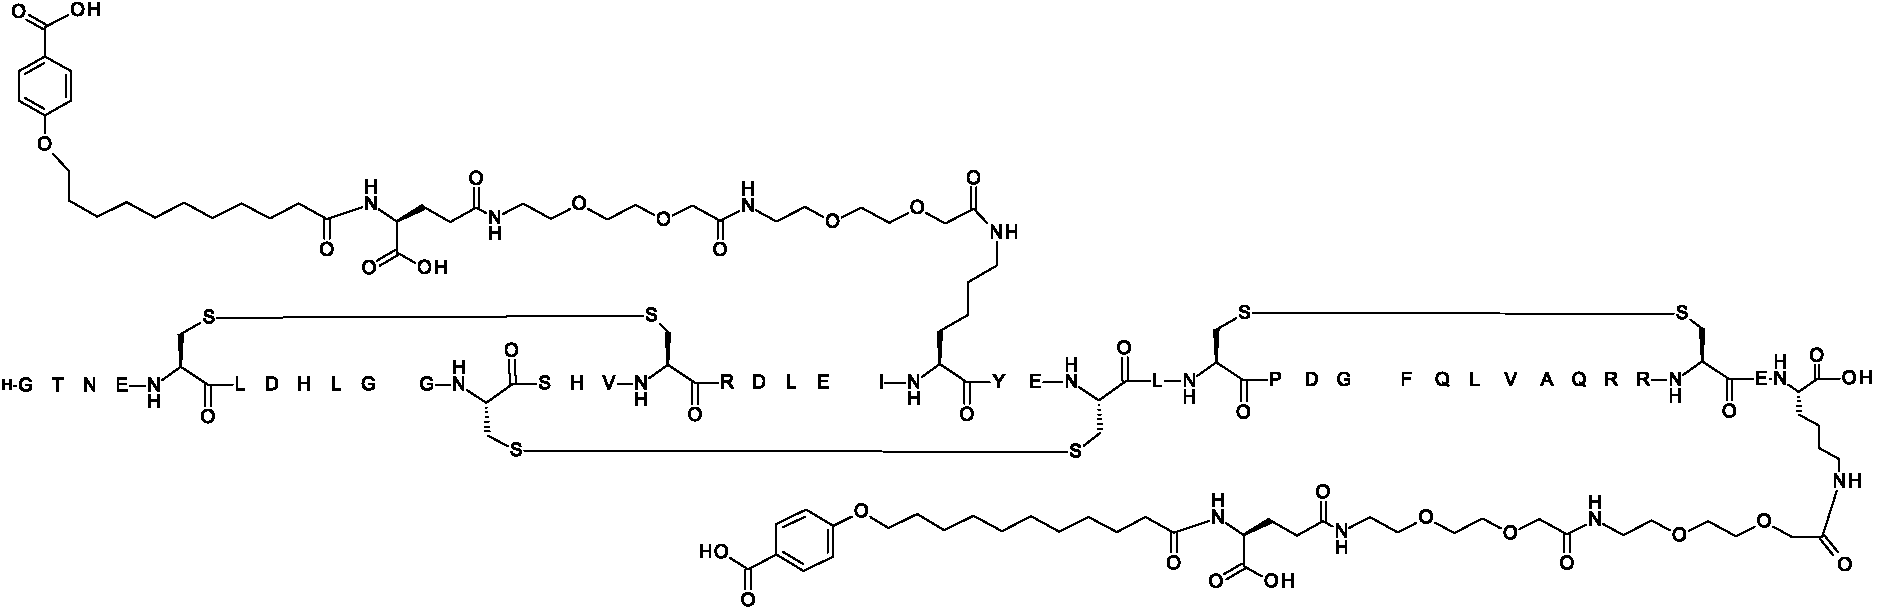
La cadena principal del péptido es la SEQ ID NO: 86
Compuesto preparado mediante el método general B
LCMS29: m/3 encontrada = 2028,3; m/4 encontrada = 1521,5; masa calc. = 6081,8
Ejemplo 114
N{alfa}(N{293}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Trp294,Leu301,Arg309,Glu312]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

La cadena principal del péptido es la SEQ ID NO: 87
Compuesto preparado mediante el método general B
LCMS29: m/3 encontrada = 2025,3; m/4 encontrada = 1519,2; m/5 encontrada = 1215,6; masa calc. = 6072,8 Ejemplo 115
N{épsilon-309}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-328}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Lys309,Glu312,Lys328]-LDL-R-(293-332)-péptido

La cadena principal del péptido es la SEQ ID NO: 88
Compuesto preparado mediante el método general B
LCMS27: m/2 encontrada = 2916,7; m/3 encontrada = 1944,9; m/4 encontrada = 1458,9; masa calc. = 5831,5 Ejemplo 116
N{épsilon-309}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Lys309,Glu312,Lys313]-LDL-R-(293-332)-péptido

La cadena principal del péptido es la SEQ ID NO: 89
Compuesto preparado mediante el método general B
LCMS29: m/2 encontrada = 2924,1; m/3 encontrada = 1949,6 m/4 encontrada = 1462,4; masa calc. = 5846,5 Ejemplo 117
N{alfa}(N{294}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301 ,Arg309,Glu312],des-Gly293-LDL-R-(294-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

La cadena principal del péptido es la SEQ ID NO: 90
Compuesto preparado mediante el método general B
LCMS29: m/3 encontrada = 1977,6; m/4 encontrada = 1483,5; m/5 encontrada = 1187,2; masa calc. = 5930,6 Ejemplo 118
N{épsilon-324}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-328}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301 ,Arg309,Glu312,Lys324,Lys328]-LDL-R-(293-332)-péptido

La cadena principal del péptido es la SEQ ID NO: 91
Compuesto preparado mediante el método general B
LCMS27: m/2 encontrada = 2930,4; m/3 encontrada = 1953,9; m/4 encontrada = 1465,7; masa calc. = 5859,6 Ejemplo 119
N{alfa}(N{292}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-Ala[Leu301,Arg309,Glu312]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

La cadena principal del péptido es la SEQ ID NO: 92
Compuesto preparado mediante el método general B
LCMS29: m/3 encontrada = 2020.6; m/4 encontrada = 1515.7; m/5 encontrada = 1212.8; masa calc. = 6058.8 Ejemplo 120
N{alfa}(N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino"]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301 ,Tyr306,Arg309,Glu312,Lys313]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys
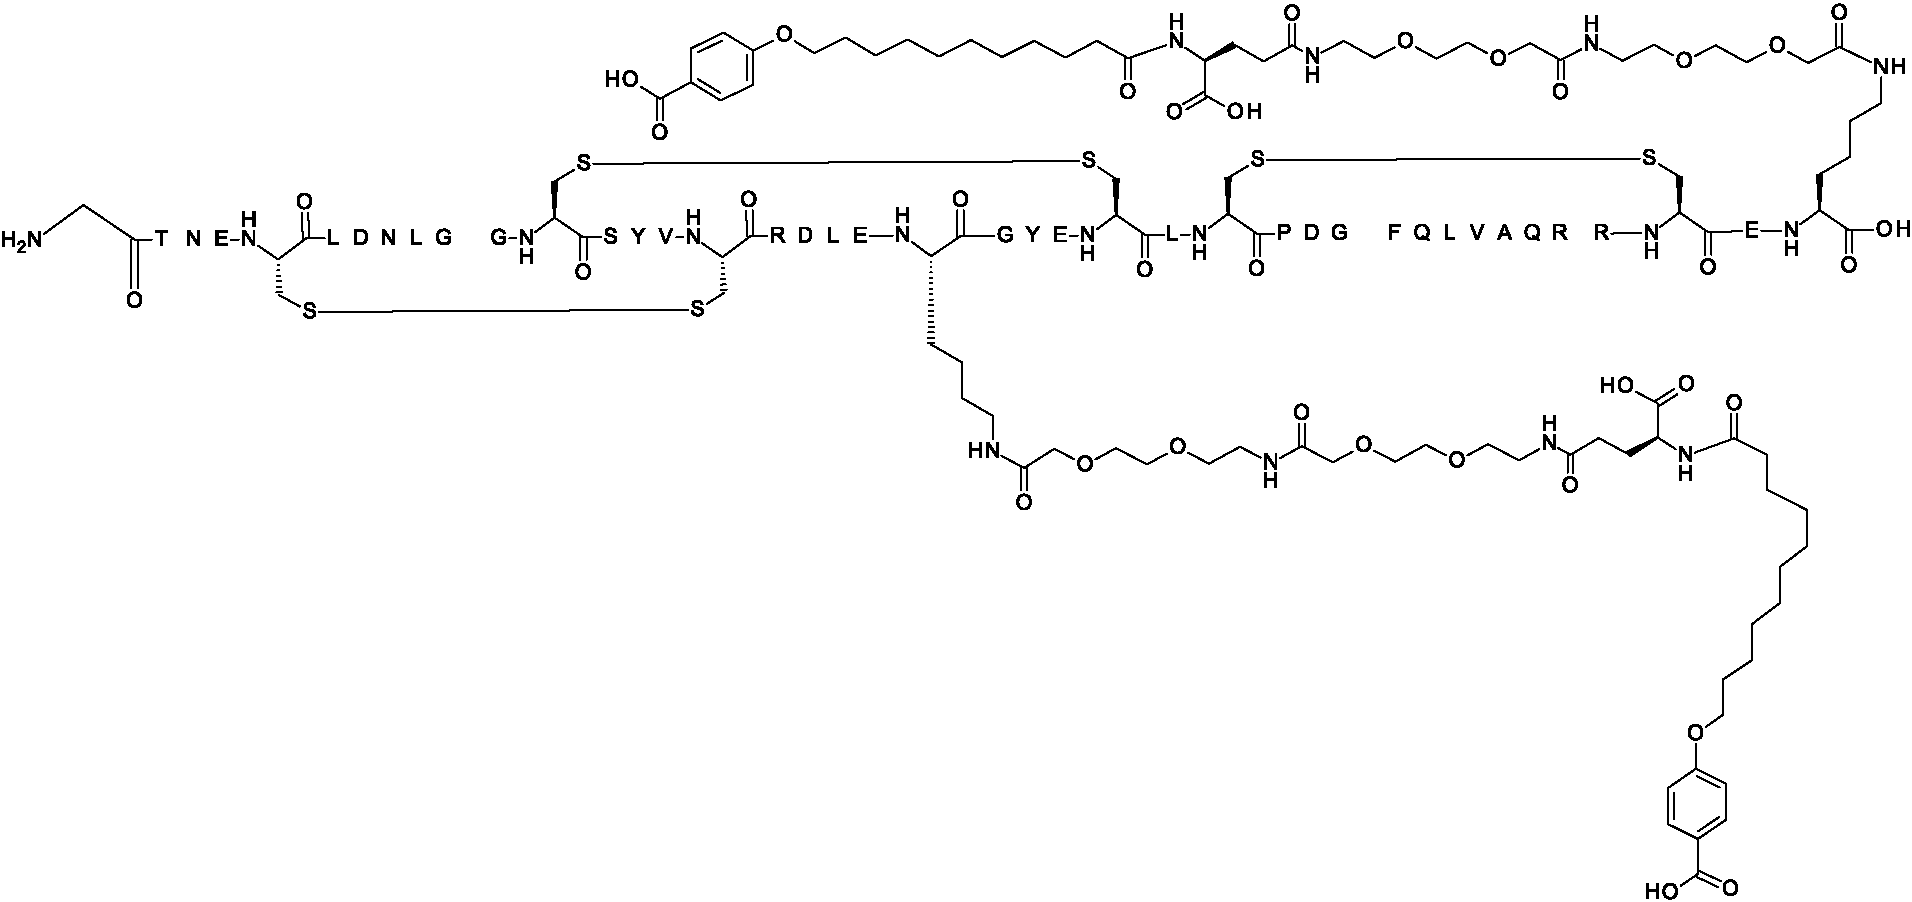
La cadena principal del péptido es la SEQ ID NO: 93
Compuesto preparado mediante el método general B
LCMS29: m/3 encontrada = 2010,2; m/4 encontrada = 1508,2; m/5 encontrada = 1206,8; masa calc. = 6028,7 Ejemplo 121
N{293}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-332}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys332]-LDL-R-(293-332)-péptido

La cadena principal del péptido es la SEQ ID NO: 11
Compuesto preparado mediante el método general B
LCMS27: m/2 encontrada = 2930,3; m/3 encontrada = 1953,7; m/4 encontrada = 1465,8; masa calc. = 5858,6 Ejemplo 122
N{293}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-328}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys328]-LDL-R-(293-332)-péptido

La cadena principal del péptido es la SEQ ID NO: 40
Compuesto preparado mediante el método general B
LCMS27: m/2 encontrada = 2930,1; m/3 encontrada = 1953,9; m/4 encontrada = 1465,7; masa calc. = 5859,6 Ejemplo 123
N{293}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-324}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys324]-LDL-R-(293-332)-péptido

La cadena principal del péptido es la SEQ ID NO: 22
Compuesto preparado mediante el método general B
LCMS29: m/2 encontrada = 2930,9; m/3 encontrada = 1954,3; m/4 encontrada = 1465,9; masa calc. = 5859,6 Ejemplo 124
N{épsilon-309}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-332}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Lys309,Glu312,Lys332]-LDL-R-(293-332)-péptido

La cadena principal del péptido es la SEQ ID NO: 94
Compuesto preparado mediante el método general B
LCMS29: m/2 encontrada = 2916,1; m/3 encontrada = 1944,2; m/4 encontrada = 1458,4; masa calc. = 5830,6 Ejemplo 125
N{épsilon-309}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-324}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Lys309,Glu312,Lys324]-LDL-R-(293-332)-péptido

La cadena principal del péptido es la SEQ ID NO: 106
Compuesto preparado mediante el método general B
LCMS29: m/2 encontrada = 2916,6; m/3 encontrada = 1944,5; m/4 encontrada = 1458,9; masa calc. = 5831,5 Ejemplo 126
N{293}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-309}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Lys309,Glu312]-LDL-R-(293-332)-péptido

La cadena principal del péptido es la SEQ ID NO: 30
Compuesto preparado mediante el método general B
LCMS29: m/2 encontrada = 2916,7; m/3 encontrada = 1944,6; m/4 encontrada = 1458,7; masa calc. = 5831,5 Ejemplo 127
N{épsilon-321}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-332}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys321,Lys332]-LDL-R-(293-332)-péptido

La cadena principal del péptido es la SEQ ID NO: 95
Compuesto preparado mediante el método general B
LCMS29: m/3 encontrada = 1958,3; m/4 encontrada = 1469,0; masa calc. = 5871,6
Ejemplo 128
N{alfa}(N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(15-carboxipentadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys313]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(15-carboxipentadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

La cadena principal del péptido es la SEQ ID NO: 32
Compuesto preparado mediante el método general B
LCMS29: m/2 encontrada = 2966,28; m/3 encontrada = 1978,0; m/4 encontrada = 1483,5; masa calc. = 5930,7 Ejemplo 129
N{alfa}(N{épsilon-313}-[(4S)-4-carboxi-4-(15-carboxipentadecanoilamino)butanoil]-[Leu301,Arg309,Glu312,Lys313]-LDL-R-(293-332)-peptidil)-N{épsilon}[(4S)-4-carboxi-4-(15-carboxipentadecanoilamino)butanoil]Lys

La cadena principal del péptido es la SEQ ID NO: 32
Compuesto preparado mediante el método general B
LCMS29: m/2 encontrada = 2676,0; m/3 encontrada = 1784,2; m/4 encontrada = 1338,4; masa calc. = 5330,1 Ejemplo 130
N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-332}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[His300,Leu301,Arg309,Glu312,Lys313,Lys332]-LDL-R-(293-332)-péptido

La cadena principal del péptido es la SEQ ID NO: 96
Compuesto preparado mediante el método general B
LCMS29: m/3 encontrada = 1966,7; m/4 encontrada = 1475,0; masa calc. = 5896,6
Ejemplo 131
N{alfa}(N{épsilon-313}-[4-[3-[2-[2-[3-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino"]butanoil]amino]propoxi]etoxi]etoxi]propilamino]-4-oxobutanoil]-[Leu301,Arg309,Glu312,Lys313]-LDL-R-(293-332)-peptidil)-N{épsilon}[4-[3-[2-[2-[3-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]propoxi]etoxi]etoxi]propilamino]-4-oxobutanoil]Lys

La cadena principal del péptido es la SEQ ID NO: 32
Compuesto preparado mediante el método general B
LCMS29: m/3 encontrada = 2009,9; m/4 encontrada = 1507,7; masa calc. = 6026,8
Ejemplo 132
N{épsilon-313}-[4-[3-[2-[2-[3-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]propoxi]etoxi]etoxi]propilamino]-4-oxobutanoil],N{épsilon-332}-[4-[3-[2-[2-[3-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]propoxi]etoxi]etoxi]propilamino]-4-oxobutanoil]-[Leu301 ,Arg309,Glu312,Lys313,Glu321,Lys332]-LDL-R-(293-332)-péptido

La cadena principal del péptido es la SEQ ID NO: 97
Compuesto preparado mediante el método general B
LCMS29: m/3 encontrada = 1971,3; m/4 encontrada = 1478,9; masa calc. = 5911,7
Ejemplo 133
N{alfa}(N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino"]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys313,Glu321]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

La cadena principal del péptido es la SEQ ID NO: 98
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1505,0; m/5 encontrada = 1204,3; masa calc. = 6016,7
Ejemplo 134
N{alfa}([Leu301,Arg309,Glu312,Glu321]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(19-carboxinonadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

La cadena principal del péptido es la SEQ ID NO: 19
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1766,7; m/5 encontrada = 1325,3; masa calc. = 5258,0
Ejemplo 135
N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-314}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys313,Lys314]-LDL-R-(293-332)-péptido
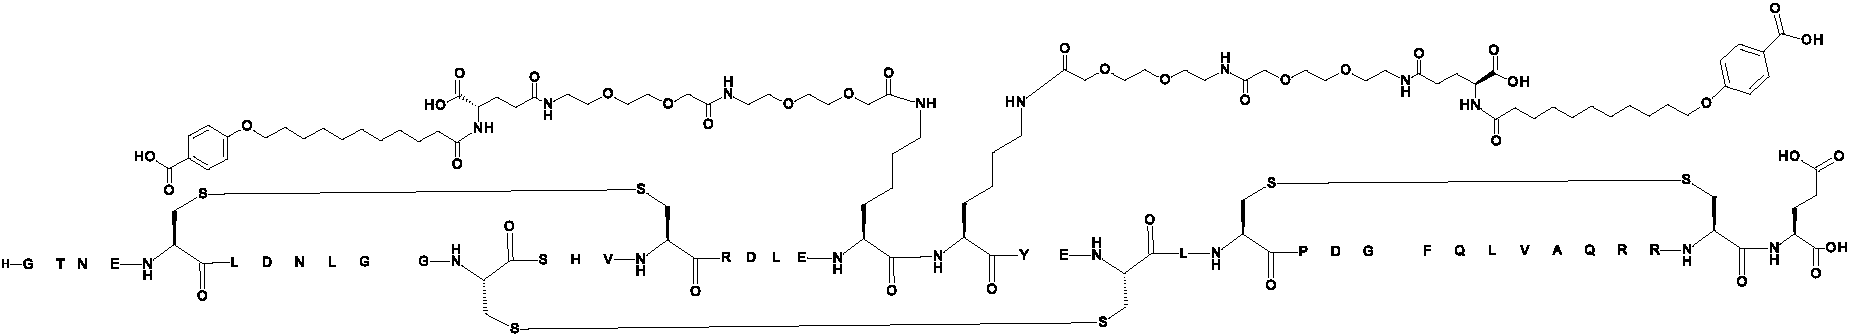
La cadena principal del péptido es la SEQ ID NO: 99
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1487,3; m/5 encontrada = 1190,0; masa calc. =5945,6
Ejemplo 136
N{épsilon-312}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil], N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11 -(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Lys313]-LDL-R-(293-332)-péptido

La cadena principal del péptido es la SEQ ID NO: 100
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1469,3; m/5 encontrada = 1175,5; masa calc. =5873,6
Ejemplo 137
N{épsilon-312}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-314}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Lys314]-LDL-R-(293-332)-péptido
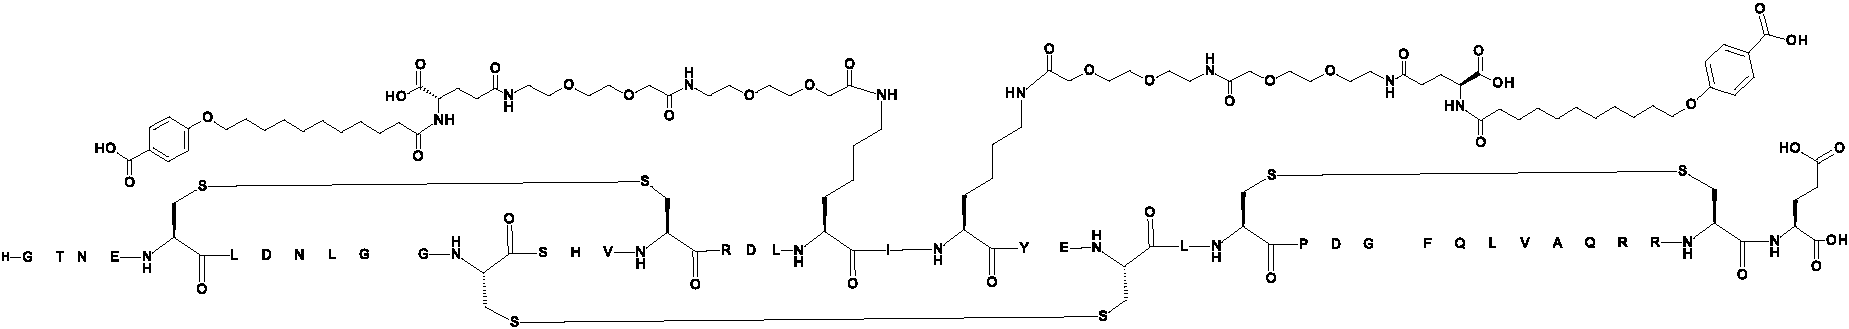
La cadena principal del péptido es la SEQ ID NO: 101
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1483,3; m/5 encontrada = 1186,8; masa calc. =5929,7
Ejemplo 138
N{épsilon-311}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Lys311,Glu312,Lys313]-LDL-R-(293-332)-péptido

La cadena principal del péptido es la SEQ ID NO: 102
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1473,0; m/5 encontrada = 1178,6; masa calc. =5889,5
Ejemplo 139
N{alfa}(N{épsilon-313}-11-(4-carboxifenoxi)undecanoil-[His300,Leu301,Arg309,Glu312,Lys313]-LDL-R-(293-332)-peptidil)-N{épsilon}11 -(4-carboxifenoxi)undecanoilLys

La cadena principal del péptido es la SEQ ID NO: 69
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1297,4; m/5 encontrada = 1038,2; masa calc. = 5186,9
Ejemplo 140
N{alfa}(N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[13-(1H-tetrazol-5-il)tridecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys313]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[13-(1H-tetrazol-5-il)tridecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

La cadena principal del péptido es la SEQ ID NO: 32
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1481,6; m/5 encontrada = 1185,3; masa calc. = 5922,7
Ejemplo 141
N{alfa}(N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(14-sulfotetradecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys313]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(14-sulfotetradecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

La cadena principal del péptido es la SEQ ID NO: 32
Compuesto preparado mediante el método general B
LCMS027: m/3 encontrada = 1992,6; m/4 encontrada = 1494,7; m/5 encontrada = 1196,0; masa calc. = 5974,8 Ejemplo 142
N{alfa}(N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[13-(metilsulfonilcarbamoilamino)tridecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys313]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[13-(metilsulfonilcarbamoilamino)tridecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

La cadena principal del péptido es la SEQ ID NO: 32
Compuesto preparado mediante el método general B
LCMS027: m/3 encontrada = 2020,7; m/4 encontrada = 1515,8; m/5 encontrada = 1212,8; masa calc. = 6058,8 Ejemplo 143
N{alfa}(N{épsilon-313}-[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]-[Leu301,Arg309,Glu312,Lys313,Glu321]-LDL-R-(293-332)-peptidil)-N{épsilon}[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]Lys

La cadena principal del péptido es la SEQ ID NO: 98
Compuesto preparado mediante el método general B
LCMS29: m/2 encontrada = 2719,0; m/3 encontrada = 1812,8; m/4 encontrada = 1359,8; masa calc. = 5436,1 Ejemplo 144
N{alfa}(N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(15-carboxipentadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys313,Glu321]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(15-carboxipentadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

La cadena principal del péptido es la SEQ ID NO: 98
Compuesto preparado mediante el método general B
LCMS29: m/3 encontrada = 1982,2; m/4 encontrada = 1486,9; m/5 encontrada = 1189,7; masa calc. = 5944,7 Ejemplo 145
N{alfa}(N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[16-(1H-tetrazol-5-il)hexadecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys313]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[16-(1H-tetrazol-5-il)hexadecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

La cadena principal del péptido es la SEQ ID NO: 32
Compuesto preparado mediante el método general B
LCMS29: m/3 encontrada = 2003,3; m/4 encontrada = 1502,7; m/5 encontrada = 1202,2; masa calc. = 6006,8 Ejemplo 146
N{alfa}(N{épsilon-313}-[(4S)-4-carboxi-4-(15-carboxipentadecanoilamino)butanoil]-[Leu301,Arg309,Glu312,Lys313,Glu321]-LDL-R-(293-332)-peptidil)-N{épsilon}[(4S)-4-carboxi-4-(15-carboxipentadecanoilamino)butanoil]Lys

La cadena principal del péptido es la SEQ ID NO: 98
Compuesto preparado mediante el método general B
LCMS29: m/3 encontrada = 1788,8; m/4 encontrada = 1341,9; m/5 encontrada = 1073,7; masa calc. = 5364,1 Ejemplo 147
N{alfa}(N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[His300,Leu301,Arg309,Glu312,Lys313,Glu321]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

La cadena principal del péptido es la SEQ ID NO: 103
Compuesto preparado mediante el método general B
LCMS29: m/2 encontrada = 3020,8; m/3 encontrada = 2014,3; m/4 encontrada = 1510,9; masa calc. = 6039,8 Ejemplo 148
N{alfa}(N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilaminojbutanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]amino ]etoxi]etoxi]acetil]-[Leu301 ,Arg309,Glu312,Lys313]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11 -(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]amino ]etoxi]etoxi]acetil]Lys
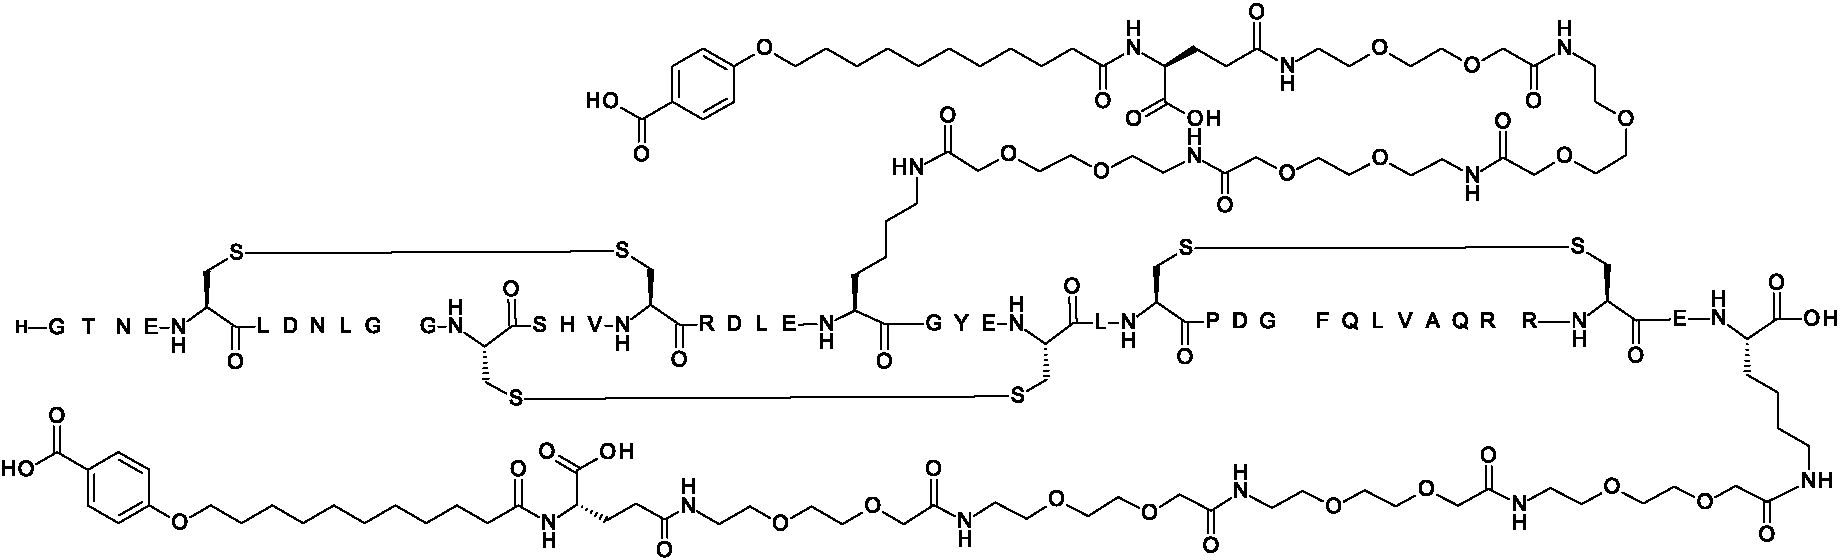
La cadena principal del péptido es la SEQ ID NO: 32
Compuesto preparado mediante el método general B
LCMS027: m/3 encontrada = 2195,5; m/4 encontrada = 1646,9; m/5 encontrada = 1317,7; masa calc. = 6583,3 Ejemplo 149
N{alfa}(N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[His300,Leu301,Arg309,Glu312,Lys313],des-Gly293-LDL-R-(294-332))-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[11-(4-carboxifenoxi)undecanoilamino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

La cadena principal del péptido es la SEQ ID NO: 74
Compuesto preparado mediante el método general B
LCMS027: m/3 encontrada = 1990,6; m/4 encontrada = 1493,2; m/5 encontrada = 1191,1; masa calc. = 5968,7 Ejemplo 150
N{alfa}(N{épsilon-328}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(15-carboxipentadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys328]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(15-carboxipentadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

La cadena principal del péptido es la SEQ ID NO: 78
Compuesto preparado mediante el método general B
LCMS27: m/2 encontrada = 2958,7; m/3 encontrada = 1973,0; m/4 encontrada = 1480,0; masa calc. = 5915,7 Ejemplo 151
N{alfa}(N{épsilon-328}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(15-carboxipentadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Glu321,Lys328]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(15-carboxipentadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

La cadena principal del péptido es la SEQ ID NO: 104
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1483,2; m/5 encontrada = 1186,8; masa calc. = 5930,0
Ejemplo 152
N{alfa}(N{épsilon-324}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(15-carboxipentadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys324]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(15-carboxipentadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

La cadena principal del péptido es la SEQ ID NO: 72
Compuesto preparado mediante el método general B
LCMS34: m/4 encontrada = 1974,6; m/5 encontrada = 1183,9; masa calc. = 5915,7
Ejemplo 153
N{alfa}(N{épsilon-324}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(15-carboxipentadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301 ,Arg309,Glu312,Glu321,Lys324]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(15-carboxipentadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

La cadena principal del péptido es la SEQ ID NO: 105
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1483,3 m/5 encontrada = 1186,8 masa calc. = 5929,8
Ejemplo 154
N{alfa}(N{épsilon-328}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301 ,Arg309,Glu312,Glu321,Lys328]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(17-carboxiheptadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys

La cadena principal del péptido es la SEQ ID NO: 104
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1497,3; m/5 encontrada = 1198,2; masa calc. = 5985,9
Ejemplo 155
N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(15-carboxipentadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil],N{épsilon-321}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(15-carboxipentadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Lys313,Lys321]-LDL-R-(293-332)-péptido

La cadena principal del péptido es la SEQ ID NO:72
Compuesto preparado mediante el método general B
LCMS01: m/4 encontrada = 1454,7; m/5 encontrada = 1164,0 masa calc. = 5815,6
Ejemplo 156
N{alfa}(N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[[4-[[11-(4-carboxifenoxi)undecanoilamino]metil]ciclohexanocarbonil]amino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]ac etil]-[Leu301 ,Arg309,Glu312,Lys313]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[[4-[[11-(4-carboxifenoxi)undecanoilamino]metil]ciclohexanocarbonil]amino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]ac etil]Lys

La cadena principal del péptido es la SEQ ID NO: 32
Compuesto preparado mediante el método general B
LCMS27: m/3 encontrada = 2094,6; m/4 encontrada = 1571,2; masa calc. = 6281,1
Ejemplo 157
N{alfa}(N{épsilon-313}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[[4-[[11-(4-carboxifenoxi)undecanoilamino]metil]ciclohexanocarbonil]amino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]ac etil]-[Leu301 ,Arg309,Glu312,Lys313,Glu321]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[[4-[[11 -(4-carboxifenoxi)undecanoilamino]metil]ciclohexanocarbonil]amino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]ac etil]Lys

La cadena principal del péptido es la SEQ ID NO: 98
Compuesto preparado mediante el método general B
LCMS27: m/3 encontrada = 2099,3; m/4 encontrada = 1574,7; masa calc. = 6295,1
Ejemplo 158
N{alfa}([Leu301,Arg309,Glu312,Glu321]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[[4-[(19-carboxinonadecanoilamino)metil]ciclohexanocarbonil]amino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]L ys
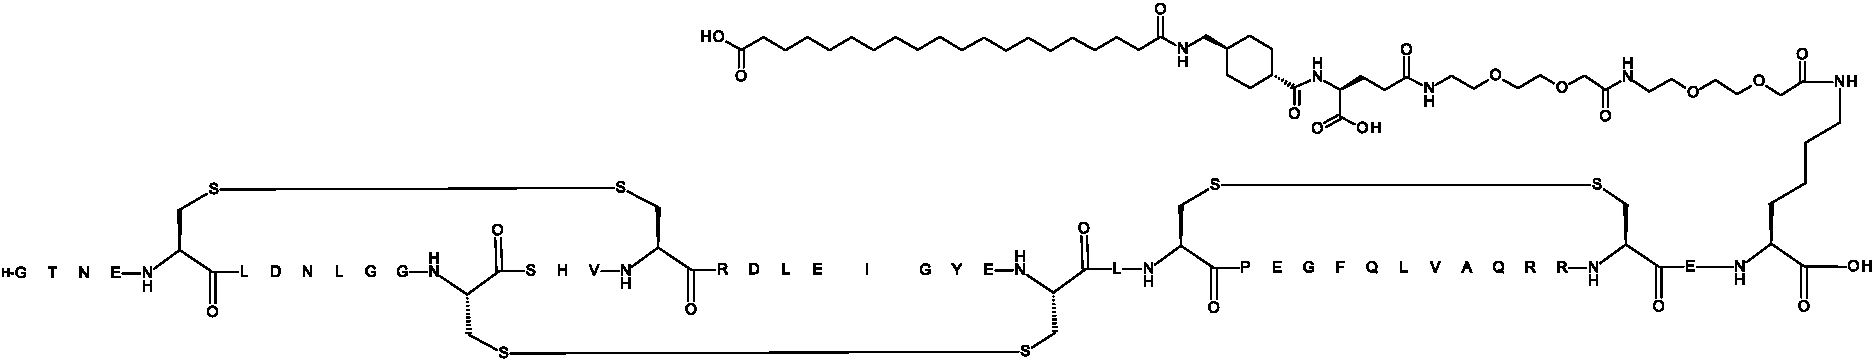
La cadena principal del péptido es la SEQ ID NO: 19
Compuesto preparado mediante el método general B
LCMS27: m/3 encontrada = 1813,2; m/4 encontrada = 1360,2; m/5 encontrada = 1088,3; masa calc. = 5437,2 Ejemplo 159
N{alfa}([Leu301 ,Arg309,Glu312,Glu321]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-[[4-[(17-carboxiheptadecanoilamino)metil]ciclohexanocarbonil]amino]butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil] Lys
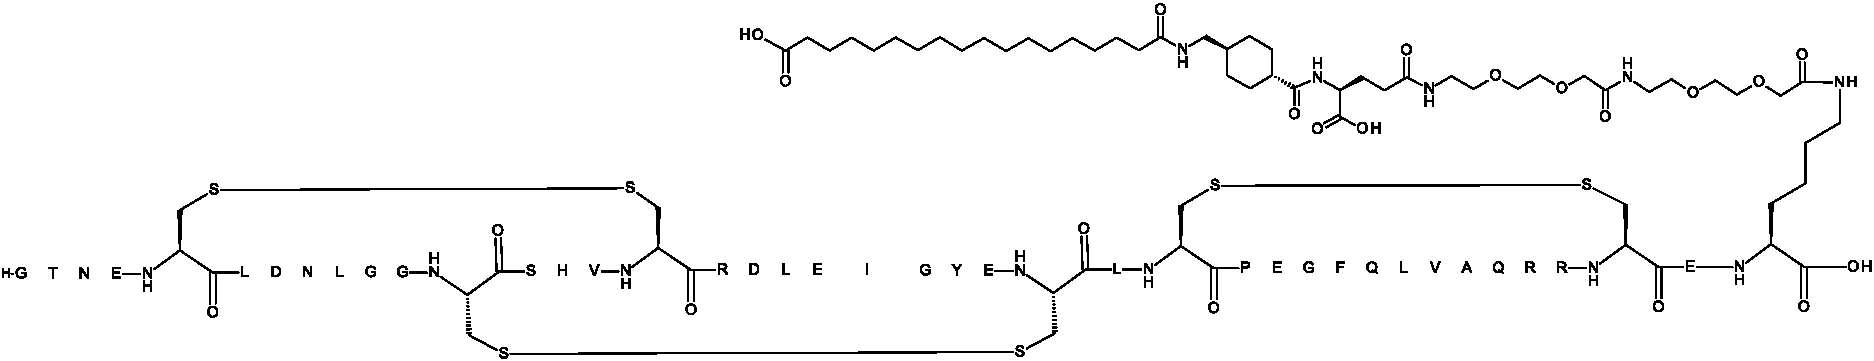
La cadena principal del péptido es la SEQ ID NO: 19
Compuesto preparado mediante el método general B
LCMS27: m/3 encontrada = 1803,9; m/4 encontrada = 1353,1; m/5 encontrada = 1082,7; masa calc. = 5409,2
-


. Métodos generales para la caracterización
.1.1 Competitivo de la unión de PCSK9-LDL-R (ELISA)
l objetivo de este ensayo es medir la afinidad de unión aparente de los compuestos del EGF(A) a PCSK9.
Debido a su capacidad para inhibir la interacción de PCSK9 con LDL-R, los compuestos de la invención pueden referirse, también, como inhibidores de PCSK9.
El día antes del experimento, el receptor humano recombinante de la lipoproteína de baja densidad (rhLDL-R; derivado de NSO; R & D Systems # 2148-LD) se disolvió a 1 pg/ml en carbonato de sodio 50 mM, pH 9,6, y después se añadieron 100 pl de la solución a cada pocillo de las placas del ensayo (Maxisorp 96, NUNC # 439454) y se recubrieron durante toda la noche a 4 °C. En el día de los experimentos, se obtuvieron las curvas de concentración de 8 puntos de los compuestos del EGF(A) que contenían PCSK9 biotinilado (0,5 ug/ml, BioSite/BPSBioscience cat. núm. 71304) por duplicado. Las mezclas de los compuestos del EGF(A) y PCSK9 biotinilado se prepararon e incubaron durante 1 hora a temperatura ambiente en el tampón del ensayo que contenía Hepes 25 mM, pH 7,2 (15630-056, 100 ml, 1M), NaCl 150 mM (Emsure 1.06404.1000) HSA al 1 % (Sigma A1887-25G) Tween 20 al 0,05 % (Calbiochem 655205) CaCl22 mM (Sigma 223506-500G). Las placas del ensayo que estaban recubiertas se lavaron después 4x en 200 pl de tampón del ensayo, y después se añadió 100 pl de la mezcla de los compuestos del EGF(A) y PCSK9 biotinilado a las placas y se incubó 2 horas a temperatura ambiente. Las placas se lavaron 4x en 200 pl de tampón del ensayo y después se incubaron con estreptavidina-HRP (25 ng/ml; VWR # 14-30-00) durante 1 hora a temperatura ambiente. La reacción se detecta mediante la adición de 50 pl de TMB-on (KEM-EN-TEC) y se incuba 10 min en la oscuridad. Después, la reacción se detuvo mediante la adición de 50 pl de H3PO44 M a la mezcla, añadido mediante pipeteo múltiple electrónico. Las placas se leyeron después en un Spectramax a 450 y 620 nm dentro de 1 hora. La lectura a 620 nm se usó para la sustracción del fondo. Los valores de IC50 se calcularon mediante el uso de Graphpad Prism, mediante regresión no lineal log(inhibidor) frente a la pendiente de respuesta-variable (cuatro parámetros), y se convirtieron en valores de Ki mediante el uso de la siguiente fórmula: Ki=IC50/(1+(Biotina-PCSK9)/(kd(Biotina-PCSK9))), donde la Kd de la biotina-PCSK9 es 1,096727714 pg/ml y [Biotina-PCSK9] = 0,5 (pg/ml).
Los resultados se muestran en las Tablas 5.1-5.5 más abajo. Mayores valores de Ki reflejan menores afinidades de unión aparente para PCSK9 y viceversa. Debe señalarse que pocos de los compuestos muestran una Ki que es sustancialmente mayor que el valor medido para EGF66, tal como un valor más arriba de 500 nM, que indica que la unión observada no es específica. Las sustituciones de aminoácidos del péptido y/o la una o más derivaciones de las cadenas laterales pueden contribuir a la pérdida de unión a LDL-R. En general, un gran número de los compuestos del EGF(A) probados muestran la capacidad para inhibir a PCSK9 en su unión al hLDL-R.
Péptidos inhibidores de PCSK9
Inicialmente un grupo de péptidos que incluyeron diversas sustituciones de aminoácidos se probaron como se describió en la sección D1.1 y los resultados se muestran en la Tabla 5.1.
- ^

El EGF66, identificado como la variante peptídica más potente en el documento WO 2012177741, tiene 5 mutaciones. Como se observó más arriba, los inventores del presente caso encontraron que varias de estas mutaciones no eran de gran importancia para el valor de EC50 determinado en el ensayo descrito en D1.1. En particular los inventores encontraron que los compuestos que incluyen el residuo Asp (D) natural en la posición 310 tenían mayores potencias que los compuestos con 310K. También parece ser que la principal sustitución de aminoácidos es 301L preferentemente en combinación con 309R. Finalmente, 307I y 299A solo contribuyeron modestamente a la afinidad de los péptidos.
Unión N-terminal del sustituyente
En un experimento subsecuente se probó si la unión de un prolongador de la semivida, por ejemplo, un sustituyente para los péptidos, influye en la EC50 determinada mediante el ensayo descrito en D.1.1. Como se describió en la presente descripción un sustituyente puede unirse mediante diferentes tecnologías y los inventores decidieron inicialmente aplicar la unión por medio de un átomo de nitrógeno mediante el uso del aminoácido N-terminal de los péptidos. Así fue como se describió en la sección B llevado a cabo mediante acilación (en solución o en resina) y alquilación.
Como se observa en la Tabla 5.2 todos los compuestos probados tienen un valor de Ki por debajo de 3,0 lo que sugiere que los diversos prolongadores y elementos enlazadores se toleran bien. Esto fue inusual ya que la
potencia, usualmente, está influida negativamente mediante la unión de una cadena lateral como se observó previamente para los péptidos similares a GLP-1.
T l .2 - Ki rn r l i P K i i n l N- rminl

Unión a Lys del sustituyente
Para evaluar posiciones alternativas para el enlace de un sustituyente a un péptido inhibidor de PCSK9 se prepararon una serie de compuestos. Se usó un péptido de base que incluye tres sustituciones de aminoácidos; N301L, N309R y K312E excepto en los ejem.58, 29 y 4 en combinación con una sustitución de Lys en diversas posiciones. Todos los compuestos probados incluyeron los 6 aminoácidos de cisteína en las posiciones 297, 304, 308, 317, 319, 331 en que usualmente están acopladas en puentes disulfuro con cisteínas.312E se incluyó para garantizar la sustitución específica del sitio excepto en el ejemplo 4 donde se obtiene la unión a 312K wt. La extensión del péptido con una Lys también se probó (Ejemplo 75 y 3). El mismo sustituyente como se describió anteriormente que incluye un prolongador diácido C18 y un enlazador gGlu-2xAdo se usó en todos los compuestos y se unió por medio de acilación. Los resultados se incluyen en la Tabla 5.3.
Tabla 5.3. - Ki r n r riv P K n n i n ni r m i n r iduo de Lys


El análisis mostró que la mayoría de los péptidos inhibidores de PCSK9 mantienen la funcionalidad. Las excepciones fueron la sustitución de Lys y la derivación en cualquiera de las posiciones 298, 301, 302 y 307 que produjo péptidos no funcionales. También, se observó que la introducción de Lys y la sustitución en la posición 296, 299, 315 y 320K redujo la afinidad aparente.
Por lo tanto, los datos también confirman el resultado de la Tabla 5.1 que indica que la sustitución de aminoácidos de Asn(N) 301 por Leu (L) es esencial para la unión.
No se observaron datos para la introducción de Lys y la sustitución en la posición 295 y 310. Como se describió anteriormente se encontró anteriormente que el mantenimiento de Asp en 310 se prefirió sobre la sustitución de 310K. Como se observará más abajo también se encontró que la unión se anula por la introducción de Asp (D) en la posición 295 (Ej. 70).
En resumen se concluyó que los compuestos que no comprenden un sustituyente unido en ninguna de las posiciones 295, 298, 302, 307 y 310 o en ninguna de las posiciones 295, 296, 298, 299, 302, 307, 310, 315 y 320 del péptido para PCSK9 generalmente son funcionales. Se concluyó además que una sustitución de aminoácidos en cualquiera de las posiciones 295, 298, 302, y 310 generalmente no es atractiva. Como se observa en las Tablas 5.1 y 5.2 la mutación V307I, sin embargo, parece ser aceptable o incluso atractiva en combinación con 301 Leu.
Se considera además que los péptidos con sustitución de aminoácidos en una de las posiciones 295, 296, 298, 302, 310 probablemente tengan una menor funcionalidad, mientras que las sustituciones en 299, 315 y 320 solamente parecen disminuir la funcionalidad ligeramente. Por otra parte esto sugiere, también, que puede existir un alto grado de flexibilidad para los residuos de aminoácidos restantes ya que la sustitución de Lys y la unión de una cadena lateral influirán en los péptidos tanto como la mayoría de las otras sustituciones de aminoácidos.
Inhibidores de PCSK9 con dos sustituyentes
Se preparó una serie de compuestos con dos sustituyentes. La sustitución doble puede obtenerse mediante acilación, alquilación o una combinación en el N-terminal o en los residuos de Lys (K). De nuevo el N-terminal puede ser un aminoácido 293G o un residuo de aminoácido variante tal como 292A, 293G, 293K y 294T (en casos donde se elimina 293G). Los compuestos se prepararon con diferentes sustituyentes, aunque los dos sustituyentes en los compuestos individuales son idénticos. La cadena principal usada en este estudio incluyó de nuevo la sustitución de aminoácidos N301L en combinación con N309R y diversas sustituciones en el N-terminal y/o de Lys según se necesite para obtener la acilación/alquilación específicas.
-


De nuevo los inventores concluyeron que los sustituyentes son muy bien tolerados en una variedad de posiciones y combinaciones.
Derivados inhibidores de PCSK9 adicionales
Para explorar adicionalmente el papel de diversas sustituciones de aminoácidos en los péptidos de PCSK9 se prepararon compuestos adicionales y se probaron como se muestra en la Tabla 5.5. Todos los compuestos incluyen un sustituyente que se une por medio de un residuo de Lys introducido mediante sustitución de aminoácidos o extensión con 333K. Todas las cadenas principales de los péptidos incluyen la sustitución de aminoácidos N301L y opcionalmente una o más de N309R e I312E. Todos los sustituyentes incluyen un diácido graso que comprende 16-20 átomos de carbono y un enlazador que es gGlu solamente o extendido con Ado-Ado y/o un resto de ácido tranexámico (Trx).
T l . - Ki r n r riv P K i i n l .


Los resultados en la Tabla 5.5, mencionados más arriba, muestran que la lisina wt interna en la posición 312 puede sustituirse con Glu (E) así como también Gln (Q), Arg (R) o Asp (D). Basados en esta variación se contempla que un amplio intervalo de residuos de aminoácidos serán tolerados en la posición 312 sin interferir con la función inhibitoria del péptido.
Otras varias sustituciones de aminoácidos también demostraron ser bien toleradas, lo que incluye a G293N, T294G, D299A, N300H, H306Y, H306D, N309S, Q324G y R329H, mientras que, como se mencionó anteriormente, N295D y N300P no son sustituciones de aminoácidos atractivas.
D.1.2 Ensayo de captación de LDL en células HepG2
Un ensayo alternativo para determinar la potencia inhibitoria de los péptidos de PCSK9 y los derivados de los mismos mediante la medición de la captación de LDL en células HepG2 se describe aquí más abajo.
Principio del ensayo: La captación de LDL está mediada principalmente por los hLDLR expresados endógenamente, y por lo tanto la capacidad de captación de LDL es una medida indirecta de la expresión de LDLR. Los hLDLR pueden ser regulados negativamente mediante incubación con PCSK9 exógeno en una manera dependiente de la dosis. Por lo tanto la incubación con PCSK9 disminuirá la capacidad de las células para captar las moléculas de LDL. Esta regulación negativa de la captación de LDL puede antagonizarse después mediante la adición de compuestos que neutralizan o inhiben la unión a PCSK9/LDLR. En consecuencia, los inhibidores de PCSK9 pueden caracterizarse basado en su capacidad para aumentar la captación de LDL en presencia de PCSK9 y por ejemplo contrarrestar la regulación negativa de hLDLR mediada por PCSK9.
El ensayo se realiza mediante el uso de células HepG2 (Sigma Aldrich ECACC: núm. de acc. 85011430) cultivadas en suero fetal bovino deficiente de lipoproteína al 10 % (Sigma Aldrich #S5394) y se mide la capacidad de las células para captar partículas LDL marcadas de manera fluorescente BODIPY (Life technologies Europe BV #L3483).
Protocolo del ensayo: Las placas de 96 pocilios (Perkin Elmer, ViewPlate-96 Black #60005182) se recubrieron con Poli-D-Lisina (10 mg/l, Sigma Aldrich #P6407 disuelta en PBS Gibco #14190-094) durante 1 hora a 37 °C en incubadora. Después, las placas se lavaron 2 x en 100 pl de PBS (Gibco #14190-094). Se prepararon las composiciones de prueba para las curvas de concentración de 8 puntos de los compuestos del EGF(A), todas las cuales contenían PCSK9 (10 ug/ml) diluido en medio del ensayo (DMEM (Gibco #31966-021), suero fetal bovino deficiente en lipoproteína al 10 % (Sigma Aldrich #S5394) y 1 % Pen Strep (Cambrex #DE17-602E)), y se añadieron a las placas en un volumen de 50ul/pocillo.
Después de 30-60 minutos, 50 000 células HepG2 (Sigma-Aldrich: ECACC: núm. Atcc. 85011430 lote: 13B023), diluidas en medio del ensayo se añadieron en un volumen de 50 pl/pocillo, y las placas se incubaron 20 horas (a 37° C, CO2 al 5 %) en bolsas de plástico permeables al CO2 (Antalis Team, Ld Pe bolsa 120/35x300x0,025 mm #281604). Después de eso, las placas se vaciaron e inmediatamente se añadieron 50 pl de FL-LDL (Life technologies Europe BV #L3483) en una concentración de 10 pg/ml en medio del ensayo a cada pocillo, y las placas se incubaron durante 2 horas (a 37° C, CO2 al 5 %) en bolsas de plástico permeables al CO2 mediante el uso de una cubierta negra sobre la tapa para proteger de la luz. Las placas se vaciaron y se lavó 2 veces con 100 pl de PBS (Gibco #14190-094). Después se añadieron 100 pl de PBS (Gibco #14190-094) y dentro de los 15 min después de eso, las placas se leyeron (lectura del fondo) mediante el uso de los siguientes filtros Ex (515 nm)/Em (520 nm) en un SpecktraMax M4 (Molecular Probes, Invitrogen Detection Technologies).
Finalmente, se calcularon los valores de EC50 mediante el uso de GraphPad Prism, ajuste de la curva de regresión no lineal, dosis-respuesta sigmoidal (pendiente variable).
Los resultados se muestran en la Tabla 6, más abajo. Valores de EC50 menores reflejan mayor capacidad para invertir la regulación negativa de la captación de LDL mediada por PCSK9, y por el contrario un alto valor de EC50 es indicativo de un compuesto con baja capacidad para inhibir la regulación negativa de la captación de LDL mediada por PCSK9.
Como puede observarse la mayoría de los compuestos presentan una EC50 en el ensayo de captación de LDL de 100-500 nM que es indicativo de compuestos con una alta capacidad para invertir la regulación negativa de la captación de LDL mediada por PCSK9.
Tabla 6 Datos de la ca tación de LDL en células He G2 EC50


D.2. PK en ratones
El objetivo de este estudio fue medir el perfil PK de los inhibidores de PCSK9 como se identificó más arriba.
Método:
Se usaron ratones C57bl/J hembras de Taconic (Ry, Dinamarca).
Dosificación del compuesto: Los compuestos se dosificaron por vía subcutánea (s.c., 500 nmol/kg) o intravenosa (i.v., 250 nmol/kg) en un volumen de 5 pl por gramo de peso corporal.
Muestreo de sangre: Se tomaron muestras de sangre a los 2 min, 15 min, 30 min, 60 min, 2 horas, 4 horas, 6 horas, 8 horas, 18 horas, 24 horas, 30 horas y 48 horas. La sangre (200 pl) se extrajo de la vena sublingual y se transfirió a tubos recubiertos con EDTA (Microvette® VetMed 200 K3E, Sarstedt nr 09.1293.100). El plasma se aisló y se usó para la cuantificación de los péptidos anti-PCSK9.
Cuantificación: Las muestras de plasma se usaron para la cuantificación de los inhibidores de PCSK9 mediante el uso de LC-MS.
Muestreo y análisis:
El plasma se pipeteó hacia tubos Micronic sobre hielo seco, y se mantuvo a -20 °C hasta su análisis de la concentración plasmática de los inhibidores de PCSK9 respectivos mediante el uso de LC-MS. En las muestras de plasma (que incluyen muestras para una curva estándar y QC, usadas para la cuantificación de desconocidos, y preparadas a partir de plasma estándar con adición de inhibidores de PCSK9 a un intervalo de concentración de 0,5 1000 nM) se precipitaron las proteínas mediante el uso de tres volúmenes de metanol al 100 % o acetonitrilo con ácido fórmico al 1 % (en dependencia del péptido anti-PCSK9) y se centrifugaron (16 000 x g, 4°C, 20 min). Los sobrenadantes se inyectaron en el sistema cromatográfico (TurboFlow Transcend 1250 & 10 válvula VIM, Thermo Fisher Scientific) que consistió en una columna de purificación Turboflow Cyclone inicial 0,5 x 50 mm (Thermo Fischer Scientific) y un péptido Aeris de elución 3,6 pm XB - columna C182,1 x 50 mm (Phenomenex) mantenida a 60 °C. El péptido anti-PCSK9 se eluyó mediante el uso de un gradiente cromatográfico con fase móvil que consistió en mezclas de agua y acetonitrilo con ácido fórmico al 0,1 % o 1 % (en dependencia de análogo o derivado del EGF(A)). El péptido anti-PCSK9 se detectó y cuantificó después de la infusión en línea del flujo LC al espectrómetro de masas LTQ OrbiTrap o el Q Exactive (Thermo Fischer Scientific) equipado con una interfase de electropulverización que operó en modo positivo, ESI+.
Cálculo de las propiedades PK:
Los perfiles de concentración plasmática-tiempo se analizaron mediante un análisis farmacocinético no compartimental mediante el uso del programa informático Phoenix WinNonlin 6.4. Los cálculos tanto para los datos de I.V. como para los de S.C. se realizaron mediante el uso de la Interpolación lineal trapezoidal lineal, con la ponderación 1/YAY. La biodisponibilidad se calculó mediante la división del AUC/Dosis para el perfil de S.C. con el AUC/Dosis para el perfil de I.V.
Resultados:
Los resultados se muestran en la Tabla 7. En la Tabla 7, Tmáx indica el tiempo para alcanzar la concentración plasmática máxima del análogo o derivado del EGF(A) probado. T / es la semivida del análogo o derivado del EGF(A). MRT es tiempo de residencia medio. F (s.c.) es la biodisponibilidad del análogo o derivado del EGF(A) después de una inyección subcutánea. Mayores valores de T / reflejan una semivida más larga del compuesto probado.
Los resultados muestran que los inhibidores de PCSK9 de la invención, en particular los análogos del LDL-R(293-332) sustituidos con un sustituyente de ácido graso muestran semividas prolongadas.
T l 7 Pr i f rm in i l n l riv l LDL-R 2 - 2 n r n

D.3. Modelo de desafío con hPCSK9
El objetivo de este estudio fue demostrar el cambio en el nivel de expresión del receptor de LDL en el hígado de ratones en respuesta a la inhibición de la acción de hPCSK9 inyectado por vía intravenosa con un péptido anti-PCSK9.
Método
Los ratones BalBC o NMRI machos saludables (Charles River, Alemania) se inyectaron con un péptido anti-PCSK9, ya sea s.c. o i.v., 15-120 minutos antes de inyectar hPCSK9 (Sino Biologicals, China) por vía intravenosa en la vena de la cola a una dosis de 0,4 mg/kg. Sesenta minutos después de la inyección de hPCSK9, los animales se anestesian con isoflurano y se someten a eutanasia mediante dislocación cervical. Después el hígado se escinde
rápidamente y se congela inmediatamente en nitrógeno líquido. Los hígados se mantuvieron a -80 grados Celsius hasta su análisis.
Inmunoelectrotransferencia para LDL-R:
Las muestras de tejido del hígado (100 mg) se homogeneizaron en 500 pl de tampón de lisis (Life Technology, FNN0011) que contenía un cóctel de inhibidores de fosfatasas; PhosStop (Roche, 04 906837 001) y un cóctel de inhibidores de proteasas; compelate (Roche, 04693 159001). Después de añadir 1 perla de acero los tejidos se homogenizaron durante 2,5 min a 30 Hz. Después de la centrifugación a 5000 xg durante 5 min, se determinó el contenido de proteínas totales mediante el uso del conjunto de ensayo de proteínas BCA (Pierce, 23225). Iguales cantidades de proteínas (60 pg) en el tampón de muestras (Life Technology, NP0007) se hirvieron durante 10 min y se centrifugaron durante 2 min a 14 000 rpm antes de cargarlas en geles de Tris-acetato 3-8 % Criterion XT (BioRad#345-0131) y se sometieron a SDS-PAGE. Las proteínas se transfirieron a membranas de nitrocelulosa (pilas regulares iBlot 2 NC, novex # IB23001) de acuerdo con las instrucciones del fabricante (Life Technology). Se confirmó que la transferencia de proteínas era igual mediante la tinción con Ponceau S (Sigma, P7170) de las membranas y éstas se bloquearon además en tampón de bloqueo (TBS-T, Tween al 2 %). Las proteínas LDL-r se detectaron con un anticuerpo primario anti LDLr de conejo (Cayman Chemical Company #10012422), mientras que las proteínas beta-actina se detectaron mediante el uso de un anticuerpo primario anti beta-actina de conejo (abcam # ab6276). Ambas proteínas se visualizaron además con anticuerpos secundarios anti-conejo de cabra conjugados con peroxidasa (Biorad #170-6516) mediante el uso el quimioluminiscente WesternBright Quantum (Advansta # K-12042-D10) y se obtuvieron imágenes mediante el uso de una cámara CCD (LAS3000, FujiFilm). El análisis cuantitativo de las señales quimioluminiscentes de las inmunoelectrotransferencias se realizó con el programa informático MultiGauge (Fujifilm).
Resultados
La figura 1 muestra los niveles de expresión hepática del LDL-R medidos por inmunoelectrotransferencia, presentados como gráfico de dispersión para los animales individuales, n=3-6. "Vehículo-vehículo" es el grupo de controles sanos (nivel del valor inicial), "vehículo-hPCSK9" es el grupo inyectado con hPCSK9 solo.
Los resultados muestran que hPCSK9 disminuye el nivel de expresión del LDL-R y este efecto es inhibido por los inhibidores de PCSK9 probados.
En la Tabla 8, se presentan los datos como el porcentaje de cambio en relación con la ventana entre el nivel del valor inicial en los animales controles sanos (ajustado a 100 %) y el nivel después de la regulación negativa por hPCSK9 solo (ajustado a 0 %).
Los 6 ejemplos probados son capaces de inhibir la acción de hPCSK9 sobre el nivel de expresión del LDL-R y el nivel de inhibición observado es similar al nivel de inhibición observado mediante el uso de la molécula de control Alirocumab.
Tabla 8:

Conclusión
Varios ejemplos de compuestos han mostrado eficacia en la inhibición de la regulación negativa de los niveles de expresión del LDL-R mediante hPCSK9.
D.4. Reducción del LDL-colesterol en hámsteres
El objetivo del estudio fue evaluar los efectos de los inhibidores de PCSK9 sobre el LDL-C en los hámsteres sirio dorado alimentados con una dieta de pienso estándar.
Método
En el estudio se usaron hámsteres sirios dorados machos (Janvier Elevage, Saint Isle, Francia), de 6 semanas de edad (91-100 g). Después de 1 semana de adaptación, los hámsteres en ayunas por 4 horas (el ayuno inició a ~08:00 am) se pesaron y se tomaron muestras de sangre (100 pl/EDTA) mediante sangrado retrorbital bajo anestesia con isoflurano alrededor del mediodía para medir el colesterol total, LDL-colesterol y HDL-colesterol. Los hámsteres se distribuyeron al azar en 5 grupos homogéneos (n=10/grupo) de acuerdo con sus niveles de 1) LDL-colesterol, 2) HDL-colesterol y 3) colesterol total. Después de la aleatorización, los hámsteres se trataron mediante inyección subcutánea una vez al día durante 5 días. El peso corporal se midió diariamente durante el periodo de tratamiento.
A los 3 días del tratamiento, los hámsteres en ayunas durante 4 horas se pesaron y se tomaron muestras de sangre (100 pl/EDTA) mediante sangrado retrorbital bajo anestesia con isoflurano a ~1 hora después de las dosis de la mañana (alrededor del mediodía) para medir el colesterol total, LDL-colesterol y HDL-colesterol.
A los 5 días de tratamiento, los hámsteres en ayunas durante 4 horas se pesaron y se tomaron muestras de sangre (volumen máximo de sangre/EDTA) mediante sangrado retrorbital bajo anestesia con isoflurano a ~1 hora después de las dosis de la mañana (alrededor del mediodía).
El plasma se aisló inmediatamente. Para cada individuo, se mantuvo ~15 pl de volumen de plasma para medir el colesterol total, LDL-colesterol y HDL-colesterol. Otro volumen de plasma (~50 pl) de cada individuo se usó después para hacer una mezcla de plasma por cada grupo de tratamiento (es decir 1 mezcla de ~500 pl por grupo, 5 mezclas) para el perfil de colesterol total por FPLC. Los hámsteres se sacrificaron después bajo anestesia con isoflurano mediante dislocación cervical y exanguinación. El hígado se cosechó, se pesó y 2 muestras de hígado (~50 mg y ~100 mg, peso no registrado) se congelaron rápidamente en nitrógeno líquido y después se almacenaron a -80 °C.
Las muestras de ~50 mg se usaron para evaluar la expresión proteica del receptor LDL hepático y de la pancadherina (control de carga) mediante inmunoelectrotransferencia y análisis de densitometría (programa informático Image J). Los datos se presentan como media /- SEM. Para el análisis estadístico se usó un ANOVA de 1 vía o de 2 vías con posprueba de Dunnett o de Bonferroni, respectivamente. Una p<0,05 se consideró significativa.
Resultados
La figura 2 muestra el colesterol LDL plasmático durante el periodo de tratamiento en hámsteres tratados mediante inyección subcutánea una vez al día durante 5 días con el vehículo o 10 nmol/kg, 30 nmol/kg, 100 nmol/kg o 300 nmol/kg del Ejemplo 2. ( **p<0,01 y ***p<0,001 frente al vehículo de prueba, ANOVA de dos vías, análisis post hoc de Dunnetts).
La Figura 3 muestra la expresión hepática del LDL-R con respecto al control de carga pan-cadherina de muestras de hígado de hámsteres tratados mediante inyección subcutánea una vez al día durante 5 días con el vehículo o con el Ejemplo 2 10 nmol/kg, el Ejemplo 2 30 nmol/kg, el Ejemplo 2 100 nmol/kg o el Ejemplo 2 300 nmol/kg) (*p<0,05, **p<0,01 y ***p<0,001 frente al vehículo, ANOVA de una vía, análisis post hoc de Dunnett).
En comparación con el vehículo, el peso corporal y la ganancia de peso no se vieron afectados en ningún tratamiento (datos no mostrados). Todas las dosis redujeron el LDL-colesterol (véase la Figura 2). Este efecto no fue significativo para la dosis más baja del Ejemplo 2, pero las dosis mayores de 100 y 300 nmol/kg redujeron los niveles de colesterol-LDL hasta un 35 % en el día 5. Estas tendencias fueron confirmadas además por el análisis de FPLC, que mostró reducciones sustanciales en los niveles de colesterol total en las fracciones correspondientes a LDL y HDL cuando los hámsteres fueron tratados con los artículos de prueba del Ejemplo 2 (datos no mostrados). También se demostró un aumento concomitante, dependiente de la dosis, de los niveles de expresión del LDL-R en los hígados (véase la Figura 2 y la Figura 3).
Conclusión
El estudio de dosis respuesta demuestra que es posible obtener un efecto significativo sobre el colesterol LDL al menos con una dosis de 30 nmol/kg después de 3 y 5 días de dosificación en los hámsteres sirios dorados con pienso normal. El efecto sobre el colesterol LDL es concomitante con niveles de expresión de receptores LDL hepáticos significativamente mayores.
D.5 Estudio de PK i.v. en perros
Para la determinación del perfil PK i.v. en perros, 3-4 perros Beagle (machos, 10-16 kg) se dosificaron por vía i.v. (2 nmol/kg, 0,1 ml/kg) con análogos de PCSK9 únicos o múltiples en cloruro de sodio 70 mM; fosfato 50 mM, polisorbato 2070 ppm; pH=7,4. Antes de la dosificación, los perros se dejaron en ayunas durante toda la noche con libre acceso al agua corriente. Los análogos se dosificaron a través de la vena safena o cefálica mediante inyección única a través de una aguja (20 G) o dosificación secuencial a través de una cánula insertada. Se obtendrá una muestra de sangre de 0,8 ml en cada tubo con recubrimiento de EDTA a 0, 0,25, 0,5, 0,75, 1, 1,5, 2, 4, 6, 8, 10, 24,
48, 72, 120, 144, 168, 192, 216, 240, 288 horas después de la administración. Para el muestreo de las primeras 4 horas, se obtuvo una muestra sangre a través de una cánula insertada cuando los perros se inmovilizaron en una plataforma. El resto de los puntos de muestreo después de las 4 horas se obtuvieron a través de la vena yugular mediante punción con una única aguja (20 G). Inmediatamente después de la obtención de la muestra de sangre, cada muestra se invirtió suavemente por 3-4 veces y se transfirió rápidamente a una caja con hielo antes de la preparación del plasma (10 min, 4 0C, 4000 rpm). Las muestras del plasma se mantuvieron a -20 0C antes del bioanálisis. La desviación máxima para el muestreo de sangre es 1 min en el día de la dosificación hasta 120 min posdosificación, 5 min para los puntos de tiempo de 4 a 10 horas, y dentro de 1 hora para el resto de los días.
Análisis del plasma:
El plasma del estudio de codosificación se pipeteó en tubos Micronic sobre hielo seco, y se mantuvo a -20 °C hasta el análisis de la concentración plasmática de los derivados de PCSK9 respectivos mediante el uso de cromatografía líquida y espectrometría de masas (LC-MS). Las muestras de plasma (que incluyen las muestras para la curva estándar y QC, usadas para la cuantificación de desconocidos, y preparadas a partir de plasma estándar con adición de los derivados de PCSK9 a un intervalo de concentración nominal de 0.5-500 nM) se precipitaron las proteínas mediante el uso de tres volúmenes de metanol (que incluye el Ejemplo 4 como estándar interno) y se centrifugaron (16 000 x g, 4 °C, 30 min). Los sobrenadantes se inyectaron en el sistema cromatográfico (TurboFlow Transcend 1250 & 10 válvula VIM, Thermo Fisher Scientific) lo cual consistió de una columna de purificación Turboflow Cyclone inicial 0,5 x 50 mm (Thermo Fischer Scientific) y un péptido Aeris de elución 3,6 pm XB - columna C182,1 x 50 mm (Phenomenex) mantenida a 60 °C. Los derivados de PCSK9 se eluyeron mediante el uso de un gradiente cromatográfico con fase móvil que consistió en mezclas de agua y acetonitrilo/metanol 50/50 % v/v con ácido fórmico al 1 % v/v. Los derivados de PCSK9 se detectaron y cuantificaron después de la infusión en línea del flujo LC al espectrómetro de masas Q Exactive (Thermo Fischer Scientific) equipado con una interfase de electropulverización que funcionó en modo positivo, ESI+. Durante el bioanálisis de las muestras de plasma, se observó un grado variable de isomerización para diferentes derivados de PCSK9. Todos los isómeros tienen masas monoisotópicas idénticas y se cuantifican juntos.
Los parámetros PK de cada análogo probado (por ejemplo, T1/2) se analizaron mediante análisis no compartimental (NCA) mediante el uso del programa informático Phoenix WinNonlin, y los cálculos de las semividas se basan en los niveles de exposición de un total de todos los isómeros con la misma masa molecular.
T l : mivi l riv l E F A n rr ifi i n i.v.

D.6 Estudio de la captación oral en ratas
Los presentes estudios investigaron la absorción gastrointestinal de los péptidos coformulados y dosificados por vía oral a ratas saludables.
Animales:
Ratas Sprague Dawley machos de Taconic, Dinamarca, con 250 g a su llegada. Las ratas se adaptaron al menos una semana en la Unidad de animales, Novo Nordisk A/S, antes del estudio. El peso corporal al inicio del estudio fue de aproximadamente 280-300 g. Las ratas se dejaron en ayunas durante 18 horas en la rejilla antes de la dosificación.
Co-formulación de péptidos
La preparación de las formulaciones líquidas para la codosificación oral de los análogos de PCSK9i in vivo (ratas) se llevó a cabo como se describe más abajo.
La concentración objetivo del péptido EGF(A) fue de 200 pM de cada análogo, formulado en una concentración objetivo de 55 mg/ml decanoato de sodio y agua. Se formularon de cinco a seis análogos peptídicos diferentes juntos en la misma formulación.
Brevemente, se preparó una solución madre (110 mg/ml) de decanoato de sodio mediante el uso de agua ultrapura y el pH de la solución se ajustó a 8,0 mediante el uso de HCl.
Los API se transfirieron a frascos de vidrio de 20 ml y se añadió 5 g de agua ultrapura (se asume una densidad de 1 mg/ml) y los API se dejaron disolver a temperatura ambiente en un mezclador de rodillo. El pH de la solución se ajustó subsecuentemente a 8,0 con NaOH hasta que el pH se estabilizó, después de lo cual se añadieron 6,5 g de la reserva de decanoato de sodio (concentración final 55 mg/ml) seguido por ajuste del pH a pH 8,0. La solución se mantuvo después a temperatura ambiente en un mezclador de rodillo durante toda la noche (protegida de la luz). Al día siguiente se realizó un ajuste final del pH a pH 8,0 en caso de ser necesario mediante el uso de NaOH.
El peso de la formulación final se ajustó a 13 g mediante el uso de agua ultrapura y subsecuentemente se filtró a través de un filtro de 0,22 pm. El contenido de API y decanoato de sodio se determinó en la formulación final para garantizar una dosificación precisa. Las formulaciones se almacenaron a 4 °C hasta su uso posterior.
La concentración de cada API en la formulación líquida se determinó mediante la absorbancia de luz UV a 215 nm. Los métodos de LC se desarrollaron para garantizar que cada API de la codosificación eluya separadamente entre sí. Los estándares de concentraciones conocidas (determinadas mediante CLND) para cada API se mezclaron juntos, y en total se usaron cinco concentraciones de estándares para generar las curvas de calibración. La concentración final determinada fue un promedio obtenido a partir de tres muestras, cada una con dos repeticiones experimentales. La concentración de caprato en la formulación líquida se determinó de una manera similar, mediante el uso de una curva de calibración que consiste de tres concentraciones de estándares.
Dosificación:
Los animales se dosificaron por vía oral mediante sonda oral con una dosis objetivo de 1000 nmol/kg de cada péptido y un volumen de 5 ml/kg en el tiempo = 0
Muestreo de sangre y separación del plasma
Se tomaron muestras de sangre en los tiempos: 15, 30, 60 y 120 min después de la dosificación. Las muestras de sangre (200 pl) se obtuvieron en tubos recubiertos con EDTA mediante punción de la vena de la lengua en ratas conscientes. Las muestras se centrifugaron durante 5 minutos a 8000 G en 40C. El plasma (60-75 pl) se separó y pipeteó en tubos Micronic (75 pl) e inmediatamente se congeló a -200C.
Análisis del plasma:
El plasma del estudio de codosificación se pipeteó en tubos Micronic sobre hielo seco, y se mantuvo a -20 °C hasta el análisis de la concentración plasmática de los derivados de PCSK9 respectivos mediante el uso de cromatografía líquida y espectrometría de masas (LC-MS).. En las muestras de plasma (que incluyen las muestras para una curva estándar y QC, usadas para la cuantificación de desconocidos, y preparadas a partir de plasma estándar con adición de derivados de PCSK9 a un intervalo de concentración nominal de 0,5-500 nM) se precipitaron las proteínas mediante el uso de tres volúmenes de metanol o acetonitrilo con ácido fórmico al 1 % v/v (que incluye el ejemplo 4 como estándar interno) y se centrifugaron (16000 x g, 4 °C, 30 min). Los sobrenadantes se inyectaron en el sistema cromatográfico (TurboFlow Transcend 1250 & 10 válvula VIM, Thermo Fisher Scientific) que consistió de una columna de purificación Turboflow Cyclone inicial 0,5 x 50 mm (Thermo Fischer Scientific) y un péptido Aeris de elución 3,6 pm XB - columna C18 2,1 x 50 mm (Phenomenex) mantenida a 60 °C. Los derivados de PCSK9 se eluyeron mediante el uso de un gradiente cromatográfico con fase móvil que consistió en mezclas de agua y acetonitrilo/metanol 50/50 % v/v con ácido fórmico al 1 % v/v. Los derivados de PCSK9 se detectaron y cuantificaron después de una infusión en línea del flujo LC al espectrómetro de masas Q Exactive o LTQ OrbiTrap Discovery (Thermo Fischer Scientific) equipado con una interfase de electropulverización que operó en modo positivo, ESI+. Durante el bioanálisis de las muestras de plasma, se observó un grado variable de isomerización para diferentes derivados de PCSK9. Todos los isómeros tienen masas monoisotópicas idénticas y se cuantifican juntos.
Cálculos de los datos:
De las concentraciones plasmáticas determinadas mediante LC-MS, se extrajeron las concentraciones plasmáticas máximas (Cmáx) para cada péptido en cada rata y la Cmáx/dosis se calculó como los valores medios ± SD para n=6-8 ratas. La dosis se calculó como el volumen de la inyección, ajustado para el peso corporal, multiplicado con la concentración real del péptido, y la unidad es pmol/kg.
En cada grupo de coformulación se incluyó un péptido de referencia (ejemplo 3). En la tabla mencionada más abajo, se enumera la Cmáx/dosis (kg/l) para 8 péptidos diferentes junto con la Cmáx/dosis (kg/l) para el péptido de
Claims (23)
1. Un derivado del EGF(A) que comprende un análogo peptídico del EGF(A) que comprende 301Leu y un sustituyente que comprende al menos un grupo de ácido graso, en donde el análogo peptídico del EGF(A) tiene 1-8 sustituciones de aminoácidos en comparación con el dominio EGF(A), aminoácidos 293-332 del LDL-R, definido mediante la SEQ ID NO:1 y en donde el derivado tiene una Ki por debajo de 5 nM cuando se mide en un ELISA competitivo de unión de PCSK9-LDL-R, como se describió en la sección D1.1 de la descripción.
2. El derivado del EGF(A) de acuerdo con la reivindicación 1, en donde dicho sustituyente comprende un ácido carboxílico, un ácido sulfónico, un resto tetrazol, un resto metilsulfonilcarbamoilamino o un resto 3-hidroxiisoxazol y 8-20 grupos -CH2- consecutivos.
3. El derivado del EGF(A) de acuerdo con la reivindicación 1, en donde dicho sustituyente tiene la Fórmula I:
Z1-Z2-Z3-Z4-Z5-Z6-Z7-Z8-Z9-Z10- [I]
en donde
Z1 se selecciona de:
Quím. 1: HOOC-(CH2)n-CO-*,
Quím. 2: tetrazolil-(CH2)n-CO-*,
Quím. 3: HOOC-(C6H4)-O-(CH2)m-CO-*,
Quím. 4: HOS(O)2-(CH2)n-CO-*,
Quím. 5: MeS(O)2NH(CO)N-(CH2)n-CO-* y
Quím. 6: 3-HO-Isoxazol-(CH2)n-CO-*
en donde
n es un número entero en el intervalo de 8-20,
m es un número entero en el intervalo de 8-11,
el grupo -COOH en Quím. 3 puede estar unido a la posición 2, 3 o 4 del anillo de fenilo, el símbolo * indica el punto de unión al nitrógeno en Z2 o, si Z2 es un enlace, al nitrógeno del elemento Z vecino;
Z2 se selecciona de
Quím. 7: *-NH-SO2-(CH2)3-CO-*,
Quím. 8: *-NH-CH2-(C6H10)-CO-* y
un enlace;
Z3 se selecciona de:
YGlu, Glu y un enlace;
Z4, Z5, Z6, Z7, Z8, Z9 se seleccionan, independientemente entre sí, de:
Glu, yGIu, Gly, Ser, Ala, Thr, Ado, Aeep, Aeeep, TtdSuc y un enlace;
Z10 se selecciona de:
Quím. 14: *-NH-CH2-(C6H4)-CH2-* y un enlace.
4. El derivado del EGF(A) de acuerdo con cualquiera de las reivindicaciones anteriores, en donde el derivado del EGF(A) comprende uno o dos sustituyentes seleccionados del grupo que consiste en:
HOOC-(CH2)18-CO-gGlu-2xADO-HOOC-(CH2)18-CO-NH-CH2-(C6H10)-CO-gGlu-2xADO-HOOC-(CH2)16-CO-gGlu-2xADO-HOOC-(CH2)16-CO-gGlu-2xADO-NH-CH2-(C6H4)-CH2-HOOC-(CH2)16-CO-gGlu-HOOC-(CH2)16-CO-NH-CH2-(C6H10)-CO-gGlu-2xADO
HOOC-(CH2)i4-CO-gGlu-2xADO-HOOC-(CH2)i4-CO-gGlu-HOOC-(CH2)i4-CO-gGlu-2xADO-HOOC-(CH2)i2-CO-gGlu-2xADO-4-HOOC-(C6H4)-O-(CH2)i0-CO-gGlu-2xADO-4-HOOC-(C6H4)-O-(CH2)10-CO-gGlu-3xADO-4-HOOC-(C6H4)-O-(CH2)i0-CO-gGlu-4-HOOC-(C6H4)-O-(CH2)i0-CO-2xgGlu-4-HOOC-(C6H4)-O-(CH2)i0-CO-gGlu-3xGly-4-HOOC-(C6H4)-O-(CH2)i0-CO-2xgGlu-2xADO-4-HOOC-(C6H4)-O-(CH2)i0-CO-gGlu-TtdSuc-4-HOOC-(C6H4)-O-(CH2)9-CO-4-HOOC-(C6H4)-O-(CH2)i0-CO-gGlu-4xADO-4-HOOC-(C6H4)-O-(CH2)i0-CO-NH-CH2-(C6Hi0)-CO-gGlu-2xADO-4-HOOC-(C6H4)-O-(CH2)9-CO-gGlu-2xADO-3-HOOC-(C6H4)-O-(CH2)9-CO-gGlu-2xADO-3-HO-Isoxazol-(CH2)i2-CO-gGlu-2xADO-HOS(O)2-(CH2)i5-CO-gGlu-2xADO-NH-CH2-(C6H4)-CH2-HOS(O)2-(CH2)i3-CO-gGlu-2xADO-Tetrazolil-(CH2)i5-CO-NH-SO2-(CH2)3-CO-ADO-ADO-NH-CH2-(C6H4)-CH2-Tetrazolil-(CH2)i2-CO-gGlu-2xADO-Tetrazolil-(CH2)i5-CO-gGlu-2xADO- y
MeS(O)2NH(CO)NH-(CH2)i2-CO-gGlu-2xADO-.
5. El derivado del EGF(A) de acuerdo con cualquiera de las reivindicaciones anteriores, en donde el análogo peptídico del EGF(A) comprende uno, dos, tres, cuatro o los cinco del(de los) siguiente(s) residuo(s) de aminoácido(s) (natural(es)): 295Asn, 296Glu, 298Leu, 302Gly y 310Asp.
6. El derivado del EGF(A) de acuerdo con cualquiera de las reivindicaciones anteriores, en donde el análogo peptídico del EGF(A) comprende el residuo 310Asp natural.
7. El derivado del EGF(A) de acuerdo con cualquiera de las reivindicaciones anteriores, en donde el análogo peptídico del EGF(A) comprende el residuo 295Asn natural.
8. El derivado del EGF(A) de acuerdo con cualquiera de las reivindicaciones anteriores, en donde el análogo peptídico del EGF(A) comprende 299Asp (D) o 299Ala (A).
9. El derivado del EGF(A) de acuerdo con cualquiera de las reivindicaciones anteriores, en donde el análogo peptídico del EGF(A) comprende 307lle (I).
10. El derivado del EGF(A) de acuerdo con cualquiera de las reivindicaciones anteriores, en donde el análogo peptídico del EGF(A) comprende 309Arg (R).
11. El derivado del EGF(A) de acuerdo con cualquiera de las reivindicaciones anteriores, en donde el análogo peptídico del EGF(A) comprende una sustitución de 3i2Lys por un aminoácido seleccionado del grupo que consiste en: 312Glu, 3i2Asp, 312Gln y 312Arg.
12. El derivado del EGF(A) de acuerdo con cualquiera de las reivindicaciones anteriores, en donde el análogo peptídico del EGF(A) comprende al menos dos sustituciones de aminoácidos identificadas mediante cualquiera de los grupos:
i. 301Leu y 309Arg
ii. 301Leu, 309Arg, 312Glu
iii. 301 Leu, 307lle y 309Arg
iv. 301Leu, 307lle, 309Arg y 312Glu
v. 301 Leu, 309Arg y 321 Glu
vi. 301Leu, 309Arg, 321Glu y 312Glu
vii. 301Leu, 307lle, 309Arg y 299Ala
viii.301Leu, 307lle, 309Arg, 299Ala y 312Glu
ix. 301 Leu y 309Arg y al menos una sustitución de Lys
x. 301Leu, 309Arg, 312Glu y al menos una sustitución de Lys
xi. 301Leu, 307lle y 309Arg y al menos una sustitución de Lys
xii. 301Leu, 307lle, 309Arg y 312Glu; y al menos una sustitución de Lys
xiii.301 Leu, 309Arg y 321Glu y al menos una sustitución de Lys
xiv.301Leu, 309Arg, 321Glu y 312Glu y al menos una sustitución de Lys
xv. 301 Leu, 307lle, 309Arg y 299Ala y al menos una sustitución de Lys y
xvi.301Leu, 307lle, 309Arg, 299Ala y 312Glu y al menos una sustitución de Lys.
13. El derivado del EGF(A) de acuerdo con cualquiera de las reivindicaciones anteriores, en donde al menos un sustituyente se une a un residuo de Lys en el análogo peptídico del EGF(A) seleccionado del grupo que consiste en: 292Lys, 293Lys, 294Lys, 296Lys, 299Lys, 300Lys, 303Lys, 305Lys, 306Lys, 309Lys, 311Lys, 312Lys, 313Lys, 314Lys, 315Lys, 316Lys, 318Lys, 320Lys, 321Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 327Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys.
14. El derivado del EGF(A) de acuerdo con cualquiera de las reivindicaciones anteriores, en donde el análogo peptídico del EGF(A) comprende al menos un residuo de Lys seleccionado del grupo que consiste en: 313Lys, 324Lys, 328Lys y 333Lys.
15. El derivado del EGF(A) de acuerdo con cualquiera de las reivindicaciones anteriores, en donde uno o dos sustituyente(s) se une/n a un residuo de Lys en el análogo peptídico del EGF(A).
16. El derivado del EGF(A) de acuerdo con la reivindicación 1, en donde el derivado del EGF(A) se selecciona del grupo de derivados del EGF(A) que consiste de: Compuestos de los ejemplos 1-44, 46-47, 51-55, 57, 60-64, 66 69, 71-102 y 106-159 descritos en la sección C.1 y la tabla 4 de la descripción.
17. Un derivado del EGF(A) seleccionado del grupo que consiste en:
i. Compuesto del ejemplo 31
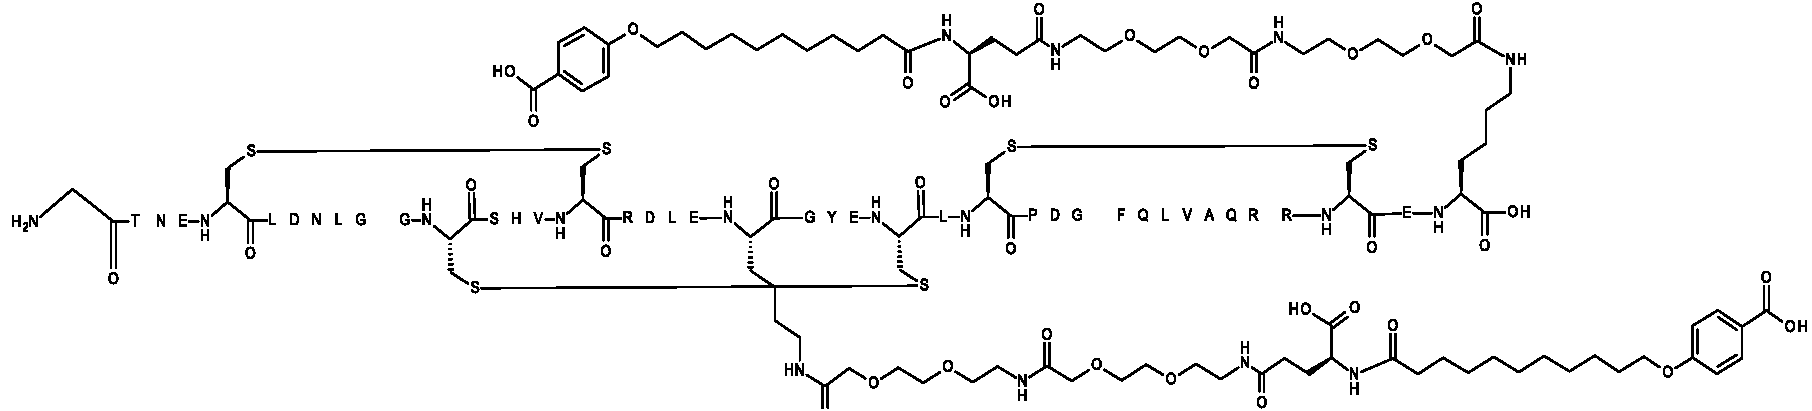
en donde la secuencia de aminoácidos de la cadena principal del péptido es la SEQ ID NO: 32,
ii. Compuesto del ejemplo 95,

en donde la secuencia de aminoácidos de la cadena principal del péptido es la SEQ ID NO: 76,
iii. Compuesto del ejemplo 128

en donde la secuencia de aminoácidos de la cadena principal del péptido es la SEQ ID NO: 32, iv. Compuesto del ejemplo 133,

en donde la secuencia de aminoácidos de la cadena principal del péptido es la SEQ ID NO: 98, v. Compuesto del ejemplo 143,

en donde la secuencia de aminoácidos de la cadena principal del péptido es la SEQ ID NO: 98, vi. Compuesto del ejemplo 144,

en donde la secuencia de aminoácidos de la cadena principal del péptido es la SEQ ID NO:98, vii. Compuesto del ejemplo 150,

en donde la secuencia de aminoácidos de la cadena principal del péptido es la SEQ ID NO:78,
viii. Compuesto del ejemplo 151,

en donde la secuencia de aminoácidos de la cadena principal del péptido es la SEQ ID NO:104,
ix. Compuesto del ejemplo 152
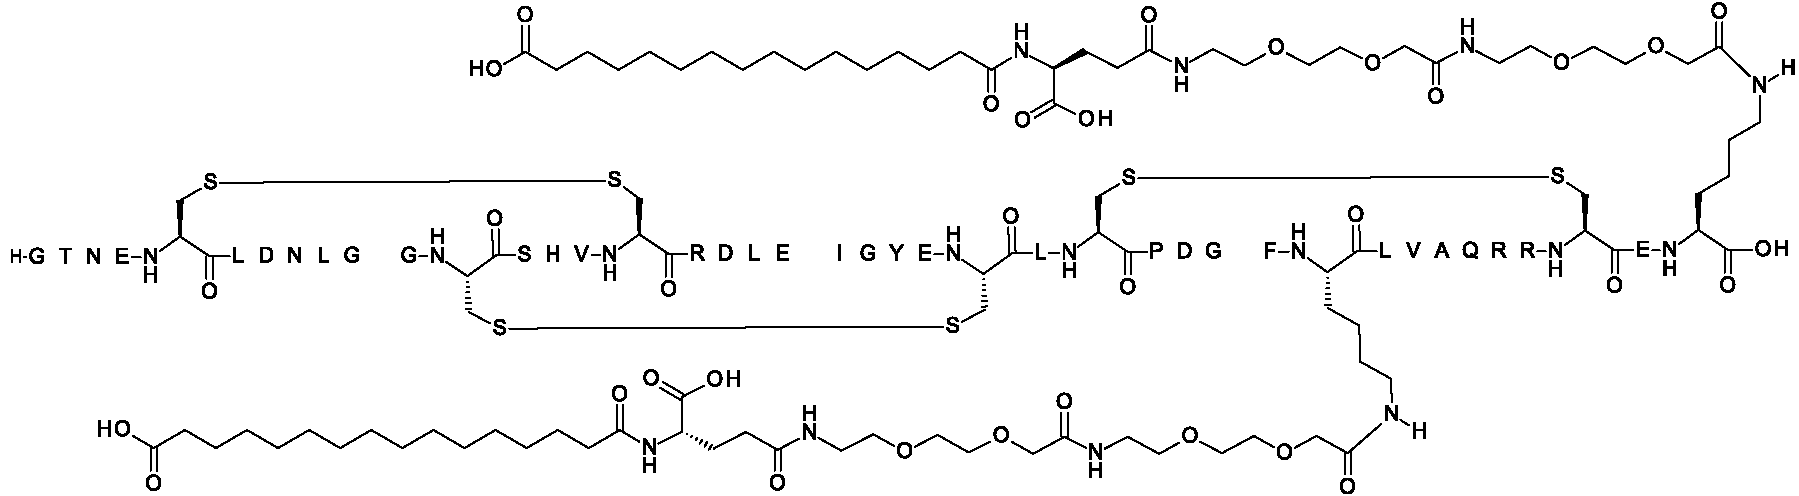
en donde la secuencia de aminoácidos de la cadena principal del péptido es la SEQ ID NO:72, y el x. Compuesto del ejemplo 153
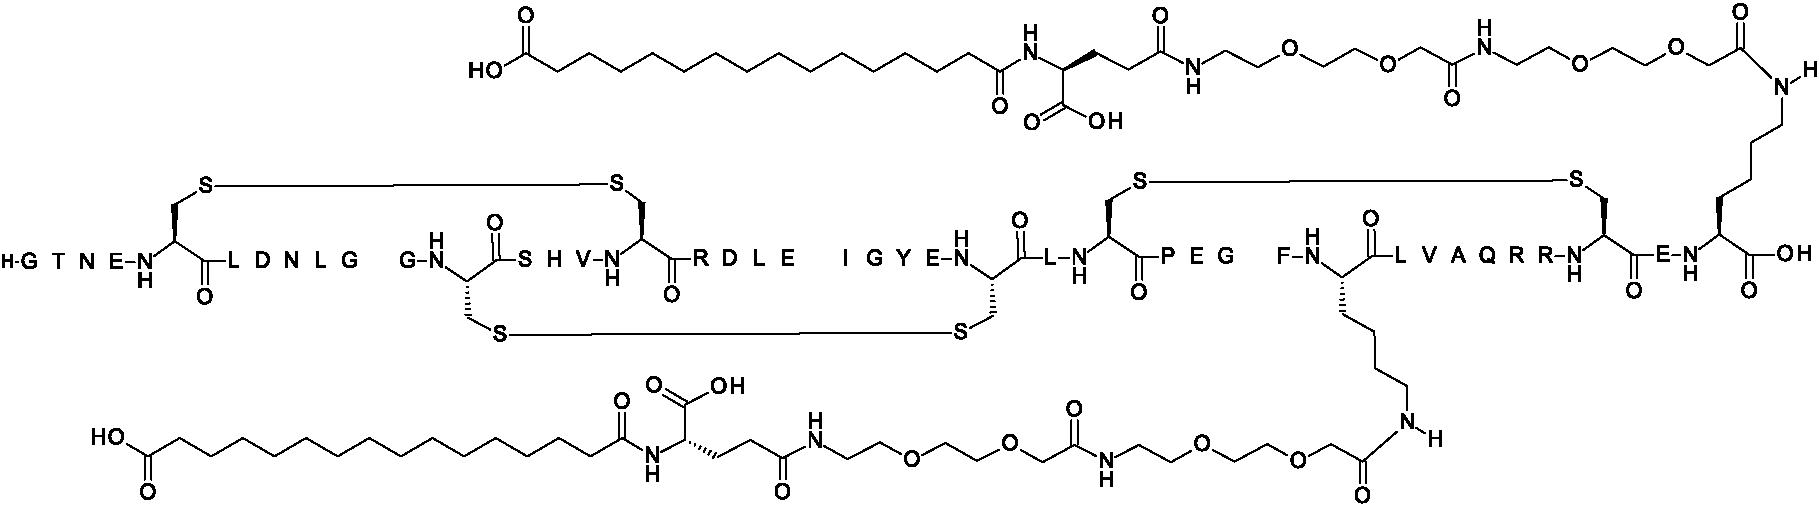
en donde la secuencia de aminoácidos de la cadena principal del péptido es la SEQ ID NO:105.
18. Un derivado del EGF(A) N{alfa}(N{épsilon-328}-[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(15-carboxipentadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]-[Leu301,Arg309,Glu312,Glu321,Lys328]-LDL-R-(293-332)-peptidil)-N{épsilon}[2-[2-[2-[[2-[2-[2-[[(4S)-4-carboxi-4-(15-carboxipentadecanoilamino)butanoil]amino]etoxi]etoxi]acetil]amino]etoxi]etoxi]acetil]Lys (Compuesto del ejemplo 151),

en donde la secuencia de aminoácidos de la cadena principal del péptido es la SEQ ID NO:104.
19. Un análogo peptídico del EGF(A) que tiene 1-8 sustituciones de aminoácidos en comparación con el dominio EGF(A), los aminoácidos 293-332 del LDL-R, definidos mediante la SEQ ID NO 1, en donde el análogo peptídico del EGF(A) comprende 301Leu, 310Asp y una sustitución de aminoácidos de 312Lys y en donde el análogo tiene una Ki por debajo de 5 nM cuando se mide en un ELISA competitivo de unión de PCSK9-LDL-R, como se describió el la sección D1.1 de la descripción.
20. Un análogo peptídico del EGF(A) que tiene 1-8 sustituciones de aminoácidos en comparación con el dominio EGF(A), los aminoácidos 293-332 del LDL-R, definidos mediante la SEQ ID NO 1, en donde el análogo peptídico del EGF(A) comprende 301Leu y 310Asp y en donde el péptido no tiene una sustitución de 299Asp por Glu, Val o His y en donde el análogo tiene una Ki por debajo de 5 nM cuando se mide en un ELISA competitivo de unión de PCSK9-LDL-R, como se describió en la descripción de la sección D1.1.
21. El análogo peptídico del EGF(A) de acuerdo con la reivindicación 19 o 20, en donde el análogo peptídico del EGF(A) comprende los residuos 297Cys, 304Cys, 308Cys, 317Cys, 319Cys y 331Cys.
22. El análogo peptídico del EGF(A) de acuerdo con cualquiera de las reivindicaciones anteriores 19-21, en donde el análogo peptídico del EGF(A) se define como el análogo peptídico del EGF(A) en cualquiera de las reivindicaciones 5-12.
23. El análogo peptídico del EGF(A) de acuerdo con cualquiera de las reivindicaciones anteriores 19-22, el EGF(A) comprende, además, al menos una sustitución de Lys seleccionada del grupo que consiste en: 292Lys, 293Lys, 294Lys, 296Lys, 299Lys, 300Lys, 303Lys, 305Lys, 306Lys, 309Lys, 311Lys, 313Lys, 314Lys, 315Lys, 316Lys, 318Lys, 320Lys, 321Lys, 322Lys, 323Lys, 324Lys, 325Lys, 326Lys, 327Lys, 328Lys, 329Lys, 330Lys, 332Lys y 333Lys.
Applications Claiming Priority (4)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| CN2016070791 | 2016-01-13 | ||
| CN2016076580 | 2016-03-17 | ||
| EP16195965 | 2016-10-27 | ||
| PCT/EP2017/050668 WO2017121850A1 (en) | 2016-01-13 | 2017-01-13 | Egf(a) analogues with fatty acid substituents |
Publications (1)
| Publication Number | Publication Date |
|---|---|
| ES2916998T3 true ES2916998T3 (es) | 2022-07-06 |
Family
ID=57868232
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| ES17701078T Active ES2916998T3 (es) | 2016-01-13 | 2017-01-13 | Análogos del EGF(A) con sustituyentes de ácidos grasos |
Country Status (26)
| Country | Link |
|---|---|
| US (2) | US10822385B2 (es) |
| EP (1) | EP3402811B1 (es) |
| JP (2) | JP6797926B2 (es) |
| KR (1) | KR102417487B1 (es) |
| CN (1) | CN108473550B (es) |
| AU (1) | AU2017207862B2 (es) |
| BR (1) | BR112018013820A2 (es) |
| CA (1) | CA3010756A1 (es) |
| CL (1) | CL2018001868A1 (es) |
| CO (1) | CO2018007440A2 (es) |
| DK (1) | DK3402811T3 (es) |
| ES (1) | ES2916998T3 (es) |
| HR (1) | HRP20220720T1 (es) |
| HU (1) | HUE058647T2 (es) |
| IL (1) | IL260043A (es) |
| LT (1) | LT3402811T (es) |
| MX (1) | MX2018008681A (es) |
| MY (1) | MY195199A (es) |
| PE (1) | PE20181376A1 (es) |
| PH (1) | PH12018501502A1 (es) |
| PL (1) | PL3402811T3 (es) |
| RS (1) | RS63298B1 (es) |
| RU (1) | RU2747877C2 (es) |
| SA (1) | SA518391996B1 (es) |
| SI (1) | SI3402811T1 (es) |
| WO (1) | WO2017121850A1 (es) |
Families Citing this family (18)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP6893517B2 (ja) | 2016-01-13 | 2021-06-23 | グリュネンタール・ゲゼルシャフト・ミト・ベシュレンクテル・ハフツング | 3−((ヘテロ−)アリール)−アルキル−8−アミノ−2−オキソ−1,3−ジアザ−スピロ−[4.5]−デカン誘導体 |
| TWI635082B (zh) | 2016-01-13 | 2018-09-11 | 歌林達有限公司 | 3-((雜-)芳基)-8-胺基-2-側氧-1,3-二氮雜-螺-[4.5]-癸烷衍生物 |
| RU2747877C2 (ru) | 2016-01-13 | 2021-05-17 | Ново Нордиск А/С | Аналоги эфр(а) с заместителями - жирными кислотами |
| RS60855B1 (sr) | 2016-01-13 | 2020-10-30 | Gruenenthal Gmbh | Derivati 8-amino-2-okso-1,3-diaza-spiro-[4.5]-dekana |
| MX378995B (es) | 2016-01-13 | 2025-03-11 | Gruenenthal Gmbh | Derivados de 3-(carboximetil)-8-amino-2-oxo-1,3-diaza-espiro-[4.5]-decano. |
| CN110945017B (zh) | 2017-07-19 | 2024-07-16 | 诺和诺德股份有限公司 | 双功能化合物 |
| MA49617A (fr) * | 2017-07-19 | 2020-05-27 | Novo Nordisk As | Analogues d'egf(a), préparation, formulations et utilisations associées |
| WO2019023295A1 (en) * | 2017-07-27 | 2019-01-31 | Saint Louis University | Fatty acid modified human epidermal growth factor |
| KR20250161677A (ko) | 2018-06-21 | 2025-11-17 | 머크 샤프 앤드 돔 엘엘씨 | Pcsk9 길항제 화합물 |
| EP3861017A1 (en) * | 2018-10-05 | 2021-08-11 | Novo Nordisk A/S | Bifunctional compounds comprising insulin peptides and egf(a) peptides |
| CA3131997A1 (en) | 2019-03-22 | 2020-10-01 | 3M Innovative Properties Company | Fall-protection system with monitoring system |
| CN110357969B (zh) * | 2019-05-27 | 2022-03-08 | 北京志道生物科技有限公司 | 一种GLP1-EGFa异源二聚体蛋白、功能及方法 |
| CN114222581A (zh) | 2019-08-07 | 2022-03-22 | 诺和诺德股份有限公司 | 包含egf(a)衍生物和n-(8-(2-羟基苯甲酰基)氨基)辛酸的盐的固体组合物 |
| JP2023500031A (ja) | 2019-11-07 | 2023-01-04 | ノヴォ ノルディスク アー/エス | Pcsk9阻害剤およびn-(8-(2-ヒドロキシベンゾイル)アミノ)カプリル酸の塩を含む固形組成物 |
| US12577259B2 (en) | 2019-12-20 | 2026-03-17 | Merck Sharp & Dohme Llc | PCSK9 antagonist compounds |
| US12428278B2 (en) | 2021-07-02 | 2025-09-30 | 3M Innovative Properties Company | Aerial lift interlocked with fall-protection safety apparatus |
| WO2023012263A1 (en) | 2021-08-04 | 2023-02-09 | Novo Nordisk A/S | Solid oral peptide formulations |
| CN117186201A (zh) * | 2022-05-30 | 2023-12-08 | 乐普(北京)医疗器械股份有限公司 | 一种支链修饰的egf(a)类似物及其应用 |
Family Cites Families (27)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP2009510999A (ja) | 2005-07-29 | 2009-03-19 | エーエムプロテイン コーポレイション | キメラ治療剤 |
| EP1922336B1 (en) | 2005-08-11 | 2012-11-21 | Amylin Pharmaceuticals, LLC | Hybrid polypeptides with selectable properties |
| WO2009022006A1 (en) | 2007-08-15 | 2009-02-19 | Novo Nordisk A/S | Insulins with an acyl moiety comprising repeating units of alkylene glycol containing amino acids |
| EP2296694B1 (en) * | 2008-04-23 | 2015-08-05 | Amgen Inc. | Neutralizing proprotein convertase subtilisin kexin type 9 (pcsk9) variants and uses thereof |
| US8673850B2 (en) | 2008-05-30 | 2014-03-18 | Institut De Recherches Cliniques De Montreal | PCSK9 inhibitors and methods of use thereof |
| TWI445716B (zh) | 2008-09-12 | 2014-07-21 | Rinat Neuroscience Corp | Pcsk9拮抗劑類 |
| CN101993485B (zh) | 2009-08-20 | 2013-04-17 | 重庆富进生物医药有限公司 | 促胰岛素分泌肽类似物同源二聚体及其用途 |
| JPWO2012017774A1 (ja) | 2010-08-02 | 2013-10-03 | 日本電気株式会社 | 偏光子及び発光装置 |
| CN102153652A (zh) | 2010-12-10 | 2011-08-17 | 浙江大学 | 一种融合蛋白的表达方法及用途 |
| JP2014510516A (ja) | 2011-02-15 | 2014-05-01 | ノヴォ ノルディスク アー/エス | 長時間作用性il−1受容体アンタゴニスト |
| KR20140041747A (ko) * | 2011-06-20 | 2014-04-04 | 제넨테크, 인크. | Pcsk9-결합 폴리펩티드 및 사용 방법 |
| MX354705B (es) * | 2011-09-23 | 2018-03-16 | Novo Nordisk As | Analogos de glucagon novedosos. |
| US9458214B2 (en) | 2011-09-26 | 2016-10-04 | Novartis Ag | Dual function fibroblast growth factor 21 proteins |
| WO2013093009A1 (en) * | 2011-12-21 | 2013-06-27 | Novo Nordisk A/S | N -terminally modified insulin derivatives |
| EP2851429B1 (en) | 2012-05-18 | 2019-07-24 | Adda Biotech Inc. | Protein and protein conjugate for diabetes treatment, and applications thereof |
| AR092076A1 (es) | 2012-08-22 | 2015-03-18 | Lilly Co Eli | Proteinas homodimericas |
| MX2015002985A (es) | 2012-09-07 | 2015-06-22 | Sanofi Sa | Proteinas de fusion para el tratamiento de un sindrome metabolico. |
| BR112015025464A2 (pt) * | 2013-04-18 | 2017-10-10 | Novo Nordisk As | coagonistas do receptor de glp-1/glucagon estáveis, prolongados para uso médico |
| KR20160067219A (ko) | 2013-10-03 | 2016-06-13 | 모더나 세라퓨틱스, 인코포레이티드 | 저밀도 지단백질 수용체를 암호화하는 폴리뉴클레오타이드 |
| BR112016017402A2 (pt) | 2014-02-21 | 2017-10-17 | Medimmune Ltd | fusões anti-pcsk9~glp-1 e métodos para uso |
| JP2017525656A (ja) * | 2014-06-04 | 2017-09-07 | ノヴォ ノルディスク アー/エス | 医療用のglp−1/グルカゴン受容体コアゴニスト |
| CN104558198A (zh) | 2014-07-25 | 2015-04-29 | 成都贝爱特生物科技有限公司 | GLP-1类似物和amylin类似物的融合蛋白制备及其用途 |
| WO2016147162A1 (en) * | 2015-03-19 | 2016-09-22 | Institut De Cardiologie De Montreal | Grp94 derived polypeptides for inhibiting pcsk9 and methods of use |
| CN105367884A (zh) | 2015-11-02 | 2016-03-02 | 陈薇 | 一种绝缘耐火抗辐射的屏蔽电缆材料及其制备方法 |
| RU2747877C2 (ru) | 2016-01-13 | 2021-05-17 | Ново Нордиск А/С | Аналоги эфр(а) с заместителями - жирными кислотами |
| MA49617A (fr) | 2017-07-19 | 2020-05-27 | Novo Nordisk As | Analogues d'egf(a), préparation, formulations et utilisations associées |
| CN110945017B (zh) | 2017-07-19 | 2024-07-16 | 诺和诺德股份有限公司 | 双功能化合物 |
-
2017
- 2017-01-13 RU RU2018127882A patent/RU2747877C2/ru active
- 2017-01-13 MY MYPI2018702319A patent/MY195199A/en unknown
- 2017-01-13 PL PL17701078T patent/PL3402811T3/pl unknown
- 2017-01-13 EP EP17701078.2A patent/EP3402811B1/en active Active
- 2017-01-13 HU HUE17701078A patent/HUE058647T2/hu unknown
- 2017-01-13 SI SI201731149T patent/SI3402811T1/sl unknown
- 2017-01-13 CN CN201780006783.6A patent/CN108473550B/zh active Active
- 2017-01-13 HR HRP20220720TT patent/HRP20220720T1/hr unknown
- 2017-01-13 PE PE2018001257A patent/PE20181376A1/es unknown
- 2017-01-13 RS RS20220538A patent/RS63298B1/sr unknown
- 2017-01-13 CA CA3010756A patent/CA3010756A1/en not_active Withdrawn
- 2017-01-13 ES ES17701078T patent/ES2916998T3/es active Active
- 2017-01-13 JP JP2018536444A patent/JP6797926B2/ja active Active
- 2017-01-13 BR BR112018013820-7A patent/BR112018013820A2/pt not_active Application Discontinuation
- 2017-01-13 LT LTEPPCT/EP2017/050668T patent/LT3402811T/lt unknown
- 2017-01-13 AU AU2017207862A patent/AU2017207862B2/en not_active Ceased
- 2017-01-13 DK DK17701078.2T patent/DK3402811T3/da active
- 2017-01-13 US US16/069,932 patent/US10822385B2/en active Active
- 2017-01-13 MX MX2018008681A patent/MX2018008681A/es unknown
- 2017-01-13 WO PCT/EP2017/050668 patent/WO2017121850A1/en not_active Ceased
- 2017-01-13 KR KR1020187022105A patent/KR102417487B1/ko not_active Expired - Fee Related
-
2018
- 2018-06-14 IL IL260043A patent/IL260043A/en unknown
- 2018-07-09 CL CL2018001868A patent/CL2018001868A1/es unknown
- 2018-07-10 SA SA518391996A patent/SA518391996B1/ar unknown
- 2018-07-12 PH PH12018501502A patent/PH12018501502A1/en unknown
- 2018-07-16 CO CONC2018/0007440A patent/CO2018007440A2/es unknown
-
2020
- 2020-09-17 US US17/024,264 patent/US20200407409A1/en not_active Abandoned
- 2020-11-17 JP JP2020190846A patent/JP2021035989A/ja not_active Withdrawn
Also Published As
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| US20200407409A1 (en) | Egf(a) analogues with fatty acid substituents | |
| JP7863526B2 (ja) | 新規glp-1類似体 | |
| ES2625735T3 (es) | Análogos y derivados de GLP-1 | |
| ES2674946T3 (es) | Análogos de glucagón que muestran actividad de receptor de GIP | |
| EA020326B1 (ru) | Агонисты смешанного действия на основе глюкозозависимого инсулинотропного пептида для лечения нарушений обмена веществ и ожирения | |
| US20200165313A1 (en) | Egf(a) analogues, preparation, formulations and uses thereof | |
| CN101005857A (zh) | 多肽延长标记 | |
| KR20230104118A (ko) | Glp-1 전구약물 및 이의 용도 | |
| TW202028229A (zh) | 包含胰島素肽及egf(a)肽之雙功能化合物 | |
| CA2792663A1 (en) | Novel glucagon analogues | |
| CN104411322B (zh) | 双酰化glp‑1衍生物 | |
| DK2773376T3 (en) | Polyethylene glycol PRODRUG adrenomedullin AND USE THEREOF | |
| EA019203B1 (ru) | Коагонисты глюкагонового рецептора/glp-1-рецептора | |
| CN104185639B (zh) | Glp-1前体药物 | |
| DK3074032T3 (en) | Fatty acid derivatives of dimeric PSD-95 inhibitors | |
| KR20210126088A (ko) | 지속성 glp-2 유사체 | |
| HK1262866B (en) | Egf(a) analogues with fatty acid substituents | |
| CA3195872A1 (en) | Glp-1 prodrugs and uses hereof | |
| JP2026031900A (ja) | Fc-アシル化ポリペプチドコンジュゲート |