JP4657455B2 - データプロセッサ - Google Patents
データプロセッサ Download PDFInfo
- Publication number
- JP4657455B2 JP4657455B2 JP2000604303A JP2000604303A JP4657455B2 JP 4657455 B2 JP4657455 B2 JP 4657455B2 JP 2000604303 A JP2000604303 A JP 2000604303A JP 2000604303 A JP2000604303 A JP 2000604303A JP 4657455 B2 JP4657455 B2 JP 4657455B2
- Authority
- JP
- Japan
- Prior art keywords
- register
- instruction
- rfi
- control
- address
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Expired - Fee Related
Links
Images









Classifications
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F9/00—Arrangements for program control, e.g. control units
- G06F9/06—Arrangements for program control, e.g. control units using stored programs, i.e. using an internal store of processing equipment to receive or retain programs
- G06F9/30—Arrangements for executing machine instructions, e.g. instruction decode
- G06F9/38—Concurrent instruction execution, e.g. pipeline or look ahead
- G06F9/3885—Concurrent instruction execution, e.g. pipeline or look ahead using a plurality of independent parallel functional units
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F9/00—Arrangements for program control, e.g. control units
- G06F9/06—Arrangements for program control, e.g. control units using stored programs, i.e. using an internal store of processing equipment to receive or retain programs
- G06F9/30—Arrangements for executing machine instructions, e.g. instruction decode
- G06F9/30003—Arrangements for executing specific machine instructions
- G06F9/3004—Arrangements for executing specific machine instructions to perform operations on memory
- G06F9/30043—LOAD or STORE instructions; Clear instruction
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F9/00—Arrangements for program control, e.g. control units
- G06F9/06—Arrangements for program control, e.g. control units using stored programs, i.e. using an internal store of processing equipment to receive or retain programs
- G06F9/30—Arrangements for executing machine instructions, e.g. instruction decode
- G06F9/30098—Register arrangements
- G06F9/30101—Special purpose registers
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F9/00—Arrangements for program control, e.g. control units
- G06F9/06—Arrangements for program control, e.g. control units using stored programs, i.e. using an internal store of processing equipment to receive or retain programs
- G06F9/30—Arrangements for executing machine instructions, e.g. instruction decode
- G06F9/30098—Register arrangements
- G06F9/3012—Organisation of register space, e.g. banked or distributed register file
- G06F9/30138—Extension of register space, e.g. register cache
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F9/00—Arrangements for program control, e.g. control units
- G06F9/06—Arrangements for program control, e.g. control units using stored programs, i.e. using an internal store of processing equipment to receive or retain programs
- G06F9/30—Arrangements for executing machine instructions, e.g. instruction decode
- G06F9/30098—Register arrangements
- G06F9/30141—Implementation provisions of register files, e.g. ports
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F9/00—Arrangements for program control, e.g. control units
- G06F9/06—Arrangements for program control, e.g. control units using stored programs, i.e. using an internal store of processing equipment to receive or retain programs
- G06F9/30—Arrangements for executing machine instructions, e.g. instruction decode
- G06F9/30145—Instruction analysis, e.g. decoding, instruction word fields
- G06F9/3016—Decoding the operand specifier, e.g. specifier format
- G06F9/30167—Decoding the operand specifier, e.g. specifier format of immediate specifier, e.g. constants
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F9/00—Arrangements for program control, e.g. control units
- G06F9/06—Arrangements for program control, e.g. control units using stored programs, i.e. using an internal store of processing equipment to receive or retain programs
- G06F9/30—Arrangements for executing machine instructions, e.g. instruction decode
- G06F9/30181—Instruction operation extension or modification
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F9/00—Arrangements for program control, e.g. control units
- G06F9/06—Arrangements for program control, e.g. control units using stored programs, i.e. using an internal store of processing equipment to receive or retain programs
- G06F9/30—Arrangements for executing machine instructions, e.g. instruction decode
- G06F9/34—Addressing or accessing the instruction operand or the result ; Formation of operand address; Addressing modes
- G06F9/342—Extension of operand address space
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F9/00—Arrangements for program control, e.g. control units
- G06F9/06—Arrangements for program control, e.g. control units using stored programs, i.e. using an internal store of processing equipment to receive or retain programs
- G06F9/30—Arrangements for executing machine instructions, e.g. instruction decode
- G06F9/34—Addressing or accessing the instruction operand or the result ; Formation of operand address; Addressing modes
- G06F9/345—Addressing or accessing the instruction operand or the result ; Formation of operand address; Addressing modes of multiple operands or results
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F9/00—Arrangements for program control, e.g. control units
- G06F9/06—Arrangements for program control, e.g. control units using stored programs, i.e. using an internal store of processing equipment to receive or retain programs
- G06F9/30—Arrangements for executing machine instructions, e.g. instruction decode
- G06F9/34—Addressing or accessing the instruction operand or the result ; Formation of operand address; Addressing modes
- G06F9/35—Indirect addressing
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F9/00—Arrangements for program control, e.g. control units
- G06F9/06—Arrangements for program control, e.g. control units using stored programs, i.e. using an internal store of processing equipment to receive or retain programs
- G06F9/30—Arrangements for executing machine instructions, e.g. instruction decode
- G06F9/34—Addressing or accessing the instruction operand or the result ; Formation of operand address; Addressing modes
- G06F9/355—Indexed addressing
- G06F9/3552—Indexed addressing using wraparound, e.g. modulo or circular addressing
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F9/00—Arrangements for program control, e.g. control units
- G06F9/06—Arrangements for program control, e.g. control units using stored programs, i.e. using an internal store of processing equipment to receive or retain programs
- G06F9/30—Arrangements for executing machine instructions, e.g. instruction decode
- G06F9/38—Concurrent instruction execution, e.g. pipeline or look ahead
- G06F9/3836—Instruction issuing, e.g. dynamic instruction scheduling or out of order instruction execution
- G06F9/3842—Speculative instruction execution
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F9/00—Arrangements for program control, e.g. control units
- G06F9/06—Arrangements for program control, e.g. control units using stored programs, i.e. using an internal store of processing equipment to receive or retain programs
- G06F9/30—Arrangements for executing machine instructions, e.g. instruction decode
- G06F9/38—Concurrent instruction execution, e.g. pipeline or look ahead
- G06F9/3836—Instruction issuing, e.g. dynamic instruction scheduling or out of order instruction execution
- G06F9/3853—Instruction issuing, e.g. dynamic instruction scheduling or out of order instruction execution of compound instructions
Landscapes
- Engineering & Computer Science (AREA)
- Software Systems (AREA)
- Theoretical Computer Science (AREA)
- Physics & Mathematics (AREA)
- General Engineering & Computer Science (AREA)
- General Physics & Mathematics (AREA)
- Advance Control (AREA)
- Executing Machine-Instructions (AREA)
Description
(関連出願の相互参照)
本願出願は、1998年3月12日出願の「Register File Indexing Method and Apparatus for Providing Indirect Control of Register in a VLIW Processor」という名称の米国仮特許出願第60/077,766号の利点を主張する。
【0002】
(発明の分野)
本発明は、一般に、超長命令語(VLIW)処理における改良に関し、より詳細には、VLIWプロセッサにおけるレジスタ・アドレッシングの間接制御を提供するための有利なレジスタファイル索引付け(RFI)技術に関する。
【0003】
(発明の背景)
1つの重要なプロセッサ・モデルは、ベクトル処理のものである。このモデルは、従来のスーパーコンピュータにおいて長年使用されてきた。このモデルの典型的な特徴は、専用ベクトル命令、専用ベクトル・ハードウェア、及びデータのブロックに効率的に操作を加える能力の使用である。まさにこの、典型的にはベクトル・データ・タイプのみに操作を加える能力により、このモデルには柔軟性がなく、多様な処理要件に効率的に対処できない。加えて、従来のベクトル・プロセッサでは、制御スカラ処理のサポートが典型的には、分離したハードウェアにおいて、或いは分離した制御プロセッサにおいて行われた。もう1つのプロセッサモデルは、従来の超長命令語(VLIW)プロセッサモデルであり、これは、標準の単一プロセッサタイプの単一機能動作を長い命令語に、専用のマルチサイクル・ベクトル処理機能なしに連結することに基づいた、並列処理モデルに相当する。ブロックデータ・ベクトル・パイプラインを効率的に動作するには、個別のベクトル要素を引き渡すための効率的なインターフェイスを有することが重要である。このため、成功したクラスの従来技術のベクトルマシンは、レジスタベースであった。このレジスタベースのベクトルプロセッサは、ベクトル要素用の高性能レジスタを提供し、要素の効率的なアクセスを機能実行ユニットによって可能にする。実施特有のベクトル長の値に結合された単一のベクトル命令が、ブロック・データ・マルチサイクル動作を引き起こす。加えて、多数のベクトルマシンが連鎖機能を提供しており、個別のベクトル要素への操作が直接、他のベクトル関数ユニットへ経路指定されて、性能が向上される。これらの従前の特徴及び能力が、本発明のための背景を提供する。本発明の一目的は、スカラ、VLIW、及び柔軟性のあるベクトル処理能力を、間接的なVLIWプロセッサにおいて効率的に組み込むことである。
【0004】
典型的な限定命令セット・コンピュータ(RISC)及びVLIWプロセッサでは、レジスタオペランドのアクセスが、レジスタファイルに格納されたオペランドのレジスタアドレスを表す短命令語(SIW)ビット・フィールドから決定される。レジスタベースのベクトルプロセッサでは、専用のハードウェアが使用される。このハードウェアは単一ベクトル命令によって開始され、専用ベクトルレジスタからのベクトル要素(オペランドデータ)のアクセスを自動化する。データのブロックにおけるマルチサイクル実行も自動化される。
【0005】
従来は、レジスタ・オペランド・データの自動アクセスをサポートするために使用された、専用のハードウェア技術もあった。例えば、米国特許第5,680,600号は、レジスタファイル・アドレッシングを自動化するためにループ又は繰り返し命令を使用して、レジスタファイルにアクセスするための技術を記載している。この手法は、レジスタ・アドレッシングをループ又は繰り返し命令に結合し、これにより、レジスタアドレスに、レジスタファイルのアドレス空間を介して増分するように指示する間に、ロード又は格納命令を繰り返させる。電子回路が、多数の逐次命令のためのコントローラメモリの必要量を低減するために指定される。従って、この従来技術の手法は、特殊なループ又は繰り返し命令によって呼び出されたロード及び格納タイプの動作にのみ適用されるようにみえる。このように、これは、以下で更に対象とされるような間接VLIW ManArray(マンアレイ)プロセッサに容易に適用可能ではない。
【0006】
(発明の概要)
ManArrayファミリのプロセッサは適切に、多数の「間接VLIW」(iVLIW)プロセッサ及びプロセッサ要素(PE)からなることができ、これらが32ビットの固定長の短命令語(SIW)を利用する。SIWを、プロセッサにつき最大8つの実行ユニットの1つによって個別に、かつ、SIMDモードの動作において、多数のPEを同期させて実行することができる。もう1つのタイプのSIWは、VLIWを間接的に参照して、最大8つのSIW命令の発行を、各プロセッサにおいて並行して、多数のPEを同期させて、並行して実行させることができる。
【0007】
オペランドがレジスタファイルに格納され、各実行ユニットが1つ又は複数の読取り及び書込みポートを有し、これがレジスタファイル或いは複数ファイルに接続される。大抵のプロセッサでは、各ポート用に選択されたレジスタが、命令におけるビットフィールドを使用してアドレス指定される。ManArrayプロセッサにおいて使用された間接VLIW技術により、VLIWを作成するSIWがVLIWメモリに格納される。各SIWがレジスタオペランド・フィールドを、レジスタによりアクセスされたオペランドデータにおける単一の動作のための定義によって固定するので、単一のオペランドフィールドが処理アルゴリズムによって必要とされるように異なっていなければならないときはいつでも、多数のVLIWが必要とされる。従って、このようなプロセッサ、及び、より一般には並列アレイプロセッサに拡張可能なものと共に使用するための、データのブロックにおける動作のための適切なレジスタファイル索引付け技術が、大変有利となる。
【0008】
このオペランド・データ固定レジスタ指定の問題が、本発明によって、間接VLIW命令を使用して、データのブロックにおけるパイプライン計算を達成する小型の手段を提供することにより解決される。レジスタファイルにおけるデータのブロックにアクセスする二重間接方法が使用されて、専用のベクトル処理ハードウェアを使用しない効率的な実施が可能となる。加えて、レジスタ・アドレッシングの自動修正が、単一ベクトル命令にも、繰り返し又はループ命令にも結合されない。むしろこの技術は、レジスタファイル索引付け(RFI)と呼ばれ、ブロックデータ操作機能の制御において十分なプログラマの柔軟性を可能にし、非RFI命令をRFI命令と混合するための能力を提供する。ブロックデータ操作機能がiVLIW ManArrayアーキテクチャに埋め込まれ、命令セット・アーキテクチャにわたるその汎用の使用を、専用のベクトル命令なしに、かつ、繰り返し又はループ命令と使用するのみに限定されることなく可能にする。本発明を利用すると、連鎖動作が、機能ユニットの間のいかなる直接経路指定もなしに、固有に使用可能であり、さらに実施を簡素化する。加えて、このレジスタファイル索引付けアーキテクチャが、コード化されるアルゴリズムのタイプに応じて特に著しくなる可能性のあるVLIWメモリの必要量を低減する。
【0009】
更に、VLIW命令のアンロールされたループ(unrolled loop)として表現されたとき、多数の計算が明確なレジスタ使用パターンを示す。これらのパターンは計算パイプラインの特性であり、本明細書で更に記載され、適合されるように、間接VLIWプロセッサに埋め込まれたManArray間接ベクトル処理と共に利用することができる。
【0010】
その他の態様の中で、本発明は、オペランドレジスタ・アドレスを生成するためのユニークな初期化方法、ユニークな二重間接実行機構、ユニークな制御方法を提供し、レジスタファイルを、独立した循環バッファに区分することができる。これはまた、RFI及び非RFI命令を混合すること、及び、VLIW処理要素の多数のアレイ編成に適用可能なスケーラブルな設計も可能にする。以下で更に詳細に対象とするように、本発明は、iVLIWアレイプロセッサにおける並列命令実行のための、VLIWメモリ、及び、結果として、SIWメモリの必要量を低減する。
【0011】
【発明の実施の形態】
本発明のこれら及び他の特徴、態様及び利点は、添付の図面と共に取られた以下の詳細な説明から、当業者には明らかになるであろう。
【0012】
【発明の実施の形態】
(詳細な説明)
本発明と共に使用するために現在好ましいManArrayアーキテクチャのさらなる詳細は、1997年6月30日出願の米国特許出願第08/885,310号、1997年10月10日出願の米国特許出願第08/949,122号、1998年10月9日出願の米国特許出願第09/169,255号、1998年10月9日出願の米国特許出願第09/169,256号、1998年10月9日出願の米国特許出願第09/169,072号、1998年11月6日出願の米国特許出願第09/187,539号、1998年12月4日出願の米国特許出願第09/205,558号、1998年12月18日出願の米国特許出願第09/215,081号、1999年1月12日出願の米国特許出願第09/228,374号、及び1999年1月28日出願の米国特許出願第09/238,446号、ならびに、1998年7月9日出願の「Methods and Apparatus for Instruction Addressing in Indirect VLIW Processors」という名称の仮特許出願第60/092,130号、1998年10月9日出願の「Efficient Complex Multiplication and Fast Fourier Transform (FFT) Implementation on the ManArray」という名称の仮特許出願第60/103,712号、1998年11月3日出願の「Methods and Apparatus for Improved Motion Estimation for Video Encoding」という名称の仮特許出願第60/106,867号、1998年12月23日出願の「Methods and Apparatus for Providing Direct Memory Access(DMA) Engine」という名称の仮特許出願第60/113,637号、及び1998年12月23日出願の「Methods and Appratus Providing Transfer Control」という名称の仮特許出願第60/113,555号においてそれぞれ判明し、全体として、参照により本明細書に組み込まれる。
【0013】
本発明の現在の好ましい実施形態では、図1Aに示されたManArrayの2×2 iVLIW単一命令多重データ・ストリーム(SIMD)プロセッサ100が、処理要素0(PE0)SP/PE0 101に結合されたコントローラ・シーケンス・プロセッサ(SP)を含み、これは「Methods and Apparatus for Dynamically Merging an Array Controller with an Array Processing Element」という名称の米国特許出願第09/169,072号において、更に詳細に記載されている。本発明によれば、3つの追加のPE151、153及び155も、レジスタファイル索引付け及びそのスケーラブルな性質を示すために利用される。PEに、それらの行列位置により、PE0(PE00)101、PE1(PE01)151、PE2(PE10)153、及びPE3(PE11)155について括弧において示されたように、ラベルを付けることもできることに留意されたい。SP/PE0 101はフェッチコントローラ103を含み、32ビット命令メモリ105からの短命令語(SIW)のフェッチを可能にする。このフェッチコントローラ103が、プログラムカウンタ(PC)、分岐機能、デジタル信号処理ループ動作、割り込みのサポートなど、プログラム可能プロセッサにおいて必要とされた典型的な機能を提供し、命令メモリ管理制御を提供し、これは、アプリケーションによって必要とされた場合、命令キャッシュを含むことができる。加えて、SIW I−フェッチ・コントローラ103は、32ビットのSIWをシステムにおける他のPEに、32ビット命令バス102によってディスパッチする。
【0014】
この例示的システムでは、説明を簡素化するために共通の要素が全体を通して使用されるが、実際の使用はそのように限定されない。例えば、結合されたSP/PE0 101における実行ユニット131を、制御機能に合わせて最適化された1組の実行ユニット、例えば、固定小数点実行ユニットに分離することができ、PE0、ならびに他のPE151、153及び155を、浮動小数点の応用例に合わせて最適化することができる。この記載のために、実行ユニット131が、SP/PE0及び他のPEにおける同じタイプのものであると仮定される。類似の方法において、SP/PE0及び他のPEが5命令スロットiVLIWアーキテクチャを使用し、これは、超長命令語メモリ(VIM)メモリ109、及び、命令復号化及びVIMコントローラ機能ユニット107を含み、これがSP/PE0のI−フェッチ・ユニット103からディスパッチされたような命令を受信してVIMアドレス及び制御信号108を生成し、これがiVLIWにアクセスするために必要とされ、109における文字SLAMDによって識別され、VIMに格納される。ManArrayパイプライン設計は、分岐待ち時間を増大させることなく、間接VLIWメモリ・アクセス機構を提供し、これは、間接実行LVIW(XV)命令のための動的に再構成可能な命令パイプラインを提供することによって行い、これは「Methods and Apparatus to Dynamically Reconfigure the Instruction Pipeline of an Indirect Very Long Instruction Word Scalable Processor」という名称の米国特許出願第09/228,374号において、さらに詳細に記載されている。iVLIWのローディングは、「Methods and Apparatus for Efficient Synchronous MIMD Operations with iVLIW PE-to-PE Communication」という名称の米国特許出願第09/187,539号において、さらに詳細に記載されている。また、SP/PE0及び他のPEに含まれているものは、共通のPE構成可能レジスタファイル127であり、これは、「Methods and Apparatus for Dynamic Instruction Controlled Reconfiguration Register File with Extended Precision」という名称の米国特許出願第09/169,255号において、更に詳細に記載されている。
【0015】
SP/PE0の結合された特性により、データメモリ・インターフェイス・コントローラ125が、メモリ121におけるSPデータによりSPコントローラの、及び、メモリ123におけるPE0データによりPE0の、データ処理必要性に対処しなければならない。SP/PE0コントローラ125は、32ビット・ブロードキャスト・データバス126を介して送信されるデータのソースでもある。他のPE151、153及び155は、共通の物理データメモリ・ユニット123'、123”及び123'''を含むが、それらに格納されたデータは一般に、各PEにおいて行われるローカル処理によって必要とされるように異なる。これらのPEデータ・メモリへのインターフェイスも、PE1、2及び3における共通の設計であり、PEローカルメモリ及びデータバス・インターフェイス論理157、157'及び157”によって示される。データ転送通信のためにPEを相互接続するものは、クラスタスイッチ171であり、「Manifold Array Processor」という名称の米国特許出願第08/885,310号、「Methods and Apparatus for Manifold Array Processing」という名称の米国特許出願第09/949,122号、及び「Methods and Apparatus for ManArray PE-to-PE Switch Control」という名称の米国特許出願第09/169,256号において、より完全に記載されている。ホストプロセッサへのインターフェイス、他の周辺デバイス、及び/又は外部メモリを、多数の方法において行うことができる。完全性のために示された主要な機構が、DMA制御装置181に含まれ、これは、スケーラブルなManArrayデータバス183を提供し、これがManArrayコアの外部のデバイス及びインターフェイスユニットに接続される。DMA制御装置181が、これらの外部デバイスがバス185を介してManArrayコアメモリとインターフェイスを取るために必要とされた、データフロー及びバス裁定機構を提供する。
【0016】
上に示された全ての特許は本発明の譲受人に譲渡され、全体として、参照により本明細書に組み込まれる。
【0017】
このとき、本発明に適合されるようなManArrayプロセッサ装置の特定の詳細を参照すると、この手法は、二重間接機構を介した、効率的かつ柔軟性のあるブロックデータ操作能力を提供するので、有利である。
(レジスタファイル索引付けプログラミング考察)
本発明の一態様によるレジスタファイル索引付け(RFI)は、各処理要素における、かつ、オペランドレジスタファイルを、直接SIWのフィールドを介するのではなく、二重間接機構を介して、或いは、専用ベクトル命令及びベクトルハードウェアを介して、或いは、要求された繰り返し又はループ命令により、アドレス指定するためのアレイコントローラにおける、方法及び装置を指す。各実行ユニットが、1つ又は複数のレジスタファイルの読取り及び書込みポートを動作する。読取り又は書込みポートは、レジスタファイルに供給されたレジスタ選択アドレス及び制御線、レジスタファイルから読み取り中であるレジスタデータのための読取りポート用のデータバス、及び、レジスタファイルへ書き込み中であるレジスタデータのための書込みポート用のデータバスからなる。これらのポートのレジスタ選択論理への入力は、典型的には図1Bの従来技術の装置において図示されたように、実行中である命令のビットフィールドからのみ来たものである。図1Bでは、プロセッサの命令レジスタ10において受信された命令が、典型的にはレジスタファイル・アドレスを含み、これらが典型的には、レジスタ12、14及び16など、ポートアドレス・レジスタにおいてラッチされ、次いで、レジスタファイル20など、レジスタファイルをアドレス指定するために直接使用されて、図1Bの格納ユニット22、ロードユニット24、ALU26、MAU28及びDSU30など、ユニットによる命令実行がサポートされた。
【0018】
この典型的なレジスタ選択のための方法に加えて、本発明によるRFI動作により、各実行ユニットの各レジスタファイルポートを、以下で更に対象とされるような簡素な制御回路を使用して、二重間接機構を介して独立して制御することもできる。
【0019】
(RFI動作)
RFI動作を、ManArray iVLIWアーキテクチャに埋め込み、二重間接機構によって呼び出すことができるので、有利である。32ビット符号化フォーマット201を有する例示的実行VLIW(XV)命令200が、図2Aに示される。命令構文、パラメータ又はオペランド、命令200によって実行された動作を要約する構文/動作テーブル203が図2Bに示される。ManArray RFI動作が、ビット20及び21であるRFI動作ビット202を、実行VLIW(XV)命令200において、図2Aに示されたように使用して、RFI動作を使用可能にする。
【0020】
更なる詳細においては、XV命令200が使用されて、指定されたSP又はPE VLIWメモリ(VIM)の個々の命令スロットが間接的に実行させられる。VIMアドレスが、ベースVIMアドレス・レジスタVb(V0又はV1)に、符号なし8ビットのオフセットVIMOFFSを加えた和として計算される。個々の命令スロットのいかなる組み合わせも、実行スロット・パラメータ「E={SLAMD}」を介して実行することができ、但し、S=格納ユニット(SU)、L=ロードユニット(LU)、A=論理演算装置(ALU)、M=乗算累算ユニット(MAU)、及びD=データ選択ユニット(DSU)である。空の「E=」パラメータは、いかなるスロットも実行しない。ユニット影響フラグ(UAF)パラメータ「F=[AMDN]」が、VLIWについて指定されたUAFを、それがロードVLIW(LV)命令を介してロードされたとき、オーバーライドする。オーバーライドは、どの算術命令スロット(A=ALU、M=MAU、D=DSU)又は、なし(N=NONE)が、VLIWのこの実行について条件フラグを設定するために可能とされるかを選択する。オーバーライドは、LV命令を介して指定されたUAF設定に影響を与えない。空の「F=」は、VLIWがロードされたときに、指定されたUAFを選択する。レジスタファイル索引付け(RFI)パラメータ「R=[01N]」が使用されて、このXVの命令スロットの間接実行についてRFIが使用可能或いは使用不可にされる。「R=0」(図2AにおけるRFI動作ビット202=00)であれば、RFI動作が使用可能にされ、RFI制御レジスタグループ0が選択される。「R=1」(ビット202=01)であれば、RFI動作が使用可能にされ、RFI制御レジスタグループ1が選択される。「R=N」(ビット202=11)であれば、RFI動作が使用不可にされる。
【0021】
RFIが使用可能にされたXV命令により、第2の間接動作が開始される。第2の間接動作は、実行される次のXV命令において活動し始め、レジスタポート・アドレスが、分離したRFI制御パラメータによって指定された方法において制御されたハードウェアを自動的に増分することを介して、間接的に指定される。RFI動作が以下で、ManArrayパイプラインに関連して、主として、パイプラインの復号化及び実行段階に関して記載される。RFI制御は、4つの部分、即ち、1)RFI制御指定、2)RFI初期化制御、3)RFI更新制御、及び、4)RFI命令実行からなる。
【0022】
(RFI制御指定)
RFI制御指定は、RFI制御レジスタを介して実行されることが好ましい。各制御レジスタが、特定の実行ユニットによって使用されたレジスタポートについての全てのRFI制御情報を指定する。制御フィールドが各ポート用の制御レジスタにあり、このフィールドが、RFI動作がこの特定のポートについて使用可能にされるかどうかを指定し、使用可能にされた場合、RFIレジスタ更新ポリシーを指定する。
【0023】
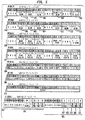
RFI制御レジスタは、図3Aにおいて例示されたManArray雑レジスタファイル(MRF)300を介してアクセスされる。このレジスタファイルは、追加のレジスタを、制限されたMRFアドレス空間内に、追加のレジスタを単一のMRFアドレスにアドレス対応することによって追加できることにおいて、ユニークである。MRF拡張レジスタ305及び315は、図3B及び図3Cにおいてそれぞれ示され、MRF拡張アドレスレジスタ(MRFXAR)301及びMRF拡張データレジスタ(MRFXDR)302及び303を使用してアクセスされる。2つのMRF拡張データレジスタ302及び303が提供されて、実施が簡素化され、各組の拡張レジスタの所期の使用が分離される。レジスタアドレスが、図4の32ビットMRFXARレジスタ410のハーフワードH1又はH0部分に、図7A及び図7Bにおいて例示されたようなロード即値命令を使用して書き込まれる。図3A乃至図3C、及び図4A及び図4Bの各部分の関係が、以下でより十分に述べられる。
【0024】
【表1】

現在好ましい実施形態では、5つの実行ユニットがRFI制御を有する。図3Cは、例示的なセットのRFI制御レジスタの要約を示す。これらのMRFXレジスタ510、520、530、540、550、560、570及び580が、図5において更に詳細に示され、各制御レジスタが、指定された実行ユニット用の読取り/書込みポートに割り当てられる。これらの実行ユニットには、論理演算装置(ALU)、乗算累算ユニット(MAU)、データ選択ユニット(DSU)、ロードユニット及び格納ユニットが含まれる。
【0026】
レジスタが2つの制御グループ(510〜540)、2つの保存及び復元コンテキストレジスタ(550及び560)、及び1つのレジスタ580において使用されて、各制御グループのためのRFI制御の初期化が制御される。予約済レジスタ570も示される。第1の制御グループ0が、図3CにおけるRFIDLS0 310及びRFIAM0 320を含む。さらなる詳細が、図5のレジスタ510及び520において示される。第2の制御グループ1が、RFIDLS1 330及びRFIAM1 340を含み、さらなる詳細がレジスタ530及び540において示される。
【0027】
iVLIWが実行されたとき、制御グループの1つがXV命令において、ビット21及び20という、図2の命令200のRFIビット202を介して指定されて、このVLIWにおける命令によって使用された、いかなるポートのRFI制御も可能にされる。本発明が、制御情報又は制御情報の部分集合を、直接命令においてなど、指定するための別の機構を使用することを除外しないことは、理解されよう。
【0028】
具体的には、制御グループ0において、図5におけるRFIDLS0 510が、単一のロードRtポート501、単一の格納Rsポート502、DSU Ry503、Rx504及びRt505用の3つのオペランド・ポートのためのポート制御情報を含む。制御グループ0における第2のレジスタ、RFIAM0 520が、MAU Ry521、Rx522、Rt523用の3つのオペランドポート、及び、ALU Ry524、Rx525及びRt526用の3つのオペランドポートのための、ポート制御情報を含む。2つの制御グループに関連付けられたものは、初期化開始ビットであり、これらは、図3CのRFIStartレジスタ380における、より詳細には図5のレジスタ580における、制御グループ0及び1について含まれる。制御グループ0では、初期化開始ビットがH0ハーフワード581に、以下のように実行ユニットにつき単一のビットと共に位置する。即ち、格納ポート開始0ビット−4 587、ロード・ポート開始0ビット−3 586、ALUポート開始0ビット−2 585、MAUポート開始0ビット−1 584、及び、DSUポート開始0ビット−0 583である。類似の方法において、第2の制御グループ1のための制御レジスタRFIDLS1 530、RFIAM1 540が、図5に示されるようにセット・アップされる。制御グループ1のための初期化開始ビットは、RFIStart580のH1ハーフワード582に位置する。他の2つのRFIレジスタRFIDLSI550及びRFIAMI560が、コンテキスト保存及び復元動作のサポートにおける割り込みにおいて、ポートアドレス値を格納してポートアドレスの値を保存する。
【0029】
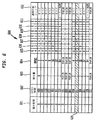
制御パラメータが、必要とされたセットの制御情報を表現することができる、いかなるフォーマットを有する可能性もあり、これは、本発明が特定のフォーマットを必要としないからであることに留意されたい。レジスタファイル・ポートのための例示的フォーマット600が、より詳細に図6に示される。RFIパラメータが4ビットに、列601及び602において示されたように符号化される。この制御情報が、次のRFI命令実行において選択される次のレジスタのアドレスを生成するために適用される、更新のタイプを指定する。現時点の好ましい実施形態では、制御パラメータが使用されて、レジスタアドレスに加算される更新増分値603が選択され、選択することができる最大順次(1ずつ増分する)レジスタファイルアドレス範囲(RFBS)604が指定される。以下で更に記載されるように、開始レジスタがこれらのパラメータと共に、索引によって選択することができる実際のレジスタセットを決定する。列605〜611が使用されて、図8及び図9に示された間接ベクトル装置の動作が記載される。これらの列605〜611では、「x」が「配慮しない」状態を表す。列612は、適用可能ユニット列であり、どの実行ユニットに制御パラメータが適用されるかを指定する。
【0030】
(RFI初期化制御)
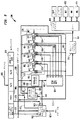
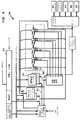
RFI初期化は2つのステップにおいて行われ、これらは図8及び図9を参照して最適に理解される。図8は、算術演算装置におけるポート論理のための例示的RFI装置800を示す。図9は、ロード及び格納ユニットにおけるポート論理のための例示的RFI装置900を示す。この例示的記載は低コストの構成を表し、これは、ALU、MAU及びDSUユニット用の制御グループ0、及び、ロード及び格納ユニット用の制御グループ0及び1を使用する。これは、図5において概説されたアーキテクチャの記述の部分集合であり、プログラマの制約を表し、全てのオプションが、制御グループ0における全ての実行ユニットについて使用可能であるが、制御グループ1は主としてブロック移動、保存及び復元動作について使用される。RFI XV命令が、第2の制御グループ1を実施において選択し、算術演算装置上の制御グループ0のみを可能とし、算術演算装置は、制御グループ1が指定されたときでも、制御グループ0指定に省略時指定される。この部分集合が実施の費用を最小化し、以下のようにより詳細に記載される。
【0031】
最初に、各レジスタファイルポートについての、図6に例示されたような制御情報が、RFI制御レジスタ810及び910に、ロード即値(LIM)命令700の使用によって書き込まれ、この符号化フォーマットが図7Aに示され、この構文/動作710が図7Bに示される。LIM命令700が最初に使用されて、図4のロードMRFXARハーフワードH1 410がロードされて、図3AにおけるMRFXDR2 303へマップされる所望の拡張RFI制御レジスタがセットアップされる。次いで、LIM命令がデータ値を所望の制御レジスタへ、MRFXDR2用のアドレスを使用することによってロードする。制御レジスタの各ハーフワード区間が別々に、LIM命令の定義によってロードされる。
【0032】
明瞭にするため、命令レジスタ814H0ハーフワードビット(15−0)からのLIMデータパスが図示されない。このデータパスが選択的に制御されて、LIM命令のH0ハーフワードが、図5において列挙されたMRF拡張レジスタのいずれかの低又は高ハーフワード部分にロードされる。例えば、LIM命令が、図5のRFIAM0レジスタ520のH1部分への、そのH0ハーフワードのローディングを引き起こすことができる。図8の共通の算術RFIポート制御論理の参照において、RFIAM0の3つの制御部分のうち1つが、810など、このポート用の更新制御レジスタ0において、この場合はALU852についてロードされる。類似の方法において、他の2つのポート制御値が、それら自体のRFIポート制御論理に含まれたそれら自体のポート更新制御レジスタ0にロードされる。他のManArray命令がRFI制御レジスタを、MRFデータバス809の使用を介してロードすることができる。MRFデータバス809は、RFIポートレジスタを、例えば、文脈切換え動作中に保存するためにも使用される。特定のLIM命令の記載は、以下の通りである。LIM命令のハーフワード形式が、16ビットの即値(イミーディエイト値)をSP又はPE目標レジスタRtの上位ハーフワード(H1)又は下位ハーフワード(H0)にロードする。16ビット即値が、符号「中間」値として解釈され、「−32768」から「65535」の範囲におけるいかなる値も受け入れられることを意味する。これは、「−32768」から「+32767」の2の補数符号付き値範囲、及び、「0」から「65535」の符号なし値範囲を包含する。
【0033】
LIM命令のワード形式が、符号付き拡張17ビット即値を目標レジスタにロードする。17ビット符号付き値を、「−65536」から「65535」の範囲におけるいかなる値にすることもできる。LIMのワード形式のための符号化が、値の絶対値をIMM16フィールドに置き、符号ビットが図7Aに示されたLOCフィールドビット23及び22である。LOCフィールドが、上位ハーフワードが全て1のビットで満たされるか、全て0のビットで満たされるかを決定する。
【0034】
RFI初期化の第2のステップでは、開始ビット、例えば、DSU854のためのビット583が、RFI開始レジスタ、図5のRFIStartにおいて設定され、これが、各算術実行ユニットのポートのための開始ビット及びmux制御ブロック812、及び、ロード又は格納ユニットのポートのためのブロック912に位置する。各開始ビットが、実行ユニットに属する全てのポートのための初期化を制御する。これが現時点での好ましいフォーマットであるが、本発明はこのフォーマットに制限されない。このビットを設定する動作が、このレジスタに書き込むことができるいかなる命令によっても実行される。このタイプの少なくとも1つの命令が使用可能である。このビットの設定の後、この特定のグループ及び実行ユニットのためのRFI制御を呼び出す次の命令が、以下で「RFI命令」と呼ばれ、命令語におけるフィールドによって最初に選択されたその実行ユニットのオペランドレジスタを有し、次いで、このグループ及び実行ユニットのための次のRFI命令により、図8及び図9に示されたRFI論理の制御下で選択されたその実行ユニットのオペランドレジスタを有する。RFI XV命令により、図2A及び図2Bにおいて記載されたように、SIWのVLIWセットがローカルのVIM(本明細書で図1AにおけるようなManArray実施のために記載されたような5つのSIW)から間接的に検索される。例えば、5つのSIWのセットの1つが、図8に示されたような命令レジスタ814にロードされる。フェッチされたSIW RtのポートのためのポートRFI論理も、図8に示される。フェッチされた命令の最初の実行では、Rtポートアドレス816がRFIブロック動作のための開始アドレスである。Rtポート・アドレス816がマルチプレクサ814を介して、開始ビット及びmux制御ブロック812によって制御信号813を介して制御されるように、ポートアドレス・レジスタ816へ、マルチプレクサ出力811を介して渡される。Rtポートアドレスは、このとき出力811において含まれ、復号化パイプライン段階の最後でポートアドレス・レジスタ816にラッチされる。ポートアドレス・レジスタ816の出力が直接、レジスタファイル818を、信号パス817を介してアドレス指定する。オペランドがレジスタファイル818から選択され、SIW動作が、指定された実行ユニットにおいて実行される。
【0035】
RFI XV命令の次の発行において、オペランドが間接的にRFI論理から指定される。これは、動作シーケンスにおける第2の間接指定である。第1の間接指定は、RFI XV命令を介したものであり、これは間接的にSIWを指定し、第2の間接指定は、RFI制御パラメータを介してセット・アップされたようなRFI論理を介したものである。これを実施するため、動作更新制御レジスタ0 810、更新加算器論理830、索引付きポート・ルック・アヘッド・レジスタ820、マルチプレクサ814及び822、及び、更新制御論理824が使用されて、更新されたポートアドレスが生成され、これが、後に続くRFI命令実行において使用される。
【0036】
基本概念は、マルチプレクサ814のアドレス出力811が、復号化サイクルにおいて十分早期に使用可能であり、更新加算器論理830が更新制御論理824信号に基づいてアドレスを更新できるようにすることである。更新されたアドレス819がmux制御信号815によって選択されてマルチプレクサ822を通過し、索引ポート・ルック・アヘッド・レジスタ820に、復号化の最後に、現在のポートアドレス811がポートアドレス・レジスタ816にロードされると同時にロードされる。次のRFI命令において、ルック・アヘッド・レジスタ値821が、フェッチされたSIWオペランド・ポート・アドレス値の代りに使用され、次の実行サイクルのためのポートアドレス・レジスタ816にラッチされ、その間に、更新加算器論理が再度、使用される次のポートアドレスを準備中である。RFI開始ビットの設定の後に続く最初のRFI命令の後、開始ビットがクリアされ、後続のRFI命令に、それらのSIWオペランドレジスタを、対応する索引付きポート・ルック・アヘッド・レジスタによって選択させるようにする。開始ビット及びmux制御ブロック812が、命令のレジスタが命令フィールドによって選択されるか、RFI索引付きポート・ルック・アヘッド・レジスタによって選択されるかを決定するための制御を提供する。その入力は、命令演算コード807、更新制御レジスタ0 810、及びRFIイネーブル信号825から来る。これらの信号が、パイプラインにおける命令の進行を指示するパイプライン制御信号(図示せず)と共に、レジスタ選択ソースを、マルチプレクサ814を介して決定する。
【0037】
索引付きポート・ルック・アヘッド・レジスタ820の使用により、非RFI命令を、RFIレジスタアドレス・シーケンスに影響を与えることなく、RFI動作の間で混合することができる。非RFI命令が検出されたとき、RFI論理が、非RFI命令の実行中に、必要とされたRFI状態を保持する。
【0038】
(RFI更新制御)
RFI動作が呼び出されたとき、レジスタファイル818における1つ又は複数のレジスタのアドレスが、RFI論理によって供給される。この論理が、次のサイクルのためのレジスタアドレスを、復号化サイクルの早期の段階において使用可能なアドレスから定数を加算或いは減算し、特定のセットのレジスタアドレス内で生成されたポートアドレスを維持することによって、更新する。現在の好ましい実施形態では、これが、増分値、及び、図6に示されたようなレジスタファイル・ブロック・サイズ(RFBS)604を、制御される各ポートについて指定することによって行われる。好ましい実施形態では、RFBS値が、1、2、4、8など、2の整数の累乗であり、論理的に、レジスタファイルを、ブロックにつきRFBS順次アドレス指定されたレジスタを有するレジスタのブロックに区分させる。開始レジスタRs(Rcurrent=最初の更新におけるRs)、RFBS値M、下限の商Q=[Rs/M]、及び正更新増分kと仮定すると、シーケンスにおける次のレジスタ番号、Rnextが、以下によって与えられる。
【0039】
Rnext=((Rcurrent+k)mod M)+Q×M
Rs/Mの余りが、下限演算により無視されるので、Q×Mの値≠Rsである。
【0040】
一例として、開始レジスタポート・アドレスが「5」であり、即ち、最初の演算のためのRcurrentとも等しいRs=R5であると仮定する。また、更新増分がk=2であり、RFBSがM=8であると仮定する。図6において、この例示的設定が行620に対応し、これは、図8で対応する信号値を以下のように列挙する。即ち、G3=x 606及び831、G2=0 607及び832、G1=1 608及び833、G0=1 609及び834、X1=1 610及び835、及びX0=0 611及び836である。信号X1及びX0が、更新加算器論理830への2入力による増分を提供する。ゲート信号G3、G2、G1、及びG0が、任意の開始レジスタが与えられたブロックサイズを維持する。更新加算器論理830は、5つの標準全加算器861、862、863、864及び865からなり、図10において更に詳細に示される。図10の全加算器1000の実行信号Ci+1 1005が、更新加算器830の各段階からの実行信号841〜844に対応する。これらの実行信号が、ANDゲート845〜848、及び、図6の指定された制御記述によって必要とされたモジュロ加算器を効果的に作成するゲート制御信号831〜834によってゲートされる。これらの仮定では、RFIを使用してこのポートを指定する連続命令が、レジスタに、以下の順序でアクセスする。即ち、R5、R7、R1、R3、R5、R7などである。開始レジスタがR8であった場合、シーケンスは、R8、R10、R12、R14、R8、R10などである。本発明は、2の累乗でない増分及び/又はRFBSを使用することを除外せず、その内部で動作するためのレジスタアドレス・シーケンスを指定する別の機構を使用することも除外しない。例えば、読取り専用メモリを使用して、更新制御論理824及び更新加算器論理830を置き換えて、望まれたいかなる所望のレジスタポート・アドレス・シーケンスも提供することができる。メモリ・ブロックを使用することで実施配線問題を引き起こす可能性があるので、離散論理において更新機能を実施できるようにすることが、現在好ましい方法である。
【0041】
図9は、ロード及び格納ユニットのためのRFI論理900を示し、これらは2つの制御レジスタグループ910及び950をそれぞれ使用するように識別されている。XV命令が、どのグループが使用されるかを、図2のビット21〜20 202を介して指定する。例示的システムでは、制御レジスタグループ1が間接的に指定されたとき、VIMからフェッチされたロード及び格納SIWが、mux制御信号951を介してマルチプレクサ952を通じて選択されたような更新制御レジスタ1 950を使用するが、算術演算装置は制御レジスタグループ0を使用することに省略時指定される。代替実施では、図9のRFIポート論理を、各算術実行ユニットについて使用することができ、全ての実行ユニットについて2つのRFIコンテキストを提供する。
【0042】
VLIWプロセッサでは、レジスタファイルの全てのポートを、現在記載されたXV命令など、単一の命令のためのRFI制御下で有することが可能である。RFIポート論理は実行ユニットの間で独立しているので、ポートを個別に、SIW実行ユニット特有の命令によって制御することができる。これは、別の命令又は命令のグループが、XV命令に加えて、独立RFI制御(即ち、異なる組の制御パラメータ)を必要とした場合、別の制御レジスタのグループを割り当てることができるという意味である。RFIセット・アップ待ち時間が相対的に短いので、図5において記載されたような制御レジスタ・セットを、容易に他のRFI命令と共有することができる。
【0043】
別のレジスタファイル索引付け装置1100が、図11に示される。このRFI機構はなお、図8及び図9に関して論じられた他のRFI手法において概説された二重間接機構を使用する。しかし、図11の手法では、プログラミングの制約が強制され、処理中のデータのブロックについて、RFI動作を非RFI動作と混合できないことが必要である。この手法は、図8及び図9において使用された、RFI及び非RFI命令を混合することができる手法とは異なる。いくつかの製品定義では、これは問題ではなく、図11の簡素化されたハードウェア手法を使用することができる。
【0044】
図11の装置1100の動作は、先のRFI手法の動作と類似している。例えば、RFI初期化のための開始ビットが、先に記載されたように使用される。図11における主な違いは、図8のレジスタ820のような、索引付きポート・ルック・アヘッド・レジスタが使用されないことである。むしろ、ポート・アドレス・レジスタ1116がなおレジスタファイル1118をアドレス指定するが、更新加算器論理1130動作が時間において変位され、図8において使用された手法と比較されるように、ラッチされたポート・アドレス・レジスタ出力1117において実行サイクル中に動作する。次の実行サイクルのための準備において、更新加算器論理1130がポート・アドレス・レジスタ1116の出力1117を、このポートのためのRFI更新制御レジスタ1110によって指定されたように更新する。この実行サイクルの終了まで、マルチプレクサ1114が制御入力1113を介して制御されて、更新加算器論理出力1119が選択されて、マルチプレクサ1114を介して出力1111に渡される。次いで、マルチプレクサ1114出力1111がポート・アドレス・レジスタ1116において、次の実行サイクルの開始のときにラッチされ、それにより、先にRFI制御セット・アップによって指定されたようなレジスタファイル・ポート・アドレスを更新する。
【0045】
XV RFI使用可能装置に加えて、RFIを使用可能にする他の手段が使用される。この追加の機構の目的は、RFI順序付けを、VLIW(XV)プログラミング・モデルにおいてのみ使用されることから切り離すことである。ブロック・ロード、ブロック格納、及びブロック移動動作を単一の命令実行によりサポートし、これを、SPにおいて独立で、或いは、PEにおいて同時に行うことができることが望ましい。追加のビットをSIWにおいて使用してこの動作を指定するよりもむしろ、これは本発明によって除外されないが、RFIを使用可能にする代替間接機構が使用される。このSIWにおけるビットの節約は、標準動作符号化のための命令フォーマットのよりよい使用を可能にするが、本発明によって提供されたRFI機能性を達成するための能力を除外しない。この代替機構は、MRFにおいて特定の場所をアドレス指定することができるいかなるSIWによっても動作する。MRFにおける多数の場所をこのために提供することができるが、これを除外する可能性のある、特定の実施における他の使用がある。この代替RFI使用可能機能を記載するため、図3AにおけるRFILSD304について示されたような、MRFにおける1つの場所が使用される。
【0046】
このRFI使用可能機構を使用するため、ハードウェア復号化論理が拡張されて、RFIイネーブル信号が、XV RFI命令が受信されたときだけでなく、ロード、格納又はDSU命令がSP又はPE命令レジスタにおいて受信されたときにも生成され、これがRFILSDアドレスを、ロードRt、格納Rs又はDSU Rt又はRsオペランドとして指定する。この代替RFI使用可能機構を使用する前に、RFI制御レジスタがセットアップされ、ブロック・ロード、格納又はDSU動作において使用される初期レジスタを指定することが必要とされる。開始ビットは、この代替RFI使用可能機構において使用されず、これは、ブロック・シーケンスの開始アドレスがポート制御レジスタに格納されるからである。ロード、格納又はDSU命令を受信すると、これはRFILDSビットをオペランド・アドレスとして使用し、RFIモードが使用可能にされ、各レジスタ・オペランド・アドレスが、事前にセットアップされたポート(オペランド)アドレスで、図8、図9及び図11の各RFI論理において示されたようなRFIポート論理によって、置換される。RFI及び非RFI動作は、図8及び図9のハードウェアを使用するときに混合することができる。実際に、ロード、格納及びDSU制御レジスタ、図9に示されたようなグループ0及び1のために2つのコンテキストを使用することによって、次いで、第1のデータのブロックにおけるRFI XV動作、第2のデータのブロックにおけるRFILSDを使用するRFI動作、及び非RFI動作を混合することができる。算術ポート・レジスタ・オペランド・アドレス範囲の適切な拡張によって、算術命令が、RFILSDアドレスを参照することによって、RFIを算術命令実行のために呼び出させることができることを理解されたい。
【0047】
(RFI命令実行)
RFI動作は、命令語に含まれた制御情報を介して使用可能にされる。この制御情報が使用されて、従来のレジスタアドレス選択フィールド(命令に含まれたオペランドアドレス・フィールド)が使用されるかどうか、或いは、レジスタのRFI選択が使用されるかどうかが指定される。現在好ましい実施形態では、命令における制御情報、図2の間接VLIW XV命令ビット21及び20 202が、RFI動作を制御するために使用される制御レジスタ又はレジスタのセットを間接的に指定する。これらの制御レジスタ・グループの1つ又は複数が、図5においてみられるように、RFI制御のために使用可能である。XV RFI命令が、RFIモードを使用可能にし、RFI動作を制御するための制御レジスタ・グループを選択する。図5に示されたRFI制御レジスタのグループ510〜580が、すべてのレジスタ・ポートがRFI制御されることを可能にし、あらゆる実行ユニットがRFIモードで同時に動作できることを意味する。
【0048】
ManArrayプロセッサがそのパイプラインの実行段階を、レジスタファイルへのライト・バックにより終了することに留意されたい。この手法は、ライト・バック・サイクルの後の次のサイクルが、この結果を次の動作において使用できるようにする。懸命なプログラミングによって、次いで、ベクトル演算の連鎖がアーキテクチャにおいて固有である。分離した迂回パスを、実行ユニットにおいて連鎖をサポートするために設ける必要はない。
【0049】
本発明に係るRFIの例示的使用に関する考察がこのとき提示されて、本発明のいくつかの有利な態様が例示される。増分値1、RFBS値(M)2の累乗、開始レジスタR2と仮定すると、レジスタアドレスが、偶数レジスタR2及びその対応する奇数レジスタ(アドレス+1)R3という、2つのレジスタの間で交替する。RFBS=4では、レジスタがサイクルを、増分1で4つの値の中でアドレス指定する。以下の表は、いくつかのアドレス・シーケンスを示す。
【0050】
【表2】
簡素な行列ベクトル乗算を、図1Aのプロセッサ100など、4−PE SIMD VLIW ManArrayプロセッサにおいて計算することが望まれると仮定する。さらに、以下の命令タイプが使用可能であると仮定する。
【0052】
【表3】
また、4×4行列Aが4つのPEであるPE0、PE1、PE2及びPE3に分配され、以下の表に示されたように、各PEが行列の行を、レジスタR4、R5、R6及びR7において含むようにする(PE0が行0を得る、PE1が行1を得る、など)と仮定する。
【0054】
【表4】
4×1ベクトルのシーケンスがメイン(SP)メモリ105から読み込まれ、行列によって乗算され、結果がローカルのPEメモリ123、123'、123”及び123'''に格納された場合、適切な順序アルゴリズムが、R2が最初にゼロであったと仮定された場合、以下のようになる可能性がある。
【0056】
【表5】
このアルゴリズムをVLIW命令により実行すると、以下を生じる。
【0058】
【表6】
これらのVLIW命令の間の唯一の違いがMAC命令の第2のレジスタ指定であっても、これは、4VLIWタイプの命令に加えて、単一のロードLDB及び単一の格納ST命令を必要とする。
【0060】
このとき、この例がRFIを使用して実行された場合、処理は以下のようになる。すなわち、R2及びR0が共にゼロに初期化され、レジスタファイル索引付けが、XV命令によって間接的に実行されたVLIWに関連付けられた以下のパラメータと共に使用されると仮定する。
【0061】
【表7】
このとき、コードを小型のVLIW形式において書くことができ、第2のレジスタRFIシーケンスがR7→R4→R5→R6→R7などで開始する。
【0063】
【表8】
最終的な効果は、9個の命令を4個の命令に減らすことである。より少ないVLIWが使用される事実が、実行されるiVLIWの数、及び、ManArrayアーキテクチャにおいてロードされなければならないVLIWの数も減らす。これらの節約は間接的であるが、微々たるものではなく、これは、VLIWメモリ(VIM)がチップの資源において高価なものに相当するからである。RFI動作が、必要とされるVLIWメモリの量を減らし、従って、より高価でないチップを可能にする。
【0065】
本発明を、現在好ましい実施形態の様々な態様に関連して開示したが、本発明を適切に、後に続く特許請求の範囲に適合する他の環境及び応用例に適用できることは、理解されよう。
【図面の簡単な説明】
【図1A】 本発明と共に使用するために適した、2×2のマンアレイiVLIWプロセッサを例示する図である。
【図1B】 典型的な従来技術のレジスタ・アドレッシング機構を例示する図である。
【図2A】 本発明に係るRFI使用可能ビットによるXV命令符号化を例示する図である。
【図2B】 本発明における使用のために適したXV構文/動作の記述を例示する図である。
【図3A】 RFI制御レジスタの場所を識別するManArray雑レジスタファイル(MRF)を例示する図である。
【図3B】 MRFX1拡張レジスタを例示する図である。
【図3C】 MRFX2拡張レジスタを例示し、シーケンスプロセッサ(SP)及び処理要素(PE)において使用されたRFIレジスタを識別する図である。
【図4A】 拡張レジスタの選択を制御するMRFXARレジスタを例示する図である。
【図4B】 MRFXDR1及びMRFXDR2のためのデータフォーマットを例示し、RFI制御レジスタが、図4AのMRFXARレジスタ値によって指定されたようにマップされる図である。
【図5】 本発明と共に使用するための好ましいRFI制御レジスタを例示する図である。
【図6】 各RFIポートについて使用された例示的な特定の制御符号化を例示する図である。
【図7A】 本発明のRFI制御値をロードするために使用することができる、適切なロード即値(LIM)命令符号化を例示する図である。
【図7B】 LIM構文/動作の記述を例示する図である。
【図8】 本発明に係る算術実行ユニットのための例示的RFI制御ブロック図を例示する図である。
【図9】 本発明に係るロード及び格納実行ユニットのための例示的RFI制御ブロック図を例示する図である。
【図10】 本発明に係る一実施形態における、各RFIポート論理における更新加算器論理ユニットにおける使用のための、従来の全加算器を例示する図である。
【図11】 本発明に係る一実施形態における、算術実行ユニットのためのコスト削減型RFI制御ブロック図を例示する図である。
Claims (8)
- レジスタファイル索引付けを有するデータプロセッサであって、
前記データプロセッサは、複数のプロセッサ要素(PEs)、命令メモリ(105)及び命令シーケンサ(103)を有し、前記複数のプロセッサ要素(PEs)のそれぞれはN(Nは複数)個の実行ユニット(ALU,DSU,MAU,LU,SU)、レジスタファイル、超長命令語制御部(107)及び超長命令語メモリ(109)を備え、
前記命令シーケンサは、前記複数のプロセッサ要素(PEs)に接続され、前記命令メモリ(105)から読み出した超長命令語実行命令(XV命令)中で指定された、各プロセッサ要素(PE)の前記超長命令語メモリ(109)のオフセットアドレスを前記複数のプロセッサ要素(PEs)に送信することにより、前記XV命令が前記超長命令語制御部(107)に前記超長命令語メモリから超長命令語をフェッチして前記N個の実行ユニットで実行するように指示し、
前記N個の実行ユニットはそれぞれ各実行ユニットに関連付けられた読み取りポート及び書込みポートを有し、前記読み取りポート及び書込みポートはレジスタファイル索引(RFI)制御レジスタ、ルックアヘッドレジスタ及び制御回路を備え、
前記制御回路は、
(i)最初に受信したレジスタファイル間接指定付きの超長命令実行語命令(RFI XV命令)で指示された最初の超長命令語の実行においては、該超長命令語のフィールドが直接前記レジスタファイル中の1つのレジスタをアドレスしてアクセスし、並行して、前記レジスタファイル索引(RFI)制御レジスタの内容に基づいて該アドレス値を更新して前記ルックアヘッドレジスタにロードするように制御し、
(ii)2回目に受信したレジスタファイル間接指定付きの超長命令実行語命令(RFI XV命令)で指示された超長命令語の実行においては、前記ルックアヘッドレジスタの更新されたアドレスが前記レジスタファイル中の1つのレジスタをアドレスしてアクセスし、並行して、前記レジスタファイル索引(RFI)制御レジスタの内容に基づいて該アドレス値を更新して前記ルックアヘッドレジスタにロードするように制御することをことを特徴とするデータプロセッサ。 - 前記プロセッサ要素が超長命令語プロセッサであることを特徴とする請求項1に記載のデータプロセッサ。
- 前記データプロセッサが、実行するための超長命令語を、前記超長命令語実行命令(XV命令)の前記オフセットアドレスを使用して前記超長命令語メモリから間接的にアクセスする間接超長命令語プロセッサであることを特徴とする請求項1に記載のデータプロセッサ。
- 前記プロセッサ要素が、アレイプロセッサアーキテクチャに含まれる、それぞれ同じ構成の複数のプロセッサ要素の1つであることを特徴とする請求項1に記載のデータプロセッサ。
- 前記制御回路は、実行するためのデータオペランドを記憶している前記レジスタファイルの更新したアドレスの供給を指示するために、1つ又は複数のレジスタファイル索引制御レジスタを使用することを特徴とする請求項1に記載のデータプロセッサ。
- 前記制御回路は、前記ルックアヘッドレジスタが指定され、定数を現在のアドレスに加算或いは減算することにより前記現在のアドレスを更新して、別のレジスタアドレスを選択することを特徴とする請求項1に記載のデータプロセッサ。
- 前記制御回路による前記更新により更に、多数のプログラム可能な前記レジスタのセットの特定の1つから開始して選択するレジスタアドレスを前記レジスタのセット内で巡回することを特徴とする請求項6に記載のデータプロセッサ。
- 各ポートの前記制御回路を、更新方法及びレジスタのアドレスのセットについて独立して構成することができ、或いは、レジスタファイル索引付けを選択的に使用不可にできる制御機構をさらに含むことを特徴とする請求項1に記載のデータプロセッサ。
Applications Claiming Priority (3)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| US09/267,570 US6446190B1 (en) | 1998-03-12 | 1999-03-12 | Register file indexing methods and apparatus for providing indirect control of register addressing in a VLIW processor |
| US09/267,570 | 1999-03-12 | ||
| PCT/US2000/006334 WO2000054144A1 (en) | 1999-03-12 | 2000-03-09 | Register file indexing methods and apparatus for providing indirect control of register addressing in a vliw processor |
Publications (2)
| Publication Number | Publication Date |
|---|---|
| JP2002539519A JP2002539519A (ja) | 2002-11-19 |
| JP4657455B2 true JP4657455B2 (ja) | 2011-03-23 |
Family
ID=23019343
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| JP2000604303A Expired - Fee Related JP4657455B2 (ja) | 1999-03-12 | 2000-03-09 | データプロセッサ |
Country Status (5)
| Country | Link |
|---|---|
| US (1) | US6446190B1 (ja) |
| JP (1) | JP4657455B2 (ja) |
| CA (1) | CA2366830A1 (ja) |
| IL (1) | IL144970A0 (ja) |
| WO (1) | WO2000054144A1 (ja) |
Families Citing this family (34)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP3790607B2 (ja) * | 1997-06-16 | 2006-06-28 | 松下電器産業株式会社 | Vliwプロセッサ |
| WO2001016702A1 (en) | 1999-09-01 | 2001-03-08 | Intel Corporation | Register set used in multithreaded parallel processor architecture |
| EP1236097A4 (en) | 1999-09-01 | 2006-08-02 | Intel Corp | BRANCH COMMAND TO THE PROCESSOR |
| GB2363869B (en) * | 2000-06-20 | 2004-06-23 | Element 14 Inc | Register addressing |
| US7681018B2 (en) | 2000-08-31 | 2010-03-16 | Intel Corporation | Method and apparatus for providing large register address space while maximizing cycletime performance for a multi-threaded register file set |
| EP1442362A1 (en) | 2001-10-24 | 2004-08-04 | Telefonaktiebolaget LM Ericsson (publ) | An arrangement and a method in processor technology |
| US7437724B2 (en) | 2002-04-03 | 2008-10-14 | Intel Corporation | Registers for data transfers |
| US7925891B2 (en) * | 2003-04-18 | 2011-04-12 | Via Technologies, Inc. | Apparatus and method for employing cryptographic functions to generate a message digest |
| US7162573B2 (en) * | 2003-06-25 | 2007-01-09 | Intel Corporation | Communication registers for processing elements |
| JP4283131B2 (ja) * | 2004-02-12 | 2009-06-24 | パナソニック株式会社 | プロセッサ及びコンパイル方法 |
| US7945760B1 (en) * | 2004-04-01 | 2011-05-17 | Altera Corporation | Methods and apparatus for address translation functions |
| US7124259B2 (en) * | 2004-05-03 | 2006-10-17 | Sony Computer Entertainment Inc. | Methods and apparatus for indexed register access |
| US7340591B1 (en) * | 2004-10-28 | 2008-03-04 | Altera Corporation | Providing parallel operand functions using register file and extra path storage |
| TWI283411B (en) | 2005-03-16 | 2007-07-01 | Ind Tech Res Inst | Inter-cluster communication module using the memory access network |
| US7383420B2 (en) * | 2005-03-24 | 2008-06-03 | Qualcomm Incorporated | Processor and method of indirect register read and write operations |
| US7933405B2 (en) * | 2005-04-08 | 2011-04-26 | Icera Inc. | Data access and permute unit |
| JP4640272B2 (ja) * | 2006-06-29 | 2011-03-02 | 村田機械株式会社 | ポート制御装置 |
| US8755515B1 (en) | 2008-09-29 | 2014-06-17 | Wai Wu | Parallel signal processing system and method |
| US8407680B2 (en) * | 2008-12-16 | 2013-03-26 | International Business Machines Corporation | Operand data structure for block computation |
| US8397186B2 (en) * | 2009-07-16 | 2013-03-12 | Synopsys, Inc. | Technique for replaying operations using replay look-ahead instructions |
| US8555036B1 (en) * | 2010-05-17 | 2013-10-08 | Nvidia Corporation | System and method for performing predicated selection of an output register |
| JP2012252374A (ja) | 2011-05-31 | 2012-12-20 | Renesas Electronics Corp | 情報処理装置 |
| US9465613B2 (en) * | 2011-12-19 | 2016-10-11 | International Business Machines Corporation | Instruction predication using unused datapath facilities |
| JP2019053343A (ja) * | 2016-01-29 | 2019-04-04 | シャープ株式会社 | アンテナ内蔵タッチパネル |
| JP2018165913A (ja) * | 2017-03-28 | 2018-10-25 | 富士通株式会社 | 演算処理装置、情報処理装置、及び演算処理装置の制御方法 |
| US11893393B2 (en) | 2017-07-24 | 2024-02-06 | Tesla, Inc. | Computational array microprocessor system with hardware arbiter managing memory requests |
| US11409692B2 (en) | 2017-07-24 | 2022-08-09 | Tesla, Inc. | Vector computational unit |
| US10671349B2 (en) | 2017-07-24 | 2020-06-02 | Tesla, Inc. | Accelerated mathematical engine |
| US11157441B2 (en) | 2017-07-24 | 2021-10-26 | Tesla, Inc. | Computational array microprocessor system using non-consecutive data formatting |
| US10564942B2 (en) | 2017-11-17 | 2020-02-18 | International Business Machines Corporation | Compiler for a processor comprising primary and non-primary functional units |
| US11561791B2 (en) | 2018-02-01 | 2023-01-24 | Tesla, Inc. | Vector computational unit receiving data elements in parallel from a last row of a computational array |
| US11714620B1 (en) | 2022-01-14 | 2023-08-01 | Triad National Security, Llc | Decoupling loop dependencies using buffers to enable pipelining of loops |
| US20250208875A1 (en) * | 2023-12-21 | 2025-06-26 | Advanced Micro Devices, Inc. | Load fusion |
| US20260133798A1 (en) * | 2024-11-12 | 2026-05-14 | International Business Machines Corporation | Method and apparatus for addressing registers within a processor based on indirect registers |
Family Cites Families (13)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JPS5178150A (ja) * | 1974-12-27 | 1976-07-07 | Fujitsu Ltd | |
| JPS63131230A (ja) * | 1986-11-21 | 1988-06-03 | Hitachi Ltd | 情報処理装置 |
| JPH0810428B2 (ja) * | 1988-12-26 | 1996-01-31 | 三菱電機株式会社 | データ処理装置 |
| US5680600A (en) | 1989-10-13 | 1997-10-21 | Texas Instruments Incorporated | Electronic circuit for reducing controller memory requirements |
| US5485629A (en) * | 1993-01-22 | 1996-01-16 | Intel Corporation | Method and apparatus for executing control flow instructions in a control flow pipeline in parallel with arithmetic instructions being executed in arithmetic pipelines |
| JPH06259581A (ja) * | 1993-03-02 | 1994-09-16 | Fujitsu Ltd | 並列計算機 |
| US5481743A (en) * | 1993-09-30 | 1996-01-02 | Apple Computer, Inc. | Minimal instruction set computer architecture and multiple instruction issue method |
| US5721854A (en) * | 1993-11-02 | 1998-02-24 | International Business Machines Corporation | Method and apparatus for dynamic conversion of computer instructions |
| US5696922A (en) * | 1993-12-10 | 1997-12-09 | Cray Research, Inc. | Recursive address centrifuge for distributed memory massively parallel processing systems |
| US5649135A (en) * | 1995-01-17 | 1997-07-15 | International Business Machines Corporation | Parallel processing system and method using surrogate instructions |
| JPH08278769A (ja) * | 1995-04-05 | 1996-10-22 | Citizen Watch Co Ltd | マイクロコンピュータ |
| US5752072A (en) * | 1996-05-09 | 1998-05-12 | International Business Machines Corporation | Sorting scheme without compare and branch instructions |
| US6081884A (en) * | 1998-01-05 | 2000-06-27 | Advanced Micro Devices, Inc. | Embedding two different instruction sets within a single long instruction word using predecode bits |
-
1999
- 1999-03-12 US US09/267,570 patent/US6446190B1/en not_active Ceased
-
2000
- 2000-03-09 WO PCT/US2000/006334 patent/WO2000054144A1/en not_active Ceased
- 2000-03-09 IL IL14497000A patent/IL144970A0/xx unknown
- 2000-03-09 JP JP2000604303A patent/JP4657455B2/ja not_active Expired - Fee Related
- 2000-03-09 CA CA002366830A patent/CA2366830A1/en not_active Abandoned
Also Published As
| Publication number | Publication date |
|---|---|
| US6446190B1 (en) | 2002-09-03 |
| IL144970A0 (en) | 2002-06-30 |
| WO2000054144A1 (en) | 2000-09-14 |
| JP2002539519A (ja) | 2002-11-19 |
| CA2366830A1 (en) | 2000-09-14 |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| US6446190B1 (en) | Register file indexing methods and apparatus for providing indirect control of register addressing in a VLIW processor | |
| US6173389B1 (en) | Methods and apparatus for dynamic very long instruction word sub-instruction selection for execution time parallelism in an indirect very long instruction word processor | |
| US6356994B1 (en) | Methods and apparatus for instruction addressing in indirect VLIW processors | |
| US12197343B2 (en) | Streaming engine with multi dimensional circular addressing selectable at each dimension | |
| JP4879307B2 (ja) | プロセッサでの条件付き実行をサポートする装置及びその方法 | |
| JP3559046B2 (ja) | データ処理マネージメントシステム | |
| JP3149348B2 (ja) | 代理命令を用いる並列処理システム及び方法 | |
| JP2647315B2 (ja) | 動的に複数モードで並列処理するアレイ | |
| US12461744B2 (en) | Streaming engine with early exit from loop levels supporting early exit loops and irregular loops | |
| US11921636B2 (en) | Streaming engine with flexible streaming engine template supporting differing number of nested loops with corresponding loop counts and loop offsets | |
| EP0911725B1 (en) | Data processing system with a plurality of processors using a shared register bank | |
| EP0473420A2 (en) | Virtual long instruction word memory architecture for digital signal processor | |
| US6430684B1 (en) | Processor circuits, systems, and methods with efficient granularity shift and/or merge instruction(s) | |
| US8671266B2 (en) | Staging register file for use with multi-stage execution units | |
| JP2916605B2 (ja) | コンピュータ用プロセツサ | |
| USRE41012E1 (en) | Register file indexing methods and apparatus for providing indirect control of register addressing in a VLIW processor | |
| US20190347203A1 (en) | Streaming engine with compressed encoding for loop circular buffer sizes |
Legal Events
| Date | Code | Title | Description |
|---|---|---|---|
| A711 | Notification of change in applicant |
Free format text: JAPANESE INTERMEDIATE CODE: A711 Effective date: 20051205 |
|
| A621 | Written request for application examination |
Free format text: JAPANESE INTERMEDIATE CODE: A621 Effective date: 20070302 |
|
| A977 | Report on retrieval |
Free format text: JAPANESE INTERMEDIATE CODE: A971007 Effective date: 20090402 |
|
| A131 | Notification of reasons for refusal |
Free format text: JAPANESE INTERMEDIATE CODE: A131 Effective date: 20090522 |
|
| A521 | Request for written amendment filed |
Free format text: JAPANESE INTERMEDIATE CODE: A523 Effective date: 20090824 |
|
| A02 | Decision of refusal |
Free format text: JAPANESE INTERMEDIATE CODE: A02 Effective date: 20100604 |
|
| A521 | Request for written amendment filed |
Free format text: JAPANESE INTERMEDIATE CODE: A523 Effective date: 20100930 |
|
| A911 | Transfer to examiner for re-examination before appeal (zenchi) |
Free format text: JAPANESE INTERMEDIATE CODE: A911 Effective date: 20101012 |
|
| TRDD | Decision of grant or rejection written | ||
| A01 | Written decision to grant a patent or to grant a registration (utility model) |
Free format text: JAPANESE INTERMEDIATE CODE: A01 Effective date: 20101213 |
|
| A01 | Written decision to grant a patent or to grant a registration (utility model) |
Free format text: JAPANESE INTERMEDIATE CODE: A01 |
|
| A61 | First payment of annual fees (during grant procedure) |
Free format text: JAPANESE INTERMEDIATE CODE: A61 Effective date: 20101222 |
|
| FPAY | Renewal fee payment (event date is renewal date of database) |
Free format text: PAYMENT UNTIL: 20140107 Year of fee payment: 3 |
|
| R150 | Certificate of patent or registration of utility model |
Free format text: JAPANESE INTERMEDIATE CODE: R150 |
|
| R250 | Receipt of annual fees |
Free format text: JAPANESE INTERMEDIATE CODE: R250 |
|
| R250 | Receipt of annual fees |
Free format text: JAPANESE INTERMEDIATE CODE: R250 |
|
| R250 | Receipt of annual fees |
Free format text: JAPANESE INTERMEDIATE CODE: R250 |
|
| LAPS | Cancellation because of no payment of annual fees |