KR20200039617A - 아데노-연관 바이러스 캡시드 변이체 및 이의 사용 방법 - Google Patents
아데노-연관 바이러스 캡시드 변이체 및 이의 사용 방법 Download PDFInfo
- Publication number
- KR20200039617A KR20200039617A KR1020197035110A KR20197035110A KR20200039617A KR 20200039617 A KR20200039617 A KR 20200039617A KR 1020197035110 A KR1020197035110 A KR 1020197035110A KR 20197035110 A KR20197035110 A KR 20197035110A KR 20200039617 A KR20200039617 A KR 20200039617A
- Authority
- KR
- South Korea
- Prior art keywords
- aav
- amino acids
- leu
- lys
- glu
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Withdrawn
Links
- 238000000034 method Methods 0.000 title claims abstract description 94
- 241000702421 Dependoparvovirus Species 0.000 title claims abstract description 30
- 210000000234 capsid Anatomy 0.000 title claims description 143
- 210000002845 virion Anatomy 0.000 claims abstract description 376
- 108090000623 proteins and genes Proteins 0.000 claims abstract description 190
- 108090000565 Capsid Proteins Proteins 0.000 claims abstract description 179
- 102100023321 Ceruloplasmin Human genes 0.000 claims abstract description 179
- 210000001178 neural stem cell Anatomy 0.000 claims abstract description 121
- 150000007523 nucleic acids Chemical class 0.000 claims abstract description 112
- 102000039446 nucleic acids Human genes 0.000 claims abstract description 110
- 108020004707 nucleic acids Proteins 0.000 claims abstract description 110
- 210000002569 neuron Anatomy 0.000 claims abstract description 88
- 230000004888 barrier function Effects 0.000 claims abstract description 13
- 150000001413 amino acids Chemical class 0.000 claims description 447
- 235000001014 amino acid Nutrition 0.000 claims description 329
- 108090000765 processed proteins & peptides Proteins 0.000 claims description 188
- 102000004196 processed proteins & peptides Human genes 0.000 claims description 161
- 229920001184 polypeptide Polymers 0.000 claims description 159
- 210000004027 cell Anatomy 0.000 claims description 157
- 108091033409 CRISPR Proteins 0.000 claims description 110
- 108010042407 Endonucleases Proteins 0.000 claims description 107
- 102000004533 Endonucleases Human genes 0.000 claims description 107
- 125000003729 nucleotide group Chemical group 0.000 claims description 80
- 239000002773 nucleotide Substances 0.000 claims description 77
- 238000010354 CRISPR gene editing Methods 0.000 claims description 49
- 108020005004 Guide RNA Proteins 0.000 claims description 49
- 241000702423 Adeno-associated virus - 2 Species 0.000 claims description 41
- 230000003472 neutralizing effect Effects 0.000 claims description 37
- 208000012902 Nervous system disease Diseases 0.000 claims description 36
- 238000007914 intraventricular administration Methods 0.000 claims description 34
- 238000007917 intracranial administration Methods 0.000 claims description 30
- 238000007913 intrathecal administration Methods 0.000 claims description 30
- 241000972680 Adeno-associated virus - 6 Species 0.000 claims description 25
- 238000010253 intravenous injection Methods 0.000 claims description 23
- 238000010362 genome editing Methods 0.000 claims description 22
- 241001164825 Adeno-associated virus - 8 Species 0.000 claims description 21
- 239000000203 mixture Substances 0.000 claims description 18
- 229940123611 Genome editing Drugs 0.000 claims description 16
- 108091023037 Aptamer Proteins 0.000 claims description 12
- 108020004459 Small interfering RNA Proteins 0.000 claims description 12
- 210000001638 cerebellum Anatomy 0.000 claims description 11
- 108010025020 Nerve Growth Factor Proteins 0.000 claims description 10
- 230000002452 interceptive effect Effects 0.000 claims description 10
- 239000000546 pharmaceutical excipient Substances 0.000 claims description 9
- 102000004190 Enzymes Human genes 0.000 claims description 8
- 108090000790 Enzymes Proteins 0.000 claims description 8
- 102000034615 Glial cell line-derived neurotrophic factor Human genes 0.000 claims description 8
- 108091010837 Glial cell line-derived neurotrophic factor Proteins 0.000 claims description 8
- 210000004899 c-terminal region Anatomy 0.000 claims description 8
- 229940053128 nerve growth factor Drugs 0.000 claims description 8
- 108010005939 Ciliary Neurotrophic Factor Proteins 0.000 claims description 7
- 102100031614 Ciliary neurotrophic factor Human genes 0.000 claims description 7
- 230000001772 anti-angiogenic effect Effects 0.000 claims description 7
- 230000000324 neuroprotective effect Effects 0.000 claims description 7
- 239000004055 small Interfering RNA Substances 0.000 claims description 7
- 108090000715 Brain-derived neurotrophic factor Proteins 0.000 claims description 6
- 102000004219 Brain-derived neurotrophic factor Human genes 0.000 claims description 6
- 108010017070 Zinc Finger Nucleases Proteins 0.000 claims description 6
- 229940077737 brain-derived neurotrophic factor Drugs 0.000 claims description 6
- 230000004069 differentiation Effects 0.000 claims description 6
- 102400001368 Epidermal growth factor Human genes 0.000 claims description 5
- 101800003838 Epidermal growth factor Proteins 0.000 claims description 5
- 102000003693 Hedgehog Proteins Human genes 0.000 claims description 5
- 108090000031 Hedgehog Proteins Proteins 0.000 claims description 5
- -1 Neuturin Proteins 0.000 claims description 5
- 102000030621 adenylate cyclase Human genes 0.000 claims description 5
- 108060000200 adenylate cyclase Proteins 0.000 claims description 5
- 229940116977 epidermal growth factor Drugs 0.000 claims description 5
- 239000008194 pharmaceutical composition Substances 0.000 claims description 5
- 230000001817 pituitary effect Effects 0.000 claims description 5
- VBEQCZHXXJYVRD-GACYYNSASA-N uroanthelone Chemical compound C([C@@H](C(=O)N[C@H](C(=O)N[C@@H](CS)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CS)C(=O)N[C@H](C(=O)N[C@@H]([C@@H](C)CC)C(=O)NCC(=O)N[C@@H](CC=1C=CC(O)=CC=1)C(=O)N[C@@H](CO)C(=O)NCC(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CS)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC=1C2=CC=CC=C2NC=1)C(=O)N[C@@H](CC=1C2=CC=CC=C2NC=1)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCCNC(N)=N)C(O)=O)C(C)C)[C@@H](C)O)NC(=O)[C@H](CO)NC(=O)[C@H](CC(O)=O)NC(=O)[C@H](CC(C)C)NC(=O)[C@H](CO)NC(=O)[C@H](CCC(O)=O)NC(=O)[C@@H](NC(=O)[C@H](CC=1NC=NC=1)NC(=O)[C@H](CCSC)NC(=O)[C@H](CS)NC(=O)[C@@H](NC(=O)CNC(=O)CNC(=O)[C@H](CC(N)=O)NC(=O)[C@H](CC(C)C)NC(=O)[C@H](CS)NC(=O)[C@H](CC=1C=CC(O)=CC=1)NC(=O)CNC(=O)[C@H](CC(O)=O)NC(=O)[C@H](CC=1C=CC(O)=CC=1)NC(=O)[C@H](CO)NC(=O)[C@H](CO)NC(=O)[C@H]1N(CCC1)C(=O)[C@H](CS)NC(=O)CNC(=O)[C@H]1N(CCC1)C(=O)[C@H](CC=1C=CC(O)=CC=1)NC(=O)[C@H](CO)NC(=O)[C@@H](N)CC(N)=O)C(C)C)[C@@H](C)CC)C1=CC=C(O)C=C1 VBEQCZHXXJYVRD-GACYYNSASA-N 0.000 claims description 5
- 208000024827 Alzheimer disease Diseases 0.000 claims description 4
- 108091007065 BIRCs Proteins 0.000 claims description 4
- 108090000379 Fibroblast growth factor 2 Proteins 0.000 claims description 4
- 102000003974 Fibroblast growth factor 2 Human genes 0.000 claims description 4
- 208000023105 Huntington disease Diseases 0.000 claims description 4
- 102000055031 Inhibitor of Apoptosis Proteins Human genes 0.000 claims description 4
- 208000018737 Parkinson disease Diseases 0.000 claims description 4
- 238000010459 TALEN Methods 0.000 claims description 4
- 108010043645 Transcription Activator-Like Effector Nucleases Proteins 0.000 claims description 4
- 108090000121 Aromatic-L-amino-acid decarboxylases Proteins 0.000 claims description 3
- 102000003823 Aromatic-L-amino-acid decarboxylases Human genes 0.000 claims description 3
- 108010078286 Ataxins Proteins 0.000 claims description 3
- 102000014461 Ataxins Human genes 0.000 claims description 3
- 206010008025 Cerebellar ataxia Diseases 0.000 claims description 3
- 102000003779 Dipeptidyl-peptidases and tripeptidyl-peptidases Human genes 0.000 claims description 3
- 108090000194 Dipeptidyl-peptidases and tripeptidyl-peptidases Proteins 0.000 claims description 3
- 208000024412 Friedreich ataxia Diseases 0.000 claims description 3
- 201000011240 Frontotemporal dementia Diseases 0.000 claims description 3
- 102000008214 Glutamate decarboxylase Human genes 0.000 claims description 3
- 108091022930 Glutamate decarboxylase Proteins 0.000 claims description 3
- 208000006289 Rett Syndrome Diseases 0.000 claims description 3
- 208000009415 Spinocerebellar Ataxias Diseases 0.000 claims description 3
- 201000004562 autosomal dominant cerebellar ataxia Diseases 0.000 claims description 3
- 206010015037 epilepsy Diseases 0.000 claims description 3
- 210000002950 fibroblast Anatomy 0.000 claims description 3
- 108091032973 (ribonucleotides)n+m Proteins 0.000 claims description 2
- VPAXJOUATWLOPR-UHFFFAOYSA-N Conferone Chemical compound C1=CC(=O)OC2=CC(OCC3C4(C)CCC(=O)C(C)(C)C4CC=C3C)=CC=C21 VPAXJOUATWLOPR-UHFFFAOYSA-N 0.000 claims description 2
- 208000015439 Lysosomal storage disease Diseases 0.000 claims description 2
- JECGPMYZUFFYJW-UHFFFAOYSA-N conferone Natural products CC1=CCC2C(C)(C)C(=O)CCC2(C)C1COc3cccc4C=CC(=O)Oc34 JECGPMYZUFFYJW-UHFFFAOYSA-N 0.000 claims description 2
- 208000005017 glioblastoma Diseases 0.000 claims description 2
- 125000003275 alpha amino acid group Chemical group 0.000 claims 14
- 102000015336 Nerve Growth Factor Human genes 0.000 claims 2
- 239000003102 growth factor Substances 0.000 claims 1
- 230000002829 reductive effect Effects 0.000 abstract description 14
- 230000001537 neural effect Effects 0.000 abstract description 9
- 238000006386 neutralization reaction Methods 0.000 abstract description 4
- 229940024606 amino acid Drugs 0.000 description 239
- 108091030071 RNAI Proteins 0.000 description 48
- 230000009368 gene silencing by RNA Effects 0.000 description 48
- 102000004169 proteins and genes Human genes 0.000 description 48
- 101150103592 SCH9 gene Proteins 0.000 description 47
- 235000018102 proteins Nutrition 0.000 description 44
- 108020004414 DNA Proteins 0.000 description 42
- 241000700605 Viruses Species 0.000 description 39
- 238000003780 insertion Methods 0.000 description 35
- 230000037431 insertion Effects 0.000 description 35
- 230000014509 gene expression Effects 0.000 description 33
- 239000002245 particle Substances 0.000 description 33
- 230000027455 binding Effects 0.000 description 30
- 230000003612 virological effect Effects 0.000 description 30
- 238000002347 injection Methods 0.000 description 29
- 239000007924 injection Substances 0.000 description 29
- 102000040430 polynucleotide Human genes 0.000 description 28
- 108091033319 polynucleotide Proteins 0.000 description 28
- 239000002157 polynucleotide Substances 0.000 description 28
- 238000010361 transduction Methods 0.000 description 28
- 230000026683 transduction Effects 0.000 description 28
- 208000015181 infectious disease Diseases 0.000 description 27
- 239000005090 green fluorescent protein Substances 0.000 description 26
- 230000035772 mutation Effects 0.000 description 26
- 108010043121 Green Fluorescent Proteins Proteins 0.000 description 22
- 102000004144 Green Fluorescent Proteins Human genes 0.000 description 22
- 238000004806 packaging method and process Methods 0.000 description 22
- 101710163270 Nuclease Proteins 0.000 description 20
- 210000001130 astrocyte Anatomy 0.000 description 20
- 108700011259 MicroRNAs Proteins 0.000 description 19
- 208000025966 Neurological disease Diseases 0.000 description 19
- KOSRFJWDECSPRO-UHFFFAOYSA-N alpha-L-glutamyl-L-glutamic acid Natural products OC(=O)CCC(N)C(=O)NC(CCC(O)=O)C(O)=O KOSRFJWDECSPRO-UHFFFAOYSA-N 0.000 description 19
- 210000004556 brain Anatomy 0.000 description 19
- 238000012217 deletion Methods 0.000 description 19
- 230000037430 deletion Effects 0.000 description 19
- 230000001225 therapeutic effect Effects 0.000 description 19
- 230000000694 effects Effects 0.000 description 18
- 210000005155 neural progenitor cell Anatomy 0.000 description 18
- 239000013598 vector Substances 0.000 description 18
- 241000699670 Mus sp. Species 0.000 description 17
- 108010034529 leucyl-lysine Proteins 0.000 description 17
- 230000000295 complement effect Effects 0.000 description 16
- 208000037265 diseases, disorders, signs and symptoms Diseases 0.000 description 16
- 230000006870 function Effects 0.000 description 16
- 230000002458 infectious effect Effects 0.000 description 16
- 239000002679 microRNA Substances 0.000 description 16
- 108010054624 red fluorescent protein Proteins 0.000 description 16
- 101100073357 Streptomyces halstedii sch2 gene Proteins 0.000 description 15
- 108010092854 aspartyllysine Proteins 0.000 description 15
- 230000002950 deficient Effects 0.000 description 15
- 201000010099 disease Diseases 0.000 description 15
- 108010055341 glutamyl-glutamic acid Proteins 0.000 description 15
- 108010050848 glycylleucine Proteins 0.000 description 15
- 210000003757 neuroblast Anatomy 0.000 description 15
- 239000013608 rAAV vector Substances 0.000 description 15
- 108091027544 Subgenomic mRNA Proteins 0.000 description 14
- 108700028369 Alleles Proteins 0.000 description 13
- 239000000463 material Substances 0.000 description 13
- 210000000449 purkinje cell Anatomy 0.000 description 13
- 238000013461 design Methods 0.000 description 12
- 238000001727 in vivo Methods 0.000 description 12
- 230000001419 dependent effect Effects 0.000 description 11
- 108010025306 histidylleucine Proteins 0.000 description 11
- 108010057821 leucylproline Proteins 0.000 description 11
- 230000004807 localization Effects 0.000 description 11
- 239000013612 plasmid Substances 0.000 description 11
- 230000006798 recombination Effects 0.000 description 11
- 238000005215 recombination Methods 0.000 description 11
- 210000000130 stem cell Anatomy 0.000 description 11
- 239000013607 AAV vector Substances 0.000 description 10
- VPZXBVLAVMBEQI-UHFFFAOYSA-N glycyl-DL-alpha-alanine Natural products OC(=O)C(C)NC(=O)CN VPZXBVLAVMBEQI-UHFFFAOYSA-N 0.000 description 10
- 238000006467 substitution reaction Methods 0.000 description 10
- 208000024891 symptom Diseases 0.000 description 10
- 238000011282 treatment Methods 0.000 description 10
- 230000002861 ventricular Effects 0.000 description 10
- 102000008055 Heparan Sulfate Proteoglycans Human genes 0.000 description 9
- 229920002971 Heparan sulfate Polymers 0.000 description 9
- 108091028043 Nucleic acid sequence Proteins 0.000 description 9
- 108090000054 Syndecan-2 Proteins 0.000 description 9
- LOKCTEFSRHRXRJ-UHFFFAOYSA-I dipotassium trisodium dihydrogen phosphate hydrogen phosphate dichloride Chemical compound P(=O)(O)(O)[O-].[K+].P(=O)(O)([O-])[O-].[Na+].[Na+].[Cl-].[K+].[Cl-].[Na+] LOKCTEFSRHRXRJ-UHFFFAOYSA-I 0.000 description 9
- 238000000338 in vitro Methods 0.000 description 9
- 108010054155 lysyllysine Proteins 0.000 description 9
- 210000004498 neuroglial cell Anatomy 0.000 description 9
- 239000002953 phosphate buffered saline Substances 0.000 description 9
- 238000003752 polymerase chain reaction Methods 0.000 description 9
- 230000035897 transcription Effects 0.000 description 9
- 238000013518 transcription Methods 0.000 description 9
- WOVKYSAHUYNSMH-RRKCRQDMSA-N 5-bromodeoxyuridine Chemical compound C1[C@H](O)[C@@H](CO)O[C@H]1N1C(=O)NC(=O)C(Br)=C1 WOVKYSAHUYNSMH-RRKCRQDMSA-N 0.000 description 8
- 108091016585 CD44 antigen Proteins 0.000 description 8
- JBCLFWXMTIKCCB-UHFFFAOYSA-N H-Gly-Phe-OH Natural products NCC(=O)NC(C(O)=O)CC1=CC=CC=C1 JBCLFWXMTIKCCB-UHFFFAOYSA-N 0.000 description 8
- IRMLZWSRWSGTOP-CIUDSAMLSA-N Leu-Ser-Ala Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H](CO)C(=O)N[C@@H](C)C(O)=O IRMLZWSRWSGTOP-CIUDSAMLSA-N 0.000 description 8
- 241001465754 Metazoa Species 0.000 description 8
- 108010079364 N-glycylalanine Proteins 0.000 description 8
- FAPWRFPIFSIZLT-UHFFFAOYSA-M Sodium chloride Chemical compound [Na+].[Cl-] FAPWRFPIFSIZLT-UHFFFAOYSA-M 0.000 description 8
- 241000193996 Streptococcus pyogenes Species 0.000 description 8
- 108010073929 Vascular Endothelial Growth Factor A Proteins 0.000 description 8
- 102000005789 Vascular Endothelial Growth Factors Human genes 0.000 description 8
- 108010019530 Vascular Endothelial Growth Factors Proteins 0.000 description 8
- 210000005056 cell body Anatomy 0.000 description 8
- 229930182830 galactose Natural products 0.000 description 8
- 238000001990 intravenous administration Methods 0.000 description 8
- 230000008774 maternal effect Effects 0.000 description 8
- 230000004048 modification Effects 0.000 description 8
- 238000012986 modification Methods 0.000 description 8
- 108010051242 phenylalanylserine Proteins 0.000 description 8
- 210000001519 tissue Anatomy 0.000 description 8
- 241000282472 Canis lupus familiaris Species 0.000 description 7
- HTTJABKRGRZYRN-UHFFFAOYSA-N Heparin Chemical compound OC1C(NC(=O)C)C(O)OC(COS(O)(=O)=O)C1OC1C(OS(O)(=O)=O)C(O)C(OC2C(C(OS(O)(=O)=O)C(OC3C(C(O)C(O)C(O3)C(O)=O)OS(O)(=O)=O)C(CO)O2)NS(O)(=O)=O)C(C(O)=O)O1 HTTJABKRGRZYRN-UHFFFAOYSA-N 0.000 description 7
- 241000880493 Leptailurus serval Species 0.000 description 7
- DRRXXZBXDMLGFC-IHRRRGAJSA-N Lys-Val-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](C(C)C)NC(=O)[C@@H](N)CCCCN DRRXXZBXDMLGFC-IHRRRGAJSA-N 0.000 description 7
- 241000124008 Mammalia Species 0.000 description 7
- KZNQNBZMBZJQJO-UHFFFAOYSA-N N-glycyl-L-proline Natural products NCC(=O)N1CCCC1C(O)=O KZNQNBZMBZJQJO-UHFFFAOYSA-N 0.000 description 7
- 210000003169 central nervous system Anatomy 0.000 description 7
- 230000006378 damage Effects 0.000 description 7
- 230000004927 fusion Effects 0.000 description 7
- 229920000669 heparin Polymers 0.000 description 7
- 229960002897 heparin Drugs 0.000 description 7
- 230000000670 limiting effect Effects 0.000 description 7
- 239000002243 precursor Substances 0.000 description 7
- VCSABYLVNWQYQE-SRVKXCTJSA-N Ala-Lys-Lys Chemical compound NCCCC[C@H](NC(=O)[C@@H](N)C)C(=O)N[C@@H](CCCCN)C(O)=O VCSABYLVNWQYQE-SRVKXCTJSA-N 0.000 description 6
- VCSABYLVNWQYQE-UHFFFAOYSA-N Ala-Lys-Lys Natural products NCCCCC(NC(=O)C(N)C)C(=O)NC(CCCCN)C(O)=O VCSABYLVNWQYQE-UHFFFAOYSA-N 0.000 description 6
- OTZMRMHZCMZOJZ-SRVKXCTJSA-N Arg-Leu-Glu Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCC(O)=O)C(O)=O OTZMRMHZCMZOJZ-SRVKXCTJSA-N 0.000 description 6
- UGKZHCBLMLSANF-CIUDSAMLSA-N Asp-Asn-Leu Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CC(C)C)C(O)=O UGKZHCBLMLSANF-CIUDSAMLSA-N 0.000 description 6
- 102100023995 Beta-nerve growth factor Human genes 0.000 description 6
- 241000283690 Bos taurus Species 0.000 description 6
- 108091026890 Coding region Proteins 0.000 description 6
- KVXVVDFOZNYYKZ-DCAQKATOSA-N Gln-Gln-Leu Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CC(C)C)C(O)=O KVXVVDFOZNYYKZ-DCAQKATOSA-N 0.000 description 6
- DBSLVQBXKVKDKJ-BJDJZHNGSA-N Leu-Ile-Ala Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](C)C(O)=O DBSLVQBXKVKDKJ-BJDJZHNGSA-N 0.000 description 6
- XFIHDSBIPWEYJJ-YUMQZZPRSA-N Lys-Ala-Gly Chemical compound OC(=O)CNC(=O)[C@H](C)NC(=O)[C@@H](N)CCCCN XFIHDSBIPWEYJJ-YUMQZZPRSA-N 0.000 description 6
- HQVDJTYKCMIWJP-YUMQZZPRSA-N Lys-Asn-Gly Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CC(N)=O)C(=O)NCC(O)=O HQVDJTYKCMIWJP-YUMQZZPRSA-N 0.000 description 6
- RRIHXWPHQSXHAQ-XUXIUFHCSA-N Met-Ile-Lys Chemical compound CSCC[C@H](N)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CCCCN)C(O)=O RRIHXWPHQSXHAQ-XUXIUFHCSA-N 0.000 description 6
- XMBSYZWANAQXEV-UHFFFAOYSA-N N-alpha-L-glutamyl-L-phenylalanine Natural products OC(=O)CCC(N)C(=O)NC(C(O)=O)CC1=CC=CC=C1 XMBSYZWANAQXEV-UHFFFAOYSA-N 0.000 description 6
- 241000288906 Primates Species 0.000 description 6
- 108010062796 arginyllysine Proteins 0.000 description 6
- 238000010367 cloning Methods 0.000 description 6
- 230000007423 decrease Effects 0.000 description 6
- 239000012634 fragment Substances 0.000 description 6
- XBGGUPMXALFZOT-UHFFFAOYSA-N glycyl-L-tyrosine hemihydrate Natural products NCC(=O)NC(C(O)=O)CC1=CC=C(O)C=C1 XBGGUPMXALFZOT-UHFFFAOYSA-N 0.000 description 6
- 210000003140 lateral ventricle Anatomy 0.000 description 6
- 108010016686 methionyl-alanyl-serine Proteins 0.000 description 6
- 210000004248 oligodendroglia Anatomy 0.000 description 6
- 238000011084 recovery Methods 0.000 description 6
- UCSJYZPVAKXKNQ-HZYVHMACSA-N streptomycin Chemical compound CN[C@H]1[C@H](O)[C@@H](O)[C@H](CO)O[C@H]1O[C@@H]1[C@](C=O)(O)[C@H](C)O[C@H]1O[C@@H]1[C@@H](NC(N)=N)[C@H](O)[C@@H](NC(N)=N)[C@H](O)[C@H]1O UCSJYZPVAKXKNQ-HZYVHMACSA-N 0.000 description 6
- 108010073969 valyllysine Proteins 0.000 description 6
- 241001655883 Adeno-associated virus - 1 Species 0.000 description 5
- 241001634120 Adeno-associated virus - 5 Species 0.000 description 5
- FJVAQLJNTSUQPY-CIUDSAMLSA-N Ala-Ala-Lys Chemical compound C[C@H](N)C(=O)N[C@@H](C)C(=O)N[C@H](C(O)=O)CCCCN FJVAQLJNTSUQPY-CIUDSAMLSA-N 0.000 description 5
- MDNAVFBZPROEHO-UHFFFAOYSA-N Ala-Lys-Val Natural products CC(C)C(C(O)=O)NC(=O)C(NC(=O)C(C)N)CCCCN MDNAVFBZPROEHO-UHFFFAOYSA-N 0.000 description 5
- NJSNXIOKBHPFMB-GMOBBJLQSA-N Asn-Pro-Ile Chemical compound CC[C@H](C)[C@@H](C(=O)O)NC(=O)[C@@H]1CCCN1C(=O)[C@H](CC(=O)N)N NJSNXIOKBHPFMB-GMOBBJLQSA-N 0.000 description 5
- 102100025907 Dyslexia-associated protein KIAA0319-like protein Human genes 0.000 description 5
- PNUFMLXHOLFRLD-KBPBESRZSA-N Gly-Tyr-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@@H](NC(=O)CN)CC1=CC=C(O)C=C1 PNUFMLXHOLFRLD-KBPBESRZSA-N 0.000 description 5
- 101000720704 Homo sapiens Neuronal migration protein doublecortin Proteins 0.000 description 5
- BCISUQVFDGYZBO-QSFUFRPTSA-N Ile-Val-Asp Chemical compound CC[C@H](C)[C@H](N)C(=O)N[C@@H](C(C)C)C(=O)N[C@H](C(O)=O)CC(O)=O BCISUQVFDGYZBO-QSFUFRPTSA-N 0.000 description 5
- 108010065920 Insulin Lispro Proteins 0.000 description 5
- FADYJNXDPBKVCA-UHFFFAOYSA-N L-Phenylalanyl-L-lysin Natural products NCCCCC(C(O)=O)NC(=O)C(N)CC1=CC=CC=C1 FADYJNXDPBKVCA-UHFFFAOYSA-N 0.000 description 5
- FACUGMGEFUEBTI-SRVKXCTJSA-N Lys-Asn-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](CC(N)=O)NC(=O)[C@@H](N)CCCCN FACUGMGEFUEBTI-SRVKXCTJSA-N 0.000 description 5
- LJADEBULDNKJNK-IHRRRGAJSA-N Lys-Leu-Val Chemical compound CC(C)C[C@H](NC(=O)[C@@H](N)CCCCN)C(=O)N[C@@H](C(C)C)C(O)=O LJADEBULDNKJNK-IHRRRGAJSA-N 0.000 description 5
- 241000699666 Mus <mouse, genus> Species 0.000 description 5
- YBAFDPFAUTYYRW-UHFFFAOYSA-N N-L-alpha-glutamyl-L-leucine Natural products CC(C)CC(C(O)=O)NC(=O)C(N)CCC(O)=O YBAFDPFAUTYYRW-UHFFFAOYSA-N 0.000 description 5
- 108010047562 NGR peptide Proteins 0.000 description 5
- 102100025929 Neuronal migration protein doublecortin Human genes 0.000 description 5
- MIJWOJAXARLEHA-WDSKDSINSA-N Ser-Gly-Glu Chemical compound OC[C@H](N)C(=O)NCC(=O)N[C@H](C(O)=O)CCC(O)=O MIJWOJAXARLEHA-WDSKDSINSA-N 0.000 description 5
- 108010021188 Superoxide Dismutase-1 Proteins 0.000 description 5
- 102100038836 Superoxide dismutase [Cu-Zn] Human genes 0.000 description 5
- 102000047185 Survival of Motor Neuron 1 Human genes 0.000 description 5
- 108700024715 Survival of Motor Neuron 1 Proteins 0.000 description 5
- GULIUBBXCYPDJU-CQDKDKBSSA-N Tyr-Leu-Ala Chemical compound [O-]C(=O)[C@H](C)NC(=O)[C@H](CC(C)C)NC(=O)[C@@H]([NH3+])CC1=CC=C(O)C=C1 GULIUBBXCYPDJU-CQDKDKBSSA-N 0.000 description 5
- 239000012190 activator Substances 0.000 description 5
- 235000004279 alanine Nutrition 0.000 description 5
- 108010038633 aspartylglutamate Proteins 0.000 description 5
- 230000015572 biosynthetic process Effects 0.000 description 5
- 230000003925 brain function Effects 0.000 description 5
- 210000005013 brain tissue Anatomy 0.000 description 5
- 210000003591 cerebellar nuclei Anatomy 0.000 description 5
- 238000012512 characterization method Methods 0.000 description 5
- 238000002425 crystallisation Methods 0.000 description 5
- 230000008025 crystallization Effects 0.000 description 5
- FSXRLASFHBWESK-UHFFFAOYSA-N dipeptide phenylalanyl-tyrosine Natural products C=1C=C(O)C=CC=1CC(C(O)=O)NC(=O)C(N)CC1=CC=CC=C1 FSXRLASFHBWESK-UHFFFAOYSA-N 0.000 description 5
- 230000002068 genetic effect Effects 0.000 description 5
- 108010089804 glycyl-threonine Proteins 0.000 description 5
- 210000001320 hippocampus Anatomy 0.000 description 5
- 108010018006 histidylserine Proteins 0.000 description 5
- 210000004962 mammalian cell Anatomy 0.000 description 5
- 238000004519 manufacturing process Methods 0.000 description 5
- 108020004999 messenger RNA Proteins 0.000 description 5
- 230000010076 replication Effects 0.000 description 5
- 108010061238 threonyl-glycine Proteins 0.000 description 5
- FWMNVWWHGCHHJJ-SKKKGAJSSA-N 4-amino-1-[(2r)-6-amino-2-[[(2r)-2-[[(2r)-2-[[(2r)-2-amino-3-phenylpropanoyl]amino]-3-phenylpropanoyl]amino]-4-methylpentanoyl]amino]hexanoyl]piperidine-4-carboxylic acid Chemical compound C([C@H](C(=O)N[C@H](CC(C)C)C(=O)N[C@H](CCCCN)C(=O)N1CCC(N)(CC1)C(O)=O)NC(=O)[C@H](N)CC=1C=CC=CC=1)C1=CC=CC=C1 FWMNVWWHGCHHJJ-SKKKGAJSSA-N 0.000 description 4
- 241000580270 Adeno-associated virus - 4 Species 0.000 description 4
- VNFWDYWTSHFRRG-SRVKXCTJSA-N Arg-Gln-Leu Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CC(C)C)C(O)=O VNFWDYWTSHFRRG-SRVKXCTJSA-N 0.000 description 4
- UHFUZWSZQKMDSX-DCAQKATOSA-N Arg-Leu-Asn Chemical compound CC(C)C[C@@H](C(=O)N[C@@H](CC(=O)N)C(=O)O)NC(=O)[C@H](CCCN=C(N)N)N UHFUZWSZQKMDSX-DCAQKATOSA-N 0.000 description 4
- GMFAGHNRXPSSJS-SRVKXCTJSA-N Arg-Leu-Gln Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCC(N)=O)C(O)=O GMFAGHNRXPSSJS-SRVKXCTJSA-N 0.000 description 4
- FSNVAJOPUDVQAR-AVGNSLFASA-N Arg-Lys-Arg Chemical compound NC(=N)NCCC[C@H](N)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CCCNC(N)=N)C(O)=O FSNVAJOPUDVQAR-AVGNSLFASA-N 0.000 description 4
- FRBAHXABMQXSJQ-FXQIFTODSA-N Arg-Ser-Ser Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CO)C(=O)N[C@@H](CO)C(O)=O FRBAHXABMQXSJQ-FXQIFTODSA-N 0.000 description 4
- BDMIFVIWCNLDCT-CIUDSAMLSA-N Asn-Arg-Glu Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CCC(O)=O)C(O)=O BDMIFVIWCNLDCT-CIUDSAMLSA-N 0.000 description 4
- OPEPUCYIGFEGSW-WDSKDSINSA-N Asn-Gly-Glu Chemical compound [H]N[C@@H](CC(N)=O)C(=O)NCC(=O)N[C@@H](CCC(O)=O)C(O)=O OPEPUCYIGFEGSW-WDSKDSINSA-N 0.000 description 4
- UJGRZQYSNYTCAX-SRVKXCTJSA-N Asp-Leu-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](CC(C)C)NC(=O)[C@@H](N)CC(O)=O UJGRZQYSNYTCAX-SRVKXCTJSA-N 0.000 description 4
- LTCKTLYKRMCFOC-KKUMJFAQSA-N Asp-Phe-Leu Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CC(C)C)C(O)=O LTCKTLYKRMCFOC-KKUMJFAQSA-N 0.000 description 4
- 101710205593 Dyslexia-associated protein KIAA0319-like protein Proteins 0.000 description 4
- PHZYLYASFWHLHJ-FXQIFTODSA-N Gln-Asn-Glu Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CCC(O)=O)C(O)=O PHZYLYASFWHLHJ-FXQIFTODSA-N 0.000 description 4
- MWMJCGBSIORNCD-AVGNSLFASA-N Glu-Leu-Leu Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CC(C)C)C(O)=O MWMJCGBSIORNCD-AVGNSLFASA-N 0.000 description 4
- LJPIRKICOISLKN-WHFBIAKZSA-N Gly-Ala-Ser Chemical compound NCC(=O)N[C@@H](C)C(=O)N[C@@H](CO)C(O)=O LJPIRKICOISLKN-WHFBIAKZSA-N 0.000 description 4
- 101000638044 Homo sapiens Neurogenic differentiation factor 1 Proteins 0.000 description 4
- QNAYBMKLOCPYGJ-REOHCLBHSA-N L-alanine Chemical compound C[C@H](N)C(O)=O QNAYBMKLOCPYGJ-REOHCLBHSA-N 0.000 description 4
- LHSGPCFBGJHPCY-UHFFFAOYSA-N L-leucine-L-tyrosine Natural products CC(C)CC(N)C(=O)NC(C(O)=O)CC1=CC=C(O)C=C1 LHSGPCFBGJHPCY-UHFFFAOYSA-N 0.000 description 4
- 101150032906 LEP gene Proteins 0.000 description 4
- WUFYAPWIHCUMLL-CIUDSAMLSA-N Leu-Asn-Ala Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](C)C(O)=O WUFYAPWIHCUMLL-CIUDSAMLSA-N 0.000 description 4
- VGPCJSXPPOQPBK-YUMQZZPRSA-N Leu-Gly-Ser Chemical compound CC(C)C[C@H](N)C(=O)NCC(=O)N[C@@H](CO)C(O)=O VGPCJSXPPOQPBK-YUMQZZPRSA-N 0.000 description 4
- USLNHQZCDQJBOV-ZPFDUUQYSA-N Leu-Ile-Asn Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CC(N)=O)C(O)=O USLNHQZCDQJBOV-ZPFDUUQYSA-N 0.000 description 4
- YRRCOJOXAJNSAX-IHRRRGAJSA-N Leu-Pro-Lys Chemical compound CC(C)C[C@@H](C(=O)N1CCC[C@H]1C(=O)N[C@@H](CCCCN)C(=O)O)N YRRCOJOXAJNSAX-IHRRRGAJSA-N 0.000 description 4
- WVJNGSFKBKOKRV-AJNGGQMLSA-N Lys-Leu-Ile Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O WVJNGSFKBKOKRV-AJNGGQMLSA-N 0.000 description 4
- GHKXHCMRAUYLBS-CIUDSAMLSA-N Lys-Ser-Asn Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CO)C(=O)N[C@@H](CC(N)=O)C(O)=O GHKXHCMRAUYLBS-CIUDSAMLSA-N 0.000 description 4
- JMNRXRPBHFGXQX-GUBZILKMSA-N Lys-Ser-Glu Chemical compound NCCCC[C@H](N)C(=O)N[C@@H](CO)C(=O)N[C@H](C(O)=O)CCC(O)=O JMNRXRPBHFGXQX-GUBZILKMSA-N 0.000 description 4
- OZVXDDFYCQOPFD-XQQFMLRXSA-N Lys-Val-Pro Chemical compound CC(C)[C@@H](C(=O)N1CCC[C@@H]1C(=O)O)NC(=O)[C@H](CCCCN)N OZVXDDFYCQOPFD-XQQFMLRXSA-N 0.000 description 4
- 102100032063 Neurogenic differentiation factor 1 Human genes 0.000 description 4
- 102000003683 Neurotrophin-4 Human genes 0.000 description 4
- 108090000099 Neurotrophin-4 Proteins 0.000 description 4
- GDBOREPXIRKSEQ-FHWLQOOXSA-N Phe-Gln-Phe Chemical compound [H]N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CC1=CC=CC=C1)C(O)=O GDBOREPXIRKSEQ-FHWLQOOXSA-N 0.000 description 4
- WEMYTDDMDBLPMI-DKIMLUQUSA-N Phe-Ile-Lys Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CCCCN)C(=O)O)NC(=O)[C@H](CC1=CC=CC=C1)N WEMYTDDMDBLPMI-DKIMLUQUSA-N 0.000 description 4
- IPFXYNKCXYGSSV-KKUMJFAQSA-N Phe-Ser-Lys Chemical compound C1=CC=C(C=C1)C[C@@H](C(=O)N[C@@H](CO)C(=O)N[C@@H](CCCCN)C(=O)O)N IPFXYNKCXYGSSV-KKUMJFAQSA-N 0.000 description 4
- XXXAXOWMBOKTRN-XPUUQOCRSA-N Ser-Gly-Val Chemical compound [H]N[C@@H](CO)C(=O)NCC(=O)N[C@@H](C(C)C)C(O)=O XXXAXOWMBOKTRN-XPUUQOCRSA-N 0.000 description 4
- 108091027967 Small hairpin RNA Proteins 0.000 description 4
- IWAVRIPRTCJAQO-HSHDSVGOSA-N Thr-Pro-Trp Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N1CCC[C@H]1C(=O)N[C@@H](CC1=CNC2=C1C=CC=C2)C(O)=O IWAVRIPRTCJAQO-HSHDSVGOSA-N 0.000 description 4
- 108700019146 Transgenes Proteins 0.000 description 4
- WQOHKVRQDLNDIL-YJRXYDGGSA-N Tyr-Thr-Ser Chemical compound [H]N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CO)C(O)=O WQOHKVRQDLNDIL-YJRXYDGGSA-N 0.000 description 4
- PVPAOIGJYHVWBT-KKHAAJSZSA-N Val-Asn-Thr Chemical compound C[C@H]([C@@H](C(=O)O)NC(=O)[C@H](CC(=O)N)NC(=O)[C@H](C(C)C)N)O PVPAOIGJYHVWBT-KKHAAJSZSA-N 0.000 description 4
- ZHQWPWQNVRCXAX-XQQFMLRXSA-N Val-Leu-Pro Chemical compound CC(C)C[C@@H](C(=O)N1CCC[C@@H]1C(=O)O)NC(=O)[C@H](C(C)C)N ZHQWPWQNVRCXAX-XQQFMLRXSA-N 0.000 description 4
- 238000004458 analytical method Methods 0.000 description 4
- 230000006907 apoptotic process Effects 0.000 description 4
- 108010008355 arginyl-glutamine Proteins 0.000 description 4
- 239000000872 buffer Substances 0.000 description 4
- 230000032823 cell division Effects 0.000 description 4
- 230000002490 cerebral effect Effects 0.000 description 4
- 210000001175 cerebrospinal fluid Anatomy 0.000 description 4
- 230000011559 double-strand break repair via nonhomologous end joining Effects 0.000 description 4
- 108010063718 gamma-glutamylaspartic acid Proteins 0.000 description 4
- HPAIKDPJURGQLN-UHFFFAOYSA-N glycyl-L-histidyl-L-phenylalanine Natural products C=1C=CC=CC=1CC(C(O)=O)NC(=O)C(NC(=O)CN)CC1=CN=CN1 HPAIKDPJURGQLN-UHFFFAOYSA-N 0.000 description 4
- XKUKSGPZAADMRA-UHFFFAOYSA-N glycyl-glycyl-glycine Natural products NCC(=O)NCC(=O)NCC(O)=O XKUKSGPZAADMRA-UHFFFAOYSA-N 0.000 description 4
- 108010087823 glycyltyrosine Proteins 0.000 description 4
- 108010037850 glycylvaline Proteins 0.000 description 4
- 108010092114 histidylphenylalanine Proteins 0.000 description 4
- 108010085325 histidylproline Proteins 0.000 description 4
- 230000006872 improvement Effects 0.000 description 4
- 108010012058 leucyltyrosine Proteins 0.000 description 4
- 238000002898 library design Methods 0.000 description 4
- 108010003700 lysyl aspartic acid Proteins 0.000 description 4
- 108010038320 lysylphenylalanine Proteins 0.000 description 4
- 108010017391 lysylvaline Proteins 0.000 description 4
- 239000003550 marker Substances 0.000 description 4
- 230000005012 migration Effects 0.000 description 4
- 238000013508 migration Methods 0.000 description 4
- 229940097998 neurotrophin 4 Drugs 0.000 description 4
- 210000000956 olfactory bulb Anatomy 0.000 description 4
- 210000001428 peripheral nervous system Anatomy 0.000 description 4
- 229920000642 polymer Polymers 0.000 description 4
- 108010015796 prolylisoleucine Proteins 0.000 description 4
- 102000005962 receptors Human genes 0.000 description 4
- 108020003175 receptors Proteins 0.000 description 4
- 239000011780 sodium chloride Substances 0.000 description 4
- 238000003786 synthesis reaction Methods 0.000 description 4
- 238000012360 testing method Methods 0.000 description 4
- 108010038745 tryptophylglycine Proteins 0.000 description 4
- 241000701161 unidentified adenovirus Species 0.000 description 4
- 241000649045 Adeno-associated virus 10 Species 0.000 description 3
- NHCPCLJZRSIDHS-ZLUOBGJFSA-N Ala-Asp-Ala Chemical compound [H]N[C@@H](C)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](C)C(O)=O NHCPCLJZRSIDHS-ZLUOBGJFSA-N 0.000 description 3
- GSCLWXDNIMNIJE-ZLUOBGJFSA-N Ala-Asp-Asn Chemical compound [H]N[C@@H](C)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CC(N)=O)C(O)=O GSCLWXDNIMNIJE-ZLUOBGJFSA-N 0.000 description 3
- KIUYPHAMDKDICO-WHFBIAKZSA-N Ala-Asp-Gly Chemical compound C[C@H](N)C(=O)N[C@@H](CC(O)=O)C(=O)NCC(O)=O KIUYPHAMDKDICO-WHFBIAKZSA-N 0.000 description 3
- CCDFBRZVTDDJNM-GUBZILKMSA-N Ala-Leu-Glu Chemical compound [H]N[C@@H](C)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCC(O)=O)C(O)=O CCDFBRZVTDDJNM-GUBZILKMSA-N 0.000 description 3
- BTRULDJUUVGRNE-DCAQKATOSA-N Ala-Pro-Lys Chemical compound C[C@H](N)C(=O)N1CCC[C@H]1C(=O)N[C@@H](CCCCN)C(O)=O BTRULDJUUVGRNE-DCAQKATOSA-N 0.000 description 3
- VRTOMXFZHGWHIJ-KZVJFYERSA-N Ala-Thr-Arg Chemical compound [H]N[C@@H](C)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCCNC(N)=N)C(O)=O VRTOMXFZHGWHIJ-KZVJFYERSA-N 0.000 description 3
- YCTIYBUTCKNOTI-UWJYBYFXSA-N Ala-Tyr-Asp Chemical compound C[C@@H](C(=O)N[C@@H](CC1=CC=C(C=C1)O)C(=O)N[C@@H](CC(=O)O)C(=O)O)N YCTIYBUTCKNOTI-UWJYBYFXSA-N 0.000 description 3
- VHAQSYHSDKERBS-XPUUQOCRSA-N Ala-Val-Gly Chemical compound C[C@H](N)C(=O)N[C@@H](C(C)C)C(=O)NCC(O)=O VHAQSYHSDKERBS-XPUUQOCRSA-N 0.000 description 3
- HJVGMOYJDDXLMI-AVGNSLFASA-N Arg-Arg-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@H](CCCNC(N)=N)NC(=O)[C@@H](N)CCCNC(N)=N HJVGMOYJDDXLMI-AVGNSLFASA-N 0.000 description 3
- JQFJNGVSGOUQDH-XIRDDKMYSA-N Arg-Glu-Trp Chemical compound C1=CC=C2C(C[C@H](NC(=O)[C@H](CCC(O)=O)NC(=O)[C@H](CCCN=C(N)N)N)C(O)=O)=CNC2=C1 JQFJNGVSGOUQDH-XIRDDKMYSA-N 0.000 description 3
- DNUKXVMPARLPFN-XUXIUFHCSA-N Arg-Leu-Ile Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O DNUKXVMPARLPFN-XUXIUFHCSA-N 0.000 description 3
- COXMUHNBYCVVRG-DCAQKATOSA-N Arg-Leu-Ser Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CO)C(O)=O COXMUHNBYCVVRG-DCAQKATOSA-N 0.000 description 3
- AOJYORNRFWWEIV-IHRRRGAJSA-N Arg-Tyr-Asp Chemical compound NC(N)=NCCC[C@H](N)C(=O)N[C@H](C(=O)N[C@@H](CC(O)=O)C(O)=O)CC1=CC=C(O)C=C1 AOJYORNRFWWEIV-IHRRRGAJSA-N 0.000 description 3
- IZSMEUDYADKZTJ-KJEVXHAQSA-N Arg-Tyr-Thr Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H]([C@@H](C)O)C(O)=O IZSMEUDYADKZTJ-KJEVXHAQSA-N 0.000 description 3
- XWGJDUSDTRPQRK-ZLUOBGJFSA-N Asn-Ala-Ser Chemical compound OC[C@@H](C(O)=O)NC(=O)[C@H](C)NC(=O)[C@@H](N)CC(N)=O XWGJDUSDTRPQRK-ZLUOBGJFSA-N 0.000 description 3
- MEFGKQUUYZOLHM-GMOBBJLQSA-N Asn-Arg-Ile Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O MEFGKQUUYZOLHM-GMOBBJLQSA-N 0.000 description 3
- AYZAWXAPBAYCHO-CIUDSAMLSA-N Asn-Asn-His Chemical compound C1=C(NC=N1)C[C@@H](C(=O)O)NC(=O)[C@H](CC(=O)N)NC(=O)[C@H](CC(=O)N)N AYZAWXAPBAYCHO-CIUDSAMLSA-N 0.000 description 3
- WPOLSNAQGVHROR-GUBZILKMSA-N Asn-Gln-Leu Chemical compound CC(C)C[C@@H](C(=O)O)NC(=O)[C@H](CCC(=O)N)NC(=O)[C@H](CC(=O)N)N WPOLSNAQGVHROR-GUBZILKMSA-N 0.000 description 3
- GNKVBRYFXYWXAB-WDSKDSINSA-N Asn-Glu-Gly Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CCC(O)=O)C(=O)NCC(O)=O GNKVBRYFXYWXAB-WDSKDSINSA-N 0.000 description 3
- FTCGGKNCJZOPNB-WHFBIAKZSA-N Asn-Gly-Ser Chemical compound NC(=O)C[C@H](N)C(=O)NCC(=O)N[C@@H](CO)C(O)=O FTCGGKNCJZOPNB-WHFBIAKZSA-N 0.000 description 3
- WIDVAWAQBRAKTI-YUMQZZPRSA-N Asn-Leu-Gly Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CC(C)C)C(=O)NCC(O)=O WIDVAWAQBRAKTI-YUMQZZPRSA-N 0.000 description 3
- DJIMLSXHXKWADV-CIUDSAMLSA-N Asn-Leu-Ser Chemical compound OC[C@@H](C(O)=O)NC(=O)[C@H](CC(C)C)NC(=O)[C@@H](N)CC(N)=O DJIMLSXHXKWADV-CIUDSAMLSA-N 0.000 description 3
- RDLYUKRPEJERMM-XIRDDKMYSA-N Asn-Trp-Leu Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CC1=CNC2=C1C=CC=C2)C(=O)N[C@@H](CC(C)C)C(O)=O RDLYUKRPEJERMM-XIRDDKMYSA-N 0.000 description 3
- XEDQMTWEYFBOIK-ACZMJKKPSA-N Asp-Ala-Glu Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](C)C(=O)N[C@@H](CCC(O)=O)C(O)=O XEDQMTWEYFBOIK-ACZMJKKPSA-N 0.000 description 3
- XBQSLMACWDXWLJ-GHCJXIJMSA-N Asp-Ala-Ile Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](C)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O XBQSLMACWDXWLJ-GHCJXIJMSA-N 0.000 description 3
- MFMJRYHVLLEMQM-DCAQKATOSA-N Asp-Arg-His Chemical compound C1=C(NC=N1)C[C@@H](C(=O)O)NC(=O)[C@H](CCCN=C(N)N)NC(=O)[C@H](CC(=O)O)N MFMJRYHVLLEMQM-DCAQKATOSA-N 0.000 description 3
- XYBJLTKSGFBLCS-QXEWZRGKSA-N Asp-Arg-Val Chemical compound NC(N)=NCCC[C@@H](C(=O)N[C@@H](C(C)C)C(O)=O)NC(=O)[C@@H](N)CC(O)=O XYBJLTKSGFBLCS-QXEWZRGKSA-N 0.000 description 3
- UGIBTKGQVWFTGX-BIIVOSGPSA-N Asp-Asn-Pro Chemical compound C1C[C@@H](N(C1)C(=O)[C@H](CC(=O)N)NC(=O)[C@H](CC(=O)O)N)C(=O)O UGIBTKGQVWFTGX-BIIVOSGPSA-N 0.000 description 3
- KNMRXHIAVXHCLW-ZLUOBGJFSA-N Asp-Asn-Ser Chemical compound C([C@@H](C(=O)N[C@@H](CC(=O)N)C(=O)N[C@@H](CO)C(=O)O)N)C(=O)O KNMRXHIAVXHCLW-ZLUOBGJFSA-N 0.000 description 3
- SBHUBSDEZQFJHJ-CIUDSAMLSA-N Asp-Asp-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](CC(O)=O)NC(=O)[C@@H](N)CC(O)=O SBHUBSDEZQFJHJ-CIUDSAMLSA-N 0.000 description 3
- CELPEWWLSXMVPH-CIUDSAMLSA-N Asp-Asp-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@H](CC(O)=O)NC(=O)[C@@H](N)CC(O)=O CELPEWWLSXMVPH-CIUDSAMLSA-N 0.000 description 3
- DXQOQMCLWWADMU-ACZMJKKPSA-N Asp-Gln-Ser Chemical compound OC(=O)C[C@H](N)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CO)C(O)=O DXQOQMCLWWADMU-ACZMJKKPSA-N 0.000 description 3
- RRKCPMGSRIDLNC-AVGNSLFASA-N Asp-Glu-Tyr Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(O)=O RRKCPMGSRIDLNC-AVGNSLFASA-N 0.000 description 3
- PGUYEUCYVNZGGV-QWRGUYRKSA-N Asp-Gly-Tyr Chemical compound OC(=O)C[C@H](N)C(=O)NCC(=O)N[C@H](C(O)=O)CC1=CC=C(O)C=C1 PGUYEUCYVNZGGV-QWRGUYRKSA-N 0.000 description 3
- JNNVNVRBYUJYGS-CIUDSAMLSA-N Asp-Leu-Ala Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](C)C(O)=O JNNVNVRBYUJYGS-CIUDSAMLSA-N 0.000 description 3
- CLUMZOKVGUWUFD-CIUDSAMLSA-N Asp-Leu-Asn Chemical compound OC(=O)C[C@H](N)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CC(N)=O)C(O)=O CLUMZOKVGUWUFD-CIUDSAMLSA-N 0.000 description 3
- GKWFMNNNYZHJHV-SRVKXCTJSA-N Asp-Lys-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](CCCCN)NC(=O)[C@@H](N)CC(O)=O GKWFMNNNYZHJHV-SRVKXCTJSA-N 0.000 description 3
- MGSVBZIBCCKGCY-ZLUOBGJFSA-N Asp-Ser-Ser Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](CO)C(=O)N[C@@H](CO)C(O)=O MGSVBZIBCCKGCY-ZLUOBGJFSA-N 0.000 description 3
- JDDYEZGPYBBPBN-JRQIVUDYSA-N Asp-Thr-Tyr Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(O)=O JDDYEZGPYBBPBN-JRQIVUDYSA-N 0.000 description 3
- WAEDSQFVZJUHLI-BYULHYEWSA-N Asp-Val-Asp Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CC(O)=O)C(O)=O WAEDSQFVZJUHLI-BYULHYEWSA-N 0.000 description 3
- 108091003079 Bovine Serum Albumin Proteins 0.000 description 3
- 101150044789 Cap gene Proteins 0.000 description 3
- 241000283707 Capra Species 0.000 description 3
- 108010051219 Cre recombinase Proteins 0.000 description 3
- 239000006144 Dulbecco’s modified Eagle's medium Substances 0.000 description 3
- LFQSCWFLJHTTHZ-UHFFFAOYSA-N Ethanol Chemical compound CCO LFQSCWFLJHTTHZ-UHFFFAOYSA-N 0.000 description 3
- ULXXDWZMMSQBDC-ACZMJKKPSA-N Gln-Asp-Asp Chemical compound C(CC(=O)N)[C@@H](C(=O)N[C@@H](CC(=O)O)C(=O)N[C@@H](CC(=O)O)C(=O)O)N ULXXDWZMMSQBDC-ACZMJKKPSA-N 0.000 description 3
- XEYMBRRKIFYQMF-GUBZILKMSA-N Gln-Asp-Leu Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CC(C)C)C(O)=O XEYMBRRKIFYQMF-GUBZILKMSA-N 0.000 description 3
- MADFVRSKEIEZHZ-DCAQKATOSA-N Gln-Gln-Lys Chemical compound C(CCN)C[C@@H](C(=O)O)NC(=O)[C@H](CCC(=O)N)NC(=O)[C@H](CCC(=O)N)N MADFVRSKEIEZHZ-DCAQKATOSA-N 0.000 description 3
- VOLVNCMGXWDDQY-LPEHRKFASA-N Gln-Glu-Pro Chemical compound C1C[C@@H](N(C1)C(=O)[C@H](CCC(=O)O)NC(=O)[C@H](CCC(=O)N)N)C(=O)O VOLVNCMGXWDDQY-LPEHRKFASA-N 0.000 description 3
- FTIJVMLAGRAYMJ-MNXVOIDGSA-N Gln-Ile-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H]([C@@H](C)CC)NC(=O)[C@@H](N)CCC(N)=O FTIJVMLAGRAYMJ-MNXVOIDGSA-N 0.000 description 3
- ZBKUIQNCRIYVGH-SDDRHHMPSA-N Gln-Leu-Pro Chemical compound CC(C)C[C@@H](C(=O)N1CCC[C@@H]1C(=O)O)NC(=O)[C@H](CCC(=O)N)N ZBKUIQNCRIYVGH-SDDRHHMPSA-N 0.000 description 3
- SYZZMPFLOLSMHL-XHNCKOQMSA-N Gln-Ser-Pro Chemical compound C1C[C@@H](N(C1)C(=O)[C@H](CO)NC(=O)[C@H](CCC(=O)N)N)C(=O)O SYZZMPFLOLSMHL-XHNCKOQMSA-N 0.000 description 3
- WTJIWXMJESRHMM-XDTLVQLUSA-N Gln-Tyr-Ala Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](C)C(O)=O WTJIWXMJESRHMM-XDTLVQLUSA-N 0.000 description 3
- RDPOETHPAQEGDP-ACZMJKKPSA-N Glu-Asp-Ala Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](C)C(O)=O RDPOETHPAQEGDP-ACZMJKKPSA-N 0.000 description 3
- HJIFPJUEOGZWRI-GUBZILKMSA-N Glu-Asp-Lys Chemical compound C(CCN)C[C@@H](C(=O)O)NC(=O)[C@H](CC(=O)O)NC(=O)[C@H](CCC(=O)O)N HJIFPJUEOGZWRI-GUBZILKMSA-N 0.000 description 3
- SBCYJMOOHUDWDA-NUMRIWBASA-N Glu-Asp-Thr Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H]([C@@H](C)O)C(O)=O SBCYJMOOHUDWDA-NUMRIWBASA-N 0.000 description 3
- CUXJIASLBRJOFV-LAEOZQHASA-N Glu-Gly-Ile Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)NCC(=O)N[C@@H]([C@@H](C)CC)C(O)=O CUXJIASLBRJOFV-LAEOZQHASA-N 0.000 description 3
- XOFYVODYSNKPDK-AVGNSLFASA-N Glu-His-His Chemical compound C1=C(NC=N1)C[C@@H](C(=O)N[C@@H](CC2=CN=CN2)C(=O)O)NC(=O)[C@H](CCC(=O)O)N XOFYVODYSNKPDK-AVGNSLFASA-N 0.000 description 3
- WTMZXOPHTIVFCP-QEWYBTABSA-N Glu-Ile-Phe Chemical compound OC(=O)CC[C@H](N)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@H](C(O)=O)CC1=CC=CC=C1 WTMZXOPHTIVFCP-QEWYBTABSA-N 0.000 description 3
- ZSWGJYOZWBHROQ-RWRJDSDZSA-N Glu-Ile-Thr Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H]([C@@H](C)O)C(O)=O ZSWGJYOZWBHROQ-RWRJDSDZSA-N 0.000 description 3
- BXSZPACYCMNKLS-AVGNSLFASA-N Glu-Ser-Phe Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](CO)C(=O)N[C@@H](CC1=CC=CC=C1)C(O)=O BXSZPACYCMNKLS-AVGNSLFASA-N 0.000 description 3
- KIEICAOUSNYOLM-NRPADANISA-N Glu-Val-Ala Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](C)C(O)=O KIEICAOUSNYOLM-NRPADANISA-N 0.000 description 3
- YQPFCZVKMUVZIN-AUTRQRHGSA-N Glu-Val-Gln Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CCC(N)=O)C(O)=O YQPFCZVKMUVZIN-AUTRQRHGSA-N 0.000 description 3
- VSVZIEVNUYDAFR-YUMQZZPRSA-N Gly-Ala-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](C)NC(=O)CN VSVZIEVNUYDAFR-YUMQZZPRSA-N 0.000 description 3
- RJIVPOXLQFJRTG-LURJTMIESA-N Gly-Arg-Gly Chemical compound OC(=O)CNC(=O)[C@@H](NC(=O)CN)CCCN=C(N)N RJIVPOXLQFJRTG-LURJTMIESA-N 0.000 description 3
- CIMULJZTTOBOPN-WHFBIAKZSA-N Gly-Asn-Asn Chemical compound NCC(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CC(N)=O)C(O)=O CIMULJZTTOBOPN-WHFBIAKZSA-N 0.000 description 3
- FMNHBTKMRFVGRO-FOHZUACHSA-N Gly-Asn-Thr Chemical compound C[C@@H](O)[C@@H](C(O)=O)NC(=O)[C@H](CC(N)=O)NC(=O)CN FMNHBTKMRFVGRO-FOHZUACHSA-N 0.000 description 3
- LCNXZQROPKFGQK-WHFBIAKZSA-N Gly-Asp-Ser Chemical compound NCC(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CO)C(O)=O LCNXZQROPKFGQK-WHFBIAKZSA-N 0.000 description 3
- ZQIMMEYPEXIYBB-IUCAKERBSA-N Gly-Glu-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@H](CCC(O)=O)NC(=O)CN ZQIMMEYPEXIYBB-IUCAKERBSA-N 0.000 description 3
- YTSVAIMKVLZUDU-YUMQZZPRSA-N Gly-Leu-Asp Chemical compound [H]NCC(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CC(O)=O)C(O)=O YTSVAIMKVLZUDU-YUMQZZPRSA-N 0.000 description 3
- LHYJCVCQPWRMKZ-WEDXCCLWSA-N Gly-Leu-Thr Chemical compound [H]NCC(=O)N[C@@H](CC(C)C)C(=O)N[C@@H]([C@@H](C)O)C(O)=O LHYJCVCQPWRMKZ-WEDXCCLWSA-N 0.000 description 3
- VEPBEGNDJYANCF-QWRGUYRKSA-N Gly-Lys-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@@H](NC(=O)CN)CCCCN VEPBEGNDJYANCF-QWRGUYRKSA-N 0.000 description 3
- NTBOEZICHOSJEE-YUMQZZPRSA-N Gly-Lys-Ser Chemical compound [H]NCC(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CO)C(O)=O NTBOEZICHOSJEE-YUMQZZPRSA-N 0.000 description 3
- RCHFYMASWAZQQZ-ZANVPECISA-N Gly-Trp-Ala Chemical compound C1=CC=C2C(C[C@@H](C(=O)N[C@@H](C)C(O)=O)NC(=O)CN)=CNC2=C1 RCHFYMASWAZQQZ-ZANVPECISA-N 0.000 description 3
- DNVDEMWIYLVIQU-RCOVLWMOSA-N Gly-Val-Asp Chemical compound NCC(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CC(O)=O)C(O)=O DNVDEMWIYLVIQU-RCOVLWMOSA-N 0.000 description 3
- PEDCQBHIVMGVHV-UHFFFAOYSA-N Glycerine Chemical compound OCC(O)CO PEDCQBHIVMGVHV-UHFFFAOYSA-N 0.000 description 3
- 102100032606 Heat shock factor protein 1 Human genes 0.000 description 3
- BDHUXUFYNUOUIT-SRVKXCTJSA-N His-Asp-Lys Chemical compound C1=C(NC=N1)C[C@@H](C(=O)N[C@@H](CC(=O)O)C(=O)N[C@@H](CCCCN)C(=O)O)N BDHUXUFYNUOUIT-SRVKXCTJSA-N 0.000 description 3
- IMCHNUANCIGUKS-SRVKXCTJSA-N His-Glu-Arg Chemical compound [H]N[C@@H](CC1=CNC=N1)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CCCNC(N)=N)C(O)=O IMCHNUANCIGUKS-SRVKXCTJSA-N 0.000 description 3
- JCOSMKPAOYDKRO-AVGNSLFASA-N His-Glu-Lys Chemical compound C1=C(NC=N1)C[C@@H](C(=O)N[C@@H](CCC(=O)O)C(=O)N[C@@H](CCCCN)C(=O)O)N JCOSMKPAOYDKRO-AVGNSLFASA-N 0.000 description 3
- SVVULKPWDBIPCO-BZSNNMDCSA-N His-Phe-Leu Chemical compound [H]N[C@@H](CC1=CNC=N1)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CC(C)C)C(O)=O SVVULKPWDBIPCO-BZSNNMDCSA-N 0.000 description 3
- WCHONUZTYDQMBY-PYJNHQTQSA-N His-Pro-Ile Chemical compound [H]N[C@@H](CC1=CNC=N1)C(=O)N1CCC[C@H]1C(=O)N[C@@H]([C@@H](C)CC)C(O)=O WCHONUZTYDQMBY-PYJNHQTQSA-N 0.000 description 3
- 241000282412 Homo Species 0.000 description 3
- 101000867525 Homo sapiens Heat shock factor protein 1 Proteins 0.000 description 3
- LQSBBHNVAVNZSX-GHCJXIJMSA-N Ile-Ala-Asn Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](C)C(=O)N[C@@H](CC(=O)N)C(=O)O)N LQSBBHNVAVNZSX-GHCJXIJMSA-N 0.000 description 3
- KUHFPGIVBOCRMV-MNXVOIDGSA-N Ile-Gln-Leu Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CCC(=O)N)C(=O)N[C@@H](CC(C)C)C(=O)O)N KUHFPGIVBOCRMV-MNXVOIDGSA-N 0.000 description 3
- MTFVYKQRLXYAQN-LAEOZQHASA-N Ile-Glu-Gly Chemical compound [H]N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CCC(O)=O)C(=O)NCC(O)=O MTFVYKQRLXYAQN-LAEOZQHASA-N 0.000 description 3
- KFVUBLZRFSVDGO-BYULHYEWSA-N Ile-Gly-Asp Chemical compound CC[C@H](C)[C@H](N)C(=O)NCC(=O)N[C@H](C(O)=O)CC(O)=O KFVUBLZRFSVDGO-BYULHYEWSA-N 0.000 description 3
- NYEYYMLUABXDMC-NHCYSSNCSA-N Ile-Gly-Leu Chemical compound CC[C@H](C)[C@@H](C(=O)NCC(=O)N[C@@H](CC(C)C)C(=O)O)N NYEYYMLUABXDMC-NHCYSSNCSA-N 0.000 description 3
- PKGGWLOLRLOPGK-XUXIUFHCSA-N Ile-Leu-Arg Chemical compound CC[C@H](C)[C@H](N)C(=O)N[C@@H](CC(C)C)C(=O)N[C@H](C(O)=O)CCCN=C(N)N PKGGWLOLRLOPGK-XUXIUFHCSA-N 0.000 description 3
- CIDLJWVDMNDKPT-FIRPJDEBSA-N Ile-Phe-Phe Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CC2=CC=CC=C2)C(=O)O)N CIDLJWVDMNDKPT-FIRPJDEBSA-N 0.000 description 3
- JSLIXOUMAOUGBN-JUKXBJQTSA-N Ile-Tyr-His Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CC1=CC=C(C=C1)O)C(=O)N[C@@H](CC2=CN=CN2)C(=O)O)N JSLIXOUMAOUGBN-JUKXBJQTSA-N 0.000 description 3
- PWWVAXIEGOYWEE-UHFFFAOYSA-N Isophenergan Chemical compound C1=CC=C2N(CC(C)N(C)C)C3=CC=CC=C3SC2=C1 PWWVAXIEGOYWEE-UHFFFAOYSA-N 0.000 description 3
- MJOZZTKJZQFKDK-GUBZILKMSA-N Leu-Ala-Gln Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H](C)C(=O)N[C@H](C(O)=O)CCC(N)=O MJOZZTKJZQFKDK-GUBZILKMSA-N 0.000 description 3
- PBCHMHROGNUXMK-DLOVCJGASA-N Leu-Ala-His Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H](C)C(=O)N[C@H](C(O)=O)CC1=CN=CN1 PBCHMHROGNUXMK-DLOVCJGASA-N 0.000 description 3
- YOZCKMXHBYKOMQ-IHRRRGAJSA-N Leu-Arg-Lys Chemical compound CC(C)C[C@@H](C(=O)N[C@@H](CCCN=C(N)N)C(=O)N[C@@H](CCCCN)C(=O)O)N YOZCKMXHBYKOMQ-IHRRRGAJSA-N 0.000 description 3
- STAVRDQLZOTNKJ-RHYQMDGZSA-N Leu-Arg-Thr Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H]([C@@H](C)O)C(O)=O STAVRDQLZOTNKJ-RHYQMDGZSA-N 0.000 description 3
- WGNOPSQMIQERPK-UHFFFAOYSA-N Leu-Asn-Pro Natural products CC(C)CC(N)C(=O)NC(CC(=O)N)C(=O)N1CCCC1C(=O)O WGNOPSQMIQERPK-UHFFFAOYSA-N 0.000 description 3
- RXGLHDWAZQECBI-SRVKXCTJSA-N Leu-Leu-Ser Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CO)C(O)=O RXGLHDWAZQECBI-SRVKXCTJSA-N 0.000 description 3
- ZAVCJRJOQKIOJW-KKUMJFAQSA-N Leu-Phe-Asp Chemical compound CC(C)C[C@H](N)C(=O)N[C@H](C(=O)N[C@@H](CC(O)=O)C(O)=O)CC1=CC=CC=C1 ZAVCJRJOQKIOJW-KKUMJFAQSA-N 0.000 description 3
- INCJJHQRZGQLFC-KBPBESRZSA-N Leu-Phe-Gly Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)NCC(O)=O INCJJHQRZGQLFC-KBPBESRZSA-N 0.000 description 3
- DRWMRVFCKKXHCH-BZSNNMDCSA-N Leu-Phe-Leu Chemical compound CC(C)C[C@H]([NH3+])C(=O)N[C@H](C(=O)N[C@@H](CC(C)C)C([O-])=O)CC1=CC=CC=C1 DRWMRVFCKKXHCH-BZSNNMDCSA-N 0.000 description 3
- BMVFXOQHDQZAQU-DCAQKATOSA-N Leu-Pro-Asp Chemical compound CC(C)C[C@@H](C(=O)N1CCC[C@H]1C(=O)N[C@@H](CC(=O)O)C(=O)O)N BMVFXOQHDQZAQU-DCAQKATOSA-N 0.000 description 3
- XOWMDXHFSBCAKQ-SRVKXCTJSA-N Leu-Ser-Leu Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H](CO)C(=O)N[C@H](C(O)=O)CC(C)C XOWMDXHFSBCAKQ-SRVKXCTJSA-N 0.000 description 3
- AMSSKPUHBUQBOQ-SRVKXCTJSA-N Leu-Ser-Lys Chemical compound CC(C)C[C@@H](C(=O)N[C@@H](CO)C(=O)N[C@@H](CCCCN)C(=O)O)N AMSSKPUHBUQBOQ-SRVKXCTJSA-N 0.000 description 3
- YIRIDPUGZKHMHT-ACRUOGEOSA-N Leu-Tyr-Tyr Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(O)=O YIRIDPUGZKHMHT-ACRUOGEOSA-N 0.000 description 3
- FBNPMTNBFFAMMH-AVGNSLFASA-N Leu-Val-Arg Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H](C(C)C)C(=O)N[C@H](C(O)=O)CCCN=C(N)N FBNPMTNBFFAMMH-AVGNSLFASA-N 0.000 description 3
- FBNPMTNBFFAMMH-UHFFFAOYSA-N Leu-Val-Arg Natural products CC(C)CC(N)C(=O)NC(C(C)C)C(=O)NC(C(O)=O)CCCN=C(N)N FBNPMTNBFFAMMH-UHFFFAOYSA-N 0.000 description 3
- AIMGJYMCTAABEN-GVXVVHGQSA-N Leu-Val-Glu Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CCC(O)=O)C(O)=O AIMGJYMCTAABEN-GVXVVHGQSA-N 0.000 description 3
- MPOHDJKRBLVGCT-CIUDSAMLSA-N Lys-Ala-Asn Chemical compound C[C@@H](C(=O)N[C@@H](CC(=O)N)C(=O)O)NC(=O)[C@H](CCCCN)N MPOHDJKRBLVGCT-CIUDSAMLSA-N 0.000 description 3
- MPGHETGWWWUHPY-CIUDSAMLSA-N Lys-Ala-Asp Chemical compound OC(=O)C[C@@H](C(O)=O)NC(=O)[C@H](C)NC(=O)[C@@H](N)CCCCN MPGHETGWWWUHPY-CIUDSAMLSA-N 0.000 description 3
- NFLFJGGKOHYZJF-BJDJZHNGSA-N Lys-Ala-Ile Chemical compound CC[C@H](C)[C@@H](C(O)=O)NC(=O)[C@H](C)NC(=O)[C@@H](N)CCCCN NFLFJGGKOHYZJF-BJDJZHNGSA-N 0.000 description 3
- IXHKPDJKKCUKHS-GARJFASQSA-N Lys-Ala-Pro Chemical compound C[C@@H](C(=O)N1CCC[C@@H]1C(=O)O)NC(=O)[C@H](CCCCN)N IXHKPDJKKCUKHS-GARJFASQSA-N 0.000 description 3
- SWWCDAGDQHTKIE-RHYQMDGZSA-N Lys-Arg-Thr Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H]([C@@H](C)O)C(O)=O SWWCDAGDQHTKIE-RHYQMDGZSA-N 0.000 description 3
- LCMWVZLBCUVDAZ-IUCAKERBSA-N Lys-Gly-Glu Chemical compound [NH3+]CCCC[C@H]([NH3+])C(=O)NCC(=O)N[C@H](C([O-])=O)CCC([O-])=O LCMWVZLBCUVDAZ-IUCAKERBSA-N 0.000 description 3
- ONPDTSFZAIWMDI-AVGNSLFASA-N Lys-Leu-Gln Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCC(N)=O)C(O)=O ONPDTSFZAIWMDI-AVGNSLFASA-N 0.000 description 3
- XIZQPFCRXLUNMK-BZSNNMDCSA-N Lys-Leu-Phe Chemical compound CC(C)C[C@@H](C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)O)NC(=O)[C@H](CCCCN)N XIZQPFCRXLUNMK-BZSNNMDCSA-N 0.000 description 3
- PDIDTSZKKFEDMB-UWVGGRQHSA-N Lys-Pro-Gly Chemical compound [H]N[C@@H](CCCCN)C(=O)N1CCC[C@H]1C(=O)NCC(O)=O PDIDTSZKKFEDMB-UWVGGRQHSA-N 0.000 description 3
- WQDKIVRHTQYJSN-DCAQKATOSA-N Lys-Ser-Arg Chemical compound C(CCN)C[C@@H](C(=O)N[C@@H](CO)C(=O)N[C@@H](CCCN=C(N)N)C(=O)O)N WQDKIVRHTQYJSN-DCAQKATOSA-N 0.000 description 3
- SQRLLZAQNOQCEG-KKUMJFAQSA-N Lys-Tyr-Ser Chemical compound NCCCC[C@H](N)C(=O)N[C@H](C(=O)N[C@@H](CO)C(O)=O)CC1=CC=C(O)C=C1 SQRLLZAQNOQCEG-KKUMJFAQSA-N 0.000 description 3
- YRAWWKUTNBILNT-FXQIFTODSA-N Met-Ala-Ala Chemical compound CSCC[C@H](N)C(=O)N[C@@H](C)C(=O)N[C@@H](C)C(O)=O YRAWWKUTNBILNT-FXQIFTODSA-N 0.000 description 3
- QAHFGYLFLVGBNW-DCAQKATOSA-N Met-Ala-Lys Chemical compound CSCC[C@H](N)C(=O)N[C@@H](C)C(=O)N[C@H](C(O)=O)CCCCN QAHFGYLFLVGBNW-DCAQKATOSA-N 0.000 description 3
- WGBMNLCRYKSWAR-DCAQKATOSA-N Met-Asp-Lys Chemical compound CSCC[C@H](N)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@H](C(O)=O)CCCCN WGBMNLCRYKSWAR-DCAQKATOSA-N 0.000 description 3
- SITLTJHOQZFJGG-UHFFFAOYSA-N N-L-alpha-glutamyl-L-valine Natural products CC(C)C(C(O)=O)NC(=O)C(N)CCC(O)=O SITLTJHOQZFJGG-UHFFFAOYSA-N 0.000 description 3
- 241001494479 Pecora Species 0.000 description 3
- 229930182555 Penicillin Natural products 0.000 description 3
- JGSARLDLIJGVTE-MBNYWOFBSA-N Penicillin G Chemical compound N([C@H]1[C@H]2SC([C@@H](N2C1=O)C(O)=O)(C)C)C(=O)CC1=CC=CC=C1 JGSARLDLIJGVTE-MBNYWOFBSA-N 0.000 description 3
- CGOMLCQJEMWMCE-STQMWFEESA-N Phe-Arg-Gly Chemical compound NC(N)=NCCC[C@@H](C(=O)NCC(O)=O)NC(=O)[C@@H](N)CC1=CC=CC=C1 CGOMLCQJEMWMCE-STQMWFEESA-N 0.000 description 3
- UNLYPPYNDXHGDG-IHRRRGAJSA-N Phe-Gln-Glu Chemical compound OC(=O)CC[C@@H](C(O)=O)NC(=O)[C@H](CCC(N)=O)NC(=O)[C@@H](N)CC1=CC=CC=C1 UNLYPPYNDXHGDG-IHRRRGAJSA-N 0.000 description 3
- KYYMILWEGJYPQZ-IHRRRGAJSA-N Phe-Glu-Glu Chemical compound OC(=O)CC[C@@H](C(O)=O)NC(=O)[C@H](CCC(O)=O)NC(=O)[C@@H](N)CC1=CC=CC=C1 KYYMILWEGJYPQZ-IHRRRGAJSA-N 0.000 description 3
- WPTYDQPGBMDUBI-QWRGUYRKSA-N Phe-Gly-Asn Chemical compound N[C@@H](Cc1ccccc1)C(=O)NCC(=O)N[C@@H](CC(N)=O)C(O)=O WPTYDQPGBMDUBI-QWRGUYRKSA-N 0.000 description 3
- YYKZDTVQHTUKDW-RYUDHWBXSA-N Phe-Gly-Gln Chemical compound C1=CC=C(C=C1)C[C@@H](C(=O)NCC(=O)N[C@@H](CCC(=O)N)C(=O)O)N YYKZDTVQHTUKDW-RYUDHWBXSA-N 0.000 description 3
- TXJJXEXCZBHDNA-ACRUOGEOSA-N Phe-Phe-His Chemical compound C1=CC=C(C=C1)C[C@@H](C(=O)N[C@@H](CC2=CC=CC=C2)C(=O)N[C@@H](CC3=CN=CN3)C(=O)O)N TXJJXEXCZBHDNA-ACRUOGEOSA-N 0.000 description 3
- VOHFZDSRPZLXLH-IHRRRGAJSA-N Pro-Asn-Phe Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CC1=CC=CC=C1)C(O)=O VOHFZDSRPZLXLH-IHRRRGAJSA-N 0.000 description 3
- VOZIBWWZSBIXQN-SRVKXCTJSA-N Pro-Glu-Lys Chemical compound NCCCC[C@H](NC(=O)[C@H](CCC(O)=O)NC(=O)[C@@H]1CCCN1)C(O)=O VOZIBWWZSBIXQN-SRVKXCTJSA-N 0.000 description 3
- VGVCNKSUVSZEIE-IHRRRGAJSA-N Pro-Phe-Asn Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CC(N)=O)C(O)=O VGVCNKSUVSZEIE-IHRRRGAJSA-N 0.000 description 3
- VVAWNPIOYXAMAL-KJEVXHAQSA-N Pro-Thr-Tyr Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(O)=O VVAWNPIOYXAMAL-KJEVXHAQSA-N 0.000 description 3
- IMNVAOPEMFDAQD-NHCYSSNCSA-N Pro-Val-Glu Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CCC(O)=O)C(O)=O IMNVAOPEMFDAQD-NHCYSSNCSA-N 0.000 description 3
- 108010079005 RDV peptide Proteins 0.000 description 3
- 241000700159 Rattus Species 0.000 description 3
- ZXLUWXWISXIFIX-ACZMJKKPSA-N Ser-Asn-Glu Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CCC(O)=O)C(O)=O ZXLUWXWISXIFIX-ACZMJKKPSA-N 0.000 description 3
- BPMRXBZYPGYPJN-WHFBIAKZSA-N Ser-Gly-Asn Chemical compound [H]N[C@@H](CO)C(=O)NCC(=O)N[C@@H](CC(N)=O)C(O)=O BPMRXBZYPGYPJN-WHFBIAKZSA-N 0.000 description 3
- JIPVNVNKXJLFJF-BJDJZHNGSA-N Ser-Ile-Lys Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CCCCN)C(=O)O)NC(=O)[C@H](CO)N JIPVNVNKXJLFJF-BJDJZHNGSA-N 0.000 description 3
- CRJZZXMAADSBBQ-SRVKXCTJSA-N Ser-Lys-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@H](CCCCN)NC(=O)[C@@H](N)CO CRJZZXMAADSBBQ-SRVKXCTJSA-N 0.000 description 3
- XKFJENWJGHMDLI-QWRGUYRKSA-N Ser-Phe-Gly Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)NCC(O)=O XKFJENWJGHMDLI-QWRGUYRKSA-N 0.000 description 3
- WUXCHQZLUHBSDJ-LKXGYXEUSA-N Ser-Thr-Asp Chemical compound OC[C@H](N)C(=O)N[C@@H]([C@H](O)C)C(=O)N[C@@H](CC(O)=O)C(O)=O WUXCHQZLUHBSDJ-LKXGYXEUSA-N 0.000 description 3
- FQPQPTHMHZKGFM-XQXXSGGOSA-N Thr-Ala-Glu Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](C)C(=O)N[C@@H](CCC(O)=O)C(O)=O FQPQPTHMHZKGFM-XQXXSGGOSA-N 0.000 description 3
- LVHHEVGYAZGXDE-KDXUFGMBSA-N Thr-Ala-Pro Chemical compound C[C@H]([C@@H](C(=O)N[C@@H](C)C(=O)N1CCC[C@@H]1C(=O)O)N)O LVHHEVGYAZGXDE-KDXUFGMBSA-N 0.000 description 3
- WFUAUEQXPVNAEF-ZJDVBMNYSA-N Thr-Arg-Thr Chemical compound C[C@@H](O)[C@H](N)C(=O)N[C@H](C(=O)N[C@@H]([C@@H](C)O)C(O)=O)CCCN=C(N)N WFUAUEQXPVNAEF-ZJDVBMNYSA-N 0.000 description 3
- OJRNZRROAIAHDL-LKXGYXEUSA-N Thr-Asn-Ser Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CO)C(O)=O OJRNZRROAIAHDL-LKXGYXEUSA-N 0.000 description 3
- MEJHFIOYJHTWMK-VOAKCMCISA-N Thr-Leu-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](CC(C)C)NC(=O)[C@@H](N)[C@@H](C)O MEJHFIOYJHTWMK-VOAKCMCISA-N 0.000 description 3
- ZMYCLHFLHRVOEA-HEIBUPTGSA-N Thr-Thr-Ser Chemical compound C[C@@H](O)[C@H](N)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CO)C(O)=O ZMYCLHFLHRVOEA-HEIBUPTGSA-N 0.000 description 3
- NMCBVGFGWSIGSB-NUTKFTJISA-N Trp-Ala-Leu Chemical compound C[C@@H](C(=O)N[C@@H](CC(C)C)C(=O)O)NC(=O)[C@H](CC1=CNC2=CC=CC=C21)N NMCBVGFGWSIGSB-NUTKFTJISA-N 0.000 description 3
- GTNCSPKYWCJZAC-XIRDDKMYSA-N Trp-Asp-Leu Chemical compound CC(C)C[C@@H](C(=O)O)NC(=O)[C@H](CC(=O)O)NC(=O)[C@H](CC1=CNC2=CC=CC=C21)N GTNCSPKYWCJZAC-XIRDDKMYSA-N 0.000 description 3
- YRSOERSDNRSCBC-XIRDDKMYSA-N Trp-His-Cys Chemical compound C1=CC=C2C(=C1)C(=CN2)C[C@@H](C(=O)N[C@@H](CC3=CN=CN3)C(=O)N[C@@H](CS)C(=O)O)N YRSOERSDNRSCBC-XIRDDKMYSA-N 0.000 description 3
- VPRHDRKAPYZMHL-SZMVWBNQSA-N Trp-Leu-Glu Chemical compound C1=CC=C2C(C[C@H](N)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCC(O)=O)C(O)=O)=CNC2=C1 VPRHDRKAPYZMHL-SZMVWBNQSA-N 0.000 description 3
- UJRIVCPPPMYCNA-HOCLYGCPSA-N Trp-Leu-Gly Chemical compound CC(C)C[C@@H](C(=O)NCC(=O)O)NC(=O)[C@H](CC1=CNC2=CC=CC=C21)N UJRIVCPPPMYCNA-HOCLYGCPSA-N 0.000 description 3
- DLZKEQQWXODGGZ-KWQFWETISA-N Tyr-Ala-Gly Chemical compound OC(=O)CNC(=O)[C@H](C)NC(=O)[C@@H](N)CC1=CC=C(O)C=C1 DLZKEQQWXODGGZ-KWQFWETISA-N 0.000 description 3
- CYDVHRFXDMDMGX-KKUMJFAQSA-N Tyr-Asn-His Chemical compound C1=CC(=CC=C1C[C@@H](C(=O)N[C@@H](CC(=O)N)C(=O)N[C@@H](CC2=CN=CN2)C(=O)O)N)O CYDVHRFXDMDMGX-KKUMJFAQSA-N 0.000 description 3
- QSFJHIRIHOJRKS-ULQDDVLXSA-N Tyr-Leu-Arg Chemical compound [H]N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCCNC(N)=N)C(O)=O QSFJHIRIHOJRKS-ULQDDVLXSA-N 0.000 description 3
- NKUGCYDFQKFVOJ-JYJNAYRXSA-N Tyr-Leu-Gln Chemical compound NC(=O)CC[C@@H](C(O)=O)NC(=O)[C@H](CC(C)C)NC(=O)[C@@H](N)CC1=CC=C(O)C=C1 NKUGCYDFQKFVOJ-JYJNAYRXSA-N 0.000 description 3
- DWAMXBFJNZIHMC-KBPBESRZSA-N Tyr-Leu-Gly Chemical compound [H]N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CC(C)C)C(=O)NCC(O)=O DWAMXBFJNZIHMC-KBPBESRZSA-N 0.000 description 3
- BYAKMYBZADCNMN-JYJNAYRXSA-N Tyr-Lys-Gln Chemical compound [H]N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CCC(N)=O)C(O)=O BYAKMYBZADCNMN-JYJNAYRXSA-N 0.000 description 3
- JLKVWTICWVWGSK-JYJNAYRXSA-N Tyr-Lys-Glu Chemical compound OC(=O)CC[C@@H](C(O)=O)NC(=O)[C@H](CCCCN)NC(=O)[C@@H](N)CC1=CC=C(O)C=C1 JLKVWTICWVWGSK-JYJNAYRXSA-N 0.000 description 3
- XGZBEGGGAUQBMB-KJEVXHAQSA-N Tyr-Pro-Thr Chemical compound C[C@H]([C@@H](C(=O)O)NC(=O)[C@@H]1CCCN1C(=O)[C@H](CC2=CC=C(C=C2)O)N)O XGZBEGGGAUQBMB-KJEVXHAQSA-N 0.000 description 3
- QPZMOUMNTGTEFR-ZKWXMUAHSA-N Val-Asn-Ala Chemical compound C[C@@H](C(=O)O)NC(=O)[C@H](CC(=O)N)NC(=O)[C@H](C(C)C)N QPZMOUMNTGTEFR-ZKWXMUAHSA-N 0.000 description 3
- HZYOWMGWKKRMBZ-BYULHYEWSA-N Val-Asp-Asp Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CC(=O)O)C(=O)N[C@@H](CC(=O)O)C(=O)O)N HZYOWMGWKKRMBZ-BYULHYEWSA-N 0.000 description 3
- NYTKXWLZSNRILS-IFFSRLJSSA-N Val-Gln-Thr Chemical compound C[C@H]([C@@H](C(=O)O)NC(=O)[C@H](CCC(=O)N)NC(=O)[C@H](C(C)C)N)O NYTKXWLZSNRILS-IFFSRLJSSA-N 0.000 description 3
- SZTTYWIUCGSURQ-AUTRQRHGSA-N Val-Glu-Glu Chemical compound CC(C)[C@H](N)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CCC(O)=O)C(O)=O SZTTYWIUCGSURQ-AUTRQRHGSA-N 0.000 description 3
- APQIVBCUIUDSMB-OSUNSFLBSA-N Val-Ile-Thr Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H]([C@@H](C)O)C(=O)O)NC(=O)[C@H](C(C)C)N APQIVBCUIUDSMB-OSUNSFLBSA-N 0.000 description 3
- LYERIXUFCYVFFX-GVXVVHGQSA-N Val-Leu-Glu Chemical compound CC(C)C[C@@H](C(=O)N[C@@H](CCC(=O)O)C(=O)O)NC(=O)[C@H](C(C)C)N LYERIXUFCYVFFX-GVXVVHGQSA-N 0.000 description 3
- UZFNHAXYMICTBU-DZKIICNBSA-N Val-Phe-Gln Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CCC(=O)N)C(=O)O)N UZFNHAXYMICTBU-DZKIICNBSA-N 0.000 description 3
- 108010000134 Vascular Cell Adhesion Molecule-1 Proteins 0.000 description 3
- 102100023543 Vascular cell adhesion protein 1 Human genes 0.000 description 3
- 108010081404 acein-2 Proteins 0.000 description 3
- 108010008685 alanyl-glutamyl-aspartic acid Proteins 0.000 description 3
- 108010069020 alanyl-prolyl-glycine Proteins 0.000 description 3
- 108010086434 alanyl-seryl-glycine Proteins 0.000 description 3
- 108010044940 alanylglutamine Proteins 0.000 description 3
- 108010084758 arginyl-tyrosyl-aspartic acid Proteins 0.000 description 3
- 108010069205 aspartyl-phenylalanine Proteins 0.000 description 3
- 108010093581 aspartyl-proline Proteins 0.000 description 3
- 108010047857 aspartylglycine Proteins 0.000 description 3
- 238000003556 assay Methods 0.000 description 3
- 230000001580 bacterial effect Effects 0.000 description 3
- 230000008901 benefit Effects 0.000 description 3
- 230000008499 blood brain barrier function Effects 0.000 description 3
- 210000001218 blood-brain barrier Anatomy 0.000 description 3
- 230000015556 catabolic process Effects 0.000 description 3
- 238000006243 chemical reaction Methods 0.000 description 3
- 239000003085 diluting agent Substances 0.000 description 3
- 239000012091 fetal bovine serum Substances 0.000 description 3
- 230000004077 genetic alteration Effects 0.000 description 3
- 231100000118 genetic alteration Toxicity 0.000 description 3
- 108010079547 glutamylmethionine Proteins 0.000 description 3
- 108010000434 glycyl-alanyl-leucine Proteins 0.000 description 3
- 108010067216 glycyl-glycyl-glycine Proteins 0.000 description 3
- 108010066198 glycyl-leucyl-phenylalanine Proteins 0.000 description 3
- 108010048994 glycyl-tyrosyl-alanine Proteins 0.000 description 3
- 108010059898 glycyl-tyrosyl-lysine Proteins 0.000 description 3
- 230000036541 health Effects 0.000 description 3
- 108010040030 histidinoalanine Proteins 0.000 description 3
- 230000001976 improved effect Effects 0.000 description 3
- 239000003112 inhibitor Substances 0.000 description 3
- 230000003834 intracellular effect Effects 0.000 description 3
- 108010027338 isoleucylcysteine Proteins 0.000 description 3
- 230000002147 killing effect Effects 0.000 description 3
- 108010090333 leucyl-lysyl-proline Proteins 0.000 description 3
- 108010073472 leucyl-prolyl-proline Proteins 0.000 description 3
- 108010045397 lysyl-tyrosyl-lysine Proteins 0.000 description 3
- 108010064235 lysylglycine Proteins 0.000 description 3
- 238000005259 measurement Methods 0.000 description 3
- 108091027963 non-coding RNA Proteins 0.000 description 3
- 102000042567 non-coding RNA Human genes 0.000 description 3
- 230000001936 parietal effect Effects 0.000 description 3
- 229940049954 penicillin Drugs 0.000 description 3
- 108010070409 phenylalanyl-glycyl-glycine Proteins 0.000 description 3
- 108010064486 phenylalanyl-leucyl-valine Proteins 0.000 description 3
- 230000008569 process Effects 0.000 description 3
- 108010077112 prolyl-proline Proteins 0.000 description 3
- 108010031719 prolyl-serine Proteins 0.000 description 3
- 230000009467 reduction Effects 0.000 description 3
- 230000001105 regulatory effect Effects 0.000 description 3
- 230000008439 repair process Effects 0.000 description 3
- 239000000523 sample Substances 0.000 description 3
- 238000012163 sequencing technique Methods 0.000 description 3
- 108010069117 seryl-lysyl-aspartic acid Proteins 0.000 description 3
- 238000002741 site-directed mutagenesis Methods 0.000 description 3
- 239000000243 solution Substances 0.000 description 3
- 229960005322 streptomycin Drugs 0.000 description 3
- 230000008685 targeting Effects 0.000 description 3
- 230000002103 transcriptional effect Effects 0.000 description 3
- 238000013519 translation Methods 0.000 description 3
- 108010015666 tryptophyl-leucyl-glutamic acid Proteins 0.000 description 3
- 108010045269 tryptophyltryptophan Proteins 0.000 description 3
- 108010051110 tyrosyl-lysine Proteins 0.000 description 3
- FWBHETKCLVMNFS-UHFFFAOYSA-N 4',6-Diamino-2-phenylindol Chemical compound C1=CC(C(=N)N)=CC=C1C1=CC2=CC=C(C(N)=N)C=C2N1 FWBHETKCLVMNFS-UHFFFAOYSA-N 0.000 description 2
- 241001164823 Adeno-associated virus - 7 Species 0.000 description 2
- CXRCVCURMBFFOL-FXQIFTODSA-N Ala-Ala-Pro Chemical compound C[C@H](N)C(=O)N[C@@H](C)C(=O)N1CCC[C@H]1C(O)=O CXRCVCURMBFFOL-FXQIFTODSA-N 0.000 description 2
- LWUWMHIOBPTZBA-DCAQKATOSA-N Ala-Arg-Lys Chemical compound NC(=N)NCCC[C@H](NC(=O)[C@@H](N)C)C(=O)N[C@@H](CCCCN)C(O)=O LWUWMHIOBPTZBA-DCAQKATOSA-N 0.000 description 2
- XEXJJJRVTFGWIC-FXQIFTODSA-N Ala-Asn-Arg Chemical compound C[C@@H](C(=O)N[C@@H](CC(=O)N)C(=O)N[C@@H](CCCN=C(N)N)C(=O)O)N XEXJJJRVTFGWIC-FXQIFTODSA-N 0.000 description 2
- NXSFUECZFORGOG-CIUDSAMLSA-N Ala-Asn-Leu Chemical compound [H]N[C@@H](C)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CC(C)C)C(O)=O NXSFUECZFORGOG-CIUDSAMLSA-N 0.000 description 2
- IKKVASZHTMKJIR-ZKWXMUAHSA-N Ala-Asp-Val Chemical compound [H]N[C@@H](C)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](C(C)C)C(O)=O IKKVASZHTMKJIR-ZKWXMUAHSA-N 0.000 description 2
- FVSOUJZKYWEFOB-KBIXCLLPSA-N Ala-Gln-Ile Chemical compound CC[C@H](C)[C@@H](C(O)=O)NC(=O)[C@H](CCC(N)=O)NC(=O)[C@H](C)N FVSOUJZKYWEFOB-KBIXCLLPSA-N 0.000 description 2
- CZPAHAKGPDUIPJ-CIUDSAMLSA-N Ala-Gln-Pro Chemical compound C[C@H](N)C(=O)N[C@@H](CCC(N)=O)C(=O)N1CCC[C@H]1C(O)=O CZPAHAKGPDUIPJ-CIUDSAMLSA-N 0.000 description 2
- MVBWLRJESQOQTM-ACZMJKKPSA-N Ala-Gln-Ser Chemical compound [H]N[C@@H](C)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CO)C(O)=O MVBWLRJESQOQTM-ACZMJKKPSA-N 0.000 description 2
- YIGLXQRFQVWFEY-NRPADANISA-N Ala-Gln-Val Chemical compound [H]N[C@@H](C)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](C(C)C)C(O)=O YIGLXQRFQVWFEY-NRPADANISA-N 0.000 description 2
- NWVVKQZOVSTDBQ-CIUDSAMLSA-N Ala-Glu-Arg Chemical compound [H]N[C@@H](C)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CCCNC(N)=N)C(O)=O NWVVKQZOVSTDBQ-CIUDSAMLSA-N 0.000 description 2
- NJPMYXWVWQWCSR-ACZMJKKPSA-N Ala-Glu-Asn Chemical compound C[C@H](N)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(N)=O)C(O)=O NJPMYXWVWQWCSR-ACZMJKKPSA-N 0.000 description 2
- LMFXXZPPZDCPTA-ZKWXMUAHSA-N Ala-Gly-Ile Chemical compound CC[C@H](C)[C@@H](C(O)=O)NC(=O)CNC(=O)[C@H](C)N LMFXXZPPZDCPTA-ZKWXMUAHSA-N 0.000 description 2
- GRPHQEMIFDPKOE-HGNGGELXSA-N Ala-His-Glu Chemical compound [H]N[C@@H](C)C(=O)N[C@@H](CC1=CNC=N1)C(=O)N[C@@H](CCC(O)=O)C(O)=O GRPHQEMIFDPKOE-HGNGGELXSA-N 0.000 description 2
- ZBLQIYPCUWZSRZ-QEJZJMRPSA-N Ala-Phe-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@@H](NC(=O)[C@H](C)N)CC1=CC=CC=C1 ZBLQIYPCUWZSRZ-QEJZJMRPSA-N 0.000 description 2
- YHBDGLZYNIARKJ-GUBZILKMSA-N Ala-Pro-Val Chemical compound CC(C)[C@@H](C(O)=O)NC(=O)[C@@H]1CCCN1C(=O)[C@H](C)N YHBDGLZYNIARKJ-GUBZILKMSA-N 0.000 description 2
- NHWYNIZWLJYZAG-XVYDVKMFSA-N Ala-Ser-His Chemical compound C[C@@H](C(=O)N[C@@H](CO)C(=O)N[C@@H](CC1=CN=CN1)C(=O)O)N NHWYNIZWLJYZAG-XVYDVKMFSA-N 0.000 description 2
- HOVPGJUNRLMIOZ-CIUDSAMLSA-N Ala-Ser-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](CO)NC(=O)[C@H](C)N HOVPGJUNRLMIOZ-CIUDSAMLSA-N 0.000 description 2
- LSMDIAAALJJLRO-XQXXSGGOSA-N Ala-Thr-Glu Chemical compound [H]N[C@@H](C)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCC(O)=O)C(O)=O LSMDIAAALJJLRO-XQXXSGGOSA-N 0.000 description 2
- IOFVWPYSRSCWHI-JXUBOQSCSA-N Ala-Thr-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H]([C@@H](C)O)NC(=O)[C@H](C)N IOFVWPYSRSCWHI-JXUBOQSCSA-N 0.000 description 2
- IETUUAHKCHOQHP-KZVJFYERSA-N Ala-Thr-Val Chemical compound CC(C)[C@H](NC(=O)[C@@H](NC(=O)[C@H](C)N)[C@@H](C)O)C(O)=O IETUUAHKCHOQHP-KZVJFYERSA-N 0.000 description 2
- JNJHNBXBGNJESC-KKXDTOCCSA-N Ala-Tyr-Phe Chemical compound [H]N[C@@H](C)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CC1=CC=CC=C1)C(O)=O JNJHNBXBGNJESC-KKXDTOCCSA-N 0.000 description 2
- QRIYOHQJRDHFKF-UWJYBYFXSA-N Ala-Tyr-Ser Chemical compound OC[C@@H](C(O)=O)NC(=O)[C@@H](NC(=O)[C@@H](N)C)CC1=CC=C(O)C=C1 QRIYOHQJRDHFKF-UWJYBYFXSA-N 0.000 description 2
- XSLGWYYNOSUMRM-ZKWXMUAHSA-N Ala-Val-Asn Chemical compound [H]N[C@@H](C)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CC(N)=O)C(O)=O XSLGWYYNOSUMRM-ZKWXMUAHSA-N 0.000 description 2
- 102000006941 Amino Acid Transport System X-AG Human genes 0.000 description 2
- 108010008063 Amino Acid Transport System X-AG Proteins 0.000 description 2
- 208000002267 Anti-neutrophil cytoplasmic antibody-associated vasculitis Diseases 0.000 description 2
- MUXONAMCEUBVGA-DCAQKATOSA-N Arg-Arg-Gln Chemical compound NC(N)=NCCC[C@H](N)C(=O)N[C@@H](CCCN=C(N)N)C(=O)N[C@@H](CCC(N)=O)C(O)=O MUXONAMCEUBVGA-DCAQKATOSA-N 0.000 description 2
- IIABBYGHLYWVOS-FXQIFTODSA-N Arg-Asn-Ser Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CO)C(O)=O IIABBYGHLYWVOS-FXQIFTODSA-N 0.000 description 2
- RRGPUNYIPJXJBU-GUBZILKMSA-N Arg-Asp-Met Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CCSC)C(O)=O RRGPUNYIPJXJBU-GUBZILKMSA-N 0.000 description 2
- TTXYKSADPSNOIF-IHRRRGAJSA-N Arg-Asp-Phe Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CC1=CC=CC=C1)C(O)=O TTXYKSADPSNOIF-IHRRRGAJSA-N 0.000 description 2
- JCAISGGAOQXEHJ-ZPFDUUQYSA-N Arg-Gln-Ile Chemical compound CC[C@H](C)[C@@H](C(=O)O)NC(=O)[C@H](CCC(=O)N)NC(=O)[C@H](CCCN=C(N)N)N JCAISGGAOQXEHJ-ZPFDUUQYSA-N 0.000 description 2
- QAODJPUKWNNNRP-DCAQKATOSA-N Arg-Glu-Arg Chemical compound NC(N)=NCCC[C@H](N)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CCCN=C(N)N)C(O)=O QAODJPUKWNNNRP-DCAQKATOSA-N 0.000 description 2
- RKRSYHCNPFGMTA-CIUDSAMLSA-N Arg-Glu-Asn Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(N)=O)C(O)=O RKRSYHCNPFGMTA-CIUDSAMLSA-N 0.000 description 2
- MZRBYBIQTIKERR-GUBZILKMSA-N Arg-Glu-Gln Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CCC(N)=O)C(O)=O MZRBYBIQTIKERR-GUBZILKMSA-N 0.000 description 2
- GOWZVQXTHUCNSQ-NHCYSSNCSA-N Arg-Glu-Val Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](C(C)C)C(O)=O GOWZVQXTHUCNSQ-NHCYSSNCSA-N 0.000 description 2
- RKQRHMKFNBYOTN-IHRRRGAJSA-N Arg-His-Lys Chemical compound C1=C(NC=N1)C[C@@H](C(=O)N[C@@H](CCCCN)C(=O)O)NC(=O)[C@H](CCCN=C(N)N)N RKQRHMKFNBYOTN-IHRRRGAJSA-N 0.000 description 2
- MJINRRBEMOLJAK-DCAQKATOSA-N Arg-Lys-Asp Chemical compound OC(=O)C[C@@H](C(O)=O)NC(=O)[C@H](CCCCN)NC(=O)[C@@H](N)CCCN=C(N)N MJINRRBEMOLJAK-DCAQKATOSA-N 0.000 description 2
- GRRXPUAICOGISM-RWMBFGLXSA-N Arg-Lys-Pro Chemical compound C1C[C@@H](N(C1)C(=O)[C@H](CCCCN)NC(=O)[C@H](CCCN=C(N)N)N)C(=O)O GRRXPUAICOGISM-RWMBFGLXSA-N 0.000 description 2
- PAPSMOYMQDWIOR-AVGNSLFASA-N Arg-Lys-Val Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](C(C)C)C(O)=O PAPSMOYMQDWIOR-AVGNSLFASA-N 0.000 description 2
- PYZPXCZNQSEHDT-GUBZILKMSA-N Arg-Met-Asn Chemical compound CSCC[C@@H](C(=O)N[C@@H](CC(=O)N)C(=O)O)NC(=O)[C@H](CCCN=C(N)N)N PYZPXCZNQSEHDT-GUBZILKMSA-N 0.000 description 2
- KSUALAGYYLQSHJ-RCWTZXSCSA-N Arg-Met-Thr Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CCSC)C(=O)N[C@@H]([C@@H](C)O)C(O)=O KSUALAGYYLQSHJ-RCWTZXSCSA-N 0.000 description 2
- CZUHPNLXLWMYMG-UBHSHLNASA-N Arg-Phe-Ala Chemical compound NC(N)=NCCC[C@H](N)C(=O)N[C@H](C(=O)N[C@@H](C)C(O)=O)CC1=CC=CC=C1 CZUHPNLXLWMYMG-UBHSHLNASA-N 0.000 description 2
- YTMKMRSYXHBGER-IHRRRGAJSA-N Arg-Phe-Asn Chemical compound C1=CC=C(C=C1)C[C@@H](C(=O)N[C@@H](CC(=O)N)C(=O)O)NC(=O)[C@H](CCCN=C(N)N)N YTMKMRSYXHBGER-IHRRRGAJSA-N 0.000 description 2
- NGYHSXDNNOFHNE-AVGNSLFASA-N Arg-Pro-Leu Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N1CCC[C@H]1C(=O)N[C@@H](CC(C)C)C(O)=O NGYHSXDNNOFHNE-AVGNSLFASA-N 0.000 description 2
- CGWVCWFQGXOUSJ-ULQDDVLXSA-N Arg-Tyr-Leu Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CC(C)C)C(O)=O CGWVCWFQGXOUSJ-ULQDDVLXSA-N 0.000 description 2
- FMYQECOAIFGQGU-CYDGBPFRSA-N Arg-Val-Ile Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O FMYQECOAIFGQGU-CYDGBPFRSA-N 0.000 description 2
- 108091026821 Artificial microRNA Proteins 0.000 description 2
- KXFCBAHYSLJCCY-ZLUOBGJFSA-N Asn-Asn-Ser Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CO)C(O)=O KXFCBAHYSLJCCY-ZLUOBGJFSA-N 0.000 description 2
- HCAUEJAQCXVQQM-ACZMJKKPSA-N Asn-Glu-Asp Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(O)=O)C(O)=O HCAUEJAQCXVQQM-ACZMJKKPSA-N 0.000 description 2
- QYXNFROWLZPWPC-FXQIFTODSA-N Asn-Glu-Gln Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CCC(N)=O)C(O)=O QYXNFROWLZPWPC-FXQIFTODSA-N 0.000 description 2
- BZMWJLLUAKSIMH-FXQIFTODSA-N Asn-Glu-Glu Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CCC(O)=O)C(O)=O BZMWJLLUAKSIMH-FXQIFTODSA-N 0.000 description 2
- SPCONPVIDFMDJI-QSFUFRPTSA-N Asn-Ile-Val Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](C(C)C)C(O)=O SPCONPVIDFMDJI-QSFUFRPTSA-N 0.000 description 2
- FHETWELNCBMRMG-HJGDQZAQSA-N Asn-Leu-Thr Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H]([C@@H](C)O)C(O)=O FHETWELNCBMRMG-HJGDQZAQSA-N 0.000 description 2
- FTSAJSADJCMDHH-CIUDSAMLSA-N Asn-Lys-Asp Chemical compound C(CCN)C[C@@H](C(=O)N[C@@H](CC(=O)O)C(=O)O)NC(=O)[C@H](CC(=O)N)N FTSAJSADJCMDHH-CIUDSAMLSA-N 0.000 description 2
- LSJQOMAZIKQMTJ-SRVKXCTJSA-N Asn-Phe-Asp Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CC(O)=O)C(O)=O LSJQOMAZIKQMTJ-SRVKXCTJSA-N 0.000 description 2
- RAUPFUCUDBQYHE-AVGNSLFASA-N Asn-Phe-Glu Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CCC(O)=O)C(O)=O RAUPFUCUDBQYHE-AVGNSLFASA-N 0.000 description 2
- HZZIFFOVHLWGCS-KKUMJFAQSA-N Asn-Phe-Leu Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CC(C)C)C(O)=O HZZIFFOVHLWGCS-KKUMJFAQSA-N 0.000 description 2
- YUUIAUXBNOHFRJ-IHRRRGAJSA-N Asn-Phe-Met Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CCSC)C(O)=O YUUIAUXBNOHFRJ-IHRRRGAJSA-N 0.000 description 2
- GKKUBLFXKRDMFC-BQBZGAKWSA-N Asn-Pro-Gly Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N1CCC[C@H]1C(=O)NCC(O)=O GKKUBLFXKRDMFC-BQBZGAKWSA-N 0.000 description 2
- VHQSGALUSWIYOD-QXEWZRGKSA-N Asn-Pro-Val Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N1CCC[C@H]1C(=O)N[C@@H](C(C)C)C(O)=O VHQSGALUSWIYOD-QXEWZRGKSA-N 0.000 description 2
- DAYDURRBMDCCFL-AAEUAGOBSA-N Asn-Trp-Gly Chemical compound C1=CC=C2C(=C1)C(=CN2)C[C@@H](C(=O)NCC(=O)O)NC(=O)[C@H](CC(=O)N)N DAYDURRBMDCCFL-AAEUAGOBSA-N 0.000 description 2
- KTDWFWNZLLFEFU-KKUMJFAQSA-N Asn-Tyr-His Chemical compound C1=CC(=CC=C1C[C@@H](C(=O)N[C@@H](CC2=CN=CN2)C(=O)O)NC(=O)[C@H](CC(=O)N)N)O KTDWFWNZLLFEFU-KKUMJFAQSA-N 0.000 description 2
- CGYKCTPUGXFPMG-IHPCNDPISA-N Asn-Tyr-Trp Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CC1=CNC2=C1C=CC=C2)C(O)=O CGYKCTPUGXFPMG-IHPCNDPISA-N 0.000 description 2
- BLQBMRNMBAYREH-UWJYBYFXSA-N Asp-Ala-Tyr Chemical compound N[C@@H](CC(O)=O)C(=O)N[C@@H](C)C(=O)N[C@@H](CC1=CC=C(C=C1)O)C(=O)O BLQBMRNMBAYREH-UWJYBYFXSA-N 0.000 description 2
- ZLGKHJHFYSRUBH-FXQIFTODSA-N Asp-Arg-Asp Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC(O)=O)C(O)=O ZLGKHJHFYSRUBH-FXQIFTODSA-N 0.000 description 2
- WSOKZUVWBXVJHX-CIUDSAMLSA-N Asp-Arg-Glu Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CCC(O)=O)C(O)=O WSOKZUVWBXVJHX-CIUDSAMLSA-N 0.000 description 2
- IXIWEFWRKIUMQX-DCAQKATOSA-N Asp-Arg-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](CCCN=C(N)N)NC(=O)[C@@H](N)CC(O)=O IXIWEFWRKIUMQX-DCAQKATOSA-N 0.000 description 2
- RDRMWJBLOSRRAW-BYULHYEWSA-N Asp-Asn-Val Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](C(C)C)C(O)=O RDRMWJBLOSRRAW-BYULHYEWSA-N 0.000 description 2
- QXHVOUSPVAWEMX-ZLUOBGJFSA-N Asp-Asp-Ser Chemical compound OC(=O)C[C@H](N)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CO)C(O)=O QXHVOUSPVAWEMX-ZLUOBGJFSA-N 0.000 description 2
- VILLWIDTHYPSLC-PEFMBERDSA-N Asp-Glu-Ile Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O VILLWIDTHYPSLC-PEFMBERDSA-N 0.000 description 2
- TVIZQBFURPLQDV-DJFWLOJKSA-N Asp-His-Ile Chemical compound CC[C@H](C)[C@@H](C(=O)O)NC(=O)[C@H](CC1=CN=CN1)NC(=O)[C@H](CC(=O)O)N TVIZQBFURPLQDV-DJFWLOJKSA-N 0.000 description 2
- CYCKJEFVFNRWEZ-UGYAYLCHSA-N Asp-Ile-Asn Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CC(N)=O)C(O)=O CYCKJEFVFNRWEZ-UGYAYLCHSA-N 0.000 description 2
- SEMWSADZTMJELF-BYULHYEWSA-N Asp-Ile-Gly Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H]([C@@H](C)CC)C(=O)NCC(O)=O SEMWSADZTMJELF-BYULHYEWSA-N 0.000 description 2
- KYQNAIMCTRZLNP-QSFUFRPTSA-N Asp-Ile-Val Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](C(C)C)C(O)=O KYQNAIMCTRZLNP-QSFUFRPTSA-N 0.000 description 2
- XWSIYTYNLKCLJB-CIUDSAMLSA-N Asp-Lys-Asn Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CC(N)=O)C(O)=O XWSIYTYNLKCLJB-CIUDSAMLSA-N 0.000 description 2
- LBOVBQONZJRWPV-YUMQZZPRSA-N Asp-Lys-Gly Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](CCCCN)C(=O)NCC(O)=O LBOVBQONZJRWPV-YUMQZZPRSA-N 0.000 description 2
- MYLZFUMPZCPJCJ-NHCYSSNCSA-N Asp-Lys-Val Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](C(C)C)C(O)=O MYLZFUMPZCPJCJ-NHCYSSNCSA-N 0.000 description 2
- IDDMGSKZQDEDGA-SRVKXCTJSA-N Asp-Phe-Asn Chemical compound OC(=O)C[C@H](N)C(=O)N[C@H](C(=O)N[C@@H](CC(N)=O)C(O)=O)CC1=CC=CC=C1 IDDMGSKZQDEDGA-SRVKXCTJSA-N 0.000 description 2
- ZVGRHIRJLWBWGJ-ACZMJKKPSA-N Asp-Ser-Gln Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](CO)C(=O)N[C@@H](CCC(N)=O)C(O)=O ZVGRHIRJLWBWGJ-ACZMJKKPSA-N 0.000 description 2
- OYSYWMMZGJSQRB-AVGNSLFASA-N Asp-Tyr-Gln Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CCC(N)=O)C(O)=O OYSYWMMZGJSQRB-AVGNSLFASA-N 0.000 description 2
- BJDHEININLSZOT-KKUMJFAQSA-N Asp-Tyr-Lys Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CCCCN)C(O)=O BJDHEININLSZOT-KKUMJFAQSA-N 0.000 description 2
- SQIARYGNVQWOSB-BZSNNMDCSA-N Asp-Tyr-Phe Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CC1=CC=CC=C1)C(O)=O SQIARYGNVQWOSB-BZSNNMDCSA-N 0.000 description 2
- 108010027344 Basic Helix-Loop-Helix Transcription Factors Proteins 0.000 description 2
- 102000018720 Basic Helix-Loop-Helix Transcription Factors Human genes 0.000 description 2
- 125000001433 C-terminal amino-acid group Chemical group 0.000 description 2
- 241000282832 Camelidae Species 0.000 description 2
- 238000007702 DNA assembly Methods 0.000 description 2
- 206010012289 Dementia Diseases 0.000 description 2
- 206010061818 Disease progression Diseases 0.000 description 2
- 238000002965 ELISA Methods 0.000 description 2
- 241000283086 Equidae Species 0.000 description 2
- 102000002140 Fatty Acid-Binding Protein 7 Human genes 0.000 description 2
- 108010001387 Fatty Acid-Binding Protein 7 Proteins 0.000 description 2
- 241000282326 Felis catus Species 0.000 description 2
- LJEPDHWNQXPXMM-NHCYSSNCSA-N Gln-Arg-Val Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](C(C)C)C(O)=O LJEPDHWNQXPXMM-NHCYSSNCSA-N 0.000 description 2
- ZPDVKYLJTOFQJV-WDSKDSINSA-N Gln-Asn-Gly Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H](CC(N)=O)C(=O)NCC(O)=O ZPDVKYLJTOFQJV-WDSKDSINSA-N 0.000 description 2
- SNLOOPZHAQDMJG-CIUDSAMLSA-N Gln-Glu-Glu Chemical compound NC(=O)CC[C@H](N)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CCC(O)=O)C(O)=O SNLOOPZHAQDMJG-CIUDSAMLSA-N 0.000 description 2
- KDXKFBSNIJYNNR-YVNDNENWSA-N Gln-Glu-Ile Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O KDXKFBSNIJYNNR-YVNDNENWSA-N 0.000 description 2
- PNENQZWRFMUZOM-DCAQKATOSA-N Gln-Glu-Leu Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(C)C)C(O)=O PNENQZWRFMUZOM-DCAQKATOSA-N 0.000 description 2
- NSORZJXKUQFEKL-JGVFFNPUSA-N Gln-Gly-Pro Chemical compound C1C[C@@H](N(C1)C(=O)CNC(=O)[C@H](CCC(=O)N)N)C(=O)O NSORZJXKUQFEKL-JGVFFNPUSA-N 0.000 description 2
- NNXIQPMZGZUFJJ-AVGNSLFASA-N Gln-His-Lys Chemical compound C1=C(NC=N1)C[C@@H](C(=O)N[C@@H](CCCCN)C(=O)O)NC(=O)[C@H](CCC(=O)N)N NNXIQPMZGZUFJJ-AVGNSLFASA-N 0.000 description 2
- GIVHPCWYVWUUSG-HVTMNAMFSA-N Gln-Ile-His Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CC1=CN=CN1)C(=O)O)NC(=O)[C@H](CCC(=O)N)N GIVHPCWYVWUUSG-HVTMNAMFSA-N 0.000 description 2
- PSERKXGRRADTKA-MNXVOIDGSA-N Gln-Leu-Ile Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O PSERKXGRRADTKA-MNXVOIDGSA-N 0.000 description 2
- IULKWYSYZSURJK-AVGNSLFASA-N Gln-Leu-Lys Chemical compound NC(=O)CC[C@H](N)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCCCN)C(O)=O IULKWYSYZSURJK-AVGNSLFASA-N 0.000 description 2
- OREPWMPAUWIIAM-ZPFDUUQYSA-N Gln-Pro-Ile Chemical compound CC[C@H](C)[C@@H](C(=O)O)NC(=O)[C@@H]1CCCN1C(=O)[C@H](CCC(=O)N)N OREPWMPAUWIIAM-ZPFDUUQYSA-N 0.000 description 2
- OSCLNNWLKKIQJM-WDSKDSINSA-N Gln-Ser-Gly Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H](CO)C(=O)NCC(O)=O OSCLNNWLKKIQJM-WDSKDSINSA-N 0.000 description 2
- SGVGIVDZLSHSEN-RYUDHWBXSA-N Gln-Tyr-Gly Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)NCC(O)=O SGVGIVDZLSHSEN-RYUDHWBXSA-N 0.000 description 2
- JKDBRTNMYXYLHO-JYJNAYRXSA-N Gln-Tyr-Leu Chemical compound NC(=O)CC[C@H](N)C(=O)N[C@H](C(=O)N[C@@H](CC(C)C)C(O)=O)CC1=CC=C(O)C=C1 JKDBRTNMYXYLHO-JYJNAYRXSA-N 0.000 description 2
- UBRQJXFDVZNYJP-AVGNSLFASA-N Gln-Tyr-Ser Chemical compound C1=CC(=CC=C1C[C@@H](C(=O)N[C@@H](CO)C(=O)O)NC(=O)[C@H](CCC(=O)N)N)O UBRQJXFDVZNYJP-AVGNSLFASA-N 0.000 description 2
- MKRDNSWGJWTBKZ-GVXVVHGQSA-N Gln-Val-Lys Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CCCCN)C(=O)O)NC(=O)[C@H](CCC(=O)N)N MKRDNSWGJWTBKZ-GVXVVHGQSA-N 0.000 description 2
- ZMXZGYLINVNTKH-DZKIICNBSA-N Gln-Val-Phe Chemical compound NC(=O)CC[C@H](N)C(=O)N[C@@H](C(C)C)C(=O)N[C@H](C(O)=O)CC1=CC=CC=C1 ZMXZGYLINVNTKH-DZKIICNBSA-N 0.000 description 2
- JJKKWYQVHRUSDG-GUBZILKMSA-N Glu-Ala-Lys Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](C)C(=O)N[C@@H](CCCCN)C(O)=O JJKKWYQVHRUSDG-GUBZILKMSA-N 0.000 description 2
- KKCUFHUTMKQQCF-SRVKXCTJSA-N Glu-Arg-Leu Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC(C)C)C(O)=O KKCUFHUTMKQQCF-SRVKXCTJSA-N 0.000 description 2
- YKLNMGJYMNPBCP-ACZMJKKPSA-N Glu-Asn-Asp Chemical compound C(CC(=O)O)[C@@H](C(=O)N[C@@H](CC(=O)N)C(=O)N[C@@H](CC(=O)O)C(=O)O)N YKLNMGJYMNPBCP-ACZMJKKPSA-N 0.000 description 2
- CKRUHITYRFNUKW-WDSKDSINSA-N Glu-Asn-Gly Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(N)=O)C(=O)NCC(O)=O CKRUHITYRFNUKW-WDSKDSINSA-N 0.000 description 2
- PAQUJCSYVIBPLC-AVGNSLFASA-N Glu-Asp-Phe Chemical compound OC(=O)CC[C@H](N)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@H](C(O)=O)CC1=CC=CC=C1 PAQUJCSYVIBPLC-AVGNSLFASA-N 0.000 description 2
- ZXQPJYWZSFGWJB-AVGNSLFASA-N Glu-Cys-Phe Chemical compound C1=CC=C(C=C1)C[C@@H](C(=O)O)NC(=O)[C@H](CS)NC(=O)[C@H](CCC(=O)O)N ZXQPJYWZSFGWJB-AVGNSLFASA-N 0.000 description 2
- SJPMNHCEWPTRBR-BQBZGAKWSA-N Glu-Glu-Gly Chemical compound OC(=O)CC[C@H](N)C(=O)N[C@@H](CCC(O)=O)C(=O)NCC(O)=O SJPMNHCEWPTRBR-BQBZGAKWSA-N 0.000 description 2
- AUTNXSQEVVHSJK-YVNDNENWSA-N Glu-Glu-Ile Chemical compound CC[C@H](C)[C@@H](C(O)=O)NC(=O)[C@H](CCC(O)=O)NC(=O)[C@@H](N)CCC(O)=O AUTNXSQEVVHSJK-YVNDNENWSA-N 0.000 description 2
- VOORMNJKNBGYGK-YUMQZZPRSA-N Glu-Gly-Met Chemical compound CSCC[C@@H](C(=O)O)NC(=O)CNC(=O)[C@H](CCC(=O)O)N VOORMNJKNBGYGK-YUMQZZPRSA-N 0.000 description 2
- CXRWMMRLEMVSEH-PEFMBERDSA-N Glu-Ile-Asn Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CC(N)=O)C(O)=O CXRWMMRLEMVSEH-PEFMBERDSA-N 0.000 description 2
- VGUYMZGLJUJRBV-YVNDNENWSA-N Glu-Ile-Glu Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CCC(O)=O)C(O)=O VGUYMZGLJUJRBV-YVNDNENWSA-N 0.000 description 2
- HVYWQYLBVXMXSV-GUBZILKMSA-N Glu-Leu-Ala Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](C)C(O)=O HVYWQYLBVXMXSV-GUBZILKMSA-N 0.000 description 2
- DNPCBMNFQVTHMA-DCAQKATOSA-N Glu-Leu-Gln Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCC(N)=O)C(O)=O DNPCBMNFQVTHMA-DCAQKATOSA-N 0.000 description 2
- NJCALAAIGREHDR-WDCWCFNPSA-N Glu-Leu-Thr Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H]([C@@H](C)O)C(O)=O NJCALAAIGREHDR-WDCWCFNPSA-N 0.000 description 2
- ILWHFUZZCFYSKT-AVGNSLFASA-N Glu-Lys-Leu Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CC(C)C)C(O)=O ILWHFUZZCFYSKT-AVGNSLFASA-N 0.000 description 2
- ZGEJRLJEAMPEDV-SRVKXCTJSA-N Glu-Lys-Met Chemical compound CSCC[C@@H](C(=O)O)NC(=O)[C@H](CCCCN)NC(=O)[C@H](CCC(=O)O)N ZGEJRLJEAMPEDV-SRVKXCTJSA-N 0.000 description 2
- ZQYZDDXTNQXUJH-CIUDSAMLSA-N Glu-Met-Ala Chemical compound C[C@@H](C(=O)O)NC(=O)[C@H](CCSC)NC(=O)[C@H](CCC(=O)O)N ZQYZDDXTNQXUJH-CIUDSAMLSA-N 0.000 description 2
- SYAYROHMAIHWFB-KBIXCLLPSA-N Glu-Ser-Ile Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](CO)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O SYAYROHMAIHWFB-KBIXCLLPSA-N 0.000 description 2
- DMYACXMQUABZIQ-NRPADANISA-N Glu-Ser-Val Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](CO)C(=O)N[C@@H](C(C)C)C(O)=O DMYACXMQUABZIQ-NRPADANISA-N 0.000 description 2
- TWYSSILQABLLME-HJGDQZAQSA-N Glu-Thr-Arg Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCCNC(N)=N)C(O)=O TWYSSILQABLLME-HJGDQZAQSA-N 0.000 description 2
- RGJKYNUINKGPJN-RWRJDSDZSA-N Glu-Thr-Ile Chemical compound CC[C@H](C)[C@@H](C(=O)O)NC(=O)[C@H]([C@@H](C)O)NC(=O)[C@H](CCC(=O)O)N RGJKYNUINKGPJN-RWRJDSDZSA-N 0.000 description 2
- ZYRXTRTUCAVNBQ-GVXVVHGQSA-N Glu-Val-Lys Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CCCCN)C(=O)O)NC(=O)[C@H](CCC(=O)O)N ZYRXTRTUCAVNBQ-GVXVVHGQSA-N 0.000 description 2
- WGYHAAXZWPEBDQ-IFFSRLJSSA-N Glu-Val-Thr Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H]([C@@H](C)O)C(O)=O WGYHAAXZWPEBDQ-IFFSRLJSSA-N 0.000 description 2
- SOYWRINXUSUWEQ-DLOVCJGASA-N Glu-Val-Val Chemical compound CC(C)[C@@H](C(O)=O)NC(=O)[C@H](C(C)C)NC(=O)[C@@H](N)CCC(O)=O SOYWRINXUSUWEQ-DLOVCJGASA-N 0.000 description 2
- WHUUTDBJXJRKMK-UHFFFAOYSA-N Glutamic acid Natural products OC(=O)C(N)CCC(O)=O WHUUTDBJXJRKMK-UHFFFAOYSA-N 0.000 description 2
- OVSKVOOUFAKODB-UWVGGRQHSA-N Gly-Arg-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@@H](NC(=O)CN)CCCN=C(N)N OVSKVOOUFAKODB-UWVGGRQHSA-N 0.000 description 2
- XCLCVBYNGXEVDU-WHFBIAKZSA-N Gly-Asn-Ser Chemical compound NCC(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CO)C(O)=O XCLCVBYNGXEVDU-WHFBIAKZSA-N 0.000 description 2
- PMNHJLASAAWELO-FOHZUACHSA-N Gly-Asp-Thr Chemical compound [H]NCC(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H]([C@@H](C)O)C(O)=O PMNHJLASAAWELO-FOHZUACHSA-N 0.000 description 2
- IXKRSKPKSLXIHN-YUMQZZPRSA-N Gly-Cys-Leu Chemical compound [H]NCC(=O)N[C@@H](CS)C(=O)N[C@@H](CC(C)C)C(O)=O IXKRSKPKSLXIHN-YUMQZZPRSA-N 0.000 description 2
- YYPFZVIXAVDHIK-IUCAKERBSA-N Gly-Glu-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](CCC(O)=O)NC(=O)CN YYPFZVIXAVDHIK-IUCAKERBSA-N 0.000 description 2
- BEQGFMIBZFNROK-JGVFFNPUSA-N Gly-Glu-Pro Chemical compound C1C[C@@H](N(C1)C(=O)[C@H](CCC(=O)O)NC(=O)CN)C(=O)O BEQGFMIBZFNROK-JGVFFNPUSA-N 0.000 description 2
- CCQOOWAONKGYKQ-BYPYZUCNSA-N Gly-Gly-Ala Chemical compound OC(=O)[C@H](C)NC(=O)CNC(=O)CN CCQOOWAONKGYKQ-BYPYZUCNSA-N 0.000 description 2
- UFPXDFOYHVEIPI-BYPYZUCNSA-N Gly-Gly-Asp Chemical compound NCC(=O)NCC(=O)N[C@H](C(O)=O)CC(O)=O UFPXDFOYHVEIPI-BYPYZUCNSA-N 0.000 description 2
- XPJBQTCXPJNIFE-ZETCQYMHSA-N Gly-Gly-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)CNC(=O)CN XPJBQTCXPJNIFE-ZETCQYMHSA-N 0.000 description 2
- YWAQATDNEKZFFK-BYPYZUCNSA-N Gly-Gly-Ser Chemical compound NCC(=O)NCC(=O)N[C@@H](CO)C(O)=O YWAQATDNEKZFFK-BYPYZUCNSA-N 0.000 description 2
- SXJHOPPTOJACOA-QXEWZRGKSA-N Gly-Ile-Arg Chemical compound NCC(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@H](C(O)=O)CCCN=C(N)N SXJHOPPTOJACOA-QXEWZRGKSA-N 0.000 description 2
- SCWYHUQOOFRVHP-MBLNEYKQSA-N Gly-Ile-Thr Chemical compound NCC(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H]([C@@H](C)O)C(O)=O SCWYHUQOOFRVHP-MBLNEYKQSA-N 0.000 description 2
- AFWYPMDMDYCKMD-KBPBESRZSA-N Gly-Leu-Tyr Chemical compound NCC(=O)N[C@@H](CC(C)C)C(=O)N[C@H](C(O)=O)CC1=CC=C(O)C=C1 AFWYPMDMDYCKMD-KBPBESRZSA-N 0.000 description 2
- VBOBNHSVQKKTOT-YUMQZZPRSA-N Gly-Lys-Ala Chemical compound [H]NCC(=O)N[C@@H](CCCCN)C(=O)N[C@@H](C)C(O)=O VBOBNHSVQKKTOT-YUMQZZPRSA-N 0.000 description 2
- FXGRXIATVXUAHO-WEDXCCLWSA-N Gly-Lys-Thr Chemical compound C[C@@H](O)[C@@H](C(O)=O)NC(=O)[C@@H](NC(=O)CN)CCCCN FXGRXIATVXUAHO-WEDXCCLWSA-N 0.000 description 2
- GAFKBWKVXNERFA-QWRGUYRKSA-N Gly-Phe-Asp Chemical compound OC(=O)C[C@@H](C(O)=O)NC(=O)[C@@H](NC(=O)CN)CC1=CC=CC=C1 GAFKBWKVXNERFA-QWRGUYRKSA-N 0.000 description 2
- QSQXZZCGPXQBPP-BQBZGAKWSA-N Gly-Pro-Cys Chemical compound C1C[C@H](N(C1)C(=O)CN)C(=O)N[C@@H](CS)C(=O)O QSQXZZCGPXQBPP-BQBZGAKWSA-N 0.000 description 2
- CSMYMGFCEJWALV-WDSKDSINSA-N Gly-Ser-Gln Chemical compound NCC(=O)N[C@@H](CO)C(=O)N[C@H](C(O)=O)CCC(N)=O CSMYMGFCEJWALV-WDSKDSINSA-N 0.000 description 2
- WNGHUXFWEWTKAO-YUMQZZPRSA-N Gly-Ser-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](CO)NC(=O)CN WNGHUXFWEWTKAO-YUMQZZPRSA-N 0.000 description 2
- DBUNZBWUWCIELX-JHEQGTHGSA-N Gly-Thr-Glu Chemical compound [H]NCC(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCC(O)=O)C(O)=O DBUNZBWUWCIELX-JHEQGTHGSA-N 0.000 description 2
- XHVONGZZVUUORG-WEDXCCLWSA-N Gly-Thr-Lys Chemical compound NCC(=O)N[C@@H]([C@H](O)C)C(=O)N[C@H](C(O)=O)CCCCN XHVONGZZVUUORG-WEDXCCLWSA-N 0.000 description 2
- RIYIFUFFFBIOEU-KBPBESRZSA-N Gly-Tyr-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@@H](NC(=O)CN)CC1=CC=C(O)C=C1 RIYIFUFFFBIOEU-KBPBESRZSA-N 0.000 description 2
- OCRQUYDOYKCOQG-IRXDYDNUSA-N Gly-Tyr-Phe Chemical compound C([C@H](NC(=O)CN)C(=O)N[C@@H](CC=1C=CC=CC=1)C(O)=O)C1=CC=C(O)C=C1 OCRQUYDOYKCOQG-IRXDYDNUSA-N 0.000 description 2
- DNAZKGFYFRGZIH-QWRGUYRKSA-N Gly-Tyr-Ser Chemical compound OC[C@@H](C(O)=O)NC(=O)[C@@H](NC(=O)CN)CC1=CC=C(O)C=C1 DNAZKGFYFRGZIH-QWRGUYRKSA-N 0.000 description 2
- IPIVXQQRZXEUGW-UWJYBYFXSA-N His-Ala-His Chemical compound C([C@H](N)C(=O)N[C@@H](C)C(=O)N[C@@H](CC=1NC=NC=1)C(O)=O)C1=CN=CN1 IPIVXQQRZXEUGW-UWJYBYFXSA-N 0.000 description 2
- XINDHUAGVGCNSF-QSFUFRPTSA-N His-Ala-Ile Chemical compound [H]N[C@@H](CC1=CNC=N1)C(=O)N[C@@H](C)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O XINDHUAGVGCNSF-QSFUFRPTSA-N 0.000 description 2
- SVHKVHBPTOMLTO-DCAQKATOSA-N His-Arg-Asp Chemical compound [H]N[C@@H](CC1=CNC=N1)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC(O)=O)C(O)=O SVHKVHBPTOMLTO-DCAQKATOSA-N 0.000 description 2
- MVADCDSCFTXCBT-CIUDSAMLSA-N His-Asp-Asp Chemical compound [H]N[C@@H](CC1=CNC=N1)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CC(O)=O)C(O)=O MVADCDSCFTXCBT-CIUDSAMLSA-N 0.000 description 2
- XMENRVZYPBKBIL-AVGNSLFASA-N His-Glu-His Chemical compound N[C@@H](Cc1cnc[nH]1)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](Cc1cnc[nH]1)C(O)=O XMENRVZYPBKBIL-AVGNSLFASA-N 0.000 description 2
- ZSKJIISDJXJQPV-BZSNNMDCSA-N His-Leu-Phe Chemical compound C([C@H](N)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CC=1C=CC=CC=1)C(O)=O)C1=CN=CN1 ZSKJIISDJXJQPV-BZSNNMDCSA-N 0.000 description 2
- HYWZHNUGAYVEEW-KKUMJFAQSA-N His-Phe-Ser Chemical compound C1=CC=C(C=C1)C[C@@H](C(=O)N[C@@H](CO)C(=O)O)NC(=O)[C@H](CC2=CN=CN2)N HYWZHNUGAYVEEW-KKUMJFAQSA-N 0.000 description 2
- VIJMRAIWYWRXSR-CIUDSAMLSA-N His-Ser-Ser Chemical compound OC[C@@H](C(O)=O)NC(=O)[C@H](CO)NC(=O)[C@@H](N)CC1=CN=CN1 VIJMRAIWYWRXSR-CIUDSAMLSA-N 0.000 description 2
- DAKSMIWQZPHRIB-BZSNNMDCSA-N His-Tyr-Leu Chemical compound [H]N[C@@H](CC1=CNC=N1)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CC(C)C)C(O)=O DAKSMIWQZPHRIB-BZSNNMDCSA-N 0.000 description 2
- 102100027704 Histone-lysine N-methyltransferase SETD7 Human genes 0.000 description 2
- 101000650682 Homo sapiens Histone-lysine N-methyltransferase SETD7 Proteins 0.000 description 2
- 101100087363 Homo sapiens RBFOX2 gene Proteins 0.000 description 2
- 241000701044 Human gammaherpesvirus 4 Species 0.000 description 2
- YOTNPRLPIPHQSB-XUXIUFHCSA-N Ile-Arg-Lys Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CCCN=C(N)N)C(=O)N[C@@H](CCCCN)C(=O)O)N YOTNPRLPIPHQSB-XUXIUFHCSA-N 0.000 description 2
- NBJAAWYRLGCJOF-UGYAYLCHSA-N Ile-Asp-Asn Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CC(=O)O)C(=O)N[C@@H](CC(=O)N)C(=O)O)N NBJAAWYRLGCJOF-UGYAYLCHSA-N 0.000 description 2
- RGSOCXHDOPQREB-ZPFDUUQYSA-N Ile-Asp-Leu Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CC(=O)O)C(=O)N[C@@H](CC(C)C)C(=O)O)N RGSOCXHDOPQREB-ZPFDUUQYSA-N 0.000 description 2
- LKACSKJPTFSBHR-MNXVOIDGSA-N Ile-Gln-Lys Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CCC(=O)N)C(=O)N[C@@H](CCCCN)C(=O)O)N LKACSKJPTFSBHR-MNXVOIDGSA-N 0.000 description 2
- LGMUPVWZEYYUMU-YVNDNENWSA-N Ile-Glu-Gln Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CCC(=O)O)C(=O)N[C@@H](CCC(=O)N)C(=O)O)N LGMUPVWZEYYUMU-YVNDNENWSA-N 0.000 description 2
- PNDMHTTXXPUQJH-RWRJDSDZSA-N Ile-Glu-Thr Chemical compound N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CCC(=O)O)C(=O)N[C@@H]([C@H](O)C)C(=O)O PNDMHTTXXPUQJH-RWRJDSDZSA-N 0.000 description 2
- DFFTXLCCDFYRKD-MBLNEYKQSA-N Ile-Gly-Thr Chemical compound CC[C@H](C)[C@@H](C(=O)NCC(=O)N[C@@H]([C@@H](C)O)C(=O)O)N DFFTXLCCDFYRKD-MBLNEYKQSA-N 0.000 description 2
- HYLIOBDWPQNLKI-HVTMNAMFSA-N Ile-His-Gln Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CC1=CN=CN1)C(=O)N[C@@H](CCC(=O)N)C(=O)O)N HYLIOBDWPQNLKI-HVTMNAMFSA-N 0.000 description 2
- HUWYGQOISIJNMK-SIGLWIIPSA-N Ile-Ile-His Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CC1=CN=CN1)C(=O)O)N HUWYGQOISIJNMK-SIGLWIIPSA-N 0.000 description 2
- CSQNHSGHAPRGPQ-YTFOTSKYSA-N Ile-Ile-Lys Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CCCCN)C(=O)O)N CSQNHSGHAPRGPQ-YTFOTSKYSA-N 0.000 description 2
- OUUCIIJSBIBCHB-ZPFDUUQYSA-N Ile-Leu-Asp Chemical compound CC[C@H](C)[C@H](N)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CC(O)=O)C(O)=O OUUCIIJSBIBCHB-ZPFDUUQYSA-N 0.000 description 2
- YGDWPQCLFJNMOL-MNXVOIDGSA-N Ile-Leu-Gln Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCC(=O)N)C(=O)O)N YGDWPQCLFJNMOL-MNXVOIDGSA-N 0.000 description 2
- HUORUFRRJHELPD-MNXVOIDGSA-N Ile-Leu-Glu Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCC(=O)O)C(=O)O)N HUORUFRRJHELPD-MNXVOIDGSA-N 0.000 description 2
- GAZGFPOZOLEYAJ-YTFOTSKYSA-N Ile-Leu-Ile Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H]([C@@H](C)CC)C(=O)O)N GAZGFPOZOLEYAJ-YTFOTSKYSA-N 0.000 description 2
- ADDYYRVQQZFIMW-MNXVOIDGSA-N Ile-Lys-Glu Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CCC(=O)O)C(=O)O)N ADDYYRVQQZFIMW-MNXVOIDGSA-N 0.000 description 2
- GVNNAHIRSDRIII-AJNGGQMLSA-N Ile-Lys-Lys Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CCCCN)C(=O)O)N GVNNAHIRSDRIII-AJNGGQMLSA-N 0.000 description 2
- GLYJPWIRLBAIJH-UHFFFAOYSA-N Ile-Lys-Pro Natural products CCC(C)C(N)C(=O)NC(CCCCN)C(=O)N1CCCC1C(O)=O GLYJPWIRLBAIJH-UHFFFAOYSA-N 0.000 description 2
- RVNOXPZHMUWCLW-GMOBBJLQSA-N Ile-Met-Asn Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CCSC)C(=O)N[C@@H](CC(=O)N)C(=O)O)N RVNOXPZHMUWCLW-GMOBBJLQSA-N 0.000 description 2
- RCMNUBZKIIJCOI-ZPFDUUQYSA-N Ile-Met-Glu Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CCSC)C(=O)N[C@@H](CCC(=O)O)C(=O)O)N RCMNUBZKIIJCOI-ZPFDUUQYSA-N 0.000 description 2
- BJECXJHLUJXPJQ-PYJNHQTQSA-N Ile-Pro-His Chemical compound CC[C@H](C)[C@@H](C(=O)N1CCC[C@H]1C(=O)N[C@@H](CC2=CN=CN2)C(=O)O)N BJECXJHLUJXPJQ-PYJNHQTQSA-N 0.000 description 2
- JODPUDMBQBIWCK-GHCJXIJMSA-N Ile-Ser-Asn Chemical compound [H]N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CO)C(=O)N[C@@H](CC(N)=O)C(O)=O JODPUDMBQBIWCK-GHCJXIJMSA-N 0.000 description 2
- ZNOBVZFCHNHKHA-KBIXCLLPSA-N Ile-Ser-Glu Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CO)C(=O)N[C@@H](CCC(=O)O)C(=O)O)N ZNOBVZFCHNHKHA-KBIXCLLPSA-N 0.000 description 2
- ZLFNNVATRMCAKN-ZKWXMUAHSA-N Ile-Ser-Gly Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CO)C(=O)NCC(=O)O)N ZLFNNVATRMCAKN-ZKWXMUAHSA-N 0.000 description 2
- JTBFQNHKNRZJDS-SYWGBEHUSA-N Ile-Trp-Ala Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CC1=CNC2=CC=CC=C21)C(=O)N[C@@H](C)C(=O)O)N JTBFQNHKNRZJDS-SYWGBEHUSA-N 0.000 description 2
- DLEBSGAVWRPTIX-PEDHHIEDSA-N Ile-Val-Ile Chemical compound CC[C@H](C)[C@H](N)C(=O)N[C@@H](C(C)C)C(=O)N[C@H](C(O)=O)[C@@H](C)CC DLEBSGAVWRPTIX-PEDHHIEDSA-N 0.000 description 2
- SWNRZNLXMXRCJC-VKOGCVSHSA-N Ile-Val-Trp Chemical compound C1=CC=C2C(C[C@H](NC(=O)[C@H](C(C)C)NC(=O)[C@@H](N)[C@@H](C)CC)C(O)=O)=CNC2=C1 SWNRZNLXMXRCJC-VKOGCVSHSA-N 0.000 description 2
- SENJXOPIZNYLHU-UHFFFAOYSA-N L-leucyl-L-arginine Natural products CC(C)CC(N)C(=O)NC(C(O)=O)CCCN=C(N)N SENJXOPIZNYLHU-UHFFFAOYSA-N 0.000 description 2
- 108090001090 Lectins Proteins 0.000 description 2
- 102000004856 Lectins Human genes 0.000 description 2
- LJHGALIOHLRRQN-DCAQKATOSA-N Leu-Ala-Arg Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H](C)C(=O)N[C@H](C(O)=O)CCCN=C(N)N LJHGALIOHLRRQN-DCAQKATOSA-N 0.000 description 2
- ZRLUISBDKUWAIZ-CIUDSAMLSA-N Leu-Ala-Asp Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H](C)C(=O)N[C@H](C(O)=O)CC(O)=O ZRLUISBDKUWAIZ-CIUDSAMLSA-N 0.000 description 2
- WNGVUZWBXZKQES-YUMQZZPRSA-N Leu-Ala-Gly Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H](C)C(=O)NCC(O)=O WNGVUZWBXZKQES-YUMQZZPRSA-N 0.000 description 2
- PVMPDMIKUVNOBD-CIUDSAMLSA-N Leu-Asp-Ser Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CO)C(O)=O PVMPDMIKUVNOBD-CIUDSAMLSA-N 0.000 description 2
- LLBQJYDYOLIQAI-JYJNAYRXSA-N Leu-Glu-Tyr Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(O)=O LLBQJYDYOLIQAI-JYJNAYRXSA-N 0.000 description 2
- OXRLYTYUXAQTHP-YUMQZZPRSA-N Leu-Gly-Ala Chemical compound [H]N[C@@H](CC(C)C)C(=O)NCC(=O)N[C@@H](C)C(O)=O OXRLYTYUXAQTHP-YUMQZZPRSA-N 0.000 description 2
- KGCLIYGPQXUNLO-IUCAKERBSA-N Leu-Gly-Glu Chemical compound CC(C)C[C@H](N)C(=O)NCC(=O)N[C@H](C(O)=O)CCC(O)=O KGCLIYGPQXUNLO-IUCAKERBSA-N 0.000 description 2
- HYIFFZAQXPUEAU-QWRGUYRKSA-N Leu-Gly-Leu Chemical compound CC(C)C[C@H](N)C(=O)NCC(=O)N[C@H](C(O)=O)CC(C)C HYIFFZAQXPUEAU-QWRGUYRKSA-N 0.000 description 2
- KOSWSHVQIVTVQF-ZPFDUUQYSA-N Leu-Ile-Asp Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CC(O)=O)C(O)=O KOSWSHVQIVTVQF-ZPFDUUQYSA-N 0.000 description 2
- HNDWYLYAYNBWMP-AJNGGQMLSA-N Leu-Ile-Lys Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CCCCN)C(=O)O)NC(=O)[C@H](CC(C)C)N HNDWYLYAYNBWMP-AJNGGQMLSA-N 0.000 description 2
- RZXLZBIUTDQHJQ-SRVKXCTJSA-N Leu-Lys-Asp Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CC(O)=O)C(O)=O RZXLZBIUTDQHJQ-SRVKXCTJSA-N 0.000 description 2
- HVHRPWQEQHIQJF-AVGNSLFASA-N Leu-Lys-Glu Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CCC(O)=O)C(O)=O HVHRPWQEQHIQJF-AVGNSLFASA-N 0.000 description 2
- FLNPJLDPGMLWAU-UWVGGRQHSA-N Leu-Met-Gly Chemical compound OC(=O)CNC(=O)[C@H](CCSC)NC(=O)[C@@H](N)CC(C)C FLNPJLDPGMLWAU-UWVGGRQHSA-N 0.000 description 2
- BIZNDKMFQHDOIE-KKUMJFAQSA-N Leu-Phe-Asn Chemical compound CC(C)C[C@H](N)C(=O)N[C@H](C(=O)N[C@@H](CC(N)=O)C(O)=O)CC1=CC=CC=C1 BIZNDKMFQHDOIE-KKUMJFAQSA-N 0.000 description 2
- AIRUUHAOKGVJAD-JYJNAYRXSA-N Leu-Phe-Glu Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CCC(O)=O)C(O)=O AIRUUHAOKGVJAD-JYJNAYRXSA-N 0.000 description 2
- PJWOOBTYQNNRBF-BZSNNMDCSA-N Leu-Phe-Lys Chemical compound CC(C)C[C@@H](C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CCCCN)C(=O)O)N PJWOOBTYQNNRBF-BZSNNMDCSA-N 0.000 description 2
- YWKNKRAKOCLOLH-OEAJRASXSA-N Leu-Phe-Thr Chemical compound CC(C)C[C@H](N)C(=O)N[C@H](C(=O)N[C@@H]([C@@H](C)O)C(O)=O)CC1=CC=CC=C1 YWKNKRAKOCLOLH-OEAJRASXSA-N 0.000 description 2
- UCBPDSYUVAAHCD-UWVGGRQHSA-N Leu-Pro-Gly Chemical compound CC(C)C[C@H](N)C(=O)N1CCC[C@H]1C(=O)NCC(O)=O UCBPDSYUVAAHCD-UWVGGRQHSA-N 0.000 description 2
- CHJKEDSZNSONPS-DCAQKATOSA-N Leu-Pro-Ser Chemical compound [H]N[C@@H](CC(C)C)C(=O)N1CCC[C@H]1C(=O)N[C@@H](CO)C(O)=O CHJKEDSZNSONPS-DCAQKATOSA-N 0.000 description 2
- IZPVWNSAVUQBGP-CIUDSAMLSA-N Leu-Ser-Asp Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CO)C(=O)N[C@@H](CC(O)=O)C(O)=O IZPVWNSAVUQBGP-CIUDSAMLSA-N 0.000 description 2
- GOFJOGXGMPHOGL-DCAQKATOSA-N Leu-Ser-Met Chemical compound CSCC[C@@H](C(O)=O)NC(=O)[C@H](CO)NC(=O)[C@@H](N)CC(C)C GOFJOGXGMPHOGL-DCAQKATOSA-N 0.000 description 2
- AEDWWMMHUGYIFD-HJGDQZAQSA-N Leu-Thr-Asn Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CC(N)=O)C(O)=O AEDWWMMHUGYIFD-HJGDQZAQSA-N 0.000 description 2
- QWWPYKKLXWOITQ-VOAKCMCISA-N Leu-Thr-Leu Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@H](C(O)=O)CC(C)C QWWPYKKLXWOITQ-VOAKCMCISA-N 0.000 description 2
- DAYQSYGBCUKVKT-VOAKCMCISA-N Leu-Thr-Lys Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCCCN)C(O)=O DAYQSYGBCUKVKT-VOAKCMCISA-N 0.000 description 2
- VJGQRELPQWNURN-JYJNAYRXSA-N Leu-Tyr-Glu Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CCC(O)=O)C(O)=O VJGQRELPQWNURN-JYJNAYRXSA-N 0.000 description 2
- YQFZRHYZLARWDY-IHRRRGAJSA-N Leu-Val-Lys Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H](C(C)C)C(=O)N[C@H](C(O)=O)CCCCN YQFZRHYZLARWDY-IHRRRGAJSA-N 0.000 description 2
- 102100032693 Leucine-rich repeat serine/threonine-protein kinase 2 Human genes 0.000 description 2
- YNNPKXBBRZVIRX-IHRRRGAJSA-N Lys-Arg-Leu Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC(C)C)C(O)=O YNNPKXBBRZVIRX-IHRRRGAJSA-N 0.000 description 2
- DGWXCIORNLWGGG-CIUDSAMLSA-N Lys-Asn-Ser Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CO)C(O)=O DGWXCIORNLWGGG-CIUDSAMLSA-N 0.000 description 2
- QUCDKEKDPYISNX-HJGDQZAQSA-N Lys-Asn-Thr Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H]([C@@H](C)O)C(O)=O QUCDKEKDPYISNX-HJGDQZAQSA-N 0.000 description 2
- IWWMPCPLFXFBAF-SRVKXCTJSA-N Lys-Asp-Leu Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CC(C)C)C(O)=O IWWMPCPLFXFBAF-SRVKXCTJSA-N 0.000 description 2
- LMVOVCYVZBBWQB-SRVKXCTJSA-N Lys-Asp-Lys Chemical compound NCCCC[C@H](N)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@H](C(O)=O)CCCCN LMVOVCYVZBBWQB-SRVKXCTJSA-N 0.000 description 2
- PHHYNOUOUWYQRO-XIRDDKMYSA-N Lys-Asp-Trp Chemical compound C1=CC=C2C(=C1)C(=CN2)C[C@@H](C(=O)O)NC(=O)[C@H](CC(=O)O)NC(=O)[C@H](CCCCN)N PHHYNOUOUWYQRO-XIRDDKMYSA-N 0.000 description 2
- WTZUSCUIVPVCRH-SRVKXCTJSA-N Lys-Gln-Arg Chemical compound NCCCC[C@H](N)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@H](C(O)=O)CCCN=C(N)N WTZUSCUIVPVCRH-SRVKXCTJSA-N 0.000 description 2
- RZHLIPMZXOEJTL-AVGNSLFASA-N Lys-Gln-Leu Chemical compound CC(C)C[C@@H](C(=O)O)NC(=O)[C@H](CCC(=O)N)NC(=O)[C@H](CCCCN)N RZHLIPMZXOEJTL-AVGNSLFASA-N 0.000 description 2
- NNCDAORZCMPZPX-GUBZILKMSA-N Lys-Gln-Ser Chemical compound C(CCN)C[C@@H](C(=O)N[C@@H](CCC(=O)N)C(=O)N[C@@H](CO)C(=O)O)N NNCDAORZCMPZPX-GUBZILKMSA-N 0.000 description 2
- ZXEUFAVXODIPHC-GUBZILKMSA-N Lys-Glu-Asn Chemical compound NCCCC[C@H](N)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(N)=O)C(O)=O ZXEUFAVXODIPHC-GUBZILKMSA-N 0.000 description 2
- LLSUNJYOSCOOEB-GUBZILKMSA-N Lys-Glu-Asp Chemical compound NCCCC[C@H](N)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(O)=O)C(O)=O LLSUNJYOSCOOEB-GUBZILKMSA-N 0.000 description 2
- KZOHPCYVORJBLG-AVGNSLFASA-N Lys-Glu-His Chemical compound C1=C(NC=N1)C[C@@H](C(=O)O)NC(=O)[C@H](CCC(=O)O)NC(=O)[C@H](CCCCN)N KZOHPCYVORJBLG-AVGNSLFASA-N 0.000 description 2
- QZONCCHVHCOBSK-YUMQZZPRSA-N Lys-Gly-Asn Chemical compound [H]N[C@@H](CCCCN)C(=O)NCC(=O)N[C@@H](CC(N)=O)C(O)=O QZONCCHVHCOBSK-YUMQZZPRSA-N 0.000 description 2
- XNKDCYABMBBEKN-IUCAKERBSA-N Lys-Gly-Gln Chemical compound NCCCC[C@H](N)C(=O)NCC(=O)N[C@H](C(O)=O)CCC(N)=O XNKDCYABMBBEKN-IUCAKERBSA-N 0.000 description 2
- FHIAJWBDZVHLAH-YUMQZZPRSA-N Lys-Gly-Ser Chemical compound NCCCC[C@H](N)C(=O)NCC(=O)N[C@@H](CO)C(O)=O FHIAJWBDZVHLAH-YUMQZZPRSA-N 0.000 description 2
- GNLJXWBNLAIPEP-MELADBBJSA-N Lys-His-Pro Chemical compound C1C[C@@H](N(C1)C(=O)[C@H](CC2=CN=CN2)NC(=O)[C@H](CCCCN)N)C(=O)O GNLJXWBNLAIPEP-MELADBBJSA-N 0.000 description 2
- SPCHLZUWJTYZFC-IHRRRGAJSA-N Lys-His-Val Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CC1=CNC=N1)C(=O)N[C@@H](C(C)C)C(O)=O SPCHLZUWJTYZFC-IHRRRGAJSA-N 0.000 description 2
- QBEPTBMRQALPEV-MNXVOIDGSA-N Lys-Ile-Glu Chemical compound OC(=O)CC[C@@H](C(O)=O)NC(=O)[C@H]([C@@H](C)CC)NC(=O)[C@@H](N)CCCCN QBEPTBMRQALPEV-MNXVOIDGSA-N 0.000 description 2
- JYXBNQOKPRQNQS-YTFOTSKYSA-N Lys-Ile-Ile Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O JYXBNQOKPRQNQS-YTFOTSKYSA-N 0.000 description 2
- ZXFRGTAIIZHNHG-AJNGGQMLSA-N Lys-Ile-Leu Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CC(C)C)C(=O)O)NC(=O)[C@H](CCCCN)N ZXFRGTAIIZHNHG-AJNGGQMLSA-N 0.000 description 2
- IZJGPPIGYTVXLB-FQUUOJAGSA-N Lys-Ile-Pro Chemical compound CC[C@H](C)[C@@H](C(=O)N1CCC[C@@H]1C(=O)O)NC(=O)[C@H](CCCCN)N IZJGPPIGYTVXLB-FQUUOJAGSA-N 0.000 description 2
- SKRGVGLIRUGANF-AVGNSLFASA-N Lys-Leu-Glu Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCC(O)=O)C(O)=O SKRGVGLIRUGANF-AVGNSLFASA-N 0.000 description 2
- VUTWYNQUSJWBHO-BZSNNMDCSA-N Lys-Leu-Tyr Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(O)=O VUTWYNQUSJWBHO-BZSNNMDCSA-N 0.000 description 2
- XOQMURBBIXRRCR-SRVKXCTJSA-N Lys-Lys-Ala Chemical compound OC(=O)[C@H](C)NC(=O)[C@H](CCCCN)NC(=O)[C@@H](N)CCCCN XOQMURBBIXRRCR-SRVKXCTJSA-N 0.000 description 2
- GAHJXEMYXKLZRQ-AJNGGQMLSA-N Lys-Lys-Ile Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O GAHJXEMYXKLZRQ-AJNGGQMLSA-N 0.000 description 2
- KJIXWRWPOCKYLD-IHRRRGAJSA-N Lys-Lys-Met Chemical compound CSCC[C@@H](C(=O)O)NC(=O)[C@H](CCCCN)NC(=O)[C@H](CCCCN)N KJIXWRWPOCKYLD-IHRRRGAJSA-N 0.000 description 2
- PLDJDCJLRCYPJB-VOAKCMCISA-N Lys-Lys-Thr Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H]([C@@H](C)O)C(O)=O PLDJDCJLRCYPJB-VOAKCMCISA-N 0.000 description 2
- BXPHMHQHYHILBB-BZSNNMDCSA-N Lys-Lys-Tyr Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(O)=O BXPHMHQHYHILBB-BZSNNMDCSA-N 0.000 description 2
- QBHGXFQJFPWJIH-XUXIUFHCSA-N Lys-Pro-Ile Chemical compound CC[C@H](C)[C@@H](C(O)=O)NC(=O)[C@@H]1CCCN1C(=O)[C@@H](N)CCCCN QBHGXFQJFPWJIH-XUXIUFHCSA-N 0.000 description 2
- SBQDRNOLGSYHQA-YUMQZZPRSA-N Lys-Ser-Gly Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CO)C(=O)NCC(O)=O SBQDRNOLGSYHQA-YUMQZZPRSA-N 0.000 description 2
- YFQSSOAGMZGXFT-MEYUZBJRSA-N Lys-Thr-Tyr Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(O)=O YFQSSOAGMZGXFT-MEYUZBJRSA-N 0.000 description 2
- IEIHKHYMBIYQTH-YESZJQIVSA-N Lys-Tyr-Pro Chemical compound C1C[C@@H](N(C1)C(=O)[C@H](CC2=CC=C(C=C2)O)NC(=O)[C@H](CCCCN)N)C(=O)O IEIHKHYMBIYQTH-YESZJQIVSA-N 0.000 description 2
- VVURYEVJJTXWNE-ULQDDVLXSA-N Lys-Tyr-Val Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](C(C)C)C(O)=O VVURYEVJJTXWNE-ULQDDVLXSA-N 0.000 description 2
- RPWQJSBMXJSCPD-XUXIUFHCSA-N Lys-Val-Ile Chemical compound CC[C@H](C)[C@H](NC(=O)[C@@H](NC(=O)[C@@H](N)CCCCN)C(C)C)C(O)=O RPWQJSBMXJSCPD-XUXIUFHCSA-N 0.000 description 2
- NYTDJEZBAAFLLG-IHRRRGAJSA-N Lys-Val-Lys Chemical compound NCCCC[C@H](N)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CCCCN)C(O)=O NYTDJEZBAAFLLG-IHRRRGAJSA-N 0.000 description 2
- RIPJMCFGQHGHNP-RHYQMDGZSA-N Lys-Val-Thr Chemical compound C[C@H]([C@@H](C(=O)O)NC(=O)[C@H](C(C)C)NC(=O)[C@H](CCCCN)N)O RIPJMCFGQHGHNP-RHYQMDGZSA-N 0.000 description 2
- WXHHTBVYQOSYSL-FXQIFTODSA-N Met-Ala-Ser Chemical compound CSCC[C@H](N)C(=O)N[C@@H](C)C(=O)N[C@@H](CO)C(O)=O WXHHTBVYQOSYSL-FXQIFTODSA-N 0.000 description 2
- IHITVQKJXQQGLJ-LPEHRKFASA-N Met-Asn-Pro Chemical compound CSCC[C@@H](C(=O)N[C@@H](CC(=O)N)C(=O)N1CCC[C@@H]1C(=O)O)N IHITVQKJXQQGLJ-LPEHRKFASA-N 0.000 description 2
- FZUNSVYYPYJYAP-NAKRPEOUSA-N Met-Ile-Ala Chemical compound [H]N[C@@H](CCSC)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](C)C(O)=O FZUNSVYYPYJYAP-NAKRPEOUSA-N 0.000 description 2
- QGRJTULYDZUBAY-ZPFDUUQYSA-N Met-Ile-Glu Chemical compound [H]N[C@@H](CCSC)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CCC(O)=O)C(O)=O QGRJTULYDZUBAY-ZPFDUUQYSA-N 0.000 description 2
- AFFKUNVPPLQUGA-DCAQKATOSA-N Met-Leu-Ala Chemical compound [H]N[C@@H](CCSC)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](C)C(O)=O AFFKUNVPPLQUGA-DCAQKATOSA-N 0.000 description 2
- BEZJTLKUMFMITF-AVGNSLFASA-N Met-Lys-Arg Chemical compound CSCC[C@H](N)C(=O)N[C@@H](CCCCN)C(=O)N[C@H](C(O)=O)CCCNC(N)=N BEZJTLKUMFMITF-AVGNSLFASA-N 0.000 description 2
- KSIPKXNIQOWMIC-RCWTZXSCSA-N Met-Thr-Arg Chemical compound CSCC[C@H](N)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@H](C(O)=O)CCCNC(N)=N KSIPKXNIQOWMIC-RCWTZXSCSA-N 0.000 description 2
- OTKQHDPECKUDSB-SZMVWBNQSA-N Met-Val-Trp Chemical compound C1=CC=C2C(C[C@H](NC(=O)[C@H](C(C)C)NC(=O)[C@@H](N)CCSC)C(O)=O)=CNC2=C1 OTKQHDPECKUDSB-SZMVWBNQSA-N 0.000 description 2
- 102000006890 Methyl-CpG-Binding Protein 2 Human genes 0.000 description 2
- 108010072388 Methyl-CpG-Binding Protein 2 Proteins 0.000 description 2
- 102000009664 Microtubule-Associated Proteins Human genes 0.000 description 2
- 108010020004 Microtubule-Associated Proteins Proteins 0.000 description 2
- 241001529936 Murinae Species 0.000 description 2
- 108010052185 Myotonin-Protein Kinase Proteins 0.000 description 2
- 102100022437 Myotonin-protein kinase Human genes 0.000 description 2
- WUGMRIBZSVSJNP-UHFFFAOYSA-N N-L-alanyl-L-tryptophan Natural products C1=CC=C2C(CC(NC(=O)C(N)C)C(O)=O)=CNC2=C1 WUGMRIBZSVSJNP-UHFFFAOYSA-N 0.000 description 2
- PESQCPHRXOFIPX-UHFFFAOYSA-N N-L-methionyl-L-tyrosine Natural products CSCCC(N)C(=O)NC(C(O)=O)CC1=CC=C(O)C=C1 PESQCPHRXOFIPX-UHFFFAOYSA-N 0.000 description 2
- 102000007072 Nerve Growth Factors Human genes 0.000 description 2
- 102100032062 Neurogenic differentiation factor 2 Human genes 0.000 description 2
- 108050000625 Neurogenic differentiation factor 2 Proteins 0.000 description 2
- 102100038550 Neurogenin-1 Human genes 0.000 description 2
- 101710096136 Neurogenin-1 Proteins 0.000 description 2
- 102100022676 Nuclear receptor subfamily 4 group A member 2 Human genes 0.000 description 2
- 108010019644 Oligodendrocyte Transcription Factor 2 Proteins 0.000 description 2
- 102000005803 Oligodendrocyte Transcription Factor 2 Human genes 0.000 description 2
- 108091034117 Oligonucleotide Proteins 0.000 description 2
- 108700026244 Open Reading Frames Proteins 0.000 description 2
- 241000283973 Oryctolagus cuniculus Species 0.000 description 2
- 102100037506 Paired box protein Pax-6 Human genes 0.000 description 2
- 102100031686 Paired mesoderm homeobox protein 2A Human genes 0.000 description 2
- 101710187404 Paired mesoderm homeobox protein 2A Proteins 0.000 description 2
- 229930040373 Paraformaldehyde Natural products 0.000 description 2
- 206010033799 Paralysis Diseases 0.000 description 2
- 241000701945 Parvoviridae Species 0.000 description 2
- BRDYYVQTEJVRQT-HRCADAONSA-N Phe-Arg-Pro Chemical compound C1C[C@@H](N(C1)C(=O)[C@H](CCCN=C(N)N)NC(=O)[C@H](CC2=CC=CC=C2)N)C(=O)O BRDYYVQTEJVRQT-HRCADAONSA-N 0.000 description 2
- WMGVYPPIMZPWPN-SRVKXCTJSA-N Phe-Asp-Asn Chemical compound C1=CC=C(C=C1)C[C@@H](C(=O)N[C@@H](CC(=O)O)C(=O)N[C@@H](CC(=O)N)C(=O)O)N WMGVYPPIMZPWPN-SRVKXCTJSA-N 0.000 description 2
- SWZKMTDPQXLQRD-XVSYOHENSA-N Phe-Asp-Thr Chemical compound [H]N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H]([C@@H](C)O)C(O)=O SWZKMTDPQXLQRD-XVSYOHENSA-N 0.000 description 2
- KJJROSNFBRWPHS-JYJNAYRXSA-N Phe-Glu-Leu Chemical compound [H]N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(C)C)C(O)=O KJJROSNFBRWPHS-JYJNAYRXSA-N 0.000 description 2
- PSKRILMFHNIUAO-JYJNAYRXSA-N Phe-Glu-Lys Chemical compound C1=CC=C(C=C1)C[C@@H](C(=O)N[C@@H](CCC(=O)O)C(=O)N[C@@H](CCCCN)C(=O)O)N PSKRILMFHNIUAO-JYJNAYRXSA-N 0.000 description 2
- APJPXSFJBMMOLW-KBPBESRZSA-N Phe-Gly-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)CNC(=O)[C@@H](N)CC1=CC=CC=C1 APJPXSFJBMMOLW-KBPBESRZSA-N 0.000 description 2
- HQCSLJFGZYOXHW-KKUMJFAQSA-N Phe-His-Cys Chemical compound C1=CC=C(C=C1)C[C@@H](C(=O)N[C@@H](CC2=CN=CN2)C(=O)N[C@@H](CS)C(=O)O)N HQCSLJFGZYOXHW-KKUMJFAQSA-N 0.000 description 2
- KRYSMKKRRRWOCZ-QEWYBTABSA-N Phe-Ile-Glu Chemical compound [H]N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CCC(O)=O)C(O)=O KRYSMKKRRRWOCZ-QEWYBTABSA-N 0.000 description 2
- LRBSWBVUCLLRLU-BZSNNMDCSA-N Phe-Leu-Lys Chemical compound CC(C)C[C@H](NC(=O)[C@@H](N)Cc1ccccc1)C(=O)N[C@@H](CCCCN)C(O)=O LRBSWBVUCLLRLU-BZSNNMDCSA-N 0.000 description 2
- BSHMIVKDJQGLNT-ACRUOGEOSA-N Phe-Lys-Tyr Chemical compound C([C@H](N)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CC=1C=CC(O)=CC=1)C(O)=O)C1=CC=CC=C1 BSHMIVKDJQGLNT-ACRUOGEOSA-N 0.000 description 2
- QRUOLOPKCOEZKU-HJWJTTGWSA-N Phe-Met-Ile Chemical compound CC[C@H](C)[C@@H](C(=O)O)NC(=O)[C@H](CCSC)NC(=O)[C@H](CC1=CC=CC=C1)N QRUOLOPKCOEZKU-HJWJTTGWSA-N 0.000 description 2
- RBRNEFJTEHPDSL-ACRUOGEOSA-N Phe-Phe-Lys Chemical compound C([C@@H](C(=O)N[C@@H](CCCCN)C(O)=O)NC(=O)[C@@H](N)CC=1C=CC=CC=1)C1=CC=CC=C1 RBRNEFJTEHPDSL-ACRUOGEOSA-N 0.000 description 2
- CVAUVSOFHJKCHN-BZSNNMDCSA-N Phe-Tyr-Cys Chemical compound C([C@H](N)C(=O)N[C@@H](CC=1C=CC(O)=CC=1)C(=O)N[C@@H](CS)C(O)=O)C1=CC=CC=C1 CVAUVSOFHJKCHN-BZSNNMDCSA-N 0.000 description 2
- DBNGDEAQXGFGRA-ACRUOGEOSA-N Phe-Tyr-Lys Chemical compound C1=CC=C(C=C1)C[C@@H](C(=O)N[C@@H](CC2=CC=C(C=C2)O)C(=O)N[C@@H](CCCCN)C(=O)O)N DBNGDEAQXGFGRA-ACRUOGEOSA-N 0.000 description 2
- YUPRIZTWANWWHK-DZKIICNBSA-N Phe-Val-Glu Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CCC(=O)O)C(=O)O)NC(=O)[C@H](CC1=CC=CC=C1)N YUPRIZTWANWWHK-DZKIICNBSA-N 0.000 description 2
- 108010022181 Phosphopyruvate Hydratase Proteins 0.000 description 2
- 102000012288 Phosphopyruvate Hydratase Human genes 0.000 description 2
- 108010038512 Platelet-Derived Growth Factor Proteins 0.000 description 2
- 102000010780 Platelet-Derived Growth Factor Human genes 0.000 description 2
- DZZCICYRSZASNF-FXQIFTODSA-N Pro-Ala-Ala Chemical compound OC(=O)[C@H](C)NC(=O)[C@H](C)NC(=O)[C@@H]1CCCN1 DZZCICYRSZASNF-FXQIFTODSA-N 0.000 description 2
- SSSFPISOZOLQNP-GUBZILKMSA-N Pro-Arg-Asp Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC(O)=O)C(O)=O SSSFPISOZOLQNP-GUBZILKMSA-N 0.000 description 2
- ICTZKEXYDDZZFP-SRVKXCTJSA-N Pro-Arg-Pro Chemical compound N([C@@H](CCCN=C(N)N)C(=O)N1[C@@H](CCC1)C(O)=O)C(=O)[C@@H]1CCCN1 ICTZKEXYDDZZFP-SRVKXCTJSA-N 0.000 description 2
- OBVCYFIHIIYIQF-CIUDSAMLSA-N Pro-Asn-Glu Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CCC(O)=O)C(O)=O OBVCYFIHIIYIQF-CIUDSAMLSA-N 0.000 description 2
- YFNOUBWUIIJQHF-LPEHRKFASA-N Pro-Asp-Pro Chemical compound C1C[C@H](NC1)C(=O)N[C@@H](CC(=O)O)C(=O)N2CCC[C@@H]2C(=O)O YFNOUBWUIIJQHF-LPEHRKFASA-N 0.000 description 2
- KTFZQPLSPLWLKN-KKUMJFAQSA-N Pro-Gln-Tyr Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(O)=O KTFZQPLSPLWLKN-KKUMJFAQSA-N 0.000 description 2
- UAYHMOIGIQZLFR-NHCYSSNCSA-N Pro-Gln-Val Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](C(C)C)C(O)=O UAYHMOIGIQZLFR-NHCYSSNCSA-N 0.000 description 2
- KIPIKSXPPLABPN-CIUDSAMLSA-N Pro-Glu-Asn Chemical compound NC(=O)C[C@@H](C(O)=O)NC(=O)[C@H](CCC(O)=O)NC(=O)[C@@H]1CCCN1 KIPIKSXPPLABPN-CIUDSAMLSA-N 0.000 description 2
- MGDFPGCFVJFITQ-CIUDSAMLSA-N Pro-Glu-Asp Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(O)=O)C(O)=O MGDFPGCFVJFITQ-CIUDSAMLSA-N 0.000 description 2
- VZKBJNBZMZHKRC-XUXIUFHCSA-N Pro-Ile-Leu Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CC(C)C)C(O)=O VZKBJNBZMZHKRC-XUXIUFHCSA-N 0.000 description 2
- CDGABSWLRMECHC-IHRRRGAJSA-N Pro-Lys-His Chemical compound C1C[C@H](NC1)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CC2=CN=CN2)C(=O)O CDGABSWLRMECHC-IHRRRGAJSA-N 0.000 description 2
- FYKUEXMZYFIZKA-DCAQKATOSA-N Pro-Pro-Gln Chemical compound [H]N1CCC[C@H]1C(=O)N1CCC[C@H]1C(=O)N[C@@H](CCC(N)=O)C(O)=O FYKUEXMZYFIZKA-DCAQKATOSA-N 0.000 description 2
- NAIPAPCKKRCMBL-JYJNAYRXSA-N Pro-Pro-Phe Chemical compound C([C@@H](C(=O)O)NC(=O)[C@H]1N(CCC1)C(=O)[C@H]1NCCC1)C1=CC=CC=C1 NAIPAPCKKRCMBL-JYJNAYRXSA-N 0.000 description 2
- SEZGGSHLMROBFX-CIUDSAMLSA-N Pro-Ser-Gln Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H](CO)C(=O)N[C@@H](CCC(N)=O)C(O)=O SEZGGSHLMROBFX-CIUDSAMLSA-N 0.000 description 2
- FNGOXVQBBCMFKV-CIUDSAMLSA-N Pro-Ser-Glu Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H](CO)C(=O)N[C@@H](CCC(O)=O)C(O)=O FNGOXVQBBCMFKV-CIUDSAMLSA-N 0.000 description 2
- SNGZLPOXVRTNMB-LPEHRKFASA-N Pro-Ser-Pro Chemical compound C1C[C@H](NC1)C(=O)N[C@@H](CO)C(=O)N2CCC[C@@H]2C(=O)O SNGZLPOXVRTNMB-LPEHRKFASA-N 0.000 description 2
- QDDJNKWPTJHROJ-UFYCRDLUSA-N Pro-Tyr-Tyr Chemical compound C([C@@H](C(=O)O)NC(=O)[C@H](CC=1C=CC(O)=CC=1)NC(=O)[C@H]1NCCC1)C1=CC=C(O)C=C1 QDDJNKWPTJHROJ-UFYCRDLUSA-N 0.000 description 2
- FIDNSJUXESUDOV-JYJNAYRXSA-N Pro-Tyr-Val Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](C(C)C)C(O)=O FIDNSJUXESUDOV-JYJNAYRXSA-N 0.000 description 2
- ZMLRZBWCXPQADC-TUAOUCFPSA-N Pro-Val-Pro Chemical compound CC(C)[C@@H](C(=O)N1CCC[C@@H]1C(=O)O)NC(=O)[C@@H]2CCCN2 ZMLRZBWCXPQADC-TUAOUCFPSA-N 0.000 description 2
- 108010003201 RGH 0205 Proteins 0.000 description 2
- 102100038187 RNA binding protein fox-1 homolog 2 Human genes 0.000 description 2
- 238000011529 RT qPCR Methods 0.000 description 2
- 108010091086 Recombinases Proteins 0.000 description 2
- 102000018120 Recombinases Human genes 0.000 description 2
- BTKUIVBNGBFTTP-WHFBIAKZSA-N Ser-Ala-Gly Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](C)C(=O)NCC(O)=O BTKUIVBNGBFTTP-WHFBIAKZSA-N 0.000 description 2
- QFBNNYNWKYKVJO-DCAQKATOSA-N Ser-Arg-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@@H](NC(=O)[C@@H](N)CO)CCCN=C(N)N QFBNNYNWKYKVJO-DCAQKATOSA-N 0.000 description 2
- UBRXAVQWXOWRSJ-ZLUOBGJFSA-N Ser-Asn-Asp Chemical compound C([C@@H](C(=O)N[C@@H](CC(=O)O)C(=O)O)NC(=O)[C@H](CO)N)C(=O)N UBRXAVQWXOWRSJ-ZLUOBGJFSA-N 0.000 description 2
- BNFVPSRLHHPQKS-WHFBIAKZSA-N Ser-Asp-Gly Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CC(O)=O)C(=O)NCC(O)=O BNFVPSRLHHPQKS-WHFBIAKZSA-N 0.000 description 2
- OLIJLNWFEQEFDM-SRVKXCTJSA-N Ser-Asp-Phe Chemical compound OC[C@H](N)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@H](C(O)=O)CC1=CC=CC=C1 OLIJLNWFEQEFDM-SRVKXCTJSA-N 0.000 description 2
- CRZRTKAVUUGKEQ-ACZMJKKPSA-N Ser-Gln-Ala Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](C)C(O)=O CRZRTKAVUUGKEQ-ACZMJKKPSA-N 0.000 description 2
- OJPHFSOMBZKQKQ-GUBZILKMSA-N Ser-Gln-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](CCC(N)=O)NC(=O)[C@@H](N)CO OJPHFSOMBZKQKQ-GUBZILKMSA-N 0.000 description 2
- FMDHKPRACUXATF-ACZMJKKPSA-N Ser-Gln-Ser Chemical compound OC[C@H](N)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CO)C(O)=O FMDHKPRACUXATF-ACZMJKKPSA-N 0.000 description 2
- LALNXSXEYFUUDD-GUBZILKMSA-N Ser-Glu-Leu Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(C)C)C(O)=O LALNXSXEYFUUDD-GUBZILKMSA-N 0.000 description 2
- DSGYZICNAMEJOC-AVGNSLFASA-N Ser-Glu-Phe Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC1=CC=CC=C1)C(O)=O DSGYZICNAMEJOC-AVGNSLFASA-N 0.000 description 2
- SNVIOQXAHVORQM-WDSKDSINSA-N Ser-Gly-Gln Chemical compound [H]N[C@@H](CO)C(=O)NCC(=O)N[C@@H](CCC(N)=O)C(O)=O SNVIOQXAHVORQM-WDSKDSINSA-N 0.000 description 2
- YMTLKLXDFCSCNX-BYPYZUCNSA-N Ser-Gly-Gly Chemical compound OC[C@H](N)C(=O)NCC(=O)NCC(O)=O YMTLKLXDFCSCNX-BYPYZUCNSA-N 0.000 description 2
- WEQAYODCJHZSJZ-KKUMJFAQSA-N Ser-His-Tyr Chemical compound C([C@H](NC(=O)[C@H](CO)N)C(=O)N[C@@H](CC=1C=CC(O)=CC=1)C(O)=O)C1=CN=CN1 WEQAYODCJHZSJZ-KKUMJFAQSA-N 0.000 description 2
- ZOPISOXXPQNOCO-SVSWQMSJSA-N Ser-Ile-Thr Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H]([C@@H](C)O)C(=O)O)NC(=O)[C@H](CO)N ZOPISOXXPQNOCO-SVSWQMSJSA-N 0.000 description 2
- MUJQWSAWLLRJCE-KATARQTJSA-N Ser-Leu-Thr Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H]([C@@H](C)O)C(O)=O MUJQWSAWLLRJCE-KATARQTJSA-N 0.000 description 2
- NNFMANHDYSVNIO-DCAQKATOSA-N Ser-Lys-Arg Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CCCNC(N)=N)C(O)=O NNFMANHDYSVNIO-DCAQKATOSA-N 0.000 description 2
- LRZLZIUXQBIWTB-KATARQTJSA-N Ser-Lys-Thr Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H]([C@@H](C)O)C(O)=O LRZLZIUXQBIWTB-KATARQTJSA-N 0.000 description 2
- KZPRPBLHYMZIMH-MXAVVETBSA-N Ser-Phe-Ile Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O KZPRPBLHYMZIMH-MXAVVETBSA-N 0.000 description 2
- UPLYXVPQLJVWMM-KKUMJFAQSA-N Ser-Phe-Leu Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CC(C)C)C(O)=O UPLYXVPQLJVWMM-KKUMJFAQSA-N 0.000 description 2
- XVWDJUROVRQKAE-KKUMJFAQSA-N Ser-Phe-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@@H](NC(=O)[C@@H](N)CO)CC1=CC=CC=C1 XVWDJUROVRQKAE-KKUMJFAQSA-N 0.000 description 2
- ADJDNJCSPNFFPI-FXQIFTODSA-N Ser-Pro-Ala Chemical compound OC(=O)[C@H](C)NC(=O)[C@@H]1CCCN1C(=O)[C@@H](N)CO ADJDNJCSPNFFPI-FXQIFTODSA-N 0.000 description 2
- FLONGDPORFIVQW-XGEHTFHBSA-N Ser-Pro-Thr Chemical compound C[C@@H](O)[C@@H](C(O)=O)NC(=O)[C@@H]1CCCN1C(=O)[C@@H](N)CO FLONGDPORFIVQW-XGEHTFHBSA-N 0.000 description 2
- PURRNJBBXDDWLX-ZDLURKLDSA-N Ser-Thr-Gly Chemical compound C[C@H]([C@@H](C(=O)NCC(=O)O)NC(=O)[C@H](CO)N)O PURRNJBBXDDWLX-ZDLURKLDSA-N 0.000 description 2
- FLMYSKVSDVHLEW-SVSWQMSJSA-N Ser-Thr-Ile Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O FLMYSKVSDVHLEW-SVSWQMSJSA-N 0.000 description 2
- SNXUIBACCONSOH-BWBBJGPYSA-N Ser-Thr-Ser Chemical compound OC[C@H](N)C(=O)N[C@@H]([C@H](O)C)C(=O)N[C@@H](CO)C(O)=O SNXUIBACCONSOH-BWBBJGPYSA-N 0.000 description 2
- OQSQCUWQOIHECT-YJRXYDGGSA-N Ser-Tyr-Thr Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H]([C@@H](C)O)C(O)=O OQSQCUWQOIHECT-YJRXYDGGSA-N 0.000 description 2
- BEBVVQPDSHHWQL-NRPADANISA-N Ser-Val-Glu Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CCC(O)=O)C(O)=O BEBVVQPDSHHWQL-NRPADANISA-N 0.000 description 2
- LGIMRDKGABDMBN-DCAQKATOSA-N Ser-Val-Lys Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CCCCN)C(=O)O)NC(=O)[C@H](CO)N LGIMRDKGABDMBN-DCAQKATOSA-N 0.000 description 2
- 241000700584 Simplexvirus Species 0.000 description 2
- 101710172711 Structural protein Proteins 0.000 description 2
- ZUXQFMVPAYGPFJ-JXUBOQSCSA-N Thr-Ala-Lys Chemical compound C[C@@H](O)[C@H](N)C(=O)N[C@@H](C)C(=O)N[C@H](C(O)=O)CCCCN ZUXQFMVPAYGPFJ-JXUBOQSCSA-N 0.000 description 2
- CEXFELBFVHLYDZ-XGEHTFHBSA-N Thr-Arg-Ser Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CO)C(O)=O CEXFELBFVHLYDZ-XGEHTFHBSA-N 0.000 description 2
- IRKWVRSEQFTGGV-VEVYYDQMSA-N Thr-Asn-Arg Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CCCNC(N)=N)C(O)=O IRKWVRSEQFTGGV-VEVYYDQMSA-N 0.000 description 2
- YBXMGKCLOPDEKA-NUMRIWBASA-N Thr-Asp-Glu Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CCC(O)=O)C(O)=O YBXMGKCLOPDEKA-NUMRIWBASA-N 0.000 description 2
- JEDIEMIJYSRUBB-FOHZUACHSA-N Thr-Asp-Gly Chemical compound C[C@@H](O)[C@H](N)C(=O)N[C@@H](CC(O)=O)C(=O)NCC(O)=O JEDIEMIJYSRUBB-FOHZUACHSA-N 0.000 description 2
- OHAJHDJOCKKJLV-LKXGYXEUSA-N Thr-Asp-Ser Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CO)C(O)=O OHAJHDJOCKKJLV-LKXGYXEUSA-N 0.000 description 2
- QILPDQCTQZDHFM-HJGDQZAQSA-N Thr-Gln-Arg Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CCCNC(N)=N)C(O)=O QILPDQCTQZDHFM-HJGDQZAQSA-N 0.000 description 2
- RKDFEMGVMMYYNG-WDCWCFNPSA-N Thr-Gln-Leu Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CC(C)C)C(O)=O RKDFEMGVMMYYNG-WDCWCFNPSA-N 0.000 description 2
- JMGJDTNUMAZNLX-RWRJDSDZSA-N Thr-Glu-Ile Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O JMGJDTNUMAZNLX-RWRJDSDZSA-N 0.000 description 2
- VYEHBMMAJFVTOI-JHEQGTHGSA-N Thr-Gly-Gln Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)NCC(=O)N[C@@H](CCC(N)=O)C(O)=O VYEHBMMAJFVTOI-JHEQGTHGSA-N 0.000 description 2
- AQAMPXBRJJWPNI-JHEQGTHGSA-N Thr-Gly-Glu Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)NCC(=O)N[C@@H](CCC(O)=O)C(O)=O AQAMPXBRJJWPNI-JHEQGTHGSA-N 0.000 description 2
- XPNSAQMEAVSQRD-FBCQKBJTSA-N Thr-Gly-Gly Chemical compound C[C@@H](O)[C@H](N)C(=O)NCC(=O)NCC(O)=O XPNSAQMEAVSQRD-FBCQKBJTSA-N 0.000 description 2
- YSXYEJWDHBCTDJ-DVJZZOLTSA-N Thr-Gly-Trp Chemical compound C[C@H]([C@@H](C(=O)NCC(=O)N[C@@H](CC1=CNC2=CC=CC=C21)C(=O)O)N)O YSXYEJWDHBCTDJ-DVJZZOLTSA-N 0.000 description 2
- XOWKUMFHEZLKLT-CIQUZCHMSA-N Thr-Ile-Ala Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](C)C(O)=O XOWKUMFHEZLKLT-CIQUZCHMSA-N 0.000 description 2
- CRZNCABIJLRFKZ-IUKAMOBKSA-N Thr-Ile-Asp Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CC(=O)O)C(=O)O)NC(=O)[C@H]([C@@H](C)O)N CRZNCABIJLRFKZ-IUKAMOBKSA-N 0.000 description 2
- BVOVIGCHYNFJBZ-JXUBOQSCSA-N Thr-Leu-Ala Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](C)C(O)=O BVOVIGCHYNFJBZ-JXUBOQSCSA-N 0.000 description 2
- IMDMLDSVUSMAEJ-HJGDQZAQSA-N Thr-Leu-Asn Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CC(N)=O)C(O)=O IMDMLDSVUSMAEJ-HJGDQZAQSA-N 0.000 description 2
- MECLEFZMPPOEAC-VOAKCMCISA-N Thr-Leu-Lys Chemical compound C[C@H]([C@@H](C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCCCN)C(=O)O)N)O MECLEFZMPPOEAC-VOAKCMCISA-N 0.000 description 2
- SCSVNSNWUTYSFO-WDCWCFNPSA-N Thr-Lys-Glu Chemical compound C[C@@H](O)[C@H](N)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CCC(O)=O)C(O)=O SCSVNSNWUTYSFO-WDCWCFNPSA-N 0.000 description 2
- KKPOGALELPLJTL-MEYUZBJRSA-N Thr-Lys-Tyr Chemical compound C[C@@H](O)[C@H](N)C(=O)N[C@@H](CCCCN)C(=O)N[C@H](C(O)=O)CC1=CC=C(O)C=C1 KKPOGALELPLJTL-MEYUZBJRSA-N 0.000 description 2
- UJQVSMNQMQHVRY-KZVJFYERSA-N Thr-Met-Ala Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCSC)C(=O)N[C@@H](C)C(O)=O UJQVSMNQMQHVRY-KZVJFYERSA-N 0.000 description 2
- WRQLCVIALDUQEQ-UNQGMJICSA-N Thr-Phe-Arg Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CCCNC(N)=N)C(O)=O WRQLCVIALDUQEQ-UNQGMJICSA-N 0.000 description 2
- WYLAVUAWOUVUCA-XVSYOHENSA-N Thr-Phe-Asp Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CC(O)=O)C(O)=O WYLAVUAWOUVUCA-XVSYOHENSA-N 0.000 description 2
- MFMGPEKYBXFIRF-SUSMZKCASA-N Thr-Thr-Gln Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCC(N)=O)C(O)=O MFMGPEKYBXFIRF-SUSMZKCASA-N 0.000 description 2
- ABCLYRRGTZNIFU-BWAGICSOSA-N Thr-Tyr-His Chemical compound C[C@H]([C@@H](C(=O)N[C@@H](CC1=CC=C(C=C1)O)C(=O)N[C@@H](CC2=CN=CN2)C(=O)O)N)O ABCLYRRGTZNIFU-BWAGICSOSA-N 0.000 description 2
- PWONLXBUSVIZPH-RHYQMDGZSA-N Thr-Val-Lys Chemical compound C[C@H]([C@@H](C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CCCCN)C(=O)O)N)O PWONLXBUSVIZPH-RHYQMDGZSA-N 0.000 description 2
- 102000040945 Transcription factor Human genes 0.000 description 2
- 108091023040 Transcription factor Proteins 0.000 description 2
- QNTBGBCOEYNAPV-CWRNSKLLSA-N Trp-Asn-Pro Chemical compound C1C[C@@H](N(C1)C(=O)[C@H](CC(=O)N)NC(=O)[C@H](CC2=CNC3=CC=CC=C32)N)C(=O)O QNTBGBCOEYNAPV-CWRNSKLLSA-N 0.000 description 2
- XZLHHHYSWIYXHD-XIRDDKMYSA-N Trp-Gln-Arg Chemical compound [H]N[C@@H](CC1=CNC2=C1C=CC=C2)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CCCNC(N)=N)C(O)=O XZLHHHYSWIYXHD-XIRDDKMYSA-N 0.000 description 2
- YXONONCLMLHWJX-SZMVWBNQSA-N Trp-Glu-Leu Chemical compound C1=CC=C2C(C[C@H](N)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(C)C)C(O)=O)=CNC2=C1 YXONONCLMLHWJX-SZMVWBNQSA-N 0.000 description 2
- SEXRBCGSZRCIPE-LYSGOOTNSA-N Trp-Thr-Gly Chemical compound C[C@H]([C@@H](C(=O)NCC(=O)O)NC(=O)[C@H](CC1=CNC2=CC=CC=C21)N)O SEXRBCGSZRCIPE-LYSGOOTNSA-N 0.000 description 2
- SDNVRAKIJVKAGS-LKTVYLICSA-N Tyr-Ala-His Chemical compound C[C@@H](C(=O)N[C@@H](CC1=CN=CN1)C(=O)O)NC(=O)[C@H](CC2=CC=C(C=C2)O)N SDNVRAKIJVKAGS-LKTVYLICSA-N 0.000 description 2
- HKIUVWMZYFBIHG-KKUMJFAQSA-N Tyr-Arg-Gln Chemical compound C1=CC(=CC=C1C[C@@H](C(=O)N[C@@H](CCCN=C(N)N)C(=O)N[C@@H](CCC(=O)N)C(=O)O)N)O HKIUVWMZYFBIHG-KKUMJFAQSA-N 0.000 description 2
- AYPAIRCDLARHLM-KKUMJFAQSA-N Tyr-Asn-Lys Chemical compound C1=CC(=CC=C1C[C@@H](C(=O)N[C@@H](CC(=O)N)C(=O)N[C@@H](CCCCN)C(=O)O)N)O AYPAIRCDLARHLM-KKUMJFAQSA-N 0.000 description 2
- UABYBEBXFFNCIR-YDHLFZDLSA-N Tyr-Asp-Val Chemical compound [H]N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](C(C)C)C(O)=O UABYBEBXFFNCIR-YDHLFZDLSA-N 0.000 description 2
- KIJLSRYAUGGZIN-CFMVVWHZSA-N Tyr-Ile-Asp Chemical compound [H]N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CC(O)=O)C(O)=O KIJLSRYAUGGZIN-CFMVVWHZSA-N 0.000 description 2
- PMHLLBKTDHQMCY-ULQDDVLXSA-N Tyr-Lys-Val Chemical compound [H]N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](C(C)C)C(O)=O PMHLLBKTDHQMCY-ULQDDVLXSA-N 0.000 description 2
- JXGUUJMPCRXMSO-HJOGWXRNSA-N Tyr-Phe-Phe Chemical compound C([C@H](N)C(=O)N[C@@H](CC=1C=CC=CC=1)C(=O)N[C@@H](CC=1C=CC=CC=1)C(O)=O)C1=CC=C(O)C=C1 JXGUUJMPCRXMSO-HJOGWXRNSA-N 0.000 description 2
- VBFVQTPETKJCQW-RPTUDFQQSA-N Tyr-Phe-Thr Chemical compound [H]N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H]([C@@H](C)O)C(O)=O VBFVQTPETKJCQW-RPTUDFQQSA-N 0.000 description 2
- RCMWNNJFKNDKQR-UFYCRDLUSA-N Tyr-Pro-Phe Chemical compound C([C@H](N)C(=O)N1[C@@H](CCC1)C(=O)N[C@@H](CC=1C=CC=CC=1)C(O)=O)C1=CC=C(O)C=C1 RCMWNNJFKNDKQR-UFYCRDLUSA-N 0.000 description 2
- SOAUMCDLIUGXJJ-SRVKXCTJSA-N Tyr-Ser-Asn Chemical compound [H]N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CO)C(=O)N[C@@H](CC(N)=O)C(O)=O SOAUMCDLIUGXJJ-SRVKXCTJSA-N 0.000 description 2
- MQGGXGKQSVEQHR-KKUMJFAQSA-N Tyr-Ser-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](CO)NC(=O)[C@@H](N)CC1=CC=C(O)C=C1 MQGGXGKQSVEQHR-KKUMJFAQSA-N 0.000 description 2
- HZDQUVQEVVYDDA-ACRUOGEOSA-N Tyr-Tyr-Leu Chemical compound C([C@@H](C(=O)N[C@@H](CC(C)C)C(O)=O)NC(=O)[C@@H](N)CC=1C=CC(O)=CC=1)C1=CC=C(O)C=C1 HZDQUVQEVVYDDA-ACRUOGEOSA-N 0.000 description 2
- SQUMHUZLJDUROQ-YDHLFZDLSA-N Tyr-Val-Asp Chemical compound [H]N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CC(O)=O)C(O)=O SQUMHUZLJDUROQ-YDHLFZDLSA-N 0.000 description 2
- ABSXSJZNRAQDDI-KJEVXHAQSA-N Tyr-Val-Thr Chemical compound [H]N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H]([C@@H](C)O)C(O)=O ABSXSJZNRAQDDI-KJEVXHAQSA-N 0.000 description 2
- RUCNAYOMFXRIKJ-DCAQKATOSA-N Val-Ala-Lys Chemical compound CC(C)[C@H](N)C(=O)N[C@@H](C)C(=O)N[C@H](C(O)=O)CCCCN RUCNAYOMFXRIKJ-DCAQKATOSA-N 0.000 description 2
- PAPWZOJOLKZEFR-AVGNSLFASA-N Val-Arg-Lys Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CCCN=C(N)N)C(=O)N[C@@H](CCCCN)C(=O)O)N PAPWZOJOLKZEFR-AVGNSLFASA-N 0.000 description 2
- VLOYGOZDPGYWFO-LAEOZQHASA-N Val-Asp-Glu Chemical compound CC(C)[C@H](N)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CCC(O)=O)C(O)=O VLOYGOZDPGYWFO-LAEOZQHASA-N 0.000 description 2
- BMGOFDMKDVVGJG-NHCYSSNCSA-N Val-Asp-Lys Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CC(=O)O)C(=O)N[C@@H](CCCCN)C(=O)O)N BMGOFDMKDVVGJG-NHCYSSNCSA-N 0.000 description 2
- CVIXTAITYJQMPE-LAEOZQHASA-N Val-Glu-Asn Chemical compound CC(C)[C@H](N)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(N)=O)C(O)=O CVIXTAITYJQMPE-LAEOZQHASA-N 0.000 description 2
- GBESYURLQOYWLU-LAEOZQHASA-N Val-Glu-Asp Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CCC(=O)O)C(=O)N[C@@H](CC(=O)O)C(=O)O)N GBESYURLQOYWLU-LAEOZQHASA-N 0.000 description 2
- XWYUBUYQMOUFRQ-IFFSRLJSSA-N Val-Glu-Thr Chemical compound C[C@H]([C@@H](C(=O)O)NC(=O)[C@H](CCC(=O)O)NC(=O)[C@H](C(C)C)N)O XWYUBUYQMOUFRQ-IFFSRLJSSA-N 0.000 description 2
- YTPLVNUZZOBFFC-SCZZXKLOSA-N Val-Gly-Pro Chemical compound CC(C)[C@H](N)C(=O)NCC(=O)N1CCC[C@@H]1C(O)=O YTPLVNUZZOBFFC-SCZZXKLOSA-N 0.000 description 2
- LAYSXAOGWHKNED-XPUUQOCRSA-N Val-Gly-Ser Chemical compound CC(C)[C@H](N)C(=O)NCC(=O)N[C@@H](CO)C(O)=O LAYSXAOGWHKNED-XPUUQOCRSA-N 0.000 description 2
- KZKMBGXCNLPYKD-YEPSODPASA-N Val-Gly-Thr Chemical compound CC(C)[C@H](N)C(=O)NCC(=O)N[C@@H]([C@@H](C)O)C(O)=O KZKMBGXCNLPYKD-YEPSODPASA-N 0.000 description 2
- AGXGCFSECFQMKB-NHCYSSNCSA-N Val-Leu-Asp Chemical compound CC(C)C[C@@H](C(=O)N[C@@H](CC(=O)O)C(=O)O)NC(=O)[C@H](C(C)C)N AGXGCFSECFQMKB-NHCYSSNCSA-N 0.000 description 2
- WBAJDGWKRIHOAC-GVXVVHGQSA-N Val-Lys-Gln Chemical compound [H]N[C@@H](C(C)C)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CCC(N)=O)C(O)=O WBAJDGWKRIHOAC-GVXVVHGQSA-N 0.000 description 2
- ZRSZTKTVPNSUNA-IHRRRGAJSA-N Val-Lys-Leu Chemical compound CC(C)C[C@H](NC(=O)[C@H](CCCCN)NC(=O)[C@@H](N)C(C)C)C(O)=O ZRSZTKTVPNSUNA-IHRRRGAJSA-N 0.000 description 2
- JVGHIFMSFBZDHH-WPRPVWTQSA-N Val-Met-Gly Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CCSC)C(=O)NCC(=O)O)N JVGHIFMSFBZDHH-WPRPVWTQSA-N 0.000 description 2
- UEPLNXPLHJUYPT-AVGNSLFASA-N Val-Met-Lys Chemical compound CC(C)[C@H](N)C(=O)N[C@@H](CCSC)C(=O)N[C@@H](CCCCN)C(O)=O UEPLNXPLHJUYPT-AVGNSLFASA-N 0.000 description 2
- GQMNEJMFMCJJTD-NHCYSSNCSA-N Val-Pro-Gln Chemical compound CC(C)[C@H](N)C(=O)N1CCC[C@H]1C(=O)N[C@@H](CCC(N)=O)C(O)=O GQMNEJMFMCJJTD-NHCYSSNCSA-N 0.000 description 2
- QIVPZSWBBHRNBA-JYJNAYRXSA-N Val-Pro-Phe Chemical compound CC(C)[C@H](N)C(=O)N1CCC[C@H]1C(=O)N[C@@H](Cc1ccccc1)C(O)=O QIVPZSWBBHRNBA-JYJNAYRXSA-N 0.000 description 2
- NZYNRRGJJVSSTJ-GUBZILKMSA-N Val-Ser-Val Chemical compound CC(C)[C@H](N)C(=O)N[C@@H](CO)C(=O)N[C@@H](C(C)C)C(O)=O NZYNRRGJJVSSTJ-GUBZILKMSA-N 0.000 description 2
- JAIZPWVHPQRYOU-ZJDVBMNYSA-N Val-Thr-Thr Chemical compound C[C@H]([C@@H](C(=O)N[C@@H]([C@@H](C)O)C(=O)O)NC(=O)[C@H](C(C)C)N)O JAIZPWVHPQRYOU-ZJDVBMNYSA-N 0.000 description 2
- MIAZWUMFUURQNP-YDHLFZDLSA-N Val-Tyr-Asn Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CC1=CC=C(C=C1)O)C(=O)N[C@@H](CC(=O)N)C(=O)O)N MIAZWUMFUURQNP-YDHLFZDLSA-N 0.000 description 2
- VTIAEOKFUJJBTC-YDHLFZDLSA-N Val-Tyr-Asp Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CC1=CC=C(C=C1)O)C(=O)N[C@@H](CC(=O)O)C(=O)O)N VTIAEOKFUJJBTC-YDHLFZDLSA-N 0.000 description 2
- GUIYPEKUEMQBIK-JSGCOSHPSA-N Val-Tyr-Gly Chemical compound CC(C)[C@H](N)C(=O)N[C@@H](Cc1ccc(O)cc1)C(=O)NCC(O)=O GUIYPEKUEMQBIK-JSGCOSHPSA-N 0.000 description 2
- JXWGBRRVTRAZQA-ULQDDVLXSA-N Val-Tyr-Leu Chemical compound CC(C)C[C@@H](C(=O)O)NC(=O)[C@H](CC1=CC=C(C=C1)O)NC(=O)[C@H](C(C)C)N JXWGBRRVTRAZQA-ULQDDVLXSA-N 0.000 description 2
- 230000004913 activation Effects 0.000 description 2
- 125000003295 alanine group Chemical group N[C@@H](C)C(=O)* 0.000 description 2
- 108010024078 alanyl-glycyl-serine Proteins 0.000 description 2
- 108010087924 alanylproline Proteins 0.000 description 2
- 108010050025 alpha-glutamyltryptophan Proteins 0.000 description 2
- 108010001271 arginyl-glutamyl-arginine Proteins 0.000 description 2
- 108010059459 arginyl-threonyl-phenylalanine Proteins 0.000 description 2
- 108010060035 arginylproline Proteins 0.000 description 2
- 108010077245 asparaginyl-proline Proteins 0.000 description 2
- 108010068265 aspartyltyrosine Proteins 0.000 description 2
- 230000033228 biological regulation Effects 0.000 description 2
- 230000000903 blocking effect Effects 0.000 description 2
- 210000000133 brain stem Anatomy 0.000 description 2
- 229910000389 calcium phosphate Inorganic materials 0.000 description 2
- 239000001506 calcium phosphate Substances 0.000 description 2
- 235000011010 calcium phosphates Nutrition 0.000 description 2
- 229910002091 carbon monoxide Inorganic materials 0.000 description 2
- 210000003710 cerebral cortex Anatomy 0.000 description 2
- 210000004720 cerebrum Anatomy 0.000 description 2
- 210000004978 chinese hamster ovary cell Anatomy 0.000 description 2
- 210000003763 chloroplast Anatomy 0.000 description 2
- 230000002759 chromosomal effect Effects 0.000 description 2
- 230000008045 co-localization Effects 0.000 description 2
- 150000001875 compounds Chemical class 0.000 description 2
- 238000010276 construction Methods 0.000 description 2
- 230000001054 cortical effect Effects 0.000 description 2
- 108010069495 cysteinyltyrosine Proteins 0.000 description 2
- 238000006731 degradation reaction Methods 0.000 description 2
- 238000011161 development Methods 0.000 description 2
- 230000005750 disease progression Effects 0.000 description 2
- 238000009826 distribution Methods 0.000 description 2
- 239000003937 drug carrier Substances 0.000 description 2
- 238000004520 electroporation Methods 0.000 description 2
- 210000002257 embryonic structure Anatomy 0.000 description 2
- 238000005538 encapsulation Methods 0.000 description 2
- 239000003623 enhancer Substances 0.000 description 2
- 238000002474 experimental method Methods 0.000 description 2
- 239000013604 expression vector Substances 0.000 description 2
- 210000000720 eyelash Anatomy 0.000 description 2
- 238000000684 flow cytometry Methods 0.000 description 2
- 229960003692 gamma aminobutyric acid Drugs 0.000 description 2
- BTCSSZJGUNDROE-UHFFFAOYSA-N gamma-aminobutyric acid Chemical compound NCCCC(O)=O BTCSSZJGUNDROE-UHFFFAOYSA-N 0.000 description 2
- 238000001415 gene therapy Methods 0.000 description 2
- 150000004676 glycans Chemical class 0.000 description 2
- 108010026364 glycyl-glycyl-leucine Proteins 0.000 description 2
- 108010050475 glycyl-leucyl-tyrosine Proteins 0.000 description 2
- 108010077435 glycyl-phenylalanyl-glycine Proteins 0.000 description 2
- 108010081551 glycylphenylalanine Proteins 0.000 description 2
- 108010077515 glycylproline Proteins 0.000 description 2
- UYTPUPDQBNUYGX-UHFFFAOYSA-N guanine Chemical compound O=C1NC(N)=NC2=C1N=CN2 UYTPUPDQBNUYGX-UHFFFAOYSA-N 0.000 description 2
- 108010028295 histidylhistidine Proteins 0.000 description 2
- 210000005260 human cell Anatomy 0.000 description 2
- FDGQSTZJBFJUBT-UHFFFAOYSA-N hypoxanthine Chemical compound O=C1NC=NC2=C1NC=N2 FDGQSTZJBFJUBT-UHFFFAOYSA-N 0.000 description 2
- 230000002401 inhibitory effect Effects 0.000 description 2
- 230000005764 inhibitory process Effects 0.000 description 2
- 230000010354 integration Effects 0.000 description 2
- 239000002523 lectin Substances 0.000 description 2
- 108010044311 leucyl-glycyl-glycine Proteins 0.000 description 2
- 108010030617 leucyl-phenylalanyl-valine Proteins 0.000 description 2
- 108010000761 leucylarginine Proteins 0.000 description 2
- 239000002502 liposome Substances 0.000 description 2
- 244000144972 livestock Species 0.000 description 2
- 108010044348 lysyl-glutamyl-aspartic acid Proteins 0.000 description 2
- 108010009298 lysylglutamic acid Proteins 0.000 description 2
- 210000001259 mesencephalon Anatomy 0.000 description 2
- 108091007426 microRNA precursor Proteins 0.000 description 2
- 230000002438 mitochondrial effect Effects 0.000 description 2
- 230000011278 mitosis Effects 0.000 description 2
- 201000006417 multiple sclerosis Diseases 0.000 description 2
- 210000001577 neostriatum Anatomy 0.000 description 2
- 210000005036 nerve Anatomy 0.000 description 2
- 210000004126 nerve fiber Anatomy 0.000 description 2
- 210000000653 nervous system Anatomy 0.000 description 2
- 230000004770 neurodegeneration Effects 0.000 description 2
- 208000015122 neurodegenerative disease Diseases 0.000 description 2
- 208000002761 neurofibromatosis 2 Diseases 0.000 description 2
- 230000000926 neurological effect Effects 0.000 description 2
- 239000003900 neurotrophic factor Substances 0.000 description 2
- 210000004940 nucleus Anatomy 0.000 description 2
- 229920002866 paraformaldehyde Polymers 0.000 description 2
- 230000036961 partial effect Effects 0.000 description 2
- 108010025488 pinealon Proteins 0.000 description 2
- 230000029279 positive regulation of transcription, DNA-dependent Effects 0.000 description 2
- 238000001556 precipitation Methods 0.000 description 2
- 238000002360 preparation method Methods 0.000 description 2
- 230000002265 prevention Effects 0.000 description 2
- 230000035755 proliferation Effects 0.000 description 2
- 229940121649 protein inhibitor Drugs 0.000 description 2
- 239000012268 protein inhibitor Substances 0.000 description 2
- 239000002994 raw material Substances 0.000 description 2
- 230000002441 reversible effect Effects 0.000 description 2
- 210000005241 right ventricle Anatomy 0.000 description 2
- 150000003839 salts Chemical class 0.000 description 2
- 238000007480 sanger sequencing Methods 0.000 description 2
- 238000002864 sequence alignment Methods 0.000 description 2
- 108010026333 seryl-proline Proteins 0.000 description 2
- 230000037432 silent mutation Effects 0.000 description 2
- 241000894007 species Species 0.000 description 2
- 230000006641 stabilisation Effects 0.000 description 2
- 238000011105 stabilization Methods 0.000 description 2
- 238000010186 staining Methods 0.000 description 2
- 230000002739 subcortical effect Effects 0.000 description 2
- 238000007920 subcutaneous administration Methods 0.000 description 2
- 239000000126 substance Substances 0.000 description 2
- 108010031491 threonyl-lysyl-glutamic acid Proteins 0.000 description 2
- 238000012546 transfer Methods 0.000 description 2
- 230000007704 transition Effects 0.000 description 2
- QORWJWZARLRLPR-UHFFFAOYSA-H tricalcium bis(phosphate) Chemical compound [Ca+2].[Ca+2].[Ca+2].[O-]P([O-])([O-])=O.[O-]P([O-])([O-])=O QORWJWZARLRLPR-UHFFFAOYSA-H 0.000 description 2
- 108010012567 tyrosyl-glycyl-glycyl-phenylalanyl Proteins 0.000 description 2
- 210000003501 vero cell Anatomy 0.000 description 2
- 238000005406 washing Methods 0.000 description 2
- BRPMXFSTKXXNHF-IUCAKERBSA-N (2s)-1-[2-[[(2s)-pyrrolidine-2-carbonyl]amino]acetyl]pyrrolidine-2-carboxylic acid Chemical compound OC(=O)[C@@H]1CCCN1C(=O)CNC(=O)[C@H]1NCCC1 BRPMXFSTKXXNHF-IUCAKERBSA-N 0.000 description 1
- 102000040650 (ribonucleotides)n+m Human genes 0.000 description 1
- HXUVTXPOZRFMOY-NSHDSACASA-N 2-[[(2s)-2-[[2-[(2-aminoacetyl)amino]acetyl]amino]-3-phenylpropanoyl]amino]acetic acid Chemical compound NCC(=O)NCC(=O)N[C@H](C(=O)NCC(O)=O)CC1=CC=CC=C1 HXUVTXPOZRFMOY-NSHDSACASA-N 0.000 description 1
- 101800000263 Acidic protein Proteins 0.000 description 1
- YSMPVONNIWLJML-FXQIFTODSA-N Ala-Asp-Pro Chemical compound C[C@H](N)C(=O)N[C@@H](CC(O)=O)C(=O)N1CCC[C@H]1C(O)=O YSMPVONNIWLJML-FXQIFTODSA-N 0.000 description 1
- FBHOPGDGELNWRH-DRZSPHRISA-N Ala-Glu-Phe Chemical compound [H]N[C@@H](C)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC1=CC=CC=C1)C(O)=O FBHOPGDGELNWRH-DRZSPHRISA-N 0.000 description 1
- ZVFVBBGVOILKPO-WHFBIAKZSA-N Ala-Gly-Ala Chemical compound C[C@H](N)C(=O)NCC(=O)N[C@@H](C)C(O)=O ZVFVBBGVOILKPO-WHFBIAKZSA-N 0.000 description 1
- CBCCCLMNOBLBSC-XVYDVKMFSA-N Ala-His-Ser Chemical compound [H]N[C@@H](C)C(=O)N[C@@H](CC1=CNC=N1)C(=O)N[C@@H](CO)C(O)=O CBCCCLMNOBLBSC-XVYDVKMFSA-N 0.000 description 1
- DVJSJDDYCYSMFR-ZKWXMUAHSA-N Ala-Ile-Gly Chemical compound [H]N[C@@H](C)C(=O)N[C@@H]([C@@H](C)CC)C(=O)NCC(O)=O DVJSJDDYCYSMFR-ZKWXMUAHSA-N 0.000 description 1
- XHNLCGXYBXNRIS-BJDJZHNGSA-N Ala-Lys-Ile Chemical compound [H]N[C@@H](C)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O XHNLCGXYBXNRIS-BJDJZHNGSA-N 0.000 description 1
- BHTBAVZSZCQZPT-GUBZILKMSA-N Ala-Pro-Met Chemical compound CSCC[C@@H](C(O)=O)NC(=O)[C@@H]1CCCN1C(=O)[C@H](C)N BHTBAVZSZCQZPT-GUBZILKMSA-N 0.000 description 1
- MMLHRUJLOUSRJX-CIUDSAMLSA-N Ala-Ser-Lys Chemical compound C[C@H](N)C(=O)N[C@@H](CO)C(=O)N[C@H](C(O)=O)CCCCN MMLHRUJLOUSRJX-CIUDSAMLSA-N 0.000 description 1
- WQKAQKZRDIZYNV-VZFHVOOUSA-N Ala-Ser-Thr Chemical compound [H]N[C@@H](C)C(=O)N[C@@H](CO)C(=O)N[C@@H]([C@@H](C)O)C(O)=O WQKAQKZRDIZYNV-VZFHVOOUSA-N 0.000 description 1
- OEVCHROQUIVQFZ-YTLHQDLWSA-N Ala-Thr-Ala Chemical compound C[C@H](N)C(=O)N[C@@H]([C@H](O)C)C(=O)N[C@@H](C)C(O)=O OEVCHROQUIVQFZ-YTLHQDLWSA-N 0.000 description 1
- SAHQGRZIQVEJPF-JXUBOQSCSA-N Ala-Thr-Lys Chemical compound C[C@H](N)C(=O)N[C@@H]([C@H](O)C)C(=O)N[C@H](C(O)=O)CCCCN SAHQGRZIQVEJPF-JXUBOQSCSA-N 0.000 description 1
- QOIGKCBMXUCDQU-KDXUFGMBSA-N Ala-Thr-Pro Chemical compound C[C@H]([C@@H](C(=O)N1CCC[C@@H]1C(=O)O)NC(=O)[C@H](C)N)O QOIGKCBMXUCDQU-KDXUFGMBSA-N 0.000 description 1
- 102400000068 Angiostatin Human genes 0.000 description 1
- 108010079709 Angiostatins Proteins 0.000 description 1
- 101100490659 Arabidopsis thaliana AGP17 gene Proteins 0.000 description 1
- KWKQGHSSNHPGOW-BQBZGAKWSA-N Arg-Ala-Gly Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](C)C(=O)NCC(O)=O KWKQGHSSNHPGOW-BQBZGAKWSA-N 0.000 description 1
- ASQYTJJWAMDISW-BPUTZDHNSA-N Arg-Asp-Trp Chemical compound C1=CC=C2C(=C1)C(=CN2)C[C@@H](C(=O)O)NC(=O)[C@H](CC(=O)O)NC(=O)[C@H](CCCN=C(N)N)N ASQYTJJWAMDISW-BPUTZDHNSA-N 0.000 description 1
- FEZJJKXNPSEYEV-CIUDSAMLSA-N Arg-Gln-Ala Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](C)C(O)=O FEZJJKXNPSEYEV-CIUDSAMLSA-N 0.000 description 1
- PNIGSVZJNVUVJA-BQBZGAKWSA-N Arg-Gly-Asn Chemical compound NC(N)=NCCC[C@H](N)C(=O)NCC(=O)N[C@@H](CC(N)=O)C(O)=O PNIGSVZJNVUVJA-BQBZGAKWSA-N 0.000 description 1
- WVNFNPGXYADPPO-BQBZGAKWSA-N Arg-Gly-Ser Chemical compound NC(N)=NCCC[C@H](N)C(=O)NCC(=O)N[C@@H](CO)C(O)=O WVNFNPGXYADPPO-BQBZGAKWSA-N 0.000 description 1
- FVBZXNSRIDVYJS-AVGNSLFASA-N Arg-Pro-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@@H]1CCCN1C(=O)[C@@H](N)CCCN=C(N)N FVBZXNSRIDVYJS-AVGNSLFASA-N 0.000 description 1
- SYFHFLGAROUHNT-VEVYYDQMSA-N Arg-Thr-Asn Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CC(N)=O)C(O)=O SYFHFLGAROUHNT-VEVYYDQMSA-N 0.000 description 1
- ZPWMEWYQBWSGAO-ZJDVBMNYSA-N Arg-Thr-Thr Chemical compound [H]N[C@@H](CCCNC(N)=N)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H]([C@@H](C)O)C(O)=O ZPWMEWYQBWSGAO-ZJDVBMNYSA-N 0.000 description 1
- FSPQNLYOFCXUCE-BPUTZDHNSA-N Arg-Trp-Asn Chemical compound C1=CC=C2C(=C1)C(=CN2)C[C@@H](C(=O)N[C@@H](CC(=O)N)C(=O)O)NC(=O)[C@H](CCCN=C(N)N)N FSPQNLYOFCXUCE-BPUTZDHNSA-N 0.000 description 1
- CIBWFJFMOBIFTE-CIUDSAMLSA-N Asn-Arg-Gln Chemical compound C(C[C@@H](C(=O)N[C@@H](CCC(=O)N)C(=O)O)NC(=O)[C@H](CC(=O)N)N)CN=C(N)N CIBWFJFMOBIFTE-CIUDSAMLSA-N 0.000 description 1
- ACRYGQFHAQHDSF-ZLUOBGJFSA-N Asn-Asn-Asn Chemical compound NC(=O)C[C@H](N)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CC(N)=O)C(O)=O ACRYGQFHAQHDSF-ZLUOBGJFSA-N 0.000 description 1
- PCKRJVZAQZWNKM-WHFBIAKZSA-N Asn-Asn-Gly Chemical compound NC(=O)C[C@H](N)C(=O)N[C@@H](CC(N)=O)C(=O)NCC(O)=O PCKRJVZAQZWNKM-WHFBIAKZSA-N 0.000 description 1
- PIWWUBYJNONVTJ-ZLUOBGJFSA-N Asn-Asp-Asn Chemical compound C([C@@H](C(=O)N[C@@H](CC(=O)O)C(=O)N[C@@H](CC(=O)N)C(=O)O)N)C(=O)N PIWWUBYJNONVTJ-ZLUOBGJFSA-N 0.000 description 1
- XSGBIBGAMKTHMY-WHFBIAKZSA-N Asn-Asp-Gly Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CC(O)=O)C(=O)NCC(O)=O XSGBIBGAMKTHMY-WHFBIAKZSA-N 0.000 description 1
- GFFRWIJAFFMQGM-NUMRIWBASA-N Asn-Glu-Thr Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H]([C@@H](C)O)C(O)=O GFFRWIJAFFMQGM-NUMRIWBASA-N 0.000 description 1
- DDPXDCKYWDGZAL-BQBZGAKWSA-N Asn-Gly-Arg Chemical compound NC(=O)C[C@H](N)C(=O)NCC(=O)N[C@H](C(O)=O)CCCN=C(N)N DDPXDCKYWDGZAL-BQBZGAKWSA-N 0.000 description 1
- HFPXZWPUVFVNLL-GUBZILKMSA-N Asn-Leu-Gln Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCC(N)=O)C(O)=O HFPXZWPUVFVNLL-GUBZILKMSA-N 0.000 description 1
- BKZFBJYIVSBXCO-KKUMJFAQSA-N Asn-Phe-His Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CC1=CNC=N1)C(O)=O BKZFBJYIVSBXCO-KKUMJFAQSA-N 0.000 description 1
- BKFXFUPYETWGGA-XVSYOHENSA-N Asn-Phe-Thr Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H]([C@@H](C)O)C(O)=O BKFXFUPYETWGGA-XVSYOHENSA-N 0.000 description 1
- VCJCPARXDBEGNE-GUBZILKMSA-N Asn-Pro-Pro Chemical compound NC(=O)C[C@H](N)C(=O)N1CCC[C@H]1C(=O)N1[C@H](C(O)=O)CCC1 VCJCPARXDBEGNE-GUBZILKMSA-N 0.000 description 1
- UGXYFDQFLVCDFC-CIUDSAMLSA-N Asn-Ser-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@H](CO)NC(=O)[C@@H](N)CC(N)=O UGXYFDQFLVCDFC-CIUDSAMLSA-N 0.000 description 1
- VLDRQOHCMKCXLY-SRVKXCTJSA-N Asn-Ser-Phe Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CO)C(=O)N[C@@H](CC1=CC=CC=C1)C(O)=O VLDRQOHCMKCXLY-SRVKXCTJSA-N 0.000 description 1
- ZUFPUBYQYWCMDB-NUMRIWBASA-N Asn-Thr-Glu Chemical compound NC(=O)C[C@H](N)C(=O)N[C@@H]([C@H](O)C)C(=O)N[C@@H](CCC(O)=O)C(O)=O ZUFPUBYQYWCMDB-NUMRIWBASA-N 0.000 description 1
- LRCIOEVFVGXZKB-BZSNNMDCSA-N Asn-Tyr-Tyr Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(O)=O LRCIOEVFVGXZKB-BZSNNMDCSA-N 0.000 description 1
- MYRLSKYSMXNLLA-LAEOZQHASA-N Asn-Val-Glu Chemical compound [H]N[C@@H](CC(N)=O)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CCC(O)=O)C(O)=O MYRLSKYSMXNLLA-LAEOZQHASA-N 0.000 description 1
- WCFCYFDBMNFSPA-ACZMJKKPSA-N Asp-Asp-Glu Chemical compound OC(=O)C[C@H](N)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@H](C(O)=O)CCC(O)=O WCFCYFDBMNFSPA-ACZMJKKPSA-N 0.000 description 1
- UFAQGGZUXVLONR-AVGNSLFASA-N Asp-Gln-Tyr Chemical compound C1=CC(=CC=C1C[C@@H](C(=O)O)NC(=O)[C@H](CCC(=O)N)NC(=O)[C@H](CC(=O)O)N)O UFAQGGZUXVLONR-AVGNSLFASA-N 0.000 description 1
- GBSUGIXJAAKZOW-GMOBBJLQSA-N Asp-Ile-Arg Chemical compound OC(=O)C[C@H](N)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CCCN=C(N)N)C(O)=O GBSUGIXJAAKZOW-GMOBBJLQSA-N 0.000 description 1
- KQBVNNAPIURMPD-PEFMBERDSA-N Asp-Ile-Glu Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CCC(O)=O)C(O)=O KQBVNNAPIURMPD-PEFMBERDSA-N 0.000 description 1
- YWLDTBBUHZJQHW-KKUMJFAQSA-N Asp-Lys-Phe Chemical compound C1=CC=C(C=C1)C[C@@H](C(=O)O)NC(=O)[C@H](CCCCN)NC(=O)[C@H](CC(=O)O)N YWLDTBBUHZJQHW-KKUMJFAQSA-N 0.000 description 1
- KPSHWSWFPUDEGF-FXQIFTODSA-N Asp-Pro-Ala Chemical compound OC(=O)[C@H](C)NC(=O)[C@@H]1CCCN1C(=O)[C@@H](N)CC(O)=O KPSHWSWFPUDEGF-FXQIFTODSA-N 0.000 description 1
- BKOIIURTQAJHAT-GUBZILKMSA-N Asp-Pro-Pro Chemical compound OC(=O)C[C@H](N)C(=O)N1CCC[C@H]1C(=O)N1[C@H](C(O)=O)CCC1 BKOIIURTQAJHAT-GUBZILKMSA-N 0.000 description 1
- BRRPVTUFESPTCP-ACZMJKKPSA-N Asp-Ser-Glu Chemical compound OC(=O)C[C@H](N)C(=O)N[C@@H](CO)C(=O)N[C@H](C(O)=O)CCC(O)=O BRRPVTUFESPTCP-ACZMJKKPSA-N 0.000 description 1
- QSFHZPQUAAQHAQ-CIUDSAMLSA-N Asp-Ser-Leu Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](CO)C(=O)N[C@@H](CC(C)C)C(O)=O QSFHZPQUAAQHAQ-CIUDSAMLSA-N 0.000 description 1
- YIDFBWRHIYOYAA-LKXGYXEUSA-N Asp-Ser-Thr Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](CO)C(=O)N[C@@H]([C@@H](C)O)C(O)=O YIDFBWRHIYOYAA-LKXGYXEUSA-N 0.000 description 1
- RSMZEHCMIOKNMW-GSSVUCPTSA-N Asp-Thr-Thr Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H]([C@@H](C)O)C(O)=O RSMZEHCMIOKNMW-GSSVUCPTSA-N 0.000 description 1
- PLOKOIJSGCISHE-BYULHYEWSA-N Asp-Val-Asn Chemical compound [H]N[C@@H](CC(O)=O)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CC(N)=O)C(O)=O PLOKOIJSGCISHE-BYULHYEWSA-N 0.000 description 1
- SFJUYBCDQBAYAJ-YDHLFZDLSA-N Asp-Val-Phe Chemical compound OC(=O)C[C@H](N)C(=O)N[C@@H](C(C)C)C(=O)N[C@H](C(O)=O)CC1=CC=CC=C1 SFJUYBCDQBAYAJ-YDHLFZDLSA-N 0.000 description 1
- JGLWFWXGOINXEA-YDHLFZDLSA-N Asp-Val-Tyr Chemical compound OC(=O)C[C@H](N)C(=O)N[C@@H](C(C)C)C(=O)N[C@H](C(O)=O)CC1=CC=C(O)C=C1 JGLWFWXGOINXEA-YDHLFZDLSA-N 0.000 description 1
- 108010032947 Ataxin-3 Proteins 0.000 description 1
- 102000007371 Ataxin-3 Human genes 0.000 description 1
- 102100021321 Ataxin-3 Human genes 0.000 description 1
- 102000007370 Ataxin2 Human genes 0.000 description 1
- 108010032951 Ataxin2 Proteins 0.000 description 1
- 206010003805 Autism Diseases 0.000 description 1
- 208000020706 Autistic disease Diseases 0.000 description 1
- 241000271566 Aves Species 0.000 description 1
- WOVKYSAHUYNSMH-UHFFFAOYSA-N BROMODEOXYURIDINE Natural products C1C(O)C(CO)OC1N1C(=O)NC(=O)C(Br)=C1 WOVKYSAHUYNSMH-UHFFFAOYSA-N 0.000 description 1
- 108091032955 Bacterial small RNA Proteins 0.000 description 1
- 101150079123 Bad gene Proteins 0.000 description 1
- 210000003771 C cell Anatomy 0.000 description 1
- 238000011746 C57BL/6J (JAX™ mouse strain) Methods 0.000 description 1
- 101100505161 Caenorhabditis elegans mel-32 gene Proteins 0.000 description 1
- 241000282465 Canis Species 0.000 description 1
- CURLTUGMZLYLDI-UHFFFAOYSA-N Carbon dioxide Chemical compound O=C=O CURLTUGMZLYLDI-UHFFFAOYSA-N 0.000 description 1
- 241000700199 Cavia porcellus Species 0.000 description 1
- 102000000844 Cell Surface Receptors Human genes 0.000 description 1
- 108010001857 Cell Surface Receptors Proteins 0.000 description 1
- 208000030939 Chronic inflammatory demyelinating polyneuropathy Diseases 0.000 description 1
- 208000003322 Coinfection Diseases 0.000 description 1
- 208000019736 Cranial nerve disease Diseases 0.000 description 1
- 241000195493 Cryptophyta Species 0.000 description 1
- HBHMVBGGHDMPBF-GARJFASQSA-N Cys-Leu-Pro Chemical compound CC(C)C[C@@H](C(=O)N1CCC[C@@H]1C(=O)O)NC(=O)[C@H](CS)N HBHMVBGGHDMPBF-GARJFASQSA-N 0.000 description 1
- MJOYUXLETJMQGG-IHRRRGAJSA-N Cys-Tyr-Arg Chemical compound [H]N[C@@H](CS)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CCCNC(N)=N)C(O)=O MJOYUXLETJMQGG-IHRRRGAJSA-N 0.000 description 1
- 102100031635 Cytoplasmic dynein 1 heavy chain 1 Human genes 0.000 description 1
- 102220605874 Cytosolic arginine sensor for mTORC1 subunit 2_D10A_mutation Human genes 0.000 description 1
- 102000053602 DNA Human genes 0.000 description 1
- 230000007018 DNA scission Effects 0.000 description 1
- 238000001712 DNA sequencing Methods 0.000 description 1
- 241000450599 DNA viruses Species 0.000 description 1
- 102000004163 DNA-directed RNA polymerases Human genes 0.000 description 1
- 108090000626 DNA-directed RNA polymerases Proteins 0.000 description 1
- 108010008532 Deoxyribonuclease I Proteins 0.000 description 1
- 102000007260 Deoxyribonuclease I Human genes 0.000 description 1
- 108010053770 Deoxyribonucleases Proteins 0.000 description 1
- 102000016911 Deoxyribonucleases Human genes 0.000 description 1
- 208000032131 Diabetic Neuropathies Diseases 0.000 description 1
- 208000000202 Diffuse Axonal Injury Diseases 0.000 description 1
- 208000005189 Embolism Diseases 0.000 description 1
- 108010067770 Endopeptidase K Proteins 0.000 description 1
- 102400001047 Endostatin Human genes 0.000 description 1
- 108010079505 Endostatins Proteins 0.000 description 1
- 241000283074 Equus asinus Species 0.000 description 1
- 241000283073 Equus caballus Species 0.000 description 1
- 240000006212 Erythrina crista-galli Species 0.000 description 1
- 241000588724 Escherichia coli Species 0.000 description 1
- RZSYLLSAWYUBPE-UHFFFAOYSA-L Fast green FCF Chemical compound [Na+].[Na+].C=1C=C(C(=C2C=CC(C=C2)=[N+](CC)CC=2C=C(C=CC=2)S([O-])(=O)=O)C=2C(=CC(O)=CC=2)S([O-])(=O)=O)C=CC=1N(CC)CC1=CC=CC(S([O-])(=O)=O)=C1 RZSYLLSAWYUBPE-UHFFFAOYSA-L 0.000 description 1
- 108091006020 Fc-tagged proteins Proteins 0.000 description 1
- 101000941893 Felis catus Leucine-rich repeat and calponin homology domain-containing protein 1 Proteins 0.000 description 1
- 102000018233 Fibroblast Growth Factor Human genes 0.000 description 1
- 108050007372 Fibroblast Growth Factor Proteins 0.000 description 1
- 241000287828 Gallus gallus Species 0.000 description 1
- 101000834253 Gallus gallus Actin, cytoplasmic 1 Proteins 0.000 description 1
- 230000010558 Gene Alterations Effects 0.000 description 1
- WUAYFMZULZDSLB-ACZMJKKPSA-N Gln-Ala-Asn Chemical compound NC(=O)C[C@@H](C(O)=O)NC(=O)[C@H](C)NC(=O)[C@@H](N)CCC(N)=O WUAYFMZULZDSLB-ACZMJKKPSA-N 0.000 description 1
- PGPJSRSLQNXBDT-YUMQZZPRSA-N Gln-Arg-Gly Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H](CCCNC(N)=N)C(=O)NCC(O)=O PGPJSRSLQNXBDT-YUMQZZPRSA-N 0.000 description 1
- PRBLYKYHAJEABA-SRVKXCTJSA-N Gln-Arg-Leu Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC(C)C)C(O)=O PRBLYKYHAJEABA-SRVKXCTJSA-N 0.000 description 1
- BTSPOOHJBYJRKO-CIUDSAMLSA-N Gln-Asp-Arg Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CCCNC(N)=N)C(O)=O BTSPOOHJBYJRKO-CIUDSAMLSA-N 0.000 description 1
- NKCZYEDZTKOFBG-GUBZILKMSA-N Gln-Gln-Arg Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CCCNC(N)=N)C(O)=O NKCZYEDZTKOFBG-GUBZILKMSA-N 0.000 description 1
- IVCOYUURLWQDJQ-LPEHRKFASA-N Gln-Gln-Pro Chemical compound C1C[C@@H](N(C1)C(=O)[C@H](CCC(=O)N)NC(=O)[C@H](CCC(=O)N)N)C(=O)O IVCOYUURLWQDJQ-LPEHRKFASA-N 0.000 description 1
- NPTGGVQJYRSMCM-GLLZPBPUSA-N Gln-Gln-Thr Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H]([C@@H](C)O)C(O)=O NPTGGVQJYRSMCM-GLLZPBPUSA-N 0.000 description 1
- IKFZXRLDMYWNBU-YUMQZZPRSA-N Gln-Gly-Arg Chemical compound NC(=O)CC[C@H](N)C(=O)NCC(=O)N[C@H](C(O)=O)CCCN=C(N)N IKFZXRLDMYWNBU-YUMQZZPRSA-N 0.000 description 1
- ORYMMTRPKVTGSJ-XVKPBYJWSA-N Gln-Gly-Val Chemical compound CC(C)[C@@H](C(O)=O)NC(=O)CNC(=O)[C@@H](N)CCC(N)=O ORYMMTRPKVTGSJ-XVKPBYJWSA-N 0.000 description 1
- HPCOBEHVEHWREJ-DCAQKATOSA-N Gln-Lys-Glu Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CCC(O)=O)C(O)=O HPCOBEHVEHWREJ-DCAQKATOSA-N 0.000 description 1
- MFORDNZDKAVNSR-SRVKXCTJSA-N Gln-Pro-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@@H]1CCCN1C(=O)[C@@H](N)CCC(N)=O MFORDNZDKAVNSR-SRVKXCTJSA-N 0.000 description 1
- NYCVMJGIJYQWDO-CIUDSAMLSA-N Gln-Ser-Arg Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H](CO)C(=O)N[C@@H](CCCNC(N)=N)C(O)=O NYCVMJGIJYQWDO-CIUDSAMLSA-N 0.000 description 1
- LPIKVBWNNVFHCQ-GUBZILKMSA-N Gln-Ser-Leu Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H](CO)C(=O)N[C@@H](CC(C)C)C(O)=O LPIKVBWNNVFHCQ-GUBZILKMSA-N 0.000 description 1
- UQKVUFGUSVYJMQ-IRIUXVKKSA-N Gln-Tyr-Thr Chemical compound C[C@H]([C@@H](C(=O)O)NC(=O)[C@H](CC1=CC=C(C=C1)O)NC(=O)[C@H](CCC(=O)N)N)O UQKVUFGUSVYJMQ-IRIUXVKKSA-N 0.000 description 1
- FITIQFSXXBKFFM-NRPADANISA-N Gln-Val-Ser Chemical compound [H]N[C@@H](CCC(N)=O)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CO)C(O)=O FITIQFSXXBKFFM-NRPADANISA-N 0.000 description 1
- WATXSTJXNBOHKD-LAEOZQHASA-N Glu-Asp-Val Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](C(C)C)C(O)=O WATXSTJXNBOHKD-LAEOZQHASA-N 0.000 description 1
- BUZMZDDKFCSKOT-CIUDSAMLSA-N Glu-Glu-Glu Chemical compound OC(=O)CC[C@H](N)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CCC(O)=O)C(O)=O BUZMZDDKFCSKOT-CIUDSAMLSA-N 0.000 description 1
- LGYZYFFDELZWRS-DCAQKATOSA-N Glu-Glu-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@H](CCC(O)=O)NC(=O)[C@@H](N)CCC(O)=O LGYZYFFDELZWRS-DCAQKATOSA-N 0.000 description 1
- WVYJNPCWJYBHJG-YVNDNENWSA-N Glu-Ile-Gln Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CCC(N)=O)C(O)=O WVYJNPCWJYBHJG-YVNDNENWSA-N 0.000 description 1
- OCJRHJZKGGSPRW-IUCAKERBSA-N Glu-Lys-Gly Chemical compound NCCCC[C@@H](C(=O)NCC(O)=O)NC(=O)[C@@H](N)CCC(O)=O OCJRHJZKGGSPRW-IUCAKERBSA-N 0.000 description 1
- MFNUFCFRAZPJFW-JYJNAYRXSA-N Glu-Lys-Phe Chemical compound OC(=O)CC[C@H](N)C(=O)N[C@@H](CCCCN)C(=O)N[C@H](C(O)=O)CC1=CC=CC=C1 MFNUFCFRAZPJFW-JYJNAYRXSA-N 0.000 description 1
- SUIAHERNFYRBDZ-GVXVVHGQSA-N Glu-Lys-Val Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](C(C)C)C(O)=O SUIAHERNFYRBDZ-GVXVVHGQSA-N 0.000 description 1
- TWYFJOHWGCCRIR-DCAQKATOSA-N Glu-Pro-Arg Chemical compound [H]N[C@@H](CCC(O)=O)C(=O)N1CCC[C@H]1C(=O)N[C@@H](CCCNC(N)=N)C(O)=O TWYFJOHWGCCRIR-DCAQKATOSA-N 0.000 description 1
- BPCLDCNZBUYGOD-BPUTZDHNSA-N Glu-Trp-Glu Chemical compound C1=CC=C2C(C[C@H](NC(=O)[C@H](CCC(O)=O)N)C(=O)N[C@@H](CCC(O)=O)C(O)=O)=CNC2=C1 BPCLDCNZBUYGOD-BPUTZDHNSA-N 0.000 description 1
- PMSDOVISAARGAV-FHWLQOOXSA-N Glu-Tyr-Phe Chemical compound C([C@H](NC(=O)[C@H](CCC(O)=O)N)C(=O)N[C@@H](CC=1C=CC=CC=1)C(O)=O)C1=CC=C(O)C=C1 PMSDOVISAARGAV-FHWLQOOXSA-N 0.000 description 1
- VXEFAWJTFAUDJK-AVGNSLFASA-N Glu-Tyr-Ser Chemical compound C1=CC(=CC=C1C[C@@H](C(=O)N[C@@H](CO)C(=O)O)NC(=O)[C@H](CCC(=O)O)N)O VXEFAWJTFAUDJK-AVGNSLFASA-N 0.000 description 1
- JBRBACJPBZNFMF-YUMQZZPRSA-N Gly-Ala-Lys Chemical compound NCC(=O)N[C@@H](C)C(=O)N[C@H](C(O)=O)CCCCN JBRBACJPBZNFMF-YUMQZZPRSA-N 0.000 description 1
- QSDKBRMVXSWAQE-BFHQHQDPSA-N Gly-Ala-Thr Chemical compound C[C@@H](O)[C@@H](C(O)=O)NC(=O)[C@H](C)NC(=O)CN QSDKBRMVXSWAQE-BFHQHQDPSA-N 0.000 description 1
- CLODWIOAKCSBAN-BQBZGAKWSA-N Gly-Arg-Asp Chemical compound NC(N)=NCCC[C@H](NC(=O)CN)C(=O)N[C@@H](CC(O)=O)C(O)=O CLODWIOAKCSBAN-BQBZGAKWSA-N 0.000 description 1
- OGCIHJPYKVSMTE-YUMQZZPRSA-N Gly-Arg-Glu Chemical compound [H]NCC(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CCC(O)=O)C(O)=O OGCIHJPYKVSMTE-YUMQZZPRSA-N 0.000 description 1
- JVACNFOPSUPDTK-QWRGUYRKSA-N Gly-Asn-Phe Chemical compound NCC(=O)N[C@@H](CC(N)=O)C(=O)N[C@H](C(O)=O)CC1=CC=CC=C1 JVACNFOPSUPDTK-QWRGUYRKSA-N 0.000 description 1
- BULIVUZUDBHKKZ-WDSKDSINSA-N Gly-Gln-Asn Chemical compound NCC(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CC(N)=O)C(O)=O BULIVUZUDBHKKZ-WDSKDSINSA-N 0.000 description 1
- FHQRLHFYVZAQHU-IUCAKERBSA-N Gly-Lys-Gln Chemical compound [H]NCC(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CCC(N)=O)C(O)=O FHQRLHFYVZAQHU-IUCAKERBSA-N 0.000 description 1
- FJWSJWACLMTDMI-WPRPVWTQSA-N Gly-Met-Val Chemical compound [H]NCC(=O)N[C@@H](CCSC)C(=O)N[C@@H](C(C)C)C(O)=O FJWSJWACLMTDMI-WPRPVWTQSA-N 0.000 description 1
- GGLIDLCEPDHEJO-BQBZGAKWSA-N Gly-Pro-Ala Chemical compound OC(=O)[C@H](C)NC(=O)[C@@H]1CCCN1C(=O)CN GGLIDLCEPDHEJO-BQBZGAKWSA-N 0.000 description 1
- IRJWAYCXIYUHQE-WHFBIAKZSA-N Gly-Ser-Ala Chemical compound OC(=O)[C@H](C)NC(=O)[C@H](CO)NC(=O)CN IRJWAYCXIYUHQE-WHFBIAKZSA-N 0.000 description 1
- FGPLUIQCSKGLTI-WDSKDSINSA-N Gly-Ser-Glu Chemical compound NCC(=O)N[C@@H](CO)C(=O)N[C@H](C(O)=O)CCC(O)=O FGPLUIQCSKGLTI-WDSKDSINSA-N 0.000 description 1
- ZLCLYFGMKFCDCN-XPUUQOCRSA-N Gly-Ser-Val Chemical compound CC(C)[C@H](NC(=O)[C@H](CO)NC(=O)CN)C(O)=O ZLCLYFGMKFCDCN-XPUUQOCRSA-N 0.000 description 1
- TVTZEOHWHUVYCG-KYNKHSRBSA-N Gly-Thr-Thr Chemical compound [H]NCC(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H]([C@@H](C)O)C(O)=O TVTZEOHWHUVYCG-KYNKHSRBSA-N 0.000 description 1
- 208000035895 Guillain-Barré syndrome Diseases 0.000 description 1
- 241000238631 Hexapoda Species 0.000 description 1
- AASLOGQZZKZWKH-SRVKXCTJSA-N His-Cys-His Chemical compound C1=C(NC=N1)C[C@@H](C(=O)N[C@@H](CS)C(=O)N[C@@H](CC2=CN=CN2)C(=O)O)N AASLOGQZZKZWKH-SRVKXCTJSA-N 0.000 description 1
- HVCRQRQPIIRNLY-IUCAKERBSA-N His-Gln-Gly Chemical compound C1=C(NC=N1)C[C@@H](C(=O)N[C@@H](CCC(=O)N)C(=O)NCC(=O)O)N HVCRQRQPIIRNLY-IUCAKERBSA-N 0.000 description 1
- VUUFXXGKMPLKNH-BZSNNMDCSA-N His-Phe-His Chemical compound C1=CC=C(C=C1)C[C@@H](C(=O)N[C@@H](CC2=CN=CN2)C(=O)O)NC(=O)[C@H](CC3=CN=CN3)N VUUFXXGKMPLKNH-BZSNNMDCSA-N 0.000 description 1
- YEKYGQZUBCRNGH-DCAQKATOSA-N His-Pro-Ser Chemical compound C1C[C@H](N(C1)C(=O)[C@H](CC2=CN=CN2)N)C(=O)N[C@@H](CO)C(=O)O YEKYGQZUBCRNGH-DCAQKATOSA-N 0.000 description 1
- XHQYFGPIRUHQIB-PBCZWWQYSA-N His-Thr-Asp Chemical compound OC(=O)C[C@@H](C(O)=O)NC(=O)[C@H]([C@H](O)C)NC(=O)[C@@H](N)CC1=CN=CN1 XHQYFGPIRUHQIB-PBCZWWQYSA-N 0.000 description 1
- 108010033040 Histones Proteins 0.000 description 1
- 241001272567 Hominoidea Species 0.000 description 1
- 101000895100 Homo sapiens Ataxin-3 Proteins 0.000 description 1
- 101000866326 Homo sapiens Cytoplasmic dynein 1 heavy chain 1 Proteins 0.000 description 1
- 101001076904 Homo sapiens Dyslexia-associated protein KIAA0319-like protein Proteins 0.000 description 1
- 101000941879 Homo sapiens Leucine-rich repeat serine/threonine-protein kinase 2 Proteins 0.000 description 1
- 101000615488 Homo sapiens Methyl-CpG-binding domain protein 2 Proteins 0.000 description 1
- 101000601647 Homo sapiens Paired box protein Pax-6 Proteins 0.000 description 1
- 101000753178 Homo sapiens Sodium/potassium-transporting ATPase subunit alpha-3 Proteins 0.000 description 1
- 101000652332 Homo sapiens Transcription factor SOX-1 Proteins 0.000 description 1
- 241001135569 Human adenovirus 5 Species 0.000 description 1
- 101100273566 Humulus lupulus CCL10 gene Proteins 0.000 description 1
- VEXZGXHMUGYJMC-UHFFFAOYSA-N Hydrochloric acid Chemical compound Cl VEXZGXHMUGYJMC-UHFFFAOYSA-N 0.000 description 1
- 206010020772 Hypertension Diseases 0.000 description 1
- UGQMRVRMYYASKQ-UHFFFAOYSA-N Hypoxanthine nucleoside Natural products OC1C(O)C(CO)OC1N1C(NC=NC2=O)=C2N=C1 UGQMRVRMYYASKQ-UHFFFAOYSA-N 0.000 description 1
- 206010021143 Hypoxia Diseases 0.000 description 1
- 206010070511 Hypoxic-ischaemic encephalopathy Diseases 0.000 description 1
- XQFRJNBWHJMXHO-RRKCRQDMSA-N IDUR Chemical compound C1[C@H](O)[C@@H](CO)O[C@H]1N1C(=O)NC(=O)C(I)=C1 XQFRJNBWHJMXHO-RRKCRQDMSA-N 0.000 description 1
- 108010042653 IgA receptor Proteins 0.000 description 1
- QTUSJASXLGLJSR-OSUNSFLBSA-N Ile-Arg-Thr Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CCCN=C(N)N)C(=O)N[C@@H]([C@@H](C)O)C(=O)O)N QTUSJASXLGLJSR-OSUNSFLBSA-N 0.000 description 1
- QYZYJFXHXYUZMZ-UGYAYLCHSA-N Ile-Asn-Asn Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CC(=O)N)C(=O)N[C@@H](CC(=O)N)C(=O)O)N QYZYJFXHXYUZMZ-UGYAYLCHSA-N 0.000 description 1
- OVDKXUDMKXAZIV-ZPFDUUQYSA-N Ile-Lys-Asn Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CC(=O)N)C(=O)O)N OVDKXUDMKXAZIV-ZPFDUUQYSA-N 0.000 description 1
- PXKACEXYLPBMAD-JBDRJPRFSA-N Ile-Ser-Ser Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CO)C(=O)N[C@@H](CO)C(=O)O)N PXKACEXYLPBMAD-JBDRJPRFSA-N 0.000 description 1
- PZWBBXHHUSIGKH-OSUNSFLBSA-N Ile-Thr-Arg Chemical compound CC[C@H](C)[C@H](N)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@H](C(O)=O)CCCN=C(N)N PZWBBXHHUSIGKH-OSUNSFLBSA-N 0.000 description 1
- YCKPUHHMCFSUMD-IUKAMOBKSA-N Ile-Thr-Asp Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CC(=O)O)C(=O)O)N YCKPUHHMCFSUMD-IUKAMOBKSA-N 0.000 description 1
- 108060003951 Immunoglobulin Proteins 0.000 description 1
- 108010021625 Immunoglobulin Fragments Proteins 0.000 description 1
- 102000008394 Immunoglobulin Fragments Human genes 0.000 description 1
- 238000012369 In process control Methods 0.000 description 1
- 206010061216 Infarction Diseases 0.000 description 1
- 108020005350 Initiator Codon Proteins 0.000 description 1
- 208000033463 Ischaemic neuropathy Diseases 0.000 description 1
- PIWKPBJCKXDKJR-UHFFFAOYSA-N Isoflurane Chemical compound FC(F)OC(Cl)C(F)(F)F PIWKPBJCKXDKJR-UHFFFAOYSA-N 0.000 description 1
- YQEZLKZALYSWHR-UHFFFAOYSA-N Ketamine Chemical compound C=1C=CC=C(Cl)C=1C1(NC)CCCCC1=O YQEZLKZALYSWHR-UHFFFAOYSA-N 0.000 description 1
- PMGDADKJMCOXHX-UHFFFAOYSA-N L-Arginyl-L-glutamin-acetat Natural products NC(=N)NCCCC(N)C(=O)NC(CCC(N)=O)C(O)=O PMGDADKJMCOXHX-UHFFFAOYSA-N 0.000 description 1
- ROHFNLRQFUQHCH-YFKPBYRVSA-N L-leucine Chemical compound CC(C)C[C@H](N)C(O)=O ROHFNLRQFUQHCH-YFKPBYRVSA-N 0.000 description 1
- LZDNBBYBDGBADK-UHFFFAOYSA-N L-valyl-L-tryptophan Natural products C1=CC=C2C(CC(NC(=O)C(N)C(C)C)C(O)=O)=CNC2=C1 LZDNBBYBDGBADK-UHFFFAOYSA-N 0.000 description 1
- IGUOAYLTQJLPPD-DCAQKATOSA-N Leu-Asn-Arg Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@H](C(O)=O)CCCN=C(N)N IGUOAYLTQJLPPD-DCAQKATOSA-N 0.000 description 1
- DBVWMYGBVFCRBE-CIUDSAMLSA-N Leu-Asn-Asn Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CC(N)=O)C(O)=O DBVWMYGBVFCRBE-CIUDSAMLSA-N 0.000 description 1
- ZURHXHNAEJJRNU-CIUDSAMLSA-N Leu-Asp-Asn Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CC(N)=O)C(O)=O ZURHXHNAEJJRNU-CIUDSAMLSA-N 0.000 description 1
- DPWGZWUMUUJQDT-IUCAKERBSA-N Leu-Gln-Gly Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H](CCC(N)=O)C(=O)NCC(O)=O DPWGZWUMUUJQDT-IUCAKERBSA-N 0.000 description 1
- GPICTNQYKHHHTH-GUBZILKMSA-N Leu-Gln-Ser Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CO)C(O)=O GPICTNQYKHHHTH-GUBZILKMSA-N 0.000 description 1
- QLDHBYRUNQZIJQ-DKIMLUQUSA-N Leu-Ile-Phe Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H](CC1=CC=CC=C1)C(O)=O QLDHBYRUNQZIJQ-DKIMLUQUSA-N 0.000 description 1
- QNTJIDXQHWUBKC-BZSNNMDCSA-N Leu-Lys-Phe Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CC1=CC=CC=C1)C(O)=O QNTJIDXQHWUBKC-BZSNNMDCSA-N 0.000 description 1
- ARRIJPQRBWRNLT-DCAQKATOSA-N Leu-Met-Asn Chemical compound CC(C)C[C@@H](C(=O)N[C@@H](CCSC)C(=O)N[C@@H](CC(=O)N)C(=O)O)N ARRIJPQRBWRNLT-DCAQKATOSA-N 0.000 description 1
- PTRKPHUGYULXPU-KKUMJFAQSA-N Leu-Phe-Ser Chemical compound [H]N[C@@H](CC(C)C)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CO)C(O)=O PTRKPHUGYULXPU-KKUMJFAQSA-N 0.000 description 1
- ZDJQVSIPFLMNOX-RHYQMDGZSA-N Leu-Thr-Arg Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@H](C(O)=O)CCCN=C(N)N ZDJQVSIPFLMNOX-RHYQMDGZSA-N 0.000 description 1
- ILDSIMPXNFWKLH-KATARQTJSA-N Leu-Thr-Ser Chemical compound CC(C)C[C@H](N)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CO)C(O)=O ILDSIMPXNFWKLH-KATARQTJSA-N 0.000 description 1
- 208000009829 Lewy Body Disease Diseases 0.000 description 1
- 201000002832 Lewy body dementia Diseases 0.000 description 1
- KNKHAVVBVXKOGX-JXUBOQSCSA-N Lys-Ala-Thr Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](C)C(=O)N[C@@H]([C@@H](C)O)C(O)=O KNKHAVVBVXKOGX-JXUBOQSCSA-N 0.000 description 1
- QUYCUALODHJQLK-CIUDSAMLSA-N Lys-Asp-Asp Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](CC(O)=O)C(O)=O QUYCUALODHJQLK-CIUDSAMLSA-N 0.000 description 1
- YEIYAQQKADPIBJ-GARJFASQSA-N Lys-Asp-Pro Chemical compound C1C[C@@H](N(C1)C(=O)[C@H](CC(=O)O)NC(=O)[C@H](CCCCN)N)C(=O)O YEIYAQQKADPIBJ-GARJFASQSA-N 0.000 description 1
- KWUKZRFFKPLUPE-HJGDQZAQSA-N Lys-Asp-Thr Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H]([C@@H](C)O)C(O)=O KWUKZRFFKPLUPE-HJGDQZAQSA-N 0.000 description 1
- VSRXPEHZMHSFKU-IUCAKERBSA-N Lys-Gln-Gly Chemical compound NCCCC[C@H](N)C(=O)N[C@@H](CCC(N)=O)C(=O)NCC(O)=O VSRXPEHZMHSFKU-IUCAKERBSA-N 0.000 description 1
- VEGLGAOVLFODGC-GUBZILKMSA-N Lys-Glu-Ser Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CO)C(O)=O VEGLGAOVLFODGC-GUBZILKMSA-N 0.000 description 1
- NJNRBRKHOWSGMN-SRVKXCTJSA-N Lys-Leu-Asn Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CC(N)=O)C(O)=O NJNRBRKHOWSGMN-SRVKXCTJSA-N 0.000 description 1
- RBEATVHTWHTHTJ-KKUMJFAQSA-N Lys-Leu-Lys Chemical compound NCCCC[C@H](N)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCCCN)C(O)=O RBEATVHTWHTHTJ-KKUMJFAQSA-N 0.000 description 1
- HVAUKHLDSDDROB-KKUMJFAQSA-N Lys-Lys-Leu Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CC(C)C)C(O)=O HVAUKHLDSDDROB-KKUMJFAQSA-N 0.000 description 1
- ALEVUGKHINJNIF-QEJZJMRPSA-N Lys-Phe-Ala Chemical compound NCCCC[C@H](N)C(=O)N[C@H](C(=O)N[C@@H](C)C(O)=O)CC1=CC=CC=C1 ALEVUGKHINJNIF-QEJZJMRPSA-N 0.000 description 1
- ZUGVARDEGWMMLK-SRVKXCTJSA-N Lys-Ser-Lys Chemical compound NCCCC[C@H](N)C(=O)N[C@@H](CO)C(=O)N[C@H](C(O)=O)CCCCN ZUGVARDEGWMMLK-SRVKXCTJSA-N 0.000 description 1
- CUHGAUZONORRIC-HJGDQZAQSA-N Lys-Thr-Asn Chemical compound C[C@H]([C@@H](C(=O)N[C@@H](CC(=O)N)C(=O)O)NC(=O)[C@H](CCCCN)N)O CUHGAUZONORRIC-HJGDQZAQSA-N 0.000 description 1
- GIKFNMZSGYAPEJ-HJGDQZAQSA-N Lys-Thr-Asp Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CC(O)=O)C(O)=O GIKFNMZSGYAPEJ-HJGDQZAQSA-N 0.000 description 1
- JHNOXVASMSXSNB-WEDXCCLWSA-N Lys-Thr-Gly Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H]([C@@H](C)O)C(=O)NCC(O)=O JHNOXVASMSXSNB-WEDXCCLWSA-N 0.000 description 1
- DLCAXBGXGOVUCD-PPCPHDFISA-N Lys-Thr-Ile Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O DLCAXBGXGOVUCD-PPCPHDFISA-N 0.000 description 1
- CAVRAQIDHUPECU-UVOCVTCTSA-N Lys-Thr-Thr Chemical compound [H]N[C@@H](CCCCN)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H]([C@@H](C)O)C(O)=O CAVRAQIDHUPECU-UVOCVTCTSA-N 0.000 description 1
- PSVAVKGDUAKZKU-BZSNNMDCSA-N Lys-Tyr-His Chemical compound C1=CC(=CC=C1C[C@@H](C(=O)N[C@@H](CC2=CN=CN2)C(=O)O)NC(=O)[C@H](CCCCN)N)O PSVAVKGDUAKZKU-BZSNNMDCSA-N 0.000 description 1
- VWJFOUBDZIUXGA-AVGNSLFASA-N Lys-Val-Met Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CCSC)C(=O)O)NC(=O)[C@H](CCCCN)N VWJFOUBDZIUXGA-AVGNSLFASA-N 0.000 description 1
- 208000002569 Machado-Joseph Disease Diseases 0.000 description 1
- 102100025169 Max-binding protein MNT Human genes 0.000 description 1
- 108010093175 Member 2 Group A Nuclear Receptor Subfamily 4 Proteins 0.000 description 1
- 206010027202 Meningitis bacterial Diseases 0.000 description 1
- DTICLBJHRYSJLH-GUBZILKMSA-N Met-Ala-Val Chemical compound CSCC[C@H](N)C(=O)N[C@@H](C)C(=O)N[C@@H](C(C)C)C(O)=O DTICLBJHRYSJLH-GUBZILKMSA-N 0.000 description 1
- IUYCGMNKIZDRQI-BQBZGAKWSA-N Met-Gly-Ala Chemical compound CSCC[C@H](N)C(=O)NCC(=O)N[C@@H](C)C(O)=O IUYCGMNKIZDRQI-BQBZGAKWSA-N 0.000 description 1
- ORRNBLTZBBESPN-HJWJTTGWSA-N Met-Ile-Phe Chemical compound CSCC[C@H](N)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@H](C(O)=O)CC1=CC=CC=C1 ORRNBLTZBBESPN-HJWJTTGWSA-N 0.000 description 1
- HZLSUXCMSIBCRV-RVMXOQNASA-N Met-Ile-Pro Chemical compound CC[C@H](C)[C@@H](C(=O)N1CCC[C@@H]1C(=O)O)NC(=O)[C@H](CCSC)N HZLSUXCMSIBCRV-RVMXOQNASA-N 0.000 description 1
- UFOWQBYMUILSRK-IHRRRGAJSA-N Met-Lys-His Chemical compound CSCC[C@H](N)C(=O)N[C@@H](CCCCN)C(=O)N[C@H](C(O)=O)CC1=CNC=N1 UFOWQBYMUILSRK-IHRRRGAJSA-N 0.000 description 1
- GGXZOTSDJJTDGB-GUBZILKMSA-N Met-Ser-Val Chemical compound [H]N[C@@H](CCSC)C(=O)N[C@@H](CO)C(=O)N[C@@H](C(C)C)C(O)=O GGXZOTSDJJTDGB-GUBZILKMSA-N 0.000 description 1
- 102000005741 Metalloproteases Human genes 0.000 description 1
- 108010006035 Metalloproteases Proteins 0.000 description 1
- 102100021299 Methyl-CpG-binding domain protein 2 Human genes 0.000 description 1
- 206010049567 Miller Fisher syndrome Diseases 0.000 description 1
- 208000001089 Multiple system atrophy Diseases 0.000 description 1
- 241000699660 Mus musculus Species 0.000 description 1
- 101100163882 Mus musculus Ascl1 gene Proteins 0.000 description 1
- 101000888418 Mus musculus Glial fibrillary acidic protein Proteins 0.000 description 1
- 108010066427 N-valyltryptophan Proteins 0.000 description 1
- 229930193140 Neomycin Natural products 0.000 description 1
- 208000037212 Neonatal hypoxic and ischemic brain injury Diseases 0.000 description 1
- 108010088225 Nestin Proteins 0.000 description 1
- 102000008730 Nestin Human genes 0.000 description 1
- 208000009869 Neu-Laxova syndrome Diseases 0.000 description 1
- 101100049938 Neurospora crassa (strain ATCC 24698 / 74-OR23-1A / CBS 708.71 / DSM 1257 / FGSC 987) exr-1 gene Proteins 0.000 description 1
- 108010077850 Nuclear Localization Signals Proteins 0.000 description 1
- 101150115192 OLIG1 gene Proteins 0.000 description 1
- 102100026073 Oligodendrocyte transcription factor 1 Human genes 0.000 description 1
- 101710195940 Oligodendrocyte transcription factor 1 Proteins 0.000 description 1
- 108010032788 PAX6 Transcription Factor Proteins 0.000 description 1
- 229910019142 PO4 Inorganic materials 0.000 description 1
- 108010011536 PTEN Phosphohydrolase Proteins 0.000 description 1
- 108020002230 Pancreatic Ribonuclease Proteins 0.000 description 1
- 102000005891 Pancreatic ribonuclease Human genes 0.000 description 1
- 206010034620 Peripheral sensory neuropathy Diseases 0.000 description 1
- SEPNOAFMZLLCEW-UBHSHLNASA-N Phe-Ala-Val Chemical compound N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](C)C(=O)N[C@@H](C(C)C)C(=O)O SEPNOAFMZLLCEW-UBHSHLNASA-N 0.000 description 1
- HXSUFWQYLPKEHF-IHRRRGAJSA-N Phe-Asn-Arg Chemical compound C1=CC=C(C=C1)C[C@@H](C(=O)N[C@@H](CC(=O)N)C(=O)N[C@@H](CCCN=C(N)N)C(=O)O)N HXSUFWQYLPKEHF-IHRRRGAJSA-N 0.000 description 1
- KIEPQOIQHFKQLK-PCBIJLKTSA-N Phe-Asn-Ile Chemical compound [H]N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O KIEPQOIQHFKQLK-PCBIJLKTSA-N 0.000 description 1
- KAHUBGWSIQNZQQ-KKUMJFAQSA-N Phe-Asn-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@H](CC(N)=O)NC(=O)[C@@H](N)CC1=CC=CC=C1 KAHUBGWSIQNZQQ-KKUMJFAQSA-N 0.000 description 1
- FMMIYCMOVGXZIP-AVGNSLFASA-N Phe-Glu-Asn Chemical compound [H]N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H](CC(N)=O)C(O)=O FMMIYCMOVGXZIP-AVGNSLFASA-N 0.000 description 1
- MPFGIYLYWUCSJG-AVGNSLFASA-N Phe-Glu-Asp Chemical compound OC(=O)C[C@@H](C(O)=O)NC(=O)[C@H](CCC(O)=O)NC(=O)[C@@H](N)CC1=CC=CC=C1 MPFGIYLYWUCSJG-AVGNSLFASA-N 0.000 description 1
- VJLLEKDQJSMHRU-STQMWFEESA-N Phe-Gly-Met Chemical compound [H]N[C@@H](CC1=CC=CC=C1)C(=O)NCC(=O)N[C@@H](CCSC)C(O)=O VJLLEKDQJSMHRU-STQMWFEESA-N 0.000 description 1
- QPVFUAUFEBPIPT-CDMKHQONSA-N Phe-Gly-Thr Chemical compound [H]N[C@@H](CC1=CC=CC=C1)C(=O)NCC(=O)N[C@@H]([C@@H](C)O)C(O)=O QPVFUAUFEBPIPT-CDMKHQONSA-N 0.000 description 1
- DOXQMJCSSYZSNM-BZSNNMDCSA-N Phe-Lys-Leu Chemical compound [H]N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CC(C)C)C(O)=O DOXQMJCSSYZSNM-BZSNNMDCSA-N 0.000 description 1
- WKLMCMXFMQEKCX-SLFFLAALSA-N Phe-Phe-Pro Chemical compound C1C[C@@H](N(C1)C(=O)[C@H](CC2=CC=CC=C2)NC(=O)[C@H](CC3=CC=CC=C3)N)C(=O)O WKLMCMXFMQEKCX-SLFFLAALSA-N 0.000 description 1
- CZQZSMJXFGGBHM-KKUMJFAQSA-N Phe-Pro-Gln Chemical compound C1C[C@H](N(C1)C(=O)[C@H](CC2=CC=CC=C2)N)C(=O)N[C@@H](CCC(=O)N)C(=O)O CZQZSMJXFGGBHM-KKUMJFAQSA-N 0.000 description 1
- FKFCKDROTNIVSO-JYJNAYRXSA-N Phe-Pro-Met Chemical compound [H]N[C@@H](CC1=CC=CC=C1)C(=O)N1CCC[C@H]1C(=O)N[C@@H](CCSC)C(O)=O FKFCKDROTNIVSO-JYJNAYRXSA-N 0.000 description 1
- QSWKNJAPHQDAAS-MELADBBJSA-N Phe-Ser-Pro Chemical compound C1C[C@@H](N(C1)C(=O)[C@H](CO)NC(=O)[C@H](CC2=CC=CC=C2)N)C(=O)O QSWKNJAPHQDAAS-MELADBBJSA-N 0.000 description 1
- BPIMVBKDLSBKIJ-FCLVOEFKSA-N Phe-Thr-Phe Chemical compound C([C@H](N)C(=O)N[C@@H]([C@H](O)C)C(=O)N[C@@H](CC=1C=CC=CC=1)C(O)=O)C1=CC=CC=C1 BPIMVBKDLSBKIJ-FCLVOEFKSA-N 0.000 description 1
- 102100032543 Phosphatidylinositol 3,4,5-trisphosphate 3-phosphatase and dual-specificity protein phosphatase PTEN Human genes 0.000 description 1
- 108091000080 Phosphotransferase Proteins 0.000 description 1
- 208000000609 Pick Disease of the Brain Diseases 0.000 description 1
- 101000708422 Podarcis siculus Tissue- and phase-specific nuclear protein Proteins 0.000 description 1
- 102000029797 Prion Human genes 0.000 description 1
- 108091000054 Prion Proteins 0.000 description 1
- KIZQGKLMXKGDIV-BQBZGAKWSA-N Pro-Ala-Gly Chemical compound OC(=O)CNC(=O)[C@H](C)NC(=O)[C@@H]1CCCN1 KIZQGKLMXKGDIV-BQBZGAKWSA-N 0.000 description 1
- DRVIASBABBMZTF-GUBZILKMSA-N Pro-Ala-Met Chemical compound C[C@@H](C(=O)N[C@@H](CCSC)C(=O)O)NC(=O)[C@@H]1CCCN1 DRVIASBABBMZTF-GUBZILKMSA-N 0.000 description 1
- SKICPQLTOXGWGO-GARJFASQSA-N Pro-Gln-Pro Chemical compound C1C[C@H](NC1)C(=O)N[C@@H](CCC(=O)N)C(=O)N2CCC[C@@H]2C(=O)O SKICPQLTOXGWGO-GARJFASQSA-N 0.000 description 1
- WVOXLKUUVCCCSU-ZPFDUUQYSA-N Pro-Glu-Ile Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H](CCC(O)=O)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O WVOXLKUUVCCCSU-ZPFDUUQYSA-N 0.000 description 1
- XYHMFGGWNOFUOU-QXEWZRGKSA-N Pro-Ile-Gly Chemical compound OC(=O)CNC(=O)[C@H]([C@@H](C)CC)NC(=O)[C@@H]1CCCN1 XYHMFGGWNOFUOU-QXEWZRGKSA-N 0.000 description 1
- ZTMLZUNPFDGPKY-VKOGCVSHSA-N Pro-Ile-Trp Chemical compound CC[C@H](C)[C@@H](C(=O)N[C@@H](CC1=CNC2=CC=CC=C21)C(=O)O)NC(=O)[C@@H]3CCCN3 ZTMLZUNPFDGPKY-VKOGCVSHSA-N 0.000 description 1
- BRJGUPWVFXKBQI-XUXIUFHCSA-N Pro-Leu-Ile Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O BRJGUPWVFXKBQI-XUXIUFHCSA-N 0.000 description 1
- HATVCTYBNCNMAA-AVGNSLFASA-N Pro-Leu-Met Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](CCSC)C(O)=O HATVCTYBNCNMAA-AVGNSLFASA-N 0.000 description 1
- GNADVDLLGVSXLS-ULQDDVLXSA-N Pro-Phe-His Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CC1=CNC=N1)C(O)=O GNADVDLLGVSXLS-ULQDDVLXSA-N 0.000 description 1
- ZVEQWRWMRFIVSD-HRCADAONSA-N Pro-Phe-Pro Chemical compound C1C[C@H](NC1)C(=O)N[C@@H](CC2=CC=CC=C2)C(=O)N3CCC[C@@H]3C(=O)O ZVEQWRWMRFIVSD-HRCADAONSA-N 0.000 description 1
- SBVPYBFMIGDIDX-SRVKXCTJSA-N Pro-Pro-Pro Chemical compound OC(=O)[C@@H]1CCCN1C(=O)[C@H]1N(C(=O)[C@H]2NCCC2)CCC1 SBVPYBFMIGDIDX-SRVKXCTJSA-N 0.000 description 1
- OWQXAJQZLWHPBH-FXQIFTODSA-N Pro-Ser-Asn Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H](CO)C(=O)N[C@@H](CC(N)=O)C(O)=O OWQXAJQZLWHPBH-FXQIFTODSA-N 0.000 description 1
- KIDXAAQVMNLJFQ-KZVJFYERSA-N Pro-Thr-Ala Chemical compound C[C@@H](O)[C@H](NC(=O)[C@@H]1CCCN1)C(=O)N[C@@H](C)C(O)=O KIDXAAQVMNLJFQ-KZVJFYERSA-N 0.000 description 1
- GZNYIXWOIUFLGO-ZJDVBMNYSA-N Pro-Thr-Thr Chemical compound [H]N1CCC[C@H]1C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H]([C@@H](C)O)C(O)=O GZNYIXWOIUFLGO-ZJDVBMNYSA-N 0.000 description 1
- DMNANGOFEUVBRV-GJZGRUSLSA-N Pro-Trp-Gly Chemical compound N([C@@H](CC=1C2=CC=CC=C2NC=1)C(=O)NCC(=O)O)C(=O)[C@@H]1CCCN1 DMNANGOFEUVBRV-GJZGRUSLSA-N 0.000 description 1
- 102100034014 Prolyl 3-hydroxylase 3 Human genes 0.000 description 1
- XBDQKXXYIPTUBI-UHFFFAOYSA-N Propionic acid Chemical class CCC(O)=O XBDQKXXYIPTUBI-UHFFFAOYSA-N 0.000 description 1
- 241000508269 Psidium Species 0.000 description 1
- 108091008103 RNA aptamers Proteins 0.000 description 1
- 230000007022 RNA scission Effects 0.000 description 1
- 241000711798 Rabies lyssavirus Species 0.000 description 1
- 108091081062 Repeated sequence (DNA) Proteins 0.000 description 1
- 108091028664 Ribonucleotide Proteins 0.000 description 1
- 241000283984 Rodentia Species 0.000 description 1
- 238000012300 Sequence Analysis Methods 0.000 description 1
- MWMKFWJYRRGXOR-ZLUOBGJFSA-N Ser-Ala-Asn Chemical compound N[C@H](C(=O)N[C@H](C(=O)N[C@H](C(=O)O)CC(N)=O)C)CO MWMKFWJYRRGXOR-ZLUOBGJFSA-N 0.000 description 1
- LVVBAKCGXXUHFO-ZLUOBGJFSA-N Ser-Ala-Asp Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](C)C(=O)N[C@@H](CC(O)=O)C(O)=O LVVBAKCGXXUHFO-ZLUOBGJFSA-N 0.000 description 1
- MMGJPDWSIOAGTH-ACZMJKKPSA-N Ser-Ala-Gln Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](C)C(=O)N[C@@H](CCC(N)=O)C(O)=O MMGJPDWSIOAGTH-ACZMJKKPSA-N 0.000 description 1
- JPIDMRXXNMIVKY-VZFHVOOUSA-N Ser-Ala-Thr Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](C)C(=O)N[C@@H]([C@@H](C)O)C(O)=O JPIDMRXXNMIVKY-VZFHVOOUSA-N 0.000 description 1
- OOKCGAYXSNJBGQ-ZLUOBGJFSA-N Ser-Asn-Asn Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CC(N)=O)C(O)=O OOKCGAYXSNJBGQ-ZLUOBGJFSA-N 0.000 description 1
- UGJRQLURDVGULT-LKXGYXEUSA-N Ser-Asn-Thr Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H]([C@@H](C)O)C(O)=O UGJRQLURDVGULT-LKXGYXEUSA-N 0.000 description 1
- YMAWDPHQVABADW-CIUDSAMLSA-N Ser-Gln-Met Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CCSC)C(O)=O YMAWDPHQVABADW-CIUDSAMLSA-N 0.000 description 1
- QKQDTEYDEIJPNK-GUBZILKMSA-N Ser-Glu-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@H](CCC(O)=O)NC(=O)[C@@H](N)CO QKQDTEYDEIJPNK-GUBZILKMSA-N 0.000 description 1
- WBINSDOPZHQPPM-AVGNSLFASA-N Ser-Glu-Tyr Chemical compound C1=CC(=CC=C1C[C@@H](C(=O)O)NC(=O)[C@H](CCC(=O)O)NC(=O)[C@H](CO)N)O WBINSDOPZHQPPM-AVGNSLFASA-N 0.000 description 1
- IOVHBRCQOGWAQH-ZKWXMUAHSA-N Ser-Gly-Ile Chemical compound [H]N[C@@H](CO)C(=O)NCC(=O)N[C@@H]([C@@H](C)CC)C(O)=O IOVHBRCQOGWAQH-ZKWXMUAHSA-N 0.000 description 1
- HBTCFCHYALPXME-HTFCKZLJSA-N Ser-Ile-Ile Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H]([C@@H](C)CC)C(=O)N[C@@H]([C@@H](C)CC)C(O)=O HBTCFCHYALPXME-HTFCKZLJSA-N 0.000 description 1
- IXZHZUGGKLRHJD-DCAQKATOSA-N Ser-Leu-Val Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H](C(C)C)C(O)=O IXZHZUGGKLRHJD-DCAQKATOSA-N 0.000 description 1
- ILZAUMFXKSIUEF-SRVKXCTJSA-N Ser-Ser-Phe Chemical compound OC[C@H](N)C(=O)N[C@@H](CO)C(=O)N[C@H](C(O)=O)CC1=CC=CC=C1 ILZAUMFXKSIUEF-SRVKXCTJSA-N 0.000 description 1
- PYTKULIABVRXSC-BWBBJGPYSA-N Ser-Ser-Thr Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CO)C(=O)N[C@@H]([C@@H](C)O)C(O)=O PYTKULIABVRXSC-BWBBJGPYSA-N 0.000 description 1
- OLKICIBQRVSQMA-SRVKXCTJSA-N Ser-Ser-Tyr Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CO)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(O)=O OLKICIBQRVSQMA-SRVKXCTJSA-N 0.000 description 1
- NERYDXBVARJIQS-JYBASQMISA-N Ser-Trp-Thr Chemical compound C[C@H]([C@@H](C(=O)O)NC(=O)[C@H](CC1=CNC2=CC=CC=C21)NC(=O)[C@H](CO)N)O NERYDXBVARJIQS-JYBASQMISA-N 0.000 description 1
- QYBRQMLZDDJBSW-AVGNSLFASA-N Ser-Tyr-Glu Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CCC(O)=O)C(O)=O QYBRQMLZDDJBSW-AVGNSLFASA-N 0.000 description 1
- JGUWRQWULDWNCM-FXQIFTODSA-N Ser-Val-Ser Chemical compound [H]N[C@@H](CO)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CO)C(O)=O JGUWRQWULDWNCM-FXQIFTODSA-N 0.000 description 1
- BQCADISMDOOEFD-UHFFFAOYSA-N Silver Chemical compound [Ag] BQCADISMDOOEFD-UHFFFAOYSA-N 0.000 description 1
- 108020004682 Single-Stranded DNA Proteins 0.000 description 1
- 108020004688 Small Nuclear RNA Proteins 0.000 description 1
- 102000039471 Small Nuclear RNA Human genes 0.000 description 1
- 108020003224 Small Nucleolar RNA Proteins 0.000 description 1
- 102000042773 Small Nucleolar RNA Human genes 0.000 description 1
- 108091060271 Small temporal RNA Proteins 0.000 description 1
- 102100021952 Sodium/potassium-transporting ATPase subunit alpha-3 Human genes 0.000 description 1
- 244000061458 Solanum melongena Species 0.000 description 1
- 235000002597 Solanum melongena Nutrition 0.000 description 1
- 241000191967 Staphylococcus aureus Species 0.000 description 1
- 208000006011 Stroke Diseases 0.000 description 1
- 238000000692 Student's t-test Methods 0.000 description 1
- 229930006000 Sucrose Natural products 0.000 description 1
- CZMRCDWAGMRECN-UGDNZRGBSA-N Sucrose Chemical compound O[C@H]1[C@H](O)[C@@H](CO)O[C@@]1(CO)O[C@@H]1[C@H](O)[C@@H](O)[C@H](O)[C@@H](CO)O1 CZMRCDWAGMRECN-UGDNZRGBSA-N 0.000 description 1
- 241000282887 Suidae Species 0.000 description 1
- QAOWNCQODCNURD-UHFFFAOYSA-L Sulfate Chemical compound [O-]S([O-])(=O)=O QAOWNCQODCNURD-UHFFFAOYSA-L 0.000 description 1
- NJEMRSFGDNECGF-GCJQMDKQSA-N Thr-Ala-Asp Chemical compound C[C@@H](O)[C@H](N)C(=O)N[C@@H](C)C(=O)N[C@H](C(O)=O)CC(O)=O NJEMRSFGDNECGF-GCJQMDKQSA-N 0.000 description 1
- GFDUZZACIWNMPE-KZVJFYERSA-N Thr-Ala-Met Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](C)C(=O)N[C@@H](CCSC)C(O)=O GFDUZZACIWNMPE-KZVJFYERSA-N 0.000 description 1
- KEGBFULVYKYJRD-LFSVMHDDSA-N Thr-Ala-Phe Chemical compound C[C@@H](O)[C@H](N)C(=O)N[C@@H](C)C(=O)N[C@H](C(O)=O)CC1=CC=CC=C1 KEGBFULVYKYJRD-LFSVMHDDSA-N 0.000 description 1
- JMZKMSTYXHFYAK-VEVYYDQMSA-N Thr-Arg-Asn Chemical compound C[C@H]([C@@H](C(=O)N[C@@H](CCCN=C(N)N)C(=O)N[C@@H](CC(=O)N)C(=O)O)N)O JMZKMSTYXHFYAK-VEVYYDQMSA-N 0.000 description 1
- GZYNMZQXFRWDFH-YTWAJWBKSA-N Thr-Arg-Pro Chemical compound C[C@H]([C@@H](C(=O)N[C@@H](CCCN=C(N)N)C(=O)N1CCC[C@@H]1C(=O)O)N)O GZYNMZQXFRWDFH-YTWAJWBKSA-N 0.000 description 1
- UNURFMVMXLENAZ-KJEVXHAQSA-N Thr-Arg-Tyr Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCCNC(N)=N)C(=O)N[C@@H](CC1=CC=C(O)C=C1)C(O)=O UNURFMVMXLENAZ-KJEVXHAQSA-N 0.000 description 1
- SKHPKKYKDYULDH-HJGDQZAQSA-N Thr-Asn-Leu Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CC(N)=O)C(=O)N[C@@H](CC(C)C)C(O)=O SKHPKKYKDYULDH-HJGDQZAQSA-N 0.000 description 1
- LXWZOMSOUAMOIA-JIOCBJNQSA-N Thr-Asn-Pro Chemical compound C[C@H]([C@@H](C(=O)N[C@@H](CC(=O)N)C(=O)N1CCC[C@@H]1C(=O)O)N)O LXWZOMSOUAMOIA-JIOCBJNQSA-N 0.000 description 1
- PZVGOVRNGKEFCB-KKHAAJSZSA-N Thr-Asn-Val Chemical compound C[C@H]([C@@H](C(=O)N[C@@H](CC(=O)N)C(=O)N[C@@H](C(C)C)C(=O)O)N)O PZVGOVRNGKEFCB-KKHAAJSZSA-N 0.000 description 1
- GCXFWAZRHBRYEM-NUMRIWBASA-N Thr-Gln-Asn Chemical compound C[C@H]([C@@H](C(=O)N[C@@H](CCC(=O)N)C(=O)N[C@@H](CC(=O)N)C(=O)O)N)O GCXFWAZRHBRYEM-NUMRIWBASA-N 0.000 description 1
- UHBPFYOQQPFKQR-JHEQGTHGSA-N Thr-Gln-Gly Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCC(N)=O)C(=O)NCC(O)=O UHBPFYOQQPFKQR-JHEQGTHGSA-N 0.000 description 1
- LIXBDERDAGNVAV-XKBZYTNZSA-N Thr-Gln-Ser Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCC(N)=O)C(=O)N[C@@H](CO)C(O)=O LIXBDERDAGNVAV-XKBZYTNZSA-N 0.000 description 1
- RCEHMXVEMNXRIW-IRIUXVKKSA-N Thr-Gln-Tyr Chemical compound C[C@H]([C@@H](C(=O)N[C@@H](CCC(=O)N)C(=O)N[C@@H](CC1=CC=C(C=C1)O)C(=O)O)N)O RCEHMXVEMNXRIW-IRIUXVKKSA-N 0.000 description 1
- SHOMROOOQBDGRL-JHEQGTHGSA-N Thr-Glu-Gly Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCC(O)=O)C(=O)NCC(O)=O SHOMROOOQBDGRL-JHEQGTHGSA-N 0.000 description 1
- NIEWSKWFURSECR-FOHZUACHSA-N Thr-Gly-Asp Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)NCC(=O)N[C@@H](CC(O)=O)C(O)=O NIEWSKWFURSECR-FOHZUACHSA-N 0.000 description 1
- QNCFWHZVRNXAKW-OEAJRASXSA-N Thr-Lys-Phe Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CC1=CC=CC=C1)C(O)=O QNCFWHZVRNXAKW-OEAJRASXSA-N 0.000 description 1
- KERCOYANYUPLHJ-XGEHTFHBSA-N Thr-Pro-Ser Chemical compound C[C@@H](O)[C@H](N)C(=O)N1CCC[C@H]1C(=O)N[C@@H](CO)C(O)=O KERCOYANYUPLHJ-XGEHTFHBSA-N 0.000 description 1
- YGCDFAJJCRVQKU-RCWTZXSCSA-N Thr-Pro-Val Chemical compound CC(C)[C@@H](C(O)=O)NC(=O)[C@@H]1CCCN1C(=O)[C@@H](N)[C@@H](C)O YGCDFAJJCRVQKU-RCWTZXSCSA-N 0.000 description 1
- FWTFAZKJORVTIR-VZFHVOOUSA-N Thr-Ser-Ala Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CO)C(=O)N[C@@H](C)C(O)=O FWTFAZKJORVTIR-VZFHVOOUSA-N 0.000 description 1
- QYDKSNXSBXZPFK-ZJDVBMNYSA-N Thr-Thr-Arg Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCCNC(N)=N)C(O)=O QYDKSNXSBXZPFK-ZJDVBMNYSA-N 0.000 description 1
- FYBFTPLPAXZBOY-KKHAAJSZSA-N Thr-Val-Asp Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CC(O)=O)C(O)=O FYBFTPLPAXZBOY-KKHAAJSZSA-N 0.000 description 1
- QGVBFDIREUUSHX-IFFSRLJSSA-N Thr-Val-Gln Chemical compound [H]N[C@@H]([C@@H](C)O)C(=O)N[C@@H](C(C)C)C(=O)N[C@@H](CCC(N)=O)C(O)=O QGVBFDIREUUSHX-IFFSRLJSSA-N 0.000 description 1
- 108091036066 Three prime untranslated region Proteins 0.000 description 1
- IQFYYKKMVGJFEH-XLPZGREQSA-N Thymidine Chemical class O=C1NC(=O)C(C)=CN1[C@@H]1O[C@H](CO)[C@@H](O)C1 IQFYYKKMVGJFEH-XLPZGREQSA-N 0.000 description 1
- 102100030248 Transcription factor SOX-1 Human genes 0.000 description 1
- 208000030886 Traumatic Brain injury Diseases 0.000 description 1
- 239000007983 Tris buffer Substances 0.000 description 1
- 229920004890 Triton X-100 Polymers 0.000 description 1
- 239000013504 Triton X-100 Substances 0.000 description 1
- NOFFAYIYPAUNRM-HKUYNNGSSA-N Trp-Gly-Phe Chemical compound C1=CC=C(C=C1)C[C@@H](C(=O)O)NC(=O)CNC(=O)[C@H](CC2=CNC3=CC=CC=C32)N NOFFAYIYPAUNRM-HKUYNNGSSA-N 0.000 description 1
- ZWZOCUWOXSDYFZ-CQDKDKBSSA-N Tyr-Ala-Lys Chemical compound NCCCC[C@@H](C(O)=O)NC(=O)[C@H](C)NC(=O)[C@@H](N)CC1=CC=C(O)C=C1 ZWZOCUWOXSDYFZ-CQDKDKBSSA-N 0.000 description 1
- AYHSJESDFKREAR-KKUMJFAQSA-N Tyr-Asn-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](CC(N)=O)NC(=O)[C@@H](N)CC1=CC=C(O)C=C1 AYHSJESDFKREAR-KKUMJFAQSA-N 0.000 description 1
- YLRLHDFMMWDYTK-KKUMJFAQSA-N Tyr-Cys-Leu Chemical compound CC(C)C[C@@H](C(O)=O)NC(=O)[C@H](CS)NC(=O)[C@@H](N)CC1=CC=C(O)C=C1 YLRLHDFMMWDYTK-KKUMJFAQSA-N 0.000 description 1
- TWAVEIJGFCBWCG-JYJNAYRXSA-N Tyr-Gln-Leu Chemical compound CC(C)C[C@@H](C(=O)O)NC(=O)[C@H](CCC(=O)N)NC(=O)[C@H](CC1=CC=C(C=C1)O)N TWAVEIJGFCBWCG-JYJNAYRXSA-N 0.000 description 1
- AZGZDDNKFFUDEH-QWRGUYRKSA-N Tyr-Gly-Ser Chemical compound OC[C@@H](C(O)=O)NC(=O)CNC(=O)[C@@H](N)CC1=CC=C(O)C=C1 AZGZDDNKFFUDEH-QWRGUYRKSA-N 0.000 description 1
- FBHBVXUBTYVCRU-BZSNNMDCSA-N Tyr-His-Leu Chemical compound C([C@@H](C(=O)N[C@@H](CC(C)C)C(O)=O)NC(=O)[C@@H](N)CC=1C=CC(O)=CC=1)C1=CN=CN1 FBHBVXUBTYVCRU-BZSNNMDCSA-N 0.000 description 1
- DMWNPLOERDAHSY-MEYUZBJRSA-N Tyr-Leu-Thr Chemical compound [H]N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CC(C)C)C(=O)N[C@@H]([C@@H](C)O)C(O)=O DMWNPLOERDAHSY-MEYUZBJRSA-N 0.000 description 1
- LMKKMCGTDANZTR-BZSNNMDCSA-N Tyr-Phe-Asp Chemical compound C([C@H](N)C(=O)N[C@@H](CC=1C=CC=CC=1)C(=O)N[C@@H](CC(O)=O)C(O)=O)C1=CC=C(O)C=C1 LMKKMCGTDANZTR-BZSNNMDCSA-N 0.000 description 1
- OKDNSNWJEXAMSU-IRXDYDNUSA-N Tyr-Phe-Gly Chemical compound C([C@H](N)C(=O)N[C@@H](CC=1C=CC=CC=1)C(=O)NCC(O)=O)C1=CC=C(O)C=C1 OKDNSNWJEXAMSU-IRXDYDNUSA-N 0.000 description 1
- QFXVAFIHVWXXBJ-AVGNSLFASA-N Tyr-Ser-Glu Chemical compound [H]N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CO)C(=O)N[C@@H](CCC(O)=O)C(O)=O QFXVAFIHVWXXBJ-AVGNSLFASA-N 0.000 description 1
- LUMQYLVYUIRHHU-YJRXYDGGSA-N Tyr-Ser-Thr Chemical compound [H]N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H](CO)C(=O)N[C@@H]([C@@H](C)O)C(O)=O LUMQYLVYUIRHHU-YJRXYDGGSA-N 0.000 description 1
- LVFZXRQQQDTBQH-IRIUXVKKSA-N Tyr-Thr-Glu Chemical compound [H]N[C@@H](CC1=CC=C(O)C=C1)C(=O)N[C@@H]([C@@H](C)O)C(=O)N[C@@H](CCC(O)=O)C(O)=O LVFZXRQQQDTBQH-IRIUXVKKSA-N 0.000 description 1
- QVYFTFIBKCDHIE-ACRUOGEOSA-N Tyr-Tyr-Lys Chemical compound C1=CC(=CC=C1C[C@@H](C(=O)N[C@@H](CC2=CC=C(C=C2)O)C(=O)N[C@@H](CCCCN)C(=O)O)N)O QVYFTFIBKCDHIE-ACRUOGEOSA-N 0.000 description 1
- HZWPGKAKGYJWCI-ULQDDVLXSA-N Tyr-Val-Leu Chemical compound CC(C)C[C@H](NC(=O)[C@@H](NC(=O)[C@@H](N)Cc1ccc(O)cc1)C(C)C)C(O)=O HZWPGKAKGYJWCI-ULQDDVLXSA-N 0.000 description 1
- 206010046865 Vaccinia virus infection Diseases 0.000 description 1
- ASQFIHTXXMFENG-XPUUQOCRSA-N Val-Ala-Gly Chemical compound CC(C)[C@H](N)C(=O)N[C@@H](C)C(=O)NCC(O)=O ASQFIHTXXMFENG-XPUUQOCRSA-N 0.000 description 1
- SLLKXDSRVAOREO-KZVJFYERSA-N Val-Ala-Thr Chemical compound C[C@H]([C@@H](C(=O)O)NC(=O)[C@H](C)NC(=O)[C@H](C(C)C)N)O SLLKXDSRVAOREO-KZVJFYERSA-N 0.000 description 1
- IDKGBVZGNTYYCC-QXEWZRGKSA-N Val-Asn-Pro Chemical compound CC(C)[C@H](N)C(=O)N[C@@H](CC(N)=O)C(=O)N1CCC[C@H]1C(O)=O IDKGBVZGNTYYCC-QXEWZRGKSA-N 0.000 description 1
- XLDYBRXERHITNH-QSFUFRPTSA-N Val-Asp-Ile Chemical compound CC[C@H](C)[C@@H](C(O)=O)NC(=O)[C@H](CC(O)=O)NC(=O)[C@@H](N)C(C)C XLDYBRXERHITNH-QSFUFRPTSA-N 0.000 description 1
- HHSILIQTHXABKM-YDHLFZDLSA-N Val-Asp-Phe Chemical compound CC(C)[C@H](N)C(=O)N[C@@H](CC(O)=O)C(=O)N[C@@H](Cc1ccccc1)C(O)=O HHSILIQTHXABKM-YDHLFZDLSA-N 0.000 description 1
- OVLIFGQSBSNGHY-KKHAAJSZSA-N Val-Asp-Thr Chemical compound C[C@H]([C@@H](C(=O)O)NC(=O)[C@H](CC(=O)O)NC(=O)[C@H](C(C)C)N)O OVLIFGQSBSNGHY-KKHAAJSZSA-N 0.000 description 1
- VCAWFLIWYNMHQP-UKJIMTQDSA-N Val-Glu-Ile Chemical compound CC[C@H](C)[C@@H](C(=O)O)NC(=O)[C@H](CCC(=O)O)NC(=O)[C@H](C(C)C)N VCAWFLIWYNMHQP-UKJIMTQDSA-N 0.000 description 1
- ZXAGTABZUOMUDO-GVXVVHGQSA-N Val-Glu-Lys Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CCC(=O)O)C(=O)N[C@@H](CCCCN)C(=O)O)N ZXAGTABZUOMUDO-GVXVVHGQSA-N 0.000 description 1
- FOADDSDHGRFUOC-DZKIICNBSA-N Val-Glu-Phe Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CCC(=O)O)C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)O)N FOADDSDHGRFUOC-DZKIICNBSA-N 0.000 description 1
- JTWIMNMUYLQNPI-WPRPVWTQSA-N Val-Gly-Arg Chemical compound CC(C)[C@H](N)C(=O)NCC(=O)N[C@H](C(O)=O)CCCNC(N)=N JTWIMNMUYLQNPI-WPRPVWTQSA-N 0.000 description 1
- NXRAUQGGHPCJIB-RCOVLWMOSA-N Val-Gly-Asn Chemical compound CC(C)[C@H](N)C(=O)NCC(=O)N[C@@H](CC(N)=O)C(O)=O NXRAUQGGHPCJIB-RCOVLWMOSA-N 0.000 description 1
- XBRMBDFYOFARST-AVGNSLFASA-N Val-His-Val Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CC1=CN=CN1)C(=O)N[C@@H](C(C)C)C(=O)O)N XBRMBDFYOFARST-AVGNSLFASA-N 0.000 description 1
- DAVNYIUELQBTAP-XUXIUFHCSA-N Val-Leu-Ile Chemical compound CC[C@H](C)[C@@H](C(=O)O)NC(=O)[C@H](CC(C)C)NC(=O)[C@H](C(C)C)N DAVNYIUELQBTAP-XUXIUFHCSA-N 0.000 description 1
- IJGPOONOTBNTFS-GVXVVHGQSA-N Val-Lys-Glu Chemical compound [H]N[C@@H](C(C)C)C(=O)N[C@@H](CCCCN)C(=O)N[C@@H](CCC(O)=O)C(O)=O IJGPOONOTBNTFS-GVXVVHGQSA-N 0.000 description 1
- MGVYZTPLGXPVQB-CYDGBPFRSA-N Val-Met-Ile Chemical compound CC[C@H](C)[C@@H](C(=O)O)NC(=O)[C@H](CCSC)NC(=O)[C@H](C(C)C)N MGVYZTPLGXPVQB-CYDGBPFRSA-N 0.000 description 1
- KISFXYYRKKNLOP-IHRRRGAJSA-N Val-Phe-Ser Chemical compound CC(C)[C@@H](C(=O)N[C@@H](CC1=CC=CC=C1)C(=O)N[C@@H](CO)C(=O)O)N KISFXYYRKKNLOP-IHRRRGAJSA-N 0.000 description 1
- ZXYPHBKIZLAQTL-QXEWZRGKSA-N Val-Pro-Asp Chemical compound CC(C)[C@@H](C(=O)N1CCC[C@H]1C(=O)N[C@@H](CC(=O)O)C(=O)O)N ZXYPHBKIZLAQTL-QXEWZRGKSA-N 0.000 description 1
- QTPQHINADBYBNA-DCAQKATOSA-N Val-Ser-Lys Chemical compound CC(C)[C@H](N)C(=O)N[C@@H](CO)C(=O)N[C@H](C(O)=O)CCCCN QTPQHINADBYBNA-DCAQKATOSA-N 0.000 description 1
- UJMCYJKPDFQLHX-XGEHTFHBSA-N Val-Ser-Thr Chemical compound C[C@H]([C@@H](C(=O)O)NC(=O)[C@H](CO)NC(=O)[C@H](C(C)C)N)O UJMCYJKPDFQLHX-XGEHTFHBSA-N 0.000 description 1
- IECQJCJNPJVUSB-IHRRRGAJSA-N Val-Tyr-Ser Chemical compound CC(C)[C@H](N)C(=O)N[C@@H](Cc1ccc(O)cc1)C(=O)N[C@@H](CO)C(O)=O IECQJCJNPJVUSB-IHRRRGAJSA-N 0.000 description 1
- 108010067390 Viral Proteins Proteins 0.000 description 1
- 150000001242 acetic acid derivatives Chemical class 0.000 description 1
- 230000002411 adverse Effects 0.000 description 1
- 230000002776 aggregation Effects 0.000 description 1
- 238000004220 aggregation Methods 0.000 description 1
- 108010076324 alanyl-glycyl-glycine Proteins 0.000 description 1
- 108010041407 alanylaspartic acid Proteins 0.000 description 1
- 108010047495 alanylglycine Proteins 0.000 description 1
- 108010070944 alanylhistidine Proteins 0.000 description 1
- VREFGVBLTWBCJP-UHFFFAOYSA-N alprazolam Chemical compound C12=CC(Cl)=CC=C2N2C(C)=NN=C2CN=C1C1=CC=CC=C1 VREFGVBLTWBCJP-UHFFFAOYSA-N 0.000 description 1
- 230000003321 amplification Effects 0.000 description 1
- 206010002026 amyotrophic lateral sclerosis Diseases 0.000 description 1
- 239000002870 angiogenesis inducing agent Substances 0.000 description 1
- 230000002491 angiogenic effect Effects 0.000 description 1
- 238000010171 animal model Methods 0.000 description 1
- 210000004959 anterior horn of lateral ventricle Anatomy 0.000 description 1
- 108010069926 arginyl-glycyl-serine Proteins 0.000 description 1
- FZCSTZYAHCUGEM-UHFFFAOYSA-N aspergillomarasmine B Natural products OC(=O)CNC(C(O)=O)CNC(C(O)=O)CC(O)=O FZCSTZYAHCUGEM-UHFFFAOYSA-N 0.000 description 1
- 210000003719 b-lymphocyte Anatomy 0.000 description 1
- 201000009904 bacterial meningitis Diseases 0.000 description 1
- 230000009286 beneficial effect Effects 0.000 description 1
- 150000001558 benzoic acid derivatives Chemical class 0.000 description 1
- 230000000740 bleeding effect Effects 0.000 description 1
- 238000006664 bond formation reaction Methods 0.000 description 1
- 230000006931 brain damage Effects 0.000 description 1
- 231100000874 brain damage Toxicity 0.000 description 1
- 230000036995 brain health Effects 0.000 description 1
- 208000009973 brain hypoxia - ischemia Diseases 0.000 description 1
- 208000029028 brain injury Diseases 0.000 description 1
- SXDBWCPKPHAZSM-UHFFFAOYSA-M bromate Inorganic materials [O-]Br(=O)=O SXDBWCPKPHAZSM-UHFFFAOYSA-M 0.000 description 1
- SXDBWCPKPHAZSM-UHFFFAOYSA-N bromic acid Chemical compound OBr(=O)=O SXDBWCPKPHAZSM-UHFFFAOYSA-N 0.000 description 1
- 230000003139 buffering effect Effects 0.000 description 1
- 235000011089 carbon dioxide Nutrition 0.000 description 1
- 210000000748 cardiovascular system Anatomy 0.000 description 1
- 239000000969 carrier Substances 0.000 description 1
- 108020001778 catalytic domains Proteins 0.000 description 1
- 238000004113 cell culture Methods 0.000 description 1
- 230000003915 cell function Effects 0.000 description 1
- 230000001413 cellular effect Effects 0.000 description 1
- 238000005119 centrifugation Methods 0.000 description 1
- 210000003198 cerebellar cortex Anatomy 0.000 description 1
- 210000003161 choroid Anatomy 0.000 description 1
- 238000004587 chromatography analysis Methods 0.000 description 1
- 210000000349 chromosome Anatomy 0.000 description 1
- 230000001684 chronic effect Effects 0.000 description 1
- 201000005795 chronic inflammatory demyelinating polyneuritis Diseases 0.000 description 1
- 238000004590 computer program Methods 0.000 description 1
- 230000021615 conjugation Effects 0.000 description 1
- 238000007796 conventional method Methods 0.000 description 1
- 239000002577 cryoprotective agent Substances 0.000 description 1
- 239000013078 crystal Substances 0.000 description 1
- 230000001086 cytosolic effect Effects 0.000 description 1
- 210000004544 dc2 Anatomy 0.000 description 1
- 238000000354 decomposition reaction Methods 0.000 description 1
- 230000003247 decreasing effect Effects 0.000 description 1
- 238000012350 deep sequencing Methods 0.000 description 1
- 230000007812 deficiency Effects 0.000 description 1
- 230000007850 degeneration Effects 0.000 description 1
- 238000002716 delivery method Methods 0.000 description 1
- 210000001787 dendrite Anatomy 0.000 description 1
- 239000005547 deoxyribonucleotide Substances 0.000 description 1
- 125000002637 deoxyribonucleotide group Chemical group 0.000 description 1
- 230000001066 destructive effect Effects 0.000 description 1
- 238000003745 diagnosis Methods 0.000 description 1
- PQYUGUXEJHLOIL-UHFFFAOYSA-N diethoxysilyl triethyl silicate Chemical compound C(C)O[SiH](O[Si](OCC)(OCC)OCC)OCC PQYUGUXEJHLOIL-UHFFFAOYSA-N 0.000 description 1
- 230000009521 diffuse axonal injury Effects 0.000 description 1
- 230000029087 digestion Effects 0.000 description 1
- 238000010790 dilution Methods 0.000 description 1
- 239000012895 dilution Substances 0.000 description 1
- 230000008034 disappearance Effects 0.000 description 1
- 208000035475 disorder Diseases 0.000 description 1
- 239000002552 dosage form Substances 0.000 description 1
- 231100000673 dose–response relationship Toxicity 0.000 description 1
- 239000003814 drug Substances 0.000 description 1
- 238000012377 drug delivery Methods 0.000 description 1
- 238000007876 drug discovery Methods 0.000 description 1
- 241001493065 dsRNA viruses Species 0.000 description 1
- 230000009977 dual effect Effects 0.000 description 1
- 239000012636 effector Substances 0.000 description 1
- 238000010828 elution Methods 0.000 description 1
- 239000003995 emulsifying agent Substances 0.000 description 1
- 238000005516 engineering process Methods 0.000 description 1
- 230000002255 enzymatic effect Effects 0.000 description 1
- 229940126864 fibroblast growth factor Drugs 0.000 description 1
- 238000001914 filtration Methods 0.000 description 1
- 238000007667 floating Methods 0.000 description 1
- 238000009472 formulation Methods 0.000 description 1
- 108020001507 fusion proteins Proteins 0.000 description 1
- 102000037865 fusion proteins Human genes 0.000 description 1
- 229940009600 gammagard Drugs 0.000 description 1
- 238000001476 gene delivery Methods 0.000 description 1
- 238000012239 gene modification Methods 0.000 description 1
- 102000034356 gene-regulatory proteins Human genes 0.000 description 1
- 108091006104 gene-regulatory proteins Proteins 0.000 description 1
- 238000010353 genetic engineering Methods 0.000 description 1
- 230000002518 glial effect Effects 0.000 description 1
- 108010078144 glutaminyl-glycine Proteins 0.000 description 1
- 208000007345 glycogen storage disease Diseases 0.000 description 1
- 230000013595 glycosylation Effects 0.000 description 1
- 238000006206 glycosylation reaction Methods 0.000 description 1
- 108010082286 glycyl-seryl-alanine Proteins 0.000 description 1
- 230000035876 healing Effects 0.000 description 1
- 210000003958 hematopoietic stem cell Anatomy 0.000 description 1
- 230000000971 hippocampal effect Effects 0.000 description 1
- 238000002744 homologous recombination Methods 0.000 description 1
- 230000006801 homologous recombination Effects 0.000 description 1
- 125000004435 hydrogen atom Chemical group [H]* 0.000 description 1
- 230000001631 hypertensive effect Effects 0.000 description 1
- 230000002267 hypothalamic effect Effects 0.000 description 1
- 210000003016 hypothalamus Anatomy 0.000 description 1
- 230000001146 hypoxic effect Effects 0.000 description 1
- 238000003384 imaging method Methods 0.000 description 1
- 238000007654 immersion Methods 0.000 description 1
- 102000018358 immunoglobulin Human genes 0.000 description 1
- 238000003364 immunohistochemistry Methods 0.000 description 1
- 238000012750 in vivo screening Methods 0.000 description 1
- 230000000415 inactivating effect Effects 0.000 description 1
- 238000010348 incorporation Methods 0.000 description 1
- 238000011534 incubation Methods 0.000 description 1
- 230000001939 inductive effect Effects 0.000 description 1
- 230000007574 infarction Effects 0.000 description 1
- 230000000977 initiatory effect Effects 0.000 description 1
- 230000003993 interaction Effects 0.000 description 1
- 230000010189 intracellular transport Effects 0.000 description 1
- 238000007918 intramuscular administration Methods 0.000 description 1
- 238000007912 intraperitoneal administration Methods 0.000 description 1
- 239000007928 intraperitoneal injection Substances 0.000 description 1
- NBQNWMBBSKPBAY-UHFFFAOYSA-N iodixanol Chemical compound IC=1C(C(=O)NCC(O)CO)=C(I)C(C(=O)NCC(O)CO)=C(I)C=1N(C(=O)C)CC(O)CN(C(C)=O)C1=C(I)C(C(=O)NCC(O)CO)=C(I)C(C(=O)NCC(O)CO)=C1I NBQNWMBBSKPBAY-UHFFFAOYSA-N 0.000 description 1
- 229960004359 iodixanol Drugs 0.000 description 1
- 238000004190 ion pair chromatography Methods 0.000 description 1
- 230000000622 irritating effect Effects 0.000 description 1
- 208000037906 ischaemic injury Diseases 0.000 description 1
- 230000000302 ischemic effect Effects 0.000 description 1
- 229960002725 isoflurane Drugs 0.000 description 1
- 229960003299 ketamine Drugs 0.000 description 1
- 210000003734 kidney Anatomy 0.000 description 1
- 238000002372 labelling Methods 0.000 description 1
- 230000029226 lipidation Effects 0.000 description 1
- 239000007788 liquid Substances 0.000 description 1
- 210000004072 lung Anatomy 0.000 description 1
- 239000012139 lysis buffer Substances 0.000 description 1
- 229920002521 macromolecule Polymers 0.000 description 1
- 230000014759 maintenance of location Effects 0.000 description 1
- 150000002690 malonic acid derivatives Chemical class 0.000 description 1
- 210000001161 mammalian embryo Anatomy 0.000 description 1
- 239000011159 matrix material Substances 0.000 description 1
- 230000001404 mediated effect Effects 0.000 description 1
- 230000021121 meiosis Effects 0.000 description 1
- 210000002901 mesenchymal stem cell Anatomy 0.000 description 1
- 208000030159 metabolic disease Diseases 0.000 description 1
- MYWUZJCMWCOHBA-VIFPVBQESA-N methamphetamine Chemical compound CN[C@@H](C)CC1=CC=CC=C1 MYWUZJCMWCOHBA-VIFPVBQESA-N 0.000 description 1
- 108010005942 methionylglycine Proteins 0.000 description 1
- 230000001617 migratory effect Effects 0.000 description 1
- 210000000337 motor cortex Anatomy 0.000 description 1
- 239000012120 mounting media Substances 0.000 description 1
- 210000003205 muscle Anatomy 0.000 description 1
- 229960004927 neomycin Drugs 0.000 description 1
- 210000005055 nestin Anatomy 0.000 description 1
- 230000003955 neuronal function Effects 0.000 description 1
- 201000001119 neuropathy Diseases 0.000 description 1
- 230000007823 neuropathy Effects 0.000 description 1
- 238000010899 nucleation Methods 0.000 description 1
- 238000003199 nucleic acid amplification method Methods 0.000 description 1
- 239000002777 nucleoside Substances 0.000 description 1
- 150000003833 nucleoside derivatives Chemical class 0.000 description 1
- 150000007524 organic acids Chemical class 0.000 description 1
- 235000005985 organic acids Nutrition 0.000 description 1
- 230000009984 peri-natal effect Effects 0.000 description 1
- 208000033300 perinatal asphyxia Diseases 0.000 description 1
- 208000033808 peripheral neuropathy Diseases 0.000 description 1
- 229940124531 pharmaceutical excipient Drugs 0.000 description 1
- 108010024654 phenylalanyl-prolyl-alanine Proteins 0.000 description 1
- 108010024607 phenylalanylalanine Proteins 0.000 description 1
- XEBWQGVWTUSTLN-UHFFFAOYSA-M phenylmercury acetate Chemical compound CC(=O)O[Hg]C1=CC=CC=C1 XEBWQGVWTUSTLN-UHFFFAOYSA-M 0.000 description 1
- NBIIXXVUZAFLBC-UHFFFAOYSA-K phosphate Chemical compound [O-]P([O-])([O-])=O NBIIXXVUZAFLBC-UHFFFAOYSA-K 0.000 description 1
- 239000010452 phosphate Substances 0.000 description 1
- 230000026731 phosphorylation Effects 0.000 description 1
- 238000006366 phosphorylation reaction Methods 0.000 description 1
- 102000020233 phosphotransferase Human genes 0.000 description 1
- 230000001766 physiological effect Effects 0.000 description 1
- 239000011148 porous material Substances 0.000 description 1
- 230000003389 potentiating effect Effects 0.000 description 1
- 125000002924 primary amino group Chemical group [H]N([H])* 0.000 description 1
- 230000000861 pro-apoptotic effect Effects 0.000 description 1
- 230000002062 proliferating effect Effects 0.000 description 1
- 108010014614 prolyl-glycyl-proline Proteins 0.000 description 1
- 108700042769 prolyl-leucyl-glycine Proteins 0.000 description 1
- 108010090894 prolylleucine Proteins 0.000 description 1
- 230000000069 prophylactic effect Effects 0.000 description 1
- 238000000159 protein binding assay Methods 0.000 description 1
- 238000000746 purification Methods 0.000 description 1
- 239000002096 quantum dot Substances 0.000 description 1
- 101150101384 rat1 gene Proteins 0.000 description 1
- 238000003753 real-time PCR Methods 0.000 description 1
- 210000003370 receptor cell Anatomy 0.000 description 1
- 239000012779 reinforcing material Substances 0.000 description 1
- 108091008146 restriction endonucleases Proteins 0.000 description 1
- 230000007441 retrograde transport Effects 0.000 description 1
- 230000001177 retroviral effect Effects 0.000 description 1
- 239000002336 ribonucleotide Substances 0.000 description 1
- 125000002652 ribonucleotide group Chemical group 0.000 description 1
- 108091008601 sVEGFR Proteins 0.000 description 1
- 201000000980 schizophrenia Diseases 0.000 description 1
- 210000004116 schwann cell Anatomy 0.000 description 1
- 238000012216 screening Methods 0.000 description 1
- 201000005572 sensory peripheral neuropathy Diseases 0.000 description 1
- 238000013207 serial dilution Methods 0.000 description 1
- 210000002966 serum Anatomy 0.000 description 1
- 229910052709 silver Inorganic materials 0.000 description 1
- 239000004332 silver Substances 0.000 description 1
- 210000003625 skull Anatomy 0.000 description 1
- 239000002904 solvent Substances 0.000 description 1
- 210000000278 spinal cord Anatomy 0.000 description 1
- 208000002320 spinal muscular atrophy Diseases 0.000 description 1
- 230000004960 subcellular localization Effects 0.000 description 1
- 239000005720 sucrose Substances 0.000 description 1
- 230000008093 supporting effect Effects 0.000 description 1
- 229930184616 taxin Natural products 0.000 description 1
- KOTXAHKUCAQPQA-AAUVPWARSA-N taxine Chemical compound C1([C@@H]([C@@H](O)C(=O)O[C@@H]2C=3/C[C@@](C([C@H](O)C4=C(C)[C@@H](OC(C)=O)CC(C4(C)C)[C@@H](OC(C)=O)\C=3)=O)(C)[C@@H](O)C2)N(C)C)=CC=CC=C1 KOTXAHKUCAQPQA-AAUVPWARSA-N 0.000 description 1
- 210000001103 thalamus Anatomy 0.000 description 1
- 238000002560 therapeutic procedure Methods 0.000 description 1
- 231100000419 toxicity Toxicity 0.000 description 1
- 230000001988 toxicity Effects 0.000 description 1
- 239000003053 toxin Substances 0.000 description 1
- 231100000765 toxin Toxicity 0.000 description 1
- 108700012359 toxins Proteins 0.000 description 1
- 108091006106 transcriptional activators Proteins 0.000 description 1
- 108091006107 transcriptional repressors Proteins 0.000 description 1
- 230000002463 transducing effect Effects 0.000 description 1
- 238000001890 transfection Methods 0.000 description 1
- 230000009466 transformation Effects 0.000 description 1
- 238000011830 transgenic mouse model Methods 0.000 description 1
- 238000003146 transient transfection Methods 0.000 description 1
- 230000014621 translational initiation Effects 0.000 description 1
- 230000009529 traumatic brain injury Effects 0.000 description 1
- 239000013638 trimer Substances 0.000 description 1
- LENZDBCJOHFCAS-UHFFFAOYSA-N tris Chemical compound OCC(N)(CO)CO LENZDBCJOHFCAS-UHFFFAOYSA-N 0.000 description 1
- 241000701447 unidentified baculovirus Species 0.000 description 1
- 241001529453 unidentified herpesvirus Species 0.000 description 1
- 208000007089 vaccinia Diseases 0.000 description 1
- 239000003981 vehicle Substances 0.000 description 1
- 230000029812 viral genome replication Effects 0.000 description 1
- 230000017613 viral reproduction Effects 0.000 description 1
- 239000013603 viral vector Substances 0.000 description 1
- XLYOFNOQVPJJNP-UHFFFAOYSA-N water Substances O XLYOFNOQVPJJNP-UHFFFAOYSA-N 0.000 description 1
- 239000003643 water by type Substances 0.000 description 1
- 230000003442 weekly effect Effects 0.000 description 1
- 238000009736 wetting Methods 0.000 description 1
- 239000000080 wetting agent Substances 0.000 description 1
- BPICBUSOMSTKRF-UHFFFAOYSA-N xylazine Chemical compound CC1=CC=CC(C)=C1NC1=NCCCS1 BPICBUSOMSTKRF-UHFFFAOYSA-N 0.000 description 1
- 229960001600 xylazine Drugs 0.000 description 1
Images


Classifications
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12N—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA
- C12N7/00—Viruses; Bacteriophages; Compositions thereof; Preparation or purification thereof
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61K—PREPARATIONS FOR MEDICAL, DENTAL OR TOILETRY PURPOSES
- A61K35/00—Medicinal preparations containing materials or reaction products thereof with undetermined constitution
- A61K35/66—Microorganisms or materials therefrom
- A61K35/76—Viruses; Subviral particles; Bacteriophages
- A61K35/761—Adenovirus
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61P—SPECIFIC THERAPEUTIC ACTIVITY OF CHEMICAL COMPOUNDS OR MEDICINAL PREPARATIONS
- A61P25/00—Drugs for disorders of the nervous system
- A61P25/28—Drugs for disorders of the nervous system for treating neurodegenerative disorders of the central nervous system, e.g. nootropic agents, cognition enhancers, drugs for treating Alzheimer's disease or other forms of dementia
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K14/00—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof
- C07K14/005—Peptides having more than 20 amino acids; Gastrins; Somatostatins; Melanotropins; Derivatives thereof from viruses
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12N—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA
- C12N15/00—Mutation or genetic engineering; DNA or RNA concerning genetic engineering, vectors, e.g. plasmids, or their isolation, preparation or purification; Use of hosts therefor
- C12N15/09—Recombinant DNA-technology
- C12N15/63—Introduction of foreign genetic material using vectors; Vectors; Use of hosts therefor; Regulation of expression
- C12N15/79—Vectors or expression systems specially adapted for eukaryotic hosts
- C12N15/85—Vectors or expression systems specially adapted for eukaryotic hosts for animal cells
- C12N15/86—Viral vectors
-
- A—HUMAN NECESSITIES
- A01—AGRICULTURE; FORESTRY; ANIMAL HUSBANDRY; HUNTING; TRAPPING; FISHING
- A01K—ANIMAL HUSBANDRY; AVICULTURE; APICULTURE; PISCICULTURE; FISHING; REARING OR BREEDING ANIMALS, NOT OTHERWISE PROVIDED FOR; NEW BREEDS OF ANIMALS
- A01K2227/00—Animals characterised by species
- A01K2227/10—Mammal
- A01K2227/105—Murine
-
- A—HUMAN NECESSITIES
- A01—AGRICULTURE; FORESTRY; ANIMAL HUSBANDRY; HUNTING; TRAPPING; FISHING
- A01K—ANIMAL HUSBANDRY; AVICULTURE; APICULTURE; PISCICULTURE; FISHING; REARING OR BREEDING ANIMALS, NOT OTHERWISE PROVIDED FOR; NEW BREEDS OF ANIMALS
- A01K2267/00—Animals characterised by purpose
- A01K2267/03—Animal model, e.g. for test or diseases
- A01K2267/0393—Animal model comprising a reporter system for screening tests
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61K—PREPARATIONS FOR MEDICAL, DENTAL OR TOILETRY PURPOSES
- A61K48/00—Medicinal preparations containing genetic material which is inserted into cells of the living body to treat genetic diseases; Gene therapy
- A61K48/0008—Medicinal preparations containing genetic material which is inserted into cells of the living body to treat genetic diseases; Gene therapy characterised by an aspect of the 'non-active' part of the composition delivered, e.g. wherein such 'non-active' part is not delivered simultaneously with the 'active' part of the composition
- A61K48/0025—Medicinal preparations containing genetic material which is inserted into cells of the living body to treat genetic diseases; Gene therapy characterised by an aspect of the 'non-active' part of the composition delivered, e.g. wherein such 'non-active' part is not delivered simultaneously with the 'active' part of the composition wherein the non-active part clearly interacts with the delivered nucleic acid
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12N—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA
- C12N2750/00—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA ssDNA viruses
- C12N2750/00011—Details
- C12N2750/14011—Parvoviridae
- C12N2750/14111—Dependovirus, e.g. adenoassociated viruses
- C12N2750/14122—New viral proteins or individual genes, new structural or functional aspects of known viral proteins or genes
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12N—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA
- C12N2750/00—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA ssDNA viruses
- C12N2750/00011—Details
- C12N2750/14011—Parvoviridae
- C12N2750/14111—Dependovirus, e.g. adenoassociated viruses
- C12N2750/14133—Use of viral protein as therapeutic agent other than vaccine, e.g. apoptosis inducing or anti-inflammatory
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12N—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA
- C12N2750/00—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA ssDNA viruses
- C12N2750/00011—Details
- C12N2750/14011—Parvoviridae
- C12N2750/14111—Dependovirus, e.g. adenoassociated viruses
- C12N2750/14141—Use of virus, viral particle or viral elements as a vector
- C12N2750/14143—Use of virus, viral particle or viral elements as a vector viral genome or elements thereof as genetic vector
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12N—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA
- C12N2750/00—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA ssDNA viruses
- C12N2750/00011—Details
- C12N2750/14011—Parvoviridae
- C12N2750/14111—Dependovirus, e.g. adenoassociated viruses
- C12N2750/14141—Use of virus, viral particle or viral elements as a vector
- C12N2750/14145—Special targeting system for viral vectors
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12N—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA
- C12N2800/00—Nucleic acids vectors
- C12N2800/30—Vector systems comprising sequences for excision in presence of a recombinase, e.g. loxP or FRT
Landscapes
- Health & Medical Sciences (AREA)
- Life Sciences & Earth Sciences (AREA)
- Chemical & Material Sciences (AREA)
- Genetics & Genomics (AREA)
- Organic Chemistry (AREA)
- Engineering & Computer Science (AREA)
- Bioinformatics & Cheminformatics (AREA)
- General Health & Medical Sciences (AREA)
- Biomedical Technology (AREA)
- Virology (AREA)
- Zoology (AREA)
- Wood Science & Technology (AREA)
- Biochemistry (AREA)
- Biotechnology (AREA)
- Medicinal Chemistry (AREA)
- General Engineering & Computer Science (AREA)
- Molecular Biology (AREA)
- Biophysics (AREA)
- Microbiology (AREA)
- Pharmacology & Pharmacy (AREA)
- Veterinary Medicine (AREA)
- Public Health (AREA)
- Animal Behavior & Ethology (AREA)
- Physics & Mathematics (AREA)
- Plant Pathology (AREA)
- Proteomics, Peptides & Aminoacids (AREA)
- Gastroenterology & Hepatology (AREA)
- Neurosurgery (AREA)
- Neurology (AREA)
- Epidemiology (AREA)
- Hospice & Palliative Care (AREA)
- Chemical Kinetics & Catalysis (AREA)
- Psychiatry (AREA)
- Mycology (AREA)
- General Chemical & Material Sciences (AREA)
- Immunology (AREA)
- Nuclear Medicine, Radiotherapy & Molecular Imaging (AREA)
- Micro-Organisms Or Cultivation Processes Thereof (AREA)
- Medicines Containing Material From Animals Or Micro-Organisms (AREA)
- Medicines That Contain Protein Lipid Enzymes And Other Medicines (AREA)
Abstract
본 발명은 변이체 캡시드 단백질을 보유한 재조합 아데노-연관 바이러스 비리온을 제공하는데, 이 때 재조합 AAV (rAAV) 비리온은 대조 AAV에 비해 증가된 신경 세포 장벽 통과 능력, 증가된 신경 줄기 세포 감염력, 증가된 신경 세포 감염력, 및 항체 중화에 대한 감소된 감수성 중 하나 이상을 나타내며, rAAV 비리온은 이종 핵산을 포함한다. 본 발명은 유전자 생성물을 개체의 신경 줄기 세포 또는 신경 세포에 전달하는 방법을 제공한다. 본 발명은 또한 신경 줄기 세포 또는 신경 세포에 존재하는 표적 핵산을 변형시키는 방법을 제공한다.
Description
상호 참조
본 출원은 2017년 8월 28일 출원된 미국 가특허출원 제 62/551,133호의 이익을 주장하며, 이 출원은 본 명세서에 그 전문이 참고문헌으로 포함된다.
도입
아데노-연관 바이러스 (AAV)는 파르보리비다에 (Parvoviridae) 과 및 데펜도바이러스 (Dependovirus) 속에 속하며, 이들의 구성원은 복제를 촉진하기 위해 아데노바이러스와 같은 헬퍼 바이러스와의 공동 감염이 필요하며, AAV는 헬퍼가 없는 경우 잠재적 감염을 확립한다. 비리온은 두 개의 개방 해독틀: 렙 (rep) 및 캡 (cap)을 가진 4.7kb 단일 가닥 DNA 게놈을 포함하는 25nm 정이십면체 캡시드로 구성된다. 비-구조적 렙 유전자는 바이러스 복제에 필수적인 4 개의 조절 단백질을 인코드하는 반면, 캡은 60량체 캡시드 외피 내부에 어셈블되는 3 개의 구조 단백질 (VP1-3)을 인코드한다. 이 바이러스 캡시드는 AAV 벡터가 세포 표면 수용체 결합, 세포내섭취, 세포내 교환 (intracellular trafficking) 및 핵에서의 언패키징(unpackaging)을 비롯한 바이러스 형질도입의 많은 생물학적 장벽을 극복 할 수 있는 능력을 매개한다.
증가된 세포 장벽 통과 능력을 부여하는 및/또는 증가된 신경 줄기 세포 감염 능력을 부여하는 및/또는 증가된 신경 세포 감염 능력을 부여하는 변이체 캡시드 단백질을 가지는 AAV 비리온이 해당 분야에 필요하다.
요약
본 발명은 변이체 캡시드 단백질을 보유한 재조합 아데노-연관 바이러스 비리온을 제공하는데, 이 때 재조합 AAV (rAAV) 비리온은 대조 AAV에 비해 증가된 신경 세포 장벽 통과 능력, 증가된 신경 줄기 세포 감염력, 증가된 신경 세포 감염력, 및 항체 중화에 대한 감소된 감수성 중 하나 이상을 나타내며, rAAV 비리온은 이종 핵산을 포함한다. 본 발명은 유전자 산물을 개체의 신경 줄기 세포 또는 신경 세포에 전달하는 방법을 제공한다. 본 발명은 또한 신경 줄기 세포 또는 신경 세포에 존재하는 표적 핵산을 변형시키는 방법을 제공한다.
도 1A-1F는 최단 경로 문제 (RASPP) 방법으로서 재조합을 적용한 후 키메라 아데노-연관 바이러스 (AAV) 라이브러리의 SCHEMA-가이드된 설계를 제공한다.
도 2는 AAV 캡 유전자를 증폭시키는데 사용되는 프라이머 서열들을 제공한다.
도 3은 SCHEMA AAV 라이브러리의 조합형 골든 게이트 어셈블리를 위한 각 서열 블록을 증폭시키기 위해 j5 DNA 어셈블리로 설계된 프라이머 서열들을 제공한다.
도 4는 SCHEMA AAV 라이브러리의 조합형 골든 게이트 클로닝을 위한 중합효소 연쇄 반응 (PCR)을 제공한다.
도 5는 pBluescript 벡터 골격으로의 조합형 골든 게이트 클로닝을 용이하게 하기 위하여 블록 연접부에 침묵 돌연변이들을 통합시키고자 설계된 프라이머들을 제공한다.
도 6A-6D는 AAV 유도된 진화 (AAV directed evolution)를 위한 Cre-의존적 선택 전략의 도시를 제공한다.
도 7은 Sure2 재조합효소 결핍 대장균에서 세균 플라스미드 번식 동안의 재조합 수준을 도시한다.
도 8은 SCH9 캡시드의 아미노산 서열을 제공한다.
도 9는 SCH2 캡시드의 아미노산 서열을 제공한다.
도 10은 SCH9 및 SCH2 AAV 캡 아미노산 서열과 모체 AAV 혈청형의 아미노산 정렬을 제공한다. SCH9 아미노산 서열: 서열 번호:1; SCH2 아미노산 서열: 서열 번호:2; AAV2 캡시드 아미노산 서열: 서열 번호:136; AAV6 캡시드 아미노산 서열: 서열 번호:11; AAV8 캡시드 아미노산 서열: 서열 번호:137; AAV9 캡시드 아미노산 서열: 서열 번호:138.
도 11A-11B는 SCH9 캡시드의 3차원 모델을 제공한다.
도 12는 재조합 자기-상보적 AAV 벡터들의 바이러스 유전체 수율을 도시한다.
도 13A-13I는 뇌실하 영역 (SVZ)에서 신경 줄기 세포들의 형질도입에 대한 SCH9의 효과를 도시한다.
도 14A-14C는 소뇌의 푸르킨예 세포들에서 SCH9 형질도입의 마커 발현을 도시한다.
도 15는 심부 소뇌 핵에서 재조합 AAV1 또는 SCH9의 편측 주사 3주 후 소뇌에서의 GFP 발현을 도시한다.
도 16A-16C는 SCH9 글리칸 결합 및 중화 항체들에 대한 내성의 특성을 도시한다.
도 17은 AAVR를 이용하는 것으로 공지되어 있는 대조인 AAV2와 비교하여, SCH2 및 SCH9의 감염력을 도시한다.
도 18A-18F는 스트렙토코쿠스 피오게네스 (Streptococcus pyogenes) Cas9 폴리펩티드 및 변이체의 아미노산 서열들을 제공한다.
도 19는 스타필로코쿠스 아우레우스 (Staphylococcus aureus) Cas9 폴리펩티드의 아미노산 서열을 제공한다.
도 20A-20C는 다양한 Cpf1 폴리펩티드의 아미노산 서열을 제공한다.
도 21A-21C는 AAV 캡시드 단백질 루프 IV (GH 루프) 영역의 아미노산 서열들의 정렬을 제공한다. 삽입 부위는 볼드체로 밑줄표시 된다.
정의
본 명세서에서 사용되는 용어 "신경 줄기 세포" (NSC)는 뇌의 주요 성체 신경 세포들로 증식, 자가-재생 및 분화될 수 있는 미분화된 신경 세포를 지칭한다. NSC는 자가 재생 (self-renewal)이 가능하며, 이는 각 세포 분열에서 하나의 딸 세포가 또한 줄기 세포가 됨을 의미한다. NSC의 비-줄기 세포 자손은 신경 전구 세포로 지칭된다. 하나의 다능성 NSC로부터 생성된 신경 전구 세포는 뉴런, 성상 세포 (유형 I 및 유형 II), 및 희소돌기아교세포로 분화될 수 있다. 그러므로, NSC는 이들의 자손이 다수의 신경 세포 운명을 가지기 때문에 "다능성"이다. 그러므로, NSC는 다음과 같은 능력을 가지는 세포로서 기능적으로 정의될 수 있다: 중추 신경계에서 발견되는 3가지 주요 세포 유형들: 뉴런, 성상세포 및 희소돌기아교세포로 분화될 수 있는 기능적 자손을 1) 증식, 2) 자가-재생, 및 3) 생성. NSC는 성숙 뉴런, 성숙 신경아교 세포, 성숙 희소돌기아교세포, 및 성숙 성상세포의 마커들에 대해 일반적으로 음성이다.
본 명세서에서 사용되는 용어 "신경 전구 세포" 또는 "신경 전구체 세포"는 자손을 생성할 수 있는 세포, 가령, 뉴런 세포 (예컨대, 뉴런 전구체 또는 성숙 뉴런), 신경아교세포 전구체, 성숙 성상세포, 또는 성숙 희소돌기아교세포를 지칭한다. 전형적으로, 상기 세포들은 신경 계통의 특징인 일부 표현형 마커를 발현한다. "뉴런 전구 세포" 또는 "뉴런 전구체 세포"는 성숙 뉴런인 자손을 생성할 수 있는 세포이다. 이들 세포들은 신경아교 세포를 생성하는 능력을 가지거나 또는 가지지 않을 수도 있다.
본 명세서에서 사용되는 "뉴런 세포"는 "신경 세포"와 호환적으로 사용되며 중추 신경계 또는 말초 신경계의 뉴런 및 아교세포를 지칭한다. 용어 "뉴런 세포"는 성상세포, 희소돌기아교세포, 및 슈반 세포와 같은 세포들을 포함한다. 상기 용어는 임의의 뇌 조직 (예컨대, 뇌 조직, 가령, 대뇌 반구, 대뇌 피질, 피질하 운동 피질, 선조체, 내포, 시상, 시상하부, 해마, 중뇌, 뇌간, 및 소뇌)의 뉴런 세포들을 포함한다. 성숙 뉴런은 하나 이상의 성숙 뉴런 마커들을 발현할 수 있는데, 이 때 이러한 마커들에는, 예컨대, 네스틴, NeuroD1, 뉴런-특이적 에놀라아제 (NSE), 뉴런-특이적 핵 단백질 (NeuN), 미세신경섬유 (NF), S100β, 타우, 미세관-연관 단백질 2 (MAP2), 타우, 더블코르틴 (DCX) 등이 포함된다.
"AAV"는 아데노-연관 바이러스의 약어이며, 바이러스 그 자체 또는 이의 유도체를 지칭하기 위해 사용될 수 있다. 상기 용어는 달리 필요한 경우를 제외하고 모든 아형들 및 자연 발생 및 재조합 형태들 모두를 포함한다. 약어 "rAAV"는 재조합 AAV 벡터 (또는 "rAAV 벡터")로도 지칭되는, 재조합 아데노-연관 바이러스를 지칭한다. 용어 "AAV"는 AAV 유형 1 (AAV-1), AAV 유형 2 (AAV-2), AAV 유형 3 (AAV-3), AAV 유형 4 (AAV-4), AAV 유형 5 (AAV-5), AAV 유형 6 (AAV-6), AAV 유형 7 (AAV-7), AAV 유형 8 (AAV-8), AAV 유형 9 (AAV-9), AAV 유형 10 (AAV-10), 조류 AAV, 소 AAV, 개 AAV, 말 AAV, 영장류 AAV, 비-영장류 AAV, 및 양 AAV를 포함한다. "영장류 AAV"는 영장류로부터 단리된 AAV를 지칭하고, "비-영장류 AAV"는 비-영장류 포유동물로부터 단리된 AAV를 지칭하고, "소 AAV"는 소과 포유동물 (예컨대, 암소) 등으로부터 단리된 AAV를 지칭한다.
본 명세서에서 사용되는 "rAAV 벡터"는 통상적으로 표적 세포로 도입하기 위한 관심 서열인, AAV 기원이 아닌 폴리뉴클레오티드 (즉, AAV에 이종인 폴리뉴클레오티드) 서열을 포함하는 AAV 벡터를 지칭한다. 일반적으로, 이종 폴리뉴클레오티드는 최소한 하나에 의해, 그리고 일반적으로 두 개의 AAV 반전된 말단 반복 서열 (ITRs)에 의해 연접된다. 용어 rAAV 벡터는 rAAV 벡터 입자들 및 rAAV 벡터 플라스미드 모두를 포함한다.
"AAV 바이러스" 또는 "AAV 바이러스 입자" 또는 "rAAV 벡터 입자"는 최소한 하나의 AAV 캡시드 단백질 (통상적으로 야생형 AAV의 캡시드 단백질들 모두) 및 캡시드화된 폴리뉴클레오티드 rAAV 벡터로 구성된 바이러스 입자를 지칭한다. 상기 입자가 이종 폴리뉴클레오티드 (즉, 야생형 AAV 게놈 이외의 폴리뉴클레오티드, 가령, 포유동물 세포에 전달되는 트랜스진)를 포함하는 경우, 이는 전형적으로 "rAAV 벡터 입자" 또는 간단히 "rAAV 벡터"로 지칭된다. 그러므로, rAAV 입자의 생성은 반드시 rAAV 벡터의 생성을 포함하는데, 이러한 벡터가 rAAV 입자 내부에 내포되기 때문이다.
"패키징"은 AAV 입자의 어셈블리 및 캡시드화를 가져오는 일련의 세포내 사건들을 지칭한다.
AAV "렙" 및 "캡" 유전자들은 아데노-연관 바이러스의 복제 및 캡시드화 단백질들을 인코드하는 폴리뉴클레오티드 서열들을 지칭한다. AAV 렙 및 캡은 본 명세서에서 AAV "패키징 유전자들"로서 지칭된다.
AAV를 위한 "헬퍼 바이러스"는 AAV (예컨대, 야생형 AAV)가 포유동물 세포에 의해 복제되고 패키징될 수 있게 하는 바이러스를 지칭한다. AAV를 위한 다양한 이러한 헬퍼 바이러스들은 해당 분야에 공지되어 있으며, 아데노바이러스, 헤르페스바이러스 및 폭스바이러스, 가령, 백시니아가 포함된다. 아데노바이러스는 수많은 상이한 하위그룹들을 포함하지만, 하위그룹 C의 아데노바이러스 유형 5가 가장 통상적으로 사용된다. 인간, 비-인간 포유동물 및 조류 기원의 수많은 아데노바이러스가 공지되어 있으며 ATCC와 같은 기탁기관으로부터 이용가능하다. 헤르페스 과의 바이러스들에는, 예를 들어, 단순 헤르페스 바이러스 (HSV) 및 엡스타인-바 바이러스 (EBV), 뿐만 아니라 거대세포바이러스 (CMV) 및 거짓광견병 바이러스 (PRV)가 포함되며; 이들 또한 ATCC와 같은 기탁기관으로부터 이용가능하다.
"헬퍼 바이러스 기능(들)"은 AAV 복제 및 패키징 (본 명세서에 기재된 복제 및 패키징에 대한 다른 요구 사항들과 함께)을 가능하게 하는 헬퍼 바이러스 게놈에 인코드되는 기능(들)을 지칭한다. 본 명세서에 기재된 "헬퍼 바이러스 기능"은 생산자 세포에게 헬퍼 바이러스를 제공하는 것, 또는, 예를 들면, 트랜스로 (in trans) 필요한 기능(들)을 인코드하는 폴리뉴클레오티드 서열들을 제공하는 것을 비롯한, 수많은 방법들로 제공될 수 있다.
"감염성" 바이러스 또는 바이러스 입자는 바이러스 종들이 자극성인 세포들 내부로 전달될 수 있는 폴리뉴클레오티드 성분을 포함하는 입자이다. 상기 용어가 반드시 바이러스의 복제 성능을 의미하는 것은 아니다. 본 명세서에서 사용되는 "감염성" 바이러스 또는 바이러스 입자는 표적 세포에 접근할 수 있고, 표적 세포를 감염시킬 수 있고, 그리고 표적 세포에서 이종 핵산을 발현시킬 수 있는 입자이다. 그러므로, "감염력"은 표적 세포에 접근하고, 표적 세포를 감염시키고, 그리고 표적 세포에서 이종 핵산을 발현시키는 바이러스 입자의 능력을 지칭한다. 감염력은 시험관내 감염력 또는 생체내 감염력을 지칭할 수 있다. 감염성 바이러스 입자들을 계수하기 위한 분석법들은 본 명세서의 다른 부분 및 해당 분야에 잘 설명되어 있다. 바이러스 감염력은 감염성 바이러스 입자 대 총 바이러스 입자의 비율로 표현될 수 있다. 총 바이러스 입자들은 바이러스 게놈 (vg) 복제수로 표현될 수 있다. 세포에서 이종 핵산을 발현시키는 바이러스 입자의 능력은 "형질도입"으로 지칭될 수 있다. 세포에서 이종 핵산을 발현시키는 바이러스 입자의 능력은 마커 유전자, 가령, 녹색 형광 단백질 (GFP) 분석 (예컨대, 바이러스는 GFP를 인코드하는 뉴클레오티드 서열을 포함함)의 평가, 이 때 GFP는 바이러스 입자로 감염된 세포에서 생성되어 탐지되고 및/또는 측정되며; 또는 생성된 단백질의 측정, 예를 들면, 효소-결합 면역흡착 측정법 (ELISA)에 의한 측정을 비롯한 수많은 기술들을 사용하여 분석될 수 있다. 바이러스 감염력은 감염성 바이러스 입자 대 총 바이러스 입자의 비율로 표현될 수 있다. 감염성 바이러스 입자 대 총 바이러스 입자의 비율을 결정하는 방법들은 해당 분야에 공지되어 있다. 예컨대, Grainger 외. (2005) Mol. Ther. 11:S337 (TCID50 감염성 역가 측정법을 기술); 및 Zolotukhin 외. (1999) Gene Ther. 6:973을 참고하라.
"복제-가능" 바이러스 (예컨대, 복제-가능 AAV)는 감염성이고, 또한 감염된 세포에서 (즉, 헬퍼 바이러스 또는 헬퍼 바이러스 기능의 존재시) 복제될 수 있는 표현형적 야생형 바이러스를 지칭한다. AAV의 경우, 복제 능력은 일반적으로 기능적 AAV 패키징 유전자들의 존재를 필요로 한다. 일반적으로, 본 명세서에 기재된 rAAV 벡터는 하나 이상의 AAV 패키징 유전자들이 없음으로 인해 포유동물 세포들에서 (특히 인간 세포들에서) 복제-불능이다. 전형적으로, AAV 패키징 유전자들과 유입하는 rAAV 벡터 사이의 재조합에 의해 복제 가능 AAV가 생성될 가능성을 최소화하기 위하여 이러한 rAAV 벡터는 임의의 AAV 패키징 유전자 서열들이 없다. 일반적으로, 본 명세서에 기재된 rAAV 벡터 제재는 임의의 복제 가능 AAV (rcAAV, 또한 RCA로도 지칭됨)가 거의 함유되어 있지 않은 제재이다 (예컨대, 102 개의 rAAV 입자 당 약 1 rcAAV 미만, 104 개의 rAAV 입자 당 약 1 rcAAV 미만, 108 개의 rAAV 입자 당 약 1 rcAAV 미만, 1012 개의 rAAV 입자 당 약 1 rcAAV 미만, 또는 rcAAV 없음).
용어 "폴리뉴클레오티드"는 데옥시리보뉴클레오티드 또는 리보뉴클레오티드, 또는 이의 유사체를 비롯하여, 임의의 길이의 뉴클레오티드들의 폴리머 형태를 지칭한다. 폴리뉴클레오티드는 변형된 뉴클레오티드, 가령, 메틸화된 뉴클레오티드 및 뉴클레오티드 유사체를 포함할 수 있고, 비-뉴클레오티드 성분들에 의해 불연속될 수 있다. 존재하는 경우, 뉴클레오티드 구조에 대한 변형들은 폴리머 어셈블리 전 또는 이후에 부여될 수 있다. 본 명세서에서 사용되는 용어 폴리뉴클레오티드는 이중- 및 단일-가닥 분자들을 호환적으로 지칭한다. 달리 특정되거나 또는 요구되지 않는 한, 폴리뉴클레오티드인 본 명세서에 기재된 본 발명의 임의의 구체예는 이중-가닥 형태 및 이중-가닥 형태를 구성하는 것으로 공지되거나 예상되는 2개의 상보적 단일-가닥 형태들 각각을 모두 포함한다.
폴리뉴클레오티드 또는 폴리펩티드는 또 다른 폴리뉴클레오티드 또는 폴리펩티드에 대한 일정한 퍼센트 "서열 동일성"을 가지며, 서열 동일성은 정렬될 때, 2개의 서열들을 비교할 때 염기 또는 아미노산의 백분율이 동일함을 의미한다. 서열 유사성은 상이한 많은 방식들로 결정될 수 있다. 서열 동일성을 결정하기 위하여, 서열들은 ncbi.nlm.nih.gov/BLAST/의 월드 와이드 웹을 통해 이용가능한 , BLAST를 비롯한 방법 및 컴퓨터 프로그램들을 사용하여 정렬될 수 있다. 또 다른 정렬 알고리즘은, Oxford Molecular Group, Inc의 전액 출자회사인 미국 위스콘신 주 Madison사의 Genetics Computing Group (GCG) 패키지로 제공되는 FASTA이다. 다른 정렬 기술들은 Methods in Enzymology, vol. 266: Computer Methods for Macromolecular Sequence Analysis (1996), ed. Doolittle, Academic Press, Inc., a division of Harcourt Brace & Co., San Diego, California, USA에 기재되어 있다. 특히 서열 내 갭들을 허용하는 정렬 프로그램들이 관심 대상이다. Smith-Waterman은 서열 정렬에서 갭을 허용하는 알고리즘의 한 유형이다. Meth. Mol. Biol. 70: 173-187 (1997)을 참고하라. 또한, Needleman and Wunsch 정렬 방법을 사용한 GAP 프로그램을 이용하여 서열들을 정렬할 수 있다. J. Mol. Biol. 48: 443-453 (1970)을 참고하라.
서열 동일성을 결정하기 위해 Smith Waterman의 로컬 상동성 알고리즘을 사용하는 BestFit 프로그램 (Advances in Applied Mathematics 2: 482-489 (1981))이 관심 대상이 된다. 갭 생성 페널티는 일반적으로 1 내지 5 범위, 통상적으로 2 내지 4 범위가 될 것이며 일부 사례들에서는 3이 될 것이다. 갭 확장 페널티는 일반적으로 약 0.01 내지 0.20 범위가 될 것이며 많은 예들에서는 0.10이 될 것이다. 상기 프로그램은 비교를 위해 입력되는 서열들에 의해 결정되는 기본 매개변수를 가진다. 바람직하게는, 서열 동일성은 상기 프로그램에 의해 결정된 기본 매개변수를 사용하여 결정된다. 이 프로그램은 또한 미국 위스콘신 주 Madison 사의, Genetics Computing Group (GCG) 패키지로부터도 이용가능하다.
또 다른 관심 프로그램은 FastDB 알고리즘이다. FastDB는 문헌 Sequence Comparison and Analysis, Macromolecule Sequencing and Synthesis, Selected Methods and Applications, pp. 127-149, 1988, Alan R. Liss, Inc의 Current Methods 부분에 기재되어 있다. 퍼센트 서열 동일성은 다음 매개변수들에 기초하여 FastDB에 의해 계산된다:
미스매치 페널티:
1.00;
갭 페널티:
1.00;
갭 크기 페널티:
0.33; 및
페널티:
30.0.
"유전자"는 전사 및 번역 후 특정 단백질을 인코딩할 수 있는 최소한 하나의 개방 해독틀을 내포하는 폴리뉴클레오티드를 지칭한다.
본 명세서에서 사용되는 용어 "가이드 RNA"는 다음을 포함하는 RNA를 지칭한다: i) 가이드 RNA-유도된 엔도뉴클레아제 (예컨대, 클래스 2 CRISPR/Cas 엔도뉴클레아제, 가령, 유형 II, 유형 V, 또는 유형 VI CRISPR/Cas 엔도뉴클레아제)에 결합하여 상기 RNA-유도된 엔도뉴클레아제를 활성화시키는 "활성화인자" 뉴클레오티드 서열; 및 ii) 표적 핵산과 혼성화하는 뉴클레오티드 서열을 포함하는 "표적자" 뉴클레오티드 서열. "활성화인자" 뉴클레오티드 서열 및 "표적자" 뉴클레오티드 서열은 별도의 RNA 분자들 (예컨대, "이중-가이드 RNA") 상에 존재할 수 있거나; 동일한 RNA 분자 ("단일-가이드 RNA") 상에 존재할 수 있다.
"작은 간섭" 또는 "짧은 간섭 RNA" 또는 siRNA는 관심 유전자 ("표적 유전자")에 표적되는 뉴클레오티드들의 RNA 이중나선이다. "RNA 이중나선"은 RNA 분자의 2개 영역 사이의 상보적 쌍에 의해 형성된 구조를 지칭한다. siRNA는 siRNA의 이중나선 부분의 뉴클레오티드 서열이 표적되는 유전자의 뉴클레오티드 서열에 상보적인 경우 유전자에 "표적"된다. 일부 사례들에서, siRNA의 이중나선의 길이는 30개 미만 뉴클레오티드이다. 일부 사례들에서, 이중나선은 29, 28, 27, 26, 25, 24, 23, 22, 21, 20, 19, 18, 17, 16, 15, 14, 13, 12, 11 또는 10개 뉴클레오티드 길이일 수 있다. 일부 사례들에서, 이중나선의 길이는 19-25개 뉴클레오티드 길이이다. siRNA의 RNA 이중나선 부분은 헤어핀 구조의 일부일 수 있다. 이중나선 부분 이외에도, 헤어핀 구조는 상기 이중나선을 형성하는 두 개의 서열들 사이에 위치한 루프 부분을 내포할 수 있다. 루프는 길이가 변화할 수 있다. 일부 사례들에서 루프는 5, 6, 7, 8, 9, 10, 11, 12 또는 13개 뉴클레오티드 길이이다. 헤어핀 구조는 또한 3' 또는 5' 오버행 부분을 내포할 수 있다. 일부 사례들에서, 오버행은 3' 또는 5' 오버행 0, 1, 2, 3, 4 또는 5개 뉴클레오티드 길이이다.
본 명세서에서 사용되는 용어 "마이크로RNA"는 내인성 마이크로RNA 및 인공 마이크로RNA (예컨대, 합성 miRNA)를 비롯한 (그러나 이에 제한되는 것은 아님) 임의의 유형의 간섭 RNA를 지칭한다. 내인성 마이크로RNA는 mRNA의 생성 이용을 조절할 수 있는 게놈에서 자연적으로 인코드되는 작은 RNA이다. 인공 마이크로RNA는 내인성 마이크로RNA가 아닌, mRNA의 활성을 조절할 수 있는 임의의 유형의 RNA 서열일 수 있다. 마이크로RNA 서열은 이들 서열들 중 하나 이상으로 구성된 RNA 분자일 수 있다. 마이크로RNA (또는 "miRNA") 서열들은 간행물들, 가령, Lim, 외, 2003, Genes & Development, 17, 991-1008, Lim 외, 2003, Science, 299, 1540, Lee 및 Ambrose, 2001, Science, 294, 862, Lau 외, 2001, Science 294, 858-861, Lagos-Quintana 외, 2002, Current Biology, 12, 735-739, Lagos-Quintana 외, 2001, Science, 294, 853-857, 및 Lagos-Quintana 외, 2003, RNA, 9, 175-179에 기재된 바 있다. 마이크로RNA의 예들에는 보다 큰 RNA의 절편이거나 또는 miRNA, siRNA, stRNA, sncRNA, tncRNA, snoRNA, smRNA, shRNA, snRNA, 또는 다른 작은 비-코딩 RNA인 임의의 RNA를 포함한다. 예컨대, 미국 특허 출원 20050272923, 20050266552, 20050142581, 및 20050075492를 참고하라. "마이크로RNA 전구물질" (또는 "전구-miRNA")은 내부에 혼입된 마이크로RNA 서열과 스템-루프 구조를 가지는 핵산을 지칭한다. "성숙 마이크로RNA" (또는 "성숙 miRNA")는 마이크로RNA 전구물질 ("전구-miRNA")로부터 절단되거나, 또는 합성 (예컨대, 무세포 합성에 의해 실험실에서 합성)되고, 약 19개 뉴클레오티드 내지 약 27개 뉴클레오티드 길이를 가지는 마이크로RNA를 포함하며, 예컨대, 성숙 마이크로RNA는 19 nt, 20 nt, 21 nt, 22 nt, 23 nt, 24 nt, 25 nt, 26 nt, 또는 27 nt 길이를 가질 수 있다. 성숙 마이크로RNA는 표적 mRNA에 결합하여 표적 mRNA의 번역을 저해할 수 있다.
폴리뉴클레오티드에 적용되는 "재조합"은 폴리뉴클레오티드가 클로닝, 제한 또는 결찰 단계들, 그리고 자연에서 발견되는 폴리뉴클레오티드와 구별되는 구조체를 생성하는 다른 절차들의 다양한 조합의 생성물임을 의미한다. 재조합 바이러스는 재조합 폴리뉴클레오티드를 포함하는 바이러스 입자이다. 상기 용어는 각각 원래 폴리뉴클레오티드 구조체의 복제물 및 원래 바이러스 구조체의 자손을 포함한다.
"대조 요소" 또는 "대조 서열"은 폴리뉴클레오티드의 복제 (replication), 복제 (duplication), 전사, 스플라이싱, 번역, 또는 분해를 비롯한 폴리뉴클레오티드의 기능적 조절에 기여하는 분자들의 상호작용에 관여하는 뉴클레오티드 서열이다. 상기 조절은 특정 과정의 빈도, 속도, 또는 특이성에 영향을 미칠 수 있으며, 본질적으로 향상되거나 저해될 수 있다. 해당 분야에 공지된 조절 요소들에는, 예를 들면, 전사 조절 서열, 가령, 프로모터 및 인핸서가 포함된다. 프로모터는 특정 조건하에서 RNA 중합효소에 결합하여 프로모터로부터 통상적으로 하류 (3' 방향으로)에 위치한 코딩 영역의 전사를 개시할 수 있는 DNA 영역이다.
"작동적으로 연결된" 또는 "작동가능하게 연결된"은 유전자 구성요소들의 근접위치를 지칭하며, 이 때 상기 요소들은 예상된 방식으로 유전자 구성요소들을 작동시킬 수 있게 하는 관계로 존재한다. 예를 들어, 프로모터는 프로모터가 코딩 서열의 전사 개시를 돕는 경우 코딩 영역에 작동적으로 연결된다. 프로모터와 코딩 영역 사이에 개입 잔기들 (intervening residues)이 존재할 수 있다.
"발현 벡터"는 관심 폴리펩티드 를 인코드하는 영역을 포함하는 벡터로서, 원하는 표적 세포에서 단백질의 발현을 수행하기 위해 사용된다. 발현 벡터는 또한 표적에서 단백질의 발현을 용이하게 하는 인코딩 영역에 작동적으로 연결된 제어 요소들을 포함한다. 발현을 위해 작동가능하게 연결되는 유전자 또는 유전자들과 조절 요소들의 조합물은 때때로 "발현 카세트"로 지칭되며 많은 수의 발현 카세트들이 해당 분야에 공지되어 있고 이용가능하거나, 해당 분야에서 이용가능한 성분들로부터 용이하게 제작될 수 있다.
"이종 (heterologous)"은 비교 대상이 되는 엔터티의 나머지와 유전적으로 별개인 엔터티로부터 유도된다는 것을 의미한다. 예를 들면, 상이한 종들에서 유래한 플라스미드 또는 벡터에 유전자 조작 기술에 의해 도입되는 폴리뉴클레오티드는 이종 폴리뉴클레오티드이다. 그 고유의 코딩 서열로부터 제거되고 자연적으로 발견되지 않는 코딩 서열에 작동적으로 연결된 프로모터는 이종 프로모터이다. 그러므로, 예를 들면, 이종 유전자 생성물을 인코드하는 이종 핵산을 포함하는 rAAV는 자연-발생의, 야생형 AAV에 통상적으로 포함되지 않는 핵산을 포함하는 rAAV이며, 인코드된 이종 유전자 생성물은 자연-발생, 야생형 AAV에 의해 통상적으로 인코드되지 않는 유전자 생성물이다. 또 다른 예로서, 캡시드 단백질의 GH 루프에 삽입되는 이종 펩티드를 포함하는 변종 AAV 캡시드 단백질은 자연-발생, 야생형 AAV에 통상적으로 포함되지 않는 펩티드의 삽입을 포함하는 변종 AAV 캡시드 단백질이다.
용어 "유전자 변경" 및 "유전자 변형" (및 이의 문법적 변화형)은, 유사분열 또는 감수분열 이외에, 유전적 요소 (예컨대, 폴리뉴클레오티드)가 세포 내부에 도입되는 과정을 지칭하기 위해 본 명세서에서 호환적으로 사용된다. 해당 요소는 상기 세포에 대해 이종일 수 있고, 또는 이는 상기 세포에 이미 존재하는 요소의 또 다른 복제본 또는 개선된 형태일 수 있다. 유전자 변경은 예를 들면, 해당 분야에 공지된 임의의 방법, 가령, 전기 천공, 인산 칼슘 침전 또는 폴리뉴클레오티드-리포좀 복합체와의 접촉을 통해 재조합 플라스미드 또는 다른 폴리뉴클레오티드로 세포를 형질 감염시킴으로써 수행될 수 있다. 유전자 변경은 또한, 예를 들면, DNA 또는 RNA 바이러스 또는 바이러스 벡터의 형질도입 또는 감염에 의해 이루어질 수도 있다. 일반적으로, 유전자 요소는 세포내 염색체 또는 미니-염색체에 도입되지만; 해당 세포 및 이의 자손의 표현형 및/또는 유전자형을 변화시키는 임의의 변경이 이러한 용어에 포함된다.
해당 서열이 시험관내에서 연장된 세포 배양 동안 그 기능을 수행할 수 있는 경우 세포는 유전자 서열로 "안정하게" 변형되었다, 형질도입되었다, 유전자 변형되었다, 또는 형질전환되었다고 언급된다. 일반적으로, 이러한 세포는 변형된 세포의 자손에 의해 또한 유전될 수 있는 유전자 변경이 도입된다는 점에서 "유전적으로 (heritably)" 변형 (유전자 변형)된다.
용어 "폴리펩티드", "펩티드" 및 "단백질"은 임의의 길이의 아미노산 폴리머들을 지칭하기 위해 본 명세서에서 호환적으로 사용된다. 상기 용어는 또한 예를 들어, 이황화물 결합 형성, 글리코실화, 지질화, 인산화 또는 라벨링 성분과의 접합(conjugation)으로 변형되어 있는 아미노산 중합체를 포함한다. 유전자 생성물을 포유 동물 대상체에게 전달하는 것과 관련하여 논의될 때 항-혈관형성 폴리펩티드, 신경보호성 폴리펩티드 등과 같은 폴리펩티드, 및 이의 조성물은 각각의 온전한 폴리펩티드 또는 그의 임의의 단편 또는 유전자 조작된 유도체를 지칭하고, 이는 온전한 단백질의 원하는 생화학적 기능을 유지한다. 유사하게, 항-혈관형성 폴리펩티드를 인코드하는 핵산, 신경보호성 폴리펩티드를 인코드하는 핵산, 및 포유동물 대상체로의 유전자 생성물 전달에 사용하기 위한 다른 이러한 핵산들 (이는 수용체 세포로 전달되는 "트랜스진"으로 지칭될 수 있음)에 대한 지칭은, 온전한 폴리펩티드를 인코드하는 폴리뉴클레오티드 또는 원하는 생화학적 기능을 보유하는 임의의 절편 또는 유전자 조작 유도체를 포함한다.
"단리된" 플라스미드, 핵산, 벡터, 바이러스, 비리온, 숙주 세포, 또는 다른 물질은 또한 제공될 수 있는 다른 성분들의 최소한 일부가 없는 물질의 제조를 지칭하며 이 때 이러한 물질 또는 유사 물질은 자연적으로 발생하거나 이로부터 처음에 제조된다. 그러므로, 예를 들면, 단리된 물질은 정제 기술을 사용하여 원료 혼합물로부터 이를 농축시켜 제조될 수 있다. 농축은 용액의 부피 당 중량과 같은 절대 기준으로 측정될 수 있거나, 또는 원료 혼합물에 존재하는 제 2의, 잠재적 간섭 물질과 관련하여 측정될 수 있다. 본 발명의 구체예들에서 농축이 증가될 수록 보다 더 단리된다. 단리된 플라스미드, 핵산, 벡터, 바이러스, 숙주 세포, 또는 다른 물질은, 일부 사례들에서, 예컨대, 약 80% 내지 약 90% 순도, 최소한 약 90% 순도, 최소한 약 95% 순도, 최소한 약 98% 순도, 또는 최소한 약 99%, 또는 그 이상의 순도로 정제된다.
용어 "치료", "치료하는 것", "치료하다" 등은 본 명세서에서 일반적으로 원하는 약동학적 및/또는 생리학적 효과를 얻는 것을 지칭하기 위해 사용된다. 이러한 효과는 질환 또는 이의 증상(들)을 완전히 또는 부분적으로 예방하는 것과 관련하여서는 예방일 수 있으며 및/또는 질환 및/또는 질환에 기여하는 유해 효과에 대한 부분적 또는 완전한 안정화 또는 치유와 관련하여서는 치료일 수 있다. 용어 "치료"는, 포유동물, 특히 인간에서 질환의 치료를 포괄하며, 다음을 포함한다: (a) 해당 질환 또는 증상(들)에 취약할 수 있으나 아직 이를 가진 것으로 진단받지 않은 대상체에서 질환 및/또는 증상(들)이 발생하지 않도록 예방하는 것; (b) 질환 및/또는 증상(들)을 저해하는 것, 즉, 질환 및/또는 관련 증상들의 발달을 정지시키는 것; 또는 (c) 질환 및 관련 증상(들)을 완화하는 것, 즉, 질환 및/또는 증상(들)의 퇴행을 유발하는 것. 치료를 필요로 하는 대상체들은 이미 병에 걸린 대상체들 (예컨대, 신경계 장애를 가진 대상체들) 뿐만 아니라 예방이 필요한 대상체들 (예컨대, 신경계 장애에 대한 감수성이 증가된 대상체들; 신경계 장애를 가진 것으로 의심되는 대상체들; 신경계 장애, 등에 대한 하나 이상의 위험 요인들을 가진 대상체들)을 포함할 수 있다.
용어 "수용체", "개체", "대상체", "숙주" 및 "환자"는 본 명세서에서 호환적으로 사용되며, 진단, 치료 또는 치료요법을 필요로 하는 임의의 포유동물 대상체, 가령, 인간을 지칭한다. "포유동물(mammal)"이란 치료 목적으로 인간, 가축 및 농장 동물, 동물원, 스포츠 또는 비-인간 영장류, 개, 말, 고양이, 소, 양, 염소, 돼지, 낙타 등과 같은 애완 동물을 비롯하여 포유류로 분류 된 동물을 의미한다. 일부 사례에서, 포유동물은 인간이다.
"치료적 유효량" 또는 "효능량"은 질병을 치료하기 위해 포유동물 또는 다른 대상체에 투여시, 또 다른 물질과 조합하여 또는 단독으로 1회 이상의 투약으로 해당 질병의 치료를 유효하게 하기에 충분한 화합물의 양을 의미한다. "치료적 유효량"은 화합물, 질병 및 질병의 중증도 그리고 치료되는 대상체의 연령, 체중, 등에 따라 달라질 것이다.
용어 "개체", "숙주", "대상체" 및 "환자"는 본 명세서에서 호환적으로 사용되며, 유인원 및 인간을 비롯한 인간 및 비-인간 영장류; 포유류 스포츠 동물 (예컨대, 말, 낙타 등); 포유류 가축 (예컨대, 양, 염소, 암소 등); 포유류 애완동물 (개, 고양이 등); 및 설치류 (예컨대, 생쥐, 쥐 등)을 비롯한 (그러나 이에 제한되는 것은 아님) 포유동물을 지칭한다. 일부 사례에서, 개체는 인간이다.
본 발명을 더욱 상세히 기재하기에 앞서, 본 발명은 상기 기재된 특정 구체예들에 제한되지 않으며, 이러한 구체예들은 물론 변화가능함을 이해하여야 한다. 본 명세서에서 사용되는 용어는 특정 구체예들을 오직 설명하기 위한 것이며, 제한을 하고자 하는 것이 아니므로, 본 발명의 범위는 첨부된 청구범위에 의해서만 제한될 것임을 또한 이해하여야 한다.
수치 범위가 제공될 경우, 내용상 명백히 달리 언급이 없는 한 상기 범위의 상한과 하한 사이의 각 중간 수치는 하한 단위의 10분의 1까지, 그리고 상기 언급된 범위 내의 그 외 임의의 언급된 또는 중간 수치는 본 발명에 포함됨을 이해하여야 한다. 이러한 보다 작은 범위들의 상한과 하한은 독립적으로 보다 작은 범위들에 포함될 수 있으며, 또한 언급된 범위에서 명시적으로 제외되는 한도를 조건으로 본 발명에 포함된다. 언급된 범위가 한도값 중 하나 또는 둘 모두를 포함하는 경우, 포함되는 이들 한도값들 중 하나 또는 둘 모두를 제외한 범위 또한 본 발명에 포함된다.
달리 정의되지 않는 한, 본 명세서에서 사용되는 모든 기술 및 과학 용어는 본 발명이 속하는 해당 분야의 기술자에 의해 일반적으로 이해되는 바와 같은 동일한 의미를 가진다. 본 명세서에 기재된 것들과 유사하거나 균등한 방법들 및 재료들 또한 본 발명을 실시 또는 테스트함에 사용될 수 있으나, 본 명세서에는 바람직한 방법들 및 재료들이 기재되어 있다. 본 명세서에서 인용된 모든 문헌들 및 특허들은 본 명세서에 참고문헌으로 포함되며, 인용되는 문헌들과 관련된 방법들 및/또는 재료들을 개시 및 기재하기 위하여 참고문헌으로 본 명세서에 포함된다.
본 명세서 및 첨부된 청구범위에서 사용되는, 단수형 "하나" 및 "그것"은 문맥에서 달리 명확히 언급이 없는 한 복수형을 포함함을 유념하여야 한다. 그러므로, 예를 들면, "하나의 신경 줄기 세포"에 대한 지칭은 복수의 이러한 세포들을 포함하며 "rAAV"에 대한 지칭은 해당 분야의 숙련된 기술자들에게 공지된 하나 또는 그 이상의 rAAV들 및 이의 균등물들, 등에 대한 지칭을 포함한다. 또한 청구범위는 임의의 선택적 요소를 제외시키도록 작성될 수 있음을 유념하여야 한다. 그러므로 이러한 표현은 청구범위 구성들을 언급하는 것과 관련하여 "단독으로", "오직" 등과 같은 제외 의미의 용어를 사용하기 위한 또는 "부정적" 제한을 사용하기 위한 선행사로서의 기능을 한다.
명확히 하기 위해, 별도의 구체예들에 관한 내용에 기재되어 있는 본 발명의 특정 특징들은 또한 하나의 구체예에서 조합으로 제공될 수도 있는 것으로 이해된다. 역으로, 간결함을 위해 하나의 구체예에 관한 내용에 기재되어 있는 본 발명의 다양한 특징들은 또한 별도로 또는 임의의 적합한 하위-조합으로 제공될 수 있다. 본 발명과 관련된 구체예들의 모든 조합이 특히 본 발명에 포함되며 각각의 그리고 모든 조합이 개별적으로 그리고 명확하게 개시되었던 것처럼 본 명세서에 개시된다. 또한, 다양한 구체예들과 이의 구성요소들의 모든 하위-조합들 또한 본 발명에 구체적으로 포함되며 각각의 그리고 모든 이러한 하위-조합들이 개별적으로 그리고 명확하게 본 출원에 개시되었던 것처럼 본 출원에 개시된다.
본 출원에서 논의되는 간행물들은 본 출원의 출원일 이전에 이들이 공개되었음을 위해서만 제공된다. 본 출원에서 어떤 것도 본 발명이 이러한 개시내용을 선행 발명보다 선행시키는 것에 대한 자격이 없음을 인정하는 것으로 해석되어서는 안 된다. 또한, 제공된 문헌의 공개일자는 실제 공개 일자와 상이할 수 있으며 따로 확인할 필요가 있을 수 있다.
상세한 설명
본 발명은 변이체 캡시드 단백질을 보유한 재조합 아데노-연관 바이러스 비리온을 제공하는데, 이 때 재조합 AAV (rAAV) 비리온은 대조 AAV에 비해 증가된 뉴런 세포 장벽 통과 능력, 증가된 신경 줄기 세포 감염력, 증가된 뉴런 세포 감염력, 및 항체 중화에 대한 감소된 감수성 중 하나 이상을 나타내며, rAAV 비리온은 이종 핵산을 포함한다. 본 발명은 유전자 산물을 개체의 신경 줄기 세포, 뉴런 전구 세포 또는 신경 세포에 전달하는 방법을 제공한다. 본 발명은 또한 신경 줄기 세포 또는 뉴런 세포에 존재하는 표적 핵산을 변형시키는 방법을 제공한다. 본 발명은 또한 신경 질환 치료 방법을 제공한다.
변이체 캡시드 폴리펩티드를 가지는 재조합 AAV 비리온
본 발명은 다음을 포함하는 감염성 (rAAV) 비리온을 제공한다: i) 본 발명의 변종 AAV 캡시드 폴리펩티드; 및 ii) 이종 폴리펩티드 (즉, 비-AAV 폴리펩티드)를 인코드하는 뉴클레오티드 서열을 포함하는 이종 핵산. 일부 사례들에서, 변이체 AAV 캡시드 단백질은 최소한 3가지 상이한 AAV 혈청형의 최소한 5개 분절들을 포함하며, 이 때 각 분절은 약 50개 아미노산 내지 약 160개 아미노산의 길이를 가진다. 변이체 캡시드 단백질은 다음 성질들 중 하나 이상을 부여한다: i) 상응하는 모체 AAV 캡시드 단백질을 포함하는 대조 AAV 비리온, 또는 야생형 AAV 비리온, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온에 의한 신경 줄기 세포 또는 신경 전구 세포의 감염력에 비해, 신경 줄기 세포 또는 신경 전구 세포의 감염력 증가; ii) 상응하는 모체 AAV 캡시드 단백질을 포함하는 대조 AAV 비리온, 또는 야생형 AAV 비리온, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온에 의한 뉴런 세포의 감염력에 비해, 뉴런 세포의 감염력 증가; iii) 상응하는 모체 AAV 캡시드 단백질을 포함하는 대조 AAV 비리온, 또는 야생형 AAV 비리온, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온에 의한 능력에 비해, 세포 장벽 통과 능력의 증가; iv) 상응하는 모체 AAV 캡시드 단백질을 포함하는 대조 AAV 비리온, 또는 야생형 AAV 비리온, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온에 의해 나타나는 내성에 비해, 인간 AAV 중화 항체들에 대한 내성 증가.
대조 AAV 비리온은 모체 AAV 캡시드 단백질을 포함할 수 있다. 대조 AAV 비리온은 야생형 AAV 캡시드를 포함하는, 예컨대, 오직 야생형 캡시드만을 포함하는 (그리고 본 발명의 임의의 변이체 AAV 캡시드는 포함하지 않는) AAV 비리온일 수 있다. 예를 들어, 대조 AAV 비리온은 야생형 AAV2 캡시드를 포함할 수 있다. 또 다른 예로서, 대조 AAV 비리온은 야생형 AAV6 캡시드를 포함할 수 있다. 또 다른 예로서, 대조 AAV 비리온은 야생형 AAV9 캡시드를 포함할 수 있다.
신경 줄기 세포 또는 신경 전구 세포의 감염력 증가
본 발명은 변이체 캡시드 단백질을 가지는 rAAV 비리온을 제공하는데, 이 때 rAAV 비리온은 NSC 또는 신경 전구 세포를 감염시키는, 변이체 캡시드 단백질을 포함하지 않는 모체 AAV인 대조의 능력에 비해, 또는 야생형 AAV의 능력에 비해, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온에 비해, 신경 줄기 세포 (NSC) 또는 신경 전구 세포의 감염력 증가를 나타내며; 이 때 rAAV 비리온은 이종 핵산을 포함한다.
일부 사례들에서, NSC는 뇌실하 영역 (SVZ) NSC이다. SVZ는 뇌실 공간을 SVZ과 분리시키는 뇌실막 세포 층을 따라 위치한다. SVZ. NSCs는 신경모세포가 되기 전 수 회 분할하는 이행 증폭 전구체들을 발생시킬 수 있다. 일부 사례들에서, NSC는 해마의 치아 이랑 내부의 과립하 구역 (SGZ)에 존재한다. 내부 과립 세포층과 폐문 사이의 경계에 있는 SGZ의 방사형 아교세포-유사 NSC (RGL)는 신경 모세포를 생성하기 전에 제한된 증식 회수를 나타내는 중간 전구 세포 (IPC)를 발생시킨다. 신경 전구 세포 (NPCs)는 이행 증폭 세포, RGLs, IPCs, 및 신경모세포를 포함한다. 일부 사례들에서, NSC는 해마로부터 얻거나, 해마에 존재한다. 일부 사례들에서, NSC는 발달중인 신경계에 존재하는데; 예컨대, NSC는 배아에 존재한다.
일부 사례들에서, 본 발명의 rAAV 비리온은 상응하는 모체 AAV 캡시드 단백질을 포함하는 AAV 비리온에 의한 NSC의 감염력에 비해, 변이체 캡시드 폴리펩티드를 포함하지 않는 AAV 비리온에 의한 NSC의 감염력에 비해, 또는 야생형 AAV 비리온 야생형 AAV 캡시드 포함)에 의한 NSC의 감염력에 비해, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온에 의한 NSC의 감염력에 비해, 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 NSC의 감염력을 나타낸다.
일부 사례들에서, 대상 rAAV 비리온은 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 주사로 투여시, 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드를 포함하는 AAV 비리온에 의한 NSC의 감염력에 비해, 또는 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 주사로 투여시 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온에 비해, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 NSC의 감염력을 나타낸다.
일부 사례들에서, 본 발명의 rAAV 비리온은 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드를 포함하는 AAV 비리온에 의한 NPC의 감염력에 비해, 변이체 캡시드 폴리펩티드를 포함하지 않는 AAV 비리온에 의한 NPC의 감염력에 비해, 또는 야생형 AAV 비리온 야생형 AAV 캡시드 포함)에 의한 NPC의 감염력에 비해, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온에 의한 NPC의 감염력에 비해, 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 NPC의 감염력을 나타낸다.
일부 사례들에서, 대상 rAAV 비리온은 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드를 포함하는 AAV 비리온에 의한 신경모세포의 감염력에 비해, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온에 비해, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 신경모세포의 감염력을 나타낸다.
일부 사례들에서, 대상 rAAV 비리온은 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 주사로 투여시, 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드를 포함하는 AAV 비리온에 의한 신경모세포의 감염력에 비해, 또는 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 주사로 투여시 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온에 비해, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 신경모세포의 감염력을 나타낸다.
일부 사례들에서, 대상 rAAV 비리온은 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드 단백질을 포함하는 AAV 비리온에 의한 이행 증폭 세포의 감염력에 비해, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온에 비해, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 이행 증폭 세포의 감염력을 나타낸다.
일부 사례들에서, 대상 rAAV 비리온은 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 주사로 투여시, 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드 단백질을 포함하는 AAV 비리온에 의한 이행 증폭 세포의 감염력에 비해, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온에 비해, 동일한 투여 경로로 투여시 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 이행 증폭 세포의 감염력을 나타낸다.
주어진 rAAV 비리온이 증가된 NSC 또는 NPC의 감염력을 나타내는지 여부는 시험관내 또는 생체내에서 결정될 수 있다. 예를 들어, 주어진 rAAV 비리온이 NSC의 감염력 증가를 나타내는지 여부는 NSC를 rAAV 비리온과 시험관내 접촉시키고, 상기 rAAV 비리온에 의해 인코드되는 이종 유전자 생성물의 NSC에서의 발현을 탐지함으로써 결정될 수 있다. 이종 유전자 생성물은 탐지가능한 신호를 제공할 수 있으며, NSC에서 탐지가능한 신호의 수준은 NSC의 감염력 증가를 나타내는지 여부에 대한 표시를 제공할 수 있다.
일부 사례들에서, 다음: a) 최소한 3가지 상이한 AAV 혈청형의 최소한 5개 분절들을 포함하는 본 발명의 변이체 캡시드, 이 때 각 분절은 아래 기재된 바와 같이 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지며; 그리고 b) 이종 유전자 생성물을 인코드하는 이종 뉴클레오티드 서열을 포함하는 본 발명의 rAAV 비리온은, 개체에 투여시, 다음: a) 대조 AAV (예컨대, 야생형 AAV 캡시드); 및 b) 이종 유전자 생성물을 인코드하는 이종 뉴클레오티드 서열을 포함하는 대조 rAAV 비리온을 개체에 투여시 생성되는 신경 줄기 세포에서의 유전자 생성물의 수준 보다 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상 더 큰 신경 줄기 세포에서의 이종 유전자 생성물 수준을 생성한다. 투여는 많은 경로들, 예컨대, 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 주사에 의할 수 있다.
주어진 rAAV 비리온이 증가된 NSC의 감염력을 나타내는지 여부는 NSC에서 rAAV 비리온에 의해 인코드되는 치료적 유전자 생성물의 치료 효과를 평가함으로써 결정될 수 있다. 치료 효과는, 예컨대, a) 신경발생의 증가; b) 신경학적 질병 또는 장애의 증상의 개선; 등을 포함할 수 있다. 예를 들면, 다음: a) 본 발명의 변종 캡시드; 및 b) 이종 치료 유전자 생성물을 인코드하는 이종 뉴클레오티드 서열을 포함하는 본 발명의 rAAV 비리온은, (예컨대, 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 주사로) 개체에 투여시, 신경 줄기 세포에서, 다음: a) 대조 AAV 캡시드 (예컨대, 야생형 AAV 캡시드); 및 b) 상기 이종 치료 유전자 생성물을 인코드하는 이종 뉴클레오티드 서열을 포함하는 대조 rAAV 비리온이 동일한 투여 경로로 투여될 때 생성되는 치료 효과 보다 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상 더 큰, 치료 유전자 생성물의 치료 효과를 생성한다.
일부 사례들에서, 대상 rAAV 비리온은 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 주사로 투여시, 상응하는 모체 AAV 캡시드 단백질을 포함하는 AAV 비리온에 의한 NSC의 감염력에 비해, 또는 야생형 AAV 비리온 (야생형 AAV 캡시드 폴리펩티드를 포함)에 의한 NSC의 감염력에 비해, 동일한 투여 경로로 투여시 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 NSC의 감염력을 나타낸다.
뉴런 세포의 증가된 감염력
상기 기재한 바와 같이, 일부 사례들에서, 본 발명의 rAAV 비리온에 존재하는 변이체 캡시드 폴리펩티드는 변이체 캡시드 단백질을 포함하지 않는 대조 모체 AAV, 또는 야생형 AAV의 뉴런 세포 감염 능력에 비해 rAAV 비리온에 증가된 뉴런 세포 감염력을 부여한다.
일부 사례들에서, 대상 rAAV 비리온은 상응하는 모체 AAV 캡시드 단백질을 포함하는 AAV 비리온에 의한 뉴런 세포의 감염력에 비해, 또는 야생형 AAV 캡시드 폴리펩티드를 포함하는 AAV 비리온에 의한 뉴런 세포의 감염력에 비해, 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 뉴런 세포의 감염력을 나타낸다.
일부 사례들에서, 대상 rAAV 비리온은 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 주사로 투여시, 상응하는 모체 AAV 캡시드 단백질을 포함하는 AAV 비리온에 의한 뉴런 세포의 감염력에 비해, 또는 야생형 AAV에 의한 뉴런 세포의 감염력에 비해, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온에 비해, 동일한 투여 경로로 투여시 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 뉴런 세포의 감염력을 나타낸다.
일부 사례들에서, 대상 rAAV 비리온은 상응하는 모체 AAV 캡시드 단백질을 포함하는 AAV 비리온에 의한 뉴런 세포의 감염력에 비해, 또는 야생형 AAV 캡시드 폴리펩티드를 포함하는 AAV 비리온에 의한 뉴런 세포의 감염력에 비해, 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 대뇌 반구, 대뇌 피질, 피질하 운동 피질, 선조체, 내포, 시상, 시상하부, 해마, 중뇌, 뇌간, 또는 소뇌의 뉴런 세포의 감염력을 나타낸다.
한 예로서, 일부 사례들에서, 대상 rAAV 비리온은 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드 단백질을 포함하는, AAV 비리온에 의한 푸르킨예 세포의 감염력에 비해, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 푸르킨예 세포의 감염력을 나타낸다.
한 예로서, 일부 사례들에서, 대상 rAAV 비리온은 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 주사로 투여시, 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드 단백질을 포함하는, AAV 비리온에 의한 푸르킨예 세포의 감염력에 비해, 동일한 투여 경로로 투여시 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 푸르킨예 세포의 감염력을 나타낸다.
한 예로서, 일부 사례들에서, 대상 rAAV 비리온은 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드 단백질을 포함하는, AAV 비리온에 의한 GABA성 세포의 감염력에 비해, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 GABA성 세포의 감염력을 나타낸다.
한 예로서, 일부 사례들에서, 대상 rAAV 비리온은 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 주사로 투여시, 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드 단백질을 포함하는, AAV 비리온에 의한 GABA성 세포의 감염력에 비해, 동일한 투여 경로로 투여시 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 GABA성 세포의 감염력을 나타낸다.
일부 사례들에서, 대상 rAAV 비리온은 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드 단백질을 포함하는, AAV 비리온에 의한 신경아교 세포의 감염력에 비해, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 신경아교 세포의 감염력을 나타낸다.
일부 사례들에서, 대상 rAAV 비리온은 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 주사로 투여시, 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드 단백질을 포함하는, AAV 비리온에 의한 신경아교 세포의 감염력에 비해, 동일한 투여 경로로 투여시 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 신경아교 세포의 감염력을 나타낸다.
일부 사례들에서, 대상 rAAV 비리온은 상응하는 모체 AAV 캡시드 단백질을 포함하는 AAV 비리온에 의한 성상세포의 감염력에 비해, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상 증가된 성상세포의 감염력을 나타낸다.
일부 사례들에서, 대상 rAAV 비리온은 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 주사로 투여시, 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드를 포함하는 AAV 비리온에 의한 성상세포의 감염력에 비해, 또는 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 주사로 투여시 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온에 비해, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 성상세포의 감염력을 나타낸다.
주어진 rAAV 비리온이 증가된 뉴런 세포의 감염력을 나타내는지 여부는 시험관내 또는 생체내에서 결정될 수 있다. 예를 들어, 주어진 rAAV 비리온이 뉴런 세포의 감염력 증가를 나타내는지 여부는 뉴런 세포를 rAAV 비리온과 시험관내 접촉시키고, 상기 rAAV 비리온에 의해 인코드되는 이종 유전자 생성물의 뉴런 세포에서의 발현을 탐지함으로써 결정될 수 있다. 이종 유전자 생성물은 탐지가능한 신호를 제공할 수 있으며, 뉴런 세포에서 탐지가능한 신호의 수준은 뉴런 세포의 감염력 증가를 나타내는지 여부에 대한 표시를 제공할 수 있다.
주어진 rAAV 비리온이 증가된 뉴런 세포의 감염력을 나타내는지 여부는 개체 에 대한 해당 rAAV 비리온의 투여 후 해당 rAAV 비리온에 의해 인코드되는 이종 유전자 생성물의 뉴런 세포에서의 발현을 탐지함으로써 결정될 수 있다. 주어진 rAAV 비리온이 증가된 뉴런 세포의 감염력을 나타내는지 여부는 해당 rAAV 비리온의 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 투여 후 해당 rAAV 비리온에 의해 인코드되는 이종 유전자 생성물의 뉴런 세포에서의 발현을 탐지함으로써 결정될 수 있다. 예를 들어, 다음: a) 최소한 3가지 상이한 AAV 혈청형의 최소한 5개 분절들을 포함하는 본 발명의 변이체 캡시드, 이 때 각 분절은 상기 기재된 바와 같이 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지며; 그리고 b) 이종 유전자 생성물을 인코드하는 이종 뉴클레오티드 서열을 포함하는 본 발명의 rAAV 비리온은, 투여시, 다음: a) 대조 AAV 캡시드 또는 야생형 AAV 캡시드; 및 b) 이종 유전자 생성물을 인코드하는 이종 뉴클레오티드 서열을 포함하는 대조 rAAV 비리온을 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 주사로 투여시 생성되는 뉴런 세포에서의 유전자 생성물의 수준 보다 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상 더 큰 뉴런 세포에서의 이종 유전자 생성물 수준을 생성한다.
주어진 rAAV 비리온이 증가된 뉴런 세포의 감염력을 나타내는지 여부는 뉴런 세포에서 rAAV 비리온에 의해 인코드되는 치료적 유전자 생성물의 치료 효과를 평가함으로써 결정될 수 있다. 치료 효과는, 예컨대, a) 뉴런 세포 기능의 증가; b) 신경학적 질병 또는 장애의 증상의 개선; 등을 포함할 수 있다. 예를 들면, 본 발명의 rAAV 비리온은 a) 상기 기재한 바와 같은 펩티드 삽입 또는 펩티드 대체를 포함하는 본 발명의 변종 캡시드; 및 b) 이종 치료 유전자 생성물을 인코드하는 이종 뉴클레오티드 서열을 포함하며, 이는 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 주사로 투여시, 뉴런 세포에서, a) 상기 펩티드 삽입 또는 펩티드 대체를 포함하지 않는 대조 AAV 캡시드; 및 b) 상기 이종 치료 유전자 생성물을 인코드하는 이종 뉴클레오티드 서열을 포함하는 대조 rAAV 비리온이 동일 투여 경로로 투여될 때 생성되는 뉴런 세포에서의 치료 효과 보다 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상 더 큰, 치료 유전자 생성물의 치료 효과를 생성한다.
세포 장벽 통과
본 발명은 변이체 캡시드 단백질을 가지는 재조합 아데노-연관 바이러스 비리온을 제공하며, 이 때 rAAV 비리온은 증가된 세포 장벽, 즉, 생리학적 장벽 통과 능력 증가를 나타낸다. 예를 들어, 세포 장벽은 신경 줄기 세포를 포함하지 않는 제 1 구획과 신경 줄기 세포를 포함하는 제 2 구획 사이에 세포들의 층을 포함할 수 있다. 이러한 장벽들에는, 예컨대, 측뇌실을 라이닝하는 뇌실막 세포층, 저세포층, 성상세포 세포체층, 혈액-뇌 장벽, 및 이행 구역층이 포함된다. 그러므로, 본 발명은 변이체 캡시드 단백질을 가지는 rAAV 비리온을 제공하며, 이 때 rAAV 비리온은 뇌실막 세포층, 저세포층, 성상세포 세포체층, 및 이행 구역층 중 하나 이상을 통과하는, 변이체 캡시드 단백질을 포함하지 않는 대조 AAV의 능력에 비해, 또는 야생형 AAV 캡시드 단백질을 포함하는 대조 AAV의 능력에 비해, 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상 증가된 상기 층의 통과 능력을 나타내며; 이 때 rAAV 비리온은 이종 유전자 생성물을 인코드하는 뉴클레오티드 서열을 포함하는 이종 핵산을 포함한다.
일부 사례들에서, 본 발명의 rAAV 비리온은 상응하는 모체 AAV 캡시드를 포함하는, 또는 야생형 AAV 캡시드 단백질을 포함하는 대조 rAAV 비리온의, 측뇌실을 라이닝하는 뇌실막 세포층 통과 능력에 비해, 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 상기 뇌실막 세포층 통과 능력을 나타낸다.
일부 사례들에서, 본 발명의 rAAV 비리온은 상응하는 모체 AAV 캡시드를 포함하는, 또는 야생형 AAV 캡시드 단백질을 포함하는 대조 rAAV 비리온의, 혈액-뇌 장벽 통과 능력에 비해, 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 상기 혈액-뇌 장벽 통과 능력을 나타낸다.
일부 사례들에서, 대상 rAAV 비리온은 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 주사로 투여시, 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드 단백질을 포함하는, AAV 비리온에 의한 뇌실막 세포층의 통과 능력에 비해, 동일한 투여 경로로 투여시 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 뇌실막 세포층 통과 능력을 나타낸다.
일부 사례들에서, 본 발명의 rAAV 비리온은 상응하는 모체 AAV 캡시드를 포함하는, 또는 야생형 AAV 캡시드 단백질을 포함하는 대조 rAAV 비리온의, 저세포층 통과 능력에 비해, 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 상기 저세포층 통과 능력을 나타낸다.
일부 사례들에서, 대상 rAAV 비리온은 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 주사로 투여시, 상응하는 모체 AAV 캡시드 단백질을 포함하는 AAV 비리온에 의한 저세포층의 통과 능력에 비해, 동일한 투여 경로로 투여시 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 저세포층 통과 능력을 나타낸다.
일부 사례들에서, 본 발명의 rAAV 비리온은 상응하는 모체 AAV 캡시드를 포함하는, 또는 야생형 AAV 캡시드 단백질을 포함하는 대조 rAAV 비리온의, 성상세포 세포체층 통과 능력에 비해, 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 상기 성상세포 세포체층 통과 능력을 나타낸다.
일부 사례들에서, 대상 rAAV 비리온은 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 주사로 투여시, 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드 단백질을 포함하는, AAV 비리온에 의한 성상세포 세포체층의 통과 능력에 비해, 동일한 투여 경로로 투여시 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 성상세포 세포체층 통과 능력을 나타낸다.
일부 사례들에서, 본 발명의 rAAV 비리온은 상응하는 모체 AAV 캡시드를 포함하는, 또는 야생형 AAV 캡시드 단백질을 포함하는 대조 rAAV 비리온의, 이행 구역층 통과 능력에 비해, 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 상기 이행 구역층 통과 능력을 나타낸다.
일부 사례들에서, 대상 rAAV 비리온은 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 주사로 투여시, 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드 단백질을 포함하는, AAV 비리온에 의한 이행 구역층의 통과 능력에 비해, 동일한 투여 경로로 투여시 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 이행 구역층 통과 능력을 나타낸다.
일부 사례들에서, 본 발명의 rAAV 비리온은 상응하는 모체 AAV 캡시드를 포함하는, 또는 야생형 AAV 캡시드 단백질을 포함하는 대조 rAAV 비리온의, 뇌 실질조직 통과 능력에 비해, 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 상기 뇌 실질조직 통과 능력을 나타낸다.
일부 사례들에서, 대상 rAAV 비리온은 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 주사로 투여시, 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드 단백질을 포함하는, AAV 비리온에 의한 뇌 실질조직의 통과 능력에 비해, 동일한 투여 경로로 투여시 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 뇌 실질조직 통과 능력을 나타낸다.
일부 사례들에서, 대상 rAAV 비리온은 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 투여로 주사시, 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드 단백질을 포함하는, 대조 AAV 비리온에 의한 뇌실막층을 지나는 국소화 정도에 비해, 동일한 투여 경로로 주사시 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 뇌실막층을 지나는 국소화를 나타낸다.
예를 들어, 일부 사례들에서, 대상 rAAV 비리온은 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 투여로 주사시, 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드 단백질을 포함하는, 대조 AAV 비리온에 의한 저세포층에 대한 국소화 정도에 비해, 동일한 투여 경로로 주사시 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 저세포층에 대한 국소화를 나타낸다.
또 다른 예로서, 일부 사례들에서, 대상 rAAV 비리온은 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 투여로 주사시, 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드 단백질을 포함하는, 대조 AAV 비리온에 의한 성상세포 세포체층에 대한 국소화 정도에 비해, 동일한 투여 경로로 주사시 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 성상세포 세포체층에 대한 국소화를 나타낸다.
또 다른 예로서, 일부 사례들에서, 대상 rAAV 비리온은 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 투여로 주사시, 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드 단백질을 포함하는, 대조 AAV 비리온에 의한 이행 구역층에 대한 국소화 정도에 비해, 동일한 투여 경로로 주사시 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 이행 구역층에 대한 국소화를 나타낸다.
또 다른 예로서, 일부 사례들에서, 대상 rAAV 비리온은 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 투여로 주사시, 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드 단백질을 포함하는, 대조 AAV 비리온에 의한 뇌 실질조직에 대한 국소화 정도에 비해, 동일한 투여 경로로 주사시 최소한 2-배, 최소한 5-배, 최소한 10-배, 최소한 15-배, 최소한 20-배, 최소한 25-배, 최소한 50-배, 또는 50-배 이상, 증가된 뇌 실질조직에 대한 국소화를 나타낸다.
중화 항체들에 의한 중화에 대한 감수성 감소
상기한 바와 같이, 일부 사례들에서, 본 발명의 rAAV 비리온은 야생형 AAV 캡시드를 포함하는 AAV에 대한 중화 항체들의 결합에 비해, 중화 항체들에 대한 감소된 결합을 나타낸다.
중화 항체들에 대한 결합 감소는 유익하다. 중화 항체들은 야생형 캡시드 단백질에 결합한다. 야생형 캡시드 단백질에 대한 중화 항체들의 결합은 바이러스 입자에서 야생형 캡시드 단백질을 포함하는 rAAV 비리온의 체류 시간 제한, 이러한 바이러스의 세포 표면에 대한 결합 저해, 바이러스 응집, 캡시드에서의 구조적 변화 유도, 그리고 바이러스 분해 및 바이러스 분해 및 탈외피화 (DNA 방출에 필요한 단계)의 저해를 비롯한 몇 가지 효과를 가질 수 있다. 그러므로 중화 항체들에 대한 감소된 결합을 가지는 rAAV 입자는 증가된 세포 감염 능력, 그리고 rAAV 비리온이 투여된 개체의 신체에서 증가된 체류 시간을 가진다. 그러므로, 유전자 생성물의 유효 전달 기간은 증가된다.
일부 사례에서, 본 발명의 rAAV 비리온은 야생형 AAV ("wt AAV") 또는 야생형 캡시드 단백질을 포함하는 AAV에 비해 중화 항체들에 대한 증가된 내성을 나타낸다. 일부 사례들에서, 본 발명의 rAAV 비리온은 wt AAV보다 중화 항체들에 대해 약 1.5-배 내지 약 10-배 10,000-배 더 큰 내성을 가지며; 예컨대, 일부 사례들에서, 본 발명의 rAAV 비리온은 wt AAV 보다 약 1.5-배 내지 약 2-배, 약 2-배 내지 약 2.-5 배, 약 2.5-배 내지 약 3-배, 약 3-배 내지 약 4-배, 약 4-배 내지 약 5-배, 약 5-배 내지 약 6-배, 약 6-배 내지 약 7-배, 약 7-배 내지 약 8-배, 약 8-배 내지 약 9-배, 또는 약 9-배 내지 약 10-배 더 큰 중화항체들에 대한 내성을 가진다. 일부 사례들에서, 본 발명의 rAAV 비리온은 wt AAV 보다 약 10-배 내지 약 10,000-배 더 큰 중화 항체들에 대한 내성을 가지는데, 예컨대, 본 발명의 rAAV 비리온은 야생형 AAV 또는 야생형 캡시드 단백질을 포함하는 AAV 보다 약 10-배 내지 약 25-배, 약 25-배 내지 약 50-배, 약 50-배 내지 약 75-배, 약 75-배 내지 약 100-배, 약 100-배 내지 약 150-배, 약 150-배 내지 약 200-배, 약 200-배 내지 약 250-배, 약 250-배 내지 약 300-배, 최소한 약 350-배, 최소한 약 400-배, 약 400-배 내지 약 450-배, 약 450-배 내지 약 500-배, 약 500-배 내지 약 550-배, 약 550-배 내지 약 600-배, 약 600-배 내지 약 700-배, 약 700-배 내지 약 800-배, 약 800-배 내지 약 900-배, 약 900-배 내지 약 1000-배, 약 1,000-배 내지 약 2,000-배, 약 2,000-배 내지 약 3,000-배, 약 3,000-배 내지 약 4,000-배, 약 4,000-배 내지 약 5,000-배, 약 5,000-배 내지 약 6,000-배, 약 6,000-배 내지 약 7,000-배, 약 7,000-배 내지 약 8,000-배, 약 8,000-배 내지 약 9,000-배, 또는 약 9,000-배 내지 약 10,000-배 더 큰 중화 항체들에 대한 내성을 가진다.
일부 사례들에서, 본 발명의 rAAV 비리온은 야생형 AAV 캡시드 단백질에 결합하는 중화 항체에 대한 감소된 결합을 나타낸다. 예를 들어, 일부 사례들에서, 본 발명의 rAAV 비리온은 야생형 AAV 캡시드 단백질에 결합하는 중화 항체에 대한 약 10-배 내지 약 10,000-배 감소된 결합을 나타낸다. 예를 들어, 일부 사례들에서, 본 발명의 rAAV 비리온은 야생형 AAV 캡시드 단백질에 대한 중화 항체의 결합 친화력에 비해 약 10-배 내지 약 25-배, 약 25-배 내지 약 50-배, 약 50-배 내지 약 75-배, 약 75-배 내지 약 100-배, 약 100-배 내지 약 150-배, 약 150-배 내지 약 200-배, 약 200-배 내지 약 250-배, 약 250-배 내지 약 300-배, 최소한 약 350-배, 최소한 약 400-배, 약 400-배 내지 약 450-배, 약 450-배 내지 약 500-배, 약 500-배 내지 약 550-배, 약 550-배 내지 약 600-배, 약 600-배 내지 약 700-배, 약 700-배 내지 약 800-배, 약 800-배 내지 약 900-배, 약 900-배 내지 약 1000-배, 약 1,000-배 내지 약 2,000-배, 약 2,000-배 내지 약 3,000-배, 약 3,000-배 내지 약 4,000-배, 약 4,000-배 내지 약 5,000-배, 약 5,000-배 내지 약 6,000-배, 약 6,000-배 내지 약 7,000-배, 약 7,000-배 내지 약 8,000-배, 약 8,000-배 내지 약 9,000-배, 또는 약 9,000-배 내지 약 10,000-배 감소된 중화 항체에 대한 결합 (예컨대, 감소된 친화력)을 나타낸다.
일부 사례들에서, 항-AAV 중화 항체는 본 발명의 rAAV 비리온에 약 10-7 M 미만, 약 5 x 10⁻⁶ M 미만, 약 10-6 M 미만, 약 5 x 10⁻⁵ M 미만, 약 10-5 M 미만, 약 10-4 M 미만, 또는 그 보다 작은 친화력으로 결합한다.
일부 사례들에서, 본 발명의 rAAV 비리온은 야생형 AAV에 비해 증가된 생체내 체류 시간을 나타낸다. 예를 들어, 일부 사례들에서, 본 발명의 rAAV 비리온은 야생형 AAV의 체류 시간보다 최소한 약 10%, 최소한 약 25%, 최소한 약 50%, 최소한 약 100%, 최소한 약 3-배, 최소한 약 5-배, 최소한 약 10-배, 최소한 약 25-배, 최소한 약 50-배, 최소한 약 100-배, 또는 그 이상 긴 체류 시간을 나타낸다.
주어진 본 발명의 rAAV가 중화 항체에 대한 감소된 결합을 나타내는지 여부는 친화력을 결정하기 위해 사용되는 임의의 다양한 표준 결합 분석법을 사용하여 결정될 수 있다.
선택적 감염력
일부 사례들에서, 본 발명의 rAAV 비리온은 신경 세포를 선택적으로 감염시키는데, 예컨대, 본 발명의 rAAV 비리온은 비-신경 세포 보다 10-배, 15-배, 20-배, 25-배, 50-배, 또는 50-배 이상의 특이성으로 신경 세포를 감염시킨다.
일부 사례들에서, 본 발명의 rAAV 비리온은 신경 줄기 세포를 선택적으로 감염시키는데, 예컨대, 대상 rAAV 비리온은 비-신경 줄기 세포, 예컨대, 중간엽 줄기 세포, 조혈 줄기 세포, 등 보다 10-배, 15-배, 20-배, 25-배, 50-배, 또는 50-배 이상의 특이성으로 신경 줄기 세포를 감염시킨다.
변이체 캡시드 폴리펩티드
상기 기재한 바와 같이, 본 발명의 rAAV 비리온은 변이체 AAV 캡시드 단백질을 포함한다. 일부 사례들에서, 본 발명의 rAAV 비리온에 존재하는 변이체 AAV 캡시드 단백질은 최소한 3가지 상이한 AAV 혈청형의 최소한 5개 분절들을 포함하며, 각 분절은 약 50개 아미노산 내지 약 160개 아미노산 길이를 가진다.
본 발명의 변이체 AAV 캡시드 단백질은 최소한 3가지 상이한 AAV 혈청형의 분절들을 포함한다. 예를 들어, 일부 사례들에서, 본 발명의 변이체 AAV 캡시드 단백질은 제 1 AAV 혈청형의 아미노산 1-160의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 1 분절; 제 2 AAV 혈청형의 아미노산 51-320의 약 50 아미노산 내지 약 160 아미노산 길이를 가지는 제 2 분절; 제 3 AAV 혈청형의 아미노산 101-480의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 3 분절; 제 2 AAV 혈청형의 아미노산 151-640의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 4 분절; 및 제 2 AAV 혈청형의 아미노산 201부터 C-말단까지의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 5 분절을 포함한다. 일부 사례들에서, 제 1 AAV 혈청형은 AAV6이고, 제 2 AAV 혈청형은 AAV9이고, 제 3 AAV 혈청형은 AAV8이다.
일부 사례들에서, 본 발명의 변이체 AAV 캡시드 단백질은 제 1 AAV 혈청형의 아미노산 1-160의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 1 분절; 제 2 AAV 혈청형의 아미노산 51-320의 약 50 아미노산 내지 약 160 아미노산 길이를 가지는 제 2 분절; 제 3 AAV 혈청형의 아미노산 101-480의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 3 분절; 제 2 AAV 혈청형의 아미노산 151-640의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 4 분절; 및 제 4 AAV 혈청형의 아미노산 201부터 C-말단까지의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 5 분절을 포함한다. 일부 사례들에서, 제 1 AAV 혈청형은 AAV6이고, 제 2 AAV 혈청형은 AAV9이고, 제 3 AAV 혈청형은 AAV8이고, 제 4 AAV 혈청형은 AAV2이다.
일부 사례들에서, 본 발명의 변이체 AAV 캡시드 단백질은 다음을 포함한다: i) 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지며 도 10에 도시된 AAV6 캡시드 아미노산 서열의 아미노산 1-160의 인접 아미노산 스트레치에 대해 최소한 85%, 최소한 90%, 최소한 95%, 최소한 98%, 최소한 99%, 또는 100% 서열 동일성을 가지는 아미노산 서열을 포함하는 제 1 분절; ii) 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지며 도 10에 도시된 AAV9 캡시드 아미노산 서열의 아미노산 1-160의 인접 아미노산 스트레치에 대해 최소한 85%, 최소한 90%, 최소한 95%, 최소한 98%, 최소한 99%, 또는 100% 서열 동일성을 가지는 아미노산 서열을 포함하는 제 2 분절; iii) 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지며 도 10에 도시된 AAV8 캡시드 아미노산 서열의 아미노산 101-480의 인접 아미노산 스트레치에 대해 최소한 85%, 최소한 90%, 최소한 95%, 최소한 98%, 최소한 99%, 또는 100% 서열 동일성을 가지는 아미노산 서열을 포함하는 제 3 분절; iv) 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지며 도 10에 도시된 AAV9 캡시드 아미노산 서열의 아미노산 151-640의 인접 아미노산 스트레치에 대해 최소한 85%, 최소한 90%, 최소한 95%, 최소한 98%, 최소한 99%, 또는 100% 서열 동일성을 가지는 아미노산 서열을 포함하는 제 4 분절; v) 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지며 도 10에 도시된 AAV9 캡시드 아미노산 서열의 C-말단의 아미노산 201의 인접 아미노산 스트레치에 대해 최소한 85%, 최소한 90%, 최소한 95%, 최소한 98%, 최소한 99%, 또는 100% 서열 동일성을 가지는 아미노산 서열을 포함하는 제 5 분절.
일부 사례들에서, 본 발명의 변이체 AAV 캡시드 단백질은 다음을 포함한다: i) 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지며 도 10에 도시된 AAV6 캡시드 아미노산 서열의 아미노산 1-160의 인접 아미노산 스트레치에 대해 최소한 85%, 최소한 90%, 최소한 95%, 최소한 98%, 최소한 99%, 또는 100% 서열 동일성을 가지는 아미노산 서열을 포함하는 제 1 분절; ii) 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지며 도 10에 도시된 AAV9 캡시드 아미노산 서열의 아미노산 1-160의 인접 아미노산 스트레치에 대해 최소한 85%, 최소한 90%, 최소한 95%, 최소한 98%, 최소한 99%, 또는 100% 서열 동일성을 가지는 아미노산 서열을 포함하는 제 2 분절; iii) 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지며 도 10에 도시된 AAV8 캡시드 아미노산 서열의 아미노산 101-480의 인접 아미노산 스트레치에 대해 최소한 85%, 최소한 90%, 최소한 95%, 최소한 98%, 최소한 99%, 또는 100% 서열 동일성을 가지는 아미노산 서열을 포함하는 제 3 분절; iv) 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지며 도 10에 도시된 AAV9 캡시드 아미노산 서열의 아미노산 151-640의 인접 아미노산 스트레치에 대해 최소한 85%, 최소한 90%, 최소한 95%, 최소한 98%, 최소한 99%, 또는 100% 서열 동일성을 가지는 아미노산 서열을 포함하는 제 4 분절; v) 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지며 도 10에 도시된 AAV2 캡시드 아미노산 서열의 C-말단의 아미노산 201의 인접 아미노산 스트레치에 대해 최소한 85%, 최소한 90%, 최소한 95%, 최소한 98%, 최소한 99%, 또는 100% 서열 동일성을 가지는 아미노산 서열을 포함하는 제 5 분절.
일부 사례들에서, 본 발명의 변이체 AAV 캡시드 단백질은 제 1 AAV 혈청형의 아미노산 1-160의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 1 분절, 제 2 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 2 분절, 제 3 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 3 분절, 제 2 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 4 분절, 제 2 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 5 분절, 제 4 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 6 분절, 제 2 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 7 분절, 및 제 2 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 8 분절을 포함한다. 일부 사례들에서, 제 1 AAV 혈청형은 AAV6이고, 제 2 AAV 혈청형은 AAV9이고, 제 3 AAV 혈청형은 AAV8이고, 제 4 AAV 혈청형은 AAV2이다.
일부 사례들에서,본 발명의 변이체 AAV 캡시드 단백질은 도 10에 도시된 SCH9 아미노산 서열에 대해 최소한 85%, 최소한 90%, 최소한 95%, 최소한 98%, 최소한 99%, 또는 100% 서열 동일성을 가지는 아미노산 서열을 포함한다. 일부 사례들에서, 상기 변이체 캡시드 단백질은 도 10에 도시된 SCH9 아미노산 서열의 아미노산 서열을 포함한다.
일부 사례들에서, 본 발명의 변이체 AAV 캡시드 단백질은 제 1 AAV 혈청형의 아미노산 1-160의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 1 분절, 제 2 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 2 분절, 제 3 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 3 분절, 제 2 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 4 분절, 제 4 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 5 분절, 제 4 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 6 분절, 제 2 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 7 분절, 및 제 2 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 8 분절을 포함한다. 일부 사례들에서, 제 1 혈청형은 AAV6이고, 제 2 AAV 혈청형은 AAV9이고, 제 3 AAV 혈청형은 AAV8이고, 제 4 AAV 혈청형은 AAV2이다.
일부 사례들에서,본 발명의 변이체 AAV 캡시드 단백질은 도 10에 도시된 SCH2 아미노산 서열에 대해 최소한 85%, 최소한 90%, 최소한 95%, 최소한 98%, 최소한 99%, 또는 100% 서열 동일성을 가지는 아미노산 서열을 포함한다. 일부 사례들에서, 상기 변이체 캡시드 단백질은 도 10에 도시된 SCH2 아미노산 서열의 아미노산 서열을 포함한다.
일부 사례들에서,본 발명의 변이체 AAV 캡시드 단백질은 도 8에 도시된 SCH9 아미노산 서열에 대해 최소한 85%, 최소한 90%, 최소한 95%, 최소한 98%, 최소한 99%, 또는 100% 서열 동일성을 가지는 아미노산 서열을 포함한다. 일부 사례들에서,본 발명의 변이체 AAV 캡시드 단백질은 도 9에 도시된 SCH2 아미노산 서열에 대해 최소한 85%, 최소한 90%, 최소한 95%, 최소한 98%, 최소한 99%, 또는 100% 서열 동일성을 가지는 아미노산 서열을 포함한다.
추가 변형
일부 사례들에서, 본 발명의 변이체 캡시드 폴리펩티드는 하나 이상의 추가 돌연변이 (예컨대, 아미노산 치환; 하나 이상의 아미노산의 삽입; 하나 이상의 아미노산의 결실)를 포함한다.
예를 들어, 일부 사례들에서, 본 발명의 변이체 캡시드 폴리펩티드는 상응하는 모체 AAV 캡시드 단백질에 비해 캡시드 단백질 GH 루프에서 약 5개 아미노산 내지 약 20개 아미노산 (예컨대, 5개 아미노산 내지 7개 아미노산, 7개 아미노산 내지 10개 아미노산, 10개 아미노산 내지 15개 아미노산, 또는 15개 아미노산 내지 20개 아미노산)의 삽입을 포함한다. 삽입 부위는 AAV 캡시드 단백질의 GH 루프, 또는 루프 IV에, 예컨대, AAV 캡시드 단백질의 GH 루프, 또는 루프 IV의 용매-접근가능한 부분에 존재할 수 있다. AAV 캡시드의 GH 루프/루프 IV에 관하여, 예컨대, van Vliet 외 (2006) Mol. Ther. 14:809; Padron 외 (2005) J. Virol. 79:5047; 및 Shen 외 (2007) Mol. Ther. 15:1955를 참고하라.
일부 사례들에서, 약 5개 아미노산 내지 약 20개 아미노산 (예컨대, 5 내지 7, 7 내지 10, 10 내지 12, 12 내지 15, 또는 15 내지 20개 아미노산) 길이의 이종 펩티드는 상응하는 모체 AAV 캡시드 단백질에 대해 상기 캡시드 단백질의 GH 루프 또는 루프 IV 내 삽입 부위에 삽입된다. 예를 들어, 도 21A-21C에 도시된 바와 같이, 삽입 부위는 AAV 캡시드 단백질, 또는 상응하는 본 발명의 변이체 AAV 캡시드 단백질 영역의 아미노산 411-650 내부에 존재할 수 있다. 도 21A-21C에 도시된 주어진 아미노산 서열들에 대해, 해당 분야의 숙련된 기술자는, 본 발명의 변이체 캡시드에서 적합한 삽입 부위를 용이하게 결정할 수 있다. 예를 들어, 삽입 부위는 AAV2의 아미노산 587과 588 사이, 또는 AAV2의 아미노산 588과 589 사이, 또는 또 다른 AAV 혈청형의 상응하는 캡시드 소단위 위치들, 또는 본 발명의 변이체 AAV 캡시드의 상응하는 캡시드 소단위 위치들이 될 수 있다. 삽입 부위 587/588은 AAV2 캡시드 단백질이 기준임을 유의하여야 한다. 5개 아미노산 내지 약 20개 아미노산 (예컨대, 5 내지 7, 7 내지 10, 10 내지 12, 12 내지 15, 또는 15 내지 20개 아미노산) 길이의 이종 펩티드는 AAV2 이외의 AAV 혈청형 (예컨대, AAV8, AAV9, 등)에서 상응하는 부위, 또는 본 발명의 변이체 AAV 캡시드의 상응하는 캡시드 소단위 위치들에 삽입될 수 있다. 해당 분야의 숙련된 기술자는 다양한 AAV 혈청형의 캡시드 단백질들의 아미노산 서열 비교에 근거하여, 임의의 주어진 AAV 혈청형의 캡시드 단백질에서 "AAV2의 아미노산 587-588에 상응하는" 삽입 부위, 또는 본 발명의 변이체 AAV 캡시드의 상응하는 캡시드 소단위 부위들이 어디인지를 알 것이다. 예컨대, AAV1은 GenBank 접근 번호 NP_049542; AAV4는 GenBank 접근 번호 NP_044927; AAV5는 GenBank 접근 번호 AAD13756; AAV6은 GenBank 접근 번호 AAB95459; AAV7은 GenBank 접근 번호 YP_077178; AAV8은 GenBank 접근 번호 YP_077180; AAV9는 GenBank 접근 번호 AAS99264; AAV10은 GenBank 접근 번호 AAT46337; 및 AAVrh10은 GenBank 접근 번호 AAO88208을 참고하라. 예컨대, 선구 AAV 캡시드는 Santiago-Ortiz 외 (2015) Gene Ther. 22:934를 참고하라.
일부 사례들에서, 본 발명의 변이체 캡시드 폴리펩티드는 LGETTRP (서열 번호:3), NETITRP (서열 번호:4), KAGQANN (서열 번호:5), KDPKTTN (서열 번호:6), KDTDTTR (서열 번호:7), RAGGSVG (서열 번호:8), AVDTTKF (서열 번호:9), 및 STGKVPN (서열 번호:10)에서 선택된 아미노산 서열을 포함하는 삽입을 포함한다.
일부 사례들에서, 본 발명의 변이체 캡시드 폴리펩티드는 LALIQDSMRA (서열 번호:151); LANQEHVKNA (서열 번호:152); TGVMRSTNSGLN (서열 번호:153); TGEVDLAGGGLS (서열 번호:154); TSPYSGSSDGLS (서열 번호:155); TGGHDSSLDGLS (서열 번호:156); TGDGGTTMNGLS (서열 번호:157); TGGHGSAPDGLS (서열 번호:158); TGMHVTMMAGLN (서열 번호:159); TGASYLDNSGLS (서열 번호:160); TVVSTQAGIGLS (서열 번호:161); TGVMHSQASGLS (서열 번호:162); TGDGSPAAPGLS (서열 번호:163); TGSDMAHGTGLS (서열 번호:164); TGLDATRDHGLSPVTGT (서열 번호:165); TGSDGTRDHGLSPVTWT (서열 번호:166); NGAVADYTRGLSPATGT (서열 번호:167); TGGDPTRGTGLSPVTGA (서열 번호:168); LQKNARPASTESVNFQ (서열 번호:169); LQRGVRIPSVLEVNGQ (서열 번호:170); LQRGNRPVTTADVNTQ (서열 번호:171); 및 LQKADRQPGVVVVNCQ (서열 번호:172)에서 선택된 아미노산 서열을 포함하는 삽입을 포함한다. 일부 사례들에서, 펩티드 삽입은 TGVMRSTNSGLN (서열 번호:153)이다. 일부 사례들에서, 펩티드 삽입은 TGEVDLAGGGLS (서열 번호: 154)이다. 일부 사례들에서, 펩티드 삽입은 TSPYSGSSDGLS (서열 번호:155)이다. 일부 사례들에서, 펩티드 삽입은 TGGHDSSLDGLS (서열 번호:156)이다. 일부 사례들에서, 펩티드 삽입은 TGDGGTTMNGLS (서열 번호:157)이다. 일부 사례들에서, 펩티드 삽입은 TGGHGSAPDGLS (서열 번호:158)이다. 일부 사례들에서, 펩티드 삽입은 TGMHVTMMAGLN (서열 번호:159)이다. 일부 사례들에서, 펩티드 삽입은 TGASYLDNSGLS (서열 번호:160)이다. 일부 사례들에서, 펩티드 삽입은 TVVSTQAGIGLS (서열 번호:161)이다. 일부 사례들에서, 펩티드 삽입은 TGVMHSQASGLS (서열 번호:162)이다. 일부 사례들에서, 펩티드 삽입은 TGDGSPAAPGLS (서열 번호:163)이다. 일부 사례들에서, 펩티드 삽입은 TGSDMAHGTGLS (서열 번호:164)이다. 일부 사례들에서, 펩티드 삽입은 TGSDGTRDHGLSPVTWT (서열 번호:166)이다. 일부 사례들에서, 펩티드 삽입은 NGAVADYTRGLSPATGT (서열 번호:167)이다. 일부 사례들에서, 펩티드 삽입은 TGGDPTRGTGLSPVTGA (서열 번호:168)이다. 일부 사례들에서, 펩티드 삽입은 LQKNARPASTESVNFQ (서열 번호:169)이다. 일부 사례들에서, 펩티드 삽입은 LQRGVRIPSVLEVNGQ (서열 번호:170)이다. 일부 사례들에서, 펩티드 삽입은 LQRGNRPVTTADVNTQ (서열 번호:171)이다. 일부 사례들에서, 펩티드 삽입은 LQKADRQPGVVVVNCQ (서열 번호:172)이다.
일부 사례들에서, 삽입 부위는 AAV2의 아미노산 587과 588 사이, AAV1의 아미노산 590과 591 사이, AAV5의 아미노산 575와 576 사이, AAV6의 아미노산 590과 591 사이, AAV7의 아미노산 589와 590 사이, AAV8의 아미노산 590과 591 사이, AAV9의 아미노산 588과 589 사이, AAV10의 아미노산 588과 589 사이, 또는 AAV10의 아미노산 588과 589 사이일 수 있다.
또 다른 예로서, 일부 사례들에서, 본 발명의 변이체 캡시드 폴리펩티드는 모체 AAV 캡시드 단백질에 비해 아미노한 치환을 포함한다. 이러한 아미노산 치환(들)은 캡시드 내 용매 접근가능한 부위, 예컨대, 용매-접근가능한 루프에 위치할 수 있다. 예를 들어, 아미노산 치환(들)은 AAV 캡시드 단백질 내 GH 루프에 위치할 수 있다. 일부 사례들에서, 변이체 캡시드 단백질은 AAV6 캡시드의 아미노산 서열 (서열 번호:11)에 비해 아미노산 451 및/또는 532에서, 또는 AAV6 이외의 혈청형에서 상응하는 아미노산에서 아미노산 치환을 포함한다. 일부 사례들에서, 변이체 캡시드 단백질은 AAV6 캡시드의 아미노산 서열 (서열 번호:11)에 비해 아미노산 319 및/또는 451에서, 532 및/또는 642에서, 또는 AAV6 이외의 혈청형에서 상응하는 아미노산에서 아미노산 치환을 포함한다. 일부 사례들에서, 변이체 캡시드 단백질은 AAV6 캡시드 (서열 번호:11)의 아미노산 서열에 비해 다음과 같은 치환들 중 하나 이상을 포함한다: I319V, N451D, D532N, 및 H642N.
이종 유전자 생성물
상기 기재한 바와 같이, rAAV 비리온은 하나 이상의 유전자 생성물 (하나 이상의 이종 유전자 생성물)을 인코드하는 뉴클레오티드를 포함하는 이종 핵산을 포함한다. 일부 사례들에서, 유전자 생성물은 폴리펩티드이다. 일부 사례들에서, 유전자 생성물은 RNA이다. 일부 사례들에서, 본 발명의 rAAV 비리온은 이종 핵산 유전자 생성물과 이종 폴리펩티드 유전자 생성물 모두를 인코드하는 이종 뉴클레오티드 서열을 포함한다. 유전자 생성물이 RNA인 경우, 일부 사례들에서, RNA 유전자 생성물은 폴리펩티드를 인코드한다. 유전자 생성물이 RNA인 경우, 일부 사례들에서, RNA 유전자 생성물은 폴리펩티드를 인코드하지 않는다. 일부 사례들에서, 본 발명의 rAAV 비리온은 단일 이종 유전자 생성물을 인코드하는 뉴클레오티드 서열을 포함하는 단일 이종 핵산을 포함한다. 일부 사례들에서, 본 발명의 rAAV 비리온은 2개의 이종 유전자 생성물을 인코드하는 뉴클레오티드 서열을 포함하는 단일 이종 핵산을 포함한다. 단일 이종 핵산이 2개의 이종 유전자 생성물을 인코드하는 경우, 일부 사례들에서, 2개의 이종 유전자 생성물을 인코드하는 뉴클레오티드 서열들은 동일한 프로모터에 작동가능하게 연결된다. 단일 이종 핵산이 2개의 이종 유전자 생성물을 인코드하는 경우, 일부 사례들에서, 2개의 이종 유전자 생성물을 인코드하는 뉴클레오티드 서열들은 2개의 상이한 프로모터에 작동가능하게 연결된다. 일부 사례들에서, 본 발명의 rAAV 비리온은 3개의 이종 유전자 생성물을 인코드하는 뉴클레오티드 서열을 포함하는 단일 이종 핵산을 포함한다. 단일 이종 핵산이 3개의 이종 유전자 생성물을 인코드하는 경우, 일부 사례들에서, 3개의 이종 유전자 생성물을 인코드하는 뉴클레오티드 서열들은 동일한 프로모터에 작동가능하게 연결된다. 단일 이종 핵산이 3개의 이종 유전자 생성물을 인코드하는 경우, 일부 사례들에서, 3개의 이종 유전자 생성물을 인코드하는 뉴클레오티드 서열들은 2 또느 3개의 상이한 프로모터에 작동가능하게 연결된다. 일부 사례들에서, 본 발명의 rAAV 비리온은 2개의 이종 핵산을 포함하며, 각각의 이종 핵산은 이종 유전자 생성물을 인코드하는 뉴클레오티드 서열을 포함한다.
일부 사례들에서, 유전자 생성물은 폴리펩티드-인코딩 RNA이다. 일부 사례들에서, 유전자 생성물은 간섭 RNA이다. 일부 사례들에서, 유전자 생성물은 마이크로RNA (miRNA)이다. 일부 사례들에서, 유전자 생성물은 압타머이다. 일부 사례들에서, 유전자 생성물은 폴리펩티드이다. 일부 사례들에서, 유전자 생성물은 치료적 폴리펩티드, 예컨대, 임상정 이점을 제공하는 폴리펩티드이다. 일부 사례들에서, 유전자 생성물은 유전자 기능의 부위-특이적 녹다운을 제공하는 부위-특이적 뉴클레아제이다. 일부 사례들에서, 유전자 생성물은 표적 핵산의 변형을 제공하는 RNA-가이드된 엔도뉴클레아제이다. 일부 사례들에서, 유전자 생성물은 다음과 같다: i) 표적 핵산의 변형을 제공하는 RNA-가이드된 엔도뉴클레아제; 및 ii) 표적 핵산에서 표적 서열에 결합하는 제 1 분절 및 RNA-가이드된 엔도뉴클레아제에 결합하는 제 2 분절을 포함하는 가이드 RNA. 일부 사례들에서, 유전자 생성물은 다음과 같다: i) 표적 핵산의 변형을 제공하는 RNA-가이드된 엔도뉴클레아제; ii) 표적 핵산에서 제 1 표적 서열에 결합하는 제 1 분절 및 RNA-가이드된 엔도뉴클레아제에 결합하는 제 2 분절을 포함하는 제 1 가이드 RNA; 및 iii) 표적 핵산에서 제 2 표적 서열에 결합하는 제 1 분절 및 RNA-가이드된 엔도뉴클레아제에 결합하는 제 2 분절을 포함하는 제 1 가이드 RNA.
핵산 유전자 생성물
유전자 생성물이 간섭 RNA (RNAi)인 경우, 적합한 RNAi는 세포 내 세포자멸 또는 혈관형성 인자 수준을 감소시키는 RNAi를 포함한다. 예를 들면, RNAi는 세포 내 세포자멸을 유도 또는 촉진시키는 유전자 생성물 수준을 감소시키는 shRNA 또는 siRNA 일 수 있다. 그 유전자 생성물이 세포자멸을 유도 또는 촉진시키는 유전자들은 본 명세서에서 "전구-세포자멸 유전자"로 지칭되며 이들 유전자들의 생성물 (mRNA; 단백질)은 "전구-세포자멸 유전자 생성물"로 지칭된다. 전구-세포자멸 유전자 생성물은, 예컨대, Bax, Bid, Bak, 및 Bad 유전자 생성물을 포함한다. 예컨대, 미국 특허 제 7,846,730을 참고하라.
한 예로서, 일부 사례들에서, 간섭 RNA는 결손 대립유전자의 RNA 및/또는 폴리펩티드 생성물의 수준을 특이적으로 감소시킨다. 예를 들어, 일부 사례들에서, RNAi는 헌팅턴을 인코드하는 RNA의 수준을 특이적으로 감소시키고 및/또는 헌팅턴 폴리펩티드의 수준을 특이적으로 감소시킨다.
또 다른 예로서, 일부 사례들에서, miRNA는 결손 대립유전자의 RNA 및/또는 폴리펩티드 생성물의 수준을 특이적으로 감소시킨다.
또 다른 예로서, 일부 사례들에서, 예컨대, SOD1 RNA 및 폴리펩티드가 결손 대립유전자에 의해 인코드되는 경우, RNAi는 초과산화물 불균등화효소-1 (SOD1) RNA를 인코드하는 RNA 의 수준을 특이적으로 감소시키고 및/또는 SOD1 폴리펩티드의 수준을 특이적으로 감소시킨다.
또 다른 예로서, 일부 사례들에서, 예컨대, SMN1 RNA 및 폴리펩티드가 한 결손 대립유전자에 의해 인코드되는 경우, RNAi는 운동 뉴런-1 (SMN1) RNA의 생존을 인코드하는 RNA의 수준을 특이적으로 감소시키고 및/또는 SMN1 폴리펩티드의 수준을 특이적으로 감소시킨다.
간섭 RNA는 또한 혈관형성 생성물, 예를 들면 혈관 내피 성장 인자 (VEGF) (예컨대, Cand5; 예컨대, 미국 공개 특허출원 제 2011/0143400; 미국 공개 특허출원 제 2008/0188437; 및 Reich 외 (2003) Mol. Vis. 9:210 참고); VEGF 수용체-1 (VEGFR1) (예컨대, Sirna-027; 예컨대, Kaiser 외 (2010) Am. J. Ophthalmol. 150:33; 및 Shen 외 (2006) Gene Ther. 13:225 참고); 또는 VEGF 수용체-2 (VEGFR2) (Kou 외 (2005) Biochem. 44:15064)에 대항하는 것일 수 있다. 또한, 미국 특허 제 6,649,596, 6,399,586, 5,661,135, 5,639,872, 및 5,639,736; 및 미국 특허 제 7,947,659 및 7,919,473을 참고하라.
유전자 생성물이 압타머인 경우, 예시적인 관심 압타머는 VEGF에 대항하는 압타머를 포함한다. 예컨대, Ng 외 (2006) Nat. Rev. Drug Discovery 5:123; 및 Lee 외 (2005) Proc. Natl. Acad. Sci. USA 102:18902를 참고하라. 예를 들면, VEGF 압타머는 뉴클레오티드 서열 5'-cgcaaucagugaaugcuuauacauccg-3' (서열 번호:12)을 포함할 수 있다. 또한 혈소판-유래 성장 인자 (PDGF)-특이적 압타머, 예컨대, E10030이 사용하기에 적합하다; 예컨대, Ni 및 Hui (2009) Ophthalmologica 223:401; 및 Akiyama 외 (2006) J. Cell Physiol. 207:407을 참고하라.
폴리펩티드 유전자 생성물
유전자 생성물이 폴리펩티드인 경우, 일부 사례들에서, 이러한 폴리펩티드는 .경 줄기 세포, 신경 전구 세포, 또는 뉴런 세포의 기능을 향상시키는 폴리펩티드이다
일부 사례들에서, 유전자 생성물은 신경 줄기 세포의 분화를 유도하는, 예컨대, 신경 줄기 세포의 뉴런, 신경아교 세포, 성상세포, 또는 희소돌기아교세포로의 분화를 유도하는 폴리펩티드이다. 신경 줄기 세포의 분화를 유도하는 폴리펩티드들의 비-제한적 예들에는 아캐트-스큐트 (achaete-scute) 패밀리 기본 나선-루프-나선 전사 인자 1 (MASH1; Deng 외. (2010) Biochem. Biophys. Res. Commun. 392:548), 페어드 유사 호메오박스 2a (paired like homeobox 2a) (PHOX2A), 뉴로게닌 1 (NGN1), 페어드 박스 6 (paired box 6, PAX6), 성별 결정 영역 Y-박스1 (SOX1), 신경발생성 분화 1 (NeuroD1), NeuroD-관련 인자 (NDRF), 희소돌기아교세포 전사 인자 2 (Olig2)가 포함된다. 예컨대, Ohtsuka 외. (1998) Cell Tissue Res. 293:23; 및 Bond 외 (2015) Cell Stem Cell 17:385를 참고하라.
예시적인 폴리펩티드에는 신경보호성 폴리펩티드 (예컨대, 신경아교 세포 유래된 신경영양 인자 (GDNF), 속눈썹 신경영양 인자 (CNTF), 뉴로트로핀-4 (NT4), 신경 성장 인자 (NGF), 및 뉴투린 (NTN)); 방향족 L-아미노산 디카르복실라제; 글루탐산 디카르복실라제; 트라이펩티딜 펩티다제; 아스파르트아실라제; 항-혈관형성 폴리펩티드 (예컨대, 가용성 VEGF 수용체; VEGF-결합 항체; VEGF-결합 항체 절편 (예컨대, 단일쇄 항-VEGF 항체); 엔도스타틴; 툼스타틴; 안지오스타틴; 가용성 Flt 폴리펩티드 (Lai 외 (2005) Mol. Ther. 12:659); 가용성 Flt 폴리펩티드를 포함하는 Fc 융합 단백질 (예컨대, Pechan 외 (2009) Gene Ther. 16:10 참고); 모양체 신경영양 인자; 뇌하수체 아데닐레이트 사이클라제-활성화 폴리펩티드; 금속단백분해효소의 조직 저해제-3 (TIMP-3); 전사 인자, 예컨대, 신경 분화 1 (Neuro D1), 희소돌기아교세포 전사 인자 1 (Olig1), 희소돌기아교세포 전사 인자 2 (Olig2), 아캐트-스큐트 패밀리 BHLH 전사 인자 1 (ASCii), DNA-단백질 저해제 ID-1 (Id1), DNA-단백질 저해제 ID-2 (Id2), 뉴로게닌, 전사 신호 전달자 및 활성화인자 3, NK2 전사 인자-유사 단백질 B; 등이 포함된다. 적합한 폴리펩티드에는, 아교세포 유래 신경영양 인자 (GDNF); 섬유모세포 성장 인자; 섬유모세포 성장 인자 2; 뉴투린 (NTN); 속눈썹 신경영양 인자 (CNTF); 신경 성장 인자 (NGF); 뉴로트로핀-4 (NT4); 뇌 유래 신경영양 인자 (BDNF); 표피 성장 인자; 세포자멸의 X-연관 저해제; 및 소닉 헤지호그 (Sonic hedgehog)가 포함되나 이에 제한되는 것은 아니다.
부위-특이적 엔도뉴클레아제
일부 사례들에서, 관심 유전자 생성물은 유전자 기능의 부위-특이적 녹다운을 제공하는 부위-특이적 엔도뉴클레아제로, 예컨대, 상기 엔도뉴클레아제는 신경 질환과 관련된 대립유전자를 녹아웃 시킨다. 예를 들면, 야생형이, 신경 구조 단백질이거나 및/또는 정상 신경 기능을 제공하는 유전자의 결손 카피를 인코드하는 경우, 부위-특이적 엔도뉴클레아제는 상기 결손 대립유전자에 표적화되어 결손 대립유전자를 녹아웃 시킬 수 있다. 일부 사례들에서, 부위-특이적 엔도뉴클레아제는 RNA-가이드된 엔도뉴클레아제이다.
부위-특이적 뉴클레아제는 또한 결손 대립유전자에 의해 인코드되는 단백질의 기능적 카피를 인코드하는 공여자 DNA와의 상동성 재조합을 자극하기 위해 사용될 수도 있다. 그러므로, 예컨대, 대상 rAAV 비리온은 결손 대립유전자를 녹아웃시키는 부위-특이적 엔도뉴클레아제를 전달하기 위해서 사용될 수도, 그리고 결손 대립유전자의 기능적 카피를 전달하기 위하여 사용될 수도 있으며, 이는 결손 대립유전자를 복구시킴으로써, 기능적 신경 단백질의 생성을 제공한다. 일부 사례들에서, 대상 rAAV 비리온은 부위-특이적 엔도뉴클레아제를 인코드하는 뉴클레오티드 서열을 포함하는 이종 핵산; 및 결손 대립유전자의 기능적 카피를 인코드하는 이종 뉴클레오티드 서열을 포함하고, 여기서 기능적 카피는 기능적 신경 단백질을 인코드한다.
신경학적 질환 및 장애들과 연관된 또는 이를 일으키는 돌연변이들을 포함할 수 있는 유전자들의 예들에는, 하이포잔틴 구아닌 포스포리복실트랜스퍼라제 (HPRT1), 신경섬유종증 유형 II (NF2), ATP1A3 (Na+/K+-ATPase의 α3 소단위를 인코딩), DYNC1H1 (세포질 디네인-1의 중쇄를 인코딩), HTT (헌팅턴을 인코딩), SOD1, SMN1, ATX3 (척수소뇌성 실조증-3을 인코딩), FXN/X25 (프라탁신을 인코딩), DMPK (근긴장성 이영양증 단백질 키나아제를 인코딩), ATXN2 (아탁신-2를 인코딩), 아트로핀-1, NR4A2 (핵 수용체 서브패밀리 4, 그룹 A, 멤버 2 단백질을 인코딩), PINK1 (PTEN 유도된 추정 키나아제 1을 인코딩), LRRK2 (류신-풍부 반복 키나아제 2를 인코딩), MeCP2 (메틸-CpG-결합 단백질-2를 인코딩), 등이 포함되나 이에 제한되는 것은 아니다.
사용하기에 적합한 부위-특이적 엔도뉴클레아제는, 예컨대, 아연 핑거 뉴클레아제 (ZFNs); 메가뉴클레아제; 및 전사 활성화인자-유사 효과기 뉴클레아제 (TALENs)를 포함하고, 이 때 이러한 부위-특이적 엔도뉴클레아제는 자연 발생하지 않으며 특정 유전자를 표적하기 위해 변형된다. 이러한 부위-특이적 뉴클레아제는 게놈 내 특정 위치들을 자르도록 조작될 수 있고, 이후 비-상동성 단부 결합은 파단을 복구 할 수 있으나 여러 뉴클레오타이드가 삽입되거나 결실된다. 이러한 부위-특이적 엔도뉴클레아제 (또한 "INDELs"로도 지칭됨)는 단백질을 프레임 밖으로 내보내고 유전자를 효과적으로 녹아웃시킨다. 예컨대, 미국 공개 특허출원 제 2011/0301073을 참고하라. 적합한 부위-특이적 엔도뉴클레아제는 유전자조작된 메가뉴클레아제 및 재-유전자조작된 호밍 엔도뉴클레아제 (re-engineered homing endonucleases)를 포함한다. 적합한 엔도뉴클레아제는 I-Tevl 뉴클레아제를 포함한다. 적합한 메가뉴클레아제는 I-Sce1 (예컨대, Bellaiche 외 (1999) Genetics 152:1037 참고); 및 I-Cre1 (예컨대, Heath 외 (1997) Nature Structural Biology 4:468 참고)을 포함한다.
RNA-가이드된 엔도뉴클레아제
일부 사례들에서, 유전자 생성물은 RNA-가이드된 엔도뉴클레아제이다. 일부 사례들에서, 유전자 생성물은 RNA-가이드된 엔도뉴클레아제를 인코드하는 뉴클레오티드 서열을 포함하는 RNA이다. 일부 사례들에서, 유전자 생성물은 가이드 RNA, 예컨대, 단일-가이드 RNA이다. 일부 사례들에서, 유전자 생성물은 다음과 같다: 1) 가이드 RNA; 및 2) RNA-가이드된 엔도뉴클레아제. 상기 가이드 RNA는 다음을 포함할 수 있다: a) RNA-가이드된 엔도뉴클레아제에 결합하는 단백질-결합 영역; 및 b) 표적 핵산에 결합하는 영역. RNA-가이드된 엔도뉴클레아제는 또한 본 명세서에서 "게놈 편집 뉴클레아제"로도 지칭된다.
RNA-가이드된 엔도뉴클레아제의 예들은 CRISPR/Cas 엔도뉴클레아제 (예컨대, 클래스 2 CRISPR/Cas 엔도뉴클레아제, 가령, 유형 II, 유형 V, 또는 유형 VI CRISPR/Cas 엔도뉴클레아제)이다. 적합한 게놈 편집 뉴클레아제는 CRISPR/Cas 엔도뉴클레아제 (예컨대, 클래스 2 CRISPR/Cas 엔도뉴클레아제, 가령, 유형 II, 유형 V, 또는 유형 VI CRISPR/Cas 엔도뉴클레아제)이다. 일부 사례들에서, 적합한 RNA-가이드된 엔도뉴클레아제는 클래스 2 CRISPR/Cas 엔도뉴클레아제이다. 일부 사례들에서, 적합한 RNA-가이드된 엔도뉴클레아제는 클래스 2 유형 II CRISPR/Cas 엔도뉴클레아제 (예컨대, Cas9 단백질)를 포함한다. 일부 사례들에서, 게놈 표적화 조성물은 클래스 2 유형 V CRISPR/Cas 엔도뉴클레아제 (예컨대, Cpf1 단백질, C2c1 단백질, 또는 C2c3 단백질)를 포함한다. 일부 사례들에서, 적합한 RNA-가이드된 엔도뉴클레아제는 클래스 2 유형 VI CRISPR/Cas 엔도뉴클레아제 (예컨대, C2c2 단백질; 또한 "Cas13a" 단백질로도 지칭됨)이다. CasX 단백질 또한 사용하기 적합하다. CasY 단백질 또한 사용하기 적합하다.
일부 사례들에서, 게놈-편집 엔도뉴클레아제는 유형 II CRISPR/Cas 엔도뉴클레아제이다. 일부 사례들에서, 게놈-편집 엔도뉴클레아제는 Cas9 폴리펩티드이다. Cas9 단백질은 Cas9 가이드 RNA의 단백질-결합 분절과의 결합에 의해 표적 핵산 서열 (예컨대, 염색체 서열 또는 염색체외 서열, 예컨대, 에피좀 서열, 미니서클 서열, 미토콘드리아 서열, 엽록체 서열 등) 내 표적 부위로 가이드된다 (예컨대, 표적 부위에서 안정화됨). 일부 사례들에서, Cas9 폴리펩티드는 도 18A에 도시된 스트렙토코쿠스 피오게네스 Cas9에 대해 최소한 50%, 최소한 60%, 최소한 70%, 최소한 80%, 최소한 90%, 최소한 95%, 최소한 98%, 최소한 99%, 또는 99% 이상의 아미노산 서열 동일성을 가지는 아미노산 서열을 포함한다. 일부 사례들에서, 본 발명의 조성물 또는 방법에서 사용되는 Cas9 폴리펩티드는 스타필로코쿠스 아우레우스 Cas9 (saCas9) 폴리펩티드이다. 일부 사례들에서, saCas9 폴리펩티드는 도 19에 도시된 saCas9 아미노산 서열에 대해 최소한 85%, 최소한 90%, 최소한 95%, 최소한 98%, 최소한 99%, 또는 100%, 아미노산 서열 동일성을 가지는 아미노산 서열을 포함한다.
일부 사례들에서, 적합한 Cas9 폴리펩티드는 고-충실도 (HF) Cas9 폴리펩티드이다. Kleinstiver 외 (2016) Nature 529:490. 예를 들면, 도 18A에 도시된 아미노산 서열의 아미노산 N497, R661, Q695, 및 Q926은, 예컨대, 알라닌으로 치환된다. 예를 들면, HF Cas9 폴리펩티드는 도 19A에 도시된 아미노산 서열에 대해 최소한 90%, 최소한 95%, 최소한 98%, 최소한 99%, 또는 100%, 아미노산 서열 동일성을 가지는 아미노산 서열을 포함할 수 있으며, 이 때 아미노산 N497, R661, Q695, 및 Q926은, 예컨대, 알라닌으로 치환된다. 적합한 Cas9 폴리펩티드는 도 18A-18F 중 어느 하나에 제시된 아미노산 서열을 포함한다.
일부 사례들에서, 적합한 Cas9 폴리펩티드는 변경된 PAM 특이성을 나타낸다. 예컨대, Kleinstiver 외 (2015) Nature 523:481을 참고하라.
일부 사례들에서, 게놈-편집 엔도뉴클레아제는 유형 V CRISPR/Cas 엔도뉴클레아제이다. 일부 사례들에서 유형 V CRISPR/Cas 엔도뉴클레아제는 Cpf1 단백질이다. 일부 사례들에서, Cpf1 단백질은 도 20에 도시된 Cpf1 아미노산 서열에 대해 최소한 30%, 최소한 35%, 최소한 40%, 최소한 45%, 최소한 50%, 최소한 55%, 최소한 60%, 최소한 65%, 최소한 70%, 최소한 75%, 최소한 80%, 최소한 85%, 최소한 90%, 최소한 95%, 최소한 90%, 또는 100%, 아미노산 서열 동일성을 가지는 아미노산 서열을 포함한다.
일부 사례들에서, 게놈-편집 엔도뉴클레아제는 CasX 또는 CasY 폴리펩티드이다. CasX 및 CasY 폴리펩티드는 Burstein 외 (2017) Nature 542:237에 기재되어 있다.
RNA-가이드된 엔도뉴클레아제
RNA-가이드된 엔도뉴클레아제는 또한 본 명세서에서 "게놈 편집 뉴클레아제"로도 지칭된다. 적합한 게놈 편집 뉴클레아제의 예들은 CRISPR/Cas 엔도뉴클레아제 (예컨대, 클래스 2 CRISPR/Cas 엔도뉴클레아제, 가령, 유형 II, 유형 V, 또는 유형 VI CRISPR/Cas 엔도뉴클레아제)이다. 적합한 게놈 편집 뉴클레아제는 CRISPR/Cas 엔도뉴클레아제 (예컨대, 클래스 2 CRISPR/Cas 엔도뉴클레아제, 가령, 유형 II, 유형 V, 또는 유형 VI CRISPR/Cas 엔도뉴클레아제)이다. 일부 사례들에서, 적합한 게놈 편집 뉴클레아제는 클래스 2 CRISPR/Cas 엔도뉴클레아제이다. 일부 사례들에서, 적합한 게놈 편집 뉴클레아제는 클래스 2 유형 II CRISPR/Cas 엔도뉴클레아제 (예컨대, Cas9 단백질)이다. 일부 사례들에서, 적합한 게놈 편집 뉴클레아제는 클래스 2 유형 V CRISPR/Cas 엔도뉴클레아제 (예컨대, Cpf1 단백질, C2c1 단백질, 또는 C2c3 단백질)이다. 일부 사례들에서, 적합한 게놈 편집 뉴클레아제는 클래스 2 유형 VI CRISPR/Cas 엔도뉴클레아제 (예컨대, C2c2 단백질; 또한 "Cas13a" 단백질로도 지칭됨)이다. CasX 단백질 또한 사용하기 적합하다. CasY 단백질 또한 사용하기 적합하다.
일부 사례들에서, 게놈 편집 뉴클레아제는 이종 폴리펩티드 (또한 "융합 파트너"로도 지칭됨)에 융합되는 융합 단백질이다. 일부 사례들에서, 게놈 편집 뉴클레아제는 하위세포 국소화를 제공하는 아미노산 서열 (융합 파트너)에 융합되는데, 즉, 융합 파트너는 하위세포 국소화 서열 (예컨대, 핵을 표적화하기 위한 하나 이상의 핵 국소화 신호 (NLSs), 둘 이상의 NLS, 셋 이상의 NLS, 등)이다.
일부 사례들에서, 게놈-편집 엔도뉴클레아제는 유형 II CRISPR/Cas 엔도뉴클레아제이다. 일부 사례들에서, 게놈-편집 엔도뉴클레아제는 Cas9 폴리펩티드이다. Cas9 단백질은 Cas9 가이드 RNA의 단백질-결합 분절과의 결합에 의해 표적 핵산 서열 (예컨대, 염색체 서열 또는 염색체외 서열, 예컨대, 에피좀 서열, 미니서클 서열, 미토콘드리아 서열, 엽록체 서열 등) 내 표적 부위로 가이드된다 (예컨대, 표적 부위에서 안정화됨). 일부 사례들에서, Cas9 폴리펩티드는 도 18A에 도시된 스트렙토코쿠스 피오게네스 Cas9에 대해 최소한 50%, 최소한 60%, 최소한 70%, 최소한 80%, 최소한 90%, 최소한 95%, 최소한 98%, 최소한 99%, 또는 99% 이상의 아미노산 서열 동일성을 가지는 아미노산 서열을 포함한다. 일부 사례들에서, 본 발명의 조성물 또는 방법에서 사용되는 Cas9 폴리펩티드는 스타필로코쿠스 아우레우스 Cas9 (saCas9) 폴리펩티드이다. 일부 사례들에서, saCas9 폴리펩티드는 도 19에 도시된 saCas9 아미노산 서열에 대해 최소한 85%, 최소한 90%, 최소한 95%, 최소한 98%, 최소한 99%, 또는 100%, 아미노산 서열 동일성을 가지는 아미노산 서열을 포함한다.
일부 사례들에서, 적합한 Cas9 폴리펩티드는 도 18A에 도시된 스트렙토코쿠스 피오게네스 Cas9에 대해 최소한 50%, 최소한 60%, 최소한 70%, 최소한 80%, 최소한 90%, 최소한 95%, 최소한 98%, 최소한 99%, 또는 99% 이상의 아미노산 서열 동일성을 가지는 아미노산 서열을 포함하지만, K848A, K1003A, 및 R1060A 치환을 가진다. Slaymaker 외. (2016) Science 351: 84-88. 일부 사례들에서, 적합한 Cas9 폴리펩티드는 도 18E에 도시된 아미노산 서열을 포함한다. 적합한 Cas9 폴리펩티드는 도 18A-18F 중 어느 하나에 도시된 아미노산 서열을 포함한다.
일부 사례들에서, 적합한 Cas9 폴리펩티드는 고-충실도 (HF) Cas9 폴리펩티드이다. Kleinstiver 외. (2016) Nature 529:490. 예를 들면, 도 18A에 도시된 아미노산 서열의 아미노산 N497, R661, Q695, 및 Q926은, 예컨대, 알라닌으로 치환된다. 예를 들면, HF Cas9 폴리펩티드는 도 18A에 도시된 아미노산 서열에 대해 최소한 90%, 최소한 95%, 최소한 98%, 최소한 99%, 또는 100%, 아미노산 서열 동일성을 가지는 아미노산 서열을 포함할 수 있으며, 이 때 아미노산 N497, R661, Q695, 및 Q926은, 예컨대, 알라닌으로 치환된다. 일부 사례들에서, 적합한 Cas9 폴리펩티드는 도 18F에 도시된 아미노산 서열을 포함한다.
일부 사례들에서, 적합한 Cas9 폴리펩티드는 변경된 PAM 특이성을 나타낸다. 예컨대, Kleinstiver 외 (2015) Nature 523:481을 참고하라.
일부 사례들에서, 게놈-편집 엔도뉴클레아제는 유형 V CRISPR/Cas 엔도뉴클레아제이다. 일부 사례들에서 유형 V CRISPR/Cas 엔도뉴클레아제는 Cpf1 단백질이다. 일부 사례들에서, Cpf1 단백질은 도 20A에 도시된 Cpf1 아미노산 서열에 대해 최소한 30%, 최소한 35%, 최소한 40%, 최소한 45%, 최소한 50%, 최소한 55%, 최소한 60%, 최소한 65%, 최소한 70%, 최소한 75%, 최소한 80%, 최소한 85%, 최소한 90%, 최소한 95%, 최소한 90%, 또는 100%, 아미노산 서열 동일성을 가지는 아미노산 서열을 포함한다. 일부 사례들에서, Cpf1 단백질은 도 20B에 도시된 Cpf1 아미노산 서열에 대해 최소한 30%, 최소한 35%, 최소한 40%, 최소한 45%, 최소한 50%, 최소한 55%, 최소한 60%, 최소한 65%, 최소한 70%, 최소한 75%, 최소한 80%, 최소한 85%, 최소한 90%, 최소한 95%, 최소한 90%, 또는 100%, 아미노산 서열 동일성을 가지는 아미노산 서열을 포함한다. 일부 사례들에서, Cpf1 단백질은 도 20C에 도시된 Cpf1 아미노산 서열에 대해 최소한 30%, 최소한 35%, 최소한 40%, 최소한 45%, 최소한 50%, 최소한 55%, 최소한 60%, 최소한 65%, 최소한 70%, 최소한 75%, 최소한 80%, 최소한 85%, 최소한 90%, 최소한 95%, 최소한 90%, 또는 100%, 아미노산 서열 동일성을 가지는 아미노산 서열을 포함한다.
효소적 불활성화 RNA-가이드된 엔도뉴클레아제
감소된 효소 활성을 가지는 RNA-가이드된 엔도뉴클레아제 또한 사용하기에 적합하다. 이러한 RNA-가이드된 엔도뉴클레아제는 "사멸" RNA-가이드된 엔도뉴클레아제로 지칭되며; 예를 들면, 실질적으로 엔도뉴클레아제 활성을 전혀 나타내지 않도록, 그러나 가이드 RNA와 복합체를 형성시에 표적 핵산에 여전히 결합하도록 하는 특정 아미노산 치환들을 포함하는 Cas9 폴리펩티드는, "사멸" Cas9 또는 "dCas9"로서 지칭된다. 일부 사례들에서, "사멸" Cas9 단백질은 이중 가닥 표적 핵산의 상보적 및 비-상보적 가닥 모두의 절단 능력이 감소된다. 예를 들면, "뉴클레아제 결손" Cas9는 기능하는 RuvC 도메인이 없고 (즉, 이중 가닥 표적 DNA의 비-상보적 가닥을 절단하지 않음) 기능하는 HNH 도메인이 없다 (즉, 이중 가닥 표적 DNA의 상보적 가닥을 절단하지 않음). 비-제한적 예로서, 일부 사례들에서, 뉴클레아제 결손 Cas9 단백질은 서열 번호: 40의 잔기 D10 및 H840 (예컨대, D10A 및 H840A)에 상응하는 아미노산 위치들 (또는 Cas9의 상동체의 상응하는 잔기들)에서 돌연변이를 보유하여, 이러한 폴리펩티드는 표적 핵산의 상보적 및 비-상보적 가닥들 모두를 절단하는 능력이 감소된다 (예컨대, 절단하지 않는다). 이러한 Cas9 단백질은 표적 핵산 (예컨대, 단일 가닥 또는 이중 가닥 표적 핵산)을 절단하는 능력이 감소되지만 표적 핵산에 결합하는 능력은 유지한다. (예컨대, 예컨대, RuvC의 촉매 도메인들 및 HNH 도메인들에서의 하나 이상의 돌연변이로 인해) 표적 핵산을 절단할 수 없는 Cas9 단백질은 "뉴클레아제 결손 Cas9", "사멸 Cas9" 또는 간단히 "dCas9"로 지칭된다. 다른 잔기들이 돌연변이 되어 상기 효과를 구현할 수 있다 (즉, 하나 또는 또 다른 뉴클레아제 부위들을 불활성화). 비-제한적 예로서, 스트렙토코쿠스 피오게네스 Cas9의 잔기 D10, G12, G17, E762, H840, N854, N863, H982, H983, A984, D986, 및/또는 A987 (또는 Cas9 상동체의 상응하는 아미노산)은 변경 (즉, 치환) 될 수 있다. 일부 사례들에서, 스트렙토코쿠스 피오게네스 Cas9 의 D10, E762, H840, N854, N863, 및 D986 (또는 Cas9 상동체의 상응하는 아미노산) 중 둘 이상이 치환된다. 일부 사례들에서, 스트렙토코쿠스 피오게네스 Cas9의 D10 및 N863 (또는 Cas9 상동체의 상응하는 아미노산)은 Ala으로 치환된다. 또한, 알라닌 치환들 이외의 돌연변이가 적합하다.
일부 사례들에서, 게놈-편집 엔도뉴클레아제는 Cas9-상승작용적 활성화 매개인자 (Cas9-SAM)로 공지된 RNA-가이드된 엔도뉴클레아제 (그리고 상응하는 가이드 RNA)이다. Cas9-SAM 시스템의 RNA-가이드된 엔도뉴클레아제 (예컨대, Cas9)는 전사 활성화 도메인 (이 때 적합한 전사 활성화 도메인들은, 예컨대, VP64, p65, MyoD1, HSF1, RTA, 및 SET7/9를 포함한다) 또는 전사 억제인자 도메인 (이 때 적합한 전사 억제인자 도메인들은, 예컨대, KRAB 도메인, NuE 도메인, NcoR 도메인, SID 도메인, 및 SID4X 도메인을 포함한다)에 융합된 "사멸" Cas9이다. Cas9-SAM 시스템의 가이드 RNA는 전사 활성화인자 도메인 (예컨대, VP64, p65, MyoD1, HSF1, RTA, 또는 SET7/9) 또는 전사 억제인자 도메인 (예컨대, KRAB 도메인, NuE 도메인, NcoR 도메인, SID 도메인, 또는 SID4X 도메인)에 융합된 어댑터 단백질에 결합하는 루프를 포함한다. 예를 들면, 일부 사례들에서, 가이드 RNA는 sgRNA의 하나 또는 두 개의 루프들에 삽입된 MS2 RNA 압타머를 포함하는 단일-가이드 RNA이고; dCas9는 VP64에 융합된 dCas9를 포함하는 융합 폴리펩티드이고; 그리고 어댑터/기능적 단백질은 다음을 포함하는 융합 폴리펩티드이다: i) MS2; ii) p65; 및 iii) HSF1. 예컨대, 미국 공개 특허출원 제 2016/0355797을 참고하라.
다음을 포함하는 키메라 폴리펩티드 또한 사용하기에 적합하다: a) 사멸 RNA-가이드된 엔도뉴클레아제; 및 b) 이종 융합 폴리펩티드. 적합한 이종 융합 폴리펩티드의 예들은, 예컨대, 메틸화효소 활성, 탈메틸화효소 활성, 전사활성화 활성, 전사 억제 활성, 전사 방출 인자 활성, 히스톤 변형 활성, RNA 절단 활성, DNA 절단 활성, DNA 통합 활성, 또는 핵산 결합 활성을 가지는 폴리펩티드를 포함한다.
가이드 RNA
클래스 2 CRISPR/Cas 엔도뉴클레아제 (예컨대, Cas9 단백질; 유형 V 또는 유형 VI CRISPR/Cas 단백질; Cpf1 단백질; 등)에 결합하여 해당 복합체를 표적 핵산 내부의 특정 위치로 표적하는 핵산은 본 명세서에서 "가이드 RNA" 또는 "CRISPR/Cas 가이드 핵산" 또는 "CRISPR/Cas 가이드 RNA"로 지칭된다. 가이드 RNA는 표적 핵산의 서열에 상보적인 뉴클레오티드 서열인, 가이드 서열 (또한 본 명세서에서 표적화 서열로도 지칭됨)을 포함하는 표적화 분절을 포함함으로써, 상기 복합체 (RNP 복합체)에 대한 표적 특이성을 제공한다.
일부 사례들에서, 가이드 RNA는 2개의 별도의 핵산 분자들: "활성화인자" 및 "표적자"를 포함하며 본 명세서에서 "이중 가이드 RNA", "이중-분자 가이드 RNA", "2-분자 가이드 RNA", 또는 "dgRNA"로 지칭된다. 일부 사례들에서, 가이드 RNA는 하나의 분자이고 (예컨대, 일부 클래스 2 CRISPR/Cas 단백질에 있어서, 상응하는 가이드 RNA는 단일 분자이고; 일부 사례들에서, 활성화인자 및 표적자는 서로에 공유적으로 결합되고, 예컨대, 중간 뉴클레오티드를 통해), 및 가이드 RNA는 "단일 가이드 RNA", "단일-분자 가이드 RNA", "1-분자 가이드 RNA", 또는 간단히 "sgRNA"로 지칭된다.
이 때 유전자 생성물은 RNA-가이드된 엔도뉴클레아제이거나, RNA-가이드된 엔도뉴클레아제 및 가이드 RNA 모두이고 유전자 생성물은 표적 핵산을 변형시킬 수 있다. 일부 사례들에서, 예컨대, 표적 핵산이 결손 대립유전자에서 결실 돌연변이 (예컨대, 신경 세포 표적 핵산에서의 결실 돌연변이)를 포함하는 경우, RNA-가이드된 엔도뉴클레아제/가이드 RNA 복합체는, 결실 돌연변이를 교정하는 뉴클레오티드 서열을 포함하는 공여자 핵산 (예컨대, 결손 대립유전자에 의해 인코드되는 단백질의 기능적 카피를 인코드하는 뉴클레오티드 서열을 포함하는 공여자 핵산)과 함께, 예컨대, 상동성-유도된 복구 (HDR)를 통해 결실 돌연변이를 교정하기 위해 사용될 수 있다.
일부 사례들에서, 유전자 생성물들은 RNA-가이드된 엔도뉴클레아제 및 2개의 별도의 sgRNA이며, 이 때 2개의 별도 sgRNA는 비-상동성 말단 결합 (NHEJ)에 의해 표적 핵산의 결실을 제공한다.
일부 사례들에서, 유전자 생성물은 다음과 같다: i) RNA-가이드된 엔도뉴클레아제; 및 ii) 하나의 가이드 RNA. 일부 사례들에서, 가이드 RNA는 단일-분자 (또는 "단일 가이드") 가이드 RNA ("sgRNA")이다. 일부 사례들에서, 가이드 RNA는 이중-분자 (또는 "이중-가이드") 가이드 RNA ("dgRNA")이다.
일부 사례들에서, 유전자 생성물들은 i) RNA-가이드된 엔도뉴클레아제; 및 ii) 2개의 별도의 sgRNA이며, 이 때 2개의 별도 sgRNA는 비-상동성 말단 결합 (NHEJ)에 의해 표적 핵산의 결실을 제공한다. 일부 사례들에서, 가이드 RNA는 sgRNA이다. 일부 사례들에서, 가이드 RNA는 dgRNA이다.
일부 사례들에서, 유전자 생성물은: i) Cpf1 폴리펩티드; 및 ii) 가이드 RNA 전구물질이며; 이 사례들에서, 전구물질은 Cpf1 폴리펩티드에 의해 절단되어 2 이상의 가이드 RNA를 생성할 수 있다.
본 발명은 개체의 뉴런 세포에서 표적 핵산의 변형 방법을 제공하며, 이 때 표적 핵산은 결실 돌연변이를 포함하고, 이 방법은 개체에게 본 발명의 rAAV 비리온을 투여하는 것을 포함하고, 여기서 rAAV 비리온은 다음을 포함하는 이종 핵산을 포함한다: i) RNA-가이드된 엔도뉴클레아제 (예컨대, Cas9 엔도뉴클레아제)를 인코드하는 뉴클레오티드 서열; ii) 표적 핵산에 상보적인 뉴클레오티드 서열을 포함하는 sgRNA를 인코드하는 뉴클레오티드 서열; 및 iii) 결실 돌연변이를 교정하는 뉴클레오티드 서열을 포함하는 공여자 DNA 주형을 인코드하는 뉴클레오티드 서열. rAAV 비리온의 투여는 HDR에 의해 표적 핵산 내 결실 돌연변이를 교정시킨다.
본 발명은 개체의 뉴런 세포에서 표적 핵산의 변형 방법을 제공하며, 이 때 표적 핵산은 결실 돌연변이를 포함하고, 이 방법은 개체에게 본 발명의 rAAV 비리온을 투여하는 것을 포함하고, 여기서 rAAV 비리온은 다음을 포함하는 이종 핵산을 포함한다: i) RNA-가이드된 엔도뉴클레아제 (예컨대, Cas9 엔도뉴클레아제)를 인코드하는 뉴클레오티드 서열; ii) 표적 핵산 내 제 1 서열에 상보적인 뉴클레오티드 서열을 포함하는 sgRNA를 인코드하는 뉴클레오티드 서열; 및 iii) 표적 핵산 내 제 2 서열에 상보적인 뉴클레오티드 서열을 포함하는 제 2 sgRNA를 인코드하는 뉴클레오티드 서열. rAAV 비리온의 투여는 NHEJ에 의해 표적 핵산 내 결실 돌연변이를 절삭한다.
본 발명은 개체의 신경 줄기 세포에서 표적 핵산의 변형 방법을 제공하며, 이 때 표적 핵산은 결실 돌연변이를 포함하고, 이 방법은 개체에게 본 발명의 rAAV 비리온을 투여하는 것을 포함하고, 여기서 rAAV 비리온은 다음을 포함하는 이종 핵산을 포함한다: i) RNA-가이드된 엔도뉴클레아제 (예컨대, Cas9 엔도뉴클레아제)를 인코드하는 뉴클레오티드 서열; ii) 표적 핵산에 상보적인 뉴클레오티드 서열을 포함하는 sgRNA를 인코드하는 뉴클레오티드 서열; 및 iii) 결실 돌연변이를 교정하는 뉴클레오티드 서열을 포함하는 공여자 DNA 주형을 인코드하는 뉴클레오티드 서열. rAAV 비리온의 투여는 HDR에 의해 표적 핵산 내 결실 돌연변이를 교정시킨다.
본 발명은 개체의 신경 줄기 세포에서 표적 핵산의 변형 방법을 제공하며, 이 때 표적 핵산은 결실 돌연변이를 포함하고, 이 방법은 개체에게 본 발명의 rAAV 비리온을 투여하는 것을 포함하고, 여기서 rAAV 비리온은 다음을 포함하는 이종 핵산을 포함한다: i) RNA-가이드된 엔도뉴클레아제 (예컨대, Cas9 엔도뉴클레아제)를 인코드하는 뉴클레오티드 서열; ii) 표적 핵산 내 제 1 서열에 상보적인 뉴클레오티드 서열을 포함하는 sgRNA를 인코드하는 뉴클레오티드 서열; 및 iii) 표적 핵산 내 제 2 서열에 상보적인 뉴클레오티드 서열을 포함하는 제 2 sgRNA를 인코드하는 뉴클레오티드 서열. rAAV 비리온의 투여는 NHEJ에 의해 표적 핵산 내 결실 돌연변이를 절삭한다.
제약학적 조성물
본 발명은 다음을 포함하는 제약학적 조성물을 제공한다: a) 상기 기재한 바와 같은 대상 rAAV 비리온; 및 b) 제약학적으로 허용가능한 담체, 희석제, 부형제, 또는 완충제. 일부 사례들에서, 제약학적으로 허용가능한 담체, 희석제, 부형제, 또는 완충제는 인간에 사용하기에 적합하다.
이러한 부형제, 담체, 희석제, 및 완충제는 과도한 독성없이 투여될 수 있는 임의의 제약학적 물질을 포함한다. 제약학적으로 허용가능한 부형제들에는, 액체, 가령, 물, 식염수, 글리세롤 및 에탄올이 포함되나 이에 제한되는 것은 아니다. 제약학적으로 허용가능한 염, 예를 들면, 무기산 염, 가령, 염산염, 브롬산염, 인산염, 황산염, 등; 그리고 유기산의 염, 가령, 아세트산염, 프로피온산염, 말론산염, 벤조산염, 등이 제약학적 조성물에 포함될 수 있다. 추가적으로, 보강 물질, 가령, 습윤 또는 유화제, pH 완충 물질, 등이 이러한 비히클에 존재할 수 있다. 널리 다양한 제약학적으로 허용가능한 부형제들이 해당 분야에 공지되어 있으므로 본 명세서에서 상세히 논의할 필요는 없다. 제약학적으로 허용가능한 부형제들은, 예를 들면, A. Gennaro (2000) "Remington: The Science and Practice of Pharmacy," 20th edition, Lippincott, Williams, & Wilkins; Pharmaceutical Dosage Forms and Drug Delivery Systems (1999) H.C. Ansel 외, eds., 7th ed., Lippincott, Williams, & Wilkins; and Handbook of Pharmaceutical Excipients (2000) A.H. Kibbe 외, eds., 3rd ed. Amer. Pharmaceutical Assoc를 비롯한 여러 간행물들에 상세히 기재되어 있다.
방법
유전자 생성물의 전달 방법
본 발명은 개체의 뉴런 세포에 유전자 생성물을 전달하는 방법을 제공하며, 이 방법은 상기 기재한 대상 rAAV 비리온을 개체에 투여하는 것을 포함한다. 유전자 생성물은 상기 기재된 바와 같은 폴리펩티드 또는 간섭 RNA (예컨대, shRNA, siRNA, 등), 압타머, 또는 부위-특이적 엔도뉴클레아제 (예컨대, RNA-가이드된 엔도뉴클레아제)일 수 있다. 유전자 생성물을 뉴런 세포에 전달하는 것은 신경 질환의 치료를 제공할 수 있다.
본 발명은 뉴런 세포에서 표적 핵산을 변형시키는 방법을 제공하며, 이 방법은 뉴런 세포를 다음과 접촉시키는 것을 포함한다: 1) 본 발명의 rAAV 비리온, 이 때 rAAV 비리온은 가이드 RNA에 결합하는 RNA-가이드된 엔도뉴클레아제를 인코드하는 뉴클레오티드 서열을 포함하는 이종 핵산; 및 2) 가이드 RNA를 포함한다. 본 발명은 뉴런 세포에서 표적 핵산을 변형시키는 방법을 제공하며, 이 방법은 본 발명의 rAAV 비리온과 뉴런 세포를 접촉시키는 것을 포함하고, 이 때 rAAV 비리온은 다음을 인코드하는 뉴클레오티드 서열을 포함하는 이종 핵산을 포함한다: i) 가이드 RNA에 결합하는 RNA-가이드된 엔도뉴클레아제; 및 ii) 가이드 RNA. 일부 사례들에서, 상기 방법은 뉴런 세포를 공여자 DNA 주형과 접촉시키는 것을 포함한다. 일부 사례들에서, RNA-가이드된 엔도뉴클레아제는 Cas9 폴리펩티드이다. 일부 사례들에서, 가이드 RNA는 단일-가이드 RNA이다.
본 발명은 개체의 NSC 세포에 유전자 생성물을 전달하는 방법을 제공하며, 이 방법은 상기 기재한 대상 rAAV 비리온을 개체에 투여하는 것을 포함한다. 유전자 생성물은 상기 기재된 바와 같은 폴리펩티드 또는 간섭 RNA (예컨대, shRNA, siRNA, 등), 압타머, 또는 부위-특이적 엔도뉴클레아제 (예컨대, RNA-가이드된 엔도뉴클레아제)일 수 있다. 유전자 생성물을 NSC에 전달하는 것은 신경 질환의 치료를 제공할 수 있다.
본 발명은 NSC에서 표적 핵산을 변형시키는 방법을 제공하며, 이 방법은 신경 줄기 세포를 다음과 접촉시키는 것을 포함한다: 1) 본 발명의 rAAV 비리온, 이 때 rAAV 비리온은 가이드 RNA에 결합하는 RNA-가이드된 엔도뉴클레아제를 인코드하는 뉴클레오티드 서열을 포함하는 이종 핵산; 및 2) 가이드 RNA를 포함한다. 본 발명은 NSC에서 표적 핵산을 변형시키는 방법을 제공하며, 이 방법은 본 발명의 rAAV 비리온과 NSC를 접촉시키는 것을 포함하고, 이 때 rAAV 비리온은 다음을 인코드하는 뉴클레오티드 서열을 포함하는 이종 핵산을 포함한다: i) 가이드 RNA에 결합하는 RNA-가이드된 엔도뉴클레아제; 및 ii) 가이드 RNA. 일부 사례들에서, 상기 방법은 NSC를 공여자 DNA 주형과 접촉시키는 것을 포함한다. 일부 사례들에서, RNA-가이드된 엔도뉴클레아제는 Cas9 폴리펩티드이다. 일부 사례들에서, 가이드 RNA는 단일-가이드 RNA이다.
본 발명은 신경 질환 (예컨대, 신경 질환) 치료 방법을 제공하며, 이 방법은 상기 기재된 유효량의 대상 rAAV 비리온을 필요로 하는 개체에 투여하는 것을 포함한다. 대상 rAAV 비리온은 두개내 주사를 통해, 또는 임의의 다른 용이한 투여 방식 또는 경로에 의해 투여될 수 있다. 다른 용이한 투여 방식 또는 경로는, 예컨대, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 등을 포함한다.
"치료적 유효량"은 실험 및/또는 임상 시험을 통해 결정될 수 있으며 비교적 넓은 범위에 속할 것이다. 예를 들면, 생체내 주사, 즉, 뇌로의 직접 주사에 있어서, 치료적 유효 용량은 약 106 내지 약 1015개 rAAV 비리온, 예컨대, 약 108 내지 1012개 rAAV 비리온 규모일 것이다. 시험관내 형질도입에 있어서, 세포로 전달되는 rAAV 비리온의 유효량은 약 108 내지 약 1013개의 rAAV 비리온 규모가 될 것이다. 그밖의 유효 투여량은 해당 분야의 숙련된 기술자가 용량 반응 곡선을 생성하는 관례적인 시험들을 통해 용이하게 정할 수 있다.
일부 사례들에서, 원하는 유전자 발현 수준을 구현하기 위하여 1회 이상의 투여 (예컨대, 2, 3, 4, 또는 그 이상의 투여)가 이용될 수 있다. 일부 사례들에서, 1회 이상의 투여는 다양한 간격, 예컨대, 매일, 매주, 월 2회, 매월, 3개월 마다, 6개월 마다, 매년 등으로 투여된다. 일부 사례들에서, 1 개월 내지 2 개월, 2 개월 내지 4 개월, 4 개월 내지 8 개월, 8 개월 내지 12 개월, 1년 내지 2년, 2년 내지 5년, 또는 5년 이상의 시기에 걸쳐 다회 투여가 투여된다.
신경학적 질환 또는 장애의 치료 방법
본 발명의 방법을 사용하여 치료될 수 있는 신경학적 질환들에는 중추 신경계 (CNS)의 신경학적 질환 및 장애, 및 말초 신경계 (PNS)의 신경학적 질환 및 장애가 포함된다.
신경학적 질환 및 장애에는 미만성 축삭 손상, 주산기 저산소 허혈성 손상, 외상성 뇌 손상, 뇌졸중, 허혈성 경색, 색전증, 및 고혈압 출혈; CNS 독소에의 노출, 세균성 수막염과 같은 중추 신경계의 감염; 저산소성-허혈성 뇌병증, 말초 신경병증 및 글리코겐 저장 질환과 같은 대사성 질환; 또는 다발성 경화증, 루이소체 치매, 알츠하이머 병, 파킨슨 병 및 헌팅턴병을 비롯한 (그러나 이에 제한되는 것은 아님) 만성 신경 손상 또는 신경퇴행성 질환이 포함되지만 이에 제한되는 것은 아니다.
신경학적 질환 및 장애에는 파킨슨 병, 알츠하이머 병, 헌팅턴병, 근위축 측삭 경화증, 프리드라이히 (Friedreich) 운동실조증, 루이소체병, 척수근 위축증, 다계통 위축증, 치매, 정신 분열증, 마비, 다발성 경화증, 척수 손상, 뇌 손상, 뇌신경 장애, 말초 감각 신경병증, 간질, 프리온 장애, 피질기저핵 변성증, 벨 마비, 길랭-바레 증후군, 픽 병, 레트 증후군, 전두엽 치매, 및 자폐증이 포함되나 이에 제한되는 것은 아니다. .
PNS의 신경학적 질환 및 장애에는, 예컨대, 당뇨 신경병증; 다발신경병증; 만성 염증성 탈수초 다발신경병증 (CIPD); 등이 포함된다.
본 발명은 신경 장애 치료 방법을 제공한다. 일부 사례들에서, 상기 방법은 본 발명의 rAAV 비리온, 또는 본 발명의 rAAV 비리온을 포함하는 조성물을, 필요로 하는 개체의 뇌에 투여하는 것을 포함한다.
해당 분야의 숙련된 기술자는 하나 이상의 매개변수들, 가령, 신경학적 질환 또는 장애와 연관된 증상들에 대한 효과를 테스트함으로써 rAAV 비리온의 유효량을 용이하게 결정할 수 있다. 일부 사례들에서, 본 발명의 유효량의 rAAV 비리온을 투여하는 것은 뇌 기능, 해부학적 완전성, 또는 뇌 건강의 소실 속도를 감소, 예컨대, 소실 속도를 2-배, 3-배, 4-배, 또는 5-배 또는 그 이상 감소시키며, 그에 따른 질환 진행은, 예컨대, 소실 및 그에 따른 질환 진행 속도를 10-배 또는 그 이상 감소시킨다. 일부 사례들에서, 본 발명의 유효량의 rAAV 비리온 투여는 뇌 기능의 증가, 뇌 해부학 또는 건강에 있어서의 개선, 및/또는 뇌 기능에 있어서의 안정화, 예컨대, 뇌 기능, 뇌 해부학 또는 건강에 있어서, 2-배, 3-배, 4-배 또는 5-배 또는 그 이상의 개선, 예컨대, 뇌 기능, 뇌 해부학 또는 건강, 및/또는 뇌 안정화에 있어서 10-배 또는 그 이상의 개선을 가져온다.
핵산 및 숙주 세포
본 발명은 상기 기재한 바와 같은 본 발명의 변이체 아데노-연관 바이러스 (AAV) 캡시드 단백질을 인코드하는 뉴클레오티드 서열을 포함하는 단리된 핵산을 제공한다.
본 발명의 재조합 AAV 벡터는 상기 기재한 바와 같은 본 발명의 재조합 AAV 비리온을 생성하기 위해 사용될 수 있다. 그러므로, 본 발명은 적합한 세포 내에 도입될 때, 본 발명의 재조합 AAV 비리온의 제조를 제공할 수 있는 재조합 AAV 벡터를 제공한다.
본 발명은 숙주 세포들, 예컨대, 본 발명의 핵산을 포함하는 단리된 (유전자 변형된) 숙주 세포들을 추가로 제공한다. 본 발명의 숙주 세포는 단리된 세포, 예컨대, 시험관내 배양물 내 세포일 수 있다. 본 발명의 숙주 세포는 하기 기재되는 본 발명의 rAAV 비리온을 제조함에 유용하다. 본 발명의 숙주 세포가 본 발명의 rAAV 비리온을 제조하기 위해 사용될 때, 이는 "패키징 세포"로 지칭된다. 일부 사례들에서, 본 발명의 숙주 세포는 본 발명의 핵산으로 안정하게 유전자 변형된다. 다른 사례들에서, 본 발명의 숙주 세포는 본 발명의 핵산으로 일시적으로 유전자 변형된다.
본 발명의 핵산은 전기천공, 칼슘 포스페이트 침전, 리포좀-매개된 형질감염, 등을 비롯한 (그러나 이에 제한되는 것은 아님) 기존의 기술들을 사용하여 숙주 세포 내부에 안정하게 또는 일시적으로 도입된다. 안정한 형질전환을 위해, 본 발명의 핵산은 일반적으로 선별 표지자, 예컨대, 몇 가지 널리 공지된 선별 표지자 중 하나, 가령, 네오마이신 저항성, 등을 추가로 포함할 것이다.
본 발명의 숙주 세포는 임의의 다양한 세포들, 예컨대, 쥐과 세포, 및 영장류 세포 (예컨대, 인간 세포)를 비롯한 예컨대, 포유동물 세포들 중 어느 하나에 본 발명의 핵산을 도입함으로써 생성된다. 적합한 포유동물 세포들에는, 일차 세포 및 세포주들이 포함되나 이에 제한되는 것은 아니며, 이 때 적합한 세포주들에는, 293 세포, COS 세포, HeLa 세포, Vero 세포, 3T3 생쥐 섬유모세포, C3H10T1/2 섬유모세포, CHO 세포, 등이 포함되나 이에 제한되는 것은 아니다. 적합한 숙주 세포들의 비-제한적 예들에는, 예컨대, HeLa 세포 (예컨대, 미국 균주 은행(American Type Culture Collection, ATCC) No. CCL-2), CHO 세포 (예컨대, ATCC Nos. CRL9618, CCL61, CRL9096), 293 세포 (예컨대, ATCC No. CRL-1573), Vero 세포, NIH 3T3 세포 (예컨대, ATCC No. CRL-1658), Huh-7 세포, BHK 세포 (예컨대, ATCC No. CCL10), PC12 세포 (ATCC No. CRL1721), COS 세포, COS-7 세포 (ATCC No. CRL1651), RAT1 세포, 생쥐 L 세포 (ATCC No. CCLI.3), 인간 배아 신장 (HEK) 세포 (ATCC No. CRL1573), HLHepG2 세포, 등이 포함된다. 본 발명의 숙주 세포는 또한 AAV를 생성하는 곤충 세포, 가령, Sf9 세포들을 감염시키기 위하여 배큘로바이러스를 사용하여 제조될 수도 있다 (예컨대, 미국 특허 제 7,271,002; 미국 특허 출원 12/297,958 참고).
일부 사례들에서, 본 발명의 유전자 변형 숙주 세포는, 상기 기재한 바와 같은 변종 AAV 캡시드 단백질을 인코드하는 뉴클레오티드 서열을 포함하는 핵산 이외에도, 하나 이상의 AAV 렙 단백질들을 인코드하는 뉴클레오티드 서열을 포함하는 핵산을 포함한다. 다른 사례들에서, 본 발명의 숙주 세포는 rAAV 벡터를 추가로 포함한다. rAAV 비리온은 본 발명의 숙주 세포를 사용하여 생성될 수 있다. rAAV 비리온의 생성 방법들은 예컨대, 미국 공개 특허출원 제 2005/0053922 및 미국 공개 특허출원 제 2009/0202490에 기재되어 있다.
본 발명의 비-제한적 양상들의 예
상기 기재된 본 발명의 구체예들을 비롯한 양상들은 단독으로 또는 하나 이상의 다른 양상들 또는 구체예들과 조합시 유리할 수 있다. 전술한 설명을 제한함이 없이, 번호 1-65의 본 발명의 특정한 비-제한적 양상들이 이하에서 제공된다. 해당 분야의 숙련된 기술자가 본 명세서를 읽을 때 자명하게 알게 되는 바와 같이, 개개 번호의 양상들 각각은 이전 또는 이후의 개개 번호의 양상들 중 어느 하나와 함께 사용되거나 조합될 수 있다. 이러한 예는 이러한 양상들의 조합 모두에 대한 뒷받침을 제공하고자 하는 것이며 양상들의 조합은 명백하게 이하에 제공되는 것에 제한되지 않는다:
양상 1. 다음을 포함하는 재조합 아데노-연관 바이러스 (rAAV) 비리온: a) 변이체 AAV 캡시드 단백질, 이 때 변이체 AAV 캡시드 단백질은 최소한 3가지 상이한 AAV 혈청형의 최소한 5개 분절들을 포함하고, 이 때 각 분절은 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지며, 이 때 변이체 캡시드 단백질은 다음 성질들 중 하나 이상을 부여하고: i) 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온에 의한 신경 줄기 세포의 감염력에 비해 신경 줄기 세포의 증가된 감염력; ii) 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온에 의한 뉴런의 감염력에 비해 뉴런의 증가된 감염력; 및 iii) 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온이 나타내는 내성에 비해 인간 AAV 중화 항체들에 대한 증가된 내성; 및 b) 이종 유전자 생성물을 인코드하는 뉴클레오티드 서열을 포함하는 이종 핵산.
양상 2. 양상 1에 있어서, 상기 변이체 AAV 캡시드 단백질은, N-말단에서 C-말단 순서로 다음을 포함하는 rAAV 비리온: 제 1 AAV 혈청형의 아미노산 1-160의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 1 분절; 제 2 AAV 혈청형의 아미노산 51-320의 약 50 아미노산 내지 약 160 아미노산 길이를 가지는 제 2 분절; 제 3 AAV 혈청형의 아미노산 101-480의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 3 분절; 제 2 AAV 혈청형의 아미노산 151-640의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 4 분절; 및 제 2 AAV 혈청형의 아미노산 201부터 C-말단까지의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 5 분절.
양상 3. 양상 2에 있어서, 제 1 AAV 혈청형은 AAV6인 rAAV 비리온.
양상 4. 양상 2에 있어서, 제 2 AAV 혈청형은 AAV9인 rAAV 비리온.
양상 5. 양상 2에 있어서, 제 3 AAV 혈청형은 AAV8인 rAAV 비리온.
양상 6. 양상 1에 있어서, 상기 변이체 AAV 캡시드 단백질은, N-말단에서 C-말단 순서로 다음을 포함하는 rAAV 비리온: 제 1 AAV 혈청형의 아미노산 1-160의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 1 분절; 제 2 AAV 혈청형의 아미노산 51-320의 약 50 아미노산 내지 약 160 아미노산 길이를 가지는 제 2 분절; 제 3 AAV 혈청형의 아미노산 101-480의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 3 분절; 제 2 AAV 혈청형의 아미노산 151-640의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 4 분절; 및 제 4 AAV 혈청형의 아미노산 201부터 C-말단까지의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 5 분절.
양상 7. 양상 6에 있어서, 제 1 AAV 혈청형은 AAV6인 rAAV 비리온.
양상 8. 양상 6에 있어서, 제 2 AAV 혈청형은 AAV9인 rAAV 비리온.
양상 9. 양상 6에 있어서, 제 3 AAV 혈청형은 AAV8인 rAAV 비리온.
양상 10. 양상 6에 있어서, 제 4 AAV 혈청형은 AAV2인 rAAV 비리온.
양상 11. 양상 1에 있어서, 상기 변이체 AAV 캡시드 단백질은, N-말단에서 C-말단의 순서로 다음을 포함하는 rAAV 비리온: 제 1 AAV 혈청형의 아미노산 1-160의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 1 분절; 제 2 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 2 분절; 제 3 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 3 분절; 제 2 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 4 분절; 제 2 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 5 분절; 제 4 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 6 분절; 제 2 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 7 분절; 및 제 2 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 8 분절.
양상 12. 양상 11에 있어서, 제 1 AAV 혈청형은 AAV6인 rAAV 비리온.
양상 13. 양상 11에 있어서, 제 2 AAV 혈청형은 AAV9인 rAAV 비리온.
양상 14. 양상 11에 있어서, 제 3 AAV 혈청형은 AAV8인 rAAV 비리온.
양상 15. 양상 11에 있어서, 제 4 AAV 혈청형은 AAV2인 rAAV 비리온.
양상 16. 양상 1에 있어서, 상기 변이체 AAV 캡시드 단백질은, N-말단에서 C-말단의 순서로 다음을 포함하는 rAAV 비리온: 제 1 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 1 분절; 제 2 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 2 분절; 제 3 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 3 분절; 제 2 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 4 분절; 제 4 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 5 분절; 제 4 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 6 분절; 제 2 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 7 분절; 및 제 2 AAV 혈청형의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 8 분절.
양상 17. 양상 16에 있어서, 제 1 AAV 혈청형은 AAV6인 rAAV 비리온.
양상 18. 양상 16에 있어서, 제 2 AAV 혈청형은 AAV9인 rAAV 비리온.
양상 19. 양상 16에 있어서, 제 3 AAV 혈청형은 AAV8인 rAAV 비리온.
양상 20. 양상 16에 있어서, 제 4 AAV 혈청형은 AAV2인 rAAV 비리온.
양상 21. 양상 1에 있어서, 상기 rAAV 비리온은 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온에 의한 신경 세포의 감염력에 비해 최소한 5-배 증가된 신경 세포의 감염력을 나타내는, rAAV 비리온.
양상 22. 양상 21에 있어서, 대조 AAV 비리온은 AAV9인 rAAV 비리온.
양상 23. 양상 21에 있어서, 대조 AAV 비리온은 AAV2인 rAAV 비리온.
양상 24. 양상 1에 있어서, 상기 rAAV 비리온은 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온에 의한 신경 세포의 감염력에 비해 최소한 10-배 증가된 신경 세포의 감염력을 나타내는, rAAV 비리온.
양상 25. 양상 24에 있어서, 대조 AAV 비리온은 AAV9인 rAAV 비리온.
양상 26. 양상 24에 있어서, 대조 AAV 비리온은 AAV2인 rAAV 비리온.
양상 27. 양상 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 서열 번호:1에 제시된 (그리고 도 8에 도시된) 아미노산 서열에 대해 최소한 약 90% 아미노산 서열 동일성을 가지는 아미노산 서열을 포함하는, rAAV 비리온.
양상 28. 양상 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 서열 번호:1에 제시된 (그리고 도 8에 도시된) 아미노산 서열에 대해 최소한 약 95% 아미노산 서열 동일성을 가지는 아미노산 서열을 포함하는, rAAV 비리온.
양상 29. 양상 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 서열 번호:1에 제시된 (그리고 도 8에 도시된) 아미노산 서열을 포함하는, rAAV 비리온.
양상 30. 양상 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 서열 번호:2에 제시된 (그리고 도 9에 도시된) 아미노산 서열에 대해 최소한 약 90% 아미노산 서열 동일성을 가지는 아미노산 서열을 포함하는, rAAV 비리온.
양상 31. 양상 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 서열 번호:2에 제시된 (그리고 도 9에 도시된) 아미노산 서열에 대해 최소한 약 95% 아미노산 서열 동일성을 가지는 아미노산 서열을 포함하는, rAAV 비리온.
양상 32. 양상 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 서열 번호:2에 제시된 (그리고 도 9에 도시된) 아미노산 서열을 포함하는, rAAV 비리온.
양상 33. 양상 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온이 나타내는 내성에 비해 인간 AAV 중화 항체들에 대한 증가된 내성을 나타내는 rAAV 비리온.
양상 34. 양상 34에 있어서, 대조 AAV 비리온은 AAV9인 rAAV 비리온.
양상 35. 양상 34에 있어서, 대조 AAV 비리온은 AAV2인 rAAV 비리온.
양상 36. 양상 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온이 나타내는 내성에 비해 인간 AAV 중화 항체들에 대해 최소한 약 1.5-배 더 큰 내성을 나타내는 rAAV 비리온.
양상 37. 양상 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온이 나타내는 내성에 비해 인간 AAV 중화 항체들에 대해 최소한 약 3-배 더 큰 내성을 나타내는 rAAV 비리온.
양상 38. 양상 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온이 나타내는 내성에 비해 인간 AAV 중화 항체들에 대해 최소한 약 5-배 더 큰 내성을 나타내는 rAAV 비리온.
양상 39. 양상 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온이 나타내는 내성에 비해 인간 AAV 중화 항체들에 대해 최소한 약 10-배 더 큰 내성을 나타내는 rAAV 비리온.
양상 40. 양상 1에 있어서, 상기 신경 줄기 세포는 뇌실하 영역 유래인 rAAV 비리온.
양상 41. 양상 1에 있어서, 상기 푸르킨예 세포는 소뇌 유래인 rAAV 비리온.
양상 42. 양상 1-41 중 어느 하나에 있어서, 유전자 생성물은 간섭 RNA 또는 압타머인 rAAV 비리온.
양상 43. 양상 1-41 중 어느 하나에 있어서, 유전자 생성물은 폴리펩티드인 rAAV 비리온.
양상 44. 양상 43에 있어서, 폴리펩티드는 신경보호성 폴리펩티드, 항-혈관형성 폴리펩티드, 신경 줄기 세포의 분화를 유도하는 폴리펩티드, 또는 신경 줄기 세포의 기능을 향상시키는 폴리펩티드인 rAAV 비리온.
양상 45. 양상 43에 있어서, 폴리펩티드는 세레브로라이신, 라미닌-IKVAV, 크립토 (cripto), 뇌하수체 아데닐레이트 사이클라제-활성화 폴리펩티드, 신경 성장 인자, 뇌 유래 신경영양 인자, 아교세포 유래 신경영양 인자, 섬유모세포 성장 인자 2, 뉴투린, 섬모 신경영양 인자, 표피 성장 인자, 세포자멸의 X-연관 저해제, 또는 소닉 헤지호그 (Sonic hedgehog)인 rAAV 비리온.
양상 46. 양상 43에 있어서, 폴리펩티드는 게놈-편집 효소인 rAAV 비리온.
양상 47. 양상 46에 있어서, 게놈-편집 효소는 Cas9 폴리펩티드, 아연 핑거 뉴클레아제, TALEN, 또는 효소적 불활성 유형 II CRISPR/Cas 폴리펩티드인 rAAV 비리온.
양상 48. 양상 47에 있어서, 폴리펩티드는 유형 II CRISPR/Cas 폴리펩티드, 유형 V CRISPR/Cas 폴리펩티드, 및 유형 VI CRISPR/Cas 폴리펩티드에서 선택된 RNA-가이드된 엔도뉴클레아제인, rAAV 비리온.
양상 49. 양상 1-41 중 어느 하나에 있어서, 유전자 생성물은 RNA-가이드된 엔도뉴클레아제 및 가이드 RNA인, rAAV 비리온.
양상 50. 다음을 포함하는 제약학적 조성물: a) 양상 1-49 중 어느 하나의 재조합 아데노-연관 바이러스 비리온; 및 b) 제약학적으로 허용가능한 부형제.
양상 51. 양상 1-49 중 어느 하나에 따른 재조합 아데노-연관 바이러스 (rAAV) 비리온 또는 양상 50의 조성물을 개체에게 투여하는 것을 포함하는, 개체의 신경 세포에 유전자 생성물을 전달하는 방법.
양상 52. 양상 51에 있어서, 상기 투여는 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 주사에 의한 방법.
양상 53. 양상 51에 있어서, 유전자 생성물은 짧은 간섭 RNA 또는 압타머인 방법.
양상 54. 양상 51에 있어서, 유전자 생성물은 폴리펩티드인 방법.
양상 55. 양상 43에 있어서, 폴리펩티드는 신경보호성 폴리펩티드, 항-혈관형성 폴리펩티드, 또는 신경 줄기 세포의 기능을 향상시키는 폴리펩티드인, 방법.
양상 56. 양상 44에 있어서, 폴리펩티드는 세레브로라이신, 라미닌-IKVAV, 크립토 (cripto), 뇌하수체 아데닐레이트 사이클라제-활성화 폴리펩티드, 신경 성장 인자, 뇌 유래 신경영양 인자, 아교세포 유래 신경영양 인자, 섬유모세포 성장 인자 2, 뉴투린, 섬모 신경영양 인자, 표피 성장 인자, 세포자멸의 X-연관 저해제, 방향족 L-아미노산 디카르복실라제, 글루탐산 디카르복실라제, 트라이펩티딜 펩티다제, 아스파르토아실라제, 또는 소닉 헤지호그 (Sonic hedgehog)인 rAAV 비리온.
양상 57. 양상 54에 있어서, 폴리펩티드는 게놈-편집 효소인 방법.
양상 58. 양상 57에 있어서, 게놈-편집 효소는 Cas9 폴리펩티드, 아연 핑거 뉴클레아제, TALEN, 또는 효소적 불활성 유형 II CRISPR/Cas 폴리펩티드인 방법.
양상 59. 양상 57에 있어서, 폴리펩티드는 유형 II CRISPR/Cas 폴리펩티드, 유형 V CRISPR/Cas 폴리펩티드, 및 유형 VI CRISPR/Cas 폴리펩티드에서 선택된 RNA-가이드된 엔도뉴클레아제인 방법.
양상 60. 양상 51에 있어서, 유전자 생성물은 RNA-가이드된 엔도뉴클레아제 및 가이드 RNA인 방법.
양상 61. 양상 1-49 중 어느 하나에 따른 재조합 아데노-연관 바이러스 (rAAV) 비리온 또는 양상 50의 조성물의 유효량을 필요로 하는 개체에게 투여하는 것을 포함하는, 신경학적 장애 치료 방법.
양상 62. 양상 62에 있어서, 상기 신경학적 장애는 척수소뇌성 실조증, 헌팅턴 병, 파킨슨 병, 알츠하이머 병, 리소좀 축적 장애, 프리드라이히 운동실조증, 교모세포종, 레트 증후군, 전두측두엽 치매, 또는 간질인 방법.
양상 63. 변이체 아데노-연관 바이러스 (AAV) 캡시드 단백질을 인코드하는 뉴클레오티드 서열을 포함하는 단리된 핵산으로서, 이 때 변이체 AAV 캡시드 단백질은 최소한 3가지 상이한 AAV 혈청형의 최소한 5개 분절들을 포함하고, 이 때 각 분절은 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지며, 이 때 변이체 캡시드 단백질은 다음 성질들 중 하나 이상을 부여하는, 단리된 핵산: i) 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온에 의한 신경 줄기 세포의 감염력에 비해 신경 줄기 세포의 증가된 감염력; ii) 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온에 의한 뉴런의 감염력에 비해 뉴런의 증가된 감염력; 및 iii) 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온이 나타내는 내성에 비해 인간 AAV 중화 항체들에 대한 증가된 내성.
양상 64. 양상 63의 핵산을 포함하는, 단리된, 유전자 변형 숙주 세포.
양상 65. 변이체 아데노-연관 바이러스 (AAV) 캡시드 단백질로서, 이 때 변이체 AAV 캡시드 단백질은 최소한 3가지 상이한 AAV 혈청형의 최소한 5개 분절들을 포함하고, 이 때 각 분절은 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지며, 이 때 변이체 캡시드 단백질은 다음 성질들 중 하나 이상을 부여하는, 단리된 핵산: i) 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온에 의한 신경 줄기 세포의 감염력에 비해 신경 줄기 세포의 증가된 감염력; ii) 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온에 의한 뉴런의 감염력에 비해 뉴런의 증가된 감염력; 및 iii) 상응하는 모체 AAV 캡시드 단백질을 포함하는, 또는 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온이 나타내는 내성에 비해 인간 AAV 중화 항체들에 대한 증가된 내성.
실시예
다음의 실시예들은 본 발명을 제조하는 방법 및 사용하는 방법에 관한 완전한 개시 및 설명을 해당 분야의 숙련된 기술자들에게 제공하기 위해 제시되며, 발명자들이 자신의 발명이라고 간주하는 것의 범위를 제한하고자 하는 것은 아니며 또한 다음의 실험들이 실시되는 모든 실험들임을 또는 단 하나의 실험임을 나타내고자 하는 것도 아니다. 사용되는 값들 (예컨대, 양, 온도, 등)에 관하여 정확도를 보장하기 위하여 노력을 하였으나, 일부 실험 오차 및 편차를 고려하여야 한다. 달리 언급이 없는 한, 부분은 중량부이고, 분자량은 중량 평균 분자량이며, 온도는 섭씨 온도이고, 그리고 압력은 대기압 또는 대기압 근방이다. 표준 약어들, 예컨대, bp, 염기쌍(들); kb, 킬로베이스(들); pl, 피코리터(들); s 또는 초, 초(들); min, 분(들); h 또는 hr, 시간(들); aa, 아미노산(들); kb, 킬로베이스(들); bp, 염기쌍(들); nt, 뉴클레오티드(들); i.m., 근육내(로); i.p., 복강내(로); s.c., 피하(로); 등이 사용될 수 있다.
실시예 1: 키메라 AAV 라이브러리의 SCHEMA-가이드된 설계
재료 및 방법들
하기 재료 및 방법들은 일반적으로 달리 언급된 경우를 제외하고 본 명세서에 기재된 실시예에 제시된 결과들에 적용한다.
SCHEMA 라이브러리 설계
SCHEMA 점수화 함수 및 RASPP 알고리즘을 사용하여 키메라 AAV들의 라이브러리를 설계하였으며 (예컨대, Voigt 외. (2002) Nature Struct. Mol. Biol. 6; 및 Endelman 외. (2004) PEDS 17 참고 - 다계통 클레이드 (예컨대, Gao 외. (2004) J. Virol. 78 참고)가 다양한 수용체 결합 특성을 가짐을 제시 (예컨대, Asokan 외. (2012) Mol. Ther. 20 참고)), 임상에서 몇몇 성공한 바 있다 (예컨대, Kotterman 외. (2015) Annu. Rev. Biomed. Eng. 17 참고). AAV2, 4, 5, 6, 8, 및 9의 아미노산 서열들을 MUSCLE을 사용하여 정렬하여 모체 서열 정렬을 생성하였다 (예컨대, Edgar 외. (2004) Nucleic Acids Res. 32 참고). 다량체 AAV 캡시드에서 소단위내부 및 소단위간 아미노산 접촉들 모두를 고려하도록 SCHEMA를 변형시켰으며, 이 때 한 쌍의 잔기는 4.5 옹스트롬 이내에 비수소 원자를 내포하는 경우 접촉되어 있다. AAV2 (1LP3), AAV4 (2G8G), AAV5 (3NTT), AAV6 (3OAH), AAV8 (2QA0), 및 AAV9 (3UX1)에 대한 접촉 잔기 위치들을 계산하기 위하여 결정 구조를 사용하였다. 최종 접촉 맵은 이러한 6개 모체 구조들의 최소한 50%에서 접촉되어 있었던 잔기 쌍들을 포함하였다. 높은 라이브러리 다양성을 구현하기 위하여, 캡시드의 결정화 영역 내에서 6개의 교차를 그리고 해당 위치에서의 성공적 재조합에 관한 기존의 예에 기초하여 위치 128에서 비결정화 VP1 영역 (아미노산 1-216) 내에서 7번째 교차를 내포하는 라이브러리가 설계되어야 한다. 예컨대, Excoffon 외. (2009) Proc. Natl. Acad. Sci. U.S.A.106을 참고하라. 6개의 모체 혈청형에서 유래한 8개의 캡시드 단백질 블록들을 내포하는 라이브러리는 160만 (68)개 이상의 키메라 변이체의 이론적 라이브러리 다양성을 산출한다. 키메라 캡시드의 SCHEMA 파괴 <E>는 모체 서열에 존재하지 않았던 새로운 아미노산 조합을 내포하는 접촉들의 수였다. 키메라 캡시드의 <m>은 가장 가까운 모체 서열로부터의 돌연변이들의 수였다.
도 1. RASPP 알고리즘을 사용하여, 평균 구조 파괴 <E>와 평균 서열 다양성 <m>의 균형을 유지하는 라이브러리들을 설계하였다. SCHEMA 점수화 함수는 라이브러리 구축을 위한 조합형 골든 게이트 어셈블리에 적합한 교차 위치들을 찾기 위해 추가로 수정되었으며, 이는 모든 AAV 모체 서열에 걸쳐 보존되는 4 개의 뉴클레오티드 스트레치들을 필요로 하였다. 가능한 교차 부위의 수를 증가시키고 이에 의해 가상 환경에서의 더 큰 서열 공간을 탐침하기 위해, 라이브러리 어셈블리 동안 모든 모체 서열에서 동일하도록 침묵 돌연변이 될 수 있는 4개의 뉴클레오티드 스트레치들이 포함되었다. 상기 라이브러리 설계를 위하여, 20개 아미노산의 최소 허용 서열 블록 길이 및 250개 아미노산의 최대 길이가 고려되었다. 낮은 αEρ, 균일한 블록 크기, 및 중요 캡시드 구조 특징들의 재조합에 기초하여 최종 라이브러리를 선택하였다.
SCHEMA 라이브러리 구축
도 2. 유형 II 제한 효소 BsaI로 조합형 골든 게이트 클로닝을 용이하게 하기 위해, pBluescript SK (+), AAV2, 4, 5, 6, 8 및 9에서 발견된 모든 BsaI 인식 부위들은 QuikChange 부위-지정 돌연변이유발에 의해 침묵 돌연변이 되었다. 도 3 & 4. DNA 어셈블리 설계 자동화 소프트웨어인 j5에서 설계된 PCR 프라이머를 사용하여 모체 캡 유전자들로부터 각 셔플된 블록에 상응하는 48개의 DNA 서열들을 PCR 증폭시켰다. 예컨대, Hillson 외. (2012) ACS Synth. Biol. 1을 참고하라. 도 5. pBluescript 벡터 골격으로의 조합형 골든 게이트 클로닝을 용이하게 하기 위하여 블록 연접부에 침묵 돌연변이들을 혼입시킨 프라이머들을 설계하였다. 골든 게이트 반응은 68 개 클론의 이론적 다양성보다 큰 라이브러리 크기를 구현하기 위해 전기적격 DH10B 대장균에 형질도입되었다. 이어서 라이브러리를 제한 효소 HindIII 및 NotI를 사용하여 pBluescript로부터 AAV 패키징 플라스미드 pSub2FloxCap으로 서브클로닝하였다.
패키징 전후에, SCHEMA 라이브러리를 Illumina 시퀀싱을 사용하여 분석하였다. AAV 캡 유전자를 내포하는 2.5-kb 단편을 HindIII 및 NotI 부위를 사용하여 pSub2FloxCap 벡터에서 절삭하고 겔 추출하였다. 이러한 겔-추출된 삽입물들을 Nextera XT DNA 샘플 준비 키트 (Illumina)에 대한 입력으로서 사용하였다. 각 샘플을 상이한 인덱스 프라이머를 사용하여 바코드처리 하였다. 생성된 라이브러리들을 고-감도 Bioanalyzer 칩 (Agilent), Qubit 분석 키트 (Invitrogen), 및 최종 정량 PCR (Kapa Biosystems)을 사용하여 정량하였다. 평균 서열 단편은 *?*1,400 bp였다. 두 라이브러리를 등몰 비율로 풀링 (pooled)하고 MiSeq, 버전 3, 5% PhiX 대조 스파이크-인 2 Х 300회를 사용하여 시퀀싱하였다. 시퀀싱 판독값은 Bowtie2를 사용하여 모든 AAV 모체에 맵핑되었으며 (예를 들어, Langmead 외. (2009) Genome Biol. 10 참고), 존재하는 특정 서열 블록들은 모체에 대한 판독 위치 및 서열 동일성을 고려하여 결정되었다.
Cre-의존적 선택을 위한 AAV 구조체들의 설계
캡의 구조체 설계 및 증폭을 위하여 사용된 PCR 프라이머들이 도 2에 제시된다. pSub2RepKO 및 pRepHelper가 사용되었다. SgraI 및 BamHI로 분해, Klenow 반응 및 평활 말단 결찰하여, AAV 패키징 플라스미드 pSub2에서 렙 녹아웃인, pSub2RepKO (예컨대, Maheshri 외. (2006) Nature Biotechnol. 24 참고)을 생성하였다. AAV 패키징 동안 트랜스로 (in trans) 렙 (Rep)을 공급하기 위해 사용되는 pRepHelper를, PmeI 및 BsmI,를 이용한 pAAV2/rh10의 순차적 분해, Klenow 반응, 및 평활 말단 결찰하여 생성하였다. 캡의 lox66 부위 5'을 삽입하기 위하여, 특유 BglII 부위를 프라이머 BglIIFwd 및 BglIIRev을 사용한 부위-지정 돌연변이유발에 의해 pSub2RepKO에 도입시켰다. 올리고뉴클레오티드 Lox66Fwd 및 Lox66Rev을 어닐링하고 pSub2RepKO의 BglII 및 HindIII 부위들에 결찰시켜 pSub2Lox66을 형성하였다. 캡의 lox71 부위 3 '을 삽입하기 위해, 프라이머 XhoIFwd/XhoIRev 및 KpnIFwd/KpnIRev 각각을 가지는 부위-지정 돌연변이유발에 의해 독특한 XhoI 및 KpnI 부위를 pSub2Lox66에 도입하였다. 올리고뉴클레오티드 SOELox71Fwd 및 SOELox71Rev을 스플라이스 오버랩 연장에 의해 어셈블리하고 Lox71Fwd 및 Lox71Rev을 사용하여 증폭시켰다. 생성된 단편 및 pSub2Lox66을 XhoI 및 KpnI로 분해하고 결찰시켜 pSub2Flox를 생성하였다. 본 선별에 사용된 pSub2Flox 및 AAV 캡 라이브러리들을 HindIII 및 NotI 로 분해하고 결찰시켜 바이러스 패키징을 위한 pSub2FloxCap 라이브러리들을 생성하였다.
AAV 벡터 제조
HEK293T 세포들을 미국 균주 은행 (American Type Culture Collection, Manassas, VA)로부터 얻었으며 10% 소 태아 혈청 (Invitrogen) 및 1% 페니실린/스트렙토마이신 (Invitrogen)을 가지는 37 ℃ 및 5% CO2의 둘베코 변형 이글 배지 (DMEM, Gibco)에서 배양하였다. 거대세포바이러스 초기 인핸서/닭 베타 액틴 (CAG) 프로모터의 제어 하에 녹색 형광 단백질 (GFP) 또는 Cre 재조합효소의 발현을 유도하는 AAV 라이브러리 또는 자기-상보적 재조합 AAV 벡터들을 선행 문헌 Koerber 외. (2008) Mol. Ther. 16, 및 Maheshri 외. (2006) Nature Biotechnol. 24에 기존에 기재된 바와 같이 HEK293T 세포들에 패키징하였다. 요약하면, AAV 벡터들은 3회 일과성 형질감염에 의해 생성되고, 아이오딕사놀 밀도 원심분리를 통해 정제되고, Amicon 여과에 의해 포스페이트 완충 식염수 (PBS)로 완충제 교환되었다. DNase-내성 바이러스 게놈 역가는 Biorad iCycler (Bio-Rad, Hercules, CA)를 사용하여 정량적 실시간 PCR에 의해 측정되었다.
SCHEMA AAV 변이체의 생체내 선별 및 특성화
7주령의 GFAP-Cre 73.12 (Jackson Laboratory Stock 012886), C57BL/6J (Jackson Laboratory Stock 000664), 또는 Ai9 tdTomato 생쥐들 (Jackson Laboratory Stock 007909)을 아이소플루레인으로 마취시키고 정위 장치에 두었다. 절개하여 두개골을 노출시키고 주사를 위한 구멍을 뚫었다. 라이브러리 선별을 위해, 5 마이크로 리터의 AAV 라이브러리의 등몰 혼합물 (1 x 10¹⁰ 바이러스 게놈/μl)을 정수리점에 대해 0.05mm 후방 및 1.0mm 측면의 좌표에서 2.5mm 깊이로 GFAP-Cre 생쥐의 우측 뇌실 (n = 3)에 100에 기술된 해밀턴 주사기를 사용하여 정위적으로 주사하였다. 생쥐 뇌 아틀라스 (Franklin and Paxinos, 2007)를 사용하여 주사 좌표들을 선택하고 테스트 주사 후 0.1% FastGreen 염료 (Sigma)를 사용하여 보정하였다. 연구 전반에 걸쳐 주사의 정확성은 맥락막에서 리포터 발현 및 맞은편 뇌실을 둘러싼 것으로 확인되었다. 주사 3주 후 생쥐들을 희생시키고 뇌 조직을 수확하였다. 주사 부위에 맞은 편에 있는 반구를 막자와 막자사발을 사용하여 드라이 아이스상에서 균질화시켰다. 균질화된 조직을 단백분해효소 K (New England Biolabs) 및 RNase A (ThermoFisher)를 보유한 Hirt 용해 완충액에서 55℃에서 3시간 동안 분해시키고 Arad 외. (1998) BioTechniques 24의 선행 문헌에 기재된 바와 같이 Hirt 법을 사용하여 염색체외 DNA를 단리하였다. PCR 프라이머 Cap_ISF 및 Cap_R을 사용하여 반전된 캡을 증폭시켰으며, 반면 프라이머 Cap_NSF 및 Cap_R은 비-반전된 캡을 특이적으로 증폭시켰다. 프라이머 Internal_Cap_ISF 및 Internal_Cap_R은 반전된 캡의 증폭이 어려운 경우 중첩 PCR에 사용될 수 있다. 3회 선별 후, Sanger 시퀀싱 (UC Berkeley DNA Sequencing Facility)에 의해 캡시드 서열을 결정하고, 주요 변이체들을 HindIII 및 NotI로 분해하고 재조합 AAV 패키징을 위해 pXX2Not에 결찰시켰다.
SCH9 및 AAV9를 생체내 특성화하기 위하여, GFP 또는 Cre를 발현하는 5 마이크로리터의 자기-상보적 재조합 벡터 (1 x 10¹⁰ 바이러스 게놈/μl)를 정수리점에 대해 0.05 mm 후방 및 1.0 mm 측부의 좌표에서 2.5 mm 깊이로 C57BL/6 또는 Ai9 tdTomato 생쥐들의 우측 뇌실에 Hamilton 주사기를 사용하여 정위적으로 주사하였다. Ai9 생쥐들에게 단일-가닥 SCH9 CAG-Cre 주사 전 연속 3일 동안 50 mg/kg BrdU (Sigma-Aldrich)를 주사하였다. 심부 소뇌 핵의 주사를 위해, GFP를 발현하는 4 마이크로리터의 재조합 AAV 벡터 (2 x 10⁹ 바이러스 게놈/μl)를 정수리에 대해 6.0 mm 후방 및 2.0 mm 측부의 좌표에서 소뇌 표면으로부터 2.2 mm 깊이로 우측 반구 내에 Hamilton 주사기를 사용하여 정위적으로 주사하였다. 동물 절차는 UC 버클리 실험실 동물 관리 및 사용위원회에 의해 승인되었으며 동물 관리에 대한 NIH 지침에 따라 수행되었다.
면역조직화학
생쥐들에게 100 mg/kg 케타민 및 10 mg/kg 자일라진을 복강내 주사하여 마취시키고 0.9% 식염수, 이어서 4% 파라포름알데히드를 심혈관으로 관류시켰다. 뇌를 4℃에서 4% 파라포름알데히드에 하룻밤동안 사후 고정시키고, PBS로 세척하고, 침지될 때까지 30% 수크로스에 보관하였다. 연속 관상 또는 시상 단면들을 Series 8000 슬라이딩 마이크로톰 (Bright)에서 40 mm 두께로 자르고 사용시까지 -20℃에서 동결방지제에 보관하였다. 자유-부유 단면들을 PBS로 3회 세척하고, 차단 용액 (PBS에서 10% 당나귀 혈청 및 1% Triton X-100)과 함께 실온에서 2시간 동안 배양하고, 차단 용액 내 일차 항체로 72시간 동안 4℃에서 염색하였다. 다음과 같은 일차 항체들이 본 연구에 사용되었다: 생쥐 항-칼빈딘 (1:2000; Abcam, ab82812), 토끼 항-GFP (1:1000; Life Technologies, A-11122), 염소 항-GFAP (1:750; Abcam, ab53554), 기니아 피그 항-DCX (1:1000, EMD Millipore, AB2253), 쥐 항-VCAM1 (1:50; EMD Millipore, MAB2627), 닭 항-GFAP (1:750; Abcam, ab4674), 쥐 항-BrdU (1:750; Abcam, ab6326), 및 토끼 항-tdTomato (1:750, Rockland, 600-401-379). PBS로 3회 세척 후, 단면들을 이차 항체와 함께 2 시간 동안 실온에서 배양하고 DAPI (Thermo Fisher)로 10분 동안 염색하였다. 염색된 단면들을 PBS로 3회 세척하고 VectaShield HardSet Antifade Mounting 배지 (Vector Laboratories)를 사용하여 슬라이드 위에 표본고정하였다.
이미지화 및 분석
Zeiss Axio Scan.Z1 또는 공초점 Zeiss LSM 880 NLO AxioExaminer (UC Berkeley Molecular Imaging Center)를 사용하여 이미지들을 얻었다. 모든 이미지 분석들은 동일한 설정으로 얻은 원본 이미지에 대해 수행되었다. 데이터를 평균 ± SEM으로 제시하고 통계적 유의성을 양쪽 꼬리 스튜던트 t-검정으로 확립하였다.
SVZ는 뇌실막 세포, 성체 NSCs (B 세포), 이행 증폭 세포 (유형 C 세포), 신경모세포 (유형 A 세포), 및 성숙 성상세포를 비롯한 다수의 세포 유형들로 구성된다. 예컨대, Lim 외. (2016) Cold Spring Harb. Perspect. Biol. 8 참고하라. SVZ에서 NSC 형질도입 효율을 평가하기 위하여, NSC 내부에서 선택적으로 발현되는 분자 마커들을 먼저 평가하였다. 대부분의 마커가 SVZ에서 다수의 세포 유형으로 발현되며, 이는 계대가 진행되는 동안 유전자 발현의 연속성을 반영하는 것이지만, 혈관 세포 부착 분자 1 (VCAM1)은 뇌실과 접촉하는 NSC의 종말발(endfeet)에 특이적으로 위치된다. 예컨대, Kokovay 외. (2012) Cell Stem Cell 11을 참고하라.
SVZ에서 형질도입 부피를 결정하기 위하여, 그룹 당 3마리의 생쥐들을 사용하여 측면 뇌실의 전방 두각 (horn)으로부터 전방 연결부까지의 SVZ에 이르는 6개 관상 단면들에서 SVZ에서 GFP 발현의 표면적을 CellProfiler를 사용하여 임계 이미지들로부터 정량하였다 (예컨대, Carpenter 외. (2006) Genome Biol. 7 참고). 전체 표면적에 단면 두께 (40 μm) 및 단면들 간의 거리를 곱하여 형질도입 부피를 얻었다. CellProfiler를 사용하여 GFP 발현의 통합 강도를 정량하기 위해 동일한 임계 이미지들을 사용하였다.
전 이주 흐름 (rostral migratory stream)에서 tdTomato 양성 신경 모세포의 백분율을 정량하기 위해, 임계값, 분절에 CellProfiler의 세포 분할 성능을 적용시키고 전 이주 흐름에서 더블코르틴 및 tdTomato 양성 세포체를 점수화하였다. 각 동물에서 전 이주 흐름을 내포하는 2 내지 5개의 시상 조직 단면들로부터 측정치를 얻었으며, 각 그룹은 4 내지 5마리 생쥐들을 보유한다. 성체 신경 줄기 세포의 형질도입을 평가하기 위하여, 뇌실하 영역 내 모든 BrdU 양성 세포들의 동일성(identity)을 tdTomato 및 GFAP 또는 DCX와의 공동국소화 (colocalization)에 의해 점수화하였다. 동물 당 4 내지 5개의 단면으로 5마리 생쥐들에서 SVZ에 걸쳐 매 5번째 시상 단면의 공초점 이미지들에 대해 카운트를 수행하였다.
tdTomato 양성인 칼빈딘 염색 면적의 백분율을 계산하기 위하여 CellProfiler 파이프라인을 사용하여 칼빈딘 염색의 임계 마스크를 생성하였다. 이 마스크를 임계 tdTomato 이미지에 적용하였고 tdTomato 양성 면적을 총 칼빈딘 면적으로 나누었다. 칼빈딘 마스크 내의 임계 tdTomato의 통합 강도도 기록되었다. 소뇌에 걸쳐 4 내지 7 개의 40 μm 시상 조직 단면에서 측정을 수행하였으며 각 그룹에 4 내지 5 마리 생쥐를 보유한다.
SCHEMA AAV 변이체의 시험관내 특성화
달리 언급이 없는 한, 모든 세포주들은 10% 소 태아 혈청 (Invitrogen) 및 1% 페니실린/스트렙토마이신 (Invitrogen)이 보충된 DMEM (Gibco)에서 37℃ 및 5% CO2에서 배양되었다. SCH9, SCH2, 및 야생형 AAV2의 헤파린 친화력을 선행 문헌 Jang 외. (2011) Mol. Ther. 19에 기재된 바와 같이 결정하였다. 1 ml HiTrap 헤파린 컬럼 (GE Healthcare Sciences)을 pH 7.5에서 150 mM NaCl 및 50 mM Tris로 평형화시켰다. 1 x 10¹¹개의 정제된 바이러스 게놈 입자들을 상기 컬럼에 부하하고 최종 농도 950 mM까지 NaCl을 50 mM씩 단계적으로 증가시켜 용리한 후, 1M NaCl로 세척하였다. 각 용리의 분획을 사용하여 HEK293T 세포들을 감염시키고, 감염 48시간 후 Guava EasyCyte 6HT 유세포 측정장치 (EMD/Millipore) (UC Berkeley Stem Cell Center, Berkeley, CA)를 사용하여 GFP 양성 세포들의 백분율을 정량하였다.
세포 형질도입을 위한 갈락토스 및 헤파란 설페이트 프로테오글리칸의 AAV 이용을 선행 문헌 Shen 외. (2013) J. Biol. Chem. 288에 기재된 바와 같이 특성화하였다. 표면에서 말단 갈락토스 잔기들을 제시하는 CHO-Lec2 세포들을 버클리 캘리포니아 대학의 조직 배양 시설로부터 얻고, 10% 소 태아 혈청 (Invitrogen) 및 1% 페니실린/스트렙토마이신 (Invitrogen)이 보충된 MEM α 뉴클레오시드 (Gibco)에서 37℃ 및 5% CO2에서 배양하였다. 씨딩 1일 후, 세포들을 4℃에서 30분 동안 배양한 다음, 100 μg/mL 에리트리나 크리스타갈리 (Erythrina cristagalli) 렉틴 (ECL) (벡터 Labs) 존재 또는 부재의 MEM으로 완전 배지 변화가 이루어졌다. 자기-상보적 rAAV CAG-GFP 비리온을 1시간 동안 PBS에서의 가용성 헤파린 (500 μg/mL)으로 처리하거나 모의처리한 후 12,000의 게놈 MOI로 세포들을 감염시키기 위해 사용하였다 (n = 3). 바이러스와 함께 1시간 배양 후, Lec2 세포들을 냉온 PBS로 3회 세척하여 결합되지 않은 AAV를 제거하고, 감염 72시간 후 GFP-발현 세포들의 백분율을 유세포 측정장치로 정량하였다.
항체 침습 성질을 분석하기 위하여, SCH9, AAV2, AAV6, AAV8, 및 AAV9를 37℃에서 1 시간 동안 열 불활성화된 IVIG의 연속 희석액 (Gammagard)으로 배양한 후, 선행 문헌 Santiago-Ortiz 외. (2015) Gene Ther. 22에 기재된 바와 같이 이를 사용하여 8,000의 게놈 MOI로 HEK293T 세포들을 감염시켰다 (n=3). 감염 48 시간 후 GFP-발현 세포들의 백분율을 유세포 측정장치로 정량하였다. 중화 항체 역가들을 제 1 IVIG 농도로 기록하였으며 여기서 50% 이상의 GFP 발현 감소가 관찰되었다.
AAVR에 대한 의존성을 연구하기 위하여, 야생형 HeLa 또는 AAVRKO 세포들 (클론 KIAA0319L)을 자기-상보적 CAG-GFP를 전달하는 SCH9, SCH2, 또는 AAV2로 20,000의 게놈 MOI로 감염시켰다 (n = 6). 감염 72 시간 후 GFP-발현 세포들의 백분율을 유세포 측정장치로 정량하였다.
결과
6개의 자연 혈청형 - AAV2, 4, 5, 6, 8, 및 9를 재조합한 키메라 AAV 라이브러리를 설계하였다. 도 1. 설계 매개변수들을 특정한 후, RASPP 법 (최단 경로 문제로서의 재조합) (예컨대, Endelman 외. (2004) PEDS 17 참고)을 적용하여 다양한 돌연변이 수준의 범위에 걸쳐 160개의 최소 파괴 라이브러리 설계 (7개의 교차 위치 세트)를 신속히 식별하였다. 이들 설계들 각각에 대하여, 가장 가까운 모체 혈청형에 대해 평균 라이브러리 파괴 점수 <E> 및 도입된 아미노산 돌연변이의 수 <m>을 계산하고 (도 1A), 모든 RASPP 설계들의 교차 위치들을 도 1B에 제시하였다. 캡시드의 결정화 영역에서 소단위 당 59의 평균 파괴 점수 <E> 및 82의 평균 돌연변이 수 <m>를 가지는 최종 설계(도 1A-C)를 몇 가지 이유로 선택하였다. 먼저, 이러한 설계는 높은 돌연변이 수준에서 <E>의 상대적 최소값을 나타내는 RASPP 라이브러리의 클러스터로 존재하였다 (도 1A). 두번째로, 선택된 설계는 주요 캡시드 구조 특징들이 셔플되어 있었으며, 자연 AAV 혈청형의 진화에서 가장 다양한 영역을 나타내는 표면 노출된 루프들 및 초가변 영역을 포함하였다 (도 1C). 이들 접촉 풍부 영역 내에서의 재조합은 파괴를 더 많이 생성하였으나, 또한 새롭고 흥미로운 기능들을 가지는 AAV 키메라들을 생성하기가 더 쉬웠다. 예를 들어, 블록 5와 6을 결합하여 파괴 점수를 크게 낮출 수 있지만, 이렇게 하는 것은 단일 부모 서열에서 유래된 표면 노출 루프 영역을 가지는 캡시드가 생성될 것이다. 마지막으로, 이러한 교차 위치들의 세트는 비교적 고른 블록 크기들의 분포를 제공하였기 때문에 선택되었다. RASPP는20-250개 아미노산으로부터 가능한 다양한 블록 크기 범위를 고려하도록 프로그램되었다. 최저 αEρ 설계들의 대다수는 2개의 긴 블록들 (블록 3 및 4에 대해 > 175개 아미노산), 이에 이어서 일련의 짧은 블록들 (블록 5-7에 대해 < 30개 아미노산)을 내포하였다 (도 1B). 대조적으로, 선택된 교차 위치들의 세트 (도 1C)는 보다 고른 블록 크기 분포를 제공하여, 모체 서열의 다양성이 제한적인 몇몇 영역 내에서 교차를 제한하는 것과는 반대로 캡시드 전체에 걸쳐 셔플링을 보장한다.
선택된 라이브러리 설계를 조합형 골든 게이트 클로닝 (예컨대, Engler 외. (2013) Methods Mol. Biol. 1073 참고)에 의해 어셈블링하고, 전기적격 대장균에서 클론하여 5 x 10⁶개 이상의 형질도입체들을 생성하고, AAV 비리온에 패키징하였다. 각각의 블록 위치에서 모체 혈청형의 빈도는 바이러스 패키징 전후의 딥 시퀀싱에 의해 분석되었다 (도 1F). 각각의 모체 혈청형 서열은 바이러스 패키징 이전에 각각의 블록 위치에서 잘 표현되고 분포되었지만, 패키징은 아마도 안정한 캡시드에 대해 상당한 선택적 압력을 가함으로써 라이브러리 조성의 극적인 변화를 초래하였을 것이다. 예를 들어, AAV4 및 AAV5의 빈도는 패키지된 라이브러리 전반에 걸쳐 각각 평균 348 및 372-배 감소하였으며, 이는 아마도 라이브러리 어셈블리에 사용된 다른 AAV 모체들과 이들 혈청형의 낮은 평균 아미노산 서열 동일성 (AAV4: 60%, AAV5: 65%)으로 인한 것일 것이다. 패키징시 라이브러리 조성의 변화는 또한 결정화 소단위 당 59로부터 4로의 평균 파괴 점수 <E> 감소 및 82로부터 28로의 평균 돌연변이수 <m> 감소를 반영하였다. Meyer 외. (2006) PEDS 19, 및 Otey 외. (2004) Chem. & Biol. 11에 기재된 바와 같은 기존의 SCHEMA를 적용함으로써, 보다 낮은 <E> 키메라들이 라이브러리에서 많이 풍부해졌다. 블록 5 및 6에서 AAV2에 대해 그리고 블록 8에서 AAV9에 대해 선호도가 존재하였다. 이러한 경향은 합리적인 캡시드 조작을 안내하기 위해 장래에 사용될 수 있을 것이다.
실시예 2: AAV 유도된 진화를 위한 Cre-의존적 선택 전략
특이적으로 NSC를 표적하기 위하여, SVZ에서 NSC를 감염시킨 AAV 변이체의 양성 선택을 이끌어 내기 위한 생체내에서의 Cre-의존성 유도된 진화 및 선택 전략이 설계되었다. 이 연구 과정에서 개념적으로 유사하지만 뚜렷이 다른 Cre-의존 시스템이 보고되었다. Deverman 외. (2016) Nature Biotechnol. 34를 참고하라.
세포-유형-특이적 프로모터의 제어하에 Cre 발현을 유도한 300마리 이상의 유전자삽입 생쥐들이 개발되었다. 예컨대, Heffner 외. (2012) Nature Commun. 3을 참고하라. 도 6. 캡 유전자를 한 쌍의 loxP 부위들과 연접시킴으로써 AAV 캡 유전자의 선택적 회수를 매개하기 위한 Cre 발현의 세포-유형-특이성이 개발되었다. Cre-발현 세포의 AAV 감염 후 두 번째 가닥 AAV 게놈 합성은 플록스(flox)된 캡의 반전을 초래하였고, 반전된 유전자 주형에서만 정방향 및 역방향 쌍으로 작용하는 PCR 프라이머를 사용하여 상기 뇌 조직들로부터 Cre-반전된 캡 유전자들을 선택적으로 회수하였다 (도 6A, B). 돌연변이체 loxP 부위 lox66 및 lox71 40을 이용하여 단방향 반전쪽으로 Cre 재조합의 평형을 유도하였다. loxP 부위들을 먼저 캡의 3' UTR에 삽입하였으며, 여기서 이들은 Cre-의존성 회수에 사용된 역방향 프라이머에 대한 표적 서열을 내포하는 짧은 스터퍼 (stuffer) 서열들과 연접하였다. 재조합은 도 7에 도시된 바와 같이 Sure2 재조합효소 결핍 대장균에서도 세균 플라스미드 번식 동안 낮은 수준으로 일어났다. 생체내 선택 중에 이러한 바람직하지 않은 반전된 캡의 회수를 방지하기 위하여, loxP 부위들을 캡에 연접하도록 재배치하여, 벡터 플라스미드 라이브러리의 세균 번식 동안 인공적인 반전이 바이러스 단백질을 인코드하지 않는 반전된 캡 서열을 생성하게 하여, 이들은 293개 세포들에 실질적으로 패키지되지 않게 되며, 대체 설계에 포함되지 않는다. 예컨대, Deverman 외. (2016) Nature Biotechnol. 34를 참고하라. 캡 유전자에 연접한 loxP 부위들의 삽입은 렙 유전자의 해독틀을 변경시켰음을 유의하라. 그리하여 렙의 번역 개시 코돈들은 제거되었으며, 캡 발현을 유도하는 바이러스 프로모터는 유지되었고 (도 6A), 대신에 별도의 렙-인코딩 헬퍼를 일과성 형질주입하여 렙을 바이러스 패키징하기 위해 트랜스로 공급하였다. 바이러스 패키징 플라스미드에 대한 이러한 변형은 qPCR에 의해 정량된 바와 같이 높은 AAV 바이러스 게놈 수율을 초래하였다 (도 6C).
SVZ에서 성체 NSC는 아교세포-원섬유 산성 단백질 (GFAP) (예컨대, Doetsch 외. (1999) Cell 97 참고), 글루타메이트 아스파르테이트 전달체 (GLAST) (예컨대, Platel 외. (2009) Glia 57 참고), 그리고 뇌 지질-결합 단백질 (BLBP) (예컨대, Giachino 외. (2014) Stem Cells 32 참고)을 비롯한 아교세포 마커들을 발현시킨다. 성체 NSC 형질도입을 선택하기 위하여, GFAP-Cre 73.12 생쥐 계통을 이용하였으며 여기서 Cre 재조합효소 발현은 생쥐 GFAP 프로모터에 의해 제어되었다. Cre 발현은 성체 GFAP-발현 신경 줄기 세포 및 성숙 성상세포에서 관찰되었다. 예컨대, Garcia 외. (2004) Nature Neurosci. 7을 참고하라. Cre는 신경 줄기 세포 이외에 성상 세포에서 발현되었지만, 뇌실내 투여 (ICV) 투여 경로는 신경 줄기 세포가 존재하는 SVZ의 우선적인 형질도입을 초래하였고, GFAP는 NSC 동일성의 중요한 마커로서 작용하였다. 예컨대, Doetsch 외. (1999) Cell 97을 참고하라. 캡의 Cre-의존적 회수를 검증하기 위해, 플록스된 캡 유전자 (pSub2FloxCap)를 내포하는 AAV 라이브러리를 뇌실내 주사를 통해 GFAP-Cre 73.12 또는 C57BL/6J 대조 생쥐들에 전달하였다. 반전 캡은 Cre를 발현하는 생쥐들의 뇌 조직에서만 증폭 될 수 있는 반면, 비-반전 캡은 두 그룹 모두에 존재하였다 (도 6D). Cre 재조합이 일어나려면, AAV 게놈은 치료적 트랜스진의 발현에 요구되는 바와 같이 이중 가닥 형태이어야 한다. 그러므로 GFAP-Cre 73.12 생쥐들에서 증폭된 비-반전된 캡 유전자들의 풀은 GFAP 양성 세포를 감염시키지 못하거나, 바이러스 수명 주기의 일부 양상들 (예컨대, 캡시드 탈외피화, 엔도솜 탈출)에서 결함이 있었거나, 또는 두번째 가닥 합성을 완료하지 못했던 캡시드를 나타낼 수 있다. 따라서 Cre-의존적 선택 전략은 표적 세포 유형에서 강력한 트랜스진 발현에 필요한 모든 단계를 완료하는 캡시드 변이체를 독점적으로 회수하였다.
실시예 3: 생체내 라이브러리 선택은 우성 SCHEMA AAV 변이체에 수렴된다.
캡의 Cre-의존적 회수를 검증한 후, 6개의 AAV 라이브러리들의 등몰 혼합물을 사용하여 생체내 선택을 개시하였으며, 라이브러리 각각은 다음과 같은 106 내지 107 개의 특유한 변이체를 내포하였다: (i) 새로운 SCHEMA AAV, (ii) 에러-유발 AAV9, (iii) 선구 AAV (예컨대, Santiago-Ortiz 외. (2015) Gene Ther. 22 참고), (iv) AAV1, 2, 4, 5, 6, 8, 및 9의 DNase I 분해 및 재어셈블리에 의해 생성된 셔플된 AAV (예컨대, Koerber 외. (2008) Mol. Ther. 16 참고), (v) 에러-유발 AAV2 (예컨대, Koerber 외. (2006) Nature Protoc. 1 참고), 및 (vi) 아미노산 588에서 AAV2 7량체 펩티드 삽입 (예컨대, Muller 외. (2003) Nature Biotechnol. 21 참고). 라이브러리 iii-vi는 기존에 우리의 유도된 진화 선택에서 매우 감염성인 클론들을 생성하였으며 SCHEMA 라이브러리에 대한 진화적 경쟁을 제공하였다. 예컨대, Dalkara 외. (2013) Sci. Transl. Med. 5; Tervo 외. (2016) Neuron; Steines 외. (2016) JCI Insight 1; Koerber 외. (2008) Mol. Ther. 16; 및 Santiago-Ortiz 외. (2015) Gene Ther. 22를 참고하라. 라이브러리를 뇌실내 투여를 통해 성체 GFAP-Cre 생쥐 (n = 3)의 우측 측면 뇌실로 주사하여 양쪽 반구에서 전체 SVZ에 걸쳐 NSC를 형질도입시켰다. 대조적으로, 직접적인 SVZ 주사는 국부 조직에 더 파괴적이며 동일한 조직 부피를 커버하기 위해 다회의 주사가 필요할 수 있다.
주사 3주 후 맞은편 뇌 반구를 수집하고, 게놈 DNA를 추출하고, GFAP 발현 세포로부터 PCR에 의해 Cre-재조합된 AAV 캡 변이체를 회수하였다. 맞은편 반구를 수집하여 측면 뇌실보다 우수하게 피질을 통한 주사관과 관련된 형질도입으로부터 캡 변이체가 회수되지 않도록 하였다. 3회의 생체내 선택 후, 24개 클론들의 Sanger 시퀀싱 분석은 SCHEMA 라이브러리로부터 유래한 2개 변이체들에 대한 수렴을 나타냈다. SCH9 (키메라 6, 9, 8, 9, 9, 2, 9, 9; <E> 9, <m> 49)는 회수된 클론들의 54%를 나타내었으나, SCH2 (키메라 6, 9, 8, 9, 2, 2, 9, 9; <E> 4, <m> 37)는 33%를 나타내었다. 잔부 클론들은 AAV2 7량체 삽입 (8%) 및 선구 라이브러리 (4%)로부터 유래되었다. SCH9는 가장 근접한 모체인 AAV9와 총 58개 돌연변이 만큼 상이하였다 (92% 아미노산 동일성). 이들 중 49개 (<m>)는 캡시드의 결정화 영역에 존재하며, 9개는 비결정화 영역에 존재한다. SCH9, SCH2, 및 다수의 모체 AAV 혈청형의 서열들의 아미노산 정렬이 각각 도 8, 9, 및 10에 제시된다. 2개의 SCHEMA 변이체는 블록 5에서만 상이하였으며, 이는 18개 아미노산 차이를 만든다. 도 11. SCH9의 3차원 구조 모델은 캡시드 표면 상에서 루프 VR-IV에서의 AAV9, 루프 V-VIII에서의 AAV2, 및 5폴드 (fivefold) 공극 구조에서의 AAV8을 도시하였다. 이러한 흥미로운 특징들 및 선택된 풀의 우세성을 기준으로 한, SCH9의 생체내 특성화.
실시예 4: SCH9는 성체 생쥐의 SVZ에서 성체 신경 줄기 세포들을 효율적으로 형질도입시킨다.
SVZ에서 SCH9의 형질도입 프로파일을 평가하기 위해, 자기-상보적 CAG-GFP 카세트를 보유하는 rAAV를 성공적으로 패키징하고 (재조합 AAV 패키징 수율들이 도 12에 기록됨) 성체 C57BL/6J 생쥐의 우측 측면 뇌실로 전달하였다. SCH9는 CNS에서의 광범위한 사용 및 척추강내 주사 후 뇌척수액 (CSF)으로부터 뇌 실질조직을 형질도입시키는 능력으로 인해 AAV9에 대해 벤치마킹되었다. 예컨대, Samaranch 외. (2012) Hum. Gene Ther. 23; 및 Schuster 외. (2014) Front. Neuroanat. 8을 참고하라. 또한, 자연 혈청형 중에서, SCH9에 가장 가깝게 관련된 서열은 AAV9이다.
도 13. 맞은편 반구의 형질도입은 주사 4주 후에 분석되었고, GFP 발현은 뇌실 주변 영역과 주로 관련되었으며 뇌실하 영역에서 강도가 가장 크다 (도 13A). 형질도입 효율은 GFP 발현의 강도 및 GFP에 양성인 SVZ의 총 부피 둘 모두에 의해 평가되었다. SCH9에 대한 통합된 GFP 형광 강도는 24-배 더 높았으며, GFP는 AAV9에 비해 12-배 더 큰 SVZ 형질도입 부피로 표현되었다 (도 13B, C). 초기 특성화로서, GFP/GFAP/VCAM1 양성 성체 신경 줄기 세포가 뇌실하 영역에서 SCH9에 의해 형질도입되었다 (도 13D).
재조합 AAV 게놈은 에피솜으로 유지되었고 SVZ에서 성체 신경발생의 세포 분열 특성화동안 점진적으로 소실되었다. 구체적으로, 신경 줄기 세포로부터 후각 망울 개재뉴런으로의 계통 진행은 7회 이상의 세포 분열을 수반하였다. 예컨대, Ponti 외. (2013) Cell Cycle 12를 참고하라. 수반되는 AAV 게놈 희석 결과, 주사 후 후기 시점들에서 트랜스진을 계속 발현하는 대부분의 세포는 천천히 NSC 또는 유사분열 후 세포들을 분열하고 있었다. 더욱이, 레트로바이러스 벡터 통합을 이용한 이전의 연구는 신경모세포가 후각 망울로 전 이주 흐름을 통과하는데 필요한 시간이 9일이며, 주사시 SVZ에 존재하는 모든 이동 증폭 세포 및 신경모세포는 분화되고 및/또는 후각 망울로 이동하여 주사 후 30일까지 수상돌기를 확립하였다. 예컨대, Petreanu 외. (2002) J. Neurosci. 22; 및 Lois 외. (1994) Science 264를 참고하라. 이들 결과는 주사 후 후기 시점들에서 전 이주 흐름에 존재하는 신경모세포가 NSC로부터 유래되었음을 나타내며, 이는 SVZ에서 NSC의 렌티바이러스 또는 비-바이러스성 형질도입을 확립하기 위해 기존에 사용된 결론이었다. 예컨대, Consiglio 외. (2004) Proc. Natl. Acad. Sci. U.S.A. 101; 및 Barnabe-Heider 외. (2008) Nature Methods 5를 참고하라. 주사 후 30 일에 tdTomato를 발현하는 이동 신경모세포의 수를 NSC 형질도입의 표시로서 결정하기 위해 유사한 계통 분석 전략을 설계하였다. Cre 재조합효소를 인코드하는 재조합 SCH9 또는 AAV9를 성체 Ai9 플록스된 STOP tdTomato 생쥐의 우측 측면 뇌실에 주사하였으며 (예컨대, Madisen 외. (2010) Nature Neurosci. 13 참고), 그 내부에서 Cre 활성은 형질도입된 세포 및 그들의 자손에서 tdTomato 발현을 초래하였다. 신경모세포의 대다수 (오른쪽 반구 83.2 ± 3.6 %, 왼쪽 반구 50.3 ± 4.4 % 주사됨)는 SCH9 발현 Cre (도 13E, G)의 주사 30일 후 전 이주 흐름에서 tdTomato에 대해 양성이었으며, 이는 AAV9 형질도입을 4-배 이상 초과하였다. 또한, 다수의 tdTomato 양성 신경모세포가 후각 망울에서 방사상으로 이동하고 과립 세포 뉴런의 형태를 채택하는 것으로 관찰되었다 (도 13F).
NSC 형질도입을 추가로 특성화하기 위해, 단일-가닥 SCH9 CAG-Cre의 주사 전에 SVZ에서 분열 세포를 표지하기 위한 티미딘 유사체 BrdU (5- 브로모-2'-데옥시우리딘)를 투여하였다. 2주의 휴식기 후, BrdU 혼입에 의한 tdTomato 발현의 GFAP+ NSC로의 공동국소화를 분석하였다 (도 13H). SVZ에서 tdTomato를 발현하는 성체 NSC (GFAP +, BrdU +, 더블코르틴-), 이행 증폭 세포 (GFAP-, BrdU +, 더블코르틴-) 및 신경모세포 (GFAP-, BrdU +, 더블코르틴 +)의 백분율을 정량하였다 (도 13I). NSC의 대략 60%가 양쪽 반구에 형질도입되며, 이는 단일-가닥 및 자기-상보적 형태 모두를 사용하여 NSC로 유전자 전달하는 SCH9의 효능을 뒷받침한다.
실시예 5: SCH9는 또한 소뇌에서 푸르킨예 세포들에 대한 친화성을 나타낸다.
표적 세포 유형의 감염을 향상시키는 캡시드 돌연변이는 뇌의 다른 영역에서의 형질도입을 동시에 개선시킬 수 있다. 도 14. 뇌실내 주사 후 SCH9 형질도입은 주로 SVZ와 관련이 있었지만, 뇌척수액에서 순환하는 벡터에 직접 접근할 수 있는 뇌 영역인 소뇌의 푸르킨예 세포들에서도 증가된 리포터 발현이 관찰되었다 (도 14A). 푸르킨예 세포들은 척수소뇌성 실조증을 비롯한 신경퇴행성 질환에 대한 유전자 요법의 주요 표적이다. 예컨대, Orr 외. (2012) J. Cell Biol. 197을 참고하라. SCH9-Cre의 전달은 리포터 발현을 활성화시켰는데 이는 CellProfiler으로 정량하여, AAV9-Cre 보다 12.2-배 더 강력하였으며 9.3-배 더 큰 칼빈딘 양성 부위에 걸쳐있었다 (도 14B, C).
뇌척수액으로부터 푸르킨예 세포를 형질도입함에 있어서 SCH9의 성공은 소뇌에 대한 유전자 전달 벡터로서의 잠재력을 제시하였다. 소뇌 유전자 요법은 푸르킨예 세포로부터 저해 입력을 받는 소뇌 회로에서 주요 허브인 깊은 소뇌 핵으로의 rAAV 전달을 이용하였다. 예컨대, Keiser 외. (2015) Brain: J. Neurol. 138; 및 Dodge 외. (2008) Mol. Ther. 16을 참고하라. 이 회로를 이용함으로써, 깊은 소뇌 핵 내부로의 rAAV 단회 주사는 벡터의 역행 수송을 통해 소뇌 피질 전반에 걸쳐 푸르킨예 세포들을 형질도입 할 수 있었다. 도 15. 소뇌로 유전자 전달하기 위해 가장 일반적으로 사용되는 혈청형인 AAV1에 의한 SCH9의 형질도입 패턴을 오른쪽 반구의 깊은 소뇌 핵으로의 편측 주사 후 비교하였다. 두 벡터 모두는 같은쪽 반구에서 소뇌 전반에 걸쳐 푸르킨예 세포들의 강한 형질도입을 뒷받침하였으며, 이는 SCH9가 역행 방향으로 수송 될 수 있음을 나타낸다.
실시예 6: SCH9는 세포 형질도입을 위해 헤파란 설페이트 프로테오글리칸 및 갈락토스 모두를 이용할 수 있다.
SCH9의 유망한 전염성 특성을 고려하여, 다음으로 SCH9가 그 다수의 모체 혈청형의 수용체 결합 능력을 조절함으로써 SCH9에 대한 선택적 이점을 부여할 수 있었는지 여부를 결정하기 위해 그 키메라 특성을 조사하였다. SCH9의 블록 6은 AAV2 캡시드의 헤파린 결합 포켓을 내포하였다. 예컨대, Kern 외. (2003) J. Virol. 77을 참고하라. 또한 블록 2 및 5는 AAV9의 갈락토스 결합 잔기들 D271, N272, N470, 및 Y446을 내포한 반면, 블록 6은 보존된 잔기 W503을 내포하였다. 예컨대, Bell 외. (2012) J. Virol. 86을 참고하라. 대조적으로, SCH2는 블록 5에서 AAV9의 AAV2로의 치환으로 인해 주요 갈락토스 결합 잔기들 중 2개가 없다.
도 16. 크로마토그래피를 먼저 사용하여 두 SCHEMA 변이체의 헤파린 친화력이 AAV2와 유사하다는 것을 입증하였으며, 이는 헤파린 포켓 외부의 키메라 서열 내용이 결합 친화력에 유의하게 영향을 미치지 않았음을 나타낸다 (도 16A). 이어서, 헤파란 설페이트 프로테오글리칸 (HSPG) 및 갈락토스의 이중 이용 가능성을 세포 표면상에서 말단 갈락토스 잔기 및 HSPG를 발현하는 CHO-Lec2 세포를 감염시킴으로써 평가하였다. Shen 외. (2013) J. Biol. Chem. 288에 이전에 기재된 바와 같이, E rythrina cristagalli lectin (ECL)의 첨가는 말단 갈락토스를 차단하는 반면, 가용성 헤파린을 사용한 바이러스 배양은 세포 진입을 위해 HSPG를 이용하는 AAV 혈청형을 경쟁적으로 저해하였다. 예상한 바와 같이, AAV2 및 AAV9 대조 벡터들은 각각 HSPG 및 갈락토스를 이용하였다. 흥미롭게도, SCH2는 HSPG에만 단독 의존하는 반면, SCH9는 HSPG와 갈락토스를 모두 사용할 수 있었으며 실제로 세포 형질도입을 막기 위해 이 둘 모두가 차단 될 것이 필요하였다 (도16B). SCH2 및 SCH9의 상이한 글리칸 결합 특성을 특성화 한 후, 이 두 변이체 모두가 자연 AAV 혈청 형에서 AAV 감염에 중요한 새로이 설명되는 단백질 수용체인 AAVR을 계속하여 이용하는지를 결정하기 위해 이들을 조사하였다. 예컨대, Pillay 외. (2016) Nature 530을 참고하라. 도 17. SCH2, SCH9, 및 AAV2 대조들은 모두 명백하게 AAVR에 의존적이었다.
마지막으로, DNA 셔플링이 중화 항체 에피토프를 파괴하는 것으로 나타났기 때문에 (예컨대, Maheshri 외. (2006) Nature Biotechnol. 24, 및 Grimm 외. (2008) J. Virol. 82 참고), 자연 AAV 혈청형에 대한 항체들의 다클론 혼합물인 인간 정맥내 면역글로불린 (IVIG)에 대한 SCH9의 내성을 정량하였다. SCH9를 중화시키는데 필요한 항체 역가는 이것이 유래된 모체 서열보다, 하기 표 1에 제시된 바와 같이 2 내지 10-배 더 높았다 (도 16C). 특히, 개선된 배수는 가장 밀접하게 관련된 모체 서열인 AAV9와 관련하여 가장 컸다.
표 1:
SCH9의 중화 IVIG 역가 및 이들이 유래된 모체 혈청형.
중화 역가는 GFP 발현의 50% 이상의 감소가 관찰되었던 첫 번째 IVIG 농도를 나타낸다.
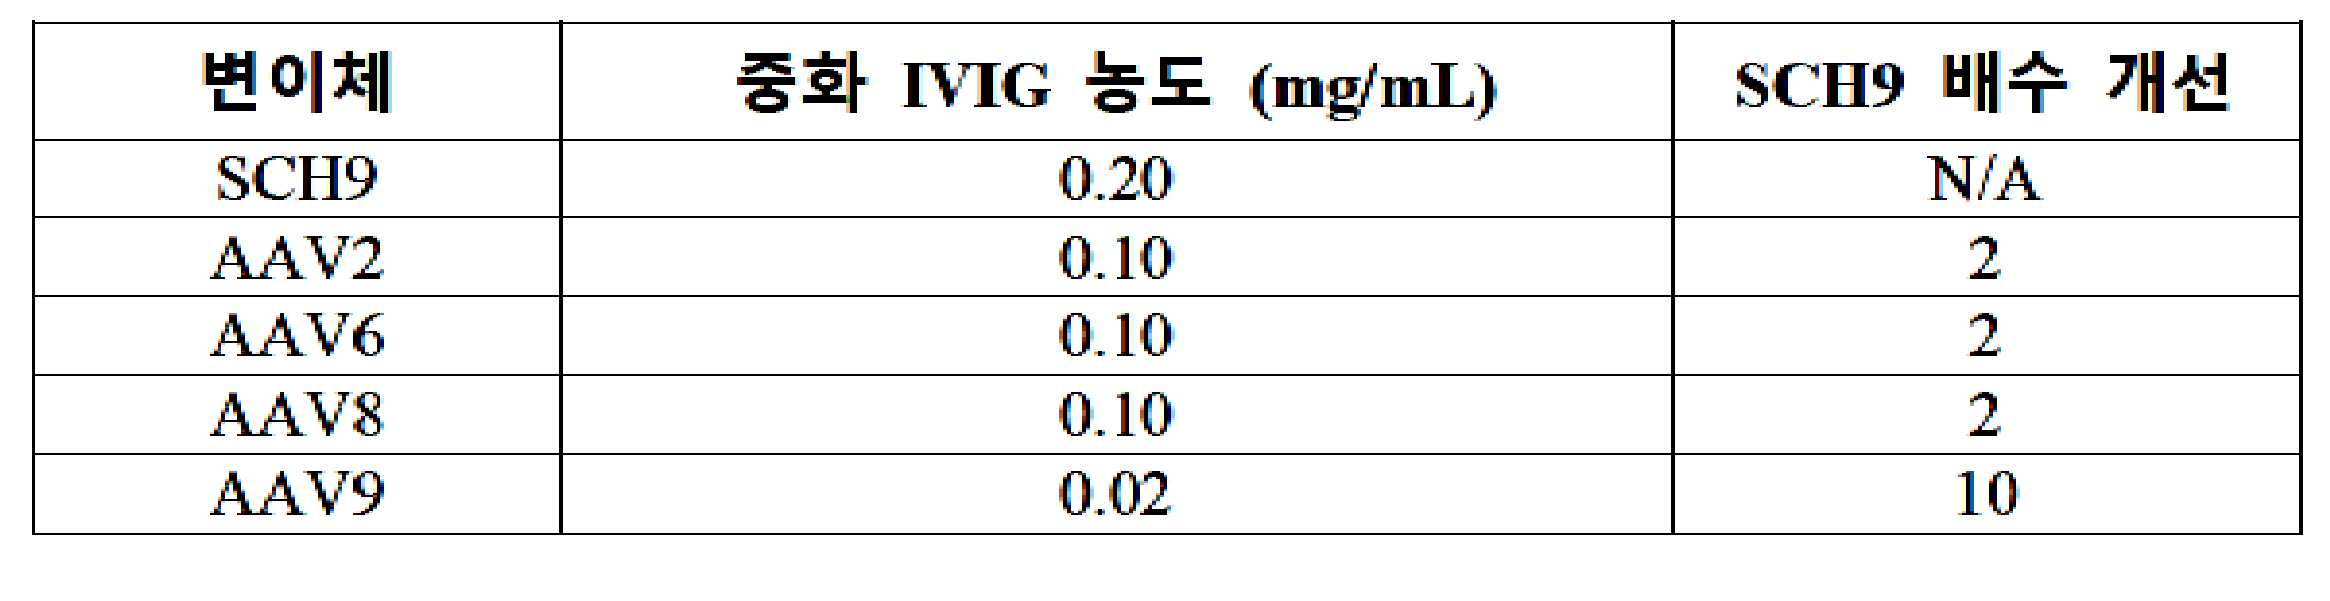
참고문헌



본 발명을 이의 특정 구체예들과 관련하여 설명하였으나, 해당 분야의 숙련된 기술자는 본 발명의 진정한 사상 및 범위로부터 벗어나지 않고 다양한 변화들이 이루어질 수 있고 균등구성이 치환될 수 있음을 이해하여야 한다. 또한, 특정 상황, 재료, 물질의 조성, 공정, 공정 단계 또는 단계들을 개조하기 위해 본 발명의 목적, 사상 및 범위에 대한 많은 변형들이 이루어질 수 있다. 이러한 모든 변형들은 첨부된 청구범위에 포함되는 것으로 한다.
SEQUENCE LISTING
<110> Schaffer, David V
Ojala, David S
Romero, Phillip A
<120> Adeno-Associated Virus Capsid Variants and Methods of Use Thereof
<130> BERK-365WO
<150> US 62/551,133
<151> 2017-08-28
<160> 172
<170> PatentIn version 3.5
<210> 1
<211> 736
<212> PRT
<213> Adeno-associated virus
<400> 1
Met Ala Ala Asp Gly Tyr Leu Pro Asp Trp Leu Glu Asp Asn Leu Ser
1 5 10 15
Glu Gly Ile Arg Glu Trp Trp Asp Leu Lys Pro Gly Ala Pro Lys Pro
20 25 30
Lys Ala Asn Gln Gln Lys Gln Asp Asp Gly Arg Gly Leu Val Leu Pro
35 40 45
Gly Tyr Lys Tyr Leu Gly Pro Phe Asn Gly Leu Asp Lys Gly Glu Pro
50 55 60
Val Asn Ala Ala Asp Ala Ala Ala Leu Glu His Asp Lys Ala Tyr Asp
65 70 75 80
Gln Gln Leu Lys Ala Gly Asp Asn Pro Tyr Leu Arg Tyr Asn His Ala
85 90 95
Asp Ala Glu Phe Gln Glu Arg Leu Gln Glu Asp Thr Ser Phe Gly Gly
100 105 110
Asn Leu Gly Arg Ala Val Phe Gln Ala Lys Lys Arg Val Leu Glu Pro
115 120 125
Leu Gly Leu Val Glu Glu Ala Ala Lys Thr Ala Pro Gly Lys Lys Arg
130 135 140
Pro Val Glu Gln Ser Pro Gln Glu Pro Asp Ser Ser Ala Gly Ile Gly
145 150 155 160
Lys Ser Gly Ala Gln Pro Ala Lys Lys Arg Leu Asn Phe Gly Gln Thr
165 170 175
Gly Asp Thr Glu Ser Val Pro Asp Pro Gln Pro Ile Gly Glu Pro Pro
180 185 190
Ala Ala Pro Ser Gly Val Gly Ser Leu Thr Met Ala Ser Gly Gly Gly
195 200 205
Ala Pro Val Ala Asp Asn Asn Glu Gly Ala Asp Gly Val Gly Ser Ser
210 215 220
Ser Gly Asn Trp His Cys Asp Ser Gln Trp Leu Gly Asp Arg Val Ile
225 230 235 240
Thr Thr Ser Thr Arg Thr Trp Ala Leu Pro Thr Tyr Asn Asn His Leu
245 250 255
Tyr Lys Gln Ile Ser Asn Ser Thr Ser Gly Gly Ser Ser Asn Asp Asn
260 265 270
Ala Tyr Phe Gly Tyr Ser Thr Pro Trp Gly Tyr Phe Asp Phe Asn Arg
275 280 285
Phe His Cys His Phe Ser Pro Arg Asp Trp Gln Arg Leu Ile Asn Asn
290 295 300
Asn Trp Gly Phe Arg Pro Lys Arg Leu Ser Phe Lys Leu Phe Asn Ile
305 310 315 320
Gln Val Lys Glu Val Thr Gln Asn Glu Gly Thr Lys Thr Ile Ala Asn
325 330 335
Asn Leu Thr Ser Thr Ile Gln Val Phe Thr Asp Ser Asp Tyr Gln Leu
340 345 350
Pro Tyr Val Leu Gly Ser Ala His Glu Gly Cys Leu Pro Pro Phe Pro
355 360 365
Ala Asp Val Phe Met Ile Pro Gln Tyr Gly Tyr Leu Thr Leu Asn Asp
370 375 380
Gly Ser Gln Ala Val Gly Arg Ser Ser Phe Tyr Cys Leu Glu Tyr Phe
385 390 395 400
Pro Ser Gln Met Leu Arg Thr Gly Asn Asn Phe Gln Phe Ser Tyr Glu
405 410 415
Phe Glu Asn Val Pro Phe His Ser Ser Tyr Ala His Ser Gln Ser Leu
420 425 430
Asp Arg Leu Met Asn Pro Leu Ile Asp Gln Tyr Leu Tyr Tyr Leu Ser
435 440 445
Lys Thr Ile Asn Gly Ser Gly Gln Asn Gln Gln Thr Leu Lys Phe Ser
450 455 460
Val Ala Gly Pro Ser Asn Met Ala Val Gln Gly Arg Asn Trp Leu Pro
465 470 475 480
Gly Pro Cys Tyr Arg Gln Gln Arg Val Ser Lys Thr Ser Ala Asp Asn
485 490 495
Asn Asn Ser Glu Tyr Ser Trp Thr Gly Ala Thr Lys Tyr His Leu Asn
500 505 510
Gly Arg Asp Ser Leu Val Asn Pro Gly Pro Ala Met Ala Ser His Lys
515 520 525
Asp Asp Glu Glu Lys Phe Phe Pro Gln Ser Gly Val Leu Ile Phe Gly
530 535 540
Lys Gln Gly Ser Glu Lys Thr Asn Val Asp Ile Glu Lys Val Met Ile
545 550 555 560
Thr Asp Glu Glu Glu Ile Arg Thr Thr Asn Pro Val Ala Thr Glu Gln
565 570 575
Tyr Gly Ser Val Ser Thr Asn Leu Gln Arg Gly Asn Arg Gln Ala Ala
580 585 590
Thr Ala Asp Val Asn Thr Gln Gly Val Leu Pro Gly Met Val Trp Gln
595 600 605
Asp Arg Asp Val Tyr Leu Gln Gly Pro Ile Trp Ala Lys Ile Pro His
610 615 620
Thr Asp Gly Asn Phe His Pro Ser Pro Leu Met Gly Gly Phe Gly Met
625 630 635 640
Lys His Pro Pro Pro Gln Ile Leu Ile Lys Asn Thr Pro Val Pro Ala
645 650 655
Asp Pro Pro Thr Ala Phe Asn Lys Asp Lys Leu Asn Ser Phe Ile Thr
660 665 670
Gln Tyr Ser Thr Gly Gln Val Ser Val Glu Ile Glu Trp Glu Leu Gln
675 680 685
Lys Glu Asn Ser Lys Arg Trp Asn Pro Glu Ile Gln Tyr Thr Ser Asn
690 695 700
Tyr Tyr Lys Ser Asn Asn Val Glu Phe Ala Val Asn Thr Glu Gly Val
705 710 715 720
Tyr Ser Glu Pro Arg Pro Ile Gly Thr Arg Tyr Leu Thr Arg Asn Leu
725 730 735
<210> 2
<211> 737
<212> PRT
<213> Adeno-associated virus
<400> 2
Met Ala Ala Asp Gly Tyr Leu Pro Asp Trp Leu Glu Asp Asn Leu Ser
1 5 10 15
Glu Gly Ile Arg Glu Trp Trp Asp Leu Lys Pro Gly Ala Pro Lys Pro
20 25 30
Lys Ala Asn Gln Gln Lys Gln Asp Asp Gly Arg Gly Leu Val Leu Pro
35 40 45
Gly Tyr Lys Tyr Leu Gly Pro Phe Asn Gly Leu Asp Lys Gly Glu Pro
50 55 60
Val Asn Ala Ala Asp Ala Ala Ala Leu Glu His Asp Lys Ala Tyr Asp
65 70 75 80
Gln Gln Leu Lys Ala Gly Asp Asn Pro Tyr Leu Arg Tyr Asn His Ala
85 90 95
Asp Ala Glu Phe Gln Glu Arg Leu Gln Glu Asp Thr Ser Phe Gly Gly
100 105 110
Asn Leu Gly Arg Ala Val Phe Gln Ala Lys Lys Arg Val Leu Glu Pro
115 120 125
Leu Gly Leu Val Glu Glu Ala Ala Lys Thr Ala Pro Gly Lys Lys Arg
130 135 140
Pro Val Glu Gln Ser Pro Gln Glu Pro Asp Ser Ser Ala Gly Ile Gly
145 150 155 160
Lys Ser Gly Ala Gln Pro Ala Lys Lys Arg Leu Asn Phe Gly Gln Thr
165 170 175
Gly Asp Thr Glu Ser Val Pro Asp Pro Gln Pro Ile Gly Glu Pro Pro
180 185 190
Ala Ala Pro Ser Gly Val Gly Ser Leu Thr Met Ala Ser Gly Gly Gly
195 200 205
Ala Pro Val Ala Asp Asn Asn Glu Gly Ala Asp Gly Val Gly Ser Ser
210 215 220
Ser Gly Asn Trp His Cys Asp Ser Gln Trp Leu Gly Asp Arg Val Ile
225 230 235 240
Thr Thr Ser Thr Arg Thr Trp Ala Leu Pro Thr Tyr Asn Asn His Leu
245 250 255
Tyr Lys Gln Ile Ser Asn Ser Thr Ser Gly Gly Ser Ser Asn Asp Asn
260 265 270
Ala Tyr Phe Gly Tyr Ser Thr Pro Trp Gly Tyr Phe Asp Phe Asn Arg
275 280 285
Phe His Cys His Phe Ser Pro Arg Asp Trp Gln Arg Leu Ile Asn Asn
290 295 300
Asn Trp Gly Phe Arg Pro Lys Arg Leu Ser Phe Lys Leu Phe Asn Ile
305 310 315 320
Gln Val Lys Glu Val Thr Gln Asn Glu Gly Thr Lys Thr Ile Ala Asn
325 330 335
Asn Leu Thr Ser Thr Ile Gln Val Phe Thr Asp Ser Asp Tyr Gln Leu
340 345 350
Pro Tyr Val Leu Gly Ser Ala His Glu Gly Cys Leu Pro Pro Phe Pro
355 360 365
Ala Asp Val Phe Met Ile Pro Gln Tyr Gly Tyr Leu Thr Leu Asn Asp
370 375 380
Gly Ser Gln Ala Val Gly Arg Ser Ser Phe Tyr Cys Leu Glu Tyr Phe
385 390 395 400
Pro Ser Gln Met Leu Arg Thr Gly Asn Asn Phe Gln Phe Ser Tyr Thr
405 410 415
Phe Glu Asp Val Pro Phe His Ser Ser Tyr Ala His Ser Gln Ser Leu
420 425 430
Asp Arg Leu Met Asn Pro Leu Ile Asp Gln Tyr Leu Tyr Tyr Leu Ser
435 440 445
Arg Thr Asn Thr Pro Ser Gly Thr Thr Thr Gln Ser Arg Leu Gln Phe
450 455 460
Ser Gln Ala Gly Ala Ser Asp Ile Arg Asp Gln Ser Arg Asn Trp Leu
465 470 475 480
Pro Gly Pro Cys Tyr Arg Gln Gln Arg Val Ser Lys Thr Ser Ala Asp
485 490 495
Asn Asn Asn Ser Glu Tyr Ser Trp Thr Gly Ala Thr Lys Tyr His Leu
500 505 510
Asn Gly Arg Asp Ser Leu Val Asn Pro Gly Pro Ala Met Ala Ser His
515 520 525
Lys Asp Asp Glu Glu Lys Phe Phe Pro Gln Ser Gly Val Leu Ile Phe
530 535 540
Gly Lys Gln Gly Ser Glu Lys Thr Asn Val Asp Ile Glu Lys Val Met
545 550 555 560
Ile Thr Asp Glu Glu Glu Ile Arg Thr Thr Asn Pro Val Ala Thr Glu
565 570 575
Gln Tyr Gly Ser Val Ser Thr Asn Leu Gln Arg Gly Asn Arg Gln Ala
580 585 590
Ala Thr Ala Asp Val Asn Thr Gln Gly Val Leu Pro Gly Met Val Trp
595 600 605
Gln Asp Arg Asp Val Tyr Leu Gln Gly Pro Ile Trp Ala Lys Ile Pro
610 615 620
His Thr Asp Gly Asn Phe His Pro Ser Pro Leu Met Gly Gly Phe Gly
625 630 635 640
Met Lys His Pro Pro Pro Gln Ile Leu Ile Lys Asn Thr Pro Val Pro
645 650 655
Ala Asp Pro Pro Thr Ala Phe Asn Lys Asp Lys Leu Asn Ser Phe Ile
660 665 670
Thr Gln Tyr Ser Thr Gly Gln Val Ser Val Glu Ile Glu Trp Glu Leu
675 680 685
Gln Lys Glu Asn Ser Lys Arg Trp Asn Pro Glu Ile Gln Tyr Thr Ser
690 695 700
Asn Tyr Tyr Lys Ser Asn Asn Val Glu Phe Ala Val Asn Thr Glu Gly
705 710 715 720
Val Tyr Ser Glu Pro Arg Pro Ile Gly Thr Arg Tyr Leu Thr Arg Asn
725 730 735
Leu
<210> 3
<211> 7
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 3
Leu Gly Glu Thr Thr Arg Pro
1 5
<210> 4
<211> 7
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 4
Asn Glu Thr Ile Thr Arg Pro
1 5
<210> 5
<211> 7
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 5
Lys Ala Gly Gln Ala Asn Asn
1 5
<210> 6
<211> 7
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 6
Lys Asp Pro Lys Thr Thr Asn
1 5
<210> 7
<211> 7
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 7
Lys Asp Thr Asp Thr Thr Arg
1 5
<210> 8
<211> 7
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 8
Arg Ala Gly Gly Ser Val Gly
1 5
<210> 9
<211> 7
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 9
Ala Val Asp Thr Thr Lys Phe
1 5
<210> 10
<211> 7
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 10
Ser Thr Gly Lys Val Pro Asn
1 5
<210> 11
<211> 736
<212> PRT
<213> Adeno-associated virus
<400> 11
Met Ala Ala Asp Gly Tyr Leu Pro Asp Trp Leu Glu Asp Asn Leu Ser
1 5 10 15
Glu Gly Ile Arg Glu Trp Trp Asp Leu Lys Pro Gly Ala Pro Lys Pro
20 25 30
Lys Ala Asn Gln Gln Lys Gln Asp Asp Gly Arg Gly Leu Val Leu Pro
35 40 45
Gly Tyr Lys Tyr Leu Gly Pro Phe Asn Gly Leu Asp Lys Gly Glu Pro
50 55 60
Val Asn Ala Ala Asp Ala Ala Ala Leu Glu His Asp Lys Ala Tyr Asp
65 70 75 80
Gln Gln Leu Lys Ala Gly Asp Asn Pro Tyr Leu Arg Tyr Asn His Ala
85 90 95
Asp Ala Glu Phe Gln Glu Arg Leu Gln Glu Asp Thr Ser Phe Gly Gly
100 105 110
Asn Leu Gly Arg Ala Val Phe Gln Ala Lys Lys Arg Val Leu Glu Pro
115 120 125
Phe Gly Leu Val Glu Glu Gly Ala Lys Thr Ala Pro Gly Lys Lys Arg
130 135 140
Pro Val Glu Gln Ser Pro Gln Glu Pro Asp Ser Ser Ser Gly Ile Gly
145 150 155 160
Lys Thr Gly Gln Gln Pro Ala Lys Lys Arg Leu Asn Phe Gly Gln Thr
165 170 175
Gly Asp Ser Glu Ser Val Pro Asp Pro Gln Pro Leu Gly Glu Pro Pro
180 185 190
Ala Thr Pro Ala Ala Val Gly Pro Thr Thr Met Ala Ser Gly Gly Gly
195 200 205
Ala Pro Met Ala Asp Asn Asn Glu Gly Ala Asp Gly Val Gly Asn Ala
210 215 220
Ser Gly Asn Trp His Cys Asp Ser Thr Trp Leu Gly Asp Arg Val Ile
225 230 235 240
Thr Thr Ser Thr Arg Thr Trp Ala Leu Pro Thr Tyr Asn Asn His Leu
245 250 255
Tyr Lys Gln Ile Ser Ser Ala Ser Thr Gly Ala Ser Asn Asp Asn His
260 265 270
Tyr Phe Gly Tyr Ser Thr Pro Trp Gly Tyr Phe Asp Phe Asn Arg Phe
275 280 285
His Cys His Phe Ser Pro Arg Asp Trp Gln Arg Leu Ile Asn Asn Asn
290 295 300
Trp Gly Phe Arg Pro Lys Arg Leu Asn Phe Lys Leu Phe Asn Ile Gln
305 310 315 320
Val Lys Glu Val Thr Thr Asn Asp Gly Val Thr Thr Ile Ala Asn Asn
325 330 335
Leu Thr Ser Thr Val Gln Val Phe Ser Asp Ser Glu Tyr Gln Leu Pro
340 345 350
Tyr Val Leu Gly Ser Ala His Gln Gly Cys Leu Pro Pro Phe Pro Ala
355 360 365
Asp Val Phe Met Ile Pro Gln Tyr Gly Tyr Leu Thr Leu Asn Asn Gly
370 375 380
Ser Gln Ala Val Gly Arg Ser Ser Phe Tyr Cys Leu Glu Tyr Phe Pro
385 390 395 400
Ser Gln Met Leu Arg Thr Gly Asn Asn Phe Thr Phe Ser Tyr Thr Phe
405 410 415
Glu Asp Val Pro Phe His Ser Ser Tyr Ala His Ser Gln Ser Leu Asp
420 425 430
Arg Leu Met Asn Pro Leu Ile Asp Gln Tyr Leu Tyr Tyr Leu Asn Arg
435 440 445
Thr Gln Asn Gln Ser Gly Ser Ala Gln Asn Lys Asp Leu Leu Phe Ser
450 455 460
Arg Gly Ser Pro Ala Gly Met Ser Val Gln Pro Lys Asn Trp Leu Pro
465 470 475 480
Gly Pro Cys Tyr Arg Gln Gln Arg Val Ser Lys Thr Lys Thr Asp Asn
485 490 495
Asn Asn Ser Asn Phe Thr Trp Thr Gly Ala Ser Lys Tyr Asn Leu Asn
500 505 510
Gly Arg Glu Ser Ile Ile Asn Pro Gly Thr Ala Met Ala Ser His Lys
515 520 525
Asp Asp Lys Asp Lys Phe Phe Pro Met Ser Gly Val Met Ile Phe Gly
530 535 540
Lys Glu Ser Ala Gly Ala Ser Asn Thr Ala Leu Asp Asn Val Met Ile
545 550 555 560
Thr Asp Glu Glu Glu Ile Lys Ala Thr Asn Pro Val Ala Thr Glu Arg
565 570 575
Phe Gly Thr Val Ala Val Asn Leu Gln Ser Ser Ser Thr Asp Pro Ala
580 585 590
Thr Gly Asp Val His Val Met Gly Ala Leu Pro Gly Met Val Trp Gln
595 600 605
Asp Arg Asp Val Tyr Leu Gln Gly Pro Ile Trp Ala Lys Ile Pro His
610 615 620
Thr Asp Gly His Phe His Pro Ser Pro Leu Met Gly Gly Phe Gly Leu
625 630 635 640
Lys His Pro Pro Pro Gln Ile Leu Ile Lys Asn Thr Pro Val Pro Ala
645 650 655
Asn Pro Pro Ala Glu Phe Ser Ala Thr Lys Phe Ala Ser Phe Ile Thr
660 665 670
Gln Tyr Ser Thr Gly Gln Val Ser Val Glu Ile Glu Trp Glu Leu Gln
675 680 685
Lys Glu Asn Ser Lys Arg Trp Asn Pro Glu Val Gln Tyr Thr Ser Asn
690 695 700
Tyr Ala Lys Ser Ala Asn Val Asp Phe Thr Val Asp Asn Asn Gly Leu
705 710 715 720
Tyr Thr Glu Pro Arg Pro Ile Gly Thr Arg Tyr Leu Thr Arg Pro Leu
725 730 735
<210> 12
<211> 20
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 12
cgcaacagga agcaacaccg 20
<210> 13
<211> 29
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 13
gctgcaatga taccgcgaaa cccacgctc 29
<210> 14
<211> 29
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 14
gagcgtgggt ttcgcggtat cattgcagc 29
<210> 15
<211> 35
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 15
gctcctggaa agaagaggcc gttgattgaa tcccc 35
<210> 16
<211> 35
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 16
ggggattcaa tcaacggcct cttctttcca ggagc 35
<210> 17
<211> 27
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 17
gacccggaaa cggactcgat cgaggag 27
<210> 18
<211> 27
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 18
ctcctcgatc gagtccgttt ccgggtc 27
<210> 19
<211> 25
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 19
gtttagccgg ggctctccag ctggc 25
<210> 20
<211> 25
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 20
gccagctgga gagccccggc taaac 25
<210> 21
<211> 33
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 21
ctcctggaaa gaagaggccg gtagagccat cac 33
<210> 22
<211> 33
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 22
gtgatggctc taccggcctc ttctttccag gag 33
<210> 23
<211> 43
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 23
caagcggccg cgtaagctta gatctctgac gtcgatggct gcg 43
<210> 24
<211> 43
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 24
cgcagccatc gacgtcagag atctaagctt acgcggccgc ttg 43
<210> 25
<211> 41
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 25
gatctataac ttcgtatagc atacattata cgaacggtac g 41
<210> 26
<211> 41
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 26
cgtaccgttc gtataatgta tgctatacga agttatttcg a 41
<210> 27
<211> 67
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 27
ccgcttgtta atcaataaac cgtttaattc gtttcagttg actcgaggtc tctgcgtatt 60
tctttct 67
<210> 28
<211> 67
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 28
agaaagaaat acgcagagac ctcgagtcaa ctgaaacgaa ttaaacggtt tattgattaa 60
caagcgg 67
<210> 29
<211> 50
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 29
cgtagataag tagcatggcg ggttaatcag gtaccacaag gaacccctag 50
<210> 30
<211> 50
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 30
ctaggggttc cttgtggtac ctgattaacc cgccatgcta cttatctacg 50
<210> 31
<211> 78
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 31
gtcagcctcg agataacttc gtataatgta tgctatacga acggtactgt ggtcgtcatt 60
ggcaactaca cctgttcg 78
<210> 32
<211> 91
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 32
cgtcacggta cctgtggaat tgtgagcgct cacaattcca cagctagcct atttaccgat 60
accacacgaa caggtgtagt tgccaatgac g 91
<210> 33
<211> 21
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 33
gtcagcctcg agataacttc g 21
<210> 34
<211> 17
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 34
cgtcacggta cctgtgg 17
<210> 35
<211> 22
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 35
catggaaact agataagaaa ga 22
<210> 36
<211> 27
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 36
ggtacgaagc ttcgatcaac tacgcag 27
<210> 37
<211> 21
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 37
agctagccta tttaccgata c 21
<210> 38
<211> 21
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 38
aagttcaact gaaacgaatt a 21
<210> 39
<211> 19
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 39
cacacgaaca ggtgtagtt 19
<210> 40
<211> 1368
<212> PRT
<213> Streptococcus pyogenes
<400> 40
Met Asp Lys Lys Tyr Ser Ile Gly Leu Asp Ile Gly Thr Asn Ser Val
1 5 10 15
Gly Trp Ala Val Ile Thr Asp Glu Tyr Lys Val Pro Ser Lys Lys Phe
20 25 30
Lys Val Leu Gly Asn Thr Asp Arg His Ser Ile Lys Lys Asn Leu Ile
35 40 45
Gly Ala Leu Leu Phe Asp Ser Gly Glu Thr Ala Glu Ala Thr Arg Leu
50 55 60
Lys Arg Thr Ala Arg Arg Arg Tyr Thr Arg Arg Lys Asn Arg Ile Cys
65 70 75 80
Tyr Leu Gln Glu Ile Phe Ser Asn Glu Met Ala Lys Val Asp Asp Ser
85 90 95
Phe Phe His Arg Leu Glu Glu Ser Phe Leu Val Glu Glu Asp Lys Lys
100 105 110
His Glu Arg His Pro Ile Phe Gly Asn Ile Val Asp Glu Val Ala Tyr
115 120 125
His Glu Lys Tyr Pro Thr Ile Tyr His Leu Arg Lys Lys Leu Val Asp
130 135 140
Ser Thr Asp Lys Ala Asp Leu Arg Leu Ile Tyr Leu Ala Leu Ala His
145 150 155 160
Met Ile Lys Phe Arg Gly His Phe Leu Ile Glu Gly Asp Leu Asn Pro
165 170 175
Asp Asn Ser Asp Val Asp Lys Leu Phe Ile Gln Leu Val Gln Thr Tyr
180 185 190
Asn Gln Leu Phe Glu Glu Asn Pro Ile Asn Ala Ser Gly Val Asp Ala
195 200 205
Lys Ala Ile Leu Ser Ala Arg Leu Ser Lys Ser Arg Arg Leu Glu Asn
210 215 220
Leu Ile Ala Gln Leu Pro Gly Glu Lys Lys Asn Gly Leu Phe Gly Asn
225 230 235 240
Leu Ile Ala Leu Ser Leu Gly Leu Thr Pro Asn Phe Lys Ser Asn Phe
245 250 255
Asp Leu Ala Glu Asp Ala Lys Leu Gln Leu Ser Lys Asp Thr Tyr Asp
260 265 270
Asp Asp Leu Asp Asn Leu Leu Ala Gln Ile Gly Asp Gln Tyr Ala Asp
275 280 285
Leu Phe Leu Ala Ala Lys Asn Leu Ser Asp Ala Ile Leu Leu Ser Asp
290 295 300
Ile Leu Arg Val Asn Thr Glu Ile Thr Lys Ala Pro Leu Ser Ala Ser
305 310 315 320
Met Ile Lys Arg Tyr Asp Glu His His Gln Asp Leu Thr Leu Leu Lys
325 330 335
Ala Leu Val Arg Gln Gln Leu Pro Glu Lys Tyr Lys Glu Ile Phe Phe
340 345 350
Asp Gln Ser Lys Asn Gly Tyr Ala Gly Tyr Ile Asp Gly Gly Ala Ser
355 360 365
Gln Glu Glu Phe Tyr Lys Phe Ile Lys Pro Ile Leu Glu Lys Met Asp
370 375 380
Gly Thr Glu Glu Leu Leu Val Lys Leu Asn Arg Glu Asp Leu Leu Arg
385 390 395 400
Lys Gln Arg Thr Phe Asp Asn Gly Ser Ile Pro His Gln Ile His Leu
405 410 415
Gly Glu Leu His Ala Ile Leu Arg Arg Gln Glu Asp Phe Tyr Pro Phe
420 425 430
Leu Lys Asp Asn Arg Glu Lys Ile Glu Lys Ile Leu Thr Phe Arg Ile
435 440 445
Pro Tyr Tyr Val Gly Pro Leu Ala Arg Gly Asn Ser Arg Phe Ala Trp
450 455 460
Met Thr Arg Lys Ser Glu Glu Thr Ile Thr Pro Trp Asn Phe Glu Glu
465 470 475 480
Val Val Asp Lys Gly Ala Ser Ala Gln Ser Phe Ile Glu Arg Met Thr
485 490 495
Asn Phe Asp Lys Asn Leu Pro Asn Glu Lys Val Leu Pro Lys His Ser
500 505 510
Leu Leu Tyr Glu Tyr Phe Thr Val Tyr Asn Glu Leu Thr Lys Val Lys
515 520 525
Tyr Val Thr Glu Gly Met Arg Lys Pro Ala Phe Leu Ser Gly Glu Gln
530 535 540
Lys Lys Ala Ile Val Asp Leu Leu Phe Lys Thr Asn Arg Lys Val Thr
545 550 555 560
Val Lys Gln Leu Lys Glu Asp Tyr Phe Lys Lys Ile Glu Cys Phe Asp
565 570 575
Ser Val Glu Ile Ser Gly Val Glu Asp Arg Phe Asn Ala Ser Leu Gly
580 585 590
Thr Tyr His Asp Leu Leu Lys Ile Ile Lys Asp Lys Asp Phe Leu Asp
595 600 605
Asn Glu Glu Asn Glu Asp Ile Leu Glu Asp Ile Val Leu Thr Leu Thr
610 615 620
Leu Phe Glu Asp Arg Glu Met Ile Glu Glu Arg Leu Lys Thr Tyr Ala
625 630 635 640
His Leu Phe Asp Asp Lys Val Met Lys Gln Leu Lys Arg Arg Arg Tyr
645 650 655
Thr Gly Trp Gly Arg Leu Ser Arg Lys Leu Ile Asn Gly Ile Arg Asp
660 665 670
Lys Gln Ser Gly Lys Thr Ile Leu Asp Phe Leu Lys Ser Asp Gly Phe
675 680 685
Ala Asn Arg Asn Phe Met Gln Leu Ile His Asp Asp Ser Leu Thr Phe
690 695 700
Lys Glu Asp Ile Gln Lys Ala Gln Val Ser Gly Gln Gly Asp Ser Leu
705 710 715 720
His Glu His Ile Ala Asn Leu Ala Gly Ser Pro Ala Ile Lys Lys Gly
725 730 735
Ile Leu Gln Thr Val Lys Val Val Asp Glu Leu Val Lys Val Met Gly
740 745 750
Arg His Lys Pro Glu Asn Ile Val Ile Glu Met Ala Arg Glu Asn Gln
755 760 765
Thr Thr Gln Lys Gly Gln Lys Asn Ser Arg Glu Arg Met Lys Arg Ile
770 775 780
Glu Glu Gly Ile Lys Glu Leu Gly Ser Gln Ile Leu Lys Glu His Pro
785 790 795 800
Val Glu Asn Thr Gln Leu Gln Asn Glu Lys Leu Tyr Leu Tyr Tyr Leu
805 810 815
Gln Asn Gly Arg Asp Met Tyr Val Asp Gln Glu Leu Asp Ile Asn Arg
820 825 830
Leu Ser Asp Tyr Asp Val Asp His Ile Val Pro Gln Ser Phe Leu Lys
835 840 845
Asp Asp Ser Ile Asp Asn Lys Val Leu Thr Arg Ser Asp Lys Asn Arg
850 855 860
Gly Lys Ser Asp Asn Val Pro Ser Glu Glu Val Val Lys Lys Met Lys
865 870 875 880
Asn Tyr Trp Arg Gln Leu Leu Asn Ala Lys Leu Ile Thr Gln Arg Lys
885 890 895
Phe Asp Asn Leu Thr Lys Ala Glu Arg Gly Gly Leu Ser Glu Leu Asp
900 905 910
Lys Ala Gly Phe Ile Lys Arg Gln Leu Val Glu Thr Arg Gln Ile Thr
915 920 925
Lys His Val Ala Gln Ile Leu Asp Ser Arg Met Asn Thr Lys Tyr Asp
930 935 940
Glu Asn Asp Lys Leu Ile Arg Glu Val Lys Val Ile Thr Leu Lys Ser
945 950 955 960
Lys Leu Val Ser Asp Phe Arg Lys Asp Phe Gln Phe Tyr Lys Val Arg
965 970 975
Glu Ile Asn Asn Tyr His His Ala His Asp Ala Tyr Leu Asn Ala Val
980 985 990
Val Gly Thr Ala Leu Ile Lys Lys Tyr Pro Lys Leu Glu Ser Glu Phe
995 1000 1005
Val Tyr Gly Asp Tyr Lys Val Tyr Asp Val Arg Lys Met Ile Ala
1010 1015 1020
Lys Ser Glu Gln Glu Ile Gly Lys Ala Thr Ala Lys Tyr Phe Phe
1025 1030 1035
Tyr Ser Asn Ile Met Asn Phe Phe Lys Thr Glu Ile Thr Leu Ala
1040 1045 1050
Asn Gly Glu Ile Arg Lys Arg Pro Leu Ile Glu Thr Asn Gly Glu
1055 1060 1065
Thr Gly Glu Ile Val Trp Asp Lys Gly Arg Asp Phe Ala Thr Val
1070 1075 1080
Arg Lys Val Leu Ser Met Pro Gln Val Asn Ile Val Lys Lys Thr
1085 1090 1095
Glu Val Gln Thr Gly Gly Phe Ser Lys Glu Ser Ile Leu Pro Lys
1100 1105 1110
Arg Asn Ser Asp Lys Leu Ile Ala Arg Lys Lys Asp Trp Asp Pro
1115 1120 1125
Lys Lys Tyr Gly Gly Phe Asp Ser Pro Thr Val Ala Tyr Ser Val
1130 1135 1140
Leu Val Val Ala Lys Val Glu Lys Gly Lys Ser Lys Lys Leu Lys
1145 1150 1155
Ser Val Lys Glu Leu Leu Gly Ile Thr Ile Met Glu Arg Ser Ser
1160 1165 1170
Phe Glu Lys Asn Pro Ile Asp Phe Leu Glu Ala Lys Gly Tyr Lys
1175 1180 1185
Glu Val Lys Lys Asp Leu Ile Ile Lys Leu Pro Lys Tyr Ser Leu
1190 1195 1200
Phe Glu Leu Glu Asn Gly Arg Lys Arg Met Leu Ala Ser Ala Gly
1205 1210 1215
Glu Leu Gln Lys Gly Asn Glu Leu Ala Leu Pro Ser Lys Tyr Val
1220 1225 1230
Asn Phe Leu Tyr Leu Ala Ser His Tyr Glu Lys Leu Lys Gly Ser
1235 1240 1245
Pro Glu Asp Asn Glu Gln Lys Gln Leu Phe Val Glu Gln His Lys
1250 1255 1260
His Tyr Leu Asp Glu Ile Ile Glu Gln Ile Ser Glu Phe Ser Lys
1265 1270 1275
Arg Val Ile Leu Ala Asp Ala Asn Leu Asp Lys Val Leu Ser Ala
1280 1285 1290
Tyr Asn Lys His Arg Asp Lys Pro Ile Arg Glu Gln Ala Glu Asn
1295 1300 1305
Ile Ile His Leu Phe Thr Leu Thr Asn Leu Gly Ala Pro Ala Ala
1310 1315 1320
Phe Lys Tyr Phe Asp Thr Thr Ile Asp Arg Lys Arg Tyr Thr Ser
1325 1330 1335
Thr Lys Glu Val Leu Asp Ala Thr Leu Ile His Gln Ser Ile Thr
1340 1345 1350
Gly Leu Tyr Glu Thr Arg Ile Asp Leu Ser Gln Leu Gly Gly Asp
1355 1360 1365
<210> 41
<211> 1368
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 41
Met Asp Lys Lys Tyr Ser Ile Gly Leu Ala Ile Gly Thr Asn Ser Val
1 5 10 15
Gly Trp Ala Val Ile Thr Asp Glu Tyr Lys Val Pro Ser Lys Lys Phe
20 25 30
Lys Val Leu Gly Asn Thr Asp Arg His Ser Ile Lys Lys Asn Leu Ile
35 40 45
Gly Ala Leu Leu Phe Asp Ser Gly Glu Thr Ala Glu Ala Thr Arg Leu
50 55 60
Lys Arg Thr Ala Arg Arg Arg Tyr Thr Arg Arg Lys Asn Arg Ile Cys
65 70 75 80
Tyr Leu Gln Glu Ile Phe Ser Asn Glu Met Ala Lys Val Asp Asp Ser
85 90 95
Phe Phe His Arg Leu Glu Glu Ser Phe Leu Val Glu Glu Asp Lys Lys
100 105 110
His Glu Arg His Pro Ile Phe Gly Asn Ile Val Asp Glu Val Ala Tyr
115 120 125
His Glu Lys Tyr Pro Thr Ile Tyr His Leu Arg Lys Lys Leu Val Asp
130 135 140
Ser Thr Asp Lys Ala Asp Leu Arg Leu Ile Tyr Leu Ala Leu Ala His
145 150 155 160
Met Ile Lys Phe Arg Gly His Phe Leu Ile Glu Gly Asp Leu Asn Pro
165 170 175
Asp Asn Ser Asp Val Asp Lys Leu Phe Ile Gln Leu Val Gln Thr Tyr
180 185 190
Asn Gln Leu Phe Glu Glu Asn Pro Ile Asn Ala Ser Gly Val Asp Ala
195 200 205
Lys Ala Ile Leu Ser Ala Arg Leu Ser Lys Ser Arg Arg Leu Glu Asn
210 215 220
Leu Ile Ala Gln Leu Pro Gly Glu Lys Lys Asn Gly Leu Phe Gly Asn
225 230 235 240
Leu Ile Ala Leu Ser Leu Gly Leu Thr Pro Asn Phe Lys Ser Asn Phe
245 250 255
Asp Leu Ala Glu Asp Ala Lys Leu Gln Leu Ser Lys Asp Thr Tyr Asp
260 265 270
Asp Asp Leu Asp Asn Leu Leu Ala Gln Ile Gly Asp Gln Tyr Ala Asp
275 280 285
Leu Phe Leu Ala Ala Lys Asn Leu Ser Asp Ala Ile Leu Leu Ser Asp
290 295 300
Ile Leu Arg Val Asn Thr Glu Ile Thr Lys Ala Pro Leu Ser Ala Ser
305 310 315 320
Met Ile Lys Arg Tyr Asp Glu His His Gln Asp Leu Thr Leu Leu Lys
325 330 335
Ala Leu Val Arg Gln Gln Leu Pro Glu Lys Tyr Lys Glu Ile Phe Phe
340 345 350
Asp Gln Ser Lys Asn Gly Tyr Ala Gly Tyr Ile Asp Gly Gly Ala Ser
355 360 365
Gln Glu Glu Phe Tyr Lys Phe Ile Lys Pro Ile Leu Glu Lys Met Asp
370 375 380
Gly Thr Glu Glu Leu Leu Val Lys Leu Asn Arg Glu Asp Leu Leu Arg
385 390 395 400
Lys Gln Arg Thr Phe Asp Asn Gly Ser Ile Pro His Gln Ile His Leu
405 410 415
Gly Glu Leu His Ala Ile Leu Arg Arg Gln Glu Asp Phe Tyr Pro Phe
420 425 430
Leu Lys Asp Asn Arg Glu Lys Ile Glu Lys Ile Leu Thr Phe Arg Ile
435 440 445
Pro Tyr Tyr Val Gly Pro Leu Ala Arg Gly Asn Ser Arg Phe Ala Trp
450 455 460
Met Thr Arg Lys Ser Glu Glu Thr Ile Thr Pro Trp Asn Phe Glu Glu
465 470 475 480
Val Val Asp Lys Gly Ala Ser Ala Gln Ser Phe Ile Glu Arg Met Thr
485 490 495
Asn Phe Asp Lys Asn Leu Pro Asn Glu Lys Val Leu Pro Lys His Ser
500 505 510
Leu Leu Tyr Glu Tyr Phe Thr Val Tyr Asn Glu Leu Thr Lys Val Lys
515 520 525
Tyr Val Thr Glu Gly Met Arg Lys Pro Ala Phe Leu Ser Gly Glu Gln
530 535 540
Lys Lys Ala Ile Val Asp Leu Leu Phe Lys Thr Asn Arg Lys Val Thr
545 550 555 560
Val Lys Gln Leu Lys Glu Asp Tyr Phe Lys Lys Ile Glu Cys Phe Asp
565 570 575
Ser Val Glu Ile Ser Gly Val Glu Asp Arg Phe Asn Ala Ser Leu Gly
580 585 590
Thr Tyr His Asp Leu Leu Lys Ile Ile Lys Asp Lys Asp Phe Leu Asp
595 600 605
Asn Glu Glu Asn Glu Asp Ile Leu Glu Asp Ile Val Leu Thr Leu Thr
610 615 620
Leu Phe Glu Asp Arg Glu Met Ile Glu Glu Arg Leu Lys Thr Tyr Ala
625 630 635 640
His Leu Phe Asp Asp Lys Val Met Lys Gln Leu Lys Arg Arg Arg Tyr
645 650 655
Thr Gly Trp Gly Arg Leu Ser Arg Lys Leu Ile Asn Gly Ile Arg Asp
660 665 670
Lys Gln Ser Gly Lys Thr Ile Leu Asp Phe Leu Lys Ser Asp Gly Phe
675 680 685
Ala Asn Arg Asn Phe Met Gln Leu Ile His Asp Asp Ser Leu Thr Phe
690 695 700
Lys Glu Asp Ile Gln Lys Ala Gln Val Ser Gly Gln Gly Asp Ser Leu
705 710 715 720
His Glu His Ile Ala Asn Leu Ala Gly Ser Pro Ala Ile Lys Lys Gly
725 730 735
Ile Leu Gln Thr Val Lys Val Val Asp Glu Leu Val Lys Val Met Gly
740 745 750
Arg His Lys Pro Glu Asn Ile Val Ile Glu Met Ala Arg Glu Asn Gln
755 760 765
Thr Thr Gln Lys Gly Gln Lys Asn Ser Arg Glu Arg Met Lys Arg Ile
770 775 780
Glu Glu Gly Ile Lys Glu Leu Gly Ser Gln Ile Leu Lys Glu His Pro
785 790 795 800
Val Glu Asn Thr Gln Leu Gln Asn Glu Lys Leu Tyr Leu Tyr Tyr Leu
805 810 815
Gln Asn Gly Arg Asp Met Tyr Val Asp Gln Glu Leu Asp Ile Asn Arg
820 825 830
Leu Ser Asp Tyr Asp Val Asp His Ile Val Pro Gln Ser Phe Leu Lys
835 840 845
Asp Asp Ser Ile Asp Asn Lys Val Leu Thr Arg Ser Asp Lys Asn Arg
850 855 860
Gly Lys Ser Asp Asn Val Pro Ser Glu Glu Val Val Lys Lys Met Lys
865 870 875 880
Asn Tyr Trp Arg Gln Leu Leu Asn Ala Lys Leu Ile Thr Gln Arg Lys
885 890 895
Phe Asp Asn Leu Thr Lys Ala Glu Arg Gly Gly Leu Ser Glu Leu Asp
900 905 910
Lys Ala Gly Phe Ile Lys Arg Gln Leu Val Glu Thr Arg Gln Ile Thr
915 920 925
Lys His Val Ala Gln Ile Leu Asp Ser Arg Met Asn Thr Lys Tyr Asp
930 935 940
Glu Asn Asp Lys Leu Ile Arg Glu Val Lys Val Ile Thr Leu Lys Ser
945 950 955 960
Lys Leu Val Ser Asp Phe Arg Lys Asp Phe Gln Phe Tyr Lys Val Arg
965 970 975
Glu Ile Asn Asn Tyr His His Ala His Asp Ala Tyr Leu Asn Ala Val
980 985 990
Val Gly Thr Ala Leu Ile Lys Lys Tyr Pro Lys Leu Glu Ser Glu Phe
995 1000 1005
Val Tyr Gly Asp Tyr Lys Val Tyr Asp Val Arg Lys Met Ile Ala
1010 1015 1020
Lys Ser Glu Gln Glu Ile Gly Lys Ala Thr Ala Lys Tyr Phe Phe
1025 1030 1035
Tyr Ser Asn Ile Met Asn Phe Phe Lys Thr Glu Ile Thr Leu Ala
1040 1045 1050
Asn Gly Glu Ile Arg Lys Arg Pro Leu Ile Glu Thr Asn Gly Glu
1055 1060 1065
Thr Gly Glu Ile Val Trp Asp Lys Gly Arg Asp Phe Ala Thr Val
1070 1075 1080
Arg Lys Val Leu Ser Met Pro Gln Val Asn Ile Val Lys Lys Thr
1085 1090 1095
Glu Val Gln Thr Gly Gly Phe Ser Lys Glu Ser Ile Leu Pro Lys
1100 1105 1110
Arg Asn Ser Asp Lys Leu Ile Ala Arg Lys Lys Asp Trp Asp Pro
1115 1120 1125
Lys Lys Tyr Gly Gly Phe Asp Ser Pro Thr Val Ala Tyr Ser Val
1130 1135 1140
Leu Val Val Ala Lys Val Glu Lys Gly Lys Ser Lys Lys Leu Lys
1145 1150 1155
Ser Val Lys Glu Leu Leu Gly Ile Thr Ile Met Glu Arg Ser Ser
1160 1165 1170
Phe Glu Lys Asn Pro Ile Asp Phe Leu Glu Ala Lys Gly Tyr Lys
1175 1180 1185
Glu Val Lys Lys Asp Leu Ile Ile Lys Leu Pro Lys Tyr Ser Leu
1190 1195 1200
Phe Glu Leu Glu Asn Gly Arg Lys Arg Met Leu Ala Ser Ala Gly
1205 1210 1215
Glu Leu Gln Lys Gly Asn Glu Leu Ala Leu Pro Ser Lys Tyr Val
1220 1225 1230
Asn Phe Leu Tyr Leu Ala Ser His Tyr Glu Lys Leu Lys Gly Ser
1235 1240 1245
Pro Glu Asp Asn Glu Gln Lys Gln Leu Phe Val Glu Gln His Lys
1250 1255 1260
His Tyr Leu Asp Glu Ile Ile Glu Gln Ile Ser Glu Phe Ser Lys
1265 1270 1275
Arg Val Ile Leu Ala Asp Ala Asn Leu Asp Lys Val Leu Ser Ala
1280 1285 1290
Tyr Asn Lys His Arg Asp Lys Pro Ile Arg Glu Gln Ala Glu Asn
1295 1300 1305
Ile Ile His Leu Phe Thr Leu Thr Asn Leu Gly Ala Pro Ala Ala
1310 1315 1320
Phe Lys Tyr Phe Asp Thr Thr Ile Asp Arg Lys Arg Tyr Thr Ser
1325 1330 1335
Thr Lys Glu Val Leu Asp Ala Thr Leu Ile His Gln Ser Ile Thr
1340 1345 1350
Gly Leu Tyr Glu Thr Arg Ile Asp Leu Ser Gln Leu Gly Gly Asp
1355 1360 1365
<210> 42
<211> 1368
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 42
Met Asp Lys Lys Tyr Ser Ile Gly Leu Asp Ile Gly Thr Asn Ser Val
1 5 10 15
Gly Trp Ala Val Ile Thr Asp Glu Tyr Lys Val Pro Ser Lys Lys Phe
20 25 30
Lys Val Leu Gly Asn Thr Asp Arg His Ser Ile Lys Lys Asn Leu Ile
35 40 45
Gly Ala Leu Leu Phe Asp Ser Gly Glu Thr Ala Glu Ala Thr Arg Leu
50 55 60
Lys Arg Thr Ala Arg Arg Arg Tyr Thr Arg Arg Lys Asn Arg Ile Cys
65 70 75 80
Tyr Leu Gln Glu Ile Phe Ser Asn Glu Met Ala Lys Val Asp Asp Ser
85 90 95
Phe Phe His Arg Leu Glu Glu Ser Phe Leu Val Glu Glu Asp Lys Lys
100 105 110
His Glu Arg His Pro Ile Phe Gly Asn Ile Val Asp Glu Val Ala Tyr
115 120 125
His Glu Lys Tyr Pro Thr Ile Tyr His Leu Arg Lys Lys Leu Val Asp
130 135 140
Ser Thr Asp Lys Ala Asp Leu Arg Leu Ile Tyr Leu Ala Leu Ala His
145 150 155 160
Met Ile Lys Phe Arg Gly His Phe Leu Ile Glu Gly Asp Leu Asn Pro
165 170 175
Asp Asn Ser Asp Val Asp Lys Leu Phe Ile Gln Leu Val Gln Thr Tyr
180 185 190
Asn Gln Leu Phe Glu Glu Asn Pro Ile Asn Ala Ser Gly Val Asp Ala
195 200 205
Lys Ala Ile Leu Ser Ala Arg Leu Ser Lys Ser Arg Arg Leu Glu Asn
210 215 220
Leu Ile Ala Gln Leu Pro Gly Glu Lys Lys Asn Gly Leu Phe Gly Asn
225 230 235 240
Leu Ile Ala Leu Ser Leu Gly Leu Thr Pro Asn Phe Lys Ser Asn Phe
245 250 255
Asp Leu Ala Glu Asp Ala Lys Leu Gln Leu Ser Lys Asp Thr Tyr Asp
260 265 270
Asp Asp Leu Asp Asn Leu Leu Ala Gln Ile Gly Asp Gln Tyr Ala Asp
275 280 285
Leu Phe Leu Ala Ala Lys Asn Leu Ser Asp Ala Ile Leu Leu Ser Asp
290 295 300
Ile Leu Arg Val Asn Thr Glu Ile Thr Lys Ala Pro Leu Ser Ala Ser
305 310 315 320
Met Ile Lys Arg Tyr Asp Glu His His Gln Asp Leu Thr Leu Leu Lys
325 330 335
Ala Leu Val Arg Gln Gln Leu Pro Glu Lys Tyr Lys Glu Ile Phe Phe
340 345 350
Asp Gln Ser Lys Asn Gly Tyr Ala Gly Tyr Ile Asp Gly Gly Ala Ser
355 360 365
Gln Glu Glu Phe Tyr Lys Phe Ile Lys Pro Ile Leu Glu Lys Met Asp
370 375 380
Gly Thr Glu Glu Leu Leu Val Lys Leu Asn Arg Glu Asp Leu Leu Arg
385 390 395 400
Lys Gln Arg Thr Phe Asp Asn Gly Ser Ile Pro His Gln Ile His Leu
405 410 415
Gly Glu Leu His Ala Ile Leu Arg Arg Gln Glu Asp Phe Tyr Pro Phe
420 425 430
Leu Lys Asp Asn Arg Glu Lys Ile Glu Lys Ile Leu Thr Phe Arg Ile
435 440 445
Pro Tyr Tyr Val Gly Pro Leu Ala Arg Gly Asn Ser Arg Phe Ala Trp
450 455 460
Met Thr Arg Lys Ser Glu Glu Thr Ile Thr Pro Trp Asn Phe Glu Glu
465 470 475 480
Val Val Asp Lys Gly Ala Ser Ala Gln Ser Phe Ile Glu Arg Met Thr
485 490 495
Asn Phe Asp Lys Asn Leu Pro Asn Glu Lys Val Leu Pro Lys His Ser
500 505 510
Leu Leu Tyr Glu Tyr Phe Thr Val Tyr Asn Glu Leu Thr Lys Val Lys
515 520 525
Tyr Val Thr Glu Gly Met Arg Lys Pro Ala Phe Leu Ser Gly Glu Gln
530 535 540
Lys Lys Ala Ile Val Asp Leu Leu Phe Lys Thr Asn Arg Lys Val Thr
545 550 555 560
Val Lys Gln Leu Lys Glu Asp Tyr Phe Lys Lys Ile Glu Cys Phe Asp
565 570 575
Ser Val Glu Ile Ser Gly Val Glu Asp Arg Phe Asn Ala Ser Leu Gly
580 585 590
Thr Tyr His Asp Leu Leu Lys Ile Ile Lys Asp Lys Asp Phe Leu Asp
595 600 605
Asn Glu Glu Asn Glu Asp Ile Leu Glu Asp Ile Val Leu Thr Leu Thr
610 615 620
Leu Phe Glu Asp Arg Glu Met Ile Glu Glu Arg Leu Lys Thr Tyr Ala
625 630 635 640
His Leu Phe Asp Asp Lys Val Met Lys Gln Leu Lys Arg Arg Arg Tyr
645 650 655
Thr Gly Trp Gly Arg Leu Ser Arg Lys Leu Ile Asn Gly Ile Arg Asp
660 665 670
Lys Gln Ser Gly Lys Thr Ile Leu Asp Phe Leu Lys Ser Asp Gly Phe
675 680 685
Ala Asn Arg Asn Phe Met Gln Leu Ile His Asp Asp Ser Leu Thr Phe
690 695 700
Lys Glu Asp Ile Gln Lys Ala Gln Val Ser Gly Gln Gly Asp Ser Leu
705 710 715 720
His Glu His Ile Ala Asn Leu Ala Gly Ser Pro Ala Ile Lys Lys Gly
725 730 735
Ile Leu Gln Thr Val Lys Val Val Asp Glu Leu Val Lys Val Met Gly
740 745 750
Arg His Lys Pro Glu Asn Ile Val Ile Glu Met Ala Arg Glu Asn Gln
755 760 765
Thr Thr Gln Lys Gly Gln Lys Asn Ser Arg Glu Arg Met Lys Arg Ile
770 775 780
Glu Glu Gly Ile Lys Glu Leu Gly Ser Gln Ile Leu Lys Glu His Pro
785 790 795 800
Val Glu Asn Thr Gln Leu Gln Asn Glu Lys Leu Tyr Leu Tyr Tyr Leu
805 810 815
Gln Asn Gly Arg Asp Met Tyr Val Asp Gln Glu Leu Asp Ile Asn Arg
820 825 830
Leu Ser Asp Tyr Asp Val Asp Ala Ile Val Pro Gln Ser Phe Leu Lys
835 840 845
Asp Asp Ser Ile Asp Asn Lys Val Leu Thr Arg Ser Asp Lys Asn Arg
850 855 860
Gly Lys Ser Asp Asn Val Pro Ser Glu Glu Val Val Lys Lys Met Lys
865 870 875 880
Asn Tyr Trp Arg Gln Leu Leu Asn Ala Lys Leu Ile Thr Gln Arg Lys
885 890 895
Phe Asp Asn Leu Thr Lys Ala Glu Arg Gly Gly Leu Ser Glu Leu Asp
900 905 910
Lys Ala Gly Phe Ile Lys Arg Gln Leu Val Glu Thr Arg Gln Ile Thr
915 920 925
Lys His Val Ala Gln Ile Leu Asp Ser Arg Met Asn Thr Lys Tyr Asp
930 935 940
Glu Asn Asp Lys Leu Ile Arg Glu Val Lys Val Ile Thr Leu Lys Ser
945 950 955 960
Lys Leu Val Ser Asp Phe Arg Lys Asp Phe Gln Phe Tyr Lys Val Arg
965 970 975
Glu Ile Asn Asn Tyr His His Ala His Asp Ala Tyr Leu Asn Ala Val
980 985 990
Val Gly Thr Ala Leu Ile Lys Lys Tyr Pro Lys Leu Glu Ser Glu Phe
995 1000 1005
Val Tyr Gly Asp Tyr Lys Val Tyr Asp Val Arg Lys Met Ile Ala
1010 1015 1020
Lys Ser Glu Gln Glu Ile Gly Lys Ala Thr Ala Lys Tyr Phe Phe
1025 1030 1035
Tyr Ser Asn Ile Met Asn Phe Phe Lys Thr Glu Ile Thr Leu Ala
1040 1045 1050
Asn Gly Glu Ile Arg Lys Arg Pro Leu Ile Glu Thr Asn Gly Glu
1055 1060 1065
Thr Gly Glu Ile Val Trp Asp Lys Gly Arg Asp Phe Ala Thr Val
1070 1075 1080
Arg Lys Val Leu Ser Met Pro Gln Val Asn Ile Val Lys Lys Thr
1085 1090 1095
Glu Val Gln Thr Gly Gly Phe Ser Lys Glu Ser Ile Leu Pro Lys
1100 1105 1110
Arg Asn Ser Asp Lys Leu Ile Ala Arg Lys Lys Asp Trp Asp Pro
1115 1120 1125
Lys Lys Tyr Gly Gly Phe Asp Ser Pro Thr Val Ala Tyr Ser Val
1130 1135 1140
Leu Val Val Ala Lys Val Glu Lys Gly Lys Ser Lys Lys Leu Lys
1145 1150 1155
Ser Val Lys Glu Leu Leu Gly Ile Thr Ile Met Glu Arg Ser Ser
1160 1165 1170
Phe Glu Lys Asn Pro Ile Asp Phe Leu Glu Ala Lys Gly Tyr Lys
1175 1180 1185
Glu Val Lys Lys Asp Leu Ile Ile Lys Leu Pro Lys Tyr Ser Leu
1190 1195 1200
Phe Glu Leu Glu Asn Gly Arg Lys Arg Met Leu Ala Ser Ala Gly
1205 1210 1215
Glu Leu Gln Lys Gly Asn Glu Leu Ala Leu Pro Ser Lys Tyr Val
1220 1225 1230
Asn Phe Leu Tyr Leu Ala Ser His Tyr Glu Lys Leu Lys Gly Ser
1235 1240 1245
Pro Glu Asp Asn Glu Gln Lys Gln Leu Phe Val Glu Gln His Lys
1250 1255 1260
His Tyr Leu Asp Glu Ile Ile Glu Gln Ile Ser Glu Phe Ser Lys
1265 1270 1275
Arg Val Ile Leu Ala Asp Ala Asn Leu Asp Lys Val Leu Ser Ala
1280 1285 1290
Tyr Asn Lys His Arg Asp Lys Pro Ile Arg Glu Gln Ala Glu Asn
1295 1300 1305
Ile Ile His Leu Phe Thr Leu Thr Asn Leu Gly Ala Pro Ala Ala
1310 1315 1320
Phe Lys Tyr Phe Asp Thr Thr Ile Asp Arg Lys Arg Tyr Thr Ser
1325 1330 1335
Thr Lys Glu Val Leu Asp Ala Thr Leu Ile His Gln Ser Ile Thr
1340 1345 1350
Gly Leu Tyr Glu Thr Arg Ile Asp Leu Ser Gln Leu Gly Gly Asp
1355 1360 1365
<210> 43
<211> 1368
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 43
Met Asp Lys Lys Tyr Ser Ile Gly Leu Ala Ile Gly Thr Asn Ser Val
1 5 10 15
Gly Trp Ala Val Ile Thr Asp Glu Tyr Lys Val Pro Ser Lys Lys Phe
20 25 30
Lys Val Leu Gly Asn Thr Asp Arg His Ser Ile Lys Lys Asn Leu Ile
35 40 45
Gly Ala Leu Leu Phe Asp Ser Gly Glu Thr Ala Glu Ala Thr Arg Leu
50 55 60
Lys Arg Thr Ala Arg Arg Arg Tyr Thr Arg Arg Lys Asn Arg Ile Cys
65 70 75 80
Tyr Leu Gln Glu Ile Phe Ser Asn Glu Met Ala Lys Val Asp Asp Ser
85 90 95
Phe Phe His Arg Leu Glu Glu Ser Phe Leu Val Glu Glu Asp Lys Lys
100 105 110
His Glu Arg His Pro Ile Phe Gly Asn Ile Val Asp Glu Val Ala Tyr
115 120 125
His Glu Lys Tyr Pro Thr Ile Tyr His Leu Arg Lys Lys Leu Val Asp
130 135 140
Ser Thr Asp Lys Ala Asp Leu Arg Leu Ile Tyr Leu Ala Leu Ala His
145 150 155 160
Met Ile Lys Phe Arg Gly His Phe Leu Ile Glu Gly Asp Leu Asn Pro
165 170 175
Asp Asn Ser Asp Val Asp Lys Leu Phe Ile Gln Leu Val Gln Thr Tyr
180 185 190
Asn Gln Leu Phe Glu Glu Asn Pro Ile Asn Ala Ser Gly Val Asp Ala
195 200 205
Lys Ala Ile Leu Ser Ala Arg Leu Ser Lys Ser Arg Arg Leu Glu Asn
210 215 220
Leu Ile Ala Gln Leu Pro Gly Glu Lys Lys Asn Gly Leu Phe Gly Asn
225 230 235 240
Leu Ile Ala Leu Ser Leu Gly Leu Thr Pro Asn Phe Lys Ser Asn Phe
245 250 255
Asp Leu Ala Glu Asp Ala Lys Leu Gln Leu Ser Lys Asp Thr Tyr Asp
260 265 270
Asp Asp Leu Asp Asn Leu Leu Ala Gln Ile Gly Asp Gln Tyr Ala Asp
275 280 285
Leu Phe Leu Ala Ala Lys Asn Leu Ser Asp Ala Ile Leu Leu Ser Asp
290 295 300
Ile Leu Arg Val Asn Thr Glu Ile Thr Lys Ala Pro Leu Ser Ala Ser
305 310 315 320
Met Ile Lys Arg Tyr Asp Glu His His Gln Asp Leu Thr Leu Leu Lys
325 330 335
Ala Leu Val Arg Gln Gln Leu Pro Glu Lys Tyr Lys Glu Ile Phe Phe
340 345 350
Asp Gln Ser Lys Asn Gly Tyr Ala Gly Tyr Ile Asp Gly Gly Ala Ser
355 360 365
Gln Glu Glu Phe Tyr Lys Phe Ile Lys Pro Ile Leu Glu Lys Met Asp
370 375 380
Gly Thr Glu Glu Leu Leu Val Lys Leu Asn Arg Glu Asp Leu Leu Arg
385 390 395 400
Lys Gln Arg Thr Phe Asp Asn Gly Ser Ile Pro His Gln Ile His Leu
405 410 415
Gly Glu Leu His Ala Ile Leu Arg Arg Gln Glu Asp Phe Tyr Pro Phe
420 425 430
Leu Lys Asp Asn Arg Glu Lys Ile Glu Lys Ile Leu Thr Phe Arg Ile
435 440 445
Pro Tyr Tyr Val Gly Pro Leu Ala Arg Gly Asn Ser Arg Phe Ala Trp
450 455 460
Met Thr Arg Lys Ser Glu Glu Thr Ile Thr Pro Trp Asn Phe Glu Glu
465 470 475 480
Val Val Asp Lys Gly Ala Ser Ala Gln Ser Phe Ile Glu Arg Met Thr
485 490 495
Asn Phe Asp Lys Asn Leu Pro Asn Glu Lys Val Leu Pro Lys His Ser
500 505 510
Leu Leu Tyr Glu Tyr Phe Thr Val Tyr Asn Glu Leu Thr Lys Val Lys
515 520 525
Tyr Val Thr Glu Gly Met Arg Lys Pro Ala Phe Leu Ser Gly Glu Gln
530 535 540
Lys Lys Ala Ile Val Asp Leu Leu Phe Lys Thr Asn Arg Lys Val Thr
545 550 555 560
Val Lys Gln Leu Lys Glu Asp Tyr Phe Lys Lys Ile Glu Cys Phe Asp
565 570 575
Ser Val Glu Ile Ser Gly Val Glu Asp Arg Phe Asn Ala Ser Leu Gly
580 585 590
Thr Tyr His Asp Leu Leu Lys Ile Ile Lys Asp Lys Asp Phe Leu Asp
595 600 605
Asn Glu Glu Asn Glu Asp Ile Leu Glu Asp Ile Val Leu Thr Leu Thr
610 615 620
Leu Phe Glu Asp Arg Glu Met Ile Glu Glu Arg Leu Lys Thr Tyr Ala
625 630 635 640
His Leu Phe Asp Asp Lys Val Met Lys Gln Leu Lys Arg Arg Arg Tyr
645 650 655
Thr Gly Trp Gly Arg Leu Ser Arg Lys Leu Ile Asn Gly Ile Arg Asp
660 665 670
Lys Gln Ser Gly Lys Thr Ile Leu Asp Phe Leu Lys Ser Asp Gly Phe
675 680 685
Ala Asn Arg Asn Phe Met Gln Leu Ile His Asp Asp Ser Leu Thr Phe
690 695 700
Lys Glu Asp Ile Gln Lys Ala Gln Val Ser Gly Gln Gly Asp Ser Leu
705 710 715 720
His Glu His Ile Ala Asn Leu Ala Gly Ser Pro Ala Ile Lys Lys Gly
725 730 735
Ile Leu Gln Thr Val Lys Val Val Asp Glu Leu Val Lys Val Met Gly
740 745 750
Arg His Lys Pro Glu Asn Ile Val Ile Glu Met Ala Arg Glu Asn Gln
755 760 765
Thr Thr Gln Lys Gly Gln Lys Asn Ser Arg Glu Arg Met Lys Arg Ile
770 775 780
Glu Glu Gly Ile Lys Glu Leu Gly Ser Gln Ile Leu Lys Glu His Pro
785 790 795 800
Val Glu Asn Thr Gln Leu Gln Asn Glu Lys Leu Tyr Leu Tyr Tyr Leu
805 810 815
Gln Asn Gly Arg Asp Met Tyr Val Asp Gln Glu Leu Asp Ile Asn Arg
820 825 830
Leu Ser Asp Tyr Asp Val Asp Ala Ile Val Pro Gln Ser Phe Leu Lys
835 840 845
Asp Asp Ser Ile Asp Asn Lys Val Leu Thr Arg Ser Asp Lys Asn Arg
850 855 860
Gly Lys Ser Asp Asn Val Pro Ser Glu Glu Val Val Lys Lys Met Lys
865 870 875 880
Asn Tyr Trp Arg Gln Leu Leu Asn Ala Lys Leu Ile Thr Gln Arg Lys
885 890 895
Phe Asp Asn Leu Thr Lys Ala Glu Arg Gly Gly Leu Ser Glu Leu Asp
900 905 910
Lys Ala Gly Phe Ile Lys Arg Gln Leu Val Glu Thr Arg Gln Ile Thr
915 920 925
Lys His Val Ala Gln Ile Leu Asp Ser Arg Met Asn Thr Lys Tyr Asp
930 935 940
Glu Asn Asp Lys Leu Ile Arg Glu Val Lys Val Ile Thr Leu Lys Ser
945 950 955 960
Lys Leu Val Ser Asp Phe Arg Lys Asp Phe Gln Phe Tyr Lys Val Arg
965 970 975
Glu Ile Asn Asn Tyr His His Ala His Asp Ala Tyr Leu Asn Ala Val
980 985 990
Val Gly Thr Ala Leu Ile Lys Lys Tyr Pro Lys Leu Glu Ser Glu Phe
995 1000 1005
Val Tyr Gly Asp Tyr Lys Val Tyr Asp Val Arg Lys Met Ile Ala
1010 1015 1020
Lys Ser Glu Gln Glu Ile Gly Lys Ala Thr Ala Lys Tyr Phe Phe
1025 1030 1035
Tyr Ser Asn Ile Met Asn Phe Phe Lys Thr Glu Ile Thr Leu Ala
1040 1045 1050
Asn Gly Glu Ile Arg Lys Arg Pro Leu Ile Glu Thr Asn Gly Glu
1055 1060 1065
Thr Gly Glu Ile Val Trp Asp Lys Gly Arg Asp Phe Ala Thr Val
1070 1075 1080
Arg Lys Val Leu Ser Met Pro Gln Val Asn Ile Val Lys Lys Thr
1085 1090 1095
Glu Val Gln Thr Gly Gly Phe Ser Lys Glu Ser Ile Leu Pro Lys
1100 1105 1110
Arg Asn Ser Asp Lys Leu Ile Ala Arg Lys Lys Asp Trp Asp Pro
1115 1120 1125
Lys Lys Tyr Gly Gly Phe Asp Ser Pro Thr Val Ala Tyr Ser Val
1130 1135 1140
Leu Val Val Ala Lys Val Glu Lys Gly Lys Ser Lys Lys Leu Lys
1145 1150 1155
Ser Val Lys Glu Leu Leu Gly Ile Thr Ile Met Glu Arg Ser Ser
1160 1165 1170
Phe Glu Lys Asn Pro Ile Asp Phe Leu Glu Ala Lys Gly Tyr Lys
1175 1180 1185
Glu Val Lys Lys Asp Leu Ile Ile Lys Leu Pro Lys Tyr Ser Leu
1190 1195 1200
Phe Glu Leu Glu Asn Gly Arg Lys Arg Met Leu Ala Ser Ala Gly
1205 1210 1215
Glu Leu Gln Lys Gly Asn Glu Leu Ala Leu Pro Ser Lys Tyr Val
1220 1225 1230
Asn Phe Leu Tyr Leu Ala Ser His Tyr Glu Lys Leu Lys Gly Ser
1235 1240 1245
Pro Glu Asp Asn Glu Gln Lys Gln Leu Phe Val Glu Gln His Lys
1250 1255 1260
His Tyr Leu Asp Glu Ile Ile Glu Gln Ile Ser Glu Phe Ser Lys
1265 1270 1275
Arg Val Ile Leu Ala Asp Ala Asn Leu Asp Lys Val Leu Ser Ala
1280 1285 1290
Tyr Asn Lys His Arg Asp Lys Pro Ile Arg Glu Gln Ala Glu Asn
1295 1300 1305
Ile Ile His Leu Phe Thr Leu Thr Asn Leu Gly Ala Pro Ala Ala
1310 1315 1320
Phe Lys Tyr Phe Asp Thr Thr Ile Asp Arg Lys Arg Tyr Thr Ser
1325 1330 1335
Thr Lys Glu Val Leu Asp Ala Thr Leu Ile His Gln Ser Ile Thr
1340 1345 1350
Gly Leu Tyr Glu Thr Arg Ile Asp Leu Ser Gln Leu Gly Gly Asp
1355 1360 1365
<210> 44
<211> 1368
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 44
Met Asp Lys Lys Tyr Ser Ile Gly Leu Ala Ile Gly Thr Asn Ser Val
1 5 10 15
Gly Trp Ala Val Ile Thr Asp Glu Tyr Lys Val Pro Ser Lys Lys Phe
20 25 30
Lys Val Leu Gly Asn Thr Asp Arg His Ser Ile Lys Lys Asn Leu Ile
35 40 45
Gly Ala Leu Leu Phe Asp Ser Gly Glu Thr Ala Glu Ala Thr Arg Leu
50 55 60
Lys Arg Thr Ala Arg Arg Arg Tyr Thr Arg Arg Lys Asn Arg Ile Cys
65 70 75 80
Tyr Leu Gln Glu Ile Phe Ser Asn Glu Met Ala Lys Val Asp Asp Ser
85 90 95
Phe Phe His Arg Leu Glu Glu Ser Phe Leu Val Glu Glu Asp Lys Lys
100 105 110
His Glu Arg His Pro Ile Phe Gly Asn Ile Val Asp Glu Val Ala Tyr
115 120 125
His Glu Lys Tyr Pro Thr Ile Tyr His Leu Arg Lys Lys Leu Val Asp
130 135 140
Ser Thr Asp Lys Ala Asp Leu Arg Leu Ile Tyr Leu Ala Leu Ala His
145 150 155 160
Met Ile Lys Phe Arg Gly His Phe Leu Ile Glu Gly Asp Leu Asn Pro
165 170 175
Asp Asn Ser Asp Val Asp Lys Leu Phe Ile Gln Leu Val Gln Thr Tyr
180 185 190
Asn Gln Leu Phe Glu Glu Asn Pro Ile Asn Ala Ser Gly Val Asp Ala
195 200 205
Lys Ala Ile Leu Ser Ala Arg Leu Ser Lys Ser Arg Arg Leu Glu Asn
210 215 220
Leu Ile Ala Gln Leu Pro Gly Glu Lys Lys Asn Gly Leu Phe Gly Asn
225 230 235 240
Leu Ile Ala Leu Ser Leu Gly Leu Thr Pro Asn Phe Lys Ser Asn Phe
245 250 255
Asp Leu Ala Glu Asp Ala Lys Leu Gln Leu Ser Lys Asp Thr Tyr Asp
260 265 270
Asp Asp Leu Asp Asn Leu Leu Ala Gln Ile Gly Asp Gln Tyr Ala Asp
275 280 285
Leu Phe Leu Ala Ala Lys Asn Leu Ser Asp Ala Ile Leu Leu Ser Asp
290 295 300
Ile Leu Arg Val Asn Thr Glu Ile Thr Lys Ala Pro Leu Ser Ala Ser
305 310 315 320
Met Ile Lys Arg Tyr Asp Glu His His Gln Asp Leu Thr Leu Leu Lys
325 330 335
Ala Leu Val Arg Gln Gln Leu Pro Glu Lys Tyr Lys Glu Ile Phe Phe
340 345 350
Asp Gln Ser Lys Asn Gly Tyr Ala Gly Tyr Ile Asp Gly Gly Ala Ser
355 360 365
Gln Glu Glu Phe Tyr Lys Phe Ile Lys Pro Ile Leu Glu Lys Met Asp
370 375 380
Gly Thr Glu Glu Leu Leu Val Lys Leu Asn Arg Glu Asp Leu Leu Arg
385 390 395 400
Lys Gln Arg Thr Phe Asp Asn Gly Ser Ile Pro His Gln Ile His Leu
405 410 415
Gly Glu Leu His Ala Ile Leu Arg Arg Gln Glu Asp Phe Tyr Pro Phe
420 425 430
Leu Lys Asp Asn Arg Glu Lys Ile Glu Lys Ile Leu Thr Phe Arg Ile
435 440 445
Pro Tyr Tyr Val Gly Pro Leu Ala Arg Gly Asn Ser Arg Phe Ala Trp
450 455 460
Met Thr Arg Lys Ser Glu Glu Thr Ile Thr Pro Trp Asn Phe Glu Glu
465 470 475 480
Val Val Asp Lys Gly Ala Ser Ala Gln Ser Phe Ile Glu Arg Met Thr
485 490 495
Asn Phe Asp Lys Asn Leu Pro Asn Glu Lys Val Leu Pro Lys His Ser
500 505 510
Leu Leu Tyr Glu Tyr Phe Thr Val Tyr Asn Glu Leu Thr Lys Val Lys
515 520 525
Tyr Val Thr Glu Gly Met Arg Lys Pro Ala Phe Leu Ser Gly Glu Gln
530 535 540
Lys Lys Ala Ile Val Asp Leu Leu Phe Lys Thr Asn Arg Lys Val Thr
545 550 555 560
Val Lys Gln Leu Lys Glu Asp Tyr Phe Lys Lys Ile Glu Cys Phe Asp
565 570 575
Ser Val Glu Ile Ser Gly Val Glu Asp Arg Phe Asn Ala Ser Leu Gly
580 585 590
Thr Tyr His Asp Leu Leu Lys Ile Ile Lys Asp Lys Asp Phe Leu Asp
595 600 605
Asn Glu Glu Asn Glu Asp Ile Leu Glu Asp Ile Val Leu Thr Leu Thr
610 615 620
Leu Phe Glu Asp Arg Glu Met Ile Glu Glu Arg Leu Lys Thr Tyr Ala
625 630 635 640
His Leu Phe Asp Asp Lys Val Met Lys Gln Leu Lys Arg Arg Arg Tyr
645 650 655
Thr Gly Trp Gly Arg Leu Ser Arg Lys Leu Ile Asn Gly Ile Arg Asp
660 665 670
Lys Gln Ser Gly Lys Thr Ile Leu Asp Phe Leu Lys Ser Asp Gly Phe
675 680 685
Ala Asn Arg Asn Phe Met Gln Leu Ile His Asp Asp Ser Leu Thr Phe
690 695 700
Lys Glu Asp Ile Gln Lys Ala Gln Val Ser Gly Gln Gly Asp Ser Leu
705 710 715 720
His Glu His Ile Ala Asn Leu Ala Gly Ser Pro Ala Ile Lys Lys Gly
725 730 735
Ile Leu Gln Thr Val Lys Val Val Asp Glu Leu Val Lys Val Met Gly
740 745 750
Arg His Lys Pro Glu Asn Ile Val Ile Glu Met Ala Arg Glu Asn Gln
755 760 765
Thr Thr Gln Lys Gly Gln Lys Asn Ser Arg Glu Arg Met Lys Arg Ile
770 775 780
Glu Glu Gly Ile Lys Glu Leu Gly Ser Gln Ile Leu Lys Glu His Pro
785 790 795 800
Val Glu Asn Thr Gln Leu Gln Asn Glu Lys Leu Tyr Leu Tyr Tyr Leu
805 810 815
Gln Asn Gly Arg Asp Met Tyr Val Asp Gln Glu Leu Asp Ile Asn Arg
820 825 830
Leu Ser Asp Tyr Asp Val Asp His Ile Val Pro Gln Ser Phe Leu Ala
835 840 845
Asp Asp Ser Ile Asp Asn Lys Val Leu Thr Arg Ser Asp Lys Asn Arg
850 855 860
Gly Lys Ser Asp Asn Val Pro Ser Glu Glu Val Val Lys Lys Met Lys
865 870 875 880
Asn Tyr Trp Arg Gln Leu Leu Asn Ala Lys Leu Ile Thr Gln Arg Lys
885 890 895
Phe Asp Asn Leu Thr Lys Ala Glu Arg Gly Gly Leu Ser Glu Leu Asp
900 905 910
Lys Ala Gly Phe Ile Lys Arg Gln Leu Val Glu Thr Arg Gln Ile Thr
915 920 925
Lys His Val Ala Gln Ile Leu Asp Ser Arg Met Asn Thr Lys Tyr Asp
930 935 940
Glu Asn Asp Lys Leu Ile Arg Glu Val Lys Val Ile Thr Leu Lys Ser
945 950 955 960
Lys Leu Val Ser Asp Phe Arg Lys Asp Phe Gln Phe Tyr Lys Val Arg
965 970 975
Glu Ile Asn Asn Tyr His His Ala His Asp Ala Tyr Leu Asn Ala Val
980 985 990
Val Gly Thr Ala Leu Ile Lys Lys Tyr Pro Ala Leu Glu Ser Glu Phe
995 1000 1005
Val Tyr Gly Asp Tyr Lys Val Tyr Asp Val Arg Lys Met Ile Ala
1010 1015 1020
Lys Ser Glu Gln Glu Ile Gly Lys Ala Thr Ala Lys Tyr Phe Phe
1025 1030 1035
Tyr Ser Asn Ile Met Asn Phe Phe Lys Thr Glu Ile Thr Leu Ala
1040 1045 1050
Asn Gly Glu Ile Arg Lys Ala Pro Leu Ile Glu Thr Asn Gly Glu
1055 1060 1065
Thr Gly Glu Ile Val Trp Asp Lys Gly Arg Asp Phe Ala Thr Val
1070 1075 1080
Arg Lys Val Leu Ser Met Pro Gln Val Asn Ile Val Lys Lys Thr
1085 1090 1095
Glu Val Gln Thr Gly Gly Phe Ser Lys Glu Ser Ile Leu Pro Lys
1100 1105 1110
Arg Asn Ser Asp Lys Leu Ile Ala Arg Lys Lys Asp Trp Asp Pro
1115 1120 1125
Lys Lys Tyr Gly Gly Phe Asp Ser Pro Thr Val Ala Tyr Ser Val
1130 1135 1140
Leu Val Val Ala Lys Val Glu Lys Gly Lys Ser Lys Lys Leu Lys
1145 1150 1155
Ser Val Lys Glu Leu Leu Gly Ile Thr Ile Met Glu Arg Ser Ser
1160 1165 1170
Phe Glu Lys Asn Pro Ile Asp Phe Leu Glu Ala Lys Gly Tyr Lys
1175 1180 1185
Glu Val Lys Lys Asp Leu Ile Ile Lys Leu Pro Lys Tyr Ser Leu
1190 1195 1200
Phe Glu Leu Glu Asn Gly Arg Lys Arg Met Leu Ala Ser Ala Gly
1205 1210 1215
Glu Leu Gln Lys Gly Asn Glu Leu Ala Leu Pro Ser Lys Tyr Val
1220 1225 1230
Asn Phe Leu Tyr Leu Ala Ser His Tyr Glu Lys Leu Lys Gly Ser
1235 1240 1245
Pro Glu Asp Asn Glu Gln Lys Gln Leu Phe Val Glu Gln His Lys
1250 1255 1260
His Tyr Leu Asp Glu Ile Ile Glu Gln Ile Ser Glu Phe Ser Lys
1265 1270 1275
Arg Val Ile Leu Ala Asp Ala Asn Leu Asp Lys Val Leu Ser Ala
1280 1285 1290
Tyr Asn Lys His Arg Asp Lys Pro Ile Arg Glu Gln Ala Glu Asn
1295 1300 1305
Ile Ile His Leu Phe Thr Leu Thr Asn Leu Gly Ala Pro Ala Ala
1310 1315 1320
Phe Lys Tyr Phe Asp Thr Thr Ile Asp Arg Lys Arg Tyr Thr Ser
1325 1330 1335
Thr Lys Glu Val Leu Asp Ala Thr Leu Ile His Gln Ser Ile Thr
1340 1345 1350
Gly Leu Tyr Glu Thr Arg Ile Asp Leu Ser Gln Leu Gly Gly Asp
1355 1360 1365
<210> 45
<211> 1367
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 45
Asp Lys Lys Tyr Ser Ile Gly Leu Ala Ile Gly Thr Asn Ser Val Gly
1 5 10 15
Trp Ala Val Ile Thr Asp Glu Tyr Lys Val Pro Ser Lys Lys Phe Lys
20 25 30
Val Leu Gly Asn Thr Asp Arg His Ser Ile Lys Lys Asn Leu Ile Gly
35 40 45
Ala Leu Leu Phe Asp Ser Gly Glu Thr Ala Glu Ala Thr Arg Leu Lys
50 55 60
Arg Thr Ala Arg Arg Arg Tyr Thr Arg Arg Lys Asn Arg Ile Cys Tyr
65 70 75 80
Leu Gln Glu Ile Phe Ser Asn Glu Met Ala Lys Val Asp Asp Ser Phe
85 90 95
Phe His Arg Leu Glu Glu Ser Phe Leu Val Glu Glu Asp Lys Lys His
100 105 110
Glu Arg His Pro Ile Phe Gly Asn Ile Val Asp Glu Val Ala Tyr His
115 120 125
Glu Lys Tyr Pro Thr Ile Tyr His Leu Arg Lys Lys Leu Val Asp Ser
130 135 140
Thr Asp Lys Ala Asp Leu Arg Leu Ile Tyr Leu Ala Leu Ala His Met
145 150 155 160
Ile Lys Phe Arg Gly His Phe Leu Ile Glu Gly Asp Leu Asn Pro Asp
165 170 175
Asn Ser Asp Val Asp Lys Leu Phe Ile Gln Leu Val Gln Thr Tyr Asn
180 185 190
Gln Leu Phe Glu Glu Asn Pro Ile Asn Ala Ser Gly Val Asp Ala Lys
195 200 205
Ala Ile Leu Ser Ala Arg Leu Ser Lys Ser Arg Arg Leu Glu Asn Leu
210 215 220
Ile Ala Gln Leu Pro Gly Glu Lys Lys Asn Gly Leu Phe Gly Asn Leu
225 230 235 240
Ile Ala Leu Ser Leu Gly Leu Thr Pro Asn Phe Lys Ser Asn Phe Asp
245 250 255
Leu Ala Glu Asp Ala Lys Leu Gln Leu Ser Lys Asp Thr Tyr Asp Asp
260 265 270
Asp Leu Asp Asn Leu Leu Ala Gln Ile Gly Asp Gln Tyr Ala Asp Leu
275 280 285
Phe Leu Ala Ala Lys Asn Leu Ser Asp Ala Ile Leu Leu Ser Asp Ile
290 295 300
Leu Arg Val Asn Thr Glu Ile Thr Lys Ala Pro Leu Ser Ala Ser Met
305 310 315 320
Ile Lys Arg Tyr Asp Glu His His Gln Asp Leu Thr Leu Leu Lys Ala
325 330 335
Leu Val Arg Gln Gln Leu Pro Glu Lys Tyr Lys Glu Ile Phe Phe Asp
340 345 350
Gln Ser Lys Asn Gly Tyr Ala Gly Tyr Ile Asp Gly Gly Ala Ser Gln
355 360 365
Glu Glu Phe Tyr Lys Phe Ile Lys Pro Ile Leu Glu Lys Met Asp Gly
370 375 380
Thr Glu Glu Leu Leu Val Lys Leu Asn Arg Glu Asp Leu Leu Arg Lys
385 390 395 400
Gln Arg Thr Phe Asp Asn Gly Ser Ile Pro His Gln Ile His Leu Gly
405 410 415
Glu Leu His Ala Ile Leu Arg Arg Gln Glu Asp Phe Tyr Pro Phe Leu
420 425 430
Lys Asp Asn Arg Glu Lys Ile Glu Lys Ile Leu Thr Phe Arg Ile Pro
435 440 445
Tyr Tyr Val Gly Pro Leu Ala Arg Gly Asn Ser Arg Phe Ala Trp Met
450 455 460
Thr Arg Lys Ser Glu Glu Thr Ile Thr Pro Trp Asn Phe Glu Glu Val
465 470 475 480
Val Asp Lys Gly Ala Ser Ala Gln Ser Phe Ile Glu Arg Met Thr Ala
485 490 495
Phe Asp Lys Asn Leu Pro Asn Glu Lys Val Leu Pro Lys His Ser Leu
500 505 510
Leu Tyr Glu Tyr Phe Thr Val Tyr Asn Glu Leu Thr Lys Val Lys Tyr
515 520 525
Val Thr Glu Gly Met Arg Lys Pro Ala Phe Leu Ser Gly Glu Gln Lys
530 535 540
Lys Ala Ile Val Asp Leu Leu Phe Lys Thr Asn Arg Lys Val Thr Val
545 550 555 560
Lys Gln Leu Lys Glu Asp Tyr Phe Lys Lys Ile Glu Cys Phe Asp Ser
565 570 575
Val Glu Ile Ser Gly Val Glu Asp Arg Phe Asn Ala Ser Leu Gly Thr
580 585 590
Tyr His Asp Leu Leu Lys Ile Ile Lys Asp Lys Asp Phe Leu Asp Asn
595 600 605
Glu Glu Asn Glu Asp Ile Leu Glu Asp Ile Val Leu Thr Leu Thr Leu
610 615 620
Phe Glu Asp Arg Glu Met Ile Glu Glu Arg Leu Lys Thr Tyr Ala His
625 630 635 640
Leu Phe Asp Asp Lys Val Met Lys Gln Leu Lys Arg Arg Arg Tyr Thr
645 650 655
Gly Trp Gly Ala Leu Ser Arg Lys Leu Ile Asn Gly Ile Arg Asp Lys
660 665 670
Gln Ser Gly Lys Thr Ile Leu Asp Phe Leu Lys Ser Asp Gly Phe Ala
675 680 685
Asn Arg Asn Phe Met Ala Leu Ile His Asp Asp Ser Leu Thr Phe Lys
690 695 700
Glu Asp Ile Gln Lys Ala Gln Val Ser Gly Gln Gly Asp Ser Leu His
705 710 715 720
Glu His Ile Ala Asn Leu Ala Gly Ser Pro Ala Ile Lys Lys Gly Ile
725 730 735
Leu Gln Thr Val Lys Val Val Asp Glu Leu Val Lys Val Met Gly Arg
740 745 750
His Lys Pro Glu Asn Ile Val Ile Glu Met Ala Arg Glu Asn Gln Thr
755 760 765
Thr Gln Lys Gly Gln Lys Asn Ser Arg Glu Arg Met Lys Arg Ile Glu
770 775 780
Glu Gly Ile Lys Glu Leu Gly Ser Gln Ile Leu Lys Glu His Pro Val
785 790 795 800
Glu Asn Thr Gln Leu Gln Asn Glu Lys Leu Tyr Leu Tyr Tyr Leu Gln
805 810 815
Asn Gly Arg Asp Met Tyr Val Asp Gln Glu Leu Asp Ile Asn Arg Leu
820 825 830
Ser Asp Tyr Asp Val Asp His Ile Val Pro Gln Ser Phe Leu Lys Asp
835 840 845
Asp Ser Ile Asp Asn Lys Val Leu Thr Arg Ser Asp Lys Asn Arg Gly
850 855 860
Lys Ser Asp Asn Val Pro Ser Glu Glu Val Val Lys Lys Met Lys Asn
865 870 875 880
Tyr Trp Arg Gln Leu Leu Asn Ala Lys Leu Ile Thr Gln Arg Lys Phe
885 890 895
Asp Asn Leu Thr Lys Ala Glu Arg Gly Gly Leu Ser Glu Leu Asp Lys
900 905 910
Ala Gly Phe Ile Lys Arg Gln Leu Val Glu Thr Arg Ala Ile Thr Lys
915 920 925
His Val Ala Gln Ile Leu Asp Ser Arg Met Asn Thr Lys Tyr Asp Glu
930 935 940
Asn Asp Lys Leu Ile Arg Glu Val Lys Val Ile Thr Leu Lys Ser Lys
945 950 955 960
Leu Val Ser Asp Phe Arg Lys Asp Phe Gln Phe Tyr Lys Val Arg Glu
965 970 975
Ile Asn Asn Tyr His His Ala His Asp Ala Tyr Leu Asn Ala Val Val
980 985 990
Gly Thr Ala Leu Ile Lys Lys Tyr Pro Lys Leu Glu Ser Glu Phe Val
995 1000 1005
Tyr Gly Asp Tyr Lys Val Tyr Asp Val Arg Lys Met Ile Ala Lys
1010 1015 1020
Ser Glu Gln Glu Ile Gly Lys Ala Thr Ala Lys Tyr Phe Phe Tyr
1025 1030 1035
Ser Asn Ile Met Asn Phe Phe Lys Thr Glu Ile Thr Leu Ala Asn
1040 1045 1050
Gly Glu Ile Arg Lys Arg Pro Leu Ile Glu Thr Asn Gly Glu Thr
1055 1060 1065
Gly Glu Ile Val Trp Asp Lys Gly Arg Asp Phe Ala Thr Val Arg
1070 1075 1080
Lys Val Leu Ser Met Pro Gln Val Asn Ile Val Lys Lys Thr Glu
1085 1090 1095
Val Gln Thr Gly Gly Phe Ser Lys Glu Ser Ile Leu Pro Lys Arg
1100 1105 1110
Asn Ser Asp Lys Leu Ile Ala Arg Lys Lys Asp Trp Asp Pro Lys
1115 1120 1125
Lys Tyr Gly Gly Phe Asp Ser Pro Thr Val Ala Tyr Ser Val Leu
1130 1135 1140
Val Val Ala Lys Val Glu Lys Gly Lys Ser Lys Lys Leu Lys Ser
1145 1150 1155
Val Lys Glu Leu Leu Gly Ile Thr Ile Met Glu Arg Ser Ser Phe
1160 1165 1170
Glu Lys Asn Pro Ile Asp Phe Leu Glu Ala Lys Gly Tyr Lys Glu
1175 1180 1185
Val Lys Lys Asp Leu Ile Ile Lys Leu Pro Lys Tyr Ser Leu Phe
1190 1195 1200
Glu Leu Glu Asn Gly Arg Lys Arg Met Leu Ala Ser Ala Gly Glu
1205 1210 1215
Leu Gln Lys Gly Asn Glu Leu Ala Leu Pro Ser Lys Tyr Val Asn
1220 1225 1230
Phe Leu Tyr Leu Ala Ser His Tyr Glu Lys Leu Lys Gly Ser Pro
1235 1240 1245
Glu Asp Asn Glu Gln Lys Gln Leu Phe Val Glu Gln His Lys His
1250 1255 1260
Tyr Leu Asp Glu Ile Ile Glu Gln Ile Ser Glu Phe Ser Lys Arg
1265 1270 1275
Val Ile Leu Ala Asp Ala Asn Leu Asp Lys Val Leu Ser Ala Tyr
1280 1285 1290
Asn Lys His Arg Asp Lys Pro Ile Arg Glu Gln Ala Glu Asn Ile
1295 1300 1305
Ile His Leu Phe Thr Leu Thr Asn Leu Gly Ala Pro Ala Ala Phe
1310 1315 1320
Lys Tyr Phe Asp Thr Thr Ile Asp Arg Lys Arg Tyr Thr Ser Thr
1325 1330 1335
Lys Glu Val Leu Asp Ala Thr Leu Ile His Gln Ser Ile Thr Gly
1340 1345 1350
Leu Tyr Glu Thr Arg Ile Asp Leu Ser Gln Leu Gly Gly Asp
1355 1360 1365
<210> 46
<211> 1053
<212> PRT
<213> Staphylococcus aureus
<400> 46
Met Lys Arg Asn Tyr Ile Leu Gly Leu Asp Ile Gly Ile Thr Ser Val
1 5 10 15
Gly Tyr Gly Ile Ile Asp Tyr Glu Thr Arg Asp Val Ile Asp Ala Gly
20 25 30
Val Arg Leu Phe Lys Glu Ala Asn Val Glu Asn Asn Glu Gly Arg Arg
35 40 45
Ser Lys Arg Gly Ala Arg Arg Leu Lys Arg Arg Arg Arg His Arg Ile
50 55 60
Gln Arg Val Lys Lys Leu Leu Phe Asp Tyr Asn Leu Leu Thr Asp His
65 70 75 80
Ser Glu Leu Ser Gly Ile Asn Pro Tyr Glu Ala Arg Val Lys Gly Leu
85 90 95
Ser Gln Lys Leu Ser Glu Glu Glu Phe Ser Ala Ala Leu Leu His Leu
100 105 110
Ala Lys Arg Arg Gly Val His Asn Val Asn Glu Val Glu Glu Asp Thr
115 120 125
Gly Asn Glu Leu Ser Thr Lys Glu Gln Ile Ser Arg Asn Ser Lys Ala
130 135 140
Leu Glu Glu Lys Tyr Val Ala Glu Leu Gln Leu Glu Arg Leu Lys Lys
145 150 155 160
Asp Gly Glu Val Arg Gly Ser Ile Asn Arg Phe Lys Thr Ser Asp Tyr
165 170 175
Val Lys Glu Ala Lys Gln Leu Leu Lys Val Gln Lys Ala Tyr His Gln
180 185 190
Leu Asp Gln Ser Phe Ile Asp Thr Tyr Ile Asp Leu Leu Glu Thr Arg
195 200 205
Arg Thr Tyr Tyr Glu Gly Pro Gly Glu Gly Ser Pro Phe Gly Trp Lys
210 215 220
Asp Ile Lys Glu Trp Tyr Glu Met Leu Met Gly His Cys Thr Tyr Phe
225 230 235 240
Pro Glu Glu Leu Arg Ser Val Lys Tyr Ala Tyr Asn Ala Asp Leu Tyr
245 250 255
Asn Ala Leu Asn Asp Leu Asn Asn Leu Val Ile Thr Arg Asp Glu Asn
260 265 270
Glu Lys Leu Glu Tyr Tyr Glu Lys Phe Gln Ile Ile Glu Asn Val Phe
275 280 285
Lys Gln Lys Lys Lys Pro Thr Leu Lys Gln Ile Ala Lys Glu Ile Leu
290 295 300
Val Asn Glu Glu Asp Ile Lys Gly Tyr Arg Val Thr Ser Thr Gly Lys
305 310 315 320
Pro Glu Phe Thr Asn Leu Lys Val Tyr His Asp Ile Lys Asp Ile Thr
325 330 335
Ala Arg Lys Glu Ile Ile Glu Asn Ala Glu Leu Leu Asp Gln Ile Ala
340 345 350
Lys Ile Leu Thr Ile Tyr Gln Ser Ser Glu Asp Ile Gln Glu Glu Leu
355 360 365
Thr Asn Leu Asn Ser Glu Leu Thr Gln Glu Glu Ile Glu Gln Ile Ser
370 375 380
Asn Leu Lys Gly Tyr Thr Gly Thr His Asn Leu Ser Leu Lys Ala Ile
385 390 395 400
Asn Leu Ile Leu Asp Glu Leu Trp His Thr Asn Asp Asn Gln Ile Ala
405 410 415
Ile Phe Asn Arg Leu Lys Leu Val Pro Lys Lys Val Asp Leu Ser Gln
420 425 430
Gln Lys Glu Ile Pro Thr Thr Leu Val Asp Asp Phe Ile Leu Ser Pro
435 440 445
Val Val Lys Arg Ser Phe Ile Gln Ser Ile Lys Val Ile Asn Ala Ile
450 455 460
Ile Lys Lys Tyr Gly Leu Pro Asn Asp Ile Ile Ile Glu Leu Ala Arg
465 470 475 480
Glu Lys Asn Ser Lys Asp Ala Gln Lys Met Ile Asn Glu Met Gln Lys
485 490 495
Arg Asn Arg Gln Thr Asn Glu Arg Ile Glu Glu Ile Ile Arg Thr Thr
500 505 510
Gly Lys Glu Asn Ala Lys Tyr Leu Ile Glu Lys Ile Lys Leu His Asp
515 520 525
Met Gln Glu Gly Lys Cys Leu Tyr Ser Leu Glu Ala Ile Pro Leu Glu
530 535 540
Asp Leu Leu Asn Asn Pro Phe Asn Tyr Glu Val Asp His Ile Ile Pro
545 550 555 560
Arg Ser Val Ser Phe Asp Asn Ser Phe Asn Asn Lys Val Leu Val Lys
565 570 575
Gln Glu Glu Asn Ser Lys Lys Gly Asn Arg Thr Pro Phe Gln Tyr Leu
580 585 590
Ser Ser Ser Asp Ser Lys Ile Ser Tyr Glu Thr Phe Lys Lys His Ile
595 600 605
Leu Asn Leu Ala Lys Gly Lys Gly Arg Ile Ser Lys Thr Lys Lys Glu
610 615 620
Tyr Leu Leu Glu Glu Arg Asp Ile Asn Arg Phe Ser Val Gln Lys Asp
625 630 635 640
Phe Ile Asn Arg Asn Leu Val Asp Thr Arg Tyr Ala Thr Arg Gly Leu
645 650 655
Met Asn Leu Leu Arg Ser Tyr Phe Arg Val Asn Asn Leu Asp Val Lys
660 665 670
Val Lys Ser Ile Asn Gly Gly Phe Thr Ser Phe Leu Arg Arg Lys Trp
675 680 685
Lys Phe Lys Lys Glu Arg Asn Lys Gly Tyr Lys His His Ala Glu Asp
690 695 700
Ala Leu Ile Ile Ala Asn Ala Asp Phe Ile Phe Lys Glu Trp Lys Lys
705 710 715 720
Leu Asp Lys Ala Lys Lys Val Met Glu Asn Gln Met Phe Glu Glu Lys
725 730 735
Gln Ala Glu Ser Met Pro Glu Ile Glu Thr Glu Gln Glu Tyr Lys Glu
740 745 750
Ile Phe Ile Thr Pro His Gln Ile Lys His Ile Lys Asp Phe Lys Asp
755 760 765
Tyr Lys Tyr Ser His Arg Val Asp Lys Lys Pro Asn Arg Glu Leu Ile
770 775 780
Asn Asp Thr Leu Tyr Ser Thr Arg Lys Asp Asp Lys Gly Asn Thr Leu
785 790 795 800
Ile Val Asn Asn Leu Asn Gly Leu Tyr Asp Lys Asp Asn Asp Lys Leu
805 810 815
Lys Lys Leu Ile Asn Lys Ser Pro Glu Lys Leu Leu Met Tyr His His
820 825 830
Asp Pro Gln Thr Tyr Gln Lys Leu Lys Leu Ile Met Glu Gln Tyr Gly
835 840 845
Asp Glu Lys Asn Pro Leu Tyr Lys Tyr Tyr Glu Glu Thr Gly Asn Tyr
850 855 860
Leu Thr Lys Tyr Ser Lys Lys Asp Asn Gly Pro Val Ile Lys Lys Ile
865 870 875 880
Lys Tyr Tyr Gly Asn Lys Leu Asn Ala His Leu Asp Ile Thr Asp Asp
885 890 895
Tyr Pro Asn Ser Arg Asn Lys Val Val Lys Leu Ser Leu Lys Pro Tyr
900 905 910
Arg Phe Asp Val Tyr Leu Asp Asn Gly Val Tyr Lys Phe Val Thr Val
915 920 925
Lys Asn Leu Asp Val Ile Lys Lys Glu Asn Tyr Tyr Glu Val Asn Ser
930 935 940
Lys Cys Tyr Glu Glu Ala Lys Lys Leu Lys Lys Ile Ser Asn Gln Ala
945 950 955 960
Glu Phe Ile Ala Ser Phe Tyr Asn Asn Asp Leu Ile Lys Ile Asn Gly
965 970 975
Glu Leu Tyr Arg Val Ile Gly Val Asn Asn Asp Leu Leu Asn Arg Ile
980 985 990
Glu Val Asn Met Ile Asp Ile Thr Tyr Arg Glu Tyr Leu Glu Asn Met
995 1000 1005
Asn Asp Lys Arg Pro Pro Arg Ile Ile Lys Thr Ile Ala Ser Lys
1010 1015 1020
Thr Gln Ser Ile Lys Lys Tyr Ser Thr Asp Ile Leu Gly Asn Leu
1025 1030 1035
Tyr Glu Val Lys Ser Lys Lys His Pro Gln Ile Ile Lys Lys Gly
1040 1045 1050
<210> 47
<211> 1300
<212> PRT
<213> Francisella tularensis
<400> 47
Met Ser Ile Tyr Gln Glu Phe Val Asn Lys Tyr Ser Leu Ser Lys Thr
1 5 10 15
Leu Arg Phe Glu Leu Ile Pro Gln Gly Lys Thr Leu Glu Asn Ile Lys
20 25 30
Ala Arg Gly Leu Ile Leu Asp Asp Glu Lys Arg Ala Lys Asp Tyr Lys
35 40 45
Lys Ala Lys Gln Ile Ile Asp Lys Tyr His Gln Phe Phe Ile Glu Glu
50 55 60
Ile Leu Ser Ser Val Cys Ile Ser Glu Asp Leu Leu Gln Asn Tyr Ser
65 70 75 80
Asp Val Tyr Phe Lys Leu Lys Lys Ser Asp Asp Asp Asn Leu Gln Lys
85 90 95
Asp Phe Lys Ser Ala Lys Asp Thr Ile Lys Lys Gln Ile Ser Glu Tyr
100 105 110
Ile Lys Asp Ser Glu Lys Phe Lys Asn Leu Phe Asn Gln Asn Leu Ile
115 120 125
Asp Ala Lys Lys Gly Gln Glu Ser Asp Leu Ile Leu Trp Leu Lys Gln
130 135 140
Ser Lys Asp Asn Gly Ile Glu Leu Phe Lys Ala Asn Ser Asp Ile Thr
145 150 155 160
Asp Ile Asp Glu Ala Leu Glu Ile Ile Lys Ser Phe Lys Gly Trp Thr
165 170 175
Thr Tyr Phe Lys Gly Phe His Glu Asn Arg Lys Asn Val Tyr Ser Ser
180 185 190
Asn Asp Ile Pro Thr Ser Ile Ile Tyr Arg Ile Val Asp Asp Asn Leu
195 200 205
Pro Lys Phe Leu Glu Asn Lys Ala Lys Tyr Glu Ser Leu Lys Asp Lys
210 215 220
Ala Pro Glu Ala Ile Asn Tyr Glu Gln Ile Lys Lys Asp Leu Ala Glu
225 230 235 240
Glu Leu Thr Phe Asp Ile Asp Tyr Lys Thr Ser Glu Val Asn Gln Arg
245 250 255
Val Phe Ser Leu Asp Glu Val Phe Glu Ile Ala Asn Phe Asn Asn Tyr
260 265 270
Leu Asn Gln Ser Gly Ile Thr Lys Phe Asn Thr Ile Ile Gly Gly Lys
275 280 285
Phe Val Asn Gly Glu Asn Thr Lys Arg Lys Gly Ile Asn Glu Tyr Ile
290 295 300
Asn Leu Tyr Ser Gln Gln Ile Asn Asp Lys Thr Leu Lys Lys Tyr Lys
305 310 315 320
Met Ser Val Leu Phe Lys Gln Ile Leu Ser Asp Thr Glu Ser Lys Ser
325 330 335
Phe Val Ile Asp Lys Leu Glu Asp Asp Ser Asp Val Val Thr Thr Met
340 345 350
Gln Ser Phe Tyr Glu Gln Ile Ala Ala Phe Lys Thr Val Glu Glu Lys
355 360 365
Ser Ile Lys Glu Thr Leu Ser Leu Leu Phe Asp Asp Leu Lys Ala Gln
370 375 380
Lys Leu Asp Leu Ser Lys Ile Tyr Phe Lys Asn Asp Lys Ser Leu Thr
385 390 395 400
Asp Leu Ser Gln Gln Val Phe Asp Asp Tyr Ser Val Ile Gly Thr Ala
405 410 415
Val Leu Glu Tyr Ile Thr Gln Gln Ile Ala Pro Lys Asn Leu Asp Asn
420 425 430
Pro Ser Lys Lys Glu Gln Glu Leu Ile Ala Lys Lys Thr Glu Lys Ala
435 440 445
Lys Tyr Leu Ser Leu Glu Thr Ile Lys Leu Ala Leu Glu Glu Phe Asn
450 455 460
Lys His Arg Asp Ile Asp Lys Gln Cys Arg Phe Glu Glu Ile Leu Ala
465 470 475 480
Asn Phe Ala Ala Ile Pro Met Ile Phe Asp Glu Ile Ala Gln Asn Lys
485 490 495
Asp Asn Leu Ala Gln Ile Ser Ile Lys Tyr Gln Asn Gln Gly Lys Lys
500 505 510
Asp Leu Leu Gln Ala Ser Ala Glu Asp Asp Val Lys Ala Ile Lys Asp
515 520 525
Leu Leu Asp Gln Thr Asn Asn Leu Leu His Lys Leu Lys Ile Phe His
530 535 540
Ile Ser Gln Ser Glu Asp Lys Ala Asn Ile Leu Asp Lys Asp Glu His
545 550 555 560
Phe Tyr Leu Val Phe Glu Glu Cys Tyr Phe Glu Leu Ala Asn Ile Val
565 570 575
Pro Leu Tyr Asn Lys Ile Arg Asn Tyr Ile Thr Gln Lys Pro Tyr Ser
580 585 590
Asp Glu Lys Phe Lys Leu Asn Phe Glu Asn Ser Thr Leu Ala Asn Gly
595 600 605
Trp Asp Lys Asn Lys Glu Pro Asp Asn Thr Ala Ile Leu Phe Ile Lys
610 615 620
Asp Asp Lys Tyr Tyr Leu Gly Val Met Asn Lys Lys Asn Asn Lys Ile
625 630 635 640
Phe Asp Asp Lys Ala Ile Lys Glu Asn Lys Gly Glu Gly Tyr Lys Lys
645 650 655
Ile Val Tyr Lys Leu Leu Pro Gly Ala Asn Lys Met Leu Pro Lys Val
660 665 670
Phe Phe Ser Ala Lys Ser Ile Lys Phe Tyr Asn Pro Ser Glu Asp Ile
675 680 685
Leu Arg Ile Arg Asn His Ser Thr His Thr Lys Asn Gly Ser Pro Gln
690 695 700
Lys Gly Tyr Glu Lys Phe Glu Phe Asn Ile Glu Asp Cys Arg Lys Phe
705 710 715 720
Ile Asp Phe Tyr Lys Gln Ser Ile Ser Lys His Pro Glu Trp Lys Asp
725 730 735
Phe Gly Phe Arg Phe Ser Asp Thr Gln Arg Tyr Asn Ser Ile Asp Glu
740 745 750
Phe Tyr Arg Glu Val Glu Asn Gln Gly Tyr Lys Leu Thr Phe Glu Asn
755 760 765
Ile Ser Glu Ser Tyr Ile Asp Ser Val Val Asn Gln Gly Lys Leu Tyr
770 775 780
Leu Phe Gln Ile Tyr Asn Lys Asp Phe Ser Ala Tyr Ser Lys Gly Arg
785 790 795 800
Pro Asn Leu His Thr Leu Tyr Trp Lys Ala Leu Phe Asp Glu Arg Asn
805 810 815
Leu Gln Asp Val Val Tyr Lys Leu Asn Gly Glu Ala Glu Leu Phe Tyr
820 825 830
Arg Lys Gln Ser Ile Pro Lys Lys Ile Thr His Pro Ala Lys Glu Ala
835 840 845
Ile Ala Asn Lys Asn Lys Asp Asn Pro Lys Lys Glu Ser Val Phe Glu
850 855 860
Tyr Asp Leu Ile Lys Asp Lys Arg Phe Thr Glu Asp Lys Phe Phe Phe
865 870 875 880
His Cys Pro Ile Thr Ile Asn Phe Lys Ser Ser Gly Ala Asn Lys Phe
885 890 895
Asn Asp Glu Ile Asn Leu Leu Leu Lys Glu Lys Ala Asn Asp Val His
900 905 910
Ile Leu Ser Ile Asp Arg Gly Glu Arg His Leu Ala Tyr Tyr Thr Leu
915 920 925
Val Asp Gly Lys Gly Asn Ile Ile Lys Gln Asp Thr Phe Asn Ile Ile
930 935 940
Gly Asn Asp Arg Met Lys Thr Asn Tyr His Asp Lys Leu Ala Ala Ile
945 950 955 960
Glu Lys Asp Arg Asp Ser Ala Arg Lys Asp Trp Lys Lys Ile Asn Asn
965 970 975
Ile Lys Glu Met Lys Glu Gly Tyr Leu Ser Gln Val Val His Glu Ile
980 985 990
Ala Lys Leu Val Ile Glu Tyr Asn Ala Ile Val Val Phe Glu Asp Leu
995 1000 1005
Asn Phe Gly Phe Lys Arg Gly Arg Phe Lys Val Glu Lys Gln Val
1010 1015 1020
Tyr Gln Lys Leu Glu Lys Met Leu Ile Glu Lys Leu Asn Tyr Leu
1025 1030 1035
Val Phe Lys Asp Asn Glu Phe Asp Lys Thr Gly Gly Val Leu Arg
1040 1045 1050
Ala Tyr Gln Leu Thr Ala Pro Phe Glu Thr Phe Lys Lys Met Gly
1055 1060 1065
Lys Gln Thr Gly Ile Ile Tyr Tyr Val Pro Ala Gly Phe Thr Ser
1070 1075 1080
Lys Ile Cys Pro Val Thr Gly Phe Val Asn Gln Leu Tyr Pro Lys
1085 1090 1095
Tyr Glu Ser Val Ser Lys Ser Gln Glu Phe Phe Ser Lys Phe Asp
1100 1105 1110
Lys Ile Cys Tyr Asn Leu Asp Lys Gly Tyr Phe Glu Phe Ser Phe
1115 1120 1125
Asp Tyr Lys Asn Phe Gly Asp Lys Ala Ala Lys Gly Lys Trp Thr
1130 1135 1140
Ile Ala Ser Phe Gly Ser Arg Leu Ile Asn Phe Arg Asn Ser Asp
1145 1150 1155
Lys Asn His Asn Trp Asp Thr Arg Glu Val Tyr Pro Thr Lys Glu
1160 1165 1170
Leu Glu Lys Leu Leu Lys Asp Tyr Ser Ile Glu Tyr Gly His Gly
1175 1180 1185
Glu Cys Ile Lys Ala Ala Ile Cys Gly Glu Ser Asp Lys Lys Phe
1190 1195 1200
Phe Ala Lys Leu Thr Ser Val Leu Asn Thr Ile Leu Gln Met Arg
1205 1210 1215
Asn Ser Lys Thr Gly Thr Glu Leu Asp Tyr Leu Ile Ser Pro Val
1220 1225 1230
Ala Asp Val Asn Gly Asn Phe Phe Asp Ser Arg Gln Ala Pro Lys
1235 1240 1245
Asn Met Pro Gln Asp Ala Asp Ala Asn Gly Ala Tyr His Ile Gly
1250 1255 1260
Leu Lys Gly Leu Met Leu Leu Gly Arg Ile Lys Asn Asn Gln Glu
1265 1270 1275
Gly Lys Lys Leu Asn Leu Val Ile Lys Asn Glu Glu Tyr Phe Glu
1280 1285 1290
Phe Val Gln Asn Arg Asn Asn
1295 1300
<210> 48
<211> 1306
<212> PRT
<213> Acidaminococcus
<400> 48
Thr Gln Phe Glu Gly Phe Thr Asn Leu Tyr Gln Val Ser Lys Thr Leu
1 5 10 15
Arg Phe Glu Leu Ile Pro Gln Gly Lys Thr Leu Lys His Ile Gln Glu
20 25 30
Gln Gly Phe Ile Glu Glu Asp Lys Ala Arg Asn Asp His Tyr Lys Glu
35 40 45
Leu Lys Pro Ile Ile Asp Arg Ile Tyr Lys Thr Tyr Ala Asp Gln Cys
50 55 60
Leu Gln Leu Val Gln Leu Asp Trp Glu Asn Leu Ser Ala Ala Ile Asp
65 70 75 80
Ser Tyr Arg Lys Glu Lys Thr Glu Glu Thr Arg Asn Ala Leu Ile Glu
85 90 95
Glu Gln Ala Thr Tyr Arg Asn Ala Ile His Asp Tyr Phe Ile Gly Arg
100 105 110
Thr Asp Asn Leu Thr Asp Ala Ile Asn Lys Arg His Ala Glu Ile Tyr
115 120 125
Lys Gly Leu Phe Lys Ala Glu Leu Phe Asn Gly Lys Val Leu Lys Gln
130 135 140
Leu Gly Thr Val Thr Thr Thr Glu His Glu Asn Ala Leu Leu Arg Ser
145 150 155 160
Phe Asp Lys Phe Thr Thr Tyr Phe Ser Gly Phe Tyr Glu Asn Arg Lys
165 170 175
Asn Val Phe Ser Ala Glu Asp Ile Ser Thr Ala Ile Pro His Arg Ile
180 185 190
Val Gln Asp Asn Phe Pro Lys Phe Lys Glu Asn Cys His Ile Phe Thr
195 200 205
Arg Leu Ile Thr Ala Val Pro Ser Leu Arg Glu His Phe Glu Asn Val
210 215 220
Lys Lys Ala Ile Gly Ile Phe Val Ser Thr Ser Ile Glu Glu Val Phe
225 230 235 240
Ser Phe Pro Phe Tyr Asn Gln Leu Leu Thr Gln Thr Gln Ile Asp Leu
245 250 255
Tyr Asn Gln Leu Leu Gly Gly Ile Ser Arg Glu Ala Gly Thr Glu Lys
260 265 270
Ile Lys Gly Leu Asn Glu Val Leu Asn Leu Ala Ile Gln Lys Asn Asp
275 280 285
Glu Thr Ala His Ile Ile Ala Ser Leu Pro His Arg Phe Ile Pro Leu
290 295 300
Phe Lys Gln Ile Leu Ser Asp Arg Asn Thr Leu Ser Phe Ile Leu Glu
305 310 315 320
Glu Phe Lys Ser Asp Glu Glu Val Ile Gln Ser Phe Cys Lys Tyr Lys
325 330 335
Thr Leu Leu Arg Asn Glu Asn Val Leu Glu Thr Ala Glu Ala Leu Phe
340 345 350
Asn Glu Leu Asn Ser Ile Asp Leu Thr His Ile Phe Ile Ser His Lys
355 360 365
Lys Leu Glu Thr Ile Ser Ser Ala Leu Cys Asp His Trp Asp Thr Leu
370 375 380
Arg Asn Ala Leu Tyr Glu Arg Arg Ile Ser Glu Leu Thr Gly Lys Ile
385 390 395 400
Thr Lys Ser Ala Lys Glu Lys Val Gln Arg Ser Leu Lys His Glu Asp
405 410 415
Ile Asn Leu Gln Glu Ile Ile Ser Ala Ala Gly Lys Glu Leu Ser Glu
420 425 430
Ala Phe Lys Gln Lys Thr Ser Glu Ile Leu Ser His Ala His Ala Ala
435 440 445
Leu Asp Gln Pro Leu Pro Thr Thr Leu Lys Lys Gln Glu Glu Lys Glu
450 455 460
Ile Leu Lys Ser Gln Leu Asp Ser Leu Leu Gly Leu Tyr His Leu Leu
465 470 475 480
Asp Trp Phe Ala Val Asp Glu Ser Asn Glu Val Asp Pro Glu Phe Ser
485 490 495
Ala Arg Leu Thr Gly Ile Lys Leu Glu Met Glu Pro Ser Leu Ser Phe
500 505 510
Tyr Asn Lys Ala Arg Asn Tyr Ala Thr Lys Lys Pro Tyr Ser Val Glu
515 520 525
Lys Phe Lys Leu Asn Phe Gln Met Pro Thr Leu Ala Ser Gly Trp Asp
530 535 540
Val Asn Lys Glu Lys Asn Asn Gly Ala Ile Leu Phe Val Lys Asn Gly
545 550 555 560
Leu Tyr Tyr Leu Gly Ile Met Pro Lys Gln Lys Gly Arg Tyr Lys Ala
565 570 575
Leu Ser Phe Glu Pro Thr Glu Lys Thr Ser Glu Gly Phe Asp Lys Met
580 585 590
Tyr Tyr Asp Tyr Phe Pro Asp Ala Ala Lys Met Ile Pro Lys Cys Ser
595 600 605
Thr Gln Leu Lys Ala Val Thr Ala His Phe Gln Thr His Thr Thr Pro
610 615 620
Ile Leu Leu Ser Asn Asn Phe Ile Glu Pro Leu Glu Ile Thr Lys Glu
625 630 635 640
Ile Tyr Asp Leu Asn Asn Pro Glu Lys Glu Pro Lys Lys Phe Gln Thr
645 650 655
Ala Tyr Ala Lys Lys Thr Gly Asp Gln Lys Gly Tyr Arg Glu Ala Leu
660 665 670
Cys Lys Trp Ile Asp Phe Thr Arg Asp Phe Leu Ser Lys Tyr Thr Lys
675 680 685
Thr Thr Ser Ile Asp Leu Ser Ser Leu Arg Pro Ser Ser Gln Tyr Lys
690 695 700
Asp Leu Gly Glu Tyr Tyr Ala Glu Leu Asn Pro Leu Leu Tyr His Ile
705 710 715 720
Ser Phe Gln Arg Ile Ala Glu Lys Glu Ile Met Asp Ala Val Glu Thr
725 730 735
Gly Lys Leu Tyr Leu Phe Gln Ile Tyr Asn Lys Asp Phe Ala Lys Gly
740 745 750
His His Gly Lys Pro Asn Leu His Thr Leu Tyr Trp Thr Gly Leu Phe
755 760 765
Ser Pro Glu Asn Leu Ala Lys Thr Ser Ile Lys Leu Asn Gly Gln Ala
770 775 780
Glu Leu Phe Tyr Arg Pro Lys Ser Arg Met Lys Arg Met Ala His Arg
785 790 795 800
Leu Gly Glu Lys Met Leu Asn Lys Lys Leu Lys Asp Gln Lys Thr Pro
805 810 815
Ile Pro Asp Thr Leu Tyr Gln Glu Leu Tyr Asp Tyr Val Asn His Arg
820 825 830
Leu Ser His Asp Leu Ser Asp Glu Ala Arg Ala Leu Leu Pro Asn Val
835 840 845
Ile Thr Lys Glu Val Ser His Glu Ile Ile Lys Asp Arg Arg Phe Thr
850 855 860
Ser Asp Lys Phe Phe Phe His Val Pro Ile Thr Leu Asn Tyr Gln Ala
865 870 875 880
Ala Asn Ser Pro Ser Lys Phe Asn Gln Arg Val Asn Ala Tyr Leu Lys
885 890 895
Glu His Pro Glu Thr Pro Ile Ile Gly Ile Asp Arg Gly Glu Arg Asn
900 905 910
Leu Ile Tyr Ile Thr Val Ile Asp Ser Thr Gly Lys Ile Leu Glu Gln
915 920 925
Arg Ser Leu Asn Thr Ile Gln Gln Phe Asp Tyr Gln Lys Lys Leu Asp
930 935 940
Asn Arg Glu Lys Glu Arg Val Ala Ala Arg Gln Ala Trp Ser Val Val
945 950 955 960
Gly Thr Ile Lys Asp Leu Lys Gln Gly Tyr Leu Ser Gln Val Ile His
965 970 975
Glu Ile Val Asp Leu Met Ile His Tyr Gln Ala Val Val Val Leu Glu
980 985 990
Asn Leu Asn Phe Gly Phe Lys Ser Lys Arg Thr Gly Ile Ala Glu Lys
995 1000 1005
Ala Val Tyr Gln Gln Phe Glu Lys Met Leu Ile Asp Lys Leu Asn
1010 1015 1020
Cys Leu Val Leu Lys Asp Tyr Pro Ala Glu Lys Val Gly Gly Val
1025 1030 1035
Leu Asn Pro Tyr Gln Leu Thr Asp Gln Phe Thr Ser Phe Ala Lys
1040 1045 1050
Met Gly Thr Gln Ser Gly Phe Leu Phe Tyr Val Pro Ala Pro Tyr
1055 1060 1065
Thr Ser Lys Ile Asp Pro Leu Thr Gly Phe Val Asp Pro Phe Val
1070 1075 1080
Trp Lys Thr Ile Lys Asn His Glu Ser Arg Lys His Phe Leu Glu
1085 1090 1095
Gly Phe Asp Phe Leu His Tyr Asp Val Lys Thr Gly Asp Phe Ile
1100 1105 1110
Leu His Phe Lys Met Asn Arg Asn Leu Ser Phe Gln Arg Gly Leu
1115 1120 1125
Pro Gly Phe Met Pro Ala Trp Asp Ile Val Phe Glu Lys Asn Glu
1130 1135 1140
Thr Gln Phe Asp Ala Lys Gly Thr Pro Phe Ile Ala Gly Lys Arg
1145 1150 1155
Ile Val Pro Val Ile Glu Asn His Arg Phe Thr Gly Arg Tyr Arg
1160 1165 1170
Asp Leu Tyr Pro Ala Asn Glu Leu Ile Ala Leu Leu Glu Glu Lys
1175 1180 1185
Gly Ile Val Phe Arg Asp Gly Ser Asn Ile Leu Pro Lys Leu Leu
1190 1195 1200
Glu Asn Asp Asp Ser His Ala Ile Asp Thr Met Val Ala Leu Ile
1205 1210 1215
Arg Ser Val Leu Gln Met Arg Asn Ser Asn Ala Ala Thr Gly Glu
1220 1225 1230
Asp Tyr Ile Asn Ser Pro Val Arg Asp Leu Asn Gly Val Cys Phe
1235 1240 1245
Asp Ser Arg Phe Gln Asn Pro Glu Trp Pro Met Asp Ala Asp Ala
1250 1255 1260
Asn Gly Ala Tyr His Ile Ala Leu Lys Gly Gln Leu Leu Leu Asn
1265 1270 1275
His Leu Lys Glu Ser Lys Asp Leu Lys Leu Gln Asn Gly Ile Ser
1280 1285 1290
Asn Gln Asp Trp Leu Ala Tyr Ile Gln Glu Leu Arg Asn
1295 1300 1305
<210> 49
<211> 1306
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 49
Thr Gln Phe Glu Gly Phe Thr Asn Leu Tyr Gln Val Ser Lys Thr Leu
1 5 10 15
Arg Phe Glu Leu Ile Pro Gln Gly Lys Thr Leu Lys His Ile Gln Glu
20 25 30
Gln Gly Phe Ile Glu Glu Asp Lys Ala Arg Asn Asp His Tyr Lys Glu
35 40 45
Leu Lys Pro Ile Ile Asp Arg Ile Tyr Lys Thr Tyr Ala Asp Gln Cys
50 55 60
Leu Gln Leu Val Gln Leu Asp Trp Glu Asn Leu Ser Ala Ala Ile Asp
65 70 75 80
Ser Tyr Arg Lys Glu Lys Thr Glu Glu Thr Arg Asn Ala Leu Ile Glu
85 90 95
Glu Gln Ala Thr Tyr Arg Asn Ala Ile His Asp Tyr Phe Ile Gly Arg
100 105 110
Thr Asp Asn Leu Thr Asp Ala Ile Asn Lys Arg His Ala Glu Ile Tyr
115 120 125
Lys Gly Leu Phe Lys Ala Glu Leu Phe Asn Gly Lys Val Leu Lys Gln
130 135 140
Leu Gly Thr Val Thr Thr Thr Glu His Glu Asn Ala Leu Leu Arg Ser
145 150 155 160
Phe Asp Lys Phe Thr Thr Tyr Phe Ser Gly Phe Tyr Glu Asn Arg Lys
165 170 175
Asn Val Phe Ser Ala Glu Asp Ile Ser Thr Ala Ile Pro His Arg Ile
180 185 190
Val Gln Asp Asn Phe Pro Lys Phe Lys Glu Asn Cys His Ile Phe Thr
195 200 205
Arg Leu Ile Thr Ala Val Pro Ser Leu Arg Glu His Phe Glu Asn Val
210 215 220
Lys Lys Ala Ile Gly Ile Phe Val Ser Thr Ser Ile Glu Glu Val Phe
225 230 235 240
Ser Phe Pro Phe Tyr Asn Gln Leu Leu Thr Gln Thr Gln Ile Asp Leu
245 250 255
Tyr Asn Gln Leu Leu Gly Gly Ile Ser Arg Glu Ala Gly Thr Glu Lys
260 265 270
Ile Lys Gly Leu Asn Glu Val Leu Asn Leu Ala Ile Gln Lys Asn Asp
275 280 285
Glu Thr Ala His Ile Ile Ala Ser Leu Pro His Arg Phe Ile Pro Leu
290 295 300
Phe Lys Gln Ile Leu Ser Asp Arg Asn Thr Leu Ser Phe Ile Leu Glu
305 310 315 320
Glu Phe Lys Ser Asp Glu Glu Val Ile Gln Ser Phe Cys Lys Tyr Lys
325 330 335
Thr Leu Leu Arg Asn Glu Asn Val Leu Glu Thr Ala Glu Ala Leu Phe
340 345 350
Asn Glu Leu Asn Ser Ile Asp Leu Thr His Ile Phe Ile Ser His Lys
355 360 365
Lys Leu Glu Thr Ile Ser Ser Ala Leu Cys Asp His Trp Asp Thr Leu
370 375 380
Arg Asn Ala Leu Tyr Glu Arg Arg Ile Ser Glu Leu Thr Gly Lys Ile
385 390 395 400
Thr Lys Ser Ala Lys Glu Lys Val Gln Arg Ser Leu Lys His Glu Asp
405 410 415
Ile Asn Leu Gln Glu Ile Ile Ser Ala Ala Gly Lys Glu Leu Ser Glu
420 425 430
Ala Phe Lys Gln Lys Thr Ser Glu Ile Leu Ser His Ala His Ala Ala
435 440 445
Leu Asp Gln Pro Leu Pro Thr Thr Leu Lys Lys Gln Glu Glu Lys Glu
450 455 460
Ile Leu Lys Ser Gln Leu Asp Ser Leu Leu Gly Leu Tyr His Leu Leu
465 470 475 480
Asp Trp Phe Ala Val Asp Glu Ser Asn Glu Val Asp Pro Glu Phe Ser
485 490 495
Ala Arg Leu Thr Gly Ile Lys Leu Glu Met Glu Pro Ser Leu Ser Phe
500 505 510
Tyr Asn Lys Ala Arg Asn Tyr Ala Thr Lys Lys Pro Tyr Ser Val Glu
515 520 525
Lys Phe Lys Leu Asn Phe Gln Met Pro Thr Leu Ala Ser Gly Trp Asp
530 535 540
Val Asn Lys Glu Lys Asn Asn Gly Ala Ile Leu Phe Val Lys Asn Gly
545 550 555 560
Leu Tyr Tyr Leu Gly Ile Met Pro Lys Gln Lys Gly Arg Tyr Lys Ala
565 570 575
Leu Ser Phe Glu Pro Thr Glu Lys Thr Ser Glu Gly Phe Asp Lys Met
580 585 590
Tyr Tyr Asp Tyr Phe Pro Asp Ala Ala Lys Met Ile Pro Lys Cys Ser
595 600 605
Thr Gln Leu Lys Ala Val Thr Ala His Phe Gln Thr His Thr Thr Pro
610 615 620
Ile Leu Leu Ser Asn Asn Phe Ile Glu Pro Leu Glu Ile Thr Lys Glu
625 630 635 640
Ile Tyr Asp Leu Asn Asn Pro Glu Lys Glu Pro Lys Lys Phe Gln Thr
645 650 655
Ala Tyr Ala Lys Lys Thr Gly Asp Gln Lys Gly Tyr Arg Glu Ala Leu
660 665 670
Cys Lys Trp Ile Asp Phe Thr Arg Asp Phe Leu Ser Lys Tyr Thr Lys
675 680 685
Thr Thr Ser Ile Asp Leu Ser Ser Leu Arg Pro Ser Ser Gln Tyr Lys
690 695 700
Asp Leu Gly Glu Tyr Tyr Ala Glu Leu Asn Pro Leu Leu Tyr His Ile
705 710 715 720
Ser Phe Gln Arg Ile Ala Glu Lys Glu Ile Met Asp Ala Val Glu Thr
725 730 735
Gly Lys Leu Tyr Leu Phe Gln Ile Tyr Asn Lys Asp Phe Ala Lys Gly
740 745 750
His His Gly Lys Pro Asn Leu His Thr Leu Tyr Trp Thr Gly Leu Phe
755 760 765
Ser Pro Glu Asn Leu Ala Lys Thr Ser Ile Lys Leu Asn Gly Gln Ala
770 775 780
Glu Leu Phe Tyr Arg Pro Lys Ser Arg Met Lys Arg Met Ala His Arg
785 790 795 800
Leu Gly Glu Lys Met Leu Asn Lys Lys Leu Lys Asp Gln Lys Thr Pro
805 810 815
Ile Pro Asp Thr Leu Tyr Gln Glu Leu Tyr Asp Tyr Val Asn His Arg
820 825 830
Leu Ser His Asp Leu Ser Asp Glu Ala Arg Ala Leu Leu Pro Asn Val
835 840 845
Ile Thr Lys Glu Val Ser His Glu Ile Ile Lys Asp Arg Arg Phe Thr
850 855 860
Ser Asp Lys Phe Phe Phe His Val Pro Ile Thr Leu Asn Tyr Gln Ala
865 870 875 880
Ala Asn Ser Pro Ser Lys Phe Asn Gln Arg Val Asn Ala Tyr Leu Lys
885 890 895
Glu His Pro Glu Thr Pro Ile Ile Gly Ile Asp Arg Gly Glu Arg Asn
900 905 910
Leu Ile Tyr Ile Thr Val Ile Asp Ser Thr Gly Lys Ile Leu Glu Gln
915 920 925
Arg Ser Leu Asn Thr Ile Gln Gln Phe Asp Tyr Gln Lys Lys Leu Asp
930 935 940
Asn Arg Glu Lys Glu Arg Val Ala Ala Arg Gln Ala Trp Ser Val Val
945 950 955 960
Gly Thr Ile Lys Asp Leu Lys Gln Gly Tyr Leu Ser Gln Val Ile His
965 970 975
Glu Ile Val Asp Leu Met Ile His Tyr Gln Ala Val Val Val Leu Glu
980 985 990
Asn Leu Asn Phe Gly Phe Lys Ser Lys Arg Thr Gly Ile Ala Glu Lys
995 1000 1005
Ala Val Tyr Gln Gln Phe Glu Lys Met Leu Ile Asp Lys Leu Asn
1010 1015 1020
Cys Leu Val Leu Lys Asp Tyr Pro Ala Glu Lys Val Gly Gly Val
1025 1030 1035
Leu Asn Pro Tyr Gln Leu Thr Asp Gln Phe Thr Ser Phe Ala Lys
1040 1045 1050
Met Gly Thr Gln Ser Gly Phe Leu Phe Tyr Val Pro Ala Pro Tyr
1055 1060 1065
Thr Ser Lys Ile Asp Pro Leu Thr Gly Phe Val Asp Pro Phe Val
1070 1075 1080
Trp Lys Thr Ile Lys Asn His Glu Ser Arg Lys His Phe Leu Glu
1085 1090 1095
Gly Phe Asp Phe Leu His Tyr Asp Val Lys Thr Gly Asp Phe Ile
1100 1105 1110
Leu His Phe Lys Met Asn Arg Asn Leu Ser Phe Gln Arg Gly Leu
1115 1120 1125
Pro Gly Phe Met Pro Ala Trp Asp Ile Val Phe Glu Lys Asn Glu
1130 1135 1140
Thr Gln Phe Asp Ala Lys Gly Thr Pro Phe Ile Ala Gly Lys Arg
1145 1150 1155
Ile Val Pro Val Ile Glu Asn His Arg Phe Thr Gly Arg Tyr Arg
1160 1165 1170
Asp Leu Tyr Pro Ala Asn Glu Leu Ile Ala Leu Leu Glu Glu Lys
1175 1180 1185
Gly Ile Val Phe Arg Asp Gly Ser Asn Ile Leu Pro Lys Leu Leu
1190 1195 1200
Glu Asn Asp Asp Ser His Ala Ile Asp Thr Met Val Ala Leu Ile
1205 1210 1215
Arg Ser Val Leu Gln Met Ala Asn Ser Asn Ala Ala Thr Gly Glu
1220 1225 1230
Asp Tyr Ile Asn Ser Pro Val Arg Asp Leu Asn Gly Val Cys Phe
1235 1240 1245
Asp Ser Arg Phe Gln Asn Pro Glu Trp Pro Met Asp Ala Asp Ala
1250 1255 1260
Asn Gly Ala Tyr His Ile Ala Leu Lys Gly Gln Leu Leu Leu Asn
1265 1270 1275
His Leu Lys Glu Ser Lys Asp Leu Lys Leu Gln Asn Gly Ile Ser
1280 1285 1290
Asn Gln Asp Trp Leu Ala Tyr Ile Gln Glu Leu Arg Asn
1295 1300 1305
<210> 50
<211> 37
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 50
cacaccaggt ctcattgcgc gcttggcgta atcatgg 37
<210> 51
<211> 37
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 51
cacaccaggt ctcattatag tgagtcgtat tacgcgc 37
<210> 52
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 52
cacaccaggt ctcaataagg cgaattgggt accg 34
<210> 53
<211> 36
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 53
cacaccaggt ctcagttcaa gaaccctctt tttcgc 36
<210> 54
<211> 35
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 54
cacaccaggt ctcagaacct ctgggcctgg ttgag 35
<210> 55
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 55
cacaccaggt ctcaaccccc aaggggtgct gtag 34
<210> 56
<211> 44
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 56
cacaccaggt ctcagggtat tttgacttca acagattcca ctgc 44
<210> 57
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 57
cacaccaggt ctcaaaagac ctgaaccgtg ctgg 34
<210> 58
<211> 37
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 58
cacaccaggt ctcactttac tgactcggag taccagc 37
<210> 59
<211> 38
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 59
cacaccaggt ctcagtagct gaaggtaaag ttgtttcc 38
<210> 60
<211> 35
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 60
cacaccaggt ctcactacac ttttgaggac gttcc 35
<210> 61
<211> 37
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 61
cacaccaggt ctcaagttcc tagactggtc ccgaatg 37
<210> 62
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 62
cacaccaggt ctcaaactgg cttcctggac cctg 34
<210> 63
<211> 36
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 63
cacaccaggt ctcagtctct gtcctgccag accatg 36
<210> 64
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 64
cacaccaggt ctcaagacgt gtaccttcag gggc 34
<210> 65
<211> 36
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 65
cacaccaggt ctcaatgaag gaagcaaact ttgccg 36
<210> 66
<211> 35
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 66
cacaccaggt ctcatcatca cacagtactc cacgg 35
<210> 67
<211> 35
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 67
cacaccaggt ctcagcaagc gcgcaattaa ccctc 35
<210> 68
<211> 36
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 68
cacaccaggt ctcagttcaa gaaccctctt tttggc 36
<210> 69
<211> 35
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 69
cacaccaggt ctcagaacct cttggtctgg ttgag 35
<210> 70
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 70
cacaccaggt ctcaaccccc agggggtgga gaat 34
<210> 71
<211> 39
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 71
cacaccaggt ctcagggtat tttgacttca accgcttcc 39
<210> 72
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 72
cacaccaggt ctcaaaagat ctgaaccgtg ctgg 34
<210> 73
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 73
cacaccaggt ctcactttgc ggactcgtcg tacg 34
<210> 74
<211> 38
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 74
cacaccaggt ctcagtaggt aatttcaaag ttgttgcc 38
<210> 75
<211> 35
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 75
cacaccaggt ctcactacag trtgagaagg tgcct 35
<210> 76
<211> 42
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 76
cacaccaggt ctcaagttct ttttaaagtt ggaaaagttg gt 42
<210> 77
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 77
cacaccaggt ctcaaactgg ctgcccgggc cttc 34
<210> 78
<211> 37
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 78
cacaccaggt ctcagtctct gttttgccag accattc 37
<210> 79
<211> 36
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 79
cacaccaggt ctcaagacat ttactaccag ggtccc 36
<210> 80
<211> 37
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 80
cacaccaggt ctcaatgaag gagttaccgg agtagag 37
<210> 81
<211> 37
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 81
cacaccaggt ctcatcatta ctcagtacag cactggc 37
<210> 82
<211> 43
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 82
cacaccaggt ctcagcaagc gcgcaattaa ccctcactaa agg 43
<210> 83
<211> 36
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 83
cacaccaggt ctcagttcga gaaccctttt cttggc 36
<210> 84
<211> 35
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 84
cacaccaggt ctcagaacct tttggcctgg ttgaa 35
<210> 85
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 85
cacaccaggt ctcaaccccc agggggtgct gtat 34
<210> 86
<211> 39
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 86
cacaccaggt ctcagggtat tttgacttta accgcttcc 39
<210> 87
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 87
cacaccaggt ctcaaaagac ttggacggtg gagg 34
<210> 88
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 88
cacaccaggt ctcactttac ggacgacgac tacc 34
<210> 89
<211> 38
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 89
cacaccaggt ctcagtaggt aaactcaaag ttgttgcc 38
<210> 90
<211> 35
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 90
cacaccaggt ctcactacaa ctttgaggag gtgcc 35
<210> 91
<211> 41
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 91
cacaccaggt ctcaagtttt tgtaggtgtt ggcgtatctc c 41
<210> 92
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 92
cacaccaggt ctcaaactgg ttcccggggc ccat 34
<210> 93
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 93
cacaccaggt ctcagtctct ctccatccac acgc 34
<210> 94
<211> 35
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 94
cacaccaggt ctcaagacgt gtacctccaa ggacc 35
<210> 95
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 95
cacaccaggt ctcaatgaag ctgctgacgg gcac 34
<210> 96
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 96
cacaccaggt ctcatcatca cccagtacag cacc 34
<210> 97
<211> 35
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 97
cacaccaggt ctcagttcga gaaccctctt cttgg 35
<210> 98
<211> 36
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 98
cacaccaggt ctcagaacct tttggtctgg ttgagg 36
<210> 99
<211> 35
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 99
cacaccaggt ctcaaccccc agggggtgct gtagc 35
<210> 100
<211> 44
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 100
cacaccaggt ctcagggtat tttgatttca acagattcca ctgc 44
<210> 101
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 101
cacaccaggt ctcaaaagac ttgaaccgtg ctgg 34
<210> 102
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 102
cacaccaggt ctcacttttc ggactcggag tacc 34
<210> 103
<211> 38
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 103
cacaccaggt ctcagtagct gaaggtaaag ttattgcc 38
<210> 104
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 104
cacaccaggt ctcactacac cttcgaggac gtgc 34
<210> 105
<211> 38
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 105
cacaccaggt ctcaagtttt tgggctgaac agacatgc 38
<210> 106
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 106
cacaccaggt ctcaaactgg ctacctggac cctg 34
<210> 107
<211> 37
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 107
cacaccaggt ctcagtctct gtcttgccac accattc 37
<210> 108
<211> 35
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 108
cacaccaggt ctcaagacgt atacctgcag ggtcc 35
<210> 109
<211> 38
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 109
cacaccaggt ctcaatgaat gaagcaaact ttgtagcc 38
<210> 110
<211> 36
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 110
cacaccaggt ctcatcatca cccagtattc cacagg 36
<210> 111
<211> 35
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 111
cacaccaggt ctcagttcga gaacccgctt cttgg 35
<210> 112
<211> 35
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 112
cacaccaggt ctcagaacct ctcggtctgg ttgag 35
<210> 113
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 113
cacaccaggt ctcaaccccc agggggtgct gtag 34
<210> 114
<211> 44
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 114
cacaccaggt ctcagggtat tttgacttta acagattcca ctgc 44
<210> 115
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 115
cacaccaggt ctcaaaagac ctggatggtg ctgg 34
<210> 116
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 116
cacaccaggt ctcactttac ggactcggag tacc 34
<210> 117
<211> 37
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 117
cacaccaggt ctcagtaggt aaactggaag ttgttgc 37
<210> 118
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 118
cacaccaggt ctcaagttct ttgcctgatt ggcc 34
<210> 119
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 119
cacaccaggt ctcaaactgg ctgccaggac cctg 34
<210> 120
<211> 37
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 120
cacaccaggt ctcagtctcg gttctgccag accatac 37
<210> 121
<211> 35
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 121
cacaccaggt ctcaagacgt gtacctgcag ggtcc 35
<210> 122
<211> 38
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 122
cacaccaggt ctcaatgaaa gagttcagct ttgactgg 38
<210> 123
<211> 35
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 123
cacaccaggt ctcatcatca cgcaatacag caccg 35
<210> 124
<211> 36
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 124
cacaccaggt ctcagttcaa gaagcctctt tttggc 36
<210> 125
<211> 36
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 125
cacaccaggt ctcagaacct cttggtctgg ttgagg 36
<210> 126
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 126
cacaccaggt ctcaaaagac ctggaccgtg ctgg 34
<210> 127
<211> 37
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 127
cacaccaggt ctcactttac ggactcagac tatcagc 37
<210> 128
<211> 38
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 128
cacaccaggt ctcagtagct gaactggaag ttgttacc 38
<210> 129
<211> 35
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 129
cacaccaggt ctcactacga gtttgagaac gtacc 35
<210> 130
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 130
cacaccaggt ctcaagtttc ttccctggac agcc 34
<210> 131
<211> 35
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 131
cacaccaggt ctcaaactac atacctggac ccagc 35
<210> 132
<211> 38
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 132
cacaccaggt ctcagtctct gtcctgccaa accatacc 38
<210> 133
<211> 34
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 133
cacaccaggt ctcaagacgt gtacctgcaa ggac 34
<210> 134
<211> 38
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 134
cacaccaggt ctcaatgaaa gagttcagct tgtccttg 38
<210> 135
<211> 37
<212> DNA
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 135
cacaccaggt ctcatcatca cccagtattc tactggc 37
<210> 136
<211> 735
<212> PRT
<213> Adeno-associated virus
<400> 136
Met Ala Ala Asp Gly Tyr Leu Pro Asp Trp Leu Glu Asp Thr Leu Ser
1 5 10 15
Glu Gly Ile Arg Gln Trp Trp Lys Leu Lys Pro Gly Pro Pro Pro Pro
20 25 30
Lys Pro Ala Glu Arg His Lys Asp Asp Ser Arg Gly Leu Val Leu Pro
35 40 45
Gly Tyr Lys Tyr Leu Gly Pro Phe Asn Gly Leu Asp Lys Gly Glu Pro
50 55 60
Val Asn Glu Ala Asp Ala Ala Ala Leu Glu His Asp Lys Ala Tyr Asp
65 70 75 80
Arg Gln Leu Asp Ser Gly Asp Asn Pro Tyr Leu Lys Tyr Asn His Ala
85 90 95
Asp Ala Glu Phe Gln Glu Arg Leu Lys Glu Asp Thr Ser Phe Gly Gly
100 105 110
Asn Leu Gly Arg Ala Val Phe Gln Ala Lys Lys Arg Val Leu Glu Pro
115 120 125
Leu Gly Leu Val Glu Glu Pro Val Lys Thr Ala Pro Gly Lys Lys Arg
130 135 140
Pro Val Glu His Ser Pro Val Glu Pro Asp Ser Ser Ser Gly Thr Gly
145 150 155 160
Lys Ala Gly Gln Gln Pro Ala Arg Lys Arg Leu Asn Phe Gly Gln Thr
165 170 175
Gly Asp Ala Asp Ser Val Pro Asp Pro Gln Pro Leu Gly Gln Pro Pro
180 185 190
Ala Ala Pro Ser Gly Leu Gly Thr Asn Thr Met Ala Thr Gly Ser Gly
195 200 205
Ala Pro Met Ala Asp Asn Asn Glu Gly Ala Asp Gly Val Gly Asn Ser
210 215 220
Ser Gly Asn Trp His Cys Asp Ser Thr Trp Met Gly Asp Arg Val Ile
225 230 235 240
Thr Thr Ser Thr Arg Thr Trp Ala Leu Pro Thr Tyr Asn Asn His Leu
245 250 255
Tyr Lys Gln Ile Ser Ser Gln Ser Gly Ala Ser Asn Asp Asn His Tyr
260 265 270
Phe Gly Tyr Ser Thr Pro Trp Gly Tyr Phe Asp Phe Asn Arg Phe His
275 280 285
Cys His Phe Ser Pro Arg Asp Trp Gln Arg Leu Ile Asn Asn Asn Trp
290 295 300
Gly Phe Arg Pro Lys Arg Leu Asn Phe Lys Leu Phe Asn Ile Gln Val
305 310 315 320
Lys Glu Val Thr Gln Asn Asp Gly Thr Thr Thr Ile Ala Asn Asn Leu
325 330 335
Thr Ser Thr Val Gln Val Phe Thr Asp Ser Glu Tyr Gln Leu Pro Tyr
340 345 350
Val Leu Gly Ser Ala His Gln Gly Cys Leu Pro Pro Phe Pro Ala Asp
355 360 365
Val Phe Met Val Pro Gln Tyr Gly Tyr Leu Thr Leu Asn Asn Gly Ser
370 375 380
Gln Ala Val Gly Arg Ser Ser Phe Tyr Cys Leu Glu Tyr Phe Pro Ser
385 390 395 400
Gln Met Leu Arg Thr Gly Asn Asn Phe Thr Phe Ser Tyr Thr Phe Glu
405 410 415
Asp Val Pro Phe His Ser Ser Tyr Ala His Ser Gln Ser Leu Asp Arg
420 425 430
Leu Met Asn Pro Leu Ile Asp Gln Tyr Leu Tyr Tyr Leu Ser Arg Thr
435 440 445
Asn Thr Pro Ser Gly Thr Thr Thr Gln Ser Arg Leu Gln Phe Ser Gln
450 455 460
Ala Gly Ala Ser Asp Ile Arg Asp Gln Ser Arg Asn Trp Leu Pro Gly
465 470 475 480
Pro Cys Tyr Arg Gln Gln Arg Val Ser Lys Thr Ser Ala Asp Asn Asn
485 490 495
Asn Ser Glu Tyr Ser Trp Thr Gly Ala Thr Lys Tyr His Leu Asn Gly
500 505 510
Arg Asp Ser Leu Val Asn Pro Gly Pro Ala Met Ala Ser His Lys Asp
515 520 525
Asp Glu Glu Lys Phe Phe Pro Gln Ser Gly Val Leu Ile Phe Gly Lys
530 535 540
Gln Gly Ser Glu Lys Thr Asn Val Asp Ile Glu Lys Val Met Ile Thr
545 550 555 560
Asp Glu Glu Glu Ile Arg Thr Thr Asn Pro Val Ala Thr Glu Gln Tyr
565 570 575
Gly Ser Val Ser Thr Asn Leu Gln Arg Gly Asn Arg Gln Ala Ala Thr
580 585 590
Ala Asp Val Asn Thr Gln Gly Val Leu Pro Gly Met Val Trp Gln Asp
595 600 605
Arg Asp Val Tyr Leu Gln Gly Pro Ile Trp Ala Lys Ile Pro His Thr
610 615 620
Asp Gly His Phe His Pro Ser Pro Leu Met Gly Gly Phe Gly Leu Lys
625 630 635 640
His Pro Pro Pro Gln Ile Leu Ile Lys Asn Thr Pro Val Pro Ala Asn
645 650 655
Pro Ser Thr Thr Phe Ser Ala Ala Lys Phe Ala Ser Phe Ile Thr Gln
660 665 670
Tyr Ser Thr Gly Gln Val Ser Val Glu Ile Glu Trp Glu Leu Gln Lys
675 680 685
Glu Asn Ser Lys Arg Trp Asn Pro Glu Ile Gln Tyr Thr Ser Asn Tyr
690 695 700
Asn Lys Ser Val Asn Val Asp Phe Thr Val Asp Thr Asn Gly Val Tyr
705 710 715 720
Ser Glu Pro Arg Pro Ile Gly Thr Arg Tyr Leu Thr Arg Asn Leu
725 730 735
<210> 137
<211> 738
<212> PRT
<213> Adeno-associated virus
<400> 137
Met Ala Ala Asp Gly Tyr Leu Pro Asp Trp Leu Glu Asp Asn Leu Ser
1 5 10 15
Glu Gly Ile Arg Glu Trp Trp Ala Leu Lys Pro Gly Ala Pro Lys Pro
20 25 30
Lys Ala Asn Gln Gln Lys Gln Asp Asp Gly Arg Gly Leu Val Leu Pro
35 40 45
Gly Tyr Lys Tyr Leu Gly Pro Phe Asn Gly Leu Asp Lys Gly Glu Pro
50 55 60
Val Asn Ala Ala Asp Ala Ala Ala Leu Glu His Asp Lys Ala Tyr Asp
65 70 75 80
Gln Gln Leu Gln Ala Gly Asp Asn Pro Tyr Leu Arg Tyr Asn His Ala
85 90 95
Asp Ala Glu Phe Gln Glu Arg Leu Gln Glu Asp Thr Ser Phe Gly Gly
100 105 110
Asn Leu Gly Arg Ala Val Phe Gln Ala Lys Lys Arg Val Leu Glu Pro
115 120 125
Leu Gly Leu Val Glu Glu Gly Ala Lys Thr Ala Pro Gly Lys Lys Arg
130 135 140
Pro Val Glu Pro Ser Pro Gln Arg Ser Pro Asp Ser Ser Thr Gly Ile
145 150 155 160
Gly Lys Lys Gly Gln Gln Pro Ala Arg Lys Arg Leu Asn Phe Gly Gln
165 170 175
Thr Gly Asp Ser Glu Ser Val Pro Asp Pro Gln Pro Leu Gly Glu Pro
180 185 190
Pro Ala Ala Pro Ser Gly Val Gly Pro Asn Thr Met Ala Ala Gly Gly
195 200 205
Gly Ala Pro Met Ala Asp Asn Asn Glu Gly Ala Asp Gly Val Gly Ser
210 215 220
Ser Ser Gly Asn Trp His Cys Asp Ser Thr Trp Leu Gly Asp Arg Val
225 230 235 240
Ile Thr Thr Ser Thr Arg Thr Trp Ala Leu Pro Thr Tyr Asn Asn His
245 250 255
Leu Tyr Lys Gln Ile Ser Asn Gly Thr Ser Gly Gly Ala Thr Asn Asp
260 265 270
Asn Thr Tyr Phe Gly Tyr Ser Thr Pro Trp Gly Tyr Phe Asp Phe Asn
275 280 285
Arg Phe His Cys His Phe Ser Pro Arg Asp Trp Gln Arg Leu Ile Asn
290 295 300
Asn Asn Trp Gly Phe Arg Pro Lys Arg Leu Ser Phe Lys Leu Phe Asn
305 310 315 320
Ile Gln Val Lys Glu Val Thr Gln Asn Glu Gly Thr Lys Thr Ile Ala
325 330 335
Asn Asn Leu Thr Ser Thr Ile Gln Val Phe Thr Asp Ser Glu Tyr Gln
340 345 350
Leu Pro Tyr Val Leu Gly Ser Ala His Gln Gly Cys Leu Pro Pro Phe
355 360 365
Pro Ala Asp Val Phe Met Ile Pro Gln Tyr Gly Tyr Leu Thr Leu Asn
370 375 380
Asn Gly Ser Gln Ala Val Gly Arg Ser Ser Phe Tyr Cys Leu Glu Tyr
385 390 395 400
Phe Pro Ser Gln Met Leu Arg Thr Gly Asn Asn Phe Gln Phe Thr Tyr
405 410 415
Thr Phe Glu Asp Val Pro Phe His Ser Ser Tyr Ala His Ser Gln Ser
420 425 430
Leu Asp Arg Leu Met Asn Pro Leu Ile Asp Gln Tyr Leu Tyr Tyr Leu
435 440 445
Ser Arg Thr Gln Thr Thr Gly Gly Thr Ala Asn Thr Gln Thr Leu Gly
450 455 460
Phe Ser Gln Gly Gly Pro Asn Thr Met Ala Asn Gln Ala Lys Asn Trp
465 470 475 480
Leu Pro Gly Pro Cys Tyr Arg Gln Gln Arg Val Ser Thr Thr Thr Gly
485 490 495
Gln Asn Asn Asn Ser Asn Phe Ala Trp Thr Ala Gly Thr Lys Tyr His
500 505 510
Leu Asn Gly Arg Asn Ser Leu Ala Asn Pro Gly Ile Ala Met Ala Thr
515 520 525
His Lys Asp Asp Glu Glu Arg Phe Phe Pro Ser Asn Gly Ile Leu Ile
530 535 540
Phe Gly Lys Gln Asn Ala Ala Arg Asp Asn Ala Asp Tyr Ser Asp Val
545 550 555 560
Met Leu Thr Ser Glu Glu Glu Ile Lys Thr Thr Asn Pro Val Ala Thr
565 570 575
Glu Glu Tyr Gly Ile Val Ala Asp Asn Leu Gln Gln Gln Asn Thr Ala
580 585 590
Pro Gln Ile Gly Thr Val Asn Ser Gln Gly Ala Leu Pro Gly Met Val
595 600 605
Trp Gln Asn Arg Asp Val Tyr Leu Gln Gly Pro Ile Trp Ala Lys Ile
610 615 620
Pro His Thr Asp Gly Asn Phe His Pro Ser Pro Leu Met Gly Gly Phe
625 630 635 640
Gly Leu Lys His Pro Pro Pro Gln Ile Leu Ile Lys Asn Thr Pro Val
645 650 655
Pro Ala Asp Pro Pro Thr Thr Phe Asn Gln Ser Lys Leu Asn Ser Phe
660 665 670
Ile Thr Gln Tyr Ser Thr Gly Gln Val Ser Val Glu Ile Glu Trp Glu
675 680 685
Leu Gln Lys Glu Asn Ser Lys Arg Trp Asn Pro Glu Ile Gln Tyr Thr
690 695 700
Ser Asn Tyr Tyr Lys Ser Thr Ser Val Asp Phe Ala Val Asn Thr Glu
705 710 715 720
Gly Val Tyr Ser Glu Pro Arg Pro Ile Gly Thr Arg Tyr Leu Thr Arg
725 730 735
Asn Leu
<210> 138
<211> 736
<212> PRT
<213> Adeno-associated virus
<400> 138
Met Ala Ala Asp Gly Tyr Leu Pro Asp Trp Leu Glu Asp Asn Leu Ser
1 5 10 15
Glu Gly Ile Arg Glu Trp Trp Ala Leu Lys Pro Gly Ala Pro Gln Pro
20 25 30
Lys Ala Asn Gln Gln His Gln Asp Asn Ala Arg Gly Leu Val Leu Pro
35 40 45
Gly Tyr Lys Tyr Leu Gly Pro Gly Asn Gly Leu Asp Lys Gly Glu Pro
50 55 60
Val Asn Ala Ala Asp Ala Ala Ala Leu Glu His Asp Lys Ala Tyr Asp
65 70 75 80
Gln Gln Leu Lys Ala Gly Asp Asn Pro Tyr Leu Lys Tyr Asn His Ala
85 90 95
Asp Ala Glu Phe Gln Glu Arg Leu Lys Glu Asp Thr Ser Phe Gly Gly
100 105 110
Asn Leu Gly Arg Ala Val Phe Gln Ala Lys Lys Arg Leu Leu Glu Pro
115 120 125
Leu Gly Leu Val Glu Glu Ala Ala Lys Thr Ala Pro Gly Lys Lys Arg
130 135 140
Pro Val Glu Gln Ser Pro Gln Glu Pro Asp Ser Ser Ala Gly Ile Gly
145 150 155 160
Lys Ser Gly Ala Gln Pro Ala Lys Lys Arg Leu Asn Phe Gly Gln Thr
165 170 175
Gly Asp Thr Glu Ser Val Pro Asp Pro Gln Pro Ile Gly Glu Pro Pro
180 185 190
Ala Ala Pro Ser Gly Val Gly Ser Leu Thr Met Ala Ser Gly Gly Gly
195 200 205
Ala Pro Val Ala Asp Asn Asn Glu Gly Ala Asp Gly Val Gly Ser Ser
210 215 220
Ser Gly Asn Trp His Cys Asp Ser Gln Trp Leu Gly Asp Arg Val Ile
225 230 235 240
Thr Thr Ser Thr Arg Thr Trp Ala Leu Pro Thr Tyr Asn Asn His Leu
245 250 255
Tyr Lys Gln Ile Ser Asn Ser Thr Ser Gly Gly Ser Ser Asn Asp Asn
260 265 270
Ala Tyr Phe Gly Tyr Ser Thr Pro Trp Gly Tyr Phe Asp Phe Asn Arg
275 280 285
Phe His Cys His Phe Ser Pro Arg Asp Trp Gln Arg Leu Ile Asn Asn
290 295 300
Asn Trp Gly Phe Arg Pro Lys Arg Leu Asn Phe Lys Leu Phe Asn Ile
305 310 315 320
Gln Val Lys Glu Val Thr Asp Asn Asn Gly Val Lys Thr Ile Ala Asn
325 330 335
Asn Leu Thr Ser Thr Val Gln Val Phe Thr Asp Ser Asp Tyr Gln Leu
340 345 350
Pro Tyr Val Leu Gly Ser Ala His Glu Gly Cys Leu Pro Pro Phe Pro
355 360 365
Ala Asp Val Phe Met Ile Pro Gln Tyr Gly Tyr Leu Thr Leu Asn Asp
370 375 380
Gly Ser Gln Ala Val Gly Arg Ser Ser Phe Tyr Cys Leu Glu Tyr Phe
385 390 395 400
Pro Ser Gln Met Leu Arg Thr Gly Asn Asn Phe Gln Phe Ser Tyr Glu
405 410 415
Phe Glu Asn Val Pro Phe His Ser Ser Tyr Ala His Ser Gln Ser Leu
420 425 430
Asp Arg Leu Met Asn Pro Leu Ile Asp Gln Tyr Leu Tyr Tyr Leu Ser
435 440 445
Lys Thr Ile Asn Gly Ser Gly Gln Asn Gln Gln Thr Leu Lys Phe Ser
450 455 460
Val Ala Gly Pro Ser Asn Met Ala Val Gln Gly Arg Asn Tyr Ile Pro
465 470 475 480
Gly Pro Ser Tyr Arg Gln Gln Arg Val Ser Thr Thr Val Thr Gln Asn
485 490 495
Asn Asn Ser Glu Phe Ala Trp Pro Gly Ala Ser Ser Trp Ala Leu Asn
500 505 510
Gly Arg Asn Ser Leu Met Asn Pro Gly Pro Ala Met Ala Ser His Lys
515 520 525
Glu Gly Glu Asp Arg Phe Phe Pro Leu Ser Gly Ser Leu Ile Phe Gly
530 535 540
Lys Gln Gly Thr Gly Arg Asp Asn Val Asp Ala Asp Lys Val Met Ile
545 550 555 560
Thr Asn Glu Glu Glu Ile Lys Thr Thr Asn Pro Val Ala Thr Glu Ser
565 570 575
Tyr Gly Gln Val Ala Thr Asn His Gln Ser Ala Gln Ala Gln Ala Gln
580 585 590
Thr Gly Trp Val Gln Asn Gln Gly Ile Leu Pro Gly Met Val Trp Gln
595 600 605
Asp Arg Asp Val Tyr Leu Gln Gly Pro Ile Trp Ala Lys Ile Pro His
610 615 620
Thr Asp Gly Asn Phe His Pro Ser Pro Leu Met Gly Gly Phe Gly Met
625 630 635 640
Lys His Pro Pro Pro Gln Ile Leu Ile Lys Asn Thr Pro Val Pro Ala
645 650 655
Asp Pro Pro Thr Ala Phe Asn Lys Asp Lys Leu Asn Ser Phe Ile Thr
660 665 670
Gln Tyr Ser Thr Gly Gln Val Ser Val Glu Ile Glu Trp Glu Leu Gln
675 680 685
Lys Glu Asn Ser Lys Arg Trp Asn Pro Glu Ile Gln Tyr Thr Ser Asn
690 695 700
Tyr Tyr Lys Ser Asn Asn Val Glu Phe Ala Val Asn Thr Glu Gly Val
705 710 715 720
Tyr Ser Glu Pro Arg Pro Ile Gly Thr Arg Tyr Leu Thr Arg Asn Leu
725 730 735
<210> 139
<211> 240
<212> PRT
<213> Adeno-associated virus
<400> 139
Thr Phe Ser Tyr Thr Phe Glu Glu Val Pro Phe His Ser Ser Tyr Ala
1 5 10 15
His Ser Gln Ser Leu Asp Arg Leu Met Asn Pro Leu Ile Asp Gln Tyr
20 25 30
Leu Tyr Tyr Leu Asn Arg Thr Gln Asn Gln Ser Gly Ser Ala Gln Asn
35 40 45
Lys Asp Leu Leu Phe Ser Arg Gly Ser Pro Ala Gly Met Ser Val Gln
50 55 60
Pro Lys Asn Trp Leu Pro Gly Pro Cys Tyr Arg Gln Gln Arg Val Ser
65 70 75 80
Lys Thr Lys Thr Asp Asn Asn Asn Ser Asn Phe Thr Trp Thr Gly Ala
85 90 95
Ser Lys Tyr Asn Leu Asn Gly Arg Glu Ser Ile Ile Asn Pro Gly Thr
100 105 110
Ala Met Ala Ser His Lys Asp Asp Glu Asp Lys Phe Phe Pro Met Ser
115 120 125
Gly Val Met Ile Phe Gly Lys Glu Ser Ala Gly Ala Ser Asn Thr Ala
130 135 140
Leu Asp Asn Val Met Ile Thr Asp Glu Glu Glu Ile Lys Ala Thr Asn
145 150 155 160
Pro Val Ala Thr Glu Arg Phe Gly Thr Val Ala Val Asn Phe Gln Ser
165 170 175
Ser Ser Thr Asp Pro Ala Thr Gly Asp Val His Ala Met Gly Ala Leu
180 185 190
Pro Gly Met Val Trp Gln Asp Arg Asp Val Tyr Leu Gln Gly Pro Ile
195 200 205
Trp Ala Lys Ile Pro His Thr Asp Gly His Phe His Pro Ser Pro Leu
210 215 220
Met Gly Gly Phe Gly Leu Lys Asn Pro Pro Pro Gln Ile Leu Ile Lys
225 230 235 240
<210> 140
<211> 240
<212> PRT
<213> Adeno-associated virus
<400> 140
Thr Phe Ser Tyr Thr Phe Glu Asp Val Pro Phe His Ser Ser Tyr Ala
1 5 10 15
His Ser Gln Ser Leu Asp Arg Leu Met Asn Pro Leu Ile Asp Gln Tyr
20 25 30
Leu Tyr Tyr Leu Asn Arg Thr Gln Asn Gln Ser Gly Ser Ala Gln Asn
35 40 45
Lys Asp Leu Leu Phe Ser Arg Gly Ser Pro Ala Gly Met Ser Val Gln
50 55 60
Pro Lys Asn Trp Leu Pro Gly Pro Cys Tyr Arg Gln Gln Arg Val Ser
65 70 75 80
Lys Thr Lys Thr Asp Asn Asn Asn Ser Asn Phe Thr Trp Thr Gly Ala
85 90 95
Ser Lys Tyr Asn Leu Asn Gly Arg Glu Ser Ile Ile Asn Pro Gly Thr
100 105 110
Ala Met Ala Ser His Lys Asp Asp Lys Asp Lys Phe Phe Pro Met Ser
115 120 125
Gly Val Met Ile Phe Gly Lys Glu Ser Ala Gly Ala Ser Asn Thr Ala
130 135 140
Leu Asp Asn Val Met Ile Thr Asp Glu Glu Glu Ile Lys Ala Thr Asn
145 150 155 160
Pro Val Ala Thr Glu Arg Phe Gly Thr Val Ala Val Asn Leu Gln Ser
165 170 175
Ser Ser Thr Asp Pro Ala Thr Gly Asp Val His Val Met Gly Ala Leu
180 185 190
Pro Gly Met Val Trp Gln Asp Arg Asp Val Tyr Leu Gln Gly Pro Ile
195 200 205
Trp Ala Lys Ile Pro His Thr Asp Gly His Phe His Pro Ser Pro Leu
210 215 220
Met Gly Gly Phe Gly Leu Lys His Pro Pro Pro Gln Ile Leu Ile Lys
225 230 235 240
<210> 141
<211> 240
<212> PRT
<213> Adeno-associated virus
<400> 141
Phe Ser Tyr Thr Phe Glu Asp Val Pro Phe His Ser Ser Tyr Ala His
1 5 10 15
Ser Gln Ser Leu Asp Arg Leu Met Asn Pro Leu Ile Asp Gln Tyr Leu
20 25 30
Tyr Tyr Leu Asn Arg Thr Gln Gly Thr Thr Ser Gly Thr Thr Asn Gln
35 40 45
Ser Arg Leu Leu Phe Ser Gln Ala Gly Pro Gln Ser Met Ser Leu Gln
50 55 60
Ala Arg Asn Trp Leu Pro Gly Pro Cys Tyr Arg Gln Gln Arg Leu Ser
65 70 75 80
Lys Thr Ala Asn Asp Asn Asn Asn Ser Asn Phe Pro Trp Thr Ala Ala
85 90 95
Ser Lys Tyr His Leu Asn Gly Arg Asp Ser Leu Val Asn Pro Gly Pro
100 105 110
Ala Met Ala Ser His Lys Asp Asp Glu Glu Lys Phe Phe Pro Met His
115 120 125
Gly Asn Leu Ile Phe Gly Lys Glu Gly Thr Thr Ala Ser Asn Ala Glu
130 135 140
Leu Asp Asn Val Met Ile Thr Asp Glu Glu Glu Ile Arg Thr Thr Asn
145 150 155 160
Pro Val Ala Thr Glu Gln Tyr Gly Thr Val Ala Asn Asn Leu Gln Ser
165 170 175
Ser Asn Thr Ala Pro Thr Thr Gly Thr Val Asn His Gln Gly Ala Leu
180 185 190
Pro Gly Met Val Trp Gln Asp Arg Asp Val Tyr Leu Gln Gly Pro Ile
195 200 205
Trp Ala Lys Ile Pro His Thr Asp Gly His Phe His Pro Ser Pro Leu
210 215 220
Met Gly Gly Phe Gly Leu Lys His Pro Pro Pro Gln Ile Met Ile Lys
225 230 235 240
<210> 142
<211> 240
<212> PRT
<213> Adeno-associated virus
<400> 142
Phe Ser Tyr Thr Phe Glu Asp Val Pro Phe His Ser Ser Tyr Ala His
1 5 10 15
Ser Gln Ser Leu Asp Arg Leu Met Asn Pro Leu Ile Asp Gln Tyr Leu
20 25 30
Tyr Tyr Leu Ser Arg Thr Asn Thr Pro Ser Gly Thr Thr Thr Gln Ser
35 40 45
Arg Leu Gln Phe Ser Gln Ala Gly Ala Ser Asp Ile Arg Asp Gln Ser
50 55 60
Arg Asn Trp Leu Pro Gly Pro Cys Tyr Arg Gln Gln Arg Val Ser Lys
65 70 75 80
Thr Ser Ala Asp Asn Asn Asn Ser Glu Tyr Ser Trp Thr Gly Ala Thr
85 90 95
Lys Tyr His Leu Asn Gly Arg Asp Ser Leu Val Asn Pro Gly Pro Ala
100 105 110
Met Ala Ser His Lys Asp Asp Glu Glu Lys Phe Phe Pro Gln Ser Gly
115 120 125
Val Leu Ile Phe Gly Lys Gln Gly Ser Glu Lys Thr Asn Val Asp Ile
130 135 140
Glu Lys Val Met Ile Thr Asp Glu Glu Glu Ile Arg Thr Thr Asn Pro
145 150 155 160
Val Ala Thr Glu Gln Tyr Gly Ser Val Ser Thr Asn Leu Gln Arg Gly
165 170 175
Asn Arg Gln Ala Ala Thr Ala Asp Val Asn Thr Gln Gly Val Leu Pro
180 185 190
Gly Met Val Trp Gln Asp Arg Asp Val Tyr Leu Gln Gly Pro Ile Trp
195 200 205
Ala Lys Ile Pro His Thr Asp Gly His Phe His Pro Ser Pro Leu Met
210 215 220
Gly Gly Phe Gly Leu Lys His Pro Pro Pro Gln Ile Leu Ile Lys Asn
225 230 235 240
<210> 143
<211> 243
<212> PRT
<213> Adeno-associated virus
<400> 143
Asn Phe Gln Phe Thr Tyr Thr Phe Glu Asp Val Pro Phe His Ser Ser
1 5 10 15
Tyr Ala His Ser Gln Ser Leu Asp Arg Leu Met Asn Pro Leu Ile Asp
20 25 30
Gln Tyr Leu Tyr Tyr Leu Ser Arg Thr Gln Thr Thr Gly Gly Thr Ala
35 40 45
Asn Thr Gln Thr Leu Gly Phe Ser Gln Gly Gly Pro Asn Thr Met Ala
50 55 60
Asn Gln Ala Lys Asn Trp Leu Pro Gly Pro Cys Tyr Arg Gln Gln Arg
65 70 75 80
Val Ser Thr Thr Thr Gly Gln Asn Asn Asn Ser Asn Phe Ala Trp Thr
85 90 95
Ala Gly Thr Lys Tyr His Leu Asn Gly Arg Asn Ser Leu Ala Asn Pro
100 105 110
Gly Ile Ala Met Ala Thr His Lys Asp Asp Glu Glu Arg Phe Phe Pro
115 120 125
Ser Asn Gly Ile Leu Ile Phe Gly Lys Gln Asn Ala Ala Arg Asp Asn
130 135 140
Ala Asp Tyr Ser Asp Val Met Leu Thr Ser Glu Glu Glu Ile Lys Thr
145 150 155 160
Thr Asn Pro Val Ala Thr Glu Glu Tyr Gly Ile Val Ala Asp Asn Leu
165 170 175
Gln Gln Gln Asn Thr Ala Pro Gln Ile Gly Thr Val Asn Ser Gln Gly
180 185 190
Ala Leu Pro Gly Met Val Trp Gln Asn Arg Asp Val Tyr Leu Gln Gly
195 200 205
Pro Ile Trp Ala Lys Ile Pro His Thr Asp Gly Asn Phe His Pro Ser
210 215 220
Pro Leu Met Gly Gly Phe Gly Leu Lys His Pro Pro Pro Gln Ile Leu
225 230 235 240
Ile Lys Asn
<210> 144
<211> 243
<212> PRT
<213> Adeno-associated virus
<400> 144
Asn Phe Gln Phe Thr Tyr Thr Phe Glu Asp Val Pro Phe His Ser Ser
1 5 10 15
Tyr Ala His Ser Gln Ser Leu Asp Arg Leu Met Asn Pro Leu Ile Asp
20 25 30
Gln Tyr Leu Tyr Tyr Leu Ser Arg Thr Gln Thr Thr Gly Gly Thr Ala
35 40 45
Asn Thr Gln Thr Leu Gly Phe Ser Gln Gly Gly Pro Asn Thr Met Ala
50 55 60
Asn Gln Ala Lys Asn Trp Leu Pro Gly Pro Cys Tyr Arg Gln Gln Arg
65 70 75 80
Val Ser Thr Thr Thr Gly Gln Asn Asn Asn Ser Asn Phe Ala Trp Thr
85 90 95
Ala Gly Thr Lys Tyr His Leu Asn Gly Arg Asn Ser Leu Ala Asn Pro
100 105 110
Gly Ile Ala Met Ala Thr His Lys Asp Asp Glu Glu Arg Phe Phe Pro
115 120 125
Ser Asn Gly Ile Leu Ile Phe Gly Lys Gln Asn Ala Ala Arg Asp Asn
130 135 140
Ala Asp Tyr Ser Asp Val Met Leu Thr Ser Glu Glu Glu Ile Lys Thr
145 150 155 160
Thr Asn Pro Val Ala Thr Glu Glu Tyr Gly Ile Val Ala Asp Asn Leu
165 170 175
Gln Gly Gln Arg Gln Ala Ala Gln Ile Gly Thr Val Asn Ser Gln Gly
180 185 190
Ala Leu Pro Gly Met Val Trp Gln Asn Arg Asp Val Tyr Leu Gln Gly
195 200 205
Pro Ile Trp Ala Lys Ile Pro His Thr Asp Gly Asn Phe His Pro Ser
210 215 220
Pro Leu Met Gly Gly Phe Gly Leu Lys His Pro Pro Pro Gln Ile Leu
225 230 235 240
Ile Lys Asn
<210> 145
<211> 241
<212> PRT
<213> Adeno-associated virus
<400> 145
Phe Gln Phe Ser Tyr Thr Phe Glu Asp Val Pro Phe His Ser Ser Tyr
1 5 10 15
Ala His Ser Gln Ser Leu Asp Arg Leu Met Asn Pro Leu Ile Asp Gln
20 25 30
Tyr Leu Tyr Tyr Leu Val Arg Thr Gln Thr Thr Gly Thr Gly Gly Thr
35 40 45
Gln Thr Leu Ala Phe Ser Gln Ala Gly Pro Ser Ser Met Ala Asn Gln
50 55 60
Ala Arg Asn Trp Val Pro Gly Pro Cys Tyr Arg Gln Gln Arg Val Ser
65 70 75 80
Thr Thr Thr Asn Gln Asn Asn Asn Ser Asn Phe Ala Trp Thr Gly Ala
85 90 95
Ala Lys Phe Lys Leu Asn Gly Arg Asp Ser Leu Met Asn Pro Gly Val
100 105 110
Ala Met Ala Ser His Lys Asp Asp Asp Asp Arg Phe Phe Pro Ser Ser
115 120 125
Gly Val Leu Ile Phe Gly Lys Gln Gly Ala Gly Asn Asp Gly Val Asp
130 135 140
Tyr Ser Gln Val Leu Ile Thr Asp Glu Glu Glu Ile Lys Ala Thr Asn
145 150 155 160
Pro Val Ala Thr Glu Glu Tyr Gly Ala Val Ala Ile Asn Asn Gln Ala
165 170 175
Ala Asn Thr Gln Ala Gln Thr Gly Leu Val His Asn Gln Gly Val Ile
180 185 190
Pro Gly Met Val Trp Gln Asn Arg Asp Val Tyr Leu Gln Gly Pro Ile
195 200 205
Trp Ala Lys Ile Pro His Thr Asp Gly Asn Phe His Pro Ser Pro Leu
210 215 220
Met Gly Gly Phe Gly Leu Lys His Pro Pro Pro Gln Ile Leu Ile Lys
225 230 235 240
Asn
<210> 146
<211> 243
<212> PRT
<213> Adeno-associated virus
<400> 146
Asn Phe Glu Phe Ser Tyr Thr Phe Glu Asp Val Pro Phe His Ser Ser
1 5 10 15
Tyr Ala His Ser Gln Ser Leu Asp Arg Leu Met Asn Pro Leu Ile Asp
20 25 30
Gln Tyr Leu Tyr Tyr Leu Ser Arg Thr Gln Ser Thr Gly Gly Thr Gln
35 40 45
Gly Thr Gln Gln Leu Leu Phe Ser Gln Ala Gly Pro Ala Asn Met Ser
50 55 60
Ala Gln Ala Lys Asn Trp Leu Pro Gly Pro Cys Tyr Arg Gln Gln Arg
65 70 75 80
Val Ser Thr Thr Leu Ser Gln Asn Asn Asn Ser Asn Phe Ala Trp Thr
85 90 95
Gly Ala Thr Lys Tyr His Leu Asn Gly Arg Asp Ser Leu Val Asn Pro
100 105 110
Gly Val Ala Met Ala Thr His Lys Asp Asp Glu Glu Arg Phe Phe Pro
115 120 125
Ser Ser Gly Val Leu Met Phe Gly Lys Gln Gly Ala Gly Arg Asp Asn
130 135 140
Val Asp Tyr Ser Ser Val Met Leu Thr Ser Glu Glu Glu Ile Lys Thr
145 150 155 160
Thr Asn Pro Val Ala Thr Glu Gln Tyr Gly Val Val Ala Asp Asn Leu
165 170 175
Gln Gln Ala Asn Thr Gly Pro Ile Val Gly Asn Val Asn Ser Gln Gly
180 185 190
Ala Leu Pro Gly Met Val Trp Gln Asn Arg Asp Val Tyr Leu Gln Gly
195 200 205
Pro Ile Trp Ala Lys Ile Pro His Thr Asp Gly Asn Phe His Pro Ser
210 215 220
Pro Leu Met Gly Gly Phe Gly Leu Lys His Pro Pro Pro Gln Ile Leu
225 230 235 240
Ile Lys Asn
<210> 147
<211> 242
<212> PRT
<213> Adeno-associated virus
<400> 147
Phe Glu Phe Ser Tyr Ser Phe Glu Asp Val Pro Phe His Ser Ser Tyr
1 5 10 15
Ala His Ser Gln Ser Leu Asp Arg Leu Met Asn Pro Leu Ile Asp Gln
20 25 30
Tyr Leu Tyr Tyr Leu Ala Arg Thr Gln Ser Asn Pro Gly Gly Thr Ala
35 40 45
Gly Asn Arg Glu Leu Gln Phe Tyr Gln Gly Gly Pro Ser Thr Met Ala
50 55 60
Glu Gln Ala Lys Asn Trp Leu Pro Gly Pro Cys Phe Arg Gln Gln Arg
65 70 75 80
Val Ser Lys Thr Leu Asp Gln Asn Asn Asn Ser Asn Phe Ala Trp Thr
85 90 95
Gly Ala Thr Lys Tyr His Leu Asn Gly Arg Asn Ser Leu Val Asn Pro
100 105 110
Gly Val Ala Met Ala Thr His Lys Asp Asp Glu Asp Arg Phe Phe Pro
115 120 125
Ser Ser Gly Val Leu Ile Phe Gly Lys Thr Gly Ala Thr Asn Lys Thr
130 135 140
Thr Leu Glu Asn Val Leu Met Thr Asn Glu Glu Glu Ile Arg Pro Thr
145 150 155 160
Asn Pro Val Ala Thr Glu Glu Tyr Gly Ile Val Ser Ser Asn Leu Gln
165 170 175
Ala Ala Asn Thr Ala Ala Gln Thr Gln Val Val Asn Asn Gln Gly Ala
180 185 190
Leu Pro Gly Met Val Trp Gln Asn Arg Asp Val Tyr Leu Gln Gly Pro
195 200 205
Ile Trp Ala Lys Ile Pro His Thr Asp Gly Asn Phe His Pro Ser Pro
210 215 220
Leu Met Gly Gly Phe Gly Leu Lys His Pro Pro Pro Gln Ile Leu Ile
225 230 235 240
Lys Asn
<210> 148
<211> 240
<212> PRT
<213> Adeno-associated virus
<400> 148
Phe Gln Phe Ser Tyr Glu Phe Glu Asn Val Pro Phe His Ser Ser Tyr
1 5 10 15
Ala His Ser Gln Ser Leu Asp Arg Leu Met Asn Pro Leu Ile Asp Gln
20 25 30
Tyr Leu Tyr Tyr Leu Ser Lys Thr Ile Asn Gly Ser Gly Gln Asn Gln
35 40 45
Gln Thr Leu Lys Phe Ser Val Ala Gly Pro Ser Asn Met Ala Val Gln
50 55 60
Gly Arg Asn Tyr Ile Pro Gly Pro Ser Tyr Arg Gln Gln Arg Val Ser
65 70 75 80
Thr Thr Val Thr Gln Asn Asn Asn Ser Glu Phe Ala Trp Pro Gly Ala
85 90 95
Ser Ser Trp Ala Leu Asn Gly Arg Asn Ser Leu Met Asn Pro Gly Pro
100 105 110
Ala Met Ala Ser His Lys Glu Gly Glu Asp Arg Phe Phe Pro Leu Ser
115 120 125
Gly Ser Leu Ile Phe Gly Lys Gln Gly Thr Gly Arg Asp Asn Val Asp
130 135 140
Ala Asp Lys Val Met Ile Thr Asn Glu Glu Glu Ile Lys Thr Thr Asn
145 150 155 160
Pro Val Ala Thr Glu Ser Tyr Gly Gln Val Ala Thr Asn His Gln Ser
165 170 175
Ala Gln Ala Gln Ala Gln Thr Gly Trp Val Gln Asn Gln Gly Ile Leu
180 185 190
Pro Gly Met Val Trp Gln Asp Arg Asp Val Tyr Leu Gln Gly Pro Ile
195 200 205
Trp Ala Lys Ile Pro His Thr Asp Gly Asn Phe His Pro Ser Pro Leu
210 215 220
Met Gly Gly Phe Gly Met Lys His Pro Pro Pro Gln Ile Leu Ile Lys
225 230 235 240
<210> 149
<211> 240
<212> PRT
<213> Adeno-associated virus
<400> 149
Phe Gln Phe Ser Tyr Glu Phe Glu Asn Val Pro Phe His Ser Ser Tyr
1 5 10 15
Ala His Ser Gln Ser Leu Asp Arg Leu Met Asn Pro Leu Ile Asp Gln
20 25 30
Tyr Leu Tyr Tyr Leu Ser Lys Thr Ile Asn Gly Ser Gly Gln Asn Gln
35 40 45
Gln Thr Leu Lys Phe Ser Val Ala Gly Pro Ser Asn Met Ala Val Gln
50 55 60
Gly Arg Asn Tyr Ile Pro Gly Pro Ser Tyr Arg Gln Gln Arg Val Ser
65 70 75 80
Thr Thr Val Thr Gln Asn Asn Asn Ser Glu Phe Ala Trp Pro Gly Ala
85 90 95
Ser Ser Trp Ala Leu Asn Gly Arg Asn Ser Leu Met Asn Pro Gly Pro
100 105 110
Ala Met Ala Ser His Lys Glu Gly Glu Asp Arg Phe Phe Pro Leu Ser
115 120 125
Gly Ser Leu Ile Phe Gly Lys Gln Gly Thr Gly Arg Asp Asn Val Asp
130 135 140
Ala Asp Lys Val Met Ile Thr Asn Glu Glu Glu Ile Lys Thr Thr Asn
145 150 155 160
Pro Val Ala Thr Glu Ser Tyr Gly Gln Val Ala Thr Asn His Gln Ser
165 170 175
Gly Gln Ala Gln Ala Ala Thr Gly Trp Val Gln Asn Gln Gly Ile Leu
180 185 190
Pro Gly Met Val Trp Gln Asp Arg Asp Val Tyr Leu Gln Gly Pro Ile
195 200 205
Trp Ala Lys Ile Pro His Thr Asp Gly Asn Phe His Pro Ser Pro Leu
210 215 220
Met Gly Gly Phe Gly Met Lys His Pro Pro Pro Gln Ile Leu Ile Lys
225 230 235 240
<210> 150
<211> 240
<212> PRT
<213> Adeno-associated virus
<400> 150
Asn Phe Glu Phe Thr Tyr Asn Phe Glu Glu Val Pro Phe His Ser Ser
1 5 10 15
Phe Ala Pro Ser Gln Asn Leu Phe Lys Leu Ala Asn Pro Leu Val Asp
20 25 30
Gln Tyr Leu Tyr Arg Phe Val Ser Thr Asn Asn Thr Gly Gly Val Gln
35 40 45
Phe Asn Lys Asn Leu Ala Gly Arg Tyr Ala Asn Thr Tyr Lys Asn Trp
50 55 60
Phe Pro Gly Pro Met Gly Arg Thr Gln Gly Trp Asn Leu Gly Ser Gly
65 70 75 80
Val Asn Arg Ala Ser Val Ser Ala Phe Ala Thr Thr Asn Arg Met Glu
85 90 95
Leu Glu Gly Ala Ser Tyr Gln Val Pro Pro Gln Pro Asn Gly Met Thr
100 105 110
Asn Asn Leu Gln Gly Ser Asn Thr Tyr Ala Leu Glu Asn Thr Met Ile
115 120 125
Phe Asn Ser Gln Pro Ala Asn Pro Gly Thr Thr Ala Thr Tyr Leu Glu
130 135 140
Gly Asn Met Leu Ile Thr Ser Glu Ser Glu Thr Gln Pro Val Asn Arg
145 150 155 160
Val Ala Tyr Asn Val Gly Gly Gln Met Ala Thr Asn Asn Gln Ser Ser
165 170 175
Thr Thr Ala Pro Ala Thr Gly Thr Tyr Asn Leu Gln Glu Ile Val Pro
180 185 190
Gly Ser Val Trp Met Glu Arg Asp Val Tyr Leu Gln Gly Pro Ile Trp
195 200 205
Ala Lys Ile Pro Glu Thr Gly Ala His Phe His Pro Ser Pro Ala Met
210 215 220
Gly Gly Phe Gly Leu Lys His Pro Pro Pro Met Met Leu Ile Lys Asn
225 230 235 240
<210> 151
<211> 10
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 151
Leu Ala Leu Ile Gln Asp Ser Met Arg Ala
1 5 10
<210> 152
<211> 10
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 152
Leu Ala Asn Gln Glu His Val Lys Asn Ala
1 5 10
<210> 153
<211> 12
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 153
Thr Gly Val Met Arg Ser Thr Asn Ser Gly Leu Asn
1 5 10
<210> 154
<211> 12
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 154
Thr Gly Glu Val Asp Leu Ala Gly Gly Gly Leu Ser
1 5 10
<210> 155
<211> 12
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 155
Thr Ser Pro Tyr Ser Gly Ser Ser Asp Gly Leu Ser
1 5 10
<210> 156
<211> 12
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 156
Thr Gly Gly His Asp Ser Ser Leu Asp Gly Leu Ser
1 5 10
<210> 157
<211> 12
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 157
Thr Gly Asp Gly Gly Thr Thr Met Asn Gly Leu Ser
1 5 10
<210> 158
<211> 12
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 158
Thr Gly Gly His Gly Ser Ala Pro Asp Gly Leu Ser
1 5 10
<210> 159
<211> 12
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 159
Thr Gly Met His Val Thr Met Met Ala Gly Leu Asn
1 5 10
<210> 160
<211> 12
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 160
Thr Gly Ala Ser Tyr Leu Asp Asn Ser Gly Leu Ser
1 5 10
<210> 161
<211> 12
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 161
Thr Val Val Ser Thr Gln Ala Gly Ile Gly Leu Ser
1 5 10
<210> 162
<211> 12
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 162
Thr Gly Val Met His Ser Gln Ala Ser Gly Leu Ser
1 5 10
<210> 163
<211> 12
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 163
Thr Gly Asp Gly Ser Pro Ala Ala Pro Gly Leu Ser
1 5 10
<210> 164
<211> 12
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 164
Thr Gly Ser Asp Met Ala His Gly Thr Gly Leu Ser
1 5 10
<210> 165
<211> 17
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 165
Thr Gly Leu Asp Ala Thr Arg Asp His Gly Leu Ser Pro Val Thr Gly
1 5 10 15
Thr
<210> 166
<211> 17
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 166
Thr Gly Ser Asp Gly Thr Arg Asp His Gly Leu Ser Pro Val Thr Trp
1 5 10 15
Thr
<210> 167
<211> 17
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 167
Asn Gly Ala Val Ala Asp Tyr Thr Arg Gly Leu Ser Pro Ala Thr Gly
1 5 10 15
Thr
<210> 168
<211> 17
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 168
Thr Gly Gly Asp Pro Thr Arg Gly Thr Gly Leu Ser Pro Val Thr Gly
1 5 10 15
Ala
<210> 169
<211> 16
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 169
Leu Gln Lys Asn Ala Arg Pro Ala Ser Thr Glu Ser Val Asn Phe Gln
1 5 10 15
<210> 170
<211> 16
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 170
Leu Gln Arg Gly Val Arg Ile Pro Ser Val Leu Glu Val Asn Gly Gln
1 5 10 15
<210> 171
<211> 16
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 171
Leu Gln Arg Gly Asn Arg Pro Val Thr Thr Ala Asp Val Asn Thr Gln
1 5 10 15
<210> 172
<211> 16
<212> PRT
<213> Artificial sequence
<220>
<223> Synthetic sequence
<400> 172
Leu Gln Lys Ala Asp Arg Gln Pro Gly Val Val Val Val Asn Cys Gln
1 5 10 15
Claims (65)
- 다음을 포함하는 재조합 아데노-연관 바이러스 (rAAV) 비리온:
a) 변이체 AAV 캡시드 단백질, 이러한 변이체 AAV 캡시드 단백질은 최소한 3가지 상이한 AAV 혈청형의 최소한 5개 분절들을 포함하고, 이 때 각 분절은 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지며, 이 때 변이체 캡시드 단백질은 다음 성질들 중 하나 이상을 부여하고:
i) 야생형 AAV 비리온을 포함하는 대조 AAV 비리온에 의한 신경 줄기 세포의 감염력에 비해 신경 줄기 세포의 증가된 감염력;
ii) 야생형 AAV 비리온을 포함하는 대조 AAV 비리온에 의한 뉴런 세포의 감염력에 비해 뉴런 세포의 증가된 감염력;
iii) 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온의 세포 장벽 통과 능력에 비해, 증가된 세포 장벽 통과 능력;
iv) 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온이 나타내는 내성에 비해 인간 AAV 중화 항체들에 대한 증가된 내성; 및
b) 이종 유전자 생성물을 인코드하는 뉴클레오티드 서열을 포함하는 이종 핵산. - 청구항 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 N-말단으로부터 C-말단 순서로 다음을 포함하는, rAAV 비리온:
a) 제 1 AAV 혈청형의 아미노산 1-160의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 1 분절;
b) 제 2 AAV 혈청형의 아미노산 51-320의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 2 분절;
c) 제 3 AAV 혈청형의 아미노산 101-480의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 3 분절;
d) 제 2 AAV 혈청형의 아미노산 151-640의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 4 분절; 및
제 2 AAV 혈청형의 아미노산 201로부터 C-말단까지 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 5 분절. - 청구항 2에 있어서, 제 1 AAV 혈청형은 AAV6인 rAAV 비리온.
- 청구항 2에 있어서, 제 2 AAV 혈청형은 AAV9인 rAAV 비리온.
- 청구항 2에 있어서, 제 3 AAV 혈청형은 AAV8인 rAAV 비리온.
- 청구항 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 N-말단으로부터 C-말단 순서로 다음을 포함하는, rAAV 비리온:
a) 제 1 AAV 혈청형의 아미노산 1-160의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 1 분절;
b) 제 2 AAV 혈청형의 아미노산 51-320의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 2 분절;
c) 제 3 AAV 혈청형의 아미노산 101-480의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 3 분절;
d) 제 2 AAV 혈청형의 아미노산 151-640의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 4 분절; 및
제 4 AAV 혈청형의 아미노산 201로부터 C-말단까지 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 5 분절. - 청구항 6에 있어서, 제 1 AAV 혈청형은 AAV6인 rAAV 비리온.
- 청구항 6에 있어서, 제 2 AAV 혈청형은 AAV9인 rAAV 비리온.
- 청구항 6에 있어서, 제 3 AAV 혈청형은 AAV8인 rAAV 비리온.
- 청구항 6에 있어서, 제 4 AAV 혈청형은 AAV2인 rAAV 비리온.
- 청구항 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 N-말단으로부터 C-말단 순서로 다음을 포함하는, rAAV 비리온:
a) 제 1 AAV 혈청형의 아미노산 1-160의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 1 분절;
b) 제 2 AAV 혈청형의 아미노산 51-320의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 2 분절;
c) 제 3 AAV 혈청형의 아미노산 101-480의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 3 분절;
d) 제 2 AAV 혈청형의 아미노산 151-640의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 4 분절; 및
e) 제 4 AAV 혈청형의 아미노산 201-800의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 5 분절.
f) 제 4 AAV 혈청형의 아미노산 251-960의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 6 분절.
g) 제 2 AAV 혈청형의 아미노산 301-1120의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 7 분절; 및
제 2 AAV 혈청형의 아미노산 351로부터 C-말단까지 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 8 분절. - 청구항 11에 있어서, 제 1 AAV 혈청형은 AAV6인 rAAV 비리온.
- 청구항 11에 있어서, 제 2 AAV 혈청형은 AAV9인 rAAV 비리온.
- 청구항 11에 있어서, 제 3 AAV 혈청형은 AAV8인 rAAV 비리온.
- 청구항 11에 있어서, 제 4 AAV 혈청형은 AAV2인 rAAV 비리온.
- 청구항 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 N-말단으로부터 C-말단 순서로 다음을 포함하는, rAAV 비리온:
a) 제 1 AAV 혈청형의 아미노산 1-160의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 1 분절;
b) 제 2 AAV 혈청형의 아미노산 51-320의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 2 분절;
c) 제 3 AAV 혈청형의 아미노산 101-480의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 3 분절;
d) 제 2 AAV 혈청형의 아미노산 151-640의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 4 분절; 및
e) 제 4 AAV 혈청형의 아미노산 201-800의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 5 분절.
f) 제 4 AAV 혈청형의 아미노산 251-960의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 6 분절.
g) 제 2 AAV 혈청형의 아미노산 301-1120의 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 7 분절; 및
제 2 AAV 혈청형의 아미노산 351로부터 C-말단까지 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지는 제 8 분절. - 청구항 16에 있어서, 제 1 AAV 혈청형은 AAV6인 rAAV 비리온.
- 청구항 16에 있어서, 제 2 AAV 혈청형은 AAV9인 rAAV 비리온.
- 청구항 16에 있어서, 제 3 AAV 혈청형은 AAV8인 rAAV 비리온.
- 청구항 16에 있어서, 제 4 AAV 혈청형은 AAV2인 rAAV 비리온.
- 청구항 1에 있어서, 상기 rAAV 비리온은 상응하는 모체 AAV 캡시드 단백질을 포함하는 대조 AAV 비리온에 의한 신경 줄기 세포의 감염력에 비해 최소한 5-배 증가된 신경 줄기 세포의 감염력을 나타내는, rAAV 비리온.
- 청구항 21에 있어서, 대조 AAV 비리온은 AAV9인 rAAV 비리온.
- 청구항 21에 있어서, 대조 AAV 비리온은 AAV2인 rAAV 비리온.
- 청구항 1에 있어서, 상기 rAAV 비리온은 상응하는 모체 AAV 캡시드 단백질을 포함하는 대조 AAV 비리온에 의한 신경 줄기 세포의 감염력에 비해 최소한 10-배 증가된 신경 줄기 세포의 감염력을 나타내는, rAAV 비리온.
- 청구항 24에 있어서, 대조 AAV 비리온은 AAV9인 rAAV 비리온.
- 청구항 24에 있어서, 대조 AAV 비리온은 AAV2인 rAAV 비리온.
- 청구항 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 도 8에 도시된 아미노산 서열에 대해 최소한 약 90% 아미노산 서열 동일성을 가지는 아미노산 서열을 포함하는, rAAV 비리온.
- 청구항 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 도 8에 도시된 아미노산 서열에 대해 최소한 약 95% 아미노산 서열 동일성을 가지는 아미노산 서열을 포함하는, rAAV 비리온.
- 청구항 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 도 8에 도시된 아미노산 서열을 포함하는, rAAV 비리온.
- 청구항 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 도 9에 도시된 아미노산 서열에 대해 최소한 약 90% 아미노산 서열 동일성을 가지는 아미노산 서열을 포함하는, rAAV 비리온.
- 청구항 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 도 9에 도시된 아미노산 서열에 대해 최소한 약 95% 아미노산 서열 동일성을 가지는 아미노산 서열을 포함하는, rAAV 비리온.
- 청구항 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 도 9에 도시된 아미노산 서열을 포함하는, rAAV 비리온.
- 청구항 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 야생형 AAV 캡시드 단백질을 포함하는 대조 AAV 비리온이 나타내는 내성에 비해 인간 AAV 중화 항체들에 대한 증가된 내성을 나타내는, rAAV 비리온.
- 청구항 33에 있어서, 대조 AAV 비리온은 AAV9인 rAAV 비리온.
- 청구항 33에 있어서, 대조 AAV 비리온은 AAV2인 rAAV 비리온.
- 청구항 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온이 나타내는 내성에 비해 인간 AAV 중화 항체들에 대해 최소한 약 1.5-배 더 큰 내성을 나타내는, rAAV 비리온.
- 청구항 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온이 나타내는 내성에 비해 인간 AAV 중화 항체들에 대해 최소한 약 3-배 더 큰 내성을 나타내는, rAAV 비리온.
- 청구항 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온이 나타내는 내성에 비해 인간 AAV 중화 항체들에 대해 최소한 약 5-배 더 큰 내성을 나타내는, rAAV 비리온.
- 청구항 1에 있어서, 상기 변이체 AAV 캡시드 단백질은 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온이 나타내는 내성에 비해 인간 AAV 중화 항체들에 대해 최소한 약 10-배 더 큰 내성을 나타내는, rAAV 비리온.
- 청구항 1에 있어서, 상기 신경 줄기 세포는 뇌실하 영역 유래인 rAAV 비리온.
- 청구항 1에 있어서, 상기 신경 줄기 세포는 소뇌 유래인 rAAV 비리온.
- 청구항 1-41 중 어느 하나에 있어서, 유전자 생성물은 간섭 RNA 또는 압타머인 rAAV 비리온.
- 청구항 1-41 중 어느 한 항에 있어서, 유전자 생성물은 폴리펩티드인, rAAV 비리온.
- 청구항 43에 있어서, 폴리펩티드는 신경보호성 폴리펩티드, 항-혈관형성 폴리펩티드, 신경 줄기 세포의 분화를 유도하는 폴리펩티드, 또는 신경 줄기 세포의 기능을 향상시키는 폴리펩티드인 rAAV 비리온.
- 청구항 43에 있어서, 폴리펩티드는 세레브로라이신, 라미닌-IKVAV, 크립토 (cripto), 뇌하수체 아데닐레이트 사이클라제-활성화 폴리펩티드, 신경 성장 인자, 뇌 유래 신경영양 인자, 아교세포 유래 신경영양 인자, 섬유모세포 성장 인자 2, 뉴투린, 섬모 신경영양 인자, 표피 성장 인자, 세포자멸의 X-연관 저해제, 방향족 L-아미노산 디카르복실라제, 글루탐산 디카르복실라제, 트라이펩티딜 펩티다제, 아스파르토아실라제, 또는 소닉 헤지호그 (Sonic hedgehog)인 rAAV 비리온.
- 청구항 43에 있어서, 폴리펩티드는 게놈-편집 효소인 rAAV 비리온.
- 청구항 46에 있어서, 게놈-편집 효소는 Cas9 폴리펩티드, 아연 핑거 뉴클레아제, TALEN, 또는 효소적 불활성 유형 II CRISPR/Cas 폴리펩티드인 rAAV 비리온.
- 청구항 47에 있어서, 폴리펩티드는 유형 II CRISPR/Cas 폴리펩티드, 유형 V CRISPR/Cas 폴리펩티드, 및 유형 VI CRISPR/Cas 폴리펩티드에서 선택된 RNA-가이드된 엔도뉴클레아제인, rAAV 비리온.
- 청구항 1-41 중 어느 한 항에 있어서, 유전자 생성물은 RNA-가이드된 엔도뉴클레아제 및 가이드 RNA인, rAAV 비리온.
- 다음을 포함하는 제약학적 조성물:
a) 청구항 1-49 중 어느 한 항의 재조합 아데노-연관 바이러스 비리온; 및
b) 제약학적으로 허용가능한 부형제. - 청구항 1-49 중 어느 한 항에 따른 재조합 아데노-연관 바이러스 (rAAV) 비리온 또는 청구항 50의 조성물을 개체에게 투여하는 것을 포함하는, 개체의 신경 줄기 세포에 유전자 생성물을 전달하는 방법.
- 청구항 51에 있어서, 상기 투여는 두개내, 뇌실내, 척추강내, 대수조-내, 또는 정맥내 주사에 의한 방법.
- 청구항 51에 있어서, 유전자 생성물은 짧은 간섭 RNA 또는 압타머인 방법.
- 청구항 51에 있어서, 유전자 생성물은 폴리펩티드인 방법.
- 청구항 54에 있어서, 폴리펩티드는 신경보호성 폴리펩티드, 항-혈관형성 폴리펩티드, 신경 줄기 세포의 분화를 유도하는 폴리펩티드, 또는 신경 줄기 세포의 기능을 향상시키는 폴리펩티드인 방법.
- 청구항 54에 있어서, 폴리펩티드는 세레브로라이신, 라미닌-IKVAV, 크립토 (cripto), 뇌하수체 아데닐레이트 사이클라제-활성화 폴리펩티드, 신경 성장 인자, 뇌 유래 신경영양 인자, 아교세포 유래 신경영양 인자, 섬유모세포 성장 인자 2, 뉴투린, 섬모 신경영양 인자, 표피 성장 인자, 세포자멸의 X-연관 저해제, 또는 소닉 헤지호그 (Sonic hedgehog)인 방법.
- 청구항 54에 있어서, 폴리펩티드는 게놈-편집 효소인 방법.
- 청구항 57에 있어서, 게놈-편집 효소는 Cas9 폴리펩티드, 아연 핑거 뉴클레아제, TALEN, 또는 효소적 불활성 유형 II CRISPR/Cas 폴리펩티드인 방법.
- 청구항 57에 있어서, 폴리펩티드는 유형 II CRISPR/Cas 폴리펩티드, 유형 V CRISPR/Cas 폴리펩티드, 및 유형 VI CRISPR/Cas 폴리펩티드에서 선택된 RNA-가이드된 엔도뉴클레아제인 방법.
- 청구항 51에 있어서, 유전자 생성물은 RNA-가이드된 엔도뉴클레아제 및 가이드 RNA인, 방법.
- 청구항 1-49 중 어느 하나에 따른 재조합 아데노-연관 바이러스 (rAAV) 비리온 또는 청구항 50의 조성물의 유효량을 필요로 하는 개체에게 투여하는 것을 포함하는, 신경학적 장애 치료 방법.
- 청구항 61에 있어서, 상기 신경학적 장애는 척수소뇌성 실조증, 헌팅턴 병, 파킨슨 병, 알츠하이머 병, 리소좀 축적 장애, 프리드라이히 운동실조증, 교모세포종, 레트 증후군, 전두측두엽 치매, 또는 간질인 방법.
- 변이체 아데노-연관 바이러스 (AAV) 캡시드 단백질을 인코드하는 뉴클레오티드 서열을 포함하는 단리된 핵산으로서, 이 때 상기 변이체 AAV 캡시드 단백질은 최소한 3가지 상이한 AAV 혈청형의 최소한 5개 분절들을 포함하고, 이 때 각 분절은 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지며, 이 때 변이체 캡시드 단백질은 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온에 의한 신경 줄기 세포의 감염력에 비해 신경 줄기 세포의 증가된 감염력을 부여하는, 단리된 핵산.
- 청구항 63의 핵산을 포함하는 단리된, 유전자 변형 숙주 세포.
- 변이체 아데노-연관 바이러스 (AAV) 캡시드 단백질로서, 이러한 변이체 AAV 캡시드 단백질은 최소한 3가지 상이한 AAV 혈청형의 최소한 5개 분절들을 포함하고, 이 때 각 분절은 약 50개 아미노산 내지 약 160개 아미노산 길이를 가지며, 이 때 변이체 캡시드 단백질은 야생형 AAV 캡시드를 포함하는 대조 AAV 비리온에 의한 신경 줄기 세포의 감염력에 비해 신경 줄기 세포의 증가된 감염력을 부여하는, 단백질.
Applications Claiming Priority (3)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| US201762551133P | 2017-08-28 | 2017-08-28 | |
| US62/551,133 | 2017-08-28 | ||
| PCT/US2018/047561 WO2019046069A1 (en) | 2017-08-28 | 2018-08-22 | ADENO-ASSOCIATED VIRUS CAPSID VARIANTS AND METHODS OF USE |
Publications (1)
| Publication Number | Publication Date |
|---|---|
| KR20200039617A true KR20200039617A (ko) | 2020-04-16 |
Family
ID=65525930
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| KR1020197035110A Withdrawn KR20200039617A (ko) | 2017-08-28 | 2018-08-22 | 아데노-연관 바이러스 캡시드 변이체 및 이의 사용 방법 |
Country Status (10)
| Country | Link |
|---|---|
| US (1) | US11680249B2 (ko) |
| EP (1) | EP3676373A4 (ko) |
| JP (1) | JP2020534788A (ko) |
| KR (1) | KR20200039617A (ko) |
| CN (1) | CN110709511A (ko) |
| AU (1) | AU2018324477A1 (ko) |
| BR (1) | BR112020003571A2 (ko) |
| CA (1) | CA3059995A1 (ko) |
| MX (1) | MX2020001997A (ko) |
| WO (1) | WO2019046069A1 (ko) |
Cited By (1)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| WO2026024045A1 (ko) * | 2024-07-22 | 2026-01-29 | 한국생명공학연구원 | 변이체 캡시드를 포함하는 아데노-연관 바이러스 및 이의 용도 |
Families Citing this family (32)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| CN107012171B (zh) | 2011-04-22 | 2021-07-13 | 加利福尼亚大学董事会 | 具有变异衣壳的腺相关病毒病毒体及其使用方法 |
| CN105247044B (zh) | 2013-05-31 | 2021-05-07 | 加利福尼亚大学董事会 | 腺相关病毒变体及其使用方法 |
| EP3800191B1 (en) | 2014-03-17 | 2025-08-20 | Adverum Biotechnologies, Inc. | Compositions and methods for enhanced gene expression in cone cells |
| US10577627B2 (en) | 2014-06-09 | 2020-03-03 | Voyager Therapeutics, Inc. | Chimeric capsids |
| EP4700118A3 (en) | 2016-07-29 | 2026-04-22 | The Regents of the University of California | Adeno-associated virus virions with varint capsid and methods of use thereof |
| CA3040179A1 (en) | 2016-10-19 | 2018-04-26 | Adverum Biotechnologies, Inc. | Modified aav capsids and uses thereof |
| EP3645052A4 (en) | 2017-06-30 | 2021-07-28 | Regents of the University of California | ADENO-ASSOCIATED VIRUS VIRIONS WITH ASSOCIATED CAPSIDE VARIANTS AND METHODS OF USE |
| TWI832036B (zh) | 2017-08-03 | 2024-02-11 | 美商航海家醫療公司 | 用於aav之遞送之組合物及方法 |
| KR20200039617A (ko) | 2017-08-28 | 2020-04-16 | 더 리젠츠 오브 더 유니버시티 오브 캘리포니아 | 아데노-연관 바이러스 캡시드 변이체 및 이의 사용 방법 |
| MX2020003042A (es) | 2017-09-29 | 2020-11-18 | Voyager Therapeutics Inc | Rescate del fenotipo neurológico central y periférico de la ataxia de friedreich mediante administración intravenosa. |
| WO2019200016A1 (en) | 2018-04-10 | 2019-10-17 | President And Fellows Of Harvard College | Aav vectors encoding clarin-1 or gjb2 and uses thereof |
| SG11202103102WA (en) | 2018-09-26 | 2021-04-29 | California Inst Of Techn | Adeno-associated virus compositions for targeted gene therapy |
| CN113383010B (zh) | 2018-09-28 | 2025-09-09 | 沃雅戈治疗公司 | 具有经工程化改造的启动子的共济蛋白表达构建体及其使用方法 |
| AU2020248116B2 (en) * | 2019-03-28 | 2025-12-04 | President And Fellows Of Harvard College | Engineered adeno-associated (AAV) vectors for transgene expression |
| TW202102526A (zh) * | 2019-04-04 | 2021-01-16 | 美商銳進科斯生物股份有限公司 | 重組腺相關病毒及其用途 |
| KR20220007056A (ko) * | 2019-04-11 | 2022-01-18 | 캘리포니아 인스티튜트 오브 테크놀로지 | 뇌에서 증진된 특이성을 갖는 바이러스 조성물 |
| JP2022531809A (ja) * | 2019-05-14 | 2022-07-11 | デューク ユニバーシティ | ATPase媒介性疾患の処置のための組成物および方法 |
| KR20230004719A (ko) | 2020-04-20 | 2023-01-06 | 테나야 테라퓨틱스, 인코포레이티드 | 조작된 캡시드를 갖는 아데노-연관 바이러스 |
| JP2023529315A (ja) * | 2020-05-26 | 2023-07-10 | シェイプ セラピューティクス インコーポレイテッド | 機能的aavカプシドのハイスループット工学操作 |
| CA3179597A1 (en) | 2020-05-29 | 2021-12-02 | John G. Flannery | Adeno-associated virus virions with variant capsids and methods of use thereof |
| US12129287B2 (en) | 2020-09-14 | 2024-10-29 | President And Fellows Of Harvard College | Recombinant adeno associated virus encoding clarin-1 and uses thereof |
| CN113754727B (zh) * | 2020-09-30 | 2022-07-12 | 广州派真生物技术有限公司 | 腺相关病毒突变体及其应用 |
| EP4229204A1 (en) | 2020-10-15 | 2023-08-23 | F. Hoffmann-La Roche AG | Nucleic acid constructs for simultaneous gene activation |
| CN113025658B (zh) * | 2021-03-10 | 2022-04-22 | 华侨大学 | 一种神经干细胞特异性基因的递送载体及其应用 |
| CN113121651B (zh) * | 2021-04-19 | 2023-11-17 | 信念医药科技(上海)有限公司 | 低中和抗体腺相关病毒衣壳蛋白 |
| US20240342311A1 (en) * | 2021-07-30 | 2024-10-17 | University Of Florida Research Foundation, Incorporated | Engineering aav vectors with improved cns targeting |
| CN114057840B (zh) * | 2021-10-14 | 2022-09-20 | 和元生物技术(上海)股份有限公司 | 包含变异的aav9衣壳蛋白的重组腺相关病毒颗粒 |
| EP4482850A1 (en) * | 2022-02-22 | 2025-01-01 | The University of North Carolina at Chapel Hill | Chimeric neurotropic aav capsids |
| CN119894920A (zh) * | 2022-07-22 | 2025-04-25 | 上海天泽云泰生物医药有限公司 | 用于靶向神经系统的新型aav衣壳及其用途 |
| CN116789738B (zh) * | 2022-12-08 | 2023-12-19 | 广州派真生物技术有限公司 | 腺相关病毒突变体及其应用 |
| CN117012275A (zh) * | 2023-08-11 | 2023-11-07 | 瑞诺元(苏州)生物科技有限公司 | 一种腺相关病毒测序数据的分析方法及系统 |
| WO2025147741A1 (en) * | 2024-01-11 | 2025-07-17 | Children's Medical Research Institute | Aav capsids and vectors for transduction of cells |
Family Cites Families (84)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| GB9206016D0 (en) | 1992-03-19 | 1992-04-29 | Sandoz Ltd | Improvements in or relating to organic compounds |
| US6440425B1 (en) | 1995-05-01 | 2002-08-27 | Aventis Pasteur Limited | High molecular weight major outer membrane protein of moraxella |
| US6001650A (en) | 1995-08-03 | 1999-12-14 | Avigen, Inc. | High-efficiency wild-type-free AAV helper functions |
| US6096548A (en) | 1996-03-25 | 2000-08-01 | Maxygen, Inc. | Method for directing evolution of a virus |
| AU2678097A (en) | 1996-04-16 | 1997-11-07 | Immusol Incorporated | Targeted viral vectors |
| US6710036B2 (en) | 1997-07-25 | 2004-03-23 | Avigen, Inc. | Induction of immune response to antigens expressed by recombinant adeno-associated virus |
| CA2303768C (en) | 1997-09-19 | 2009-11-24 | The Trustees Of The University Of Pennsylvania | Methods and vector constructs useful for production of recombinant aav |
| EP1030861A4 (en) | 1997-10-31 | 2001-09-05 | Maxygen Inc | MODIFICATION OF VIRUSTROPISMIUS AND THE ECONOMIC SPECTRUM BY VIRAL GENOM MIXING |
| US6410300B1 (en) | 1998-01-12 | 2002-06-25 | The University Of North Carolina At Chapel Hill | Methods and formulations for mediating adeno-associated virus (AAV) attachment and infection and methods for purifying AAV |
| US6551795B1 (en) | 1998-02-18 | 2003-04-22 | Genome Therapeutics Corporation | Nucleic acid and amino acid sequences relating to pseudomonas aeruginosa for diagnostics and therapeutics |
| DE19827457C1 (de) | 1998-06-19 | 2000-03-02 | Medigene Ag | Strukturprotein von AAV, seine Herstellung und Verwendung |
| JP2002525064A (ja) | 1998-09-11 | 2002-08-13 | ザ レジェンツ オブ ザ ユニヴァースティ オブ カリフォルニア | 心臓で組織特異的に発現する新規組換えアデノウイルス |
| ATE454445T1 (de) | 1998-11-10 | 2010-01-15 | Univ North Carolina | Virusvektoren und verfahren für ihre herstellung und verabreichung. |
| US6943153B1 (en) | 1999-03-15 | 2005-09-13 | The Regents Of The University Of California | Use of recombinant gene delivery vectors for treating or preventing diseases of the eye |
| US6498244B1 (en) | 1999-05-28 | 2002-12-24 | Cell Genesys, Inc. | Adeno-associated virus capsid immunologic determinants |
| US7314912B1 (en) | 1999-06-21 | 2008-01-01 | Medigene Aktiengesellschaft | AAv scleroprotein, production and use thereof |
| DE19933288A1 (de) | 1999-07-15 | 2001-01-18 | Medigene Ag | Strukturprotein von Adeno-assoziiertem Virus mit veränderter Antigenität, seine Herstellung und Verwendung |
| DE19933719A1 (de) | 1999-07-19 | 2001-01-25 | Medigene Ag | Strukturprotein in Adeno-assoziiertem Virus mit veränderten chromatographischen Eigenschaften, seine Herstellung und Verwendung |
| US8232081B2 (en) | 1999-09-21 | 2012-07-31 | Basf Se | Methods and microorganisms for production of panto-compounds |
| US20070026394A1 (en) | 2000-02-11 | 2007-02-01 | Lawrence Blatt | Modulation of gene expression associated with inflammation proliferation and neurite outgrowth using nucleic acid based technologies |
| US6855314B1 (en) | 2000-03-22 | 2005-02-15 | The United States Of America As Represented By The Department Of Health And Human Services | AAV5 vector for transducing brain cells and lung cells |
| WO2002053703A2 (en) | 2001-01-05 | 2002-07-11 | Children's Hospital, Inc. | Aav2 vectors and methods |
| US7749492B2 (en) | 2001-01-05 | 2010-07-06 | Nationwide Children's Hospital, Inc. | AAV vectors and methods |
| US20030129203A1 (en) | 2001-08-27 | 2003-07-10 | Nautilus Biotech S.A. | Mutant recombinant adeno-associated viruses |
| US7647184B2 (en) | 2001-08-27 | 2010-01-12 | Hanall Pharmaceuticals, Co. Ltd | High throughput directed evolution by rational mutagenesis |
| SG10202108118RA (en) | 2001-11-13 | 2021-08-30 | Univ Pennsylvania | A method of detecting and/or identifying adeno-associated virus (aav) sequences and isolating novel sequences identified thereby |
| ES2467156T3 (es) | 2001-12-21 | 2014-06-12 | Medigene Ag | Una biblioteca de genes estructurales modificados o de partículas modificadas de cápside útiles para la identificación de clones virales con tropismo celular deseado |
| US20060292117A1 (en) | 2002-04-17 | 2006-12-28 | Loiler Scott A | Improved rAAv vectors |
| US20040142416A1 (en) | 2002-04-30 | 2004-07-22 | Laipis Philip J. | Treatment for phenylketonuria |
| AU2003223775A1 (en) | 2002-04-30 | 2003-11-17 | Duke University | Adeno-associated viral vectors and methods for their production from hybrid adenovirus and for their use |
| US7071172B2 (en) | 2002-04-30 | 2006-07-04 | The University Of North Carolina At Chapel Hill | Secretion signal vectors |
| US7254489B2 (en) | 2002-05-31 | 2007-08-07 | Microsoft Corporation | Systems, methods and apparatus for reconstructing phylogentic trees |
| US7220577B2 (en) | 2002-08-28 | 2007-05-22 | University Of Florida Research Foundation, Inc. | Modified AAV |
| US20070172460A1 (en) | 2003-03-19 | 2007-07-26 | Jurgen Kleinschmidt | Random peptide library displayed on aav vectors |
| WO2004108922A2 (en) | 2003-04-25 | 2004-12-16 | The Trustees Of The University Of Pennsylvania | Use of aav comprising a capsid protein from aav7 or aav8 for the delivery of genes encoding apoprotein a or e genes to the liver |
| EP1486567A1 (en) | 2003-06-11 | 2004-12-15 | Deutsches Krebsforschungszentrum Stiftung des öffentlichen Rechts | Improved adeno-associated virus (AAV) vector for gene therapy |
| PL2357189T3 (pl) | 2003-06-19 | 2017-08-31 | Genzyme Corporation | Wiriony AAV o zmniejszonej immunoreaktywności i ich zastosowanie |
| CA2530582C (en) | 2003-06-23 | 2014-09-09 | A&G Pharmaceutical, Inc. | Compositions and methods for restoring sensitivity of tumor cells to antitumor therapy and inducing apoptosis |
| US9233131B2 (en) | 2003-06-30 | 2016-01-12 | The Regents Of The University Of California | Mutant adeno-associated virus virions and methods of use thereof |
| US9441244B2 (en) | 2003-06-30 | 2016-09-13 | The Regents Of The University Of California | Mutant adeno-associated virus virions and methods of use thereof |
| US20050019927A1 (en) | 2003-07-13 | 2005-01-27 | Markus Hildinger | DECREASING GENE EXPRESSION IN A MAMMALIAN SUBJECT IN VIVO VIA AAV-MEDIATED RNAi EXPRESSION CASSETTE TRANSFER |
| US20050148069A1 (en) * | 2003-09-24 | 2005-07-07 | Gage Fred H. | IGF-1 instructs multipotent adult CNS neural stem cells to an oligodendroglial lineage |
| HUE054805T2 (hu) | 2003-09-30 | 2021-09-28 | Univ Pennsylvania | Adeno-asszociált vírus (AAV) kládok, szekvenciák, az azokat tartalmazó vektorok és alkalmazásaik |
| US7427396B2 (en) | 2004-06-03 | 2008-09-23 | Genzyme Corporation | AAV vectors for gene delivery to the lung |
| AU2005316476A1 (en) | 2004-12-15 | 2006-06-22 | University Of Florida Research Foundation, Inc. | Chimeric vectors |
| WO2006101634A1 (en) | 2005-02-17 | 2006-09-28 | The Regents Of The University Of California | Müller cell specific gene therapy |
| EP3085389A1 (en) | 2005-04-07 | 2016-10-26 | The Trustees Of The University Of Pennsylvania | Method of increasing the function of an aav vector |
| US7867484B2 (en) | 2006-01-27 | 2011-01-11 | University Of North Carolina At Chapel Hill | Heparin and heparan sulfate binding chimeric vectors |
| WO2007120542A2 (en) | 2006-03-30 | 2007-10-25 | The Board Of Trustees Of The Leland Stanford Junior University | Aav capsid library and aav capsid proteins |
| WO2007131180A2 (en) | 2006-05-04 | 2007-11-15 | Wayne State University | Restoration of visual responses by in vivo delivery of rhodopsin nucleic acids |
| CN1966082B (zh) | 2006-11-03 | 2010-06-30 | 许瑞安 | 一种防治结直肠癌的基因药物及其制备方法和用途 |
| US9725485B2 (en) | 2012-05-15 | 2017-08-08 | University Of Florida Research Foundation, Inc. | AAV vectors with high transduction efficiency and uses thereof for gene therapy |
| EP2481797A1 (en) | 2007-04-13 | 2012-08-01 | Catalyst Biosciences, Inc. | Modified factor VII polypeptides and uses thereof |
| EP1985708B1 (en) | 2007-04-27 | 2015-04-15 | Universität Rostock | Selective targeting of viruses to neural precursor cells |
| WO2009137006A2 (en) | 2008-04-30 | 2009-11-12 | The University Of North Carolina At Chapel Hill | Directed evolution and in vivo panning of virus vectors |
| EP2315833B8 (en) | 2008-05-20 | 2015-05-27 | Eos Neuroscience, Inc. | Vectors for delivery of light-sensitive proteins and methods of use |
| EP2297185A1 (en) | 2008-06-17 | 2011-03-23 | Amsterdam Molecular Therapeutics (AMT) B.V. | Parvoviral capsid with incorporated gly-ala repeat region |
| US8889641B2 (en) | 2009-02-11 | 2014-11-18 | The University Of North Carolina At Chapel Hill | Modified virus vectors and methods of making and using the same |
| CN101532024A (zh) | 2009-04-30 | 2009-09-16 | 许瑞安 | 一种用于基因治疗的新型细胞特异性内含microRNA结合序列的基因HAAVmir |
| WO2010138263A2 (en) | 2009-05-28 | 2010-12-02 | University Of Massachusetts | Novel aav 's and uses thereof |
| WO2011117258A2 (en) | 2010-03-22 | 2011-09-29 | Association Institut De Myologie | Methods of increasing efficiency of vector penetration of target tissue |
| US8663624B2 (en) | 2010-10-06 | 2014-03-04 | The Regents Of The University Of California | Adeno-associated virus virions with variant capsid and methods of use thereof |
| CN107012171B (zh) | 2011-04-22 | 2021-07-13 | 加利福尼亚大学董事会 | 具有变异衣壳的腺相关病毒病毒体及其使用方法 |
| EP3147295B2 (en) | 2011-08-24 | 2023-11-22 | The Board of Trustees of the Leland Stanford Junior University | New avv capsid proteins for nucleic acid transfer |
| EP3470523A1 (en) | 2012-05-09 | 2019-04-17 | Oregon Health & Science University | Adeno associated virus plasmids and vectors |
| TWI775096B (zh) | 2012-05-15 | 2022-08-21 | 澳大利亞商艾佛蘭屈澳洲私營有限公司 | 使用腺相關病毒(aav)sflt-1治療老年性黃斑部退化(amd) |
| EP2940131B1 (en) | 2012-12-25 | 2019-02-20 | Takara Bio Inc. | Aav variant |
| ES2741502T3 (es) | 2013-02-08 | 2020-02-11 | Univ Pennsylvania | Cápside de AAV8 modificada para la transferencia génica para terapias de retina |
| EP3004339B1 (en) | 2013-05-29 | 2021-07-07 | Cellectis | New compact scaffold of cas9 in the type ii crispr system |
| CN105247044B (zh) | 2013-05-31 | 2021-05-07 | 加利福尼亚大学董事会 | 腺相关病毒变体及其使用方法 |
| US9597415B2 (en) | 2013-06-28 | 2017-03-21 | Inserm (Institute National De La Sante Et De La Recherche Medicale) | Methods for expressing a polynucleotide of interest in the retina of a subject |
| AU2014324717B2 (en) | 2013-09-26 | 2020-10-08 | University Of Florida Research Foundation, Inc. | Synthetic combinatorial AAV capsid library for targeted gene therapy |
| NZ718926A (en) | 2013-10-11 | 2021-12-24 | Massachusetts Eye & Ear Infirmary | Methods of predicting ancestral virus sequences and uses thereof |
| GB201403684D0 (en) | 2014-03-03 | 2014-04-16 | King S College London | Vector |
| EP3800191B1 (en) | 2014-03-17 | 2025-08-20 | Adverum Biotechnologies, Inc. | Compositions and methods for enhanced gene expression in cone cells |
| EP3137497B2 (en) | 2014-05-02 | 2025-03-05 | Genzyme Corporation | Aav vectors for retinal and cns gene therapy |
| WO2015191693A2 (en) | 2014-06-10 | 2015-12-17 | Massachusetts Institute Of Technology | Method for gene editing |
| CN108347932B (zh) | 2015-02-20 | 2022-09-13 | 衣阿华大学研究基金会 | 用于治疗遗传性眼病的方法和组合物 |
| JP7095994B2 (ja) | 2015-03-02 | 2022-07-05 | アドヴェラム バイオテクノロジーズ, インコーポレイテッド | ポリヌクレオチドを網膜錐体に硝子体内送達するための組成物及び方法 |
| PT3265568T (pt) | 2015-03-06 | 2020-08-20 | Massachusetts Eye & Ear Infirmary | Terapias de aumento de genes para a degeneração hereditária da retina causada por mutações no gene prpf31 |
| US20190000940A1 (en) * | 2015-07-31 | 2019-01-03 | Voyager Therapeutics, Inc. | Compositions and methods for the treatment of aadc deficiency |
| WO2017197355A2 (en) | 2016-05-13 | 2017-11-16 | 4D Molecular Therapeutics Inc. | Adeno-associated virus variant capsids and methods of use thereof |
| MA44546B1 (fr) | 2016-06-15 | 2021-03-31 | Univ California | Virus adéno-associés variants et procédés d'utilisation |
| KR20200039617A (ko) | 2017-08-28 | 2020-04-16 | 더 리젠츠 오브 더 유니버시티 오브 캘리포니아 | 아데노-연관 바이러스 캡시드 변이체 및 이의 사용 방법 |
-
2018
- 2018-08-22 KR KR1020197035110A patent/KR20200039617A/ko not_active Withdrawn
- 2018-08-22 EP EP18850221.5A patent/EP3676373A4/en not_active Withdrawn
- 2018-08-22 MX MX2020001997A patent/MX2020001997A/es unknown
- 2018-08-22 JP JP2019562303A patent/JP2020534788A/ja not_active Withdrawn
- 2018-08-22 AU AU2018324477A patent/AU2018324477A1/en not_active Abandoned
- 2018-08-22 WO PCT/US2018/047561 patent/WO2019046069A1/en not_active Ceased
- 2018-08-22 BR BR112020003571-8A patent/BR112020003571A2/pt not_active IP Right Cessation
- 2018-08-22 CA CA3059995A patent/CA3059995A1/en active Pending
- 2018-08-22 CN CN201880035665.2A patent/CN110709511A/zh active Pending
- 2018-08-22 US US16/500,706 patent/US11680249B2/en active Active
Cited By (2)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| WO2026024045A1 (ko) * | 2024-07-22 | 2026-01-29 | 한국생명공학연구원 | 변이체 캡시드를 포함하는 아데노-연관 바이러스 및 이의 용도 |
| WO2026024048A1 (ko) * | 2024-07-22 | 2026-01-29 | 한국생명공학연구원 | 변이체 캡시드를 포함하는 아데노-연관 바이러스 및 이의 용도 |
Also Published As
| Publication number | Publication date |
|---|---|
| EP3676373A1 (en) | 2020-07-08 |
| US20200095559A1 (en) | 2020-03-26 |
| CA3059995A1 (en) | 2019-03-07 |
| AU2018324477A1 (en) | 2019-10-17 |
| CN110709511A (zh) | 2020-01-17 |
| BR112020003571A2 (pt) | 2020-08-25 |
| US11680249B2 (en) | 2023-06-20 |
| MX2020001997A (es) | 2020-07-20 |
| JP2020534788A (ja) | 2020-12-03 |
| EP3676373A4 (en) | 2021-06-09 |
| WO2019046069A1 (en) | 2019-03-07 |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| US11680249B2 (en) | Adeno-associated virus capsid variants and methods of use thereof | |
| JP7706582B2 (ja) | 変異カプシドを有するアデノ随伴ウイルスビリオン及びその使用方法 | |
| CN115023242B (zh) | 腺相关病毒载体变体 | |
| JP2023126919A (ja) | バリアントカプシドを有するアデノ随伴ウイルスビリオン及びその使用方法 | |
| US11155817B2 (en) | Therapeutic for treatment of diseases including the central nervous system | |
| CN108699565B (zh) | 用于定向腺相关病毒(aav)的靶向肽 | |
| Pignataro et al. | Adeno-associated viral vectors serotype 8 for cell-specific delivery of therapeutic genes in the central nervous system | |
| AU2018261003A2 (en) | Compositions and methods of treating Huntington's Disease | |
| KR20230043794A (ko) | 변이체 캡시드를 갖는 아데노-연관 바이러스 비리온 및 이의 사용 방법 | |
| US20230044220A1 (en) | Treatment of chronic pain | |
| WO2024226790A1 (en) | Aav capsid variants and uses thereof | |
| US20220098254A1 (en) | NEUROD1 and DLX2 VECTOR | |
| CN119213135A (zh) | 具有改善的肺向性的腺伴随病毒变体衣壳及其用途 | |
| AU2020299718B2 (en) | cPLA2e inducing agents and uses thereof | |
| WO2025235689A2 (en) | Peptides targeting alpl for blood-brain barrier crossing | |
| WO2025235682A1 (en) | Peptides targeting tfrc for blood-brain barrier crossing | |
| WO2023184688A1 (zh) | 功能性β-半乳糖苷酶变体、AAV介导的人β-半乳糖苷酶表达载体及其用途 | |
| HK40091867A (zh) | 变体腺伴随病毒及使用方法 | |
| CN116761812A (zh) | Neurod1和dlx2载体 | |
| JP2023543360A (ja) | Dlx2ベクター | |
| CN116670160A (zh) | Dlx2载体 | |
| WO2020187272A1 (zh) | 一种用于基因治疗的融合蛋白及其应用 |
Legal Events
| Date | Code | Title | Description |
|---|---|---|---|
| PA0105 | International application |
Patent event date: 20191127 Patent event code: PA01051R01D Comment text: International Patent Application |
|
| PG1501 | Laying open of application | ||
| A201 | Request for examination | ||
| PA0201 | Request for examination |
Patent event code: PA02012R01D Patent event date: 20210823 Comment text: Request for Examination of Application |
|
| PC1202 | Submission of document of withdrawal before decision of registration |
Comment text: [Withdrawal of Procedure relating to Patent, etc.] Withdrawal (Abandonment) Patent event code: PC12021R01D Patent event date: 20220803 |
|
| WITB | Written withdrawal of application |