RU2180974C2 - Способ сжатия изолированных слов - Google Patents
Способ сжатия изолированных слов Download PDFInfo
- Publication number
- RU2180974C2 RU2180974C2 RU2000107717A RU2000107717A RU2180974C2 RU 2180974 C2 RU2180974 C2 RU 2180974C2 RU 2000107717 A RU2000107717 A RU 2000107717A RU 2000107717 A RU2000107717 A RU 2000107717A RU 2180974 C2 RU2180974 C2 RU 2180974C2
- Authority
- RU
- Russia
- Prior art keywords
- signal
- speech
- word
- sections
- section
- Prior art date
Links
- 238000000034 method Methods 0.000 title claims abstract description 7
- 238000007906 compression Methods 0.000 title description 15
- 230000006835 compression Effects 0.000 title description 15
- 230000003044 adaptive effect Effects 0.000 claims abstract description 10
- 238000013139 quantization Methods 0.000 claims abstract description 9
- 230000000694 effects Effects 0.000 abstract description 2
- 230000003247 decreasing effect Effects 0.000 abstract 2
- 238000002955 isolation Methods 0.000 abstract 1
- 239000000126 substance Substances 0.000 abstract 1
- 230000005236 sound signal Effects 0.000 description 6
- 230000007704 transition Effects 0.000 description 6
- 238000001228 spectrum Methods 0.000 description 4
- 230000000873 masking effect Effects 0.000 description 3
- 238000005070 sampling Methods 0.000 description 3
- 230000005540 biological transmission Effects 0.000 description 2
- 230000015572 biosynthetic process Effects 0.000 description 2
- 238000006243 chemical reaction Methods 0.000 description 2
- 230000007423 decrease Effects 0.000 description 2
- 238000010586 diagram Methods 0.000 description 2
- 230000000737 periodic effect Effects 0.000 description 2
- 238000003786 synthesis reaction Methods 0.000 description 2
- 206010011878 Deafness Diseases 0.000 description 1
- 238000004891 communication Methods 0.000 description 1
- 238000013144 data compression Methods 0.000 description 1
- 230000008030 elimination Effects 0.000 description 1
- 238000003379 elimination reaction Methods 0.000 description 1
- 230000010355 oscillation Effects 0.000 description 1
- 230000004044 response Effects 0.000 description 1
- 230000013707 sensory perception of sound Effects 0.000 description 1
- 238000004088 simulation Methods 0.000 description 1
- 230000002123 temporal effect Effects 0.000 description 1
- 210000001260 vocal cord Anatomy 0.000 description 1
Images
Landscapes
- Compression, Expansion, Code Conversion, And Decoders (AREA)
Abstract
Изобретение относится к цифровой обработке речи. Его использование в системах речевого ответа абонентам телефонной сети, в справочных службах, для озвучивания объявлений на транспорте, в иных общественных местах обеспечивает достижение технического результата в виде сокращения объема памяти для хранения и воспроизведения требуемой речевой информации. Способ заключается в том, что разделяют предварительно записанный в оперативное запоминающее устройство сигнал очередного слова на отрезки равной длины, вычисляют в каждом из них средний модуль этого сигнала и число смен знака в нем, определяют по этим данным два образа обрабатываемого слова, описывающие характер изменения его сигнала во времени по уровню и мгновенной частоте. Технический результат достигается благодаря тому, что определяют внутри слова участки локальной стационарности, на которых одновременно уровень сигнала и его мгновенная частота почти не изменяются, выделяют внутри каждого такого участка отрезок сигнала, служащий эталонным периодом основного тона речи, переписывают данные отрезки сигнала один за другим в постоянное запоминающее устройство, снабжая каждый из них паролем, содержащим информацию о продолжительности данного отрезка сигнала, числе его повторений при воспроизведении слова и величине адаптивного шага квантования, пропорционального среднему модулю сигнала на данном участке локальной стационарности. 4 ил.
Description
Изобретение относится к технике цифровой обработки речи и может быть использовано в различных приложениях, например в системах речевого ответа абонентам телефонной сети (автоответчики), в справочных службах, для озвучивания объявлений на транспорте, в общественных местах и т.д.
Известен алгоритм сжатия данных звука ISO/MPEG (MUSICAM), использующий информационное сжатие для передачи с высоким качеством сигналов звукового сопровождения телевизионных программ, а также программ цифрового спутникового радиовещания [1] . Этот алгоритм основан на особенностях восприятия звуков ухом человека - так называемом психоакустическом эффекте. Доказано, что человек воспринимает примерно 10% информации, содержащейся в звуковом сигнале, остальные 90% являются избыточными и их можно не передавать по каналу связи. Сигнал определенной частоты (тон), воздействуя на ухо человека, не позволяет различать (маскирует) другие тоны, близкие к данному по частоте и меньшие по уровню. В реальном звуковом сигнале одновременно присутствуют несколько маскирующих тонов на различных частотах. Компоненты сигнала, уровни которых ниже порога маскирования, ухом не воспринимаются и являются избыточными.
Недостатком описанного алгоритма сжатия звукового сигнала является сложность в его реализации. Как и в частотных вокодерах, для сжатия осуществляется анализ мгновенного энергетического спектра сигнала, в данном случае с помощью гребенки фильтров, разделяющих спектр на 32 частотных полосы. В каждой из них по отдельности выполняется аналого-цифровое преобразование, обработке подвергаются поочередно "кадры" сигнала длительностью 24 мсек, с частотой выборки отсчетов, равной 48 кГц. Устранение из передаваемого "кадра" частотных полос с уровнем сигнала ниже порога маскирования, в сочетании с динамическим распределением битов информации между оставшимися полосами, позволяет достичь почти 6-кратного сжатия спектра стереофонического сигнала, с сохранением практически неизменного, очень высокого качества звучания.
Сложность в реализации алгоритма [1] оправдана необходимостью получения высокого качества звучания радиовещательного стереофонического сигнала, которое вовсе не требуется в устройствах типа автоответчиков, для справочных служб и т.д., где достаточно только обеспечить высокую разборчивость и натуральность речи.
Наиболее близким техническим решением (прототипом) является алгоритм цифрового преобразования звукового сигнала на примере изолированных слов, произносимых произвольным диктором, описанный в [2]. Этот адаптивный алгоритм, использующий избыточность речевого сигнала во временной области, позволяет обеспечить распознавание произвольного голоса, независимо от его громкости, темпа речи и частоты основного тона. В отличие от [1], где так же, как и во всех известных вокодерных системах передачи речи, сжатие сигнала достигается путем устранения его частотной избыточности, в [2] показана возможность использования временной избыточности речевого сигнала. Эта избыточность проявляется в сильных корреляционных связях, охватывающих до (10-12) соседних отсчетов речевого сигнала, взятых с частотой дискретизации, равной 8 кГц. В свою очередь, связи между соседними отсчетами вызваны резкой неравномерностью спектра мощности речевого сигнала, имеющего максимум в области (400-500) Гц и быстро спадающего на высоких частотах со скоростью от 6 до 12 дБ на октаву.
Особенно заметно проявляется избыточность речи при произнесении так называемых вокализованных (гласных) звуков, которым соответствуют участки локальной стационарности протяженностью до (150-200) мсек. На каждом таком участке размещаются десятки почти однотипных отрезков сигнала с периодом основного тона речи, индивидуального для каждого голоса. Для мужских голосов этот период колебания голосовых связок составляет (5-20) мсек, а для высоких женских и детских голосов он изменяется в диапазоне (2-5) мсек.
Произнесение звонких согласных (типа "б", "в", "г", "д" и т.д.), а также "м", "н" тоже сопровождается периодическим повторением отрезков основного тона речи, изменяется только их форма, амплитуда и количество на протяжении звучания данной согласной. И только глухие согласные (например, "п", "ф", "к", т" и другие) не содержат в своем составе периодических отрезков, звуковой сигнал напоминает шум и отличается низким уровнем звучания, малой протяженностью во времени и высокой частотой смены знака сигнала (переходов через ноль).
Недостатком прототипа [2] является то, что алгоритм его функционирования направлен, главным образом, на распознавание изолированных (разделенных паузами) слов, произносимых любым голосом, а задача сжатия речи путем устранения избыточности рассматривается как вспомогательная и решается лишь частично. При этом устраняется та небольшая часть избыточности, которая связана с индивидуальными особенностями голоса диктора. Основная же часть избыточности, вызванная многократной повторяемостью отрезков сигнала на периодах основного тона речи, сохраняется неизменной.
Техническим результатом предлагаемого изобретения является сокращение объема памяти, удешевление и уменьшение габаритов постоянных запоминающих устройств, необходимых для хранения и воспроизведения требуемой речевой информации, содержащей изолированные (разделенные паузами) слова.
Предлагаемый способ сжатия изолированных слов, заключающийся в том, что по превышению заданного порогового уровня определяются начало и конец очередного слова, оно предварительно записывается в оперативное запоминающее устройство (О3У) и подразделяется на отрезки равной длины, в каждом из которых вычисляется средний модуль сигнала и число смен знака, по этим данным определяются два "образа" слова, описывающие характер изменения сигнала во времени по уровню и мгновенной частоте, отличается тем, что определяются участки локальной стационарности внутри слова, на которых одновременно уровень сигнала и его мгновенная частота почти не изменяются, внутри каждого такого участка выделяется отрезок сигнала, служащий эталонным периодом основного тона речи, данные отрезки сигнала один за другим переписываются в постоянное запоминающее устройство (ПЗУ), при этом каждый из них снабжается "паролем", содержащим информацию о продолжительности данного отрезка сигнала, числе его повторений при воспроизведении слова и величине адаптивного шага квантования, пропорционального среднему модулю сигнала на данном участке локальной стационарности.
В соответствии с предлагаемым способом опишем подход к сжатию речевых сигналов, основанный на упрощенном описании одного эталонного, из числа периодически повторяющихся на каждом из участков локальной стационарности, отрезка с периодом основного тона речи, и дальнейшем синтезе речи по этим отрезкам.
Сжатие происходит на временной основе, при этом используется избыточность квазистационарных участков вокализованной речи и устраняются малые уровни, т.е. сигнал в паузах приравнивается к нулю. Речь разбивается на отрезки, равные 16 мсек, не превышающие половины интервала локальной стационарности (порядка 40 мсек). На каждом отрезке определяется средний модуль, число переходов через ноль и устанавливается адаптивный шаг квантования по уровню, равный половине среднего модуля. Использование адаптивного шага квантования позволяет снизить разрядность кода отсчета речевого сигнала без заметных потерь почти в 3 раза.
На вокализованном участке в процессе синтеза слова воспроизводится один период основного тона речи столько раз, сколько звучит этот участок слова.
Невокализованные участки речи сжимаются в меньшей степени, но они короче гласных звуков, поэтому, взяв за основу средний период основного тона речи и его повторяемость, можно сжать сигнал приблизительно в 10 раз, что в сочетании с использованием адаптивного шага квантования и снижением разрядности кода отсчета дает выигрыш порядка 30 раз.
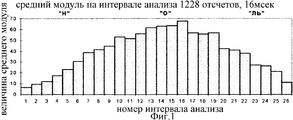
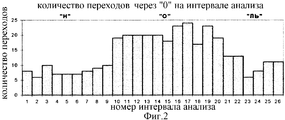
На фиг. 1 и 2 изображены гистограммы распределения во времени среднего модуля сигнала и количества переходов через ноль на интервалах анализа длиной 16 мсек, при произнесении женским голосом слова "НОЛЬ". Эти гистограммы представляют собой два "образа" слова, описывающие характер изменения сигнала во времени по уровню и мгновенной частоте. На фиг. 2 отчетливо заметны участки локальной стационарности, соответствующие звукам "Н" (с 1 по 9), "О" (с 10 по 20) и "ЛЬ" (с 21 по 26). Этим участкам на фиг. 1 соответствуют разные средние модули сигнала.
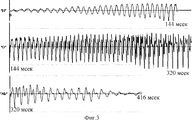
На фиг. 3 представлены временные диаграммы реального речевого сигнала при произнесении слова "НОЛЬ". Разделение всего слова на интервалы локальной стационарности, соответствующие звукам "Н" длиной 144 мсек, "О" длиной 176 мсек, "ЛЬ" длиной 96 мсек основано на данных гистограммы на фиг. 2.
Общая протяженность слова составляет 416 мсек или 3328 отсчетов частоты дискретизации 8 кГц. На фиг. 3 явно прослеживаются периоды основного тона речи, для данного голоса порядка 3 мсек, или 24 отсчета.
На периодах основного тона речи имеется два перехода через ноль для невокализованных звуков "Н" и "ЛЬ". Для вокализованного звука "О" частота переходов через ноль вдвое выше. Средние уровни сигнала на невокализованных участках в 1,5-2 раза ниже, чем на вокализованном. Каждый из участков локальной стационарности характеризуется своей формой сигнала, многократно повторяющейся с периодом основного тона речи.
Используя гистограмму на фиг. 1, можно подразделить каждый звук на несколько участков, близких по уровню. Внутри каждого из них можно выделить один период основного тона и повторить его в соответствии с длиной данного участка.
Дополнительное сжатие достигается путем снижения разрядности кода отсчета сигнала. Для этого шаг квантования по уровню устанавливается адаптивным, пропорционально среднему модулю сигнала на интервале анализа. Моделирование на ПК алгоритма сжатия показало, что удовлетворительное качество звучания достигается при использовании трехразрядного кода. Это соответствует передаче знакового разряда отсчета и двух разрядов модуля, то есть чисел ±3, поэтому выбран адаптивный шаг квантования, равный половине среднего модуля сигнала.
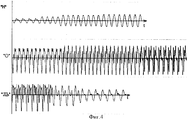
На фиг. 4 приведены временные диаграммы синтезированного по описанному алгоритму слова. В соответствии с гистограммой на фиг. 1, для описания звука "Н" выбраны четыре эталонных периода основного тона речи с разной величиной адаптивного шага квантования. Для вокализованного звука "О" выбрано всего три эталонных периода основного тона, один на границе звуков "Н-О", второй в середине звука "О" и третий на переходе звука "О" в "ЛЬ". Поскольку звук "О" наиболее протяженный и составляет почти половину слова, на нем достигается наиболее эффективное сжатие. Звук "ЛЬ" наименее протяженный и для его описания достаточно трех эталонных периодов основного тона речи, а именно на переходе "О" в "ЛЬ", в середине звука и в конце, на участке затухания сигнала.
Всего на протяжении слова были выбраны и запомнены десять эталонных периодов основного тона речи общей протяженностью 240 трехразрядных отсчетов, то есть 90 байт. С учетом необходимых описаний ("пароля") каждого эталонного периода, по два байта на период, на все синтезированное слово потребуется 110 байт.
До сжатия слово содержало 3328 восьмиразрядных отсчетов, то есть для его описания требовалось 3328 байт. Таким образом, предложенный алгоритм обеспечил 30-кратное сжатие необходимого объема памяти. При этом сохранилась узнаваемость по голосу, качество звучания соответствовало экспертной оценке в 3 балла по 5-балльной шкале.
Отметим также, что предложенный алгоритм сжатия позволяет с легкостью осуществлять обмен степени сжатия на качество звучания путем изменения разрядности кода отсчетов сигнала и количества эталонных периодов основного тона речи, входящих в состав синтезированного слова.
Литература
1. Алгоритм сжатия данных звука ISO/MPEG (MUSICAM). Глеб Высоцкий, [Image] GS Урал, июль 1998 г., статья в сети Интернет.
1. Алгоритм сжатия данных звука ISO/MPEG (MUSICAM). Глеб Высоцкий, [Image] GS Урал, июль 1998 г., статья в сети Интернет.
2. Брайнина И. С., Кузнецов М.В. Устройство для распознавания изолированных слов. Патент 2136659, 6 G 10 L 7/04, БИ 24, 1999.
Claims (1)
- Способ сжатия изолированных слов при цифровой обработке речи, заключающийся в том, что разделяют предварительно записанный в оперативное запоминающее устройство сигнал очередного слова на отрезки равной длины, вычисляют в каждом из них средний модуль этого сигнала и число смен знака в нем, определяют по этим данным два образа обрабатываемого слова, описывающих характер изменения его сигнала во времени по уровню и мгновенной частоте, отличающийся тем, что определяют внутри слова участки локальной стационарности, на которых одновременно уровень сигнала и его мгновенная частота почти не изменяются, выделяют внутри каждого такого участка отрезок сигнала, служащий эталонным периодом основного тона речи, переписывают данные отрезки сигнала один за другим в постоянное запоминающее устройство, снабжая каждый из них паролем, содержащим информацию о продолжительности данного отрезка сигнала, числе его повторений при воспроизведении слова и величине адаптивного шага квантования, пропорционального среднему модулю сигнала на данном участке локальной стационарности.
Priority Applications (1)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| RU2000107717A RU2180974C2 (ru) | 2000-03-29 | 2000-03-29 | Способ сжатия изолированных слов |
Applications Claiming Priority (1)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| RU2000107717A RU2180974C2 (ru) | 2000-03-29 | 2000-03-29 | Способ сжатия изолированных слов |
Publications (2)
| Publication Number | Publication Date |
|---|---|
| RU2180974C2 true RU2180974C2 (ru) | 2002-03-27 |
| RU2000107717A RU2000107717A (ru) | 2002-04-10 |
Family
ID=20232545
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| RU2000107717A RU2180974C2 (ru) | 2000-03-29 | 2000-03-29 | Способ сжатия изолированных слов |
Country Status (1)
| Country | Link |
|---|---|
| RU (1) | RU2180974C2 (ru) |
Citations (4)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| DE3808038A1 (de) * | 1988-03-10 | 1989-09-28 | Siemens Ag | Verfahren zur automatischen anpassung eines spracherkennungssystems |
| US5268991A (en) * | 1990-03-07 | 1993-12-07 | Mitsubishi Denki Kabushiki Kaisha | Apparatus for encoding voice spectrum parameters using restricted time-direction deformation |
| US5933803A (en) * | 1996-12-12 | 1999-08-03 | Nokia Mobile Phones Limited | Speech encoding at variable bit rate |
| RU2136059C1 (ru) * | 1998-01-05 | 1999-08-27 | Поволжский институт информатики, радиотехники и связи | Устройство для распознавания изолированных слов |
-
2000
- 2000-03-29 RU RU2000107717A patent/RU2180974C2/ru active
Patent Citations (4)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| DE3808038A1 (de) * | 1988-03-10 | 1989-09-28 | Siemens Ag | Verfahren zur automatischen anpassung eines spracherkennungssystems |
| US5268991A (en) * | 1990-03-07 | 1993-12-07 | Mitsubishi Denki Kabushiki Kaisha | Apparatus for encoding voice spectrum parameters using restricted time-direction deformation |
| US5933803A (en) * | 1996-12-12 | 1999-08-03 | Nokia Mobile Phones Limited | Speech encoding at variable bit rate |
| RU2136059C1 (ru) * | 1998-01-05 | 1999-08-27 | Поволжский институт информатики, радиотехники и связи | Устройство для распознавания изолированных слов |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| KR100361236B1 (ko) | 차분코딩원리를구현하는전송시스템 | |
| US8229738B2 (en) | Method for differentiated digital voice and music processing, noise filtering, creation of special effects and device for carrying out said method | |
| FI20011509A7 (fi) | Vaihtelevanopeuksinen vokooderi | |
| US20190378532A1 (en) | Method and apparatus for dynamic modifying of the timbre of the voice by frequency shift of the formants of a spectral envelope | |
| JP2903533B2 (ja) | 音声符号化方式 | |
| US7583804B2 (en) | Music information encoding/decoding device and method | |
| DE69905152T2 (de) | Vorrichtung und verfahren zur verbesserung der qualität kodierter sprache mittels hintergrundrauschen | |
| EP1426926A2 (en) | Apparatus and method for changing the playback rate of recorded speech | |
| KR100750115B1 (ko) | 오디오 신호 부호화 및 복호화 방법 및 그 장치 | |
| JP2000152394A (ja) | 軽度難聴者用補聴装置、軽度難聴者対応伝送システム、軽度難聴者対応記録再生装置、及び軽度難聴者対応再生装置 | |
| JP2586043B2 (ja) | マルチパルス符号化装置 | |
| JP2776300B2 (ja) | 音声信号処理回路 | |
| JP4322390B2 (ja) | 聴覚訓練方法 | |
| WO1991006945A1 (en) | Speech compression system | |
| Thibolet et al. | A comparison of the performance of four low-bit-rate speech waveform coders | |
| Holmes | A survey of methods for digitally encoding speech signals | |
| JPH058839B2 (ru) | ||
| JPH0376480B2 (ru) | ||
| JP2847730B2 (ja) | 音声符号化方式 | |
| JPH0414813B2 (ru) | ||
| KR0144841B1 (ko) | 음향신호의 적응적 부호화 및 복호화장치 | |
| JP2853126B2 (ja) | マルチパルス符号化装置 | |
| JPH03132800A (ja) | マルチパルス型音声符号化及び復号化装置 | |
| JPH0481199B2 (ru) | ||
| JPH0632035B2 (ja) | 音声符号化方法とその装置 |