ES2728278T3 - Composiciones que comprenden anticuerpos dirigidos al factor P y C5 - Google Patents
Composiciones que comprenden anticuerpos dirigidos al factor P y C5 Download PDFInfo
- Publication number
- ES2728278T3 ES2728278T3 ES12821311T ES12821311T ES2728278T3 ES 2728278 T3 ES2728278 T3 ES 2728278T3 ES 12821311 T ES12821311 T ES 12821311T ES 12821311 T ES12821311 T ES 12821311T ES 2728278 T3 ES2728278 T3 ES 2728278T3
- Authority
- ES
- Spain
- Prior art keywords
- seq
- antibody
- sequence
- chain variable
- variable region
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Active
Links
Classifications
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K16/00—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies
- C07K16/18—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies against material from animals or humans
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61K—PREPARATIONS FOR MEDICAL, DENTAL OR TOILETRY PURPOSES
- A61K39/00—Medicinal preparations containing antigens or antibodies
- A61K39/395—Antibodies; Immunoglobulins; Immune serum, e.g. antilymphocytic serum
- A61K39/39533—Antibodies; Immunoglobulins; Immune serum, e.g. antilymphocytic serum against materials from animals
- A61K39/3955—Antibodies; Immunoglobulins; Immune serum, e.g. antilymphocytic serum against materials from animals against proteinaceous materials, e.g. enzymes, hormones, lymphokines
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61P—SPECIFIC THERAPEUTIC ACTIVITY OF CHEMICAL COMPOUNDS OR MEDICINAL PREPARATIONS
- A61P27/00—Drugs for disorders of the senses
- A61P27/02—Ophthalmic agents
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61P—SPECIFIC THERAPEUTIC ACTIVITY OF CHEMICAL COMPOUNDS OR MEDICINAL PREPARATIONS
- A61P37/00—Drugs for immunological or allergic disorders
- A61P37/02—Immunomodulators
- A61P37/06—Immunosuppressants, e.g. drugs for graft rejection
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61P—SPECIFIC THERAPEUTIC ACTIVITY OF CHEMICAL COMPOUNDS OR MEDICINAL PREPARATIONS
- A61P43/00—Drugs for specific purposes, not provided for in groups A61P1/00-A61P41/00
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K16/00—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies
- C07K16/18—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies against material from animals or humans
- C07K16/24—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies against material from animals or humans against cytokines, lymphokines or interferons
-
- G—PHYSICS
- G01—MEASURING; TESTING
- G01N—INVESTIGATING OR ANALYSING MATERIALS BY DETERMINING THEIR CHEMICAL OR PHYSICAL PROPERTIES
- G01N33/00—Investigating or analysing materials by specific methods not covered by groups G01N1/00 - G01N31/00
- G01N33/48—Biological material, e.g. blood, urine; Haemocytometers
- G01N33/50—Chemical analysis of biological material, e.g. blood, urine; Testing involving biospecific ligand binding methods; Immunological testing
- G01N33/68—Chemical analysis of biological material, e.g. blood, urine; Testing involving biospecific ligand binding methods; Immunological testing involving proteins, peptides or amino acids
- G01N33/6863—Cytokines, i.e. immune system proteins modifying a biological response such as cell growth proliferation or differentiation, e.g. TNF, CNF, GM-CSF, lymphotoxin, MIF or their receptors
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61K—PREPARATIONS FOR MEDICAL, DENTAL OR TOILETRY PURPOSES
- A61K39/00—Medicinal preparations containing antigens or antibodies
- A61K2039/505—Medicinal preparations containing antigens or antibodies comprising antibodies
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61K—PREPARATIONS FOR MEDICAL, DENTAL OR TOILETRY PURPOSES
- A61K39/00—Medicinal preparations containing antigens or antibodies
- A61K2039/505—Medicinal preparations containing antigens or antibodies comprising antibodies
- A61K2039/507—Comprising a combination of two or more separate antibodies
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/20—Immunoglobulins specific features characterized by taxonomic origin
- C07K2317/21—Immunoglobulins specific features characterized by taxonomic origin from primates, e.g. man
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/30—Immunoglobulins specific features characterized by aspects of specificity or valency
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/30—Immunoglobulins specific features characterized by aspects of specificity or valency
- C07K2317/33—Crossreactivity, e.g. for species or epitope, or lack of said crossreactivity
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/40—Immunoglobulins specific features characterized by post-translational modification
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/50—Immunoglobulins specific features characterized by immunoglobulin fragments
- C07K2317/55—Fab or Fab'
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/50—Immunoglobulins specific features characterized by immunoglobulin fragments
- C07K2317/56—Immunoglobulins specific features characterized by immunoglobulin fragments variable (Fv) region, i.e. VH and/or VL
- C07K2317/565—Complementarity determining region [CDR]
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/70—Immunoglobulins specific features characterized by effect upon binding to a cell or to an antigen
- C07K2317/76—Antagonist effect on antigen, e.g. neutralization or inhibition of binding
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/90—Immunoglobulins specific features characterized by (pharmaco)kinetic aspects or by stability of the immunoglobulin
- C07K2317/92—Affinity (KD), association rate (Ka), dissociation rate (Kd) or EC50 value
Landscapes
- Health & Medical Sciences (AREA)
- Chemical & Material Sciences (AREA)
- Life Sciences & Earth Sciences (AREA)
- Immunology (AREA)
- Medicinal Chemistry (AREA)
- Organic Chemistry (AREA)
- General Health & Medical Sciences (AREA)
- Engineering & Computer Science (AREA)
- Molecular Biology (AREA)
- Bioinformatics & Cheminformatics (AREA)
- Proteomics, Peptides & Aminoacids (AREA)
- Biochemistry (AREA)
- Pharmacology & Pharmacy (AREA)
- Public Health (AREA)
- Veterinary Medicine (AREA)
- Animal Behavior & Ethology (AREA)
- Biophysics (AREA)
- Genetics & Genomics (AREA)
- Chemical Kinetics & Catalysis (AREA)
- Nuclear Medicine, Radiotherapy & Molecular Imaging (AREA)
- General Chemical & Material Sciences (AREA)
- Microbiology (AREA)
- Hematology (AREA)
- Cell Biology (AREA)
- Biomedical Technology (AREA)
- Urology & Nephrology (AREA)
- Biotechnology (AREA)
- Epidemiology (AREA)
- Mycology (AREA)
- Food Science & Technology (AREA)
- Physics & Mathematics (AREA)
- Analytical Chemistry (AREA)
- General Physics & Mathematics (AREA)
- Pathology (AREA)
- Endocrinology (AREA)
- Ophthalmology & Optometry (AREA)
- Transplantation (AREA)
- Peptides Or Proteins (AREA)
- Medicines Containing Antibodies Or Antigens For Use As Internal Diagnostic Agents (AREA)
- Micro-Organisms Or Cultivation Processes Thereof (AREA)
Abstract
Una composición que comprende un primer anticuerpo, o el fragmento de enlace al antígeno del mismo, que se une al Factor P, y un segundo anticuerpo, o el fragmento de enlace al antígeno del mismo, que se une a C5, en donde dicho primer anticuerpo, o el fragmento de enlace al antígeno del mismo, tiene la secuencia de dominio variable de cadena ligera y pesada seleccionada del grupo que consiste en una secuencia VH de la SEQ ID NO: 175 y una secuencia VL de la SEQ ID NO: 176; una secuencia VH de la SEQ ID NO: 7 y una secuencia VL de la SEQ ID NO: 8; una secuencia VH de la SEQ ID NO: 91 y una secuencia VL de la SEQ ID NO: 92; una secuencia VH de la SEQ ID NO: 105 y una secuencia VL de la SEQ ID NO: 106; una secuencia VH de la SEQ ID NO: 119 y una secuencia VL de la SEQ ID NO: 120; una secuencia VH de la SEQ ID NO: 189 y una secuencia VL de la SEQ ID NO: 190; una secuencia VH de la SEQ ID NO: 203 y una secuencia VL de la SEQ ID NO: 204; una secuencia VH de la SEQ ID NO: 217 y una secuencia VL de la SEQ ID NO: 218; y una secuencia VH de la SEQ ID NO: 231 y una secuencia VL de la SEQ ID NO: 232; y dicho segundo anticuerpo o el fragmento de enlace al antígeno del mismo que se une a C5 tiene la secuencia de dominio variable de cadena ligera y pesada seleccionada del grupo que consiste en una secuencia VH de la SEQ ID NO: 416 y una secuencia VL de la SEQ ID NO: 417, una secuencia VH de la SEQ ID NO: 432 y una secuencia VL de la SEQ ID NO: 433; una secuencia VH de la SEQ ID NO: 448 y una secuencia VL de la SEQ ID NO: 449; una secuencia VH de la SEQ ID NO: 460 y una secuencia VL de la SEQ ID NO: 461; y una secuencia VH de la SEQ ID NO: 476 y una secuencia VL de la SEQ ID NO: 477, en donde dicha composición inhibe la senda del complemento alternativa.
Description
DESCRIPCIÓN
Composiciones que comprenden anticuerpos dirigidos al factor P y C5
ANTECEDENTES DE LA INVENCIÓN
La degeneración macular relacionada con el envejecimiento (AMD) es una enfermedad progresiva y una causa primordial de la pérdida de visión y ceguera en los americanos mayores de 65 años de edad. La degeneración macular relacionada con el envejecimiento afecta primordialmente a la mácula; una parte de la retina responsable de la alta agudeza visual necesaria para leer o conducir. La mayoría de los pacientes con degeneración macular relacionada con el envejecimiento sufren de una etapa temprana de la enfermedad que se caracteriza por la presencia de depósitos retinales extracelulares denominados como drusa. Las drusas son depósitos retinales extracelulares del diseño celular, mediadores inflamatorios, y componentes de la matriz extracelular. Las últimas etapas de la degeneración macular relacionada con el envejecimiento se manifiestan como una forma seca o húmeda, ambas asociadas con la pérdida de visión. La degeneración macular relacionada con el envejecimiento seca, también conocida como atrofia geográfica, aparece en el examen oftalmoscópico como regiones claramente demarcadas correspondientes a áreas locales de pérdida del epitelio pigmentado retinal (RPE). La degeneración macular relacionada con el envejecimiento húmeda está asociada con la neovascularización del coroides, que causa una pérdida de integridad en la membrana de Bruch y crecimiento de vasos en la retina, en donde con frecuencia pueden tener hemorragia. Esta filtración provoca un daño permanente a las células retinales, las cuales mueren y crean puntos ciegos en la visión central.
El sistema humano innato está compuesto de la senda de complemento. La senda de complemento sirve para defender contra la infección bacteriana piogénica que puentea la inmunidad innata y adaptable; y para el desecho de los productos de los complejos inmunes y la lesión inflamatoria. El complemento es un sistema de más de 30 proteínas involucradas en las reacciones en cascada en el plasma y en las superficies celulares. El sistema de complemento y sus componentes de complemento están involucrados en diferentes procesos inmunes. Por ejemplo, el complejo de complemento C5b-9, también denominado como el complejo terminal o el complejo de ataque de membrana (MAC), tiene un papel importante en la muerte celular mediante la inducción de daños en la permeabilidad de la membrana.
Existen tres sendas de activación del complemento conocidas: las sendas clásica, de lectina, y alternativa. Las tres sendas conducen a la disociación de C3 mediante la convertasa de C3 y la disociación subsiguiente de C5 mediante la convertasa de C5, liberando C3a, C5a, y C5b. El Factor P es un regulador clave de la senda de complemento alternativa. Se propone que tiene dos funciones principales in vivo. Primera, el Factor P estabiliza las convertasas C3 y C5 mediante el enlace con C3b de la enzima de convertasa, y de esta manera, prolonga la vida media de la convertasa C3. Segunda, el Factor P puede determinar cuáles células serán lisadas al unirse a una superficie celular y funcionando como una plantilla sobre la cual se pueden formar las convertasas, conduciendo a la activación de la senda de complemento alternativa y a la lisis de la célula.
El trabajo reciente ha demostrado que los componentes de complemento C3 y C5 son constituyentes principales de las drusas en los pacientes con degeneración macular relacionada con el envejecimiento (AMD). Mulling, R. F. y colaboradores (2000) FASEB J. 14, 835-46. Su presencia, así como aquella del complejo de ataque de membrana (MAC) C5b-9, y otras proteínas reactivas en fase aguda en las células del epitelio pigmentado retinal que se sobreponen a las drusas, se ha especulado como involucrada en el proceso que puede desencadenar la activación del complemento y la formación del complejo de ataque de membrana. Johnson, L. y colaboradores (2001) Exp. Eye Res. 73, 887-896. Por consiguiente, existe una evidencia creciente de que los componentes de complemento son más que meros mediadores de la inmunidad innata.
Los documentos WO2006/052591, WO2009/110918, WO2011/109494 y WO2011/112850 describen anticuerpos anti-FP que inhiben la función de la senda del complemento alternativa (AP). Se dice que los anticuerpos son útiles en el tratamiento de varios trastornos, incluida la degeneración macular relacionada con el envejecimiento (AMD).
El documento WO2010/015608 describe los anticuerpos anti-C5 mencionados en la tabla 2 de la presente solicitud. Los anticuerpos inhiben la senda clásica y la alternativa de la activación del complemento y se dice que son útiles en el tratamiento de la AMD.
Se ha descrito que la intervención nutricional inhibe el progreso de la degeneración macular relacionada con el envejecimiento (AMD) seca hasta la degeneración macular relacionada con el envejecimiento (AMD) húmeda. En el presente, los únicos tratamientos aprobados por la FDA para la degeneración macular relacionada con el envejecimiento húmeda incluyen terapia fotodinámica (PDT), un aptámero anti-VEGF, tal como pegaptanib, y anticuerpos anti-VEGF, ranibizumab. Estos fármacos o terapias se administran típicamente a los pacientes que ya hayan sufrido de una pérdida de visión sustancial.
Sigue existiendo una necesidad de desarrollar un tratamiento efectivo para la degeneración macular relacionada con el envejecimiento (AMD), en particular para la degeneración macular relacionada con el envejecimiento (AMD) seca,
con el fin de reemplazar o complementar los tratamientos actuales. En particular, existe una necesidad de tratamientos que puedan proporcionar una detección temprana, prevención, o restauración de la pérdida de visión.
BREVE DESCRIPCIÓN DE LA INVENCIÓN
El alcance de la invención está definido por las reivindicaciones adjuntas.
La presente invención se refiere a una composición que comprende un primer anticuerpo, o el fragmento de enlace al antígeno del mismo, que se une al Factor P, y un segundo anticuerpo, o el fragmento de enlace al antígeno, que se une a C5, en donde dicho primer anticuerpo o el fragmento de enlace al antígeno del mismo es como se define en la reivindicación 1; y dicho segundo anticuerpo o el fragmento de enlace al antígeno del mismo que se une a C5 es como se define en la reivindicación 1, en donde dicha composición inhibe la senda del complemento alternativa.
En la presente se divulga un anticuerpo aislado, o el fragmento de enlace al antígeno del mismo, que se enlaza al Factor P humano o de cinomolgo, en donde este anticuerpo se enlaza al dominio TSR5 (SEQ ID NO: 406). Por ejemplo, los anticuerpos, o los fragmentos de enlace al antígeno descritos en la presente, se enlazan a una región del dominio TSR5, la cual comprende la secuencia de la SEQ ID NO: 407, más específicamente estos anticuerpos también se enlazan a una región del dominio TSR5 del Factor P, la cual comprende la secuencia de aminoácidos KSISC (SEQ ID NO: 408). En ciertas modalidades, los anticuerpos aislados, o los fragmentos de enlace al antígeno de los mismos, se enlazan a un epítopo del Factor P que comprende la secuencia de aminoácidos de la SEQ ID NO: 407. En otras modalidades, los anticuerpos aislados, o los fragmentos de enlace al antígeno de los mismos, se enlazan a un epítopo del Factor P que comprende la secuencia de aminoácidos de la SEQ ID NO: 408.
Los anticuerpos aislados, o los fragmentos de enlace al antígeno, descritos en la presente, se enlazan al Factor P, con una KD menor o igual a 1.2 nM. Por ejemplo, los anticuerpos aislados o los fragmentos de enlace al antígeno descritos en la presente, se pueden enlazar al Factor P humano o de cinomolgo con una KD menor o igual a 1.1 nM, menor o igual a 1 nM, menor o igual a 600 pM, menor o igual a 500 pM, menor o igual a 400 pM, menor o igual a 300 pM, menor o igual a 200 pM, menor o igual a 100 pM, menor o igual a 75 pM, menor o igual a 50 pM, menor o igual a 40 pM, menor o igual a 30 pM, menor o igual a 20 pM, o menor o igual a 10 pM.
La afinidad de enlace de los anticuerpos aislados y de los fragmentos de enlace al antígeno descritos en la presente, se pueden determinar mediante una titulación de solución en equilibrio (SET). Los métodos para la titulación de solución en equilibrio (SET) se conocen en la técnica, y se describen con mayor detalle más adelante. De una manera alternativa, la afinidad de enlace de los anticuerpos aislados, o de los fragmentos, descritos en la presente, se pueden determinar mediante un ensayo Biacore. Los métodos para los ensayos cinéticos Biacore son conocidos en la materia, y se describen con mayor detalle más adelante.
Los anticuerpos aislados y los fragmentos de enlace al antígeno descritos en la presente, se pueden utilizar para inhibir la senda de complemento alternativa. Por ejemplo, un anticuerpo aislado o el fragmento de enlace al antígeno del mismo, puede inhibir la senda de complemento alternativa como una medida mediante un ensayo hemolítico in vitro con una IC50 menor o igual a 25 nM, menor o igual a 20 nM, menor o igual a 16 nM, menor o igual a 15 nM, menor o igual a 14 nM, menor o igual a 13 nM, menor o igual a 12 nM, menor o igual a 11 nM, menor o igual a 10 nM, menor o igual a 9 nM, menor o igual a 8 nM, menor o igual a 7 nM. De una manera más específica, un anticuerpo aislado o el fragmento de enlace al antígeno del mismo, como se describe en la presente, puede inhibir la senda de complemento alternativa en un ser humano, como una medida mediante un ensayo hemolítico in vitro con una IC50 menor o igual a 16 nM, o menor o igual a 9 nM.
Un anticuerpo aislado o el fragmento de enlace al antígeno del mismo, como se describe en la presente, puede inhibir la senda de complemento alternativa como una medida mediante un ensayo de depósito de C3b in vitro con una IC50 menor o igual a 10 nM, menor o igual a 7nM, menor o igual a 6 nM, menor o igual a 5 nM, menor o igual a 4 nM, menor o igual a 3 nM, menor o igual a 2 nM, menor o igual a 1 nM, menor o igual a 15nM, menor o igual a 1 nM menor o igual a 0.5 nM, o menor o igual a 0.1 nM. De una manera más específica, un anticuerpo aislado o el fragmento de enlace al antígeno del mismo, como se describe en la presente, puede inhibir la senda de complemento alternativa en un ser humano, como una medida mediante un ensayo de depósito de C3b in vitro con una IC50 menor o igual a 3 nM, o menor o igual a 2 nM.
Un anticuerpo aislado o el fragmento de enlace al antígeno del mismo, como se describe en la presente, puede inhibir la senda de complemento alternativa con una IC50 menor o igual a 25 nM, menor o igual a 20 nM, menor o igual a 15 nM, menor o igual a 10 nM, menor o igual a 9 nM, menor o igual a 8 nM, menor o igual a 7 nM, o menor o igual a 6 nM, como una medida mediante el depósito del complejo de ataque de membrana del complemento. De una manera más específica, un anticuerpo aislado o un fragmento del mismo, como se describe en la presente, puede inhibir la senda de complemento alternativa en un ser humano con una IC50 menor o igual a 25 nM, o menor o igual a 7.5 nM, como una medida mediante depósito del complejo de ataque de membrana del complemento.
Un anticuerpo aislado o el fragmento de enlace al antígeno del mismo, como se describe en la presente, puede inhibir la senda de complemento alternativa con una IC50 menor o igual a 80 nM, menor o igual a 50 nM, menor o igual a 45 nM, o menor o igual a 35 nM, como una medida mediante la generación de C3a.
Un anticuerpo aislado o el fragmento de enlace al antígeno del mismo, como se describe en la presente, también puede inhibir la senda de complemento alternativa con una IC50 menor o igual a 80 nM, menor o igual a 50 nM, menor o igual a 45 nM, o menor o igual a 35 nM, como una medida mediante la generación de iC3b.
Un anticuerpo aislado o el fragmento de enlace al antígeno del mismo, como se describe en la presente, también puede inhibir la senda de complemento alternativa con una IC50 menor o igual a 80 nM, menor o igual a 50 nM, menor o igual a 45 nM, o menor o igual a 35 nM, como una medida mediante la generación de C5a.
Un anticuerpo aislado o el fragmento de enlace al antígeno del mismo, como se describe en la presente, también puede inhibir la senda de complemento alternativa con una IC50 menor o igual a 80 nM, menor o igual a 50 nM, menor o igual a 45 nM, o menor o igual a 35 nM, como una medida mediante la generación de C5b.
Un anticuerpo aislado o el fragmento de enlace al antígeno del mismo, como se describe en la presente, también puede inhibir la senda de complemento alternativa mediante la desestabilización y/o el bloqueo de la actividad de la convertasa C3 y/o C5, como se mide mediante una disminución en la producción de C3a, C3b, iC3b, C5a, y/o C5b.
Un anticuerpo aislado o el fragmento de enlace al antígeno del mismo, como se describe en la presente, también puede inhibir la generación de C5a con una IC50 menor o igual a 80 nM, menor o igual a 50 nM, menor o igual a 45 nM, o menor o igual a 35 nM.
Los anticuerpos aislados, o el fragmento de enlace al antígeno de los mismos, también pueden bloquear el enlace del Factor P a C3b y/o pueden impedir el enlace del Factor P a la superficie celular o al ADN o a los oligonucleótidos.
Los anticuerpos aislados, o los fragmentos de enlace al antígeno de los mismos, como se describe en la presente, pueden ser anticuerpos monoclonales, anticuerpos humanos o humanizados, anticuerpos quiméricos, anticuerpos de una sola cadena, fragmentos Fab, fragmentos Fv, fragmentos F(ab’)2, o fragmentos ScFv, y/o isotipos de IgG.
Los anticuerpos aislados, o los fragmentos de enlace al antígeno de los mismos, como se describe en la presente, también pueden incluir una estructura en donde un aminoácido haya sido sustituido en la estructura del anticuerpo a partir de las secuencias de la línea germinal VH o VL humanas respectivas.
En la presente se divulga un anticuerpo aislado o el fragmento de enlace al antígeno del mismo, que tiene las secuencias de cadena pesada y ligera de los Fabs descritos en la Tabla 1. Por ejemplo, el anticuerpo aislado o el fragmento de enlace al antígeno del mismo, puede tener las secuencias de cadena pesada y ligera de Fab NVS962, NVS963, NVS964, NVS965, NVS966, NVS967, NVS962-G, NVS962-S, NVS962-T, NVS962-Q, NVS962-S31A, NVS965-Q, NVS965-S, NVS965-T, NVS804, NVS805, NVS806, NVS807, o NVS808. Los anticuerpos o fragmentos de enlace al antígeno adecuados para su uso en la composición de acuerdo con la invención son como se definen en la reivindicación 1.
En la presente se divulga un anticuerpo aislado o el fragmento de enlace al antígeno del mismo, que tiene las secuencias del dominio variable de cadena pesada y ligera de los Fabs descritos en la Tabla 1. Por ejemplo, el anticuerpo aislado o el fragmento de enlace al antígeno del mismo, puede tener la secuencia del dominio variable de cadena pesada y ligera de Fab NVS962, NVS963, NVS964, NVS965, NVS966, NVS967, NVS962-G, NVS962-S, NVS962-T, NVS962-Q, NVS962-S31A, NVS965-Q, NVS965-S, NVS965-T, NVS804, NVS805, NVS806, NVS807, o NVS808.
Los anticuerpos o fragmentos de enlace al antígeno adecuados para su uso en la composición de acuerdo con la invención son como se definen en la reivindicación 1.
En la presente se divulga un anticuerpo aislado o el fragmento de enlace al antígeno del mismo, que incluye una CDR1 de cadena pesada seleccionada a partir del grupo que consiste en las SEQ ID NOs: 1, 15, 29, 43, 57, 71, 85, 99, 113, 127, 141, 155, 169, 183, 197, 211,225, 239, 253, y 267; una CDR2 de cadena pesada seleccionada a partir del grupo que consiste en las SEQ ID NOs: 2, 16, 30, 44, 58, 72, 86, 100, 114, 128, 142, 156, 170, 184, 198, 212, 226, 240, 254, y 268; y una CDR3 de cadena pesada seleccionada a partir del grupo que consiste en las SEQ ID NOs: 3, 17, 31, 45, 59, 73, 87, 101, 115, 129, 143, 157, 171, 185, 199, 213, 227, 241, 255, y 269, en donde el anticuerpo aislado o el fragmento de enlace al antígeno del mismo, se enlaza al Factor P humano. El anticuerpo aislado o el fragmento de enlace al antígeno del mismo que se divulga en la presente incluye además una CDR1 de cadena ligera seleccionada a partir del grupo que consiste en las SEQ ID NOs: 4, 18, 32, 46, 60, 74, 88, 102, 116, 130, 144, 158, 172, 186, 200, 214, 228, 242, 256, y 270; una CDR2 de cadena ligera seleccionada a partir del grupo que consiste en las SEQ ID NOs: 5, 19, 33, 47, 61, 75, 89, 103, 117, 131, 145, 159, 173, 187, 201, 215, 229, 243, 257, y 271; y una CDR3 de cadena ligera seleccionada a partir del grupo que consiste en las SEQ ID NOs: 6, 20, 34, 48, 62, 76, 90, 104, 118, 132, 146, 160, 174, 188, 202, 216, 230, 244, 258, y 272.
En la presente se divulga un anticuerpo aislado o el fragmento de enlace al antígeno del mismo, que incluye una
CDR1 de cadena ligera seleccionada a partir del grupo que consiste en las SEQ ID NOs: 4, 18, 32, 46, 60, 74, 88, 102, 116, 130, 144, 158, 172, 186, 200, 214, 228, 242, 256, y 270; una CDR2 de cadena ligera seleccionada a partir del grupo que consiste en las SEQ ID NOs: 5, 19, 33, 47, 61, 75, 89, 103, 117, 131, 145, 159, 173, 187, 201, 215, 229, 243, 257, y 271; y una CDR3 de cadena ligera seleccionada a partir del grupo que consiste en las SEQ ID NOs: 6, 20, 34, 48, 62, 76, 90, 104, 118, 132, 146, 160, 174, 188, 202, 216, 230, 244, 258, y 272, en donde el anticuerpo aislado o el fragmento de enlace al antígeno del mismo, se enlaza al Factor P humano.
En la presente se divulga un anticuerpo aislado o el fragmento de enlace al antígeno del mismo, que se enlaza al Factor P que tiene las HCDR1, HCDR2, HCDR3 y LCDR1, LCDR2, LCDR3, en donde las HCDR1, HCDR2, HCDR3 comprenden las SEQ ID NOs: 1, 2, 3, y las LCDR1, LCDR2, LCDR3 comprenden las SEQ ID NOs: 4, 5, 6; o las HCDR1, HCDR2, HCDR3 y LCDR1, LCDR2, LCDR3, en donde las HCDR1, HCDR2, HCDR3 comprenden las SEQ ID NOs 15, 16, 17, y las LCDR1, LCDR2, LCDR3 comprenden las SEQ ID NOs: 18, 19, 20; o las HCDR1, HCDR2, HCDR3 y las LCDR1, LCDR2, lCd R3, en donde las HCDR1, HCDR2, HCDR3 comprenden las SEQ ID NOs 29, 30, 31, y las LCDR1, LCDR2, LCDR3 comprenden las SEQ ID NOs: 32, 33, 34; o las HCDR1, HCDR2, HCDR3 y las LCDR1, LCDR2, LCDR3, en donde las HCDR1, HCDR2, HCDR3 comprenden las SEQ ID NOs 43, 44, 45, y las LCDR1, LCDR2, LCDR3 comprenden las SEQ ID NOs: 46, 47, 48; o las HCDR1, HCDR2, HCDR3 y las LCDR1, LCDR2, LCDR3, en donde las HCDR1, HCDR2, HCDR3 comprenden las SEQ iD NOs 57, 58, 59, y las LCDR1, LCDR2, LCDR3 comprenden las SEQ ID NOs: 60, 61, 62; o las HCDR1, HCDR2, HCDR3 y las LCDR1, LCDR2, LCDR3, en donde las HCDR1, HCDR2, HCDR3 comprenden las SEQ iD NOs 71, 72, 73, y las LCDR1, LCDR2, LCDR3 comprenden las SEQ ID NOs: 74, 75, 76; o las HCDR1, HCDR2, HCDR3 y las LCDR1, LCDR2, LCDR3, en donde las HCDR1, HCDR2, HCDR3 comprenden las SEQ iD NOs 85, 86, 87, y las LCDR1, LCDR2, LCDR3 comprenden las SEQ ID NOs: 88, 89, 90; o las HCDR1, HCDR2, HCDR3 y las lCd R1, LCDR2, LCDR3, en donde las HCDR1, HCDR2, HCDR3 comprenden las SEQ ID NOs 99, 100, 101, y las LCDR1, LCDR2, LCDR3 comprenden las SEQ ID NOs: 102, 103, 104; o las HCDR1, HCDR2, HCDR3 y las LCDR1, LCDR2, LCDR3, en donde las HCDR1, HCDR2, HCDR3 comprenden las SEQ ID NOs 113, 114, 115, y las LCDR1, LCDR2, LCd R3 comprenden las SEQ ID NOs: 116, 117, 118; o las HCDR1, HCDR2, HCDR3 y las LCDR1, LCDR2, LCDR3, en donde las HCDR1, HCDR2, HCDR3 comprenden las SEQ ID NOs 127, 128, 129, y las LCDR1, LCDR2, LCd R3 comprenden las SEQ ID NOs: 130, 131, 132; o las HCDR1, HCDR2, HCDR3 y las LCDR1, LCDR2, LCDR3, en donde las HCDR1, HCDR2, HCDR3 comprenden las SEQ ID NOs: 141, 142, 143, y las LCDR1, LCDR2, LCd R3 comprenden las SEQ ID NOs: 144, 145, 146; o las HCDR1, HCDR2, HCDR3 y las LCDR1, LCDR2, LCDR3, en donde las HCDR1, HCDR2, HCDR3 comprenden las SEQ ID NOs: 155, 156, 157, y las LCDR1, LCDR2, LCd R3 comprenden las SEQ ID NOs: 158, 159, 160; o las HCDR1, HCDR2, HCDR3 y las LCDR1, LCDR2, LCDR3, en donde las HCDR1, HCDR2, HCDR3 comprenden las SEQ ID NOs: 169, 170, 171, y las LCDR1, LCDR2, LCd R3 comprenden las SEQ ID NOs: 172, 173, 174; o las HCDR1, HCDR2, HCDR3 y las LCDR1, LCDR2, LCDR3, en donde las HCDR1, HCDR2, HCDR3 comprenden las SEQ ID NOs: 183, 184, 185, y las LCDR1, LCDR2, LCDR3 comprenden las SEQ ID NOs: 186, 187, 188; o las HCDR1, HCDR2, HCDR3 y las LCDR1, LCDR2, LCDR3, en donde las HCDR1, HCDR2, HCDR3 comprenden las SEQ ID NOs: 197, 198, 199, y las LCDR1, LCDR2, LCDR3 comprenden las SEQ ID NOs: 200, 201, 202; o las HCDR1, HCDR2, HCDR3 y las LCDR1, LCDR2, LCDR3, en donde las HCDR1, HCDR2, HCDR3 comprenden las SEQ ID NOs 211, 212, 213, y las LCDR1, LCDR2, LCDR3 comprenden las SEQ ID NOs: 214, 215, 216; o las HCDR1, HCDR2, HCDR3 y las LCDR1, LCDR2, LCDR3, en donde las HCDR1, HCDR2, HCDR3 comprenden las SEQ ID NOs 225, 226, 227, y las LCDR1, LCDR2, LCDR3 comprenden las SEQ ID NOs: 228, 229, 230; o las HCDR1, HCDR2, HCDR3 y las LCDR1, LCDR2, LCDR3, en donde las HCDR1, HCDR2, HCDR3 comprenden las SEQ ID NOs 239, 240, 241, y las LCDR1, LCDR2, LCDR3 comprenden las SEQ ID NOs: 242, 243, 244; o las HCDR1, HCDR2, HCDR3 y las LCDR1, LCDR2, LCDR3, en donde las HCDR1, HCDR2, HCDR3 comprenden las SEQ ID NOs 253, 254, 255, y las LCDR1, LCDR2, LCDR3 comprenden las SEQ ID NOs: 256, 257, 258; o las HCDR1, HCDR2, HCDR3 y las LCDR1, LCDR2, LCDR3, en donde las HCDR1, HCDR2, HCDR3 comprenden las SEQ ID NOs 267, 268, 269, y las LCDR1, LCDR2, LCDR3 comprenden las SEQ ID NOs: 270, 271,272.
En la presente se divulga un anticuerpo aislado o el fragmento de enlace al antígeno del mismo, que incluye una secuencia de dominio variable de cadena pesada seleccionada a partir del grupo que consiste en las SEQ iD NOs: 7, 21, 35, 49, 63, 77, 91, 105, 119, 133, 147, 161, 175, 189, 203, 217, 231, 245, 259 y 273. En la presente también se divulga un anticuerpo aislado o el fragmento de enlace al antígeno que comprende además una secuencia de dominio variable de cadena ligera en donde el dominio variable de cadena pesada y el dominio variable de cadena ligera se combinan para formar un sitio de enlace al antígeno para el Factor P. Además, en la presenta se divulga el anticuerpo aislado o el fragmento de enlace al antígeno que incluye además una secuencia de dominio variable de cadena ligera seleccionada a partir de las SEQ ID NOs: 8, 22, 36, 50, 64, 78, 92, 106, 120, 134, 148, 162, 176, 190, 204, 218, 232, 246, 260, y 274, en donde este anticuerpo aislado o el fragmento de enlace al antígeno del mismo, se enlaza al Factor P.
En la presente se divulga un anticuerpo aislado o el fragmento de enlace al antígeno del mismo, que incluye una secuencia de dominio variable de cadena ligera seleccionada a partir del grupo que consiste en las SEQ ID NOs: 8, 22, 36, 50, 64, 78, 92, 106, 120, 134, 148, 162, 176, 190, 204, 218, 232, 246, 260, y 274, en donde este anticuerpo aislado o el fragmento de enlace al antígeno del mismo, se enlaza al Factor P humano. También se divulga en la presente el anticuerpo aislado o el fragmento de enlace al antígeno que comprende además una secuencia de dominio variable de cadena pesada en donde el dominio variable de cadena ligera y el dominio variable de cadena
pesada se combinan para formar un sitio de enlace al antígeno para el Factor P.
En la presente se divulga un anticuerpo aislado o el fragmento de enlace al antígeno del mismo, que se enlaza al Factor P, que puede tener los dominios variables de cadena pesada y ligera comprendiendo las secuencias de las SEQ ID NOs: 7 y 8; 21 y 22; 35 y 36; 49 y 50; 63 y 64; 77 y 78; 91 y 92; 104 y 105; 118 y 119; 132 y 133; 146 y 147; 160 y 161; 174 y 175; 188 y 189; 202 y 203; 216 y 217; 230 y 231; 244 y 245; 258 y 259; o 272 y 273, respectivamente.
En la presente se divulga un anticuerpo aislado o el fragmento de enlace al antígeno del mismo, que incluye un dominio variable de cadena pesada que tiene cuando menos el 90 por ciento de identidad de secuencia con una secuencia seleccionada a partir del grupo que consiste en las SEQ ID NOs: 7, 21, 35, 49, 63, 77, 91, 105, 119, 133, 147, 161, 175, 189, 203, 217, 231, 245, 259 y 273, en donde este anticuerpo se enlaza al Factor P. También se divulga en la presente el anticuerpo aislado o el fragmento de enlace al antígeno del mismo, también incluye un dominio variable de cadena ligera que tiene cuando menos el 95 por ciento de identidad de secuencia con una secuencia seleccionada a partir del grupo que consiste en las SEQ ID NOs: 8, 22, 36, 50, 64, 78, 92, 106, 120, 134, 148, 162, 176, 190, 204, 218, 232, 246, 260, y 274.
Se divulga en la presente un anticuerpo aislado o el fragmento de enlace al antígeno del mismo, que puede incluir un dominio variable de cadena ligera que tiene cuando menos el 90 por ciento de identidad de secuencia con una secuencia seleccionada a partir del grupo que consiste en las SEQ ID NOs: 8, 22, 36, 50, 64, 78, 92, 106, 120, 134, 148, 162, 176, 190, 204, 218, 232, 246, 260, y 274, en donde este anticuerpo se enlaza al Factor P.
Se divulga en la presente un anticuerpo aislado, o el fragmento de enlace al antígeno del mismo, que se enlaza al Factor P, que puede tener una cadena pesada que comprende la secuencia de las SEQ ID NOs: 9, 23, 37, 51, 65, 79, 93, 107, 121, 135, 149, 163, 177, 191, 205, 219, 233, 247, 261 o 275. También se divulga en la presente el anticuerpo aislado también incluye una cadena ligera que se puede combinar con la cadena pesada para formar un sitio de enlace al antígeno para el Factor P humano. También se divulga en la presente un anticuerpo aislado o el fragmento de enlace al antígeno del mismo, que incluye una cadena ligera que tiene una secuencia que comprende las SEQ ID NOs: 10, 24, 38, 52, 66, 80, 94, 108, 122, 136, 150, 164, 178, 192, 206, 220, 234, 248, 262, o 276.
Se divulga en la presente un anticuerpo aislado o el fragmento de enlace al antígeno del mismo, que incluye una cadena pesada que tiene cuando menos el 90 por ciento de identidad de secuencia con una secuencia seleccionada a partir del grupo que consiste en las SEQ ID NOs: 9, 23, 37, 51, 65, 79, 93, 107, 121, 135, 149, 163, 177, 191, 205, 219, 233, 247, 261 y 275, en donde este anticuerpo se enlaza al Factor P. También se divulga en la presente un anticuerpo aislado o el fragmento de enlace al antígeno del mismo, que también incluye una cadena ligera que tiene cuando menos el 95 por ciento de identidad de secuencia con una secuencia seleccionada a partir del grupo que consiste en las SEQ ID NOs: 10, 24, 38, 52, 66, 80, 94, 108, 122, 136, 150, 164, 178, 192, 206, 220, 234, 248, 262, y 276.
Se divulga en la presente un anticuerpo aislado o al fragmento de enlace al antígeno del mismo, que incluye una cadena ligera que tiene cuando menos el 90 por ciento de identidad de secuencia con una secuencia seleccionada a partir del grupo que consiste en las SEQ ID NOs: 9, 23, 37, 51, 65, 79, 93, 107, 121, 135, 149, 163, 177, 191, 205, 219, 233, 247, 261 y 275, en donde este anticuerpo se enlaza al Factor P.
Se divulgan en la presente composiciones que comprenden el anticuerpo aislado, o el fragmento de enlace al antígeno del mismo, descrito en la presente así como, composiciones de anticuerpos en combinación con un vehículo farmacéuticamente aceptable. Además se divulgan composiciones farmacéuticas que comprenden un anticuerpo o el fragmento de enlace al antígeno del mismo, de la Tabla 1, tal como, por ejemplo, el anticuerpo NVS962, NVS963, NVS964, NVS965, NVS966, NVS967, NVS962-G, NVS962-S, NVS962-T, NVS962-Q, NVS962-S31A, NVS965-Q, NVS965-S, NVS965-T, NVS804, NVS805, NVS806, NVS807, o NVS808. Los anticuerpos o fragmentos de enlace al antígeno adecuados para su uso en la composición de acuerdo con la invención son como se definen en la reivindicación 1.
Se divulga en la presente un ácido nucleico aislado, el cual comprende una secuencia que codifica un polipéptido que incluye un dominio variable de cadena pesada que tiene cuando menos el 90 por ciento de identidad de secuencia con una secuencia seleccionada a partir del grupo que consiste en las SEQ ID NOs: 7, 21, 35, 49, 63, 77, 91, 105, 119, 133, 147, 161, 175, 189, 203, 217, 231,245, 259 y 273.
Se divulga en la presente un ácido nucleico aislado, el cual comprende una secuencia que codifica un polipéptido que incluye un dominio variable de cadena ligera que tiene cuando menos el 90 por ciento de identidad de secuencia con una secuencia seleccionada a partir del grupo que consiste en las SEQ ID NOs: 8, 22, 36, 50, 64, 78, 92, 106, 120, 134, 148, 162, 176, 190, 204, 218, 232, 246, 260, y 274.
Se divulga en la presente un vector que incluye una o más de las moléculas de ácidos nucleicos descritos en la presente.
Se divulga en la presente una célula huésped aislada que incluye una secuencia de ADN recombinante que codifica una cadena pesada del anticuerpo descrito anteriormente, y una segunda secuencia de ADN recombinante que codifica una cadena ligera del anticuerpo descrito anteriormente, en donde estas secuencias de ADN se enlazan operativamente a un promotor y son capaces de ser expresadas en la célula huésped. Se contempla que el anticuerpo puede ser un anticuerpo monoclonal humano. También se contempla que la célula huésped es una célula de mamífero no humano.
Se divulga en la presente un método para inhibir la muerte celular mediada por el complemento, en donde el método incluye el paso de poner en contacto una célula con una cantidad efectiva de una composición que comprende el anticuerpo aislado o los fragmentos de enlace al antígeno del mismo descritos en la presente. Se contempla que la célula es una célula humana. Además se contempla que la célula está en un sujeto. Todavía además se contempla que el sujeto es humano.
Se divulga en la presente un método para inhibir la senda de complemento alternativa en una célula, en donde el método incluye el paso de poner en contacto la célula con una cantidad efectiva de una composición que comprende el anticuerpo aislado o los fragmentos de enlace al antígeno del mismo descritos en la presente. En un aspecto, se contempla que la célula es una célula humana. Además se contempla que la célula está en un sujeto. Todavía además se contempla que el sujeto es humano.
Se divulga en la presente un método para inhibir la formación del complejo de ataque de membrana en una célula, en donde el método incluye el paso de poner en contacto la célula con una cantidad efectiva de una composición que comprende el anticuerpo aislado o los fragmentos de enlace al antígeno del mismo descritos en la presente. Se contempla que la célula es una célula humana. Además se contempla que la célula está en un sujeto. Todavía además se contempla que el sujeto es humano.
Cualquiera de los anticuerpos aislados anteriores o los fragmentos de enlace al antígeno de los mismos, puede ser un anticuerpo monoclonal o el fragmento de enlace al antígeno del mismo.
Esta combinación se puede utilizar para inhibir la inflamación ocular. La inflamación ocular se puede determinar mediante la medición de la acumulación de neutrófilos y/o el reclutamiento de macrófagos en la retina.
En un aspecto, esta combinación se puede utilizar para inhibir la acumulación de neutrófilos en la retina, o el reclutamiento de macrófagos en la retina.
En un aspecto, el anticuerpo en esta combinación que se enlaza al Factor P, se enlaza a una región del Factor P que comprende la SEQ ID NO: 408. Además, este anticuerpo se enlaza a una región del Factor P que comprende la SEQ ID NO: 407.
La combinación de anticuerpos o de fragmentos de enlace de los mismos que se enlazan al Factor P y al C5, incluyen un primer anticuerpo o el fragmento de enlace al antígeno seleccionado a partir de la Tabla 1 como se define en la reivindicación 1, y un segundo anticuerpo o el fragmento de enlace al antígeno seleccionado a partir de la Tabla 2 como se define en la reivindicación 1. En un aspecto, el primer anticuerpo, o el fragmento de enlace al antígeno del mismo, se enlaza al mismo epítopo que un anticuerpo descrito en la Tabla 1, y el segundo anticuerpo, o el fragmento de enlace al antígeno del mismo, se enlaza al mismo epítopo que un anticuerpo descrito en la Tabla 2.
La composición se refiere a un primero y segundo anticuerpos o un fragmento de enlace al antígeno de los mismos (los cuales pueden estar en combinación como una composición), en donde el primer anticuerpo o el fragmento de enlace al antígeno del mismo, incluye las regiones variables de cadena pesada y ligera que tienen secuencias de aminoácidos seleccionadas de las SEQ ID NOs: 7 y 8; SEQ ID NOs: 91 y 92; SEQ ID NOs: 105 y 106; SEQ ID NOs: 119 y 120; SEQ ID NOs: 175 y 176; SEQ ID NOs: 189 y 190; SEQ ID NOs: 203 y 204; SEQ ID NOs: 217 y 218; SEQ ID NOs: 231 y 232; respectivamente, y en donde el segundo anticuerpo o el fragmento de enlace al antígeno del mismo, incluye las regiones variables de cadena pesada y ligera que tienen secuencias de aminoácidos seleccionadas de las SEQ ID NOs: 416 y 417; SEQ ID NOs: 432 y 433; SEQ ID NOs: 448 y 449; SEQ ID NOs: 460 y 461; o SEQ ID NOs: 476 y 477, respectivamente.
En un aspecto adicional, la invención incluye un primero y segundo anticuerpos o el fragmento de enlace al antígeno de los mismos (los cuales pueden estar en combinación como una composición), en donde: (a) el primer anticuerpo, o el fragmento de enlace al antígeno del mismo, incluye una región variable de cadena pesada, la cual comprende las SEQ ID NOs: 7, 91, 105, 119, 175, 189, 203, 217 o 231 e incluye además una región variable de cadena ligera, en donde esta región variable de cadena pesada y esta región variable de cadena ligera se combinan para formar un sitio de enlace al antígeno para el Factor P, y (b) en donde el segundo anticuerpo o el fragmento de enlace al antígeno del mismo, incluye una región variable de cadena pesada, la cual comprende las SEQ ID NOs: 416, 432, 448, 460 o 476, e incluye además una región variable de cadena ligera, en donde esta región variable de cadena pesada y esta región variable de cadena ligera se combinan para formar un sitio de enlace al antígeno para C5. En un aspecto adicional, el primer anticuerpo o el fragmento de enlace al antígeno del mismo, incluye la secuencia de región variable de cadena ligera de las SEQ ID NOs: 8, 92, 106, 120, 176, 190, 204, 218 o 232 y el segundo anticuerpo o el fragmento de enlace al antígeno del mismo, incluye la secuencia de región variable de cadena ligera
de las SEQ ID NOs: 417, 433, 449, 461 o 477.
En un aspecto adicional, la invención incluye un primero y segundo anticuerpos o el fragmento de enlace al antígeno de los mismos (los cuales pueden estar en combinación como una composición), en donde: (a) el primer anticuerpo o el fragmento de enlace al antígeno del mismo, incluye un dominio variable de cadena ligera, el cual comprende las SEQ ID NOs: 8, 92, 106, 120, 176, 190, 204, 218 o 232 e incluye además un dominio variable de cadena pesada, en donde el dominio variable de cadena ligera y el dominio variable de cadena pesada se combinan para formar un sitio de enlace al antígeno para el Factor P, y (b) en donde el segundo anticuerpo o el fragmento de enlace al antígeno del mismo, incluye una región variable de cadena ligera que comprende un dominio variable de cadena ligera que incluye las SEQ ID NOs: 417, 433, 449, 461 o 477, y comprende además un dominio variable de cadena pesada, en donde el dominio variable de cadena ligera y el dominio variable de cadena pesada se combinan para formar un sitio de enlace al antígeno para C5.
En un aspecto, la invención incluye un primero y segundo anticuerpos o el fragmento de enlace al antígeno de los mismos (los cuales pueden estar en combinación como una composición), en donde: (a) el primer anticuerpo, o el fragmento de enlace al antígeno del mismo, incluye una cadena pesada de las SEQ ID NOs: 9, 93, 107, 121, 177, 191, 205, 219 o 233 e incluye además una cadena ligera, en donde la cadena pesada y la cadena ligera se combinan para formar un sitio de enlace al antígeno para el Factor P, y (b) en donde el segundo anticuerpo o el fragmento de enlace al antígeno del mismo, incluye una cadena pesada de las SEQ ID NOs: 418, 434, 450, 462, o 478, e incluye además una cadena ligera, en donde la cadena pesada y la cadena ligera se combinan para formar un sitio de enlace al antígeno para C5. En un aspecto adicional, el primer anticuerpo o el fragmento de enlace al antígeno del mismo, incluye una cadena ligera de las SEQ ID NOs: 10, 94, 108, 122, 178, 192, 206, 220 o 234 y en donde el segundo anticuerpo o el fragmento de enlace al antígeno del mismo, incluye una cadena ligera de las SEQ ID NOs: 419, 435, 451,463, o 479.
En un aspecto, la invención incluye un primero y segundo anticuerpos o el fragmento de enlace al antígeno de los mismos (los cuales pueden estar en combinación como una composición), en donde: (a) el primer anticuerpo, o el fragmento de enlace al antígeno del mismo, incluye una cadena ligera de las SEQ ID NOs: 10, 94, 108, 122, 178, 192, 206, 220 o 234 e incluye además una cadena pesada, en donde la cadena ligera y la cadena pesada se combinan para formar un sitio de enlace al antígeno para el Factor P, y (b) en donde el segundo anticuerpo o el fragmento de enlace al antígeno del mismo, incluye una cadena ligera de las SEQ ID NOs: 419, 435, 451, 463, o 479, e incluye además una cadena pesada, en donde la cadena ligera y la cadena pesada se combinan para formar un sitio de enlace al antígeno para C5.
En un aspecto adicional, la invención incluye un primero y segundo anticuerpos o el fragmento de enlace al antígeno de los mismos (los cuales pueden estar en combinación como una composición), en donde el primer anticuerpo, o el fragmento de enlace al antígeno del mismo, incluye una cadena pesada con una secuencia de aminoácidos seleccionada a partir de las SEQ ID NOs: 9, 93, 107, 121, 177, 191, 205, 219 o 233 e incluye además una cadena ligera con una secuencia de aminoácidos seleccionada a partir de las SEQ ID NOs: 10, 94, 108, 122, 178, 192, 206, 220 o 234, y en donde el segundo anticuerpo o el fragmento de enlace al antígeno del mismo, incluye una cadena pesada con una secuencia de aminoácidos seleccionada a partir de las SEQ ID NOs: 418, 434, 450, 462, o 478, e incluye además una cadena ligera con una secuencia de aminoácidos seleccionada a partir de las SEQ ID NOs: 419, 435, 451,463, o 479.
En un aspecto todavía adicional, la invención incluye un primero y segundo anticuerpos o el fragmento de enlace al antígeno de los mismos (los cuales pueden estar en combinación como una composición), en donde el primer anticuerpo, o el fragmento de enlace al antígeno del mismo, incluye una cadena pesada y una cadena ligera con una secuencia de aminoácidos, respectivamente, seleccionada a partir de las SEQ ID NOs: 9 y 10, 93 y 94, 107 y 108, 121 y 122, 177 y 178, 191 y 192, 205 y 206, 219 y 220 o 233 y 234, y en donde el segundo anticuerpo o el fragmento de enlace al antígeno del mismo, incluye una cadena pesada y una cadena ligera con una secuencia de aminoácidos, respectivamente, seleccionada a partir de las SEQ ID NOs: 418 y 419, 434 y 435; 450 y 451; 462 y 463; o 478 y 479.
La invención se refiere además a una molécula de ácido nucleico aislada, la cual comprende una secuencia de nucleótidos que codifica el primero y segundo anticuerpo o el fragmento de enlace al antígeno del mismo, como se define en la reivindicación 1. Esta secuencia de ácido nucleico se puede incluir en un vector, el cual a su vez se puede incluir en una célula huésped que, en un aspecto, es capaz de expresar esa secuencia de ácido nucleico.
Se divulga en la presente un método para el tratamiento de degeneración macular relacionada con el envejecimiento en un sujeto, el cual comprende administrar a este sujeto, una cantidad efectiva de un primero y segundo anticuerpos o el fragmento de enlace al antígeno de los mismos, en combinación como una composición. El sujeto puede ser un ser humano.
Se divulga en la presente un método para inhibir la senda de complemento alternativa en un sujeto, el cual comprende administrar a este sujeto, una cantidad efectiva de un primero y segundo anticuerpos o el fragmento de enlace al antígeno de los mismos, en combinación como una composición. El sujeto puede ser un ser humano.
DEFINICIONES
A menos que se definan de otra manera, los términos técnicos y científicos utilizados en la presente tienen el mismo significado que es entendido comúnmente por los expertos ordinarios en la materia a la que pertenece esta invención.
El término "anticuerpo", como se utiliza en la presente, significa anticuerpos enteros y cualquier fragmento de enlace al antígeno (es decir, "porción de enlace al antígeno") o cadenas individuales de los mismos. Un "anticuerpo entero" es una glicoproteína que comprende cuando menos dos cadenas pesadas (H) y dos cadenas ligeras (L) interconectadas por enlaces de disulfuro. Cada cadena pesada está comprendida de una región variable de cadena pesada (abreviada en la presente como VH), y una región constante de cadena pesada. La región constante de cadena pesada está comprendida de tres dominios, CH1, CH2, y CH3. Cada cadena ligera está comprendida de una región variable de cadena ligera (abreviada en la presente como VL), y una región constante de cadena ligera. La región constante de cadena ligera está comprendida de un dominio, CL. Las regiones VH y VL se pueden subdividir adicionalmente en regiones de hipervariabilidad, denominadas como regiones determinantes de complementariedad (CDR), intercaladas con regiones que están más conservadas, denominadas como regiones de estructura (FR). Cada VH y VL está compuesta de tres regiones determinantes de complementariedad y cuatro regiones de estructura configuradas desde el término amino hasta el término carboxilo en el siguiente orden: FR1, CDR1, FR2, CDR2, FR3, CDR3, FR4. Las regiones variables de las cadenas pesada y ligera contienen un dominio de enlace que interactúa con un antígeno. Las regiones constantes de los anticuerpos pueden mediar el enlace de la inmunoglobulina a los tejidos o factores del huésped, incluyendo diferentes células del sistema inmunitario (por ejemplo, las células efectoras), y el primer componente (C1q) del sistema de complemento clásico.
El término "porción de enlace al antígeno" o “fragmento de enlace al antígeno” de un anticuerpo, como se utiliza en la presente, se refiere a uno o más fragmentos de un anticuerpo intacto, que retienen la capacidad para enlazarse específicamente a un antígeno dado (por ejemplo, Factor P). Las funciones de enlace al antígeno de un anticuerpo se pueden llevar a cabo mediante los fragmentos de un anticuerpo intacto. Los ejemplos de los fragmentos de enlace abarcados dentro del término porción de enlace al antígeno o fragmento de enlace al antígeno de un anticuerpo incluyen un fragmento Fab, un fragmento monovalente que consiste en los dominios VL, VH, CL, y CH1; un fragmento F(ab)2, un fragmento bivalente que comprende dos fragmentos Fab enlazados por un puente de bisulfuro en la región de articulación; un fragmento Fd que consiste en los dominios VH y CH1; un fragmento Fv que consiste en los dominios VL y VH de un solo brazo de un anticuerpo; un fragmento de anticuerpo de un solo dominio (DAB) (Ward y colaboradores, 1989 Nature 341:544-546), que consiste en un dominio VH o un dominio VL; y una región determinante de complementariedad aislada (CDR).
Adicionalmente, aunque los dos dominios del fragmento Fv, VL y VH, son codificados por genes separados, se pueden unir, empleando métodos recombinantes, mediante un enlazador peptídico artificial, que les hace posible formarse como una sola cadena de proteína, en donde se emparejan las regiones VL y VH para formar moléculas monovalentes (conocidas como Fv de una sola cadena (scFv); véanse, por ejemplo, Bird y colaboradores, 1988 Science 242:423-426; y Huston y colaboradores, 1988 Proc. Natl. Acad. Sci. 85:5879-5883). Estos anticuerpos de una sola cadena incluyen una o más porciones o fragmentos de enlace al antígeno de un anticuerpo. Estos fragmentos de anticuerpo se obtienen empleando las técnicas convencionales conocidas por los expertos en este campo, y los fragmentos se rastrean para determinar su utilidad de la misma manera que los anticuerpos intactos.
Los fragmentos de enlace al antígeno también se pueden incorporar en anticuerpos de un solo dominio, maxicuerpos, minicuerpos, intracuerpos, diacuerpos, triacuerpos, tetracuerpos, v-NAR y bis-scFv (véase, por ejemplo, Hollinger y Hudson, 2005, Nature Biotechnology, 23, 9, 1126-1136). Las porciones de enlace al antígeno de los anticuerpos se pueden injertar en andamiajes basados en polipéptidos, tales como fibronectina tipo III (Fn3) (véase la Patente de los Estados Unidos de Norteamérica Número 6,703,199, la cual describe monocuerpos de polipéptido de fibronectina).
Los fragmentos de enlace al antígeno se pueden incorporar en las moléculas de una sola cadena que comprenden un par de segmentos Fv en fila (VH-CH1-VH-CH1) que, junto con los polipéptidos de cadena ligera complementarios, forman un par de regiones de enlace al antígeno (Zapata y colaboradores, 1995 Protein Eng.
8(10):1057-1062; y Patente de los Estados Unidos de Norteamérica Número 5,641,870).
Como se utiliza en la presente, el término "afinidad" se refiere a la fuerza de interacción entre el anticuerpo y el antígeno en los sitios antigénicos individuales. Dentro de cada sitio antigénico, la región variable el "brazo" del anticuerpo interactúa a través de las fuerzas no covalentes débiles con el antígeno en numerosos sitios; mientras más interacciones haya, más fuerte será la afinidad. Como se utiliza en la presente, el término "alta afinidad" para un anticuerpo de IgG o un fragmento del mismo (por ejemplo, un fragmento Fab), se refiere a un anticuerpo que tiene una KD de 10-8M o menor, de 10-9M o menor, o de 10-10M, o de 10-11M o menor, o de 10-12M o menor, o de 10-13M o menor para un antígeno objetivo. Sin embargo, el enlace de alta afinidad puede variar para otros isotipos de anticuerpos. Por ejemplo, el enlace de alta afinidad para un isotipo de IgM se refiere a un anticuerpo que tiene una KD de 10-7M o menor, o de 10-8M o menor.
El término "aminoácido" se refiere a los aminoácidos que se presentan naturalmente y sintéticos, así como a los análogos de aminoácidos y a los miméticos de aminoácidos que funcionan de una manera similar a los aminoácidos que se presentan naturalmente. Los aminoácidos que se presentan naturalmente son aquellos codificados por el código genético, así como los aminoácidos que son modificados posteriormente, por ejemplo, hidroxi-prolina, ycarboxi-glutamato, y o-fosfoserina. Los análogos de aminoácidos se refieren a los compuestos que tienen la misma estructura química básica que un aminoácido que se presente naturalmente, es decir, un carbono-alfa que se enlaza a un hidrógeno, un grupo carboxilo, un grupo amino, y un grupo R, por ejemplo, homoserina, norleucina, sulfóxido de metionina, metionina-metil-sulfonio. Estos análogos tienen grupos R modificados (por ejemplo, norleucina), o estructuras base peptídicas modificadas, pero retienen la misma estructura química básica que un aminoácido que se presente naturalmente. Los miméticos de aminoácidos se refieren a los compuestos químicos que tienen una estructura que es diferente de la estructura química general de un aminoácido, pero que funcionan de una manera similar a un aminoácido que se presente naturalmente.
El término "especificidad de enlace", como se utiliza en la presente, se refiere a la capacidad de un sitio de combinación de anticuerpo individual para reaccionar solamente con un determinante antigénico.
La frase "se enlaza específicamente (o selectivamente)" a un anticuerpo (por ejemplo, un anticuerpo de enlace de Factor P), se refiere a una reacción de enlace que determina la presencia de un antígeno cognado (por ejemplo, un Factor P humano o un Factor P de cinomolgo) en una población heterogénea de proteínas y otros productos biológicos. Las frases "un anticuerpo que reconoce un antígeno" y "un anticuerpo específico para un antígeno" se utilizan de una manera intercambiable en la presente con el término "un anticuerpo que se enlace específicamente a un antígeno".
El término “condiciones o trastornos asociados con degeneración macular” se refiere a cualquiera de un número de condiciones en donde se degenera la mácula retinal o llega a ser disfuncional, por ejemplo, como una consecuencia del crecimiento disminuido de las células de la mácula, mayor muerte o reconfiguración de las células de la mácula (por ejemplo, células RPE), pérdida de la función biológica normal, o una combinación de estos eventos. La degeneración macular da como resultado la pérdida de integridad de la histoarquitectura de las células y/o de la matriz extracelular de la mácula normal y/o la pérdida de función de las células de la mácula. Los ejemplos de los trastornos relacionados con la degeneración macular incluyen degeneración macular relacionada con el envejecimiento, distrofia macular de Carolina del Norte, distrofia del fondo de Sorsby, enfermedad de Stargardt, distrofia de patrón, enfermedad de Best, drusas dominantes, y malattia leventinese (drusas radiales). El término también abarca los cambios extramaculares que se presentan antes o en seguida de la disfunción y/o degeneración de la mácula. Por consiguiente, el término “trastorno relacionado con degeneración macular” también incluye ampliamente cualquier condición que altere o dañe la integridad o función de la mácula (por ejemplo, daño a RPE o a la membrana de Bruch). Por ejemplo, el término abarca desprendimiento retinal, degeneraciones corio-retinales, degeneraciones retinales, degeneraciones de foto-receptores, degeneraciones de RPE, mucopolisacaridosis, distrofias de bastones-conos, distrofias de conos-bastones y degeneraciones de conos.
El término “componente de complemento”, “proteínas de complemento”, o “proteínas de componente de complemento”, se refiere a las moléculas que están involucradas en la activación del sistema de complemento. Los componentes de la senda clásica incluyen, por ejemplo, C1q, C1r, C1s, C4, C2, C3, C5, C6, C7, C8, C9, y complejo C5b-9 (complejo de ataque de membrana: MAC). Los componentes de la senda alternativa incluyen, por ejemplo, Factor B, Factor D, Factor H, Factor I, y Properdina.
El término “actividades celulares reguladas por la senda de complemento” incluyen el daño celular resultante del complejo de ataque de C5b-9, los cambios de la permeabilidad vascular, la contracción y migración de las células de músculo liso, la proliferación de células-T, la adherencia inmune, la acumulación de células dendríticas, monocitos, granulocitos y plaquetas, fagocitosis, migración y activación de neutrófilos (PMN), y macrófagos.
Además, la activación de las sendas de complemento da como resultado el incremento de la respuesta pro inflamatoria contribuida por los subproductos dentro de la senda de complemento. Los trastornos asociados con la activación de la senda de complemento incluyen nefritis, asma, lesión por reperfusión, hemodiálisis, artritis reumatoide, lupus sistémico, soriasis, esclerosis múltiple, trasplante, enfermedad de Alzheimer, aHUS, MPGN II, o cualquier otra enfermedad mediada por el complemento. Los trastornos asociados con la degeneración macular incluyen degeneración macular relacionada con el envejecimiento (AMD), distrofia macular de Carolina del Norte, distrofia del fondo de Sorsby, enfermedad de Stargardt, distrofia del patrón, enfermedad de Best, drusas dominantes, y malattia leventinese (drusas radiales), cambios extramaculares que se presentan antes o en seguida de disfunción y/o degeneración de la mácula, desprendimiento retinal, degeneraciones corio-retinales, degeneraciones retinales, degeneraciones de foto-receptores, degeneraciones de RPE, mucopolisacaridosis, distrofias de bastones-conos, distrofias de conos-bastones, y degeneraciones de conos.
El término "anticuerpo quimérico" es una molécula de anticuerpo en donde: (a) la región constante, o una porción de la misma, es alterada, reemplazada o intercambiada, de tal manera que el sitio de enlace al antígeno (región variable) se enlaza a una región constante de una clase, función efectora, y/o especie diferente o alterada, o a una
molécula enteramente diferente que confiere nuevas propiedades al anticuerpo quimérico, por ejemplo, una enzima, toxina, hormona, factor de crecimiento, fármaco, etc.; o (b) la región variable, o una porción de la misma, es alterada, reemplazada o intercambiada con una región variable que tiene una especificidad de antígeno diferente o alterada. Por ejemplo, un anticuerpo de ratón se puede modificar, mediante el reemplazo de su región constante con la región constante a partir de una inmunoglobulina humana. Debido al reemplazo con una región constante humana, el anticuerpo quimérico puede retener su especificidad en el reconocimiento del antígeno, mientras que tiene una antigenicidad reducida en el ser humano comparándose con el anticuerpo de ratón original.
Los términos “proteína del Factor P" o "antígeno del Factor P”, o “Factor P”, se utilizan de una manera intercambiable, y se refieren a la proteína del Factor P en diferentes especies. Por ejemplo, el Factor P humano tiene la secuencia como se estipula en la Tabla 1: SEQ ID NOs: 401. El Factor P humano se puede obtener en Complement Tech (Tyler, TX). El Factor P de cinomolgo se puede purificar a partir de suero de cinomolgo (protocolo adaptado de Nakano y colaboradores, (1986) J Immunol Methods 90: 77-83). Los ejemplos de la proteína del Factor P a partir de otras especies se proporcionan en la Tabla 1, SEQ ID NOs: 402, 403, 404 o 405, así como los dominios y fragmentos de enlace de proteína del Factor P (por ejemplo, SEQ ID NOs: 406, 407, o 408). El Factor P también se conoce en la técnica como “Properdina”.
El término “variante conservadoramente modificada” se aplica a las secuencias tanto de aminoácidos como de ácidos nucleicos. Con respecto a las secuencias de ácidos nucleicos particulares, las variantes conservadoramente modificadas se refieren a los ácidos nucleicos que codifican secuencias de aminoácidos idénticas o esencialmente idénticas, o en donde el ácido nucleico no codifica una secuencia de aminoácidos, hasta secuencias esencialmente idénticas. Debido a la degeneración del código genético, un gran número de ácidos nucleicos funcionalmente idénticos codifican cualquier proteína dada. Por ejemplo, los codones GCA, GCC, GCG y GCU codifican todos el aminoácido alanina. Por consiguiente, en toda posición en donde una alanina sea especificada por un codón, el codón se puede alterar hasta cualquiera de los codones correspondientes descritos sin alterar el polipéptido codificado. Estas variaciones de ácidos nucleicos son “variaciones silenciosas", las cuales son una especie de variaciones conservadoramente modificadas. Toda secuencia de ácido nucleico en la presente que codifique un polipéptido, también describe toda posible variación silenciosa del ácido nucleico. Una persona experta reconocerá que cada codón en un ácido nucleico (excepto AUG, el cual es ordinariamente el único codón para metionina, y TGG, el cual es ordinariamente el único codón para triptófano) se puede modificar para proporcionar una molécula funcionalmente idéntica. De conformidad con lo anterior, cada variación silenciosa de un ácido nucleico que codifique un polipéptido es implícita en cada secuencia descrita.
Para las secuencias de polipéptidos, las “variantes conservadoramente modificadas” incluyen las sustituciones, supresiones o adiciones individuales a una secuencia de polipéptido lo cual da como resultado la sustitución de un aminoácido con un aminoácido químicamente similar. Las tablas de sustituciones conservadoras que proporcionan los aminoácidos funcionalmente similares, son bien conocidas en este campo. Las variantes conservadoramente modificadas son en adición a, y no excluyen, las variantes polimórficas, los homólogos inter-especies, y los alelos de la invención. Los siguientes ocho grupos contienen los aminoácidos que son sustituciones conservadoras unos por otros: 1) Alanina (A), Glicina (G); 2) Ácido aspártico (D), Ácido glutámico (E); 3) Asparagina (N), Glutamina (Q); 4) Arginina (R), Lisina (K); 5) Isoleucina (I), Leucina (L), Metionina (M), Valina (V); 6) Fenilalanina (F), Tirosina (Y), Triptófano (W); 7) Serina (S), Treonina (T); y 8) Cisteína (C), Metionina (M) (véase, por ejemplo, Creighton, Proteins (1984)). En algunas modalidades, el término "modificaciones conservadoras de secuencias" se utilizan para referirse a las modificaciones de aminoácidos que no afecten o alteren significativamente las características de enlace del anticuerpo que contenga la secuencia de aminoácidos.
El término "epítopo" significa un determinante de proteína capaz de enlazarse específicamente a un anticuerpo. Los epítopos normalmente consisten en agrupaciones superficiales químicamente activas de moléculas, tales como aminoácidos o cadenas laterales de azúcar, y usualmente tienen características estructurales tridimensionales específicas, así como características de carga específicas. Los epítopos de conformación y no de conformación se distinguen porque se pierde el enlace con el primero pero no con el último en la presencia de solventes desnaturalizantes.
El término "anticuerpo humano", como se utiliza en la presente, pretende incluir los anticuerpos que tienen regiones variables en donde tanto la región de estructura como las regiones determinantes de complementariedad se derivan a partir de secuencias de origen humano. Adicionalmente, si el anticuerpo contiene una región constante, la región constante también se deriva a partir de estas secuencias humanas, por ejemplo, las secuencias de la línea germinal humana, o las versiones mutadas de las secuencias de la línea germinal humana. Los anticuerpos humanos de la invención pueden incluir residuos de aminoácidos no codificados por las secuencias humanas (por ejemplo, mutaciones introducidas mediante mutagénesis aleatoria o específica del sitio in vitro, o mediante mutación somática in vivo).
El término "anticuerpo monoclonal humano" se refiere a los anticuerpos que exhiben una sola especificidad de enlace, que tienen regiones variables en donde tanto las regiones de estructura como las regiones determinantes de complementariedad se derivan a partir de secuencias humanas. En una modalidad, los anticuerpos monoclonales humanos son producidos por un hibridoma, el cual incluye una célula-B obtenida a partir de un animal no humano
transgénico, por ejemplo, un ratón transgénico, que tenga un genoma que comprenda un transgén de cadena pesada humano, y un transgén de cadena ligera fusionados a una célula inmortalizada.
Un anticuerpo "humanizado" es un anticuerpo que retiene la reactividad de un anticuerpo no humano, mientras que es menos inmunogénico en los seres humanos. Esto se puede lograr, por ejemplo, mediante la retención de las regiones determinantes de complementariedad no humanas, y reemplazando las partes restantes del anticuerpo con sus contrapartes humanas (es decir, la región constante así como las porciones de estructura de la región variable). Véanse, por ejemplo, Morrison y colaboradores, Proc. Natl. Acad. Sci. EUA, 81:6851 -6855, 1984; Morrison y Oi, Adv. Immunol., 44:65-92, 1988; Verhoeyen y colaboradores, Science, 239:1534-1536, 1988; Padlan, Molec. Immun., 28:489-498, 1991; y Padlan, Molec. Immun., 31:169-217, 1994. Otros ejemplos de la tecnología de ingeniería humana incluyen, pero no se limitan a, la tecnología Xoma que se da a conocer en la Patente de los Estados Unidos de Norteamérica Número US 5,766,886.
Los términos "idéntica" o porcentaje de "identidad", en el contexto de dos o más secuencias de ácidos nucleicos o de polipéptido, se refieren a dos o más secuencias o subsecuencias que son iguales. Dos secuencias son "sustancialmente idénticas" si las dos secuencias tienen un porcentaje especificado de residuos de aminoácidos o nucleótidos que son iguales (es decir, identidad del 60 por ciento, y opcionalmente identidad del 65 por ciento, del 70 por ciento, del 75 por ciento, 80 por ciento, 85 por ciento, 90 por ciento, 95 por ciento, o del 99 por ciento sobre una región especificada, o, cuando no se especifique, sobre toda la secuencia), al compararse y alinearse para una máxima correspondencia sobre una ventana de comparación, o la región designada medida utilizando uno de los siguientes algoritmos de comparación de secuencias, o mediante alineación manual e inspección visual. Opcionalmente, la identidad existe sobre una región que es de cuando menos aproximadamente 50 nucleótidos (o 10 aminoácidos) de longitud, o más preferiblemente, sobre una región que es de 100 a 500 o 1,000 o más nucleótidos (o 20, 50, 200 o más aminoácidos) de longitud.
Para la comparación de secuencias, típicamente una secuencia actúa como una secuencia de referencia, con la cual se comparan las secuencias de prueba. Cuando se utiliza un algoritmo de comparación de secuencias, se introducen las secuencias de prueba y de referencia en una computadora, se designan las coordenadas de las subsecuencias, si es necesario, y se designan los parámetros del programa de algoritmo de secuencias. Se pueden utilizar los parámetros del programa por omisión, o se pueden designar parámetros alternativos. El algoritmo de comparación de secuencias calcula entonces el porcentaje de identidad de secuencia para las secuencias de prueba en relación con la secuencia de referencia, basándose en los parámetros del programa.
Una "ventana de comparación", como se utiliza en la presente, incluye la referencia a un segmento de cualquiera del número de posiciones contiguas seleccionadas a partir del grupo que consiste en de 20 a 600, usualmente de aproximadamente 50 a aproximadamente 200, más usualmente de aproximadamente 100 a aproximadamente 150, en donde se puede comparar una secuencia con una secuencia de referencia del mismo número de posiciones contiguas después de que se alinean óptimamente las dos secuencias. Los métodos de alineación de secuencias para comparación son bien conocidos en este campo. La alineación óptima de las secuencias para comparación se puede conducir, por ejemplo, mediante el algoritmo de homología local de Smith y Waterman (1970) Adv. Appl. Math. 2: 482c, mediante el algoritmo de alineación de homología de Needleman y Wunsch, J. Mol. Biol. 48:443, 1970, mediante el método de búsqueda de similitudes de Pearson y Lipman, Proc. Nat’l. Acad. Sci. EUA 85: 2444, 1988, mediante implementaciones computarizadas de estos algoritmos (GAP, BESTFIT, FASTA, y TFASTA en el Wisconsin Genetics Software Package, Genetics Computer Group, 575 Science Dr., Madison, WI), o mediante alineación manual e inspección visual (véase, por ejemplo, Brent y colaboradores, Current Protocols in Molecular Biology, John Wiley & Sons, Inc. (Ringbou, Editor, 2003)).
Dos ejemplos de algoritmos que son adecuados para determinar el porcentaje de identidad de secuencias y de similitud de secuencias son los algoritmos BLAST y BLAST 2.0, los cuales se describen en Altschul y colaboradores, Nuc. Acids Res. 25:3389-3402, 1977; y Altschul y colaboradores, J. Mol. Biol. 215:403-410, 1990, respectivamente. El software para llevar a cabo los análisis BLAST está públicamente disponible a través del National Center for Biotechnology Information. Este algoritmo involucra identificar primero los pares de secuencias de alto puntaje (HSPs), mediante la identificación de las palabras cortas de longitud W en la secuencia pedida, las cuales concuerdan o satisfacen algún puntaje umbral T de valor positivo cuando se alinean con una palabra de la misma longitud en una secuencia de la base de datos. T es referido como el umbral de puntaje de palabra vecina (Altschul y colaboradores, supra). Estos impactos de palabra vecina iniciales actúan como siembras para iniciar las búsquedas con el fin de encontrar pares de secuencias de alto puntaje más largos que las contengan. Los impactos de palabras se extienden en ambas direcciones a lo largo de cada secuencia por tanto como se pueda aumentar el puntaje de alineación acumulativo. Los puntajes acumulativos se calculan utilizando, para las secuencias de nucleótidos, los parámetros M (puntaje de recompensa para un par de residuos emparejados; siempre >0), y N (puntaje de multa para los residuos mal emparejados; siempre <0). Para las secuencias de aminoácidos, se utiliza una matriz de puntaje para calcular el puntaje acumulativo. La extensión de los impactos de palabras en cada dirección se detienen cuando: el puntaje de alineación acumulativo cae fuera por la cantidad X desde su máximo valor alcanzado; el puntaje acumulativo llega a cero o menos, debido a la acumulación de una o más alineaciones de residuos de puntaje negativo; o se llega al final de cualquiera de las secuencias. Los parámetros W, T, y X del algoritmo BLAST determinan la sensibilidad y velocidad de la alineación. El programa BLASTN (para secuencias de
nucleótidos) utiliza como omisión una longitud de palabra (W) de 11, una expectativa (E) de 10, M=5, N=-4, y una comparación de ambas cadenas. Para las secuencias de aminoácidos, el programa BLASTP utiliza por omisión una longitud de palabra de 3, y una expectativa (E) de 10, y la matriz de puntaje BLOSUM62 (véase Henikoff y Henikoff, Proc. Natl. Acad. Sci. EUa 89:10915, 1989) alineaciones (B) de 50, expectativa (E) de 10, M=5, N=-4, y una comparación de ambas cadenas.
El algoritmo BLAST también lleva a cabo un análisis estadístico de la similitud entre dos secuencias (véase, por ejemplo, Karlin y Altschul, Proc. Natl. Acad. Sci. EUA 90:5873-5787, 1993). Una medida de similitud proporcionada por el algoritmo BLAST es la probabilidad de suma más pequeña (P(N)), que proporciona una indicación de la probabilidad por la cual se presentaría un emparejamiento entre dos secuencias de nucleótidos o de aminoácidos por azar. Por ejemplo, un ácido nucleico se considera similar a una secuencia de referencia si la probabilidad de suma más pequeña en una comparación del ácido nucleico de prueba con el ácido nucleico de referencia es menor de aproximadamente 0.2, más preferiblemente menor de aproximadamente 0.01, y de una manera muy preferible menor de aproximadamente 0.001.
El porcentaje de identidad entre dos secuencias de aminoácidos también se puede determinar utilizando el algoritmo de E. Meyers y W. Miller (Comput. Appl. Biosci., 4:11-17, 1988), el cual se ha incorporado en el programa ALIGN (Versión 2.0), utilizando una tabla de residuos ponderados PAM120, una multa por longitud de hueco de 12, y una multa por hueco de 4. En adición, el porcentaje de identidad entre dos secuencias de aminoácidos se puede determinar utilizando el algoritmo de Needleman y Wunsch (J. Mol, Biol. 48:444-453, 1970), el cual se ha incorporado en el programa GAP en el paquete de software GCG (disponible en la red informática mundial en gcg.com), utilizando ya sea una matriz Blossom 62 o bien una matriz PAM250, y un peso de hueco de 16, 14, 12, 10, 8, 6, o 4, y un peso por longitud de 1,2, 3, 4, 5, o 6.
De otra manera que no sea el porcentaje de identidad de secuencias observado anteriormente, otra indicación de que dos secuencias de ácidos nucleicos o polipéptidos son sustancialmente idénticas, es que el polipéptido codificado por el primer ácido nucleico reacciona cruzadamente inmunológicamente con los anticuerpos reproducidos contra el polipéptido codificado por el segundo ácido nucleico, como se describe más adelante. Por consiguiente, un polipéptido típicamente es sustancialmente idéntico a un segundo polipéptido, por ejemplo, cuando los dos polipéptidos difieren solamente por sustituciones conservadoras. Otra indicación de que dos secuencias de ácidos nucleicos son sustancialmente idénticas, es que las dos moléculas o sus complementos se hibridan una a la otra bajo condiciones restringentes, como se describe más adelante. Todavía otra indicación de que dos secuencias de ácidos nucleicos son sustancialmente idénticas, es que se pueden utilizar los mismos cebadores para amplificar la secuencia.
El término “inhibir (o inhibe) la senda de complemento alternativa” se refiere a la capacidad de los anticuerpos del Factor P para interferir con la activación de la senda de complemento alternativa. Específicamente, “inhibir” se refiere a una reducción estadísticamente significativa (es decir, p < 0.05) en la activación de complemento alternativa como se mide mediante uno o más ensayos descritos en la presente, incluyendo la formación de MAC, ensayo hemolítico, o ensayo de depósito de C3b en una célula o sujeto en seguida del contacto con un anticuerpo anti-Factor P o un fragmento del mismo, como se describe en la presente en relación con un control. Como se utiliza en la presente, “inhibir (o inhibe) la senda de complemento alternativa” también se puede referir a una mejora clínicamente relevante en la función visual o en la anatomía retinal en seguida del tratamiento con un anticuerpo anti-Factor P, como se describe en la presente, en un paciente diagnosticado con degeneración macular relacionada con el envejecimiento, como se describe más adelante.
El término "anticuerpo aislado" se refiere a un anticuerpo que está sustancialmente libre de otros anticuerpos que tengan diferentes especificidades antigénicas (por ejemplo, un anticuerpo aislado que se enlaza específicamente al Factor P está sustancialmente libre de anticuerpos que se enlacen específicamente con antígenos diferentes del Factor P). Un anticuerpo aislado que se enlaza específicamente al Factor P, sin embargo, puede tener reactividad cruzada con otros antígenos. Más aún, un anticuerpo aislado puede estar sustancialmente libre de otro material celular y/o de productos químicos.
El término "isotipo" se refiere a la clase de anticuerpos (por ejemplo, IgM, IgE, IgG, tal como IgG1 o IgG4), que es proporcionada por los genes de región constante de cadena pesada. El isotipo también incluye las versiones modificadas de una de estas clases, en donde las modificaciones se han hecho para alterar la función de Fc, por ejemplo, para mejorar o reducir las funciones efectoras o el enlace con los receptores de Fc.
El término "Kasoc" o "Ka", como se utiliza en la presente, pretende referirse al índice de asociación de una interacción particular de anticuerpo-antígeno, mientras que el término "Kdis" o "Kd" como se utiliza en la presente, pretende referirse al índice de disociación de una interacción particular de anticuerpo-antígeno. El término "Kd", como se utiliza en la presente, pretende referirse a la constante de disociación, la cual se obtiene a partir de la proporción de Kd a Ka (es decir, Kd/Ka), y se expresa como una concentración molar (M). Los valores Kd para los anticuerpos se pueden determinar empleando los métodos bien establecidos en este campo. Los métodos para determinar la Kd de un anticuerpo, incluyen la medición de resonancia de plasmón superficial, mediante la utilización de un sistema biosensor, tal como un sistema Biacore®, o la medición de la afinidad en la solución por medio de una
titulación de solución en equilibrio (SET).
Los términos "anticuerpo monoclonal" o “composición de anticuerpo monoclonal", como se utilizan en la presente, se refieren a una preparación de moléculas de anticuerpo de una sola composición molecular. Una composición de anticuerpo monoclonal exhibe una sola especificidad de enlace y afinidad por un epítopo particular.
El término "ácido nucleico" se utiliza en la presente de una manera intercambiable con el término "polinucleótido", y se refiere a los desoxirribonucleótidos o a los ribonucleótidos y polímeros de los mismos, ya sea en la forma de una sola cadena o de doble cadena. El término abarca los ácidos nucleicos que contienen análogos de nucleótidos conocidos, o residuos de estructura o enlaces modificados, que son sintéticos, que se presentan naturalmente, y que no se presentan naturalmente, los cuales tienen propiedades de enlace similares a las del ácido nucleico de referencia, y los cuales se metabolizan de una manera similar a los nucleótidos de referencia. Los ejemplos de estos análogos incluyen, sin limitación, fosforotioatos, fosforamidatos, fosfonatos de metilo, fosfonatos de metilo quirales, 2-O-metil-ribonucleótidos, ácidos nucleicos peptídicos (PNAs).
A menos que se indique de otra manera, una secuencia de ácido nucleico particular también abarca implícitamente variantes conservadoramente modificadas de la misma (por ejemplo, sustituciones de codones degenerados), y secuencias complementarias, así como la secuencia explícitamente indicada. De una manera más específica, como se detalla más adelante, se pueden lograr sustituciones de codones degenerados mediante la generación de secuencias en donde la tercera posición de uno o más (o todos) codones seleccionados, es sustituida con residuos de base mixta y/o de desoxi-inosina (Batzer y colaboradores, Nucleic Acid Res. 19:5081, 1991; Ohtsuka y colaboradores, J. Biol. Chem. 260:2605-2608, 1985; y Rossolini y colaboradores, Mol. Cell. Probes 8:91-98, 1994).
El término "operablemente enlazado" se refiere a una relación funcional entre dos o más segmentos de polinucleótido (por ejemplo, ADN). Típicamente, el término se refiere a la relación funcional de una secuencia reguladora de transcripción con una secuencia transcrita. Por ejemplo, una secuencia promotora o potenciadora se enlaza operablemente a una secuencia de codificación si estimula o modula la transcripción de la secuencia de codificación en una célula huésped apropiada o en otro sistema de expresión. En términos generales, las secuencias reguladoras de transcripción del promotor que se enlazan operablemente a una secuencia transcrita, están físicamente contiguas a la secuencia transcrita, es decir, son de acción-cis. Sin embargo, algunas secuencias reguladoras de transcripción, tales como las potenciadoras, no necesitan estar físicamente contiguas o localizadas en estrecha proximidad a las secuencias de codificación cuya transcripción potencian.
Como se utiliza en la presente, el término "optimizada" significa una secuencia de nucleótidos que se ha alterado para codificar una secuencia de aminoácidos, utilizando los codones que son preferidos en la célula u organismo de producción, en general una célula eucariótica, por ejemplo, una célula de Pichia, una célula de ovario de hámster chino (CHO), o una célula humana. La secuencia de nucleótidos optimizada se diseña para retener completamente o tanto como sea posible la secuencia de aminoácidos originalmente codificada por la secuencia de nucleótidos de partida, que también se conoce como la secuencia "progenitora". Las secuencias optimizadas de la presente se han diseñado para tener codones que son preferidos en las células de mamífero. Sin embargo, también se prevé en la presente la expresión optimizada de estas secuencias en otras células eucarióticas o células procarióticas. Las secuencias de aminoácidos codificadas por las secuencias de nucleótidos optimizadas también son referidas como optimizadas.
Los términos "polipéptido" y "proteína" se utilizan de una manera intercambiable en la presente para referirse a un polímero de residuos de aminoácidos. Los términos se aplican a los polímeros de aminoácidos en donde uno o más residuos de aminoácidos son un mimético químico artificial de un aminoácido que se presente naturalmente correspondiente, así como a los polímeros de aminoácidos que se presentan naturalmente y a los polímeros de aminoácidos que no se presentan naturalmente. A menos que se indique de otra manera, una secuencia de polipéptido particular también abarca implícitamente variantes conservadoramente modificadas del mismo.
El término "anticuerpo humano recombinante", como se utiliza en la presente, incluye todos los anticuerpos humanos que se preparan, se expresan, se crean, o se aíslan por medios recombinantes, tales como los anticuerpos aislados a partir de un animal (por ejemplo, un ratón) que sea transgénico o transcromosómico para los genes de inmunoglobulina humana, o para un hibridoma preparado a partir de los mismos, los anticuerpos aislados a partir de una célula huésped transformada para expresar el anticuerpo humano, por ejemplo, a partir de un transfectoma, los anticuerpos aislados a partir de una biblioteca de anticuerpos humanos de combinación recombinantes, y los anticuerpos preparados, expresados, creados, o aislados por cualquier otro medio que involucre el empalme de todo o una porción de un gen de inmunoglobulina humana, y las secuencias para otras secuencias de ADN. Estos anticuerpos humanos recombinantes tienen regiones variables en donde las regiones de estructura y las regiones determinantes de complementariedad se derivan a partir de las secuencias de inmunoglobulina de la línea germinal humana. Sin embargo, en ciertas modalidades, estos anticuerpos humanos recombinantes se pueden someter a mutagénesis in vitro (o, cuando se utiliza un animal transgénico para las secuencias de Ig humana, mutagénesis somática in vivo), y por lo tanto, las secuencias de aminoácidos de las regiones VH y VL de los anticuerpos recombinantes son secuencias que, aunque se derivan a partir de, y se relacionan con, las secuencias VH y VL de la línea germinal humana, pueden no existir naturalmente dentro del repertorio de la línea germinal de anticuerpos
humanos in vivo.
El término "célula huésped recombinante" (o simplemente "célula huésped") se refiere a una célula en donde se ha introducido un vector de expresión recombinante. Se debe entender que estos términos pretenden referirse no solamente a la célula objeto particular, sino también a la progenie de esta célula. Debido a que se pueden presentar ciertas modificaciones en las siguientes generaciones debido ya sea a mutación o a influencias del medio ambiente, esta progenie, de hecho, puede no ser idéntica a la célula progenitora, pero aun así estar incluida dentro del alcance del término "célula huésped" como se utiliza en la presente.
El término "sujeto" incluye los animales humanos y no humanos. Los animales no humanos incluyen a todos los vertebrados (por ejemplo, mamíferos y no mamíferos), tales como primates no humanos (por ejemplo, mono cinomolgo), ovejas, perros, vacas, pollos, anfibios, y reptiles. Excepto cuando se observe, los términos "paciente" o "sujeto" se utilizan en la presente de una manera intercambiable. Como se utiliza en la presente, el término “cino” o “cinomolgo” se refiere a un mono cinomolgo (Macaca fascicularis).
Como se utiliza en la presente, el término “tratar” o "tratamiento" de cualquier enfermedad o trastorno (es decir, degeneración macular relacionada con el envejecimiento (AMD)) se refiere, en una modalidad, a mitigar la enfermedad o el trastorno (es decir, hacer más lento o detener o reducir el desarrollo de la enfermedad o de cuando menos uno de los síntomas clínicos de la misma). En otra modalidad, "tratar" o "tratamiento" se refiere a aliviar o mitigar cuando menos un parámetro físico, incluyendo aquellos que no puedan ser discernibles por el paciente. En todavía otra modalidad, "tratar" o "tratamiento" se refiere a modular la enfermedad o el trastorno, ya sea físicamente (por ejemplo, la estabilización de un síntoma discernible), fisiológicamente (por ejemplo, la estabilización de un parámetro físico), o ambas. En todavía otra modalidad, "tratar" o "tratamiento" se refiere a prevenir o retardar el establecimiento o desarrollo o progreso de la enfermedad o del trastorno. “Prevención” en lo que se refiere a la degeneración macular relacionada con el envejecimiento (AMD) significa cualquier acción que previene o retarda el empeoramiento en la función visual, la anatomía retinal y/o el parámetro de una enfermedad de degeneración macular relacionada con el envejecimiento (AMD), como se describe más adelante, en un paciente en riesgo del empeoramiento. De una manera más específica, "tratamiento" de degeneración macular relacionada con el envejecimiento (AMD) significa cualquier acción que da como resultado la mejora o preservación de la función visual y/o anatomía retinal. Los métodos para evaluar el tratamiento y/o la prevención de enfermedad se conocen en la técnica, y se describe en la presente más adelante.
El término "vector" pretende referirse a una molécula de polinucleótido capaz de transportar a otro polinucleótido con el que se ha enlazado. Un tipo de vector es un "plásmido", el cual se refiere a un ciclo de ADN de doble cadena circular en donde se pueden ligar segmentos adicionales de ADN. Otro tipo de vector es un vector viral, tal como un vector viral adeno-asociado (AAV o AAV2), en donde se pueden ligar segmentos de ADN adicionales en el genoma viral. Ciertos vectores son capaces de tener una réplica autónoma en una célula huésped en donde se introducen (por ejemplo, los vectores bacterianos que tienen un origen de réplica bacteriano, y los vectores de mamífero episomales). Otros vectores (por ejemplo, vectores de mamífero no episomales) se pueden integrar en el genoma de una célula huésped después de su introducción en la célula huésped, y de esta manera, se replican junto con el genoma del huésped. Más aún, ciertos vectores son capaces de dirigir la expresión de los genes con los que se enlazan operativamente. Estos vectores son referidos en la presente como "vectores de expresión recombinante" (o simplemente, "vectores de expresión"). En general, los vectores de expresión útiles en las técnicas de ADN recombinante están con frecuencia en la forma de plásmidos. En la presente memoria descriptiva, "plásmido" y "vector" se pueden utilizar de una manera intercambiable, debido a que el plásmido es la forma más comúnmente utilizada de vector. Sin embargo, la invención pretende incluir las otras formas de vectores de expresión, tales como vectores virales (por ejemplo, retrovirus defectuosos en réplica, adenovirus, y virus adeno-asociados), los cuales sirven para funciones equivalentes.
BREVE DESCRIPCIÓN DE LOS DIBUJOS
La Figura 1 ilustra el sitio de enlace del Factor P. La Figura 1A ilustra la posición relativa del dominio TSR5 del Factor P y los fragmentos de secuencia de TSR5: A, B, C, y D. La Figura 1B muestra la secuencia de TSR5 humana alineada con la secuencia de ratón. Los paréntesis indican los fragmentos de secuencia de TSR5. La Figura 1C ilustra los anticuerpos que se enlazan a una región B de TSR5.
La Figura 2 muestra los resultados de un ensayo hemolítico que demuestra la inhibición de la senda de complemento alternativa en suero humano al 20 por ciento.
La Figura 3 muestra un isobolograma generado utilizando los datos a partir del ensayo hemolítico ilustrado en la Figura 2.
La Figura 4 muestra el porcentaje de inhibición de los infiltrados de macrófagos en un modelo de poli-IC de ratón, que compara la inhibición de los anticuerpos anti-Factor P y anti-C5 individualmente y en combinación.
La Figura 5 muestra un isobolograma generado utilizando los datos a partir de los resultados de poli-IC ilustrados en
la Figura 4.
DESCRIPCIÓN DETALLADA
La presente invención se basa, en parte, en el descubrimiento de moléculas de anticuerpos que se enlazan específicamente con el Factor P tanto humano como de cinomolgo. La composición de acuerdo con la invención se refiere a los anticuerpos de formato de IgG completos, así como a los fragmentos de enlace al antígeno de los mismos, tales como los fragmentos Fab (por ejemplo, véanse los anticuerpos NVS965-S y NVS807).
Se divulgan en la presente anticuerpos que se enlazan específicamente con el Factor P (por ejemplo, Factor P humano, Factor P de cinomolgo, Factor P de rata, Factor P de conejo), composiciones farmacéuticas, métodos de producción, y métodos de uso de estos anticuerpos y composiciones.
Anticuerpos del Factor P y fragmentos de enlace al antígeno
Se divulgan en la presente anticuerpos que se enlazan específicamente con el Factor P. Se divulgan en la presente anticuerpos que se enlazan específicamente con el Factor P humano, de cinomolgo, de rata y/o de conejo. Se divulgan en la presente anticuerpos que incluyen los anticuerpos monoclonales humanos y Fabs aislados como se describe en los Ejemplos.
Se divulgan en la presente anticuerpos que se enlazan específicamente con una proteína del Factor P (por ejemplo, Factor P humano y/o de cinomolgo), en donde los anticuerpos comprenden un dominio VH que tiene una secuencia de aminoácidos de las SEQ ID NOs: 7, 21,35, 49, 63, 77, 91, 105, 119, 133, 147, 161, 175, 189, 203, 217, 231,245, 259 o 273. Se divulgan también en la presente anticuerpos que se enlazan específicamente con una proteína del Factor P, en donde los anticuerpos comprenden una CDR VH que tiene una secuencia de aminoácidos de cualquiera de las CDRs VH enlistadas en la Tabla 1 que se encuentra más adelante. En particular, se divulgan en la presente anticuerpos que se enlazan específicamente con una proteína del Factor P (por ejemplo, Factor P humano y/o de cinomolgo), en donde los anticuerpos comprenden (o de una manera alternativa, consisten en) una, dos, tres, o más CDRs VH que tienen una secuencia de aminoácidos de cualquiera de las CDRs VH enlistadas en la Tabla 1 que se encuentra más adelante.
Se divulgan en la presente anticuerpos que se enlazan específicamente con una proteína del Factor P, comprendiendo estos anticuerpos un dominio VL que tiene una secuencia de aminoácidos de las SEQ ID NOs: 8, 22, 36, 50, 64, 78, 92, 106, 120, 134, 148, 162, 176, 190, 204, 218, 232, 246, 260, o 274. Se divulgan en la presente anticuerpos que se enlazan específicamente con una proteína del Factor P (por ejemplo, Factor P humano y/o de cinomolgo), comprendiendo estos anticuerpos una CDR VL que tiene una secuencia de aminoácidos de cualquiera de las CDRs VL enlistadas en la Tabla 1 que se encuentra más adelante. Además se divulgan en la presente anticuerpos que se enlazan específicamente con una proteína del Factor P (por ejemplo, Factor P humano y/o de cinomolgo), comprendiendo estos anticuerpos (o de una manera alternativa, consistiendo en) una, dos, tres o más CDRs VL que tienen una secuencia de aminoácidos de cualquiera de las CDRs VL enlistadas en la Tabla 1 que se encuentra más adelante.
Se divulgan en la presente anticuerpos que incluyen aminoácidos que se han mutado, y no obstante, tienen cuando menos el 60, 70, 80, 85, 90 o 95 por ciento de identidad en las regiones determinantes de complementariedad (CDRs) con las regiones determinantes de complementariedad (CDRs) ilustradas en las secuencias descritas en la Tabla 1. También se divulgan en la presente secuencias de aminoácidos mutantes en donde no más de 1, 2, 3, 4 o 5 aminoácidos se han mutado en las regiones determinantes de complementariedad (CDRs) cuando se comparan con las regiones determinantes de complementariedad (CDRs) ilustradas en la secuencia descrita en la Tabla 1.
Se divulgan en la presente secuencias de ácidos nucleicos que codifican VH, VL, la cadena pesada de longitud completa, y la cadena ligera de longitud completa de los anticuerpos que se enlazan específicamente con una proteína del Factor P (por ejemplo, Factor P humano y/o de cinomolgo). Estas secuencias de ácidos nucleicos se pueden optimizar para la expresión en células de mamífero (por ejemplo, la Tabla 1 muestra las secuencias de ácidos nucleicos optimizadas para la cadena pesada y la cadena ligera).
En la siguiente Tabla 1 NVS962, NVS806, NVS807, NVS808, NVS962-S, NVS962-Q, NVS962S31A, NVS962-G y NVS962-T son anticuerpos de acuerdo con la composición de la invención.
NVS963, NVS964, NVS965, NVS966, NVS967, NVS804, NVS805, NVS809, NVS965-T, NVS965-Q, NVS965-S se proporcionan con fines comparativos.
a a
Ejemplos de Anticuerpos del Factor P, Fabs y Proteínas del Factor P


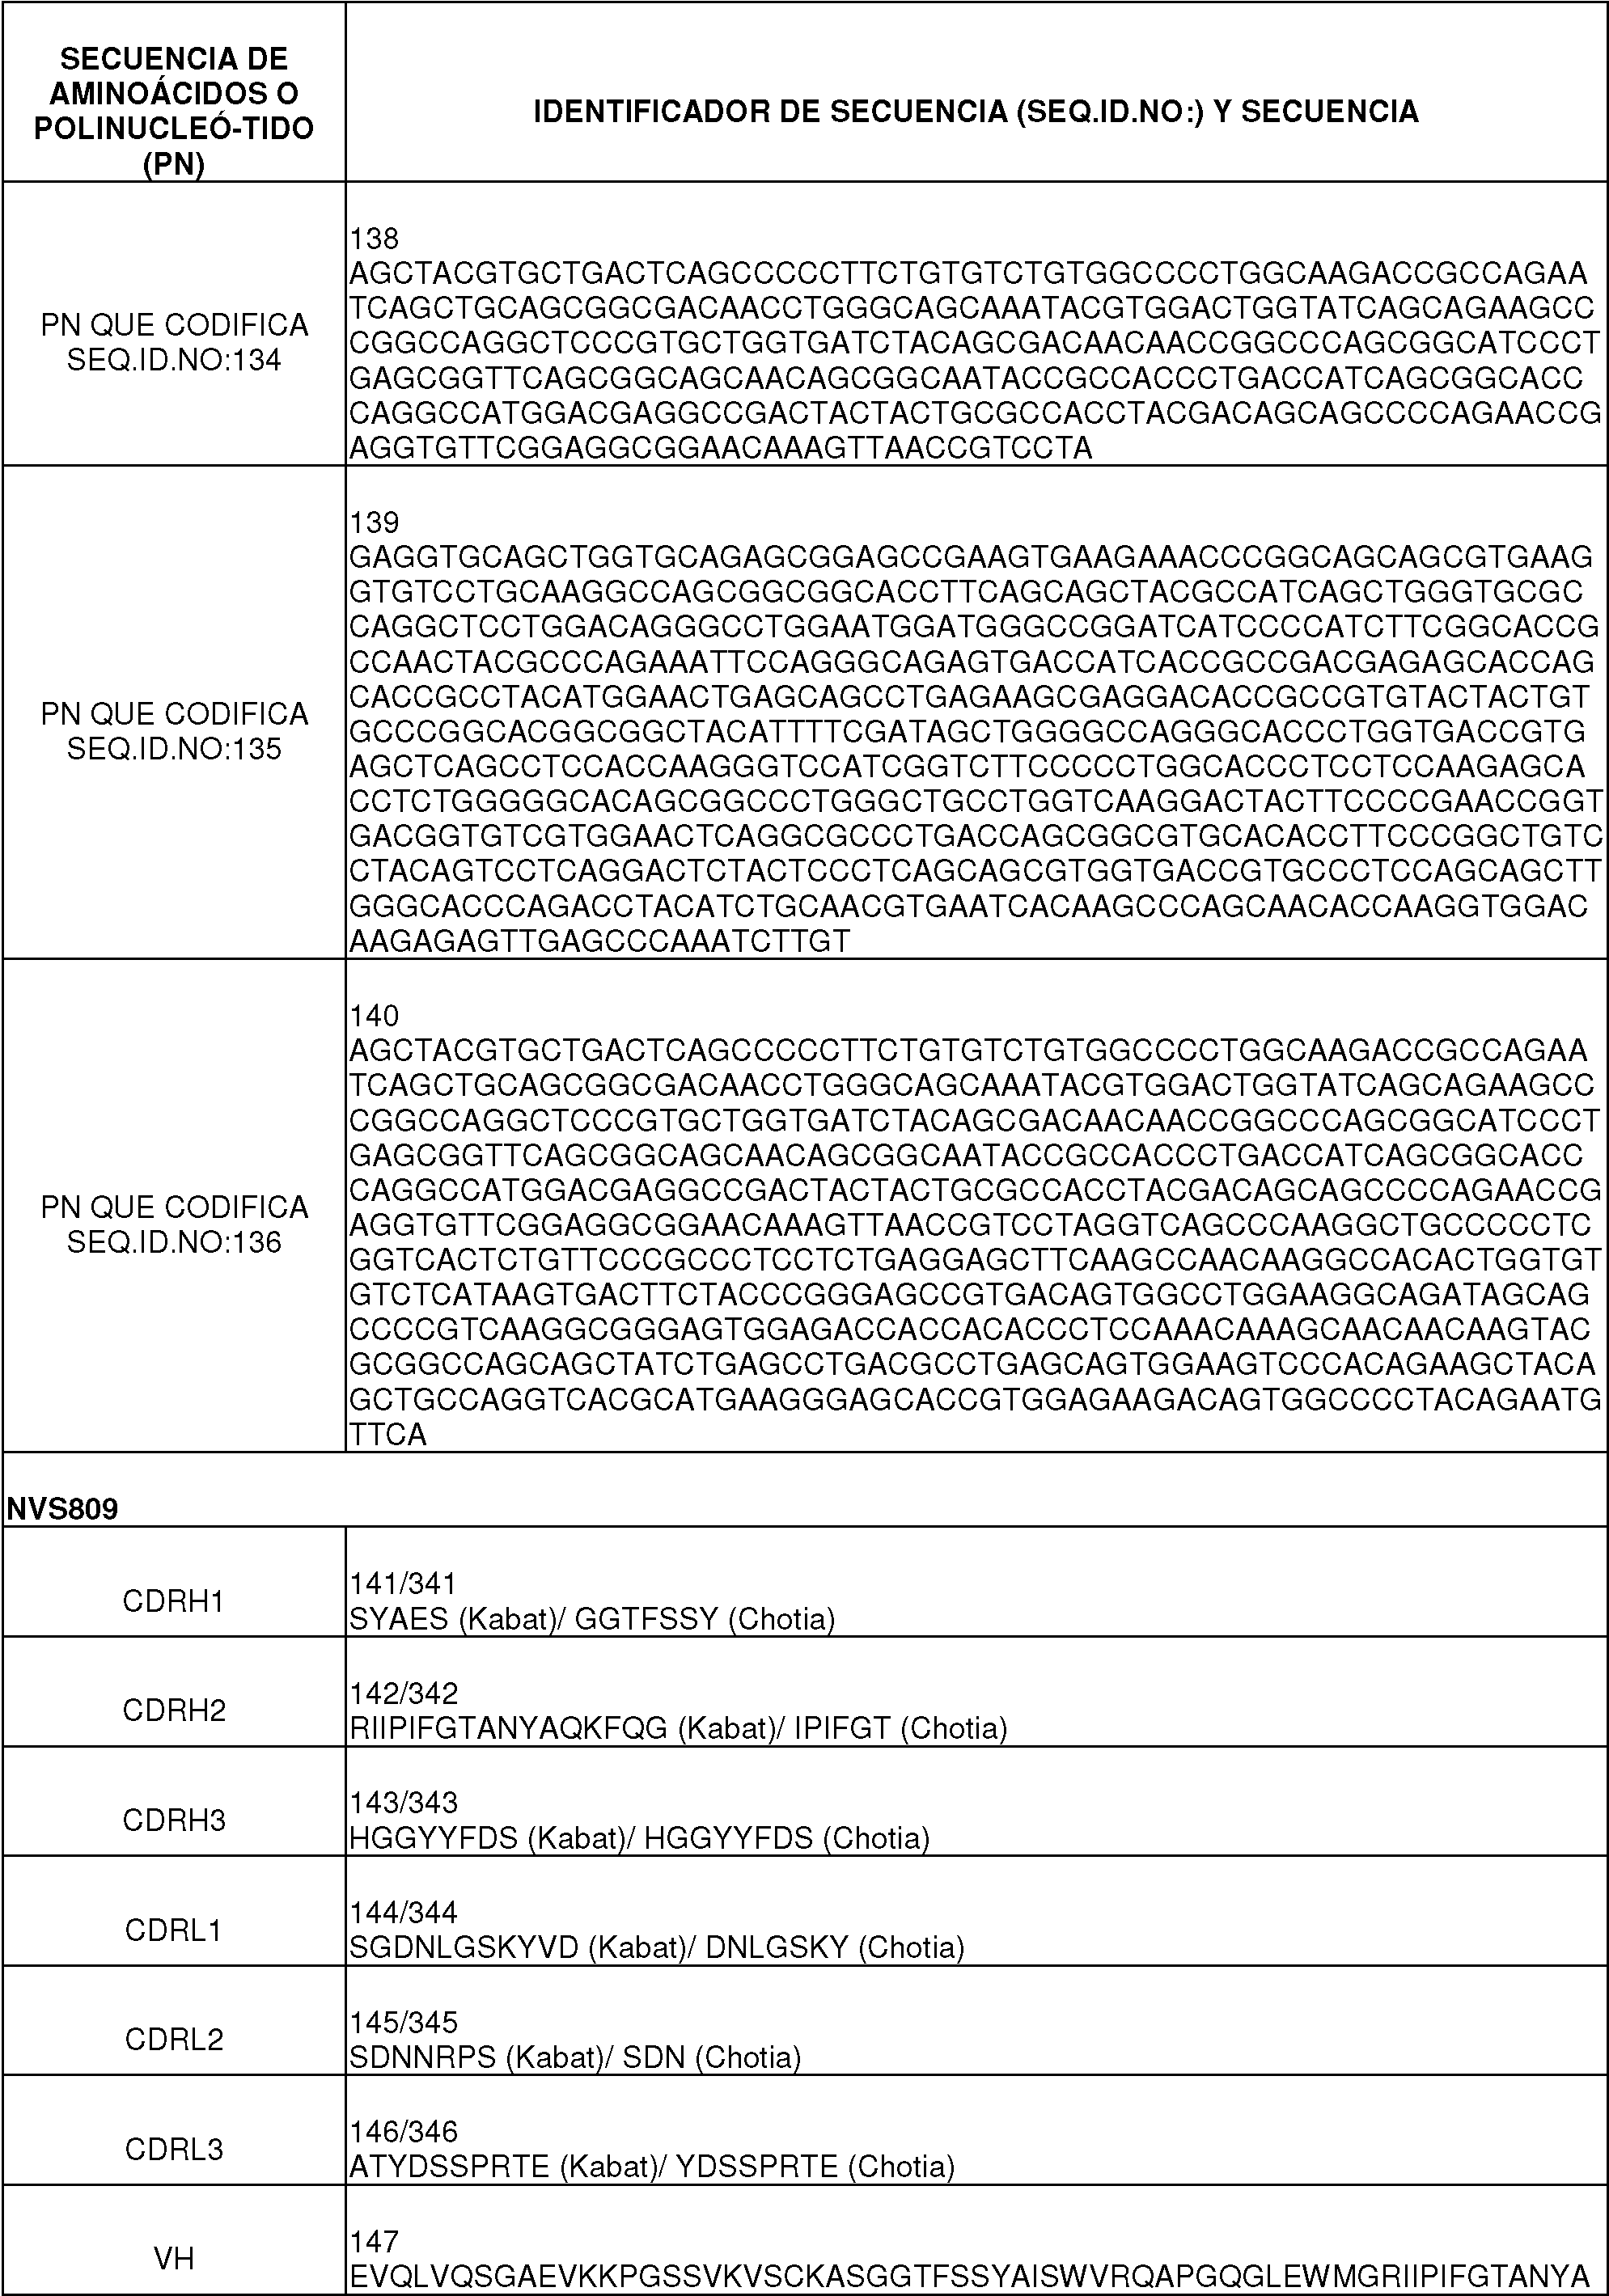

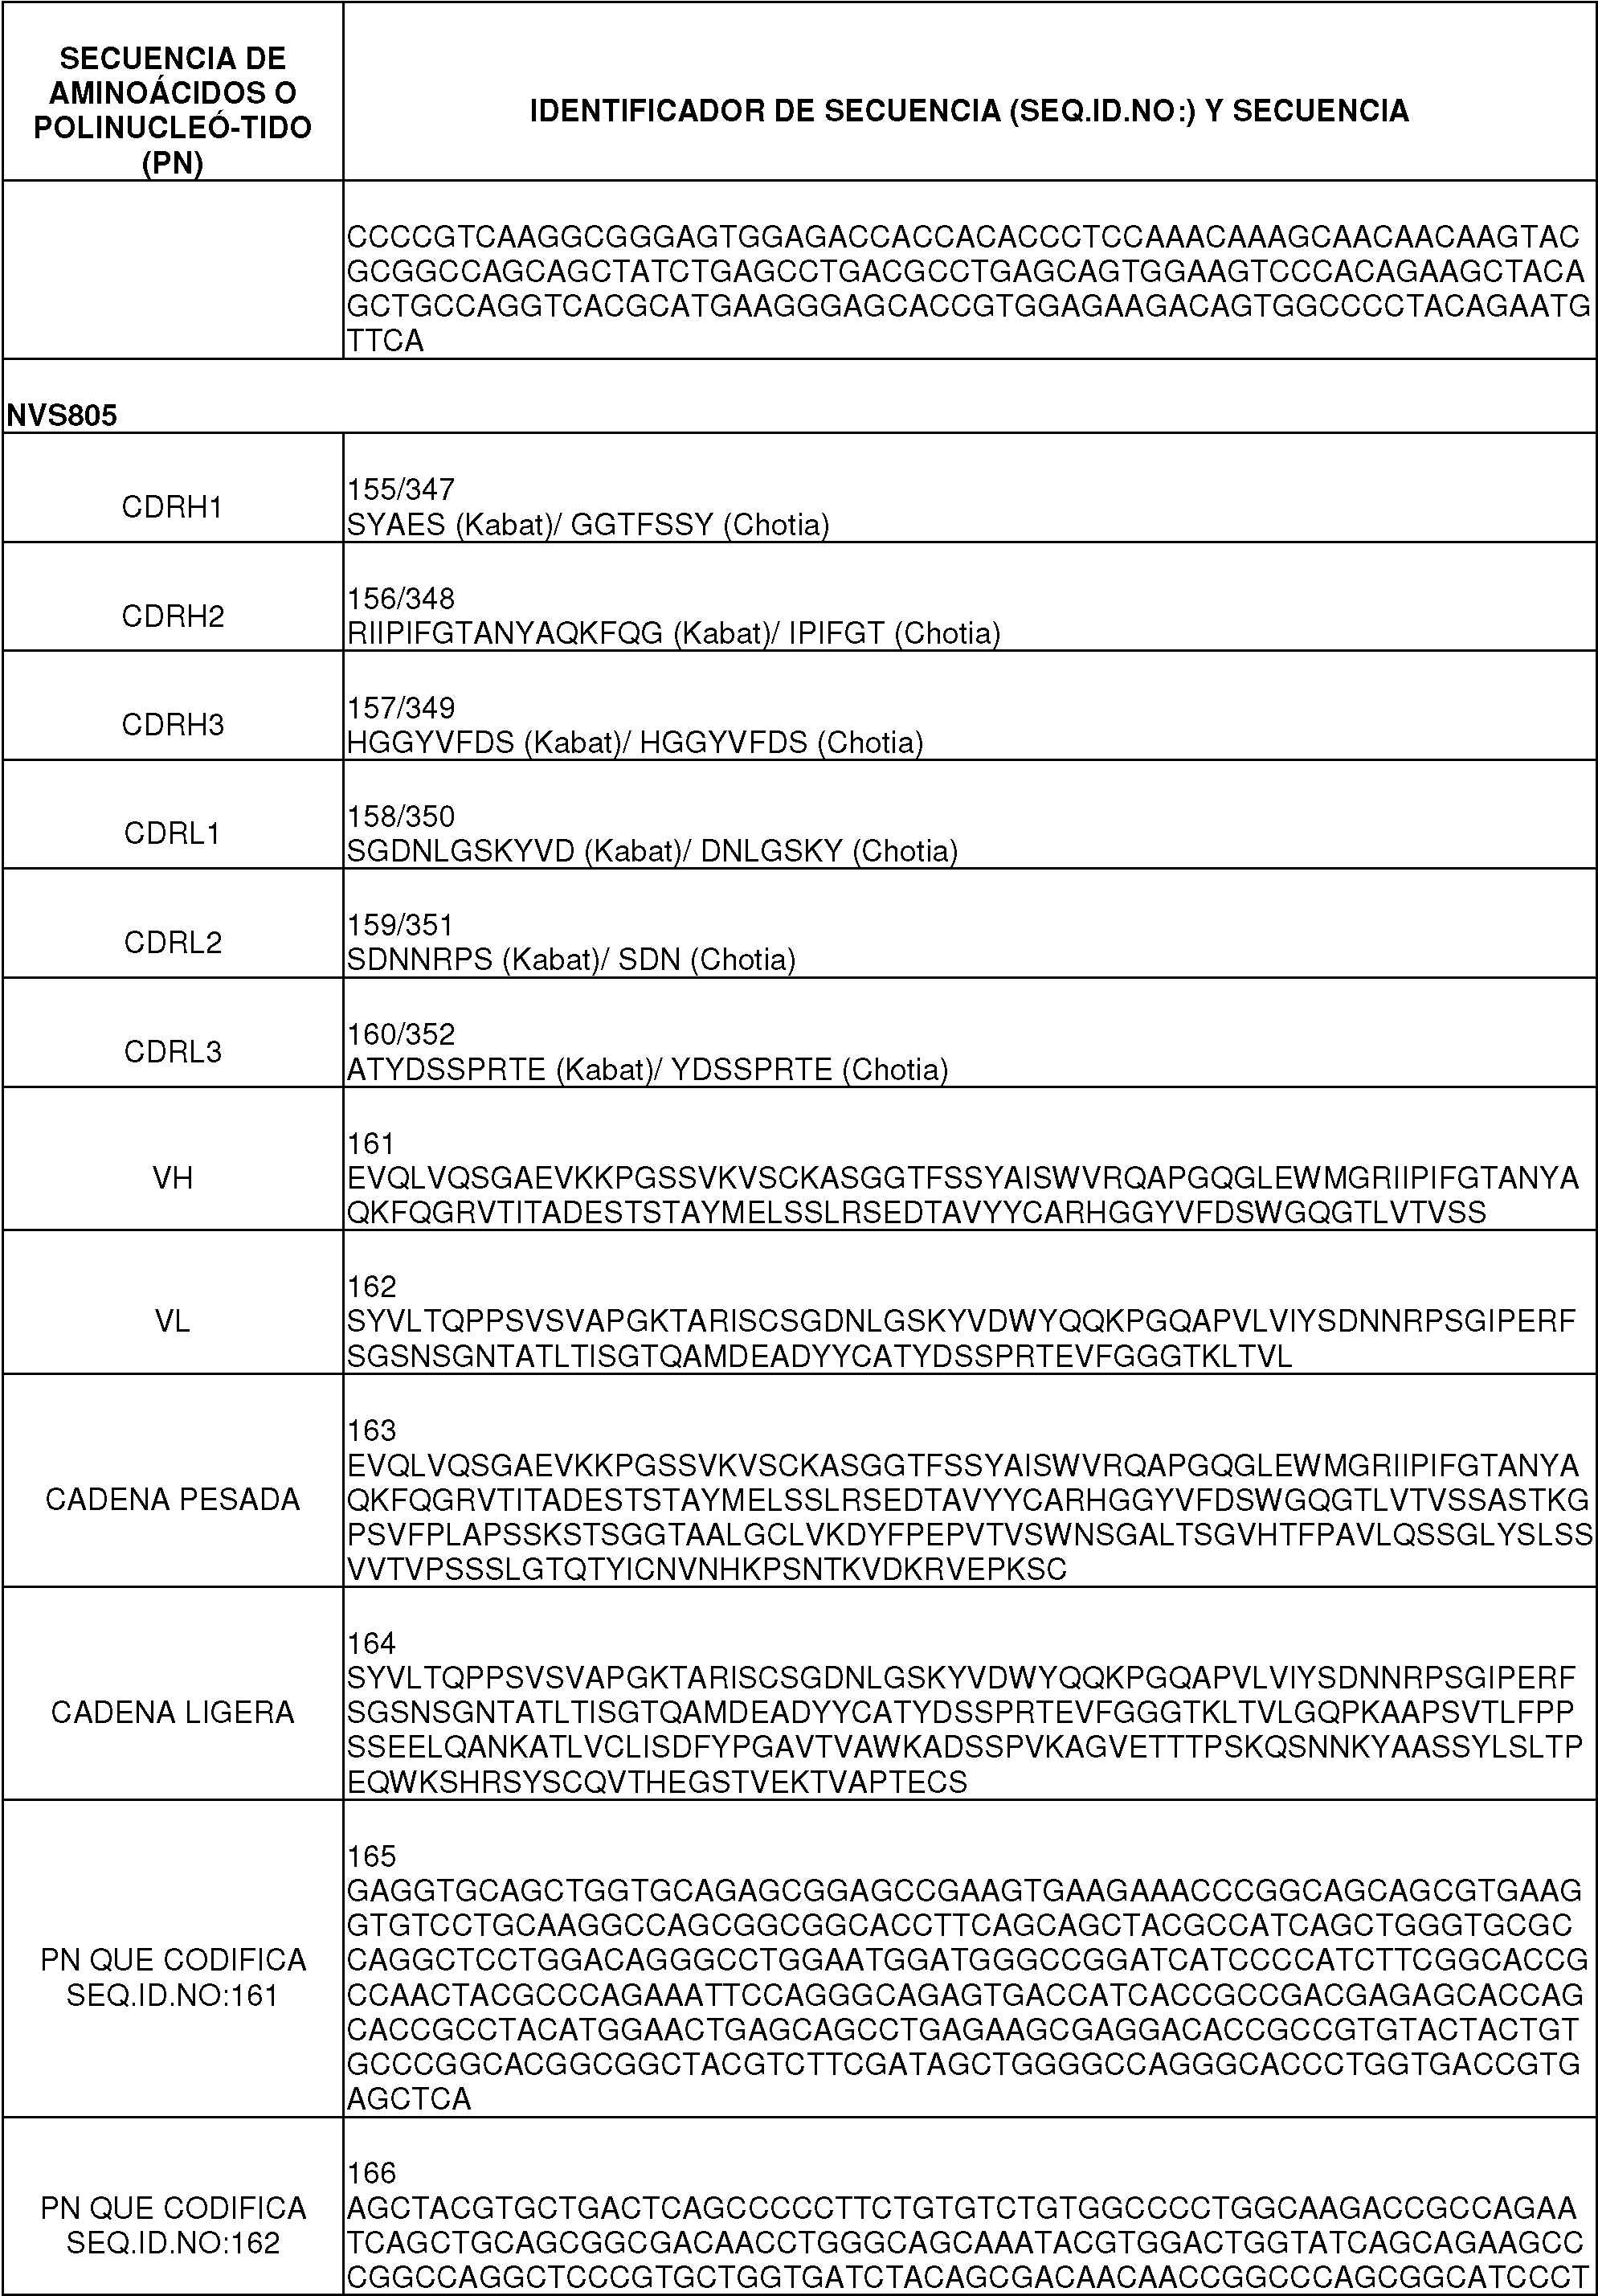


Tabla 2
E m l Ani r F Pr ín

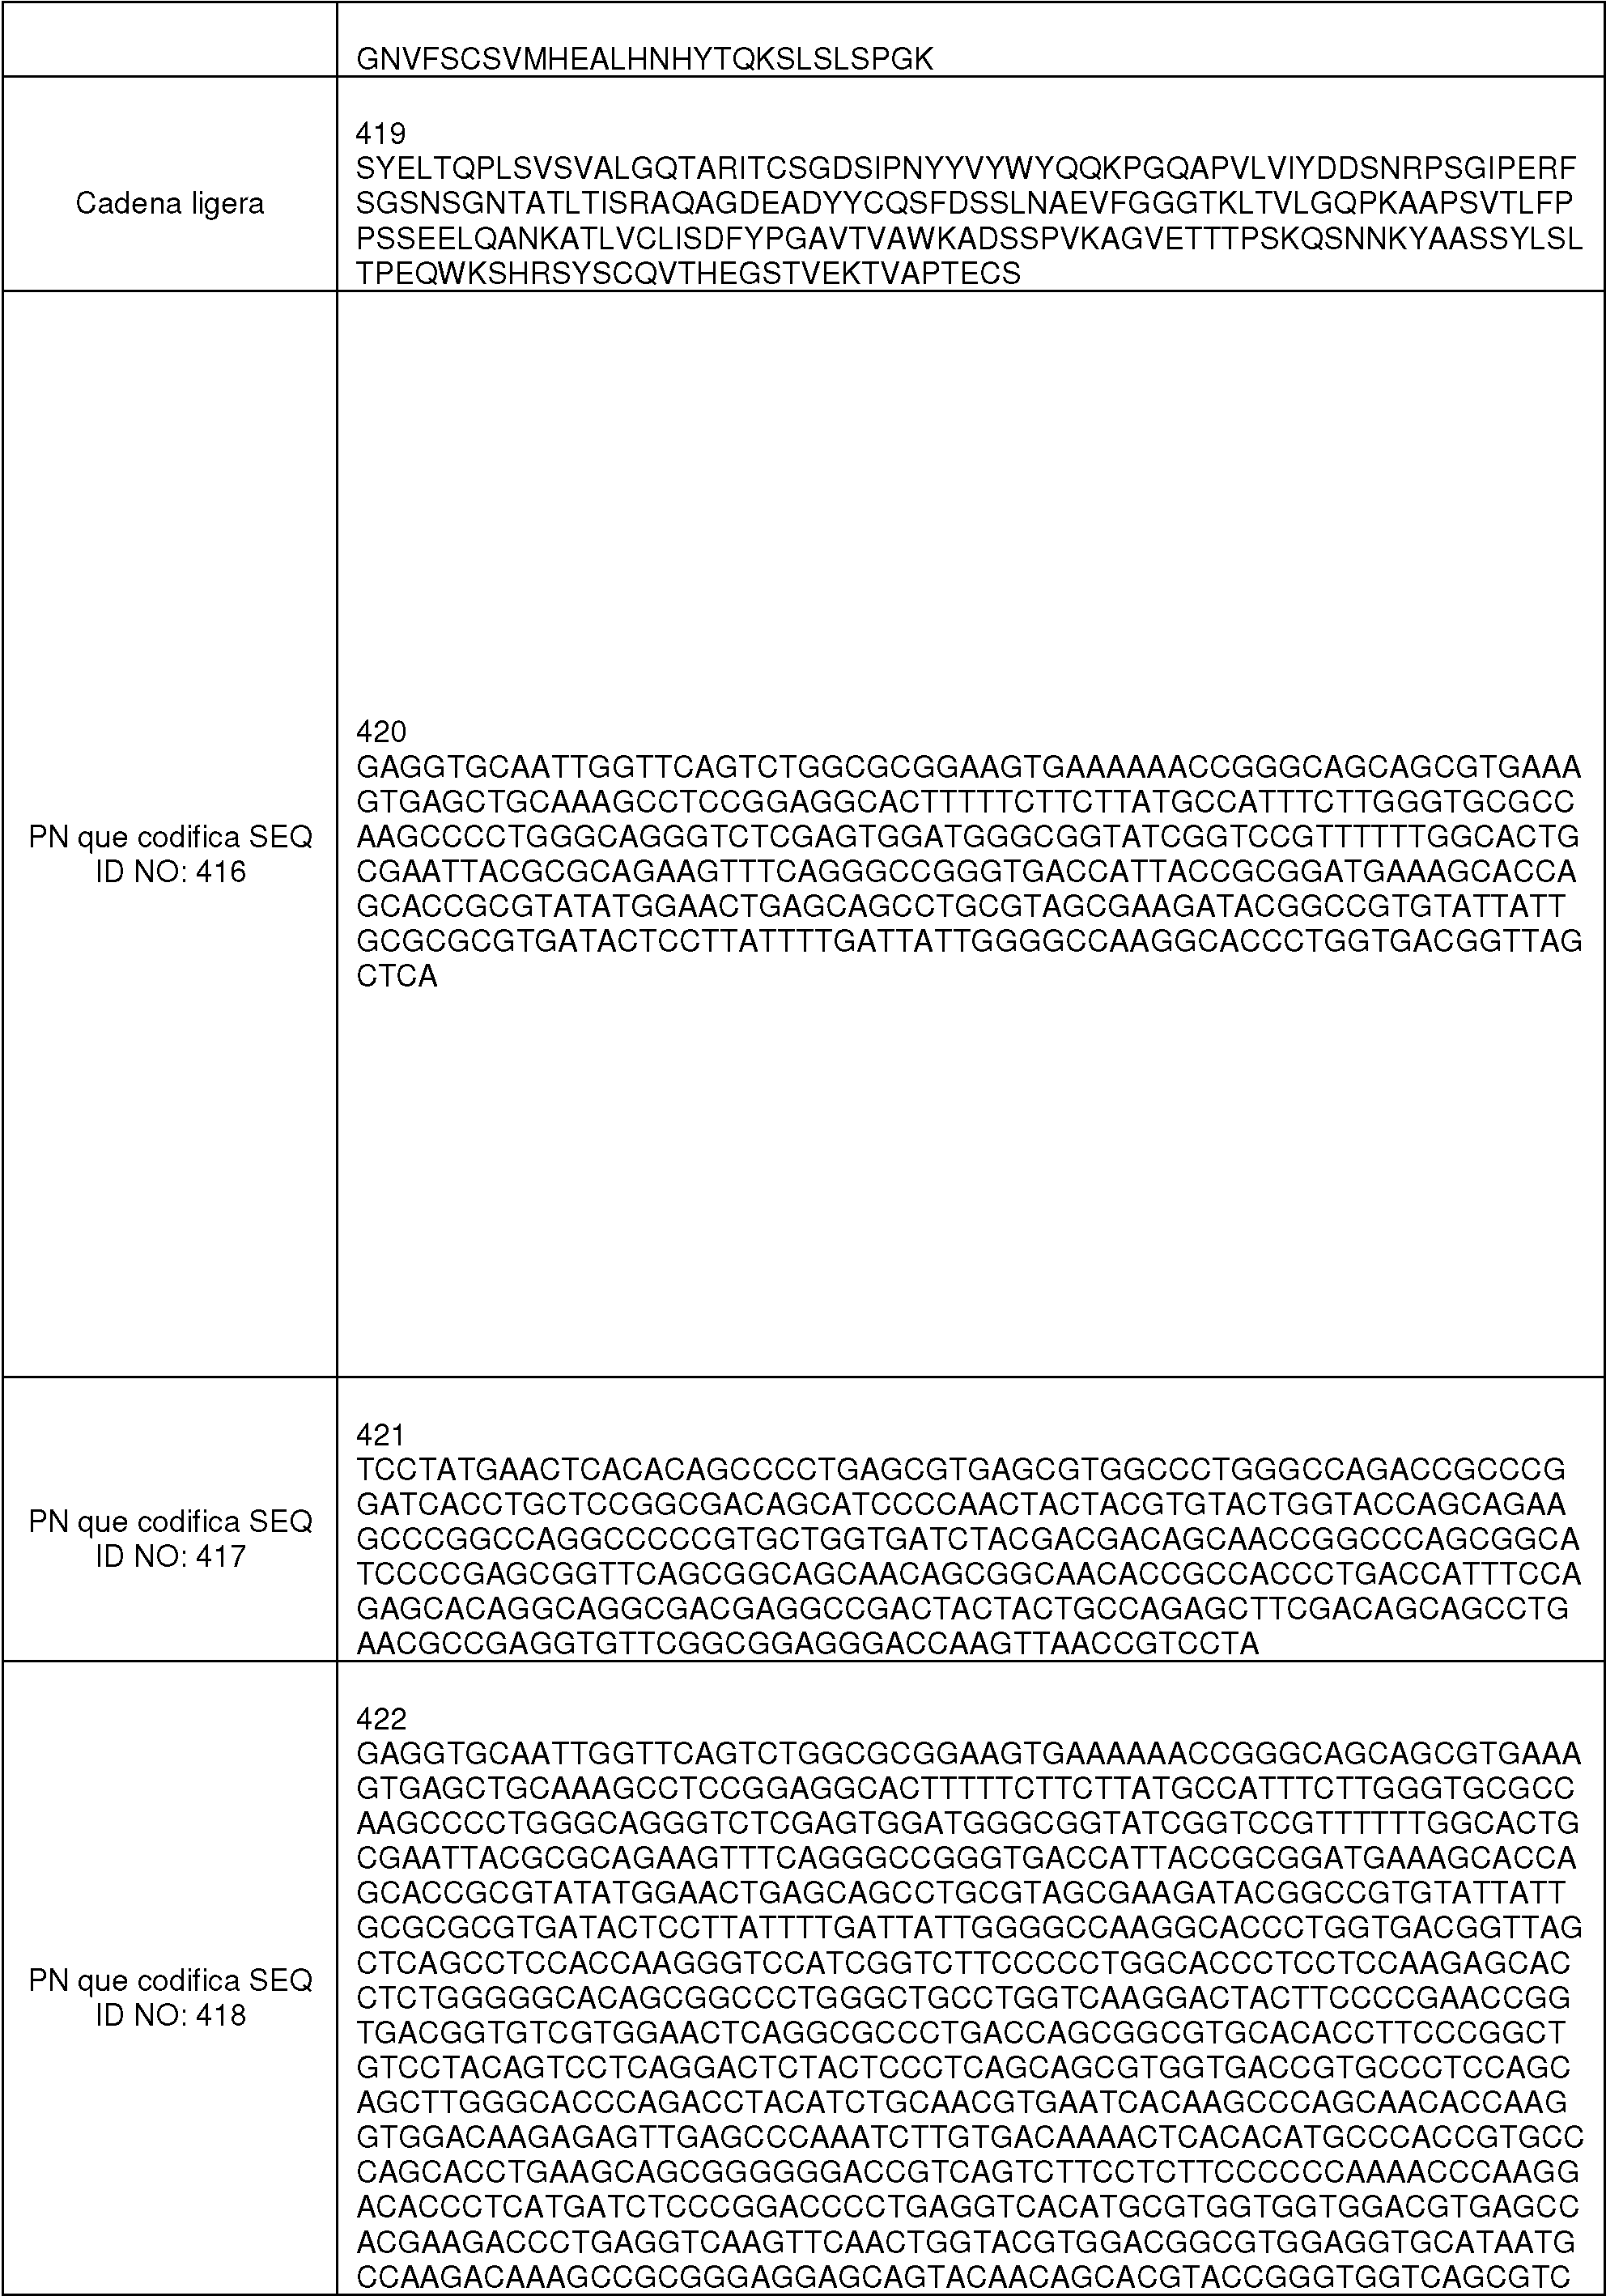


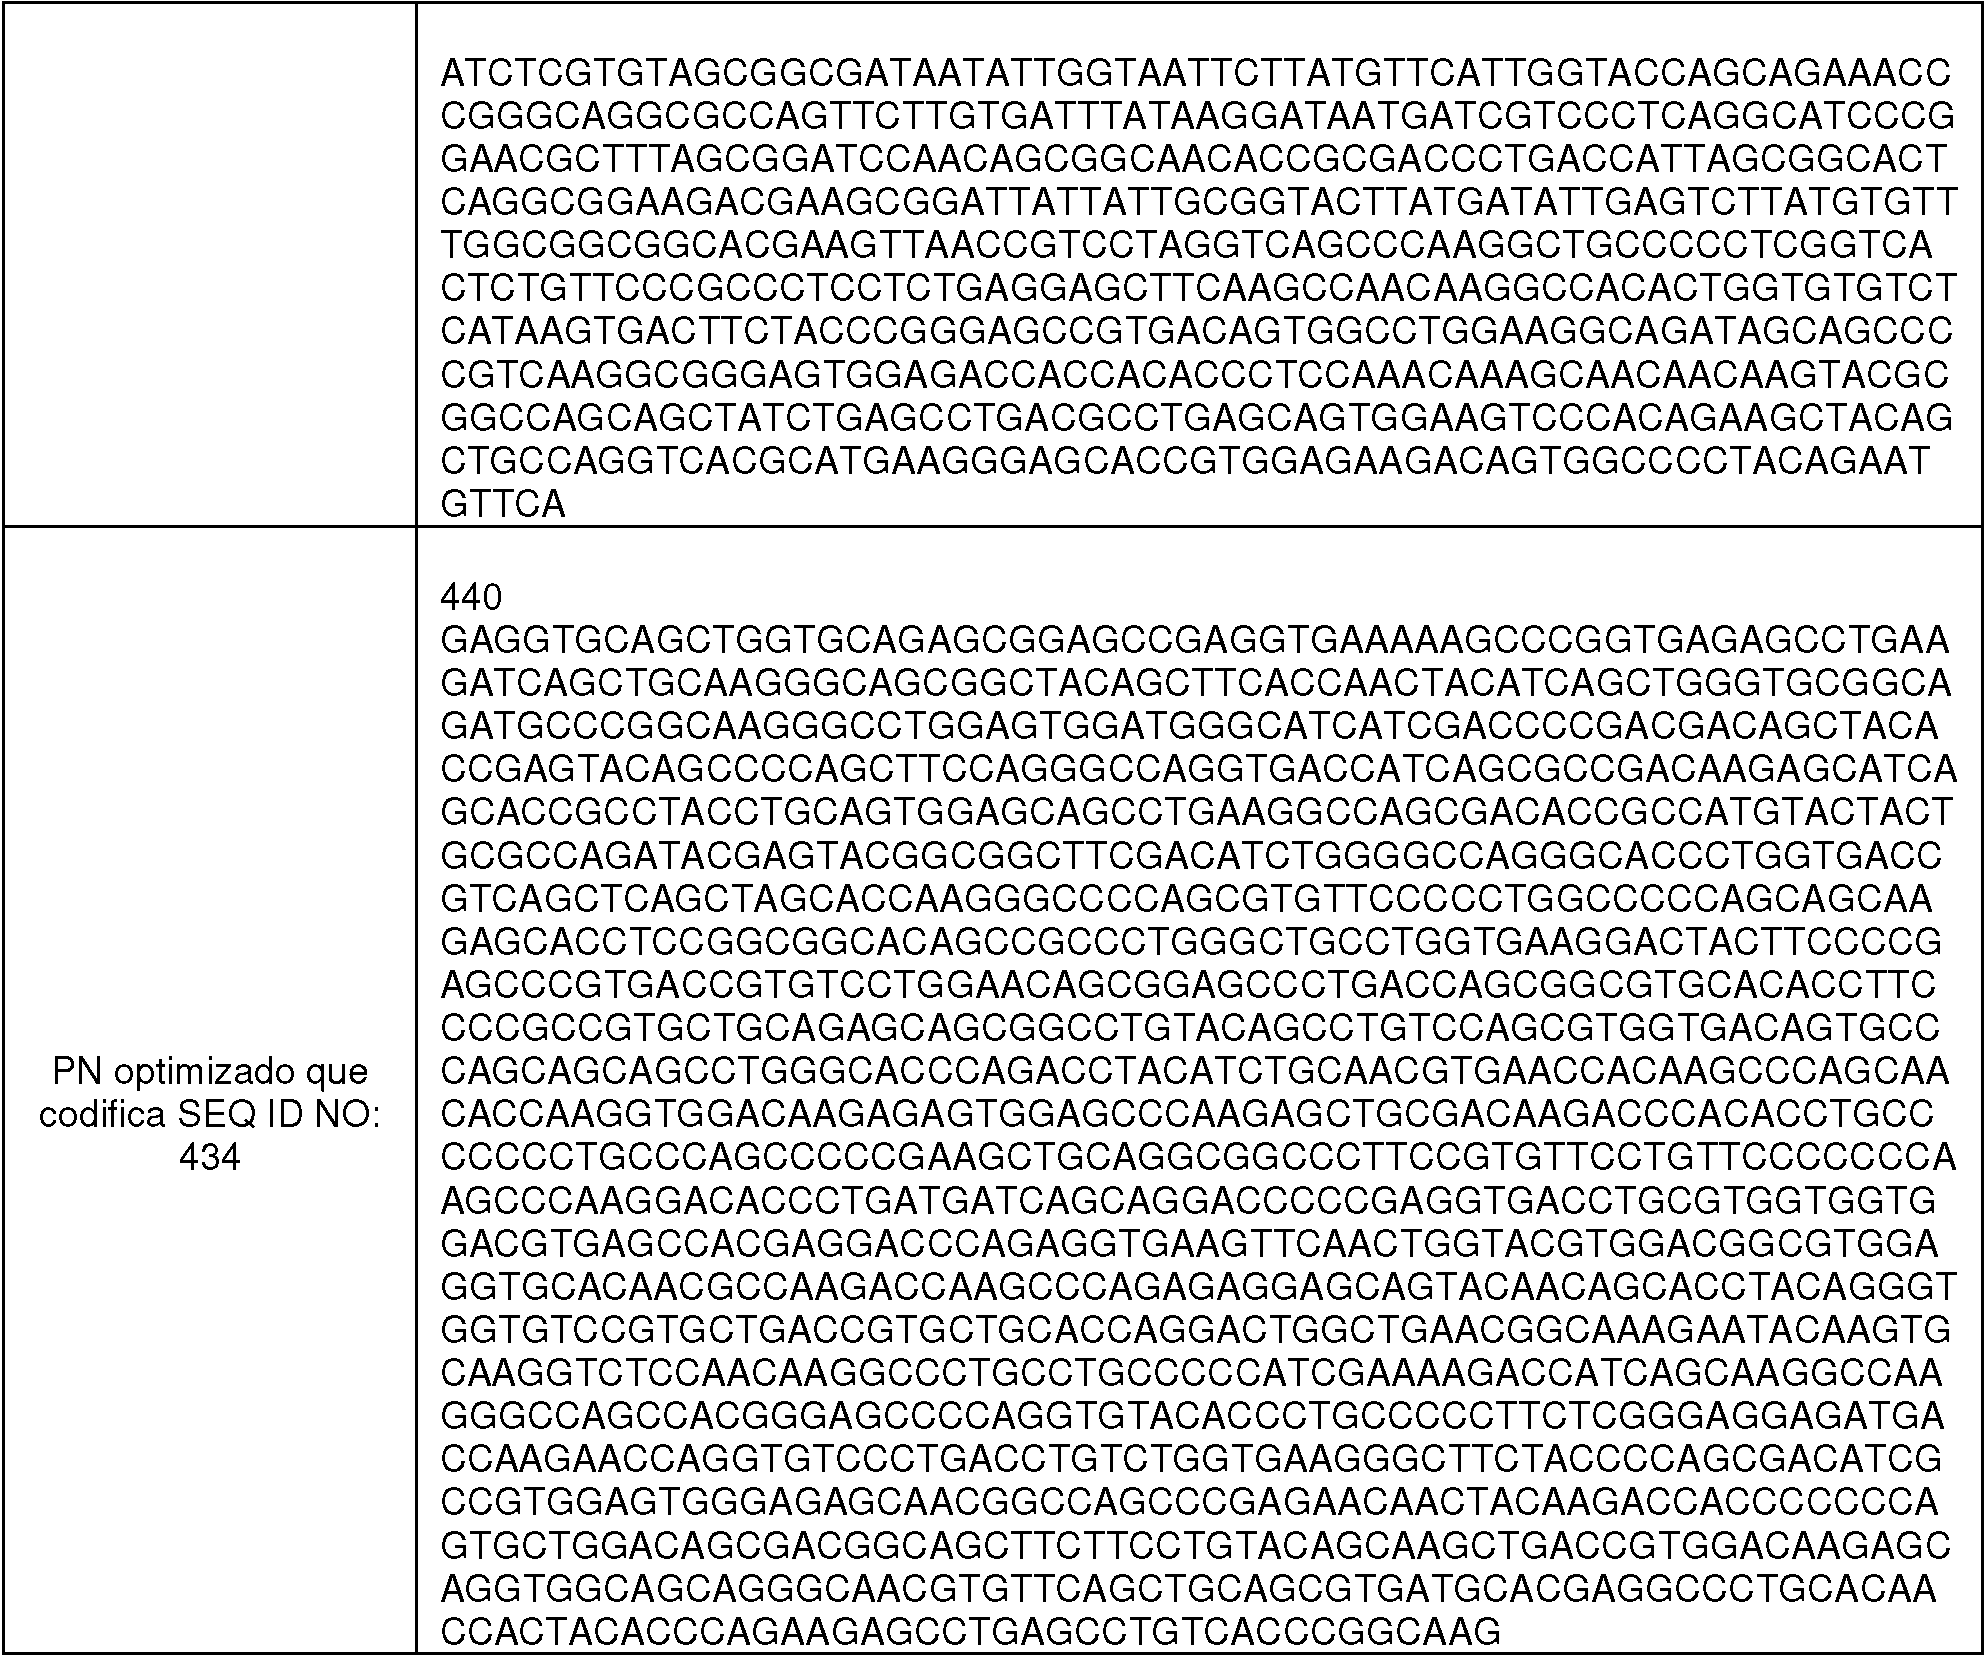
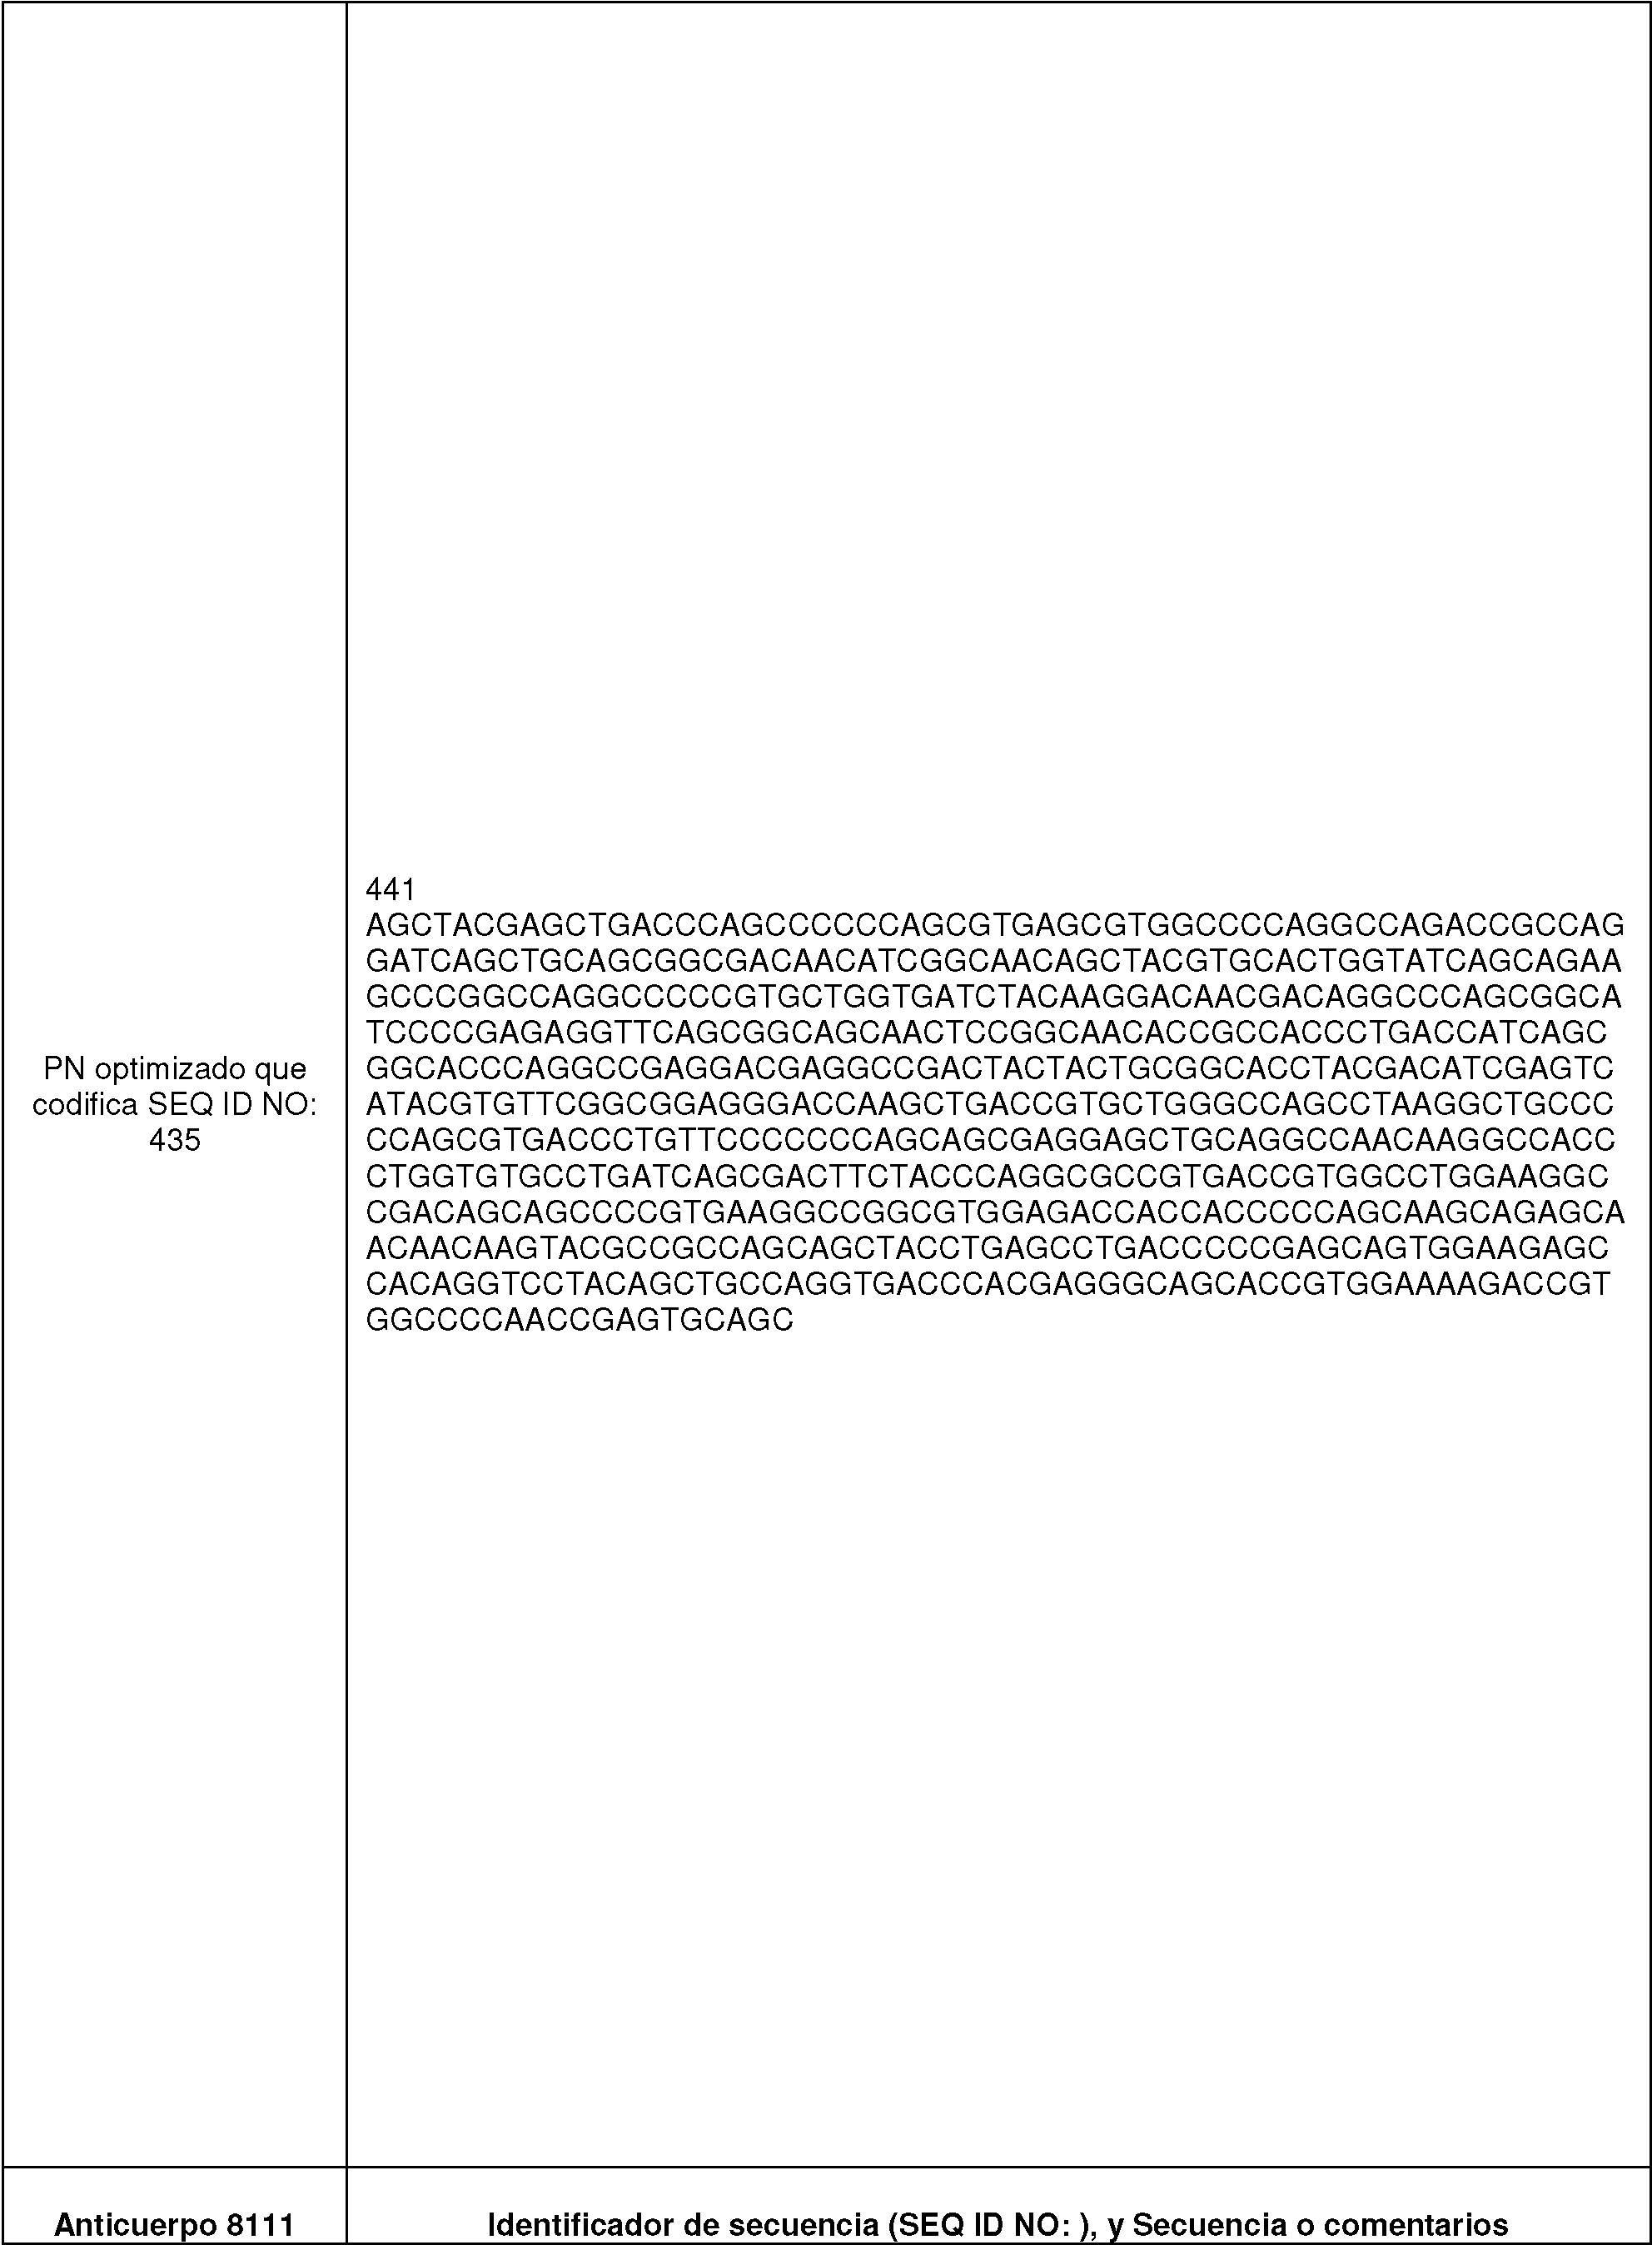


Otros anticuerpos divulgados en la presente incluyen aquellos en donde los aminoácidos o ácidos nucleicos que codifican los aminoácidos se han mutado, y no obstante, tienen cuando menos el 60, 65, 70, 75, 80, 85, 90, o 95 por ciento de identidad con las secuencias descritas en la Tabla 1. También se divulgan en la presente secuencias de aminoácidos mutantes en donde no más de 1, 2, 3, 4 o 5 aminoácidos se han mutado en las regiones variables cuando se comparan con las regiones variables ilustradas en la secuencia descrita en la Tabla 1, mientras que conservan sustancialmente la misma actividad de enlace al antígeno.
Debido a que cada uno de estos anticuerpos se pueden enlazar al Factor P, las secuencias de VH, VL, cadena ligera de longitud completa, y cadena pesada de longitud completa (secuencias de aminoácidos y secuencias de nucleótidos que codifican las secuencias de aminoácidos), se pueden "mezclar y emparejar", para crear otros anticuerpos de enlace del Factor P. Estos anticuerpos de enlace del Factor P "mezclados y emparejados" se pueden probar utilizando los ensayos de enlace conocidos en la técnica (por ejemplo, ELISAs, y otros ensayos descritos en la sección de ejemplos). Cuando estas cadenas se mezclan y se emparejan, una secuencia VH a partir de un par de VH/VL particular debe ser reemplazada con una secuencia VH estructuralmente similar. De la misma manera, una secuencia de cadena pesada de longitud completa a partir de un par particular de cadena pesada de longitud completa/cadena ligera de longitud completa, debe ser reemplazada con una secuencia de cadena pesada de longitud completa estructuralmente similar. De la misma manera, una secuencia VL a partir de un par particular de VH/VL debe ser reemplazada con una secuencia VL estructuralmente similar. De la misma manera, una secuencia de cadena ligera de longitud completa a partir de un par particular de cadena pesada de longitud completa/cadena ligera de longitud completa, debe ser reemplazada con una secuencia de cadena ligera de longitud completa estructuralmente similar. De conformidad con lo anterior, se divulga en la presente un anticuerpo aislado, o una región de enlace al antígeno del mismo, que tiene: un dominio variable de cadena pesada que comprende una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 7, 21,35, 49, 63, 77, 91, 105, 119, 133, 147, 161, 175, 189, 203, 217, 231, 245, 259 y 273, y un dominio variable de cadena ligera, el cual comprende una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 8, 22, 36, 50, 64, 78, 92, 106, 120, 134, 148, 162, 176, 190, 204, 218, 232, 246, 260, y 274, en donde el anticuerpo se enlaza específicamente al Factor P (por ejemplo, Factor P humano y/o de cinomolgo).
También se divulga en la presente (i) un anticuerpo aislado que tiene: una cadena pesada de longitud completa, la cual comprende una secuencia de aminoácidos que se ha optimizado para la expresión en una célula de mamífero seleccionada a partir del grupo que consiste en las SEQ ID NOs: 9, 23, 37, 51, 65, 79, 93, 107, 121, 135, 149, 163, 177, 191, 205, 219, 233, 247, 261 y 275, y una cadena ligera de longitud completa, la cual comprende una secuencia de aminoácidos que se ha optimizado para la expresión en una célula de mamífero seleccionada a partir del grupo que consiste en las SEQ ID NOs: 10, 24, 38, 52, 66, 80, 94, 108, 122, 136, 150, 164, 178, 192, 206, 220, 234, 248, 262 y 276; o (ii) una proteína funcional que comprende una porción de enlace al antígeno de la misma.
Los términos “región determinante de complementariedad", y "CDR", como se utilizan en la presente, se refieren a las secuencias de aminoácidos dentro de las regiones variables de anticuerpos que confieren especificidad de antígeno y afinidad de enlace. En general, hay tres regiones determinantes de complementariedad (CDRs) en cada región variable de cadena pesada (HCDR1, HCDR2, HCDR3), y tres regiones determinantes de complementariedad (CDRs) en cada región variable de cadena ligera (LCDR1, LCDR2, LCDR3).
Los límites precisos de la secuencia de aminoácidos de una región determinante de complementariedad (CDR) dada
se pueden determinar fácilmente utilizando cualquiera de un número de esquemas bien conocidos, incluyendo aquellos descritos por Kabat y colaboradores (1991), “Sequences of Proteins of Immunological Interest", 5a Edición, Public Health Service, National Institutes of Health, Bethesda, MD (esquema de numeración “Kabat”), Al-Lazikani y colaboradores (1997) JMB 273,927-948 (esquema de numeración “Chotia”).
Por ejemplo, bajo Kabat, los residuos de aminoácidos de la región determinante de complementariedad (CDR) en el dominio variable de cadena pesada (VH) son numerados como 31-35 (HCDR1), 50-65 (HCDR2), y 95-102 (HCDR3); y los residuos de aminoácidos de la región determinante de complementariedad (CDR) en el dominio variable de cadena ligera (VL) son numerados como 24-34 (LCDR1), 50-56 (LCDR2), y 89-97 (LCDR3). Bajo Chotia, los aminoácidos de la región determinante de complementariedad (CDR) en la VH se numeran como 26-32 (HCDR1), 52-56 (HCDR2), y 95-102 (HCDR3); y los residuos de aminoácidos en la VL se numeran como 26-32 (LCDR1), 50 52 (LCDR2), y 91-96 (LCDR3). Mediante la combinación de las definiciones de las regiones determinantes de complementariedad (CDRs) tanto de Kabat como de Chotia, las regiones determinantes de complementariedad (CDRs) consisten en los residuos de aminoácidos 26-35 (HCDR1), 50-65 (HCDR2), y 95-102 (HCDR3) en la VH humana, y en los residuos de aminoácidos 24-34 (LCDR1), 50-56 (LCDR2), y 89-97 (LCDR3) en la VL humana.
Se divulgan en la presente anticuerpos de enlace al Factor P que comprenden la cadena pesada y la cadena ligera de las CDR1s, CDR2s, y CDR3s, como se describe en la Tabla 1, o combinaciones de las mismas. Las secuencias de aminoácidos de las CDR1s VH de los anticuerpos se muestran en las SEQ ID NOs: 1, 15, 29, 43, 57, 71, 85, 99, 113, 127, 141, 155, 169, 183, 197, 211, 225, 239, 253, o 267. Las secuencias de aminoácidos de las c Dr 2s v H de los anticuerpos se muestran en las SEQ ID NOs: 2, 16, 30, 44, 58, 72, 86, 100, 114, 128, 142, 156, 170, 184, 198, 212, 226, 240, 254, o 268. Las secuencias de aminoácidos de las CDR3s VH de los anticuerpos se muestran en las SEQ ID NOs: 3, 17, 31, 45, 59, 73, 87, 101, 115, 129, 143, 157, 171, 185, 199, 213, 227, 241, 255, o 269. Las secuencias de aminoácidos de las CDR1s VL de los anticuerpos se muestran en las SEQ ID NOs: 4, 18, 32, 46, 60, 74, 88, 102, 116, 130, 144, 158, 172, 186, 200, 214, 228, 242, 256, o 270. Las secuencias de aminoácidos de las CDR2s VL de los anticuerpos se muestran en las s Eq ID NOs: 5, 19, 33, 47, 61, 75, 89, 103, 117, 131, 145, 159, 173, 187, 201, 215, 229, 243, 257, o 271. Las secuencias de aminoácidos de las CDR3s VL de los anticuerpos se muestran en las SEQ ID NOs: 6, 20, 34, 48, 62, 76, 90, 104, 118, 132, 146, 160, 174, 188, 202, 216, 230, 244, 258, o 272. Estas regiones CDR se delinean utilizando el sistema de Kabat.
De una manera alternativa, como se define utilizando el sistema de Chotia (Al-Lazikani y colaboradores (1997) JMB 273,927-948), las secuencias de aminoácidos de las CDR1s VH de los anticuerpos se muestran en las SEQ ID NOs: 281, 287, 293, 299, 305, 311, 317, 323, 329, 335, 341, 347, 353, 359, 365, 371, 377, 383, 389, o 395. Las secuencias de aminoácidos de las CDR2s VH de los anticuerpos se muestran en las SEQ ID NOs: 282, 288, 294, 300, 306, 312, 318, 324, 330, 336, 342, 348, 354, 360, 366, 372, 378, 384, 390, o 396. Las secuencias de aminoácidos de las CDR3s VH de los anticuerpos se muestran en las SEQ ID NOs: 283, 289, 295, 301, 307, 313, 319, 325, 331, 337, 343, 349, 355, 361, 367, 373, 379, 385, 391, o 397. Las secuencias de aminoácidos de las CDR1s VL de los anticuerpos se muestran en las SEQ ID NOs: 284, 290, 296, 302, 308, 314, 320, 326, 332, 338, 344, 350, 356, 362, 368, 374, 380, 386, 392, o 398. Las secuencias de aminoácidos de las CDR2s VL de los anticuerpos se muestran en las SEQ ID NOs: 285, 291, 297, 303, 309, 315, 321, 327, 333, 339, 345, 351, 357, 363, 369, 375, 381,387, 393, o 399. Las secuencias de aminoácidos de las CDR3s VL de los anticuerpos se muestran en las SEQ ID NOs: 286, 292, 298, 304, 310, 316, 322, 328, 334, 340, 346, 352, 358, 364, 370, 376, 382, 388, 394, o 400.
Dado que cada uno de estos anticuerpos puede enlazarse al Factor P y que la especificidad de enlace al antígeno es proporcionada primordialmente por las regiones CDR1,2 y 3, las secuencias de VH CDR1,2 y 3 y las secuencias de VL CDR1, 2 y 3 se pueden "mezclar y emparejar" (es decir, regiones determinantes de complementariedad (CDRs) a partir de diferentes anticuerpos se pueden mezclar y emparejar, aunque cada anticuerpo de preferencia contiene una VH CDR1, 2 y 3 y una VL CDR1, 2 y 3 para crear otras moléculas de enlace al Factor P. Estos anticuerpos de enlace al Factor P "mezclados y emparejados" se pueden probar utilizando los ensayos de enlace conocidos en la materia y aquellos descritos en los Ejemplos (por ejemplo, ELISAs, SET, Biacore). Cuando las secuencias de CDRs VH se mezclan y se emparejan, la secuencia de CDR1, CDR2 y/o CDR3 a partir de una secuencia VH particular debe ser reemplazada con una secuencia de CDR estructuralmente similar. De la misma manera, cuando las CDRs VL se mezclan y se emparejan, la secuencia de CDR1, CDR2 y/o CDR3 a partir de una secuencia VL particular debe ser reemplazada con una secuencia de CDR estructuralmente similar. Será fácilmente evidente para la persona con una experiencia ordinaria que las secuencia VH y VL novedosas se pueden crear mediante la sustitución de una o más secuencias de la región CDR VH y/o VL con secuencias estructuralmente similares a partir de las secuencias de las regiones determinantes de complementariedad (CDRs) mostradas en la presente para los anticuerpos monoclonales.
Los anticuerpos o los fragmentos de enlace al antígeno de los mismos divulgados en la presente pueden tener las secuencias de cadena pesada y ligera de los Fabs descritos en la Tabla 1. Se divulga en la presente el anticuerpo o el fragmento de enlace al antígeno del mismo que puede tener la secuencia de cadena pesada y ligera de Fab NVS962, NVS963, NVS964, NVS965, NVS966, NVS967, NVS805, NVS806, NVS807, NVS808, NVS809, NVS962-S, NVS962-Q, NVS962-S31A, NVS962-G, NVS962-T, NVS965-S, NVS965-T, o NVS965-Q.
El anticuerpo o el fragmento de enlace al antígeno divulgado en la presente en que se enlaza específicamente un Factor P comprende una CDR1 de región variable de cadena pesada, una CDR2 de región variable de cadena pesada, una CDR3 de región variable de cadena pesada, una CDR1 de región variable de cadena ligera, una CDR2 de región variable de cadena ligera, y una CDR3 de región variable de cadena ligera, como son definidas por Kabat y descritas en la Tabla 1. En todavía otras modalidades de la invención, el anticuerpo o el fragmento de enlace al antígeno en que se enlaza específicamente un Factor P comprende una CDR1 de región variable de cadena pesada, una CDR2 de región variable de cadena pesada, una CDR3 de región variable de cadena pesada, una CDR1 de región variable de cadena ligera, una CDR2 de región variable de cadena ligera, y una CDR3 de región variable de cadena ligera como son definidas por Chotia y descritas en la Tabla 1.
Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 1; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 2; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 3; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 4; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 5; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 6. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 15; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 16; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 17; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 18; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 19; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 20. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 29; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 30; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 31; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 32; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 33; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 34. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 43; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 44; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 45; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 46; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 47; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 48. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 57; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 58; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 59; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 60; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 61; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 62. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 71; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 72; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 73; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 74; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 75; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 76. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 85; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 86; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 87; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 88; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 89; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 90. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 99; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 100; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 101; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 102; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 103; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 104. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 113; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 114; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 115; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 116; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 117; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 118. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 127; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 128; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 129; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 130; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 131; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 132. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 141; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 142; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 143; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 144; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 145; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 146. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 155; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 156; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 157; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 158; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 159; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 160. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual
comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 169; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 170; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 171; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 172; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 173; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 174. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 183; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 184; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 185; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 186; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 187; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 188. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 197; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 198; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 199; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 200; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 201; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 202. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 211; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 212; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 213; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 214; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 215; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 216. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 225; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 226; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 227; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 228; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 229; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 230. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 239; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 240; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 241; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 242; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 243; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 244. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 253; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 254; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 255; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 256; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 257; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 258. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 267; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 268; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 269; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 270; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 271; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 271.
Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 281; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 282; una Cd R3 de región variable de cadena pesada de la SEQ ID NO: 283; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 284; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 285; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 286. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 287; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 288; una Cd R3 de región variable de cadena pesada de la SEQ ID NO: 289; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 290; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 291; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 292. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 293; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 294; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 295; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 296; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 297; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 298. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 299; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 300; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 301; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 302; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 303; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 304. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 305; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 306; una Cd R3 de región variable de cadena pesada de la SEQ ID NO: 307; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 308; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 309; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 310. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 311; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 312; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 313; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 314; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 315; y una CDR3 de región variable de cadena ligera de la SEQ ID NO:
316. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 317; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 318; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 319; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 320; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 321; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 322. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 323; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 324; una Cd R3 de región variable de cadena pesada de la SEQ ID NO: 325; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 326; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 327; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 328. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 329; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 330; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 331; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 332; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 333; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 334. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 335; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 336; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 337; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 338; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 339; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 340. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 341; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 342; una Cd R3 de región variable de cadena pesada de la SEQ ID NO: 343; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 344; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 345; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 346. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 347; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 348; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 349; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 350; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 351; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 352. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 353; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 354; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 355; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 356; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 357; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 358. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 359; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 360; una Cd R3 de región variable de cadena pesada de la SEQ ID NO: 361; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 362; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 363; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 364. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 365; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 366; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 367; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 368; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 369; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 370. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 371; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 372; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 373; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 374; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 375; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 376. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SeQ ID NO: 377; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 378; una Cd R3 de región variable de cadena pesada de la SEQ ID NO: 379; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 380; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 381; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 382. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 383; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 384; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 385; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 386; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 387; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 388. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SEQ ID NO: 389; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 390; una CDR3 de región variable de cadena pesada de la SEQ ID NO: 391; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 392; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 393; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 394. Se divulga en la presente un anticuerpo que se enlaza específicamente al Factor P, el cual comprende una CDR1 de región variable de cadena pesada de la SeQ ID NO: 395; una CDR2 de región variable de cadena pesada de la SEQ ID NO: 396; una Cd R3 de región variable de cadena pesada de la SEQ ID NO: 397; una CDR1 de región variable de cadena ligera de la SEQ ID NO: 398; una CDR2 de región variable de cadena ligera de la SEQ ID NO: 399; y una CDR3 de región variable de cadena ligera de la SEQ ID NO: 400.
Se divulgan en la presente los anticuerpos o los fragmentos de enlace al antígeno que se enlaza específicamente al Factor P como se describe en la Tabla 1.
Como se utiliza en la presente, un anticuerpo humano comprende las regiones variables de cadena pesada o ligera o las cadenas pesada o ligera de longitud completa que son "el producto de" o "derivadas a partir de" una secuencia de la línea germinal particular, si las regiones variables o las cadenas de longitud completa del anticuerpo se obtienen a partir de un sistema que utilice genes de inmunoglobulina de la línea germinal humana. Estos sistemas incluyen la inmunización de un ratón transgénico que lleve genes de inmunoglobulina humana con el antígeno de interés, o el rastreo de una biblioteca de genes de inmunoglobulina humana exhibida sobre fagos con el antígeno de interés. Un anticuerpo humano que es "el producto de" o "derivado a partir de" una secuencia de inmunoglobulina de la línea germinal humana se puede identificar como tal mediante la comparación de la secuencia de aminoácidos del anticuerpo humano con las secuencias de aminoácidos de las inmunoglobulinas de la línea germinal humana, y se selecciona la secuencia de inmunoglobulina de la línea germinal humana que esté más cerca en la secuencia (es decir, mayor porcentaje de identidad), con la secuencia del anticuerpo humano. Un anticuerpo humano que es "el producto de" o "derivado a partir de" una secuencia de inmunoglobulina de la línea germinal humana particular, puede contener diferencias de aminoácidos, comparándose con la secuencia de la línea germinal, debido, por ejemplo, a las mutaciones somáticas que se presentan naturalmente, o a la introducción intencional de mutaciones dirigidas al sitio. Sin embargo, en las regiones de estructura VH o VL, un anticuerpo humano seleccionado típicamente es cuando menos el 90 por ciento idéntico en la secuencia de aminoácidos a una secuencia de aminoácidos codificada por un gen de inmunoglobulina de la línea germinal humana, y contiene residuos de aminoácidos que identifican el anticuerpo humano como humano cuando se compara con las secuencias de aminoácidos de inmunoglobulina de la línea germinal de otras especies (por ejemplo, las secuencias de la línea germinal de murino). En ciertos casos, un anticuerpo humano puede ser cuando menos el 60 por ciento, el 70 por ciento, el 80 por ciento, el 90 por ciento, o cuando menos el 95 por ciento, o inclusive cuando menos el 96 por ciento, el 97 por ciento, el 98 por ciento, o el 99 por ciento idéntico en la secuencia de aminoácidos a la secuencia de aminoácidos codificada por el gen de inmunoglobulina de la línea germinal. Típicamente, un anticuerpo humano recombinante exhibirá no más de diez diferencias de aminoácidos de la secuencia de aminoácidos codificada por el gen de inmunoglobulina de la línea germinal humana en las regiones de estructura VH o VL. En ciertos casos, el anticuerpo humano puede exhibir no más de cinco, o inclusive no más de cuatro, tres, dos, o una diferencia de aminoácidos de la secuencia de aminoácidos codificada por el gen de inmunoglobulina de la línea germinal. Los ejemplos de los genes de inmunoglobulina de la línea germinal humana incluyen, pero no se limitan a, los fragmentos de la línea germinal del dominio variable descritos más adelante, así como DP47 y DPK9.
Anticuerpos Homólogos
Se divulga en la presente un anticuerpo o un fragmento de enlace al antígeno del mismo, que comprende secuencias de aminoácidos que son homólogas a las secuencias descritas en la Tabla 1, y el anticuerpo se enlaza a una proteína del Factor P (por ejemplo, Factor P humano y/o de cinomolgo), y conserva las propiedades funcionales deseadas de los anticuerpos descritos en la Tabla 1.
Por ejemplo, se divulga en la presente un anticuerpo aislado, o un fragmento de enlace al antígeno funcional del mismo, que comprende un dominio variable de cadena pesada y un dominio variable de cadena ligera, en donde el dominio variable de cadena pesada comprende una secuencia de aminoácidos que es cuando menos el 80 por ciento, cuando menos el 90 por ciento, o cuando menos el 95 por ciento idéntica a una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 7, 21, 35, 49, 63, 77, 91, 105, 119, 133, 147, 161, 175, 189, 203, 217, 231, 245, 259 y 273; el dominio variable de cadena ligera comprende una secuencia de aminoácidos que es cuando menos el 80 por ciento, de cuando menos el 90 por ciento, o cuando menos el 95 por ciento idéntica a una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 8, 22, 36, 50, 64, 78, 92, 106, 120, 134, 148, 162, 176, 190, 204, 218, 232, 246, 260, y 274; y el anticuerpo se enlaza específicamente al Factor P (por ejemplo, Factor P humano y/o de cinomolgo).
Se divulgan en la presente secuencias de aminoácidos VH y/o VL que pueden ser el 50 por ciento, 60 por ciento, 70 por ciento, 80 por ciento, 90 por ciento, 95 por ciento, 96 por ciento, 97 por ciento, 98 por ciento, o el 99 por ciento idénticas a las secuencias estipuladas en la Tabla 1. También se divulgan en la presente secuencias de aminoácidos VH y/o VL que pueden ser idénticas, excepto por una sustitución de aminoácido en no más de una, dos, tres, cuatro, o cinco posiciones de aminoácidos. Un anticuerpo que tenga las regiones VH y VL con una alta identidad (es decir, del 80 por ciento o mayor) con las regiones VH y VL de las descritas en la Tabla 1, se puede obtener mediante mutagénesis (por ejemplo, mutagénesis dirigida al sitio o mediada por reacción en cadena de la polimerasa (PCR)) de las moléculas de ácidos nucleicos que codifiquen las SEQ ID NOs: 7, 21, 35, 49, 63, 77, 91, 105, 119, 133, 147, 161, 175, 189, 203, 217, 231, 245, 259 o 273 y las SEQ ID NOs: 8, 22, 36, 50, 64, 78, 92, 106, 120, 134, 148, 162, 176, 190, 204, 218, 232, 246, 260, o 274, respectivamente, seguido por la prueba del anticuerpo alterado codificado para determinar la función retenida, utilizando los ensayos funcionales descritos en la presente.
Se divulgan en la presente secuencias de aminoácidos de cadena pesada de longitud completa y/o de cadena ligera de longitud completa que pueden ser el 50 por ciento, 60 por ciento, 70 por ciento, 80 por ciento, 90 por ciento, 95
por ciento, 96 por ciento, 97 por ciento, 98 por ciento, o el 99 por ciento idénticas a las secuencias estipuladas en la Tabla 1. Un anticuerpo que tenga una cadena pesada de longitud completa y una cadena ligera de longitud completa con una alta identidad (es decir, del 80 por ciento o mayor) con las cadenas pesadas de longitud completa de cualquiera de las SEQ ID NOs: 9, 23, 37, 51,65, 79, 93, 107, 121, 135, 149, 163, 177, 191, 205, 219, 233, 247, 261 o 275, y las cadenas ligeras de longitud completa de cualquiera de las SEQ ID NOs: 10, 24, 38, 52, 66, 80, 94, 108, 122, 136, 150, 164, 178, 192, 206, 220, 234, 248, 262, o 276, se puede obtener mediante mutagénesis (por ejemplo, mutagénesis dirigida al sitio o mutagénesis mediada por reacción en cadena de la polimerasa) de las moléculas de ácidos nucleicos que codifiquen estos polipéptidos, seguido por la prueba del anticuerpo alterado codificado para determinar la función retenida, utilizando los ensayos funcionales descritos en la presente.
Se divulgan en la presente secuencias de nucleótidos de cadena pesada de longitud completa y/o de cadena ligera de longitud completa que pueden ser el 60 por ciento, el 70 por ciento, el 80 por ciento, el 90 por ciento, el 95 por ciento, el 96 por ciento, el 97 por ciento, el 98 por ciento o el 99 por ciento idénticas a las secuencias estipuladas en la Tabla 1.
Se divulgan en la presente secuencias de nucleótidos de las regiones variables de cadena pesada y/o de las regiones variables de cadena ligera que pueden ser el 60 por ciento, el 70 por ciento, el 80 por ciento, el 90 por ciento, el 95 por ciento, el 96 por ciento, el 97 por ciento, el 98 por ciento o el 99 por ciento idénticas a las secuencias estipuladas en la Tabla 1.
Como se utiliza en la presente, el porcentaje de identidad entre las dos secuencias es una función del número de posiciones idénticas compartidas por las secuencias (es decir, el porcentaje de identidad es igual al número de posiciones idénticas/número total de posiciones x 100), tomando en cuenta el número de huecos, y la longitud de cada hueco, que se necesite introducir para la alineación óptima de las dos secuencias. La comparación de las secuencias y la determinación del porcentaje de identidad entre dos secuencias, se pueden llevar a cabo utilizando un algoritmo matemático, como se describe en los ejemplos no limitantes que se encuentran más adelante.
De una manera adicional o alternativa, las secuencias de proteína de la presente invención se pueden utilizar adicionalmente como una "secuencia pedida", para llevar a cabo una búsqueda contra las bases de datos públicas, por ejemplo, con el fin de identificar las secuencias relacionadas. Por ejemplo, estas búsquedas se pueden llevar a cabo utilizando el programa BLAST (Versión 2.0) de Altschul y colaboradores, 1990 J. Mol. Biol. 215:403-10.
Anticuerpos con Modificaciones Conservadoras.
Se divulga en la presente un anticuerpo que tiene una región variable de cadena pesada que comprende las secuencias de CDR1, CDR2, y CDR3, y una región variable de cadena ligera que comprende las secuencias de CDR1, CDR2, y CDR3, en donde una o más de estas secuencias de CDR tienen secuencias de aminoácidos especificadas basadas en los anticuerpos descritos en la presente, o modificaciones conservadoras de las mismas, y en donde los anticuerpos retienen las propiedades funcionales deseadas de los anticuerpos de enlace del Factor P de la invención. De conformidad con lo anterior, se divulga en la presente un anticuerpo aislado, o un fragmento de enlace al antígeno del mismo, que consiste en una región variable de cadena pesada que comprende las secuencias de CDR1, CDR2, y CDR3, y una región variable de cadena ligera que comprende las secuencias de CDR1, CDR2, y CDR3, en donde: las secuencias de aminoácidos de CDR1 de región variable de cadena pesada se seleccionan a partir del grupo que consiste en las SEQ ID NOs: 1, 15, 29, 43, 57, 71, 85, 99, 113, 127, 141, 155, 169, 183, 197, 211, 225, 239, 253, y 267, y las modificaciones conservadoras de las mismas; las secuencias de aminoácido de CDR2 de región variable de cadena pesada se seleccionan a partir del grupo que consiste en las SEQ ID NOs: 2, 16, 30, 44, 58, 72, 86, 100, 114, 128, 142, 156, 170, 184, 198, 212, 226, 240, 254, y 268, y las modificaciones conservadoras de las mismas; las secuencias de aminoácidos de CDR3 de región variable de cadena pesada se seleccionan a partir del grupo que consiste en las SEQ ID NOs: 3, 17, 31, 45, 59, 73, 87, 101, 115, 129, 143, 157, 171, 185, 199, 213, 227, 241, 255, y 269, y las modificaciones conservadoras de las mismas; las secuencias de aminoácidos de CDR1 de región variable de cadena ligera se seleccionan a partir del grupo que consiste en las SEQ ID NOs: 4, 18, 32, 46, 60, 74, 88, 102, 116, 130, 144, 158, 172, 186, 200, 214, 228, 242, 256, y 270, y las modificaciones conservadoras de las mismas; las secuencias de aminoácidos de CDR2 de región variable de cadena ligera se seleccionan a partir del grupo que consiste en las SEQ ID NOs: 5, 19, 33, 47, 61, 75, 89, 103, 117, 131, 145, 159, 173, 187, 201, 215, 229, 243, 257, y 271, y las modificaciones conservadoras de las mismas; las secuencias de aminoácidos de CDR3 de región variable de cadena ligera se seleccionan a partir del grupo que consiste en las SEQ ID NOs: 6, 20, 34, 48, 62, 76, 90, 104, 118, 132, 146, 160, 174, 188, 202, 216, 230, 244, 258, y 272, y las modificaciones conservadoras de las mismas; y el anticuerpo o el fragmento de enlace al antígeno del mismo, se enlaza específicamente al Factor P.
El anticuerpo divulgado en la presente está optimizado para la expresión en una célula de mamífero, tiene una secuencia de cadena pesada de longitud completa y una secuencia de cadena ligera de longitud completa, en donde una o más de estas secuencias tienen secuencias de aminoácidos especificadas basadas en los anticuerpos descritos en la presente, o modificaciones conservadoras de las mismas, y en donde los anticuerpos retienen las propiedades funcionales deseadas de los anticuerpos de enlace del Factor P de la invención. De conformidad con lo anterior, se divulga en la presente un anticuerpo aislado optimizado para su expresión en una célula de mamífero,
que consiste en una cadena pesada de longitud completa y una cadena ligera de longitud completa, en donde: la cadena pesada de longitud completa tiene las secuencias de aminoácidos seleccionadas a partir del grupo que consiste en las SEQ ID NOs: 9, 23, 37, 51, 65, 79, 93, 107, 121, 135, 149, 163, 177, 191, 205, 219, 233, 247, 261 y 275, y las modificaciones conservadoras de las mismas; y la cadena ligera de longitud completa tiene las secuencias de aminoácidos seleccionadas a partir del grupo que consiste en las SEQ ID NOs: 10, 24, 38, 52, 66, 80, 94, 108, 122, 136, 150, 164, 178, 192, 206, 220, 234, 248, 262, y 276, y las modificaciones conservadoras de las mismas; y el anticuerpo se enlaza específicamente al Factor P (por ejemplo, Factor P humano y/o de cinomolgo).
Anticuerpos que se enlazan al mismo epítopo
Se divulgan en la presente anticuerpos que se enlazan al mismo epítopo que los anticuerpos de enlace al Factor P descritos en la Tabla 1. Los anticuerpos adicionales, por consiguiente, se pueden identificar basándose en su capacidad para competir con (por ejemplo, para inhibir de una manera competitiva el enlace de, de una manera estadísticamente significativa) otros anticuerpos de la invención en los ensayos de enlace del Factor P (tales como aquellos descritos en los Ejemplos). La capacidad de un anticuerpo de prueba para inhibir el enlace de los anticuerpos divulgados en la presente a una proteína del Factor P, demuestra que el anticuerpo de prueba puede competir con este anticuerpo por el enlace con el Factor P; este anticuerpo, de acuerdo con una teoría no limitante, se puede enlazar al mismo epítopo o a un epítopo relacionado (por ejemplo, un epítopo estructuralmente similar o espacialmente proximal) sobre la proteína del Factor P que el anticuerpo con el que compite. El anticuerpo divulgado en la presente que se enlaza al mismo epítopo sobre el Factor P que los anticuerpos divulgados en la presente es un anticuerpo monoclonal humano. Estos anticuerpos monoclonales humanos se pueden preparar y aislar como se describe en la presente. Como se utiliza en la presente, un anticuerpo “compite” por el enlace cuando el anticuerpo competidor inhibe el enlace al Factor P de un anticuerpo o el fragmento de enlace al antígeno de la invención, por más del 50 por ciento, en la presencia de una concentración equimolar del anticuerpo competidor.
Se divulgan en la presente los anticuerpos o los fragmentos de enlace al antígeno que se enlazan al dominio de repetición de trombospondina tipo 5 (TSR5) del Factor P (SEQ ID NO: 406). Los anticuerpos o los fragmentos de enlace al antígeno divulgados en la presente se enlazan a una región del dominio TSR5 del Factor P, la cual comprende la SEQ ID NO: 407. También los anticuerpos o los fragmentos de enlace al antígeno divulgados en la presente se enlazan a una región del dominio TSR5 del Factor P, la cual comprende la SEQ ID NO: 408.
Se divulgan en la presente los anticuerpos aislados o los fragmentos de enlace al antígeno que se enlazan a un epítopo que comprende la SEQ ID NO: 407, y en donde el epítopo comprende la SEQ ID NO: 408. Se divulgan en la presente los anticuerpos o los fragmentos de enlace al antígeno que se enlazan a un péptido de acuerdo con la SEQ ID NO: 407, y en donde el epítopo del Factor P incluye la SEQ ID NO: 408.
Anticuerpos Diseñados y Modificados.
Un anticuerpo divulgado en la presente se puede preparar además utilizando un anticuerpo que tenga una o más de las secuencias VH y/o VL mostradas en la presente como material de partida para diseñar un anticuerpo modificado, cuyo anticuerpo modificado puede tener propiedades alteradas del anticuerpo de partida. Un anticuerpo se puede diseñar mediante la modificación de uno o más residuos dentro de una o ambas regiones variables (es decir, VH y/o VL), por ejemplo, dentro de una o más regiones CDR, y/o dentro de una o más regiones de estructura. De una manera adicional o alternativa, un anticuerpo se puede diseñar mediante la modificación de los residuos dentro de las regiones constantes, por ejemplo, para alterar las funciones efectoras del anticuerpo.
Un tipo de diseño de región variable que se puede llevar a cabo es el injerto de CDR. Los anticuerpos interactúan con los antígenos objetivo predominantemente a través de los residuos de aminoácidos que se localizan en las seis regiones determinantes de complementariedad (CDRs) de cadena pesada y ligera. Por esta razón, las secuencias de aminoácidos dentro de las regiones determinantes de complementariedad son más diversos entre los anticuerpos individuales que las secuencias que están fuera de las regiones determinantes de complementariedad. Debido a que las secuencias de regiones determinantes de complementariedad son responsables de la mayoría de las interacciones de anticuerpo-antígeno, es posible expresar los anticuerpos recombinantes que imiten las propiedades de los anticuerpos que se presenten naturalmente específicos, mediante la construcción de vectores de expresión que incluyan secuencias de las regiones determinantes de complementariedad a partir del anticuerpo que se presente naturalmente específico, injertadas sobre las secuencias de estructura a partir de un anticuerpo diferente con propiedades diferentes (véanse, por ejemplo, Riechmann, L. y colaboradores, 1998 Nature 332:323-327; Jones, P. y colaboradores, 1986 Nature 321:522-525; Queen, C. y colaboradores, 1989 Proc. Natl. Acad., E.U.A. 86:10029-10033; Patente de los Estados Unidos de Norteamérica Número 5,225,539 a Winter, y Patentes de los Estados Unidos de Norteamérica Números 5,530,101; 5,585,089; 5,693,762 y 6,180,370 a Queen y colaboradores).
De conformidad con lo anterior, se divulga en la presente un anticuerpo aislado, o un fragmento de enlace al antígeno del mismo, el cual comprende una región variable de cadena pesada, la cual comprende las secuencias de CDR1 que tienen una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 1, 15, 29, 43, 57, 71, 85, 99, 113, 127, 141, 155, 169, 183, 197, 211, 225, 239, 253, y 267; las secuencias de CDR2 que tienen una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 2, 16,
30, 44, 58, 72, 86, 100, 114, 128, 142, 156, 170, 184, 198, 212, 226, 240, 254, y 268; las secuencias de CDR3 que tienen una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 3, 17, 31,45, 59, 73, 87, 101, 115, 129, 143, 157, 171, 185, 199, 213, 227, 241,255, y 269, respectivamente; y una región variable de cadena ligera que tiene las secuencias de CDR1 que tienen una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 4, 18, 32, 46, 60, 74, 88, 102, 116, 130, 144, 158, 172, 186, 200, 214, 228, 242, 256, y 270; las secuencias de CDR2 que tienen una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 5, 19, 33, 47, 61, 75, 89, 103, 117, 131, 145, 159, 173, 187, 201, 215, 229, 243, 257, y 271; y las secuencias de CDR3 que consisten en un secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 6, 20, 34, 48, 62, 76, 90, 104, 118, 132, 146, 160, 174, 188, 202, 216, 230, 244, 258, y 272, respectivamente. Por consiguiente, estos anticuerpos contienen las secuencias de regiones determinantes de complementariedad (CDRs) VH y VL de los anticuerpos monoclonales, y no obstante, pueden contener secuencias de estructura diferentes de estos anticuerpos.
De una manera alternativa, se divulga en la presente un anticuerpo aislado, o un fragmento de enlace al antígeno del mismo, el cual comprende una región variable de cadena pesada, la cual comprende las secuencias de CDR1 que tienen una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 281, 287, 293, 299, 305, 311, 317, 323, 329, 335, 341, 347, 353, 359, 365, 371, 377, 383, 389, y 395; las secuencias de CDR2 que tienen una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 282, 288, 294, 300, 306, 312, 318, 324, 330, 336, 342, 348, 354, 360, 366, 372, 378, 384, 390, y 396; las secuencias de CDR3 que tienen una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 283, 289, 295, 301, 307, 313, 319, 325, 331, 337, 343, 349, 355, 361, 367, 373, 379, 385, 391, y 397, respectivamente; y una región variable de cadena ligera que tiene las secuencias de CDR1 que tienen una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 284, 290, 296, 302, 308, 314, 320, 326, 332, 338, 344, 350, 356, 362, 368, 374, 380, 386, 392, y 398; las secuencias de c Dr 2 que tienen una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 285, 291, 297, 303, 309, 315, 321, 327, 333, 339, 345, 351, 357, 363, 369, 375, 381, 387, 393, y 399; y las secuencias de CDR3 que consisten en un secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 286, 292, 298, 304, 310, 316, 322, 328, 334, 340, 346, 352, 358, 364, 370, 376, 382, 388, 394, y 400, respectivamente. Por consiguiente, estos anticuerpos contienen las secuencias de regiones determinantes de complementariedad (CDRs) VH y VL de los anticuerpos monoclonales, y no obstante pueden contener secuencias de estructura diferentes de estos anticuerpos.
Estas secuencias de estructura se pueden obtener a partir de las bases de datos de ADN públicas o de las referencias publicadas que incluyan secuencias de genes de anticuerpos de la línea germinal. Por ejemplo, las secuencias de ADN de la línea germinal para los genes de región variable de cadena pesada y ligera humanos se pueden encontrar en la base de datos de secuencias de la línea germinal humana "VBase" (disponible en la red informática mundial (la web o www) en www.mrc-cpe.cam.ac.uk/vbase), así como en Kabat, E. A. y colaboradores, 1991 Sequences of Proteins of Immunological Interest, Quinta Edición, Departamento de Salud y Servicios Humanos de los Estados Unidos, NIH Publicación Número 91-3242; Tomlinson, I. M. y colaboradores, 1992 J. Mol. Biol.
227:776-798; y Cox, J. P. L. y colaboradores, 1994 Eur. J. Immunol. 24:827-836.
Un ejemplo de las secuencias de estructura para utilizarse en los anticuerpos divulgados en la presente son aquellas que son estructuralmente similares a las secuencias de estructura utilizadas por los anticuerpos divulgados en la presente, por ejemplo, las secuencias en consenso y/o las secuencias de estructura utilizadas por los anticuerpos monoclonales divulgados en la presente. Las secuencias de CDR1, CDR2, y CDR3 VH, y las secuencias de CDR1, CDR2, y CDR3 VL, se pueden injertar en las regiones de estructura que tengan una secuencia idéntica a la que se encuentra en el gen de inmunoglobulina de la línea germinal a partir del cual se derive la secuencia de estructura, o las secuencias de CDR se pueden injertar en las regiones de estructura que contengan una o más mutaciones, comparándose con las secuencias de la línea germinal. Por ejemplo, se ha encontrado que, en ciertos casos, es benéfico mutar los residuos de las regiones de estructura para mantener o mejorar la capacidad de enlace al antígeno del anticuerpo (véanse, por ejemplo, las Patentes de los Estados Unidos de Norteamérica Números 5,530,101; 5,585,089; 5,693,762 y 6,180,370 a Queen y colaboradores). Las estructuras que se pueden utilizar como andamiajes sobre los cuales construir los anticuerpos y fragmentos de enlace al antígeno descritos en la presente incluyen, pero no se limitan a, VH1A, VH1B, VH3, Vk1, Vl2, y Vk2. Se conocen en la técnica estructuras adicionales, y se pueden encontrar, por ejemplo, en la base de datos VBase de la red amplia mundial, en vbase.mrccpe.cam.ac.uk/index.php?&MMN_position=1:1.
De conformidad con lo anterior, se divulgan en la presente anticuerpos aislados de enlace al Factor P, o a los fragmentos de enlace al antígeno de los mismos, los cuales comprenden una región variable de cadena pesada, la cual comprende una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ Id NOs: 7, 21, 35, 49, 63, 77, 91, 105, 119, 133, 147, 161, 175, 189, 203, 217, 231, 245, 259 y 273, o una secuencia de aminoácidos que tiene una, dos, tres, cuatro o cinco sustituciones, supresiones o adiciones de aminoácidos en la región de estructura de estas secuencias, y la cual comprende además una región variable de cadena ligera que tiene una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 8, 22, 36, 50, 64, 78, 92, 106, 120, 134, 148, 162, 176, 190, 204, 218, 232, 246, 260, y 274, o una secuencia de aminoácidos que tiene una, dos, tres, cuatro o cinco sustituciones, supresiones o adiciones de aminoácidos en la región de estructura
de estas secuencias.
Otro tipo de modificación de región variable es mutar los residuos de aminoácidos dentro de las regiones CDR1, CDR2, y/o CDR3 VH y/o VL, para mejorar de esta manera una o más propiedades de enlace (por ejemplo, la afinidad) del anticuerpo de interés, conocida como "maduración de afinidad". Se puede llevar a cabo mutagénesis dirigida al sitio o mutagénesis mediada por reacción en cadena de la polimerasa para introducir las mutaciones, y se puede evaluar el efecto sobre el enlace del anticuerpo, u otra propiedad funcional de interés, en ensayos in vitro o in vivo, como se describe en la presente, y como se proporciona en los ejemplos. Se pueden introducir modificaciones conservadoras (como se discute anteriormente). Las mutaciones pueden ser sustituciones, adiciones, o supresiones de aminoácidos. Más aún, típicamente no se alteran más de 1,2, 3, 4, o 5 residuos dentro de una región CDR.
De conformidad con lo anterior, se divulgan en la presente anticuerpos de enlace al Factor P aislados, o los fragmentos de enlace al antígeno de los mismos, que consisten en una región variable de cadena pesada que tiene una región VH CDR1 que consiste en un secuencia de aminoácidos seleccionada a partir del grupo que tiene las SEQ ID NOs: 1, 15, 29, 43, 57, 71, 85, 99, 113, 127, 141, 155, 169, 183, 197, 211, 225, 239, 253, y 267 o una secuencia de aminoácidos que tiene una, dos, tres, cuatro o cinco sustituciones, supresiones o adiciones de aminoácidos, comparándose con las SEQ ID NOs: 1, 15, 29, 43, 57, 71, 85, 99, 113, 127, 141, 155, 169, 183, 197, 211, 225, 239, 253, o 267; una región VH CDR2 que tiene una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 2, 16, 30, 44, 58, 72, 86, 100, 114, 128, 142, 156, 170, 184, 198, 212, 226, 240, 254, y 268 o una secuencia de aminoácidos que tiene una, dos, tres, cuatro o cinco sustituciones, supresiones o adiciones de aminoácidos, comparándose con las SEQ ID NOs: 2, 16, 30, 44, 58, 72, 86, 100, 114, 128, 142, 156, 170, 184, 198, 212, 226, 240, 254, o 268; una región VH CDR3 que tiene una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 3, 17, 31, 45, 59, 73, 87, 101, 115, 129, 143, 157, 171, 185, 199, 213, 227, 241, 255, y 269, o una secuencia de aminoácidos que tiene una, dos, tres, cuatro o cinco sustituciones, supresiones o adiciones de aminoácidos, comparándose con las SEQ ID NOs: 3, 17, 31, 45, 59, 73, 87, 101, 115, 129, 143, 157, 171, 185, 199, 213, 227, 241,255, o 269; una región VL CDR1 que tiene una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 4, 18, 32, 46, 60, 74, 88, 102, 116, 130, 144, 158, 172, 186, 200, 214, 228, 242, 256, y 270, o una secuencia de aminoácidos que tiene una, dos, tres, cuatro o cinco sustituciones, supresiones o adiciones de aminoácidos, comparándose con las SEQ ID NOs: 4, 18, 32, 46, 60, 74, 88, 102, 116, 130, 144, 158, 172, 186, 200, 214, 228, 242, 256, o 270; una región VL CDR2 que tiene una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 5, 19, 33, 47, 61, 75, 89, 103, 117, 131, 145, 159, 173, 187, 201, 215, 229, 243, 257, y 271, o una secuencia de aminoácidos que tiene una, dos, tres, cuatro o cinco sustituciones, supresiones o adiciones de aminoácidos, comparándose con las SEQ ID NOs: 5, 19, 33, 47, 61, 75, 89, 103, 117, 131, 145, 159, 173, 187, 201, 215, 229, 243, 257, o 271; y una región VL CDR3 que tiene una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 6, 20, 34, 48, 62, 76, 90, 104, 118, 132, 146, 160, 174, 188, 202, 216, 230, 244, 258, y 272, o una secuencia de aminoácidos que tiene una, dos, tres, cuatro o cinco sustituciones, supresiones o adiciones de aminoácidos, comparándose con las SEQ ID NOs: 6, 20, 34, 48, 62, 76, 90, 104, 118, 132, 146, 160, 174, 188, 202, 216, 230, 244, 258, o 272.
De conformidad con lo anterior, se divulgan en la presente anticuerpos de enlace al Factor P aislados, o los fragmentos de enlace al antígeno de los mismos, que consisten en una región variable de cadena pesada que tiene una región VH CDR1 que consiste en un secuencia de aminoácidos seleccionada a partir del grupo que tiene las SEQ ID NOs: 281,287, 293, 299, 305, 311,317, 323, 329, 335, 341,347, 353, 359, 365, 371,377, 383, 389, y 395 o una secuencia de aminoácidos que tiene una, dos, tres, cuatro o cinco sustituciones, supresiones o adiciones de aminoácidos, comparándose con las SEQ ID NOs: 281,287, 293, 299, 305, 311, 317, 323, 329, 335, 341, 347, 353, 359, 365, 371, 377, 383, 389, o 395; una región VH CDR2 que tiene una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 282, 288, 294, 300, 306, 312, 318, 324, 330, 336, 342, 348, 354, 360, 366, 372, 378, 384, 390, y 396 o una secuencia de aminoácidos que tiene una, dos, tres, cuatro o cinco sustituciones, supresiones o adiciones de aminoácidos, comparándose con las SEQ ID NOs: 282, 288, 294, 300, 306, 312, 318, 324, 330, 336, 342, 348, 354, 360, 366, 372, 378, 384, 390, o 396; una región VH CDR3 que tiene una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 283, 289, 295, 301, 307, 313, 319, 325, 331, 337, 343, 349, 355, 361, 367, 373, 379, 385, 391, y 397, o una secuencia de aminoácidos que tiene una, dos, tres, cuatro o cinco sustituciones, supresiones o adiciones de aminoácidos, comparándose con las SEQ ID NOs: 283, 289, 295, 301, 307, 313, 319, 325, 331, 337, 343, 349, 355, 361, 367, 373, 379, 385, 391, o 397; una región VL CDR1 que tiene una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 284, 290, 296, 302, 308, 314, 320, 326, 332, 338, 344, 350, 356, 362, 368, 374, 380, 386, 392, y 398, o una secuencia de aminoácidos que tiene una, dos, tres, cuatro o cinco sustituciones, supresiones o adiciones de aminoácidos, comparándose con las SEQ ID NOs: 284, 290, 296, 302, 308, 314, 320, 326, 332, 338, 344, 350, 356, 362, 368, 374, 380, 386, 392, o 398; una región VL CDR2 que tiene una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 285, 291, 297, 303, 309, 315, 321, 327, 333, 339, 345, 351,357, 363, 369, 375, 381,387, 393, y 399, o una secuencia de aminoácidos que tiene una, dos, tres, cuatro o cinco sustituciones, supresiones o adiciones de aminoácidos, comparándose con las SEQ ID NOs: 285, 291, 297, 303, 309, 315, 321, 327, 333, 339, 345, 351, 357, 363, 369, 375, 381, 387, 393, o 399; y una región VL CDR3 que tiene una secuencia de aminoácidos seleccionada a partir del grupo que consiste en las SEQ ID NOs: 286, 292, 298, 304, 310, 316, 322, 328, 334, 340, 346, 352, 358, 364, 370, 376, 382, 388, 394, y 400, o una secuencia de
aminoácidos que tiene una, dos, tres, cuatro o cinco sustituciones, supresiones o adiciones de aminoácidos, comparándose con las SEQ ID NOs: 286, 292, 298, 304, 310, 316, 322, 328, 334, 340, 346, 352, 358, 364, 370, 376, 382, 388, 394, o 400.
Injerto de dominios de enlace al antígeno en estructuras o andamiajes alternativos.
Se puede emplear una amplia variedad de estructuras o andamiajes de anticuerpo/inmunoglobulina siempre que el polipéptido resultante incluya cuando menos una región de enlace que se enlace específicamente al Factor P. Estas estructuras o andamiajes incluyen los 5 idiotipos principales de las inmuno-globulinas humanas, o fragmentos de los mismos, e incluyen las inmunoglobulinas de otras especies de animales, de preferencia que tengan aspectos humanizados. Los anticuerpos de cadena pesada individuales, tales como aquellos identificados en los camélidos son de un interés particular en este aspecto. Los expertos en este campo continúan descubriendo y desarrollando estructuras, andamiajes y fragmentos novedosos.
En un aspecto, la presente divulgación pertenece a la generación de anticuerpos no basados en inmunoglobulina utilizando andamiajes que no son de inmunoglobulina sobre los cuales se pueden injertar las regiones determinantes de complementariedad (CDRs) de la invención. Se pueden emplear estructuras y andamiajes que no sean de inmunoglobulina conocidos o futuros, siempre que comprendan una región de enlace específica para la proteína del Factor P objetivo. Las estructuras o andamiajes que no son de inmunoglobulina conocidos incluyen, pero no se limitan a, fibronectina (Compound Therapeutics, Inc., Waltham, MA), anquirina (Molecular Partners AG, Zurich, Suiza), anticuerpos de dominio (Domantis, Ltd., Cambridge, MA, y Ablynx nv, Zwijnaarde, Bélgica), lipocalina (Pieris Proteolab AG, Freising, Alemania), productos farmacéuticos inmunológicos modulares pequeños (Trubion Pharmaceuticals Inc., Seattle, WA), maxicuerpos (Avidia, Inc., Mountain View, CA), Proteína A (Affibody AG, Suecia), y afilina (gamma-cristalina o ubiquitina) (Scil Proteins GmbH, Halle, Alemania).
Los andamiajes de fibronectina se basan en el dominio de fibronectina tipo III (por ejemplo, el décimo módulo de la fibronectina tipo III (dominio 10 Fn3)). El dominio de fibronectina tipo III tiene 7 u 8 cadenas beta que están distribuidas entre dos hojas beta, que por sí mismas se empacan unas contra otras para formar el núcleo de la proteína, y que además contienen ciclos (análogos a las regiones determinantes de complementariedad (CDRs)) que conectan las cadenas beta unas con otras y se exponen al solvente. Hay cuando menos tres de estos ciclos en cada orilla del emparedado de hojas beta, en donde la orilla es el límite de la proteína perpendicular a la dirección de las cadenas beta (véase la Patente de los Estados Unidos de Norteamérica Número US 6,818,418). Estos andamiajes basados en fibronectina no son una inmunoglobulina, aunque el pliegue global está estrechamente relacionado con aquel del fragmento de anticuerpo funcional más pequeño, la región variable de la cadena pesada, que comprende la unidad entera de reconocimiento de antígeno en la IgG de camello y de llama. Debido a esta estructura, el anticuerpo que no es de inmunoglobulina imita las propiedades de enlace al antígeno que son de una naturaleza y afinidad similar a aquellas de los anticuerpos. Estos andamiajes se pueden utilizar en una estrategia de selección aleatoria y mezcla en ciclo in vitro, que es similar al proceso de maduración de afinidad de los anticuerpos in vivo. Estas moléculas basadas en fibronectina se pueden utilizar como andamiajes en donde las regiones de ciclo de la molécula pueden ser reemplazadas con las regiones determinantes de complementariedad (CDRs) de la invención utilizando técnicas de clonación convencionales.
La tecnología de anquirina se basa en el uso de proteínas con módulos de repetición derivados de anquirina como andamiajes para soportar las regiones variables, las cuales se pueden utilizar para enlazarse a diferentes objetivos. El módulo de repetición de anquirina es un polipéptido de 33 aminoácidos que consiste en dos hélices-a anti paralelas y una vuelta-B. El enlace de las regiones variables se optimiza en su mayor parte utilizando la exhibición de ribosomas.
Los avímeros se derivan a partir de la proteína que contiene el dominio A natural, tal como LRP-1. Estos dominios se utilizan por naturaleza para las interacciones de proteína-proteína, y en el ser humano, más de 250 proteínas se basan estructuralmente en los dominios-A. Los avímeros consisten en un número de diferentes monómeros de “dominio-A” (2-10) enlazados por medio de enlazadores de aminoácidos. Se pueden crear avímeros que pueden enlazarse a un antígeno objetivo empleando la metodología descrita, por ejemplo, en las Publicaciones de Solicitud de Patente de los Estados Unidos de Norteamérica Números 20040175756; 20050053973; 20050048512; y 20060008844.
Los ligandos de afinidad Affibody son proteínas simples pequeñas compuestas de un haz de tres hélices basado en el andamiaje de uno de los dominios de enlace a IgG de la proteína A. La proteína A es una proteína superficial a partir de la bacteria Staphylococcus aureus. Este dominio de andamiaje consiste en 58 aminoácidos, 13 de los cuales se seleccionan aleatoriamente para generar bibliotecas Affibody con un gran número de variantes de ligandos (véase, por ejemplo, la Patente de los Estados Unidos de Norteamérica Número US 5,831,012). Las moléculas Affibody imitan a los anticuerpos, tienen un peso molecular de 6 kDa, comparándose con el peso molecular de los anticuerpos, el cual es de 150 kDa. A pesar de su pequeño tamaño, el sitio de enlace de las moléculas Affibody es similar a aquel de un anticuerpo.
Las anticalinas son productos desarrollados por la compañía Pieris ProteoLab AG. Se derivan a partir de las
lipocalinas, un grupo ampliamente extendido de proteínas pequeñas y robustas que usualmente están involucradas en el transporte o almacenamiento fisiológico de los compuestos químicamente sensibles o insolubles. Se presentan varias lipocalinas naturales en los tejidos o en los líquidos corporales humanos. La arquitectura de la proteína hace recordar a las inmunoglobulinas, con ciclos hipervariables encima de una estructura rígida. Sin embargo, en contraste con los anticuerpos o con sus fragmentos recombinantes, las lipocalinas están compuestas de una sola cadena de polipéptido con 160 a 180 residuos de aminoácidos, lo cual es apenas marginalmente mayor que un solo dominio de inmunoglobulina. El conjunto de cuatro ciclos, el cual forma la buchaca de enlace, muestra una plasticidad estructural pronunciada y tolera una variedad de cadenas laterales. El sitio de enlace, por consiguiente, se puede reconfigurar en un proceso registrado con el objeto de reconocer las moléculas objetivo prescritas de forma diferente con una alta afinidad y especificidad. Se ha utilizado una proteína de la familia de lipocalina, la proteína de enlace a bilina (BBP) de Pieris Brassicae, para desarrollar anticalinas mediante la mutagenización del conjunto de cuatro ciclos. Un ejemplo de una solicitud de patente que describe las anticalinas está en la Publicación Internacional del TCP Número WO 199916873.
Las moléculas de afilina son proteínas pequeñas que no son de inmunoglobulina, las cuales están diseñadas para tener afinidades específicas hacia las proteínas y las moléculas pequeñas. Las nuevas moléculas de afilina se pueden seleccionar muy rápidamente a partir de dos bibliotecas, cada una de los cuales se basa en una proteína de andamiaje diferente derivada del ser humano. Las moléculas de afilina no muestran ninguna homología estructural con las proteínas de inmunoglobulina. Actualmente, se emplean dos andamiajes de afilina, uno de los cuales es la gamma-cristalina, una proteína estructural humana del lente del ojo, y el otro es el de las proteínas de la superfamilia de ''ubiquitina''. Ambos andamiajes humanos son muy pequeños, muestran una alta estabilidad a la temperatura, y son casi resistentes a los cambios de pH y a los agentes desnaturalizantes. Esta alta estabilidad se debe principalmente a la estructura de hoja beta expandida de las proteínas. Los ejemplos de las proteínas derivadas de gamma-cristalina se describen en la Publicación Internacional Número WO200104144, y los ejemplos de las proteínas "de tipo ubiquitina" se describen en la Publicación Internacional Número WO 2004106368.
Los miméticos de epítopos de proteína (PEM) son moléculas de tipo péptido cíclicas de tamaño mediano (MW 1-2kDa) que imitan a las estructuras secundarias de horquilla-beta de las proteínas, la principal estructura secundaria involucrada en las interacciones de proteína-proteína.
Se divulgan en la presente anticuerpos completamente humanos que se enlazan específicamente con una proteína del Factor P. Comparándose con los anticuerpos quiméricos o humanizados, los anticuerpos de enlace al Factor P humano divulgados en la presente tienen además una antigenicidad reducida cuando se administran a sujetos humanos.
Anticuerpos de camélido
Las proteínas de anticuerpos obtenidas a partir de los miembros de la familia del camello y el dromedario (Camelus bactrianus y Camelus dromedarius), incluyendo los miembros del nuevo mundo, tales como las especies de llama (Lama paceos, Lama glama y lama vicugna), se han caracterizado con respecto al tamaño, la complejidad estructural, y la antigenicidad para los sujetos humanos. Ciertos anticuerpos de IgG a partir de esta familia de mamíferos, como se encuentran en la naturaleza, carecen de cadenas ligeras y, por consiguiente, son estructuralmente distintos de la estructura cuaternaria típica de cuatro cadenas que tiene dos cadenas pesadas y dos cadenas ligeras, para los anticuerpos de otros animales. Véase la Publicación Internacional del TCP Número PCT/EP93/02214 (Publicación Internacional Número WO 94/04678 publicada el 3 de marzo de 1994).
Una región del anticuerpo de camélido, que es el único dominio variable pequeño identificado como VHH, se puede obtener mediante ingeniería genética para proporcionar una proteína pequeña que tiene una alta afinidad por un objetivo, que da como resultado una proteína derivada de anticuerpo de bajo peso molecular conocida como un “nanocuerpo de camélido”. Véase la Patente de los Estados Unidos de Norteamérica Número 5,759,808 expedida el 2 de junio de 1998; véase también Stijlemans, B. y colaboradores, 2004 J Biol Chem 279: 1256-1261; Dumoulin, M. y colaboradores, 2003 Nature 424: 783-788; Pleschberger, M. y colaboradores, 2003 Bioconjugate Chem 14: 440 448; Cortez-Retamozo, V. y colaboradores, 2002 Int J Cancer 89: 456-62; y Lauwereys, M. y colaboradores, 1998 EMBO J 17: 3512-3520. Las bibliotecas diseñadas de anticuerpos de camélido y fragmentos de anticuerpos están comercialmente disponibles, por ejemplo, en Ablynx, Ghent, Bélgica. Como con otros anticuerpos de origen no humano, una secuencia de aminoácidos de un anticuerpo de camélido se puede alterar de una manera recombinante para obtener una secuencia que se parezca más cercanamente a una secuencia humana, es decir, el nanocuerpo se puede “humanizar”. Por consiguiente, se puede reducir adicionalmente la baja antigenicidad natural de los anticuerpos de camélido para los seres humanos.
El nanocuerpo de camélido tiene un peso molecular de aproximadamente una décima parte de aquel de una molécula de IgG humana, y la proteína tiene un diámetro físico de solamente unos cuantos nanómetros. Una consecuencia del pequeño tamaño es la capacidad de los nanocuerpos de camélido para enlazarse a los sitios antigénicos que son funcionalmente invisibles para las proteínas de anticuerpo más grandes, es decir, los nanocuerpos de camélido son útiles como reactivos para detectar los antígenos que sean de otra manera crípticos, utilizando las técnicas inmunológicas clásicas, y como posibles agentes terapéuticos. Por consiguiente, todavía otra
consecuencia del pequeño tamaño es que un nanocuerpo de camélido puede ser inhibidor como un resultado del enlace a un sitio específico en una ranura o hendidura estrecha de una proteína objetivo y, por consiguiente, puede servir en una capacidad que se parezca más cercanamente a la función de un fármaco de bajo peso molecular clásico, que aquella de un anticuerpo clásico.
El bajo peso molecular y el tamaño compacto además dan como resultado nanocuerpos de camélido que son extremadamente termoestables, estables a pHs extremos y a la digestión proteolítica, y pobremente antigénicos. Otra consecuencia es que los nanocuerpos de camélido se mueven fácilmente desde el sistema circulatorio hacia los tejidos, e incluso cruzan la barrera hematoencefálica y pueden tratar los trastornos que afecten al tejido nervioso. Los nanocuerpos pueden facilitar adicionalmente el transporte de fármacos a través de la barrera hematoencefálica. Véase la Solicitud de Patente de los Estados Unidos de Norteamérica Número 20040161738 publicada el 19 de agosto de 2004. Estas características, combinadas con la baja antigenicidad para los seres humanos, indican el gran potencial terapéutico. Además, estas moléculas se pueden expresar completamente en las células procarióticas, tales como de E. coli, y se expresan como proteínas de fusión con los bacteriófagos, y son funcionales.
De conformidad con lo anterior, se divulga en la presente un anticuerpo o nanocuerpo de camélido que tiene una alta afinidad por el Factor P. Tal como se divulga en la presente, el anticuerpo o nanocuerpo de camélido se produce naturalmente en el animal camélido, es decir, es producido por el camélido en seguida de la inmunización con el Factor P o con un fragmento peptídico del mismo, utilizando las técnicas descritas en la presente para otros anticuerpos. De una manera alternativa, el nanocuerpo de camélido que se enlaza al Factor P se diseña, es decir, se produce, mediante una selección, por ejemplo, a partir de una biblioteca de fagos que exhiban las proteínas de nanocuerpos de camélido apropiadamente mutagenizadas, utilizando procedimientos de paneo con el Factor P como un objetivo, como se describe en los Ejemplos de la presente. Los nanocuerpos diseñados se pueden hacer además a la medida mediante ingeniería genética para tener una vida media en un sujeto receptor de 45 minutos a dos semanas. En un anticuerpo o nanocuerpo de camélido especifico divulgado en la presente, se obtiene mediante el injerto de las secuencias de las regiones determinantes de complementariedad (CDRs) de la cadena pesada o ligera de los anticuerpos humanos divulgados en la presente, en las secuencias de estructura del nanocuerpo o del anticuerpo de un solo dominio, como se describe, por ejemplo, en la Publicación Internacional del TCP Número PCT/EP93/02214.
Moléculas biespecíficas y anticuerpos multivalentes
Se divulgan en la presente moléculas biespecíficas o multiespecíficas que comprenden un anticuerpo de enlace del Factor P, o un fragmento del mismo, tal como se divulga en la presente. Un anticuerpo divulgado en la presente, o las regiones de enlace al antígeno del mismo, se pueden derivar o enlazar a otra molécula funcional, por ejemplo, a otro péptido o proteína (por ejemplo, otro anticuerpo o ligando para un receptor), con el fin de generar una molécula biespecífica que se enlace con cuando menos dos sitios de enlace o moléculas objetivo diferentes. El anticuerpo divulgado en la presente, de hecho, se puede derivar o enlazar a más de una molécula funcional diferente para generar moléculas multiespecíficas que se enlacen a más de dos sitios de enlace y/o moléculas objetivo diferentes; estas moléculas multiespecíficas también pretenden ser abarcadas por el término "molécula biespecífica", como se utiliza en la presente. Para crear una molécula biespecífica de la invención, un anticuerpo divulgado en la presente se puede enlazar funcionalmente (por ejemplo, mediante acoplamiento químico, fusión genética, asociación no covalente, o de otra manera) a una o más moléculas de enlace diferentes, tales como otro anticuerpo, fragmento de anticuerpo, péptido o mimético de enlace, de tal manera que resulte una molécula biespecífica.
De conformidad con lo anterior, se divulgan en la presente moléculas biespecíficas que comprenden cuando menos una primera especificidad de enlace para el Factor P, y una segunda especificidad de enlace para un segundo epítopo objetivo. Por ejemplo, el segundo epítopo objetivo es otro epítopo del Factor P diferente del primer epítopo objetivo.
Adicionalmente, en donde la molécula biespecífica es multiespecífica, la molécula puede incluir además una tercera especificidad de enlace, en adición al primero y segundo epítopos objetivo.
Las moléculas biespecíficas divulgadas en la presente comprenden, como una especificidad de enlace, cuando menos un anticuerpo, o un fragmento de anticuerpo del mismo, incluyendo, por ejemplo, un Fab, Fab', F(ab')2, Fv, o un Fv de una sola cadena. El anticuerpo también puede ser un dímero de cadena ligera o de cadena pesada, o cualquier fragmento mínimo del mismo, tal como un Fv, o una construcción de una sola cadena, como se describe en Ladner y colaboradores, Patente de los Estados Unidos de Norteamérica Número 4,946,778.
Los diacuerpos son moléculas biespecíficas bivalentes, en donde los dominios VH y VL se expresan sobre una sola cadena de polipéptido, conectados por un enlazador que es demasiado corto para permitir el emparejamiento entre los dos dominios sobre la misma cadena. Los dominios VH y VL se emparejan con dominios de complementariedad de otra cadena, creando de esta manera dos sitios de enlace al antígeno (véanse, por ejemplo, Holliger y colaboradores, 1993 Proc. Natl. Acad. Sci. EUA 90:6444-6448; Poljak y colaboradores, 1994 Structure 2:1121-1123). Los diacuerpos se pueden producir mediante la expresión de dos cadenas de polipéptido con la estructura VHA-VLB y VHB-VLA (configuración VH-VL), o bien VLA-VHB y VLB-VHA (configuración VL-VH) dentro de la misma célula. La
mayoría de ellos se pueden expresar en una forma soluble en bacterias. Los diacuerpos de una sola cadena (scDb) se producen mediante la conexión de las dos cadenas del polipéptido que forman el diacuerpo con un enlazador de aproximadamente 15 residuos de aminoácidos (véanse Holliger y Winter, 1997 Cancer Immunol. Immunother., 45(3-4):128-30; Wu y colaboradores, 1996 Immunotechnology, 2(1 ):21 -36). Los diacuerpos de una sola cadena se pueden expresar en bacterias en una forma monomérica activa soluble (véanse Holliger y Winter, 1997 Cancer Immunol. Immunother., 45(34): 128-30; Wu y colaboradores, 1996 Immunotechnology, 2(1 ):21 -36; Pluckthun y Pack, 1997 Immunotechnology, 3(2): 83-105; Ridgway y colaboradores, 1996 Protein Eng., 9(7):617-21). Un diacuerpo se puede fusionar a Fc para generar un "di-diacuerpo” (véase Lu y colaboradores, 2004 J. Biol. Chem., 279(4):2856-65).
Otros anticuerpos que se pueden emplear en las moléculas biespecíficas son los anticuerpos monoclonales de murino, quiméricos, y humanizados.
Las moléculas biespecíficas se pueden preparar mediante la conjugación de las especificidades de enlace constituyentes, empleando los métodos conocidos en este campo. Por ejemplo, cada especificidad de enlace de la molécula biespecífica se puede generar por separado, y luego se conjugan unas con otras. Cuando las especificidades de enlace son proteínas o péptidos, se pueden utilizar una variedad de agentes de acoplamiento o reticulación para la conjugación covalente. Los ejemplos de los agentes de reticulación incluyen Proteína A, carbodiimida, S-acetil-tioacetato de N-succinimidilo (SATA), 5,5'-ditiobis-(ácido 2-nitro-benzoico) (DTNB), o-fenilendimaleimida (oPDM), 3-(2-ditiopiridil)-propionato de N-succinimidilo (SPDP), y 4-(N-maleimido-metil)-ciclohexan-1-carboxilato de sulfo-succinimidilo (sulfo-SMCC) (véanse, por ejemplo, Karpovsky y colaboradores, 1984 J. Exp. Med.
160:1686; Liu, MA y colaboradores, 1985 Proc. Natl. Acad. Sci. e Ua 82:8648). Otros métodos incluyen aquellos descritos en Paulus, 1985 Behring Ins. Mitt. No. 78,118-132; Brennan y colaboradores, 1985 Science 229:81-83; y Glennie y colaboradores, 1987 J. Immunol. 139: 2367-2375). Los agentes de conjugación son SATA y sulfo-SMCC, ambos disponibles en Pierce Chemical Co. (Rockford, IL).
Cuando las especificidades de enlace son anticuerpos, se pueden conjugar mediante enlace de sulfhidrilo de las regiones de articulación del término C de las dos cadenas pesadas. En un ejemplo particular, la región de articulación se modifica para contener un número non de residuos de sulfhidrilo, por ejemplo, uno, antes de la conjugación.
De una manera alternativa, ambas especificidades de enlace se pueden codificar en el mismo vector, y se pueden expresar y ensamblar en la misma célula huésped. Este método es particularmente útil cuando la molécula biespecífica es una proteína de fusión de mAb x mAb, mAb x Fab, Fab x F(ab')2, o ligando x Fab. Una molécula biespecífica divulgada en la presente puede ser una molécula de una sola cadena que comprenda un anticuerpo de una sola cadena y un determinante de enlace, o una molécula biespecífica de una sola cadena que comprenda dos determinantes de enlace. Las moléculas biespecíficas pueden comprender cuando menos dos moléculas de una sola cadena. Los métodos para la preparación de las moléculas biespecíficas se describen, por ejemplo, en la Patente de los Estados Unidos de Norteamérica Número 5,260,203; en la Patente de los Estados Unidos de Norteamérica Número 5,455,030; en la Patente de los Estados Unidos de Norteamérica Número 4,881,175; en la Patente de los Estados Unidos de Norteamérica Número 5,132,405; en la Patente de los Estados Unidos de Norteamérica Número 5,091,513; en la Patente de los Estados Unidos de Norteamérica Número 5,476,786; en la Patente de los Estados Unidos de Norteamérica Número 5,013,653; en la Patente de los Estados Unidos de Norteamérica Número 5,258,498; y en la Patente de los Estados Unidos de Norteamérica Número 5,482,858.
El enlace de las moléculas biespecíficas a sus objetivos específicos se puede confirmar, por ejemplo, mediante el ensayo inmunosorbente enlazado con enzimas (ELISA), el radioinmunoensayo (RIA), el análisis FACS, un bioensayo (por ejemplo, inhibición del crecimiento), o ensayo Western blot. Cada uno de estos ensayos detecta en general la presencia de los complejos de proteína-anticuerpo de un interés particular, mediante el empleo de un reactivo marcado (por ejemplo, un anticuerpo) específico para el complejo de interés.
En otro aspecto se divulgan en la presente compuestos multivalentes que comprenden cuando menos dos porciones de enlace al antígeno idénticas o diferentes de los anticuerpos divulgados en la presente, que se enlazan al Factor P. Las porciones de enlace al antígeno se pueden enlazar entre sí por medio de fusión de proteína, o de un enlace covalente o no covalente. De una manera alternativa, los métodos de enlace se han descrito para las moléculas biespecíficas. Se pueden obtener compuestos tetravalentes, por ejemplo, mediante la reticulación de los anticuerpos divulgados en la presente con un anticuerpo que se enlace a las regiones constantes de los anticuerpos divulgados en la presente, por ejemplo, la región Fc o de articulación.
El dominio trimerizante se describe, por ejemplo, en la patente de Borean Número EP 1012 280B1. Los módulos pentamerizantes se describen, por ejemplo, en la Publicación del TCP Número PCT/EP97/05897.
Anticuerpos con una Vida Media Prolongada.
Se divulgan en la presente anticuerpos que se enlazan específicamente a la proteína del Factor P, que tienen una vida media prolongada in vivo.
Muchos factores pueden afectar a la vida media de una proteína in vivo. Por ejemplo, la filtración del riñón, el metabolismo en el hígado, la degradación mediante las enzimas proteolíticas (proteasas), y las respuestas inmunogénicas (por ejemplo, neutralización de proteína mediante los anticuerpos, y absorción por los macrófagos y las células dendríticas). Se pueden emplear una variedad de estrategias para prolongar la vida media de los anticuerpos divulgados en la presente. Por ejemplo, mediante enlace químico a polietilenglicol (PEG), reCODE PEG, andamiaje de anticuerpo, poli-ácido siálico (PSA), almidón de hidroxi-etilo (HES), ligandos de enlace de albúmina, y protectores de carbohidratos; mediante fusión genética a proteínas que se enlacen a las proteínas de suero, tales como albúmina, IgG, FcRn, y transferrina; mediante acoplamiento (genéticamente o químicamente) a otras fracciones de enlace que se enlacen a las proteínas del suero, tales como nanocuerpos, Fabs, DARPins, avímeros, aficuerpos, y anticalinas; mediante fusión genética a rPEG, albúmina, dominio de albúmina, proteínas de enlace de albúmina, y Fc; o mediante incorporación en nanovehículos, formulaciones de liberación lenta, o dispositivos médicos.
Para prolongar la circulación en suero de los anticuerpos in vivo, se pueden unir moléculas poliméricas inertes, tales como PEG de alto peso molecular, a los anticuerpos o a un fragmento de los mismos, con o sin un enlazador multifuncional, ya sea a través de conjugación específica del sitio del PEG al término N o C de los anticuerpos, o bien por medio de los grupos épsilon-amino presentes sobre los residuos de lisina. Para pegilar un anticuerpo, el anticuerpo o el fragmento del mismo típicamente se hace reaccionar con polietilenglicol (PEG), tal como un éster reactivo o un derivado de aldehído de PEG, bajo condiciones en donde uno o más grupos PEG lleguen a unirse al anticuerpo o al fragmento de anticuerpo. La pegilación se puede llevar a cabo mediante una reacción de acilación o mediante una reacción de alquilación con una molécula de PEG reactiva (o un polímero soluble en agua reactivo análogo). Como se utiliza en la presente, el término "polietilenglicol" pretende abarcar cualquiera de las formas de PEG que se han utilizado para derivar otras proteínas, tales como mono-alcoxilo (de 1 a 10 átomos de carbono)- o ariloxi-polietilenglicol, o polietilenglicol-maleimida. En ciertas modalidades divulgadas en la presente, el anticuerpo que se va a pegilar es un anticuerpo aglicosilado. Se empleará la derivación de polímero lineal o ramificado que dé como resultado una pérdida mínima en la actividad biológica. El grado de conjugación se puede monitorear estrechamente mediante SDS-PAGE y espectrometría de masas, para asegurar una conjugación apropiada de las moléculas de PEG a los anticuerpos. El PEG sin reaccionar se puede separar de los conjugados de anticuerpo-PEG mediante cromatografía por exclusión de tamaños o mediante cromatografía de intercambio de iones. Los anticuerpos derivados de PEG se pueden probar para determinar su actividad de enlace, así como para determinar su eficacia in vivo, empleando los métodos bien conocidos por los expertos en este campo, por ejemplo, mediante los inmunoensayos descritos en la presente. Los métodos para pegilar proteínas son conocidos en la técnica, y se pueden aplicar a los anticuerpos divulgados en la presente. Véanse, por ejemplo, la Patente Europea Número Ep 0 154 316 por Nishimura y colaboradores, y la Patente Europea Número EP 0401 384 por Ishikawa y colaboradores.
Otras tecnologías de pegilación modificada incluyen la tecnología de reconstitución de diseño dirigido químicamente ortogonal (ReCODE PEG), la cual incorpora cadenas laterales químicamente especificadas en proteínas biosintéticas por medio de un sistema reconstituido que incluye sintetasa de ARNt y ARNt. Esta tecnología hace posible la incorporación de más de 30 nuevos aminoácidos en las proteínas biosintéticas en E. coli, levadura, y células de mamífero. El ARNt incorpora un aminoácido no nativo en cualquier lugar en donde se coloque un codón ámbar, convirtiendo el ámbar desde un codón de paro hasta uno que señale la incorporación del aminoácido químicamente especificado.
También se puede emplear la tecnología de pegilación recombinante (rPEG) para prolongar la vida media en suero. Esta tecnología involucra fusionar genéticamente una cola de proteína no estructurada de 300 a 600 aminoácidos con una proteína farmacéutica existente. Debido a que el peso molecular aparente de esta cadena de proteína no estructurada es aproximadamente 15 veces más grande que su peso molecular real, se aumenta mucho la vida media en suero de la proteína. En contraste con la PEGilación tradicional, que requiere de conjugación química y re purificación, el proceso de fabricación se simplifica mucho, y el producto es homogéneo.
La polisialilación es otra tecnología que utiliza el polímero natural de poli-ácido siálico (PSA) para prolongar la vida activa y mejorar la estabilidad de los péptidos y proteínas terapéuticas. El poli-ácido siálico (PSA) es un polímero de ácido siálico (un azúcar). Cuando se utiliza para el suministro de proteínas y de fármacos peptídicos terapéuticos, el poli-ácido siálico (PSA) proporciona un micro-medio ambiente protector después de la conjugación. Esto aumenta la vida activa de la proteína terapéutica en la circulación, e impide que sea reconocida por el sistema inmunitario. El polímero de PSA se encuentra naturalmente en el cuerpo humano. Fue adoptado por ciertas bacterias que evolucionaron durante millones de años para recubrir sus paredes con él. Estas bacterias naturalmente polisialiladas fueron entonces capaces, en virtud de la imitación molecular, de cubrir el sistema de defensa del cuerpo. El poli-ácido siálico (PSA), la tecnología de vaina final de la naturaleza, se puede producir fácilmente a partir de estas bacterias en grandes cantidades y con características físicas previamente determinadas. El poli-ácido siálico (PSA) bacteriano es completamente no inmunogénico, inclusive cuando se acople a proteínas, debido a que es químicamente idéntico al poli-ácido siálico (PSA) del cuerpo humano.
Otra tecnología incluye el uso de derivados de almidón de hidroxi-etilo (“HES”) enlazados a anticuerpos. El almidón de hidroxi-etilo es un polímero natural modificado derivado a partir del almidón de maíz ceroso, y puede ser
metabolizado por las enzimas del cuerpo. Normalmente se administran soluciones de almidón de hidroxi-etilo para sustituir el volumen deficiente de sangre, y para mejorar las propiedades reológicas de la sangre. La hesilación de un anticuerpo hace posible la prolongación de la vida media en circulación, al aumentar la estabilidad de la molécula, así como mediante la reducción de la eliminación renal, dando como resultado una actividad biológica incrementada. Al variar los diferentes parámetros, tales como el peso molecular de HES, se pueden hacer a la medida un gran número de conjugados de anticuerpos de HES.
También se pueden generar anticuerpos con una mayor vida media in vivo mediante la introducción de una o más modificaciones de aminoácidos (es decir, sustituciones, inserciones, o supresiones) en un dominio constante de IgG, o en un fragmento de enlace de FcRn del mismo (de preferencia un fragmento Fc o un fragmento de dominio Fc de articulación). Véanse, por ejemplo, la Publicación Internacional Número WO98/23289; la Publicación Internacional Número w O 97/34631; y Patente de los Estados Unidos de Norteamérica Número 6,277,375.
Además, los anticuerpos se pueden conjugar a albúmina (por ejemplo, albúmina de suero humano; HSA) con el objeto de hacer que el anticuerpo o el fragmento de anticuerpo sea más estable in vivo, o tenga una vida media más larga in vivo. Las técnicas son bien conocidas en este campo; véanse, por ejemplo, las Publicaciones Internacionales Números WO 93/15199, WO 93/15200, y WO 01/77137; y la Patente Europea Número EP 413,622. En adición, en el contexto de un anticuerpo biespecífico como se describe anteriormente, las especificidades del anticuerpo se pueden diseñar de tal manera que un dominio de enlace del anticuerpo se enlace al Factor P, mientras que un segundo dominio de enlace del anticuerpo se enlace a la albúmina de suero, de preferencia la albúmina de suero humano (HSA).
Las estrategias para aumentar la vida media son especialmente útiles en los nanocuerpos, enlazadores basados en fibronectina, y otros anticuerpos o proteínas para los cuales se desee una mayor vida media in vivo.
Conjugados de Anticuerpos.
Se divulgan en la presente anticuerpos o fragmentos de los mismos que se enlazan específicamente a una proteína del Factor P recombinantemente fusionada o químicamente conjugada (incluyendo conjugaciones tanto covalentes como no covalentes) a una proteína o polipéptido heterólogo (o fragmento del mismo, de preferencia a un polipéptido de cuando menos 10, cuando menos 20, cuando menos 30, cuando menos 40, cuando menos 50, cuando menos 60, cuando menos 70, cuando menos 80, cuando menos 90, o cuando menos 100 aminoácidos), para generar proteínas de fusión. En particular, se divulgan en la presente proteínas de fusión que comprenden un fragmento de enlace al antígeno de un anticuerpo descrito en la presente (por ejemplo, un fragmento Fab, un fragmento Fd, un fragmento Fv, un fragmento F(ab)2, un dominio VH, una VH CDR, un dominio VL, o una VL CDR), y una proteína, polipéptido, o péptido heterólogos. Los métodos para fusionar o conjugar las proteínas, los polipéptidos, o los péptidos a un anticuerpo o a un fragmento de anticuerpo, son conocidos en la materia. Véanse, por ejemplo, las Patentes de los Estados Unidos de Norteamérica Números 5,336,603, 5,622,929, 5,359,046, 5,349,053, 5,447,851, y 5,112,946; las Patentes Europeas Números EP 307,434 y EP 367,166; las Publicaciones Internacionales Números WO 96/04388 y WO 91/06570; Ashkenazi y colaboradores, 1991, Proc. Natl. Acad. Sci. EUA 88: 10535-10539; Zheng y colaboradores, 1995, J. Immunol. 154:5590-5600; y Vil y colaboradores, 1992, Proc. Natl. Acad. Sci. EUA 89:11337-11341.
Se pueden generar proteínas de fusión adicionales a través de las técnicas de mezcla de genes, mezcla de motivos, mezcla de hexones, y/o mezcla de codones (colectivamente referidas como "mezcla de ADN"). La mezcla de ADN se puede emplear para alterar las actividades de los anticuerpos divulgados en la presente o de los fragmentos de los mismos (por ejemplo, los anticuerpos o fragmentos de los mismos con más altas afinidades y más bajos índices de disociación). Véanse en general las Patentes de los Estados Unidos de Norteamérica Números 5,605,793, 5,811,238, 5,830,721, 5,834,252, y 5,837,458; Patten y colaboradores, 1997, Curr. Opinion Biotechnol. 8:724-33; Harayama, 1998, Trends Biotechnol. 16(2):76-82; Hansson y colaboradores, 1999, J. Mol. Biol. 287:265-76; y Lorenzo y Blasco, 1998, Biotechniques 24(2):308-313. Los anticuerpos o fragmentos de los mismos, o los anticuerpos codificados o fragmentos de los mismos, se pueden alterar al someterse a mutagénesis aleatoria mediante reacción en cadena de la polimerasa susceptible a error, inserción aleatoria de nucleótidos, u otros métodos, antes de la recombinación. Un polinucleótido que codifique un anticuerpo o fragmento del mismo que se enlace específicamente a una proteína del Factor P, se puede recombinar con uno o más componentes, motivos, secciones, partes, dominios, fragmentos, etc., de una o más moléculas heterólogas.
Más aún, los anticuerpos o fragmentos de los mismos se pueden fusionar a secuencias marcadoras, tales como un péptido, para facilitar la purificación. En las modalidades preferidas, la secuencia de aminoácidos marcadora es un péptido de hexa-histidina, tal como la marca proporcionada en un vector pQE (QIAGEN, Inc., 9259 Eton Avenue, Chatsworth, CA, 91311), entre otros, muchos de los cuales están comercialmente disponibles. Como se describe en Gentz y colaboradores, 1989, Proc. Natl. Acad. Sci. EUA 86:821 -824, por ejemplo, la hexa-histidina proporciona una purificación conveniente de la proteína de fusión. Otras marcas peptídicas útiles para la purificación incluyen, pero no se limitan a, la marca de hemaglutinina (“HA”), la cual corresponde a un epítopo derivado a partir de la proteína de hemaglutinina de influenza (Wilson y colaboradores, 1984, Cell 37:767), y la marca “flag”.
Los anticuerpos divulgados en la presente o los fragmentos de los mismos, se conjugan a un agente de diagnóstico o detectable. Estos anticuerpos pueden ser útiles para monitorear o pronosticar el establecimiento, desarrollo, progreso, y/o gravedad de una enfermedad o trastorno, como parte de un procedimiento de prueba clínica, tal como la determinación de la eficacia de una terapia particular. Este diagnóstico y detección se puede llevar a cabo mediante el acoplamiento del anticuerpo a sustancias detectables que incluyen, pero no se limitan a, diferentes enzimas, tales como, pero no limitándose a, peroxidasa de radícula roja, fosfatasa alcalina, beta-galactosidasa, o acetil-colinesterasa; los grupos protésicos, tales como, pero no limitándose a, estreptavidina/biotina y avidina/biotina; materiales fluorescentes, tales como, pero no limitándose a, umbeliferona, fluoresceína, isocianato de fluoresceína, rodamina, dicloro-triazinil-amina/fluoresceína, cloruro de dansilo o ficoeritrina; materiales luminiscentes, tales como, pero no limitándose a, luminol; materiales bioluminiscentes, tales como, pero no limitándose a, luciferasa, luciferina, y ecuorina; materiales radioactivos, tales como, pero no limitándose a, yodo (131I, 125I, 123I, y 121I,), carbono (14C), azufre (35S), tritio (3H), indio (115In, 113In, 112In, y 111In,), tecnecio (99Tc), talio (201Ti), galio (68Ga, 67Ga), paladio (103Pd), molibdeno (99Mo), xenón (133Xe), flúor (18F), 153Sm, 177Lu, 159Gd, 149Pm, 140La, 175Yb, 166Ho, 90Y, 47Sc, 186Re, 188Re,142 Pr, 105Rh, 97Ru, 68Ge, 57Co, 65Zn, 85Sr, 32P, 153Gd, 169Yb, 51Cr, 54Mn, 75Se, 113Sn, y 117Tin; y los metales emisores de positrones que utilizan diferentes tomografías de emisión de positrones, y los iones de metales paramagnéticos no radioactivos.
Se divulgan en la presente además los usos de los anticuerpos o fragmentos de los mismos conjugados a una fracción terapéutica. Un anticuerpo o fragmento del mismo se puede conjugar a una fracción terapéutica, tal como una citotoxina, por ejemplo, un agente citostático o citocida, un agente terapéutico, o un ion de metal radioactivo, por ejemplo emisores-alfa. Una citotoxina o un agente citotóxico incluye cualquier agente que sea perjudicial para las células.
Adicionalmente, un anticuerpo o fragmento del mismo se puede conjugar a una fracción terapéutica o a una fracción de fármaco que codifique una respuesta biológica dada. Las fracciones terapéuticas o las fracciones de fármaco no deben interpretarse como limitadas a los agentes terapéuticos químicos clásicos. Por ejemplo, la fracción de fármaco puede ser una proteína, péptido, o polipéptido que posea una actividad biológica deseada. Estas proteínas pueden incluir, por ejemplo, una toxina, tal como abrina, risina A, exotoxina de Pseudomonas, toxina de cólera, o toxina de difteria; una proteína, tal como el factor de necrosis tumoral, interferón-a, interferón-p, factor de crecimiento de nervios, factor de crecimiento derivado de plaquetas, activador de plasminógeno de tejido, un agente apoptótico, un agente anti-angiogénico; o un modificador de la respuesta biológica, tal como, por ejemplo, una linfocina.
Más aún, un anticuerpo se puede conjugar a fracciones terapéuticas, tales como un ion de metal radioactivo, tales como emisores-alfa, tales como 213Bi, o quelantes macrocíclicos útiles para la conjugación de iones de radiometales, incluyendo, pero no limitándose a, 131In, 131LU, 131Y, 131Ho, 131Sm, a los polipéptidos. En ciertas modalidades, el quelante macrocíclico es el ácido 1,4,7,10-tetra-aza-ciclododecan-N,N’,N’’,N’” -tetra-acético (DOTA), el cual se puede unir al anticuerpo por medio de una molécula enlazadora. Estas moléculas enlazadoras se conocen comúnmente en la técnica, y se describen en Denardo y colaboradores, 1998, Clin. Cancer Res. 4(10):2483-90; Peterson y colaboradores, 1999, Bioconjug. Chem. 10(4):553-7; y Zimmerman y colaboradores, 1999, Nucl. Med. Biol.
26(8):943-50.
Las técnicas para conjugar las fracciones terapéuticas a los anticuerpos son bien conocidas; véanse, por ejemplo, Arnon y colaboradores, “Monoclonal Antibodies For Immunotargeting Of Drugs In Cancer Therapy”, en Monoclonal Antibodies And Cancer Therapy, Reisfeld y colaboradores (Editores), páginas 243-56 (Alan R. Liss, Inc. 1985); Hellstrom y colaboradores, “Antibodies For Drug Delivery”, en Controlled Drug Delivery (Segunda Edición), Robinson y colaboradores, (Editores), páginas 623-53 (Marcel Dekker, Inc. 1987); Thorpe, “Antibody Carriers Of Cytotoxic Agents In Cancer Therapy: A Review”, en Monoclonal Antibodies 84: Biological And Clinical Applications, Pinchera y colaboradores (Editores), páginas 475-506 (1985); “Analysis, Results, And Future Prospective Of The Therapeutic Use Of Radiolabeled Antibody In Cancer Therapy”, en Monoclonal Antibodies For Cancer Detection And Therapy, Baldwin y colaboradores, (Editores), páginas 303-16 (Academic Press 1985), y Thorpe y colaboradores, 1982, Immunol. Rev. 62:119-58.
Los anticuerpos también se pueden unir a soportes sólidos, los cuales son particularmente útiles para los inmunoensayos o para la purificación del antígeno objetivo. Estos soportes sólidos incluyen, pero no se limitan a, vidrio, celulosa, poliacrilamida, nylon, poliestireno, poli-cloruro de vinilo, o polipropileno.
Métodos para la producción de los anticuerpos de la invención
Ácidos nucleicos que codifican los anticuerpos
Se divulgan en la presente moléculas de ácidos nucleicos sustancialmente purificadas que codifican los polipéptidos que comprenden segmentos o dominios de las cadenas de anticuerpo de enlace al Factor P descritas anteriormente. Algunos de los ácidos nucleicos divulgados en la presente comprenden la secuencia de nucleótidos que codifica la región variable de cadena pesada mostrada en las SEQ ID NOs: 7, 21, 35, 49, 63, 77, 91, 105, 119, 133, 147, 161, 175, 189, 203, 217, 231, 245, 259 o 273, y/o la secuencia de nucleótidos que codifica la región variable de cadena ligera mostrada en las SEQ ID NOs: 8, 22, 36, 50, 64, 78, 92, 106, 120, 134, 148, 162, 176, 190, 204, 218, 232, 246,
260, o 274. También se divulgan en la presente las moléculas de ácidos nucleicos identificadas en la Tabla 1. Algunas otras moléculas de ácidos nucleicos divulgadas en la presente comprenden secuencias de nucleótidos que son sustancialmente idénticas (por ejemplo, cuando menos el 65 por ciento, el 80 por ciento, el 95 por ciento, o el 99 por ciento idénticas) a las secuencias de nucleótidos identificadas en la Tabla 1. Cuando se expresan a partir de vectores de expresión apropiados, los polipéptidos codificados por estos polinucleótidos son capaces de exhibir una capacidad de enlace al antígeno del Factor P.
También se divulgan en la presente polinucleótidos que codifican cuando menos una región determinante de complementariedad (CDR), y usualmente las tres regiones determinantes de complementariedad (CDRs) a partir de la cadena pesada o ligera del anticuerpo de enlace al Factor P estipulado anteriormente. Algunos otros polinucleótidos codifican todas o sustancialmente todas las secuencias de región variable de la cadena pesada y/o de la cadena ligera del anticuerpo de enlace al Factor P estipulado anteriormente. Debido a la degeneración del código, una variedad de secuencias de ácidos nucleicos codificarán cada una de las secuencias de aminoácidos de inmunoglobulina.
Las moléculas de ácidos nucleicos divulgadas en la presente pueden codificar tanto una región variable como una región constante del anticuerpo. Algunas secuencias de ácidos nucleicos divulgadas en la presente comprenden nucleótidos que codifican una secuencia de cadena pesada madura que es sustancialmente idéntica (por ejemplo, cuando menos el 80 por ciento, el 90 por ciento, o el 99 por ciento idéntica) a la secuencia de cadena pesada madura estipulada en las SEQ ID NOs: 9, 23, 37, 51, 65, 79, 93, 107, 121, 135, 149, 163, 177, 191, 205, 219, 233, 247, 261 o 275. Algunas otras secuencias de ácidos nucleicos comprenden nucleótidos que codifican una secuencia de cadena ligera madura que es sustancialmente idéntica (por ejemplo, cuando menos el 80 por ciento, el 90 por ciento, o el 99 por ciento idéntica) a la secuencia de cadena ligera madura estipulada en las SEQ ID NOs: 10, 24, 38, 52, 66, 80, 94, 108, 122, 136, 150, 164, 178, 192, 206, 220, 234, 248, 262, o 276.
Las secuencias de polinucleótidos se pueden producir mediante la síntesis de ADN en fase sólida de novo, o mediante mutagénesis con reacción en cadena de la polimerasa de una secuencia existente (por ejemplo, las secuencias descritas en los Ejemplos que se encuentran más adelante), que codifique un anticuerpo de enlace al Factor P o su fragmento de enlace. La síntesis química directa de los ácidos nucleicos se puede llevar a cabo mediante los métodos conocidos en este campo, tales como el método de fosfotriéster de Narang y colaboradores, 1979, Meth. Enzymol. 68:90; el método de fosfodiéster de Brown y colaboradores, Meth. Enzymol. 68:109, 1979; el método de dietil-fosforamidita de Beaucage y colaboradores, Tetra. Lett., 22:1859, 1981; y el método de soporte sólido de la Patente de los Estados Unidos de Norteamérica Número 4,458,066. La introducción de mutaciones a una secuencia de polinucleótido mediante reacción en cadena de la polimerasa se puede llevar a cabo como se describe, por ejemplo, en PCR Technology: Principles and Applications for DNA Amplification, H. A. Erlich (Editor), Freeman Press, NY, NY, 1992; PCR Protocols: A Guide to Methods and Applications, Innis y colaboradores (Editores), Academic Press, San Diego, CA, 1990; Mattila y colaboradores, Nucleic Acids Res. 19:967, 1991; y Eckert y colaboradores, PCR Methods and Applications 1:17, 1991.
También se divulgan en la presente vectores de expresión y células huésped para producir los anticuerpos de enlace al Factor P descritos anteriormente. Se pueden emplear diferentes vectores de expresión para expresar los polinucleótidos que codifiquen las cadenas de anticuerpo de enlace al Factor P o los fragmentos de enlace. Se pueden utilizar vectores de expresión tanto basados en virus como no virales para producir los anticuerpos en una célula huésped de mamífero. Los vectores y sistemas no virales incluyen plásmidos, vectores episomales, típicamente con un casete de expresión para expresar una proteína o ARN, y cromosomas artificiales humanos (véase, por ejemplo, Harrington y colaboradores, Nat Genet 15:345, 1997). Por ejemplo, los vectores no virales útiles para la expresión de los polinucleótidos y polipéptidos de enlace al Factor P en las células de mamífero (por ejemplo, humanas) incluyen los vectores pThioHis A, B, y C, pcDNA3.1/His, pEBVHis A, B, y C, (Invitrogen, San Diego, CA), MPSV, y otros numerosos vectores conocidos en la técnica para expresar otras proteínas. Los vectores virales útiles incluyen los vectores basados en retrovirus, adenovirus, virus adeno-asociados, virus de herpes, vectores basados en SV40, virus de papiloma, virus HBP Epstein Barr, vectores de virus de vacuna, y virus de Semliki Forest (SFV). Véanse, Brent y colaboradores, supra; Smith, Annu. Rev. Microbiol. 49:807, 1995; y Rosenfeld y colaboradores, Cell 68:143, 1992.
La elección del vector de expresión depende de las células huésped pretendidas en donde se vaya a expresar el vector. Típicamente, los vectores de expresión contienen un promotor y otras secuencias reguladoras (por ejemplo, potenciadoras), que se enlazan operablemente a los polinucleótidos que codifican la cadena o fragmento de anticuerpo de enlace al Factor P. En algunas modalidades, se emplea un promotor inducible para impedir la expresión de las secuencias insertadas, excepto bajo condiciones de inducción. Los promotores inducibles incluyen, por ejemplo, arabinosa, lacZ, promotor de metalotioneína, o un promotor de choque por calor. Los cultivos de los organismos transformados se pueden expandir bajo condiciones no inductoras sin forzar la población para las secuencias de codificación cuyos productos de expresión sean mejor tolerados por las células huésped. En adición a los promotores, también se pueden requerir o desear otros elementos reguladores para la expresión eficiente de una cadena o fragmento de anticuerpo de enlace al Factor P. Estos elementos típicamente incluyen un codón de inicio de ATG, y un sitio de enlace de ribosoma adyacente, u otras secuencias. En adición, la eficiencia de la expresión se puede mejorar mediante la inclusión de potenciadores apropiados para el sistema celular en uso (véanse, por
ejemplo, Scharf y colaboradores, Results Probl. Cell Differ. 20:125, 1994; y Bittner y colaboradores, Meth. Enzymol., 153:516, 1987). Por ejemplo, se puede utilizar el potenciador de SV40 o el potenciador de CMV para aumentar la expresión en las células huésped de mamífero.
Los vectores de expresión también pueden proporcionar una posición de la secuencia de señal de secreción para formar una proteína de fusión con los polipéptidos codificados por las secuencias de anticuerpos de enlace al Factor P insertadas. Más frecuentemente, las secuencias de anticuerpos de enlace al Factor P insertadas, se enlazan a una secuencia de señal antes de incluirse en el vector. Los vectores que se van a utilizar para recibir a las secuencias que codifiquen los dominios variables de cadena ligera y pesada del anticuerpo de enlace al Factor P, algunas veces también codifican las regiones constantes o partes de las mismas. Estos vectores permiten la expresión de las regiones variables como proteínas de fusión con las regiones constantes, conduciendo de esta manera a la producción de anticuerpos intactos o fragmentos de los mismos. Típicamente, estas regiones constantes son humanas.
Las células huésped para alojar y expresar las cadenas de los anticuerpos de enlace al Factor P pueden ser procarióticas o eucarióticas. E. coli es un huésped procariótico útil para la clonación y expresión de los polinucleótidos divulgados en la presente. Otros huéspedes microbianos adecuados para utilizarse incluyen bacilos, tales como Bacillus subtilis, y otras enterobacteriáceas, tales como las especies de Salmonella, Serratia, y diferentes Pseudomonas. En estos huéspedes procarióticos, también se pueden hacer vectores de expresión, los cuales típicamente contienen secuencias de control de expresión compatibles con la célula huésped (por ejemplo, un origen de réplica). En adición, estará presente cualquier número de una variedad de promotores bien conocidos, tales como el sistema promotor de lactosa, un sistema promotor de triptófano (trp), un sistema promotor de beta-lactamasa, o un sistema promotor a partir del fago lambda. Los promotores típicamente controlan la expresión, opcionalmente con una secuencia operadora, y tienen secuencias del sitio de enlace de ribosoma y similares, para iniciar y completar la transcripción y la traducción. También se pueden emplear otros microbios, tales como levadura, para expresar los polipéptidos de enlace al Factor P divulgados en la presente. También se pueden utilizar células de insecto en combinación con vectores de baculovirus.
En algunas modalidades preferidas, se utilizan células huésped de mamífero para expresar y producir los polipéptidos de enlace al Factor P divulgados en la presente. Por ejemplo, pueden ser ya sea una línea celular de hibridoma que exprese los genes de inmunoglobulina endógenos (por ejemplo, el clon de hibridoma de mieloma 1 D6.C9, como se describe en los Ejemplos), o bien una línea celular de mamífero que aloje un vector de expresión exógeno (por ejemplo, las células de mieloma SP2/0 ejemplificadas más adelante). Éstas incluyen cualquier célula animal o humana mortal normal, o normal, o anormal inmortal. Por ejemplo, se han desarrollado un número de líneas celulares huésped adecuadas para secretar las inmunoglobulinas intactas, incluyendo las líneas celulares de CHO, diferentes líneas celulares COS, las células HeLa, las líneas celulares de mieloma, las células-B transformadas, y los hibridomas. El uso del cultivo celular de tejido de mamífero para expresar polipéptidos se discute en general, por ejemplo, en Winnacker, FROM GENES TO CLONES, VCH Publishers, N.Y., N.Y., 1987. Los vectores de expresión para las células huésped de mamífero pueden incluir secuencias de control de expresión, tales como un origen de réplica, un promotor, y un potenciador (véase, por ejemplo, Queen, y colaboradores, Immunol. Rev. 89:49-68, 1986), y los sitios de información de procesamiento necesarios, tales como los sitios de enlace de ribosoma, los sitios de empalme de ARN, los sitios de poliadenilación, y las secuencias terminadoras de transcripción. Estos vectores de expresión normalmente contienen promotores derivados a partir de los genes de mamífero o a partir de los virus de mamífero. Los promotores adecuados pueden ser constitutivos, específicos del tipo de célula, específicos de la etapa, y/o modulables o regulables. Los promotores útiles incluyen, pero no se limitan a, el promotor de metalotioneína, el promotor tardío mayor de adenovirus constitutivo, el promotor de MMTV inducible por dexametasona, el promotor SV40, el promotor MRP poll-II, el promotor MPSV constitutivo, el promotor CMV inducible por tetraciclina (tal como el promotor CMV inmediato-temprano humano), el promotor CMV constitutivo, y combinaciones de promotores-potenciadores conocidas en este campo.
Los métodos para introducir vectores de expresión que contengan las secuencias de polinucleótidos de interés varían dependiendo del tipo de huésped celular. Por ejemplo, comúnmente se utiliza la transfección con cloruro de calcio para las células procarióticas, mientras que se puede utilizar el tratamiento con fosfato de calcio o electroporación para otros huéspedes celulares. (Véase en general Sambrook y colaboradores, supra). Otros métodos incluyen, por ejemplo, electroporación, tratamiento con fosfato de calcio, transformación mediada por liposomas, inyección y microinyección, métodos balísticos, virosomas, inmunoliposomas, conjugados de policatión:ácido nucleico, ADN desnudo, viriones artificiales, fusión con la proteína estructural de virus de herpes VP22 (Elliot y O'Hare, Cell 88:223, 1997), absorción de ADN mejorada por el agente, y transducción ex vivo. Para la producción de alto rendimiento de proteínas recombinantes a largo plazo, con frecuencia se deseará una expresión estable. Por ejemplo, se pueden preparar líneas celulares que expresen establemente las cadenas de anticuerpos de enlace al Factor P o los fragmentos de enlace, utilizando los vectores de expresión divulgados en la presente que contengan orígenes de réplica virales o elementos de expresión endógenos y un gen marcador seleccionable. En seguida de la introducción del vector, se puede permitir que las células crezcan durante 1 a 2 días en un medio enriquecido, antes de cambiarse al medio selectivo. El propósito del marcador seleccionable es conferir resistencia a la selección, y su presencia permite el crecimiento de las células que expresen con éxito las secuencias introducidas en el medio selectivo. Las células establemente transfectadas, resistentes, se pueden hacer proliferar utilizando
técnicas de cultivo de tejido apropiadas para el tipo de célula.
Generación de los anticuerpos monoclonales de la invención
Los anticuerpos monoclonales (mAbs) se pueden producir mediante una variedad de técnicas, incluyendo la metodología de anticuerpos monoclonales convencional, por ejemplo, la técnica de hibridación de células somáticas convencional de Kohler y Milstein, 1975 Nature 256: 495. Se pueden emplear muchas técnicas para producir anticuerpos monoclonales, por ejemplo, transformación viral u oncogénica de los linfocitos-B.
Un sistema animal para preparar hibridomas es el sistema de murino, de rata y de conejo. La producción de hibridoma en el ratón es un procedimiento bien establecido. Los protocolos y técnicas de inmunización para el aislamiento de los esplenocitos inmunizados para la fusión son conocidos en este campo. También se conocen los componentes de fusión (por ejemplo, células de mieloma de murino), y los procedimientos de fusión.
Los anticuerpos quiméricos o humanizados de la presente invención se pueden preparar basándose en la secuencia de un anticuerpo monoclonal de murino preparado como se describe anteriormente. El ADN que codifica las inmunoglobulinas de cadena pesada y ligera se puede obtener a partir del hibridoma de murino de interés, y se puede diseñar para contener secuencias de inmunoglobulina que no sean de murino (por ejemplo, humanas), empleando técnicas de biología molecular convencionales. Por ejemplo, con el fin de crear un anticuerpo quimérico, las regiones variables de murino se pueden enlazar a las regiones constantes humanas, empleando los métodos conocidos en la materia (véase, por ejemplo, la Patente de los Estados Unidos de Norteamérica Número 4,816,567 a Cabilly y colaboradores). Con el objeto de crear un anticuerpo humanizado, las regiones determinantes de complementariedad de murino se pueden insertar en una estructura humana, empleando los métodos conocidos en este campo. Véanse, por ejemplo, la Patente de los Estados Unidos de Norteamérica Número 5225539 a Winter, y las Patentes de los Estados Unidos de Norteamérica Números 5530101; 5585089; 5693762 y 6180370 a Queen y colaboradores.
En cierta modalidad, los anticuerpos de la invención son anticuerpos monoclonales humanos. Estos anticuerpos monoclonales humanos dirigidos contra el Factor P, se pueden generar utilizando ratones transgénicos o transcromosómicos que lleven partes del sistema inmunitario humano, en lugar del sistema de ratón. Estos ratones transgénicos y transcromosómicos incluyen los ratones referidos en la presente como ratones HuMAb y ratones KM, respectivamente, y son referidos colectivamente en la presente como "ratones con Ig humana".
El ratón HuMAb® (Medarex, Inc.) contiene mini-loc/ del gen de inmunoglobulina humana, que codifican las secuencias de inmunoglobulina de cadena pesada (p y y) y ligera k humanas no reconfiguradas, junto con las mutaciones dirigidas que inactivan los loc/ de las cadenas p y k endógenos (véase, por ejemplo, Lonberg y colaboradores, 1994 Nature 368(6474): 856-859). De conformidad con lo anterior, los ratones exhiben una expresión reducida de la IgM o k de ratón, y, en respuesta a la inmunización, los transgenes de cadena pesada y ligera humanos introducidos sufren cambio de clase y mutación somática para generar la IgGK monoclonal humana de alta afinidad (Lonberg, N. y colaboradores, 1994, supra; revisado en Lonberg, N., 1994 Handbook of Experimental Pharmacology 113:49-101; Lonberg, N. y Huszar, D., 1995 Intern. Rev. Immunol.13: 65-93, y Harding, F. y Lonberg, N., 1995 Ann. N. Y. Acad. Sci. 764:536-546). La preparación y uso de ratones HuMAb, y las modificaciones genómicas llevadas por estos ratones, se describen adicionalmente en Taylor, L. y colaboradores, 1992 Nucleic Acids Research 20:6287-6295; Chen, J. y colaboradores, 1993 International Immunology 5: 647-656; Tuaillon y colaboradores, 1993 Proc. Natl. Acad. Sci. EUA 94:3720-3724; Choi y colaboradores, 1993 Nature Genetics 4:117-123; Chen, J. y colaboradores, 1993 EMBO J. 12: 821-830; Tuaillon y colaboradores, 1994 J. Immunol. 152:2912-2920; Taylor, L. y colaboradores, 1994 International Immunology 579-591; y Fishwild, D. y colaboradores, 1996 Nature Biotechnology 14: 845-851. Véanse además las Patentes de los Estados Unidos de Norteamérica Números 5,545,806; 5,569,825; 5,625,126; 5,633,425; 5,789,650; 5,877,397; 5,661,016; 5,814,318; 5,874,299; y 5,770,429; todas a Lonberg y Kay; la Patente de los Estados Unidos de Norteamérica Número 5,545,807 a Surani y colaboradores; las Publicaciones del TCP Números WO 92103918, WO 93/12227, WO 94/25585, WO 97113852, WO 98/24884 y WO 99/45962, todas a Lonberg y Kay; y la Publicación del TCP Número WO 01/14424 a Korman y colaboradores.
En otra modalidad, los anticuerpos humanos de la invención se pueden reproducir utilizando un ratón que lleve secuencias de inmunoglobulina humana sobre transgenes y transcromosomas, tal como un ratón que lleve un transgén de cadena pesada humana y un transcromosoma de cadena ligera humana. Estos ratones, referidos en la presente como "ratones KM", se describen con detalle en la Publicación del TCP Número WO 02/43478 a Ishida y colaboradores.
Todavía además, en la técnica están disponibles sistemas de animales transgénicos alternativos que expresan genes de inmunoglobulina humana, y se pueden utilizar para reproducir los anticuerpos de enlace al Factor P de la invención. Por ejemplo, se puede utilizar un sistema transgénico alternativo referido como el xeno-ratón (Abgenix, Inc.). Estos ratones se describen, por ejemplo, en las Patentes de los Estados Unidos de Norteamérica Números 5,939,598; 6,075,181; 6,114,598; 6,150,584 y 6,162,963 a Kucherlapati y colaboradores.
Más aún, en la técnica están disponibles sistemas de animales transcromosómicos alternativos que expresan genes de inmunoglobulina humana, y se pueden utilizar para reproducir los anticuerpos de enlace al Factor P de la invención. Por ejemplo, se pueden utilizar los ratones que llevan tanto un transcromosoma de cadena pesada humana como un transcromosoma de cadena ligera humana, referidos como "ratones TC"; estos ratones se describen en Tomizuka y colaboradores, 2000 Proc. Natl. Acad. Sci. EUA 97:722-727. Adicionalmente, se han descrito en la técnica vacas que llevan transcromosomas de cadena pesada y ligera humanos (Kuroiwa y colaboradores, 2002 Nature Biotechnology 20:889-894), y se pueden utilizar para reproducir los anticuerpos de enlace al Factor P de la invención.
Los anticuerpos monoclonales humanos de la invención también se pueden preparar utilizando los métodos de exhibición de fagos para rastrear bibliotecas de genes de inmunoglobulina humana. Estos métodos de exhibición de fagos para aislar los anticuerpos humanos están establecidos en la técnica, o se describen en los Ejemplos que se encuentran más adelante. Véanse, por ejemplo: las Patentes de los Estados Unidos de Norteamérica Números 5,223,409; 5,403,484; y 5,571,698 a Ladner y colaboradores; las Patentes de los Estados Unidos de Norteamérica Números 5,427,908 y 5,580,717 a Dower y colaboradores; las Patentes de los Estados Unidos de Norteamérica Números 5,969,108 y 6,172,197 a McCafferty y colaboradores; y las Patentes de los Estados Unidos de Norteamérica Números 5,885,793; 6,521,404; 6,544,731; 6,555,313; 6,582,915 y 6,593,081 a Griffiths y colaboradores.
Los anticuerpos monoclonales humanos de la invención también se pueden preparar utilizando ratones SCID, en los cuales se han reconstituido células inmunes humanas, de tal manera que se puede generar una respuesta de anticuerpo humano después de la inmunización. Estos ratones se describen, por ejemplo, en las Patentes de los Estados Unidos de Norteamérica Números 5,476,996 y 5,698,767 a Wilson y colaboradores.
Diseño de estructura o Fc
Los anticuerpos diseñados divulgados en la presente incluyen aquellos en donde se han hecho modificaciones a los residuos de estructura dentro de la VH y/o VL, por ejemplo, para mejorar las propiedades del anticuerpo. Típicamente, estas modificaciones de estructura se hacen para disminuir la inmunogenicidad del anticuerpo. Por ejemplo, un planteamiento es "retro-mutar" uno o más residuos de estructura hasta la secuencia de la línea germinal correspondiente. De una manera más específica, un anticuerpo que se haya sometido a mutación somática puede contener residuos de estructura que difieran de la secuencia de la línea germinal a partir de la cual se derive el anticuerpo. Estos residuos se pueden identificar mediante la comparación de las secuencias de estructura del anticuerpo con las secuencias de la línea germinal a partir de la cual se deriva el anticuerpo. Para regresar las secuencias de la región de estructura hasta su configuración de la línea germinal, las mutaciones somáticas se pueden "retro-mutar" hasta la secuencia de la línea germinal, por ejemplo, mediante mutagénesis dirigida al sitio. Estos anticuerpos "retro-mutados" también pretenden ser abarcados por la invención.
Otro tipo de modificación de estructura involucra la mutación de uno o más residuos dentro de la región de estructura, o inclusive dentro de una o más regiones determinantes de complementariedad, para remover los epítopos de células-T, con el fin de reducir de esta manera la inmunogenicidad potencial del anticuerpo. Este planteamiento también es referido como "desinmunización", y se describe con mayor detalle en la Publicación de Patente de los Estados Unidos de Norteamérica Número 20030153043 por Carr y colaboradores.
En adición o de una manera alternativa a las modificaciones hechas dentro de la estructura o de las regiones determinantes de complementariedad, los anticuerpos de la invención se pueden diseñar para incluir modificaciones dentro de la región Fc, típicamente para alterar una o más propiedades funcionales del anticuerpo, tales como la vida media en suero, la fijación del complemento, el enlace del receptor Fc, y/o la citotoxicidad celular dependiente del antígeno. Adicionalmente, un anticuerpo de la invención se puede modificar químicamente (por ejemplo, se pueden unir una o más fracciones químicas al anticuerpo), o se puede modificar para alterar su glicosilación, nuevamente con el fin de alterar una o más propiedades funcionales del anticuerpo. Cada una de estas modalidades se describe con mayor detalle más adelante. La numeración de los residuos en la región Fc es aquella del índice EU de Kabat.
En una modalidad, la región de articulación de CH1 se modifica de tal manera que se altera el número de residuos de cisteína en la región de articulación, por ejemplo, se aumenta o se disminuye. Este planteamiento se describe adicionalmente en la Patente de los Estados Unidos de Norteamérica Número 5,677,425 por Bodmer y colaboradores. El número de residuos de cisteína en la región de articulación de CH1 se altera, por ejemplo, para facilitar el ensamble de las cadenas ligera y pesada, o con el fin de aumentar o disminuir la estabilidad del anticuerpo.
En otra modalidad, se muta la región de articulación Fc de un anticuerpo para disminuir la vida media biológica del anticuerpo. Más específicamente, se introducen una o más mutaciones de aminoácidos en la región de interfase del dominio CH2-CH3 del fragmento de articulación Fc, de tal manera que el anticuerpo tenga el enlace de Proteína A de Estafilocosilo deteriorado (SpA) en relación con el enlace de SpA del dominio de articulación Fc nativo. Este planteamiento se describe con mayor detalle en la Patente de los Estados Unidos de Norteamérica Número
6,165,745 por Ward y colaboradores.
En otra modalidad, el anticuerpo se modifica para aumentar su vida media biológica. Son posibles diferentes planteamientos. Por ejemplo, se pueden introducir una o más de las siguientes mutaciones: T252L, T254S, T256F, como se describe en la Patente de los Estados Unidos de Norteamérica Número 6,277,375 a Ward. De una manera alternativa, con el fin de aumentar la vida media biológica, el anticuerpo se puede alterar dentro de la región CH1 o CL para contener un epítopo de enlace de receptor de salvamento tomado a partir de dos ciclos de un dominio CH2 de una región Fc de una IgG, como se describe en las Patentes de los Estados Unidos de Norteamérica Números 5,869,046 y 6,121,022 por Presta y colaboradores.
En todavía otras modalidades, se altera la región Fc reemplazando cuando menos un residuo de aminoácido con un residuo de aminoácido diferente, con el fin de alterar las funciones efectoras del anticuerpo. Por ejemplo, uno o más aminoácidos pueden ser reemplazados con un residuo de aminoácido diferente, de tal manera que el anticuerpo tenga una afinidad alterada por un ligando efector, pero retenga la capacidad de enlace de antígeno del anticuerpo progenitor. El ligando efector con el cual se altera la afinidad puede ser, por ejemplo, un receptor de Fc, o el componente C1 del complemento. Este planteamiento se describe con mayor detalle en las Patentes de los Estados Unidos de Norteamérica Números 5,624,821 y 5,648,260, ambas por Winter y colaboradores.
En otra modalidad, uno o más aminoácidos seleccionados a partir de los residuos de aminoácidos, pueden ser reemplazados con un residuo de aminoácido diferente, de tal manera que el anticuerpo tenga un enlace de C1q alterado, y/o una citotoxicidad dependiente del complemento (CDC) reducida o abolida. Este planteamiento se describe con mayor detalle en la Patente de los Estados Unidos de Norteamérica Número 6,194,551 por Idusogie y colaboradores.
En otra modalidad, se alteran uno o más residuos de aminoácidos para alterar de esta manera la capacidad del anticuerpo para fijar el complemento. Este planteamiento se describe adicionalmente en la Publicación del TCP Número w O 94/29351 por Bodmer y colaboradores.
En todavía otra modalidad, se modifica la región Fc para aumentar la capacidad del anticuerpo para mediar la citotoxicidad celular dependiente del anticuerpo (ADCC), y/o para aumentar la afinidad del anticuerpo por un receptor de Fcy, mediante la modificación de uno o más aminoácidos. Este planteamiento se describe adicionalmente en la Publicación del TCP Número WO00/42072 por Presta. Más aún, los sitios de enlace sobre la IgG1 humana para FcyRI, FcyRII, FcyRIII y FcRn, se han mapeado, y se han descrito las variantes con un mejor enlace (véase Shields, R. L. y colaboradores, 2001 J. Biol. Chem. 276:6591-6604).
En todavía otra modalidad, se modifica la glicosilación de un anticuerpo. Por ejemplo, se puede hacer un anticuerpo aglicosilado (es decir, el anticuerpo carece de glicosilación). La glicosilación se puede alterar, por ejemplo, para aumentar la afinidad del anticuerpo por el antígeno. Estas modificaciones de carbohidratos se pueden llevar a cabo mediante, por ejemplo, la alteración de uno o más sitios de glicosilación dentro de la secuencia del anticuerpo. Por ejemplo, se pueden hacer una o más sustituciones de aminoácidos que den como resultado la eliminación de uno o más sitios de glicosilación de estructura de región variable, para eliminar de esta manera la glicosilación en ese sitio. Esta aglicosilación puede aumentar la afinidad del anticuerpo por el antígeno. Este planteamiento se describe con mayor detalle en las Patentes de los Estados Unidos de Norteamérica Números 5,714,350 y 6,350,861 por Co y colaboradores.
Adicionalmente o de una manera alternativa, se puede hacer un anticuerpo que tenga un tipo de glicosilación alterada, tal como un anticuerpo hipofucosilado que tenga cantidades reducidas de residuos de fucosilo, o un anticuerpo que tenga un aumento de estructuras de GlcNac de bisección. Se ha demostrado que estos patrones de glicosilación alterada aumentan la capacidad de citotoxicidad celular dependiente del anticuerpo de los anticuerpos. Estas modificaciones de carbohidratos se pueden llevar a cabo, por ejemplo, mediante la expresión del anticuerpo en una célula huésped con una maquinaria de glicosilación alterada. Las células con la maquinaria de glicosilación alterada han sido descritas en este campo, y se pueden utilizar como células huésped en donde se expresan los anticuerpos recombinantes de la invención, para producir de esta manera un anticuerpo con una glicosilación alterada. Por ejemplo, la Patente Europea Número EP 1,176,195 por Hang y colaboradores, describe una línea celular con un gen FUT8 funcionalmente interrumpido, el cual codifica una fucosil-transferasa, de tal manera que los anticuerpos expresados en esta línea celular exhiben hipofucosilación. La Publicación del TCP Número WO03/035835 por Presta describe una línea celular de ovario de hámster chino variante, las células Lecl3, con una capacidad reducida para unir la fucosa a los carbohidratos enlazados con Asn(297), que también da como resultado una hipofucosilación de los anticuerpos expresados en esa célula huésped (véase también Shields, R. L. y colaboradores, 2002 J. Biol. Chem. 277:26733-26740). La Publicación del t Cp Número WO 99/54342 por Umana y colaboradores, describe líneas celulares diseñadas para expresar las glicosil-transferasas modificadoras de glicoproteína (por ejemplo, beta(1,4)-N-acetil-glucosaminil-transferasa III (GnTIII)), de tal manera que los anticuerpos expresados en las líneas celulares diseñadas exhiben un aumento de estructuras de GlcNac de bisección, lo cual da como resultado un aumento en la actividad de la citotoxicidad celular dependiente del anticuerpo de los anticuerpos (véase también Umana y colaboradores, 1999 Nat. Biotech. 17:176-180).
Métodos para el diseño de anticuerpos alterados
Como se discute anteriormente, los anticuerpos de enlace al Factor P que tienen las secuencias VH y VL o las secuencias de cadena pesada y ligera de longitud completa mostradas en la presente, se pueden utilizar para crear nuevos anticuerpos de enlace al Factor P, mediante la modificación de las secuencias de cadena pesada y/o de cadena ligera de longitud completa. Las secuencias VH y/o VL, o las regiones constantes unidas a las mismas. Por consiguiente, en otro aspecto de la invención, se utilizan las características estructurales de un anticuerpo de enlace al Factor P de la invención para crear anticuerpos de enlace al Factor P estructuralmente relacionados que retienen cuando menos una propiedad funcional de los anticuerpos de la invención, tal como el enlace al Factor P humano, y también la inhibición de una o más propiedades funcionales del Factor P (por ejemplo, la inhibición del depósito de MAC en un ensayo de depósito de MAC, la inhibición de la lisis de los glóbulos rojos sanguíneos en un ensayo hemolítico).
Por ejemplo, una o más regiones determinantes de complementariedad de los anticuerpos de la presente invención, o mutaciones de las mismas, se pueden combinar de una manera recombinante con las regiones de estructura conocidas y/o con otras regiones determinantes de complementariedad (CDRs), para crear anticuerpos de enlace al Factor P recombinantemente diseñados adicionales de la invención, como se discute anteriormente. Otros tipos de modificaciones incluyen aquellas descritas en la sección anterior. El material de partida para el método de diseño es una o más de las secuencias VH y/o VL proporcionadas en la presente, o una o más regiones determinantes de complementariedad (CDRs) de las mismas. Con el fin de crear el anticuerpo diseñado, no es necesario preparar realmente (es decir, expresar como una proteína) un anticuerpo que tenga una o más de las secuencias VH y/o VL proporcionadas en la presente, o una o más regiones determinantes de complementariedad (CDRs) de las mismas. En su lugar, se utiliza la información contenida en las secuencias como el material de partida para crear secuencias de una "segunda generación" derivadas a partir de las secuencias originales, y luego se preparan las secuencias de la "segunda generación" y se expresan como una proteína.
De conformidad con lo anterior, se divulga en la presente un método para la preparación de un anticuerpo de enlace al Factor P que consiste en una secuencia de anticuerpo de región variable de cadena pesada que tiene una secuencia de CDR1 seleccionada a partir del grupo que consiste en las SEQ ID NOs: 1, 15, 29, 43, 57, 71, 85, 99, 113, 127, 141, 155, 169, 183, 197, 211, 225, 239, 253, y 267, una secuencia de CDR2 seleccionada a partir del grupo que consiste en las SEQ ID NOs: 2, 16, 30, 44, 58, 72, 86, 100, 114, 128, 142, 156, 170, 184, 198, 212, 226, 240, 254, y 268, y/o una secuencia de CDR3 seleccionada a partir del grupo que consiste en las SEQ ID NOs: 3, 17, 31,45, 59, 73, 87, 101, 115, 129, 143, 157, 171, 185, 199, 213, 227, 241,255, y 269; y una secuencia de anticuerpo de región variable de cadena ligera que tiene una secuencia de CDR1 seleccionada a partir del grupo que consiste en las SEQ ID NOs: 4, 18, 32, 46, 60, 74, 88, 102, 116, 130, 144, 158, 172, 186, 200, 214, 228, 242, 256, y 270, una secuencia de CDR2 seleccionada a partir del grupo que consiste en las SEQ ID NOs: 5, 19, 33, 47, 61, 75, 89, 103, 117, 131, 145, 159, 173, 187, 201, 215, 229, 243, 257, y 271, y/o una secuencia de CDR3 seleccionada a partir del grupo que consiste en las SEQ ID NOs: 6, 20, 34, 48, 62, 76, 90, 104, 118, 132, 146, 160, 174, 188, 202, 216, 230, 244, 258, y 272; alterar cuando menos un residuo de aminoácido dentro de la secuencia de anticuerpo de región variable de cadena pesada y/o de la secuencia de anticuerpo de región variable de cadena ligera para crear cuando menos una secuencia de anticuerpo alterada; y expresar la secuencia de anticuerpo alterada como una proteína.
De conformidad con lo anterior, se divulga en la presente un método para la preparación de un anticuerpo de enlace al Factor P que consiste en una secuencia de anticuerpo de región variable de cadena pesada que tiene una secuencia de CDR1 seleccionada a partir del grupo que consiste en las SEQ ID NOs: 281, 287, 293, 299, 305, 311, 317, 323, 329, 335, 341, 347, 353, 359, 365, 371, 377, 383, 389, y 395, una secuencia de CDR2 seleccionada a partir del grupo que consiste en las SEQ ID NOs: 282, 288, 294, 300, 306, 312, 318, 324, 330, 336, 342, 348, 354, 360, 366, 372, 378, 384, 390, y 396, y/o una secuencia de CDR3 seleccionada a partir del grupo que consiste en las SEQ ID NOs: 283, 289, 295, 301, 307, 313, 319, 325, 331,337, 343, 349, 355, 361, 367, 373, 379, 385, 391, y 397; y una secuencia de anticuerpo de región variable de cadena ligera que tiene una secuencia de CDR1 seleccionada a partir del grupo que consiste en las SEQ ID NOs: 284, 290, 296, 302, 308, 314, 320, 326, 332, 338, 344, 350, 356, 362, 368, 374, 380, 386, 392, y 398, una secuencia de CDR2 seleccionada a partir del grupo que consiste en las SEQ ID NOs: 285, 291, 297, 303, 309, 315, 321, 327, 333, 339, 345, 351, 357, 363, 369, 375, 381, 387, 393, y 399, y/o una secuencia de CDR3 seleccionada a partir del grupo que consiste en las SEQ ID NOs: 286, 292, 298, 304, 310, 316, 322, 328, 334, 340, 346, 352, 358, 364, 370, 376, 382, 388, 394, y 400; alterar cuando menos un residuo de aminoácido dentro de la secuencia de anticuerpo de región variable de cadena pesada y/o de la secuencia de anticuerpo de región variable de cadena ligera para crear cuando menos una secuencia de anticuerpo alterada; y expresar la secuencia de anticuerpo alterada como una proteína.
De conformidad con lo anterior, se divulga en la presente un método para la preparación de un anticuerpo de enlace al Factor P optimizado para la expresión en una célula de mamífero que consiste en: una secuencia de anticuerpo de cadena pesada de longitud completa que tiene una secuencia seleccionada a partir del grupo de las SEQ ID NOs: 9, 23, 37, 51,65, 79, 93, 107, 121, 135, 149, 163, 177, 191,205, 219, 233, 247, 261 y 275; y una secuencia de anticuerpo de cadena ligera de longitud completa que tiene una secuencia seleccionada a partir del grupo de las SEQ ID NOs: 10, 24, 38, 52, 66, 80, 94, 108, 122, 136, 150, 164, 178, 192, 206, 220, 234, 248, 262, y 276; alterar cuando menos un residuo de aminoácido dentro de la secuencia de anticuerpo de cadena pesada de longitud
completa y/o la secuencia de anticuerpo de cadena ligera de longitud completa para crear cuando menos una secuencia de anticuerpo alterada; y expresar la secuencia de anticuerpo alterada como una proteína. En una modalidad, la alteración de la cadena pesada o ligera está en la región de estructura de la cadena pesada o ligera.
La secuencia de anticuerpo alterada también se puede preparar mediante el rastreo de bibliotecas de anticuerpos que tengan secuencias de CDR3 fijas o determinantes de enlace esencial mínimo, como se describen en la Patente de los Estados Unidos de Norteamérica Número US20050255552, y la diversidad sobre las secuencias de CDR1 y CDR2. El rastreo se puede llevar a cabo de acuerdo con cualquier tecnología de rastreo apropiada para rastrear anticuerpos a partir de bibliotecas de anticuerpos, tal como la tecnología de exhibición de fagos.
Se pueden emplear las técnicas de biología molecular convencionales para preparar y expresar la secuencia de anticuerpo alterada. El anticuerpo codificado por las secuencias de anticuerpo alteradas, es uno que retiene una, algunas, o todas las propiedades funcionales de los anticuerpos de enlace al Factor P descritos en la presente, cuyas propiedades funcionales incluyen, pero no se limitan a, enlazarse específicamente al Factor P humano y/o de cinomolgo; y el anticuerpo inhibe la lisis de los glóbulos rojos sanguíneos en un ensayo hemolítico.
En ciertas modalidades de los métodos para diseñar los anticuerpos de la invención, se pueden introducir mutaciones de una manera aleatoria o selectivamente a lo largo de toda o parte de una secuencia de codificación del anticuerpo de enlace al Factor P, y los anticuerpos de enlace al Factor P modificados resultantes se pueden rastrear para determinar su actividad de enlace y/u otras propiedades funcionales como se describe en la presente. Los métodos de mutación se han descrito en este campo. Por ejemplo, la Publicación Internacional del TCP Número WO 02/092780 por Short describe métodos para crear y rastrear mutaciones de anticuerpos utilizando mutagénesis de saturación, ensamble de ligamiento sintético, o una combinación de los mismos. De una manera alternativa, la Publicación Internacional del TCP Número WO 03/ 074679 por Lazar y colaboradores, describe métodos para utilizar los métodos de rastreo por computación para optimizar las propiedades físico-químicas de los anticuerpos.
En ciertas modalidades de la invención, se han diseñado anticuerpos para remover los sitios de desamidación. Se sabe que la desamidación provoca cambios estructurales y funcionales en un péptido o en una proteína. La desamidación puede dar como resultado una disminución en la bioactividad, así como alteraciones en la farmacocinética y antigenicidad del producto farmacéutico de proteína (Anal Chem. 1 de marzo de 2005; 77(5): 1432-9).
Las propiedades funcionales de los anticuerpos alterados se pueden evaluar empleando ensayos convencionales disponibles en la técnica y/o descritos en la presente, tales como los que se estipulan en los Ejemplos (por ejemplo, ELISAs).
Usos Profilácticos y Terapéuticos
Los anticuerpos que se enlazan al Factor P, como se describe en la presente, se pueden utilizar en una concentración terapéuticamente útil para el tratamiento de una enfermedad o de un trastorno asociado con un aumento en la actividad del complemento mediante la administración a un sujeto que lo necesite, de una cantidad efectiva de los anticuerpos o los fragmentos de enlace al antígeno de la invención. Se divulga en la presente un método para el tratamiento de degeneración macular relacionada con el envejecimiento (AMD), mediante la administración a un sujeto que lo necesite, de una cantidad efectiva de los anticuerpos de la invención.
Los anticuerpos de la invención se pueden utilizar, entre otras cosas, para prevenir el progreso de la degeneración macular relacionada con el envejecimiento (AMD) seca hasta la degeneración macular relacionada con el envejecimiento (AMD) húmeda, para hacer más lento y/o prevenir el progreso de la atrofia geográfica, para tratar o prevenir el edema macular, para reducir la frecuencia de inyección de Lucentis (ranibizumab), y para mejorar la pérdida de visión debida al progreso de la degeneración macular relacionada con el envejecimiento (AMD) seca y húmeda. También se puede utilizar en combinación con las terapias anti-VEGF para el tratamiento de los pacientes con degeneración macular relacionada con el envejecimiento (AMD) húmeda.
El tratamiento y/o la prevención de la enfermedad ocular, tal como la degeneración macular relacionada con el envejecimiento (AMD), puede ser determinado por un oftalmólogo o un profesional para el cuidado de la salud, empleando medidas clínicamente relevantes de la función visual y/o la anatomía retinal. El tratamiento de la degeneración macular relacionada con el envejecimiento (AMD) significa cualquier acción (por ejemplo, la administración de un anticuerpo anti-Factor P descrito en la presente) contemplada para mejorar o conservar la función visual y/o la anatomía retinal. En adición, prevención en lo que se refiere a la degeneración macular relacionada con el envejecimiento (AMD), significa cualquier acción (por ejemplo, la administración de un anticuerpo anti-Factor P descrito en la presente) que prevenga o haga más lento el empeoramiento en la función visual, en la anatomía retinal, y/o un parámetro de enfermedad de la degeneración macular relacionada con el envejecimiento (AMD), como se define en la presente, en un paciente que esté en riesgo de tener dicho empeoramiento.
La función visual puede incluir, por ejemplo, agudeza visual, agudeza visual con baja iluminación, campo visual,
campo visual central, visión periférica, sensibilidad al contraste, adaptación a la oscuridad, recuperación de fotoestrés, discriminación de colores, velocidad de lectura, dependencia de dispositivos de asistencia (por ejemplo, tipografía grande, dispositivos amplificadores, telescopios), reconocimiento facial, eficiencia en la operación de un vehículo de motor, capacidad para llevar a cabo una o más actividades de la vida diaria, y/o la satisfacción reportada por el paciente en relación con la función visual. Por consiguiente, se puede decir que el tratamiento de la degeneración macular relacionada con el envejecimiento (AMD) se presenta en donde un sujeto tenga una disminución de cuando menos el 10 por ciento o la falta de hasta el 10 por ciento o más de un aumento en el tiempo hasta un grado previamente especificado de adaptación a la oscuridad. En adición, se puede decir que el tratamiento de la degeneración macular relacionada con el envejecimiento (AMD) se presenta cuando un sujeto exhiba cuando menos hasta el 10 por ciento de reducción o la falta de hasta el 10 por ciento o más de un aumento en el área total del escotoma visual central expresado como un ángulo visual determinado por un profesional calificado del cuidado de la salud (es decir, un oftalmólogo).
Las medidas de ejemplo de la función visual incluyen agudeza visual de Snellen, agudeza visual de ETDRS, agudeza visual con baja iluminación, cuadrícula de Amsler, campo visual de Goldmann, campo visual de Humphrey, microperimetría, diagramas de Pelli-Robson, tarjeta SKILL, placas de colores de Ishihara, prueba de colores de Farnsworth D15 o D100, y las pruebas validadas para velocidad de lectura, reconocimiento facial, simulaciones de conducción automotriz, y la satisfacción reportada por el paciente. Por consiguiente, se puede decir que el tratamiento de la degeneración macular relacionada con el envejecimiento (AMD) se logra después de una ganancia de, o fracaso para perder, 2 o más líneas (o 10 letras) de visión en una escala ETDRS. En adición, se puede decir que el tratamiento de la degeneración macular relacionada con el envejecimiento (AMD) se presenta cuando un sujeto exhibe cuando menos hasta el 10 por ciento de aumento o la falta del 10 por ciento de disminución en la velocidad de lectura (palabras por minuto). En adición, se puede decir que el tratamiento de la degeneración macular relacionada con el envejecimiento (AMD) se presenta cuando un sujeto exhibe cuando menos un aumento del 20 por ciento o la falta de un 20 por ciento de disminución en la proporción de las placas correctamente identificadas en una prueba de Ishihara o en los discos secuenciados en una prueba de Farnsworth.
Los aspectos indeseables de la anatomía retinal que se pueden tratar o prevenir incluyen, por ejemplo, drusas, drusas suaves, drusas duras, drusas cuticulares, drusas laminares basales, drusas confluentes, drusas grandes (por ejemplo, mayores de 125 micras de diámetro), atrofia de RPE, atrofia de foto-receptores, atrofia geográfica, neovascularización coroidal, neovascularización sub-retinal, neovascularización retinal, neovascularización coroidal clásica, neovascularización coroidal oculta, proliferación angiomatosa retinal, anastomosis corio-retinal, una anormalidad de la anatomía coroidal, hemorragia sub-retinal, hemorragia intra-retinal, hemorragia vítrea, escarificación macular, fibrosis sub-retinal, y fibrosis retinal. Por consiguiente, el tratamiento de, por ejemplo, atrofia geográfica, se puede determinar por un 20 por ciento o más de reducción en la velocidad de crecimiento de la lesión comparándose con un control o con una velocidad de crecimiento previamente documentada en el mismo sujeto y en el mismo ojo.
Los medios de ejemplo para evaluar la anatomía retinal incluyen funduscopía, fotografía del fondo, angiografía con fluoresceína, angiografía con verde de indocianina, tomografía de coherencia ocular (OCT), tomografía de coherencia ocular del dominio espectral, oftalmoscopía de láser de exploración, microscopía confocal, óptica adaptable, autofluorescencia del fondo, biopsia, necropsia, e inmunohistoquímica. Por consiguiente, se puede decir que la degeneración macular relacionada con el envejecimiento (AMD) que se vaya a tratar en un sujeto será después de una reducción de hasta el 10 por ciento en la medición del espesor macular como se determina mediante OCT, y/o una reducción de la hiperfluorescencia como se determina mediante la angiografía con fluoresceína.
Las mediciones de ejemplo de la anatomía retinal incluyen área de drusas, volumen de drusas, área de lesión por atrofia geográfica, velocidad de crecimiento de atrofia geográfica, y área de la membrana neovascular.
En algunas modalidades, la presente invención proporciona métodos para el tratamiento de una enfermedad o trastorno relacionado con el complemento, mediante la administración a un sujeto que lo necesite, de una cantidad efectiva de los anticuerpos de la invención. Los ejemplos de las enfermedades o trastornos conocidos relacionados con el complemento incluyen: trastornos neurológicos, esclerosis múltiple, embolia, Síndrome de Guillain-Barre, lesión cerebral traumática, enfermedad de Parkinson, trastornos de una activación inapropiada o indeseable del complemento, complicaciones de hemodiálisis, rechazo de alo-injerto híper-agudo, rechazo de xeno-injerto, toxicidad inducida por interleucina-2 durante la terapia con IL-2, trastornos inflamatorios, enfermedades de inflamación o autoinmunes, enfermedad de Crohn, síndrome de insuficiencia respiratoria de adultos, lesión térmica, incluyendo quemaduras o congelaciones, condiciones posteriores a reperfusión isquémica, infarto de miocardio, angioplastía de globo, síndrome posterior a la bomba en la derivación cardiopulmonar o en la derivación renal, hemodiálisis, isquemia renal, reperfusión arterial mesentérica después de reconstrucción aórtica, enfermedad infecciosa o sepsis, trastornos del inmuno-complejo y enfermedades auto-inmunes, artritis reumatoide, lupus eritematoso sistémico (SLE), nefritis por lupus eritematoso sistémico, nefritis proliferativa, anemia hemolítica, y miastenia grave. En adición, otras enfermedades relacionadas con el complemento conocidas son enfermedades pulmonares y trastornos tales como dispnea, hemoptisis, síndrome de insuficiencia respiratoria de adultos, asma, enfermedad pulmonar obstructiva crónica (COPD), enfisema, embolias e infartos pulmonares, neumonía, enfermedades de polvo
fibrogénico, polvos y minerales inertes (por ejemplo, silicio, polvo de carbón, berilio, y asbesto), fibrosis pulmonar, enfermedades por polvos orgánicos, lesión química (debido a gases y productos químicos irritantes, por ejemplo cloro, fosgeno, dióxido de azufre, sulfuro de hidrógeno, dióxido de nitrógeno, amoniaco, y ácido clorhídrico), lesión por humo, lesión térmica (por ejemplo, quemadura, congelación), asma, alergia, broncoconstricción, neumonitis por hipersensibilidad, enfermedades parasitarias, Síndrome de Goodpasture, vasculitis pulmonar, e inflamación asociada con el inmuno-complejo.
Se divulgan en la presente métodos para el tratamiento de una enfermedad o trastorno relacionado con el complemento, mediante la administración a un sujeto que lo necesite, de una cantidad efectiva de los anticuerpos de la invención, en donde esta enfermedad o trastorno es asma, artritis (por ejemplo, artritis reumatoide), enfermedad cardíaca autoinmune, esclerosis múltiple, enfermedad inflamatoria del intestino, lesiones por isquemia-reperfusión, Síndrome de Barraquer-Simons, hemodiálisis, lupus sistémico, lupus eritematoso, soriasis, esclerosis múltiple, trasplante, enfermedades del sistema nervioso central, tales como enfermedad de Alzheimer y otras condiciones neurodegenerativas, aHUS, glomerulonefritis, penfigoide buloso, o MPGN II.
Se divulgan en la presente métodos para el tratamiento de glomerulonefritis, mediante la administración a un sujeto que lo necesite, de una cantidad efectiva de una composición que comprenda un anticuerpo de la presente invención. Los síntomas de la glomerulonefritis incluyen, pero no se limitan a, proteinuria; índice reducido de filtración glomerular (GFR); cambios de electrolitos en suero, incluyendo azotemia (uremia, nitrógeno de urea excesivo en sangre - BUN), y retención de sal, que conducen a retención de agua, dando como resultado hipertensión y edema; hematuria y sedimentos urinarios anormales, incluyendo vaciados de glóbulos rojos; hipoalbuminemia; hiperlipidemia; y lipiduria. Se divulgan en la presente métodos para el tratamiento de hemoglobinuria nocturna paroxismal (PNH), mediante la administración a un sujeto que lo necesite, de una cantidad efectiva de una composición que comprenda un anticuerpo de la presente invención.
Se divulgan en la presente métodos para reducir la disfunción de los sistemas inmunitario y hemostático asociada con la circulación extracorpórea, mediante la administración a un sujeto que lo necesite, de una cantidad efectiva de una composición tal como se define en la reivindicación 1. Los anticuerpos de la presente invención se pueden utilizar en cualquier procedimiento que involucre la circulación de la sangre del paciente desde un vaso sanguíneo del paciente, a través de un conducto, y de regreso hasta un vaso sanguíneo del paciente, teniendo el conducto una superficie luminal que comprenda un material capaz de provocar cuando menos una de la activación del complemento, la activación de las plaquetas, la activación de los leucocitos, o la adhesión de plaquetas-leucocitos. Estos procedimientos incluyen, pero no se limitan a, todas las formas de SC, así como los procedimientos que involucran la introducción de un órgano, tejido, o vaso artificial o extraño en el circuito sanguíneo de un paciente.
A los sujetos que se van a tratar con los agentes terapéuticos de la presente invención también se les puede administrar otros agentes terapéuticos con los métodos conocidos para el tratamiento de las condiciones asociadas con degeneración macular, tales como tratamientos con antibióticos, como se describen en la Patente de los Estados Unidos de Norteamérica Número 6,218,368. En otros tratamientos, los agentes inmunosupresores, tales como la ciclosporina, son agentes capaces de suprimir las respuestas inmunes. Estos agentes incluyen fármacos citotóxicos, corticosteroides, fármacos anti-inflamatorios no esteroideos (NSAIDs), inmunosupresores de linfocitos-T específicos, y anticuerpos o fragmentos de los mismos (véase el Physicians' Desk Reference, 53a Edición, Medical Economics Company Inc., Montvale, N. J. (1999)). El tratamiento inmunosupresor típicamente se continúa a intervalos durante un período de una semana, un mes, tres meses, seis meses, o un año. En algunos pacientes, el tratamiento se administra durante el resto de la vida del paciente.
Cuando los agentes terapéuticos de la presente invención se administran junto con otro agente, los dos se pueden administrar en secuencia en cualquier orden, o de una manera simultánea. En algunos aspectos, un anticuerpo de la presente invención se administra a un sujeto que también esté recibiendo terapia con un segundo agente (por ejemplo, verteporfina). En otros aspectos, la molécula de enlace se administra en conjunto con tratamientos quirúrgicos.
Los agentes adecuados para el tratamiento de combinación con los anticuerpos de enlace al Factor P incluyen los agentes conocidos en la técnica que sean capaces de modular las actividades de los componentes de complemento (véase, por ejemplo, la Patente de los Estados Unidos de Norteamérica Número 5,808,109). Se ha reportado que otros agentes disminuyen la actividad mediada por el complemento. Estos agentes incluyen: aminoácidos (Takada, Y. y colaboradores, Immunology 1978, 34, 509); ésteres de fosfonato (Becker, L. Biochem. Biophy. Acta 1967, 147, 289); sustancias polianiónicas (Conrow, R. B. y colaboradores, J. Med. Chem. 1980, 23, 242); fluoruros de sulfonilo (Hansch, C.; Yoshimoto, M. J. Med. Chem. 1974, 17, 1160, y las referencias citadas en el mismo); polinucleótidos (DeClercq, P. F. y colaboradores, Biochem. Biophys. Res. Commun. 1975, 67, 255); ácidos primarios (Glovsky, M. M. y colaboradores, J. Immunol. 1969, 102, 1); porfinas (Lapidus, M. y Tomasco, J. Immunopharmacol. 1981, 3, 137); varios productos anti-inflamatorios (Burge, J. J. y colaboradores, J. Immunol. 1978, 120, 1625); fenoles (Muller-Eberhard, H. J. 1978, en Molecular Basis of Biological Degradative Processes, Berlín, R. D. y colaboradores, Editores, Academic Press, Nueva York, página 65); y benzamidinas (Vogt, W. y colaboradores, Immunology 1979, 36, 138). Algunos de estos agentes funcionan mediante la inhibición general de las proteasas y las esterasas. Otros no son específicos para cualquier paso intermedio particular en la senda de complemento, sino que más bien inhiben más de un paso de la activación del complemento. Los ejemplos de los últimos compuestos incluyen las
benzamidinas, que bloquean la utilización de C1, C4, y C3b (véase, por ejemplo, Vogt y colaboradores, Immunol.
1979, 36, 138).
Los agentes adicionales conocidos en este campo que pueden inhibir la actividad de los componentes de complemento incluyen K-76, un metabolito fúngico a partir de Stachybotrys (Corey y colaboradores, J. Amer. Chem. Soc. 104: 5551, 1982). Se ha demostrado que tanto K-76 como K-76 COOH, inhiben al complemento principalmente en el paso C3b (Hong y colaboradores, J. Immunol. 122: 2418, 1979; Miyazaki y colaboradores, Microbiol. Immunol.
24: 1091, 1980), e impiden la generación de un factor quimiotáctico a partir del complemento humano normal (Bumpers y colaboradores, Lab. Clinc. Med. 102: 421, 1983). En altas concentraciones de K-76 o de K-76 COOH, se exhibe alguna inhibición de las reacciones de C2, C3, C6, C7, y C9 con sus intermediarios precedentes respectivos. También se ha reportado que K-76 o que K-76 COOH inhibe el sistema inactivador de C3b del complemento (Hong y colaboradores, J. Immunol. 127: 104-108, 1981). Otros agentes adecuados para practicar los métodos de la presente invención incluyen griseofulvina (Weinberg, en Principles of Medicinal Chemistry, Segunda Edición, Foye, W. O., Editores, Lea & Febiger, Filadelfia, Pa., página 813, 1981), isopanarina (Djura y colaboradores, Aust. J. Chem. 36: 1057, 1983),y los metabolitos del fago de Siphonodictyon coralli (Sullivan y colaboradores, Tetrahedron 37: 979, 1981).
Un régimen de terapia de combinación puede ser aditivo, o puede producir resultados sinérgicos (por ejemplo, reducciones en la actividad de la senda de complemento mayores que las esperadas para el uso combinado de los dos agentes).
Combinación de anticuerpos anti-complemento
En un aspecto, la invención proporciona combinaciones de cualquiera o más del anti-Factor P con un anticuerpo adicional que se enlaza a, e inhibe la actividad de, un componente diferente de la senda del complemento, tal como se define en la reivindicación 1. En particular, la invención incluye cualquiera o más de los anticuerpos anti-Factor P o los fragmentos de enlace al antígeno descritos en la presente, en combinación con un anticuerpo o el fragmento de enlace al antígeno que se enlaza al componente de complemento 5 (C5), tal como se define en la reivindicación 1. Los anticuerpos o los fragmentos de enlace al antígeno de los mismos que se enlazan a C5 e inhiben la activación del complemento se pueden encontrar, por ejemplo, en la Patente de los Estados Unidos de Norteamérica Número 8,241,628. De una manera más específica, los anticuerpos o los fragmentos de enlace al antígeno de los mismos que se enlazan a C5 e inhiben la senda del complemento, se muestran y se describen en la Tabla 2. Se divulga en la presente una combinación de un anticuerpo anti-Factor P o el fragmento de enlace al antígeno del mismo, como se muestra y se describe en la Tabla 1 con el anticuerpo anti-C58109 de la Tabla 2. De una manera más específica, un aspecto de la invención se refiere a una combinación del anticuerpo NVS962 de la Tabla 1 (o un fragmento de enlace al antígeno del mismo) con el anticuerpo 8109 de la Tabla 2 (o un fragmento de enlace al antígeno del mismo).
En un aspecto, las combinaciones de los anticuerpos anti-Factor P y anti-C5 descritos en la presente demuestran una inhibición sinérgica de la senda del complemento, en particular la senda de complemento alternativa. Esa inhibición se puede demostrar, por ejemplo, utilizando los ensayos hemolíticos o poli-IC descritos en los Ejemplos más adelante. El sinergismo en la inhibición de la senda de complemento alternativa, logrado utilizando una combinación de los anticuerpos anti-Factor-P y anti-C5 descritos en la presente, se puede determinar utilizando métodos que son bien conocidos en la materia. Por ejemplo, se puede determinar un efecto sinérgico de la combinación del anticuerpo anti-Factor P y el anticuerpo anti-C5 en relación con un efecto meramente aditivo utilizando un software específico, tal como un Chalice Analyzer.
Dicho de una manera breve, se puede utilizar el Chalice Analyzer (Lehar y colaboradores, Nature Biotechnology 2009, 7: 659) para determinar si la combinación de los anticuerpos inhibidores del complemento (por ejemplo, anti Factor P y anti-C5) actúan sinérgicamente para bloquear la activación del complemento. Los efectos de la combinación se pueden caracterizar comparando la inhibición en cada punto de datos con aquella de un modelo de combinación de referencia que se haya derivado a partir de las curvas del agente individual (Greco, Bravo, Parsons (1995). The search for synergy: a critical review from a response surface perspective. Pharmacol Rev 47(2): 331 -85). En el modelo de aditividad de Loewe (Loewe (1928). Die cuantitativon Probleme der Pharmakologie. Ergebn. Physiol. 27: 47-187), /L o e w e (Cx ,CY ) es la inhibición que satisface (C x /IC x ) + (C y /IC y ) = 1, e ICx ,y son las concentraciones efectivas en /L o e w e para las curvas del agente individual ajustadas. La aditividad de Loewe es la referencia generalmente aceptada para el sinergismo (Greco y colaboradores), debido a que representa la respuesta generada a la combinación si X e Y son el mismo compuesto.
El cambio de potencia usualmente se muestra utilizando un isobolograma (Greco y colaboradores) que muestra cuánto fármaco menos se requiere en la combinación para lograr un nivel de efecto deseado, cuando se compara con las dosis del agente individual necesarias para alcanzar ese efecto. La elección del nivel de efecto para el despliegue del isobolograma y los cálculos del índice de combinación se pueden seleccionar ya sea manualmente o automáticamente en el Chalice Analyzer. El algoritmo de selección de iso-nivel automática encuentra la /d a to s observada con la /d a to s - / L o e w e más grande, excluyendo los puntos en donde /d a to s excede a la /m a x del menor agente individual. Esta exclusión se aplica para asegurar que el isobolograma refleje el mejor sinergismo en los niveles
cubiertos por ambos agentes individuales. Habiendo seleccionado un nivel del isobolograma /c o r t e , el isobolograma se dibuja mediante la identificación del locus de las concentraciones que corresponden a cruzar el iso-nivel seleccionado. El isobolograma muestra el análisis de sinergismo isobolográfico estándar comparándose con el estándar del "fármaco consigo mismo" de dosis aditiva de Loewe. Para tener un nivel del isobolograma especificado, se exhibe el contorno del iso-efecto observado (por ejemplo, la línea curva en la Figura 3) con el contorno de dosis aditiva teórico (por ejemplo, la línea recta en la Figura 3), en una escala de concentración lineal normalizada con ICe fe c to para ambas sustancias en la combinación. La referencia de dosis aditivas siempre es una línea que conecta las dos concentraciones de ICe f e c t o . Los puntos de cruce de ICe fe c to se encuentran mediante la interpolación de las curvas sigmoideas ajustadas de respuesta a la dosis.
El cambio de potencia se califica como el índice de combinación (Chou, Talalay (1984). Quantitative analysis of dose-effect relationships: the combined effects of múltiple drugs or enzyme inhibitors. Adv Enzyme Regul 22: 27-55) CI. Para un nivel de iso-efecto seleccionado /c o r t e , CIi = (Cx /ECx ) i + (Cy /ECy ) i , en donde (Cx /ECx ) i para un punto de datos particular, es la proporción de la concentración medida del compuesto X a su concentración efectiva en el nivel de inhibición seleccionado. El CI se puede pensar como una estimación aproximada de cuánto fármaco en combinación se necesitó en relación con la dosis individual del agente requerida para lograr el nivel de efecto seleccionado, y un valor de 0.1 significa que solamente se necesitó una décima parte de las cantidades equivalentes de los agentes individuales para la combinación con el fin de alcanzar el mismo nivel de efecto. Los valores CI en el intervalo de 0.5 a 0.7 son típicos para las mediciones in vitro de las combinaciones clínicas actuales (Greco y colaboradores). Un valor CI de 1.0 indica un efecto aditivo de una combinación de anticuerpos, mientras que un valor CI de menos de 0.5 indica un efecto sinérgico fuerte resultante de la combinación de anticuerpos. En el Chalice Analyzer, el mejor CI se reporta a partir de los muchos valores de índice de combinación calculados para cada concentración que cruza /c o r t e . Entre todos los valores CI medidos, aquel con el mayor nivel de la señal al ruido se reporta como el mejor índice de combinación.
Las combinaciones de anticuerpos anti-Factor P y anti-C5 como se describen en la presente, se pueden administrar individualmente o como una sola composición. En adición, la dosis relativa de un anticuerpo anti-Factor P y anti-C5 puede estar en una proporción de 1:1, o puede estar en una proporción diferente. La dosis específica de un anticuerpo anti-Factor P en relación con un anticuerpo anti-C5 puede ser determinada finalmente por el médico tratante o por el profesional del cuidado de la salud, para lograr la mejora en la condición patológica que se trate. Por ejemplo, cuando se utiliza una combinación como se describe en la presente, para tratar la degeneración macular relacionada con el envejecimiento (AMD), un médico o un profesional del cuidado de la salud puede hacer a la medida la dosis relativa de los anticuerpos anti-Factor P y anti-C5 con el fin de alcanzar el beneficio terapéutico óptimo, como se determine utilizando las mediciones y los criterios descritos en la presente.
Composiciones Farmacéuticas
Se divulgan en la presente composiciones farmacéuticas que comprenden los anticuerpos de enlace al Factor P (intactos o fragmentos de enlace) formulados junto con un vehículo farmacéuticamente aceptable. Las composiciones adicionalmente pueden contener uno o más agentes terapéuticos diferentes que sean adecuados para el tratamiento o la prevención de, por ejemplo, la angiogénesis patológica o el crecimiento tumoral. Los vehículos farmacéuticamente aceptables mejoran o estabilizan la composición, o se pueden utilizar para facilitar la preparación de la composición. Los vehículos farmacéuticamente aceptables incluyen solventes, medios de dispersión, recubrimientos, agentes anti-bacterianos y anti-fúngicos, y agentes isotónicos y retardantes de absorción, y similares, que sean fisiológicamente compatibles.
Una composición farmacéutica de la presente invención se puede administrar mediante una variedad de métodos conocidos en la técnica. La vía y/o el modo de administración varían dependiendo de los resultados deseados. Se prefiere que la administración sea intravítrea, intravenosa, intramuscular, intraperitoneal, o subcutánea, o que se administre proximal al sitio del objetivo. El vehículo farmacéuticamente aceptable debe ser adecuado para la administración intravítrea, intravenosa, intramuscular, subcutánea, parenteral, espinal o epidérmica (por ejemplo, mediante inyección o infusión). Dependiendo de la vía de administración, el compuesto activo, es decir, la molécula de anticuerpo biespecífica y multiespecífica, se puede recubrir en un material para proteger al compuesto a partir de la acción de los ácidos y otras condiciones naturales que puedan inactivar el compuesto.
La composición debe ser estéril y fluida. Se puede mantener una fluidez apropiada, por ejemplo, mediante el uso de un recubrimiento, tal como lecitina, mediante el mantenimiento del tamaño de partículas requerido en el caso de la dispersión, y mediante el uso de tensoactivos. En muchos casos, es preferible incluir agentes isotónicos, por ejemplo, azúcares, poli-alcoholes, tales como manitol o sorbitol, y cloruro de sodio en la composición. La absorción a largo plazo de las composiciones inyectables se puede provocar incluyendo en la composición un agente que retarde la absorción, por ejemplo, monoestearato de aluminio o gelatina.
Las composiciones farmacéuticas de la invención se pueden preparar de acuerdo con los métodos bien conocidos y rutinariamente practicados en la materia. Véase, por ejemplo, Remington: The Science and Practice of Pharmacy, Mack Publishing Co., 20a Edición, 2000; y Sustained and Controlled Release Drug Delivery Systems, J.R. Robinson, Editor, Marcel Dekker, Inc., Nueva York, 1978. Las composiciones farmacéuticas se elaboran de preferencia bajo
condiciones GMP. Típicamente, se emplea una dosis terapéuticamente efectiva o una dosis eficaz del anticuerpo de enlace al Factor P en las composiciones farmacéuticas de la invención. Los anticuerpos de enlace al Factor P se formulan en formas de dosificación farmacéuticamente aceptables mediante los métodos convencionales conocidos por aquellos con experiencia en la materia. Los regímenes de dosificación se ajustan para proporcionar la respuesta óptima deseada (por ejemplo, una respuesta terapéutica). Por ejemplo, se puede administrar un solo bolo, se pueden administrar varias dosis divididas a través del tiempo, o la dosis se puede reducir o incrementar proporcionalmente como sea indicado por las exigencias de la situación terapéutica. Es en especial conveniente formular las composiciones parenterales en una forma unitaria de dosificación para facilidad de administración y uniformidad de la dosificación. Forma unitaria de dosificación como se utiliza en la presente, se refiere a las unidades físicamente separadas adecuadas como dosificaciones unitarias para los sujetos que se vayan a tratar; conteniendo cada unidad una cantidad previamente determinada del compuesto activo calculada para producir el efecto terapéutico deseado en asociación con el vehículo farmacéutico requerido.
Los niveles de dosificación reales de los principios activos en las composiciones farmacéuticas de la presente invención se pueden variar como para obtener una cantidad del principio principio que sea efectiva para lograr la respuesta terapéutica deseada para un paciente, composición, y modo de administración particular, sin que sea tóxica para el paciente. El nivel de dosificación seleccionado depende de una variedad de factores farmacocinéticos, incluyendo la actividad de las composiciones particulares de la presente invención empleadas, o del éster, sal o amida de las mismas, la vía de administración, el tiempo de administración, la velocidad de excreción del compuesto particular que sea empleado, la duración del tratamiento, otros fármacos, los compuestos y/o materiales utilizados en combinación con las composiciones particulares empleadas, la edad, sexo, peso, condición, salud general e historial médico previo del paciente que sea tratado, y factores similares.
Un médico o veterinario puede comenzar las dosis de los anticuerpos de la invención empleados en la composición farmacéutica en niveles más bajos que los requeridos para conseguir el efecto terapéutico deseado y para aumentar gradualmente la dosificación hasta que se logre el efecto deseado. En general, las dosis eficaces de las composiciones de la presente invención, para el tratamiento de un trastorno inflamatorio alérgico descrito en el presente documento varían dependiendo de muchos factores diferentes, incluyendo los medios de administración, el sitio objetivo, el estado fisiológico del paciente, si el paciente es humano o animal, otros medicamentos administrados, y si el tratamiento es profiláctico o terapéutico. Las dosificaciones de tratamiento se deben titular para optimizar la seguridad y la eficacia. Para la administración sistémica con un anticuerpo, la dosificación está en el intervalo de aproximadamente 0.0001 a 100 miligramos/kilogramo, y más habitualmente de 0.01 a 15 miligramos/kilogramo de peso corporal del huésped. Para la administración intravítrea con un anticuerpo, la dosificación puede estar en el intervalo de 0.1 miligramos/ojo a 5 miligramos/ojo. Por ejemplo, 0.1 miligramos/mililitro, 0.2 miligramos/ mililitro, 0.3 miligramos/mililitro, 0.4 miligramos/mililitro, 0.5 miligramos/mililitro, 0.6 miligramos/ mililitro, 0.7 miligramos/mililitro, 0.8 miligramos/mililitro, 0.9 miligramos/mililitro, 1.0 miligramo/ mililitro, 1.1 miligramos/mililitro, 1.2 miligramos/mililitro, 1.3 miligramos/mililitro, 1.4 miligramos/ mililitro, 1.5 miligramos/mililitro, 1.6 miligramos/mililitro, 1.7 miligramos/mililitro, 1.8 miligramos/ mililitro, 1.9 miligramos/mililitro, 2.0 miligramos/mililitro, 2.1 miligramos/mililitro, 2.2 miligramos/ mililitro, 2.3 miligramos/mililitro, 2.4 miligramos/mililitro, 2.5 miligramos/mililitro, 2.6 miligramos/ mililitro, 2.7 miligramos/mililitro, 2.8 miligramos/mililitro, 2.9 miligramos/mililitro, 3.0 miligramos/ mililitro, 3.1 miligramos/mililitro, 3.2 miligramos/mililitro, 3.3 miligramos/mililitro, 3.4 miligramos/ mililitro, 3.5 miligramos/mililitro, 3.6 miligramos/mililitro, 3.7 miligramos/mililitro, 3.8 miligramos/mililitro, 3.9 miligramos/mililitro, 4.0 miligramos/mililitro, 4.1 miligramos/mililitro, 4.2 miligramos/ mililitro, 4.3 miligramos/mililitro, 4.4 miligramos/mililitro, 4.5 miligramos/mililitro, 4.6 miligramos/mililitro, 4.7 miligramos/mililitro, 4.8 miligramos/mililitro, 4.9 miligramos/mililitro, o 5.0 miligramos/ mililitro. Un régimen de tratamiento de ejemplo implica la administración sistémica una vez cada dos semanas o una vez al mes o una vez cada 3 a 6 meses. Un régimen de tratamiento de ejemplo implica la administración sistémica una vez cada dos semanas o una vez al mes o una vez cada 3 a 6 meses
El anticuerpo se administra generalmente en múltiples ocasiones. Los intervalos entre las dosis individuales pueden ser semanal, mensual o anual. Los intervalos también pueden ser irregulares como se indica midiendo los niveles sanguíneos del anticuerpo de enlace al Factor P en el paciente. Además, un médico puede determinar intervalos de dosificación alternativos y se administra mensualmente o según sea necesario para ser eficaz. La eficacia se basa en el crecimiento de la lesión, la tasa de rescate Lucentis, el espesor de la retina determinado mediante Tomografía de Coherencia Óptica del Dominio Espectral (SD-OCT), y la agudeza visual secundaria. En algunos métodos de administración sistémica, la dosificación se ajusta para lograr una concentración de anticuerpo en plasma de 1 a 1.000 miligramos/mililitro, y en algunos métodos, de 25 a 500 gramos/mililitro. Alternativamente, el anticuerpo puede administrarse como una formulación de liberación sostenida, en cuyo caso se requerirá una administración menos frecuente. La dosis y frecuencia varían dependiendo de la vida media del anticuerpo en el paciente. En general, los anticuerpos humanizados muestran una vida media más larga que la de los anticuerpos quiméricos y los anticuerpos no humanos. La dosificación y frecuencia de administración pueden variar dependiendo de si el tratamiento es profiláctico o terapéutico. En las aplicaciones profilácticas, se administra una dosificación relativamente baja a intervalos relativamente infrecuentes durante un largo período de tiempo. Algunos pacientes continúan recibiendo el tratamiento por el resto de sus vidas. En las aplicaciones terapéuticas, a veces se requiere una dosis relativamente alta a intervalos relativamente cortos hasta que se reduzca o se termine el progreso de la enfermedad, y preferiblemente hasta que el paciente muestre una mejora parcial o completa de los síntomas de la enfermedad. A
partir de entonces, al paciente se le puede administrar un régimen profiláctico.
Ejemplos
Los siguientes ejemplos se proporcionan para ilustrar adicionalmente la invención pero no para limitar su alcance. Ejemplo 1:______Generación de Anticuerpos del Factor P con Maduración de Afinidad
Se utilizó una biblioteca de exhibición de fagos completamente humanos para generar los anticuerpos de enlace al Factor P descritos en este documento.
Se utilizó el Factor P humano y de cinomolgo biotinilado y no biotinilado en solución y en paneos en fase sólida. Se realizó la panorámica estándar, así como los enfoques RapMAT (Prassler y colaboradores, (2009) Immunotherapy 1 (4):. 571-583). Después de la maduración de afinidad (Knappik y colaboradores, (2000) J. Mol. Biol., 296: 57-86), se eligió posteriormente un conjunto de 10 anticuerpos para la conversión hasta un formato Fab con puentes de disulfuro. Los Fab con puentes de disulfuro resultantes se muestran en la Tabla 1 (NVS962, NVS963, NVS964, NVS965, NVS966, NVS967).
Ejemplo 2:______Optimización Adicional de Anticuerpos
El siguiente ejemplo describe los métodos que se pueden usar para optimizar aún más los anticuerpos descritos en el presente documento.
Eliminación de los sitios de desamidación
Los sitios de desamidación fueron identificados mediante mapeo de péptidos y cromatografía de exclusión por tamaños (SEC), ejecutada bajo condiciones reductoras. El material desamidado ha disminuido la potencia en un ensayo de depósito de MAC y disminuyó la afinidad para el Factor P humano y de cinomolgo medida mediante Biacore y SET. El grado de desamidación aumentó con el tiempo (3 semanas), a temperaturas más altas (5 días a 37°C), y bajo condiciones reductoras. La desamidación se puede detectar utilizando un columna de intercambio de iones, dando como resultando múltiples picos y la observación del pico desamidado adicional. Las secuencias de aminoácidos que son más propensas a la desamidación son: SNG, LNG, LNN, ELN (Daugherty, A. y Mrsny, R. (2010) Current Trends in Monoclonal Development and Manufacturing. Springer. páginas 103-129). De conformidad con lo anterior, nos comprometimos en una serie de estudios para eliminar los sitios de desamidación y poner a prueba los anticuerpos modificados para la función retenida
Se volvieron a diseñar dos Fabs, NVS962 y NVS965, para reemplazar un sitio de desaminación en la cadena pesada, que se presenta específicamente en una asparagina en la posición 30. Se generaron los siguientes nuevos Fabs para eliminar el sitio de desamidación y los reemplazos de aminoácidos correspondientes que se muestran en la Tabla 2
Tabla 2
Fabs Desamidados

Un Fab adicional que se generó reemplazó la serina 31 con una alanina en el Fab NVS962, generando el Fab NVS962-S31A. Las secuencias de los Fabs modificados se muestran en la Tabla 1.
Eliminación de los sitios de disociación
Se llevó a cabo una optimización adicional en NVS962-S y S-NVS965 para eliminar un sitio de disociación en CDR3 de la cadena pesada. Específicamente, la cadena pesada se disoció en Y102S103. La siguiente tabla describe las sustituciones de aminoácidos que se hicieron para destruir el sitio de disociación. Las secuencias de los Fabs modificados se muestran en la Tabla 1.
Tabla 3
Fabs Modificados

Ejemplo 3:______Caracterización de Anticuerpos Optimizados
El siguiente ejemplo describe los métodos que se pueden emplear para medir la afinidad del anticuerpo. Estos y otros métodos de medición de la afinidad de enlace son conocidos en la materia.
Determinación de afinidad
La afinidad del anticuerpo para el Factor P se midió mediante resonancia de plasmón superficial (SPR) usando un Biacore T200 (Biacore) y la titulación de solución en equilibrio (SET). Las explicaciones de cada tecnología y los resultados medios correspondientes para el enlace al Factor P se describen a continuación. Los supuestos de modelado toman en cuenta las concentraciones del Factor P en el sistema, la cinética de la biosíntesis y vida media del Factor P, así como el programa de dosificación deseado, y sugieren que un Fab con una afinidad superior a 500 pM para el Factor P es suficiente para niveles más bajos del Factor P libre.
Determinación Biacore
La cinética de una interacción, es decir, los índices de formación de complejos (ka) y de disociación (kd), se pueden determinar a partir de la información en un sensograma. Si se produce el enlace a medida que pasa la muestra a través de una superficie del sensor preparada, aumenta la respuesta en el sensograma. Si se alcanza el equilibrio se verá una señal constante. La sustitución de la muestra con regulador provoca que las moléculas enlazadas se disocien y disminuye la respuesta. El software de evaluación Biacore genera los valores de ka y kd ajustando los datos a los modelos de interacción (Tabla 4).
Los experimentos cinéticos Biacore se realizaron con el BIAcore T100 (GE Healthcare), utilizando chips sensores CM5 (Ge Healthcare, BR-1005/30) a 25°C. El regulador de ejecución fue HBS-EP (+) (g E Healthcare, BR-1001/88). Dicho de una manera breve, se llevaron a cabo los siguientes pasos para determinar la afinidad de enlace.
• Preparar el chip sensor con IgG anti-FP inmovilizada: El anticuerpo monoclonal anti-FP de ratón (Quidel, A235) (30 microgramos/mililitro en regulador de acoplamiento de acetato a un pH de 5.0 (GE Healthcare, BR-1003/51)) se acopló a dos celdas de flujo diferentes (FC1 y 2) en un chip CM5 a una velocidad de flujo de 10 microlitros/minuto durante 600 segundos mediante el uso del procedimiento de acoplamiento de amino de acuerdo con las instrucciones del proveedor (GE Healthcare, BR-1000/50). El nivel final inmovilizada será > 7000 RU.
• FP de captura en la segunda celda de flujo: Se inyectó 1 microgramo/mililitro de FP en el regulador de ejecución a 10 micro-litros/minuto en la segunda celda de flujo (Fc2) para alcanzar un nivel de captura de aproximadamente 20 RU para Fab o de aproximadamente 7 RU para el análisis cinético de IgG.
• Inyectar Fab o IgG anti-FP en diferentes concentraciones en ambas celdas de flujo: Inyectar solución anti-FP (de 0.3125 nM a aproximadamente 10 nM en regulador; en diluciones en serie de 1:2) en ambas celdas de flujo (Fc1 y 2) a 60 microlitros/minuto durante 240 segundos.
• Disociación: Inyectar regulador de ejecución HBS-EP(+) a 60 microlitros/minuto en ambas celdas de flujo
para monitorear la disociación entre FP y Fab/IgG anti-FP. El tiempo de disociación se estableció en 2,400 segundos para las concentraciones de Fab/IgG de 2.5 M y 5 nM, y en 300 segundos para todas las demás concentraciones, incluyendo otra concentración de Fab/IgG de 5 nM.
• Regeneración: La regeneración se llevó a cabo al final de cada ciclo en ambas celdas de flujo con 10 mM de glicina-HCl, pH de 1.7 (proporcionada por GE Healthcare) tensoactivo P20 al 0.05 por ciento (GE Healthcare, BR-1000/54) a una velocidad de flujo de 60 microlitros/minuto durante 15 segundos dos veces.
• Análisis Cinético: Las constantes de las velocidades cinéticas se obtuvieron mediante la aplicación de un modelo de enlace de 1:1 con el software BIAevaluation 1.1, en el que los valores Rmax se ajustaron localmente.
Los resultados de la determinación de la cinética de enlace de Biacore se muestran en la Tabla 4. Como se muestra, los anticuerpos descritos en el presente documento muestran una alta afinidad de enlace al Factor P humano, con valores de KD típicamente menores o iguales a 1 nM, y en muchos casos menores o iguales a 200 pM. Estos anticuerpos también muestran una afinidad muy alta para el Factor P de cinomolgo (afinidad de enlace de menos de 500 pM).
Determinación SET
En contraste con los ensayos cinéticos utilizando superficies detectoras, tales como SPR, SET es un método que determina las afinidades en solución. Es una medida de equilibrio que no proporciona los datos cinéticos.
En la SET, una cantidad constante de anticuerpo se incuba con diferentes concentraciones de antígeno hasta que se alcanza el equilibrio. La concentración de anticuerpo libre en la solución de equilibrio, se determina mediante la aplicación de la solución sobre una placa recubierta con antígeno MSDMR (Meso Scale DiscoveryMR) seguido de incubación con un anticuerpo secundario marcado con ECL y la medición de la intensidad de la señal. En bajas concentraciones de antígeno, se consigue una señal fuerte (alta concentración de anticuerpo libre que se enlaza al antígeno en la placa), mientras que para una alta concentración de antígeno, el anticuerpo es completamente capturado por el antígeno, lo que da como resultado una señal baja. Si hay un número suficiente de concentraciones de antígeno en un rango coincidente disponible, la curva de titulación permite una determinación razonable de la afinidad, utilizando el modelo de ajuste apropiado. Para una valoración completa, se tienen que aplicar concentraciones de antígeno por lo menos 10 veces más altas que la Kd esperada. La concentración constante de anticuerpo aplicada en el ensayo debe estar en el intervalo de, o por debajo de, la Kd (Tabla 4).
Para la determinación de la Kd mediante una titulación de solución en equilibrio (SET), las fracciones de monómero de la proteína de anticuerpo se utilizaron (al menos el 90 por ciento del contenido de monómero, analizado mediante la SEC analítica; Superdex75 (Amersham Pharmacia) para Fab, o Tosoh G3000SWXL (Tosoh Bioscience) para IgG, respectivamente).
La determinación de afinidad en solución se llevó a cabo básicamente como se describe en la literatura (Friguet y colaboradores. 305-19). Con el fin de mejorar la sensibilidad y la precisión del método de SET, se transfirió desde el ELISA clásico hasta la tecnología basada en ECL (Haenel y colaboradores., 2005).
1 miligramo/mililitro de fragmentos de anticuerpos específicos (Fab)2 de cabra anti-humanos (Dianova) se marcaron con MSD Sulfo-TAGMR NHS-éster (Meso Scale Discovery, Gaithersburg, MD, EUA) de acuerdo con las instrucciones del fabricante.
El Factor P humano (Complement Technology Cat #: A139) y el Factor P de cinomolgo purificados a partir de suero de cinomolgo (protocolo adaptado de Nakano, y colaboradores, (1986) J Immunol Methods 90:. 77-83) se recubrieron en placas de enlace estándar MSD (Meso-Scale Discovery, 384 pozos: MSD Cat #: L21XA, 96 pozos: MSD Cat #: L15XA) de 0.2 a 0.3 microgramos/mililitro en 25 microlitros de suero regulado con fosfato (PBS), y se incubaron durante la noche a 4°C. Los inhibidores del factor P se diluyeron a una concentración fija (1 pM o 10 pM) en regulador de incubación (suero regulado con fosfato (PBS) con albúmina de suero bovino (BSA) al 2 por ciento (Sigma Cat #: A4503) y Tween 20 al 1 por ciento, y T riton X al 1 por ciento (Sigma Cat #: 234729)), y se agregaron a una dilución en serie del Factor P (humano o de cinomolgo) en regulador de incubación. Las muestras se dejaron alcanzar el equilibrio mediante incubación a temperatura ambiente durante la noche. Las placas se lavaron 3 veces en regulador de lavado (suero regulado con fosfato (PBS) con Tween 20 al 0.05 por ciento), y se bloquearon con 100 microlitros de regulador de incubación a temperatura ambiente durante 2 horas. Las placas se lavaron 3 veces en regulador de lavado. Se añadieron a la placa las muestras que contenían los inhibidores del Factor-P y la titulación del Factor-P (25 microlitros), y se incubaron a temperatura ambiente durante 15 minutos. Las placas se lavaron 3 veces en regulador de lavado. Se agregaron 25 microlitros del anticuerpo de detección (Anti-humano (de cabra) sulfo-TAG, 1:1000 en regulador de incubación, MSD Cat #: R32AJ-1), y se incubaron a temperatura ambiente durante 60 minutos. Las placas se lavaron 3 veces en regulador de lavado, y se añadieron 50 microlitros de regulador de lectura MSD T 1x (con tensoactivo, MSD Cat #: R92TC-1). Las placas se leyeron en un MSD Spector Imager 6000. Los datos se analizaron usando el software GraphPad Prism v4, sustrayéndose el fondo (un promedio
de los pozos que no contenían Fab) de cada valor. Los valores del eje X (concentración del Factor P en solución) se transformaron en el log10x. Los valores KD (KD) se ajustaron a partir del siguiente modelo:
Fab:
Y = (Top -((Top / (2 x Fab)) x ((((10 A x) Fab) KD) (((((10 A x) Fab) KD) x ((( 10 A x) Fab) KD)) -((4 x (10 A x)) x Fab)) a 0,5))))
Top = señal en la concentración del antígeno = 0
x = concentración de Factor P en solución
Fab = concentración de analito monovalente aplicado (Fab)
Tabla 4
Afinidad de Enlace de Anticuer os del Factor P


Ejemplo 4:______ Los anticuerpos del Factor P inhiben la senda de complemento alternativa
Ensayo de hemólisis
En las técnicas hemolíticas, todos los componentes del complemento deben estar presentes y deben ser funcionales. Por lo tanto, las técnicas hemolíticas pueden detectar tanto la integridad funcional como las deficiencias del sistema del complemento (Van y colaboradores, 1980; Minh y colaboradores, 1983; Tanaka y colaboradores, 1986). Para medir la capacidad funcional de la senda clásica, se utilizan los glóbulos rojos sanguíneos de oveja recubiertos con hemolisina (IgG de conejo para glóbulos rojos sanguíneos de oveja) o con glóbulos rojos sanguíneos de pollo que sean sensibilizados con anticuerpos de conejo anti-pollo, como las células objetivo (células sensibilizadas). Estos complejos de Ag-Ab activan la senda clásica y dan como resultado la lisis de las células objetivo cuando los componentes son funcionales y están presentes en una concentración adecuada. Para determinar la capacidad funcional de la senda alternativa en suero humano y de cinomolgo, se utilizan glóbulos rojos sanguíneos de conejo como las células objetivo (véase la Patente de los Estados Unidos de Norteamérica Número 6,087,120).
El ensayo hemolítico es un ensayo funcional básico que pone a prueba la activación del complemento y se ha utilizado para evaluar la capacidad de los mAbs anti-FP humanos y de las moléculas Fab para bloquear la lisis de los glóbulos rojos sanguíneos (RBCs) por medio de las sendas del complemento. La inhibición in vitro e in vivo de la actividad del complemento mediante un fragmento Fv de una sola cadena que reconoce el C5 humano, se puede medir usando un ensayo hemolítico (Thomas y colaboradores, 1996; Rinder y colaboradores, 1995; Rinder y colaboradores, 1995). El bloqueo de la generación de C5a y C5b-9 inhibe la activación de los leucocitos y de las plaquetas durante la circulación extracorpórea. En pocas palabras, para los ensayos de la senda clásica, se utilizan los glóbulos rojos sanguíneos sensibilizados (por ejemplo, RBCs de pollo) como objetivos para la lisis mediante las proteínas del complemento presentes en el suero. El siguiente ensayo es de interés para la caracterización y detección de anticuerpos del Factor P por su inhibición de la senda del complemento alternativa.
Este procedimiento fue adaptado a partir de (Rinder y colaboradores., 1995; Thomas y colaboradores., 1996).
Reactivos:
Glóbulos rojos sanguíneos de conejo (Rb RBCs) - Lampire, Cat # 7246408.
Suero humano - Novartis Blood Research Program; o suero de cinomolgo - Alpha Genesis.
Regulador de Gelatina Veronal (GVB) - Boston BioProducts, Cat # IBB-300.
EGTA - Boston BioProducts, Cat # BM-151.
MgCl2.
Placa de 96 pozos de fondo en U - Corning, Cat # 3795.
Placa de 96 pozos de fondo plano - Corning, Cat # 3370.
• NP-40 - Sigma, Cat # 74385.
Protocolo:
Los glóbulos rojos sanguíneos de conejo (RBCs) se lavaron y se ajustaron a 8.33 x 10⁷ células/mililitro en GVB/EGTA/Mg++. Se agregaron 50 microlitros de Fab diluido en GVB a los pozos en una placa de fondo redondo de 96 pozos. A continuación se agregaron 50 microlitros de suero diluido en GVB con EGTA y Mg++. Los pozos de control se prepararon de la siguiente manera: suero sin Fab (control negativo) y células más NP-40 al 0.1 por ciento (control de lisis del 100 por ciento), y pozos de referencia con NP-40. El suero con y sin Fab y los controles se incubaron a temperatura ambiente durante 30 minutos. En ese punto, se agregaron 30 microlitros de glóbulos rojos sanguíneos de conejo (Rb RBCs) para los pozos de muestra y de control, y se agregaron 30 microlitros de regulador a los pozos de referencia. Las células se incubaron generalmente durante 30 minutos a 37°C, y la placa se centrifugó a 2,000 revoluciones por minuto (rpm) durante 5 minutos. El sobrenadante se cosechó y se transfirió a una placa de fondo plano. La absorbencia del sobrenadante se leyó a una OD415 y OD570. El porcentaje de hemólisis se calculó utilizando la siguiente fórmula:
(ODmuestra - ODsuero ref.)-(OD0%lisis - ODregulador ref.)
% Hemolisis = ____________________________________________________
(OD100%lisis - ODNP40 ref.)-(OD0%lisis - ODregulador ref.)
La Tabla 5 ejemplifica la capacidad de los anticuerpos de Factor P y de los fragmentos de enlace al antígeno para inhibir la hemólisis en suero humano al 10 por ciento o en suero de cinomolgo al 20 por ciento. Cada uno de los anticuerpos de Factor P descritos en la presente inhibieron la hemólisis con una IC50 de menos de, o igual a, 50 nM.
En contraste, cuando se llevó a cabo el ensayo utilizando glóbulos rojos sanguíneos sensibilizados, con el objeto de examinar la activación de la senda del complemento clásica, se encontró que los anticuerpos del Factor P descritos en la presente no inhiben la senda del complemento clásica (no se muestran los datos).
Ensayo de Depósito de C3b
Un método para medir la actividad del inhibidor contra el complemento C3 en la senda alternativa es medir su producto de descomposición, C3b, depositándose sobre zimosan. Este ensayo basado en ELISA se llevó a cabo de acuerdo con los siguientes pasos: 25 microlitros de 1 miligramo/mililitro de Zimosan A (Sigma Z4250) en regulador de carbonato, pH de 9.6 (Pierce Cat # 28382) se recubrieron sobre una placa de ELISA Maxisorp de 384 pozos (Nunc 464718) durante la noche a 4°C. Al día siguiente, la placa recubierta con zimosan se aspiró y se bloqueó con 100 microlitros por pozo de regulador de bloqueo ELISA, Synblock (AbD Serotec BUFO34C) durante 2 horas a temperatura ambiente. En una reacción separada, los inhibidores, diluidos en serie en regulador de gelatina Veronal (Boston Bioproducts IBB320 - Barbital 10 mM, NaCl 145 mM, gelatina al 0.1 por ciento, MgCl2 0.5 mM, EGTA 10 mM), se agregaron al suero al 10 por ciento complementado con MgCl2 y EGTA para una concentración final de la reacción total de MgCl2 1 mM y EGTA 10 mM. El control positivo no contuvo inhibidor y el control negativo tuvo EDTA 25 mM. La mezcla se dejó alcanzar el equilibrio mediante incubación a temperatura ambiente durante 30 minutos. Para remover el regulador de bloqueo, se aspiró el regulador, y la placa se lavó una vez con TBS/Tween-20 al 0.05 por ciento. Se agregaron a la placa 25 microlitros por pozo del suero al 10 por ciento que contenía los inhibidores o los controles, y se incubaron a 37°C durante 30 minutos (determinado previamente cuando el transcurso del tiempo está dentro del rango lineal de depósito de C3b sobre zimosan). Después de la incubación durante 30 minutos, la placa se lavó tres veces con TBS/Tween-20 al 0.05 por ciento. Para detectar el depósito de C3b sobre zimosan, se agregaron a la placa 25 microlitros por pozo de anticuerpo policlonal conjugado con C3-HRP de pollo anti-humano (Immunology Consultants Laboratory, Inc., Cat # CC3-80P-1) diluido de acuerdo con el fabricante en suero regulado con fosfato (PBS) con albúmina de suero bovino (BSA) al 2 por ciento, Fracción V (Fisher Cat # ICN 16006980), Tween 20 al 0.1 por ciento (Sigma Cat # P1379), y Triton X-100 al 0.1 por ciento (Sigma Cat # P234729), y se incubaron a temperatura ambiente durante 1 hora. Después, la placa se lavó tres veces con TBS/Tween-20 al 0.05 por ciento, y luego se agregaron 25 microlitros de solución de sustrato Ultra TMB (Pierce Cat # 34028). Cuando la solución en el pozo cambió a un color azul, la reacción fue detenida con 15 microlitros de ácido sulfúrico 2N. La placa se leyó a 450 nanómetros usando el Spectromax con corrección para la placa de plástico a 570 nanómetros (lectura a OD450-570nm). El porcentaje de depósito de C3b sobre el zimosan se calculó utilizando la siguiente fórmula:
[(ODsin inhibidor -OD EDTA 25mM)—(ODmuestra - OD EDTA 25mM)]
% Depósito C3b = 100 - 100 *
(ODsin inhibidor - OD EDTA 25mM)
Se demostró que cada uno de los anticuerpos probados inhibe el depósito de C3b con una IC50 por lo menos menor o igual a 10 nM (Tabla 5).
Ensayo de Depósito de MAC
Otro ensayo que se utilizó para determinar la capacidad de los anticuerpos del Factor P para inhibir la senda del complemento alternativa fue medir la capacidad de los anticuerpos para inhibir la generación del complejo de ataque a la membrana (MAC), que está corriente abajo de la convertasa C3, y la actividad del Factor P. Brevemente, se recubrió una placa con Zimosan A (Sigma) a 1 miligramo/mililitro en regulador de carbonato, pH de 9.5, para activar la senda alternativa. Los Fabs fueron previamente incubados con suero (suero al 20 por ciento, MgCh 5 mM, EDTA 10 mM), entonces se añadieron a la placa, y se incubaron durante la noche a temperatura ambiente. Después de lavar la placa tres veces con TBST, se detectó el MAC mediante la incubación con anti-C5b-9-ALP (Diatec) durante 1 hora, seguido por tres lavados con TBST, y la incubación con fosfato de 4-metilumbeliferilo (Fisher) complementado con MgCl22 mM durante 30 minutos. La reacción se detuvo con EDTA 0.2 M, y la placa se leyó a una excitación = 355 nanómetros, emisión = 460 nanómetros. Se calculó la inhibición del depósito de MAC para cada muestra en relación con la línea base (suero humano tratado con EDTA) y con el control positivo (suero humano), y se utilizó para generar la curva de IC50 con PRISM.
La Tabla 5 muestra los datos que demuestran la capacidad de los anticuerpos del Factor P para inhibir el depósito de MAC, indicando de esta manera que los anticuerpos inhibieron la senda del complemento alternativa. Específicamente, los anticuerpos inhibieron el depósito de MAC con una IC50 de menos o igual a 25 nM.
Ensayo de Depósito de C3a
Otro método utilizado para evaluar la capacidad de los anticuerpos del Factor P para inhibir la senda del complemento alternativa es medir la capacidad de los anticuerpos para inhibir la generación de C3a en seguida de la disociación de C3 mediante la convertasa de C3. El ensayo se llevó a cabo en placas Maxisorp recubiertas con zimosan a 10 miligramos/mililitro, y suero humano al 10 por ciento y al 20 por ciento previamente incubado con Fab anti-properdina diluido en una serie de 2n. El suero se añadió a las placas durante 30 minutos, en cuyo tiempo se recolectó el suero para la evaluación de la generación de C3a.
Las placas Maxisorp se recubrieron con el anticuerpo anti-C3a des-arg neo (1 microgramo/mililitro) durante la noche, se lavaron tres veces, y se bloquearon con diluyente durante dos horas a temperatura ambiente. Después de la aspiración del diluyente, se añadió suero durante una hora. Las placas se lavaron tres veces, y se agregaron 100 microlitros/pozo de anticuerpo de detección de ratón anti-humano C3a-Biotina diluido a 1:1000 en el diluyente. Después de una incubación adicional durante una hora, se agregó a los pozos un anticuerpo secundario de estreptavidina-HRP diluido a 1:5000 en el diluyente durante una hora a temperatura ambiente. Las placas se lavaron cuatro veces antes de la adición del sustrato de detección de TMB. La reacción se detuvo utilizando la solución de paro estándar, y se leyó la absorbencia a 450-570 nanómetros.
En paralelo con la adición del suero, se produjo una curva estándar usando C3a des-arg purificado diluido en suero. Empezando en 5 microgramos/mililitro, el C3a des-arg se diluyó en serie a 1:4 para generar una curva de 7 puntos. Los pozos de la curva estándar se trataron, se lavaron, y se leyeron como anteriormente.
Tabla 5
Análisis Funcional de A^ nticuer os del Factor P


ND: No determinado
Ejemplo 5:______ Reactividad Cruzada entre Especies
Con el fin de determinar si, además de humano y cinomolgo, los anticuerpos anti-Factor P descritos en la presente se enlazarían al factor P de otras especies, se llevaron a cabo ensayos de depósito de MAC y hemolíticos, como se describe anteriormente. El análisis BIAcore o los ensayos hemolíticos se llevaron a cabo como se describe anteriormente. Las concentraciones séricas utilizadas para cada especie fueron las siguientes: sueros al 10 y 20 por ciento de conejo, al 10 y 20 por ciento de cinomolgo, y al 10 y 20 por ciento de suero humano. Se evaluó el enlace del Factor P de rata mediante BIAcore. Como se muestra en la Tabla 6 a continuación, los anticuerpos del Factor P fueron capaces de reaccionar cruzadamente con varias especies, incluyendo conejo, rata y cinomolgo.
Tabla 6
R ivi r z n r E i

ND: no determinado
Ejemplo 6:______ Mapeo de Epítopos
El Factor P está comprendido de varios dominios de repetición de trombospondina (TSR 0-6). El dominio TSR0 también es referido como el dominio N-terminal. El mapeo de epítopos de los Fabs del Factor P se llevó a cabo mediante la creación de quimeras de ratón y de humano para cada TSR. Los ensayos funcionales anteriores mostraron que los Fabs no se enlazan al Factor P de ratón (ensayos hemolíticos), aunque cada una de las quimeras fue funcional en suero agotado de Factor P. Empleando este método, se determinó que todos los Fabs se enlazan al TSR5 (SEQ ID NO: 406). La Figura 1C muestra la región B del TSR5 que se enlaza a los anticuerpos. Se demostró que el anticuerpo disponible comercialmente, A233, no se enlaza en esta región. El enlace se puede evaluar mediante un ELISA o Biacore empleando los métodos convencionales. Para un Ab, NVS487, los datos no fueron concluyentes debido a la reactividad cruzada con el Factor P de ratón. La alineación de secuencias entre el dominio TSR5 de Factor P de ratón y humano muestra que el epítopo incluye los aminoácidos de la SEQ ID NO: 408.
Ejemplo 7:______ Inhibición in vivo de la Senda de Complemento Alternativa
Se llevaron a cabo experimentos en mono cinomolgo con los anticuerpos divulgados en la presente para determinar su capacidad para inhibir la senda del complemento alternativa.
El artículo de prueba, NVS962, se administró en los niveles de dosis mostrados en la Tabla 7. La vía de administración fue intravítrea (IVT) o intravenosa (IV).
Tabla 7
Diseño del Estudio in Vivo
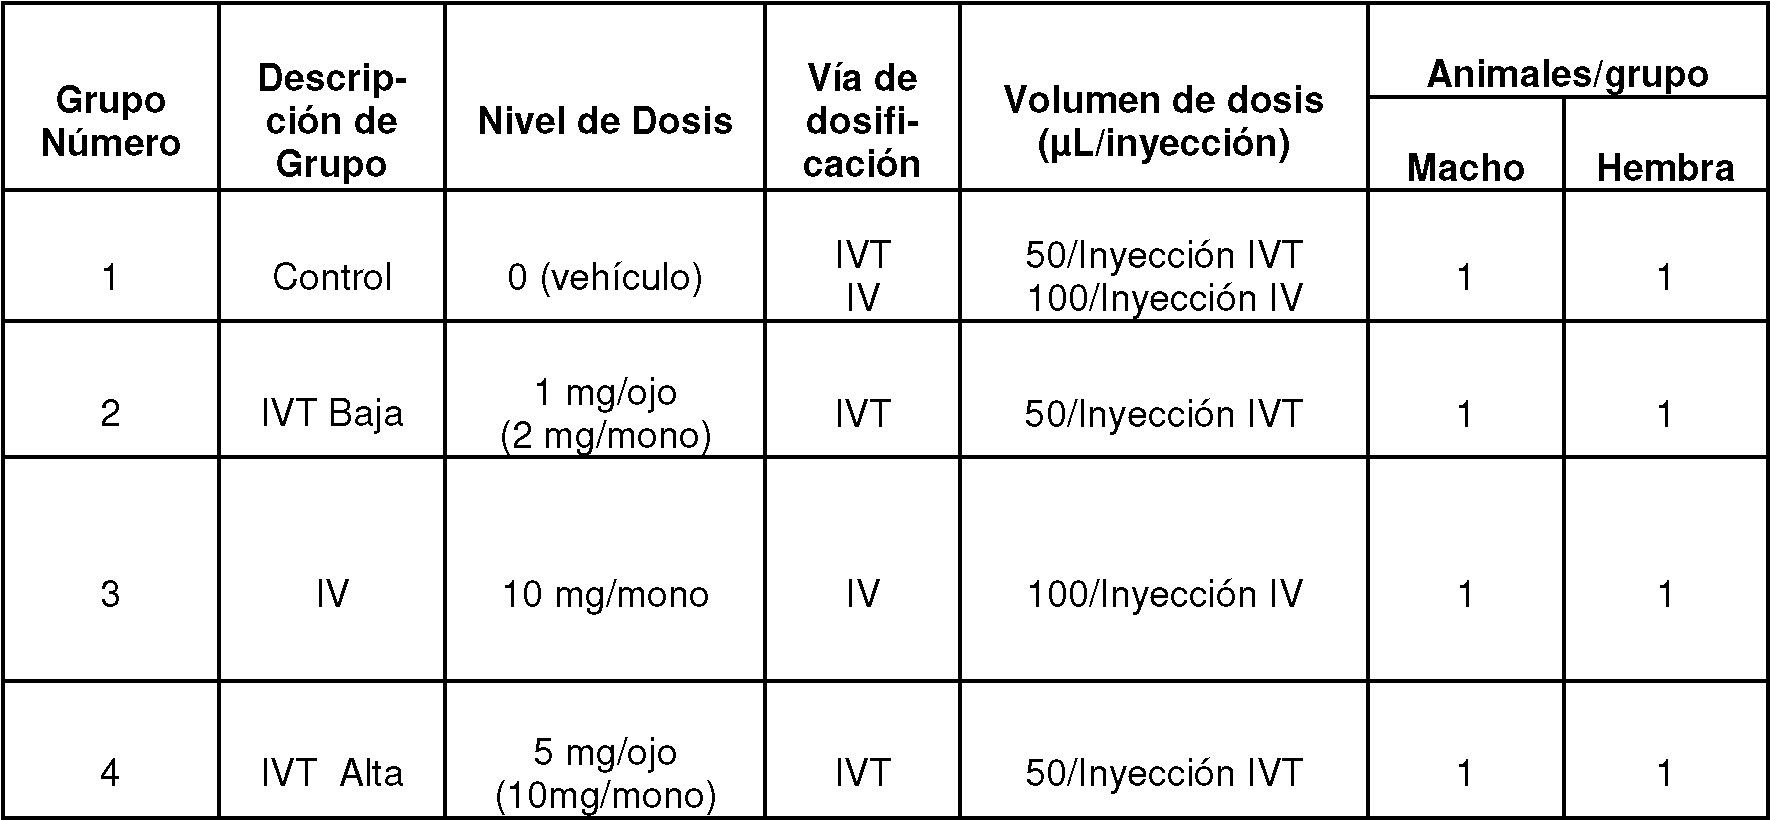
El artículo de prueba y las soluciones de vehículo (vehículo: His 10 mM/His-HCl; trehalosa al 10 por ciento; Tween 20 al 0.02 por ciento, pH de 5.5) se administraron por vía intravítrea y por vía intravenosa en los días 1, 15 y 29 del estudio, como se indica en la Tabla 7.
La evaluación de la toxicidad se basa en la mortalidad, en las observaciones clínicas, los pesos corporales, la farmacodinámica (análisis hemolítico), los exámenes oftalmológicos, las mediciones de la presión intraocular, la electro-retinografía, la hematología, la química clínica, los pesos de los órganos, y en la patología.
No hubo mortalidades durante el estudio y no se vieron hallazgos relacionados con el artículo de prueba después de la evaluación de los signos clínicos, los pesos corporales, los exámenes oftalmológicos, las mediciones de la presión intraocular, la electro-retinografía, la hematología, la química clínica, los pesos de los órganos, y la patología.
La actividad hemolítica mediada por el complemento se midió usando el ensayo hemolítico descrito anteriormente (véase el Ejemplo 4). El análisis de los datos del ensayo hemolítico mostró que la administración intravenosa (IV) de NVS962 condujo a una inhibición completa o casi completa pero de corta duración, de la actividad hemolítica del complemento inmediatamente después de la administración. Cuando se administró por vía intravítrea (IVT) en una dosis de 1 miligramo/ojo, el artículo de prueba tuvo poco o ningún efecto sobre la actividad hemolítica del complemento en suero. Con 5 miligramos/ojo y en suero de cinomolgo al 10 por ciento, se observó una inhibición completa o casi completa de la actividad hemolítica del complemento.
Ejemplo 8:______ Inhibición Sinérgica de la Senda de Complemento Alternativa mediante Combinaciones de Anticuerpos
Ensayo de hemólisis
Los ensayos hemolíticos utilizando las versiones Fab del anticuerpo anti-C5 8109 de la Tabla 2 y el anticuerpo anti Factor P NVS962 a partir de la Tabla 1, se llevaron a cabo como se describe en el Ejemplo 4.
La Figura 2 ejemplifica la capacidad de los anticuerpos del Factor P y de los fragmentos de enlace al antígeno en combinaciones con los anticuerpos anti-C5 y los fragmentos de enlace al antígeno, para inhibir la hemólisis en suero humano al 20 por ciento. Los Fabs anti-Factor P 500 nM y anti-C5 500 nM individualmente no demuestran inhibición alguna de la hemólisis cuando se incuban durante 60 minutos. En contraste, la combinación de los anticuerpos anti Factor P y anti-C5 en la misma concentración y en concentraciones tan bajas como de 167 nM, demuestran una inhibición casi completa de la hemólisis. Además, la inhibición casi completa de la hemólisis tiene una duración de hasta 250 minutos.
Los datos del ensayo hemolítico se utilizaron con el software Chalice Analyzer para determinar si la combinación de los anticuerpos inhibidores del complemento actuaba de una forma sinérgica para bloquear la activación del complemento. Los efectos de la combinación se pueden caracterizar mediante la comparación de la inhibición de cada punto de datos con aquella de un modelo de referencia de combinación que se derivó a partir de las curvas de un solo agente (Greco, Bravo, Parsons (1995). The search for synergy: a critical review from a response surface perspecctive. Pharmacol Rev 47 (2): 331-85). En el modelo de aditividad de Loewe (Loewe (1928) Die quantitativen Probleme der Pharmakologie. Ergebn. Physiol. 27: 47-187), /L o e w e (Cx , Cy ) es la inhibición que satisface (Cx / ICx ) + (Cy / ICy ) = 1, y ICx,y son las concentraciones efectivas en /L o e w e para las curvas ajustadas de un solo agente. La aditividad de Loewe es la referencia generalmente aceptada para el sinergismo (Greco y colaboradores), debido a que representa la respuesta de la combinación generada si X e Y son el mismo compuesto.
El cambio de potencia se muestra generalmente usando un isobolograma (Greco y colaboradores) que muestra cuánto fármaco menos se requiere en combinación para lograr un nivel de efecto deseado, en comparación con las dosis necesarias del único agente para lograr ese efecto. La elección del nivel de efecto para los cálculos del despliegue del isobolograma y el índice de combinación, se puede hacer manualmente o se puede seleccionar automáticamente en el Chalice Analyzer. El algoritmo de selección automática del iso-nivel encuentra el Idatos observados con la relación más grande de Idatos-L o e w e , excluyendo los puntos con Idatos que excedan el Im a x menor del único agente. Esta exclusión se aplica para asegurar que el isobolograma refleje el mejor sinergismo en los niveles comprendidos por ambos agentes individuales. Después de haber seleccionado un nivel de isobolograma /c o r t e , se dibuja el isobolograma mediante la identificación del locus de las concentraciones que corresponden al cruce del isonivel seleccionado. El isobolograma muestra el análisis isobolográfico estándar del sinergismo en comparación con el estándar del "fármaco consigo mismo" de dosis aditiva de Loewe. Para un nivel de isobolograma especificado, se exhibe el contorno del iso-efecto observado (por ejemplo, la línea curva en la Figura 3), con el contorno teórico de dosis aditiva (por ejemplo, la línea recta en la Figura 3), en una escala de concentración lineal normalizada al ICe fe c to para ambas sustancias en la combinación. La referencia de la dosis aditiva siempre es una línea que conecta las dos concentraciones ICe f e c t o . Los puntos de cruce de ICe fe c to se encuentran mediante la interpolación de las curvas sigmoideas ajustadas de respuesta a la dosis.
El cambio de potencia se califica como el índice de combinación CI (Chou, Talalay (1984). Quantitative analysis of dose-effect relationships: the combined effects of multiple drugs or enzyme inhibitors. Adv Enzyme Regul 22: 27-55). Para un nivel de iso-efecto seleccionado Icorte, CIi = (Cx /ECx ) i + (Cy /ECy ) i , en donde (Cx /ECx ) i para un punto de datos particular, es la proporción de la concentración medida del compuesto X a su concentración efectiva en el nivel de inhibición seleccionado. El CI puede ser pensado como una estimación aproximada de cuánto fármaco se necesitó en combinación en relación con las dosis del único agente requeridas para lograr el nivel de efecto seleccionado, y un valor de 0.1 significa que solamente fue necesaria una décima parte de las cantidades equivalentes de los agentes individuales para que la combinación alcanzara el mismo nivel de efecto. Los valores de CI en el intervalo de 0.5 a 0.7 son típicos para las mediciones in vitro de las combinaciones clínicas actuales (Greco y colaboradores). Un valor de CI de 1.0 indica un efecto aditivo de una combinación de anticuerpos, mientras que un valor de CI de menos de 0.5 indica un efecto sinérgico resultante de la combinación de anticuerpos. En el Chalice Analyzer, el mejor CI se reporta de los muchos valores de índice de combinación calculados para cada concentración cruzada en Ico rte. Entre todos los valores de CI medidos, se reporta que aquel con el mayor nivel de la señal al ruido es el mejor índice de combinación.
Los datos del ensayo hemolítico se expresaron como el porcentaje de inhibición, y se cargaron en una tabla de Excel 8x8, en donde las concentraciones de los anticuerpos se expresaron como valores en pM. La plantilla de Excel se cargó en el software Chalice (Lehar y colaboradores, 2009), y el índice de combinación se generó mediante la creación de una curva de isobolograma utilizando la IC20 para cada anticuerpo (CI = Cx /ICx + Cy /Cy , en donde ICx e ICy son, respectivamente, las concentraciones del anticuerpo anti-Factor P y el anticuerpo anti-C5 solos, que dan como resultado un efecto de inhibición del 20 por ciento, y Cx y CY son las concentraciones de cada fármaco en la mezcla que producen una inhibición del 20 por ciento). El índice de combinación en una inhibición del 20 por ciento es de 0.36, indicando sinergismo entre el anticuerpo anti-Factor P y el anticuerpo anti-C5 (Figura 3).
Infiltración de Macrófagos
Se evaluó in vivo el efecto de los Fabs anti-Factor P y anti-C5 individualmente o en combinación utilizando el modelo de murino de poli-IC de inflamación ocular. Los ratones se inyectaron intravenosamente (i.v.) con un análogo sintético de dsARN, poli-I:C en 0.1 mililitro de suero regulado con fosfato (PBS) sistémicamente, en ratones C57BL/6, junto con los anticuerpos anti-Factor P (anticuerpo NVS962 de la Tabla 1) y anti-C5 (anticuerpo 8019 de la Tabla 2) individualmente o en combinación. Los ratones se sacrificaron en los puntos del tiempo indicados. Se recolectaron los ojos y las retinas, y se prepararon los extractos de proteínas para el análisis de citoquinas y quimiocinas usando un ensayo Multiplex (Pierce). Para determinar la infiltración de leucocitos en la retina, los ojos se fijaron en para-formaldehído al 4 por ciento y se tiñeron con el anticuerpo F4/80 conjugado con Alexa Fluor 488 para los macrófagos. Las retinas se montaron planas con la vasculatura retinal orientada superiormente sobre un portaobjetos de vidrio y se puso el cubreobjetos con una gota de medio de montaje Vectashield (Vector Laboratories Inc, Burtingame, CA). Se capturaron imágenes fluorescentes de cinco regiones (de 500 micras) en cada retina utilizando la cámara Axiocam MR3 en un microscopio Axio.ImageM1 (Zeiss). Se cuantificó el número de neutrófilos y
macrófagos con el software Axiovision (Versión 4.5 Zeiss). Utilizando la tomografía de coherencia óptica (OCT), se obtuvieron imágenes de las retinas y se analizaron a partir de los ratones tratados con poli-I :C. Estos resultados (Figura 4) demuestran que, en las concentraciones más altas ensayadas (20 microgramos) se observó una inhibición de macrófagos no mayor del 45 por ciento. En contraste, las combinaciones de los anticuerpos anti-Factor P y anti-C5, en concentraciones tan bajas como de 2 microgramos, demostraron una inhibición del 79 por ciento, y el aumento de la concentración alcanzó una inhibición del 100 por ciento (en comparación con una inhibición de solamente el 13 por ciento y el 32 por ciento, respectivamente, para los anticuerpos anti-C5 y anti-Factor P en forma individual).
Los datos del modelo in vivo de poli-IC (infiltración de macrófagos) descritos en el párrafo anterior se expresaron como el porcentaje de inhibición y se cargaron en una tabla de Excel 4x4, en donde las dosis de anticuerpos se expresaron como valores en microgramos (gg). La plantilla de Excel se cargó en el Chalice Analyzer (descrito anteriormente), y se generó el índice de combinación mediante la creación de una curva de isobolograma utilizando la IC50 para cada anticuerpo (CI = Cx/ICx Cy/ICy, en donde ICx e ICy son, respectivamente, las concentraciones del anticuerpo anti-Factor P y del anticuerpo anti-C5 solos, que dan como resultado un efecto de inhibición del 50 por ciento, y Cx y Cy son las concentraciones de cada fármaco en la mezcla que producen una inhibición del 50 por ciento). El índice de combinación en la inhibición del 50 por ciento es de 0.42 (véase la Figura 5), lo que indica sinergismo entre el anticuerpo anti-Factor P y el anticuerpo anti-C5.
Claims (11)
1. Una composición que comprende un primer anticuerpo, o el fragmento de enlace al antígeno del mismo, que se une al Factor P, y un segundo anticuerpo, o el fragmento de enlace al antígeno del mismo, que se une a C5, en donde dicho primer anticuerpo, o el fragmento de enlace al antígeno del mismo, tiene la secuencia de dominio variable de cadena ligera y pesada seleccionada del grupo que consiste en una secuencia VH de la SEQ ID NO: 175 y una secuencia VL de la SEQ ID NO: 176; una secuencia VH de la SEQ ID NO: 7 y una secuencia VL de la SEQ ID NO: 8; una secuencia VH de la SEQ ID NO: 91 y una secuencia VL de la SEQ ID NO: 92; una secuencia VH de la SEQ ID NO: 105 y una secuencia VL de la SEQ ID NO: 106; una secuencia VH de la SEQ ID NO: 119 y una secuencia VL de la SEQ ID NO: 120; una secuencia VH de la SEQ ID NO: 189 y una secuencia VL de la s Eq ID NO: 190; una secuencia VH de la SEQ ID NO: 203 y una secuencia VL de la SEQ ID NO: 204; una secuencia VH de la SEQ ID NO: 217 y una secuencia VL de la SEQ ID NO: 218; y una secuencia VH de la SEQ ID NO: 231 y una secuencia VL de la SEQ ID NO: 232; y dicho segundo anticuerpo o el fragmento de enlace al antígeno del mismo que se une a C5 tiene la secuencia de dominio variable de cadena ligera y pesada seleccionada del grupo que consiste en una secuencia VH de la SEQ ID NO: 416 y una secuencia VL de la SEQ ID NO: 417, una secuencia VH de la SEQ ID NO: 432 y una secuencia VL de la SEQ ID NO: 433; una secuencia VH de la SeQ ID NO: 448 y una secuencia VL de la SeQ ID NO: 449; una secuencia VH de la SEQ ID NO: 460 y una secuencia VL de la SEQ ID NO: 461; y una secuencia VH de la SEQ ID NO: 476 y una secuencia VL de la SEQ ID NO: 477, en donde dicha composición inhibe la senda del complemento alternativa.
2. La composición de acuerdo con la reivindicación 1, en donde el primer anticuerpo o el fragmento de enlace al antígeno del mismo comprende la secuencia de dominio variable de cadena ligera y pesada de una secuencia VH de la SEQ ID NO: 175 y una secuencia VL de la SEQ ID NO: 176.
3. La composición de acuerdo con la reivindicación 1 o 2, en donde el segundo anticuerpo o el fragmento de enlace al antígeno del mismo comprende la secuencia de dominio variable de cadena ligera y pesada de una secuencia VH de la SEQ ID NO: 416 y una secuencia VL de la SEQ ID NO: 417.
4. La composición de acuerdo con la reivindicación 1, en donde el primer anticuerpo o el fragmento de enlace al antígeno del mismo comprende la secuencia de cadena pesada de la SEQ ID NO: 177 y una secuencia de cadena ligera de la SEQ ID NO: 178.
5. La composición de acuerdo con la reivindicación 1 o 4, en donde el segundo anticuerpo o el fragmento de enlace al antígeno del mismo comprende la secuencia de cadena pesada de la SEQ ID NO: 418 y una secuencia de cadena ligera de la SEQ ID NO: 419.
6. Una molécula de ácido nucleico aislada que comprende una secuencia de nucleótidos que codifica el primer y el segundo anticuerpo o el fragmento de enlace al antígeno de los mismos según se definen la reivindicación 1.
7. La composición de acuerdo con la reivindicación 4 o 5 o el ácido nucleico aislado de acuerdo con la reivindicación 6, en donde la cadena pesada del primer anticuerpo o el fragmento de enlace al antígeno de este está codificada por una secuencia de nucleótidos que comprende la SEQ ID NO: 181 y la cadena ligera del primer anticuerpo está codificada por una secuencia de nucleótidos que comprende la SEQ ID NO: 182.
8. La composición de acuerdo con la reivindicación 5 o el ácido nucleico aislado de acuerdo con la reivindicación 6, en donde la cadena pesada del segundo anticuerpo o el fragmento de enlace al antígeno de este está codificada por una secuencia de nucleótidos que comprende la SEQ ID NO: 422 y la cadena ligera del segundo anticuerpo está codificada por una secuencia de nucleótidos que comprende la SEQ ID NO: 423.
9. La composición de acuerdo con la reivindicación 5 o el ácido nucleico aislado de acuerdo con la reivindicación 6, en donde la cadena pesada del segundo anticuerpo o el fragmento de enlace al antígeno de este está codificada por una secuencia de nucleótidos que comprende la SEQ ID NO: 424 y la cadena ligera del segundo anticuerpo está codificada por una secuencia de nucleótidos que comprende la SEQ ID NO: 425.
10. Una composición de acuerdo con una cualquiera de las reivindicaciones 1 a 5 para su uso en el tratamiento de la degeneración macular relacionada con el envejecimiento.
11. La composición de acuerdo con una cualquiera de las reivindicaciones 1 a 5 para su uso en la prevención del progreso de la AMD seca hasta AMD húmeda, la ralentización y/o prevención del progreso de la atrofia geográfica, el tratamiento o la prevención del edema macular, la reducción de la frecuencia de la inyección de ranibizumab y la mejora de la pérdida de visión debida al progreso de AMD seca y húmeda.
Applications Claiming Priority (2)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| US201161578458P | 2011-12-21 | 2011-12-21 | |
| PCT/IB2012/057394 WO2013093762A1 (en) | 2011-12-21 | 2012-12-17 | Compositions and methods for antibodies targeting factor p |
Publications (1)
| Publication Number | Publication Date |
|---|---|
| ES2728278T3 true ES2728278T3 (es) | 2019-10-23 |
Family
ID=47666430
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| ES12821311T Active ES2728278T3 (es) | 2011-12-21 | 2012-12-17 | Composiciones que comprenden anticuerpos dirigidos al factor P y C5 |
Country Status (28)
| Country | Link |
|---|---|
| US (3) | US9051365B2 (es) |
| EP (2) | EP3330288A1 (es) |
| JP (2) | JP6231493B2 (es) |
| KR (1) | KR102159843B1 (es) |
| CN (2) | CN104114576B (es) |
| AP (1) | AP2014007761A0 (es) |
| AR (1) | AR089393A1 (es) |
| AU (4) | AU2012356170B2 (es) |
| BR (1) | BR112014015111A2 (es) |
| CA (1) | CA2859493A1 (es) |
| CL (2) | CL2014001640A1 (es) |
| CO (1) | CO6990668A2 (es) |
| CR (1) | CR20140303A (es) |
| CU (1) | CU20140073A7 (es) |
| EA (1) | EA201491214A1 (es) |
| ES (1) | ES2728278T3 (es) |
| HK (1) | HK1254156A1 (es) |
| IL (1) | IL233279B (es) |
| MA (1) | MA35740B1 (es) |
| MX (1) | MX2014007665A (es) |
| PE (1) | PE20150159A1 (es) |
| PH (1) | PH12014501410A1 (es) |
| SG (2) | SG11201403416TA (es) |
| TN (1) | TN2014000258A1 (es) |
| TW (1) | TW201339174A (es) |
| UY (1) | UY34537A (es) |
| WO (1) | WO2013093762A1 (es) |
| ZA (1) | ZA201404432B (es) |
Families Citing this family (19)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| PY09026846A (es) | 2008-08-05 | 2015-09-01 | Novartis Ag | Composiciones y métodos para anticuerpos que se dirigen a la proteína de complemento c5 |
| WO2013006449A2 (en) | 2011-07-01 | 2013-01-10 | The Trustees Of The University Of Pennsylvania | Anti-properdin antibodies and uses thereof |
| ES2728278T3 (es) | 2011-12-21 | 2019-10-23 | Novartis Ag | Composiciones que comprenden anticuerpos dirigidos al factor P y C5 |
| KR102948178B1 (ko) | 2013-07-12 | 2026-04-10 | 아스텔라스 유에스 엘엘씨 | 안과적 질환을 치료하거나 예방하기 위한 방법 |
| SG10201808053XA (en) | 2014-03-19 | 2018-10-30 | Infinity Pharmaceuticals Inc | Heterocyclic compounds for use in the treatment of pi3k-gamma mediated disorders |
| US20150320755A1 (en) | 2014-04-16 | 2015-11-12 | Infinity Pharmaceuticals, Inc. | Combination therapies |
| US20150320754A1 (en) | 2014-04-16 | 2015-11-12 | Infinity Pharmaceuticals, Inc. | Combination therapies |
| CN107921127B (zh) * | 2015-05-22 | 2022-04-08 | 纪念斯隆-凯特琳癌症中心 | 对于prame肽具有特异性的t细胞受体样抗体 |
| WO2017218515A1 (en) | 2016-06-14 | 2017-12-21 | Regeneron Pharmaceuticals, Inc. | Anti-c5 antibodies and uses thereof |
| MX391135B (es) | 2016-06-24 | 2025-03-21 | Infinity Pharmaceuticals Inc | Terapias de combinacion. |
| CA3049806A1 (en) * | 2017-01-30 | 2018-08-02 | Alexion Pharmaceuticals, Inc. | Monovalent anti-properdin antibodies and antibody fragments |
| CN111201246B (zh) | 2017-07-11 | 2023-10-27 | 亚力兄制药公司 | 结合补体成分c5或血清白蛋白的多肽及其融合蛋白 |
| EP3697285A4 (en) * | 2017-10-17 | 2021-06-30 | Apeliotus Technologies, Inc. | FUNCTIONAL BIOMARKERS FOR STATIN THERAPY IN AGE-RELATED MACULAR DEGENERATION (AMD) |
| GB2569144B (en) * | 2017-12-06 | 2021-06-16 | Proimmune Ltd | Method for screening the activity of mutated expressed polypeptides |
| MX2020006113A (es) | 2017-12-13 | 2020-08-24 | Regeneron Pharma | Combinaciones de anticuerpos anti-c5 y usos de las mismas. |
| HRP20240756T1 (hr) | 2018-05-18 | 2024-09-13 | Daiichi Sankyo Co., Ltd. | Anti-muc1-eksatekan antitijelo-lijek konjugat |
| US20220056115A1 (en) * | 2018-09-17 | 2022-02-24 | Kyoto University | Administration of an anti-c5 agent for treatment of hepatic injury or failure |
| CN113748213A (zh) * | 2019-03-29 | 2021-12-03 | 公立大学法人横滨市立大学 | 筛选方法及毒性评价方法 |
| US20240050432A1 (en) | 2020-12-08 | 2024-02-15 | Infinity Pharmaceuticals, Inc. | Eganelisib for use in the treatment of pd-l1 negative cancer |
Family Cites Families (134)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| US4458066A (en) | 1980-02-29 | 1984-07-03 | University Patents, Inc. | Process for preparing polynucleotides |
| US4816567A (en) | 1983-04-08 | 1989-03-28 | Genentech, Inc. | Recombinant immunoglobin preparations |
| EP0154316B1 (en) | 1984-03-06 | 1989-09-13 | Takeda Chemical Industries, Ltd. | Chemically modified lymphokine and production thereof |
| US5225539A (en) | 1986-03-27 | 1993-07-06 | Medical Research Council | Recombinant altered antibodies and methods of making altered antibodies |
| US4946778A (en) | 1987-09-21 | 1990-08-07 | Genex Corporation | Single polypeptide chain binding molecules |
| US5260203A (en) | 1986-09-02 | 1993-11-09 | Enzon, Inc. | Single polypeptide chain binding molecules |
| US4881175A (en) | 1986-09-02 | 1989-11-14 | Genex Corporation | Computer based system and method for determining and displaying possible chemical structures for converting double- or multiple-chain polypeptides to single-chain polypeptides |
| EP0307434B2 (en) | 1987-03-18 | 1998-07-29 | Scotgen Biopharmaceuticals, Inc. | Altered antibodies |
| US5013653A (en) | 1987-03-20 | 1991-05-07 | Creative Biomolecules, Inc. | Product and process for introduction of a hinge region into a fusion protein to facilitate cleavage |
| US5091513A (en) | 1987-05-21 | 1992-02-25 | Creative Biomolecules, Inc. | Biosynthetic antibody binding sites |
| AU612370B2 (en) | 1987-05-21 | 1991-07-11 | Micromet Ag | Targeted multifunctional proteins |
| US5132405A (en) | 1987-05-21 | 1992-07-21 | Creative Biomolecules, Inc. | Biosynthetic antibody binding sites |
| US5258498A (en) | 1987-05-21 | 1993-11-02 | Creative Biomolecules, Inc. | Polypeptide linkers for production of biosynthetic proteins |
| US5677425A (en) | 1987-09-04 | 1997-10-14 | Celltech Therapeutics Limited | Recombinant antibody |
| US5336603A (en) | 1987-10-02 | 1994-08-09 | Genentech, Inc. | CD4 adheson variants |
| US5506247A (en) | 1988-04-15 | 1996-04-09 | T Cell Sciences, Inc. | Compounds that inhibit complement and/or suppress immune activity |
| US5476996A (en) | 1988-06-14 | 1995-12-19 | Lidak Pharmaceuticals | Human immune system in non-human animal |
| US5223409A (en) | 1988-09-02 | 1993-06-29 | Protein Engineering Corp. | Directed evolution of novel binding proteins |
| GB8823869D0 (en) | 1988-10-12 | 1988-11-16 | Medical Res Council | Production of antibodies |
| KR900005995A (ko) | 1988-10-31 | 1990-05-07 | 우메모또 요시마사 | 변형 인터류킨-2 및 그의 제조방법 |
| WO1990006952A1 (fr) | 1988-12-22 | 1990-06-28 | Kirin-Amgen, Inc. | Facteur de stimulation de colonies de granulocytes modifies chimiquement |
| US5530101A (en) | 1988-12-28 | 1996-06-25 | Protein Design Labs, Inc. | Humanized immunoglobulins |
| US5112946A (en) | 1989-07-06 | 1992-05-12 | Repligen Corporation | Modified pf4 compositions and methods of use |
| FR2650598B1 (fr) | 1989-08-03 | 1994-06-03 | Rhone Poulenc Sante | Derives de l'albumine a fonction therapeutique |
| WO1991006570A1 (en) | 1989-10-25 | 1991-05-16 | The University Of Melbourne | HYBRID Fc RECEPTOR MOLECULES |
| US6075181A (en) | 1990-01-12 | 2000-06-13 | Abgenix, Inc. | Human antibodies derived from immunized xenomice |
| US6673986B1 (en) | 1990-01-12 | 2004-01-06 | Abgenix, Inc. | Generation of xenogeneic antibodies |
| ES2284161T3 (es) | 1990-01-12 | 2007-11-01 | Amgen Fremont Inc. | Generacion de anticuerpos xenogenicos. |
| US6150584A (en) | 1990-01-12 | 2000-11-21 | Abgenix, Inc. | Human antibodies derived from immunized xenomice |
| US5427908A (en) | 1990-05-01 | 1995-06-27 | Affymax Technologies N.V. | Recombinant library screening methods |
| US5349053A (en) | 1990-06-01 | 1994-09-20 | Protein Design Labs, Inc. | Chimeric ligand/immunoglobulin molecules and their uses |
| US6172197B1 (en) | 1991-07-10 | 2001-01-09 | Medical Research Council | Methods for producing members of specific binding pairs |
| GB9015198D0 (en) | 1990-07-10 | 1990-08-29 | Brien Caroline J O | Binding substance |
| US5625126A (en) | 1990-08-29 | 1997-04-29 | Genpharm International, Inc. | Transgenic non-human animals for producing heterologous antibodies |
| US5877397A (en) | 1990-08-29 | 1999-03-02 | Genpharm International Inc. | Transgenic non-human animals capable of producing heterologous antibodies of various isotypes |
| US6255458B1 (en) | 1990-08-29 | 2001-07-03 | Genpharm International | High affinity human antibodies and human antibodies against digoxin |
| US5545806A (en) | 1990-08-29 | 1996-08-13 | Genpharm International, Inc. | Ransgenic non-human animals for producing heterologous antibodies |
| US5789650A (en) | 1990-08-29 | 1998-08-04 | Genpharm International, Inc. | Transgenic non-human animals for producing heterologous antibodies |
| US5874299A (en) | 1990-08-29 | 1999-02-23 | Genpharm International, Inc. | Transgenic non-human animals capable of producing heterologous antibodies |
| US5661016A (en) | 1990-08-29 | 1997-08-26 | Genpharm International Inc. | Transgenic non-human animals capable of producing heterologous antibodies of various isotypes |
| US6300129B1 (en) | 1990-08-29 | 2001-10-09 | Genpharm International | Transgenic non-human animals for producing heterologous antibodies |
| US5770429A (en) | 1990-08-29 | 1998-06-23 | Genpharm International, Inc. | Transgenic non-human animals capable of producing heterologous antibodies |
| US5814318A (en) | 1990-08-29 | 1998-09-29 | Genpharm International Inc. | Transgenic non-human animals for producing heterologous antibodies |
| US5633425A (en) | 1990-08-29 | 1997-05-27 | Genpharm International, Inc. | Transgenic non-human animals capable of producing heterologous antibodies |
| AU8507191A (en) | 1990-08-29 | 1992-03-30 | Genpharm International, Inc. | Transgenic non-human animals capable of producing heterologous antibodies |
| ATE145428T1 (de) | 1990-12-14 | 1996-12-15 | Cell Genesys Inc | Chimärische ketten zur transduktion von rezeptorverbundenen signalwegen |
| PT1696031E (pt) | 1991-12-02 | 2010-06-25 | Medical Res Council | Produção de auto-anticorpos a partir de reportórios de segmentos de anticorpo e exibidos em fagos |
| JP4157160B2 (ja) | 1991-12-13 | 2008-09-24 | ゾーマ テクノロジー リミテッド | 改変抗体可変領域の調製のための方法 |
| AU3328493A (en) | 1991-12-17 | 1993-07-19 | Genpharm International, Inc. | Transgenic non-human animals capable of producing heterologous antibodies |
| US5622929A (en) | 1992-01-23 | 1997-04-22 | Bristol-Myers Squibb Company | Thioether conjugates |
| FR2686899B1 (fr) | 1992-01-31 | 1995-09-01 | Rhone Poulenc Rorer Sa | Nouveaux polypeptides biologiquement actifs, leur preparation et compositions pharmaceutiques les contenant. |
| FR2686901A1 (fr) | 1992-01-31 | 1993-08-06 | Rhone Poulenc Rorer Sa | Nouveaux polypeptides antithrombotiques, leur preparation et compositions pharmaceutiques les contenant. |
| US5714350A (en) | 1992-03-09 | 1998-02-03 | Protein Design Labs, Inc. | Increasing antibody affinity by altering glycosylation in the immunoglobulin variable region |
| US5447851B1 (en) | 1992-04-02 | 1999-07-06 | Univ Texas System Board Of | Dna encoding a chimeric polypeptide comprising the extracellular domain of tnf receptor fused to igg vectors and host cells |
| CA2118508A1 (en) | 1992-04-24 | 1993-11-11 | Elizabeth S. Ward | Recombinant production of immunoglobulin-like domains in prokaryotic cells |
| PT1621554E (pt) | 1992-08-21 | 2009-07-13 | Univ Bruxelles | Imunoglobtainas desprovidas de cadeias leves |
| AU6819494A (en) | 1993-04-26 | 1994-11-21 | Genpharm International, Inc. | Transgenic non-human animals capable of producing heterologous antibodies |
| JPH08511420A (ja) | 1993-06-16 | 1996-12-03 | セルテック・セラピューテイクス・リミテッド | 抗 体 |
| SE9400088D0 (sv) | 1994-01-14 | 1994-01-14 | Kabi Pharmacia Ab | Bacterial receptor structures |
| US5834252A (en) | 1995-04-18 | 1998-11-10 | Glaxo Group Limited | End-complementary polymerase reaction |
| US5837458A (en) | 1994-02-17 | 1998-11-17 | Maxygen, Inc. | Methods and compositions for cellular and metabolic engineering |
| US5605793A (en) | 1994-02-17 | 1997-02-25 | Affymax Technologies N.V. | Methods for in vitro recombination |
| US6074642A (en) | 1994-05-02 | 2000-06-13 | Alexion Pharmaceuticals, Inc. | Use of antibodies specific to human complement component C5 for the treatment of glomerulonephritis |
| HUT76369A (en) | 1994-07-29 | 1997-08-28 | Smithkline Beecham Corp | Novel soluble protein compounds |
| US5641870A (en) | 1995-04-20 | 1997-06-24 | Genentech, Inc. | Low pH hydrophobic interaction chromatography for antibody purification |
| US5869046A (en) | 1995-04-14 | 1999-02-09 | Genentech, Inc. | Altered polypeptides with increased half-life |
| US6121022A (en) | 1995-04-14 | 2000-09-19 | Genentech, Inc. | Altered polypeptides with increased half-life |
| US6087120A (en) | 1996-02-02 | 2000-07-11 | Haemoprobe B.V. | Measurement of complement activation by biomaterials by means of complement convertase cleavage of peptide substrates |
| ATE279947T1 (de) | 1996-03-18 | 2004-11-15 | Univ Texas | Immunglobulinähnliche domäne mit erhöhten halbwertszeiten |
| WO1998023289A1 (en) | 1996-11-27 | 1998-06-04 | The General Hospital Corporation | MODULATION OF IgG BINDING TO FcRn |
| US6277375B1 (en) | 1997-03-03 | 2001-08-21 | Board Of Regents, The University Of Texas System | Immunoglobulin-like domains with increased half-lives |
| WO1998052976A1 (en) | 1997-05-21 | 1998-11-26 | Biovation Limited | Method for the production of non-immunogenic proteins |
| EP1012280B1 (en) | 1997-06-11 | 2004-11-10 | Borean Pharma A/S | Trimerising module |
| JP3614866B2 (ja) | 1997-06-12 | 2005-01-26 | リサーチ コーポレイション テクノロジーズ,インコーポレイティド | 人工抗体ポリペプチド |
| EP1007092B1 (en) | 1997-08-26 | 2006-08-09 | Amgen Fremont Inc. | A process for inhibiting complement activation via the alternative pathway |
| DE19742706B4 (de) | 1997-09-26 | 2013-07-25 | Pieris Proteolab Ag | Lipocalinmuteine |
| US6194551B1 (en) | 1998-04-02 | 2001-02-27 | Genentech, Inc. | Polypeptide variants |
| AU3657899A (en) | 1998-04-20 | 1999-11-08 | James E. Bailey | Glycosylation engineering of antibodies for improving antibody-dependent cellular cytotoxicity |
| US6015803A (en) | 1998-05-04 | 2000-01-18 | Wirostko; Emil | Antibiotic treatment of age-related macular degeneration |
| US6818418B1 (en) | 1998-12-10 | 2004-11-16 | Compound Therapeutics, Inc. | Protein scaffolds for antibody mimics and other binding proteins |
| KR100940380B1 (ko) | 1999-01-15 | 2010-02-02 | 제넨테크, 인크. | 효과기 기능이 변화된 폴리펩티드 변이체 |
| US7108982B1 (en) | 1999-02-19 | 2006-09-19 | University Of Iowa Research Foundation | Diagnostics and the therapeutics for macular degeneration |
| JP2003506016A (ja) | 1999-02-19 | 2003-02-18 | ザ ユニヴァーシティー オブ アイオワ リサーチ ファンデーション | 動脈壁破裂障害のための診断剤および治療剤 |
| EP1804064A1 (en) | 1999-02-19 | 2007-07-04 | University Of Iowa Research Foundation | Diagnostics and therapeutics for macular degeneration |
| PT1176195E (pt) | 1999-04-09 | 2013-07-18 | Kyowa Hakko Kirin Co Ltd | Processo para controlar a actividade de uma molécula funcional sob o ponto de vista imunológico |
| DE19932688B4 (de) | 1999-07-13 | 2009-10-08 | Scil Proteins Gmbh | Design von Beta-Faltblatt-Proteinen des gamma-II-kristallins antikörperähnlichen |
| CN102766210B (zh) | 1999-08-24 | 2015-07-08 | E.R.施贵宝&圣斯有限责任公司 | 人ctla-4抗体及其应用 |
| US7011952B2 (en) | 2000-02-22 | 2006-03-14 | University Of Iowa Research Foundation | Diagnostics and therapeutics for macular degeneration-related disorders |
| EP1274720A4 (en) | 2000-04-12 | 2004-08-18 | Human Genome Sciences Inc | FUSION PROTEINS CONTAINING ALBUMIN |
| DK2026073T3 (en) | 2000-04-29 | 2016-07-25 | Univ Iowa Res Found | Diagnosis and treatment of macular degeneration-related disorders |
| WO2001084144A1 (en) | 2000-05-04 | 2001-11-08 | Jussi Halleen | Method for in vitro screening of drug candidates useful for the prevention of bone resorption |
| US7943129B2 (en) | 2000-05-26 | 2011-05-17 | National Research Council Of Canada | Single-domain brain-targeting antibody fragments derived from llama antibodies |
| EP1186299A1 (en) | 2000-09-12 | 2002-03-13 | Universitair Medisch Centrum Utrecht | The diagnosis, prevention, and/or succesful treatment of atherosclerosis, infectious diseases, and disturbances in the immune system |
| EP2113516B1 (en) | 2000-10-10 | 2014-05-21 | Genentech, Inc. | Antibodies against C5 inhibiting type II endothelial cell activation |
| IL155977A0 (en) | 2000-11-30 | 2003-12-23 | Medarex Inc | Transgenic transchromosomal rodents for making human antibodies |
| US7091323B2 (en) | 2001-04-24 | 2006-08-15 | Bayer Corporation | Human TIMP-1 antibodies |
| US20040175756A1 (en) | 2001-04-26 | 2004-09-09 | Avidia Research Institute | Methods for using combinatorial libraries of monomer domains |
| US20050048512A1 (en) | 2001-04-26 | 2005-03-03 | Avidia Research Institute | Combinatorial libraries of monomer domains |
| US20050053973A1 (en) | 2001-04-26 | 2005-03-10 | Avidia Research Institute | Novel proteins with targeted binding |
| WO2002092780A2 (en) | 2001-05-17 | 2002-11-21 | Diversa Corporation | Novel antigen binding molecules for therapeutic, diagnostic, prophylactic, enzymatic, industrial, and agricultural applications, and methods for generating and screening thereof |
| KR100988949B1 (ko) | 2001-10-25 | 2010-10-20 | 제넨테크, 인크. | 당단백질 조성물 |
| AU2003217912A1 (en) | 2002-03-01 | 2003-09-16 | Xencor | Antibody optimization |
| ITMI20021527A1 (it) | 2002-07-11 | 2004-01-12 | Consiglio Nazionale Ricerche | Anticorpi anti componente c5 del complemento e loro uso |
| ATE472556T1 (de) | 2002-12-02 | 2010-07-15 | Amgen Fremont Inc | Gegen den tumor nekrose faktor gerichtete antikörper und deren verwendungen |
| EP1601377A4 (en) | 2003-02-21 | 2009-07-15 | Genentech Inc | METHOD FOR THE PREVENTION AND TREATMENT OF TISSUE DAMAGE IN CONNECTION WITH ISCHEMIC REPERFUSION DAMAGE |
| WO2004075838A2 (en) | 2003-02-21 | 2004-09-10 | Rikshospitalet-Radiumhospitalet Hf | Method and compositions for the treatment of meconium aspiration syndrome |
| US20070123466A1 (en) | 2003-05-13 | 2007-05-31 | New York Society For The Ruptured And Crippled Maintaining The Hospital For Special Surgery | Method of treating recurrent miscarriages |
| WO2004103294A2 (en) | 2003-05-15 | 2004-12-02 | Tanox, Inc. | Methods and compositions for the prevention and treatment of sepsis |
| DE10324447A1 (de) | 2003-05-28 | 2004-12-30 | Scil Proteins Gmbh | Generierung künstlicher Bindungsproteine auf der Grundlage von Ubiquitin |
| JP4782700B2 (ja) | 2004-01-20 | 2011-09-28 | カロバイオス ファーマシューティカルズ インコーポレイティッド | 最低限必須な結合決定基を用いた抗体特異性の移入 |
| US20050169921A1 (en) | 2004-02-03 | 2005-08-04 | Leonard Bell | Method of treating hemolytic disease |
| US20070116710A1 (en) | 2004-02-03 | 2007-05-24 | Leonard Bell | Methods of treating hemolytic anemia |
| US7514539B2 (en) | 2004-04-26 | 2009-04-07 | Centocor, Inc. | Epitope directed selection of antibodies to murine tissue factor |
| US20060008844A1 (en) | 2004-06-17 | 2006-01-12 | Avidia Research Institute | c-Met kinase binding proteins |
| US7423128B2 (en) * | 2004-11-03 | 2008-09-09 | Amgen Fremont Inc. | Anti-properdin antibodies, and methods for making and using same |
| CA2654440C (en) | 2005-06-06 | 2013-09-03 | Girish J. Kotwal | Methods for treatment or prophylaxis of atherosclerosis and reperfusion injury |
| PL2860192T3 (pl) | 2005-10-12 | 2018-03-30 | Morphosys Ag | Wytwarzanie i profilowanie w pełni ludzkich, uzyskanych z HuCAL GOLD terapeutycznych przeciwciał swoistych wobec ludzkiego CD38 |
| PT2500030E (pt) | 2005-11-04 | 2015-09-24 | Genentech Inc | Uso de inibidores da via do complemento para tratar doenças oculares |
| DOP2006000277A (es) | 2005-12-12 | 2007-08-31 | Bayer Pharmaceuticals Corp | Anticuerpos anti mn y métodos para su utilización |
| US20070196367A1 (en) | 2006-02-22 | 2007-08-23 | Valentin Dinu | Methods of preventing and treating Alzheimer's disease, age related macular degeneration and other diseases involving extra-cellular debris through the inhibition of the complement system |
| EP2596807B1 (en) | 2006-03-08 | 2015-12-16 | Archemix LLC | Complement binding aptamers and anti-C5 agents useful in the treatment of ocular disorders |
| ES2965283T3 (es) | 2006-03-15 | 2024-05-28 | Alexion Pharma Inc | Tratamiento de pacientes con hemoglobinuria paroxística nocturna mediante un inhibidor del complemento |
| CA2685208C (en) * | 2007-04-24 | 2014-04-08 | Novelmed Therapeutics, Inc. | Methods and compositions of inhibiting complement and cellular activation with dextran sulfate |
| WO2008154018A2 (en) | 2007-06-11 | 2008-12-18 | The Trustees Of The University Of Pennsylvania | Properdin modulation of alternative pathway and uses thereof |
| US8981060B2 (en) | 2007-08-27 | 2015-03-17 | Novelmed Therapuetics, Inc. | Method of inhibiting complement activation with factor Bb specific antibodies |
| EP2262831B1 (en) * | 2008-03-03 | 2015-01-21 | NovelMed Therapeutics, Inc. | Anti-properdin antibodies |
| WO2009121065A2 (en) | 2008-03-28 | 2009-10-01 | Apellis Ag | Modulation and repletion/enhancement of the complement system for treatment of trauma |
| AU2009280162B2 (en) * | 2008-08-04 | 2015-02-05 | Fisher & Paykel Healthcare Limited | Respiratory mask sealing interface |
| PY09026846A (es) | 2008-08-05 | 2015-09-01 | Novartis Ag | Composiciones y métodos para anticuerpos que se dirigen a la proteína de complemento c5 |
| CN103068396B (zh) * | 2010-03-02 | 2016-07-06 | 诺沃姆德治疗公司 | 抑制c5和备解素相互作用的抗-备解素抗体在制备抑制交替途径活化的药剂中的用途 |
| CN103003302B (zh) | 2010-03-10 | 2015-09-30 | 诺沃姆德治疗公司 | 人源化和嵌合抗-备解素抗体 |
| CN107638565B (zh) * | 2011-04-08 | 2021-12-21 | 莱斯特大学 | 用于治疗与masp-2依赖性补体活化相关的状况的方法 |
| WO2013006449A2 (en) * | 2011-07-01 | 2013-01-10 | The Trustees Of The University Of Pennsylvania | Anti-properdin antibodies and uses thereof |
| ES2728278T3 (es) | 2011-12-21 | 2019-10-23 | Novartis Ag | Composiciones que comprenden anticuerpos dirigidos al factor P y C5 |
-
2012
- 2012-12-17 ES ES12821311T patent/ES2728278T3/es active Active
- 2012-12-17 EP EP17208690.2A patent/EP3330288A1/en not_active Withdrawn
- 2012-12-17 WO PCT/IB2012/057394 patent/WO2013093762A1/en not_active Ceased
- 2012-12-17 AP AP2014007761A patent/AP2014007761A0/xx unknown
- 2012-12-17 EA EA201491214A patent/EA201491214A1/ru unknown
- 2012-12-17 CN CN201280069461.3A patent/CN104114576B/zh active Active
- 2012-12-17 SG SG11201403416TA patent/SG11201403416TA/en unknown
- 2012-12-17 PE PE2014001019A patent/PE20150159A1/es not_active Application Discontinuation
- 2012-12-17 MX MX2014007665A patent/MX2014007665A/es unknown
- 2012-12-17 CA CA2859493A patent/CA2859493A1/en not_active Abandoned
- 2012-12-17 BR BR112014015111A patent/BR112014015111A2/pt active Search and Examination
- 2012-12-17 CN CN201710116142.8A patent/CN106831985A/zh active Pending
- 2012-12-17 EP EP12821311.3A patent/EP2794656B1/en active Active
- 2012-12-17 KR KR1020147019752A patent/KR102159843B1/ko active Active
- 2012-12-17 SG SG10201703249PA patent/SG10201703249PA/en unknown
- 2012-12-17 AU AU2012356170A patent/AU2012356170B2/en not_active Ceased
- 2012-12-17 US US13/716,526 patent/US9051365B2/en active Active
- 2012-12-17 JP JP2014548290A patent/JP6231493B2/ja active Active
- 2012-12-20 TW TW101148813A patent/TW201339174A/zh unknown
- 2012-12-20 UY UY0001034537A patent/UY34537A/es not_active Application Discontinuation
- 2012-12-21 AR ARP120104897A patent/AR089393A1/es unknown
-
2014
- 2014-06-13 TN TNP2014000258A patent/TN2014000258A1/en unknown
- 2014-06-17 ZA ZA2014/04432A patent/ZA201404432B/en unknown
- 2014-06-19 CL CL2014001640A patent/CL2014001640A1/es unknown
- 2014-06-19 IL IL233279A patent/IL233279B/en active IP Right Grant
- 2014-06-19 US US14/309,330 patent/US9988440B2/en active Active
- 2014-06-19 MA MA37143A patent/MA35740B1/fr unknown
- 2014-06-19 PH PH12014501410A patent/PH12014501410A1/en unknown
- 2014-06-23 CR CR20140303A patent/CR20140303A/es unknown
- 2014-06-23 CU CU2014000073A patent/CU20140073A7/es unknown
- 2014-06-25 CO CO14136778A patent/CO6990668A2/es unknown
- 2014-10-30 HK HK18113230.3A patent/HK1254156A1/en unknown
-
2016
- 2016-05-13 AU AU2016203134A patent/AU2016203134B2/en not_active Ceased
- 2016-05-24 CL CL2016001256A patent/CL2016001256A1/es unknown
-
2017
- 2017-05-12 JP JP2017095425A patent/JP6486407B2/ja active Active
-
2018
- 2018-05-07 US US15/973,225 patent/US10865237B2/en active Active
- 2018-08-21 AU AU2018219993A patent/AU2018219993A1/en not_active Abandoned
-
2020
- 2020-05-08 AU AU2020203047A patent/AU2020203047A1/en not_active Abandoned
Also Published As
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| US10865237B2 (en) | Nucleic acids encoding anti-Factor P antibodies | |
| ES2541142T3 (es) | Composiciones y métodos para anticuerpos dirigidos contra la proteína C5 del complemento | |
| US10385127B2 (en) | Compositions and methods for antibodies targeting EPO | |
| ES2957214T3 (es) | Composiciones y métodos para anticuerpos contra la BMP6 | |
| NZ721901A (en) | Electronic cheque-based payment system | |
| HK40049388A (en) | Compositions and methods for antibodies targeting epo | |
| HK1197418A (en) | Compositions comprising antibodies targeting factor p and c5 | |
| HK1197418B (en) | Compositions comprising antibodies targeting factor p and c5 | |
| NZ626296B2 (en) | Compositions and methods for antibodies targeting factor p | |
| BR112015011363B1 (pt) | Anticorpo anti-epo, e usos do mesmo |