JP3952009B2 - 翻訳メモリシステム、翻訳方法、および翻訳メモリシステム用プログラム - Google Patents

翻訳メモリシステム、翻訳方法、および翻訳メモリシステム用プログラム Download PDF

Info

Publication number
JP3952009B2
JP3952009B2 JP2003403459A JP2003403459A JP3952009B2 JP 3952009 B2 JP3952009 B2 JP 3952009B2 JP 2003403459 A JP2003403459 A JP 2003403459A JP 2003403459 A JP2003403459 A JP 2003403459A JP 3952009 B2 JP3952009 B2 JP 3952009B2
Authority
JP
Japan
Prior art keywords
character string
language character
language
file
attribute information
Prior art date
Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
Expired - Fee Related
Application number
JP2003403459A
Other languages
English (en)
Other versions
JP2005165652A (ja
Inventor
清孝 今野
Current Assignee (The listed assignees may be inaccurate. Google has not performed a legal analysis and makes no representation or warranty as to the accuracy of the list.)
NEC Corp
Original Assignee
NEC Corp
Priority date (The priority date is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the date listed.)
Filing date
Publication date
Application filed by NEC Corp filed Critical NEC Corp
Priority to JP2003403459A priority Critical patent/JP3952009B2/ja
Publication of JP2005165652A publication Critical patent/JP2005165652A/ja
Application granted granted Critical
Publication of JP3952009B2 publication Critical patent/JP3952009B2/ja
Anticipated expiration legal-status Critical
Expired - Fee Related legal-status Critical Current

Links

Images

Landscapes

  • Machine Translation (AREA)

Description

本発明は、翻訳メモリによって翻訳を行う翻訳メモリシステム、翻訳方法および翻訳メモリシステムに適用される翻訳メモリシステム用プログラムに関する。
翻訳メモリによって翻訳を行う翻訳メモリシステムが知られている。翻訳メモリとは、既に翻訳されている原文およびその訳文を一組にして記憶装置に記憶しておき、新規に入力された原文の訳文を、記憶装置の中から抽出する機能のことを指す。この機能によって翻訳を行うシステムを翻訳メモリシステムと呼ぶ。
翻訳メモリシステムとして、例えば、特許文献1に記載された翻訳システムがある。特許文献1に記載された翻訳システムは、文章記録部に原文とその訳文とを記録している。そして、入力部から与えられる新規の原文が、文章記録部内に記録された原文と等しいか否かを判定し、等しい場合には、その原文(予め記録された原文)と対になる訳文を新規原文の翻訳結果として使用する。
また、翻訳メモリによらずに翻訳を行う翻訳システムも知られている。そして、このような翻訳システムの中には、入力される原文に応じた表示態様で訳文を出力する翻訳システムもある(例えば、特許文献2参照)。特許文献2に記載された翻訳システムは、入力された原文を解析して目的言語の訳文に変換する。そして、変換結果に対して、原文の文字属性に応じた変換を行い表示する。このとき、例えば、『原文において「下線付き体」で表示されていた語は、訳文において「斜字体」で表示する』等の規則を定めた文字属性変換表を用いて、翻訳結果に対する文字属性の変換を行う。
また、特許文献3には、原文のフォントサイズやキャラクタースタイルなどを記憶する原文イメージ保存装置が記載されている。この原文イメージ保存装置は、辞書、文法規則および知識ベースを備える機械翻訳装置とともに使用され、機械翻訳装置は、訳文を表示する際、原文イメージ保存装置が記憶する情報に基づいて、訳文の表示を行う。例えば、「royal」という語がゴシック体で表現されているという情報を原文イメージ保存装置が記憶していた場合には、「王室の」という訳語もゴシック体で表現される。
特開平5−135095号公報(第3−5頁) 特開平2−139666号公報(第2頁、第2図、第3図) 特開平3−9472号公報(第2−3頁、第1−4図)
特許文献2,3に記載されているように、翻訳メモリによらずに翻訳を行う翻訳システム(原文の解析により翻訳を行ったり、辞書、文法規則、知識ベース等により翻訳を行う翻訳システム)では、訳文を原文の文字属性に応じた表示態様で表示することが可能となっている。
しかし、既に翻訳されている原文およびその訳文を一組にして記憶装置に記憶させておく従来の翻訳メモリシステムでは、記憶装置に記憶した訳文を抽出して出力するだけであるので、原文の文字属性に応じた表示態様の訳文を出力することができなかった。そのため、訳文を、原文の文字属性に応じた表示態様にするために、原文をディスプレイ装置に表示させたり、印刷したりして、原文の表示態様を参照しながら、オペレータが訳文の文字属性を変更しなければならなかった。したがって、オペレータの作業負担が大きく、また、オペレータのミスにより訳文を原文と完全に同一な表示態様で表示できない場合もあった。
そこで、本発明は、原文に応じた表示態様で表示される訳文を得ることができる翻訳メモリシステム、翻訳方法、およびその翻訳メモリシステムに適用される翻訳メモリシステム用プログラムを提供することを目的とする。
本発明による翻訳メモリシステムは、第1の言語で記述される第1言語文字列を記憶する第1言語文字列記憶手段と、第1言語文字列が第2の言語に翻訳された文字列である第2言語文字列を、当該第1言語文字列が記憶される第1言語文字列記憶手段の記憶領域と対応する記憶領域に記憶するとともに、文字列の表示態様としてフォントの種類、フォントサイズ、下線の有無、表示色の一部または全部を定めた文字属性情報を個々の第2言語文字列毎に記憶する第2言語文字列記憶手段と、新規の第1言語文字列が入力される入力手段と、新規の第1言語文字列と同一の第1言語文字列を第1言語文字列記憶手段が記憶する第1言語文字列の中から検索する検索手段と、検索手段によって検索された第1言語文字列が記憶される第1言語文字列記憶手段の記憶領域と対応する記憶領域に記憶された第2言語文字列と、当該第2言語文字列の表示態様を定めた文字属性情報とを第2言語文字列記憶手段から抽出する抽出手段と、抽出手段によって抽出された第2言語文字列および文字属性情報を出力する出力手段とを備えたことを特徴とする。
入力手段には、新規の第1言語文字列と、当該第1言語文字列の表示態様を定めた文字属性情報とが入力され、出力手段が、検出手段が新規の第1言語文字列と同一の第1言語文字列を検索できなかった場合に、新規の第1言語文字列およびその文字属性情報を出力するように構成されていてもよい。そのような構成によれば、第1言語文字列を検索できず、その結果、第2言語文字列およびその文字属性情報を抽出できなかった場合に、第2言語文字列等の代わりに、新規の第1言語文字列およびその文字属性情報を出力することができる。
例えば、第1言語文字列記憶手段が、個々の第1言語文字列を記憶した順番を特定可能に個々の第1言語文字列を記憶し、検索手段が、新規の第1言語文字列と同一の第1言語文字列が第1言語文字列記憶手段の複数の記憶領域に記憶されている場合には、複数の記憶領域に記憶されている各第1言語文字列のうち、最後に記憶された第1言語文字列を検索するように構成されていてもよい。
また、例えば、文字属性情報により定まる表示態様で文字列を表示する表示手段と、表示手段が複数の文字列を表示した場合に、複数の文字列のうちの一つの文字列をオペレータから指定される指定受付手段とを備え、第1言語文字列記憶手段が、文字属性情報を個々の第1言語文字列毎に記憶し、検索手段が、新規の第1言語文字列と同一の第1言語文字列が第1言語文字列記憶手段の複数の記憶領域に記憶されている場合には、複数の記憶領域に記憶されている各第1言語文字列を、各第1言語文字列毎の文字属性情報により定まる表示態様で表示手段に表示させ、指定受付手段がオペレータから指定された第1言語文字列を、第1言語文字列記憶手段が記憶する第1言語文字列の中から検索するように構成されていてもよい。そのような構成によれば、各第1言語文字列を、各第1言語文字列毎の文字属性情報により定まる表示態様で表示手段に表示させ、オペレータに対し、オペレータが意図している検索対象の第1言語文字列の指定を促すことができる。
また、例えば、第1言語文字列記憶手段が、文字属性情報を個々の第1言語文字列毎に記憶し、入力手段には、新規の第1言語文字列と、当該第1言語文字列の表示態様を定めた文字属性情報とが入力され、検索手段が、新規の第1言語文字列と同一の第1言語文字列であって、文字属性情報が入力手段に入力された文字属性情報と同一である第1言語文字列を検索するように構成されていてもよい。
入力手段には、文字属性情報により表示態様が定められた新規の第1言語文字列を記述したファイルが入力されてもよい
入力手段が、入力されたファイルのコピーを作成し、入力されたファイルから新規の第1言語文字列を読み込み、検索手段が、入力手段がファイルから読み込んだ新規の第1言語文字列と同一の第1言語文字列を第1言語文字列記憶手段が記憶する第1言語文字列の中から検索し、抽出手段が、検索された第1言語文字列が記憶される第1言語文字列記憶手段の記憶領域と対応する記憶領域に記憶された第2言語文字列と、当該第2言語文字列の表示態様を定めた文字属性情報とを第2言語文字列記憶手段から抽出し、出力手段が、入力手段によってコピーされたファイルにおける新規の文字列が記述された位置で、新規の第1言語文字列を、抽出手段によって抽出された文字属性情報により表示態様が定められた第2言語文字列に置換するようにして、コピーされたファイルに第2言語文字列を記述するように構成されていてもよい。そのような構成によれば、入力されるファイルを表示したときのレイアウトと、第2言語文字列が記述されるファイルを表示したときのレイアウトを揃えることができる。
入力手段には、文字属性情報により表示態様が定められた新規の第1言語文字列を記述するとともに画像データを含んでいるファイルが入力されてもよい。画像データもコピーされるので、第2言語文字列が記述されるファイル内に、入力されたファイルに含まれる画像データをそのまま保持することができる。
入力手段が、入力されたファイルから新規の第1言語文字列を読み込み、検索手段が、入力手段がファイルから読み込んだ新規の第1言語文字列と同一の第1言語文字列を第1言語文字列記憶手段が記憶する第1言語文字列の中から検索し、抽出手段が、検索された第1言語文字列が記憶される第1言語文字列記憶手段の記憶領域と対応する記憶領域に記憶された第2言語文字列と、当該第2言語文字列の表示態様を定めた文字属性情報とを第2言語文字列記憶手段から抽出し、出力手段が、入力手段に入力されたファイルとは異なるファイルに、抽出手段によって抽出された文字属性情報により表示態様が定められた第2言語文字列を記述するように構成されていてもよい。
また、本発明による翻訳方法は、第1の言語で記述される第1言語文字列を記憶する第1言語文字列記憶手段と、第1言語文字列が第2の言語に翻訳された文字列である第2言語文字列を、当該第1言語文字列が記憶される第1言語文字列記憶手段の記憶領域と対応する記憶領域に記憶するとともに、文字列の表示態様としてフォントの種類、フォントサイズ、下線の有無、表示色の一部または全部を定めた文字属性情報を個々の第2言語文字列毎に記憶する第2言語文字列記憶手段と、新規の第1言語文字列を記述したファイルが入力される入力手段とを備えた翻訳メモリシステムに適用される翻訳方法であって、入力手段が、入力されたファイルのコピーを作成し、入力されたファイルから新規の第1言語文字列を読み込み、検索手段が、新規の第1言語文字列と同一の第1言語文字列を第1言語文字列記憶手段が記憶する第1言語文字列の中から検索し、抽出手段が、検索手段によって検索された第1言語文字列が記憶される第1言語文字列記憶手段の記憶領域と対応する記憶領域に記憶された第2言語文字列と、当該第2言語文字列の表示態様を定めた文字属性情報とを第2言語文字列記憶手段から抽出し、出力手段が、入力手段によってコピーされたファイルにおける前記新規の第1言語文字列が記述された位置で、前記新規の第1言語文字列を、抽出手段によって抽出された文字属性情報により表示態様が定められた第2言語文字列に置換するようにして、前記コピーされたファイルに前記第2言語文字列を記述することを特徴とする。
また、本発明による翻訳メモリシステム用プログラムは、第1の言語で記述される第1言語文字列を記憶する第1言語文字列記憶手段と、第1言語文字列が第2の言語に翻訳された文字列である第2言語文字列を、当該第1言語文字列が記憶される第1言語文字列記憶手段の記憶領域と対応する記憶領域に記憶するとともに、文字列の表示態様としてフォントの種類、フォントサイズ、下線の有無、表示色の一部または全部を定めた文字属性情報を個々の第2言語文字列毎に記憶する第2言語文字列記憶手段と、新規の第1言語文字列を記述したファイルが入力される入力手段とを備えたコンピュータに、入力手段に入力されたファイルのコピーを作成し、入力されたファイルから新規の第1言語文字列を読み込む処理、新規の第1言語文字列と同一の第1言語文字列を第1言語文字列記憶手段が記憶する第1言語文字列の中から検索する処理、検索された第1言語文字列が記憶される第1言語文字列記憶手段の記憶領域と対応する記憶領域に記憶された第2言語文字列と、当該第2言語文字列の表示態様を定めた文字属性情報とを第2言語文字列記憶手段から抽出する処理、およびコピーされたファイルにおける前記新規の第1言語文字列が記述された位置で、前記新規の第1言語文字列を、抽出手段によって抽出された文字属性情報により表示態様が定められた第2言語文字列に置換するようにして、前記コピーされたファイルに前記第2言語文字列を記述する処理を実行させることを特徴とする。
本発明によれば、第2言語文字列とともに、新規の第1言語文字列に応じて、その第2言語文字列の文字属性情報も出力させることができる。したがって、オペレータは、出力される第2言語文字列の属性を変更する作業を行う必要がなく、オペレータの作業負担は軽減される。
以下、本発明を実施するための最良の形態を、図面を参照して説明する。なお、以下の説明において、「文字属性情報」とは、文字列の表示態様を定めた情報である。文字属性情報は、例えば、フォントの種類、フォントサイズ、下線の有無等を定める。なお、ここに挙げたフォントの種類、フォントサイズ、下線の有無等は、文字属性情報が定める項目の例示であり、これら以外の項目について定めていてもよい。例えば、文字属性情報が、文字列の表示色を定めていてもよい。また、文字属性情報は、フォントの種類、フォントサイズ、下線の有無、表示色等、多くの項目について定めていることが好ましいが、例えば、例えば、フォントの種類だけというように、1つの項目について定めるものであってもよい。
また、以下の説明において、翻訳前の言語(第1の言語)で記述された文字列を原文と記す。原文を目的の言語(第2の言語)に翻訳した文字列を訳文と記す。
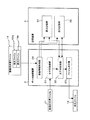
図1は、本発明による翻訳メモリシステムの構成の例を示すブロック図である。翻訳メモリシステムは、データ処理装置2と、記憶装置3とを備える。さらに、データ処理装置2は、文字列取得部21と、文字列検索部22と、ファイル出力部23と、登録情報取得部24とを備える。また、記憶装置3は、原文記憶部31と、訳文記憶部32とを備える。
原文記憶部31は、原文となる文字列、およびその文字列の表示態様を定めた文字属性情報を記憶する。訳文記憶部32は、訳文となる文字列、およびその文字列の表示態様を定めた文字属性情報を記憶する。本例では、原文記憶部31および訳文記憶部32は、1つの文毎に、文字列および文字属性情報を記憶するものとする。なお、1つの文を構成する各文字が全て同じ表示態様で表示されるとは限らない。例えば、1つの文を構成する文字の一部のフォントが、他の文字のフォントと異なっていたり、一部の文字に下線が付されていたりすることがある。この場合、1つの文を構成する各文字のうち、どの文字がどのフォントで表されるのか、どの文字に下線が付されるのか等を文字属性情報として記憶する。
登録情報取得部24には、システム管理者によって作成された登録用文書ファイル13が入力される。登録用文書ファイルには、原文を記述した原文ファイル13aと、その原文の訳文を記述した訳文ファイル13bとが含まれる。原文ファイル13aには、文字属性情報によって表示態様が定められた原文が記述されている。同様に、訳文ファイル13bには、文字属性情報によって表示態様が定められた訳文が記述されている。対になる原文と訳文の組み合わせにおいて、例えば、原文と訳文の表示態様が同じになるように定められる。なお、表示態様が同じとは、フォントの種類、フォントサイズ、下線の有無等の文字属性が同じということである。ただし、対になる原文と訳文の組み合わせにおいて、原文と訳文の表示態様が異なるように定められていてもよい。
図2(a)は、原文ファイル13aに記述された文字列の例を示す説明図であり、図2(b)は、訳文ファイル13bに記述された文字列の例を示す説明図である。図2では、原文ファイル13aは日本語で記述され、訳文ファイル13bは英語で記述される場合の例を示している。
原文ファイルの第1文は、「雨時々晴れ。」という文である。この文を構成する文字列の文字属性情報は、文字「雨」および文字「晴れ。」がゴシック体であり、文字「時々」が太字のゴシック体、かつ斜字体であり、下線付きであるということを定めている。訳文ファイルの第1文は、「Showers with sunny intervals. 」という文である。この文を構成する文字列の文字属性情報は、文字「with」が太字のゴシック体、かつ斜字体であり、下線付きであり、他の文字がゴシック体であることを定めている。原文と訳文の第1文同士を比較すると、原文の「時々」に相当する「with」は、原文の「時々」と同じ表示態様になるように定められ、他の文字は全てゴシック体で表示されるように定められている。したがって、第1文では、原文と訳文の表示態様が同じになるように定められている。
原文ファイルの第2文は、「晴れのち雨。」という文である。この文を構成する文字列の文字属性情報は、文字「晴れ」および文字「雨。」がゴシック体であり、文字「のち」が太字のゴシック体、かつ斜字体であり、下線付きであるということを定めている。訳文ファイルの第2文は、「Rain after sunshine.」という文である。この文を構成する文字列の文字属性情報は、文字「after 」が太字のゴシック体、かつ斜字体であり、下線付きであり、他の文字が明朝体であることを定めている。原文と訳文の第2文同士を比較すると、原文の「のち」に相当する「after 」は、原文の「のち」と同じ表示態様になるように定められ、他の文字は全て明朝体で表示されるように定められている。したがって、第2文では、原文と訳文の表示態様が一部異なるように定められている。
登録情報取得部24は、原文ファイル13aに含まれる文字列と、その文字列の表示態様を定める文字属性情報を原文記憶部31に記憶させる。また、登録情報取得部24は、原文の文字列および文字属性情報を記憶させた原文記憶部31内の記憶領域と対応する訳文記憶部32内の記憶領域に、その原文と対になる訳文の文字列および文字属性情報を記憶させる。既に説明したように、本例では、原文記憶部31および訳文記憶部32は、1つの文毎に文字列および文字属性情報を記憶する。したがって、登録情報取得部24は、原文に含まれる1つの文を構成する文字列、およびその文字列の文字属性情報を原文記憶部31内の記憶領域に記憶させる。そして、その記憶領域と対応する訳文記憶部32内の記憶領域に、その文の訳文となる1つの文を構成する文字列、およびその文字列の文字属性情報を記憶させる。
なお、原文記憶部31および訳文記憶部32は、原文記憶部31内の記憶領域と、その記憶領域に対応する訳文記憶部32の記憶領域とが隣り合うように構成されていてもよい。図3は、そのような構成における対応する記憶領域を示す説明図である。図3に示すように、原文記憶部31のある記憶領域に、原文に含まれる1つの文を構成する文字列、およびその文字列の文字属性情報が記憶される。そして、その隣りの記憶領域に、その文の訳文となる1つの文を構成する文字列、およびその文字列の文字属性情報が記憶される。その隣の記憶領域には、また原文の文字列および文字属性情報が記憶される。図3に示すように、原文記憶部31の記憶領域と、訳文記憶部32の記憶領域とが交互に並び、隣り合う1組の記憶領域に1対の原文および訳文の文字列などを記憶する構成であってもよい。
登録情報取得部24が、対になる原文および訳文を文字属性情報とともに原文記憶部31および訳文記憶部32に記憶させることによって、新規に入力される原文に対する訳文を訳文記憶部32から抽出することが可能になる。
文字列取得部21には、新規の文書ファイル11が入力される。新規の文書ファイル11は、登録情報取得部24が原文の文字列および文字属性情報と、訳文の文字列および文字属性情報とを記憶装置3に記憶させた後に入力されるファイルである。新規の文書ファイル11には、文字属性情報によって表示態様が定められた新規の原文が記述されている。文字列取得部21は、新規の文書ファイル11から、文字属性情報によって表示態様が定められた新規の原文を読み込むことにより、文字属性情報および新規の原文を取得する。
文字列検索部22は、新規の文書ファイル11に記述された原文に含まれる各文毎に、その文を構成する文字列と同一の文字列を、原文記憶部31が記憶する文字列の中から検索する。さらに、文字列検索部22は、検索した文字列の訳文となる文字列、およびその文字列の文字属性情報を訳文記憶部32から抽出する。
ファイル出力部23は、文字列検索部22によって抽出された文字列およびその文字列の文字属性情報を出力する。ここで、文字属性情報により表示態様が定められた文字列を出力することも、文字列および文字属性の出力態様の一つである。ファイル出力部23は、文字列検索部22によって抽出された文字属性情報により表示態様が定められた文字列を訳文ファイル12に記述(出力)する。なお、訳文ファイル12は、図1に示した記憶装置3に記憶されても、図示していない他の記憶装置に記憶されてもよい。
以下の説明では、文字列取得部21が、新規の文書ファイル11のコピーを作成するものとする。そして、ファイル出力部23が、コピーされたファイルにおける新規の原文が記述された位置で、その新規の原文を、文字列検索部22によって抽出された文字属性情報により表示態様が定められた訳文に置換するようにして、コピーされたファイルに訳文の文字列を記述するものとして説明する。この場合、訳文ファイル12は、最初に、新規の文書ファイル11のコピーとして作成されることになる。
文字列取得部21、ファイル出力部23および登録情報取得部24は、例えば、プログラムにしたがって動作するCPUおよび情報記憶媒体に対してデータの読み書きを行うドライブ装置(フロッピー(登録商標)ディスクドライブ、CD−ROMドライブ等)によって実現される。また、文字列検索部22は、例えば、プログラムにしたがって動作するCPUによって実現される。このプログラムは、例えば、RAM等の記憶装置に記憶される。
このプログラムは、第1の言語で記述される第1言語文字列を記憶する第1言語文字列記憶手段と、第1言語文字列が第2の言語に翻訳された文字列である第2言語文字列を、当該第1言語文字列が記憶される第1言語文字列記憶手段の記憶領域と対応する記憶領域に記憶するとともに、文字列の表示態様としてフォントの種類、フォントサイズ、下線の有無、表示色の一部または全部を定めた文字属性情報を個々の第2言語文字列毎に記憶する第2言語文字列記憶手段と、新規の第1言語文字列を記述したファイルが入力される入力手段とを備えたコンピュータに、入力手段に入力されたファイルのコピーを作成し、入力されたファイルから新規の第1言語文字列を読み込む処理、新規の第1言語文字列と同一の第1言語文字列を第1言語文字列記憶手段が記憶する第1言語文字列の中から検索する処理、検索された第1言語文字列が記憶される第1言語文字列記憶手段の記憶領域と対応する記憶領域に記憶された第2言語文字列と、当該第2言語文字列の表示態様を定めた文字属性情報とを第2言語文字列記憶手段から抽出する処理、およびコピーされたファイルにおける前記新規の第1言語文字列が記述された位置で、前記新規の第1言語文字列を、抽出手段によって抽出された文字属性情報により表示態様が定められた第2言語文字列に置換するようにして、前記コピーされたファイルに前記第2言語文字列を記述する処理を実行させるための翻訳メモリシステム用プログラムである。
次に、動作について説明する。
まず、登録情報取得部24が、登録用文書ファイル13に基づいて、対になる原文および訳文を記憶装置3に記憶させる動作について説明する。図4は、登録情報取得部24が、対になる原文および訳文を記憶装置3に記憶させる動作の処理経過の例を示すフローチャートである。
登録情報取得部24は、原文ファイル13aおよび訳文ファイル13bを含む登録用文書ファイル13が入力されると、原文ファイル13aから、文字列、およびその文字列の文字属性情報を取得する(ステップS11)。ステップS11において、登録情報取得部24は、1つの文毎に、文を構成する文字列、およびその文字列の文字属性情報を取得する。登録情報取得部24は、文の切れ目に用いられる記号の存在によって、文の切れ目を判定すればよい。
例えば、日本語の場合、文の切れ目には句点が用いられる。したがって、登録情報取得部24は、原文の最初の文字から句点までが1つの文になっていて、以降、句点の次の文字から次の句点までが1つの文になっていると判定すればよい。また、例えば、英語の場合、文の切れ目にはピリオドが用いられる。したがって、登録情報取得部24は、原文の最初の文字からピリオドまでが1つの文になっていて、以降、ピリオドの次の文字から次のピリオドまでが1つの文になっていると判定すればよい。ここでは、日本語と英語の場合を例に説明したが、他の言語の場合も同様である。
登録情報取得部24は、ステップS11の後、訳文ファイル13bから、文字列、およびその文字列の文字属性情報を取得する(ステップS12)。ステップS12においても、登録情報取得部24は、1つの文毎に、文を構成する文字列、およびその文字列の文字属性情報を取得する。既に説明したように、登録情報取得部24は、文の切れ目に用いられる記号の存在によって、文の切れ目を判定すればよい。
ステップS11,S12で取得したそれぞれの文字列は、必ず1つの文を構成しているとは限らない。例えば、原文や訳文の最初にタイトルを示す文字列が記述され、タイトルの後で改行され、文が始まる場合がある。この場合、タイトルの最初の文字から、句点やピリオド等の記号までが、1つの文であると判定されることになる。しかし、この場合、タイトルの部分は、後に続く文とは分けて、1つの文とみなすことが好ましい。また、英語の場合、ピリオドは、文の切れ目だけでなく、語の省略を表す場合にも用いられる。したがって、登録情報取得部24は、文の途中に用いられたピリオドの位置で文が終了したと判定してしまう場合がある。
そこで、ステップS11,S12の後、登録情報取得部24は、ディスプレイ装置等の表示手段(図1において図示せず。)に、ステップS11,S12で取得したそれぞれの文字列を表示させて、その文字列が原文および訳文として対になっていることの確認をオペレータに促す。そして、表示した文字列が原文および訳文として対になっていることの確認を、例えば、キーボードやマウス等の入力デバイス(図1において図示せず。)を介して、オペレータから入力される(ステップS13)。
なお、表示した文字列を見たオペレータによって、2つの文であるべき文字列が1つの文として取得されていると判断された場合、登録情報取得部24は、表示した文字列において文の切れ目となる位置を、入力デバイスを介して、オペレータから入力される。2つの文であるべき文字列が1つの文として取得されている場合というは、例えば、1つの文であるとみなすべきタイトルと、そのタイトルの後に続く文とが1つの文として取得されている場合である。この例の場合、登録情報取得部24は、タイトルの最後の文字が文の切れ目になるという指定をオペレータから受け付ければよい。また、オペレータは、そのような指定を行えばよい。登録情報取得部24は、オペレータに指定された文の切れ目より前の部分を、ステップS11あるいはステップS12で取得した文字列とみなす。その文の切れ目より後ろの部分は、再度ステップS11あるいはステップS12の処理を行うときに再び取得する。
また、表示した文字列を見たオペレータによって、1つの文の途中までしか取得されていないと判断された場合、登録情報取得部24は、オペレータの操作にしたがい、さらに文字列を取得する。1つの文の途中までしか取得されていない場合というのは、例えば、文の途中に用いられたピリオドまでが1つの文として取得された場合である。この例の場合、登録情報取得部24は、入力デバイスを介してオペレータから、次のピリオド(文の切れ目に用いられる記号)までの文字列をさらに取得する旨の指示を受け付ければよい。また、オペレータは、そのような指示を入力すればよい。登録情報取得部24は、この指示に応じて、さらに原文ファイル13aまたは訳文ファイル13bから文字列、およびその文字列の文字属性情報を取得する。そして、登録情報取得部24は、既にステップS11あるいはステップS12で取得した文字列と、さらに取得した文字列とが1つの文を構成していると判定する。
以上のような処理の結果、表示した文字列が原文および訳文として対になっていることの確認が、オペレータから入力されたならば、登録情報取得部24は、ステップS14の処理を行う。
ステップS14において、登録情報取得部24は、原文ファイル13aから取得した文字列(1つの文を構成する文字列)、およびその文字列の文字属性情報を、原文記憶部31に記憶させる。さらに、登録情報取得部24は、その記憶領域に対応する訳文記憶部32の記憶領域に、訳文ファイル13bから取得した文字列(1つの文を構成する文字列)、およびその文字列の文字属性情報を記憶させる。
登録情報取得部24は、ステップS14の後、原文ファイル13aおよび訳文ファイル13bからの文字列の取得が終了したか否かを判定する(ステップS15)。原文ファイル13aおよび訳文ファイル13bにまだ取得していない文字列が存在するならば、文字列の取得が終了していないと判定し、ステップS11以降の処理を繰り返す。また、原文ファイル13aおよび訳文ファイル13bから全ての文字列を取得しているならば、文字列の取得が終了したと判定し、処理を終了する。
例えば、図2に例示する文字列を記述した原文ファイル13aおよび訳文ファイル13bが入力されたとする。すると、図4に示す登録情報取得部24の処理によって、「雨時々晴れ。」という文字列が原文記憶部31に記憶される。また、文字「雨」および文字「晴れ。」がゴシック体であり、文字「時々」が太字のゴシック体、かつ斜字体であり、下線付きであるということを定めた文字属性情報も、原文記憶31に記憶される。そして、その記憶領域に対応する訳文記憶部32の記憶領域に、「Showers with sunny intervals. 」という文字列が記憶される。また、文字「with」が太字のゴシック体、かつ斜字体であり、下線付きであり、他の文字がゴシック体であることを定めた文字属性情報も記憶される。原文の第2文、訳文の第2文についても、同様に記憶される。
なお、ある表示態様の原文を翻訳するときに、原文とは異なる表示態様の訳文を得ることをシステム管理者が意図している場合には、対になる原文と訳文において、文字属性情報が異なるようにしておけばよい。例えば、図2(a)の第2文(文字「雨」等はゴシック体)の翻訳結果として、図2(b)の第2文(文字「Rain」等は明朝体)を出力することをシステム管理者が意図している場合には、図2の第2文で例示したように、文字属性情報が異なるようにして、原文ファイル13aおよび訳文ファイル13bを作成しておけばよい。
次に、新規の文書ファイル11に記述された原文の訳文を記述した訳文ファイル12を出力する動作について説明する。図5は、この動作の処理経過の例を示すフローチャートである。
文字列取得部21は、新規の文書ファイル11が入力されると、そのファイルのコピーを作成する。なお、コピーされたファイルは、訳文ファイル12として用いられ、翻訳メモリシステムは、コピーされたファイルに記述されている原文を訳文に置換するようにして、訳文を訳文ファイル12に記述していく。
また、文字列取得部21は、新規の文書ファイル11に記述されている原文から、文字列、およびその文字列の文字属性情報を取得する(ステップS21)。ステップS21において、文字列取得部21は、1つの文毎に、文を構成する文字列、およびその文字列の文字属性情報を取得する。文字列取得部21は、文の切れ目に用いられる記号の存在によって、文の切れ目を判定すればよい。
ただし、既に説明したように、文の切れ目に用いられる記号のみによって判定を行うと、2つの文であるべき文字列が1つの文として取得されたり、1つの文の途中までが1つの文として取得される場合が生じる。したがって、文字列取得部21は、ステップS13の処理と同様に、取得した文字列をディスプレイ装置等の表示手段(図1において図示せず。)に表示させる。表示した文字列を見たオペレータによって、2つの文であるべき文字列が1つの文として取得されていると判断された場合、文字列取得部21は、表示した文字列において文の切れ目となる位置を、キーボードやマウス等の入力デバイス(図1において図示せず。)を介して、オペレータから入力される。文字列取得部21は、オペレータに指定された文の切れ目より前の部分を、ステップS21で取得した文字列とみなす。その文の切れ目より後ろの部分は、再度ステップS21の処理を行うときに再び取得する。また、表示した文字列を見たオペレータによって、1つの文の途中までしか取得されていないと判断された場合、文字列取得部21は、オペレータの指示にしたがい、さらに文字列、およびその文字列の文字属性情報を取得する。そして、文字列取得部21は、既に取得した文字列と、さらに取得した文字列とが1つの文を構成していると判定する。オペレータの操作にしたがって、1つの文を確定するまでの動作は、ステップS13において1つの文を確定する場合の動作と同様である。
以上のような処理の結果、表示した文が1つの文になっていることの確認がオペレータから入力されたならば、文字列検索部22によるステップS22の処理に移行する。
なお、文字列取得部21は、ステップS21において、文字列を取得する際、その文字列が記述されている位置(例えば、新規の文書ファイル11の内容を表示した場合におけるその文字列の表示位置)を判定する。
ステップS21では、1つの文毎に、文を構成する文字列、およびその文字列の文字属性情報を取得するので、以下に説明するステップS21〜S25の処理も、1つの文の文字列ごとに行われる。
ステップS22において、文字列検索部22は、文字列取得部21が取得した文字列(1つの文を構成する文字列)と同一の文字列を、原文記憶部31が記憶する文字列の中から検索する(ステップS22)。文字列取得部21が取得した文字列と同一の文字列が原文記憶部31に1つしか記憶されていなければ、文字列検索部22は、その文字列を検索すればよい。
ただし、文字列取得部21が取得した文字列と同一の文字列が、原文記憶部31の複数の記憶領域に記憶されている場合もあり得る。例えば、原文記憶部31のある記憶領域に記憶されている文字列と、原文記憶部31の他の記憶領域に記憶されている文字列とが同一であり、それぞれの文字列の文字属性情報が異なっている場合があり得る。このように、文字列取得部21が取得した文字列と同一の文字列が原文記憶部31の複数の記憶領域に記憶されている場合、文字列検索部22は、その各記憶領域に記憶されている文字列を、それぞれディスプレイ装置等の表示手段(図1において図示せず。)に表示させる。このとき、文字列検索部22は、各文字列を、各文字列の文字属性情報によって定まる表示態様で表示させる。このように、表示態様が異なる同一の文字列をそれぞれ表示して、オペレータに対し、オペレータが意図している検索対象の文字列の指定を促す。そして、キーボードやマウス等の入力デバイス(図1において図示せず。)は、表示された複数の文字列のうちの一つの文字列を、オペレータから指定される。文字列検索部22は、入力デバイスを介してオペレータから指定された文字列を検索する。
文字列検索部22は、文字列取得部21が取得した文字列と同一の文字列の検索に成功したか否かを判定する(ステップS23)。文字列取得部21が取得した文字列と同一の文字列をステップS22で検索できたならば、文字列検索部22は、検索した文字列と対になる訳文の文字列、およびその文字列の文字属性情報を訳文記憶部32から抽出する。このとき、検索した文字列の記憶領域に対応する訳文記憶部32の記憶領域から訳文の文字列および文字属性情報を抽出すればよい。そして、ファイル出力部23が、その文字列および文字属性情報を出力する(ステップS24)。ステップS24において、ファイル出力部23は、抽出された文字属性情報によって、抽出された文字列の表示態様を定め、表示する場合にはその表示態様で表示されるように、抽出された文字列を訳文ファイル12に書き込む。なお、訳文ファイル12は、新規の文書ファイル11のコピーとして作成されたファイルであるので、訳文ファイル12には、ステップS21において取得された文字列(原文)が記述されている。ファイル出力部23は、訳文ファイル12におけるその原文が記述された位置で、その原文を、文字列検索部22によって抽出された文字属性情報により表示態様が定められた訳文に置換するようにして、訳文を訳文ファイル12に記述する。なお、訳文ファイル12内で置換対象となる原文が記述された位置は、ステップS21で判定された位置と同じ位置である。
文字列取得部21が取得した文字列と同一の文字列を文字列検索部22がステップS22で検索できなかったならば、ファイル出力部23は、文字列取得部21が取得した文字列、およびその文字列の文字属性情報を出力する(ステップS25)。なお、文字列取得部21が取得した文字列と同一の文字列をステップS22で検索できなかった場合というのは、文字列取得部21が取得した文字列が原文記憶部31に記憶されていない場合である。ステップS25において、ファイル出力部23は、ステップS24で訳文を記述する場合と同様に、ステップS21で取得した文字列を訳文ファイル12に記述する。すなわち、訳文ファイル12には、ステップS21において取得された文字列(原文)が記述されている。ファイル出力部23は、訳文ファイル12におけるその原文が記述された位置で、その原文を、ステップS21で取得した文字属性情報により表示態様が定められた文字列に置換するようにして、ステップS21で取得した文字列を訳文ファイル12に記述する。なお、この場合、置換前の文字列と置換後の文字列とは、同一である。
ステップS24またはステップS25の処理が終了したならば、文字列取得部21は、新規の文書ファイル11からの文字列の取得が終了したか否かを判定する(ステップS26)。新規の原文ファイル11にまだ取得していない文字列が存在するならば、文字列の取得が終了していないと判定し、再度ステップS21の処理を実行し、文字列検索部22およびファイル出力部23は、再度ステップS22〜ステップS24(またはステップS25)の処理を実行する。新規の文書ファイル11から全ての文字列を取得しているならば、文字列の取得が終了したと判定し、処理を終了する。この結果、原文に応じた表示態様で訳文が記述された訳文ファイル12が得られる。
また、新規の文書ファイル11には、画像データ(線図で描かれた図形データも含む。)が含まれていてもよい。新規の文書ファイル11に含まれる画像データは、そのまま訳文ファイル12にコピーされる。また、ファイル出力部23は、コピーされたファイル(訳文ファイル12)において、原文が記述された位置で、その原文を訳文に置換するようにして、訳文を記述する。従って、新規の文書ファイル11に含まれる図形データを、訳文ファイル12においてもそのまま保持することができる。また、新規の文書ファイル11を表示した場合のレイアウトを、訳文ファイル12においてもそのまま保持することができる。
以下に、ステップS21〜S26の処理の具体例を示す。ただし、図2(a)に示す原文に基づいて文字列および文字属性情報が原文記憶部31に記憶され、図2(b)に示す訳文に基づいて文字列および文字属性情報が訳文記憶部32に記憶されているものとする。図6(a)は、新規の文書ファイル11に記述されている原文の例を示す。図6(a)に示す原文が記述された新規の文書ファイル11が文字列取得部21に入力された場合、文字列取得部21は、図6(a)に示す第1文の文字列「雨時々晴れ。」という文字列と、その文字属性情報を取得する(ステップS21)。この文字属性情報は、文字「雨」および文字「晴れ。」がゴシック体であり、文字「時々」が太字のゴシック体、かつ斜字体であり、下線付きであるということを定めている。また、文字列取得部21は、新規の文書ファイル11のコピーを作成する。
次に、文字列検索部22は、ステップS21で取得された文字列「雨時々晴れ。」と同一の文字列を、原文記憶部31が記憶する文字列の中から検索する(ステップS22)。本例では、原文記憶部31は、「雨時々晴れ。」という文字列を記憶している(図2(a)参照。)。したがって、文字列検索部22は、「雨時々晴れ。」という文字列を原文記憶部31から検索することができる(ステップS23のY)。したがって、ステップS24に移行する。
文字列検索部22は、検索した文字列「雨時々晴れ。」が記憶される記憶領域に対応する訳文記憶部32の記憶領域から訳文の文字列および文字属性情報を抽出する。文字列「雨時々晴れ。」の記憶領域に対応する訳文記憶部32の記憶領域には、「Showers with sunny intervals. 」という文字列と、その文字列の文字属性情報が記憶されている。この文字属性情報は、文字「with」が太字のゴシック体、かつ斜字体であり、下線付きであり、他の文字がゴシック体であることを定めている(図2(b)参照。)。したがって、文字列検索部22は、「Showers with sunny intervals. 」という文字列、およびその文字属性情報を抽出する。そして、ファイル出力部23は、抽出した文字属性情報によって表示態様が定められた文字列「Showers with sunny intervals. 」を、訳文ファイル12(新規の文書ファイル11のコピー)に記述する。このとき、「雨時々晴れ。」が記述されていた位置で、「雨時々晴れ。」を「Showers with sunny intervals. 」に置換するようにして、「Showers with sunny intervals. 」を記述する。この結果、訳文ファイルには、第1文として、図6(b)に示す第1文「Showers with sunny intervals. 」が書き込まれる。
次に、文字列取得部21は、新規の文書ファイル11からの文字列の取得が終了したか否かを判定する(ステップS26)。新規の文書ファイル11には、まだ取得されていない第2文「晴れの日。」が残っているので(図6(a)参照。)、文字列取得部21は、文字列の取得が終了していないと判定する(ステップS26のN)。そして、文字列取得部21は、図6(a)に示す第2文の文字列「晴れの日。」という文字列と、その文字列の文字属性情報を取得する(ステップS21)。この文字属性情報は、文字「晴れ」および文字「日」がゴシック体であり、文字「の」が太字のゴシック体、かつ斜字体であり、下線付きであることを定めている。
次に、文字列検索部22は、ステップS21で取得された文字列「晴れの日。」と同一の文字列を、原文記憶部31が記憶する文字列の中から検索する(ステップS22)。本例では、原文記憶部31は、「晴れの日。」という文字列を記憶していない(図2(a)参照。)。したがって、文字列検索部22は、「晴れの日。」という文字列を原文記憶部31から検索することができない(ステップS23のN)。したがって、ステップS25に移行する。
ファイル出力部23は、ステップS21で取得した文字属性情報によって表示態様が定められた文字列「晴れの日。」(この文字列も、ステップS21取得されたものである。)を、訳文ファイル12(新規の文書ファイル11のコピー)に記述する。このとき、「晴れの日。」が記述されていた位置で、「晴れの日」を「晴れの日」に置換するようにして、記述する。この場合では、置換前の文字列と置換後の文字列とは、同一である。この結果、訳文ファイルには、第2文として、図6(b)に示す第2文「晴れの日。」が書き込まれる。
次に、文字列取得部21は、新規の文書ファイル11からの文字列の取得が終了したか否かを判定する(ステップS26)。新規の文書ファイル11からは、全ての文字列を取得しているので(ステップS26のY)、処理を終了する。以上の処理によって、図6(b)に示す文字列が記述された訳文ファイル12が出力される。なお、第2文「晴れの日。」については、原文と訳文の組が記憶装置3に記憶されていないために、翻訳できなかったことになる。この場合、オペレータが、訳文ファイル12を編集し、翻訳および翻訳後の文字列の属性変更を行えばよい。オペレータは、訳文記憶部31から抽出された文字列の属性については変更する必要がなく、図6(b)の第2文のように、翻訳されなかった文に対してのみ編集を行えばよい。したがって、オペレータの編集作業負担は軽減される。
従来の、翻訳メモリシステムは、予め、対になる原文と訳文のみを記憶し、文字属性情報を記憶していなかった。そのため、出力される訳文を表示したときの表示態様は、デフォルトで定められた表示態様となり、入力される原文の表示態様に応じたものにはなっていなかった。したがって、従来の翻訳メモリシステムに、例えば、図7(a)に示す文字列を入力したとしても、出力結果は、図7(b)に示すような予め定められた表示態様で表される文字列となり、入力される原文に応じた表示態様にならない。
本発明によれば、訳文記憶部32は、訳文の文字列とともにその文字列の文字属性情報も記憶する。したがって、表示時に原文に応じた表示態様で表示されるように、訳文の文字列を訳文ファイル12に書き込むことができる。その結果、オペレータは、原文に応じて表示態様が定められた文字列を記述した訳文ファイル12を得ることができる。オペレータは、その文字列の属性を変更する操作を行う必要はなく、翻訳されなかった文に対してのみ編集作業を行えばよい。したがって、オペレータの作業負担を軽減させることができる。
また、原文記憶部31は、新規に入力された原文の文字列と同一の文字列を原文記憶部31から検索できなかった場合に、新規に入力された文字列を、表示した場合における表示態様がそのまま保持されるようにして、訳文ファイル12に書き込む。したがって、訳文を出力できない場合に、入力された文字列をそのままの表示態様で出力することができる。
また、文字列取得部21は、新規の文書ファイル11のコピーを作成し、ファイル出力部23は、コピーされたファイルである訳文ファイル12に対して訳文を記述する。そして、ファイル出力部23は、訳文ファイル12において、原文が記述された位置で、その原文を訳文に置換するようにして、訳文を記述する。従って、新規の文書ファイル11に含まれる図形データを、訳文ファイル12においてもそのまま保持することができる。また、新規の文書ファイル11を表示した場合のレイアウトを、訳文ファイル12においてもそのまま保持することができる。
また、原文記憶部31は、原文の文字列とともに、その文字列の文字属性情報も記憶する。したがって、同一の文字列が原文記憶部31に複数記憶されている場合、その複数の同一文字列を、それぞれ文字属性情報に応じた表示態様で表示し、オペレータに対し、オペレータが意図している検索対象の文字列の指定を促すことができる。
以上の説明では、ステップS22において、文字列取得部21が取得した文字列と同一の文字列が原文記憶部31の複数の記憶領域に記憶されているとき、オペレータに検索対象文字列の指定を促す場合を説明した。オペレータに検索対象文字列の指定を促すのではなく、文字列検索部22が、複数の記憶領域に記憶された同一の文字列の中から一つの文字列を特定してよい。例えば、同一の文字列が原文記憶部31の複数の記憶領域に記憶されている場合、文字列検索部22が、最後に記憶された文字列を検索してもよい。この場合、文字検索部22は、複数の同一文字列をそれぞれの表示態様で表示して、オペレータに指定を促すことなく文字検索を行う。したがって、複数の同一文字列をそれぞれの表示態様で表示する必要がないので、この場合には、原文記憶部31に文字属性情報を記憶させなくてもよい。ただし、原文記憶部31は、個々の文字列を記憶した順番を特定できるように個々の文字列を記憶する。例えば、文字列を記憶する記憶領域に予め順番を設けておき、登録情報取得部24が文字列を原文記憶部31に記憶させる場合、文字列の順番に応じた記憶領域に文字列を記憶させればよい。したがって、同一の文字列が原文記憶部31の複数の記憶領域に記憶されている場合、文字列検索部22は、その複数の記憶領域のうち最も後の順番が定められた記憶領域に記憶されている文字列を検索してもよい。また、原文記憶部31が、個々の文字列を記憶した順番を特定できるように個々の文字列を記憶する構成として、文字列と、その文字列が記憶された時刻とを記憶するようにしてもよい。
また、ステップS22の検索処理において、検索部22は、文字列取得部21が取得した文字列と同一の文字列であって、文字属性情報が、文字列取得部21が取得部した文字属性情報と同一である文字列を抽出してもよい。すなわち、検索部22は、文字列の同一性だけでなく文字属性情報の同一性も判定し、文字列と文字属性情報の双方において同一性を確認した場合に、原文記憶部31に記憶されているその文字列を検索対象として特定してもよい。
また、上記の説明では、ファイル出力部23が、新規の文書ファイル11のコピーに対して訳文を記述する場合を示した。新規の文書ファイル11のコピーではなく、新規の文書ファイル11とは別の新たなファイルに対して訳文を記述してもよい。ファイル出力部23は、ステップS22の検索が成功した場合には、文字列検索部22によって抽出された文字属性情報により表示態様が定められた訳文(検索部22によって抽出された文字列)を新たなファイルに記述すればよい。ステップS22の検索が成功しなかった場合には、ステップS21で取得した文字属性情報により表示態様が定められた原文(ステップS21で取得された原文)を新たなファイルに記述すればよい。
また、上記の説明では、訳文をファイルとして出力する場合を説明したが、ディスプレイ装置等の表示手段(図1において図示せず。)に表示させてもよい。すなわち、訳文を表示出力させてもよい。この場合、ファイル出力部23は、文字属性情報によって定められる表示態様で訳文をディスプレイ装置等に表示させればよい。また、新規の文書ファイル11に記述されている原文とともに訳文を表示させてもよい。さらに、入力デバイス(図1において図示せず。)を介して、オペレータから、表示させた文字列の編集操作を受け付けてもよい。
また、上記の説明では、原文記憶部31および訳文記憶部32に1文毎に文字列を記憶させ、ステップS21〜S25の処理を1文毎に行う場合を示した。1文ではなく、句単位や単語単位に処理を行ってもよい。その場合、原文記憶部31および訳文記憶部32に句(または単語)毎に文字列を記憶させ、ステップS21〜S25の処理を句(または単語)毎に行えばよい。また、原文ファイル13a、訳文ファイル13bおよび新規の文書ファイル11において、句(または単語)の切れ目を示す記号を記述しておき、登録情報取得部24および文字列取得部21は、その記号によって、句の切れ目(または単語の切れ目)を判定すればよい。
以上の説明において、原文記憶部31は、第1言語文字列記憶手段に相当する。訳文記憶部32は、第2言語文字列記憶手段に相当する。文字列取得部21は、入力手段に相当する。文字列検索部22は、検索手段および抽出手段に相当する。ファイル出力部23は、出力手段に相当する。また、ディスプレイ装置(図1において図示せず。)は、表示手段に相当する。また、キーボードやマウスなどの入力デバイス(図1において図示せず。)は、指定受付手段に相当する。
本発明は、翻訳メモリによって翻訳を行う翻訳メモリシステムに適用可能である。また、原文と訳文とを並べて表示して、表示した原文と訳文の編集操作を可能とする対訳エディタシステム等にも適用可能である。
本発明による翻訳メモリシステムの構成の例を示すブロック図である。 原文ファイルおよび訳文ファイルに記述された文字列の例を示す説明図である。 対応する記憶領域の例を示す説明図である。 原文および訳文を記憶装置に記憶させる動作の処理経過の例を示すフローチャートである。 訳文を記述した訳文ファイルを出力する動作の処理経過の例を示すフローチャートである。 新規の文書ファイルおよび出力される訳文ファイルに記述される文字列の例を示す説明図である。 従来の翻訳メモリシステムにおいて出力される訳文の表示態様の例を示す説明図である。
符号の説明
2 データ処理装置
3 記憶装置
11 新規の文書ファイル
12 訳文ファイル
13 登録用文書ファイル
13a 原文ファイル
13b 訳文ファイル
21 文字列取得部
22 文字列検索部
23 ファイル出力部
24 登録情報取得部
31 原文記憶部
32 訳文記憶部

Claims (11)

  1. 第1の言語で記述される第1言語文字列を記憶する第1言語文字列記憶手段と、
    第1言語文字列が第2の言語に翻訳された文字列である第2言語文字列を、当該第1言語文字列が記憶される第1言語文字列記憶手段の記憶領域と対応する記憶領域に記憶するとともに、文字列の表示態様としてフォントの種類、フォントサイズ、下線の有無、表示色の一部または全部を定めた文字属性情報を個々の第2言語文字列毎に記憶する第2言語文字列記憶手段と、
    新規の第1言語文字列が入力される入力手段と、
    前記新規の第1言語文字列と同一の第1言語文字列を第1言語文字列記憶手段が記憶する第1言語文字列の中から検索する検索手段と、
    検索手段によって検索された第1言語文字列が記憶される第1言語文字列記憶手段の記憶領域と対応する記憶領域に記憶された第2言語文字列と、当該第2言語文字列の表示態様を定めた文字属性情報とを第2言語文字列記憶手段から抽出する抽出手段と、
    抽出手段によって抽出された第2言語文字列および文字属性情報を出力する出力手段とを備えた
    ことを特徴とする翻訳メモリシステム。
  2. 入力手段には、新規の第1言語文字列と、当該第1言語文字列の表示態様を定めた文字属性情報とが入力され
    出力手段は、検出手段が前記新規の第1言語文字列と同一の第1言語文字列を検索できなかった場合に、前記新規の第1言語文字列および前記文字属性情報を出力する
    請求項1に記載の翻訳メモリシステム。
  3. 第1言語文字列記憶手段は、個々の第1言語文字列を記憶した順番を特定可能に個々の第1言語文字列を記憶し、
    検索手段は、新規の第1言語文字列と同一の第1言語文字列が第1言語文字列記憶手段の複数の記憶領域に記憶されている場合には、前記複数の記憶領域に記憶されている各第1言語文字列のうち、最後に記憶された第1言語文字列を検索する
    請求項1または請求項2に記載の翻訳メモリシステム。
  4. 文字属性情報により定まる表示態様で文字列を表示する表示手段と、
    表示手段が複数の文字列を表示した場合に、前記複数の文字列のうちの一つの文字列をオペレータから指定される指定受付手段とを備え、
    第1言語文字列記憶手段は、文字属性情報を個々の第1言語文字列毎に記憶し、
    検索手段は、新規の第1言語文字列と同一の第1言語文字列が第1言語文字列記憶手段の複数の記憶領域に記憶されている場合には、前記複数の記憶領域に記憶されている各第1言語文字列を、各第1言語文字列毎の文字属性情報により定まる表示態様で表示手段に表示させ、指定受付手段がオペレータから指定された第1言語文字列を、第1言語文字列記憶手段が記憶する第1言語文字列の中から検索する
    請求項1または請求項2に記載の翻訳メモリシステム。
  5. 第1言語文字列記憶手段は、文字属性情報を個々の第1言語文字列毎に記憶し、
    入力手段には、新規の第1言語文字列と、当該第1言語文字列の表示態様を定めた文字属性情報とが入力され
    検索手段は、前記新規の第1言語文字列と同一の第1言語文字列であって、文字属性情報が入力手段に入力された文字属性情報と同一である第1言語文字列を検索する
    請求項1または請求項2に記載の翻訳メモリシステム。
  6. 入力手段には、文字属性情報により表示態様が定められた新規の第1言語文字列を記述したファイルが入力される請求項1から請求項5のうちのいずれか1項に記載の翻訳メモリシステム。
  7. 入力手段は、入力されたファイルのコピーを作成し、入力されたファイルから新規の第1言語文字列を読み込み、
    検索手段は、入力手段がファイルから読み込んだ新規の第1言語文字列と同一の第1言語文字列を第1言語文字列記憶手段が記憶する第1言語文字列の中から検索し、
    抽出手段は、検索された第1言語文字列が記憶される第1言語文字列記憶手段の記憶領域と対応する記憶領域に記憶された第2言語文字列と、当該第2言語文字列の表示態様を定めた文字属性情報とを第2言語文字列記憶手段から抽出し、
    出力手段は、入力手段によってコピーされたファイルにおける前記新規の文字列が記述された位置で、前記新規の第1言語文字列を、抽出手段によって抽出された文字属性情報により表示態様が定められた第2言語文字列に置換するようにして、前記コピーされたファイルに前記第2言語文字列を記述する
    請求項6に記載の翻訳メモリシステム。
  8. 入力手段には、文字属性情報により表示態様が定められた新規の第1言語文字列を記述するとともに画像データを含んでいるファイルが入力される請求項7に記載の翻訳メモリシステム。
  9. 入力手段は、入力されたファイルから新規の第1言語文字列を読み込み、
    検索手段は、入力手段がファイルから読み込んだ新規の第1言語文字列と同一の第1言語文字列を第1言語文字列記憶手段が記憶する第1言語文字列の中から検索し、
    抽出手段は、検索された第1言語文字列が記憶される第1言語文字列記憶手段の記憶領域と対応する記憶領域に記憶された第2言語文字列と、当該第2言語文字列の表示態様を定めた文字属性情報とを第2言語文字列記憶手段から抽出し、
    出力手段は、入力手段に入力されたファイルとは異なるファイルに、抽出手段によって抽出された文字属性情報により表示態様が定められた第2言語文字列を記述する
    請求項6に記載の翻訳メモリシステム。
  10. 第1の言語で記述される第1言語文字列を記憶する第1言語文字列記憶手段と、第1言語文字列が第2の言語に翻訳された文字列である第2言語文字列を、当該第1言語文字列が記憶される第1言語文字列記憶手段の記憶領域と対応する記憶領域に記憶するとともに、文字列の表示態様としてフォントの種類、フォントサイズ、下線の有無、表示色の一部または全部を定めた文字属性情報を個々の第2言語文字列毎に記憶する第2言語文字列記憶手段と、新規の第1言語文字列を記述したファイルが入力される入力手段とを備えた翻訳メモリシステムに適用される翻訳方法であって、
    入力手段が、入力されたファイルのコピーを作成し、入力されたファイルから新規の第1言語文字列を読み込み、
    検索手段が、前記新規の第1言語文字列と同一の第1言語文字列を第1言語文字列記憶手段が記憶する第1言語文字列の中から検索し、
    抽出手段が、検索手段によって検索された第1言語文字列が記憶される第1言語文字列記憶手段の記憶領域と対応する記憶領域に記憶された第2言語文字列と、当該第2言語文字列の表示態様を定めた文字属性情報とを第2言語文字列記憶手段から抽出し、
    出力手段が、入力手段によってコピーされたファイルにおける前記新規の第1言語文字列が記述された位置で、前記新規の第1言語文字列を、抽出手段によって抽出された文字属性情報により表示態様が定められた第2言語文字列に置換するようにして、前記コピーされたファイルに前記第2言語文字列を記述する
    ことを特徴とする翻訳方法。
  11. 第1の言語で記述される第1言語文字列を記憶する第1言語文字列記憶手段と、第1言語文字列が第2の言語に翻訳された文字列である第2言語文字列を、当該第1言語文字列が記憶される第1言語文字列記憶手段の記憶領域と対応する記憶領域に記憶するとともに、文字列の表示態様としてフォントの種類、フォントサイズ、下線の有無、表示色の一部または全部を定めた文字属性情報を個々の第2言語文字列毎に記憶する第2言語文字列記憶手段と、新規の第1言語文字列を記述したファイルが入力される入力手段とを備えたコンピュータに、
    入力手段に入力されたファイルのコピーを作成し、入力されたファイルから新規の第1言語文字列を読み込む処理、
    前記新規の第1言語文字列と同一の第1言語文字列を第1言語文字列記憶手段が記憶する第1言語文字列の中から検索する処理、
    検索された第1言語文字列が記憶される第1言語文字列記憶手段の記憶領域と対応する記憶領域に記憶された第2言語文字列と、当該第2言語文字列の表示態様を定めた文字属性情報とを第2言語文字列記憶手段から抽出する処理、および
    コピーされたファイルにおける前記新規の第1言語文字列が記述された位置で、前記新規の第1言語文字列を、抽出手段によって抽出された文字属性情報により表示態様が定められた第2言語文字列に置換するようにして、前記コピーされたファイルに前記第2言語文字列を記述する処理
    を実行させるための翻訳メモリシステム用プログラム。
JP2003403459A 2003-12-02 2003-12-02 翻訳メモリシステム、翻訳方法、および翻訳メモリシステム用プログラム Expired - Fee Related JP3952009B2 (ja)

Priority Applications (1)

Application Number Priority Date Filing Date Title
JP2003403459A JP3952009B2 (ja) 2003-12-02 2003-12-02 翻訳メモリシステム、翻訳方法、および翻訳メモリシステム用プログラム

Applications Claiming Priority (1)

Application Number Priority Date Filing Date Title
JP2003403459A JP3952009B2 (ja) 2003-12-02 2003-12-02 翻訳メモリシステム、翻訳方法、および翻訳メモリシステム用プログラム

Publications (2)

Publication Number Publication Date
JP2005165652A JP2005165652A (ja) 2005-06-23
JP3952009B2 true JP3952009B2 (ja) 2007-08-01

Family

ID=34726759

Family Applications (1)

Application Number Title Priority Date Filing Date
JP2003403459A Expired - Fee Related JP3952009B2 (ja) 2003-12-02 2003-12-02 翻訳メモリシステム、翻訳方法、および翻訳メモリシステム用プログラム

Country Status (1)

Country Link
JP (1) JP3952009B2 (ja)

Families Citing this family (2)

* Cited by examiner, † Cited by third party
Publication number Priority date Publication date Assignee Title
JP2017041039A (ja) * 2015-08-19 2017-02-23 日本電信電話株式会社 変換装置、変換方法、及びプログラム
JP6564910B2 (ja) * 2018-05-31 2019-08-21 日本電信電話株式会社 変換装置、変換方法、及びプログラム

Also Published As

Publication number Publication date
JP2005165652A (ja) 2005-06-23

Similar Documents

Publication Publication Date Title
JP2862626B2 (ja) 電子辞書及び情報検索方法
JP4404211B2 (ja) マルチリンガル翻訳メモリ、翻訳方法および翻訳プログラム
US20050015720A1 (en) Document processing apparatus and document processing method
JPH07282063A (ja) 機械翻訳装置
EP2312460A1 (en) Information processing device and information processing method
JP2848729B2 (ja) 翻訳方法および翻訳装置
JP3122417B2 (ja) 情報表示方法及び情報処理装置
JP2005165652A (ja) 翻訳メモリシステム、翻訳方法、および翻訳メモリシステム用プログラム
JP4643183B2 (ja) 翻訳装置および翻訳プログラム
JP6565012B2 (ja) 翻訳支援システム
JP2006252164A (ja) 中国語文書処理装置
JP2005031813A (ja) 抄録作成支援システム、プログラム、抄録作成支援方法及び特許文献検索システム並びにその検索方法
JP3791565B2 (ja) 文字入力装置
JP2023152349A (ja) 日本語入力システムの漢字仮名変換
JPH07219962A (ja) キーワード作成装置
JPH11232003A (ja) ドキュメント表示装置,表示方法および記憶媒体
JPH07182348A (ja) 翻訳装置
JP2006252167A (ja) 文書処理装置
JPH04227570A (ja) 翻訳表示装置
JPH0421169A (ja) 翻訳装置
JPH0520420A (ja) 図形処理装置
JPS61229161A (ja) 文書作成編集装置
JPS6366665A (ja) 文書解析整形装置
JPH0785026A (ja) 辞書更生方法及び装置
JPH03129562A (ja) インデックス作成支援装置

Legal Events

Date Code Title Description
RD03 Notification of appointment of power of attorney

Free format text: JAPANESE INTERMEDIATE CODE: A7423

Effective date: 20051118

RD04 Notification of resignation of power of attorney

Free format text: JAPANESE INTERMEDIATE CODE: A7424

Effective date: 20051118

A131 Notification of reasons for refusal

Free format text: JAPANESE INTERMEDIATE CODE: A131

Effective date: 20070123

A521 Written amendment

Free format text: JAPANESE INTERMEDIATE CODE: A523

Effective date: 20070316

TRDD Decision of grant or rejection written
A01 Written decision to grant a patent or to grant a registration (utility model)

Free format text: JAPANESE INTERMEDIATE CODE: A01

Effective date: 20070403

A61 First payment of annual fees (during grant procedure)

Free format text: JAPANESE INTERMEDIATE CODE: A61

Effective date: 20070416

R150 Certificate of patent or registration of utility model

Free format text: JAPANESE INTERMEDIATE CODE: R150

FPAY Renewal fee payment (event date is renewal date of database)

Free format text: PAYMENT UNTIL: 20110511

Year of fee payment: 4

FPAY Renewal fee payment (event date is renewal date of database)

Free format text: PAYMENT UNTIL: 20110511

Year of fee payment: 4

FPAY Renewal fee payment (event date is renewal date of database)

Free format text: PAYMENT UNTIL: 20120511

Year of fee payment: 5

FPAY Renewal fee payment (event date is renewal date of database)

Free format text: PAYMENT UNTIL: 20120511

Year of fee payment: 5

FPAY Renewal fee payment (event date is renewal date of database)

Free format text: PAYMENT UNTIL: 20130511

Year of fee payment: 6

FPAY Renewal fee payment (event date is renewal date of database)

Free format text: PAYMENT UNTIL: 20140511

Year of fee payment: 7

LAPS Cancellation because of no payment of annual fees