BRPI0917220B1 - métodos de hidrolisar um óleo ou gordura, de síntese biocatalítica de um lipídeo estruturado, de catalisar uma reação de interesterificação para produzir novos triacilglicerídeos, de interesterificação para preparar um alimento, ração ou um óleo, e de produzir um diacilglicerol - Google Patents
métodos de hidrolisar um óleo ou gordura, de síntese biocatalítica de um lipídeo estruturado, de catalisar uma reação de interesterificação para produzir novos triacilglicerídeos, de interesterificação para preparar um alimento, ração ou um óleo, e de produzir um diacilglicerol Download PDFInfo
- Publication number
- BRPI0917220B1 BRPI0917220B1 BRPI0917220-3A BRPI0917220A BRPI0917220B1 BR PI0917220 B1 BRPI0917220 B1 BR PI0917220B1 BR PI0917220 A BRPI0917220 A BR PI0917220A BR PI0917220 B1 BRPI0917220 B1 BR PI0917220B1
- Authority
- BR
- Brazil
- Prior art keywords
- low
- oil
- polypeptide
- amino acid
- sequence
- Prior art date
Links
Classifications
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12P—FERMENTATION OR ENZYME-USING PROCESSES TO SYNTHESISE A DESIRED CHEMICAL COMPOUND OR COMPOSITION OR TO SEPARATE OPTICAL ISOMERS FROM A RACEMIC MIXTURE
- C12P7/00—Preparation of oxygen-containing organic compounds
- C12P7/64—Fats; Fatty oils; Ester-type waxes; Higher fatty acids, i.e. having at least seven carbon atoms in an unbroken chain bound to a carboxyl group; Oxidised oils or fats
- C12P7/6436—Fatty acid esters
- C12P7/6445—Glycerides
- C12P7/6472—Glycerides containing polyunsaturated fatty acid [PUFA] residues, i.e. having two or more double bonds in their backbone
-
- A—HUMAN NECESSITIES
- A23—FOODS OR FOODSTUFFS; TREATMENT THEREOF, NOT COVERED BY OTHER CLASSES
- A23D—EDIBLE OILS OR FATS, e.g. MARGARINES, SHORTENINGS OR COOKING OILS
- A23D7/00—Edible oil or fat compositions containing an aqueous phase, e.g. margarines
- A23D7/02—Edible oil or fat compositions containing an aqueous phase, e.g. margarines characterised by the production or working-up
- A23D7/04—Working-up
-
- A—HUMAN NECESSITIES
- A23—FOODS OR FOODSTUFFS; TREATMENT THEREOF, NOT COVERED BY OTHER CLASSES
- A23D—EDIBLE OILS OR FATS, e.g. MARGARINES, SHORTENINGS OR COOKING OILS
- A23D9/00—Other edible oils or fats, e.g. shortenings or cooking oils
- A23D9/02—Other edible oils or fats, e.g. shortenings or cooking oils characterised by the production or working-up
- A23D9/04—Working-up
-
- C—CHEMISTRY; METALLURGY
- C11—ANIMAL OR VEGETABLE OILS, FATS, FATTY SUBSTANCES OR WAXES; FATTY ACIDS THEREFROM; DETERGENTS; CANDLES
- C11B—PRODUCING, e.g. BY PRESSING RAW MATERIALS OR BY EXTRACTION FROM WASTE MATERIALS, REFINING OR PRESERVING FATS, FATTY SUBSTANCES, e.g. LANOLIN, FATTY OILS OR WAXES; ESSENTIAL OILS; PERFUMES
- C11B3/00—Refining fats or fatty oils
- C11B3/003—Refining fats or fatty oils by enzymes or microorganisms, living or dead
-
- C—CHEMISTRY; METALLURGY
- C11—ANIMAL OR VEGETABLE OILS, FATS, FATTY SUBSTANCES OR WAXES; FATTY ACIDS THEREFROM; DETERGENTS; CANDLES
- C11C—FATTY ACIDS FROM FATS, OILS OR WAXES; CANDLES; FATS, OILS OR FATTY ACIDS BY CHEMICAL MODIFICATION OF FATS, OILS, OR FATTY ACIDS OBTAINED THEREFROM
- C11C1/00—Preparation of fatty acids from fats, fatty oils, or waxes; Refining the fatty acids
- C11C1/02—Preparation of fatty acids from fats, fatty oils, or waxes; Refining the fatty acids from fats or fatty oils
- C11C1/04—Preparation of fatty acids from fats, fatty oils, or waxes; Refining the fatty acids from fats or fatty oils by hydrolysis
- C11C1/045—Preparation of fatty acids from fats, fatty oils, or waxes; Refining the fatty acids from fats or fatty oils by hydrolysis using enzymes or microorganisms, living or dead
-
- C—CHEMISTRY; METALLURGY
- C11—ANIMAL OR VEGETABLE OILS, FATS, FATTY SUBSTANCES OR WAXES; FATTY ACIDS THEREFROM; DETERGENTS; CANDLES
- C11C—FATTY ACIDS FROM FATS, OILS OR WAXES; CANDLES; FATS, OILS OR FATTY ACIDS BY CHEMICAL MODIFICATION OF FATS, OILS, OR FATTY ACIDS OBTAINED THEREFROM
- C11C3/00—Fats, oils, or fatty acids by chemical modification of fats, oils, or fatty acids obtained therefrom
- C11C3/04—Fats, oils, or fatty acids by chemical modification of fats, oils, or fatty acids obtained therefrom by esterification of fats or fatty oils
- C11C3/08—Fats, oils, or fatty acids by chemical modification of fats, oils, or fatty acids obtained therefrom by esterification of fats or fatty oils with fatty acids
-
- C—CHEMISTRY; METALLURGY
- C11—ANIMAL OR VEGETABLE OILS, FATS, FATTY SUBSTANCES OR WAXES; FATTY ACIDS THEREFROM; DETERGENTS; CANDLES
- C11C—FATTY ACIDS FROM FATS, OILS OR WAXES; CANDLES; FATS, OILS OR FATTY ACIDS BY CHEMICAL MODIFICATION OF FATS, OILS, OR FATTY ACIDS OBTAINED THEREFROM
- C11C3/00—Fats, oils, or fatty acids by chemical modification of fats, oils, or fatty acids obtained therefrom
- C11C3/12—Fats, oils, or fatty acids by chemical modification of fats, oils, or fatty acids obtained therefrom by hydrogenation
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12N—MICROORGANISMS OR ENZYMES; COMPOSITIONS THEREOF; PROPAGATING, PRESERVING, OR MAINTAINING MICROORGANISMS; MUTATION OR GENETIC ENGINEERING; CULTURE MEDIA
- C12N9/00—Enzymes; Proenzymes; Compositions thereof; Processes for preparing, activating, inhibiting, separating or purifying enzymes
- C12N9/14—Hydrolases (3)
- C12N9/16—Hydrolases (3) acting on ester bonds (3.1)
- C12N9/18—Carboxylic ester hydrolases (3.1.1)
- C12N9/20—Triglyceride splitting, e.g. by means of lipase
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12P—FERMENTATION OR ENZYME-USING PROCESSES TO SYNTHESISE A DESIRED CHEMICAL COMPOUND OR COMPOSITION OR TO SEPARATE OPTICAL ISOMERS FROM A RACEMIC MIXTURE
- C12P7/00—Preparation of oxygen-containing organic compounds
- C12P7/64—Fats; Fatty oils; Ester-type waxes; Higher fatty acids, i.e. having at least seven carbon atoms in an unbroken chain bound to a carboxyl group; Oxidised oils or fats
- C12P7/6409—Fatty acids
- C12P7/6418—Fatty acids by hydrolysis of fatty acid esters
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12P—FERMENTATION OR ENZYME-USING PROCESSES TO SYNTHESISE A DESIRED CHEMICAL COMPOUND OR COMPOSITION OR TO SEPARATE OPTICAL ISOMERS FROM A RACEMIC MIXTURE
- C12P7/00—Preparation of oxygen-containing organic compounds
- C12P7/64—Fats; Fatty oils; Ester-type waxes; Higher fatty acids, i.e. having at least seven carbon atoms in an unbroken chain bound to a carboxyl group; Oxidised oils or fats
- C12P7/6409—Fatty acids
- C12P7/6427—Polyunsaturated fatty acids [PUFA], i.e. having two or more double bonds in their backbone
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12P—FERMENTATION OR ENZYME-USING PROCESSES TO SYNTHESISE A DESIRED CHEMICAL COMPOUND OR COMPOSITION OR TO SEPARATE OPTICAL ISOMERS FROM A RACEMIC MIXTURE
- C12P7/00—Preparation of oxygen-containing organic compounds
- C12P7/64—Fats; Fatty oils; Ester-type waxes; Higher fatty acids, i.e. having at least seven carbon atoms in an unbroken chain bound to a carboxyl group; Oxidised oils or fats
- C12P7/6409—Fatty acids
- C12P7/6427—Polyunsaturated fatty acids [PUFA], i.e. having two or more double bonds in their backbone
- C12P7/6431—Linoleic acids [18:2[n-6]]
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12P—FERMENTATION OR ENZYME-USING PROCESSES TO SYNTHESISE A DESIRED CHEMICAL COMPOUND OR COMPOSITION OR TO SEPARATE OPTICAL ISOMERS FROM A RACEMIC MIXTURE
- C12P7/00—Preparation of oxygen-containing organic compounds
- C12P7/64—Fats; Fatty oils; Ester-type waxes; Higher fatty acids, i.e. having at least seven carbon atoms in an unbroken chain bound to a carboxyl group; Oxidised oils or fats
- C12P7/6409—Fatty acids
- C12P7/6427—Polyunsaturated fatty acids [PUFA], i.e. having two or more double bonds in their backbone
- C12P7/6432—Eicosapentaenoic acids [EPA]
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12P—FERMENTATION OR ENZYME-USING PROCESSES TO SYNTHESISE A DESIRED CHEMICAL COMPOUND OR COMPOSITION OR TO SEPARATE OPTICAL ISOMERS FROM A RACEMIC MIXTURE
- C12P7/00—Preparation of oxygen-containing organic compounds
- C12P7/64—Fats; Fatty oils; Ester-type waxes; Higher fatty acids, i.e. having at least seven carbon atoms in an unbroken chain bound to a carboxyl group; Oxidised oils or fats
- C12P7/6409—Fatty acids
- C12P7/6427—Polyunsaturated fatty acids [PUFA], i.e. having two or more double bonds in their backbone
- C12P7/6434—Docosahexenoic acids [DHA]
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12P—FERMENTATION OR ENZYME-USING PROCESSES TO SYNTHESISE A DESIRED CHEMICAL COMPOUND OR COMPOSITION OR TO SEPARATE OPTICAL ISOMERS FROM A RACEMIC MIXTURE
- C12P7/00—Preparation of oxygen-containing organic compounds
- C12P7/64—Fats; Fatty oils; Ester-type waxes; Higher fatty acids, i.e. having at least seven carbon atoms in an unbroken chain bound to a carboxyl group; Oxidised oils or fats
- C12P7/6436—Fatty acid esters
- C12P7/6445—Glycerides
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12P—FERMENTATION OR ENZYME-USING PROCESSES TO SYNTHESISE A DESIRED CHEMICAL COMPOUND OR COMPOSITION OR TO SEPARATE OPTICAL ISOMERS FROM A RACEMIC MIXTURE
- C12P7/00—Preparation of oxygen-containing organic compounds
- C12P7/64—Fats; Fatty oils; Ester-type waxes; Higher fatty acids, i.e. having at least seven carbon atoms in an unbroken chain bound to a carboxyl group; Oxidised oils or fats
- C12P7/6436—Fatty acid esters
- C12P7/6445—Glycerides
- C12P7/6454—Glycerides by esterification
-
- C—CHEMISTRY; METALLURGY
- C12—BIOCHEMISTRY; BEER; SPIRITS; WINE; VINEGAR; MICROBIOLOGY; ENZYMOLOGY; MUTATION OR GENETIC ENGINEERING
- C12P—FERMENTATION OR ENZYME-USING PROCESSES TO SYNTHESISE A DESIRED CHEMICAL COMPOUND OR COMPOSITION OR TO SEPARATE OPTICAL ISOMERS FROM A RACEMIC MIXTURE
- C12P7/00—Preparation of oxygen-containing organic compounds
- C12P7/64—Fats; Fatty oils; Ester-type waxes; Higher fatty acids, i.e. having at least seven carbon atoms in an unbroken chain bound to a carboxyl group; Oxidised oils or fats
- C12P7/6436—Fatty acid esters
- C12P7/6445—Glycerides
- C12P7/6458—Glycerides by transesterification, e.g. interesterification, ester interchange, alcoholysis or acidolysis
Landscapes
- Chemical & Material Sciences (AREA)
- Organic Chemistry (AREA)
- Life Sciences & Earth Sciences (AREA)
- Engineering & Computer Science (AREA)
- Wood Science & Technology (AREA)
- Zoology (AREA)
- Oil, Petroleum & Natural Gas (AREA)
- Microbiology (AREA)
- Chemical Kinetics & Catalysis (AREA)
- Health & Medical Sciences (AREA)
- Biochemistry (AREA)
- General Chemical & Material Sciences (AREA)
- Bioinformatics & Cheminformatics (AREA)
- Genetics & Genomics (AREA)
- General Health & Medical Sciences (AREA)
- General Engineering & Computer Science (AREA)
- Biotechnology (AREA)
- Polymers & Plastics (AREA)
- Food Science & Technology (AREA)
- Molecular Biology (AREA)
- Biomedical Technology (AREA)
- Medicinal Chemistry (AREA)
- Enzymes And Modification Thereof (AREA)
- Fats And Perfumes (AREA)
- Preparation Of Compounds By Using Micro-Organisms (AREA)
- Micro-Organisms Or Cultivation Processes Thereof (AREA)
- Bakery Products And Manufacturing Methods Therefor (AREA)
Abstract
.
Description
(54) Título: MÉTODOS DE HIDROLISAR UM ÓLEO OU GORDURA, DE SÍNTESE BIOCATALÍTICA DE UM LIPÍDEO ESTRUTURADO, DE CATALISAR UMA REAÇÃO DE INTERESTERIFICAÇÃO PARA PRODUZIR NOVOS TRIACILGLICERÍDEOS, DE INTERESTERIFICAÇÃO PARA PREPARAR UM ALIMENTO, RAÇÃO OU UM ÓLEO, E DE PRODUZIR UM DIACILGLICEROL (73) Titular: BUNGE OILS, INC.. Endereço: 11720 Borman Drive, St. Louis, MISSOURI 63146, ESTADOS UNIDOS DA AMÉRICA(US) (72) Inventor: CHRISTOPHER L. G. DAYTON; NELSON BARTON; ANALIA BUENO; JOSLIN G.CUENCA; TIM HITCHMAN; KATIE A. KLINE; JONATHAN LYON; MARK L. MILLER; MARK A. WALL.
Código de Controle: 6AB0145F5205606C A8670C13542B3079
Prazo de Validade: 20 (vinte) anos contados a partir de 28/08/2009, observadas as condições legais
Expedida em: 21/11/2018
Assinado digitalmente por:
Alexandre Gomes Ciancio
Diretor Substituto de Patentes, Programas de Computador e Topografias de Circuitos Integrados
1/293 “MÉTODOS DE HIDROLISAR UM ÓLEO OU GORDURA, DE SÍNTESE BIOCATALÍTICA DE UM LIPÍDEO ESTRUTURADO, DE CATALISAR UMA REAÇÃO DE INTERESTERIFICAÇÃO PARA PRODUZIR NOVOS TRIACILGLICERÍDEOS, DE INTERESTERIFICAÇÃO PARA PREPARAR UM ALIMENTO, RAÇÃO OU UM ÓLEO, E DE PRODUZIR UM DIACILGLICEROL”
REFERÊNCIA CRUZADA COM PEDIDO RELACIONADO [0001] Este pedido reivindica o benefício do Pedido de Patente dos E.U.A. n° 12/202.204, depositado em 29 de agosto de 2008, que é incorporado aqui integralmente por referência.
LISTAGEM DE SEQUÊNCIAS [0002] O presente pedido está sendo depositado com uma Listagem de Sequências submetida com o nome de arquivo 011631-0045-228_SeqListing.txt, e tamanho de 46.086 bytes, que foi criado em 25 de agosto. A Listagem de Sequências é incorporada aqui integralmente por referência.
CAMPO TÉCNICO [0003] Proporciona-se aqui polipeptídios apresentando atividade de hidrolase, incluindo atividade de lipase, saturase, palmitase e/ou estearatase, polinucleotídeos que codificam os mesmos, e métodos de preparar e usar estes polinucleotídeos e polipeptídios. Proporciona-se também aqui peptídios e polipeptídios, p. ex., enzimas, apresentando uma atividade de hidrolase, p. ex., lipases, saturases, palmitases e/ou estearatases, e métodos para o tratamento de gorduras e óleos com referidos peptídios e polipeptídios para preparar produtos de óleo hidrolisados, como óleos vegetais ou animais com baixo teor de saturação, p. ex., óleos de soja ou canola, os produtos de óleo assim tratados, e produtos compreendendo referidos óleos tratados. FUNDAMENTOS [0004] As principais aplicações industriais para hidrolases, p. ex., lipases, saturases, palmitases e/ou estearatases, incluem a indústria de alimentos e bebidas, como agentes anti-staling para produtos de panificação, e na produção de margarina e outras pastas para espalhamento com aromas de manteiga natural; em sistemas de eliminação de rejeitos; e na indústria farmacêutica onde eles serão usados como
Petição 870180005321, de 22/01/2018, pág. 8/316
2/293 auxiliares digestivos.
[0005] Óleos e gorduras processados são um componente importante de alimentos, aditivos alimentícios, e auxiliares de processamento de alimentos, e também são matérias-primas renováveis importantes para a indústria química. Eles encontram-se disponíveis em grandes quantidades a partir do processamento de sementes oleaginosas de plantas, como o arroz farelo, milho, colza, canola, girassol, azeitonas, palma ou soja. Outras fontes de óleos e gorduras valiosos incluem peixe, restos de restaurantes, e gorduras animais processadas. Estas gorduras e óleos são uma mistura de triacilglicerídeos ou lipídios, i.e. ácidos graxos (FA) esterificados sobre uma plataforma de glicerol. Cada óleo ou gordura contém uma ampla variedade de diferentes estruturas lipídicas, definidas pelo teor de FA [ácidos graxos] e sua distribuição regioquímica na cadeia principal de glicerol. Estas propriedades dos lipídios individuais determinam as propriedades físicas do triacilglicerídeo puro. Consequentemente, o teor de triacilglicerídeos de uma gordura ou óleo determina, em grande parte, as propriedades físicas, químicas e biológicas do óleo. O valor de lipídios aumenta muito como uma função de sua pureza. A alta pureza pode ser obtida por meio de cromatografia fracionada ou destilação, separando-se o triacilglicerídeo desejado do fundo misto da fonte de gordura ou óleo. No entanto, isto é oneroso e os rendimentos são frequentemente limitados pelos baixos níveis em que o triacilglicerídeo ocorre naturalmente. Adicionalmente, a facilidade de purificação do produto é frequentemente comprometida pela presença de muitos triacilglicerídeos estruturalmente e fisicamente ou quimicamente similares no óleo.
[0006] Uma alternativa à purificação de triacilglicerídeos ou outros lipídios de uma fonte natural consiste em sintetizar os lipídios. Os produtos de referidos processos são denominados lipídios estruturados porque eles contêm um conjunto definido de ácidos graxos distribuídos de uma maneira definida na cadeia principal de glicerol. O valor de lipídios também aumenta muito com o controle do teor de ácido graxo e a distribuição no lipídio. A eliminação de triglicerídeos, gorduras ou óleos de ácido graxo [FA] indesejável, ou a substituição de FA com propriedades indesejáveis por ácidos graxos com propriedades químicas, físicas ou biológicas melhores ou mais
Petição 870180005321, de 22/01/2018, pág. 9/316
3/293 desejáveis, aumenta o valor dos lipídios. Em particular, existe uma necessidade de lipases que podem hidrolisar, p. ex., hidrolisar seletivamente, um ácido graxo saturado (uma “saturase”), ou aqueles que, em particular, podem hidrolisar, p. ex., hidrolisar seletivamente, um ácido palmítico (uma “palmitase”) ou um ácido esteárico (uma “estearatase”) de uma cadeia principal de glicerol. Lipases, como saturases, p. ex., palmitases e/ou estearatases podem ser usadas para efetuar tal controle onde o FA está sendo removido, adicionado ou substituído, são ácidos graxos saturados, p. ex., ácido palmítico ou ácido esteárico.
SUMÁRIO [0007] Proporciona-se aqui polipeptídios apresentando atividade de hidrolase, incluindo atividade de lipase. Em um aspecto, proporciona-se aqui classes inéditas de lipases denominadas “saturases”, “palmitases” e “estearatases”. Proporciona-se também polinucleotídeos codificando polipeptídios apresentando atividade de saturase, p. ex., palmitase e/ou estearatase, e métodos de preparar e usar estes polinucleotídeos e polipeptídios. Em um aspecto, proporciona-se aqui polipeptídios, p. ex., enzimas, apresentando uma atividade de hidrolase, p. ex., atividade de lipase, saturase, palmitase e/ou estearatase apresentando atividade de enzima termoestável e/ou termotolerante (catalítica). As atividades enzimáticas dos polipeptídios e peptídios como proporcionados aqui incluem (compreendem ou consistem de) uma atividade de saturase ou uma atividade de lipase, incluindo hidrólise de lipídios, reações de acidólise (p. ex., para substituir um ácido graxo esterificado com um ácido graxo livre), reações de transesterificação (p. ex., troca de ácidos graxos entre triacilglicerídeos), síntese de éster, reações de intercâmbio de éster e atividade de acil hidrolase lipídica (LAH). Em outro aspecto, os polipeptídios como proporcionados aqui são usados para sintetizar produtos quirais enanatiomericamente puros.
[0008] Os polipeptídios como proporcionados aqui podem ser usados em uma variedade de contextos farmacêuticos, agrícolas e industriais, incluindo a fabricação de cosméticos e nutracêuticos. Adicionalmente, os polipeptídios como proporcionados aqui podem ser usados no processamento de alimentos, fabricação de cerveja, aditivos para banhos, produção de álcool, síntese de peptídios, enantiosseletividade,
Petição 870180005321, de 22/01/2018, pág. 10/316
4/293 preparação de peles na indústria de couros, controle de rejeitos e degradação de resíduos animais, recuperação de prata na indústria fotográfica, tratamento médico, desengomamento de seda, degradação por biofilme, conversão de biomassa a etanol, biodefesa, agentes antimicrobianos e desinfetantes, produtos para tratamento pessoal e cosméticos, reagentes biotecnológicos, no incremento o rendimento de amido da moagem a úmido, e como farmacêuticos, como auxiliares digestivos e agentes antiinflamatórios (antiflogísticos).
[0009] Em determinadas concretizações, proporciona-se aqui composições (p. ex., lipases, saturases, itases e/ou estearatases) e métodos para produzir óleos com baixo teor de saturação, p. ex., óleos com um menor teor de ácidos graxos saturados, incluindo óleos com baixo teor de ácidos graxos de palmitato, estearato, miristato, laurato ou butirato e/ou ácido caprílico (ácido octanóico). Qualquer óleo vegetal, p. ex., óleo de canola, óleo de soja, ou óleo ou gordura animal, p. ex., talol, pode ser tratado com uma composição, ou por meio de um método, como proporcionado aqui. Quaisquer alimentos, itens comestíveis, ou produtos para assamento, fritura ou cozimento (p. ex., temperos, marinadas, condimentos, óleos pulverizáveis, margarinas, óleos para cozimento, maionese, óleos para cozimento, óleos para saladas, coberturas despejáveis e aplicáveis com colher, e análogos, e produtos preparados com os mesmos) podem compreender um óleo vegetal ou gordura animal que foi tratada com uma composição ou por meio de um método como proporcionado aqui. Óleos vegetais modificados para serem óleos com baixo teor de saturação podem ser usados em quaisquer alimentos, itens comestíveis ou produtos para assamento ou cozimento, p. ex., temperos, marinadas, condimentos, óleos pulverizáveis, margarinas, óleos para cozimento, maionese, óleos para cozimento, óleos para saladas, coberturas despejáveis e aplicáveis com colher e análogos. Em uma concretização, proporciona-se aqui óleos, como óleos vegetais, p. ex., óleo de canola ou óleo de soja, e alimentos ou produtos para assamento ou cozimento, incluindo temperos, marinadas, condimentos, óleos pulverizáveis, margarinas, maionese, óleos para cozimento, óleos para cozimento, óleos para fritura, óleos para saladas, coberturas despejáveis e aplicáveis com colher, e análogos, em que o óleo
Petição 870180005321, de 22/01/2018, pág. 11/316
5/293 ou alimento, produto para assamento ou cozimento foi modificado usando-se uma enzima como proporcionado aqui. Em um aspecto, estes óleos vegetais, p. ex., óleo de canola, óleo de mamona, óleo de coco, óleo de coriandro, óleo de milho, óleo de semente de algodão, óleo de avelã, óleo de semente de cânhamo, óleo de linhaça, óleo de planta-dos-prados [meadowfoam], óleo de oliva, óleo de palma, óleo de palmito, óleo de amendoim, óleo de colza, óleo de farelo de arroz, óleo de açafrão, óleo de sasanqua, óleo de soja, óleo de semente de girassol, óleo de abeto, óleo de tsubaki, variedades de óleos “naturais” apresentando composições com teor alterado de ácidos graxos via Organismos Geneticamente Modificados (GMO) ou “cruzamento” tradicional, como óleos com baixo teor de saturação, ou alto teor oléico, baixo teor linolênico (óleo de canola com alto teor oléico, óleo de soja com baixo teor linolênico ou óleos de girassol com alto teor esteárico), gorduras animais (talol, banha, gordura de manteiga, e gordura de frango), óleos de peixe (óleo de candlefish [Thaleichthys pacificus], óleo de fígado de bacalhau, óleo de Hoplostethus atlanticus [olho-de-vidro laranja], óleo de sardinha, óleo de arrenque, e óleo de savelha), ou misturas de quaisquer dos acima, e alimentos ou produtos de assamento, fritura ou cozimento, compreendem óleos com um menor teor de ácidos graxos saturados, incluindo óleos com baixo teor de ácido palmítico, ácido mirístico, ácido láurico, ácido esteárico, ácido caprílico (ácido octanóico) etc., processados por meio do uso de uma composição ou método como proporcionado aqui.
[0010] Em um aspecto, proporciona-se aqui polipeptídios, por exemplo, enzimas e anticorpos catalíticos, apresentando uma atividade de hidrolase, p. ex., lipase, saturase, palmitase e/ou estearatase, incluindo atividades enzimáticas termoestáveis e termotolerantes, e atividades ácido graxo-específicas ou ácido graxo-seletivas, e atividades enzimáticas tolerantes a baixo ou alto pH, e nucleotídeos codificando estes polipeptídios, incluindo vetores, células hospedeiras, plantas transgênicas e animais não-humanos, e métodos para preparar e usar estes polinucleotídeos e peptídios. [0011] Em outro aspecto, proporciona-se aqui ácidos nucleicos isolados, sintéticos ou recombinantes compreendendo (a) um ácido nucleico (polinucleotídeo) que codifica pelo menos um
Petição 870180005321, de 22/01/2018, pág. 12/316
6/293 polipeptídio, sendo que o ácido nucleico compreende uma sequência apresentando pelo menos cerca de 50 %, 51 %, 52 %, 53 %, 54 %, 55 %, 56 %, 57 %, 58 %, 59 %, 60 %, 61 %, 62 %, 63 %, 64 %, 65 %, 66 %, 67 %, 68 %, 69 %, 70 %, 71 %, 72 %, 73 %, 74 %, 75 %, 76 %, 77 %, 78 %, 79 %, 80 %, 81 %, 82 %, 83 %, 84 %, 85 %, 86 %, 87 %, 88 %, 89 %, 90 %, 91 %, 92 %, 93 %, 94 %, 95 %, 96 %, 97 %, 98 %, 99 %, ou mais, ou identidade completa (100 %) de sequências com:
(i) SEQ ID NO: 1, SEQ ID NO:3, SEQ ID NO:5, SEQ ID NO:7, SEQ ID NO:9,
SEQ ID NO: 11, SEQ ID NO: 13, SEQ ID NO: 15, SEQ ID NO: 17, SEQ ID NO: 19, SEQ ID NO:22 ou SEQ ID NO:23, ou (ii) o ácido nucleico da SEQ ID NO: 1 apresentando uma ou mais alterações de nucleotídeos (ou o seu equivalente) codificando uma, duas, três, quatro, cinco, seis, sete, oito, nove, dez, onze, doze, treze, quatorze, quinze, dezesseis, dezessete, dezoito, dezenove, vinte, vinte e uma, vinte e duas, vinte e três, vinte e quatro ou mais ou todas as alterações de aminoácidos (ou o seu equivalente) como apresentado na Tabela 3, Tabela 4, Tabela 9, Tabela 10, Tabela 11, Tabela 16 ou Tabela 23, sendo que o ácido nucleico de (i) ou (ii) codifica pelo menos um polipeptídio apresentando uma atividade de hidrolase, p. ex., uma atividade de lipase, de saturase, de palmitase e/ou de estearatase, ou codifica um polipeptídio ou peptídio capaz de gerar um anticorpo específico para hidrolase (p. ex., uma lipase, uma saturase, uma palmitase e/ou uma estearatase) (um polipeptídio ou peptídio que atua como um epitopo ou imunógeno), (b) o ácido nucleico (polinucleotídeo) de (a), sendo que as identidades de sequências são identificadas: (A) por meio de análise com um algorismo de comparação de sequências ou por meio de inspeção visual, ou (B) em uma região de pelo menos cerca de 10, 15, 20, 25, 30, 35, 40, 45, 50, 55, 60, 65, 70, 75, 100, 125, 150, 175, 200, 250, 300, 350, 400, 450, 500, 550, 600, 650, 700, 750, 800, 850, 900, 950, 1000, 1050, 1100,
Petição 870180005321, de 22/01/2018, pág. 13/316
7/293
1150, 1200, 1250, 1300, 1350, 1400, 1450, 1500, 1550 ou mais resíduos, ou o comprimento pleno de um cDNA, transcrição (mRNA) ou gene, (c) o ácido nucleico (polipeptídio) de (a) ou (b), sendo que o algoritmo de comparação de sequências é um algoritmo BLAST versão 2.2.2 em que um ajuste de filtragem é ajustado para blastall -p blastp -d “nr pataa” -F F, e todas as outras opções são ajustadas como default, (d) um ácido nucleico (polinucleotídeo) codificando pelo menos um polipeptídio ou peptídio apresentando uma atividade de hidrolase, p. ex., uma atividade de lipase, de saturase, de palmitase e/ou de estearatase, sendo que o ácido nucleico compreende uma sequência que hibrida em condições estringentes com o complemento do ácido nucleico de (a), (b) ou (c), sendo que as condições estringentes compreendem uma etapa de lavagem compreendendo uma lavagem em 0,2X SSC a uma temperatura de cerca de 65°C durante cerca de 15 minutos, (e) um ácido nucleico (polinucleotídeo) que codifica pelo menos um polipeptídio apresentando uma atividade de hidrolase, p. ex., uma atividade de lipase, de saturase, de palmitase e/ou de estearatase, sendo que o polipeptídio compreende a sequência da SEQ ID NO:2, ou seus fragmentos enzimaticamente ativos, apresentando pelo menos uma, duas, três, quatro, cinco, seis, sete, oito, nove, dez, onze, doze, treze, quatorze, quinze, dezesseis, dezessete, dezoito, dezenove, vinte, vinte e uma, vinte e duas, vinte e três, vinte e quatro, ou mais ou todas as alterações de aminoácidos (ou o seu equivalente) como apresentado na Tabela 3, Tabela 4, Tabela 9, Tabela 10, Tabela 11, Tabela 16 ou Tabela 23, (f) um ácido nucleico (polinucleotídeo) que codifica pelo menos um polipeptídio apresentando uma atividade de hidrolase, p. ex., uma atividade de lipase, de saturase, de palmitase e/ou de estearatase,
Petição 870180005321, de 22/01/2018, pág. 14/316
8/293 sendo que o polipeptídio compreende a sequência da SEQ ID NO:2,
SEQ ID NO:4, SEQ ID NO:6, SEQ ID NO:8, SEQ ID NO: 10, SEQ ID
NO: 12, SEQ ID NO: 14, SEQ ID NO: 16, SEQ ID NO: 18, ou SEQ ID
NO:20 ou seus fragmentos enzimaticamente ativos, (g) (A) o ácido nucleico (polinucleotídeo) de qualquer um de (a) a (f) e que codifica um polipeptídio apresentando pelo menos uma substituição conservativa de aminoácidos e conservando sua atividade de hidrolase, p. ex., atividade de lipase, saturase, palmitase e/ou estearatase, ou, (B) o ácido nucleico de (g)(A), sendo que a pelo menos uma substituição conservativa de aminoácidos compreende substituir um aminoácido por outro aminoácido com características similares; ou, uma substituição conservativa compreende: substituição de um aminoácido alifático por outro aminoácido alifático; substituição de uma serina por uma treonina ou vice versa; substituição de um resíduo ácido por outro resíduo ácido; substituição de um resíduo portando um grupo amida por outro resíduo portando um grupo amida; troca de um resíduo básico com outro resíduo básico; ou substituição de um resíduo aromático por outro resíduo aromático, (h) o ácido nucleico (polinucleotídeo) de qualquer um de (a) a (g) que codifica um polipeptídio apresentando uma atividade de hidrolase, p. ex., uma atividade de lipase, de saturase, de palmitase e/ou de estearatase mas carecendo de uma sequência-sinal, (i) o ácido nucleico (polinucleotídeo) de qualquer um de (a) a (h) que codifica um polipeptídio apresentando uma atividade de hidrolase, p. ex., uma atividade de lipase, de saturase, de palmitase e/ou de estearatase compreendendo adicionalmente uma sequência heteróloga, (j) o ácido nucleico (polinucleotídeo) de (i), sendo que a sequência heteróloga compreende, ou consiste de uma sequência que codifica: (A) uma sequência-sinal heteróloga, (B) a sequência de (A), sendo que
Petição 870180005321, de 22/01/2018, pág. 15/316
9/293 a sequência-sinal heteróloga é derivada de uma enzima heteróloga, ou, (C) um marcador, um epitopo, um peptídio de objetivação, uma sequência clivável, uma porção detectável ou uma enzima, ou (k) uma sequência de ácido nucleico (polinucleotídeo) totalmente (completamente) complementar à sequência de qualquer um de (a) a (j).
[0012] Em um aspecto, o ácido nucleico isolado, sintético ou recombinante codifica um polipeptídio ou peptídio apresentando uma atividade de hidrolase, p. ex., atividade de lipase, saturase, palmitase e/ou estearatase, que é termoestável. Os polipeptídios e peptídios codificados por ácidos nucleicos como proporcionados aqui, ou qualquer polipeptídio ou peptídio como proporcionado aqui, podem conservar atividade enzimática ou de ligação (p. ex., ligação a substrato) em condições compreendendo uma faixa de temperatura entre cerca de -100°C a cerca de -80°C, de cerca de -80°C a cerca de -40°C, de cerca de -40°C a cerca de -20°C, de cerca de -20°C a cerca de 0°C, de cerca de 0°C a cerca de 5°C, de cerca de 5°C a cerca de 15°C, de cerca de 15°C a cerca de 25°C, de cerca de 25°C a cerca de 37°C, de cerca de 37°C a cerca de 45°C, de cerca de 45°C a cerca de 55°C, de cerca de 55°C a cerca de 70°C, de cerca de 70°C a cerca de 75°C, de cerca de 75°C a cerca de 85°C, de cerca de 85°C a cerca de 90°C, de cerca de 90°C a cerca de 95°C, de cerca de 95°C a cerca de 100°C, de cerca de 100°C a cerca de 105°C, 5 cerca de 105°C a cerca de 110°C, de cerca de 110°C a cerca de 120°C, ou 95°C, 96°C, 97°C, 98°C, 99°C, 100°C, 101°C, 102°C, 103°C, 104°C, 105°C, 106°C, 107°C, 108°C, 109°C, 110°C, 111°C, 112°C, 113°C, 114°C, 115°C ou mais. Proporciona-se aqui os polipeptídios termoestáveis que conservam uma atividade de hidrolase, p. ex., atividade de lipase, saturase, palmitase e/ou estearatase, a uma temperatura nas faixas descritas acima, a cerca de pH 3,0, de cerca de pH 3,5, de cerca de pH 4,0, de cerca de pH 4,5, de cerca de pH 5,0, de cerca de pH 5,5, de cerca de pH 6,0, de cerca de pH 6,5, de cerca de pH 7,0, de cerca de pH 7,5, de cerca de pH 8,0, de cerca de pH 8,5, de cerca de pH 9,0, de cerca de pH 9,5, de cerca de pH 10,0, de cerca de pH 10,5, de cerca de pH 11,0, de cerca de pH 11,5, de cerca de pH 12,0 ou mais.
Petição 870180005321, de 22/01/2018, pág. 16/316
10/293 [0013] Em um aspecto, polipeptídios como proporcionados aqui podem ser termotolerantes e podem conservar uma atividade de hidrolase, p. ex., atividade de lipase, saturase, palmitase e/ou estearatase após exposição a uma temperatura na faixa de cerca de -100°C a cerca de -80°C, de cerca de -80°C a cerca de -40°C, de cerca -40°C a cerca de -20°C, de cerca de -20°C a cerca de 0°C, de cerca de 0°C a cerca de 5°C, de cerca de 5°C a t 15°C, de cerca de 15°C a cerca de 25°C, de cerca de 25°C a cerca de 37°C, de cerca de 37°C a cerca de 45°C, de cerca de 45°C a cerca de 55°C, de cerca de 55°C a cerca de 70°C, de cerca de 70°C a cerca de 75°C, de cerca de 75°C a cerca de 85°C, de cerca de 85°C a cerca de 90°C, de cerca de 90°C a cerca de 95°C, de cerca de 95°C a cerca de C, de cerca de 100°C a cerca de 105°C, de cerca de 105°C a cerca de 110°C, de cerca de 110°C a cerca de 120°C, ou 95°C, 96°C, 97°C, 98°C, 99°C, 100°C, 101°C, 102°C, 103°C, 104°C, 105°C, 106°C, 107°C, 108°C, 109°C, 110°C, H l°C, 112°C, 113°C, 114°C, 115°C ou mais.
[0014] Em algumas concretizações, os polipeptídios termotolerantes conservam uma atividade de hidrolase, p. ex., atividade de lipase, saturase, palmitase e/ou estearatase, após exposição a uma temperatura nas faixas descritas acima, a cerca de pH 3,0, cerca de pH 3,5, cerca de pH 4,0, cerca de pH 4,5, cerca de pH 5,0, cerca de pH 5,5, cerca de pH 6,0, cerca de pH 6,5, cerca de pH 7,0, cerca de pH 7,5, cerca de pH 8,0, cerca de pH 8,5, cerca de pH 9,0, cerca de pH 9,5, cerca de pH 10,0, cerca de pH 10,5, cerca de pH 11,0, cerca de pH 11,5, cerca de pH 12,0 ou mais.
[0015] Em uma concretização, ácidos nucleicos isolados, sintéticos ou recombinantes compreendem uma sequência que hibrida em condições estringentes com um ácido nucleico como proporcionado aqui, p. ex., um ácido nucleico exemplar como proporcionado aqui compreendendo uma sequência como apresentada na SEQ ID NO:1, SEQ ID NO:3, SEQ ID NO:5, SEQ ID NO:7, SEQ ID NO:9, SEQ ID NO:11, SEQ ID NO:13, SEQ ID NO:15, SEQ ID NO:17, SEQ ID NO:19, SEQ ID NO:22 ou SEQ ID NO:23, ou uma sequência como apresentada na SEQ ID NO:1 apresentando uma, duas, três, quatro, cinco, seis, sete, oito, nove, dez, onze ou doze ou mais ou todas as alterações de resíduos (modificações de sequências na SEQ ID NO:1) apresentadas na Tabela 3, Tabela 4, Tabela 9, Tabela 10, Tabela 11, Tabela 16 ou
Petição 870180005321, de 22/01/2018, pág. 17/316
11/293
Tabela 23, ou fragmentos ou subsequências dos mesmos, e as sequências (totalmente) complementares aos mesmos. Em um aspecto, o ácido nucleico codifica um polipeptídio apresentando uma atividade de hidrolase, p. ex., atividade de lipase, saturase, palmitase e/ou estearatase. O ácido nucleico pode ter comprimento de pelo menos cerca de 10, 15, 20, 25, 30, 35, 40, 45, 50, 55, 60, 65, 70, 75, 100, 125, 150, 175, 200, 250, 300, 350, 400, 450, 500, 550, 600, 650, 700 ou mais resíduos ou o comprimento pleno de um gene ou transcrição compreendendo SEQ ID NO:1, e apresentando uma sequência como apresentada na SEQ ID NO:1 apresentando uma, duas, três, quatro, cinco, seis, sete, oito, nove, dez, onze ou doze ou mais ou todas as alterações de resíduos (modificações de sequências de aminoácidos) a SEQ ID NO:1 apresentada na Tabela 3, Tabela 4, Tabela 9, Tabela 10, Tabela 11, Tabela 16 ou Tabela 23; e as sequências (totalmente) complementares às mesmas. Em um aspecto, as condições estringentes incluem uma etapa de lavagem compreendendo uma lavagem em 0,2X SSC a uma temperatura de cerca de 65°C durante cerca de 15 minutos.
[0016] Em uma concretização, uma sonda de ácido nucleico, p. ex., uma sonda para identificar um ácido nucleico que codifica um polipeptídio apresentando uma atividade de hidrolase, p. ex., atividade de lipase, saturase, palmitase e/ou estearatase, compreende uma sonda compreendendo ou consistindo de pelo menos cerca de 10, 15, 20, 30, 35, 40, 45, 50, 55, 60, 65, 70, 75, 80, 85, 90, 95, 100, 150, 200, 250, 300, 350, 400, 500, 550, 600, 650, 700, 750, 800, 850, 900, 950, 1000 ou mais bases consecutivas de uma sequência como proporcionada aqui, ou fragmentos ou subsequências da mesma, sendo que a sonda identifica o ácido nucleico por meio de ligação ou hibridização. A sonda pode compreender um oligonucleotídeo compreendendo pelo menos cerca de 10 a 50, cerca de 20 a 60, cerca de 30 a 70, cerca de 40 a 80, ou cerca de 60 a 100 bases consecutivas de uma sequência compreendendo uma sequência como proporcionada aqui, ou fragmentos ou subsequências da mesma. A sonda pode compreender um oligonucleotídeo compreendendo pelo menos cerca de 10 a 50, cerca de 20 a 60, cerca de 30 a 70, cerca de 40 a 80, ou cerca de 60 a 100 bases consecutivas de uma sequência de
Petição 870180005321, de 22/01/2018, pág. 18/316
12/293 ácido nucleico como proporcionada aqui, ou uma subsequência da mesma.
[0017] Em uma concretização, um par de sequências de iniciador de amplificação para amplificar um ácido nucleico que codifica um polipeptídio apresentando uma atividade de hidrolase, p. ex., atividade de lipase, saturase, palmitase e/ou estearatase, compreende um par de iniciadores compreendendo ou consistindo de um par de iniciadores capazes de amplificar um ácido nucleico compreendendo uma sequência como proporcionada aqui, ou fragmentos ou subsequências da mesma. Um ou cada membro do par de sequências de iniciador de amplificação pode compreender um oligonucleotídeo compreendendo pelo menos cerca de 10 a 50 bases consecutivas da sequência.
[0018] Em uma concretização, métodos de amplificar um ácido nucleico que codifica um polipeptídio apresentando uma atividade de hidrolase, p. ex., atividade de lipase, saturase, palmitase e/ou estearatase, compreendem amplificação de um ácido nucleico modelo com um par de sequências de iniciador de amplificação capaz de amplificar uma sequência de ácido nucleico como proporcionada aqui, ou fragmentos ou subsequências da mesma.
[0019] Em uma concretização, cassetes de expressão compreendem um ácido nucleico como proporcionado aqui ou uma subsequência do mesmo. Em um aspecto, a cassete de expressão pode compreender o ácido nucleico que é ligado operacionalmente a um promotor. O promotor pode ser um promotor viral, bacteriano, mamífero ou de planta. Em um aspecto, o promotor de planta pode ser um promotor de batata, arroz, milho, trigo, tabaco ou cevada. O promotor pode ser um promotor constitutivo. O promotor constitutivo pode compreender CaMV35S. Em outro aspecto, o promotor pode ser um promotor induzível. Em um aspecto, o promotor pode ser um promotor tecido-específico ou um promotor ambientalmente regulado ou um promotor desenvolvimentalmente regulado. Assim, o promotor pode ser, p. ex., um promotor semente-específico, um promotor folha-específico, um promotor raiz-específico, um promotor caule-específico, ou um promotor induzido por abscisão. Em um aspecto, a cassete de expressão pode compreender adicionalmente uma planta ou vetor de expressão de planta.
Petição 870180005321, de 22/01/2018, pág. 19/316
13/293 [0020] Em uma concretização, veículos de clonagem compreendem uma cassete de expressão (p. ex., um vetor) aqui proporcionada ou um ácido nucleico como proporcionado aqui. O veículo de clonagem pode ser um vetor viral, ou um plasmídio, um fago, um fagomídeo, um cosmídeo, um fosmídeo, um bacteriófago ou um cromossomo artificial. O vetor viral pode compreender um vetor de adenovírus, um vetor retroviral ou um vetor viral adeno-associado. O veículo de clonagem pode compreender um cromossomo artificial bacteriano (BAC), um plasmídio, um vetor derivado de bacteriófago P1 (PAC), um cromossomo artificial de levedura (YAC), ou um cromossomo artificial mamífero (MAC).
[0021] Em uma concretização, células transformadas compreendem um ácido nucleico como proporcionado aqui ou uma cassete de expressão (p. ex., um vetor) como proporcionado aqui, ou um veículo de clonagem como proporcionado aqui. Em um aspecto, a célula transformada pode ser uma célula bacteriana, uma célula mamífera, uma célula fúngica, uma célula de levedura, uma célula de inseto ou uma célula de planta. Em um aspecto, a célula de planta pode ser uma célula de batata, trigo, arroz, milho, tabaco ou cevada. A célula transformada pode ser qualquer uma das células hospedeiras familiares daqueles versados na arte, incluindo células procarióticas, células eucarióticas, como células bacterianas, células fúngicas, células de levedura, células mamíferas, células de insetos, ou células de plantas. Células bacterianas exemplares incluem quaisquer espécies nos gêneros Escherichia, Bacillus, Streptomyces, Salmonella, Pseudomonas e Staphylococcus, incluindo, p. ex., Escherichia coli, Lactococcus lactis, Bacillus subtilis, Bacillus cereus, Salmonella typhimurium, Pseudomonas fluorescens. Células fúngicas exemplares incluem qualquer espécie de Aspergillus. Células de levedura exemplares incluem quaisquer espécies de Pichia, Saccharomyces, Schizosaccharomyces, ou Schwanniomyces, incluindo Pichia pastoris, Saccharomyces cerevisiae, ou Schizosaccharomyces pombe. Células de insetos exemplares incluem quaisquer espécies de Spodoptera ou Drosophila, incluindo Drosophila S2 e Spodoptera Sf9. Células animais exemplares incluem CHO, COS ou melanoma de Bowes ou qualquer linhas de células de camundongo ou humano.
Petição 870180005321, de 22/01/2018, pág. 20/316
14/293 [0022] Em uma concretização, plantas transgênicas compreendem um ácido nucleico como proporcionado aqui ou uma cassete de expressão (p. ex., um vetor) como proporcionado aqui. A planta transgênica pode ser uma planta de milho, uma planta de batata, uma planta de tomate, uma planta de trigo, uma planta de colza oleaginosa, uma planta de colza, uma planta de soja, uma planta de arroz, uma planta de cevada ou uma planta de tabaco.
[0023] Em uma concretização, sementes transgênicas compreendem um ácido nucleico como proporcionado aqui ou uma cassete de expressão (p. ex., um vetor) como proporcionada aqui. A semente transgênica pode ser arroz, uma semente de milho, um grão de trigo, uma semente de colza oleaginosa, uma semente de colza, uma semente de soja, uma semente de palma, uma semente de girassol, uma semente de gergelim, uma semente de amendoim ou uma semente de planta de tabaco.
[0024] Em uma concretização, polipeptídios isolados, sintéticos ou recombinantes apresentam uma atividade de hidrolase, p. ex., uma atividade de lipase, de saturase, de palmitase e/ou de estearatase, ou polipeptídios capaz de gerar uma resposta imune específica para uma hidrolase, p. ex., uma lipase, uma saturase, uma palmitase e/ou uma estearatase (p. ex., um epitopo); e, em aspectos alternativos, peptídios e polipeptídios como proporcionados aqui compreendem uma sequência:
(a) apresentando pelo menos cerca de 50 %, 51 %, 52 %, %, 54 %, 55 %, 56 %, 57 %, 58 %, 59 %, 61 %, 62 %, 63 %, 64 %, %, 66 %, 67 %, 68 %, 69 %, 70 %, 71 %, 72 %, 73 %, 74 %, 75 %, %, 78 %, 79 %, 80 %, 81 %, 82 %, 83 %, 84 %, 85 %, 86 %, 87 %, %, 89 %, 90 %, 91 %, 92 %, 93 %, 94 %, 95 %, 96 %, 97 %, 98 %, %, ou mais, ou apresenta 100 % de identidade de sequências (completa) com:
(i) a sequência de aminoácidos da SEQ ID NO:2, ou seus fragmentos enzimaticamente ativos, e apresentando pelo menos uma, duas, três, quatro, cinco, seis, sete, oito, nove, dez, onze, doze, treze, quatorze, quinze, dezesseis, dezessete, dezoito, dezenove, vinte, vinte e uma,
Petição 870180005321, de 22/01/2018, pág. 21/316
15/293 vinte e duas, vinte e três, vinte e quatro ou mais ou todas as alterações de resíduos de aminoácidos (ou o seu equivalente) como apresentado na Tabela 3, Tabela 4, Tabela 9, Tabela 10, Tabela 11, Tabela 16 ou
Tabela 23, ou (ii) a sequência de aminoácidos da SEQ ID NO:2, SEQ ID NO:4, SEQ ID NO:6, SEQ ID NO:8, SEQ ID NO: 10, SEQ ID NO: 12, SEQ ID NO: 14, SEQ ID NO: 16, SEQ ID NO: 18, ou SEQ ID NO:20 em que o polipeptídio ou peptídio de (i) ou (ii) apresenta uma atividade de hidrolase, p. ex., uma atividade de lipase, de saturase, de palmitase e/ou de estearatase, ou o polipeptídio ou peptídio é capaz de gerar um anticorpo específico para hidrolase (p. ex., lipase, saturase, palmitase e/ou estearatase) (um polipeptídio ou peptídio que atua como um epitopo ou imunógeno), (b) o polipeptídio ou peptídio de (a), sendo que as identidades de sequências são identificadas: (A) por meio de análise com um algorismo de comparação de sequências ou por meio de uma inspeção visual, ou (B) em uma região de pelo menos cerca de 20, 25, 30, 35, 40, 45, 50, 55, 60, 75, 100, 150, 200, 250, 300 ou mais resíduos de aminoácidos, ou sobre todo o comprimento do polipeptídio ou peptídio ou enzima, e/ou subsequências enzimaticamente ativas (fragmentos) dos mesmos, (c) o polipeptídio ou peptídio de (b), sendo que o algoritmo de comparação de sequências é um algoritmo BLAST versão 2.2.2 em que um ajuste de filtragem é ajustado para blastall -p blastp -d “nr pataa” -F F, e todas as outras opções são ajustadas como default;
(d) uma sequência de aminoácidos codificada pelo ácido nucleico aqui proporcionado, sendo que o polipeptídio apresenta (i) uma atividade de hidrolase, p. ex., de lipase, de saturase, de palmitase e/ou de estearatase, ou, (ii) apresenta atividade imunogênica pelo fato de que é capaz de gerar um anticorpo que se liga especificamente a um polipeptídio apresentando uma sequência de (a), e/ou subsequências
Petição 870180005321, de 22/01/2018, pág. 22/316
16/293 enzimaticamente ativas (fragmentos) dos mesmos;
(e) uma sequência de aminoácidos de qualquer um de (a) a (d), e compreendendo pelo menos uma substituição conservativa de resíduo de aminoácido, e o polipeptídio ou peptídio conserva uma atividade de hidrolase, uma atividade de lipase, de saturase, de palmitase e/ou de estearatase;
(f) a sequência de aminoácidos de (e), sendo que a substituição conservativa compreende substituição de um aminoácido alifático com outro aminoácido alifático; substituição de uma serina com uma treonina ou vice versa; substituição de um resíduo ácido por outro resíduo ácido; substituição de um resíduo portando um grupo amida por outro resíduo portando um grupo amida; troca de um resíduo básico com outro resíduo básico; ou, substituição de um resíduo aromático por outro resíduo aromático, ou uma combinação do mesmo, (g) a sequência de aminoácidos de (f), sendo que o resíduo alifático compreende alanina, valina, leucina, isoleucina ou um equivalente sintéticos dos mesmos; o resíduo ácido compreende ácido aspártico, ácido glutâmico ou um equivalente sintéticos dos mesmos; o resíduo compreendendo um grupo amida compreende asparagina, glutamina ou um equivalente sintéticos dos mesmos; o resíduo básico compreende lisina, arginina, histidina ou um equivalente sintéticos dos mesmos; ou, o resíduo aromático compreende fenilalanina, tirosina, triptofano ou um equivalente sintético dos mesmos;
(h) o polipeptídio de qualquer um de (a) a (f) apresentando uma atividade de hidrolase, p. ex., uma atividade de lipase, de saturase, de palmitase e/ou de estearatase mas carecendo de uma sequência-sinal, (i) o polipeptídio de qualquer um de (a) a (h) apresentando uma atividade de hidrolase, p. ex., uma atividade de lipase, de saturase, de palmitase e/ou de estearatase compreendendo adicionalmente uma sequência heteróloga;
Petição 870180005321, de 22/01/2018, pág. 23/316
17/293 (j) o polipeptídio de (i), sendo que a sequência heteróloga compreende, ou consiste de:
(A) uma sequência-sinal heteróloga, (B) a sequência de (A), sendo que a sequência-sinal heteróloga é derivada de uma enzima heteróloga, e/ou, (C) um marcador, um epitopo, um peptídio de objetivação, uma sequência clivável, uma porção detectável ou uma enzima; ou (m) compreendendo uma sequência de aminoácidos codificada por qualquer sequência de ácido nucleico como proporcionado aqui.
[0025] Sequências de peptídios ou polipeptídios exemplares como proporcionado aqui incluem SEQ ID NO:2, e subsequências da mesma e variantes da mesma, p. ex., com pelo menos cerca de 30, 35, 40, 45, 50, 75, 100, 150, 200, 250, 300, 350, 400, 450, 500 ou mais resíduos de comprimento, ou sobre todo o comprimento de uma enzima, todos apresentando uma, duas, três, quatro, cinco, seis, sete, oito, nove, dez, onze, doze ou mais ou todas as alterações de resíduos de aminoácidos (modificações de sequências de aminoácidos SEQ ID NO:2) apresentadas na Tabela 3, Tabela 4, Tabela 9, Tabela 10, Tabela 11, Tabela 16 ou e 23. Sequências de peptídios ou polipeptídios exemplares como proporcionado aqui incluem sequências codificadas por um ácido nucleico como proporcionado aqui. Sequências de peptídios ou polipeptídios exemplares aqui proporcionadas incluem polipeptídios ou peptídios ligam-se especificamente por meio de um anticorpo como proporcionado aqui. Em um aspecto, um polipeptídio como proporcionado aqui apresenta pelo menos uma atividade de hidrolase, p. ex., atividade de lipase, saturase, palmitase e/ou estearatase. Em um aspecto, a atividade é uma atividade regiosseletiva e/ou quimiosseletiva.
[0026] Em um aspecto, o polipeptídio isolado, sintético ou recombinante pode compreender o polipeptídio como proporcionado aqui que não apresenta uma sequência-sinal (peptídio), p. ex., não apresenta sua sequência-sinal homóloga sequência-sinal homóloga, e em um aspecto, compreende uma sequência-sinal heteróloga (peptídio). Em um aspecto, o polipeptídio isolado, sintético ou recombinante pode compreender o polipeptídio como proporcionado aqui
Petição 870180005321, de 22/01/2018, pág. 24/316
18/293 compreendendo uma sequência-sinal heteróloga, como uma sequência-sinal de hidrolase heteróloga ou não-hidrolase (p. ex., não-lipase, não-saturase ou nãopalmitase). Em um aspecto, proteínas quiméricas compreendem um primeiro domínio compreendendo uma sequência-sinal como proporcionado aqui e pelo menos um segunda domínio. A proteína pode ser uma proteína de fusão. O segundo domínio pode compreender uma enzima. A enzima pode ser uma hidrolase (p. ex., uma lipase, saturase, palmitase e/ou estearatase) como proporcionado aqui, ou, outra hidrolase. [0027] Em um aspecto, a atividade de hidrolase (p. ex., lipase, saturase, palmitase e/ou estearatase) compreende uma atividade específica a cerca de 37°C na faixa de cerca de 100 a cerca de 1000 unidades miligrama de proteína. Em outro aspecto, a atividade de hidrolase (p. ex., lipase, saturase, palmitase e/ou estearatase) compreende uma atividade específica de cerca de 500 a cerca de 750 unidades por miligrama de proteína. Alternativamente, a atividade de hidrolase compreende uma atividade específica a 37°C na faixa de cerca de 500 a cerca de 1200 unidades por miligrama de proteína. Em um aspecto, a atividade de hidrolase compreende uma atividade específica a 37°C na faixa de cerca de 750 a cerca de 1000 unidades por miligrama de proteína. Em outro aspecto, a termotolerância compreende retenção de pelo menos metade da atividade específica da hidrolase a 37°C após ser aquecida a uma temperatura elevada. Alternativamente, o termotolerância pode compreender retenção de atividade específica a 37°C na faixa de cerca de 500 a cerca de 1200 unidades por miligrama de proteína após ser aquecida a uma temperatura elevada. [0028] Em uma concretização, os polipeptídios isolados, sintéticos ou recombinantes como proporcionados aqui compreendem pelo menos um sítio de glicosilação. Em um aspecto, a glicosilação pode ser uma glicosilação N-ligada. Em um aspecto, o polipeptídio pode ser glicosilado após ser expresso em um P. pastoris ou um S. pombe ou em plantas, como plantas produtoras de óleo, p. ex., soja, canola, arroz, girassol, ou variantes geneticamente modificadas (GMO) destas plantas.
[0029] Em um aspecto, o polipeptídio pode conservar uma atividade de hidrolase (p. ex., lipase, saturase, palmitase ou estearatase) em condições compreendendo cerca de pH 6,5, pH 6, pH 5,5, pH 5, pH 4,5 ou pH 4,0 ou menor. Em outro aspecto, o
Petição 870180005321, de 22/01/2018, pág. 25/316
19/293 polipeptídio pode conservar uma atividade de hidrolase (p. ex., lipase, saturase, palmitase e/ou estearatase) em condições compreendendo cerca de pH 7, pH 7,5, pH 8,0, pH 8,5, pH 9, pH 9,5, pH 10, pH 10,5, pH 11, pH 11,5, pH 12,0 ou mais.
[0030] Em uma concretização, preparações de proteína compreendem um polipeptídio como proporcionado aqui, sendo que a preparação de proteína compreende um líquida, um sólido ou um gel.
[0031] Em um aspecto, heterodímeros como proporcionados aqui compreendem um polipeptídio e um segundo domínio. Em um aspecto, o segundo domínio pode ser um polipeptídio e o heterodímero pode ser uma proteína de fusão. Em um aspecto, o segundo domínio pode ser um epitopo ou um marcador. Em um aspecto, homodímeros como proporcionados aqui compreendem um polipeptídio como proporcionado aqui.
[0032] Em uma concretização, polipeptídios imobilizados como proporcionados aqui apresentam uma atividade de hidrolase (p. ex., lipase, saturase, palmitase e/ou estearatase), sendo que o polipeptídio compreende um polipeptídio como proporcionado aqui, um polipeptídio codificado por um ácido nucleico como proporcionado aqui, ou um polipeptídio compreendendo um polipeptídio como proporcionado aqui e um segundo domínio. Em um aspecto, um polipeptídio como proporcionado aqui pode ser imobilizado em uma célula, uma vesícula, um liposoma, uma película, uma membrana, um metal, uma resina, um polímero, uma cerâmica, um vidro, um microeletrodo, uma partícula grafítica, uma pérola, um gel, uma placa, um cristal, um tablete, uma pílula, uma cápsula, um pó, um aglomerado, uma superfície, uma estrutura porosa, um conjunto ou um tubo capilar, ou materiais, como grãos, cascas, casca, pele, cabelo, esmalte, osso, concha e materiais que se derivam dos mesmos. Polinucleotídeos, polipeptídios e enzimas como proporcionados aqui podem ser formulados em uma forma sólida, como um pó, uma preparação liofilizada, grânulos, um tablete, uma barra, um cristal, uma cápsula, uma pílula, um pellet, ou em uma forma líquida, como uma solução aquosa, um aerossol, um gel, uma pasta, uma calda, uma emulsão aquosa/oleosa, um creme, uma cápsula, ou uma suspensão vesicular ou micelar.
Petição 870180005321, de 22/01/2018, pág. 26/316
20/293 [0033] Em uma concretização, suplementos alimentícios para um animal compreendem um polipeptídio como proporcionado aqui, p. ex., um polipeptídio codificado pelo ácido nucleico como proporcionado aqui. Em um aspecto, o polipeptídio no suplemento alimentício pode ser glicosilado. Em uma concretização, matrizes de fornecimento de enzimas comestíveis compreendem um polipeptídio como proporcionado aqui, p. ex., um polipeptídio codificado pelo ácido nucleico como proporcionado aqui. Em um aspecto, a matriz de fornecimento compreende um pellet. Em um aspecto, o polipeptídio pode ser glicolisado. Em um aspecto, a atividade de hidrolase é termotolerante. Em outro aspecto, a atividade de hidrolase é termoestável. [0034] Em uma concretização, métodos de isolar ou identificar um polipeptídio apresentam uma atividade de hidrolase (p. ex., lipase, saturase, palmitase e/ou estearatase) compreendendo as etapas de: proporcionar um anticorpo como proporcionado aqui; (b) proporcionar uma amostra compreendendo peptídios; e (c) contactar a amostra da etapa (b) com o anticorpo da etapa (a) em condições em que o anticorpo pode ligar-se especificamente ao polipeptídio, com isto isolando ou identificando um polipeptídio apresentando uma atividade de hidrolase (p. ex., lipase, saturase, palmitase e/ou estearatase).
[0035] Em uma concretização, métodos de preparar um anticorpo anti-hidrolase compreendem administrar a um animal não-humano um ácido nucleico como proporcionado aqui ou um polipeptídio como proporcionado aqui ou subsequências dos mesmos em uma quantidade suficiente para gerar uma resposta imune humoral, gerando com isso um anticorpo anti-hidrolase. Proporciona-se aqui métodos de preparar um anticorpo anti-hidrolase compreendendo administrar a um animal nãohumano um ácido nucleico como proporcionado aqui ou um polipeptídio como proporcionado aqui ou subsequências dos mesmos em uma quantidade suficiente para gerar uma resposta imune.
[0036] Em uma concretização, métodos de produzir um polipeptídio recombinante compreendem as etapas de: (a) prover um ácido nucleico como proporcionado aqui ligado operacionalmente a um promotor; e (b) expressando o ácido nucleico da etapa (a) em condições que permitem
Petição 870180005321, de 22/01/2018, pág. 27/316
21/293 a expressão do polipeptídio, produzindo com isso um polipeptídio recombinante. Em um aspecto, o método pode compreender adicionalmente transformar uma célula hospedeira com o ácido nucleico da etapa (a) seguido de expressão do ácido nucleico da etapa (a), produzindo com isso um polipeptídio recombinante em uma célula transformada.
[0037] Em uma concretização, métodos para identificar um polipeptídio apresentando uma atividade de hidrolase (p. ex., lipase, saturase, palmitase e/ou estearatase) compreendem as seguintes etapas: (a) proporcionar um polipeptídio como proporcionado aqui; ou um polipeptídio codificado por um ácido nucleico como proporcionado aqui; (b) proporcionar um substrato de hidrolase; e (c) contactar o polipeptídio ou um fragmento ou variante do mesmo da etapa (a) com o substrato da etapa (b) e detectar uma diminuição na quantidade de substrato ou um aumento da quantidade de um produto de reação, sendo que uma diminuição da quantidade do substrato ou um aumento da quantidade do produto de reação detecta um polipeptídio apresentando uma atividade de hidrolase (p. ex., lipase, saturase, palmitase e/ou estearatase).
[0038] Em uma concretização, métodos para identificar um substrato de hidrolase compreendem as seguintes etapas: (a) proporcionar um polipeptídio como proporcionado aqui; ou um polipeptídio codificado por um ácido nucleico como proporcionado aqui; (b) proporcionar um substrato de teste; e (c) contactar o polipeptídio da etapa (a) com o substrato de teste da etapa (b) e detectar uma diminuição da quantidade de substrato ou um aumento da quantidade de produto de reação, sendo que uma diminuição da quantidade do substrato ou um aumento da quantidade de um produto de reação identifica o substrato como um substrato de hidrolase (p. ex., lipase, saturase, palmitase e/ou estearatase).
[0039] Em uma concretização, métodos de determinar se um composto de teste se liga especificamente a um polipeptídio compreendem as seguintes etapas: (a) expressar um ácido nucleico ou um vetor compreendendo o ácido nucleico em condições permissivas para tradução do ácido nucleico a um polipeptídio, sendo que
Petição 870180005321, de 22/01/2018, pág. 28/316
22/293 o ácido nucleico compreende um ácido nucleico como proporcionado aqui, ou, proporcionar um polipeptídio como proporcionado aqui; (b) proporcionar um composto de teste; (c) contactar o polipeptídio com o composto de teste; e (d) determinar se o composto de teste da etapa (b) se liga especificamente ao polipeptídio.
[0040] Em uma concretização, métodos para identificar um modulador de uma atividade de hidrolase (p. ex., lipase, saturase, palmitase e/ou estearatase) compreendem as seguintes etapas: (a) proporcionar um polipeptídio como proporcionado aqui ou um polipeptídio codificado por um ácido nucleico como proporcionado aqui; (b) proporcionar um composto de teste; (c) contactar o polipeptídio da etapa (a) com o composto de teste da etapa (b) e medir uma atividade da hidrolase, sendo que uma alteração na atividade de hidrolase medida na presença do composto de teste, comparada com a atividade na ausência do composto de teste proporciona uma determinação de que o composto de teste modula a atividade de hidrolase. Em um aspecto, a atividade de hidrolase (p. ex., lipase, saturase, palmitase e/ou estearatase) pode ser medida proporcionando-se um substrato de hidrolase e detectando uma diminuição da quantidade do substrato ou um aumento da quantidade de um produto de reação, ou, um aumento da quantidade do substrato ou uma diminuição da quantidade de um produto de reação. Uma diminuição da quantidade do substrato ou um aumento da quantidade do produto de reação com o composto de teste em comparação com a quantidade de substrato ou produto de reação sem o composto de teste identifica o composto de teste como um ativador da atividade de hidrolase. Um aumento da quantidade do substrato ou uma diminuição da quantidade do produto de reação com o composto de teste em comparação com a quantidade de substrato ou produto de reação sem o composto de teste identifica o composto de teste como um inibidor da atividade de hidrolase.
[0041] Em uma concretização, sistemas de computador compreendem um processador e um dispositivo de armazenamento de dados, sendo que referido dispositivo de armazenamento de dados possui armazenado no mesmo uma sequência de polipeptídios ou uma sequência de ácido nucleico como proporcionada aqui (p. ex., um polipeptídio codificado por um ácido nucleico como proporcionado
Petição 870180005321, de 22/01/2018, pág. 29/316
23/293 aqui). Em um aspecto, o sistema de computador pode compreender adicionalmente um algoritmo de comparação de sequências e um dispositivo de armazenamento de dados apresentando pelo menos uma sequência de referência armazenada no mesmo. Em outro aspecto, o algoritmo de comparação de sequências compreende um programa de computador que indica polimorfismos. Em um aspecto, o sistema de computador pode compreender adicionalmente um identificador que identifica uma ou mais características em referida sequência. Em uma concretização, meios processáveis por computador apresentam armazenados nos mesmos uma sequência de polipeptídios ou uma sequência de ácido nucleico como definido aqui.
[0042] Em uma concretização, métodos para identificar uma característica em uma sequência compreendem as etapas de: (a) ler a sequência usando um programa de computador que identifica uma ou mais características em uma sequência, sendo que a sequência compreende uma sequência de polipeptídios ou uma sequência de ácido nucleico como proporcionada aqui; e (b) identificar uma ou mais características na sequência com o programa de computador.
[0043] Em outra concretização, proporciona-se aqui métodos para comparar uma primeira sequência com uma segunda sequência compreendendo as etapas de: (a) ler a primeira sequência e a segunda sequência por meio do uso de um programa de computador que compara sequências, sendo que a primeira sequência compreende uma sequência de polipeptídios ou uma sequência de ácido nucleico como proporcionada aqui; e (b) determinar diferenças entre a primeira sequência e a segunda sequência com o programa de computador. A etapa de determinar diferenças entre a primeira sequência e a segunda sequência pode compreender adicionalmente a etapa de identificar polimorfismos. Em um aspecto, o método pode compreender adicionalmente um identificador que identifica uma ou mais características em uma sequência. Em outro aspecto, o método pode compreender ler a primeira sequência usando um programa de computador e identificar uma ou mais características na sequência.
[0044] Em uma concretização, métodos para isolar ou recuperar um ácido nucleico que codifica um polipeptídio apresentam uma atividade de hidrolase (p. ex., lipase,
Petição 870180005321, de 22/01/2018, pág. 30/316
24/293 saturase, palmitase e/ou estearatase) de uma amostra compreendendo as etapas de: (a) proporcionar um par de sequências de iniciador de amplificação para amplificar um ácido nucleico que codifica um polipeptídio apresentando uma atividade de hidrolase, sendo que o par de iniciadores é capaz de amplificar um ácido nucleico como proporcionado aqui; (b) isolar um ácido nucleico da amostra ou tratar a amostra de tal modo que o ácido nucleico na amostra seja acessível para hibridização com o par de iniciadores de amplificação; e, (c) combinar o ácido nucleico da etapa (b) com o par de iniciadores de amplificação da etapa (a) e amplificar ácido nucleico da amostra, com isto isolando ou recuperando um ácido nucleico que codifica um polipeptídio apresentando uma atividade de hidrolase de uma amostra. Em uma concretização, a amostra é uma amostra ambiental, p. ex., uma amostra de água, uma amostra de líquido, uma amostra de solo, uma amostra de ar ou uma amostra biológica, p. ex., uma célula bacteriana, uma célula protozoária, uma célula de inseto, uma célula de levedura, uma célula de planta, uma célula fúngica ou uma célula mamífera. Um ou cada membro do par de sequências de iniciador de amplificação pode compreender um oligonucleotídeo compreendendo pelo menos cerca de 10 a 50 ou mais bases consecutivas de uma sequência como proporcionado aqui.
[0045] Em uma concretização, métodos de incrementar a termotolerância ou termoestabilidade de um polipeptídio de hidrolase compreendem glicosilar um polipeptídio de hidrolase, sendo que o peptídio compreende pelo menos trinta aminoácidos contíguos de um polipeptídio como proporcionado aqui; ou um polipeptídio codificado por uma sequência de ácido nucleico como proporcionada aqui, aumentando com isso a termotolerância ou termoestabilidade do polipeptídio de hidrolase. Em um aspecto, a hidrolase atividade específica pode ser termoestável ou termotolerante a uma temperatura na faixa de mais de cerca de 37°C a cerca de 95°C. [0046] Em uma concretização, métodos para superexpressar um polipeptídio recombinante de hidrolase (p. ex., lipase, saturase, palmitase e/ou estearatase) em uma célula compreendem que expressar um vetor compreendendo um ácido nucleico como proporcionado aqui ou uma sequência de ácido nucleico como proporcionada aqui, sendo que as identidades de sequências são identificadas por meio de análise
Petição 870180005321, de 22/01/2018, pág. 31/316
25/293 com um algorismo de comparação de sequências ou por meio de inspeção visual, sendo que a superexpressão é efetuada por meio do uso de um promotor de alta atividade, um vetor dicistrônico ou por meio de amplificação gênica do vetor.
[0047] Em uma concretização, composições detergentes compreendendo um polipeptídio como proporcionado aqui ou um polipeptídio codificado por um ácido nucleico como proporcionado aqui compreendem uma atividade de hidrolase, p. ex., atividade de lipase, saturase, palmitase e/ou estearatase. Em um aspecto, a hidrolase pode ser uma hidrolase não-tensoativa. Em outro aspecto, a hidrolase pode ser uma hidrolase tensoativa.
[0048] Em uma concretização, métodos para lavar um objeto compreendem as seguintes etapas: (a) proporcionar uma composição compreendendo a polipeptídio apresentando uma atividade de hidrolase, p. ex., atividade de lipase, saturase, palmitase e/ou estearatase, sendo que o polipeptídio compreende: um polipeptídio como proporcionado aqui ou um polipeptídio codificado por um ácido nucleico como proporcionado aqui; (b) proporcionar um objeto; e (c) contactar o polipeptídio da etapa (a) e o objeto da etapa (b) em condições em que a composição pode lavar o objeto.
[0049] Em uma concretização, métodos de preparar uma planta transgênica compreendem as seguintes etapas: (a) introduzir uma sequência de ácido nucleico heteróloga em uma célula de planta, sendo que a sequência nucleica heteróloga compreende uma sequência de ácido nucleico como proporcionada aqui, produzindo com isso uma célula de planta transformada; e (b) produzir uma planta transgênica a partir da célula transformada. Em um aspecto, a etapa (a) pode compreendem adicionalmente introduzir a sequência de ácido nucleico heteróloga por meio de eletroporação ou microinjeção de protoplastos de células de plantas. Em outro aspecto, a etapa (a) pode compreender adicionalmente introduzir a sequência de ácido nucleico heteróloga diretamente no tecido da planta por meio de bombardeio de partículas de DNA. Alternativamente, a etapa (a) pode compreender adicionalmente introduzir a sequência de ácido nucleico heteróloga na célula de planta DNA usando o hospedeiro Agrobacterium tumefaciens. Em um aspecto, a célula de planta pode ser uma célula de batata, milho, arroz, trigo, tabaco, ou cevada.
Petição 870180005321, de 22/01/2018, pág. 32/316
26/293 [0050] Em uma concretização, métodos de expressar uma sequência de ácido nucleico heteróloga em uma célula compreendem as seguintes etapas: (a) transformar a célula de planta com uma sequência de ácido nucleico heteróloga ligada operacionalmente a um promotor, sendo que a sequência nucleica heteróloga compreende um ácido nucleico como proporcionado aqui; (b) desenvolver a planta em condições em que a sequência de ácido nucleico heteróloga é expressa na célula de planta.
[0051] Em uma concretização, um primeiro método para a síntese biocatalítica de um lipídio estruturado compreende as seguintes etapas: (a) proporcionar um polipeptídio (p. ex., uma lipase, saturase, palmitase e/ou estearatase) como proporcionado aqui; (b) proporcionar uma composição compreendendo um triacilglicerídeo (TAG); (c) contactar o polipeptídio da etapa (a) com a composição da etapa (b) em condições em que o polipeptídio hidrolisa um resíduo acila na posição Sn2 do triacilglicerídeo (TAG), produzindo com isso um 1,3-diacilglicerídeo (DAG); (d) proporcionar um éster R1; (e) proporcionar uma hidrolase R1-específica, e (f) contactar o 1,3- DAG da etapa (c) com o éster R1 da etapa (d) e a hidrolase R1específica da etapa (e) em condições em que a hidrolase R1-específica catalisa a esterificação da posição Sn2, produzindo com isso o lipídio estruturado. A hidrolase como proporcionada aqui pode ser uma lipase Sn2-específica. O lipídio estruturado pode compreender uma alternativa à manteiga de cacau (CBA), uma manteiga de cacau sintética, uma manteiga de cacau natural, 1,3-dipalmitoil-2-oleoilglicerol (POP), 1,3-distearoil-2-oleoilglicerol (SOS), 1-palmitoil-2-oleoil-3-stearoilglicerol (POS) ou 1oleoil-2,3-dimiristoila glicerol (OMM).
[0052] Em uma concretização, um segundo método para síntese biocatalítica de um lipídio estruturado compreende as seguintes etapas: (a) proporcionar uma hidrolase (p. ex., uma lipase, saturase, palmitase e/ou estearatase) como proporcionada aqui; (b) proporcionar uma composição compreendendo um triacilglicerídeo (TAG); (c) contactar o polipeptídio da etapa (a) com a composição da etapa (b) em condições em que o polipeptídio hidrolisa um resíduo acila na posição Sn1 ou Sn3 do triacilglicerídeo (TAG), produzindo com isso um 1,2-DAG ou 2,3-DAG;
Petição 870180005321, de 22/01/2018, pág. 33/316
27/293 e (d) promover migração de acila no 1,2-DAG ou 2,3-DAG da etapa (c) em condições cineticamente controladas, produzindo com isso uma composição compreendendo um 1,3-D AG.
[0053] Este segundo método pode compreender adicionalmente prover um éster R1 e uma lipase R1-específica, e contactar o 1,3-D AG da etapa (d) com o éster R1 e a lipase R1-específica em condições em que a lipase R1-específica catalisa a esterificação da posição Sn2, produzindo com isso um lipídio estruturado. A hidrolase p. ex., uma lipase, saturase, palmitase e/ou estearatase como proporcionada aqui pode ser uma enzima Sn1 ou Sn3-específica. O lipídio estruturado pode compreender qualquer óleo vegetal, p. ex., um óleo de soja, um óleo de canola, alternativa à manteiga de cacau (CBA), uma manteiga de cacau sintética, uma manteiga de cacau natural, 1,3-dipalmitoil-2-oleoilglicerol (POP), 1,3-aroil-2-oleoilglicerol (SOS), 1palmitoil-2-oleoil-3-estearoilglicerol (POS) ou 1-il-2,3-dimiristoilglicerol (OMM).
[0054] O éster R1 pode compreender uma porção com menor teor de saturação do que o resíduo acila hidrolisado, sendo que neste caso o lipídio estruturado assim produzido é um óleo ou gordura com baixo teor de saturação do que o TAG original. O éster R1 pode compreender um ou mais de um ácido graxo ômega-3, um ácido graxo ômega-6, um ácido graxo mono-insaturado, um ácido graxo poli-insaturado, um grupo fosfro, um éster de fitoesterol, e orizanol. Mais especificamente o éster R1 pode compreender uma porção selecionada do grupo que consiste de ácido alfa-linolênico, ácido eicosapentaenóico, ácido docosaexaenóico, ácido gama-linolênico, ácido dihomo-gama-linolênico, ácido araquidônico, ácido oléico, ácido palmoléico, colina, serina, beta-sitosterol, cumestrol, dietilestilbestrol, e orizanol.
[0055] Em um aspecto deste segundo método, a etapa (d) compreende adicionalmente usar resinas de troca de íon. As condições cineticamente modificadas podem compreender condições de não-equilíbrio resultando na produção de um produto final apresentando uma relação superior a 2:1 de 1,3-D AG a 2,3-DAG. A composição da etapa (b) pode compreender uma ácido graxo fluorogênico (FA). A composição da etapa (b) pode compreender um éster de FA [ácido graxo] de umbeliferila. O produto final pode ser enantiomericamente puro.
Petição 870180005321, de 22/01/2018, pág. 34/316
28/293 [0056] Em uma concretização, um método para preparar um óleo ou gordura com baixo teor de saturação compreende as seguintes etapas: (a) proporcionar um polipeptídio (uma hidrolase, p. ex., uma lipase, saturase, palmitase e/ou estearatase) como proporcionado aqui; (b) proporcionar um óleo ou gordura, e (c) contactar o polipeptídio da etapa (a) com o óleo ou gordura da etapa (b) em condições em que a hidrolase pode modificar o óleo ou gordura, p. ex., remover pelo menos um ácido graxo saturado, p. ex., ácido palmítico, esteárico, láurico, caprílico (ácido octanóico) e análogos. A modificação pode compreender uma hidrólise catalisada com hidrolase da gordura ou óleo. A hidrólise pode ser uma hidrólise completa ou parcial da gordura ou óleo. O óleo hidrolisado pode compreender um éster de glicerol de um ácido graxo poliinsaturado que pode substituir o ácido graxo saturado removido, ou um óleo de peixe, animal, ou vegetal. O óleo vegetal pode compreender um óleo de oliva, canola, girassol, palma, soja ou óleo láurico ou óleo de farelo de arroz ou uma combinação dos mesmos.
[0057] Em uma concretização, um método para preparar um óleo ou gordura com baixo teor de saturação, que pode incluir ácidos graxos essenciais, compreende as seguintes etapas: (a) proporcionar um polipeptídio (p. ex., uma lipase, saturase, palmitase e/ou estearatase) como proporcionado aqui; (b) proporcionar uma composição compreendendo um triacilglicerídeo (TAG); (c) contactar o polipeptídio da etapa (a) com a composição da etapa (b) em condições em que o polipeptídio hidrolisa um resíduo acila na posição Sn1 ou Sn3 do triacilglicerídeo (TAG), produzindo com isso um 1,2-DAG ou 2,3-DAG; e (d) promover a migração de acila no 1,2-DAG ou 2,3DAG da etapa em condições cineticamente modificadas, produzindo com isso um 1,3DAG.
[0058] O método pode compreender adicionalmente prover um éster R1 e uma lipase R1-específica, e contactar o 1,3-DAG da etapa (d) com o éster R1 e a lipase R1-específica em condições em que a lipase R1-específica catalisa a esterificação da posição Sn2, produzindo com isso um lipídio estruturado. O éster R1 pode compreender uma porção com menor teor de saturação do que o resíduo acila hidrolisado, sendo que neste caso o lipídio estruturado assim produzido é um óleo ou
Petição 870180005321, de 22/01/2018, pág. 35/316
29/293 gordura com menor teor de saturação do que o TAG original. O éster R1 pode compreender um ácido graxo ômega-3 (alfa-linolênico, eicosapentaenóico (EPA), docosaexaenóico (DHA)), um ácido graxo ômega-6 (gama-linolênico, di-homo-gamalinolênico (DGLA), ou araquidônico), um ácido graxo mono-insaturado (oléico, palmoléico, e análogos), grupos fosfo (colina e serina), ésteres de fitoesterol (betasitosterol, cumestrol, e dietilestilbestrol), e orizanol. A hidrolase, p. ex., uma lipase, saturase, palmitase e/ou estearatase como proporcionada aqui pode ser uma enzima Sn1-específica ou uma enzima Sn3-específica. O óleo ou gordura com menor teor de saturação pode ser preparada por meio da hidrólise descrita acima a partir de qualquer óleo álgico, óleo vegetal, ou um óleo ou gordura animal, p. ex., óleo de Neochloris oleoabundans, óleo de Scenedesmus dimorphus, óleo de Euglena gracilis, óleo de Phaeodactylum tricornmutum, óleo de Pleurochrysis carterae, óleo de Prymnesium parvum, óleo de Tetraselmis chui, óleo de Tetraselmis suecica, óleo de Isochrysis galbana, óleo de Nannochloropsis salina, óleo de Botryococcus braunii, óleo de Dunaliella tertiolecta, óleo de espécies de Nannochloris, óleo de espécies de Spirulina, óleo de Chlorophycease (algas verdes), e óleo de Bacilliarophy, óleo de canola, óleo de mamona, óleo de coco, óleo de coriandro, óleo de milho, óleo de semente de algodão, óleo de avelã, óleo de semente de cânhamo, óleo de linhaça, óleo de plantados-prados, óleo de oliva, óleo de palma, óleo de palmito, óleo de amendoim, óleo de colza, óleo de farelo de arroz, óleo de açafrão, óleo de sasanqua, óleo de soja, óleo de semente de girassol, óleo de abeto, óleo de tsubaki, variedades de óleos “naturais” apresentando composições de ácido graxo alteradas via Organismos Geneticamente Modificados (GMO) ou “cruzamento” tradicional, como óleos com alto teor oléico, baixo teor linolênico, ou óleos com baixo teor de saturação (óleo de canola com alto teor oléico, óleo de soja com baixo teor linolênico ou óleos de girassol com alto teor esteárico); gorduras animais (talol, banha, gordura de manteiga, e gordura de frango), óleos de peixe (óleo de Thaleichthys pacificus, óleo de fígado de bacalhau, óleo de olho-de-vidro, óleo de sardinha, óleo de arrenque, e óleo de savelha), ou combinações de qualquer um dos acima. O óleo ou gordura com baixa saturação preparada dessa forma podem ser usados em alimentos ou no assamento, fritura ou cozimento de
Petição 870180005321, de 22/01/2018, pág. 36/316
30/293 produtos compreendendo óleos ou gorduras com um teor menor de ácidos graxos, incluindo óleos com baixo teor de ácido palmítico, ácido oléico, ácido láurico, ácido esteárico, ácido caprílico (ácido octanóico) etc., processados usando uma composição ou método como proporcionado aqui.
[0059] Em uma concretização, um método para refinar um lubrificante compreende as seguintes etapas: (a) proporcionar uma composição compreendendo uma hidrolase (p. ex., uma lipase, saturase, palmitase e/ou estearatase) como proporcionada aqui; (b) proporcionar um lubrificante; e (c) tratar o lubrificante com a hidrolase em condições em que a hidrolase (p. ex., uma lipase, saturase, palmitase e/ou estearatase) como proporcionada aqui pode hidrolisar seletivamente óleos no lubrificante, refinando-o com isso. O lubrificante pode ser um óleo hidráulico.
[0060] Em uma concretização, um método de tratar um tecido compreende as seguintes etapas: (a) proporcionar uma composição compreendendo uma hidrolase (p. ex., uma lipase, saturase, palmitase e/ou estearatase) como proporcionada aqui, sendo que a hidrolase pode hidrolisar seletivamente ésteres carboxílicos; (b) proporcionar um tecido; e (c) tratar o tecido com a hidrolase sob condição em que a hidrolase pode hidrolisar seletivamente ésteres carboxílicos tratando com isso o tecido. O tratamento do tecido pode compreender o aperfeiçoamento do toque e caimento do tecido acabado, o tingimento, a obtenção do retardo de chama, obtenção de hidro-repelência, obtenção de abrilhantamento óptico, ou obtenção de acabamento de resina. O tecido pode compreender algodão, viscose, rayon, lyocell, linho, rami, todas as combinações dos mesmos, ou misturas dos mesmos com poliésteres, lã, poliamidas, acrílicos ou poliacrílicos. Em uma concretização, um tecido, fio ou fibra compreendendo uma hidrolase como proporcionada aqui pode ser adsorvida, absorvida ou imobilizada sobre a superfície do tecido, fio ou fibra.
[0061] Em uma concretização, um método para remover ou diminuir a quantidade de uma mancha de alimento ou óleo compreende contactar uma hidrolase (p. ex., uma lipase, saturase, palmitase e/ou estearatase) como proporcionada aqui com a mancha de alimento ou óleo em condições em que a hidrolase pode hidrolisar óleo ou gordura na mancha. A hidrolase (p. ex., uma lipase, saturase, palmitase e/ou estearatase)
Petição 870180005321, de 22/01/2018, pág. 37/316
31/293 como proporcionada aqui pode apresentar uma estabilidade incrementada à desnaturação por tensoativos e para desativação com calor. A hidrolase (p. ex., uma lipase, saturase, palmitase e/ou estearatase) como proporcionada aqui pode apresentam um detergente ou uma solução de lavanderia.
[0062] Em uma concretização, uma composição dietética compreende uma hidrolase (p. ex., uma lipase, saturase, palmitase e/ou estearatase) como proporcionada aqui. A composição dietética pode compreender adicionalmente uma base nutricional compreendendo uma gordura. A hidrolase pode ser ativada por um sal de bile. A composição dietética pode compreender adicionalmente uma fórmula infantil à base de leite de vaca. A hidrolase pode hidrolisar ácidos graxos de cadeia longa.
[0063] Em uma concretização, um método de reduzir o teor de gordura no leite ou composições dietéticas à base de vegetais compreende as seguintes etapas: (a) proporcionar uma composição compreendendo uma hidrolase (p. ex., uma lipase, saturase, palmitase e/ou estearatase) como proporcionada aqui; (b) proporcionar uma composição compreendendo um leite ou um óleo vegetal, e (c) tratar a posição da etapa (b) com a hidrolase em condições em que a hidrolase pode hidrolisar o óleo ou gordura na composição. Em uma concretização, uma composição dietética para um humano ou para animais não-ruminantes, compreende uma base nutricional, sendo que a base compreende e nenhuma ou pouca hidrolase, e uma quantidade efetiva de uma hidrolase (p. ex., uma lipase, saturase, palmitase e/ou estearatase) como proporcionado aqui para incrementar a absorção de gordura e o crescimento de um humano ou animal não-ruminante.
[0064] Em uma concretização, um método de catalisar uma reação de interesterificação para produzir novos triacilglicerídeos compreende as seguintes etapas: (a) proporcionar uma composição compreendendo um polipeptídio (p. ex., uma lipase, saturase, palmitase e/ou estearatase) como proporcionado aqui, sendo que o polipeptídio pode catalisar uma reação de interesterificação; (b) proporcionar uma mistura de triacilglicerídeos e ácidos graxos livres; (c) tratar a mistura da etapa (b) com o polipeptídio em condições em que o polipeptídio pode catalisar troca de
Petição 870180005321, de 22/01/2018, pág. 38/316
32/293 ácidos graxos livres pelos grupos acila de triacilglicerídeos, produzindo com isso novos triacilglicerídeos enriquecidos com os ácidos graxos adicionados. O polipeptídio pode ser uma lipase Sn1,3-específica.
[0065] Em uma concretização, um método de interesterificação para preparar um óleo apresentando um ácido com baixo teor trans e um baixo teor de ácidos graxos de cadeia intermediária, compreende as seguintes etapas: (a) proporcionar uma reação de interesterificação mistura compreendendo um material-fonte de ácido esteárico selecionado do grupo que consiste de ácido esteárico, monoésteres de ácido esteárico de alcoóis monoídricos com baixo peso molecular e misturas dos mesmos, (b) proporcionar um óleo vegetal líquido; (c) proporcionar um polipeptídio (p. ex., uma lipase, saturase, palmitase e/ou estearatase) como proporcionado aqui, sendo que o polipeptídio compreende uma atividade de lipase 1,3-específica; (d) interesterificar o material-fonte de ácido esteárico e o óleo vegetal triacilglicerídeo, (e) separar componentes de ácidos graxos livres interesterificados de componentes de glicerídeos componentes da mistura de interesterificação para proporcionar um produto de óleo de margarina interesterificado e uma mistura de ácido graxo compreendendo ácidos graxos, monoésteres de ácido graxo ou misturas dos mesmos liberados do óleo vegetal, e (f) hidrogenar a mistura de ácidos graxos. Em uma concretização do método de interesterificação, a reação de interesterificação continua até que haja uma equilíbrio substancial dos grupos éster nas posições 1, 3 do componente glicerídeo com componentes de ácidos graxos não-glicerídeos da mistura de reação.
[0066] Em uma concretização, um método para preparar uma composição compreende 1-palmitoil-3-stearoil-2-monoleína (POSt) e 1,3-distearoil-2-monoleína (StOSt) compreendendo proporcionar um polipeptídio (p. ex., uma lipase, saturase, palmitase e/ou estearatase) como proporcionado aqui, sendo que o polipeptídio é capaz de interesterificação catalisada por lipase 1,3-específica de 1,3-dipalmitoil-2monoleína (POP) com ácido esteárico ou tristearina, e contactar referido polipeptídio com uma composição compreendendo referido POP na presença de uma fonte de estearina como ácido esteárico ou tritearina para preparar um produto enriquecido
Petição 870180005321, de 22/01/2018, pág. 39/316
33/293 com 1-palmitoil-3-stearoil-2-oleína (POSt) ou 1,3-distearoil-2-monoleína (StOSt).
[0067] Em uma concretização, um método para melhorar ou prevenir a toxicidade mediada com lipopolissacarídeo (LPS) compreende administrar a um paciente uma composição farmacêutica compreendendo uma hidrolase (p. ex., uma lipase, saturase, palmitase e/ou estearatase) como proporcionado aqui. Em uma concretização, um método para destoxificar uma endotoxina compreende contactar a endotoxina com uma hidrolase (p. ex., uma lipase, saturase, palmitase e/ou estearatase) como proporcionada aqui. Em uma concretização, um método para desacilar uma cadeia de ácido graxo 2' ou 3' de um lipídio A compreende contactar o lipídio A com um polipeptídio como proporcionado aqui.
[0068] Em uma concretização, métodos para alterar a especificidade por substrato ou a preferência por substrato de uma enzima lipase parental (hidrolase de ácido graxo) apresentando uma sequência de aminoácidos correspondente à sequência de aminoácidos na SEQ ID N0:2 compreendem a etapa de gerar (inserir) pelo menos 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11 ou 12 ou mais mutações de resíduos de aminoácidos na SEQ ID NO:2 como mostrado na Tabela 3, Tabela 4, Tabela 9, Tabela 10, Tabela 11, Tabela 16 ou Tabela 23, gerando com isso uma nova enzima hidrolase apresentando uma sequência de aminoácidos modificada e uma especificidade alterada por substrato ou preferência por substrato em comparação com a enzima lipase parental (hidrolase de ácido graxo) SEQ ID NO:2.
[0069] Em um aspecto, a especificidade por especificidade por substrato ou preferência por substrato da nova enzima lipase (hidrolase de ácido graxo) compreende hidrólise preferencial ou incrementada do ácido palmítico de um óleo, ou, a especificidade por substrato ou preferência por substrato da nova enzima lipase (hidrolase de ácido graxo) compreende hidrólise preferencial ou incrementada de ácido esteárico de um óleo.
[0070] Em um aspecto, a sequência de aminoácidos modificada (em comparação com a SEQ ID NO:2 “parental”) compreende pelo menos uma modificação de aminoácidos A48C; D49R; D61 A; D61E; R72E; R72K; V83M; R85Y; E95K; E116A; E1161; E116L; E116N; E116Q; E116R; E116T; E116V; S133A; A144I; E149H; A150I;
Petição 870180005321, de 22/01/2018, pág. 40/316
34/293
I151G; I151A; P162G; P162K; V163R; D164R; R172H; R172L; ou A225S, ou seu equivalente, ou uma combinação dos mesmos, e/ou pelo menos uma modificação de códon (GCG)35(GCT); (GGC)45(GGA); (GCG)92(GCT), (GTG) 102(GTT); (AGC) 108(AGT); (CTG)117(CTT); (CTG) 124(TTG); (CGG) 126(AGG); (GTC) 128(GTG); (AGT) 133(TCT); (TTC)135(TTT); (GTG)183(GTT); (ACC) 188(ACG), ou seu equivalente, ou uma combinação dos mesmos, e a especificidade por substrato ou preferência por substrato da nova enzima lipase (hidrolase de ácido graxo) compreende hidrólise preferencial ou incrementada de ácido palmítico de um óleo. Em um aspecto, a sequência de aminoácidos modificada (em comparação com a SEQ ID NO:2 “parental”) compreende I20L; V62S; G77P; V83C; D88H; Y113G; E116T; E116G; H140K; K146S; I167S; L180E; E194M; A211Q; S212Y; G215C; G215V; G215W; A218H; A218S; V223A; A225M; A225Q, ou uma combinação das mesmas, e a especificidade por substrato ou preferência por substrato da nova enzima lipase (hidrolase de ácido graxo) compreende hidrólise preferencial ou incrementada de ácido esteárico de um óleo.
[0071] Em uma concretização, métodos para preparar uma enzima apresentando uma especificidade por substrato ou preferência de substrato compreendem hidrólise preferencial ou incrementada de ácido palmítico de um óleo, compreendendo as etapas de: (a) proporcionar uma hidrolase parental (p. ex., uma lipase, saturase, palmitase e/ou estearatase) enzima apresentando uma especificidade por substrato ou preferência por substrato compreendendo hidrólise preferencial de ácido palmítico de um óleo, sendo que a enzima hidrolase parental (p. ex., uma lipase, saturase, palmitase e/ou estearatase) apresenta uma sequência como proporcionada aqui; e (b) preparar pelo menos 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11 ou 12 ou mais modificações de resíduos de aminoácidos na enzima lipase parental (p. ex., uma lipase, saturase, palmitase e/ou estearatase), sendo que as modificações de resíduos de aminoácidos correspondem às mutações de sequência de aminoácidos na SEQ ID NO:2 como mostrado na Tabela 3, Tabela 4, Tabela 9, Tabela 10, Tabela 11, Tabela 16 ou Tabela 23, gerando com isso uma enzima apresentando uma especificidade por substrato ou preferência por substrato compreendendo hidrólise preferencial ou incrementada de
Petição 870180005321, de 22/01/2018, pág. 41/316
35/293 ácido palmítico de um óleo.
[0072] Em uma concretização, métodos para preparar uma enzima apresentando uma especificidade por substrato ou preferência por substrato compreendem hidrólise preferencial ou incrementada de ácido esteárico de um óleo, compreendendo as etapas de: (a) proporcionar uma enzima hidrolase parental (p. ex., uma lipase, saturase, palmitase e/ou estearatase) enzima apresentando uma especificidade por substrato ou preferência por substrato compreendendo hidrólise preferencial de ácido esteárico de um óleo, sendo que a enzima hidrolase parental (p. ex., uma lipase, saturase, palmitase e/ou estearatase) apresenta uma sequência como proporcionada aqui; e (b) preparar pelo menos 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11 ou 12 ou mais modificações de resíduos de aminoácidos na enzima hidrolase parental (p. ex., uma lipase, saturase, palmitase e/ou estearatase), sendo que as modificações de resíduos de aminoácidos correspondem às mutações na sequência de aminoácidos na SEQ ID NO:2 como mostrado na Tabela 3, Tabela 4, Tabela 9, Tabela 10, Tabela 11, Tabela 16 ou Tabela 23, gerando com isso uma enzima apresentando uma especificidade por substrato ou preferência por substrato compreendendo hidrólise preferencial ou incrementada de ácido esteárico de um óleo.
[0073] Em uma concretização, métodos para preparar uma enzima hidrolase de ácido graxo (p. ex., uma lipase, saturase, palmitase e/ou estearatase) enzima apresentando uma especificidade por substrato ou preferência por substrato compreendem hidrólise preferencial de um ácido graxo particular, compreendendo as etapas de (a) proporcionar uma sequência de enzima hidrolase de ácido graxo (p. ex., uma lipase, saturase, palmitase e/ou estearatase) como proporcionado aqui; (b) gerando (inserir) pelo menos 1, 2, 3, 4, 5, 6, 7, 8, 9, 1 ou 12 ou mais mutações de resíduo base no ácido nucleico, sendo que as mutações correspondem àquelas alterações de sequências como apresentado na Tabela 3, Tabela 4, Tabela 9, Tabela 10, Tabela 16 ou Tabela 23; e, (c) testar a atividade da enzima recentemente gerada quanto a uma especificidade por substrato ou preferência por substrato compreendendo hidrólise preferencial de um ácido graxo particular, realizando com isso a nova enzima lipase de ácido graxo (p. ex., uma lipase, saturase, palmitase e/ou
Petição 870180005321, de 22/01/2018, pág. 42/316
36/293 estearatase) apresentando uma especificidade por substrato ou preferência por substrato compreendendo hidrólise preferencial de um ácido graxo particular. Em um aspecto, a enzima hidrolase de ácido graxo (p. ex., uma lipase, saturase, palmitase e/ou estearatase) compreende uma sequência como apresentada na SEQ ID NO:2. Em um aspecto, o ácido graxo é ácido linolênico, ácido linoléico, ácido oléico, ácido palmítico ou ácido esteárico.
[0074] Em uma concretização, métodos para preparar uma enzima hidrolase de ácido graxo (p. ex., uma lipase, saturase, palmitase e/ou estearatase) apresentando uma especificidade por substrato ou preferência por substrato compreendem hidrólise preferencial de um ácido graxo particular, e compreendem as etapas de (a) proporcionar uma sequência de ácido nucleico que codifica enzima hidrolase de ácido graxo (p. ex., uma lipase, saturase, palmitase e/ou estearatase) como proporcionado aqui; (b) gerando (inserir) pelo menos 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11 ou 12 ou mais mutações de resíduo base no ácido nucleico, sendo que as mutações correspondem àquelas alterações de sequências como apresentadas na Tabela 3, Tabela 4, Tabela 9, Tabela 10, Tabela 11, Tabela 16 ou Tabela 23; e, (c) expressar o ácido nucleico gerado para preparar a nova enzima hidrolase de ácido graxo (p. ex., lipase, saturase, palmitase e/ou estearatase), realizando com isso uma enzima hidrolase de ácido graxo (p. ex., lipase, saturase, palmitase e/ou estearatase) apresentando uma especificidade por substrato ou preferência por substrato compreendendo hidrólise preferencial de um ácido graxo particular.
[0075] Em um aspecto, a sequência codificante de enzima hidrolase de ácido graxo (p. ex., lipase, saturase, palmitase e/ou estearatase) compreende uma sequência como apresentada na SEQ ID NO:1. Em um aspecto, o ácido graxo é ácido linolênico, ácido linoléico, ácido oleico, ácido palmítico ou ácido esteárico. Em um aspecto, a especificidade por substrato ou preferência por substrato da nova enzima hidrolase de ácido graxo (p. ex., lipase, saturase, palmitase e/ou estearatase) é ácido palmítico em comparação com uma especificidade por substrato ou preferência por substrato de ácido esteárico para a enzima hidrolase de ácido graxo parental (p. ex., lipase, saturase, palmitase e/ou estearatase), ou a especificidade por substrato ou
Petição 870180005321, de 22/01/2018, pág. 43/316
37/293 preferência por substrato da nova enzima hidrolase de ácido graxo (p. ex., lipase, saturase, palmitase e/ou estearatase) é ácido esteárico em comparação com uma especificidade por substrato ou preferência de substrato de ácido palmítico para a enzima hidrolase de ácido graxo parental (p. ex., lipase, ase, palmitase e/ou estearatase).
[0076] Em uma concretização, lipases compreendem uma sequência de aminoácidos como apresentada na SEQ ID 2 mas também compreendendo pelo menos a modificação de resíduo de aminoácido A48C; D49R; D61 A; E; R72E; R72K; V83M; R85Y; E95K; E116A; E1161; E116L; E116N; E116Q; E116R; T; E116V; S133A; A144I; E149H; A150I; I151G; I151A; P162G; P162K; V163R; 4R; R172H; R172L; ou A225S, ou seu equivalente, ou uma combinação das mesmas, e/ou pelo menos uma modificação de códon (GCG)35(GCT); (GGC)45(GGA); (GCG)92(GCT), (GTG)102(GTT); (AGC)108(AGT); (CTG)117(CTT); (CTG)124(TTG);
(CGG)126(AGG); (GTC)128(GTG); (AGT)133(TCT); (TTC)135(TTT);
(GTG)183(GTT); (ACC)188(ACG), ou seu equivalente, ou uma combinação dos mesmos.
[0077] Em um aspecto, a especificidade por substrato ou preferência por substrato da nova lipase compreende hidrólise preferencial ou incrementada de um ácido graxo de um óleo em comparação com a SEQ ID NO:2 “parental”. Em um aspecto, o ácido graxo é ácido linolênico, ácido linoléico, ácido oleico, ácido palmítico ou ácido esteárico.
[0078] Os detalhes de uma ou mais concretizações como proporcionado aqui são apresentados nos desenhos anexos e na descrição abaixo. Outras particularidades, objetos, e vantagens como proporcionados aqui serão perceptíveis a partir da descrição e dos desenhos, e das reivindicações.
[0079] Todas as publicações, patentes, pedidos de patentes, sequências GenBank e depósitos na ATCC, citados aqui são incorporados aqui expressamente por referência, para todos os fins.
DESCRIÇÃO DOS DESENHOS [0080] Os desenhos a seguir são ilustrativos de concretizações como
Petição 870180005321, de 22/01/2018, pág. 44/316
38/293 proporcionadas aqui e não devem limitar o escopo das reivindicações.
[0081] A patente ou o depósito do pedido contém pelo menos um desenho executado em cores. Cópias desta patente ou publicação de pedido de patente com desenho(s) em cores serão fornecidas pelo Departamento mediante requisição e pagamento a taxa necessária.
[0082] A Figura 1 é um diagrama de blocos de um sistema de computador.
[0083] A Figura 2 é um diagrama de fluxo que ilustra um aspecto de um processo para comparar um novo nucleotídeo ou sequência de proteína com um banco de dados de sequências para determinar os níveis de homologia entre a nova sequência e as sequências no banco de dados.
[0084] A Figura 3 é um diagrama de fluxo que ilustra um aspecto de um processo em um computador para determinar se duas sequências são homólogas.
[0085] A Figura 4 é um diagrama de fluxo que ilustra um aspecto de um processo identificador 300 para detectar a presença de uma característica em uma sequência. [0086] A Figura 5 ilustra um método exemplar como proporcionado aqui compreendendo o uso de lipases proporcionadas aqui para processar um lipídio, p. ex., um lipídio de um óleo de soja, para hidrolisar seletivamente um ácido palmítico para produzir um “óleo de soja palmítico reduzido”.
[0087] A Figura 6a ilustra os efeitos de mutações de GSSMSM palmitase exemplares sobre a hidrólise de palmitato e estearato relativamente à SEQ ID NO:2 parental, como discutido detalhadamente no Exemplo 4, abaixo. A Figura 6b ilustra os efeitos de mutações GSSMSM de estearatase exemplares sobre a hidrólise de palmitato e estearato relativamente à SEQ ID NO:2 parental como discutido detalhadamente no Exemplo 4, abaixo.
[0088] A Figura 7 mostra a SEQ ID NO:2, com as posições particulares de mutação de palmitato e estearato listadas em negrito com um fonte maior.
[0089] Mutações sublinhadas (p. ex., 61A, E) são posições alternativas de resíduos de aminoácidos (sequências alternativas para concretizações alternativas) para melhorar a hidrólise de palmitato. Mutações em itálico (p. ex., 20L) são posições alternativas de resíduos de aminoácidos (sequências alternativas para concretizações
Petição 870180005321, de 22/01/2018, pág. 45/316
39/293 alternativas) para melhorar a hidrólise de estearato. A posição 116 é uma posição alternativa de mutação de resíduo de aminoácido (uma sequência alternativa para uma concretização alternativa) para melhorar a hidrólise de ambos, palmitato e estearato.
[0090] A Figura 8 mostra dados confirmatório do ensaio com óleo de soja para selecionar clones da biblioteca de palmitase.
[0091] Símbolos de referência iguais nos vários desenhos indicam elementos iguais.
DESCRIÇÃO DETALHADA [0092] Concretizações alternativas compreendem polipeptídios, incluindo lipases, saturases, palmitases e/ou estearatases, polinucleotídeos que codificam os mesmos, e métodos de preparar e usar estes polinucleotídeos e polipeptídios. Concretizações alternativas compreendem polipeptídios, p. ex., enzimas, apresentando uma atividade de hidrolase, p. ex., atividade de lipase, saturase, palmitase e/ou estearatase, incluindo atividade de hidrolase termoestável e termotolerante, e polinucleotídeos que codificam estas enzimas, e preparando e usando estes polinucleotídeos e polipeptídios. As atividades de hidrolase dos polipeptídios e peptídios como proporcionados aqui incluem atividade de lipase (hidrólise de lipídios), reações de interesterificação, síntese de éster, reações de intercâmbio de ésteres, atividade de acil hidrolase de lipídio (LAH) e atividade enzimática relacionada. Para os fins deste pedido de patente, reações de interesterificação podem incluir reações de acidólise (envolvendo a reação de um ácido graxo e um triacilglicerídeo), alcoólise (envolvendo reação de um álcool e um triacilglicerídeo), glicerolise (envolvendo a reação de um éster e um triacilglicerídeo) e reações de transesterificação (envolvendo a reação de um triacilglicerídeo). Os polipeptídios como proporcionados aqui podem ser usados em uma variedade de contextos farmacêuticos, agrícolas e industriais, incluindo a fabricação de cosméticos e nutracêuticos. Em outro aspecto, os polipeptídios como proporcionados aqui são usados para sintetizar produtos quirais enantiomericamente puros.
[0093] Em determinadas concretizações, enzimas como proporcionadas aqui
Petição 870180005321, de 22/01/2018, pág. 46/316
40/293 podem ser catalisadores altamente seletivos. Elas podem ter a capacidade de catalisar reações com estereo-, regio- e quimio-seletividades não possíveis na química sintética convencional. Em uma concretização, enzimas como proporcionadas aqui podem ser versáteis. Em vários aspectos, elas podem funcionar em solventes orgânicos, operar a pHs extremos (por exemplo, pHs elevados e pHs baixos), temperaturas extremas (por exemplo, temperaturas elevadas e temperaturas baixas), níveis extremos de salinidade (por exemplo, alta salinidade e baixa salinidade), e catalisam reações com compostos que são estruturalmente nãorelacionados com seus substratos fisiológicos naturais.
[0094] Em um aspecto, os polipeptídios como proporcionados aqui compreendem hidrolases apresentando atividade de lipase, saturase, palmitase e/ou estearatase e podem ser usados, p. ex., na síntese biocatalítica de lipídios estruturados (lipídios que contêm um conjunto definido de ácidos graxos distribuídos de uma maneira definida na cadeia principal de glicerol), incluindo qualquer óleo vegetal, p. ex., canola, soja, alternativas a óleo de soja, alternativas à manteiga de cacau, glicerídeos de 1,3-diacila (DAGs), 2-monoacilglicerídeos (MAGs) e triacilglicerídeos (TAGs), como 1,3dipalmitoil-2-oleoilglicerol (POP), 1,3-distearoil-2-oleoilglicerol (StOSt), 1-palmitoil-2oleoil-3-stearoilglicerol (POSt) ou 1-oleoil-2,3-dimiristoilglicerol (OMM), ácidos graxos poli-insaturados (PUFAs), ácidos graxos poliinsaturados de cadeia longa, como ácido araquidônico, ácido docosaexaenóico (DHA) e ácido eicosapentaenóico (EPA).
[0095] Em determinada concretização, as enzimas e métodos como proporcionados aqui podem ser usados para remover, adicionar ou trocar qualquer ácido graxo de uma composição, p. ex., preparar um óleo com um menor teor de ácidos graxos saturados (p. ex., um óleo “com baixo teor de saturação”) ou um teor diferente de ácido graxo (p. ex., convertendo um óleo compreendendo ácidos graxos “saturados” a um óleo compreendendo ácidos graxos “insaturados” alternativos).
[0096] Exemplos de ácidos graxos saturados que podem ser removidos, adicionados ou “rearranjados” em um lipídio, p. ex., um óleo, usando-se uma enzima ou por meio da prática de um método como proporcionado aqui incluem:
Acético: CH3COOH
Petição 870180005321, de 22/01/2018, pág. 47/316
41/293
Butírico: CH3(CH2)2COOH
Capróico: CH3(CH2)4COOH
Caprílico: CH3(CH2)6COOH
Cáprico: CH3(CH2)8COOH
Undacanóico: CH3(CH2)9COOH
Láurico: (ácido dodecanóico): CH3(CH2)roCOOH
Mirístico: (ácido tetradecanóico): CH3(CH2)12COOH
Pentadecanóico: CH3(CH2)13COOH
Palmítico: (ácido hexadecanóico): CH3(CH2)14COOH
Margárico: CH3(CH2)15COOH
Esteárico (ácido octadecanóico): CH3(CH2)16COOH
Araquídico (ácido eicosanóico): CH3(CH2)18COOH Beênico: CH3(CH2)20COOH [0097] Exemplos de ácidos graxos insaturados ômega-3 que podem ser removidos, adicionados ou “rearranjados” em um lipídio, p. ex., um óleo, usando-se uma enzima ou por meio da prática de um método como proporcionado aqui incluem:
α-linolênico (ALA): CH3CH2CH=CHCH2CH=CHCH2CH=CH(CH2)7COOH estearaiadônico (octadecatetraenóico) :
CH3CH2CH=CHCH2CH=CHCH2CH=CHCH2CH=CH(CH2)4COOH eicosapentaenóico (EPA):
CH3CH2CH=CHCH2CH=CHCH2CH=CHCH2CH=CHCH2CH=CH(CH2)3CO OH docosaexaenóico (DHA) CH3CH2CH=CHCH2CH=CHCH2CH=CHCH2CH=CHCH2CH=CHCH2CH=C
H(CH2)2COOH [0098] Exemplos de ácidos graxos insaturados ômega-6 que podem ser removidos, adicionados ou “rearranjados” em um lipídio, p. ex., um óleo, usando-se uma enzima ou por meio da prática de um método como proporcionado aqui incluem:
Linoleico (ácido 9,12-octadecadienóico):
CH3(CH2)4CH=CHCH2CH=CH(CH2)7COOH
Petição 870180005321, de 22/01/2018, pág. 48/316
42/293
Gama-linolênico (ácido 6,9,12-octadecatrienóico):
CH3(CH2)4CH=CHCH2CH=CHCH2CH=CH(CH2)4COOH
Eicosadienóico (ácido 11,14-eicosadienóico):
CH3(CH2)4CH=CHCH2CH=CH(CH2)9COOH
Di-homo-gama-linolênico (ácido 8,11,14-eicosatrienóico):
CH3(CH2)4CH=CHCH2CH=CHCH2CH=CH(CH2)6COOH
Araquidônico (ácido 5,8,11,14-eicosatetraenóico):
CH2)4CH=CHCH2CH=CHCH2CH-CHCH2CH=CH(CH2)3COOH
Dosadienóico (ácido 13,16-docosadienóico):
CH3(CH2)4CH=CHCH2CH=CH(CH2)11COOH
Adrênico (ácido 7,10,13,16-docosatetraenóico):
CH3(CH2)4CH=CHCH2CH=CHCH2CH=CHCH2CH=CH(CH2)5COOH Docosapentaenóico (ácido 4,7,10,13,16-docosapentaenóico):
CH2)4CH=CHCH2CH=CHCH2CH=CHCH2CH=CHCH2CH=CH(CH2)2 COOH [0099] Exemplos de ácidos graxos ômega-9 que como pode ser removidos, adicionados ou “rearranjados” em um lipídio, p. ex., um óleo, usando-se uma enzima ou por meio da prática de um método como proporcionado aqui, incluem:
Oleico (ácido 9-octadecenóico): CH3(CH2)7CH=CH(CH2)7COOH Eicosenóico (ácido 11-eicosenóico) CH3(CH2)7CH=CH(CH2)9COOH Mead (ácido 5,8,11-eicosatrienóico):
CH3(CH2)7CH=CHCH2CH=CHCH2CH=CH(CH2)3COOH
Eurico (ácido 13-docosenóico): CH3(CH2)7CH=CH(CH2)nCOOH Nervônico (ácido 15-tetracosenóico): CH3(CH2)7CH=CH(CH2)13COOH. Palmitoleico:
CH3(CH2)7CH=CH(CH2)5COOH [0100] Em um aspecto, proporciona-se aqui classes inéditas de lipases denominadas “saturases”, p. ex., “palmitases” e “estearatases”. O termo “saturase” como previamente usado na literatura descrevia uma enzima que porta a saturação de ligações específicas em um via metabólica, p. ex., hidrogenação de uma dupla
Petição 870180005321, de 22/01/2018, pág. 49/316
43/293 ligação (Moise, et al., J Biol Chem, 2005, 280(30):27815- 27825). No entanto, proporciona-se aqui “saturases” inéditas e previamente subscritas, sendo que as saturases descritas aqui hidrolisam ésteres de ácido graxo saturado, sendo que os ésteres hidrolisados podem ser ésteres de ácidos graxos saturados e glicerol, umbeliferol ou outros alcoóis.
[0101] Proporciona-se aqui também “palmitases” e “estearatases” previamente descritas, sendo que as palmitases e estearatases hidrolisam ácido palmítico e ácido esteárico, respectivamente, por exemplo, da cadeia principal de glicerol. As “saturases” aqui descritas também podem ser denominadas “hidrolases saturadas”. De maneira análoga, as “palmitases” aqui descritas também podem ser denominadas “palmitato hidrolases” e as “estearatases” aqui descritas também podem ser denominadas “estearato hidrolases”.
[0102] Em outro aspecto, as saturases aqui descritas hidrolisam seletivamente pelo menos 60 %, 61 %, 62 %, 63 %, 64 %, 65 %, 66 %, 67 %, 68 %, 69 %, 70 %, 71 %, 72 %, 73 %, 74 %, 75 %, 76 %, 77 %, 78 %, 79 %, 80 %, 81 %, 82 %, 83 %, 84 %, 85 %, 86 %, 87 %, 88 %, 89 %, 90 %, 91 %, 92 %, 93 % 94 %, 95 %, 96 %, 97 %, 98 %, 99 % ou 100 % dos ácidos graxos saturados. Em outro aspecto, as palmitases aqui descritas hidrolisam seletivamente ácidos graxos de tal forma que pelo menos 61 %, 62 %, 63 %, 64 %, 65 %, 66 %, 67 %, 68 %, 69 %, 70 %, 71 %, 72 %, 73 %, 74 %, 75 %, 77 %, 78 %, 79 %, 80 %, 81 %, 82 %, 83 %, 84 %, 85 %, 86 %, 87 %, 88 %, 89 %, %, 91 %, 93 %, 94 %, 95 %, 96 %, 97 %, 98 %, 99 % ou 100 % dos ácidos graxos hidrolisados são ácido palmítico. Em outro aspecto, as estearatases aqui descritas hidrolisam seletivamente ácidos graxos de tal forma que pelo menos 60 %, 61 %, 62 %, 63 %, 64 %, 65 %, 66 %, 67 %, %, 69 %, 70 %, 71 %, 72 %, 73 %, 74 %, 75 %, 76 %, 77 %, 78 %, 79 %, 80 %, 81 %, 82 %, 83 %, 84 %, 85 %, 86 %, 87 %, 88 %, 89 %, 90 %, 91 %, 92 %, 93 %, 94 %, 95 %, 96 %, 97 %, 98 %, 99 % ou 100 % dos ácidos graxos hidrolisados são ácido esteárico.
[0103] Em um aspecto, como ilustrado na Figura 5, métodos de uso de uma enzima como proporcionada aqui podem processar um lipídio, p. ex., um lipídio de um
Petição 870180005321, de 22/01/2018, pág. 50/316
44/293 óleo de soja ou de outro óleo vegetal, para hidrolisar seletivamente um ácido graxo saturado, p. ex., um ácido palmítico ou ácido esteárico, (p. ex., de um óleo contendo estes ácidos graxos saturados) para produzir um “óleo com baixo teor de saturação (ou com menor teor de saturação)”, p. ex., um “óleo palmítico reduzido”, como um “óleo vegetal palmítico reduzido”, p. ex., um “óleo de soja palmítico reduzido”. Enzimas como proporcionadas aqui também podem ser usadas para hidrolisar seletivamente qualquer ácido graxo, particularmente ácidos graxos saturados, de uma cadeia principal de glicerol para produzir um “óleo com baixo teor de saturação (ou com menor teor de saturação)”, incluindo hidrolisar seletivamente um ácido graxo saturado, p. ex., um ácido palmítico ou um ácido esteárico, de uma posição Sn1 ou uma posição Sn2 de uma cadeia principal de glicerol, adicionalmente à hidrólise de uma posição Sn3 (p. ex., hidrólise de ácido palmítico da posição Sn3 ilustrada na Figura 5).
[0104] Em um aspecto proporciona-se uma síntese exemplar de triglicerídeos, óleos ou gorduras com baixo teor de saturação. Esta síntese exemplar pode usar ácidos graxos livres ou ésteres de ácido graxo, dependendo da enzima usada. Em um aspecto, as hidrolases, p. ex., lipases, saturases, palmitases e/ou estearatases, como proporcionadas aqui são usadas para remover ou hidrolisar ácidos graxos saturados, como ácido acético, ácido butírico, ácido capróico, ácido caprílico, ácido cáprico, ácido undecanóico, ácido láurico, ácido mirístico, ácido pentadecanóico, ácido palmítico, ácido margárico, ácido esteárico, ácido aquídico, ou ácido beênico de um triglicerídeo, óleo ou gordura. Em um aspecto, os ácidos graxos removidos ou hidrolisados são substituídos por ácidos graxos com benefícios comprovados à saúde (como correlação reduzida com doença cardiovascular), ou propriedades químicas aperfeiçoadas (como estabilidade oxidativa ou reatividade) ou propriedades físicas aperfeiçoadas (como ponto de fusão, ou sensação na boca). Em um aspecto os ácidos graxos adicionados são ácidos graxos insaturados ômega-3, como ácido α-linolênico, ácido estearidônico ácido eicosapentaenóico (EPA), ou ácido docosaexaenóico (DHA), ou PUFAs ou ácidos graxos de óleo de peixe. Em um aspecto os ácidos graxos adicionados são ácidos graxos insaturados ômega-6, como ácido linoleico, ácido gama-linoleico, ácido eicosadienóico, ácido di-homo-gama-linoleico, ácido
Petição 870180005321, de 22/01/2018, pág. 51/316
45/293 araquidônico, ácido docosadienóico, ácido adrênico, ou ácido docosapentaenóico. Em um aspecto os ácidos graxos adicionados são ácidos graxos insaturados ômega-9, como ácido oleico, ácido eicosaenóico, ácido mead, ácido erúcico, ácido nervônico, ou ácido itoleico. Em um aspecto os ácidos graxos adicionados (p. ex., ômega-3, ômega-6, ou ômega-9) são adicionados por meio de reação de ácidos graxos com os triglicerídeos, óleo ou gordura após a remoção ou hidrólise de ácidos graxos saturados pelas hidrolases, p. ex., lipases, saturases, palmitases e/ou estearatases, como proporcionadas aqui. Em um aspecto os ácidos graxos adicionados (p. ex., ômega-3, ômega-6, ou ômega-9) são adicionados por meio de reação de ésteres de ácido graxo, incluindo ésteres de glicerol, ou ésteres de etila ou metila, com os triglicerídeos, óleo ou gordura após a remoção ou hidrólise de ácidos graxos saturados pelas hidrolases, p. ex., lipases, saturases, palmitases e/ou estearatases, como proporcionadas aqui. Em um aspecto a reação para adicionar ácidos graxos (p. ex., ômega-3, ômega-6, ou ômega-9) é catalisada por uma hidrolase ou lipase, como uma lipase não-específica (incluindo não-regioespecífica e não-ácido graxo-específica), ou uma lipase Sn1,3específica, ou uma lipase Sn1-específica, ou uma lipase Sn3-específica, ou uma lipase Sn2-específica, ou uma lipase ácido graxo-específica.
[0105] Os métodos e composições (hidrolases, p. ex., lipases, saturases, palmitases e/ou estearatases) como proporcionados aqui podem ser usados na produção de nutracêuticos (p. ex., óleos e ácidos graxos poliinsaturados), vários alimentos e aditivos alimentícios (p. ex., emulsificantes, substitutos de gordura, margarinas e pastas para espalhamento), cosméticos (p. ex., emulsificantes, cremes), farmacêuticos e agentes de fornecimento de drogas (p. ex., liposomas, tabletes, formulações), e aditivos para ração animal (p. ex., ácidos graxos poliinsaturados, como ácidos linoleicos).
[0106] Em um aspecto, lipases como proporcionadas aqui podem atuar sobre ésteres de ácido graxo (FA) fluorogênico, p. ex., ésteres de FA de umbelliferila. Em um aspecto, perfis de especificidades de FA de lipases preparadas ou modificadas por meio dos métodos como proporcionados aqui podem ser obtidos por meio de medição de suas atividades relativas em uma série de ésteres de FA de umbelliferila,
Petição 870180005321, de 22/01/2018, pág. 52/316
46/293 como ésteres de palmitato, estearato, oleato, laurato, PUFA, ou butirato.
[0107] Em um aspecto, um polipeptídio (p. ex., anticorpo ou enzima - p. ex., uma lipase, saturase, palmitase e/ou estearatase) como proporcionado aqui para estas reações é imobilizado, p. ex., como descrito abaixo. Em aspectos alternativos, os métodos como proporcionados aqui não requerem um solvente orgânico, podem proceder com taxas de reação relativamente rápidas. Ver, p. ex., Patente U.S. n° 5.552.317; 5.834.259.
[0108] Em determinadas concretizações, os métodos e composições (lipases, saturases, palmitases e/ou estearatases) como proporcionados aqui podem ser usados para hidrolisar (incluindo hidrolisar seletivamente) óleos, como oleso de peixes, óleos animais e óleos vegetais, e lipídios, como ácidos poli-insaturados. Em um aspecto, os polipeptídios como proporcionados aqui são usados para preparar óleos com baixo teor de saturação, p. ex., por meio de remoção (hidrolisação) de pelo menos um ácido graxo de um óleo; e a hidrólise pode ser uma hidrólise seletiva, p. ex., removendo apenas um ácido graxo particular, como um ácido graxo palmítico, esteárico, ou outro ácido graxo saturado, ou apenas removendo um ácido graxo de uma posição, p. ex., Sn1, Sn2 ou Sn3. Em um aspecto, os polipeptídios como proporcionados aqui são usados para processar ácidos graxos (como ácidos graxos poli-insaturados), p. ex., ácidos graxos de óleo de peixe, p. ex., para uso em ou como um alimento ou aditivo alimentício, ou um óleo para cozimento, fritura, assamento ou óleo comestível. Em outra concretização, os métodos e composições (lipases, saturases, palmitases e/ou estearatases) como proporcionados aqui podem ser usados para hidrolisar seletivamente ésteres saturados sobre ésteres insaturados em ácidos ou alcoóis. Em outra concretização, os métodos e composições (lipases, saturases, palmitases e/ou estearatases) como proporcionados aqui podem ser usados para tratar látices para diversos fins, p. ex., para tratar látices usados em composições fixadoras de cabelos para remover odores desagradáveis. Em outra concretização, os métodos e composições (lipases, saturases, palmitases e/ou estearatases) como proporcionados aqui podem ser usados no tratamento de uma deficiência de lipase em um animal, p. ex., um mamífero, como um humano. Em outra concretização, os métodos e composições (lipases, saturases, palmitases e/ou estearatases) como proporcionados aqui podem ser usados
Petição 870180005321, de 22/01/2018, pág. 53/316
47/293 para preparar lubrificantes, como óleos hidráulicos. Em outra concretização, os métodos e composições (lipases, saturases, palmitases e/ou estearatases) como proporcionados aqui podem ser usados na preparação e no uso de detergentes. Em outra concretização, os métodos e composições (lipases, saturases, palmitases e/ou estearatases) como proporcionados aqui podem ser usados em processos para o acabamento químico de tecidos, fibras ou fios. Em um aspecto, os métodos e composições (lipases, saturases, palmitases e/ou estearatases) como proporcionados aqui podem ser usados para obter retardo de chamas em um tecido usando-se, p. ex., um ácido carboxílico substituído por halogênio ou um éster do mesmo, i.e. um ácido carboxílico fluorado, clorado ou bromatado ou um éster do mesmo. Em um aspecto, proporciona-se os métodos de gerar lipases de bibliotecas ambientais.
[0109] Em uma concretização, as “hidrolases” como proporcionadas aqui compreendem polipeptídios (p. ex., anticorpos, enzimas) e peptídios (p. ex., “sítios ativos”) apresentando qualquer atividade de hidrolase, i.e., os polipeptídios como proporcionados aqui podem apresentar qualquer atividade de hidrolase, incluindo p. ex., uma atividade de lipase, saturase, palmitase e/ou estearatase. Em outra concretização, as “hidrolases” como proporcionadas aqui incluem todos os polipeptídios apresentando qualquer atividade de lipase, saturase, palmitase e/ou estearatase, incluindo atividade de síntese de lipídios ou de hidrólise de lipídios, i.e., os polipeptídios como proporcionados aqui podem apresentar qualquer atividade de lipase, saturase, palmitase e/ou estearatase. Em outra concretização, lipases, saturases, palmitases e/ou estearatases como proporcionadas podem incluir enzimas ativas na bioconversão de lipídios por meio da catálise de hidrólise, alcoólise, acidólise, esterificação e aminólise. Em um aspecto, hidrolases (p. ex., lipases, saturases, palmitases e/ou estearatases) como proporcionadas aqui podem hidrolisar emulsões de lipídios. Em um aspecto, enzimas como proporcionadas aqui podem atuar preferencialmente em ligações Sn-1, Sn-2 e/ou Sn-3 de triacilglicerídeos para liberar um ou mais ácidos graxos da cadeia principal de glicerol. Por exemplo, atividade de hidrolase, lipase, saturase, palmitase e/ou estearatase dos polipeptídios como proporcionados aqui incluem a síntese de manteiga de cacau, ácidos graxos
Petição 870180005321, de 22/01/2018, pág. 54/316
48/293 poli-insaturados (PUFAs), 1,3-diacil glicerídeos (DAGs), 2-monoacilglicerídeos (MAGs) e triacilglicerídeos (TAGs). Em outra concretização, atividade de lipase, saturase, palmitase e/ou estearatase dos polipeptídios como proporcionados aqui também compreende a produção de óleos com baixo teor de saturação, p. ex., óleo de soja ou óleo de canola, por meio da remoção de um ácido graxo, p. ex., um ácido palmítico, oléico, láurico ou ácido esteárico. Em aspectos alternativos, enzimas como proporcionadas aqui também podem hidrolisar e/ou isomerizar ligações a altas temperaturas, baixas temperaturas, pHs alcalinos e a pHs ácidos. Em um aspecto a hidrolase, p. ex., lipase como proporcionada aqui é uma saturase que catalisa reações de hidrólise, alcoólise, acidólise, esterificação e aminólise onde o ácido carboxílico ou ácido graxo na molécula formado ou reagido é um ácido graxo saturado, como ácido acético, ácido butírico, ácido láurico, ácido mirístico, ácido palmítico, ácido esteárico ou ácido araquídico. Em um aspecto a hidrolase, p. ex., lipase ou saturase como proporcionada aqui é uma palmitase que catalisa reações de hidrólise, alcoólise, acidólise, esterificação e aminólise em que o átomos de carbono ou ácido graxo na molécula formado ou reagido é um ácido palmítico. Em um aspecto a hidrolase, p. ex., lipase ou saturase como proporcionada aqui é uma estearatase que catalisa reações de hidrólise, alcoólise, acidólise, esterificação e aminólise em que o ácido carboxílico ou ácido graxo na molécula formado ou reagido é um ácido esteárico.
[0110] Em determinadas concretizações, proporciona-se aqui enzimas compreendendo variantes de hidrolase (p. ex., “variante de lipase”, “variante de saturase”, “variante de palmitase” ou “variante de estearatase”) das enzimas como proporcionado aqui; estas enzimas podem apresentar uma sequência de aminoácidos que é derivada da sequência de aminoácidos de um “precursor”. O precursor pode incluir hidrolase naturalmente ocorrente e/ou uma hidrolase recombinante. A sequência de aminoácidos da variante de hidrolase é “derivada” da sequência de aminoácidos de hidrolase precursora por meio de substituição, deleção ou inserção de um ou mais aminoácidos da sequência de aminoácidos precursora. Referida modificação é da “sequência de DNA precursora” que codifica a sequência de aminoácidos da lipase precursora ao invés de manipulação da enzima hidrolase
Petição 870180005321, de 22/01/2018, pág. 55/316
49/293 precursora per se. Métodos vantajosos para referida manipulação da sequência de DNA precursora incluem métodos revelados aqui, e também métodos conhecidos por aqueles versados na arte.
GERANDO E MANIPULANDO ÁCIDOS NUCLEICOS [0111] Em um aspecto, ácidos nucleicos, incluindo cassetes de expressão, como vetores de expressão, codificando os polipeptídios (p. ex., hidrolases, como lipases saturases, palmitases e/ou estearatases, e anticorpos) são proporcionados aqui. Em outro aspecto, proporciona-se aqui ácidos nucleicos apresentando uma sequência como apresentada na SEQ ID NO:1 e apresentando pelo menos uma, duas, três, quatro, cinco, seis, sete, oito, nove, dez, onze ou doze ou mais ou todas as alterações de resíduo base descritas na Tabela 3, Tabela 4, Tabela 9, Tabela 10, Tabela 11, Tabela 16 ou Tabela 23 (ou o seu equivalente). Em uma concretização, proporciona-se aqui ácidos nucleicos codificando polipeptídios apresentando uma sequência como apresentada na SEQ ID NO:2 e apresentando pelo menos uma, duas, três, quatro, cinco, seis, sete, oito, nove, dez, onze ou doze ou mais ou todas as alterações de resíduos de aminoácidos descritas na Tabela 3, Tabela 4, Tabela 9, Tabela 10, Tabela 11, Tabela 16 ou Tabela 23 (ou o seu equivalente).
[0112] SEQ ID NO: 1
ATGCTGAAACCGCCTCCCTACGGACGCCTGCTGCGCGAACTGGCCGATATC CCGGCCATCGTGACGGCACCGTTCCGGGGCGCTGCGAAAATGGGCAAACTG GCGGATGGCGAGCCGGTACTGGTGCTGCCCGGCTTCCTGGCCGACGACAAC GCCACCTCGGTGCTGCGCAAGACCTTCGATGTCGCGGGCTTTGCCTGTTCG GGCTGGGAACGCGGCTTCAACCTCGGCATTCGTGGCGACCTCGTGGACCGG CTGGTCGACCGGCTGCGGGCGGTGTCGGAGGCGGCCGGTGGTCAGAAGGT GATCGTGGTCGGCTGGAGCCTCGGCGGCCTCTATGCGCGCGAGCTGGGCCA CAAGGCGCCCGAACTGATCCGGATGGTCGTCACGCTCGGCAGTCCGTTCGC GGGCGACCTCCACGCCAACCATGCGTGGAAGATCTACGAGGCGATCAACAG CCACACGGTCGACAACCTGCCGATCCCGGTCGATTTCCAGATTAAGCCGCC GGTGCGCACCATCGCGGTGTGGTCGCCGCTCGACGGGGTGGTGGCGCCGG AGACCTCGGAAGGCTCGCCCGAGCAGTCGGACGAGCGGCTAGAGCTGGCG
GTGACCCACATGGGCTTTGCCGCATCGAAGACCGGGGCCGAGGCTGTGGTC CGGCTGGTCGCGGCGCGGCTCTAG [0113] SEQ ID NO:2 (codificada pela SEQ ID NO:1):
[0114] código de 1 letra:
Petição 870180005321, de 22/01/2018, pág. 56/316
50/293
MLK.PPPYGRLLRELADIPAIVTAPFRGAAKMGKLADGEPVLVLPGFLADDNATSVLR
KTFDVAGFACSGWERGFNLGIRGDLVDRLVDRLRAVSEAAGGQKVIVVGWSLGGL
YARELGHKAPELIRMVVTLGSPFAGDLHANHAWKIYEAINSHTVDNLPIPVDFQIKPP
VRTIAVWSPLDGVVAPETSEGSPEQSDERLELAVTHMGFAASKTGAEAVVRLVAAR
L[0115] código de 3 letras:
Met Leu Lys Pro Pro Pro Tyr Gly Arg Leu Leu Arg Glu Leu Ala Asp
Ile Pro Ala Ile Vai Thr Ala Pro Phe Arg Gly Ala Ala Lys Met Gly
Lys Leu Ala Asp Gly Glu Pro Vai Leu Vai Leu Pro Gly Phe Leu Ala
Asp Asp Asn Ala Thr Ser Vai Leu Arg Lys Thr Phe Asp Vai Ala Gly Phe Ala Cys Ser Gly Trp Glu Arg Gly Phe Asn Leu Gly Ile Arg Gly Asp Leu Vai Asp Arg Leu Vai Asp Arg Leu Arg Ala Vai Ser Glu Ala Ala Gly Gly Gin Lys Vai Ile Vai Vai Gly Trp Ser Leu Gly Gly Leu Tyr Ala Arg Glu Leu Gly His Lys Ala Pro Glu Leu Ile Arg Met Vai Vai Thr Leu Gly Ser Pro Phe Ala Gly Asp Leu His Ala Asn His Ala Trp Lys Ile Tyr Glu Ala Ile Asn Ser His Thr Vai Asp Asn Leu Pro Ile Pro Vai Asp Phe Gin Ile Lys Pro Pro Vai Arg Thr Ile Ala Vai Trp Ser Pro Leu Asp Gly Vai Vai Ala Pro Glu Thr Ser Glu Gly Ser Pro Glu Gin Ser Asp Glu Arg Leu Glu Leu Ala Vai Thr His Met Gly Phe Ala Ala Ser Lys Thr Gly Ala Glu Ala Vai Vai Arg Leu Vai Ala Ala Arg Leu [0116] SEQ ID NO:3:
ATGGCCGGCCACCAGGGCGCGCGGGGCCCCAAAGACGGTCCGCCGGCGATGGTG ATCCCGGGCTTCCTCGCCCACGACAGGCACACGACACGATTGCGCCGGGAACTC GCCGAGGCGGGGTTCAGGGTTCACCCCTGGCGGCAGGGCTGGAACATGGGAGCG CGTGCCGACACGCTCGAGAAATTGAAGCGGGCAGTGGACCAGTGCGGTCATGAC GAGCCGATCCTGCTGGTCGGCTGGAGTCTGGGCGGGCTCTACGCGAGGGAGGTC GCGCGCGCCGAGCCGGATCAGGTGCGGGCGGTGGTCACTCTTGGTTCCCCGGTGT CGGGCGACCGGCGCCGCTACACCAACGTGTGGAAGCTGTACGAATGGGTGGCGG GTCACCCGGTGGACGACCCGCCGATCCCCGACAAGGAGGAAAAGCCGCCGGTGC CGACCCTGGCTTTGTGGTCGGCGGATGACGGGATCGTCGGCGCCCCGTCGGCGCG CGGGACTCAGTTATCTCACGACAAGGCGGTCGAGATGCGAACGAGCCACATGGG CTTTGCCATGTCGGCGAAGAGCGCACGCTTTGTTGTCGCCGAGATCGTGAAGTTC CTGAAGAAAACCGAAGGTTCCGAGTCGCACGATTGA [0117] SEQ ID NO:4 (codificada pela SEQ ID NO:3):
MAGHQGARGPKDGPPAMVIPGFLAHDRHTTRLRRELAEAGFRVHPWRQGWNMGA RADTLEKLKRAVDQCGHDEPILLVGWSLGGLYAREVARAEPDQVRAVVTLGSPVSG DRRRYTNVWKLYEWVAGHPVDDPP1PDKEEKPPVPTLALWSADDGIVGAPSARGTQ LSHDKAVEMRTSHMGFAMSAKSARFVVAEIVKFLKKTEGSESHD [0118] SEQ ID NO:5:
Petição 870180005321, de 22/01/2018, pág. 57/316
51/293
GTGAGCGAGAAAGGCGCACCCAAGGGAAGGCAGCGGCTGAAGGAGATCGGCGC GCTTCTGTTCCACGCGCCTCGCAGCTTGGGCCATCTGGGCGCGCGCGGCCCCAAG GACGGTCCTCCGGTGATGGTCATCCCGGGATTCCTCGCGCACGACTTGCATACGA CGCAGTTGCGCCGGGCGCTCGCGAAGGCAGGCTTCCGAGTGCATCCGTGGCGGC AGGGGATGAACCTTGGAGCGCGCGCCGATACGCTCGAAATTCTGAAGCGCGCGG TGGATTCCTGCGGCTCGAGCGAGCCGATGCTGCTCGTCGGCTGGAGCCTGGGCGG TCTCTATGCCCGGGAGATCGCGCGTGCGGAGCCGGACCGGGTGCGGGCGGTGGT GACGATGGGATCGCCGGTGTGGGGCGACCGCAGGCGCTACACCAACGTGTGGAA GCTGTACGAACGGATTGCCGGCCATCCGGTCGACAAGCCGCCGATCCCGGACAA GAGCCAGAAGCCGCCGGTGCCGACTCTGGCTTTGTGGTCGCAGCATGATGGCATC GTCGGCGCGCCCTCGGCGAGAGGGACGAAGAAGACCCGCGACAAGGCGGTCGC CATCGACACGACTCACATGGGGTTTGCCATGTCGCCCAAGACGACGCGCGCGGC AGTGCGTGAGATCGTGGGCTTTTTGAATGAAGTCGAAGGCGGTTCGTCACCCCGG GCGTGA [0119] SEQ ID NO:6 (codificada pela SEQ ID NO:5):
MSEKGAPKGRQRLKEIGALLFHAPRSLGHLGARGPKDGPPVMVIPGFLAHDLHTTQL RRALAKAGFRVHPWRQGMNLGARADTLEILKRAVDSCGSSEPMLLVGWSLGGLYA REIARAEPDRVRAVVTMGSPVWGDRRRYTNVWKLYERIAGHPVDKPPIPDKSQKPP VPTLALWSQHDGIVGAPSARGTKKTRDKAVAIDTTHMGFAMSPKTTRAAVREIVGF LNEVEGGSSPRA [0120] SEQ ID NO:7: ATGAGGCTGCGCGAGGGGGGCGCGCTCGTATCGCGGGCCTATCGCGCCTTCGGG CGCCTCGGCGAGCGCGGCCCGGCGGACGGGCCGCCGCTGATGGTGATCCCGGGC TTCCTCGCCACCGATCGCACCACTTTGGGGCTGCAGCGGGCGCTGGCCAAGGGCG> GCTACAAGGTGACCGGATGGGGCATGGGCCTCAACAGCGGCGTCACCGAAGACA TAGTCGACCGCATCGCCGCTCGGGTCGAAAGGTTTGGAGCCGGCCGCAAAGTGA TCCTCGTCGGCTGGAGCCTCGGCGGACTCTACGCGCGCGTGGTCGCGCAGGAGC GGCCGGATCTCGTCGACAAGGTGGTCACGCTCGGCTCGCCCTTTTCGGGCGACAG GCGCCGCAACAACAATGTCTGGCGGCTCTACGAGTTCGTC GCCGGCCATCCGGTCAACAGCCCGCCGATCGACAAGGACCCCGAGGTGAAGCCG CCGGTGCCGACGCTCGCTATCTGGTCGCGGCGCGACGGCATCGTCTCTCCGGCGG GCGCGCGCGGGCGGGAGGGAGAGCGCGACGCCGAGCTCGAGCTCGACTGCAGC CACATGGGCTTTGCGGTCAGCGCCAGGGCTTATCCCAAGATCGTGGAGGCGGTG CGGGCGTTTCCGGAAAACATCCGTTCGCGCTGA [0121] SEQ ID NO:8 (codificada pela SEQ ID NO:7):
MRLREGGALVSRAYRAFGRLGERGPADGPPLMVIPGFLATDRTTLGLQRALAKGGY KVTGWGMGLNSGVTEDIVDRIAARVERFGAGRKVILVGWSLGGLYARVVAQERPD LVDKVVTLGSPFSGDRRRNNNVWRLYEFVAGHPVNSPPIDKDPEVKPPVPTLAIWSR RDGIVSPAGARGREGERDAELELDCSHMGFAVSARAYPKJVEAVRAFPENIRSR [0122] SEQ ID NO:9:
Petição 870180005321, de 22/01/2018, pág. 58/316
52/293
ATGAAGCCGCCGCCCGGATGGATGAAGATCCGGGAGGCGGGCTCGCTCCTCGCG CGCTTCTACCGCGCGTTCGGCAAGCTCGAGCCGCGCGGGCCGGCGGACGGGCCG AAGCTGATGGTGATCCCGGGTTTCCTCGCGGGCGACAGGACGACGCTCGGGCTG cagcgagcgctggccggcggcggctaccgggtcgccggctgggggctgggggtg AACCGCGGCGTTTCGGAGGACGTGGTCGACCGGATCGGCCAGCAAGTCGCGCGG TTCGGGGCGGGCGAGAAGGTGATCCTGGTCGGCTGGAGCCTTGGCGGGCTTTAT GCGCGCGTGGTGGCGCAGGAGCGGCCCGACCTCGTCGAGAAGGTGGTGACCTTG GGCTCGCCGTTTTCGGGCGACCGGCGGCGCAACAACAATGTGTGGCGGCTCTATG AGTGGGTGGCTGGGCATCCGGTGAACGATCCGCCGATCGACAAGGACCCGGCGA AGAAGCCCCCGGTGCCGACGCTCGCGATCTGGTCGCGGCGTGATGGGATCGTGG CGGTCGAAGGCGCGCGGGGGCGGCCGGAGGAGCGGGATGCCGAGCTGGAGATC GATTGCAGCCACATGGGGTTTGGGGTCAGCGGCAAGGCGTTTCCCCGAATCGTA GAGGCGGTGAAGGGGTTCTAA [0123] SEQ ID NO: 10 (codificada pela SEQ ID NO:9): MKPPPGWMKIREAGSLLARFYRAFGKLEPRGPADGPKLMVIPGFLAGDRTTLGLQR ALAGGGYRVAGWGLGVNRGVSEDVVDRIGQQVARFGAGEKVILVGWSLGGLYAR VVAQERPDLVEKVVTLGSPFSGDRRRNNNVWRLYEWVAGHPVNDPPIDKDPAKKPP VPTLAIWSRRDGIVAVEGARGRPEERDAELEIDCSHMGFGVSGKAFPRIVEAVKGF [0124] SEQ ID NO: 11: GTGTTGGTGCTGCCGGCGTTCCTCGCCAACGACCTTCCCACTTCGCTTCTCCGCAG GACGCTGAAGGCGAACGGGTTTCGCCCGTTCGGCTGGGCGAACGGTTTCAACTTA. GGTGCACGGCCGGACACGCTCCAGCGCCTGAGCGCACGGCTCGATGCGGTGGTT CAGGAAGCGGGCAGGCCGGTTGCATTGATCGGCTGGAGCCTTGGCGGGCTTTAT GCCCGAGAGCTGGCGAAACGCAGGTCGGCTGAGGTGTCGGCAGTGATCACGCTC GGCACGCCCTTCTCGGTTGACCTCAGACGCAACAACGCCTGGAAGCTGTACGAG CTCATCAACGATCATCCTGTCGATGCCCCTCCCTTGGATGTTCAGGTCGACGCGA AGCCACCCGTCCGAACCTTCGCTTTGTGGTCGCGTCGCGACGGGATCGTAGCGCC CGCGAGCGCGCACGGCATGGAGGGCGAGTTCGACCAGGCGATCGAGCTGCAGTG CACGCACAACGAGATGGTCAGTGATCCGGAGGCCCTCTCCACGATCGTTACCTTG CTGCGGGAAAATGTTGGCTCCTGA [0125] SEQIDNO: 12 (codificada pela SEQ ID NO: 11):
MLVLPAFLANDLPTSLLRRTLKANGFRPFGWANGFNLGARPDTLQRLSARLDAVVQ EAGRPVALIGWSLGGLYARELAKRRSAEVSAVITLGTPFSVDLRRNNAWKLYELIND HPVDAPPLDVQVDAKPPVRTFALWSRRDGIVAPASAHGMEGEFDQAIELQCTHNEM VSDPEALSTIVTLLRENVGS [0126] SEQIDNO: 13:
Petição 870180005321, de 22/01/2018, pág. 59/316
53/293
GTGAATACAGCCGACCTATTGAAGCCACCACCCGCAAGCATGACAGTTCTCGAG GCGAGAGCGCTGCTGGACATATGCAAGATGAGCGCCCCATTGGCGCGCTTGCTA TTCAAAAAGAACTCGCCCTGGCGCAAACAACGGGTTCTCGTAATACCTGGCTTTG GCGCTGATGATCGCTACACCTGGCCGTTGCGCAATTTCGTCCAGGCACAGGGCTA TGCCACGACTGGCTGGGGCCTGGGCACCAACAAGGCAGGTCTCAATATGCCGCA TCAACTATCCGACGTCCACCCCAGATGGAAGCTAAAACCCAAGACGCCGTACCG TGGTGAGGCGGGCGTACCTTACGTGATTGACCGCTTGATCGAACGGTTTGACGAA TTGGCATCGACGGATCCGCAACCCATCGCACTTATAGGTTGGAGTCTGGGTGGTT TCATGGCCCGTGAAGTTGCCCGAGAGCGCCCAAACCAGGTG AGTC AGGTTAT1A CCCTCGGTTCTCCTGTCATCGGAGGCCCAAAATACACCCTCGCTGCATCGGCTTT CATCCGGCGCAAATACGATTTGGACTGGGTGGAGCAAGTGATCGCGGAGCGGGA AGATCGCCCCATTACTGTTCCTATTACAGCAATAGTCAGCCAGTCTGATGGCATC GTCGGATATTCAGCGGCAATCGATCACCACAGTCCCGCTGTGCAGCATTT ACATA TGGATGTTGCCCATTTGGGCTTTCCTTACAACACGAGGGTTTGGTCAGAAATCGC CAATGCGCTCAACTCTTTAGAGGTGGAGAAGGAGCGTGTTTAG [0127] SEQ ID NO: 14 (codificada pela SEQ ID NO: 13):
MNTADLLKPPPASMTVLEARALLDICKMSAPLARLLFKKNSPWRKQRVLVIPGFGA DDRYTWPLRNFVQAQGYATTGWGLGTNKAGLNMPHQLSDVHPRWKLKPKTPYRG EAGVPYVIDRLIERFDELASTDPQPIALIGWSLGGFMAREVARERPNQVSQV1TLGSPV IGGPKYTLAASAFIRRKYDLDWVEQVIAEREDRPITVPITAIVSQSDGIVGYSAAIDHH SPAVQHLHMDVAHLGFPYNTRVWSEIANALNSLEVEKERV [0128] SEQ ID NO: 15:
ATGGAGCTCGCCAAGGTCACCGCCCTGATGAAGGCCACCGCCCTCGAGATCGCG ATCCTCACCGGCCACCTCGTCCTCTACCCCTCCGGGATCGTGGCCGAGCGCCTCG CGGCCGCCCCCTCTTCACCGTCCTCCCCGTCCGCGGGCCCGACGGGCCGACGTCC GGTCGTCCTGCTGCACGGTTTCGTGGACAACCGCTCGGTCTTCGTCCTGCTGCGC CGTGCCCTCACCCGGAGCGGCCGTGACTGCGTCGAGTCGCTCAACTACTCGCCGC TCACCTGCGACCTGCGGGCCGCCGCCGAACTGCTGGGGCGCCGGGTGGACGAGA TCCGCGCCCGGACCGGACACGCCGAGGTCGACATCGTCGGCCACAGCCTGGGCG GGCTCATCGCCCGTTATTACGTACAGCGTCTCGGCGGTGACAGCCGGGTGCGCAC CCTGGTCATGCTCGGCACCCCGCACTCCGGCACCACCGTGGCCCGGCTCGCCGAC GCGCATCCGCTGGTGCGGCAGATGCGGCCGGGTTCGGAGGTGCTGCGGGAGCTC GCCGCGCCCTCGCCCGGCTGCCGTACCCGGTTCGTGAGCTTCTGGAGCGACCTC GACCAGGTGATGGTGCCGGTGGACACGGCCTGCCTGGACCACCCCGACCTGCTG GTGCACAACGTCCGGGTCAGCGGGATCGGTCATCTCGCGCTGCCGGTCCATCCCA CGGTGGCGGCCGGGGTCCGGGAGGCCCTCGACGCGAGCGGCGCGGGGGTCCCGG GGGTGCGGGAGGAGGGGCCCGGCGCCGGCGCCGTGGCGTGA [0129] SEQ ID NO:16 (codificada pela SEQ ID NO:15):
MELAKVTALMKATALEIAILTGHLVLYPSGIVAERLAAAPSSPSSPSAGPTGRRPVVL LHGFVDNRSVFVLLRRALTRSGRDCVESLNYSPLTCDLRAAAELLGRRVDEIRARTG HAEVDIVGHSLGGLIARYYVQRLGGDSRVRTLVMLGTPHSGTTVARLADAHPLVRQ MRPGSEVLRELAAPSPGCRTRFVSFWSDLDQVMVPVDTACLDHPDLLVHNVRVSGI GHLALPVHPTVAAGVREALDASGAGVPGVREEGPGAGAVA [0130] SEQ ID NO: 17:
Petição 870180005321, de 22/01/2018, pág. 60/316
54/293
GTGGCCGCCGCGGACAGCGGGACGGCGGAAGGGCAAAGGCTTCGGCCGCCGAG CCTGTTCCTGATGCTGGCCGAGGCGAGGGGCTTGCTCGAACTGAACTCGAGCCTG TTGTTGTCGCCGCTGTTGTTGCGGGCGCCGAAGGGCGACGGACATCCGGTGCTGG CGCTGCCGGGCTTTCTCGCCAGCGATCTGTCGATGGCGCCGATGCGGCGCTATCT GAAAGAACTCGGCTACGATGCCCATGCGTGGAACATGGGCCGCAATCTCGGCGG CGTCGCGTCCAAGCGCGAAGCCTTGCGCGACCTGTTGCGGCGCATTTACAGCCAG ACGGGCCGCAAGGTCAGCCTGGTCGGCTGGAGTCTCGGCGGCGTCTATGCGCGC GATCTCGCTTTGCAGGCGCCCGACATGGTGCGTTCCGTGATCACGCTCGGCAGTC CGTTTGCCAGCGACATCAGGGCGACCAACGCCACGCGGCTCTACGAGGCGCTGT CGGGAGAAAGGGTCGACGACAATCCGGAGTTAACAGCGGCGATCGCCGGCGACC TGCCGGTGCCGGCGACCTCGATCTATTCCCGTACCGACGGTATCGTGAACTGGCA CACCAGCCTGCTGCGTCCTTCCGCAACGGCTGAAAACATCGAGGTTTACTTCGCC AGCCATATCGGGCTCGGCGTCAACCCGGCAGCGCTGTGGGCGGTGGCCGACCGC CTGGCGCAGCCCGAGGGGGAATTTAAGCATTTTGACCGGTCGGGTCCCTTTGCCA TTGCCTATGGCCCCCCTGAAAATGCACAATCCTGA [0131] SEQ ID NO: 18 (codificada pela SEQ ID NO: 17):
MAAADSGTAEGQRLRPPSLFLMLAEARGLLELNSSLLLSPLLLRAPKGDGHPVLALP GFLASDLSMAPMRRYLKELGYDAHAWNMGRNLGGVASKREALRDLLRR1YSQTGR KVSLVGWSLGGVYARDLALQAPDMVRSVITLGSPFASD1RATNATRLYEALSGERV DDNPELTAAIAGDLPVPATSIYSRTDGIVNWHTSLLRPSATAENIEVYFASHIGLGVNP AALWAVADRLAQPEGEFKHFDRSGPFAIAYGPPENAQS [0132] SEQ ID NO: 19:
ATGCCGGAGCGAAACGAAGCGCAGGCCCCGCCGCGTCTTCGTCCGCCGGGGCTC GGGCTGTTCCTCGCCGAAGCGCGGGGCATTTTCGAGCTCAACGCGAGCCTGTTGC TGTCGCCGCTTCTGTTGCGCGCGCCGCGCGGCGACGGCCATCCGGTGCTGGCGTT GCCGGGCTTTCTTGCCAGTGATCTATCGATGGCGCCGTTGCGCCGCTACCTCACC GAGCTCGGCTACGACACCCACGCCTGGCGCATGGGCCGCAATGTCGGCGGCATC GCGAAGATGCGGATCGCGCTGCTCGAGCGGCTCACGCAGATCCATGCCGAGTGC GGCCGCAAGGTCTCGATTGTCGGCTGGAGTCTCGGCGGCGTCTATGCGCGCGACC TCGCGTTGCAGGCGCCCGAGATGGTGCGCTACGTCGTCACCCTCGGCAGCCCCTT CGCCAGCGACGTCCGCGCCACCAATGCGACGCGGCTCTATGAGGCGATGTCGGG CGAAACGGTCGGCGACAATGTCGACCTCGTGCAGGCGATTGCCGGCGACCTGCC GGTTCCCGTGACCTCGATCTATTCGAAGAGCGACGGCATCGTGAACTGGCGGACC TGCCTGCTGCGCCCGTCCGCGACCGCCGAGAATATCGAGGTCTATTTCGCGAGCC ATGTCGGCATCGGCGTCAATCCGGCCGCGCTGTGGGCGATCGCGGACCGGCTGG CCCAGCGGGAAGGCGAATrCCGCCCCTTCGACCGGTCCGGTCCTTTTGCCATTGC CTACGCGCCCCCGGAACAGGCACAATCGATCTGA [0133] SEQ ID NO:20 (codificada pela SEQ ID NO: 19):
MPERNEAQAPPRLRPPGLGLFLAEARGIFELNASLLLSPLLLRAPRGDGHPVLALPGF LASDLSMAPLRRYLTELGYDTHAWRMGRNVGGIAKMRIALLERLTQIHAECGRKVS 1VGWSLGGVYARDLALQAPEMVRYWTLGSPFASDVRATNATRLYEAMSGETVGD NVDLVQAIAGDLPVPVTSIYSKSDGIVNWRTCLLRPSATAENIEVYFASHVGIGVNPA ALWAIADRLAQREGEFRPFDRSGPFAIAYAPPEQAQSI [0134] Proporciona-se aqui métodos para descobrir novas sequências de
Petição 870180005321, de 22/01/2018, pág. 61/316
55/293 hidrolase usando os ácidos nucleicos como proporcionados aqui. Proporciona-se aqui também métodos para modificar os ácidos nucleicos como proporcionados aqui por meio de, p. ex., tecnologias GSSMSM e GeneReassemblySM. Os ácidos nucleicos como proporcionados aqui podem ser preparados, isolados e/ou manipulados por meio de, p. ex., clonagem e expressão de bibliotecas de cDNA, amplificação de mensagem ou DNA genômico por meio de PCR, e análogos.
[0135] A fonte inicial de ácidos nucleicos e polipeptídios exemplares selecionados compreende:
| SEQ ID NO: | FONTE |
| 1,2 | Obtido de amostra ambiental |
| 3, 4 | Obtido de amostra ambiental |
| 5, 6 | Obtido de amostra ambiental |
| 7, 8 | Obtido de amostra ambiental |
| 9, 10 | Obtido de amostra ambiental |
| 11, 12 | Obtido de amostra ambiental |
| 13, 14 | Obtido de amostra ambiental |
| 15, 16 | Bactérias |
| 17, 18 | Obtido de amostra ambiental |
| 19, 20 | Obtido de amostra ambiental |
[0136] Na prática dos métodos como proporcionados aqui, genes homólogos podem ser modificados por meio de manipulação de um ácido nucleico modelo, como descrito aqui. O objeto reivindicado pode ser praticado em conjunto com qualquer método ou protocolo ou dispositivo conhecido na arte, que são bem descritos na literatura científica e de patentes.
TÉCNICAS GERAIS [0137] Em determinadas concretizações, proporciona-se aqui ácidos nucleicos incluindo RNA, RNAi (p. ex., siRNA, miRNA), ácido nucleico anti-senso, cDNA, DNA genômico, vetores, vírus ou híbridos dos mesmos, ácidos nucleicos isolados de uma variedade de fontes, manipulados geneticamente, amplificados, e/ou
Petição 870180005321, de 22/01/2018, pág. 62/316
56/293 expressos/gerados recombinantemente. Polipeptídios recombinantes gerados a partir destes ácidos nucleicos podem ser isolados invidualmente ou clonados e testados para uma desejada atividade (p. ex., hidrolase, como p. ex., uma atividade de lipase, saturase, palmitase e/ou estearatase). É possível usar qualquer sistema de expressão recombinante, incluindo sistemas de expressão bacteriana, mamífera, de levedura, fúngica, de insetos ou de células de planta.
[0138] Alternativamente, estes ácidos nucleicos podem ser sintetizados in vitro por meio de técnicas bem conhecidas de síntese química, como descrito em, p. ex., Adams (1983) J. Am. Chem. Soc. 105:661; Belousov (1997) Nucleic Acids Res. 25:3440-3444; Frenkel (1995) Free Radic. Biol. Med. 19:373-380; Blommers (1994) Biochemistry 33:7886-7896; Narang (1979) Meth. Enzymol. 68:90; Brown (1979) Meth. Enzymol. 68:109; Beaucage (1981) Tetra. Lett. 22:1859; Patente U.S. n° 4.458.066.
[0139] Técnicas para a manipulação de ácidos nucleicos, como, p. ex., subclonagem, sondas de marcação (p. ex., marcação de iniciadores randômica usando polimerase de Klenow, tradução de vinco, amplificação), sequenciamento, hibridização e análogos são bem descritos na literatura científica e de patentes, ver, p. ex., Sambrook, ed., MOLECULAR CLONING: A LABORATORY MANUAL (2a ed.), vols. 1-3, Cold Spring Harbor Laboratory, (1989); CURRENT PROTOCOLS IN MOLECULAR BIOLOGY, Ausubel, ed. John Wiley & Sons, Inc., New York (1997); LABORATORY TECHNIQUES IN BIOCHEMISTRY AND MOLECULAR BIOLOGY: HYBRIDIZATION WITH NUCLEIC ACID PROBES, Part I. Theory and Nucleic Acid Preparation, Tijssen, ed. Elsevier, N. Y. (1993).
[0140] Outro meio útil de obtenção e manipulação de ácidos nucleicos usados para praticar os métodos como proporcionados aqui consiste em clonar de amostras genômicas, e, se desejado, selecionar e re-clonar insertos isolados ou amplificados de, p. ex., clones genômicos ou clones de cDNA. Fontes de ácido nucleico usadas nos métodos como proporcionados aqui incluem bibliotecas genômicas ou de cDNA contidas em, p. ex., cromossomos artificiais mamíferos (MACs), ver, p. ex., Patentes U.S. nums. 5.721.118; 6.025.155; cromossomos artificiais humanos, ver, p. ex.,
Petição 870180005321, de 22/01/2018, pág. 63/316
57/293
Rosenfeld (1997) Nat. Genet. 15:333-335; cromossomos artificiais de levedura (YAC); cromossomos artificiais bacterianos (BAC); cromossomos artificiais de P1, ver, p. ex., Woon (1998) Genomics 50:306-316; vetores derivados de P1 (PACs), ver, p. ex., Kern (1997) Biotechniques 23:120-124; cosmídeos, vírus recombinantes, fagos ou plasmídeos.
[0141] As expressões “ácido nucleico” ou “sequência de ácido nucleico” podem incluir um oligonucleotídeo, nucleotídeo, polinucleotídeo, ou um fragmento de qualquer um destes, DNA ou RNA (p. ex., mRNA, rRNA, tRNA, RNAi) de origem genômica ou sintética que pode ser de filamento simples ou de filamento duplo e pode representar um filamento senso ou anti-senso, um ácido nucleico de peptídio (PNA), ou qualquer material similar a DNA ou RNA, de origem natural ou sintética, incluindo, p. ex., RNAi (RNA “interferente” de filamento duplo), ribonucleoproteínas (p. ex., iRNPs). O termo compreende ácidos nucleicos, i.e., oligonucleotídeos, contendo análogos conhecidos de nucleotídeos naturais. O termo também compreende estruturas similares a ácido nucleico com espinhas dorsais sintéticas, ver p. ex. Mata (1997) Toxicol. Appl. Pharmacol. 144:189-197; Strauss-Soukup (1997) Biochemistry 36:8692-8698; Samstag (1996) Antisense Nucleic Acid Drug Dev 6:153-156.
[0142] Como usado aqui, o termo “promotor” inclui todas as sequências capazes de impelir a transcrição de uma sequência codificante em uma célula, p. ex., uma célula de planta. Assim, promotores usados nas construções como proporcionadas aqui incluem elementos de controle transcricional com ação cis e sequências reguladoras que estão envolvidas na regulação ou modulação do timing e/ou da taxa de transcrição de um gene. Por exemplo, um promotor pode ser um elemento de controle transcricional com ação cis, incluindo um acentuador, um promotor, um terminador de transcrição, uma origem de replicação, uma sequência de integração cromossômica, regiões não-traduzidas a 5' e 3', ou uma sequência intrônica, que estão envolvidas na regulação transcricional. Estas sequências com ação cis interagem tipicamente com proteínas ou outras biomoléculas para realizar (ligar/desligar, regular, modular, etc.) transcrição. Promotores “constitutivos” são aqueles que impelem a expressão continuamente sob a maior parte das condições
Petição 870180005321, de 22/01/2018, pág. 64/316
58/293 ambientais e estados de desenvolvimento ou diferenciação celular. Promotores “induzíveis” ou “reguláveis” dirigem a expressão do ácido nucleico como proporcionado aqui sob a influência de condições ambientais ou condições de desenvolvimento. Exemplos de condições ambientais que podem afetar a transcrição por promotores induzíveis incluem condições anaeróbicas, temperatura elevada, seca, ou a presença de luz.
[0143] Promotores “tecido-específicos” são elementos de controle transcricional que só são ativos em tecidos ou órgãos ou células particulares, p. ex., em plantas ou animais. A regulação tecido-específica pode ser obtida por meio de determinados fatores intrínsecos que asseguram que genes que codificam proteínas específicas para um dado tecido sejam expressos. Tais fatores são conhecidos por existirem em mamíferos e plantas de forma a permitir o desenvolvimento de tecidos específicos.
[0144] O termo “planta” inclui plantas inteiras, partes de plantas (p. ex., folhas, caules, folhes, raízes, etc.), protoplastos de plantas, sementes e células de plantas e progênie dos mesmos. A classe de plantas que podem ser usadas no método como proporcionado aqui é geralmente tão ampla quanto a classe de plantas superiores passíveis de técnicas de transformação, incluindo angiospermas (plantas monocotiledôneas e dicotiledôneas), e também gimnospermas. Ela inclui plantas de uma variedade de níveis plóides, incluindo estados poliplóides, diplóides, haplóides e hemizigóticos. Como usado aqui, o termo “planta transgênica” inclui plantas ou células de plantas em que uma sequência de ácido nucleico heteróloga foi inserida, p. ex., os ácidos nucleicos e várias construções recombinantes (p. ex., cassetes de expressão) como proporcionadas aqui.
[0145] Em um aspecto, um ácido nucleico que codifica um polipeptídio como proporcionado aqui é montado em fase apropriada com uma sequência leader capaz de dirigira a secreção do polipeptídio traduzido ou fragmento do mesmo.
[0146] Em uma concretização, proporciona-se aqui proteínas de fusão e ácidos nucleicos que codificam as mesmas. Um polipeptídio como proporcionado aqui pode ser fundido a um peptídio ou polipeptídio heterólogo, como peptídios de identificação N-terminais que conferem características desejadas, como estabilidade incrementada
Petição 870180005321, de 22/01/2018, pág. 65/316
59/293 ou purificação simplificada. Peptídios e polipeptídios como proporcionados aqui também podem ser sintetizados e expressos como proteínas de fusão com um ou mais domínios adicionais ligados aos mesmos para, p. ex., produzir um peptídio mais imunogênico, para isolar mais facilmente um peptídio sintetizado recombinantemente, para identificar e isolar anticorpos e células B que expressam anticorpos, e análogos. Domínios facilitadores de detecção e purificação incluem, p. ex., peptídios queladores de metal, como tratos de poliistidina e módulos de histidina-triptofano que permitem a purificação em metais imobilizados, domínios de proteína A que permitem a purificação em imunoglobulina imobilizada, e o domínio usado no sistema de purificação por afinidade/extensão FLAGS (Immunex Corp, Seattle WA). A inclusão de uma sequência ligante clivável, como Fator Xa ou sequências de clivagem de enteroquinase (Invitrogen, San Diego CA) entre um domínio de purificação e o polipeptídio ou peptídio compreendendo unidade repetitiva, pode facilitar a purificação. Por exemplo, um vetor de expressão pode incluir uma sequência de ácido nucleico que codifica epitopo ligada a seis resíduos histidina, seguido de uma tioredoxina e um sítio de clivagem de enteroquinase (ver, p. ex., Williams (1995) Biochemistry 34:1787-1797; Dobeli (1998) Protein Expr. Purif. 12:404-414). Os resíduos histidina facilitam a detecção e a purificação enquanto o sítio de clivagem de enteroquinase proporciona um meio para purificar o epitopo do restante da proteína de fusão. Tecnologia relativa a vetores codificando proteínas de fusão e a aplicação de proteínas de fusão são bem descritas na literatura científica e de patentes, ver p. ex., Kroll (1993) DNA Cell. Biol., 12:441-53.
SEQUÊNCIAS TRANSCRICIONAIS E DE CONTROLE TRADUCIONAL [0147] Em outra concretização, proporciona-se aqui sequências de ácido nucleico (p. ex., DNA, iRNA) ligadas operacionalmente a sequência(s) de controle de expressão (p. ex., transcricional ou traducional), p. ex., promotores ou acentuadores, para dirigir ou modular a expressão/síntese de RNA. A sequência de controle de expressão pode encontrar-se em um vetor de expressão. Promotores bacterianos exemplares incluem lacI, lacZ, T3, T7, gpt, lambda PR, PL e trp. Promotores eucarióticos exemplares incluem imediato precoce do CMV, timidina quinase do HSV,
Petição 870180005321, de 22/01/2018, pág. 66/316
60/293
SV40 precoce e tardio, retrovírus de LTRs, e metalotioneína de camundongo.
[0148] Promotores vantajosos para expressar um polipeptídio em bactérias incluem os promotores trp ou lac de E. coli, o promotor lacI, o promotor lacZ, o promotor T3, o promotor T7, o promotor gpt, o promotor lambda PR, o promotor lambda PL, promotores de óperons codificando enzimas glicolíticas, como 3fosfoglicerato quinase (PGK), e o promotor de fosfatase ácida. Promotores eucarióticos incluem o promotor precoce imediato do CMV, o promotor de timidina quinase do HSV, promotores de choque por calor, o promotor tardio e precoce do SV40, LTRs de retrovírus, e o promotor de metalotioneína-I de camundongo. Outros promotores conhecidos por controlarem a expressão de genes em células procarióticas ou eucarióticas ou seus vírus também podem ser usados.
PROMOTORES DE PLANTA TECIDO-ESPECÍFICOS [0149] Em uma concretização, proporciona-se aqui cassetes de expressão que podem ser expressas de uma maneira tecido-específica, p. ex., que podem expressar uma hidrolase como proporcionada aqui de uma maneira tecido-específica. Em outra concretização, proporciona-se aqui plantas ou sementes que expressam uma hidrolase como proporcionada aqui de uma maneira tecido-específica. A especificidade para tecido pode ser semente-específica, caule-específica, folhaespecífica, raiz-específica, fruto-específica e análogos.
[0150] Em um aspecto, um promotor constitutivo, como o promotor CaMV 35S pode ser usados para expressão em partes específicas da planta ou semente ou em toda a planta. Por exemplo, para a superexpressão de uma hidrolase como proporcionada aqui, é possível usar um fragmento de promotor de planta que dirigirá a expressão de um ácido nucleico em algum ou em todos os tecidos de uma planta,a p. ex., uma planta regenerada. Referidos promotores “constitutivos” são ativos sob a maior parte das condições ambientais e estados de desenvolvimento ou diferenciação celular. Exemplos de promotores constitutivos incluem a região de iniciação de transcrição 35S do vírus do mosaico da couve-flor (CaMV), o promotor 1'- ou 2' derivado de T-DNA de Agrobacterium tumefaciens, e outras regiões de iniciação de transcrição de vários genes de plantes conhecidos por aqueles com prática na arte.
Petição 870180005321, de 22/01/2018, pág. 67/316
61/293
Referidos genes incluem, p. ex., ACTIl de Arabidopsis (Huang (1996) Plant Mol. Biol. 33:125-139); Cat3 de Arabidopsis (GenBank No. U43147, Zhong (1996) Mol. Gen. Genet. 251 :196-203); o gene que codifica proteína desaturase do portador de estearoil-acila de Brassica napus (Genbank No. X74782, Solocombe (1994) Plant Physiol 104:1 167-1176); GPcI do milho (GenBank No. X15596; Martinez (1989) J. Mol. Biol 208:551-565); o Gpc2 do milho (GenBank No. U45855, Manjunath (1997) Plant Mol. Biol. 33:97-112); promotores de plantas descritos nas Patentes U.S. nums. 4.962.028; 5.633.440.
[0151] Em uma concretização, proporciona-se aqui promotores tecido-específicos ou promotores constitutivos derivados de vírus que podem incluir, p. ex., o promotor subgenômico do tobamovírus (Kumagai (1995) Proc. Natl. Acad. Sci. USA 92:16791683; o vírus baciliforme tungro do arroz RTBV), que replica apenas em células de floema em plantas de arroz infectadas, com seu promotor que impele forte expressão do gene repórter floema-específico; o promotor do vírus do mosaico da cassava vein (CVMV), com maior atividade em elementos vasculares, em células mesófilas de folhas, e em pontas de raízes (Verdaguer (1996) Plant Mol. Biol. 31:1129-1139).
[0152] Alternativamente, o promotor de planta pode dirigir a expressão de um ácido nucleico expressando hidrolase em um tipo específico de tecido, órgão ou célula (i.e. promotores tecido-específicos) ou, de outra forma, pode encontrar-se sob o controle ambiental ou desenvolvimental mais preciso ou sob o controle de um promotor induzível. Exemplos de condições ambientais que podem afetar a transcrição incluem condições anaeróbicas, temperatura elevada, a presença de luz, ou pulverizados com químicos/hormônios. Em uma concretização, proporciona-se aqui promotores do milho que são induzíveis por seca (Busk (1997) supra); o promotor da batata induzível por frio, seca e alta salinidade (Kirch (1997) Plant Mol. Biol. 33:897 909).
[0153] Promotores tecido-específicos podem promover transcrição apenas dentro de uma determinada janela de tempo do estado desenvolvimental dentro daquele tecido. Ver, p. ex., Blazquez (1998) Plant Cell 10:791-800, caracterizando o promotor do gene LEAFY de Arabidopsis. Ver também Cardon (1997) Plant J 12:367-77,
Petição 870180005321, de 22/01/2018, pág. 68/316
62/293 descrevendo o fator de transcrição SPL3, que reconhece uma unidade repetitiva de sequência conservada na região promotora do gene API de identidade do meristema floral de A. thaliana; e Mandel (1995) Plant Molecular Biology, vol. 29, pp 995-1004, descrevendo o promotor de meristema eIF4. É possível usar promotores tecidoespecíficos que são ativos durante o ciclo de vida de um tecido particular. Em um aspecto, os ácidos nucleicos como proporcionados aqui são ligados operacionalmente a um promotor ativo primariamente apenas em células de fibras de algodão. Em um aspecto, os ácidos nucleicos como proporcionados aqui são ligados operacionalmente a um promotor ativo primariamente durante os estágios do alongamento das células das fibras do algodão, p. ex., como descrito por Rinehart (1996) supra. Os ácidos nucleicos podem ser ligados operacionalmente ao promotor do gene Fbl2A para serem expressos preferencialmente em células de fibras de algodão (Ibid). Ver também, John (1997) Proc. Natl. Acad. Sci. USA 89:5769-5773; John, et al., Patentes U.S. nums. 5.608.148 e 5.602.321, descrevendo promotores específicos para fibras de algodão e métodos para a construção de plantas de algodão transgênicas. Promotores raiz-específicos também podem ser usados para expressar os ácidos nucleicos como proporcionados aqui. Exemplos de promotores raiz-específicos incluem o promotor do gene da álcool desidrogenase (DeLisle (1990) Int. Rev. Cytol. 39-60). Outros promotores que podem ser usados para expressar os ácidos nucleicos como proporcionados aqui de, p. ex., promotores óvulo-específicos, embriãoespecíficos, endosperma-específicos, integumento-específicos, semente-específicos, ou alguma combinação dos mesmos; um promotor folha-específico (ver, p. ex., (1997) Plant J. 11 :1285 1295, descrevendo um promotor folha-específico no milho); o promotor ORF 13 de Agrobacterium rhizogenes (que apresenta alta atividade em raízes, ver, p. ex., Hansen (1997) supra); um promotor específico para pólen de milho (ver, p. ex., Guerrero (1990) Mol. Gen. Genet. 224:161 168); um promotor do tomate ativo durante o amadurecimento dos frutos, senescência e abscisão de folhas e, em menor grau, de flores pode ser usado (ver, p. ex., Blume (1997) Plant J. 12:731 746); um promotor pistilo-específico do gene SK2 da batata (ver, p. ex., Ficker (1997) Plant Mol. Biol. 35:425 431); o gene Blec4 da ervilha, que é ativo no tecido epidérmico de
Petição 870180005321, de 22/01/2018, pág. 69/316
63/293 ápices de brotos vegetativos e florais de alfafa transgênica, tornando-o uma ferramenta útil para objetivar a expressão de genes estranhos à camada epidérmica de fibras ou brotos que se desenvolvem ativamente; o gene BEL1 óvulo-específico (ver, p. ex., Reiser (1995) Cell 83:735-742, GenBank No. U39944); e/ou, o promotor em Klee, Patente U.S. n° 5.589.583, descrevendo uma região promotora de planta [que] é capaz de conferir altos níveis de transcrição no tecido meristemático e/ou em células que se dividem rapidamente.
[0154] Alternativamente, promotores de plantas que são induzíveis mediante exposição a hormônios de plantas, como auxinas, são usados para expressar os ácidos nucleicos como proporcionados aqui. Em uma concretização, proporciona-se aqui promotores compreendendo fragmento de promotor E1 de elementos responsivos à auxina (AuxREs, auxin-response) na soja (Glycine max L.) (Liu (1997) Plant Physiol. 115:397-407); o promotor GST6 de Arabidopsis responsivo à auxina (também responsivo ao ácido salicílico e peróxido de hidrogênio) (Chen (1996) Plant J. 10: 955-966); o promotor parC induzível com auxina do tabaco (Sakai (1996) 37:906-913); um elemento de resposta à biotina de planta (Streit (1997) Mol. Plant Microbe Interact. 10:933-937); e o promotor responsivo ao ácido abscíssico do hormônio do estresse (Sheen (1996) Science 274:1900-1902).
[0155] Os ácidos nucleicos como proporcionados aqui também podem ser ligados operacionalmente a promotores de plantas que são induzíveis mediante exposição a reagentes químicos que podem ser aplicados na planta, como herbicidas ou antibióticos. Por exemplo, o promotor In2-2 do milho, ativado por protetores do herbicida benzenossulfonamida, pode ser usado (De Veylder (1997) Plant Cell Physiol. 38:568-577); a aplicação de diferentes protetores de herbicidas induz padrões distintos de expressão gênica, incluindo a expressão na raiz, hidatódio, e no meristema apical de brotos. Sequências codificantes podem encontrar-se sob o controle de, p. ex., um promotor induzível com tetraciclina, p. ex., como descrito com plantas de tabaco transgênicas contendo o gene arginina descarboxilase de Avena sativa L. (aveia) (Masgrau (1997) Plant J. 11 :465-473); ou, um elemento responsivo ao ácido salicílico (Stange (1997) Plant J. 11 :1315-1324). Usando promotores
Petição 870180005321, de 22/01/2018, pág. 70/316
64/293 induzidos quimicamente (p. ex., induzidos com hormônio ou praguicida), i.e., promotor responsivo a um químico que pode ser aplicado na planta transgênica no campo, a expressão de um polipeptídio como proporcionado aqui pode ser usada em um estágio particular de desenvolvimento da planta. Em determinadas concretizações, proporciona-se plantas transgênicas contendo um gene induzível codificando para polipeptídios como proporcionados aqui cuja faixa de hospedeiros é limitada a espécies de plantas alvos, como milho, arroz, cevada, trigo, batata ou outras culturas, induzíveis em qualquer estágio do desenvolvimento da cultura.
[0156] Promotores de plantas tecido-específicos podem impelir a expressão de sequências ligadas operacionalmente em tecidos diferentes do tecido-alvo. Assim, um promotor tecido-específico é um que impele a expressão preferencialmente no tecidoalvo ou no tipo de célula, mas também pode levar a alguma expressão em outros tecidos.
[0157] Os ácidos nucleicos como proporcionados aqui também podem ser ligados operacionalmente a promotores de plantas que são induzíveis mediante exposição a reagentes químicos. Estes reagentes incluem, p. ex., herbicidas, auxinas sintéticas, ou antibióticos que podem ser aplicados, p. ex., pulverizados, sobre plantas transgênicas. A expressão induzível dos ácidos nucleicos produtores de hidrolase como proporcionados aqui permitirá ao cultivador selecionar plantas com a relação ótima de amido:açúcar. O desenvolvimento de partes de plantas pode, assim, ser controlado.
[0158] Em uma concretização, proporciona-se aqui meios para facilitar a colheita de plantas e de partes de plantas. Por exemplo, em várias concretizações, o promotor In2-2 do milho, ativado por protetores do herbicida benzenossulfonamida, é usado (De Veylder (1997) Plant Cell Physiol. 38:568-577); a aplicação de diferentes protetores de herbicidas induz padrões distintos de expressão gênica, incluindo a expressão na raiz, hidatódios, e no meristema apical de brotos. Sequências codificantes como proporcionadas aqui também encontram-se sob o controle de um promotor induzível com tetraciclina, p. ex., como descrito com plantas de tabaco transgênicas contendo o gene arginina descarboxilase de Avena sativa L. (aveia) (Masgrau (1997) Plant J.
Petição 870180005321, de 22/01/2018, pág. 71/316
65/293
11:465-473); ou, um elemento responsivo ao ácido salicílico (Stange (1997) Plant J.
11:1315-1324).
[0159] Desejando-se expressão apropriada do polipeptídio, deveria-se incluir uma região de poliadenilação na ponta 3' da região codificante. A região de poliadenilação pode ser derivada do gene natural, de uma variedade de outros genes de plantas, ou de genes no T-DNA de Agrobacteria.
VETORES DE EXPRESSÃO E VEÍCULOS DE CLONAGEM [0160] Em uma concretização, proporciona-se aqui vetores de expressão, cassetes de expressão e veículos de clonagem compreendendo ácidos nucleicos, p. ex., sequências codificando as hidrolases e anticorpos. Vetores de expressão e veículos de clonagem como proporcionados aqui podem compreender partículas virais, baculovírus, fago, plasmídeos, fagomídeos, cosmídeos, fosmídeos, cromossomos artificiais bacterianos, DNA viral (p. ex., vaccinia, adenovírus, vírus da varíola aviária, pseudo-raiva e derivados de SV40), cromossomos artificiais baseados em P1, plasmídeos de levedura, cromossomos artificiais de levedura, e quaisquer outros vetores específicos para hospedeiros específicos de interesse (como bacillus, Aspergillus e levedura). Vetores como proporcionados aqui podem incluir sequências de DNA cromossômicas, não-cromossômicas e sintéticas. Conhece-se na arte grandes números de vetores vantajosos e que são comercialmente obteníveis. Vetores exemplares incluem: bacterianos: vetores pQE (Qiagen), plasmídeos pBLUESCRIPT™, vetores pNH, (vetores lambda-ZAP (Stratagene); ptrc99a, pKK2233, pDR540, pRIT2T (Pharmacia); Eukaryotic: pXTl, pSG5 (Stratagene), pSVK3, pBPV, pMSG, pSVLSV40 (Pharmacia). No entanto, qualquer outro plasmídeo ou outro vetor pode ser usado desde que eles sejam replicáveis e viáveis no hospedeiro. É possível usar vetores com baixo número de cópias ou com alto número de cópias.
[0161] Em uma concretização, uma “cassete de expressão” como proporcionada aqui compreende uma sequência de nucleotídeos que é capaz de efetuar a expressão de um gene estrutural (i.e., uma sequência codificante de proteína, como uma hidrolase como proporcionada aqui) em um hospedeiro compatível com referidas sequências. Cassetes de expressão incluem pelo menos um promotor ligado
Petição 870180005321, de 22/01/2018, pág. 72/316
66/293 operacionalmente com a sequência codificante do polipeptídio; e, opcionalmente, com outras sequências, p. ex., sinais de terminação de transcrição. Fatores adicionais necessários ou úteis para efetuar a expressão também podem ser usados, p. ex., acentuadores. “Ligado operacionalmente” como usado aqui refere-se à ligação de um promotor a montante de uma sequência de DNA de tal forma que o promotor media a transcrição da sequência de DNA. Assim, cassetes de expressão também incluem plasmídeos, vetores de expressão, vírus recombinantes, qualquer forma de vetor de “DNA nu” recombinante, e análogos. Um “vetor” compreende um ácido nucleico que pode infectar, transfectar, transduzir transientemente ou permanentemente uma célula. Deve-se reconhecer que um vetor pode ser um ácido nucleico desnudo, ou um ácido nucleico complexado com proteína ou lipídio. O vetor compreende opcionalmente ácidos nucleicos e/ou proteínas e/ou membranas virais ou bacterianas (p. ex., uma membrana celular, um envelope lipídico viral, etc.). Vetores incluem, mas não são limitados a réplicons (p. ex., réplicons de RNA, bacteriófagos) aos quais fragmentos de DNA podem ser ligados e tornam-se replicados. Assim, vetores incluem, mas sem limitar-se ao RNA, RNA ou DNA linear ou circular auto-replicante autônomo (p. ex., plasmídeos, vírus, e análogos, ver, p. ex., Patente U.S. n° 5.217.879), e inclui ambos, plasmídeos de expressão e de não-expressão. Onde uma cultura de células ou microorganismos recombinantes é descrita como abrigando um “vetor de expressão” isto inclui ambos, DNA linear e circular extra-cromossômico e DNA que foi incorporado no(s) cromossomo(s) do hospedeiro. Onde um vetor está sendo mantido por uma célula hospedeira, o vetor pode ser, ou replicado estavelmente pelas células durante a mitose como uma estrutura autônoma, ou é incorporado no genoma do hospedeiro.
[0162] O vetor de expressão pode compreender um promotor, um sítio de ligação de ribossoma para início de tradução e um terminador de transcrição. O vetor também pode incluir sequências apropriadas para amplificar a expressão. Vetores de expressão mamíferos podem compreender uma origem de replicação, qualquer sítios de ligação de ribossoma necessários, um sítio de poliadenilação, sítios doador e receptor de recomposição, sequências de terminação transcricional, e sequências de
Petição 870180005321, de 22/01/2018, pág. 73/316
67/293 flanqueamento não-transcritas a 5'. Em alguns aspectos, sequências de DNA derivadas da recomposição [splice] SV40 e sítios de poliadenilação podem ser usadas para proporcionar os requeridos elementos genéticos não-transcritos.
[0163] Em um aspecto, os vetores de expressão contêm um ou mais genes marcadores selecionáveis para permitir a seleção de células hospedeiras contendo o vetor. Referidos marcadores selecionáveis incluem genes que codificam diidrofolato redutase ou genes que conferem resistência à neomicina para cultura de células eucarióticas, genes que conferem resistência à tetraciclina ou ampicilina em E. coli, e o gene TRP1 de S. cerevisiae. Regiões promotoras podem ser selecionadas de qualquer gene desejado usando vetores de cloranfenicol transferase (CAT) ou outros vetores com marcadores selecionáveis.
[0164] Vetores para expressar o polipeptídio ou fragmento do mesmo em células eucarióticas também podem conter acentuadores para aumentar os níveis de expressão. Acentuadores são elementos de DNA com ação cis, usualmente com cerca de 10 a cerca de 300 pares de bases de comprimento que atuam sobre um promotor para incrementar sua transcrição. Exemplos incluem o acentuador do SV40 no lado tardio dos pares de bases de 100 a 270 da origem de replicação, o acentuador do promotor precoce do citomegalovírus, o acentuador de polioma do lado tardio da origem de replicação, e os acentuadores de adenovírus.
[0165] Uma sequência de DNA pode ser inserida em um vetor por meio de diversos procedimentos. De uma forma geral, a sequência de DNA é ligada à posição desejada no vetor após digestão do inserto e do vetor com endonucleases de restrição apropriadas. Alternativamente, pontas rombudas tanto no inserto e no vetor podem ser ligadas. Conhece-se na arte uma variedade de técnicas de clonagem, p. ex., como descrito em Ausubel e Sambrook. Tais procedimentos e outros devem ser compreendidos pelo escopo daqueles com prática na arte.
[0166] O vetor pode ser em forma de um plasmídio, uma partícula viral, ou um fago. Outros vetores incluem sequências de DNA cromossômicas, nãocromossômicas e sintéticas, derivados de SV40; plasmídeos bacterianos, DNA de fago, baculovírus, plasmídeos de levedura, vetores derivados de combinações de
Petição 870180005321, de 22/01/2018, pág. 74/316
68/293 plasmídeos e DNA de fago, DNA viral, como vaccinia, adenovírus, varíola das aves, e pseudo-raiva. Uma variedade de vetores de clonagem e de expressão para uso com hospedeiros procarióticos e eucarióticos é descrita, por exemplo, por Sambrook.
[0167] Vetores bacterianos particulares que podem ser usados incluem os plasmídeos comercialmente obteníveis compreendendo elementos genéticos do bem conhecido vetor de clonagem pBR322 (ATCC 3707), pKK223-3 (Pharmacia Fine Chemicals, Uppsala, Suécia), GEM1™ (Promega Biotec, Madison, WI, E.U.A.) pQE70, pQE60, pQE-9 (Qiagen), pD10, psiX174 Pbluescript II KS™, pNH8A, pNH16a, pNH18A, pNH46A (Stratagene), ptrc99a, pKK223-3, pKK233-3, 40, pRIT5 (Pharmacia), pKK232-8 e pCM7. Vetores eucarióticos particulares incluem 2CAT, pOG44, pXT1, pSG (Stratagene) pSVK3, pBPV, pMSG, e pSVL (Pharmacia). No entanto, é possível usar qualquer outro vetor desde que seja replicável e viável na célula hospedeira.
[0168] Os ácidos nucleicos como proporcionados aqui podem ser expressos em cassetes de expressão, vetores ou vírus e expressos transientemente ou estavelmente em células de plantas e sementes. Um sistema de expressão transiente exemplar usa sistemas de expressão epissômicos, p. ex., RNA viral do vírus do mosaico da couve-flor (CaMV) gerado no núcleo por meio de transcrição de um minicromossomo epissômico contendo DNA superenrolado, ver, p. ex., Covey (1990) Proc. Natl. Acad. Sci. USA 87:1633-1637. Alternativamente, sequências codificantes, i.e., todas as sequências ou sub-fragmentos de sequências como proporcionado aqui podem ser inseridos em um genoma de célula hospedeira de planta tornando-se uma parte integral do DNA cromossômico do hospedeiro. Transcrições no sentido senso ou anti-senso podem ser expressas desta maneira. Um vetor compreendendo as sequências (p. ex., promotores ou regiões codificantes) de ácidos nucleicos como proporcionado aqui podem compreender um gene marcador que confere um fenótipo selecionável em uma célula de planta ou uma semente. Por exemplo, o marcador pode codificar resistência a biocidas, particularmente resistência a antibióticos, como resistência à canamicina, G418, bleomicina, higromicina, ou resistência a herbicidas, como resistência ao clorosulfuron ou Basta.
Petição 870180005321, de 22/01/2018, pág. 75/316
69/293 [0169] Vetores de expressão capazes de expressar ácidos nucleicos e proteínas em plantas são bem conhecidos na arte, e podem incluir, p. ex., vetores de Agrobacterium spp., vírus X da batata (ver, p. ex., Angell (1997) EMBO J. 16:36753684), vírus do mosaico do tabaco (ver, p. ex., Casper (1996) Gene 173:69-73), vírus da atrofia do tomateiro [vírus bushy stunt] do tomate (ver, p. ex., Hillman (1989) Virology 169:42-50), potyvírus do tabaco (ver, p. ex., Dolja (1997) Virology 234:243252), vírus do mosaico dourado do feijão (ver, p. ex., Morinaga (1993) Microbiol Immunol. 37:471-476), vírus do mosaico da couve-flor (ver, p. ex., Cecchini (1997) Mol. Plant Microbe Interact. 10:1094-1101), elemento intercambiável Ac/Ds do milho (ver, p. ex., Rubin (1997) Mol. Cell. Biol. 17:6294-6302; Kunze (1996) Curr. Top. Microbiol. Immunol. 204:161-194), e o elemento intercambiável supressor-mutador (Spm) do milho (ver, p. ex., Schlappi (1996) Plant Mol. Biol. 32:717-725); e derivados dos mesmos.
[0170] Em um aspecto, o vetor de expressão pode apresentar dois sistemas de replicação para permitir que seja mantido em dois organismos, por exemplo em células mamíferas, de levedura, fúngicas ou de insetos para a expressão e em um hospedeiro procariótico para clonagem e amplificação. Adicionalmente, para integrar vetores de expressão, o vetor de expressão pode conter pelo menos uma sequência homóloga ao genoma da célula hospedeira. Ele pode conter duas sequências homólogas que flanqueiam a construção de expressão. O vetor integrante pode ser dirigido a um lócus específico no hospedeiro por meio de seleção da sequência homóloga apropriada para inclusão no vetor. Construções para integrar vetores são bem conhecidos na arte.
[0171] Vetores de expressão como proporcionados aqui também podem incluir um gene marcador selecionável para permitir a seleção de cepas bacterianas que foram transformadas, p. ex., genes que tornam bactérias resistentes a drogas, como ampicilina, cloranfenicol, eritromicina, canamicina, neomicina e tetraciclina. Marcadores selecionáveis também podem incluir genes biossintéticos, como aqueles nas vias biossintéticas da histidina, triptofano e leucina.
CÉLULAS HOSPEDEIRAS E CÉLULAS TRANSFORMADAS
Petição 870180005321, de 22/01/2018, pág. 76/316
70/293 [0172] Em uma concretização, proporciona-se aqui células transformadas compreendendo uma sequência de ácido nucleico, p. ex., uma sequência que codifica uma hidrolase ou um anticorpo, ou um vetor como proporcionado aqui. A célula hospedeira pode ser qualquer uma das células hospedeiras familiares àqueles versados na arte, incluindo células procarióticas, células eucarióticas, como células bacterianas, células fúngicas, células de levedura, células mamíferas, células de insetos, ou células de plantas.
[0173] Enzimas como proporcionadas aqui podem ser expressas em qualquer célula hospedeira, p. ex., qualquer célula bacteriana, qualquer célula de levedura, qualquer Saccharomyces ou Schizosaccharomyces spp., qualquer Pichia spp., p. ex., Pichia pastoris, Saccharomyces cerevisiae ou Schizosaccharomyces pombe. Células bacterianas exemplares incluem qualquer Streptomyces ou Bacillus spp., p. ex., E. coli, Lactococcus lactis, Bacillus subtilis, Bacillus cereus, Salmonella typhimurium ou qualquer espécies nos gêneros Bacillus, Streptomyces e Staphylococcus. Células de insetos exemplares incluem Drosophila S2 e Spodoptera Sf9. Células animais exemplares incluem CHO, COS ou melanoma de Bowes ou qualquer linha de células de camundongo ou de humano. A seleção de um hospedeiro apropriado encontra-se dentro das capacidades daqueles com prática na arte. Técnicas para transformar uma ampla variedade de espécies de plantas superiores são bem conhecidas e encontramse descritas na literatura técnica e científica. Ver, p. ex., Weising (1988) Ann. Rev. Genet. 22:421-477, Patente U.S. n° 5.750.870.
[0174] O vetor pode ser introduzido nas células hospedeiras usando-se qualquer uma de uma variedade de técnicas, incluindo transformação, transfecção, transdução, infecção viral, canhões de genes, ou transferência de genes mediada com Ti. Métodos particulares incluem transfecção com fosfato de cálcio, transfecção mediada com DEAE-Dextrano, lipofecção, ou eletroporação (Davis, L., Dibner, M., Battey, I., Basic Methods in Molecular Biology, (1986)).
[0175] Onde apropriado, as células hospedeiras manipuladas podem ser cultivadas em meio nutriente convencional modificado, conforme apropriado, para ativar promotores, selecionar transformantes ou amplificação dos genes como
Petição 870180005321, de 22/01/2018, pág. 77/316
71/293 proporcionado aqui. Após a transformação de uma cepa hospedeira apropriada e desenvolvimento da cepa hospedeira a uma densidade de células apropriada, o promotor selecionado pode ser induzido através de meios apropriados (p. ex., deslocamento de temperatura ou indução química) e as células podem ser cultivadas durante um período adicional para permitir que produzam o desejado polipeptídio ou fragmento do mesmo.
[0176] Em um aspecto, os ácidos nucleicos ou vetores como proporcionados aqui são introduzidos nas células para seleção, de modo que assim os ácidos nucleicos entram nas células de uma maneira vantajosa para expressão subsequente do ácido nucleico. O método de introdução é amplamente determinado pelo tipo de célula objetivado. Métodos exemplares incluem precipitação com CaPO4, fusão de liposomas, lipofecção (p. ex., LIPOFECTIN™), eletroporação, infecção viral, etc. Os ácidos nucleicos candidatos podem integrar de forma estável no genoma da célula hospedeira (por exemplo, com introdução retroviral) ou podem existir, ou transientemente ou de forma estável no citoplasma (i.e. por meio do uso de plasmídeos tradicionais, usando sequências reguladoras convencionais, marcadores de seleção, etc.). Concretizações alternativas compreendem vetores retrovirais capazes de transfectar referidos alvos (p. ex., células mamíferas, humanas) porque, p. ex., muitas seleções farmaceuticamente importantes requerem alvos celulares humanos ou mamíferos-modelo.
[0177] Células podem ser colhidas por meio de centrifugação, rompidas por meios físicos ou químicos, e o extrato bruto resultante é conservado para purificação ulterior. Células microbianas usadas para expressão de proteínas podem ser rompidas por meio de qualquer método convencional, incluindo ciclização de congelamentodescongelamento, sonicação, disrupção mecânica, ou uso de agentes de lise celular. Referidos métodos são bem conhecidos por aqueles versados na arte. O polipeptídio expresso ou fragmento do mesmo pode ser recuperado e purificado de culturas de células recombinantes por meio de métodos incluindo precipitação com etanol ou sulfato de amônio, extração com ácido, cromatografia de troca de ânion ou cátion, cromatografia de fosfocelulose, cromatografia de interação hidrofóbica, cromatografia
Petição 870180005321, de 22/01/2018, pág. 78/316
72/293 de afinidade, cromatografia de hidroxilapatita e cromatografia de lectina. É possível usar etapas de redobragem, conforme necessário, no completamento da configuração do polipeptídio. Se desejado, é possível usar cromatografia líquida de alto desempenho (HPLC) para etapas de purificação final.
[0178] Também é possível usar vários sistemas de cultura de células mamíferas para expressar proteína recombinante. Exemplos de sistemas de expressão mamíferos incluem as linhas COS-7 de fibroblastos de rim de macaco e outras linhas de células capazes de expressar proteínas de um vetor compatível, como as linhas de células C127, 3T3, CHO, HeLa e BHK.
[0179] As construções em células hospedeiras podem ser usadas de uma maneira convencional para produzir o produto gênico codificado pela sequência recombinante. Dependendo do hospedeiro usaro em um procedimento de produção recombinante, os polipeptídios produzidos por células hospedeiras contendo o vetor podem ser glicosilados ou podem ser não-glicosilados. Polipeptídios como proporcionados aqui podem ou não incluir um resíduo de aminoácido metionina inicial.
[0180] Também é possível usar sistemas de tradução isentos de células para produzir um polipeptídio como proporcionado aqui. Sistemas de tradução isentos de células podem usar mRNAs transcritos de uma construção de DNA compreendendo um promotor ligado operacionalmente a um ácido nucleico que codifica o polipeptídio ou fragmento do mesmo. Em alguns aspectos, a construção de DNA pode ser linearizada antes de se conduzir uma reação de transcrição in vitro. O mRNA transcrito é então incubado com um extrato de tradução isento de células apropriado, como um extrato de reticulócitos de coelho, para produzir o desejado polipeptídio ou fragmento do mesmo.
[0181] Os vetores de expressão podem conter um ou mais genes marcadores selecionáveis para proporcionar uma característica fenotípica para seleção de células hospedeiras transformadas, como resistência à neomicina ou diidrofolato redutase para cultura de células eucariótica, ou, como resistência à tetraciclina ou ampicilina em E. coli.
Amplificação de ácidos nucleicos
Petição 870180005321, de 22/01/2018, pág. 79/316
73/293 [0182] Em outra concretização, proporciona-se aqui ácidos nucleicos que codificam os polipeptídios, ou ácidos nucleicos modificados, [] podem ser reproduzidos, p. ex., por meio de amplificação. Em uma concretização, proporcionase aqui pares de iniciadores de amplificação para amplificar ácidos nucleicos que codificam uma hidrolase, p. ex., uma lipase, saturase, palmitase e/ou estearatase, sendo que os pares de iniciadores são capazes de amplificar sequências de ácido nucleico como proporcionado aqui. Alguém com prática na arte poderá projetar pares de sequências de iniciadores de amplificação para qualquer parte do comprimento pleno destas sequências.
[0183] Também é possível usar reações de amplificação para quantificar a quantidade de ácido nucleico em uma amostra (como a quantidade de mensagem em uma amostra de célula), marcar o ácido nucleico (p. ex., aplicá-lo em um conjunto ou um manchamento), detectar o ácido nucleico, ou quantificar a quantidade de um ácido nucleico específico em uma amostra. Em um aspecto como proporcionado aqui, a mensagem isolada de uma célula ou uma biblioteca de cDNA é amplificada. A pessoa versada pode selecionar e projetar iniciadores de amplificação de oligonucleotídeos vantajosos. Métodos de amplificação também são bem conhecidos na arte, e incluem, p. ex., reação em cadeia de polimerase, PCR (ver, p. ex., PCR PROTOCOLS, A GUIDE TO METHODS AND APPLICATIONS, ed. Innis, Academic Press, N. Y. (1990) e PCR STRATEGIES (1995), ed. Innis, Academic Press, Inc., N. Y., reação em cadeia de ligase (LCR) (ver, p. ex., Wu (1989) Genomics 4:560; Landegren (1988) Science 241 :1077; Barringer (1990) Gene 89:117); amplificação de transcrição (ver, p. ex., Kwoh (1989) Proc. Natl. Acad. Sci USA 86:1173); e, replicação de sequências autosustentadas (ver, p. ex., Guatelli (1990) Proc. Acad. Sci. USA 87:1874); amplificação de Q Beta replicase (ver, p. ex., Smith (1997) J. Microbiol. 35:1477-1491), ensaio de amplificação de Q-beta automatizado (ver, p. ex., (1996) Mol. Cell. Probes 10:257271) e outras técnicas NASBA mediadas com RNA polimerase, Cangene, Mississauga, Ontário); ver também Berger (1987) Methods Enzymol. 307-316; Sambrook; Ausubel; Patentes U.S. nums. 4.683.195 e 4.683.202; Sooknanan 5) Biotechnology 13:563-564.
Petição 870180005321, de 22/01/2018, pág. 80/316
74/293 [0184] Em uma concretização, proporciona-se aqui pares de iniciadores de amplificação compreendendo sequências como proporcionadas aqui, por exemplo, sendo que o par de iniciadores compreende um primeiro membro apresenta uma sequência como apresentada por cerca dos primeiros (a 5') 12, 13, 14, 15, 16, 17, 18, 19, 20, 21, 22, 23, 24, 25, 26, 27, 28, 29, 30, 31, 32, 33, 34, 35, 36, 37, 38, 39 ou 40 ou mais resíduos de um ácido nucleico como proporcionado aqui, e um segunda membro apresentando uma sequência como apresentada por cerca dos primeiros (a 5') 12, 13, 14, 15, 16, 17, 18, 19, 20, 21, 22, 23, 24, 25, 26, 27, 28, 29, 30, 31, 32, 33, 34, 35, 36, 37, 38, 39 ou 40 ou mais resíduos do filamento complementar do primeiro membro.
DETERMINAÇÃO DO GRAU DE IDENTIDADE DE SEQUÊNCIAS [0185] Em uma concretização, proporciona-se aqui ácidos nucleicos apresentando pelo menos identidade de ácido nucleico, ou identidade de sequências completa (100 %) com um ácido nucleico como proporcionado aqui, p. ex., um ácido nucleico exemplar como proporcionado aqui (p. ex., apresentando uma sequência como apresentada na SEQ ID NO:1, SEQ ID NO:3, SEQ ID NO:5, SEQ ID NO:7, SEQ ID NO:9, SEQ ID NO: 11, SEQ ID NO: 13, SEQ ID NO: 15, SEQ ID NO: 17, SEQ ID NO: 19, SEQ ID NO:22 ou SEQ ID NO:23, ou SEQ ID NO:1 modificada para codificar uma, duas, três, três, quatro, cinco, seis, sete, oito ou mais (várias) ou todas as variações de bases descritas na Tabela 3, Tabela 4, Tabela 9, Tabela 10, Tabela 11, Tabela 16 ou Tabela 23, ou seu equivalente); e polipeptídios apresentando pelo menos 50 %, 51 %, 52 %, 53 %, 54 %, 55 %, 56 %, 57 %, %, 59 %, 60 %, 61 %, 62 %, 63 %, 64 %, 65 %, 66 %, 67 %, 68 %, 69 %, 70 %, 71 %, %, 73 %, 74 %, 75 %, 76 %, 77 %, 78 %, 79 %, 80 %, 81 %, 82 %, 83 %, 84 %, 85 %, %, 87 %, 88 %, 89 %, 90 %, 91 %, 92 %, 93 %, 94 %, 95 %, 96 %, 97 %, 98 %, 99 %, ou mais, ou identidade de sequências completa (100 %) com um polipeptídio como proporcionado aqui, p. ex., um polipeptídio exemplar apresentando uma sequência como apresentada na SEQ ID NO:2, SEQ ID NO:4, SEQ ID NO:6, SEQ ID NO:8, SEQ ID NO:10, SEQ ID NO:12, SEQ ID NO:14, SEQ ID NO:16, SEQ ID NO: 18, ou SEQ ID NO:20 ou SEQ ID NO:2 apresentando uma, duas, três, quatro, cinco, seis, sete, oito ou mais (várias) ou todas as variações de aminoácidos descritas na Tabela 3, Tabela 4, Tabela 9, Tabela 10,
Petição 870180005321, de 22/01/2018, pág. 81/316
75/293
Tabela 11, Tabela 16 ou Tabela 23, ou seu equivalente. Em aspectos alternativos, a identidade de sequências pode ser em uma região de pelo menos cerca de 5, 10, 20, 30, 40, 50, 100, 150, 200, 300, 350, 400, 450, 500, 550, 600, 650, 700, 750, 800, 850, 900, 950, 1000, ou mais resíduos consecutivos, ou o comprimento pleno do ácido nucleico ou polipeptídio. A extensão da identidade de sequências (homologia) pode ser determinada usando-se qualquer programa de computador e parâmetros associados, incluindo aqueles aqui descritos, como BLAST 2.2.2, ou FASTA versão 3.0t78, com os parâmetros default. Como usado aqui, os termos “computador”, “programa de computador” e “processador” são usados em seus contextos gerais mais amplos e incorporam todos esses dispositivos, como descrito detalhadamente abaixo.
[0186] A tabela abaixo descreve características selecionadas de polipeptídios e ácidos nucleicos exemplares como proporcionados aqui, incluindo comparação de identidade de sequências das sequências exemplares com bancos de dados públicos para identificar atividade de enzimas como proporcionado aqui por meio de análise de homologia (identidade de sequências). Todas as sequências descritas na tabela (todas as sequências exemplares como proporcionadas aqui) foram submetidas a uma busca BLAST (como descrito em detalhe, abaixo) contra dois conjuntos de bancos de dados. O primeiro banco de dados é disponível através do NCBI (National Center for Biotechnology Information). Todos os resultados de buscas contra estes bancos de dados são encontrados nas colunas intituladas “Descrição NR”, “Código de acesso NR”, “E-value NR” ou “Organismo NR”. “NR” refere-se ao banco de dados de nucleotídeos não-redundante mantido pelo Centro Nacional para Informação de Biotecnologia (NCBI, National Center for Biotechnology Information). Este banco de dados é um composto do GenBank, atualizações do GenBank, e atualizações do EMBL. As entradas na coluna “Descrição NR” referem-se à linha de definição em qualquer dado registro de NCBI, que inclui uma descrição da sequência, como o organismo-fonte, nome do gene/nome da proteína, ou alguma descrição da função da sequência - identificando assim uma atividade das enzimas exemplares listadas como proporcionado aqui por meio de análise de homologia (identidade de sequências). As entradas na coluna “Código de acesso NR” referem-se ao identificador único dado a
Petição 870180005321, de 22/01/2018, pág. 82/316
76/293 um registro de sequência. As entradas na coluna “E-value NR” referem-se ao valor esperado (E-value, Expect value), que representa a probabilidade de que um escore de alinhamento tão bom quanto aquele encontrado entre a sequência de pesquisa [query] (as sequências como proporcionadas aqui) e uma sequência de banco de dados poderia ser encontrado no mesmo número de comparações entre sequências randômicas como foi feito na presente busca BLAST. As entradas na coluna “Organismo NR” referem-se ao organismo-fonte da sequência identificada como o acerto [hit] BLAST mais próximo (homologia de sequências). O segundo conjunto de bancos de dados é conhecido coletivamente como o banco de dados GENESEQ™, que é obtenível via Thomson Derwent (Philadelphia, PA). Todos os resultados de buscas contra este banco de dados são encontrados nas colunas intituladas “Descrição de proteína GENESEQ™”, “Código de acesso de proteína GENESEQ™”, “E-value de proteína GENESEQ™”, “Descrição de DNA GENESEQ™”, “Código de acesso de DNA GENESEQ™” ou “E-value de DNA GENESEQ™”. A informação encontrada nestas colunas é comparável com a informação encontrada nas colunas NR descritas acima, exceto que foi derivada de buscas BLAST contra o banco de dados GENESEQ™ em lugar dos bancos de dados do NCBI. AS colunas “Comprimento do DNA de pesquisa” e “Comprimento da proteína de pesquisa” referem-se ao número de nucleotídeos ou ao número de aminoácidos, respectivamente, na sequência como proporcionado aqui que foram pesquisados ou buscados contra os bandos de dados NCBI ou GENESEQ™. As colunas “Comprimento do DNA NR ou GENESEQ™” e “Comprimento da proteína NR ou GENESEQ™” referem-se ao número de nucleotídeos ou ao número de aminoácidos, respectivamente, na sequência do equivalência máxima da busca BLAST. Os resultados proporcionados nestas colunas são da busca que retornaram o menor Evalue, seja dos bancos de dados do NCBI ou do banco de dados Geneseq. As colunas “GENESEQ™/NR %ID proteína” e “GENESEQ™ /NR %ID DNA” referem-se ao percentual de identidade de sequências entre a sequência como proporcionada aqui e a sequência do BLAST de equivalência máxima. Os resultados proporcionados nestas colunas são da busca que returnaram o menor E-value, seja dos bancos de
Petição 870180005321, de 22/01/2018, pág. 83/316
77/293 dados do NCBI ou do banco de dados GENESEQ™.
Petição 870180005321, de 22/01/2018, pág. 84/316
| SEQ ID NO: | Descrição NR | Código de acesso NR | E-value NR | Organi smo NR | Descrição da proteína Geneseq | Código de Acesso de Proteína Geneseq | E-value de Proteína Geneseq | Descrição de DNA Geneseq | Código de Acesso de DNA Geneseq | E-value de DNA Geneseq | Gene s eq/NR %ID DNA |
| 1,2 | proteína hipotética Sala_0282 [Shingopyxis alaskensis RB2256] gi|98975854|gb|ABF52005. 1|proteína hipotética conservada [Sphingopyxis alaskensis RB2256] | 103485777 | 7,00E- 40 | Sphing o pyxis alaske nsis RB225 6 | Peptídio SEQ ID NO: 2 expressando atividade de hidrolase | AQZ64879 | 1,00E-127 | Peptídio SEQ ID NO: 2 expressando atividade de hidrolase, | AQZ64878 | 0 | |
| 3, 4 | proteína hipotética Sala_0282 [Shingopyxis alaskensis RB2256] gi|98975854|gb|ABF52005. 1|proteína hipotética conservada [Sphingopyxis alaskensis RB2256] | 103485777 | 2,00E- 40 | Sphing o pyxis alaske nsis RB225 6 | Peptídio SEQ ID NO: 2 expressando atividade de hidrolase | AQZ64879 | 3,00E-39 | Proteína codificada por gene essencial procariótico #30232 | ACA26233 | 1,8 |
78/293
Petição 870180005321, de 22/01/2018, pág. 85/316
| SEQ ID NO: | Descrição NR | Código de acesso NR | E-value NR | Organi smo NR | Descrição da proteína Geneseq | Código de Acesso de Proteína Geneseq | E-value de Proteína Geneseq | Descrição de DNA Geneseq | Código de Acesso de DNA Geneseq | E-value de DNA Geneseq | Gene s eq/NR %ID DNA |
| 5, 6 | proteína hipotética Sala_0282 [Shingopyxis alaskensis RB2256]gi|98975854|gb|AB F52005.1 |proteína hipotética conservada [Sphingopyxis alaskensis RB2256] | 103485777 | 8,00E- 42 | Sphing o pyxis alaske nsis RB225 6 | Peptídio SEQ ID NO: 2 expressando atividade de hidrolase | AQZ64879 | 3,00E-39 | Peptídio SEQ ID NO: 2 expressando atividade de hidrolase | AQZ64878 | 0,53 | |
| 7, 8 | proteína hipotética Sala_0282 [Shingopyxis alaskensis RB2256] gi|98975854|gb|ABF52005. 1|proteína hipotética conservada [Sphingopyxis alaskensis RB2256] | 103485777 | 1.00E- 46 | Sphing o pyxis alaske nsis RB225 6 | Peptídio SEQ ID NO: 2 expressando atividade de hidrolase | AQZ64879 | 7,00E-44 | Peptídio SEQ ID NO: 2 expressando atividade de hidrolase | AQZ64878 | 1,00E-04 |
79/293
Petição 870180005321, de 22/01/2018, pág. 86/316
| SEQ ID NO: | Descrição NR | Código de acesso NR | E-value NR | Organi smo NR | Descrição da proteína Geneseq | Código de Acesso de Proteína Geneseq | E-value de Proteína Geneseq | Descrição de DNA Geneseq | Código de Acesso de DNA Geneseq | E-value de DNA Geneseq | Gene s eq/NR %ID DNA |
| 9, 10 | proteína hipotética Sala_0282 [Shingopyxis alaskensis RB2256]gi|98975854|gb|AB F52005.1 |proteína hipotética conservada [Sphingopyxis alaskensis RB2256] | 103485777 | 3.00E- 51 | Sphing o pyxis alaske nsis RB225 6 | Peptídio SEQ ID NO: 2 expressando atividade de hidrolase | AQZ64879 | 2,00E | Peptídio SEQ ID NO: 2 expressando atividade de hidrolase | AQZ64878 | 1,00E-07 | |
| 11, 12 | proteína hipotética SKA58_17128[Sphingomon as sp.SKA58]gi|94422701|gb| EAT07736.1|proteína hipotética SKA58_17128[Sphingomon as sp.SKA58] | 94497812 | 4.00E- 46 | Sphing omona s sp. SKA58 | Peptídio SEQ ID NO: 2 expressando atividade de hidrolase | AQZ64879 | 3.00E-42 | Proteína SEQ ID NO:2739 diagnóstico e terapêutica humana | ACN41328 | 1.6 |
80/293
Petição 870180005321, de 22/01/2018, pág. 87/316
| SEQ ID NO: | Descrição NR | Código de acesso NR | E-value NR | Organi smo NR | Descrição da proteína Geneseq | Código de Acesso de Proteína Geneseq | E-value de Proteína Geneseq | Descrição de DNA Geneseq | Código de Acesso de DNA Geneseq | E-value de DNA Geneseq | Gene s eq/NR %ID DNA |
| 13, 14 | proteína hipotética PPSIR1_24779[Plesiocysti s pacifica SIR- 1]gi|149817999|gb|EDM77 458.1|proteína hipotética PPSIR1_24779[Plesiocysti s pacifica SIR-1] | 149921112 | 3.00E- 32 | Plesioc ystis pacific a SIR-1 | Proteína SEQ ID NO: 2 contendo atividade de hidrolase. | AOG53993 | 1.00E-155 | Proteína SEQ ID NO: 2 contendo atividade de hidrolase. | AOG53992 | 0 | |
| 15, 16 | lipase [Streptomyces avermitilis MA- 4680]gi|29607114|dbj|BAC 71173.1|lipase putativa [Streptomyces avermitilis MA-4680] | 29830004 | 1.00E- 100 | Strepto m yces avermit ilis MA4680 | Peptídio SEQ ID NO: 2 expressando atividade de hidrolase. | AQZ6464 | 5.00E-21 | ACL64205 | 0.003 |
81/293
Petição 870180005321, de 22/01/2018, pág. 88/316
| SEQ ID NO: | Descrição NR | Código de acesso NR | E-value NR | Organi smo NR | Descrição da proteína Geneseq | Código de Acesso de Proteína Geneseq | E-value de Proteína Geneseq | Descrição de DNA Geneseq | Código de Acesso de DNA Geneseq | E-value de DNA Geneseq | Gene s eq/NR %ID DNA |
| 17, 18 | proteína hipotética blr2879[Bradyhizobium japonicum USDA 110] gi|27351136|dbj|BAC48144 .1|blr2879[Bradyrhizobium japonicum USDA 110] | 27377990 | 1.00E- 115 | Bradyr hizobiu m japonic um USDA 110 | Proteína SEQ ID NO:5 de antígeno micobacteria no de Mycobacteriu m tuberculosis. | ABM15916 | 8.00E-48 | Peptídio SEQ ID NO: 2 expressando atividade de hidrolase. | AQZ64878 | 1.00E-05 | |
| 19, 20 | proteína hipotética blr2879[Bradyrhizobium japonicum USDA 110]gi|27351136|dbj|BAC4 8144.1|blr2879[Bradyrhizob ium japonicum USDA 110] | 27377990 | 1.00E- 118 | Bradyr hizobiu m japonic um USDA 110 | Proteína SEQ ID NO: 5 de antígeno micobacteria no de Mycobacteriu m tuberculosis. | ABM15916 | 1.00E-44 | Peptídio SEQ ID NO: 2 expressando atividade de hidrolase. | AQZ64878 | 2.00E-04 |
82/293
Petição 870180005321, de 22/01/2018, pág. 89/316
| SEQ ID NO: | Descrição NR | Código de acesso NR | E-value NR | Organi smo NR | Descrição da proteína Geneseq | Código de Acesso de Proteína Geneseq | E-value de Proteína Geneseq | Descrição de DNA Geneseq | Código de Acesso de DNA Geneseq | E-value de DNA Geneseq | Gene s eq/NR %ID DNA |
| 1,2 | proteína hipotética Sala_0282[Sphingopyxis alaskensis RB2256]gi|98975854|gb|AB F52005.1 |proteína hipotética conservada [Sphingopyxis alaskensis RB2256] | 684 | 227 | 684 | 227 | ||||||
| 3, 4 | proteína hipotética Sala_0282[Sphingopyxis alaskensis RB2256]gi|98975854|gb|AB F52005.1|proteína hipotética conservada [Sphingopyxis alaskenis RB2256] | 633 | 210 | 0 | 249 | 47 |
83/293
Petição 870180005321, de 22/01/2018, pág. 90/316
| SEQ ID NO: | Descrição NR | Código de acesso NR | E-value NR | Organi smo NR | Descrição da proteína Geneseq | Código de Acesso de Proteína Geneseq | E-value de Proteína Geneseq | Descrição de DNA Geneseq | Código de Acesso de DNA Geneseq | E-value de DNA Geneseq | Gene s eq/NR %ID DNA |
| 5, 6 | proteína hipotética Sala_0282[Sphingopyxis alaskensis RB2256]gi|98975854|gb|AB F52005.1 |proteína hipotética conservada [Sphingopyxis alaskenis RB2256] | 711 | 236 | 0 | 249 | 42 | |||||
| 7, 8 | proteína hipotética Sala_0282[Sphingopyxis alaskensis RB2256]gi|98975854|gb|AB F52005.1|proteína hipotética conservada [Sphingopyxis alaskenis RB2256] | 669 | 222 | 0 | 249 | 46 |
84/293
Petição 870180005321, de 22/01/2018, pág. 91/316
| SEQ ID NO: | Descrição NR | Código de acesso NR | E-value NR | Organi smo NR | Descrição da proteína Geneseq | Código de Acesso de Proteína Geneseq | E-value de Proteína Geneseq | Descrição de DNA Geneseq | Código de Acesso de DNA Geneseq | E-value de DNA Geneseq | Gene s eq/NR %ID DNA |
| 9, 10 | proteína hipotética Sala_0282[Sphingopyxis alaskensis RB2256]gi|98975854|gb|AB F52005.1 |proteína hipotética conservada [Sphingopyxis alaskenis RB2256] | 669 | 222 | 0 | 249 | 48 | |||||
| 11, 12 | proteína hipotética SKA58_17128[Sphingomon as sp. SKA58]gi|94422701 |gb|EA T07736.1 |proteína hipotética SKA58_17128[Sphingomon as sp.SKA58] | 570 | 189 | 0 | 298 | 46 |
85/293
Petição 870180005321, de 22/01/2018, pág. 92/316
| SEQ ID NO: | Descrição NR | Código de acesso NR | E-value NR | Organi smo NR | Descrição da proteína Geneseq | Código de Acesso de Proteína Geneseq | E-value de Proteína Geneseq | Descrição de DNA Geneseq | Código de Acesso de DNA Geneseq | E-value de DNA Geneseq | Gene s eq/NR %ID DNA |
| 13, 14 | proteína hipotética PPSIR1_24779[Plesiocysti s pacifica SIR- 1]gi|149817999|gb|EDM77 458.1|proteína hipotética PPSIR1_24779[Plesiocysti s pacifica SIR-1] | 807 | 268 | 807 | 268 | ||||||
| 15, 16 | lipase[Streptomycies avermitilis MA- 4680]gi|29607114|dbj|BSC 71173.1|lipase putativa [Streptomyces avermitilis MA-4680] | 804 | 267 | 0 | 286 | 69 |
86/293
Petição 870180005321, de 22/01/2018, pág. 93/316
| SEQ ID NO: | Descrição NR | Código de acesso NR | E-value NR | Organi smo NR | Descrição da proteína Geneseq | Código de Acesso de Proteína Geneseq | E-value de Proteína Geneseq | Descrição de DNA Geneseq | Código de Acesso de DNA Geneseq | E-value de DNA Geneseq | Gene s eq/NR %ID DNA |
| 17, 18 | proteína hipotética blr2879[Bradyrhizobium japonicum USDA 110]gi|27351136|dbj|BAC4 8144.1|blr2879[Bradyrhizob ium japonicum USDA 110] | 798 | 265 | 0 | 266 | 79 | |||||
| 19, 20 | proteína hipotética blr2879[Bradyrhizobium japonicum USDA 110]gi|27351136|dbj|BAC4 8144.1|blr2879[Bradyrhizob ium japonicum USDA 110] | 798 | 265 | 0 | 266 | 79 |
87/293
Petição 870180005321, de 22/01/2018, pág. 94/316
88/293 [0187] Sequências homólogas também incluem sequências de RNA em que uridinas substituem as timinas nas sequências de ácido nucleico. As sequências homólogas podem ser obtidas usando-se qualquer um dos procedimentos aqui descritos ou podem resultar da correção de um erro de sequenciamento. Deve-se considerar que as sequências de ácido nucleico como apresentadas aqui podem ser representadas no formato de caráter simples tradicional (ver, p. ex., Stryer, Lubert. Biochemistry, 3a ed., W. H Freeman & Co., New York) ou em qualquer outro formato que registre a identidade dos nucleotídeos em uma sequência.
[0188] Vários programas de comparação de sequências identificados aqui e conhecidos por alguém com prática na arte podem ser usados para comparação de sequências. Identidades de sequências de proteína e/ou ácido nucleico (homologias) podem ser avaliadas usando-se qualquer um da variedade de programas e ritmos de comparação de sequências conhecidos na arte. Referidos algoritmos e programas incluem, embora sem limitação, TBLASTN, BLASTP, FASTA, TFASTA, e CLUSTALW (Pearson e Lipman, Proc. Natl. Acad. Sci. USA 85(8):2444-2448, 1988; Altschul et al., J. Mol. Biol. 3):403-410, 1990; Thompson et al., Nucleic Acids Res. 22(2):4673-4680, 1994; Higgins, Methods Enzymol. 266:383-402, 1996; Altschul et al., J. Mol. Biol. 215(3):403-410, 0; Altschul et al., Nature Genetics 3:266-272, 1993).
[0189] Homologia ou identidade podem ser medidas usando software de análise de sequências (p. ex., Sequence Analysis Software Package do Genetics Computer Group, University of Wisconsin Biotechnology Center, 1710 University Avenue, Madison, WI 53705). Referido software busca equivalência de sequências similares atribuindo graus de homologia a várias deleções, substituições e outras modificações. Os termos “homologia” e “identidade” no contexto de dois ou mais ácidos nucleicos ou sequências de polipeptídios, referem-se a duas ou mais sequences ou subsequências que são iguais ou que apresentam um percentual especificado de resíduos de aminoácidos ou nucleotídeos que são iguais quando comparados e alinhados para correspondência máxima em uma janela de comparação ou região designada conforme medido usando-se qualquer número de algoritmos de comparação de sequências ou por meio de alinhamento manual e inspeção visual. Para comparação de sequências, uma sequência pode atuar como uma sequência
Petição 870180005321, de 22/01/2018, pág. 95/316
89/293 de referência (p. ex., uma sequência de polipeptídio ou ácido nucleico exemplar como proporcionado aqui) com a qual se compara sequências de teste. Quando se usa um algoritmo de comparação de sequências, introduz-se sequências de teste e de referência em um computador, designa-se coordenadas de subsequências, se necessário, e atribuise parâmetros de programas de algoritmos de sequências. É possível usar parâmetros de programas default, ou é possível atribuir parâmetros alternativos. O algoritmo de comparação de sequências calcula então o percentual de identidades de sequências para as sequências de teste relativamente à sequência de referência, com base nos parâmetros do programa.
[0190] Uma “janela de comparação”, como usado aqui, inclui referência a um segmento de qualquer um dos números de resíduos contíguos. Por exemplo, em aspectos alternativos como proporcionados aqui, resíduos contíguos compreendendo em qualquer ponto de uma faixa de 20 até o comprimento pleno de uma sequência exemplar de polipeptídio ou ácido nucleico, são comparados com uma sequência de referência do mesmo número de posições contíguas após as duas sequências terem sido alinhadas otimamente. Se a sequência de referência apresentar a identidade de sequências requerida para uma sequência exemplar de polipeptídio ou ácido nucleico, p. ex., em aspectos alternativos, 50 %, 51 %, 52 %, 53 %, 54 %, %, 56 %, 57 %, 58 %, 59 %, 60 %, 61 %, 62 %, 63 %, 64 %, 65 %, 66 %, 67 %, 68 %, %, 70 %, 71 %, 72 %, 73 %, 74 %, 75 %, 76 %, 77 %, 78 %, 79 %, 80 %, 81 %, 82 %, %, 84 %, 85 %, 86 %, 87 %, 88 %, 89 %, 90 % 91 %, 92 %, 93 %, 94 %, 95 %, 96 %, %, 98 %, 99 %, ou mais de identidade de sequências, ou identidade completa (100 %), com uma sequência exemplar de polipeptídio ou ácido nucleico como proporcionado aqui, a sequência encontra-se dentro do escopo como proporcionado aqui. Em concretizações alternativas, sequências que compreendem de cerca de 20 a 600, de cerca de 50 a 200, e cerca de 100 a 150 são comparadas com uma sequência de referência do mesmo número de posições contíguas após as duas sequências terem sido alinhadas otimamente. Métodos de alinhamento de sequência para comparação são bem conhecidas na arte. O alinhamento ótimo de sequências para comparação pode ser conduzido, p. ex., pelo algoritmo de homologia local de Smith & Waterman, Adv. Appl. Math. 2:482, 1981, por meio
Petição 870180005321, de 22/01/2018, pág. 96/316
90/293 do algoritmo de alinhamento de homologia de Needleman & Wunsch, J. Mol. Biol. 48:443, 1970, por meio do método de busca por similaridade de Person & Lipman, Proc. Nat'l. Acad. Sci. USA 85:2444, 1988, por meio de implementações computadorizadas destes algoritmos (GAP, BESTFIT, FASTA, e TFASTA no Wisconsin Genetics Software Package, Genetics Computer Group, 575 Science Dr., Madison, WI), ou por meio de alinhamento manufla e inspeção visual. Outros algoritmos para determinar a homologia ou identidade incluem, por exemplo, adicionalmente ao programa de ferramentas básicas de pesquisa de alinhamento local (BLAST, basic local alignment search tools) (Basic Local Alignment Search Tool no National Center for Biological Information), ALIGN, análise de sequências multiplamente alinhadas AMAS (Analysis of Multiply Aligned Sequences), alinhamento de sequências múltiplas de proteína AMPS (Protein Multiple Sequence Alignment), ferramenta de avaliação estatística de segmentos alinhados ASSET (Aligned Segment Statistical Evaluation Tool), BANDS, BESTSCOR, nodo de análise comparativa biológica de sequências BIOSCAN (Biological Sequence Comparative Analysis Node), BLIMPS (BLocks IMProved Searcher), FASTA, Intervals & Points, BMB, CLUSTAL V, CLUSTAL W, CONSENSUS, LCONSENSUS, WCONSENSUS, algoritmo de Smith-Waterman, DARWIN, algoritmo de Las Vegas, ferramenta de alinhamento forçado de nucleotídeos FNAT (Forced Nucleotide Alignment Tool), Framealign, Framesearch, DYNAMIC, FILTER, pacote de análise de sequências de Fristensky FSAP (Fristensky Sequence Analysis Package), programa de alinhamento global GAP (Global Alignment Program), GENAL, GIBBS, GenQuest, ISSC (Sensitive Sequence Comparison), alinhamento de sequências locais LALIGN (Local Sequence Alignment), programa de conteúdo local LCP (Local Content Program), MACAW (Multiple Alignment Construction & Analysis Workbench), programa de alinhamentos múltiplos MAP (Multiple Alignment Program), MBLKP, MBLKN, alinhamento de multi-sequências induzido por padrão PIMA (Pattern-Induced Multisequence Alignment), alinhamento de sequências por algoritmo genético SAGA (Sequence Alignment by Genetic Algorithm) e WHAT-IF. Referidos programas de alinhamento também podem ser usados para selecionar bancos de dados de genoma para identificar sequências de polinucleotídeos apresentando sequências substancialmente idênticas. Uma quantidade de bancos de dados de genoma encontram-se disponíveis, por
Petição 870180005321, de 22/01/2018, pág. 97/316
91/293 exemplo, uma porção substancial do genoma humano encontra-se disponível como parte do projeto de sequenciamento do genoma humano [Human Genome Sequencing Project] (Gibbs, 1995). Vários genomas foram sequenciados, p. ex., M. genitalium (Fraser et al., 1995), M. jannaschii (Bult et al., 1996), H. influenzae (Fleischmann et al., 1995), E. coli (Blattner et al., 1997), e levedura (S. cerevisiae) (Mewes et al., 1997), e D. melanogaster (Adams et al., 2000). Também se conseguiu significativo progresso no sequenciamento dos genomas de organismos-modelo, como camundongo, C. elegans, e Arabidopsis sp. Bancos de dados contendo informação genômica anotada com alguma informação funcional são mentidos por diferentes organizações, e são acessíveis através da internet.
[0191] Algoritmos BLAST, BLAST 2.0 e BLAST 2.2.2 também são usados. Eles são descritos em Altschul (1977) Nuc. Acids Res. 25:3389-3402; Altschul (1990) J. Mol. Biol. 403-410. Software para realizar análises BLAST é publicamente disponível por meio do National Center for Biotechnology Information. Este algoritmo envolve identificar primeiro pares de sequências com escores elevados (HSPs, high scoring sequence pairs) por meio da identificação de palavras curtas com comprimento W na sequência de pesquisa, que, ou equivalem a, ou satisfazem algum escore T de limiar valorizado como positivo quando alinhado com uma palavra com o mesmo procedimento em uma sequência de banco de dados. T é referido como o limite [neighborhood word score threshold] (Altschul (1990) supra). Estes acertos de palavras iniciais nas adjacências [initial neighborhood word hits] atuam como sementes para iniciar buscas com o objetivo de encontrar HSPs mais longos contendo os mesmos. Os acertos de palavras são estendidos em ambas as direções ao longo de cada sequência enquanto o escore de alinhamento cumulativo puder ser incrementado. Escores cumulativos são calculados usando-se, para sequências de nucleotídeos, os parâmetros M (escore de recompensa para um par de resíduos de equiparação [matching]; sempre >0). Para sequências de aminoácidos, usa-se uma matriz de classificação para calcular o escore cumulativo. A extensão dos acertos de palavras em cada direção é interrompida quando: o escore de alinhamento cumulativo é descartado pela quantidade X de seu valor máximo obtido; o escore cumulativo cai para zero ou menos, devido ao acúmulo de um ou mais alinhamentos de resíduos com escore negativo; ou o fim de qualquer das sequências é atingido. Os parâmetros de algoritmo BLAST W, T,
Petição 870180005321, de 22/01/2018, pág. 98/316
92/293 e X determinam a sensibilidade e a velocidade do alinhamento. O programa BLASTN (para sequências de nucleotídeos) usa como defaults um comprimento de palavra (W, wordlength) de 11, uma expectativa (E, expectation) de 10, M=5, N=-4 e uma comparação de ambos os filamentos. Para sequências de aminoácidos, o programa BLASTP usa como defaults um comprimento de palavra de 3, e expectativas (E) de 10, e a matriz de classificação BLOSUM62 (ver Henikoff & Henikoff (1989) Proc. Natl. Acad. Sci. USA 89:10915) alinhamentos (B) de 50, expectativa (E) de 10, M=5, N= -4, e uma comparação de ambos os filamentos. O algoritmo BLAST também realiza uma análise estatística da similaridade entre duas sequências (ver, p. ex., Karlin & Altschul (1993) Proc. Natl. Acad. Sci. USA 90:5873). Uma medida de similaridade proporcionada por algoritmo BLAST é a menor probabilidade de soma [smallest sum probability] (P(N)), que proporciona uma indicação da probabilidade com que poderia ocorrer, por acaso, uma equiparação entre duas sequências de nucleotídeos ou aminoácidos. Por exemplo, um ácido nucleico é considerado similar a uma sequência de referência se a menor probabilidade de soma em uma comparação do ácido nucleico de teste com o ácido nucleico de referência for menor do que cerca de 0,2, ou alternativamente, menor do que cerca de 0,01, ou alternativamente, menor do que cerca de 0,001.
[0192] Em um aspecto, homologias de sequências de ácido nucleicos e proteínas são avaliadas usando-se a ferramenta básica de pesquisa de alinhamento local (BLAST, Basic Local Alignment Search Tool) (“BLAST”). Por exemplo, é possível usar cinco programas BLAST para realizar a seguinte tarefa: (1) BLASTP e BLAST3 comparam uma sequência de pesquisa de aminoácidos contra um banco de dados de sequências de proteínas; (2) BLASTN compara uma sequência de pesquisa e nucleotídeos contra um banco de dados de sequências de nucleotídeos; (3) BLASTX compara produtos de tradução conceitual de seis matrizes de uma sequência de nucleotídeos de pesquisa (ambos os filamentos) contra um banco de dados de sequências de proteínas; (4) TBLASTN compara uma sequência de proteínas de pesquisa contra um banco de dados de sequências de nucleotídeos traduzidas em todas as seis matrizes de leitura (ambos os filamentos); e (5) TBLASTX compara as traduções de seis matrizes de uma sequência de pesquisa de nucleotídeos contra as traduções de seis matrizes de um banco de dados de sequências de
Petição 870180005321, de 22/01/2018, pág. 99/316
93/293 nucleotídeos.
[0193] Em um aspecto, os programas BLAST identificam sequências homólogas por meio da identificação de segmentos similares, que são referidos aqui como “pares de segmentos com escore elevado”, entre uma sequência de pesquisa de aminoácidos ou ácido nucleico e uma sequência de teste que é obtida alternativamente de um banco de dados de sequências de proteínas ou ácidos nucleicos. Pares de segmentos com escore elevado podem ser identificados alternativamente (i.e., alinhados) por meio de uma matriz de classificação, muitos dos quais são conhecidos na arte. Em um aspecto, a matriz de classificação usada é a matriz BLOSUM62 (Gonnet et al., Science 256:1443-1445, 1992; Henikoff e Henikoff, Proteins 17:49-61, 1993). Em um aspecto, as matrizes PAM ou PAM250 também podem ser usadas (ver, p. ex., Schwartz e Dayhoff, eds., 1978, Matrices for Detecting Distance Relationships: Atlas of Protein Sequence and Structure, Washington: National Biomedical Research Foundation).
[0194] Em um aspecto, para determinar se um ácido nucleico apresenta a identidade de sequências requerida como compreendido pelo escopo como proporcionado aqui, usase os programas NCBI BLAST 2.2.2, opções default para blastp. Há cerca de 38 pontos de ajuste no programa BLAST 2.2.2. Neste aspecto exemplar como proporcionado aqui, todos os valores default são usados, exceto para o ajuste de filtragem default (i.e., todos os parâmetros ajustados em default, exceto a filtragem que é ajustada em OFF); em seu lugar usa-se um ajuste “-F F”, que desabilita a filtragem. O uso de filtragem default resulta frequentemente em violações de Karlin-Altschul devido a comprimentos curtso de sequência.
[0195] Os valores default usados neste aspecto exemplar como proporcionado aqui, incluem:
“Filtro para baixa complexidade: ligado [ON]
Tamanho da Palavra: 3
Matriz: Blosum62
Custos de Gap: Existência: 11
Extensão: 1” [0196] Outros ajustes default são: filtro para baixa complexidade OFF, tamanho de
Petição 870180005321, de 22/01/2018, pág. 100/316
94/293 palavra de 3 para proteína, matriz BLOSUM62, penalidade de existência de intervalo de 11 e uma penalidade de extensão de intervalo de -1. Em um aspecto, a opção “-W” tem default 0. Isto significa que, se não ajustado, o tamanho de palavra tem default de 3 para proteínas, e de 11 para nucleotídeos.
SISTEMAS DE COMPUTADOR E PRODUTOS DE PROGRAMA DE COMPUTADOR [0197] Para determinar e identificar identidades de sequências, homologias estruturais, unidades repetitivas e análogos in silico, a sequência como proporcionada aqui pode ser armazenada, registrada, e manipulada em qualquer meio que pode ser lido e acessado por um computador. Em determinadas concretizações, proporciona-se aqui computadores, sistemas de computador, meios legíveis por computador, produtos de programa de computador e análogos, contendo ali (compreendendo) sequências de ácidos nucleicos e polipeptídios como proporcionado aqui registradas ou armazenadas nos mesmos. Como usado aqui, as palavras “registrado” e “armazenado” referem-se a um processo para armazenar informação em um meio de computador. Uma pessoa versada na arte saberá adotar facilmente quaisquer métodos conhecidos para registrar informação em um meio legível por computador para gerar produtos compreendendo uma ou mais das sequências de ácido nucleico e/ou polipeptídio como proporcionado aqui.
[0198] Outro aspecto como proporcionado aqui é um meio legível por computador apresentando registrado sobre si pelo menos uma sequência de ácido nucleico e/ou polipeptídio como proporcionado aqui. Meios legíveis por computador incluem meios legíveis magneticamente, meios legíveis opticamente, meios legíveis eletronicamente e meios magnéticos/ópticos. Por exemplo, os meios legíveis por computador podem ser um disco rígido, um disco flexível, uma fita magnética, CD-ROM, disco digital versátil (DVD, Digital Versatile Disk), memória de acesso randômico (RAM), ou memória de leitura apenas (ROM) e também outros tipos de outros meios conhecidos por aqueles versados na arte.
[0199] Aspectos como proporcionados aqui incluem sistemas (p. ex., sistemas baseados na internet), particularmente sistemas de computador, que armazenam e manipulam as sequências e informação de sequências aqui descritas. Um exemplo de um sistema de computador 100 é ilustrado em forma de diagrama de blocos na Figura 1. Como usado aqui, “um sistema de computador” refere-se aos componentes de hardware,
Petição 870180005321, de 22/01/2018, pág. 101/316
95/293 componentes de software, e componentes de armazenamento de dados utilizados para analisar uma sequência de nucleotídeos ou polipeptídios como proporcionado aqui. O sistema de computador 100 pode incluir um processador para processar, acessar e manipular os dados de sequências. O processador 105 pode ser qualquer tipo bem conhecido de unidade central de processamento, como, por exemplo, o Pentium III da Intel Corporation, ou processador similar da Sun, Motorola, Compaq, AMD ou International Business Machines. O sistema de computador 100 é um sistema de uso geral que compreende o processador 105 e um ou mais componentes internos para armazenamento de dados 110 para armazenar dados, e um ou mais dispositivos de recuperação de dados para recuperar os dados armazenados nos componentes de armazenamento de dados. Uma pessoa versada na arte poderá perceber facilmente que qualquer um dos sistemas de computador correntemente disponíveis é apropriado.
[0200] Em um aspecto, o sistema de computador 100 inclui um processador 105 conectado a um [barramento] bus que é conectado a uma memória principal 115 (implementada alternativamente como RAM) e um ou mais dispositivos internos de armazenamento de dados 110, como um disco rígido e/ou outro meio legível por computador apresentando dados registrados sobre o mesmo. O sistema de computador 100 pode incluir adicionalmente um ou mais dispositivos de recuperação de dados 118 para ler os dados armazenados nos dispositivos internos de armazenamento de dados 110. O dispositivo de recuperação de dados 118 pode representar, por exemplo, um drive de disco flexível, um drive de disco compacto, um drive de fita magnética, ou um modem capaz de conexão com um sistema remoto de armazenamento da dados (p. ex., via a internet) etc. Em algumas concretizações, o dispositivo interno de armazenamento de dados 110 é um meio removível legível por computador, como um disco flexível, um disco compacto, uma fita magnética, etc. contendo lógica de controle e/ou dados registrados sobre os mesmos. O sistema de computador 100 pode inclui vantajosamente, ou pode ser programado por meio de software apropriado para leitura da lógica de controle e/ou dos dados do componente de armazenamento de dados uma vez inseridos no dispositivo de recuperação de dados. O sistema de computador 100 inclui um visor 120 que é usado para apresentar a saída a um usuário do computador. Também deveria-se notar que o sistema
Petição 870180005321, de 22/01/2018, pág. 102/316
96/293 de computador 100 pode ser ligado a outros sistemas de computador 125a-c em uma rede ou rede de longa distância para proporcionar acesso centralizado ao sistema de computador 100. O software para acessar e processar as sequências de nucleotídeos ou aminoácidos como proporcionado aqui pode residir na memória principal 115 durante a execução. Em alguns aspectos, o sistema de computador 100 pode compreender adicionalmente um algoritmo de comparação de sequências para comparar uma sequência de ácido nucleico como proporcionada aqui. O algoritmo e sequência(s) podem ser armazenados em um meio legível por computador. Um “algoritmo de comparação de sequências” refere-se a um ou mais programas que são implementados (localmente ou remotamente) no sistema de computador 100 para comparar uma sequência de nucleotídeos com outras sequências de nucleotídeos e/ou compostos armazenados em um meio de armazenamento de dados. Por exemplo, o algoritmo de comparação de sequências pode comparar as sequências de nucleotídeos como proporcionado aqui armazenadas em um meio legível por computador, com sequências de referência armazenadas em um meio legível por computador para identificar homologias ou unidades repetitivas reestruturais.
[0201] Os parâmetros usados com os algoritmos acima podem ser adaptados dependendo do comprimento da sequência e do grau de homologia estudado. Em alguns aspectos, os parâmetros podem ser parâmetros default usados pelos algoritmos na ausência de instruções do usuário. A Figura 2 é um diagrama de fluxo que ilustra um aspecto de um processo 200 para comparar uma nova sequência de nucleotídeos ou proteínas com um banco de dados de sequências para determinar os níveis de homologia entre a nova sequência e as sequências no banco de dados. O banco de dados de sequências pode ser um banco de dados privado armazenado dentro do sistema de computador 100, ou um banco de dados público, como GENBANK, que é obtenível através da Internet. O processo 200 começa em um estado de partida 201 e move-se então para um estado 202 em que a nova sequência a ser comparada é armazenada em um sistema de computador 100. Como discutido acima, a memória poderia ser qualquer tipo de memória, incluindo RAM ou um dispositivo de armazenamento interno. O processo 200 move-se então para um estado 204 em que um banco de dados de sequências é aberto
Petição 870180005321, de 22/01/2018, pág. 103/316
97/293 para análise e comparação. O processo 200 move-se então para um estado 206 em que a primeira sequência armazenada no banco de dados é lida em uma memória no computador. Realiza-se então uma comparação em um estado 210 para determinar se a primeira sequência é igual à segunda sequência. É importante notar que esta etapa não é limitada à realização de uma comparação exata entre a nova sequência e a primeira sequência no banco de dados. Métodos bem conhecidos são conhecidos por aqueles com prática na arte para comparar duas sequências de nucleotídeos ou proteínas, mesmo que não sejam idênticos. Por exemplo, é possível introduzir intervalos em uma sequência para elevar o nível de homologia entre as duas sequências testadas. Os parâmetros que controlam se intervalos ou outras características são introduzidos em uma sequência durante a comparação são introduzidos normalmente pelo usuário do sistema de computador. Uma vez que uma comparação das duas sequências foi realizada no estado 210, realiza-se uma determinação em um estado de decisão 210 se as duas sequências são iguais. Evidentemente, o termo “igual” não se limita às sequências que são absolutamente idênticas. Sequências que se encontram dentro dos parâmetros de homologia introduzidos pelo usuário serão marcadas como “iguais” no processo 200. Caso se determine que as duas sequências são iguais, o processo 200 move-se para um estado 214 em que o nome da sequência do banco de dados é apresentado ao usuário. Este estado notifica o usuário de que a sequência com o nome apresentado preenche as restrições de homologia que foram introduzidas. Uma vez que o nome da sequência armazenada é apresentado ao usuário, o processo 200 move-se para um estado de decisão 218 em que se determina se existem mais sequências no banco de dados. Se não existirem mais sequências no banco de dados, então o processo 200 termina em um estado terminal 220. No entanto, se existirem mais sequências no banco de dados, então o processo 200 move-se para um estado 224 em que um apontador é movido para a sequência seguinte no banco de dados de forma que possa ser comparado com a nova sequência. Desta maneira, a nova sequência é alinhada e comparada com cada sequência no banco de dados. Deveria-se observar que se for necessário fazer uma determinação no estado de decisão 212 de que as sequências não foram homólogas, então o processo 200 poderia mover-se imediatamente para o estado de decisão 218 para determinar se
Petição 870180005321, de 22/01/2018, pág. 104/316
98/293 qualquer outras sequências foram obteníveis no banco de dados para comparação. Assim, um aspecto como proporcionado aqui é um sistema de computador compreendendo um processador, um dispositivo de armazenamento de dados apresentando armazenado sobre o mesmo uma sequência de ácido nucleico como proporcionado aqui e um comparador de sequências para conduzir a comparação. O comparador de sequências pode indicar um nível de homologia entre as sequências comparadas, ou identificar unidades repetitivas estruturais, ou pode identificar unidades repetitivas estruturais em sequências que são comparadas com estes códigos de ácidos nucleicos e códitos de polipeptídios. A Figura 3 é um diagrama de fluxo que ilustra uma concretização de um processo 250 em um computador para determinar se duas sequências são homólogas. O processo 250 começa em um estado de partida 252 move-se então para um estado 254 em que uma primeira sequência a ser comparada é armazenada em uma memória. A segunda sequência a ser comparada é então armazenada em uma memória em um estado 256. O processo 250 move-se então para um estado 260 em que o primeiro caráter na primeira sequência é lido e, então, para um estado 262 em que o primeiro caráter da segunda sequência é lido. Deveria-se compreender que, se a sequência for uma sequência de nucleotídeos, então o caráter poderia ser A, T, C, G ou U. Se a sequência fora uma sequência de proteínas, então pode ser um código de aminoácido de uma letra só para que a primeira e a sequência possam ser facilmente comparadas. Realiza-se uma determinação em um estado de decisão 264 para verificar se os dois caracteres são iguais. Se forem iguais, então o processo 250 move-se para um estado 268 em que os próximos caracteres na primeira e na segunda sequências são lidos. Realiza-se uma determinação para verificar se os próximos caracteres são iguais. Se foram, então o processo 250 continua esta alça até [encontrar] dois caracteres que não são iguais. Caso se determine que os próximos dois caracteres não são iguais, o processo 250 move-se para um estado de decisão 274 para determinar se há quaisquer outros caracteres em qualquer das sequências a ser lido. Se não houver quaisquer outros caracteres a serem lidos, então o processo 250 move-se para um estado 276 em que o nível de homologia entre a primeira e segunda sequências é apresentado ao usuário. O nível de homologia é determinado calculando-se a proporção de caracteres entre as sequências que foram iguais dentro do
Petição 870180005321, de 22/01/2018, pág. 105/316
99/293 número total de sequências na primeira sequência. Assim, se cada caráter em uma primeira sequência de 100 nucleotídeos for alinhado com cada caráter em uma segunda sequência, o nível de homologia poderia ser de 100 %.
[0202] Alternativamente, o programa de computador pode comparar uma sequência de referência com uma sequência como proporcionada aqui para determinar se as sequências diferem em uma ou mais posições. O programa pode registrar o comprimento e a identidade de resíduos de aminoácidos ou nucleotídeos inseridos, deletados ou substituídos com relação à sequência de referência ou à sequência como proporcionada aqui. O programa de computador pode ser um programa que determinar se uma sequência de referência contém um polimorfismo de nucleotídeo simples (SNP) com relação a uma sequência como proporcionada aqui, ou, se uma sequência como proporcionada aqui compreende um SNP de uma sequência conhecida. Assim, em alguns aspectos, o programa de computador é um programa que identifica SNPs. O método pode ser implementado pelos sistemas de computador descritos acima e o método ilustrado na Figura 3. O método pode ser realizado por meio de leitura de uma sequência como proporcionada aqui e das sequências de referência por meio do uso do programa de computador e identificação das diferenças com o programa de computador.
[0203] Em outros aspectos o sistema baseado em computador compreende um identificador para identificar características em um ácido nucleico ou polipeptídio como proporcionado aqui. Um “identificador” refere-se a um ou mais programas que identificam determinadas características em uma sequência de ácido nucleico. Por exemplo, um identificador pode compreender um programa que identifica uma matriz de leitura aberta (ORP) em uma sequência de ácido nucleico. A Figura 4 é um diagrama de fluxo que ilustra um aspecto de um identificador processo 300 para detectar a presença de uma característica em uma sequência. O processo 300 começa em um estado de partida 302 e move-se então para um estado 304 em que uma primeira sequência que se pretende verificar quanto a características é armazenada em uma memória 115 no sistema de computador 100. O processo 300 move-se então para um estado 306 em que um banco de dados de características de sequências é aberto. Um banco de dados do tipo referido inclui uma lista de cada um dos atributos de características juntamente com o nome da
Petição 870180005321, de 22/01/2018, pág. 106/316
100/293 característica. Por exemplo, um nome de característica poderia ser “Códon de iniciação” e o atributo poderia ser “ATG”. Outro exemplo poderia ser o nome de característica “TAATAA Box” e o atributo da característica poderia ser “TAATAA”. Um exemplo de um banco de dados do tipo referido é produzido pelo University of Wisconsin Genetics Computer Group. Alternativamente, as características podem ser unidades repetitivas de polipeptídios estruturais, como hélices alfa, folhas-beta, ou unidades repetitivas de polipeptídios funcionais, como sítios enzimáticos ativos, unidades repetitivas de hélice-volta-hélice ou outras unidades repetitivas conhecidas por alguém com prática na arte. Uma vez que o banco de dados de características é aberto no estado 306, o processo 300 move-se para um estado 308 em que a primeira característica é lida do banco de dados. Uma comparação do atributo da primeira característica com a primeira sequência é feita então em um estado 310. Realiza-se uma determinação em um estado de decisão 316 para verificar se o atributo da característica foi encontrado na primeira sequência. Se o atributo foi encontrado, então o processo 300 move-se para um estado 318 em que o nome da característica encontrada é apresentado ao usuário. O processo 300 move-se então para um estado de decisão 320 em que se realiza uma determinação para verificar se existem mais características no banco de dados. Se não existirem mais características, então o processo 300 termina em um estado terminal 324. No entanto, se existirem mais características no banco de dados, então o processo 300 lê a próxima característica de sequência em um estado 326 e refaz a alça para o estado 310 em que o atributo da próxima característica é comparado contra a primeira sequência. Se o atributo da característica não é encontrado na primeira sequência no estado de decisão 316, o processo 300 move-se diretamente para o estado de decisão 320 para determinar se existem quaisquer outras características no banco de dados. Assim, em um aspecto, um programa de computador que identifica matrizes de leitura aberta (ORFs).
[0204] Uma sequência de polipeptídio ou ácido nucleico como proporcionada aqui pode ser armazenada e manipulada em uma variedade de programas processadores de dados em uma variedade de formatos. Por exemplo, uma sequência pode ser armazenada em um arquivo de processamento de texto, como MICROSOFTWORD™ ou RDPERFECT™ ou como um arquivo ASCII em uma variedade de programas de banco de
Petição 870180005321, de 22/01/2018, pág. 107/316
101/293 dados familiares aqueles com prática na arte, como DB2, SYBASE, ou ORACLE™. Adicionalmente, é possível usar muitos programas de computador e bancos de dados como algoritmos de comparação de sequências, identificadores, ou fontes de sequências de nucleotídeos de referência ou sequências de polipeptídio a serem comparadas com uma sequência de ácido nucleico como proporcionada aqui. Os programas e bancos de dados podem compreender: MACPATTERN™ (EMBL), DISCOVERYBASE™ (Molecular Applications Group), GENEMINE™ (Molecular Applications Group), LOOK™ (Molecular Applications Group), MACLOOK™ (Molecular Applications Group), BLAST e BLAST2 (NCBI), BLASTN e BLASTX (Altschul et al, J. Mol. Biol. 215: 403, 1990), FASTA (Pearson e Lipman, Proc. Natl. Acad. Sci. USA, 85: 2444, 1988), FASTDB™ (Brutlag et al. Comp. App. Biosci. 6:237-245, 1990), CATALYST™ (Molecular Simulations Inc.),
CATALYST™/SHAPE™ (Molecular Simulations Inc.), CERIUS2.DBACCESS™ (Molecular Simulations Inc.), HYPOGEN™ (Molecular Simulations Inc.), Insight II, (Molecular Simulations Inc.), DISCOVER™ (Molecular Simulations Inc.), CHARMm™ (Molecular Simulations Inc.), FELIX™ (Molecular Simulations Inc.), DELPHI™s (Molecular Simulations Inc.), QUANTEMM™, (Molecular Simulations Inc.), HOMOLOGY™ (Molecular Simulations Inc.), MODELER™ (Molecular Simulations Inc.), ISIS™ (Molecular Simulations Inc.), Quanta/Protein Design (Molecular Simulations Inc.), WEBLAB™ (Molecular Simulations Inc.), WEBLAB™ Diversity Explorer (Molecular Simulations Inc.), GENE EXPLORER™ (Molecular Simulations Inc.), SEQFOLD™ (Molecular Simulations Inc.), o banco de dados MDL Available Chemicals Directory, o banco de dados MDL Drug Data Report, o banco de dados Comprehensive Medicinal Chemistry, banco de dados Derwent's World Drug Index, o banco de dados BioByteMasterFile, o banco de dados Genbank, e o banco de dados Genseqn. Alguém com prática na arte perceberá muitos outros programas e bancos de dados considerando a presente revelação.
[0205] Unidades repetitivas que podem ser detectadas usando os programas acima incluem sequências que codificam zíperes de leucina, unidades repetitivas de hélice-voltahélice, sítios de glicosilação, sítios de ubiquação, hélices alfa, e folhas-beta [beta sheets], sequências-sinal que codificam peptídios-sinal que dirigem a secreção das proteínas codificadas, sequências implicadas na regulação de transcrição, como homeoboxes,
Petição 870180005321, de 22/01/2018, pág. 108/316
102/293 extensões ácidas, sítios enzimáticos ativos, sítios de ligação a substrato, e sítios de clivagem enzimática.
HIBRIDIZAÇÃO DE ÁCIDOS NUCLEICOS [0206] Em determinadas concretizações, proporciona-se aqui ácidos nucleicos isolados, sintéticos ou recombinantes que hibridam em condições estringentes com o ácido nucleico aqui proporcionado, p. ex., uma sequência exemplar proporcionada aqui, p. ex., uma sequência como apresentada na SEQ ID NO:1, SEQ O:3, SEQ ID NO:5, SEQ ID NO:7, SEQ ID NO:9, SEQ ID NO:1 1, SEQ ID NO: 13, ID NO: 15, SEQ ID NO: 17, SEQ ID NO: 19, SEQ ID NO:22 ou SEQ ID NO:23, ou SEQ O:1 modificada para codificar uma, duas, três, quatro, cinco, seis, sete, oito ou mais (várias) ou todas as variações de bases descritas na Tabela 3, Tabela 4, Tabela 9, Tabela 10, Tabela 11, Tabela 16 ou Tabela 23, ou seu equivalente, e subsequências e sequências complementares das mesmas, ou um ácido nucleico que codifica um polipeptídio como proporcionado aqui. As condições estringentes podem ser condições de alta estringência, condições de média estringência, condições de baixa estringência, incluindo as condições de alta e reduzida estringência aqui descritas.
[0207] “Hibridização” refere-se ao processo por meio do qual um filamento de ácido nucleico conjuga-se com um filamento complementar por meio de pareamento de bases. Reações de hibridização podem ser sensíveis e seletivas de forma que uma sequência de interesse particular pode ser identificada mesmo em amostras em que está presente a baixas concentrações. Condições estringentes podem ser definidas, por exemplo, por meio das concentrações de sal ou formamida nas soluções de pré-hibridização e soluções de hibridização, ou por meio da temperatura de hibridização, e são, todas, bem conhecidas na arte. Por exemplo, a estringência pode ser incrementada reduzindo-se a concentração do sal, aumentando a concentração de formamida, ou elevando a temperatura de hibridização, alterando o tempo de hibridização, como descrito abaixo em detalhe. Em aspectos alternativos, ácidos nucleicos como proporcionados aqui são definidos por sua capacidade de hibridizar em várias condições de estringência (p. ex., alta, média, e baixa), como apresentado aqui.
[0208] Em concretizações alternativas, ácidos nucleicos como proporcionados aqui
Petição 870180005321, de 22/01/2018, pág. 109/316
103/293 como definidos por sua capacidade de hibridizar em condições estringentes podem apresentar entre cerca de cinco resíduos e o comprimento pleno do ácido nucleico como proporcionado aqui; p. ex., eles podem ter comprimentos de, pelo menos, 5, 10, 15, 20, 25, 30, 35, 40, 50, 55, 60, 65, 70, 75, 80, 90, 100, 150, 200, 250, 300, 350, 400, 450, 500, 550, 600, 650, 700, 750, 800, 850, 900, 950, 1000, ou mais resíduos. Ácidos nucleicos mais curtos do que o comprimento pleno também são incluídos. Estes ácidos nucleicos podem ser úteis como, p. ex., sondas de hibridização, sondas de marcação, sondas de oligonucleotídeos de PCR, iRNA, sequências anti-senso ou sequências que codificam peptídios de ligação de anticorpos (epitopos), unidades repetitivas, sítios ativos e análogos. [0209] Em um aspecto, ácidos nucleicos como proporcionados aqui são definidos por sua capacidade de hibridizar sob alta estringência [] compreendem condições de cerca de 50 % de formamida a cerca de 37°C a 42°C. Em um aspecto, ácidos nucleicos como proporcionados aqui são definidos por sua capacidade de hibridizar sob estringência reduzida compreendendo condições de cerca de 35 % a 25 % de formamida a cerca de 30°C a 35°C.
[0210] Alternativamente, ácidos nucleicos como proporcionados aqui são definidos por sua capacidade de hibridizar sob alta estringência compreendendo condições a 42°C em 50 % de formamida, 5X SSPE, 0,3 %, e um ácido nucleico bloqueador de sequência repetitiva, como cot-1 ou DNA de esperma de salmão 200 ug/ml (p. ex., DNA de esperma de salmão cisalhado e desnaturado). Em um aspecto, ácidos nucleicos como proporcionados aqui são definidos por sua capacidade de hibridizar em condições de reduzida estringência compreendendo 35 % de formamida a uma temperatura reduzida de 35°C.
[0211] Após a hibridização, o filtro pode ser lavado com 6X SSC, 0,5 % SDS a 50°C. Estas condições são consideradas como sendo condições “moderadas” acima de 25 % de formamida e condições “baixas” abaixo de 25 % de formamida. Um exemplo específico de condições “moderadas” de hibridização é quando a hibridização acima é conduzida a 30 % de formamida. Um exemplo específico de condições de hibridização de “baixa estringência” é quando a hibridização acima é conduzida a 10 % de formamida.
Petição 870180005321, de 22/01/2018, pág. 110/316
104/293 [0212] A faixa de temperatura correspondente a um nível particular de estringência pode ser ainda mais estreitada calculando-se a relação de purina para pirimidina do ácido nucleico de interesse, e ajustando-se a temperatura correspondentemente. Ácidos nucleicos como proporcionados aqui também são definidos por sua capacidade de hibridizar em condições de alta, média e baixa estringência como apresentado em Ausubel e Sambrook. Variações nas faixas e condições acima são bem conhecidas na arte. Condições de hibridização são discutidas adicionalmente abaixo.
[0213] O procedimento acima pode ser modificado para identificar ácidos nucleicos apresentando níveis decrescentes de homologia com a sequência de sonda. Por exemplo, para se obter ácidos nucleicos com homologia decrescente com a sonda detectável, é possível usar condições menos estringentes. Por exemplo, a temperatura de hibridização pode ser diminuída em incrementos de 5°C, de 68°C a 42°C em um tamponador de hibridização apresentando uma concentração de Na+ de aproximadamente 1M. Após a hibridização, o filtro pode ser lavado com 2X SSC, 0,5 % de SDS à temperatura de hibridização. Estas condições são consideradas como sendo condições “moderadas” acima de 50°C e condições “baixas” abaixo de 50°C. Um exemplo específico de condições “moderadas” de hibridização é quando a hibridização acima é conduzida a 55°C. Um exemplo específico de condições de hibridização de “baixa estringência” é quando a hibridização acima é conduzida a 45°C.
[0214] Alternativamente, a hibridização pode ser realizada em tamponadores, como 6X SSC, contendo formamida a uma temperatura de 42°C. Neste caso, a concentração de formamida no tamponador de hibridização pode ser reduzida em incrementos de 5 %, de 50 % a 0 %, para identificar clones apresentando níveis decrescentes de homologia com a sonda. Após a hibridização, o filtro pode ser lavado com 6X SSC, 0,5 % de SDS a 50°C. Estas condições são consideradas como sendo condições “moderadas” acima de 25 % de formamida e condições “baixas” abaixo de 25 % de formamida. Um exemplo específico de condições “moderadas” de hibridização é quando a hibridização acima é conduzida a 30 % de formamida. Um exemplo específico de condições de hibridização de “baixa estringência” é quando a hibridização acima é conduzida a 10 % de formamida.
[0215] No entanto, a seleção de um formato de hibridização não é crítica - é a
Petição 870180005321, de 22/01/2018, pág. 111/316
105/293 estringência de condições de lavagem que indica as condições que determinam se um ácido nucleico encontra-se dentro do escopo como proporcionado aqui. Condições de lavagem usadas para identificar ácidos nucleicos dentro do escopo como proporcionado aqui incluem, p. ex.,: uma concentração salina de cerca de 0,02 molar a pH 7 e uma temperatura de pelo menos cerca de 50°C ou cerca de 55°C a cerca de 60°C; ou, uma concentração salina de cerca de 0,15 M de NaCl a 72°C durante cerca de 15 minutos; ou, uma concentração salina de cerca de 0,2X SSC a uma temperatura de pelo menos cerca de 50°C ou cerca de 55°C a cerca de 60°C durante cerca de 15 a cerca de 20 minutos; ou, o complexo de hibridização é lavado duas vezes com uma solução com uma concentração salina de cerca de 2X SSC contendo 0,1 % de SDS à temperatura ambiente durante 15 minutos e então lavada duas vezes com 0,1 X SSC contendo 0,1 % de SDS a 68°C durante 15 minutos; ou condições equivalentes. Ver Sambrook, Tijssen e Ausubel para uma descrição de tamponador SSC e condições equivalentes.
[0216] Estes métodos podem ser usados para isolar ácidos nucleicos como proporcionados aqui.
SONDAS DE OLIGONUCLEOTÍDEOS E MÉTODOS PARA USAR OS MESMOS [0217] Em determinadas concretizações, proporciona-se aqui sondas de ácidos nucleicos para identificar ácidos nucleicos que codificam um polipeptídio com uma atividade de hidrolase, p. ex., atividade de lipase, saturase, palmitase e/ou estearatase. Em um aspecto, a sonda compreende pelo menos 10 bases consecutivas de um ácido nucleico como proporcionado aqui. Alternativamente, uma sonda como proporcionado aqui pode consistir de pelo menos cerca de 5, 6, 7, 8, 9, 10, 15, 20, 25, 30, 35, 40, 45, 50, 60, 70, 80, 90, 100, 110, 120, 130, 150, 160, 170, 180, 190, 200 ou mais, ou de cerca de 10 a 50, de cerca de 20 a 60 cerca de 30 a 70, bases consecutivas de uma sequência como apresentada em um ácido nucleico como proporcionado aqui. As sondas identificam um ácido nucleico por meio de ligação e/ou hibridização. As sondas podem ser usadas em conjuntos como proporcionado aqui, ver discussão abaixo, incluindo, p. ex., conjuntos capilares. As sondas como proporcionadas aqui também podem ser usadas para isolar outros ácidos nucleicos ou polipeptídios.
[0218] As sondas como proporcionadas aqui podem ser usadas para determinar se
Petição 870180005321, de 22/01/2018, pág. 112/316
106/293 uma amostra biológica, como uma amostra de solo, contém um organismo apresentando uma sequência de ácido nucleico como proporcionada aqui (p. ex., um ácido nucleico que codifica hidrolase) ou um organismo do qual o ácido nucleico foi obtido. Em referidos procedimentos, obtém-se uma amostra biológica que abriga o organismo do qual o ácido nucleico foi isolado, e obtém-se ácidos nucleicos da amostra. Os ácidos nucleicos são contactados com a sonda em condições que permitem que a sonda hibride especificamente com quaisquer sequências complementares presentes na amostra. Onde necessário, condições que permitem que a sonda hibride especificamente com sequências complementares podem ser determinadas colocando-se a sonda em contato com sequências complementares de amostras conhecidas por conterem a sequência complementar, como sequências de controle que não contêm a sequência complementar. Condições de hibridização, como a concentração salina do tamponador de hibridização, a concentração de formamida do tamponador de hibridização, ou a temperatura de hibridização, podem ser variadas para identificar condições que permitem que a sonda hibride especificamente com ácidos nucleicos complementares (ver discussão sobre condições de hibridização específicas).
[0219] Se a amostra contém o organismo do qual o ácido nucleico foi isolado, detectase então a hibridização específica da sonda. A hibridização pode ser detectada por meio de marcação da sonda com um agente detectável, como um isótopo radioativo, um corante fluorescente ou uma enzima capaz de catalisar a formação de um produto detectável. Muitos métodos para o uso das sondas marcadas para detectar a presença de ácidos nucleicos complementares em uma amostra são familiares para aqueles versados na arte. Estes incluem Southern Blots, Northern Blots, procedimentos de hibridização de colônias, e manchamentos pontuais [dot blots]. Protocolos para cada um destes procedimentos são proporcionados em Ausubel e Sambrook.
[0220] Alternativamente, mais de uma sonda (pelo menos uma que é capaz de hibridizar especificamente com quaisquer sequências complementares que estão presentes na amostra de ácido nucleico) pode ser usada em uma reação de amplificação para determinar se a amostra contém um organismo contendo uma sequência de ácido nucleico como proporcionada aqui (p. ex., um organismo do qual o ácido nucleico foi
Petição 870180005321, de 22/01/2018, pág. 113/316
107/293 isolado). Em um aspecto, as sondas compreendem oligonucleotídeos. Em um aspecto, a reação de amplificação pode compreender uma reação PCR. Protocolos de PCR são descritos em Ausubel e Sambrook (ver discussão sobre reações de amplificação). Em procedimentos do tipo referido os ácidos nucleicos na amostra são contactados com as sondas, a reação de amplificação é realizada, e detecta-se qualquer produto de amplificação resultante. O produto de amplificação pode ser detectado realizando-se eletroforese em gel nos produtos de reação e manchando-se o gel com um intercalador, como brometo de etídio. Alternativamente, uma ou mais das sondas podem ser marcadas com um isótopo radioativo, e a presença de um produto de amplificação radioativo pode ser detectada por meio de autorradiografia apoós eletroforese em gel.
[0221] Sondas derivadas de sequências próximas das pontas 3' ou 5' de uma sequência de ácido nucleico como proporcionada aqui também podem ser usadas em procedimentos de caminhada cromossômica para identificar clones contendo sequências adicionais, p. ex., sequências genômicas. Referidos métodos permitem o isolamento de genes que codificam proteínas de interesse adicionais do organismo hospedeiro.
[0222] Em um aspecto, sequências de ácido nucleico como proporcionadas aqui são usadas como sondas para identificar ácidos nucleicos relacionados assim-identificados. Em alguns aspectos, os ácidos nucleicos relacionados assim-identificados podem ser DNAs ou DNAs genômicos de organismos diferentes daquele do qual o ácido nucleico proporcionado foi isolado primeiro. Nesses procedimentos, uma amostra de ácido nucleico é contactada com a sonda em condições que permitem à sonda hibridiar especificamente com sequências relacionadas. A hibridização da sonda com ácidos nucleicos do organismo relacionado é então detectada usando-se quaisquer dos métodos descritos acima.
[0223] Em reações de hibridização de ácido nucleico, as condições usadas para se obter um nível particular de estringência variarão, dependendo da natureza dos ácidos nucleicos que estão sendo hibridizados. Por exemplo, o comprimento, o grau de complementaridade, composição da sequência de nucleotídeos (p. ex., teor de GC v. AT), e tipo de ácido nucleico (p. ex., RNA v. DNA) das regiões hibridizantes dos ácidos nucleicos, podem ser considerados na seleção de condições de hibridização. Uma consideração adicional é se um dos ácidos nucleicos é imobilizado, por exemplo, em um
Petição 870180005321, de 22/01/2018, pág. 114/316
108/293 filtro. A hibridização pode ser realizada em condições de baixa estringência, moderada estringência ou alta estringência. Como um exemplo de hibridização de ácido nucleico, uma membrana polimérica contendo ácidos nucleicos desnaturados imobilizados é préhibridada primeiro durante 30 minutos a 45°C em uma solução consistindo de 0,9 M de NaCl, 50 mM de NaH2PO4, pH 7,0, 5,0 mM de Na2EDTA, 0,5 % de SDS, 10X de Denhardt, e 0,5 mg/ml de ácido polirriboadenílico. Aproximadamente 2 X 10⁷ cpm (atividade específica 4-9 X 10⁸ cpm/ug) de sonda de oligonucleotídeo marcada com ponta P são então adicionados à solução. Após 12-16 horas de incubação, a membrana é lavada durante 30 minutos à temperatura ambiente (t.a.) em 1X SET (150 mM de NaCl, 20 mM de cloridrato de Tris, pH 7,8, 1 mM de Na2EDTA) contendo 0,5 % de SDS, seguido de uma lavagem de 30 minutos em IX SET fresco a Tm- 10°C ara a sonda de oligonucleotídeo. A membrana é então exposta a película autorradiográfica para detecção de sinais de hibridização.
[0224] Variando-se a estringência das condições de hibridização usadas para identificar ácidos nucleicos, como cDNAs ou DNAs genômicos, que hibridam com a sonda detectável, ácidos nucleicos apresentando níveis de diferentes de homologia com a sonda podem ser identificados e isolados. A estringência pode ser variada conduzindo-se a hibridização em temperaturas variáveis abaixo das temperaturas de fusão das sondas. A temperatura de fusão, Tm, é a temperatura (sob pH e concentração iônica definidos) em que 50 % da sequência-alvo hibrida com uma sonda perfeitamente complementar. Condições muito estringentes são selecionadas como sendo iguais a, ou cerca de 5°C mais baixas do que a Tm para uma sonda particular. A temperatura de fusão da sonda pode ser calculada usando-se as seguintes fórmulas exemplares. Para sondas com comprimentos entre 14 e 70 nucleotídeos, a temperatura de fusão (Tm) é calculada usando-se a fórmula: 81,5+16,6(log [Na+])+0,41 (fração G+C)-(600/N) sendo que N é o comprimento da sonda. Se a hibridização é realizada em uma solução contendo formamida, a temperatura de fusão pode ser calculada usando-se a equação: Tm=81,5+16,6(log [Na+])+0,41 (fração G+C)(0,63 % amida)-(600/N) sendo que N é o comprimento da sonda. A pré-hibridização pode ser realizada em 6X SSC, 5X reagente de Denhardt, 0,5 % de SDS, 100 pg de DNA de esperma de salmão fragmentado desnaturado ou 6X SSC, 5X reagente de Denhardt, 0,5
Petição 870180005321, de 22/01/2018, pág. 115/316
109/293 % de SDS, 100 pg de DNA de esperma de salmão fragmentado desnaturado, 50 % de formamida. Fórmulas para SSC e reagente de Denhardt e outras soluções encontram-se listadas, p. ex., em Sambrook.
[0225] Em um aspecto, a hibridização é conduzida adicionando-se a sonda detectável às soluções de pré-hibridização listadas acima. Onde a sonda compreende DNA de filamento duplo, ela é desnaturada antes da adição com a solução de hibridização. O filtro é contactado com a solução de hibridização durante um período de tempo suficiente para permitir que a sonda hibride com cDNAs ou DNAs genômicos contendo sequências complementares ao mesmo ou homólogas ao mesmo. Para sondas com comprimento acima de 200 nucleotídeos, a hibridização pode ser realizada a 15-25°C abaixo da Tm. Para sondas mais curtas, como sondas de oligonucleotídeo, a hibridização pode ser conduzida a 5-10°C abaixo da Tm. Em um aspecto, hibridações em 6X SSC são conduzidas a aproximadamente 68°C. Em um aspecto, hibridações em soluções contendo 50 % de formamida são conduzidas a aproximadamente 42°C. Todas as hibridações precedentes poderiam ser considerada como sendo em condições de alta estringência.
[0226] Em um aspecto, após a hibridização, o filtro é lavado para remover qualquer sonda detectável não-ligada especificamente. A estringência usada para lavar os filtros também pode ser variada dependendo da natureza dos ácidos nucleicos que estão sendo hibridizados, do comprimento dos ácidos nucleicos que estão sendo hibridizados, do grau de complementaridade, da composição da sequência de nucleotídeos (p. ex., teor de GC v. AT), e do tipo de ácido nucleico (p. ex., RNA v. DNA). Exemplos de lavagens com condições de estringência progressivamente maiores são como a seguir: 2X SSC, 0,1 % de SDS à temperatura ambiente durante 15 minutos (baixa estringência); 0,1 X SSC, 0,5 % de SDS à temperatura ambiente durante 30 minutos até 1 hora (moderada estringência); 0,1X SSC, 0,5 % de SDS durante de 15 a 30 minutos entre a temperatura de hibridização e 68°C (alta estringência); e 0,15M de NaCl durante 15 minutos a 72°C (muito alta estringência). Uma lavagem final com baixa estringência pode ser conduzida em 0,1X SSC à temperatura ambiente. Os exemplos acima são meramente ilustrativos de um conjunto de condições que podem ser usadas para lavar filtros. Alguém com prática na arte saberá que há numerosas receitas para lavagens com diferentes estringências.
Petição 870180005321, de 22/01/2018, pág. 116/316
110/293 [0227] Ácidos nucleicos que foram hibridizados com a sonda podem ser identificados por meio de autorradiografia ou outras técnicas convencionais. O procedimento acima pode ser modificado para identificar ácidos nucleicos apresentando níveis decrescentes de homologia com a sequência da sonda. Por exemplo, para se obter ácidos nucleicos de homologia decrescente com relação à sonda detectável, é possível usar condições menos estringentes. Por exemplo, a temperatura de hibridização pode ser diminuída em incrementos de 5°C de 68°C a 42°C em um tamponador de hibridização apresentando uma concentração de Na+ de aproximadamente 1M. Após a hibridização, o filtro pode ser lavado com SC, 0,5 % de SDS à temperatura de hibridização. Estas condições são consideradas como sendo condições “moderadas” se acima de 50°C e condições “baixas” se abaixo de 50°C. Um exemplo de condições de hibridização “moderada” é quando a hibridização acima é realizada a 55°C. Um exemplo de condições de hibridização de “baixa estringência” é quando a hibridização acima é realizada a 45°C.
[0228] Alternativamente, a hibridização pode ser realizada em tamponadores, como 6X SSC, contendo formamida a uma temperatura de 42°C. Neste caso, a concentração de formamida no tamponador de hibridização pode ser reduzida em incrementos de 5 % de 50 % a 0 % para identificar clones apresentando níveis decrescentes de homologia com a sonda. Após a hibridização, o filtro pode ser lavado com 6X SSC, 0,5 % de SDS a 50°C. Estas condições são consideradas como sendo condições “moderadas” se acima de 25 % de formamida e condições “baixas” abaixo de 25 % de formamida. Um exemplo específico de condições de hibridização “moderadas” é quando a hibridização acima é conduzida a 30 % de formamida. Um exemplo específico de condições de hibridização de “baixa estringência” é quando a hibridização acima é conduzida a 10 % de formamida.
[0229] Estas sondas e métodos como proporcionados aqui podem ser usados para isolar, ou identificar (p. ex., usando um conjunto), ácidos nucleicos apresentando uma sequência com pelo menos cerca de 50 %, 51 %, 52 %, 53 %, 54 %, 55 %, 56 %, 57 %, %, 59 %, 60 %, 61 %, 62 %, 63 %, 64 %, 65 %, 66 %, 67 %, 68 %, 69 %, 70 %, 71 %, %, 73 %, 74 %, 75 %, 76 %, 77 %, 78 %, 79 %, 80 %, 81 %, 82 %, 83 %, 84 %, 85 %, %, 87 %, 88 %, 89 %, 90 %, 91 %, 92 %, 93 %, 94 %, 95 %, 96 %, 97 %, 98 %, 99 %, ou mais, de identidade de sequências com uma sequência de ácido nucleico como
Petição 870180005321, de 22/01/2018, pág. 117/316
111/293 proporcionada aqui compreendendo pelo menos cerca de 10, 15, 20, 25, 30, 35, 40, 50, 75, 100, 150, 200, 250, 300, 350, 400, 500, 550, 600, 650, 700, 750, 800, 850, 900, 950, 1000, ou mais bases consecutivas das mesmas, e as sequências complementares às mesmas. A homologia pode ser medida usando-se um algoritmo de alinhamento, como discutido aqui. Por exemplo, os polinucleotídeos homólogos podem apresentar uma sequência codificantes que é uma variante alélica naturalmente ocorrente de uma das sequências codificantes aqui descritas. Referidas variantes alélicas podem apresentar uma substituição, deleção ou adição de um ou mais nucleotídeos quando comparado com um ácido nucleico como proporcionado aqui.
[0230] Adicionalmente, as sondas e métodos como proporcionados aqui podem ser usados para isolar, ou identificar (p. ex., usando um conjunto), ácidos nucleicos que codificar polipeptídios apresentando pelo menos cerca de 51 %, 52 %, 53 %, 54 %, 55 %, 56 %, 57 %, 58 %, 59 %, 60 %, 61 %, %, 63 %, 64 %, 65 %, 67 %, 68 %, 69 %, 70 %, 71 %, 72 %, 73 %, 74 %, 75 %, 76 %, 77 %, 78 %, 79 %, 80 %, 81 %, 83 %, 84 %, 85 %, 86 %, 87 %, 88 %, 89 %, 90 %, 91 %, 92 %, 93 %, 94 %, 95 %, 96 %, 97 %, 99 %, ou mais de identidade de sequências (homologia) com um polipeptídio como proporcionado aqui compreendendo pelo menos 5, 10, 15, 20, 25, 30, 35, 40, 50, 75, 100, ou 150 ou mais aminoácidos consecutivos dos mesmos conforme determinado usando-se um algoritmo de alinhamento de sequências, p. ex.,, como a versão FASTA 3.0t78 com os parâmetros default, ou um programa BLAST 2.2.2 com ajustes exemplares como apresentados aqui.
INIBINDO A EXPRESSÃO DE HIDROLASES [0231] Em determinadas concretizações, proporciona-se aqui ácidos nucleicos complementares a (p. ex., sequências anti-senso a) as sequências de ácido nucleico como proporcionadas aqui, p. ex., sequências codificando hidrolase. Sequências anti-senso são capazes de inibir o transportada, recomposição ou transcrição de genes codificando hidrolase. A inibição pode ser efetuada por meio da objetivação de DNA genômico ou de RNA mensageiro. A inibição pode ser efetuada usando-se DNA, p. ex., uma ribozima inibidora, ou um RNA, p. ex., um iRNA de filamento duplo, compreendendo uma sequência como proporcionada aqui. A transcrição ou função do ácido nucleico objetivado pode ser
Petição 870180005321, de 22/01/2018, pág. 118/316
112/293 inibida, por exemplo, por meio de hibridização e/ou clivagem. Proporciona-se aqui conjuntos de inibidores compreendendo oligonucleotídeos capazes de ligar gene de hidrolase e/ou mensagem, em qualquer dos casos prevenindo ou inibindo a produção ou função de hidrolase. A associação pode ser por meio de hibridização específica para sequências. Outra classe útil de inibidores inclui oligonucleotídeos que causam a inativação ou clivagem da mensagem de hidrolase. O oligonucleotídeo pode apresentar atividade de enzima que causa referida clivagem, como ribozimas. O oligonucleotídeo pode ser modificado quimicamente ou conjugado com uma enzima ou composição capaz de clivar o ácido nucleico complementar. É possível selecionar um combinado [pool] de muitos oligossarídeos diferentes do tipo referido quanto àqueles com a atividade desejada. OLIGONUCLEOTÍDEOS ANTI-SENSO [0232] Em determinadas concretizações, proporciona-se aqui oligonucleotídeos antisenso capazes de ligar mensagem de hidrolase que podem inibir a atividade de hidrolase por meio de mRNA de objetivação ou DNA genômico. Estratégicas para projetar oligonucleotídeos anti-senso são bem descritas na literatura científica e de patentes, e a pessoa versada na arte pode projetar referidos oligossarídeos de hidrolase usando os reagentes inéditos como proporcionados aqui. Por exemplo, protocolos de caminhada gênica [gene walking]/mapeamento de RNA para selecionar oligonucleotídeos anti-senso efetivos são bem conhecidos na arte, ver, p. ex., Ho (2000) Methods Enzymol. 314:168183, descrevendo um ensaio de mapeamento de RNA, que se baseia em técnicas moleculares convencionais para proporcionar uma método fácil e confiável para seleção potente de sequências anti-senso. Ver também Smith (2000) Eur. J. Pharm. Sci. 91-198.
[0233] Em um aspecto, ácidos nucleicos gerados recombinantemente, ou naturalmente ocorrentes isolados, são usados como oligonucleotídeos anti-senso. Os oligonucleotídeos anti-senso podem ter qualquer comprimento; por exemplo, em aspectos alternativos, os oligonucleotídeos anti-senso têm entre cerca de 5 a 100, de cerca de 10 a 80, de cerca de 15 a 60, de cerca de 18 a 40. Os oligonucleotídeos anti-senso podem ser DNA ou RNA de filamento simples ou de filamento duplo. O comprimento ótimo pode ser determinado por meio de seleção de rotina. Os oligonucleotídeos anti-senso podem estar presentes em qualquer concentração. A concentração ótima pode ser determinada por
Petição 870180005321, de 22/01/2018, pág. 119/316
113/293 meio de seleção de rotina. Conhece-se uma ampla variedade de análogos de ácido nucleico e nucleotídeos sintéticos, não-naturalmente ocorrentes, que podem servir para tratar deste problema potencial. Por exemplo, é possível usar ácidos nucleicos de peptídeos (PNAs, peptide nucleic acids) contendo espinhas dorsais não-iônicas, como unidades de N-(2-aminoetil)glicina. Oligonucleotídeos anti-senso apresentando ligações fosforotioato também podem ser usados, como descrito no WO 97/03211; WO 96/39154; Mata (1997) Toxicol Appl Pharmacol 144:189-197; Antisense Therapeutics, ed. Agrawal (Humana Press, Totowa, N. J., 1996). Proporciona-se aqui oligonucleotídeos anti-senso apresentando análogos de cadeia principal de DNA sintética, que também podem incluir ácidos nucleicos de fósforo-ditioato, metilfosfonato, fosforamidato, fosfotriéster de alquila, sulfamato, 3'-tioacetal, metileno(metilimino), 3'-N-carbamato, e de morfolina carbamato, como descrito acima.
[0234] É possível usar metodologia de química combinatorial para criar vastos números de oligonucleotídeos que podem ser rapidamente selecionados quanto a oligonucleotídeos específicos que apresentam especificidades e afinidades de ligação apropriadas com relação a qualquer alvo, como as sequências de hidrolase senso e antisenso como proporcionadas aqui (ver, p. ex., Gold (1995) J. of Biol. Chem. 270:1358113584).
RIBOZIMAS INIBIDORAS [0235] Em determinadas concretizações, proporciona-se aqui ribozimas capazes de ligar mensagem de hidrolase que pode inibir a atividade de hidrolase por meio de mRNA de objetivação. Estratégicas para detectar ribozimas e selecionar a sequência anti-senso específica para hidrolase para objetivação são bem descritas na literatura científica e de patentes, e a pessoa versada na arte pode projetar referidas ribozimas usando-se os reagentes inéditos como proporcionados aqui. Ribozimas atuam ligando-se a um RNA-alvo por meio da porção de ligação do RNA-alvo de uma ribozima que é mantida em estreita proximidade com a porção enzimática do RNA que cliva o RNA-alvo. Assim, a ribozima reconhece e liga-se a um RNA alvo por meio de pareamento de bases complementar, e, uma vez ligada no sítio correto, atua enzimaticamente para clivar e inativar o RNA-alvo. A clivagem do RNA-alvo dessa maneira destruirá sua capacidade de dirigir a síntese de uma
Petição 870180005321, de 22/01/2018, pág. 120/316
114/293 proteína codificada e a clivagem ocorre na sequência codificante. Após uma ribozima terse ligado e clivado seu RNA-alvo, ela é liberada tipicamente daquele RNA e, assim, pode ligar-se e clivar novos alvos repeatidamente.
[0236] Em algumas circunstâncias, a natureza enzimática de uma ribozima pode ser vantajosa relativamente a outras tecnologias, como tecnologia anti-senso (em que uma molécula de ácido nucleico simplesmente liga-se a um alvo de ácido nucleico para bloquear sua transcrição, tradução ou associação com outra molécula) porque a concentração efetiva de ribozima necessária para efetuar um tratamento terapêutico pode ser menor do que aquela de um oligonucleotídeo anti-senso. Esta vantagem potencial reflete a capacidade da ribozima de atuar enzimaticamente. Assim, uma única molécula de ribozima é capaz de clivar muitas moléculas de RNA-alvo. Adicionalmente, uma ribozima é tipicamente um inibidor altamente específico, sendo que a especificidade de inibição depende não só do mecanismo de pareamento de bases de ligação, mas também do mecanismo por meio do qual a molécula inibe a expressão do RNA a que se liga. Ou seja, a inibição é causada por meio de clivagem do RNA-alvo e, assim, a especificidade é definida como a relação da taxa de clivagem do RNA objetivado sobre a taxa de clivagem de RNA não-objetivado. Este mecanismo de clivagem depende de fatores adicionais além daqueles envolvidos no pareamento de bases. Assim, a especificidade de ação de uma ribozima pode ser maior do que aquela do oligonucleotídeo anti-senso que se liga ao mesmo sítio de RNA.
[0237] A molécula de RNA de ribozima enzimática pode ser formada numa configuração de unidade repetitiva tipo cabeça-de-martelo [hammerhead], mas também pode ser formada na unidade repetitiva de um grampo-de-cabelo [hairpin], vírus da heptatite delta, íntron de grupo I ou RNA similar a RNase P- (em associação com uma sequência-guia de RNA). Exemplos de referidas unidades repetitivas cabeça-de-martelo [hammerhead] são descritas por Rossi (1992) Aids Research and Human Retroviruses 8:183; unidades repetitivas grampo-de-cabelo [hairpin] por Hampel (1989) Biochemistry 28:4929, e Hampel (1990) Nuc. Acids Res. 18:299; a unidade repetitiva do vírus da heptatite delta por Perrotta (1992) Biochemistry 31:16; a unidade repetitiva de RNaseP por Guerrier-Takada (1983) Cell 35:849; e o íntron de grupo I por Cech (Patente U.S. n°
Petição 870180005321, de 22/01/2018, pág. 121/316
115/293
4.987.071). A indicação destas unidades repetitivas específicas não deve ser considerada como limitante; aqueles versados na arte perceberão que uma molécula de RNA enzimático como proporcionada aqui pode apresentar um sítio de específico de ligação a substrato que é complementar a uma ou mais das regiões de RNA de gene-alvo, e apresenta sequência de nucleotídeos dentro ou em volta daquele sítio de ligação a substrato que confere à molécula uma atividade de clivagem de RNA.
INTERFERÊNCIA DE RNA (RNAi) [0238] Em determinadas concretizações, proporciona-se aqui moléculas inibidoras de RNA, assim-chamadas moléculas “RNAi”, compreendendo uma sequência de hidrolase como proporcionada aqui. A molécula de RNAi pode compreender uma molécula de RNA de filamento duplo (dsRNA), p. ex., siRNA e/ou miRNA. O RNAi pode inibir a expressão de uma hidrolase (p. ex., lipase, saturase, palmitase e/ou estearatase) ou transcrição. Em um aspecto, a molécula de RNAi, p. ex., siRNA e/ou miRNA, tem comprimento de cerca de 10, 11, 12, 13, 14, 15, 16, 17, 18, 19, 20, 21, 22, 23, 24, 25, 26, 27, 28, 29 ou 30 ou mais nucleotídeos dúplices. Embora a invenção não seja limitada a qualquer mecanismo de ação particular, o RNAi pode entrar numa célula e causar a degradação de um RNA de filamento simples (ssRNA) com sequências similares ou idênticas, incluindo mRNAs endógenos. Quando a célula é exposta a RNA de filamento duplo (dsRNA), o mRNA do gene homólogo é degradado seletivamente por meio de um processo denominado interferência de RNA (RNAi). Um mecanismo básico possível por trás do RNAi é a quebra de um RNA de filamento duplo (dsRNA) que se equipara a uma sequência de genes específica em pedaços curtos denominada RNA interferente curto, que dispara a degradação do mRNA que se equipara a sua sequência.
[0239] Em um aspecto, os RNAi's como proporcionados aqui são usados em terapêuticas de silenciamento de genes, ver, p. ex., Shuey (2002) Drug Discov. Today 7:1040-1046. Em determinadas concretizações, proporciona-se aqui métodos para degradar seletivamente RNA usando os RNAi's. O processo pode ser praticado in vitro, ex vivo ou in vivo. Em um aspecto, as moléculas de RNAi como proporcionadas aqui podem ser usadas para gerar uma mutação de perda-de-função em uma célula, um órgão ou um animal. Métodos para preparar e usar moléculas de RNAi para degradar seletivamente
Petição 870180005321, de 22/01/2018, pág. 122/316
116/293
RNA são bem conhecidos na arte, ver, p. ex., Patente U.S. n° 6.506.559; 6.511.824; 6.515.109; 6.489.127.
MODIFICAÇÃO DE ÁCIDOS NUCLEICOS [0240] Em determinadas concretizações, proporciona-se aqui métodos de gerar variantes dos ácidos nucleicos, p. ex., aquelas que codificam uma hidrolase ou um anticorpo como proporcionado aqui. Estes métodos podem ser repetidos ou usados em várias combinações para gerar hidrolases ou anticorpos apresentando uma atividade alterada ou diferente, ou uma estabilidade alterada ou diferente daquela de uma hidrolase ou anticorpo codificado pelo ácido nucleico modelo. Estes métodos também podem ser repetidos ou usados em várias combinações, p. ex., para gerar variações na expressão do gene/mensagem, tradução da mensagem ou estabilidade da mensagem. Em outro aspecto, a composição genética de uma célula é alterada por meio de, p. ex., modificação de um gene homólogo ex vivo, seguido de sua reinserção na célula.
[0241] O termo “variante” pode incluir polinucleotídeos ou polipeptídios como proporcionados aqui modificados em um ou mais pares de bases, códons, íntrons, éxons, ou resíduos de aminoácidos respectivamente) ainda contêm a atividade biológica de uma hidrolase como proporcionada aqui. Variantes podem ser produzidas por meio de qualquer número de meios, incluindo métodos, como, por exemplo, PCR propensa a erro, embaralhamento, mutagênese oligonucleotídeo-dirigida, PCR de montagem, mutagênese sexual, mutagênese in vivo, mutagênese de cassete, mutagênese de conjunto recursiva, mutagênese de conjunto exponencial, mutagênese sítio-específica, GeneReassembly, GSSMSM e qualquer combinação dos mesmos. Técnicas para produzir hidrolases variantes apresentando atividade a um pH ou temperatura, por exemplo, que é diferente de uma hidrolase de tipo selvagem, são incluídas aqui.
[0242] Um ácido nucleico como proporcionado aqui pode ser alterado por quaisquer meios. Por exemplo, métodos randômicos ou estocásticos, ou, métodos não-estocásticos, ou “evolução dirigida”, ver, p. ex., Patente U.S. n° 6.361.974. Métodos para a mutação randômica de genes são bem conhecidos na arte, ver, p. ex., Patente U.S. n° 5.830.696. Por exemplo, é possível usar mutágenos para mutar randomicamente um gene. Mutágenos incluem, p. ex., luz ultravioleta ou irradiação gama, ou um mutágeno químico,
Petição 870180005321, de 22/01/2018, pág. 123/316
117/293
p. ex., mitomicina, ácido nitroso, psorálenos fotoativados, sozinhos ou em combinação, para induzir quebras de DNA passíveis de reparo por meio de recombinação. Outros mutágenos químicos incluem, por exemplo, bissulfito de sódio, ácido nitroso, hidroxilamina, hidrazina ou ácido fórmico. Outros mutágenos são análogos de precursores de nucleotídeos, p. ex., nitrosoguanidina, 5-bromouracila, 2- aminopurina, ou acridina. Estes agentes podem ser adicionados a uma reação PCR em lugar do precursor de nucleotídeos, mutando com isso a sequência. Agentes intercalantes, como proflavina, acriflavina, quinacrina e análogos também podem ser usados.
[0243] É possível usar qualquer técnica da biologia molecular, p. ex., mutagênese de PCR randômica, ver, p. ex., Rice (1992) Proc. Natl. Acad. Sci. USA 89:5467-5471; ou, mutagênese de cassete combinatorial múltipla, ver, p. ex., Crameri (1995) Biotechniques 18:194-196. Alternativamente, ácidos nucleicos, p. ex., genes, podem ser remontados após fragmento randômica, ou “estocástica”, ver, p. ex., Patentes U.S. nums. 6.291.242; 6.287.862; 6.287.861; 5.955.358; 5.830.721; 5.824.514; 5.811.238; 5.605.793. Em aspectos alternativos, modificações, adições ou deleções são introduzidas por meio de PCR propensa a erro, embaralhamento, mutagênese oligonucleotídeo-dirigida, PCR de montagem, mutagênese de PCR sexual, mutagênese in vivo, mutagênese de cassete, mutagênese de conjunto recursiva, mutagênese de conjunto exponencial, mutagênese sítio-específica, Gene Site Saturation MutagenesisSM (GSSMSM), remontagem de ligação sintética (SLR), recombinação, recombinação de sequências recursiva, mutagênese de DNA modificada com fosfotioato, mutagênese de modelo contendo uracila, mutagênese de dúplice intervalado, mutagênese de reparo de malpareamento pontual, mutagênese de cepa hospedeira reparo-deficiente, mutagênese química, mutagênese radiogênica, mutagênese de deleção, mutagênese de restrição-seleção, mutagênese de restriçãopurificação, síntese de genes artificiais, mutagênese de conjunto, criação de multímeros de ácido nucleico quiméricos, e/ou uma combinação destes e outros métodos.
[0244] As publicações a seguir descrevem uma variedade de procedimentos de recombinação recursiva e/ou métodos que podem ser incorporados nos métodos como proporcionados aqui: Stemmer (1999) “Molecular breeding of viruses for targeting and other clinical properties” Tumor Targeting 4:1-4; Ness (1999) Nature Biotechnology 17:893-896;
Petição 870180005321, de 22/01/2018, pág. 124/316
118/293
Chang (1999) “Evolution of a cytokine using DNA family shuffling” Nature Biotechnology 17:793-797; Minshull (1999) “Protein evolution by molecular breeding” Current Opinion in Chemical Biology 3:284-290; Christians (1999) “Directed evolution of thymidine kinase for AZT phosphorylation using DNA family shuffling” Nature Biotechnology 17:259-264; Crameri (1998) “DNA shuffling of a family of genes from diverse species accelerates directed evolution” Nature 391 :288- 291; Crameri (1997) “Molecular evolution of an arsenate detoxification pathway by DNA shuffling”, Nature Biotechnology 15:436-438; Zhang (1997) “Directed evolution of an effective fucosidase from a galactosidase by DNA shuffling and screening” Proc. Natl. Acad. Sci. USA 94:4504-4509; Patten et al. (1997) “Applications of DNA Shuffling to Pharmaceuticals and Vaccines” Current Opinion in Biotechnology 8:724-733; Crameri et al. (1996) “Construction and evolution of antibodyphage libraries by DNA shuffling” Nature Medicine 2:100-103; Gates et al. (1996) “Affinity selective isolation of ligands from peptide libraries through visor on a lac repressor 'headpiece dimer'“ Journal of Molecular Biology 255:373-386; Stemmer (1996) “Sexual PCR and Assembly PCR” em: The Encyclopedia of Molecular Biology. VCH Publishers, New York, pp.447-457; Crameri e Stemmer (1995) “Combinatorial multiple cassette mutagenesis creates all the permutations of mutant and wildtype cassettes” BioTechniques 18:194-195; Stemmer et al. (1995) “Single-stepo assembly of a gene and entire plasmid form large numbers of oligodeoxyribonucleotides” Gene, 164:49-53; Stemmer (1995) “The Evolution of Molecular Computation” Science 270: 1510; Stemmer (1995) “Searching Sequence Space” Bio/Technology 13:549-553; Stemmer (1994) “Rapid evolution of a protein in vitro by DNA shuffling” Nature 370:389-391; e Stemmer (1994) “DNA shuffling by random fragmentation and reassembly: in vitro recombination for molecular evolution”. Proc. Natl. Acad. Sci. USA 91 :10747-10751.
[0245] Métodos mutacionais de gerar diversidade incluem, por exemplo, mutagênese sítio-dirigida (Ling et al. (1997) “Approaches to DNA mutagenesis: an overview” Anal hem. 254(2): 157-178; Dale et al. (1996) “Oligonucleotide-directed random mutagenesis using the phosphorothioate method” Métodos Mol. Biol. 57:369-374; Smith (1985) “In vitro mutagenesis” Ann. Rev. Genet. 19:423-462; Botstein & Shortle (1985) “Strategies e applications of in vitro mutagenesis” Science 229:1193-1201; Carter (1986) “Site-directed
Petição 870180005321, de 22/01/2018, pág. 125/316
119/293 mutagenesis” Biochem. J. 237:1-7; e Kunkel (1987) “The efficiency of oligonucleotide directed mutagenesis” in Nucleic Acids & Molecular Biology (Eckstein, F. e Lilley, D. M. J. eds., Springer Verlag, Berlin)); mutagênese usando modelos contendo uracila (Kunkel (1985) “Rapid and efficient site-specific mutagenesis without phenotypic selection” Proc. Natl. Acad. Sci. USA 82:488-492; Kunkel et al. (1987) “Rapid and efficient site-specific mutagenesis without phenotypic selection” Methods in Enzymol. 154, 367-382; e Bass et al. (1988) “Mutant Tip repressors with new DNA-binding specificities” Science 242:240245); mutagênese oligonucleotídeo-dirigida (Methods in Enzymol. 100: 468-500 (1983); Methods in Enzymol. 154: 329-350 (1987); Zoller & Smith (1982) “Oligonucleotide-directed mutagenesis using M13-derived vectors: an efficient and general procedure for the production of point mutations in any DNA fragment” Nucleic Acids Res. 10:6487-6500; Zoller & Smith (1983) “Oligonucleotide-directed mutagenesis of DNA fragments cloned into M13 vectors”, Methods in Enzymol. 100:468-500; e Zoller & Smith (1987) “Oligonucleotide directed mutagenesis: a simple method using two oligonucleotide primers and a singlestranded DNA template” Methods in Enzymol. 154:329-350); phosphorothioate-modified DNA mutagenesis (Taylor et al. (1985) “The use of phosphorothoate-modified DNA in restriction enzyme reactions to prepare nicked DNA”, Nucl. Acids Res. 13: 8749- 8764; Taylor et al. (1985) “The rapid generation of oligonucleotide-directed mutations at high frequency using phosphorothioate-modified DNA” Nucl. Acids Res. 13: 8765-8787 (1985); Nakamaye (1986) “Inhibition of restriction endonuclease Nci I cleavage by phosphorothioate groups and its application to oligonucleotide-directed mutagenesis” Nucl. Acids Res. 14: 9679-9698; Sayers et al. (1988) “Y-T Exonucleases in phosphorothioatebased oligonucleotide-directed mutagenesis” Nucl. Acids Res. 16:791-802; e Sayers et al. (1988) “Strand specific cleavage of phosphorothioate-containing DNA by reaction with restriction endonucleases in the presence of ethidium bromide” Nucl. Acids Res. 16: 803814); mutagênese usando DNA de dúplex intervalado (Kramer et al. (1984) “The gapped duplex DNA approach to oligonucleotide-directed mutation construction” Nucl. Acids Res. 12: 9441-9456; Kramer & Fritz (1987) Methods in Enzymol. “Oligonucleotide-directed construction of mutations via gapped duplex DNA” 154:350-367; Kramer et al. (1988) “Improved enzymatic in vitro reactions in the gapped duplex DNA approach to nucleotide
Petição 870180005321, de 22/01/2018, pág. 126/316
120/293 directed construction of mutations” Nucl. Acids Res. 16: 7207; e Fritz et al. 1988) “Oligonucleotide-directed construction of mutations: a gapped duplex DNA procedure without enzymatic reactions in vitro” Nucl. Acids Res. 16: 6987-6999).
[0246] Protocolos adicionais usados nos métodos como proporcionados aqui incluem reparo de malpareamento pontual (Kramer (1984) “Point Mismatch Repair” Cell 38:879887), mutagênese usando cepas hospedeiras reparo-deficientes (Carter et al. (1985) “Improved oligonucleotide site-directed mutagenesis using M13 vectors” Nucl. Acids Res. 13: 4431-4443; e Carter (1987) “Improved oligonucleotide-directed mutagenesis using M13 vectors” Methods in Enzymol. 154: 382-403), mutagênese de deleção (Eghtedarzadeh (1986) “Use of oligonucleotides to generate large deletions” Nucl. Acids Res. 14: 5115), restriction-selection and restriction- selection and restriction-purificação (Wells et al. (1986) “Importance of hydrogen-bond formation in stabilizing the transition state of subtilisin” Phil. Trans. R. Soc. Lond. A 317: 415-423), mutagenesis by total gene synthesis (Nambiar et al. (1984) “Total synthesis and cloning of a gene coding for the ribonuclease S protein” Science 223: 1299-1301; Sakamar e Khorana (1988) “Total synthesis e expression of a gene for the a-subunit of bovine rod outer segment guanine nucleotide-binding protein (transducin)” Nucl. Acids Res. 14: 6361- 6372; Wells et al. (1985) “Cassette mutageneis: an efficient method for generation of multiple mutations at defined sites” Gene 34:315-323; e Grundstrom et al. (1985) “Oligonucleotide-directed mutagenesis by microscale 'shot-gun' gene synthesis” Nucl. Acids Res. 13: 3305-3316), double-strand break repair (Mandecki (1986); Arnold (1993) “Protein engineering for unusual environments” Current Opinion in Biotechnology 4:450-455. “Oligonucleotide-directed double-strand break repair in plasmids of Escherichia coli: a method for site-specific mutagenesis” Proc. Natl. Acad. Sci. USA, 83:7177-7181). Detalhes adicionais sobre muitos dos métodos acima podem ser encontrados em Methods in Enzymology, volume 154, que também descreve controles úteis para problemas de detecção de problemas com vários métodos de mutagênese.
Problemas adicionais usados nos métodos como proporcionados aqui incluem aqueles discutidos nas Patentes U.S. nums. 5.605.793 para Stemmer (25 de fevereiro de 1997), “Methods for in vitro Recombination”; Patente U.S. n° 5.811.238 para Stemmer et al. (22 de setembro de 1998) “Methods for Generating Polinucleotides
Petição 870180005321, de 22/01/2018, pág. 127/316
121/293 having Desired Characteristics by Iterative Selection and Recombination”; Patente U.S. n° 5.830.721 para Stemmer et al. (3 de novembro de 1998), “DNA Mutagenesis by Random Fragmentation and Reassembly”; Patente U.S. n° 5.834.252 para Stemmer, et al. (10 de novembro de 1998) “End-Complementary Polymerase Reaction”; Patente U.S. n° 5.837.458 para Minshull, et al. (17 de novembro de 1998), “Methods and Compositions for Cellular and Metabolic Engineering”; WO 95/22625, Stemmer e Crameri, “Mutagenesis by Random mentation and Reassembly”; WO 96/33207 por Stemmer e Lipschutz “End Complementary Polymerase Chain Reaction”; WO 97/20078 por Stemmer e Crameri “Methods for Generating Polinucleotides having Desired Characteristics by Iterative Selection and Recombination”; WO 97/35966 por Minshull e Stemmer, “Methods and positions for Cellular and Metabolic Engineering”; WO 99/41402 by Punnonen et al. “Targeting of Genetic Vaccine Vectors”; WO 99/41383 por Punnonen et al. “Antigen Library Immunization”; WO 99/41369 por Punnonen et al. “Genetic Vaccine Vector Engineering”; WO 99/41368 por Punnonen et al. “Optimization of Immunomodulatory Properties of Genetic Vaccines”; EP 752008 por Stemmer e Crameri, “DNA Mutagenesis by Random Fragmentation and Reassembly”; EP 0932670 por Stemmer “Evolving Cellular DNA Uptake by Recursive Sequence Recombination”; WO 99/23107 by Stemmer et al., “Modification of Virus Tropism and Host Range by Viral Genome Shuffling”; WO 99/21979 por Apt et al., “Human Papillomavirus Vectors”; WO 98/31837 por del Cardayre et al. “Evolution of Whole Cells and Organisms by Recursive Sequences Recombination”; WO 98/27230 por Patten e Stemmer, “Methods and Compositions for Polypeptide Engineering”; WO 98/27230 por Stemmer et al., “Methods for Optimization of Gene Therapy by Recursive Sequence Shuffling and Selection”, WO 00/00632, “Methods for Generating Highly Diverse Libraries”, WO 00/09679, “Methods for Obtaining in vitro Recombined Polinucleotide Sequence Banks and Resulting Sequences”, WO 98/42832 por Arnold et al., “Recombination of Polinucleotide Sequences Using Random or Defined Primers”, WO 99/29902 por Arnold et al., “Method for Creating Polinucleotide and Polypeptide Sequences”, WO 98/41653 por Vind, “An In vitro Method for Construction of a DNA Library”, WO
Petição 870180005321, de 22/01/2018, pág. 128/316
122/293
98/41622 by Borchert et al., “Method for Constructing a Library Using DNA Shuffling”, e WO 98/42727 por Pati e Zarling, “Sequence Alterations using Homologous Recombination”.
[0247] Protocolos que podem ser usados (proporcionando detalhes relativos a vários métodos geradores de diversidade) são descritos, p. ex., no Pedido de Patente dos E.U.A. número de série (USSN) 09/407,800, “SHUFFLING OF CODON ALTERED GENES”, por Patten et al. depositado em 28 de setembro de 1999; “EVOLUTION OF WHOLE CELLS AND ORGANISMS BY RECURSIVE SEQUENCES RECOMBINATION” por del Cardayre et al., Patente U.S. n° 6.379.964; “OLIGONUCLEOTIDE MEDIATED NUCLEIC ACID RECOMBINATION” por Crameri et al., Patentes U.S. nums. 6.319.714; 6.368.861; 6.376.246; 6.423.542; 6.426.224 e PCT/US00/01203; “USE OF CODON-VARIED OLIGONUCLEOTIDE SYNTHESIS FOR THETIC SHUFFLING” por Welch et al., Patente U.S. n° 6.436.675; METHODS FOR MAKING CHARACTER STRINGS, POLYNUCLEOTIDES & PEPTIDES HAVING DESIRED CHARACTERISTICS” por Selifonov et al., depositado em 18 de janeiro de 2000, (PCT/US00/01202) e, p. ex., “METHODS FOR MAKING CHARACTER STRINGS, POLYNUCLEOTIDES & POLYPEPTIDES HAVING DESIRED RACTERISTICS” por Selifonov et al., depositado em 18 de julho de 2000 (número de série dos E.U.A. n° 09/618,579); “METHODS OF POPULATING DATA STRUCTURES FOR USE IN EVOLUTIONARY SIMULATIONS” por Selifonov e Stemmer, depositado em 18 de janeiro de 2000 (PCT/US00/01138); e “SINGLE-STRANDED NUCLEIC ACID TEMPLATE-MEDIATED RECOMBINATION AND NUCLEIC ACID FRAGMENT ISOLATION” por Affholter, depositado em 6 de setembro de 2000 (número de série dos E.U.A. n° 09/656,549); e Patentes U.S. nums. 6.177.263; 6.153.410.
[0248] Métodos não-estocásticos ou de “evolução dirigida” incluem, p. ex., mutagênese de saturação de sítio gênicoSM (GSSMSM, gene site saturation mutagenesisSM), remontagem de ligação sintética (SLR ou GeneReassembly), ou uma combinação dos mesmos são usados para modificar os ácidos nucleicos como proporcionados aqui para gerar hidrolases com propriedades novas ou alteradas (p. ex., atividade em condições altamente ácidas ou alcalinas, temperaturas elevadas, e análogos).
Petição 870180005321, de 22/01/2018, pág. 129/316
123/293
Polipeptídios codificados pelos ácidos nucleicos modificados podem ser selecionados quanto a uma atividade antes de se testar quanto à atividade proteolítica ou outra atividade. É possível usar qualquer modalidade de testagem, p. ex., usando uma plataforma de conjunto capilar. Ver, p. ex., Patentes U.S. nums. 6.361.974; 6.280.926; 5.939.250. MUTAGÊNESE DE SATURAÇÃO, OU TECNOLOGIA GSSMsm [0249] Em um aspecto como proporcionado aqui, uma modificação gênica nãoestocástica, um “processo de evolução dirigida”, é usado para gerar hidrolases e anticorpos com propriedades novas ou alteradas. Variações deste método foram denominados “Gene Site Saturation Mutagenesis [mutagênese de saturação de sítio gênico]”, “mutagênese de saturação de sítio”, “mutagênese de saturação” ou simplesmente “GSSMSM”. Podem ser usados em combinação com outros processos de mutagenização. Em um aspecto, proporciona-se aqui métodos para preparar enzimas e anticorpos usando tecnologia GSSMSM, p. ex., como aqui descrito e também nas Patentes U.S. nums. 6.171.820; 6.579.258; 6.238.884.
[0250] Em um aspecto, tecnologia GSSMSM compreende prover um polinucleotídeo modelo e uma pluralidade de oligonucleotídeos, sendo que cada oligonucleotídeo compreende uma sequência homóloga ao polinucleotídeo modelo, objetivando com isso uma sequência específica do polinucleotídeo modelo, e uma sequência que é uma variante do gene homólogo, gerando polinucleotídeos de progênie compreendendo variações de sequências não-estocásticas por meio de replicaçaõ do polinucleotídeo tardio com os oligonucleotídeos, gerando com isso polinucleotídeos compreendendo variações de sequências de genes homólogos.
[0251] Em um aspecto, iniciadores de códons contendo uma sequência N,N,G/T degenerada são usados para introduzir mutações pontuais em um polinucleotídeo, de forma a gerar um conjunto de progênie em que uma faixa plena de substituições de aminoácidos simples é representada em cada posição de aminoácido, p. ex., uma resíduo de aminoácido em um sítio ativo para enzima ou sítio de ligação de ligante a ser modificado. Estes oligonucleotídeos podem compreender uma primeira sequência homóloga contígua, uma sequência N,N,G/T degenerada, e, opcionalmente, uma segunda sequência homóloga. Os produtos traducionais de progênie a jusante do uso de referidos
Petição 870180005321, de 22/01/2018, pág. 130/316
124/293 oligonucleotídeos incluem todas as possíveis alterações de aminoácidos em cada sítio de aminoácido juntamente com o polipeptídio, porque a degeneração da sequência N,N,G/T inclui códons para todos os 20 aminoácidos. Em um aspecto, um oligonucleotídeo degenerado do tipo referido (constituído de, p. ex., uma cassete N,N,G/T degenerada) é usado para submeter cada códon original em um modelo de polinucleotídeo parental a uma faixa cheia de substituições de códons. Em outro aspecto, usa-se pelo menos duas cassetes degeneradas - no mesmo oligonucleotídeo ou não, para submeter pelo menos dois códons originais em um modelo de polinucleotídeo parental a uma faixa plena de substituições de códons. Por exemplo, mais de uma sequência N,N,G/T pode ser condida em um oligonucleotídeo para introduzir mutações de aminoácidos em mais de um sítio. Esta pluralidade de sequências N,N,G/T pode ser diretamente contígua, ou separada por uma ou mais sequências de nucleotídeos adicionais. Em outro aspecto, oligonucleotídeos úteis para introduzir adições e deleções podem ser usados sozinhos ou em combinação com os códons contendo a sequência N,N,G/T, para introduzir qualquer combinação ou permutação de adições, deleções e/ou substituições de aminoácidos.
[0252] Em um aspecto, a mutagênese simultânea de duas ou mais posições de aminoácidos contíguas é realizada usando um oligonucleotídeo que contém tripletos N,N,G/T contíguos, i.e. uma sequência (N,N,G/T)n degenerada. Em outro aspecto usa-se cassetes degeneradas apresentando menos degeneração do que a sequência N,N,G/T. Por exemplo, pode ser desejável, em alguns casos, usar (p. ex., em um oligonucleotídeo) uma sequência de tripleto degenerada constituído de apenas um N, sendo que referido N pode encontrar-se na primeira, segunda ou terceira posição do tripleto. Quaisquer outras bases incluindo quaisquer combinações e permutações das mesmas podem ser usadas nas duas posições remanescentes do tripleto. Alternativamente, em alguns casos (p. ex., em um oligo) pode ser desejável uma sequência de tripleto N,N,N degenerada.
[0253] Em um aspecto, o uso de tripletos degenerados (p. ex., tripletos N,N,G/T) permite a geração sistemática e fácil de uma faixa cheia de possíveis aminoácidos naturais (para um total de 20 aminoácidos) em cada posição de aminoácido em um polipeptídio (em aspectos alternativos, os métodos também incluem a geração de quase todas as possíveis substituições por resíduo de aminoácido, ou códon, posição). Por exemplo, para um
Petição 870180005321, de 22/01/2018, pág. 131/316
125/293 polipeptídio de 100 aminoácidos, é possível gerar 2000 espécies distintas (i.e., 20 possíveis aminoácidos por posição X 100 posições de aminoácidos). Por meio do uso de um oligonucleotídeo ou de um conjunto de oligonucleotídeos contendo um tripleto G/T degenerado, 32 sequências individuais podem codificar para todos os 20 possíveis aminoácidos naturais. Assim, em um vaso de reação em que uma sequência de polinucleotídeo parental é submetida a mutagênese de saturação usando-se pelo menos um oligonucleotídeo do tipo referido, há 32 polinucleotídeos de progênie distintos codificando 20 polipeptídios distintos. Em contraste, o uso de um oligonucleotídeo nãodegenerado na mutagênese sítio-direcionada leva a apenas um produto de polipeptídio de progênie por vaso de reação. Oligonucleotídeos não-degenerados podem ser usados opcionalmente em combinação com iniciadores degenerados revelados; por exemplo, oligonucleotídeos não-degenerados podem ser usados para gerar mutações pontuais específicas em um polinucleotídeo de trabalho. Isto proporciona um meio de gerar mutações pontuais silentes específicas, mutações pontuais que levam às alterações de aminoácidos correspondentes, e mutações pontuais que causam a geração de códons de interrupção e a expressão correspondente de fragmentos de polipeptídios.
[0254] Em um aspecto, cada vaso de reação de mutagênese de saturação contém polinucleotídeos codificando pelo menos 20 moléculas de polipeptídio de progênie (p. ex., hidrolase, p. ex., lipase, saturase, palmitase e/ou estearatase) de tal forma que todos os 20 aminoácidos naturais são representados naquela uma posição de aminoácido específica correspondendo à posição de códon mutagenizada no polinucleotídeo parental (outros aspectos usam menos de todas as 20 combinações naturais). Os polipeptídios de progênie degenerados 32 vezes gerados de cada vaso de reação de mutagênese de saturação podem ser submetidos a amplificação clonal (p. ex., clonados em um hospedeiro vantajoso, p. ex., hospedeiro de E. coli, usando, p. ex., um vetor de expressão) e submetidos a seleção de expressão. Quando um polipeptídio de progênie individual é identificado por meio de seleção para apresentar uma alteração favorável na propriedade (quando comparado com o polipeptídio parental, como seletividade incrementada para hidrólise de ésteres de palmitato versus hidrólise de ésteres de oleato), ele pode ser sequenciado para identificar a substituição de aminoácido correspondentemente favorável ali contida.
Petição 870180005321, de 22/01/2018, pág. 132/316
126/293 [0255] Em um aspecto, mediante a mutagenização de cada posição de aminoácido em um polipeptídio parental usando mutagênese de saturação como revelado aqui, é possível identificar alterações de aminoácidos favoráveis em mais de uma posição de aminoácido. É possível gerar uma ou mais novas moléculas de progênie que contêm uma combinação de todas ou parte destas substituições de aminoácidos favoráveis. Por exemplo, se 2 alterações de aminoácidos favoráveis são identificadas em cada uma das 3 posições de aminoácidos em um polipeptídio, as permutações incluem 3 possibilidades em cada posição (nenhuma alteração do aminoácido original, e cada uma das duas alterações favoráveis) 3 posições. Assim, há 3 x 3 x 3 ou 27 possibilidades no total, incluindo 7 que foram previamente examinadas - 6 mutações pontuais simples (i.e. 2 em cada uma das três posições) e nenhuma alteração em qualquer posição.
[0256] Em outro aspecto, é possível usar mutagênese de saturação de sítio juntamente com outros meios estocásticos ou não-estocásticos para variar a sequência, p. ex., remontagem de ligação sintética (ver abaixo), embaralhamento, quimerização, recombinação e outros processos de mutagenização e agentes mutagenizantes. Proporciona-se aqui processo(s) mutagenizantes, incluindo mutagênese de saturação, usados de uma maneira iterativa.
REMONTAGEM DE LIGAÇÃO SINTÉTICA (SLR) [0257] Em um aspecto proporcionado aqui encontram-se sistemas de modificação gênica não-estocásticos denominados “remontagem de ligação sintética”, ou simplesmente “SLR”, também conhecida como tecnologia “GeneReassembly, um “processo de evolução dirigida”, para gerar polipeptídios, p. ex., enzimas (como hidrolases, p. ex., lipases, saturases, palmitases e/ou estearatases) ou anticorpos como proporcionados aqui, com propriedades novas ou alteradas. SLR é um método de ligar fragmentos de oligonucleotídeos entre si de forma não-estocástica. Este método difere do embaralhamento de oligonucleotídeos estocástico pelo fato de que os blocos construtivos de ácidos nucleicos não são embaralhados, concatenados ou quimerizados randomicamente, mas, ao invés, são montados não-estocasticamente. Ver, p. ex., Patentes U.S. nums. 6.773.900; 6.740.506; 6.713.282; 6.635.449; 6.605.449; 6.537.776.
[0258] Em um aspecto, SLR compreende as seguintes etapas: (a) proporcionar um
Petição 870180005321, de 22/01/2018, pág. 133/316
127/293 polinucleotídeo modelo, sendo que o polinucleotídeo modelo compreende codificação de sequência de um gene homólogo; (b) proporcionar um pluralidade de polinucleotídeos de blocos construtivos, sendo que os polinucleotídeos de blocos construtivos são projetados para remontagem de cruzamento [cross-over] com o polinucleotídeo modelo em uma sequência predeterminada, e um polinucleotídeo de blocos construtivos compreende uma sequência que é uma variante do gene homólogo e uma sequência homóloga ao polinucleotídeo modelo que flanqueia a sequência variante; (c) combinar um polinucleotídeo de blocos construtivos com um polinucleotídeo modelo de tal forma que o polinucleotídeo de blocos construtivos se remonte em cross-over com o polinucleotídeo modelo para gerar polinucleotídeos compreendendo variações de sequências de genes homólogos.
[0259] SLR não depende da presença de altos níveis de homologia entre polinucleotídeos a serem rearranjados. Assim, este método pode ser usado para gerar nãoestocasticamente bibliotecas (ou conjuntos) de moléculas de progênie constituídas de mais de 10100 quimeras diferentes. SLR pode ser usada para gerar bibliotecas constituídas de mais de 101000 diferentes quimeras de progênie. Em um aspecto proporcionado aqui encontram-se métodos não-estocásticos de produzir um conjunto de moléculas de ácido nucleico quiméricas finalizadas apresentando uma ordem de montagem global que é selecionada por projeto. Este método inclui as etapas de gerar por projeto uma pluralidade de blocos construtivos de ácido nucleico específicos apresentando pontas ligáveis mutuamente compatíveis úteis, e montar estes blocos construtivos de ácido nucleico, de tal forma a se obter uma ordem de montagem global projetada.
[0260] As pontas ligáveis mutuamente compatíveis dos blocos construtivos de ácido nucleico a serem montados são consideradas como sendo “úteis” para este tipo de montagem ordenada se permitirem que os blocos construtivos sejam acoplados em ordens predeterminadas. Assim a ordem de montagem global em que os blocos construtivos de ácido nucleico podem ser acoplados é especificada pelo projeto das pontas ligáveis. Pretendendo-se usar mais de uma etapa de montagem, então a ordem de montagem global em que os blocos construtivos de ácido nucleico podem ser acoplados também é especificada pela ordem sequencial da(s) etapa(s) de montagem. Em um aspecto, as
Petição 870180005321, de 22/01/2018, pág. 134/316
128/293 peças construtivas recombinadas são tratadas com uma enzima, como um ligase (p. ex.,
T4 DNA ligase), para se obter ligação covalente das peças construtivas.
[0261] Em um aspecto, o projeto dos blocos construtivos de oligonucleotídeos é obtido analisando-se um conjunto de modelos de sequências de ácidos nucleicos progenitores que servem como uma base para produzir um conjunto de progênie de polinucleotídeos quiméricos finalizados. Estes modelos de oligonucleotídeos parentais servem, portanto, como uma fonte de informação de sequência que auxilia no projeto dos blocos construtivos de ácido nucleico que se pretende mutagenizar, p. ex., quimerizar ou embaralhar. Em um aspecto deste método, as sequências de um pluralidade de modelos de ácidos nucleicos parentais são alinhadas de forma a selecionar um ou mais pontos de demarcação. Os pontos de demarcação podem localizar-se em uma área de homologia, e são constituídos de um ou mais nucleotídeos. Estes pontos de demarcação são compartilhados alternativamente por pelo menos dois dos modelos progenitores. Os pontos de demarcação podem ser usados desta forma para delinear os limites de blocos construtivos de oligonucleotídeos a serem gerados para rearranjar os polinucleotídeos parentais. Os pontos de demarcação identificados e selecionados nas moléculas progenitoras servem como pontos de quimerização potenciais na montagem das moléculas de progênie quimérica final. Um ponto de demarcação pode ser uma área de homologia (constituída de pelo menos uma base de nucleotídeo homóloga) compartilhada por pelo menos duas sequências de polinucleotídeos parentais. Alternativamente, um ponto de demarcação pode ser uma área de homologia que é compartilhada por pelo menos metade das sequências de polinucleotídeos parentais, ou, pode ser uma área de homologia que é compartilhada por pelo menos dois terços das sequências de polinucleotídeos parentais. Em concretizações alternativas, um ponto de demarcação útil é um área de homologia que é compartilhada por pelo menos três quartos das sequências de polinucleotídeos parentais, ou, pode ser compartilhada por quase todas as sequências de polinucleotídeos parentais. Em um aspecto, um ponto de demarcação é um área de homologia que é compartilhada por todas as sequências de polinucleotídeos parentais.
[0262] Em um aspecto, um processo de remontagem de ligação é realizado exaustivamente de forma a gerar uma biblioteca exaustiva de polinucleotídeos quiméricos
Petição 870180005321, de 22/01/2018, pág. 135/316
129/293 de progênie. Em outras palavras, todas as possíveis combinações ordenadas dos blocos construtivos de ácido nucleico são representados no conjunto de moléculas de ácido nucleico quiméricas finalizadas. Ao mesmo tempo, em outro aspecto, a ordem de montagem (i.e. a ordem de montagem de cada bloco construtivo na sequência de 5' a 3' de cada ácido nucleico quimérico finalizado) em cada combinação é por projeto (ou nãoestocástica) como descrito acima. Proporciona-se aqui métodos não-estocásticos que reduzem a possibilidade de produtos secundários indesejados.
[0263] Em outro aspecto, o método de remontagem de ligação é realizado sistematicamente. Por exemplo, o método é realizado de forma a gerar uma biblioteca sistematicamente compartimentalizada de moléculas de progênie, com compartimentos que podem ser selecionados sistematicamente, p. ex., um por um. Proporciona-se aqui métodos compreendendo o uso seletivo e judicioso de blocos construtivos de ácido nucleico específicos, acoplados com o uso seletivo e judicioso de reações de montagem escalonadas sequencialmente, um projeto pode ser obtido em que conjuntos de produtos de progênie específicos são preparados em cada um dos vários vasos de reação. Isto permite realizar um exame e um procedimento de seleção sistemáticos. Assim, estes métodos permitem que um número potencialmente muito grande de moléculas de progênie seja examinado sistematicamente em grupos menores. Devido a sua capacidade de realizar quimerizações de uma maneira que é altamente flexível porém também exaustiva e sistemática, particularmente quando há um baixo nível de homologia entre as moléculas progenitoras, estes métodos proporcionam a geração de uma biblioteca (ou conjunto) constituído de um grande número de moléculas de progênie. Em virtude da natureza nãoestocástica dos presente métodos de remontagem de ligação, as moléculas de progênie geradas pode compreender uma biblioteca de moléculas de ácido nucleico quiméricas finalizadas apresentando uma ordem de montagem global que é selecionada por projeto. A mutagênese de saturação e os métodos otimizados de evolução dirigida também podem ser usados para gerar diferentes espécies moleculares de progênie.
[0264] Em um aspecto, os métodos aqui proporcionam liberdade de escolha e controle relativamente à seleção de pontos de demarcação, do tamanho e do número dos blocos construtivos de ácido nucleico, e do tamanho e projeto dos acoplamentos. A exigência por
Petição 870180005321, de 22/01/2018, pág. 136/316
130/293 homologia intermolecular pode ser altamente relaxada. Efetivamente, é possível escolher pontos de demarcação em áreas de pouca ou nenhuma homologia intermolecular. Por exemplo, devido à variação do códon [codon wobble], i.e. a degeneração de códons, é possível introduzir substituições de nucleotídeos em blocos construtivos de ácidos nucleicos sem alterar o aminoácido originalmente codificado no modelo progenitor correspondente. Alternativamente, um códon pode ser alterado de tal forma que a codificação para um aminoácido original é alterada. Em um aspecto, é possível introduzir substituições no bloco construtivo de ácido nucleico de forma a incrementar a incidência de pontos de demarcação homólogos intermoleculares e, assim, permite obter um número incrementado de acoplamentos entre os blocos construtivos, que, por sua vez, permite gerar um número maior de moléculas quiméricas de progênie.
[0265] Em outro aspecto, a natureza sintética da etapa em que os blocos construtivos são gerados permite o projeto e a introdução de nucleotídeos (p. ex., um ou mais nucleotídeos, que, por exemplo, podem ser códons ou íntrons ou sequências reguladoras) que, mais tarde, podem ser removidas opcionalmente em um processo in vitro (p. ex., por meio de mutagênese) ou em um processo in vivo (p. ex., usando a capacidade de recomposição de genes de um organismo hospedeiro). Considera-se que, em muitos casos, a introdução destes nucleotídeos também pode ser desejável por muitas outras razões adicionalmente ao benefício potencial de criar um ponto de demarcação útil.
[0266] Em um aspecto, usa-se um bloco construtivo de ácido nucleico para introduzir um íntron. Assim, introduz-se íntrons funcionais em um gene fabricado pelo Homem preparado de acordo com os métodos aqui descritos. O(s) íntron(s) introduzido(s) artificialmente podem ser funcionais em uma células hospedeira para recomposição de genes de forma similar à que íntrons naturalmente ocorrentes servem funcionalmente na recomposição de genes.
SISTEMA OTIMIZADO DE EVOLUÇÃO DIRIGIDA [0267] Em determinadas concretizações, proporciona-se aqui sistemas de modificação gênica não-estocásticos denominados “sistema otimizado de evolução dirigida” para gerar hidrolases e anticorpos com propriedades novas ou alteradas. A evolução dirigida otimizada é dirigida ao uso de ciclos repetido de reclassificação,
Petição 870180005321, de 22/01/2018, pág. 137/316
131/293 recombinação e seleção que permitem a evolução molecular dirigida de ácidos nucleicos por meio de recombinação. A evolução dirigida otimizada permite a geração de uma grande população de sequências quiméricas desenvolvidas sendo que a população gerada é enriquecida significantemente para sequências que apresentam um número predeterminado de eventos de crossover.
[0268] Um evento de crossover é um ponto em uma sequência quimérica em que ocorre um desvio na sequência de uma variante parental para outra variante parental. Um ponto do tipo referido encontra-se normalmente na junção de onde oligonucleotídeos de dois parentais são ligados entre si para formar uma sequência simples. Este método permite o cálculo das concentrações corretas de sequências de oligonucleotídeos de forma que a população quimérica final de sequências é enriquecida com o número selecionado de eventos de crossover. Isto proporciona mais controle sobre a seleção de variantes quiméricas apresentando um número predeterminado de eventos de crossover.
[0269] Adicionalmente, este método proporciona um meio vantajoso para explorar uma tremenda quantidade do espaço de variantes de proteínas possíveis em comparação com outros sistemas. Previamente, caso se gerasse, por exemplo, 1013 moléculas quiméricas durante uma reação, seria extremamente difícil testar um número tão alto de variantes quiméricas para uma atividade particular. Além disso, uma porção significativa da população de progênie poderia apresentar um número muito grande de eventos de crossover, o que resultou em proteínas que se mostraram menos prováveis de apresentar níveis incrementados de uma atividade particular. Por meio do uso destes métodos, a população de moléculas quiméricas pode ser enriquecida com aquelas variantes que apresentam um número particular de eventos de crossover. Assim, embora ainda se possa gerar 1013 moléculas quiméricas durante uma reação, cada uma das moléculas selecionadas para análise adicional apresenta, da forma mais provável, por exemplo, apenas três eventos de crossover. Como a população de progênie resultante pode tender a apresentar um número predeterminado de eventos de crossover, o limite sobre a variedade funcional entre as moléculas quiméricas é reduzido. Isto proporciona um número mais controlável de variáveis quando se calcula qual oligonucleotídeo dos polinucleotídeos parentais originais poderia ser responsável por afetar uma característica particular.
Petição 870180005321, de 22/01/2018, pág. 138/316
132/293 [0270] Um método para criar uma sequência de polinucleotídeo de progênie quimérica consiste em criar oligonucleotídeos correspondendo a fragmentos ou porções de cada sequência parental. Em concretizações alternativas, cada oligonucleotídeo inclui uma região única de superposição, de forma que a misturação dos oligonucleotídeos entre si resulta em uma nova variante que tem cada fragmento de oligonucleotídeo montada na ordem correta. Alternativamente, protocolos para praticar estes métodos como proporcionados aqui podem ser encontrados nas Patentes U.S. nums. 6.773.900; 6.740.506; 6.713.282; 6.635.449; 6.605.449; 6.537.776; 6.361.974.
[0271] O número de oligonucleotídeos gerados para cada variante parental porta uma relação com o número total de crossovers resultantes na molécula quimérica que é criada por fim. Por exemplo, três variantes de sequências de nucleotídeos parentais poderiam ser proporcionadas para sofrerem uma reação de ligação para se encontrar uma variante quimérica apresentando, por exemplo, maior atividade a alta temperatura. Como um exemplo, é possível gerar um conjunto de 50 sequências de oligonucleotídeos correspondendo a cada uma das porções de cada variante parental. Assim, durante o processo de remontagem de ligação poderia haver até 50 eventos de crossover dentro de cada uma das sequências quiméricas. A probabilidade de que cada um dos polinucleotídeos quiméricos gerados venha a conter oligonucleotídeos de cada variante parental em ordem alternante é muito baixa. Se cada fragmento de oligonucleotídeo estiver presente na reação de ligação na mesma quantidade molar é provável que, em algumas posições, oligonucleotídeos do mesmo polinucleotídeo parental venham a ligar-se próximos uns dos outros e, assim, não resultam em um evento de crossover. Se a concentração de cada oligonucleotídeo de cada parental for mantida constante durante qualquer ligação neste exemplo, há uma chance de 1/3 (presumindo 3 parentais) que um oligonucleotídeo da mesma variante parental venha a ligar-se dentro da sequência quimérica e produzir nenhum crossover.
[0272] Assim, é possível determinar uma função densidade de probabilidade (PDF, probability density function) para predizer a população de eventos de crossover que provavelmente ocorrerão durante cada etapa em uma reação de ligação dado um número determinado de variantes parentais variantes parentais, um número de oligonucleotídeos
Petição 870180005321, de 22/01/2018, pág. 139/316
133/293 correspondendo a cada variante, e as concentrações de cada variante durante cada etapa na reação de ligação. A estatística e a matemática por trás da determinação da PDF é descrita abaixo. Usando-se estes métodos é possível calcular referida função densidade de probabilidade, e, assim, enriquecer a população de progênie quimérica com um número predeterminado de eventos de crossover resultando de uma reação de ligação particular. Além disso, é possível predeterminar um número-alvo de eventos de crossover, e então o sistema pode ser programado para calcular as quantidades de partida de cada oligonucleotídeo parental durante cada etapa na reação de ligação de forma a resultar em uma função densidade de probabilidade que se centra no número predeterminado de eventos de crossover. Estes métodos são dirigidos ao uso de ciclos repetidos de reclassificação redutiva, recombinação e seleção que permitem a evolução molecular dirigida de um ácido nucleico que codifica um polipeptídio por meio de recombinação. Este sistema permite a geração de uma grande população de sequências quiméricas desenvolvidas, sendo que a população gerada é significativamente enriquecida com sequências que apresentam um número predeterminado de eventos de crossover. Um evento de crossover é um ponto em uma sequência quimérica em que ocorre um desvio na sequência de uma variante parental para outra variante parental. Um ponto do tipo referido encontra-se normalmente na junção de onde oligonucleotídeos de dois parentais são ligados entre si para formar uma única sequência. O método permite o cálculo das concentrações corretas de sequências de oligonucleotídeo de forma que a população quimérica final de sequências é enriquecida com o número selecionado de eventos de crossover. Isto proporciona mais controle sobre a seleção de variantes quiméricas apresentando um número predeterminado de eventos de crossover.
DETERMINANDO EVENTOS DE CROSSOVER [0273] Aspectos como proporcionados aqui incluem um sistema e software que recebe uma função densidade de probabilidade (PDF) de crossover desejada, o número de genes parentais a serem remontados, e o número de fragmentos na remontagem como entradas [inputs]. A saída [output] deste programa é um “PDF fragmento” que pode ser usado para determinar uma receita para produzir genes remontados, e a PDF de crossover estimada daqueles genes. O processamento aqui descrito é realizado alternativamente em
Petição 870180005321, de 22/01/2018, pág. 140/316
134/293
MATLAB™ (The Mathworks, Natick, Massachusetts) uma linguagem de programação e ambiente de desenvolvimento para computação técnica.
PROCESSOS ITERATIVOS [0274] Em determinadas concretizações, proporciona-se aqui processos que podem ser repetidos iterativamente. Por exemplo, um ácido nucleico (ou, o ácido nucleico) responsável por uma hidrolase alterada ou fenótipo de anticorpo é identificado, re-isolado, novamente modificado, re-testado quanto à atividade. Este processo pode ser repetido iterativamente até que um fenótipo desejado possa ser manipulado. Por exemplo, toda uma via catabólica ou anabólica bioquímica pode ser manipulada em uma célula, incluindo atividade proteolítica.
[0275] De maneira análoga, caso se determine que um oligonucleotídeo particular não tem qualquer efetivo sobre a característica desejada (p. ex., um novo fenótipo de hidrolase), este pode ser removido como uma variável por meio da sintetização de oligonucleotídeos parentais maiores que incluem a sequência a ser removida. Como a incorporação da sequência dentro de uma sequência maior impede quaisquer eventos de crossover, não haverá mais variação desta sequência nos polinucleotídeos de progênie. Esta prática iterativa de determinar quais oligonucleotídeos são os mais relacionados com a característica desejada, e quais não são relacionados, permite exploração mais eficiente de todas as possíveis variantes de proteína que poderiam proporcionar uma atividade ou característica particular.
EMBARALHAMENTO IN VIVO [0276] O embaralhamento in vivo de moléculas é usado em métodos como proporcionados aqui que proporcionam variantes de polipeptídios como proporcionados aqui, p. ex., anticorpos, hidrolases, e análogos. O embaralhamento in vivo pode ser realizado usando-se a propriedade natural de células de recombinar multímeros. Embora a recombinação in vivo tenha proporcionado a principal via natural para a diversidade molecular, a recombinação genética permanece um processo relativamente complexo que envolve 1) o reconhecimento de homologias; 2) clivagem de filamento, invasão de filamento, e etapas metabólicas que levam à produção de quiasma recombinante; e finalmente 3) a resolução do quiasma em moléculas recombinadas distintas. A formação
Petição 870180005321, de 22/01/2018, pág. 141/316
135/293 do quiasma requer o reconhecimento de sequências homólogas.
[0277] Em determinadas concretizações, proporciona-se aqui métodos para produzir um polinucleotídeo híbrido de pelo menos um primeiro polinucleotídeo e um segunda polinucleotídeo. Em outras concretizações, proporciona-se aqui métodos usados para produzir um polinucleotídeo híbrido por meio da introdução de pelo menos um primeiro polinucleotídeo e um segundo polinucleotídeo que compartilham pelo menos uma região de homologia parcial de sequências em uma célula hospedeira apropriada. As regiões de homologia parcial de sequências promovem processos que resultam em reorganizaçao de sequências produzindo um polinucleotídeo híbrido. Em um aspecto, o termo “polinucleotídeo híbrido” compreende qualquer sequência de nucleotídeos que resulta de um método como proporcionado aqui, e em uma concretização contém sequência de pelo menos duas sequências de polinucleotídeo originais. Referidos polinucleotídeos híbridos podem resultar de eventos de recombinação intermolecular que promovem integração de sequência entre moléculas de DNA. Adicionalmente, referidos polinucleotídeos híbridos podem resultar de processos de reclassificação redutiva intermolecular que usam sequências repetidas para alterar uma sequência de nucleotídeos dentro de uma molécula de DNA.
PRODUZINDO VARIANTES DE SEQUÊNCIAS [0278] Em determinadas concretizações, proporciona-se aqui métodos de preparar variantes de sequências do ácido nucleico e sequências de hidrolase e anticorpo como proporcionado aqui ou isolar hidrolases usando os ácidos nucleicos e polipeptídios como proporcionados aqui. Em determinadas concretizações, proporciona-se aqui variantes de um gene de hidrolase como proporcionado aqui, que podem ser alteradas por quaisquer meios, incluindo, p. ex., métodos randômicos ou estocásticos, ou, métodos nãoestocásticos, ou de “evolução dirigida”, como descrito acima.
[0279] Proporciona-se aqui métodos de gerar uma variante de um ácido nucleico que codifica um polipeptídio apresentando atividade de hidrolase, p. ex., atividade de lipase, saturase, palmitase e/ou estearatase, compreendendo as etapas de: (a) proporcionar um ácido nucleico modelo compreendendo um ácido nucleico como proporcionado aqui; e (b) modificar, deletar ou adicionar um ou mais nucleotídeos na sequência-modelo, ou uma
Petição 870180005321, de 22/01/2018, pág. 142/316
136/293 combinação dos mesmos, para gerar uma variante do ácido nucleico modelo. Em um aspecto, o método pode compreender adicionalmente expressar o ácido nucleico variante para gerar uma hidrolase variante, p. ex., um polipeptídio de lipase, saturase, palmitase e/ou estearatase. As modificações, adições ou deleções podem ser introduzidas por meio de um método compreendendo PCR propensa a erro, embaralhamento, mutagênese oligonucleotídeo-dirigida, PCR de montagem, mutagênese de PCR sexual, mutagênese in vivo, mutagênese de cassete, mutagênese de conjunto recursiva, mutagênese de conjunto exponencial, mutagênese sítio-específica, mutagênese de saturação de sítio gênico Gene Site Saturation Mutagenesis-SM (GSSMSM), remontagem de ligação sintética (SLR ou GeneReassembly) ou uma combinação dos mesmos. Em outro aspecto, as modificações, adições ou deleções são introduzidas por meio de um método compreendendo recombinação, recombinação de sequências recursiva, mutagênese de DNA modificada com fosfotioato, mutagênese de modelo contendo uracila, mutagênese de dúplex intervalado, mutagênese de reparo de malpareamento pontual, mutagênese de cepa hospedeira reparo-deficiente, mutagênese química, mutagênese radiogênica, mutagênese de deleção, mutagênese de restrição-seleção, mutagênese de restrição-purificação, síntese de genes artificiais, mutagênese de conjunto, criação de multímeros de ácidos nucleicos quiméricos e uma combinação dos mesmos.
[0280] Em um aspecto, o método pode ser repetido iterativamente até se produzir uma hidrolase, p. ex., uma lipase, uma saturase, uma palmitase e/ou uma estearatase apresentando uma atividade alterada ou diferente, ou uma estabilidade alterada ou diferente daquela de um polipeptídio codificado pelo ácido nucleico modelo.
[0281] Em um aspecto, a variante hidrolase, p. ex., polipeptídio de lipase, saturase, palmitase e/ou estearatase é termotolerante, e conserva alguma atividade após ser exposto a uma temperatura elevada. Em outro aspecto, a hidrolase variante, p. ex., polipeptídio de lipase, saturase, palmitase ou estearatase apresenta glicosilação incrementada em comparação com a hidrolase, p. ex., lipase, saturase, palmitase e/ou estearatase codificada por um ácido nucleico modelo. Alternativamente, a hidrolase variante, p. ex., polipeptídio de lipase, saturase, palmitase e/ou estearatase apresenta atividade de hidrolase, p. ex., lipase, saturase, palmitase e/ou estearatase, sob uma alta
Petição 870180005321, de 22/01/2018, pág. 143/316
137/293 temperatura, sendo que a hidrolase, p. ex., lipase, saturase, palmitase e/ou estearatase codificada pelo ácido nucleico modelo não é ativa sob a alta temperatura.
[0282] Em um aspecto, o método pode ser repetido iterativamente até que uma sequência codificante de hidrolase, p. ex., uma lipase, uma saturase, uma palmitase e/ou uma estearatase, apresentando um uso de códon alterado daquele do ácido nucleico modelo seja produzida. Em outro aspecto, o método pode ser repetido iterativamente até que um gene de hidrolase, p. ex., um gene de lipase, saturase, palmitase e/ou estearatase, apresentando níveis mais altos ou mais baixos de expressão de mensagem ou estabilidade daquele do ácido nucleico modelo seja produzido. Em outro aspecto, a formulação do produto de hidrolase final, p. ex., produto de lipase, saturase, palmitase e/ou estearatase, permite um aumento ou modulação do desempenho da hidrolase, p. ex., lipase, saturase, palmitase e/ou estearatase no produto.
[0283] As variantes isoladas podem ser naturalmente ocorrentes. Variantes também podem ser criadas in vitro. Variantes podem ser criadas usando-se técnicas de manipulação genética, como mutagênese sítio-direcionada, mutagênese química randômica, procedimentos de deleção de Exonuclease III, e técnicas convencionais de clonagem. Alternativamente, referidas variantes, fragmentos, análogos, ou derivados podem ser criados usando-se procedimentos de modificação ou síntese química. Outros métodos de preparar variantes também são familiares para aqueles versados na arte. Estes incluem procedimentos em que sequências de ácido nucleico obtidas de isolados naturais são modificadas para gerar ácidos nucleicos que codificam polipeptídios apresentando características que incrementam seu valor em aplicações industriais ou de laboratório. Nesses procedimentos, gera-se e caracteriza um grande número de sequências variantes apresentando uma ou mais diferenças de nucleotídeos com relação à sequência obtida do isolado natural. Estas diferenças de nucleotídeos podem resultar em alterações de aminoácidos com relação aos polipeptídios codificados pelos ácidos nucleicos dos isolados naturais.
[0284] Por exemplo, variantes podem ser criadas usando PCR propensa a erro. Na
PCR propensa a erro, a PCR é realizada em condições em que a fidelidade da cópia da
DNA polimerase é tal que, se obtém uma alta taxa de mutações pontuais ao longo de todo
Petição 870180005321, de 22/01/2018, pág. 144/316
138/293 o comprimento do produto de PCR. PCR propensa a erro é descrita, p. ex., em Leung, D. W., et al., Technique, 1:11-15, ) e Caldwell, R. C. & Joyce G.F., PCR Methods Applic, 2:2833, 1992. Em resumo, em procedimentos do tipo referido, ácidos nucleicos a serem mutagenizados são misturados com iniciadores de PCR, tamponador de reação, MgCl2, MnCl2, Taq polimerase e uma concentração apropriada de dNTPs para se obter uma taxa elevada de mutação pontual ao longo de todo o comprimento do produto de PCR. Por exemplo, a reação pode ser realizada usando-se 20 fmols de ácido nucleico a serem mutagenizados, 30 pmols de cada iniciador de PCR, um tamponador de reação compreendendo 50 mM de KCl, 10 mM de Tris HCl (pH 8,3) e 0,01 % de gelatina, 7 mM de MgCl2, 0,5 mM de MnCl2, 5 unidades de Taq polimerase, 0,2 mM de dGTP, 0,2 mM de dATP, 1 mM de dCTP, e 1 mM de dTTP. A PCR pode ser realizada durante 30 ciclos de 94°C durante 1 min, 45°C durante 1 min, e 72°C durante 1 min. No entanto, deve-se considerar que estes parâmetros podem ser variados conforme apropriado. Os ácidos nucleicos mutagenizados são clonados em um vetor apropriado e as atividades dos polipeptídios codificados pelos ácidos nucleicos mutagenizados são avaliadas.
[0285] Variantes também podem ser criadas usando-se mutagênese oligonucleotídeodirecionada para gerar mutações sítio-específicas em qualquer DNA clonado de interesse. A mutagênese de oligonucleotídeo é descrita, p. ex., em Reidhaar-Olson (1988) Science 241 :53-57. Em resumo, em procedimentos do tipo referido, uma pluralidade de oligonucleotídeos de filamento duplo portando uma ou mais mutações a serem introduzidas no DNA clonado são sintetizados e inseridos no DNA clonado a ser mutagenizado. Clones contendo o DNA mutagenizado são recuperados e as atividades dos polipeptídios que eles codificam são avaliadas.
[0286] Outro método para gerar variantes é a PCR de montagem. A PCR de montagem envolve a montagem de um produto de PCR de uma mistura de pequenos fragmentos de DNA. Ocorre um grande número de diferentes reações PCR em paralelo no mesmo frasco, com os produtos de uma reação iniciando os produtos de outra reação. A PCR de montagem é descrita, p. ex., na Patente U.S. n° 5.965.408.
[0287] Outro método adicional de gerar variantes é a mutagênese de PCR sexual. Na mutagênese de PCR sexual ocorre recombinação homóloga forçada entre moléculas de
Petição 870180005321, de 22/01/2018, pág. 145/316
139/293
DNA com sequência de DNA diferente, mas altamente relacionada, in vitro, como um resultado da fragmento randômico da molécula de DNA baseado em homologia de sequências, seguido de fixação do crossover por meio de extensão de iniciador em uma reação PCR. A mutagênese de PCR sexual é descrita, p. ex., em Stemmer (1994) Proc. Natl. Acad. Sci. USA 91: 10747-10751. Em resumo, nesses procedimentos, uma pluralidade de ácidos nucleicos a serem recombinados é digerida com DNase para gerar fragmentos apresentando um tamanho médio de 50-200 nucleotídeos. Fragmentos do tamanho médio desejado são purificados e suspensos em uma mistura de PCR. A PCR é conduzida em condições que facilitam a combinação entre os fragmentos de ácido nucleico. Por exemplo, a PCR pode ser realizada por meio de suspensão dos fragmentos purificados a uma concentração de 10-30 ng/l em uma solução de 0,2 mM de cada dNTP, 2,2 mM de MgCl2, 50 mM de KCl, 10 mM de Tris HCl, pH 9,0, e 0,1 % de Triton X-2,5 unidades de Taq polimerase 100:1 de mistura de reação são adicionados e realiza-se a PCR usando o regime a seguir: 94°C durante 60 segundos, 94°C durante 30 segundos, 50-55°C durante 30 segundos, 72°C durante 30 segundos (30-45 vezes) e 72°C durante 5 minutos. No entanto, deve-se considerar que estes parâmetros podem ser variados conforme apropriado. Em alguns aspectos, oligonucleotídeos podem ser incluídos nas reações PCR. Em outros aspectos, o fragmento de Klenow de DNA polimerase I pode ser usado em um primeiro conjunto de reações PCR e Taq polimerase pode ser usado em um conjunto subsequente de reações PCR. Sequências recombinantes são isoladas e as atividades dos polipeptídios que elas codificam são avaliadas.
[0288] Variantes também podem ser criadas por meio de mutagênese in vivo. Em alguns aspectos, mutações randômicas em uma sequência de interesse são geradas por meio de propagação da sequência de interesse em uma cepa bacteriana, como uma cepa de E. coli, que porta mutações em uma ou mais das vias de reparo de DNA. Referidas cepas “mutadoras [mutator]” apresentam uma taxa maior de mutações randômicas do que um parental de tipo selvagem. A propagação do DNA em uma destas cepas gerará eventualmente mutações randômicas dentro do DNA. Cepas mutadoras vantajosas para uso na mutagênese in vivo são descritas, p. ex., na Publicação PCT n° WO 91/16427.
[0289] Variantes também podem ser geradas usando-se mutagênese de cassete. Na
Petição 870180005321, de 22/01/2018, pág. 146/316
140/293 mutagênese de cassete, uma pequena região de uma molécula de DNA de filamento duplo é substituída por uma “cassete” de oligonucleotídeo sintética que difere da sequência nativa. Frequentemente o oligonucleotídeo contém sequência nativa completamente e/ou parcialmente randomizada.
[0290] Mutagênese de conjunto recursiva também pode ser usada para gerar variantes. Mutagênese de conjunto recursiva é um algoritmo para a manipulação de proteína (mutagênese de proteína) desenvolvido para produzir populações diversas de mutantes relacionados fenotipicamente cujos membros diferem quando à sequência de aminoácidos. Este método usa um mecanismo de feedback para controlar ciclos sucessivos de mutagênese de cassete combinatorial. Mutagênese de conjunto recursiva é descrita, p. ex., em Arkin (1992) Proc. Natl. Acad. Sci. USA 89:7811-7815.
[0291] Em alguns aspectos, variantes são criadas usando-se exponential ensemble metagêneses/mutagênese de conjunto exponencial. A mutagênese de conjunto exponencial é um processo para gerar bibliotecas combinatoriais com um elevado percentual de mutantes únicos e funcionais, sendo que pequenos grupos de resíduos são randomizados em paralelo para identificar, em cada posição alterada, aminoácidos que levam a proteínas funcionais. Mutagênese de conjunto exponencial é descrita, p. ex., por Delegrave 3) Biotechnology Res. 11 :1548-1552. Mutagênese randômica e sítiodirecionada são descritas, p. ex., por Arnold (1993) Current Opinion in Biotechnology 4:450455.
[0292] Em alguns aspectos, as variantes são criadas usando-se procedimentos de embaralhamento em que porções de uma pluralidade de ácidos nucleicos que codificam polipeptídios distintos são fundidas em conjunto para criar sequências de ácido nucleico quiméricas que codificam polipeptídios quiméricos como descrito, por exemplo, nas Patentes U.S. nums. 5.965.408; 5.939.250.
[0293] Proporciona-se aqui variantes de polipeptídios compreendendo sequências em que um ou mais dos resíduos de aminoácidos (p. ex., de um polipeptídio exemplar, p. ex., SEQ ID NO:2, SEQ ID NO:4, SEQ ID NO:6, SEQ ID NO:8, SEQ ID NO: 10, SEQ ID NO: 12, SEQ ID NO: 14, SEQ ID NO: 16, SEQ ID NO: 18, ou SEQ ID NO:20 ou SEQ ID NO:2 apresentando uma, duas, três, quatro, cinco, seis, sete, oito ou mais (várias) ou todas as
Petição 870180005321, de 22/01/2018, pág. 147/316
141/293 variações de aminoácidos descritas na Tabela 3, Tabela 4, Tabela 9, Tabela 10, Tabela 11, Tabela 16 ou Tabela 23, ou o seu equivalente) são substituídas por um resíduo de aminoácido conservado ou não-conservado (p. ex., um resíduo de aminoácido conservado) e referido resíduo de aminoácido substituído pode ou não ser um que é codificado pelo código genético. Substituições conservativas são aquelas que substituem um dado aminoácido em um polipeptídio por outro aminoácido com características similares. Assim, polipeptídios aqui indicados incluem aqueles com substituições conservativas de sequências, p. ex., as sequências exemplares como proporcionadas aqui (p. ex., SEQ ID NO:2, SEQ ID NO:4, SEQ ID NO:6, SEQ ID NO:8, SEQ ID NO: 10, SEQ ID NO: 12, SEQ ID NO: 14, SEQ ID NO: 16, SEQ ID NO: 18, ou SEQ ID NO:20 ou SEQ ID NO:2 apresentando uma, duas, três, quatro, cinco, seis, sete, oito ou mais (vários) ou todas as variações de aminoácidos descritas na Tabela 3, Tabela 4, Tabela 9, Tabela 10, Tabela 11, Tabela 16 ou Tabela 23, ou seu equivalente), incluindo mas sem limitação as seguintes substituições: substituições de um aminoácido alifático, como alanina, valina, leucina e isoleucina por outro aminoácido alifático; substituição de uma serina por uma treonina ou vice versa; substituição de um resíduo ácido, como ácido aspártico e ácido glutâmico por outro resíduo ácido; substituição de um resíduo portando um grupo amida, como asparagina e glutamina, por outro resíduo portando um grupo amida; troca de um resíduo básico, como lisina e arginina por outro resíduo básico; e substituição de um resíduo aromático, como fenilalanina, tirosina, ou triptofano por outro resíduo aromático. Outras variantes são aquelas em que um ou mais dos resíduos de aminoácidos dos polipeptídios como proporcionados aqui incluem um grupo substituinte.
[0294] Outras variantes dentro do escopo como proporcionado aqui são aquelas em que o polipeptídio é associado com outro composto, como um composto para incrementar a meia-vida do peptídio, por exemplo, polietileno glicol. Variantes adicionais dentro do escopo como proporcionado aqui são aquelas em que aminoácidos adicionais são fundidos ao polipeptídio, como uma sequência líder, uma sequência secretora, uma sequência de pró-proteína ou uma sequência que facilita a purificação, enriquecimento, ou estabilização do polipeptídio. Em alguns aspectos, as variantes, fragmentos, derivados e análogos dos polipeptídios como proporcionados aqui conservam a mesma função
Petição 870180005321, de 22/01/2018, pág. 148/316
142/293 biológica ou atividade que os polipeptídios exemplares, p. ex., uma atividade proteolítica, como aqui descrita. Em outros aspectos, a variante, fragmento, derivado, ou análogo inclui uma pró-proteína, de tal forma que a variante, fragmento, derivado, ou análogo possa ser ativado por meio de clivagem da porção pró-proteína para produzir um polipeptídio ativo.
OTIMIZANDO CÓDONS PARA OBTER NÍVEIS ELEVADOS DE EXPRESSÃO DE PROTEÍNA EM CÉLULAS HOSPEDEIRAS [0295] Em determinadas concretizações, proporciona-se aqui métodos para modificar ácidos nucleicos que codificam hidrolase para modificar o uso de códon. Em uma concretização, proporciona-se aqui métodos para modificar códons em um ácido nucleico que codifica uma hidrolase para incrementar ou diminuir sua expressão em uma célula hospedeira, p. ex., uma célula bacteriana, de inseto, mamífera, de levedura ou de planta. Proporciona-se aqui também ácidos nucleicos que codificam uma hidrolase modificada para incrementar sua expressão em uma célula hospedeira, hidrolase assim-modificada, e métodos de preparar as hidrolases modificadas. O método compreende identificar um códon “não-preferido” ou um códon “menos preferido” em ácido nucleico que codifica hidrolase e substituir um ou mais destes códons não-preferidos ou códons menos preferidos por um “códon preferido” que codifica o mesmo aminoácido que o códon substituído e pelo menos um códon não-preferido ou menos preferido no aminoácido foi substituído por um códon preferido que codifica o mesmo aminoácido. Um códon preferido é um códon super-representado em sequências codificantes em genes na célula hospedeira e um códon não-preferido ou menos preferido é um códon sub-representado em sequências codificantes em genes na célula hospedeira.
[0296] Células hospedeiras para expressar os ácidos nucleicos, cassetes de expressão e vetores como proporcionados aqui incluem células de bactérias, de levedura, de fungos, de plantas, células de insetos e células mamíferas. Em determinadas concretizações, proporciona-se aqui métodos para otimizar o uso de códon em todas estas células, ácidos nucleicos com códon alterado e polipeptídios preparados com os ácidos nucleicos com códon alterado. Células hospedeiras exemplares incluem bactérias gramnegativas, como Escherichia coli e Pseudomonas fluorescens; bactérias gram-positivas, como Lactobacillus gasseri, Lactococcus lactis, Lactococcus cremoris, Bacillus subtilis.
Petição 870180005321, de 22/01/2018, pág. 149/316
143/293
Células hospedeiras exemplares também incluem organismos eucarióticos, p. ex., várias leveduras, como Saccharomyces sp., incluindo Saccharomyces cerevisiae, Schizosaccharomyces pombe, Pichia pastoris, e Kluyveromyces lactis, Hansenula polymorpha, Aspergillus niger, e células mamíferas e linhas de células e células de insetos e linhas de células. Outras células hospedeiras exemplares incluem células bacterianas, como E. coli, Streptomyces, Bacillus subtilis, Bacillus cereus, Salmonella typhimurium e várias espécies nos gêneros Pseudomonas, Streptomyces e Staphylococcus, células fúngicas, como Aspergillus, levedura, como qualquer espécie de Pichia, Saccharomyces, Schizosaccharomyces, Schwanniomyces, incluindo Pichia pastoris, Saccharomyces cerevisiae, ou Schizosaccharomyces pombe, células de insetos, como Drosophila S2 e Spodoptera Sf9, células animais, como CHO, COS ou de melanoma de Bowes e adenoviruses. A seleção de um hospedeiro apropriado encontra-se dentro das capacidades daqueles versados na arte. Em determinadas concretizações, proporciona-se aqui ácidos nucleicos e polipeptídios otimizados para expressão nestes organismos e espécies.
[0297] Por exemplo, os códons de um ácido nucleico codificando uma hidrolase isolada de uma célula bacteriana são modificados de tal forma que o ácido nucleico é expresso em uma célula bacteriana diferente das bactérias de que a hidrolase foi derivada, uma levedura, um fungo, uma célula de planta, uma célula de inseto ou uma célula mamífera. Métodos para otimizar códons são bem conhecidos na arte, ver, p. ex., Patente U.S. n° 5.795.737; Baca (2000) Int. J. Parasitol. 30:113-118; Hale (1998) Protein Expr. Purif. 12:185-188; Narum (2001) Infect. Immun. 69:7250-7253. Ver também Narum (2001) Infect. Immun. 69:7250-7253, descrevendo códons otimizadores em sistemas de camundongo; Outchkourov (2002) Protein Expr. Purif. 24:18-24, descrevendo códons otimizadores na levedura; Feng (2000) Biochemistry 39:15399-15409, descrevendo códons otimizadores em E. coli; Humphreys (2000) Protein Expr. Purif. 20:252-264, descrevendo o uso de códon otimizador que afeta a secreção em E. coli.
ANIMAIS NÃO-HUMANOS TRANSGÊNICOS [0298] Em determinadas concretizações, proporciona-se aqui animais não-humanos transgênicos compreendendo um ácido nucleico, um polipeptídio (p. ex., uma hidrolase ou
Petição 870180005321, de 22/01/2018, pág. 150/316
144/293 um anticorpo como proporcionado aqui), uma cassete de expressão, um vetor, uma célula transfectada ou uma célula transformada como proporcionado aqui. Os animais nãohumanos transgênicos podem ser, p. ex., cabras, coelhos, ovelhas, porcos, vacas, ratos e camundongos, compreendendo os ácidos nucleicos como proporcionados aqui. Estes animais podem ser usados, p. ex., como modelos in vivo para estudar a atividade de hidrolase, ou, como modelos para selecionar agentes que alteram a atividade de hidrolase in vivo. As sequências codificantes para os polipeptídios a serem expressas nos animais não-humanos transgênicos podem ser projetadas para serem constitutivas, ou sob o controle de fatores tecido-específicos, desenvolvimento-específicos, ou induzíveis transcricionais regulatórios. Animais não-humanos transgênicos podem ser projetados e gerados usando-se qualquer método conhecido na arte; ver, p. ex., Patentes U.S. nums. 6.211.428; 6.187.992; 6.156.952; 6.118.044; 6.111.166; 7.541; 5.959.171; 5.922.854; 5.892.070; 5.880.327; 5.891.698; 5.639.940; 5.573.933; 7.742; 5.087.571, descrevendo a preparação e o uso de células transformadas e ovos e camundongos, ratos, coelhos, ovelhas, porcos e vacas transgênicos. Ver também, p. ex., Pollock (1999) J. Immunol. Methods 147-157, descrevendo a produção de proteínas recombinantes no leite de animais leiteiros transgênicos; Baguisi (1999) Nat. Biotechnol. 17:456-461, demonstrando a produção de cabras transgênicas. A Patente U.S. n° 6.211.428, descreve a preparação e o uso de mamíferos não-humanos transgênicos que expressam em seus cérebros uma construção de ácido nucleico compreendendo uma sequência de DNA. A Patente U.S. n° 5.387.742 descreve a injeção de sequências de DNA sintéticas ou recombinantes clonadas em ovos de camundongo fertilizados, implantando os ovos injetados em fêmeas pseudoprenhes, e desenvolvendo a termo camundongos transgênicos cujas células expressam proteínas relacionadas com a patologia da doença de Alzheimer. A Patente U.S. n° 6.187.992 descreve a preparação e o uso de um camundongo transgênico cujo genoma compreende uma disrupção do gene que codifica a proteína precursora do amilóide (APP). [0299] “Animais knockout” também podem ser usados para a prática dos métodos como proporcionados aqui. Por exemplo, em um aspecto, os animais transgênicos ou modificados como proporcionados aqui compreendem um “animal knockout”, p. ex., um “camundongo knockout”, manipulado de forma a não expressar um gene endógeno, que é
Petição 870180005321, de 22/01/2018, pág. 151/316
145/293 substituído por um gene que expressa uma hidrolase, ou uma proteína de fusão compreendendo uma hidrolase como proporcionada aqui. Como indicado acima, knockouts funcionais também podem ser gerados usando sequências anti-senso como proporcionado aqui, p. ex., moléculas de RNAi de filamento duplo.
SEMENTES E PLANTAS TRANSGÊNICAS [0300] Em determinadas concretizações, proporciona-se aqui sementes e plantas transgênicas compreendendo um ácido nucleico, um polipeptídio (p. ex., uma hidrolase ou um anticorpo como proporcionado aqui), uma cassete de expressão ou vetor ou uma célula transfectada ou célula transformada como proporcionado aqui. A planta transgênica pode ser dicotiledônea (um dicot) ou monocotiledônea (um monocot). Em uma concretização, proporciona-se aqui métodos de preparar e usar estas sementes e plantas transgênicas. A planta ou célula de planta transgênica expressando um polipeptídio como proporcionado aqui pode ser construída de acordo com qualquer método conhecido na arte. Ver, por exemplo, Patente U.S. n° 6.309.872.
[0301] Ácidos nucleicos e construções de expressão como proporcionados aqui podem ser introduzidos em uma célula hospedeira por quaisquer meios. Por exemplo, ácidos nucleicos ou construções de expressão podem ser introduzidos no genoma de um hospedeiro de planta desejado, ou, os ácidos nucleicos ou construções de expressão podem ser episomas. A introdução no genoma de uma planta desejada pode ser tal que a produção de hidrolase do hospedeiro é regulada por elementos de controle traducionais e transcricionais endógenos.
[0302] Em um aspecto, proporciona-se aqui “plantas knockout” cuja inserção de sequência por meio de, p. ex., recombinação homóloga, disrompeu a expressão do gene endógeno. Meios para gerar plantas “knockout” são bem conhecidos na arte, ver, p. ex., Strepp (1998) Proc Natl. Acad. Sci. USA 95:4368-4373; Miao (1995) Plant J 7:359-365. Ver a discussão sobre plantas transgênicas, abaixo.
[0303] Os ácidos nucleicos como proporcionados aqui podem ser usados para conferir características desejadas em substancialmente qualquer planta, p. ex., em plantas produtoras de colza oleaginosa, incluindo farelo de arroz, colza (canola), girassol, oliva, palma ou soja, e análogos, ou em plantas produtoras de glicose ou amido, como milho,
Petição 870180005321, de 22/01/2018, pág. 152/316
146/293 batata, trigo, arroz, cevada, e análogos. Ácidos nucleicos como proporcionados aqui podem ser usados para manipular vias metabólicas de uma planta de forma a otimizar ou alterar a expressão do hospedeiro de uma hidrolase ou um substrato ou produto de uma hidrolase, p. ex., um óleo, um lipídio, como um mono-, di- ou tri-acilglicerídeo e análogos. O pode alterar as relações de lipídios, conversão e turnover de lipídios em uma planta. Isto pode facilitar o processamento industrial de uma planta. Alternativamente, as hidrolases como proporcionadas aqui podem ser usadas na produção de uma planta transgênica para produzir um composto produzido não-naturalmente por aquela planta. Isto pode diminuir os custos de produção ou criar um produto inédito.
[0304] Em um aspecto, a primeira etapa na produção de uma planta transgênica envolve preparar uma construção de expressão para expressão em uma célula de planta. Estas técnicas são bem conhecidas na arte. Elas podem incluir selecionar e clonar um promotor, uma sequência codificante para facilitar a ligação eficiente de ribosomas ao mRNA, e selecionar as sequências terminadoras de genes apropriadas. Um promotor constitutivo exemplar é CaMV35S, do vírus do mosaico da couve-flor, que geralmente resulta em um alto grau de expressão em plantas. Outros promotores são mais específicos e respondem a sinais no ambiente interno e externo da planta. Um promotor induzível-comluz exemplar é o promotor do gene cab, que codifica a proteína de ligação principal da clorofila a/b.
[0305] Em um aspecto, o ácido nucleico é modificado para se obter maior expressão em uma célula de planta. Por exemplo, uma sequência como proporcionada aqui provavelmente apresentará um maior percentual de pares de nucleotídeos A-T em comparação com aquele observado em uma planta, algumas das quais preferem pares de nucleotídeos G-C. Portanto, nucleotídeos A-T na sequência codificante podem ser substituídos por nucleotídeos G-C sem alterar significativamente a sequência de aminoácidos para incrementar a produção do produto gênico em células de plantas.
[0306] Gene marcador selecionável pode ser adicionado à construção gênica de forma a identificar plantas ou tecidos que integraram o transgene de maneira bem sucedida. Isto pode ser necessário porque conseguir a incorporação e expressão de genes em células de plantas é um evento raro, ocorrendo apenas em um pequeno percentual dos tecidos ou
Petição 870180005321, de 22/01/2018, pág. 153/316
147/293 células objetivadas. Genes marcadores selecionáveis codificam proteínas que proporcionam resistência a agentes que são normalmente tóxicos para plantas, como antibióticos ou herbicidas. Apenas células de plantas que apresentam integrado o gene marcador selecionável sobreviverão quando desenvolvidas em um meio contendo o antibiótico ou herbicida apropriado. Quanto a outros genes inseridos, genes marcadores também requerem sequências promotoras e terminadoras para a função apropriada.
[0307] Em um aspecto, a preparação de sementes ou plantas transgênicas compreende incorporar sequências como proporcionadas aqui e, opcionalmente, genes marcadores em uma construção de expressão-alvo (p. ex., um plasmídio, um fago), juntamente com o posicionamento das sequências promotoras e das sequências terminadoras. Isto pode envolver transferir o gene modificado para dentro da planta por meio de um método apropriado. Por exemplo, uma construção pode ser introduzida diretamente no DNA genômico da célula de planta usando-se técnicas, como eletroporação e microinjeção de protoplastos de células de planta, ou as construções podem ser introduzidas diretamente no tecido de planta usando-se métodos balísticos, como bombardeio com partículas de DNA. Por exemplo, ver, p. ex., Christou (1997) Plant Mol. Biol. 35:197-203; Pawlowski (1996) Mol. Biotechnol. 6:17-30; Klein (1987) Nature 327:7073; Takumi (1997) Genes Genet. Syst. 72:63-69, discutindo o uso do bombardeio de partículas para introduzir transgenes no trigo; e Adam (1997) supra, para o uso do bombardeio de partículas para introduzir YACs em células de plantas. Por exemplo, Rinehart (1997) supra, usou o bombardeio com partículas para gerar plantas de algodão transgênicas. Aparelho para acelerar partículas é descrito na Patente U.S. n° 5.015.580; e o instrumento de aceleração de partículas comercialmente obtenível BioRad (Biolistics) PDS-2000; ver também, John, Patente U.S. n° 5.608.148; e Ellis, Patente U.S. n° 5.681.730, descrevendo a transformação mediada-com-partículas de gimnospermas.
[0308] Em um aspecto, protoplastos podem ser imobilizados e injetados com um ácido nucleico, p. ex., uma construção de expressão. Embora a regeneração de plantas a partir de protoplastos não seja fácil com cereais, a regeneração de plantas é possível em legumes usando embriogênese somática a partir de calo derivado de protoplasto. Tecidos organizados podem ser transformados com DNA desnudo usando-se a técnica do canhão
Petição 870180005321, de 22/01/2018, pág. 154/316
148/293 de genes, sendo que o DNA é revestido sobre microprojéteis de tungstênio, disparados com 1/100 do tamanho das células, que carreiam o DNA profundamente para o interior de células e organelas. Tecido transformado é então induzido a regenerar, usualmente por meio de embriogênese somática. Esta técnica foi bem sucedida em várias espécies de cereais incluindo milho e arroz.
[0309] Ácidos nucleicos, p. ex., construções de expressão, também podem ser introduzidos nas células de plantas usando vírus recombinantes. Células de plantas podem ser transformadas usando-se vetores virais, como, p. ex., vetores derivados do vírus do mosaico do tabaco (Rouwendal (1997) Plant Mol. Biol. 33:989-999), ver (1996) “Use of viral replicons for the expression of genes in plants”, Mol. Biotechnol. 9-221.
[0310] Alternativamente, ácidos nucleicos, p. ex., uma construção de expressão, podem ser combinados com regiões flanqueadoras de T-DNA vantajosas e introduzidos em um vetor hospedeiro de Agrobacterium tumefaciens convencional. As funções de virulência do hospedeiro de Agrobacterium tumefaciens dirigirão a inserção da construção e marcador adjacente para o interior do DNA de célula de planta quando a cell é infectada pelas bactérias. Técnicas de transformação mediadas com Agrobacterium tumefaciens, incluindo desarmamento e uso de vetores binários, são bem descritas na literatura científica. Ver, p. ex., Horsch (1984) Science 233:496-498; Fraley (1983) Proc. Natl. Acad. Sci. USA 80:4803 (1983); Gene Transfer to Plants, Potrykus, ed. (Springer- Verlag, Berlin 1995). O DNA em uma célula de A. tumefaciens está contido no cromossomo bacteriano e também em outra estrutura conhecida como um plasmídeo Ti (tumor-inducing [indutor de tumor]).
[0311] O plasmídio Ti contém uma extensão de DNA denominada T-DNA (comprimento de -20 kb) que é transferida para a célula de planta no processo de infecção e uma série de genes vir (virulência) que dirigem o processo de infecção. A. tumefaciens só pode infectar uma planta através de lesões: quando uma raiz ou um caule de planta é lesionado ele fornece determinados sinais químicos, em resposta aos quais os genes vir de A. tumefaciens se tornam ativados e dirigem uma série de eventos necessários para a transferência do T-DNA do plasmídio Ti para o cromossomo da planta. O T-DNA entra então na célula de planta através da lesão. Uma especulação é que o T-DNA aguarda até
Petição 870180005321, de 22/01/2018, pág. 155/316
149/293 que o DNA de planta seja replicado ou transcrito, insere-se depois no DNA exposto da planta. Para usar A. tumefaciens como um vetor de transgene, a seção indutora de tumor do T-DNA precisa ser removida, ao mesmo tempo que se conserva as regiões limítrofes do T-DNA e os genes vir.
[0312] O transgene é então inserido entre as regiões limítrofes do T-DNA, sendo que é transferido para a célula de planta e torna-se integrado nos cromossomos da planta.
[0313] Em determinadas concretizações, proporciona-se aqui métodos para a transformação de plantas monocotiledôneas usando-se os ácidos nucleicos como proporcionados aqui, incluindo cereais importantes, ver Hiei (1997) Plant Mol. Biol. 35:205218. Ver também, p. ex., Horsch, Science (1984) 233:496; Fraley (1983) Proc. Natl. Acad. Sci USA 80:4803; Thykjaer (1997) supra; Park (1996) Plant Mol. Biol. 32:1135-1148, discutindo a integração do T-DNA no DNA genômico. Ver também D'Halluin, Patente U.S. n° 5.712.135, descrevendo um processo para a integração estável de um DNA que compreende um gene que é funcional em uma célula de um cereal, ou outra planta monocotiledônea.
[0314] Em um aspecto, a terceira etapa pode envolver a seleção e a regeneração de plantas inteiras capazes de transmitir o gene alvo incorporado para a próxima geração. Referidas técnicas de regeneração baseiam-se em manipulação de determinados fitohormônios em um meio de crescimento de cultura de tecidos, baseando-se tipicamente em um marcador de biocida e/ou herbicida que foi introduzido juntamente com as sequências de nucleotídeos desejadas. A regeneração de plantas a partir de protoplastos cultivados é descrita por Evans et al., Protoplasts Isolation and Culture, Handbook of Plant Cell Culture, pp. 124-176, MacMillilan Publishing Company, New York, 1983; e Binding, Regeneration of Plants, Plant Protoplasts, pp. 21-73, CRC Press, Boca Raton, 1985. A regeneração também pode ser obtida de calos de plantas, explantes, órgãos, ou partes dos mesmos. Referidas técnicas de regeneração são descritas geralmente por Klee (1987) Ann. Rev. of Plant Phys. 38:467-486. Para se obter plantas inteiras a partir de tecidos transgênicos, como embriões imaturos, elas podem desenvolvidas em condições ambientais controladas em uma série de meios contendo nutrientes e hormônios, um processo conhecido como cultura de tecidos. Uma vez que plantas inteiras são geradas e produzem sementes,
Petição 870180005321, de 22/01/2018, pág. 156/316
150/293 começa a avaliação da progênie.
[0315] Após a cassete de expressão ser incorporada estavelmente em plantas transgênicas, ela pode ser introduzida em outras plantas por meio de cruzamento sexual. É possível usar qualquer uma de várias técnicas de criação convencionais, dependendo da espécie a ser cruzada. Como a expressão transgênica dos ácidos nucleicos como proporcionados aqui leva a alterações fenotípicas, plantas compreendendo os ácidos nucleicos recombinantes como proporcionados aqui podem ser cruzadas sexualmente com uma segunda planta para se obter um produto final. Assim, as sementes como proporcionadas aqui podem ser derivadas de um cruzamento entre duas plantas transgênicas como proporcionadas aqui, ou um cruzamento entre uma planta como proporcionada aqui e outra planta. Os efeitos desejados (p. ex., expressão dos polipeptídios como proporcionados aqui para proporcionar uma planta com teor de óleo ou lipídios alterado, incrementado e/ou diminuído) podem ser incrementados quando ambas as plantas parentais expressam os polipeptídios como proporcionados aqui. Os efeitos desejados podem ser passados para futuras gerações de plantas através de meios de propagação convencionais.
[0316] Os ácidos nucleicos e polipeptídios como proporcionados aqui são expressos em ou inseridos em qualquer planta ou semente. Plantas transgênicas como proporcionadas aqui podem ser dicotiledôneas ou monocotiledôneas. Exemplos de plantas monocotiledôneas transgênicas como proporcionadas aqui são capins, como capim do prado (erva-de-febra, Poa), capim de forragem, como festuca, lólio, capim temperado, como Agrostis, e cereais, p. ex., trigo, aveia, centeio, cevada, arroz, sorgo, e maiz (milho). Exemplos de plantas dicotiledôneas transgênicas como proporcionadas aqui são tabaco, legumes, como tremoços, batata, beterraba açucareira, ervilha, feijão e soja, e plantas crucíferas (família Brassicaceae), como couve-flor, colza, e o organismo modelo estreitamente relacionado Arabidopsis thaliana. Assim, as sementes e plantas transgênicas como proporcionadas aqui incluem uma faixa de plantas, incluindo, embora sem limitação, espécies dos gêneros Anacardium, Arachis, Asparagus, Atropa, Avena, Brassica, Citrus, Citrullus, Capsicum, Carthamus, Cocos, Coffea, Cucumis, Cucurbita, Daucus, Elaeis, Fragaria, Glycine, Gossypium, Helianthus, Heterocallis, Hordeum, Hyoscyamus, Lactuca,
Petição 870180005321, de 22/01/2018, pág. 157/316
151/293
Linum, Lolium, Lupinus, Lycopersicon, Malus, Manihot, Majorana, Medicago, Nicotiana, Olea, Oryza, Panieum, Pannisetum, Persea, Phaseolus, Pistachio, Pisum, Pyrus, Prunus, Raphanus, Ricinus, Secale, Senecio, Sinapis, Solarium, Sorghum, Theobromus, Trigonella, Triticum, Vicia, Vitis, Vigna, e Zea.
[0317] Em concretizações alternativas, os ácidos nucleicos como proporcionados aqui são expressos em plantas que contêm células de fibras, incluindo, p. ex., algodão, bombax (Kapok, Ceiba pentandra), salgueiro do deserto, chaparral, Krascheninnikovia lanata, balsa, rami, amaranto, cânhamo, vinagreira [Hibiscus sabdariffa], juta, sisal abaca e linho. Em concretizações alternativas, as plantas transgênicas como proporcionadas aqui podem ser membros do gênero Gossypium, incluindo membros de qualquer espécie de Gossypium, como G. arboreum;. G. herbaceum, G. barbadense, e G. hirsutum.
[0318] Em determinadas concretizações, as plantas transgênicas aqui indicadas podem ser usadas para produzir grandes quantidades dos polipeptídios (p. ex., anticorpos, hidrolases) como proporcionados aqui. Por exemplo, ver Palmgren (1997) Trends Genet. 13:348; Chong (1997) Transgenic Res. 6:289-296 (produzindo proteína beta-caseína do leite humano em plantas de batata transgênicas usando um promotor de manopina sintase bidirecional induzível com auxina (mas1',2') com métodos de transformação do disco foliar mediada com Agrobacterium tumefaciens).
[0319] Usando procedimentos conhecidos, alguém com prática na arte poderá selecionar plantas como proporcionadas aqui por meio de detecção do aumento ou da diminuição de proteína ou mRNA de transgene em plantas transgênicas. Meios para detectar e quantificar mRNAs ou proteínas são bem conhecidos na arte.
[0320] Proporciona-se aqui ácidos graxos ou derivados de ácido graxo de plantas transgênicas como proporcionadas aqui, p. ex., plantas oleaginosas transgênicas. Em um aspecto produz-se plantas oleaginosas transgênicas compreendendo pelo menos uma hidrolase como proporcionada aqui. Em um aspecto, a planta transgênica compreende um gene de hidrolase ligado operacionalmente a um promotor, permitindo uma expressão do gene, seja em compartimentos celulares, extracelulares ou de tecidos diferentes daqueles em que os lipídios de plantas se acumulam, ou permitindo a indução exógena da hidrolase. Em um aspecto, sementes e/ou frutos contendo os lipídios das plantas são recolhidos, as
Petição 870180005321, de 22/01/2018, pág. 158/316
152/293 sementes e/ou frutos são despedaçados (se necessário após tratamento com indução do gene de hidrolase (p. ex., lipase, saturase, palmitase e/ou estearatase)) de forma a colocar em contato os lipídios e a hidrolase como proporcionado aqui nas sementes e/ou frutos. A mistura pode ser deixada incubar para permitir hidrólise enzimática dos lipídios do material moído por meio de ação catalítica da lipase, como proporcionado aqui, contida no material despedaçado. Em um aspecto, os ácidos graxos formados por meio da hidrólise são extraídos e/ou são convertidos para se obter os derivados de ácido graxo desejados. [0321] Este processo de hidrólise enzimática como proporcionado aqui usa condições de operação brandas e pode ser em pequena escala e usar instalações não dispendiosas. Neste aspecto a planta como proporcionada aqui é induzida a produzir a hidrolase para transformação de lipídios de planta. Usando esta estratégia, a enzima é impedida de entrar em contato com lipídios de plantas armazenados de forma a evitar qualquer risco de hidrólise prematura (“auto-degradação da planta”) antes da colheita. As unidades de despedaçamento e incubação podem ser leves e de pequena escala; muitas são conhecidas na indústria agrícola e podem ser realizadas em sítios em que as plantas são colhidas.
[0322] Em um aspecto, plantas transgênicas como proporcionadas aqui são produzidas por meio de transformação de plantas oleaginosa naturais. As plantas geneticamente transformadas como proporcionadas aqui são então reproduzidas sexualmente de forma a produzir sementes transgênicas como proporcionadas aqui. Estas sementes podem ser usadas para se obter progênie da planta transgênica.
[0323] Em um aspecto, o gene de hidrolase é ligado operacionalmente a um promotor induzível para prevenir qualquer contato prematuro de hidrolase e lipídio de planta. Este promotor pode dirigir a expressão do gene a compartimentos diferentes daqueles em que os lipídios se acumulam, ou o promotor pode iniciar a expressão da hidrolase em um momento desejado por meio de uma indução exógena.
POLIPEPTÍDIOS E PEPTÍDIOS [0324] Em determinadas concretizações, proporciona-se aqui polipeptídios isolados, sintéticos ou recombinantes apresentando uma identidade de sequência (p. ex., pelo menos 50 % de identidade de sequência) com a SEQ ID NO:2, SEQ ID NO:4, SEQ ID
Petição 870180005321, de 22/01/2018, pág. 159/316
153/293
NO:6, SEQ ID NO:8, SEQ ID NO: 10, SEQ ID NO: 12, SEQ ID NO: 14, SEQ ID NO: 16, SEQ ID NO: 18, ou SEQ ID NO:20 ou SEQ ID NO:2 apresentando uma, duas, três, quatro, cinco, seis, sete, oito ou mais (várias) ou todas as variações de aminoácidos descritas na Tabela 3, Tabela 4, Tabela 9, Tabela 10, Tabela 11, Tabela 16 ou Tabela 23, ou seu equivalente. Em determinadas concretizações, proporciona-se aqui ácidos nucleicos que codificam polipeptídios apresentando uma sequência como apresentada na SEQ ID NO:2, SEQ ID NO:4, SEQ ID NO:6, SEQ ID NO:8, SEQ ID NO:10, SEQ ID NO:12, SEQ ID NO:14, SEQ ID NO:16, SEQ ID NO: 18, ou SEQ ID NO:20 ou SEQ ID NO:2 apresentando uma, duas, três, quatro, cinco, seis, sete, oito ou mais (vários) ou todas as variações de aminoácidos descritas na Tabela 3, Tabela 4, Tabela 9, T ble 10, Tabela 11, Tabela 16 ou Tabela 23, ou seu equivalente.
[0325] A identidade de sequências pode ser sobre o comprimento pleno do polipeptídio, ou a identidade pode ser sobre uma região de pelo menos cerca de 50, 60, 70, 80, 90, 100, 150, 200, 250, 300, 350, 400, 500, 550, 600, 650, 700 ou mais resíduos. Polipeptídios como proporcionados aqui também podem ser mais curtos do que o comprimento pleno de polipeptídios exemplares. Em um aspecto proporcionado aqui compreende-se peptídios compreendendo apenas uma subsequência de uma sequência como proporcionada aqui, sequências exemplares podem ter cerca de 5, 10, 15, 20, 25, 30, 35, 40, 45, 50, 55, 60, 65, 70, 75, 80, 85, 90, 100, 125, 150, 175, 200, 250, 300, 350, 400, 450, 500, 550, 600, 650, 700, ou mais resíduos. Em aspectos alternativos, polipeptídios (peptídios, fragmentos) podem compreender tamanho entre cerca de 5 e o comprimento pleno de um polipeptídio, p. ex., uma enzima como proporcionada aqui; sendo que tamanhos exemplares são de cerca de 5, 10, 15, 20, 25, 30, 35, 40, 45, 50, 55, 60, 65, 70, 75, 80, 85, 90, 100, 125, 150, 175, 200, 250, 300, 350, 400, 450, 500, 550, 600, 650, 700, ou mais resíduos, p. ex., resíduos contíguos de uma hidrolase exemplar como proporcionada aqui. Peptídios como proporcionados aqui podem ser úteis como, p. ex., sondas de marcação, antígenos, tolerágenos, unidades repetitivas, sítios com atividade de hidrolase.
[0326] Polipeptídios como proporcionados aqui também incluem anticorpos capazes de ligação com uma hidrolase como proporcionada aqui.
Petição 870180005321, de 22/01/2018, pág. 160/316
154/293 [0327] Polipeptídios como proporcionados aqui também incluem sequências de aminoácidos que são “substancialmente idênticos” a sequências como proporcionadas aqui, incluindo sequências que diferem de uma sequência de referência por uma ou mais substituições, deleções, ou inserções conservativas ou não-conservativas de aminoácidos, particularmente quando uma substituição do tipo referido ocorre em um sítio que não o sítio ativo da molécula, e desde que o polipeptídio conserve substancialmente suas propriedades funcionais. Uma substituição de aminoácido conservativa, por exemplo, substitui um aminoácido por outro da mesma classe (p. ex., substituição de um aminoácido hidrofóbico, como isoleucina, valina, leucina, ou metionina, por outro, ou substituição de um aminoácido polar por outro, como substituição de arginina para lisina, ácido glutâmico por ácido aspártico ou glutamina por asparagina). Um ou mais aminoácidos podem ser deletados, por exemplo, de uma hidrolase, resultando na modificação da estrutura do polipeptídio, sem alterar significativamente sua atividade biológica. Por exemplo, aminoácidos com ponta amino ou carboxila que não são requeridos para a atividade de hidrolase podem ser removidos.
[0328] “Aminoácido” ou “sequência de aminoácidos” podem incluir um oligopeptídio, peptídio, polipeptídio, ou sequência de proteína, ou um fragmento, porção, ou subunidade de qualquer um destes, e moléculas sintéticas ou naturalmente ocorrentes.
[0329] Os termos “polipeptídio” e “proteína” podem incluir aminoácidos conjugados entre si por ligações peptídicas ou ligações peptídicas modificadas, i.e., isoésteres de peptídios, e podem conter aminoácidos modificados diferentes dos 20 aminoácidos codificados por genes. O termo “polipeptídio” também inclui peptídios e fragmentos de polipeptídios, unidades repetitivas e análogos. O termo também inclui polipeptídios glicosilados. Os peptídios e polipeptídios como proporcionados aqui também incluem todas as formas “miméticas” e “peptidomiméticas”, como descrito mais detalhadamente abaixo.
[0330] Os polipeptídios como proporcionados aqui incluem hidrolases em uma forma ativa ou inativa. Por exemplo, os polipeptídios como proporcionados aqui incluem próproteínas antes da “maturação” ou processamento de sequências pré-pro, p. ex., por meio de uma enzima de processamento de pró-proteína, como uma pró-proteína convertase para gerar uma proteína madura “ativa”. Os polipeptídios como proporcionados aqui
Petição 870180005321, de 22/01/2018, pág. 161/316
155/293 incluem hidrolases inativas para outras razões, p. ex., antes da “ativação” por um evento de processamento pós-traducional, p. ex., uma ação endo- ou exo-peptidase ou proteinase, um evento de fosforilação, uma amidação, uma glicosilação ou uma sulfatação, um evento de dimerização, e análogos. Métodos para identificar sequências de domínio “pré-pro” e sequências-sinal são bem conhecidos na arte, ver, p. ex., Van de Ven (1993) Crit. Rev. Oncog. 4(2):115-136. Por exemplo, para identificar uma sequência pré-pro, a proteína é purificada de um espaço extracelular e a sequência de proteína N-terminal é determinada e comparada com a forma não-processada.
[0331] Os polipeptídios como proporcionados aqui incluem todas as formas ativas, incluindo subsequências ativas, p. ex., domínios catalíticos ou sítios ativos, de uma enzima como proporcionada aqui. Em determinadas concretizações, proporciona-se aqui domínios catalíticos ou sítios ativos como apresentados abaixo. Em outras concretizações, proporciona-se aqui peptídios ou polipeptídios compreendendo ou consistindo de um domínio de sítio ativo como predito por meio do uso de um banco de dados, como Pfam (que é uma coleção grande de alinhamentos de múltiplas sequências e modelos ocultos de Markov cobrindo muitas famílias de proteínas comuns, The Pfam protein families database, A. Bateman, E. Birney, L. Cerruti, R. Durbin, L. Etwiller, S.R. Eddy, S. GriffithsJones, K.L. Howe, M. Marshall, e E.L.L. Sonnhammer, Nucleic Acids Research, 30(l):276280, 2002) ou equivalente.
[0332] Em determinadas concretizações, proporciona-se aqui polipeptídios com ou sem uma sequência-sinal e/ou uma sequência pré-pro. Em uma concretização, proporciona-se aqui polipeptídios com sequências-sinal heterólogas e/ou sequências prépro. A sequência pré-pro (incluindo uma sequência como proporcionada aqui usada como um domínio pré-pro heterólogo) pode localizar-se sobre a ponta amino ou a ponta carbóxi do domínio. Em outra concretização, proporciona-se aqui sequências-sinal isoladas, sintéticas ou recombinantes, sequências pré-pro e domínios catalíticos (p. ex., “sítios ativos”) compreendendo ou consistindo de sequências como proporcionado aqui. A sequência-sinal, domínios pré-pro e/ou domínio catalítico como proporcionados aqui podem ser parte de uma proteína de fusão, p. ex., como um domínio heterólogo em uma proteína quimérica. Em determinadas concretizações proporciona-se aqui ácidos nucleicos
Petição 870180005321, de 22/01/2018, pág. 162/316
156/293 que codificam estes domínios catalíticos (CDs), domínios pré-pro e sequências-sinal (SPs, p. ex., um peptídio apresentando uma sequência compreendendo/consistindo de resíduos amino-terminais de um polipeptídio como proporcionado aqui). Em determinadas concretizações proporciona-se aqui sequências-sinal compreendendo um peptídio compreendendo/consistindo de uma sequência como apresentada nos resíduos de 1 a 12, de 1 a 13, de 1 a 14, de 1 a 15, de 1 a 16, de 1 a 17, de 1 a 18, de 1 a 19, de 1 a 20, 1, de 1 a 22, de 1 a 23, de 1 a 24, de 1 a 25, de 1 a 26, de 1 a 27, de 1 a 28, de 1 a 28, de 1 a 30, de 1 a 31, de 1 a to 33, de 1 a 34, de 1 a 35, de 1 a 36, de 1 a 37, de 1 a 38, de 1 a 39, de 1 a 40, de 1 a 41, de 1 a 42, de 1 a 43, de 1 a 44, de 1 a 45, de 1 a 46, de 1 a 47, de 1 a 48, de 1 a 49 ou 1 a 50, de um polipeptídio como proporcionado aqui.
[0333] Polipeptídios e peptídios como proporcionados aqui podem ser isolados de fontes naturais, podem ser sintéticos, ou podem ser polipeptídios gerados de forma recombinante. Peptídios e proteínas podem ser expressos recombinantemente in vitro ou in vivo. Os peptídios e polipeptídios como proporcionados aqui podem ser preparados e isolados usando-se qualquer método conhecido na arte. Polipeptídio e peptídios como proporcionados aqui também podem ser sintetizados, inteiros ou em parte, usando-se métodos químicos bem conhecidos na arte, usando-se métodos químicos bem conhecidos na arte. Ver, p. ex., Caruthers (1980) Nucleic Acids Res. Symp. Ser. 215-223; Horn (1980) Nucleic Acids Res. Symp. Ser. 225-232; Banga, A.K., Therapeutic Peptides and Proteins, Formulation, Processing and Delivery Systems (1995) Technomic Publishing Co., Lancaster, PA. Por exemplo, a síntese de peptídios pode ser realizada usando-se várias técnicas de fase sólida (ver p. ex., Roberge (1995) Science 269:202; Merrifield (1997) Methods Enzymol. 289:3-13) e síntese automatizada pode ser obtida, p. ex., usando o sintetizador de peptídios ABI 43 IA Peptide Synthesizer (Perkin Elmer) de acordo com as instruções fornecidas pelo fabricante.
[0334] Os peptídios e polipeptídios como proporcionados aqui também podem ser glicosilados. A glicosilação pode ser adicionada pós-traducionalmente, seja quimicamente ou por meio de mecanismos biossintéticos celulares, sendo que estes últimos incorporam o uso de unidades repetitivas de glicosilação conhecidas, que podem ser nativas com relação à sequência ou podem ser adicionados como um peptídio ou adicionadas na
Petição 870180005321, de 22/01/2018, pág. 163/316
157/293 sequência codificante de ácido nucleico. A glicosilação pode ser ligada a O, ou ligada a N. [0335] Proteínas ou polipeptídios “recombinantes” referem-se a proteínas ou polipeptídios produzidas por meio de técnicas de DNA recombinantes; i.e., produzidas de células transformadas por meio de uma construção de DNA exógena codificando a proteína ou polipeptídio desejado. Ácidos nucleicos “sintéticos” (incluindo oligonucleotídeos), polipeptídios ou proteínas como proporcionados aqui incluem aqueles preparados por qualquer síntese química, p. ex., como descrito abaixo.
[0336] “Fragmentos” como usado aqui são uma porção de uma proteína naturalmente ocorrente que pode existir em pelo menos duas conformações diferentes. Fragmentos podem ter a mesma, ou substancialmente a mesma sequência de aminoácidos que a proteína naturalmente ocorrente. “Fragmentos enzimaticamente ativos” como usado aqui são uma porção de uma sequência de aminoácidos (codificando uma proteína) que conserva pelo menos uma atividade funcional da proteína com que está relacionada. “Substancialmente igual” significa que uma sequência de aminoácidos é amplamente, mas não inteiramente, a mesma, porém conserva pelo menos uma atividade funcional da sequência com que está relacionada. De uma forma geral duas sequências de aminoácidos são “substancialmente iguais” ou “substancialmente homólogas” se elas foram pelo menos cerca de 85 % idênticas. Fragmentos que apresentam estruturas tridimensionais diferentes como a proteína naturalmente ocorrente também são incluídos. Um exemplo disto é uma molécula “pró-forma”, como uma pró-proteína com baixa atividade que pode ser modificada por meio de clivagem para produzir uma enzima madura com atividade significativamente maior.
[0337] Os peptídios e polipeptídios como proporcionados aqui, como definido acima, incluem todas as formas “miméticas” e “peptidomiméticas”. Os termos “mimético” e “peptidomimético” referem-se a um composto químico sintético que apresenta substancialmente as mesmas características estruturais e/ou funcionais dos polipeptídios como proporcionados aqui. O mimético pode ser constituído inteiramente de análogos sintéticos, não-naturais, de aminoácidos, ou é uma molécula quimérica de aminoácidos de peptídio parcialmente natural e análogos parcialmente não-naturais de aminoácidos. O mimético também pode incorporar qualquer quantidade de substituições conservativas de
Petição 870180005321, de 22/01/2018, pág. 164/316
158/293 aminoácidos naturais, desde que referidas substituições não alterem substancialmente a estrutura e/ou atividade do mimético. Como com polipeptídios como proporcionados aqui que são variantes conservativas, experimentação de rotina determinará se um mimético encontra-se no escopo como proporcionado aqui, i.e., que sua estrutura e/ou função não é alterada substancialmente. Assim, em um aspecto, uma composição mimética encontrase dentro do escopo como proporcionado aqui se apresentar uma atividade de hidrolase. [0338] Composições miméticas de polipeptídios como proporcionado aqui podem conter qualquer combinação de componentes estruturais não-naturais. Em aspecto alternativo, composições miméticas como proporcionado aqui incluem um ou todos os três grupos estruturais a seguir: a) grupos de ligação de resíduo diferentes das ligações de ligação amida natural (“ligação de peptídio”); b) resíduos não-naturais em lugar de resíduos de aminoácidos naturalmente ocorrentes; ou c) resíduos que induzem emulação estrutural secundária, i.e., para induzir ou estabilizar uma estrutura secundária, p. ex., uma volta beta [beta turn], volta gama [gama turn], folha-beta [beta sheet], conformação de hélice alfa, e análogos. Por exemplo, um polipeptídio como proporcionado aqui pode ser caracterizado como um mimético quando todos ou alguns de seus resíduos são conjugados por meios químicos diferentes de ligações peptídicas naturais. Resíduos peptidomiméticos individuais podem ser conjugados por ligações peptídicas, outras ligações químicas ou meios de acoplamento, como, p. ex., glutaraldeído, ésteres de N-hidroxissuccinimida, maleimidas bifuncionais, N,N'-dicicloexilcarbodiimida (DCC) ou N,N'-diisopropilcarbodiimida (DIC). Grupos de ligação que podem ser uma alternativa para as ligações de ligação amida tradicional (“ligação peptídica”) incluem, p. ex., cetometileno (p. ex., -C(=O)- para -C(=0)NH-), aminometileno (CH2-NH), etileno, olefina (CH=CH), éter (CH2-O), tioéter (CH2-S), tetrazol (CN4-), tiazol, retroamida, tioamida, ou éster (ver, p. ex., Spatola (1983) em Chemistry and Biochemistry of Amino Acids, Peptides and Proteins, vol. 267-357, “Peptide Backbone Modifications”, Marcell Dekker, NY).
[0339] Um polipeptídio como proporcionado aqui também pode ser caracterizado como um mimético por conter todos ou alguns resíduos não-naturais em lugar de resíduos de aminoácidos naturalmente ocorrentes. Resíduos não-naturais são bem descritos na literatura científica e de patentes; e algumas composições não-naturais exemplares úteis
Petição 870180005321, de 22/01/2018, pág. 165/316
159/293 como miméticos de resíduos de aminoácidos naturais, e diretrizes são descritas abaixo. Miméticos de aminoácidos aromáticos podem ser gerados substituindo-se, p. ex., por Dou L- nafilalanina; D- ou L-fenilglicina; D- ou L-2 tieneilalanina; D- ou L-1, -2,3-, ou 4pireneilalanina; D- ou L-3 tieneilalanina; D- ou L-(2-piridinil)-alanina; D- ou L-(3-piridinil)alanina; D- ou L-(2-pirazinil)-alanina; D- ou L-(4-isopropil)-fenilglicina; D-(trifluorometil)fenilglicina; D-(trifluorometil)-fenilalanina; D-p-fluoro-fenilalanina; D- ou L-pbifenilfenilalanina; D- ou L-p-metóxi- bifenilfenilalanina; D- ou L-2-indol(alquil)alaninas; e, Dou L-alquilaininas, onde alquila pode ser metila substituído ou não substituído, etila, propila, hexila, butila, pentila, isopropila, iso-butila, sec-isotila, iso-pentila, ou um aminoácido nãoácido. Anéis aromáticos de um aminoácido não-natural incluem, p. ex., anéis aromáticos tiazolila, tiofenila, pirazolila, benzimidazolila, naftila, furanila, pirrolila, e piridila.
[0340] Miméticos de aminoácidos ácidos podem ser gerados por meio de substituição por meio de, p. ex., aminoácidos não-carboxilato enquanto mantendo uma carga negativa; (fosfono)alanina; treonina sulfatada. Grupos laterais carboxila (p. ex., aspartila ou glutamila) também podem ser modifiacados seletivamente por meio de reação com carbodiimidas (R'-N-C-N-Rj, como, p. ex., 1-cicloexil-3(2-morfolinil-(4-etil)carbodiimida ou 1-etil-3(4azonia-4,4-dimetolpentil)carbodiimida.
[0341] Aspartila ou glutamila também pode ser convertida a resíduos asparaginila e glutaminila por meio de reação com íons amônio.
[0342] Miméticos de aminoácidos básicos podem ser gerados por meio de substituição com, p. ex., (adicionalmente a lisina e arginina) os aminoácidos ornitina, citrulina, ou ácido (guanidino)-acético, ou ácido (guanidino)alquil-acético, sendo que alquila é definido acima. Derivado nitrilo (p. ex., contendo a porção CN em lugar de COOH) pode ser substituído por asparagina ou glutamina. Resíduos asparaginila e glutaminila podem ser desaminados aos resíduos aspartila ou glutamila correspondentes. Miméticos de resíduo arginina podem ser gerados reagindo-se arginila com, p. ex., um ou mais reagentes convencionais, incluindo, p. ex., fenilglioxal, 2,3-butanodiona, 1,2-ciclo-hexanodiona, ou ninidrina, alternativamente em condições alcalinas. Mimétidos de resíduo tirosina podem ser gerados reagindo-se tirosila com, p. ex., compostos diazônio aromáticos ou nitrometano. N-acetilimidizol e tetranitrometano podem ser usados para formar espécies de O-acetil tirosila e derivados 3
Petição 870180005321, de 22/01/2018, pág. 166/316
160/293 nitro, respectivamente. Miméticos de resíduo cisteína também podem ser gerados reagindo-se resíduos cisteinila com, p. ex., alfa-haloacetatos, como 2-cloroacético ou cloroacetamida e aminas correspondentes; dando derivados carboximetila ou oxiamidometila. Miméticos de resíduo cisteína também podem ser gerados por meio de reação com, p. ex., bromo-trifluoroacetona, ácido alfa-bromo-beta-(5-imidozoil)propiônico; fosfato de cloroacetila, N-alquilmaleimidas, dissulfeto de 3-nitro-2-piridila; dissulfeto de metil 2-piridila; p-cloromercuribenzoato; 2-cloromercuri-4 nitrofenol; ou cloro-7-nitrobenzo-oxa1,3-diazol. Miméticos de lisina podem ser gerados (e resíduos amino-terminais podem ser alterados) reagindo-se lisinila com, p. ex., anidridos de ácido succínico ou outros anidridos de ácido carboxílico. Lisina e outros miméticos de resíduo contendo alfa-amino também podem ser gerados por meio de reação com imidoésteres, como picolinimidato de metila, fosfato de piridoxal, piridoxal, cloroboroidreto, ácido trinitro-benzenossulfônico, Ometilisouréia, 2,4, pentanodiona, e reações com glioxilato catalisadas-com-transamidase. Miméticos de metionina podem ser gerados por meio de reação com, p. ex., sulfóxido de metionina. Miméticos de prolina incluem, p. ex., ácido pipecólico, ácido tiazolidina carboxílico, 3- ou 4-hidróxi prolina, desidroprolina, 3- ou 4-metilprolina, ou 3,3,dimetilprolina. Miméticos de resíduos histidina podem ser gerados por meio de reação com histidila com, p. ex., dietilprocarbonato ou brometo de para-bromofenacila. Outros miméticos incluem, p. ex., aqueles gerados por meio de hidroxilação de prolina e lisina; fosforilação dos grupos hidroxila de resíduos serila ou treonina; metilação dos grupos alfaamino de lisina, arginina e histidina; acetilação da amina N-terminal; metilação de resíduos de amida de cadeia principal ou substituição com aminoácidos de N-metila; ou amidação de grupos carboxila C-terminais.
[0343] Um resíduo, p. ex., um aminoácido, de um polipeptídio como proporcionado aqui também pode ser substituído por um aminoácido (ou resíduo peptidomimético) da quiralidade oposta. Assim, qualquer amino ácido naturalmente ocorrente na configuração L (que também pode ser referido como R ou S, dependendo da estrutura da entidade química) pode ser substituído pelo aminoácido com o mesmo tipo estrutural químico ou um peptidomimético, porém de quiralidade oposta, referido como o aminoácido D-, mas também referido como a forma R- ou S-.
Petição 870180005321, de 22/01/2018, pág. 167/316
161/293 [0344] Em determinadas concretizações, proporciona-se aqui métodos para modificar os polipeptídios como proporcionados aqui por meio de processos naturais, como processamento pós-traducional (p. ex., fosforilação, acilação, etc.), ou por meio de técnicas de modificação química, e os polipeptídios modificados resultantes. Modificações podem ocorrer em qualquer lugar no polipeptídio, incluindo a cadeia principal peptídica, as cadeias laterais de aminoácido e as pontas amino ou carboxila. Deve-se considerar que o mesmo tipo de modificação pode estar presente nos mesmo graus ou em graus variáveis em diversos sítios em um dado polipeptídio. Também um dado polipeptídio pode apresentam muitos tipos de modificações. Modificações incluem acetilação, acilação, ADP-ribosilação, amidação, ligação covalente de flavina, ligação covalente de uma porção heme, ligação covalente de nucleotídeo ou derivado de nucleotídeo, ligação covalente de um lipídio ou derivado de lipídio, ligação covalente de um fosfatidilinositol, ciclização por reticulação, formulação de ligação dissulfeto, desmetilação, formação de reticulações covalentes, formulação de cisteína, formação de piroglutamato, formilação, gama-carboxilação, glicosilação, formulação de âncora GPI, hidroxilação, iodatação, metilação, miristoilação, oxidação, peg-ilação, processamento proteolítico, fosforilação, prenilação, racemização, selenoilação, sulfatação, e adição mediada com RNA-de-transferência de aminoácidos a proteína, como arginilação. Ver, p. ex., Creighton, T.E., Proteins - Structure and Molecular Properties 2a ed., W.H. Freeman e Company, New York (1993); Posttranslational Covalent Modification of Proteins, B.C. Johnson, Ed., Academic Press, New York, pp. 1-12 (1983).
[0345] Também é possível usar métodos de síntese química de fase sólida de peptídios para sintetizar os polipeptídios, ou fragmentos dos mesmos, como proporcionado aqui. Referidos métodos tem sido conhecidos na arte desde o início dos anos de 1960 (Merrifield, R. B., J. Am. Chem. Soc, 85:2149-2154, 1963) (ver também Stewart, J. M. e Young, J. D., Solid Phase Peptides Synthesis, 2a ed., Pierce Chemical Co., Rockford, III., pp. 11-12)) e foram usados recentemente em kits de laboratório comercialmente obteníveis para a síntese e projeto de peptídios (Cambridge Research Biochemicals). Referidos kits de laboratório comercialmente obteníveis usaram geralmente os ensinamentos de H. M. Geysen et al, Proc. Natl. Acad. Sci., USA, 81:3998 (1984) e proporcionam a sintetização de peptídios sobre as pontas de uma multiplicidade de “rods/bastões” ou
Petição 870180005321, de 22/01/2018, pág. 168/316
162/293 “pins/pinaturalmente ocorrentes” sendo que todos estes são conectados a uma única placa. Quando se usa um sistema do tipo referido, uma placa de bastões ou pinos é invertida e inserida em uma segunda placa de poços ou reservatórios correspondentes, que contêm soluções para ligar ou ancorar um aminoácido apropriado nas pontas dos pinos ou bastões. Repetindo uma etapa de processo do tipo referido, i.e., invertendo e inserindo as pontas dos bastões e pinos em soluções apropriadas, aminoácidos são construídos em peptídios desejados. Adicionalmente, está disponível uma quantidade de sistemas de síntese de peptídios FMOC. Por exemplo, a montagem de um polipeptídio ou fragmento pode ser realizada em um suporte sólido usando-se um sintetizador de peptídios automatizado Applied Biosystems, Inc. Model 431 A™. Referido equipamento proporciona fácil acesso aos peptídios como proporcionados aqui, seja por meio de síntese direta ou por meio de síntese de uma série de fragmentos que podem ser acoplados usando-se técnicas conhecidas.
ENZIMAS [0346] Em determinadas concretizações, proporciona-se aqui hidrolases, p. ex., lipases, saturases, palmitases e/ou estearatases, p. ex., proteínas compreendendo pelo menos cerca de 50 %, 51 %, 52 %, 53 %, 55 %, 56 %, 57 %, 58 %, 59 %, 60 %, 61 %, 62 %, 63 %, 64 %, 65 %, 66 %, 67 %, 68 %, 69 %, 71 %, 72 %, 73 %, 74 %, 75 %, 76 %, 77 %, 78 %, 79 %, 80 %, 81 %, 82 %, 83 %, 84 %, 85 %, 86 %, 87 %, 88 %, 89 %, 90 %, 91 %, 92 %, 93 %, 94 %, 95 %, 96 %, 97 %, 98 %, 99 %, ou mais, ou completa (100 %) identidade de sequências, com um polipeptídio exemplar como proporcionado aqui (p. ex., SEQ ID NO:2, SEQ ID NO:4, SEQ ID NO:6, SEQ ID NO:8, SEQ ID NO: 10, SEQ ID NO: 12, SEQ ID NO: 14, SEQ ID NO: 16, SEQ ID NO: 18, ou SEQ ID NO:20 ou SEQ ID NO:2 apresentando uma, duas, três, quatro, cinco, seis, sete, oito ou mais (várias) ou todas as variações de aminoácidos descritas na Tabela 3, Tabela 4, Tabela 9, Tabela 10, Tabela 11, Tabela 16 ou Tabela 23, ou seu equivalente, anticorpos que os ligam, e métodos para preparar e usar os mesmos. Os polipeptídios como proporcionados aqui podem apresentam qualquer atividade de hidrolase, p. ex., atividade de lipase, saturase, palmitase e/ou estearatase. Em aspectos alternativos, uma atividade de uma enzima como proporcionada aqui compreende hidrólise ou síntese de lipídios ou óleos. As hidrolases
Petição 870180005321, de 22/01/2018, pág. 169/316
163/293 como proporcionadas aqui podem modificar óleos por meio de hidrólise, acidólise, alcoólise, glicerólise, esterificação, transesterificaçaõ e/ou interesterificação, incluindo reações de “migração forçada”.
[0347] Em aspectos alternativos, as hidrolases como proporcionadas aqui podem apresentar atividades modificadas ou novas, em comparação com as hidrolases exemplares ou as atividades aqui descritas. Proporciona-se aqui hidrolases com e sem sequências-sinal e as próprias sequências-sinal. Proporciona-se aqui hidrolases imobilizadas, anticorpos anti-hidrolase e fragmentos dos mesmos. Proporciona-se aqui proteínas para inibir a atividade de hidrolase, p. ex., anticorpos que se ligam ao sítio com atividade de hidrolase. Proporciona-se aqui homodímeros e heterocomplexos, p. ex., proteínas de fusão, heterodímeros, etc., compreendendo as hidrolases como proporcionadas aqui. Proporciona-se aqui hidrolases apresentando atividade numa ampla faixa de altas e baixas temperaturas e pH's (p. ex., condições aquosas ácidas e básicas).
[0348] Em um aspecto, uma ou mais hidrolases (p. ex., lipases, saturases, palmitases e/ou estearatases) como proporcionadas aqui são usadas para a síntese biocatalítica de lipídios estruturados, i.e., lipídios que contêm um conjunto definido de ácidos graxos distribuídos de uma maneira definida sobre a cadeia principal de glicerol, incluindo alternativas à manteiga de cacau, ácidos graxos poli-insaturados (PUFAs), glicerídeos de 1,3-diacila (DAGs), 2-monoacilglicerídeos (MAGs) e triacilglicerídeos (TAGs).
[0349] Proporciona-se aqui métodos de gerar enzimas apresentando Kcat/Km alterada (maior ou menor). Em um aspecto, usa-se mutagênese sítio-direcionada para criar enzimas hidrolase adicionais com especificidades de substrato alternativas. Isto pode ser realizado, por exemplo, reprojetando-se a regiaode de ligação de substrato ou o sítio ativo da enzima. Em um aspecto, hidrolases como proporcionadas aqui são mais estáveis a altas temperaturas, como de 80°C a 85°C a 90°C a 95°C, em comparação com hidrolases de organismos convencionais ou moderados.
[0350] Várias proteínas como proporcionadas aqui apresentam uma atividade de hidrolase, p. ex., atividade de lipase, saturase, palmitase e/ou estearatase, sob diversas condições. Proporciona-se aqui métodos de preparar hidrolases com diferentes eficiências catalíticas e estabilidades relativamente a temperatura, agentes oxidantes e condições de
Petição 870180005321, de 22/01/2018, pág. 170/316
164/293 pH. Estes métodos podem usar, p. ex., as técnicas de mutagênese sítio-direcionada e/ou mutagênese randômica. Em um aspecto, é possível usar evolução dirigida para produzir hidrolases com estabilidade e especificidades alternativas.
[0351] As proteínas como proporcionadas aqui são usadas em métodos que podem identificar moduladores de hidrolase, p. ex., ativadores ou inibidores. Em resumo, amostras de teste (p. ex., compostos, como membros de bibliotecas combinatoriais ou de peptídios, brodos, extratos, e análogos) são adicionadas a ensaios de hidrolase para determinar sua capacidade de modular, p. ex., inibir ou ativar, a clivagem de substrato. Estes inibidores podem ser usados na indústria e na pesquisa para reduzir ou impedir isomerização indesejada. Moduladores encontrados com o uso dos métodos como proporcionados aqui podem ser usados para alterar (p. ex., diminuir ou aumentar) o espectro de atividade de uma hidrolase.
[0352] Em um aspecto, proporciona-se aqui métodos de descobrir hidrolases usando os ácidos nucleicos, polipeptídios e anticorpos como proporcionados aqui. Em um aspecto, bibliotecas de fago lambda são selecionadas para a descoberta de hidrolases baseadaem-expressão. Proporciona-se aqui bibliotecas de fago lambda para uso na seleção, de forma a permitir a detecção de clones tóxicos; acesso aperfeiçoado a substrato; necessidade reduzida de manipulação de um hospedeiro, desvio do potencial para qualquer viés resultante de excisão em massa da biblioteca; e crescimento mais rápido a baixas densidades de clones.
[0353] A seleção de bibliotecas de fago lambda pode ser em fase líquida ou em fase sólida. Proporciona-se aqui métodos para selecionar em fase líquida. Isto pode proporcionar uma maior flexibilidade em condições de ensaio; flexibilidade de substrato adicional; maior sensibilidade para clones fracos; e facilidade de automação relativamente à seleção de fase sólida.
[0354] Em outras concretizações, proporciona-se aqui métodos de seleção usando as proteínas e ácidos nucleicos como proporcionados aqui envolvendo automação robótica. Isto permite a execução de muitas milhares de reações biocatalíticas e ensaios de seleção em um curto período de tempo, p. ex., por dia, e também assegurar um alto nível de precisão e reprodutibilidade (ver discussão sobre conjuntos, abaixo). Como um resultado,
Petição 870180005321, de 22/01/2018, pág. 171/316
165/293 uma biblioteca de compostos derivados pode ser produzida em questão de semanas. [0355] Em determinadas concretizações, proporciona-se aqui enzimas hidrolase que são hidrolases não-naturalmente ocorrentes apresentando uma diferente atividade de hidrolase, estabilidade, especificidade por substrato, perfil de pH e/ou características de desempenho em comparação com a hidrolase não-naturalmente ocorrente. Estas hidrolases apresentam uma sequência de aminoácidos não encontrada na natureza. Elas podem ser derivadas por meio de substituição de uma pluralidade de resíduos de aminoácidos de uma hidrolase precursora com aminoácidos diferentes. A hidrolase precursora pode ser uma hidrolase naturalmente ocorrente ou uma hidrolase recombinante. Em um aspecto, as variantes de hidrolase compreendem a substituição de qualquer um dos aminoácidos L naturalmente ocorrentes nas posições de resíduos de aminoácidos designadas.
SEQUÊNCIAS-SINAL DE HIDROLASE, DOMÍNIOS CATALÍTICOS E PRÉ-PRO [0356] Em determinadas concretizações, proporciona-se aqui sequências-sinal (p. ex., peptídios-sinal (SPs)), domínios pré-pro e domínios catalíticos (CDs). As SPs, domínios pré-pro e/ou CDs como proporcionados aqui podem ser peptídios isolados, sintéticos ou recombinantes ou podem ser parte de uma proteína de fusão, p. ex., como um domínio heterólogo em uma proteína quimérica. Em determinadas concretizações, proporciona-se aqui ácidos nucleicos codificando estes domínios catalíticos (CDs), domínios pré-pro e sequências-sinal (SPs, p. ex., um peptídio apresentando uma sequência compreendendo/consistindo de resíduos amino-terminais de um polipeptídio como proporcionado aqui). Em determinadas concretizações, proporcionase aqui sequências-sinal compreendendo um peptídio compreendendo/consistindo de uma sequência como apresentada nos resíduos de 1 a 12, de 1 a 13, de 1 a 14, de 1 a 15, de 1 a 16, de 1 a 17, de 1 a 18, de 1 a 19, de 1 a 20, de 1 a 21, de 1 a 22, de 1 a 23, de 1 a 24, de 1 a 25, de 1 a 26, de 1 a 27, de 1 a 28, de 1 a 28, de 1 a 30, de 1 a 31, de 1 a 32, de 1 a 33, de 1 a 34, de 1 a 35, de 1 a 36, de 1 a 37, de 1 a 38, de 1 a 39, de 1 a 40, de 1 a 41, de 1 a 42, de 1 a 43, de 1 a 44 (ou um peptídio mais longo) de um polipeptídio como proporcionado aqui. Em uma concretização, proporciona-se aqui sequências-sinal isoladas, sintéticas ou recombinantes compreendendo/consistindo de uma sequência-sinal
Petição 870180005321, de 22/01/2018, pág. 172/316
166/293 como proporcionada aqui derivada de outra enzima como proporcionada aqui, ou outro tipo de enzima ou polipeptídio.
[0357] As sequências-sinal de hidrolase (SPs), sequências de CDs, e/ou pré-pro como proporcionadas aqui podem ser peptídios isolados, ou sequências ligadas a outra hidrolase ou um peptídio não-hidrolase, p. ex., como uma proteína de fusão (quimérica). Em determinadas concretizações, proporciona-se aqui polipeptídios compreendendo sequências-sinal de hidrolase como proporcionado aqui. Em um aspecto, polipeptídios compreendendo sequências-sinal de hidrolase SPs, CDs, e/ou pré-pro como proporcionado aqui compreendem sequências heterológas com relação a hidrolases como proporcionadas aqui (p. ex., uma proteína de fusão compreendendo um SP, CD, e/ou prépro como proporcionado aqui e sequências de outra hidrolase ou um proteína nãohidrolase). Proporciona-se aqui hidrolases como proporcionadas aqui com sequências heterólogas SPs, CDs, e/ou sequências pré-pro, p. ex., sequências com uma sequênciasinal de levedura. Uma hidrolase como proporcionada aqui pode compreender um SP heterólogo e/ou pré-pro em um vetor, p. ex., um vetor de série pPIC (Invitrogen, Carlsbad, CA).
[0358] Em um aspecto, SPs, CDs, e/ou sequências pré-pro como proporcionadas aqui são identificadas após identificação de polipeptídios de hidrolase inéditos. As vias pelas quais proteínas são selecionadas e transportadas para sua localização celular apropriada são frequentemente referidas como vias de objetivação de proteína. Um dos elementos mais importantes em todos estes sistemas de objetivação é uma sequência curta de aminoácidos na ponta amino de um polipeptídio recentemente sintetizado denominado a seqüência-sinal. Esta sequência-sinal dirige uma proteína para sua localização apropriada na célula e é removida durante o transporte ou quando a proteína atinge sua destinação final. A maior parte das proteínas lisosômicas, de membrana ou secretadas apresenta uma seqüência-sinal amino-terminal que marca as mesmas para translocação no lúmen do retículo endoplasmático. As sequências-sinal podem variar em termos de comprimento de 13 a 45 ou mais resíduos de aminoácidos. Vários métodos de reconhecimento de sequências-sinal são conhecidos por aqueles com prática na arte. Por exemplo, em um aspecto, peptídios-sinal de hidrolase inéditos são identificados por meio de um método
Petição 870180005321, de 22/01/2018, pág. 173/316
167/293 referido como SignalP. SignalP usa uma rede neural combinada que reconhece ambos, peptídios-sinal e seus sítios de clivagem. (Nielsen, et al., “Identification of prokaryotic and eukaryotic signal peptides and prediction of their cleavage sites”. Protein Engineering, vol. 10, no. 1, p. 1-6 (1997).
[0359] Deveria-se compreender que em alguns aspectos hidrolases como proporcionadas aqui podem não apresentar SPs e/ou sequências pré-pro, e/ou domínios catalíticos (CDs). Em um aspecto, proporciona-se aqui polipeptídios (p. ex., hidrolases) carecendo todo ou parte de um domínio SP, CD e/ou pré-pro. Em outro aspecto, proporciona-se aqui ácidos nucleicos codificando uma sequência-sinal (SP), CD, e/ou prépro de uma hidrolase ligada operacionalmente a uma sequência de ácido nucleico de uma hidrolase diferente ou, opcionalmente, uma sequência-sinal (SPs) e/ou domínio pré-pro de uma proteína não-hidrolase pode ser desejado.
[0360] Em determinadas concretizações, proporciona-se aqui polipeptídios isolados, sintéticos ou recombinantes compreendendo sequências-sinal (SPs), domínio pré-pro e/ou domínios catalíticos (CDs) como proporcionados aqui e sequências heterológas. As sequências heterológas são sequências não naturalmente associadas (p. ex., a uma hidrolase) com uma SP, domínio pré-pro e/ou CD. A sequência à qual a SP, domínio prépro e/ou CD não são naturalmente associados podem ser nas pontas amino-terminais de SP, domínio pré-pro e/ou CD, ponta carbóxi-terminal, e/ou em ambas as pontas da SP e/ou do CD. Em determinadas concretizações, proporciona-se aqui polipeptídios isolados, sintéticos ou recombinantes compreendendo (ou consistindo de) um polipeptídio compreendendo uma sequência-sinal (SP), domínio pré-pro e/ou domínio catalítico (CD) como proporcionado com a condição de que não seja associado com qualquer sequência a que é naturalmente associado (p. ex., sequência de hidrolase). Proporciona-se aqui ácidos nucleicos isolados ou recombinantes codificando estes polipeptídios. Assim, em um aspecto, o ácido nucleico isolado, sintético ou recombinante como proporcionado aqui compreende sequência codificante para uma seqüência-sinal, domínio pré-pro e/ou domínio catalítico (CD) como proporcionado aqui e uma sequência heteróloga (i.e., uma sequência não naturalmente associada com a sequência-sinal (SP), domínio pré-pro e/ou domínio catalítico (CD) como proporcionado aqui). A sequência heteróloga pode encontrar
Petição 870180005321, de 22/01/2018, pág. 174/316
168/293 se na ponta terminal a 3', na ponta terminal a 5', e/ou em ambas as pontas da SP, domínio pré-pro e/ou sequência codificante de CD.
[0361] Em determinadas concretizações, proporciona-se aqui fusão de subsequências N-terminais ou C-terminais de enzimas como proporcionado aqui (p. ex., sequências-sinal, sequências pré-pro) com outros polipeptídios, proteínas ativas ou fragmentos de proteína. A produção de uma enzima como proporcionada aqui (p. ex., uma hidrolase, p. ex., uma lipase, saturase, palmitase e/ou estearatase) também pode ser realizada expressando a enzima como uma proteína de fusão inativa que é ativada mais tarde por um evento de clivagem proteolítica (usando uma atividade de protease endógena ou exógena, p. ex., tripsina) que resulta na separação do parceiro da proteína de fusão e da enzima madura, p. ex., hidrolase como proporcionada aqui. Em um aspecto, a proteína de fusão como proporcionada aqui é expressa de uma construção híbrida de nucleotídeos que codifica uma única matriz de leitura aberta contendo os seguintes elementos: a sequência de nucleotídeos para a proteína de fusão, uma sequência ligante (definida como uma sequência de nucleotídeos que codifica uma sequência de aminoácidos flexível que conjuga dois domínios de proteína menos flexíveis), sítio de reconhecimento de clivagem de protease, e a sequência de enzima madura (p. ex., qualquer enzima como proporcionada aqui, p. ex., uma hidrolase). Em aspectos alternativos, a proteína de fusão pode compreender uma sequência de pectato liase, uma sequência de xilanase, uma sequência de fosfatase de ácido fosfatídico, ou outra sequência, p. ex., uma sequência que foi mostrada previamente como sendo superexpressa em um sistema hospedeiro de interesse. É possível usar qualquer sistema hospedeiro (ver discussão, acima), por exemplo, E. coli ou Pichiapastoris. O arranjo das sequências de nucleotídeos na construção quimérica de nucleotídeos pode ser determinado com base nos níveis de expressão de proteína alcançados com cada construção de fusão. Procedendo da ponta 5' da construção de nucleotídeos até a ponta 3' prime da construção, em um aspecto, a sequência de nucleotídeos é montada como a seguir: sequência sinal/proteína de fusão/sequência ligante/sítio de reconhecimento de clivagem por protease/enzima madura (p. ex., qualquer enzima como proporcionada aqui, p. ex., uma hidrolase) ou sequência sinal/sequência pró/enzima madura/sequência ligante/proteína de fusão. A expressão de
Petição 870180005321, de 22/01/2018, pág. 175/316
169/293 enzima (p. ex., qualquer enzima como proporcionada aqui, uma hidrolase) como uma proteína de fusão inativa pode aperfeiçoar a expressão glocal da sequência da enzima, pode reduzir qualquer toxicidade potencial associada com a superexprodução de enzima ativa e/ou pode incrementar a vida-de-prateleira da enzima antes do uso, porque a enzima estaria inativa até que a proteína de fusão, p. ex. pectato liase) seja separada da enzima, p. ex. hidrolase, como proporcionada aqui.
[0362] Em uma concretização, proporciona-se aqui formulações específicas para a ativação de uma hidrolase como proporcionada aqui expressa como uma proteína de fusão. Em um aspecto, a ativação da atividade de hidrolase expressa inicialmente como uma proteína de fusão inativa é conseguida usando-se uma atividade proteolítica ou potencialmente uma atividade proteolítica em combinação com uma peptidase aminoterminal ou carbóxi-terminal (a peptidase pode ser uma enzima como proporcionada aqui, ou, outra enzima). Este evento de ativação pode ser realizado de diversas maneiras e em diversos pontos no processo de fabricação/armazenamento antes da aplicação no desengomamento de óleo. Processos exemplares como proporcionados aqui incluem: clivagem por meio de uma atividade endógena pelo hospedeiro produtor mediante secreção da construção de fusão no meio de fermentação; clivagem por uma atividade de protease endógena que é ativada ou entra em contato com construção de fusão expressa intracelularmente mediante ruptura das células hospedeiras; passagem da construção de fusão bruta ou purificada por uma coluna de atividade de protease imobilizada para realizar clivagem e ativação de enzima (p. ex., hidrolase como proporcionada aqui, p. ex., p. ex., uma lipase, saturase, palmitase e/ou estearatase) antes da formulação de enzima; tratamento da construção de fusão bruta ou purificada com uma fonte solúvel de atividade proteolítica; ativação de uma hidrolase (p. ex., uma hidrolase como proporcionada aqui) na refinaria de óleo usando uma fonte solúvel ou insolúvel de atividade proteolítica imediatamente antes do uso no processo; e/ou, ativação da atividade de hidrolase (p. ex., uma lipase, saturase, palmitase e/ou estearatase como proporcionada aqui) por meio de circulação contínua da formulação de construção de fusão através de uma coluna de atividade de protease imobilizada sob temperatura reduzida (por exemplo, qualquer uma entre cerca de 4°C e 20°C). Este evento de ativação pode ser realizado antes do
Petição 870180005321, de 22/01/2018, pág. 176/316
170/293 fornecimento no sítio de uso, ou pode ocorrer no-local na refinaria de óleo. GLICOSILAÇÃO [0363] Os peptídios e polipeptídios como proporcionados aqui (p. ex., hidrolases, anticorpos) também podem ser glicosilados, por exemplo, em um aspecto, compreendendo pelo menos um sítio de glicosilação, p. ex., uma glicosilação ligada a N ou ligada a O. Em um aspecto, o polipeptídio pode ser glicosilado após ser expresso em um P. pastoris ou em um S. pombe. A glicosilação pode ser adicionada pós-traducionalmente, seja quimicamente ou por meio de mecanismos biossintéticos celulares, sendo que este último incorpora o uso de unidades repetitivas de glicosilação conhecidas, que podem ser nativas para a sequência ou podem ser adicionados como um peptídio ou adicionados na sequência codificante de ácido nucleico.
HIDROLASES HÍBRIDAS E BIBLIOTECAS DE PEPTÍDIOS [0364] Em determinadas concretizações, proporciona-se aqui hidrolases híbridas (p. ex., proteínas sintéticas) e proteínas de fusão, incluindo bibliotecas de peptídios, compreendendo sequências como proporcionadas aqui. As bibliotecas de peptídio como proporcionadas aqui podem ser usadas para isolar moduladores de peptídios (p. ex., ativadores ou inibidores) de alvos. As bibliotecas de peptídios como proporcionadas aqui podem ser usadas para identificar parceiros de ligação formais de alvos, como ligantes, p. ex., citocinas, hormônios e análogos.
[0365] Em um aspecto, as proteínas de fusão como proporcionadas aqui (p. ex., a porção peptídica) são estabilizados conformacionalmente (relativamente a peptídios lineares) de forma a permitir uma maior afinidade de ligação com alvos. Em outro aspecto, proporciona-se aqui fusões de hidrolases como proporcionado aqui e outros peptídios, incluindo peptídios conhecidos e randômicos. Eles podem ser fundidos de tal modo que a estrutura da enzima ou anticorpo (p. ex., hidrolase) não seja significativamente perturbada e o peptídio seja estabilizado conformacionalmente por via metabólica ou por via estrutural. Isto permite a criação de uma biblioteca de peptídios que é facilmente monitorada tanto quanto a sua presença em células e quanto a sua quantidade.
[0366] Variantes de sequências de aminoácidos como proporcionado aqui podem ser caracterizadas por uma natureza predeterminada da variação, uma característica que as
Petição 870180005321, de 22/01/2018, pág. 177/316
171/293 separa de uma forma naturalmente ocorrente, p. ex., uma variação alélica ou inter-espécie de uma sequência de hidrolase. Em um aspecto, as variantes como proporcionadas aqui apresentam a mesma atividade biológica qualitativa que o análogo naturalmente ocorrente. Alternativamente, as variantes podem ser selecionadas por apresentarem características modificadas. Em um aspecto, embora o sítio ou região para introduzir uma variação de sequência de aminoácidos seja predeterminado, a mutação por si só não precisa ser predeterminada. Por exemplo, para otimizar o desempenho de uma mutação em um dado sítio, é possível realizar mutagênese randômica no códon-alvo ou na região-alvo, e as variantes de hidrolase expressas são selecionadas quanto à combinação ótima de atividade desejada. Técnicas para preparar mutações de substituição em sítios predeterminados no DNA apresentando uma sequência conhecida são bem conhecidas, como discutido aqui, por exemplo, mutagênese de iniciador M13 e mutagênese de PCR. A seleção dos mutantes pode ser realizada usando-se ensaios de atividades proteolíticas. Em aspectos alternativos, substituições de aminoácidos podem ser resíduos individuais; inserções podem ser da ordem de cerca de 1 a 20 aminoácidos, embora seja possível realizar inserções consideravelmente maiores. Deleções podem compreender de cerca de 1 até cerca de 20, 30, 40, 50, 60, 70 resíduos ou mais. Para se obter um derivado final com as propriedades ótimas, é possível usar substituições, deleções, inserções ou qualquer combinação dos mesmos. De uma forma geral, estas alterações são realizadas sobre alguns poucos aminoácidos para minimizar a alteração da molécula. No entanto, alterações maiores podem ser toleradas em determinados casos.
[0367] Em determinadas concretizações, proporciona-se aqui hidrolases em que a estrutura da cadeia principal peptídica, a estrutura secundária ou a estrutura terciária, p. ex., uma estrutura helicoidal alfa ou estrutura de folha-beta [beta-sheet], foi modificada. Em um aspecto, a carga ou hidrofobicidade foi modificada. Em um aspecto, o volume de uma cadeia lateral foi modificado. Realiza-se alterações substanciais em termos de função ou identidade imunológica por meio de seleção de substituições que são menos conservativas. Por exemplo, é possível realizar substituições que afetam mais significativamente: a estrutura da cadeia principal polipeptídica na área de alteração, por exemplo, uma estrutura helicoidal alfa ou uma estrutura de folha-beta [beta-sheet]; uma
Petição 870180005321, de 22/01/2018, pág. 178/316
172/293 carga ou um sítio hidrofóbico da molécula, que pode encontrar-se em um sítio ativo; ou uma cadeia lateral. Em outras concretizações, proporciona-se aqui proteínas compreendendo substituições de sequências como proporcionado aqui, p. ex., em que (a) um radical hidrofílico, p. ex., serila ou treonila, são substituídos por (ou por) um resíduo hidrofóbico, p. ex., leucila, isoleucila, fenilalanila, valila ou alanila; (b) uma cisteína ou prolina é substituída para (ou por) qualquer outro resíduo; (c) um resíduo apresentando uma cadeia lateral eletropositiva, p. ex., lisila, arginila, ou histidila, é substituída para (ou por) um resíduo eletronegativo, p. ex., glutamila ou aspartila; ou (d) um resíduo apresentando uma cadeia lateral massiva, p. ex., fenilalanina, é substituído para (ou por) um que não apresenta uma cadeia lateral, p. ex., glicina. As variantes podem apresentar a mesma atividade biológica qualitativa (i.e. atividade de hidrolase) embora seja possível selecionar variantes para modificar as características das hidrolases conforme necessário.
[0368] Em um aspecto, hidrolases como proporcionadas aqui compreendem epitopos ou marcadores de purificação, sequências-sinal ou outras sequências de fusão, etc. Em um aspecto, as hidrolases como proporcionadas aqui podem ser fundidas a um peptídio randômico para formar um polipeptídio de fusão. Por “fundido” ou “ligado operacionalmente” como usado aqui compreende-se que o peptídio randômico e a hidrolase são ligados entre si, de tal modo a minimizar a disrupção da estabilidade da estrutura de hidrolase, p. ex., ele conserva a atividade de hidrolase. O polipeptídio de fusão (ou polinucleotídeo de fusão que codifica o polipeptídio de fusão) também pode compreender adicionalmente componentes, incluindo peptídios múltiplos em múltiplas alças.
[0369] Em um aspecto, os peptídios (p. ex., subsequências de hidrolase) e ácidos nucleicos codificando os mesmos são randomizados, seja totalmente randomizados ou eles sofrem viés em sua randomização, p. ex., em termos de frequência de nucleotídeos/resíduos geralmente ou por posição. “Randomizado” significa que cada ácido nucleico e peptídio consiste de nucleotídeos e aminoácidos substancialmente randômicos, respectivamente. Em um aspecto, os ácidos nucleicos que dão origem aos peptídios podem ser sintetizados quimicamente, e, assim, podem incorporar qualquer nucleotídeo em qualquer posição. Assim, quando ácidos nucleicos são expressos para formar
Petição 870180005321, de 22/01/2018, pág. 179/316
173/293 peptídios, qualquer resíduo de aminoácido pode ser incorporado em qualquer posição. O processo sintético pode ser projetado para gerar ácidos nucleicos randomizados, de forma a permitira a formação de todas ou da maior parte das combinações possíveis ao longo do comprimento do ácido nucleico, formando com isso uma biblioteca de ácidos nucleicos randomizados. A biblioteca pode proporcionar uma população suficientemente diversa estruturalmente de produtos de expressão randomizados de forma a afetar uma faixa de respostas celulares probabilisticamente suficiente para proporcionar uma ou mais células apresentando uma resposta desejada. Proporciona-se aqui bibliotecas de interação suficientemente grandes de forma que pelo menos um de seus membros apresente uma estrutura que lhe proporcione afinidade por alguma molécula, proteína, ou outro fator. METODOLOGIAS DE SELEÇÃO E DISPOSITIVOS DE MONITORAMENTO “ON-LINE” [0370] Na prática dos métodos como proporcionados aqui, é possível usar uma variedade de dispositivos e metodologias em conjunto com os polipeptídios e ácidos nucleicos como proporcionados aqui, p. ex., para selecionar polipeptídios quanto à atividade de hidrolase, para selecionar compostos como ativadores ou inibidores potenciais de uma atividade de hidrolase (p. ex., para seleção de drogas potenciais), quanto a anticorpos que se ligam a um polipeptídio como proporcionado aqui, quanto a ácidos nucleicos que hibridam com um ácido nucleico como proporcionado aqui, para selecionar células que expressam um polipeptídio como proporcionado aqui e análogos. Ver, p. ex., Patente U.S. n° 6.337.187.
CONJUNTOS CAPILARES [0371] Conjuntos capilares, como GIGAMATRIX™, Diversa Corporation, San Diego, CA, podem ser usados para nos métodos como proporcionados aqui. Ácidos nucleicos ou polipeptídios como proporcionados aqui podem ser imobilizados ou aplicados em um conjunto, incluindo conjuntos capilares. É possível usar conjuntos para selecionar ou monitorar bibliotecas de composições (p. ex., moléculas pequenas, anticorpos, ácidos nucleicos, etc.) quando a sua capacidade de ligar-se a ou modular a atividade de um ácido nucleico ou um polipeptídio como proporcionado aqui. Conjuntos capilares proporcionam outro sistema para reter e selecionar amostras. Por exemplo, um dispositivo de seleção de amostras pode incluir uma pluralidade de capilares formados em um conjunto de capilares
Petição 870180005321, de 22/01/2018, pág. 180/316
174/293 adjacentes, sendo que cada capilar compreende pelo menos uma parede definindo um lúmeno para reter uma amostra. O dispositivo pode incluir adicionalmente material intersticial disposto entre capilares adjacentes no conjunto, e um ou mais indícios de referência formados no interior do material intersticial. Uma capilar para selecionar uma amostra, sendo que o capilar é adaptado para ser ligado em um conjunto de capilares, pode incluir uma primeira parede definindo um lúmen para reter a amostra, e uma segunda parede formada de um material filtrante, para filtrar a energia de excitação proporcionada no lúmen para excitar a amostra.
[0372] Um polipeptídio ou ácido nucleico, p. ex., um ligante ou um substrato, pode ser introduzido em um componente em pelo menos uma porção de um capilar de um conjunto de capilares. Cada capilar do conjunto de capilares pode compreender pelo menos uma parede que define um lúmen para reter o primeiro componente. É possível introduzir uma bolha de ar no capilar por tras do primeiro componente. Um segundo componente pode ser introduzido no capilar, sendo que o segundo componente é separado do primeiro componente pela bolha de ar. Uma amostra de interesse pode ser introduzida como um primeiro líquido marcado com uma partícula detectável em um capilar de um conjunto de capilares, sendo que cada capilar do conjunto de capilares compreende pelo menos uma parede que define um lúmen para reter o primeiro líquido e a partícula detectável, e sendo que a pelo menos uma parede é revestidas com um material de ligação para ligação da partícula detectável com a pelo menos uma parede. O método pode incluir adicionalmente remover o primeiro líquido do tubo capilar, sendo que a partícula detectável ligada é mantida no interior do capilar, e introduzir um segundo líquida no tubo capilar.
[0373] O conjunto de capilares pode incluir uma pluralidade de capilares individuais compreendendo pelo menos uma parede exterior definindo um lúmen. A parede exterior do capilar pode constituir-se de uma ou mais paredes fundidas entre si. De maneira análoga, a parede pode definor um lúmen com forma cilíndrica, quadrada, hexagonal ou qualquer outra forma geométrica, desde que as paredes formem um lúmen para retenção de um líquido ou amostra. Os capilares do conjunto de capilares podem ser mantidos juntos em estreita proximidade para formar uma estrutura planar. Os capilares podem ser ligados entre si, por serem fundidos (p. ex., onde os capilares são confeccionados em vidro),
Petição 870180005321, de 22/01/2018, pág. 181/316
175/293 colados, ligados ou pinçados lado a lado. O conjunto de capilares pode ser formado de qualquer número de capilares individuais, por exemplo, em uma compreende de 100 a 4.000.000 capilares. Um conjunto de capilares pode formar uma placa de microtitulação apresentando cerca de 100.000 ou mais capilares individuais ligados entre si.
Conjuntos, ou “Biochips” [0374] Ácidos nucleicos ou polipeptídios como proporcionados aqui podem ser imobilizados em ou aplicados sobre um conjunto. Conjuntos também podem ser usados para selecionar ou monitorar bibliotecas de composições (p. ex., moléculas pequenas, anticorpos, ácidos nucleicos, etc.) quanto a sua capacidade de ligar-se a, ou modular a atividade de, um ácido nucleico ou um polipeptídio como proporcionado aqui. Por exemplo, em um aspecto como proporcionado aqui, um parâmetro monitorado é a expressão de transcrição de um gene de hidrolase. Uma ou mais, ou todas as transcrições de uma célula podem ser medidas por meio de hibridização de uma amostra compreendendo transcripções da célula, ou, ácidos nucleicos representativos de ou complementares a transcripções de uma célula, por meio de hibridização a ácidos nucleicos imobilizados em um conjunto, ou “biochip”. Por meio do uso de um “y” de ácidos nucleicos em um microchip, algumas ou todas as transcrições de uma célula podem ser quantificadas simultaneamente. Alternativamente, conjuntos compreendendo ácido nucleico genômico também podem ser usados para determinar o genótipo de uma cepa recentemente manipulada preparada por meio dos métodos como proporcionados aqui. “Conjuntos” de polipeptídios também podem ser usados para quantificar simultaneamente uma pluralidade de proteínas. A presente invenção pode ser praticada com qualquer “conjunto” conhecido, também referido como “microconjunto” ou “conjunto de ácidos nucleicos” ou “conjunto de polipeptídios” ou “conjunto de anticorpos” ou chip”, ou variação dos mesmos. Conjuntos são, genericamente, uma pluralidade de “pontos [spots]” ou “elementos-alvos”, sendo que cada elemento-alvo compreende uma quantidade definida de uma ou mais moléculas biológicas, p. ex., oligonucleotídeos, imobilizados sobre uma área definida de uma superfície de substrato para ligação específica a uma molécula de amostra, p. ex., transcrições de mRNA.
[0375] Os “conjuntos” ou “microconjuntos” ou “biochips” ou “chips” como
Petição 870180005321, de 22/01/2018, pág. 182/316
176/293 proporcionado aqui podem compreender uma pluralidade de elementos-alvos, sendo que cada elemento-alvo compreende uma quantidade definida de um ou mais polipeptídios (incluindo anticorpos) ou ácidos nucleicos imobilizados sobre uma área definida de uma superfície de substrato.
[0376] Em um aspecto, as hidrolases são usadas como formas imobilizadas. Qualquer método de imobilização pode ser usado, p. ex., imobilização sobre um suporte inerte, como dietilaminoetil-celulose, vidro poroso, quitina ou células. Células que expressam hidrolases como proporcionadas aqui podem ser imobilizadas por meio de reticulação, p. ex., com glutaraldeído sobre uma superfície de substrato.
[0377] Na prática dos métodos como proporcionados aqui, qualquer conjunto e/ou método conhecido de preparação e uso de conjuntos pode ser incorporado integralmente ou em parte, ou variações dos mesmos, como descrito, por exemplo, nas Patentes U.S. nums. 6.277.628; 6.277.489; 6.261.776; 6.258.606; 6.054.270; 6.048.695; 6.045.996; 6.022.963; 6.013.440; 5.965.452; 5.959.098; 5.856.174; 5.830.645; 5.770.456; 5.632.957; 5.556.752; 5.143.854; 5.807.522; 5.800.992; 5.744.305; 5.700.637; 5.556.752; 5.434.049; ver também, p. ex., WO 99/51773; WO 99/09217; WO 97/46313; WO 96/17958; ver também, p. ex., Johnston (1998) Curr. Biol. 8:R171-R174; Schummer (1997) Biotechniques 23:1087-1092; Kern (1997) Biotechniques 23:120-124; Solinas-Toldo (1997) Genes, Chromosomes & Cancer 20:399-407; Bowtell (1999) Nature Genetics Supp. 21 :25-32. Ver também pedidos de patentes publicados dos E.U.A. nums. 20010018642; 20010019827; 20010016322; 20010014449; 20010014448; 20010012537; 20010008765.
ANTICORPOS E MÉTODOS DE SELEÇÃO BASEADOS EM ANTICORPOS [0378] Em determinadas concretizações, proporciona-se aqui anticorpos isolados, sintéticos ou recombinantes que se ligam especificamente a uma hidrolase como proporcionada aqui. Estes anticorpos podem ser usados para isolar, identificar ou quantificar a hidrolase como proporcionada aqui ou polipeptídios relacionados. Estes anticorpos podem ser usados para isolar outros polipeptídios como proporcionados aqui ou outras hidrolases relacionadas.
[0379] “Anticorpos” como proporcionados aqui podem compreendem peptídio(s) ou polipeptídio(s) derivado(s), modelado(s) segundo, ou substancialmente codificados por um
Petição 870180005321, de 22/01/2018, pág. 183/316
177/293 gene de imunoglobulina ou genes de imunoglobulina, ou fragmentos dos mesmos, capazes de ligar-se especificamente a um antígeno ou epitopo, ver, p. ex., Fundamental Immunology, terceira edição, W.E. Paul, ed., Raven Press, N. Y. (1993); Wilson 4) J. Immunol. Methods 175:267-273; Yarmush (1992) J. Biochem. Biophys. Methods 25:85-97. O termo anticorpo inclui porções de ligação de antígeno, i.e., “sítios de ligação de antígeno”, (p. ex., fragmentos, subsequências, regiões determinadoras de complementaridade (CDRs)) que conservam a capacidade de ligar-se a antígeno, incluindo (i) um fragmento Fab, um fragmento monovalente consistindo dos domínios VL, VH, CL e CH1; (ii) um fragmento F(ab')2, um fragmento divalente compreendendo dois fragmentos Fab ligados por uma ponte dissulfeto na região de dobradiça; (iii) um fragmento Fd consistindo dos domínios VH e CH1; (iv) um fragmento Fv consistindo dos domínios VL e VH de um braço simples de um anticorpo, (v) um fragmento dAb (Ward et al., (1989) Nature 341:544-546), que consiste de um domínio VH; e (vi) uma região determinadora de complementaridade (CDR) isolada. Anticorpos de cadeia simples também são incluídos por referência no termo “anticorpo”. Proporciona-se aqui anticorpos, incluindo sítios de ligação de antígeno e anticorpos de cadeia simples que se ligam especificamente a uma hidrolase como proporcionada aqui. Na prática dos métodos como proporcionados aqui, também é possível usar polipeptídios apresentando uma atividade de hidrolase.
[0380] Os anticorpos podem ser usados em imunoprecipitação, manchamento, colunas de imunoafinidade, e análogos. Se desejado, sequências de ácido nucleico codificando antígenos específicos podem ser gerados por meio de imunização, seguido de isolamento do polipeptídio ou ácido nucleico, amplificação ou clonagem e imobilização do polipeptídio sobre um conjunto como proporcionado aqui. Alternativamente, os métodos como proporcionados aqui podem ser usados para modificar a estrutura de um anticorpo produzido por uma célula a ser modificada, p. ex., a afinidade de um anticorpo pode ser incrementada ou diminuída. Adicionalmente, a capacidade de preparar ou modificar anticorpos pode ser um fenótipo manipulado em uma célula por meio dos métodos como proporcionados aqui.
[0381] Métodos de imunização, produção e isolamento de anticorpos (policlonais e monoclonais) são conhecidos por aqueles com prática na arte e são descritos na literatura
Petição 870180005321, de 22/01/2018, pág. 184/316
178/293 científica e de patentes, ver, p. ex., Coligan, CURRENT PROTOCOLS IN IMMUNOLOGY, Wiley/Greene, NY (1991); Stites (eds.) BASIC AND CLINICAL IMMUNOLOGY (7a ed.) Lange Medical Publications, Los Altos, CA (“Stites”); Goding, MONOCLONAL ANTIBODIES: PRINCIPLES AND PRACTICE (2a ed.) Academic Press, New York, NY (1986); Kohler (1975) Nature 256:495; Harlow (1988) ANTIBODIES, A LABORATORY MANUAL Cold Spring Harbor Publications, New York. Anticorpos também podem ser gerados in vitro, p. ex., usando bibliotecas de apresentação de fago expressando sítio de ligação de anticorpo recombinante, adicionalmente aos métodos tradicionais in vivo usando animais. Ver, p. ex., Hoogenboom (1997) Trends Biotechnol. 2-70; Katz (1997) Annu. Rev. Biophys. Biomol. Struct. 26:27-45.
[0382] É possível usar polipeptídios ou peptídios para gerar anticorpos, que se ligam especificamente aos polipeptídios como proporcionados aqui. Os anticorpos resultantes podem ser usados em procedimentos de cromatografia de imunoafinidade para isolar ou purificar o polipeptídio ou determinar se o polipeptídio está presente em uma amostra biológica. Nesses procedimentos, uma preparação de proteína, como um extrato, ou uma amostra biológica, é contactada com um anticorpo capaz de ligar-se especificamente a um dos polipeptídios como proporcionados aqui.
[0383] Em procedimentos de imunoafinidade, o anticorpo é ligado a um suporte sólido, com uma pérola ou outra matriz de coluna. A preparação de proteína é colocada em contato com o anticorpo em condições em que o anticorpo se liga especificamente a um dos polipeptídios como proporcionados aqui. Após uma lavagem para remover proteínas ligadas de forma não-específica, os polipeptídios ligados especificamente são eluídos.
[0384] A capacidade de proteínas em uma amostra biológica ligar-se ao anticorpo pode ser determinada usando-se qualquer um de uma variedade de procedimentos familiares àqueles com prática na arte. Por exemplo, a ligação pode ser determinada por meio de marcação do anticorpo com um marcador detectável, como um agente fluorescente, um marcador enzimático, ou um radioisótopo. Alternativamente, a ligação do anticorpo à amostra pode ser detectada usando-se um anticorpo secundário apresentando um marcador detectável do tipo referido. Ensaios particulares incluem ensaios ELISA, ensaios sandwich, ensaios rádio-imunológicos, e manchamentos Western Blots.
Petição 870180005321, de 22/01/2018, pág. 185/316
179/293 [0385] Anticorpos policlonais gerados contra os polipeptídios como proporcionados aqui podem ser obtidos por meio de injeção direta dos polipeptídios em um animal, ou por meio de administração dos polipeptídios a um animal não-humano. O anticorpo assim obtido ligar-se-á então ao polipeptídio propriamente dito. Desta maneira, mesmo uma sequência que codifica apenas um fragmento do polipeptídio pode ser usada para gerar anticorpos que podem ligar-se ao polipeptídio nativo integral. Referidos anticorpos podem então ser usados para isolar o polipeptídio de células expressando aquele polipeptídio.
[0386] Para a preparação de anticorpos monoclonais, é possível usar qualquer técnica que proporciona anticorpos produzidos por meio de culturas contínuas de linhas de células. Exemplos incluem a técnica do hibridoma, a técnica do trioma, a técnica do hibridoma de células B humanas, e a técnica do hibridoma EBV (ver, p. ex., Cole (1985) em Monoclonal Antibodies and Cancer Therapy, Alan R. Liss, Inc., pp. 77-96).
[0387] Técnicas descritas para a produção de anticorpos de cadeia simples (ver, p. ex., Patente U.S. n° 4.946.778) podem ser adaptadas para produzir anticorpos de cadeia simples para os polipeptídios como proporcionados aqui. Alternativamente, camundongos transgênicos podem ser usados para expressar anticorpos humanizados para estes polipeptídios ou fragmentos dos mesmos.
[0388] Anticorpos gerados contra os polipeptídios como proporcionados aqui (incluindo anticorpos anti-idiotipos) podem ser usados na seleção quanto a polipeptídios similares de outras amostras de organismos. Em técnicas do tipo referido, polipeptídios do organismo são contactadas com o anticorpo e detecta-se aqueles polipeptídios que se ligam especificamente ao anticorpo. Qualquer um dos procedimentos descritos acima pode ser usado para detectar ligação de anticorpo.
HIDROLASES IMOBILIZADAS [0389] Em um aspecto, a hidrolase como proporcionada aqui, p. ex., lipases, saturases, palmitases e/ou estearatases, são usadas como formas imobilizadas, p. ex., para processar lipídios, na síntese estruturada de lipídios, para digerir proteínas e análogos. As lipases imobilizadas como proporcionadas aqui podem ser usadas, p. ex., para hidrólise de triacilglicerídeos, diacilglicerídeos ou ésteres ou para a esterificação ou transesterificação de ácidos graxos, diacilglicerídeos ou triacilglicerídeos, ou na
Petição 870180005321, de 22/01/2018, pág. 186/316
180/293 interesterificação de gorduras. Em um aspecto, a lipase é específica para a esterificação de ácidos graxos com álcool, 1,3-específicos ou específicos para a hidrólise de glicerídeos parciais, ésteres ou triacilglicerídeos. Lipases imobilizadas como proporcionadas aqui podem ser usadas em um leito empacotado para a transesterificação contínua de gorduras livres de solvente. Ver, p. ex., Patente U.S. n° 4.818.695; 5.569.594.
[0390] É possível usar qualquer método de imobilização ou forma de suporte, p. ex., conjuntos, pérolas, suportes capilares e análogos, como descrito acima. Em um aspecto, a imobilização de hidrolase pode ocorrer sobre um suporte inerte, como dietilaminoetilcelulose, vidro poroso, quitina ou células. Células que expressam hidrolases como proporcionado aqui podem ser imobilizadas por meio de reticulação, p. ex., com glutaraldeído, sobre uma superfície de substrato. Hidrolases imobilizadas como proporcionadas aqui podem ser preparadas contendo hidrolase ligada a um suporte hidrofóbico particulado poroso e seco, com um tensoativo, como um éster de ácido graxo de polioxietileno sorbitol ou um éster de ácido graxo de poliglicerol. O suporte pode ser um polímero olefínico alifático, como um polietileno ou um polipropileno, um homo- ou copolímero de estireno ou uma mistura dos mesmos ou um suporte inorgânico pré-tratado. Estes suportes podem ser selecionados dentre polímeros olefínicos alifáticos, polímeros de oxidação, combinações destes polímeros ou suportes inorgânicos pré-tratados de forma a tornar estes suportes hidrofóbicos. Este pré-tratamento pode compreender silanização com um composto de silício orgânico. O material inorgânico pode ser uma sílica, uma alumina, um vidro ou uma cerâmica. Suportes podem ser preparados de poliestireno, copolímero de estireno, polietileno, polipropileno ou de copolímeros derivados de (met)acrilatos. Ver, p. ex., Patente U.S. n° 5.773.266.
[0391] As enzimas hidrolase, fragmentos das mesmas e ácidos nucleicos que codificam os fragmentos de enzimas podem ser fixadas sobre um suporte sólido. Isto é frequentemente econômico e eficiente no uso das hidrolases em processos industriais. Por exemplo, um consórcio ou coquetel de enzimas hidrolase (ou fragmentos ativos das mesmas), que é usado em um esquema reacional química específico, pode ser ligado a um suporte sólido e mergulhado em uma tina de processo. A reação enzimática pode ocorrer. Em seguida, o suporte sólido pode ser retirado da tina, juntamente com as enzimas
Petição 870180005321, de 22/01/2018, pág. 187/316
181/293 fixadas ao mesmo, para uso repetido. Em uma concretização como proporcionada aqui, um ácido nucleico isolado como proporcionado aqui é fixado a um suporte sólido. Em outra concretização como proporcionada aqui, o suporte sólido é selecionado do grupo de um gel, uma resina, um polímero, uma cerâmica, um vidro, um microeletrodo e qualquer combinação dos mesmos.
[0392] Por exemplo, suportes sólidos aqui proporcionados incluem géis. Alguns exemplos de géis incluem SEPHAROSE™ (GE Healthcare, Piscataway, NJ), gelatina, glutaraldeído, glutaraldeído tratado com quitosano, albumina-glutaraldeído, quitosanoxantano, gel Toyopearl (gel de polímero), alginato, alginato-polilisina, carragenina, agarose, glioxil agarose, agarose magnética, dextrano-agarose, poli(sulfonato de carbamoíla) hidrogel, hidrogel de BSA-PEG, álcool de polivinila fosforilado (PVA), monoaminoetil-Naminoetila (MANA), amino, ou qualquer combinação dos mesmos.
[0393] Outros suportes sólidos aqui proporcionados compreendem resinas ou polímeros. Alguns exemplos de resinas ou polímeros incluem celulose, acrilamida, nylon, rayon, poliéster, resina de troca de ânion, AMBERLITE™ XAD-7, AMBERLITE™ XAD-8, AMBERLITE™ IRA-94, AMBERLITE™ IRC-50 (Rohm and Haas, Philadelphia, PA), polivinila, poliacrílico, polimetacrilato, ou qualquer combinação dos mesmos.
[0394] Outro tipo de suporte sólido aqui proporcionado compreende cerâmica. Alguns exemplos incluem cerâmica não-porosa, cerâmica porosa, SiO2, Al2O3. Outro tipo de suporte sólido útil na presente invenção é vidro. Alguns exemplos incluem não-vidro poroso, vidro poroso, vidro de aminopropila ou qualquer combinação dos mesmos. Outro tipo de suporte sólido que pode ser usado é um microeletrodo. Um exemplo é uma magnetita revestida com polietilenoimina. É possível usar partículas grafíticas como um suporte sólido.
[0395] Outro tipo de suporte sólido aqui proporcionado compreende produtos de terra de diatomáceas e silicatos. Alguns exemplos incluem silicatos de magnésio e cálcio sintético CELITE®, KENITE®, DIACTIV®, PRIMISIL®, DIAFIL® diatomites e MICROCEL®, CALFLO®, SILASORB™, e CELKATE® (World Minerals Inc., Santa Barbara, CA). [0396] Outro exemplo de um suporte sólido é ou compreende uma célula, como uma célula vermelha do sangue.
Petição 870180005321, de 22/01/2018, pág. 188/316
182/293
KITS [0397] Em determinadas concretizações, proporciona-se aqui kits compreendendo as composições, p. ex., ácidos nucleicos, cassetes de expressão, vetores, células, sementes transgênicas ou plantas ou partes de plantas, peptídios (p. ex., hidrolases) e/ou anticorpos como proporcionados aqui. Os kits também podem conter material instrucional que ensina as metodologias e usos industriais como proporcionado aqui, conforme descrito aqui. APLICAÇÕES INDUSTRIAIS E MÉDICAS [0398] As hidrolases (p. ex., lipases, saturases, palmitases e/ou estearatases) aqui proporcionadas possuem usos industriais e aplicações médicas, e alguns usos e composições exemplares são descritos abaixo. Os processos como proporcionados aqui compreendem converter um fosfolipídio não-hidratável a uma forma hidratável, desengomamento de óleo, processamento de alimentos, processamento de óleos, (p. ex., preparar um óleo com baixo teor de saturação) de plantas, peixes, algas e análogos, apenas para indicar algumas aplicações.
PROCESSAMENTO DE ALIMENTOS E RAÇÕES [0399] Em determinadas concretizações, proporciona-se aqui processos para a manufatura de queijos usando hidrolases (p. ex., lipases, saturases, palmitases e/ou estearatases) como proporcionadas aqui. Em outras concretizações, proporciona-se aqui queijos compreendendo hidrolases. Em um aspecto, as enzimas como proporcionadas aqui (p. ex., lipases, saturases, palmitases e/ou estearatases ou uma combinação das mesmas) são usadas para processar queijos para acentuação do sabor, para incrementar o rendimento e/ou para “estabilizar” queijos, p. ex., por meio de redução da tendência de “oil-off”, ou, em um aspecto, as enzimas como proporcionadas aqui são usadas para produzir queijo a partir de leite para queijo.
[0400] Estes processos como proporcionados aqui podem incorporar qualquer método ou protocolo, p. ex., como descrito, p. ex., nas Patentes U.S. nums. 6.551.635, e 6.399.121, WO 03/070013, WO 00/054601. Por exemplo, em um aspecto, hidrolases (p. ex., lipases, saturases, palmitases e/ou estearatases) como proporcionadas aqui são usadas para estabilizar emulsão de gordura em leite ou composições compreendendo leite, p. ex., creme, e são usadas para estabilizar composições de leite, p. ex., para a fabricação de
Petição 870180005321, de 22/01/2018, pág. 189/316
183/293 cremes ou licores de creme. Em uma concretização, proporciona-se aqui processos para incrementar o aroma de um queijo usando pelo menos uma enzima como proporcionada aqui, o processo compreendendo incubar uma proteína, uma gordura e uma protease e uma lipase (p. ex., como proporcionado aqui) em um meio aquoso em condições que produzem um aroma de queijo acentuado (p. ex., amargor reduzido), p. ex., como descrito no WO 99/66805. Em um aspecto, lipases como proporcionadas aqui são usadas para incrementar o aroma em um queijo (p. ex., um coalho) via misturação com água, uma protease, e uma fosfolipase a uma temperatura elevada, p. ex., entre cerca de 75°C a 95°C, como descrito, p. ex., na Patente U.S. n° 4.752,483. Em um aspecto, usa-se lipases como proporcionadas aqui para acelerar o envelhecimento do queijo via adição de uma enzima como proporcionada aqui a um queijo (p. ex., um leite para queijo) antes de se adicionar um coagulante ao leite, ou adicionar uma enzima (p. ex., uma lipase) como proporcionada aqui a um coalho com sal antes do processamento, p. ex., como descrito, p. ex., na Patente U.S. n° 4.707.364. Em um aspecto, lipases como proporcionadas aqui são usadas para degradar um triacilglicerídeo em gordura de leite para liberar ácidos graxos livres, resultando em acentuação do aroma. Uma enzima como proporcionada aqui também pode ser usada em qualquer um destes processos como proporcionados aqui, ver, p. ex., Brindisi (2001) J. of Food Sci. 66:1100- 1107.
SÍNTESE ESTRUTURADA E PROCESSAMENTO DE ÓLEOS [0401] Em determinadas concretizações, proporciona-se aqui métodos para a síntese estruturada de óleos, lipídios e análogos usando-se hidrolases (p. ex., lipases, saturases, palmitases e/ou estearatases) como proporcionadas aqui. Os métodos como proporcionados aqui compreendem uma síntese biocatalítica de lipídio estruturados, i.e., lipídios que contêm um conjunto definido de ácidos graxos distribuídos de uma maneira definida sobre uma cadeia principal, p. ex., uma cadeia principal de glicerol. Produtos gerados usando-se as hidrolases e praticando os métodos como proporcionados aqui incluem óleos com baixo teor de saturação, p. ex., óleos de vegetais (p. ex., soja, canola), animais, plantas, peixes, algas, sendo que referidos óleos foram processados ou tratados com um polipeptídio como proporcionado aqui; e alimentos, rações, suplementos, farmacêuticos e análogos compreendendo óleos com baixo teor de saturação preparados
Petição 870180005321, de 22/01/2018, pág. 190/316
184/293 por meio da prática dos métodos e/ou composições (p. ex., enzimas) como proporcionados aqui. Produtos gerados usando-se as hidrolases e praticando os métodos como proporcionados aqui também incluem alternativas à manteiga de cacau, lipídios contendo ácidos graxos poli-insaturados (PUFAs), lipídios contendo ácidos graxos essenciais, lipídios contendo ácidos graxos monoinsaturados, lipídios contendo fosfo-colina e fosfoserina, lipídios contendo fitosteróis, glicerídeos de 1,3-diacila (DAGs), 2monoacilglicerídeos (MAGs) e triacilglicerídeos (TAGs).
[0402] Os métodos como proporcionados aqui permitem a síntese de lipídios ou de ácidos graxos com regiosseletividades e estereosseletividades definidas. Proporciona-se aqui óleos, lipídios e análogos, e óleos que podem ser usados em alimentos e rações e materiais para cozimento (p. ex., óleos para cozimento, óleos para fritura, óleos para cozimento, temperos, marinadas, condimentos, óleos pulverizáveis, margarinas, maionese, coberturas despejáveis e aplicáveis com colher, alternativas à manteiga de cacau, e análogos) que foram processados e tratados com polipeptídios ou peptídios (p. ex., hidrolases, como lipases, saturases, palmitases e/ou estearatases) como proporcionados aqui. Em determinadas concretizações, proporciona-se aqui farmacêuticos, nutracêuticos e cosméticos compreendendo polipeptídios (p. ex., hidrolases, como lipases, saturases, palmitases e/ou estearatases; ou peptídios ou anticorpos) como proporcionados aqui.
[0403] Em determinadas concretizações, proporciona-se aqui métodos para o processamento (modificação) de óleos, lipídios e análogos usando-se hidrolases como proporcionadas aqui. Os métodos podem ser usados para processar óleos de plantas, animais, microorganismos. Os métodos como proporcionados aqui podem ser usados na síntese estruturada de óleos similares àqueles encontrados em plantas, animais, e microorganismos. Lipídios e óleos podem ser processados com o fim de apresentarem uma característica desejada. Lipídios e óleos que podem ser processados por meio dos métodos como proporcionados aqui (usando-se as hidrolases como proporcionadas aqui) incluem alternativas à manteiga de cacau, lipídios contendo ácidos graxos poli-insaturados (PUFAs), lipídios contendo ácidos graxos essenciais, lipídios contendo ácidos graxos monoinsaturados, lipídios contendo fosfo-colina e fosfo-serina, lipídios contendo fitosteróis,
Petição 870180005321, de 22/01/2018, pág. 191/316
185/293 glicerídeos de 1,3-diacila (DAGs), 2-monoacilglicerídeos (MAGs) e triacilglicerídeos (TAGs). Em um aspecto, os óleos e gorduras processados e sintéticos como proporcionados aqui (p. ex., alternativas à manteiga de cacau e óleos vegetais) podem ser usados numa variedade de aplicações, p. ex., na produção de alimentos (p. ex., confeitos, massas) e na formulação de farmacêuticos, nutracêuticos e cosméticos. Proporciona-se aqui métodos de processamento de gorduras e óleos, p. ex., sementes oleaginosas, de plantas, incluindo, p. ex., canola, mamona, coco, coriandro, milho, semente de algodão, avelã, semente de cânhamo, linhaça, planta-dos-prados, oliva, óleo de palma, palmito, amendoim, colza, farelo de arroz, açafrão, sasanqua, soja, girassol, talol, tsubaki, variedades de óleos “naturais” apresentando composições de ácidos graxos alterados via Organismos Geneticamente Modificados (GMO, Genetically Modified Organisms) ou cruzamento tradicional, como óleos com alto teor oléico, baixo teor linolênico, ou óleos com baixo teor de saturação (canola com elevado teor oléico, soja com baixo teor linolênico, ou girassol com alto teor esteárico) ou combinações de qualquer um dos acima usando uma hidrolase como proporcionada aqui.
[0404] Em determinadas concretizações, proporciona-se aqui métodos para o processamento de óleos de animais, p. ex., peixes (Thaleichthys pacificus, fígado de bacalhau, olho-de-vidro, sardinha, arenque, savelha, e análogos), mamíferos (carne de porco, carne de boi, e análogos) e aves (frangos, e análogos), usando-se as hidrolases como proporcionadas aqui. Em determinadas concretizações, proporciona-se aqui métodos para a síntese estruturada de óleos similares àqueles encontrados em animais, p. ex., peixes, aves, e mamíferos e microorganismos, usando-se as hidrolases como proporcionadas aqui. Em um aspecto, estes óleos sintéticos ou processados são usados como aditivos alimentícios, alimentos, como ingredientes em formulações farmacêuticas, nutracêuticos ou em cosméticos. Por exemplo, em um aspecto as hidrolases como proporcionadas aqui são usadas para hidrolisar ácidos graxos removendo-se os mesmos de óleos de peixe de tal modo que os ácidos graxos possam ser recuperados e usados como um aditivo alimentício. Em um aspecto, as hidrolases como proporcionadas aqui podem ser usadas para processar óleo de restos de restaurantes e gorduras animais processadas.
Petição 870180005321, de 22/01/2018, pág. 192/316
186/293 [0405] Em outras concretizações, proporciona-se aqui métodos de processar gorduras e óleos, p. ex., de óleos algáceos, incluindo, p. ex., óleo de Neochloris oleoabundans, óleo de Scenedesmus dimorphus, óleo de Euglena gracilis, óleo de Phaeodactylum tricornutum, óleo de Pleurochrysis carterae, óleo de Prymnesium parvum, óleo de Tetraselmis chui, óleo de Tetraselmis suecica, óleo de Isochrysis galbana, óleo de Nannocloropsis salina, óleo de Botryococcus braunii, óleo de Dunaliella tertiolecta, óleo de espécies de Nannochloris, óleo de espécies de Spirulina, óleo de Chlorophycease (algas verdes), e óleo de Bacilliarophy ou combinações de qualquer um de referidos óleos e gorduras.
[0406] Em um aspecto, as hidrolases como proporcionadas aqui são biocatalisadores versáteis na síntese orgânica, p. ex., na síntese estruturada de óleos, lipídios e análogos. Enzimas como proporcionadas aqui (incluindo hidrolases, p. ex., lipases, saturases, palmitases e/ou estearatases) podem aceitar uma ampla faixa de substratos, incluindo alcoóis secundários e terciários, p. ex., de um produto natural, como alfa-terpineol, linalool e análogos. Em alguns aspectos, as hidrolases como proporcionadas aqui apresentam enantioespecificidade de boa a excelente (p. ex., estereoespecificidade).
[0407] Em determinadas concretizações, proporciona-se aqui é um processo de conversão de óleo (p. ex., óleos vegetais, manteigas de cacau, e análogos) compreendendo pelo menos uma enzima (p. ex., uma lipase, saturase, palmitase e/ou estearatase) como proporcionada aqui. Em um aspecto, um processo de conversão de óleo compreende uma acilação e hidrólise controlada, p. ex., uma acilação de glicerol, que pode resultar em alta pureza para uma ampla faixa de produtos. Em um aspecto, hidrolases (p. ex., uma lipase, saturase, palmitase e/ou estearatase) como proporcionadas aqui são usadas para produzir óleos de diacilglicerol e óleos nutricionais estruturados. Em determinadas concretizações, proporciona-se aqui processos para a esterificação de propileno glicol usando-se uma enzima como proporcionadas aqui, p. ex., uma lipase regioe/ou quimio-seletiva para a esterificação mono-substituída na posição Sn-I. Proporcionase aqui processos para a síntese estruturada de óleos com perfis objetivados de ácidos graxos saturados ou insaturados usando uma enzima como proporcionada aqui, p. ex., uma lipase regio- e/ou quimio-seletiva para a remoção de um ácido graxo saturado, ou, para a adição de um ácido graxo em uma cadeia principal de glicerol.
Petição 870180005321, de 22/01/2018, pág. 193/316
187/293 [0408] Em um aspecto, os métodos como proporcionados aqui compreendem adicionalmente processos para a remoção seletiva de ácidos graxos (p. ex., ácidos graxos indesejáveis) de óleos, p. ex., separando ácidos graxos saturados e/ou insaturados de óleos, usando-se uma hidrolase (p. ex., uma lipase, saturase, palmitase e/ou estearatase) como proporcionadas aqui. O processo como proporcionado aqui pode separar ácidos graxos saturados e/ou insaturados de qualquer óleo, p. ex., um óleo de soja. A enzima pode ser quimiosseletiva e/ou enantiosseletiva. Em um aspecto, estes processos geram gorduras e óleos com elevada estabilidade, p. ex., óleos “saudáveis” para fritura. Este processo exemplar como proporcionado aqui pode ser usado para gerar óleos com menos enxofre, p. ex., usando um processo compreendendo remoção de enxofre do óleo bruto. As enzimas como proporcionadas aqui também podem ser usadas em processos de interesterificação par estes e outros fins.
[0409] Em um aspecto, uma enzima como proporcionada aqui é usada para gerar um óleo graxo “não-trans”. Em um aspecto, um óleo “não-trans” é gerado a partir de um óleo parcialmente hidrogenado para produzir um óleo apenas cis. A enzima pode ser quimiosseletiva e/ou enantiosseletiva.
[0410] Em outras concretizações, proporciona-se aqui processos para modificar manteigas de cacau usando uma enzima como proporcionada aqui. Cerca de 80 % das manteigas de cacau compreendem trialquilglicerídeos POP, SOS e POS (P é ácido graxo palmítico, O é ácido graxo oleico, S é ácido graxo esteárico). A estrutura de ácido graxo saturado-insaturado-saturado de manteigas de cacau confere seus perfis de fusão característicos, p. ex., em chocolates. Em um aspecto, os processos sintéticos estruturados e diretos como proporcionados aqui são usados em manteigas de cacau para reduzir as variações da manteiga de cacau ou para produzir manteigas de cacau sintéticas (“alternativas à manteiga de cacau”). Em um aspecto, uma hidrolase quimiosseletiva e/ou enantiosseletiva (p. ex., uma regiosseletiva) (p. ex., lipase ou esterase) como proporcionada aqui é usado para preparar uma alternativa à manteiga de cacau, p. ex., um substituinte de manteiga de cacau, um substituto de manteiga de cacau e/ou um equivalente de manteiga de cacau. Proporciona-se aqui alternativas à manteiga de cacau, incluindo substitutos à manteiga de cacau, substitutos de manteiga de cacau e equivalentes
Petição 870180005321, de 22/01/2018, pág. 194/316
188/293 de manteiga de cacau e seus intermediários de fabricação compreendendo uma enzima como proporcionada aqui. Um processo como proporcionado aqui (usando uma enzima como proporcionada aqui) para a preparação de alternativas à manteiga de cacau pode compreender misturação com um óleo vegetal, p. ex., um óleo de palma, com karité ou equivalente, illipé ou equivalente e esterinas Sal ou equivalente, e tratar os óleos misturados com os polipeptídios como proporcionados aqui. Em um aspecto, o processo como proporcionado aqui compreende o uso de interesterificação. O processo como proporcionado aqui pode gerar formas composicionais ou cristalinas que emulam a manteiga de cacau “natural”.
[0411] Em determinadas concretizações, proporciona-se aqui processos (usando-se uma enzima como proporcionada aqui) para produzir um diacilglicerol (DAG), p. ex., 1,3diacilglicerol, usando um óleo vegetal, p. ex., um óleo de baixo custo. A enzima pode ser quimiosseletiva e/ou enantiosseletiva. O processo como proporcionado aqui pode resultar em uma composição compreendendo DAG apresentando boa estabilidade, longa vida-deprateleira e desempenho sob alta temperatura.
[0412] As enzimas (hidrolases, p. ex., lipases, saturases palmitases e/ou estearatases) como proporcionadas aqui e métodos como proporcionados aqui também podem ser usados no tratamento enzimático de óleos comestíveis, como descrito, p. ex., na Patente U.S. n° 6.025.171. Neste método exemplar, enzimas como proporcionadas aqui são imobilizadas preparando-se uma emulsão contendo uma fase hidrofóbica contínua, como um óleo de triacilglicerídeo, e uma fase aquosa dispersada contendo uma enzima anfifílica, como lipase como proporcionada aqui, e material de suporte que é parcialmente dissolvido e parcialmente não-dissolvido na fase aquosa, e removendo-se água da fase aquosa até que a fase se transforme em partículas-veículo revestidas com enzima sólida. A parte dissolvida do material de suporte pode ser um material que é insolúvel em água e óleo, ou material solúvel em água em forma não-dissolvida porque a fase aquosa já é saturada com o material solúvel em água. A fase aquosa pode ser formada com um líquido de fermentação de lipase bruto contendo resíduos de fermentação e biomassa que podem servir como materiais de suporte. A lipase imobilizada é útil para rearranjo de éster e desacidificação em óleos. Após a reação, a enzima imobilizada pode ser regenerada para
Petição 870180005321, de 22/01/2018, pág. 195/316
189/293 uma reação subsequente por meio de adição de água para se obter dissolução parcial do veículo, e com a enzima resultante e fase aquosa contendo veículo dispersa em uma fase aquosa evaporando água para, novamente, formar partículas-veículo revestidas com enzima.
[0413] As enzimas (p. ex., lipases, saturases, palmitases e/ou estearatases) como proporcionadas aqui e métodos como proporcionados aqui também podem ser usados para preparar óleos transesterificados, como descrito, p. ex., na Patente U.S. n° 5.288.619. Proporciona-se aqui métodos para a transesterificação enzimática para a preparação de um óleo de margarina apresentando teor de ácido graxo de cadeia intermediária com baixo teor e baixo teor de ácido trans. O método inclui as etapas de proporcionar uma mistura de reação de transesterificação contendo um material-fonte de ácido esteárico e um óleo vegetal líquido comestível, transesterificar o material-fonte de ácido esteárico e o óleo vegetal usando uma lipase específica para posição 1-, 3-, e então, finalmente, hidrogenar a mistura de ácido graxo para proporcionar um material-fonte de ácido esteárico reciclado para uma reação de reciclagem com o óleo vegetal. Proporciona-se aqui um método em contra-corrente para preparar um óleo transesterificado. O método inclui as etapas de prover uma zona de reação de transesterificação contendo uma lipase específica para posição 1-, 3, introduzir um óleo vegetal na zona de transesterificação, introduzir um material-fonte de ácido esteárico, conduzir um fluido em contra-corrente de gás supercrítico ou gás liquefeito subcrítico, realizar uma reação de transesterificação do fluxo de triacilglicerídeo com o ácido esteárico ou monoéster de ácido esteárico na zona de reação, retirar um fluxo de óleo de margarina de trialquilglicerídeo transesterificado, retirar uma fase de fluido em contra-corrente, hidrogenar o monoéster de ácido esteárico ou de ácido esteárico transesterificado para proporcionar um material-fonte de ácido esteárico reciclado hidrogenado, e introduzir o material-fonte de ácido esteárico reciclado hidrogenado na zona de reação.
[0414] Em um aspecto, para permitir que a enzima como proporcionada aqui venha a atuar, ambas as fases, a fase óleo e a fase aquosa, que contêm a enzima, precisam ser intimamente misturadas. Pode não ser suficiente simplesmente agitar os mesmos. Boa dispersão da enzima no óleo é auxiliada se for dissolvida em uma pequena quantidade de
Petição 870180005321, de 22/01/2018, pág. 196/316
190/293 água, p. ex., 0,5-5 % em peso (relativamente ao óleo), e emulsificada no óleo nesta forma, para formar gotículas com diâmetro menor que 10 micrômetros (média ponderal). As gotículas podem ser menores que 1 micrômetro. É possível realizar agitação turbulenta com velocidades radiais acima de 100 cm/s. O óleo também pode ser circulado no reator usando-se uma bomba rotativa externa. A fase aquosa contendo a enzima também pode ser finamente dispersada por meio da ação de ultrassom. Usa-se um dispositivo de dispersão.
[0415] Em um aspecto, uma reação enzimática como proporcionada aqui ocorre na superfície limítrofe entre a fase óleo e a fase aquosa. O objetivo de todas estas medidas para misturação criar a maior superfície possível para a fase aquosa que contém a enzima. A adição de tensoativos aumenta a microdispersão da fase aquosa. Em alguns casos, portanto, tensoativos com valores de HLB [n.t.: balanço hidrofílico-lipofílico] acima de 9, como sulfato de Na-dodecila, são adicionados à solução de enzima, como descrito, p. ex., na EP-A 0 513 709. Um método efetivo similar para aperfeiçoar a emulsificação é a adição de lisolecitina. As quantidades adicionadas podem situar-se na faixa de 0,001 % a 1 %, com referência ao óleo. A temperatura durante o tratamento com enzima não é crítica. É possível usar temperaturas entre 20°C e 80°C, mas estas últimas só podem ser aplicadas durante um curto período. Neste aspecto, usa-se uma lipase como proporcionada aqui apresentando uma boa tolerância à temperatura e/ou a baixo pH. Temperaturas de aplicação entre 30°C e 50°C são ótimas. O período de tratamento depende da temperatura e pode ser mantido mais curto com uma temperatura crescente. Tempos de 0,1 a 10 horas, ou, de 1 a 5 horas geralmente são suficientes. A reação ocorre em um reator, que pode ser dividido em estágios. Portanto, é possível operação contínua, juntamente com operação em bateladas. A reação pode ser realizada em diferentes estágios de temperatura. Por exemplo, a incubação pode ocorrer durante 3 horas a 40°C, depois durante 1 hora a 60°C. Se a reação prosseguir em estágios, isto também abre a possibilidade de ajustar diferentes valores de pH nos estágios individuais. Por exemplo, no primeiro estágio, o pH da solução pode ser ajustado em 7, por exemplo, e em um segundo estágio em 2,5, por meio de adição de ácido cítrico ou outros ácidos vantajosos. Em pelo menos um estágio, contudo, o pH das solução de enzima precisa estar abaixo de 4, ou, abaixo de 3. Se o pó foi ajustado
Petição 870180005321, de 22/01/2018, pág. 197/316
191/293 subsequentemente abaixo deste nível, pode-se verificar uma deterioração do efeito. Portanto, o ácido cítrico pode ser adicionado à solução de enzima antes que esta última seja misturada no óleo.
[0416] As enzimas (hidrolases, p. ex., lipases, saturases, palmitases e/ou estearatases) como proporcionadas aqui e métodos como proporcionados aqui também podem ser usados para preparar óleos, como descrito, p. ex., no Pedido de Patente dos E.U.A. n° 11/567.318, incorporado aqui integralmente por referência. Proporciona-se aqui processos contíguos para o tratamento enzimático de lipídios. O método refere-se a um processo e dispositivo para a interesterificação enzimática contínua de composições contendo lipídios usando-se uma pluralidade de reatores de leito fixo, sendo que o fluxo da composição contendo lipídeo através do aparelho pode permanecer substancialmente constante à medida que a atividade enzimática de um leito fixo diminui ao longo do tempo, e mesmo quando um leito fixo é retirado de forma desconectada [off-line], como para reparo, substituição, ou recompletamento.
[0417] Em uma concretização, proporciona-se aqui é um método de hidrolisar um óleo ou gordura reagindo-se o óleo ou gordura com uma enzima palmitase. Em uma concretização, a hidrólise é realizada na presença de um emulsificante apresentando caráter HLB maior do que 12. Em uma concretização, a enzima palmitase é codificada por uma sequência de ácido nucleico apresentando pelo menos 50 %, 60 %, 70 %, 75 %, 80 %, 85 %, 90 %, 95 %, 97 %, 99 %, 99,5 % ou 100 % de identidade de sequência com SEQ ID NO:1 e apresentando i) uma alteração de nucleotídeo (ou o seu equivalente) que codifica o resíduo de aminoácido na posição 95 (ou o seu equivalente) como apresentado na Tabela 9, ii) alterações de nucleotídeos (ou seus equivalentes) codificando os resíduos de aminoácidos nas posições 85 e 172 (ou o seu equivalente) como apresentado na Tabela 15, iii) uma alteração de nucleotídeo (ou o seu equivalente) codificando o resíduo de aminoácido na posição 83 (ou o seu equivalente) como apresentado na Tabela 16, e iv) as mutações silentes a seguir 35GCT, 102GTT, 108AGT, 117CTT, 126AGG, 133TCT, e 188ACG. Em uma concretização, a sequência de ácido nucleico é a sequência da SEQ ID NO:1 e apresentando i) uma alteração de nucleotídeo (ou o seu equivalente) codificando o resíduo de aminoácido na posição 95 (ou o seu equivalente) como apresentados na Tabela
Petição 870180005321, de 22/01/2018, pág. 198/316
192/293
9, ii) alterações de nucleotídeos (ou seus equivalentes) codificando os resíduos de aminoácidos nas posições 85 e 172 (ou seus equivalentes) como apresentado na Tabela 15, iii) uma alteração de nucleotídeo (ou o seu equivalente) codificando o resíduo de aminoácido na posição 83 (ou o seu equivalente) como apresentado na Tabela 16, e iv) as mutações silentes a seguir 35GCT, 102GTT, 108AGT, 117CTT, 126AGG, 133TCT, e 188ACG. Em uma concretização, a enzima palmitase é o acerto [hit] de tolerância térmica 29 como descrito na Tabela 9, e apresentando i) uma alteração de nucleotídeo (ou seu equivalente) codificando o resíduo de aminoácido na posição 95 (ou o seu equivalente) como apresentado na Tabela 9, ii) alterações de nucleotídeos (ou seus equivalentes) codificando os resíduos de aminoácidos nas posições 85 e 172 (ou seus equivalentes) como apresentado na Tabela 15, iii) uma alteração de nucleotídeo (ou seu equivalente) codificando o resíduo de aminoácido na posição 83 (ou seu equivalente) como apresentado na Tabela 16, e iv) as mutações silentes a seguir 35GCT, 102GTT, 108AGT, 117CTT, 126AGG, 133TCT, e 188ACG. Em uma concretização, a enzima palmitase usada nos métodos proporcionados aqui é a enzima 29 SM com as mutações silentes a seguir 35GCT, 102GTT, 108AGT, 117CTT, 126AGG, 133TCT, e 188ACG como descrito no Exemplo 12.
[0418] Em determinadas concretizações, o emulsificante apresenta HLB maior do que 12, 14, 16, ou 18. Em determinadas concretizações, o emulsificante é selecionado dentre oleato de sódio, oleato de potássio, linoleato de sódio, linoleato de potássio, linolenato de sódio, linolenato de potássio, laureato de sódio, laureato de potássio, estearato de sódio, estearato de potássio, palmitato de sódio, palmitato de potássio, oleato de palma sódico, oleato de palma de potássio ou uma combinação dos mesmos. Em determinadas concretizações, a mistura de reação compreende cerca de 1 a 20 % em água com base no peso total dos reagentes. Em uma concretização, a mistura de reação compreende cerca de 1, 3, 5, 7, 10, 15, 17 ou 20 % de água baseado no peso total dos reagentes.
[0419] Em determinadas concretizações, o óleo ou gordura é misturada com o emulsificante antes da adição da enzima palmitase. Em determinadas concretizações, a mistura de óleo/gordura e emulsificante é homogeneizada antes e/ou após a adição da enzima palmitase para assegurar emulsão uniforme.
Petição 870180005321, de 22/01/2018, pág. 199/316
193/293 [0420] Em determinadas concretizações, a reação é conduzida a cerca de 20 a 70°C. Em determinadas concretizações, a reação é conduzida a cerca de 20, 30, 40, 50, 60 ou 70°C. Em determinadas concretizações, a enzima palmitase aqui proporcionada reduz o teor de palmitato do óleo/gordura a cerca de 5 % ou menos. Em determinadas concretizações, a enzima palmitase aqui proporcionada reduz o teor de palmitato do óleo/gordura a cerca de 5, 4, 3, 2, 1 % ou menos. Em determinadas concretizações, a desejada redução do teor de palmitato ocorre em cerca de, ou menos de cerca de 48 h, 24 h, 20 h, 16 h, 12 h, 10 h, 5 h ou 3 h. Em determinadas concretizações, o método compreende adicionalmente um pré-tratamento ou [] o óleo/gordura para remover goma e fase aquosa, e para reduzir ácidos graxos livres. É possível usar quaisquer métodos de pré-tratamento considerados vantajosos por alguém com prática na arte. Em determinadas concretizações, o método compreende adicionalmente a adição de uma base (adição cáustica) para formar sabões.
[0421] Em determinadas concretizações, o óleo usado na reação é óleo refinado ou óleo bruto. Em uma concretização, a reação compreende adicionalmente a adição de um fosfolipídio. Qualquer fosfolipídio considerado vantajoso por alguém com prática na arte pode ser usado nas reações. Em uma concretização, o fosfolipídio é lecitina. Em uma concretização, o óleo usado nas reações aqui proporcionadas é um óleo refinado e a reação compreende adição de um fosfolipídio.
NUTRACÊUTICOS [0422] Em um aspecto, as composições e métodos como proporcionadas aqui podem ser usadas para preparar nutracêuticos por meio do processamento ou da sintetização de lipídios e óleos usando-se as enzimas como proporcionadas aqui, p. ex., hidrolases, p. ex., lipases, saturases, palmitases e/ou estearatases como proporcionadas aqui. Em um aspecto, os óleos ou lipídios processados ou sintetizados incluem ácidos graxos poliinsaturado (PUFAs), diacilglicerídeos, p. ex., glicerídeos de 1,3-diacila (DAGs), monoacilglicerídeos, p. ex., 2-monoacilglicerídeos (MAGs) e triacilglicerídeos (TAGs). Em um aspecto, os nutracêuticos são preparados por meio de processamento de diacilglicerídeos, p. ex., glicerídeos de 1,3-diacila (DAGs), monoacilglicerídeos, p. ex., 2monoacilglicerídeos (MAGs) e/ou triacilglicerídeos (TAGs) de fontes de plantas (p. ex.,
Petição 870180005321, de 22/01/2018, pág. 200/316
194/293 colza oleaginosa) fontes ou de fontes animais (p. ex., óleo de peixe). Em determinadas concretizações, proporciona-se aqui nutracêuticos (p. ex., composições dietéticas) compreendendo polipeptídios (p. ex., enzimas, peptídios, anticorpos) como proporcionados aqui.
[0423] Em um aspecto, as composições e métodos como proporcionadas aqui podem ser usadas para fortificar composições dietéticas, particularmente produtos à base de leite de vaca, p. ex., fórmulas infantis à base de leite de vaca, com hidrolases ativadas com sal de bile. As composições preparadas por meio dos métodos e composições como proporcionados aqui podem ser usadas para alimentar crianças neonatas e prematuras, incluindo a administração de uma hidrolase ativada com sal de bile como proporcionada aqui para incrementar a digestão de gordura e, portanto, a taxa de crescimento. Em determinadas concretizações, proporciona-se aqui composições e métodos para tratar sujeitos quanto à produção inadequada de enzima pancreática por meio da administração de hidrolase ativada com sal de bile em conjunto com a ingestão de gorduras; ver também a discussão abaixo.
[0424] Em determinadas concretizações, proporciona-se aqui composições dietéticas compreendendo uma hidrolase, p. ex., hidrolase ativada com sal de bile como proporcionado aqui. Em determinadas concretizações, proporciona-se aqui composições dietéticas compreendendo uma base nutricional compreendendo uma gordura e uma quantidade efetiva de hidrolase ativada com sal de bile como proporcionado aqui. Em uma concretização, proporciona-se aqui fórmulas infantis à base de leite de vaca compreendendo uma hidrolase, p. ex., hidrolase ativada com sal de bile como proporcionado aqui. Em um aspecto, a hidrolase como proporcionada aqui é ativa na digestão de ácidos graxos de cadeia longa, p. ex., de C12 a C22, que compõem um percentual muito alto da maior parte dos leites, p. ex., 99 % do leite de mama humano. Ver, p. ex., Patente U.S. n° 5.000.975.
[0425] Em determinadas concretizações, proporciona-se aqui composições dietéticas compreendendo uma gordura de óleo vegetal e uma hidrolase como proporcionado aqui. Em outras concretizações, proporciona-se aqui métodos de processar produtos à base de leite e/ou composições compreendendo óleo vegetal para preparar composições
Petição 870180005321, de 22/01/2018, pág. 201/316
195/293 dietéticas. Em um aspecto, as composições processadas compreendem um óleo de ácido láurico, um óleo de ácido oleico, um óleo de ácido palmítico e/ou um óleo de ácido linoleico. Em um aspecto, é possível usar um óleo de farelo de arroz, óleo oleico de girassol e/ou óleo de canola como óleos de ácidos oleicos. Em um aspecto, gorduras e óleos, p. ex., sementes oleaginosas, de plantas, incluindo, p. ex., canola, mamona, coco, coriandro, semente de algodão, avelã, semente de cânhamo, linhaça, planta-dos-prados, oliva, óleo de palma, palmito, amendoim, colza, farelo de arroz, açafrão, sasanqua, soja, girassol, talol, tsubaki, variedades de óleos “naturais” apresentando composições alteradas de ácidos graxos via Organismos Geneticamente Modificados (OGM) ou “cruzamento” tradicional (como óleos com alto teor oleico, baixo teor linolênico, ou baixo teor de saturação (canola com alto teor oleico, soja com baixo teor linolênico, ou girassol com alto teor esteárico), combinações de qualquer um dos acima para uso nos nutracêuticos e composições dietéticas são processados usando uma hidrolase como proporcionada aqui. Ver, p. ex., Patente U.S. n° 4.944.944.
[0426] Em um aspecto, as enzimas como proporcionadas aqui são fornecidas em uma forma que é estável ao armazenamento na fórmula e/ou no estomago, mas ativas quando a formulação atinge a porção do trato gastrintestinal em que a fórmula normalmente seria digerida. Formulações (p. ex., microcápsulas) para liberam no intestino são bem conhecidas na arte, p. ex., polímeros biodegradáveis, como polilactídeo ou poliglicolídeo, como descritos, p. ex., nas Patentes U.S. nums. 4.767.628; 4.897.268; 4.925.673; 5.902.617.
CONFEITOS, MANTEIGA DE CACAU (COCOA) E ALIMENTOS [0427] Em um aspecto, as composições e métodos como proporcionadas aqui podem ser usadas para preparar e processar manteigas duras, como manteiga de cacau (cocao butter). Em outro aspecto, proporciona-se aqui confeitos, manteiga de cacau e alimentos compreendendo polipeptídios (p. ex., enzimas, peptídios, anticorpos) como proporcionados aqui.
[0428] As composições e métodos como proporcionados aqui podem ser usadas para preparar alternativas à manteiga de cacau por meio de técnicas sintéticas “estruturadas” usando-se as enzimas, p. ex., hidrolases, p. ex., lipases, saturases, palmitases e/ou
Petição 870180005321, de 22/01/2018, pág. 202/316
196/293 estearatases como proporcionadas aqui. Por exemplo, em um aspecto, os métodos como proporcionados aqui processam ou sintetizam triacilglicerídeos, diacilglicerídeos e/ou monoacilglicerídeos para uso como, p. ex., alternativas à manteiga de cacau. Em um aspecto, os métodos como proporcionados aqui geram uma manteiga dura com uma “região plástica” definida para manter suficientemente dureza abaixo da temperatura ambiente ou à temperatura ambiente. Em um aspecto, o lipídio processado ou sintetizado é projetado para apresentar uma “região plástica” muito estreita, p. ex., em um aspecto, onde ela se funde rápido, aproximadamente à temperatura corporal. A manteiga de cacau natural começa a amolecer a aproximadamente 30°C a 32°C, e funde-se completamente a aproximadamente 36°C. A manteiga de cacau natural pode conter 70 % em peso ou mais de três 1,3-disaturado-2-oleoíla gliceróis, que são 1,3-dipalmitoil-2-oleoil glicerol (POP), 1palmitoil-2-oleoil-3-estearoíla glicerol (POSt) e 1,3-distearoil-2-oleoil glicerol (StOSt). Estes três gliceróis apresentam um comportamento de fusão similar entre si, e são responsáveis por propriedades de fusão da manteiga de cacau, apresentando uma região plástica muito estreita. Em determinadas concretizações, proporciona-se aqui manteigas de cacau sintéticas ou manteigas de cacau processadas (sintetizadas ou processadas usando-se uma hidrolase como proporcionada aqui, todas as composições possíveis são referidas como alternativas à manteiga de cacau) com percentuais variáveis de 1,3-dipalmitoil-2oleoil glicerol (POP), 1-itoil-2-oleoil glicerol (POSt) e 1,3-distearoil-2-oleoil glicerol (StOSt), dependendo das propriedades desejadas da manteiga de cacau sintética, e, manteigas de cacau sintéticas com mais ou menos de 70 % em peso dos três 1,3-dissaturado-2-oleoíl gliceróis. As manteigas de manteiga de cacau sintéticas como proporcionadas aqui podem substituir parcialmente ou completamente manteigas de cacau naturais ou nãoprocessadas, e podem manter ou melhorar propriedades essenciais da manteiga dura.
[0429] Em determinadas concretizações, proporciona-se aqui manteigas de cacau sintéticas ou manteigas de cacau processadas (sintetizadas ou processadas usando uma hidrolase como proporcionada aqui) com propriedades desejadas para uso em produtos de confeitaria, panificação e farmacêuticos. Em outras concretizações, proporciona-se aqui produtos para confeitaria, panificação e farmacêuticos, e análogos, compreendendo uma hidrolase como proporcionada aqui. Em um aspecto, com os métodos proporcionados aqui
Petição 870180005321, de 22/01/2018, pág. 203/316
197/293 prepara-se ou processa-se lipídio (uma gordura) de um confeito (p. ex., um chocolate) ou a ser usado em um confeito. Em um aspecto, um lipídio é preparado ou processado de tal forma que o chocolate apresenta menos impressão digital do que chocolate preparado de manteiga de cacau natural, embora ainda apresentando fortes características de fusão na boca. Em um aspecto, um lipídio é preparado ou processado de tal forma que é possível preparar um confeito (p. ex., chocolate) a uma temperatura ambiente comparativamente alta, ou, pode ser preparado usando-se uma água de arrefecimento a uma temperatura comparativamente alta. Em um aspecto, o lipídio é preparado ou processado de tal forma que um confeito (p. ex., chocolate) pode ser armazenado em condições relativamente mais quentes, p. ex., em condições tropicais ou semi-tropicais ou em edifícios com aquecimento central. Em um aspecto, o lipídios são preparados ou processados de tal forma que um confeito (p. ex., chocolate) apresentará um teor de lipídios (gordura) com uma composição e qualidade consistentes. As enzimas como proporcionadas aqui podem ser usadas para proporcionar uma composição substituta para manteiga de cacau que pode melhorar significativamente sua estabilidade térmica e substituí-la numa ampla faixa de aplicações. PRODUÇÃO DE MARGARINA E GORDURA VEGETAL [0430] Em determinadas concretizações, proporciona-se aqui gorduras sintéticas ou processadas, p. ex., margarina e gordura vegetal, sintetizadas ou processadas usando-se uma hidrolase como proporcionada aqui. Em outras concretizações, proporciona-se aqui gorduras sintéticas ou processadas, p. ex., margarina e gordura vegetal, compreendendo polipeptídios (p. ex., enzimas, peptídios, anticorpos) como proporcionados aqui.
[0431] Em uma concretização, proporciona-se aqui gorduras processadas compreendendo um óleo vegetal, como canola, mamona, coco, coriandro, milho, semente de algodão, avelã, semente de cânhamo, linhaça, planta-dos-prados, oliva, óleo de palma, palmito, amendoim, colza, farelo de arroz, açafrão, sasanqua, gergelim, soja, girassol, talol, tsubaki, variedades de óleos “naturais” apresentando composições com ácidos graxos alterados via Organismos Geneticamente Modificados (GMO) ou “cruzamento” tradicional como óleos com baixo teor de oleico, baixo teor de linolênico, ou baixo teor de saturação (canola com elevado teor oléico, soja com baixo teor linolênico, ou girassol com alto teor esteárico) sintetizados ou processados usando-se uma hidrolase como definida aqui. As
Petição 870180005321, de 22/01/2018, pág. 204/316
198/293 gorduras sintéticas ou processadas, p. ex., margarina e gordura vegetal, são projetadas para apresentarem uma “plasticidade” desejada. Muitos dos produtos de gordura plástica, como margarina e gordura vegetal, são produzidos a partir de estoques duros e de óleos líquidos como matérias-primas. Por exemplo, líquidos óleos, como canola, mamona, coco, coriandro, milho, semente de algodão, avelã, semente de cânhamo, linhaça, planta-dosprados, oliva, óleo de palma, palmito, amendoim, colza, farelo de arroz, açafrão, sasanqua, gergelim, soja, girassol, talol, tsubaki, variedades de óleos “natural” apresentando composições de ácidos graxos alteradas via Organismos Geneticamente Modificados (GMO) ou “cruzamento” tradicional, como óleos com alto teor oleico, baixo teor linolênico, ou baixo teor de saturação (canola com elevado teor oléico, soja com baixo teor linolênico, ou girassol com alto teor esteárico), são misturados com seus óleos endurecidos (estoques duros), e a mistura é ajustada de modo a apresentar uma consistência apropriada (plasticidade). Os produtos de gordura plástica, como margarina e gordura vegetal assimproduzidas tendem a causar a formação de cristalinos relativamente grosseiros porque gorduras e óleos usados porque as matérias-primas são constituídas de ácidos graxos apresentando quase o mesmo comprimento de cadeia de carbono. Em outras palavras, eles apresentam uma composição altamente unificada de ácidos graxos. Por esta razão, a plasticidade destes produtos pode ser mantida em um grau apropriado apenas dentro de uma faixa estreita de temperatura, de modo que os óleos líquidos aqui contidos apresentam uma tendência a exudar. Proporciona-se aqui métodos de preparar ou processar gorduras projetadas de tal forma que apresentam uma composição variada (e definida) de ácidos graxos. O óleo resultante, p. ex., margarina ou gordura vegetal, pode apresentar uma faixa mais ampla de plasticidade.
[0432] Em um aspecto, os métodos e composições como proporcionados aqui são usados para preparar ou processar óleos vegetais, como canola, mamona, coco, coriandro, milho, semente de algodão, avelã, semente de cânhamo, linhaça, planta-dos-prados, oliva, óleo de palma, palmito, amendoim, colza, farelo de arroz, açafrão, sasanqua, gergelim, soja, girassol, talol, tsubaki, variedades de óleos “naturais” apresentando composições de ácidos graxos alteradas via Organismos Geneticamente Modificados (GMO) ou “cruzamento” tradicional, como óleos com alto teor oleico, baixo teor linolênico, ou baixo
Petição 870180005321, de 22/01/2018, pág. 205/316
199/293 teor de saturação (canola com elevado teor oléico, soja com baixo teor linolênico, ou girassol com alto teor esteárico) usando-se as hidrolases como proporcionadas aqui, incluindo inter-esterificação e transesterificação enzimática, ver p. ex., Patente U.S. n° 5.288.619 e Pedido de Patente dos E.U.A. número de série 1 1/567.318. Os métodos e composições como proporcionados aqui podem ser usados em lugar de inter-esterificação randômica como descrito, p. ex., na Patente U.S. n° 3.949.105. Em um aspecto, os métodos e composições como proporcionados aqui são usados na transesterificação enzimática para a preparação de um óleo, p. ex., um óleo de margarina, apresentando teor de ácidos graxos com baixo teor de ácidos trans e baixo teor de cadeias intermediárias.
[0433] Em um aspecto, a estrutura simétrica de um óleo, p. ex., um óleo de palma ou de tipo láurico é modificado, p. ex., numa estrutura randômica. Assim, os métodos como proporcionados aqui podem ser usados para modificar as propriedades de produtos de gordura plástica. Em um aspecto, a modificação de óleos por meio dos métodos como proporcionados aqui pode ser projetada de forma a impedir ou desacelerar gradualmente o endurecimento do óleo ao longo do tempo, particularmente quando os produtos estão sendo armazenados.
[0434] Em um aspecto, os métodos e composições como proporcionados aqui em uma mistura de reação de transficação compreendendo um material-fonte de ácido esteárico e um óleo vegetal líquido comestível, trans-esterificação do material-fonte de ácido esteárico e o óleo vegetal usando uma lipase especifica para a posição 1-, 3- como proporcionado aqui, e então hidrogenação da mistura de ácidos graxos de forma a proporcionar um material-fonte de ácido esteárico reciclado para uma reação re-cíclica com o óleo vegetal. Ver, p. ex., a Patente U.S. n° 5.288.619.
[0435] Em um aspecto, uma reação de inter-esterificação é conduzida com uma lipase como proporcionadas aqui. Em um aspecto, a lipase como proporcionada aqui apresenta seletividade pelas posições 1- e 3- do triacilglicerídeo de forma a desacelerar ou inibir um aumento da quantidade de triacilglicerídeos tri-saturados no óleo. Nesta reação como proporcionada aqui, é possível superar deficiências da inter-esterificação randômica convencional e dificuldade de inter-esterificação com uma lipase não-específica, porque a inter-esterificação é conduzida por uma enzima como proporcionada aqui apresentando
Petição 870180005321, de 22/01/2018, pág. 206/316
200/293 especificidade pelas posições 1- e 3- de triacilglicerídeos. Em um aspecto, a exudação de óleos líquidos contidos nos produtos é desacelerada ou impedida com um aumento de temperatura na reação para inibir uma elevação do ponto de fusão causada por um aumento da quantidade de triacilglicerídeos tri-saturados. Isto trata do problema de endurecimento dos produtos durante o armazenamento de longo prazo.
COMPOSIÇÕES FARMACÊUTICAS E TRATAMENTO DE DEFICIÊNCIAS DE HIDROLASE [0436] Em determinadas concretizações, proporciona-se aqui métodos e composições (enzimas como proporcionadas aqui, p. ex., esterases, acilases, lipases, fosfolipases ou proteases como proporcionadas aqui) que podem ser usadas no tratamento de uma deficiência de hidrolase em um animal, p. ex., um mamífero, como um humano. Por exemplo, em um aspecto, os métodos e composições como proporcionados aqui são usados para tratar pacientes que sofrem de uma deficiência de uma lipase pancreática. Em um aspecto, a lipase é administrada oralmente. Uma enzima como proporcionada aqui pode ser fornecida em lugar de, ou com uma preparação de enzima de pâncreas de porco. [0437] Em determinadas concretizações, proporciona-se aqui composições farmacêuticas compreendendo polipeptídios (p. ex., enzimas, peptídios, anticorpos) como proporcionados aqui. Estas posições farmacêuticas podem ser em forma de tabletes, pílulas, géis, cápsulas, hidrogéis, sprays, pós, aerossóis, implantes, liposomas, cremes, unguentos, líquidos, uma microesfera, uma partícula multiparticulada, uma emulsão, uma suspensão, nanoestruturas e análogos. As posições farmacêuticas compreendendo polipeptídios (p. ex., enzimas, peptídios, anticorpos) como proporcionado aqui podem ser administradas em qualquer forma, p. ex., oralmente, intradermicamente, intraperitonealmente, por meio de I.V., topicamente e análogos. Em um aspecto, as composições farmacêuticas como proporcionadas aqui são formuladas para fornecimento tópico, sublingual, oral, intravenoso, subcutâneo, intramuscular, transdermal, intraarterial, intraarticular, ou intradérmico.
[0438] Em um aspecto, as composições como proporcionadas aqui usadas para estes tratamentos são ativas em condições ácidas. Em um aspecto, as composições como proporcionadas aqui são administradas oralmente em formulações (p. ex., tabletes, pílulas,
Petição 870180005321, de 22/01/2018, pág. 207/316
201/293 géis, cápsulas, hidrogéis, sprays, pós, aerossóis) que passam através das regiões ácidas do estômago e descarregam a enzima apenas no ambiente relativamente alcalino do jejuno. Em um aspecto, uma hidrolase como proporcionada aqui é formulada com um veículo, como lactose, sacarose, sorbitol, manitol, amido, derivados de celulose ou gelatina ou qualquer outro excipiente do tipo referido. Também é possível adicionar um lubrificante, como estearato de magnésio, estearato de cálcio ou cera de polietileno glicol. Uma solução concentrada de açúcar, que pode conter aditivos, como talco, dióxido de titânio, gelatina ou goma arábica, pode ser adicionado como um revestimento. É possível usar cápsulas moles ou duras para encapsular uma hidrolase como um líquida ou como uma preparação sólida. Ver, p. ex., a Patente U.S. n° 5.691.181; 5.858.755.
DETERGENTES [0439] Em determinadas concretizações, proporciona-se aqui métodos e composições (enzimas, p. ex., lipases, saturases, palmitases e/ou estearatases como proporcionadas aqui) que podem ser usadas na preparação e no uso de detergentes. Uma hidrolase como proporcionada aqui pode ser adicionada a, p. ex., combinada com, qualquer composição detergente conhecida, sólida ou líquida, com ou sem alterar a composição da composição detergente. Por exemplos, uma hidrolase como proporcionadas aqui pode ser adicionada a qualquer sabão, p. ex., sulfatos alifáticos, como sulfatos de alquila ou alquenila de cadeia reta ou ramificada, sulfatos de amida, sulfatos de alquil éter ou alquenil éter apresentando um grupo alquila ou alquenila de cadeia reta ou ramificada a que um ou mais de óxido de etileno, óxido de propileno e óxido de butileno é/são adicionado(s), sulfonatos alifáticos, como sulfonatos de alquila, sulfonatos de amida, sulfossuccinatos de dialquila, sulfonatos de alfa-olefinas, de olefinas do tipo vinilideno e de olefinas internas, sulfonatos aromáticos, como alquilbenzenossulfonatos de cadeia reta ou ramificada, éter carbonatos de alquila ou alquenila ou amidas apresentando um grupo alquila ou alquenila de cadeia reta ou ramificada a que um ou mais dentre óxido de etileno, óxido de propileno e óxido de butileno são adicionados, ou amidas, ésteres ou sais de alfa-sulfo-ácido graxo, tensoativos de tipo aminoácido, tensoativos de fosfato, como fosfatos ácidos de alquila ou alquenila, e fosfatos de alquila ou alquenila, tensoativos anfóteros de tipo ácido sulfônico, tensoativos anfóteros de tipo betaína, alquil ou alquenil éteres ou alcoóis apresentando um grupo alquila ou
Petição 870180005321, de 22/01/2018, pág. 208/316
202/293 alquenila de cadeia reta ou ramificada aque um ou mais dentre óxido de etileno, óxido de propileno e óxido de butileno são adicionados, fenil éteres de polióxi-etilenoalquila apresentando um grupo alquila de cadeia reta ou ramificada a que um mais dentre óxido de etileno, óxido de propileno e óxido de butileno são adicionados, alcanolamidas de ácidos graxos superiores ou produtos de adição química de óxido de alquileno, ésteres de ácido graxo de sacarose, monoésteres de glicerol de ácido graxo, óxidos de alquil- ou alquenilamina, tensoativos catiônicos do tipo sal de tetraalquil-amônio, ou uma combinação dos mesmos. Ver, p. ex., a Patente U.S. n° 5.827.718.
[0440] Em algumas concretizações, proporciona-se aqui composições detergentes compreendendo um ou mais polipeptídios (hidrolases) como proporcionados aqui. É possível usar formas tensoativas e/ou não-tensoativas. Em um aspecto, a quantidade de hidrolase total, tensoativa e/ou não-tensoativa, pode ser de cerca de 0,0001 % a cerca de 1,0 %, ou de cerca de 0,0002 % a cerca de 0,5 %, em peso, da composição detergente. Em um aspecto da composição detergente, a hidrolase tensoativa é de cerca de 5 % a cerca de 67 % e a hidrolase não-tensoativa é de cerca de 33 % a cerca de 95 % da atividade total de hidrolase na mistura enzimática. Em um aspecto, o pH ótimo da mistura enzimática total é entre cerca de 5 a cerca de 10,5.
[0441] Em um aspecto, as composições detergentes como proporcionadas aqui incluem hidrolases alcalinas como proporcionadas aqui que funcionam em valores de pH alcalinos, porque o pH de uma solução de lavagem pode encontrar-se em uma faixa de pH alcalino em condições de lavagem ordinárias. Ver, p. ex., a Patente U.S. n° 5.454.971.
[0442] Os polipeptídios como proporcionados aqui (enzimas como proporcionadas aqui) podem ser usados em qualquer composição detergente, que são bem conhecidos na arte, ver, p. ex., a Patente U.S. n° 5.069.810; 6.322.595; 6.313.081. Por exemplo, em um aspecto, proporciona-se uma composição detergente para lavanderia. Ela pode compreender de 0,8 ppm a 80 ppm de uma lipase como proporcionada aqui.
[0443] Qualquer método de preparação e uso de composições detergentes pode ser usado com enzimas como proporcionadas aqui, ver, p. ex., a Patente U.S. n° 6.413.928; 6.399.561; 6.365.561; 6.380.147. As composições detergentes podem ser uma composição aquosa de uma e duas partes, uma composição líquida não-aquosa, um sólido
Petição 870180005321, de 22/01/2018, pág. 209/316
203/293 fundido, uma forma granular, uma forma particulada, um tablete comprimido, uma forma de gel, um pó, um gel, um hidrogel, um liposoma, um aerossol, uma pasta e/ou uma forma de calda. As hidrolases como proporcionadas aqui também podem ser usadas como um produto aditivo de detergente em uma forma sólida ou forma líquida. Referidos produtos aditivos destinam-se a suplementar ou reforçar o desempenho de composições detergentes convencionais e podem ser adicionados em qualquer estágio do processo de limpeza.
[0444] Em determinadas concretizações, proporciona-se aqui métodos capazes de remover sujeiras brutas causadas por alimentos, películas de resíduos alimentícios e outras composições alimentícias menores usando-se estas posições detergentes. Hidrolases como proporcionadas aqui podem facilitar a remoção de manchas por meio de hidrólise catalítica de lipídios, gorduras ou óleos. Hidrolases como proporcionadas aqui podem ser usadas em detergentes lava-louças e em detergentes para lavanderia têxtil.
[0445] O teor efetivo de enzima ativa depende do método de fabricação de uma composição detergente e não é crítico, presumindo que a composição detergente possui a atividade enzimática desejada. Em um aspecto, a quantidade de hidrolases presente na composição final compreende de cerca de 0,001 mg a 0,5 mg grama da composição detergente. A enzima particular selecionada para uso no processo e produtos aqui proporcionados depende das condições de utilidade final, incluindo a forma física do produto, pH de uso, temperatura de uso, e tipos de solos a serem degradados ou alterados. A enzima pode ser selecionada de forma a proporcionar atividade e estabilidade ótimas para qualquer conjunto dado de condições de utilidade. Em um aspecto, as hidrolases proporcionadas aqui são ativas nas faixas de pH de cerca de 4 a cerca de 12 e na faixa de temperatura de cerca de 20°C a cerca de 95°C. Os detergentes como proporcionados aqui podem compreender tensoativos catiônicos, não-iônicos semi-polares ou zwitteriônicos; ou, misturas dos mesmos.
[0446] Em uma concretização, enzimas como proporcionadas aqui podem ser formuladas em detergentes em pó e líquidos apresentando pH entre 4,0 e 12,0 em níveis de cerca de 0,01 a cerca de 5 % (alternativamente de 0,1 % a 0,5 %) em peso. Estas composições detergentes também podem incluir outras enzimas, como proteases,
Petição 870180005321, de 22/01/2018, pág. 210/316
204/293 celulases, lipases ou endoglicosidases, endo-beta-1,4-glucanases, beta-glucanases, endobeta-1,3(4)-glucanases, cutinases, peroxidases, lacases, amilases, glucoamilases, pectinases, redutases, oxidases, fenoloxidases, ligninases, pululanases, arabinanases, hemicelulases, mananases, xiloglucanases, xilanases, pectina acetil esterases, ramnogalacturonano acetil esterases, poligalacturonases, ramnogalacturonases, galactanases, pectina liases, pectina metilesterases, cellbioidrolases e/ou transglutaminases. Estas composições detergentes também podem incluir reforçadores e estabilizadores.
[0447] A adição de hidrolases como proporcionadas aqui a composições de limpeza convencionais não cria qualquer limitação especial ao uso. Em outras palavras, qualquer temperatura e pH vantajosos para o detergente também são vantajosos para as composições como proporcionadas aqui desde que a enzima seja ativa e, ou tolerante ao pH e/ou baseado em temperatura de uso intencionado. Adicionalmente, as hidrolases como proporcionadas aqui podem ser usadas em uma composição de limpeza sem detergentes, seja sozinhas ou em combinação com agentes seqüestrantes e estabilizadores.
[0448] Em determinadas concretizações, proporciona-se aqui composições de limpeza incluindo composições detergentes para a limpeza de superfícies duras, composições detergentes para limpeza de tecidos, composições para lavagem de louças, composições para limpeza oral, composições para limpeza de dentaduras, e soluções para limpeza de lentes de contato.
[0449] Em determinadas concretizações, proporciona-se aqui métodos para a lavagem de um objeto compreendendo contactar o objeto com um polipeptídio como proporcionado aqui em condições suficientes para lavagem. Uma hidrolase como proporcionada aqui pode ser incluída como um aditivo para detergente. A composição detergente como proporcionada aqui pode ser formulada, por exemplo, como uma composição detergente para lavanderia à mão ou à máquina compreendendo um polipeptídio como proporcionado aqui. Um aditivo para lavanderia vantajoso para o prétratamento de tecidos manchados pode compreender um polipeptídio como proporcionado aqui. Uma composição amaciante para tecidos pode compreender uma hidrolase como
Petição 870180005321, de 22/01/2018, pág. 211/316
205/293 proporcionada aqui. Alternativamente, uma hidrolase como proporcionada aqui pode ser formulada como uma composição detergente para uso em operações de limpeza de superfícies duras domésticas gerais. Em aspectos alternativos, aditivos detergentes e composições detergentes como proporcionados aqui podem compreender uma ou mais outras enzimas, como uma protease, uma lipase, uma cutinase, outra protease, uma carboidrase, uma celulase, uma pectinase, uma mananase, uma arabinase, uma galactanase, uma xilanase, uma oxidase, p. ex., uma lactase, e/ou uma peroxidase (ver também acima). As propriedades da enzima(s) como proporcionada aqui são selecionadas para serem compatíveis com o detergente selecionado (i.e. pH ótimo, compatibilidade com outros ingredientes enzimáticos e não-enzimáticos, etc.) e a enzima(s) está presente em quantidades efetivas. Em um aspecto, enzimas como proporcionadas aqui são usadas para remover materiais mal-cheirosos de tecidos. Várias composições detergentes e métodos para preparar as mesmas e que podem ser usados aqui encontram-se descritos, p. ex., nas Patentes U.S. nums. 6.333.301; 6.329.333; 6.326.341; 6.297.038; 6.309.871; 6.204.232; 6.197.070; 5.856.164.
[0450] Quando formuladas como composições vantajosas para uso em um método de lavagem a máquina de lavanderia, as hidrolases como proporcionadas aqui podem compreender tanto um composto tensoativo e um composto reforçador. Elas podem compreender adicionalmente um ou mais componentes detergentes, p. ex., compostos poliméricos orgânicos, agentes alvejantes, enzimas adicionais, supressores de espumação, dispersantes, dispersantes de sabão de cal, agentes de suspensão de sujeira e agentes anti-redeposição e inibidores de corrosão. Composições de lavanderia como proporcionadas aqui também podem conter agentes amaciantes, como componentes detergentes adicionais. Composições contendo hidrolases como proporcionadas aqui podem proporcionar limpeza de tecidos, remoção de manchas, manutenção de brancura, amaciamento, aspecto de cor, inibição da transferência de corantes e sanitização quando formuladas como composições detergentes para lavanderia.
[0451] A densidade das composições detergentes para lavanderia como proporcionadas aqui pode compreendem de cerca de 200 a 1500 g/litro, ou, de cerca de
400 a 1200 g/litro, ou, de cerca de 500 a 950 g/litro, ou, de 600 a 800 g/litro, de composição;
Petição 870180005321, de 22/01/2018, pág. 212/316
206/293 isto pode ser medido a cerca de 20°C.
[0452] A forma “compacta” de composições detergentes para lavanderia como proporcionadas aqui é melhor refletida por densidade e, em termos de composição, pela quantidade de sal de carga inorgânico. Sais de carga inorgânicos são ingredientes convencionais de composições detergentes em forma de pó. Em composições detergentes convencionais os sais de carga estão presentes em quantidades substanciais, tipicamente de 17 % a 35 % em peso da composição total. Em um aspecto das composições compactas, o sal de carga está presente em quantidades que não excedem 15 % da composição total, ou, que não excedem 10 %, ou que não excedem 5 % em peso da composição. Os sais de carga inorgânicos podem ser selecionados dentre os sais alcalinos e sais de metal acalino terroso de sulfatos e cloretos, p. ex., sulfato de sódio.
[0453] Composições detergentes líquidas como proporcionadas aqui também podem encontrar-se em uma “forma concentrada”. Em um aspecto, as composições detergentes líquidas podem conter uma quantidade menor de água, em comparação com detergentes líquidos convencionais. Em aspectos alternativos, o teor de água do detergente líquido concentrado é menor que 40 %, ou menor que 30 %, ou menor que 20 % em peso da composição detergente. Compostos detergentes como proporcionados aqui podem compreender formulações como descritas no WO 97/01629.
[0454] Hidrolases como proporcionadas aqui podem ser úteis na formulação de diversas composições de limpeza. Vários compostos conhecidos são tensoativos vantajosos incluindo detergentes não-iônicos, aniônicos, catiônicos, ou zwitteriônicos, p. ex., como revelados nas Patentes U.S. nums. 4.404.128; 4.261.868; 5.204.015. Adicionalmente é possível usar enzimas como proporcionadas aqui, por exemplo, em aplicações de sabão em barra ou líquido, formulações para tratamento de louças, produtos ou soluções para limpeza de lentes de contato, hidrólise de peptídios, tratamento de resíduos, aplicações têxteis, como enzimas de clivagem por fusão na produção de proteínas, e análogos. Hidrolases como proporcionadas aqui podem proporcionar desempenho incrementado em uma composição detergente em comparação com outra protease detergente, ou seja, o grupo de enzimas pode incrementar a limpeza de determinadas manchas sensíveis enzimas, como capim ou sangue, como determinado por
Petição 870180005321, de 22/01/2018, pág. 213/316
207/293 meio de avaliação usual após um ciclo de lavagem convencional. Hidrolases como proporcionadas aqui podem ser formuladas em detergentes líquidos e em pó conhecidos apresentando pH entre 6,5 e 12,0 em níveis de cerca de 0,01 a cerca de 5 % (por exemplo, de cerca de 0,1 % a 0,5 %) em peso. Estas composições de limpeza detergentes também podem incluir outras enzimas, como outras esterases, fosfolipases, proteases, amilases, celulases, lipases ou endoglicosidases conhecidas, e também reforçadores e estabilizadores.
TRATAMENTO DE ALIMENTOS E PROCESSAMENTO DE ALIMENTOS [0455] As hidrolases como proporcionadas aqui podem ser usadas para a separação de componentes de materiais de plantas. Por exemplo, hidrolases como proporcionadas aqui podem ser usadas na separação de material rico em proteína (p. ex., células de plantas) em componentes, p. ex., sacarose de beterraba açucareira ou amido ou açúcares de batata, polpa ou frações de casca. Em um aspecto, hidrolases como proporcionadas aqui podem ser usadas para separar culturas ricas em proteína ou ricas em óleo em frações de proteína e óleo valiosas. O processo de separação pode ser realizado por meio do uso de métodos conhecidos na arte.
[0456] As hidrolases como proporcionadas aqui podem ser usadas na preparação de sucos de frutas ou vegetais, xaropes, extratos e análogos para incrementar o rendimento. As hidrolases como proporcionadas aqui podem ser usadas no tratamento enzimático (p. ex., hidrólise de proteínas) de vários materiais derivados de paredes de células de plantas ou de materiais residuais, p. ex., da produção de vinho ou de sucos, ou resíduos agrícolas, como cascas de hortaliças, cascas de feijões, polpa de beterraba açucareira, polpa de oliva, polpa de batata, e análogos. As hidrolases como proporcionadas aqui podem ser usadas par modificar a consistência e o aspecto de frutos ou hortaliças processadas. As hidrolases como proporcionadas aqui podem ser usadas para tratar material de planta de forma a facilitar o processamento de material de planta, incluindo alimentos, facilitar a purificação ou extração de componentes de plantas. As hidrolases como proporcionadas aqui podem ser usadas para melhorar o valor alimentício, diminuir a capacidade de ligação de água, melhorar a degradabilidade em plantas aquáticas rejeitadas e/ou melhorar a conversão de material de planta para ensilagem, e análogos.
Petição 870180005321, de 22/01/2018, pág. 214/316
208/293
RAÇÕES ANIMAIS E ADITIVOS ALIMENTÍCIOS OU PARA RAÇÕES [0457] Em determinadas concretizações, proporciona-se aqui métodos para tratar rações animais e alimentos e aditivos alimentícios ou para rações usando hidrolases como proporcionadas aqui, animais incluindo mamíferos (p. ex., humanos), aves, peixes e análogos. Em outras concretizações, proporciona-se aqui rações animais, alimentos, suplementos alimentícios e para rações, e aditivos compreendendo hidrolases como proporcionadas aqui. Em determinadas concretizações, proporciona-se aqui hidrolases para uso na modificação de ração animal ou de um alimento, p. ex., para processar o alimento ou ração, seja in vitro (por meio de modificação de componentes da ração ou do alimento) ou in vivo. Em outro aspecto, hidrolase como proporcionada aqui pode ser fornecida por meio de expressão das enzimas diretamente em culturas alimentícias transgênicas (como, p. ex., plantas, sementes transgênicas e análogos), como milho, soja, colza, tremoço e análogos. Em um aspecto, proporciona-se aqui plantas transgênicas, partes de plantas e células de plantas transgênicas compreendendo uma sequência de ácido nucleico codificando um polipeptídio como proporcionado aqui. Em um aspecto, o ácido nucleico é expresso de tal forma que a hidrolase como proporcionada aqui é produzida em quantidades recuperáveis. A hidrolase pode ser recuperada de qualquer planta ou parte de planta. Alternativamente, a planta ou parte de planta contendo o polipeptídio recombinante pode ser usada tal qual para melhorar a qualidade de um alimento ou ração, p. ex., melhorar o valor nutricional, a palatabilidade e as propriedades reológicas, ou para destruir um fator antinutritivo.
INTERESTERIFICAÇÃO [0458] Em um aspecto, os métodos e composições proporcionados aqui podem ser usados para modificar propriedades de misturas de triacilglicerídeos, e, em um aspecto, sua consistência. Em um aspecto, uma enzima como proporcionada aqui pode ser usada na presença de um catalisador, como sódio metálico ou metóxido de sódio para promover a migração de acila entre moléculas de glicerídeo de tal forma que os produtos consistem de misturas de glicerídeos em que os resíduos de acila graxa são distribuídos randomicamente entre as moléculas de glicerídeos.
[0459] Em um aspecto, as enzimas como proporcionadas aqui podem ser usadas para
Petição 870180005321, de 22/01/2018, pág. 215/316
209/293 produzir produtos de interesterificação em condições de reação em que a hidrólise de gordura é minimizada de forma que a interesterificação catalisada com lipase se torne a reação dominante. Estas condições podem incluir, por exemplo, restringir a quantidade de água no sistema.
[0460] Em um aspecto, enzimas como proporcionadas aqui podem ser usadas para catalisar reações de interesterificação usando-se misturas de triacilglicerídeos e ácidos graxos livres, como descrito, p. ex., na EP 0 093 602 B2. Nestes casos, ácido graxo livre pode ser substituído pelos grupos acila dos triacilglicerídeos para produzir novos triacilglicerídeos enriquecidos com ácido graxo adicionado. Em um aspecto, lipases 1,3específicas como proporcionadas aqui podem ser usadas para confinar a reação às posição 1- e 3- dos glicerídeos, o que permite obter uma mistura de triacilglicerídeos que não é obtida por meio de interesterificação química ou reação com uma lipase nãoespecífica. Em um aspecto, lipases não-específicas são usadas para atingir resultados similares à interesterificação química.
[0461] A capacidade de produzir misturas inéditas de triacilglicerídeos usando lipases específicas para posições como proporcionadas aqui é útil para a indústria de óleos e gorduras por que algumas destas misturas apresentam propriedades valiosas. Um exemplo é a interesterificação catalisada com lipase 1,3-específica de 1,3-dipalmitoil-2monoleína (POP), que é o principal triacilglicerídeo da seção média do óleo de palma, com ácido esteárico ou triestearina dando produtos enriquecidos com a valiosa 1-palmitoil-3estearoil-2-monoleína (POSt) e 1,3-distearoil-2-monoleína (StOSt). POSt e StOSt são os componentes mais importantes da manteiga de cacau. Assim, um aspecto como proporcionado aqui proporciona uma reação de interesterificação para produzir equivalentes de manteiga de cacau a partir de materiais de partida baratos.
[0462] Em um aspecto, proporciona-se aqui métodos de produção de um substituto de gordura dura usando-se as lipases 1,3-específicas como proporcionadas aqui. Em um aspecto, um substituto de gordura dura compreende uma mistura de fração média de palma e StOSt, POSt ou StOSt/POSt com pelo menos 85 % de pureza.
[0463] A invenção será descrita adicionalmente com referência aos exemplos a seguir; no entanto, deve-se compreender que a invenção não se limita a referidos exemplos.
Petição 870180005321, de 22/01/2018, pág. 216/316
210/293
Exemplos
Exemplo 1: Ensaios exemplares de lipase-saturase [0464] O exemplo a seguir descreve ensaios exemplares para selecionar uma atividade de hidrolase p. ex., uma atividade de lipase, de saturase, de palmitase e/ou de estearatase. Em um aspecto, estes ensaios exemplares podem ser usados como seleções de rotina para determinar se um polipeptídio se encontra dentro do escopo como proporcionado aqui. Referidos ensaios incluem o uso de compostos indicadores de pH para detectar a clivagem de ácidos graxos de triacilglicerídeos, métodos espectrofotométricos, HPLC, GC, MS, TLC e outras. Jaeger (1994) FEMS Microbiol. Rev. 15:29-63; Ader (1997) Métodos Enzymol. 286:351-386; Vorderwulbecke (1992) Enzyme Microb. Technol. 14:631639; Renard (1987) Lipids 22: 539-541.
SELEÇÃO DA ATIVIDADE DE LIPASE/ESTERASE [0465] Colônias são colhidas com palitos-de-dentes estéreis e usadas para inocular individualmente cada um dos poços de placas de microtitulação de 96 poços. Os poços continham 250 pl de meio LB com 100 pg/ml de ampicilina, 80 pg/ml de meticilina, e 10 % vol/vol de glicerol (LB Amp/Meth, glicerol). As células foram desenvolvidas de um dia para o outro a 37°C sem agitação. Assim, cada poço continha uma cultura de consumo de células de E. coli, sendo que cada uma continha um pBLUESCRIPT™ com um inserto de DNA único.
[0466] As placas de 96 poços foram usadas para inocular multiplamente uma placa simples (a “placa condensada”) contendo em cada poço 200 pl de LB Amp/Meth, glicerol. Esta etapa foi realizada usando a ferramenta de replicação de alta densidade (HDRT, High Density Replicating Tool) de um BIOMEK™ (Beckman Coulter, Inc., Fullerton, CA) com um alvejante a 1 %, água, isopropanol, ciclo de esterilização com secagem a ar entre cada inoculação. Assim, cada poço da placa condensada continha de 10 a 12 clones pBLUESCRIPT™ diferentes de cada uma das placas de biblioteca-fonte. A placa condensada foi desenvolvida durante 16 horas a 37°C e então usada para inocular duas placas-irmãs de microtitulação brancas com 96 poços (Polyfiltronics, Inc., Rockland MA) contendo em cada poço 250 pl de LB Amp/Meth (sem glicerol). A placa condensada original foi colocada em armazenamento a -80°C. As duas placas-irmãs condensadas foram
Petição 870180005321, de 22/01/2018, pág. 217/316
211/293 incubadas a 37°C durante 18 horas.
[0467] A 'solução de consumo de substrato 600 μM' de esterase de cadeia curta foi preparada como a seguir: 25 g de cada um dos seguintes compostos foram dissolvidos no volume apropriado de DMSO dando uma solução 25,2 mM. Os compostos usados foram ionoato de 4-metilumbeliferila, butirato de 4-metilumbeliferila, e heptanoato de 4metilumbeliferila. Adicionou-se 250 microlitos de cada solução de DMSO a cerca de 9 ml de tamponador HEPES 50 mM, pH 7,5 que contida 0,6 % de Triton X-100 e 0,6 mg ml de maltosida de dodecila (Anatrace, Maumee, OH). O volume foi levado a 10,5 ml com o tamponador HEPES saimca dando uma suspensão ligeiramente turva.
[0468] A 'solução de consumo de substrato 600 μM' de cadeia curta foi preparada como a seguir: 25 mg de cada um dos compostos a seguir foram dissolvidos em DMSO a 25,2 mM como acima. Os compostos usados foram elaidato de 4-metilumbeliferila, palmitato de 4-metilumbeliferila, oleato de 4- metilumbeliferila, e estearato de 4metilumbeliferila. Todos exigiram breve aquecimento em um banho a 70°C para se conseguir a dissolução. Duzentos e cinquenta microlitros de cada solução em DMSO foram adicionados a um tamponador de HEPES e diluídos a 10,5 ml como acima. Todos os sete derivados de umbeliferila foram obtidos da Sigma Chemical Co. (St. Louis, MO).
[0469] Cinquenta pl da 'solução de consumo de substrato 600 μM' de esterase de cadeia longa ou esterase de cadeia longa foram adicionados em cada um dos poços de uma placa condensada branca usando o BIOMEK™ dando uma concentração final de substrato de cerca de 100 pM. Os valores de fluorescência foram registrados (excitação=326 nm, emissão=450 nm) em um fluorímetro de leitura de placas imediatamente após a adição do substrato. A placa foi incubada a 70°C durante 60 minutos no caso dos substratos de cadeia longa, e 30 minutos à temperatura ambiente no caso dos substratos de cadeia longa. Os valores de fluorescência foram registrados novamente. Os valores de fluorescência iniciais e finais foram comparados para determinar se um clone ativo estava presente.
[0470] Para isolar o clone individual que portou a atividade, as placas Source GenBank foram descongeladas e os poços individuais usados para inocular individualmente uma nova placa contendo LB Amp/Meth. Como acima, a placa foi inoculada a 37°C para
Petição 870180005321, de 22/01/2018, pág. 218/316
212/293 desenvolver as células, 50 μΙ de solução de consumo de substrato 600 μΜ foram adicionados usando-se o BIOMEK™ e determinou-se a fluorescência. Uma vez que o poço ativo da placa fonte foi identificado, células deste poço ativo foram aplicadas por meio de filamento sobre agar com LB/Amp/Meth e desenvolvidas de um dia para o outro a 37°C para se obter colônias individuais. Colheu-se oito colônias individuais com um palito-dedentes estéril e foram usadas para inocular individualmente os poços de uma placa de microtitulação de 96 poços. Os poços continham 250 μl de LB Amp/Meth. As células foram desenvolvidas de um dia para o outro a 37°C sem agitação. Uma fração de 200 μl foi removida de cada poço e analisada com os substratos de cadeia curta ou longa apropriados, como acima. O clone mais ativo foi identificado e os 50 μl remanescentes da cultura foram usados para aplicação por filetes sobre uma placa de agar com LB/Amp/Meth. Colheu-se oito colônias individuais, que foram desenvolvidas e analisadas como acima. O clone mais ativo foi usado para inocular culturas de 3 ml de Amp/Meth, que foram desenvolvias de um dia para o outro. O DNA plasmídico foi isolado das culturas para sequenciamento.
Exemplo 2: Protocolos exemplares para a determinação por LCMS do perfil de ácido graxo liberado resultante de hidrólise enzimática de óleo vegetal [0471] O exemplo a seguir descreve métodos exemplares (protocolos) para conduzir hidrólise enzimática de óleo vegetal, como óleo de soja (usado neste exemplo), (incluindo preparação de enzima) usando, por exemplo, enzimas como proporcionadas aqui. Este exemplo também descreve métodos exemplares (protocolos) para detectar e quantificar os ácidos graxos liberados do óleo. O método é descrito usando-se a lipase SEQ ID NO:2, porém é aplicável a outras enzimas, incluindo as enzimas como proporcionadas aqui, p. ex., as enzimas exemplares apresentando uma[] sequências como apresentada na SEQ ID NO:2 e apresentando uma, duas, três, quatro, cinco, seis, sete, oito, nove, dez, onze ou doze ou mais ou todas as modificações de resíduos de aminoácidos descritas na Tabela 3, Tabela 4, Tabela 9, Tabela 10, Tabela 1 1, Tabela 16 ou Tabela 23.
EXPRESSÃO DE PROTEÍNA EM PLACA DE 96 POÇOS PROFUNDOS:
1. Desenvolver clones de lipase de E. coli de um dia para o outro a 30°C em 1 ml de meio TB contendo carbenicilina (100 μg/ml) em placas de 96 poços
Petição 870180005321, de 22/01/2018, pág. 219/316
213/293 profundos com []. Registrar a localização e a identidade de clones.
2. Inocular placas de 96 poços profundos frescas contendo meio TB (1 ml; 100 pg/ml de carbenicilina) com as culturas líquidas (10 pl/poço).
3. Incubar a cultura de um dia para o outro a 30°C enquanto se agita a 200 rpm.
4. Induzir a expressão de proteína por meio de transferência de 500 pl de cada cultura de um dia para o outro para uma placa de 96 poços fresca contendo meio TB (500 pl/poço; 100 pg/ml de carbenicilina) e tetraciclina anidra (200 ng/ml).
5. Incubar a 30°C durante 2 horas com agitação a 200 rpm
6. Colher células por meio de centrifugação de cada placa durante 10 minutos a 3000 x g. Remover o sobrenadante. É possível usar placas de células imediatamente quanto a ensaios com óleo ou armazenadas a -20°C durante o uso posterior.
REAÇÃO DE HIDRÓLISE ENZIMÁTICA DE ÓLEO:
1. Adicionar 100 pl de B-PER™ (Pierce Chemical, Rockford, IL) em cada pellet de células. Se os pellets forem armazenados a -20°C, deixá-los descongelar durante 10 min à temperatura ambiente antes da adição de B-PER™.
2. Adicionar 400 pl de óleo de soja em cada poço de placa com 96 poços profundos.
3. Adicionar várias pérolas (vidro de 710-1180 pm) poço. Selar placas com CAPMATS™ (Whatman, Florham Park, NJ).
4. Células são lisadas e gera-se uma emulsão de óleo/enzima/tamponador usando um moinho misturador (Retsch Inc., Newtown, PA). Colocar um par de placas fechadas hermeticamente no moinho misturador e agitar durante 30 segundos a uma frequência de 30 ciclos/segundo.
5. Substituir os selos CAPMATS™ por um selo permeável a gás.
6. Incubar as placas durante 2 horas a 37°C enquanto se agita a 200 rpm. EXTRAÇÃO DE ÁCIDOS GRAXOS:
1. Adicionar 1 ml de solvente de extração (CHCl3:MeOH:4N HCl (2 : 1 : 0,075)) em cada poço cada poço da placa de 96 poços profundos.
Petição 870180005321, de 22/01/2018, pág. 220/316
214/293
2. Pipetar a mistura para cima e para baixo várias vezes até que pareça homogênea.
3. Cobrir as placas com um selo de folha de alumínio.
4. Centrifugar durante 5 minutos a 3000 x g. Abrir o selo por corte com uma lâmina de barbear.
5. Penetrar a ponta de pipeta através da fase superior e transferir 5 pl da fase inferior para uma nova placa de 96 poços profundos contendo 995 pl/poço de MeOH (i.e. uma diluição a 1/200 da fase inferior). Tomar cuidado para não contaminar com a fase superior. Armazenar as misturas de extração separadas a 4°C.
6. Transferir 150 pl da diluição a 1/200 de todas as amostras para uma placa de 96 poços em poliestireno.
7. Para prevenir a evaporação, selar as placas com aquecimento. Assegurarse que o selo não contacte o MeOH porque isto impedirá a adesão apropriada.
8. Analisar as amostras por meio de LC/MS.
ANÁLISE DE LC/MS:
1. Amostras submetidas no formato de placa de 96 poços são injetadas via um coletador de amostras HTCP AL™ auto sampler (LEAP Technologies, Carrboro, NC) em uma mistura isocrática de H2C/MeCN (10/90, vol/vol) e 0,1 % de ácido fórmico, fornecido com bombas LC-10ADVP™ (Shimadzu, Kyoto, Japão) a 1,2 ml/min.
2. A separação é obtida com um uma coluna SYNERGI MAX-RP™ (Phenomenex, Sutter Creek, CA) de 150 x 2,00 mm e detecção. A quantificação é completada com um espectrômetro de massa API 4000™ triple-quad (Applied Biosystems, Foster, CA) usando ionização por eletrospray (ESI) e monitoramento múltiplo de íons para massas 277, 279, 281, 255, 283 no modo de íon negativo.
3. Controle de instrumentação e geração de dados é realizada com o programa
ANALYST 1.3™ (Applied Biosystems, Foster, CA).
Petição 870180005321, de 22/01/2018, pág. 221/316
215/293
4. LC/MS calibrada para cada ácido graxo na faixa de 0,5 a 50 pg usando-se amostras convencionais (Sigma). Esta faixa adequa-se melhor a uma curva padrão de regressão quadrática que é usada para calcular a quantidade de cada ácido graxo liberado em amostras de enzima.
Exemplo 3: Protocolos exemplares para seleção de HTP de bibliotecas de evolução de lipase quanto à seletividade incrementada por hidrólise de ésteres de palmitato ou de estearato versus ésteres de oleato [0472] O exemplo a seguir descreve métodos exemplares (protocolos) para seleção de alta vazão (HTP) de “bibliotecas de evolução” de lipase quanto à seletividade por hidrólise de ésteres de palmitato ou estearato versus ésteres de oleato. Este método exemplar (protocolo/seleção de HTP) descreve a seleção de bibliotecas de evolução de lipase derivadas da SEQ ID NO:2, mas é aplicável a outras enzimas, incluindo as enzimas como proporcionadas aqui, p. ex., as enzimas exemplares apresentando as sequências como apresentadas na SEQ ID NO:2 e apresentando uma, duas, três, quatro, cinco, seis, sete, oito, nove, dez, onze ou doze ou mais ou todas as modificações de resíduos de aminoácidos descritas na Tabela 3 ou Tabela 4; e este método exemplar (protocolo) é aplicável a outros tipos de bibliotecas.
[0473] Estas seleções de HTP exemplares são conduzidas usando-se dois substratos fluorogênicos: metilumbeliferila ésteres de palmitato ou estearato versus metilumbeliferila éster de oleato.
FLUXO DA SELEÇÃO DE HTP:
1. Clones da biblioteca são distribuídos em placas de microtitulação e ensaiados em uma seleção de HTP primária.
2. Clones identificados como apresentando seletividade aperfeiçoada são designados como acertos primários.
3. Acertos primários são re-distribuídos em placas de microtitulação, e ensaiados em uma seleção de HTP secundária.
4. Clones confirmados como apresentando seletividade aperfeiçoada são designados como acertos secundários.
5. Acertos secundários são sequênciados para identificar mutações de
Petição 870180005321, de 22/01/2018, pág. 222/316
216/293 sequências presentes e ensaiadas sobre óleo (ver protocolo separado).
PROTOCOLO DE ENSAIO DE HTP
1. Dotar com código de barras, placas de ensaio pretas com 384 poços; dotar com código de barras, placas de crescimento de 384 poços e encher com 30 pl/poço de meio LB (100 pg/ml de carbenicilina).
2. Alfinetar ou colher com palito-de-dentes clones em placas de crescimento e desenvolver de um dia para o outro a 30°C em um incubador umidificado.
3. Induzir a expressão de lipase por meio da adição de 30 pl/poço de meio LB (100 pg/ml de carbenicilina) contendo 4 pg/ml de tetraciclina anidra e incubar durante 2 horas a 30°C.
4. Lisar células adicionando 20 pl/poço de B-PER™ (Pierce Chemical, Rockford, IL); manter à temperatura ambiente até colocar no robô.
5. Realizar o ensaio de atividade de lipase no robô (ver abaixo).
6. Clones identificados como apresentando seletividade incrementada por MeUMB ésteres de palmitato ou estearato relativamente a MeUMB éster são designados como acertos.
7. Colher com palito-de-dentes clones de acerto [hit clones] em placas de 96 poços profundos contendo meio LB (1 ml/poço; 100 pg/ml de carbenicilina) e desenvolver de um dia para o outro a 30°C.
8. Para acertos primários, re-agrupar em placas de 384 poços e repetir as etapas de 1 a 8 na seleção secundária; designar clones de acerto como acertos secundários.
9. Para acertos secundários, após a etapa 8 submeter a sequenciamento. PROTOCOLO DO EXEMPLO DE SELEÇÃO DE HTP AUTOMATIZADA
1. Apricot: Misturar e transforir uma fração (10 pl) de células lisadas da “Placa de Crescimento” (ver Etapas 1 -4 acima) para cada uma das duas placas de ensaio separadas (1 & 2).
2. MULTIDROP™ (Thermo Electron Corporation, Milford, MA): Adicionar 70 pl de substrato 1 (UMB- 16:0) na placa de ensaio 1; adicionar 70 pl de substrato 2 (UMB-18: 1) na placa de ensaio 2
Petição 870180005321, de 22/01/2018, pág. 223/316
217/293
3. Incubar placas de ensaio durante 20 minutos a 37°C.
4. Ler em fluorímetro: Excitação a 360 nm e Emissão a 465 nm [0474] Clones de acerto secundários determinados como apresentando sequências únicas são agrupados e desenvolvidos em placas de 96 poços e analisados sobre óleo de soja (ver abaixo).
ESTRUTURAS DE SUBSTRATOS FLUOROGÊNICOS USADOS NA SELEÇÃO DE HTP [0475]


oleato de 4-metilumbeliferila [0476] palmitato de 4-metilumbeliferila
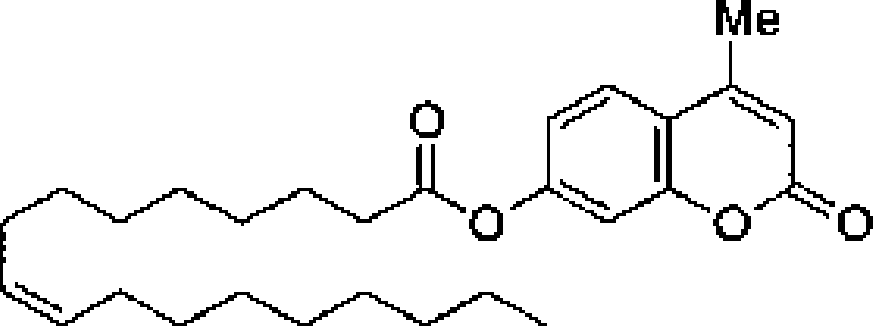
[0477]
Exemplo 4: Evolução exemplar para hidrólise aperfeiçoada de ésteres de palmitato ou estearato usando tecnologia GSSMSM [0478] O exemplo a seguir descreve e resume os resultados da “evolução de enzima” exemplar e protocolos de seleção que identificaram enzimas exemplares como proporcionadas aqui, p. ex., enzimas apresentando uma sequência como apresentada na
SEQ ID NO:2 mas também apresentando uma modificação de resíduo como apresentado na Tabela 3 ou Tabela 4; ou enzimas codificadas por um ácido nucleico apresentando uma sequência como apresentada na SEQ ID NO:1 mas também apresentando uma modificação de resíduo como apresentado na Tabela 3 ou Tabela 4. Em um aspecto, um ensaio de seleção exemplar para identificar estas enzimas exemplares como
Petição 870180005321, de 22/01/2018, pág. 224/316
218/293 proporcionadas aqui usou óleo de soja como um substrato, e os ácidos graxos liberados (hidrolisados) do óleo de soja foram caracterizados, p. ex., como ácido linolênico, ácido linoleico, ácido oleico, ácido palmítico ou ácido esteárico.
[0479] Óleo de soja apresenta a seguinte distribuição de ácido graxo: Linolênico = 8 %; Linoleico = 53 %; Oleico = 23 %; Palmítico = 12 %; Esteárico = 4 %. Assim, se o percentual de ácido palmítico liberado (hidrolisado) de óleo de soja por uma enzima exemplar como proporcionada aqui for maior do que 12 %, então aquela enzima apresenta uma preferidos para hidrolisar (liberar) ácido palmítico.
SELEÇÃO DE PALMITASE: PREPARANDO UMA “BIBLIOTECA DE PALMITASE” [0480] Um biblioteca de palmitase de variantes da SEQ ID NO:2 foi preparada por meio de tecnologia GSSMSM (número da patente 6.171.820). Introduziu-se mutações pontuais usando oligonucleotídeos degenerados, uma posição de aminoácido de cada vez, de modo que cada códon original é substituído por cada um dos 20 aminoácidos naturalmente codificados. As variantes mutadas foram transformadas no hospedeiro de Escherichia coli TOP10 (Invitrogen, E.U.A.) para expressão e seleção. A biblioteca foi construída em um vetor de expressão pASK-5, que foi modificado do vetor pASK-IBA (IBA GmbH, Alemanha). Para preparar pASK-5, o ligante de clonagem original foi substituído por novos sítios de clonagem, especificamente, a sequência de Xbal a Hindlll de pASK-IBAfoi substituída pela seguinte sequência:
RBS ArgSerHisHisHisHisHisHis
TCTAGATAACGAGGGCAAAACCATGGGAGGATCCAGATCTCATCACCATCACCATCACTAAGCTT (SEQ ID NO:21) Xbal Ncol BamHI BglII Hindlll [0481] A expressão das variantes de GSSMSM foi induzida com anidrotetraciclina após se ter alcançado densidades ótimas de células hospedeiras.
[0482] Enzimas apresentando sequências de aminoácidos geradas por meio de tecnologia GSSMSM foram selecionadas por meio de um protocolo de seleção de alta vazão (HTP), p. ex., o protocolo descrito no Exemplo 3, que determinou qual ácido graxo foi hidrolisado preferivelmente de uma gordura - óleo de soja neste ensaio. O objetivo do projeto de evolução foi o de melhorar a seletividade por palmitato da sequência parental, SEQ ID NO:2, sobre óleo. O ensaio compreendia contactar a nova enzima / a enzima com sequência modificada com óleo de soja, que compreende vários ácidos graxos, incluindo
Petição 870180005321, de 22/01/2018, pág. 225/316
219/293 ácido linolênico, ácido linoleico, ácido oleico, ácido palmítico e ácido esteárico (ver o % de distribuição, listados acima) e medir a quantidade de cada ácido graxo hidrolisado por cada enzima modificada. Identificou-se uma “biblioteca” de sequências que permitiram que uma enzima hidrolisasse preferivelmente um ácido palmítico (ou um ácido esteárico, ver abaixo), do óleo de soja (a assim-chamada “Biblioteca de Palmitato”):
• Realizou-se seleções primárias e secundárias usando uma seleção de HTP,
p. ex. o método descrito no Exemplo 3;
• Sequenciamento de acertos secundários identificou mutações de aminoácidos que resultaram na seletividade aperfeiçoada pela hidrólise do palmitato versus oleato na seleção de HTP em comparação com, por exemplo, a sequência parental, SEQ ID NO:2.
• Para cada variante de códon que codifica uma mutação de aminoácido, um clone foi colhido com palito-de-dentes e distribuído em placas de 96 poços para ensaio sobre óleo;
• Dos ensaios sobre óleo obteve-se a seletividade das enzimas mutantes para palmitato ou estearato ou outros ácidos graxos (Tabela 3) • O acerto máximo [top hit] deu palmitato como 59 % dos ácidos graxos (FAs) liberados versus (vs) 43 % para a SEQ ID NO:2 no mesmo ensaio; isto corresponde a um aumento do fator de seletividade de 3,6 a 4,9;
• Diversos clones também apresentaram aumentos na seletividade pelo estearato. Tabela 1, abaixo, resume mutações GSSM/GSSMSM (ver acima) selecionadas para inclusão na “biblioteca de palmitato” a ser combinada por meio de tecnologia GeneReassemblySM (ver Exemplo 5). Em um ensaio exemplar, identificou-se quatorze (14) mutações individuais de aminoácidos como dando os maiores incrementos na hidrólise de palmitato em ensaios sobre óleo (ver também Tabelas 1, 3 e 4, abaixo). Resíduos são marcados de acordo com a ordem em que eles ocorrem na SEQ ID NO:2 parental (ver e 7), entre resíduos que proporcionam aumentos significativos nos ensaios de hidrólise de palmitato ou estearato. O “AA original” na SEQ ID NO:2 e mutações benéficas (“Novos Aminoácidos”), i.e.,
Petição 870180005321, de 22/01/2018, pág. 226/316
220/293 sequências exemplares como proporcionadas aqui, são dados. Em um aspecto, as mutações individuais para arginina (R) nas posições de resíduos 163 e 164 podem ser incluídas alternativamente de tal forma que esta biblioteca exemplar virá a incluir clones com as sequências 163V-164D (SEQ ID NO: 2), 163R-164D, e 163V-164R, mas não a sequência 163R164R.
Tabela 1
| Resíduo | Aminoácido original | Novos aminoácidos |
| 61 | D | A,E |
| 72 | R | E,K |
| 116 | E | A,Q,R,T,V |
| 133 | S | A |
| 151 | I | G,A |
| 163 | V | R |
| 164 | D | R |
[0483] A Figura 6a ilustra os efeitos de mutações GSSMSM exemplares de palmitase sobre a hidrólise de palmitato e estearato relativamente à SEQ ID NO:2 parental. Para cada uma das quatorze (14) mutações individuais de aminoácidos selecionadas para inclusão na biblioteca de palmitase GeneReassemblySM demonstra-se graficamente o percentual de alteração do palmitato e estearato liberados, relativamente à SEQ ID NO:2 parental. Muitas destas mutações proporcionaram aumentos significativos na hidrólise de palmitato, acompanhados de aumentos pequenos até significativos na hidrólise de estearato. No entanto, várias mutações causam ligeiras diminuições na hidrólise de estearato. Asteriscos indicam mutações identificadas como proporcionando seletividade incrementada de tipo saturase.
SELEÇÃO DE ESTEARATO: PREPARANDO UMA “BIBLIOTECA DE ESTEARATO (ESTEARATASE)” [0484] Uma biblioteca de estearatase of variantes da SEQ ID NO:2 foi preparada por meio de tecnologia GSSMSM (número de patente 6.171.820). Introduziu-se mutações pontuais usando oligonucleotídeos degenerados, uma posição de aminoácido de cada vez, de modo que cada códon original possa ser substituído por cada um dos 20 aminoácidos naturalmente codificados. As variantes mutadas foram transformadas no hospedeiro de
Petição 870180005321, de 22/01/2018, pág. 227/316
221/293
Escherichia coli TOP10 (Invitrogen, E.U.A.) para expressão e seleção. A biblioteca foi construída em vetor de expressão pASK-5 (como descrito acima). A expressão das variantes GSSMSM foi induzida com anidrotetraciclina após se obter as densidades ótimas de células hospedeiras [0485] Enzimas apresentando sequências de aminoácidos geradas por meio de tecnologia GSSMSM foram selecionadas por meio do protocolo de seleção de alta vazão (HTP), p. ex., o protocolo descrito no Exemplo 3, que determinou qual ácido graxo foi hidrolisado preferivelmente de uma gordura - óleo de soja neste ensaio. O ensaio compreendeu contactar a enzima nova/com-sequência-modificada com óleo de soja, que compreende vários ácidos graxos, incluindo ácido linolênico, ácido linoleico, ácido oleico, ácido palmítico e ácido esteárico (ver o % de distribuição, listados acima) e medir a quantidade de ácido graxo hidrolisada por cada enzima modificada. Identificou-se uma “biblioteca” de sequências que permitiram que uma enzima hidrolisasse preferivelmente um ácido esteárico (ou um ácido palmítico, ver acima), do óleo de soja (a assim-chamada “Biblioteca de Estearato”):
• Conduziu-se seleções primária e secundária usando uma seleção de HTP, p.
ex. o método descrito no Exemplo 3;
• O sequenciamento de acertos secundários identificou mutações de aminoácidos que resultaram na seletividade aperfeiçoada para hidrólise de estearato versus oleato na seleção de HTP em comparação com, por exemplo, a sequência parental, SEQ ID NO:2.
• Para cada variante de códon que codifica uma mutação de aminoácido, um clone foi colhido com palito-de-dentes e distribuído em placas de 96 poços para ensaio sobre óleo.
• Ensaios em óleo de acertos secundários sequenciados proporcionaram a seletividade das enzimas mutantes para palmitato ou estearato ou outros ácidos graxos (Tabela 3).
• O acerto máximo [top hit] deu estearato como 22 % dos FAs liberados vs 9 % para a SEQ ID NO:2 no mesmo ensaio; isto corresponde a um aumento do fator de seletividade de 2,3 a 5,5;
Petição 870180005321, de 22/01/2018, pág. 228/316
222/293 • Vários clones também apresentaram aumentos na seletividade pelo palmitato. [0486] Tabela 2, abaixo, resume as mutações GSSMSM (ver acima) selecionadas para inclusão na “biblioteca de estearatase” a serem combinadas por meio de tecnologia GeneReassemblySM. Em um ensaio exemplar, vinte de duas (22) mutações individuais de aminoácidos foram identificadas como proporcionando os maiores incrementos de hidrólise de estearato em ensaios em óleo (ver também Tabelas 2, 3 e 4, abaixo). Resíduos são marcados de acordo com a ordem em que eles ocorrem na SEQ ID NO:2 “parental”, entre resíduos que proporcionam incrementos significativos na hidrólise do palmitato ou estearato em ensaios sobre óleo. O “Aminoácido Original” na SEQ ID NO:2 e mutações benéficas (“Novos Aminoácidos”), i.e., sequências exemplares como proporcionadas aqui, são dados. Em um aspecto, a mutação individual para alanina (A) na posição de resíduo 223 é incluída como uma mutação fixa de tal forma que cada clone nesta biblioteca exemplar contém esta mutação.
Tabela 2
| Resíduo | Aminoácido original | Novos aminoácidos |
| 20 | I | L |
| 62 | V | S |
| 77 | G | P |
| 83 | V | C |
| 88 | D | H |
| 113 | Y | G |
| 116 | E | G,T |
| 140 | H | K |
| 146 | K | S |
| 167 | I | S |
| 180 | L | E |
| 194 | E | M |
| 211 | A | Q |
| 212 | S | Y |
| 215 | G | C,V,W |
| 218 | A | H,S |
| 223 | V | A |
| 225 | A | Q,M |
[0487] A Figura 6b (ver também acima) ilustra os efeitos de doze (12) das vinte e duas (22) mutações principais de estearatase GSSMSM sobre a hidrólise do palmitato e
Petição 870180005321, de 22/01/2018, pág. 229/316
223/293 estearato relativamente à SEQ ID NO:2 parental. Para cada uma das doze (12) mutações individuais de aminoácidos dadas na Figura 6b e selecionadas para inclusão na biblioteca de estearatase GeneReassemblyTM mostra-se graficamente o percentual de alteração do palmitato e estearato liberado, relativamente à SEQ ID NO:2 parental. A maior parte destas mutações proporcionou aumentos significativos de hidrólise de estearato, mas aumentos de ligeiros a significativos da hidrólise do palmitato hidrólise. Asteriscos indicam mutações identificadas como proporcionando seletividade incrementada do tipo saturase, i.e. aumentos de seletividade por hidrólise do palmitato e estearato versus hidrólise de ácidos graxos insaturados no óleo, p. ex., oleato, linoleato e linolenato.
• Sumário • Seleção da “biblioteca GSSMSM” (ver acima onde a tecnologia GSSMSM é descrita em detalhe) baseada na SEQ ID NO:2 parental deu clones mutantes de aminoácidos individuais com melhoramentos significativos da seletividade por palmitato e estearato, e da seletividade saturada, i.e. seletividade por hidrólise do palmitato e estearato (p. ex., hidrólise seletiva de palmitato e/ou estearato de óleo de soja);
• Verificou-se clones com melhoramentos significativos da seletividade por estearato (hidrólise seletiva do ácido esteárico relativamente a outros ácidos graxos);
• Descobriu-se mutantes GSSMSM com seletividade incrementada por palmitato (hidrólise seletiva do ácido palmítico relativamente a outros ácidos graxos) relativamente à enzima da SEQ ID NO:2.
[0488] A Tabela 3 e Tabela 4, abaixo, descrevem (também resumem) as sequências das enzimas hidrolase exemplares como proporcionadas aqui, p. ex., as enzimas exemplares apresentando uma sequência como apresentada na SEQ ID NO:2 e apresentando pelo menos uma (um, várias ou todas) as alterações de resíduos de aminoácidos descritas nas tabelas. A Tabela 3 e Tabela 4 também resumem dados de atividade para enzimas exemplares selecionadas; sendo que os dados incluem a equiparação de enzimas exemplares particulares com sua atividade de hidrolase positiva compreendendo catálise da hidrólise de (liberação de) um ácido graxo de palmitato ou de
Petição 870180005321, de 22/01/2018, pág. 230/316
224/293 estearato de óleo de soja, como identificado por meio de um protocolo de seleção de alta vazão (HTP), como descrito acima.
[0489] Na Tabela 3 e Tabela 4, o termo “Aminoácido Original” indica o resíduo de aminoácido objetivado (indicada sob “resíduo de aminoácido”) na enzima SEQ ID NO:2 “parental” (“objetivada” para alteração); e o termo “Novos aminoácidos” indica o resíduo de aminoácido recentemente projetado (que substituiu o resíduo “objetivado” correspondente na “velha sequência”) na enzima exemplar (nova) como proporcionada aqui. A listagem do resíduo “Novo Aminoácido” encontra-se sob a coluna “estearato” versus “palmitato” indica qual das duas seleções de ácido graxo de alta vazão (HTP) (i.e., liberação de ácido palmítico em uma seleção, e liberação de ácido esteárico na outra seleção, ver o Exemplo 3) foi usada para detectar (identificar) uma enzima particular com a variação de resíduo indicada (nova sequência de enzima, resíduo “Novo aminoácido”).
[0490] Por exemplo, na primeira linha da Tabela 3, no resíduo de aminoácido 7, a tirosina (ou “Y”) da enzima SEQ ID NO:2 “parental” é substituída por um resíduo de aminoácido arginina (ou “R”), e esta nova enzima (Y7R) apresenta atividade que difere daquela da enzima parental (ver Tabela 3); por exemplo, “Dados do óleo” resume a preferidos por substrato (ácido graxo) da nova enzima (p. ex., a enzima Y7R) por meio de listagem dos ácidos graxos liberados (hidrolisados) gerados quando a enzima foi exposta a (contactada com) óleo de soja (ensaios descritos acima), observando-se que o substrato óleo de soja apresenta vários possíveis grupos constituintes de ácido graxo hidrolisáveis, incluindo ácido linolênico, ácido linoleico, ácido oleico, ácido palmítico, ácido esteárico.
[0491] Por exemplo, na primeira linha, para a enzima Y7R, 8,3 % dos ácidos graxos liberados (do óleo de soja reagido) foram ácido linolênico, 22,1 % dos ácidos graxos liberados foram ácido linoleico, 19,7 % dos ácidos graxos liberados foram ácido oleico; 41,5 % dos ácidos graxos liberados foram ácido palmítico; 8,4 % dos ácidos graxos liberados foram ácido esteárico (estes quatro números somam 100 %).
[0492] A coluna P + S adiciona ambos os pontos de dados P e S para resumir quanto dos ácidos graxos liberados foram ácido palmítico e ácido esteárico (41,5 % mais 8,4 % = 49,9 % dos ácidos graxos hidrolisados foram ácido palmítico e ácido esteárico, ou “P + S”).
Petição 870180005321, de 22/01/2018, pág. 231/316
225/293
Tabela 3
| Resíduo Aminoácido | de Aminoácido Original | Acertos da seleção de HTP | P+S | |
| Novo Aminoácido Palmitato | Novo Aminoácido Estearato | |||
| 7 | Y | R | 49,9% | |
| 8 | G | E, A218R | ||
| 12 | R | F | 47,8% | |
| K | 54,2% | |||
| L | 45,4% | |||
| M | 43,3% | |||
| 16 | D | M | 43,2% | |
| 18 | P | G | 41,8% | |
| 20 | I | L | 50,3% | |
| V | 44,6% | |||
| 22 | T | M, G215V | 52.1% | |
| 27 | G | Q | 57.2% | |
| S | 43.6% | |||
| 29 | A | G | 51.5% | |
| 32 | G | E | crosta | |
| D, L180E | 44.6% | |||
| 34 | L | E | 45.8% | |
| V | crosta | |||
| 36 | D | A | 51.0% | |
| G | 50.9% | |||
| 40 | V | P | 32.2% | |
| 42 | V | I | 47.2% | |
| L | 47.8% | |||
| 43 | L | V | 51.5% | |
| 45 | G | A | 44.4% | |
| L | 52.7% | |||
| 48 | A | G | 45.4% | |
| V | 70.1% | |||
| V | 55.7% | |||
| T | 33.60% | |||
| 54 | S | H | 55.6% | |
| 61 | D | A | 60.5% | |
| E | 55.0% | |||
| S | 49.8% | |||
| 62 | V | E | E | 53.0% |
| A | 56.6% | |||
| G | 56.5% | |||
| M | 51.9% | |||
| N | 49.7% |
Petição 870180005321, de 22/01/2018, pág. 232/316
226/293
| Resíduo Aminoácido | de Aminoácido Original | Acertos da seleção de HTP | P+S | |
| Novo Aminoácido Palmitato | Novo Aminoácido Estearato | |||
| Q | 52.4% | |||
| S | 55.5% | |||
| T | 50.7% | |||
| D | 52.5% | |||
| L | ||||
| W | 50.2% | |||
| 66 | A | N | 54.2% | |
| R | 52.1% | |||
| 72 | R | E | 58.3% | |
| K | 61.0% | |||
| P | 27.2% | |||
| S | 55.3% | |||
| T | 55.9% | |||
| Y | 50.1% | |||
| 74 | F | I | 53.8% | |
| L | 54.8% | |||
| P | 52.3% | |||
| R | 50,5% | |||
| 77 | G | P | 38,1% | |
| 78 | I | D | 47,1% | |
| E | 37,1% | |||
| P | 40,9% | |||
| 80 | G | P | 51,9% | |
| 82 | L | P | 37,3% | |
| 83 | V | C | 47,7% | |
| M | 59,3% | |||
| 84 | D | V | 40,2% | |
| 87 | V | A | 49,2% | |
| C | 46,1% | |||
| D | 43,9% | |||
| E | 46,6% | |||
| G | ||||
| P | 53,3% | |||
| S | 45,2% | |||
| T | 42,8% | |||
| H | 52,9% | |||
| N | 50,3% | |||
| 88 | D | E | 44,6% | |
| F | 50,3% | |||
| H | 45,9% | |||
| L | 49,1% |
Petição 870180005321, de 22/01/2018, pág. 233/316
227/293
| Resíduo Aminoácido | de Aminoácido Original | Acertos da seleção de HTP | P+S | |
| Novo Aminoácido Palmitato | Novo Aminoácido Estearato | |||
| P | 59,6% | |||
| P | 48,9% | |||
| Q | 47,1% | |||
| 89 | R | S | 54,5% | |
| 92 | A | D | 47,3% | |
| E | 59,3% | |||
| R | 42,6% | |||
| S | 48,7% | |||
| T | 52,1% | |||
| V | 57,5% | |||
| 93 | V | M | 48,2% | |
| 96 | A | C I | C I | 51,4% crosta |
| S | S | 46,8% | ||
| 98 | G | A | 45,0% | |
| L | crosta | |||
| 101 | K | A | 49,8% | |
| 103 | I | L | 36,8% | |
| 107 | W | P | 46,20% | |
| A | 39,5% | |||
| C | 39,4% | |||
| G | 47,5% | |||
| H | 42,0% | |||
| R | 68,0% | |||
| S | 36,8% | |||
| L | 64,8% | |||
| P, E217Q | 46,2% | |||
| V | 37,8% | |||
| V, E217Q | 44,80% | |||
| 108 | S | stop | 19,0% | |
| A | 43,0% | |||
| C | 26,0% | |||
| G | 47,5% | |||
| K | 57,8% | |||
| L | 44,0% | |||
| P | 56,9% | |||
| Q | 58,6% | |||
| R | 54,7% | |||
| V | 53,4% | |||
| T, A218T | E, E217Q | 46,50% |
Petição 870180005321, de 22/01/2018, pág. 234/316
228/293
| Resíduo Aminoácido | de Aminoácido Original | Acertos da seleção de HTP | P+S | |
| Novo Aminoácido Palmitato | Novo Aminoácido Estearato | |||
| 109 | L | M | 49,0% | |
| 110 | G | L | 54,4% | |
| 113 | Y | E | 35,8% | |
| G | 39,8% | |||
| F | 36,5% | |||
| 116 | E | A | 66,6% | |
| F | 54,7% | |||
| G | 53,8% | |||
| H | 57,9% | |||
| L | 58,5% | |||
| L | 55,1% | |||
| P | 58,0% | |||
| Q | 59,6% | |||
| Q | 60,5% | |||
| R, H140R | 60,6% | |||
| R | 61,8% | |||
| S | 58,6% | |||
| S | 59,7% | |||
| T | 67,6% | |||
| V R, H140R | 67,8% | |||
| 117 | L | R, I161L | 54,1% | |
| R | 51,6% | |||
| 120 | K | I L | L | 46,7% 60,8% |
| F | 52,6% | |||
| M | 49,9% | |||
| S | S | 53,3% | ||
| 132 | G | D, S212A | 56,2% | |
| 133 | S | A | 53,2% | |
| A | 55,8% | |||
| G | 45,6% | |||
| P | 56,0% | |||
| R | 51,7% | |||
| T | 54,9% | |||
| V, L139,H | 53,2% | |||
| 134 | P | G | 7,2% | |
| R | ||||
| 135 | F | K | 51,8% | |
| 139 | L | H, S133V | 53,2% | |
| 140 | H | K | 45,5% |
Petição 870180005321, de 22/01/2018, pág. 235/316
229/293
| Resíduo Aminoácido | de Aminoácido Original | Acertos da seleção de HTP | P+S | |
| Novo Aminoácido Palmitato | Novo Aminoácido Estearato | |||
| R, E116R | ||||
| 141 | A | R | 40,2% | |
| T | 43,3% | |||
| 142 | N | M | 46,1% | |
| R | 53,8% | |||
| S | 43,2% | |||
| T | 64,3% | |||
| 144 | A | T, N142K | 33,9% | |
| 146 | K | S | 50,2% | |
| G | 49,4% | |||
| L | 51,6% | |||
| A | 52,2% | |||
| 147 | I | F | 56,5% | |
| F | 50,5% | |||
| L | 52,2% | |||
| 150 | A | L | 59,7% | |
| L | 53,3% | |||
| 151 | I | A | 48,6% | |
| G | 53,0% | |||
| H | 60,0% | |||
| P | 33,7% | |||
| S | 52,2% | |||
| T | 49,2% | |||
| 152 | N | E | 28,0% | |
| G | 53,0% | |||
| H | 46,7% | |||
| M | 35,7% | |||
| R | 21,1% | |||
| 155 | T | C | 51,1% | |
| 157 | D | S | 50,4% | |
| G | 48,7% | |||
| T | 54,7% | |||
| 158 | N | A | 51,2% | |
| 159 | L | M | 51,5% | |
| 160 | P | T | 52,8% | |
| 161 | I | L, L117R | 54,1% | |
| L | 51,6% | |||
| 162 | P | K | crosta | |
| R | crosta | |||
| 163 | V | E | 55,7% |
Petição 870180005321, de 22/01/2018, pág. 236/316
230/293
| Resíduo Aminoácido | de Aminoácido Original | Acertos da seleção de HTP | P+S | |
| Novo Aminoácido Palmitato | Novo Aminoácido Estearato | |||
| R | 63,9% | |||
| T | 49,7% | |||
| 164 | D | A | 42,1% | |
| E | crosta | |||
| H | 39,8% | |||
| K | 49,4% | |||
| L | crosta | |||
| R | 61,3% | |||
| S | 47,9% | |||
| T | 53,0% | |||
| V | 42,3% | |||
| W | crosta | |||
| 166 | Q | G | 49,9% | |
| N | 41,3% | |||
| R | crosta | |||
| 167 | I | R | R | 53,3% |
| S | S | 47,3% | ||
| 170 | P | Q | 45,6% | |
| A | 52,5% | |||
| A, S212H | 34,7% | |||
| 171 | V | K | 34,1% | |
| 172 | R | P | 51,7% | |
| Q | 54,9% | |||
| S | 40,2% | |||
| 178 | S | K | 50,6% | |
| 180 | L | E | 54,0% | |
| H | 44,6% | |||
| Q | crosta | |||
| F, G32D | 44,6% | |||
| 183 | V | I | crosta | |
| 193 | P | 49,4% | ||
| 194 | E | A | crosta | |
| M | 47,9% | |||
| Q | crosta | |||
| D, P193S | 49,4% | |||
| 197 | D | K | 39,4% | |
| 198 | E | stop | 56,1% | |
| 200 | L | V | 55,3% | |
| 204 | V | L | 45,9% | |
| R | 45,7% |
Petição 870180005321, de 22/01/2018, pág. 237/316
231/293
| Resíduo Aminoácido | de Aminoácido Original | Acertos da seleção de HTP | P+S | |
| Novo Aminoácido Palmitato | Novo Aminoácido Estearato | |||
| 210 | A | V | 50,2% |
211
A
E H K L Q F N P R W Y
212
213
214
I
T, E217A
C
R
A E G H L P
Q R T
V W
Y
I
G
T
T stop
A, G132D
H, P170A
35,3%
48,1%
39,4%
45,0%
50,3%
32,6%
46,1%
49,2%
55,2%
47,8%
48,9%
50,8%
52,7%
52,7%
49,8%
46,2%
49,3%
50,3%
53,2%
36,8%
36,6%
44,3%
46,5%
53,2%
12,2%
41,8%
50,2%
53,7%
38,7%
48,4%
47,1%
34,7%
47,9%
57,7%
56,7%
55,5%
51,6%
53,0%
52,2%
V
Petição 870180005321, de 22/01/2018, pág. 238/316
232/293
| Acertos da seleção de HTP | ||||
| Resíduo | de Aminoácido | Novo | Novo | |
| Aminoácido | Aminoácido | P+S | ||
| Aminoácido | Original | Palmitato | Estearato |
| Y P N R Y Y | 54,5% 51,9% 56,9% 55,1% 62,7% 62,7% | |||
| 215 | G | A | A | 56,6% |
| I | 54,1% | |||
| L | 29,9% | |||
| H | 50,2% | |||
| S | 52,1% | |||
| M | 47,9% | |||
| V | 55,6% | |||
| P | 47,3% | |||
| C | 60,4% | |||
| W | 52,8% | |||
| stop | 53,9% | |||
| V, T22M | 52,1% | |||
| 216 | A | T | T | 50,9% |
| R | 41,9% | |||
| Y | 34,8% | |||
| V | V | 56,9% | ||
| C | 59,7% | |||
| S | S | 55,0% | ||
| L | 55,6% | |||
| 217 | E | Q | 36,6% | |
| R | 59,4% | |||
| S | 53,5% | |||
| A | 46,2% | |||
| G | 44,8% | |||
| P | 46,2% | |||
| 218 | A | M | 42,5% | |
| H | H | 49,1% | ||
| Q | Q | 47,7% | ||
| R | 53,4% | |||
| W | 51,9% | |||
| S | 51,1% | |||
| T | 50,0% | |||
| K | 52,4% |
R, G8E
R, 228K
Petição 870180005321, de 22/01/2018, pág. 239/316
233/293
| Resíduo Aminoácido | de Aminoácido Original | Acertos da seleção de HTP | P+S |
| Novo Aminoácido Palmitato | Novo Aminoácido Estearato | ||
| 223 | V | A | 48,8% |
| M | 31,6% | ||
| R | 23,4% | ||
| T | crosta | ||
| 224 | A | F | 49,5% |
| G | 58,2% | ||
| G | 48,4% | ||
| I | 41,7% | ||
| Q | 46,4% | ||
| Y | 43,7% | ||
| 225 | A | G | 49,3% |
| L | 54,3% | ||
| M | 49,0% | ||
| Q | 45,8% | ||
| T | 43,2% | ||
| 226 | R | H | 48,3% |
| T | 41,2% | ||
| 227 | L | R | 41,4% |
Tabela 3 (continuação)
| Ácidos graxos liberados de óleo por enzima | ||||||
| Resíduo de Aminoácido | Linolênico | Linoleico | Oleico | Palmítico | Esteárico | P+S |
| 7 | 8,3% | 22,1% | 19,7% | 41,5% | 8,4% | 49,9% |
| 8 | ||||||
| 12 | 11,5% | 13,0% | 27,7% | 38,5% | 9,3% | 47,8% |
| 5,2% | 22,1% | 18,5% | 47,2% | 7,1% | 54,2% | |
| 14,7% | 13,9% | 26,0% | 34,4% | 11,0% | 45,4% | |
| 10,3% | 12,8% | 33,6% | 34,0% | 9,4% | 43,3% | |
| 16 | 7,2% | 25,1% | 24,6% | 36,1% | 7,1% | 43,2% |
| 18 | 12,5% | 20,0% | 25,7% | 36,2% | 5,6% | 41,8% |
| 20 | 8,2% | 21,2% | 20,3% | 38,5% | 11,7% | 50,3% |
| 12,2% | 23,2% | 20,0% | 40,1% | 4,5% | 44,6% | |
| 22 | 8,0% | 19,5% | 20,4% | 47,1% | 5,0% | 52,1% |
| 27 | 7,5% | 17,6% | 17,6% | 47,4% | 9,8% | 57,2% |
| 9,1% | 23,2% | 24,0% | 35,8% | 7,8% | 43,6% | |
| 29 | 9,0% | 19,9% | 19,6% | 40,9% | 10,7% | 51,5% |
| 32 | 19,8% | 29,1% | 34,0% | crosta | 17,1% | crosta |
| 14,6% | 12,1% | 28,7% | 36,6% | 7,9% | 44,6% |
Petição 870180005321, de 22/01/2018, pág. 240/316
234/293
| 34 | 5,6% 21,1% | 31,0% 35,3% | 17,5% 37,1% | 40,9% crosta | 4,9% 6,5% | 45,8% crosta |
| 36 | 7,1% | 22,1% | 19,9% | 43,8% | 7,1% | 51,0% |
| 8,7% | 22,9% | 17,6% | 48,2% | 2,7% | 50,9% | |
| 40 | 0,0% | 51,4% | 16,4% | 22,4% | 9,7% | 32,2% |
| 42 | 14,8% | 12,1% | 25,8% | 34,6% | 12,6% | 47,2% |
| 7,7% | 13,9% | 30,7% | 34,8% | 13,0% | 47,8% | |
| 43 | 8,9% | 19,9% | 19,7% | 44,4% | 7,1% | 51,5% |
| 45 | 10,3% | 23,8% | 21,5% | 38,5% | 5,9% | 44,4% |
| 5,9% | 22,3% | 19,1% | 49,7% | 3,0% | 52,7% | |
| 48 | 15,0% | 18,0% | 21,7% | 38,1% | 7,2% | 45,4% |
| 4,3% | 11,5% | 14,2% | 61,0% | 9,1% | 70,1% | |
| 7,6% | 17,3% | 19,4% | 43,8% | 12,0% | 55,7% | |
| 23,6% | 13,4% | 29,3% | 22,5% | 11,1% | 33,60% | |
| 54 | 8,1% | 19,3% | 17,0% | 48,4% | 7,3% | 55,6% |
| 61 | 5,6% | 19,8% | 14,1% | 53,9% | 6,6% | 60,5% |
| 6,4% | 20,1% | 18,5% | 47,3% | 7,7% | 55,0% | |
| 7,7% | 19,9% | 22,6% | 41,5% | 8,3% | 49,8% | |
| 62 | 7,6% | 18,8% | 20,7% | 44,6% | 8,3% | 53,0% |
| 9,2% | 17,6% | 16,6% | 45,6% | 11,0% | 56,6% | |
| 6,7% | 20,3% | 16,5% | 47,6% | 8,8% | 56,5% | |
| 7,7% | 20,9% | 19,5% | 44,9% | 6,9% | 51,9% | |
| 7,9% | 21,7% | 20,7% | 40,7% | 9,0% | 49,7% | |
| 8,5% | 20,8% | 18,4% | 42,6% | 9,8% | 52,4% | |
| 5,4% | 26,0% | 13,1% | 37,0% | 18,5% | 55,5% | |
| 10,0% | 21,9% | 17,5% | 40,2% | 10,5% | 50,7% | |
| 6,1% | 23,2% | 18,2% | 47,1% | 5,4% | 52,5% | |
| 9,9% | 21,3% | 18,6% | 46,7% | 3,6% | 50,2% | |
| 66 | 7,5% | 16,8% | 21,5% | 48,0% | 6,2% | 54,2% |
| 11,4% | 18,0% | 18,5% | 47,2% | 4,8% | 52,1% | |
| 72 | 7,9% | 16,5% | 17,3% | 54,2% | 4,1% | 58,3% |
| 4,4% | 20,7% | 13,9% | 52,2% | 8,7% | 61,0% | |
| 6,8% | 44,6% | 21,4% | 20,2% | 7,0% | 27,2% | |
| 8,6% | 17,3% | 18,8% | 45,7% | 9,6% | 55,3% | |
| 7,5% | 17,4% | 19,3% | 45,1% | 10,7% | 55,9% | |
| 6,7% | 23,1% | 20,1% | 40,2% | 9,9% | 50,1% | |
| 74 | 7,4% | 19,6% | 19,3% | 45,4% | 8,4% | 53,8% |
| 8,0% | 19,3% | 18,0% | 44,8% | 10,0% | 54,8% | |
| 8,7% | 20,5% | 18,6% | 42,2% | 10,1% | 52,3% | |
| 7,1% | 21,7% | 20,7% | 41,1% | 9,4% | 50,5% | |
| 77 | 10,3% | 41,0% | 10,6% | 17,8% | 20,4% | 38,1% |
| 78 | 9,8% | 22,5% | 20,6% | 43,8% | 3,4% | 47,1% |
| 26,2% | 23,0% | 13,8% | 15,4% | 21,7% | 37,1% | |
| 14,4% | 1,3,2% | 31,4% | 32,3% | 8,6% | 40,9% |
Petição 870180005321, de 22/01/2018, pág. 241/316
235/293
| 80 | 7,4% | 21,0% | 19,7% | 42,9% | 9,0% | 51,9% |
| 82 | 13,0% | 28,3% | 21,4% | 33,3% | 4,0% | 37,3% |
| 83 | 7,5% | 20,0% | 24,7% | 31,1% | 16,6% | 47,7% |
| 6,8% | 18,6% | 15,3% | 51,5% | 7,8% | 59,3% | |
| 84 | 0,0% | 32,4% | 27,4% | 21,0% | 19,2% | 40,2% |
| 87 | 12,7% | 11,9% | 26,2% | 39,7% | 9,5% | 49,2% |
| 14,5% | 11,8% | 27,6% | 33,1% | 13,0% | 46,1% | |
| 9,3% | 12,3% | 34,5% | 32,7% | 11,2% | 43,9% | |
| 12,2% | 10,5% | 30,8% | 33,6% | 13,0% | 46,6% | |
| 10,6% | 9,9% | 26,2% | 40,6% | 12,7% | 53,3% | |
| 14,4% | 12,4% | 27,9% | 36,0% | 9,2% | 45,2% | |
| 6,7% | 25,8% | 24,7% | 39,5% | 3,3% | 42,8% | |
| 4,4% | 23,2% | 19,4% | 48,5% | 4,5% | 52,9% | |
| 11,7% | 11,3% | 26,7% | 31,5% | 18,8% | 50,3% | |
| 88 | 14,1% | 13,4% | 27,9% | 34,7% | ,9,9% | 44,6% |
| 13,4% | 15,2% | 21,0% | 36,7% | 13,6% | 50,3% | |
| 13,3% | 12,5% | 28,3% | 32,5% | 13,4% | 45,9% | |
| 13,0% | 9,2% | 28,7°A; | 40,3% | 8,8% | 49,1% | |
| 2,9% | 22,5% | 15,0% | 59,0% | 0,7% | 59,6% | |
| 4,2% | 35,5% | 11,4% | 35,6% | 13,3% | 48,9% | |
| 14,7% | 9,7% | 28,5% | 34,9% | 12,2% | 47,1% | |
| 89 | 0,0% | 35,4% | 10,1% | 39,0% | 15,5% | 54,5% |
| 92 | 13,1% | 16,1% | 23,5% | 36,4% | 10,9% | 47,3% |
| 12,0% | 10,4% | 18,2% | 48,0% | 11,4% | 59,3% | |
| 13,5% | 11,3% | 32,6% | 34,8% | 7,7% | 42,6% | |
| 8,3% | 25,1% | 17,9% | 46,1% | 2,6% | 48,7% | |
| 13,7% | 9,8% | 24,4% | 39,6% | 12,5% | 52,1% | |
| 4,9% | 20,0% | 17,5% | 51,7% | 5,8% | 57,5% | |
| 93 | 11,7% | 9,3% | 30,8% | 40,8% | 7,4% | 48,2% |
| 96 | 10,3% | 12,4% | 25,9% | 37,8% | 13,6% | 51,4% |
| 17,5% | 35,4% | 35,5% | crosta | 11,6% | crosta | |
| 12,5% | 12,0% | 28,7% | 33,3% | 13,6% | 46,8% | |
| 98 | 13,4% | 19,9% | 21,7% | 39,7% | 5,3% | 45,0% |
| 18,5% | 30,8% | 36,8% | crosta | 13,9% | crosta | |
| 101 | 9,8% | 12,5% | 27,9% | 39,7% | 10,1% | 49,8% |
| 103 | 9,1% | 36,6% | 17,5% | 26,0% | 10,8% | 36,8% |
| 107 | 11,9% | 10,1% | 31,8% | 30,5% | 15,7% | 46,20% |
| 0,0% | 20,4% | 40,1% | 12,1% | 27,4% | 39,5% | |
| 0,0% | 29,6% | 30,9% | 6,8% | 32,6% | 39,4% | |
| 0,0% | 29,6% | 22,9% | 9,5% | 38,0% | 47,5% | |
| 2,2% | 12,0% | 43,9% | 22,0% | 19,9% | 42,0% | |
| 30,4% | 12,5% | 46,2% | 10,9% | 57,1% | 68,0% | |
| 12,0% | 20,5% | 30,7% | 5,2% | 31,6% | 36,8% | |
| 5,0% | 16,0% | 14,2% | 62,2% | 2,6% | 64,8% | |
| 11,9% | 10,1% | 31,8% | 30,5% | 15,7% | 46,2% |
Petição 870180005321, de 22/01/2018, pág. 242/316
236/293
| 0,0% 13,2% | 15,6% 21,6% | 46,5% 20,4% | 10,2% 31,3% | 27,6% 13,5% | 37,8% 44,80% | |
| 108 | 9,0% | 49,0% | 23,0% | 12,3% | 6,7% | 19,0% |
| 0,0% | 51,0% | 6,1% | 33,1% | 9,9% | 43,0% | |
| 11,0% | 18,4% | 44,6% | 4,1% | 21,9% | 26,0% | |
| 0,0% | 29,6% | 22,9% | 9,5% | 38,0% | 47,5% | |
| 0,0% | 32,0% | 10,2% | 53,5% | 4,3% | 57,8% | |
| 0,0% | 45,6% | 10,4% | 38,2% | 5,8% | 44,0% | |
| 0,0% | 28,4% | 14,7% | 51,2% | 5,7% | 56,9% | |
| 5,4% | 18,9% | 17,2% | 52,8% | 5,8% | 58,6% | |
| 0,0% | 10,6% | 34,7% | 5,9% | 48,8% | 54,7% | |
| 0,0% | 21,9% | 24,7% | 32,7% | 20,8% | 53,4% | |
| 12,1% | 13,9% | 27,6% | 33,8% | 12,7% | 46,50% | |
| 109 | 10,9% | 8,8% | 31,3% | 37,7% | 11,3% | 49,0% |
| 110 | 0,4% | 21,4% | 23,9% | 54,4% | 0,0% | 54,4% |
| 113 | 5,0% | 44,1% | 15,1% | 21,0% | 14,8% | 35,8% |
| 13,6% | 14,6% | 32,0% | 15,2% | 24,6% | 39,8% | |
| 13,9% | 25,9% | 23,7% | 36,5% | 0,0% | 36,5% | |
| 116 | 4,8% | 17,4% | 11,2% | 55,5% | 11,1% | 66,6% |
| 7,8% | 17,7% | 19,8% | 47,0% | 7,7% | 54,7% | |
| 3,3% | 26,7% | 16,1% | 33,1% | 20,7% | 53,8% | |
| 7,3% | 18,3% | 16,5% | 47,8% | 10,1% | 57,9% | |
| 4,3% | 22,9% | 14,2% | 54,3% | 4,2% | 58,5% | |
| 4,6% | 26,8% | 13,5% | 41,6% | 13,5% | 55,1% | |
| 0,0% | 32,4% | 9,6% | 38,3% | 19,8% | 58,0% | |
| 8,1% | 16,1% | 16,2% | 50,4% | 9,3% | 59,6% | |
| 7,3% | 20,5% | 11,7% | 49,2% | 11,2% | 60,5% | |
| 6,9% | 19,6% | 12,9% | 52,1% | 8,5% | 60,6% | |
| 5,4% | 17,4% | 15,4% | 50,8% | 11,0% | 61,8% | |
| 8,7% | 18,7% | 13,9% | 49,1% | 9,5% | 58,6% | |
| 6,7% | 22,8% | 10,8% | 46,3% | 13,4% | 59,7% | |
| 6,4% | 17,2% | 8,8% | 50,3% | 17,2% | 67,6% | |
| 5,6% | 17,6% | 9,0% | 59,0% | 8,8% | 67,8% | |
| 117 | 6,2% | 21,4% | 18,3% | 46,0% | 8,0% | 54,1% |
| 8,9% | 21,8% | 17,7% | 40,6% | 11,0% | 51,6% | |
| 120 | 15,3% | 17,9% | 20,1% | 44,4% | 2,3% | 46,7% |
| 7,5% | 15,4% | 16,3% | 51,3% | 9,5% | 60,8% | |
| 17,3% | 4,4% | 25,7% | 44,0% | 8,6% | 52,6% | |
| 4,1% | 25,5% | 20,5% | 36,9% | 13,0% | 49,9% | |
| 15,7% | 10,1% | 20,9% | 36,8% | 16,5% | 53,3% | |
| 132 | 0,0% | 32,8% | 10,9% | 56,2% | 0,0% | 56,2% |
| 133 | 6,6% | 20,7% | 19,5% | 49,9% | 3,3% | 53,2% |
| 9,3% | 18,3% | 16,5% | 45,1% | 10,8% | 55,8% | |
| 3,3% | 30,4% | 20,7% | 45,6% | 0,0% | 45,6% | |
| 0,0% | 34,3% | 9,6% | 56,0% | 0,0% | 56,0% |
Petição 870180005321, de 22/01/2018, pág. 243/316
237/293
| 13,2% 10,1% 0,0% | 12,9% 11,6% 35,9% | 22,2% 23,3% 10,9% | 42,7% 46,5% 46,9% | 9,0% 8,4% 6,3% | 51,7% 54,9% 53,2% | |
| 134 | 0,0% | 56,2% | 36,6% | 7,2% | 0,0% | 7,2% |
| 135 | 0,0% | 41,1% | 7,2% | 51,8% | 0,0% | 51,8% |
| 139 | 0,0% | 35,9% | 10,9% | 46,9% | 6,3% | 53,2% |
| 140 | 9,7% | 23,4% | 21,4% | 32,7% | 12,8% | 45,5% |
| 141 | 11,2% | 12,1% | 36,5% | 28,2% | 12,1% | 40,2% |
| 14,7% | 13,9% | 28,1% | 38,3% | 5,0% | 43,3% | |
| 142 | 16,3% | 18,8% | 18,8% | 10,3% | 35,7% | 46,1% |
| 0,0% | 34,5% | 11,7% | 43,4% | 10,5% | 53,8% | |
| 8,6% | 15,8% | 32,5% | 22,8% | 20,4% | 43,2% | |
| 2,4% | 9,6% | 23,7% | 47,7% | 16,7% | 64,3% | |
| 144 | 0,0% | 14,9% | 51,2% | 13,4% | 20,4% | 33,9% |
| 146 | 13,6% | 10,3% | 26,0% | 31,4% | 18,7% | 50,2% |
| 12,6% | 12,4% | 25,5% | 36,5% | 12,9% | 49,4% | |
| 6,6% | 22,4% | 19,5% | 48,2% | 3,4% | 51,6% | |
| 9,0% | 19,7% | 19,0% | 41,7% | 10,5% | 52,2% | |
| 147 | 8,0% | 17,9% | 17,6% | 48,8% | 7,7% | 56,5% |
| 7,2% | 24,5% | 17,9% | 33,0% | 17,4% | 50,5% | |
| 9,5% | 20,6% | 17,7% | 42,2% | 9,9% | 52,2% | |
| 150 | 7,7% | 15,1% | 17,5% | 50,4% | 9,2% | 59,7% |
| 7,5% | 20,6% | 18,6% | 41,3% | 12,0% | 53,3% | |
| 151 | 7,8% | 26,1% | 17,5% | 46,4% | 2,2% | 48,6% |
| 5,0% | 29,6% | 12,4% | 48,9% | 4,1% | 53,0% | |
| 0,0% | 25,5% | 14,5% | 55,5% | 4,5% | 60,0% | |
| 0,0% | 14,2% | 52,1% | 20,0% | 13,7% | 33,7% | |
| 0,0% | 17,3% | 30,5% | 43,3% | 8,9% | 52,2% | |
| 8,0% | 22,7% | 20,2% | 44,0% | 5,1% | 49,2% | |
| 152 | 0,0% | 56,3% | 15,7% | 23,6% | 4,4% | 28,0% |
| 8,0% | 12,7% | 26,3% | 22,5% | 30,5% | 53,0% | |
| 0,0% | 27,1% | 26,2% | 26,2% | 20,5% | 46,7% | |
| 0,0% | 20,1% | 44,2% | 24,8% | 10,8% | 35,7% | |
| 9,5% | 31,2% | 38,3% | 2,2% | 18,9% | 21,1% | |
| 155 | 18,4% | 4,9% | 25,6% | 41,5% | 9,6% | 51,1% |
| 157 | 7,9% | 19,5% | 22,2% | 41,2% | 9,2% | 50,4% |
| 9,6% | 21,7% | 20,1% | 39,1% | 9,6% | 48,7% | |
| 7,2% | 25,2% | 13,0% | 34,9% | 19,8% | 54,7% | |
| 158 | 14,0% | 1,2% | 33,5% | 42,8% | 8,5% | 51,2% |
| 159 | 6,3% | 28,4% | 13,8% | 36,7% | 14,8% | 51,5% |
| 160 | 5,6% | 20,8% | 20,8% | 46,6% | 6,2% | 52,8% |
| 161 | 6,2% | 21,4% | 18,3% | 46,0% | 8,0% | 54,1% |
| 8,9% | 21,8% | 17,7% | 40,6% | 11,0% | 51,6% | |
| 162 | 10,2% | 45,6% | 38,4% | crosta | 5,7% | crosta |
Petição 870180005321, de 22/01/2018, pág. 244/316
238/293
| 22,1% | 39,2% | 32,7% | crosta | 6,0% | crosta | |
| 163 | 5,9% | 22,9% | 15,5% | 47,4% | 8,3% | 55,7% |
| 8,6% | 17,1% | 10,4% | 61,4% | 2,5% | 63,9% | |
| 6,4% | 23,5% | 20,4% | 45,7% | 4,0% | 49,7% | |
| 164 | 8,4% | 26,9% | 22,6% | 39,2% | 2,9% | 42,1% |
| 13,0% | 38,4% | 37,5% | crosta | 11,2% | crosta | |
| 9,6% | 29,5% | 21,1% | 35,1% | 4,7% | 39,8% | |
| 17,8% | 12,3% | 20,5% | 38,7% | 10,7% | 49,4% | |
| 23,3% | 23,1% | 39,1% | crosta | 14,5% | crosta | |
| 6,5% | 15,2% | 17,1% | 58,0% | 3,3% | 61,3% | |
| 9,1% | 23,1% | 19,8% | 40,1% | 7,8% | 47,9% | |
| 9,2% | 20,1% | 17,7% | 41,2% | 11,8% | 53,0% | |
| 15,6% | 17,7% | 24,4% | 29,9% | 12,4% | 42,3% | |
| 15,9% | 37,0% | 35,5% | crosta | 11,7% | crosta | |
| 166 | 5,5% | 21,8% | 22,8% | 44,5% | 5,4% | 49,9% |
| 14,6% | 22,3% | 21,8% | 33,2% | 8,1% | 41,3% | |
| 22,3% | 33,3% | 36,8% | crosta | 7,6% | crosta | |
| 167 | 7,2% | 19,4% | 20,1% | 44,8% | 8,4% | 53,3% |
| 10,0% | 21,9% | 20,7% | 36,3% | 11,0% | 47,3% | |
| 170 | 12,5% | 12,4% | 29,4% | 37,8% | 7,8% | 45,6% |
| 8,5% | 18,2% | 20,8% | 43,0% | 9,5% | 52,5% | |
| 3,5% | 22,0% | 39,8% | 8,9% | 25,9% | 34,7% | |
| 171 | 8,0% | 22,4% | 35,5% | 33,4% | 0,7% | 34,1% |
| 172 | 8,0% | 18,8% | 21,4% | 43,6% | 8,1% | 51,7% |
| 7,4% | 19,1% | 18,6% | 45,1% | 9,8% | 54,9% | |
| 22,5% | 0,0% | 37,3% | 40,2% | 0,0% | 40,2% | |
| 178 | 14,5% | 12,9% | 22,0% | 32,3% | 18,3% | 50,6% |
| 180 | 8,6% | 19,0% | 18,5% | 42,1% | 11,8% | 54,0% |
| 11,8% | 14,2% | 29,3% | 32,1% | 12,5% | 44,6% | |
| 11,5% | 40,0% | 36,3% | crosta | 12,2% | crosta | |
| 14,6% | 12,1% | 28,7% | 36,6% | 7,9% | 44,6% | |
| 183 | 10,6% | 35,4% | 40,7% | crosta | 13,3% | crosta |
| 193 | 3,0% | 32,4% | 15,2% | 49,4% | 0,0% | 49,4% |
| 194 | 10,9% | 38,7% | 42,0% | crosta | 8,4% | crosta |
| 9,6% | 21,8% | 20,7% | 34,6% | 13,2% | 47,9% | |
| 12,6% | 31,0% | 37,8% | crosta | 18,6% | crosta | |
| 3,0% | 32,4% | 15,2% | 49,4% | 0,0% | 49,4% | |
| 197 | 9,8% | 0,0% | 50,9% | 39,4% | 0,0% | 39,4% |
| 198 | 7,7% | 19,7% | 16,6% | 46,8% | 9,3% | 56,1% |
| 200 | 8,5% | 16,8% | 19,3% | 48,7% | 6,7% | 55,3% |
| 204 | 13,7% | 12,8% | 27,6% | 32,2% | 13,7% | 45,9% |
| 9,9% | 14,0% | 30,5% | 23,2% | 22,5% | 45,7% | |
| 210 | 7,2% | 22,0% | 20,7% | 39,0% | 11,2% | 50,2% |
| 211 | 9,0% | 16,2% | 39,4% | 24,0% | 11,2% | 35,3% |
Petição 870180005321, de 22/01/2018, pág. 245/316
239/293
| 10,2% | 17,0% | 24,7% | 35,7% | 12,4% | 48,1% | |
| 13,8% | 10,4% | 36,5% | 24,1% | 15,3% | 39,4% | |
| 6,5% | 12,2% | 36,3% | 30,5% | 14,5% | 45,0% | |
| 6,9% | 26,6% | 16,1% | 32,7% | 17,7% | 50,3% | |
| 3,4% | 36,2% | 27,7% | 32,6% | 0,0% | 32,6% | |
| 6,9% | 26,5% | 20,5% | 28,9% | 17,3% | 46,1% | |
| 0,0% | 35,1% | 15,6% | 39,6% | 9,7% | 49,2% | |
| 0,0% | 25,3% | 19,5% | 46,8% | 8,4% | 55,2% | |
| 6,6% | 19,7% | 25,9% | 37,2% | 10,6% | 47,8% | |
| 7,7% | 22,8% | 20,7% | 36,6% | 12,3% | 48,9% | |
| 16,3% | 4,6% | 28,2% | 49,1% | 1,7% | 50,8% | |
| 8,0% | 22,1% | 17,2% | 41,2% | 11,5% | 52,7% | |
| 8,0% | 22,1% | 17,2% | 41,2% | 11,5% | 52,7% | |
| 18,2% | 3,2% | 28,7% | 42,4% | 7,5% | 49,8% | |
| 11,9% | 10,1% | 31,8% | 30,5% | 15,7% | 46,2% | |
| 212 | 7,5% | 25,6% | 17,6% | 36,5% | 12,8% | 49,3% |
| 19,1% | 0,9% | 29,7% | 46,8% | 3,5% | 50,3% | |
| 8,8% | 28,4% | 9,6% | 33,7% | 19,5% | 53,2% | |
| 19,4% | 24,8% | 18,9% | 33,5% | 3,3% | 36,8% | |
| 19,1% | 26,9% | 17,5% | 31,6% | 4,9% | 36,6% | |
| 5,5% | 42,3% | 7,9% | 30,8% | 13,5% | 44,3% | |
| 4,6% | 23,9% | 25,1% | 35,5% | 11,0% | 46,5% | |
| 8,8% | 28,4% | 9,6% | 33,7% | 19,5% | 53,2% | |
| 0,0% | 65,4% | 22,4% | 10,5% | 1,7% | 12,2% | |
| 3,3% | 14,2% | 40,6% | 30,7% | 11,1% | 41,8% | |
| 11,2% | 13,6% | 25,0% | 40,3% | 9,9% | 50,2% | |
| 10,6% | 16,6% | 19,1% | 42,7% | 11,0% | 53,7% | |
| 21,1% | 22,7% | 17,4% | 17,5% | 21,2% | 38,7% | |
| 7,6% | 24,0% | 20,0% | 38,9% | 9,5% | 48,4% | |
| 10,3% | 20,4% | 22,2% | 33,7% | 13,4% | 47,1% | |
| 3,5% | 22,0% | 39,8% | 8,9% | 25,9% | 34,7% | |
| 213 | 7,6% | 28,2% | 16,3% | 30,4% | 17,5% | 47,9% |
| 5,3% | 18,8% | 18,1% | 41,3% | 16,4% | 57,7% | |
| 7,5% | 21,0% | 14,8% | 48,5% | 8,2% | 56,7% | |
| 8,3% | 17,8% | 18,5% | 44,6% | 10,9% | 55,5% | |
| 214 | 9,1% | 20,2% | 19,1% | 47,0% | 4,5% | 51,6% |
| 8,3% | 19,8% | 18,9% | 44,6% | 8,4% | 53,0% | |
| 7,7% | 20,5% | 19,6% | 45,3% | 7,0% | 52,2% | |
| 7,1% | 21,5% | 16,9% | 42,4% | 12,1% | 54,5% | |
| 7,0% | 25,9% | 15,1% | 39,9% | 12,0% | 51,9% | |
| 6,9% | 18,0% | 18,3% | 48,5% | 8,4% | 56,9% | |
| 7,4% | 19,2% | 18,2% | 45,6% | 9,5% | 55,1% | |
| 5,3% | 21,1% | 10,9% | 47,3% | 15,4% | 62,7% | |
| 5,3% | 21,1% | 10,9% | 47,3% | 15,4% | 62,7% | |
| 215 | 7,8% | 19,8% | 15,8% | 46,4% | 10,2% | 56,6% |
Petição 870180005321, de 22/01/2018, pág. 246/316
240/293
| 7,9% | 20,2% | 17,7% | 40,6% | 13,6% | 54,1% | |
| 20,0% | 24,8% | 25,4% | 25,7% | 4,1% | 29,9% | |
| 4,4% | 26,2% | 19,2% | 45,1% | 5,1% | 50,2% | |
| 8,1% | 19,6% | 20,1% | 42,7% | 9,4% | 52,1% | |
| 2,3% | 30,1% | 19,7% | 31,8% | 16,1% | 47,9% | |
| 5,9% | 23,7% | 14,8% | 39,3% | 16,3% | 55,6% | |
| 9,6% | 26,0% | 17,0% | 36,5% | 10,9% | 47,3% | |
| 4,7% | 20,8% | 14,1% | 42,2% | 18,2% | 60,4% | |
| 4,2% | 31,0% | 12,0% | 40,7% | 12,1% | 52,8% | |
| 6,7% | 21,3% | 18,1% | 41,7% | 12,3% | 53,9% | |
| 8,0% | 19,5% | 20,4% | 47,1% | 5,0% | 52,1% | |
| 216 | 8,3% | 21,9% | 18,9% | 40,9% | 10,0% | 50,9% |
| 0,0% | 28,0% | 30,1% | 22,8% | 19,1% | 41,9% | |
| 34,6% | 0,0% | 30,6% | 33,7% | 1,1% | 34,8% | |
| 7,3% | 17,8% | 17,9% | 47,0% | 10,0% | 56,9% | |
| 6,6% | 16,6% | 17,2% | 50,6% · | 9,7% | • 59,7% | |
| 7,7% | 18,1% | 19,2% | 44,5% | 10,5% | 55,0% | |
| 7,5% | 20,3% | 16,5% | 45,0% | 10,6% | 55,6% | |
| 217 | 0,0% | 42,3% | 21,0% | 24,3% | 12,3% | 36,6% |
| 6,8% | 16,7% | 17,1% | 50,1% | 9,3% | 59,4% | |
| 7,4% | 20,5% | 18,7% | 44,1% | 9,4% | 53,5% | |
| 11,9% | 10,1% | 31,8% | 30,5% | 15,7% | 46,2% | |
| 13,2% | 21,6% | 20,4% | 31,3% | 13,5% | 44,8% | |
| 12,1% | 13,9% | 27,6% | 33,8% | 12,7% | 46,2% | |
| 218 | 0,7% | 39,0% | 17,8% | 30,3% | 12,1% | 42,5% |
| 4,7% | 26,8% | 19,4% | 30,5% | 18,7% | 49,1% | |
| 7,1% | 22,8% | 22,4% | 38,3% | 9,4% | 47,7% | |
| 7,2% | 19,9% | 19,6% | 44,1% | 9,2% | 53,4% | |
| 8,5% | 19,7% | 19,9% | 42,2% | 9,7% | 51,9% | |
| 7,2% | 25,9% | 15,8% | 37,6% | 13,5% | 51,1% | |
| 8,0% | 21,1% | 20,9% | 41,9% | 8,2% | 50,0% | |
| 8,7% | 19,9% | 19,0% | 42,9% | 9,4% | 52,4% | |
| 223 | 4,5% | 29,5% | 17,2% | 15,8% | 33,0% | 48,8% |
| 0,0% | 38,4% | 30,1% | 31,6% | 0,0% | 31,6% | |
| 20,2% | 22,8% | 33,6% | 17,3% | 6,0% | 23,4% | |
| 19,0% | 37,0% | 34,9% | crosta | 9,1% | crosta | |
| 224 | 8,0% | 20,5% | 22,1% | 41,0% | 8,4% | 49,5% |
| 6,6% | 18,2% | 17,1% | 51,4% | 6,8% | 58,2% | |
| 7,9% | 22,1% | 21,6% | 37,0% | 11,4% | 48,4% | |
| 14,4% | 19,0% | 24,9% | 33,1% | 8,5% | 41,7% | |
| 3,1% | 26,3% | 24,2% | 40,8% | 5,6% | 46,4% | |
| 10,3% | 20,1% | 25,8% | 38,1% | 5,7% | 43,7% | |
| 225 | 9,7% | 22,2% | 18,8% | 41,8% | 7,5% | 49,3% |
| 4,3% | 23,5% | 17,8% | 47,9% | 6,4% | 54,3% | |
| 12,0% | 21,9% | 17,1% | 39,1% | 9,9% | 49,0% |
Petição 870180005321, de 22/01/2018, pág. 247/316
241/293
| 12,9% 15,9% | 23,8% 22,6% | 17,5% 18,3% | 34,1% 38,0% | 11,7% 5,2% | 45,8% 43,2% | |
| 226 | 4,9% | 24,9% | 21,9% | 45,8% | 2,5% | 48,3% |
| 6,5% | 29,5% | 22,8% | 32,4% | 8,8% | 41,2% | |
| 227 | 13,6% | 23,1% | 21,9% | 38,3% | 3,2% | 41,4% |
[0493] A Tabela 4 é um resumo, ou ainda compilação, de dados mostrados na Tabela 3 (acima). Por exemplo, o termo “posição” indicou a posição de resíduo de aminoácido na SEQ ID NO:2; o termo “Aminoácido Original”, como na Tabela 3, indicou o resíduo “parental” inalterado, enquanto que o termo “Novo Aminoácido” como na Tabela 3, indicou o resíduo de aminoácido alterado (novo) naquela posição. Os termos “WT_P” e “WT_S” indicam a preferidos por substrato (liberação de ácido graxo) da enzima “parental”, p. ex. SEQ ID NO:2 para um substrato particular (ácido graxo) ao indicar a quantidade de ácido graxo liberada (hidrolisada) do óleo de soja (como na Tabela 3), sendo que “P” é ácido palmítico, e “S” é ácido esteárico.
[0494] As colunas “palmitato” e “estearato” indicam a quantidade de ácido palmítico e de ácido esteárico indicam a quantidade de ácido palmítico e ácido esteárico liberada (por meio de hidrólise enzimática) do óleo de soja, que compreende ácido linolênico, ácido linoleico, ácido oleico, ácido palmítico, ácido esteárico, como discutido acima. “P + S” mostra quantidades combinadas de ácidos graxos hidrolisados que foram ácido palmítico e ácido esteárico, ou “P + S”. Os termos “delta_P” e “delta S” indicam a alteração de preferidos de uma enzima exemplar como proporcionada aqui (p. ex., D61A da primeira linha) para hidrolisar ácido palmítico e ácido esteárico, respectivamente, em comparação com a atividade correspondente da SEQ ID NO:2. O termo “delta P+S” indica a alteração total ou somada da preferência de uma enzima exemplar como proporcionado aqui (p. ex., D61A da primeira linha) para hidrolisar ácido palmítico e ácido esteárico em comparação com a atividade correspondente da SEQ ID NO:2. A seção “mutações de palmitato” resume as enzimas exemplares como proporcionadas aqui apresentando uma preferência de atividade (hidrólise de ácido graxo) por liberar ácido palmítico versus outros ácidos graxos. A seção “mutações de estearato” resume a enzima exemplar como proporcionada aqui apresentando uma preferência de atividade para liberar ácido esteárico versus outros ácidos graxos (de óleo de soja, ensaio descrito acima).
Petição 870180005321, de 22/01/2018, pág. 248/316
242/293
Mutações de Palmitato Exemplares
Tabela 4
| Posição | Aminoácido Original | Novo Aminoácido | WT_P | WT_S | Palmitato | Estearato |
| 61 | D | A | 45% | 6% | 54% | 7% |
| 61 | D | E | 45% | 6% | 47% | 8% |
| 72 | R | E | 45% | 6% | 54% | 4% |
| 72 | R | K | 45% | 6% | 52% | 9% |
| 116 | E | A | 45% | 6% | 56% | 11% |
| 116 | E | Q | 45% | 6% | 50% | 9% |
| 116 | E | R | 45% | 6% | 52% | 9% |
| 116 | E | T | 45% | 6% | 50% | 17% |
| 116 | E | V | 45% | 6% | 59% | 9% |
| 133 | S | A | 45% | 6% | 45% | 11% |
| 151 | I | G | 45% | 6% | 49% | 4% |
| 151 | I | A | 45% | 6% | 46% | 2% |
| 163 | V | R* | 45% | 6% | 61% | 2% |
| 164 | D | R* | 45% | 6% | 58% | 3% |
Tabela 4 (continuação)
| Mutações de estearato | ||
| Λ . ... Novo Aminoácid Posição Aminoácid o Original o | WT_P WT_S | Palmitato Estearato |
| 20 I L | 45% 6% | 39% 12% |
| 62 V S | 45% 6% | 37% 18% |
| 77 G P | 45% 6% | 18% 20% |
| 83 V C | 45% 6% | 31% 17% |
| 88 D H | 45% 6% | 33% 13% |
| 113 Y G | 45% 6% | 15% 25% |
| 116 E T | 45% 6% | 50% 17% |
| 116 E G | 45% 6% | 33% 21% |
| 140 H K | 45% 6% | 33% 13% |
| 146 K S | 45% 6% | 31% 19% |
| 167 I S | 45% 6% | 36% 11% |
| 180 L E | 45% 6% | 42% 12% |
| 194 E M | 45% 6% | 35% 13% |
| 211 A Q | 45% 6% | 33% 18% |
| 212 S Y 215 G C 215 G V 215 G W | 45% 6% 45% 6% 45% 6% 45% 6%- | 34% 13% 42% 18% 39% 16% 41% 12% |
Petição 870180005321, de 22/01/2018, pág. 249/316
243/293
| 218 | A | H | 45% | 6% • | 30% | 19% |
| 218 | A | S | 45% | 6% | 38% | 14% |
| 223 | V | A | 45% | 6% | 16% | 33% |
| 225 | A | M | 45% | 6% | 39% | 10% |
| Q | 45% | 6% | 34% | 12% |
Tabela 4 (continuação)
| Mutações de palmitato | ||||||
| Posição | Aminoácid o Original | Novo Aminoácid o | P + S | delta_P | delta_S | delta_P+S |
| 61 | D | A | 60% | 1% | 9% | |
| 61 | D | E | 55% | 2% | 2% | 4% |
| 72 | R | E | 58% | 9% | -2% | 7% |
| 72 | R | K | 61% | 7% | 3% | 10% |
| 116 | E | A | 67% | 11% | 5% | 16% |
| 116 | E | Q | 60% | 5% | 3% | 9% |
| 116 | E | R | 61% | 7% | 3% | 10% |
| 116 | E | T | 68% | 5% | 11% | 17% |
| 116 | E | V | 68% | 14% | 3% | 17% |
| 133 | S | A | 56% | 0% | 5% | 5% |
| 151 | I | G | 53% | 4% | -2% | 2% |
| 151 | I | A | 49% | I% | -4% | -2% |
| 163 | V | R* | 64% | 16% | -4% | 13% |
| 164 | D | R* | 61% | 13% | -3% | 10% |
Tabela 4 (continuação)
| Mutações de estearato | ||||||
| Posição | Aminoácid o Original | Novo Aminoácid o | P + S | delta_P | delta_S | delta_P+S |
| 20 | I | L | 51% | -6% | 6% | 0% |
| 62 | V | S | 55% | -8% | 12% | 4% |
| 77 | G | P | 38% | -27% | 14% | -13% |
| 83 | V | C | 48% | -14% | 11% | -3% |
| 88 | D | H | 46% | -12% | 7% | -5% |
| 113 | Y | G | 40% | -30% | 19% | -11% |
| 116 | E | T | 68% | 5% | 11% | 17% |
| 116 | E | G | 54% | -12% | 15% | 3% |
Petição 870180005321, de 22/01/2018, pág. 250/316
244/293
| Mutações de estearato | ||||||
| Posição | Aminoácid o Original | Novo Aminoácid o | P + S | delta_P | delta_S | delta_P+S |
| 140 | H | K | 46% | -12% | 7% | -5% |
| 146 | K | S | 50% | -14% | 13% | -1% |
| 167 | I | S | 47% | -9% | 5% | -4% |
| 180 | L | E | 54% | -3% | 6% | 3% |
| 194 | E | M | 48% | -10% | 7% | -3% |
| 211 | A | Q | 50% | -12% | 12% | -1% |
| 212 | S | Y | 47% | -11% | 7% | -4% |
| 215 | G | C | 60% | -3% | 12% | 9% |
| 215 | G | V | 56% | -6% | 10% | 5% |
| 215 | G | W | 53% | -4% | 6% | 2% |
| 218 | A | H | 49% | -15% | 13% | -2% |
| 218 | A | S | 51% | -7% | 8% | 0% |
| 223 | V | A | 49% | -29% | 27% | -2% |
| 225 | A | M | 49% | -6% | 4% | -2% |
| Q | 46% | -11% | 6% | -5% |
Exemplo 5: Evolução exemplar para hidrólise aperfeiçoada de palmitato usando tecnologia GeneReassemblySM [0495] Quatorze (14) mutações individuais de aminoácidos identificadas da seleção GSSMSM que cobrem sete (7) posições de aminoácidos foram combinadas por meio da tecnologia GeneReassemblySM (Patente U.S. n° 6.605.449). As sequências de ácido nucleico de comprimento pleno geradas da fase GeneReassemblyTM foram clonadas em um vetor de expressão pASK-5 (ver descrição acima) para expressão no hospedeiro de Escherichia coli HMS 175 (Novagen, E.U.A.). A expressão das variantes GeneReassembly foi induzida com anidrotetraciclina após se obter as densidades ótimas de células hospedeiras.
[0496] As 14 mutações que proporcionaram os maiores aumentos de hidrólise do palmitato, identificados na Tabela 2, foram selecionadas quanto à inclusão em uma biblioteca de palmitase GeneReassembly gerada por meio dos métodos descritos acima. Clones iniciais foram selecionados em palmitato de umbeliferila quanto à atividade dando
Petição 870180005321, de 22/01/2018, pág. 251/316
245/293 cerca de 145 clones únicos para sequência, que foram ensaiados quanto à atividade em óleo de soja, como descrito acima.
[0497] A Figura 8 mostra dados de seleção primária e secundária para ensaios em óleo de soja em clones selecionados da biblioteca de palmitase. Clones que proporcionaram palmitato acima de 70 % de faz hidrolisados no ensaio primário (nas condições convencionais de taxa inicial do método de ensaio) foram selecionados para serem re-ensaiados em óleo de soja. Para cada ensaio em óleo de soja, os faz extraídos foram diluídos 50 vezes e 100 vezes para análise por meio de LCMS ou GC. Onde se encontrou mutações não-objetivadas adicionais isto também é indicado. As relações de hidrólise de FA detectadas e as quantidades de cada FA detectado são apresentadas. Na figura, “alto” e “baixo” indica valores que foram fora da faixa da curva de calibração. As linhas são separadas de acordo com a ordem do percentual de palmitato liberado no ensaio secundário, e então por total de palmitato liberado. Numerosos clones mostraram seletividade por palmitato significativamente incrementada (até 100 %), em comparação com a SEQ ID NO:2 parental (61,2 %). Os 25 acertos máximos de palmitase selecionados com base no ensaio secundário descrito acima foram subclonados em sistemas de Pseudomonas (Dow Global Technologies Inc., Pedido de Patente Publicado dos E.U.A. n° 20050130160 e Dow Global Technologies Inc., Pedido de Patente Publicado dos E.U.A. n° 20050186666). A sequência de ácido nucleico que codifica a enzima ou polipeptídio foi inserida no vetor pMYC (Dow Global Technologies Inc., Pedido de Patente Publicado dos E.U.A. n° 20050130160) ou no vetor pDOW1169 (Dow Global Technologies Inc., Pedido de Patente Publicado dos E.U.A. n° 20080058262) e depois introduzida no hospedeiro de Pseudomonas fluorescens por meio de eletroporação. As células transformadas foram selecionadas seja por meio de crescimento em meio mínimo para as construções de pDOW1169 ou em meio rico acrescido de tetraciclina para as construções de pMYC. A expressão da enzima ou polipeptídio foi induzida com IPTG após se obter as densidades óptimas de células hospedeiras.
[0498] A Tabela 5 mostra dados de ensaios em óleo de soja, realizados em duplicata, dos 25 acertos máximos expressos nos sistemas de Pseudomonas. Os 4 acertos construídos no vetor pDOWl 169 encontram-se listados em tipo negritado sublinhado,
Petição 870180005321, de 22/01/2018, pág. 252/316
246/293 todos os outros acertos foram construídos no vetor pMYC. Adicionou-se enzima a 5 g de óleo bruto, resultando em um teor final de água de 20 %. Em seguida, a mistura foi homogeneizada com uma sonda de 7 mm e incubada durante 40 horas a 25°C com agitação de barra magnética. Frações foram removidas e analisadas quanto a ácidos graxos por meio de conversão de FA a FAME e quantificação de FAME por meio de GC [n.t.> cromatografia gasosa] como descrito no Exemplo 8. As 25 enzimas foram carregadas nos 5 g de óleo de soja com base em unidades iguais de atividade de UMB-palmitato. Nestas reações palmitato em óleo foi reduzido significativamente de 11 % em óleo não tratado a 5 % ou menos em óleos tratados com enzima indicando uma preferência incrementada por hidrólise do palmitato em comparação com a enzima parental SEQ ID NO:2.
Tabela 5
| Posição do aminoácido e aminoácic | o presente | ||||||||||||||
| Enzima | Palmitato | Estearato | Oleato | Linoleato | Linolenato | 53 | 61 | 72 | 116 | 126 | 133 | 151 | 160 | 163 | 164 |
| 1 | 6,0% | 4,3% | 24,9% | 59,7% | 5,1% | A | E | A | A | R | |||||
| 1 | 6,4% | 4,3% | 24,8% | 59,3% | 5,2% | A | E | A | A | R | |||||
| 2 | 6,6% | 4,3% | 24,8% | 59,2%, | 5,1% | A | E | V | A | R | |||||
| 2 | 6,9% | 4,3% | 24,7% | 59,0% | 5,1% | A | E | V | A | R | |||||
| 3 | 9,0% | 4,3% | 24,1% | 57,3% | 5,2% | E | E | V | A | R | |||||
| 3 | 8,4% | 4,3% | 24,3% | 57,8% | 5,2% | E | E | V | A | R | |||||
| 4 | 3,9% | 4,3% | 25,1% | 61,6% | 5,1% | A | A | K | A | R | |||||
| 4 | 5,8% | 4,4% | 25,0% | 59,7% | 5,2% | A | A | K | A | R | |||||
| 5 | 5,6% | 4,3% | 25,0% | 60,0% | 5,1% | E | V | R | |||||||
| 5 | 5,8% | 4,3% | 25,0% | 59,8% | 5,1% | E | V | R | |||||||
| 6 | 4,9% | 4,3% | 24,9% | 60,8% | 5,1% | E | V | ||||||||
| 6 | 5,7% | 4,3% | 24,8% | 60,1% | 5,1% | E | V | ||||||||
| 7 | 5,0% | 4,3% | 24,9% | 60,7% | 5,1% | E | E | V | A | A | |||||
| 7 | 4,9% | 4,3% | 24,9% | 60,8% | 5,1% | E | E | V | A | A | |||||
| 8 | 5,2% | 4,0% | 24,7% | 61,3% | 4,8% | E | V | A | R | ||||||
| 8 | 5,2% | 4,0% | 24,7% | 61,3% | 4,8% | E | V | A | R | ||||||
| 9 | 5,3% | 4,1% | 24,8% | 60,9% | 4,9% | V | A | R | |||||||
| 9 | 5,5% | 4,2% | 24,9% | 60,6% | 4,9% | V | A | R | |||||||
| 10 | 5,7% | 4,0% | 23,3% | 56,2% | 10,8% | E | E | V | A | R | |||||
| 10 | 5,6% | 4,3% | 25,0% | 60,1% | 5,0% | E | E | V | A | R | |||||
| 11 | 8,3% | 5,7% | 23,3% | 57,7% | 5,0% | T | E | E | A | A | P | R | |||
| 11 | 5,9% | 3,8% | 24,5% | 60,6% | 5,2% | E | E | A | A | R | |||||
| 12 | 7,8% | 5,1% | 24,8% | 57,3% | 5,0% | E | E | V | R | ||||||
| 12 | 5,7% | 4,4% | 25,0%- | 59,7% | 5,1% | E | E | V | R | ||||||
| 13 | 4,8% | 3,3% | 24,7% | 62,2% | 4,9% | E | K | V | R | ||||||
| 13 | 5,9% | 4,0% | 24,5% | 60,8% | 4,9% | E | K | V | R |
Petição 870180005321, de 22/01/2018, pág. 253/316
247/293
| 14 | 5,594 | 3,8% | 25,2% | 60,6% | 5,0% | E | K | V | |||||||
| 14 | 5,9% | 4,5% | 24,8%, | 59,9% | 4,9% | E | K | V | |||||||
| 15 | 5,8% | 3,6% | 25,0% | 60,7% | 5,0% | E | E | T | |||||||
| 15 | 5,6% | 4,3% | 24,9% | 60,4% | 4,9% | E | E | T | R | ||||||
| 16 | 6,1% | 4,0% | 24,1%, | 60,9% | 4,9% | E | E | V | A | ||||||
| 16 | 6,2% | 4,0% | 24,1% | 60,9% | 4,8% | E | E | V | A | ||||||
| 17 | 5,7% | 4,4% | 24,9% | 59,9% | 5,1% | E | K | R | |||||||
| 17 | 5,0% | 4,3% | 25,0% | 60,8% | 4,9% | E | K | R | |||||||
| 18 | 8,3% | 4,2% | 23,5% | 55,7% | 8,2% | E | E | V | R | ||||||
| 18 | 7,9% | 4,2% | 23,7% | 56,0% | 8,2% | E | E | V | R | ||||||
| 19 | 6,8% | 4,2% | 24,0% | 56,9% | 8,1% | K | V | A | R | ||||||
| 19 | 6,8% | 4,2% | 24,0% | 56,9% | 8,1% | K | V | A | R | ||||||
| 20 | 6,1% | 4,2% | 24,0% | 57,5% | 8,2% | E | R | A | R | ||||||
| 20 | 5,4% | 4,1% | 23,9% | 58,5% | 8,0% | E | R | A | R | ||||||
| 21 | 6,7% | 4,0% | 23,3%: | 58,0% | 8,0% | A | E | A | A | ||||||
| 21 | 6,5% | 3,9% | 23,2% | 58,5% | 7,9% | A | E | A | A | ||||||
| 22 | 5,4% | 4,0% | 23,9% | 58,6% | 8,0% | E | E | A | A | R | |||||
| 22 | 5,3% | 4,1% | 24,0% | 58,7% | 8,0% | E | E | A | A | R | |||||
| 23 | 6,6% | 3,9% | 23,2% | 58,4% | 7,9% | E | V | A | |||||||
| 23 | 6,4% | 3,9% | 23,1% | 58,8% | 7,8% | E | V | A | |||||||
| 24 | 6,0% | 4,3% | 24,3% | 57,3% | 8,1% | A | E | V | |||||||
| 24 | 5,7% | 4,3% | 24,3% | 57,6% | 8,1% | A | E | V | |||||||
| 25 | ND | ND | ND | ND | ND | A | E | V | R | ||||||
| 25 | 6,0% | 4,0% | 24,0% | 58,1% | 8,0% | A | E | V | R | ||||||
| 26 | 4,8% | 4,2% | 24,2% | 58,9% | 7,9% | E | K |
ND: (não determinado) [0499] A Tabela 6 abaixo mostra dados para a termoestabilidade dos 25 acertos máximos de palmitase selecionados com base no ensaio secundário descrito acima. Estes dados foram obtidos usando os acertos expressos no hospedeiro de E. coli HMS 174. Clones foram distribuídos em placas de 96 poços e incubados durante 10 minutos à temperatura ambiente (t.a.), 45, 50 ou 55°C depois ensaiados à temperatura ambiente sobre MeUMB-palmitato. O percentual de atividade residual é determinado dividindo-se a atividade após incubação a cada temperatura pela atividade após incubação à temperatura ambiente. Mostra-se também, para cada uma das palmitases, as mutações presentes, e exemplos de atividade e seletividade por palmitato sobre óleo de soja. A SEQ ID NO:2 conservou aproximadamente 15 % de atividade após incubação durante 10 min. a 50°C, mas não apresentou atividade após incubação a 55°C.
Petição 870180005321, de 22/01/2018, pág. 254/316
248/293
Tabela 6
| % de estabilidade | Posição do aminoácido e aminoácido presente | ||||||||||
| Enzima | 55C | 50C | 45C | 61 | 72 | 116 | 133 | 151 | 163 | 164 | outra |
| 27 | 23,0% | 62,7% | E | K | V | ||||||
| 28 | 22,8% | 62,1% | E | K | V | R | |||||
| 29 | 55,9% | E | K | R | |||||||
| 30 | 24,1% | 68,8% | 75,6% | E | E | V | A | ||||
| 31 | 22,0% | 68,1% | 82,5% | E | E | V | A | R | |||
| 32 | 27,1% | 58,4% | E | E | V | R | |||||
| 33 | 26,1% | 56,6% | E | E | V | A | R | ||||
| 34 | 24,7% | 54,0% | E | E | V | A | R | ||||
| 35 | 8,1% | 64,1% | 67,6% | E | E | T | R | ||||
| 36 | 10,3% | 53,8% | 75,7% | E | E | A | A | R | |||
| 37 | 9,2% | 54,8% | 61,5% | E | E | A | R | ||||
| 38 | 45,4% | 68,4% | E | E | A | A | A | ||||
| 39 | 22,9% | 61,9% | E | E | A | A | R | ||||
| 40 | 35,3% | 77,1% | E | V | A | R | |||||
| 41 | 30,6% | 70,2% | E | V | A | ||||||
| 42 | 20,3% | 71,8% | 79,3% | E | A | A | G | R | |||
| 43 | 64,2% | E | A | A | |||||||
| 44 | 63,2% | A | K | V | |||||||
| 45 | 56,0% | A | K | V | A | A | R | ||||
| 46 | 80,7% | A | K | A | R | ||||||
| 47 | 22,2% | 71,8% | 88,1% | A | E | V | A | R | |||
| 48 | 60,6% | 83,2% | A | E | V | A | R | ||||
| 49 | 50,7% | 68,0% | A | E | V | ||||||
| 50 | 50,2% | 77,2% | A | E | V | R | |||||
| 51 | 21,1% | 53,6% | A | E | V | A | R | ||||
| 52 | 56,5% | A | E | Q | A | A | R |
Petição 870180005321, de 22/01/2018, pág. 255/316
249/293
| % de estabilidade | Posição do aminoácido e aminoácido presente | ||||||||||
| Enzima | 55C | 50C | 45C | 61 | 72 | 116 | 133 | 151 | 163 | 164 | outra |
| 53 | 73,6% | 118,3 % | A | E | A | A | |||||
| 54 | 69,2% | 110,7 % | A | E | A | A | R | ||||
| 55 | 82,2% | A | V | ||||||||
| 56 | 51,4% | A | A | A | |||||||
| 57 | 82,8% | K | V | A | G | ||||||
| 58 | 60,1% | K | V | R | |||||||
| 59 | 58,3% | K | V | A | P162 S | ||||||
| 60 | 57,9% | K | V | A | R | V62F | |||||
| 61 | 56,3% | K | V | A | R | ||||||
| 62 | 51,9% | K | Q | A | R | ||||||
| 63 | 74,8% | K | A | ||||||||
| 64 | 58,8% | K | A | A | |||||||
| 65 | 49,6% | 72,0% | E | V | R | ||||||
| 66 | 46,3% | 66,0% | E | V | |||||||
| 67 | 55,1% | E | V | A | R | ||||||
| 68 | 51,7% | E | V | A | A | ||||||
| 69 | 23,6% | 54,6% | E | A | |||||||
| 70 | 76,2% | E | A | R | |||||||
| 71 | 59,2% | V | A | ||||||||
| 72 | 51,8% | V | A | R |
Exemplo 6: Protocolo de laboratório para avaliação de enzimas palmitase, estearatase ou saturase candidatas [0500] Enzimas e polipeptídios exemplares como proporcionados aqui foram expressos no sistema de Pseudomonas (Dow Global Technologies Inc., Pedido de Patente
Petição 870180005321, de 22/01/2018, pág. 256/316
250/293
Publicado dos E.U.A. n° 20050130160). O ácido nucleico que codifica a enzima ou polipeptídio é inserido no vetor pMYC (Dow Global Technologies Inc., Pedido de Patente Publicado dos E.U.A. n° 20050130160) e foi então introduzido no hospedeiro auxotrófico de Pseudomonas fluorescens por meio de eletroporação. As células transformadas foram selecionadas de acordo com o crescimento em meio mínimo. A expressão da enzima ou polipeptídio foi induzida com IPTG após se observar as densidades ótimas de células hospedeiras.
[0501] O procedimento a seguir deve ser usado para se avaliar a capacidade de uma enzima ou outro polipeptídio como proporcionado aqui de hidrolisar uma amostra de óleo. A enzima palmitase é adicionada a 1 kg de óleo bruto resultando em 20 % de teor final de água. A mistura é então homogeneizada com um misturador de topo e incubada à temperatura ambiente com misturação constante usando-se um misturador de impulsor. Removeu-se frações (0,5 ml) a 0 h, 21 h, 43 h, 65 h, e 72 h e estas foram tratadas para conversão de FAME & análise de GC [n.t.: cromatografia gasosa] como descrito no Exemplo 8. O procedimento acima foi usado com a SEQ ID NO:2, a amostra de óleo foi um óleo de soja bruto. Após 72 h, amostras de ambos, óleo não-tratado e óleo tratado com enzima, proporcionaram os resultados mostrados na Tabela 7.
Tabela 7
| Composição de ácidos graxos | Óleo não tratado (%) | Óleo tratado com enzima (%) |
| C16:0 | 11,1 | 3,7 |
| C18:0 | 4,1 | 4,2 |
| C18:1 | 22,1 | 24,3 |
| C18:2 | 54,5 | 59,5 |
| C18:3 | 8,2 | 8,3 |
[0502] Os resultados mostram uma diminuição significativa na quantidade de ácido palmítico (C16:0), sendo que uma diminuição do tipo referido é considerada desejável.
Exemplo 7: Avaliação de Lipases, Saturase ou Palmitases com homologia de sequência com o polipeptídio SEQ ID NO:2 exemplar [0503] Diversas sequências homólogas de lipase foram subclonadas no vetor pMALc2x (New England Biolabs, E.U.A.) por meio do método de clonagem xi (Genlantis, E.U.A.).
Petição 870180005321, de 22/01/2018, pág. 257/316
251/293
As construções contendo SEQ ID NO:2, SEQ ID NO:6, SEQ ID NO: 14, ou SEQ ID NO: 16 foram transformadas no hospedeiro de Escherichia coli ArcticExpress RP (Stratagene, E.U.A.) para expressão. A expressão das lipases encontra-se sob o controle de um promotor que é induzido com IPTG após se obter as densidades ótimas de células hospedeiras. As enzimas recombinantes foram testadas em óleo de soja para seletividade para FA [ácido graxo] (Tabela 8). As lipases compreendendo SEQ ID NO:2, SEQ ID NO:6, SEQ ID NO:14, ou SEQ ID NO:16 foram expressas e clivadas do marcador de fusão MBP usando condições convencionais. Uma colônia simples foi inoculada em meio LB contendo 20 pg/ml de gentamicina e agitada a 200 rpm de um dia para o outro a 30°C. Esta cultura realizada de um dia para o outro foi inoculada em meio LB fresco contendo 20 pg/ml de gentamicina a uma leitura a OD600 de 0,05. Esta cultura foi agitada a 200 rpm e 30°C até se obter uma leitura a OD600 de 0,5. Culturas foram transferidas a 12°C [com] agitação a 200 rpm e deixadas equilibrar à temperatura inferior antes da indução da expressão de lipase por meio de adição de 0,5 mM de IPTG, seguido de crescimento adicional durante 24 horas. Células foram recolhidas por meio de centrifugação, suspensas em tamponador Tris pH 8, contém NaCl, CaCl2, DNaseI, e lisozima, e então lisadas por meio de sonificação. Lisados de células foram clarificados por meio de centrifugação. Enzimas foram clivadas do MBP por meio de incubação da fusão lipase-MBP com FactorXa durante 6 horas à temperatura ambiente, seguido de mais 18 horas a 12°C. Todos os lisados clarificados com enzimas recombinantes ativas, intactas, mostraram preferências fortes e similares para hidrólise do palmitato relativamente a outro FA quando ensaiado em óleo de soja (Tabela 8).
Tabela 8
| Similaridade com a SEQ ID NO:2 | Ácidos graxos hidrolisados (%) | ||||||
| Enzima | Identidade | Similaridad e | Palmitat o | Estearat o | Oleato | Linoleat o | Linolena to |
| Óleo de soja | NA | NA | 11,0% | 4,3% | 24,9% | 59,7% | 5,1% |
| SEQ ID NO: 2 | 100 % | 100 | 50,9% | 5,1% | 16,9% , | 18,1% | 9,0% |
| SEQ ID | 27 % | 42 % | 45,8% | 2,0 | 14,2% | 37,9% | 0,0% |
Petição 870180005321, de 22/01/2018, pág. 258/316
252/293
| NO: 14 | |||||||
| SEQ ID NO: 12 | 47 % | 62 % | 50,4 % | 4,1% | 16,1% | 23,4% | 6,0% |
| SEQ ID NO: 6 | 41 % | 56 % | 37,0 % | 6,2% | 28,5% | 20,7% | 7,6% |
Exemplo 8: Método para a conversão de ácidos graxos livres ou triglicerídeos a metil ésteres de ácido graxo (FAME) e quantificação de FAME por meio de cromatografia gasosa.
[0504] Ácidos graxos liberados de lipídios, triglicerídeos, gorduras ou óleos por meio da ação de lipases, p. ex., saturases, palmitases e/ou estearatases podem ser quantificados diretamente por meio de LCMS usando-se o método descrito no Exemplo 2. Alternativamente, estes ácidos graxos hidrolisados podem ser convertidos a metil ésteres de ácido graxo (FAME) usando metanólise catalisada com ácido, e, depois, quantificados por meio de cromatografia gasosa (GC). Neste exemplo:
• O óleo após reação com lipases, p. ex., saturases, palmitases e/ou estearatases é tratado por meio de adição de 1 ml de solvente de extração (CHCl3:MeOH:4N HCl(2:1:0,075)) por 0,5 ml de volume de reação.
• Uma fração de 45 pl de óleo extraído é transferida para um frasco com tampa rosqueada de 4 ml. A cada frasco adiciona-se uma pequena barra de agitação, seguido de 2 ml de hexano e 400 pl de MeOH a 20 % (vol/vol) em HCl.
• Os frascos são então fechados hermeticamente e aquecidos com agitação durante 15 minutos. Os frascos são então removidos do calor e deixados resfriar antes de se adicionar 800 pl de H2O.
• A mistura é então submetida a agitação suficiente para se obter um vórtice, e uma amostra (500 pl) da camada superior de hexano contendo FAMES é transferida para um frasco de auto-coletador para a cromatografia gasosa.
A cada amostra adiciona-se 500 pl de 0,5 mg/ml de C15:0 FAME como um padrão interno.
[0505] Os FAME sintetizados usando este método são então analisados por meio de cromatografia gasosa usando-se os seguintes parâmetros operacionais:
Petição 870180005321, de 22/01/2018, pág. 259/316
253/293 • O equipamento é um Hewlett Packard 6890 Series GC com auto-coletador de amostras • A coluna usada é uma Supelco SP-2380 Fused Silica Capillary Column de 30 m x 0,25 mm e 0,2 pm de espessura da película • O injetor e detector são ajustados a 260°C; O fluxo de gás-veículo hélio é ajustado em 0,6 ml/min; a estufa é ajustada em uma temperatura inicial de 150°C. Amostras (1 ml) são injetadas com uma proporção de injeção a 10:1. O método de GC usado compreende:
- Rampa 1 : 4°C/min durante 10 min = 190°C
- Rampa 2: 15°C/min durante 4 min = 250°C
- Tempo de espera: a 250°C durante 2 min [0506] O ácidos graxos de triglicerídeos também podem ser analisados por meio de conversão a FAME, mesmo na presença de ácidos graxos hidrolisados. Usando o método acima e o método abaixo em combinação, isto pode ser usado para determinar a seletividade por ácidos graxos de uma lipase, p. ex., saturase, palmitase, e/ou estearatase, e o efeito da enzima sobre o óleo. O método para análise de ácidos graxos ligados glicerol (ou outros alcoóis) usa metanólise catalisada com base:
• O óleo após reação com lipases, p. ex., saturases, palmitases e/ou estearatases é tratado por meio de adição de 1 ml de solvente de extração (CHCl3: MeOH :4N HCl (2: 1 :0,075)) por 0,5 ml de volume de reação.
• Uma fração de 45 pl de óleo extraído é transferida para um tubo de micrófuga.
Os 500 pl de heptano são adicionados, seguido de 50 pl de KOH metanólico 2 N.
• A mistura é submetida a agitação suficiente para se obter um vórtice vigorosamente durante 30 segundos, depois centrifugada.
• Uma fração (50 pl) da camada superior de heptano contendo FAME é transferida para um frasco auto-coletador e combina-se isto com 450 pl de hexano contém o padrão interno C15:0.
• Análise de FAME por meio de cromatografia gasosa é como delineada acima. Exemplo 9: Evolução exemplar para tolerância térmica aperfeiçoada de palmitase usando
Petição 870180005321, de 22/01/2018, pág. 260/316
254/293 tecnologia GSSMSM [0507] A palmitase exemplar da invenção que incluiu mutações D61E, R72K, e V163R da SEQ ID NO:2 (Enzima 17, Tabela 5, acima) foi selecionada como o mutante de seletividade principal dentre os ciclos de evolução precedentes (Exemplos 4 e 5, acima). Evolução adicional para melhorar a tolerância térmica da enzima seletiva principal (SEQ ID NO:2 com mutações D61E, R72K, e V163R) foi conduzida usando-se tecnologia GSSMSM (ver, p. ex., Patente U.S. n° 6.171.820).
[0508] Em resumo, a evolução por meio de GSSM foi realizada introduzindo-se mutações pontuais usando-se oligonucleotídeos degenerados, uma posição de aminoácido a cada dado momento, de forma que cada códon original pudesse ser substituído por cada um dos 20 aminoácidos naturalmente codificados. A biblioteca foi construída no vetor pDOW-Kan, analisada com gel de agarose, tratada com DPNI e depois transformada em células competentes XL1 Blue de E. coli. Desenvolveu-se colônias, que foram colhidas e sequênciaüenciadas. Colônias foram combinadas e o DNA foi preparado usando-se o kit Qiagen mini-prep (n° de catálogo 27106, Qiagen, Valencia, CA).
[0509] Células competentes de Pseudomonas fluorescens foram então transformadas com o DNA. O hospedeiro de Pseudomonas fluorescens foi obtido da Dow Global Technologies Inc. (Pedido de Patente Publicado dos E.U.A. n° 20050130160, Pedido de Patente Publicado dos E.U.A. n° 20050186666 e Pedido de Patente Publicado dos E.U.A. n° 20060110747). O vetor pDOW-Kan foi construído adicionando-se um marcador de resistência à canamicina a pDOWl 169 (Dow Global Technologies Inc., Pedido de Patente Publicado dos E.U.A. n° 20080058262). As células foram desenvolvidas em meio mínimo M9 (Dow Global Technologies Inc., Pedido de Patente Publicado dos E.U.A. n° 20050186666) suplementado com uracila e canamicina. Todos os exemplos a seguir que descrevem o uso do vetor pDOW-kan, Pseudomonas fluorescens, e meio M9, referem-se todos ao mesmo vetor pDOW-kan, Pseudomonas fluorescens, e meio M9 descrito acima.
[0510] A biblioteca GSSM foi selecionada em formato de 384 poços. Realizou-se triagens de HTP primária e secundária usando o UMB-Palmitato (como descrito acima no Exemplo 3). Para identificar mutações que mantêm a atividade enquanto a enzima se encontra a uma temperatura elevada o ensaio foi conduzido incubando-se o substrato
Petição 870180005321, de 22/01/2018, pág. 261/316
255/293 fluorogênico com o lisado de células integrais a 54°C durante 30 minutos, precedido de uma incubação de 30 minutos do lisado de células integrais com tamponador durante 30 minutos a 54°C a assegurar que a enzima atingiu 54°C antes do carregamento sobre substrato.
[0511] Mediu-se a fluorescência de cada mutante (ver coluna 2, Tabela 9) e qualquer mutante com uma leitura de fluorescência de mais do que 2 desvios padrão acima do controle foi determinado como sendo um “acerto” [“hit”] - ou seja, um mutante com tolerância térmica suficientemente incrementada. Identificou-se 117 acertos com alterações únicas de aminoácidos, a partir da seleção com UMB-Palmitato (ver Tabela 9, abaixo). As alterações de aminoácidos nos 117 acertos de mutações simples ocorreram em 50 resíduos; 22 % da proteína apresentaram alterações de aminoácidos. Os 117 acertos foram avaliados adicionalmente quanto ao desempenho sobre óleo bruto em ensaios convencionais de 5 g (ver Exemplo 5) a 25°C e 45°C. Resultados são mostrados na Tabela 10, abaixo.
Tabela 9:
| Enzim a | UMBPalmitato | Códon origina I | Novo códon | Aminoáci da original | Novo aminoáci do | Posiçãa do resíduo de aminoacid o | Mutações adicionais |
| TT1 | 43670 | TAG | C17 | ¥ | L | 7 | |
| TT2 | 40432 | GGC | CTG | A | L | 15 | |
| TT3 | 21247 | GGC | ATG | A | M | 15 | |
| TT4 | 65535 | GAT | TGG | □ | W | 16 | |
| TT5 | 23779 | ATG | ATT | M | I | 31 | |
| TT6 | 65535 | GGC | GAG | G | E | 32 | |
| TT7 | 65535 | GGC | CGT | G | P | 32 | |
| TT3 | 26222 | CTG | ATG | L | M | 34 | |
| TT5 | 60900 | CTG | ATT | L | I | 43 | |
| TT1D | 23008 | TTC | TTT | F | F | 46 | |
| TT11 | 65535 | GGC | TGT | A | C | 43 | |
| TT12 | 55409 | GGC | ATG | A | M | 43 | |
| TT13 | 65535 | GGC | ACT | A | T | 43 | |
| TT14 | 65535 | GAC | AAT | □ | N | 49 | |
| TT15 | 57979 | GAC | CGT | □ | R | 49 | |
| TT16 | 65535 | GAC | TGT | □ | Ξ | 49 | |
| 1717 | 23108 | GGC | ATG | A | M | 52 | |
| TT1B | 65535 | TCG | TTT | Ξ | F | 63 | |
| TT19 | 65535 | TCG | TAT | Ξ | Y | 63 | |
| TT2D | 24003 | CGG | GGT | R | A | 35 | |
| TT21 | 37005 | CGG | GAT | R | □ | 35 | |
| TT22 | 65535 | CGG | CAG | R | Q | 35 | |
| TT23 | 39478 | CGG | TGT | R | Ξ | 35 | |
| TT24 | 65535 | CGG | ACG | R | T | 35 | |
| TT25 | 65535 | CGG | TAT | R | ¥ | 35 |
Petição 870180005321, de 22/01/2018, pág. 262/316
256/293
| T1-26 | 52743 | GAG | AAG | E | K | 95 | (GCG)92(G GT) |
| TT27 | 30520 | GCG | GTT | A | V | 92 | |
| T1-23 | 13239 | GCG | GAG | A | E | 92 | |
| TT29 | 25319 | GAG | GAT | E | D | 95 | |
| TT3D | 21305 | GAG | GCT | E | A | 95 | |
| TT31 | 42531 | GCG | AAG | A | K | 96 | |
| TT32 | 23046 | GCG | AGG | A | R | 96 | |
| TT33 | 19339 | GCC | TCG | A | Ξ | 97 | |
| TT34 | 17199 | MG | CGT | K | R | 101 | |
| TT35 | 33316 | GTG | TTG | V | L | 104 | |
| TT36 | 45591 | TAT | GTT | Y | L | 113 | |
| TT37 | 31618 | GAG | GCG | E | A | 116 | |
| TT3B | 65535 | GAG | TGT | E | C | 116 | |
| TT39 | 65535 | GAG | GAT | E | □ | 116 |
| TT4D | 36485 | GAG | TTT | E | F | 116 | |
| TT41 | 65535 | GAG | ATT | E | I | 116 | (TTC}135(T π) |
| TT42 | 43338 | GAG | ATT | E | I | 116 | |
| TT43 | 33696 | GAG | GTT | E | L | 116 | |
| TT44 | 53069 | GAG | AAT | E | N | 116 | |
| TT45 | 65535 | GAG | GAG | E | Q | 116 | |
| TT46 | 42681 | GAG | AGT | E | Ξ | 116 | |
| TT47 | 65535 | GAG | AGT | E | T | 116 | |
| TT4S | 65535 | GAG | GTT | E | V | 116 | |
| TT49 | 60385 | GAG | TGG | E | w | 116 | |
| TT5D | 42924 | GAG | TAT | E | Y | 116 | |
| TT51 | 13591 | GTG | ATG | L | M | 117 | |
| TT52 | 65535 | AAG | AGG | K | R | 120 | |
| TT53 | 50984 | AGT | GCT | S | A | 133 | |
| TT54 | 65535 | GCG | TCG | A | Ξ | 136 | |
| TT55 | 32933 | GGC | TTT | G | F | 137 | |
| TT56 | 65535 | GTC | ATG | L | M | 139 | |
| TT57 | 54461 | GAG | AGG | H | R | 140 | |
| TT58 | 20741 | AAC | TGG | N | W | 142 | |
| TT59 | 25491 | GCG | ATT | A | I | 144 | |
| TT6D | 19150 | GCG | TTG | A | L | 144 | |
| TT61 | 54979 | GCG | ATG | A | M | 144 | |
| TT62 | 33234 | GCG | GTG | A | V | 144 | |
| TT63 | 51208 | GAG | CAT | E | H | 149 | |
| TT64 | 21503 | GCG | ATT | A | I | 150 | |
| TT65 | 51405 | GCG | ATG | A | M | 150 | |
| TT66 | 65535 | GCG | TGG | A | W | 150 | |
| TT67 | 25795 | AGC | AAT | S | N | 153 | |
| TT68 | 13156 | AGC | GGT | £ | G | 153 | |
| TT69 | 65535 | AAC | GAC | N | □ | 153 | |
| TT70 | 65535 | GCG | GGT | P | G | 162 | |
| TT71 | 13622 | GCG | AAG | P | K | 162 | |
| TT72 | 55639 | GCG | TCG | P | Ξ | 162 | R163F |
| TT73 | 26167 | GCG | TCG | P | Ξ | 162 | I167L |
| TT74 | 20774 | GCG | TCG | P | Ξ | 162 | |
| TT75 | 65535 | GTG | ATT | V | I | 133 | |
| TT76 | 20029 | GAG | GCG | Q | A | 166 | |
| TT77 | 21399 | GAG | GAG | C | E | 166 |
Petição 870180005321, de 22/01/2018, pág. 263/316
257/293
| TT78 | 32863 | CAG | ACG | Q | T | 166 | |
| TT79 | 25576 | ATT | TTT | I | F | 167 | |
| TT8D | 16567 | ATT | AAG | I | K | 167 | |
| TT81 | 26239 | ATT | CTG | I | L | 167 |
| TT82 | 19330 | ATT | CGT | I | R | 167 | |
| TT83 | 31994 | ATT | TAT | I | Y | 167 | |
| TT&4 | 65535 | CGC | CAT | R | H | 172 | |
| TT85 | 38603 | CGC | AAG | R | K | 172 | |
| TT86 | 24428 | CGC | CTT | R | L | 172 | |
| TT87 | 37581 | CGC | TAT | R | Y | 172 | |
| TT88 | 30655 | CTC | AAG | L | K | 180 | |
| TT89 | 65535 | CTC | AGG | L | R | 180 | |
| TT&D | 64023 | GCG | TGT | A | C | 185 | |
| TT91 | 41225 | GCG | AAT | A | N | 185 | |
| TT92 | 65535 | GAA | GCG | E | A | 190 | |
| TT93 | 65535 | GAA | AAG | E | K | 190 | |
| TT&4 | 65535 | GAA | ATG | E | M | 190 | |
| TT55 | 65535 | GAA | CAG | E | Q | 190 | |
| TT96 | 65535 | GAA | AGG | E | R | 190 | |
| TT&7 | 17914 | CTA | ATT | L | I | 200 | |
| TT98 | 18910 | CTA | GTA | L | V | 200 | E2D1Y |
| TT99 | 35222 | CTA | GIT | L | V | 200 | |
| TT1DD | 38817 | GAG | TAT | E | Y | 201 | |
| TT1D1 | 65535 | GCG | CAT | A | H | 203 | |
| TT1D2 | 65535 | GCG | CCG | A | P | 203 | |
| TT1D3 | 65535 | GCG | AGG | A | R | 203 | |
| TT1D4 | 47048 | ATG | UT | M | L | 207 | |
| TT1D5 | 65535 | ACC | CAT | T | H | 214 | |
| TT1D6 | 65535 | ACC | AAG | T | K | 214 | |
| TT1D7 | 48095 | ACC | AGG | T | R | 214 | |
| TT1DS | 35774 | ACC | TCG | T | Ξ | 214 | |
| TT1D9 | 65535 | ACC | GTT | T | V | 214 | |
| TT110 | 53546 | GGG | GCG | G | A | 215 | |
| TT111 | 65535 | CTG | ATT | L | I | 222 | |
| TT112 | 24987 | GCG | TCT | A | Ξ | 225 | |
| TT113 | 26618 | CGG | TAT | R | Y | 163 | |
| TT114 | 22246 | CGG | ATG | R | M | 163 | |
| TT115 | 42199 | CGG | ACG | R | T | 163 | |
| TT116 | 42127 | CGG | TTG | R | L | 163 | |
| TT117 | 33933 | CGG | TGT | R | C | 163 |
Tabela 10
| Palmitato | Palmitato 3 horas | Palmitato 24 horas | |||||||||
| Enzima | Mutação | 45C 24 H | 25 C 24 H | 25 C 48 H | 45 C 48 H | 55C 3H | 45 C 3H | 25 C 3H | 55 C 24 H | 45 C 24 H | 25 C 24 H |
| TT41 | E1161, (TTC)13 5(TTT) | 8,0% | 9,9% | 9,4% | 7,2% | 9,4% | 9,3% | 10,7% | 9,3% | 7,1% | 9,5% |
| TT43 | E116L | 7,3% | 7,6% | 6,8% | 6,5% | 9,0% | 9,1% | 9,8% | 6,3% | 6,8% | 8,1% |
| TT44 | E116N | 5,9% | 6,5% | 5,3% | 4,9% | 8,9% | 9,9% | 10,3% | 7,1% | 6,4% | 8,1% |
Petição 870180005321, de 22/01/2018, pág. 264/316
258/293
| Palmitato | Palmitato 3 horas | Palmitato 24 horas | |||||||||
| Enzima | Mutação | 45C 24 H | 25 C 24 H | 25 C 48 H | 45 C 48 H | 55C 3 H | 45 C 3 H | 25 C 3 H | 55 C 24 H | 45 C 24 H | 25 C 24 H |
| TT59 | A1441 | 9,7% | 10,1% | 9,7% | 9,2% | 10,4% | 10,3% | 9,8% | 9,5% | 10,2% | |
| TT61 | A144M | 9,0% | 9,2% | 8,4% | 8,4% | 10,6% | 10,5% | 10,3% | 9,8% | 10,1% | 9,5% |
| TT62 | A144V | 7,4% | 7,5% | 6,7% | 9,2% | 9,7% | 9,9% | 7,7% | 8,6% | 7,6% | |
| TT63 | E149H | 9,0% | 10,2% | 9,5% | 8,8% | 10,2% | 9,8% | 10,7% | 9,4% | 8,7% | 9,6% |
| TT64 | A1501 | 6,9% | 7,3% | 6,8% | 6,5% | 7,4% | 7,0% | 8,8% | 6,6% | 5,9% | 6,8% |
| TT118 | N158D, P162G | 7,5% | 8,2% | 6,7% | 9,7% | 10,2% | 10,4% | 8,3% | 6,7% | 9,1% | |
| TT70 | P162G | 8,5% | 9,7% | 7,9% | 7,3% | 9,7% | 10,2% | 10,9% | 7,6% | 6,6% | 9,4% |
| TT71 | P162K | 6,6% | 8,7% | 6,9% | 6,3% | 9,0% | 9,1% | 10,4% | 8,2% | 6,1% | 7,9% |
| TT113 | R163Y | 6,4% | 7,3% | 6,0% | 5,6% | 7,6% | 7,0% | 9,7% | 6,4% | 6,1% | 6,2% |
| TT84 | R172H | 6,3% | 6,3% | 5,5% | 5,2% | 8,1% | 8,0% | 9,5% | 6,3% | 6,9% | 7,5% |
| TT86 | R172 L | 6,1% | 6,8% | 6,1% | 5,8% | 8,7% | 8,6% | 9,6% | 6,8% | 6,3% | 6,9% |
| TT105 | T214H | 6,4% | 7,3% | 6,1% | 6,1% | 8,3% | 7,8% | 9,5% | 6,7% | 7,3% | 7,0% |
| TT112 | A225S | 8,6% | 9,2% | 8,6% | 8,1% | 9,9% | 9,8% | 10,3% | 8,9% | 7,9% | 8,9% |
| TT7 | G32P | 6,1% | 8,7% | 8,3% | 5,8% | 8,6% | 8,5% | 9,0% | 8,1% | 7,1% | 7,0% |
| TT11 | A48C | 8,0% | 8,2% | 7,5% | 7,3% | 8,7% | 9,3% | 10,1% | 6,5% | 6,7% | 7,5% |
| TT25 | R85Y | 6,8% | 8,7% | 6,8% | 7,8% | 7,6% | 9,9% | 8,0% | 6,0% | 7,1% | |
| TT26 | E95K, (GCG)92 (GCT) | 7,5% | 8,9% | 6,9% | 6,8% | 8,1% | 7,9% | 9,8% | 6,7% | 5,7% | 7,1% |
| Controle negativo | negativo | 10,7% | 10,8% | 10,8% | 10,5% | ||||||
| Controle negativo | negativo | 10,7% | 10,8% | 10,7% | 10,6% | ||||||
| Controle negativo | negativo | 10,8% | 10,8% | 10,8% | 10,7% | ||||||
| TT35 | V104L | 6,0% | 7,3% | 5,6% | 5,7% | 7,9% | 7,7% | 9,1% | 6,3% | 6,3% | 6,5% |
| TT36 | Y113L | 7,1% | 7,3% | 6,5% | 6,7% | 8,9% | 8,8% | 9,3% | 7,1% | 6,9% | 6,6% |
| TT37 | E116A | 8,0% | 8,2% | 7,3% | 7,6% | 9,6% | 9,5% | 10,2% | 8,5% | 7,4% | 8,6% |
| TT38 | E116C | 7,1% | 7,5% | 5,7% | 6,5% | ||||||
| TT39 | E116D | 6,4% | 6,6% | 5,8% | 5,9% | ||||||
| TT48 | E116V | 6,9% | 7,5% | 6,2% | 6,6% | ||||||
| TT52 | K120R | 5,7% | 6,0% | 5,1% | 6,5% | ||||||
| TT56 | L139M | 7,6% | 8,1% | 6,9% | 7,1% | 9,9% | 10,1% | 9,9% | 9,5% | 9,5% | 8,5% |
| TT65 | A150M | 6,2% | 6,4% | 5,6% | 5,9% | ||||||
| TT74 | P162S | 7,0% | 7,0% | 5,8% | 6,2% | ||||||
| TT116 | R163L | 6,3% | 6,4% | 5,8% | 6,1% | ||||||
| TT80 | I167K | 6,5% | 6,9% | 5,6% | 6,4% | ||||||
| TT4 | D16W | 6,3% | 6,7% | 5,7% | 6,4% | ||||||
| TT92 | E190A | 6,7% | 6,7% | 5,9% | 5,9% | ||||||
| TT95 | E190Q | 6,7% | 6,9% | 5,9% | 6,3% |
Petição 870180005321, de 22/01/2018, pág. 265/316
259/293
| Palmitato | Palmitato 3 horas | Palmitato 24 horas | |||||||||
| Enzima | Mutação | 45C | 25 C | 25 C | 45 C | 55C | 45 C | 25 C | 55 C | 45 C | 25 C |
| 24 H | 24 H | 48 H | 48 H | 3 H | 3 H | 3 H | 24 H | 24 H | 24 H | ||
| TT100 | E201Y | 6,5% | 7,4% | 5,8% | 6,4% | ||||||
| TT101 | A203H | 6,2% | 6,5% | 5,8% | 6,3% | ||||||
| TT104 | M207L | 7,8% | 7,8% | 6,8% | 7,4% | 9,5% | 9,3% | 10,3% | 8,7% | 6,9% | 7,9% |
| TT107 | T214R | 6,6% | 6,9% | 5,5% | 6,1% | ||||||
| TT109 | T214V | 6,3% | 7,8% | 5,4% | 5,7% | ||||||
| TT6 | G32E | 6,6% | 6,9% | 5,7% | 6,5% | ||||||
| TT8 | L34M | 6,8% | 7,2% | 6,2% | 6,6% | ||||||
| TT12 | A48M | 10,2% | 10,8% | 10,1% | 10,4% | ||||||
| TT14 | D49N | 6,7% | 7,6% | 5,3% | 6,4% | 8,5% | 7,8% | 8,9% | 7,7% | 5,4% | 5,8% |
| TT1 | Y7L | 6,5% | 7,2% | 5,0% | 6,2% | ||||||
| TT120 | P162S, R163F | 6,6% | 7,5% | 6,3% | 6,4% | 8,7% | 9,1% | 10,3% | 6,9% | 6,6% | 7,5% |
| Controle negativo | Negativo | 10,6% | 10,7% | 10,6% | 10,7% | ||||||
| SEQ ID NO: 2 com D61E, R72K e V163R | Parenter al | 6,1% | 6,1% | 4,8% | 6,2% | ||||||
| SEQ ID NO: 2 com D61E, R72K e V163R | Parenter al | 6,0% | 6,2% | 5,4% | 6,0% | ||||||
| TT45 | E116Q | 5,9% | 5,7% | 5,6% | 4,9% | 8,2% | 8,4% | 8,4% | 7,4% | 7,1% | 7,0% |
| TT47 | E116T | 5,7% | 4,7% | 5,4% | 4,2% | 8,0% | 8,6% | 8,6% | 6,9% | 7,9% | 6,2% |
| TT52 | K120R | 6,0% | 5,7% | 5,6% | 5,0% | 8,4% | 9,4% | 8,8% | 9,7% | 8,6% | 6,4% |
| TT57 | H14OR | 7,1% | 6,8% | 6,8% | 6,0% | 8,8% | 8,7% | 9,5% | 7,9% | 8,2% | 7,2% |
| TT58 | N142W | 10,3% | 3,5% | 10,3% | 10,2% | ||||||
| TT59 | A1441 | 10,5% | 10,2% | 10,3% | 9,8% | ||||||
| TT60 | A144L | 9,1% | 8,4% | 8,9% | 8,1% | ||||||
| TT66 | A150W | 7,1% | 6,5% | 6,5% | 7,3% | 7,7% | 9,0% | 6,9% | 6,1% | 6,7% | |
| TT2 | AI5L | 7,5% | 6,7% | 7,1% | 6,5% | ||||||
| TT3 | A15M | 7,7% | 7,3% | 7,4% | 7,3% | ||||||
| TT115 | R163T | 7,1% | 6,5% | 6,3% | 5,9% | ||||||
| TT78 | Q166T | 5,8% | 4,5% | 5,5% | 4,0% | ||||||
| TT79 | 1167F | 6,7% | 5,4% | 6,2% | 4,7% | 8,5% | 8,7% | 9,4% | 8,0% | 7,2% | 6,2% |
| TT83 | I167Y | 5,8% | 5,7% | 5,2% | 4,9% | 8,6% | 9,0% | 8,6% | 8,0% | 9,2% | 6,3% |
| TT89 | L18OR | 6,1% | 5,2% | 5,8% | 4,6% |
Petição 870180005321, de 22/01/2018, pág. 266/316
260/293
| Palmitato | Palmitato 3 horas | Palmitato 24 horas | |||||||||
| Enzima | Mutação | 45C 24 H | 25 C 24 H | 25 C 48 H | 45 C 48 H | 55C 3 H | 45 C 3 H | 25 C 3 H | 55 C 24 H | 45 C 24 H | 25 C 24 H |
| TT75 | V1831 | 6,1% | 5,6% | 5,6% | 5,0% | ||||||
| TT90 | A185C | 7,2% | 6,2% | 6,9% | 8,8% | 8,1% | 9,2% | 8,3% | 6,5% | 6,8% | |
| TT89 | L18OR | 6,2% | 5,4% | 5,4% | 4,4% | ||||||
| TT108 | T214S | 6,6% | 5,6% | 5,0% | 8,5% | 8,5% | 8,5% | 7,8% | 9,1% | 6,2% | |
| TT110 | G215A | 6,2% | 6,1% | 5,4% | 5,1% | ||||||
| TT9 | L43I | 6,2% | 5,9% | 5,5% | 4,9% | 8,0% | 7,6% | 9,2% | 7,0% | 5,9% | 5,8% |
| TT15 | D49R | 7,9% | 7,1% | 8,0% | 9,0% | 8,6% | 9,7% | 8,3% | 7,5% | 8,6% | |
| TT16 | D49S | 6,8% | 5,8% | 6,5% | 4,7% | ||||||
| TT18 | S68F | 6,2% | 5,6% | 6,1% | 4,9% | ||||||
| TT19 | S68Y | 6,5% | 5,5% | 7,0% | 4,7% | ||||||
| TT22 | R85Q | 6,8% | 6,2% | 6,3% | 5,3% | ||||||
| TT23 | R85S | 6,6% | 6,0% | 6,3% | 5,3% | ||||||
| TT24 | R85T | 6,9% | 5,9% | 6,7% | 5,2% | ||||||
| TT31 | A96K | 6,7% | 5,5% | 6,4% | 4,8% | ||||||
| SEQ ID NO: 2 com D61E, R72K e V163R | Parenter al | 6,4% | 5,7% | 6,1% | 4,7% | ||||||
| TT34 | K101R | 6,9% | 5,6% | 4,4% | 6,3% | ||||||
| TT40 | E1 16F | 7,1% | 6,4% | 5,7% | 6,8% | ||||||
| TT46 | E116S | 7,1% | 7,0% | 5,9% | 7,0% | ||||||
| TT49 | E116W | 7,5% | 7,4% | 6,6% | 7,6% | ||||||
| TT50 | E116Y | 6,9% | 6,6% | 5,4% | 6,3% | ||||||
| TT53 | S133A | 7,2% | 7,2% | 6,0% | 7,1% | ||||||
| TT54 | A136S | 7,1% | 6,6% | 5,8% | 6,9% | ||||||
| TT55 | G137F | 7,7% | 6,6% | 5,6% | 7,2% | ||||||
| TT60 | A144L | 10,5% | 10,0% | 9,3% | 9,8% | ||||||
| TT68 | S153G | 6,9% | 6,4% | 5,5% | 6,5% | ||||||
| TT3 | A15M | 7,3% | 6,9% | 5,8% | 6,9% | ||||||
| TT13 | A48T | 7,2% | 6,0% | 5,1% | 7,0% | ||||||
| TT115 | R163T | 8,2% | 8,1% | 6,8% | 7,8% | ||||||
| TT73 | P162S, I167L | 6,4% | 6,3% | 5,4% | 6,4% | ||||||
| TT117 | R163C | 6,7% | 6,1% | 5,2% | 6,4% | ||||||
| TT114 | R163M | 8,2% | 7,3% | 7,2% | 7,2% | ||||||
| TT115 | R163T | 5,7% | 5,1% | 4,4% | 5,0% | ||||||
| TT113 | R163Y | 6,9% | 6,6% | 5,8% | 6,6% | ||||||
| TT77 | Q166E | 6,2% | 5,8% | 5,0% | 6,0% | ||||||
| TT81 | I167L | 7,1% | 6,9% | 6,1% | 6,6% |
Petição 870180005321, de 22/01/2018, pág. 267/316
261/293
| Palmitato | Palmitato 3 horas | Palmitato 24 horas | |||||||||
| Enzima | Mutação | 45C 24 H | 25 C 24 H | 25 C 48 H | 45 C 48 H | 55C 3 H | 45 C 3 H | 25 C 3 H | 55 C 24 H | 45 C 24 H | 25 C 24 H |
| TT82 | I167R | 7,8% | 7,2% | 6,2% | 7,2% | ||||||
| TT85 | R172K | 6,4% | 5,7% | 5,0% | 5,9% | ||||||
| TT87 | R172Y | 6,5% | 6,4% | 5,2% | 6,0% | ||||||
| TT88 | L180K | 6,2% | 6,1% | 5,2% | 6,7% | ||||||
| TT89 | L18OR | 7,2% | 6,0% | 5,1% | 6,9% | ||||||
| TT93 | E190K | 7,3% | 6,7% | 5,6% | 7,1% | ||||||
| TT94 | E190M | 6,9% | 6,8% | 5,5% | 6,0% | ||||||
| TT96 | E190R | 6,9% | 6,3% | 5,4% | 6,5% | ||||||
| TT97 | L2001 | 5,7% | 5,7% | 5,0% | 5,9% | ||||||
| TT5 | M31I | 6,8% | 5,8% | 5,0% | 6,4% | ||||||
| TT102 | A203P | 7,5% | 6,6% | 5,9% | 6,8% | ||||||
| TT103 | A203R | 6,6% | 6,2% | 5,4% | 6,2% | ||||||
| TT5 | M311 | 7,4% | 7,1% | 6,2% | 7,1% | ||||||
| TT6 | G32E | 7,2% | 6,7% | 6,3% | 6,4% | ||||||
| TT13 | A48T | 7,1% | 6,8% | 5,8% | 6,9% | ||||||
| TT17 | A52M | 6,9% | 5,7% | 5,0% | 6,4% | ||||||
| TT1 | Y7L | 6,5% | 6,5% | 5,8% | 6,6% | ||||||
| TT20 | R85A | 7,1% | 5,7% | 5,1% | 6,3% | ||||||
| TT28 | A92E | 7,3% | 5,8% | 5,0% | 6,7% | ||||||
| TT27 | A92V | 6,9% | 5,5% | 4,8% | 6,3% | ||||||
| TT30 | E95A | 7,9% | 5,7% | 4,9% | 7,2% | ||||||
| TT29 | E95D | 7,6% | 5,6% | 5,0% | 6,9% | ||||||
| TT32 | A96R | 6,7% | 6,6% | 5,8% | 6,2% | ||||||
| TT33 | A97S | 7,4% | 5,4% | 4,8% | 6,7% | ||||||
| TT114 | R163M | 7,2% | 5,8% | 5,8% | 7,6% | 7,5% | 7,0% | 8,9% | 6,0% | 7,2% | 5,8% |
| TT116 | R163L | 7,0% | 5,9% | 5,1% | 7,2% | 8,1% | 7,4% | 9,4% | 7,8% | 7,0% | 5,9% |
[0512] Um uso de códon em um dado resíduo que não resulta em uma alteração de aminoácido é referido como uma mutação silente. Mutações silentes são obtidas como acertos [hits] devido à expressão incrementada relativamente à enzima parental, e foram observadas a 37 sítios na seleção GSSM (Tabela 11, abaixo).
Tabela 11
| Códon original | Novo códon | Aminoácido | Aminoácido | Sítio de aminoácido |
| GCG | GCT | A | A | 35 |
| GGC | GGT | G | G | 37 |
| CTG | CTT | L | L | 41 |
| GGC | GGA | G | G | 45 |
Petição 870180005321, de 22/01/2018, pág. 268/316
262/293
| GCC | GCT | A | A | 52 |
| CGG | CGA | R | R | 89 |
| GCC | GCT | A | A | 97 |
| GTG | GTT | V | V | 102 |
| AGC | AGT | S | S | 108 |
| CTC | TTG | L | L | 109 |
| GCG | GCT | A | A | 114 |
| CGC | CGG | R | R | 115 |
| CTG | CTT | L | L | 117 |
| CTG | TTG | L | L | 124 |
| CGG | AGG | R | R | 126 |
| GTC | GTG | V | V | 128 |
| GTC | GTG | V | V | 129 |
| AGT | TCT | S | S | 133 |
| GGC | GGT | G | G | 137 |
| GAC | GAT | D | D | 138 |
| CTC | CTT | L- | L | 139 |
| AAC | AAT | N | N | 142 |
| CGC | AGG | R | R | 172 |
| GTG | GTT | V | V | 183 |
| ACC | ACG | T | T | 188 |
| TCG | AGT | S | S | 192 |
| CCC | CCT | P | P | 193 |
| CTG | CTT | L | L | 202 |
| GCG | GCT | A | A | 203 |
| ACC | ACT | T | T | 205 |
| CAC | CAT | H | H | 206 |
| GGC | GGT | G | G | 208 |
| TCG | TCT | S | S | 212 |
| CTG | CTT | L | L | 222 |
| GTC | GTG | V | V | 223 |
| CGG | AGG | R | R | 226 |
| CTC | TTG | L | L | 227 |
[0513] Exemplo 10: Evolução exemplar para tolerância térmica aperfeiçoada da palmitase usando tecnologia TMCASM [0514] As mutações com desempenho superior identificadas durante a evolução com GSSM (Exemplo 9, acima) foram avaliadas em ensaios primário e secundário em óleo para inclusão na evolução TMCA. Realizou-se ensaios com 5 g de óleo bruto, como descrito no Exemplo 5, mas com teor de água de 10 %, com os 117 acertos únicos a 25°C e 45°C. O
Petição 870180005321, de 22/01/2018, pág. 269/316
263/293 perfil de óleo foi avaliado após 24 e 48 horas de reação. Acertos primários foram submetidos a ensaios secundários em óleo a 25°C, 45°C e 55°C. Frações foram removidas a 3, 24, e 48 horas para se avaliar os perfis de óleo. As que desempenharam melhor estão listadas na Tabela 12 abaixo, sendo que o palmitato permaneceu no óleo listado como um percentual do total de ácidos graxos ligados. Para avaliar o impacto de um refino cáustico intermediário, os ensaios a 45°C foram refinados causticamente por meio de adição de NaOH a 11 % (estimado para 7 % de FFA) e aquecidos com agitação contínua a 60°C. Adicionou-se enzima fresca ao óleo refinado a 20 % de teor de água, isto foi homogeneizado e a reação em óleo prosseguiu com agitação durante mais 24 horas a 45°C. O teor final de palmitato nas amostras refinadas cáusticas é mostrado na última coluna, “CR 24H”.
[0515] Dos que desempenharam melhor mostrados na Tabela 12, 15 mutantes (mostrados em negrito e itálico na Tabela 12) foram selecionados para combinação usando tecnologia TMCA. A biblioteca TMCA foi construída como descrito na Publicação PCT n° WO 2009/018449 e como descrito adicionalmente abaixo. Esta biblioteca consistia de 9216 variantes únicas.
Tabela 12:
| Palmitato | Palmitato 2 horas | Palmitato 24 horas | Palmitato 48 horas | ||||||||||||
| Enzim a | Mutações | 45C 24H | 25C 24H | 25C 48H | 45C 48H | 55 C 3H | 45C 3H | 25C 3H | 55C 24H | 45C 24H | 25C 24H | 55C 48H | 45C 48H | 25C 24H | CR 24H |
| TT11 | A48C | 8,0 % | 8,2% | 7,5% | 7,3% | 8,7% | 9,3% | 10,1 % | 6,5% | 6,7% | 7,5% | 6,7% | 6,6% | 6,8% | 5,3% |
| TT41 | E116l, (TTC)135 (TTT) | 8,0 % | 9,9% | 9,4% | 7,2% | 9,4% | 9,3% | 10,7 % | 9,3% | 7,1% | 9,5% | 9,1% | 6,5% | 9,1% | 5,6% |
| TT43 | E116L | 7,3 % | 7,6% | 6,8% | 6,5% | 9,0%, | 9,1% | 9,8% | 6,3% | 6,8% | 8,1% | 6,2% | 6,0% | 6,8% | 4,8% |
| TT44 | E116N | 5,9 % | 6,5% | 5,3% | 4,9% | 8,9% | 9,9% | 10,3 % | 7,1% | 6,4% | 8,1% | 6,5% | 5,6% | 7,2% | 4,4% |
| T770 | P162G | 8,5 % | 9,7% | 7,9% | 7,3% | 9,7%- | 10,2% | 10,9 % | 7,6% | 6,6% | 9,4% | 6,7% | 5,6% | 8,4% | 4,7% |
| TT84 | R172H | 6,3 % | 6,3% | 5,5% | 5,2% | 8,1% | 8,0% | 9,5% | 6,3% | 6,9% | 7,5% | 6,8% | 6,4% | 6,7% | 6,1% |
| TT64 | A1501 | 6,9 % | 7,3% | 6,8% | 6,5% | 7,4%, | 7,0% | 8,8% | 6,6% | 5,9% | 6,8% | 6,8% | 5,4% | 6,0% | 5,2% |
| TT63 | E149H | 9,0 % | 10,2 % | 9,5% | 8,8% | 10,2% | 9,8% | 10,7 % | 9,4% | 8,7% | 9,6% | 9,4% | 8,7% | 9,6% | 8,2% |
Petição 870180005321, de 22/01/2018, pág. 270/316
264/293
| TT26 | E95K, (GCG)92( GCT) | 7,5 % | 8,9% | 6,9% | 6,8% | 8,1% | 7,9%, | 9,8% | 6,7% | 5,7% | 7,1% | 6,9% | 5,1% | 6,4% | 4,7% |
| TT71 | P162K | 6,6 % | 8,7% | 6,9% | 6,3% | 9,0%, | 9,1% | 10,4 % | 8,2% | 6,1% | 7,9% | 7,6% | 5,3% | 6,7% | 4,5% |
| TT86 | R172L | 6,1 % | 6,8% | 6,1% | 5,8% | 8,7% | 8,6% | 9,6% | 6,8% | 6,3% | 6,9% | 6,7% | 6,4% | 6,3% | 5,1% |
| TT25 | R85 Y | 6,8 % | 8,7% | 6,8% | 7,8%- | 7,6% | 9,9% | 8,0% | 6,0% | 7,1% | 8,2% | 6,7% | 6,7% | 6,3% | |
| TT118 | N158D, P162G | 7,5 % | 8,2% | 6,7% | 9,7% | 10,2% | 10,4 % | 8,3% | 6,7% | 9,1% | 9,2% | 6,1% | 7,6% | ||
| TT59 | A1441 | 9,7 % | 10,1 % | 9,7% | 9,2% | 10,4% | 10,3% | 9,8% | 9,5% | 10,2% | 9,9% | 9,6% | 10,3 % | 9,1% | |
| TT112 | A225S | 8,6 % | 9,2% | 8,6% | 8,1% | 9,9% | 9,8% | 10,3 % | 8,9% | 7,9% | 8,9% | 9,5% | 7,5% | 8,6% | 6,1% |
| TT15 | D49R | 7,9 % | 7,1% | 8,0% | 9,0% | 8,6% | 9,7% | 8,3% | 7,5% | 8,6% | 8,9% | 7,4% | 8,8% | 8,2% | |
| TT14 | D49N | 6,7 % | 7,6% | 5,3% | 6,4% | 8,5% | 7,8% | 8,9% | 7,7% | 5,4% | 5,8% | 7,9% | 5,5% | 5,6% | 4,8% |
| TT62 | A144V | 7,4 % | 7,5% | 6,7% | 9,2% | 9,7% | 9,9% | 7,7% | 8,6% | 7,6% | 7,6% | 8,7% | 7,4% | 6,8% | |
| TT105 | T214H | 6,4 % | 7,3% | 6,1% | 6,1% | 8,3% | 7,8% | 9,5% | 6,7% | 7,3% | 7,0% | 6,3% | 6,8% | 5,7% | 4,8% |
| TT61 | A144M | 9,0 % | 9,2% | 8,4% | 8,4% | 10,6% | 10,5% | 10,3 % | 9,8% | 10,1 % | 9,5% | 9,0% | 9,7% | 8,6% | |
| TT113 | R163Y | 6,4 % | 7,3% | 6,0% | 5,6% | 7,6% | 7,0% | 9,7% | 6,4% | 6,1% | 6,2% | 6,5% | 5,9% | 5,5% | 5,3% |
| TT7 | G32P | 6,1 % | 8,7% | 8,3% | 5,8% | 8,6% | 8,5% | 9,0% | 8,1% | 7,1% | 7,0% | 7,6% | 6,8% | 6,5% | |
| TT120 | P162S, R163F | 6,6 % | 7,5% | 6,3% | 6,4% | 8,7% | 9,1% | 10,3 % | 6,9% | 6,6% | 7,5% | ||||
| TT37 | E116A | 8,0 % | 8,2% | 7,3% | 7,6% | 9,6% | 9,5% | 10,2 % | 8,5% | 7,4% | 8,6% |
[0516] Tecnologia de montagem combinatorial personalizada de sítios múltiplos (TMCA, Tailored Multi-Site Combinatorial Assembly), tecnologia TMCA (ver Publicação PCT n° WO 09/018449), compreende um método para produzir uma pluralidade de polinucleotídeos de progênie apresentando diferentes combinações de várias mutações em múltiplos sítios. O método pode ser realizado, em parte, por meio de uma combinação de pelo menos uma ou mais das seguintes etapas:
[0517] Obtenção de informação de sequência de um polinucleotídeo (“primeiro” ou “modelo”). Por exemplo, a primeira sequência ou sequência modelo pode ser uma sequência de tipo selvagem (p. ex., SEQ ID NO:2 com mutações D61E, R72K, e V163R) ou uma sequência mutada. A informação de sequência pode ser do polinucleotídeo
Petição 870180005321, de 22/01/2018, pág. 271/316
265/293 completo (p. ex., um gene ou uma matriz de leitura aberta) ou de regiões parciais de interesse, como uma sequência que codifica um sítio para ligação, especificidade de ligação, catálise, ou especificidade por substrato.
[0518] Identificação de três ou mais mutações de interesse ao longo da primeira sequência (ou sequência modelo) de polinucleotídeo. Por exemplo, mutações podem encontrar-se em 3, 4, 5, 6, 8, 10, 12, 20 ou mais posições dentro da primeira sequência ou sequência modelo. As posições podem ser predeterminadas por meio da posição absoluta ou pelo contexto de três resíduos circundantes ou homologia. Por exemplo, para TMCA de polipeptídios de palmitase, as principais alterações de aminoácidos termotolerantes que resultaram em desempenho aperfeiçoado de enzima foram incluídas como mutações de interesse. As sequências que flanqueiam as posições de mutação de cada lado podem ser mostradas. Cada posição de mutação pode conter duas ou mais mutações, como para diferentes aminoácidos. Referidas mutações podem ser identificadas com o uso de tecnologia Gene Site Saturation MutagenesisSM (GSSMSM), como descrito aqui e, p. ex., nas Patentes U.S. nums. 6.171.820; 6.562.594; e 6.764.835.
[0519] Proporcionar iniciadores (p. ex., oligonucleotídeos sintéticos) compreendendo as mutações de interesse. Em uma concretização, proporciona-se um iniciador para cada mutação de interesse. Assim, um primeiro polinucleotídeo ou polinucleotídeo modelo apresentando 3 mutações de interesse pode usar 3 iniciadores naquela posição. O iniciador também pode ser proporcionado como um combinado [pool] de iniciadores contendo uma posição degenerada de forma que a mutação de interesse encontra-se na faixa de qualquer nucleotídeo ou aminoácido naturalmente ocorrente, ou um subconjunto daquela faixa. Por exemplo, é possível proporcionar um combinado [pool] de iniciadores que favorecem mutações para resíduos de aminoácidos alifáticos. Os iniciadores podem ser preparados como iniciadores diretos ou invertidos, ou os iniciadores podem ser preparados como pelo menos um iniciador direto e pelo menos um iniciador invertido. Quando mutações são posicionadas próximas entre si, pode ser vantajoso usar iniciadores que contêm mutações para mais do que uma posição ou diferentes combinações de mutações em múltiplas posições.
[0520] Proporcionar um polinucleotídeo contendo a sequência modelo. O primeiro ou
Petição 870180005321, de 22/01/2018, pág. 272/316
266/293 polinucleotídeo modelo pode ser circular, ou pode ser super-enrolado, como um plasmídio ou vetor para clonagem, sequenciamento ou expressão. O polinucleotídeo pode ser de filamento simples (“ssDNA”), ou pode ser de filamento duplo (“dsDNA”). Por exemplo, o método TCMA submete o dsDNA modelo superenrolado (“sc” [supercoiled]) a uma etapa de aquecimento a 95°C durante 1 min (ver Levy, Nucleico Acid Res., 28(12):e57(i-vii) (2000)).
[0521] Adicionar os iniciadores ao polinucleotídeo modelo em uma mistura de reação. Os iniciadores e o polinucleotídeo modelo são combinados em condições que permitem que os iniciadores recombinem com o polinucleotídeo modelo. Em uma concretização do protocolo de TMCA, os iniciadores são adicionados ao polinucleotídeo em uma mistura de reação simples, mas podem ser adicionados em múltiplas reações.
[0522] Realizando uma reação/reações de extensão de polimerase. Os produtos de extensão (p. ex., como uma “progênie” ou “polinucleotídeo estendido modificado”) podem ser amplificados por meios convencionais. Os produtos podem ser analisados de acordo com o comprimento, sequência, propriedades desejadas do ácido nucleico, ou expressos como polipeptídios. Outros métodos de análise incluem hibridização in-situ, seleção de sequência ou seleção de expressão. A análise pode incluir um ou mais ciclos de triagem e seleção de uma propriedade desejada. Os produtos também podem ser transformados em uma célula ou outro sistema de expressão, como um sistema isento de células. O sistema isento de células pode conter enzimas relacionadas com replicação de DNA, reparo, recombinação, transcrição, ou para tradução. Hospedeiros exemplares incluem células e linhas de células bacterianas, de levedura, de planta e de animal, e incluem E. coli, Pseudomonas fluorescens, Pichia pastoris e Aspergillus niger. Por exemplo, é possível usar cepas XL1-Blue ou Stb12 de E. coli.
[0523] O método da invenção pode ser usado com os mesmos iniciadores ou com iniciadores diferentes em diferentes condições de reação para promover produtos apresentando diferentes combinações ou números de mutações.
[0524] Realizando-se o método exemplar descrito acima, este protocolo também proporciona um ou mais polinucleotídeos produzidos por meio deste método de evolução
TMCA, que pode então ser triado ou selecionado quanto a uma propriedade desejada. Um
Petição 870180005321, de 22/01/2018, pág. 273/316
267/293 ou mais dos polinucleotídeos de progênie podem ser expressos como polipeptídios, e opcionalmente triados ou selecionados quando à propriedade desejada. Assim, esta concretização do protocolo de evolução TMCA proporciona polinucleotídeos e os polipeptídios codificados, e também bibliotecas de referidos polinucleotídeos que codificam referidos polipeptídios. Esta concretização do protocolo de evolução TMCA proporciona adicionalmente a seleção de bibliotecas por meio de triagem ou seleção da biblioteca para se obter um ou mais polinucleotídeos que codificam um ou mais polipeptídios apresentando a desejada atividade.
[0525] Outra concretização do protocolo de evolução TMCA descrito na Publicação PCT n° WO 2009/018449 compreende um método de produzir uma pluralidade de polinucleotídeos modificados. Referidos métodos incluem geralmente (a) adicionar pelo menos três iniciadores a um polinucleotídeo modelo de filamento duplo em uma mistura de reação simples, sendo que os pelo menos três iniciadores não se superpõem, e sendo que cada um dos pelo menos três iniciadores compreende pelo menos uma mutação diferente dos outros iniciadores, sendo que pelo menos um iniciador é um iniciador direto que pode recombinar com um filamento minus do modelo e pelo menos um iniciador é um iniciador invertido que pode recombinar com um filamento plus do modelo, e (b) submeter a mistura de reação a uma reação de extensão de polimerase dando uma pluralidade de polinucleotídeos estendidos modificados dos pelo menos três iniciadores.
[0526] Outra concretização do protocolo de evolução TMCA descrito na Publicação PCT n° WO 2009/018449 compreende um método em que uma célula é transformada com a pluralidade de produtos estendidos que não foram tratados com uma ligase. Em outra concretização da invenção, a pluralidade de polinucleotídeos estendidos modificados é recuperada da célula. Em outra concretização, a pluralidade de polinucleotídeos estendidos modificados recuperados é analisada, por exemplo, por meio de expressão de pelo menos um da pluralidade de polinucleotídeos estendidos modificados, e análise do polipeptídio expresso dos mesmos. Em outra concretização, seleciona-se a pluralidade de polinucleotídeos estendidos modificados compreendendo as mutações de interesse. Em outra concretização do protocolo de evolução TMCA, informação de sequência relativa ao polinucleotídeo modelo é obtida, e é possível identificar três ou mais mutações de interesse
Petição 870180005321, de 22/01/2018, pág. 274/316
268/293 ao longo do polinucleotídeo modelo. Em outra concretização, produtos obtidos por meio da extensão de polimerase podem ser analisados antes de transformar a pluralidade de produtos modificados estendidos em uma célula.
[0527] Em uma concretização do protocolo de evolução TMCA, produtos obtidos por meio da extensão de polimerase são tratados com uma enzima, p. ex., uma enzima de restrição, como uma enzima de restrição DpnI, destruindo com isso a sequência do polinucleotídeo modelo. Os produtos tratados podem ser transformados em uma célula, p. ex., uma célula de E. coli. Em uma concretização do protocolo de evolução TMCA, é possível usar pelo menos dois, ou pelo menos três, ou pelo menos quatro, ou pelo menos cinco, ou pelo menos seis, ou pelo menos sete, ou pelo menos oito, ou pelo menos nove, ou pelo menos dez, ou pelo menos onze, ou pelo menos doze, ou mais iniciadores. Em uma concretização, cada iniciador compreende uma mutação pontual simples. Em outra concretização, dois iniciadores direto ou dois iniciadores invertido compreendem uma alteração diferente na mesma posição do polinucleotídeo modelo. Em outra concretização, pelo menos um iniciador compreende pelo menos duas alterações em diferentes posições do polinucleotídeo modelo. Em outra concretização adicional, pelo menos um iniciador compreende pelo menos duas alterações em diferentes posições e pelo menos dois iniciadores direto ou dois iniciadores invertido compreendem uma alteração diferente na mesma posição do polinucleotídeo modelo. Em uma concretização do protocolo de evolução TMCA, os iniciadores direto são agrupados em um grupo direto e os iniciadores invertido são agrupados em um grupo invertido, e os iniciadores no grupo direto e os iniciadores no grupo invertido, independentemente um do outro, são normalizados para apresentarem concentração igual no grupo correspondente independentemente das posição no polinucleotídeo modelo, e sendo que, após a normalização, adiciona-se à reação uma quantidade igual dos iniciadores direto e invertido. Neste método de normalização, é possível induzir um viés da combinação de algumas posições. O viés pode dever-se, por exemplo, a uma concentração relativamente baixa de iniciador em uma posição contendo um iniciador individual, em comparação com uma posição contendo iniciadores múltiplos. “Viés posicional” refere-se a polinucleotídeos resultantes que apresentam uma forte preferência pela incorporação de iniciadores em uma posição
Petição 870180005321, de 22/01/2018, pág. 275/316
269/293 individual relativamente às outras posições dentro de seu grupo de iniciadores direto ou invertido. Isto resulta em uma combinação de polinucleotídeos modificados que podem apresentar um alto percentual de mutações dentro de uma posição de iniciador individual, porém um baixo percentual de mutações em outra posição dentro do grupo de iniciadores direto ou invertido. Este viés é desfavorável quando o objetivo da TMCA for o de gerar polinucleotídeos de progênie compreendendo todas as possíveis combinações de alterações ao modelo. O viés pode ser corrigido, por exemplo, por meio de normalização dos iniciadores, igualando um combinado [pool] em cada posição.
[0528] Em uma concretização do protocolo de evolução TMCA, a normalização do iniciador é realizada organizando-se os iniciadores em múltiplos grupos dependendo de sua localização no polinucleotídeo modelo, sendo que os iniciadores que cobrem a mesma região selecionada no modelo encontram-se em um grupo; normalizando os iniciadores agrupados dentro de cada grupo para apresentarem concentração igual; combinando os iniciadores direto dentro de um grupo em um grupo direto e normalizando a concentração para ser igual entre cada grupo dos iniciadores direto; combinando os iniciadores invertido dentro de um grupo em um grupo invertido e normalizando a concentração para ser igual entre cada grupo dos iniciadores invertido; e adicionando uma quantidade igual dos iniciadores direto e invertido combinados na reação. Não se observou viés para combinações de posições. Em uma concretização do protocolo de evolução TMCA, proporciona-se um conjunto de iniciadores degenerados, sendo que cada um compreende uma posição degenerada, sendo que a mutação de interesse encontra-se em uma faixa de diferentes nucleotídeos na posição degenerada. Em outra concretização, proporcionase um conjunto de iniciadores degenerados compreendendo pelo menos um códon degenerado correspondendo a pelo menos um códon do polinucleotídeo modelo e pelo menos uma sequência adjacente que é homóloga a uma sequência adjacente ao códon da sequência do polinucleotídeo modelo. Em outra concretização, o códon degenerado é N9N9N e codifica qualquer um dos 20 aminoácidos naturalmente ocorrentes. Em outra concretização, o códon degenerado codifica menos de 20 aminoácidos naturalmente ocorrentes.
[0529] Outra concretização do protocolo de evolução TMCA descrito na Publicação
Petição 870180005321, de 22/01/2018, pág. 276/316
270/293
PCT n° WO 2009/018449 compreende um método de produzir uma pluralidade de polinucleotídeos modificados compreendendo as mutações de interesse. Referidos métodos incluem geralmente (a) adicionar pelo menos dois iniciadores a um polinucleotídeo modelo de filamento duplo em uma mistura de reação simples, sendo que os pelo menos dois iniciadores não se superpõem, e sendo que cada um dos pelo menos dois iniciadores compreendem pelo menos uma mutação diferente do outro iniciador(es), sendo que pelo menos um iniciador é um iniciador direto que pode recombinar com um filamento minus do modelo e pelo menos um iniciador é um iniciador invertido que pode recombinar com um filamento plus do modelo, (b) submeter a mistura de reação a uma reação de extensão de polimerase dando uma pluralidade de polinucleotídeos estendidos modificados dos pelo menos dois iniciadores, (c) tratar a pluralidade de polinucleotídeos estendidos modificados com uma enzima, destruindo com isso o polinucleotídeo modelo, (d) transformar os polinucleotídeos estendidos modificados tratados que não foram tratados com uma ligase em uma célula, (e) recuperar a pluralidade de polinucleotídeos estendidos modificados da célula, e (f) selecionar a pluralidade de polinucleotídeos estendidos modificados compreendendo as mutações de interesse.
[0530] Neste exemplo, as 15 mutações selecionadas para inclusão na biblioteca TMCA termo-tolerante são mostradas na Tabela 13, abaixo. Usou-se seis modelos de DNA: SEQ ID NO:2 com mutações D61E, R72K, e V163R (parental), parental com mutação E95K, parental com mutação P162G, parental com mutação P162K, parental com mutação E95K & P162G, e parental com mutações E95K & P162K. Os plasmídeos do parental com mutação E95K, parental com mutação P162G, parental com mutação P162K foram passados através de células competentes XL1 Blue de E. coli para metilar o DNA. Realizou-se seis evoluções de TMCA separadas, uma para cada um dos seis modelos em combinação com os oligos listados na Tabela 14 abaixo.
Tabela 13:
| MUTAÇÃO | NOVO CÓDON |
| A48C | TGT |
| D49R | CGT |
| R85Y | TAT |
Petição 870180005321, de 22/01/2018, pág. 277/316
271/293
| E95K | AAG |
| E1161 | AU |
| E116L | CTT |
| E116N | AAT |
| A1441 | AU |
| E149H | CAT |
| A1501 | An |
| P162G | GGT |
| P162K | AAG |
| R172H | CAT |
| R172L | CTT |
| A225S | TCT |
Tabela 14
| Nome do oligo | Sequência de oligo -5'-3' |
| A1441-R | TCGACCGTGTGGCTGTTGATCGCCTCGTAGATCTTCCAAATATGGTTGGCGTGGAGGTCGC (SEQ ID NO:24) |
| A1441-A150I-R | TCGACCGTGTGGCTGTTGATAATCTCGTAGATCTTCCAAATATGGTTGGCGTGGAGGTCGC (SEQ ID NO:25) |
| A1441-E149H- A150I-R | TCGACCGTGTGGCTGTTGATAATATGGTAGATCTTCCAAATATGGTTGGCGTGGAGGTCGC (SEQ ID NO:26) |
| A1441-E149H-R | TCGACCGTGTGGCTGTTGATCGCATGGTAGATCTTCCAAATATGGTTGGCGTGGAGGTCGC (SEQ ID NO:27) |
| A150I-R | TCGACCGTGTGGCTGTTGATAATCTCGTAGATCTTCCACGCATGGTTGGCGTGGAGGTCGC (SEQ ID NO:28) |
| A225S-R | TTGGGCTCGAGTCAGAGCCGAGACGCGACCAGCCGGACCACAG (SEQ ID NO:29) |
| A48C-D49R-F | TGGTGCTGCCCGGCTTCCTGTGTCGTGACAACGCCACCTCGGTGCT (SEQ ID NO:30) |
| A48C-F | TGGTGCTGCCCGGCTTCCTGTGTGACGACAACGCCACCTCGGTGCT (SEQ ID NO:31) |
| D49R-F | TGGTGCTGCCCGGCTTCCTGGCCCGTGACAACGCCACCTCGGTGCT (SEQ ID NO:32) |
| E116I-F | TCGGCGGCCTCTATGCGCGCATTCTGGGCCACAAGGCGCCCGA (SEQ ID NO:33) |
| E116L-F | TCGGCGGCCTCTATGCGCGCCTICTGGGCCACAAGGCGCCCGA (SEQ ID NO:34) |
| E116N-F | TCGGCGGCCTCTATGCGCGCAATCTGGGCCACAAGGCGCCCGA (SEQ ID NO:35) |
| E149H -A1 50I-R | TCGACCGTGTGGCTGTTGATAATATGGTAGATCTTCCACGCATGGTTGGCGTGGAGGTCGC (SEQ ID NO:36) |
| E149H-R | TCGACCGTGTGGCTGTTGATCGCATGGTAGATCTTCCACGCATGGTTGGCGTGGAGGTCGC (SEQ ID NO:37) |
| R172H-R | GGCGACCACACCGCGATGGTATGCACCGGCGGCTTAATCTGGA (SEQ ID NO:38) |
| R172L-R | GGCGACCACACCGCGATGGTAAGCACCGGCGGCTTAATCTGGA (SEQ ID NO:39) |
| R85Y-F | TTCGTGGCGACCTCGTGGACTATCTGGTCGACCGGCTGCGGGC (SEQ ID NO:40) |
[0531] Membros da biblioteca foram amplificados no vetor pDOW-kan, analisados com gel de agarose, e tratados com DPNI. Amostras foram então transformadas em células competentes XL1 Blue de E. coli. Colônias foram colhidas, desenvolvidas e seqüenciadas. Resultados de sequenciamento indicaram que a mutação E116L e as mutações nos
Petição 870180005321, de 22/01/2018, pág. 278/316
272/293 aminoácidos 144, 149 e 150 foram sub-representados em comparação com o máximo teórico. Portanto, criou-se outra biblioteca de TMCA usando uma mistura normalizada de todos os seis modelos. As reações de TMCA foram repetidas usando-se todos os oligos listados na Tabela 14, exceto aqueles para as mutações E1161 e E116N. A quantidade de iniciadores usados para a mutação E116L e para a região 4 (aminoácidos 144, 149 & 150) foi dobrada. As amostras foram amplificadas no vetor pDOW-kan, analisadas por meio de gel de agarose, e tratadas com DPNI. O DNA da amostra foi transformado em células competentes XL1 Blue de E. coli. Colônias foram colhidas, desenvolvidas e seqüenciadas. A incorporação de mutações nos aminoácidos 144, 149, e 150 foi aperfeiçoada, mas a E116L ainda estava sub-representada em comparação com o máximo teórico. O DNA de ambas as bibliotecas foi transformado em células competentes XL1 Blue de E. coli. Colônias foram combinadas e o DNA foi preparado usando-se o kit Qiagen mini-prep. O DNA foi então usado para transformar células competentes de Pseudomonas fluorescens. As células foram desenvolvidas em meio LB suplementado com uracila (750 pg/ml) e canamicina (50 pg/ml). Obteve-se um número suficiente de colônias para super-amostrar [oversample] a biblioteca em 10 vezes. A biblioteca foi super-amostrada [oversampled] em 10 vezes contribuindo para a sub-representação de E116L.
[0532] A resultante biblioteca de TMCA termotolerante foi desenvolvida em meio mínimo M9 suplementado com uracila (750 pg/ml) e canamicina (50 pg/ml) e foi selecionada usando-se a triagem de HTP descrita no Exemplo 3, acima. A biblioteca foi incubada a 60°C durante 30 minutos antes e após a adição de UMB-palmitato. As placas de 384 poços foram então lidas com excitação a 365 nm e emissão a 460 nm. Cada placa foi resfriada rapidamente por meio de centrifugação e o espectrofotômetro foi pré-aquecido para minimizar distorções nas leituras. Apresentou-se os valores de fluorescência em cada placa de 384 poços. Os acertos foram identificados como aqueles apresentando >2 desvios padrão acima do controle positivo (mutação E116L simples). Uma triagem secundária de HTP analisou acertos primários de HTP a duas temperaturas de 60°C e 63°C. Acertos secundários foram definidos como >4 desvios padrão acima do controle positivo médio na placa a 63°C e conservando >50 % de atividade entre 60°C e 63°C.
[0533] Identificou-se 318 acertos secundários únicos de HTP. Estes acertos contêm
Petição 870180005321, de 22/01/2018, pág. 279/316
273/293 entre 2 e 9 mutações. Realizou-se ensaios convencionais com 5 g de óleo bruto (como descrito no Exemplo 5) com lisados clarificados dos 318 acertos. Dos 318 acertos secundários de HTP, aqueles que reduziram o palmitato mais efetivamente às temperaturas elevadas (45°C ou 60°C) do que a 25°C no ensaio em óleo, foram selecionados como “acertos de óleo [oil hits]” de tolerância térmica. Identificou-se 57 acertos de óleo primários de tolerância térmica, e foram caracterizados por meio de ensaios de óleo adicionais (ver Tabelas 15 e 16, abaixo). Realizou-se mais ensaios com 5 g de óleo, e identificou-se 9 acertos de óleo que apresentaram perfis preferidos de desempenho de temperatura adicionalmente a níveis variáveis de atividade total (ver Tabela 17, abaixo).
Tabela 15:
| Palmitato 24 h | Palmitato 48 h | |||||||||||||||
| Acerto de tolerância térmica n° | 48 | 85 | 95 | 116 | 144 | 149 | 150 | 162 | 172 | 225 | 25°C | 45°C | 60°C | 25°C | 45°C | 60°C |
| 12 | A48C | E116I | A1441 | E149H | A1501 | 8,1% | 7,5% | 9,6% | 7,3% | 7,1% | 9,5% | |||||
| 16 | A48C | E116I | R172H | A225S | 10,4% | 9,5% | 10,4% | 9,7% | 9,1% | 10,6% | ||||||
| 17 | A48C | R172H | A225S | 7,3% | 7,4% | 10,2% | 6,4% | 6,8% | 10,2% | |||||||
| 29* | R85Y | R172H | 5,0% | 5,8% | 6,3% | 4,3% | 6,3% | 6,7% | ||||||||
| 38 | A48C | R85Y | E95K | E116L | R172H | A225S | 9,9% | 7,8% | 9,9% | 8,7% | 7,1% | 9,8% | ||||
| 40* | A48C | R85Y | E95K | P162G | R172H | A225S | 10,0% | 9,1% | 8,8% | 9,7% | 8,4% | 9,3% | ||||
| 41* | A48C | R85Y | E95K | P162G | R172H | 10,1% | 8,4% | 8,7% | 9,8% | 8,8% | 8,6% | |||||
| 53 | A48C | R85Y | E116I | P162K | R172H | A225S | 10,0% | 9,1% | 8,1% | 9,7% | 8,6% | 7,7% | ||||
| 64 | R85Y | E116L | P162G | A225S | 7,5% | 6,7% | 10,2% | 6,3% | 6,0% | 10,1% | ||||||
| 66 | P162G | R172H | A225S | 9,6% | 9,4% | 10,5% | 8,3% | 8,8% | 10,6% | |||||||
| 74* | R85Y | E95K | E116L | R172H | A225S | 5,5% | 6,2% | 6,3% | 4,9% | 5,7% | 6,5% | |||||
| 77 | A48C | E95K | A1501 | P162G | R172H | A225S | 10,0% | 9,0% | 10,5% | 9,7% | 9,0% | 10,6% | ||||
| 81 | A48C | R85Y | E116L | P162G | R172H | A225S | 10,2% | 8,9% | 7,4% | 9,4% | 8,3% | 7,2% | ||||
| 88 | E95K | P162G | R172H | A225S | 8,2% | 7,4% | 8,0% | 7,2% | 6,8% | 10,6% | ||||||
| 89 | R85Y | P162G | R172H | A225S | 9,2% | 7,9% | 7,6% | 8,1% | 7,5% | 7,6% | ||||||
| 94 | A48C | R85Y | E95K | E116L | R172H | A225S | 10,5% | 10,1% | 10,8% | 10,3% | 9,9% | 10,9% | ||||
| 104 | A48C | R85Y | E116I | A1441 | P162K | 10,7% | 10,5% | 10,6% | 10,7% | 10,6% | 10,7% | |||||
| 105 | A48C | R85Y | E116L | A1501 | R172H | A225S | 6,6% | 9,1% | 9,0% | 10,0% | 8,9% | 8,8% | ||||
| 108 | A48C | E116L | P162G | R172H | A225S | 9,2% | 7,8% | 10,4% | 8,6% | 7,2% | 10,5% | |||||
| 109 | A48C | R85Y | E95K | E116L | P162G | R172H | A225S | 10,0% | 10,3% | 8,4% | 9,6% | 10,0% | 7,8% | |||
| 114 | R85Y | E95K | P162G | R172H | A225S | 9,5% | 9,1% | 8,4% | 8,5% | 8,7% | 8,4% |
Petição 870180005321, de 22/01/2018, pág. 280/316
274/293
| Palmitato 24 h | Palmitato 48 h | |||||||||||||||
| Acerto de tolerância térmica n° | 48 | 85 | 95 | 116 | 144 | 149 | 150 | 162 | 172 | 225 | 25°C | 45°C | 60°C | 25°C | 45°C | 60°C |
| 118 | R85Y | P162G | R172H | 9,7% | 8,7% | 8,1% | 8,9% | 8,3% | 7,9% | |||||||
| 134 | A48C | P162G | R172H | A225S | 10,3% | 9,4% | 9,2% | 10,3% | 9,0% | 9,2% | ||||||
| 135 | R85Y | P162K | R172H | 6,8% | 7,0% | 9,6% | 6,0% | 7,0% | 9,4% | |||||||
| 136 | A48C | P162K | R172H | 9,2% | 8,1% | 8,0% | 8,7% | 8,1% | 7,6% | |||||||
| 155 | P162K | R172H | A225S | 9,5% | 8,6% | 10,5% | 8,5% | 8,1% | 10,5% | |||||||
| 161 | R85Y | E95K | E116N | A1441 | 9,8% | 9,6% | 9,8% | 9,7% | 11,6% | 9,7% | ||||||
| 184 | A48C | E95K | E116N | A1441 | A1501 | 10,5% | 10,4% | 10,4% | 10,5% | 10,5% | 10,4% | |||||
| 202 | E116N | P162G | R172H | 8,8% | 7,4% | 8,2% | 8,1% | 6,9% | 8,0% | |||||||
| 204 | R85Y | E116I | P162G | R172H | 9,4% | 8,3% | 6,7% | 8,8% | 7,4% | 7,1% | ||||||
| 211 | A48C | R85Y | E116L | P162G | R172H | 9,6% | 8,9% | 8,7% | 8,6% | 8,3% | 8,5% | |||||
| 215 | A48C | E116I | P162G | R172L | A225S | 10,4% | 10,1% | 10,3% | 10,5% | 10,0% | 10,0% | |||||
| 216 | R85Y | P162G | R172H | A225S | 9,7% | 9,6% | 8,9% | 9,0% | 8,0% | 8,8% | ||||||
| 229 | A48C | R85Y | P162G | R172L | A225S | 10,3% | 9,8% | 10,1% | 10,0% | 9,7% | 10,1% | |||||
| 235 | A48C | E116I | P162G | R172L | 10,3% | 10,0% | 10,3% | 10,0% | 9,3% | 10,4% | ||||||
| 236 | A48C | P162G | 10,1% | 9,7% | 9,7% | 10,1% | 9,3% | 9,6% | ||||||||
| 238 | R85Y | E116N | P162G | R172H | A225S | 9,2% | 7,6% | 7,6% | 8,3% | 6,9% | 7,6% | |||||
| 239 | A48C | P162G | 10,2% | 8,8% | 10,1% | 9,8% | 7,8% | 10,3% | ||||||||
| 241 | E116L | P162G | R172L | A225S | 7,4% | 10,2% | 6,5% | 6,6% | 10,3% | |||||||
| 243 | E116I | P162G | A225S | 9,2% | 7,5% | 10,3% | 8,2% | 6,8% | 10,4% | |||||||
| 244 | R85Y | P162G | 10,1% | 7,6% | 7,8% | 9,6% | 6,9% | 8,0% | ||||||||
| 246 | A48C | R85Y | E95K | E116I | P162G | R172H | 10,2% | 9,7% | 10,6% | 9,7% | 9,7% | 10,5% | ||||
| 247 | R85Y | E95K | E116I | P162G | A225S | 10,1% | 7,8% | 10,0% | 9,8% | 7,0% | 10,1% | |||||
| 248 | R85Y | E95K | P162G | R172H | 9,6% | 8,7% | 9,8% | 8,6% | 7,9% | 9,9% | ||||||
| 257 | E95K | P162G | R172H | 8,7% | 8,0% | 9,5% | 7,2% | 7,4% | 9,4% | |||||||
| 263 | 10,3% | 9,9% | 9,8% | 10,1% | 10,0% | 9,7% | ||||||||||
| 269 | E95K | E116I | P162G | R172L | A225S | 9,5% | 8,6% | 10,5% | 9,1% | 8,0% | 10,6% | |||||
| 274 | R85Y | E95K | P162G | R172L | 10,1% | 9,4% | 10,5% | 10,5% | 9,0% | 10,5% | ||||||
| 278 | A48C | E116L | R172H | A225S | 10,1% | 9,2% | 10,4% | 10,2% | 9,1% | 10,4% | ||||||
| 282 | A48C | R85Y | E116N | A1441 | R172H | A225S | 10,6% | 10,6% | 10,5% | 10,6% | 10,5% | 10,4% | ||||
| 284 | A48C | E95K | E1161 | A1441 | E149H | R172H | A225S | 10,6% | 10,6% | 10,5% | 10,6% | 10,5% | 10,5% | |||
| 286 | E1161 | A1441 | R172H | 10,5% | 10,5% | 10,2% | 10,4% | 10,4% | 10,0% | |||||||
| 288 | R85Y | A1441 | A1501 | 10,4% | 10,4% | 9,9% | 10,3% | 10,1% | 9,8% | |||||||
| 292 | A48C | E116N | A1441 | A1501 | R172H | 10,5% | 10,6% | 10,0% | 10,2% | 10,9% | 9,8% | |||||
| 296 | A48C | E116N | A1441 | E149H | A1501 | R172H | 10,6% | 10,6% | 10,6% | 10,6% | 10,6% | 10,5% |
Petição 870180005321, de 22/01/2018, pág. 281/316
275/293
| Palmitato 24 h | Palmitato 48 h | |||||||||||||||
| Acerto de tolerância térmica n° | 48 | 85 | 95 | 116 | 144 | 149 | 150 | 162 | 172 | 225 | 25°C | 45°C | 60°C | 25°C | 45°C | 60°C |
| 297 | A48C | R85Y | E1161 | 10,3% | 9,8% | 10,5% | 10,2% | 9,7% | 10,5% | |||||||
| 298 | R85Y | E116N | R172H | 8,6% | 7,8% | 10,2% | 7,9% | 7,3% | 10,2% | |||||||
| • | Acerl | tos de | tolerância | térmica 29,4 | 10,41 e 74 também conl | têm mutações |
adicionais (ver mutações adicionais listadas na Tabela 16, abaixo).
Tabela 16: Mutações adicionais também contidas em acertos de tolerância térmica 29, 40, 41 e 74.
| Acerto de tolerância térmica n° | Velho códon | Novo códon | Velho aminoácido | Novo aminoácido | Posição de aminoácido |
| 29 | GTG | ATG | V | M | 83 |
| 40 | GCG | GCT | A | A | 92 |
| 41 | GCG | GCT | A | A | 92 |
| 74 | GCG | GCT | A | A | 92 |
Tabela 17:
| Enzima | Palmitato 3h | Palmitato 24h | Palmitato 48h | ||||||
| 25°C | 45°C | 60°C | 25°C | 45°C | 60°C | 25°C | 45°C | 60°C | |
| Negativo | 10.7% | 10.6% | 10.7% | 10.6% | 10.5% | 10.6% | 10.6% | 10.5% | 10.6% |
| Parental | 7.8% | 7.3% | 10.3% | 5.4% | 6.2% | 10.3% | 5.9% | 10.3% | |
| 29 | 8.1% | 6.5% | 9.1% | 4.9% | 5.7% | 8.8% | 4.2% | 5.9% | 8.9% |
| 40 | 10.5% | 10.3% | 10.0% | 10.0% | 9.1% | 8.8% | 9.7% | 8.4% | 9.3% |
| 41 | 10.5% | 10.3% | 9.9% | 10.1% | 8.4% | 8.7% | ' 9.8% | 8.8% | 8.6% |
| 74 | 9.2% | 8.0% | 9.9% | 6.2% | 6.1% | 9.8% | 5.1% | 6.1% | 9.8% |
| 81 | 10.3% | 9.8% | 9.3% | 9.5% | 8.1% | 8.0% | 8.2% | 7.4% | 7.9% |
| 202 | 10.2% | 9.4% | 10.5% | 9.3% | 7.4% | 10.4% | 8.5% | 7.2% | 10.4% |
| 204 | 10.5% | 10.1% | 9.7% | 10.0% | 9.0% | 8.7% | 9.4% | 8.6% | 8.5% |
| 238 | 10.4% | 9.8% | 9.5% | 9.8% | 7.7% | 9.0% | 8.5% | 7.6% | 8.9% |
| 244 | 10.3% | 9.6% | 10.4% | 9.5% | 8.0% | 10.2% | 8.3% | 7.5% | 10.2% |
Exemplo 11: Evolução exemplar para a expressão incrementada de palmitase usando tecnologia TMCASM [0534] As 37 mutações silentes individuais identificadas durante a seleção com GSSM (ver Tabela 11, Exemplo 9, acima) foram avaliadas para expressão (ver Tabela 18, abaixo).
Petição 870180005321, de 22/01/2018, pág. 282/316
276/293
Culturas de 50 ml foram expressas em meio M9, suplementado com uracila e canamicina, em frascos de 250 ml. Acertos foram desenvolvidos a 30°C durante de 16 a 20 horas antes e após a indução com 0,3 mM de IPTG. Células foram pelotizadas por meio de centrifugação e lisadas com B-PER™ (número de catálogo 78248, Pierce Protein Research Products, Rockford, IL). Uma porção do lisado integral foi centrifugada para clarificação. Ambos, o lisado de células integrais e lisados clarificados, foram analisados quanto à concentração total de proteína usando o Bio-Rad Protein Assay Bio-Rad, Hercules, CA, n° de catálogo 500-0006) baseado no método de Bradford, e quanto à atividade no substrato fluorogênico UMB-palmitato, e por meio de SDS-PAGE. Os valores foram normalizados com valor parental ajustado em 100 %. Identificou-se 16 acertos via demonstração da atividade incrementada relativamente ao parental).
Tabela 18:
| % de atividade do parental | % de solubilidade | |||
| Sítio do aminoácido | Integral | Clarificado | Atividade | Proteína |
| 35 | 352 | 247 | 53 | 79 |
| 37 | 191 | 126 | 50 | 83 |
| 41 | 163 | 103 | 48 | 91 |
| 45 | 706 | 640 | 68 | 89 |
| 52 | 252 | 161 | 48 | 57 |
| 89 | 281 | 190 | 51 | 47 |
| 97 | 167 | 102 | 46 | 77 |
| 102 | 617 | 525 | 64 | 72 |
| 108 | 583 | 452 | 58 | 60 |
| 109 | 373 | 244 | 49 | 72 |
| 114 | 238 | 147 | 46 | 72 |
| 115 | n.d. | |||
| 117 | 653 | 555 | 64 | 70 |
| 124 | 442 | 336 | 57 | 62 |
| 126 | 509 | 368 | 55 | 70 |
Petição 870180005321, de 22/01/2018, pág. 283/316
277/293
| % de atividade do parental | % de solubilidade | |||
| Sítio do aminoácido | Integral | Clarificado | Atividade | Proteína |
| 128 | 416 | 327 | 59 | 70 |
| 129 | 354 | 260 | 55 | 73 |
| 133 | 511 | 455 | 67 | 47 |
| 137 | 339 | 240 | 53 | 54 |
| 138 | 266 | 186 | 53 | 75 |
| 139 | 135 | 101 | 56 | 105 |
| 142 | 221 | 175 | 60 | 63 |
| 172 | 243 | 210 | 65 | 59 |
| 183 | 433 | 356 | 62 | 65 |
| 188 | 455 | 325 | 54 | 97 |
| 192 | 253 | 179 | 53 | 60 |
| 193 | 117 | 59 | 38 | 57 |
| 202 | 196 | 121 | 47 | 63 |
| 203 | 339 | 247 | 55 | 68 |
| 205 | 63 | 31 | 37 | 68 |
| 206 | 125 | 78 | 47 | 63 |
| 208 | 232 | 162 | 53 | 99 |
| 212 | 320 | 238 | 56 | 87 |
| 222 | 126 | 75 | 45 | 86 |
| 223 | 149 | 88 | 45 | 99 |
| 226 | 213 | 110 | 39 | 81 |
| 227 | 183 | 174 | 71 | 71 |
| Positivo | 100 | 100 | 75 | 71 |
| Negativo | 0 | 1 |
[0535] As 11 principais mutações silentes individuais (Tabela 19, abaixo) foram combinadas usando-se tecnologia TMCA, como descrito no Número de Publicação PCR WO 2009/018449 e descrito adicionalmente abaixo).
Tabela 19:
Petição 870180005321, de 22/01/2018, pág. 284/316
278/293
| Códon original | Novo códon | Sítio do aminoácido |
| GCG | GCT | 35 |
| GGC | GGA | 45 |
| GTG | GTT | 102 |
| AGC | AGT | 108 |
| CTG | CTT | 117 |
| CTG | TTG | 124 |
| CGG | AGG | 126 |
| GTC | GTG | 128 |
| AGT | TCT | 133 |
| GTG | GTT | 183 |
| ACC | ACG | 188 |
[0536] Para a evolução de TMCA, usou-se quatro modelos de DNA: (1) palmitase “Parental A” (SEQ ID NO:2 com mutações D61E, R72K, e V163R), (2) palmitase “Parental B” (Parental A com mutações adicionais (GGC)45 (GGA) e (CTG)117(CTT)), (3) palmitase “Parental C” (Parental A com mutação adicional (GGC)45(GGA)), e (4) “Parental D” (Parental A com mutação adicional (CTG)117(CTT)). Nota: Mutações são listadas proporcionando-se o códon original, seguido do número de posição do aminoácido modificado, seguido do novo códon. Por exemplo, (GGC)45(GGA) indica que o códon para o aminoácido na posição 45 da SEQ ID NO:2 foi substituído de (GGC) para (GGA).
[0537] Um primeiro ciclo de reações TMCA foi completado com cada um dos quatro modelos de DNA e os iniciadores para as regiões 1 e 4 (ver Tabela 20, abaixo; região 1: aminoácido5; região 4: aminoácidos l83 e 188), criando com isso quatro sub-bibliotecas. Os produtos da sub-biblioteca foram purificados usando-se o kit Qiagen PCR clean-up. Cada sub-biblioteca, contendo uma mistura de produtos purificados e, portanto, contendo múltiplos modelos, foi então usada em uma segunda reação simples de TMCA por subbiblioteca com iniciadores para as regiões 2 e 3 (ver Tabela 21, abaixo; região 2: aminoácidos 102 e 108; região 3: aminoácidos 124, 126, 128 e 133).
Tabela 20:
| Nome do oligo | Sequência do oligo - 5'-3' |
| 35GCT | CTGCGAAAATGGGCAAACTGGCTGATGGCGAGCCGGTACTGGT (SEQ ID |
Petição 870180005321, de 22/01/2018, pág. 285/316
279/293
| NO:41) | |
| 183GTT | TGCTCGGGCGAGCCTTCCGAGGTCTCCGGCGCCACAACCCCGTCGAGC GGCGACCACA (SEQ ID NO:42) |
| 183GTT188A CG | TGCTCGGGCGAGCCTTCCGACGTCTCCGGCGCCACAACCCCGTCGAGC GGCGACCACA (SEQ ID NO:43) |
| 188ACG | TGCTCGGGCGAGCCTTCCGACGTCTCCGGCGCCACCACCCCGTCGAGC GGCGACCACA (SEQ ID NO:44) |
Tabela 21:
| Nome do oligo | Sequência do oligo - 5'-3' |
| 102GTT-RC | AGGCGGCCGGTGGTCAGAAGGTTATCGTGGTCGGCTGGAG CCTCGGCGGCCTCTATGCGC (SEQ ID NO:45) |
| 102GTTIO8AGT- RC | AGGCGGCCGGTGGTCAGAAGGTTATCGTGGTCGGCTGGAG TCTCGGCGGCCTCTATGCGC (SEQ ID NO:46) |
| 108AGT-RC | AGGCGGCCGGTGGTCAGAAGGTGATCGTGGTCGGCTGGAG TCTCGGCGGCCTCTATGCGC (SEQ ID NO:47) |
| 124TTG133TCTsh ort-RC | TCGCCCGCGAACGGAGAGCCGAGCGTGACGACCATCCGGA TCAATTCGGGCGCCTTGTGG (SEQ ID NO:48) |
| 124TTG126AGGsh ort-RC | TCGCCCGCGAACGGACTGCCGAGCGTGACGACCATCCTGA TCAATTCGGGCGCCTTGTGG (SEQ ID NO:49) |
| 124TTG 126AGG 128GTGshort-RC | TCGCCCGCGAACGGACTGCCGAGCGTGACCACCATCCTGA TCAATTCGGGCGCCTTGTGG (SEQ ID NO:50) |
| 126AGG133TCTsh ort-RC | TCGCCCGCGAACGGAGAGCCGAGCGTGACGACCATCCTGA TCAGTTCGGGCGCCTTGTGG (SEQ ID NO:51) |
| 124TTG 126AG G 128GTG 133 TCTshort-RC | TCG CCCGCG AACGG AG AGCCGAG CGTGACCACCATCCTGATCAATTCGGGCG CCTTGTGG (SEQ ID NO:52) |
| 133TCTshort-RC | TCGCCCGCGAACGGAGAGCCGAGCGTGACGACCATCCGGA TCAGTTCGGGCGCCTTGTGG (SEQ ID NO:53) |
Petição 870180005321, de 22/01/2018, pág. 286/316
280/293
| 128GTG133TCTsh ort-RC | TCGCCCGCGAACGGAGAGCCGAGCGTGACCACCATCCGGA TCAGTTCGGGCGCCTTGTGG (SEQ ID NO:54) |
| 124TTG126AGG1 33TCTGshort-RC | TCGCCCGCGAACGGAGAGCCGAGCGTGACGACCATCCTGA TCAATTCGGGCGCCTTGTGG (SEQ ID NO:55) |
| 126AGGshort-RC | TCGCCCGCGAACGGACTGCCGAGCGTGACGACCATCCTGA TCAGTTCGGGCGCCTTGTGG (SEQ ID NO:56) |
| 124TTG128GTGsh ort-RC | TCGCCCGCGAACGGACTGCCGAGCGTGACCACCATCCGGA TCAATTCGGGCGCCTTGTGG (SEQ ID NO:57) |
| 126AGG128GTG1 33TCTshort-RC | TCGCCCGCGAACGGAGAGCCGAGCGTGACCACCATCCTGA TCAGTTCGGGCGCCTTGTGG (SEQ ID NO:58) |
| 124TTG128GTG13 3TCTshort-RC | TCGCCCGCGAACGGAGAGCCGAGCGTGACCACCATCCGGA TCAATTCGGGCGCCTTGTGG (SEQ ID NO:59) |
| 124TTGshort-RC | TCGCCCGCGAACGGACTGCCGAGCGTGACGACCATCCGGA TCAATTCGGGCGCCTTGTGG (SEQ ID NO:60) |
| 128GTGshort-RC | TCGCCCGCGAACGGACTGCCGAGCGTGACCACCATCCGGA TCAGTTCGGGCGCCTTGTGG (SEQ ID NO:61) |
[0538] As amostras foram amplificadas no vetor pDOW-kan, analisadas por meio de gel de agarose, tratadas com DPNI e depois transformadas em células competentes XL1 Blue de E. coli. Colônias foram desenvolvidas, colhidas e seqüenciadas. Colônias foram combinadas e o DNA foi preparado para cada sub-biblioteca usando o kit Qiagen mini-prep (número de catálogo 27106, Qiagen, Valencia, CA). Células competentes de Pseudomonas fluorescens foram então transformadas com o DNA. As células foram desenvolvidas em meio LB suplementado com uracila (750 pg/ml) e canamicina (50 pg/ml). Obteve-se um número suficiente de colônias obtido para uma super-amostragem de sete vezes da biblioteca (pelo menos 14.000 colônias).
[0539] A biblioteca foi distribuída, desenvolvida em meio mínimo M9 suplementado com uracila (750 pg/ml) e canamicina (50 pg/ml) e analisada com 400 pM de palmitato de
4-metilumbeliferila em 80 mM de HEPES a pH 7,5. As amostras foram incubadas durante minutos a 54°C antes e após a adição do substrato. A fluorescência foi lida a Ex360 nm
Petição 870180005321, de 22/01/2018, pág. 287/316
281/293 & Em465 nm. 46 amostras de mutação silentes deram sequências únicas (ver Tabela 22, abaixo). A leitura de fluorescência para cada uma das 46 amostras de mutações silentes também é listada na Tabela 22, primeira coluna “atividade de UMB”. Amostras de mutações silentes 2, 7, 9, 10, 13, 16, 23, 25, 40, e 44 apresentaram alterações de aminoácidos (AA) adicionalmente às mutações silentes (ver Tabela 23, abaixo).
Tabela 22:
| Atividade UMB | Ace rto n° | Velho códon | Novo códon | AA n° | Velh o códo n | Novo códo n | AA n° | Velh o códo n | Novo códo n | AA n° | Velh o códo n | Novo códo n | AA n° | Velh o códo n | Novo códo n | AA n° | Velh o códo n | Novo códo n | AA n° |
| 31850 | 1 | GCG | GCT | 35 | AGC | AGT | 108 | GTG | GTT | 183 | ACC | ACG | 188 | ||||||
| 33936 | 2 | GCG | GCT | 35 | GTG | GTT | 102 | AGC | AGT | 108 | CTG | TTG | 124 | GTC | GTG | 128 | AGT | TCT | 133 |
| 42764 | 3 | GCG | GCT | 35 | ACC | ACG | 188 | ||||||||||||
| 39330 | 4 | GCG | GCT | 35 | GTG | GTT | 183 | ACC | ACG | 188 | |||||||||
| 38876 | 5 | GCG | GCT | 35 | GTG | GTT | 102 | AGC | AGT | 108 | GTC | GTG | 128 | ||||||
| 31705 | 6 | GCG | GCT | 35 | GTG | GTT | 102 | AGC | AGT | 108 | CTG | TTG | 124 | GTC | GTG | 128 | AGT | TCT | 133 |
| 35315 | 7 | GCG | GCT | 35 | GTG | GTT | 102 | CTG | TTG | 124 | GTC | GTG | 128 | ||||||
| 36662 | 8 | GCG | GCT | 35 | GTG | GTT | 183 | ||||||||||||
| 35945 | 9 | GCG | GCT | 35 | GTC | GTG | 128 | AGT | TCT | 133 | |||||||||
| 37161 | 10 | GCG | GCT | 35 | AGT | TCT | 133 | GTG | GTT | 183 | ACC | ACG | 188 | ||||||
| 35399 | 11 | GCG | GCT | 35 | AGC | AGT | 108 | CTG | TTG | 124 | AGT | TCT | 133 | GTC | GTT | 183 | ACC | ACG | 188 |
| 39316 | 12 | GCG | GCT | 35 | GGC | GGA | 45 | GTG | GTT | 102 | AGC | AGT | 108 | CTG | CTT | 117 | CGG | AGG | 126 |
| 39682 | 13 | GCG | GCT | 35 | GGC | GGA | 45 | CTG | CTT | 117 | CTG | TTG | 124 | GTG | GTT | 183 | |||
| 46354 | 14 | GCG | GCT | 35 | GGC | GGA | 45 | AGC | AGT | 108 | CTG | CTT | 117 | CGG | AGG | 126 | ACC | ACG | 188 |
| 39952 | 15 | GCG | GCT | 45 | GTG | GTT | 102 | CTG | CTT | 117 | GTC | GTG | 128 | AGT | TCT | 133 | |||
| 37049 | 16 | GGC | GGA | 45 | GTG | GTT | 102 | AGC | AGT | 108 | CTG | CTT | 117 | CGG | AGG | 126 | |||
| 34741 | 17 | GCG | GCT | 45 | GTG | GTT | 102 | CTG | CTT | 117 | |||||||||
| 34261 | 18 | GCG | GCT | 35 | GGC | GGA | 45 | AGC | AGT | 108 | CTG | CTT | 117 | ACC | ACG | 188 | |||
| 30495 | 19 | GCG | GCT | 35 | GGC | GGA | 45 | CTG | CTT | 117 | CTG | TTG | 124 | GTC | GTG | 128 | AGT | TCT | 133 |
| 31485 | 20 | GCG | GCT | 35 | GGC | GGA | 45 | AGC | AGT | 108 | CTG | CTT | 117 | CTG | TTG | 124 | AGT | TCT | 133 |
| 34474 | 21 | GCG | GCT | 35 | GGC | GGA | 45 | AGC | AGT | 108 | CTG | CTT | 117 | AGT | TCT | 133 | ACC | ACG | 188 |
| 36301 | 22 | CGC | GCT | 35 | GGC | GGA | 45 | GTT | GTT | 102 | CTG | CTT | 117 | CTG | TTG | 124 | CGG | AGG | 126 |
| 37711 | 23 | GGC | GGA | 45 | AGC | AGT | 108 | CTG | CTT | 117 | ACC | ACG | 188 | ||||||
| 37855 | 24 | GCG | GCT | 35 | GGC | GGA | 45 | CTG | CTT | 117 | ACC | ACG | 188 | ||||||
| 34094 | 25 | GCG | GCT | 35 | GGC | GGA | 45 | AGC | AGT | 108 | CGG | AGG | 126 | GTC | GTG | 128 | AGT | TCT | 133 |
| 41223 | 26 | GCG | GCT | 35 | GGC | GGA | 45 | AGC | AGT | 108 | AGT | TCT | 133 | ||||||
| 35751 | 27 | GCG | GCT | 35 | GGC | GGA | 45 | ||||||||||||
| 34878 | 28 | GCG | GCT | 35 | GGC | GGA | 45 | CTG | TTG | 90 | CTG | GTT | 183 | ||||||
| 36361 | 29 | GCG | GCT | 35 | GGC | GGA | 45 | AGC | AGT | 108 | GTC | GTG | 128 | AGT | TCT | 133 | |||
| 35801 | 30 | GCG | GCT | 35 | GGC | GGA | 45 | GTG | GTT | 102 | GTG | GTG | 128 | GTG | GTT | 183 | ACC | ACG | 188 |
| 42393 | 31 | GCG | GCT | 35 | GGC | GGA | 45 | GTG | GTT | 102 | AGC | AGT | 108 | CGG | AGG | 126 | GTC | GTG | 128 |
| 29278 | 32 | GCG | GCT | 35 | CTG | CTT | 117 | GTG | GTT | 188 | |||||||||
| 34274 | 33 | GCG | GCT | 35 | CTG | CTT | 117 | ACC | ACG | 183 | ACC | ACG | 188 | ||||||
| 36610 | 34 | GCG | GCT | 35 | AGC | AGT | 108 | GTG | GTT | 117 | CTG | TTG | 124 | GTC | GTG | 128 | AGC | AGT | 153 |
| 42445 | 35 | GCG | GCT | 35 | GTG | GTT | 102 | CTG | GTT | 108 | CTG | CTT | 117 | CGG | AGG | 126 | AGT | TCT | 133 |
| 41151 | 36 | GTG | GTT | 102 | AGC | AGT | 108 | CTG | CTT | 117 | CGC | AGG | 126 | ||||||
| 39376 | 37 | GCG | GCT | 35 | GTG | GTT | 102 | AGC | AGT | 117 | GTG | GTT | 183 | ACC | ACG | 188 | |||
| 35116 | 38 | GCG | GCT | 35 | GTG | GTT | 102 | CTG | CTT | 117 | CTG | TTG | 124 | GTG | GTT | 183 | ACC | ACG | 188 |
| 35224 | 39 | GCG | GCT | 35 | AGC | AGT | 108 | CTG | CTT | 117 | GTC | GTG | 128 | AGT | TCT | 133 | GTG | GTT | 183 |
| 39996 | 40 | GCG | GCT | 35 | CTG | CTT | 117 | CTG | TTG | 124 | AGT | TCT | 133 | ||||||
| 35206 | 41 | CTG | CTT | 117 | CGG | AGG | 126 | AGT | TCT | 133 | CGC | CAC | 172 | ACC | ACG | 188 | |||
| 34163 | 42 | AGC | AGT | 108 | CTG | CTT | 117 | GTG | GTT | 183 | ACC | ACG | 188 | ||||||
| 34789 | 43 | AGC | AGT | 108 | CTG | CTT | 117 | CTG | TTG | 124 | CGG | AGG | 126 | GTC | GTG | 128 | GTG | GTT | 183 |
| 33168 | 44 | GCG | GCT | 35 | CTG | CTT | 117 | ACC | ACG | 188 | |||||||||
| 37120 | 45 | GCG | GCT | 35 | CTG | CTT | 117 | GTG | GTT | 183 | |||||||||
| 38626 | 46 | GCG | GCT | 35 | GTG | GTT | 102 | CTG | CTT | 117 | AGT | TCT | 133 | GTG | GTT | 183 | ACC | ACG | 188 |
Petição 870180005321, de 22/01/2018, pág. 288/316
282/293
Tabela 2 (continuação)
| Atividade | Acerto | Velho | Novo | AA | Velho | Novo | AA | Velho | Novo | AA |
| UMB | n° | códon | códon | n° | códon | códon | n° | códon | códon | n° |
| 31850 | 1 | |||||||||
| 33936 | 2 | GTG | GTT | 183 | ||||||
| 42764 | 3 | |||||||||
| 39330 | 4 | |||||||||
| 38876 | 5 | |||||||||
| 31705 | 6 | GTG | GTT | 183 | ||||||
| 35315 | 7 | |||||||||
| 36662 | 8 | |||||||||
| 35945 | 9 | |||||||||
| 37161 | 10 | |||||||||
| 35399 | 11 | |||||||||
| 39316 | 12 | AGT | TCT | 133 | ||||||
| 39682 | 13 | ACC | ACG | 188 | ||||||
| 46354 | 14 | |||||||||
| 39952 | 15 | |||||||||
| 37049 | 16 | ACC | ACG | 188 | ||||||
| 34741 | 17 | |||||||||
| 34261 | 18 | |||||||||
| 30495 | 19 | |||||||||
| 31485 | 20 | |||||||||
| 34474 | 21 | |||||||||
| 36301 | 22 | GTC | GTG | 128 | ||||||
| 37711 | 23 | |||||||||
| 37855 | 24 | |||||||||
| 34094 | 25 | |||||||||
| 41223 | 26 | |||||||||
| 35751 | 27 | |||||||||
| 34878 | 28 | |||||||||
| 36361 | 29 | |||||||||
| 35801 | 30 | |||||||||
| 42393 | 31 | AGT | TCT | 133 | GTG | GTT | 183 | ACC | ACG | 188 |
| 29278 | 32 | |||||||||
| 34274 | 33 | |||||||||
| 36610 | 34 | ACC | ACG | 188 | ||||||
| 42445 | 35 | ACC | ACG | 188 | ||||||
| 41151 | 36 | |||||||||
| 39376 | 37 | |||||||||
| 35116 | 38 | |||||||||
| 35224 | 39 | ACC | ACG | 188 | ||||||
| 39996 | 40 | |||||||||
| 35206 | 41 | |||||||||
| 34163 | 42 | |||||||||
| 34789 | 43 | ACC | ACG | 188 | ||||||
| 33168 | 44 | |||||||||
| 37120 | 45 | |||||||||
| 38626 | 46 |
Petição 870180005321, de 22/01/2018, pág. 289/316
283/293
Tabela 23:
| Mutações adicionais | |||||
| Acerto de mutação silente n° | Velho códon | Novo códon | Velho AA | Novo AA | AA n° |
| 2 | CCG | TCG | P | S | 162 |
| 7 | ACG | ATG | T | M | 22 |
| 9 | AGC | GGC | S | G | 153 |
| 10 | GAA | AAA | E | K | 190 |
| 13 | CGC | CAC | R | H | 172 |
| 16 | ATG | ATA | M | 1 | 31 |
| 23 | GTG | ATG | V | M | 83 |
| 25 | CTA | ATA | L | 1 | 200 |
| 40 | GCA | GTA | A | V | 211 |
| 44 | ACG | ATG | T | M | 22 |
[0540] As 46 amostras de mutação silente único foram desenvolvidas em frascos agitados de 250 ml. Lisados clarificados foram quantificados usando-se o ensaio de proteína Bio-Rad Protein Assay (Bio-Rad, Hercules, CA, n° de catálogo 500-0006) com base no método de Bradford e então normalizados para expressão de proteína total. A expressão foi analisadas por meio de SDS-PAGE.
[0541] O parental (SEQ ID NO:2 com mutações D61E, R72K, e V163R), controle negativo, e 4 acertos principais de mutações silentes foram expressos em escala de 1 L. Cada amostra foi lisada por meio de micro-fluidizador ou na presença do detergente BPER. A concentração de proteína foi quantificada para lisados brutos e clarificados usando-se o ensaio de proteína Bio-Rad Protein Assay (Bio-Rad, Hercules, CA, n° de catálogo 5000006) baseado no método de Bradford. Cada faixa do gel de SDS-PAGE foi então carregado com proteína total igual. Observou-se níveis de palmitase similares em todas as condições de solubilidade e lise testadas. Acertos de mutações silentes 26, 34, 35 e 37 (Tabelas 22 e 23, acima) apresentaram um maior percentual de expressão da palmitase, em comparação com o parental (SEQ ID NO:2 com mutações D61E, R72K, e V163R). O acerto de mutação silente 35 apresentou o maior percentual de expressão de palmitase. O acerto de mutação silente 35 apresentou as seguintes sete mutações silentes em comparação com o parental: (GCG)35(GCT), (GTG)102(GTT), (AGC)108(AGT), (CTG)117(CTT), (CGG) 126(AGG), (AGT) 133(TCT), e (ACC)188(ACG).
Exemplo 12: Evolução exemplar para a expressão incrementada de palmitases termoPetição 870180005321, de 22/01/2018, pág. 290/316
284/293 tolerantes [0542] Para avaliar a expressão das 9 principais palmitases termo-tolerantes candidatas (Exemplo 10, Tabelas 15, 16, e 17), as 7 principais mutações silentes (Exemplo 11) foram incorporadas em cada termo-tolerante principal como descrito abaixo. Os resultado foi que cada termo-tolerante principal (acertos termo-tolerantes 29, 40, 41,74, 81, 202, 204, 238, e 244) apresentou as mutações silentes incorporadas a seguir (35GCT, 102GTT, 108AGT, 117CTT, 126AGG, 133TCT, 188ACG) em cada um. Com as mutações silentes incorporadas, cada termo-tolerante principal foi renomeado adicionando-se “SM [silent mutation]” no final do número de acerto termo-tolerante. Por exemplo, o acerto termotolerante 29 com as mutações silentes incorporado foi renomeado “29 SM”. Da mesma forma, o acerto 40 tornou-se “40 SM”, o acerto 41 tornou-se “41 SM”, o acerto 74 tornouse “74 SM”, o acerto 81 tornou-se “81 SM”, o acerto 202 tornou-se “202 SM”, o acerto 204 tornou-se “204 SM”, o acerto 238 tornou-se “238 SM”, e o acerto 244 tornou-se “244 SM”. Para incorporar as 7 principais mutações silentes nos 9 principais termo-tolerantes, usouse tecnologia TMCA como descrito no número de publicação PCT WO 2009/018449 e como descrito abaixo.
[0543] Para o primeiro ciclo de evolução de TMCA, os 9 principais termo-tolerantes e o acerto principal de expressão (acerto de mutação silente n° 35) foram passados através de células competentes XL1 Blue de E. coli para metilar o DNA. O acerto de mutação silente n° 35 foi usado como o modelo de DNA. Os oligos listados na Tabela 24 abaixo foram usados para incorporar combinações de mutações no modelo de DNA.
Tabela 24:
| Nome do oligo | Sequência do oligo -5'-3' |
| 1-ForJC | TGGTGCTGCCCGGCTTCCTGTGTGACGACAACGCCAC CTCGGT (SEQ ID NO:62) |
| 2-ForJC | TTCGTGGCGACCTCGTGGACTATCTGGTCGACCGGCT GCGG (SEQ ID NO:63) |
| 2-Alt-ForJC | TCGGCATTCGTGGCGACCTCATGGACTATCTGGTCGA CCGGCTGCGG (SEQ ID NO:64) |
| 3-ForJC | CTGGTCGACCGGCTGCGGGCTGTGTCGAAGGCGGCC GGTGGTCAGAAG (SEQ ID NO:65) |
| 4-RevJC | TCGGGCGCCTTGTGGCCAAGAATGCGCGCATAGAGGC CGCCGA (SEQ ID NO:66) |
| 4-Alt-RevJC | TCGGGCGCCTTGTGGCCAAGATTGCGCGCATAGAGGC CGCCGA (SEQ ID NO:67) |
| 4-Alt2-RevJC | TCGGGCGCCTTGTGGCCAAGAAGGCGCGCATAGAGG |
Petição 870180005321, de 22/01/2018, pág. 291/316
285/293
| CCGCCGA (SEQ ID NO:68) | |
| 5-RevJC | cGGCTTAATCTGGAAATCCCGACCGATCGGCAGGTTGT CGACCG (SEQ ID NO:69) |
| 6-RevJC | GGCGACCACACCGCGATGGTATGCACCGGCGGCTTAA TCTGGA (SEQ ID NO:70) |
| 7-RevJC | TTGGGCTCGAGTCAGAGCCGAGACGCGACCAGCCGG ACCACAG (SEQ ID NO:71) |
[0544] As amostras foram amplificadas no vetor pDOW-kan, analisadas por meio de gel de agarose, e tratadas com DPNI. Amostras foram transformadas em células competentes XL1 Blue de E. coli. Colônias foram colhidas, desenvolvidas e seqüenciadas. O sequenciamento identificou várias combinações de mutações. No entanto, algumas combinações foram sub-representadas. Portanto, algumas das novas construções do primeiro ciclo de evolução TMCA foram selecionadas para uso como modelos para o próximo ciclo de evolução TMCA. Os modelos usados encontram-se listados na Tabela 25 abaixo.
Tabela 25:
| Nome do modelo | Aminoácidos com mutações desejadas |
| F8 | 48, 92, 95, 162, 172 |
| H10 | 48, 116L, 162, 172 |
| A8 | 85, 92, 95 |
| C11 | 116N,172 |
[0545] As combinações de modelos e oligos usadas no segundo ciclo de evolução TMCA são listadas na Tabela 26 abaixo. Realizou-se uma reação TMCA separada para cada linha na Tabela 26, criando uma biblioteca individual para cada linha. Por exemplo, uma linha consistiu do modelo F8 e iniciadores 2For e 7 Rev. Um segundo ciclo consistiu do modelo F8 e dos iniciadores 2For e 6 Rev. Note-se que vários dos mesmos iniciadores foram usados como no primeiro ciclo. Determinou-se dois iniciadores adicionais para o segundo ciclo de PCR. Estes oligos foram denominados 116LF e 162F. O oligo 116LF possui a sequência invertida e complementar do oligo 4-Alt2-RevJC. O oligo 162F apresenta a sequência invertida e complementar de 5-RevJC.
Tabela 26:
Petição 870180005321, de 22/01/2018, pág. 292/316
286/293
| Modelo para o segundo ciclo de TMCA | Aminoácidos a adicionar no segundo ciclo de TMCA | Iniciadores para o segundo ciclo de TMCA |
| F8 | 85,225 | 2For & 7 Rev |
| F8 | 85 | 2For & 6Rev |
| H10 | 85,225 | 2For & 7 Rev |
| Acerto de mutação silente n° 35 | 83, 85, 172 | 2Alt & 6REV |
| A8 | 116L, 172, 225 | 116L F & 6Rev &7Rev |
| C11 | 85, 162, 225 | 2For & 5Rev & 7Rev |
| Acerto de mutação silente n° 35 | 85,116,162,172 | 2For, 4Rev,5Rev,6Rev |
| Acerto de mutação silente n° 35 | 85,162 | 2For & 5Rev |
| C11 | 162 | 162F & SRev |
[0546] As amostras foram amplificadas no vetor pDOW-kan, analisadas por meio de gel de agarose, e tratadas com DPNI. As amostras foram transformadas em células competentes XL1 Blue de E. coli. Colônias foram colhidas, desenvolvida e seqüenciadas. O sequenciamento identificou representação suficientemente elevada de 7 das 9 construções desejadas. No entanto, como as outras duas construções foram subrepresentadas, exigiu-se um ciclo adicional de evolução TMCA para se obter principais termo-tolerantes remanescentes em combinação com as sete mutações silentes. Usou-se duas novas construções como modelos para o terceiro ciclo de evolução TMCA. Este modelos encontram-se listados na Tabela 27 abaixo. As combinações de modelos e oligos usadas no terceiro ciclo encontram-se listadas na Tabela 28 abaixo. Realizou-se uma reação de TMCA separada para cada linha na Tabela 28, criando uma biblioteca individual para cada linha. Por exemplo, um ciclo consistiu do modelo F3 e dos iniciadores 162F e 7 Rev. O segundo ciclo consistiu do modelo B5 e dos iniciadores 162F e 6 Rev.
Tabela 27:
| Nome do modelo | Aminoácidos com mutações desejadas |
| F3 | 85, 116N, 172 |
| B5 | 85, 116I, 162 |
Tabela 28:
| Modelo para o terceiro ciclo de TMCA | Aminoácidos a adicionar no terceiro ciclo de TMCA | Iniciadores a usar no terceiro ciclo de TMCA |
| F3 | 162, 225 | 162F & Rev |
| B5 | 172 | 162F & Rev |
[0547] As amostras foram amplificadas no vetor pDOW-kan, analisadas por meio de
Petição 870180005321, de 22/01/2018, pág. 293/316
287/293 gel de agarose, e tratadas com DPNI. Amostras foram transformadas em células competentes XL1 Blue de E. coli. Colônias foram colhidas, desenvolvidas e seqüenciadas. Obteve-se suficiente representação das duas construções remanescentes. DNA para todas as desejadas construções de XL1 Blue de E. coli foi preparado e transformado em células competentes de Pseudomonas fluorescens. As células foram desenvolvidas em meio LB suplementado com uracila (750 pg/ml) e canamicina (50 pg/ml). As amostras foram confirmadas por meio de sequenciamento.
[0548] Para seleção, a biblioteca foi desenvolvida em meio mínimo M9 suplementado com uracila (750 pg/ml) e canamicina (50 pg/ml). Realizou-se ensaios de óleo convencionais por meio de carregamento de lisados clarificados com teor de 10 % de água usando tamponador de fosfato em ensaios de óleo bruto nos níveis de atividade de UMBPalmitato listados na coluna da esquerda da Tabela 29. Ensaios de óleo foram carregados, homogeneizados e subsequentemente misturados continuamente como para reações convencionais, a 25°C, 45°C, e 60°C. Adicionou-se frações de 50 pl de NaOH a 11 % a 3 e 20 horas para cada reação em óleo, depois isto foi homogeneizado. Frações foram removidas a 20, 44, e 68 horas e submetidas à extração convencional com clorofórmio metanol e metanólise total, seguido de análise por GC de FAME (como descrito no Exemplo 8, acima). O palmitato remanescente no óleo é listado para cada fração na Tabela 29. O acerto de mutação silente 29 SM termo-tolerante reduziu o palmitato drasticamente ao longo período a 25°C (Tabela 29).
Tabela 29:
| Palmitato 20 h (50 ul de cáustico a 3 h) | Palmitato 44 h (cáustico a 3 h & 20 h) | Palmitato 68 h (cáustico a 3 h & 20 h) | ||||||||
| Atividade de UMB | Enzima | 25°C | 45°C | 60°C | 25°C | 45°C | 60°C | 25°C | 45°C | 60°C |
| 0 | Negativo | 10,6% | 10,6% | 10,7% | 10,7% | 10,6% | 10,6% | 10,6% | 10,6 % | 10,6% |
| 3,2 | Parental | 6,6% | 7,0% | 9,1% | 5,5% | 7,0% | 8,9% | 5,4% | 7,0% | 9,0% |
| 10,8 | 29 SM | 4,5% | 5,1% | 6,3% | 3,3% | 4,8% | 6,3% | 2,8% | 5,0% | 6,3% |
| 1,1 | 40 SM | 10,3% | 9,9% | 8,8% | 10,1% | 7,9% | 8,7% | 9,3% | 7,1% | 8,7% |
| 1,1 | 41 SM | 10,3% | 10,1% | 8,1% | 10,2% | 8,4% | 7,9% | 9,6% | 7,5% | 7,9% |
| 11,8 | 74 SM | 8,2% | 5,3% | 7,2% | 5,0% | 4,4% | 7,4% | 3,0% | 4,4% | 7,6% |
| 7,2 | 81 SM | 10,2% | 9,2% | 7,2% | 9,2% , | 6,7% | 6,7% | 6,6% | 5,7% | 6,6% |
| 3,7 | 202 SM | 9,7% | 6,6% | 7,6% | 7,8% | 5,3% | 7,6% | 5,3% | 5,1% | |
| 9,1 | 204 SM | 10,2% | 8,6% | 7,3% | 8,9% | 6,3% | 7,4% | 9,6% | 5,9% | 7,4% |
| 4,7 | 238 SM | 9,9% | 8,1% | 6,7% | 7,6% | 6,0% | 6,5% | 5,0% | 5,9% | 6,5% |
| 3,7 | 244 SM | 9,7% | 8,3% | 8,1% | 7,3% | 6,1% | 8,1% | 5,3% | 6,2% | 8,1% |
Petição 870180005321, de 22/01/2018, pág. 294/316
288/293
Exemplo 13: Sal de potássio de ácido oleico como emulsificante permite que a enzima gere óleo de palmitato a 1 % [0549] Amostras de óleo foram incubadas com 10 % de oleato de potássio para avaliar o impacto deste emulsificante em reações com óleo com a palmitase. Lisados clarificados do Acerto 29SM ou controle negativo foram carregados, a 5 % de teor de água, em ensaios de óleo pré-tratado (A e B) e óleo bruto (C). O pré-tratamento foi realizado por meio de tratamento com enzima, aquecimento, centrifugação e, depois, filtragem do óleo para remover goma e a fase aquosa, e para reduzir ácidos graxos livres, como descrito no Exemplo 14, para gerar um óleo de palmitato a <5 % isento de goma. O óleo foi homogeneizado antes e após a adição de enzima para assegurar emulsões uniformes. 0,5 g de sal de potássio obtido comercialmente de ácido oleico foi pesado em 5 g de óleo, misturado a 60°C para solubilizar, e, depois, homogeneizado. A adição de cáustico para neutralização de 1 % de FFA foi adicionada às reações listadas “cáustico”. Ensaios em óleo foram carregados com enzima, re-homogeneizados e subsequentemente misturados continuamente como para reações convencionais. Frações foram removidas a 3, 24, 48, 72, e 120 horas. Frações foram submetidas a extração com clorofórmio metanol e metanólise total, seguido de análise por GC de FAME (como descrito no Exemplo 8, acima). O palmitato remanescente no óleo é listado para cada fração na Tabela 30 abaixo. Os óleos pré-tratados foram levados sucessivamente a um nível de palmitato a 1 %.
Tabela 30:
| Palmitato | ||||||
| A | 3,7 % de óleo de palmitato | 3 h | 24 h | 48 h | ||
| enzima | 3,4 % | 3,2 % | 3,1 % | |||
| Oleato+enzima | 2,3 % | 1,2 % | 1,2 % | |||
| Oleato+cáustico+enzima | 2,3 % | 1,1 % | 1,2 % | |||
| Oleato+cáustico (ensaio de controle negativo) | 3,4 % | 3,3 % | 3,3 % | |||
| B | 4,5 % de óleo de palmitato | 3 h | 24 h | |||
| Oleato+enzima | 4,2 % | 1,1 % | 1,0 % | |||
| Oleato (ensaio de controle negativo) | 7,0 % | 6,7 % | 6,9 % | |||
| C | Óleo bruto | 3 h | 24 h | 48 h | 72 h | 120 h |
| enzima | 7,9 % | 4,9 % | 4,7 % | 4,6 % | 5,4 % | |
| Oleato+enzima | 10,0 % | 7,9 % | 6,6 % | 5,5 % | 3,9 % | |
| Oleato+cáustico+enzima | 10,7 % | 10,4 % | 10,6 % | 10,5 % | 10,4 % | |
| Oleato+cáustico (ensaio de controle negativo) | 10,7 % | 10,6 % | 10,6 % | 10,5 % | 10,5 % |
Exemplo 14: 2 kg de óleo com centrifugação intermediária e emulsão do oleato
Petição 870180005321, de 22/01/2018, pág. 295/316
289/293 proporcionam 1 % de óleo de palmitato [0550] O impacto combinado de polipeptídio, uma etapa de filtração intermediária, e adição de oleato de potássio para atingir óleo de palmitato a 1 % foi avaliado em escala de bancada de laboratório. 2 kg de óleo bruto foram reagidos com 29 SM a um teor de água de 5 %. A reação em óleo foi homogeneizada durante 1 minuto com um [equipamento] IKA à velocidade 6 atingindo uma temperatura de 25°C. Um misturador de topo foi equipado com um impulsor de misturado de tintas e misturou a reação em óleo a 390 rpm. Após 1 hora de reação, a velocidade de misturação foi acelerada a 530 rpm. A temperatura da reação foi monitorada e flutuada de 21°C a 29°C com aquecimento intermitente proveniente de um bloco de aquecimento. Amostras foram removidas para o monitoramento das alterações no perfil do óleo. Após 28 horas, a reação em óleo foi aquecida a 66°C e centrifugada em um [equipamento] gyrotester.
[0551] A fração em óleo foi resfriada à temperatura ambiente de um dia para o outro com misturação por impulsor, depois resfriada com um banho de gelo a menos de 10°C. Adicionou-se terra de diatomáceas e os TAGS e DAGS foram separados dos ácidos graxos livres por meio de filtração através de um funil Buchner resfriado, com papel Whatman.
[0552] 1 kg deste óleo de palmitato reduzido foi usado para iniciar reações com oleato de potássio como um emulsificante. 100 g de oleato de potássio foram adicionados ao óleo. As reações foram aquecidas a 60°C com agitação para assegurar a solubilidade. O óleo foi resfriado a 23°C, depois adicionou-se 50 ml de enzima para se atingir 5 % de teor de água. Este óleo foi homogeneizado antes e após a adição de enzima 29 SM para assegurar emulsões uniformes. Frações foram removidas a 6, 21, 24, 28, após a filtração, após a adição de oleato, no início do novo ensaio e 3, 20, e 22 horas já no segundo ensaio. Frações foram submetidas a extração convencional com clorofórmio metanol, e metanólise total, seguido de análise por GC de FAME (como descrito no Exemplo 8, acima). Ácidos graxos que permaneceram ligados no óleo são listados para cada fração na Tabela 31, abaixo. O acerto 29 SM foi capaz de levar os níveis de palmitato a 1 % no óleo.
Tabela 31:
| Palmitato | Estearato | Oleato | Linoleato | Linolenato | ||
| Óleo | 10,7% | 4,8% | 23,2% | 52,9% | 8,4% | |
| 6 h | 7,5% | 4,7% | 23,7% | 55,4% | 8,7% | |
| 21 h | 5,0% | 4,7% | 24,2% | 57,5% | 8,7% |
Petição 870180005321, de 22/01/2018, pág. 296/316
290/293
| 24 h | 4,9% | 4,7% | 24,2% | 57,6% | 8,7% | |
| 28 h | 4,7% | 4,6% | 24,2% | 57,9% | 8,6% | |
| Óleo filtrado | 4,8% | 4,6% | 24,2% | 57,8% | 8,6% | |
| Óleo+oleato | 4,9% | 4,6% | 24,2% | 57,7% | 8,6% | |
| +0 h | 4,7% | 4,6% | 24,2% | 57,9% | 8,5% | |
| +3 h | 2,6% | 4,6% | 24,5% | 59,9% | 8,4% | |
| +20 h | 1,0% | 4,3% | 24,4% | 62,7% | 7,7% | |
| +22 h | 1,0% | 4,2% | 24,3% | 62,8% | 7,6% |
Exemplo 15: Dupla centrifugação e filtração dá óleo de palmitato com baixo teor [0553] A capacidade de separar o oleato de potássio após reações em óleo foi demonstrada abaixo, 2 kg de óleo bruto foram reagidos com 29 SM a 5 % de teor de água, A reação em óleo foi homogeneizada durante 1 minuto com um [equipamento] IKA a velocidade 6 atingindo-se uma temperatura de 25°C, Um misturador de topo foi equipado com um impulsor de misturador de tintas e misturou a reação em óleo a 390 rpm, Após 1 hora de reação, a velocidade de misturação foi acelerada a 530 rpm, A temperatura de reação foi monitorada e flutuada de 21 °C a 29°C com aquecimento intermitente a partir de um bloco de aquecimento, Amostras foram removidas para monitorar alterações no perfil do óleo, Após 28 horas, a reação em óleo foi aquecida a 80°C e centrifugada em um [equipamento] gyrotester, A fração em óleo foi resfriada à temperatura ambiente de um dia para o outro com misturação por impulsor, depois resfriada em banho de gelo a menos de 10°C. Adicionou-se terra de diatomáceas, e os TAGS e DAGS foram separados dos ácidos graxos livres por meio de filtração através de um funil Buchner resfriado, com filtro Whatman, 1 kg deste óleo tratado foi usado para iniciar reações com oleato de potássio como um emulsificante, Adicionou-se 50 g de oleato de potássio para se obter 5 %, Isto foi misturado e homogeneizado, 50 ml de enzima foram carregados para se atingir 5 % de teor de água, e isto foi homogeneizado durante 1 minuto a 6 no IKA atingindo 26,6°C, Esta reação em óleo foi misturada com um impulsor de misturador de tintas acoplado a um misturador de topo a 400 rpm, Usou-se aquecimento intermitente com bloco de aquecimento, Frações foram removidas a 3, 20, 24, e a 8, 28, e 48 horas após o início do segundo ensaio, Frações foram submetidas a extração convencional com clorofórmio metanol, e metanólise total, seguido de análise com GC de FAME (como descrito no Exemplo 8, acima), Ácidos graxos remanescentes ligados no óleo são listados para cada fração na Tabela 32, abaixo, 29 SM impeliu os níveis de palmitato a 1,5 %, Este óleo foi
Petição 870180005321, de 22/01/2018, pág. 297/316
291/293 aquecido a 85°C e centrifugado removendo-se os fragmentos de proteína, A fração em óleo foi resfriada a 6°C com misturação por impulsor, adicionou-se terra de diatomáceas e o material foi separado por meio de um funil de Buchner, A filtração foi continuada a 25°C.
Tabela 32:
| Palmitato | Estearato | Oleato | Linoleato | Linolenato | ||
| Óleo | 10,7% | 4,8% | 23,2% | 52,9% | 8,4% | |
| 3 h | 8,3% | 4,7% | 23,5% | 54,8% | 8,7% | |
| 20 h | 4,9% | 4,7% | 24,3% | 57,4% | 8,7% | |
| 24 h | 4,7% | 4,6% | 24,1% | 57,9% | 8,7% | |
| +8 h | 3,2% | 4,6% | 24,4% | 59,3% | 8,5% | |
| +28 h | 1,9% | 4,5% | 24,4% | 60,9% | 8,3% | |
| +48 h | 1,5% | 4,4% | 24,5% | 61,5% | 8,1% |
Exemplo 16: Otimização de códon [0554] Versões com códon otimizado para a expressão em Pseudomonas fluorescens do acerto 29 de mutação silente termo-tolerante principal (Exemplo 12) foram projetadas por meio de dois métodos diferentes, A primeira versão de códon otimizado substituiu todos os códons no acerto 29SM por aqueles preferidos por Pseudomonas fluorescens, incluindo as 7 melhor mutações silentes incorporadas (Exemplo 12). Esta versão foi denominada 29SM-Pf (SEQ ID NO :22), O uso de códon preferido para Pseudomonas fluorescens foi determinado por meio de revisão do Banco de Dados de Uso de Códons [Codon Usage Database] obtenível online no website [endereço da rede mundial de computadores] do Kazusa DNA Research Institute (2-6-7 Kazusa-kamatari, Kisarazu, Chiba 292-0818 JAPÃO, recuperado em 2009 da Internet <URL:http://www,kazusa,or,jp/codon/index,html>).
[0555] Em particular, os padrões de uso de códon para Pseudomonas fluorescens PfO-1 (recuperado em 2009 da Internet <URL: http://www,kazusa,or,jp/codon/cgibin/showcodon,cgi?species=205922>) e Pseudomonas fluorescens Pf-5 (recuperado em 2009 da Internet <URL: http://www,kazusa,or,jp/codon/cgibin/showcodon,cgi?species=220664>) foram usados no projeto da sequência com códon otimizado, SEQ ID NO: 22.
[0556] A segunda versão de códon otimizado também substituiu todos os códons no acerto 29SM por aqueles preferidos por Pseudomonas fluorescens, exceto [pelo fato de que] mantiveram as principais 7 mutações silentes (Exemplo 11), Esta versão foi
Petição 870180005321, de 22/01/2018, pág. 298/316
292/293 denominada 29SM-PÍ+SM (SEQ ID NO:23), 29SM-Pf+SM (SEQ ID NO:23) é o melhor candidato relativamente a 29SM-PÍ (SEQ ID NO:22), [0557] SEQ ID NO: 22:
A TGCTCAAGCCCCCACCTTACGGCCGTCTGCTCCGCGAACTGGCTGA TA TCCC GGCGA TCGTGA CTGCTCCGTTCCGCGGCGCAGCCAAAA TGGGCAAA CTGGCA GATGGCGAGCCGGTACTGGTGCTGCCCGGCTTCCTGGCGGACGACAACGCGA CCAGCGTGCTGCGGAAGACCTTCGAGGTCGCCGGCTTTGCGTGCAGCGGCTG GGAAAAGGGCTTCAACCTCGGCATTCGTGGCGACCTCATGGACTACCTGGTCG ACCGCCTGCGCGCCGTGAGCGAGGCCGCGGGGGGGCAGAAGGTAATCGTGG TCGGCTGGTCCCTCGGCGGCCTCTACGCCCGGGAGTTGGGCCACAAGGCCCC
CGAACTGA TCCGTA TGGTCGTCACGCTCGGCTCCCCGTTCGCCGGCGA CCTCC ACGCGAACCATGCCTGGAAGATCTACGAGGCCATCAACTCCCACACGGTCGAC AA CCTGCCGA TCCCGCGCGA TTTCCAGA TTAAGCCGCCGGTGCA TACCA TCGC CGTGTGGA GCCCGCTCGA CGGGGTGGTGGCCCCGGA GA CGA GCGAAGGCAG CCCCGAGCAGAGCGACGAGCGCTTGGAGCTGGCCGTGACCCACATGGGCTTT GCGGCTAGCAAGACCGGGGCGGAGGCAGTGGTCCGCCTGGTCGCCGCCCGC CTCTGA [0558] SEQ ID NO: 23:
A TGCTCAAGCCCCCACCTTACGGCCGTCTGCTCCGCGAACTGGCTGA TA TCCC GGCGATCGTGACTGCTCCGTTCCGCGGCGCAGCCAAAATGGGCAAACTGGCT GATGGCGAGCCGGTACTGGTGCTGCCCGGCTTCCTGGCGGACGACAACGCGA CCAGCGTGCTGCGGAAGACCTTCGAGGTCGCCGGCTTTGCGTGCAGCGGCTG GGAAAAGGGCTTCAACCTCGGCATTCGTGGCGACCTCATGGACTACCTGGTCG ACCGCCTGCGCGCCGTGAGCGAGGCCGCGGGGGGGCAGAAGGTTATCGTGG TCGGCTGGAGTCTCGGCGGCCTCTACGCCCGGGAGCTTGGCCACAAGGCCCC CGAACTGATCAGGATGGTCGTCACGCTCGGCTCTCCGTTCGCCGGCGACCTCC ACGCGAACCATGCCTGGAAGATCTACGAGGCCATCAACTCCCACACGGTCGAC AA CCTGCCGA TCCCGCGCGA TTTCCA GA TTAAGCCGCCGGTGCA TACCA TCGC CGTGTGGAGCCCGCTCGACGGGGTGGTGGCCCCGGAGACGAGCGAAGGCAG CCCCGAGCAGAGCGACGAGCGCTTGGAGCTGGCCGTGACCCACATGGGCTTT GCGGCTAGCAAGACCGGGGCGGAGGCAGTGGTCCGCCTGGTCGCCGCCCGC CTCTGA [0559] As sequências de ambas as versões de códon otimizado do gene foram enviadas para DNA 2,0 Incorporated (Menlo Park, CA) para síntese de DNA, Os genes foram sintetizados no vetor pJ201 com um sítio de restrição Spel e Xhol de cada lado do gene, Quando os genes sintetizados foram fornecidos, os plasmídios foram cortados com enzimas de restrição, DNA do vetor pDOW-Kan também foi cortado com as mesmas enzimas de restrição, depois tratado com fosfatase alcalina intestinal de bezerro (New England Biolabs Product #M0290L), Todas as amostras foram purificadas com gel e
Petição 870180005321, de 22/01/2018, pág. 299/316
293/293 extraídas usando o kit de extração com gel QIAquick gel extraction kit (Qiagen, Product #28706), O vetor e insertos foram então ligados usando-se o kit Roche Rapid Ligation (Roche, n° do produto 11635379001), Produtos de ligação foram então transformados em células competentes XL1 Blue de E, coli, Colônias foram colhidas, desenvolvidas e o DNA foi preparado usando-se o kit Qiagen mini-prep, As amostras de DNA foram confirmadas por sequências, e o DNA foi então usado para transformar Pseudomonas fluorescens, [0560] 29SM-Pf (SEQ ID NO:22), 29SM-Pf+SM (SEQ ID NO:23), 29SM, o parental (SEQ ID NO:2 com mutações D61E, R72K, e V163R) e o controle de vetor/hospedeiro foram então desenvolvidos e induzidos em frascos agitados de 250 ml, A concentração de proteína nos lisados clarificados foi quantificada usando-se o ensaio de proteína Bio-Rad Protein Assay (Bio-Rad, Hercules, CA, n° de catálogo 500-0006) baseado no método de Bradford e então isto foi normalizado quanto à expressão de proteína total, Expressão analisada com SDS-PAGE, sendo que cada faixa do gel de SDS-PAGE foi carregada com proteína total igual, 29SM-Pf e 29SM-Pf+SM apresentaram um maior percentual de proteína palmitase expressa em comparação com 29SM e o parental, 29SM-Pf+SM apresentou um percentual ligeiramente maior de expressão de palmitase do que 29SM-Pf, Portanto, o melhoramento da expressão foi ligeiramente mais pronunciado na presença das mutações silentes, [0561] Descreveu-se aqui uma quantidade de concretizações como proporcionadas aqui, No entanto, deve-se compreender que é possível realizar várias modificações sem afastar-se do espírito e do escopo como proporcionados aqui, Assim, outras concretizações encontram-se dentro do escopo das reivindicações a seguir.
Petição 870180005321, de 22/01/2018, pág. 300/316
1/15
Claims (32)
1/32
FIGURA 1
1. Método de hidrolisar um óleo ou gordura, caracterizado pelo fato de que consiste essencialmente das etapas de:
(a) obter uma composição consistindo essencialmente de um óleo ou gordura, sendo que o óleo ou gordura pode ser hidrolisado por meio de um polipeptídio apresentando uma atividade de hidrolase, sendo que referido polipeptídio é selecionado do grupo que consiste de polipeptídios isolados, sintéticos e recombinantes apresentando uma atividade de hidrolase e o referido polipeptídio
i. consistindo de uma sequência de aminoácidos como apresentada na SEQ ID NO:2 mas também consistindo de pelo menos uma das modificações de resíduos de aminoácidos D61A; D61E; R72E; R72K; E116A; E116Q; E116R; E116T; E116V; S133A; I151G; I151A; V163R ou D164R, ou uma combinação das mesmas, ou ii. consistindo de uma sequência de aminoácidos como apresentada na SEQ ID NO:2 mas também consistindo de pelo menos uma das modificações de resíduos de aminoácidos I20L; V62S; G77P; V83C; D88H; Y113G; E116T; E116G; H140K; K146S; I167S; L180E; E194M; A211Q; S212Y; G215C; G215V; G215W; A218H; A218S; V223A; A225M ou A225Q, ou uma combinação das mesmas;
(b) adicionar o polipeptídio da etapa (a) à composição consistindo essencialmente do referido óleo ou gordura em uma quantidade suficiente e em condições suficientes para causar hidrólise do óleo ou gordura, hidrolisando com isso o óleo ou gordura.
2/32
NÃO
FIM
220
FIGURA 2
53/32
252
FIGURA 3 τ
τ
2/15 combinação dos mesmos.
2. Método, de acordo com a reivindicação 1, caracterizado pelo fato de que referido óleo ou gordura hidrolisada apresenta um menor teor de gordura saturada do que referido óleo ou gordura antes da hidrólise.
3*!5W*WW
3/15
3. Método, de acordo com as reivindicações 1 ou 2, caracterizado pelo fato de que referido óleo ou gordura consiste essencialmente de um óleo algáceo, um óleo animal, um óleo vegetal, um óleo apresentando uma composição alterada de ácido graxo, um óleo com baixo teor de saturação, óleo de peixe ou uma
Petição 870180067395, de 03/08/2018, pág. 8/22
4/32
FIGURA 4
4/15
4. Método, de acordo com a reivindicação 3, caracterizado pelo fato de que referido óleo consiste essencialmente de óleo de Neochloris oleoabundans, óleo de Scenedesmus dimorphus, óleo de Euglena gracilis, óleo de Phaeodactylum tricornutum, óleo de Pleurochrysis carterae, óleo de Prymnesium parvum, óleo de Tetraselmis chui, óleo de Tetraselmis suecica, óleo de Isochrysis galbana, óleo de Nannochloropsis salina, óleo de Botryococcus braunii, óleo de Dunaliella tertiolecta, óleo de espécies de Nannochloris, óleo de espécies de Spirulina, óleo de Chlorophycease, óleo de Bacilliarophy, óleo de canola, óleo de mamona, óleo de coco, óleo de coriandro, óleo de milho, óleo de semente de algodão, óleo de avelã, outros óleos de nozes, óleo de semente de cânhamo, óleo de linhaça, óleo de planta dos prados [meadowfoam], óleo de oliva, óleo de palma, óleo de palmito, óleo de amendoim, óleo de colza, óleo de farelo de arroz, óleo de açafrão, óleo de sasanqua, óleo de gergelim, óleo de soja, óleo de semente de girassol, óleo de abeto, óleo de tsubaki, talol banha, gordura de manteiga, gordura de frango; ou uma combinação de quaisquer dos referidos óleos ou gorduras.
5/32
FIGURAS ’l'l
5/15 específica catalisa a esterificação da posição Sn2, produzindo com isso o lipídeo estruturado.
5. Método, de acordo com a reivindicação 3, caracterizado pelo fato de que o ácido graxo alterado consiste essencialmente de óleo com alto teor oléico, óleo com baixo teor linolênico ou uma combinação dos mesmos, ou de que o óleo com baixo teor de saturação consiste essencialmente de óleo de canola com alto teor oléico, óleo de soja com baixo teor linolênico, óleo de girassol com alto teor esteárico ou uma combinação dos mesmos, ou de que o óleo de peixe consiste essencialmente de óleo de Thaleichthys pacificus, óleo de fígado de bacalhau, óleo de Hoplostethus atlanticus, óleo de sardinha, óleo de arenque, óleo de savelha ou uma combinação dos mesmos.
6/32
FIGURA 6A
6/15
G215V; G215W; A218H; A218S; V223A; A225M ou A225Q, ou uma combinação das mesmas;
(b) proporcionar uma composição consistindo essencialmente de um triacilglicerídeo (TAG);
(c) colocar em contato o polipeptídio da etapa (a) com a composição da etapa (b) em condições em que o polipeptídio hidrolisa um resíduo acila na posição Sn1 ou Sn3 do triacilglicerídeo (TAG), produzindo com isso um 1,2-DAG ou 2,3DAG; e (d) promover a migração de acila no 1,2-DAG ou 2,3-DAG da etapa (c) em condições cineticamente controladas, produzindo com isso um 1,3-DAG.
6. Método, de acordo com a reivindicação 1, caracterizado pelo fato de que referidas gorduras ou óleos consistem essencialmente de moléculas apresentando uma cadeia principal de triacilglicerídeo e sendo que durante referida hidrólise, ácidos graxos são removidos de pelo menos algumas das espinhas dorsais de triacilglicerídeo.
Petição 870180067395, de 03/08/2018, pág. 9/22
7/32
K o
I—
62S
62S
77Ρ
77P
113G ]113G 116T L_]116T
116G ]116G
211Q o +-> ce
E
CQ 0.
CQ L. CQ φ tfí LU
J211Q
215CJ
CQ <0 £
Z3 ll
215V·
- I215V
215W|_
L_j215W
218H ]218H
218S
218S
J223A
7/15
7. Método, de acordo com a reivindicação 6, caracterizado pelo fato de que referidos ácidos graxos consistem essencialmente de um ou mais dentre ácido acético, butírico, capróico, caprílico, undecanóico, láurico, mirístico, pentadecanóico, palmítico, margárico, esteárico, araquídico ou beênico.
8/32
FIGURA 7
MLKPPPYGRL LRELADIPAl VTAPFRGAAK MGKLADGEPV LVLPGFLADD 20L
61Ã,E 72E,K natsvlrktf DVagfacsgw eRgfnlGirg dlVdrlvDrl RAVSEAAGGQ 62S 77P 83C 88H
113G133A kviwgwslg glYarElghk apelirmwt lgSpfagdlH anhawKiyea 116A,Q,R,T,V;g,T 140K146S
167S
151G,A163R
Inshtvdnlp ipVDfqIkpp vrtiavwspL dgwapetse gspEqsderl
164R 180E194M
2127
211Q 218B,S 225M,Q elavthmgfa ASktGaeAw rlVaArl- (SEQ ID NO:2)
215C,V,W 223A
8/15 apresentada na SEQ ID NO:2 mas também consistindo de pelo menos uma das modificações de resíduos de aminoácidos I20L; V62S; G77P; V83C; D88H; Y113G; E116T; E116G; H140K; K146S; I167S; L180E; E194M; A211Q; S212Y; G215C; G215V; G215W; A218H; A218S; V223A; A225M ou A225Q, ou uma combinação das mesmas;
(b) proporcionar uma mistura de triacilglicerídeos e ácidos graxos livres;
(c) tratar a composição da etapa (b) com o polipeptídio em condições em que o polipeptídio pode catalisar a troca de ácidos graxos livres com os grupos acila de triacilglicerídeos, produzindo com isso, novos triacilglicerídeos enriquecidos com referido ácido graxo.
8. Método, de acordo com a reivindicação 6, caracterizado pelo fato de que referidos ácidos graxos são removidos seletivamente de uma posição Sn1, Sn2 ou Sn3 na cadeia principal de triacilglicerídeo.
9/32
FIGURA 8.1
9/15 hidrolase e o referido polipeptídio
i. consistindo de uma sequência de aminoácidos como apresentada na SEQ ID 2 mas também consistindo de pelo menos uma das modificações de resíduos de aminoácidos D61A; D61E; R72E; R72K; E116A; E116Q; E116R; E116T; E116V; S133A; I151G; 1151 A; V163R ou D164R, ou uma combinação das mesmas, ou ii. consistindo de uma sequência de aminoácidos como apresentada na SEQ ID 2 mas também consistindo de pelo menos uma das modificações de resíduos de aminoácidos I20L; V62S; G77P; V83C; D88H; Y113G; E116T; E116G; H140K; K146S; I167S; L180E; E194M; A211Q; S212Y; G215C; G215V; G215W; A218H; A218S; V223A; A225M ou A225Q, ou uma combinação das mesmas;
(d) interesterificar o material-fonte de ácido esteárico e o triacilglicerídeo do alimento, ração, ou óleo, e (e) separar componentes de ácido graxo de componentes de glicerídeos interesterificados da mistura de interesterificação para proporcionar um produto de óleo interesterificado e uma mistura de ácidos graxos consistindo essencialmente de ácidos graxos, monoésteres de ácido graxo, ou misturas dos mesmos liberados do alimento, ração ou óleo.
32. Método, de acordo com a reivindicação 31, caracterizado pelo fato de que referida reação de interesterificação é prosseguida até que ocorra equilíbrio dos grupos éster nas posições 1-, 3- do componente de glicerídeo com ácidos graxos não-glicerídeos da mistura de reação.
33. Método, de acordo com a reivindicação 31, caracterizado pelo fato de que referidos triacilglicerídeos interesterificasdos apresentam um menor teor de gordura saturada do que referidos triacilglicerídeos da etapa (b).
34. Método de produzir um diacilglicerol (DAG), caracterizado pelo fato de que o método consistindo essencialmente das etapas de (a) prover uma composição de óleo consistindo essencialmente de uma quantidade de TAG,
Petição 870180067395, de 03/08/2018, pág. 16/22
9. Método, de acordo com a reivindicação 1, caracterizado pelo fato de que referido óleo ou gordura está presente em uma ração ou em um alimento e referida hidrólise é realizada antes do consumo de referida ração ou alimento por um animal ou um indivíduo.
10/32
FIGURA 8.2
10/15 (b) proporcionar um polipeptídeo apresentando uma atividade de hidrolase, sendo que o referido polipeptídio é selecionado do grupo que consiste de polipeptídios isolados, sintéticos e recombinantes apresentando uma atividade de hidrolase e o referido polipeptídio
i. consistindo de uma sequência de aminoácidos como apresentada na SEQ ID NO:2 mas também consistindo de pelo menos uma das modificações de resíduos de aminoácidos D61A; D61E; R72E; R72K; E116A; E116Q; E116R; E116T; E116V; S133A; I151G; I151A; V163R ou D164R, ou uma combinação das mesmas, ou ii. consistindo de uma sequência de aminoácidos como apresentada na SEQ ID NO:2 mas também consistindo de pelo menos uma das modificações de resíduos de aminoácidos I20L; V62S; G77P; V83C; D88H; Y113G; E116T; E116G; H140K; K146S; I167S; L180E; E194M; A211Q; S212Y; G215C; G215V; G215W; A218H; A218S; V223A; A225M ou A225Q, ou uma combinação das mesmas;
(c) colocar em contato a referida composição de óleo da etapa (a) com o referido polipeptídio da etapa (b) em condições suficientes para o polipeptídio hidrolisar um resíduo acila no TAG para formar um DAG.
35. Método, de acordo com a reivindicação 34, caracterizado pelo fato de que o referido polipeptídio é Sn2-específico e referido DAG é um 1,3-DAG; ou em que o referido polipeptídio é Sn1 ou Sn3-específico e o referido DAG é um 1,2-DAG ou um 2,3-DAG.
36. Método, de acordo com a reivindicação 34, caracterizado pelo fato de que o referido resíduo acila consiste essencialmente de um ácido graxo saturado e o referido DAG é uma gordura com menor teor de saturação do que referido TAG, ou em que o referido resíduo acila consiste essencialmente de um ácido graxo trans e o referido DAG é uma gordura com menor teor trans do que o referido
TAG.
Petição 870180067395, de 03/08/2018, pág. 17/22
10. Método, de acordo com a reivindicação 1, caracterizado pelo fato de que referido óleo ou gordura consiste essencialmente de um ou mais dentre um triacilglicerol, um diacilglicerol, ou um monoacilglicerol, e sendo que referido polipeptídio da etapa (a) é colocado em contato com o referido óleo ou gordura em condições em que o referido polipeptídio hidrolisa um ou mais dentre os referidos triacilglicerol, diacilglicerol ou monoacilglicerol.
11/32
FIGURA 8.3
12132
FIGURA 8.4
11/15
37. Método de hidrolisar um óleo ou gordura, caracterizado pelo fato de que consiste essencialmente dasetapas de:
(a) obter uma composição consistindo essencialmente de um óleo ou gordura, sendo que o óleo ou gordura pode ser hidrolisado por um polipeptídio apresentando uma atividade de hidrolase, sendo que o referido polipeptídio é selecionado do grupo que consiste de polipeptídios isolados, sintéticos e recombinantes apresentando uma atividade de hidrolase e o referido polipeptídio
i. consistindo de uma sequência de aminoácidos como apresentada na SEQ ID NO:2 mas também consistindo de pelo menos uma das modificações de resíduos de aminoácidos D61A; D61E; R72E; R72K; E116A; E116Q; E116R; E116T; E116V; S133A; I151G; I151A; V163R ou D164R, ou uma combinação das mesmas, ou ii. consistindo de uma sequência de aminoácidos como apresentada na SEQ ID NO:2 mas também consistindo de pelo menos uma das modificações de resíduos de aminoácidos I20L; V62S; G77P; V83C; D88H; Y113G; E116T; E116G; H140K; K146S; I167S; L180E; E194M; A211Q; S212Y; G215C; G215V; G215W; A218H; A218S; V223A; A225M; ou A225Q, ou uma combinação das mesmas;
(b) adicionar o polipeptídio da etapa (a) à composição consistindo essencialmente do referido óleo ou gordura em uma quantidade suficiente e em condições suficientes para causar hidrólise do óleo ou gordura, hidrolisando com isso o óleo ou gordura.
38. Método de síntese biocatalítica de um lipídeo estruturado caracterizado pelo fato de que consiste essencialmente das seguintes etapas:
(a) proporcionar um polipeptídeo apresentando uma atividade de hidrolase, sendo que o referido polipeptídio é selecionado do grupo que consiste de polipeptídios isolados, sintéticos e recombinantes apresentando uma atividade de hidrolase e o referido polipeptídio
i. consistindo de uma sequência de aminoácidos como apresentada na SEQ ID NO:2 mas também consistindo de pelo menos uma das
Petição 870180067395, de 03/08/2018, pág. 18/22
11. Método, de acordo com a reivindicação 10, caracterizado pelo fato de que referida hidrólise causa a diminuição da quantidade de triacilglicerol, diacilglicerol ou monoacilglicerol na composição.
12/15 modificações de resíduos de aminoácidos D61A; D61E; R72E; R72K; E116A; E116Q; E116R; E116T; E116V; S133A; I151G; I151A; V163R ou D164R, ou uma combinação das mesmas, ou ii. consistindo de uma sequência de aminoácidos como apresentada na SEQ ID NO:2 mas também consistindo de pelo menos uma das modificações de resíduos de aminoácidos I20L; V62S; G77P; V83C; D88H; Y113G; E116T; E116G; H140K; K146S; I167S; L180E; E194M; A211Q; S212Y; G215C; G215V; G215W; A218H; A218S; V223A; A225M ou A225Q, ou uma combinação das mesmas;
(b) proporcionar uma composição consistindo essencialmente de um triacilglicerídeo (TAG);
(c) contactar o polipeptídio da etapa (a) com a composição da etapa (b) em condições em que o polipeptídio hidrolisa um resíduo acila na posição Sn2 do triacilglicerídeo (TAG), produzindo com isso um 1,3-diacilglicerídeo (DAG);
(d) prover um éster R1;
(e) prover uma hidrolase R1-específica, e (f) colocar em contato o 1,3-DAG da etapa (c) com o éster R1 da etapa (d) e a hidrolase específica da etapa (e) em condições em que a hidrolase R1-específica catalisa a esterificação da posição Sn2, produzindo com isso o lipídeo estruturado.
39. Método de síntese biocatalítica de um lipídeo estruturado, caracterizado pelo fato de que consiste essencialmente dasseguintes etapas:
(a) proporcionar um polipeptídeo apresentando uma atividade de hidrolase, sendo que o referido polipeptídio é selecionado do grupo que consiste de polipeptídios isolados, sintéticos e recombinantes apresentando uma atividade de hidrolase e o referido polipeptídio
i. consistindo de uma sequência de aminoácidos como apresentada na SEQ ID NO:2 mas também consistindo de pelo menos uma das modificações de resíduos de aminoácidos D61A; D61E; R72E; R72K; E116A; E116Q; E116R; E116T; E116V; S133A; I151G; I151A; V163R ou D164R, ou uma combinação das mesmas, ou
Petição 870180067395, de 03/08/2018, pág. 19/22
12. Método, de acordo com a reivindicação 1, caracterizado pelo fato de que o óleo ou gordura consiste essencialmente de um éster de glicerol de um ácido graxo poliinsaturado.
13/32
FIGURA 8.5
13/15 ii. consistindo de uma sequência de aminoácidos como apresentada na SEQ ID NO:2 porém também consistindo de pelo menos uma das modificações de resíduos de aminoácidos I20L; V62S; G77P; V83C; D88H; Y113G; E116T; E116G; H140K; K146S; I167S; L180E; E194M; A211Q; S212Y; G215C; G215V; G215W; A218H; A218S; V223A; A225M ou A225Q, ou uma combinação das mesmas;
(b) proporcionar uma composição consistindo essencialmente de um triacilglicerídeo (TAG);
(c) colocar em contato o polipeptídio da etapa (a) com a composição da etapa (b) em condições em que o polipeptídio hidrolisa um resíduo acila na posição Sn1 ou Sn3 do triacilglicerídeo (TAG), produzindo com isso um 1,2-DAG ou 2,3DAG; e (d) promover migração de acila no 1,2-DAG ou 2,3-DAG da etapa (c) sob condições cineticamente controladas, produzindo com isso um 1,3-DAG.
40. Método de catalisar uma reação de interesterificação para produzir novos triacilglicerídeos, caracterizado pelo fato de que consiste essencialmente dasseguintes etapas:
(a) proporcionar uma composição consistindo essencialmente de um polipeptídio apresentando uma atividade de lipase 1,3-específica, sendo que referido polipeptídio é selecionado do grupo que consiste de polipeptídeos isolados, sintéticos ou recombinantes apresentando uma atividade de hidrolase e o referido polipeptídio ou
i. consistindo de uma sequência de aminoácidos como apresentada na SEQ ID NO:2 mas também consistindo de pelo menos uma das modificações de resíduos de aminoácidos D61A; D61E; R72E; R72K; E116A; E116Q; E116R; E116T; E116V; S133A; I151G; I151A; V163R ou D164R, ou uma combinação das mesmas, ou ii. consistindo de uma sequência de aminoácidos como apresentada na SEQ ID NO:2 mas também consistindo de pelo menos uma das modificações de resíduos de aminoácidos I20L; V62S; G77P; V83C; D88H; Y113G;
Petição 870180067395, de 03/08/2018, pág. 20/22
13. Método, de acordo com a reivindicação 1, caracterizado pelo fato de que referido óleo ou gordura hidrolisada consiste essencialmente de qualquer um ou mais dentre um óleo ou gordura com baixo teor de saturação, um óleo ou gordura não-trans, um lipídeo contendo ácidos graxos essenciais, um lipídeo contendo ácidos graxos monoinsaturados, um lipídeo contendo fosfo-colina, um lipídeo contendo fosfo-serina, um lipídeo contendo um fitosterol, um 1,3diacilglicerídeo, um 2-monoacilglicerídeo, e um triacilglicerídeo.
Petição 870180067395, de 03/08/2018, pág. 10/22
14/32
FIGURA 8.6
14/15
E116T; E116G; H140K; K146S; I167S; L180E; E194M; A211Q; S212Y; G215C; G215V; G215W; A218H; A218S; V223A; A225M ou A225Q, ou uma combinação das mesmas;
(b) proporcionar uma mistura de triacilglicerídeos e ácidos graxos livres;
(c) tratar a composição da etapa (b) com o polipeptídio em condições em que o polipeptídio pode catalisar a troca de ácidos graxos livres com os grupos acila de triacilglicerídeos, produzindo com isso, novos triacilglicerídeos enriquecidos com referidos ácidos graxos.
41. Método de interesterificação para preparar um alimento, ração ou um óleo, caracterizado pelo fato de que consiste essencialmente de as seguintes etapas:
(a) proporcionar uma mistura de reação de interesterificação consistindo essencialmente de um material-fonte de ácido esteárico selecionado do grupo que consiste de ácido esteárico, monoésteres do ácido esteárico com alcoóis monoídricos com baixo peso molecular e misturas dos mesmos, (b) prover um alimento, ração ou um óleo contendo um triacilglicerídeo;
(c) prover um polipeptídeo apresentando uma atividade de hidrolase, sendo que o referido polipeptídio é selecionado do grupo que consiste de polipeptídios isolados, sintéticos e recombinantes apresentando uma atividade de hidrolase e o referido polipeptídio
i. consistindo de uma sequência de aminoácidos como apresentada na SEQ ID:2 mas também consistindo de pelo menos uma das modificações de resíduos de aminoácidos D61A; D61E; R72E; R72K; E116A; E116Q; E116R; E116T; E116V; S133A; I151G; I151A; V163R ou D164R, ou uma combinação das mesmas, ou ii. consistindo de uma sequência de aminoácidos como apresentada na SEQ ID:2 mas também consistindo de pelo menos uma das modificações de resíduos de aminoácidos I20L; V62S; G77P; V83C; D88H; Y113G; E116T; E116G; H140K; K146S; I167S; L180E; E194M; A211Q; S212Y; G215C; G215V; G215W; A218H; A218S; V223A; A225M ou A225Q, ou uma combinação das
Petição 870180067395, de 03/08/2018, pág. 21/22
14. Método, de acordo com a reivindicação 1, caracterizado pelo fato de que referida composição consiste essencialmente de uma composição dietética à base de vegetais ou leite, sendo que o polipeptídio pode hidrolisar o óleo ou gordura na composição, reduzindo com isso seu teor de gordura.
15/32
FIGURA 8.7
15/15 mesmas;
(d) interesterificar o material-fonte de ácido esteárico e o triacilglicerídeo do alimento, ração, ou óleo, e (e) separar componentes de ácido graxo livre de componentes de glicerídeo interesterificado da mistura de interesterificação para proporcionar um produto de óleo interesterificado e uma mistura de ácidos graxos consistindo essencialmente de ácidos graxos, monoésteres de ácido graxo, ou misturas dos mesmos liberados do alimento, ração ou óleo.
42. Método de produzir um diacilglicerol (DAG), caracterizado pelo fato de que o método consiste essencialmente de as etapas de (a) prover uma composição de óleo consistindo essencialmente de uma quantidade de TAG, (b) prover um polipeptídeo apresentando uma atividade de hidrolase, sendo que o referido polipeptídio é selecionado do grupo que consiste de polipeptídios isolados, sintéticos e recombinantes apresentando uma atividade de hidrolase e o referido polipeptídio
i. consistindo de uma sequência de aminoácidos como apresentada na SEQ ID:2 mas também consistindo de pelo menos uma das modificações de resíduos de aminoácidos D61A; D61E; R72E; R72K; E116A; E116Q; E116R; E116T; E116V; S133A; I151G; I151A; V163R ou D164R, ou uma combinação das mesmas, ou ii. consistindo de uma sequência de aminoácidos como apresentada na SEQ ID NO:2 mas também consistindo de pelo menos uma das modificações de resíduos de aminoácidos I20L; V62S; G77P; V83C; D88H; Y113G; E116T; E116G; H140K; K146S; I167S; L180E; E194M; A211Q; S212Y; G215C; G215V; G215W; A218H; A218S; V223A; A225M ou A225Q, ou uma combinação das mesmas;
(c) colocar em contato a referida composição de óleo da etapa (a) com o referido polipeptídio da etapa (b) em condições suficientes para o polipeptídio para hidrolisar um resíduo acila no TAG para formar um DAG.
Petição 870180067395, de 03/08/2018, pág. 22/22
15. Método de síntese biocatalítica de um lipídeo estruturado caracterizado pelo fato de que consiste essencialmente das seguintes etapas:
(a) proporcionar um polipeptídeo apresentando uma atividade de hidrolase, sendo que referido polipeptídio é selecionado do grupo que consiste de polipeptídios isolados, sintéticos e recombinantes apresentando uma atividade de hidrolase e sendo que o referido polipeptídio
i. consistindo de uma sequência de aminoácidos como apresentada na SEQ ID NO:2 mas também consistindo de pelo menos uma das modificações de resíduos de aminoácidos D61A; D61E; R72E; R72K; E116A; E116Q; E116R; E116T; E116V; S133A; I151G; I151A; V163R ou D164R, ou uma combinação dos mesmos, ou ii. consistindo de uma sequência de aminoácidos como apresentada na SEQ ID 2 mas também consistindo de pelo menos uma modificação de resíduos de aminoácidos I20L; V62S; G77P; V83C; D88H; Y113G; E116T; E116G; H140K; K146S; I167S; L180E; E194M; A211Q; S212Y; G215C; G215V; G215W; A218H; A218S; V223A; A225M ou A225Q, ou uma combinação das mesmas;
(b) proporcionar uma composição consistindo essencialmente de a triacilglicerídeo (TAG);
(c) colocar em contato o polipeptídio da etapa (a) com a composição da etapa (b) em condições em que o polipeptídio hidrolisa um resíduo acila na posição Sn2 do triacilglicerídeo (TAG), produzindo com isso um 1,3-diacilglicerídeo (DAG);
(d) proporcionar um éster R1;
(e) proporcionar uma hidrolase R1-específica, e (f) colocar em contato o 1,3-DAG da etapa (c) com o éster R1 da etapa (d) e a hidrolase R1-específica da etapa (e) em condições em que a hidrolase R1
Petição 870180067395, de 03/08/2018, pág. 11/22
16/32
FIGURA 8.8 «·“'·-’'- ·**-«~ ®· «. ~v s Λ.«Λ»« _.5- «ΛΪ &SÉ® « >» s b2tL. «» &
16. Método, de acordo com a reivindicação 15, caracterizado pelo fato de que a hidrolase R1-específica é uma lipase Sn2-específica.
17/32
FIGURA 8.9 r~———·,.——' í .----:—·ι -,-.-7-.-77,-------—»------:-------m—« .. ,u.
17. Método, de acordo com a reivindicação 15, caracterizado pelo fato de que referido éster R1 consiste essencialmente de um ácido graxo de saturação menor do que referido resíduo acila hidrolisado, ou de que referido éster R1 pode consistir essencialmente de um ou mais de um ácido graxo ômega-3, um ácido graxo ômega-6, um ácido graxo ômega-9, um ácido graxo monoinsaturado, um grupo fosfo, um éster de fitosterol, ou orizanol, ou de que referido éster R1 consiste essencialmente de uma porção selecionada do grupo que consiste de ácido alfa-linolênico, ácido estearidônico, ácido eicosapentaenóico, ácido docosaexaenóico, ácido gama-linolênico, ácido dihomo-gama-linolênico, ácido araquidônico, ácido oléico, ácido palmoléico, colina, serina, beta-sitosterol, cumestrol, e dietilstilbestrol.
18/32
FIGURA 8.10
'.gwitfgaw 4 v·?
*>rÇ
18. Método de síntese biocatalítica de um lipídeo estruturado caracterizado pelo fato de que consiste essencialmente das seguintes etapas:
(a) proporcionar um polipeptídeo apresentando uma atividade de hidrolase, sendo que o referido polipeptídio é selecionado do grupo que consiste de polipeptídios isolados, sintéticos e recombinantes apresentando uma atividade de hidrolase e o referido polipeptídio
i. consistindo de uma sequência de aminoácidos como apresentada na SEQ ID NO:2 mas também consistindo de pelo menos uma das modificações de resíduos de aminoácidos D61A; D61E; R72E; R72K; E116A; E116Q; E116R; E116T; E116V; S133A; I151G; I151A; V163R ou D164R, ou uma combinação das mesmas, ou ii. consistindo de uma sequência de aminoácidos como apresentado na SEQ ID NO:2 mas também consistindo de pelo menos uma das modificações de resíduos de aminoácidos I20L; V62S; G77P; V83C; D88H; Y113G; E116T; E116G; H140K; K146S; I167S; L180E; E194M; A211Q; S212Y; G215C;
Petição 870180067395, de 03/08/2018, pág. 12/22
19/32
FIGURA 8.11 a-· J! WA't -? -^· * IVffü· l» ÍWI411 jW ffwtu·'
19. Método, de acordo com a reivindicação 18, caracterizado pelo fato de que consiste essencialmente da etapa adicional de proporcionar um éster R1 e uma lipase R1-específica, e contactar o 1,3-DAG da etapa (d) com o éster R1 e a lipase R1-específica em condições em que a lipase R1-específica catalisa a esterificação da posição Sn2, produzindo com isso um lipídeo estruturado.
20/32
FIGURA 8.12
20. Método, de acordo com a reivindicação 19, caracterizado pelo fato de que referida lipase R1-específica é uma lipase Sn1 ou Sn3-específica.
21/32
FIGURA 8.13
21. Método, de acordo com a reivindicação 15 ou 19, caracterizado pelo fato de que referido lipídeo estruturado é selecionado do grupo que consiste de uma alternativa à manteiga de cacau (CBA), uma manteiga de cacau sintética, uma manteiga de cacau natural, 1,3-dipalmitoil-2-oleoilglicerol (POP), 1,3-distearoil-2oleoilglicerol (SOS), 1-palmitoil-2-oleoil-3-stearoilglicerol (POS) ou 1-oleoil-2,3dimiristoilglicerol (OMM).
22/32
FIGURA 8.14
22. Método, de acordo com a reivindicação 19, caracterizado pelo fato de que referido éster R1 consiste essencialmente de um ácido graxo com menor teor de saturação do que referido resíduo acila hidrolisado.
23/32
FIGURA 8.15
23. Método, de acordo com a reivindicação 22, caracterizado pelo fato de que referido éster R1 pode consistir essencialmente de um ou mais de um ácido graxo ômega-3, um ácido graxo ômega-6, um ácido graxo monoinsaturado, um grupo fosfo, um éster de fitosterol, e orizanol.
Petição 870180067395, de 03/08/2018, pág. 13/22
24/32
FIGURA 8.16
W|
24. Método, de acordo com a reivindicação 22, caracterizado pelo fato de que referido éster R1 consiste essencialmente de uma porção selecionada do grupo que consiste de ácido alfa-linolênico, ácido eicosapentaenóico, ácido docosaexaenóico, ácido gama-linolênico, ácido di-homo-gama-linolênico, ácido araquidônico, ácido oléico, ácido palmoléico, colina, serina, beta-sitosterol, cumestrol, dietilstilbestrol e orizanol.
25/32
FIGURA 8.17
25. Método, de acordo com a reivindicação 18, caracterizado pelo fato de que a etapa (d) consiste essencialmente de adicionalmente o uso de resinas de troca de íon.
26/32
FIGURA 8.18
26. Método, de acordo com a reivindicação 18, caracterizado pelo fato de que referidas condições cineticamente controladas da etapa (d) consiste essencialmente de condições de não-equilíbrio resultando na produção de um produto final apresentando uma relação de 1,3-DAG para 2,3-DAG maior do que 2:1.
27/32
FIGURA 8.19
27. Método, de acordo com a reivindicação 15 ou 19, caracterizado pelo fato de que referido lipídeo estruturado sintetizado apresenta um menor teor de gordura saturada do que referido triacilglicerídeo.
28/32
FIGURA 8.20
28. Método de catalisar uma reação de interesterificação para produzir novos triacilglicerídeos, caracterizado pelo fato de que consiste essencialmente dasseguintes etapas:
(a) proporcionar uma composição consistindo essencialmente de um polipeptídio apresentando uma atividade de lipase 1,3-específica, sendo que o referido polipeptídio é selecionado do grupo que consiste de polipeptídeos isolados, sintéticos ou recombinantes apresentando uma atividade de hidrolase e o referido polipeptídio ou
i. consistindo de uma sequência de aminoácidos como apresentada na SEQ ID NO:2 mas também consistindo de pelo menos uma das modificações de resíduos de aminoácidos D61A; D61E; R72E; R72K; E116A; E116Q; E116R; E116T; E116V; S133A; I151G; I151A; V163R ou D164R, ou uma combinação das mesmas, ou ii. consistindo de uma sequência de aminoácidos como
Petição 870180067395, de 03/08/2018, pág. 14/22
29/32
FIGURA 8.21
29. Método, de acordo com a reivindicação 28, caracterizado pelo fato de que referida composição da etapa (b) consiste essencialmente de 1,3dipalmitoil-2-monoleína (POP) e os novos triacilglicerídeos da etapa (c) consiste essencialmente de um ou ambos de 1-palmitoil-3-estearoil-2-monoleína (POSt) e 1,3-distearoil-2-monoleína (StOSt).
30/32
FIGURA 8.22
30. Método, de acordo com a reivindicação 28, caracterizado pelo fato de que referidos novos triacilglicerídeos da etapa (c) apresentam um menor teor de gordura saturada do que referidos triacilglicerídeos da etapa (b).
31/32
FIGURA 8.23
31. Método de interesterificação para preparar um alimento, ração ou um óleo, caracterizado pelo fato de que consiste essencialmente de as seguintes etapas:
(a) proporcionar uma mistura de reação de interesterificação consistindo essencialmente de um material-fonte de ácido esteárico selecionado do grupo que consiste de ácido esteárico, monoésteres de ácido esteárico com alcoóis monoídricos com baixo peso molecular e misturas dos mesmos, (b) proporcionar um alimento, ração ou um óleo contendo um triacilglicerídeo;
(c) proporcionar um polipeptídeo apresentando uma atividade de hidrolase, sendo que o referido polipeptídio é selecionado do grupo que consiste de polipeptídios isolados, sintéticos e recombinantes apresentando uma atividade de
Petição 870180067395, de 03/08/2018, pág. 15/22
32/32
Λ
FIGURA 8.24
K
Applications Claiming Priority (3)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| US12/202,204 US8153391B2 (en) | 2008-08-29 | 2008-08-29 | Hydrolases, nucleic acids encoding them and methods for making and using them |
| US12/202,204 | 2008-08-29 | ||
| PCT/US2009/004904 WO2010024924A2 (en) | 2008-08-29 | 2009-08-28 | Hydrolases, nucleic acids encoding them and methods for making and using them |
Publications (2)
| Publication Number | Publication Date |
|---|---|
| BRPI0917220A2 BRPI0917220A2 (pt) | 2015-08-11 |
| BRPI0917220B1 true BRPI0917220B1 (pt) | 2018-11-21 |
Family
ID=41664688
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| BRPI0917220-3A BRPI0917220B1 (pt) | 2008-08-29 | 2009-08-28 | métodos de hidrolisar um óleo ou gordura, de síntese biocatalítica de um lipídeo estruturado, de catalisar uma reação de interesterificação para produzir novos triacilglicerídeos, de interesterificação para preparar um alimento, ração ou um óleo, e de produzir um diacilglicerol |
Country Status (13)
| Country | Link |
|---|---|
| US (6) | US8153391B2 (pt) |
| EP (1) | EP2329032B1 (pt) |
| CN (1) | CN102325891B (pt) |
| AR (2) | AR073236A1 (pt) |
| BR (1) | BRPI0917220B1 (pt) |
| CA (1) | CA2735265C (pt) |
| ES (1) | ES2484919T3 (pt) |
| MX (1) | MX2011002226A (pt) |
| MY (1) | MY162662A (pt) |
| PL (1) | PL2329032T3 (pt) |
| RU (1) | RU2525675C2 (pt) |
| UA (1) | UA101214C2 (pt) |
| WO (1) | WO2010024924A2 (pt) |
Families Citing this family (20)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| US10813630B2 (en) | 2011-08-09 | 2020-10-27 | Corquest Medical, Inc. | Closure system for atrial wall |
| US10314594B2 (en) | 2012-12-14 | 2019-06-11 | Corquest Medical, Inc. | Assembly and method for left atrial appendage occlusion |
| US10307167B2 (en) | 2012-12-14 | 2019-06-04 | Corquest Medical, Inc. | Assembly and method for left atrial appendage occlusion |
| PE20150179A1 (es) * | 2012-06-14 | 2015-02-07 | Bunge Global Innovation Llc | Proceso para la produccion de aceites bajos en acidos grasos saturados |
| US20140142689A1 (en) | 2012-11-21 | 2014-05-22 | Didier De Canniere | Device and method of treating heart valve malfunction |
| US9566443B2 (en) | 2013-11-26 | 2017-02-14 | Corquest Medical, Inc. | System for treating heart valve malfunction including mitral regurgitation |
| CN104087626A (zh) * | 2014-07-07 | 2014-10-08 | 嘉必优生物工程(武汉)有限公司 | 含有2-棕榈酸甘油酯的组合物的制备方法 |
| US10842626B2 (en) | 2014-12-09 | 2020-11-24 | Didier De Canniere | Intracardiac device to correct mitral regurgitation |
| US20170049121A1 (en) | 2015-08-20 | 2017-02-23 | Bunge Oils, Inc. | High stearic high oleic shortening compositions and methods of making and using the same |
| CN109929820B (zh) * | 2017-12-19 | 2022-10-11 | 丰益(上海)生物技术研发中心有限公司 | 新型的甘油单-二酰酯脂肪酶 |
| CN108034647B (zh) * | 2018-01-31 | 2020-08-04 | 江南大学 | 一种饱和脂肪酸特异性脂肪酶突变体及其应用 |
| JP7359539B2 (ja) * | 2018-03-29 | 2023-10-11 | 日清オイリオグループ株式会社 | 油脂組成物、加熱調理用油脂組成物、加熱調理用油脂組成物の製造方法、並びに、油脂組成物における酸価上昇及び色調上昇の抑制方法 |
| WO2019213754A1 (en) * | 2018-05-07 | 2019-11-14 | Gates Ian D | Method of enzymatic biotransformation of petroleum hydrocarbon |
| WO2019219904A2 (en) * | 2018-05-18 | 2019-11-21 | Dsm Ip Assets B.V. | Mutant lipase and use thereof |
| US20220046953A1 (en) * | 2018-12-13 | 2022-02-17 | Cargill, Incorporated | Modified Triglyceride Including Omega-3 Fatty Acid Residue |
| US20240271180A1 (en) | 2020-09-07 | 2024-08-15 | Boehringer Ingelheim International Gmbh | Method for detecting contaminating lipase activity |
| CN116457470A (zh) * | 2020-09-07 | 2023-07-18 | 勃林格殷格翰国际公司 | 用于检测污染脂肪酶活性的方法 |
| MX2023012736A (es) | 2021-04-30 | 2023-11-09 | Root Applied Sciences Inc | Dispositivo para recoger material del aire. |
| EP4490518A1 (en) | 2022-03-09 | 2025-01-15 | Boehringer Ingelheim International Gmbh | Method for detecting contaminating carboxylesterase activity |
| CN119677854A (zh) * | 2022-08-10 | 2025-03-21 | 勃林格殷格翰国际公司 | 靶向多种水解酶的人工miRNA |
Family Cites Families (138)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| US3949105A (en) | 1974-03-25 | 1976-04-06 | Lever Brothers Company | Margarine fat |
| US4261868A (en) | 1979-08-08 | 1981-04-14 | Lever Brothers Company | Stabilized enzymatic liquid detergent composition containing a polyalkanolamine and a boron compound |
| US4458066A (en) | 1980-02-29 | 1984-07-03 | University Patents, Inc. | Process for preparing polynucleotides |
| IE52535B1 (en) | 1981-02-16 | 1987-12-09 | Ici Plc | Continuous release pharmaceutical compositions |
| US4404128A (en) | 1981-05-29 | 1983-09-13 | The Procter & Gamble Company | Enzyme detergent composition |
| IE54838B1 (en) | 1982-04-30 | 1990-02-28 | Unilever Plc | Improvements in and relating to interesterification of triglycerides of fatty acids |
| DK402583D0 (da) | 1983-09-05 | 1983-09-05 | Novo Industri As | Fremgangsmade til fremstilling af et immobiliseret lipasepraeparat og anvendelse deraf |
| US4707364A (en) | 1984-01-27 | 1987-11-17 | Miles Laboratories, Inc. | Composition for accelerating cheese aging |
| US5204015A (en) | 1984-05-29 | 1993-04-20 | Genencor International, Inc. | Subtilisin mutants |
| US5087571A (en) | 1984-06-22 | 1992-02-11 | President And Fellows Of Harvard College | Method for providing a cell culture from a transgenic non-human mammal |
| US5691181A (en) | 1984-08-21 | 1997-11-25 | Celltech Limited | DNA encoding lipase from human gastric mucosal tissue |
| US4683202A (en) | 1985-03-28 | 1987-07-28 | Cetus Corporation | Process for amplifying nucleic acid sequences |
| US4683195A (en) | 1986-01-30 | 1987-07-28 | Cetus Corporation | Process for amplifying, detecting, and/or-cloning nucleic acid sequences |
| DE3587814T2 (de) | 1985-03-30 | 1994-11-10 | Marc Ballivet | Verfahren zum erhalten von dns, rns, peptiden, polypeptiden oder proteinen durch dns-rekombinant-verfahren. |
| US4752483A (en) | 1986-05-30 | 1988-06-21 | Campbell Soup Company | Method for producing a highly flavored cheese ingredient |
| US4962028A (en) | 1986-07-09 | 1990-10-09 | Dna Plant Technology Corporation | Plant promotors |
| US4925673A (en) | 1986-08-18 | 1990-05-15 | Clinical Technologies Associates, Inc. | Delivery systems for pharmacological agents encapsulated with proteinoids |
| US4946778A (en) | 1987-09-21 | 1990-08-07 | Genex Corporation | Single polypeptide chain binding molecules |
| US4987071A (en) | 1986-12-03 | 1991-01-22 | University Patents, Inc. | RNA ribozyme polymerases, dephosphorylases, restriction endoribonucleases and methods |
| US5015580A (en) | 1987-07-29 | 1991-05-14 | Agracetus | Particle-mediated transformation of soybean plants and lines |
| US5573933A (en) | 1987-04-14 | 1996-11-12 | Luminis Pty, Ltd. | Transgenic pigs |
| US4897268A (en) | 1987-08-03 | 1990-01-30 | Southern Research Institute | Drug delivery system and method of making the same |
| US4944944A (en) | 1987-11-19 | 1990-07-31 | Oklahoma Medical Research Foundation | Dietary compositions and methods using bile salt-activated lipase |
| US5700637A (en) | 1988-05-03 | 1997-12-23 | Isis Innovation Limited | Apparatus and method for analyzing polynucleotide sequences and method of generating oligonucleotide arrays |
| US6054270A (en) | 1988-05-03 | 2000-04-25 | Oxford Gene Technology Limited | Analying polynucleotide sequences |
| US5000975A (en) | 1988-12-29 | 1991-03-19 | American Home Products Corporation | Randomized palm oil fat composition for infant formulas |
| US5217879A (en) | 1989-01-12 | 1993-06-08 | Washington University | Infectious Sindbis virus vectors |
| US5069810A (en) | 1989-03-16 | 1991-12-03 | Olin Corporation | Cleaning composition comprising microbial lipase SD2 and sodium dodecylbenzene sulfonate |
| US5744101A (en) | 1989-06-07 | 1998-04-28 | Affymax Technologies N.V. | Photolabile nucleoside protecting groups |
| US5527681A (en) | 1989-06-07 | 1996-06-18 | Affymax Technologies N.V. | Immobilized molecular synthesis of systematically substituted compounds |
| US5143854A (en) | 1989-06-07 | 1992-09-01 | Affymax Technologies N.V. | Large scale photolithographic solid phase synthesis of polypeptides and receptor binding screening thereof |
| US5800992A (en) | 1989-06-07 | 1998-09-01 | Fodor; Stephen P.A. | Method of detecting nucleic acids |
| US5288619A (en) | 1989-12-18 | 1994-02-22 | Kraft General Foods, Inc. | Enzymatic method for preparing transesterified oils |
| JPH06507782A (ja) | 1990-06-15 | 1994-09-08 | サイオス ノバ インコーポレイテッド | アルツハイマー病のアミロイド形成開症状を示すヒト以外の組換え哺乳動物 |
| JP3234598B2 (ja) | 1990-11-23 | 2001-12-04 | プラント・ジエネテイツク・システムズ・エヌ・ベー | 単子葉植物の形質転換方法 |
| IE914504A1 (en) | 1990-12-20 | 1992-07-01 | Ixsys | Optimization of binding proteins |
| US6110700A (en) | 1991-03-11 | 2000-08-29 | The General Hospital Corporation | PRAD1 cyclin and its cDNA |
| DE4115938A1 (de) | 1991-05-16 | 1992-11-19 | Metallgesellschaft Ag | Enzymatisches verfahren zur verminderung des gehaltes an phosphorhaltigen bestandteilen in pflanzlichen und tierischen oelen |
| US5922854A (en) | 1991-06-14 | 1999-07-13 | Kumar; Ramesh | Purifying Human Hemogloblin from transgenic pig red cells and plasmids containing pig globin nucleic acids |
| CA2075135A1 (en) | 1991-08-02 | 1993-02-03 | David E. Ellis | Particle-mediated transformation of gymnosperms |
| US5632957A (en) | 1993-11-01 | 1997-05-27 | Nanogen | Molecular biological diagnostic systems including electrodes |
| JPH05236997A (ja) | 1992-02-28 | 1993-09-17 | Hitachi Ltd | ポリヌクレオチド捕捉用チップ |
| US5902617A (en) | 1992-05-19 | 1999-05-11 | Pabst; Patrea L. | Enzyme supplemented baby formula |
| US5445955A (en) | 1992-05-25 | 1995-08-29 | The Nisshin Oil Mills, Ltd. | Immobilization of lipase on a polymer carrier containing epoxy and tertiary amino groups |
| EP0571982A1 (en) | 1992-05-27 | 1993-12-01 | Showa Denko Kabushiki Kaisha | Alkaline lipase, method for producing the same, microorganism producing the same and detergent composition containing alkaline lipase |
| AU5676394A (en) | 1992-11-20 | 1994-06-22 | Agracetus, Inc. | Transgenic cotton plants producing heterologous bioplastic |
| JPH08511159A (ja) | 1993-05-20 | 1996-11-26 | ロダース・クロックラーン・ビー・ブイ | 固定化リパーゼ |
| JP2859520B2 (ja) | 1993-08-30 | 1999-02-17 | ノボ ノルディスク アクティーゼルスカブ | リパーゼ及びそれを生産する微生物及びリパーゼ製造方法及びリパーゼ含有洗剤組成物 |
| AU7925094A (en) | 1993-09-30 | 1995-04-18 | Agracetus, Inc. | Transgenic cotton plants producing heterologous peroxidase |
| US6045996A (en) | 1993-10-26 | 2000-04-04 | Affymetrix, Inc. | Hybridization assays on oligonucleotide arrays |
| US5965452A (en) | 1996-07-09 | 1999-10-12 | Nanogen, Inc. | Multiplexed active biologic array |
| US6468742B2 (en) | 1993-11-01 | 2002-10-22 | Nanogen, Inc. | Methods for determination of single nucleic acid polymorphisms using bioelectronic microchip |
| US5605793A (en) | 1994-02-17 | 1997-02-25 | Affymax Technologies N.V. | Methods for in vitro recombination |
| US5837458A (en) | 1994-02-17 | 1998-11-17 | Maxygen, Inc. | Methods and compositions for cellular and metabolic engineering |
| US6117679A (en) | 1994-02-17 | 2000-09-12 | Maxygen, Inc. | Methods for generating polynucleotides having desired characteristics by iterative selection and recombination |
| US5834252A (en) | 1995-04-18 | 1998-11-10 | Glaxo Group Limited | End-complementary polymerase reaction |
| US5639940A (en) | 1994-03-03 | 1997-06-17 | Pharmaceutical Proteins Ltd. | Production of fibrinogen in transgenic animals |
| WO1995024494A1 (en) | 1994-03-09 | 1995-09-14 | Abbott Laboratories | Humanized milk |
| CA2184688A1 (en) | 1994-03-09 | 1995-09-14 | Pedro Antonio Prieto | Transgenic animals producing oligosaccharides and glycoconjugates |
| ES2250969T3 (es) | 1994-03-29 | 2006-04-16 | Novozymes A/S | Amilasa alcalina de bacilo. |
| US5807522A (en) | 1994-06-17 | 1998-09-15 | The Board Of Trustees Of The Leland Stanford Junior University | Methods for fabricating microarrays of biological samples |
| US5750870A (en) | 1994-06-17 | 1998-05-12 | Agritope, Inc. | Plant genetic transformation methods and transgenic plants |
| US5959171A (en) | 1994-08-17 | 1999-09-28 | Pharming B.V. | Method for the production of biologically active polypeptides in a mammal's |
| CA2198451A1 (en) | 1994-09-01 | 1996-03-07 | Gurparkash Singh | Transgenic animal expressing a familial form of human amyloid precursor protein |
| US6111166A (en) | 1994-09-19 | 2000-08-29 | Medarex, Incorporated | Transgenic mice expressing human Fcα and β receptors |
| US5795737A (en) | 1994-09-19 | 1998-08-18 | The General Hospital Corporation | High level expression of proteins |
| US5880327A (en) | 1994-09-21 | 1999-03-09 | American National Red Cross | Transgenic mammals expressing human coagulation factor VIII |
| US5556752A (en) | 1994-10-24 | 1996-09-17 | Affymetrix, Inc. | Surface-bound, unimolecular, double-stranded DNA |
| EP0713917A1 (fr) * | 1994-11-28 | 1996-05-29 | Societe Des Produits Nestle S.A. | Procédé d'hydrolyse des triglycérides d'acides gras polyinsaturés |
| US6187992B1 (en) | 1994-12-05 | 2001-02-13 | Merck & Co., Inc. | Transgenic mouse having a disrupted amyloid precursor protein gene |
| US5830645A (en) | 1994-12-09 | 1998-11-03 | The Regents Of The University Of California | Comparative fluorescence hybridization to nucleic acid arrays |
| US5633440A (en) | 1994-12-20 | 1997-05-27 | Dna Plant Technology Corporation | P119 promoters and their uses |
| US6093562A (en) | 1996-02-05 | 2000-07-25 | Novo Nordisk A/S | Amylase variants |
| US5959098A (en) | 1996-04-17 | 1999-09-28 | Affymetrix, Inc. | Substrate preparation process |
| US6313081B1 (en) | 1995-04-28 | 2001-11-06 | Henkel Kommanditgesellschaft Auf Aktien (Kgaa) | Detergents comprising cellulases |
| US5552317A (en) | 1995-05-26 | 1996-09-03 | Industrial Technology Research Institute | Method for preparing optically active homophenylalanine and esters thereof using lipase from wheat germ or Candida lipolytica |
| ES2248814T3 (es) * | 1995-05-31 | 2006-03-16 | Cognis Ip Management Gmbh | Procedimiento mejorado de fraccionamiento de grasas. |
| US5856174A (en) | 1995-06-29 | 1999-01-05 | Affymetrix, Inc. | Integrated nucleic acid diagnostic device |
| US5958672A (en) | 1995-07-18 | 1999-09-28 | Diversa Corporation | Protein activity screening of clones having DNA from uncultivated microorganisms |
| US5830696A (en) | 1996-12-05 | 1998-11-03 | Diversa Corporation | Directed evolution of thermophilic enzymes |
| US6238884B1 (en) | 1995-12-07 | 2001-05-29 | Diversa Corporation | End selection in directed evolution |
| US6358709B1 (en) | 1995-12-07 | 2002-03-19 | Diversa Corporation | End selection in directed evolution |
| US6537776B1 (en) | 1999-06-14 | 2003-03-25 | Diversa Corporation | Synthetic ligation reassembly in directed evolution |
| US5965408A (en) | 1996-07-09 | 1999-10-12 | Diversa Corporation | Method of DNA reassembly by interrupting synthesis |
| US6740506B2 (en) | 1995-12-07 | 2004-05-25 | Diversa Corporation | End selection in directed evolution |
| US6361974B1 (en) | 1995-12-07 | 2002-03-26 | Diversa Corporation | Exonuclease-mediated nucleic acid reassembly in directed evolution |
| US6171820B1 (en) | 1995-12-07 | 2001-01-09 | Diversa Corporation | Saturation mutagenesis in directed evolution |
| US5939250A (en) | 1995-12-07 | 1999-08-17 | Diversa Corporation | Production of enzymes having desired activities by mutagenesis |
| US6022963A (en) | 1995-12-15 | 2000-02-08 | Affymetrix, Inc. | Synthesis of oligonucleotide arrays using photocleavable protecting groups |
| US6013440A (en) | 1996-03-11 | 2000-01-11 | Affymetrix, Inc. | Nucleic acid affinity columns |
| US6096548A (en) | 1996-03-25 | 2000-08-01 | Maxygen, Inc. | Method for directing evolution of a virus |
| US6197070B1 (en) | 1996-05-15 | 2001-03-06 | The Procter & Gamble Company | Detergent compositions comprising alpha combination of α-amylases for malodor stripping |
| WO1998004663A1 (en) | 1996-07-30 | 1998-02-05 | The Procter & Gamble Company | Detergent composition comprising two cellulase components, with and without a cellulose-binding domain |
| US6326341B1 (en) | 1996-09-11 | 2001-12-04 | The Procter & Gamble Company | Low foaming automatic dishwashing compositions |
| US5834259A (en) | 1996-10-28 | 1998-11-10 | Monsanto Company | Process and composition for preparing D-aspartic acid |
| HUP0000486A3 (en) | 1996-12-19 | 2001-10-29 | Unilever Nv | Immobilized enzyme and its use for the processing of triglyceride oils |
| US6069122A (en) | 1997-06-16 | 2000-05-30 | The Procter & Gamble Company | Dishwashing detergent compositions containing organic diamines for improved grease cleaning, sudsing, low temperature stability and dissolution |
| EP1717322B1 (en) | 1997-01-17 | 2012-07-18 | Codexis Mayflower Holdings, LLC | Evolution of whole cells and organisms by recursive sequence recombination |
| US6326204B1 (en) | 1997-01-17 | 2001-12-04 | Maxygen, Inc. | Evolution of whole cells and organisms by recursive sequence recombination |
| DE19703364A1 (de) | 1997-01-30 | 1998-08-06 | Henkel Ecolab Gmbh & Co Ohg | Pastenförmiges Wasch- und Reinigungsmittel |
| US6153410A (en) | 1997-03-25 | 2000-11-28 | California Institute Of Technology | Recombination of polynucleotide sequences using random or defined primers |
| US6826296B2 (en) | 1997-07-25 | 2004-11-30 | Affymetrix, Inc. | Method and system for providing a probe array chip design database |
| IL134702A (en) | 1997-09-11 | 2004-03-28 | Bioventures Inc | High density arrays and methods of making the same |
| US6465178B2 (en) | 1997-09-30 | 2002-10-15 | Surmodics, Inc. | Target molecule attachment to surfaces |
| EP2386568B1 (en) | 1997-10-30 | 2014-08-06 | Novozymes A/S | Alpha-amylase mutants |
| ES2190120T3 (es) | 1997-11-10 | 2003-07-16 | Procter & Gamble | Procedimiento para la preparacion de una pastilla de detergente. |
| US6118044A (en) | 1997-11-14 | 2000-09-12 | Sankyo Company, Limited | Transgenic animal allergy models and methods for their use |
| US6506559B1 (en) | 1997-12-23 | 2003-01-14 | Carnegie Institute Of Washington | Genetic inhibition by double-stranded RNA |
| US6156952A (en) | 1998-04-09 | 2000-12-05 | Constituent Institution Of The University Of Maryland System | HIV transgenic animals and uses therefor |
| JP2003527450A (ja) | 1998-05-01 | 2003-09-16 | ノボ ノルディスク アクティーゼルスカブ | N−ヒドロキシアセトアニリドの様な増強剤 |
| US6048695A (en) | 1998-05-04 | 2000-04-11 | Baylor College Of Medicine | Chemically modified nucleic acids and methods for coupling nucleic acids to solid support |
| DE19824705A1 (de) | 1998-06-03 | 1999-12-09 | Henkel Kgaa | Amylase und Protease enthaltende Wasch- und Reinigungsmittel |
| JP4335995B2 (ja) | 1998-07-22 | 2009-09-30 | 昭 神谷 | 環境保全型粒状洗浄用組成物 |
| GB2340755B (en) | 1998-08-24 | 2002-09-25 | Cannon Rubber Ltd | Breast pump insert |
| US6277628B1 (en) | 1998-10-02 | 2001-08-21 | Incyte Genomics, Inc. | Linear microarrays |
| US6277489B1 (en) | 1998-12-04 | 2001-08-21 | The Regents Of The University Of California | Support for high performance affinity chromatography and other uses |
| US6368861B1 (en) | 1999-01-19 | 2002-04-09 | Maxygen, Inc. | Oligonucleotide mediated nucleic acid recombination |
| US6376246B1 (en) | 1999-02-05 | 2002-04-23 | Maxygen, Inc. | Oligonucleotide mediated nucleic acid recombination |
| US6436675B1 (en) | 1999-09-28 | 2002-08-20 | Maxygen, Inc. | Use of codon-varied oligonucleotide synthesis for synthetic shuffling |
| US6399121B1 (en) | 1999-03-16 | 2002-06-04 | Novozymes A/S | Process for producing cheese |
| US6511824B1 (en) | 1999-03-17 | 2003-01-28 | Exelixis, Inc. | Nucleic acids and polypeptides of invertebrate TWIK channels and methods of use |
| US6309871B1 (en) | 1999-03-31 | 2001-10-30 | Novozymes A/S | Polypeptides having alkaline α-amylase activity |
| US6221653B1 (en) | 1999-04-27 | 2001-04-24 | Agilent Technologies, Inc. | Method of performing array-based hybridization assays using thermal inkjet deposition of sample fluids |
| US6653151B2 (en) | 1999-07-30 | 2003-11-25 | Large Scale Proteomics Corporation | Dry deposition of materials for microarrays using matrix displacement |
| US6337187B1 (en) | 1999-11-05 | 2002-01-08 | Millennium Pharmaceuticals, Inc. | 18891, a novel human lipase |
| US20010008765A1 (en) | 1999-12-06 | 2001-07-19 | Fuji Photo Film Co., Ltd. | DNA chip and reactive solid carrier |
| US6531644B1 (en) | 2000-01-14 | 2003-03-11 | Exelixis, Inc. | Methods for identifying anti-cancer drug targets |
| EP1332153A4 (en) | 2000-10-12 | 2006-01-11 | Exelixis Inc | HUMAN ECT2 AND METHOD OF USE THEREOF |
| US6309872B1 (en) | 2000-11-01 | 2001-10-30 | Novozymes Biotech, Inc | Polypeptides having glucoamylase activity and nucleic acids encoding same |
| AU2002306484A1 (en) | 2002-02-13 | 2003-09-04 | Dow Global Technologies Inc. | Over-expression of extremozyme genes in pseudomonads and closely related bacteria |
| FI115842B (fi) * | 2002-03-27 | 2005-07-29 | Valio Oy | Menetelmä konjugoidun linolihapon valmistamiseksi |
| CA2515583C (en) * | 2003-03-07 | 2015-07-14 | Diversa Corporation | Hydrolases, nucleic acids encoding them and methods for making and using them |
| EP1692282B1 (en) | 2003-11-19 | 2012-08-08 | Pfenex, Inc. | Improved protein expression systems in auxotrophic Pseudomonas fluorescens |
| WO2006037334A1 (en) * | 2004-10-08 | 2006-04-13 | Novozymes A/S | Hydrolysis of ester bonds with lipase |
| DE102005012113A1 (de) * | 2004-12-27 | 2006-07-27 | BSH Bosch und Siemens Hausgeräte GmbH | Geschirrspülmaschine mit einer Trocknungsvorrichtung |
| CA2601472A1 (en) * | 2005-03-08 | 2006-09-14 | Verenium Corporation | Hydrolases, nucleic acids encoding them and methods for improving paper strength |
| WO2008027099A2 (en) | 2006-05-30 | 2008-03-06 | Dow Global Technologies Inc. | Rpa optimization |
| UA97127C2 (uk) | 2006-12-06 | 2012-01-10 | Бандж Ойлз, Инк. | Спосіб безперервної ферментативної обробки композиції, що містить ліпід, та система для його здійснення |
-
2008
- 2008-08-29 US US12/202,204 patent/US8153391B2/en active Active
-
2009
- 2009-08-28 WO PCT/US2009/004904 patent/WO2010024924A2/en not_active Ceased
- 2009-08-28 MY MYPI2011000873A patent/MY162662A/en unknown
- 2009-08-28 AR ARP090103330A patent/AR073236A1/es active IP Right Grant
- 2009-08-28 UA UAA201103761A patent/UA101214C2/ru unknown
- 2009-08-28 PL PL09789233T patent/PL2329032T3/pl unknown
- 2009-08-28 CN CN200980143308.9A patent/CN102325891B/zh not_active Expired - Fee Related
- 2009-08-28 MX MX2011002226A patent/MX2011002226A/es active IP Right Grant
- 2009-08-28 BR BRPI0917220-3A patent/BRPI0917220B1/pt not_active IP Right Cessation
- 2009-08-28 RU RU2011111747/10A patent/RU2525675C2/ru not_active IP Right Cessation
- 2009-08-28 CA CA2735265A patent/CA2735265C/en active Active
- 2009-08-28 EP EP09789233.5A patent/EP2329032B1/en active Active
- 2009-08-28 ES ES09789233.5T patent/ES2484919T3/es active Active
-
2011
- 2011-04-08 US US13/083,455 patent/US8227215B2/en active Active
- 2011-04-08 US US13/083,484 patent/US8349578B2/en active Active
- 2011-04-08 US US13/083,461 patent/US8313918B2/en active Active
- 2011-04-08 US US13/083,480 patent/US8541191B2/en not_active Expired - Fee Related
- 2011-04-08 US US13/083,472 patent/US8420342B2/en active Active
-
2016
- 2016-09-07 AR ARP160102735A patent/AR105958A2/es not_active Application Discontinuation
Also Published As
| Publication number | Publication date |
|---|---|
| US20100055234A1 (en) | 2010-03-04 |
| CN102325891B (zh) | 2015-01-07 |
| ES2484919T3 (es) | 2014-08-12 |
| US8541191B2 (en) | 2013-09-24 |
| US20110281312A1 (en) | 2011-11-17 |
| EP2329032B1 (en) | 2014-04-30 |
| US20110287496A1 (en) | 2011-11-24 |
| MY162662A (en) | 2017-06-30 |
| US8349578B2 (en) | 2013-01-08 |
| MX2011002226A (es) | 2011-04-05 |
| US20110287136A1 (en) | 2011-11-24 |
| PL2329032T3 (pl) | 2014-09-30 |
| RU2525675C2 (ru) | 2014-08-20 |
| US20120276618A1 (en) | 2012-11-01 |
| US8313918B2 (en) | 2012-11-20 |
| WO2010024924A2 (en) | 2010-03-04 |
| CN102325891A (zh) | 2012-01-18 |
| US8153391B2 (en) | 2012-04-10 |
| US20110287495A1 (en) | 2011-11-24 |
| EP2329032A2 (en) | 2011-06-08 |
| US8420342B2 (en) | 2013-04-16 |
| BRPI0917220A2 (pt) | 2015-08-11 |
| CA2735265C (en) | 2019-04-23 |
| CA2735265A1 (en) | 2010-03-04 |
| RU2011111747A (ru) | 2012-10-10 |
| AR105958A2 (es) | 2017-11-29 |
| WO2010024924A3 (en) | 2010-04-29 |
| US8227215B2 (en) | 2012-07-24 |
| UA101214C2 (ru) | 2013-03-11 |
| AR073236A1 (es) | 2010-10-20 |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| EP2329032B1 (en) | Methods using polypeptides having hydrolase activity | |
| BRPI0408157B1 (pt) | ácido nucléico recombinante, polipeptídeo recombinante com atividade lipase, célula transformada, métodos empregando os mesmos e composição | |
| US9238804B2 (en) | Hydrolases, nucleic acids encoding them and methods for making and using them | |
| EP1910530A2 (en) | Hydrolases, nucleic acids encoding them and methods for making and using them | |
| US8465942B2 (en) | Hydrolases, nucleic acids encoding them and methods for making and using them | |
| US8709775B2 (en) | Hydrolases, nucleic acids encoding them and methods for making and using them | |
| BRPI0918265B1 (pt) | Sequência de ácido nucleico recombinante, cassete de expressão, vetor ou veículo de clonagem, célula transformada, polipeptídeo recombinante, preparação de proteína, alimento, alimentação, suplemento de alimento, suplemento alimentar, auxiliar dietético ou composição dietética, método de produção de um polipeptídeo recombinante e palmitase |
Legal Events
| Date | Code | Title | Description |
|---|---|---|---|
| B06A | Patent application procedure suspended [chapter 6.1 patent gazette] | ||
| B06A | Patent application procedure suspended [chapter 6.1 patent gazette] | ||
| B09A | Decision: intention to grant [chapter 9.1 patent gazette] | ||
| B16A | Patent or certificate of addition of invention granted [chapter 16.1 patent gazette] |
Free format text: PRAZO DE VALIDADE: 20 (VINTE) ANOS CONTADOS A PARTIR DE 28/08/2009, OBSERVADAS AS CONDICOES LEGAIS. |
|
| B21F | Lapse acc. art. 78, item iv - on non-payment of the annual fees in time |
Free format text: REFERENTE A 12A ANUIDADE. |
|
| B24J | Lapse because of non-payment of annual fees (definitively: art 78 iv lpi, resolution 113/2013 art. 12) |
Free format text: EM VIRTUDE DA EXTINCAO PUBLICADA NA RPI 2640 DE 10-08-2021 E CONSIDERANDO AUSENCIA DE MANIFESTACAO DENTRO DOS PRAZOS LEGAIS, INFORMO QUE CABE SER MANTIDA A EXTINCAO DA PATENTE E SEUS CERTIFICADOS, CONFORME O DISPOSTO NO ARTIGO 12, DA RESOLUCAO 113/2013. |