JP3887005B2 - プロセッサ集積回路 - Google Patents
プロセッサ集積回路 Download PDFInfo
- Publication number
- JP3887005B2 JP3887005B2 JP2005513026A JP2005513026A JP3887005B2 JP 3887005 B2 JP3887005 B2 JP 3887005B2 JP 2005513026 A JP2005513026 A JP 2005513026A JP 2005513026 A JP2005513026 A JP 2005513026A JP 3887005 B2 JP3887005 B2 JP 3887005B2
- Authority
- JP
- Japan
- Prior art keywords
- speed
- arithmetic
- unit
- program
- low
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Expired - Fee Related
Links
Images






Classifications
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F1/00—Details not covered by groups G06F3/00 - G06F13/00 and G06F21/00
- G06F1/26—Power supply means, e.g. regulation thereof
- G06F1/32—Means for saving power
- G06F1/3203—Power management, i.e. event-based initiation of a power-saving mode
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F13/00—Interconnection of, or transfer of information or other signals between, memories, input/output devices or central processing units
- G06F13/14—Handling requests for interconnection or transfer
- G06F13/20—Handling requests for interconnection or transfer for access to input/output bus
- G06F13/28—Handling requests for interconnection or transfer for access to input/output bus using burst mode transfer, e.g. direct memory access DMA, cycle steal
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F15/00—Digital computers in general; Data processing equipment in general
- G06F15/76—Architectures of general purpose stored program computers
- G06F15/78—Architectures of general purpose stored program computers comprising a single central processing unit
- G06F15/7839—Architectures of general purpose stored program computers comprising a single central processing unit with memory
- G06F15/7842—Architectures of general purpose stored program computers comprising a single central processing unit with memory on one IC chip (single chip microcontrollers)
-
- G—PHYSICS
- G06—COMPUTING OR CALCULATING; COUNTING
- G06F—ELECTRIC DIGITAL DATA PROCESSING
- G06F30/00—Computer-aided design [CAD]
- G06F30/30—Circuit design
-
- Y—GENERAL TAGGING OF NEW TECHNOLOGICAL DEVELOPMENTS; GENERAL TAGGING OF CROSS-SECTIONAL TECHNOLOGIES SPANNING OVER SEVERAL SECTIONS OF THE IPC; TECHNICAL SUBJECTS COVERED BY FORMER USPC CROSS-REFERENCE ART COLLECTIONS [XRACs] AND DIGESTS
- Y02—TECHNOLOGIES OR APPLICATIONS FOR MITIGATION OR ADAPTATION AGAINST CLIMATE CHANGE
- Y02D—CLIMATE CHANGE MITIGATION TECHNOLOGIES IN INFORMATION AND COMMUNICATION TECHNOLOGIES [ICT], I.E. INFORMATION AND COMMUNICATION TECHNOLOGIES AIMING AT THE REDUCTION OF THEIR OWN ENERGY USE
- Y02D10/00—Energy efficient computing, e.g. low power processors, power management or thermal management
Landscapes
- Engineering & Computer Science (AREA)
- Theoretical Computer Science (AREA)
- Physics & Mathematics (AREA)
- Computer Hardware Design (AREA)
- General Engineering & Computer Science (AREA)
- General Physics & Mathematics (AREA)
- Evolutionary Computation (AREA)
- Geometry (AREA)
- Executing Machine-Instructions (AREA)
- Semiconductor Integrated Circuits (AREA)
- Microcomputers (AREA)
- Advance Control (AREA)
- Multi Processors (AREA)
Description
まず図11を用いて、CD上の音楽データを圧縮し、記録メディアに圧縮記録する録音動作について説明する。
図において、オーディオ製品はデータの圧縮処理を行うオーディオプロセッサLSI900と、オーディオプロセッサLSI900を制御する制御マイコン901と、CDからデータの読み取り動作を行うCDコントローラ902と、圧縮データを格納する記録メディア903とから構成される。
図12において、低速演算器910は50MHzまでの動作が可能なものであり、高速演算器920は100MHz動作を可能にしたものである。高速演算器920は、低速演算器910からパイプライン処理段数を増やすことで、100MHz動作を可能にしたものであり、低速演算器910と高速演算器920とでプログラムの互換はないものである。
図13に示すように、低速DSP919はDMAリクエストの後1クロックで、DMAリード信号S9100を出力するのに対し、高速DSP929は、DMAリクエストの後3クロックで、DMAリード信号S9200を出力する。すなわち、低速DSP919のDMAのレイテンシは1クロック、高速DSP929は、3クロックである。
前記第2の接続切替部が、各演算器と前記第2の記憶部の各メモリ領域との接続を制御することにより、並列演算処理を行う各演算器と前記演算処理を行う際に使用する各メモリ領域とを接続し、各演算器による並列演算処理を前記第1及び第2の記憶部を共用して行うものである。
また、プログラムのダウンロードの手順を1回で済ますことができる効果がある。
(実施の形態1)
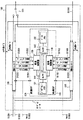
図1は、本発明の実施の形態1におけるプロセッサ集積回路100の内部構成を示す図である。
図において、プロセッサ集積回路100は、演算器群である50MHzまでの動作が可能な低速演算器110及び100MHzまでの動作が可能な高速演算器120と、低速演算器110または高速演算器120を動作させるためのプログラムを格納する第1の記憶部であるプログラムメモリ131と、低速演算器110または高速演算器120が演算処理の際に使用するメモリ領域であるデータメモリ(第2の記憶部)132と、演算処理を行う低速演算器110または高速演算器120とプログラムメモリとを接続する第1の接続切替部である演算器セレクタ141と、演算処理を行う低速演算器110または高速演算器120とデータメモリ132とを接続する第2の接続切替部である演算器セレクタ142と、低速演算器110を低速DSP(Digital signal Processor)119として用いたとき、該低速DSPに対するアクセスを調停し、DMA(Direct Memory Access)を行うDMA調停回路である低速DSP用DMAコントローラ115と、高速演算器120を高速DSP129として用いたとき、該高速DSPに対するアクセスを調停し、DMAを行うDMA調停回路である高速DSP用DMAコントローラ125とから構成される。
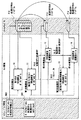
図2は、本発明の実施の形態2におけるプロセッサ集積回路200の内部構成を示す図である。
図1と同じ動作をする構成要素については同じ符号を用い、説明を省略する。
図2において、本実施の形態2に係るプロセッサ集積回路の第1の記憶部は、4つのメモリ領域であるプログラムメモリ1311、1312、1313、1314を有しており、実施の形態1における第1の記憶部であるプログラムメモリ131を、4つのモジュールに分割したものである。また、第2の記憶部は、4つのメモリ領域であるデータメモリ1321、1322、1323、1324を有しており、実施の形態1における第2の記憶部であるデータメモリ132を、4つのモジュールに分割したものである。
図3は、図2における低速DSP219、及び高速DSP229の周辺回路を含むプロセッサ集積回路300を示す図であり、図1、図2と同じ構成要素については同じ符号を用い、説明を省略する。
図において、プロセッサ集積回路300には、クロックゲート365、366、367、368が備えられ、それぞれ制御マイコン(図示せず)からのクロックON/OFF制御回路361の設定により、低速DSP用DMAコントローラ115、低速DSP219、高速DSP用DMAコントローラ125、高速DSP229に供給するクロックをON/OFFする。
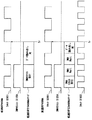
図4は本発明の実施の形態2に係るプロセッサ集積回路における、低速DSP219及び高速DSP229の同期関係を示したタイミング図である。
制御マイコン(図示せず)は、両DSPが動作開始できる状態であることを確認して、時刻Ta1において、起動制御回路370を用いてタイミング信号ゲート375、376を解除する。低速DSP219と高速DSP229とはともに同一の制御信号により時刻Ta1からオーディオデータ信号S1202をDMAコントローラにてデータメモリに取り込みはじめる。
図5は図3で説明したプロセッサ集積回路に2分周回路501を備えた図である。
図において、2分周回路501は、入力されたクロックS1802の、1/2の周波数のクロックS2801を低速DSP用DMAコントローラ115、低速DSP219、高速DSP用DMAコントローラ125に供給する。一方、高速DSP229には、分周前のクロックS1802が供給される。高速DSP用DMAコントローラ125に供給するクロックと高速DSP229に供給するクロック周波数の比「1:2」というのが従来のプロセッサ集積回路900とは、異なっている。
一般に「ムーアの法則」として知られているように、半導体プロセスは年々微細化が進み、LSIの価格は低下していく。このため、AV機器ではモデルチェンジ毎に、LSIのプロセスを進めて、コスト削減を行っている。
図において、動作実績のあるプログラムで動作する低速DSPのみを内蔵した既存のプロセッサ集積回路800は、0.18ミクロンピッチのプロセスで設計されている。
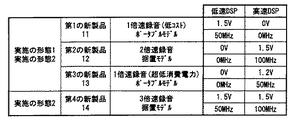
図10は、図9のフロー図における第1、2、3、4の新製品ごとに、低速DSP219と高速DSP229の使用モード、電源電圧、動作周波数をまとめた図である。以下、図9、図10を用いて説明する。
まず、プログラム変更工程(第1のプログラム変更工程)では、第1の新製品11におけるプロセッサ集積回路のプログラムメモリ1311、1312、1313、1314に格納されている低速DSP用プログラムP10を、高速演算器120を動作させる高速DSP用プログラムP12とする。第1の接続工程では、図2における第1の記憶部であるプログラムメモリ1311、1312、1313、1314のすべてを、第1の切替部である演算器セレクタ1411、1412、1413、1414の切り替えにより高速演算器120と接続させ、第2の接続工程では、図2における第2の記憶部であるデータメモリ1321、1322、1323、1324のすべてを、第2の切替部である演算器セレクタ1421、1422、1423、1424の切り替えにより高速演算器120と接続させる。そして、高速DSP用プログラムを実行させることにより、既存のオーディオ製品10、または第1の新製品11の2倍の処理能力が得られる。
本実施の形態3において、第3の新製品13は、前記第2の新製品と同じプログラムP12を用い、さらに、前記第1の接続工程及び第2の接続工程により、図2におけるプログラムメモリ1311、1312、1313、1314、及びデータメモリ1321、1322、1323、1324と、高速演算器120とが前記第2の新製品と同様、接続されている。
まず、第2のプログラム変更工程では、第2の新製品におけるプロセッサ集積回路のプログラムメモリ1311、1312、1313、1314に格納されている高速DSP用プログラムP12を、低速演算器110及び高速演算器120を並列演算処理させるデュアルDSP用プログラムP14とする。なお、本実施の形態3において、デュアルDSPプログラムP14は、図2で説明したように、低速DSP用プログラムP10から変更させたプログラムとし、低速DSP用プログラムP10で行う処理を「音声圧縮処理」と「記録判断処理」の2つのプログラムに分割したものとする。
Claims (2)
- 2種類以上の演算器からなる演算器群と、
複数のメモリ領域を有し、該複数のメモリ領域に少なくとも1つの前記演算器を動作させるための1つまたは2つ以上のプログラムを格納する第1の記憶部と、
少なくとも1つの前記演算器が演算処理を行う際に使用する複数のメモリ領域を有する第2の記憶部と、
前記演算器群のうちの演算処理を行う演算器と、当該演算器が使用するプログラムが格納された前記第1の記憶部のメモリ領域とをそれぞれ接続する第1の接続切替部と、
前記演算器群のうちの演算処理を行う演算器と、前記第2の記憶部のメモリ領域とをそれぞれ接続する第2の接続切替部とを備え、
複数の前記演算器を用いて並列演算処理を行う際には、前記第1の記憶部は、各演算器がそれぞれ実行する複数個のプログラムを同時に格納し、
並列演算処理実行時に、前記第1の接続切替部が、各演算器と前記第1の記憶部の各メモリ領域との接続を制御することにより、並列演算処理を行う各演算器と前記複数個のプログラムが格納された各メモリ領域とを接続し、
前記第2の接続切替部が、各演算器と前記第2の記憶部の各メモリ領域との接続を制御することにより、並列演算処理を行う各演算器と前記演算処理を行う際に使用する各メモリ領域とを接続し、
各演算器による並列演算処理を前記第1及び第2の記憶部を共用して行う、
ことを特徴とするプロセッサ集積回路。 - 請求項1に記載のプロセッサ集積回路において、
前記並列演算処理を行う各演算器は、同一の制御信号でデータの入出力を開始させるものであり、
該入出力データの処理単位の比を、前記各演算器のプログラム周期の比として使用し、各演算器の同期をとる、
ことを特徴とするプロセッサ集積回路。
Applications Claiming Priority (3)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| JP2003289410 | 2003-08-07 | ||
| JP2003289410 | 2003-08-07 | ||
| PCT/JP2004/011661 WO2005015386A1 (ja) | 2003-08-07 | 2004-08-06 | プロセッサ集積回路及びプロセッサ集積回路を用いた製品開発方法 |
Related Child Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| JP2006286678A Division JP2007073067A (ja) | 2003-08-07 | 2006-10-20 | プロセッサ集積回路及びプロセッサ集積回路を用いた製品開発方法 |
Publications (2)
| Publication Number | Publication Date |
|---|---|
| JPWO2005015386A1 JPWO2005015386A1 (ja) | 2006-10-05 |
| JP3887005B2 true JP3887005B2 (ja) | 2007-02-28 |
Family
ID=34131557
Family Applications (2)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| JP2005513026A Expired - Fee Related JP3887005B2 (ja) | 2003-08-07 | 2004-08-06 | プロセッサ集積回路 |
| JP2006286678A Pending JP2007073067A (ja) | 2003-08-07 | 2006-10-20 | プロセッサ集積回路及びプロセッサ集積回路を用いた製品開発方法 |
Family Applications After (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| JP2006286678A Pending JP2007073067A (ja) | 2003-08-07 | 2006-10-20 | プロセッサ集積回路及びプロセッサ集積回路を用いた製品開発方法 |
Country Status (7)
| Country | Link |
|---|---|
| US (2) | US20060206689A1 (ja) |
| EP (2) | EP1662376A4 (ja) |
| JP (2) | JP3887005B2 (ja) |
| CN (2) | CN100552655C (ja) |
| AT (1) | ATE485562T1 (ja) |
| DE (1) | DE602004029729D1 (ja) |
| WO (1) | WO2005015386A1 (ja) |
Families Citing this family (3)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| JP6212073B2 (ja) * | 2015-06-29 | 2017-10-11 | ファナック株式会社 | プログラムの内容に応じて格納先を自動選択する機能を備えた数値制御装置 |
| US11476947B2 (en) * | 2019-05-24 | 2022-10-18 | Google Llc | Low power coherent receiver for short-reach optical communication |
| CN113485189A (zh) * | 2021-07-09 | 2021-10-08 | 绍兴光大芯业微电子有限公司 | 低速单片机实现代码高速运行且数据掉电不丢失的系统、方法、装置、存储器及其存储介质 |
Family Cites Families (28)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| FI70682C (fi) * | 1984-06-20 | 1987-08-05 | Kemira Oy | Traeskyddsmedel och dess anvaendning som ytbehandlingsmedel. |
| US4727491A (en) * | 1984-06-27 | 1988-02-23 | Compaq Computer Corporation | Personal computer having normal and high speed execution modes |
| US4991169A (en) * | 1988-08-02 | 1991-02-05 | International Business Machines Corporation | Real-time digital signal processing relative to multiple digital communication channels |
| JPH0452832A (ja) * | 1990-06-15 | 1992-02-20 | Mitsubishi Electric Corp | 演算制御システム |
| JP3027627B2 (ja) * | 1991-02-25 | 2000-04-04 | 松下電工株式会社 | プログラマブルコントローラの演算プロセッサ |
| CA2069711C (en) * | 1991-09-18 | 1999-11-30 | Donald Edward Carmon | Multi-media signal processor computer system |
| JPH05324455A (ja) * | 1992-04-07 | 1993-12-07 | Nec Corp | マルチプロセッサとメモリとのバス結合方式 |
| JPH0628173A (ja) * | 1992-07-07 | 1994-02-04 | Minolta Camera Co Ltd | プログラムの置換方法及び装置 |
| JP3240863B2 (ja) * | 1994-12-21 | 2001-12-25 | 株式会社エフ・エフ・シー | 調停回路 |
| US5748945A (en) * | 1996-05-31 | 1998-05-05 | International Business Machiens Corporation | Method for slave DMA emulation on a computer system bus |
| US6513057B1 (en) * | 1996-10-28 | 2003-01-28 | Unisys Corporation | Heterogeneous symmetric multi-processing system |
| JP2000029696A (ja) | 1998-07-08 | 2000-01-28 | Sony Corp | プロセッサおよびパイプライン処理制御方法 |
| US6415345B1 (en) * | 1998-08-03 | 2002-07-02 | Ati Technologies | Bus mastering interface control system for transferring multistream data over a host bus |
| US6240521B1 (en) * | 1998-09-10 | 2001-05-29 | International Business Machines Corp. | Sleep mode transition between processors sharing an instruction set and an address space |
| US20020034971A1 (en) * | 1999-02-08 | 2002-03-21 | Chienchung Chang | Data allocation for multiple applications on a microprocessor or dsp |
| JP2001014214A (ja) * | 1999-06-28 | 2001-01-19 | Matsushita Electric Ind Co Ltd | メモリ共有方法、およびこの方法を使用したマルチプロセッサ設備 |
| DE19939763A1 (de) * | 1999-08-21 | 2001-02-22 | Philips Corp Intellectual Pty | Multiprozessorsystem |
| US6738840B1 (en) * | 1999-08-31 | 2004-05-18 | Koninklijke Philips Electronics N.V. | Arrangement with a plurality of processors having an interface for a collective memory |
| JP2001092662A (ja) * | 1999-09-22 | 2001-04-06 | Toshiba Corp | プロセッサコア及びこれを用いたプロセッサ |
| US6501999B1 (en) * | 1999-12-22 | 2002-12-31 | Intel Corporation | Multi-processor mobile computer system having one processor integrated with a chipset |
| JP4640880B2 (ja) | 2000-07-14 | 2011-03-02 | 国立大学法人東京工業大学 | マイクロプロセッサシステム |
| US6795875B2 (en) * | 2000-07-31 | 2004-09-21 | Microsoft Corporation | Arbitrating and servicing polychronous data requests in direct memory access |
| KR20020069008A (ko) * | 2000-09-06 | 2002-08-28 | 코닌클리즈케 필립스 일렉트로닉스 엔.브이. | 두 개의 프로세서를 포함하는 시스템 및 컴퓨팅 장치 |
| US6892266B2 (en) * | 2000-11-15 | 2005-05-10 | Texas Instruments Incorporated | Multicore DSP device having coupled subsystem memory buses for global DMA access |
| US6986066B2 (en) * | 2001-01-05 | 2006-01-10 | International Business Machines Corporation | Computer system having low energy consumption |
| JP2002215597A (ja) * | 2001-01-15 | 2002-08-02 | Mitsubishi Electric Corp | マルチプロセッサ装置 |
| JP2003186567A (ja) * | 2001-12-19 | 2003-07-04 | Matsushita Electric Ind Co Ltd | マイクロプロセッサ |
| US7069189B2 (en) * | 2002-12-31 | 2006-06-27 | Intel Corporation | Method and apparatus for controlling multiple resources using thermal related parameters |
-
2004
- 2004-08-06 JP JP2005513026A patent/JP3887005B2/ja not_active Expired - Fee Related
- 2004-08-06 CN CNB2007101851097A patent/CN100552655C/zh not_active Expired - Fee Related
- 2004-08-06 US US10/567,373 patent/US20060206689A1/en not_active Abandoned
- 2004-08-06 EP EP04771636A patent/EP1662376A4/en not_active Withdrawn
- 2004-08-06 WO PCT/JP2004/011661 patent/WO2005015386A1/ja not_active Ceased
- 2004-08-06 CN CNB2004800227081A patent/CN100390728C/zh not_active Expired - Fee Related
- 2004-08-06 DE DE602004029729T patent/DE602004029729D1/de not_active Expired - Lifetime
- 2004-08-06 AT AT09155014T patent/ATE485562T1/de not_active IP Right Cessation
- 2004-08-06 EP EP09155014A patent/EP2065808B1/en not_active Expired - Lifetime
-
2006
- 2006-10-20 JP JP2006286678A patent/JP2007073067A/ja active Pending
-
2009
- 2009-10-23 US US12/588,673 patent/US20100049944A1/en not_active Abandoned
Also Published As
| Publication number | Publication date |
|---|---|
| JPWO2005015386A1 (ja) | 2006-10-05 |
| EP2065808B1 (en) | 2010-10-20 |
| EP2065808A1 (en) | 2009-06-03 |
| EP1662376A4 (en) | 2009-02-18 |
| CN100390728C (zh) | 2008-05-28 |
| EP1662376A1 (en) | 2006-05-31 |
| ATE485562T1 (de) | 2010-11-15 |
| US20100049944A1 (en) | 2010-02-25 |
| JP2007073067A (ja) | 2007-03-22 |
| CN101149716A (zh) | 2008-03-26 |
| CN1833221A (zh) | 2006-09-13 |
| DE602004029729D1 (de) | 2010-12-02 |
| US20060206689A1 (en) | 2006-09-14 |
| CN100552655C (zh) | 2009-10-21 |
| WO2005015386A1 (ja) | 2005-02-17 |
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| US7890741B2 (en) | Low power digital audio decoding/playing system for computing devices | |
| CN100474281C (zh) | 用于计算设备的低功耗数字音频解码/播放系统 | |
| US8773328B2 (en) | Intelligent DMA in a mobile multimedia processor supporting multiple display formats | |
| US8499182B2 (en) | Semiconductor device and data processing system | |
| US20030060911A1 (en) | Low power digital audio decoding/playing system for computing devices | |
| RU2450329C2 (ru) | Эффективный механизм сохранения адреса возврата из прерывания | |
| US20100049944A1 (en) | Processor integrated circuit and product development method using the processing integrated circuit | |
| US20030163659A1 (en) | Electronic device for data processing, such as an audio processor for an audio/video decoder | |
| CN118897822B (zh) | 支持动态重构的risc-v扩展指令集构建方法及装置 | |
| JP3996982B2 (ja) | プロセッサ | |
| CN101727897B (zh) | 一种语音合成装置和方法及其所应用的监护仪 | |
| JP2006018490A (ja) | マイクロプロセッサ及び情報処理方法 | |
| JP2968749B2 (ja) | マイクロプログラム調速制御回路 | |
| JPH10283186A (ja) | プロセッサ | |
| JP3211234B2 (ja) | 情報処理装置 | |
| Zhang et al. | Design of portable media player based on linux and MIPS-core au1200 processor | |
| JP2003099252A (ja) | データ処理装置およびその制御方法 | |
| JPH0934830A (ja) | バスマスタ回路 | |
| JPS6230649B2 (ja) | ||
| Lagattuta | Design and Implementation of an FPGA Based Media Platform | |
| JP2007004702A (ja) | 情報演算装置、情報処理装置、および情報演算方法 | |
| JPH11328011A (ja) | 記憶制御装置および情報処理機器 | |
| JPH0638232B2 (ja) | プロセツサ回路 | |
| JPS61122765A (ja) | メモリ拡張方式 | |
| JPH06302133A (ja) | ディスク装置及びディスク制御用マイクロコンピュータ |
Legal Events
| Date | Code | Title | Description |
|---|---|---|---|
| A131 | Notification of reasons for refusal |
Free format text: JAPANESE INTERMEDIATE CODE: A131 Effective date: 20060905 |
|
| A521 | Request for written amendment filed |
Free format text: JAPANESE INTERMEDIATE CODE: A523 Effective date: 20061020 |
|
| TRDD | Decision of grant or rejection written | ||
| A01 | Written decision to grant a patent or to grant a registration (utility model) |
Free format text: JAPANESE INTERMEDIATE CODE: A01 Effective date: 20061114 |
|
| A61 | First payment of annual fees (during grant procedure) |
Free format text: JAPANESE INTERMEDIATE CODE: A61 Effective date: 20061122 |
|
| R150 | Certificate of patent or registration of utility model |
Free format text: JAPANESE INTERMEDIATE CODE: R150 |
|
| FPAY | Renewal fee payment (event date is renewal date of database) |
Free format text: PAYMENT UNTIL: 20091201 Year of fee payment: 3 |
|
| FPAY | Renewal fee payment (event date is renewal date of database) |
Free format text: PAYMENT UNTIL: 20101201 Year of fee payment: 4 |
|
| FPAY | Renewal fee payment (event date is renewal date of database) |
Free format text: PAYMENT UNTIL: 20111201 Year of fee payment: 5 |
|
| LAPS | Cancellation because of no payment of annual fees |