KR20170084202A - 항체 약물 접합체 - Google Patents
항체 약물 접합체 Download PDFInfo
- Publication number
- KR20170084202A KR20170084202A KR1020177015786A KR20177015786A KR20170084202A KR 20170084202 A KR20170084202 A KR 20170084202A KR 1020177015786 A KR1020177015786 A KR 1020177015786A KR 20177015786 A KR20177015786 A KR 20177015786A KR 20170084202 A KR20170084202 A KR 20170084202A
- Authority
- KR
- South Korea
- Prior art keywords
- seq
- antibody
- cancer
- amino acid
- acid sequence
- Prior art date
- Legal status (The legal status is an assumption and is not a legal conclusion. Google has not performed a legal analysis and makes no representation as to the accuracy of the status listed.)
- Withdrawn
Links
Images


Classifications
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K16/00—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies
- C07K16/18—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies against material from animals or humans
- C07K16/28—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies against material from animals or humans against receptors, cell surface antigens or cell surface determinants
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61K—PREPARATIONS FOR MEDICAL, DENTAL OR TOILETRY PURPOSES
- A61K31/00—Medicinal preparations containing organic active ingredients
- A61K31/33—Heterocyclic compounds
- A61K31/395—Heterocyclic compounds having nitrogen as a ring hetero atom, e.g. guanethidine or rifamycins
- A61K31/535—Heterocyclic compounds having nitrogen as a ring hetero atom, e.g. guanethidine or rifamycins having six-membered rings with at least one nitrogen and one oxygen as the ring hetero atoms, e.g. 1,2-oxazines
- A61K31/5365—Heterocyclic compounds having nitrogen as a ring hetero atom, e.g. guanethidine or rifamycins having six-membered rings with at least one nitrogen and one oxygen as the ring hetero atoms, e.g. 1,2-oxazines ortho- or peri-condensed with heterocyclic ring systems
-
- A61K47/48384—
-
- A61K47/48561—
-
- A61K47/48569—
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61K—PREPARATIONS FOR MEDICAL, DENTAL OR TOILETRY PURPOSES
- A61K47/00—Medicinal preparations characterised by the non-active ingredients used, e.g. carriers or inert additives; Targeting or modifying agents chemically bound to the active ingredient
- A61K47/50—Medicinal preparations characterised by the non-active ingredients used, e.g. carriers or inert additives; Targeting or modifying agents chemically bound to the active ingredient the non-active ingredient being chemically bound to the active ingredient, e.g. polymer-drug conjugates
- A61K47/51—Medicinal preparations characterised by the non-active ingredients used, e.g. carriers or inert additives; Targeting or modifying agents chemically bound to the active ingredient the non-active ingredient being chemically bound to the active ingredient, e.g. polymer-drug conjugates the non-active ingredient being a modifying agent
- A61K47/68—Medicinal preparations characterised by the non-active ingredients used, e.g. carriers or inert additives; Targeting or modifying agents chemically bound to the active ingredient the non-active ingredient being chemically bound to the active ingredient, e.g. polymer-drug conjugates the non-active ingredient being a modifying agent the modifying agent being an antibody, an immunoglobulin or a fragment thereof, e.g. an Fc-fragment
- A61K47/6801—Drug-antibody or immunoglobulin conjugates defined by the pharmacologically or therapeutically active agent
- A61K47/6803—Drugs conjugated to an antibody or immunoglobulin, e.g. cisplatin-antibody conjugates
- A61K47/68033—Drugs conjugated to an antibody or immunoglobulin, e.g. cisplatin-antibody conjugates the drug being a maytansine
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61K—PREPARATIONS FOR MEDICAL, DENTAL OR TOILETRY PURPOSES
- A61K47/00—Medicinal preparations characterised by the non-active ingredients used, e.g. carriers or inert additives; Targeting or modifying agents chemically bound to the active ingredient
- A61K47/50—Medicinal preparations characterised by the non-active ingredients used, e.g. carriers or inert additives; Targeting or modifying agents chemically bound to the active ingredient the non-active ingredient being chemically bound to the active ingredient, e.g. polymer-drug conjugates
- A61K47/51—Medicinal preparations characterised by the non-active ingredients used, e.g. carriers or inert additives; Targeting or modifying agents chemically bound to the active ingredient the non-active ingredient being chemically bound to the active ingredient, e.g. polymer-drug conjugates the non-active ingredient being a modifying agent
- A61K47/68—Medicinal preparations characterised by the non-active ingredients used, e.g. carriers or inert additives; Targeting or modifying agents chemically bound to the active ingredient the non-active ingredient being chemically bound to the active ingredient, e.g. polymer-drug conjugates the non-active ingredient being a modifying agent the modifying agent being an antibody, an immunoglobulin or a fragment thereof, e.g. an Fc-fragment
- A61K47/6835—Medicinal preparations characterised by the non-active ingredients used, e.g. carriers or inert additives; Targeting or modifying agents chemically bound to the active ingredient the non-active ingredient being chemically bound to the active ingredient, e.g. polymer-drug conjugates the non-active ingredient being a modifying agent the modifying agent being an antibody, an immunoglobulin or a fragment thereof, e.g. an Fc-fragment the modifying agent being an antibody or an immunoglobulin bearing at least one antigen-binding site
- A61K47/6849—Medicinal preparations characterised by the non-active ingredients used, e.g. carriers or inert additives; Targeting or modifying agents chemically bound to the active ingredient the non-active ingredient being chemically bound to the active ingredient, e.g. polymer-drug conjugates the non-active ingredient being a modifying agent the modifying agent being an antibody, an immunoglobulin or a fragment thereof, e.g. an Fc-fragment the modifying agent being an antibody or an immunoglobulin bearing at least one antigen-binding site the antibody targeting a receptor, a cell surface antigen or a cell surface determinant
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61K—PREPARATIONS FOR MEDICAL, DENTAL OR TOILETRY PURPOSES
- A61K47/00—Medicinal preparations characterised by the non-active ingredients used, e.g. carriers or inert additives; Targeting or modifying agents chemically bound to the active ingredient
- A61K47/50—Medicinal preparations characterised by the non-active ingredients used, e.g. carriers or inert additives; Targeting or modifying agents chemically bound to the active ingredient the non-active ingredient being chemically bound to the active ingredient, e.g. polymer-drug conjugates
- A61K47/51—Medicinal preparations characterised by the non-active ingredients used, e.g. carriers or inert additives; Targeting or modifying agents chemically bound to the active ingredient the non-active ingredient being chemically bound to the active ingredient, e.g. polymer-drug conjugates the non-active ingredient being a modifying agent
- A61K47/68—Medicinal preparations characterised by the non-active ingredients used, e.g. carriers or inert additives; Targeting or modifying agents chemically bound to the active ingredient the non-active ingredient being chemically bound to the active ingredient, e.g. polymer-drug conjugates the non-active ingredient being a modifying agent the modifying agent being an antibody, an immunoglobulin or a fragment thereof, e.g. an Fc-fragment
- A61K47/6835—Medicinal preparations characterised by the non-active ingredients used, e.g. carriers or inert additives; Targeting or modifying agents chemically bound to the active ingredient the non-active ingredient being chemically bound to the active ingredient, e.g. polymer-drug conjugates the non-active ingredient being a modifying agent the modifying agent being an antibody, an immunoglobulin or a fragment thereof, e.g. an Fc-fragment the modifying agent being an antibody or an immunoglobulin bearing at least one antigen-binding site
- A61K47/6851—Medicinal preparations characterised by the non-active ingredients used, e.g. carriers or inert additives; Targeting or modifying agents chemically bound to the active ingredient the non-active ingredient being chemically bound to the active ingredient, e.g. polymer-drug conjugates the non-active ingredient being a modifying agent the modifying agent being an antibody, an immunoglobulin or a fragment thereof, e.g. an Fc-fragment the modifying agent being an antibody or an immunoglobulin bearing at least one antigen-binding site the antibody targeting a determinant of a tumour cell
-
- A—HUMAN NECESSITIES
- A61—MEDICAL OR VETERINARY SCIENCE; HYGIENE
- A61P—SPECIFIC THERAPEUTIC ACTIVITY OF CHEMICAL COMPOUNDS OR MEDICINAL PREPARATIONS
- A61P35/00—Antineoplastic agents
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K16/00—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies
- C07K16/18—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies against material from animals or humans
- C07K16/28—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies against material from animals or humans against receptors, cell surface antigens or cell surface determinants
- C07K16/30—Immunoglobulins [IG], e.g. monoclonal or polyclonal antibodies against material from animals or humans against receptors, cell surface antigens or cell surface determinants from tumour cells
-
- G01N33/57492—
-
- G—PHYSICS
- G01—MEASURING; TESTING
- G01N—INVESTIGATING OR ANALYSING MATERIALS BY DETERMINING THEIR CHEMICAL OR PHYSICAL PROPERTIES
- G01N33/00—Investigating or analysing materials by specific methods not covered by groups G01N1/00 - G01N31/00
- G01N33/48—Biological material, e.g. blood, urine; Haemocytometers
- G01N33/50—Chemical analysis of biological material, e.g. blood, urine; Testing involving biospecific ligand binding methods; Immunological testing
- G01N33/53—Immunoassay; Biospecific binding assay; Materials therefor
- G01N33/575—Immunoassay; Biospecific binding assay; Materials therefor for cancer
- G01N33/5758—Immunoassay; Biospecific binding assay; Materials therefor for cancer involving compounds serving as markers for tumours, cancers or neoplasias, e.g. cellular determinants, receptors, heat shock/stress proteins, A-protein, oligosaccharides or metabolites
- G01N33/5759—Immunoassay; Biospecific binding assay; Materials therefor for cancer involving compounds serving as markers for tumours, cancers or neoplasias, e.g. cellular determinants, receptors, heat shock/stress proteins, A-protein, oligosaccharides or metabolites involving compounds localised on the membrane of tumour or cancer cells
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2299/00—Coordinates from 3D structures of peptides, e.g. proteins or enzymes
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/20—Immunoglobulins specific features characterized by taxonomic origin
- C07K2317/21—Immunoglobulins specific features characterized by taxonomic origin from primates, e.g. man
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/20—Immunoglobulins specific features characterized by taxonomic origin
- C07K2317/24—Immunoglobulins specific features characterized by taxonomic origin containing regions, domains or residues from different species, e.g. chimeric, humanized or veneered
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/30—Immunoglobulins specific features characterized by aspects of specificity or valency
- C07K2317/33—Crossreactivity, e.g. for species or epitope, or lack of said crossreactivity
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/50—Immunoglobulins specific features characterized by immunoglobulin fragments
- C07K2317/51—Complete heavy chain or Fd fragment, i.e. VH + CH1
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/50—Immunoglobulins specific features characterized by immunoglobulin fragments
- C07K2317/515—Complete light chain, i.e. VL + CL
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/50—Immunoglobulins specific features characterized by immunoglobulin fragments
- C07K2317/52—Constant or Fc region; Isotype
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/50—Immunoglobulins specific features characterized by immunoglobulin fragments
- C07K2317/55—Fab or Fab'
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/50—Immunoglobulins specific features characterized by immunoglobulin fragments
- C07K2317/56—Immunoglobulins specific features characterized by immunoglobulin fragments variable (Fv) region, i.e. VH and/or VL
- C07K2317/565—Complementarity determining region [CDR]
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/60—Immunoglobulins specific features characterized by non-natural combinations of immunoglobulin fragments
- C07K2317/62—Immunoglobulins specific features characterized by non-natural combinations of immunoglobulin fragments comprising only variable region components
- C07K2317/622—Single chain antibody (scFv)
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/70—Immunoglobulins specific features characterized by effect upon binding to a cell or to an antigen
- C07K2317/73—Inducing cell death, e.g. apoptosis, necrosis or inhibition of cell proliferation
- C07K2317/732—Antibody-dependent cellular cytotoxicity [ADCC]
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/70—Immunoglobulins specific features characterized by effect upon binding to a cell or to an antigen
- C07K2317/76—Antagonist effect on antigen, e.g. neutralization or inhibition of binding
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/70—Immunoglobulins specific features characterized by effect upon binding to a cell or to an antigen
- C07K2317/77—Internalization into the cell
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2317/00—Immunoglobulins specific features
- C07K2317/90—Immunoglobulins specific features characterized by (pharmaco)kinetic aspects or by stability of the immunoglobulin
- C07K2317/92—Affinity (KD), association rate (Ka), dissociation rate (Kd) or EC50 value
-
- C—CHEMISTRY; METALLURGY
- C07—ORGANIC CHEMISTRY
- C07K—PEPTIDES
- C07K2319/00—Fusion polypeptide
-
- G—PHYSICS
- G01—MEASURING; TESTING
- G01N—INVESTIGATING OR ANALYSING MATERIALS BY DETERMINING THEIR CHEMICAL OR PHYSICAL PROPERTIES
- G01N2333/00—Assays involving biological materials from specific organisms or of a specific nature
- G01N2333/435—Assays involving biological materials from specific organisms or of a specific nature from animals; from humans
- G01N2333/705—Assays involving receptors, cell surface antigens or cell surface determinants
Landscapes
- Health & Medical Sciences (AREA)
- Life Sciences & Earth Sciences (AREA)
- Chemical & Material Sciences (AREA)
- Immunology (AREA)
- Engineering & Computer Science (AREA)
- Medicinal Chemistry (AREA)
- General Health & Medical Sciences (AREA)
- Bioinformatics & Cheminformatics (AREA)
- Animal Behavior & Ethology (AREA)
- Pharmacology & Pharmacy (AREA)
- Public Health (AREA)
- Veterinary Medicine (AREA)
- Epidemiology (AREA)
- Organic Chemistry (AREA)
- Cell Biology (AREA)
- Molecular Biology (AREA)
- Biochemistry (AREA)
- Proteomics, Peptides & Aminoacids (AREA)
- Genetics & Genomics (AREA)
- Biophysics (AREA)
- Biomedical Technology (AREA)
- Hematology (AREA)
- Urology & Nephrology (AREA)
- General Chemical & Material Sciences (AREA)
- Microbiology (AREA)
- Physics & Mathematics (AREA)
- General Physics & Mathematics (AREA)
- Pathology (AREA)
- Biotechnology (AREA)
- Chemical Kinetics & Catalysis (AREA)
- Food Science & Technology (AREA)
- Nuclear Medicine, Radiotherapy & Molecular Imaging (AREA)
- Analytical Chemistry (AREA)
- Peptides Or Proteins (AREA)
- Medicinal Preparation (AREA)
- Medicines Containing Antibodies Or Antigens For Use As Internal Diagnostic Agents (AREA)
- Oncology (AREA)
- Preparation Of Compounds By Using Micro-Organisms (AREA)
- Micro-Organisms Or Cultivation Processes Thereof (AREA)
- Pharmaceuticals Containing Other Organic And Inorganic Compounds (AREA)
Abstract
본 출원은 항-P-카드헤린 항체, 그의 항원 결합 단편, 및 상기 항체 또는 항원 결합 단편의 항체 약물 접합체를 개시한다. 본 발명은 또한 항체, 항원 결합 단편, 및 항체 약물 접합체를 사용하여 암을 치료하는 방법에 관한 것이다. 항체, 항원 결합 단편, 및 항체 약물 접합체를 제조하는 방법, 및 항체 및 항원 결합 단편을 진단 시약으로서 사용하는 방법이 또한 본원에 개시된다.
Description
서열 목록
본 출원은 ASCII 포맷으로 전자 제출된 서열 목록을 함유하며, 이는 그 전문이 본원에 참조로 포함된다. 2015년 11월 12일에 생성된 상기 ASCII 사본은 파일명이 PAT056506-WO-PCT_SL.txt이고 크기가 146,966 바이트이다.
발명의 분야
본 발명은 일반적으로 암의 치료를 위한 항-P-카드헤린 항체, 항체 단편, 항체 약물 접합체, 및 그의 용도에 관한 것이다.
P-카드헤린
전형적 카드헤린은 칼슘-의존성 세포-대-세포 접촉을 매개하는 부착형 연접부에서 발현되는 세포 부착 분자의 패밀리를 나타낸다. 태반 카드헤린 (P-카드헤린; 또한 카드헤린 3, 유형 1 또는 "CDH3"으로도 공지됨)은 정상 조직에서 제한되게 발현되지만 피부, 식도, 폐 및 구강의 기저 상피 세포를 포함한 여러 조직의 미분화 또는 분화 중인 세포 유형에서 발현되는 것으로 공지되어 있다. (예를 들어, 문헌 [Albergaria et al., Int. J. Dev. Biol. 55:811-822 (2011)] 참조).
P-카드헤린의 구조는 3종의 특유한 도메인으로 이루어진다: 5종의 카드헤린 반복부를 직렬로 함유하는 세포외 도메인 (ECD), 막횡단 도메인, 및 카테닌 결합 도메인을 함유하는 세포내 테일. ECD는 다중 P-카드헤린 분자 사이의 시스- 및 트랜스 상호작용 둘 다를 매개하며, 반면에 카테닌 결합 도메인은 P-카드헤린을 단백질 예컨대 p120 카테닌에 연결하고 이에 따라 세포성 세포골격 요소에 연결한다. (예를 들어, 문헌 [Wu et al., PNAS 107:17592-7 (2010)] 참조).
P-카드헤린 및 암
P-카드헤린 (또한 "Pcad", "PCad", "P-Cad" 또는 CDH3으로도 지칭됨)은 또한 특히 유방암, 위암, 자궁내막암, 두경부암, 및 결장직장암을 포함한 수많은 악성 종양에서 과다발현되는 것으로 공지되어 있다. 일부 유방, 자궁내막, 난소, 결장직장 및 방광 종양에서 P-카드헤린의 과다발현은 또한 P-카드헤린 발현 수준이 낮거나 또는 부재하는 경우와 비교하여 더 나쁜 예후와 상관관계가 있었다. 유방암에서, P-카드헤린은 고등급 침습성 암종에서 빈번하게 과다발현되고, 기저-유사 종양의 신뢰할만한 마커이다. (예를 들어, 문헌 [Paredes et al., Br. Can. Res. 9:214-226 (2007); Sanders et al., Int. J. Can. 79:573-579 (1998); Albergaria et al., Int. J. Dev. Biol. 55:811-822 (2011); Sousa et al., Histol. Histopathol. 25:963-975 (2010)] 참조).
특정 암 유형, 예컨대 유방암 및 난소암에서, P-카드헤린은 종양 세포 운동성, 침습성 및 전이를 촉진하는 것으로 공지되어 있다. (예를 들어, 문헌 [Cheung et al., Oncogene 30:2964-74 (2011); Ribeiro et al., Oncogene 29: 392-402 (2010)] 참조).
수많은 암-관련 과정은 P-카드헤린 mRNA 및 단백질의 발현을 촉진하는 것으로 공지되어 있다. 돌연변이 또는 발현 상실을 통한 종양 억제자 BRCA1의 불활성화는 유방암 세포주 및 환자 시편 둘 다에서 증가된 P-카드헤린 발현과 연관되었다. 전사 인자 C-EBPβ 및 항에스트로겐 ICI182780 (풀베스트란트)은 또한, 다른 과정을 통한 CDH3 프로모터의 저메틸화와 같이, P-카드헤린 발현을 이상조절하고 종양 세포에서 그의 상향조절을 유도하는 것으로 공지되어 있다. 폐포 횡문근육종에서, 키메라 종양원성 전사 인자 PAX3-FOXOA1 및 PAX7-FOXOA1 (전위로부터 유발됨)은 P-카드헤린 발현을 직접 유도하여, 증가된 종양 공격성을 유발한다. (예를 들어, 문헌 [Albergaria et al., Int. J. Dev. Biol. 55:811-822 (2011); Thuault et al., Oncogene 15:1474-86 (2012); Ames et al., Clin. Can. Res. 11;4003-11 (2005); Gorski et al., Br. Can . Res. Treat. 122:721-31 (2010); Paredes et al., Clin. Can. Res. 11:5869-5877 (2005); Albergaria et al., Human Mol. Gen. 19:2554-2566 (2010)] 참조).
항체 약물 접합체
항체 약물 접합체 ("ADC")는 암의 치료에서 세포독성제의 국부 전달을 위해 사용되었다 (예를 들어, 문헌 [Lambert, Curr. Opinion In Pharmacology 5:543-549, 2005] 참조). ADC는 약물 모이어티의 표적화 전달을 가능하게 하여, 최소 독성과 함께 최대 효능이 달성될 수 있다. 보다 많은 ADC가 유망한 임상 결과를 제시함에 따라, 암 요법을 위한 새로운 치료제를 개발하는 것에 대한 증가된 필요성이 존재한다. 더욱이, 공지된 암 표적에 대한 치료상 유효한 ADC를 제조하려는 모든 시도가 성공적이지는 않았다. ADC의 치료 유효성을 가져올 수 있는 인자의 예는 친화도, 항체의 접합 능력, 링커의 절단가능성 또는 안정성; 항체-약물 접합체의 안정성, 항체 약물 접합체의 응집 경향, 및 각 항체에 접합하는 약물/페이로드 분자의 비 ("DAR" 또는 "약물 항체 비")를 포함한다.
응집 및 안정성 결여는 임상 세팅에서 항체 약물 접합체에 대한 유해 반응의 가능성을 증가시키고, 효능을 감소시킬 뿐만 아니라, ADC의 제조 비용을 추가할 수 있다.
따라서 치료상 유효한 ADC 분자에 대한 필요성이 존재한다.
본 출원은 인간 P-카드헤린 단백질에 결합하는 항체 또는 그의 항원 결합 단편을 개시한다. 한 실시양태에서, 항체 또는 그의 항원 결합 단편은 서열식별번호(SEQ ID NO): 126의 위치 124, 125, 151, 153, 154, 155, 156, 159, 160, 161, 162, 163, 168, 170, 171, 및 172에서의 아미노산으로부터 선택된 1개 이상의 잔기에서 P-카드헤린에 결합한다. 또 다른 실시양태, 항체 또는 그의 항원 결합 단편은 서열식별번호: 126의 위치 124, 125, 151, 153, 154, 155, 156, 159, 160, 161, 162, 163, 168, 170, 171, 및 172에서의 아미노산에서 인간 P-카드헤린 단백질에 결합한다. 일부 실시양태에서, 항체 또는 그의 항원 결합 단편은 서열식별번호: 126의 위치 124, 151, 153-156, 및 172로부터 선택된 1개 이상의 아미노산 잔기에서 인간 P-카드헤린에 결합하는 중쇄 가변 영역을 포함한다. 추가 실시양태에서, 중쇄 가변 영역은 서열식별번호: 128의 위치 52, 54, 56, 60, 65, 105, 또는 107로부터 선택된 1개 이상의 아미노산 잔기를 포함하는, 인간 P-카드헤린 단백질에 대한 중쇄 결합 파라토프를 포함한다. 또 다른 실시양태에서, 항체는 서열식별번호: 126의 위치 124, 125, 155, 156, 159-163, 168, 170, 및 171로부터 선택된 1개 이상의 아미노산 잔기에서 인간 P-카드헤린에 결합하는 경쇄 가변 영역을 포함한다. 추가 실시양태에서, 인간 P-카드헤린 단백질에 대한 경쇄 가변 영역 결합 파라토프는 서열식별번호: 129의 위치 1, 2, 27, 28, 30, 68, 92, 93, 또는 94로부터 선택된 1개 이상의 아미노산 잔기를 포함한다. 구체적 실시양태에서, 항체 또는 그의 항원 결합 단편은 상기 논의된 바와 같은 중쇄 가변 영역 및 경쇄 가변 영역을 포함한다.
다른 실시양태에서, 본 출원은 다음을 포함하는, 인간 P-카드헤린에 결합하는 항체 또는 그의 항원 결합 단편을 개시한다:
a) 서열식별번호: 1의 VH CDR1, 서열식별번호: 2의 VH CDR2, 및 서열식별번호: 3의 VH CDR3을 포함하며, 여기서 CDR은 카바트(Kabat) 정의에 따라 정의된 것인 중쇄 가변 영역; 및 서열식별번호: 11의 VL CDR1, 서열식별번호: 12의 VL CDR2, 및 서열식별번호: 13의 VL CDR3을 포함하며, 여기서 CDR은 카바트 정의에 따라 정의된 것인 경쇄 가변 영역;
b) 서열식별번호: 21의 VH CDR1, 서열식별번호: 22의 VH CDR2, 및 서열식별번호: 23의 VH CDR3을 포함하며, 여기서 CDR은 카바트 정의에 따라 정의된 것인 중쇄 가변 영역; 및 서열식별번호: 31의 VL CDR1, 서열식별번호: 32의 VL CDR2, 및 서열식별번호: 33의 VL CDR3을 포함하며, 여기서 CDR은 카바트 정의에 따라 정의된 것인 경쇄 가변 영역;
c) 서열식별번호: 41의 VH CDR1, 서열식별번호: 42의 VH CDR2, 및 서열식별번호: 43의 VH CDR3을 포함하며, 여기서 CDR은 카바트 정의에 따라 정의된 것인 중쇄 가변 영역; 및 서열식별번호: 51의 VL CDR1, 서열식별번호: 52의 VL CDR2, 및 서열식별번호: 53의 VL CDR3을 포함하며, 여기서 CDR은 카바트 정의에 따라 정의된 것인 경쇄 가변 영역;
d) 서열식별번호: 61의 VH CDR1, 서열식별번호: 62의 VH CDR2, 및 서열식별번호: 63의 VH CDR3을 포함하며, 여기서 CDR은 카바트 정의에 따라 정의된 것인 중쇄 가변 영역; 및 서열식별번호: 71의 VL CDR1, 서열식별번호: 72의 VL CDR2, 및 서열식별번호: 73의 VL CDR3을 포함하며, 여기서 CDR은 카바트 정의에 따라 정의된 것인 경쇄 가변 영역;
e) 서열식별번호: 81의 VH CDR1, 서열식별번호: 82의 VH CDR2, 및 서열식별번호: 83의 VH CDR3을 포함하며, 여기서 CDR은 카바트 정의에 따라 정의된 것인 중쇄 가변 영역; 및 서열식별번호: 91의 VL CDR1, 서열식별번호: 92의 VL CDR2, 및 서열식별번호: 93의 VL CDR3을 포함하며, 여기서 CDR은 카바트 정의에 따라 정의된 것인 경쇄 가변 영역; 또는
f) 서열식별번호: 101의 VH CDR1, 서열식별번호: 102의 VH CDR2, 및 서열식별번호: 103의 VH CDR3을 포함하며, 여기서 CDR은 카바트 정의에 따라 정의된 것인 중쇄 가변 영역; 및 서열식별번호: 111의 VL CDR1, 서열식별번호: 112의 VL CDR2, 및 서열식별번호: 113의 VL CDR3을 포함하며, 여기서 CDR은 카바트 정의에 따라 정의된 것인 경쇄 가변 영역.
본 출원은 또한 다음을 포함하는, P-카드헤린에 결합하는 항체 또는 그의 항원 결합 단편을 개시한다:
a) 서열식별번호: 7의 아미노산 서열을 포함하는 중쇄 가변 영역 (VH), 및 서열식별번호: 17의 아미노산 서열을 포함하는 경쇄 가변 영역 (VL);
b) 서열식별번호: 27의 아미노산 서열을 포함하는 중쇄 가변 영역 (VH), 및 서열식별번호: 37의 아미노산 서열을 포함하는 경쇄 가변 영역 (VL);
c) 서열식별번호: 47의 아미노산 서열을 포함하는 중쇄 가변 영역 (VH), 및 서열식별번호: 57의 아미노산 서열을 포함하는 경쇄 가변 영역 (VL);
d) 서열식별번호: 67의 아미노산 서열을 포함하는 중쇄 가변 영역 (VH), 및 서열식별번호: 77의 아미노산 서열을 포함하는 경쇄 가변 영역 (VL);
e) 서열식별번호: 87의 아미노산 서열을 포함하는 중쇄 가변 영역 (VH), 및 서열식별번호: 97의 아미노산 서열을 포함하는 경쇄 가변 영역 (VL); 또는
f) 서열식별번호: 107의 아미노산 서열을 포함하는 중쇄 가변 영역 (VH), 및 서열식별번호: 117의 아미노산 서열을 포함하는 경쇄 가변 영역 (VL).
다른 실시양태에서, 본 출원은 다음을 포함하는, P-카드헤린에 결합하는 항체 또는 그의 항원 결합 단편을 개시한다:
a) 서열식별번호: 9의 아미노산 서열을 포함하는 중쇄, 및 서열식별번호: 19의 아미노산 서열을 포함하는 경쇄;
b) 서열식별번호: 29의 아미노산 서열을 포함하는 중쇄, 및 서열식별번호: 39의 아미노산 서열을 포함하는 경쇄;
c) 서열식별번호: 49의 아미노산 서열을 포함하는 중쇄, 및 서열식별번호: 59의 아미노산 서열을 포함하는 경쇄;
d) 서열식별번호: 69의 아미노산 서열을 포함하는 중쇄, 및 서열식별번호: 79의 아미노산 서열을 포함하는 경쇄;
e) 서열식별번호: 89의 아미노산 서열을 포함하는 중쇄, 및 서열식별번호: 99의 아미노산 서열을 포함하는 경쇄; 또는
f) 서열식별번호: 109의 아미노산 서열을 포함하는 중쇄, 및 서열식별번호: 119의 아미노산 서열을 포함하는 경쇄.
본 출원은 추가로, 본원에 개시된 항체와 동일한 인간 P-카드헤린의 에피토프에 결합하거나, 또는 인간 P-카드헤린에의 결합에 대해 본원에 개시된 항체와 경쟁하는 항체 또는 그의 항원 결합 단편을 개시한다.
일부 실시양태에서, P-카드헤린 항체 또는 그의 항원 결합 단편은 인간 또는 인간화 항체이다. 다른 실시양태에서, 항체 또는 그의 항원 결합 단편은 모노클로날 항체이다. 추가 실시양태에서, 항체 또는 그의 항원 결합 단편은 단일 쇄 항체 (scFv)이다.
본 출원은 또한 하기 화학식을 포함하는 항체 약물 접합체 (ADC) 또는 그의 제약상 허용되는 염을 개시한다:

여기서
Ab는 본원에 개시된 바와 같은 P-카드헤린 항체 또는 그의 항원 결합 단편이고; L은 링커이고; D는 약물 모이어티이고; m은 1 내지 8 정수이고; n은 1 내지 10 정수이다. 일부 실시양태에서, m은 1이다. 다른 실시양태에서, n은 3 또는 4이다.
일부 실시양태에서, ADC의 항체 또는 그의 항원 결합 단편은 다음을 포함한다:
a) 서열식별번호: 7의 아미노산 서열을 포함하는 VH 영역 및 서열식별번호: 17의 아미노산 서열을 포함하는 VL 영역; 또는
b) 서열식별번호: 27의 아미노산 서열을 포함하는 VH 영역 및 서열식별번호: 37의 아미노산 서열을 포함하는 VL 영역.
추가 실시양태에서, 항체 약물 접합체의 항체 또는 그의 항원 결합 단편은 다음을 포함한다:
(a) 서열식별번호: 1의 VH CDR1, (b) 서열식별번호: 2의 VH CDR2, (c) 서열식별번호: 3의 VH CDR3을 포함하는 VH 영역, 및 (d) 서열식별번호: 11의 VL CDR1, (e) 서열식별번호: 12의 VL CDR2, 및 (f) 서열식별번호: 13의 VL CDR3을 포함하는 VL 영역 (여기서 CDR은 카바트 정의에 따라 정의됨); 또는
(a) 서열식별번호: 21의 VH CDR1, (b) 서열식별번호: 22의 VH CDR2, (c) 서열식별번호: 23의 VH CDR3을 포함하는 VH 영역, 및 (d) 서열식별번호: 31의 VL CDR1, (e) 서열식별번호: 32의 VL CDR2, 및 (f) 서열식별번호: 33의 VL CDR3을 포함하는 VL 영역 (여기서 CDR은 카바트 정의에 따라 정의됨).
다른 실시양태에서, 항체 약물 접합체의 항체 또는 그의 항원 결합 단편은 다음을 포함한다:
a) 서열식별번호: 9의 중쇄 및 서열식별번호: 19의 경쇄; 또는
b) 서열식별번호: 29의 중쇄 및 서열식별번호: 39의 경쇄.
추가 실시양태에서, 항체 약물 접합체의 링커는 절단가능한 링커, 비-절단가능한 링커, 친수성 링커, 사전하전된 링커 및 디카르복실산계 링커로 이루어진 군으로부터 선택된다. 일부 실시양태에서, 링커는 N-숙신이미딜-3-(2-피리딜디티오)프로피오네이트 (SPDP), N-숙신이미딜 4-(2-피리딜디티오)펜타노에이트 (SPP), N-숙신이미딜 4-(2-피리딜디티오)부타노에이트 (SPDB), N-숙신이미딜-4-(2-피리딜디티오)-2-술포-부타노에이트 (술포-SPDB), N-숙신이미딜 아이오도아세테이트 (SIA), N-숙신이미딜(4-아이오도아세틸)아미노벤조에이트 (SIAB), 말레이미드 PEG NHS, N-숙신이미딜 4-(말레이미도메틸) 시클로헥산카르복실레이트 (SMCC), N-술포숙신이미딜 4-(말레이미도메틸) 시클로헥산카르복실레이트 (술포-SMCC), 및 2,5-디옥소피롤리딘-1-일 17-(2,5-디옥소-2,5-디히드로-1H-피롤-1-일)-5,8,11,14-테트라옥소-4,7,10,13-테트라아자헵타데칸-1-오에이트 (CX1-1)로 이루어진 군으로부터 선택된 가교 시약으로부터 유래된다.
일부 실시양태에서, 항체 약물 접합체의 약물 모이어티는 V-ATPase 억제제, 아폽토시스촉진제, Bcl2 억제제, MCL1 억제제, HSP90 억제제, IAP 억제제, mTor 억제제, 미세관 안정화제, 미세관 탈안정화제, 아우리스타틴, 돌라스타틴, 메이탄시노이드, MetAP (메티오닌 아미노펩티다제), 단백질 CRM1의 핵 유출의 억제제, DPPIV 억제제, 프로테아솜 억제제, 미토콘드리아에서의 포스포릴 전달 반응의 억제제, 단백질 합성 억제제, 키나제 억제제, CDK2 억제제, CDK9 억제제, 키네신 억제제, HDAC 억제제, DNA 손상 작용제, DNA 알킬화제, DNA 삽입제, DNA 작은 홈 결합제 및 DHFR 억제제로 이루어진 군으로부터 선택된다. 추가 실시양태에서, 세포독성제는 메이탄시노이드이다. 구체적 실시양태에서, 메이탄시노이드는 N(2')-데아세틸-N(2')-(3-메르캅토-1-옥소프로필)-메이탄신 (DM1) 또는 N(2')-데아세틸-N2-(4-메르캅토-4-메틸-1-옥소펜틸)-메이탄신 (DM4)이다.
구체적 실시양태에서, 항체 약물 접합체는 하기 화학식을 갖거나 또는 그의 제약상 허용되는 염이다:
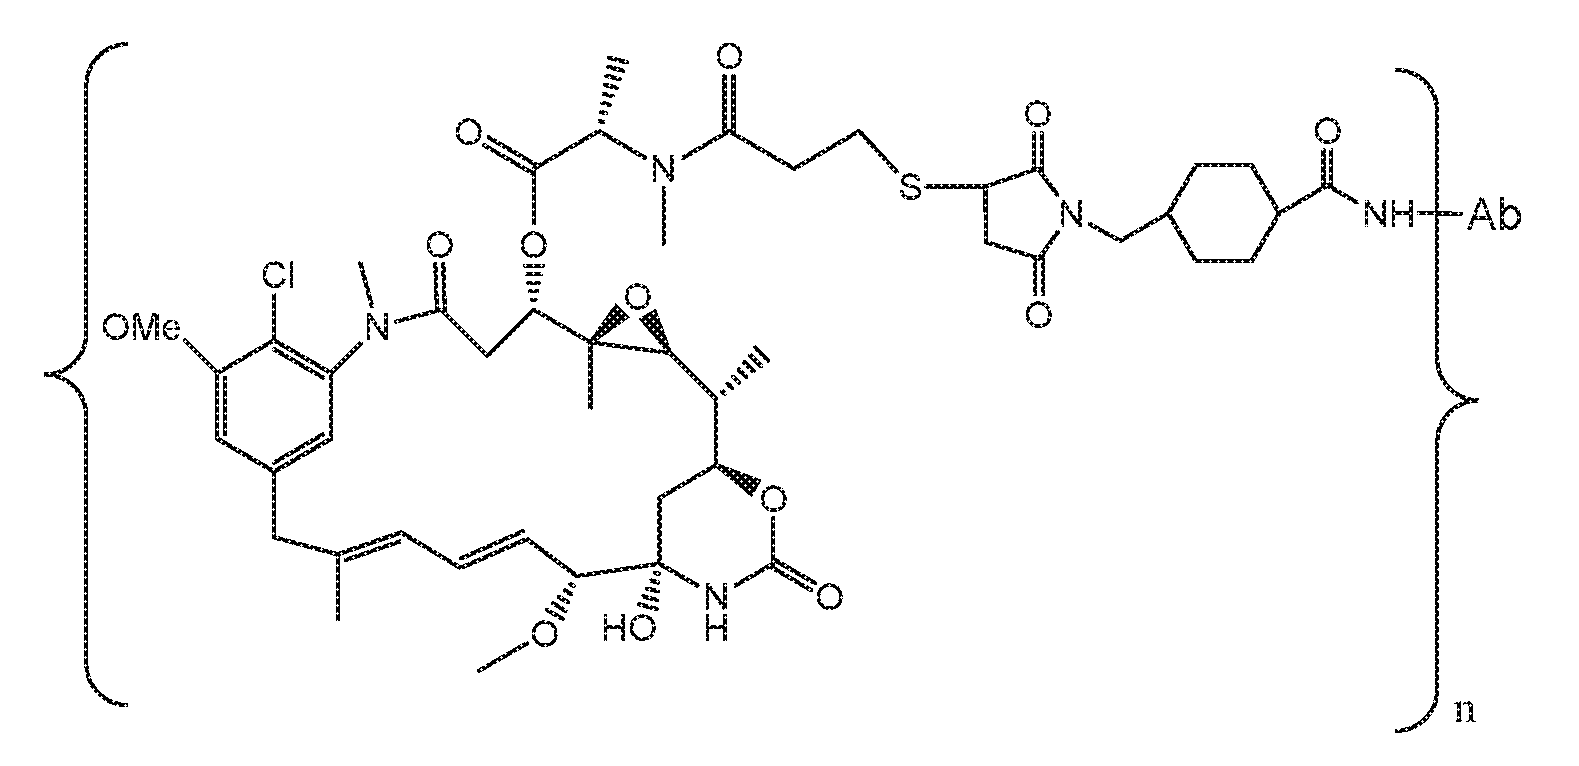
여기서 Ab는 서열식별번호: 1의 중쇄 CDR1, 서열식별번호: 2의 중쇄 CDR2, 서열식별번호: 3의 중쇄 CDR3, 및 서열식별번호: 11의 경쇄 CDR1, 서열식별번호: 12의 경쇄 CDR2, 서열식별번호: 13의 경쇄 CDR3을 포함하는 항체 또는 그의 항원 결합 단편이며, 여기서 CDR은 카바트 정의에 따라 정의되고; n은 1 내지 10이다.
본 출원은 또한 본원에 개시된 바와 같은 인간 P-카드헤린 항체 또는 그의 항원 결합 단편, 또는 이들 항체를 포함하는 항체 약물 접합체, 및 제약상 허용되는 담체를 포함하는 제약 조성물을 개시한다. 일부 실시양태에서, 제약 조성물은 동결건조물로서 제조된다. 추가 실시양태에서, 동결건조물은 항체, 그의 항원 결합 단편, 또는 이들 항체의 항체 약물 접합체, 히스티딘, 수크로스, 및 폴리소르베이트 20을 포함한다. 구체적 실시양태에서, 제약 조성물은 약 10mg/mL의 본원에 개시된 항체 약물 접합체, 20mM 히스티딘, 240mM 수크로스, 및 0.02% 폴리소르베이트 20을 포함한다.
본 출원은 또한 암의 치료를 필요로 하는 환자에게 본원에 개시된 항체 약물 접합체 또는 제약 조성물을 투여하는 것을 포함하는, 상기 환자에서 암을 치료하는 방법을 개시한다. 일부 실시양태에서, 방법은 항체 약물 접합체 또는 제약 조성물을 1종 이상의 추가의 치료 화합물과 조합하여 환자에게 투여하는 것을 포함한다.
다른 실시양태에서, 본 출원은 의약으로서 사용하기 위한 본원에 개시된 바와 같은 P-카드헤린 항체 약물 접합체 또는 제약 조성물을 개시한다. 구체적 실시양태에서, 항체 약물 접합체 또는 제약 조성물은 암의 치료를 필요로 하는 환자에서의 암의 치료에 사용하기 위한 것이다.
또한 본원에는 암의 치료를 필요로 하는 환자에서 암을 치료하기 위한, 또는 암의 치료를 위한 의약의 제조에서의 P-카드헤린 항체 또는 그의 항원 결합 단편, 또는 항체 약물 접합체의 용도가 개시된다.
일부 실시양태에서, 암은 P-카드헤린을 발현한다. 추가 실시양태에서, 암은 부신피질 암종, 방광암, 골암, 유방암, 중추 신경계 비정형 기형/횡문근양 종양, 결장암, 결장직장암, 배아성 종양, 자궁내막암, 식도암, 위암, 두경부암, 간세포성암, 카포시 육종, 간암, 소세포 폐암 및 비소세포 폐암을 포함한 폐암, 난소암, 직장암, 횡문근육종, 소장암, 연부 조직 육종, 편평 세포 암종, 편평 경부암, 위암, 자궁암, 질암, 및 외음부암, 부신피질 암종, 방광암, 골암, 유방암, 중추 신경계 비정형 기형/횡문근양 종양, 결장암, 결장직장암, 배아성 종양, 자궁내막암, 식도암, 위암, 두경부암, 간세포성암, 카포시 육종, 간암, 소세포 폐암 및 비소세포 폐암을 포함한 페암, 난소암, 직장암, 횡문근육종, 소장암, 연부 조직 육종, 편평 세포 암종, 편평 경부암, 위암, 자궁암, 질암, 및 외음부암으로 이루어진 군으로부터 선택된다. 구체적 실시양태에서, 암은 방광암, 유방암, 결장암, 결장직장암, 자궁내막암, 식도암, 위암, 두경부암, 폐암, 및 난소암으로 이루어진 군으로부터 선택된다.
본 출원은 또한 본원에 개시된 바와 같은 P-카드헤린 항체 또는 항원 결합 단편을 코딩하는 핵산을 개시한다. 구체적 실시양태에서, 핵산은 서열식별번호: 8, 28, 48, 68, 88, 108, 18, 38, 58, 78, 98, 118, 10, 30, 50, 70, 90, 110, 20, 40, 60, 80, 100, 및 120의 뉴클레오티드 서열을 포함한다. 추가 실시양태에서, 본 출원은 본원에 개시된 핵산을 포함하는 벡터, 뿐만 아니라 본원에 개시된 벡터 또는 핵산을 포함하는 숙주 세포를 고려한다. 숙주 세포를 배양하는 것 및 배양물로부터 항체를 회수하는 것을 포함하는, P-카드헤린 항체 또는 항원 결합 단편을 제조하는 방법이 추가로 개시된다.
추가 실시양태에서, 본 출원은 다음을 포함하는, 항-P-카드헤린 항체 약물 접합체를 제조하는 방법을 개시한다:
(a) SMCC를 약물 모이어티 DM-1에 화학적으로 연결하는 것;
(b) 상기 링커-약물을 제47항의 세포 배양물로부터 회수된 항체에 접합시키는 것; 및
(c) 항체 약물 접합체를 정제하는 것.
또 다른 실시양태에서, 항-P-카드헤린 항체 약물 접합체를 제조하는 방법은 다음을 포함한다:
(a) SMCC를 약물 모이어티 DM-1에 화학적으로 연결하는 것;
(b) 상기 링커-약물을 본원에 개시된 바와 같은 항체에 접합시키는 것; 및
(c) 항체 약물 접합체를 정제하는 것.
일부 실시양태에서, 이들 방법에 따라 제조된 항체 약물 접합체는 UV 분광광도계로 측정된 평균 DAR이 약 3.8이다.
다른 실시양태에서, 본원에 개시된 항체 또는 그의 항원 결합 단편은 진단 시약으로서 사용된다. 진단 시약의 일부 실시양태에서, 항체 또는 그의 항원 결합 단편은 방사성표지, 형광단, 발색단, 영상화제, 또는 금속 이온으로 표지된다.
도 1은 인간 P-카드헤린의 세포외 도메인의 최초 2종의 카드헤린-반복 도메인 (도메인-도메인 연접부에 3개의 칼슘 결합 부위가 위치함)을 제시하는, 인간 P-카드헤린 EC1_EC2의 결정 구조의 전체도를 도시한다.
도 2는 결정의 비대칭 유닛을 형성하는, 2종의 인간 P-카드헤린 단백질과 복합체화된 2종의 P-카드헤린 항체 Fab의 결정 구조의 전체도를 도시한다. 삽도는 2종의 P-카드헤린 분자의 EC1 도메인을 수반하는 접촉 영역의 근접도이다. 2종의 복합체 사이에는 단지 소수의 결정 접촉만이 존재한다.
도 3은 P-카드헤린 항체 NOV169N31Q의 Fab의 잔기와 접촉하는 인간 P-카드헤린 에피토프 잔기 (서열식별번호: 133)를 도시하는 그래프이다. 인간 P-카드헤린 EC1 도메인의 아미노산 서열은 수평축 상에 열거되어 있다. 비-수소 원자 사이의 4.0Å의 컷오프 거리를 사용하여 프로그램 NCONT에 의해 확인된 바와 같이, 그래프의 상단 부분은 단백질 항원과 항체 사이의 직접 분자간 접촉의 수를 제시한다. 프로그램 AREAIMOL에 의해 계산된 바와 같이, 그래프의 하단 부분은 항체 결합시에 P-카드헤린 잔기에 의해 일어난 용매-접근가능한 표면에서의 감소 (Å2)를 제시한다. EC1 도메인의 β-배럴 구조는 β-가닥의 넘버링에 상응하는 표지를 갖는 일련의 화살표로 개략적으로 제시되어 있다.
도 4는 항체와 상호작용하는 모든 아미노산 잔기 (4.0Å 컷오프 거리)가 흑색 막대로 제시되어 있는 인간 P-카드헤린의 N-말단 카드헤린-반복 (EC1) 도메인의 결정 구조 (회색 그림)의 근접도를 도시한다 (항체 도).
도 5는 인간 (서열식별번호: 133) 및 시노몰구스 ("시노"; 마카카 파시쿨라리스(Macaca fascicularis)) (서열식별번호: 134) P-카드헤린 EC1 도메인의 서열 정렬을 도시한다. 흑색 볼드체의 아미노산 잔기는 NOV169N31Q 항체와의 직접 분자간 접촉 (< 4.0Å)에 수반된다. 회색 볼드체 및 화살표로 나타내어진 아미노산 잔기는 멀리 떨어져 있지만 항체 결합시에 그의 용매-접근가능한 표면의 감소를 경험한다. 에피토프 잔기의 두 카테고리는 시노몰구스 P-카드헤린에서 완전히 보존된다는 것을 주목한다.
도 6은 인간 카드헤린의 EC1 도메인 (출현 순서로 각각 서열식별번호: 135-143)의 다중 서열 정렬을 도시한다. P-카드헤린은 또한 "카드헤린-3"으로서 지칭된다는 것을 주목한다. 박스표시 잔기는 용매-접근가능한 표면의 감소에 의해 결정된 바와 같이 항원-항체 계면에 위치한다. 인간 카드헤린 1 내지 4에서 발견된 삽입은 굵은 선으로 박스표시되어 있다. 주요 에피토프 잔기 Glu155는 다른 인간 카드헤린에서 보존되지 않는다는 것을 주목한다.
도 7은 P-카드헤린 매개 세포 부착에 대한 P-카드헤린 항체 NOV169N31Q의 효과를 예시하는 현미경사진을 도시한다. 세포를 타원체 형성의 유도 전에 NOV169N31Q 또는 비-특이적 인간 IgG1 항체로 전처리하였다. 타원체 형상 및 밀도를 132시간 인큐베이션 기간 후에 현미경검사에 의해 평가하였다.
도 8은 P-카드헤린 양성 (HCC70 및 HCC1954) 및 음성 (HT29) 세포주에서 NOV169N31Q-MCC-DM1의 시험관내 세포독성 효력을 예시하는 그래프를 도시한다. (A) HCC1954 (P-카드헤린+), (B) HCC70 (P-카드헤린+) 및 (C) HT29 (P-카드헤린-) 세포에서의 NOV169N31Q-MCC-DM1의 시험관내 용량-반응. 생존율을 유리 메이탄신 (L-DM1-Me; 채워진 원형), 이소형 대조군 ADC (IgG1-MCC-DM1; 개방 사각형), NOV169N31Q-MCC-DM1의 항체 성분 (NOV169N31Q; 개방 삼각형) 및 NOV169N31Q-MCC-DM1 (채워진 삼각형)을 사용한 처리 5일 후에 측정하였다.
도 9는 NOV169N31Q 및 NOV169N31Q-MCC-DM1의 ADCC 활성을 예시하는 그래프를 도시한다. 표적 세포를 고정된 수의 새로운 인간 NK 이펙터 세포 (5:1 이펙터 대 표적 세포 비) 및 증가하는 양의 NOV169N31Q (폐쇄 원형), IgG1 대조군 항체 (개방 원형), NOV169N31Q-MCC-DM1 (폐쇄 사각형) 또는 IgG1-SMCC-DM1 (개방 사각형)과 함께 인큐베이션하였다. 모든 샘플을 삼중으로 실행하였으며; 세포 생존율을 24시간 후에 평가하였다.
도 10은 HCC70 삼중 음성 유방암 피하 종양 이종이식편 모델에서 NOV169N31Q-MCC-DM1 ADC의 활성을 예시하는 일련의 IHC 영상을 도시한다. 영상은 단일 용량의 NOV169N31Q-MC-DM1 후 유사분열 정지 (p-히스톤 H3)를 예시한다.
도 11a는 P-카드헤린의 발현을 제시하기 위한 HCC70 종양 조직 상의 P-카드헤린에 대한 IHC의 대표적인 영상을 도시한다.
도 11b는 HCC70 유방암 이종이식편 모델에서 다양한 P-카드헤린 ADC의 효능을 예시하는 그래프를 도시한다.
도 12는 HCC70 유방암 이종이식편 모델에 대한 NOV169N31Q-MCC-DM1의 용량 반응 효능을 예시하는 그래프를 도시한다.
도 13a는 P-카드헤린의 발현을 제시하기 위한 HCC1954 종양 조직 상의 P-카드헤린에 대한 IHC의 대표적인 영상을 도시한다.
도 13b는 HCC1954 유방암 이종이식편 모델에서 NOV169N31Q-MCC-DM1의 효능을 예시하는 그래프이다.
도 13c는 HCC1954 유방암 이종이식편 모델에서 NOV169N31Q-MCC-DM1의 효능을 예시하는 그래프이다.
도 13d는 NOV169N31Q-MCC-DM1을 사용하는 처리에 대한 반응으로 HCC1954 유방암 이종이식편 마우스의 체중에서의 변화를 도시하는 그래프이다.
도 14a는 P-카드헤린의 발현을 제시하기 위한 BICR6 종양 조직 상의 P-카드헤린에 대한 IHC의 대표적인 영상을 도시한다.
도 14b는 BICR6 두경부암 이종이식편 모델에서 NOV169N31Q-MCC-DM1의 효능을 예시하는 그래프를 도시한다.
도 15a는 P-카드헤린의 발현을 제시하기 위한 scaBER 종양 조직 상의 P-카드헤린에 대한 IHC의 대표적인 영상을 도시한다.
도 15b는 scaBER 방광암 이종이식편 모델에서 NOV169N31Q-MCC-DM1의 효능을 예시하는 그래프를 도시한다.
도 16은 휴프라임(HuPrime) ED2267 식도암 이종이식편 모델에서 NOV169N31Q-MCC-DM1의 효능을 예시하는 그래프를 도시한다.
도 17은 HCC70 유방암 이종이식편 모델에서 2종의 상이한 링커 (MCC 대 CX1-1)를 사용하여 DM1에 접합된 항-P-카드헤린 NEG0067 항체의 효능을 비교하는 그래프를 도시한다.
도 18은 HCC70 유방암 이종이식편 모델에서 SPDB-DM4 링커-페이로드를 사용하여 접합된 3종의 뮤린 하이브리도마-유래 항-P-카드헤린 ADC의 효능을 비교하는 그래프를 도시한다.
정의
달리 언급되지 않는 한, 본원에 사용된 하기 용어 및 어구는 하기 의미를 갖도록 의도된다.
용어 "알킬"은 명시된 개수의 탄소 원자를 갖는 1가 포화 탄화수소 쇄를 지칭한다. 예를 들어, C1-6 알킬은 1 내지 6개의 탄소 원자를 갖는 알킬 기를 지칭한다. 알킬 기는 직쇄형 또는 분지형일 수 있다. 대표적인 분지형 알킬 기는 1, 2, 또는 3개의 분지를 갖는다. 알킬 기의 예는 메틸, 에틸, 프로필 (n-프로필 및 이소프로필), 부틸 (n-부틸, 이소부틸, sec-부틸, 및 t-부틸), 펜틸 (n-펜틸, 이소펜틸, 및 네오펜틸), 및 헥실을 포함하나 이에 제한되지는 않는다.
본원에 사용된 용어 "항체"는 상응하는 항원에 비-공유, 가역적, 및 특이적 방식으로 결합할 수 있는 이뮤노글로불린 패밀리의 폴리펩티드를 지칭한다. 예를 들어, 자연 발생 IgG 항체는 디술피드 결합에 의해 상호-연결된 적어도 2개의 중쇄 (H) 및 2개의 경쇄 (L)를 포함하는 사량체이다. 각각의 중쇄는 중쇄 가변 영역 (본원에서 VH로 약칭됨) 및 중쇄 불변 영역으로 구성된다. 중쇄 불변 영역은 3개의 도메인인 CH1, CH2 및 CH3으로 구성된다. 각각의 경쇄는 경쇄 가변 영역 (본원에서 VL로 약칭됨) 및 경쇄 불변 영역으로 구성된다. 경쇄 불변 영역은 1개의 도메인인 CL로 구성된다. VH 및 VL 영역은 프레임워크 영역 (FR)으로 불리는 보다 보존된 영역이 산재되어 있는 상보성 결정 영역 (CDR)으로 불리는 초가변 영역으로 추가로 세분될 수 있다. 각각의 VH 및 VL은 아미노-말단에서 카르복시-말단으로 하기 순서로 배열된 3개의 CDR 및 4개의 FR로 구성된다: FR1, CDR1, FR2, CDR2, FR3, CDR3, 및 FR4. 중쇄 및 경쇄의 가변 영역은 항원과 상호작용하는 결합 도메인을 함유한다. 항체의 불변 영역은 면역계의 다양한 세포 (예를 들어, 이펙터 세포) 및 전형적 보체계의 제1 성분 (Clq)을 포함한 숙주 조직 또는 인자에 대한 이뮤노글로불린의 결합을 매개할 수 있다.
용어 "항체"는 모노클로날 항체, 인간 항체, 인간화 항체, 키메라 항체, 및 항-이디오타입 (항-Id) 항체 (예를 들어, 본 발명의 항체에 대한 항-Id 항체를 포함함)를 포함하나 이에 제한되지는 않는다. 항체는 임의의 이소형/부류 (예를 들어, IgG, IgE, IgM, IgD, IgA 및 IgY), 또는 하위부류 (예를 들어, IgG1, IgG2, IgG3, IgG4, IgA1 및 IgA2)일 수 있다.
"상보성-결정 도메인" 또는 "상보성-결정 영역 ("CDR")은 상호교환가능하게 VL 및 VH의 초가변 영역을 지칭한다. CDR은 항체 쇄의 표적 단백질-결합 부위이며, 이러한 표적 단백질에 대한 특이성을 보유한다. 각각의 인간 VL 또는 VH에 3개의 CDR (N-말단으로부터 순차적으로 넘버링된 CDR1-3)이 존재하며, 이들은 가변 도메인의 약 15-20%를 구성한다. CDR은 표적 단백질의 에피토프에 대해 구조적으로 상보적이며, 따라서 결합 특이성의 직접적인 원인이 된다. VL 또는 VH의 나머지 스트레치, 소위 프레임워크 영역은 아미노산 서열에서의 보다 적은 변형을 나타낸다 (Kuby, Immunology, 4th ed., Chapter 4. W.H. Freeman & Co., New York, 2000).
CDR 및 프레임워크 영역의 위치는 관련 기술분야에 널리 공지된 다양한 정의, 예를 들어 카바트, 코티아(Chothia), 국제 이뮤노제네틱스(ImMunoGeneTics) 데이터베이스 (IMGT) (월드와이드 웹 상의 www.imgt.org/), 및 AbM을 사용하여 결정될 수 있다 (예를 들어, 문헌 [Johnson et al., Nucleic Acids Res., 29:205-206 (2001); Chothia and Lesk, J. Mol. Biol., 196:901-917 (1987); Chothia et al., Nature, 342:877-883 (1989); Chothia et al., J. Mol. Biol., 227:799-817 (1992); Al-Lazikani et al., J.Mol.Biol., 273:927-748 (1997)] 참조). 항원 결합 부위의 정의는 또한 하기에 기재되어 있다: 문헌 [Ruiz et al., Nucleic Acids Res., 28:219-221 (2000); 및 Lefranc, M.P., Nucleic Acids Res., 29:207-209 (2001); MacCallum et al., J. Mol. Biol., 262:732-745 (1996); 및 Martin et al., Proc. Natl. Acad. Sci. USA, 86:9268-9272 (1989); Martin et al., Methods Enzymol., 203:121-153 (1991); 및 Rees et al., In Sternberg M.J.E. (ed.), Protein Structure Prediction, Oxford University Press, Oxford, 141-172 (1996)].
경쇄 및 중쇄 둘 다는 구조적 및 기능적 상동성의 영역으로 분류될 수 있다. 용어 "불변" 및 "가변"은 기능적으로 사용된다. 이와 관련하여, 경쇄 (VL) 및 중쇄 (VH) 부분 둘 다의 가변 도메인은 항원 인식 및 특이성을 결정하는 것으로 인지될 것이다. 반대로, 경쇄 (CL) 및 중쇄 (CH1, CH2 또는 CH3)의 불변 도메인은 중요한 생물학적 특성 예컨대 분비, 경태반 이동성, Fc 수용체 결합, 보체 결합 등을 부여한다. 통상적으로, 불변 영역 도메인의 넘버링은 항체의 항원 결합 부위 또는 아미노-말단에서 더 멀어질수록 증가한다. N-말단은 가변 영역이고, C-말단은 불변 영역이며; CH3 및 CL 도메인은 실제로 각각 중쇄 및 경쇄의 카르복시-말단 도메인을 포함한다.
본원에 사용된 용어 "항원 결합 단편"은 항원의 에피토프와 (예를 들어, 결합, 입체 장애, 안정화/불안정화, 공간 분포에 의해) 특이적으로 상호작용하는 능력을 보유하는 항체의 1개 이상의 부분을 지칭한다. 결합 단편의 예는 단일 쇄 Fv (scFv), 낙타류 항체, 디술피드-연결된 Fv (sdFv), Fab 단편, F(ab') 단편, VL, VH, CL 및 CH1 도메인으로 이루어진 1가 단편; 힌지 영역에서 디술피드 가교에 의해 연결된 2개의 Fab 단편을 포함하는 2가 단편인 F(ab)2 단편; VH 및 CH1 도메인으로 이루어진 Fd 단편; 항체의 단일 아암의 VL 및 VH 도메인으로 이루어진 Fv 단편; VH 도메인으로 이루어진 dAb 단편 (Ward et al., Nature 341:544-546, 1989); 및 단리된 상보성 결정 영역 (CDR), 또는 항체의 다른 에피토프-결합 단편을 포함하나 이에 제한되지는 않는다.
추가로, Fv 단편의 2개의 도메인인 VL 및 VH가 개별 유전자에 의해 코딩되더라도, 재조합 방법을 사용하여, 이들이 VL 및 VH 영역이 쌍형성되어 1가 분자를 형성하는 단일 단백질 쇄 (단일 쇄 Fv ("scFv")로 공지됨; 예를 들어, 문헌 [Bird et al., Science 242:423-426, 1988; 및 Huston et al., Proc. Natl. Acad. Sci. 85:5879-5883, 1988] 참조)로 만들어지게 할 수 있는 합성 링커에 의해 이들이 연결될 수 있다. 이러한 단일 쇄 항체는 또한 용어 "항원 결합 단편" 내에 포괄되도록 의도된다. 이들 항원 결합 단편은 관련 기술분야의 통상의 기술자에게 공지된 통상적인 기술을 사용하여 수득되고, 단편은 무손상 항체와 동일한 방식으로 유용성에 대해 스크리닝된다.
항원 결합 단편은 또한 단일 도메인 항체, 맥시바디, 미니바디, 단일 도메인 항체, 인트라바디, 디아바디, 트리아바디, 테트라바디, v-NAR 및 비스-scFv 내로 혼입될 수 있다 (예를 들어, 문헌 [Hollinger and Hudson, Nature Biotechnology 23:1126-1136, 2005] 참조). 항원 결합 단편은 피브로넥틴 유형 III (Fn3)과 같은 폴리펩티드를 기재로 하는 스캐폴드 내로 그라프팅될 수 있다 (피브로넥틴 폴리펩티드 모노바디를 기재하는 미국 특허 번호 6,703,199 참조).
항원 결합 단편은 한 쌍의 직렬 Fv 절편 (VH-CH1-VH-CH1)을 포함하는 단일 쇄 분자 내로 혼입될 수 있으며, 이는 상보적 경쇄 폴리펩티드와 함께 한 쌍의 항원 결합 영역을 형성한다 (문헌 [Zapata et al., Protein Eng. 8:1057-1062, 1995]; 및 미국 특허 번호 5,641,870).
본원에 사용된 용어 "모노클로날 항체" 또는 "모노클로날 항체 조성물"은 실질적으로 동일한 아미노산 서열을 가지거나 또는 동일한 유전자 공급원으로부터 유래된 폴리펩티드 (항체 및 항원 결합 단편을 포함함)를 지칭한다. 이 용어는 또한 단일 분자 조성물의 항체 분자의 제제를 포함한다. 모노클로날 항체 조성물은 특정한 에피토프에 대한 단일 결합 특이성 및 친화도를 나타낸다.
본원에 사용된 용어 "인간 항체"는 프레임워크 및 CDR 영역 둘 다가 인간 기원의 서열로부터 유래된 것인 가변 영역을 갖는 항체를 포함한다. 추가로, 항체가 불변 영역을 함유하는 경우에, 불변 영역은 또한 이러한 인간 서열, 예를 들어 인간 배선 서열, 또는 인간 배선 서열의 돌연변이된 버전, 또는 인간 프레임워크 서열 분석으로부터 유래된 컨센서스 프레임워크 서열을 함유하는 항체로부터 유래된다 (예를 들어 문헌 [Knappik et al., J. Mol. Biol. 296:57-86, 2000]에 기재된 바와 같음). 1개 이상의 CDR이 친화도 성숙을 위해 또는 제조/페이로드 접합 목적을 위해 돌연변이된 것인 인간 서열로부터 유래된 항체가 또한 포함된다. 문헌 [Hybridoma. 1997 Aug;16(4):381-9.Rapid development of affinity matured monoclonal antibodies using RIMMS. Kilpatrick KE, Wring SA, Walker DH, Macklin MD, Payne JA, Su JL, Champion BR, Caterson B, McIntyre GD. Department of Molecular Sciences, Glaxo Wellcome, Research Triangle Park, NC 27709, USA]을 참조한다.
본 발명의 인간 항체는 인간 서열에 의해 코딩되지 않는 아미노산 잔기 (예를 들어, 시험관내 무작위 또는 부위-특이적 돌연변이유발 또는 생체내 체세포 돌연변이에 의해 도입된 돌연변이, 또는 안정성 또는 제조를 촉진하기 위한 보존적 치환)를 포함할 수 있다.
본원에 사용된 용어 "인식하다"는 에피토프가 선형이든지 또는 입체형태적이든지 간에, 그의 에피토프를 발견하고 이와 상호작용하는 (예를 들어, 결합하는) 항체 또는 그의 항원 결합 단편을 지칭한다. 용어 "에피토프"는 본 발명의 항체 또는 항원 결합 단편이 특이적으로 결합하는 항원 상의 부위를 지칭한다. 에피토프는 인접 아미노산 또는 단백질의 3차 폴딩에 의해 병치된 비인접 아미노산 둘 다로부터 형성될 수 있다. 인접 아미노산으로부터 형성된 에피토프는 전형적으로 변성 용매에 대한 노출시에 보유되고, 반면에 3차 폴딩에 의해 형성된 에피토프는 전형적으로 변성 용매를 사용한 처리시에 상실된다. 에피토프는 고유한 공간 입체형태에 전형적으로 적어도 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14 또는 15개의 아미노산을 포함한다. 에피토프의 공간 입체형태를 결정하는 방법은 관련 기술분야의 기술, 예를 들어 X선 결정학 및 2-차원 핵 자기 공명을 포함한다 (예를 들어, 문헌 [Epitope Mapping Protocols in Methods in Molecular Biology, Vol. 66, G. E. Morris, Ed. (1996)] 참조).
본원에 사용된 용어 "친화도"는 단일 항원 부위에서 항체와 항원 사이의 상호작용의 강도를 지칭한다. 각각의 항원 부위 내에서, 항체 "아암"의 가변 영역은 다수의 부위에서 항원과 약한 비-공유 결합력을 통해 상호작용하며; 상호작용이 더 많을수록 친화도가 더 강해진다.
용어 "단리된 항체"는 상이한 항원 특이성을 갖는 다른 항체가 실질적으로 없는 항체를 지칭한다. 그러나, 한 항원에 특이적으로 결합하는 단리된 항체는 다른 항원에 대한 교차-반응성을 가질 수 있다. 더욱이, 단리된 항체는 다른 세포 물질 및/또는 화학물질이 실질적으로 없을 수 있다.
용어 "상응하는 인간 배선 서열"은, 인간 배선 이뮤노글로불린 가변 영역 서열에 의해 코딩되는 모든 다른 공지된 가변 영역 아미노산 서열과 비교하여 참조 가변 영역 아미노산 서열 또는 하위서열과 가장 높게 결정된 아미노산 서열 동일성을 공유하는 인간 가변 영역 아미노산 서열 또는 하위서열을 코딩하는 핵산 서열을 지칭한다. 상응하는 인간 배선 서열은 또한 모든 다른 평가된 가변 영역 아미노산 서열과 비교하여 참조 가변 영역 아미노산 서열 또는 하위서열과 가장 높은 아미노산 서열 동일성을 갖는 인간 가변 영역 아미노산 서열 또는 하위서열을 지칭할 수 있다. 상응하는 인간 배선 서열은 프레임워크 영역 단독, 상보성 결정 영역 단독, 프레임워크 및 상보성 결정 영역, 가변 절편 (상기 정의된 바와 같음), 또는 가변 영역을 포함하는 서열 또는 하위서열의 다른 조합일 수 있다. 서열 동일성은 본원에 기재된 방법을 사용하여, 예를 들어 BLAST, ALIGN, 또는 관련 기술분야에 공지된 또 다른 정렬 알고리즘을 사용하여 2개의 서열을 정렬시켜 결정될 수 있다. 상응하는 인간 배선 핵산 또는 아미노산 서열은 참조 가변 영역 핵산 또는 아미노산 서열과 적어도 약 90%, 91, 92%, 93%, 94%, 95%, 96%, 97%, 98%, 99%, 또는 100% 서열 동일성을 가질 수 있다. 상응하는 인간 배선 서열은, 예를 들어 공중 이용가능한 국제 이뮤노제네틱스 데이터베이스 (IMGT) (월드와이드 웹 상의 www.imgt.org/) 및 V-베이스 (월드와이드 웹 상의 vbase.mrc-cpe.cam.ac.uk)를 통해 결정될 수 있다.
항원 (예를 들어, 단백질)과 항체, 항체 단편, 또는 항체-유래 결합제 사이의 상호작용을 기재하는 것과 관련하여 사용되는 경우에, 어구 "특이적으로 결합하다" 또는 "선택적으로 결합하다"는, 예를 들어 생물학적 샘플, 예를 들어 혈액, 혈청, 혈장 또는 조직 샘플 중 단백질 및 다른 생물제제의 이종 집단 내 항원의 존재를 결정하는 결합 반응을 지칭한다. 따라서, 특정 지정된 면역검정 조건 하에, 특정한 결합 특이성을 갖는 항체 또는 결합제는 배경의 적어도 2배로 특정한 항원에 결합하고 샘플에 존재하는 다른 항원에 실질적으로 유의한 양으로 결합하지 않는다. 한 실시양태에서, 지정된 면역검정 조건 하에, 특정한 결합 특이성을 갖는 항체 또는 결합제는 배경의 적어도 10배로 특정한 항원에 결합하고 샘플에 존재하는 다른 항원에 실질적으로 유의한 양으로 결합하지 않는다. 이러한 조건 하의 항체 또는 결합제에 대한 특이적 결합은 항체 또는 결합제가 특정한 단백질에 대한 그의 특이성에 대해 선택된 것을 요구할 수 있다. 원하는 경우 또는 적절한 경우, 이 선택은 다른 종 (예를 들어, 마우스 또는 래트) 또는 다른 하위유형으로부터의 분자와 교차-반응하는 항체를 제외시킴으로써 달성될 수 있다. 대안적으로, 일부 실시양태에서, 특정 목적 분자와 교차-반응하는 항체 또는 항체 단편이 선택된다.
다양한 면역검정 포맷을 사용하여 특정한 단백질과 특이적으로 면역반응성인 항체를 선택할 수 있다. 예를 들어, 고체-상 ELISA 면역검정을 상용적으로 사용하여 단백질과 특이적으로 면역반응성인 항체를 선택한다 (특이적 면역반응성을 결정하는데 사용될 수 있는 면역검정 포맷 및 조건의 기재에 대해서는, 예를 들어 문헌 [Harlow & Lane, Using Antibodies, A Laboratory Manual (1998)] 참조). 전형적으로 특이적 또는 선택적 결합 반응은 배경에 비해 적어도 2배의 신호를 생성할 것이고, 보다 전형적으로 배경에 비해 적어도 10 내지 100배의 신호를 생성할 것이다.
용어 "평형 해리 상수 (KD, M)"는 해리율 상수 (kd, 시간-1)를 회합률 상수 (ka, 시간-1, M-1)로 나눈 것을 지칭한다. 평형 해리 상수는 관련 기술분야에서의 임의의 공지된 방법을 사용하여 측정될 수 있다. 본 발명의 항체의 평형 해리 상수는 일반적으로 약 10-7 또는 10-8 M 미만, 예를 들어 약 10-9 M 또는 10-10 M 미만, 일부 실시양태에서, 약 10-11 M, 10-12 M 또는 10-13 M 미만일 것이다.
용어 "생체이용률"은 환자에게 투여된 주어진 양의 약물의 전신 이용률 (즉, 혈액/혈장 수준)을 지칭한다. 생체이용률은 투여된 투여 형태로부터 전신 순환에 도달하는 약물의 시간 (속도) 및 총량 (정도) 둘 다의 측정치를 나타내는 절대적 용어이다.
본원에 사용된 어구 "로 본질적으로 이루어진"은 방법 또는 조성물에 포함되는 활성 제약 작용제의 종류 또는 종, 뿐만 아니라 방법 또는 조성물의 의도된 목적에 대해 불활성인 임의의 부형제를 지칭한다. 일부 실시양태에서, 어구 "로 본질적으로 이루어진"은 본 발명의 항체 약물 접합체 이외의 1종 이상의 추가의 활성제의 포함을 명백히 제외한다. 일부 실시양태에서, 어구 "로 본질적으로 이루어진"은 본 발명의 항체 약물 접합체 및 제2 공-투여된 작용제 이외의 1종 이상의 추가의 활성제의 포함을 명백히 제외한다.
용어 "아미노산"은 자연 발생, 합성, 및 비천연 아미노산, 뿐만 아니라 자연 발생 아미노산과 유사한 방식으로 기능하는 아미노산 유사체 및 아미노산 모방체를 지칭한다. 자연 발생 아미노산은 유전자 코드에 의해 코딩된 것, 뿐만 아니라 나중에 변형되는 그러한 아미노산, 예를 들어 히드록시프롤린, γ-카르복시글루타메이트, 및 O-포스포세린이다. 아미노산 유사체는 자연 발생 아미노산과 동일한 기본 화학 구조, 즉 수소, 카르복실 기, 아미노 기, 및 R 기에 결합된 α-탄소를 갖는 화합물, 예를 들어 호모세린, 노르류신, 메티오닌 술폭시드, 메티오닌 메틸 술포늄을 지칭한다. 이러한 유사체는 변형된 R 기 (예를 들어, 노르류신) 또는 변형된 펩티드 백본을 갖지만, 자연 발생 아미노산과 동일한 기본 화학 구조를 보유한다. 아미노산 모방체는 아미노산의 일반 화학 구조와 상이한 구조를 갖지만, 자연 발생 아미노산과 유사한 방식으로 기능하는 화학적 화합물을 지칭한다.
용어 "보존적으로 변형된 변이체"는 아미노산 및 핵산 서열 둘 다에 적용된다. 특정한 핵산 서열과 관련하여, 보존적으로 변형된 변이체는 동일하거나 또는 본질적으로 동일한 아미노산 서열을 코딩하는 핵산을 지칭하거나, 또는 핵산이 아미노산 서열을 코딩하지 않는 경우에는 본질적으로 동일한 서열을 지칭한다. 유전자 코드의 축중성 때문에, 다수의 기능적으로 동일한 핵산이 임의의 주어진 단백질을 코딩한다. 예를 들어, 코돈 GCA, GCC, GCG 및 GCU는 모두 아미노산 알라닌을 코딩한다. 따라서, 코돈에 의해 알라닌이 특정되는 모든 위치에서, 코돈은 코딩되는 폴리펩티드를 변경시키지 않으면서 기재된 상응하는 코돈 중 어느 것으로 변경될 수 있다. 이러한 핵산 변이는 보존적으로 변형된 변이의 일종인 "침묵 변이"이다. 폴리펩티드를 코딩하는 본원의 모든 핵산 서열은 또한 핵산의 모든 가능한 침묵 변이를 기재한다. 통상의 기술자는 핵산 내의 각각의 코돈 (통상적으로 메티오닌에 대한 유일한 코돈인 AUG, 및 통상적으로 트립토판에 대한 유일한 코돈인 TGG 제외)이 기능적으로 동일한 분자를 생성하도록 변형될 수 있다는 것을 인식할 것이다. 따라서, 폴리펩티드를 코딩하는 핵산의 각각의 침묵 변이는 각각의 기재된 서열에 내포된다.
폴리펩티드 서열의 경우에, "보존적으로 변형된 변이체"는 아미노산을 화학적으로 유사한 아미노산으로 치환시키는, 폴리펩티드 서열에 대한 개별 치환, 결실 또는 부가를 포함한다. 기능적으로 유사한 아미노산을 제공하는 보존적 치환 표가 관련 기술분야에 널리 공지되어 있다. 이러한 보존적으로 변형된 변이체는 본 발명의 다형성 변이체, 종간 상동체, 및 대립유전자에 부가적인 것이고 이들을 배제하지 않는다. 하기하는 8개의 군은 서로에 대해 보존적 치환인 아미노산을 함유한다: 1) 알라닌 (A), 글리신 (G); 2) 아스파르트산 (D), 글루탐산 (E); 3) 아스파라긴 (N), 글루타민 (Q); 4) 아르기닌 (R), 리신 (K); 5) 이소류신 (I), 류신 (L), 메티오닌 (M), 발린 (V); 6) 페닐알라닌 (F), 티로신 (Y), 트립토판 (W); 7) 세린 (S), 트레오닌 (T); 및 8) 시스테인 (C), 메티오닌 (M) (예를 들어, 문헌 [Creighton, Proteins (1984)] 참조). 일부 실시양태에서, 용어 "보존적 서열 변형"은 아미노산 서열을 함유하는 항체의 결합 특징에 유의하게 영향을 미치지 않거나 또는 이를 변경시키지 않는 아미노산 변형을 지칭하는데 사용된다.
본원에 사용된 용어 "최적화된"은 생산 세포 또는 유기체, 일반적으로는 진핵 세포, 예를 들어 효모 세포, 피키아(Pichia) 세포, 진균 세포, 트리코더마(Trichoderma) 세포, 차이니즈 햄스터 난소 세포 (CHO) 또는 인간 세포에서 선호되는 코돈을 사용하여 아미노산 서열을 코딩하도록 변경된 뉴클레오티드 서열을 지칭한다. 최적화된 뉴클레오티드 서열은, 또한 "모" 서열로도 공지되어 있는 출발 뉴클레오티드 서열에 의해 원래 코딩되는 아미노산 서열을 완전하게 또는 가능한 한 많이 보유하도록 조작된다.
2개 이상의 핵산 또는 폴리펩티드 서열과 관련하여 용어 "동일한 퍼센트" 또는 "퍼센트 동일성"은 2개 이상의 서열 또는 하위서열이 동일한 정도를 지칭한다. 2개의 서열은, 이들이 비교되는 영역에 걸쳐 동일한 아미노산 또는 뉴클레오티드 서열을 갖는 경우에 "동일"하다. 2개의 서열은, 하기 서열 비교 알고리즘 중 1개를 사용하거나 또는 수동 정렬 및 육안 검사에 의한 측정시에 비교 윈도우 또는 지정된 영역에 걸쳐 최대한 상응하도록 비교 및 정렬하였을 때, 2개의 서열이 동일한 아미노산 잔기 또는 뉴클레오티드의 명시된 백분율 (즉, 명시된 영역에 걸쳐, 또는 명시되지 않은 경우에는 전체 서열에 걸쳐 60% 동일성, 임의로 65%, 70%, 75%, 80%, 85%, 90%, 95%, 또는 99% 동일성)을 갖는 경우에 "실질적으로 동일하다". 임의로, 동일성은 적어도 약 30개 뉴클레오티드 (또는 10개 아미노산) 길이인 영역, 또는 보다 바람직하게는 100 내지 500 또는 1000개 또는 그 초과의 뉴클레오티드 (또는 20, 50, 200개 또는 그 초과의 아미노산) 길이인 영역에 걸쳐 존재한다.
서열 비교를 위해, 전형적으로 1개의 서열은 시험 서열이 비교되는 참조 서열로서 작용한다. 서열 비교 알고리즘을 사용하는 경우에, 시험 및 참조 서열은 컴퓨터에 입력되고, 필요한 경우에 하위서열 좌표가 지정되고, 서열 알고리즘 프로그램 파라미터가 지정된다. 디폴트 프로그램 파라미터가 사용될 수 있거나, 또는 대안적 파라미터가 지정될 수 있다. 이어서, 서열 비교 알고리즘은 프로그램 파라미터에 기반하여 참조 서열에 비해 시험 서열의 퍼센트 서열 동일성을 계산한다.
본원에 사용된 "비교 윈도우"는, 20 내지 600개, 통상적으로 약 50 내지 약 200개, 보다 통상적으로 약 100 내지 약 150개로 이루어진 군으로부터 선택된 인접 위치의 수 중 어느 1개의 절편에 대한 참조를 포함하며, 여기서 2개의 서열이 최적으로 정렬된 후에 한 서열이 인접 위치의 동일한 수의 참조 서열과 비교될 수 있다. 비교를 위한 서열의 정렬 방법은 관련 기술분야에 널리 공지되어 있다. 비교를 위한 최적의 서열의 정렬은, 예를 들어, 문헌 [Smith and Waterman, Adv. Appl. Math. 2:482c (1970)]의 국부 상동성 알고리즘, 문헌 [Needleman and Wunsch, J. Mol. Biol. 48:443 (1970)]의 상동성 정렬 알고리즘, 문헌 [Pearson and Lipman, Proc. Natl. Acad. Sci. USA 85:2444 (1988)]의 유사성 검색 방법, 이들 알고리즘의 컴퓨터 구현 (위스콘신주 매디슨 사이언스 드라이브 575 소재의 제네틱스 컴퓨터 그룹(Genetics Computer Group)의 위스콘신 제네틱스 소프트웨어 패키지(Wisconsin Genetics Software Package)에서의 GAP, BESTFIT, FASTA, 및 TFASTA), 또는 수동 정렬 및 육안 검사 (예를 들어, 문헌 [Brent et al., Current Protocols in Molecular Biology, 2003] 참조)에 의해 수행될 수 있다.
퍼센트 서열 동일성 및 서열 유사성을 결정하는데 적합한 알고리즘의 두가지 예는 각각 문헌 [Altschul et al., Nuc. Acids Res. 25:3389-3402, 1977; 및 Altschul et al., J. Mol. Biol. 215:403-410, 1990]에 기재되어 있는 BLAST 및 BLAST 2.0 알고리즘이다. BLAST 분석을 수행하기 위한 소프트웨어는 국립 생물 정보 센터를 통해 공중 이용가능하다. 이러한 알고리즘은 먼저 데이터베이스 서열 내 동일한 길이의 워드와 정렬했을 때 일부 양의 값의 역치 점수 T에 매칭되거나 또는 이를 충족시키는, 질의 서열 내의 길이 W의 짧은 워드를 확인함으로써 높은 점수화 서열 쌍 (HSP)을 확인하는 것을 수반한다. T는 이웃 워드 점수 역치를 지칭한다 (Altschul et al., 상기 문헌). 이들 초기 이웃 워드 히트는 이들을 함유하는 보다 긴 HSP를 찾는 검색을 개시하기 위한 시드로서 작용한다. 워드 히트는 누적 정렬 점수가 증가될 수 있는 한, 각각의 서열을 따라 양쪽 방향으로 연장된다. 누적 점수는 뉴클레오티드 서열에 대해 파라미터 M (매칭 잔기의 쌍에 대한 보상 점수; 항상 > 0) 및 N (미스매칭 잔기에 대한 페널티 점수; 항상 < 0)을 사용하여 계산한다. 아미노산 서열의 경우에는 점수화 매트릭스를 사용하여 누적 점수를 계산한다. 누적 정렬 점수가 그의 최대 달성 값으로부터 X의 양만큼 하락하거나; 1개 이상의 음-점수화 잔기 정렬의 축적으로 인해 누적 점수가 0 이하로 떨어지거나; 또는 어느 한쪽의 서열의 말단에 도달한 경우에, 각각의 방향으로의 워드 히트의 연장이 중단된다. BLAST 알고리즘 파라미터 W, T 및 X는 정렬의 감수성 및 속도를 결정한다. BLASTN 프로그램 (뉴클레오티드 서열의 경우)은 디폴트로서 워드 길이 (W) 11, 예상값 (E) 10, M=5, N=-4 및 두 가닥의 비교를 사용한다. 아미노산 서열의 경우, BLASTP 프로그램은 디폴트로서 워드 길이 3, 및 예상값 (E) 10, 및 BLOSUM62 점수화 매트릭스 (문헌 [Henikoff and Henikoff, (1989) Proc. Natl. Acad. Sci. USA 89:10915] 참조) 정렬 (B) 50, 예상값 (E) 10, M=5, N=-4, 및 두 가닥의 비교를 사용한다.
BLAST 알고리즘은 또한 2개의 서열 사이의 유사성에 대한 통계적 분석을 수행한다 (예를 들어, 문헌 [Karlin and Altschul, Proc. Natl. Acad. Sci. USA 90:5873-5787, 1993] 참조). BLAST 알고리즘에 의해 제공되는 유사성의 한 척도는 2개의 뉴클레오티드 또는 아미노산 서열 사이의 매치가 우연히 발생할 확률의 지표를 제공하는 최소 합계 확률 (P(N))이다. 예를 들어, 핵산은 참조 핵산에 대한 시험 핵산의 비교에서 최소 합계 확률이 약 0.2 미만, 보다 바람직하게는 약 0.01 미만, 가장 바람직하게는 약 0.001 미만인 경우에 참조 서열과 유사한 것으로 간주된다.
PAM120 가중치 잔기 표, 갭 길이 페널티 12 및 갭 페널티 4를 사용하여, ALIGN 프로그램 (버전 2.0) 내로 혼입된 문헌 [E. Meyers and W. Miller, Comput. Appl. Biosci. 4:11-17, 1988]의 알고리즘을 사용하여 2개의 아미노산 서열 사이의 퍼센트 동일성이 또한 결정될 수 있다. 추가로, Blossom 62 매트릭스 또는 PAM250 매트릭스, 및 갭 가중치 16, 14, 12, 10, 8, 6, 또는 4 및 길이 가중치 1, 2, 3, 4, 5, 또는 6을 사용하여, GCG 소프트웨어 패키지 (www.gcg.com에서 이용가능함) 내의 GAP 프로그램 내로 혼입된 문헌 [Needleman and Wunsch, J. Mol. Biol. 48:444-453, 1970]의 알고리즘을 사용하여 2개의 아미노산 서열 사이의 퍼센트 동일성이 결정될 수 있다.
상기 나타낸 서열 동일성의 백분율 이외에, 2개의 핵산 서열 또는 폴리펩티드가 실질적으로 동일하다는 또 다른 지표는, 제1 핵산에 의해 코딩된 폴리펩티드가 하기 기재된 바와 같이 제2 핵산에 의해 코딩된 폴리펩티드에 대해 생성된 항체와 면역학적으로 교차 반응성이라는 것이다. 따라서, 폴리펩티드는 전형적으로, 예를 들어 2개의 펩티드가 보존적 치환에 의해서만 상이한 경우에 제2 폴리펩티드와 실질적으로 동일하다. 2개의 핵산 서열이 실질적으로 동일하다는 또 다른 지표는, 2개의 분자 또는 그의 보체가 하기 기재된 바와 같이 엄격한 조건 하에 서로 혼성화된다는 것이다. 2개의 핵산 서열이 실질적으로 동일하다는 또 다른 지표는 동일한 프라이머를 사용하여 서열을 증폭시킬 수 있다는 것이다.
용어 "핵산"은 본원에서 용어 "폴리뉴클레오티드"와 상호교환가능하게 사용되며, 단일- 또는 이중-가닥 형태의 데옥시리보뉴클레오티드 또는 리보뉴클레오티드 및 그의 중합체를 지칭한다. 용어는 합성, 자연 발생 및 비-자연 발생이고, 참조 핵산과 유사한 결합 특성을 가지며, 참조 뉴클레오티드와 유사한 방식으로 대사되는, 공지된 뉴클레오티드 유사체 또는 변형된 백본 잔기 또는 연결을 함유하는 핵산을 포괄한다. 이러한 유사체의 예는 비제한적으로, 포스포로티오에이트, 포스포르아미데이트, 메틸 포스포네이트, 키랄-메틸 포스포네이트, 2-O-메틸 리보뉴클레오티드, 펩티드-핵산 (PNA)을 포함한다.
달리 나타내지 않는 한, 특정한 핵산 서열은 또한 명시적으로 나타낸 서열, 뿐만 아니라 그의 보존적으로 변형된 변이체 (예를 들어, 축중성 코돈 치환) 및 상보적 서열을 내포적으로 포괄한다. 구체적으로, 하기에 상술되는 바와 같이, 1개 이상의 선택된 (또는 모든) 코돈의 제3 위치가 혼합-염기 및/또는 데옥시이노신 잔기로 치환된 서열을 생성시킴으로써 축중성 코돈 치환이 달성될 수 있다 (Batzer et al., (1991) Nucleic Acid Res. 19:5081; Ohtsuka et al., (1985) J. Biol. Chem. 260:2605-2608; 및 Rossolini et al., (1994) Mol. Cell. Probes 8:91-98).
핵산과 관련하여 용어 "작동가능하게 연결된"은 2개 이상의 폴리뉴클레오티드 (예를 들어, DNA) 절편 사이의 기능적인 관계를 지칭한다. 전형적으로, 이는 전사되는 서열에 대한 전사 조절 서열의 기능적 관계를 지칭한다. 예를 들어, 프로모터 또는 인핸서 서열이 적절한 숙주 세포 또는 다른 발현 시스템 내에서 코딩 서열의 전사를 자극하거나 또는 조정하는 경우에, 그것은 코딩 서열에 작동가능하게 연결되어 있다. 일반적으로, 전사되는 서열에 작동가능하게 연결된 프로모터 전사 조절 서열은 전사되는 서열에 물리적으로 인접하며, 즉 이들은 시스-작용성이다. 그러나, 일부 전사 조절 서열, 예컨대 인핸서는 전사를 증진시키는 코딩 서열에 물리적으로 인접하거나 또는 그에 근접하게 위치할 필요가 없다.
용어 "폴리펩티드" 및 "단백질"은 아미노산 잔기의 중합체를 지칭하는 것으로 본원에서 상호교환가능하게 사용된다. 용어는 자연 발생 아미노산 중합체 및 비-자연 발생 아미노산 중합체, 뿐만 아니라 1개 이상의 아미노산 잔기가 상응하는 자연 발생 아미노산의 인공적인 화학적 모방체인 아미노산 중합체에도 적용된다. 달리 나타내지 않는 한, 특정한 폴리펩티드 서열은 또한 그의 보존적으로 변형된 변이체도 내포적으로 포괄한다.
본원에 사용된 용어 "항체 약물 접합체" 또는 "면역접합체"는 또 다른 작용제, 예컨대 화학요법제, 독소, 면역요법제, 영상화 프로브 등과의 항체 또는 그의 항원 결합 단편의 연결을 지칭한다. 연결은 공유 결합, 또는 정전기력을 통한 것과 같은 비-공유 상호작용일 수 있다. 관련 기술분야에 공지된 다양한 링커가 항체 약물 접합체를 형성하기 위해 사용될 수 있다. 추가로, 항체 약물 접합체는 면역접합체를 코딩하는 폴리뉴클레오티드로부터 발현될 수 있는 융합 단백질 형태로 제공될 수 있다. 본원에 사용된 "융합 단백질"은 원래 개별 단백질 (펩티드 및 폴리펩티드를 포함함)을 코딩하는 2개 이상의 유전자 또는 유전자 단편의 연결을 통해 생성된 단백질을 지칭한다. 융합 유전자의 번역은 각각의 원래 단백질로부터 유래된 기능적 특성을 갖는 단일 단백질을 생성한다.
용어 "대상체"는 인간 및 비-인간 동물을 포함한다. 비-인간 동물은 모든 척추동물, 예를 들어, 포유동물 및 비-포유동물, 예컨대 비-인간 영장류, 양, 개, 소, 닭, 양서류 및 파충류를 포함한다. 언급되는 경우를 제외하고, 용어 "환자" 또는 "대상체"는 본원에서 상호교환가능하게 사용된다.
본원에 사용된 용어 "세포독소" 또는 "세포독성제"는 세포의 성장 및 증식에 해롭고, 세포 또는 악성종양을 감소, 억제 또는 파괴하는 작용을 할 수 있는 임의의 작용제를 지칭한다.
본원에 사용된 용어 "항암제"는 세포독성제, 화학요법제, 방사선요법 및 방사선요법제, 표적화 항암제, 및 면역요법제를 포함하나 이에 제한되지는 않는, 암과 같은 세포 증식성 장애를 치료하는데 사용될 수 있는 임의의 작용제를 지칭한다.
본원에 사용된 용어 "약물 모이어티" 또는 "페이로드"는 본 발명의 항체 또는 항원 결합 단편에 접합된 화학적 모이어티를 지칭하고, 임의의 치료제 또는 진단제, 예를 들어, 항암제, 항염증제, 항감염제 (예를 들어, 항진균제, 항박테리아제, 항기생충제, 항바이러스제), 또는 마취제를 포함할 수 있다. 예를 들어, 약물 모이어티는 항암제, 예컨대 세포독소일 수 있다. 특정 실시양태에서, 약물 모이어티는 V-ATPase 억제제, HSP90 억제제, IAP 억제제, mTor 억제제, 미세관 안정화제, 미세관 탈안정화제, 아우리스타틴, 돌라스타틴, 메이탄시노이드, MetAP (메티오닌 아미노펩티다제), 단백질 CRM1의 핵 유출의 억제제, DPPIV 억제제, 미토콘드리아에서의 포스포릴 전달 반응의 억제제, 단백질 합성 억제제, 키나제 억제제, CDK2 억제제, CDK9 억제제, 프로테아솜 억제제, 키네신 억제제, HDAC 억제제, DNA 손상 작용제, DNA 알킬화제, DNA 삽입제, DNA 작은 홈 결합제 및 DHFR 억제제로부터 선택된다. 이들 각각을 본 발명의 항체 및 방법과 상용성인 링커에 부착시키는 방법은 관련 기술분야에 공지되어 있다. 예를 들어, 문헌 [Singh et al., (2009) Therapeutic Antibodies: Methods and Protocols, vol. 525, 445-457]을 참조한다. 추가로, 페이로드는 생물물리학적 프로브, 형광단, 스핀 표지, 적외선 프로브, 친화도 프로브, 킬레이트화제, 분광학적 프로브, 방사성 프로브, 지질 분자, 폴리에틸렌 글리콜, 중합체, 스핀 표지, DNA, RNA, 단백질, 펩티드, 표면, 항체, 항체 단편, 나노입자, 양자점, 리포솜, PLGA 입자, 사카라이드 또는 폴리사카라이드일 수 있다.
용어 "메이탄시노이드 약물 모이어티"는 메이탄시노이드 화합물의 구조를 갖는 항체-약물 접합체의 하위구조를 의미한다. 메이탄신은 동아프리카 관목 메이테누스 세라타(Maytenus serrata)로부터 최초로 단리되었다 (미국 특허 번호 3,896,111). 후속적으로, 특정 미생물은 또한 메이탄시노이드, 예컨대 메이탄시놀 및 C-3 메이탄시놀 에스테르를 생산한다는 것이 발견되었다 (미국 특허 번호 4,151,042). 합성 메이탄시놀 및 메이탄시놀 유사체가 보고되었다. 미국 특허 번호 4,137,230; 4,248,870; 4,256,746; 4,260,608; 4,265,814; 4,294,757; 4,307,016; 4,308,268; 4,308,269; 4,309,428; 4,313,946; 4,315,929; 4,317,821; 4,322,348; 4,331,598; 4,361,650; 4,364,866; 4,424,219; 4,450,254; 4,362,663; 및 4,371,533, 및 문헌 [Kawai et al. (1984) Chem. Pharm. Bull. 3441-3451)]을 참조하며, 이들 각각은 명백하게 참조로 포함된다. 접합에 유용한 특정 메이탄시노이드의 예는 DM1, DM3 및 DM4를 포함한다.
"종양"은 신생물성 세포 성장 및 증식 (악성이든지 또는 양성이든지 간에), 및 모든 전암성 및 암성 세포 및 조직을 지칭한다.
용어 "항종양 활성"은 종양 세포 증식, 생존율, 또는 전이성 활성의 비율에서의 감소를 의미한다. 예를 들어, 항종양 활성은 요법이 없는 대조군과 비교하여, 요법 동안 발생하는 비정상 세포의 성장 속도에서의 저하, 또는 종양 크기 안정성 또는 감소, 또는 요법으로 인한 보다 긴 생존에 의해 나타날 수 있다. 이러한 활성은 이종이식편 모델, 동종이식편 모델, MMTV 모델, 및 항종양 활성을 조사하기 위한 관련 기술분야에 공지된 다른 공지된 모델을 포함하나 이에 제한되지는 않는, 허용되는 시험관내 또는 생체내 종양 모델을 사용하여 평가될 수 있다.
용어 "악성종양"은 비-양성 종양 또는 암을 지칭한다. 본원에 사용된 용어 "암"은 탈조절되거나 또는 비제어된 세포 성장을 특징으로 하는 악성종양을 포함한다. 예시적인 암은 다음을 포함한다: 암종, 육종, 백혈병, 및 림프종.
용어 "암"은 원발성 악성 종양 (예를 들어, 그 세포가 대상체의 원래 종양의 부위 이외의 다른 신체 내의 부위로 이동하지 않은 종양) 및 속발성 악성 종양 (예를 들어, 전이, 즉 종양 세포가 원래 종양의 부위와 상이한 속발성 부위로 이동함으로써 발생하는 종양)을 포함한다.
용어 "P-카드헤린" (또한 Pcad, PCad, 또는 CDH3으로도 공지됨)은 진뱅크(GenBank) 수탁 번호 NP_001784, NP_001784.2 (아미노산 서열), 및 NM_001793.4, 진뱅크 수탁 번호 AA14462, NG_009096, 및 NG_009096.1 (뉴클레오티드 서열)로 공개된 P-카드헤린의 핵산 및 아미노산 서열을 지칭한다. 인간 P-카드헤린 도메인 1-5에 대한 서열 정보는 세포외의 것이고, 진뱅크 수탁 번호 NM_001793.4 및 NP_001784로 공개되어 있다.
"P-카드헤린"은 또한 그의 전장에 걸쳐 상기 진뱅크 수탁 번호 NP_001784, NP_001784.2의 아미노산 서열과 적어도 약 90%, 91%, 92%, 93%, 94%, 95%, 96%, 97%, 98%, 99%, 또는 100% 서열 동일성을 갖는 단백질 및 아미노산 서열을 지칭한다.
구조적으로, P-카드헤린 핵산 서열은 그의 세포외 도메인에 걸쳐 진뱅크 수탁 번호 NM_001793.4, 진뱅크 수탁 번호 AA14462, NG_009096, 및 NG_009096.1의 핵산 서열과 적어도 약 90%, 91%, 92%, 93%, 94%, 95%, 96%, 97%, 98%, 99%, 또는 100% 서열 동일성을 갖는다.
본원에 사용된 용어 임의의 질환 또는 장애의 "치료하다", "치료하는", 또는 "치료"는 한 실시양태에서, 질환 또는 장애를 호전시키는 것 (즉, 질환 또는 그의 임상 증상 중 적어도 1종의 발생을 저속화 또는 정지 또는 감소시키는 것)을 지칭한다. 또 다른 실시양태에서, "치료하다", "치료하는", 또는 "치료"는 환자에 의해 식별가능하지 않을 수 있는 것들을 포함한 적어도 1종의 물리적 파라미터를 완화 또는 호전시키는 것을 지칭한다. 또 다른 실시양태에서, "치료하다," 치료하는," 또는 "치료"는 물리적으로 (예를 들어, 식별가능한 증상의 안정화), 생리학적으로 (예를 들어, 물리적 파라미터의 안정화), 또는 둘 다의 방식으로 질환 또는 장애를 조정하는 것을 지칭한다. 또 다른 실시양태에서, "치료하다", "치료하는", 또는 "치료"는 질환 또는 장애의 발병 또는 발생 또는 진행의 예방 또는 지연을 지칭한다.
용어 "치료상 허용되는 양" 또는 "치료 유효 용량"은 상호교환가능하게 목적하는 결과 (즉, 종양 크기의 감소, 종양 성장의 억제, 전이의 방지, 바이러스, 박테리아, 진균 또는 기생충 감염의 억제 또는 방지)를 가져오는데 충분한 양을 지칭한다. 일부 실시양태에서, 치료상 허용되는 양은 바람직하지 않은 부작용을 유도 또는 유발하지 않는다. 일부 실시양태에서, 치료상 허용되는 양은 부작용, 그러나 단지 환자의 상태의 관점에서 건강관리 제공자에 의해 허용되는 것들만을 유도 또는 유발한다. 치료상 허용되는 양은 먼저 저용량을 투여한 다음, 목적하는 효과가 달성될 때까지 그 용량을 점차 증가시킴으로써 결정될 수 있다. 본 발명의 분자의 "예방 유효 투여량" 및 "치료 유효 투여량"은 각각 암과 연관된 증상을 포함한 질환 증상의 발병을 예방하거나, 또는 그의 중증도의 감소를 일으킬 수 있다.
용어 "공-투여하다"는 개체의 혈액 중에 2종의 활성제의 존재를 지칭한다. 공-투여되는 활성제는 공동으로 또는 순차적으로 전달될 수 있다.
본 발명은 P-카드헤린에 결합하는 항체, 항체 단편 (예를 들어, 항원 결합 단편), 및 그의 약물 접합체, 즉 항체 약물 접합체 또는 ADC를 제공한다. 특히, 본 발명은 P-카드헤린에 결합하고 이러한 결합시에 내재화되는 항체 및 항체 단편 (예를 들어, 항원 결합 단편)을 제공한다. 본 발명의 항체 및 항체 단편 (예를 들어, 항원 결합 단편)은 항체 약물 접합체를 제조하기 위해 사용될 수 있다. 추가로, 본 발명은 바람직한 약동학적 특징 및 다른 바람직한 속성을 갖는 항체 약물 접합체를 제공하고, 따라서 P-카드헤린을 발현하는 암을 치료하기 위해 사용될 수 있다. 본 발명은 추가로 본 발명의 항체 약물 접합체를 포함하는 제약 조성물, 및 암의 치료를 위한 이러한 제약 조성물의 제조 및 사용 방법을 제공한다.
항체 약물 접합체
본 발명은 또한 P-카드헤린에 특이적으로 결합하는 항체, 항원 결합 단편 또는 그의 기능적 등가물이 약물 모이어티에 연결된 것인, 면역접합체로도 지칭되는 항체 약물 접합체를 제공한다. 한 측면에서, 본 발명의 항체, 항원 결합 단편 또는 그의 기능적 등가물은 링커에 의한 공유 부착을 통해 항암제인 약물 모이어티에 연결된다. 본 발명의 항체 약물 접합체는 P-카드헤린을 발현하는 종양 조직에 유효 용량의 항암제 (예를 들어, 세포독성제)를 선택적으로 전달할 수 있으며, 이에 의해 보다 큰 선택성 (및 보다 낮은 효과적인 용량)이 달성될 수 있다.
한 측면에서, 본 발명은 화학식 I의 면역접합체를 제공한다:
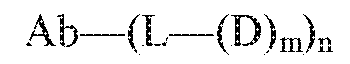
여기서 Ab는 본원에 개시된 P-카드헤린 결합 항체를 나타내고;
L은 링커이고;
D는 약물 모이어티이고;
m은 1 내지 8의 정수이고;
n은 1 내지 20의 정수이다. 한 실시양태에서, n은 1 내지 10, 2 내지 8, 또는 2 내지 5의 정수이다. 구체적 실시양태에서, n은 2, 3, 또는 4이다. 일부 실시양태에서, m은 1이고; 다른 실시양태에서 m은 2, 3 또는 4이다.
항체에 대한 약물 비가 특이적 접합체 분자에 대한 정확한 값 (예를 들어, 화학식 I에서 n 곱하기 m)을 갖는 경우에, 이러한 값은, 많은 분자를 함유하는 샘플을 기재하기 위해 사용되는 경우에, 전형적으로 접합 단계와 연관된 어느 정도의 불균질성으로 인해 종종 평균 값일 것으로 이해된다. 면역접합체의 샘플에 대한 평균 로딩은 본원에서 항체에 대한 약물 비, 또는 "DAR"로 지칭된다. 일부 실시양태에서, 약물이 메이탄시노이드인 경우에, 그것은 "MAR"로 지칭된다. 일부 실시양태에서, DAR은 약 2 내지 약 6이고, 전형적으로 약 3, 3.5, 4, 4.5, 5, 5.5, 6, 6.5, 7.0, 7.5, 8.0이다. 일부 실시양태에서, 중량 기준으로 샘플의 적어도 50%는 평균 DAR 플러스 또는 마이너스 2를 갖는 화합물이고, 바람직하게는 샘플의 적어도 50%는 평균 DAR 플러스 또는 마이너스 1을 함유하는 접합체이다. 실시양태는 DAR이 약 3.5, 3.6, 3.7, 3.8 또는 3.9인 면역접합체를 포함한다. 일부 실시양태에서, '약 n'의 DAR은 DAR에 대해 측정된 값이 n의 20% 내에 있는 것을 의미한다.
본 발명은 또한 약물 모이어티에 연결 또는 접합된, 본원에 개시된 바와 같은 항체, 항체 단편 (예를 들어, 항원 결합 단편) 및 그의 기능적 등가물을 포함하는 면역접합체에 관한 것이다. 한 실시양태에서, 약물 모이어티 D는 하기 구조를 갖는 것을 포함한 메이탄시노이드 약물 모이어티이다:
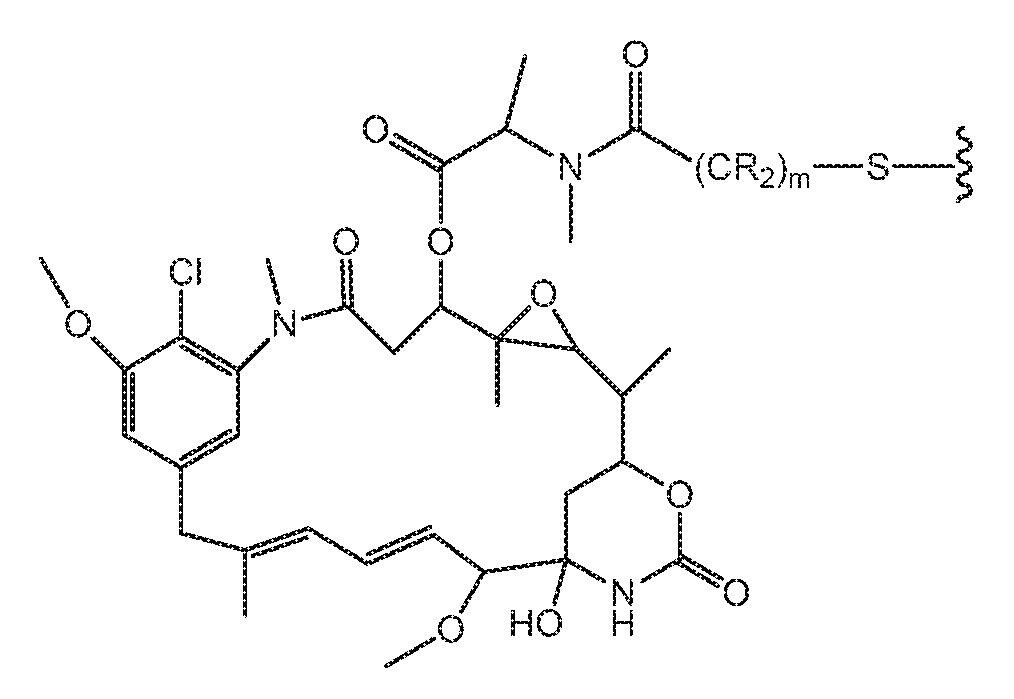
여기서, 파상선은 항체 약물 접합체의 링커에 대한 메이탄시노이드의 황 원자의 공유 부착을 나타낸다. R은 각 경우에 독립적으로 H 또는 C1-C6 알킬이다. 황 원자에 아미드 기를 부착시키는 알킬렌 쇄는 메타닐, 에타닐, 또는 프로필일 수 있고, 즉 m은 1, 2, 또는 3이다. (미국 특허 번호 633,410, 미국 특허 번호 5,208,020, 문헌 [Chari et al. (1992) Cancer Res. 52;127-131, Lui et al. (1996) Proc. Natl. Acad. Sci. 93:8618-8623]).
메이탄시노이드 약물 모이어티의 모든 입체 이성질체, 즉 메이탄시노이드의 키랄 탄소에서 R 및 S 배위의 임의의 조합이 본 발명의 면역접합체에 고려된다. 한 실시양태에서 메이탄시노이드 약물 모이어티는 하기 입체화학을 갖는다.

한 실시양태에서, 메이탄시노이드 약물 모이어티는 N2'-데아세틸-N2'-(3-메르캅토-1-옥소프로필)-메이탄신 (또한 DM1로도 공지됨)이다. DM1은 하기 구조 화학식에 의해 나타내어진다.
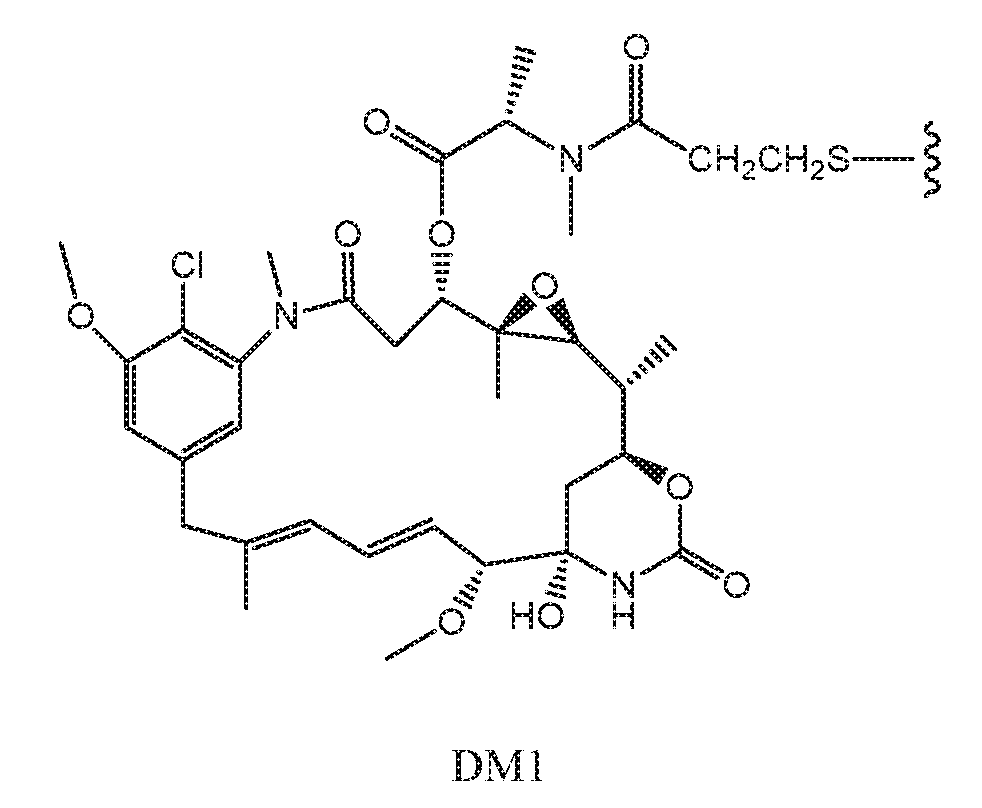
또 다른 실시양태에서 메이탄시노이드 약물 모이어티는 N2'-데아세틸-N2'-(4-메르캅토-1-옥소펜틸)-메이탄신 (또한 DM3으로도 공지됨)이다. DM3은 하기 구조 화학식에 의해 나타내어진다.
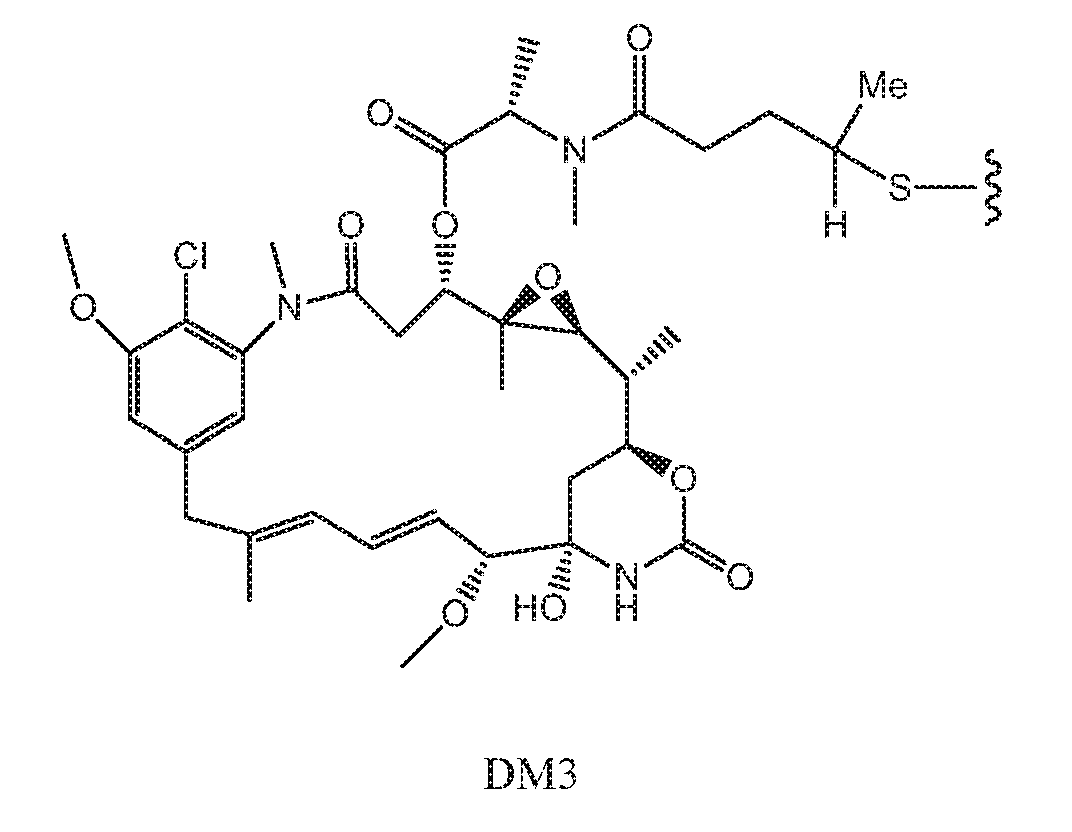
또 다른 실시양태에서 메이탄시노이드 약물 모이어티는 N2'-데아세틸-N2'-(4-메틸-4-메르캅토-1-옥소펜틸)-메이탄신 (또한 DM4로도 공지됨)이다. DM4는 하기 구조 화학식에 의해 나타내어진다.

약물 모이어티 D는 링커 L을 통해 항체 Ab에 연결될 수 있다. L은 공유 결합을 통해 항체에 약물 모이어티를 연결할 수 있는 임의의 화학적 모이어티이다. 가교 시약은 항체 약물 접합체를 형성하기 위해 약물 모이어티 및 항체를 연결하는데 사용될 수 있는 이관능성 또는 다관능성 시약이다. 항체 약물 접합체는 약물 모이어티 및 항체 둘 다에 결합할 수 있는 반응성 관능기를 갖는 가교 시약을 사용하여 제조될 수 있다. 예를 들어, 시스테인, 티올 또는 아민, 예를 들어 항체의 N-말단 또는 아미노산 측쇄, 예컨대 리신은 가교 시약의 관능기와 결합을 형성할 수 있다.
한 실시양태에서, L은 절단가능한 링커이다. 또 다른 실시양태에서, L은 비-절단가능한 링커이다. 일부 실시양태에서, L은 산-불안정성 링커, 광-불안정성 링커, 펩티다제 절단가능한 링커, 에스테라제 절단가능한 링커, 디술피드 결합 절단가능한 링커, 친수성 링커, 사전하전된 링커, 또는 디카르복실산계 링커이다.
약물 모이어티, 예를 들어 메이탄시노이드와 항체 사이에 비-절단가능한 링커를 형성하는 적합한 가교 시약은 관련 기술분야에 널리 공지되어 있고, 황 원자를 포함하는 비-절단가능한 링커 (예컨대 SMCC) 또는 황 원자가 없는 것을 형성할 수 있다. 약물 모이어티, 예를 들어 메이탄시노이드와 항체 사이에 비-절단가능한 링커를 형성하는 바람직한 가교 시약은 말레이미도계 또는 할로아세틸계 모이어티를 포함한다. 본 발명에 따르면, 이러한 비-절단가능한 링커는 말레이미도계 또는 할로아세틸계 모이어티로부터 유래된 것으로 언급된다.
말레이미도계 모이어티를 포함하는 가교 시약은 N-숙신이미딜-4-(말레이미도메틸)시클로헥산카르복실레이트 (SMCC), 술포숙신이미딜 4-(N-말레이미도메틸) 시클로헥산-1-카르복실레이트 (술포-SMCC), SMCC의 "장쇄" 유사체 (LC-SMCC)인 N-숙신이미딜-4-(말레이미도메틸)시클로헥산-1-카르복시-(6-아미노카프로에이트), κ-말레이미도운데칸산 N-숙신이미딜 에스테르 (KMUA), γ-말레이미도부티르산 N-숙신이미딜 에스테르 (GMBS), ε-말레이미도카프로산 N-숙신이미딜 에스테르 (EMCS), m-말레이미도벤조일-N-히드록시숙신이미드 에스테르 (MBS), N-(α-말레이미도아세톡시)-숙신이미드 에스테르 (AMSA), 숙신이미딜-6-(β-말레이미도프로피온아미도)헥사노에이트 (SMPH), N-숙신이미딜-4-(p-말레이미도페닐)-부티레이트 (SMPB), N-(-p-말레이미도페닐)이소시아네이트 (PMIP) 및 폴리에틸렌 글리콜 스페이서, 예컨대 MAL-PEG-NHS를 함유하는 말레이미도계 가교 시약을 포함하나 이에 제한되지는 않는다. 이들 가교 시약은 말레이미도계 모이어티로부터 유래된 비-절단가능한 링커를 형성한다. 말레이미도계 가교 시약의 대표적인 구조는 하기에 제시되어 있다.

또 다른 실시양태에서, 링커 L은 N-숙신이미딜-4-(말레이미도메틸)시클로헥산카르복실레이트 (SMCC), 술포숙신이미딜 4-(N-말레이미도메틸) 시클로헥산-1-카르복실레이트 (술포-SMCC) 또는 MAL-PEG-NHS로부터 유래된다.
할로아세틸계 모이어티를 포함하는 가교 시약은 N-숙신이미딜 아이오도아세테이트 (SIA), N-숙신이미딜(4-아이오도아세틸)아미노벤조에이트 (SIAB), N-숙신이미딜 브로모아세테이트 (SBA) 및 N-숙신이미딜 3-(브로모아세트아미도)프로피오네이트 (SBAP)를 포함한다. 이들 가교 시약은 할로아세틸계 모이어티로부터 유래된 비-절단가능한 링커를 형성한다. 할로아세틸계 가교 시약의 대표적인 구조는 하기에 제시되어 있다.

한 실시양태에서, 링커 L은 N-숙신이미딜 아이오도아세테이트 (SIA) 또는 N-숙신이미딜(4-아이오도아세틸)아미노벤조에이트 (SIAB)으로부터 유래된다.
약물 모이어티, 예를 들어 메이탄시노이드와 항체 사이에 절단가능한 링커를 형성하는 적합한 가교 시약은 관련 기술분야에 널리 공지되어 있다. 디술피드 함유 링커는 생리학적 조건 하에 발생할 수 있는 디술피드 교환을 통해 절단가능한 링커이다. 본 발명에 따르면, 이러한 절단가능한 링커는 디술피드계 모이어티로부터 유래된 것으로 언급된다. 적합한 디술피드 가교 시약은 N-숙신이미딜-3-(2-피리딜디티오)프로피오네이트 (SPDP), N-숙신이미딜-4-(2-피리딜디티오)펜타노에이트 (SPP), N-숙신이미딜-4-(2-피리딜디티오)부타노에이트 (SPDB) 및 N-숙신이미딜-4-(2-피리딜디티오)-2-술포-부타노에이트 (술포-SPDB)를 포함하며, 그 구조는 하기에 제시되어 있다. 이들 디술피드 가교 시약은 디술피드계 모이어티로부터 유래된 절단가능한 링커를 형성한다.
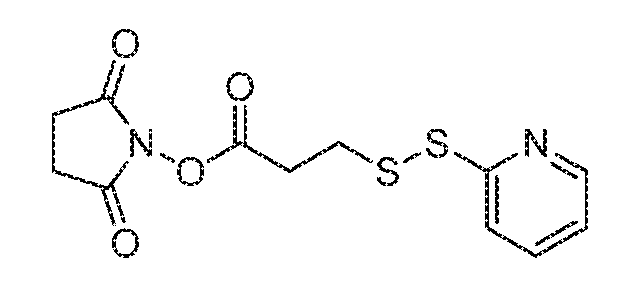
N-숙신이미딜-3-(2-피리딜디티오)프로피오네이트 (SPDP),
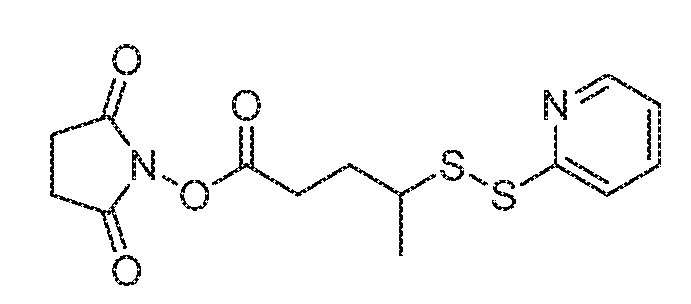
N-숙신이미딜-4-(2-피리딜디티오)펜타노에이트 (SPP),
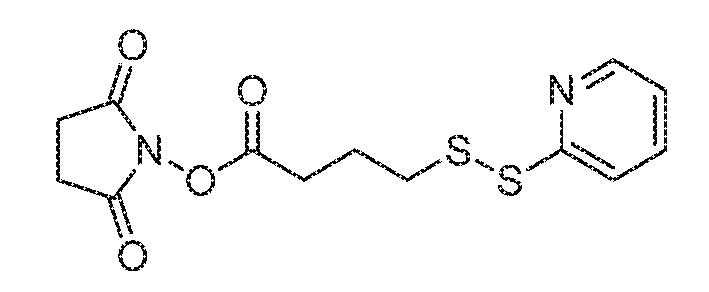
N-숙신이미딜-4-(2-피리딜디티오)부타노에이트 (SPDB) 및
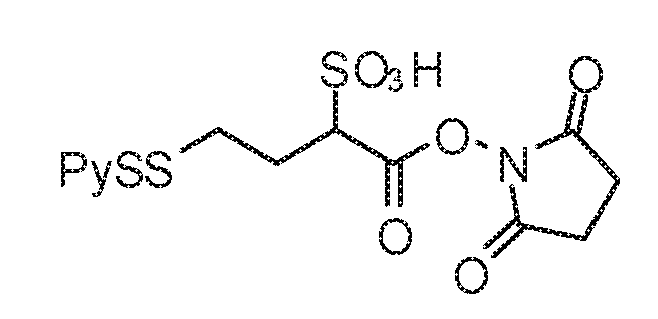
N-숙신이미딜-4-(2-피리딜디티오)-2-술포-부타노에이트 (술포-SPDB).
한 실시양태에서, 링커 L은 N-숙신이미딜-4-(2-피리딜디티오) 부타노에이트 (SPDB)로부터 유래된다.
약물 모이어티, 예를 들어 메이탄시노이드와 항체 사이에 하전된 링커를 형성하는 적합한 가교 시약은 사전하전된 가교 시약으로 공지되어 있다. 한 실시양태에서, 링커 L은 사전하전된 가교 시약 CX1-1로부터 유래된다. CX1-1의 구조는 하기와 같다.

2,5-디옥소피롤리딘-1-일 17-(2,5-디옥소-2,5-디히드로-1H-피롤-1-일)-5,8,11,14-테트라옥소-4,7,10,13-테트라아자헵타데칸-1-오에이트 (CX1-1)
상기 도시된 각각의 가교 시약은, 가교 시약의 한 말단에는 항체의 1급 아민과 반응하여 아미드 결합을 형성하는 NHS-에스테르, 및 다른 말단에는 메이탄시노이드 약물 모이어티의 술프히드릴과 반응하여 티오에테르 또는 디술피드 결합을 형성하는 말레이미드 기 또는 피리디닐디술피드 기를 함유한다.
한 실시양태에서, 본 발명의 접합체는 하기 구조 화학식 중 어느 1종에 의해 나타내어진다:

여기서
Ab는 P-카드헤린에 특이적으로 결합하는 항체 또는 그의 항원 결합 단편이고;
n은, Ab의 1급 아민과의 아미드 결합의 형성을 통해 Ab에 부착된 D-L 기의 수를 나타내며, 1 내지 20의 정수이다. 한 실시양태에서, n은 1 내지 10, 2 내지 8 또는 2 내지 5의 정수이다. 구체적 실시양태에서, n은 3 또는 4이다.
한 실시양태에서, 접합체 중 항체에 대한 약물 (예를 들어, DM1 또는 DM4)의 평균 몰비 (즉, 평균 n 값, 또한 메이탄시노이드 항체 비 (MAR)로도 공지됨)는 약 1 내지 약 10, 약 2 내지 약 8 (예를 들어, 1.9, 2.0, 2.1, 2.2, 2.3, 2.4, 2.5, 2.6, 2.7, 2.8, 2.9, 3.0, 3.1, 3.2, 3.3, 3.4, 3.5, 3.6, 3.7, 3.8, 3.9, 4.0, 4.1, 4.2, 4.3, 4.4, 4.5, 4.6, 4.7, 4.8, 4.9, 5.0, 5.1, 5.2, 5.3, 5.4, 5.5, 5.6, 5.7, 5.8, 5.9, 6.0, 6.1, 6.2, 6.3, 6.4, 6.5, 6.6, 6.7, 6.8, 6.9, 7.0, 7.1, 7.2, 7.3, 7.4, 7.5, 7.6, 7.7, 7.8, 7.9, 8.0, 또는 8.1), 약 2.5 내지 약 7, 약 3 내지 약 5, 약 2.5 내지 약 4.5 (예를 들어, 약 2.5, 약 2.6, 약 2.7, 약 2.8, 약 2.9, 약 3.0, 약 3.1, 약 3.3, 약 3.4, 약 3.5, 약 3.6, 약 3.7, 약 3.8, 약 3.9, 약 4.0, 약 4.1, 약 4.2, 약 4.3, 약 4.4, 약 4.5), 약 3.0 내지 약 4.0, 약 3.2 내지 약 4.2, 또는 약 4.5 내지 5.5 (예를 들어, 약 4.5, 약 4.6, 약 4.7, 약 4.8, 약 4.9, 약 5.0, 약 5.1, 약 5.2, 약 5.3, 약 5.4, 또는 약 5.5)이다.
본 발명의 한 측면에서, 본 발명의 접합체는 실질적으로 높은 순도를 갖고 하기 특색 중 1개 이상을 갖는다: (a) 접합체 종의 약 90% 초과 (예를 들어, 약 91%, 92%, 93%, 94%, 95%, 96%, 97%, 98%, 99%, 또는 100% 이상), 바람직하게는 약 95% 초과는 단량체임, (b) 접합체 제제 중 비접합 링커 수준은 약 10% 미만 (예를 들어, 약 9%, 8%, 7%, 6%, 5%, 4%, 3%, 2%, 1%, 또는 0% 이하)임 (총 링커 대비) , (c) 접합체 종의 10% 미만 (예를 들어, 약 9%, 8%, 7%, 6%, 5%, 4%, 3%, 2%, 1%, 또는 0% 이하)은 가교됨, (d) 접합체 제제 중 유리 약물 (예를 들어, DM1 또는 DM4) 수준은 약 2% 미만 (예를 들어, 약 1.5%, 1.4%, 1.3%, 1.2%, 1.1%, 1.0%, 0.9%, 0.8%, 0.7%, 0.6%, 0.5%, 0.4%, 0.3%, 0.2%, 0.1%, 또는 0% 이하)임 (총 세포독성제 대비 mol/mol) 및/또는 (e) 보관시에 (예를 들어, 약 1주, 약 2주, 약 3주, 약 1개월, 약 2개월, 약 3개월, 약 4개월, 약 5개월, 약 6개월, 약 1년, 약 2년, 약 3년, 약 4년, 또는 약 5년 후에) 유리 약물 (예를 들어, DM1 또는 DM4)의 수준에서의 실질적인 증가는 없음. 유리 약물 (예를 들어, DM1 또는 DM4)의 수준에서의 "실질적인 증가"는 특정 보관 시간 (예를 들어, 약 1주, 약 2주, 약 3주, 약 1개월, 약 2개월, 약 3개월, 약 4개월, 약 5개월, 약 6개월, 약 1년, 약 2년, 약 3년, 약 4년, 또는 약 5년) 후에, 유리 약물 (예를 들어, DM1 또는 DM4)의 수준에서의 증가가 약 0.1%, 약 0.2%, 약 0.3%, 약 0.4%, 약 0.5%, 약 0.6%, 약 0.7%, 약 0.8%, 약 0.9%, 약 1.0%, 약 1.1%, 약 1.2%, 약 1.3%, 약 1.4%, 약 1.5%, 약 1.6%, 약 1.7%, 약 1.8%, 약 1.9%, 약 2.0%, 약 2.2%, 약 2.5%, 약 2.7%, 약 3.0%, 약 3.2%, 약 3.5%, 약 3.7%, 또는 약 4.0% 미만인 것을 의미한다.
본원에 사용된 용어 "비접합 링커"는 가교 시약 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)으로부터 유래된 링커와 공유 연결된 항체를 지칭하며, 여기서 항체는 링커를 통해 약물 (예를 들어, DM1 또는 DM4)에 공유 커플링되지 않는다 (즉, "비접합 링커"는 Ab-MCC, Ab-SPDB, 또는 Ab-CX1-1에 의해 나타내어질 수 있음).
1. 약물 모이어티
본 발명은 P-카드헤린에 특이적으로 결합하는 면역접합체를 제공한다. 본 발명의 항체 약물 접합체는 약물 모이어티, 예를 들어, 항암제, 자가면역 치료제, 항염증제, 항진균제, 항박테리아제, 항기생충제, 항바이러스제, 또는 마취제에 접합된 항-P-카드헤린 항체, 항체 단편 (예를 들어, 항원 결합 단편) 또는 기능적 등가물을 포함한다. 본 발명의 항체, 항체 단편 (예를 들어, 항원 결합 단편) 또는 기능적 등가물은 관련 기술분야에 공지된 임의의 방법을 사용하여 여러 동일 또는 상이한 약물 모이어티에 접합될 수 있다.
특정 실시양태에서, 본 발명의 면역접합체의 약물 모이어티는 V-ATPase 억제제, 아폽토시스촉진제, Bcl2 억제제, MCL1 억제제, HSP90 억제제, IAP 억제제, mTor 억제제, 미세관 안정화제, 미세관 탈안정화제, 아우리스타틴, 돌라스타틴, 메이탄시노이드, MetAP (메티오닌 아미노펩티다제), 단백질 CRM1의 핵 유출의 억제제, DPPIV 억제제, Eg5 억제제, 프로테아솜 억제제, 미토콘드리아에서의 포스포릴 전달 반응의 억제제, 단백질 합성 억제제, 키나제 억제제, CDK2 억제제, CDK9 억제제, 키네신 억제제, HDAC 억제제, DNA 손상 작용제, DNA 알킬화제, DNA 삽입제, DNA 작은 홈 결합제 및 DHFR 억제제로 이루어진 군으로부터 선택된다.
한 실시양태에서, 본 발명의 면역접합체의 약물 모이어티는 메이탄시노이드 약물 모이어티, 예컨대 비제한적으로, DM1, DM3 또는 DM4이다.
추가로, 본 발명의 항체, 항체 단편 (예를 들어, 항원 결합 단편) 또는 기능적 등가물은 주어진 생물학적 반응을 변형시키는 약물 모이어티에 접합될 수 있다. 약물 모이어티는 전형적 화학 치료제로 제한되는 것으로 해석되지 않아야 한다. 예를 들어, 약물 모이어티는 목적하는 생물학적 활성을 보유하는 단백질, 펩티드, 또는 폴리펩티드일 수 있다. 이러한 단백질은, 예를 들어, 독소, 예컨대 아브린, 리신 A, 슈도모나스 외독소, 콜레라 독소 또는 디프테리아 독소, 단백질, 예컨대 종양 괴사 인자, α-인터페론, β-인터페론, 신경 성장 인자, 혈소판 유래 성장 인자, 조직 플라스미노겐 활성화제, 시토카인, 아폽토시스제, 항-혈관신생제, 또는 생물학적 반응 조절제, 예컨대, 예를 들어, 림포카인일 수 있다.
한 실시양태에서, 본 발명의 항체, 항체 단편 (예를 들어, 항원 결합 단편) 또는 기능적 등가물은 약물 모이어티, 예컨대 세포독소, 약물 (예를 들어, 면역억제제) 또는 방사성독소에 접합된다. 세포독소의 예는 탁산 (예를 들어, 국제 (PCT) 특허 출원 번호 WO 01/38318 및 PCT/US03/02675 참조), DNA-알킬화제 (예를 들어, CC-1065 유사체), 안트라시클린, 튜부리신 유사체, 두오카르마이신 유사체, 아우리스타틴 E, 아우리스타틴 F, 메이탄시노이드, 및 반응성 폴리에틸렌 글리콜 모이어티를 포함하는 세포독성제 (예를 들어, 문헌 [Sasse et al., J. Antibiot. (Tokyo), 53, 879-85 (2000), Suzawa et al., Bioorg. Med. Chem., 8, 2175-84 (2000), Ichimura et al., J. Antibiot. (Tokyo), 44, 1045-53 (1991), Francisco et al., Blood (2003)] (인쇄물 공개 이전의 전자 공개), 미국 특허 번호 5,475,092, 6,340,701, 6,372,738, 및 6,436,931, 미국 특허 출원 공개 번호 2001/0036923 A1, 계류 미국 특허 출원 일련 번호 10/024,290 및 10/116,053, 및 국제 (PCT) 특허 출원 번호 WO 01/49698 참조), 탁손, 시토칼라신 B, 그라미시딘 D, 에메틴, 미토마이신, 에토포시드, 테노포시드, 빈크리스틴, 빈블라스틴, t. 콜키신, 독소루비신, 다우노루비신, 디히드록시 안트라신 디온, 미톡산트론, 미트라마이신, 악티노마이신 D, 1-데히드로테스토스테론, 글루코코르티코이드, 프로카인, 테트라카인, 리도카인, 프로프라놀롤, 및 퓨로마이신 및 그의 유사체 또는 상동체를 포함하나 이에 제한되지는 않는다. 치료제는 또한, 예를 들어 항대사물 (예를 들어, 메토트렉세이트, 6-메르캅토퓨린, 6-티오구아닌, 시타라빈, 5-플루오로우라실 데카르바진), 제거제 (예를 들어, 메클로레타민, 티오테파 클로람부실, 멜팔란, 카르무스틴 (BSNU) 및 로무스틴 (CCNU), 시클로포스파미드, 부술판, 디브로모만니톨, 스트렙토조토신, 미토마이신 C, 및 시스-디클로로디아민 백금 (II) (DDP) 시스플라틴, 안트라시클린 (예를 들어, 다우노루비신 (이전에 다우노마이신) 및 독소루비신), 항생제 (예를 들어, 닥티노마이신 (이전에 악티노마이신), 블레오마이신, 미트라마이신, 및 안트라마이신 (AMC)), 및 항유사분열제 (예를 들어, 빈크리스틴 및 빈블라스틴)를 포함한다. (예를 들어, 시애틀 제네틱스(Seattle Genetics) US20090304721 참조).
본 발명의 항체, 항체 단편 (항원 결합 단편) 또는 기능적 등가물에 접합될 수 있는 세포독소의 다른 예는 두오카르마이신, 칼리케아미신, 메이탄신 및 아우리스타틴, 및 그의 유도체를 포함한다.
다양한 유형의 세포독소, 링커, 및 치료제를 항체에 접합시키는 방법이 관련 기술분야에 공지되어 있으며, 예를 들어 문헌 [Saito et al., (2003) Adv. Drug Deliv. Rev. 55:199-215; Trail et al., (2003) Cancer Immunol. Immunother. 52:328-337; Payne, (2003) Cancer Cell 3:207-212; Allen, (2002) Nat. Rev. Cancer 2:750-763; Pastan and Kreitman, (2002) Curr. Opin. Investig. Drugs 3:1089-1091; Senter and Springer, (2001) Adv. Drug Deliv. Rev. 53:247-264]을 참조한다.
본 발명의 항체, 항체 단편 (예를 들어, 항원 결합 단편) 또는 기능적 등가물은 또한 방사성 동위원소에 접합되어 방사성면역접합체로 지칭되는 세포독성 방사성제약을 생성할 수 있다. 진단적으로 또는 치료적으로 사용하기 위해 항체에 접합될 수 있는 방사성 동위원소의 예는 아이오딘-131, 인듐-111, 이트륨-90, 및 루테튬-177을 포함하나 이에 제한되지는 않는다. 방사성면역접합체를 제조하는 방법은 관련 기술분야에 확립되어 있다. 제발린(Zevalin)™ (디이씨 파마슈티칼스(DEC Pharmaceuticals)) 및 벡사르(Bexxar)™ (코릭사 파마슈티칼스(Corixa Pharmaceuticals))를 포함한 방사성면역접합체의 예가 상업적으로 입수가능하고, 본 발명의 항체를 사용하여 방사성면역접합체를 제조하는데 유사한 방법이 사용될 수 있다. 특정 실시양태에서, 마크로시클릭 킬레이트화제는 링커 분자를 통해 항체에 부착될 수 있는 1,4,7,10-테트라아자시클로도데칸-N,N',N",N"'-테트라아세트산 (DOTA)이다. 이러한 링커 분자는 관련 기술분야에 통상적으로 공지되어 있고, 문헌 [Denardo et al., (1998) Clin Cancer Res. 4(10):2483-90; Peterson et al., (1999) Bioconjug. Chem. 10(4):553-7; 및 Zimmerman et al., (1999) Nucl. Med. Biol. 26(8):943-50]에 기재되어 있으며, 이들 각각은 그 전문이 참조로 포함된다.
본 발명의 항체, 항체 단편 (예를 들어, 항원 결합 단편) 또는 기능적 등가물은 또한 이종 단백질 또는 폴리펩티드 (또는 그의 단편, 바람직하게는 적어도 10, 적어도 20, 적어도 30, 적어도 40, 적어도 50, 적어도 60, 적어도 70, 적어도 80, 적어도 90 또는 적어도 100개 아미노산의 폴리펩티드)에 접합되어 융합 단백질을 생성할 수 있다. 특히, 본 발명은 본원에 기재된 항체 단편 (예를 들어, 항원 결합 단편) (예를 들어, Fab 단편, Fd 단편, Fv 단편, F(ab)2 단편, VH 도메인, VH CDR, VL 도메인 또는 VL CDR) 및 이종 단백질, 폴리펩티드, 또는 펩티드를 포함하는 융합 단백질을 제공한다.
추가의 융합 단백질은 유전자-셔플링, 모티프-셔플링, 엑손-셔플링, 및/또는 코돈-셔플링 ("DNA 셔플링"으로 총칭됨)의 기술을 통해 생성될 수 있다. DNA 셔플링은 본 발명의 항체 또는 그의 단편의 활성을 변경시키기 위해 사용될 수 있다 (예를 들어, 보다 높은 친화도 및 보다 낮은 해리율을 갖는 항체 또는 그의 단편). 일반적으로, 미국 특허 번호 5,605,793, 5,811,238, 5,830,721, 5,834,252, 및 5,837,458; 문헌 [Patten et al., (1997) Curr. Opinion Biotechnol. 8:724-33; Harayama, (1998) Trends Biotechnol. 16(2):76-82; Hansson et al., (1999) J. Mol. Biol. 287:265-76; 및 Lorenzo and Blasco, (1998) Biotechniques 24(2):308- 313]을 참조한다 (각각의 이들 특허 및 공개는 그 전문이 본원에 참조로 포함됨). 항체 또는 그의 단편, 또는 코딩된 항체 또는 그의 단편은 재조합 전에 오류-유발 PCR, 무작위 뉴클레오티드 삽입 또는 다른 방법에 의한 무작위 돌연변이유발에 적용됨으로써 변경될 수 있다. 항원에 특이적으로 결합하는 항체 또는 그의 단편을 코딩하는 폴리뉴클레오티드는 1종 이상의 이종 분자의 1종 이상의 성분, 모티프, 절편, 부분, 도메인, 단편 등과 재조합될 수 있다.
더욱이, 본 발명의 항체, 항체 단편 (예를 들어, 항원 결합 단편) 또는 기능적 등가물은 마커 서열, 예컨대 펩티드에 접합되어 정제를 용이하게 할 수 있다. 바람직한 실시양태에서, 마커 아미노산 서열은 특히 헥사-히스티딘 펩티드 (서열식별번호: 130), 예컨대 pQE 벡터 (퀴아젠 인크(QIAGEN, Inc.), 91311 캘리포니아주 채츠워스 에톤 애비뉴 9259)에 제공된 태그이며, 이들 중 다수가 상업적으로 입수가능하다. 문헌 [Gentz et al., (1989) Proc. Natl. Acad. Sci. USA 86:821-824]에 기재된 바와 같이, 예를 들어 헥사-히스티딘 (서열식별번호: 130)은 융합 단백질의 편리한 정제를 제공한다. 정제에 유용한 다른 펩티드 태그는 인플루엔자 헤마글루티닌 단백질로부터 유래된 에피토프에 상응하는 헤마글루티닌 ("HA") 태그 (Wilson et al., (1984) Cell 37:767), 및 "FLAG" 태그 (A. Einhauer et al., J. Biochem. Biophys. Methods 49: 455-465, 2001)를 포함하나 이에 제한되지는 않는다. 본 발명에 따르면, 항체 또는 항원 결합 단편은 또한 종양-침투 펩티드에 접합되어 그의 효능을 증진시킬 수 있다.
다른 실시양태에서, 본 발명의 항체, 항체 단편 (예를 들어, 항원 결합 단편) 또는 기능적 등가물은 진단제 또는 검출가능한 작용제에 접합된다. 이러한 면역접합체는 특정한 요법의 효능을 결정하는 것과 같은 임상 시험 절차의 일부로서 질환 또는 장애의 발병, 발생, 진행 및/또는중증도를 모니터링 또는 예후하는데 유용할 수 있다. 이러한 진단 및 검출은 다양한 효소, 예컨대 비제한적으로, 양고추냉이 퍼옥시다제, 알칼리성 포스파타제, 베타-갈락토시다제 또는 아세틸콜린에스테라제; 보결분자단, 예컨대 비제한적으로, 스트렙타비딘/비오틴 및 아비딘/비오틴; 형광 물질, 예컨대 비제한적으로, 알렉사 플루오르 350, 알렉사 플루오르 405, 알렉사 플루오르 430, 알렉사 플루오르 488, 알렉사 플루오르 500, 알렉사 플루오르 514, 알렉사 플루오르 532, 알렉사 플루오르 546, 알렉사 플루오르 555, 알렉사 플루오르 568, 알렉사 플루오르 594, 알렉사 플루오르 610, 알렉사 플루오르 633, 알렉사 플루오르 647, 알렉사 플루오르 660, 알렉사 플루오르 680, 알렉사 플루오르 700, 알렉사 플루오르 750, 움벨리페론, 플루오레세인, 플루오레세인 이소티오시아네이트, 로다민, 디클로로트리아지닐아민 플루오레세인, 단실 클로라이드 또는 피코에리트린; 발광 물질, 예컨대 루미놀; 생물발광 물질, 예컨대 비제한적으로, 루시페라제, 루시페린 및 에쿼린; 방사성 물질, 예컨대 비제한적으로, 아이오딘 (131I, 125I, 123I, 및 121I), 탄소 (14C), 황 (35S), 삼중수소 (3H), 인듐 (115In, 113In, 112In, 및 111In), 테크네튬 (99Tc), 탈륨 (201Ti), 갈륨 (68Ga, 67Ga), 팔라듐 (103Pd), 몰리브데넘 (99Mo), 크세논 (133Xe), 플루오린 (18F), 153Sm, 177Lu, 159Gd, 149Pm, 140La, 175Yb, 166Ho, 90Y, 47Sc, 186Re, 188Re, 142Pr, 105Rh, 97Ru, 68Ge, 57Co, 65Zn, 85Sr, 32P, 153Gd, 169Yb, 51Cr, 54Mn, 75Se, 64Cu, 113Sn, 및 117Sn; 및 다양한 양전자 방출 단층촬영에 사용되는 양전자 발광 금속, 및 비-방사성 상자성 금속 이온을 포함하나 이에 제한되지는 않는 검출가능한 물질에 항체를 커플링시켜 달성될 수 있다.
본 발명의 항체, 항체 단편 (예를 들어, 항원 결합 단편) 또는 기능적 등가물은 또한 표적 항원의 면역검정 또는 정제에 특히 유용한 고체 지지체에 부착될 수 있다. 이러한 고체 지지체는 유리, 셀룰로스, 폴리아크릴아미드, 나일론, 폴리스티렌, 폴리비닐 클로라이드 또는 폴리프로필렌을 포함하나 이에 제한되지는 않는다.
2. 링커
본원에 사용된 "링커"는 또 다른 모이어티, 예컨대 약물 모이어티에 항체, 항체 단편 (예를 들어, 항원 결합 단편) 또는 기능적 등가물을 연결할 수 있는 임의의 화학적 모이어티이다. 링커는 화합물 또는 항체가 활성인 채로 유지되는 조건에서 절단 (절단가능한 링커), 예컨대 산-유도된 절단, 광-유도된 절단, 펩티다제-유도된 절단, 에스테라제-유도된 절단, 및 디술피드 결합 절단에 감수성일 수 있다. 대안적으로, 링커는 절단에 대해 실질적으로 저항성일 수 있다 (예를 들어, 안정한 링커 또는 비절단가능한 링커). 일부 측면에서, 링커는 사전하전된 링커, 친수성 링커, 또는 디카르복실산계 링커이다.
한 측면에서, 본 발명에 사용된 링커는 가교 시약, 예컨대 N-숙신이미딜-3-(2-피리딜디티오)프로피오네이트 (SPDP), N-숙신이미딜 4-(2-피리딜디티오)펜타노에이트 (SPP), N-숙신이미딜 4-(2-피리딜디티오)부타노에이트 (SPDB), N-숙신이미딜-4-(2-피리딜디티오)-2-술포-부타노에이트 (술포-SPDB), N-숙신이미딜 아이오도아세테이트 (SIA), N-숙신이미딜(4-아이오도아세틸)아미노벤조에이트 (SIAB), 말레이미드 PEG NHS, N-숙신이미딜 4-(말레이미도메틸) 시클로헥산카르복실레이트 (SMCC), N-술포숙신이미딜 4-(말레이미도메틸) 시클로헥산카르복실레이트 (술포-SMCC) 또는 2,5-디옥소피롤리딘-1-일 17-(2,5-디옥소-2,5-디히드로-1H-피롤-1-일)-5,8,11,14-테트라옥소-4,7,10,13-테트라아자헵타데칸-1-오에이트 (CX1-1)로부터 유래된다.
비-절단가능한 링커는 약물, 예컨대 메이탄시노이드를 항체에 안정한 공유 방식으로 연결할 수 있는 임의의 화학적 모이어티이고, 절단가능한 링커에 대한 상기 열거된 카테고리 하에 속하지 않는다. 따라서, 비-절단가능한 링커는 산-유도된 절단, 광-유도된 절단, 펩티다제-유도된 절단, 에스테라제-유도된 절단 및 디술피드 결합 절단에 대해 실질적으로 저항성이다. 추가로, 비-절단가능한 것은 약물, 예컨대 메이탄시노이드 또는 항체가 그의 활성을 잃지 않는 조건에서 디술피드 결합을 절단하는 산, 광불안정성-절단제, 펩티다제, 에스테라제, 또는 화학적 또는 생리학적 화합물에 의해 유도된 절단을 견디는 링커 내 또는 링커에 연결된 화학 결합의 능력을 지칭한다.
산-불안정성 링커는 산성 pH에서 절단가능한 링커이다. 예를 들어, 특정 세포내 구획, 예컨대 엔도솜 및 리소솜은 산성 pH (pH 4-5)를 갖고, 산-불안정성 링커를 절단하는데 적합한 조건을 제공한다.
광-불안정성 링커는 신체 표면 및 광에 접근가능한 많은 체강에서 유용한 링커이다. 또한, 적외선이 조직을 침투할 수 있다.
일부 링커는 펩티다제에 의해 절단될 수 있으며, 즉 펩티다제 절단가능한 링커일 수 있다. 단지 특정 펩티드만이 세포 내부 또는 외부에서 용이하게 절단되며, 예를 들어 문헌 [Trout et al., 79 Proc. Natl. Acad.Sci. USA, 626-629 (1982) 및 Umemoto et al. 43 Int. J. Cancer, 677-684 (1989)]을 참조한다. 추가로, 펩티드는 α-아미노산, 및 화학적으로 한 아미노산의 카르복실레이트와 제2 아미노산의 아미노 기 사이의 아미드 결합인 펩티드성 결합으로 구성된다. 다른 아미드 결합, 예컨대 카르복실레이트와 리신의 α-아미노 기 사이의 결합은 펩티드성 결합이 아닌 것으로 이해되고, 비-절단가능한 것으로 고려된다.
일부 링커는 에스테라제에 의해 절단될 수 있으며, 즉 에스테라제 절단가능한 링커일 수 있다. 다시, 단지 특정 에스테르만이 세포 내부 또는 외부에 존재하는 에스테라제에 의해 절단될 수 있다. 에스테르는 카르복실산 및 알콜의 축합에 의해 형성된다. 단순 에스테르는 단순 알콜, 예컨대 지방족 알콜, 및 소형 시클릭 및 소형 방향족 알콜로 생성된 에스테르이다.
사전하전된 링커는 항체 약물 접합체 내로의 혼입 후에 자신의 전하를 보유하는 하전된 가교 시약으로부터 유래된다. 사전하전된 링커의 예는 US 2009/0274713에서 찾아볼 수 있다.
3. 접합 및 ADC 제조
본 발명의 접합체는 관련 기술분야에 공지된 임의의 방법, 예컨대 미국 특허 번호 7,811,572, 6,411,163, 7,368,565, 및 8,163,888, 및 미국 출원 공개 2011/0003969, 2011/0166319, 2012/0253021 및 2012/0259100에 기재된 것에 의해 제조될 수 있다. 이들 특허 및 특허 출원 공개의 전체 교시는 본원에 참조로 포함된다.
1-단계 방법
한 실시양태에서, 본 발명의 접합체는 1-단계 방법에 의해 제조될 수 있다. 방법은 적합한 pH에서 임의로 1종 이상의 공-용매를 함유하는 실질적으로 수성 매질 중에서 항체, 약물 및 가교제를 합하는 것을 포함한다. 한 실시양태에서, 방법은 본 발명의 항체를 약물 (예를 들어, DM1 또는 DM4)과 접촉시켜 항체 및 약물을 포함하는 제1 혼합물을 형성하고, 이어서 항체 및 약물을 포함하는 제1 혼합물을 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)와 약 4 내지 약 9의 pH를 갖는 용액 중에서 접촉시켜 (i) 접합체 (예를 들어, Ab-MCC-DM1, Ab-SPDB-DM4, 또는 Ab-CX1-1-DM1), (ii) 유리 약물 (예를 들어, DM1 또는 DM4), 및 (iii) 반응 부산물을 포함하는 혼합물을 제공하는 단계를 포함한다.
한 실시양태에서, 1-단계 방법은 항체를 약물 (예를 들어, DM1 또는 DM4) 및 이어서 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)와 약 6 이상 (예를 들어, 약 6 내지 약 9, 약 6 내지 약 7, 약 7 내지 약 9, 약 7 내지 약 8.5, 약 7.5 내지 약 8.5, 약 7.5 내지 약 8.0, 약 8.0 내지 약 9.0, 또는 약 8.5 내지 약 9.0)의 pH를 갖는 용액 중에서 접촉시키는 것을 포함한다. 예를 들어, 본 발명의 방법은 세포-결합제를 약물 (DM1 또는 DM4) 및 이어서 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)와 약 6.0, 약 6.1, 약 6.2, 약 6.3, 약 6.4, 약 6.5, 약 6.6, 약 6.7, 약 6.8, 약 6.9, 약 7.0, 약 7.1, 약 7.2, 약 7.3, 약 7.4, 약 7.5, 약 7.6, 약 7.7, 약 7.8, 약 7.9, 약 8.0, 약 8.1, 약 8.2, 약 8.3, 약 8.4, 약 8.5, 약 8.6, 약 8.7, 약 8.8, 약 8.9, 또는 약 9.0의 pH를 갖는 용액 중에서 접촉시키는 것을 포함한다. 구체적 실시양태에서, 본 발명의 방법은 세포-결합제를 약물 (예를 들어, DM1 또는 DM4) 및 이어서 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)와 약 7.8의 pH (예를 들어, 7.6 내지 8.0의 pH 또는 7.7 내지 7.9의 pH)를 갖는 용액 중에서 접촉시키는 것을 포함한다.
1-단계 방법 (즉, 항체를 약물 (예를 들어, DM1 또는 DM4) 및 이어서 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)와 접촉시키는 것)은 관련 기술분야에 공지된 임의의 적합한 온도에서 수행될 수 있다. 예를 들어, 1-단계 방법은 약 20℃ 이하 (예를 들어, 약 -10℃ (단 용액은, 예를 들어 세포독성제 및 이관능성 가교 시약을 용해시키도록 사용된 유기 용매의 존재에 의해 동결되는 것이 방지됨) 내지 약 20℃, 약 0℃ 내지 약 18℃, 약 4℃ 내지 약 16℃)에서, 실온 (예를 들어, 약 20℃ 내지 약 30℃ 또는 약 20℃ 내지 약 25℃)에서, 또는 승온 (예를 들어, 약 30℃ 내지 약 37℃)에서 수행될 수 있다. 한 실시양태에서, 1-단계 방법은 약 16℃ 내지 약 24℃ (예를 들어, 약 16℃, 약 17℃, 약 18℃, 약 19℃, 약 20℃, 약 21℃, 약 22℃, 약 23℃, 약 24℃, 또는 약 25℃)의 온도에서 수행된다. 또 다른 실시양태에서, 1-단계 방법은 약 15℃ 이하 (예를 들어, 약 -10℃ 내지 약 15℃, 또는 약 0℃ 내지 약 15℃)의 온도에서 수행된다. 예를 들어, 방법은 약 15℃, 약 14℃, 약 13℃, 약 12℃, 약 11℃, 약 10℃, 약 9℃, 약 8℃, 약 7℃, 약 6℃, 약 5℃, 약 4℃, 약 3℃, 약 2℃, 약 1℃, 약 0℃, 약 -1℃, 약 -2℃, 약 -3℃, 약 -4℃, 약 -5℃, 약 -6℃, 약 -7℃, 약 -8℃, 약 -9℃, 또는 약 -10℃의 온도에서 항체를 약물 (예를 들어, DM1 또는 DM4) 및 이어서 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)와 접촉시키는 것을 포함하며, 단 용액은, 예를 들어 가교제 (예를 들어, SMCC, 술포-SMCC, 술포-SPDB SPDB, 또는 CX1-1)를 용해시키도록 사용된 유기 용매(들)의 존재에 의해 동결되는 것이 방지된다. 한 실시양태에서, 방법은 약 -10℃ 내지 약 15℃, 약 0℃ 내지 약 15℃, 약 0℃ 내지 약 10℃, 약 0℃ 내지 약 5℃, 약 5℃ 내지 약 15℃, 약 10℃ 내지 약 15℃, 또는 약 5℃ 내지 약 10℃의 온도에서 항체를 약물 (예를 들어, DM1 또는 DM4) 및 이어서 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)와 접촉시키는 것을 포함한다. 또 다른 실시양태에서, 방법은 약 10℃의 온도 (예를 들어, 8℃ 내지 12℃의 온도 또는 9℃ 내지 11℃의 온도)에서 항체를 약물 (예를 들어, DM1 또는 DM4) 및 이어서 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)와 접촉시키는 것을 포함한다.
한 실시양태에서, 상기 기재된 접촉은, 항체를 제공하고, 이어서 항체를 약물 (예를 들어, DM1 또는 DM4)과 접촉시켜 항체 및 약물 (예를 들어, DM1 또는 DM4)을 포함하는 제1 혼합물을 형성하고, 이어서 항체 및 약물 (예를 들어, DM1 또는 DM4)을 포함하는 제1 혼합물을 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)와 접촉시킴으로써 달성된다. 예를 들어, 한 실시양태에서, 항체를 반응 용기에 제공하고, 약물 (예를 들어, DM1 또는 DM4)을 반응 용기에 첨가하고 (이에 의해 항체를 접촉시킴), 이어서 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)를 항체 및 약물 (예를 들어, DM1 또는 DM4)을 포함하는 혼합물에 첨가한다 (이에 의해 항체 및 약물을 포함하는 혼합물을 접촉시킴). 한 실시양태에서, 항체를 반응 용기에 제공하고, 항체를 용기에 제공한 직후에 약물 (예를 들어, DM1 또는 DM4)을 반응 용기에 첨가한다. 또 다른 실시양태에서, 항체를 반응 용기에 제공하고, 항체를 용기에 제공한 후 소정의 시간 간격 (예를 들어, 세포-결합제를 공간에 제공한 후 약 5분, 약 10분, 약 20분, 약 30분, 약 40분, 약 50분, 약 1시간, 약 1일 또는 그 초과) 후에 약물 (예를 들어, DM1 또는 DM4)을 반응 용기에 첨가한다. 약물 (예를 들어, DM1 또는 DM4)은 신속하게 (즉, 짧은 시간 간격, 예컨대 약 5분, 약 10분 내에) 또는 천천히 (예컨대 펌프를 사용하여) 첨가할 수 있다.
이어서, 항체를 약물 (예를 들어, DM1 또는 DM4)과 접촉시킨 직후에 또는 항체를 약물 (예를 들어, DM1 또는 DM4)과 접촉시키고 나서 약간의 나중 시점 (예를 들어, 약 5분 내지 약 8시간 또는 그 초과의 시점)에 항체 및 약물 (예를 들어, DM1 또는 DM4)을 포함하는 혼합물을 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)와 접촉시킬 수 있다. 예를 들어, 한 실시양태에서, 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)는, 항체를 포함하는 반응 용기에 약물 (예를 들어, DM1 또는 DM4)을 첨가한 직후에, 항체 및 약물 (예를 들어, DM1 또는 DM4)을 포함하는 혼합물에 첨가한다. 대안적으로, 항체를 약물 (예를 들어, DM1 또는 DM4)과 접촉시키고 나서 약 5분, 약 10분, 약 20분, 약 30분, 약 1시간, 약 2시간, 약 3시간, 약 4시간, 약 5시간, 약 6시간, 약 7시간, 약 8시간, 또는 그 초과 후에 항체 및 약물 (예를 들어, DM1 또는 DM4)을 포함하는 혼합물을 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)와 접촉시킬 수 있다.
항체 및 약물 (예를 들어, DM1 또는 DM4)을 포함하는 혼합물이 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)와 접촉한 후, 반응이 약 1시간, 약 2시간, 약 3시간, 약 4시간, 약 5시간, 약 6시간, 약 7시간, 약 8시간, 약 9시간, 약 10시간, 약 11시간, 약 12시간, 약 13시간, 약 14시간, 약 15시간, 약 16시간, 약 17시간, 약 18시간, 약 19시간, 약 20시간, 약 21시간, 약 22시간, 약 23시간, 약 24시간, 또는 그 초과 (예를 들어, 약 30시간, 약 35시간, 약 40시간, 약 45시간, 또는 약 48시간) 동안 진행되도록 한다.
한 실시양태에서, 1-단계 방법은 임의의 미반응 약물 (예를 들어, DM1 또는 DM4) 및/또는 미반응 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)를 켄칭하는 켄칭 단계를 추가로 포함한다. 켄칭 단계는 전형적으로 접합체의 정제 전에 수행한다. 한 실시양태에서, 혼합물은 혼합물을 켄칭 시약과 접촉시킴으로써 켄칭한다. 본원에 사용된 "켄칭 시약"은 유리 약물 (예를 들어, DM1 또는 DM4) 및/또는 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)와 반응하는 시약을 지칭한다. 한 실시양태, 말레이미드 또는 할로아세트아미드 켄칭 시약, 예컨대 4-말레이미도부티르산, 3-말레이미도프로피온산, N-에틸말레이미드, 아이오도아세트아미드 또는 아이오도아세트아미도프로피온산은 약물 (예를 들어, DM1 또는 DM4) 중 임의의 미반응 기 (예컨대 티올)가 켄칭되도록 보장하는데 사용될 수 있다. 켄칭 단계는 약물 (예를 들어, DM1)의 이량체화를 방지하는 것을 도울 수 있다. 이량체화된 DM1은 제거하기가 어려울 수 있다. 극성의 하전된 티올-켄칭 시약 (예컨대 4-말레이미도부티르산 또는 3-말레이미도프로피온산)으로 켄칭시에, 과량의 미반응 DM1은 정제 단계 동안 공유-연결된 접합체로부터 용이하게 분리될 수 있는 극성의 하전된 수용성 부가물로 전환된다. 비극성 및 중성 티올-켄칭 시약으로의 켄칭이 또한 사용될 수 있다. 한 실시양태에서, 혼합물은 미반응 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)와 반응하는 켄칭 시약과 접촉시킴으로써 켄칭된다. 예를 들어, 임의의 미반응 SMCC를 켄칭하기 위해 친핵체가 혼합물에 첨가될 수 있다. 친핵체는 바람직하게는 아미노 기 함유 친핵체, 예컨대 리신, 타우린 및 히드록실아민이다.
바람직한 실시양태에서, 반응 (즉, 항체를 약물 (예를 들어, DM1 또는 DM4) 및 이어서 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)와 접촉시키는 반응)은 혼합물을 켄칭 시약과 접촉시키기 전에 완전히 진행되도록 한다. 이와 관련하여, 항체 및 약물 (예를 들어, DM1 또는 DM4)을 포함하는 혼합물이 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)와 접촉되고 나서 약 1시간 내지 약 48시간 (예를 들어, 약 1시간, 약 2시간, 약 3시간, 약 4시간, 약 5시간, 약 6시간, 약 7시간, 약 8시간, 약 9시간, 약 10시간, 약 11시간, 약 12시간, 약 13시간, 약 14시간, 약 15시간, 약 16시간, 약 17시간, 약 18시간, 약 19시간, 약 20시간, 약 21시간, 약 22시간, 약 23시간, 약 24시간, 또는 약 25시간 내지 약 48시간) 후에 켄칭 시약이 혼합물에 첨가된다.
대안적으로, 혼합물은 혼합물의 pH를 약 5.0 (예를 들어, 4.8, 4.9, 5.0, 5.1 또는 5.2)으로 저하시킴으로써 켄칭된다. 또 다른 실시양태에서, 혼합물은 pH를 6.0 미만, 5.5 미만, 5.0 미만, 4.8 미만, 4.6 미만, 4.4 미만, 4.2 미만, 4.0 미만으로 저하시킴으로써 켄칭된다. 대안적으로, pH는 약 4.0 (예를 들어, 3.8, 3.9, 4.0, 4.1 또는 4.2) 내지 약 6.0 (예를 들어, 5.8, 5.9, 6.0, 6.1 또는 6.2), 약 4.0 내지 약 5.0, 약 4.5 (예를 들어, 4.3, 4.4, 4.5, 4.6 또는 4.7) 내지 약 5.0으로 저하된다. 한 실시양태에서, 혼합물은 혼합물의 pH를 4.8로 저하시킴으로써 켄칭된다. 또 다른 실시양태에서, 혼합물은 혼합물의 pH를 5.5로 저하시킴으로써 켄칭된다.
한 실시양태에서, 1-단계 방법은 불안정하게 결합된 링커를 항체로부터 방출시키는 유지 단계를 추가로 포함한다. 유지 단계는 접합체의 정제 전에 (예를 들어, 반응 단계 후에, 반응 단계와 켄칭 단계 사이에, 또는 켄칭 단계 후에) 혼합물을 유지하는 것을 포함한다. 예를 들어, 방법은 (a) 항체를 약물 (예를 들어, DM1 또는 DM4)과 접촉시켜 항체 및 약물 (예를 들어, DM1 또는 DM4)을 포함하는 혼합물을 형성하고; 이어서 항체 및 약물 (예를 들어, DM1 또는 DM4)을 포함하는 혼합물을 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)와 약 4 내지 약 9의 pH를 갖는 용액 중에서 접촉시켜 (i) 접합체 (예를 들어, Ab-MCC-DM1, Ab-SPDB-DM4 또는 Ab-CX1-1-DM1), (ii) 유리 약물 (예를 들어, DM1 또는 DM4), 및 (iii) 반응 부산물을 포함하는 혼합물을 제공하는 단계, (b) 단계 (a)에서 제조된 혼합물을 유지하여, 불안정하게 결합된 링커를 세포 결합제로부터 방출시키는 단계, 및 (c) 혼합물을 정제하여 정제된 접합체를 제공하는 단계를 포함한다.
또 다른 실시양태에서, 방법은 (a) 항체를 약물 (예를 들어, DM1 또는 DM4)과 접촉시켜 항체 및 약물 (예를 들어, DM1 또는 DM4)을 포함하는 혼합물을 형성하고; 이어서 항체 및 약물 (예를 들어, DM1 또는 DM4)을 포함하는 혼합물을 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)와 약 4 내지 약 9의 pH를 갖는 용액 중에서 접촉시켜 (i) 접합체, (ii) 유리 약물 (예를 들어, DM1 또는 DM4), 및 (iii) 반응 부산물을 포함하는 혼합물을 제공하는 단계, (b) 단계 (a)에서 제조된 혼합물을 켄칭하여 임의의 미반응 약물 (예를 들어, DM1 또는 DM4) 및/또는 미반응 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)를 켄칭하는 단계, (c) 단계 (b)에서 제조된 혼합물을 유지하여, 불안정하게 결합된 링커를 세포-결합제로부터 방출시키는 단계, 및 (d) 혼합물을 정제하여 정제된 접합체 (예를 들어, Ab-MCC-DM1, Ab-SPDB-DM4 또는 Ab-CX1-1-DM1)를 제공하는 단계를 포함한다.
대안적으로, 유지 단계는 접합체의 정제 후에 수행될 수 있고, 추가의 정제 단계가 이어질 수 있다.
바람직한 실시양태에서, 반응은 유지 단계 전에 완전히 진행되도록 한다. 이와 관련하여, 항체 및 약물 (예를 들어, DM1 또는 DM4)을 포함하는 혼합물이 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)와 접촉되고 나서 약 1시간 내지 약 48시간 (예를 들어, 약 1시간, 약 2시간, 약 3시간, 약 4시간, 약 5시간, 약 6시간, 약 7시간, 약 8시간, 약 9시간, 약 10시간, 약 11시간, 약 12시간, 약 13시간, 약 14시간, 약 15시간, 약 16시간, 약 17시간, 약 18시간, 약 19시간, 약 20시간, 약 21시간, 약 22시간, 약 23시간, 약 24시간, 또는 약 24시간 내지 약 48시간) 후에 유지 단계가 수행될 수 있다.
유지 단계는 용액을 적합한 온도 (예를 들어, 약 0℃ 내지 약 37℃)에서 적합한 기간 (예를 들어, 약 1시간 내지 약 1주, 약 1시간 내지 약 24시간, 약 1시간 내지 약 8시간, 또는 약 1시간 내지 약 4시간) 동안 유지하여, 안정하게 결합된 링커를 항체로부터 실질적으로 방출시키지 않으면서 불안정하게 결합된 링커를 항체로부터 방출시키는 것을 포함한다. 한 실시양태에서, 유지 단계는, 용액을 약 20℃ 이하 (예를 들어, 약 0℃ 내지 약 18℃, 약 4℃ 내지 약 16℃)에서, 실온 (예를 들어, 약 20℃ 내지 약 30℃ 또는 약 20℃ 내지 약 25℃)에서, 또는 승온 (예를 들어, 약 30℃ 내지 약 37℃)에서 유지하는 것을 포함한다. 한 실시양태에서, 유지 단계는 용액을 약 16℃ 내지 약 24℃ (예를 들어, 약 15℃, 약 16℃, 약 17℃, 약 18℃, 약 19℃, 약 20℃, 약 21℃, 약 22℃, 약 23℃, 약 24℃, 또는 약 25℃)의 온도에서 유지하는 것을 포함한다. 또 다른 실시양태에서, 유지 단계는 용액을 약 2℃ 내지 약 8℃ (예를 들어, 약 0℃, 약 1℃, 약 2℃, 약 3℃, 약 4℃, 약 5℃, 약 6℃, 약 7℃, 약 8℃, 약 9℃, 또는 약 10℃)의 온도에서 유지하는 것을 포함한다. 또 다른 실시양태에서, 유지 단계는 용액을 약 37℃ (예를 들어, 약 34℃, 약 35℃, 약 36℃, 약 37℃, 약 38℃, 약 39℃ 또는 약 40℃)의 온도에서 유지하는 것을 포함한다.
유지 단계의 지속기간은 유지 단계가 수행되는 온도 및 pH에 좌우된다. 예를 들어, 유지 단계의 지속기간은 유지 단계를 승온에서 수행함으로써 실질적으로 감소될 수 있으며, 이때 세포 결합제-세포독성제 접합체의 안정성에 의해 최대 온도가 제한된다. 유지 단계는 용액을 약 1시간 내지 약 1일 (예를 들어, 약 1시간, 약 2시간, 약 3시간, 약 4시간, 약 5시간, 약 6시간, 약 7시간, 약 8시간, 약 9시간, 약 10시간, 약 12시간, 약 14시간, 약 16시간, 약 18시간, 약 20시간, 약 22시간, 또는 약 24시간), 약 10시간 내지 약 24시간, 약 12시간 내지 약 24시간, 약 14시간 내지 약 24시간, 약 16시간 내지 약 24시간, 약 18시간 내지 약 24시간, 약 20시간 내지 약 24시간, 약 5시간 내지 약 1주, 약 20시간 내지 약 1주, 약 12시간 내지 약 1주 (예를 들어, 약 12시간, 약 16시간, 약 20시간, 약 24시간, 약 2일, 약 3일, 약 4일, 약 5일, 약 6일, 또는 약 7일), 또는 약 1일 내지 약 1주 동안 유지하는 것을 포함할 수 있다.
한 실시양태에서, 유지 단계는 용액을 약 2℃ 내지 약 8℃의 온도에서 적어도 약 12시간의 기간 내지 최대 1주 동안 유지하는 것을 포함한다. 또 다른 실시양태에서, 유지 단계는 용액을 약 2℃ 내지 약 8℃의 온도에서 밤새 (예를 들어, 약 12 내지 약 24시간, 바람직하게는 약 20시간) 유지하는 것을 포함한다.
유지 단계를 위한 pH 값은 바람직하게는 약 4 내지 약 10이다. 한 실시양태에서, 유지 단계를 위한 pH 값은 약 4 이상, 그러나 약 6 미만 (예를 들어, 4 내지 5.9) 또는 약 5 이상, 그러나 약 6 미만 (예를 들어, 5 내지 5.9)이다. 또 다른 실시양태에서, 유지 단계를 위한 pH 값은 약 6 내지 약 10 (예를 들어, 약 6.5 내지 약 9, 약 6 내지 약 8)의 범위이다. 예를 들어, 유지 단계를 위한 pH 값은 약 6, 약 6.5, 약 7, 약 7.5, 약 8, 약 8.5, 약 9, 약 9.5, 또는 약 10일 수 있다.
구체적 실시양태에서, 유지 단계는, 혼합물을 25℃에서 약 6-7.5의 pH에서 약 12시간 내지 약 1주 동안 인큐베이션하거나, 혼합물을 4℃에서 약 4.5-5.9의 pH에서 약 5시간 내지 약 5일 동안 인큐베이션하거나, 또는 혼합물을 25℃에서 약 4.5-5.9의 pH에서 약 5시간 내지 약 1일 동안 인큐베이션하는 것을 포함할 수 있다.
1-단계 방법은 수크로스를 반응 단계에 첨가하여 접합체의 용해도 및 회수를 증가시키는 것을 임의로 포함할 수 있다. 바람직하게는, 수크로스는 약 0.1% (w/v) 내지 약 20% (w/v) (예를 들어, 약 0.1% (w/v), 1% (w/v), 5% (w/v), 10% (w/v), 15% (w/v), 또는 20% (w/v))의 농도로 첨가된다. 바람직하게는, 수크로스는 약 1% (w/v) 내지 약 10% (w/v) (예를 들어, 약 0.5% (w/v), 약 1% (w/v), 약 1.5% (w/v), 약 2% (w/v), 약 3% (w/v), 약 4% (w/v), 약 5% (w/v), 약 6% (w/v), 약 7% (w/v), 약 8% (w/v), 약 9% (w/v), 약 10% (w/v), 또는 약 11% (w/v))의 농도로 첨가된다. 추가로, 반응 단계는 완충제의 첨가를 또한 포함할 수 있다. 관련 기술분야에 공지된 임의의 적합한 완충제가 사용될 수 있다. 적합한 완충제는, 예를 들어 시트레이트 완충제, 아세테이트 완충제, 숙시네이트 완충제, 및 포스페이트 완충제를 포함한다. 한 실시양태에서, 완충제는 HEPPSO (N-(2-히드록시에틸)피페라진-N'-(2-히드록시프로판술폰산)), POPSO (피페라진-1,4-비스-(2-히드록시-프로판-술폰산) 탈수화물), HEPES (4-(2-히드록시에틸)피페라진-1-에탄술폰산), HEPPS (EPPS) (4-(2-히드록시에틸)피페라진-1-프로판술폰산), TES (N-[트리스(히드록시메틸)메틸]-2-아미노에탄술폰산), 및 그의 조합으로 이루어진 군으로부터 선택된다.
한 실시양태에서, 1-단계 방법은 혼합물을 정제하여 정제된 접합체 (예를 들어, Ab-MCC-DM1, Ab-SPDB-DM4 또는 Ab-CX1-1-DM1)를 제공하는 단계를 추가로 포함할 수 있다. 관련 기술분야에 공지된 임의의 정제 방법이 본 발명의 접합체를 정제하는데 사용될 수 있다. 한 실시양태에서, 본 발명의 접합체는 접선 흐름 여과 (TFF), 비-흡착성 크로마토그래피, 흡착성 크로마토그래피, 흡착성 여과, 선택적 침전, 또는 임의의 다른 적합한 정제 방법, 뿐만 아니라 그의 조합을 사용하여 정제한다. 또 다른 실시양태에서, 접합체를 상기 기재된 정제 방법에 적용하기 전에, 접합체를 먼저 1종 이상의 PVDF 막을 통해 여과한다. 대안적으로, 접합체를 상기 기재된 정제 방법에 적용한 후에, 접합체를 1종 이상의 PVDF 막을 통해 여과한다. 예를 들어, 한 실시양태에서, 접합체를 1종 이상의 PVDF 막을 통해 여과한 다음, 접선 흐름 여과를 사용하여 정제한다. 대안적으로, 접합체를 접선 흐름 여과를 사용하여 정제한 다음, 1종 이상의 PVDF 막을 통해 여과한다.
펠리콘 유형 시스템 (밀리포어(Millipore), 매사추세츠주 빌러리카), 사르토콘 카세트 시스템 (사토리우스 아게(Sartorius AG), 뉴욕주 엣지우드), 및 센트라세트 유형 시스템 (폴 코포레이션(Pall Corp.), 뉴욕주 이스트 힐스)을 포함한 임의의 적합한 TFF 시스템이 정제에 이용될 수 있다.
임의의 적합한 흡착성 크로마토그래피 수지가 정제에 이용될 수 있다. 바람직한 흡착성 크로마토그래피 수지는 히드록시아파타이트 크로마토그래피, 소수성 전하 유도 크로마토그래피 (HCIC), 소수성 상호작용 크로마토그래피 (HIC), 이온 교환 크로마토그래피, 혼합 모드 이온 교환 크로마토그래피, 고정화된 금속 친화성 크로마토그래피 (IMAC), 염료 리간드 크로마토그래피, 친화성 크로마토그래피, 역상 크로마토그래피, 및 그의 조합을 포함한다. 적합한 히드록시아파타이트 수지의 예는 세라믹 히드록시아파타이트 (CHT 유형 I 및 유형 II, 바이오-라드 래보러토리즈(Bio-Rad Laboratories), 캘리포니아주 허큘레스), HA 울트로젤 히드록시아파타이트 (폴 코포레이션, 뉴욕주 이스트 힐스), 및 세라믹 플루오로아파타이트 (CFT 유형 I 및 유형 II, 바이오-라드 래보러토리즈, 캘리포니아주 허큘레스)를 포함한다. 적합한 HCIC 수지의 예는 MEP 하이퍼셀 수지 (폴 코포레이션, 뉴욕주 이스트 힐스)이다. 적합한 HIC 수지의 예는 부틸-세파로스, 헥실-세파로스, 페닐-세파로스, 및 옥틸 세파로스 수지 (모두 뉴저지주 피스카타웨이 소재의 지이 헬스케어(GE Healthcare)로부터의 것), 뿐만 아니라 마크로-프렙 메틸 및 마크로-프렙 t-부틸 수지 (바이오라드 래보러토리즈, 캘리포니아주 허큘레스)를 포함한다. 적합한 이온 교환 수지의 예는 SP-세파로스, CM-세파로스, 및 Q-세파로스 수지 (모두 뉴저지주 피스카타웨이 소재의 지이 헬스케어로부터의 것), 및 우노스피어 S 수지 (바이오-라드 래보러토리즈, 캘리포니아주 허큘레스)를 포함한다. 적합한 혼합 모드 이온 교환체의 예는 베이커본드 ABx 수지 (제이티 베이커(JT Baker), 뉴저지주 필립스버그)를 포함한다. 적합한 IMAC 수지의 예는 킬레이팅 세파로스 수지 (지이 헬스케어, 뉴저지주 피스카타웨이) 및 프로피니티 IMAC 수지 (바이오-라드 래보러토리즈, 캘리포니아주 허큘레스)를 포함한다. 적합한 염료 리간드 수지의 예는 블루 세파로스 수지 (지이 헬스케어, 뉴저지주 피스카타웨이) 및 아피-겔 블루 수지 (바이오-라드 래버러토리즈, 캘리포니아주 허큘레스)를 포함한다. 적합한 친화도 수지의 예는 단백질 A 세파로스 수지 (예를 들어, 맙셀렉트, 지이 헬스케어, 뉴저지주 피스카타웨이) 및 렉틴 친화도 수지, 예를 들어 렌틸 렉틴 세파로스 수지 (지이 헬스케어, 뉴저지주 피스카타웨이)를 포함하며, 여기서 항체는 적절한 렉틴 결합 부위를 보유한다. 적합한 역상 수지의 예는 C4, C8, 및 C18 수지 (그레이스 비닥(Grace Vydac), 캘리포니아주 헤스페리아)를 포함한다.
임의의 적합한 비-흡착성 크로마토그래피 수지가 정제에 이용될 수 있다. 적합한 비-흡착성 크로마토그래피 수지의 예는 세파덱스(SEPHADEX)™ G-25, G-50, G-100, 세파크릴(SEPHACRYL)™ 수지 (예를 들어, S-200 및 S-300), 슈퍼덱스(SUPERDEX)™ 수지 (예를 들어, 슈퍼덱스™ 75 및 슈퍼덱스™ 200), 바이오-겔(BIO-GEL)® 수지 (예를 들어, P-6, P-10, P-30, P-60, 및 P-100), 및 관련 기술분야의 통상의 기술자에게 공지된 다른 것을 포함하나 이에 제한되지는 않는다.
2-단계 방법 및 원-포트 방법
한 실시양태에서, 본 발명의 접합체는 미국 특허 7,811,572 및 미국 특허 출원 공개 번호 2006/0182750에 기재된 바와 같이 제조될 수 있다. 방법은 (a) 본 발명의 항체를 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)와 접촉시켜 링커 (즉, Ab-SMCC, Ab-SPDB 또는 Ab-CX1-1)를 항체에 공유 부착시키고, 이에 의해 링커가 결합되어 있는 항체를 포함하는 제1 혼합물을 제조하는 단계; (b) 제1 혼합물을 정제 방법에 임의로 적용하여 링커가 결합되어 있는 항체의 정제된 제1 혼합물을 제조하는 단계; (c) 링커가 결합되어 있는 항체를 약물 (예를 들어, DM1 또는 DM4)과 약 4 내지 약 9의 pH를 갖는 용액 중에서 반응시킴으로써 제1 혼합물 중에서 링커가 결합되어 있는 항체에 약물 (예를 들어, DM1 또는 DM4)에 접합시켜 (i) 접합체 (예를 들어, Ab-MCC-DM1, Ab-SPDB-DM4 또는 Ab-CX1-1-DM1), (ii) 유리 약물 (예를 들어, DM1 또는 DM4); 및 (iii) 반응 부산물을 포함하는 제2 혼합물을 제조하는 단계; 및 (d) 제2 혼합물을 정제 방법에 적용하여 접합체를 제2 혼합물의 다른 성분으로부터 정제하는 단계를 포함한다. 대안적으로, 정제 단계 (b)가 생략될 수 있다. 본원에 기재된 임의의 정제 방법이 단계 (b) 및 (d)에 사용될 수 있다. 한 실시양태에서, TFF가 단계 (b) 및 (d) 둘 다에 사용된다. 또 다른 실시양태에서, TFF가 단계 (b)에 사용되고, 흡착성 크로마토그래피 (예를 들어, CHT)가 단계 (d)에 사용된다.
1-단계 시약 및 계내 방법
한 실시양태에서, 본 발명의 접합체는 미국 특허 6,441,163 및 미국 특허 출원 공개 번호 2011/0003969 및 2008/0145374에 기재된 바와 같이, 사전-형성된 약물-링커 화합물 (예를 들어, SMCC-DM1, 술포-SMCC-DM1, SPDB-DM4 또는 CX1-1-DM1)을 본 발명의 항체에 접합시키고, 이어서 정제 단계를 수행함으로써 제조될 수 있다. 본원에 기재된 임의의 정제 방법이 사용될 수 있다. 약물-링커 화합물은 약물 (예를 들어, DM1 또는 DM4)을 가교제 (예를 들어, SMCC, 술포-SMCC, SPDB, 술포-SPDB 또는 CX1-1)와 반응시킴으로써 제조된다. 약물-링커 화합물 (예를 들어, SMCC-DM1, 술포-SMCC-DM1, SPDB-DM4 또는 CX1-1-DM1)은 임의로 정제에 적용된 후에 항체에 접합된다.
항-P-카드헤린 항체
본 발명은 인간 P-카드헤린에 특이적으로 결합하는 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)을 제공한다. 본 발명의 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)은 실시예에 기재된 바와 같이 단리된 인간 모노클로날 항체 또는 그의 단편을 포함하나 이에 제한되지는 않는다.
본 발명은 특정 실시양태에서 P-카드헤린에 특이적으로 결합하는 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)을 제공하며, 상기 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)은 서열식별번호: 7, 27, 47, 67, 87, 또는 107의 아미노산 서열을 갖는 VH 도메인을 포함한다. 본 발명은 특정 실시양태에서 또한 P-카드헤린에 특이적으로 결합하는 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)을 제공하며, 상기 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)은 하기 표 1에 열거된 VH CDR 중 어느 1개의 아미노산 서열을 갖는 VH CDR을 포함한다. 특정한 실시양태에서, 본 발명은 P-카드헤린에 특이적으로 결합하는 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)을 제공하며, 상기 항체는 하기 표 1에 열거된 VH CDR 중 어느 것의 아미노산 서열을 갖는 1, 2, 3, 4, 5개 또는 그 초과의 VH CDR을 포함한다 (또는 대안적으로 이로 이루어진다).
본 발명은 P-카드헤린에 특이적으로 결합하는 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)을 제공하며, 상기 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)은 서열식별번호: 17, 37, 57, 77, 97, 또는 117의 아미노산 서열을 갖는 VL 도메인을 포함한다. 본 발명은 또한 P-카드헤린에 특이적으로 결합하는 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)을 제공하며, 상기 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)은 하기 표 1에 열거된 VL CDR 중 어느 1개의 아미노산 서열을 갖는 VL CDR을 포함한다. 특히, 본 발명은 P-카드헤린에 특이적으로 결합하는 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)을 제공하며, 상기 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)은 하기 표 1에 열거된 VL CDR 중 어느 것의 아미노산 서열을 갖는 1, 2, 3개 또는 그 초과의 VL CDR을 포함한다 (또는 대안적으로 이로 이루어진다).
본 발명의 다른 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)은 돌연변이되었지만, CDR 영역에서 표 1에 기재된 서열에 제시된 CDR 영역과 적어도 60, 70, 80, 90 또는 95 퍼센트 동일성을 갖는 아미노산을 포함한다. 일부 실시양태에서, 항체는 CDR 영역에서 표 1에 기재된 서열에 제시된 CDR 영역과 비교하였을 때 1, 2, 3, 4 또는 5개 이하의 아미노산이 돌연변이된 것인 돌연변이 아미노산 서열을 포함한다.
본 발명은 또한 P-카드헤린에 특이적으로 결합하는 항체의 VH, VL, 전장 중쇄, 및 전장 경쇄를 코딩하는 핵산 서열을 제공한다. 이러한 핵산 서열은 포유동물 세포에서의 발현에 대해 최적화될 수 있다.
표 1. 본 발명의 항-P-카드헤린 항체의 예
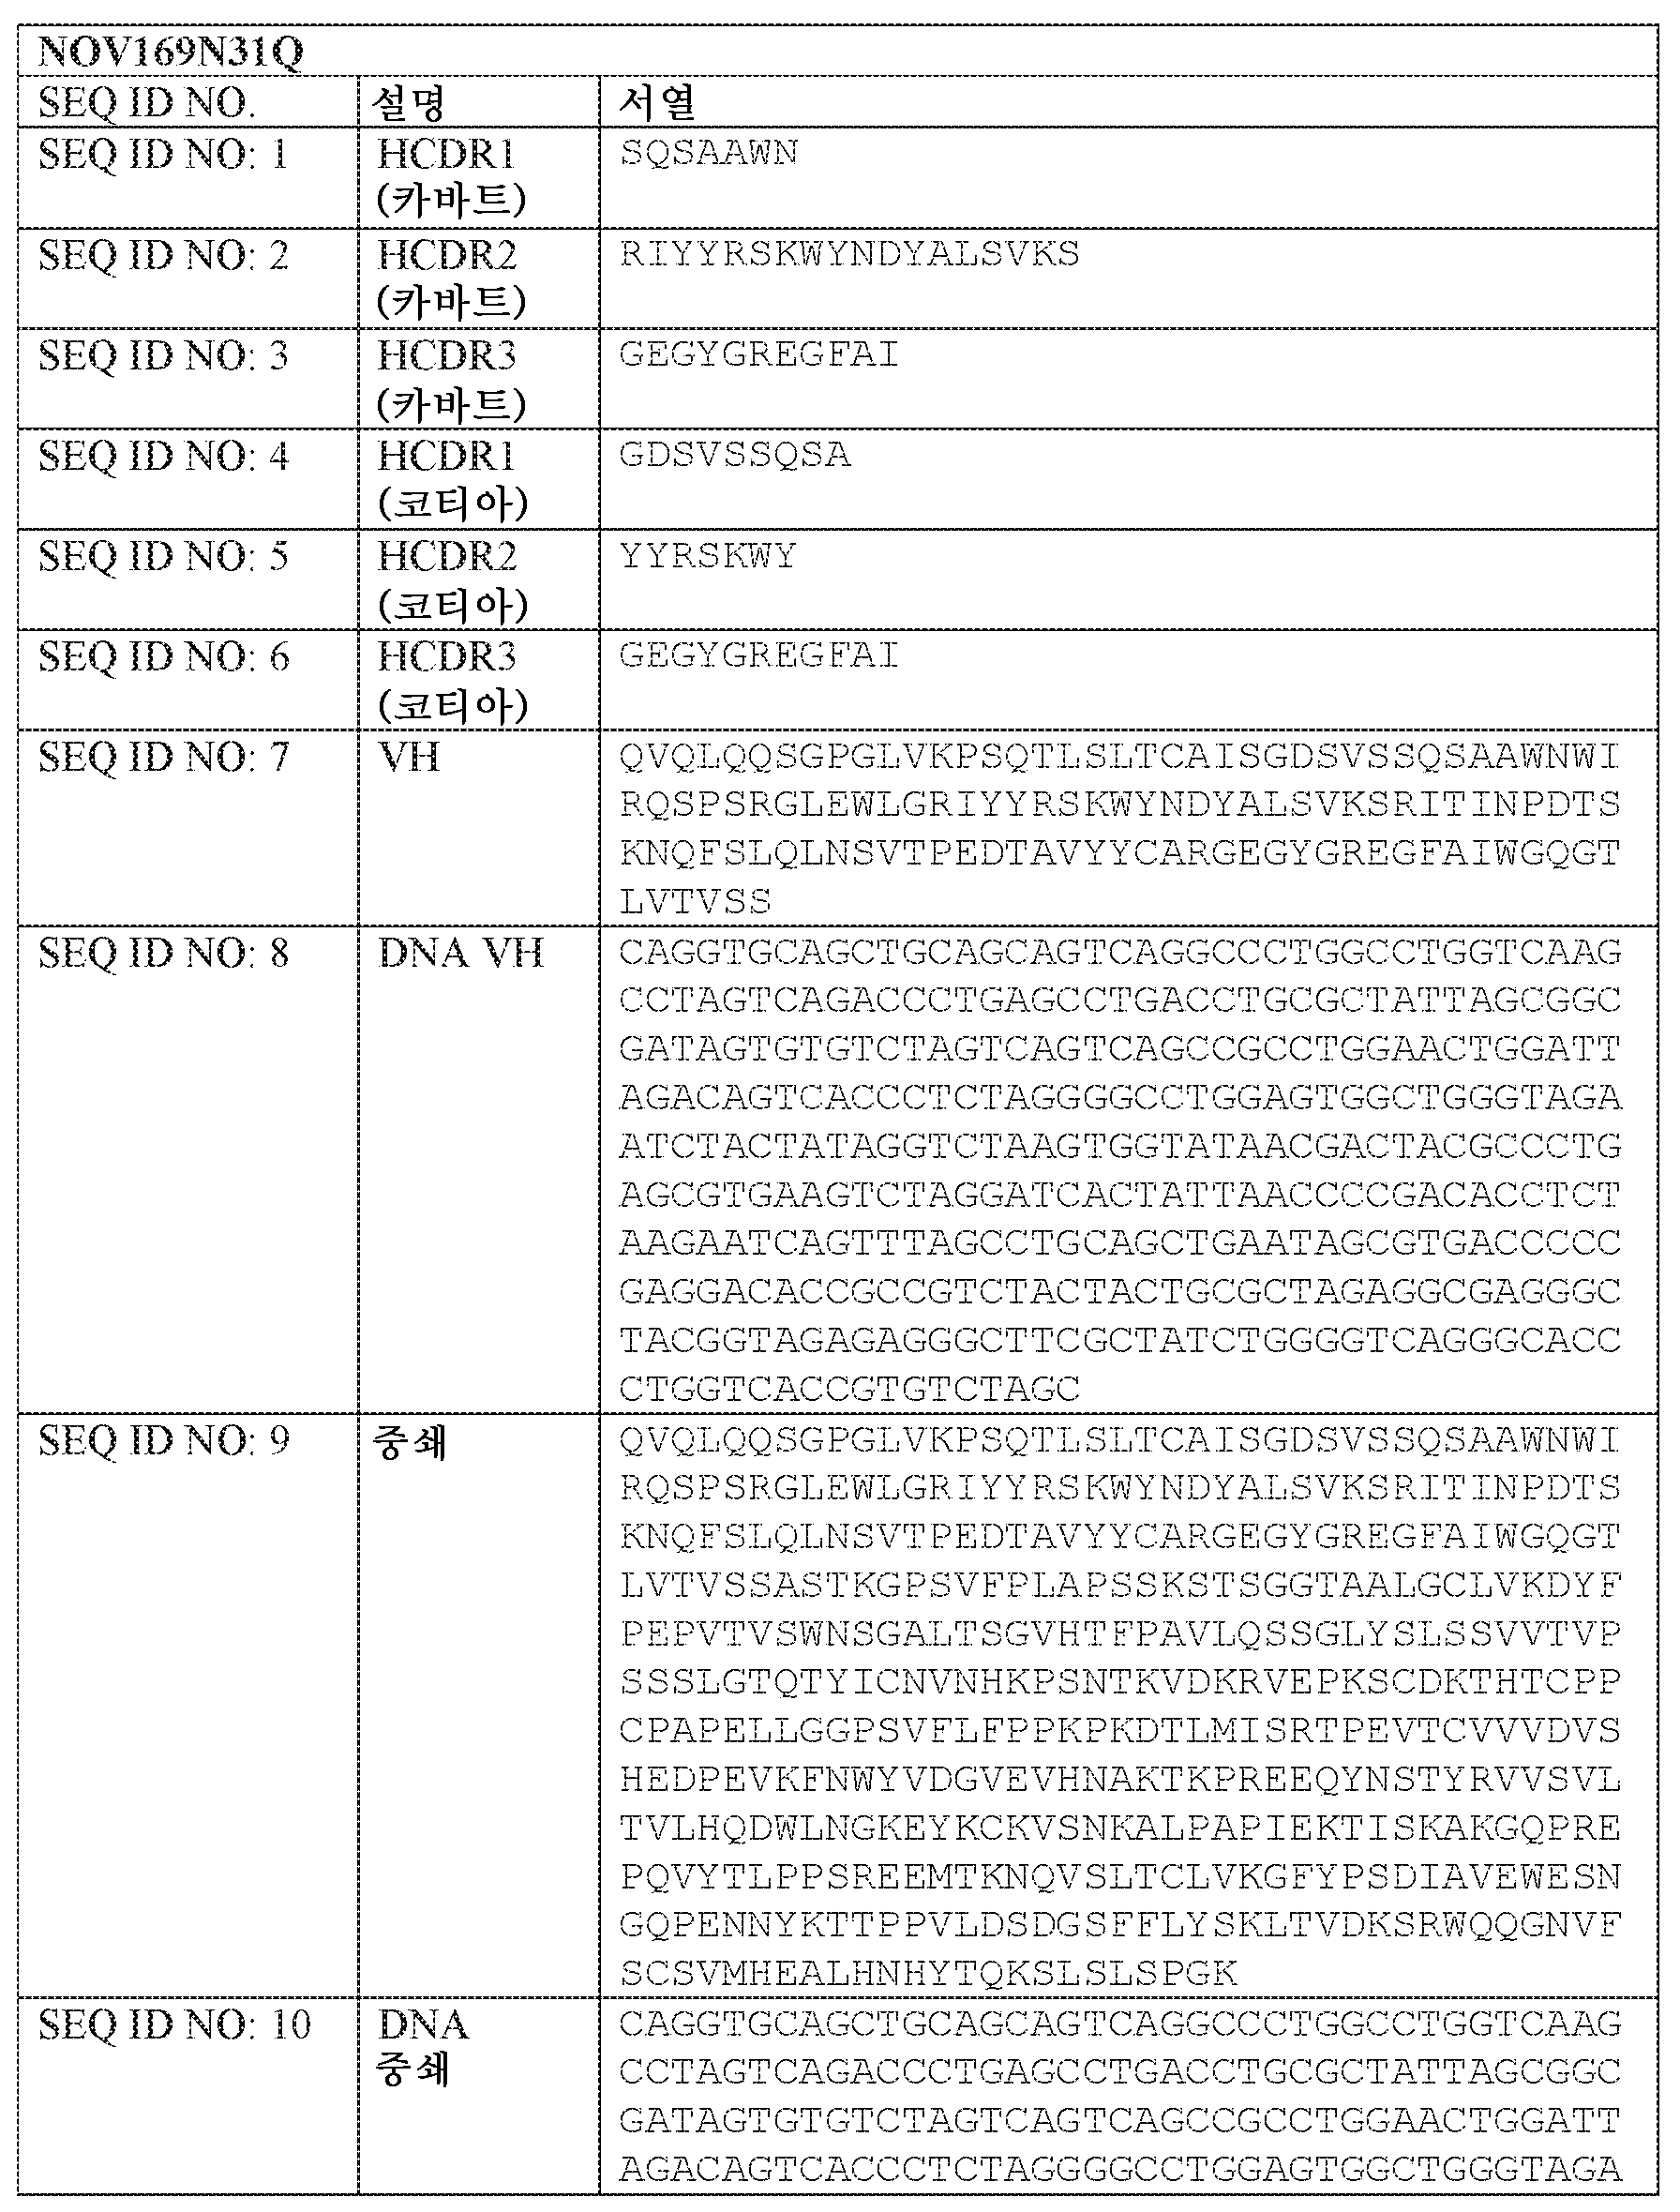

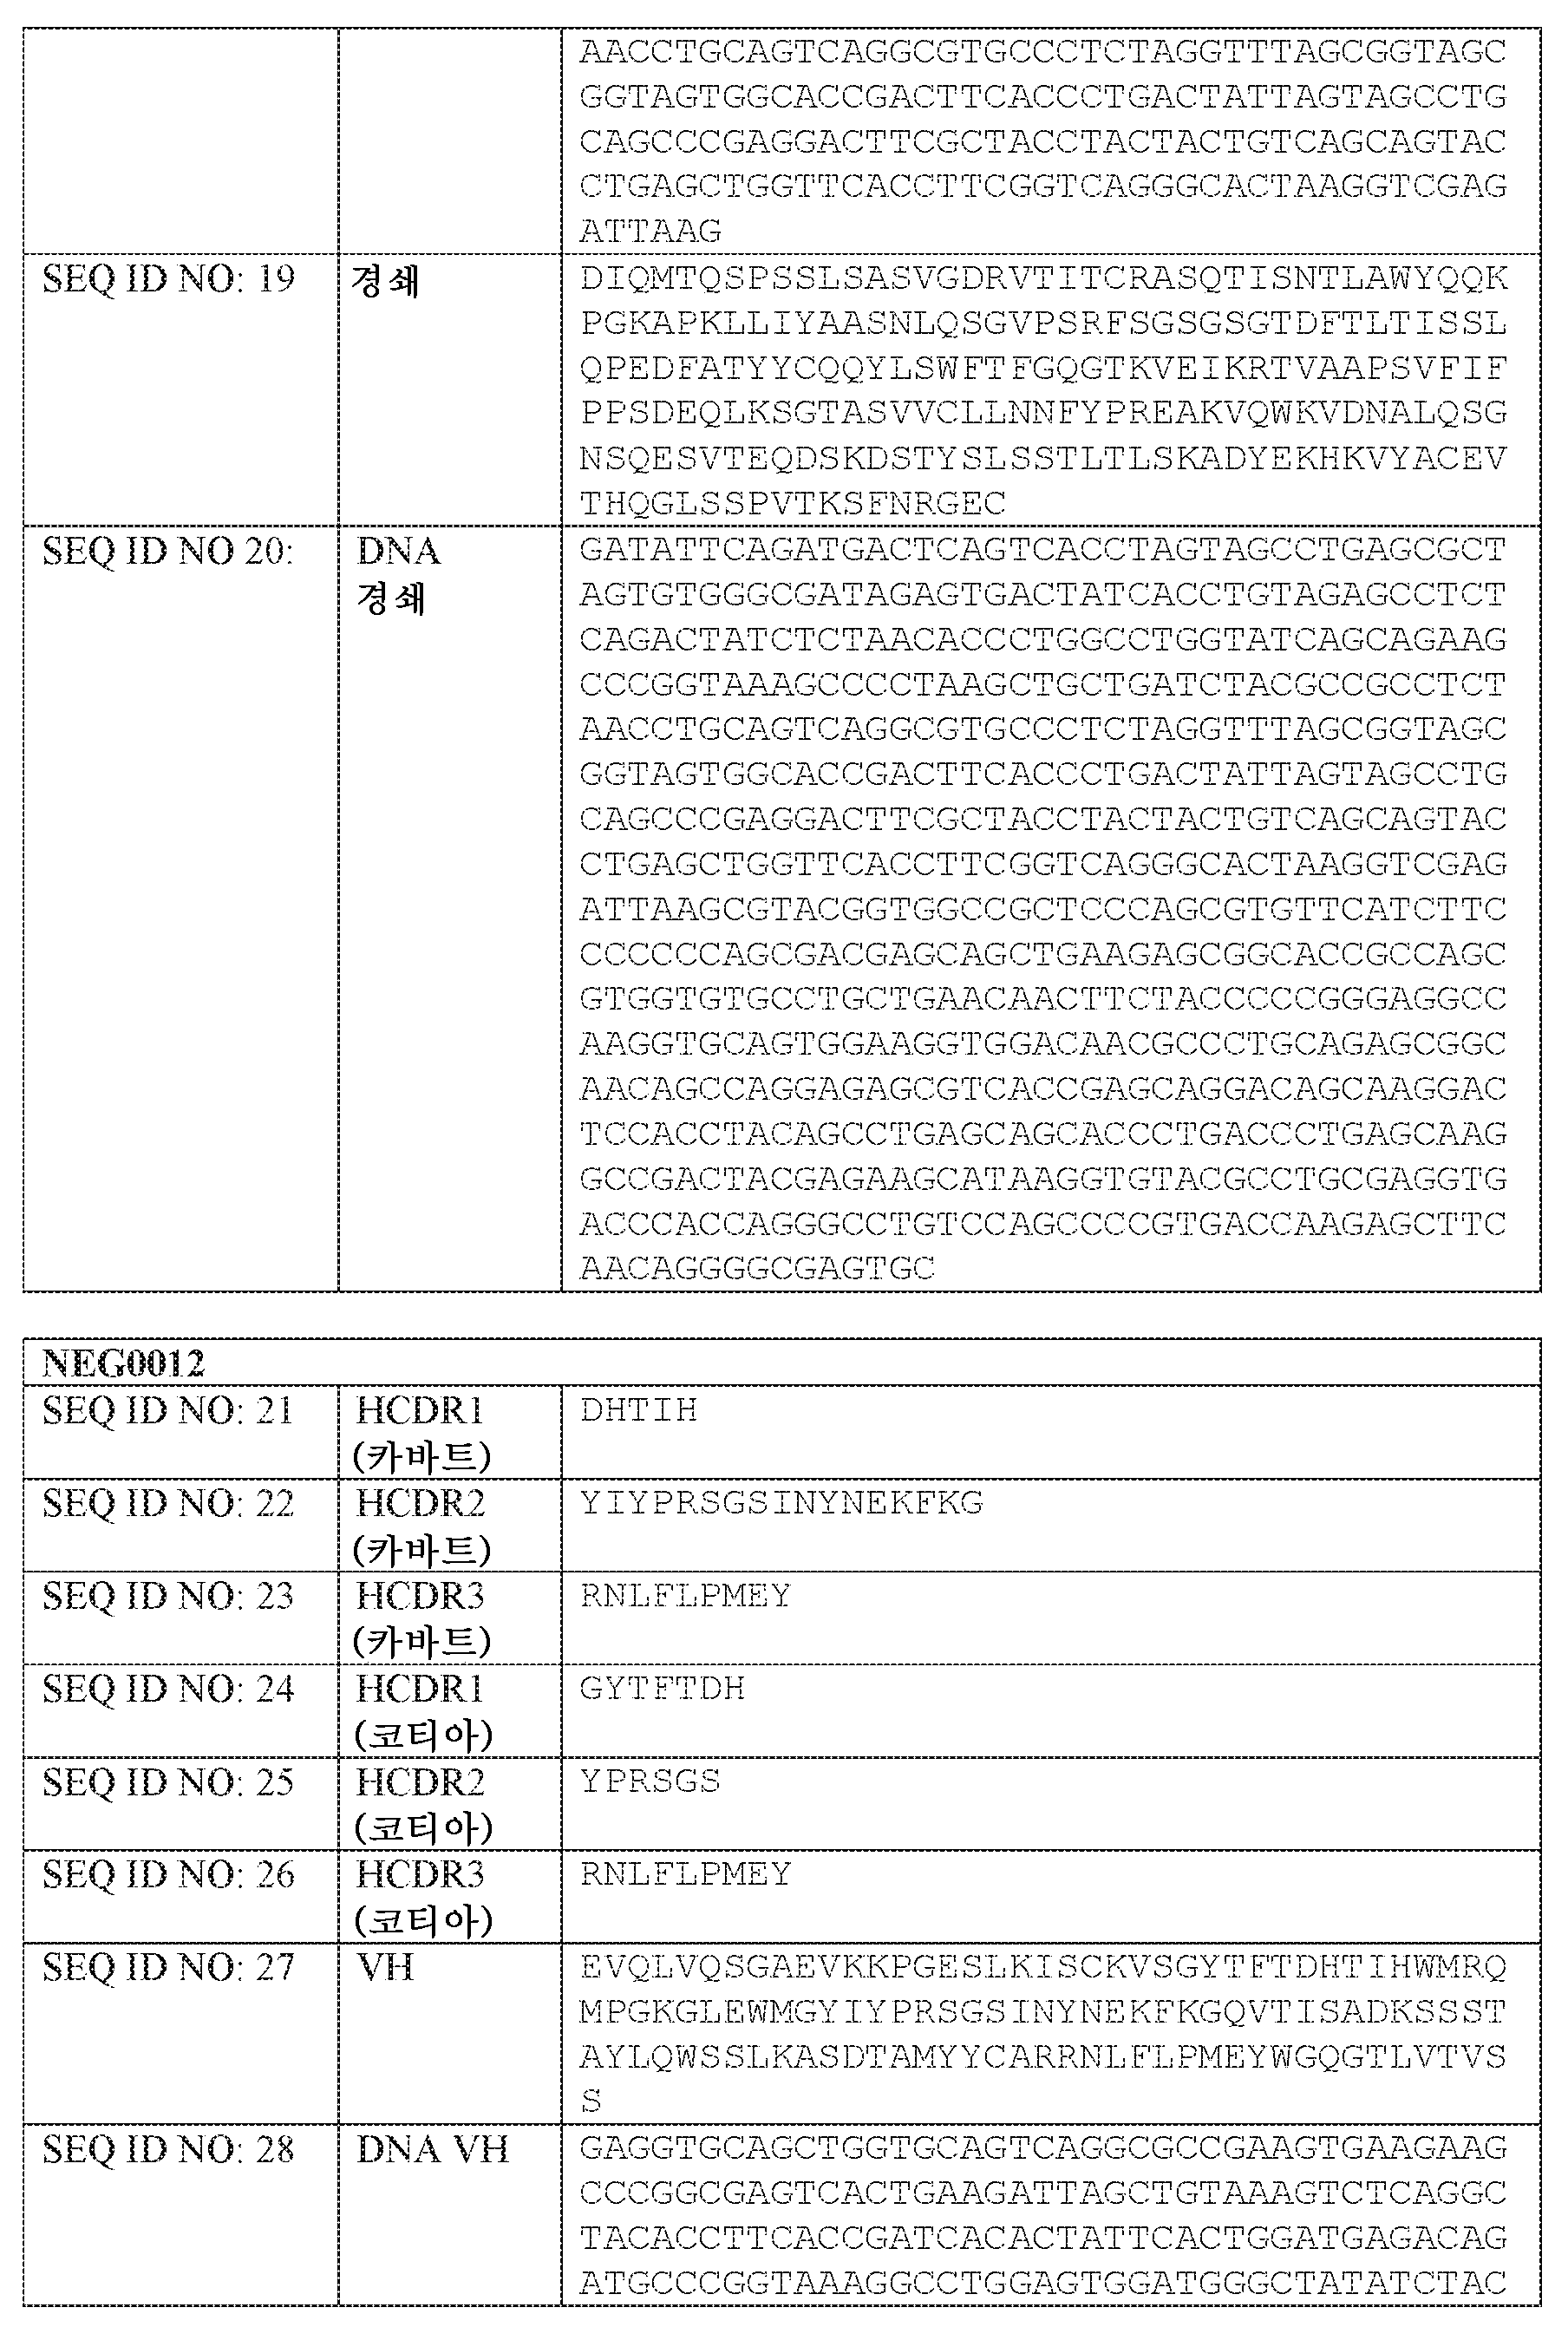
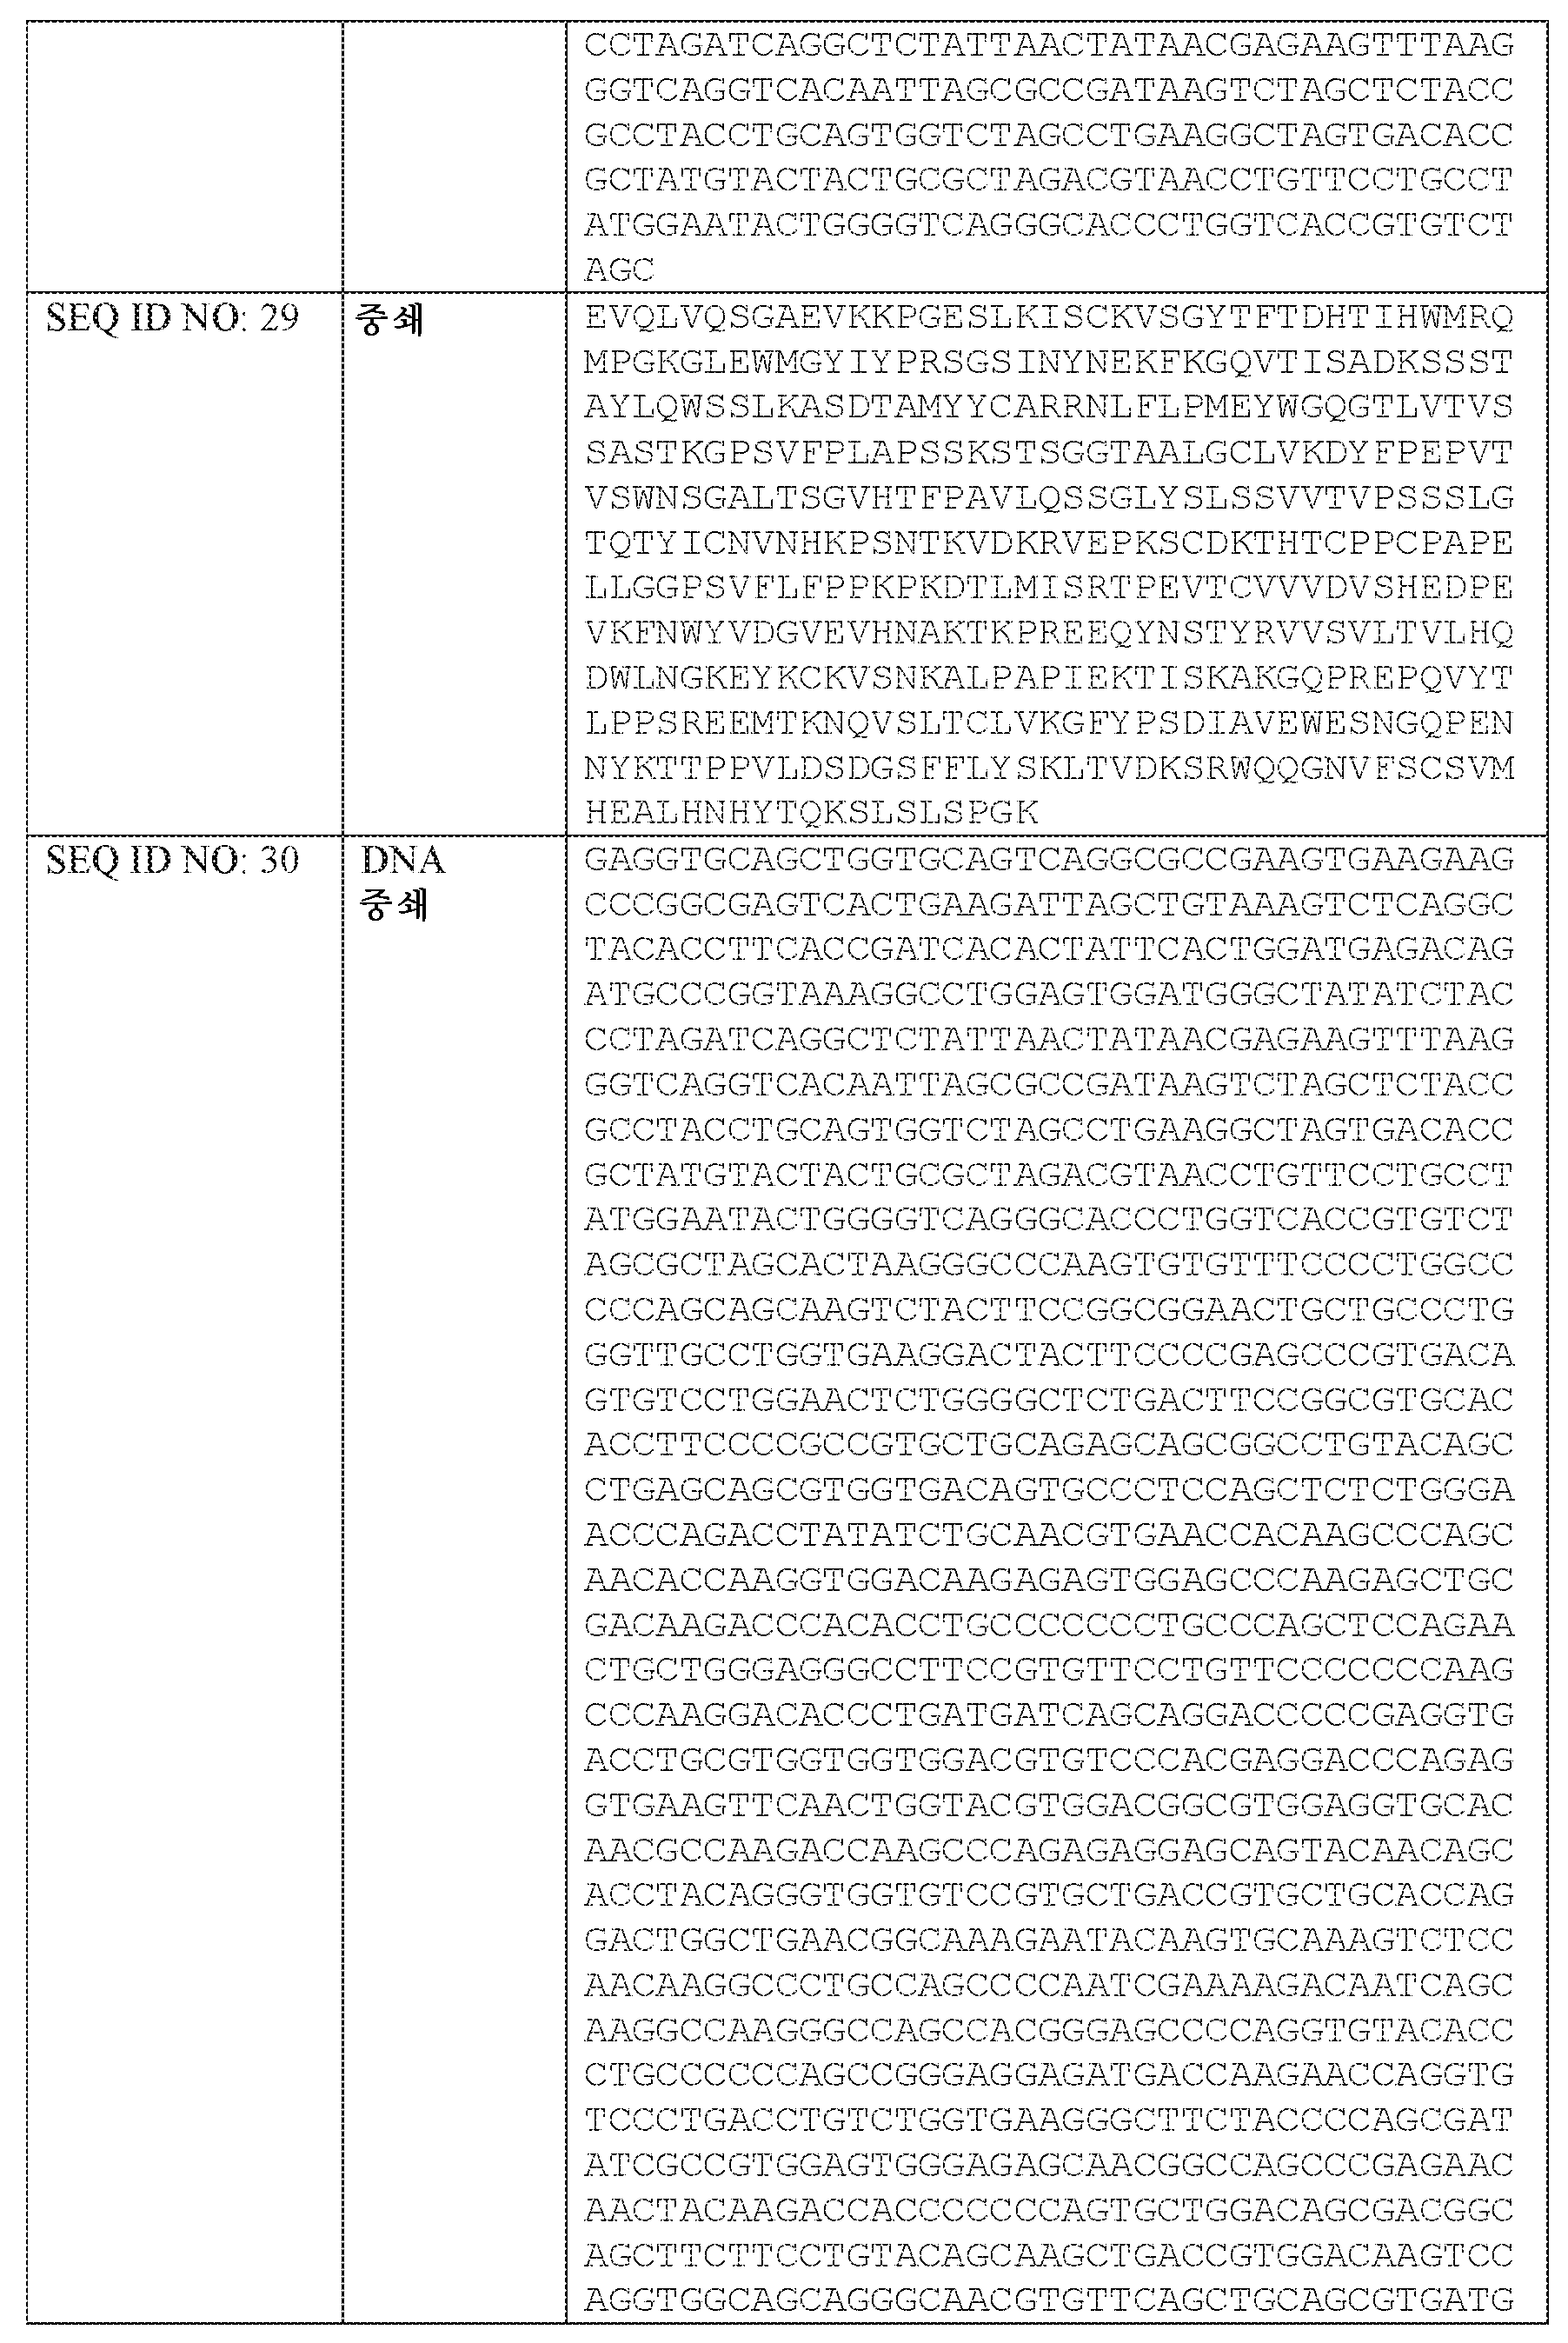


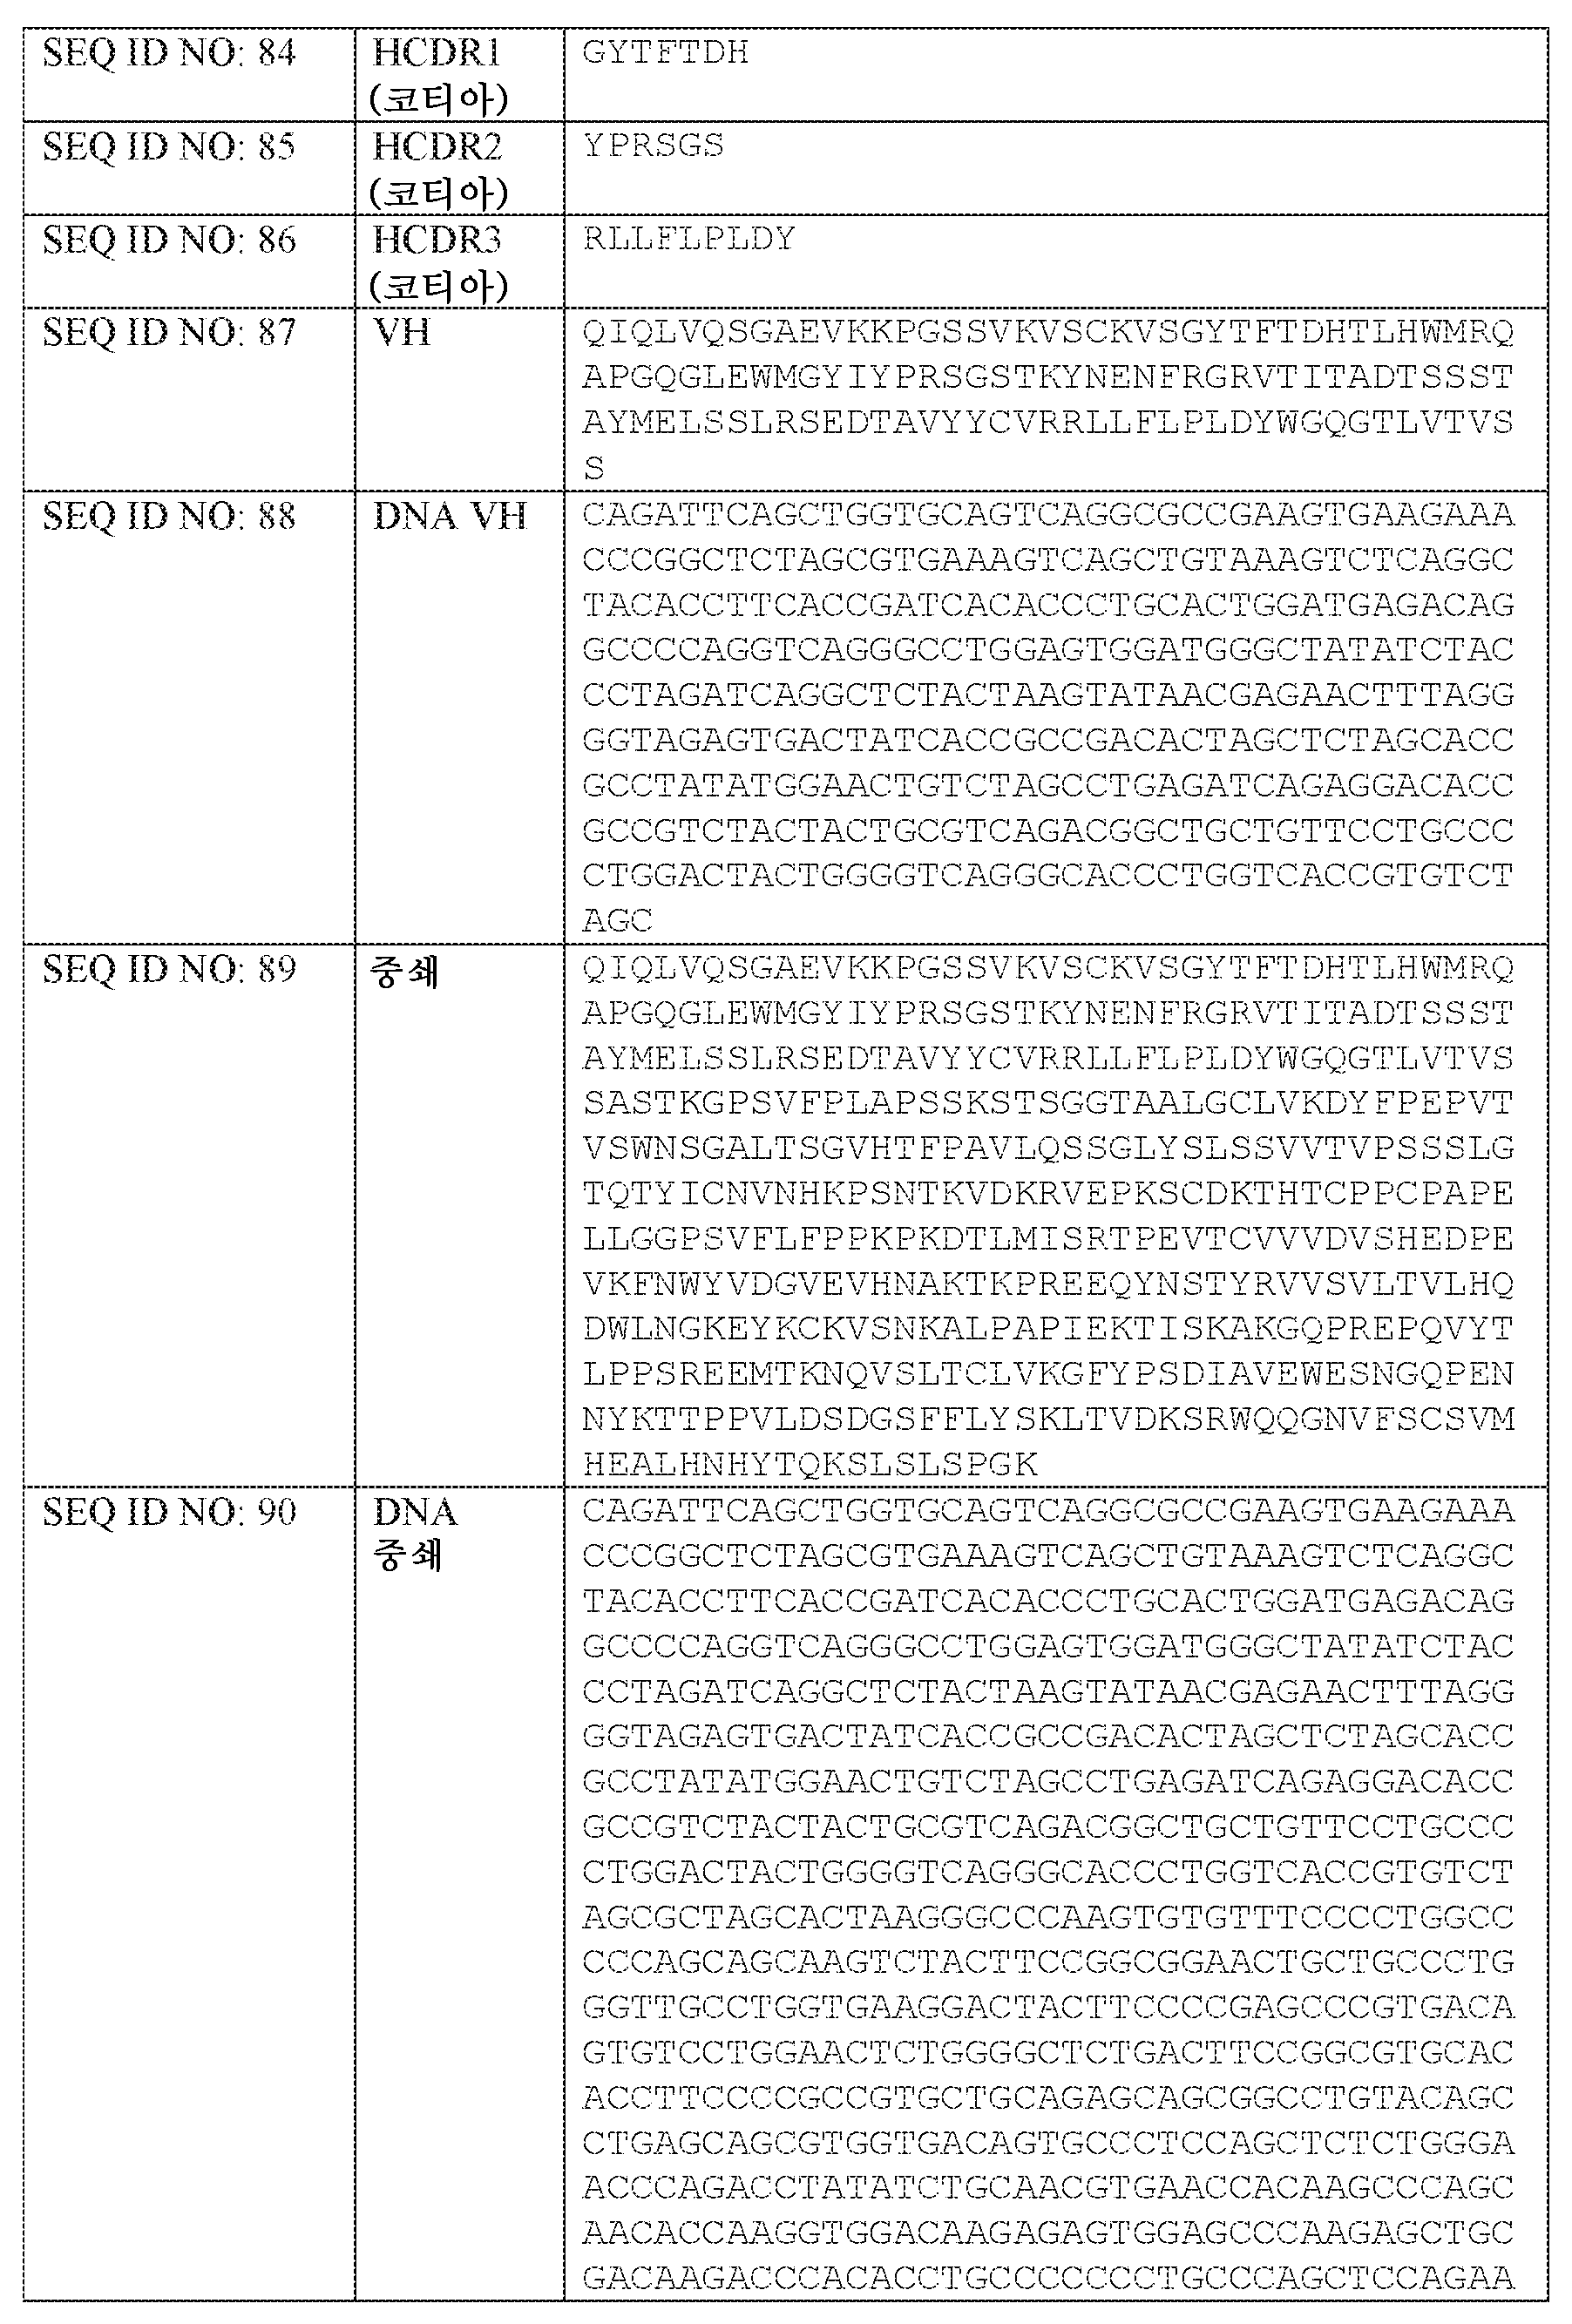
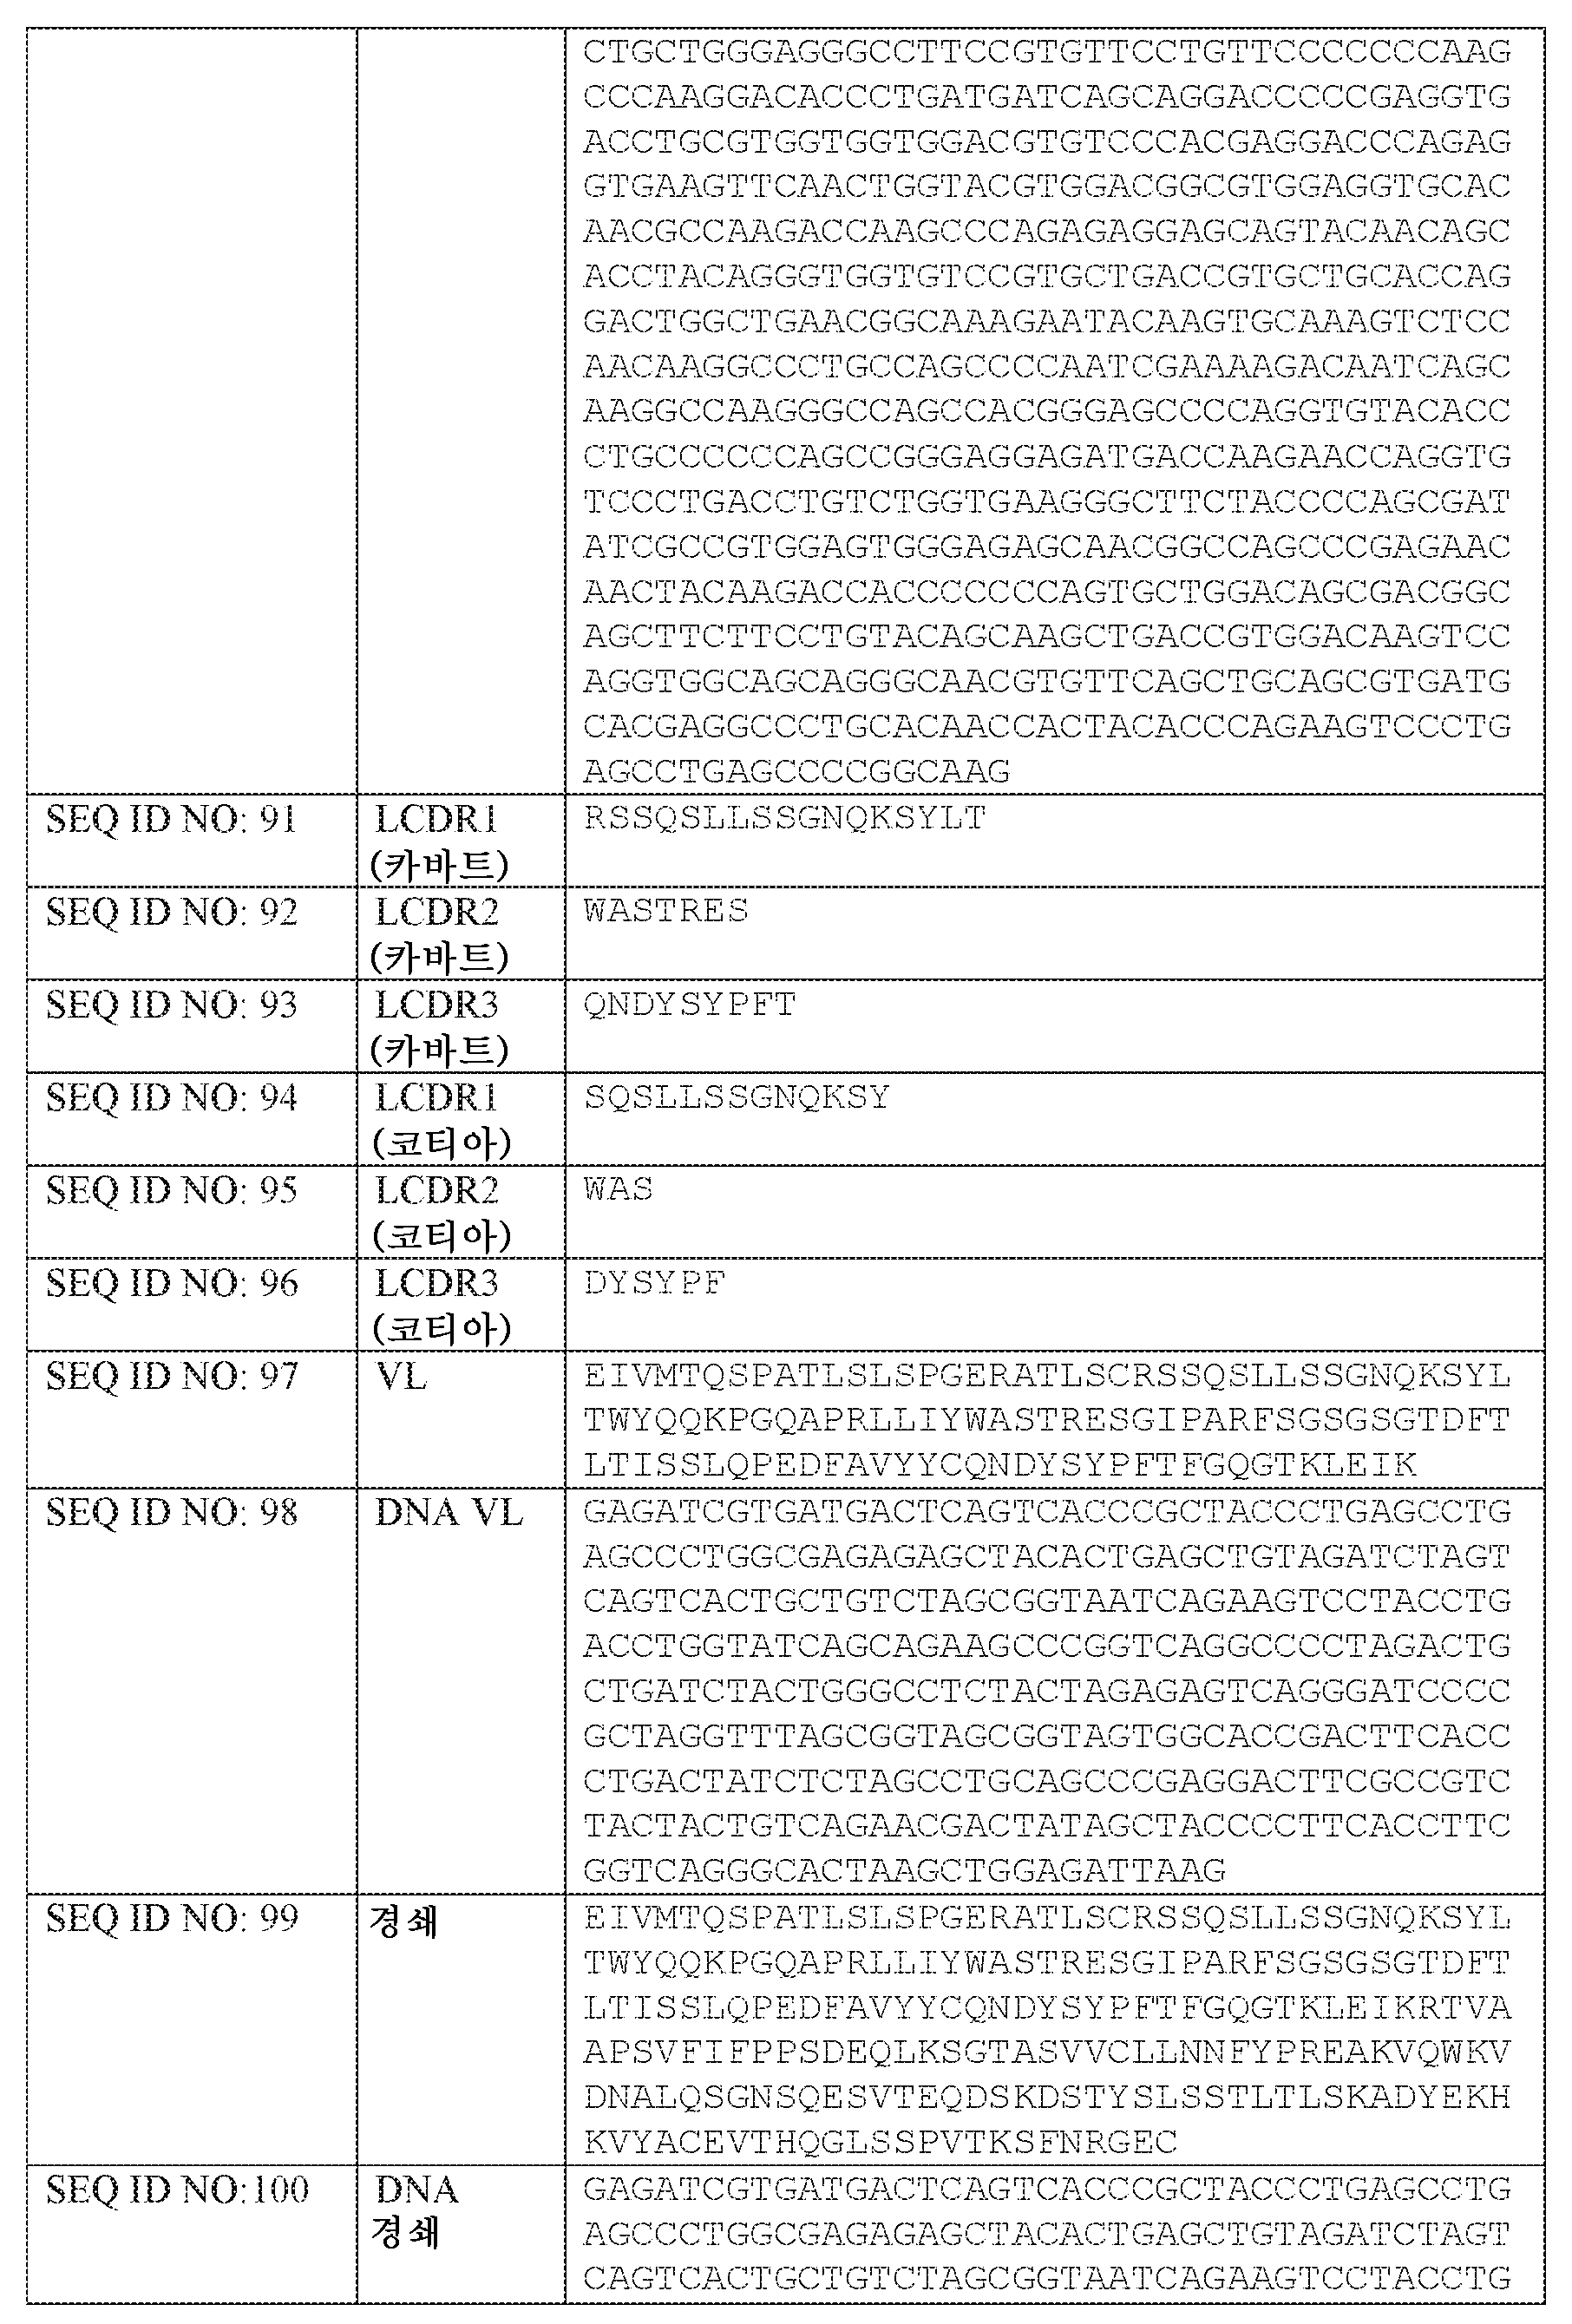

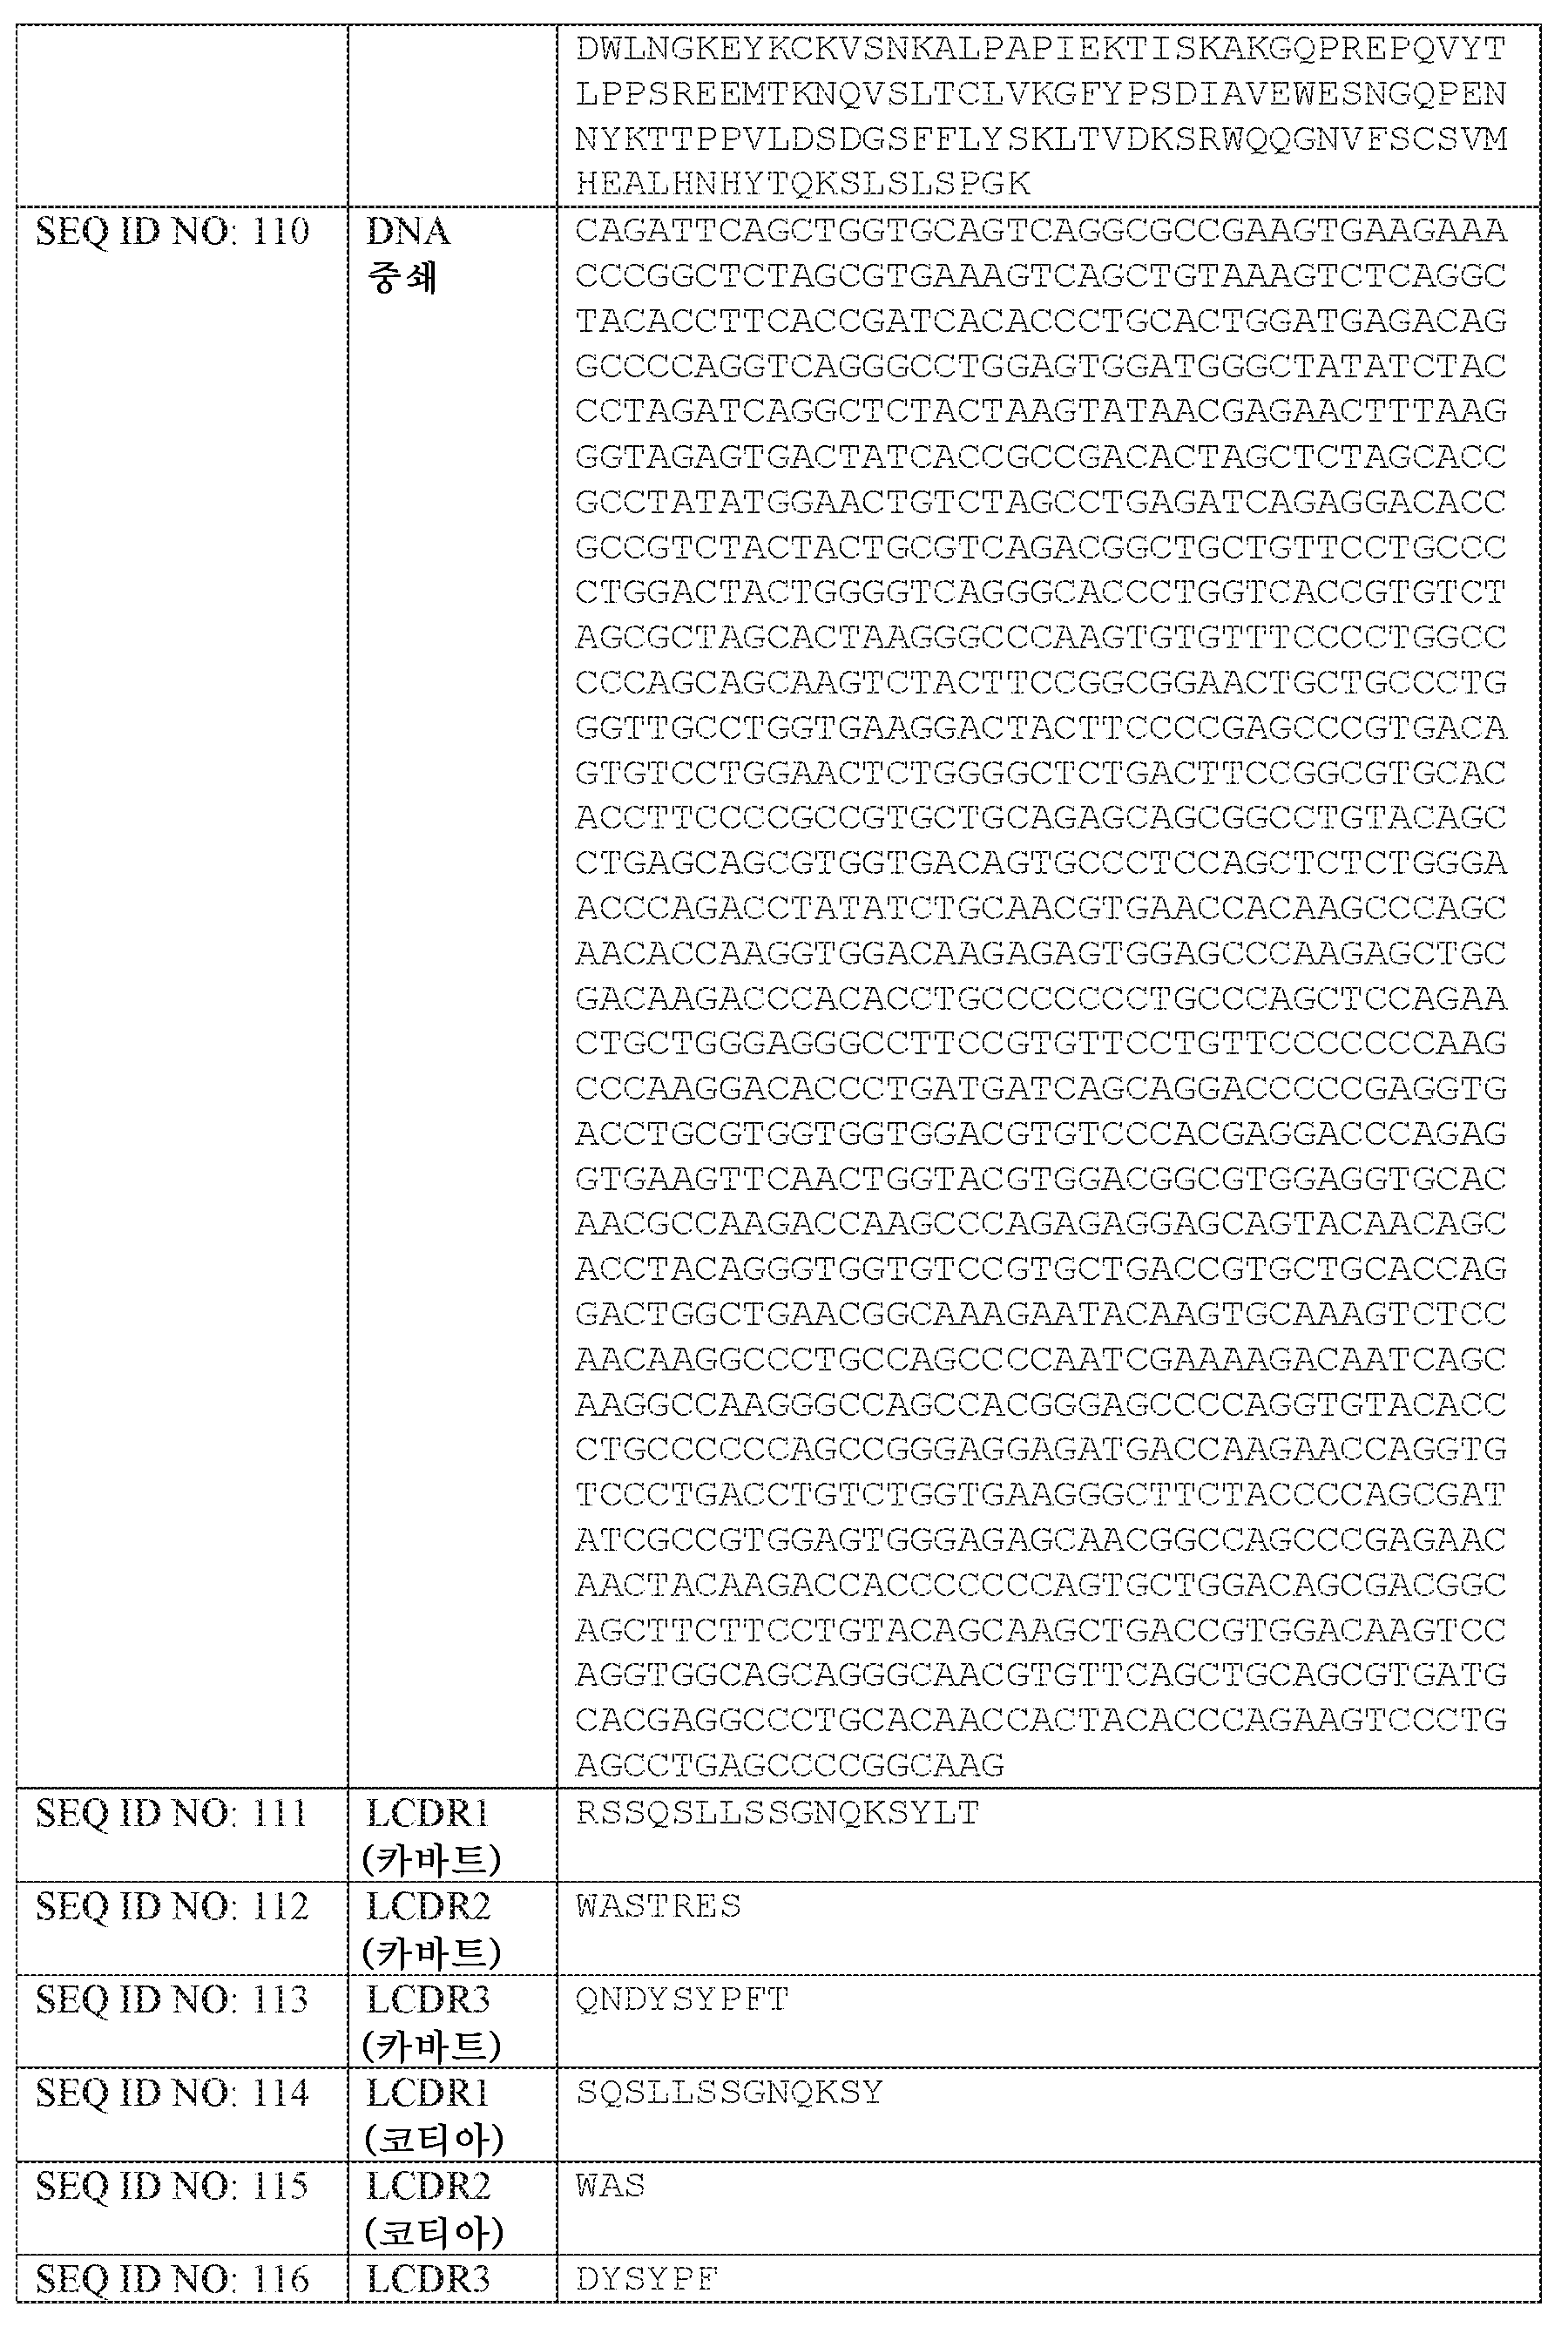
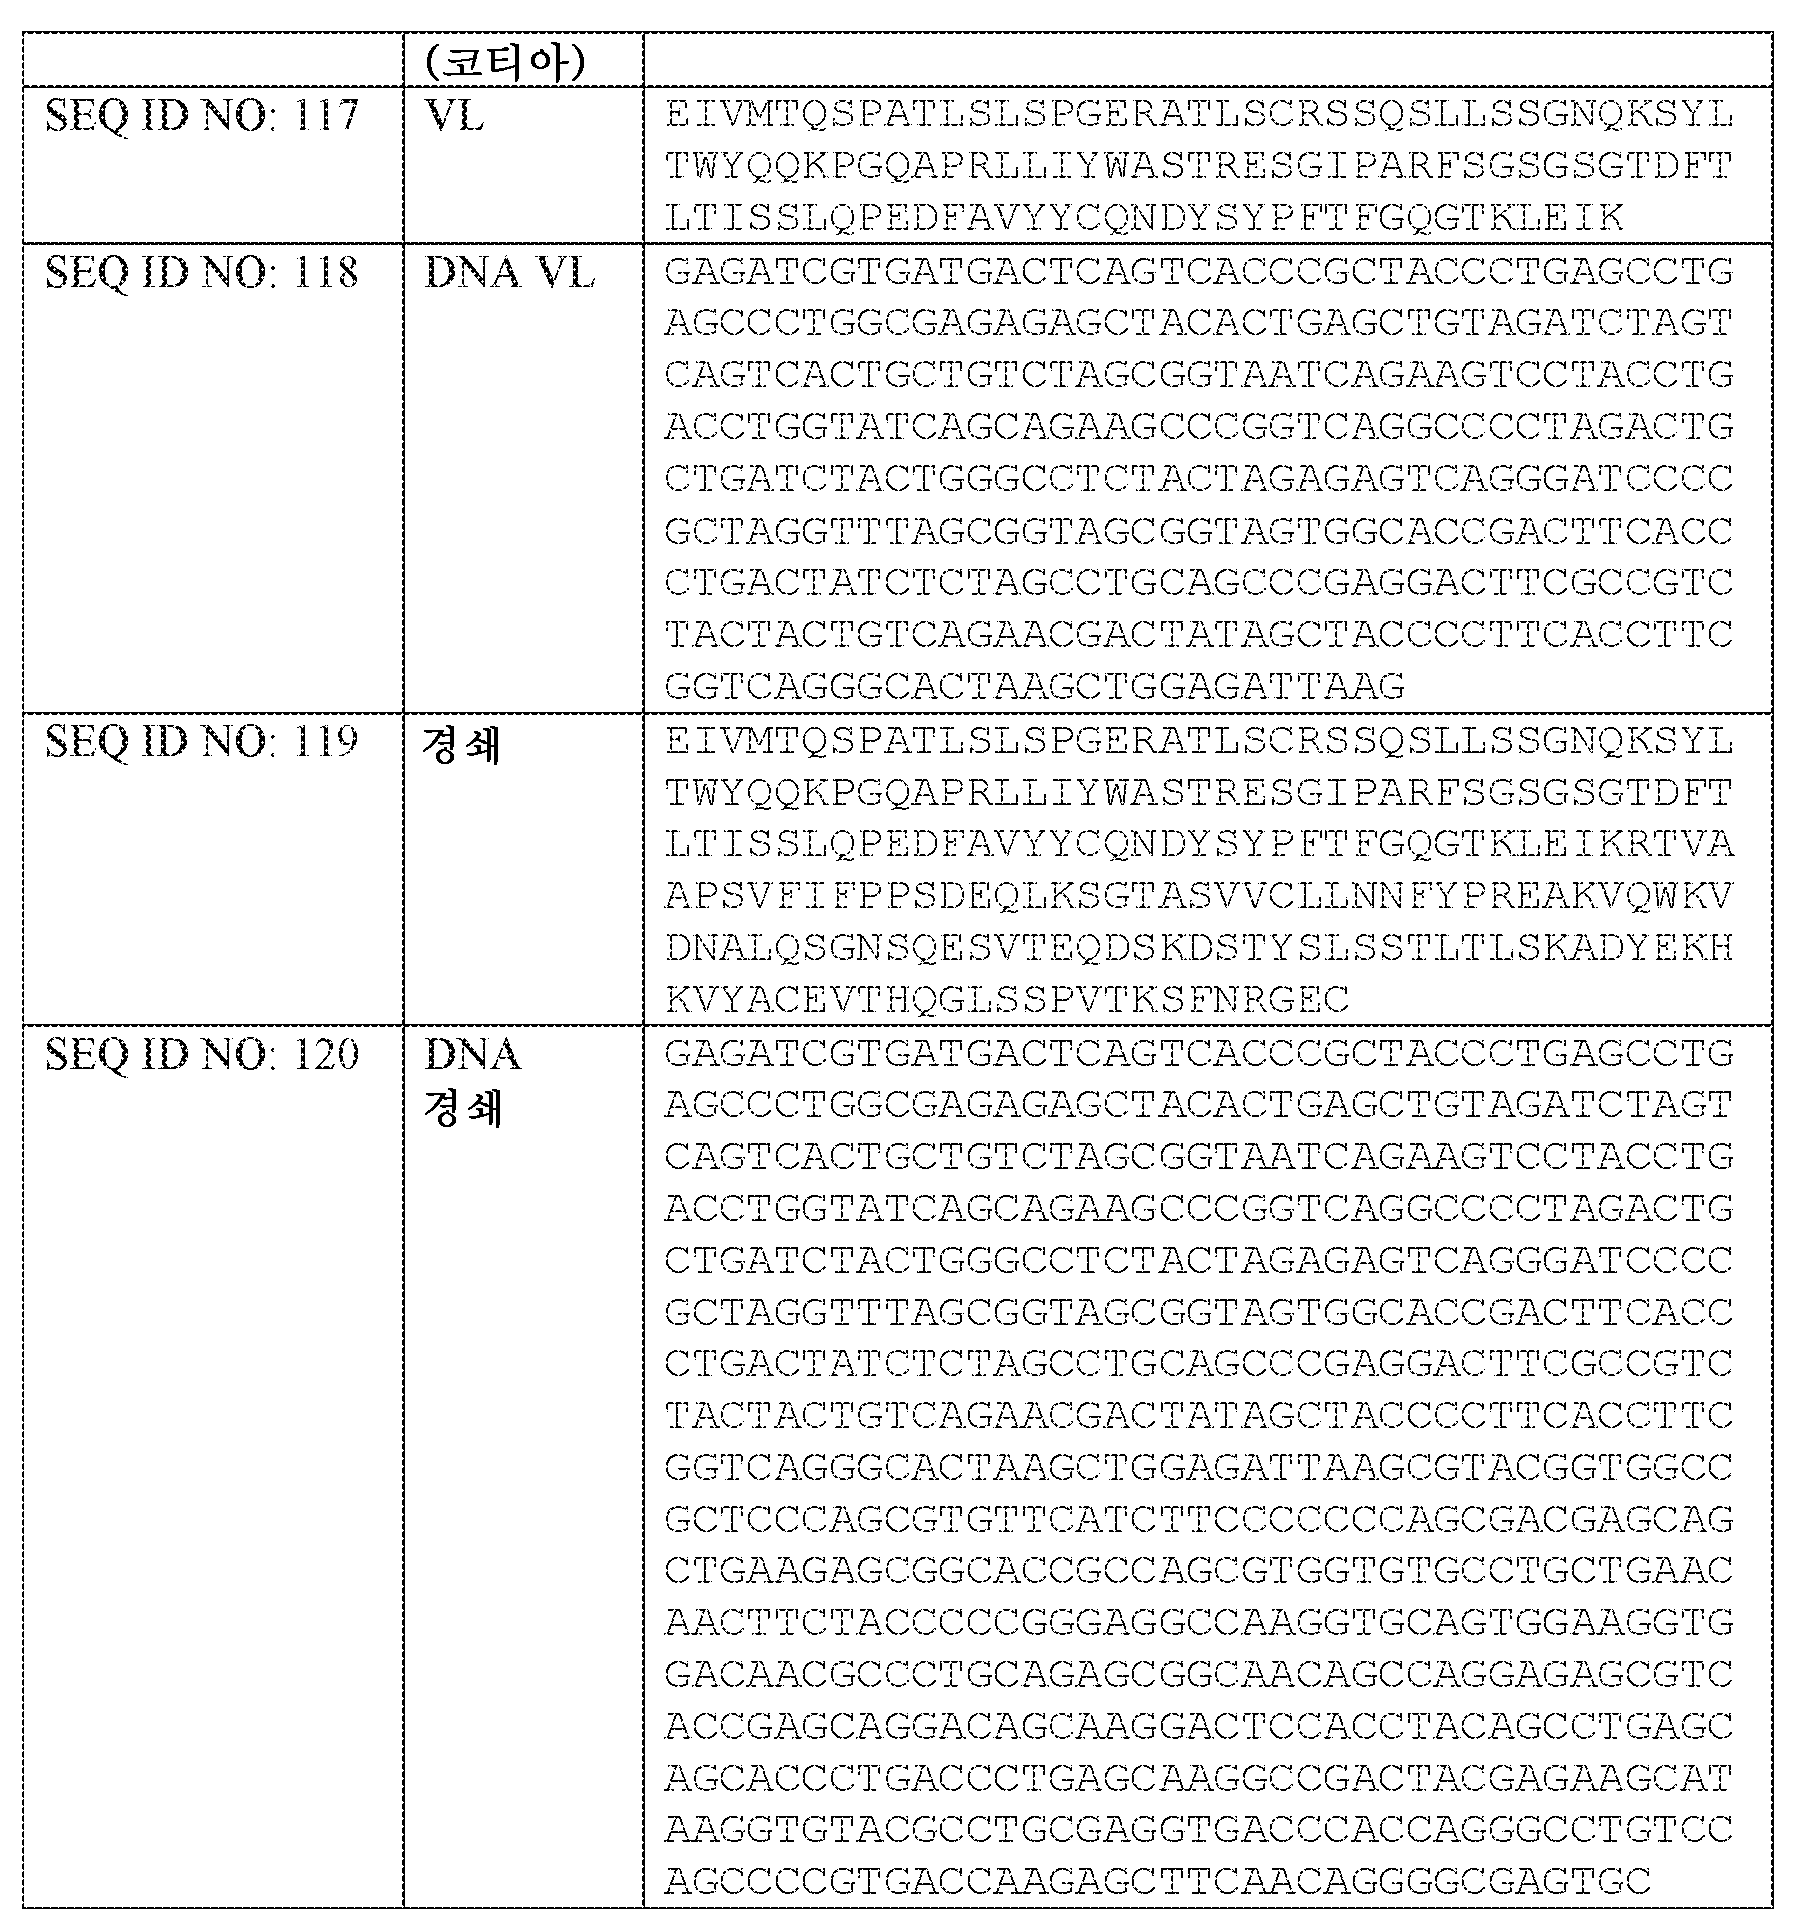
본 발명의 다른 항체는 아미노산 또는 아미노산을 코딩하는 핵산이 돌연변이되었지만, 표 1에 기재된 서열에 대해 적어도 60, 70, 80, 90 또는 95 퍼센트 동일성을 갖는 것을 포함한다. 일부 실시양태에서, 가변 영역에서 표 1에 기재된 서열에 제시된 가변 영역과 비교하였을 때 1, 2, 3, 4 또는 5개의 아미노산이 돌연변이되었지만, 표 1에 열거된 항체와 실질적으로 동일한 치료 활성을 보유한다.
각각의 이들 항체가 P-카드헤린에 결합할 수 있기 때문에, VH, VL, 전장 경쇄, 및 전장 중쇄 서열 (아미노산 서열 및 아미노산 서열을 코딩하는 뉴클레오티드 서열)은 "혼합 및 매칭"되어 본 발명의 다른 P-카드헤린-결합 항체를 생성할 수 있다. 이러한 "혼합 및 매칭"된 P-카드헤린-결합 항체는 관련 기술분야에 공지된 결합 검정 (예를 들어, ELISA, 및 실시예 섹션에 기재된 다른 검정)을 사용하여 시험될 수 있다. 이들 쇄가 혼합 및 매칭되는 경우에, 특정한 VH/VL 쌍형성으로부터의 VH 서열은 구조적으로 유사한 VH 서열로 대체되어야 한다. 마찬가지로, 특정한 전장 중쇄 / 전장 경쇄 쌍형성으로부터의 전장 중쇄 서열은 구조적으로 유사한 전장 중쇄 서열로 대체되어야 한다. 마찬가지로, 특정한 VH/VL 쌍형성으로부터의 VL 서열은 구조적으로 유사한 VL 서열로 대체되어야 한다. 마찬가지로, 특정한 전장 중쇄 / 전장 경쇄 쌍형성으로부터의 전장 경쇄 서열은 구조적으로 유사한 전장 경쇄 서열로 대체되어야 한다. 따라서, 한 측면에서, 본 발명은 서열식별번호: 7, 27, 47, 67, 87 및 107로 이루어진 군으로부터 선택된 아미노산 서열을 포함하는 중쇄 가변 영역; 및 서열식별번호: 17, 37, 57, 77, 97 및 117로 이루어진 군으로부터 선택된 아미노산 서열을 포함하는 경쇄 가변 영역를 가지며, P-카드헤린에 특이적으로 결합하는, 단리된 모노클로날 항체 또는 항원 결합 영역을 제공한다.
또 다른 측면에서, 본 발명은 (i) 서열식별번호: 9, 29, 49, 69, 89, 및 109로 이루어진 군으로부터 선택된 포유동물 발현 시스템의 세포에서의 발현에 대해 최적화된 아미노산 서열을 포함하는 전장 중쇄; 및 서열식별번호: 19, 39, 59, 79, 99, 및 119로 이루어진 군으로부터 선택된 포유동물의 세포에서의 발현에 대해 최적화된 아미노산 서열을 포함하는 전장 경쇄를 갖는 단리된 모노클로날 항체; 또는 (ii) 그의 항원 결합 부분을 포함하는 기능적 단백질을 제공한다.
또 다른 측면에서, 본 발명은 표 1에 기재된 바와 같은 중쇄 및 경쇄 CDR1, CDR2 및 CDR3, 또는 그의 조합을 포함하는 P-카드헤린-결합 항체를 제공한다. 항체의 VH CDR1의 아미노산 서열은 서열식별번호: 1, 21, 41, 61, 81, 및 101에 제시되어 있다. 항체의 VH CDR2의 아미노산 서열 및 서열식별번호: 2, 22, 42, 62, 82, 및 102에 제시되어 있다. 항체의 VH CDR3의 아미노산 서열은 서열식별번호: 3, 23, 43, 63, 83, 및 103에 제시되어 있다. 항체의 VL CDR1의 아미노산 서열은 서열식별번호: 11, 31, 51, 71, 91, 및 111에 제시되어 있다. 항체의 VL CDR2의 아미노산 서열은 서열식별번호: 12, 32, 52, 72, 92, 및 112에 제시되어 있다. 항체의 VL CDR3의 아미노산 서열은 서열식별번호: 13, 33, 53, 73, 93, 및 113에 제시되어 있다.
각각의 이들 항체가 P-카드헤린에 결합할 수 있고 항원-결합 특이성이 주로 CDR1, 2 및 3 영역에 의해 제공된다는 것을 고려해 볼 때, VH CDR1, CDR2 및 CDR3 서열 및 VL CDR1, CDR2 및 CDR3 서열은 "혼합 및 매칭"될 수 있다 (즉, 상이한 항체로부터의 CDR이 혼합 및 매칭될 수 있다). 이러한 "혼합 및 매칭"된 P-카드헤린-결합 항체는 관련 기술분야에 공지된 결합 검정 및 실시예에 기재된 것 (예를 들어, ELISA)을 사용하여 시험될 수 있다. VH CDR 서열이 혼합 및 매칭되는 경우에, 특정한 VH 서열로부터의 CDR1, CDR2 및/또는 CDR3 서열은 구조적으로 유사한 CDR 서열(들)로 대체되어야 한다. 마찬가지로, VL CDR 서열이 혼합 및 매칭되는 경우에, 특정한 VL 서열로부터의 CDR1, CDR2 및/또는 CDR3 서열은 구조적으로 유사한 CDR 서열(들)로 대체되어야 한다. 1개 이상의 VH 및/또는 VL CDR 영역 서열을 본 발명의 모노클로날 항체에 대해 본원에 제시된 CDR 서열로부터의 구조적으로 유사한 서열로 치환함으로써 신규 VH 및 VL 서열이 생성될 수 있다는 것은 통상의 기술자에게 자명할 것이다.
따라서, 본 발명은 서열식별번호: 1, 21, 41, 61, 81, 및 101로 이루어진 군으로부터 선택된 아미노산 서열을 포함하는 중쇄 CDR1; 서열식별번호: 2, 22, 42, 62, 82, 및 102로 이루어진 군으로부터 선택된 아미노산 서열을 포함하는 중쇄 CDR2; 서열식별번호: 3, 23, 43, 63, 83, 및 103으로 이루어진 군으로부터 선택된 아미노산 서열을 포함하는 중쇄 CDR3; 서열식별번호: 11, 31, 51, 71, 91, 및 111로 이루어진 군으로부터 선택된 아미노산 서열을 포함하는 경쇄 CDR1; 서열식별번호: 12, 32, 52, 72, 92, 및 112로 이루어진 군으로부터 선택된 아미노산 서열을 포함하는 경쇄 CDR2; 및 서열식별번호: 13, 33, 53, 73, 93, 및 113으로 이루어진 군으로부터 선택된 아미노산 서열을 포함하는 경쇄 CDR3을 포함하며; P-카드헤린에 특이적으로 결합하는, 단리된 모노클로날 항체 또는 항원 결합 영역을 제공한다.
구체적 실시양태에서, P-카드헤린에 특이적으로 결합하는 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)은 서열식별번호: 1의 중쇄 CDR1, 서열식별번호: 2의 중쇄 CDR2; 서열식별번호: 3의 중쇄 CDR3; 서열식별번호: 11의 경쇄 CDR1; 서열식별번호: 12의 경쇄 CDR2; 및 서열식별번호: 13의 경쇄 CDR3을 포함한다.
또 다른 구체적 실시양태에서, P-카드헤린에 특이적으로 결합하는 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)은 서열식별번호: 21의 중쇄 CDR1, 서열식별번호: 22의 중쇄 CDR2; 서열식별번호: 23의 중쇄 CDR3; 서열식별번호: 31의 경쇄 CDR1; 서열식별번호: 32의 경쇄 CDR2; 및 서열식별번호: 33의 경쇄 CDR3을 포함한다.
또 다른 실시양태에서, P-카드헤린에 특이적으로 결합하는 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)은 서열식별번호: 41의 중쇄 CDR1, 서열식별번호: 42의 중쇄 CDR2; 서열식별번호: 43의 중쇄 CDR3; 서열식별번호: 51의 경쇄 CDR1; 서열식별번호: 52의 경쇄 CDR2; 및 서열식별번호: 53의 경쇄 CDR3을 포함한다.
추가 실시양태에서, P-카드헤린에 특이적으로 결합하는 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)은 서열식별번호: 61의 중쇄 CDR1, 서열식별번호: 62의 중쇄 CDR2; 서열식별번호: 63의 중쇄 CDR3; 서열식별번호: 71의 경쇄 CDR1; 서열식별번호: 72의 경쇄 CDR2; 및 서열식별번호: 73의 경쇄 CDR3을 포함한다.
또 다른 구체적 실시양태에서, P-카드헤린에 특이적으로 결합하는 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)은 서열식별번호: 81의 중쇄 CDR1, 서열식별번호: 82의 중쇄 CDR2; 서열식별번호: 83의 중쇄 CDR3; 서열식별번호: 91의 경쇄 CDR1; 서열식별번호: 92의 경쇄 CDR2; 및 서열식별번호: 93의 경쇄 CDR3을 포함한다.
추가의 구체적 실시양태에서, P-카드헤린에 특이적으로 결합하는 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)은 서열식별번호: 101의 중쇄 CDR1, 서열식별번호: 102의 중쇄 CDR2; 서열식별번호: 103의 중쇄 CDR3; 서열식별번호: 111의 경쇄 CDR1; 서열식별번호: 112의 경쇄 CDR2; 및 서열식별번호: 113의 경쇄 CDR3을 포함한다.
특정 실시양태에서, P-카드헤린에 특이적으로 결합하는 항체는 표 1에 기재된 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)이다.
1. 에피토프 및 동일한 에피토프에 결합하는 항체의 확인
한 실시양태에서, 본 발명은 서열식별번호: 126의 위치 124, 125, 151, 153, 154, 155, 156, 159, 160, 161, 162, 163, 168, 170, 171, 및 172에서의 아미노산으로부터 선택된 1개 이상의 잔기를 포함하는 인간 P-카드헤린 상의 에피토프에 특이적으로 결합하는 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)을 제공한다. 일부 실시양태에서, 본 발명은 서열식별번호: 126의 위치 124, 151, 153-156, 및 172로부터 선택된 1개 이상의 아미노산 잔기에서 인간 P-카드헤린에 결합하는 중쇄를 포함하는 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)을 제공한다. 다른 실시양태에서, 본 발명은 서열식별번호: 126의 위치 124, 125, 155, 156, 159-163, 168, 170, 및 171로부터 선택된 1개 이상의 아미노산 잔기에서 인간 P-카드헤린에 결합하는 경쇄를 포함하는 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)을 제공한다. 일부 실시양태에서, 항체 또는 항체 단편은 서열식별번호: 128의 위치 52, 54, 56, 60, 65, 105, 또는 107로부터 선택된 1개 이상의 아미노산 잔기를 포함하는 인간 P-카드헤린 단백질에 대한 중쇄 결합 파라토프를 포함한다. 다른 실시양태에서, 항체 또는 항체 단편은 서열식별번호: 129의 위치 1, 2, 27, 28, 30, 68, 92, 93, 또는 94로부터 선택된 1개 이상의 아미노산 잔기를 포함하는 인간 P-카드헤린 단백질에 대한 경쇄 결합 파라토프를 포함한다
본 발명은 또한, 표 1에 기재된 항-P-카드헤린 항체와 동일한 에피토프에 특이적으로 결합하거나, 또는 표 1에 기재된 항체와 교차 경쟁하는 항체 및 항체 단편 (예를 들어, 항원 결합 단편)을 제공한다. 추가의 항체 및 항체 단편 (예를 들어, 항원 결합 단편)은 P-카드헤린 결합 검정에서, 예를 들어, 비아코어(BIACORE) 또는 결합 측정에 대한 관련 기술분야의 통상의 기술자에게 공지된 검정을 통해, 본 발명의 다른 항체와 교차-경쟁하는 (예를 들어, 실질적으로 유의한 방식으로 그의 결합을 경쟁적으로 억제하는) 능력에 기반하여 확인될 수 있다. P-카드헤린 (예를 들어, 인간 P-카드헤린)에 대한 본 발명의 항체 및 항체 단편 (예를 들어, 항원 결합 단편)의 결합을 억제하는 시험 항체의 능력은 시험 항체가 P-카드헤린에의 결합에 대해 상기 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)과 경쟁할 수 있고; 이러한 항체는, 비제한적 이론에 따르면, 그가 경쟁하는 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)과 동일 또는 관련된 (예를 들어, 구조적으로 유사하거나 또는 공간적으로 근위 또는 중첩하는) P-카드헤린 단백질 상의 에피토프에 결합할 수 있다는 것을 입증한다. 특정 실시양태에서, 표 1에 기재된 항체 또는 항체 단편 (예를 들어, 항원 결합 단편)과 동일한 P-카드헤린 상의 에피토프에 결합하는 항체는 인간 또는 인간화 모노클로날 항체이다. 이러한 인간 또는 인간화 모노클로날 항체는 본원에 기재된 바와 같이 제조 및 단리될 수 있다.
2. Fc 영역의 프레임워크의 추가의 변경
본 발명의 면역접합체는, 예를 들어 항체의 특성을 개선시키기 위해, VH 및/또는 VL 내의 프레임워크 잔기에 대한 변형을 추가로 포함하는 변형된 항체 또는 그의 항원 결합 단편을 포함할 수 있다. 일부 실시양태에서, 프레임워크 변형은 항체의 면역원성을 감소시키기 위해 이루어진다. 예를 들어, 한 접근법은 1개 이상의 프레임워크 잔기를 상응하는 배선 서열로 "역-돌연변이"시키는 것이다. 보다 구체적으로, 체세포 돌연변이를 겪은 항체는 항체가 유래된 배선 서열과는 상이한 프레임워크 잔기를 함유할 수 있다. 이러한 잔기는 항체 프레임워크 서열을 항체가 유래된 배선 서열과 비교함으로써 확인될 수 있다. 프레임워크 영역 서열을 그의 배선 구성으로 되돌리기 위해, 예를 들어 부위-지정 돌연변이유발에 의해, 체세포 돌연변이가 배선 서열로 "역-돌연변이"될 수 있다. 이러한 "역-돌연변이"된 항체는 또한 본 발명에 포괄되도록 의도된다.
또 다른 유형의 프레임워크 변형은 프레임워크 영역 내 또는 심지어 1개 이상의 CDR 영역 내의 1개 이상의 잔기를 돌연변이시켜 T-세포 에피토프를 제거함으로써 항체의 잠재적인 면역원성을 감소시키는 것을 수반한다. 이러한 접근법은 또한 "탈면역화"으로 지칭되고, 미국 특허 공개 번호 20030153043 (Carr et al.)에 추가로 상세하게 기재되어 있다.
프레임워크 또는 CDR 영역 내에서 이루어진 변형에 추가로 또는 그에 대안적으로, 본 발명의 항체는 전형적으로 항체의 1종 이상의 기능적 특성, 예컨대 혈청 반감기, 보체 고정, Fc 수용체 결합, 및/또는 항원-의존성 세포성 세포독성을 변경시키기 위해 Fc 영역 내의 변형을 포함하도록 조작될 수 있다. 추가로, 본 발명의 항체는 항체의 1종 이상의 기능적 특성을 다시 변경시키기 위해 화학적으로 변형될 수 있거나 (예를 들어, 1개 이상의 화학적 모이어티가 항체에 부착될 수 있음) 또는 그의 글리코실화를 변경시키도록 변형될 수 있다. 각각의 이들 실시양태가 하기에 추가로 상세하게 기재되어 있다.
한 실시양태에서, CH1의 힌지 영역은 힌지 영역 내의 시스테인 잔기의 수가 변경, 예를 들어 증가 또는 감소되도록 변형된다. 이러한 접근법은 미국 특허 번호 5,677,425 (Bodmer et al.)에 추가로 기재되어 있다. CH1의 힌지 영역 내의 시스테인 잔기의 수는, 예를 들어 경쇄 및 중쇄의 조립을 용이하게 하거나 또는 항체의 안정성을 증가 또는 감소시키도록 변경된다.
또 다른 실시양태에서, 항체의 생물학적 반감기를 감소시키도록 항체의 Fc 힌지 영역이 돌연변이된다. 보다 구체적으로, 1개 이상의 아미노산 돌연변이가 Fc-힌지 단편의 CH2-CH3 도메인 계면 영역 내로 도입되어, 항체가 천연 Fc-힌지 도메인 스타필로코실 단백질 A (SpA) 결합에 비해 손상된 SpA 결합을 갖게 된다. 이러한 접근법은 미국 특허 번호 6,165,745 (Ward et al.)에 추가로 상세하게 기재되어 있다.
또 다른 실시양태에서, Fc 영역은 항체의 이펙터 기능을 변경시키기 위해 적어도 1개의 아미노산 잔기를 상이한 아미노산 잔기를 대체함으로써 변경된다. 예를 들어, 1개 이상의 아미노산이 상이한 아미노산 잔기로 대체되어, 항체가 이펙터 리간드에 대해 변경된 친화도를 갖지만 모 항체의 항원-결합 능력은 보유하도록 할 수 있다. 친화도가 변경된 이펙터 리간드는, 예를 들어 Fc 수용체 또는 보체의 C1 성분일 수 있다. 이러한 접근법은, 예를 들어 미국 특허 번호 5,624,821 및 5,648,260 (둘 다 Winter et al.)에 기재되어 있다.
또 다른 실시양태에서, 아미노산 잔기로부터 선택된 1개 이상의 아미노산이 상이한 아미노산 잔기로 대체되어, 항체가 변경된 C1q 결합 및/또는 감소 또는 폐지된 보체 의존성 세포독성 (CDC)을 갖도록 할 수 있다. 이러한 접근법은, 예를 들어 미국 특허 번호 6,194,551 (Idusogie et al.)에 기재되어 있다.
또 다른 실시양태에서, 1개 이상의 아미노산 잔기가 변경되어 이에 의해 보체를 고정하는 항체의 능력을 변경시킨다. 이러한 접근법은, 예를 들어 PCT 공개 WO 94/29351 (Bodmer et al.)에 기재되어 있다. 구체적 실시양태에서, 본 발명의 항체 또는 그의 항원 결합 단편의 1개 이상의 아미노산은 1개 이상의 동종이형 아미노산 잔기, 예컨대 IgG1 하위부류 및 카파 이소형에 대해 도 4에 제시된 것에 의해 대체된다. 동종이형 아미노산 잔기는 또한 문헌 [Jefferis et al., MAbs. 1:332-338 (2009)]에 기재된 바와 같이, IgG1, IgG2, 및 IgG3 하위부류의 중쇄의 불변 영역, 뿐만 아니라 카파 이소형의 경쇄의 불변 영역을 포함하나 이에 제한되지는 않는다.
또 다른 실시양태에서, Fc 영역은 1개 이상의 아미노산을 변형시킴으로써 항체 의존성 세포 세포독성 (ADCC)을 매개하는 항체의 능력을 증가시키고/거나 Fcγ 수용체에 대한 항체의 친화도를 증가시키도록 변형된다. 이러한 접근법은, 예를 들어 PCT 공개 WO 00/42072 (Presta)에 기재되어 있다. 또한, FcγRI, FcγRII, FcγRIII 및 FcRn에 대한 인간 IgG1 상의 결합 부위가 맵핑되었고, 개선된 결합을 갖는 변이체가 기재었다 (문헌 [Shields et al., J. Biol. Chem. 276:6591-6604, 2001] 참조).
또 다른 실시양태에서, 항체의 글리코실화가 변형된다. 예를 들어, 비-글리코실화 항체가 제조될 수 있다 (즉, 항체에 글리코실화가 결여됨). 글리코실화는, 예를 들어 "항원"에 대한 항체의 친화도를 증가시키도록 변경될 수 있다. 이러한 탄수화물 변형은, 예를 들어 항체 서열 내 글리코실화의 1개 이상의 부위를 변경시킴으로써 달성될 수 있다. 예를 들어, 1개 이상의 가변 영역 프레임워크 글리코실화 부위의 제거를 유발하는 1개 이상의 아미노산 치환이 이루어져 이에 의해 그 부위에서 글리코실화를 제거할 수 있다. 이러한 비-글리코실화는 항원에 대한 항체의 친화도를 증가시킬 수 있다. 이러한 접근법은, 예를 들어 미국 특허 번호 5,714,350 및 6,350,861 (Co et al.)에 기재되어 있다.
추가로 또는 대안적으로, 글리코실화의 변경된 유형을 갖는 항체, 예컨대 푸코실 잔기의 감소된 양을 갖는 저푸코실화 항체 또는 증가된 양분성 GlcNac 구조를 갖는 항체가 제조될 수 있다. 이러한 변경된 글리코실화 패턴은 항체의 ADCC 능력을 증가시키는 것으로 입증되었다. 이러한 탄수화물 변형은, 예를 들어 변경된 글리코실화 기구를 갖는 숙주 세포에서 항체를 발현시킴으로써 달성될 수 있다. 변경된 글리코실화 기구를 갖는 세포는 관련 기술분야에 기재되어 있고, 본 발명의 재조합 항체를 발현시켜 변경된 글리코실화를 갖는 항체를 생산하는 숙주 세포로서 사용될 수 있다. 예를 들어, EP 1,176,195 (Hang et al.)는 푸코실 트랜스퍼라제를 코딩하는, 기능적으로 파괴된 FUT8 유전자를 갖는 세포주를 기재하며, 이러한 세포주에서 발현된 항체는 저푸코실화를 나타낸다. PCT 공개 WO 03/035835 (Presta)는 Asn(297)-연결된 탄수화물에 푸코스를 부착시키는 능력이 감소되어 숙주 세포에서 발현된 항체에서 저푸코실화를 유발하는 변이체 CHO 세포주인 Lecl3 세포를 기재한다 (또한, 문헌 [Shields et al., (2002) J. Biol. Chem. 277:26733-26740] 참조). PCT 공개 WO 99/54342 (Umana et al.)는 당단백질-변형 글리코실 트랜스퍼라제 (예를 들어, 베타(1,4)-N 아세틸글루코스아미닐트랜스퍼라제 III (GnTIII))를 발현하도록 조작된 세포주를 기재하며, 이러한 조작된 세포주에서 발현된 항체는 증가된 양분성 GlcNac 구조를 나타내고, 이는 항체의 증가된 ADCC 활성을 유발한다 (또한 문헌 [Umana et al., Nat. Biotech. 17:176-180, 1999] 참조).
또 다른 실시양태에서, 항체는 그의 생물학적 반감기를 증가시키도록 변형된다. 다양한 접근법이 가능하다. 예를 들어, 미국 특허 번호 6,277,375 (Ward)에 기재된 바와 같이, 하기 돌연변이 중 1종 이상이 도입될 수 있다: T252L, T254S, T256F. 대안적으로, 생리학적 반감기를 증가시키기 위해, 항체는 미국 특허 번호 5,869,046 및 6,121,022 (Presta et al.)에 기재된 바와 같이, IgG의 Fc 영역의 CH2 도메인의 2개 루프로부터 취해진 샐비지 수용체 결합 에피토프를 함유하도록 CH1 또는 CL 영역 내에서 변경될 수 있다.
3. P-카드헤린 항체의 생산
항-P-카드헤린 항체 및 그의 항체 단편 (예를 들어, 항원 결합 단편)은 재조합 발현, 화학적 합성, 및 항체 사량체의 효소적 소화를 포함하나 이에 제한되지는 않는 관련 기술분야에 공지된 임의의 수단에 의해 생산될 수 있고, 반면에 전장 모노클로날 항체는, 예를 들어 하이브리도마 또는 재조합 생산에 의해 수득될 수 있다. 재조합 발현은 관련 기술분야에 공지된 임의의 적절한 숙주 세포, 예를 들어 포유동물 숙주 세포, 박테리아 숙주 세포, 효모 숙주 세포, 곤충 숙주 세포 등으로부터 일어날 수 있다.
본 발명은 본원에 기재된 항체를 코딩하는 폴리뉴클레오티드, 예를 들어 본원에 기재된 바와 같은 상보성 결정 영역을 포함하는 중쇄 또는 경쇄 가변 영역 또는 절편을 코딩하는 폴리뉴클레오티드를 추가로 제공한다. 일부 실시양태에서, 중쇄 가변 영역을 코딩하는 폴리뉴클레오티드는 서열식별번호: 8, 28, 48, 68, 88, 및 108로 이루어진 군으로부터 선택된 폴리뉴클레오티드와 적어도 85%, 89%, 90%, 91%, 92%, 93%, 94%, 95%, 96%, 97%, 98%, 99%, 또는 100% 핵산 서열 동일성을 갖는다. 일부 실시양태에서, 경쇄 가변 영역을 코딩하는 폴리뉴클레오티드는 서열식별번호: 18, 38, 58, 78, 98, 및 118로 이루어진 군으로부터 선택된 폴리뉴클레오티드와 적어도 85%, 89%, 90%, 91%, 92%, 93%, 94%, 95%, 96%, 97%, 98%, 99%, 또는 100% 핵산 서열 동일성을 갖는다.
일부 실시양태에서, 중쇄를 코딩하는 폴리뉴클레오티드는 서열식별번호: 10, 30, 50, 70, 90, 또는 110의 폴리뉴클레오티드와 적어도 85%, 89%, 90%, 91%, 92%, 93%, 94%, 95%, 96%, 97%, 98%, 99%, 또는 100% 핵산 서열 동일성을 갖는다. 일부 실시양태에서, 경쇄를 코딩하는 폴리뉴클레오티드는 서열식별번호: 20, 40, 60, 80, 100, 또는 120의 폴리뉴클레오티드와 적어도 85%, 89%, 90%, 91%, 92%, 93%, 94%, 95%, 96%, 97%, 98%, 99%, 또는 100% 핵산 서열 동일성을 갖는다.
본 발명의 폴리뉴클레오티드는 단지 항-P-카드헤린 항체의 가변 영역 서열만을 코딩할 수 있다. 이들은 또한 항체의 가변 영역 및 불변 영역 둘 다를 코딩할 수 있다. 폴리뉴클레오티드 서열 중 일부는 예시된 마우스 항-P-카드헤린 항체 중 1종의 중쇄 및 경쇄 둘 다의 가변 영역을 포함하는 폴리펩티드를 코딩한다. 일부 다른 폴리뉴클레오티드는 마우스 항체 중 1종의 중쇄 및 경쇄의 가변 영역에 대해 각각 실질적으로 동일한 2개의 폴리펩티드 절편을 코딩한다.
폴리뉴클레오티드 서열은 신생 고체-상 DNA 합성에 의해 또는 항-P-카드헤린 항체 또는 그의 결합 단편을 코딩하는 기존 서열 (예를 들어, 하기 실시예에 기재된 바와 같은 서열)의 PCR 돌연변이유발에 의해 생산될 수 있다. 핵산의 직접적인 화학적 합성은 관련 기술분야에 공지된 방법, 예컨대 문헌 [Narang et al., Meth. Enzymol. 68:90, 1979]의 포스포트리에스테르 방법, 문헌 [Brown et al., Meth. Enzymol. 68:109, 1979]의 포스포디에스테르 방법, 문헌 [Beaucage et al., Tetra. Lett., 22:1859, 1981]의 디에틸포스포르아미다이트 방법, 및 미국 특허 번호 4,458,066의 고체 지지체 방법에 의해 달성될 수 있다. PCR에 의해 폴리뉴클레오티드 서열에 돌연변이를 도입하는 것은, 예를 들어 문헌 [PCR Technology: Principles and Applications for DNA Amplification, H.A. Erlich (Ed.), Freeman Press, NY, NY, 1992; PCR Protocols: A Guide to Methods and Applications, Innis et al. (Ed.), Academic Press, San Diego, CA, 1990; Mattila et al., Nucleic Acids Res. 19:967, 1991; 및 Eckert et al., PCR Methods and Applications 1:17, 1991]에 기재된 바와 같이 수행될 수 있다.
또한 본 발명에서는 상기 기재된 항-P-카드헤린 항체를 생산하기 위한 발현 벡터 및 숙주 세포가 제공된다. 다양한 발현 벡터가 항-P-카드헤린 항체 쇄 또는 결합 단편을 코딩하는 폴리뉴클레오티드를 발현하는데 사용될 수 있다. 포유동물 숙주 세포에서 항체를 생산하기 위해 바이러스-기반 및 비-바이러스 발현 벡터 둘 다가 사용될 수 있다. 비-바이러스 벡터 및 시스템은 플라스미드, 에피솜 벡터 (전형적으로, 단백질 또는 RNA 발현을 위한 발현 카세트를 가짐), 및 인간 인공 염색체 (예를 들어, 문헌 [Harrington et al., Nat Genet 15:345, 1997] 참조)를 포함한다. 예를 들어, 포유동물 (예를 들어, 인간) 세포에서 항-P-카드헤린 폴리뉴클레오티드 및 폴리펩티드를 발현하는데 유용한 비-바이러스 벡터는 pThioHis A, B & C, pcDNATM3.1/His, pEBVHis A, B & C (인비트로젠(Invitrogen), 캘리포니아주 샌디에고), MPSV 벡터, 및 다른 단백질을 발현하는 것으로 관련 기술분야에 공지된 수많은 다른 벡터를 포함한다. 유용한 바이러스 벡터는 레트로바이러스, 아데노바이러스, 아데노연관 바이러스, 헤르페스 바이러스를 기반으로 하는 벡터, SV40, 유두종 바이러스, HBP 엡스타인 바르 바이러스를 기반으로 하는 벡터, 백시니아 바이러스 벡터 및 셈리키 포레스트 바이러스 (SFV)를 포함한다. 문헌 [Brent et al., supra; Smith, Annu. Rev. Microbiol. 49:807, 1995; 및 Rosenfeld et al., Cell 68:143, 1992]을 참조한다.
발현 벡터의 선택은 벡터를 발현하고자 의도되는 숙주 세포에 좌우된다. 전형적으로, 발현 벡터는 항-P-카드헤린 항체 쇄 또는 단편을 코딩하는 폴리뉴클레오티드에 작동가능하게 연결된 프로모터 및 다른 조절 서열 (예를 들어, 인핸서)을 함유한다. 일부 실시양태에서, 유도성 프로모터는 유도 조건 하인 경우를 제외하고 삽입된 서열의 발현을 방지하기 위해 사용된다. 유도성 프로모터는, 예를 들어 아라비노스, lacZ, 메탈로티오네인 프로모터 또는 열 쇼크 프로모터를 포함한다. 형질전환된 유기체의 배양물은, 발현 산물이 숙주 세포에 의해 보다 우수하게 허용되는 서열을 코딩하는 집단으로 편향되지 않으면서 비유도 조건 하에서 확장될 수 있다. 프로모터 이외에도, 다른 조절 요소가 또한 항-P-카드헤린 항체 쇄 또는 단편의 효율적 발현을 위해 요구 또는 요망될 수 있다. 이들 요소는 전형적으로 ATG 개시 코돈 및 인접한 리보솜 결합 부위 또는 다른 서열을 포함한다. 추가로, 발현 효율은 사용하는 세포 시스템에 적절한 인핸서를 포함시키는 것에 의해 증진될 수 있다 (예를 들어, 문헌 [Scharf et al., Results Probl. Cell Differ. 20:125, 1994; 및 Bittner et al., Meth. Enzymol., 153:516, 1987] 참조). 예를 들어, SV40 인핸서 또는 CMV 인핸서가 포유동물 숙주 세포에서의 발현을 증가시키기 위해 사용될 수 있다.
발현 벡터는 또한 삽입된 항-P-카드헤린 항체 서열에 의해 코딩되는 폴리펩티드와의 융합 단백질을 형성하기 위한 분비 신호 서열 위치를 제공할 수 있다. 보다 종종, 삽입된 항-P-카드헤린 항체 서열은 벡터에 포함되기 전에 신호 서열에 연결된다. 항-P-카드헤린 항체 경쇄 및 중쇄 가변 도메인을 코딩하는 서열을 받는데 사용되는 벡터는 때때로 또한 그의 불변 영역 또는 부분도 코딩한다. 이러한 벡터는 불변 영역과의 융합 단백질로서의 가변 영역의 발현을 가능하게 함으로써 무손상 항체 또는 그의 단편이 생산되게 한다. 전형적으로, 이러한 불변 영역은 인간의 것이다.
항-P-카드헤린 항체 쇄를 보유 및 발현하기 위한 숙주 세포는 원핵 또는 진핵일 수 있다. 이. 콜라이(E. coli)는 본 발명의 폴리뉴클레오티드를 클로닝 및 발현하는데 유용한 한 원핵 숙주이다. 사용하기에 적합한 다른 미생물 숙주는 바실루스, 예컨대 바실루스 서브틸리스(Bacillus subtilis), 및 다른 엔테로박테리아세아에, 예컨대 살모넬라(Salmonella), 세라티아(Serratia), 및 다양한 슈도모나스(Pseudomonas) 종을 포함한다. 이들 원핵 숙주에서, 전형적으로 숙주 세포와 상용성인 발현 제어 서열 (예를 들어, 복제 기점)을 함유하는 발현 벡터를 또한 제조할 수 있다. 추가로, 임의의 수의 다양한 널리 공지된 프로모터, 예컨대 락토스 프로모터 시스템, 트립토판 (trp) 프로모터 시스템, 베타-락타마제 프로모터 시스템, 또는 파지 람다로부터의 프로모터 시스템이 존재할 것이다. 프로모터는 임의로 오퍼레이터 서열과 함께, 전형적으로 발현을 제어하고, 전사 및 번역을 개시 및 완료하기 위한 리보솜 결합 부위 서열 등을 갖는다. 다른 미생물, 예컨대 효모가 또한 본 발명의 항-P-카드헤린 폴리펩티드를 발현하는데 사용될 수 있다. 바큘로바이러스 벡터와 조합되어 곤충 세포가 또한 사용될 수 있다.
일부 바람직한 실시양태에서, 포유동물 숙주 세포는 본 발명의 항-P-카드헤린 폴리펩티드를 발현 및 생산하는데 사용된다. 예를 들어, 이들은 내인성 이뮤노글로불린 유전자를 발현하는 하이브리도마 세포주 (예를 들어, 실시예에 기재된 바와 같은 골수종 하이브리도마 클론) 또는 외인성 발현 벡터를 보유하는 포유동물 세포주 (예를 들어, 하기 예시된 SP2/0 골수종 세포)일 수 있다. 이들은 임의의 정상적인 사멸, 또는 정상적이거나 비정상적인 불멸 동물 또는 인간 세포를 포함한다. 예를 들어, CHO 세포주, 다양한 Cos 세포주, HeLa 세포, 골수종 세포주, 형질전환된 B-세포 및 하이브리도마를 포함한, 무손상 이뮤노글로불린을 분비할 수 있는 다수의 적합한 숙주 세포주가 개발되었다. 폴리펩티드를 발현하기 위한 포유동물 조직 세포 배양의 사용은, 예를 들어 문헌 [Winnacker, From Genes to Clones, VCH Publishers, N.Y., N.Y., 1987]에 일반적으로 논의되어 있다. 포유동물 숙주 세포를 위한 발현 벡터는 발현 제어 서열, 예컨대 복제 기점, 프로모터, 및 인핸서 (예를 들어, 문헌 [Queen et al., Immunol. Rev. 89:49-68, 1986] 참조), 및 필수적인 프로세싱 정보 부위, 예컨대 리보솜 결합 부위, RNA 스플라이스 부위, 폴리아데닐화 부위, 및 전사 종결인자 서열을 포함할 수 있다. 이들 발현 벡터는 통상적으로 포유동물 유전자 또는 포유동물 바이러스로부터 유래된 프로모터를 함유한다. 적합한 프로모터는 구성적, 세포 유형-특이적, 단계-특이적, 및/또는 조정가능하거나 조절가능한 것일 수 있다. 유용한 프로모터는 메탈로티오네인 프로모터, 구성적 아데노바이러스 주요 후기 프로모터, 덱사메타손-유도성 MMTV 프로모터, SV40 프로모터, MRP polIII 프로모터, 구성적 MPSV 프로모터, 테트라시클린-유도성 CMV 프로모터 (예컨대 인간 극초기 CMV 프로모터), 구성적 CMV 프로모터, 및 관련 기술분야에 공지된 프로모터-인핸서 조합을 포함하나 이에 제한되지는 않는다.
관심 폴리뉴클레오티드 서열을 함유하는 발현 벡터를 도입하는 방법은 세포 숙주의 유형에 따라 달라진다. 예를 들어, 염화칼슘 형질감염은 통상적으로 원핵 세포에 이용되고, 반면에 인산칼슘 처리 또는 전기천공은 다른 세포 숙주에 사용될 수 있다 (일반적으로 [Sambrook et al., 상기 문헌] 참조). 다른 방법, 예를 들어 전기천공, 인산칼슘 처리, 리포솜-매개 형질전환, 주사 및 미세주사, 탄도적 방법, 비로솜, 이뮤노리포솜, 다가양이온:핵산 접합체, 네이키드 DNA, 인공 비리온, 포진 바이러스 구조 단백질 VP22에 대한 융합 (Elliot and O'Hare, Cell 88:223, 1997), DNA의 작용제-증진 흡수, 및 생체외 형질도입을 포함한다. 재조합 단백질의 장기 고수율 생산을 위해, 안정한 발현이 종종 요망될 것이다. 예를 들어, 항-P-카드헤린 항체 쇄 또는 결합 단편을 안정하게 발현하는 세포주는 바이러스 복제 기점 또는 내인성 발현 요소 및 선택 마커 유전자를 함유하는 본 발명의 발현 벡터를 사용하여 제조될 수 있다. 벡터의 도입 후에, 세포는 선택 배지로 교체하기 전에 농축 배지에서 1-2일 동안 성장하게 할 수 있다. 선택 마커의 목적은 선택에 대한 저항성을 부여하는 것이고, 그의 존재는 선택 배지에서 도입 서열을 성공적으로 발현하는 세포의 성장을 가능하게 한다. 저항성의 안정하게 형질감염된 세포는 세포 유형에 적절한 조직 배양 기술을 사용하여 증식될 수 있다.
치료 및 진단 용도
본 발명의 항체, 항체 단편 (예를 들어, 항원 결합 단편), 및 항체 약물 접합체는 암, 예컨대 고형 암의 치료를 포함하나 이에 제한되지는 않는 다양한 적용에 유용하다. 특정 실시양태에서, 본 발명의 항체, 항체 단편 (예를 들어, 항원 결합 단편), 및 항체 약물 접합체는 종양 성장의 억제, 분화의 유도, 종양 부피의 감소, 및/또는 종양의 종양발생성의 감소에 유용하다. 사용 방법은 시험관내, 생체외, 또는 생체내 방법일 수 있다.
한 측면에서, 본 발명의 항체, 항체 단편 (예를 들어, 항원 결합 단편), 및 항체 약물 접합체는 생물학적 샘플에서 P-카드헤린의 존재를 검출하는데 유용하다. 본원에 사용된 용어 "검출하는"은 정량적 또는 정성적 검출을 포괄한다. 특정 실시양태에서, 생물학적 샘플은 세포 또는 조직을 포함한다. 특정 실시양태에서, 이러한 조직은 다른 조직에 비해 더 높은 수준으로 P-카드헤린을 발현하는 정상 및/또는 암성 조직을 포함한다.
한 측면에서, 본 발명은 생물학적 샘플에서 P-카드헤린의 존재를 검출하는 방법을 제공한다. 특정 실시양태에서, 방법은 항원에 대한 항체의 결합을 허용하는 조건 하에 생물학적 샘플을 항-P-카드헤린 항체와 접촉시키는 것, 및 항체와 항원 사이에 복합체가 형성되는지 여부를 검출하는 것을 포함한다.
한 측면에서, 본 발명은 P-카드헤린의 증가된 발현과 연관된 장애를 진단하는 방법을 제공한다. 특정 실시양태에서, 방법은 시험 세포를 항-P-카드헤린 항체와 접촉시키는 것; P-카드헤린 항원에 대한 항-P-카드헤린 항체의 결합을 검출함으로써 시험 세포 상의 P-카드헤린의 발현의 수준을 (정량적으로 또는 정성적으로) 결정하는 것; 및 시험 세포에서의 P-카드헤린의 발현의 수준을 대조군 세포 (예를 들어, 시험 세포와 동일한 조직 기원의 정상 세포 또는 이러한 정상 세포와 필적할만한 수준에서 P-카드헤린을 발현하는 세포) 상의 P-카드헤린의 발현의 수준과 비교하는 것을 포함하며, 여기서 대조군 세포와 비교하여 시험 세포 상의 P-카드헤린의 발현의 더 높은 수준은 P-카드헤린의 증가된 발현과 연관된 장애의 존재를 나타낸다. 특정 실시양태에서, 시험 세포는 P-카드헤린의 증가된 발현과 연관된 장애를 갖는 것으로 의심되는 개체로부터 수득된다. 특정 실시양태에서, 장애는 세포 증식성 장애, 예컨대 암 또는 종양이다. 특정 실시양태에서, 방법은 시험 세포에서의 P-카드헤린 유전자의 카피수를 측정하는 것을 포함한다. 특정 실시양태에서, 방법은 PAX-FOXO 전위 돌연변이를 검출하는 것을 포함한다. 유전자의 카피수 및/또는 전위 돌연변이는 관련 기술분야에 공지된 표준 방법, 예를 들어, PCR, RTPCR 등을 사용하여 검출될 수 있다.
특정 실시양태에서, 진단 또는 검출 방법, 예컨대 상기 기재된 것은 표면 상에 P-카드헤린을 발현하는 세포로부터 수득된 막 제제에서 또는 세포의 표면 상에 발현된 P-카드헤린에 대한 항-P-카드헤린 항체의 결합을 검출하는 것을 포함한다. 세포의 표면 상에 발현된 P-카드헤린에 대한 항-P-카드헤린 항체의 결합을 검출하기 위한 예시적인 검정은 "FACS" 검정이다.
특정의 다른 방법이 P-카드헤린에 대한 항-P-카드헤린 항체의 결합을 검출하는데 사용될 수 있다. 이러한 방법은 관련 기술분야에 널리 공지된 항원-결합 검정, 예컨대 웨스턴 블롯, 방사선면역검정, ELISA (효소 연결 면역흡착 검정), "샌드위치" 면역검정, 면역침전 검정, 형광 면역검정, 단백질 A 면역검정, 및 면역조직화학 (IHC)을 포함하나 이에 제한되지는 않는다.
특정 실시양태에서, 항-P-카드헤린 항체는 표지된다. 표지는 직접적으로 검출되는 표지 또는 모이어티 (예컨대 형광, 발색, 전자-밀집, 화학발광, 및 방사성 표지), 뿐만 아니라 예를 들어 효소적 반응 또는 분자 상호작용을 통해 간접적으로 검출되는 효소 또는 리간드와 같은 모이어티를 포함하나 이에 제한되지는 않는다.
특정 실시양태에서, 항-P-카드헤린 항체는 불용성 매트릭스 상에 고정화된다. 고정화는 용액 중 유리 상태로 남아있는 임의의 P-카드헤린 단백질로부터 항-P-카드헤린 항체를 분리하는 것을 수반한다. 이는 통상적으로 항-P-카드헤린 항체를 검정 절차 전에, 수불용성 매트릭스 또는 표면에 대한 흡착에 의해 (Bennich et al., 미국 특허 번호 3,720,760), 또는 공유 커플링에 의해 (예를 들어, 글루타르알데히드 가교를 사용함) 불용화시킴으로써, 또는 예를 들어 면역침전에 의해 항-P-카드헤린 항체와 P-카드헤린 단백질 사이의 복합체의 형성 후에 항-P-카드헤린 항체를 불용화시킴으로써 달성된다.
진단 또는 검출의 임의의 상기 실시양태는 항-P-카드헤린 항체 대신에 또는 그에 추가로 본 발명의 면역접합체를 사용하여 수행될 수 있다.
한 실시양태에서, 본 발명은 본 발명의 항체, 항체 단편 (예를 들어, 항원 결합 단편), 또는 항체 약물 접합체를 환자에게 투여하는 것을 포함하는, 질환을 치료 또는 에방하는 방법을 제공한다. 본 발명은 또한 환자에서 질환을 치료 또는 예방하기 위한 본 발명의 항체, 항체 단편 (예를 들어 항원 결합 단편), 또는 항체 약물 접합체의 용도를 제공한다. 일부 실시양태에서, 본 발명은 환자에서의 질환의 치료 또는 예방에 사용하기 위한 본 발명의 항체, 항체 단편 (예를 들어 항원 결합 단편), 또는 항체 약물 접합체를 제공한다. 추가 실시양태에서, 본 발명은 환자에서의 질환의 치료 또는 예방을 위한 의약의 제조에서의 본 발명의 항체, 항체 단편 (예를 들어 항원 결합 단편), 또는 항체 약물 접합체의 용도를 제공한다.
특정 실시양태에서, 본 발명의 항체, 항체 단편 (예를 들어, 항원 결합 단편), 및 항체 약물 접합체로 치료되는 질환은 암이다. 특정 실시양태에서, 암은 본 발명의 항체, 항체 단편 (예를 들어, 항원 결합 단편), 및 항체 약물 접합체가 결합하는 P-카드헤린 발현 세포를 특징으로 한다. 특정 실시양태에서, 암은 건강한 환자에 비해 P-카드헤린의 발현의 증가를 특징으로 한다. 일부 실시양태에서, P-카드헤린의 발현은 P-카드헤린 RNA의 증가에 의해 측정될 수 있다. 다른 실시양태에서, 암은 P-카드헤린의 DNA 카피수의 증가를 특징으로 한다. p-카드헤린 발현의 수준을 측정 또는 결정하는 다른 방법은 관련 기술분야의 통상의 기술자에게 공지되어 있다. 치료 및/또는 예방될 수 있는 질환의 예는 부신피질 암종, 방광암, 골암, 유방암, 중추 신경계 비정형 기형/횡문근양 종양, 결장암, 결장직장암, 배아성 종양, 자궁내막암, 식도암, 위암, 두경부암, 간세포성암, 카포시 육종, 간암, 소세포 폐암 및 비소세포 폐암을 포함한 폐암, 난소암, 직장암, 횡문근육종, 소장암, 연부 조직 육종, 편평 세포 암종, 편평 경부암, 위암, 자궁암, 질암, 및 외음부암을 포함하나 이에 제한되지는 않는다.
본 발명은 치료 유효량의 본 발명의 항체, 항체 단편 (예를 들어, 항원 결합 단편), 또는 항체 약물 접합체를 투여하는 것을 포함하는, 암을 치료하는 방법을 제공한다. 특정 실시양태에서, 암은 고형 암이다. 특정 실시양태에서, 대상체는 인간이다. 특정 실시양태에서, 암은 저항성 암 및/또는 재발성 암이다. 특정 측면에서, 예를 들어, 저항성 암은 티로신 키나제 억제제, 예컨대 비제한적으로, EGFR 억제제, Her2 억제제, Her3 억제제, IGFR 억제제 및 Met 억제제에 저항성이다. 특정 실시양태에서 암은 Her2 저항성 암이다.
특정 실시양태에서, 본 발명은 대상체에게 치료 유효량의 본 발명의 항체, 항체 단편 (예를 들어, 항원 결합 단편), 또는 항체 약물 접합체를 투여하는 것을 포함하는, 종양 성장을 억제하는 방법을 제공한다. 특정 실시양태에서, 대상체는 인간이다. 특정 실시양태에서, 대상체는 종양을 갖고 있거나 또는 종양이 제거되었다. 특정 실시양태에서, 종양은 다른 티로신 키나제 억제제, 예컨대 비제한적으로, EGFR 억제제, Her2 억제제, Her3 억제제, IGFR 억제제 및 Met 억제제에 저항성이다.
특정 실시양태에서, 종양은 항-P-카드헤린 항체가 결합하는 P-카드헤린을 발현한다. 특정 실시양태에서, 종양은 인간 P-카드헤린을 과다발현한다. 특정 실시양태에서, 종양은 P-카드헤린 유전자의 증가된 카피수를 갖는다.
본 발명은 또한 치료 유효량의 본 발명의 항체, 항체 단편 (예를 들어, 항원 결합 단편), 또는 항체 약물 접합체를 투여하는 것을 포함하는, 상기 항체, 항체 단편 (예를 들어, 항원 결합 단편), 또는 항체 약물 접합체를 사용한 치료를 위해 환자를 선택하는 방법을 제공한다. 특정 측면에서 방법은 티로신 키나제 억제제 저항성 암을 갖는 환자를 선택하는 것을 포함한다. 특정 측면에서 티로신 키나제 억제제 저항성 암은 EGFR 억제제, Her2 억제제, Her3 억제제, IGFR 억제제 및/또는 Met 억제제에 저항성인 것으로 고려된다. 특정 측면에서 저항성 암은 Her2 저항성 암인 것으로 고려된다. 보다 구체적으로 Her2 저항성 암은 트라스투주맙 또는 트라스투주맙 엠탄신에 반응하지 않는 것으로 고려된다. 특정 측면에서 암은 신생 저항성 암인 것으로 고려되고, 다른 측면에서 암은 재발성 암, 예를 들어 Her2 재발성 암인 것으로 고려된다. 본 발명의 특정 측면에서 방법은 신생 저항성 또는 재발성 암을 갖는 환자를 선택하는 것 및 P-카드헤린의 발현을 측정하는 것을 포함한다. 특정 측면에서 재발성 암 또는 종양은 초기에는 P-카드헤린 발현 암 또는 종양이지 않았지만, 티로신 키나제 억제제 (예를 들어, 트라스투주맙 또는 트라스투주맙 엠탄신)를 사용한 치료 후에 티로신 키나제 저항성 또는 재발성 암 또는 종양인 P-카드헤린 양성 암이 되는 것으로 고려된다.
질환의 치료를 위해, 본 발명의 항체, 항체 단편 (예를 들어, 항원 결합 단편), 또는 항체 약물 접합체의 적절한 투여량은 다양한 인자, 예컨대 치료될 질환의 유형, 질환의 중증도 및 경과, 질환의 반응성, 선행 요법, 환자의 임상 병력 등에 좌우된다. 항체 또는 작용제는 한번에 또는 수일 내지 수개월 동안 지속되는 일련의 치료에 걸쳐, 또는 치유가 일어나거나 질환 상태의 축소 (예를 들어, 종양 크기의 감소)가 달성될 때까지 투여될 수 있다. 최적의 투여 스케줄이 환자 신체 내의 약물 축적의 측정으로부터 계산될 수 있고, 개별 항체, 항체 단편 (예를 들어, 항원 결합 단편), 또는 항체 약물 접합체의 상대 효능에 따라 달라질 것이다. 치료하는 의사는 체액 또는 조직 내 약물의 측정된 체류 시간 및 농도에 기반하여 투여를 위한 반복률을 추정할 수 있다.
조합 요법
특정 경우에서, 본 발명의 항체, 항체 단편 (예를 들어, 항원 결합 단편), 또는 항체 약물 접합체는 다른 치료제, 예컨대 다른 항암제, 항알레르기제, 항오심제 (또는 항구토제), 통증 완화제, 세포보호제, 및 그의 조합과 조합된다.
한 실시양태에서, 본 발명의 항체, 항체 단편 (예를 들어, 항원 결합 단편), 또는 항체 약물 접합체는 제약 조합 제제에서 또는 조합 요법으로서의 투여 요법에서 항암 특성을 갖는 제2 화합물과 함께 조합된다. 제약 조합 제제 또는 투여 요법의 제2 화합물은 서로에 불리하게 영향을 미치지 않도록 조합의 항체 또는 면역접합체에 대한 상보적 활성을 가질 수 있다. 예를 들어, 본 발명의 항체, 항체 단편 (예를 들어, 항원 결합 단편), 또는 항체 약물 접합체는, 비제한적으로, 화학요법제, 티로신 키나제 억제제, P-카드헤린 하류 신호전달 경로 억제제, IAP 억제제, Bcl2 억제제, Mcl1 억제제, 및 다른 P-카드헤린 억제제와 조합되어 투여될 수 있다.
본원에 사용된 용어 "제약 조합물"은 단일 투여 단위 형태의 고정된 조합물, 또는 2종 이상의 치료제가 독립적으로 동시에 또는 개별적으로 시간 간격 내에 (특히, 이들 시간 간격이 조합 파트너가 협력적 효과, 예를 들어 상승작용적 효과를 나타내는 것을 가능하게 하는 경우) 투여될 수 있는 조합 투여를 위한 비-고정 조합물 또는 부분들의 키트를 지칭한다.
용어 "조합 요법"은 본 개시내용에 기재된 치료적 상태 또는 장애를 치료하기 위한 2종 이상의 치료제의 투여를 지칭한다. 이러한 투여는 고정된 비의 활성 성분을 갖는 단일 캡슐과 같이, 이들 치료제를 실질적으로 동시 방식으로 공-투여하는 것을 포함한다. 대안적으로, 이러한 투여는 각각의 활성 성분에 대해 다중 또는 개별 용기 (예를 들어, 캡슐, 분말, 및 액체)로 공-투여하는 것을 포괄한다. 분말 및/또는 액체는 투여 전에 재구성되거나 또는 목적하는 용량으로 희석될 수 있다. 추가로, 이러한 투여는 또한 대략적으로 동일한 시간에 또는 상이한 시간에 각각의 유형의 치료제를 순차적인 방식으로 사용하는 것을 또한 포괄한다. 어느 경우든, 치료 요법은 본원에 기재된 상태 또는 장애를 치료하는데 있어서 약물 조합물의 유익한 효과를 제공할 것이다.
조합 요법은 "상승작용"을 제공하고 "상승작용적" 효과를 입증할 수 있으며, 즉, 활성 성분을 함께 사용할 경우 달성되는 효과가 화합물을 개별적으로 사용하여 유발되는 효과의 합계보다 더 크다. 상승작용적 효과는 활성 성분이 (1) 공동-제제화되고 조합된 단위 투여 제제로 동시에 투여 또는 전달되는 경우; (2) 개별 제제로서 교대로 또는 병렬로 전달되는 경우; 또는 (3) 일부 다른 요법에 의한 경우에 달성될 수 있다. 교대 요법으로 전달되는 경우에, 상승작용적 효과는 화합물이, 예를 들어 개별 주사기로 상이하게 주사함으로써 순차적으로 투여 또는 전달되는 경우에 달성될 수 있다. 일반적으로, 교대 요법 동안에는, 유효 투여량의 각각의 활성 성분이 순차적으로, 즉 연속으로 투여되고, 반면에 조합 요법에서는 유효 투여량의 2종 이상의 활성 성분이 함께 투여된다.
조합 요법에 사용하기 위해 고려되는 일반적인 화학요법제는 아나스트로졸 (아리미덱스(Arimidex)®), 비칼루타미드 (카소덱스(Casodex)®), 블레오마이신 술페이트 (블레녹산(Blenoxane)®), 부술판 (밀레란(Myleran)®), 부술판 주사 (부술펙스(Busulfex)®), 카페시타빈 (젤로다(Xeloda)®), N4-펜톡시카르보닐-5-데옥시-5-플루오로시티딘, 카르보플라틴 (파라플라틴(Paraplatin)®), 카르무스틴 (BiCNU®), 클로람부실 (류케란(Leukeran)®), 시스플라틴 (플라티놀(Platinol)®), 클라드리빈 (류스타틴(Leustatin)®), 시클로포스파미드 (시톡산(Cytoxan)® 또는 네오사르(Neosar)®), 시타라빈, 시토신 아라비노시드 (시토사르-U(Cytosar-U)®), 시타라빈 리포솜 주사 (데포사이트(DepoCyt)®), 다카르바진 (DTIC-돔(DTIC-Dome)®), 닥티노마이신 (악티노마이신 D, 코스메간(Cosmegan)), 다우노루비신 히드로클로라이드 (세루비딘(Cerubidine)®), 다우노루비신 시트레이트 리포솜 주사 (다우녹솜(DaunoXome)®), 덱사메타손, 도세탁셀 (탁소테레(Taxotere)®), 독소루비신 히드로클로라이드 (아드리아마이신(Adriamycin)®, 루벡스(Rubex)®), 에토포시드 (베페시드(Vepesid)®), 플루다라빈 포스페이트 (플루다라(Fludara)®), 5-플루오로우라실 (아드루실(Adrucil)®, 에푸덱스(Efudex)®), 플루타미드 (유렉신(Eulexin)®), 테자시티빈, 겜시타빈 (디플루오로데옥시시티딘), 히드록시우레아 (히드레아(Hydrea)®), 이다루비신 (이다마이신(Idamycin)®), 이포스파미드 (이펙스(IFEX)®), 이리노테칸 (캄프토사르(Camptosar)®), L-아스파라기나제 (엘스파르(ELSPAR)®), 류코보린 칼슘, 멜팔란 (알케란(Alkeran)®), 6-메르캅토퓨린 (퓨린톨(Purinethol)®), 메토트렉세이트 (폴렉스(Folex)®), 미톡산트론 (노반트론(Novantrone)®), 밀로타르그, 파클리탁셀 (탁솔(Taxol)®), 포에닉스 (이트륨90/MX-DTPA), 펜토스타틴, 카르무스틴 이식물을 갖는 폴리페프로산 20 (글리아델(Gliadel)®), 타목시펜 시트레이트 (놀바덱스(Nolvadex)®), 테니포시드 (부몬(Vumon)®), 6-티오구아닌, 티오테파, 티라파자민 (티라존(Tirazone)®), 주사용 토포테칸 히드로클로라이드 (하이캄틴(Hycamptin)®), 빈블라스틴 (벨반(Velban)®), 빈크리스틴 (온코빈(Oncovin)®), 및 비노렐빈 (나벨빈(Navelbine)®)을 포함한다.
한 측면에서, 본 발명은 암의 치료를 필요로 하는 대상체에게 본 발명의 항체 약물 접합체를 1종 이상의 티로신 키나제 억제제, 예컨대 비제한적으로, EGFR 억제제, Her2 억제제, Her3 억제제, IGFR 억제제, 및 Met 억제제와 조합하여 투여하는 것에 의해 암을 치료하는 방법을 제공한다.
예를 들어, 티로신 키나제 억제제는 에를로티닙 히드로클로라이드 (타르세바(Tarceva)®); 리니파닙 (N-[4-(3-아미노-1H-인다졸-4-일)페닐]-N'-(2-플루오로-5-메틸페닐)우레아, 또한 ABT 869로도 공지됨, 제넨테크(Genentech)로부터 입수가능함); 수니티닙 말레이트 (수텐트(Sutent)®); 보수티닙 (4-[(2,4-디클로로-5-메톡시페닐)아미노]-6-메톡시-7-[3-(4-메틸피페라진-1-일)프로폭시]퀴놀린-3-카르보니트릴, 또한 SKI-606으로도 공지되고, 미국 특허 번호 6,780,996에 기재됨); 다사티닙 (스프리셀(Sprycel)®); 파조파닙 (보트리엔트(Votrient)®); 소라페닙 (넥사바르(Nexavar)®); 작티마 (ZD6474); 및 이마티닙 또는 이마티닙 메실레이트 (글리벡(Gilvec)® 및 글리벡(Gleevec)®)를 포함하나 이에 제한되지는 않는다.
표피 성장 인자 수용체 (EGFR) 억제제는 에를로티닙 히드로클로라이드 (타르세바(Tarceva)®), 게피티닙 (이레사(Iressa)®); N-[4-[(3-클로로-4-플루오로페닐)아미노]-7-[[(3"S")-테트라히드로-3-푸라닐]옥시]-6-퀴나졸리닐]-4(디메틸아미노)-2-부텐아미드, 토복(Tovok)®); 반데타닙 (카프렐사(Caprelsa)®); 라파티닙 (타이커브(Tykerb)®); (3R,4R)-4-아미노-1-((4-((3-메톡시페닐)아미노)피롤로[2,1-f][1,2,4]트리아진-5-일)메틸)피페리딘-3-올 (BMS690514); 카네르티닙 디히드로클로라이드 (CI-1033); 6-[4-[(4-에틸-1-피페라지닐)메틸]페닐]-N-[(1R)-1-페닐에틸]-7H-피롤로[2,3-d]피리미딘-4-아민 (AEE788, CAS 497839-62-0); 무브리티닙 (TAK165); 펠리티닙 (EKB569); 아파티닙 (BIBW2992); 네라티닙 (HKI-272); N-[4-[[1-[(3-플루오로페닐)메틸]-1H-인다졸-5-일]아미노]-5-메틸피롤로[2,1-f][1,2,4]트리아진-6-일]-카르밤산, (3S)-3-모르폴리닐메틸 에스테르 (BMS599626); N-(3,4-디클로로-2-플루오로페닐)-6-메톡시-7-[[(3aα,5β,6aα)-옥타히드로-2-메틸시클로펜타[c]피롤-5-일]메톡시]-4-퀴나졸린아민 (XL647, CAS 781613-23-8); 및 4-[4-[[(1R)-1-페닐에틸]아미노]-7H-피롤로[2,3-d]피리미딘-6-일]-페놀 (PKI166, CAS 187724-61-4)을 포함하나 이에 제한되지는 않는다.
EGFR 항체는 세툭시맙 (에르비툭스(Erbitux)®); 파니투무맙 (벡티빅스(Vectibix)®); 마투주맙 (EMD-72000); 트라스투주맙 (헤르셉틴(Herceptin)®); 니모투주맙 (hR3); 잘루투무맙; TheraCIM h-R3; MDX0447 (CAS 339151-96-1); 및 ch806 (mAb-806, CAS 946414-09-1)을 포함하나 이에 제한되지는 않는다.
인간 표피 성장 인자 수용체 2 (Her2 수용체) (또한 Neu, ErbB-2, CD340, 또는 p185로도 공지됨) 억제제는 트라스투주맙 (헤르셉틴(Herceptin)®); 페르투주맙 (옴니타르그(Omnitarg)®); 트라스투주맙 엠탄신 (카드실라(Kadcyla)®); 네라티닙 (HKI-272, (2E)-N-[4-[[3-클로로-4-[(피리딘-2-일)메톡시]페닐]아미노]-3-시아노-7-에톡시퀴놀린-6-일]-4-(디메틸아미노)부트-2-엔아미드, PCT 공개 번호 WO 05/028443에 기재됨); 라파티닙 또는 라파티닙 디토실레이트 (타이커브(Tykerb)®); (3R,4R)-4-아미노-1-((4-((3-메톡시페닐)아미노)피롤로[2,1-f][1,2,4]트리아진-5-일)메틸)피페리딘-3-올 (BMS690514); (2E)-N-[4-[(3-클로로-4-플루오로페닐)아미노]-7-[[(3S)-테트라히드로-3-푸라닐]옥시]-6-퀴나졸리닐]-4-(디메틸아미노)-2-부텐아미드 (BIBW-2992, CAS 850140-72-6); N-[4-[[1-[(3-플루오로페닐)메틸]-1H-인다졸-5-일]아미노]-5-메틸피롤로[2,1-f][1,2,4]트리아진-6-일]-카르밤산, (3S)-3-모르폴리닐메틸 에스테르 (BMS 599626, CAS 714971-09-2); 카네르티닙 디히드로클로라이드 (PD183805 또는 CI-1033); 및 N-(3,4-디클로로-2-플루오로페닐)-6-메톡시-7-[[(3aα,5β,6aα)-옥타히드로-2-메틸시클로펜타[c]피롤-5-일]메톡시]-4-퀴나졸린아민 (XL647, CAS 781613-23-8)을 포함하나 이에 제한되지는 않는다.
Her3 억제제는 LJM716, MM-121, AMG-888, RG7116, REGN-1400, AV-203, MP-RM-1, MM-111, 및 MEHD-7945A를 포함하나 이에 제한되지는 않는다
MET 억제제는 카보잔티닙 (XL184, CAS 849217-68-1); 포레티닙 (GSK1363089, 이전에 XL880, CAS 849217-64-7); 티반티닙 (ARQ197, CAS 1000873-98-2); 1-(2-히드록시-2-메틸프로필)-N-(5-(7-메톡시퀴놀린-4-일옥시)피리딘-2-일)-5-메틸-3-옥소-2-페닐-2,3-디히드로-1H-피라졸-4-카르복스아미드 (AMG 458); 크리조티닙 (잘코리(Xalkori)®, PF-02341066); (3Z)-5-(2,3-디히드로-1H-인돌-1-일술포닐)-3-({3,5-디메틸-4-[(4-메틸피페라진-1-일)카르보닐]-1H-피롤-2-일}메틸렌)-1,3-디히드로-2H-인돌-2-온 (SU11271); (3Z)-N-(3-클로로페닐)-3-({3,5-디메틸-4-[(4-메틸피페라진-1-일)카르보닐]-1H-피롤-2-일}메틸렌)-N-메틸-2-옥소인돌린-5-술폰아미드 (SU11274); (3Z)-N-(3-클로로페닐)-3-{[3,5-디메틸-4-(3-모르폴린-4-일프로필)-1H-피롤-2-일]메틸렌}-N-메틸-2-옥소인돌린-5-술폰아미드 (SU11606); 6-[디플루오로[6-(1-메틸-1H-피라졸-4-일)-1,2,4-트리아졸로[4,3-b]피리다진-3-일]메틸]-퀴놀린 (JNJ38877605, CAS 943540-75-8); 2-[4-[1-(퀴놀린-6-일메틸)-1H-[1,2,3]트리아졸로[4,5-b]피라진-6-일]-1H-피라졸-1-일]에탄올 (PF04217903, CAS 956905-27-4); N-((2R)-1,4-디옥산-2-일메틸)-N-메틸-N'-[3-(1-메틸-1H-피라졸-4-일)-5-옥소-5H-벤조[4,5]시클로헵타[1,2-b]피리딘-7-일]술파미드 (MK2461, CAS 917879-39-1); 6-[[6-(1-메틸-1H-피라졸-4-일)-1,2,4-트리아졸로[4,3-b]피리다진-3-일]티오]-퀴놀린 (SGX523, CAS 1022150-57-7); 및 (3Z)-5-[[(2,6-디클로로페닐)메틸]술포닐]-3-[[3,5-디메틸-4-[[(2R)-2-(1-피롤리디닐메틸)-1-피롤리디닐]카르보닐]-1H-피롤-2-일]메틸렌]-1,3-디히드로-2H-인돌-2-온 (PHA665752, CAS 477575-56-7)을 포함하나 이에 제한되지는 않는다.
IGF1R 억제제는 BMS-754807, XL-228, OSI-906, GSK0904529A, A-928605, AXL1717, KW-2450, MK0646, AMG479, IMCA12, MEDI-573, 및 BI836845를 포함하나 이에 제한되지는 않는다. 예를 들어, 검토를 위해 문헌 [Yee, JNCI, 104; 975 (2012)]을 참조한다.
또 다른 측면에서, 본 발명은 암의 치료를 필요로 하는 대상체에게 본 발명의 항체 약물 접합체를 1종 이상의 P-카드헤린 하류 신호전달 경로 억제제, 예컨대 비제한적으로, MEK 억제제, Braf 억제제, PI3K/Akt 억제제, SHP2 억제제, 및 또한 mTor와 조합하여 투여하는 것에 의해 암을 치료하는 방법을 제공한다.
예를 들어, 미토겐-활성화 단백질 키나제 (MEK) 억제제는 XL-518 (또한 GDC-0973으로도 공지됨, CAS 번호 1029872-29-4, 에이씨씨 코포레이션(ACC Corp.)으로부터 입수가능함); 2-[(2-클로로-4-아이오도페닐)아미노]-N-(시클로프로필메톡시)-3,4-디플루오로-벤즈아미드 (또한 CI-1040 또는 PD184352로도 공지되고, PCT 공개 번호 WO2000035436에 기재됨); N-[(2R)-2,3-디히드록시프로폭시]-3,4-디플루오로-2-[(2-플루오로-4-아이오도페닐)아미노]-벤즈아미드 (또한 PD0325901로도 공지되고, PCT 공개 번호 WO2002006213에 기재됨); 2,3-비스[아미노[(2-아미노페닐)티오]메틸렌]-부탄디니트릴 (또한 U0126으로도 공지되고, 미국 특허 번호 2,779,780에 기재됨); N-[3,4-디플루오로-2-[(2-플루오로-4-아이오도페닐)아미노]-6-메톡시페닐]-1-[(2R)-2,3-디히드록시프로필]-시클로프로판술폰아미드 (또한 RDEA119 또는 BAY869766으로도 공지되고, PCT 공개 번호 WO2007014011에 기재됨); (3S,4R,5Z,8S,9S,11E)-14-(에틸아미노)-8,9,16-트리히드록시-3,4-디메틸-3,4,9, 19-테트라히드로-1H-2-벤족사시클로테트라데신-1,7(8H)-디온] (또한 E6201로도 공지되고, PCT 공개 번호 WO2003076424에 기재됨); 2'-아미노-3'-메톡시플라본 (또한 PD98059로도 공지됨, 독일 비아핀 게엠베하 운트 코., 카게(Biaffin GmbH & Co., KG)로부터 입수가능함); 베무라페닙 (PLX-4032, CAS 918504-65-1); (R)-3-(2,3-디히드록시프로필)-6-플루오로-5-(2-플루오로-4-아이오도페닐아미노)-8-메틸피리도[2,3-d]피리미딘-4,7(3H,8H)-디온 (TAK-733, CAS 1035555-63-5); 피마세르팁 (AS-703026, CAS 1204531-26-9); 및 트라메티닙 디메틸 술폭시드 (GSK-1120212, CAS 1204531-25-80)를 포함하나 이에 제한되지는 않는다.
포스포이노시티드 3-키나제 (PI3K) 억제제는 4-[2-(1H-인다졸-4-일)-6-[[4-(메틸술포닐)피페라진-1-일]메틸]티에노[3,2-d]피리미딘-4-일]모르폴린 (또한 GDC 0941로도 공지되고, PCT 공개 번호 WO 09/036082 및 WO 09/055730에 기재됨); 2-메틸-2-[4-[3-메틸-2-옥소-8-(퀴놀린-3-일)-2,3-디히드로이미다조[4,5-c]퀴놀린-1-일]페닐]프로피오니트릴 (또한 BEZ 235 또는 NVP-BEZ 235로도 공지되고, PCT 공개 번호 WO 06/122806에 기재됨); 4-(트리플루오로메틸)-5-(2,6-디모르폴리노피리미딘-4-일)피리딘-2-아민 (또한 BKM120 또는 NVP-BKM120으로도 공지되고, PCT 공개 번호 WO2007/084786에 기재됨); 토자세르팁 (VX680 또는 MK-0457, CAS 639089-54-6); (5Z)-5-[[4-(4-피리디닐)-6-퀴놀리닐]메틸렌]-2,4-티아졸리딘디온 (GSK1059615, CAS 958852-01-2); (1E,4S,4aR,5R,6aS,9aR)-5-(아세틸옥시)-1-[(디-2-프로페닐아미노)메틸렌]-4,4a,5,6,6a,8,9,9a-옥타히드로-11-히드록시-4-(메톡시메틸)-4a,6a-디메틸-시클로펜타[5,6]나프토[1,2-c]피란-2,7,10(1H)-트리온 (PX866, CAS 502632-66-8); 및 8-페닐-2-(모르폴린-4-일)-크로멘-4-온 (LY294002, CAS 154447-36-6)을 포함하나 이에 제한되지는 않는다.
mTor은 템시롤리무스 (토리셀(Torisel)®); 리다포롤리무스 (이전에 데포롤리무스로 공지됨, (1R,2R,4S)-4-[(2R)-2 [(1R,9S,12S,15R,16E,18R,19R,21R, 23S,24E,26E,28Z,30S,32S,35R)-1,18-디히드록시-19,30-디메톡시-15,17,21,23,29,35-헥사메틸-2,3,10,14,20-펜타옥소-11,36-디옥사-4-아자트리시클로[30.3.1.04,9]헥사트리아콘타-16,24,26,28-테트라엔-12-일]프로필]-2-메톡시시클로헥실 디메틸포스피네이트, 또한 AP23573 및 MK8669로도 공지되고, PCT 공개 번호 WO 03/064383에 기재됨); 에베롤리무스 (아피니토르(Afinitor)® 또는 RAD001); 라파마이신 (AY22989, 시롤리무스(Sirolimus)®); 시마피모드 (CAS 164301-51-3); (5-{2,4-비스[(3S)-3-메틸모르폴린-4-일]피리도[2,3-d]피리미딘-7-일}-2-메톡시페닐)메탄올 (AZD8055); 2-아미노-8-[트랜스-4-(2-히드록시에톡시)시클로헥실]-6-(6-메톡시-3-피리디닐)-4-메틸-피리도[2,3-d]피리미딘-7(8H)-온 (PF04691502, CAS 1013101-36-4); 및 N2-[1,4-디옥소-4-[[4-(4-옥소-8-페닐-4H-1-벤조피란-2-일)모르폴리늄-4-일]메톡시]부틸]-L-아르기닐글리실-L-α-아스파르틸L-세린- (서열식별번호: 131), 내부 염 (SF1126, CAS 936487-67-1)을 포함하나 이에 제한되지는 않는다.
또 다른 측면에서, 본 발명은 암의 치료를 필요로 하는 대상체에게 본 발명의 항체 약물 접합체를 1종 이상의 아폽토시스촉진제, 예컨대 비제한적으로, IAP 억제제, Bcl2 억제제, MCl1 억제제, Trail 작용제, Chk 억제제와 조합하여 투여하는 것에 의해 암을 치료하는 방법을 제공한다.
예를 들어, IAP 억제제는 LCL161, GDC-0917, AEG-35156, AT406, 및 TL32711을 포함하나 이에 제한되지는 않는다. IAP 억제제의 다른 예는 WO04/005284, WO 04/007529, WO05/097791, WO 05/069894, WO 05/069888, WO 05/094818, US2006/0014700, US2006/0025347, WO 06/069063, WO 06/010118, WO 06/017295, 및 WO08/134679 (이들 모두는 본원에 참조로 포함됨)에 개시된 것을 포함하나 이에 제한되지는 않는다.
BCL-2 억제제는 4-[4-[[2-(4-클로로페닐)-5,5-디메틸-1-시클로헥센-1-일]메틸]-1-피페라지닐]-N-[[4-[[(1R)-3-(4-모르폴리닐)-1-[(페닐티오)메틸]프로필]아미노]-3-[(트리플루오로메틸)술포닐]페닐]술포닐]벤즈아미드 (또한 ABT-263으로도 공지되고, PCT 공개 번호 WO 09/155386에 기재됨); 테트로카르신 A; 안티마이신; 고시폴 ((-)BL-193); 오바토클락스; 에틸-2-아미노-6-시클로펜틸-4-(1-시아노-2-에톡시-2-옥소에틸)-4H크로몬-3-카르복실레이트 (HA14 - 1); 오블리메르센 (G3139, 게나센스(Genasense)®); Bak BH3 펩티드; (-)-고시폴 아세트산 (AT-101); 4-[4-[(4'-클로로[1,1'-비페닐]-2-일)메틸]-1-피페라지닐]-N-[[4-[[(1R)-3-(디메틸아미노)-1-[(페닐티오)메틸]프로필]아미노]-3-니트로페닐]술포닐]-벤즈아미드 (ABT-737, CAS 852808-04-9); 및 나비토클락스 (ABT-263, CAS 923564-51-6)를 포함하나 이에 제한되지는 않는다.
DR4 (TRAILR1) 및 DR5 (TRAILR2)를 포함하는 아폽토시스촉진 수용체 효능제 (PARA)는 둘라네르민 (AMG-951, RhApo2L/TRAIL); 마파투무맙 (HRS-ETR1, CAS 658052-09-6); 렉사투무맙 (HGS-ETR2, CAS 845816-02-6); 아포맙 (아포맙(Apomab)®); 코나투무맙 (AMG655, CAS 896731-82-1); 및 티가투주맙 (CS1008, CAS 946415-34-5, 다이이치 산쿄(Daiichi Sankyo)로부터 입수가능함)을 포함하나 이에 제한되지는 않는다.
체크포인트 키나제 (CHK) 억제제는 7-히드록시스타우로스포린 (UCN-01); 6-브로모-3-(1-메틸-1H-피라졸-4-일)-5-(3R)-3-피페리디닐-피라졸로[1,5-a]피리미딘-7-아민 (SCH900776, CAS 891494-63-6); 5-(3-플루오로페닐)-3-우레이도티오펜-2-카르복실산 N-[(S)-피페리딘-3-일]아미드 (AZD7762, CAS 860352-01-8); 4-[((3S)-1-아자비시클로[2.2.2]옥트-3-일)아미노]-3-(1H-벤즈이미다졸-2-일)-6-클로로퀴놀린-2(1H)-온 (CHIR 124, CAS 405168-58-3); 7-아미노닥티노마이신 (7-AAD), 이소그라눌라티미드, 데브로모히메니알디신; N-[5-브로모-4-메틸-2-[(2S)-2-모르폴리닐메톡시]-페닐]-N'-(5-메틸-2-피라지닐)우레아 (LY2603618, CAS 911222-45-2); 술포라판 (CAS 4478-93-7, 4-메틸술피닐부틸 이소티오시아네이트); 9,10,11,12-테트라히드로-9,12-에폭시-1H-디인돌로[1,2,3-fg:3',2',1'-kl]피롤로[3,4-i][1,6]벤조디아조신-1,3(2H)-디온 (SB-218078, CAS 135897-06-2); 및 TAT-S216A (YGRKKRRQRRRLYRSPAMPENL (서열식별번호: 132)), 및 CBP501 ((d-Bpa)sws(d-Phe-F5)(d-Cha)rrrqrr)을 포함하나 이에 제한되지는 않는다.
추가 실시양태에서, 본 발명은 암의 치료를 필요로 하는 대상체에게 본 발명의 항체 약물 접합체를 1종 이상의 면역조정제 (예를 들어, 공동자극 분자의 활성화제 또는 면역 체크포인트 분자의 억제제 중 1종 이상)와 조합하여 투여하는 것에 의해 암을 치료하는 방법을 제공한다.
특정 실시양태에서, 면역조정제는 공동자극 분자의 활성화제이다. 한 실시양태에서, 공동자극 분자의 효능제는 OX40, CD2, CD27, CDS, ICAM-1, LFA-1 (CD11a/CD18), ICOS (CD278), 4-1BB (CD137), GITR, CD30, CD40, BAFFR, HVEM, CD7, LIGHT, NKG2C, SLAMF7, NKp80, CD160, B7-H3 또는 CD83 리간드의 효능제 (예를 들어, 효능작용 항체 또는 그의 항원-결합 단편, 또는 가용성 융합체)로부터 선택된다.
특정 실시양태에서, 면역조정제는 면역 체크포인트 분자의 억제제이다. 한 실시양태에서, 면역조정제는 PD-1, PD-L1, PD-L2, CTLA4, TIM3, LAG3, VISTA, BTLA, TIGIT, LAIR1, CD160, 2B4 및/또는 TGFR 베타의 억제제이다. 한 실시양태에서, 면역 체크포인트 분자의 억제제는 PD-1, PD-L1, LAG-3, TIM-3 또는 CTLA4, 또는 그의 임의의 조합을 억제한다. 용어 "억제" 또는 "억제제"는 특정 파라미터, 예를 들어 주어진 분자, 예를 들어 면역 체크포인트 억제제의 활성의 감소를 포함한다. 예를 들어, 활성, 예를 들어, PD-1 또는 PD-L1 활성의 적어도 5%, 10%, 20%, 30%, 40%, 50% 또는 그 초과의 억제는 이 용어에 포함된다. 따라서, 억제는 100%일 필요는 없다.
억제 분자의 억제는 DNA, RNA 또는 단백질 수준에서 수행될 수 있다. 일부 실시양태에서, 억제 핵산 (예를 들어, dsRNA, siRNA 또는 shRNA)은 억제 분자의 발현을 억제하는데 사용될 수 있다. 다른 실시양태에서, 억제 신호의 억제제는 폴리펩티드, 예를 들어 가용성 리간드 (예를 들어, PD-1-Ig 또는 CTLA-4 Ig), 또는 억제 분자에 결합하는 항체 또는 그의 항원-결합 단편; 에를 들어, PD-1, PD-L1, PD-L2, CTLA4, TIM3, LAG3, VISTA, BTLA, TIGIT, LAIR1, CD160, 2B4 및/또는 TGFR 베타, 또는 그의 조합에 결합하는 항체 또는 그의 단편 (또한 본원에서 "항체 분자"로도 지칭됨)이다.
한 실시양태에서, 항체 분자는 전장 항체 또는 그의 단편 (예를 들어, Fab, F(ab')2, Fv, 또는 단일 쇄 Fv 단편 (scFv))이다. 또 다른 실시양태에서, 항체 분자는, 예를 들어 IgG1, IgG2, IgG3, IgG4, IgM, IgA1, IgA2, IgD, 및 IgE의 중쇄 불변 영역으로부터 선택된, 특히 IgG1, IgG2, IgG3, 및 IgG4의 중쇄 불변 영역, 보다 특히 IgG1 또는 IgG4 (예를 들어, 인간 IgG1 또는 IgG4)의 중쇄 불변 영역으로부터 선택된 중쇄 불변 영역 (Fc)을 갖는다. 한 실시양태에서, 중쇄 불변 영역은 인간 IgG1 또는 인간 IgG4이다. 한 실시양태에서, 불변 영역은 항체 분자의 특성을 변형시키기 위해 (예를 들어, Fc 수용체 결합, 항체 글리코실화, 시스테인 잔기의 수, 이펙터 세포 기능, 또는 보체 기능 중 1종 이상을 증가 또는 감소시키기 위해) 변경, 예를 들어 돌연변이된다.
특정 실시양태에서, 항체 분자는 이중특이적 또는 다중특이적 항체 분자 형태이다. 한 실시양태에서, 이중특이적 항체 분자는 PD-1 또는 PD-L1에 대한 제1 결합 특이성 및 제2 결합 특이성, 예를 들어 TIM-3, LAG-3 또는 PD-L2에 대한 제2 결합 특이성을 갖는다. 한 실시양태에서, 이중특이적 항체 분자는 PD-1 또는 PD-L1 및 TIM-3에 결합한다. 또 다른 실시양태에서, 이중특이적 항체 분자는 PD-1 또는 PD-L1 및 LAG-3에 결합한다. 또 다른 실시양태에서, 이중특이적 항체 분자는 PD-1 및 PD-L1에 결합한다. 또 다른 실시양태에서, 이중특이적 항체 분자는 PD-1 및 PD-L2에 결합한다. 또 다른 실시양태에서, 이중특이적 항체 분자는 TIM-3 및 LAG-3에 결합한다. 상기 분자의 임의의 조합은 다중특이적 항체 분자, 예를 들어 PD-1 또는 PD-1에 대한 제1 결합 특이성, 및 TIM-3, LAG-3, 또는 PD-L2 중 2종 이상에 대한 제2 및 제3 결합 특이성을 포함하는 삼중특이적 항체로 제조될 수 있다.
특정 실시양태에서, 면역조정제는 PD-1, 예를 들어 인간 PD-1의 억제제이다. 또 다른 실시양태에서, 면역조정제는 PD-L1, 예를 들어 인간 PD-L1의 억제제이다. 한 실시양태에서, PD-1 또는 PD-L1의 억제제는 PD-1 또는 PD-L1에 대한 항체 분자이다. PD-1 또는 PD-L1 억제제는 단독으로, 또는 다른 면역조정제와 조합되어, 예를 들어 LAG-3, TIM-3 또는 CTLA4의 억제제와 조합되어 투여될 수 있다. 예시적인 실시양태에서, PD-1 또는 PD-L1의 억제제, 예를 들어 항-PD-1 또는 PD-L1 항체 분자는 LAG-3 억제제, 예를 들어 항-LAG-3 항체 분자와 조합되어 투여된다. 또 다른 실시양태에서, PD-1 또는 PD-L1의 억제제, 예를 들어 항-PD-1 또는 PD-L1 항체 분자는 TIM-3 억제제, 예를 들어 항-TIM-3 항체 분자와 조합되어 투여된다. 또 다른 실시양태에서, PD-1 또는 PD-L1의 억제제, 예를 들어 항-PD-1 항체 분자는 LAG-3 억제제, 예를 들어 항-LAG-3 항체 분자 및 TIM-3 억제제, 예를 들어 항-TIM-3 항체 분자와 조합되어 투여된다. 면역조정제와 PD-1 억제제 (예를 들어, PD-L2, CTLA4, TIM3, LAG3, VISTA, BTLA, TIGIT, LAIR1, CD160, 2B4 및/또는 TGFR 중 1종 이상)와의 다른 조합이 또한 본 발명 내에 있다. 관련 기술분야에 공지되어 있거나 또는 본원에 개시된 임의의 항체 분자는 체크포인트 분자의 억제제의 상기 조합에 사용될 수 있다.
한 실시양태에서, PD-1 억제제는 니볼루맙, 펨브롤리주맙 또는 피딜리주맙으로부터 선택된 항-PD-1 항체이다. 일부 실시양태에서, 항-PD-1 항체는 니볼루맙이다. 니볼루맙에 대한 대체 명칭은 MDX-1106, MDX-1106-04, ONO-4538, 또는 BMS-936558을 포함한다. 일부 실시양태에서, 항-PD-1 항체는 니볼루맙 (CAS 등록 번호: 946414-94-4)이다. 니볼루맙은 PD1을 특이적으로 차단하는 완전 인간 IgG4 모노클로날 항체이다. PD1에 특이적으로 결합하는 니볼루맙 (클론 5C4) 및 다른 인간 모노클로날 항체는 미국 특허 번호 8,008,449 및 PCT 공개 번호 WO2006/121168에 개시되어 있다.
다른 실시양태에서, 항-PD-1 항체는 펨브롤리주맙이다. 펨브롤리주맙 (상표명 키트루다(KEYTRUDA), 이전에 람브롤리주맙, 또한 머크(Merck) 3745, MK-3475 또는 SCH-900475로도 공지됨)은 PD1에 결합하는 인간화 IgG4 모노클로날 항체이다. 펨브롤리주맙은, 예를 들어 문헌 [Hamid, O. et al. (2013) New England Journal of Medicine 369 (2): 134-44], PCT 공개 번호 WO2009/114335, 및 미국 특허 번호 8,354,509에 개시되어 있다.
일부 실시양태에서, 항-PD-1 항체는 피딜리주맙이다. 피딜리주맙 (CT-011; 큐어 테크(Cure Tech))은 PD1에 결합하는 인간화 IgG1k 모노클로날 항체이다. 피딜리주맙 및 다른 인간화 항-PD-1 모노클로날 항체는 PCT 공개 번호 WO2009/101611에 개시되어 있다. 다른 항-PD1 항체는 미국 특허 번호 8,609,089, 미국 공개 번호 2010028330, 및/또는 미국 공개 번호 20120114649에 개시되어 있다. 다른 항-PD1 항체는 AMP 514 (암플리뮨(Amplimmune))를 포함한다.
일부 실시양태에서, PD-1 억제제는 이뮤노어드헤신 (예를 들어, 불변 영역 (예를 들어, 이뮤노글로불린 서열의 Fc 영역)에 융합된 PD-L1 또는 PD-L2의 세포외 또는 PD-1 결합 부분을 포함하는 이뮤노어드헤신)이다. 일부 실시양태에서, PD-1 억제제는 AMP-224이다.
일부 실시양태에서, PD-L1 억제제는 항-PD-L1 항체이다. 일부 실시양태에서, 항-PD-L1 억제제는, 예를 들어 WO 2013/0179174에 개시되고, 본원에 개시된 서열 (또는 그에 대해 실질적으로 동일 또는 유사한 서열, 예를 들어 명시된 서열에 대해 적어도 85%, 90%, 95% 또는 그 초과 동일한 서열)을 갖는 YW243.55.S70, MPDL3280A, MEDI-4736, 또는 MDX-1105MSB-0010718C (또한 A09-246-2로도 지칭됨)로부터 선택된다.
한 실시양태에서, 항-PD-L1 억제제는 MDX-1105이다. 또한 BMS-936559로도 공지된 MDX-1105는 PCT 공개 번호 WO2007/005874에 기재된 항-PD-L1 항체이다.
한 실시양태에서, PD-L1 억제제는 YW243.55.S70이다. YW243.55.S70 항체는 PCT 공개 번호 WO 2010/077634 (각각 서열식별번호: 20 및 21에 제시된 중쇄 및 경쇄 가변 영역 서열)에 기재된 항-PD-L1이다.
한 실시양태에서, PD-L1 억제제는 MDPL3280A (제넨테크 / 로슈(Roche))이다. MDPL3280A는 PD-L1에 결합하는 인간 Fc 최적화된 IgG1 모노클로날 항체이다. MDPL3280A 및 PD-L1에 대한 다른 인간 모노클로날 항체는 미국 특허 번호 7,943,743 및 미국 공개 번호 20120039906에 개시되어 있다.
다른 실시양태에서, PD-L2 억제제는 AMP-224이다. AMP-224는 PD1과 B7-H1 사이의 상호작용을 차단하는 PD-L2 Fc 융합 가용성 수용체이다 (B7-DCIg; 암플리뮨; 예를 들어 PCT 공개 번호 WO2010/027827 및 WO2011/066342에 개시됨).
한 실시양태에서, LAG-3 억제제는 항-LAG-3 항체 분자이다. 한 실시양태에서, LAG-3 억제제는 BMS-986016이다.
제약 조성물
면역접합체를 포함하는 제약 또는 멸균 조성물을 제조하기 위해, 본 발명의 면역접합체는 제약상 허용되는 담체 또는 부형제와 혼합된다. 조성물은 추가로 암 (예컨대 비제한적으로, 방광암, 유방암, 결장암, 결장직장암, 자궁내막암, 식도암, 바렛 식도암, 위암, 두경부암, 폐암, 다발성 골수종, 난소암, 간암, 췌장암, 급성 골수성 백혈병, 만성 골수성 백혈병, 골육종, 편평 세포 암종, 말초 신경초 종양 슈반세포종, 교모세포종, 투명 세포 연부 조직 육종, 악성 중피종, 신경섬유종증, 신암, 흑색종, 전립선암, 양성 전립선 비대증 (BPH), 여성형유방증, 및 횡문근육종)을 치료 또는 예방하는데 적합한 1종 이상의 다른 치료제를 함유할 수 있다.
치료제 및 진단제의 제제는 생리학상 허용되는 담체, 부형제 또는 안정화제와 혼합되어, 예를 들어 동결건조 분말, 슬러리, 수용액, 로션 또는 현탁액의 형태로 제조될 수 있다 (예를 들어, 문헌 [Hardman et al., Goodman and Gilman's The Pharmacological Basis of Therapeutics, McGraw-Hill, New York, N.Y., 2001; Gennaro, Remington: The Science and Practice of Pharmacy, Lippincott, Williams, and Wilkins, New York, N.Y., 2000; Avis, et al. (eds.), Pharmaceutical Dosage Forms: Parenteral Medications, Marcel Dekker, NY, 1993; Lieberman, et al. (eds.), Pharmaceutical Dosage Forms: tablets, Marcel Dekker, NY, 1990; Lieberman, et al. (eds.) Pharmaceutical Dosage Forms: Disperse Systems, Marcel Dekker, NY, 1990; Weiner and Kotkoskie, Excipient Toxicity and Safety, Marcel Dekker, Inc., New York, N.Y., 2000] 참조).
한 실시양태에서, 본 발명의 항체 약물 접합체의 임상 서비스 형태 (CSF)는 ADC, 히스티딘, 수크로스, 및 폴리소르베이트 20을 함유하는 바이알 내의 동결건조물이다. 동결건조물은 주사용수로 재구성될 수 있고, 용액은 pH 약 5.0에서 ADC, 히스티딘, 수크로스, 및 폴리소르베이트 20을 포함한다. 하나의 구체적 실시양태에서, 동결건조물은 pH 5.3에서 10 mg/ml의 ADC, 20 mM 히스티딘, 240 mM 수크로스, 및 0.02% 폴리소르베이트 20을 포함한다.
치료제에 대한 투여 요법을 선택하는 것은 물질의 혈청 또는 조직 전환율, 증상의 수준, 물질의 면역원성, 및 생물학적 매트릭스에서의 표적 세포의 접근가능성을 포함한 여러 인자에 좌우된다. 특정 실시양태에서, 투여 요법은 허용되는 부작용 수준에 부합하도록 환자에게 전달되는 치료제의 양을 최대화한다. 따라서, 전달되는 생물제제의 양은 부분적으로 특정한 물질 및 치료될 상태의 중증도에 좌우된다. 항체, 시토카인, 및 소형 분자의 적절한 용량을 선택하는데 있어서의 지침이 입수가능하다 (예를 들어, 문헌 [Wawrzynczak, Antibody Therapy, Bios Scientific Pub. Ltd, Oxfordshire, UK, 1996; Kresina (ed.), Monoclonal Antibodies, Cytokines and Arthritis, Marcel Dekker, New York, N.Y., 1991; Bach (ed.), Monoclonal Antibodies and Peptide Therapy in Autoimmune Diseases, Marcel Dekker, New York, N.Y., 1993; Baert et al., New Engl. J. Med. 348:601-608, 2003; Milgrom et al., New Engl. J. Med. 341:1966-1973, 1999; Slamon et al., New Engl. J. Med. 344:783-792, 2001; Beniaminovitz et al., New Engl. J. Med. 342:613-619, 2000; Ghosh et al., New Engl. J. Med. 348:24-32, 2003; Lipsky et al., New Engl. J. Med. 343:1594-1602, 2000] 참조).
적절한 용량의 결정은, 예를 들어 치료에 영향을 미치는 것으로 관련 기술분야에 공지되어 있거나 또는 그러한 것으로 의심되거나 또는 치료에 영향을 미칠 것으로 예측되는 파라미터 또는 인자를 사용하여 임상의에 의해 이루어진다. 일반적으로, 용량은 최적 용량보다 다소 적은 양에서 시작하고, 그 후 임의의 부정적 부작용에 비해 바람직하거나 최적인 효과가 달성될 때까지 소량 증분으로 증가시킨다. 중요한 진단 척도는, 예를 들어 염증의 증상 또는 생산된 염증성 시토카인의 수준의 것을 포함한다.
본 발명의 제약 조성물 중 활성 성분의 실제 투여량 수준은 환자에게 독성이 없으면서 특정한 환자, 조성물 및 투여 방식에 대해 목적하는 치료 반응을 달성하는데 효과적인 활성 성분의 양이 달성되도록 달라질 수 있다. 선택된 투여량 수준은 사용되는 본 발명의 특정한 조성물, 또는 그의 에스테르, 염 또는 아미드의 활성, 투여 경로, 투여 시간, 사용될 특정한 화합물의 배출 속도, 치료 지속기간, 사용되는 특정한 조성물과 조합되어 사용되는 다른 약물, 화합물 및/또는 물질, 치료될 환자의 연령, 성별, 체중, 상태, 전반적 건강 및 과거 병력, 및 의학 기술분야에 공지된 다른 인자를 포함한 다양한 약동학적 인자에 좌우될 것이다.
본 발명의 항체 또는 그의 단편을 포함하는 조성물은 연속 주입에 의해, 또는 예를 들어 1일, 1주의 간격으로, 또는 1주에 1-7회, 격주 1회, 3주마다 1회, 4주마다 1회, 5주마다 1회, 6주마다 1회, 7주마다 1회, 또는 8주마다 1회의 용량으로 제공될 수 있다. 용량은 정맥내로, 피하로, 국소로, 경구로, 비강으로, 직장으로, 근육내, 뇌내로, 또는 흡입에 의해 제공될 수 있다. 구체적 투여 프로토콜은 유의한 바람직하지 않은 부작용을 피하는 최대 용량 또는 투여 빈도를 수반하는 것이다.
본 발명의 면역접합체의 경우에, 환자에게 투여되는 투여량은 0.0001 mg/kg 내지 100 mg/kg 환자 체중일 수 있다. 투여량은 0.0001 mg/kg 내지 30 mg/kg, 0.0001 mg/kg 내지 20 mg/kg, 0.0001 mg/kg 내지 10 mg/kg, 0.0001 mg/kg 내지 5 mg/kg, 0.0001 내지 2 mg/kg, 0.0001 내지 1 mg/kg, 0.0001 mg/kg 내지 0.75 mg/kg, 0.0001 mg/kg 내지 0.5 mg/kg, 0.0001 mg/kg 내지 0.25 mg/kg, 0.0001 내지 0.15 mg/kg, 0.0001 내지 0.10 mg/kg, 0.001 내지 0.5 mg/kg, 0.01 내지 0.25 mg/kg 또는 0.01 내지 0.10 mg/kg 환자 체중일 수 있다. 본 발명의 항체 또는 그의 단편의 투여량은 환자 체중 (킬로그램 (kg))에 투여되는 용량 (mg/kg)을 곱하는 것을 사용하여 계산될 수 있다.
본 발명의 면역접합체의 용량은 반복될 수 있고, 투여는 1일 미만, 적어도 1일, 2일, 3일, 5일, 10일, 15일, 30일, 45일, 2개월, 75일, 3개월, 4개월, 5개월, 또는 적어도 6개월의 간격을 둘 수 있다. 일부 실시양태에서, 본 발명의 면역접합체는 매주 2회, 매주 1회, 2주마다 1회, 3주마다 1회, 4주마다 1회, 또는 보다 덜 빈번하게 제공될 수 있다. 구체적 실시양태에서, 본 발명의 면역접합체의 용량은 2주마다 반복된다.
특정한 환자에 대한 유효량은 치료될 상태, 환자의 전반적 건강, 투여의 방법, 경로 및 용량 및 부작용의 중증도와 같은 인자에 따라 달라질 수 있다 (예를 들어, 문헌 [Maynard et al., A Handbook of SOPs for Good Clinical Practice, Interpharm Press, Boca Raton, Fla., 1996; Dent, Good Laboratory and Good Clinical Practice, Urch Publ., London, UK, 2001] 참조).
투여 경로는, 예를 들어 국소 또는 피부 적용, 정맥내, 복강내, 뇌내, 근육내, 안내, 동맥내, 뇌척수내, 병변내 주사 또는 주입, 또는 지속 방출 시스템 또는 이식물에 의한 것일 수 있다 (예를 들어, 문헌 [Sidman et al., Biopolymers 22:547-556, 1983; Langer et al., J. Biomed. Mater. Res. 15:167-277, 1981; Langer, Chem. Tech. 12:98-105, 1982; Epstein et al., Proc. Natl. Acad. Sci. USA 82:3688-3692, 1985; Hwang et al., Proc. Natl. Acad. Sci. USA 77:4030-4034, 1980]; 미국 특허 번호 6,350,466 및 6,316,024 참조). 필요한 경우에, 조성물은 또한 주사 부위에서의 통증을 덜기 위해 가용화제 또는 국부 마취제 예컨대 리도카인, 또는 둘 다를 포함할 수 있다. 추가로, 폐 투여는 또한, 예를 들어 흡입기 또는 네뷸라이저의 사용, 및 에어로졸화제를 사용한 제제화에 의해 사용될 수 있다. 예를 들어, 미국 특허 번호 6,019,968, 5,985,320, 5,985,309, 5,934,272, 5,874,064, 5,855,913, 5,290,540, 및 4,880,078; 및 PCT 공개 번호 WO 92/19244, WO 97/32572, WO 97/44013, WO 98/31346, 및 WO 99/66903 (이들 각각은 그 전문이 본원에 참조로 포함됨)을 참조한다.
또한, 본 발명의 조성물은 또한 관련 기술분야에 공지된 1종 이상의 다양한 방법을 이용하여 1종 이상의 투여 경로를 통해 투여될 수 있다. 통상의 기술자가 인지하는 바와 같이, 투여 경로 및/또는 방식은 목적하는 결과에 따라 달라질 것이다. 본 발명의 면역접합체에 대한 선택된 투여 경로는 정맥내, 근육내, 피내, 복강내, 피하, 척수 또는 다른 비경구 투여 경로, 예를 들어 주사 또는 주입에 의한 것을 포함한다. 비경구 투여는 경장 및 국소 투여 이외에 통상적으로 주사에 의한 투여 방식을 나타내고, 비제한적으로, 정맥내, 근육내, 동맥내, 척수강내, 피막내, 안와내, 심장내, 피내, 복강내, 경기관, 피하, 각피하, 관절내, 피막하, 지주막하, 척수내, 경막외 및 흉골내 주사 및 주입을 포함할 수 있다. 대안적으로, 본 발명의 조성물은 투여의 비-비경구 경로, 예컨대 국소, 표피 또는 점막 경로를 통해, 예를 들어 비강내로, 경구로, 질로, 직장으로, 설하로 또는 국소로 투여될 수 있다. 한 실시양태에서, 본 발명의 면역접합체는 주입에 의해 투여된다. 또 다른 실시양태에서, 본 발명의 면역접합체는 피하로 투여된다.
본 발명의 면역접합체가 제어 방출 또는 지연 방출 시스템으로 투여되는 경우에, 제어 또는 지연 방출을 달성하기 위해 펌프가 사용될 수 있다 (문헌 [Langer, supra; Sefton, CRC Crit. Ref Biomed. Eng. 14:20, 1987; Buchwald et al., Surgery 88:507, 1980; Saudek et al., N. Engl. J. Med. 321:574, 1989] 참조). 본 발명의 요법의 제어 또는 지속 방출을 달성하기 위해 중합체 물질이 사용될 수 있다 (예를 들어, 문헌 [Medical Applications of Controlled Release, Langer and Wise (eds.), CRC Pres., Boca Raton, Fla., 1974; Controlled Drug Bioavailability, Drug Product Design and Performance, Smolen and Ball (eds.), Wiley, New York, 1984; Ranger and Peppas, J. Macromol. Sci. Rev. Macromol. Chem. 23:61, 1983] 참조; 또한 문헌 [Levy et al., Science 228:190, 1985; During et al., Ann. Neurol. 25:351, 1989; Howard et al., J. Neurosurg. 7 1:105, 1989]; 미국 특허 번호 5,679,377; 미국 특허 번호 5,916,597; 미국 특허 번호 5,912,015; 미국 특허 번호 5,989,463; 미국 특허 번호 5,128,326; PCT 공개 번호 WO 99/15154; 및 PCT 공개 번호 WO 99/20253 참조). 지속 방출 제제에 사용된 중합체의 예는 폴리(2-히드록시 에틸 메타크릴레이트), 폴리(메틸 메타크릴레이트), 폴리(아크릴산), 폴리(에틸렌-코-비닐 아세테이트), 폴리(메타크릴산), 폴리글리콜리드 (PLG), 폴리무수물, 폴리(N-비닐 피롤리돈), 폴리(비닐 알콜), 폴리아크릴아미드, 폴리(에틸렌 글리콜), 폴리락티드 (PLA), 폴리(락티드-코-글리콜리드) (PLGA) 및 폴리오르토에스테르를 포함하나 이에 제한되지는 않는다. 한 실시양태에서, 지속 방출 제제에 사용된 중합체는 불활성이고, 여과가능한 불순물이 없고, 보관, 멸균 및 생분해성에 대해 안정하다. 제어 또는 지속 방출 시스템이 예방적 또는 치료적 표적에 근접하게 배치될 수 있고, 따라서 전신 용량의 단지 일부만이 요구된다 (예를 들어, 문헌 [Goodson, in Medical Applications of Controlled Release, supra, vol. 2, pp. 115-138, 1984] 참조).
제어 방출 시스템은 문헌 [Langer, Science 249:1527-1533, 1990]에 의한 검토에서 논의된다. 관련 기술분야의 통상의 기술자에게 공지된 임의의 기술이 본 발명의 1종 이상의 면역접합체를 포함하는 지속 방출 제제를 생산하는데 사용될 수 있다. 예를 들어, 미국 특허 번호 4,526,938, PCT 공개 WO 91/05548, PCT 공개 WO 96/20698, 문헌 [Ning et al., Radiotherapy & Oncology 39:179-189, 1996; Song et al., PDA Journal of Pharmaceutical Science & Technology 50:372-397, 1995; Cleek et al., Pro. Int'l. Symp. Control. Rel. Bioact. Mater. 24:853-854, 1997; 및 Lam et al., Proc. Int'l. Symp. Control Rel. Bioact. Mater. 24:759-760, 1997] (이들 각각은 그 전문이 본원에 참조로 포함됨)을 참조한다.
본 발명의 면역접합체가 국소로 투여되는 경우에, 이들은 연고, 크림, 경피 패치, 로션, 겔, 스프레이, 에어로졸, 용액, 에멀젼 형태, 또는 관련 기술분야의 통상의 기술자에게 널리 공지된 다른 형태로 제제화될 수 있다. 예를 들어, 문헌 [Remington's Pharmaceutical Sciences and Introduction to Pharmaceutical Dosage Forms, 19th ed., Mack Pub. Co., Easton, Pa. (1995)]을 참조한다. 비-분무가능한 국소 투여 형태의 경우, 국소 적용에 적합한 담체 또는 1종 이상의 부형제를 포함하고 일부 경우에 물보다 더 큰 동적 점도를 갖는 점성 내지 반고체 또는 고체 형태가 전형적으로 사용된다. 적합한 제제는 비제한적으로, 용액, 현탁액, 에멀젼, 크림, 연고, 분말, 도찰제, 살브 등을 포함하며, 이는 원하는 경우에 다양한 특성, 예컨대, 예를 들어 삼투압에 영향을 미치기 위해 보조제 (예를 들어, 보존제, 안정화제, 습윤제, 완충제, 또는 염)로 멸균되거나 또는 그와 혼합된다. 다른 적합한 국소 투여 형태는 분무가능한 에어로졸 제제를 포함하며, 여기서 활성 성분은 일부 경우에 고체 또는 액체 불활성 담체와 조합되어 가압 휘발성 물질 (예를 들어, 기체상 추진제, 예컨대 프레온)과의 혼합물 또는 압착병 내에 포장된다. 보습제 또는 함습제가 또한 원하는 경우에 제약 조성물 및 투여 형태에 첨가될 수 있다. 이러한 추가의 성분의 예는 관련 기술분야에 널리 공지되어 있다.
면역접합체를 포함하는 조성물이 비강내로 투여되는 경우에, 이는 에어로졸 형태, 스프레이, 미스트 내에 또는 점적제 형태로 제제화될 수 있다. 특히, 본 발명에 따라 사용하기 위한 예방제 또는 치료제는 적합한 추진제 (예를 들어, 디클로로디플루오로메탄, 트리클로로플루오로메탄, 디클로로테트라플루오로에탄, 이산화탄소 또는 다른 적합한 기체)를 사용하여 가압 팩 또는 네뷸라이저로부터 에어로졸 스프레이 제공물 형태로 편리하게 전달될 수 있다. 가압 에어로졸의 경우에, 투여 단위는 계량된 양을 전달하기 위해 밸브를 제공함으로써 결정될 수 있다. 흡입기 또는 취입기에 사용하기 위한 캡슐 및 카트리지 (예를 들어, 젤라틴으로 구성됨)는 화합물의 분말 혼합물 및 적합한 분말 기재, 예컨대 락토스 또는 전분을 함유하도록 제제화될 수 있다.
제2 치료제, 예를 들어 시토카인, 스테로이드, 화학요법제, 항생제 또는 방사선과의 공-투여 또는 치료 방법이 관련 기술분야에 공지되어 있다 (예를 들어, 문헌 [Hardman et al., (eds.) (2001) Goodman and Gilman's The Pharmacological Basis of Therapeutics, 10.sup.th ed., McGraw-Hill, New York, N.Y.; Poole and Peterson (eds.) (2001) Pharmacotherapeutics for Advanced Practice:A Practical Approach, Lippincott, Williams & Wilkins, Phila., Pa.; Chabner and Longo (eds.) (2001) Cancer Chemotherapy and Biotherapy, Lippincott, Williams & Wilkins, Phila., Pa.] 참조). 유효량의 치료제는 증상을 적어도 10%; 적어도 20%; 적어도 약 30%; 적어도 40%, 또는 적어도 50% 감소시킬 수 있다.
본 발명의 면역접합체와 조합되어 투여될 수 있는 추가의 요법 (예를 들어, 예방제 또는 치료제)은 본 발명의 면역접합체와 5분 미만의 간격, 30분 미만의 간격, 1시간 간격, 약 1시간 간격, 약 1 내지 약 2시간 간격, 약 2시간 내지 약 3시간 간격, 약 3시간 내지 약 4시간 간격, 약 4시간 내지 약 5시간 간격, 약 5시간 내지 약 6시간 간격, 약 6시간 내지 약 7시간 간격, 약 7시간 내지 약 8시간 간격, 약 8시간 내지 약 9시간 간격, 약 9시간 내지 약 10시간 간격, 약 10시간 내지 약 11시간 간격, 약 11시간 내지 약 12시간 간격, 약 12시간 내지 18시간 간격, 18시간 내지 24시간 간격, 24시간 내지 36시간 간격, 36시간 내지 48시간 간격, 48시간 내지 52시간 간격, 52시간 내지 60시간 간격, 60시간 내지 72시간 간격, 72시간 내지 84시간 간격, 84시간 내지 96시간 간격, 또는 96시간 내지 120시간 간격으로 투여될 수 있다. 2종 이상의 요법은 1회 동일한 환자 방문에서 투여될 수 있다.
특정 실시양태에서, 본 발명의 면역접합체는 생체내에서 적절한 분포가 보장되도록 제제화될 수 있다. 예를 들어, 혈액-뇌 장벽 (BBB)은 많은 고도로 친수성인 화합물을 배제시킨다. 본 발명의 치료 화합물이 (원하는 경우에) BBB를 횡단하는 것을 보장하기 위해, 이들은, 예를 들어 리포솜 내에 제제화될 수 있다. 리포솜의 제조 방법에 대해서는, 예를 들어, 미국 특허 번호 4,522,811; 5,374,548; 및 5,399,331을 참조한다. 리포솜은 특정 세포 또는 기관 내로 선택적으로 수송되어 표적화 약물 전달을 증진시키는 1개 이상의 모이어티를 포함할 수 있다 (예를 들어, 문헌 [Ranade, (1989) J. Clin. Pharmacol. 29:685] 참조). 예시적인 표적화 모이어티는 폴레이트 또는 비오틴 (예를 들어 미국 특허 번호 5,416,016 (Low et al.)); 만노시드 (Umezawa et al., (1988) Biochem. Biophys. Res. Commun. 153:1038); 항체 (Bloeman et al., (1995) FEBS Lett. 357:140; Owais et al., (1995) Antimicrob. Agents Chemother. 39:180); 계면활성제 단백질 A 수용체 (Briscoe et al., (1995) Am. J. Physiol. 1233:134); p 120 (Schreier et al., (1994) J. Biol. Chem. 269:9090)을 포함하며; 또한 문헌 [K. Keinanen; M. L. Laukkanen (1994) FEBS Lett. 346:123; J. J. Killion; I. J. Fidler (1994) Immunomethods 4:273]을 참조한다.
본 발명은 본 발명의 면역접합체를 포함하는 제약 조성물을 이를 필요로 하는 대상체에게 단독으로 또는 다른 요법과 조합하여 투여하기 위한 프로토콜을 제공한다. 본 발명의 조합 요법의 요법 (예를 들어, 예방제 또는 치료제)은 대상체에게 병용으로 또는 순차적으로 투여될 수 있다. 본 발명의 조합 요법의 요법 (예를 들어, 예방제 또는 치료제)은 또한 주기적으로 투여될 수 있다. 주기 요법은 소정의 기간 동안의 제1 요법 (예를 들어, 제1 예방제 또는 치료제)의 투여, 이어서 소정의 기간 동안의 제2 요법 (예를 들어, 제2 예방제 또는 치료제)의 투여, 및 상기 순차적인 투여의 반복, 즉 요법 (예를 들어, 작용제) 중 1종에 대한 저항성의 발생을 감소시키고/거나, 요법 (예를 들어, 작용제) 중 1종의 부작용을 회피 또는 감소시키고/거나, 요법의 효능을 개선시키기 위한 주기를 수반한다.
본 발명의 조합 요법의 요법 (예를 들어, 예방제 또는 치료제)은 대상체에게 공동으로 투여될 수 있다.
용어 "공동으로"는 정확하게 동일한 시간에서의 요법 (예를 들어, 예방제 또는 치료제)의 투여로 제한되는 것이 아니라, 오히려 본 발명의 항체 또는 그의 단편을 포함하는 제약 조성물이, 본 발명의 항체 약물 접합체가 다른 요법(들)과 함께 작용하여 이들이 달리 투여되는 경우보다 증가된 이익을 제공할 수 있도록 하는 순서 및 시간 간격 내에 대상체에 투여되는 것을 의미한다. 예를 들어, 각각의 요법은 동시에 또는 상이한 시점에 임의의 순서로 순차적으로 대상체에게 투여될 수 있지만; 동시에 투여되지 않는 경우에도, 이들은 목적하는 치료 또는 예방 효과를 제공하기 위해 충분히 가까운 시간 내로 투여되어야 한다. 각각의 요법은 대상체에게 임의의 적절한 형태로 및 임의의 적합한 경로에 의해 개별적으로 투여될 수 있다. 다양한 실시양태에서, 요법 (예를 들어, 예방제 또는 치료제)은 5분 미만의 간격, 15분 미만의 간격, 30분 미만의 간격, 1시간 미만의 간격, 약 1시간 간격, 약 1시간 내지 약 2시간 간격, 약 2시간 내지 약 3시간 간격, 약 3시간 내지 약 4시간 간격, 약 4시간 내지 약 5시간 간격, 약 5시간 내지 약 6시간 간격, 약 6시간 내지 약 7시간 간격, 약 7시간 내지 약 8시간 간격, 약 8시간 내지 약 9시간 간격, 약 9시간 내지 약 10시간 간격, 약 10시간 내지 약 11시간 간격, 약 11시간 내지 약 12시간 간격, 24시간 간격, 48시간 간격, 72시간 간격, 또는 1주 간격으로 대상체에게 투여된다. 다른 실시양태에서, 2종 이상의 요법 (예를 들어, 예방제 또는 치료제)은 동일한 환자 방문 내에서 투여된다.
조합 요법의 예방제 또는 치료제는 대상체에게 동일한 제약 조성물로 투여될 수 있다. 대안적으로, 조합 요법의 예방제 또는 치료제는 대상체에게 개별 제약 조성물로 공동으로 투여될 수 있다. 예방제 또는 치료제는 대상체에게 동일 또는 상이한 투여 경로에 의해 투여될 수 있다. 조합 요법의 예방제 또는 치료제는 대상체에게 동일한 제약 조성물로 투여될 수 있다. 대안적으로, 조합 요법의 예방제 또는 치료제는 대상체에게 개별 제약 조성물로 공동으로 투여될 수 있다. 예방제 또는 치료제는 대상체에게 동일 또는 상이한 투여 경로에 의해 투여될 수 있다.
실시예
실시예 1: 항체의 생성
인간, 시노몰구스 원숭이, 마우스 및 래트 P-카드헤린 단백질에 대한 발현 구축물의 생성
인간, 마우스 및 래트 P-카드헤린 세포외 도메인 (ECD)을 진뱅크 또는 유니프롯(Uniprot) 데이터베이스로부터의 아미노산 서열 (하기 표 2 참조)에 기반하여 유전자 합성하였다. 시노몰구스 원숭이 P-카드헤린 ECD cDNA 주형을 다양한 시노 조직으로부터 단리된 mRNA를 사용하여 생성된 아미노산 서열 정보에 기반하여 유전자 합성하였다. 모든 합성된 DNA 단편을 정제가 가능하도록 C-말단 헥사-히스티딘 태그 (서열식별번호: 130)를 갖는 적절한 발현 벡터 내로 클로닝하였다.
표 2: P-카드헤린에 대한 아미노산 서열 정보


P-카드헤린 바큘로바이러스 생성
재조합 P-카드헤린 ECD 단백질을 발현하는 바큘로바이러스를 공동-형질감염/플라크 정제 방법 (O'Reilly et al., 1992) 또는 Bac-To-Bac 발현 시스템 방법 (인비트로젠)에 의해 제조업체의 프로토콜에 따라 생성하였다. 형질감염된 곤충 세포로부터 생성된 바이러스를 표준 저 MOI 감염 방법을 사용하여 증폭시켰다.
재조합 P-카드헤린 단백질의 발현
무혈청 배지 (독점적, 사내 제조 레시피)에서 성장하는 Tn5 세포의 현탁 배양물을 1.5e6개 세포/ml의 밀도로 시딩하고, 동시에 10 pfu/ml의 MOI 또는 3%의 부피에서 재조합 P-카드헤린 바큘로바이러스로 감염시켰다. P-카드헤린 바큘로바이러스 배양 제제를 2L 유리 에를렌마이어 플라스크 또는 웨이브 바이오리액터 (지이 헬스케어 라이프 사이언시스(GE Healthcare Life Sciences))에서 증식시켰다. 2L 플라스크에서 발현된 P-카드헤린 제제를 무혈청 배지 내 27℃에서 120 rpm으로 진탕시켰다. 웨이브 바이오리액터에서 발현된 제제를 28℃에서 7.5°의 각도로 25rpm으로 진탕시켰다. 플라스크 또는 웨이브 바이오리액터로부터 수거된 상청액을 4℃에서 10분 동안 1800 rpm으로 배양물을 원심분리함으로써 감염 2일 후에 수거하였다. 이어서, 상청액을 0.2 μM 필터 유닛으로 여과하였다. 1 L 초과의 발현을 위해, 세포 배양 상청액을 케이빅스타트(KvickStart) 한외여과 편평 시트 카세트를 갖는 AKTA교차흐름 시스템 (지이 헬스케어 라이프 사이언시스)을 사용하여 2-10x로 농축시켰다. 농축된 물질을 0.2 μM 필터 유닛으로 여과하였다.
인간, 시노몰구스 원숭이, 마우스 및 래트 pCAD ECD 단백질의 정제
재조합 헥사-히스티딘 (서열식별번호: 130) 태그부착된 pCAD 세포외 도메인 단백질 (예를 들어, 인간 pCAD-6xHis (서열식별번호: 130으로서 개시된 "6xHis"), 시노1 pCAD-6xHis (서열식별번호: 130으로서 개시된 "6xHis"), 시노2 pCAD-6xHis (서열식별번호: 130으로서 개시된 "6xHis"), 마우스 pCAD-6xHis (서열식별번호: 130으로서 개시된 "6xHis"), 래트 pCAD-6xHis (서열식별번호: 130으로서 개시된 "6xHis"))을 세포 배양 상청액으로부터 정제하였다. 정화된 상청액을 25 mM 비스트리스프로판, 0.3 M NaCl, 1 mM CaCl2, pH 6.2로 평형화된 니켈 세파로스 수지 (지이 헬스케어 라이프 사이언시스) 칼럼 상에서의 고정화된 금속 친화성 크로마토그래피 (IMAC)에 통과시켰다. 상청액은 5-8 mL/분의 유량으로 IMAC 칼럼에 적용된다. 25 mM 비스트리스프로판, 0.3 M NaCl, 1 mM CaCl2, pH 6.2로의 기준선 세척 후에, 5 칼럼 부피를 위해 세척 완충제 (20 mM 트리스, 0.3 M NaCl, 1 mM CaCl2, pH 7.5)로 전환시켰다. 풀링된 단백질을 필요한 경우에 10 kD 또는 30 kD 공칭 분자량 컷오프를 갖는 아미콘 울트라 15 mL 원심 농축기를 사용하여 농축시켰다. 이어서, 풀 단백질을 20 mM 트리스, 0.3 M NaCl, 1 mM CaCl2, pH 7.5 중에서 사전-평형화된 슈퍼덱스 200 26/60 칼럼 (지이 헬스케어 라이프 사이언시스)을 이용하는 겔 여과에 의해 정제하였다. 관련 분획을 풀링하고, SDS-PAGE에 의해 분석하였다. 단백질 농도를 브래드포드 단백질 검정 (써멀 피셔(Thermal Fisher))에 의해 결정하였다.
마우스의 면역화 및 하이브리도마의 생산
정제된 인간 P-카드헤린 ECD를 Bcl-2 트랜스제닉 마우스 (C57BL/6-Tgn (bcl-2) 22 wehi 계통)의 면역화 전에 프로인트 완전 아주반트로 1:1 희석하였다. 마우스를 다중 부위에서의 반복적 면역화 (RIMMS)가 요구되는 절차를 사용하여 면역화하였다 (McIntyre GD. Hybridoma 1997). 간략하게, 마우스의 말초 림프절 (PLN)에 근위인 8개의 특정 부위에 1-3 μg의 항원을 주사하였다. 이 절차를 12-일 기간에 걸쳐 8회 반복하였다. 제12일에, 시험 혈액을 수집하고, 혈청 항체 역가를 ELISA에 의해 분석하였다. 풀링된 PLN을 제15일에 높은 역가의 마우스로부터 제거하였다. 림프구를 수거하기 위해, PLN을 보통의 DMEM으로 2회 세척한 다음, .22 마이크로미터 스크린 (팔콘(Falcon) #352350)에 통과시켜 해리하였다. 생성된 림프구를 시토퓨전(Cytofusion) 배지 (BTX프레스(BTXpress) 시토퓨전® 전기천공 배지 카탈로그# 47001)에서의 융합 전에 추가로 2회 세척하였다. F0 골수종 세포를 림프구와 4개 림프구 대 1개 FO 세포의 비로 혼합하였다. 세포 혼합물을 원심분리하고, 7ml의 시토퓨전 배지 중에 현탁시키고, 후속적으로 9ml 전기융합 챔버 (하버드 어패러투스 코액셜 챔버(Harvard Apparatus Coaxial Chamber) 9ML 부품#470020)에 첨가하였다. 전기융합을 시토 펄스 사이언시스, 인크(Cyto Pulse Sciences, Inc) CEEF-50B 하이브리뮨/하이브리도마 시스템을 사용하여 제조업체의 지침서에 따라 수행하였다. 융합된 세포를 챔버에서 5분 회수되도록 하고, HAT (DMEM + 20% FBS, Pen/Strep/Glu, 1x NEAA, 0.5x HFCS)가 없는 융합 배지에서 1/10으로 희석하고, 37℃에서 1시간 동안 배치하였다. 4x HAT 배지 (DMEM + 20% FBS, Pen/Strep/Glu, 1x NEAA, 4x HAT, 0.5x HFCS)를 첨가하여 1x 용액을 제조하고, 밀도를 1.67x 10⁴개 세포/ml로 조정하였다. 이어서, 세포를 384-웰 플레이트에 60 μL / 웰로 플레이팅하였다.
P-카드헤린에 대한 항체를 분비하는 하이브리도마의 스크리닝
융합 10일 후에, 하이브리도마 플레이트를 P-카드헤린-특이적 항체의 존재에 대해 스크리닝하였다. ELISA 스크린을 위해, 맥시소르프(Maxisorp) 384-웰 플레이트 (눈크(Nunc) #464718)를 50 μL의 인간 P-카드헤린 (PBS 중 15 ng/웰로 희석됨)로 코팅하고, 4℃에서 밤새 인큐베이션하였다. 남아있는 단백질을 흡인하고, 웰을 PBS 중 1% BSA를 사용하여 차단하였다. 실온에서 30분 인큐베이션한 후에, 웰을 PBS + 0.05% 트윈 (PBST)으로 4회 세척하였다. 15 μL의 하이브리도마 상청액을 ELISA 플레이트로 옮겼다. PLN 제거 시점에 취한 15 μL의 마우스 혈청을 PBS 중에 1:1000으로 희석하고, 양성 대조군으로서 첨가하였다. PBST. 50 μL의 2차 항체 (염소 항 마우스 IgG - HRP (잭슨 이뮤노 리서치(Jackson Immuno Research) #115-035-071), PBS 중에 1:5000으로 희석됨)를 ELISA 플레이트 상의 모든 웰에 첨가하였다. 실온에서 1시간 동안 인큐베이션한 후에, 플레이트를 PBST로 8회 세척하였다. 25 μL의 TMB (KPL #50-76-05)를 첨가하고, 실온에서 30분 인큐베이션한 후에; 플레이트를 605 nm의 흡광도에서 판독하였다. 양성 웰로부터의 세포를 HT 배지 (DMEM + 20% FBS, Pen/Strep/Glu, 1x NEAA, 1x HT, 0.5x HFCS)에서 24-웰 플레이트로 확장시켰다.
항체 정제
항체를 함유하는 상청액을 단백질 G (업스테이트(Upstate) # 16-266 (매사추세츠주 빌러리카))를 사용하여 정제하였다. 상청액을 로딩하기 전에, 수지를 10 칼럼 부피의 PBS로 평형화하였다. 샘플의 결합 후에, 칼럼을 10 칼럼 부피의 PBS로 세척한 다음, 항체를 5 칼럼 부피의 0.1 M 글리신, pH 2.0으로 용리시켰다. 칼럼 분획을 1/10 부피의 트리스 HCl, pH 9.0으로 즉시 중화시켰다. 분획의 OD280을 측정하고, 양성 분획을 풀링하고, PBS, pH 7.2에 대해 밤새 투석하였다.
항-P-카드헤린 항체의 인간화 및 친화도 성숙
하이브리도마 유래된 항-P-카드헤린 항체의 VH 및 VL 서열을 하기와 같이 인간화 및 친화도 성숙시켰다.
인간화 서열의 생성
호모 사피엔스(homo sapiens)에 대한 코돈 최적화를 포함하는 인간화 VL 및 VH 도메인을 코딩하는 DNA 서열을 진아트(GeneArt) (라이프 테크놀러지스 인크.(Life Technologies Inc.), 독일 레겐스부르크)에서 주문하였다. VL 및 VH 도메인을 코딩하는 서열을 진아트 유래 벡터로부터 포유동물 세포에서의 분비에 적합한 발현 벡터 내로 잘라 붙였다. 중쇄 및 경쇄를 공동-형질감염을 가능하게 하기 위해 개별 발현 벡터 내로 클로닝하였다. 발현 벡터의 요소는 프로모터 (시토메갈로바이러스 (CMV) 인핸서-프로모터), 분비를 용이하게 하는 신호 서열, 폴리아데닐화 신호 및 전사 종결인자 (소 성장 호르몬 (BGH) 유전자), 에피솜 복제 및 원핵생물에서의 복제를 가능하게 하는 요소 (예를 들어 SV40 기점 및 ColE1 또는 관련 기술분야에 공지된 다른 것), 및 선택을 가능하게 하는 요소 (암피실린 저항성 유전자 및 제오신 마커)를 포함한다.
인간화 항체의 발현 및 정제
SV40 대형 T 항원을 구성적으로 발현하는 인간 배아 신장 세포 (HEK293-T ATCC11268)는 인간화 및/또는 최적화 IgG 단백질의 일시적 발현을 위한 바람직한 숙주 세포주 중 하나이다. 형질감염 시약으로서 PEI (폴리에틸렌이민, MW 25.000 선형, 폴리사이언시스(Polysciences), 미국 카탈로그 번호 23966)를 사용하여 형질감염을 수행한다. 실온 (RT)에서 900 ml 세포 배양 등급 물에 1g의 PEI를 주의깊게 용해시킴으로써 PEI 원액을 제조한다. PEI의 용해를 용이하게 하기 위해, 용액을 HCl 첨가에 의해 pH 3-5로 산성화시키고, 이어서 NaOH를 사용하여 최종 pH 7.05로 중화시킨다. 최종적으로, 부피를 1L로 조정하고, 용액을 0.22 μm 필터를 통해 여과하고, 분취하고, 추가로 사용할 때까지 -80℃에서 동결시킨다. 해동되면, 분취물을 최대 3회까지 -20℃에서 재-동결시킬 수 있지만, -20℃에서 장기 보관하지 않아야 한다.
HEK 293T 세포를 세포의 형질감염 및 증식을 위한 무혈청 배양 배지, 및 생산/공급 배지로서의 엑스셀(ExCell) VPRO 무혈청 배양 배지 (에스에이에프씨 바이오사이언시스(SAFC Biosciences), 미국, 카탈로그 번호 24561C)를 사용하여 배양하였다. 일시적 형질감염을 위해 제조된 세포를 현탁 배양으로 배양한다. 소규모 (<5L) 형질감염을 위해, 세포를 5% CO2 하에 가습 인큐베이터 내의 오비탈 진탕기 (100-120 rpm) 상의 코닝(Corning) 진탕 플라스크 (코닝, 매사추세츠주 튜크스베리) (시드 플라스크)에서 성장시킨다. 형질감염을 위해 시드 배양물 내의 세포는 지수 성장기 (5x10⁵ 내지 3x10⁶개/mL의 세포 밀도)에서 유지되어야 하고 >90% 생존율을 나타내야 한다. 이 범위 밖의 세포 밀도는 희석 후의 유도기 또는 감소된 형질감염 효율을 유발할 것이다. 소규모 (<5L) 형질감염을 위해 세포의 분취물을 시드 배양물로부터 취하고 노파르티스(Novartis) 무혈청 배양 배지를 사용하여 최종 부피의 36% 중에 1.4x10⁶개 세포/mL로 조정한다. DNA를 최종 배양 부피의 7% 중에 1 mg/L (최종 부피)로 희석하고 이어서 서서히 혼합함으로써 DNA 용액 (용액 1: 1 L 형질감염을 위해 0.5mg의 중쇄 및 0.5 mg의 경쇄 발현 플라스미드)을 제조한다. 박테리아 오염을 방지하기 위해, 이 용액을 0.22μm 필터 (예를 들어 밀리포어 스테리컵)를 사용하여 여과한다. 이어서, 3 mg/L (최종 부피)의 PEI 용액을 또한 최종 배양 부피의 7% 중에 희석하고, 서서히 혼합한다 (용액 2). 두 용액을 실온 (RT)에서 5-10분 동안 인큐베이션한다. 그 후, 용액 2를 용액 1에 서서히 혼합하면서 첨가하고, 실온에서 추가로 5-15분 동안 인큐베이션한다. 이어서, 형질감염 혼합물을 세포에 첨가하고, 4 내지 6시간 동안 세포 배양을 계속한다. 최종적으로, 엑스셀® VPRO 무혈청 배양 배지의 첨가에 의해 총 생산 부피의 나머지 50%를 달성한다. 형질감염 후 11일 동안 세포 배양을 계속한다. 배양물을 4℃에서 20분 동안 4500 rpm으로 원심분리 (헤라우스(Heraeus)®, 멀티퓨즈(Multifuge) 3 S-R, 써모 사이언티픽(Thermo Scientific), 일리노이주 록포드)함으로써 수거한다. 회수된 세포 상청액을 스테리컵 필터 (0.22 μm)를 통해 멸균 여과하고, 추가로 가공할 때까지 4℃에서 보관한다.
새로 소독된 (0.25 M NaOH) 하이트랩 프로트A 맙셀렉트®슈어(MabSelect®SuRe), 5ml 칼럼을 사용하여, 냉각 캐비넷 내 4℃에서 "AKTA 100 익스플로러 에어" 크로마토그래피 시스템 상에서 정제를 수행하였다. 칼럼을 5 CV의 PBS (깁코(Gibco), 라이프 테크놀로지스, 캘리포니아주 칼스배드)로 평형화한 다음, 멸균 여과된 상청액 (2 L)을 4.0 ml/분으로 로딩하였다. 칼럼을 8 CV의 PBS로 세척하여 비결합 샘플을 용리시키고, 다시 5 CV의 PBS로 세척하였다. 항체를 5 CV의 50 mM 시트레이트, 70 mM NaCl pH 3.2로 용리시켰다. 용리물을 3ml 분획으로 수집하였으며; 분획을 풀링하고, 1 M 트리스 HCl pH10을 사용하여 pH 7로 조정하였다. 풀을 풀링하고, 멸균 여과하고 (밀리포어 스테리플립, 0.22 um), OD 280 nm를 분광광도계 ND-1000 (나노드롭(NanoDrop))으로 측정하고, 단백질 농도를 서열 데이터에 기반하여 계산하였다. 용리물을 응집 (SEC-MALS) 및 순도 (SDS-PAGE, LAL 및 MS)에 대해 시험하였다. 제2 정제 단계를 위해, 필요한 경우에, 제1 정제로부터의 풀을 새로 소독된 (0.5 M NaOH) SPX (하이 로드 16/60 슈퍼덱스 200 등급 120 mL (지이-헬스케어)) 내로 로딩하였다. 칼럼을 PBS로 평형화하고, 1 ml/분의 PBS 완충제를 사용하여 전개를 수행하고, 용리물을 1.2 ml 분획으로 수집하고, 제1 정제 단계에 대해 기재된 바와 같이 분석하였다.
모르포시스(Morphosys) HuCAL 플라티눔(PLATINUM)® 파지 라이브러리 패닝으로부터의 항체
인간 P-카드헤린을 인식하는 항체의 선택을 위해, 다중 패닝 전략을 이용하였다. 인간 P-카드헤린 단백질에 대한 치료 항체를, 항체 변이체 단백질의 공급원으로서 상업적으로 입수가능한 파지 디스플레이 라이브러리인 모르포시스 HuCAL 플라티눔® 라이브러리를 사용하여 P-카드헤린에 결합한 클론을 선택함으로써 생성하였다. 파지미드 라이브러리는 HuCAL® 개념에 기반하고 (Knappik et al., 2000, J Mol Biol 296: 57-86), 파지 표면 상에 Fab를 디스플레이하기 위한 시스디스플레이(CysDisplay)™ 기술을 사용한다 (WO01/05950).
항-P-카드헤린 항체 고체 상 및 액체 상의 단리를 위해, 세포 기반 패닝 전략을 사용하였다.
재조합 P-카드헤린에 대한 고체 상 패닝
항원 선택 과정 전에 코팅 체크 ELISA를 수행하여 항원에 대한 최적 코팅 농도를 결정하였다. His 태그를 갖는 재조합 P-카드헤린 단백질을 수동 흡착을 통해 맥시소르프™ 플레이트 (눈크) 상에 코팅함으로써 고체 상 패닝 접근법에 사용하였다. 96-웰 맥시소르프™ 플레이트 (눈크)의 적절한 수 (서브-라이브러리 풀의 수에 좌우됨)의 웰을 4℃에서 밤새 125 nM 항원으로 코팅하였다. 코팅된 웰을 PBS (포스페이트 완충 염수)/5% 분유/5% BSA (소 혈청 알부민)/0.1 % 트윈 20/1mM CaCl2로 차단하였다. 각각의 패닝에 대해, 약 50 uL HuCAL 플라티눔® 파지-항체를 실온 (RT)에서 2시간 동안 용액 중에서 차단하였다. 차단 절차 후에, 사전-차단된 파지 혼합물을 잘 코팅 및 차단된 각각의 항원에 첨가하고, 마이크로타이터 플레이트 (MTP) 진탕기 상에서 RT에서 2시간 (h) 동안 인큐베이션하였다. 이후에, 비특이적으로 결합된 파지를 PBS를 사용한 여러 세척 단계에 의해 세척 제거하였다. 특이적으로 결합된 파지의 용리를 위해, 25 mM DTT (디티오트레이톨)를 실온에서 10분 (min) 동안 첨가하였다. DTT 용리물을 이. 콜라이 (에스케리키아 콜라이(Escherichia coli)) TG-F+ 세포의 감염을 위해 사용하였다. 감염 후에, 박테리아를 LB (용원성 브로쓰)/Cam (클로람페니콜) 한천 플레이트 상에 플레이팅하고, 30℃에서 밤새 인큐베이션하였다. 콜로니를 플레이트로부터 긁어내고, 파지 구출, 선택된 클론의 폴리클로날 증폭, 및 파지 생산을 위해 사용하였다. 정제된 파지를 사용하여 다음 패닝 라운드를 시작하였다.
고체 상 패닝의 제2 및 제3 라운드를 보다 엄격한 세척 조건을 제외하고는 제1 라운드의 프로토콜에 따라 수행하였다.
선택된 Fab 단편의 서브클로닝 및 미세발현
가용성 Fab의 신속한 발현을 용이하게 하기 위해, 선택된 HuCAL 플라티눔® 파지의 Fab 코딩 삽입물을 pMORPH®30 디스플레이 벡터로부터 pMORPH®x11 발현 벡터 pMORPH®x11_FH 내로 서브클로닝하였다.
초기 스크리닝 및 특징화를 위해 개별 Fab-발현 이. 콜라이 클론의 밤샘 배양물을 0.5 mg/mL 리소자임, 0.8 mM EDTA 및 4 U/μl 벤조나제를 사용하여 용해시켰다. Fab 함유 이. 콜라이 용해물을 ELISA 및 FACS 스크리닝을 위해 사용하였다.
ELISA 스크리닝
ELISA 스크리닝을 사용하여, 단일 Fab 클론을 표적 항원에의 결합에 대해 패닝 산출물로부터 확인하였다. Fab는 Fab 함유 조 이. 콜라이 용해물을 사용하여 시험한다.
제조된 이. 콜라이 용해물에서의 Fab 발현의 검증을 위해, 맥시소르프™ (눈크) 384 웰 플레이트를 PBS 중에 1:1000으로 희석된 Fd 단편 특이적 양 항-인간 IgG로 코팅하였다. PBS 중 5% 탈지유 분말로 플레이트를 차단한 후에, Fab-함유 이. 콜라이 용해물을 첨가하였다. Fab의 결합을 아토포스(Attophos) 형광 기질 (로슈, 카탈로그 #11681982001)을 사용하여 알칼리성 포스파타제에 접합된 F(ab)2 특이적 염소 항-인간 IgG (1:5000 희석됨)에 의해 검출하였다. 430 nm에서의 여기와 함께 535 nm에서의 형광 방출을 기록하였다.
P-카드헤린 항원 결합 Fab 단편의 확인을 위해 맥시소르프™ (눈크) 384 웰 플레이트를 PBS 중 수동 흡착을 통해 25 nM 인간 P-카드헤린 항원으로 코팅하였다. PBS 중 5% 탈지유 분말로 플레이트를 차단한 후에, Fab-함유 이. 콜라이 용해물을 첨가하였다. Fab의 결합을 아토포스 형광 기질 (로슈, 카탈로그 #11681982001)을 사용하여 알칼리성 포스파타제에 접합된 F(ab)2 특이적 염소 항-인간 IgG (1:5000 희석됨)에 의해 검출하였다. 430 nm에서의 여기와 함께 535 nm에서의 형광 방출을 기록하였다.
FACS 스크리닝 (형광 활성화 세포 분류)
FACS 스크리닝에서, 세포 표면 발현된 항원에 결합하는 단일 Fab 클론을 패닝 산출물로부터 확인한다. Fab를 Fab 함유 조 이. 콜라이 용해물을 사용하여 세포 결합에 대해 시험한다.
50 μl의 세포-현탁액을 새로운 96-웰 플레이트 내로 옮기고 (1x10⁵개 세포/웰이 됨), 50 μl의 Fab 함유 박테리아 추출물과 혼합하였다.
이어서, 세포-항체 현탁액을 진탕기 상의 얼음 상에서 1시간 동안 인큐베이션하였다. 인큐베이션 후에, 세포를 회전 침강시키고, 빙냉 FACS 완충제로 2회 세척하였다. 각각의 세척 단계 후에, 세포를 원심분리하고, 주의깊게 재현탁시켰다.
2차 검출 항체 (PE 접합된 염소 항 인간 IgG; 디아노바(Dianova))를 첨가하고, 샘플을 얼음 상에서 인큐베이션하고, 후속적으로 Fab 인큐베이션에 따라 세척하고, 형광 강도를 FACS칼리버(FACSCalibur)™ 기기에서 결정하였다.
HuCAL® Fab 단편의 발현 및 정제
Fab 단편의 발현을 이. 콜라이 TG1 F- 세포에서 수행하였다. 배양물을 30℃에서 18시간 동안 진탕시켰다. 세포를 수거하고 파괴시켰다. His6-태그부착된 Fab 단편 (서열식별번호: 130으로서 개시된 "His6")을 IMAC 및 겔 여과를 통해 단리하고, 단백질 농도를 280 nm에서 UV-분광광도측정법에 의해 결정하였다.
Fab 제제의 동일성 및 순도를 질량 분광측정법 (MS)에 의해 천연 상태에서 결정하였다.
교차-반응성 분석
정제된 Fab를 인간, 시노, 래트 및 마우스 P-카드헤린 ECD 단백질에의 결합에 대해 ELISA에서 시험하였다. 이 목적을 위해 맥시소르프™ (눈크) 384 웰 플레이트를 4℃에서 밤새 PBS 중 10 ug/mL의 농도의 항원으로 코팅하였다. Fab의 결합을 아토포스 형광 기질 (로슈, 카탈로그 #11681982001)을 사용하여 알칼리성 포스파타제에 접합된 F(ab)2 특이적 염소 항-인간 IgG (1:5000 희석됨)에 의해 검출하였다. 430 nm에서의 여기와 함께 535 nm에서의 형광 방출을 기록하였다.
IgG로의 전환 및 IgG 발현
HEK 세포에서 전장 IgG를 발현하기 위해, 중쇄 (VH) 및 경쇄 (VL)의 가변 도메인 단편을 Fab 발현 벡터로부터 인간 IgG1에 대해 적절한 pMorph®_hIg 벡터 내로 서브클로닝하였다. 세포 배양 상청액을 형질감염 10일 후에 수거하였다. 멸균 여과 후에, 용액을 액체 취급 스테이션을 사용하는 단백질 A 친화성 크로마토그래피에 적용하였다. 1x 둘베코 PBS (pH 7.2, 인비트로젠)로 완충제 교환을 수행하고, 샘플을 멸균 여과하였다 (0.2 μm 세공 크기). 단백질 농도를 280 nm에서 UV-분광광도측정법에 의해 결정하고, IgG의 순도를 SDS-PAGE에서 변성, 환원 조건 하에 분석하였다.
생물검정
상기 기재된 패닝 방법에 따라 수득된 항-P-카드헤린 항체를 하기 예시된 검정에서 평가하였다:
HCC1954 세포 내재화 검정
표적 매개 세포 내재화를 겪는 항-P-카드헤린 항체의 능력을 결정하기 위해 P-카드헤린 발현 HCC1954 종양 세포주를 사용하여 현미경검사 기반 내재화 검정을 확립하였다.
세포를 완전-성장 배지 (RPMI-1640 + 10% FCS) 중에 재현탁시키고, 100 μl 중 5x10³개 세포/웰의 세포 밀도로 편평-바닥 현미경용 96-웰 검정 플레이트 (뷰플레이트(ViewPlate)®-96 F TC, 퍼킨 엘머(Perkin Elmer), #6005225) 내로 시딩하고, 37℃ 및 5% CO2에서 2일 동안 인큐베이션하였다.
2일 후에, HuCAL® 항체 (IgG)를 PBS 중에 목적하는 농도로 희석하였다. 100 μl의 항체 용액을 시딩된 세포에 첨가하고, 2시간 동안 인큐베이션하였다. 그 후에, 세포를 PBS로 2회 세척하고, 1x 셀픽스(CellFIX) 시약 (셀픽스™, 비디 바이오사이언시스(BD Biosciences), # 340181)으로 고정하고, PBS로 다시 2회 세척하고, 0.1% 트리톤 X-100으로 투과화하였다. 이어서, 세포를 1x 오디세이(Odyssey) 완충제 (리-코르(Li-Cor), 번호 927-40000)에 의해 1시간 동안 차단하였다. 흡인 후에, 세포를 훽스트 (비스벤지미드 H 33342 트리클로라이드, #B2261, 시그마(Sigma)) 및 알렉사 플루오르® 488 염소 항-인간 IgG (인비트로젠, #A-11013)로 1시간 동안 염색하였다. 염색한 후에, 세포를 PBS로 3회 세척하고, 셀로믹스 어레이스캔 VTI HCS 판독기 (써모 피셔 사이언티픽(Thermo Fischer Scientific))를 사용하여 분석하였다. 절반 최대 내재화 농도 (IC50 값)를 평가하기 위해, 4배 희석 단계에서 10 nM 내지 2.4 pM 범위를 커버하는 IgG 적정을 수행하였다.
번역후 변형 (PTM) 부위의 제거
상기 기재된 내재화 검정에서 확인되고 P-카드헤린 발현 종양 세포 HCC1954 내로 효율적으로 내재화되는 것으로 밝혀진 1종의 항체인 NOV169는 HCDR1에 단일 N31S PTM 부위를 함유하는 것으로 밝혀졌다. 탈아미드화를 방지하기 위해 이 부위를 단일 점 쿤켈 돌연변이유발에 의해 N31Q 부위로 전환시켜, 항체 NOV169N31Q를 생성하였다. 모 NOV169와 비교하여, NOV169N31Q에 의한 재조합 인간 P-카드헤린에 대한 동등한 결합 강도를 포르테바이오 KD 결정에 의해 확인하였다.
항체의 개요
표 1은 모르포시스 HuCAL 플라티눔® 파지 라이브러리로부터 단리된 항-P-카드헤린 항체 및 뮤린 하이브리도마로부터 유래된 인간화 항-P-카드헤린 항체에 대한 관련 서열 정보를 제시한다.
실시예 2: 인간 P-카드헤린 EC1_EC2 및 그와 NOV169N31Q Fab와의 복합체의 X선 결정학적 구조 결정
인간 P-카드헤린의 3차원 구조는 지금까지 공지되지 않았다. 인간 P-카드헤린 ECD (세포외 도메인) 단편 (최초 2종의 N-말단 카드헤린-반복 도메인, 또는 EC1_EC2, 아미노산 108 내지 324, 서열식별번호: 2, 표 1), 뿐만 아니라 그와 NOV169N31Q의 Fab 단편 (표 1)과의 복합체의 결정 구조를 결정하였다. 하기 상술된 바와 같이, 인간 P-카드헤린 EC1_EC2를 발현, 재폴딩, 정제 및 결정화하였다. 추가로, 정제된 인간 P-카드헤린 EC1_EC2를 NOV169N31Q Fab와 혼합하여 복합체를 형성하였으며, 이를 또한 후속적으로 정제 및 결정화하였다. 이어서, 단백질 결정학을 사용하여 유리 상태 및 NOV169N31Q Fab에 결합된 인간 P-카드헤린 EC1_EC2에 대한 원자 해상도 데이터를 생성함으로써 에피토프를 정의하였다.
결정학을 위한 인간 P-카드헤린 EC1_EC2 및 NOV169N31Q Fab의 단백질 생산
결정학을 위해 생산된 인간 P-카드헤린 EC1_EC2 및 NOV169N31Q Fab의 아미노산 서열이 표 3에 제시되어 있다. 인간 P-카드헤린 EC1_EC2의 구축물은 재조합 발현 벡터로부터의 N-말단 잔기 (서열식별번호: 127에 소문자로 제시됨)와 함께, 인간 P-카드헤린 (유니프롯 식별자 P22223, 서열식별번호: 126)의 잔기 108 내지 324 (밑줄표시됨)로 구성되었다. NOV169N31Q Fab의 경우, 중쇄 및 경쇄의 아미노산 서열은 C-말단 확인/정제 태그 (각각 서열식별번호: 128 및 129에 소문자로 제시됨)와 함께 제시되어 있다.
표 3: 결정 구조 결정에 사용된 단백질

N-말단 헥사히스티딘 태그 (서열식별번호: 130)에 이어서 프리시전 절단 부위를 갖는 인간 P-카드헤린 EC1_EC2를 pET28 벡터를 사용하여 이. 콜라이 BL21 (DE3) 스타 (인비트로젠)에서 클로닝 및 발현하였다. 18℃에서 IPTG로 밤새 유도한 후에, 세포 (67g)를 수거하고, 700 ml의 50 mM 트리스 pH 8.0, 500 mM NaCl, 10% 글리세롤, 2mM TCEP, 및 EDTA-무함유 완전 프로테아제 억제제 칵테일 (로슈)의 14개 정제 중에서 프렌치 프레스로 용해시켰다. 원심분리 (SS34 로터에 의해 18,000 rpm으로 35분) 후에, 상청액을 멸균 여과하고 (0.45μm), 완충제 A (50 mM 트리스 pH 8.0, 500 mM NaCl, 10% 글리세롤)로 사전-평형화된 조 FF 금속 킬레이트화 크로마토그래피 칼럼 (5ml, 지이 헬스케어) 상에 로딩하였다. 칼럼을 먼저 평형 완충제로 세척한 다음, 25 mM 이미다졸을 포함하는 완충제 A로 세척하고, 이어서 25 mM에서 500 mM 이미다졸 구배로 용리시켰다. 이어서, 용리된 단백질 (36 mg)을 50 mM 트리스 pH 8.0에 대해 밤새 투석하는 동안 프리시전 프로테아제 (mg당 10 μg)를 사용하여 절단하였다. 여과 (0.22μm) 후에, 샘플을 50 mM 트리스 pH 8.0으로 사전-평형화된 모노큐 음이온 교환 크로마토그래피 칼럼 (지이 헬스케어) 상에 로딩하고, 0.0 M 내지 1.0 M NaCl 구배로 용리시켰다. P-카드헤린 EC1_EC2 (25.6 mg)를 함유하는 주요 피크를 수집하고, SDS-PAGE 및 HPLC에 의해 분석하였다. 이어서, 분획 풀을 이전과 같이 50 mM 트리스 pH 8.0, 500 mM NaCl, 10% 글리세롤로 사전-평형화된 조 FF 금속 킬레이트화 크로마토그래피 칼럼 (5ml, 지이 헬스케어) 상에 재로딩하였다. P-카드헤린 EC1_EC2 단백질을 관통으로 회수하고, HPLC 및 LC-MS에 의해 분석하였다. LC-MS 분석은 예상 분자량 (23,837Da)을 제시하였다.
NOV169N31Q Fab를 이. 콜라이에서 1 리터 규모로 발현하였다. 먼저, Fab 단편을 코딩하는 플라스미드를 화학적 적격 TG1F- 이. 콜라이 세포로 형질전환시켰다. 박테리아를 LB/한천/1% 글루코스/34μg/ml 클로람페니콜 플레이트 상에서 37℃에서 밤새 성장시킨 후에, 1개의 콜로니를 사용하여 6 ml 전배양물 (2xYT/1.0% 글루코스/34μg/ml 클로람페니콜)에 접종시켰다. 배양물을 220 rpm으로 진탕하면서, 30℃에서 밤새 인큐베이션하였다. 다음 날, 전배양물을 1 리터 발현 배양물 (2xYT/0.1% 글루코스/34μg/ml 클로람페니콜)로 옮겼다. 발현 배양물을 OD600nm 0.6-0.8에 도달할 때까지 220 rpm으로 진탕하면서, 30℃에서 인큐베이션하였다. IPTG를 최종 농도 0.5 mM로 첨가함으로써 발현을 유도하였다. 25℃ 및 220 rpm에서 밤새 발현을 계속하였다. 다음 날, 세포를 펠릿화하고, -80℃에서 동결시켰다.
Fab 단편을 AEKTA 익스프레스 시스템 (소프트웨어: 유니콘_v5.11) 상에서 자동화 프로토콜을 사용하여 2 단계로 정제하였다. 박테리아 펠릿을 먼저 40 ml 용해 완충제 (200 mM Na 포스페이트 pH 7.4, 0.5M NaCl, 0.1% 리소자임, 2mM MgCl2, 10U/ml 벤조나제, 완전 EDTA-무함유 프로테아제 억제제의 1개 정제/50ml) 중에 재현탁시키고, 진탕 하에 실온에서 1시간 동안 인큐베이션하였다. 세포 파편을 30분 동안 16,000 g로 원심분리에 의해 제거하였다. Fab 함유 상청액을 0.2 μM 시린지 필터 (폴(Pall), #PN4525)에 통과시키고, 구동 완충제 (20mM Na 포스페이트, 0.5M NaCl, 10mM 이미다졸, pH 7.4)로 사전-평형화된 시스템 상에 로딩하였다. 제1 정제 단계를 1 ml 하이트랩 HP 칼럼 (지이 헬스케어) 상에서 수행하였다. 칼럼을 구동 완충제로 세척하고, His6-태그부착된 Fab 단편 (서열식별번호: 130으로서 개시된 "His6")을 용리 완충제 (20mM Na 포스페이트, 0.5M NaCl, 250mM 이미다졸, pH 7.4)로 용리시켰다. 피크 분획을 겔 여과 칼럼 (하이로드 16/60 슈퍼덱스 75; 지이 헬스케어) 상에 자동적으로 적용하였다. 정제된 Fab 단편을 PBS 중에서 용리시켰다. Fab 단편의 농도를 아미노산 서열로부터 추정된 흡광 계수를 사용하여 UV280nm 측정에 의해 및 램버트-비어(Lambert-Beer) 방정식을 적용함으로써 결정하였다.
인간 P-카드헤린 EC1_EC2의 결정화 및 구조 결정
인간 P-카드헤린 EC1_EC2를 10mM 트리스-HCl pH 7.4, 25mM NaCl에 대해 투석하고, 15mg/ml로 농축시키고, 20℃에서 결정화에 대해 스크리닝하였다.
결정을 시팅 드롭 증기 확산에 의해 96-웰 SD2 플레이트에서 성장시켰다. 상세하게, 0.2 μl의 단백질을 0.2 μl의 저장 용액과 혼합하고, 드롭을 20℃에서 80 μl의 동일한 저장 용액에 대해 평형화하였다. X선 회절 분석에 적합한 결정을 0.085M HEPES pH 7.5, 3,655M NaCl, 15% 글리세롤로 이루어진 저장 용액으로 수득하였다.
데이터 수집을 위해, 1개의 인간 P-카드헤린 EC1_EC2 결정을 크리오-루프에 탑재하고, 액체 질소 중에서 집적 급속 냉각시켰다. 회절 데이터를 필라투스(Pilatus) 픽셀 검출기 및 0.99999Å 파장의 X선을 갖는 스위스 라이트 소스(Swiss Light Source)의 빔라인 X10SA (PX-II) (폴 셰러 인스티튜트(Paul Scherrer Institute), 스위스)에서 수집하였다. 총, 각각 0.25deg 진동의 720종 영상이 결정에서 200mm의 검출기 거리로 기록되었다. APRV-INDEX (Kroemer, Dreyer, Wendt (2004) Acta Crystallogr. Sect. D: Biol. Crystallogr. 60:1679-1682)에서 구현된 바와 같이 XDS (Kabsch (1993) J. Appl. Crystallogr. 26:795-800)를 사용하여 1.40Å 해상도에서 데이터를 처리 및 척도화하였다. 결정은 셀 치수 a= 120.89 Å, b= 76.52 Å, c= 46.21 Å, 알파=90°, 베타= 107.79°, 감마=90°를 갖는 공간군 C2에 존재하였다. 인간 P-카드헤린 EC1_EC2 구조를 프로그램 페이저(Phaser) (McCoy et al., (2007) J. Appl. Cryst. 40:658-674) 및 PDB 엔트리 1L3W (엑스. 라에비스(X. Laevis) C-카드헤린, 3.08Å, 55% 서열 동일성)를 사용하여 분자 대체에 의해 해상하였다. 최종 모델을 COOT (Emsley et al., (2010) Acta Crystallogr. Sect. D: Biol. Crystallogr. 66:486-501)에서 구축하고, 부스터(Buster) (글로벌 페이징, 리미티드(Global Phasing, LTD))를 사용하여 각각 결합 길이 및 결합 각에 대해 0.010 Å 및 1.13°의 rmsd로 각각 19.8% 및 21.3%의 R작업 및 R유리 값으로 정밀화하였다.
인간 P-카드헤린 EC1_EC2 구조
인간 P-카드헤린 EC1_EC2 (아미노산 잔기 108 내지 322)의 결정 구조는 도 1에 제시되어 있다. 두 카드헤린 도메인은 잘-정의된 전자-밀도를 갖고 예상된 전체 폴드를 제시하였다. 3개의 칼슘 이온이 도메인 계면에서 관찰되었다.
카드헤린의 ECD 도메인은 세포간 부착을 제어하는 부착 연접부의 세포외 아키텍처에서 역할을 하는 것으로 제안되었다. 연접부 조립은 카드헤린 클러스터의 엑토도메인 사이의 트랜스 및 시스 동형 상호작용 둘 다를 수반한다 (Boggon et al., (2002) Science 296:1308-1313; Harrison et al., (2011) Structure 19:244-256). 트랜스 동형 상호작용은 반대 배향의 2종 카드헤린 분자의 EC1 도메인 사이의 N-말단 Trp 교환 ("가닥 교체된 이량체")을 수반한다 (2종의 상이한 세포에 의해 제시됨). 대조적으로, 시스 동형 상호작용은 동일한 배향의 한 분자의 N-말단 세포외 카드헤린 (EC1) 도메인 및 또 다른 분자의 제2 (EC2) 도메인을 수반한다. 트랜스 상호작용은 시스 상호작용보다 훨씬 더 강한 것으로 생각된다. 트랜스 상호작용이 세포간 부착의 분자적 근거를 형성하는 반면, 시스 상호작용은 분자 클러스터링을 통한 세포 부착을 촉진하는 것으로 여겨진다.
인간 P-카드헤린 EC1_EC2 단편의 결정 구조는 Trp 교환을 통한 트랜스 동형 상호작용에 수반된 N-말단 절편이 결정에서의 이러한 상호작용에 참여하지 않고 그 자신의 도메인에 결합되었다는 것을 제시하였다. 추가로, 결정 패킹의 분석은 대칭-관련 P-카드헤린 EC1_EC2 분자 중 1종이 다른 카드헤린에 대해 이미 보고된 것과 고도로 유사한 시스 동형 상호작용을 만들고 있었다는 것을 밝혀냈으며, 이 경우에 결정화는 시스 동형 상호작용에 의해 유도되었다는 것을 제시하였다.
NOV169N31Q Fab 복합체의 결정화 및 구조 결정
인간 P-카드헤린 EC1_EC2와 NOV169N31Q Fab와의 복합체는, 정제된 인간 P-카드헤린 EC1_EC2 및 NOV169N31Q Fab를 1.5:1.0 몰비 (HPLC에 의해 측정된 농도)로 혼합하고, 복합체를 EDTA-무함유 완전 프로테아제 억제제 칵테일 (로슈)의 2개 정제를 사용하여 10mM 트리스-HCl pH 7.5, 150mM NaCl에서 평형화된 슈퍼덱스 200 (지이 헬스케어) 크기 배제 크로마토그래피 상에서 정제함으로써 제조하였다. 피크 분획을 SDS-PAGE 및 LCMS에 의해 분석하였다. 인간 P-카드헤린 EC1_EC2 /NOV169N31Q Fab 복합체를 함유하는 분획을 약 12 mg/ml로 농축시키고, CaCl2를 5mM의 최종 농도로 첨가하고, 샘플을 20℃에서 결정화에 대해 스크리닝하였다.
결정을 시팅 드롭 증기 확산에 의해 96-웰 SD2 플레이트에서 성장시켰다. 상세하게, 0.2 μl의 단백질을 0.2 μl의 저장 용액과 혼합하고, 드롭을 20℃에서 80 μl의 동일한 저장 용액에 대해 평형화하였다. X선 회절 분석에 적합한 결정을 0.2M 아세트산칼슘, 10% (w/v) PEG 8,000, 0.1M MES pH 6.5로 이루어진 저장 용액으로 수득하였다.
데이터 수집 전에, 1개의 인간 P-카드헤린 EC1_EC2/NOV169N31Q Fab 결정을 저장 용액과 20% PEG 8,000, 30% 글리세롤과의 1:1 혼합물로 잠시 옮기고, 액체 질소 중에서 급속 냉각시켰다.
회절 데이터를 필라투스 픽셀 검출기 및 0.99999Å 파장의 X선을 갖는 스위스 라이트 소스의 빔라인 X10SA (PX-II) (폴 셰러 인스티튜트, 스위스)에서 수집하였다. 총, 각각 0.25deg 진동의 720종 영상이 결정에서 340mm의 검출기 거리로 기록되었다. APRV-INDEX (Kroemer, Dreyer, Wendt (2004) Acta Crystallogr. Sect. D: Biol. Crystallogr. 60:1679-1682)에서 구현된 바와 같이 XDS (Kabsch (1993) J. Appl. Crystallogr. 26:795-800)를 사용하여 2.10Å 해상도에서 데이터를 처리 및 척도화하였다. 결정은 셀 치수 a= 172.69 Å, b= 77.79 Å, c= 133.41 Å, 알파=90°, 베타=90.0°, 감마=90°를 갖는 공간군 P21212에 존재하였다. 인간 P-카드헤린 EC1_EC2/NOV169N31Q Fab 복합체 구조를 페이저 (McCoy et al., (2007) J. Appl. Cryst. 40:658-674)를 사용하여 분자 대체에 의해 해상하였다. 최종 모델을 COOT (Emsley et al., (2010) Acta Crystallogr. Sect. D: Biol. Crystallogr. 66:486-501)에서 구축하고, 부스터 (글로벌 페이징, 리미티드)를 사용하여 각각 결합 길이 및 결합 각에 대해 0.010 Å 및 1.18°의 rmsd로 각각 19.2% 및 22.1%의 R작업 및 R유리 값으로 정밀화하였다. NOV169N31Q Fab에서의 임의의 원자의 4.0 Å 이내의 원자를 함유하는 인간 P-카드헤린 EC1_EC2의 잔기를 CCP4 프로그램 스위트 의 프로그램 Ncont에 의해 확인하였으며 (Collaborative Computing Project, Number 4 (1994) Acta Crystallogr. Sect. D: Biol. Crystallogr. 50:760-763), 이는 표 4 및 5에 열거되어 있다. NOV169N31Q 항체의 결합시에 용매에 덜 접근가능해지는 인간 P-카드헤린 EC1_EC2의 잔기를 CCP4 프로그램 스위트의 프로그램 AREAIMOL에 의해 확인하였다.
NOV169N31Q에 대한 P-카드헤린 EC1_EC2 에피토프
P-카드헤린 EC1_EC2/NOV169N31Q Fab 복합체의 결정 구조를 사용하여 NOV169N31Q에 대한 P-카드헤린 EC1_EC2 에피토프를 확인하였다. X선 분석은 NOV169N31Q가 인간 P-카드헤린의 EC1 도메인 (N-말단 카드헤린-반복 도메인)에 결합한다는 것을 제시한다 (도 2). 결정의 비대칭 유닛에 NOV169N31Q Fab - 인간 P-카드헤린 EC1_EC2 복합체의 2 카피가 존재한다 (비대칭 유닛은 결정학적 대칭 오퍼레이터를 적용함으로써 전체 결정을 재현하는데 필요한 모든 구조 정보를 함유함). 두 카피는 결정 패킹으로 인한 작은 변동을 제외하고는 NOV169N31Q Fab와 접촉하는 거의 동일한 잔기를 공유한다.
NOV169N31Q Fab에 의한 인간 P-카드헤린 EC1_EC2 상의 상호작용 표면은 2개의 불연속 (즉, 비인접) 서열에 의해 형성되고, 전적으로 P-카드헤린의 EC1 도메인 내에 포함되며, 잔기 123 내지 127, 및 잔기 151 내지 177을 포괄한다 (도 3). 그 중에서, 잔기 124 및 125, 및 잔기 151 내지 172는 표 4 및 5에 상술되고 도 3에 제시된 바와 같이 4.0Å (비-수소 원자 사이)보다 더 짧은 직접 분자간 접촉에 기여하고 있다. 이들 잔기는 NOV169N31Q Fab에 의해 인식되는 3차원 표면을 형성한다 (도 4).
표 4. 인간 P-카드헤린 EC1_EC2와 NOV169N31Q Fab 중쇄 (H) 사이의 상호작용. P-카드헤린 잔기는 P22223 (서열식별번호: 126)에 기반하여 넘버링된다. Fab 중쇄 잔기는 그의 선형 아미노산 서열 (서열식별번호: 128)에 기반하여 넘버링된다. 제시된 P-카드헤린 잔기는 NOV169N31Q Fab에서의 원자의 4.0 Å 이내의 적어도 1개의 원자를 갖는다.
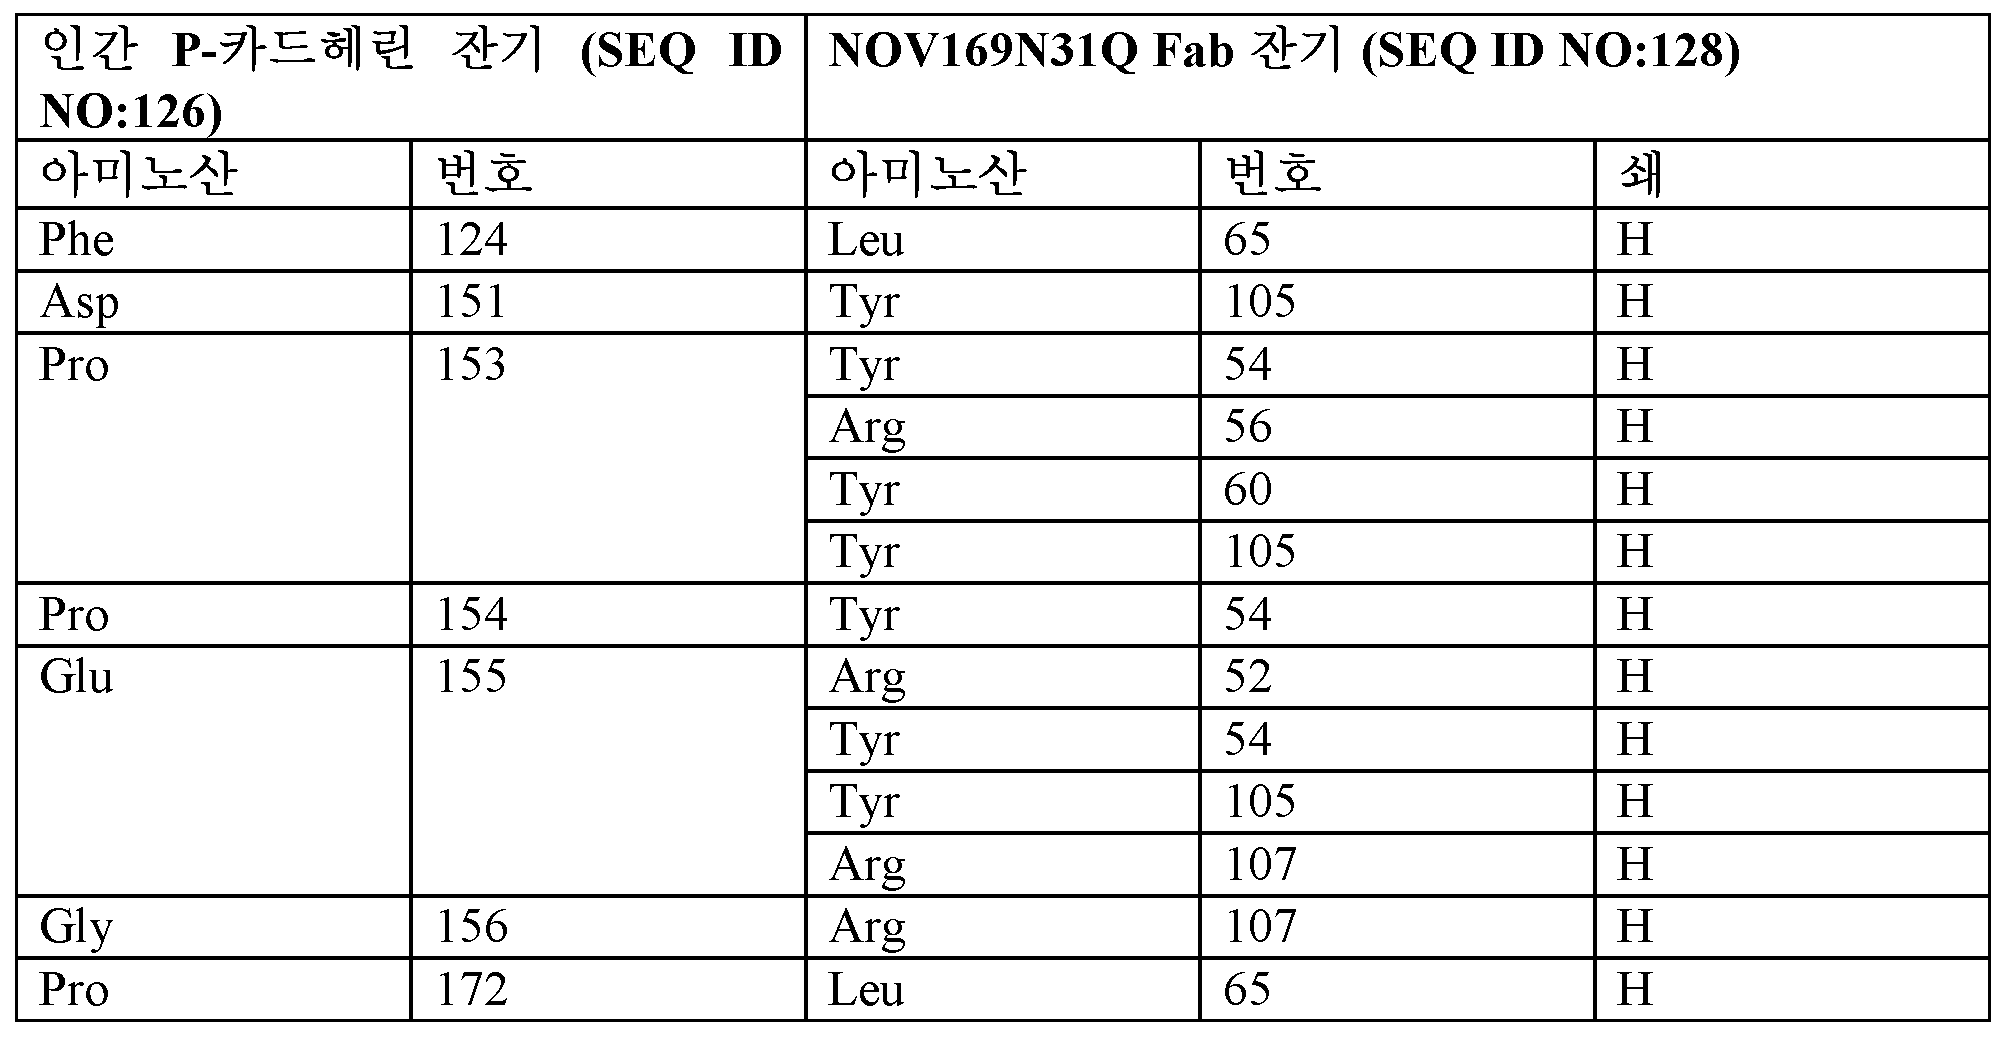
표 5. 인간 P-카드헤린 EC1_EC2와 NOV169N31Q Fab 경쇄 (L) 사이의 상호작용. P-카드헤린 잔기는 P22223 (서열식별번호: 126)에 기반하여 넘버링된다. Fab 경쇄 잔기는 그의 선형 아미노산 서열 (서열식별번호: 129)에 기반하여 넘버링된다. 제시된 P-카드헤린 잔기는 NOV169N31Q Fab에서의 원자의 4.0 Å 이내의 적어도 1개의 원자를 갖는다.

인간 P-카드헤린의 다른 세포외 카드헤린-반복 도메인과 달리, EC1 도메인은 어떠한 공지된 N-연결 또는 O-연결 글리코실화 부위도 보유하지 않는다. 따라서, P-카드헤린에 결합하는 NOV169N31Q는 글리코실화와 관계없다. 또한 주목할만하게는, 인간 P-카드헤린 EC1 도메인의 아미노산 서열은 시노몰구스 (마카카 파시쿨라리스) P-카드헤린에서 완전히 보존된다 (도 5). 따라서, NOV169N31Q에 의해 인식되는 P-카드헤린 에피토프는 독성학적 연구에 사용된 이 원숭이 종에서 완전히 보존된다.
인간 P-카드헤린 EC1_EC2의 Glu155는 NOV169N31Q Fab와 가장 많이 접촉하는 에피토프 잔기이다 (도 3 참조). 흥미롭게도, Glu155는, 모든 인간 카드헤린의 다중 서열 정렬에 의해 제시된 바와 같이, 단지 인간 카드헤린 1 내지 4에서만 발견되는 비-보존 삽입 내에 위치한다 (도 6). Glu155 그 자체는 인간 카드헤린 1, 2 및 4에서 보존되지 않으므로, NOV169N31Q는 인간 카드헤린-3 (일명 인간 P-카드헤린)에 대한 높은 선택성을 나타낼 것으로 예상된다.
상기에 이미 언급된 바와 같이, 카드헤린은 카드헤린 클러스터의 엑토도메인 사이의 강한 트랜스 및 약한 시스 동형 상호작용 둘 다를 수반하는 세포간 부착의 분자 메카니즘에서 중요한 역할을 한다. (Boggon et al., (2002) Science 296:1308-1313; Harrison et al., (2011) Structure 19:244-256). 인간 P-카드헤린 EC1_EC2 /NOV169N31Q Fab 복합체의 결정 구조에 기반하여, NOV169N31Q에 대한 결합 에피토프는 시스 동형 상호작용에 수반된 EC1 도메인의 표면 영역과 부분적으로 중첩되지만, 트랜스 (세포간) 동형 상호작용에 수반된 N-말단 영역과는 그렇지 않은 것처럼 보인다. 결과적으로, NOV169N31Q는 카드헤린 결합에 대해 강한 트랜스 상호작용과 경쟁하지 않고, 따라서 그의 결합 에피토프에 보다 용이하게 접근할 가능성이 보다 많다. 더욱이, 트랜스 동형 상호작용이 보존되는 것과 같이, 이 항체의 그의 표적 항원에 대한 결합은 세포간 부착을 완전히 파괴할 것으로 예상되지 않는다.
실시예 3: P-카드헤린 항체 약물 접합체의 생성 및 특징화
1-단계 방법에 의한 DM1 접합체의 제조
P-카드헤린에 대한 항체를 접선 흐름 여과 (TFF#1)를 통해 반응 완충제 (15 mM 인산칼륨, 2 mM EDTA, pH 7.6) 내로 투석여과한 후에 접합 반응을 시작하였다. 후속적으로, 항체 (5.0 mg/mL)를 DM1 (항체 양에 비해 5.6배 몰 과량)과 혼합한 다음, SMCC (항체 양에 비해 4.7배 과량)와 혼합하였다. 대략 16시간 동안 2 mM EDTA 및 10% DMA를 함유하는 15 mM 인산칼륨 완충제 (pH 7.6) 중에서 20℃에서 반응을 수행하였다. pH를 5.50으로 조정하기 위해 1 M 아세트산을 첨가하여 반응을 켄칭하였다. pH 조정 후에, 반응 혼합물을 다중-층 (0.45/0.22 μm) PVDF 필터를 통해 여과하고, 정제하고, 접선 흐름 여과 (TFF#2)를 사용하여 8.22% 수크로스를 함유하는 20 mM 히스티딘 완충제 (pH 5.6) 내로 투석여과하였다. 접선 흐름 여과에 대한 기기 파라미터는 하기 표 6에 열거되어 있다.
표 6. 접선 흐름 여과에 대한 기기 파라미터
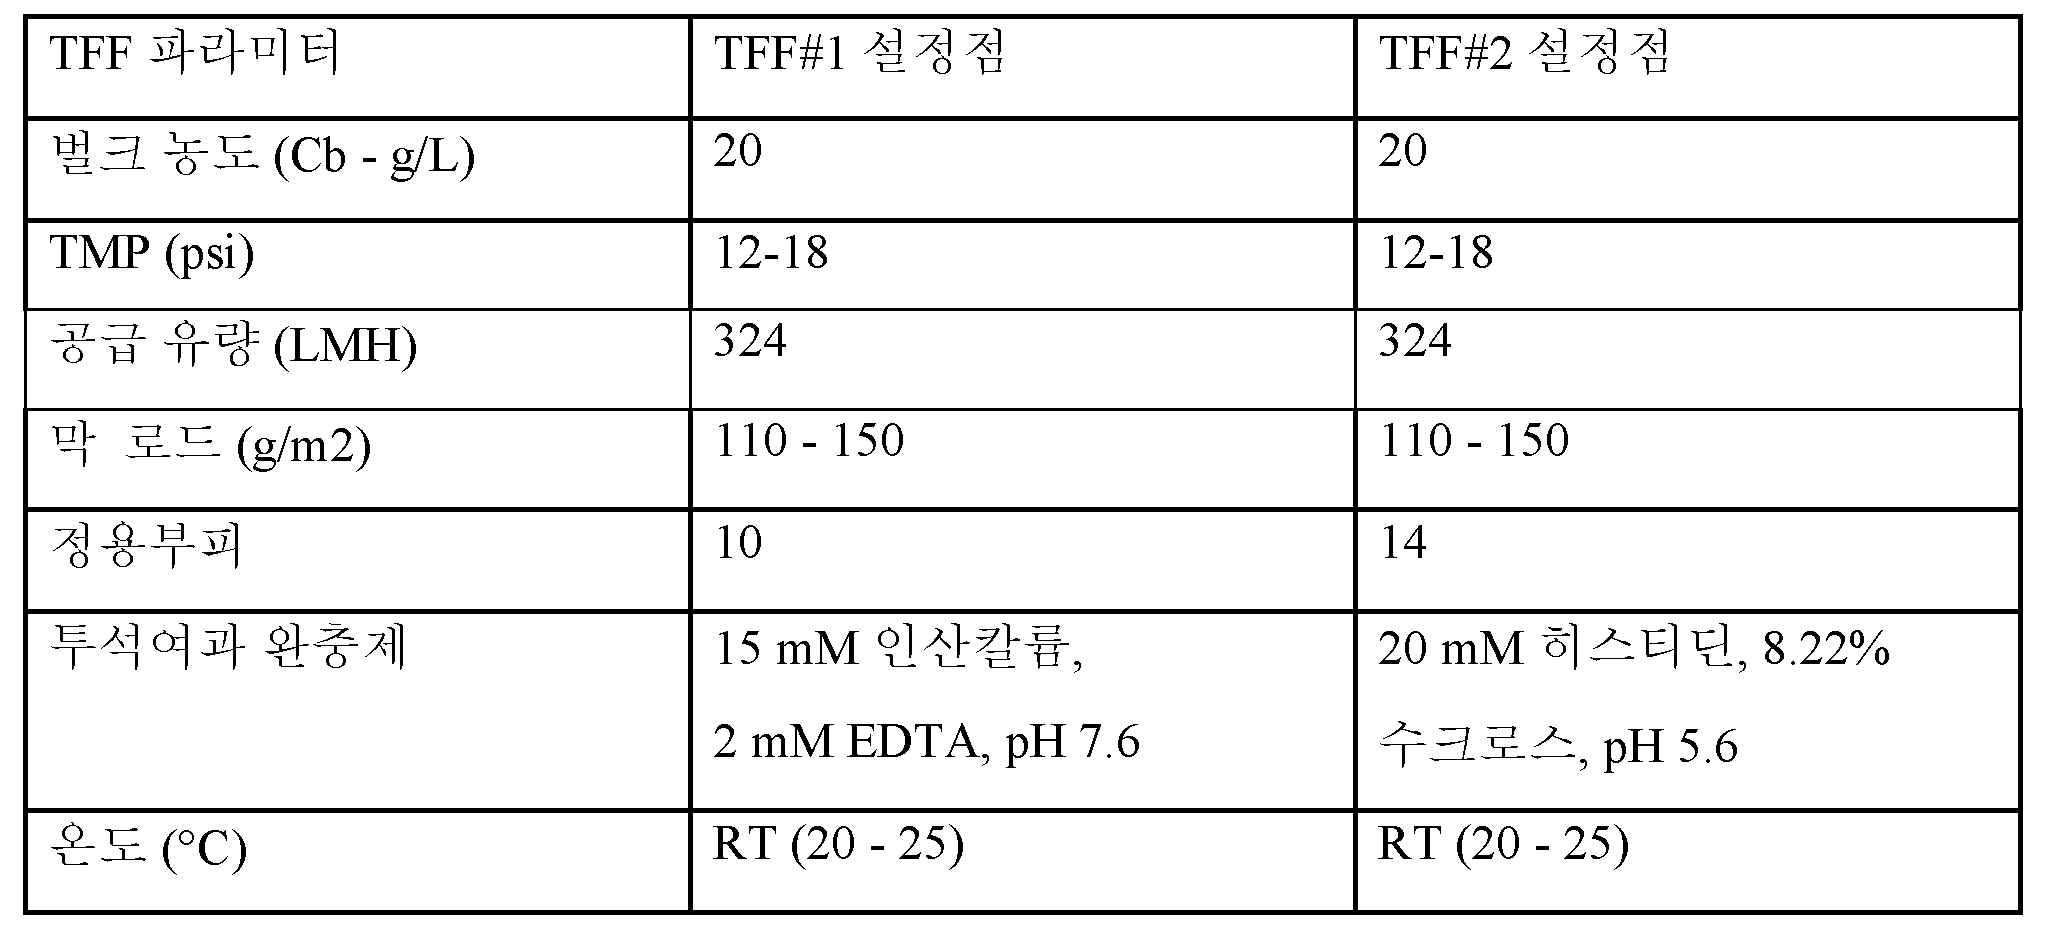
상기 기재된 방법으로부터 수득된 접합체를 하기에 의해 분석하였다: 세포독성제 로딩 (항체에 대한 메이탄시노이드 비, MAR)에 대해 UV 분광분석법; 접합체 단량체의 결정에 대해 SEC-HPLC; 및 유리 메이탄시노이드 백분율에 대해 역상 HPLC 또는 소수성 차폐 상 (Hisep)-HPLC. 데이터는 표 7에 제시되어 있다.
표 7. 1-단계 방법을 사용하여 제조된 P-카드헤린 ADC의 특성

계내 방법에 의한 DM1 접합체의 제조
본 발명의 접합체는 또한 하기 절차에 따른 계내 방법에 의해 제조될 수 있다. P-카드헤린 항체를 술포숙신이미딜 4-(N-말레이미도메틸) 시클로헥산-1-카르복실레이트 (술포-SMCC) 링커를 사용하여 DM1에 접합시켰다. DM1 및 술포-SMCC 이종이관능성 링커의 원액을 DMA 중에서 제조하였다. 1.3:1 몰 당량의 DM1 대 링커 비 및 1.95 mM의 DM1의 최종 농도로, 술포-SMCC 및 DM1 티올을 함께 혼합하여, 40% v/v의 수성 50 mM 숙시네이트 완충제, 2 mM EDTA, pH 5.0을 함유하는 DMA 중에서 25℃에서 10분 동안 반응시켰다. 이어서, 50 mM EPPS, pH 8.0 및 10% DMA (v/v) 중 2.5 mg/mL의 Ab의 최종 접합 조건 하에 약 6.5:1의 SMCC 대 Ab의 몰 당량 비를 제공하도록 항체를 반응의 분취물과 반응시켰다. 25℃에서 대략 18시간 후에, 접합 반응 혼합물을 10 mM 숙시네이트, 250 mM 글리신, 0.5% 수크로스, 0.01% 트윈 20, pH 5.5로 평형화된 세파덱스™ G25 칼럼을 사용하여 정제하였다.
표 8. DM1-접합된 항체의 특성
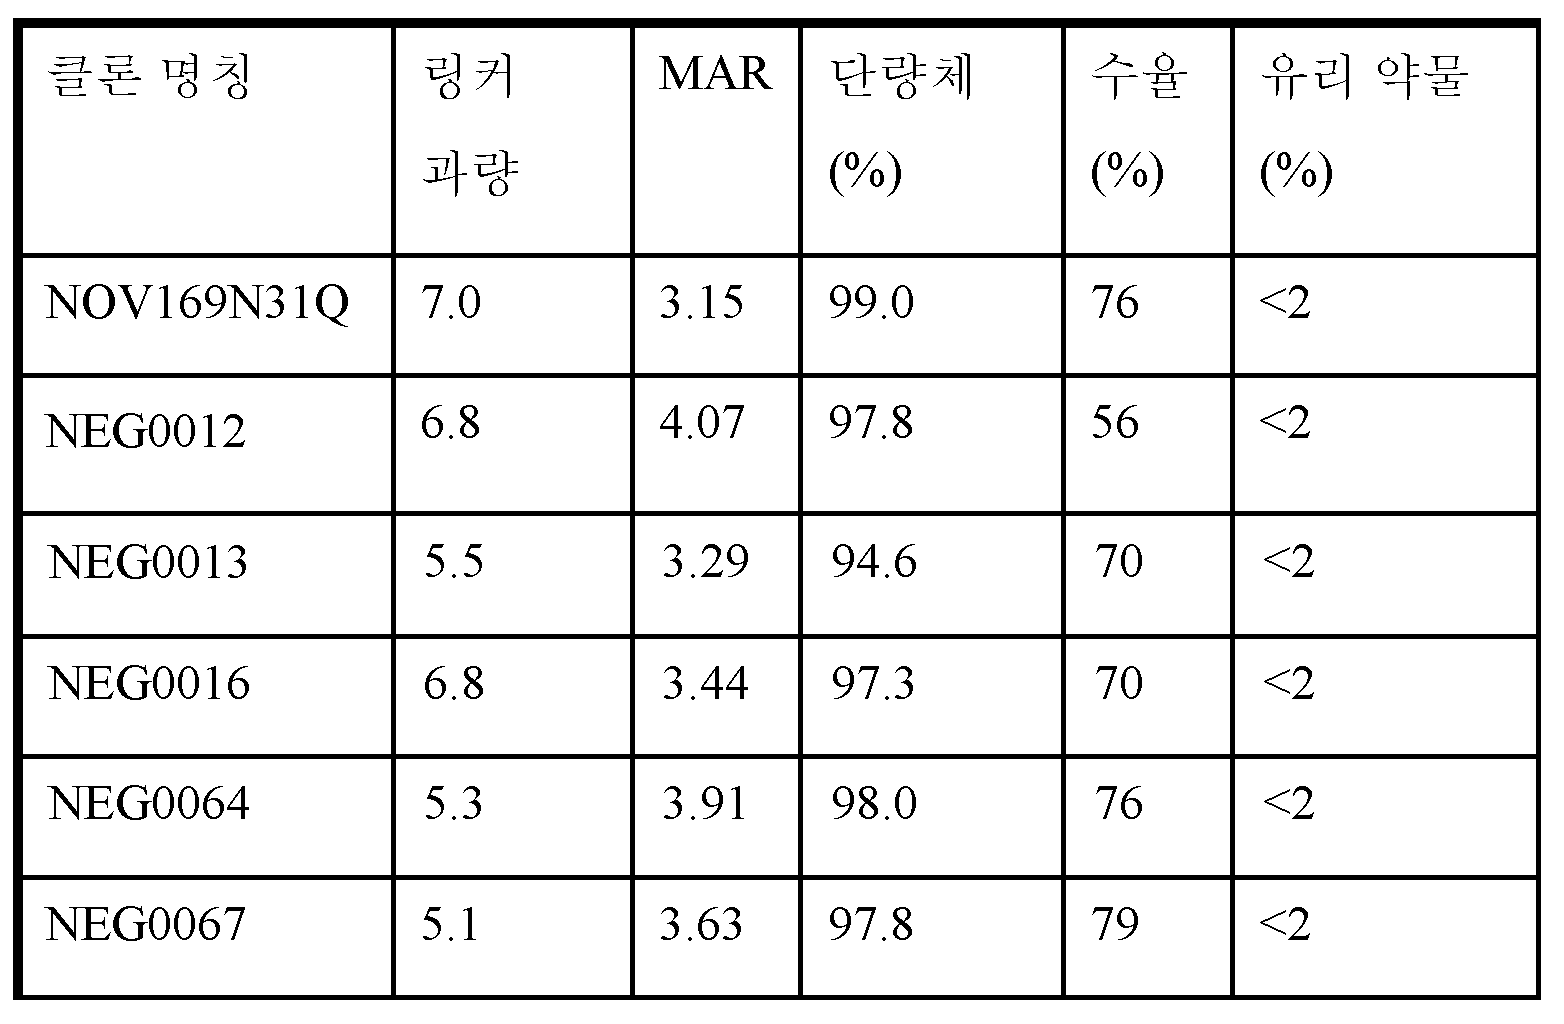
SPDB 링커를 사용한 ADC의 제조
P-카드헤린 항체 (8 mg/ml)를 25℃에서 120분 동안 50 mM 인산칼륨, 50 mM NaCl, 2 mM EDTA 및 5% DMA를 함유하는 60 mM EPPS 완충제 (pH 8.5) 중에서 N-숙신이미딜 4-(2-피리딜디티오)부타노에이트 (SPDB, 4.0-4.1배 몰 과량)로 변형시켰다. 후속적으로, 변형된 Ab를 정제 없이 25℃에서 18시간 동안 50 mM 인산칼륨, 50 mM NaCl, 2 mM EDTA 및 5% DMA를 함유하는 60 mM EPPS 완충제 (pH 8.5) 중 4 mg/mL의 최종 변형된 항체 농도로 DM4 (비결합 링커에 비해 1.5배 몰 과량)에 접합시켰다. 접합 반응 혼합물을 10 mM 숙시네이트, 250 mM 글리신, 0.5% 수크로스, 0.01% 트윈 20, pH 5.5로 평형화 및 용리된 세파덱스™ G25 칼럼을 사용하여 정제하였다.
표 9. DM4-접합된 항체의 특성
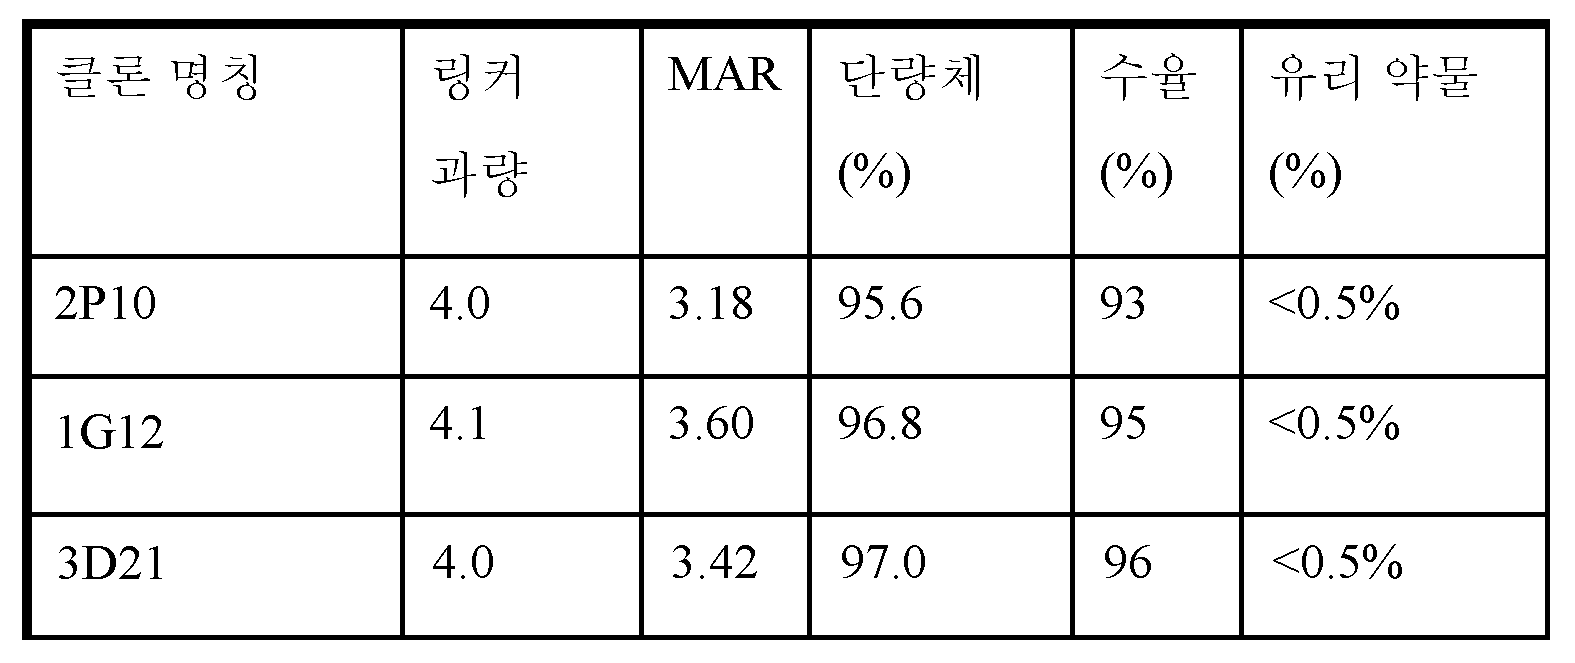
CX1-1 링커를 사용한 ADC의 제조
항체 NEG0067 (5.0 mg/mL)을 DM1 (항체 양에 비해 7.4배 몰 과량)과 혼합한 다음, CX1-1 (항체 양에 비해 5.7배 과량)과 혼합하였다. 반응을 25℃에서 대략 16시간 동안 2 mM EDTA 및 5% DMA를 함유하는 50 mM EPPS [4-(2-히드록시에틸)-1-피페라진프로판술폰산] 완충제 (pH 8.0) 중에서 수행하였다. 이어서, 반응 혼합물을 10 mM 숙시네이트, 250 mM 글리신, 0.5% 수크로스, 0.01% 트윈 20, pH 5.5에서 평형화 및 용리된 세파덱스™ G25 칼럼을 사용하여 정제하였다.
표 10. CX1-1/DM1 접합된 NEG0067의 특성
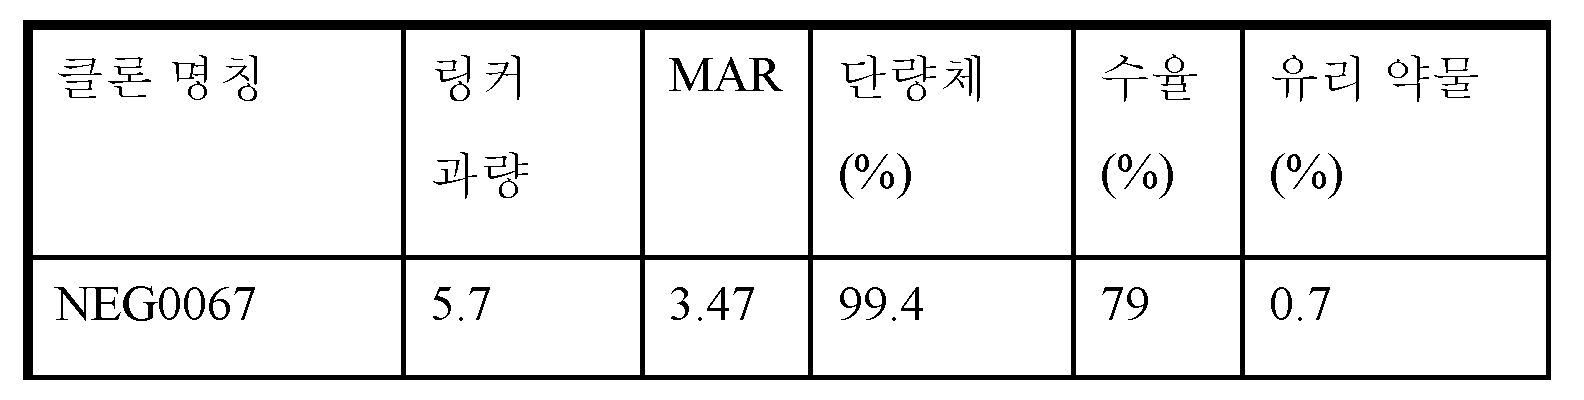
실시예 4: P-카드헤린에 대한 P-카드헤린 항체 및 ADC의 친화도
P-카드헤린 및 그의 종 오르토로그에 대한 다양한 항체 및 항체 약물 접합체 (Ab-MCC-DM1 포맷)의 친화도를 CM5 센서 칩을 사용하는 비아코어® T100 기기 (지이 헬스케어, 펜실베니아주 피츠버그) 또는 비아코어® 2000 기기 (지이 헬스케어, 펜실베니아주 피츠버그)를 사용하여 SPR 기술을 사용하여 결정하였다.
간략하게, 2% 오디세이® 차단 완충제 (리-코르 바이오사이언시스(Li-Cor Biosciences), 네브래스카주 링컨)로 보충된 HBS-P+ (0.01 M HEPES, pH 7.4, 0.15 M NaCl, 0.05% 계면활성제 P20)를 비아코어® T100 기기 상에서의 모든 실험에 대한 구동 완충제로서 사용하였다. 2% 오디세이® 차단 완충제로 보충된 HBS-P (0.01 M HEPES, pH 7.4, 0.15 M NaCl, 0.005% 계면활성제 P20)를 비아코어® 2000 기기 상에서의 모든 실험에 대한 구동 완충제로서 사용하였다. 고정화 수준 및 분석물 상호작용을 반응 단위 (RU)에 의해 측정하였다. 파일럿 실험을 수행하여 단백질 A (지이 헬스케어, 펜실베니아주 피츠버그)의 고정화 및 시험 항체의 포획의 실행가능성을 시험 및 확인하였다.
동역학 측정을 위해, 항체를 고정화된 단백질 A를 통해 센서 칩 표면에 포획하고 유리 용액 중에서 P-카드헤린 단백질이 결합하는 능력을 결정하는 실험을 수행하였다. 간략하게, pH 4.5에서의 28 μg/ml의 단백질 A를 2300-3300 RU에 도달하도록 2개의 유동 셀 상에서 10 μl/분의 유량으로 아민 커플링을 통해 CM5 센서 칩 상에 고정화하였다. 이어서, 0.01-0.25 μg/ml의 시험 항체를 3분 동안 5 μl/분으로 주입하였다. 포획된 항체의 수준을 일반적으로 400 RU 미만으로 유지하였다. 후속적으로, 6.25-100 nM의 P-카드헤린 ECD를 2배 연속으로 희석하고, 참조 및 시험 유동 셀 둘 다 위에서 2-4분 동안 40 μl/분의 유량으로 주입하였다. 시험된 ECD에 관한 표 11이 하기 열거되어 있다. 결합의 해리가 5분 동안 이어졌다. 각각의 주입 주기 후에, 칩 표면을 45초 동안 100 μl/분으로 PBS/6 M 구아니딘 HCl, pH 7.4를 사용하여 재생시켰다. 모든 실험을 25℃에서 수행하고, 반응 데이터를 비아코어 T100 평가 소프트웨어 버전 2.0.3 (지이 헬스케어)을 사용하여 간단한 1:1 상호작용 모델로 전반적으로 피팅하여 비아코어® T100 기기 상에서의 온 레이트 (ka), 오프-레이트 (kd) 및 친화도 (KD)의 추정치를 수득하였다. 비아코어® 2000 기기 상에서 실행된 실험을 스크러버 2(Scrubber 2)® 소프트웨어 버전 2.0b (바이오로직 소프트웨어)를 사용하여 간단한 1:1 상호작용 모델로 전반적으로 피팅하여 온 레이트 (ka), 오프-레이트 (kd) 및 친화도 (KD)의 추정치를 수득하였다.
표 11: 친화도 검정에 사용된 P-카드헤린 ECD 이소형 및 공급원

표 12는 표 1에 개시된 다양한 P-카드헤린 항체의 도메인 결합 및 친화도를 열거한다. 표에 제시된 바와 같이, 항체 NOV169N31Q, NEG0012, NEG0013, NEG0016, NEG0064, 및 NEG0067 모두는 나노몰 수준에서 인간 P-카드헤린과 반응하였고, 시노몰구스 원숭이 P-카드헤린 ECD에 대해 시험된 것과 유사한 친화도를 갖는다. NOV169N31Q를 제외한 모든 항체는 래트와 교차 반응하였다.
표 12. 인간 P-카드헤린 및 종 오르토로그에 대해 수득된 항-P-카드헤린 항체 및 ADC의 친화도 추정치

ND = 결정되지 않음
실시예 5: 생화학적 검정에서의 NOV169N31Q-MCC-DM1/NOV169N31Q 선택성
NOV169N31Q-MCC-DM1의 오프-타겟 교차-반응성에 대한 잠재력을 검사하기 위해, NOV169N31Q를 그의 상응하는 ECD: E-카드헤린 (CDH1) 또는 N-카드헤린 (CDH2)에서 가장 높은 정도의 아미노산 서열 동일성을 갖는 2종의 밀접하게 관련된 전형적 카드헤린 패밀리 구성원에의 결합에 대해 평가하였다.
P-카드헤린 vs E-카드헤린 및 N-카드헤린에 대한 결합 특이성을 평가하기 위해, 맥시소르프 384-웰 플레이트를 재조합 인간 E-카드헤린 또는 N-카드헤린 ECD와 함께 4℃에서 밤새 놓아두고, Fab 단편을 효소-연결 면역흡착 검정 (ELISA) 포맷을 사용하여 검정하였다. 세척 후에, 플레이트를 1xPBST 중 5% 탈지유를 사용하여 2시간 동안 차단하였다. Fab-함유 이. 콜라이 용해물을 첨가하고, 실온 (RT)에서 1시간 동안 결합하도록 하였다. 결합된 Fab 단편을 검출하기 위해, 플레이트를 TBST로 5x 세척하고, AP-항 인간 IgG F(ab')2를 1/2500 희석비로 첨가하였다. RT에서 1시간 후에, 플레이트를 TBST로 5x 세척하고, 아토포스 기질을 제조업체 설명서에 따라 첨가하였다. 플레이트를 기질 첨가 5분 후에 ELISA 판독기에서 판독하였다.
ELISA 방법론을 이용하여, 항-P-카드헤린 항체 후보 NOV169N31Q의 경우 인간 E-카드헤린 또는 N-카드헤린에 대한 어떠한 유의한 결합도 검출되지 않았다.
실시예 6: 생화학적 검정에서의 NOV169N31Q-MCC-DM1/NOV169N31Q 선택성
NOV169N31Q-MCC-DM1의 오프-타겟 교차-반응성에 대한 잠재력을 검사하기 위해, NOV169N31Q를 그의 상응하는 ECD: E-카드헤린 (CDH1) 또는 N-카드헤린 (CDH2)에서 가장 높은 정도의 아미노산 서열 동일성을 갖는 2종의 밀접하게 관련된 전형적 카드헤린 패밀리 구성원에의 결합에 대해 평가하였다.
P-카드헤린 vs E-카드헤린 및 N-카드헤린에 대한 결합 특이성을 평가하기 위해, 맥시소르프 384-웰 플레이트를 재조합 인간 E-카드헤린 또는 N-카드헤린 ECD와 함께 4℃에서 밤새 놓아두고, Fab 단편을 효소-연결 면역흡착 검정 (ELISA) 포맷을 사용하여 검정하였다. 세척 후에, 플레이트를 1xPBST 중 5% 탈지유를 사용하여 2시간 동안 차단하였다. Fab-함유 이. 콜라이 용해물을 첨가하고, 실온 (RT)에서 1시간 동안 결합하도록 하였다. 결합된 Fab 단편을 검출하기 위해, 플레이트를 TBST로 5x 세척하고, AP-항 인간 IgG F(ab')2를 1/2500 희석비로 첨가하였다. RT에서 1시간 후에, 플레이트를 TBST로 5x 세척하고, 아토포스 기질을 제조업체 설명서에 따라 첨가하였다. 플레이트를 기질 첨가 5분 후에 ELISA 판독기에서 판독하였다.
ELISA 방법론을 이용하여, 항-P-카드헤린 항체 후보 NOV169N31Q의 경우 인간 E-카드헤린 또는 N-카드헤린에 대한 어떠한 유의한 결합도 검출되지 않았다.
실시예 7: P-카드헤린 기능에 대한 NOV169N31Q 영향의 평가
세포 검정에서 P-카드헤린에 대한 기능적 효과를 발휘하는 항-P-카드헤린 항체 NOV169N31Q (항체 약물 접합체 NOV169N31Q-MCC-DM1의 성분)의 능력을 평가하기 위해 연구를 수행하였다. P-카드헤린은 암 세포의 세포 표면 상에 발현되는 동형 세포 부착 분자이며, 따라서 P-카드헤린 양성 HCT116 세포 및 P-카드헤린 음성 HT-29 세포를 사용하는 타원체 완전성 검정을 사용하여 항체의 잠재적 길항 특성을 평가하였다. 명시야 현미경검사 및 세포 DNA의 7-AAD 형광 검출에 의해 결정된 바와 같이, 본 검정의 판독물은 타원체의 형상 및 기밀도이다.
HCT116 세포 (P-카드헤린 양성) 또는 HT29 세포 (P-카드헤린 음성)를 인간 IgG1 이소형 대조군 Ab (10 μg/mL) 또는 NOV169N31Q (10 μg/mL)와 함께 또는 그 없이, 96-웰 둥근 바닥 초저 부착 플레이트 (코닝 카탈로그# 7007)에 웰당 6,000개 세포의 밀도로 시딩하였다. 세포를 37℃, 5% CO2에서 오비탈 진탕기 (60 rpm) 상에 배치하였다. 세포 DNA를 표지하기 위해 세포를 플레이팅한지 116시간 후에 7-아미노악티노마이신 D (7-AAD; 비디 파밍겐(BD Pharmingen), 카탈로그 # 559925)를 첨가하였다. 세포를 플레이팅한지 132시간 후에 텍사스 레드 필터를 사용하여 GE IN 세포 분석기 2000 상에서 7-AAD 영상화를 수행하였다. 7-9 "z" 영상 스택을 각 웰로부터 취하고, 영상 스택을 IN 셀 디벨롭퍼 툴박스(IN Cell Developer Toolbox) 1.8 프로그램을 사용하여 붕괴시켰다.
도 7에서, 명시야 현미경검사 및 7-AAD (DNA 기반) 영상화에 의해 결정된 타원체 밀도 분석에 의해 입증된 바와 같이, NOV169N31Q는 P-카드헤린 발현 HCT116 세포에서 P-카드헤린-매개 세포 부착에 대한 작지만 식별가능한 효과를 제시하였지만, P-카드헤린 음성 HT29 세포에서는 그렇지 않았다. 대조적으로, 비-특이적 대조군 인간 IgG1 항체는 다세포 타원체의 완전성에 대해 어떠한 영향도 미치지 않았다. 따라서, NOV169N31Q는 시험관내 및/또는 생체내 P-카드헤린 기능의 부분 길항제일 수 있다.
실시예 8: 세포 증식 및 생존의 NOV169N31Q-MCC-DM1 억제
세포 증식 및 생존을 억제하는 NOV169N31Q-MCC-DM1의 능력을 셀타이터글로(CellTiterGlo)® 증식 검정을 사용하여 평가하였다.
세포주를 조직 배양 인큐베이터 내 5% CO2, 37℃에서 그의 성장에 최적인 배지에서 배양하였다. 증식 검정을 위한 시딩 전에, 최적 성장 밀도를 보장하기 위해 검정으로부터 적어도 2일 전에 세포를 분할하였다. 시딩 날에, 세포를 0.25% 트립신을 사용하여 조직 배양 플라스크로부터 들어 떼어냈다. 세포 생존율 및 세포 밀도를 세포 계수기 (바이-셀(Vi-Cell) XR 세포 생존율 분석기, 베크만 쿨터(Beckman Coulter))를 사용하여 결정하였다. 85% 초과의 생존율을 갖는 세포를 흑색-벽 투명 바닥 96-웰 플레이트 (코닝 카탈로그 # 3904) 내 50 μL의 표준 성장 배지에서 웰당 2,500개 세포의 밀도로 배양하였다. 플레이트의 가장자리에 접경하는 웰을 웰 부피에 대한 증발의 효과를 최소화하기 위해 PBS로 채웠다. 플레이트를 조직 배양 인큐베이터 내 37℃에서 밤새 인큐베이션하였다. 다음 날, 유리 메이탄신 (L-DM1-Me), NOV169N31Q-MCC-DM1 및 비-표적화 ADC 대조군 (IgG1-SMCC-DM1)을 표준 성장 배지에서 2X로 제조하였다. 이어서, 준비된 약물 처리제를 세포에 첨가하여 0 - 100 nM 범위의 최종 농도 및 웰당 100 μL의 최종 부피가 되었다. 각 약물 농도를 삼중으로 시험하였다. 플레이트를 조직 배양 인큐베이터 내 37℃에서 밤새 또는 5일 동안 인큐베이션하고, 이 후에 세포를 용해시키고 총 아데노신 트리포스페이트 (ATP) 함량을 측정하는 시약인 100 μL의 셀타이터 글로® (프로메가(Promega), 카탈로그# G7573)의 첨가를 통해 세포 생존율을 평가하였다. 플레이트를 세포 용해를 유도하기 위해 3분 동안 적절한 혼합을 제공하는 속도로 오비탈 진탕기 상에서 실온에서 암흑 하에 인큐베이션하였다. 플레이트를 실온에서 10분 동안 인큐베이션하여 발광 신호를 안정화시킨 후에 발광 계수기 (왈락 1450 마이크로베타 트리룩스, 퍼킨 엘머)를 사용하여 판독하였다. 비처리 세포의 발광 계수를 시딩 후의 날 (제0일 판독) 및 약물 노출 5일 후 (제5일 판독)에 취하였다. 검정 설명서에 따라, 비처리 세포의 제5일 판독을 제0일 판독과 비교하였다. 인큐베이션 기간 동안 적어도 1회의 세포 배가를 갖는 검정은 유효한 것으로 간주하였다. 약물 처리제의 효과를 평가하기 위해, 비처리 세포 (100% 생존율)를 함유하는 웰로부터의 발광 계수를 사용하여 처리된 샘플을 정규화하였다. IC50 값을 그래프 패드 프리즘 6 소프트웨어를 사용하여 계산하였다. 각 세포주를 적어도 3회 평가하였으며, 대표적인 IC50 값이 제시되어 있다.
NOV169N31Q-MCC-DM1은 각 항체에 결합된 3.8개의 DM1 분자의 표적 평균을 갖는다 (항체에 대한 약물 비, 또는 DAR, 3.8). 3종의 대표적인 세포주의 용량-반응 곡선이 제시되어 있다 (도 8). 세포 성장 또는 생존의 50%를 억제하는데 요구되는 처리제의 농도 (IC50)를 계산하였으며, 시험된 세포주의 대표적인 IC50 값이 표 13에 요약되어 있다.
미접합 항체 NOV169N31Q는 세포독성도 아니고 증식성도 아닌 것으로 입증되었고, 반면에 NOV169N31Q-MCC-DM1은 P-카드헤린-발현 세포주에서 증식 및 생존을 강력하게 억제하였다. 어느 분자도 P-카드헤린 음성 세포주 HT29에서 활성이 아니었다 (도 8). 대조적으로, NOV169N31Q-MCC-DM1은 2종의 유방암 세포주 HCC1954 및 HCC70의 성장을 강력하게 억제하였다. 표 13은 세포주의 패널에서 NOV169N31Q-MCC-DM1의 활성을 요약한다. 이소형 매칭되는 비-표적화 대조군 ADC (IgG1-MCC-DM1)와 비교하여, NOV169N31Q-MCC-DM1은 종종 세포당 P-카드헤린의 >50,000개 초과의 세포 표면 카피를 발현하는 세포주에 대한 세포독성 활성을 제시하였다. 이들 연구는 NOV169N31Q-MCC-DM1의 세포독성 효과가 ADC의 내재화된 메이탄신 성분으로 인한 것이고 NOV169N31Q-MCC-DM1은 P-카드헤린을 과다발현하는 세포를 특이적으로 표적화한다는 것을 나타낸다.
표 13: 인간 암 세포주의 패널에서의 P-카드헤린 발현 및 NOV169N31Q-MCC-DM1 활성. 세포주의 패널에서의 유리 메이탄신 (L-DM1-Me) 및 이소형 대조군 ADC (IgG1-MCC-DM1)와 비교된 NOV169N31Q-MCC-DM1의 IC50 (nM) 값. NOV169N31Q-MCC-DM1에 대한 최대 세포 사멸 값이 보고되어 있다. 여기서 보고된 값은 다중 반복을 대표하는 개별 검정으로부터의 값이다.

실시예 9: NOV169N31Q 및 NOV169N31Q-MCC-DM1 유도된 ADCC 활성의 시험관내 평가
NOV169N31Q 및 NOV169N31Q-MCC-DM1을, 증식에 대한 그의 영향 이외에도, 항체 의존성 세포성 세포독성 (ADCC)을 매개하는 그의 능력에 대해 또한 평가하였다.
이펙터 세포는 올셀즈, 엘엘씨(AllCells, LLC)로부터 입수한 무훼손 인간 자연 킬러 (NK) 세포 (카탈로그 # PB012: 새로운/무훼손 정상 PB CD56+ NK 세포)였다. 표적 세포를 노파르티스 셀 서비시즈 (NCS)를 통해 아메리칸 타입 컬쳐 콜렉션 (P-카드헤린 양성 HCC1954, P-카드헤린 음성 HT-29)으로부터 입수하였다. HCC1954 및 HT-29 표적 세포를 트립신-무함유 세포 해리 완충제 (깁코로부터의 "세포 해리 완충제", 카탈로그 # 13151-014)를 사용하여 조직 배양 용기로부터 들어올리고, PBS로 2-3회 세척하고, 배양 배지에 재현탁시켰다. 세포를 수동으로 또는 자동화 세포 계수기를 사용하여 계수하였다. >90% 생존율의 세포를 배양 배지에 1x10⁵개 세포/mL로 현탁시켰다. 인간 NK 세포를 세척하고, 표적 세포주와 동일한 방식으로 계수하였다. 이어서, 이펙터 세포를 세포 배양 배지에 1-2 x10⁶개 세포/mL로 현탁시켰다.
처리는 NOV169N31Q 항체, 매칭되는 이소형 대조군 항체 (IgG1 대조군), 뿐만 아니라 항체 약물 접합체 NOV169N31Q-MCC-DM1 및 IgG1-SMCC-DM1을 포함한다. 50μL의 배지 중 5000개의 표적 세포를 96-웰 편평 바닥 플레이트 (코닝 #3603)에 시딩하였다. 이어서, 시험 및 대조군 항체를 37℃에서 20분 동안 25μL 배지 중 4X 최종 농도 (최종 농도 범위 50 - 0.0001μg/mL, 무 처리 대조군 이외에도)로 첨가하였다. 이어서, 이펙터 세포를 25μL의 배지 중 5:1의 이펙터 세포 대 표적 세포 비 (E:T) (예를 들어, 5:1 비를 위해 웰당 25000개 이펙터 세포)로 첨가하였다. 처리군 및 대조군 (표적 세포 단독, 이펙터 세포 단독, 세포 부재)을 삼중으로 실행하였다. 이어서, 플레이트의 바닥에 세포를 농축시키기 위해 원심분리에서 500 RPM (브레이크 부재)으로 플레이트를 회전시켰다. 이어서, 플레이트를 정상 세포 배양 조건 (37℃, 5% CO2) 하에 24시간 동안 인큐베이션하였다.
인큐베이션 기간 후에, 배지를 플레이트로부터 제거하고, 웰을 PBS로 2-3회 세척하여 비-부착 이펙터 세포를 제거하였다. 100μL의 셀 타이터 글로 (프로메가 카탈로그# G7570)를 각 웰에 첨가하고, 플레이트를 광으로부터 차폐하고, 2분 동안 오비탈 진탕기 상에 배치하였다. 이어서, 플레이트를 발광 계수기 (왈락 트리룩스 마이크로베타 1450) 상에서 판독하였다. 발광 계수기에 의해 검출된 신호는 ATP의 양 또는 웰에 남아있는 세포의 수에 정비례한다. 대조군 웰을 기준선으로서 사용하여, 각 처리에 대한 생존 세포 수를 비처리 대조군의 퍼센트로서 결정할 수 있다.
NOV169N31Q-MCC-DM1 및 NOV169N31Q 둘 다는 용량-의존성 방식으로 시험관내 인간 자연 킬러 (NK) 세포의 존재 하에 P-카드헤린 과다발현 세포에 대한 ADCC 활성을 매개하는 능력을 나타냈다 (도 9). 이 활성은, 항체 및 ADC 둘 다에 대해 매칭되는 이소형 대조군이 어떠한 유의한 세포 사멸도 나타내지 않은 바와 같이, P-카드헤린 특이적인 것으로 밝혀졌다. NOV169N31Q와 NOV169N31Q-MCC-DM1 모두 P-카드헤린 음성 세포주 HT-29에 대한 어떠한 ADCC의 유도도 나타내지 않으며, 이는 또한 항체 및 항체 약물 접합체의 특이적 효과를 나타낸다. 따라서, 종양 세포로의 세포독성 페이로드의 전달 이외에도, ADCC는 생체내 종양 세포 사멸에 대한 NOV169N31Q-MCC-DM1 작용의 또 다른 잠재적 메카니즘을 나타낸다.
실시예 10: 항-P-카드헤린 ADC에 의한 생체내 온-타겟 약동학적 마커 조정
생체내 G2/M 정지의 약동학적 마커 [포스포-히스톤 H3 (pHH3)을 갖는 세포의 축적]를 조정하는 P-카드헤린 ADC NOV169N31Q-MCC-DM1의 능력을 평가하기 위해 연구를 수행하였다. 목표는 NOV169N31Q-MCC-DM1, 이소형 대조군 ADC 또는 비히클 단독으로 처리된 마우스로부터의 종양에서 G2/M 세포 주기 정지의 정도 및 지속기간을 평가하는 것이었다.
면역조직화학에 의해 평가된 바와 같이, pHH3 양성 핵의 축적을 측정하기 위해, 인간 히스톤 H3 (pHH3)의 인산화 Ser10을 둘러싸는 잔기에 상응하는 합성 포스포펩티드로 동물을 면역화시킴으로써 생산된 토끼 폴리클로날 항체를 셀 시그널링 테크놀로지(Cell Signaling Technology) (매사추세츠주 댄버스, 카탈로그# 9701)로부터 입수하였다. 간략하게, IHC 프로토콜은 가열 및 벤타나 셀 컨디셔닝 #1 항원 회복 시약에 대한 표준 노출을 포함하였다. 1차 항체를 1:50으로 희석하고, 실온에서 60분 동안 인큐베이션하였다. 후속적으로, 잭슨 이뮤노리서치 래버러토리즈(Jackson ImmunoResearch Laboratories) 염소 항-토끼 비오티닐화 2차 항체 (카탈로그# 111-065-144, 펜실베니아주 웨스트 그로브)와 함께 32분 동안 인큐베이션을 수행하였다.
피하 종양 이종이식편 모델에서의 HCC70 삼중 음성 유방암 모델에서 항-P-카드헤린 ADC 유도된 PD 마커 변화를 평가하기 위해, 암컷 SCID-베이지 마우스에 행크 평형 염 용액 중 50% 매트리겔(Matrigel)™ (비디 바이오사이언시스)을 함유하는 현탁액 중 10x106개 세포를 피하로 이식하였다.
현탁액 중 세포를 함유하는 총 주입 부피는 200 μl였다. 마우스를 종양이 평균 ~130 mm3이 되었을 때 NOV169N31Q-MCC-DM1 (10 mg/kg), 비-특이적 IgG1-MCC-DM1 이소형 대조군 (10 mg/kg) 또는 공 비히클 대조군 (20 mM 히스티딘, 8.22% 수크로스, 0.02% PS-20, pH 5.6)의 단일 정맥내 (IV) 용량을 투여받도록 무작위 배정하였다 (n=3/군). 종양을 투여 후 최대 21일 시점에 수집하였다. PD 반응의 측정으로서, 포스포-히스톤 H3 (pHH3) 수준의 정성적 평가를 상기 기재된 면역조직화학적 염색에 의해 수행하였다.
도 10에서, 메이탄시노이드 페이로드의 예상되는 작용 메카니즘과 일치하게, 일부 기준선 포스포-히스톤 H3 면역염색 염색이 비히클 처리된 종양에서 검출된 반면, 이들 수준은 NOV169N31Q-MCC-DM1 처리 후, 특히 투여 후 제2일 내지 제7일에 상승하였다. 이들 데이터는 NOV169N31Q-MCC-DM1이 메이탄시노이드 페이로드의 작용 메카니즘과 일치하게, 종양 이종이식편에서 강건한 세포 PD 반응을 도출할 수 있다는 것을 입증한다.
실시예 11: 마우스에서의 HCC70 삼중 음성 유방암 (TNBC) 모델에 대한 항-P-카드헤린 ADC의 생체내 효능 (ADC 효능 스크리닝)
유방암에서, P-카드헤린은 빈번하게 고도로 발현되며, 이는 각 세포의 표면 상에 대략 66,000개의 수용체를 갖는 HCC70 세포주에 의해 예시되었다. HCC70 종양 상의 P-카드헤린 면역염색의 대표적인 사진이 이 이종이식편 모델에서의 염색 패턴을 시각화하기 위해 제시되어 있다 (도 11a). IHC를 벤타나 디스커버리 XT 자동염색기를 사용하여 수행하였다. 포르말린 고정, 파라핀 포매된 종양의 절편을 탈파라핀화되고, 벤타나 셀 컨디셔닝 #1 (CCIS) 항원 회복 시약으로 처리한 다음, 10ug/ml의 농도에서 1차 항체 [비디 트랜스덕션 랩(BD Transduction Lab)으로부터의 마우스 모노클로날 항-인간 P-cad 항체 (카탈로그#610228, 로트 09934)] 중에서 실온에서 60분 동안 인큐베이션하였다. 이에 이어서 1:250의 작업 농도로 사용되는 비오티닐화 염소 항-마우스 (잭슨 래보러토리즈(Jackson Laboratories), 카탈로그#115-066-072, 로트# 63620)와 인큐베이션하였다. DAB 맵 키트 (벤타나 메디칼(Ventana Medical), 카탈로그#760-124)를 사용하여 검출을 수행하였다. 비-특이적 마우스 IgG 항체 (벡터 래보러토리즈(Vector Laboratories) 카탈로그# I-2000, 로트# V0610)를 대조군으로서 사용하여 P-카드헤린 항체로 관찰된 염색이 특이적이라는 것을 보장하였다.
종양이 ~215 mm3에 도달하였을 때, 마우스를 종양 부피에 따라 처리군으로 무작위화하고 (n= 8/군), 비히클 또는 7 mg/kg의 ADC의 단일 IV 투여를 투여하였다. 7 mg/kg 용량 수준이 이 모델에서 ADC 후보 사이의 차이를 식별하기 위한 윈도우를 제공할 것으로 예상됨에 따라 그것을 선택하였다. 용량을 개별 마우스 체중에 대해 조정하였다. IV 용량 부피는 8 ml/kg이었다.
NEG0012-MCC-DM1 및 NOV169N31Q-MCC-DM1 처리군에서의 평균 종양 부피는 제42일에 이소형-매칭되는 huIgG1-MCC-DM1 대조군과 유의하게 상이하였다 (일원 ANOVA; 던 방법, p ≤ 0.05). ADC 후보로 처리된 다른 군은 대조군과 비교하여 통계적으로 상이한 종양 부피를 나타내지 않았다 (도 11b). 이는 주요 ADC 후보로서 NEG0012-MCC-DM1 및 NOV169N31Q-MCC-DM1을 선정하였다. 임의의 군에서 어떠한 유의한 체중 감소도 관찰되지 않았다.
실시예 12: 마우스에서의 HCC70 삼중 음성 유방암 (TNBC) 모델에 대한 NOV169N31Q-MCC-DM1의 용량 의존성 생체내 효능
각 세포의 표면 상에 대략 66,000개의 수용체를 갖는 HCC70 세포주는 시험관내 NOV169N31Q-MCC-DM1에 감수성인 것으로 제시되었다. HCC70 모델에서 NOV169N31Q-MCC-DM1에 의한 표적화된 항종양 활성을 입증하기 위해, 2.5, 5, 10 및 15 mg/kg 또는 10 mg/kg의 NOV169N31Q-MCC-DM1 또는 비-특이적 이소형 대조군 IgG1-MCC-DM1의 단일 IV 처리를 투여하였다. 암컷 SCID 마우스에서 각 마우스의 우측 측복부 내로의 10 x 106개 세포의 피하 주사에 의해 HCC70 종양을 확립하였다. 종양이 ~143 mm3에 도달하였을 때, 마우스를 종양 부피에 따라 처리군으로 무작위화하였다 (n= 9). 모든 시험 작용제를 나타낸 용량 수준 및 스케줄로 투여하고, 용량을 개별 마우스 체중에 대해 조정하였다. IV 용량 부피는 5 ml/kg이었다.
NOV169N31Q-MCC-DM1 처리는 용량 비례 항종양 효능을 유발하였으며, 이때 %ΔT/ΔC 값은 48% (2.5 mg/kg), 1% (5 mg/kg)이고, 반면에 10 및 15 mg/kg의 용량은 각각 64% 및 61%의 평균 퇴행을 유발하였다. 최대 효능은 10 mg/kg에서 달성되었다. 시험된 5, 10 및 15 mg/kg 군은 비히클 처리군과 통계적으로 상이하였다 (P<0.05, 순위 기반 ANOVA /던 방법, 제59일). 연구가 종결되었을 때, 10 및 15 mg/kg의 용량 수준은 처리후 최대 86일까지 지속되는 마우스에서의 지속적인 종양 퇴행을 도출하였다.
모든 시험 작용제는 연구에서 허용되었고, 마우스 P-카드헤린에 결합하지 않는 ADC에 대해 예상된 바와 같이, 임의의 처리군에서 독성의 어떠한 명백한 임상 증상도 관찰되지 않았다. 모든 군에서, 마우스 P-카드헤린에 결합하지 않는 ADC에 대해 예상된 바와 같이, 무작위화시 평균 체중과 비교하여 체중 증가가 관찰되었으며, 이는 비히클-처리된 마우스의 경우와 유사하였다 (도 12 및 표 14).
표 14: 제59일에 HCC70 유방암 이종이식편 모델에서의 NOV169N31Q-MCC-DM1 용량 반응 효능. 종양 부피 및 체중에 대한 처리의 효과는 평균 ± SEM으로 제시되어 있다. 처리 제59일에 실험을 평가하였다. *p<0.001 대 비히클 (순위 기반 크루스칼-왈리스 일원 ANOVA /던 방법). % ΔT/ΔC = 100 ΔT/ΔC, 여기서: ΔT = 연구 제21일에서의 약물-처리군의 평균 종양 부피 - 투여 개시일에서의 약물-처리군의 평균 종양 부피; ΔC = 연구 제21일에서의 대조군의 평균 종양 부피 - 투여 개시일에서의 대조군의 평균 종양 부피. % 퇴행 = (1 - T최종 / T개시) x 100
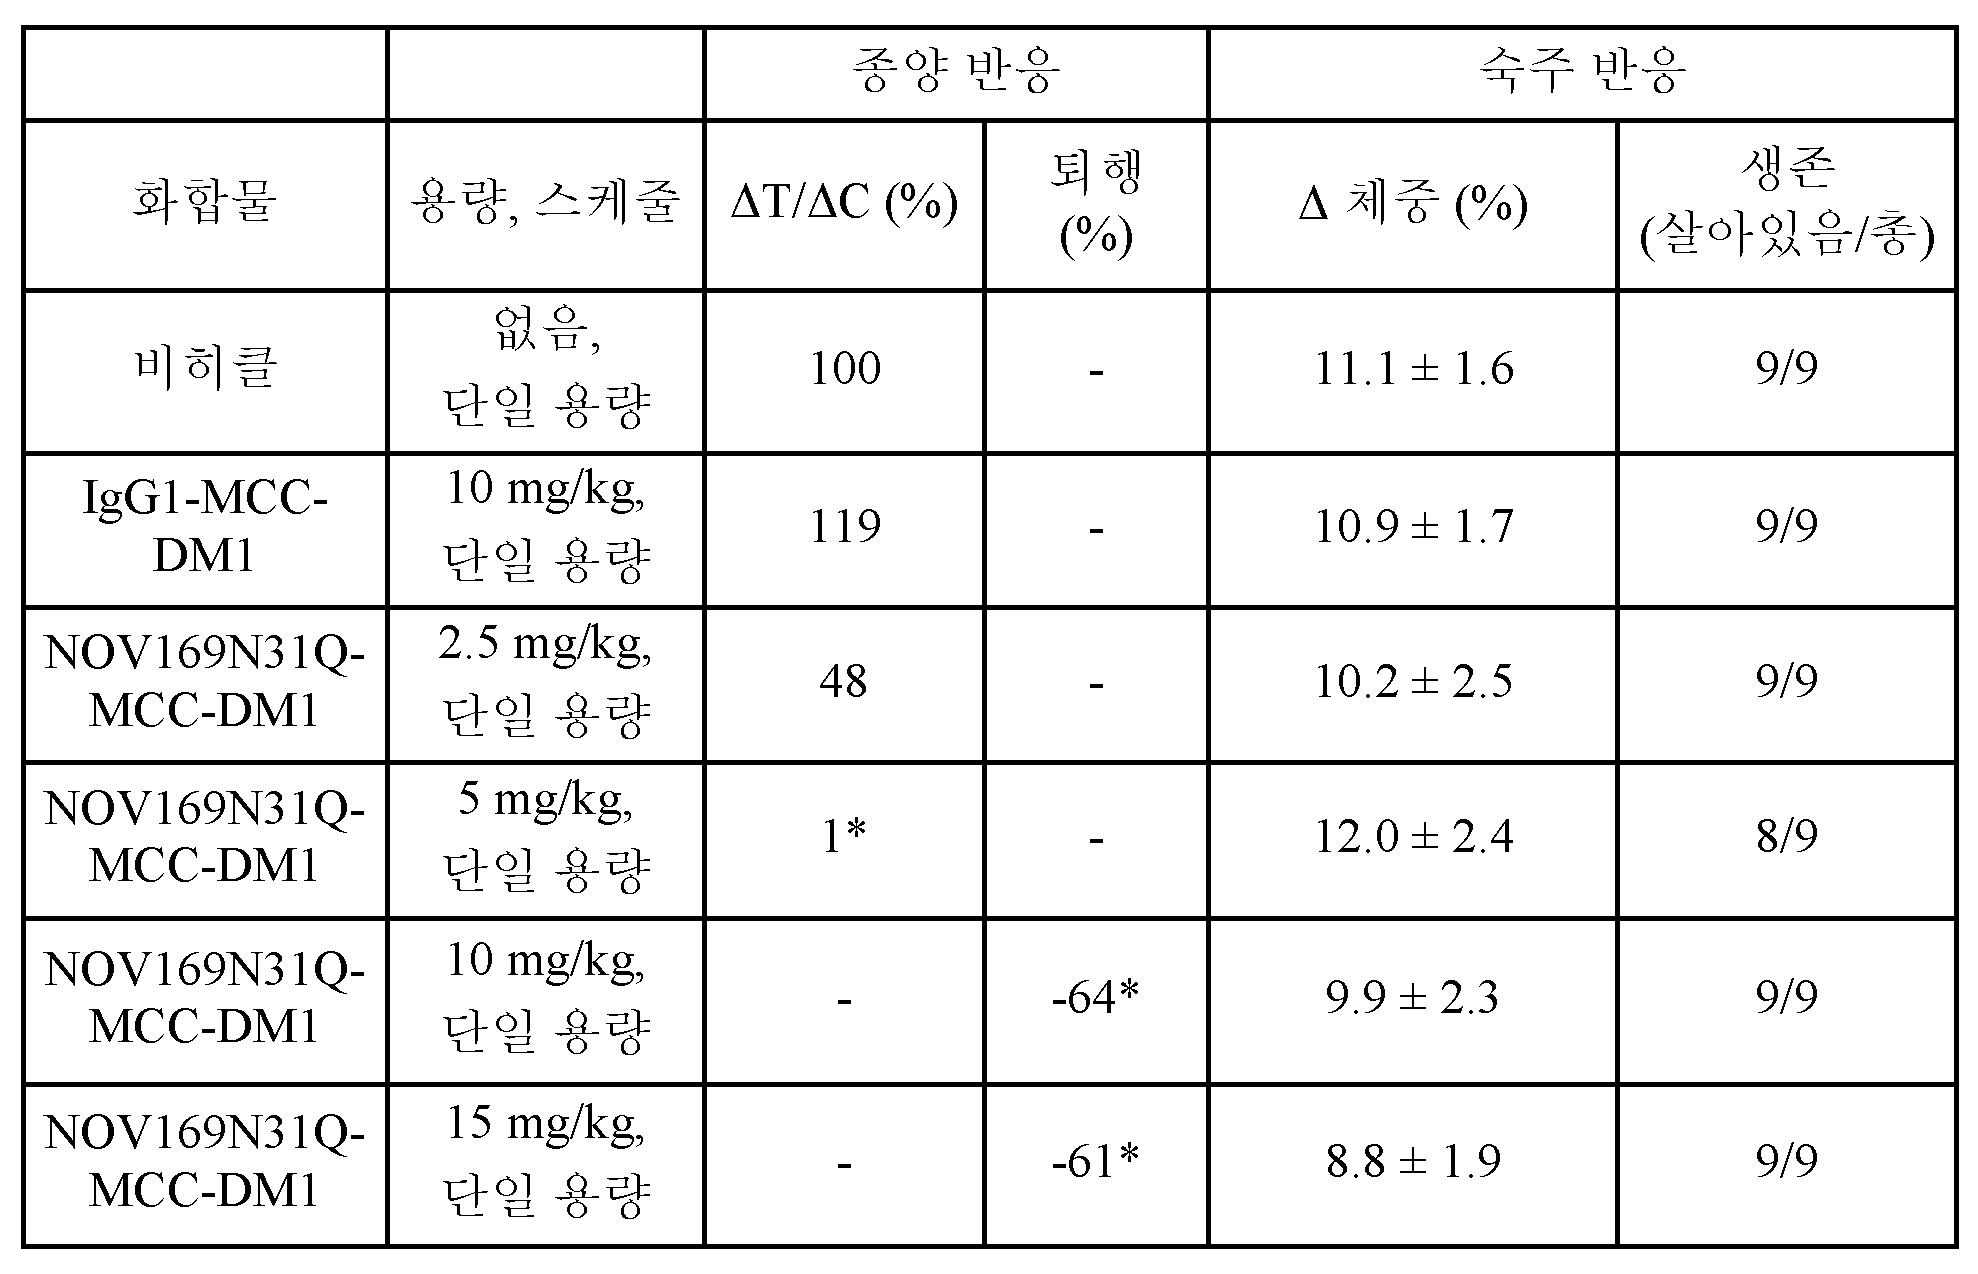
실시예 13: 마우스에서의 HCC1954 유방암 모델에 대한 NOV169N31Q-MCC-DM1의 생체내 효능
추가의 유방암 모델에서 효능을 입증하기 위해, NOV169N31Q-MCC-DM1 활성을 SCID-베이지 마우스에서의 HCC1954 기저-유사 (Her2+) 유방암 이종이식편 모델에서 평가하였다. HCC1954 모델을 시험관내 P-카드헤린 발현 (84,000개 수용체/세포) 및 NOV169N31Q-MCC-DM1에 대한 감수성에 기반하여 선택하였다. 이전에 기재된 바와 같이 면역조직화학을 수행하여 HCC70 종양에서의 종양 P-카드헤린 단백질 수준을 확인하였다 (도 13a).
종양이 ~150 mm3에 도달하였을 때, 마우스를 종양 부피에 따라 처리군으로 무작위화하고 (n= 9/군), 비히클 또는 10 mg/kg의 IgG1-MCC-DM1 또는 NOV169N31Q-MCC-DM1의 단일 IV 투여를 투여하였다. 용량을 개별 마우스 체중에 대해 조정하였다. IV 용량 부피는 5 ml/kg이었다.
NOV169N31Q-MCC-DM1 처리는 HCC1954 종양의 56% 퇴행을 유발하였으며, 이는 제55일까지 지속적이었다 (대 비히클 또는 IgG1-MCC-DM1, p<0.05, 순위 기반 크루스칼-왈리스 일원 ANOVA /던 방법). IgG1-MCC-DM1의 효능은 75%의 %ΔT/ΔC이고, 비히클과 유의하게 상이하지 않았다 (p>0.05). 모든 시험 작용제는 연구에서 허용되었고, 임의의 처리군에서 독성의 어떠한 명백한 임상 증상도 관찰되지 않았다 (도 13b 및 표 15A).
표 15A: 제31일에 HCC1954 유방암 이종이식편 모델에서의 NOV169N31Q-MCC-DM1 효능. 종양 부피 및 체중에 대한 처리의 효과는 평균 ± SEM으로 제시되어 있다. 처리 제31일에 실험을 평가하였다. *p<0.001 대 비히클 (순위 기반 크루스칼-왈리스 일원 ANOVA /던 방법).
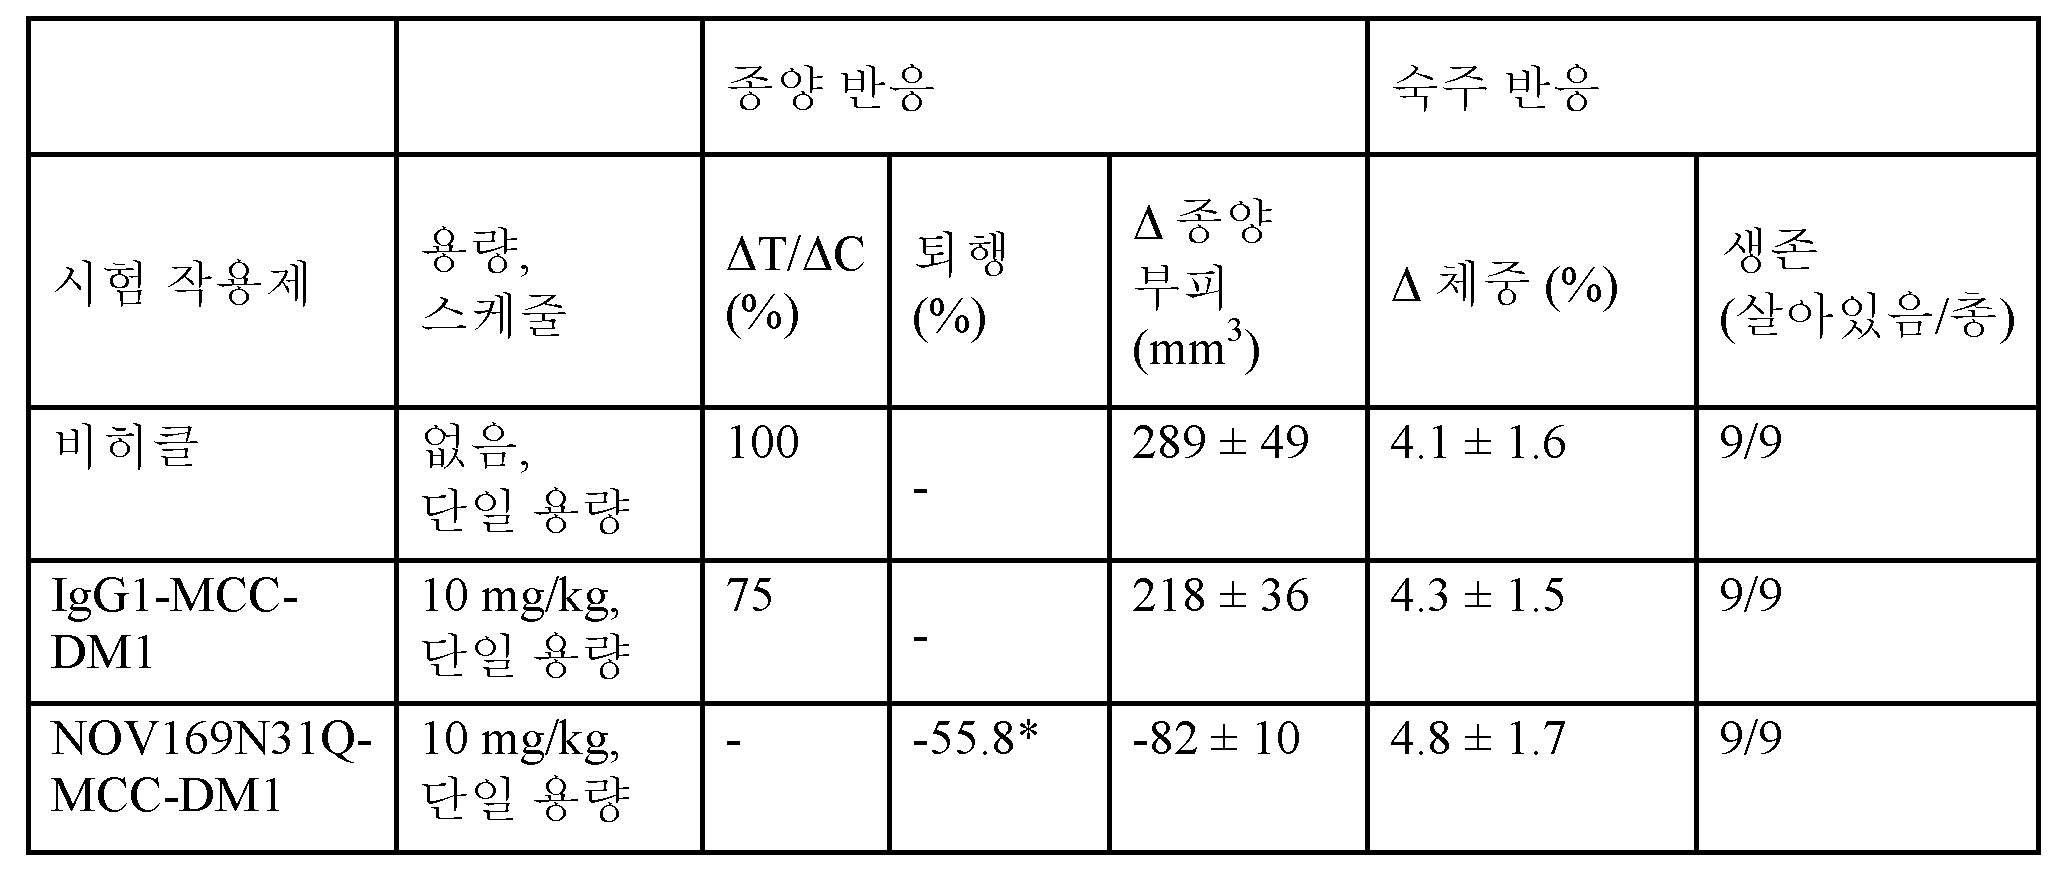
또 다른 예에서, NOV169N31Q-MCC-DM1 활성을 SCID 마우스에서의 HCC1954 기저-유사 (Her2+) 유방암 이종이식편 모델에서 평가하였다. HCC1954 모델을 시험관내 P-카드헤린 발현 (84,000개 수용체/세포) 및 NOV169N31Q-MCC-DM1에 대한 감수성에 기반하여 선택하였다. 종양이 ~190 mm3에 도달하였을 때, 마우스를 종양 부피에 따라 처리군으로 무작위화하고 (n= 5/군), 비히클, 15mg/kg의 NOV169N31Q 또는 15 mg/kg의 NOV169N31Q-MCC-DM1의 2회 (제0일 및 제7일에 제공됨) IV 투여를 투여하였다. 용량을 개별 마우스 체중에 대해 조정하였다. IV 용량 부피는 10 ml/kg이었다. NOV169N31Q-MCC-DM1 처리는 HCC1954 종양의 100% 퇴행을 유발하였으며, 이는 제56일에 연구의 종료시까지 지속적이었다 (대 비히클, p<0.05, 순위 기반 크루스칼-왈리스 일원 ANOVA 방법 /던 방법, 도 13c). NOV169N31Q의 효능은 121.4%의 %ΔT/ΔC이고, 비히클과 유의하게 상이하지 않았다 (p>0.05). 모든 시험 작용제는 연구에서 허용되었고, 임의의 처리군에서 독성의 어떠한 명백한 임상 증상도 관찰되지 않았다 (도 13d 및 표 15B).
표 15B: 제56일에 HCC1954 유방암 이종이식편 모델에서의 NOV169N31Q-MCC-DM1 효능. 종양 부피 및 체중에 대한 처리의 효과는 평균 ± SEM으로 제시되어 있다. 처리 제56일에 실험을 평가하였다. *p<0.05 대 비히클 (순위 기반 크루스칼-왈리스 일원 ANOVA /던 방법).
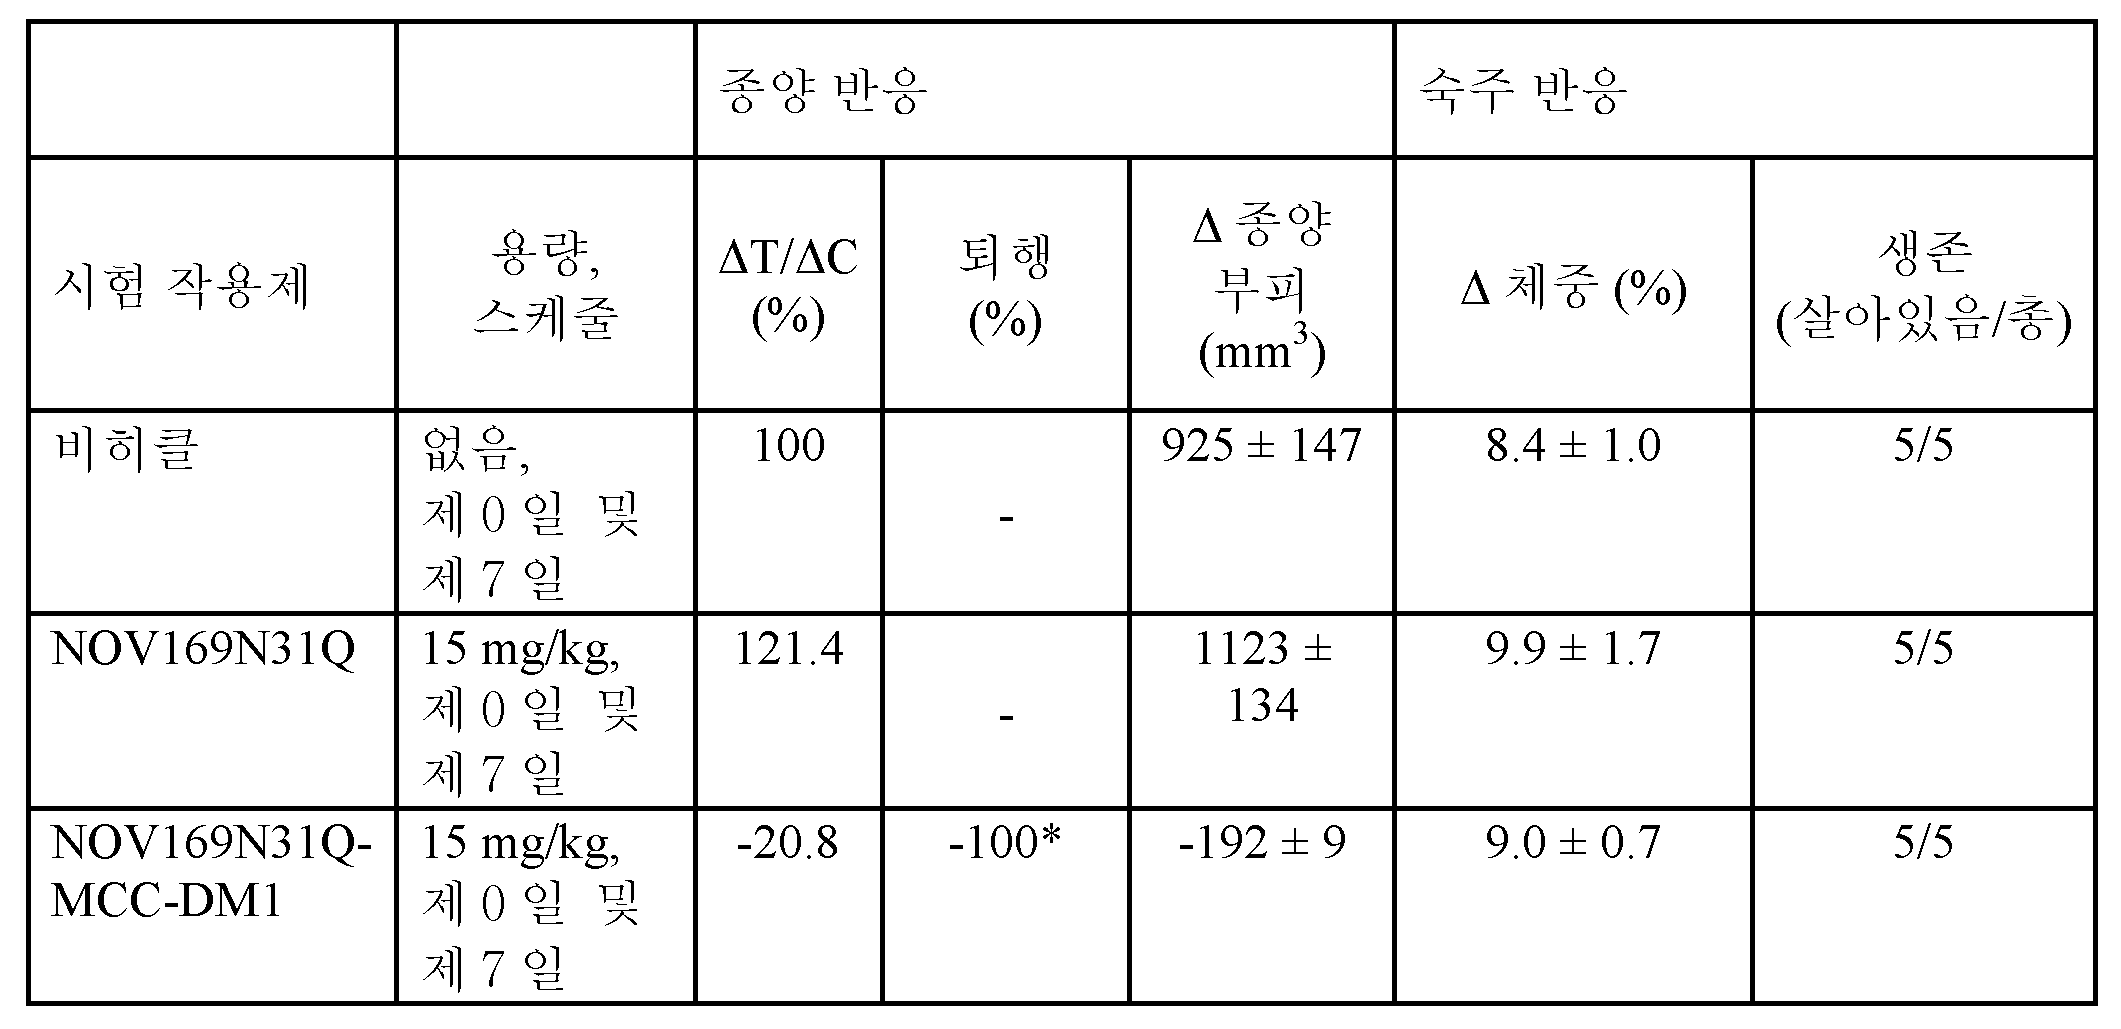
실시예 14: 마우스에서의 BICR6 두경부 (하인두 편평 세포 암종) 암 모델에 대한 NOV169N31Q-MCC-DM1의 생체내 효능
NOV169N31Q-MCC-DM1의 효능 평가를 시험관내 BICR6 세포주에서 70,000개 수용체/세포의 그의 P-카드헤린 발현 및 NOV169N31Q-MCC-DM1에 대한 감수성에 기반하여 수행하였다. 이전에 기재된 바와 같이 면역조직화학을 수행하여 BICR6 종양에서의 종양 P-카드헤린 수준을 확인하였으며, 여기서 종양 세포의 82%는 P-카드헤린에 대해 적어도 2+ 염색된다 (도 14a).
BICR6 종양을 암컷 SCID-베이지 마우스에서 각 마우스의 우측 측복부 내로의 5 x 10⁶개 종양 세포의 피하 생착에 의해 확립하였다. 종양이 ~130 mm3에 도달하였을 때, 마우스를 종양 부피에 따라 처리군으로 무작위화하고 (n= 10/군), q7d 스케줄 (q7dx2)에 걸쳐 제공되는 비히클 또는 10 mg/kg의 IgG1-MCC-DM1 또는 NOV169N31Q-MCC-DM1의 IV 투여를 투여하였다. 용량을 개별 마우스 체중에 대해 조정하였다. IV 용량 부피는 5 ml/kg이었다.
NOV169N31Q-MCC-DM1 처리는 최대 37% 종양 퇴행을 유발하였다 (연구 제26일에). 전체적으로, 종양 정체 반응은 NOV169N31Q-MCC-DM1에 의해 투여 후 최대 42일 동안 지속적이었다 (ΔT/ΔC 1%, p < 0.05, 순위 기반 크루스칼-왈리스 일원 ANOVA /터키 검정). 모든 시험 작용제는 연구에서 허용되었고, 임의의 처리군에서 독성의 어떠한 명백한 임상 증상도 관찰되지 않았다 (도 14b 및 표 16).
표 16: 제42일에 하인두 (두경부) 이종이식편 모델의 BICR6 인간 편평 세포 암종에서의 NOV169N31Q-MCC-DM1 효능. 종양 부피 및 체중에 대한 처리의 효과는 평균 ± SEM으로 제시되어 있다. 처리 제42일에 실험을 평가하였다. *p<0.05 대 비히클 (순위 기반 크루스칼-왈리스 일원 ANOVA /터키 검정).

실시예 15: 마우스에서의 scaBER 방광암 모델에 대한 NOV169N31Q-MCC-DM1의 생체내 효능
NOV169N31Q-MCC-DM1의 항종양 활성을 시험관내 63,000개 수용체/세포의 P-카드헤린 발현 및 NOV169N31Q-MCC-DM1에 대한 감수성에 기반하여 선택된 scaBER 방광암 이종이식편 모델에서 평가하였다. 면역조직화학을 수행하여 scaBER 종양에서의 종양 P-카드헤린 수준을 확인하였으며, 이는 대략 52% 종양 세포가 적어도 2+ 염색되었음을 제시한다 (도 15a).
scaBER 종양을 암컷 SCID-베이지 마우스에서 각 마우스의 우측 측복부 내로의 종양 단편의 피하 생착에 의해 확립하였다. 종양이 ~130 mm3에 도달하였을 때, 마우스를 종양 부피에 따라 처리군으로 무작위화하고 (n= 10/군), 2주 간격으로 2회 (Q2W x 2) 제공되는 비히클 또는 10 mg/kg의 IgG1-MCC-DM1 또는 NOV169N31Q-MCC-DM1의 IV 투여를 투여하였다. 용량을 개별 마우스 체중에 대해 조정하였다. IV 용량 부피는 5 ml/kg이었다.
NOV169N31Q-MCC-DM1 처리는 18%의 ΔT/ΔC를 유발하였다 (대 비히클 또는 IgG1-MCC-DM1, p<0.05, ANOVA/터키 검정, 제35일). IgG1-MCC-DM1의 효능은 86%의 ΔT/ΔC이고, 비히클과 유의하게 상이하지 않았다 (p>0.05). 모든 시험 작용제는 연구에서 허용되었고, 임의의 처리군에서 독성의 어떠한 명백한 임상 증상도 관찰되지 않았다 (도 15b 및 표 17).
표 17: 제42일에 scaBER 인간 방광 편평세포 암종 이종이식편 모델에서의 NOV169N31Q-MCC-DM1 효능. 종양 부피 및 체중에 대한 처리의 효과는 평균 ± SEM으로 제시되어 있다. 처리 제42일에 실험을 평가하였다. *p<0.001 대 비히클 (순위 기반 크루스칼-왈리스 일원 ANOVA /터키 검정).
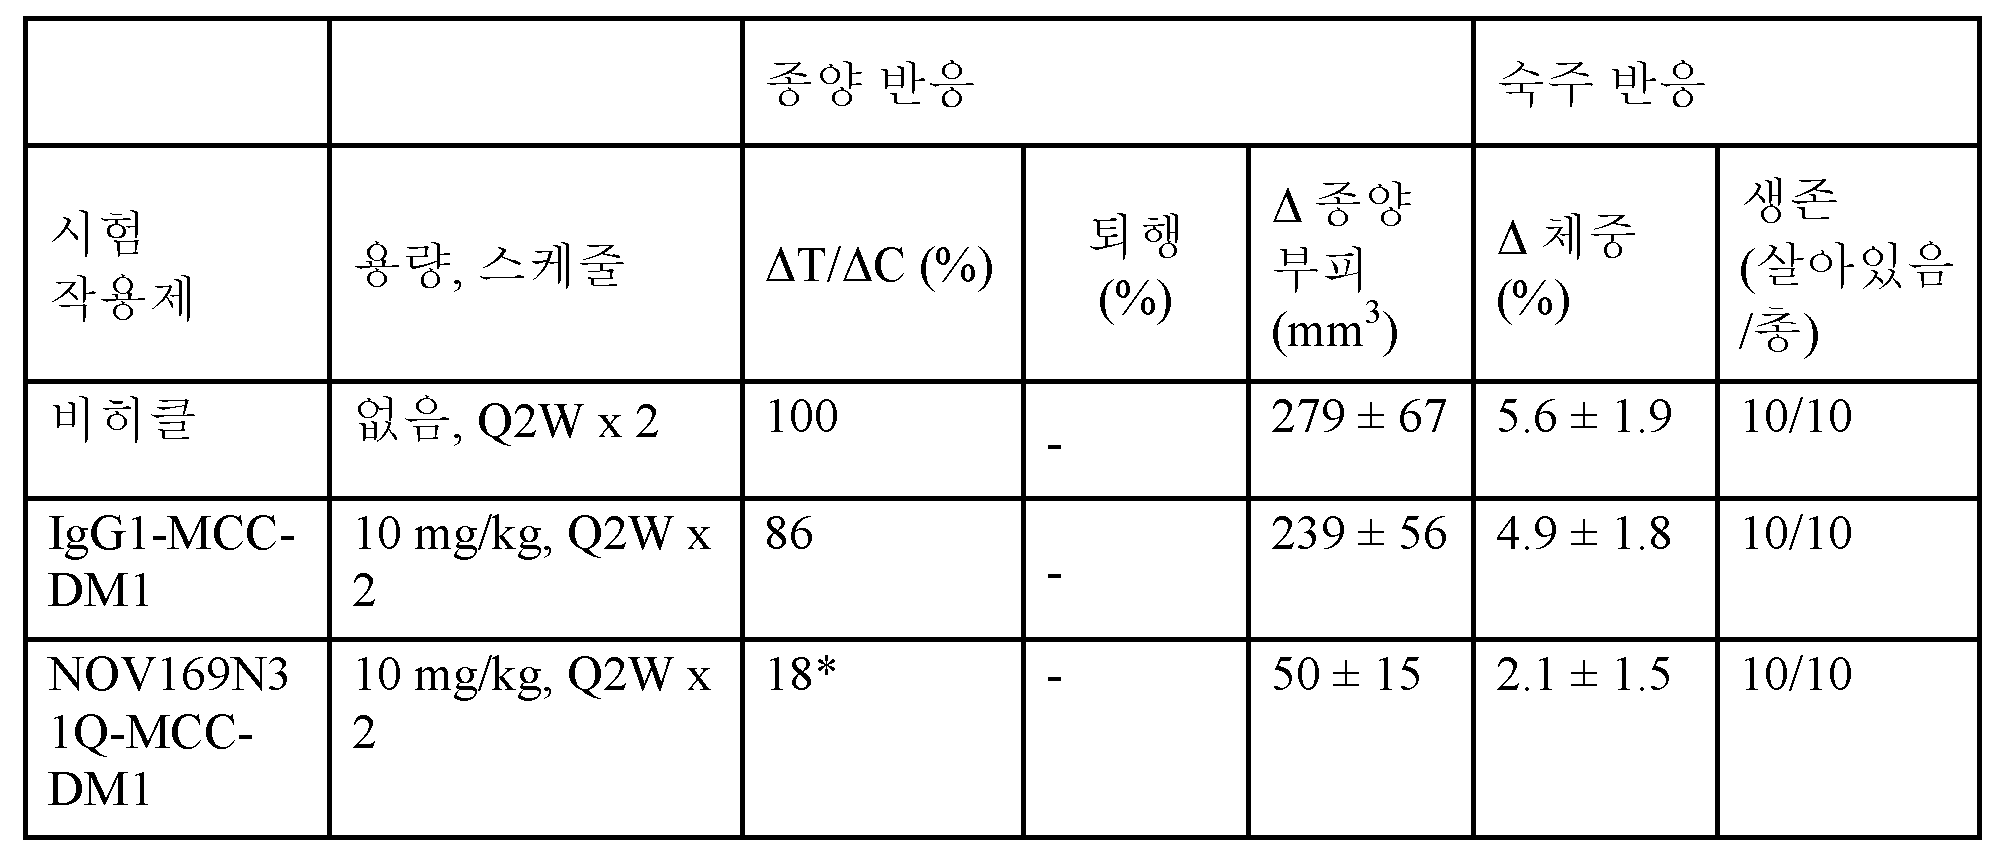
실시예 16: 마우스에서 휴프라임® ES2267 식도암 모델에 대한 NOV169N31Q-MCC-DM1의 생체내 효능
NOV169N31Q-MCC-DM1의 항종양 활성을 P-카드헤린 발현 ES2267 식도암 이종이식편 모델에서 평가하였다. 암컷 BALB/c 누드 마우스에서 각 마우스의 우측 측복부에 종양 단편을 피하로 이식하였다. 종양이 ~154 mm3에 도달하였을 때, 마우스를 처리군으로 무작위화하였다 (n= 5). 10 mg/kg으로 투여되는 NOV169N31Q-MCC-DM1 또는 인간화 비-특이적 이소형 대조군 3207-MCC-DM1을 무작위화 후 제0일 및 제13일에 IV 투여하였다. 용량을 개별 마우스 체중에 대해 조정하였다. IV 용량 부피는 10 ml/kg이었다.
10 mg/kg의 NOV169N31Q-MCC-DM1을 사용한 처리는 비히클과 비교하였을 때 제21일에 58% 평균 퇴행을 나타내는 항종양 효능을 유발하였다. 더욱이, 10 mg/kg의 비-특이적 이소형 대조군 IgG1-MCC-DM1을 사용한 처리 후에는 어떠한 유의한 항종양 효능도 관찰되지 않았다. 제21일에, 및 연구의 마지막 날 (제53일)에, 시험된 NOV169N31Q-MCC-DM1은 비히클 및 이소형 대조군 IgG1-MCC-DM1 처리군과 통계적으로 상의하였다 (P<0.05, ANOVA/홀름-시닥 방법, 제21일). 모든 시험 작용제는 잘 허용되었고, 마우스 P-카드헤린에 결합하지 않는 ADC에 대해 예상된 바와 같이, 임의의 처리군에서 어떠한 체중 감소도 관찰되지 않았다 (도 16 및 표 18).
표 18: 제21일에 휴프라임® ES2267 식도암 이종이식편 모델에서의 NOV169N31Q-MCC-DM1 효능 (투여 후 최대 종양 퇴행). 종양 부피 및 체중에 대한 처리의 효과는 평균 ± SEM으로 제시되어 있다. NOV169N31Q-MCC-DM1 종양이 처리 후 그의 최대 퇴행에 도달하였을 때, 처리 제21일에 실험을 평가하였다. *p = 0.014 대 비히클 (순위 기반 일원 ANOVA/홀름-시닥 방법).

실시예 17: HCC70 유방암 이종이식편 모델에서 2종의 링커 (MCC 및 CX1-1)를 사용하여 DM1에 접합된 NEG0067의 효능 비교
HCC70 유방암 이종이식편 모델을 사용하여, MCC 대 CX-1-1 링커를 사용하여 DM1에 접합된 항-P-카드헤린 항체 NEG0067의 항종양 효능을 비교하였다. 종양이 ~215 mm3에 도달하였을 때, 마우스를 종양 부피에 따라 처리군으로 무작위화하고 (n= 8/군), 비히클 또는 7 mg/kg의 ADC의 단일 IV 투여를 투여하였다. 용량을 개별 마우스 체중에 대해 조정하였다. IV 용량 부피는 8 ml/kg이었다.
NEG0067-CX1-1-DM1 군에서의 평균 종양 부피는 대조군 IgG1-CX1-1-DM1 군과 유의하게 상이하였고 (일원 ANOVA; 던 방법, p ≤ 0.05), 반면에 NEG0067-MCC-DM1은 IgG1-MCC-DM1과 통계적으로 상이하지 않았다. 그러나, huIgG1-MCC-DM1 처리군과 비교하여 IgG1-CX1-1-DM1 처리군에서 증가된 활성의 경향이 존재하였다 (도 17).
실시예 18: HCC70 유방암 이종이식편 모델에서 SPDB-DM4 링커-페이로드 (절단가능한 링커)를 사용하여 접합된 뮤린 하이브리도마-유래 항-P-카드헤린 ADC의 효능 평가
HCC70 유방암 이종이식편 모델을 사용하여 SBDB-DM4 링커-페이로드를 사용하는 3종의 뮤린 하이브리도마-유래 ADC의 항종양 효능을 비교하였다. 종양이 ~150mm3에 도달하였을 때, 마우스를 종양 부피에 따라 처리군으로 무작위화하고 (n= 10/군), 비히클 또는 5 mg/kg의 ADC의 단일 IV 투여를 투여하였다. 용량을 개별 마우스 체중에 대해 조정하였다.
단일 5 mg/kg 용량의 모든 3종의 SPDB-DM4 연결된 ADC는 지속적인 종양 퇴행을 유의하게 유도하였으며 (p ≤ 0.05), 이때 2P10-SPDB-DM4 처리군에서는 일부 종양 재성장이 있었다. 1G12-SPDB-DM4 또는 3D21-SPDB-DM4로 처리된 군에서 종양은 완전히 퇴행된 채로 남아있었다 (도 18).
실시예 19: ADC 제제
ADC NOV169N31Q-MCC-DM1의 임상 서비스 형태 (CSF)는 50 mg NOV169N31Q-MCC-DM1을 함유하는 바이알 내의 동결건조물이다. 5 mL 주사용수로 동결건조물을 재구성한 후에, 5.3의 pH에서 10 mg/mL NOV169N31Q-MCC-DM1, 20 mM L-히스티딘/L-히스티딘 히드로클로라이드 1수화물, 240 mM 수크로스 및 0.02 % 폴리소르베이트 20을 함유하는 용액이 수득된다.
후속 정맥내 투여를 위해, 수득된 용액은 통상적으로 담체 용액 내로 추가로 희석되어 즉시 사용가능한 주입용 ADC 용액이 될 것이다.
CSF를 위해, 10 mg/mL의 ADC 농도를 선택하였다. 등장성 제제를 생성하기 위해 240 mM의 수크로스 농도를 선택하여, 무정형 동결건조물 케이크 구조를 유지하고, 단백질 안정화를 제공하였다.
가장 안정한 제제를 선택하기 위한 중요한 안정성-지시 분석 방법은, 특히, 응집 수준을 결정하기 위한 크기 배제 크로마토그래피, 육안으로 보이지 않는 미립자 물질 시험, 유리 독소 결정 및 효력 시험을 포괄하였다. 사전-스크리닝 연구는 0.02%의 농도에서의 폴리소르베이트 20이 기계적 응력에 대해 충분한 안정화를 제공한다는 것을 제시하였다. 실시간 및 가속된 안정성 조건 (25℃ 및 40℃)에서의 액체 및 동결건조 안정성 연구는 5.0 내지 5.5의 pH-값에서의 히스티딘계 제제가 전체적인 최고 저장 안정성을 제공한다는 것을 입증하였다. 주목할만하게 이 범위에서 유리 독소의 응집과 방출 사이의 모든 시험된 제제의 균형이 충족될 수 있다. 25℃ 및 40℃에서의 2-개월 안정성 연구는 매우 낮은 수준의 응집 및 분해 산물을 입증하였다.
본원에 기재된 실시예 및 실시양태는 단지 예시적 목적을 위한 것이고, 그에 비추어 다양한 변형 또는 변화가 관련 기술분야의 통상의 기술자에게 시사될 것이며, 본 출원의 취지 및 범위 및 첨부된 청구범위의 범주 내에 포함되는 것으로 이해된다.
SEQUENCE LISTING
<110> NOVARTIS AG
<120> ANTIBODY DRUG CONJUGATES
<130> PAT056506-WO-PCT
<140>
<141>
<150> 62/079,942
<151> 2014-11-14
<160> 143
<170> PatentIn version 3.5
<210> 1
<211> 7
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 1
Ser Gln Ser Ala Ala Trp Asn
1 5
<210> 2
<211> 18
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 2
Arg Ile Tyr Tyr Arg Ser Lys Trp Tyr Asn Asp Tyr Ala Leu Ser Val
1 5 10 15
Lys Ser
<210> 3
<211> 11
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 3
Gly Glu Gly Tyr Gly Arg Glu Gly Phe Ala Ile
1 5 10
<210> 4
<211> 9
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 4
Gly Asp Ser Val Ser Ser Gln Ser Ala
1 5
<210> 5
<211> 7
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 5
Tyr Tyr Arg Ser Lys Trp Tyr
1 5
<210> 6
<211> 11
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 6
Gly Glu Gly Tyr Gly Arg Glu Gly Phe Ala Ile
1 5 10
<210> 7
<211> 123
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 7
Gln Val Gln Leu Gln Gln Ser Gly Pro Gly Leu Val Lys Pro Ser Gln
1 5 10 15
Thr Leu Ser Leu Thr Cys Ala Ile Ser Gly Asp Ser Val Ser Ser Gln
20 25 30
Ser Ala Ala Trp Asn Trp Ile Arg Gln Ser Pro Ser Arg Gly Leu Glu
35 40 45
Trp Leu Gly Arg Ile Tyr Tyr Arg Ser Lys Trp Tyr Asn Asp Tyr Ala
50 55 60
Leu Ser Val Lys Ser Arg Ile Thr Ile Asn Pro Asp Thr Ser Lys Asn
65 70 75 80
Gln Phe Ser Leu Gln Leu Asn Ser Val Thr Pro Glu Asp Thr Ala Val
85 90 95
Tyr Tyr Cys Ala Arg Gly Glu Gly Tyr Gly Arg Glu Gly Phe Ala Ile
100 105 110
Trp Gly Gln Gly Thr Leu Val Thr Val Ser Ser
115 120
<210> 8
<211> 369
<212> DNA
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polynucleotide"
<400> 8
caggtgcagc tgcagcagtc aggccctggc ctggtcaagc ctagtcagac cctgagcctg 60
acctgcgcta ttagcggcga tagtgtgtct agtcagtcag ccgcctggaa ctggattaga 120
cagtcaccct ctaggggcct ggagtggctg ggtagaatct actataggtc taagtggtat 180
aacgactacg ccctgagcgt gaagtctagg atcactatta accccgacac ctctaagaat 240
cagtttagcc tgcagctgaa tagcgtgacc cccgaggaca ccgccgtcta ctactgcgct 300
agaggcgagg gctacggtag agagggcttc gctatctggg gtcagggcac cctggtcacc 360
gtgtctagc 369
<210> 9
<211> 453
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 9
Gln Val Gln Leu Gln Gln Ser Gly Pro Gly Leu Val Lys Pro Ser Gln
1 5 10 15
Thr Leu Ser Leu Thr Cys Ala Ile Ser Gly Asp Ser Val Ser Ser Gln
20 25 30
Ser Ala Ala Trp Asn Trp Ile Arg Gln Ser Pro Ser Arg Gly Leu Glu
35 40 45
Trp Leu Gly Arg Ile Tyr Tyr Arg Ser Lys Trp Tyr Asn Asp Tyr Ala
50 55 60
Leu Ser Val Lys Ser Arg Ile Thr Ile Asn Pro Asp Thr Ser Lys Asn
65 70 75 80
Gln Phe Ser Leu Gln Leu Asn Ser Val Thr Pro Glu Asp Thr Ala Val
85 90 95
Tyr Tyr Cys Ala Arg Gly Glu Gly Tyr Gly Arg Glu Gly Phe Ala Ile
100 105 110
Trp Gly Gln Gly Thr Leu Val Thr Val Ser Ser Ala Ser Thr Lys Gly
115 120 125
Pro Ser Val Phe Pro Leu Ala Pro Ser Ser Lys Ser Thr Ser Gly Gly
130 135 140
Thr Ala Ala Leu Gly Cys Leu Val Lys Asp Tyr Phe Pro Glu Pro Val
145 150 155 160
Thr Val Ser Trp Asn Ser Gly Ala Leu Thr Ser Gly Val His Thr Phe
165 170 175
Pro Ala Val Leu Gln Ser Ser Gly Leu Tyr Ser Leu Ser Ser Val Val
180 185 190
Thr Val Pro Ser Ser Ser Leu Gly Thr Gln Thr Tyr Ile Cys Asn Val
195 200 205
Asn His Lys Pro Ser Asn Thr Lys Val Asp Lys Arg Val Glu Pro Lys
210 215 220
Ser Cys Asp Lys Thr His Thr Cys Pro Pro Cys Pro Ala Pro Glu Leu
225 230 235 240
Leu Gly Gly Pro Ser Val Phe Leu Phe Pro Pro Lys Pro Lys Asp Thr
245 250 255
Leu Met Ile Ser Arg Thr Pro Glu Val Thr Cys Val Val Val Asp Val
260 265 270
Ser His Glu Asp Pro Glu Val Lys Phe Asn Trp Tyr Val Asp Gly Val
275 280 285
Glu Val His Asn Ala Lys Thr Lys Pro Arg Glu Glu Gln Tyr Asn Ser
290 295 300
Thr Tyr Arg Val Val Ser Val Leu Thr Val Leu His Gln Asp Trp Leu
305 310 315 320
Asn Gly Lys Glu Tyr Lys Cys Lys Val Ser Asn Lys Ala Leu Pro Ala
325 330 335
Pro Ile Glu Lys Thr Ile Ser Lys Ala Lys Gly Gln Pro Arg Glu Pro
340 345 350
Gln Val Tyr Thr Leu Pro Pro Ser Arg Glu Glu Met Thr Lys Asn Gln
355 360 365
Val Ser Leu Thr Cys Leu Val Lys Gly Phe Tyr Pro Ser Asp Ile Ala
370 375 380
Val Glu Trp Glu Ser Asn Gly Gln Pro Glu Asn Asn Tyr Lys Thr Thr
385 390 395 400
Pro Pro Val Leu Asp Ser Asp Gly Ser Phe Phe Leu Tyr Ser Lys Leu
405 410 415
Thr Val Asp Lys Ser Arg Trp Gln Gln Gly Asn Val Phe Ser Cys Ser
420 425 430
Val Met His Glu Ala Leu His Asn His Tyr Thr Gln Lys Ser Leu Ser
435 440 445
Leu Ser Pro Gly Lys
450
<210> 10
<211> 1359
<212> DNA
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polynucleotide"
<400> 10
caggtgcagc tgcagcagtc aggccctggc ctggtcaagc ctagtcagac cctgagcctg 60
acctgcgcta ttagcggcga tagtgtgtct agtcagtcag ccgcctggaa ctggattaga 120
cagtcaccct ctaggggcct ggagtggctg ggtagaatct actataggtc taagtggtat 180
aacgactacg ccctgagcgt gaagtctagg atcactatta accccgacac ctctaagaat 240
cagtttagcc tgcagctgaa tagcgtgacc cccgaggaca ccgccgtcta ctactgcgct 300
agaggcgagg gctacggtag agagggcttc gctatctggg gtcagggcac cctggtcacc 360
gtgtctagcg ctagcactaa gggcccaagt gtgtttcccc tggcccccag cagcaagtct 420
acttccggcg gaactgctgc cctgggttgc ctggtgaagg actacttccc cgagcccgtg 480
acagtgtcct ggaactctgg ggctctgact tccggcgtgc acaccttccc cgccgtgctg 540
cagagcagcg gcctgtacag cctgagcagc gtggtgacag tgccctccag ctctctggga 600
acccagacct atatctgcaa cgtgaaccac aagcccagca acaccaaggt ggacaagaga 660
gtggagccca agagctgcga caagacccac acctgccccc cctgcccagc tccagaactg 720
ctgggagggc cttccgtgtt cctgttcccc cccaagccca aggacaccct gatgatcagc 780
aggacccccg aggtgacctg cgtggtggtg gacgtgtccc acgaggaccc agaggtgaag 840
ttcaactggt acgtggacgg cgtggaggtg cacaacgcca agaccaagcc cagagaggag 900
cagtacaaca gcacctacag ggtggtgtcc gtgctgaccg tgctgcacca ggactggctg 960
aacggcaaag aatacaagtg caaagtctcc aacaaggccc tgccagcccc aatcgaaaag 1020
acaatcagca aggccaaggg ccagccacgg gagccccagg tgtacaccct gccccccagc 1080
cgggaggaga tgaccaagaa ccaggtgtcc ctgacctgtc tggtgaaggg cttctacccc 1140
agcgatatcg ccgtggagtg ggagagcaac ggccagcccg agaacaacta caagaccacc 1200
cccccagtgc tggacagcga cggcagcttc ttcctgtaca gcaagctgac cgtggacaag 1260
tccaggtggc agcagggcaa cgtgttcagc tgcagcgtga tgcacgaggc cctgcacaac 1320
cactacaccc agaagtccct gagcctgagc cccggcaag 1359
<210> 11
<211> 11
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 11
Arg Ala Ser Gln Thr Ile Ser Asn Thr Leu Ala
1 5 10
<210> 12
<211> 7
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 12
Ala Ala Ser Asn Leu Gln Ser
1 5
<210> 13
<211> 8
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 13
Gln Gln Tyr Leu Ser Trp Phe Thr
1 5
<210> 14
<211> 7
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 14
Ser Gln Thr Ile Ser Asn Thr
1 5
<210> 15
<211> 3
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 15
Ala Ala Ser
1
<210> 16
<211> 5
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 16
Tyr Leu Ser Trp Phe
1 5
<210> 17
<211> 106
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 17
Asp Ile Gln Met Thr Gln Ser Pro Ser Ser Leu Ser Ala Ser Val Gly
1 5 10 15
Asp Arg Val Thr Ile Thr Cys Arg Ala Ser Gln Thr Ile Ser Asn Thr
20 25 30
Leu Ala Trp Tyr Gln Gln Lys Pro Gly Lys Ala Pro Lys Leu Leu Ile
35 40 45
Tyr Ala Ala Ser Asn Leu Gln Ser Gly Val Pro Ser Arg Phe Ser Gly
50 55 60
Ser Gly Ser Gly Thr Asp Phe Thr Leu Thr Ile Ser Ser Leu Gln Pro
65 70 75 80
Glu Asp Phe Ala Thr Tyr Tyr Cys Gln Gln Tyr Leu Ser Trp Phe Thr
85 90 95
Phe Gly Gln Gly Thr Lys Val Glu Ile Lys
100 105
<210> 18
<211> 318
<212> DNA
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polynucleotide"
<400> 18
gatattcaga tgactcagtc acctagtagc ctgagcgcta gtgtgggcga tagagtgact 60
atcacctgta gagcctctca gactatctct aacaccctgg cctggtatca gcagaagccc 120
ggtaaagccc ctaagctgct gatctacgcc gcctctaacc tgcagtcagg cgtgccctct 180
aggtttagcg gtagcggtag tggcaccgac ttcaccctga ctattagtag cctgcagccc 240
gaggacttcg ctacctacta ctgtcagcag tacctgagct ggttcacctt cggtcagggc 300
actaaggtcg agattaag 318
<210> 19
<211> 213
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 19
Asp Ile Gln Met Thr Gln Ser Pro Ser Ser Leu Ser Ala Ser Val Gly
1 5 10 15
Asp Arg Val Thr Ile Thr Cys Arg Ala Ser Gln Thr Ile Ser Asn Thr
20 25 30
Leu Ala Trp Tyr Gln Gln Lys Pro Gly Lys Ala Pro Lys Leu Leu Ile
35 40 45
Tyr Ala Ala Ser Asn Leu Gln Ser Gly Val Pro Ser Arg Phe Ser Gly
50 55 60
Ser Gly Ser Gly Thr Asp Phe Thr Leu Thr Ile Ser Ser Leu Gln Pro
65 70 75 80
Glu Asp Phe Ala Thr Tyr Tyr Cys Gln Gln Tyr Leu Ser Trp Phe Thr
85 90 95
Phe Gly Gln Gly Thr Lys Val Glu Ile Lys Arg Thr Val Ala Ala Pro
100 105 110
Ser Val Phe Ile Phe Pro Pro Ser Asp Glu Gln Leu Lys Ser Gly Thr
115 120 125
Ala Ser Val Val Cys Leu Leu Asn Asn Phe Tyr Pro Arg Glu Ala Lys
130 135 140
Val Gln Trp Lys Val Asp Asn Ala Leu Gln Ser Gly Asn Ser Gln Glu
145 150 155 160
Ser Val Thr Glu Gln Asp Ser Lys Asp Ser Thr Tyr Ser Leu Ser Ser
165 170 175
Thr Leu Thr Leu Ser Lys Ala Asp Tyr Glu Lys His Lys Val Tyr Ala
180 185 190
Cys Glu Val Thr His Gln Gly Leu Ser Ser Pro Val Thr Lys Ser Phe
195 200 205
Asn Arg Gly Glu Cys
210
<210> 20
<211> 639
<212> DNA
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polynucleotide"
<400> 20
gatattcaga tgactcagtc acctagtagc ctgagcgcta gtgtgggcga tagagtgact 60
atcacctgta gagcctctca gactatctct aacaccctgg cctggtatca gcagaagccc 120
ggtaaagccc ctaagctgct gatctacgcc gcctctaacc tgcagtcagg cgtgccctct 180
aggtttagcg gtagcggtag tggcaccgac ttcaccctga ctattagtag cctgcagccc 240
gaggacttcg ctacctacta ctgtcagcag tacctgagct ggttcacctt cggtcagggc 300
actaaggtcg agattaagcg tacggtggcc gctcccagcg tgttcatctt cccccccagc 360
gacgagcagc tgaagagcgg caccgccagc gtggtgtgcc tgctgaacaa cttctacccc 420
cgggaggcca aggtgcagtg gaaggtggac aacgccctgc agagcggcaa cagccaggag 480
agcgtcaccg agcaggacag caaggactcc acctacagcc tgagcagcac cctgaccctg 540
agcaaggccg actacgagaa gcataaggtg tacgcctgcg aggtgaccca ccagggcctg 600
tccagccccg tgaccaagag cttcaacagg ggcgagtgc 639
<210> 21
<211> 5
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 21
Asp His Thr Ile His
1 5
<210> 22
<211> 17
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 22
Tyr Ile Tyr Pro Arg Ser Gly Ser Ile Asn Tyr Asn Glu Lys Phe Lys
1 5 10 15
Gly
<210> 23
<211> 9
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 23
Arg Asn Leu Phe Leu Pro Met Glu Tyr
1 5
<210> 24
<211> 7
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 24
Gly Tyr Thr Phe Thr Asp His
1 5
<210> 25
<211> 6
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 25
Tyr Pro Arg Ser Gly Ser
1 5
<210> 26
<211> 9
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 26
Arg Asn Leu Phe Leu Pro Met Glu Tyr
1 5
<210> 27
<211> 118
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 27
Glu Val Gln Leu Val Gln Ser Gly Ala Glu Val Lys Lys Pro Gly Glu
1 5 10 15
Ser Leu Lys Ile Ser Cys Lys Val Ser Gly Tyr Thr Phe Thr Asp His
20 25 30
Thr Ile His Trp Met Arg Gln Met Pro Gly Lys Gly Leu Glu Trp Met
35 40 45
Gly Tyr Ile Tyr Pro Arg Ser Gly Ser Ile Asn Tyr Asn Glu Lys Phe
50 55 60
Lys Gly Gln Val Thr Ile Ser Ala Asp Lys Ser Ser Ser Thr Ala Tyr
65 70 75 80
Leu Gln Trp Ser Ser Leu Lys Ala Ser Asp Thr Ala Met Tyr Tyr Cys
85 90 95
Ala Arg Arg Asn Leu Phe Leu Pro Met Glu Tyr Trp Gly Gln Gly Thr
100 105 110
Leu Val Thr Val Ser Ser
115
<210> 28
<211> 354
<212> DNA
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polynucleotide"
<400> 28
gaggtgcagc tggtgcagtc aggcgccgaa gtgaagaagc ccggcgagtc actgaagatt 60
agctgtaaag tctcaggcta caccttcacc gatcacacta ttcactggat gagacagatg 120
cccggtaaag gcctggagtg gatgggctat atctacccta gatcaggctc tattaactat 180
aacgagaagt ttaagggtca ggtcacaatt agcgccgata agtctagctc taccgcctac 240
ctgcagtggt ctagcctgaa ggctagtgac accgctatgt actactgcgc tagacgtaac 300
ctgttcctgc ctatggaata ctggggtcag ggcaccctgg tcaccgtgtc tagc 354
<210> 29
<211> 448
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 29
Glu Val Gln Leu Val Gln Ser Gly Ala Glu Val Lys Lys Pro Gly Glu
1 5 10 15
Ser Leu Lys Ile Ser Cys Lys Val Ser Gly Tyr Thr Phe Thr Asp His
20 25 30
Thr Ile His Trp Met Arg Gln Met Pro Gly Lys Gly Leu Glu Trp Met
35 40 45
Gly Tyr Ile Tyr Pro Arg Ser Gly Ser Ile Asn Tyr Asn Glu Lys Phe
50 55 60
Lys Gly Gln Val Thr Ile Ser Ala Asp Lys Ser Ser Ser Thr Ala Tyr
65 70 75 80
Leu Gln Trp Ser Ser Leu Lys Ala Ser Asp Thr Ala Met Tyr Tyr Cys
85 90 95
Ala Arg Arg Asn Leu Phe Leu Pro Met Glu Tyr Trp Gly Gln Gly Thr
100 105 110
Leu Val Thr Val Ser Ser Ala Ser Thr Lys Gly Pro Ser Val Phe Pro
115 120 125
Leu Ala Pro Ser Ser Lys Ser Thr Ser Gly Gly Thr Ala Ala Leu Gly
130 135 140
Cys Leu Val Lys Asp Tyr Phe Pro Glu Pro Val Thr Val Ser Trp Asn
145 150 155 160
Ser Gly Ala Leu Thr Ser Gly Val His Thr Phe Pro Ala Val Leu Gln
165 170 175
Ser Ser Gly Leu Tyr Ser Leu Ser Ser Val Val Thr Val Pro Ser Ser
180 185 190
Ser Leu Gly Thr Gln Thr Tyr Ile Cys Asn Val Asn His Lys Pro Ser
195 200 205
Asn Thr Lys Val Asp Lys Arg Val Glu Pro Lys Ser Cys Asp Lys Thr
210 215 220
His Thr Cys Pro Pro Cys Pro Ala Pro Glu Leu Leu Gly Gly Pro Ser
225 230 235 240
Val Phe Leu Phe Pro Pro Lys Pro Lys Asp Thr Leu Met Ile Ser Arg
245 250 255
Thr Pro Glu Val Thr Cys Val Val Val Asp Val Ser His Glu Asp Pro
260 265 270
Glu Val Lys Phe Asn Trp Tyr Val Asp Gly Val Glu Val His Asn Ala
275 280 285
Lys Thr Lys Pro Arg Glu Glu Gln Tyr Asn Ser Thr Tyr Arg Val Val
290 295 300
Ser Val Leu Thr Val Leu His Gln Asp Trp Leu Asn Gly Lys Glu Tyr
305 310 315 320
Lys Cys Lys Val Ser Asn Lys Ala Leu Pro Ala Pro Ile Glu Lys Thr
325 330 335
Ile Ser Lys Ala Lys Gly Gln Pro Arg Glu Pro Gln Val Tyr Thr Leu
340 345 350
Pro Pro Ser Arg Glu Glu Met Thr Lys Asn Gln Val Ser Leu Thr Cys
355 360 365
Leu Val Lys Gly Phe Tyr Pro Ser Asp Ile Ala Val Glu Trp Glu Ser
370 375 380
Asn Gly Gln Pro Glu Asn Asn Tyr Lys Thr Thr Pro Pro Val Leu Asp
385 390 395 400
Ser Asp Gly Ser Phe Phe Leu Tyr Ser Lys Leu Thr Val Asp Lys Ser
405 410 415
Arg Trp Gln Gln Gly Asn Val Phe Ser Cys Ser Val Met His Glu Ala
420 425 430
Leu His Asn His Tyr Thr Gln Lys Ser Leu Ser Leu Ser Pro Gly Lys
435 440 445
<210> 30
<211> 1344
<212> DNA
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polynucleotide"
<400> 30
gaggtgcagc tggtgcagtc aggcgccgaa gtgaagaagc ccggcgagtc actgaagatt 60
agctgtaaag tctcaggcta caccttcacc gatcacacta ttcactggat gagacagatg 120
cccggtaaag gcctggagtg gatgggctat atctacccta gatcaggctc tattaactat 180
aacgagaagt ttaagggtca ggtcacaatt agcgccgata agtctagctc taccgcctac 240
ctgcagtggt ctagcctgaa ggctagtgac accgctatgt actactgcgc tagacgtaac 300
ctgttcctgc ctatggaata ctggggtcag ggcaccctgg tcaccgtgtc tagcgctagc 360
actaagggcc caagtgtgtt tcccctggcc cccagcagca agtctacttc cggcggaact 420
gctgccctgg gttgcctggt gaaggactac ttccccgagc ccgtgacagt gtcctggaac 480
tctggggctc tgacttccgg cgtgcacacc ttccccgccg tgctgcagag cagcggcctg 540
tacagcctga gcagcgtggt gacagtgccc tccagctctc tgggaaccca gacctatatc 600
tgcaacgtga accacaagcc cagcaacacc aaggtggaca agagagtgga gcccaagagc 660
tgcgacaaga cccacacctg ccccccctgc ccagctccag aactgctggg agggccttcc 720
gtgttcctgt tcccccccaa gcccaaggac accctgatga tcagcaggac ccccgaggtg 780
acctgcgtgg tggtggacgt gtcccacgag gacccagagg tgaagttcaa ctggtacgtg 840
gacggcgtgg aggtgcacaa cgccaagacc aagcccagag aggagcagta caacagcacc 900
tacagggtgg tgtccgtgct gaccgtgctg caccaggact ggctgaacgg caaagaatac 960
aagtgcaaag tctccaacaa ggccctgcca gccccaatcg aaaagacaat cagcaaggcc 1020
aagggccagc cacgggagcc ccaggtgtac accctgcccc ccagccggga ggagatgacc 1080
aagaaccagg tgtccctgac ctgtctggtg aagggcttct accccagcga tatcgccgtg 1140
gagtgggaga gcaacggcca gcccgagaac aactacaaga ccaccccccc agtgctggac 1200
agcgacggca gcttcttcct gtacagcaag ctgaccgtgg acaagtccag gtggcagcag 1260
ggcaacgtgt tcagctgcag cgtgatgcac gaggccctgc acaaccacta cacccagaag 1320
tccctgagcc tgagccccgg caag 1344
<210> 31
<211> 17
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 31
Arg Ser Ser Gln Ser Leu Leu Ser Ser Gly Asp Gln Lys Asn Tyr Leu
1 5 10 15
Thr
<210> 32
<211> 7
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 32
Trp Ala Ser Thr Arg Glu Ser
1 5
<210> 33
<211> 9
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 33
Gln Asn Asp Tyr Arg Tyr Pro Leu Thr
1 5
<210> 34
<211> 13
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 34
Ser Gln Ser Leu Leu Ser Ser Gly Asp Gln Lys Asn Tyr
1 5 10
<210> 35
<211> 3
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 35
Trp Ala Ser
1
<210> 36
<211> 6
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 36
Asp Tyr Arg Tyr Pro Leu
1 5
<210> 37
<211> 113
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 37
Asp Ile Val Met Thr Gln Thr Pro Leu Ser Leu Pro Val Thr Pro Gly
1 5 10 15
Glu Pro Ala Ser Ile Ser Cys Arg Ser Ser Gln Ser Leu Leu Ser Ser
20 25 30
Gly Asp Gln Lys Asn Tyr Leu Thr Trp Tyr Leu Gln Lys Pro Gly Gln
35 40 45
Ser Pro Gln Leu Leu Ile Tyr Trp Ala Ser Thr Arg Glu Ser Gly Val
50 55 60
Pro Asp Arg Phe Ser Gly Ser Gly Ser Gly Thr Asp Phe Thr Leu Lys
65 70 75 80
Ile Ser Arg Val Glu Ala Glu Asp Val Gly Val Tyr Tyr Cys Gln Asn
85 90 95
Asp Tyr Arg Tyr Pro Leu Thr Phe Gly Gln Gly Thr Lys Leu Glu Ile
100 105 110
Lys
<210> 38
<211> 339
<212> DNA
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polynucleotide"
<400> 38
gatatcgtga tgactcagac ccccctgagc ctgcccgtga cccctggcga gcctgcctct 60
attagctgta gatctagtca gtcactgctg tctagcggcg atcagaagaa ctacctgacc 120
tggtatctgc agaagcccgg tcagtcacct cagctgctga tctactgggc ctctactaga 180
gaatcaggcg tgcccgatag gtttagcggt agcggtagtg gcaccgactt caccctgaag 240
atctctaggg tggaagccga ggacgtgggc gtctactact gtcagaacga ctatagatac 300
cccctgacct tcggtcaggg cactaagctg gagattaag 339
<210> 39
<211> 220
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 39
Asp Ile Val Met Thr Gln Thr Pro Leu Ser Leu Pro Val Thr Pro Gly
1 5 10 15
Glu Pro Ala Ser Ile Ser Cys Arg Ser Ser Gln Ser Leu Leu Ser Ser
20 25 30
Gly Asp Gln Lys Asn Tyr Leu Thr Trp Tyr Leu Gln Lys Pro Gly Gln
35 40 45
Ser Pro Gln Leu Leu Ile Tyr Trp Ala Ser Thr Arg Glu Ser Gly Val
50 55 60
Pro Asp Arg Phe Ser Gly Ser Gly Ser Gly Thr Asp Phe Thr Leu Lys
65 70 75 80
Ile Ser Arg Val Glu Ala Glu Asp Val Gly Val Tyr Tyr Cys Gln Asn
85 90 95
Asp Tyr Arg Tyr Pro Leu Thr Phe Gly Gln Gly Thr Lys Leu Glu Ile
100 105 110
Lys Arg Thr Val Ala Ala Pro Ser Val Phe Ile Phe Pro Pro Ser Asp
115 120 125
Glu Gln Leu Lys Ser Gly Thr Ala Ser Val Val Cys Leu Leu Asn Asn
130 135 140
Phe Tyr Pro Arg Glu Ala Lys Val Gln Trp Lys Val Asp Asn Ala Leu
145 150 155 160
Gln Ser Gly Asn Ser Gln Glu Ser Val Thr Glu Gln Asp Ser Lys Asp
165 170 175
Ser Thr Tyr Ser Leu Ser Ser Thr Leu Thr Leu Ser Lys Ala Asp Tyr
180 185 190
Glu Lys His Lys Val Tyr Ala Cys Glu Val Thr His Gln Gly Leu Ser
195 200 205
Ser Pro Val Thr Lys Ser Phe Asn Arg Gly Glu Cys
210 215 220
<210> 40
<211> 660
<212> DNA
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polynucleotide"
<400> 40
gatatcgtga tgactcagac ccccctgagc ctgcccgtga cccctggcga gcctgcctct 60
attagctgta gatctagtca gtcactgctg tctagcggcg atcagaagaa ctacctgacc 120
tggtatctgc agaagcccgg tcagtcacct cagctgctga tctactgggc ctctactaga 180
gaatcaggcg tgcccgatag gtttagcggt agcggtagtg gcaccgactt caccctgaag 240
atctctaggg tggaagccga ggacgtgggc gtctactact gtcagaacga ctatagatac 300
cccctgacct tcggtcaggg cactaagctg gagattaagc gtacggtggc cgctcccagc 360
gtgttcatct tcccccccag cgacgagcag ctgaagagcg gcaccgccag cgtggtgtgc 420
ctgctgaaca acttctaccc ccgggaggcc aaggtgcagt ggaaggtgga caacgccctg 480
cagagcggca acagccagga gagcgtcacc gagcaggaca gcaaggactc cacctacagc 540
ctgagcagca ccctgaccct gagcaaggcc gactacgaga agcataaggt gtacgcctgc 600
gaggtgaccc accagggcct gtccagcccc gtgaccaaga gcttcaacag gggcgagtgc 660
<210> 41
<211> 5
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 41
Asp His Thr Ile His
1 5
<210> 42
<211> 17
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 42
Tyr Ile Tyr Pro Arg Ser Gly Ser Ile Asn Tyr Asn Glu Lys Phe Lys
1 5 10 15
Gly
<210> 43
<211> 9
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 43
Arg Asn Leu Phe Leu Pro Met Glu Tyr
1 5
<210> 44
<211> 7
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 44
Gly Tyr Thr Phe Thr Asp His
1 5
<210> 45
<211> 6
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 45
Tyr Pro Arg Ser Gly Ser
1 5
<210> 46
<211> 9
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 46
Arg Asn Leu Phe Leu Pro Met Glu Tyr
1 5
<210> 47
<211> 118
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 47
Glu Val Gln Leu Val Gln Ser Gly Ala Glu Val Lys Lys Pro Gly Glu
1 5 10 15
Ser Leu Lys Ile Ser Cys Lys Val Ser Gly Tyr Thr Phe Thr Asp His
20 25 30
Thr Ile His Trp Met Arg Gln Met Pro Gly Lys Gly Leu Glu Trp Met
35 40 45
Gly Tyr Ile Tyr Pro Arg Ser Gly Ser Ile Asn Tyr Asn Glu Lys Phe
50 55 60
Lys Gly Gln Val Thr Ile Ser Ala Asp Lys Ser Ser Ser Thr Ala Tyr
65 70 75 80
Leu Gln Trp Ser Ser Leu Lys Ala Ser Asp Thr Ala Met Tyr Tyr Cys
85 90 95
Ala Arg Arg Asn Leu Phe Leu Pro Met Glu Tyr Trp Gly Gln Gly Thr
100 105 110
Leu Val Thr Val Ser Ser
115
<210> 48
<211> 354
<212> DNA
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polynucleotide"
<400> 48
gaggtgcagc tggtgcagtc aggcgccgaa gtgaagaagc ccggcgagtc actgaagatt 60
agctgtaaag tctcaggcta caccttcacc gatcacacta ttcactggat gagacagatg 120
cccggtaaag gcctggagtg gatgggctat atctacccta gatcaggctc tattaactat 180
aacgagaagt ttaagggtca ggtcacaatt agcgccgata agtctagctc taccgcctac 240
ctgcagtggt ctagcctgaa ggctagtgac accgctatgt actactgcgc tagacgtaac 300
ctgttcctgc ctatggaata ctggggtcag ggcaccctgg tcaccgtgtc tagc 354
<210> 49
<211> 448
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 49
Glu Val Gln Leu Val Gln Ser Gly Ala Glu Val Lys Lys Pro Gly Glu
1 5 10 15
Ser Leu Lys Ile Ser Cys Lys Val Ser Gly Tyr Thr Phe Thr Asp His
20 25 30
Thr Ile His Trp Met Arg Gln Met Pro Gly Lys Gly Leu Glu Trp Met
35 40 45
Gly Tyr Ile Tyr Pro Arg Ser Gly Ser Ile Asn Tyr Asn Glu Lys Phe
50 55 60
Lys Gly Gln Val Thr Ile Ser Ala Asp Lys Ser Ser Ser Thr Ala Tyr
65 70 75 80
Leu Gln Trp Ser Ser Leu Lys Ala Ser Asp Thr Ala Met Tyr Tyr Cys
85 90 95
Ala Arg Arg Asn Leu Phe Leu Pro Met Glu Tyr Trp Gly Gln Gly Thr
100 105 110
Leu Val Thr Val Ser Ser Ala Ser Thr Lys Gly Pro Ser Val Phe Pro
115 120 125
Leu Ala Pro Ser Ser Lys Ser Thr Ser Gly Gly Thr Ala Ala Leu Gly
130 135 140
Cys Leu Val Lys Asp Tyr Phe Pro Glu Pro Val Thr Val Ser Trp Asn
145 150 155 160
Ser Gly Ala Leu Thr Ser Gly Val His Thr Phe Pro Ala Val Leu Gln
165 170 175
Ser Ser Gly Leu Tyr Ser Leu Ser Ser Val Val Thr Val Pro Ser Ser
180 185 190
Ser Leu Gly Thr Gln Thr Tyr Ile Cys Asn Val Asn His Lys Pro Ser
195 200 205
Asn Thr Lys Val Asp Lys Arg Val Glu Pro Lys Ser Cys Asp Lys Thr
210 215 220
His Thr Cys Pro Pro Cys Pro Ala Pro Glu Leu Leu Gly Gly Pro Ser
225 230 235 240
Val Phe Leu Phe Pro Pro Lys Pro Lys Asp Thr Leu Met Ile Ser Arg
245 250 255
Thr Pro Glu Val Thr Cys Val Val Val Asp Val Ser His Glu Asp Pro
260 265 270
Glu Val Lys Phe Asn Trp Tyr Val Asp Gly Val Glu Val His Asn Ala
275 280 285
Lys Thr Lys Pro Arg Glu Glu Gln Tyr Asn Ser Thr Tyr Arg Val Val
290 295 300
Ser Val Leu Thr Val Leu His Gln Asp Trp Leu Asn Gly Lys Glu Tyr
305 310 315 320
Lys Cys Lys Val Ser Asn Lys Ala Leu Pro Ala Pro Ile Glu Lys Thr
325 330 335
Ile Ser Lys Ala Lys Gly Gln Pro Arg Glu Pro Gln Val Tyr Thr Leu
340 345 350
Pro Pro Ser Arg Glu Glu Met Thr Lys Asn Gln Val Ser Leu Thr Cys
355 360 365
Leu Val Lys Gly Phe Tyr Pro Ser Asp Ile Ala Val Glu Trp Glu Ser
370 375 380
Asn Gly Gln Pro Glu Asn Asn Tyr Lys Thr Thr Pro Pro Val Leu Asp
385 390 395 400
Ser Asp Gly Ser Phe Phe Leu Tyr Ser Lys Leu Thr Val Asp Lys Ser
405 410 415
Arg Trp Gln Gln Gly Asn Val Phe Ser Cys Ser Val Met His Glu Ala
420 425 430
Leu His Asn His Tyr Thr Gln Lys Ser Leu Ser Leu Ser Pro Gly Lys
435 440 445
<210> 50
<211> 1344
<212> DNA
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polynucleotide"
<400> 50
gaggtgcagc tggtgcagtc aggcgccgaa gtgaagaagc ccggcgagtc actgaagatt 60
agctgtaaag tctcaggcta caccttcacc gatcacacta ttcactggat gagacagatg 120
cccggtaaag gcctggagtg gatgggctat atctacccta gatcaggctc tattaactat 180
aacgagaagt ttaagggtca ggtcacaatt agcgccgata agtctagctc taccgcctac 240
ctgcagtggt ctagcctgaa ggctagtgac accgctatgt actactgcgc tagacgtaac 300
ctgttcctgc ctatggaata ctggggtcag ggcaccctgg tcaccgtgtc tagcgctagc 360
actaagggcc caagtgtgtt tcccctggcc cccagcagca agtctacttc cggcggaact 420
gctgccctgg gttgcctggt gaaggactac ttccccgagc ccgtgacagt gtcctggaac 480
tctggggctc tgacttccgg cgtgcacacc ttccccgccg tgctgcagag cagcggcctg 540
tacagcctga gcagcgtggt gacagtgccc tccagctctc tgggaaccca gacctatatc 600
tgcaacgtga accacaagcc cagcaacacc aaggtggaca agagagtgga gcccaagagc 660
tgcgacaaga cccacacctg ccccccctgc ccagctccag aactgctggg agggccttcc 720
gtgttcctgt tcccccccaa gcccaaggac accctgatga tcagcaggac ccccgaggtg 780
acctgcgtgg tggtggacgt gtcccacgag gacccagagg tgaagttcaa ctggtacgtg 840
gacggcgtgg aggtgcacaa cgccaagacc aagcccagag aggagcagta caacagcacc 900
tacagggtgg tgtccgtgct gaccgtgctg caccaggact ggctgaacgg caaagaatac 960
aagtgcaaag tctccaacaa ggccctgcca gccccaatcg aaaagacaat cagcaaggcc 1020
aagggccagc cacgggagcc ccaggtgtac accctgcccc ccagccggga ggagatgacc 1080
aagaaccagg tgtccctgac ctgtctggtg aagggcttct accccagcga tatcgccgtg 1140
gagtgggaga gcaacggcca gcccgagaac aactacaaga ccaccccccc agtgctggac 1200
agcgacggca gcttcttcct gtacagcaag ctgaccgtgg acaagtccag gtggcagcag 1260
ggcaacgtgt tcagctgcag cgtgatgcac gaggccctgc acaaccacta cacccagaag 1320
tccctgagcc tgagccccgg caag 1344
<210> 51
<211> 17
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 51
Arg Ser Ser Gln Ser Leu Leu Ser Ser Gly Asn Gln Lys Asn Tyr Leu
1 5 10 15
Thr
<210> 52
<211> 7
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 52
Trp Ala Ser Thr Arg Glu Ser
1 5
<210> 53
<211> 9
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 53
Gln Asn Asp Tyr Ser Tyr Pro Leu Thr
1 5
<210> 54
<211> 13
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 54
Ser Gln Ser Leu Leu Ser Ser Gly Asn Gln Lys Asn Tyr
1 5 10
<210> 55
<211> 3
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 55
Trp Ala Ser
1
<210> 56
<211> 6
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 56
Asp Tyr Ser Tyr Pro Leu
1 5
<210> 57
<211> 113
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 57
Asp Ile Val Met Thr Gln Thr Pro Leu Ser Leu Pro Val Thr Pro Gly
1 5 10 15
Glu Pro Ala Ser Ile Ser Cys Arg Ser Ser Gln Ser Leu Leu Ser Ser
20 25 30
Gly Asn Gln Lys Asn Tyr Leu Thr Trp Tyr Leu Gln Lys Pro Gly Gln
35 40 45
Ser Pro Gln Leu Leu Ile Tyr Trp Ala Ser Thr Arg Glu Ser Gly Val
50 55 60
Pro Asp Arg Phe Ser Gly Ser Gly Ser Gly Thr Asp Phe Thr Leu Lys
65 70 75 80
Ile Ser Arg Val Glu Ala Glu Asp Val Gly Val Tyr Tyr Cys Gln Asn
85 90 95
Asp Tyr Ser Tyr Pro Leu Thr Phe Gly Gln Gly Thr Lys Leu Glu Ile
100 105 110
Lys
<210> 58
<211> 339
<212> DNA
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polynucleotide"
<400> 58
gatatcgtga tgactcagac ccccctgagc ctgcccgtga cccctggcga gcctgcctct 60
attagctgta gatctagtca gtcactgctg tctagcggta atcagaagaa ctacctgacc 120
tggtatctgc agaagcccgg tcagtcacct cagctgctga tctactgggc ctctactaga 180
gaatcaggcg tgcccgatag gtttagcggt agcggtagtg gcaccgactt caccctgaag 240
atctctaggg tggaagccga ggacgtgggc gtctactact gtcagaacga ctatagctac 300
cccctgacct tcggtcaggg cactaagctg gagattaag 339
<210> 59
<211> 220
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 59
Asp Ile Val Met Thr Gln Thr Pro Leu Ser Leu Pro Val Thr Pro Gly
1 5 10 15
Glu Pro Ala Ser Ile Ser Cys Arg Ser Ser Gln Ser Leu Leu Ser Ser
20 25 30
Gly Asn Gln Lys Asn Tyr Leu Thr Trp Tyr Leu Gln Lys Pro Gly Gln
35 40 45
Ser Pro Gln Leu Leu Ile Tyr Trp Ala Ser Thr Arg Glu Ser Gly Val
50 55 60
Pro Asp Arg Phe Ser Gly Ser Gly Ser Gly Thr Asp Phe Thr Leu Lys
65 70 75 80
Ile Ser Arg Val Glu Ala Glu Asp Val Gly Val Tyr Tyr Cys Gln Asn
85 90 95
Asp Tyr Ser Tyr Pro Leu Thr Phe Gly Gln Gly Thr Lys Leu Glu Ile
100 105 110
Lys Arg Thr Val Ala Ala Pro Ser Val Phe Ile Phe Pro Pro Ser Asp
115 120 125
Glu Gln Leu Lys Ser Gly Thr Ala Ser Val Val Cys Leu Leu Asn Asn
130 135 140
Phe Tyr Pro Arg Glu Ala Lys Val Gln Trp Lys Val Asp Asn Ala Leu
145 150 155 160
Gln Ser Gly Asn Ser Gln Glu Ser Val Thr Glu Gln Asp Ser Lys Asp
165 170 175
Ser Thr Tyr Ser Leu Ser Ser Thr Leu Thr Leu Ser Lys Ala Asp Tyr
180 185 190
Glu Lys His Lys Val Tyr Ala Cys Glu Val Thr His Gln Gly Leu Ser
195 200 205
Ser Pro Val Thr Lys Ser Phe Asn Arg Gly Glu Cys
210 215 220
<210> 60
<211> 660
<212> DNA
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polynucleotide"
<400> 60
gatatcgtga tgactcagac ccccctgagc ctgcccgtga cccctggcga gcctgcctct 60
attagctgta gatctagtca gtcactgctg tctagcggta atcagaagaa ctacctgacc 120
tggtatctgc agaagcccgg tcagtcacct cagctgctga tctactgggc ctctactaga 180
gaatcaggcg tgcccgatag gtttagcggt agcggtagtg gcaccgactt caccctgaag 240
atctctaggg tggaagccga ggacgtgggc gtctactact gtcagaacga ctatagctac 300
cccctgacct tcggtcaggg cactaagctg gagattaagc gtacggtggc cgctcccagc 360
gtgttcatct tcccccccag cgacgagcag ctgaagagcg gcaccgccag cgtggtgtgc 420
ctgctgaaca acttctaccc ccgggaggcc aaggtgcagt ggaaggtgga caacgccctg 480
cagagcggca acagccagga gagcgtcacc gagcaggaca gcaaggactc cacctacagc 540
ctgagcagca ccctgaccct gagcaaggcc gactacgaga agcataaggt gtacgcctgc 600
gaggtgaccc accagggcct gtccagcccc gtgaccaaga gcttcaacag gggcgagtgc 660
<210> 61
<211> 5
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 61
Asp His Thr Leu His
1 5
<210> 62
<211> 17
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 62
Tyr Ile Tyr Pro Arg Ser Gly Ser Thr Lys Tyr Asn Glu Asn Phe Arg
1 5 10 15
Gly
<210> 63
<211> 9
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 63
Arg Leu Leu Phe Leu Pro Leu Asp Tyr
1 5
<210> 64
<211> 7
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 64
Gly Tyr Thr Phe Thr Asp His
1 5
<210> 65
<211> 6
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 65
Tyr Pro Arg Ser Gly Ser
1 5
<210> 66
<211> 9
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 66
Arg Leu Leu Phe Leu Pro Leu Asp Tyr
1 5
<210> 67
<211> 118
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 67
Gln Ile Gln Leu Val Gln Ser Gly Ala Glu Val Lys Lys Pro Gly Ser
1 5 10 15
Ser Val Lys Val Ser Cys Lys Val Ser Gly Tyr Thr Phe Thr Asp His
20 25 30
Thr Leu His Trp Met Arg Gln Ala Pro Gly Gln Gly Leu Glu Trp Met
35 40 45
Gly Tyr Ile Tyr Pro Arg Ser Gly Ser Thr Lys Tyr Asn Glu Asn Phe
50 55 60
Arg Gly Arg Val Thr Ile Thr Ala Asp Thr Ser Ser Ser Thr Ala Tyr
65 70 75 80
Met Glu Leu Ser Ser Leu Arg Ser Glu Asp Thr Ala Val Tyr Tyr Cys
85 90 95
Ala Arg Arg Leu Leu Phe Leu Pro Leu Asp Tyr Trp Gly Gln Gly Thr
100 105 110
Leu Val Thr Val Ser Ser
115
<210> 68
<211> 354
<212> DNA
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polynucleotide"
<400> 68
cagattcagc tggtgcagtc aggcgccgaa gtgaagaaac ccggctctag cgtgaaagtc 60
agctgtaaag tctcaggcta caccttcacc gatcacaccc tgcactggat gagacaggcc 120
ccaggtcagg gcctggagtg gatgggctat atctacccta gatcaggctc tactaagtat 180
aacgagaact ttaggggtag agtgactatc accgccgaca ctagctctag caccgcctat 240
atggaactgt ctagcctgag atcagaggac accgccgtct actactgcgc tagacggctg 300
ctgttcctgc ccctggacta ctggggtcag ggcaccctgg tcaccgtgtc tagc 354
<210> 69
<211> 448
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 69
Gln Ile Gln Leu Val Gln Ser Gly Ala Glu Val Lys Lys Pro Gly Ser
1 5 10 15
Ser Val Lys Val Ser Cys Lys Val Ser Gly Tyr Thr Phe Thr Asp His
20 25 30
Thr Leu His Trp Met Arg Gln Ala Pro Gly Gln Gly Leu Glu Trp Met
35 40 45
Gly Tyr Ile Tyr Pro Arg Ser Gly Ser Thr Lys Tyr Asn Glu Asn Phe
50 55 60
Arg Gly Arg Val Thr Ile Thr Ala Asp Thr Ser Ser Ser Thr Ala Tyr
65 70 75 80
Met Glu Leu Ser Ser Leu Arg Ser Glu Asp Thr Ala Val Tyr Tyr Cys
85 90 95
Ala Arg Arg Leu Leu Phe Leu Pro Leu Asp Tyr Trp Gly Gln Gly Thr
100 105 110
Leu Val Thr Val Ser Ser Ala Ser Thr Lys Gly Pro Ser Val Phe Pro
115 120 125
Leu Ala Pro Ser Ser Lys Ser Thr Ser Gly Gly Thr Ala Ala Leu Gly
130 135 140
Cys Leu Val Lys Asp Tyr Phe Pro Glu Pro Val Thr Val Ser Trp Asn
145 150 155 160
Ser Gly Ala Leu Thr Ser Gly Val His Thr Phe Pro Ala Val Leu Gln
165 170 175
Ser Ser Gly Leu Tyr Ser Leu Ser Ser Val Val Thr Val Pro Ser Ser
180 185 190
Ser Leu Gly Thr Gln Thr Tyr Ile Cys Asn Val Asn His Lys Pro Ser
195 200 205
Asn Thr Lys Val Asp Lys Arg Val Glu Pro Lys Ser Cys Asp Lys Thr
210 215 220
His Thr Cys Pro Pro Cys Pro Ala Pro Glu Leu Leu Gly Gly Pro Ser
225 230 235 240
Val Phe Leu Phe Pro Pro Lys Pro Lys Asp Thr Leu Met Ile Ser Arg
245 250 255
Thr Pro Glu Val Thr Cys Val Val Val Asp Val Ser His Glu Asp Pro
260 265 270
Glu Val Lys Phe Asn Trp Tyr Val Asp Gly Val Glu Val His Asn Ala
275 280 285
Lys Thr Lys Pro Arg Glu Glu Gln Tyr Asn Ser Thr Tyr Arg Val Val
290 295 300
Ser Val Leu Thr Val Leu His Gln Asp Trp Leu Asn Gly Lys Glu Tyr
305 310 315 320
Lys Cys Lys Val Ser Asn Lys Ala Leu Pro Ala Pro Ile Glu Lys Thr
325 330 335
Ile Ser Lys Ala Lys Gly Gln Pro Arg Glu Pro Gln Val Tyr Thr Leu
340 345 350
Pro Pro Ser Arg Glu Glu Met Thr Lys Asn Gln Val Ser Leu Thr Cys
355 360 365
Leu Val Lys Gly Phe Tyr Pro Ser Asp Ile Ala Val Glu Trp Glu Ser
370 375 380
Asn Gly Gln Pro Glu Asn Asn Tyr Lys Thr Thr Pro Pro Val Leu Asp
385 390 395 400
Ser Asp Gly Ser Phe Phe Leu Tyr Ser Lys Leu Thr Val Asp Lys Ser
405 410 415
Arg Trp Gln Gln Gly Asn Val Phe Ser Cys Ser Val Met His Glu Ala
420 425 430
Leu His Asn His Tyr Thr Gln Lys Ser Leu Ser Leu Ser Pro Gly Lys
435 440 445
<210> 70
<211> 1344
<212> DNA
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polynucleotide"
<400> 70
cagattcagc tggtgcagtc aggcgccgaa gtgaagaaac ccggctctag cgtgaaagtc 60
agctgtaaag tctcaggcta caccttcacc gatcacaccc tgcactggat gagacaggcc 120
ccaggtcagg gcctggagtg gatgggctat atctacccta gatcaggctc tactaagtat 180
aacgagaact ttaggggtag agtgactatc accgccgaca ctagctctag caccgcctat 240
atggaactgt ctagcctgag atcagaggac accgccgtct actactgcgc tagacggctg 300
ctgttcctgc ccctggacta ctggggtcag ggcaccctgg tcaccgtgtc tagcgctagc 360
actaagggcc caagtgtgtt tcccctggcc cccagcagca agtctacttc cggcggaact 420
gctgccctgg gttgcctggt gaaggactac ttccccgagc ccgtgacagt gtcctggaac 480
tctggggctc tgacttccgg cgtgcacacc ttccccgccg tgctgcagag cagcggcctg 540
tacagcctga gcagcgtggt gacagtgccc tccagctctc tgggaaccca gacctatatc 600
tgcaacgtga accacaagcc cagcaacacc aaggtggaca agagagtgga gcccaagagc 660
tgcgacaaga cccacacctg ccccccctgc ccagctccag aactgctggg agggccttcc 720
gtgttcctgt tcccccccaa gcccaaggac accctgatga tcagcaggac ccccgaggtg 780
acctgcgtgg tggtggacgt gtcccacgag gacccagagg tgaagttcaa ctggtacgtg 840
gacggcgtgg aggtgcacaa cgccaagacc aagcccagag aggagcagta caacagcacc 900
tacagggtgg tgtccgtgct gaccgtgctg caccaggact ggctgaacgg caaagaatac 960
aagtgcaaag tctccaacaa ggccctgcca gccccaatcg aaaagacaat cagcaaggcc 1020
aagggccagc cacgggagcc ccaggtgtac accctgcccc ccagccggga ggagatgacc 1080
aagaaccagg tgtccctgac ctgtctggtg aagggcttct accccagcga tatcgccgtg 1140
gagtgggaga gcaacggcca gcccgagaac aactacaaga ccaccccccc agtgctggac 1200
agcgacggca gcttcttcct gtacagcaag ctgaccgtgg acaagtccag gtggcagcag 1260
ggcaacgtgt tcagctgcag cgtgatgcac gaggccctgc acaaccacta cacccagaag 1320
tccctgagcc tgagccccgg caag 1344
<210> 71
<211> 17
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 71
Arg Ser Ser Gln Ser Leu Leu Ser Ser Gly Asn Gln Lys Ser Tyr Leu
1 5 10 15
Thr
<210> 72
<211> 7
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 72
Trp Ala Ser Thr Arg Glu Ser
1 5
<210> 73
<211> 9
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 73
Gln Asn Asp Tyr Ser Tyr Pro Phe Thr
1 5
<210> 74
<211> 13
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 74
Ser Gln Ser Leu Leu Ser Ser Gly Asn Gln Lys Ser Tyr
1 5 10
<210> 75
<211> 3
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 75
Trp Ala Ser
1
<210> 76
<211> 6
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 76
Asp Tyr Ser Tyr Pro Phe
1 5
<210> 77
<211> 113
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 77
Glu Ile Val Met Thr Gln Ser Pro Ala Thr Leu Ser Leu Ser Pro Gly
1 5 10 15
Glu Arg Ala Thr Leu Ser Cys Arg Ser Ser Gln Ser Leu Leu Ser Ser
20 25 30
Gly Asn Gln Lys Ser Tyr Leu Thr Trp Tyr Gln Gln Lys Pro Gly Gln
35 40 45
Ala Pro Arg Leu Leu Ile Tyr Trp Ala Ser Thr Arg Glu Ser Gly Ile
50 55 60
Pro Ala Arg Phe Ser Gly Ser Gly Ser Gly Thr Asp Phe Thr Leu Thr
65 70 75 80
Ile Ser Ser Leu Gln Pro Glu Asp Phe Ala Val Tyr Tyr Cys Gln Asn
85 90 95
Asp Tyr Ser Tyr Pro Phe Thr Phe Gly Gln Gly Thr Lys Leu Glu Ile
100 105 110
Lys
<210> 78
<211> 339
<212> DNA
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polynucleotide"
<400> 78
gagatcgtga tgactcagtc acccgctacc ctgagcctga gccctggcga gagagctaca 60
ctgagctgta gatctagtca gtcactgctg tctagcggta atcagaagtc ctacctgacc 120
tggtatcagc agaagcccgg tcaggcccct agactgctga tctactgggc ctctactaga 180
gagtcaggga tccccgctag gtttagcggt agcggtagtg gcaccgactt caccctgact 240
atctctagcc tgcagcccga ggacttcgcc gtctactact gtcagaacga ctatagctac 300
cccttcacct tcggtcaggg cactaagctg gagattaag 339
<210> 79
<211> 220
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 79
Glu Ile Val Met Thr Gln Ser Pro Ala Thr Leu Ser Leu Ser Pro Gly
1 5 10 15
Glu Arg Ala Thr Leu Ser Cys Arg Ser Ser Gln Ser Leu Leu Ser Ser
20 25 30
Gly Asn Gln Lys Ser Tyr Leu Thr Trp Tyr Gln Gln Lys Pro Gly Gln
35 40 45
Ala Pro Arg Leu Leu Ile Tyr Trp Ala Ser Thr Arg Glu Ser Gly Ile
50 55 60
Pro Ala Arg Phe Ser Gly Ser Gly Ser Gly Thr Asp Phe Thr Leu Thr
65 70 75 80
Ile Ser Ser Leu Gln Pro Glu Asp Phe Ala Val Tyr Tyr Cys Gln Asn
85 90 95
Asp Tyr Ser Tyr Pro Phe Thr Phe Gly Gln Gly Thr Lys Leu Glu Ile
100 105 110
Lys Arg Thr Val Ala Ala Pro Ser Val Phe Ile Phe Pro Pro Ser Asp
115 120 125
Glu Gln Leu Lys Ser Gly Thr Ala Ser Val Val Cys Leu Leu Asn Asn
130 135 140
Phe Tyr Pro Arg Glu Ala Lys Val Gln Trp Lys Val Asp Asn Ala Leu
145 150 155 160
Gln Ser Gly Asn Ser Gln Glu Ser Val Thr Glu Gln Asp Ser Lys Asp
165 170 175
Ser Thr Tyr Ser Leu Ser Ser Thr Leu Thr Leu Ser Lys Ala Asp Tyr
180 185 190
Glu Lys His Lys Val Tyr Ala Cys Glu Val Thr His Gln Gly Leu Ser
195 200 205
Ser Pro Val Thr Lys Ser Phe Asn Arg Gly Glu Cys
210 215 220
<210> 80
<211> 660
<212> DNA
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polynucleotide"
<400> 80
gagatcgtga tgactcagtc acccgctacc ctgagcctga gccctggcga gagagctaca 60
ctgagctgta gatctagtca gtcactgctg tctagcggta atcagaagtc ctacctgacc 120
tggtatcagc agaagcccgg tcaggcccct agactgctga tctactgggc ctctactaga 180
gagtcaggga tccccgctag gtttagcggt agcggtagtg gcaccgactt caccctgact 240
atctctagcc tgcagcccga ggacttcgcc gtctactact gtcagaacga ctatagctac 300
cccttcacct tcggtcaggg cactaagctg gagattaagc gtacggtggc cgctcccagc 360
gtgttcatct tcccccccag cgacgagcag ctgaagagcg gcaccgccag cgtggtgtgc 420
ctgctgaaca acttctaccc ccgggaggcc aaggtgcagt ggaaggtgga caacgccctg 480
cagagcggca acagccagga gagcgtcacc gagcaggaca gcaaggactc cacctacagc 540
ctgagcagca ccctgaccct gagcaaggcc gactacgaga agcataaggt gtacgcctgc 600
gaggtgaccc accagggcct gtccagcccc gtgaccaaga gcttcaacag gggcgagtgc 660
<210> 81
<211> 5
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 81
Asp His Thr Leu His
1 5
<210> 82
<211> 17
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 82
Tyr Ile Tyr Pro Arg Ser Gly Ser Thr Lys Tyr Asn Glu Asn Phe Arg
1 5 10 15
Gly
<210> 83
<211> 9
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 83
Arg Leu Leu Phe Leu Pro Leu Asp Tyr
1 5
<210> 84
<211> 7
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 84
Gly Tyr Thr Phe Thr Asp His
1 5
<210> 85
<211> 6
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 85
Tyr Pro Arg Ser Gly Ser
1 5
<210> 86
<211> 9
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 86
Arg Leu Leu Phe Leu Pro Leu Asp Tyr
1 5
<210> 87
<211> 118
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 87
Gln Ile Gln Leu Val Gln Ser Gly Ala Glu Val Lys Lys Pro Gly Ser
1 5 10 15
Ser Val Lys Val Ser Cys Lys Val Ser Gly Tyr Thr Phe Thr Asp His
20 25 30
Thr Leu His Trp Met Arg Gln Ala Pro Gly Gln Gly Leu Glu Trp Met
35 40 45
Gly Tyr Ile Tyr Pro Arg Ser Gly Ser Thr Lys Tyr Asn Glu Asn Phe
50 55 60
Arg Gly Arg Val Thr Ile Thr Ala Asp Thr Ser Ser Ser Thr Ala Tyr
65 70 75 80
Met Glu Leu Ser Ser Leu Arg Ser Glu Asp Thr Ala Val Tyr Tyr Cys
85 90 95
Val Arg Arg Leu Leu Phe Leu Pro Leu Asp Tyr Trp Gly Gln Gly Thr
100 105 110
Leu Val Thr Val Ser Ser
115
<210> 88
<211> 354
<212> DNA
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polynucleotide"
<400> 88
cagattcagc tggtgcagtc aggcgccgaa gtgaagaaac ccggctctag cgtgaaagtc 60
agctgtaaag tctcaggcta caccttcacc gatcacaccc tgcactggat gagacaggcc 120
ccaggtcagg gcctggagtg gatgggctat atctacccta gatcaggctc tactaagtat 180
aacgagaact ttaggggtag agtgactatc accgccgaca ctagctctag caccgcctat 240
atggaactgt ctagcctgag atcagaggac accgccgtct actactgcgt cagacggctg 300
ctgttcctgc ccctggacta ctggggtcag ggcaccctgg tcaccgtgtc tagc 354
<210> 89
<211> 448
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 89
Gln Ile Gln Leu Val Gln Ser Gly Ala Glu Val Lys Lys Pro Gly Ser
1 5 10 15
Ser Val Lys Val Ser Cys Lys Val Ser Gly Tyr Thr Phe Thr Asp His
20 25 30
Thr Leu His Trp Met Arg Gln Ala Pro Gly Gln Gly Leu Glu Trp Met
35 40 45
Gly Tyr Ile Tyr Pro Arg Ser Gly Ser Thr Lys Tyr Asn Glu Asn Phe
50 55 60
Arg Gly Arg Val Thr Ile Thr Ala Asp Thr Ser Ser Ser Thr Ala Tyr
65 70 75 80
Met Glu Leu Ser Ser Leu Arg Ser Glu Asp Thr Ala Val Tyr Tyr Cys
85 90 95
Val Arg Arg Leu Leu Phe Leu Pro Leu Asp Tyr Trp Gly Gln Gly Thr
100 105 110
Leu Val Thr Val Ser Ser Ala Ser Thr Lys Gly Pro Ser Val Phe Pro
115 120 125
Leu Ala Pro Ser Ser Lys Ser Thr Ser Gly Gly Thr Ala Ala Leu Gly
130 135 140
Cys Leu Val Lys Asp Tyr Phe Pro Glu Pro Val Thr Val Ser Trp Asn
145 150 155 160
Ser Gly Ala Leu Thr Ser Gly Val His Thr Phe Pro Ala Val Leu Gln
165 170 175
Ser Ser Gly Leu Tyr Ser Leu Ser Ser Val Val Thr Val Pro Ser Ser
180 185 190
Ser Leu Gly Thr Gln Thr Tyr Ile Cys Asn Val Asn His Lys Pro Ser
195 200 205
Asn Thr Lys Val Asp Lys Arg Val Glu Pro Lys Ser Cys Asp Lys Thr
210 215 220
His Thr Cys Pro Pro Cys Pro Ala Pro Glu Leu Leu Gly Gly Pro Ser
225 230 235 240
Val Phe Leu Phe Pro Pro Lys Pro Lys Asp Thr Leu Met Ile Ser Arg
245 250 255
Thr Pro Glu Val Thr Cys Val Val Val Asp Val Ser His Glu Asp Pro
260 265 270
Glu Val Lys Phe Asn Trp Tyr Val Asp Gly Val Glu Val His Asn Ala
275 280 285
Lys Thr Lys Pro Arg Glu Glu Gln Tyr Asn Ser Thr Tyr Arg Val Val
290 295 300
Ser Val Leu Thr Val Leu His Gln Asp Trp Leu Asn Gly Lys Glu Tyr
305 310 315 320
Lys Cys Lys Val Ser Asn Lys Ala Leu Pro Ala Pro Ile Glu Lys Thr
325 330 335
Ile Ser Lys Ala Lys Gly Gln Pro Arg Glu Pro Gln Val Tyr Thr Leu
340 345 350
Pro Pro Ser Arg Glu Glu Met Thr Lys Asn Gln Val Ser Leu Thr Cys
355 360 365
Leu Val Lys Gly Phe Tyr Pro Ser Asp Ile Ala Val Glu Trp Glu Ser
370 375 380
Asn Gly Gln Pro Glu Asn Asn Tyr Lys Thr Thr Pro Pro Val Leu Asp
385 390 395 400
Ser Asp Gly Ser Phe Phe Leu Tyr Ser Lys Leu Thr Val Asp Lys Ser
405 410 415
Arg Trp Gln Gln Gly Asn Val Phe Ser Cys Ser Val Met His Glu Ala
420 425 430
Leu His Asn His Tyr Thr Gln Lys Ser Leu Ser Leu Ser Pro Gly Lys
435 440 445
<210> 90
<211> 1344
<212> DNA
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polynucleotide"
<400> 90
cagattcagc tggtgcagtc aggcgccgaa gtgaagaaac ccggctctag cgtgaaagtc 60
agctgtaaag tctcaggcta caccttcacc gatcacaccc tgcactggat gagacaggcc 120
ccaggtcagg gcctggagtg gatgggctat atctacccta gatcaggctc tactaagtat 180
aacgagaact ttaggggtag agtgactatc accgccgaca ctagctctag caccgcctat 240
atggaactgt ctagcctgag atcagaggac accgccgtct actactgcgt cagacggctg 300
ctgttcctgc ccctggacta ctggggtcag ggcaccctgg tcaccgtgtc tagcgctagc 360
actaagggcc caagtgtgtt tcccctggcc cccagcagca agtctacttc cggcggaact 420
gctgccctgg gttgcctggt gaaggactac ttccccgagc ccgtgacagt gtcctggaac 480
tctggggctc tgacttccgg cgtgcacacc ttccccgccg tgctgcagag cagcggcctg 540
tacagcctga gcagcgtggt gacagtgccc tccagctctc tgggaaccca gacctatatc 600
tgcaacgtga accacaagcc cagcaacacc aaggtggaca agagagtgga gcccaagagc 660
tgcgacaaga cccacacctg ccccccctgc ccagctccag aactgctggg agggccttcc 720
gtgttcctgt tcccccccaa gcccaaggac accctgatga tcagcaggac ccccgaggtg 780
acctgcgtgg tggtggacgt gtcccacgag gacccagagg tgaagttcaa ctggtacgtg 840
gacggcgtgg aggtgcacaa cgccaagacc aagcccagag aggagcagta caacagcacc 900
tacagggtgg tgtccgtgct gaccgtgctg caccaggact ggctgaacgg caaagaatac 960
aagtgcaaag tctccaacaa ggccctgcca gccccaatcg aaaagacaat cagcaaggcc 1020
aagggccagc cacgggagcc ccaggtgtac accctgcccc ccagccggga ggagatgacc 1080
aagaaccagg tgtccctgac ctgtctggtg aagggcttct accccagcga tatcgccgtg 1140
gagtgggaga gcaacggcca gcccgagaac aactacaaga ccaccccccc agtgctggac 1200
agcgacggca gcttcttcct gtacagcaag ctgaccgtgg acaagtccag gtggcagcag 1260
ggcaacgtgt tcagctgcag cgtgatgcac gaggccctgc acaaccacta cacccagaag 1320
tccctgagcc tgagccccgg caag 1344
<210> 91
<211> 17
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 91
Arg Ser Ser Gln Ser Leu Leu Ser Ser Gly Asn Gln Lys Ser Tyr Leu
1 5 10 15
Thr
<210> 92
<211> 7
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 92
Trp Ala Ser Thr Arg Glu Ser
1 5
<210> 93
<211> 9
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 93
Gln Asn Asp Tyr Ser Tyr Pro Phe Thr
1 5
<210> 94
<211> 13
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 94
Ser Gln Ser Leu Leu Ser Ser Gly Asn Gln Lys Ser Tyr
1 5 10
<210> 95
<211> 3
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 95
Trp Ala Ser
1
<210> 96
<211> 6
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 96
Asp Tyr Ser Tyr Pro Phe
1 5
<210> 97
<211> 113
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 97
Glu Ile Val Met Thr Gln Ser Pro Ala Thr Leu Ser Leu Ser Pro Gly
1 5 10 15
Glu Arg Ala Thr Leu Ser Cys Arg Ser Ser Gln Ser Leu Leu Ser Ser
20 25 30
Gly Asn Gln Lys Ser Tyr Leu Thr Trp Tyr Gln Gln Lys Pro Gly Gln
35 40 45
Ala Pro Arg Leu Leu Ile Tyr Trp Ala Ser Thr Arg Glu Ser Gly Ile
50 55 60
Pro Ala Arg Phe Ser Gly Ser Gly Ser Gly Thr Asp Phe Thr Leu Thr
65 70 75 80
Ile Ser Ser Leu Gln Pro Glu Asp Phe Ala Val Tyr Tyr Cys Gln Asn
85 90 95
Asp Tyr Ser Tyr Pro Phe Thr Phe Gly Gln Gly Thr Lys Leu Glu Ile
100 105 110
Lys
<210> 98
<211> 339
<212> DNA
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polynucleotide"
<400> 98
gagatcgtga tgactcagtc acccgctacc ctgagcctga gccctggcga gagagctaca 60
ctgagctgta gatctagtca gtcactgctg tctagcggta atcagaagtc ctacctgacc 120
tggtatcagc agaagcccgg tcaggcccct agactgctga tctactgggc ctctactaga 180
gagtcaggga tccccgctag gtttagcggt agcggtagtg gcaccgactt caccctgact 240
atctctagcc tgcagcccga ggacttcgcc gtctactact gtcagaacga ctatagctac 300
cccttcacct tcggtcaggg cactaagctg gagattaag 339
<210> 99
<211> 220
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 99
Glu Ile Val Met Thr Gln Ser Pro Ala Thr Leu Ser Leu Ser Pro Gly
1 5 10 15
Glu Arg Ala Thr Leu Ser Cys Arg Ser Ser Gln Ser Leu Leu Ser Ser
20 25 30
Gly Asn Gln Lys Ser Tyr Leu Thr Trp Tyr Gln Gln Lys Pro Gly Gln
35 40 45
Ala Pro Arg Leu Leu Ile Tyr Trp Ala Ser Thr Arg Glu Ser Gly Ile
50 55 60
Pro Ala Arg Phe Ser Gly Ser Gly Ser Gly Thr Asp Phe Thr Leu Thr
65 70 75 80
Ile Ser Ser Leu Gln Pro Glu Asp Phe Ala Val Tyr Tyr Cys Gln Asn
85 90 95
Asp Tyr Ser Tyr Pro Phe Thr Phe Gly Gln Gly Thr Lys Leu Glu Ile
100 105 110
Lys Arg Thr Val Ala Ala Pro Ser Val Phe Ile Phe Pro Pro Ser Asp
115 120 125
Glu Gln Leu Lys Ser Gly Thr Ala Ser Val Val Cys Leu Leu Asn Asn
130 135 140
Phe Tyr Pro Arg Glu Ala Lys Val Gln Trp Lys Val Asp Asn Ala Leu
145 150 155 160
Gln Ser Gly Asn Ser Gln Glu Ser Val Thr Glu Gln Asp Ser Lys Asp
165 170 175
Ser Thr Tyr Ser Leu Ser Ser Thr Leu Thr Leu Ser Lys Ala Asp Tyr
180 185 190
Glu Lys His Lys Val Tyr Ala Cys Glu Val Thr His Gln Gly Leu Ser
195 200 205
Ser Pro Val Thr Lys Ser Phe Asn Arg Gly Glu Cys
210 215 220
<210> 100
<211> 660
<212> DNA
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polynucleotide"
<400> 100
gagatcgtga tgactcagtc acccgctacc ctgagcctga gccctggcga gagagctaca 60
ctgagctgta gatctagtca gtcactgctg tctagcggta atcagaagtc ctacctgacc 120
tggtatcagc agaagcccgg tcaggcccct agactgctga tctactgggc ctctactaga 180
gagtcaggga tccccgctag gtttagcggt agcggtagtg gcaccgactt caccctgact 240
atctctagcc tgcagcccga ggacttcgcc gtctactact gtcagaacga ctatagctac 300
cccttcacct tcggtcaggg cactaagctg gagattaagc gtacggtggc cgctcccagc 360
gtgttcatct tcccccccag cgacgagcag ctgaagagcg gcaccgccag cgtggtgtgc 420
ctgctgaaca acttctaccc ccgggaggcc aaggtgcagt ggaaggtgga caacgccctg 480
cagagcggca acagccagga gagcgtcacc gagcaggaca gcaaggactc cacctacagc 540
ctgagcagca ccctgaccct gagcaaggcc gactacgaga agcataaggt gtacgcctgc 600
gaggtgaccc accagggcct gtccagcccc gtgaccaaga gcttcaacag gggcgagtgc 660
<210> 101
<211> 5
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 101
Asp His Thr Leu His
1 5
<210> 102
<211> 17
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 102
Tyr Ile Tyr Pro Arg Ser Gly Ser Thr Lys Tyr Asn Glu Asn Phe Lys
1 5 10 15
Gly
<210> 103
<211> 9
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 103
Arg Leu Leu Phe Leu Pro Leu Asp Tyr
1 5
<210> 104
<211> 7
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 104
Gly Tyr Thr Phe Thr Asp His
1 5
<210> 105
<211> 6
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 105
Tyr Pro Arg Ser Gly Ser
1 5
<210> 106
<211> 9
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 106
Arg Leu Leu Phe Leu Pro Leu Asp Tyr
1 5
<210> 107
<211> 118
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 107
Gln Ile Gln Leu Val Gln Ser Gly Ala Glu Val Lys Lys Pro Gly Ser
1 5 10 15
Ser Val Lys Val Ser Cys Lys Val Ser Gly Tyr Thr Phe Thr Asp His
20 25 30
Thr Leu His Trp Met Arg Gln Ala Pro Gly Gln Gly Leu Glu Trp Met
35 40 45
Gly Tyr Ile Tyr Pro Arg Ser Gly Ser Thr Lys Tyr Asn Glu Asn Phe
50 55 60
Lys Gly Arg Val Thr Ile Thr Ala Asp Thr Ser Ser Ser Thr Ala Tyr
65 70 75 80
Met Glu Leu Ser Ser Leu Arg Ser Glu Asp Thr Ala Val Tyr Tyr Cys
85 90 95
Val Arg Arg Leu Leu Phe Leu Pro Leu Asp Tyr Trp Gly Gln Gly Thr
100 105 110
Leu Val Thr Val Ser Ser
115
<210> 108
<211> 354
<212> DNA
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polynucleotide"
<400> 108
cagattcagc tggtgcagtc aggcgccgaa gtgaagaaac ccggctctag cgtgaaagtc 60
agctgtaaag tctcaggcta caccttcacc gatcacaccc tgcactggat gagacaggcc 120
ccaggtcagg gcctggagtg gatgggctat atctacccta gatcaggctc tactaagtat 180
aacgagaact ttaagggtag agtgactatc accgccgaca ctagctctag caccgcctat 240
atggaactgt ctagcctgag atcagaggac accgccgtct actactgcgt cagacggctg 300
ctgttcctgc ccctggacta ctggggtcag ggcaccctgg tcaccgtgtc tagc 354
<210> 109
<211> 448
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 109
Gln Ile Gln Leu Val Gln Ser Gly Ala Glu Val Lys Lys Pro Gly Ser
1 5 10 15
Ser Val Lys Val Ser Cys Lys Val Ser Gly Tyr Thr Phe Thr Asp His
20 25 30
Thr Leu His Trp Met Arg Gln Ala Pro Gly Gln Gly Leu Glu Trp Met
35 40 45
Gly Tyr Ile Tyr Pro Arg Ser Gly Ser Thr Lys Tyr Asn Glu Asn Phe
50 55 60
Lys Gly Arg Val Thr Ile Thr Ala Asp Thr Ser Ser Ser Thr Ala Tyr
65 70 75 80
Met Glu Leu Ser Ser Leu Arg Ser Glu Asp Thr Ala Val Tyr Tyr Cys
85 90 95
Val Arg Arg Leu Leu Phe Leu Pro Leu Asp Tyr Trp Gly Gln Gly Thr
100 105 110
Leu Val Thr Val Ser Ser Ala Ser Thr Lys Gly Pro Ser Val Phe Pro
115 120 125
Leu Ala Pro Ser Ser Lys Ser Thr Ser Gly Gly Thr Ala Ala Leu Gly
130 135 140
Cys Leu Val Lys Asp Tyr Phe Pro Glu Pro Val Thr Val Ser Trp Asn
145 150 155 160
Ser Gly Ala Leu Thr Ser Gly Val His Thr Phe Pro Ala Val Leu Gln
165 170 175
Ser Ser Gly Leu Tyr Ser Leu Ser Ser Val Val Thr Val Pro Ser Ser
180 185 190
Ser Leu Gly Thr Gln Thr Tyr Ile Cys Asn Val Asn His Lys Pro Ser
195 200 205
Asn Thr Lys Val Asp Lys Arg Val Glu Pro Lys Ser Cys Asp Lys Thr
210 215 220
His Thr Cys Pro Pro Cys Pro Ala Pro Glu Leu Leu Gly Gly Pro Ser
225 230 235 240
Val Phe Leu Phe Pro Pro Lys Pro Lys Asp Thr Leu Met Ile Ser Arg
245 250 255
Thr Pro Glu Val Thr Cys Val Val Val Asp Val Ser His Glu Asp Pro
260 265 270
Glu Val Lys Phe Asn Trp Tyr Val Asp Gly Val Glu Val His Asn Ala
275 280 285
Lys Thr Lys Pro Arg Glu Glu Gln Tyr Asn Ser Thr Tyr Arg Val Val
290 295 300
Ser Val Leu Thr Val Leu His Gln Asp Trp Leu Asn Gly Lys Glu Tyr
305 310 315 320
Lys Cys Lys Val Ser Asn Lys Ala Leu Pro Ala Pro Ile Glu Lys Thr
325 330 335
Ile Ser Lys Ala Lys Gly Gln Pro Arg Glu Pro Gln Val Tyr Thr Leu
340 345 350
Pro Pro Ser Arg Glu Glu Met Thr Lys Asn Gln Val Ser Leu Thr Cys
355 360 365
Leu Val Lys Gly Phe Tyr Pro Ser Asp Ile Ala Val Glu Trp Glu Ser
370 375 380
Asn Gly Gln Pro Glu Asn Asn Tyr Lys Thr Thr Pro Pro Val Leu Asp
385 390 395 400
Ser Asp Gly Ser Phe Phe Leu Tyr Ser Lys Leu Thr Val Asp Lys Ser
405 410 415
Arg Trp Gln Gln Gly Asn Val Phe Ser Cys Ser Val Met His Glu Ala
420 425 430
Leu His Asn His Tyr Thr Gln Lys Ser Leu Ser Leu Ser Pro Gly Lys
435 440 445
<210> 110
<211> 1344
<212> DNA
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polynucleotide"
<400> 110
cagattcagc tggtgcagtc aggcgccgaa gtgaagaaac ccggctctag cgtgaaagtc 60
agctgtaaag tctcaggcta caccttcacc gatcacaccc tgcactggat gagacaggcc 120
ccaggtcagg gcctggagtg gatgggctat atctacccta gatcaggctc tactaagtat 180
aacgagaact ttaagggtag agtgactatc accgccgaca ctagctctag caccgcctat 240
atggaactgt ctagcctgag atcagaggac accgccgtct actactgcgt cagacggctg 300
ctgttcctgc ccctggacta ctggggtcag ggcaccctgg tcaccgtgtc tagcgctagc 360
actaagggcc caagtgtgtt tcccctggcc cccagcagca agtctacttc cggcggaact 420
gctgccctgg gttgcctggt gaaggactac ttccccgagc ccgtgacagt gtcctggaac 480
tctggggctc tgacttccgg cgtgcacacc ttccccgccg tgctgcagag cagcggcctg 540
tacagcctga gcagcgtggt gacagtgccc tccagctctc tgggaaccca gacctatatc 600
tgcaacgtga accacaagcc cagcaacacc aaggtggaca agagagtgga gcccaagagc 660
tgcgacaaga cccacacctg ccccccctgc ccagctccag aactgctggg agggccttcc 720
gtgttcctgt tcccccccaa gcccaaggac accctgatga tcagcaggac ccccgaggtg 780
acctgcgtgg tggtggacgt gtcccacgag gacccagagg tgaagttcaa ctggtacgtg 840
gacggcgtgg aggtgcacaa cgccaagacc aagcccagag aggagcagta caacagcacc 900
tacagggtgg tgtccgtgct gaccgtgctg caccaggact ggctgaacgg caaagaatac 960
aagtgcaaag tctccaacaa ggccctgcca gccccaatcg aaaagacaat cagcaaggcc 1020
aagggccagc cacgggagcc ccaggtgtac accctgcccc ccagccggga ggagatgacc 1080
aagaaccagg tgtccctgac ctgtctggtg aagggcttct accccagcga tatcgccgtg 1140
gagtgggaga gcaacggcca gcccgagaac aactacaaga ccaccccccc agtgctggac 1200
agcgacggca gcttcttcct gtacagcaag ctgaccgtgg acaagtccag gtggcagcag 1260
ggcaacgtgt tcagctgcag cgtgatgcac gaggccctgc acaaccacta cacccagaag 1320
tccctgagcc tgagccccgg caag 1344
<210> 111
<211> 17
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 111
Arg Ser Ser Gln Ser Leu Leu Ser Ser Gly Asn Gln Lys Ser Tyr Leu
1 5 10 15
Thr
<210> 112
<211> 7
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 112
Trp Ala Ser Thr Arg Glu Ser
1 5
<210> 113
<211> 9
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 113
Gln Asn Asp Tyr Ser Tyr Pro Phe Thr
1 5
<210> 114
<211> 13
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 114
Ser Gln Ser Leu Leu Ser Ser Gly Asn Gln Lys Ser Tyr
1 5 10
<210> 115
<211> 3
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 115
Trp Ala Ser
1
<210> 116
<211> 6
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 116
Asp Tyr Ser Tyr Pro Phe
1 5
<210> 117
<211> 113
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 117
Glu Ile Val Met Thr Gln Ser Pro Ala Thr Leu Ser Leu Ser Pro Gly
1 5 10 15
Glu Arg Ala Thr Leu Ser Cys Arg Ser Ser Gln Ser Leu Leu Ser Ser
20 25 30
Gly Asn Gln Lys Ser Tyr Leu Thr Trp Tyr Gln Gln Lys Pro Gly Gln
35 40 45
Ala Pro Arg Leu Leu Ile Tyr Trp Ala Ser Thr Arg Glu Ser Gly Ile
50 55 60
Pro Ala Arg Phe Ser Gly Ser Gly Ser Gly Thr Asp Phe Thr Leu Thr
65 70 75 80
Ile Ser Ser Leu Gln Pro Glu Asp Phe Ala Val Tyr Tyr Cys Gln Asn
85 90 95
Asp Tyr Ser Tyr Pro Phe Thr Phe Gly Gln Gly Thr Lys Leu Glu Ile
100 105 110
Lys
<210> 118
<211> 339
<212> DNA
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polynucleotide"
<400> 118
gagatcgtga tgactcagtc acccgctacc ctgagcctga gccctggcga gagagctaca 60
ctgagctgta gatctagtca gtcactgctg tctagcggta atcagaagtc ctacctgacc 120
tggtatcagc agaagcccgg tcaggcccct agactgctga tctactgggc ctctactaga 180
gagtcaggga tccccgctag gtttagcggt agcggtagtg gcaccgactt caccctgact 240
atctctagcc tgcagcccga ggacttcgcc gtctactact gtcagaacga ctatagctac 300
cccttcacct tcggtcaggg cactaagctg gagattaag 339
<210> 119
<211> 220
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 119
Glu Ile Val Met Thr Gln Ser Pro Ala Thr Leu Ser Leu Ser Pro Gly
1 5 10 15
Glu Arg Ala Thr Leu Ser Cys Arg Ser Ser Gln Ser Leu Leu Ser Ser
20 25 30
Gly Asn Gln Lys Ser Tyr Leu Thr Trp Tyr Gln Gln Lys Pro Gly Gln
35 40 45
Ala Pro Arg Leu Leu Ile Tyr Trp Ala Ser Thr Arg Glu Ser Gly Ile
50 55 60
Pro Ala Arg Phe Ser Gly Ser Gly Ser Gly Thr Asp Phe Thr Leu Thr
65 70 75 80
Ile Ser Ser Leu Gln Pro Glu Asp Phe Ala Val Tyr Tyr Cys Gln Asn
85 90 95
Asp Tyr Ser Tyr Pro Phe Thr Phe Gly Gln Gly Thr Lys Leu Glu Ile
100 105 110
Lys Arg Thr Val Ala Ala Pro Ser Val Phe Ile Phe Pro Pro Ser Asp
115 120 125
Glu Gln Leu Lys Ser Gly Thr Ala Ser Val Val Cys Leu Leu Asn Asn
130 135 140
Phe Tyr Pro Arg Glu Ala Lys Val Gln Trp Lys Val Asp Asn Ala Leu
145 150 155 160
Gln Ser Gly Asn Ser Gln Glu Ser Val Thr Glu Gln Asp Ser Lys Asp
165 170 175
Ser Thr Tyr Ser Leu Ser Ser Thr Leu Thr Leu Ser Lys Ala Asp Tyr
180 185 190
Glu Lys His Lys Val Tyr Ala Cys Glu Val Thr His Gln Gly Leu Ser
195 200 205
Ser Pro Val Thr Lys Ser Phe Asn Arg Gly Glu Cys
210 215 220
<210> 120
<211> 660
<212> DNA
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polynucleotide"
<400> 120
gagatcgtga tgactcagtc acccgctacc ctgagcctga gccctggcga gagagctaca 60
ctgagctgta gatctagtca gtcactgctg tctagcggta atcagaagtc ctacctgacc 120
tggtatcagc agaagcccgg tcaggcccct agactgctga tctactgggc ctctactaga 180
gagtcaggga tccccgctag gtttagcggt agcggtagtg gcaccgactt caccctgact 240
atctctagcc tgcagcccga ggacttcgcc gtctactact gtcagaacga ctatagctac 300
cccttcacct tcggtcaggg cactaagctg gagattaagc gtacggtggc cgctcccagc 360
gtgttcatct tcccccccag cgacgagcag ctgaagagcg gcaccgccag cgtggtgtgc 420
ctgctgaaca acttctaccc ccgggaggcc aaggtgcagt ggaaggtgga caacgccctg 480
cagagcggca acagccagga gagcgtcacc gagcaggaca gcaaggactc cacctacagc 540
ctgagcagca ccctgaccct gagcaaggcc gactacgaga agcataaggt gtacgcctgc 600
gaggtgaccc accagggcct gtccagcccc gtgaccaaga gcttcaacag gggcgagtgc 660
<210> 121
<211> 829
<212> PRT
<213> Homo sapiens
<400> 121
Met Gly Leu Pro Arg Gly Pro Leu Ala Ser Leu Leu Leu Leu Gln Val
1 5 10 15
Cys Trp Leu Gln Cys Ala Ala Ser Glu Pro Cys Arg Ala Val Phe Arg
20 25 30
Glu Ala Glu Val Thr Leu Glu Ala Gly Gly Ala Glu Gln Glu Pro Gly
35 40 45
Gln Ala Leu Gly Lys Val Phe Met Gly Cys Pro Gly Gln Glu Pro Ala
50 55 60
Leu Phe Ser Thr Asp Asn Asp Asp Phe Thr Val Arg Asn Gly Glu Thr
65 70 75 80
Val Gln Glu Arg Arg Ser Leu Lys Glu Arg Asn Pro Leu Lys Ile Phe
85 90 95
Pro Ser Lys Arg Ile Leu Arg Arg His Lys Arg Asp Trp Val Val Ala
100 105 110
Pro Ile Ser Val Pro Glu Asn Gly Lys Gly Pro Phe Pro Gln Arg Leu
115 120 125
Asn Gln Leu Lys Ser Asn Lys Asp Arg Asp Thr Lys Ile Phe Tyr Ser
130 135 140
Ile Thr Gly Pro Gly Ala Asp Ser Pro Pro Glu Gly Val Phe Ala Val
145 150 155 160
Glu Lys Glu Thr Gly Trp Leu Leu Leu Asn Lys Pro Leu Asp Arg Glu
165 170 175
Glu Ile Ala Lys Tyr Glu Leu Phe Gly His Ala Val Ser Glu Asn Gly
180 185 190
Ala Ser Val Glu Asp Pro Met Asn Ile Ser Ile Ile Val Thr Asp Gln
195 200 205
Asn Asp His Lys Pro Lys Phe Thr Gln Asp Thr Phe Arg Gly Ser Val
210 215 220
Leu Glu Gly Val Leu Pro Gly Thr Ser Val Met Gln Val Thr Ala Thr
225 230 235 240
Asp Glu Asp Asp Ala Ile Tyr Thr Tyr Asn Gly Val Val Ala Tyr Ser
245 250 255
Ile His Ser Gln Glu Pro Lys Asp Pro His Asp Leu Met Phe Thr Ile
260 265 270
His Arg Ser Thr Gly Thr Ile Ser Val Ile Ser Ser Gly Leu Asp Arg
275 280 285
Glu Lys Val Pro Glu Tyr Thr Leu Thr Ile Gln Ala Thr Asp Met Asp
290 295 300
Gly Asp Gly Ser Thr Thr Thr Ala Val Ala Val Val Glu Ile Leu Asp
305 310 315 320
Ala Asn Asp Asn Ala Pro Met Phe Asp Pro Gln Lys Tyr Glu Ala His
325 330 335
Val Pro Glu Asn Ala Val Gly His Glu Val Gln Arg Leu Thr Val Thr
340 345 350
Asp Leu Asp Ala Pro Asn Ser Pro Ala Trp Arg Ala Thr Tyr Leu Ile
355 360 365
Met Gly Gly Asp Asp Gly Asp His Phe Thr Ile Thr Thr His Pro Glu
370 375 380
Ser Asn Gln Gly Ile Leu Thr Thr Arg Lys Gly Leu Asp Phe Glu Ala
385 390 395 400
Lys Asn Gln His Thr Leu Tyr Val Glu Val Thr Asn Glu Ala Pro Phe
405 410 415
Val Leu Lys Leu Pro Thr Ser Thr Ala Thr Ile Val Val His Val Glu
420 425 430
Asp Val Asn Glu Ala Pro Val Phe Val Pro Pro Ser Lys Val Val Glu
435 440 445
Val Gln Glu Gly Ile Pro Thr Gly Glu Pro Val Cys Val Tyr Thr Ala
450 455 460
Glu Asp Pro Asp Lys Glu Asn Gln Lys Ile Ser Tyr Arg Ile Leu Arg
465 470 475 480
Asp Pro Ala Gly Trp Leu Ala Met Asp Pro Asp Ser Gly Gln Val Thr
485 490 495
Ala Val Gly Thr Leu Asp Arg Glu Asp Glu Gln Phe Val Arg Asn Asn
500 505 510
Ile Tyr Glu Val Met Val Leu Ala Met Asp Asn Gly Ser Pro Pro Thr
515 520 525
Thr Gly Thr Gly Thr Leu Leu Leu Thr Leu Ile Asp Val Asn Asp His
530 535 540
Gly Pro Val Pro Glu Pro Arg Gln Ile Thr Ile Cys Asn Gln Ser Pro
545 550 555 560
Val Arg Gln Val Leu Asn Ile Thr Asp Lys Asp Leu Ser Pro His Thr
565 570 575
Ser Pro Phe Gln Ala Gln Leu Thr Asp Asp Ser Asp Ile Tyr Trp Thr
580 585 590
Ala Glu Val Asn Glu Glu Gly Asp Thr Val Val Leu Ser Leu Lys Lys
595 600 605
Phe Leu Lys Gln Asp Thr Tyr Asp Val His Leu Ser Leu Ser Asp His
610 615 620
Gly Asn Lys Glu Gln Leu Thr Val Ile Arg Ala Thr Val Cys Asp Cys
625 630 635 640
His Gly His Val Glu Thr Cys Pro Gly Pro Trp Lys Gly Gly Phe Ile
645 650 655
Leu Pro Val Leu Gly Ala Val Leu Ala Leu Leu Phe Leu Leu Leu Val
660 665 670
Leu Leu Leu Leu Val Arg Lys Lys Arg Lys Ile Lys Glu Pro Leu Leu
675 680 685
Leu Pro Glu Asp Asp Thr Arg Asp Asn Val Phe Tyr Tyr Gly Glu Glu
690 695 700
Gly Gly Gly Glu Glu Asp Gln Asp Tyr Asp Ile Thr Gln Leu His Arg
705 710 715 720
Gly Leu Glu Ala Arg Pro Glu Val Val Leu Arg Asn Asp Val Ala Pro
725 730 735
Thr Ile Ile Pro Thr Pro Met Tyr Arg Pro Arg Pro Ala Asn Pro Asp
740 745 750
Glu Ile Gly Asn Phe Ile Ile Glu Asn Leu Lys Ala Ala Asn Thr Asp
755 760 765
Pro Thr Ala Pro Pro Tyr Asp Thr Leu Leu Val Phe Asp Tyr Glu Gly
770 775 780
Ser Gly Ser Asp Ala Ala Ser Leu Ser Ser Leu Thr Ser Ser Ala Ser
785 790 795 800
Asp Gln Asp Gln Asp Tyr Asp Tyr Leu Asn Glu Trp Gly Ser Arg Phe
805 810 815
Lys Lys Leu Ala Asp Met Tyr Gly Gly Gly Glu Asp Asp
820 825
<210> 122
<211> 822
<212> PRT
<213> Rattus norvegicus
<400> 122
Met Glu Leu Leu Ser Gly Pro Leu Val Phe Leu Leu Leu Leu Leu Gln
1 5 10 15
Val Cys Trp Leu Arg Ser Val Val Ser Glu Ser Tyr Arg Glu Asp Phe
20 25 30
Ile Arg Glu Ala Gly Val Thr Leu Glu Val Gly Gly Thr Asp Leu Glu
35 40 45
Pro Ser Gln Ala Leu Glu Lys Glu Ala Leu Ala Gly His Glu Val Leu
50 55 60
Gly Ala Asp Ser Gly Gly Ile Ile Thr Leu Asn Arg Glu Thr Val Gln
65 70 75 80
Gly Gly Lys Gly Val Met Asn Ser Pro Pro Ser Arg Ile Leu Arg Arg
85 90 95
Arg Lys Arg Glu Trp Val Met Pro Pro Ile Ser Val Pro Glu Asn Gly
100 105 110
Lys Gly Pro Phe Pro Gln Arg Leu Asn Gln Leu Lys Ser Asn Lys Asp
115 120 125
Arg Gly Thr Lys Leu Phe Tyr Ser Ile Thr Gly Pro Gly Ala Asp Ser
130 135 140
Pro Pro Glu Gly Val Phe Thr Ile Glu Lys Glu Thr Gly Trp Leu Leu
145 150 155 160
Leu Asn Met Pro Leu Asp Arg Glu Lys Ile Val Lys Tyr Glu Leu Phe
165 170 175
Gly His Ala Val Ser Glu Asn Gly Ala Ser Val Glu Glu Pro Met Asn
180 185 190
Ile Ser Ile Ile Val Thr Asp Gln Asn Asp Asn Lys Pro Lys Phe Thr
195 200 205
Gln Asp Thr Phe Arg Gly Ser Val Pro Glu Gly Val Met Pro Gly Thr
210 215 220
Ser Val Met Gln Val Thr Ala Thr Asp Glu Asp Asp Ala Ile Asn Thr
225 230 235 240
Tyr Asn Gly Val Val Ala Tyr Ser Ile His Ser Gln Glu Pro Lys Glu
245 250 255
Pro His Asp Leu Met Phe Thr Ile His Lys Ser Thr Gly Thr Ile Ser
260 265 270
Val Ile Ser Ser Gly Leu Asp Arg Glu Lys Val Pro Glu Tyr Thr Leu
275 280 285
Thr Ile Gln Ala Thr Asp Met Asp Gly Asp Gly Ser Thr Thr Thr Ala
290 295 300
Glu Ala Val Val Gln Ile Leu Asp Thr Asn Asp Asn Ala Pro Glu Phe
305 310 315 320
Gln Pro Gln Lys Tyr Glu Ala Trp Val Pro Glu Asn Ala Val Gly His
325 330 335
Glu Val Gln Arg Leu Thr Val Thr Asp Leu Asp Ser Pro Asn Ser Pro
340 345 350
Ala Trp Arg Ala Thr Tyr His Ile Val Gly Gly Asp Asp Gly Asp His
355 360 365
Phe Thr Val Ala Thr His Pro Glu Thr Asn Gln Gly Ile Leu Thr Thr
370 375 380
Lys Lys Gly Leu Asp Phe Glu Ala Gln Asn Gln His Thr Leu Tyr Ile
385 390 395 400
Glu Val Thr Asn Glu Ala Ser Phe Ala Val Lys Leu Pro Thr Ala Thr
405 410 415
Ala Thr Val Val Val His Val Glu Asp Val Asn Glu Ala Pro Val Phe
420 425 430
Val Pro Pro Ser Lys Val Ile Glu Ala Gln Glu Gly Ile Ser Ile Gly
435 440 445
Glu Leu Val Cys Val Tyr Thr Ala Gln Asp Pro Asp Lys Glu Glu Gln
450 455 460
Lys Ile Ser Tyr Ser Ile Leu Arg Asp Pro Ala Ser Trp Leu Ala Val
465 470 475 480
Asp Pro Asp Ser Gly Gln Ile Thr Ala Ala Gly Ile Leu Asp Arg Glu
485 490 495
Asp Glu Gln Phe Val Lys Asn Asp Ile Tyr Glu Val Met Val Leu Ala
500 505 510
Thr Asp Asn Gly Asn Pro Pro Thr Thr Gly Thr Gly Thr Leu Leu Leu
515 520 525
Thr Leu Thr Asp Ile Asn Asp His Gly Pro Ile Pro Glu Pro Arg Gln
530 535 540
Ile Ile Ile Cys Asn Gln Ser Pro Val Pro Gln Val Leu Asn Ile Thr
545 550 555 560
Asp Lys Asp Leu Ser Pro Asn Ser Ser Pro Phe Gln Ala Gln Leu Thr
565 570 575
His Asp Ser Asp Ile Tyr Trp Met Ala Glu Val Ser Glu Lys Gly Asp
580 585 590
Thr Val Ala Leu Ser Leu Lys Lys Phe Leu Lys Gln Asp Thr Tyr Asp
595 600 605
Leu His Leu Ser Leu Ser Asp His Gly Asn Arg Glu Gln Leu Thr Met
610 615 620
Ile Arg Ala Thr Val Cys Asp Cys His Gly Gln Val Leu Asn Asp Cys
625 630 635 640
Pro Arg Pro Trp Lys Gly Gly Phe Ile Leu Pro Val Leu Gly Ala Val
645 650 655
Leu Ala Leu Leu Thr Leu Leu Leu Ala Leu Leu Leu Leu Val Arg Lys
660 665 670
Lys Arg Lys Val Lys Glu Pro Leu Leu Leu Pro Glu Asp Asp Thr Arg
675 680 685
Asp Asn Val Phe Tyr Tyr Gly Glu Glu Gly Gly Gly Glu Glu Asp Gln
690 695 700
Asp Tyr Asp Ile Thr Gln Leu His Arg Gly Leu Glu Ala Arg Pro Glu
705 710 715 720
Val Val Leu Arg Asn Asp Val Ala Pro Thr Phe Ile Pro Thr Pro Met
725 730 735
Tyr Arg Pro Arg Pro Ala Asn Pro Asp Glu Ile Gly Asn Phe Ile Ile
740 745 750
Glu Asn Leu Lys Ala Ala Asn Thr Asp Pro Thr Ala Pro Pro Tyr Asp
755 760 765
Ser Leu Leu Val Phe Asp Tyr Glu Gly Ser Gly Ser Asp Ala Ala Ser
770 775 780
Leu Ser Ser Leu Thr Ser Ser Thr Ser Asp Gln Asp Gln Asp Tyr Asn
785 790 795 800
Tyr Leu Thr Glu Trp Gly Ser Arg Phe Lys Lys Leu Ala Asp Met Tyr
805 810 815
Gly Gly Gly Glu Asp Asp
820
<210> 123
<211> 822
<212> PRT
<213> Mus musculus
<400> 123
Met Glu Leu Leu Ser Gly Pro His Ala Phe Leu Leu Leu Leu Leu Gln
1 5 10 15
Val Cys Trp Leu Arg Ser Val Val Ser Glu Pro Tyr Arg Ala Gly Phe
20 25 30
Ile Gly Glu Ala Gly Val Thr Leu Glu Val Glu Gly Thr Asp Leu Glu
35 40 45
Pro Ser Gln Val Leu Gly Lys Val Ala Leu Ala Gly Gln Gly Met His
50 55 60
His Ala Asp Asn Gly Asp Ile Ile Met Leu Thr Arg Gly Thr Val Gln
65 70 75 80
Gly Gly Lys Asp Ala Met His Ser Pro Pro Thr Arg Ile Leu Arg Arg
85 90 95
Arg Lys Arg Glu Trp Val Met Pro Pro Ile Phe Val Pro Glu Asn Gly
100 105 110
Lys Gly Pro Phe Pro Gln Arg Leu Asn Gln Leu Lys Ser Asn Lys Asp
115 120 125
Arg Gly Thr Lys Ile Phe Tyr Ser Ile Thr Gly Pro Gly Ala Asp Ser
130 135 140
Pro Pro Glu Gly Val Phe Thr Ile Glu Lys Glu Ser Gly Trp Leu Leu
145 150 155 160
Leu His Met Pro Leu Asp Arg Glu Lys Ile Val Lys Tyr Glu Leu Tyr
165 170 175
Gly His Ala Val Ser Glu Asn Gly Ala Ser Val Glu Glu Pro Met Asn
180 185 190
Ile Ser Ile Ile Val Thr Asp Gln Asn Asp Asn Lys Pro Lys Phe Thr
195 200 205
Gln Asp Thr Phe Arg Gly Ser Val Leu Glu Gly Val Met Pro Gly Thr
210 215 220
Ser Val Met Gln Val Thr Ala Thr Asp Glu Asp Asp Ala Val Asn Thr
225 230 235 240
Tyr Asn Gly Val Val Ala Tyr Ser Ile His Ser Gln Glu Pro Lys Glu
245 250 255
Pro His Asp Leu Met Phe Thr Ile His Lys Ser Thr Gly Thr Ile Ser
260 265 270
Val Ile Ser Ser Gly Leu Asp Arg Glu Lys Val Pro Glu Tyr Arg Leu
275 280 285
Thr Val Gln Ala Thr Asp Met Asp Gly Glu Gly Ser Thr Thr Thr Ala
290 295 300
Glu Ala Val Val Gln Ile Leu Asp Ala Asn Asp Asn Ala Pro Glu Phe
305 310 315 320
Glu Pro Gln Lys Tyr Glu Ala Trp Val Pro Glu Asn Glu Val Gly His
325 330 335
Glu Val Gln Arg Leu Thr Val Thr Asp Leu Asp Val Pro Asn Ser Pro
340 345 350
Ala Trp Arg Ala Thr Tyr His Ile Val Gly Gly Asp Asp Gly Asp His
355 360 365
Phe Thr Ile Thr Thr His Pro Glu Thr Asn Gln Gly Val Leu Thr Thr
370 375 380
Lys Lys Gly Leu Asp Phe Glu Ala Gln Asp Gln His Thr Leu Tyr Val
385 390 395 400
Glu Val Thr Asn Glu Ala Pro Phe Ala Val Lys Leu Pro Thr Ala Thr
405 410 415
Ala Thr Val Val Val His Val Lys Asp Val Asn Glu Ala Pro Val Phe
420 425 430
Val Pro Pro Ser Lys Val Ile Glu Ala Gln Glu Gly Ile Ser Ile Gly
435 440 445
Glu Leu Val Cys Ile Tyr Thr Ala Gln Asp Pro Asp Lys Glu Asp Gln
450 455 460
Lys Ile Ser Tyr Thr Ile Ser Arg Asp Pro Ala Asn Trp Leu Ala Val
465 470 475 480
Asp Pro Asp Ser Gly Gln Ile Thr Ala Ala Gly Ile Leu Asp Arg Glu
485 490 495
Asp Glu Gln Phe Val Lys Asn Asn Val Tyr Glu Val Met Val Leu Ala
500 505 510
Thr Asp Ser Gly Asn Pro Pro Thr Thr Gly Thr Gly Thr Leu Leu Leu
515 520 525
Thr Leu Thr Asp Ile Asn Asp His Gly Pro Ile Pro Glu Pro Arg Gln
530 535 540
Ile Ile Ile Cys Asn Gln Ser Pro Val Pro Gln Val Leu Asn Ile Thr
545 550 555 560
Asp Lys Asp Leu Ser Pro Asn Ser Ser Pro Phe Gln Ala Gln Leu Thr
565 570 575
His Asp Ser Asp Ile Tyr Trp Met Ala Glu Val Ser Glu Lys Gly Asp
580 585 590
Thr Val Ala Leu Ser Leu Lys Lys Phe Leu Lys Gln Asp Thr Tyr Asp
595 600 605
Leu His Leu Ser Leu Ser Asp His Gly Asn Arg Glu Gln Leu Thr Met
610 615 620
Ile Arg Ala Thr Val Cys Asp Cys His Gly Gln Val Phe Asn Asp Cys
625 630 635 640
Pro Arg Pro Trp Lys Gly Gly Phe Ile Leu Pro Ile Leu Gly Ala Val
645 650 655
Leu Ala Leu Leu Thr Leu Leu Leu Ala Leu Leu Leu Leu Val Arg Lys
660 665 670
Lys Arg Lys Val Lys Glu Pro Leu Leu Leu Pro Glu Asp Asp Thr Arg
675 680 685
Asp Asn Val Phe Tyr Tyr Gly Glu Glu Gly Gly Gly Glu Glu Asp Gln
690 695 700
Asp Tyr Asp Ile Thr Gln Leu His Arg Gly Leu Glu Ala Arg Pro Glu
705 710 715 720
Val Val Leu Arg Asn Asp Val Val Pro Thr Phe Ile Pro Thr Pro Met
725 730 735
Tyr Arg Pro Arg Pro Ala Asn Pro Asp Glu Ile Gly Asn Phe Ile Ile
740 745 750
Glu Asn Leu Lys Ala Ala Asn Thr Asp Pro Thr Ala Pro Pro Tyr Asp
755 760 765
Ser Leu Leu Val Phe Asp Tyr Glu Gly Ser Gly Ser Asp Ala Ala Ser
770 775 780
Leu Ser Ser Leu Thr Thr Ser Ala Ser Asp Gln Asp Gln Asp Tyr Asn
785 790 795 800
Tyr Leu Asn Glu Trp Gly Ser Arg Phe Lys Lys Leu Ala Asp Met Tyr
805 810 815
Gly Gly Gly Glu Asp Asp
820
<210> 124
<211> 595
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 124
Met Lys Phe Leu Val Asn Val Ala Leu Val Phe Met Val Val Tyr Ile
1 5 10 15
Ser Tyr Ile Tyr Ala Asp His Gln Thr Ser Leu Tyr Lys Lys Ala Gly
20 25 30
Phe Glu Gly Asp Arg Thr Asp Trp Val Val Ala Pro Ile Ser Val Pro
35 40 45
Glu Asn Gly Lys Gly Pro Phe Pro Gln Arg Leu Asn Gln Leu Lys Ser
50 55 60
Asn Lys Asp Arg Asp Thr Lys Ile Phe Tyr Ser Ile Thr Gly Pro Gly
65 70 75 80
Ala Asp Ser Pro Pro Glu Gly Val Phe Ala Val Glu Lys Glu Thr Gly
85 90 95
Trp Leu Leu Leu Asn Lys Pro Leu Asp Arg Glu Glu Ile Ala Lys Tyr
100 105 110
Glu Leu Phe Gly His Ala Val Ser Glu Asn Gly Ala Ser Val Glu Asp
115 120 125
Pro Met Asn Ile Ser Ile Ile Val Thr Asp Gln Asn Asp His Lys Pro
130 135 140
Lys Phe Thr Gln Asp Thr Phe Arg Gly Ser Val Leu Glu Gly Val Leu
145 150 155 160
Pro Gly Thr Ser Val Met Gln Val Thr Ala Thr Asp Glu Asp Asp Ala
165 170 175
Ile His Thr Tyr Asn Gly Val Val Ala Tyr Ser Ile His Ser Gln Glu
180 185 190
Pro Lys Asp Pro His Asp Leu Met Phe Thr Ile His Arg Ser Thr Gly
195 200 205
Thr Ile Ser Val Ile Ser Ser Gly Leu Asp Arg Glu Lys Val Pro Glu
210 215 220
Tyr Thr Leu Thr Ile Gln Ala Thr Asp Met Asp Gly Asp Gly Ser Thr
225 230 235 240
Thr Thr Ala Val Ala Val Val Glu Ile Leu Asp Ala Asn Asp Asn Ala
245 250 255
Pro Val Phe Asp Pro Gln Lys Tyr Glu Ser His Val Pro Glu Asn Ala
260 265 270
Val Gly His Glu Val Gln Arg Leu Thr Val Thr Asp Leu Asp Ala Pro
275 280 285
Asn Ser Pro Ala Trp Arg Ala Thr Tyr Leu Ile Val Gly Gly Asp Asp
290 295 300
Gly Asp His Phe Thr Ile Ala Thr His Pro Glu Ser Asn Gln Gly Ile
305 310 315 320
Leu Thr Thr Arg Lys Gly Leu Asp Phe Glu Ala Lys Asn Gln His Thr
325 330 335
Leu Tyr Val Glu Val Thr Asn Glu Ala Pro Phe Val Leu Lys Leu Pro
340 345 350
Thr Ser Thr Ala Thr Ile Val Val His Val Glu Asp Val Asn Glu Ala
355 360 365
Pro Val Phe Val Pro Pro Ser Lys Val Val Glu Val Gln Glu Gly Ile
370 375 380
Pro Thr Gly Glu Ala Val Cys Val Tyr Thr Ala Lys Asp Pro Asp Lys
385 390 395 400
Glu Asn Gln Lys Ile Ser Tyr Arg Ile Leu Arg Asp Pro Ala Gly Trp
405 410 415
Leu Ala Met Asp Pro Asp Ser Gly Gln Val Thr Val Ala Gly Thr Leu
420 425 430
Asp Arg Glu Asp Glu Arg Phe Val Arg Asn Asn Ile Tyr Glu Val Met
435 440 445
Val Leu Ala Val Asp Asn Gly Ser Pro Pro Thr Thr Gly Thr Gly Thr
450 455 460
Leu Leu Leu Thr Leu Ile Asp Val Asn Asp His Gly Pro Val Pro Glu
465 470 475 480
Pro Arg Glu Ile Thr Ile Cys Asn Gln Ser Pro Glu Ser Gln Val Leu
485 490 495
Asn Ile Thr Asp Lys Asp Leu Ser Pro His Thr Ser Pro Phe Gln Ala
500 505 510
Gln Leu Thr Asp Asp Ser Asp Ile Tyr Trp Met Ala Glu Val Asn Glu
515 520 525
Lys Asp Asp Thr Val Val Leu Ser Leu Lys Lys Phe Leu Lys Gln Asp
530 535 540
Thr Tyr Asp Val His Leu Ser Leu Ser Asp His Gly Asn Lys Glu Gln
545 550 555 560
Leu Thr Val Ile Arg Ala Thr Val Cys Asp Cys His Gly His Val Glu
565 570 575
Lys Cys Pro Asp Pro Trp Lys Gly Gly Gly Ala His His His His His
580 585 590
His Gly Ala
595
<210> 125
<211> 595
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 125
Met Lys Phe Leu Val Asn Val Ala Leu Val Phe Met Val Val Tyr Ile
1 5 10 15
Ser Tyr Ile Tyr Ala Asp His Gln Thr Ser Leu Tyr Lys Lys Ala Gly
20 25 30
Phe Glu Gly Asp Arg Thr Asp Trp Val Val Ala Pro Ile Ser Val Pro
35 40 45
Glu Asn Gly Lys Gly Pro Phe Pro Gln Arg Leu Asn Gln Leu Lys Ser
50 55 60
Asn Lys Asp Arg Asp Thr Lys Ile Phe Tyr Ser Ile Thr Gly Pro Gly
65 70 75 80
Ala Asp Ser Pro Pro Glu Gly Val Phe Ala Val Glu Lys Glu Thr Gly
85 90 95
Trp Leu Leu Leu Asn Lys Pro Leu Asp Arg Glu Glu Ile Ala Lys Tyr
100 105 110
Glu Leu Phe Gly His Ala Val Ser Glu Asn Gly Ala Ser Val Glu Asp
115 120 125
Pro Met Asn Ile Ser Ile Ile Val Thr Asp Gln Asn Asp His Lys Pro
130 135 140
Lys Phe Thr Gln Asp Thr Phe Arg Gly Ser Val Leu Glu Gly Val Leu
145 150 155 160
Pro Gly Thr Ser Val Met Gln Val Thr Ala Thr Asp Glu Asp Asp Ala
165 170 175
Ile His Thr Tyr Asn Gly Val Val Ala Tyr Ser Ile His Ser Gln Glu
180 185 190
Pro Lys Asp Pro His Asp Leu Met Phe Thr Ile His Arg Ser Thr Gly
195 200 205
Thr Ile Ser Val Ile Ser Ser Gly Leu Asp Arg Glu Lys Val Pro Glu
210 215 220
Tyr Thr Leu Thr Ile Gln Ala Thr Asp Met Asp Gly Asp Gly Ser Thr
225 230 235 240
Thr Thr Ala Val Ala Val Val Glu Ile Leu Asp Ala Asn Asp Asn Ala
245 250 255
Pro Val Phe Asp Pro Gln Lys Tyr Glu Ser His Val Pro Glu Asn Ala
260 265 270
Val Gly His Glu Val Gln Arg Leu Thr Val Thr Asp Leu Asp Ala Pro
275 280 285
Asn Ser Pro Ala Trp Arg Ala Thr Tyr Leu Ile Val Gly Gly Asp Asp
290 295 300
Gly Asp His Phe Thr Ile Ala Thr His Pro Glu Ser Asn Gln Gly Ile
305 310 315 320
Leu Thr Thr Arg Lys Gly Leu Asp Phe Glu Ala Lys Asn Gln His Thr
325 330 335
Leu Tyr Val Glu Val Thr Asn Glu Ala Pro Phe Val Leu Lys Leu Pro
340 345 350
Thr Ser Thr Ala Thr Ile Val Val His Val Glu Asp Val Asn Glu Ala
355 360 365
Pro Val Phe Val Pro Pro Ser Lys Val Val Glu Val Gln Glu Gly Ile
370 375 380
Pro Thr Gly Glu Ala Val Cys Val Tyr Thr Ala Lys Asp Pro Asp Lys
385 390 395 400
Glu Asn Gln Lys Ile Ser Tyr Arg Ile Leu Arg Asp Pro Ala Gly Trp
405 410 415
Leu Ala Met Asp Pro Asp Ser Gly Gln Val Thr Val Ala Gly Thr Leu
420 425 430
Asp Arg Glu Asp Glu Arg Phe Val Arg Asn Asn Ile Tyr Glu Val Met
435 440 445
Val Leu Ala Val Asp Asn Gly Ser Pro Pro Thr Thr Gly Thr Gly Thr
450 455 460
Leu Leu Leu Thr Leu Ile Asp Val Asn Asp His Gly Pro Val Pro Glu
465 470 475 480
Pro Arg Glu Ile Thr Ile Cys Asn Gln Ser Pro Glu Ser Gln Val Leu
485 490 495
Asn Ile Thr Asp Lys Asp Leu Ser Pro His Thr Ser Pro Phe Gln Ala
500 505 510
Gln Leu Thr Asp Asp Ser Asp Ile Tyr Trp Met Ala Glu Val Asn Glu
515 520 525
Lys Asp Asp Thr Val Val Leu Ser Leu Lys Lys Phe Leu Lys Gln Gly
530 535 540
Thr Tyr Asp Val His Leu Ser Leu Ser Asp His Gly Asn Lys Glu Gln
545 550 555 560
Leu Thr Val Ile Arg Ala Thr Val Cys Asp Cys His Gly His Val Glu
565 570 575
Lys Cys Pro Asp Pro Trp Lys Gly Gly Gly Ala His His His His His
580 585 590
His Gly Ala
595
<210> 126
<211> 829
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 126
Met Gly Leu Pro Arg Gly Pro Leu Ala Ser Leu Leu Leu Leu Gln Val
1 5 10 15
Cys Trp Leu Gln Cys Ala Ala Ser Glu Pro Cys Arg Ala Val Phe Arg
20 25 30
Glu Ala Glu Val Thr Leu Glu Ala Gly Gly Ala Glu Gln Glu Pro Gly
35 40 45
Gln Ala Leu Gly Lys Val Phe Met Gly Cys Pro Gly Gln Glu Pro Ala
50 55 60
Leu Phe Ser Thr Asp Asn Asp Asp Phe Thr Val Arg Asn Gly Glu Thr
65 70 75 80
Val Gln Glu Arg Arg Ser Leu Lys Glu Arg Asn Pro Leu Lys Ile Phe
85 90 95
Pro Ser Lys Arg Ile Leu Arg Arg His Lys Arg Asp Trp Val Val Ala
100 105 110
Pro Ile Ser Val Pro Glu Asn Gly Lys Gly Pro Phe Pro Gln Arg Leu
115 120 125
Asn Gln Leu Lys Ser Asn Lys Asp Arg Asp Thr Lys Ile Phe Tyr Ser
130 135 140
Ile Thr Gly Pro Gly Ala Asp Ser Pro Pro Glu Gly Val Phe Ala Val
145 150 155 160
Glu Lys Glu Thr Gly Trp Leu Leu Leu Asn Lys Pro Leu Asp Arg Glu
165 170 175
Glu Ile Ala Lys Tyr Glu Leu Phe Gly His Ala Val Ser Glu Asn Gly
180 185 190
Ala Ser Val Glu Asp Pro Met Asn Ile Ser Ile Ile Val Thr Asp Gln
195 200 205
Asn Asp His Lys Pro Lys Phe Thr Gln Asp Thr Phe Arg Gly Ser Val
210 215 220
Leu Glu Gly Val Leu Pro Gly Thr Ser Val Met Gln Val Thr Ala Thr
225 230 235 240
Asp Glu Asp Asp Ala Ile Tyr Thr Tyr Asn Gly Val Val Ala Tyr Ser
245 250 255
Ile His Ser Gln Glu Pro Lys Asp Pro His Asp Leu Met Phe Thr Ile
260 265 270
His Arg Ser Thr Gly Thr Ile Ser Val Ile Ser Ser Gly Leu Asp Arg
275 280 285
Glu Lys Val Pro Glu Tyr Thr Leu Thr Ile Gln Ala Thr Asp Met Asp
290 295 300
Gly Asp Gly Ser Thr Thr Thr Ala Val Ala Val Val Glu Ile Leu Asp
305 310 315 320
Ala Asn Asp Asn Ala Pro Met Phe Asp Pro Gln Lys Tyr Glu Ala His
325 330 335
Val Pro Glu Asn Ala Val Gly His Glu Val Gln Arg Leu Thr Val Thr
340 345 350
Asp Leu Asp Ala Pro Asn Ser Pro Ala Trp Arg Ala Thr Tyr Leu Ile
355 360 365
Met Gly Gly Asp Asp Gly Asp His Phe Thr Ile Thr Thr His Pro Glu
370 375 380
Ser Asn Gln Gly Ile Leu Thr Thr Arg Lys Gly Leu Asp Phe Glu Ala
385 390 395 400
Lys Asn Gln His Thr Leu Tyr Val Glu Val Thr Asn Glu Ala Pro Phe
405 410 415
Val Leu Lys Leu Pro Thr Ser Thr Ala Thr Ile Val Val His Val Glu
420 425 430
Asp Val Asn Glu Ala Pro Val Phe Val Pro Pro Ser Lys Val Val Glu
435 440 445
Val Gln Glu Gly Ile Pro Thr Gly Glu Pro Val Cys Val Tyr Thr Ala
450 455 460
Glu Asp Pro Asp Lys Glu Asn Gln Lys Ile Ser Tyr Arg Ile Leu Arg
465 470 475 480
Asp Pro Ala Gly Trp Leu Ala Met Asp Pro Asp Ser Gly Gln Val Thr
485 490 495
Ala Val Gly Thr Leu Asp Arg Glu Asp Glu Gln Phe Val Arg Asn Asn
500 505 510
Ile Tyr Glu Val Met Val Leu Ala Met Asp Asn Gly Ser Pro Pro Thr
515 520 525
Thr Gly Thr Gly Thr Leu Leu Leu Thr Leu Ile Asp Val Asn Asp His
530 535 540
Gly Pro Val Pro Glu Pro Arg Gln Ile Thr Ile Cys Asn Gln Ser Pro
545 550 555 560
Val Arg Gln Val Leu Asn Ile Thr Asp Lys Asp Leu Ser Pro His Thr
565 570 575
Ser Pro Phe Gln Ala Gln Leu Thr Asp Asp Ser Asp Ile Tyr Trp Thr
580 585 590
Ala Glu Val Asn Glu Glu Gly Asp Thr Val Val Leu Ser Leu Lys Lys
595 600 605
Phe Leu Lys Gln Asp Thr Tyr Asp Val His Leu Ser Leu Ser Asp His
610 615 620
Gly Asn Lys Glu Gln Leu Thr Val Ile Arg Ala Thr Val Cys Asp Cys
625 630 635 640
His Gly His Val Glu Thr Cys Pro Gly Pro Trp Lys Gly Gly Phe Ile
645 650 655
Leu Pro Val Leu Gly Ala Val Leu Ala Leu Leu Phe Leu Leu Leu Val
660 665 670
Leu Leu Leu Leu Val Arg Lys Lys Arg Lys Ile Lys Glu Pro Leu Leu
675 680 685
Leu Pro Glu Asp Asp Thr Arg Asp Asn Val Phe Tyr Tyr Gly Glu Glu
690 695 700
Gly Gly Gly Glu Glu Asp Gln Asp Tyr Asp Ile Thr Gln Leu His Arg
705 710 715 720
Gly Leu Glu Ala Arg Pro Glu Val Val Leu Arg Asn Asp Val Ala Pro
725 730 735
Thr Ile Ile Pro Thr Pro Met Tyr Arg Pro Arg Pro Ala Asn Pro Asp
740 745 750
Glu Ile Gly Asn Phe Ile Ile Glu Asn Leu Lys Ala Ala Asn Thr Asp
755 760 765
Pro Thr Ala Pro Pro Tyr Asp Thr Leu Leu Val Phe Asp Tyr Glu Gly
770 775 780
Ser Gly Ser Asp Ala Ala Ser Leu Ser Ser Leu Thr Ser Ser Ala Ser
785 790 795 800
Asp Gln Asp Gln Asp Tyr Asp Tyr Leu Asn Glu Trp Gly Ser Arg Phe
805 810 815
Lys Lys Leu Ala Asp Met Tyr Gly Gly Gly Glu Asp Asp
820 825
<210> 127
<211> 219
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 127
Gly Pro Asp Trp Val Val Ala Pro Ile Ser Val Pro Glu Asn Gly Lys
1 5 10 15
Gly Pro Phe Pro Gln Arg Leu Asn Gln Leu Lys Ser Asn Lys Asp Arg
20 25 30
Asp Thr Lys Ile Phe Tyr Ser Ile Thr Gly Pro Gly Ala Asp Ser Pro
35 40 45
Pro Glu Gly Val Phe Ala Val Glu Lys Glu Thr Gly Trp Leu Leu Leu
50 55 60
Asn Lys Pro Leu Asp Arg Glu Glu Ile Ala Lys Tyr Glu Leu Phe Gly
65 70 75 80
His Ala Val Ser Glu Asn Gly Ala Ser Val Glu Asp Pro Met Asn Ile
85 90 95
Ser Ile Ile Val Thr Asp Gln Asn Asp His Lys Pro Lys Phe Thr Gln
100 105 110
Asp Thr Phe Arg Gly Ser Val Leu Glu Gly Val Leu Pro Gly Thr Ser
115 120 125
Val Met Gln Val Thr Ala Thr Asp Glu Asp Asp Ala Ile Tyr Thr Tyr
130 135 140
Asn Gly Val Val Ala Tyr Ser Ile His Ser Gln Glu Pro Lys Asp Pro
145 150 155 160
His Asp Leu Met Phe Thr Ile His Arg Ser Thr Gly Thr Ile Ser Val
165 170 175
Ile Ser Ser Gly Leu Asp Arg Glu Lys Val Pro Glu Tyr Thr Leu Thr
180 185 190
Ile Gln Ala Thr Asp Met Asp Gly Asp Gly Ser Thr Thr Thr Ala Val
195 200 205
Ala Val Val Glu Ile Leu Asp Ala Asn Asp Asn
210 215
<210> 128
<211> 244
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 128
Gln Val Gln Leu Gln Gln Ser Gly Pro Gly Leu Val Lys Pro Ser Gln
1 5 10 15
Thr Leu Ser Leu Thr Cys Ala Ile Ser Gly Asp Ser Val Ser Ser Gln
20 25 30
Ser Ala Ala Trp Asn Trp Ile Arg Gln Ser Pro Ser Arg Gly Leu Glu
35 40 45
Trp Leu Gly Arg Ile Tyr Tyr Arg Ser Lys Trp Tyr Asn Asp Tyr Ala
50 55 60
Leu Ser Val Lys Ser Arg Ile Thr Ile Asn Pro Asp Thr Ser Lys Asn
65 70 75 80
Gln Phe Ser Leu Gln Leu Asn Ser Val Thr Pro Glu Asp Thr Ala Val
85 90 95
Tyr Tyr Cys Ala Arg Gly Glu Gly Tyr Gly Arg Glu Gly Phe Ala Ile
100 105 110
Trp Gly Gln Gly Thr Leu Val Thr Val Ser Ser Ala Ser Thr Lys Gly
115 120 125
Pro Ser Val Phe Pro Leu Ala Pro Ser Ser Lys Ser Thr Ser Gly Gly
130 135 140
Thr Ala Ala Leu Gly Cys Leu Val Lys Asp Tyr Phe Pro Glu Pro Val
145 150 155 160
Thr Val Ser Trp Asn Ser Gly Ala Leu Thr Ser Gly Val His Thr Phe
165 170 175
Pro Ala Val Leu Gln Ser Ser Gly Leu Tyr Ser Leu Ser Ser Val Val
180 185 190
Thr Val Pro Ser Ser Ser Leu Gly Thr Gln Thr Tyr Ile Cys Asn Val
195 200 205
Asn His Lys Pro Ser Asn Thr Lys Val Asp Lys Lys Val Glu Pro Lys
210 215 220
Ser Glu Phe Asp Tyr Lys Asp Asp Asp Asp Lys Gly Ala Pro His His
225 230 235 240
His His His His
<210> 129
<211> 213
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
polypeptide"
<400> 129
Asp Ile Gln Met Thr Gln Ser Pro Ser Ser Leu Ser Ala Ser Val Gly
1 5 10 15
Asp Arg Val Thr Ile Thr Cys Arg Ala Ser Gln Thr Ile Ser Asn Thr
20 25 30
Leu Ala Trp Tyr Gln Gln Lys Pro Gly Lys Ala Pro Lys Leu Leu Ile
35 40 45
Tyr Ala Ala Ser Asn Leu Gln Ser Gly Val Pro Ser Arg Phe Ser Gly
50 55 60
Ser Gly Ser Gly Thr Asp Phe Thr Leu Thr Ile Ser Ser Leu Gln Pro
65 70 75 80
Glu Asp Phe Ala Thr Tyr Tyr Cys Gln Gln Tyr Leu Ser Trp Phe Thr
85 90 95
Phe Gly Gln Gly Thr Lys Val Glu Ile Lys Arg Thr Val Ala Ala Pro
100 105 110
Ser Val Phe Ile Phe Pro Pro Ser Asp Glu Gln Leu Lys Ser Gly Thr
115 120 125
Ala Ser Val Val Cys Leu Leu Asn Asn Phe Tyr Pro Arg Glu Ala Lys
130 135 140
Val Gln Trp Lys Val Asp Asn Ala Leu Gln Ser Gly Asn Ser Gln Glu
145 150 155 160
Ser Val Thr Glu Gln Asp Ser Lys Asp Ser Thr Tyr Ser Leu Ser Ser
165 170 175
Thr Leu Thr Leu Ser Lys Ala Asp Tyr Glu Lys His Lys Val Tyr Ala
180 185 190
Cys Glu Val Thr His Gln Gly Leu Ser Ser Pro Val Thr Lys Ser Phe
195 200 205
Asn Arg Gly Glu Ala
210
<210> 130
<211> 6
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
6xHis tag"
<400> 130
His His His His His His
1 5
<210> 131
<211> 4
<212> PRT
<213> Artificial Sequence
<220>
<221> source
<223> /note="Description of Artificial Sequence: Synthetic
peptide"
<400> 131
Arg Gly Asp Ser
1
<210> 132
<211> 22
<212> PRT
<213> Human immunodeficiency virus
<400> 132
Tyr Gly Arg Lys Lys Arg Arg Gln Arg Arg Arg Leu Tyr Arg Ser Pro
1 5 10 15
Ala Met Pro Glu Asn Leu
20
<210> 133
<211> 101
<212> PRT
<213> Homo sapiens
<400> 133
Asp Trp Val Val Ala Pro Ile Ser Val Pro Glu Asn Gly Lys Gly Pro
1 5 10 15
Phe Pro Gln Arg Leu Asn Gln Leu Lys Ser Asn Lys Asp Arg Asp Thr
20 25 30
Lys Ile Phe Tyr Ser Ile Thr Gly Pro Gly Ala Asp Ser Pro Pro Glu
35 40 45
Gly Val Phe Ala Val Glu Lys Glu Thr Gly Trp Leu Leu Leu Asn Lys
50 55 60
Pro Leu Asp Arg Glu Glu Ile Ala Lys Tyr Glu Leu Phe Gly His Ala
65 70 75 80
Val Ser Glu Asn Gly Ala Ser Val Glu Asp Pro Met Asn Ile Ser Ile
85 90 95
Ile Val Thr Asp Gln
100
<210> 134
<211> 101
<212> PRT
<213> Macaca fascicularis
<400> 134
Asp Trp Val Val Ala Pro Ile Ser Val Pro Glu Asn Gly Lys Gly Pro
1 5 10 15
Phe Pro Gln Arg Leu Asn Gln Leu Lys Ser Asn Lys Asp Arg Asp Thr
20 25 30
Lys Ile Phe Tyr Ser Ile Thr Gly Pro Gly Ala Asp Ser Pro Pro Glu
35 40 45
Gly Val Phe Ala Val Glu Lys Glu Thr Gly Trp Leu Leu Leu Asn Lys
50 55 60
Pro Leu Asp Arg Glu Glu Ile Ala Lys Tyr Glu Leu Phe Gly His Ala
65 70 75 80
Val Ser Glu Asn Gly Ala Ser Val Glu Asp Pro Met Asn Ile Ser Ile
85 90 95
Ile Val Thr Asp Gln
100
<210> 135
<211> 59
<212> PRT
<213> Homo sapiens
<400> 135
Cys Pro Glu Asn Glu Lys Gly Pro Phe Pro Lys Asn Leu Val Gln Ile
1 5 10 15
Lys Ser Asn Lys Asp Lys Glu Gly Lys Val Phe Tyr Ser Ile Thr Gly
20 25 30
Gln Gly Ala Asp Thr Pro Pro Val Gly Val Phe Ile Ile Glu Arg Glu
35 40 45
Thr Gly Trp Leu Lys Val Thr Glu Pro Leu Asp
50 55
<210> 136
<211> 59
<212> PRT
<213> Homo sapiens
<400> 136
Leu Pro Glu Asn Ser Arg Gly Pro Phe Pro Gln Glu Leu Val Arg Ile
1 5 10 15
Arg Ser Asp Arg Asp Lys Asn Leu Ser Leu Arg Tyr Ser Val Thr Gly
20 25 30
Pro Gly Ala Asp Gln Pro Pro Thr Gly Ile Phe Ile Ile Asn Pro Ile
35 40 45
Ser Gly Gln Leu Ser Val Thr Lys Pro Leu Asp
50 55
<210> 137
<211> 59
<212> PRT
<213> Homo sapiens
<400> 137
Val Pro Glu Asn Gly Lys Gly Pro Phe Pro Gln Arg Leu Asn Gln Leu
1 5 10 15
Lys Ser Asn Lys Asp Arg Asp Thr Lys Ile Phe Tyr Ser Ile Thr Gly
20 25 30
Pro Gly Ala Asp Ser Pro Pro Glu Gly Val Phe Ala Val Glu Lys Glu
35 40 45
Thr Gly Trp Leu Leu Leu Asn Lys Pro Leu Asp
50 55
<210> 138
<211> 59
<212> PRT
<213> Homo sapiens
<400> 138
Val Pro Glu Asn Ser Arg Gly Pro Phe Pro Gln Gln Leu Val Arg Ile
1 5 10 15
Arg Ser Asp Lys Asp Asn Asp Ile Pro Ile Arg Tyr Ser Ile Thr Gly
20 25 30
Val Gly Ala Asp Gln Pro Pro Met Glu Val Phe Ser Ile Asp Ser Met
35 40 45
Ser Gly Arg Met Tyr Val Thr Arg Pro Met Asp
50 55
<210> 139
<211> 54
<212> PRT
<213> Homo sapiens
<400> 139
Ile Asp Glu Glu Lys Asn Thr Ser Leu Pro His His Val Gly Lys Ile
1 5 10 15
Lys Ser Ser Val Ser Arg Lys Asn Ala Lys Tyr Leu Leu Lys Gly Glu
20 25 30
Tyr Val Gly Lys Val Phe Arg Val Asp Ala Glu Thr Gly Asp Val Phe
35 40 45
Ala Ile Glu Arg Leu Asp
50
<210> 140
<211> 56
<212> PRT
<213> Homo sapiens
<400> 140
Leu Leu Glu Glu Tyr Thr Gly Ser Asp Tyr Gln Tyr Val Gly Lys Leu
1 5 10 15
His Ser Asp Gln Asp Arg Gly Asp Gly Ser Leu Lys Tyr Ile Leu Ser
20 25 30
Gly Asp Gly Ala Gly Asp Leu Phe Ile Ile Asn Glu Asn Thr Gly Asp
35 40 45
Ile Gln Ala Thr Lys Arg Leu Asp
50 55
<210> 141
<211> 56
<212> PRT
<213> Homo sapiens
<400> 141
Val Leu Glu Glu Tyr Met Gly Ser Asp Pro Leu Tyr Val Gly Lys Leu
1 5 10 15
His Ser Asp Val Asp Lys Gly Asp Gly Ser Ile Lys Tyr Ile Leu Ser
20 25 30
Gly Glu Gly Ala Ser Ser Ile Phe Ile Ile Asp Glu Asn Thr Gly Asp
35 40 45
Ile His Ala Thr Lys Arg Leu Asp
50 55
<210> 142
<211> 56
<212> PRT
<213> Homo sapiens
<400> 142
Val Leu Glu Glu Phe Ser Gly Pro Glu Pro Ile Leu Val Gly Arg Leu
1 5 10 15
His Thr Asp Leu Asp Pro Gly Ser Lys Lys Ile Lys Tyr Ile Leu Ser
20 25 30
Gly Asp Gly Ala Gly Thr Ile Phe Gln Ile Asn Asp Val Thr Gly Asp
35 40 45
Ile His Ala Ile Lys Arg Leu Asp
50 55
<210> 143
<211> 56
<212> PRT
<213> Homo sapiens
<400> 143
Leu Leu Glu Glu Tyr Thr Gly Thr Asp Thr Gln Tyr Val Gly Lys Leu
1 5 10 15
His Thr Asp Gln Asp Lys Gly Asp Gly Asn Leu Lys Tyr Ile Leu Thr
20 25 30
Gly Asp Gly Ala Gly Ser Leu Phe Val Ile Asp Glu Asn Thr Gly Asp
35 40 45
Ile His Ala Ala Lys Lys Leu Asp
50 55
Claims (55)
- 서열식별번호: 126의 위치 124, 125, 151, 153, 154, 155, 156, 159, 160, 161, 162, 163, 168, 170, 171, 및 172에서의 아미노산으로부터 선택된 1개 이상의 잔기에서 인간 P-카드헤린 단백질에 결합하는 항체 또는 그의 항원 결합 단편.
- 제1항에 있어서, 서열식별번호: 126의 위치 124, 125, 151, 153, 154, 155, 156, 159, 160, 161, 162, 163, 168, 170, 171, 및 172에서의 아미노산에서 인간 P-카드헤린 단백질에 결합하는 항체.
- 제1항에 있어서, 서열식별번호: 126의 위치 124, 151, 153-156, 및 172로부터 선택된 1개 이상의 아미노산 잔기에서 인간 P-카드헤린에 결합하는 중쇄 가변 영역을 포함하는 항체.
- 제3항에 있어서, 인간 P-카드헤린 단백질에 대한 중쇄 가변 영역 결합 파라토프가 서열식별번호: 128의 위치 52, 54, 56, 60, 65, 105, 또는 107로부터 선택된 1개 이상의 아미노산 잔기를 포함하는 것인 항체.
- 제1항에 있어서, 서열식별번호: 126의 위치 124, 125, 155, 156, 159-163, 168, 170, 및 171로부터 선택된 1개 이상의 아미노산 잔기에서 인간 P-카드헤린에 결합하는 경쇄 가변 영역을 포함하는 항체.
- 제5항에 있어서, 인간 P-카드헤린 단백질에 대한 경쇄 가변 영역 결합 파라토프가 서열식별번호: 129의 위치 1, 2, 27, 28, 30, 68, 92, 93, 또는 94로부터 선택된 1개 이상의 아미노산 잔기를 포함하는 것인 항체.
- 제3항의 중쇄 영역 및 제5항의 경쇄 가변 영역을 포함하는 항체 또는 그의 항원 결합 단편.
- a. 서열식별번호: 1의 VH CDR1, 서열식별번호: 2의 VH CDR2, 및 서열식별번호: 3의 VH CDR3을 포함하며, 여기서 CDR은 카바트(Kabat) 정의에 따라 정의된 것인 중쇄 가변 영역; 및 서열식별번호: 11의 VL CDR1, 서열식별번호: 12의 VL CDR2, 및 서열식별번호: 13의 VL CDR3을 포함하며, 여기서 CDR은 카바트 정의에 따라 정의된 것인 경쇄 가변 영역;
b. 서열식별번호: 21의 VH CDR1, 서열식별번호: 22의 VH CDR2, 및 서열식별번호: 23의 VH CDR3을 포함하며, 여기서 CDR은 카바트 정의에 따라 정의된 것인 중쇄 가변 영역; 및 서열식별번호: 31의 VL CDR1, 서열식별번호: 32의 VL CDR2, 및 서열식별번호: 33의 VL CDR3을 포함하며, 여기서 CDR은 카바트 정의에 따라 정의된 것인 경쇄 가변 영역;
c. 서열식별번호: 41의 VH CDR1, 서열식별번호: 42의 VH CDR2, 및 서열식별번호: 43의 VH CDR3을 포함하며, 여기서 CDR은 카바트 정의에 따라 정의된 것인 중쇄 가변 영역; 및 서열식별번호: 51의 VL CDR1, 서열식별번호: 52의 VL CDR2, 및 서열식별번호: 53의 VL CDR3을 포함하며, 여기서 CDR은 카바트 정의에 따라 정의된 것인 경쇄 가변 영역;
d. 서열식별번호: 61의 VH CDR1, 서열식별번호: 62의 VH CDR2, 및 서열식별번호: 63의 VH CDR3을 포함하며, 여기서 CDR은 카바트 정의에 따라 정의된 것인 중쇄 가변 영역; 및 서열식별번호: 71의 VL CDR1, 서열식별번호: 72의 VL CDR2, 및 서열식별번호: 73의 VL CDR3을 포함하며, 여기서 CDR은 카바트 정의에 따라 정의된 것인 경쇄 가변 영역;
e. 서열식별번호: 81의 VH CDR1, 서열식별번호: 82의 VH CDR2, 및 서열식별번호: 83의 VH CDR3을 포함하며, 여기서 CDR은 카바트 정의에 따라 정의된 것인 중쇄 가변 영역; 및 서열식별번호: 91의 VL CDR1, 서열식별번호: 92의 VL CDR2, 및 서열식별번호: 93의 VL CDR3을 포함하며, 여기서 CDR은 카바트 정의에 따라 정의된 것인 경쇄 가변 영역; 또는
f. 서열식별번호: 101의 VH CDR1, 서열식별번호: 102의 VH CDR2, 및 서열식별번호: 103의 VH CDR3을 포함하며, 여기서 CDR은 카바트 정의에 따라 정의된 것인 중쇄 가변 영역; 및 서열식별번호: 111의 VL CDR1, 서열식별번호: 112의 VL CDR2, 및 서열식별번호: 113의 VL CDR3을 포함하며, 여기서 CDR은 카바트 정의에 따라 정의된 것인 경쇄 가변 영역
을 포함하는, P-카드헤린에 결합하는 항체 또는 그의 항원 결합 단편. - a. 서열식별번호: 7의 아미노산 서열을 포함하는 중쇄 가변 영역 (VH), 및 서열식별번호: 17의 아미노산 서열을 포함하는 경쇄 가변 영역 (VL);
b. 서열식별번호: 27의 아미노산 서열을 포함하는 중쇄 가변 영역 (VH), 및 서열식별번호: 37의 아미노산 서열을 포함하는 경쇄 가변 영역 (VL);
c. 서열식별번호: 47의 아미노산 서열을 포함하는 중쇄 가변 영역 (VH), 및 서열식별번호: 57의 아미노산 서열을 포함하는 경쇄 가변 영역 (VL);
d. 서열식별번호: 67의 아미노산 서열을 포함하는 중쇄 가변 영역 (VH), 및 서열식별번호: 77의 아미노산 서열을 포함하는 경쇄 가변 영역 (VL);
e. 서열식별번호: 87의 아미노산 서열을 포함하는 중쇄 가변 영역 (VH), 및 서열식별번호: 97의 아미노산 서열을 포함하는 경쇄 가변 영역 (VL); 또는
f. 서열식별번호: 107의 아미노산 서열을 포함하는 중쇄 가변 영역 (VH), 및 서열식별번호: 117의 아미노산 서열을 포함하는 경쇄 가변 영역 (VL)
을 포함하는, P-카드헤린에 결합하는 항체 또는 그의 항원 결합 단편. - a. 서열식별번호: 9의 아미노산 서열을 포함하는 중쇄, 및 서열식별번호: 19의 아미노산 서열을 포함하는 경쇄;
b. 서열식별번호: 29의 아미노산 서열을 포함하는 중쇄, 및 서열식별번호: 39의 아미노산 서열을 포함하는 경쇄;
c. 서열식별번호: 49의 아미노산 서열을 포함하는 중쇄, 및 서열식별번호: 59의 아미노산 서열을 포함하는 경쇄;
d. 서열식별번호: 69의 아미노산 서열을 포함하는 중쇄, 및 서열식별번호: 79의 아미노산 서열을 포함하는 경쇄;
e. 서열식별번호: 89의 아미노산 서열을 포함하는 중쇄, 및 서열식별번호: 99의 아미노산 서열을 포함하는 경쇄;
f. 서열식별번호: 109의 아미노산 서열을 포함하는 중쇄, 및 서열식별번호: 119의 아미노산 서열을 포함하는 경쇄
를 포함하는, P-카드헤린에 결합하는 항체 또는 그의 항원 결합 단편. - 제8항 내지 제10항 중 어느 한 항에 청구된 바와 같은 항체와 동일한 인간 P-카드헤린의 에피토프에 결합하거나, 또는 인간 P-카드헤린에의 결합에 대해 제8항 내지 제10항 중 어느 한 항에 청구된 바와 같은 항체와 경쟁하는 항체.
- 하기 화학식을 포함하는 항체 약물 접합체 또는 그의 제약상 허용되는 염.
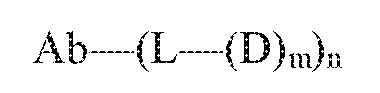
여기서
Ab는 제1항 내지 제11항 중 어느 한 항에 따른 항체 또는 그의 항원 결합 단편이고;
L은 링커이고;
D는 약물 모이어티이고;
m은 1 내지 8의 정수이고;
n은 1 내지 10의 정수이다. - 제12항에 있어서, 상기 m이 1인 항체 약물 접합체.
- 제11항 또는 제12항에 있어서, 상기 n이 3 또는 4인 항체 약물 접합체.
- 제12항 내지 제14항 중 어느 한 항에 있어서, 항체 또는 항원 결합 영역이 서열식별번호: 7의 아미노산 서열을 포함하는 VH 영역 및 서열식별번호: 17의 아미노산 서열을 포함하는 VL 영역을 포함하는 것인 항체 약물 접합체.
- 제12항 내지 제14항 중 어느 한 항에 있어서, 항체 또는 항원 결합 영역이 서열식별번호: 27의 아미노산 서열을 포함하는 VH 영역 및 서열식별번호: 37의 아미노산 서열을 포함하는 VL 영역을 포함하는 것인 항체 약물 접합체.
- 제12항 내지 제14항 중 어느 한 항에 있어서, 상기 항체 또는 그의 항원 결합 단편이 (a) 서열식별번호: 1의 VH CDR1, (b) 서열식별번호: 2의 VH CDR2, (c) 서열식별번호: 3의 VH CDR3을 포함하는 VH 영역, 및 (d) 서열식별번호: 11의 VL CDR1, (e) 서열식별번호: 12의 VL CDR2, 및 (f) 서열식별번호: 13의 VL CDR3을 포함하는 VL 영역을 포함하며, 여기서 CDR은 카바트 정의에 따라 정의된 것인 항체 약물 접합체.
- 제12항 내지 제14항 중 어느 한 항에 있어서, 상기 항체 또는 그의 항원 결합 단편이 (a) 서열식별번호: 21의 VH CDR1, (b) 서열식별번호: 22의 VH CDR2, (c) 서열식별번호: 23의 VH CDR3을 포함하는 VH 영역, 및 (d) 서열식별번호: 31의 VL CDR1, (e) 서열식별번호: 32의 VL CDR2, 및 (f) 서열식별번호: 33의 VL CDR3을 포함하는 VL 영역을 포함하며, 여기서 CDR은 카바트 정의에 따라 정의된 것인 항체 약물 접합체.
- 제12항 내지 제14항 중 어느 한 항에 있어서, 상기 항체 또는 그의 항원 결합 단편이 서열식별번호: 9의 중쇄 및 서열식별번호: 19의 경쇄를 포함하는 것인 항체 약물 접합체.
- 제12항 내지 제14항 중 어느 한 항에 있어서, 상기 항체가 서열식별번호: 29의 중쇄 및 서열식별번호: 39의 경쇄를 포함하는 것인 항체 약물 접합체.
- 제12항 내지 제20항 중 어느 한 항에 있어서, 상기 항체가 모노클로날 항체인 항체 약물 접합체.
- 제12항 내지 제21항 중 어느 한 항에 있어서, 상기 링커가 절단가능한 링커, 비-절단가능한 링커, 친수성 링커, 사전하전된 링커 및 디카르복실산계 링커로 이루어진 군으로부터 선택된 것인 항체 약물 접합체.
- 제22항에 있어서, 링커가 N-숙신이미딜-3-(2-피리딜디티오)프로피오네이트 (SPDP), N-숙신이미딜 4-(2-피리딜디티오)펜타노에이트 (SPP), N-숙신이미딜 4-(2-피리딜디티오)부타노에이트 (SPDB), N-숙신이미딜-4-(2-피리딜디티오)-2-술포-부타노에이트 (술포-SPDB), N-숙신이미딜 아이오도아세테이트 (SIA), N-숙신이미딜(4-아이오도아세틸)아미노벤조에이트 (SIAB), 말레이미드 PEG NHS, N-숙신이미딜 4-(말레이미도메틸) 시클로헥산카르복실레이트 (SMCC), N-술포숙신이미딜 4-(말레이미도메틸) 시클로헥산카르복실레이트 (술포-SMCC), 및 2,5-디옥소피롤리딘-1-일 17-(2,5-디옥소-2,5-디히드로-1H-피롤-1-일)-5,8,11,14-테트라옥소-4,7,10,13-테트라아자헵타데칸-1-오에이트 (CX1-1)로 이루어진 군으로부터 선택된 가교 시약으로부터 유래된 것인 항체 약물 접합체.
- 제23항에 있어서, 상기 링커가 N-숙신이미딜 4-(말레이미도메틸) 시클로헥산카르복실레이트 (SMCC), N-숙신이미딜 4-(2-피리딜디티오)부타노에이트 (SPDB), 및 2,5-디옥소피롤리딘-1-일 17-(2,5-디옥소-2,5-디히드로-1H-피롤-1-일)-5,8,11,14-테트라옥소-4,7,10,13-테트라아자헵타데칸-1-오에이트 (CX1-1)로 이루어진 군으로부터 선택된 가교 시약으로부터 유래된 것인 항체 약물 접합체.
- 제12항 내지 제24항 중 어느 한 항에 있어서, 상기 약물 모이어티가 V-ATPase 억제제, 아폽토시스촉진제, Bcl2 억제제, MCL1 억제제, HSP90 억제제, IAP 억제제, mTor 억제제, 미세관 안정화제, 미세관 탈안정화제, 아우리스타틴, 돌라스타틴, 메이탄시노이드, MetAP (메티오닌 아미노펩티다제), 단백질 CRM1의 핵 유출의 억제제, DPPIV 억제제, 프로테아솜 억제제, 미토콘드리아에서의 포스포릴 전달 반응의 억제제, 단백질 합성 억제제, 키나제 억제제, CDK2 억제제, CDK9 억제제, 키네신 억제제, HDAC 억제제, DNA 손상 작용제, DNA 알킬화제, DNA 삽입제, DNA 작은 홈 결합제 및 DHFR 억제제로 이루어진 군으로부터 선택된 것인 항체 약물 접합체.
- 제25항에 있어서, 세포독성제가 메이탄시노이드인 항체 약물 접합체.
- 제26항에 있어서, 메이탄시노이드가 N(2')-데아세틸-N(2')-(3-메르캅토-1-옥소프로필)-메이탄신 (DM1) 또는 N(2')-데아세틸-N2-(4-메르캅토-4-메틸-1-옥소펜틸)-메이탄신 (DM4)인 항체 약물 접합체.
- 제12항에 있어서, 하기 화학식을 갖는 항체 약물 접합체 또는 그의 제약상 허용되는 염.

여기서 Ab는 서열식별번호: 1의 중쇄 CDR1, 서열식별번호: 2의 중쇄 CDR2, 서열식별번호: 3의 중쇄 CDR3, 및 서열식별번호: 11의 경쇄 CDR1, 서열식별번호: 12의 경쇄 CDR2, 서열식별번호: 13의 경쇄 CDR3을 포함하는 항체 또는 그의 항원 결합 단편이며, 여기서 CDR은 카바트 정의에 따라 정의되고; n은 1 내지 10이다. - 제1항 내지 제11항 중 어느 한 항의 항체 또는 그의 항원 결합 단편 및 제약상 허용되는 담체를 포함하는 제약 조성물.
- 제12항 내지 제28항 중 어느 한 항의 항체 약물 접합체 및 제약상 허용되는 담체를 포함하는 제약 조성물.
- 제29항 또는 제30항에 있어서, 동결건조물로서 제조되는 제약 조성물.
- 제31항에 있어서, 상기 동결건조물이 제1항 내지 제11항 중 어느 한 항의 항체 또는 제12항 내지 제28항 중 어느 한 항의 항체 약물 접합체, 히스티딘, 수크로스, 및 폴리소르베이트 20을 포함하는 것인 제약 조성물.
- 제32항에 있어서, 약 10mg/mL의 제28항의 항체 약물 접합체, 20mM 히스티딘, 240mM 수크로스, 및 0.02% 폴리소르베이트 20을 포함하는 제약 조성물.
- 암의 치료를 필요로 하는 환자에게 제12항 내지 제28항 중 어느 한 항의 항체 약물 접합체, 또는 제29항 내지 제33항 중 어느 한 항의 제약 조성물을 투여하는 것을 포함하는, 상기 환자에서 암을 치료하는 방법.
- 제34항에 있어서, 항체 약물 접합체 또는 제약 조성물이 1종 이상의 추가의 치료 화합물과 조합되어 환자에게 투여되는 것인 방법.
- 제12항 내지 제33항 중 어느 한 항에 있어서, 의약으로서 사용하기 위한 항체 약물 접합체, 또는 제약 조성물.
- 제12항 내지 제33항 중 어느 한 항에 있어서, 암의 치료를 필요로 하는 환자에서의 암의 치료에 사용하기 위한 항체 약물 접합체, 또는 제약 조성물.
- 암의 치료를 필요로 하는 환자에서 암을 치료하기 위한 제1항 내지 제11항 중 어느 한 항의 항체, 제12항 내지 제28항 중 어느 한 항의 항체 약물 접합체, 또는 제29항 내지 제33항 중 어느 한 항의 제약 조성물의 용도.
- 암의 치료를 위한 의약의 제조에서의 제1항 내지 제11항 중 어느 한 항의 항체 또는 제12항 내지 제28항 중 어느 한 항의 항체 약물 접합체의 용도.
- 제34항 내지 제39항 중 어느 한 항에 있어서, 암이 P-카드헤린을 발현하는 것인 방법, 항체 약물 접합체, 또는 용도.
- 제40항에 있어서, 암이 부신피질 암종, 방광암, 골암, 유방암, 중추 신경계 비정형 기형/횡문근양 종양, 결장암, 결장직장암, 배아성 종양, 자궁내막암, 식도암, 위암, 두경부암, 간세포성암, 카포시 육종, 간암, 소세포 폐암 및 비소세포 폐암을 포함한 폐암, 난소암, 직장암, 횡문근육종, 소장암, 연부 조직 육종, 편평 세포 암종, 편평 경부암, 위암, 자궁암, 질암, 및 외음부암, 부신피질 암종, 방광암, 골암, 유방암, 중추 신경계 비정형 기형/횡문근양 종양, 결장암, 결장직장암, 배아성 종양, 자궁내막암, 식도암, 위암, 두경부암, 간세포성암, 카포시 육종, 간암, 소세포 폐암 및 비소세포 폐암을 포함한 폐암, 난소암, 직장암, 횡문근육종, 소장암, 연부 조직 육종, 편평 세포 암종, 편평 경부암, 위암, 자궁암, 질암, 및 외음부암으로 이루어진 군으로부터 선택된 것인 방법, 항체 약물 접합체, 또는 용도.
- 제38항에 있어서, 암이 방광암, 유방암, 결장암, 결장직장암, 자궁내막암, 식도암, 위암, 두경부암, 폐암, 및 난소암으로 이루어진 군으로부터 선택된 것인 방법, 항체 약물 접합체, 또는 용도.
- 제1항 내지 제11항 중 어느 한 항에 있어서, 인간 또는 인간화 항체인 항체 또는 항원 결합 단편.
- 제1항 내지 제11항 및 제43항 중 어느 한 항에 있어서, 모노클로날 항체인 항체 또는 항원 결합 단편.
- 제1항 내지 제11항, 제43항 및 제44항 중 어느 한 항에 있어서, 단일 쇄 항체 (scFv)인 항체 또는 항원 결합 단편.
- 제1항 내지 제11항 및 제43항 내지 제45항 중 어느 한 항의 항체 또는 항원 결합 단편을 코딩하는 핵산.
- 제46항에 있어서, 서열식별번호: 8, 28, 48, 68, 88, 108, 18, 38, 58, 78, 98, 118, 10, 30, 50, 70, 90, 110, 20, 40, 60, 80, 100, 및 120의 뉴클레오티드 서열을 포함하는 핵산.
- 제46항 또는 제47항의 핵산을 포함하는 벡터.
- 제48항에 따른 벡터 또는 제46항 또는 제47항에 따른 핵산을 포함하는 숙주 세포.
- 제49항의 숙주 세포를 배양하는 것 및 배양물로부터 항체를 회수하는 것을 포함하는, 항체 또는 항원 결합 단편을 제조하는 방법.
- (a) SMCC를 약물 모이어티 DM-1에 화학적으로 연결하는 것;
(b) 상기 링커-약물을 제47항의 세포 배양물로부터 회수된 항체에 접합시키는 것; 및
(c) 항체 약물 접합체를 정제하는 것
을 포함하는, 항-P-카드헤린 항체 약물 접합체를 제조하는 방법. - (a) SMCC를 약물 모이어티 DM-1에 화학적으로 연결하는 것;
(b) 상기 링커-약물을 제1항 내지 제11항, 제43항 및 제44항 중 어느 한 항에 청구된 바와 같은 항체에 접합시키는 것; 및
(c) 항체 약물 접합체를 정제하는 것
을 포함하는, 항-P-카드헤린 항체 약물 접합체를 제조하는 방법. - UV 분광광도계로 측정된 평균 DAR이 약 3.8인 제51항 또는 제52항에 따라 제조된 항체 약물 접합체.
- 제1항 내지 제11항 및 제43항 내지 제45항 중 어느 한 항의 항체 또는 그의 항원 결합 단편을 포함하는 진단 시약.
- 제54항에 있어서, 항체 또는 그의 항원 결합 단편이 방사성표지, 형광단, 발색단, 영상화제, 또는 금속 이온으로 표지된 것인 진단 시약.
Applications Claiming Priority (3)
| Application Number | Priority Date | Filing Date | Title |
|---|---|---|---|
| US201462079942P | 2014-11-14 | 2014-11-14 | |
| US62/079,942 | 2014-11-14 | ||
| PCT/IB2015/058801 WO2016075670A1 (en) | 2014-11-14 | 2015-11-13 | Antibody drug conjugates |
Publications (1)
| Publication Number | Publication Date |
|---|---|
| KR20170084202A true KR20170084202A (ko) | 2017-07-19 |
Family
ID=54695810
Family Applications (1)
| Application Number | Title | Priority Date | Filing Date |
|---|---|---|---|
| KR1020177015786A Withdrawn KR20170084202A (ko) | 2014-11-14 | 2015-11-13 | 항체 약물 접합체 |
Country Status (27)
| Country | Link |
|---|---|
| US (2) | US10005836B2 (ko) |
| EP (1) | EP3218410B1 (ko) |
| JP (1) | JP6831783B2 (ko) |
| KR (1) | KR20170084202A (ko) |
| CN (1) | CN108064244B (ko) |
| AR (1) | AR102649A1 (ko) |
| AU (1) | AU2015347015B2 (ko) |
| BR (1) | BR112017009813A2 (ko) |
| CA (1) | CA2967188A1 (ko) |
| CL (1) | CL2017001217A1 (ko) |
| CO (1) | CO2017004782A2 (ko) |
| CR (1) | CR20170200A (ko) |
| EA (1) | EA201791050A1 (ko) |
| EC (1) | ECSP17034845A (ko) |
| ES (1) | ES2987508T3 (ko) |
| GT (1) | GT201700102A (ko) |
| IL (1) | IL252015A0 (ko) |
| MA (1) | MA40913A (ko) |
| MX (1) | MX2017006301A (ko) |
| PE (1) | PE20170912A1 (ko) |
| PH (1) | PH12017500890A1 (ko) |
| PY (1) | PY1570443A (ko) |
| SG (1) | SG11201703464UA (ko) |
| TN (1) | TN2017000173A1 (ko) |
| TW (1) | TW201625692A (ko) |
| UY (1) | UY36401A (ko) |
| WO (1) | WO2016075670A1 (ko) |
Families Citing this family (27)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| PE20170912A1 (es) * | 2014-11-14 | 2017-07-12 | Novartis Ag | Conjugados de anticuerpo-farmaco |
| WO2016203432A1 (en) * | 2015-06-17 | 2016-12-22 | Novartis Ag | Antibody drug conjugates |
| TWI808055B (zh) | 2016-05-11 | 2023-07-11 | 美商滬亞生物國際有限公司 | Hdac 抑制劑與 pd-1 抑制劑之組合治療 |
| TWI794171B (zh) | 2016-05-11 | 2023-03-01 | 美商滬亞生物國際有限公司 | Hdac抑制劑與pd-l1抑制劑之組合治療 |
| AU2017277534A1 (en) * | 2016-06-08 | 2019-01-03 | Abbvie Inc. | Anti-EGFR antibody drug conjugates |
| EP3501554A4 (en) * | 2016-08-19 | 2020-04-15 | FUJIFILM Toyama Chemical Co., Ltd. | COMPOSITION CONTAINING A BUFFER |
| ES2944589T3 (es) | 2016-08-25 | 2023-06-22 | Hoffmann La Roche | Nanopartículas de silicio multifuncionalizadas y usos de las mismas en procedimientos de detección basados en electroquimioluminiscencia |
| KR102760578B1 (ko) | 2016-12-22 | 2025-02-03 | 큐 바이오파마, 인크. | T-세포 조절 다량체 폴리펩타이드 및 이의 사용 방법 |
| EP3360898A1 (en) | 2017-02-14 | 2018-08-15 | Boehringer Ingelheim International GmbH | Bispecific anti-tnf-related apoptosis-inducing ligand receptor 2 and anti-cadherin 17 binding molecules for the treatment of cancer |
| JOP20190187A1 (ar) | 2017-02-03 | 2019-08-01 | Novartis Ag | مترافقات عقار جسم مضاد لـ ccr7 |
| WO2018185618A1 (en) | 2017-04-03 | 2018-10-11 | Novartis Ag | Anti-cdh6 antibody drug conjugates and anti-gitr antibody combinations and methods of treatment |
| WO2019197610A1 (en) * | 2018-04-13 | 2019-10-17 | INSERM (Institut National de la Santé et de la Recherche Médicale) | New vaccinal strategy |
| AU2019277029C1 (en) | 2018-06-01 | 2024-01-04 | Novartis Ag | Binding molecules against BCMA and uses thereof |
| CA3138058A1 (en) * | 2019-05-20 | 2020-11-26 | Matthew T. Burger | Mcl-1 inhibitor antibody-drug conjugates and methods of use |
| CN118994397A (zh) | 2019-05-21 | 2024-11-22 | 诺华股份有限公司 | 针对bcma的三特异性结合分子及其用途 |
| CN114286828A (zh) * | 2019-06-24 | 2022-04-05 | 诺华股份有限公司 | 针对靶向b细胞成熟抗原的多特异性抗体的给药方案和组合疗法 |
| JP2022544543A (ja) * | 2019-08-15 | 2022-10-19 | シルバーバック セラピューティックス インコーポレイテッド | ベンザゼピンコンジュゲートの製剤およびその使用 |
| WO2021168274A1 (en) | 2020-02-21 | 2021-08-26 | Silverback Therapeutics, Inc. | Nectin-4 antibody conjugates and uses thereof |
| WO2021231376A2 (en) | 2020-05-12 | 2021-11-18 | Cue Biopharma, Inc. | Multimeric t-cell modulatory polypeptides and methods of use thereof |
| AU2021300362A1 (en) | 2020-07-01 | 2023-02-23 | ARS Pharmaceuticals, Inc. | Anti-ASGR1 antibody conjugates and uses thereof |
| TWI771198B (zh) | 2020-10-20 | 2022-07-11 | 中央研究院 | 用於檢測生物樣本的檢測方法及檢測系統 |
| EP4259658A4 (en) * | 2020-12-10 | 2024-12-04 | Wuxi Biologics Ireland Limited | An antibody against p-cadherin and uses thereof |
| KR20240007939A (ko) * | 2021-05-13 | 2024-01-17 | 우시 바이올로직스 아일랜드 리미티드 | 항-p-카드헤린 항체를 포함하는 항체 콘쥬게이트 및 이의 용도 |
| CN116970083B (zh) * | 2022-04-22 | 2025-04-11 | 上海优卡迪生物医药科技有限公司 | 结合Trop2的抗体或Trop2抗原结合片段以及抗Trop2CAR和应用 |
| EP4554677A1 (en) * | 2022-07-15 | 2025-05-21 | Boehringer Ingelheim International GmbH | Binding molecules for the treatment of cancer |
| WO2025109003A1 (en) | 2023-11-21 | 2025-05-30 | 3B Pharmaceuticals Gmbh | P-cadherin ligands |
| WO2025149667A1 (en) | 2024-01-12 | 2025-07-17 | Pheon Therapeutics Ltd | Antibody drug conjugates and uses thereof |
Family Cites Families (110)
| Publication number | Priority date | Publication date | Assignee | Title |
|---|---|---|---|---|
| US2429001A (en) | 1946-12-28 | 1947-10-14 | Axel H Stone | Artificial hand |
| US2779780A (en) | 1955-03-01 | 1957-01-29 | Du Pont | 1, 4-diamino-2, 3-dicyano-1, 4-bis (substituted mercapto) butadienes and their preparation |
| US3720760A (en) | 1968-09-06 | 1973-03-13 | Pharmacia Ab | Method for determining the presence of reagin-immunoglobulins(reagin-ig)directed against certain allergens,in aqueous samples |
| US4458066A (en) | 1980-02-29 | 1984-07-03 | University Patents, Inc. | Process for preparing polynucleotides |
| DE3378250D1 (en) | 1982-04-22 | 1988-11-24 | Ici Plc | Continuous release formulations |
| US4522811A (en) | 1982-07-08 | 1985-06-11 | Syntex (U.S.A.) Inc. | Serial injection of muramyldipeptides and liposomes enhances the anti-infective activity of muramyldipeptides |
| US5128326A (en) | 1984-12-06 | 1992-07-07 | Biomatrix, Inc. | Drug delivery systems based on hyaluronans derivatives thereof and their salts and methods of producing same |
| US5374548A (en) | 1986-05-02 | 1994-12-20 | Genentech, Inc. | Methods and compositions for the attachment of proteins to liposomes using a glycophospholipid anchor |
| MX9203291A (es) | 1985-06-26 | 1992-08-01 | Liposome Co Inc | Metodo para acoplamiento de liposomas. |
| EP0307434B2 (en) | 1987-03-18 | 1998-07-29 | Scotgen Biopharmaceuticals, Inc. | Altered antibodies |
| US5677425A (en) | 1987-09-04 | 1997-10-14 | Celltech Therapeutics Limited | Recombinant antibody |
| US5108921A (en) | 1989-04-03 | 1992-04-28 | Purdue Research Foundation | Method for enhanced transmembrane transport of exogenous molecules |
| AU6430190A (en) | 1989-10-10 | 1991-05-16 | Pitman-Moore, Inc. | Sustained release composition for macromolecular proteins |
| US5208020A (en) | 1989-10-25 | 1993-05-04 | Immunogen Inc. | Cytotoxic agents comprising maytansinoids and their therapeutic use |
| WO1991006287A1 (en) | 1989-11-06 | 1991-05-16 | Enzytech, Inc. | Protein microspheres and methods of using them |
| US5714350A (en) | 1992-03-09 | 1998-02-03 | Protein Design Labs, Inc. | Increasing antibody affinity by altering glycosylation in the immunoglobulin variable region |
| US5912015A (en) | 1992-03-12 | 1999-06-15 | Alkermes Controlled Therapeutics, Inc. | Modulated release from biocompatible polymers |
| CA2076465C (en) | 1992-03-25 | 2002-11-26 | Ravi V. J. Chari | Cell binding agent conjugates of analogues and derivatives of cc-1065 |
| CA2118508A1 (en) | 1992-04-24 | 1993-11-11 | Elizabeth S. Ward | Recombinant production of immunoglobulin-like domains in prokaryotic cells |
| JPH08511420A (ja) | 1993-06-16 | 1996-12-03 | セルテック・セラピューテイクス・リミテッド | 抗 体 |
| GB9323884D0 (en) | 1993-11-19 | 1994-01-05 | Eisai London Res Lab Ltd | Physiological modulation |
| US5834252A (en) | 1995-04-18 | 1998-11-10 | Glaxo Group Limited | End-complementary polymerase reaction |
| US5605793A (en) | 1994-02-17 | 1997-02-25 | Affymax Technologies N.V. | Methods for in vitro recombination |
| US5837458A (en) | 1994-02-17 | 1998-11-17 | Maxygen, Inc. | Methods and compositions for cellular and metabolic engineering |
| US6132764A (en) | 1994-08-05 | 2000-10-17 | Targesome, Inc. | Targeted polymerized liposome diagnostic and treatment agents |
| ATE252894T1 (de) | 1995-01-05 | 2003-11-15 | Univ Michigan | Oberflächen-modifizierte nanopartikel und verfahren für ihre herstellung und verwendung |
| US6121022A (en) | 1995-04-14 | 2000-09-19 | Genentech, Inc. | Altered polypeptides with increased half-life |
| US5869046A (en) | 1995-04-14 | 1999-02-09 | Genentech, Inc. | Altered polypeptides with increased half-life |
| AU710347B2 (en) | 1995-08-31 | 1999-09-16 | Alkermes Controlled Therapeutics, Inc. | Composition for sustained release of an agent |
| US6169071B1 (en) | 1996-07-12 | 2001-01-02 | Mcgill University | Compounds and methods for modulating cell adhesion |
| US6056973A (en) | 1996-10-11 | 2000-05-02 | Sequus Pharmaceuticals, Inc. | Therapeutic liposome composition and method of preparation |
| US5895748A (en) | 1996-11-27 | 1999-04-20 | Johnson; Keith R. | Panel of antibodies for detecting cadherins and catenins in tissues and method of using the panel of antibodies |
| US6277375B1 (en) | 1997-03-03 | 2001-08-21 | Board Of Regents, The University Of Texas System | Immunoglobulin-like domains with increased half-lives |
| WO1998052976A1 (en) | 1997-05-21 | 1998-11-26 | Biovation Limited | Method for the production of non-immunogenic proteins |
| JP3614866B2 (ja) | 1997-06-12 | 2005-01-26 | リサーチ コーポレイション テクノロジーズ,インコーポレイティド | 人工抗体ポリペプチド |
| US5989463A (en) | 1997-09-24 | 1999-11-23 | Alkermes Controlled Therapeutics, Inc. | Methods for fabricating polymer-based controlled release devices |
| SE512663C2 (sv) | 1997-10-23 | 2000-04-17 | Biogram Ab | Inkapslingsförfarande för aktiv substans i en bionedbrytbar polymer |
| US6194551B1 (en) | 1998-04-02 | 2001-02-27 | Genentech, Inc. | Polypeptide variants |
| AU3657899A (en) | 1998-04-20 | 1999-11-08 | James E. Bailey | Glycosylation engineering of antibodies for improving antibody-dependent cellular cytotoxicity |
| IL124650A0 (en) | 1998-05-26 | 1998-12-06 | Yeda Res & Dev | Methods and therapeutic compositions for treating cancer |
| IL143236A0 (en) | 1998-12-16 | 2002-04-21 | Warner Lambert Co | Treatment of arthritis with mek inhibitors |
| KR100940380B1 (ko) | 1999-01-15 | 2010-02-02 | 제넨테크, 인크. | 효과기 기능이 변화된 폴리펩티드 변이체 |
| PT1176195E (pt) | 1999-04-09 | 2013-07-18 | Kyowa Hakko Kirin Co Ltd | Processo para controlar a actividade de uma molécula funcional sob o ponto de vista imunológico |
| EP1990409A3 (en) | 1999-07-20 | 2011-05-18 | MorphoSys AG | Bacteriophage |
| ES2276708T3 (es) | 1999-11-24 | 2007-07-01 | Immunogen, Inc. | Agentes citotoxicos que comprenden taxanos y su uso terapeutico. |
| ES2274823T3 (es) | 1999-12-29 | 2007-06-01 | Immunogen, Inc. | Agentes cototoxicos que comprenden doxorrubicinas y daunorrubicinas y su utilizacion terapeutica. |
| US7700359B2 (en) | 2000-06-02 | 2010-04-20 | Novartis Vaccines And Diagnostics, Inc. | Gene products differentially expressed in cancerous cells |
| DE60136277D1 (de) | 2000-07-19 | 2008-12-04 | Takara Bio Inc | Verfahren zum nachweis von krebs |
| WO2002006213A2 (en) | 2000-07-19 | 2002-01-24 | Warner-Lambert Company | Oxygenated esters of 4-iodo phenylamino benzhydroxamic acids |
| US7118853B2 (en) | 2000-07-26 | 2006-10-10 | Applied Genomics, Inc. | Methods of classifying, diagnosing, stratifying and treating cancer patients and their tumors |
| US6333410B1 (en) | 2000-08-18 | 2001-12-25 | Immunogen, Inc. | Process for the preparation and purification of thiol-containing maytansinoids |
| WO2002097395A2 (en) | 2001-05-31 | 2002-12-05 | Chiron Corporation | P-cadherin as a target for anti-cancer therapy |
| US6441163B1 (en) | 2001-05-31 | 2002-08-27 | Immunogen, Inc. | Methods for preparation of cytotoxic conjugates of maytansinoids and cell binding agents |
| KR100988949B1 (ko) | 2001-10-25 | 2010-10-20 | 제넨테크, 인크. | 당단백질 조성물 |
| BR0307544A (pt) | 2002-02-01 | 2004-12-07 | Ariad Gene Therapeutics Inc | Compostos contendo fósforos, componentes e composição bem como, sua utilização através de métodos de tratamentos |
| US7799827B2 (en) | 2002-03-08 | 2010-09-21 | Eisai Co., Ltd. | Macrocyclic compounds useful as pharmaceuticals |
| TWI275390B (en) | 2002-04-30 | 2007-03-11 | Wyeth Corp | Process for the preparation of 7-substituted-3- quinolinecarbonitriles |
| JP2006515318A (ja) | 2002-10-29 | 2006-05-25 | ファルマシア・コーポレーション | 特異的に発現する癌関連遺伝子、それによってコードされるポリペプチドおよびその使用方法 |
| US7456153B2 (en) | 2002-11-14 | 2008-11-25 | Adherex Technologies Inc. | Compounds and methods for modulating functions of classical cadherins |
| WO2004056875A1 (en) | 2002-12-23 | 2004-07-08 | Wyeth | Antibodies against pd-1 and uses therefor |
| US20040137539A1 (en) | 2003-01-10 | 2004-07-15 | Bradford Sherry A. | Cancer comprehensive method for identifying cancer protein patterns and determination of cancer treatment strategies |
| US20040137538A1 (en) | 2003-01-10 | 2004-07-15 | Bradford Sherry A. | Cancer comprehensive assay kit for identifying cancer protein patterns |
| WO2004086038A2 (en) | 2003-03-28 | 2004-10-07 | Institut Curie | A method for screening compounds having the capacity to control tumor cell invasion or metastasis using constitutively active akt |
| US8088387B2 (en) | 2003-10-10 | 2012-01-03 | Immunogen Inc. | Method of targeting specific cell populations using cell-binding agent maytansinoid conjugates linked via a non-cleavable linker, said conjugates, and methods of making said conjugates |
| US20050002919A1 (en) | 2003-06-09 | 2005-01-06 | The Brigham And Women's Hospital, Inc. | Cadherin directed molecular and cellular localization |
| US7399865B2 (en) | 2003-09-15 | 2008-07-15 | Wyeth | Protein tyrosine kinase enzyme inhibitors |
| US20050221398A1 (en) | 2004-01-16 | 2005-10-06 | Ipsogen, Sas, A Corporation Of France | Protein expression profiling and breast cancer prognosis |
| WO2005090572A2 (en) | 2004-03-24 | 2005-09-29 | Oncotherapy Science, Inc. | Compositions and methods for treating pancreatic cancer |
| US20080008719A1 (en) | 2004-07-10 | 2008-01-10 | Bowdish Katherine S | Methods and compositions for the treatment of prostate cancer |
| JP5165387B2 (ja) | 2005-02-11 | 2013-03-21 | イムノゲン インコーポレーティッド | 安定な薬物複合体を調製するための方法 |
| NZ562234A (en) | 2005-04-26 | 2009-09-25 | Pfizer | P-cadherin antibodies |
| US8603986B2 (en) | 2005-04-28 | 2013-12-10 | Mcgill University | Compounds and methods for modulating cadherin-mediated processes |
| PL2161336T5 (pl) | 2005-05-09 | 2017-10-31 | Ono Pharmaceutical Co | Ludzkie przeciwciała monoklonalne przeciwko białku Programmed Death 1 (PD-1) oraz sposoby leczenia raka z zastosowaniem samych przeciwciał anty-PD-1 lub w połączeniu z innymi środkami immunoterapeutycznymi |
| GB0510390D0 (en) | 2005-05-20 | 2005-06-29 | Novartis Ag | Organic compounds |
| CA2612241C (en) | 2005-07-01 | 2018-11-06 | Medarex, Inc. | Human monoclonal antibodies to programmed death ligand 1 (pd-l1) |
| WO2007014011A2 (en) | 2005-07-21 | 2007-02-01 | Ardea Biosciences, Inc. | N-(arylamino)-sulfonamide inhibitors of mek |
| AU2006287416A1 (en) | 2005-09-07 | 2007-03-15 | Medimmune, Llc | Toxin conjugated Eph receptor antibodies |
| WO2007075672A2 (en) | 2005-12-23 | 2007-07-05 | Lankenau Institute For Medical Research | Prognostic cancer markers |
| JO2660B1 (en) | 2006-01-20 | 2012-06-17 | نوفارتيس ايه جي | Pi-3 inhibitors and methods of use |
| WO2007102525A1 (en) | 2006-02-28 | 2007-09-13 | Oncotherapy Science, Inc. | Methods for damaging cells using effector functions of anti-cdh3 antibodies |
| WO2007140371A2 (en) | 2006-05-30 | 2007-12-06 | Genentech, Inc. | Antibodies and immunoconjugates and uses therefor |
| US20080026481A1 (en) | 2006-06-16 | 2008-01-31 | Michael Mitas | Molecular based two-marker assays that predict outcome of adenocarcinoma patients |
| WO2008104803A2 (en) | 2007-02-26 | 2008-09-04 | Oxford Genome Sciences (Uk) Limited | Proteins |
| KR101586617B1 (ko) | 2007-06-18 | 2016-01-20 | 머크 샤프 앤 도메 비.브이. | 사람 프로그램된 사멸 수용체 pd-1에 대한 항체 |
| AU2008298948B2 (en) | 2007-09-12 | 2014-09-04 | F. Hoffmann-La Roche Ag | Combinations of phosphoinositide 3-kinase inhibitor compounds and chemotherapeutic agents, and methods of use |
| EP2214675B1 (en) | 2007-10-25 | 2013-11-20 | Genentech, Inc. | Process for making thienopyrimidine compounds |
| RU2531758C2 (ru) | 2008-02-11 | 2014-10-27 | Куретек Лтд. | Моноклональные антитела для лечения опухолей |
| US8168757B2 (en) | 2008-03-12 | 2012-05-01 | Merck Sharp & Dohme Corp. | PD-1 binding proteins |
| EP2281006B1 (en) | 2008-04-30 | 2017-08-02 | Immunogen, Inc. | Cross-linkers and their uses |
| US8168784B2 (en) | 2008-06-20 | 2012-05-01 | Abbott Laboratories | Processes to make apoptosis promoters |
| WO2010001585A1 (en) | 2008-06-30 | 2010-01-07 | Oncotherapy Science, Inc. | Anti-cdh3 antibodies labeled with radioisotope label and uses thereof |
| ES2545609T3 (es) | 2008-08-25 | 2015-09-14 | Amplimmune, Inc. | Composiciones de antagonistas de PD-1 y métodos de uso |
| JP2012500652A (ja) | 2008-08-25 | 2012-01-12 | アンプリミューン、インコーポレーテッド | 標的化共刺激ポリペプチドおよび癌を処置するための使用方法 |
| WO2010054007A1 (en) | 2008-11-07 | 2010-05-14 | Fabrus Llc | Combinatorial antibody libraries and uses thereof |
| EP4209510B1 (en) | 2008-12-09 | 2024-01-31 | F. Hoffmann-La Roche AG | Anti-pd-l1 antibodies and their use to enhance t-cell function |
| EP3192811A1 (en) | 2009-02-09 | 2017-07-19 | Université d'Aix-Marseille | Pd-1 antibodies and pd-l1 antibodies and uses thereof |
| US8455249B2 (en) | 2009-05-01 | 2013-06-04 | The University Of Tokyo | Highly effective anti-cadherin antibody for induction of antibody-dependent cellular cytotoxicity in vivo |
| US20130017199A1 (en) | 2009-11-24 | 2013-01-17 | AMPLIMMUNE ,Inc. a corporation | Simultaneous inhibition of pd-l1/pd-l2 |
| DK2519542T3 (en) * | 2009-12-28 | 2019-01-14 | Onco Therapy Science Inc | ANTI-CDH3 ANTIBODIES AND APPLICATIONS THEREOF. |
| KR101900110B1 (ko) | 2010-02-10 | 2018-09-18 | 후지필름 알아이 파르마 가부시키가이샤 | 방사성 금속 표지 항카드헤린 항체 |
| JP2014015396A (ja) | 2010-10-29 | 2014-01-30 | Perseus Proteomics Inc | 高い親和性を有する抗cdh3抗体 |
| PL2634194T3 (pl) * | 2010-10-29 | 2018-12-31 | Perseus Proteomics Inc | Przeciwciało przeciwko cdh3 o dużej zdolności do internalizacji |
| EP2699598B1 (en) | 2011-04-19 | 2019-03-06 | Pfizer Inc | Combinations of anti-4-1bb antibodies and adcc-inducing antibodies for the treatment of cancer |
| US9127061B2 (en) | 2011-06-24 | 2015-09-08 | Perseus Proteomics Inc. | Anti-human P-cadherin (CDH3) recombinant antibody |
| CA2869704A1 (en) * | 2012-04-04 | 2013-10-10 | Perseus Proteomics Inc. | Drug conjugate comprising anti-cdh3 (pcadherin) antibody |
| WO2013179174A1 (en) | 2012-05-29 | 2013-12-05 | Koninklijke Philips N.V. | Lighting arrangement |
| SG11201506358PA (en) * | 2013-02-15 | 2015-09-29 | Perseus Proteomics Inc | Anti-cdh3 humanized antibody, drug conjugate thereof, and use thereof |
| PE20170912A1 (es) * | 2014-11-14 | 2017-07-12 | Novartis Ag | Conjugados de anticuerpo-farmaco |
| WO2016203432A1 (en) * | 2015-06-17 | 2016-12-22 | Novartis Ag | Antibody drug conjugates |
| US11605302B2 (en) | 2020-11-10 | 2023-03-14 | Rockwell Collins, Inc. | Time-critical obstacle avoidance path planning in uncertain environments |
-
2015
- 2015-11-13 PE PE2017000847A patent/PE20170912A1/es unknown
- 2015-11-13 SG SG11201703464UA patent/SG11201703464UA/en unknown
- 2015-11-13 BR BR112017009813A patent/BR112017009813A2/pt not_active Application Discontinuation
- 2015-11-13 JP JP2017525950A patent/JP6831783B2/ja active Active
- 2015-11-13 MX MX2017006301A patent/MX2017006301A/es unknown
- 2015-11-13 ES ES15798251T patent/ES2987508T3/es active Active
- 2015-11-13 CA CA2967188A patent/CA2967188A1/en not_active Abandoned
- 2015-11-13 US US14/940,961 patent/US10005836B2/en active Active
- 2015-11-13 TN TN2017000173A patent/TN2017000173A1/en unknown
- 2015-11-13 PY PY201501570443A patent/PY1570443A/es unknown
- 2015-11-13 CR CR20170200A patent/CR20170200A/es unknown
- 2015-11-13 AU AU2015347015A patent/AU2015347015B2/en not_active Ceased
- 2015-11-13 UY UY0001036401A patent/UY36401A/es not_active Application Discontinuation
- 2015-11-13 EA EA201791050A patent/EA201791050A1/ru unknown
- 2015-11-13 EP EP15798251.3A patent/EP3218410B1/en active Active
- 2015-11-13 WO PCT/IB2015/058801 patent/WO2016075670A1/en not_active Ceased
- 2015-11-13 CN CN201580071419.9A patent/CN108064244B/zh active Active
- 2015-11-13 AR ARP150103709A patent/AR102649A1/es unknown
- 2015-11-13 MA MA040913A patent/MA40913A/fr unknown
- 2015-11-13 TW TW104137588A patent/TW201625692A/zh unknown
- 2015-11-13 KR KR1020177015786A patent/KR20170084202A/ko not_active Withdrawn
-
2017
- 2017-04-30 IL IL252015A patent/IL252015A0/en unknown
- 2017-05-12 CO CONC2017/0004782A patent/CO2017004782A2/es unknown
- 2017-05-12 GT GT201700102A patent/GT201700102A/es unknown
- 2017-05-12 CL CL2017001217A patent/CL2017001217A1/es unknown
- 2017-05-12 PH PH12017500890A patent/PH12017500890A1/en unknown
- 2017-06-05 EC ECIEPI201734845A patent/ECSP17034845A/es unknown
-
2018
- 2018-05-24 US US15/988,659 patent/US10626172B2/en active Active
Also Published As
Similar Documents
| Publication | Publication Date | Title |
|---|---|---|
| US10626172B2 (en) | Antibody drug conjugates | |
| US11833215B2 (en) | CKIT antibody drug conjugates | |
| AU2017202150B2 (en) | Antibody drug conjugates and corresponding antibodies | |
| AU2018215701B2 (en) | Anti-CCR7 antibody drug conjugates | |
| US9789203B2 (en) | cKIT antibody drug conjugates | |
| US20140308201A1 (en) | Antibody drug conjugates | |
| US20190194315A1 (en) | Antibody drug conjugates | |
| CN106659790A (zh) | 抗cdh6抗体药物缀合物 |
Legal Events
| Date | Code | Title | Description |
|---|---|---|---|
| PA0105 | International application |
St.27 status event code: A-0-1-A10-A15-nap-PA0105 |
|
| PG1501 | Laying open of application |
St.27 status event code: A-1-1-Q10-Q12-nap-PG1501 |
|
| P22-X000 | Classification modified |
St.27 status event code: A-2-2-P10-P22-nap-X000 |
|
| R18-X000 | Changes to party contact information recorded |
St.27 status event code: A-3-3-R10-R18-oth-X000 |
|
| R18-X000 | Changes to party contact information recorded |
St.27 status event code: A-3-3-R10-R18-oth-X000 |
|
| PC1203 | Withdrawal of no request for examination |
St.27 status event code: N-1-6-B10-B12-nap-PC1203 |
|
| P22-X000 | Classification modified |
St.27 status event code: A-2-2-P10-P22-nap-X000 |
|
| P22-X000 | Classification modified |
St.27 status event code: A-2-2-P10-P22-nap-X000 |